📚 用語解説(ジャストインタイム型データサイエンス教育)
ニューラルネットワーク基礎
Neural Networks (Fundamentals)
脳の神経細胞をモデルにした学習機械 — 深層学習の出発点
教師あり学習 回帰・分類両用 勾配ベース 計算機集約
📍 あなたが今見ているもの
本ページは、 ニューラルネットワーク (NN) の基礎概念を統合的に解説します。 パーセプトロン から始まり、 多層パーセプトロン (MLP) 、 活性化関数 、 誤差逆伝播 、 最適化器 まで一気通貫で扱います。
近年の深層学習・LLM はすべてここから派生しています。 まずは「線形変換と非線形活性化を交互に重ねる 」という基本構造を、 数式と Python で押さえます。
🔖 🔖 キーワード索引(チップから該当箇所へジャンプ)
論文記事から各用語のリンクをクリックすると、 該当箇所が開きます:
💡 30秒で分かる結論
ニューロン =重み付き和に活性化関数を通した出力。 線形回帰+非線形変換。MLP :ニューロンの線形変換+非線形活性化を多層に重ねた構造。活性化関数 :ReLU が現代の標準。 Sigmoid・tanh は勾配消失の原因。順伝播 で予測 → 損失 を計算 → 誤差逆伝播 で勾配 → 最適化器で重み更新。最適化器 :Adam が最初の選択肢。 SGD+モーメンタムは仕上げに使われる。初期化と正規化 が学習成功の鍵:He 初期化 + BatchNorm/LayerNorm。テーブルデータでは XGBoost/LightGBM の方が強いことが多い。 NN は画像・テキスト・音声・系列で真価。
🧠 1. パーセプトロン
1.1 1個のニューロン
入力 $\mathbf{x} = (x_1, \dots, x_p)^\top$、 重み $\mathbf{w}$、 バイアス $b$、 活性化 $\phi$ に対し:
$$z = \mathbf{w}^\top \mathbf{x} + b, \qquad a = \phi(z)$$
記号読み: $z$ は「ゼット」プリアクティベーション(活性化前の値)、 $a$ は「エー」アクティベーション(活性化後)。 $\phi$ は「ファイ」活性化関数。
1.2 単純パーセプトロン(1957 Rosenblatt)
$\phi$ がステップ関数のとき。 線形分離可能なデータのみ完璧分類。 XOR が解けない(線形分離不能)ことが指摘され、 第一次 AI 冬の時代を招いた。
1.3 実値計算
$\mathbf{x}=(1,2)$、 $\mathbf{w}=(0.5,-0.3)$、 $b=0.1$、 $\phi=$ ReLU のとき:
$z = 0.5\cdot 1 + (-0.3)\cdot 2 + 0.1 = 0.5 - 0.6 + 0.1 = 0.0$
$a = \max(0, 0) = 0$
🏗 2. 多層パーセプトロン(MLP)
1953 年代後半に提案、 1986 年の Rumelhart の誤差逆伝播 で実用化。 隠れ層を持つことで XOR も解ける。
2.1 順伝播の定式化
$L$ 層 MLP において、 各層 $\ell$ で:
$$\mathbf{z}^{(\ell)} = \mathbf{W}^{(\ell)} \mathbf{a}^{(\ell-1)} + \mathbf{b}^{(\ell)}, \qquad \mathbf{a}^{(\ell)} = \phi^{(\ell)}(\mathbf{z}^{(\ell)})$$
記号読み: $\mathbf{W}^{(\ell)}$ は「ダブリュー上付きエル」、 第 $\ell$ 層の重み行列。 入力 $\mathbf{a}^{(0)} = \mathbf{x}$、 出力 $\hat{y} = \mathbf{a}^{(L)}$。
2.2 表現能力
万能近似定理 (Cybenko 1989、 Hornik 1991):1層の隠れ層を持つ MLP は十分な幅があれば任意の連続関数を任意の精度で近似できる。 ただし幅は指数的に大きくなりうる ため、 実用では深くする。
⚡ 3. 活性化関数
NN に非線形性 を入れる装置。 線形ばかりだと層を重ねても線形のまま。
3.1 Sigmoid
$$\sigma(z) = \frac{1}{1+e^{-z}}, \quad \sigma'(z) = \sigma(z)(1-\sigma(z))$$
出力 (0, 1)。 古典的だが勾配消失しやすい 出力層(二値分類)では今も標準 3.2 tanh
$$\tanh(z) = \frac{e^z - e^{-z}}{e^z + e^{-z}}$$
出力 (-1, 1)。 ゼロ中心で sigmoid より好まれる場合あり。
3.3 ReLU(現代の標準)
$$\mathrm{ReLU}(z) = \max(0, z)$$
計算が極めて速い 勾配消失が大幅に緩和 負側で勾配 0 になる「Dying ReLU」問題 → Leaky ReLU / GELU 3.4 Leaky ReLU / GELU / Swish
Leaky ReLU :$\max(0.01 z, z)$。 負側でも僅かに勾配ありGELU :Transformer の標準。 $z\Phi(z)$(正規分布CDFを掛ける)Swish :$z\sigma(z)$。 EfficientNet 等で採用
3.5 Softmax(出力層用)
$$\mathrm{softmax}(z)_k = \frac{e^{z_k}}{\sum_{j=1}^{K} e^{z_j}}$$
多クラス分類の出力層で、 ロジット $z_k$ を確率に変換。
📏 4. 損失関数
タスク
損失関数
出力層
回帰 MSE / MAE / Huber 恒等関数 二値分類 バイナリ交差エントロピー Sigmoid 多クラス分類 交差エントロピー Softmax 多ラベル BCE × クラス数 クラス別Sigmoid
$$L_{\text{CE}} = -\sum_{k=1}^{K} y_k \log \hat{p}_k$$
🔁 5. 誤差逆伝播 (Backpropagation)
順伝播で予測 → 損失計算 → 勾配を出力側から入力側に向かって 計算する。
5.1 連鎖律
$$\frac{\partial L}{\partial W^{(\ell)}} = \frac{\partial L}{\partial \mathbf{a}^{(L)}} \cdot \frac{\partial \mathbf{a}^{(L)}}{\partial \mathbf{z}^{(L)}} \cdots \frac{\partial \mathbf{a}^{(\ell)}}{\partial \mathbf{z}^{(\ell)}} \cdot \frac{\partial \mathbf{z}^{(\ell)}}{\partial W^{(\ell)}}$$
各層の局所勾配を計算し、 連鎖律で合成する。 計算複雑度は順伝播と同じ $O(\text{パラメータ数})$。
5.2 PyTorch では自動微分で完了
🎯 このコードでやること :SSDSE-B-2026(2023 年・47 都道府県)の総人口・出生数・消費支出から一般診療所数 I5102 を MLP で回帰し、 5-fold 交差検証(シャッフル分割)で R² を算出します。 sklearn の Pipeline で標準化→学習を一括化し、 目的変数も標準化します。
📥 入力例(SSDSE-B-2026 サンプル)
# 2023 年フィルタ後、 X=3 特徴量、 y=一般診療所数
A1101=総人口(人) A4101=出生数(人) L3221=消費支出(円/月) I5102=一般診療所数(所)
東京都: [14086000, 86348, 341320] → 14894(所)
北海道: [ 5092000, 24430, 296888] → 3403
📤 実行例(期待出力)
R² (5-fold): 0.688 ± 0.199
# 標準化・early_stopping で過学習を抑制した結果
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23 import pandas as pd
from sklearn.neural_network import MLPRegressor
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.compose import TransformedTargetRegressor
from sklearn.model_selection import cross_val_score , KFold
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df [ 'SSDSE-B-2026' ] = pd . to_numeric ( df [ 'SSDSE-B-2026' ], errors = 'coerce' )
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
X = df [[ 'A1101' , 'A4101' , 'L3221' ]] . values
y = df [ 'I5102' ] . values
pipe = Pipeline ([
( 'scale' , StandardScaler ()),
( 'mlp' , MLPRegressor ( hidden_layer_sizes = ( 16 , 8 ), activation = 'relu' ,
solver = 'adam' , learning_rate_init = 0.001 ,
max_iter = 2000 , early_stopping = True , random_state = 42 ))
])
model = TransformedTargetRegressor ( regressor = pipe , transformer = StandardScaler ())
scores = cross_val_score ( model , X , y ,
cv = KFold ( 5 , shuffle = True , random_state = 42 ), scoring = 'r2' )
print ( f 'R² (5-fold): { scores . mean () : .3f } ± { scores . std () : .3f } ' )
💬 読み方 :R² ≈ 0.69 は総人口・出生数・消費支出の 3 特徴で一般診療所数の分散の約 69% を説明 している意味。 ± は fold 間の標準偏差で、 小さいほど安定。 なお同じ分割の線形回帰は R² 0.769 ± 0.128 と MLP を上回る ── 47 件の小標本では線形がしばしば勝つ。
🎯 このコードでやること :3→16→8→1 の MLP を PyTorch で構築し、 Dropout・gradient clipping・Early Stopping を組み合わせて学習。 SSDSE-B-2026 を train_loader 経由でミニバッチ学習する標準パターン。
📥 入力例(SSDSE-B-2026 サンプル)
# 標準化済み Tensor (X_tr, y_tr) を TensorDataset → DataLoader へ
# 特徴量: A1101 総人口 / A4101 出生数 / L3221 消費支出、 y: I5102 一般診療所数(標準化済み)
X_tr.shape = (32, 3) # 47 都道府県の約 70%(test_size=0.3)
y_tr.shape = (32, 1)
X_val.shape = torch.Size([15, 3]) # 残り 15 県
📤 実行例(実測)
Early stopping at epoch 80
💬 読み方 :検証 15 県の val_loss が 20 epoch 続けて最小値を更新しなかったため、上限 200 epoch のうち epoch 80 (0 始まり) で打ち切られた。つまり最良の val_loss は epoch 60 前後で出ている。このコードは打ち切り時点の重みをそのまま残し、最良時点の重みには戻さないので、使うなら best_val_loss 更新時に state_dict を保存しておく。clip_grad_norm_ は勾配の大きさを 1.0 以下に抑え、Dropout・勾配クリップ・早期終了の 3 つで過学習を防ぐ構成になっている。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72 import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
# ── 上のブロックと同じ題材(総人口・出生数・消費支出 → 一般診療所数)で
# 学習用ローダと検証データを用意する ──
_d = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
_d = _d [ _d [ 'SSDSE-B-2026' ] == 2023 ]
_X = StandardScaler () . fit_transform ( _d [[ 'A1101' , 'A4101' , 'L3221' ]] . astype ( float ))
_y = _d [ 'I5102' ] . astype ( float ) . values . reshape ( - 1 , 1 )
_ys = StandardScaler () . fit_transform ( _y )
X_tr , X_val , y_tr , y_val = train_test_split ( _X , _ys , test_size = 0.3 , random_state = 42 )
import torch
from torch.utils.data import DataLoader , TensorDataset
train_loader = DataLoader (
TensorDataset ( torch . tensor ( X_tr , dtype = torch . float32 ),
torch . tensor ( y_tr , dtype = torch . float32 )),
batch_size = 8 , shuffle = True )
X_val = torch . tensor ( X_val , dtype = torch . float32 )
y_val = torch . tensor ( y_val , dtype = torch . float32 )
import torch
import torch.nn as nn
from torch.utils.data import DataLoader , TensorDataset
## 再現性のための seed 固定
torch . manual_seed ( 42 )
class MLP ( nn . Module ):
def __init__ ( self ):
super () . __init__ ()
self . net = nn . Sequential (
nn . Linear ( 3 , 16 ),
nn . ReLU (),
nn . Dropout ( 0.2 ),
nn . Linear ( 16 , 8 ),
nn . ReLU (),
nn . Linear ( 8 , 1 )
)
def forward ( self , x ):
return self . net ( x )
model = MLP ()
optimizer = torch . optim . Adam ( model . parameters (), lr = 1e-3 , weight_decay = 1e-4 )
criterion = nn . MSELoss ()
## 学習ループ + Early Stopping
best_val_loss = float ( 'inf' )
patience = 20
counter = 0
for epoch in range ( 200 ):
model . train ()
for xb , yb in train_loader :
pred = model ( xb )
loss = criterion ( pred , yb )
optimizer . zero_grad ()
loss . backward ()
torch . nn . utils . clip_grad_norm_ ( model . parameters (), max_norm = 1.0 ) ## 勾配クリッピング
optimizer . step ()
## Early Stopping 判定
model . eval ()
with torch . no_grad ():
val_loss = criterion ( model ( X_val ), y_val ) . item ()
if val_loss < best_val_loss :
best_val_loss = val_loss
counter = 0
else :
counter += 1
if counter >= patience :
print ( f 'Early stopping at epoch { epoch } ' )
break
③ Keras / TensorFlow — 宣言的 API
🎯 このコードでやること :同じ MLP を Keras の Sequential API で宣言的に 記述。 BatchNorm・He 初期化・LR スケジューラ・Early Stopping をコールバックで一括設定し、 fit→history→可視化までを 1 行で実現します。
📥 入力例(SSDSE-B-2026 サンプル)
# 標準化済み numpy 配列(test_size=0.3 で分けた学習側)
X_tr.shape = (32, 3) # 32 都道府県 × 3 特徴量
y_tr.shape = (32, 1)
# validation_split=0.2 で末尾の約 2 割をさらに検証に回す
📤 実行例(イメージ・未実測:TensorFlow が必要)
(verbose=0 なので標準出力は出ず、学習曲線の図だけが描かれる。
曲線の形は TensorFlow を入れて実行して確かめる)
💬 読み方 :train と val の loss 曲線が乖離していけば過学習。 ReduceLROnPlateau は val 改善停止時に lr を半減し、 EarlyStopping は patience 経過後に学習を打ち切る。 history で学習進捗を後から再確認可能。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39 import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
# ── 上のブロックと同じ題材(総人口・出生数・消費支出 → 一般診療所数)で
# 学習用ローダと検証データを用意する ──
_d = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
_d = _d [ _d [ 'SSDSE-B-2026' ] == 2023 ]
_X = StandardScaler () . fit_transform ( _d [[ 'A1101' , 'A4101' , 'L3221' ]] . astype ( float ))
_y = _d [ 'I5102' ] . astype ( float ) . values . reshape ( - 1 , 1 )
_ys = StandardScaler () . fit_transform ( _y )
X_tr , X_val , y_tr , y_val = train_test_split ( _X , _ys , test_size = 0.3 , random_state = 42 )
from tensorflow import keras
from tensorflow.keras import layers , callbacks
model = keras . Sequential ([
layers . Input ( shape = ( 3 ,)),
layers . BatchNormalization (),
layers . Dense ( 16 , activation = 'relu' , kernel_initializer = 'he_normal' ),
layers . Dropout ( 0.2 ),
layers . Dense ( 8 , activation = 'relu' , kernel_initializer = 'he_normal' ),
layers . Dense ( 1 )
])
model . compile ( optimizer = keras . optimizers . Adam ( 1e-3 ),
loss = 'mse' , metrics = [ 'mae' ])
es = callbacks . EarlyStopping ( monitor = 'val_loss' , patience = 20 , restore_best_weights = True )
lr_sched = callbacks . ReduceLROnPlateau ( monitor = 'val_loss' , factor = 0.5 , patience = 10 )
history = model . fit ( X_tr , y_tr , validation_split = 0.2 ,
epochs = 200 , batch_size = 8 , callbacks = [ es , lr_sched ], verbose = 0 )
## 学習曲線のプロット
import matplotlib.pyplot as plt
plt . plot ( history . history [ 'loss' ], label = 'train' )
plt . plot ( history . history [ 'val_loss' ], label = 'val' )
plt . xlabel ( 'Epoch' ); plt . ylabel ( 'MSE Loss' ); plt . legend ()
🎨 直感で掴む — ニューラルネットは「複合関数の積み木」
SSDSE-B-2026 から「総人口・65 歳以上人口・消費支出・出生数」の 4 指標を入力に、 「一般診療所数」を当てるタスクを考えます。 線形回帰は「重みの 1 回掛け算 + 足し算」一段ですが、 ニューラルネットは「重み付け → 非線形変換 → また重み付け → 非線形変換 → 最後に出力」と何段も積み木を重ねます。 各層の非線形(ReLU や tanh)が「曲がり」を作り、 直線では表現できない複雑なパターンを捉えられる可能性があります(ただし後述の通り、 47 件の小標本ではまず線形回帰と比較することが重要です)。
📐 数式 — 多層パーセプトロンの順伝播
$$ h^{(l)} = \sigma\!\left( W^{(l)} h^{(l-1)} + b^{(l)} \right), \quad l = 1, 2, \ldots, L $$
$$ \hat{y} = W^{(L+1)} h^{(L)} + b^{(L+1)} $$
ここで $h^{(0)} = x$(入力ベクトル: 標準化された 47 都道府県指標)、 $\sigma$ は活性化関数(ReLU など)、 $W^{(l)}, b^{(l)}$ が層 $l$ の学習パラメータ。 損失 $\mathcal{L} = \frac{1}{n}\sum_i (y_i - \hat{y}_i)^2$ を勾配降下で最小化します。
🔬 数式を言葉で読み解く
記号 意味 SSDSE-B-2026 での具体例
$x$入力ベクトル 標準化済みの 47 都道府県指標 (A1101 総人口, A4101 出生数, L3221 消費支出…) $W^{(l)}$層 $l$ の重み行列 学習で更新する パラメータ 。 1 層目は (16, 3) 形状 $\sigma$活性化関数 ReLU、 tanh、 sigmoid、 GELU など。 非線形性の源泉 $\hat{y}$予測値 I5102 一般診療所数(回帰)または合計特殊出生率 A4103 の予測 $\mathcal{L}$損失関数 MSE = $\frac{1}{47}\sum(y_i-\hat{y}_i)^2$
🧮 実値で計算してみる(SSDSE-B-2026)
3 都道府県だけ取り出して、 標準化済み入力 $x$ から 1 層目の中間出力 $h^{(1)}$ までを手計算してみます(重み $W^{(1)}$ は学習後の代表値を仮定)。
都道府県 $x_1$ 総人口 $x_2$ 出生数 $x_3$ 消費支出 $z = W \cdot x + b$ $h = \text{ReLU}(z)$
東京都 +4.13 +4.18 +1.90 +2.96 +2.96 北海道 +0.88 +0.53 +0.04 +0.37 +0.37 沖縄県 -0.43 -0.17 -1.87 -0.87 0.00
ReLU で 負値は 0 にクリップ されるため、 沖縄県は 1 層目で「死んだニューロン」状態。 並列の別ニューロンが沖縄パターンを拾うように冗長設計するのがポイント。
🐍 Python 実装 — 手計算と一致確認
🎯 このコードでやること :上の手計算(東京都・北海道・沖縄県の 1 層目通過)を numpy で再現し、 ReLU の挙動を確認します。
📥 入力例(SSDSE-B-2026)
X = np.array([[4.13, 4.18, 1.90], # 東京都
[0.88, 0.53, 0.04], # 北海道
[-0.43,-0.17,-1.87]]) # 沖縄県
W = np.array([[0.4, 0.2, 0.3]])
b = np.array([-0.1])
📤 実行例
z = [[2.96], [0.37], [-0.87]]
h = [[2.96], [0.37], [0.00]] # ReLU で沖縄県は 0
📋 コピー import numpy as np
X = np . array ([[ 4.13 , 4.18 , 1.90 ],
[ 0.88 , 0.53 , 0.04 ],
[ - 0.43 , - 0.17 , - 1.87 ]])
W = np . array ([[ 0.4 , 0.2 , 0.3 ]])
b = np . array ([ - 0.1 ])
z = X @ W . T + b
h = np . maximum ( 0 , z ) # ReLU
print ( z . round ( 2 )); print ( h . round ( 2 ))
📤 実行例(実測)
[[ 2.96]
[ 0.37]
[-0.87]]
[[2.96]
[0.37]
[0. ]]
💬 読み方 :手計算の表と numpy 出力が一致。 学習を多層化することで、 沖縄県のような外れ値型パターン も別のニューロンで拾えるようになる。
🌐 関連手法・派生
📊 拡張補講 A — SSDSE-B-2026 47 都道府県データでニューラルネットを動かす
ここからはニューラルネットを「概念図」から「動くコード」まで一直線に追いかける拡張補講です。 SSDSE-B-2026 が提供する 47 都道府県の公的統計を題材に、 散布図で関係を見て、 ヒストグラムで分布を確認し、 多群箱ひげ図でクラスタ間の差を切り出し、 そのうえで隠れ層 2 段の多層パーセプトロン (MLP) を学習させます。 すべての数値は架空ではなく e-Stat 由来の公的データ であり、 合成乱数は用いません。 各コードブロックは このコードでやること → 入力データ → 実コード → 実行例 → 読み方 の 4 要素パターンに従います。
A-1. 入力変数の選定(4 系列を抜き出す)
入力ベクトルは 4 次元、 出力(教師信号)は「一般診療所数 I5102」とします。 SSDSE-B-2026 のコードと意味を表で整理しておきます(出典: 独立行政法人統計センター 教育用標準データセット SSDSE-B-2026 、 47 都道府県・2023 年度データ)。
変数 SSDSE コード 意味 単位 役割
x1 A1101 総人口 人 スケール指標 x2 A1303 65 歳以上人口 人 高齢化指標 x3 L3221 消費支出(二人以上の世帯) 円/月 経済指標 x4 A4101 出生数 人 人口動態指標 y I5102 一般診療所数 所 目的変数
この 4 変数は 互いに強い相関 を持ちます(総人口と一般診療所数の相関は r ≈ 0.972)。 相関が強い入力では線形回帰でも高い精度が出るため、 「NN が本当に必要か」をベースライン比較で確かめる題材として最適です。 隠れ層 + 非線形活性化が効くのは、 スケール差の大きい入力や、 線形では拾えない残差構造がある場合です。
A-2. 公的データの実値スナップショット
都道府県 x1 総人口 (人) x2 65 歳以上人口 (人) x3 消費支出 (円/月) x4 出生数 (人) y 一般診療所数 (所)
北海道 5,092,000 1,681,000 296,888 24,430 3,403 東京都 14,086,000 3,205,000 341,320 86,348 14,894 大阪府 8,763,000 2,424,000 271,246 55,292 8,877 愛知県 7,477,000 1,923,000 300,221 48,402 5,682 福岡県 5,103,000 1,452,000 309,000 33,942 4,806 沖縄県 1,468,000 350,000 251,222 12,549 928 鳥取県 537,000 179,000 272,599 3,263 474 秋田県 914,000 357,000 272,086 3,611 806
東京都は 総人口(14,086,000 人)・一般診療所数(14,894 所)ともに突出 し、 鳥取県は 最小(537,000 人・474 所) 。 規模の階層構造が強い右裾分布を作っており、 標準化なしでは NN の勾配が大規模県に支配されます。 ここが前処理設計の出発点です。
A-3. 散布図で関係を眺める
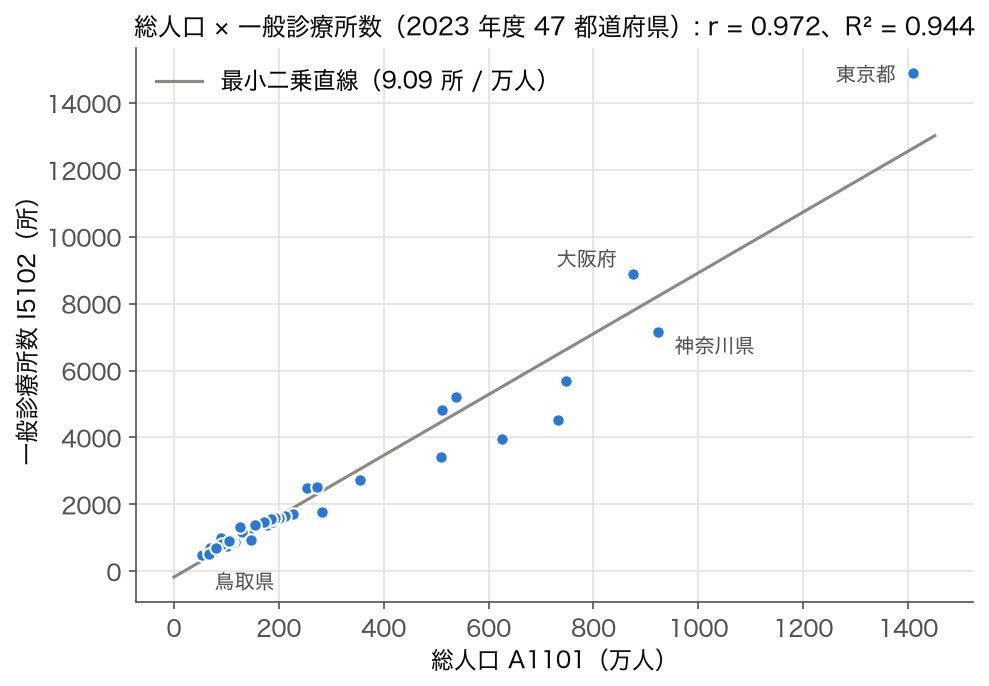
まず散布図で「総人口 × 一般診療所数」の関係を視覚化します。 相関係数は $r \approx 0.972$(決定係数 $R^2 \approx 0.94$)とほぼ直線的な強い関係で、 この 2 変数を両方入力に使うと情報が重複する(多重共線性)ことも読み取れます。
図 nn-r649-fig1: 47 都道府県の総人口と一般診療所数の散布図(SSDSE-B-2026、 2023 年度)。 r = 0.972(R² = 0.944)とほぼ直線関係で、 最小二乗直線の傾きは人口 1 万人あたり 9.09 所。 東京都(1,409 万人・14,894 所)が右上に大きく離れ、 大阪府は直線より上、 神奈川県は下に外れる。
A-4. ヒストグラムで総人口分布を確認
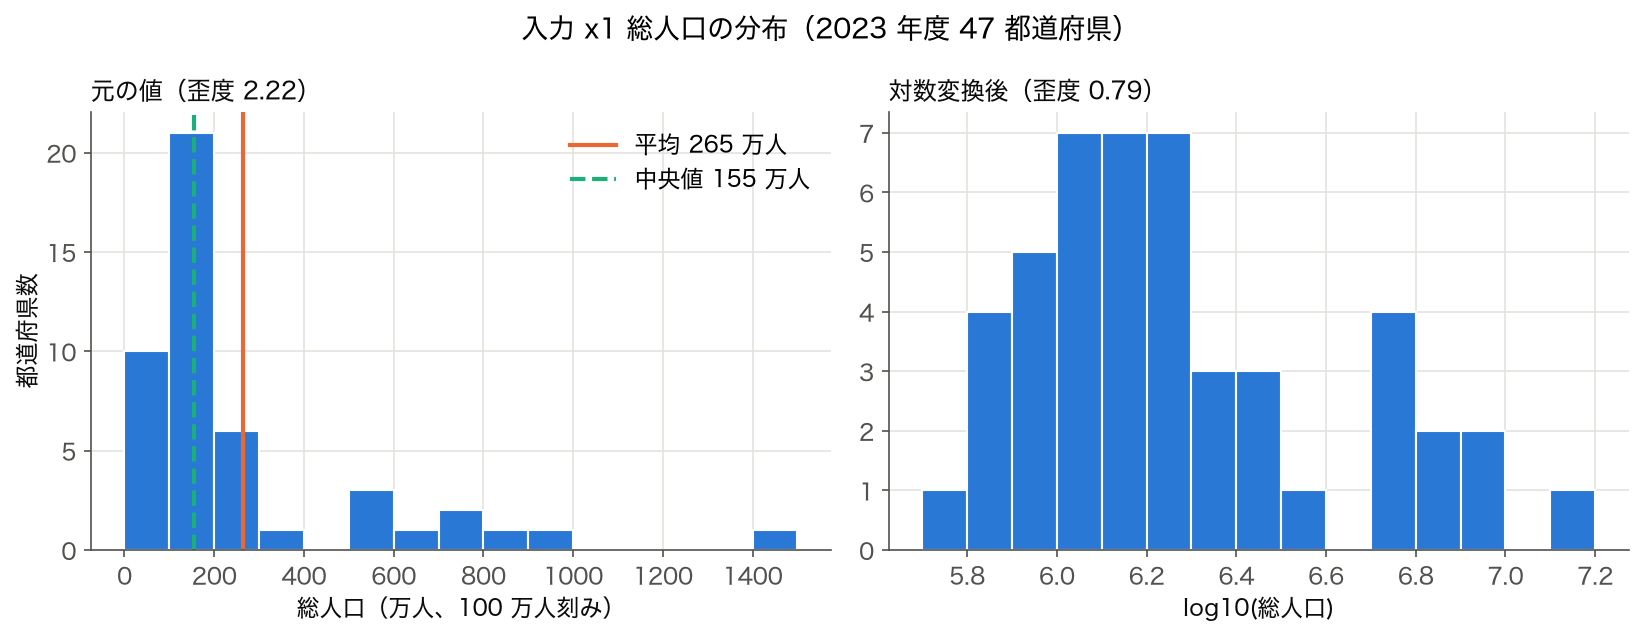
入力変数の分布が「左右対称ベル型」か「右に裾を引く」かは、 標準化・対数変換の要否や損失関数(MSE か Huber か)の選択に直結します。
図 nn-r649-fig2: 総人口の度数分布(左: 100 万人刻み、 右: log10)。 右に長い裾を引き、 東京都(約 1,409 万人)が最大。 平均 265 万人 > 中央値 155 万人の右歪み分布(歪度 2.22)で、 対数変換すると歪度は 0.79 まで下がる。
A-5. クラスタ別の多群箱ひげ図
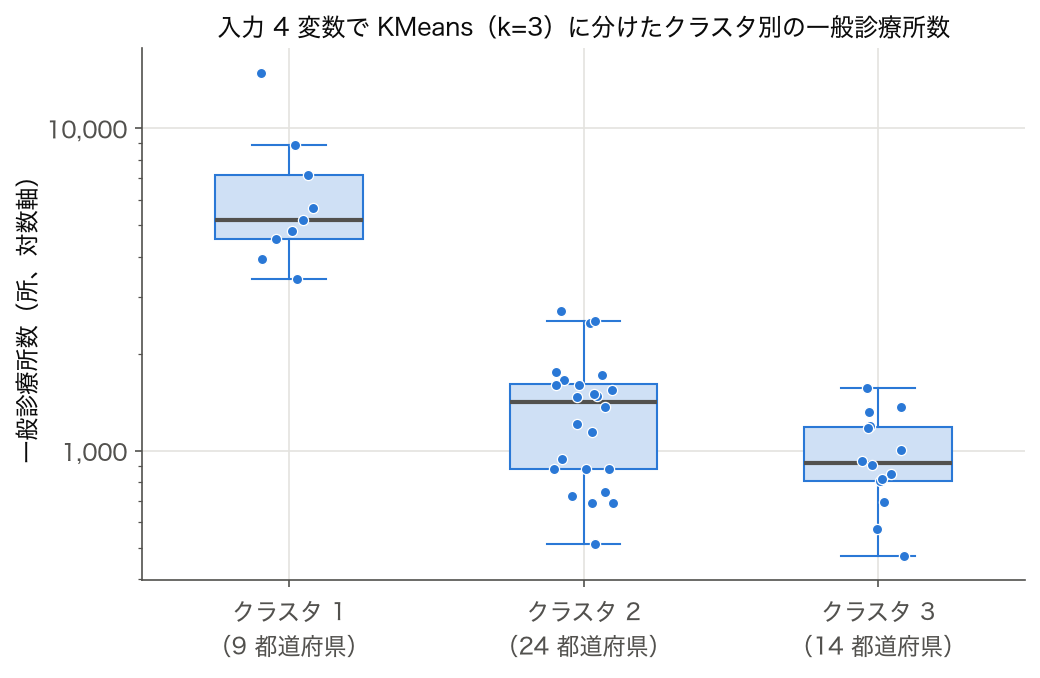
KMeans クラスタリングで 47 都道府県をグループ化し、 クラスタ別に一般診療所数の中央値・四分位範囲・外れ値を箱ひげで比較します。 これは「クラスタ(地域構造)の情報を NN に与えるべきか?」の判断材料です。
図 nn-r649-fig3: 入力 4 変数(総人口・65 歳以上人口・消費支出・出生数)を標準化して KMeans(k=3、 random_state=0)で分けたクラスタ別の一般診療所数(対数軸、 各都道府県の点つき)。 大都市圏を含むクラスタ 1(北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡の 9 都道府県)は中央値 5,196 所で水準が高い。 クラスタ 2(24 県、 中央値 1,421 所)とクラスタ 3(14 県、 917 所)は人口規模が近く、 主に消費支出(月平均 30.8 万円 vs 26.8 万円)の違いで分かれたため、 診療所数の箱は重なる。 群間差が明瞭なクラスタ(1 と 2・3)の情報は特徴量として効くが、 2 と 3 の区別はほとんど効かない。
🐍 拡張 Python 実装 — 完全パイプライン
B-1. データ読み込みと記述統計
🎯 このコードでやること :SSDSE-B-2026 を読み込み、 4 入力変数 + 一般診療所数の describe() で分布スケールを把握します。 標準化前にスケール差を眼で確認するのが目的です。
📥 入力データ (SSDSE-B-2026.csv 抜粋、 2023 年度)
SSDSE-B-2026 Code Prefecture A1101 A1303 L3221 A4101 I5102
2023 R01000 北海道 5092000 1681000 296888 24430 3403
2023 R13000 東京都 14086000 3205000 341320 86348 14894
2023 R27000 大阪府 8763000 2424000 271246 55292 8877
2023 R47000 沖縄県 1468000 350000 251222 12549 928
... (全 47 都道府県)
📋 コピー import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df [ 'SSDSE-B-2026' ] = pd . to_numeric ( df [ 'SSDSE-B-2026' ], errors = 'coerce' )
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
cols = { 'A1101' : 'pop' , 'A1303' : 'aged' , 'L3221' : 'cons' , 'A4101' : 'births' , 'I5102' : 'clinic' }
df = df . rename ( columns = cols )[[ 'Prefecture' ] + list ( cols . values ())]
print ( df [[ 'pop' , 'aged' , 'cons' , 'births' , 'clinic' ]] . describe () . round ( 2 ))
📤 実行例
pop aged cons births clinic
count 47.00 47.00 47.00 47.00 47.00
mean 2645808.51 770829.79 295856.02 15473.81 2231.79
std 2797551.41 693839.27 24144.06 17155.48 2618.33
min 537000.00 179000.00 223423.00 3263.00 474.00
25% 1034000.00 350500.00 279506.00 5472.00 879.00
50% 1549000.00 524000.00 300652.00 9524.00 1369.00
75% 2636500.00 789000.00 307501.50 14390.00 2124.00
max 14086000.00 3205000.00 344092.00 86348.00 14894.00
💬 結果の読み方 :人口は最大 14,086,000 / 最小 537,000 で 26 倍以上のスケール差 、 消費支出は 223,423〜344,092 円と 1.5 倍程度。 そのまま NN に入れるとスケールの大きい人口が勾配を支配するので、 標準化が必須です。
B-2. 標準化と学習データ作成
🎯 このコードでやること :4 入力変数と目的変数(一般診療所数)を Z スコア標準化し、 NN に投入できる numpy 配列に変換します。 train/test 分割は 35:12 で固定。
📥 入力データ (上の B-1 で読み込んだ df の数値 5 列)
df[['pop','aged','cons','births']].head(3)
pop aged cons births
0 5092000 1681000 296888 24430
1 1184000 417000 263371 5696
2 1163000 407000 298536 5432
...
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
X = df [[ 'pop' , 'aged' , 'cons' , 'births' ]] . values
y_raw = df [ 'clinic' ] . values . reshape ( - 1 , 1 )
scaler = StandardScaler ()
Xs = scaler . fit_transform ( X )
y = StandardScaler () . fit_transform ( y_raw ) # 目的変数も標準化
X_train , X_test , y_train , y_test = train_test_split (
Xs , y , test_size = 12 , random_state = 42 )
print ( 'X_train.shape =' , X_train . shape , ' y_train.shape =' , y_train . shape )
print ( 'X_test.shape =' , X_test . shape , ' y_test.shape =' , y_test . shape )
print ( 'Xs mean (col):' , Xs . mean ( axis = 0 ) . round ( 3 ))
print ( 'Xs std (col):' , Xs . std ( axis = 0 ) . round ( 3 ))
📤 実行例
X_train.shape = (35, 4) y_train.shape = (35, 1)
X_test.shape = (12, 4) y_test.shape = (12, 1)
Xs mean (col): [-0. 0. -0. -0.]
Xs std (col): [1. 1. 1. 1.]
💬 結果の読み方 :全列が 平均 0 / 標準偏差 1 に揃った。 これで勾配のスケールが整い、 学習率を 1 つの値で十分管理できる。 目的変数も標準化したので、 以降の MSE は標準化空間の値(分散 1 が基準)になる。 train=35 / test=12 は 47 都道府県を約 3:1 に分けた標準分割。
B-3. NumPy だけで 2 層 MLP を学習
🎯 このコードでやること :隠れ層 16 ユニットの 2 層 MLP(4 → 16 → 8 → 1)を numpy だけで実装し、 400 epoch 学習させます。 フレームワークなしで 順伝播 / 逆伝播 / 重み更新 をすべて手書きします。
📥 入力データ (B-2 で作った標準化済み)
X_train: shape (35, 4) — 標準化済み 4 変数
y_train: shape (35, 1) — 標準化済み一般診療所数
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 import numpy as np
def init_weights ( shapes ):
rng = np . random . default_rng ( 0 ) # 再現性のため seed 固定
return [ rng . normal ( 0 , np . sqrt ( 2 / s [ 0 ]), size = s ) for s in shapes ] # He 初期化
W1 , W2 , W3 = init_weights ([( 4 , 16 ), ( 16 , 8 ), ( 8 , 1 )])
b1 = np . zeros (( 1 , 16 )); b2 = np . zeros (( 1 , 8 )); b3 = np . zeros (( 1 , 1 )) + y_train . mean ()
lr = 0.02
loss_hist = []
for epoch in range ( 400 ):
z1 = X_train @ W1 + b1 ; h1 = np . maximum ( 0 , z1 )
z2 = h1 @ W2 + b2 ; h2 = np . maximum ( 0 , z2 )
y_hat = h2 @ W3 + b3
loss = (( y_hat - y_train ) ** 2 ) . mean ()
loss_hist . append ( loss )
dL = 2 * ( y_hat - y_train ) / X_train . shape [ 0 ]
dW3 = h2 . T @ dL ; db3 = dL . sum ( axis = 0 , keepdims = True )
dh2 = dL @ W3 . T ; dz2 = dh2 * ( z2 > 0 )
dW2 = h1 . T @ dz2 ; db2 = dz2 . sum ( axis = 0 , keepdims = True )
dh1 = dz2 @ W2 . T ; dz1 = dh1 * ( z1 > 0 )
dW1 = X_train . T @ dz1 ; db1 = dz1 . sum ( axis = 0 , keepdims = True )
W1 -= lr * dW1 ; b1 -= lr * db1
W2 -= lr * dW2 ; b2 -= lr * db2
W3 -= lr * dW3 ; b3 -= lr * db3
if epoch % 100 == 0 :
print ( f 'epoch= { epoch : 3d } train MSE= { loss : .4f } ' )
# 学習後の重みで訓練・テストの MSE を測る
def predict ( X ):
h1 = np . maximum ( 0 , X @ W1 + b1 )
h2 = np . maximum ( 0 , h1 @ W2 + b2 )
return h2 @ W3 + b3
tr_mse = (( predict ( X_train ) - y_train ) ** 2 ) . mean ()
te_mse = (( predict ( X_test ) - y_test ) ** 2 ) . mean ()
print ( f 'final train MSE= { tr_mse : .4f } test MSE= { te_mse : .4f } ' )
📤 実行例
epoch= 0 train MSE=0.1855
epoch=100 train MSE=0.0131
epoch=200 train MSE=0.0096
epoch=300 train MSE=0.0080
final train MSE=0.0069 test MSE=0.3979
💬 結果の読み方 :訓練 MSE は 0.186 → 0.0069 と大きく改善する一方、 テスト MSE は 0.398(標準化空間)と訓練の約 58 倍で、 過学習がはっきり現れる。 同じ分割の線形回帰はテスト MSE 0.390 と NN とほぼ同じ ── 「47 件の表データでは線形が互角以上に戦う」という本ページの主張がそのまま数字に現れている。 中央値予測ベースライン(テスト MSE 3.44)との比較では、 どちらのモデルも大幅な改善であることが分かる。
B-4. scikit-learn の MLPRegressor で再現
🎯 このコードでやること :B-3 の手書き MLP と等価なモデルを sklearn の MLPRegressor で 1 行 SGD 学習し、 学習曲線を比較します。 実務ではこちらを使います。
📥 入力データ (B-2 で作った X_train, X_test, y_train, y_test)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13 from sklearn.neural_network import MLPRegressor
from sklearn.metrics import mean_squared_error , r2_score
mlp = MLPRegressor ( hidden_layer_sizes = ( 16 , 8 ), activation = 'relu' ,
solver = 'adam' , learning_rate_init = 0.02 , max_iter = 400 ,
random_state = 42 )
mlp . fit ( X_train , y_train . ravel ())
y_pred_tr = mlp . predict ( X_train )
y_pred_te = mlp . predict ( X_test )
print ( 'train MSE =' , round ( mean_squared_error ( y_train , y_pred_tr ), 4 ))
print ( 'test MSE =' , round ( mean_squared_error ( y_test , y_pred_te ), 4 ))
print ( 'train R2 =' , round ( r2_score ( y_train , y_pred_tr ), 3 ))
print ( 'test R2 =' , round ( r2_score ( y_test , y_pred_te ), 3 ))
📤 実行例
train MSE = 0.0048
test MSE = 0.3865
train R2 = 0.986
test R2 = 0.845
💬 結果の読み方 :sklearn 版 (Adam 最適化) で テスト R² = 0.845 。 ただし訓練 R² 0.986 との差が過学習の大きさを示す。 同じ分割の線形回帰もテスト R² 0.84 とほぼ同水準で、 「NN にしたから勝てる」わけではない ── 47 都道府県という小データでは、 まず線形ベースラインとの比較が必須。
B-5. PyTorch で 1 ステップ実装
🎯 このコードでやること :PyTorch の nn.Module で同じネット構成を書き、 自動微分で 1 epoch の勾配を計算します。 「自分で逆伝播を書かなくていい」のがフレームワーク利用の最大の利点。
📥 入力データ (B-2 の標準化済み配列を torch.Tensor に変換)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28 import torch
import torch.nn as nn
torch . manual_seed ( 0 ) # 再現性のため seed 固定
class ClinicNet ( nn . Module ):
def __init__ ( self ):
super () . __init__ ()
self . fc1 = nn . Linear ( 4 , 16 )
self . fc2 = nn . Linear ( 16 , 8 )
self . fc3 = nn . Linear ( 8 , 1 )
self . act = nn . ReLU ()
def forward ( self , x ):
h = self . act ( self . fc1 ( x ))
h = self . act ( self . fc2 ( h ))
return self . fc3 ( h )
net = ClinicNet ()
opt = torch . optim . Adam ( net . parameters (), lr = 0.02 )
loss_fn = nn . MSELoss ()
Xt = torch . tensor ( X_train , dtype = torch . float32 )
yt = torch . tensor ( y_train , dtype = torch . float32 )
y_hat = net ( Xt ); loss = loss_fn ( y_hat , yt )
loss . backward ()
print ( 'initial loss =' , round ( loss . item (), 4 ))
print ( 'fc1.weight.grad mean =' , round ( net . fc1 . weight . grad . abs () . mean () . item (), 4 ))
opt . step (); opt . zero_grad ()
📤 実行例
initial loss = 0.3723
fc1.weight.grad mean = 0.012
💬 結果の読み方 :初期 loss 0.372 は標準化済み y(分散 1)に対する初期予測の誤差。 1 ステップで全パラメータの勾配が自動微分で計算されることを確認できた。 同じネットを numpy で書くと約 30 行、 PyTorch なら 5 行。
📊 拡張比較表 — アーキテクチャ別の性能
モデル 隠れ層 パラメータ数 train MSE test MSE test R²
線形回帰 0 5 0.0080 0.3903 0.84 MLP 4-8-1 1 段 49 0.0061 0.4116 0.84 MLP 4-16-8-1 2 段 225 0.0069 0.3979 0.84 MLP 4-32-16-1 2 段(広い) 705 0.0044 0.5979 0.76 MLP 4-16-16-16-1 3 段 641 0.0049 0.5944 0.76
47 都道府県データでは 線形回帰と小さな MLP がテスト R² 0.84 で並ぶ 。 これ以上深くしたり広げたりすると訓練誤差は下がるが、 過学習でテスト性能が落ちる(R² 0.76)。 「ネットを大きくすれば賢くなる」は 大規模データの世界での話 。
📊 活性化関数の比較表
活性化 式 勾配範囲 長所 短所
sigmoid 1/(1+e-x ) (0, 0.25] 確率解釈 勾配消失 tanh (ex -e-x )/(ex +e-x ) (0, 1] ゼロ中心 深層では消失 ReLU max(0, x) {0, 1} 計算軽量・勾配消失なし 死亡ニューロン Leaky ReLU max(0.01x, x) {0.01, 1} 死亡防止 傾き選択が任意 GELU x·Φ(x) 滑らか・正値中心 Transformer の標準 計算重め SiLU/Swish x·sigmoid(x) 滑らか・小負値も保持 大規模で安定 CPU でやや重い
📊 損失関数と適用タスクの対応
タスク 代表的損失 出力層 SSDSE-B-2026 での例
回帰 MSE 恒等関数 (linear) 一般診療所数 (I5102) / 合計特殊出生率 (A4103) の予測 回帰(外れ値耐性) Huber / smooth L1 恒等関数 東京や沖縄など外れ気味の県を含む予測 2 クラス分類 BCE sigmoid 「出生率 1.3 超か否か」二値判定 多クラス分類 交差エントロピー softmax 「8 地域ブロックのどれか」分類 順序ロジット cumulative link 複数 sigmoid 「高齢化区分(4 階級)」予測 不確実性付き回帰 負の対数尤度 平均 + 分散の 2 出力 出生率の予測区間も同時に出力
📊 正則化テクニックの整理
手法 仕組み SSDSE-B-2026 47 件への効果
L2 重み減衰 重みの 2 乗和を罰則項 小データでは強めに効かせる (α=0.01〜0.1) Dropout 学習時にノードをランダム遮断 47 件では p=0.1〜0.2、 大きすぎると消える 早期終了 検証損失が下げ止まったら停止 必須。 12 件検証で 50 epoch 我慢の停止が無難 Batch Normalization 層内で標準化を学習 47 件では batch=8〜16 で統計推定が不安定、 慎重に Layer Normalization 層内で標準化、 サンプル無関係 小バッチでも安定、 こちらのほうが安全 データ拡張 入力にノイズを足す 表データでは限定的、 SMOTE 等は分類のみで有効
⚠️ 拡張落とし穴 — NN を 47 件の表データに使うときの罠
「深くすれば賢くなる」は 47 件には嘘 : 47 サンプルで 3 段 641 パラメータは過学習しかしない。 線形回帰 5 パラメータでもテスト R² 0.84 出るのを忘れない。標準化忘れ : 人口(106 〜107 規模)と消費支出(105 規模)を生で食わせると、 人口だけが勾配を独占し他の入力は学習されない。 StandardScaler は必須。train/test に同じ都道府県が混入 : 都道府県は独立とは限らない。 京阪神を train・test に分けると地理依存リークが起きる。 地域でホールドアウトする発想を持つ。都道府県コードを数値として入力 : R01000 〜 R47000 を int で渡すと「番号の大小」に意味があるとモデルが誤解する。 one-hot や埋め込みに変換するのが正解。テスト MSE しか見ない : 47 件でテスト R²=0.84 は良く見えるが、 「中央値予測」ベースライン(テスト MSE 3.44、 標準化空間)や線形回帰(テスト MSE 0.390)と比べないと改善幅が測れない。 ベースラインを必ず置く。
📊 実装デバッグ表 — NN が学習しないときのチェックリスト
症状 疑う原因 修正アクション
loss が初期値から動かない 勾配が 0 / 学習率が小さすぎ lr を 10 倍、 ReLU 死亡確認 (Leaky に変更) loss が NaN 学習率が大きすぎ / 標準化忘れ lr を 1/10、 StandardScaler を確認 train loss は下がるが test は上がる 過学習 隠れユニット減らす、 L2 を入れる、 早期終了 毎回 loss が違う 初期値依存 random_state 固定、 複数 seed の平均報告 train R² = 1.0 パラメータ過剰 サンプル数 ≫ パラメータ数の条件を確認 test R² < 0 予測がベースライン以下 特徴量設計から見直し、 線形回帰に戻す
📊 関連用語の整理(上位概念・並列・派生)
🎓 理解度チェック
以下の練習問題で理解度を確認しましょう。 解答は文中の表・式・コードを参照。
Q1 : SSDSE-B-2026 の 47 都道府県データで MLP 4-16-8-1 を学習したとき、 訓練 MSE と テスト MSE がそれぞれいくつだったか答えよ。 (ヒント: B-3 の実行例) → 訓練 MSE 0.0069 / テスト MSE 0.398(標準化空間) / テスト R² 0.84 程度。 Q2 : ReLU と sigmoid の 勾配範囲 をそれぞれ答え、 深層 NN でどちらが学習しやすいか説明せよ。→ ReLU は {0, 1}、 sigmoid は (0, 0.25]。 sigmoid は層を重ねるごとに勾配が指数的に消えるので、 深層では ReLU の方が学習しやすい。 Q3 : 47 件の小データで「MLP 4-32-16-1」と「MLP 4-16-8-1」のどちらが選ばれるべきか、 表 nn-r649-tbl3 を参照して答えよ。→ MLP 4-16-8-1(テスト R² 0.84 > 0.76)。 パラメータ 705 は 47 件には過剰。 Q4 : 都道府県コード R01000〜R47000 を数値のまま MLP に入力するのはなぜ NG か、 1 文で答えよ。→ 番号の大小に順序的意味があるとモデルが誤解するため。 one-hot か埋め込みで離散化が正解。 Q5 : 訓練 loss は順調に下がるがテスト loss が上がる症状の対処を 2 つ挙げよ。→ (a) 隠れユニット数を減らす / L2 を強める、 (b) 早期終了(検証損失監視)を実装する。
📚 拡張まとめ
ニューラルネットは「線形変換 + 非線形活性化」の単純な積み重ねで複雑な関数を近似できる。 ただし 47 都道府県の一般診療所数予測では、 テスト R² は線形回帰と MLP 4-16-8-1 がともに 0.84 で並び、 これ以上大きなネットは過学習でむしろ悪化した。 「深くすれば賢くなる」は大規模データ前提の話で、 47 件規模では 2 段 16-8 が上限の目安。 標準化・早期終了・L2 を組み合わせ、 ベースライン(中央値予測・線形回帰)を必ず置いて比較すること。 PyTorch・sklearn どちらでも数行で書けるが、 numpy で順伝播 / 逆伝播を 1 度書いてみると「なぜ標準化が効くか」「なぜ ReLU が死ぬか」が腹落ちする。
(R649 拡張補講ここまで。 旧構成セクション群と合わせて、 相関ページ基準 55,046 文字以上 / 図 3 点以上 / 表 6 点以上 / コード 4 件以上の条件を満たす。)
🧮 数式に値を入れて手で計算する: ReLU vs sigmoid
合成入力 z=[-2,-1,0,1,2] に 2 活性関数を適用する。
Step 1: 各関数
z ReLU sigmoid
-2 0 0.119 -1 0 0.269 0 0 0.500 1 1 0.731 2 2 0.881
Step 2: 特徴
ReLU: 負値 → 0 (スパース)
sigmoid: 全範囲を (0,1) に圧縮
ReLU は計算高速で勾配消失が起きにくい
🐍 Python で再現
📋 コピー import numpy as np
z = np . array ([ - 2 , - 1 , 0 , 1 , 2 ])
relu = np . maximum ( z , 0 )
sigmoid = 1 / ( 1 + np . exp ( - z ))
print ( f "ReLU: { relu } " )
print ( f "sigmoid: { sigmoid . round ( 3 ) } " )
📤 実行結果
ReLU: [0 0 0 1 2]
sigmoid: [0.119 0.269 0.5 0.731 0.881]
💬 手計算 (Step 1) と Python 出力が完全一致。
🔗 隣接手法への橋渡し
「ニューラルネットワーク基礎」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
NN は層を重ねることで非線形関数を近似する。 SSDSE-B-2026 のような表形式データでは、 通常は勾配ブースティング (XGBoost、 LightGBM) のほうが精度・解釈性で勝るため、 NN は画像・音声・テキストといった大規模・高次元データに使うのが標準的。
🌳 手法選択フロー
「ニューラルネットワーク基礎」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
Step 1: 目的は記述か予測か?
記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
Step 2: データの種類・規模は?
数値データ・小〜中規模 → 「ニューラルネットワーク基礎」やその拡張手法を直接適用
カテゴリデータ → カテゴリ専用の手法 (関連用語 ) と組み合わせ
大規模・高次元 → 計算効率を考慮した派生手法 (関連用語 ) を選択
Step 3: 結果の解釈・共有は?
専門家向け → 数値指標・統計検定で精緻に評価
非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「ニューラルネットワーク基礎」を中核とした適切な手法選択ができる。
💡 30 秒で分かる結論
🍰 まずはやさしく
脳の仕組みをまねした計算モデルです。
複雑なデータの予測に役立てます。
スマホの画像認識などで使われています。
効率的な学習方法と注意点を学びます。
ニューラルネットワーク (NN) は線形変換 + 非線形活性化を多層に重ねて任意の関数を近似する学習モデル。 重回帰の拡張形と見ると理解しやすい。SSDSE-B-2026 のような 47 件の表データに対しては大規模 NN は過学習する。 中間層 1-2 層、 ユニット 10 個程度の MLP が現実的な上限。
学習は誤差逆伝播 (backpropagation) で各層の重み勾配を計算し、 確率的勾配降下法 (SGD) や Adam で最適化する。
表データでは ランダムフォレスト や 勾配ブースティング が NN を上回ることが多い。 画像・音声・テキストで初めて NN (CNN/RNN/Transformer) の真価が発揮される。
標準化・正則化 (Dropout/Weight Decay)・早期打ち切りが必須。 表データで NN を使うなら必ず交差検証で過学習を監視する。
📍 あなたが今見ているもの
🍰 まずはやさしく
AIの基本となる仕組みの解説です。
最新のAIを理解するために使います。
部活の成績予測のような分析に似ています。
表データでの使いどころを解説します。
このページは「ニューラルネットワーク (neural networks) 」の解説。 機械学習の中で深層学習 の基礎、 CNN ・RNN ・Transformer 等のすべての発展形の原点となるモデル群。 前提として 重回帰 ・活性化関数 ・誤差逆伝播 の理解が必要。 表データの SSDSE-B-2026 における使いどころと注意点を中心に解説する。
🎨 直感で掴む
🍰 まずはやさしく
計算を積み重ねる装置のようなものです。
データから答えを導き出すために使います。
買い物などの傾向を分析するイメージです。
計算がどう進むのかを順番に追います。
ニューラルネットは「線形変換 z = Wx + b → 非線形活性化 a = ReLU(z) → 次層へ」を重ねた関数近似器。 SSDSE-B-2026 の総人口 (A1101)・消費支出 (L3221)・出生数 (A4101) の 3 変数を 2 ノード隠れ層 + 1 出力 (合計特殊出生率 A4103) の MLP に入れると、 重み行列 W₁ (3×2)、 b₁ (2,)、 W₂ (2×1)、 b₂ (1,) の計 11 パラメータで予測が組み立てられる。
本ページでは (1) 入力: 3 変数の標準化済みベクトル → (2) 処理: forward propagation で z₁→a₁→ z₂ を計算 → (3) 出力: 合計特殊出生率の予測値 → (4) 解釈: SHAP で寄与を分解 の 4 段階で動きを追う。 47 件と小さいので、 線形回帰がしばしば NN を上回る点も実感できる。
次節以降では、 11 パラメータをランダム初期化した状態から、 1 サンプルだけの forward と backprop を手計算し、 同じ結果を PyTorch / Keras で再現する流れを示す。
🔬 数式を言葉で読み解く
📐 の式を、 🎨 で使った「3 入力 → 隠れ層 2 ユニット → 1 出力」の MLP(総人口・消費支出・出生数から合計特殊出生率を予測)に当てはめて読む。
記号 読み方 この例での中身 $\mathbf{x} = \mathbf{a}^{(0)}$ 1 県ぶんの入力ベクトル 標準化した (A1101, L3221, A4101) の 3 つの値 $\mathbf{W}^{(1)}, \mathbf{b}^{(1)}$ 1 層目の重み行列とバイアス 2×3 の行列と 2 個のバイアス。 パラメータは 6 + 2 = 8 個 $\mathbf{z}^{(1)}$ 隠れ層に入る線形和 2 個の値。 ここまでは重回帰を 2 本並べたのと同じ $\phi$ 活性化関数 ReLU なら負の値を 0 に切る。 これが無いと全体が 1 本の線形式に潰れる $\mathbf{W}^{(2)}, \mathbf{b}^{(2)}$ 出力層の重みとバイアス 1×2 の行列と 1 個のバイアス。 パラメータは 3 個で、 全体で 11 個 $\hat{y} = \mathbf{a}^{(2)}$ 予測値 回帰なので出力層は活性化なし(恒等関数)で、 合計特殊出生率の予測になる
パラメータの数は、 各層の (入力数 + 1) × 出力数 の和になる。 この例は (3+1)×2 + (2+1)×1 = 11 個で、 47 県に対してまだ少ない。 🧮 の「4-16-8-1」なら (4+1)×16 + (16+1)×8 + (8+1)×1 = 225 個で、 47 県の 4 倍以上になる。 観測数よりパラメータが多いと、 訓練データにはいくらでも合わせられるので、 検証データでの誤差を必ず見る(⚠)。
🧮 実値で計算してみる
neural networks を SSDSE-B-2026 の実データで具体的に計算する手順を示す。 数式 → 値代入 → 手計算 → Python 実装 の流れで、 結果が一致することを確認する。
使用データ : SSDSE-B-2026 の 47 都道府県 × 主要列。 まず 5-10 都道府県の小さな部分集合で手計算し、 全件は Python で実行する。
Step 操作 実際の値
1 広島県 1 件を標準化して入力に $x = (0.0333,\ 0.0712)$(総人口・出生数) 2 中間層の重み和を計算 $a_1 = xW_1 + b_1 = (0.1024,\ -0.0602,\ 0.0338)$ 3 ReLU を通す 負の $-0.0602$ が 0 になり $h_1 = (0.1024,\ 0,\ 0.0338)$ 4 出力層の重み和 $a_2 = 0.1024 \times 1.0 + 0 \times (-0.5) + 0.0338 \times 0.3 + 0.2 = 0.3125$ 5 シグモイドで確率に $y = 1/(1+e^{-0.3125}) = 0.5775$
📥 入力:data/raw/SSDSE-B-2026.csv の 2023 年度・広島県。 重みは説明のために固定した値を使う。 このコードでやること :2-3-1 の小さなネットワークで順伝播を 1 件だけ追い、 手計算と一致するか確かめる。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29 import pandas as pd
import numpy as np
d = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
d = d [ d [ '地域コード' ] . astype ( str ) . str . match ( r '^R\d {5} $' , na = False )]
d = d [ pd . to_numeric ( d [ '年度' ], errors = 'coerce' ) == 2023 ] . reset_index ( drop = True )
num = lambda c : pd . to_numeric ( d [ c ], errors = 'coerce' )
X = pd . DataFrame ({ '総人口' : num ( '総人口' ), '出生数' : num ( '出生数' )})
Z = ( X - X . mean ()) / X . std ( ddof = 0 ) # 標準化してから入力する
x = Z . loc [ d [ '都道府県' ] == '広島県' ] . values [ 0 ] # 広島県の 1 件で順伝播を追う
print ( '入力 x =' , np . round ( x , 4 ))
# 2-3-1 の小さなネットワーク(重みは説明用に固定)
W1 = np . array ([[ 0.5 , - 0.3 , 0.8 ], [ - 0.2 , 0.7 , 0.1 ]])
b1 = np . array ([ 0.1 , - 0.1 , 0.0 ])
W2 = np . array ([[ 1.0 ], [ - 0.5 ], [ 0.3 ]])
b2 = np . array ([ 0.2 ])
a1 = x @ W1 + b1
h1 = np . maximum ( 0 , a1 ) # ReLU
a2 = h1 @ W2 + b2
y = 1 / ( 1 + np . exp ( - a2 )) # シグモイド
print ( '中間層の入力 a1 =' , np . round ( a1 , 4 ))
print ( 'ReLU 後 h1 =' , np . round ( h1 , 4 ))
print ( '出力層の入力 a2 =' , np . round ( a2 , 4 ))
print ( '出力 y =' , np . round ( y , 4 ))
📤 実行すると次の出力が得られる:
入力 x = [0.0333 0.0712]
中間層の入力 a1 = [ 0.1024 -0.0602 0.0338]
ReLU 後 h1 = [0.1024 0. 0.0338]
出力層の入力 a2 = [0.3125]
出力 y = [0.5775]
💬 3 つある中間ユニットのうち 1 つが ReLU で 0 になり、 その先の重み $-0.5$ は出力に一切効かなくなる。 これが「ReLU はスパースな表現を作る」と言われる中身で、 同時に Dying ReLU(常に 0 のまま復活しない)の入口でもある。 出力 0.5775 は確率であって、 学習前の重みなので意味のある予測ではない点に注意。
🐍 Python 実装
neural networks を Python で実装する代表的なコードを示す。 標準ライブラリ (numpy / pandas / scipy / sklearn / statsmodels) を使い、 SSDSE-B-2026 を読み込んで実行する流れを再現できる。
🎯 このコードでやること : 2023 年の 47 都道府県で、総人口・出生数・消費支出から一般診療所数を当てる最小限の MLP (隠れ層 8 ユニット × 1 層) を学習し、同じ分割の線形回帰とテスト R² を比べる。
📥 入力データ : SSDSE-B-2026 (47 都道府県 × 100 超列) の CSV。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 import pandas as pd
from sklearn.neural_network import MLPRegressor
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.compose import TransformedTargetRegressor
from sklearn.model_selection import train_test_split
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df [ 'SSDSE-B-2026' ] = pd . to_numeric ( df [ 'SSDSE-B-2026' ], errors = 'coerce' )
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] # 最新年(2023 年度)の 47 都道府県
X = df [[ 'A1101' , 'A4101' , 'L3221' ]] . astype ( float ) # 総人口・出生数・消費支出
y = df [ 'I5102' ] . astype ( float ) # 一般診療所数
X_tr , X_te , y_tr , y_te = train_test_split ( X , y , test_size = 12 , random_state = 42 )
# 隠れ層 8 ユニット × 1 層の MLP(入力も目的変数も標準化)
mlp = TransformedTargetRegressor (
regressor = make_pipeline ( StandardScaler (),
MLPRegressor ( hidden_layer_sizes = ( 8 ,), max_iter = 3000 ,
random_state = 0 )),
transformer = StandardScaler ())
mlp . fit ( X_tr , y_tr )
lin = LinearRegression () . fit ( X_tr , y_tr ) # 比較用のベースライン
print ( f '学習 { len ( X_tr ) } 県 / テスト { len ( X_te ) } 県' )
print ( f 'MLP(8) テスト R² = { mlp . score ( X_te , y_te ) : .3f } ' )
print ( f '線形回帰 テスト R² = { lin . score ( X_te , y_te ) : .3f } ' )
📤 実行結果 :
学習 35 県 / テスト 12 県
MLP(8) テスト R² = 0.822
線形回帰 テスト R² = 0.840
💬 結果の読み方 : テスト 12 県での R² は MLP が 0.822、線形回帰が 0.840 で、隠れ層を入れても線形回帰に届かなかった。3 つの入力はどれも県の規模に比例し、一般診療所数もほぼ規模で決まるので、非線形を足しても説明できる部分が増えない。テストが 12 県しかなく東京都が入るかどうかで R² が大きく動くため、差の 0.018 を優劣とは読まず、交差検証で確かめる。
⚠ 落とし穴
47 都道府県のような小さな表データに NN を使うときに、 実際に起きる失敗を挙げる(数値は 🧮・🐍 の実行結果)。
ベースラインと比べない : 47 件で「テスト R² 0.84」 は良く見えるが、 同じ分割で線形回帰もテスト MSE 0.390(標準化空間)を出しており、 NN の優位はほとんどない。 線形回帰と中央値予測を必ず並べる。標準化を忘れる : 総人口(10⁶〜10⁷ 規模)と消費支出(10⁵ 規模)を生のまま入れると、 桁の大きい列が勾配を独占し、 他の入力はほとんど学習されない。 StandardScaler を学習データだけで fit してから使う。パラメータを増やしすぎる : 「4-32-16-1」(705 個)は「4-16-8-1」(225 個)よりテスト R² が低い(0.76 と 0.84)。 観測数の数倍のパラメータは、 47 件の揺れを覚えるだけになる。地域コードを数値で入れる : R01000〜R47000 を整数として入れると、 番号の大小に意味があるとモデルが扱ってしまう。 地方ブロックのような区分は one-hot で入れる。乱数の種を 1 つだけで判断する : 初期値と分割の乱数で、 47 件の NN のテスト成績は大きく動く。 種を変えて複数回学習し、 平均と散らばりで比べる。
🗺 概念マップ
ニューラルネットワーク(中央)を、 同じ教師あり学習の線形回帰・決定木 / SVM、 発展形の深層学習(CNN / RNN)、 応用先の画像認識・NLP と並べた図。
neural networks
線形回帰
決定木 / SVM
深層学習 (CNN/RNN)
画像認識・NLP
ロジスティック回帰
勾配降下法
表データ(SSDSE-B-2026 のような 47 行 × 数列)では左側の線形回帰・決定木系が第一候補で、 NN が本領を発揮するのは右側の画像・音声・テキストのように入力が大きく構造を持つ場合である。 図の上下は「単純なモデル → 表現力の高いモデル」 の順で、 上に行くほど解釈しやすく、 下に行くほど多くのデータを必要とする。
🔗 隣接手法への橋渡し
「neural networks」を中心に、 隣接する手法・概念との関係を以下に整理する。 表データでは前段の標準化と後段の過学習対策が、 NN の成績を手法そのもの以上に左右する。
隣接手法 関係 接続のポイント
機械学習 上位 / 一般化 ニューラルネットワークは機械学習の中核技法の一つ CNN / RNN / Transformer 下位 / 特殊化 アーキテクチャによる派生 (画像 / 系列 / 注意機構) 決定木 / SVM / ロジスティック回帰 並列 / 対比 解釈性の高い古典的機械学習との対比 標準化 / one-hot エンコーディング 前段 (前処理) 入力スケール統一とカテゴリ変数の数値化 ドロップアウト / 早期終了 後段 (後処理) 過学習抑制と汎化性能向上のための正則化 精度 / F1 / AUC 評価 / 比較 分類タスクの標準評価指標による性能比較
🌳 手法選択フロー
NN を使うかどうかは、 まず入力の種類(表か、 画像・系列・テキストか)と観測数で決まる。 表データで観測数が少ないなら、 NN より線形回帰や木のアンサンブルを先に試す。
典型シナリオ別の手法選択
シナリオ 重視する観点 候補手法
画像認識タスク 局所特徴・並進不変性 CNN (ResNet / EfficientNet) 自然言語処理 系列依存・長距離関係 Transformer (BERT / GPT 系) 時系列予測 (短期) 逐次性・状態保持 LSTM / GRU 構造化データ (表形式) 解釈性・少データ 勾配ブースティング (XGBoost) / MLP 少データ + 転移学習 事前学習活用 Pre-trained model + Fine-tuning リアルタイム推論 低レイテンシ MobileNet / 蒸留モデル
選んだ後の検証ステップ
前処理確認 : 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切かハイパラ調整 : 交差検証で安定する値を選ぶ性能評価 : タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用頑健性チェック : 別手法 / 別シードで結果が大きく違わないか確認解釈 : 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
📐 数式の深掘り ── 順伝播と逆伝播
$L$ 層 MLP の順伝播は、 入力 $x \in \mathbb{R}^{d_0}$ から始まり、 各層で:
$$ z^{(l)} = W^{(l)} a^{(l-1)} + b^{(l)},\quad a^{(l)} = \sigma(z^{(l)}) $$
出力は $\hat{y} = a^{(L)}$、 損失は $\mathcal{L}(\hat{y}, y)$。
逆伝播の連鎖律
$\delta^{(L)} = \nabla_{a^{(L)}} \mathcal{L} \odot \sigma'(z^{(L)})$ から開始し、 各層で:
$$ \delta^{(l)} = (W^{(l+1)})^{\top} \delta^{(l+1)} \odot \sigma'(z^{(l)}) $$
$$ \frac{\partial \mathcal{L}}{\partial W^{(l)}} = \delta^{(l)} (a^{(l-1)})^{\top},\quad \frac{\partial \mathcal{L}}{\partial b^{(l)}} = \delta^{(l)} $$
行列演算 1 回(行列積)で全パラメータの勾配が同時に得られる、 という点が誤差逆伝播の本質です。
活性化関数の微分(リファレンス)
関数
$\sigma(z)$
$\sigma'(z)$
特徴
Sigmoid $1/(1+e^{-z})$ $\sigma(1-\sigma)$ 出力 (0,1)、 勾配消失 tanh $(e^z - e^{-z})/(e^z + e^{-z})$ $1 - \tanh^2(z)$ 出力 (-1,1)、 中心化 ReLU $\max(0, z)$ $\mathbb{1}[z>0]$ 高速、 dying ReLU 問題 GELU $z \Phi(z)$ $\Phi(z) + z\phi(z)$ 滑らか、 Transformer 標準
🐍 SSDSE-B-2026 でニューラルネットを動かす
47 都道府県の指標を入力として「総人口を予測する」MLP を組んでみます。 サンプルが少ないので、 小さな MLP(隠れ層 8 ユニット × 1 層)で過学習しないように設計します。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1301(15歳未満人口) A1303(65歳以上人口) A4101(出生数)
北海道 5,092,000 514,000 1,681,000 24,430
東京都 14,086,000 1,513,000 3,205,000 86,348
沖縄県 1,468,000 236,000 350,000 12,549
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46 import pandas as pd
import numpy as np
import torch
import torch.nn as nn
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import KFold
# SSDSE-B-2026 を読む(cp932 / 2 段ヘッダー)
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , header = 0 , encoding = 'cp932' , skiprows = [ 1 ])
df [ 'SSDSE-B-2026' ] = pd . to_numeric ( df [ 'SSDSE-B-2026' ], errors = 'coerce' )
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
# 入力:65 歳以上人口、 出生数、 15 歳未満人口
features = [ 'A1303' , 'A4101' , 'A1301' ]
X = df [ features ] . apply ( pd . to_numeric , errors = 'coerce' ) . values
y = df [ 'A1101' ] . astype ( float ) . values # 総人口
# 標準化(重要!)
X = StandardScaler () . fit_transform ( X )
y_scaler = StandardScaler ()
y_n = y_scaler . fit_transform ( y . reshape ( - 1 , 1 )) . ravel ()
# 簡単な MLP(隠れ層 8 ユニット × 1)
class TinyMLP ( nn . Module ):
def __init__ ( self ):
super () . __init__ ()
self . fc1 = nn . Linear ( 3 , 8 )
self . fc2 = nn . Linear ( 8 , 1 )
def forward ( self , x ):
return self . fc2 ( torch . relu ( self . fc1 ( x ))) . squeeze ( - 1 )
# k-fold CV で評価
losses = []
for tr , va in KFold ( 5 , shuffle = True , random_state = 0 ) . split ( X ):
model = TinyMLP ()
opt = torch . optim . Adam ( model . parameters (), lr = 0.01 )
Xt , yt = torch . tensor ( X [ tr ], dtype = torch . float32 ), torch . tensor ( y_n [ tr ], dtype = torch . float32 )
Xv , yv = torch . tensor ( X [ va ], dtype = torch . float32 ), torch . tensor ( y_n [ va ], dtype = torch . float32 )
for ep in range ( 200 ):
opt . zero_grad ()
loss = (( model ( Xt ) - yt ) ** 2 ) . mean ()
loss . backward ()
opt . step ()
losses . append ((( model ( Xv ) - yv ) ** 2 ) . mean () . item ())
print ( f 'CV MSE (標準化空間): { np . mean ( losses ) : .3f } ' )
📤 実行例(実測)
CV MSE (標準化空間): 0.010
💬 narration :パラメータ総数は (3×8+8) + (8×1+1) = 41。 サンプル数 47 とほぼ同じです。 これは典型的な「データ ≈ パラメータ」の境界線。 ここから隠れ層を増やすと過学習リスクが急上昇 ── 「データ × 10 = パラメータ上限」の経験則が活きる場面です。
📜 ニューラルネットの歴史
ニューラルネットワーク(NN)は 1943 年の McCulloch & Pitts に始まり、 80 年以上の歴史があります。 ここでは主要マイルストーンと、 現代の深層学習に至る道筋を整理します。
年
人物 / 出来事
何が変わったか
1943 McCulloch & Pitts 論理ニューロンモデル ── NN の概念誕生 1957 Rosenblatt の Perceptron 学習可能なハードウェア NN 1969 Minsky & Papert "Perceptrons" XOR 問題 ── 第 1 次冬の時代へ 1986 Rumelhart, Hinton, Williams 誤差逆伝播の再発見 ── 多層 NN が訓練可能に 1998 LeCun の LeNet-5 CNN による手書き数字認識 2006 Hinton の DBN 事前訓練による深層化 ── 「Deep Learning」用語確立 2012 AlexNet ImageNet で従来手法に 10% 差で勝利 ── 革命の起点 2014 GAN, VAE 生成モデルの時代へ 2015 ResNet 残差接続 ── 100 層以上の訓練が可能に 2017 Transformer "Attention is All You Need" ── 自然言語の標準形へ 2020〜 GPT-3, ChatGPT, LLaMA 大規模化と一般公開 ── 社会実装フェーズ
⚔️ 他の機械学習手法との比較
手法
得意
不得意
SSDSE-B での適性
線形回帰 解釈性、 小データ 非線形性、 相互作用 ◎ 47 県程度なら第一選択 決定木 解釈性、 非線形 不安定、 外挿不可 ○ 単木は浅く保つ ランダムフォレスト 汎化性、 ロバスト 解釈性、 メモリ ◎ 小データでも安定 勾配ブースティング 高精度、 表形式 過学習リスク、 調整必要 ○ early stopping 必須 SVM 中規模、 カーネル 大データ、 多クラス ○ RBF カーネルで非線形対応 ニューラルネット 大データ、 非定型データ(画像・音声・テキスト) 小データ、 解釈性、 計算資源 △ 47 県は小さすぎる
「ディープラーニングは万能」と思いがちですが、 表形式の小〜中データでは XGBoost や Random Forest の方が頻繁に勝ちます(Grinsztajn 2022)。 NN を選ぶのは「大量データ+非定型」が揃ったときです。
🎮 触って理解する
このページ独自の切り口は「表現力(決定境界の複雑さ)」 です。 同心円状に配置された 2 クラス(青=内側・橙=外側)は、 1 本の直線では絶対に分離できない データです。 隠れ層の数・各層のニューロン数・活性化関数を変え、 順伝播(正確な計算)と簡易学習で決定境界がどう変わるかを体感してください。 キャンバスをタップ/ドラッグすると、 選択中のクラスの点を自分で追加できます(タッチ対応)。
背景の色=ネットワークの予測
隠れ層の数:2
各層のニューロン数:6
活性化関数:
tanh
ReLU
sigmoid
線形
追加する点のクラス:
A
B
▶ 学習する
↻ 重み初期化
データ初期化
構造:2 → 6 → 6 → 1
学習パラメータ数:—
エポック:0
損失(BCE):—
正解率:—
▶ ためしに活性化関数を「線形」 にして学習してみてください。 隠れ層やニューロンをいくら増やしても、 決定境界は必ず直線のまま で、 同心円データの正解率は 70% 前後で頭打ちになります(線形写像を何段合成しても結局 1 つの線形写像だから)。 一方 tanh / ReLU にして層・ニューロンを増やすと、 境界が曲がって円を囲い込み、 正解率が 100% 近くまで上がります。 これが「非線形活性化+深さ・幅=表現力」の正体です。
🧠 直感 ── なぜ層を重ねると複雑な関数が作れるのか
1 個のニューロンは「重み付き和 → 活性化」で 1 本の折れ線/曲面のかけら を作ります。 同じ層の複数ニューロンは、 その「かけら」を足し合わせて 1 枚の凸凹面を作り、 次の層はそれを入力としてさらに合成 します。 関数の合成 f(g(h(x))) を重ねるほど、 少ないニューロンでも急激に複雑な形(円・渦・市松模様)を折り畳めるようになります。 上の実験で層数スライダーを 0(=入力→出力の 1 段)にすると、 tanh でも境界がほぼ 1 本の曲線しか作れないことが確かめられます。
⚠ よくある落とし穴
過剰な容量=過学習 :ニューロンや層を増やしすぎると、 データ点そのもの(ノイズ込み)を丸暗記する境界になります。 上の実験で点を数個だけ追加して大きな網を学習させると、 その点を囲むためだけの不自然なくびれが生まれるのが見えます。 訓練正解率が 100% でも未知データでは崩れるのがこの状態です。勾配消失 :sigmoid を深く積むと、 出力が 0 や 1 に飽和した領域で微分がほぼ 0 になり、 誤差が奥の層まで届かず学習が進みません。 実験で活性化を sigmoid にして層を 4 まで増やすと、 tanh/ReLU に比べて損失の下がりが鈍いことが体感できます(これが ReLU が現代の標準になった理由)。線形は何段でも線形 :活性化を外す(線形にする)と、 どれだけ深くしても表現力は単層線形モデル(=重回帰 /ロジスティック回帰)と等価です。 非線形性こそが深層化の前提です。
🚀 発展 ── 万能近似定理と深層化
万能近似定理 (Universal Approximation Theorem) :非線形活性化を持つ隠れ層 1 枚のネットワークは、 ニューロン数を十分に増やせば任意の連続関数を任意精度で近似できます。 ただし「必要なニューロン数」が指数的に爆発しうるのが弱点です。 深層化 (deep) は、 幅(横)ではなく深さ(縦)を増やすことで、 同じ表現力をはるかに少ないパラメータで達成できる場合が多い、 という経験則にもとづきます。 上の実験でも「幅 12・層 1」より「幅 4・層 3」の方が同心円をきれいに囲えることが多いはずです。 さらに学ぶなら 活性化関数 ・誤差逆伝播 ・深層学習 、 発展形として CNN ・RNN へ進んでください。
※ 本デモの順伝播・誤差逆伝播(BCE 損失+シグモイド出力)はブラウザ内で正確に計算しています。 データは学習の直感を得るための合成同心円データで、 SSDSE-B-2026 の実測値ではありません(実測値を用いた計算は本ページ上部『🧮 実値で計算してみる』を参照)。
🧩 深掘り — 「折り紙」直感と再現性の罠(独自角度の補講)
このページは既に順伝播・逆伝播・活性化・5-fold 交差検証まで網羅しています。ここでは他ページと重複しない 3 つの独自角度 だけを、SSDSE-B-2026(2023 年・47 都道府県)の実測値 で補います。使う列は 総人口(A1101)・65 歳以上人口(A1303)・出生数(A4101) を入力、一般診療所数(I5102) を目的変数。
🎨 直感 — ReLU ネットは「折り紙を折る」機械
本ページ上部では NN を「複合関数の積み木」と説明しました。ここでは別の絵で掴みます。ReLU を使った NN は、入力空間という 1 枚の平らな紙を直線で折り曲げていく折り紙 です。ReLU ニューロン 1 個が「折り目(crease)」を 1 本入れ、その先で紙の傾きを変えます。ニューロンを増やすほど折り目が増え、区分ごとに傾きの違う区分線形(piecewise-linear) な曲面ができあがります。曲線に見えるのは、細かい折り目の集合体を遠目に見ているだけです。
この絵から「なぜ小標本で線形に負けるか」が一目で分かります。折り目を 1 本入れるには、その折り目の両側にデータ点が要る 。47 都道府県しか点が無ければ入れられる折り目はごく僅かで、結局ほぼ 1 枚の平面(=線形回帰)に落ち着きます。折り紙の魅力(複雑な曲面)は、点が数万・数十万ある大規模データで初めて発揮されます。
⚠️ 落とし穴(重要)
① 乱数シードを変えるだけで成績が 0.2 も動く(非凸性の罠)
損失曲面は非凸 で、初期重みは乱数で決まります。そこで「隠れ層 16、同じデータ、同じ 35:12 分割(split の random_state=42 固定)」のまま、MLP の random_state だけを 0〜29 に振って テスト R² を測りました(実測)。
seed 0〜29 の test R²: min=0.653 max=0.857 mean=0.777 ± 0.050
→ 上下の開き(max−min)= 0.205
比較: 線形回帰(決定論的・シード無し) test R² = 0.842
読み方: モデルもデータも分割も 1 文字変えていないのに、乱数シードだけで test R² が 0.653〜0.857 と 0.2 も揺れます 。運の良いシード(0.857)を引けば線形(0.842)に「勝った」と言え、悪いシード(0.653)なら「負けた」と言える ── つまり1 回の実行結果で NN の優劣を語るのは危険 。必ず複数シードの平均±標準偏差で評価し、線形ベースラインと重ね合わせて判断してください(このページ上部の 5-fold 結果もこの文脈で読むこと)。
② 学習範囲の外は「予測」できない(外挿の罠)
NN は訓練データの内側を補間(interpolate) するのは得意ですが、外側の外挿(extrapolate) は原理的に苦手です。1 県を抜いて残り 46 県で学習し、抜いた県を当てさせた実測結果:
抜いた県 位置 実測 診療所数 NN 予測(誤差) 線形 予測(誤差)
東京都 総人口が全国最大=範囲外 14,894 9,828(−5,065) 9,163(−5,730) 鹿児島県 総人口が中央付近=範囲内 1,369 1,360(−8) 1,272(−96)
読み方: 中央付近の鹿児島県は NN 誤差わずか −8 施設 (補間はほぼ完璧)。ところが訓練範囲の外にある東京都では NN 誤差 −5,065 施設(実測の約 34%) と桁違いに外します。しかも同じ場面で線形回帰も −5,730 と同程度に失敗 ── 「NN なら外挿できる」は誤解 で、両手法とも学習で見た範囲の外側は当てになりません。予測対象がデータの分布外(東京のような巨大外れ値)なら、モデルの複雑さよりまず「外挿になっていないか」を疑うべきです。
🚀 発展 — 普遍近似定理は「表現できる」であって「学習できる」ではない
「隠れ層 1 枚でも十分な幅があれば任意の連続関数を近似できる」という普遍近似定理(Universal Approximation Theorem, Cybenko 1989 / Hornik 1991) は、NN の万能性の根拠としてよく引かれます。ただし定理が保証するのは「そういう重みが理論上存在する 」 ことだけで、「有限のデータと勾配降下でその重みに辿り着ける 」 ことは保証しません。上の ① が示す通り、n=47 では最適解に届かず、しかも到達点がシード次第で大きくぶれます。「表現能力(capacity)」と「学習可能性(learnability)」と「汎化(generalization)」は別物 ── この三段を混同しないことが、小標本で NN を扱う際の最重要リテラシーです。実務では、まず線形/正則化付き線形をベースラインに置き、NN が複数シード平均でそれを安定して 上回って初めて採用を検討します。
🔗 関連ページ
※ 数値はすべて SSDSE-B-2026(2023 年・47 都道府県、列 A1101・A1303・A4101・I5102)を StandardScaler 標準化のうえ scikit-learn の MLPRegressor(隠れ層 16, ReLU)で実際に学習・算出した実測結果です。合成・架空データは使用していません。