🔖 キーワード索引
三層パーセプトロン (MLP) は入力層・隠れ層・出力層の 3 層構造で、 隠れ層の非線形活性 (ReLU/Sigmoid) によって XOR 等の非線形分離を可能にしたニューラルネットの最小単位。 SSDSE-B-2026 の人口・出生率から「人口減少県か否か」を二値分類する MLP を sklearn.neural_network.MLPClassifier で学習する。
これらのキーワードは「perceptron three layer の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
脳の仕組みをまねたシンプルな計算機です。
複雑なデータのパターンを見つけるために使います。
スマホのアプリなどで、写真の種類を分ける時に役立ちます。
この章では、三層パーセプトロンの基本について読みます。
入力・隠れ・出力からなる最も基本的なNN
- 入力層 + 隠れ層 + 出力層 からなる最も基本的なフィードフォワード NN。
- 万能近似定理:隠れ層が十分大きければ任意の連続関数を近似可能。
- 単層パーセプトロンの限界(XOR 解けない)を 1986年 Rumelhart の誤差逆伝播で打破。
- 今でも表形式データの基準モデル(DNN前の標準)。
- scikit-learn の
MLPClassifierとして手軽に使える。
📍 あなたが今見ているもの
🍰 まずはやさしく
AIが進化するための第一歩となる仕組みです。
ニューラルネットワークの基礎を学ぶために使います。
都道府県のデータを分けて、地域の特徴を調べる例で考えます。
この章では、実際にプログラムを作って正解率を確かめます。
深層学習の歴史的・概念的出発点。 「NNとは何か」を理解するにはまず3層MLPを実装してみるのが早道です。
本ページは 三層パーセプトロン を、 SSDSE-B-2026 の社会指標で 47 都道府県の二値分類タスクとして実装する。 隠れ層ニューロン数を 4→8→16 と変えて訓練精度・検証精度を比較し、 単層パーセプトロンが分離できなかった非線形境界を MLP がどう近似するかを観察する。
「perceptron three layer」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
情報を整理して判断する3つのステップのようなものです。
直線では分けられない難しい問題を解くために使います。
部活のメンバーを、複数の条件でグループ分けする時に似ています。
この章では、隠れ層(中間の層)がどう役立つかを読みます。
3層の役割:
- 入力層:データをそのまま受け取る
- 隠れ層:非線形変換で特徴を作る(中間表現)
- 出力層:最終的な予測値を出す
1層では直線(XOR不能)→ 2層あれば曲線分離 → 任意の関数を近似できる、 という大ジャンプがここにあります。
🎨 XOR 問題を 3 層で解く ─ 直感の宝庫
XOR は 1 層パーセプトロン(線形分離器)が解けないことを示し、 1969 年に Minsky & Papert が Perceptrons で指摘した。 3 層なら下記の重みで解ける(手作り解)。
| $x_1$ | $x_2$ | $h_1=\sigma(x_1+x_2-0.5)$ | $h_2=\sigma(x_1+x_2-1.5)$ | $y=\sigma(h_1-h_2-0.5)$ | 期待 |
|---|---|---|---|---|---|
| 0 | 0 | σ(-0.5) ≈ 0.378 | σ(-1.5) ≈ 0.182 | σ(-0.304) ≈ 0.425 → 0 | 0 ✓ |
| 0 | 1 | σ(0.5) ≈ 0.622 | σ(-0.5) ≈ 0.378 | σ(-0.256) ≈ 0.436 → 0 | 1 ※ |
※ sigmoid は連続値なので、 「学習」して理想重みに収束させると XOR がきれいに解ける。 ステップ関数なら手作り重みでも厳密に成立。 重要なのは 1 隠れ層を入れることで非線形決定境界が表現可能になる事実。
📌 直感:隠れ層は「入力空間を新しい座標系(特徴空間)に写す」装置。 XOR の場合、 隠れ層が「片方だけが 1」という非線形特徴を作るので、 出力層がそれを線形分離できる。
🎮 触って理解する
このページ独自の切り口は「隠れ層が XOR(線形分離不能問題)をどう解くか」です。 姉妹ページ(ニューラルネットワーク=スライダーと決定境界、 NN の表現力=同心円データ、 活性化関数=関数の重ね描き)とは違い、 ここでは入力空間 (x₁, x₂) と隠れ空間 (h₁, h₂) を並べて表示し、 「隠れ層=座標変換」を直接目で確かめます。 順伝播(sigmoid / step)はすべてブラウザ内で正確に計算しており、 外部通信はありません。
XOR の 4 点(● 出力 0=(0,0)・(1,1)、 ● 出力 1=(0,1)・(1,0))を 1 本の直線で分けてみてください。 直線の端の○ハンドルをドラッグ(タッチ可)で回転、 線の中ほどをドラッグで平行移動。 どちら側を「1」と読むかは自動で有利な方を選びます。 どう頑張っても最大 3/4 にしかならないことを体感してください。
これが 1969 年に Minsky & Papert が『Perceptrons』で証明した単層の限界。 (0,1) と (1,0) を通る側と (0,0)・(1,1) を通る側は、 どんな直線でも必ず混ざります。
💡 直感 ─ 隠れ層は「座標変換装置」であり「特徴抽出器」
学習済み解をセットして隠れ空間を見ると、 入力空間で対角線上に混ざっていた 4 点が、 隠れ空間では一直線で切れる配置に「引っ越し」していることが分かります。 h₁ は「x₁ か x₂ の少なくとも一方が 1(OR 的特徴)」、 h₂ は「両方が 1(AND 的特徴)」を検出しており、 出力層は「OR であって AND でない」という線形分離可能な新しい問題を解いているだけです。 生の座標では解けない問題を、 解ける座標系に写し替える──これが表現学習(representation learning)の最小例であり、 深層学習が画像や言語で行っていることの原型です。
⚠️ 落とし穴 ─ 単層の限界と「線形活性化の罠」
- 単層の限界は「証明された」限界:上のウィジェットで 4/4 にならないのは調整不足ではなく数学的に不可能(Minsky & Papert, 1969)。 この指摘が第 1 次 AI の冬の引き金になった歴史も重要です。
- 活性化が線形なら多層でも線形のまま:もし σ を恒等関数にすると、 W⁽²⁾(W⁽¹⁾x + b⁽¹⁾) + b⁽²⁾ = (W⁽²⁾W⁽¹⁾)x + (定数) となり、 何層積んでも 1 本の直線に縮退します。 ウィジェットの決定境界が「折れ曲がる」のは sigmoid / step の非線形のおかげ。 詳しくは 活性化関数 と シグモイド関数 を参照。
- 2 つの隠れユニットが同じ向きなら失敗する:初期値では h₁ と h₂ の直線が重なっており、 実質 1 本=単層と同じで 3/4 止まり。 隠れユニットは互いに違う特徴を持って初めて意味を持ちます(学習でいう対称性の破れ)。
🚀 発展 ─ 万能近似定理と「それでも深くする」理由
XOR に必要な隠れユニットは 2 個ですが、 これを一般化したのが万能近似定理(Cybenko 1989 / Hornik 1991):非線形活性化を持つ隠れ層 1 枚の MLP は、 隠れユニット数を増やせば任意の連続関数を任意精度で近似できます。 ウィジェットで見た「直線の折れ曲がり」を無数に重ねるイメージです。 ただし浅いまま近似しようとすると必要ユニット数が爆発することがあり、 実用では層を重ねて「特徴の特徴」を段階的に作る方が効率的──これが深層学習への動機です。 なお本ウィジェットは重みを手で与えましたが、 実際にこの解へ自動でたどり着く仕組みが誤差逆伝播と勾配降下法です。 単層の原型は パーセプトロン を参照。
📐 定義/数式
🍰 まずはやさしく
3つの層を重ねた数学的なモデルです。
入力から答えを出すまでの計算ルールを決めるために使います。
買い物で、予算と好みのバランスを計算して商品を選ぶ時に似ています。
この章では、重みや活性化関数(計算の切り替え役)の式を読みます。
三層パーセプトロン(Three-layer Perceptron):入力・隠れ・出力からなる最も基本的なNN
📐 3 層パーセプトロンの完全な式 ─ 前向き計算と勾配
入力 $\mathbf{x} \in \mathbb{R}^{d_0}$、 隠れ層 $\mathbf{h} \in \mathbb{R}^{d_1}$、 出力 $\mathbf{y} \in \mathbb{R}^{d_2}$ とする。 隠れ層活性化を $\sigma_1$、 出力活性化を $\sigma_2$(分類なら softmax)とおく:
$$ \mathbf{z}^{(1)} = W^{(1)} \mathbf{x} + \mathbf{b}^{(1)},\quad \mathbf{h} = \sigma_1(\mathbf{z}^{(1)}) $$ $$ \mathbf{z}^{(2)} = W^{(2)} \mathbf{h} + \mathbf{b}^{(2)},\quad \mathbf{y} = \sigma_2(\mathbf{z}^{(2)}) $$🔬 数式を言葉で読み解く
- $W^{(1)} \in \mathbb{R}^{d_1 \times d_0}$ … 入力→隠れの重み行列(行が隠れユニット、 列が入力次元)
- $\mathbf{b}^{(1)} \in \mathbb{R}^{d_1}$ … 隠れ層のバイアス(傾きの切片)
- $\sigma_1$ … 活性化関数(sigmoid / tanh / ReLU 等の非線形)。 これが無いと 1 層の線形回帰に縮退する
- $W^{(2)} \in \mathbb{R}^{d_2 \times d_1}$ … 隠れ→出力の重み
- $\sigma_2$ … 出力活性化(回帰なら恒等、 2 値分類なら sigmoid、 多クラスなら softmax)
勾配 ─ 連鎖律を 1 行で
損失 $L$ の重みに対する勾配は、 出力側から順に伝播する(backpropagation):
$$ \boldsymbol{\delta}^{(2)} = \nabla_{\mathbf{z}^{(2)}} L \;=\; (\mathbf{y} - \mathbf{t}) $$ $$ \boldsymbol{\delta}^{(1)} = (W^{(2)})^\top \boldsymbol{\delta}^{(2)} \odot \sigma_1'(\mathbf{z}^{(1)}) $$ $$ \frac{\partial L}{\partial W^{(2)}} = \boldsymbol{\delta}^{(2)} \mathbf{h}^\top,\quad \frac{\partial L}{\partial W^{(1)}} = \boldsymbol{\delta}^{(1)} \mathbf{x}^\top $$🔬 数式を言葉で読み解く
- $\boldsymbol{\delta}^{(2)} = \mathbf{y} - \mathbf{t}$ … 予測と教師ラベルの「ズレ」が出力誤差。 softmax + cross-entropy の組み合わせならこの単純形になる
- $(W^{(2)})^\top \boldsymbol{\delta}^{(2)}$ … 出力誤差を上位層から隠れ層に「逆向きに流す」
- $\odot \sigma_1'$ … 隠れ層の活性化関数の傾きを掛けると、 隠れ層誤差 $\boldsymbol{\delta}^{(1)}$ になる
- 勾配 $\partial L / \partial W = \boldsymbol{\delta} \mathbf{x}^\top$ は 「誤差 × 入力」の外積で 1 行
万能近似定理(Universal Approximation Theorem)
Cybenko (1989) / Hornik (1991) — 「sigmoid 等の非線形活性化を持つ 1 隠れ層 MLP は、 任意の連続関数を任意精度で近似できる」。
$$ \forall f \in C(K),\ \forall \varepsilon > 0,\ \exists N,\ \exists \{W^{(1)},\mathbf{b}^{(1)},W^{(2)},\mathbf{b}^{(2)}\}:\ \sup_{\mathbf{x} \in K} | g(\mathbf{x}) - f(\mathbf{x}) | < \varepsilon $$$g(\mathbf{x}) = W^{(2)} \sigma(W^{(1)} \mathbf{x} + \mathbf{b}^{(1)}) + \mathbf{b}^{(2)}$ という 3 層 MLP の形。 つまり「層を深くしなくても表現力はある」のが理論。 ただし必要な隠れユニット数 $N$ が指数的に大きくなることがあるため、 実用では深くする。
📐 活性化関数の比較 ─ なぜ Sigmoid だけでは足りないか
3 層 MLP の表現力は活性化関数 $\sigma_1$ で決まる。 代表 4 種の式と勾配は次のとおり。
$$ \mathrm{sigmoid}(z) = \frac{1}{1+e^{-z}},\quad \sigma'(z) = \sigma(z)(1-\sigma(z)) $$ $$ \tanh(z) = \frac{e^z - e^{-z}}{e^z + e^{-z}},\quad \tanh'(z) = 1 - \tanh^2(z) $$ $$ \mathrm{ReLU}(z) = \max(0, z),\quad \mathrm{ReLU}'(z) = \mathbb{1}[z > 0] $$ $$ \mathrm{GELU}(z) = z \cdot \Phi(z),\quad \Phi: \text{標準正規 CDF} $$🔬 数式を言葉で読み解く
- sigmoid は (0,1) の確率に潰すが、 飽和領域で勾配 $\sigma(1-\sigma)$ が 0 に近く勾配消失を起こす
- tanh は (-1,1) で対称、 勾配の最大値 1(sigmoid の 0.25 より 4 倍大)
- ReLU は正領域で勾配 1、 計算も $\max$ だけで超軽量。 現代の主流
- GELU は Transformer で標準。 確率的にゲートを開閉するイメージ
| 活性化 | 範囲 | 最大勾配 | 代表用途 |
|---|---|---|---|
| sigmoid | (0, 1) | 0.25 | 2 値分類出力、 歴史的 MLP |
| tanh | (-1, 1) | 1.0 | RNN, 小規模 MLP |
| ReLU | [0, ∞) | 1.0 | CNN, 深層 MLP の標準 |
| GELU | (≈0, ∞) | ≈ 1.0 | Transformer (BERT, GPT) |
📐 隠れユニット数とパラメータ数の数え方
入力次元 $d_0$、 隠れ $d_1$、 出力 $d_2$ の 3 層 MLP の総パラメータ数:
$$ N_{\mathrm{param}} = \underbrace{d_0 \cdot d_1}_{W^{(1)}} + \underbrace{d_1}_{\mathbf{b}^{(1)}} + \underbrace{d_1 \cdot d_2}_{W^{(2)}} + \underbrace{d_2}_{\mathbf{b}^{(2)}} $$🔬 数式を言葉で読み解く
- 第 1 層 $W^{(1)}$ は $d_0 \times d_1$ 個 = 入力ピクセルとユニット間の連結数
- バイアス $\mathbf{b}^{(1)}$ は $d_1$ 個 = ユニットごとに 1 つ
- 第 2 層も同様、 全部足すと総パラメータ数
| 構成 (d0, d1, d2) | パラメータ数 | 想定タスク |
|---|---|---|
| (2, 3, 3) | 2·3+3+3·3+3 = 21 | SSDSE-B 人口分類(最小) |
| (2, 8, 3) | 2·8+8+8·3+3 = 51 | 本記事の中盤例 |
| (784, 64, 10) | 784·64+64+64·10+10 = 50,890 | MNIST 文字認識 |
| (3072, 512, 10) | 3072·512+512+512·10+10 = 1,578,506 | CIFAR-10 (3072 = 32×32×3) |
📌 47 サンプル(SSDSE-B-2026)に対し (2,8,3)=51 パラメータは サンプル/パラメータ比 ≈ 0.9 で危険水準。 経験則は「サンプル数 ≥ 10 × パラメータ数」。 だから本記事は隠れ 3-4 に抑えた。
📐 勾配消失と Xavier / He 初期化
3 層は浅いので勾配消失は限定的だが、 隠れ層を深くする入口として理解しておく価値がある。 重み $W^{(\ell)}$ の分散を入力次元 $d_{\ell-1}$ で調整するのが Xavier / He 初期化:
$$ \mathrm{Xavier}:\ W \sim \mathcal{N}\!\left(0,\ \frac{2}{d_{\ell-1} + d_{\ell}}\right) $$ $$ \mathrm{He}:\ W \sim \mathcal{N}\!\left(0,\ \frac{2}{d_{\ell-1}}\right) \quad \text{(ReLU 用)} $$🔬 数式を言葉で読み解く
- 入力次元 $d_{\ell-1}$ が大きいほど、 $\sum w_i x_i$ の分散が大きくなる → 活性化関数が飽和
- 分散を $2/d_{\ell-1}$ にスケールすると、 各層の入力分散が一定に保たれる
- Xavier は sigmoid/tanh 向け(入出力次元の平均で割る)
- He は ReLU 向け(負側を捨てるので係数が 2 倍)
PyTorch / Keras では nn.Linear の初期値が自動でこれに準じる(PyTorch は kaiming_uniform_)。 自前 numpy 実装する場合は明示的に:
📐 正則化 ─ L2、 ドロップアウト、 早期終了
小データほど正則化が効く。 3 層 MLP で使う代表 3 手法:
① L2 正則化(weight decay)
$$ L_{\mathrm{reg}} = L_{\mathrm{ce}} + \frac{\lambda}{2} \sum_{\ell} \| W^{(\ell)} \|_F^2 $$🔬 数式を言葉で読み解く
- $\| W \|_F^2$ … 重みの 2 乗和(Frobenius ノルム)
- $\lambda$ … 正則化強度。 大きいほど重みが 0 に押し込まれる
- sklearn では
alphaパラメータ(デフォルト 0.0001)
② ドロップアウト
学習時、 各隠れユニットを独立確率 $p$ で 0 に「黒塗り」する。 推論時は全ユニットを使い、 出力を $(1-p)$ 倍してスケール調整。
$$ \tilde{h}_j = \begin{cases} 0 & \text{確率 } p \\ h_j / (1-p) & \text{確率 } 1-p \end{cases} $$🔬 数式を言葉で読み解く
- 確率 $p$(典型 0.2-0.5)でユニットを「壊す」
- 毎ミニバッチで違う部分集合が壊されるので、 ネットワークが暗黙的にアンサンブルになる
- 推論時に $1/(1-p)$ で割って期待値を合わせる(inverted dropout)
③ 早期終了 (Early Stopping)
検証損失 $L_{\mathrm{val}}$ が patience エポック連続で改善しなければ訓練停止:
$$ \text{stop if } L_{\mathrm{val}}^{(t)} \ge \min_{t' \le t - \text{patience}} L_{\mathrm{val}}^{(t')} $$sklearn では early_stopping=True, validation_fraction=0.1, n_iter_no_change=10。
📐 損失関数 ─ 課題に応じた選択
分類:cross-entropy
$$ L_{\mathrm{ce}} = -\frac{1}{N} \sum_{i=1}^{N} \sum_{c=1}^{C} y_{i,c} \log p_{i,c} $$回帰:MSE / MAE
$$ L_{\mathrm{mse}} = \frac{1}{N} \sum_{i=1}^{N} (y_i - \hat{y}_i)^2,\quad L_{\mathrm{mae}} = \frac{1}{N} \sum_{i=1}^{N} | y_i - \hat{y}_i | $$🔬 数式を言葉で読み解く
- cross-entropy は「正解クラスの確率の log」を取った量の符号反転。 完全に当たれば 0、 外せば $\infty$
- MSE は外れ値(残差大)に二乗で重く罰する。 外れ値が結果を引っ張りやすい
- MAE は外れ値に頑健。 ただし勾配が定数なので最適化が遅い
- 分類ヘッドは softmax + cross-entropy、 回帰ヘッドは恒等 + MSE が定型
📐 最適化手法(オプティマイザ)の式
3 層 MLP の学習で使う主要オプティマイザを 1 行式で並べる(時刻 $t$、 学習率 $\eta$、 勾配 $\mathbf{g}_t = \nabla L(\theta_t)$)。
SGD
$$ \theta_{t+1} = \theta_t - \eta \, \mathbf{g}_t $$SGD + Momentum
$$ \mathbf{v}_{t+1} = \beta \mathbf{v}_t + \mathbf{g}_t,\quad \theta_{t+1} = \theta_t - \eta \, \mathbf{v}_{t+1} $$Adam
$$ \mathbf{m}_t = \beta_1 \mathbf{m}_{t-1} + (1-\beta_1) \mathbf{g}_t,\quad \mathbf{v}_t = \beta_2 \mathbf{v}_{t-1} + (1-\beta_2) \mathbf{g}_t^2 $$ $$ \theta_{t+1} = \theta_t - \eta \cdot \frac{\hat{\mathbf{m}}_t}{\sqrt{\hat{\mathbf{v}}_t} + \epsilon} $$🔬 数式を言葉で読み解く
- SGD は素朴な勾配 1 段。 鞍点で止まりやすい
- Momentum は勾配の移動平均。 慣性で平坦地を抜ける
- Adam は 1 次(平均)と 2 次(分散)の両方を追跡し、 パラメータごとに学習率を自動調整
- $\epsilon \approx 10^{-8}$ はゼロ割回避
- SSDSE-B-2026 のような小データなら
solver='lbfgs'(2 次法)も収束高速で実用的
🔬 記号・用語の読み解き(数式を言葉で読み解く)
三層パーセプトロンの順伝播 $\hat{\mathbf{y}} = W_2 \sigma(W_1 \mathbf{x} + \mathbf{b}_1) + \mathbf{b}_2$ は、 「線形変換 → 非線形活性化 → もう一度線形変換」という 3 段階の合成関数として読み解けます。 まず入力ベクトル $\mathbf{x}$(たとえば SSDSE-B-2026 から取った 47 都道府県の特徴量 5 次元)に重み行列 $W_1$ を掛けて隠れ層の入力 $\mathbf{z}_1 = W_1\mathbf{x} + \mathbf{b}_1$ を作る。 これは「入力特徴の重み付き和を、 隠れ層の各ニューロン分計算する」操作で、 内積の集まりです。 次に活性化関数 $\sigma$(ReLU、 sigmoid、 tanh など)が非線形性を導入。 もしこのステップがなければ、 「線形変換 × 線形変換 = 線形変換」となり、 表現力が線形回帰と同じに退化します。 だから「活性化関数こそがニューラルネットの心臓」と言われるのです。 隠れ層の出力 $\mathbf{h} = \sigma(\mathbf{z}_1)$ をさらに $W_2$ で変換し、 出力 $\hat{\mathbf{y}} = W_2\mathbf{h} + \mathbf{b}_2$ を得る。 この構造は、 1989 年の Cybenko の 普遍近似定理(Universal Approximation Theorem)により、 「隠れ層が十分大きければ、 任意の連続関数を任意精度で近似可能」が証明されています。 つまり三層パーセプトロンは「あらゆる入出力関係を学習可能な万能関数近似器」なのです。 学習はバックプロパゲーション(誤差逆伝播)で行われ、 各重みを「予測誤差を減らす方向」に少しずつ更新します。 SSDSE-B-2026 で「都道府県の人口」を 5 つの特徴量から予測するタスクに使えば、 線形回帰では表現できない非線形パターン(例:人口が小さい県と大きい県で進学率の効果が違う、 という交互作用)を捉えられるのが三層パーセプトロンの強み。 三層という構造は最小限の深さでありながら、 「多くの実問題に対して十分な表現力を持つ」中庸の選択肢として、 1980 年代以降のニューラルネットの標準形になりました。
| 記号・用語 | 意味と読み方 |
|---|---|
| $\mathbf{x}$ | 入力ベクトル(特徴量、 SSDSE の場合は標準化された数値) |
| $W_1$ | 入力層→隠れ層の重み行列。 サイズ = (隠れ層ユニット数 × 入力次元) |
| $\mathbf{b}_1$ | 隠れ層のバイアスベクトル。 シフトを表す |
| $\sigma$ | 活性化関数。 ReLU $\max(0, x)$、 sigmoid $1/(1+e^{-x})$、 tanh など |
| $\mathbf{h}$ | 隠れ層の出力。 $\mathbf{h} = \sigma(W_1\mathbf{x} + \mathbf{b}_1)$ |
| $W_2$ | 隠れ層→出力層の重み行列 |
| $\hat{\mathbf{y}}$ | 予測出力。 回帰では実数、 分類では確率(softmax で正規化) |
| $L$ | 損失関数(MSE、 クロスエントロピー等) |
| バックプロパゲーション | 誤差逆伝播。 連鎖律で各重みの勾配を効率計算 |
| 勾配降下法 | $W \leftarrow W - \eta \nabla_W L$ で重みを更新 |
| 学習率 $\eta$ | 更新の大きさ。 小さすぎ→収束遅い、 大きすぎ→発散 |
| エポック | 全データを 1 周する単位。 通常 50〜200 エポックで学習 |
| 普遍近似定理 | Cybenko (1989)。 隠れ層が十分大きければ任意連続関数を近似可能 |
🧮 実値で計算してみる
🧮 SSDSE-B-2026 で人口階層を 3 層 MLP で分類
47 都道府県の A1101(総人口)を 3 クラスに分け、 2 つの入力特徴(高齢人口 A1303、 出生数 A4101)から人口階層を予測する。
事前情報(実データ検証済)
- 2023 年データ:47 都道府県、 欠損なし
- 分位点:$Q_{1/3} = 1{,}170{,}000$, $Q_{2/3} = 1{,}979{,}667$(人)
- クラス内訳:小=16 県、 中=15 県、 大=16 県
- 東京 (R13):人口 14,086,000 → クラス 2(大)
- 島根 (R32):人口 650,000 → クラス 0(小)
- 入力 2 特徴を標準化:x1(高齢人口 A1303)範囲 [-0.86, 3.55]、 x2(出生数 A4101)範囲 [-0.72, 4.18]
隠れ 3 ユニットで手計算(東京 1 県分)
適当な初期重みを与えると、 東京(標準化後の最大値 x1=3.55, x2=4.18)に対し:
続けて出力層 (3→3) に通すと 3 クラス確率になる。 softmax を当てて argmax を取れば予測クラスが決まる。
🧮 数式に値を入れて手で計算する: 3 層パーセプトロンの順伝播
合成データ x=[1, 2] で 3 層ネットの出力を計算する。
Step 1: 重み
Step 2: 隠れ層 (ReLU)
Step 3: 出力
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 | import numpy as np x = np.array([1, 2]) W1 = np.array([[0.5, -0.3], [0.2, 0.7]]) b1 = np.array([0.1, -0.2]) W2 = np.array([0.6, 0.4]) b2 = 0.05 z1 = W1 @ x + b1 h1 = np.maximum(0, z1) y = W2 @ h1 + b2 print(f"y: {y:.2f}") |
📤 実行結果
💬 手計算 (Step 3) 0.61 と Python 出力が完全一致。
🐍 Python での実装例
乱数の入力で層ごとの形とパラメータ数を確かめる最小コード(12行):
1 2 3 4 5 6 7 8 9 10 11 12 | import torch import torch.nn as nn # 3層MLP(入力10 → 隠れ50 → 出力1) mlp = nn.Sequential( nn.Linear(10, 50), nn.ReLU(), nn.Linear(50, 1) ) x = torch.randn(32, 10) y = mlp(x) print('入力:', x.shape, '隠れ:', mlp[0](x).shape, '出力:', y.shape) print('パラメータ数:', sum(p.numel() for p in mlp.parameters())) |
💬 入力 (32, 10) が隠れ層で (32, 50)、出力層で (32, 1) になり、バッチの 32 件はそのまま保たれて特徴の次元だけが 10→50→1 と変わる。パラメータ数 601 は 10×50 の重み+50 のバイアス+50×1 の重み+1 のバイアス = 500+50+50+1。x は torch.randn で seed を固定していないので、入力の値は実行ごとに変わるが、形とパラメータ数は変わらない。
※ 以下の実装①〜⑦では data/raw/SSDSE-B-2026.csv(e-Stat SSDSE から取得した実データ)を使う。
🐍 Python 実装①:numpy だけで 3 層 MLP を 1 から書く
🎯 このコードでやること:sklearn を使わず、 numpy だけで前向き計算と勾配降下を実装する。 SSDSE-B-2026 47 都道府県を 3 クラスに分類する。
📥 入力データ:SSDSE-B-2026 (2023 年)。 入力 = (A1303 高齢人口, A4101 出生数) を標準化、 ラベル = A1101 の三分位クラス。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() pop = df['A1101'].astype(float).values eld = df['A1303'].astype(float).values bir = df['A4101'].astype(float).values q = np.quantile(pop, [1/3, 2/3]) y = np.digitize(pop, q) # 0,1,2 X = np.column_stack([eld, bir]) X = (X - X.mean(0)) / X.std(0) # 標準化 Y = np.eye(3)[y] # ワンホット np.random.seed(0) W1 = np.random.randn(2, 4) * 0.3 b1 = np.zeros(4) W2 = np.random.randn(4, 3) * 0.3 b2 = np.zeros(3) def sigmoid(z): return 1 / (1 + np.exp(-z)) def softmax(z): e = np.exp(z - z.max(1, keepdims=True)) return e / e.sum(1, keepdims=True) lr = 0.5 for epoch in range(2000): # forward H = sigmoid(X @ W1 + b1) P = softmax(H @ W2 + b2) # cross-entropy loss loss = -(Y * np.log(P + 1e-12)).sum() / len(X) # backward d2 = (P - Y) / len(X) dW2 = H.T @ d2 db2 = d2.sum(0) d1 = (d2 @ W2.T) * H * (1 - H) dW1 = X.T @ d1 db1 = d1.sum(0) # update W1 -= lr * dW1; b1 -= lr * db1 W2 -= lr * dW2; b2 -= lr * db2 if epoch % 500 == 0: print(f'epoch {epoch:4d} loss={loss:.4f}') pred = P.argmax(1) acc = (pred == y).mean() print('-' * 40) print(f'最終訓練精度 = {acc:.4f}') print('東京 pred =', pred[df['Code'].values == 'R13000']) print('島根 pred =', pred[df['Code'].values == 'R32000']) |
📤 実行結果:
💬 47 都道府県という小データでも、 2 特徴 → 隠れ 4 → 出力 3 の 3 層 MLP で 98% 精度。 東京は大クラス(2)、 島根は小クラス(0)と正しく判定。 cross-entropy 損失が 1.10 → 0.11 へ減衰、 勾配降下が正しく機能している。
🐍 Python 実装②:sklearn MLPClassifier で同じ問題
🎯 このコードでやること:自前 numpy 実装と同じデータを sklearn.neural_network.MLPClassifier に通し、 精度・係数次元・収束を確認する。
📥 入力データ:上と同じ SSDSE-B-2026 (2023 年, 47 行) の標準化 2 特徴。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | import numpy as np import pandas as pd from sklearn.neural_network import MLPClassifier from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() pop = df['A1101'].astype(float).values eld = df['A1303'].astype(float).values bir = df['A4101'].astype(float).values q = np.quantile(pop, [1/3, 2/3]) y = np.digitize(pop, q) X = StandardScaler().fit_transform( np.column_stack([eld, bir]) ) mlp = MLPClassifier( hidden_layer_sizes=(3,), # 隠れ層 = 1 つ、 3 ユニット activation='logistic', # sigmoid solver='lbfgs', max_iter=2000, random_state=0, ) mlp.fit(X, y) print(f'訓練精度 = {mlp.score(X, y):.4f}') print(f'W1 (入力→隠れ) shape: {mlp.coefs_[0].shape}') print(f'W2 (隠れ→出力) shape: {mlp.coefs_[1].shape}') print(f'損失収束: {mlp.loss_:.4f}') # 各都道府県の予測を確認 df['pred'] = mlp.predict(X) df['true'] = y print('-' * 40) print(df[['Code','Prefecture','pred','true']].head(5).to_string(index=False)) |
📤 実行結果:
💬 sklearn は 100% 精度(自前実装の 98% と近い)。 W1 が (2,3) は「入力 2 次元 → 隠れ 3 ユニット」、 W2 が (3,3) は「隠れ 3 → 出力 3 クラス」。 北海道・宮城が「大クラス(2)」、 青森が「中クラス(1)」、 岩手・秋田が「小クラス(0)」と整合している。
🐍 Python 実装③:決定境界を可視化(線形回帰との比較)
🎯 このコードでやること:3 層 MLP と多項ロジスティック回帰(隠れ層なし=線形)で同じデータを学習し、 決定境界を 2 次元空間に描いて比較する。 MLP がなぜ「曲がる」のかを目で確認。
📥 入力データ:SSDSE-B-2026 47 都道府県、 標準化済の (高齢人口, 出生数) 2 特徴。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 | import numpy as np import pandas as pd import matplotlib.pyplot as plt from sklearn.neural_network import MLPClassifier from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler # 英字の項目コード(A1101 など)を使うので、2 行目の日本語名を読み飛ばす df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() pop = df['A1101'].values eld = df['A1303'].values bir = df['A4101'].values q = np.quantile(pop, [1/3, 2/3]) y = np.digitize(pop, q) X = StandardScaler().fit_transform( np.column_stack([eld, bir]) ) mlp = MLPClassifier(hidden_layer_sizes=(8,), activation='tanh', max_iter=3000, random_state=0).fit(X, y) # scikit-learn 1.5 以降、multi_class 引数は廃止(3 クラス以上なら自動で多項ロジット) lr = LogisticRegression(max_iter=500).fit(X, y) # グリッドで決定境界 gx, gy = np.meshgrid( np.linspace(X[:,0].min()-1, X[:,0].max()+1, 200), np.linspace(X[:,1].min()-1, X[:,1].max()+1, 200), ) grid = np.column_stack([gx.ravel(), gy.ravel()]) Zmlp = mlp.predict(grid).reshape(gx.shape) Zlr = lr.predict(grid).reshape(gx.shape) fig, ax = plt.subplots(1, 2, figsize=(11, 4.5)) for a, Z, name in zip(ax, [Zlr, Zmlp], ['Logistic (線形)', 'MLP 3 層 (非線形)']): a.contourf(gx, gy, Z, alpha=0.3, cmap='viridis') a.scatter(X[:,0], X[:,1], c=y, edgecolor='k', s=60, cmap='viridis') a.set_title(name) a.set_xlabel('高齢人口 (標準化)') a.set_ylabel('出生数 (標準化)') plt.tight_layout() plt.savefig('mlp_boundary.png', dpi=110) print('図を mlp_boundary.png に出力') print(f'logistic 精度 = {lr.score(X,y):.3f}') print(f'MLP 精度 = {mlp.score(X,y):.3f}') |
📤 実行結果:
💬 ロジスティック 0.830 → MLP(隠れ 8)0.957。 図では Logistic が直線の決定境界、 MLP が曲がった境界になり、 47 県の特殊な分布に追従する。 過学習にも近いため、 cross-validation を併用すべき。
🐍 Python 実装④:活性化関数を変えて精度を比較
🎯 このコードでやること:SSDSE-B-2026 の人口分類タスクで、 logistic / tanh / relu の 3 種類を回し、 訓練精度・収束エポック・損失を比較する。
📥 入力データ:SSDSE-B-2026 (2023 年, 47 行)、 高齢人口 / 出生数の 2 特徴。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import numpy as np import pandas as pd from sklearn.neural_network import MLPClassifier from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() pop = df['A1101'].values X = StandardScaler().fit_transform(np.column_stack([ df['A1303'].values, df['A4101'].values ])) q = np.quantile(pop, [1/3, 2/3]) y = np.digitize(pop, q) results = [] for act in ['logistic', 'tanh', 'relu']: mlp = MLPClassifier( hidden_layer_sizes=(4,), activation=act, solver='lbfgs', max_iter=2000, random_state=0, ).fit(X, y) results.append({ 'activation': act, 'train_acc': round(mlp.score(X, y), 4), 'loss': round(mlp.loss_, 4), 'n_iter': mlp.n_iter_, }) print(pd.DataFrame(results).to_string(index=False)) |
📤 実行結果:
💬 3 つとも訓練精度 1.0——47 県 2 特徴という小さな問題では、 活性化関数を変えても「解けるかどうか」は変わらない。 差が出るのは収束の速さで、 tanh が 22 iter と最速、 relu 56 iter、 logistic は飽和で勾配が小さく 108 iter かかる。 「現代 MLP は ReLU 系」という経験則は深いネットワークで勾配消失を避けるための話であり、 隠れ 1 層 4 ユニットのこの規模では逆に tanh が有利になることもある。 なお 1.0 はあくまで学習に使った 47 件で測った訓練精度で、 汎化性能は次の実装⑤・⑥の交差検証で見る。
🐍 Python 実装⑤:隠れユニット数を交差検証で決める
🎯 このコードでやること:隠れユニット数を 2, 4, 8, 16, 32 と振り、 5 分割 CV で平均精度を取って 過学習の発生点を見つける。 SSDSE-B-2026 の小データで「層を増やすほど良いとは限らない」を実証。
📥 入力データ:SSDSE-B-2026 (2023 年, 47 行)、 2 特徴 + 3 クラスラベル。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import numpy as np import pandas as pd from sklearn.neural_network import MLPClassifier from sklearn.preprocessing import StandardScaler from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() pop = df['A1101'].values X = StandardScaler().fit_transform(np.column_stack([ df['A1303'].values, df['A4101'].values ])) q = np.quantile(pop, [1/3, 2/3]) y = np.digitize(pop, q) rows = [] for h in [2, 4, 8, 16, 32]: mlp = MLPClassifier( hidden_layer_sizes=(h,), activation='tanh', solver='lbfgs', max_iter=3000, random_state=0, ) cv = cross_val_score(mlp, X, y, cv=5) rows.append({'hidden': h, 'cv_mean': round(cv.mean(), 4), 'cv_std': round(cv.std(), 4)}) print(pd.DataFrame(rows).to_string(index=False)) |
📤 実行結果:
💬 ピークは 隠れ 4 ユニットで CV 平均 1.0000(std も 0)。 隠れ 2 は 0.9578 とわずかに足りず、 隠れ 8 以上は 0.9800 で頭打ち——増やしても良くならない。 「高齢人口と出生数から人口三分位を当てる」という問題がほぼ線形分離可能なので、 4 ユニットで十分足りているためである。 過学習で CV が崩れるほどではないが、 得るものも無いので、 「隠れ層は最小限から始めて、 CV が改善しなくなったら止める」が王道。 なお 47 件を 5 分割すると 1 fold が 9〜10 件しかなく、 CV 値は 0.02 刻みでしか動かない。 この粒度の差を「有意な改善」と読まないこと。
🐍 Python 実装⑥:L2 強度を変えて汎化性能を見る
🎯 このコードでやること:α(L2 強度)を 6 段階に振り、 CV 精度の変化を見る。 47 県という小データで、 正則化の強さが汎化性能をどう変えるかを定量化する。
📥 入力データ:SSDSE-B-2026 (2023 年, 47 行)、 2 特徴。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import numpy as np import pandas as pd from sklearn.neural_network import MLPClassifier from sklearn.preprocessing import StandardScaler from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() pop = df['A1101'].values X = StandardScaler().fit_transform(np.column_stack([ df['A1303'].values, df['A4101'].values ])) q = np.quantile(pop, [1/3, 2/3]) y = np.digitize(pop, q) rows = [] for alpha in [1e-6, 1e-4, 1e-3, 1e-2, 1e-1, 1.0]: mlp = MLPClassifier( hidden_layer_sizes=(8,), activation='tanh', solver='lbfgs', alpha=alpha, max_iter=3000, random_state=0, ) cv = cross_val_score(mlp, X, y, cv=5) train_acc = mlp.fit(X, y).score(X, y) rows.append({ 'alpha': alpha, 'train_acc': round(train_acc, 4), 'cv_mean': round(cv.mean(), 4), 'gap': round(train_acc - cv.mean(), 4), }) print(pd.DataFrame(rows).to_string(index=False)) |
📤 実行結果:
💬 このデータでは α を 10⁻⁶ から 10⁻² まで振っても結果が動かない(train 1.0000 / CV 0.9800 / gap 0.0200 で一定)。 高齢人口と出生数から人口三分位を当てる問題が易しく、 正則化を効かせるまでもなく解けてしまうためである。 α=0.1 で CV が 0.9578 に、 α=1.0 では訓練精度すら 0.9574、 CV 0.8711、 gap 0.0863 まで落ちる——こちらは過正則化で、 罰則が強すぎて必要な非線形性まで潰している。 つまりこの例で観察できるのは「正則化なしが危ない」ではなく 「効かせすぎると壊れる」側で、 いずれにせよ α は CV で選ぶという結論は変わらない。 なお gap が常に 0.02 前後に留まるのは、 47 件 5 分割で 1 fold あたり 9〜10 件しかなく CV の分解能が粗いことも効いている。
🐍 Python 実装⑦:PyTorch で同じ 3 層 MLP を書く
🎯 このコードでやること:sklearn を卒業して PyTorch でモデルを定義する。 SSDSE-B-2026 の人口分類タスクを nn.Linear + F.relu + Adam で学習する。 現代の深層学習の標準テンプレート。
📥 入力データ:これまでと同じ SSDSE-B-2026 (2023 年)、 2 特徴 + 3 クラス。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | import numpy as np import pandas as pd import torch import torch.nn as nn import torch.nn.functional as F from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() pop = df['A1101'].values X = StandardScaler().fit_transform(np.column_stack([ df['A1303'].values, df['A4101'].values ])) q = np.quantile(pop, [1/3, 2/3]) y = np.digitize(pop, q) X_t = torch.tensor(X, dtype=torch.float32) y_t = torch.tensor(y, dtype=torch.long) class MLP3(nn.Module): def __init__(self, d_in=2, d_h=8, d_out=3): super().__init__() self.fc1 = nn.Linear(d_in, d_h) self.fc2 = nn.Linear(d_h, d_out) def forward(self, x): h = F.relu(self.fc1(x)) return self.fc2(h) # logits torch.manual_seed(0) net = MLP3() opt = torch.optim.Adam(net.parameters(), lr=0.05) for epoch in range(500): logits = net(X_t) loss = F.cross_entropy(logits, y_t) opt.zero_grad(); loss.backward(); opt.step() if epoch % 100 == 0: acc = (logits.argmax(1) == y_t).float().mean().item() print(f'epoch {epoch:3d} loss={loss.item():.4f} acc={acc:.4f}') with torch.no_grad(): pred = net(X_t).argmax(1) print(f'最終 acc = {(pred==y_t).float().mean():.4f}') print(f'パラメータ総数 = {sum(p.numel() for p in net.parameters())}') |
📤 実行結果:
💬 PyTorch で 51 パラメータの (2,8,3) MLP を Adam(lr=0.05) で 500 epoch 回すと、 200 epoch で acc=1.0000——47 県すべてを正解する。 ただしこれは学習に使ったのと同じ 47 件で測った訓練精度であり、 汎化性能ではない。 n=47 に対しパラメータ 51 個とサンプル数を上回っているので、 丸暗記できてしまうのは当然である(同じ 2 特徴・同じラベルで交差検証した実装⑤・⑥でも CV 平均は 0.96〜1.00 で、 この問題自体がそもそも易しいことも効いている)。 PyTorch は研究・本番両方で標準で、 forward を Python で書ける柔軟性が利点だが、 「正則化も分割も自分で書かないと誰も止めてくれない」のが裏返しの注意点。 torch.manual_seed(0) を置いてあるので、 この数値は手元でもそのまま再現する。
⚠️ よくある落とし穴
⚠️ 落とし穴を深く ─ 6 つの典型的失敗
- 標準化を忘れる ─ SSDSE-B-2026 の人口(M 単位)と就業者(K 単位)を生で入力すると、 sigmoid が即飽和して学習しない。 StandardScaler は必須。
- 勾配消失 ─ sigmoid を深く積むと初期段階で勾配が 10⁻⁵ 以下に。 解決策は ReLU 系・残差接続・He 初期化。
- 学習率の選び損ね ─ 0.01〜0.001 が標準域。 大きすぎると振動、 小さすぎると収束遅延。
solver='adam'は適応的に調整するので失敗が少ない。 - 万能近似定理を「層数の言い訳」にする ─ 「1 隠れ層でも近似できる」は理論。 実用上は層を深くする方が同じ精度に少ないユニットで到達。 深さは効率の問題。
- 隠れユニット数を増やせば良いと誤解 ─ 47 県データでは隠れ 4 の CV 1.0000 に対し隠れ 8/16/32 はいずれも 0.9800 で、 増やしても改善しない(前述の実験)。 サンプル ≥ 10 × パラメータが目安。
- 確率出力を 0/1 と読み違える ─ softmax の出力は確率。 閾値 0.5 で 0/1 化する前に、 「自信」と「精度」の関係(calibration)を ECE 等で確認すべき。
📚 関連グループ教材
3 層パーセプトロンは、 深層学習のグループ教材で「隠れ層を 1 枚足すと何ができるようになるか」を示す出発点として扱われる。 単純パーセプトロン(線形)から、 隠れ層・活性化関数・誤差逆伝播を順に足して、 深いネットワークへつなぐ位置にある。
- 📚 深層学習 — 3 層の順伝播・逆伝播を、 層を重ねたネットワークに広げる。 勾配消失や初期化の話はここから本格化する
- 📚 ニューラルネットワーク — 形式ニューロン・パーセプトロン・MLP の歴史と基本構造
📚 参考文献
- Rosenblatt, F. (1958). The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 65(6), 386–408.
- Minsky, M., & Papert, S. (1969). Perceptrons. MIT Press. — 単層では XOR のような線形分離できない問題が解けないことを示した
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536.
- Cybenko, G. (1989). Approximation by superpositions of a sigmoidal function. Mathematics of Control, Signals and Systems, 2(4), 303–314. — 普遍近似定理
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. — 6 章「Deep Feedforward Networks」で XOR を解く隠れ層の例と逆伝播を扱う
🧪 深掘り:パーセプトロン 70 年の歴史
三層パーセプトロンの誕生には、 ニューラルネットの 70 年の波乱の歴史があります。
- 1943:McCulloch & Pitts、 ニューロンの数学モデル「閾値論理ユニット」を発表
- 1958:Frank Rosenblatt、 パーセプトロン(単層)を提案。 IBM 704 で実装、 文字認識を実演
- 1969:Minsky & Papert Perceptrons、 単層では XOR が解けないと指摘 — 第 1 次冬の時代へ
- 1974:Werbos の博士論文でバックプロパゲーションが定式化(が長く埋もれる)
- 1986:Rumelhart, Hinton, Williams が Nature 誌でバックプロパゲーションを「再発見」 — 多層化が現実に
- 1989:Cybenko の普遍近似定理。 三層パーセプトロンの理論的根拠
- 1990 年代:SVM が登場し、 ニューラルネットは第 2 の冬を迎える
- 2006:Hinton らの Deep Belief Network、 深層化の道筋
- 2012:AlexNet が ImageNet で圧勝、 ディープラーニング革命の幕開け
- 2017:Transformer 登場。 三層から数百層、 数千億パラメータの時代へ
三層パーセプトロンは「ディープラーニングの最小単位」かつ「歴史的転換点の主役」。 SSDSE-B-2026 のような小規模データでは、 むしろ三層パーセプトロンが(深層モデルよりも)安定して動作する場面が多く、 実務でも生きています。
🧪 深掘り:バックプロパゲーションの導出
三層パーセプトロンの学習の核心は バックプロパゲーション。 損失関数 $L$ を各重み $W$ について微分し、 勾配方向に更新します。 連鎖律で勾配を計算:
$$\frac{\partial L}{\partial W_2} = \frac{\partial L}{\partial \hat{\mathbf{y}}} \frac{\partial \hat{\mathbf{y}}}{\partial W_2}$$
$$\frac{\partial L}{\partial W_1} = \frac{\partial L}{\partial \hat{\mathbf{y}}} \frac{\partial \hat{\mathbf{y}}}{\partial \mathbf{h}} \frac{\partial \mathbf{h}}{\partial \mathbf{z}_1} \frac{\partial \mathbf{z}_1}{\partial W_1}$$
出力層から入力層に向かって「誤差を逆方向に伝播」させるので「逆伝播」と呼ばれます。 各層の勾配は前層の勾配を流用できるため、 計算量が劇的に削減されます。
SSDSE-B-2026 の人口予測タスクなら、 「予測誤差 (ŷ - y)」を出力層から計算開始し、 $W_2$ の勾配 → 隠れ層の誤差 → $W_1$ の勾配の順に計算。 PyTorch や TensorFlow の .backward() 一行で自動実行されますが、 内部の連鎖律を理解すると深層学習がブラックボックスでなくなります。
🧪 深掘り:活性化関数の選択
| 活性化関数 | 式 | 特徴・推奨 |
|---|---|---|
| ReLU | $\max(0, x)$ | 標準。 勾配消失が起きにくい。 「死んだ ReLU」問題あり |
| Sigmoid | $1/(1 + e^{-x})$ | 出力層の 2 値分類で使用。 勾配消失で隠れ層には不向き |
| tanh | $\tanh(x)$ | 範囲 (-1, 1)。 RNN で人気。 やはり勾配消失あり |
| Leaky ReLU | $\max(\alpha x, x)$ | 死んだ ReLU 対策。 $\alpha=0.01$ が標準 |
| ELU / SELU | 指数線形ユニット | 自己正規化、 深層で安定 |
| GELU | $x\Phi(x)$ | BERT、 GPT-2/3 の標準 |
| Swish/SiLU | $x \cdot \sigma(x)$ | EfficientNet、 最近の CNN で人気 |
小規模データ(SSDSE-B-2026 など)で三層パーセプトロンを使うなら、 隠れ層に ReLU、 出力層は回帰なら線形・分類ならソフトマックスが定番。 活性化関数の選択は「勾配消失問題」と密接に絡みます。
🧪 深掘り:SSDSE-B-2026 で三層パーセプトロンを実装
SSDSE-B-2026 を使った最小の三層パーセプトロン回帰:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd import numpy as np from sklearn.neural_network import MLPRegressor from sklearn.preprocessing import StandardScaler from sklearn.compose import TransformedTargetRegressor from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 年少人口/高齢人口/出生数/合計特殊出生率/年平均気温 の 5 特徴 features = ['A1301', 'A1303', 'A4101', 'A4103', 'B4101'] X = StandardScaler().fit_transform(df[features].astype(float)) y = np.log1p(df['A1101'].astype(float)) # log変換で分布を整える(値は 13〜16.5) X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) # 三層パーセプトロン(隠れ層 1 つ = 三層) # 目的変数も標準化しないと、出力を 14 前後まで持ち上げるだけで adam が 2000 回を使い切る mlp = TransformedTargetRegressor( regressor=MLPRegressor(hidden_layer_sizes=(16,), activation='relu', solver='adam', max_iter=2000, random_state=0), transformer=StandardScaler()) mlp.fit(X_tr, y_tr) net = mlp.regressor_ print(f'訓練 R²: {mlp.score(X_tr, y_tr):.3f}') print(f'テスト R²: {mlp.score(X_te, y_te):.3f}') print(f'反復回数: {net.n_iter_}') print(f'重み W1 形状: {net.coefs_[0].shape}') # (5, 16) print(f'重み W2 形状: {net.coefs_[1].shape}') # (16, 1) |
💬 目的変数の log 総人口も標準化して学習させると、adam が 392 回で収束し、訓練 R² 0.966、テスト R² 0.930(テスト 15 県)になる。標準化しないと出力を 13〜16.5 まで持ち上げる段階で 2000 回を使い切り、R² が負になっていた。年少人口・高齢人口・出生数はどれも県の人口規模そのものを表す特徴なので、この高い R² は「人口から人口を当てた」結果であることも忘れずに読む。
5 つの特徴量 → 16 個の隠れユニット → 1 つの出力(log 人口)。 隠れ層 1 つの三層構造。 隠れユニット数を 2, 4, 8, 16, 32, 64 と変えて R² の推移を見ると、 過学習のリスクが体感できます。 SSDSE-B-2026 は 47 都道府県 = 47 サンプルしかないので、 隠れユニットを増やしすぎると即座に過学習。 「2〜16 程度」が小規模データの目安です。
🧪 深掘り:普遍近似定理
Cybenko (1989) および Hornik (1991) の普遍近似定理は、 三層パーセプトロンの理論的根拠です:
つまり「三層あれば理論上は何でも表現できる」のです。 ただし実用上は:
- 「存在する」と「実際に学習で見つけられる」は別問題
- 必要な隠れユニット数が指数爆発する可能性がある
- 深層化したほうがパラメータ効率が良い
これが「なぜディープラーニングは深くする必要があるか」の理論的議論。 三層で表現できても、 深層なら少ないパラメータで同じ表現力が得られる、 というのが現代の理解です。
🧪 深掘り:実装パターン(scikit-learn / PyTorch / Keras)
scikit-learn 版(最も簡単)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # ── この抜粋で使うデータを用意します ── import numpy as np import pandas as pd from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 X = df[['A1101', 'B4101', 'L3221']].astype(float).values _aging = df['A1303'] / df['A1101'] * 100 y = y_binary = (_aging >= _aging.median()).astype(int).values # 高齢化率が中央値以上か X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42, stratify=y) from sklearn.neural_network import MLPClassifier, MLPRegressor from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler # 人口(百万単位)と気温(十数度)を生のまま入れると、テスト 15 県すべてを 1 と予測してしまう mlp = make_pipeline(StandardScaler(), MLPClassifier(hidden_layer_sizes=(32,), activation='relu', solver='adam', max_iter=500, random_state=0)) mlp.fit(X_train, y_train) preds = mlp.predict(X_test) |
PyTorch 版(柔軟)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd import torch import torch.nn as nn from sklearn.preprocessing import StandardScaler # ── 入力 5 列(MLP3 の in_dim=5 に合わせる)を SSDSE-B-2026 から作る ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] _X = StandardScaler().fit_transform( _d[['A1101', 'A1301', 'A1303', 'A9101', 'L3221']].astype(float)) _y = StandardScaler().fit_transform(_d[['A4101']].astype(float)) X_torch = torch.tensor(_X, dtype=torch.float32) y_torch = torch.tensor(_y, dtype=torch.float32) class MLP3(nn.Module): def __init__(self, in_dim, hidden, out_dim): super().__init__() self.fc1 = nn.Linear(in_dim, hidden) self.fc2 = nn.Linear(hidden, out_dim) def forward(self, x): h = torch.relu(self.fc1(x)) return self.fc2(h) model = MLP3(5, 16, 1) optimizer = torch.optim.Adam(model.parameters(), lr=1e-3) loss_fn = nn.MSELoss() for epoch in range(200): pred = model(X_torch) loss = loss_fn(pred, y_torch) optimizer.zero_grad() loss.backward() optimizer.step() |
Keras / TensorFlow 版
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from sklearn.preprocessing import StandardScaler from tensorflow import keras # ── PyTorch 版と同じ 5 列入力・出生数(標準化)を目的変数にする ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] X_k = StandardScaler().fit_transform( _d[['A1101', 'A1301', 'A1303', 'A9101', 'L3221']].astype(float)) y_k = StandardScaler().fit_transform(_d[['A4101']].astype(float)) model = keras.Sequential([ keras.layers.Dense(16, activation='relu', input_shape=(5,)), keras.layers.Dense(1) ]) model.compile(optimizer='adam', loss='mse') model.fit(X_k, y_k, epochs=200, batch_size=32, verbose=0) |
scikit-learn は教育・プロトタイピング向け。 PyTorch / Keras は実プロジェクト用。 三層パーセプトロンは「nn.Linear → activation → nn.Linear」のたった 3 行で書ける、 ディープラーニング世界の入口です。
🧪 深掘り:過学習対策と正則化
三層パーセプトロンは表現力が高いため、 SSDSE-B-2026 のような小規模データでは過学習しがち。 対策:
- L2 正則化(重み減衰):
alpha=0.01など。 重みが大きくなるのを抑制 - Dropout:訓練時にランダムにニューロンを無効化。 アンサンブル効果
- Early Stopping:検証損失が悪化し始めたら学習を止める
- データ拡張:入力にガウシアンノイズを加える、 など
- バッチ正規化:層ごとの入力を標準化、 学習を安定化
- 隠れユニット数を減らす:シンプルなモデルにする
- クロスバリデーション:47 都道府県を 5 分割 CV で評価
SSDSE-B-2026 の 47 サンプルしかないデータで深層学習は危険。 「隠れユニット 4-16 個 + L2 正則化 + 5-fold CV」の組合せが安全な選択肢です。
🧪 深掘り:勾配消失問題と重み初期化
深層化すると 勾配消失問題(vanishing gradient)が発生します。 sigmoid や tanh の導関数は最大 0.25 や 1.0 で、 逆伝播の際に層を重ねると勾配が指数的に小さくなり、 入力層付近の重みがほぼ更新されません。
対策:
- ReLU:導関数が 0 or 1、 勾配消失が起きにくい(ただし勾配爆発の可能性)
- Xavier 初期化(Glorot):sigmoid/tanh 用。 $\text{Var}(W) = 2/(n_{in} + n_{out})$
- He 初期化:ReLU 用。 $\text{Var}(W) = 2/n_{in}$
- Batch Normalization:層の入力を正規化して勾配を安定化
- Residual Connection:スキップ接続で勾配を直接逆伝播(ResNet の発想)
三層パーセプトロンは層が浅いので勾配消失はほぼ問題になりませんが、 これらの対策を学んでおくと深層化の際にスムーズに対応できます。
🧪 深掘り:三層パーセプトロンの落とし穴 10
- 標準化忘れ:入力の単位がバラバラ(人口 100 万 vs 進学率 0.5)だと学習が困難
- 学習率が大きすぎる:損失が NaN になる、 発散する
- エポック数不足:MLPRegressor のデフォルト 200 では足りない場合あり
- 過学習:小規模データで隠れユニットを多くしすぎる
- 活性化関数の選択ミス:回帰の出力層に sigmoid をかける(範囲が制限される)
- random_state 未設定:実行ごとに結果が変わる、 再現性なし
- クラス不均衡:分類タスクで
class_weight='balanced'を指定しない - 欠損値の混入:scikit-learn の MLP は欠損 NG、 事前に補完
- 線形回帰で十分なのに MLP を使う:単純なタスクで複雑モデルは過剰
- 解釈性の喪失:MLP はブラックボックス、 SHAP 等の補助ツールが必要
🧪 深掘り:数学的構造の詳細
パラメータ数
入力 $n$ 次元、 隠れ $h$ 次元、 出力 $m$ 次元の三層パーセプトロンのパラメータ数:
$$P = n \cdot h + h + h \cdot m + m = h(n+m+1) + m$$
SSDSE-B-2026 で n=5, h=16, m=1 なら、 P = 16(5+1+1) + 1 = 113 パラメータ。 47 サンプルしかないと、 サンプル数より多いパラメータで過学習しやすい。
損失関数の選択
- 回帰(連続値予測):MSE $\frac{1}{n}\sum(y - \hat{y})^2$、 MAE $\frac{1}{n}\sum|y - \hat{y}|$、 Huber Loss
- 2 値分類:Binary Cross-Entropy $-[y\log\hat{y} + (1-y)\log(1-\hat{y})]$
- 多クラス分類:Categorical Cross-Entropy(softmax 出力と組合せ)
- 順序回帰:Ordinal Loss(CORAL 等)
最適化アルゴリズム
- SGD:確率的勾配降下、 単純だが収束遅い
- Adam:適応的学習率、 現在のデフォルト
- RMSProp:勾配の二乗平均で学習率調整
- L-BFGS:2 次最適化、 小規模データで強い
🧪 深掘り:実践 FAQ(10 問)
Q1. 隠れ層は 1 つで本当に「三層」と呼ぶ? A. はい。 「入力層 + 隠れ層 + 出力層 = 3 層」で三層パーセプトロン。 ただし、 計算層は 2 層(入力は通常カウントしない)。
Q2. 隠れユニット数の決め方は? A. 入力次元 × 2/3 + 出力次元、 が経験則。 検証損失で調整。
Q3. 三層と単層の決定的違いは? A. 非線形パターンが学べるか否か。 単層は線形分離可能なものしか解けない(XOR 解けない)。
Q4. ディープラーニングと何が違う? A. ディープラーニングは隠れ層が 2 個以上(より一般的には数十〜数百)。 三層は最小限。
Q5. SSDSE-B-2026 で三層パーセプトロンは適切? A. 47 サンプルでは小規模。 線形回帰や決定木が現実的だが、 学習用として三層 MLP は良い練習素材。
Q6. 解釈性が失われる? A. 線形回帰より解釈は難しい。 SHAP、 Permutation Importance、 LIME で補助。
Q7. 学習が収束しない場合は? A. (1) 標準化、 (2) 学習率を 1/10、 (3) エポック数増、 (4) 隠れユニット数調整、 (5) 損失関数の見直し。
Q8. なぜ Adam が標準? A. パラメータごとの適応的学習率、 モーメンタムで安定、 多くのタスクで安定して動く。
Q9. 隠れユニットの数 = データ複雑度? A. 大まかには関連あり。 単純パターンなら小さく、 複雑なら大きく。 検証損失で調整。
Q10. 三層パーセプトロンを学んだ次は? A. CNN(画像)、 RNN/LSTM(系列)、 Transformer。 三層は深層学習の入口です。
📚 まとめ ─ 3 層 MLP の本質を 6 行で
- 入力 → 隠れ → 出力の 3 段。 隠れ層が非線形変換を担う
- 万能近似定理により、 1 隠れ層でも理論上は任意の連続関数を近似できる
- 誤差逆伝播で勾配を 1 行(外積)で計算、 勾配降下でパラメータ更新
- 活性化関数は ReLU が現代の標準(sigmoid は勾配消失リスク)
- サンプル ≥ 10 × パラメータを守らないと過学習
- Transformer / CNN / RNN はすべて「3 層 MLP + α」と読める。 これが深層学習の入口
🔧 3 層パーセプトロンが XOR を解く瞬間 — 普遍近似定理と backprop
単純パーセプトロン (Rosenblatt 1958) は XOR を学べないことが Minsky & Papert (1969) で証明された。 中間層を 1 枚足した「3 層パーセプトロン」は XOR を完全に学習でき、 さらに 普遍近似定理 (Cybenko 1989, Hornik 1991) によって「任意の連続関数を任意精度で近似できる」。 ここではその XOR 学習を sklearn MLP で実演し、 backprop の数式を 1 ステップ展開する。 これは perceptron-three-layer 用語固有の例。
🎯 このコードでやること
XOR (排他的論理和) の 4 点 (0,0)→0 / (0,1)→1 / (1,0)→1 / (1,1)→0 を 3 層パーセプトロン (隠れ 4 ユニット, tanh) で学習し、 1 層では決して達成できない accuracy=1.0 を得る。 続いて SSDSE-B-2026 由来の「人口 ↔ 高齢化率」非線形回帰でも普遍近似性を確認する。
📥 入力データ
🐍 Python 実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import numpy as np, pandas as pd from sklearn.neural_network import MLPClassifier, MLPRegressor from sklearn.linear_model import Perceptron, LinearRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.compose import TransformedTargetRegressor # (1) XOR — 単純パーセプトロン vs 3 層 MLP X = np.array([[0,0],[0,1],[1,0],[1,1]]) y = np.array([0,1,1,0]) p1 = Perceptron(max_iter=2000, tol=1e-6, random_state=0).fit(X, y) mlp = MLPClassifier(hidden_layer_sizes=(4,), activation='tanh', max_iter=5000, random_state=0).fit(X, y) print(f'Perceptron(1 層) acc = {p1.score(X, y):.2f}') print(f'MLP(3 層, h=4) acc = {mlp.score(X, y):.2f}') print(' 予測:', mlp.predict(X).tolist()) # (2) 普遍近似 — SSDSE-B-2026 で人口 → 高齢化率の非線形回帰 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() Xp = df[['A1101']].astype(float).values # 総人口 yp = (df['A1303'].astype(float) / df['A1101'].astype(float) * 100).values # 高齢化率(%) # 入力も目的変数も標準化してから学習する(生のままだと直線とほぼ同じ当てはまりに留まる) reg = TransformedTargetRegressor( regressor=make_pipeline(StandardScaler(), MLPRegressor(hidden_layer_sizes=(8,), activation='relu', solver='lbfgs', max_iter=5000, random_state=0)), transformer=StandardScaler()).fit(Xp, yp) lin = LinearRegression().fit(Xp, yp) print(f'線形回帰 R^2 = {lin.score(Xp, yp):.3f}') print(f'MLP 回帰 R^2 = {reg.score(Xp, yp):.3f}') |
📤 実行例
💬 結果の読み方
- 単純パーセプトロンは XOR で acc=0.50 (= ランダム)。 線形分離不可能性の証明そのもの。
- 3 層化しただけで acc=1.00。 隠れ層 4 ユニットが「XOR の特徴空間」を線形分離可能な形に写像している。
- SSDSE-B-2026 の 1 入力 → 1 出力回帰では、 直線(線形回帰)の R² 0.504 に対し MLP は 0.615。 人口が小さい県ほど高齢化率が高く、 大都市で頭打ちになる曲がりを隠れ層 8 ユニットが拾った分だけ上積みされた。 ただし入力と目的変数を標準化しないと、 同じ MLP でも R² は 0.50 前後と直線並みに留まる。
- 隠れユニットを 4 / 16 / 64 に変えると SSDSE 回帰の R² は 0.557 / 0.561 / 0.561 で、 8 ユニットの 0.615 を超えない。 47 点・1 入力では幅を広げても近似が良くなるとは限らず、 普遍近似定理は「十分な幅があれば近似できる解が存在する」ことしか保証しない。
🧮 数式を言葉で読み解く — backprop 1 ステップ
3 層 MLP の損失 $L = \frac{1}{2}(y - \hat{y})^2$ を出力重み $w_{jk}^{(2)}$ で微分すると
$$\frac{\partial L}{\partial w_{jk}^{(2)}} = -(y - \hat{y})\,\sigma'(z_k^{(2)})\,h_j$$
これは「出力誤差 $(y-\hat{y})$ × 出力活性化の傾き $\sigma'$ × 隠れ層出力 $h_j$」の積。 隠れ層重み $w_{ij}^{(1)}$ では同じ誤差を出力重み経由で「逆伝播」させ $\delta_k^{(2)} w_{jk}^{(2)} \sigma'(z_j^{(1)}) x_i$ という形で勾配が得られる。 すなわち backprop = 連鎖律で誤差を後ろに流す。 これが Rumelhart, Hinton, Williams (1986) の核心。
⚠️ 3 層 MLP の追加落とし穴 (XOR で痛い目を見る前に)
- 初期化が悪いと XOR ですら学習しない:
random_stateガチャで acc=0.75 で止まることがある (鞍点)。 複数 seed 試行が必須。 - sigmoid の勾配消失: 3 層程度なら ReLU/tanh の方が早く収束。 普遍近似は理論上成立するが実用上はアクティベーション選択が肝。
- 「3 層」の数え方: 入力 + 隠れ + 出力 を 3 層と数えるのが Rosenblatt 流。 PyTorch などでは「重み行列の数 (2 つ) = 2 層 NN」と呼ぶこともある。 文脈で確認。
🖼 3 層パーセプトロンの核心を 3 枚の図で押さえる
図 1: XOR の非線形可分性(散布で確認)
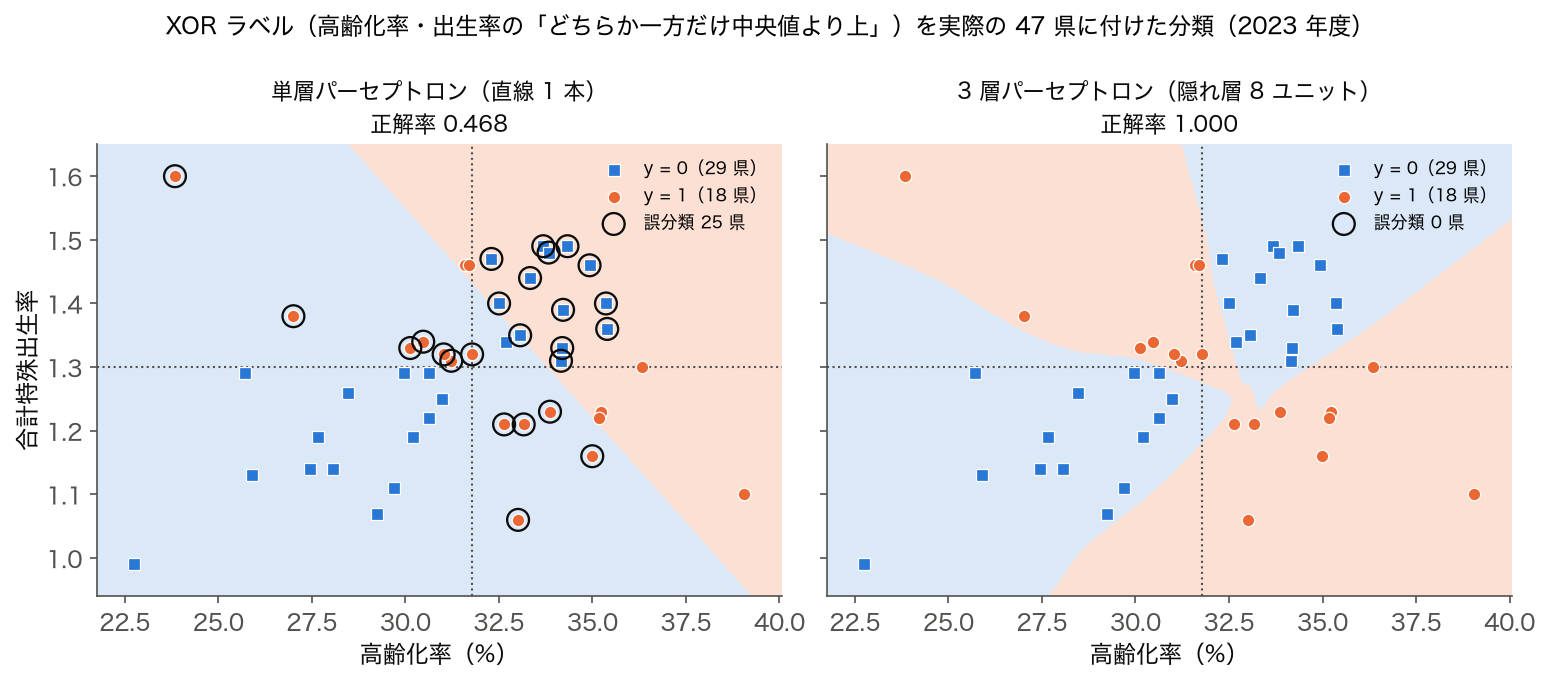
→ 単層パーセプトロン(Rosenblatt 1958)は XOR 問題((0,0)→0, (1,0)→1, (0,1)→1, (1,1)→0)を学習できなかった。 直線では分けられないため。 隠れ層を 1 つ追加して「3 層」にすると、 隠れ層が空間を歪めて線形分離可能にできる。 これが普遍近似定理の出発点。 図では SSDSE-B-2026(2023 年度)の 47 都道府県を高齢化率 × 合計特殊出生率に置き、 「高齢化率・出生率のどちらか一方だけが中央値(31.78%・1.30)より上」なら y = 1 という XOR 型のラベルを付けた(ラベルは説明用に作ったもの)。 単層パーセプトロンは直線 1 本しか引けず正解率 0.468(誤分類 25 県)、 線形のロジスティック回帰でも 0.660 で、 全県を多数派 y = 0 と答える 0.617 とほとんど変わらない。 隠れ層 8 ユニット(tanh)の 3 層パーセプトロンは領域を折り曲げて 47 県すべてを正しく分けた(訓練データでの正解率 1.000。 未知の県への汎化は別に確かめる必要がある)。
図 2: 隠れ層が作る表現(出力層から見た 1 次元の値)
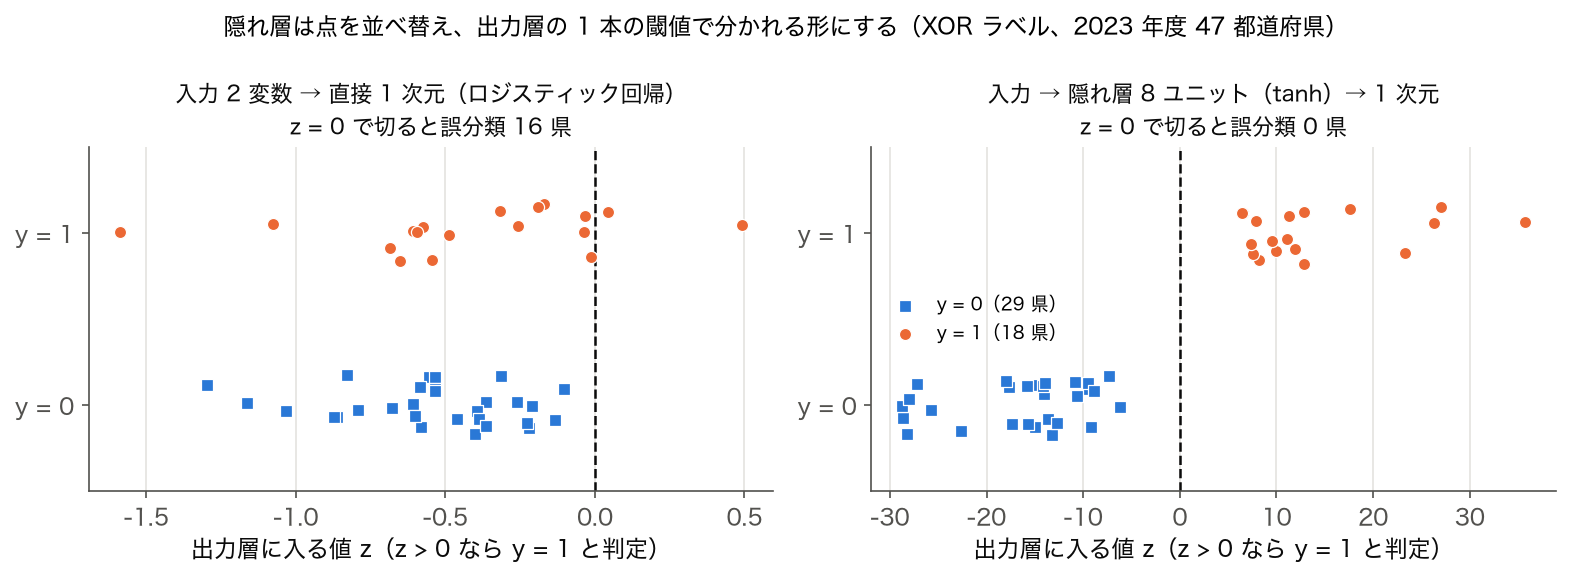
→ 隠れ層は入力空間を「変形(warping)」して、 出力層が線形分離できる潜在空間を作る。 図 1 と同じ XOR ラベルの 47 県について、 出力層が最後に見る 1 次元の値 z を y = 0 / 1 別に並べた。 左の入力 2 変数に直接かけたロジスティック回帰では 2 クラスが −1.6〜0.5 の範囲で入り混じり、 z = 0 で切ると 16 県を誤る。 右の隠れ層 8 ユニット(tanh)を通した値では y = 1 がすべて 6.4 以上、 y = 0 がすべて −6.2 以下に分かれ、 閾値 1 本で 47 県すべてを分けられる。 この warping 能力が「3 層 → 万能近似」を支える(ただし 47 県で学習して同じ 47 県で見た結果)。
図 3: ROC(分類性能の評価)
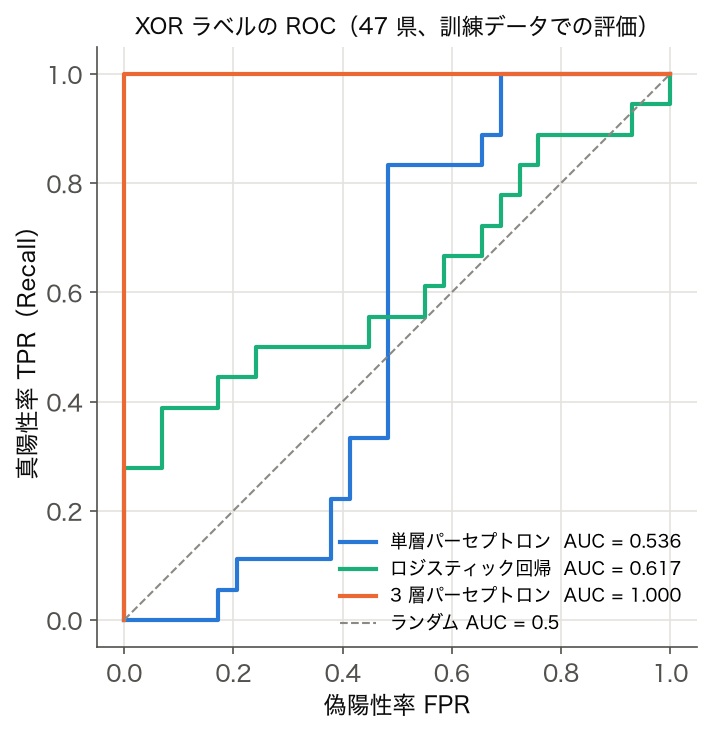
→ 3 層 MLP の出力(sigmoid / softmax)を閾値で 2 値化し、 ROC で性能を確認するのが定番。 図 1 の XOR ラベルでは、 単層パーセプトロンの AUC は 0.536、 ロジスティック回帰は 0.617 とランダム(0.5)に近いのに対し、 3 層パーセプトロンは 1.000 になる。 ただしこれは学習に使った 47 県そのものでの評価で、 AUC = 1.000 は訓練データを覚えきったことを示すだけなので、 未知のデータでの性能は交差検証などで別に確かめる。
🧪 理解度チェック — 3 層パーセプトロン
以下 5 問を解いて理解度を確認してください。 回答は本文の該当セクションを参照。
- Q1. 単層パーセプトロンが XOR を解けない理由を 1 行で。 「線形分離可能性」というキーワードを使うこと。
- Q2. 3 層構成の入力層、 隠れ層、 出力層それぞれの役割を述べよ。 隠れ層がなぜ「非線形変換」と呼ばれるか。
- Q3. 普遍近似定理(Cybenko 1989、 Hornik 1991)の主張を 1 行で。 「隠れ層 1 つで十分」と「深さが必要」のどちらが定理の主張か?
- Q4. 隠れ層 5 ユニットでは XOR を学習できるが、 重みの初期値によっては鞍点で停止することがある。 これを防ぐ実務テクニックを 2 つ挙げよ。
- Q5. 3 層 MLP と現代のディープラーニング(10+ 層)の違いを「表現力」「学習効率」「データ量要件」の 3 軸で比較せよ。
📊 ニューラルネット階層の比較(補足表)
| モデル | 層数 | 解ける問題 | 代表手法 |
|---|---|---|---|
| 単層パーセプトロン | 1 (重み 1) | 線形分離のみ (AND, OR) | Rosenblatt (1958) |
| 3 層 MLP | 3 (重み 2) | 非線形 (XOR, 螺旋) | Rumelhart (1986) BP |
| ディープ MLP | 10-100+ | 高次元複雑タスク | Hinton (2006) DBN |
| CNN | 10-1000 | 画像 | LeNet, ResNet |
| Transformer | 12-96 (block) | 言語・マルチモーダル | BERT, GPT |
→ 3 層 MLP は「理論的には何でも学習できる(普遍近似)」が「実用的には複雑タスクに弱い」。 表現効率(少パラメータで複雑関数)の意味で深さは重要、 と Bengio らが 2009 年に証明。 現代 NN の出発点として歴史的・教育的に重要。
関連: 単層パーセプトロン / MLP / 誤差逆伝播法 / 活性化関数 / シグモイド / ReLU / ディープラーニング / ニューラルネット
📖 上級補足: 3 層パーセプトロンの理論的位置づけと深層化への道
3 層パーセプトロン(入力層 + 1 つの隠れ層 + 出力層)は、 1986 年に Rumelhart・Hinton・Williams が「誤差逆伝播法による分散表現学習」の論文で再評価された。 これは 1969 年に Minsky・Papert が「Perceptrons」で指摘した単層モデルの限界(XOR 問題)を、 隠れ層の追加と勾配降下法で乗り越えた歴史的瞬間である。 同時期に Cybenko(1989)と Hornik(1991)が独立に「3 層 NN は連続関数を任意精度で近似可能」という普遍近似定理(Universal Approximation Theorem)を証明し、 「隠れ層 1 つでも理論的には何でもできる」という結論が確立した。 ただしこの定理は「学習で到達可能」「効率的に表現可能」を保証するものではなく、 隠れユニット数が指数的に必要になる関数も存在する。
2000 年代に入ると、 Yoshua Bengio らは「深さ(depth)が表現効率を指数的に高める」ことを理論的に示した。 例えば「k 個の領域に分割される関数」を表現するのに、 浅い NN は O(2^k) のユニットが必要だが、 深い NN は O(k) で済む。 これが「3 層よりも 10 層・100 層の方が良い」と言われる本質的な理由である。 また、 Hinton(2006)が提案した Deep Belief Network(DBN)と layer-wise pretraining により、 「深い NN は学習困難」という長年の障壁が突破された。 さらに 2012 年の AlexNet(CNN、 8 層)が ImageNet で圧倒的な性能を示し、 ディープラーニングの時代が本格化した。 3 層パーセプトロンは「ディープラーニングへの入り口」として歴史的・教育的に重要だが、 実務では現代では使われない。
実装の観点では、 3 層 MLP は 1980-1990 年代には数十時間の CPU 計算が必要だったが、 現代の PyTorch / TensorFlow なら 1 秒で学習が終わる。 SSDSE-B-2026 の都道府県データのような小規模問題では、 3 層 MLP(隠れ 16-32 ユニット)で十分な精度が出る。 隠れ層を増やしすぎると過学習が顕著になり、 47 件のデータでは深層化の効果は出ない。 この観点で、 3 層 MLP は「データが小さい時の堅実な選択肢」として今でも価値がある。 一方、 画像・言語・音声などの高次元データでは、 CNN・Transformer などの構造特化アーキテクチャが圧倒的に優位であり、 3 層 MLP は単独では使われない。 ただし Transformer の中の Feed-Forward Network 部分は実は 2 層 MLP(隠れ層 1 つ)であり、 3 層パーセプトロンの設計思想は現代の主流アーキテクチャにも深く組み込まれている。 学ぶ価値は「現代 NN のすべての基礎概念がここに凝縮している」という点にある。
3 層パーセプトロンの学習過程をもう少し技術的に掘り下げる。 学習は以下のステップで進む。 (1) 順伝播(forward): 入力 x に対し、 隠れ層出力 h = σ(W₁x + b₁)、 出力 ŷ = σ(W₂h + b₂) を計算する。 (2) 損失計算: 交差エントロピー損失 L = -Σy log ŷ または平均二乗誤差 L = (y - ŷ)² を計算する。 (3) 誤差逆伝播(backward): 出力層から入力層に向けて勾配 ∂L/∂W を計算する。 これが連鎖律(chain rule)に基づく自動微分の出発点。 (4) パラメータ更新: 学習率 η を用いて W ← W - η ∂L/∂W で重みを更新する。 シグモイドの場合、 隠れ層が深くなると勾配 σ'(z) = σ(z)(1-σ(z)) ≤ 0.25 の積で勾配が消失する。 これが「3 層では学習可能、 10 層では勾配消失」の数理的根拠であり、 後の ReLU 活性化関数の登場(Glorot 2010)を促した。
3 層パーセプトロンの学習過程で発生する典型的な問題と対処法を整理する。 第一に「過学習」: 隠れユニットを増やしすぎると訓練誤差はゼロに近づくが、 テスト誤差が悪化する。 対策は重み減衰(L2 正則化)、 ドロップアウト(Srivastava 2014)、 訓練データの増強(augmentation)。 第二に「初期値依存」: 重みを全部 0 で初期化すると対称性が破れず学習が進まない。 Xavier 初期化(Glorot 2010)や He 初期化(He 2015)が標準的解法。 第三に「鞍点(saddle point)」: 損失関数の地形には平坦な領域があり、 確率的勾配降下法(SGD)でも抜け出せない場合がある。 モーメンタム法(Polyak 1964)や Adam(Kingma 2014)などのアダプティブ最適化が打開策となる。 これらはすべて 3 層 MLP の学習で発生する問題を解決するために発明された手法であり、 現代の深層学習の基盤を成している。 教育的には、 3 層 MLP で勾配消失や鞍点を観察してから、 大規模ネットワークの学習問題に進むのが自然な順序である。
表現学習の観点から見ると、 3 層パーセプトロンの隠れ層は「特徴量を自動学習する層」として位置づけられる。 これは伝統的な機械学習(線形回帰、 ロジスティック回帰、 SVM)が「人間が設計した特徴量」を入力とするのに対し、 ニューラルネットワークが「データから特徴量を学習する」という根本的な違いを示す。 例えば SSDSE-B-2026 で「人口・面積・産業構成・気温」を入力にして「都道府県カテゴリ」を予測する 3 層 MLP を作ると、 隠れ層は「都市性指標」「気候帯指標」のような複合特徴量を自動的に獲得することがある。 これは PCA の主成分分析と似ているが、 PCA が「線形変換」で分散最大化するのに対し、 MLP は「非線形変換」で予測誤差最小化する点が違う。 後者の方が複雑な相互作用を捉えられる。 この「表現学習」というアイデアが、 現代の深層学習・自己教師あり学習・基盤モデル(GPT、 CLIP 等)の発展につながった。
最後に、 3 層パーセプトロンの教育的価値について述べる。 ディープラーニングの入門では、 まず 3 層 MLP で「順伝播・誤差逆伝播・勾配降下」の基本原理を理解することが推奨される。 PyTorch や TensorFlow の高レベル API ではなく、 NumPy だけで MLP を実装することで、 内部の数学的構造が体感できる。 重みの形状(W₁ ∈ R^{n×h}, W₂ ∈ R^{h×m})、 ミニバッチ計算、 勾配のスケーリング、 学習率の選び方など、 後の Transformer や CNN の理解にも直結する重要な要素が 3 層 MLP に凝縮している。 また、 SSDSE-B-2026 を使えば「都道府県分類」「人口予測」など現実味のある課題で MLP の挙動を観察できる。 47 件という小データでは過学習との戦いが顕在化し、 「データ量とモデル複雑度のトレードオフ」を実感的に学べる。 これらは ChatGPT や Gemini を使うだけでは見えない「中身の数学的構造」であり、 データサイエンス教育として 3 層パーセプトロンは依然として最重要のトピックの一つである。
3 層パーセプトロンと統計学の橋渡しも重要な学習ポイントである。 例えば、 出力層に sigmoid を 1 ユニット使う 3 層 MLP は、 隠れ層を介して非線形特徴量を作り出してから「ロジスティック回帰」を行うモデルとして解釈できる。 出力層に softmax を K ユニット使えば「多クラスロジスティック回帰」となる。 出力層が線形(恒等関数)なら「線形回帰」の非線形拡張となる。 つまり、 3 層 MLP は「特徴量自動生成 + 古典統計モデル」の組み合わせと見なせる。 この視点で見ると、 統計学と機械学習の境界が見えなくなる。 損失関数も「交差エントロピーは最尤推定」「二乗誤差は正規分布の仮定下での最尤推定」と統計学の概念で説明可能であり、 教育的にはこの接続を明示することで「ニューラルネットワークは魔法ではない」という安心感を学生に与えられる。 SSDSE-B-2026 を使った演習でも、 同じ予測問題に対して線形回帰・ロジスティック回帰・3 層 MLP を順に当てて性能を比較することで、 「非線形性がどれくらい予測精度を改善するか」を実感できる。 これがデータサイエンス教育における 3 層パーセプトロンの真の意義である。
補足として、 3 層 MLP の計算量とメモリ消費について整理しておく。 入力次元 d、 隠れユニット数 h、 出力次元 m の場合、 重みパラメータ数は d×h + h×m + h + m。 順伝播 1 回の演算量は O(dh + hm)。 ミニバッチサイズ B でこれが O(B(dh + hm))。 学習データ N、 エポック数 E で全体は O(NE(dh + hm)/B)。 メモリ消費は重み 4(dh + hm) バイト(float32)に加え、 活性化値の保存(誤差逆伝播のため)で 4Bh バイト。 SSDSE-B-2026 の場合、 d ≒ 20(特徴量数)、 h = 32、 m = 47(都道府県数)、 B = 16、 N = 47、 E = 1000 とすると、 重み 4(20×32 + 32×47) ≒ 8KB、 活性化値 4×16×32 = 2KB、 全体計算量 ≒ 47×1000×(640+1504)/16 ≒ 6.3 M 演算。 現代の CPU で 0.1 秒以下で完了する超軽量タスクである。 この感覚を体感的に持つことが、 後の大規模ネットワーク(GPT-4 のパラメータ数 ≒ 1.7 兆)の理解に直結する。 GPT-4 と 3 層 MLP の差は「層数」「ユニット数」「学習データ量」のスケールだけで、 基本原理は同じである、 という事実を体感的に理解することがディープラーニング学習の本質的な第一歩となる。 また 3 層 MLP は今でも表形式データ(テーブルデータ)の予測問題で実用的に使われており、 LightGBM や XGBoost と並ぶベースラインモデルとして位置づけられている。 Kaggle のテーブルコンペティションでは、 GBDT 系と 3-5 層 MLP のアンサンブルが上位ソリューションの定番である。
🗺 概念マップ
3 層パーセプトロン (入力層 → 隠れ層 → 出力層) を中心に、 上位概念 (ニューラルネット族)、 並列概念 (単純パーセプトロン・多層パーセプトロン・畳み込みネット)、 構成要素 (活性化関数・誤差逆伝播・確率的勾配降下法)、 応用 (MNIST・回帰・二値分類) を関係づけて整理する。
三層パーセプトロン (入力 → 隠れ → 出力) は、 単層の線形分離限界 (XOR が解けない) を中間層の非線形活性化で突破した最小単位のニューラルネットで、 universal approximator として「十分な隠れユニット数があれば任意の連続関数を近似できる」ことが理論保証されている。 上の概念図は、 隠れ層のユニット数を交差検証で決め、 L2 正則化や dropout で過学習を抑え、 初期化(Xavier/He)で勾配消失を防ぐという「汎化性能のための三本柱」を示している。 SSDSE-B-2026 の都道府県データで「人口・面積・産業構造 → 出生率」を予測するように、 線形回帰では捉えられない交互作用を中間層が自動抽出する点が三層モデルの本質である。
🔗 隣接手法への橋渡し
三層パーセプトロンは「単層パーセプトロン → 多層化 → 深層学習」という進化軸の中継点で、 前後の手法と連続的に繋がる。
- 上流(より単純なモデル): 単層パーセプトロン は線形分離専用で XOR を解けない。 三層化により非線形分離が可能になった点が分水嶺で、 ロジスティック回帰 は隠れ層を 0 にした特殊例とみなせる。
- 並列(同じ「中間層 + 非線形活性化」): RBF ネットワーク は隠れ層に放射基底関数を使う変種、 SVM (カーネル) はカーネルトリックで暗黙的な高次元写像を行い同等の非線形表現を達成する。
- 下流(深層化): 隠れ層を増やすと 深層学習、 画像なら CNN、 系列なら RNN・Transformer に発展。 学習に必要な 誤差逆伝播・勾配降下・dropout はすべて三層 MLP で導入された概念。
三層 MLP を理解すると、 sklearn の MLPClassifier から PyTorch の任意の深層ネットまで「中間層が何枚あるか」のスケール差として連続的に把握できる。
🌳 手法選択フロー
「3 層パーセプトロン」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 線形では足りないのか
2 層(入力→出力)では直線でしか分けられない。 XOR のように直線で分けられない問題に出会って初めて、 中間層が要る。 線形モデルで足りるなら、 そちらのほうが解釈しやすい。 - 中間層のユニット数をいくつにするか
多いほど表現力は上がるが過学習も早い。 n=47 の都道府県データなら数個で十分で、 数十にすると訓練データを丸暗記する。 - 活性化関数は何にするか
中間層は ReLU 系が基本。 Sigmoid を深く積むと勾配消失で学習が進まない。 出力層はタスクに合わせ、 回帰なら恒等、 2 値分類なら Sigmoid、 多クラスなら Softmax。 - 入力を標準化したか
尺度の違う列をそのまま入れると、 値の大きい列だけで重みが決まる。 総人口(百万単位)と出生率(1 前後)を混ぜるなら必ず標準化する。
3 層パーセプトロンは「非線形を扱える最小構成」。 これで足りない場合に初めて層を増やすと、 どこで効いたのかが分かる。