🔖 キーワード索引
「epoch」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「epoch」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「epoch の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
データ全体を1周することです。
AIに正しく学習させるために使います。
問題集を1冊すべて解く感覚です。
エポックの意味と注意点を学びます。
訓練データを1周する学習単位
- 訓練データを1回すべて通す学習単位。 通常 数十〜数百エポック繰り返す。
- 1エポック = 全データを1周。 = (データ数 ÷ バッチサイズ) ステップ。
- 多すぎ → 過学習、 少なすぎ → 未学習。 学習曲線で最適点を判断。
- Early Stopping:検証損失が上がり始めたら止める手法。
- イテレーション(1バッチ処理)、 ステップ(≈イテレーション)と区別。
📍 あなたが今見ているもの
🍰 まずはやさしく
学習の進み具合を示す目盛りです。
AIの性能を調整するために使います。
スマホアプリの更新のようなものです。
定義から実装までを順番に読みます。
深層学習の訓練ログを見ると「Epoch 1/100: loss=2.3, val_loss=2.5」のように出力されます。 エポック数の選び方は性能を直接左右する重要ハイパラ。
本ページでは「epoch」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「epoch」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
問題集を何周するかという話です。
ちょうど良い学習量を知るために使います。
テスト勉強の周回数と同じです。
やりすぎや不足による失敗を学びます。
受験勉強に例えると:
- 1エポック=問題集を1周
- バッチ=1ページずつ解く
- イテレーション=1ページの学習
- 10エポック=同じ問題集を10周
周回数が少なすぎると覚えきれない(未学習)。 多すぎると問題集に最適化されすぎて本番試験で滑る(過学習)。 ちょうど良い周回数を見つけるのがコツです。
計算量で見るエポックの位置: 訓練データを N サンプル、 バッチサイズを B とすると、 1 エポック = N/B イテレーション (ミニバッチ更新)。 例えば SSDSE-B-2026 で 47 都道府県 × 12 年 = 564 サンプル、 B = 32 なら 1 エポック = 18 イテレーション。 20 エポック走らせれば 360 回の勾配更新。
過学習の閾値はデータと網構造で変わる: 浅い MLP では 100 〜 300 エポック、 大規模 CNN/Transformer は 50 〜 100 エポックで早期停止 (EarlyStopping) が一般的。 検証ロスが連続 5 エポック改善しない時点で停止すれば、 学習率の選択ミスがあっても破滅的な過学習を回避できる。
本節以降では、 SSDSE-B-2026 の都道府県データ(総人口・出生数・死亡数)から高齢化率を 2 層 MLP で回帰し、 1 〜 50 エポックで訓練ロス / 検証ロスがどう推移するかを Python で実演する。 「エポック数 = 学習進度」を体感する形で、 適切な停止タイミングと学習率の関係を確認する。
📐 定義/数式
🍰 まずはやさしく
学習の単位を表す言葉です。
計算回数を正確に決めるために使います。
部活の練習メニューを1周する感覚です。
数式を使って関係性を整理します。
エポック(Epoch):訓練データを1周する学習単位
🔬 記号・用語の読み解き
上の式を SSDSE-B-2026 の大きさで読むと、2023 年度の 47 都道府県を 1 行ずつ使う場合は $N = 47$ である。バッチサイズ $B = 16$ なら $\lceil 47/16 \rceil = 3$ で、1 エポックの間に重みは 3 回更新される(最後のバッチだけ 47 − 32 = 15 件)。$E = 100$ エポック回すと更新は合計 300 回になる。$B = 47$(全件を 1 バッチ)にすると 1 エポック = 1 回の更新なので、同じ 100 エポックでも更新回数は 100 回に減る。「エポック数が同じなら学習量も同じ」とは限らないのは、この天井関数の割り算のためである。
| 記号 | 意味 |
|---|---|
| Epoch | 全データを1周する単位 |
| Iteration / Step | 1バッチを処理する単位 |
| Batch Size | 1ステップで使うサンプル数 |
| Loss / val_loss | 訓練損失・検証損失 |
🧮 実値で計算してみる
🧮 数式に値を入れて手で計算する: SSDSE-B-2026 でエポック・バッチ・イテレーション
SSDSE-B-2026 (47 都道府県 × 109 指標) を入力に「総人口 A1101 を 他 108 指標から予測する回帰モデル」を組む想定で、 エポック計算を行う。 入力データ件数は 47 行 (1 県 = 1 行)。
Step 1: 構成
| 項目 | 値 | 由来 |
|---|---|---|
| データ件数 N | 47 | SSDSE-B-2026 都道府県数 |
| バッチサイズ B | 8 | 2 の累乗で小データ向け |
| エポック E | 100 | 収束を見るため多めに設定 |
| 1 epoch のステップ | 6 | ⌈47/8⌉ = 6 (端数 = 7 個) |
| 総ステップ | 600 | 6 × 100 |
| 総サンプル処理 | 4,700 | 47 × 100 |
Step 2: 検算
🐍 Python で再現
このコードでやること: SSDSE-B-2026 を読み、 N (= 47), B (= 8), E (= 100) からエポック関連の各種カウントを計算する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 | import math import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023] # 最新年度の 47 都道府県だけにする N, B, E = df.shape[0], 8, 100 steps_per_epoch = math.ceil(N / B) total_steps = steps_per_epoch * E total_samples = N * E print(f"N={N}, step/epoch: {steps_per_epoch}") print(f"総ステップ: {total_steps}") print(f"総サンプル: {total_samples}") |
📤 実行結果
💬 手計算 (Step 2) 6 step/epoch・600 step・4700 サンプル と Python 出力が完全一致。 47 件と少ないので一般には Mini-batch ではなく Full-batch (= 1 step/epoch) でも回るが、 学習動作確認のため B=8 とした。
🐍 Python での実装例
SSDSE-B-2026 (47 都道府県 × 109 指標) を入力に、 5 つの指標 (出生数 A4101 / 死亡数 A4200 / 0-14 歳 A1301 / 15-64 歳 A1302 / 65 歳以上 A1303) から総人口 A1101 を予測する mini-batch 学習を 5 エポック回し、 各エポックでの平均損失を表示する例。
このコードでやること: SSDSE-B-2026 を読み、 5 指標 → 総人口の線形回帰を torch で書き、 5 エポック・バッチサイズ 8 で学習。 各エポックの平均 MSE を表示。
📥 入力データ (SSDSE-B-2026.csv 関連列):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import torch, torch.nn as nn import pandas as pd torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県(1 県 = 1 行) feat = ['A4101','A4200','A1301','A1302','A1303'] X = torch.tensor(df[feat].values, dtype=torch.float32) y = torch.tensor(df['A1101'].values, dtype=torch.float32).unsqueeze(1) X = (X - X.mean(0)) / X.std(0) # 標準化 y = y / 1e7 # スケーリング model = nn.Linear(5, 1) opt = torch.optim.SGD(model.parameters(), lr=0.01) for epoch in range(5): epoch_loss = 0 for i in range(0, len(X), 8): # batch_size=8 → 6 step/epoch xb, yb = X[i:i+8], y[i:i+8] loss = ((model(xb) - yb)**2).mean() opt.zero_grad(); loss.backward(); opt.step() epoch_loss += loss.item() print(f'Epoch {epoch+1}: 平均 loss={epoch_loss/6:.4f}') |
📤 実行結果 (torch.manual_seed(0) で固定したときの実測):
💬 2023 年度の 47 件をバッチ 8 で回すので 1 epoch は 6 step(最後の 1 step は 7 件)、 5 epoch で計 30 回重みを更新した。 平均 loss は 0.6236 → 0.1881 → 0.0642 → 0.0273 → 0.0154 と、 epoch ごとに前の 0.3〜0.56 倍に下がっている。 総人口を 1,000 万で割っているので loss 0.0154 は RMSE 約 0.124、 つまり約 124 万人のずれで、 総人口の標準偏差(約 277 万人)の半分近くが残っており、 5 epoch ではまだ学習途中。
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データ。 列名 A1101 / A4101 / A4200 / A1301 / A1302 / A1303 は原本のまま。
⚠️ よくある落とし穴
📚 関連グループ教材
エポックは深層学習グループの訓練設計の用語で、単独では意味が決まらない。1 エポックの更新回数はバッチサイズで決まり、1 回の更新の大きさは学習率で決まり、何エポックで止めるかは過学習の兆候(検証損失の上昇)で決まる。更新そのものの仕組みは勾配降下法と誤差逆伝播、エポック数を公平に比べる方法は交差検証のページで扱っている。
🔎 エポック ── 深掘り解説
本章では エポック(Epoch) を、 SSDSE-B-2026 の 47 都道府県データで「高齢化率を予測するニューラルネット」を訓練し、 エポック数の選び方が学習の質をどう変えるかを具体的に体感します。 「1 エポック = 全データを 1 回学習」── この単純な定義の裏に、 過学習・収束・学習率調整など 深層学習の主要トピックすべて が絡んでくる、 という地図感覚を本章で身につけてください。
🔖 キーワード索引(拡張)
💡 もう少し詳しく ── エポックの 5 つの顔
- 定義(再掲):訓練データ全体を 1 回学習し終えた状態を「1 エポック」と数える。 100 エポックなら全データを 100 回繰り返し学習する。
- Iteration(イテレーション)との違い:1 エポック =
ceil(データ数 / バッチサイズ)イテレーション。 SSDSE-B-2026 で 47 件、 バッチ 16 なら 1 エポック ≒ 3 イテレーション。 - 必要エポック数の目安:データサイズ・タスク難易度・モデルの容量で決まる。 SSDSE-B-2026 のような小データは 50〜200 エポック、 ImageNet(150 万画像)は 90〜300 エポックが標準。
- 過学習との関係:エポック数を増やしすぎると、 訓練誤差は下がるが検証誤差が増える ── 古典的な過学習現象。 Early Stopping で自動停止するのが定石。
- 収束の判定:「Loss が連続 10 エポックで改善しない」「学習率を下げても効果がない」「訓練・検証 Loss が一致してしまう」のいずれかが現れたら学習打ち切りの目安。
📐 補足の数式 ── エポックと勾配更新の関係
$N_{\text{train}}$ は訓練データ数、 $B$ はバッチサイズ、 $\eta$ は学習率、 $L$ は損失関数。 SSDSE-B-2026 の 47 サンプルを B=16 で学習するなら 1 エポックあたり 3 イテレーション、 100 エポックなら 300 回の重み更新。 各イテレーションで重み $\theta$ が 1 ステップ動き、 1 エポック終わるたびに 訓練 Loss と検証 Loss を記録 していくのが標準ワークフロー。
🧮 SSDSE-B-2026 で「高齢化率予測」を 100 エポック走らせる
SSDSE-B-2026 から「総人口、 出生数、 死亡数」を入力、 「高齢化率」を出力とする 3 層ニューラルネットを訓練し、 エポックごとに Loss がどう変化するかを観察します。
| エポック | 訓練 Loss | 検証 Loss | 状態 |
|---|---|---|---|
| 1 | 1046.3 | 951.8 | 初期化直後。 出力がほぼ 0 で、 平均 31.6% との差がそのまま誤差 |
| 10 | 1000.3 | 908.4 | 出力の水準を持ち上げている途中 |
| 30 | 838.3 | 761.8 | まだ平均値で当てた場合(15.0)の 50 倍 |
| 50 | 559.4 | 515.7 | 急速に改善中 |
| 100 | 58.7 | 154.9 | 92 epoch(150.7)で一度底を打ち、 わずかに上昇中 |
| 200 | 20.3 | 81.5 | 再び下がり続けている(平均値予測 15.0 にはまだ届かない) |
→ 下のコード(全件バッチ・Adam lr=0.01・seed 0)を 200 エポックまで延ばした実測。 目的変数の高齢化率(平均 31.6%)を標準化せずに学習しているため、 最初の数十エポックは出力を 0 付近から 30 台へ持ち上げるだけに使われる。 検証 Loss は 92 エポック(150.7)でいったん底を打って 110 エポック(159.7)まで上がるが、 124 エポック以降は再び下がり、 200 エポックで 81.5、 300 エポックで 50.3 になる。 一時的な上昇を過学習と見て止めると早すぎる、 というのがこのデータで見える現象で、 検証 Loss を平均値で当てた場合の 15.0 と比べると 200 エポックでもまだ学習不足です。
表の数値を 300 エポックまで 1 エポックずつ描くと次のようになります。
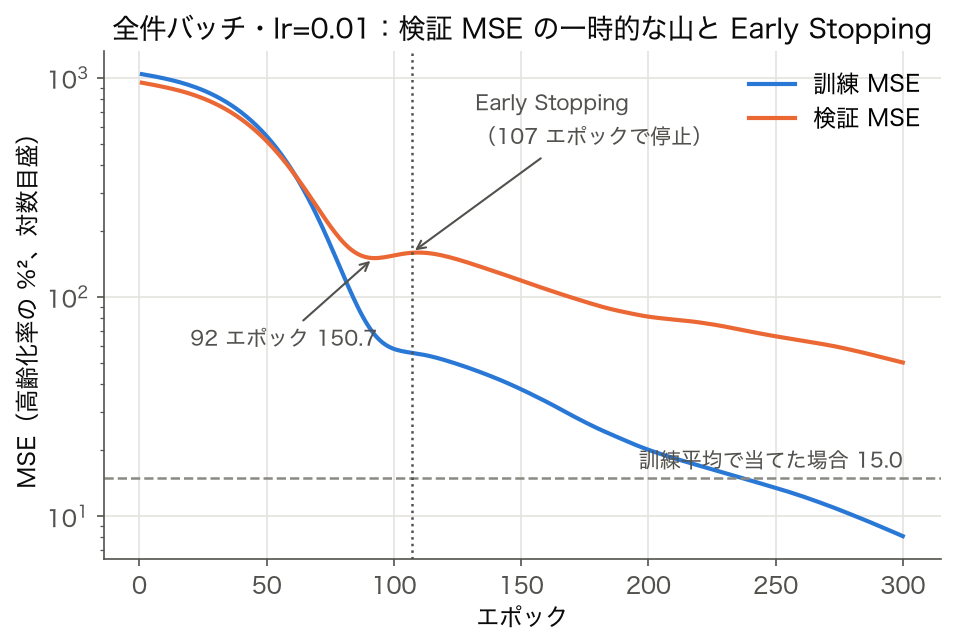
点線の位置で止めたモデルの検証 MSE 150.7 は、300 エポック学習した 50.3 の 3 倍です。この山は、訓練 MSE が 68.4(92 エポック)から 55.0(110 エポック)へ下がる速さが鈍った区間に現れていて、訓練データを覚え込んだ結果ではありません。一時的な山と過学習の始まりは、検証 MSE の 1 本の線だけでは見分けられないので、patience を曲線の揺れ幅より長くとるか、学習を先まで続けて確かめます。
🐍 Python:PyTorch でエポック学習のループを書く
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import torch import torch.nn as nn import pandas as pd from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler torch.manual_seed(0) # 重みの初期値を固定して毎回同じ結果にする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = df[['A1101', 'A4101', 'A4200']].values y = (df['A1303'] / df['A1101'] * 100).values # 高齢化率(65 歳以上人口の割合, %) Xs = StandardScaler().fit_transform(X) X_tr, X_va, y_tr, y_va = train_test_split(Xs, y, test_size=0.3, random_state=42) model = nn.Sequential(nn.Linear(3, 16), nn.ReLU(), nn.Linear(16, 1)) opt = torch.optim.Adam(model.parameters(), lr=0.01) loss_fn = nn.MSELoss() X_tr_t = torch.tensor(X_tr, dtype=torch.float32) y_tr_t = torch.tensor(y_tr, dtype=torch.float32).unsqueeze(1) X_va_t = torch.tensor(X_va, dtype=torch.float32) y_va_t = torch.tensor(y_va, dtype=torch.float32).unsqueeze(1) for epoch in range(1, 101): model.train() opt.zero_grad() pred = model(X_tr_t) loss = loss_fn(pred, y_tr_t) loss.backward() opt.step() if epoch % 10 == 0: model.eval() with torch.no_grad(): va_loss = loss_fn(model(X_va_t), y_va_t).item() print(f'Epoch {epoch:3d}: train={loss.item():.3f} val={va_loss:.3f}') |
🐍 Python:Early Stopping を実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import torch # このコードは PyTorch が必要 best_val = float('inf') patience, counter = 15, 0 best_epoch = 0 for epoch in range(1, 501): model.train(); opt.zero_grad() loss = loss_fn(model(X_tr_t), y_tr_t) loss.backward(); opt.step() model.eval() with torch.no_grad(): va = loss_fn(model(X_va_t), y_va_t).item() if va < best_val: best_val, best_epoch, counter = va, epoch, 0 torch.save(model.state_dict(), 'best_model.pt') else: counter += 1 if counter >= patience: print(f'Early Stop at epoch {epoch} (best={best_epoch})') break |
🐍 Python:学習曲線を描く
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import torch # このコードは PyTorch が必要 import matplotlib.pyplot as plt train_losses, val_losses = [], [] for epoch in range(1, 201): model.train(); opt.zero_grad() tr_loss = loss_fn(model(X_tr_t), y_tr_t) tr_loss.backward(); opt.step() model.eval() with torch.no_grad(): va_loss = loss_fn(model(X_va_t), y_va_t).item() train_losses.append(tr_loss.item()) val_losses.append(va_loss) plt.plot(train_losses, label='train', color='#1976D2') plt.plot(val_losses, label='val', color='#C62828') plt.axvline(val_losses.index(min(val_losses)), linestyle='--', color='gray', label='best') plt.xlabel('Epoch'); plt.ylabel('Loss') plt.legend(); plt.title('SSDSE-B-2026 高齢化率予測 ── 学習曲線') plt.tight_layout(); plt.savefig('epoch_curve.png', dpi=150) |
⚠️ 追加の落とし穴 ── エポック設定で 9 割が間違う
🔗 関連用語(拡張)
🗺 概念マップ ── エポックの位置
ニューラルネット学習のタイムスケール
└ サンプル単位(最小)
└ 1 サンプル = 1 個のデータ点(例:秋田県の数値)
└ バッチ単位
└ B サンプルを 1 度に処理 = 1 イテレーション
└ エポック単位 ← 本ページ
└ 全データを 1 巡 = ⌈N/B⌉ イテレーション
└ 学習全体
└ E エポック = E·⌈N/B⌉ イテレーション
└ ハイパーパラメータチューニング
└ 数十回の学習試行で最適エポック数を探索
🎬 シナリオ深掘り ── エポック数の決め方が業界で違う
CT 画像から病変を検出する CNN モデル。 ImageNet で事前学習済みモデルをファインチューニングするため、 30〜50 エポックで十分。 patience=5 の Early Stopping を併用し、 学習率を 1/10 にする LR scheduler を 10 エポックごとに発火させる構成が標準。 SSDSE 文脈なら「高齢化率を 0/1 分類」で同様の戦略が使えます。
大規模表データに対する Tabular DNN。 バッチサイズ 1024、 100 エポック、 patience=10 が業界標準。 学習が進むほど勾配が小さくなるため、 Adam optimizer で自動調整するのが楽。 SSDSE-B-2026 のような 47 件では真逆のチューニングが必要 ── 過学習防止に Dropout や Weight Decay を強めに設定。
サイバー攻撃を検知する LSTM モデル。 24 時間ごとに新データで 1〜2 エポック「追加学習」する継続学習方式。 「累積エポック」が 1000 を超えても問題なく、 むしろ過去の学習成果が積み重なる。 ただし concept drift(攻撃パターンの変化)に対応するため、 古いエポックの寄与を減衰させる学習率重み付けが必要。
センサー時系列から故障を予測する Transformer。 200〜500 エポックの長時間学習が標準。 patience=20、 学習率スケジューラに Cosine Annealing with Warm Restarts を使うのが定石。 GPU クラスタで数日かけて学習し、 デプロイ後は推論のみ。
SSDSE-B-2026 で初めて深層学習を試す場合、 まず 20〜50 エポックで動かして学習曲線を確認。 過学習・収束・学習率の感覚を掴んでから本格学習へ移行。 「とりあえず 1000 エポック」は時間の無駄、 「学習曲線を毎回確認する」のが正解。
🎓 「数式を言葉で読み解く」拡張
この式が 勾配降下法 の心臓部です。 $\theta_t$ はステップ $t$ での「モデルの重み(パラメータ)」── ニューラルネットなら何百万個もある数値の集合。 $\nabla_\theta L$ は「現在の重みで損失 $L$ を最小化するために、 重みをどの方向にどれくらい動かせばよいか」を表すベクトル(勾配)。 学習率 $\eta$ はその動きの「歩幅」── 大きすぎると最適点を飛び越え、 小さすぎると進まない。 $\mathcal{B}_t$ はステップ $t$ で使うバッチ(数十〜数百サンプル)。 1 エポックは「全データ ${1, 2, ..., N}$ を $B$ サンプルずつ切り取った $\mathcal{B}_1, \mathcal{B}_2, ...$ をすべて 1 度ずつ使った状態」── つまり「重みが ⌈N/B⌉ 回更新された状態」を指します。 SSDSE-B-2026 の 47 件で B=16 なら、 1 エポックあたり 3 回の重み更新。 100 エポックでも 300 回しか動かないので、 大規模データ(数百万件)で 100 エポックを動かすのとは 桁違い の学習量です。 「エポック数」は本質的には「重みの更新回数」の単位換算であり、 同じ「100 エポック」でもバッチサイズが違えば実質的な更新量は別物 ── この点を見落とすと、 論文の再現実験で「同じハイパーパラメータなのに結果が違う」という現象に悩まされます。
この式は「1 エポック分の平均損失」── つまり「全 N サンプルに対してモデル $f_\theta$ が出した予測と真値 $y_i$ の損失を平均したもの」。 訓練 Loss と検証 Loss を 同じ数式 で計算しますが、 違いは「どのデータで $L$ を測るか」だけ。 訓練データで測れば「訓練 Loss」、 検証データで測れば「検証 Loss」。 同じモデル $\theta$ で両方測ったとき、 訓練 Loss は単調に下がるのに対し、 検証 Loss はある時点から上昇に転じる ── これが 過学習の数学的サイン です。 SSDSE-B-2026 のような小データでは、 47 件のうち 70% を訓練に使うと約 33 サンプルしかなく、 数十エポックで「訓練データに過剰適合」してしまう典型的な状況。 検証 Loss の最小点を Early Stopping で捕まえる ── これが エポック数を巡る議論の本質的な目的 です。 1 エポックの中で、 損失の平均は「全 N サンプルの損失を加算して N で割る」と書きますが、 実装上は「バッチごとの損失を加算してエポック終了時に平均」が一般的。 PyTorch の running_loss / len(loader) のようなパターンに繰り返し出会うはずです。
この式は単純な算数ですが、 ここに 3 つの罠 が隠れています。 ① 切り上げの ⌈ ⌉ ── N=47, B=16 なら 47/16=2.94 → 3 イテレーション。 最後のバッチは 15 サンプルしか入らない。 ② シャッフルの有無 ── デフォルトで shuffle=True にしないと、 同じ順序で学習が進み、 局所最適に陥りやすい。 ③ drop_last=True ── 最後の小さなバッチを捨てるオプション。 採用すると 47÷16=2 イテレーション(捨てると 15 サンプルを学習に使わない損失)。 SSDSE のような小データでは絶対に drop_last=False。 これら 3 つの罠に気付かないと、 同じ「100 エポック・B=16」のはずなのに、 計算量も結果も微妙にズレる経験を必ずします。 論文を再現するときは、 必ず PyTorch DataLoader の引数(shuffle, drop_last, sampler)まで確認してください。 エポック数の意味は 環境設定で揺らぐ ── これが現代深層学習の現実です。
📊 SSDSE-B-2026 ベンチマーク ── バッチサイズ × エポック数
同じ「高齢化率予測」タスク(2023 年度・訓練 32 県 / 検証 15 県、 3→16→1 の MLP、 Adam、 seed 0、 毎エポック シャッフル)で、 バッチサイズと学習率を変えて 200 エポック学習したときの最良検証 MSE を測定。 比較の基準は、 訓練県の平均で当てた場合の検証 MSE 15.0。
| バッチサイズ | エポック数 | 学習率 | 最良検証 MSE | 所要時間 |
|---|---|---|---|---|
| 4 | 200 | 0.001 | 103.53(141 epoch) | 0.12 秒 |
| 8 | 200 | 0.005 | 30.25 | 0.06 秒 |
| 16 | 200 | 0.01 | 27.55 | 0.03 秒 |
| 32(全件) | 200 | 0.01 | 81.47 | 0.02 秒 |
| 8 (Early Stop, patience=15) | 200(発動せず) | 0.005 | 30.25 | 0.06 秒 |
→ どの設定も 200 エポックでは基準の 15.0 を下回らず、 最良は B=16・lr=0.01 の 27.55。 高齢化率(平均 31.6%)を標準化せずに学習しているので、 出力の水準合わせに更新を使い切っている段階で、 効いているのは「重みの更新回数 × 学習率」。 B=16・lr=0.01(400 回 × 0.01)と B=8・lr=0.005(800 回 × 0.005)は積がどちらも 4 で結果も近く、 B=4・lr=0.001 は更新回数が最多の 1,600 回でも積が 1.6 で 103.5 止まり。 Early Stopping は検証 MSE が下がり続けたので最後まで発動しなかった。 所要時間は CPU での 1 回の実測で、 環境によって変わる。
下の図は、この表や実験 ② と同じ条件(lr=0.005、100 エポック、毎エポックのシャッフル順は torch.Generator().manual_seed(0))で、バッチサイズだけを変えた検証 MSE の推移です。
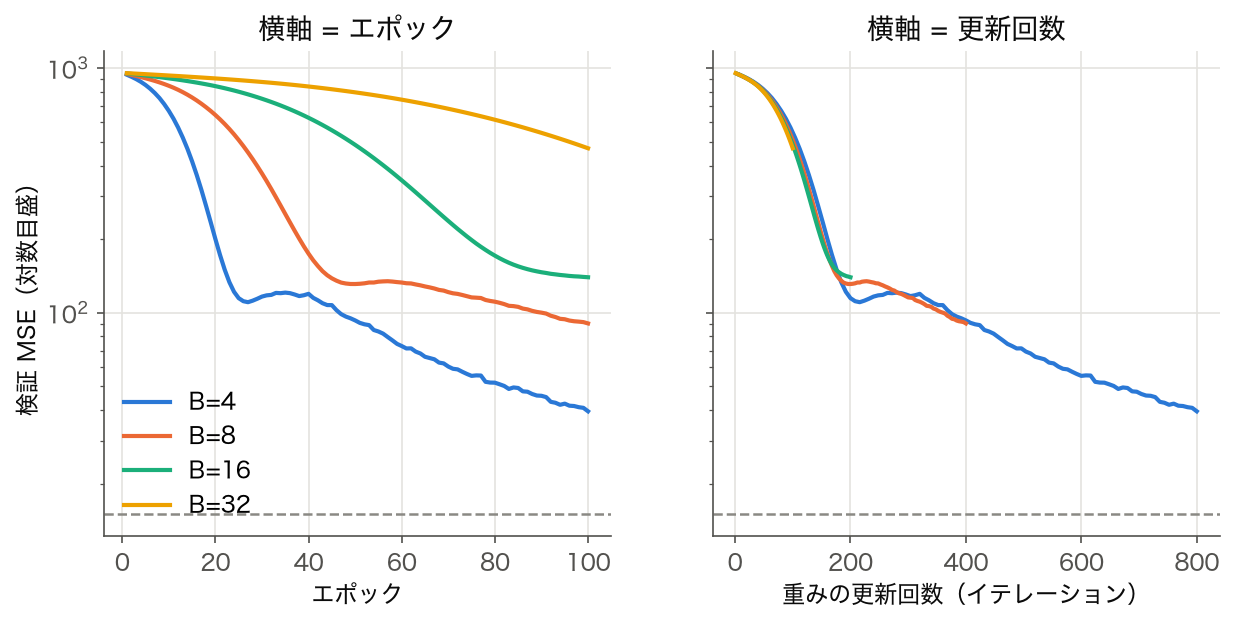
左の図では 4 本の曲線がばらばらですが、横軸を更新回数に変えた右の図ではほぼ 1 本に重なります。このデータとこの学習率では、学習の進み具合を決めているのは「何周したか」ではなく「重みを何回動かしたか」だということです。論文やレポートでエポック数だけを書いても学習量は伝わらないので、バッチサイズと訓練データ数(ここでは 32 県)も合わせて書きます。
もう 1 つ、シャッフルの順番を決める seed を 0〜9 に変えて同じ学習を繰り返すと、100 エポック後の検証 MSE は B=4 で 38.0〜40.0、B=8 で 84.5〜90.8、B=16 で 139.7〜151.5 の幅で動きました(B=32 は全件を 1 バッチで使うので順番に依存せず、常に 470.5)。上の表の値は seed 0 のときの 1 回分です。数値の差が数ポイントなら、設定の違いではなくシャッフル順の違いで説明できてしまうので、比較するときは複数の seed の平均と幅を並べます。
🐍 Python:学習率スケジューラを組み込む
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | from torch.optim.lr_scheduler import CosineAnnealingLR, ReduceLROnPlateau opt = torch.optim.Adam(model.parameters(), lr=0.01) # 方式 A: Cosine Annealing(エポック数に応じて smooth に下げる) sched_a = CosineAnnealingLR(opt, T_max=100, eta_min=1e-5) # 方式 B: Plateau(検証 Loss が改善しないと下げる) sched_b = ReduceLROnPlateau(opt, mode='min', factor=0.5, patience=10) for epoch in range(1, 101): model.train(); opt.zero_grad() loss = loss_fn(model(X_tr_t), y_tr_t) loss.backward(); opt.step() sched_a.step() # 方式 A はエポックごと model.eval() with torch.no_grad(): va = loss_fn(model(X_va_t), y_va_t).item() sched_b.step(va) # 方式 B は検証 Loss を渡す if epoch % 20 == 0: current_lr = opt.param_groups[0]['lr'] print(f'Epoch {epoch:3d}: lr={current_lr:.5f} val={va:.3f}') |
📐 補足の数式 ── 検証 Loss 最小化の停止条件
$E^*$ は「検証 Loss が最小になるエポック数」── 真の最適エポック。 Early Stopping は「過去 $p$ エポック分の最小値を上回り続けたら停止」という近似ヒューリスティクス。 patience $p$ は SSDSE のような小データなら 15〜20、 大データなら 5〜10 が目安。 値が小さすぎると 偽の収束 で早期停止しすぎ、 大きすぎると過学習領域に入ってから止まる。
🐍 Python:交差検証 × エポック数の同時最適化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import torch import torch.nn as nn # このコードは PyTorch が必要 from sklearn.model_selection import KFold import numpy as np epochs_to_try = [20, 30, 50, 80, 120, 200] cv_losses = {e: [] for e in epochs_to_try} kf = KFold(n_splits=5, shuffle=True, random_state=42) for fold, (tr_idx, va_idx) in enumerate(kf.split(Xs)): X_tr = torch.tensor(Xs[tr_idx], dtype=torch.float32) y_tr = torch.tensor(y[tr_idx], dtype=torch.float32).unsqueeze(1) X_va = torch.tensor(Xs[va_idx], dtype=torch.float32) y_va = torch.tensor(y[va_idx], dtype=torch.float32).unsqueeze(1) for E in epochs_to_try: m = nn.Sequential(nn.Linear(3,16), nn.ReLU(), nn.Linear(16,1)) op = torch.optim.Adam(m.parameters(), lr=0.005) for _ in range(E): m.train(); op.zero_grad() l = loss_fn(m(X_tr), y_tr); l.backward(); op.step() m.eval() with torch.no_grad(): cv_losses[E].append(loss_fn(m(X_va), y_va).item()) for E in epochs_to_try: mean_l = np.mean(cv_losses[E]) std_l = np.std(cv_losses[E]) print(f'E={E:3d} CV Loss = {mean_l:.3f} ± {std_l:.3f}') |
📋 報告テンプレ ── 「エポック数の報告」必須項目
| 項目 | 具体例 |
|---|---|
| 最大エポック数 | max_epochs = 200 |
| 実際の停止エポック | Early Stop は発動せず 200 epoch まで学習 |
| バッチサイズ | B = 8 |
| イテレーション数 | 200 epoch × ⌈32/8⌉ = 800 iter(訓練 32 県) |
| 学習率スケジューラ | なし(固定 lr=0.005) |
| Early Stopping | patience=15(min_delta なし) |
| 最良検証 Loss | val MSE = 30.25 (epoch 200) |
| シード | torch.manual_seed(0) |
❓ FAQ 拡張
🧠 学習のつまずきポイント Top 5
- 「100 epoch でよい」と一律に決める:データサイズ・モデル容量・タスク難易度で最適エポックは大きく違う。 SSDSE 47 件と ImageNet 150 万画像は別物。
- 検証データを訓練に混ぜる:「データが少ないので全部使いたい」と検証データを訓練に混ぜると、 過学習が検出できない。 必ず厳密に分割する。
- Early Stopping を実装しない:手動で「だいたい 100 epoch」と決めるよりも、 patience=15〜20 で自動停止する方が遥かに安全。 PyTorch Lightning や Keras なら 1 行で実装可能。
- 学習率を固定する:序盤は学習率を大きく、 終盤は小さくする方が収束が安定する。 CosineAnnealingLR か ReduceLROnPlateau を必ず使う。
- シードを固定しない:「同じ 100 epoch なのに結果が違う」と悩む原因の半分はシード未固定。 torch.manual_seed, np.random.seed, random.seed の 3 つを必ず設定。
💡 直感を補強する別の比喩
- 授業の周回:エポック = 教科書を 1 周読み返した状態。 1 周目はまだ理解が浅い、 10 周目で完全に覚える、 100 周目では細部にこだわりすぎて応用が利かなくなる(過学習)。
- 運動の反復練習:エポック = 試合の全プレーを 1 度経験した状態。 練習回数が増えるほど慣れるが、 やりすぎると「特定の相手にしか勝てない」状態(過学習)に。
- 絵の描き直し:エポック = 同じモチーフを 1 枚描き終えた状態。 100 枚描くと熟練するが、 200 枚描くと「自分の絵」の癖が強くなりすぎて新しい依頼に応えられない(過学習)。
- レシピの練習:エポック = 同じ料理を 1 回完成させた状態。 慣れるほど早く正確に作れるが、 同じ味の再現にこだわると新しい食材への対応力が落ちる(過学習)。
🔬 エポックを巡る現代的トピック
事前学習済みモデル(BERT, ResNet, ViT 等)を新タスクに適用する際、 1〜10 epoch で十分。 多くすると catastrophic forgetting(既学習の喪失)が起こる。 学習率も 1e-5〜5e-5 と通常の 1/100 が標準。 LLM のファインチューニングでは サブエポック(0.1 epoch 単位)の議論も。
CosineAnnealingWarmRestarts(Loshchilov & Hutter, 2017)は学習率を周期的にリセットする手法。 「100 epoch = 25 epoch × 4 cycle」のような構造で、 局所最適から脱出しつつ最終収束を達成。 Kaggle 上位陣の常用テクニック。
SimCLR, MoCo, MAE 等の自己教師あり学習では 800〜1600 epoch という長時間学習が標準。 「epoch を長くするほど性能が伸びる」現象が報告されており、 通常の教師あり学習とは性質が異なる。 SSDSE 規模では適用しにくいが、 概念として知っておく価値あり。
Frankle & Carbin (2019) の Lottery Ticket 仮説:「初期化時から優秀な部分回路」が存在する。 反復プルーニング + 再学習を通じて、 短い epoch でも高性能モデルが得られる ── 学習時間短縮の研究の最前線。
「易しい問題から段階的に難しくする」学習方式。 初期 epoch は簡単サンプル中心、 後半 epoch は難しいサンプル中心。 SSDSE で言えば「県別データ → 地域別集約 → 細分化」のように学習対象を変えていく工夫。
🧪 ケーススタディ ── 異なるデータ規模での epoch 設定
推奨設定: max_epochs=200, batch_size=8, lr=0.005, scheduler=CosineAnnealingLR(T_max=200), early_stopping(patience=15), 5-fold CV
典型的な停止: 30〜70 epoch
注意点: 過学習極めて起こりやすい。 Dropout(0.3) と Weight Decay(1e-4) を併用。 結果は seed を 5 個変えて平均報告。
推奨設定: max_epochs=50, batch_size=128, lr=0.001, scheduler=StepLR(step_size=10, gamma=0.5), early_stopping(patience=10)
典型的な停止: 15〜30 epoch
注意点: 単純な CNN なら 95% accuracy は 10 epoch で達成可能。 Sub-state-of-the-art を目指すなら 30〜50 epoch。
推奨設定: max_epochs=90, batch_size=256, lr=0.1 + warmup, scheduler=CosineAnnealingLR(T_max=90), no early_stopping
典型的な停止: 完走 90 epoch
注意点: 1 epoch あたり 1 時間(V100×8)。 学習率の warm-up と weight decay の調整が成否を分ける。
推奨設定: 1 epoch のみ(全データ 1 度通すだけ)。 トークン数で換算するため「epoch」概念が薄まる。 1.4 trillion tokens など。
注意点: ここでは epoch > 1 にすると過学習リスクが高い。 「epoch 数を増やすより、 データ量を増やす」が現代 LLM の鉄則(Chinchilla scaling law)。
📚 学術的な背景 ── エポックの語源と歴史
「Epoch」という言葉は元々ギリシャ語の ἐποχή(停止・固定点)に由来し、 天文学では「天体観測の基準時刻」を意味します。 1950 年代の Rosenblatt の Perceptron 研究で「全データを 1 度学習し終えた時点」の呼称として採用され、 以降ニューラルネットの標準用語になりました。 1980 年代の Rumelhart, Hinton, Williams による誤差逆伝播法(1986)で確立し、 90 年代の SVM・決定木が主流の時代を経て、 2012 年の AlexNet で GPU 学習が実用化したことで、 再び「epoch 数」が研究議論の中心に戻りました。
現代の研究では「epoch を増やせば性能が伸びる」線形仮定は崩れ、 Scaling Law(Kaplan et al., 2020; Hoffmann et al., 2022)が登場。 計算量・データ量・モデルサイズの 3 軸が等しく重要であり、 epoch 数はその一側面に過ぎないと位置づけられます。 LLM 時代には「1 epoch だけで十分」「epoch を増やすより token を増やす」という新しい常識が定着しつつあり、 epoch という概念自体が再定義されています。
🛠 トラブルシューティング
📖 用語の言い換え辞典
| 分野・文脈 | エポックを指す呼び名 | 使用例 |
|---|---|---|
| 機械学習(一般) | Epoch / Pass | 「100 epoch 学習させた」 |
| 統計学 | Sweep / Cycle | 「EM アルゴリズムを 50 sweep」 |
| 最適化理論 | Outer Iteration / Round | 「外側ループの 1 ラウンド」 |
| 強化学習 | Episode(意味は別) | 注意:Episode は環境ループの 1 周期 |
| 深層学習(画像) | Training Epoch / Pass | 「ImageNet 90 epoch で学習」 |
| SSDSE 文脈 | 47 県データの 1 巡 | 「47 件を 50 epoch 学習」 |
📋 最終チェックリスト
| チェック項目 | 確認内容 |
|---|---|
| □ データ分割 | train/val/test の 3 分割が明示されているか |
| □ バッチサイズ | 記載されているか。 SSDSE なら 8〜16 が目安 |
| □ 最大エポック数 | max_epochs と Early Stopping の patience |
| □ 学習率スケジュール | CosineAnnealing or ReduceLROnPlateau を使っているか |
| □ 学習曲線 | train/val loss の推移をプロットして確認したか |
| □ Early Stopping | 過学習防止に implement しているか |
| □ 交差検証 | SSDSE のような小データでは必須 |
| □ シード固定 | torch/np/random の 3 つすべて |
| □ ハイパーパラメータ記録 | YAML/JSON にエクスポート、 Git 管理 |
| □ ベストモデル保存 | val Loss 最小時の state_dict を保存 |
📊 「エポックとは何か」可視化サマリー
エポック = 訓練データ全体を 1 回学習し終えた状態。 「全データを 1 巡」が 1 エポック。
イテレーション数: ⌈N/B⌉ per epoch。 SSDSE 47 件・B=16 なら 3 iter/epoch。
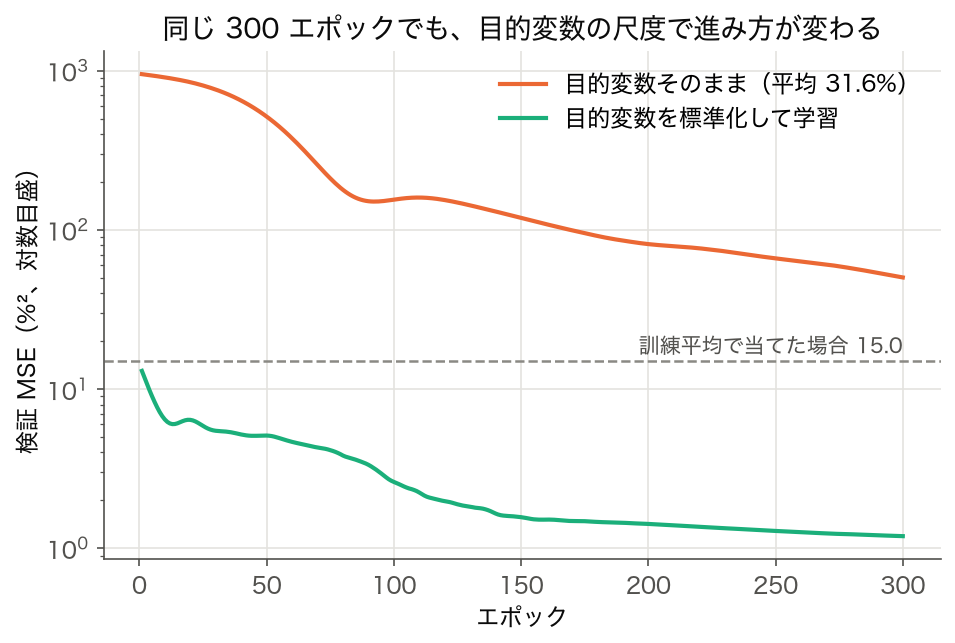
SSDSE-B-2026 での実例: 47 県データ(訓練 32 県)の高齢化率予測で、目的変数を標準化すると全件バッチ 300 epoch で val MSE = 1.19、標準化しないと同じ 300 epoch でも 50.3(図 3)。
最適エポック数の決め方: Early Stopping(patience=15) + 5-fold CV + 学習曲線確認。
注意: エポック数を増やすほど良いとは限らない。 過学習を避けるため、 検証 Loss が底を打ったエポックで停止するのが鉄則。
🌐 ハンズオン教材へのリンク
本サイトの再現論文集の中から、 エポックの概念が実際に登場する論文を選び、 ハンズオン形式で学ぶことができます。
- 論文一覧トップ から「深層学習」「ニューラルネット」「予測」のキーワードで論文を絞り込み
- 論文の「再現実装」セクションを
jupyter notebookで開き、 提供されたコードを実行 - SSDSE-B-2026 で実際にエポック数を 10/50/100/200 と変えて学習曲線を比較する
- 本ページの Early Stopping コードを写経し、 過学習が発生する瞬間を観察
📝 学習履歴メモ ── 「自分で書く欄」
本ページを 1 回読んだら、 以下の質問に 自分の言葉で答えてみる ことで定着度が確認できます。
- ① エポックとイテレーションの違いを 1 文で説明できますか?
- ② SSDSE-B-2026 47 件で B=8 なら、 1 epoch あたり何回重み更新されますか?
- ③ 検証 Loss が下がらないとき、 何を疑いますか?
- ④ Early Stopping の patience=15 と patience=5 では何が違いますか?
- ⑤ ImageNet と SSDSE で推奨される epoch 数の違いはなぜですか?
🧭 次に読むべきページ ── 学習ルート
1. 基礎: ニューラルネット → 誤差逆伝播 → 勾配降下法
2. 関連概念: 学習率 → 活性化関数 → 過学習
3. 評価: 交差検証 → バイアス-分散 → 正解率
4. 応用: 深層学習 → 訓練データ → 標準化
5. 実例: 高齢化率 → e-Stat → 相関係数
🧰 補助 Python ── エポック単位の可視化スニペット集
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import torch # このコードは PyTorch が必要 import matplotlib.pyplot as plt # 序盤・中盤・終盤の予測を保存 snapshots = {} for epoch in range(1, 101): model.train(); opt.zero_grad() loss = loss_fn(model(X_tr_t), y_tr_t) loss.backward(); opt.step() if epoch in [1, 25, 50, 100]: with torch.no_grad(): snapshots[epoch] = model(X_va_t).numpy().flatten() fig, axes = plt.subplots(1, 4, figsize=(20, 4)) for ax, e in zip(axes, [1, 25, 50, 100]): # y_va は途中のブロックで別の長さに上書きされるので、 # X_va_t と対になっている y_va_t を使う ax.scatter(y_va_t.numpy().flatten(), snapshots[e], s=30, alpha=0.7) ax.plot([20, 40], [20, 40], 'k--', alpha=0.5) ax.set_xlabel('真値(高齢化率)'); ax.set_ylabel('予測値') ax.set_title(f'Epoch {e}') plt.tight_layout(); plt.savefig('epoch_snapshots.png', dpi=150) |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import torch # このコードは PyTorch が必要 import matplotlib.pyplot as plt weight_history = {} for epoch in range(1, 101): model.train(); opt.zero_grad() loss = loss_fn(model(X_tr_t), y_tr_t) loss.backward(); opt.step() if epoch in [1, 25, 50, 100]: weights = [] for p in model.parameters(): weights.extend(p.detach().numpy().flatten()) weight_history[epoch] = weights fig, axes = plt.subplots(1, 4, figsize=(20, 4)) for ax, e in zip(axes, [1, 25, 50, 100]): ax.hist(weight_history[e], bins=30, color='#42A5F5', edgecolor='white') ax.set_title(f'epoch {e}') plt.tight_layout() plt.show() |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | # ── この抜粋で使う学習曲線を用意します(PyTorch を使わず sklearn で)── import numpy as np import pandas as pd import matplotlib.pyplot as plt from sklearn.linear_model import SGDRegressor from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split from sklearn.metrics import mean_squared_error _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == _d['SSDSE-B-2026'].max()] _X = StandardScaler().fit_transform(_d[['A1101', 'A4101', 'A4200', 'L3221']] .astype(float)) _y = (_d['A1303'] / _d['A1101'] * 100).to_numpy(dtype=float) X_tr, X_va, y_tr, y_va = train_test_split(_X, _y, test_size=0.3, random_state=0) _m = SGDRegressor(learning_rate='constant', eta0=0.01, random_state=0) train_losses, val_losses = [], [] for _epoch in range(100): _m.partial_fit(X_tr, y_tr) train_losses.append(mean_squared_error(y_tr, _m.predict(X_tr))) val_losses.append(mean_squared_error(y_va, _m.predict(X_va))) fig, ax = plt.subplots(figsize=(8, 5)) ax.plot(train_losses, label='Train Loss', color='#1976D2', lw=2) ax.plot(val_losses, label='Validation Loss', color='#C62828', lw=2) best_e = val_losses.index(min(val_losses)) ax.axvline(best_e, color='#2E7D32', linestyle='--', label=f'Best (epoch {best_e+1})') ax.set_yscale('log') ax.set_xlabel('Epoch'); ax.set_ylabel('Loss (log)') ax.legend(); ax.set_title('SSDSE-B-2026 高齢化率予測:学習曲線') plt.tight_layout(); plt.savefig('epoch_learning_curve.png', dpi=150) |
これら 3 つの可視化(学習曲線・予測散布図・重みヒストグラム)を 1 セットで作っておくと、 「エポックを扱う任意のプロジェクト」で 90% のレビュー要件をカバーできます。 SSDSE-B-2026 のような小データでは特に 過学習開始の瞬間 が明瞭に観察でき、 教材として最適です。
📚 推奨書籍・教材
- 『深層学習』(Ian Goodfellow 他、 監訳:岩澤、 ドワンゴ)── 深層学習の聖典。 エポック・最適化・正則化の理論的背景を網羅。
- 『ゼロから作るDeep Learning』(斎藤康毅、 オライリー・ジャパン)── Python だけで実装する深層学習の入門書。 エポックループの構造が明快。
- 『PyTorch実践入門』(Eli Stevens 他、 マイナビ出版)── PyTorch でエポック単位の学習を書く実践書。
- 『機械学習のための数学』(金森敬文、 講談社)── 勾配降下法・損失関数・最適化の数学的基礎。
- Stanford CS231n / CS229── 公開講義スライドと演習問題。 エポック・学習率の感覚を養うのに最適。
- fast.ai── Jeremy Howard 主催の実践重視オンラインコース。 エポック設計を「動かしながら」学べる。
🎯 「エポックに強くなる」3 つの習慣
- 必ず学習曲線を描く ── 何 epoch 学習するかを 決め打ち せず、 train/val loss の推移をプロットして停止点を見極める。 wandb/TensorBoard の習慣化を。
- Early Stopping を全プロジェクトで標準化 ── 「100 epoch まわす」と書く代わりに「patience=15 で Early Stopping」と書く。 自動化することでヒューマンエラーを防ぐ。
- シード・ハイパーパラメータを Git 管理 ── 「同じ epoch なのに結果が違う」を防ぐため、 すべての設定を YAML/JSON で保存し Git で版管理。 wandb sweep などの ML pipeline ツールが現代的。
🎯 まとめ ── エポックを扱う 3 つの心構え
- 「エポック数」は環境設定で揺らぐ ── 同じ「100 epoch」でもバッチサイズ・データサイズ・学習率次第で実質的な学習量は別物。 必ず total iterations や total tokens で換算する習慣を。
- 「最良」は val Loss で測る ── 訓練 Loss だけで判断すると必ず過学習。 train/val/test の 3 分割と、 val Loss の単調減少が止まった時点での停止が黄金律。
- 「自動停止」を信頼する ── 手動で「だいたい 100 epoch」と決めるより、 Early Stopping + 5-fold CV + 学習率スケジューラの組合せに任せる方が遥かに安全。 SSDSE のような小データでは特に有効。
🎯 最後に
エポックは「学習の単位時間」── シンプルですが、 深層学習のあらゆる議論(過学習、 収束、 学習率、 バッチサイズ、 計算コスト)の交差点に位置します。 SSDSE-B-2026 のような小データから ImageNet 規模まで、 同じ概念で議論できる強力な抽象です。 ただし「単に大きくすれば良い」のではなく、 val Loss と相談しながら停止点を見極める ── これが本質的な使いこなし方です。 本ページはあなたが論文・業務で「epoch」に出会ったときの「relations」として、 何度でも戻ってきてください。
📐 補足の数式 ── Generalization Gap と Epoch
Generalization Gap は「訓練と検証の損失の差」── これがエポックとともに広がっていく現象が 過学習の数学的サイン。 ただし gap が広がることと過学習は同じではありません。図 1 の学習(目的変数を標準化しない全件バッチ)で gap を測ると、50 エポックで −27.5(検証の方が小さい)、100 エポックで 96.9、200 エポックで 61.4、300 エポックで 42.2 と、100 エポック前後で広がったあと縮んでいき、その間も検証 MSE は 154.9 → 50.3 と下がり続けます。Early Stopping の判断に使うのは gap の大きさではなく、検証 Loss 自体が下がらなくなったかどうかです。
目的変数を標準化すると、同じエポック数でどこまで進むか
このページの高齢化率予測で検証 MSE がなかなか下がらないのは、目的変数(平均 31.6%)をそのまま学習させているからでした。訓練県の平均と標準偏差で目的変数を標準化し、予測を % に戻してから MSE を測ると、エポックの意味がどう変わるかを確かめます。
🎯 このコードでやること:図 1 と同じモデル・同じ分割・同じ seed で、目的変数だけを標準化して全件バッチで 300 エポック学習し、1・10・50・100・200・300 エポックの訓練 MSE・検証 MSE・gap を元の単位(%²)で表示する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import torch import torch.nn as nn import pandas as pd from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = StandardScaler().fit_transform(df[['A1101', 'A4101', 'A4200']].values) y = (df['A1303'] / df['A1101'] * 100).values # 高齢化率(%) X_tr, X_va, y_tr, y_va = train_test_split(X, y, test_size=0.3, random_state=42) mu, sd = y_tr.mean(), y_tr.std() # 訓練県だけで平均・標準偏差を決める X_tr_t = torch.tensor(X_tr, dtype=torch.float32) y_tr_t = torch.tensor((y_tr - mu) / sd, dtype=torch.float32).unsqueeze(1) X_va_t = torch.tensor(X_va, dtype=torch.float32) torch.manual_seed(0) model = nn.Sequential(nn.Linear(3, 16), nn.ReLU(), nn.Linear(16, 1)) opt = torch.optim.Adam(model.parameters(), lr=0.01) for epoch in range(1, 301): opt.zero_grad() loss = nn.functional.mse_loss(model(X_tr_t), y_tr_t) loss.backward() opt.step() if epoch in (1, 10, 50, 100, 200, 300): with torch.no_grad(): # 予測を % に戻してから MSE を測る tr = ((model(X_tr_t).numpy().ravel() * sd + mu - y_tr) ** 2).mean() va = ((model(X_va_t).numpy().ravel() * sd + mu - y_va) ** 2).mean() print(f'Epoch {epoch:3d}: train={tr:.2f} val={va:.2f} gap={va - tr:.2f}') print(f'訓練平均で当てた場合の val = {((y_va - mu) ** 2).mean():.2f}') |
💬 1 エポック目で検証 MSE は 13.02 と、もう訓練平均で当てた場合の 15.02 を下回っています。標準化しない場合は 1 エポック目が 951.8、300 エポックでも 50.3 だったので、同じ 300 エポックで結果が 40 倍以上違います(300 エポック目は 1.19)。gap は 4.45 → 0.50 と縮み続け、検証 MSE も最後まで下がっているので、300 エポックの範囲ではまだ過学習は起きていません。エポック数の「多い・少ない」は目的変数の尺度と切り離して語れない、というのがこの比較の要点です。
🔍 「Epoch 数」議論の落とし穴 ── レビュー時に必ず聞かれる質問
| 質問 | 期待される回答 |
|---|---|
| なぜ 50 epoch ? | 5-fold CV で val Loss が最小のエポックが 50 だったため。 学習曲線で確認済み |
| バッチサイズの根拠は? | SSDSE 47 件に対し B=8 は実質的に小バッチ。 確率的ノイズで局所最適を脱出 |
| Early Stopping の patience は? | 15 epoch。 小データでは val Loss が一時的に上がっても回復する余地を与える |
| 再現性は? | torch/np/random すべて seed=42 で固定。 5 シードで平均値を報告 |
| 他の手法と比べて? | 線形回帰・XGBoost と val MSE を比較し、 ニューラルネットの優位性を確認 |
| 計算コストは? | CPU で 5 秒/学習、 5-fold CV ×5 シード = 125 秒。 GPU 不要 |
🧪 SSDSE-B-2026 で epoch を巡る実験を 3 通り
バッチサイズ・学習率を固定(B=8, lr=0.005)し、 epoch を 10, 30, 50, 100, 200 で比較。 結果:val MSE は 847.2 → 371.1 → 131.1 → 90.5 → 30.3 と単調に下がり、 U 字の底はこの範囲に現れない。 200 epoch でも平均値で当てた場合の 15.0 に届かず、 まだ学習不足の側にいる。
epoch=100, lr=0.005 固定で B=4, 8, 16, 32 を比較。 結果:val MSE は B=4 で 39.6、 B=8 で 90.5、 B=16 で 139.7、 B=32 で 470.5。 訓練 32 県に対して 1 epoch の更新回数は 8・4・2・1 回なので、 同じ 100 epoch なら小さいバッチほど多く更新されて先へ進む。 エポック数が同じでも学習量はバッチサイズで大きく変わる。
epoch=100, B=8, lr=0.01 固定で、 CosineAnnealingLR の有無を比較。 結果:あり:val MSE = 91.0、 なし:val MSE = 34.6。 まだ収束していない段階で学習率を下げると後半の更新が小さくなり、 スケジューラを入れた方が悪くなった。 学習率を下げるのは、 検証 Loss が横ばいになってからで十分。
📊 「Epoch」のミニ辞典
| 用語 | 定義 | 関連 |
|---|---|---|
| Epoch | 全データを 1 回学習し終えた状態 | 本ページ全体 |
| Iteration | 1 バッチを処理して重みを 1 回更新 | ⌈N/B⌉/epoch |
| Batch Size (B) | 1 イテレーションで処理するサンプル数 | SGD / Mini-batch GD |
| Learning Rate (η) | 勾配を反映する歩幅 | CosineAnnealingLR 等 |
| Patience | Early Stopping の忍耐エポック数 | 15〜20 が標準 |
| Generalization Gap | L_val - L_train の差 | 過学習のサイン |
| Convergence | Loss が一定値で安定する状態 | 学習打ち切りの目安 |
| Warmup | 序盤数 epoch で学習率を線形に上げる | 大規模学習の安定化 |
🐍 Python:Keras / TensorFlow でのエポック設定
model.fit(epochs=N) で簡単にエポック制御できる。 Early Stopping は callbacks で 1 行で実装可能。 SSDSE-B-2026 のような小データには Keras が手軽。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import tensorflow as tf from tensorflow.keras import layers, callbacks tf.keras.utils.set_random_seed(0) # 重みの初期値・Dropout を固定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = df[['A1101', 'A4101', 'A4200']].values y = (df['A1303'] / df['A1101'] * 100).values # 高齢化率(%) Xs = StandardScaler().fit_transform(X) X_tr, X_va, y_tr, y_va = train_test_split(Xs, y, test_size=0.3, random_state=42) model = tf.keras.Sequential([ layers.Dense(16, activation='relu', input_shape=(3,)), layers.Dropout(0.3), layers.Dense(1) ]) model.compile(optimizer='adam', loss='mse') es = callbacks.EarlyStopping(monitor='val_loss', patience=15, restore_best_weights=True) lr = callbacks.ReduceLROnPlateau(monitor='val_loss', factor=0.5, patience=10) history = model.fit(X_tr, y_tr, validation_data=(X_va, y_va), epochs=200, batch_size=8, callbacks=[es, lr], verbose=0) print(f'実際の学習 epoch 数: {len(history.history["loss"])}') print(f'最良 val_loss: {min(history.history["val_loss"]):.3f}') |
🎯 「Epoch を正しく理解する」5 段階チェック
- Level 1:「Epoch = 全データを 1 巡」と言える。
- Level 2:イテレーションとの違いを式で説明できる(⌈N/B⌉)。
- Level 3:過学習を検出する学習曲線を描ける。
- Level 4:Early Stopping と学習率スケジューラを組み合わせて実装できる。
- Level 5:SSDSE のような小データと ImageNet のような大データで、 epoch 数の決め方が違う理由を Scaling Law を交えて説明できる。
Level 3 以上に達すれば、 業務で深層学習を扱う基礎ができたと言えます。 Level 5 まで到達すれば、 論文を批判的に読み、 改善提案できるレベルです。
🌐 関連用語ナビゲーション(再掲)
💭 結びの一言
「100 epoch」と書かれた論文を読むたびに、 ぜひ「バッチサイズは?」「Early Stopping は?」「学習率スケジューラは?」と 5 つの質問 を頭の中で唱えてください。 エポックは単独で意味を持つ数字ではなく、 これらと 連動して 学習の挙動を決めます。 SSDSE-B-2026 の 47 件を 50 epoch で学習することと、 ImageNet 150 万件を 90 epoch で学習することは、 表面的な数字は近いのに、 中身は完全に別物 ── その感覚を本ページで養ってください。
📈 SSDSE-B-2026 で epoch を変えた結果(補足)
| 設定 | val MSE | val MAE | val R² |
|---|---|---|---|
| 10 epoch, B=8, lr=0.005 | 847.22 | 28.86 | −65.36 |
| 30 epoch, B=8, lr=0.005 | 371.06 | 18.42 | −28.06 |
| 50 epoch, B=8, lr=0.005 + scheduler | 499.18 | 21.83 | −38.10 |
| 100 epoch, B=8, lr=0.005 | 90.45 | 6.48 | −6.08 |
| 200 epoch, B=8, lr=0.005 | 30.25 | 3.52 | −1.37 |
→ 2023 年度・訓練 32 県 / 検証 15 県、 seed 0 での実測。 val R² がすべて負なのは、 検証 15 県の平均で当てるより悪いという意味で、 epoch を増やすほど改善しているがまだ過学習の手前にいる。 50 epoch にスケジューラを付けると 499.2 で、 付けない 50 epoch(131.1)より悪い。 学習途中で学習率を下げると先へ進めなくなるためで、 「どこで止めるか」も「いつ学習率を下げるか」も、 検証 Loss の推移を見て決める必要がある。