🔖 キーワード索引
別名・略称:コスト関数
「損失関数 (loss function)」は予測値 ŷ と正解 y の乖離をスカラーで表す関数 L(y, ŷ)。 これを最小化することが学習。 本ページの中核キーワードを以下に整理する。
これらのキーワードは「loss function の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
予測のズレを測るものさしです。
正解との差を数値にするために使います。
テストの点数で弱点を知るのと似ています。
ここでは損失関数の基本を学びます。
損失関数(Loss Function):モデルの予測誤差を測る関数
- 損失関数=モデルの予測がどれだけ外れているかを 1 つの数値で表す関数 $L(y, \hat y)$。
- 学習=損失を最小化するパラメータを探す。 これがほぼ全機械学習の共通骨格。
- 回帰の定番:MSE(平均二乗誤差)、 MAE(平均絶対誤差)。 分類の定番:クロスエントロピー、 Hinge損失。
- MSE は外れ値に弱い(2 乗するため)、 MAE / Huber は 外れ値に強い。
- 勾配降下で最適化するには 微分可能性 と 凸性 が望ましい。
📍 あなたが今見ているもの
🍰 まずはやさしく
モデルの性格を決めるルールです。
何を優先して学習させるか決めます。
部活で何を重視して練習するか似ています。
損失関数が学習にどう影響するか読みます。
🎨 直感で掴む
🍰 まずはやさしく
間違いへの厳しさを決める仕組みです。
どんなミスを嫌うかを設定するために使います。
スマホの予測変換のズレを直すイメージです。
種類ごとの特徴と使い分け方を学びます。
よく使う損失関数
| 名前 | タスク | 式(1サンプル) | 特徴 |
|---|---|---|---|
| MSE | 回帰 | (y-ŷ)² | 外れ値に敏感、 微分易 |
| MAE | 回帰 | |y-ŷ| | 外れ値に頑健 |
| Huber | 回帰 | MSE と MAE の混合 | 両者のいいとこ取り |
| BCE | 2値分類 | -[y log ŷ + (1-y) log(1-ŷ)] | 確率出力に最適 |
| CE | 多クラス分類 | -Σ yₖ log ŷₖ | softmax と組 |
| Hinge | SVM | max(0, 1-y·ŷ) | マージン最大化 |
「どの損失を使うか=モデルがどんな間違いを嫌うか」。 たとえば「大きく外したら倍々に罰する」のが MSE、 「同じ重みで罰する」のが MAE。
📐 定義 / 数式
🍰 まずはやさしく
ズレを計算するための数式です。
誤差を最小にする値を計算するために使います。
買い物で予算との差を出す計算に似ています。
具体的な数式と記号の意味を読み解きます。
📐 主要損失関数のラインナップ(回帰・分類・ロバスト)
損失関数は「予測のずれをどう罰するか」のルールであり、 タスク(回帰/分類)や外れ値耐性によって使い分ける。 ここでは実務で頻出する 6 種類を式と性質で並べる。
数式を言葉で読み解く(外れ値耐性の視点)
$L_{\text{MSE}}$ は誤差の 2 乗で罰するため、 誤差 18 のサンプル 1 件で MSE は 324 増える。 一方 $L_{\text{MAE}}$ は 絶対値なので 18 のまま。 これがロバスト性の差を生む。 Huber は誤差が $\delta$ 以下なら MSE、 超えたら MAE に切り替わる連続関数で、 「中央付近は MSE の滑らかさを保ちつつ、 外れ値領域では MAE で押さえ込む」設計。
$L_{\text{BCE}}$ の $-\log \hat p$ は、 真ラベル $y=1$ なのに予測確率 $\hat p$ を 0 に近づけると無限大に発散する。 「自信を持って外す」予測を強く罰する設計であり、 確率出力モデル(ロジスティック回帰・ソフトマックス NN)の最適化と数学的に等価。
📐 Focal Loss / Smooth L1 / Triplet Loss(実務でよく使う派生)
標準的な MSE / BCE では対処しきれないタスクのために、 実務では タスク特化の損失関数が多数提案されている。
| 損失 | 提案論文・年 | 代表タスク | 解決する課題 |
|---|---|---|---|
| Focal Loss | Lin et al. 2017 | 物体検出 / 不均衡分類 | 背景クラス過多で BCE が薄まる |
| Smooth L1 | Girshick 2015 (Fast R-CNN) | bbox 座標回帰 | MSE の外れ値感度を緩和 |
| Triplet | FaceNet 2015 | 顔認証・埋め込み学習 | 同類は近く、 異類は遠く |
| Dice Loss | Milletari 2016 (V-Net) | 医用セグメンテーション | 微小領域でも IoU を最適化 |
📌 選択指針:損失関数は「タスクの評価指標を直接最適化するもの」を選ぶのが原則。 IoU で評価されるセグメンテーションなら Dice Loss、 ランキングなら Listwise Loss など。 MSE/BCE で安易に通すのは「とりあえず動く」だけで最適ではない。
📐 損失関数のチューニング指針(実務ノウハウ集)
ここでは、 教科書には書かれにくいが現場で重要になる、 損失関数のチューニングに関する実務ノウハウを 5 つ示す。 学習が「思ったように収束しない」「精度は出るが本番で外す」といった症状の多くは、 損失関数の細部設定で解決する。
5 つの実務ノウハウ
- ①損失の桁を揃える: マルチタスク学習で MSE 損失と CE 損失を加算するとき、 桁が違うと片方が支配する。 学習開始時のミニバッチで両者の値を確認し、 1 桁以上違う場合は係数で揃える。
- ②学習初期の損失曲線を確認する: 最初の数エポックで損失が急減 → 正常、 ほぼ動かない → 学習率が低すぎるか勾配消失、 振動する → 学習率が高すぎるか損失関数とデータの不整合。
- ③検証損失が訓練損失より低くなる現象: バッチ正規化や Dropout の影響で起こりうるが、 大半は「データリーク」のサイン。 train/test 分割を疑う。
- ④損失の早期収束は過学習の前兆: 訓練損失が 0 に近づき検証損失が動かなくなったら、 正則化(L1/L2/Dropout)を強める、 もしくは学習を早期停止する。
- ⑤外れ値に対するモデル感度を可視化する: モデルを学習した後、 訓練データの最大残差サンプルを除外して再学習し、 係数や予測がどれだけ変わるかを見る。 大きく変われば外れ値支配、 変わらなければ頑健。
SSDSE-B-2026 を使ったチューニング演習
「人口 vs 転入者数」の単純線形回帰について、 ノウハウ⑤を実践してみる。 東京(最大の外れ値)を除外して再学習し、 係数がどれだけ動くかで「東京の影響度」を定量化する。
このコードでやること:ノウハウ⑤(外れ値感度の可視化)を、 最小の合成データで確認する。 $y \approx 10x$ に従う 8 点のうち 1 点だけを極端な外れ値("東京型"の巨大都市)にし、 その 1 点を除外して最小二乗(MSE)回帰を再学習、 傾きがどれだけ動くかで「外れ値の支配度」を定量化する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np # 合成データ: y ≈ 10x。最後の 1 点だけ極端な外れ値("東京型"の巨大都市) x = np.array([5, 8, 10, 12, 15, 18, 20, 140], dtype=float) y = np.array([52, 78, 101, 118, 152, 178, 205, 700], dtype=float) # 全点で最小二乗(MSE)フィット a_all, b_all = np.polyfit(x, y, 1) # 外れ値(最後の 1 点)を除いて再フィット a_drop, b_drop = np.polyfit(x[:-1], y[:-1], 1) print(f"全 8 点 : 傾き = {a_all:.2f}") print(f"外れ値除外 : 傾き = {a_drop:.2f}") print(f"傾きの変化率 = {(a_drop - a_all) / a_all * 100:.1f}%") |
📤 実行結果:
外れ値除外 : 傾き = 10.13
傾きの変化率 = 121.7%
💬 結果の読み方:たった 1 点(全体の 12.5%)を除いただけで傾きが倍以上動く(変化率 100% 超)。 この「1 サンプルで係数が大きく動く」状態は外れ値支配のサインで、 MSE のままでは典型的なサンプルの関係を過小評価してしまう。 こういうデータでは Huber 損失や対数変換で外れ値の影響を抑えるのが定石である。
損失関数選びの最終チェックリスト
本ページで扱った内容を、 実務で使えるワンページのチェックリストに集約する。 新しい AI プロジェクトを始めるたびに、 このリストを順に確認すれば損失関数選びで大きく外すことは無くなる。
- ✅ タスクは回帰か分類か(回帰なら MSE/MAE/Huber、 分類なら CE/Weighted CE/Focal)
- ✅ データに外れ値はあるか(あるなら MSE 単独は避ける)
- ✅ ノイズの分布は対称か非対称か(非対称なら対数変換や Huber を検討)
- ✅ クラス比はどうか(不均衡なら Weighted CE 以降を初手で選ぶ)
- ✅ 損失関数は微分可能か(深層学習なら微分可能性が必須、 MAE は工夫が必要)
- ✅ 業務上「平均」と「中央値」のどちらに最適化したいか(明示的に選ぶ)
- ✅ 学習中の損失曲線は健全か(急減・振動・停滞のどれか確認)
- ✅ 検証損失と訓練損失の関係は妥当か(リーク・過学習のサインを見逃さない)
- ✅ 外れ値除外で係数がどれだけ動くか(変動 5% 以下なら頑健、 10% 超なら要対策)
- ✅ 業務 KPI と損失関数の方向は一致しているか(学習指標と業務指標を擦り合わせ)
このチェックリストは、 SSDSE-B-2026 のような公的データを使った教育演習でも、 企業の本番 AI プロジェクトでも、 共通して機能する普遍的なものである。 損失関数を「与えられた MSE をそのまま使う」のではなく、 「データ・業務・統計仮定に応じて意識的に選ぶ」習慣が、 機械学習エンジニアと統計家の最も重要な差異の 1 つになる。 本ページの議論を、 自分の手元データに照らして繰り返し読み直してほしい。
🔬 記号・式を言葉で読み解く
- $y_i$
- i 番目の真の値(教師ラベル)
- $\hat y_i = f_\theta(x_i)$
- i 番目の予測値(モデル出力)
- $L(y, \hat y)$
- 1サンプル分の損失。 「予測がどれだけ外れたか」
- $\theta$
- モデルのパラメータ(重み・バイアス)
- $R(\theta)$
- 正則化項。 過学習を抑える
🔬 勾配の数式を言葉で読み解く(最適化との接続)
SGD は $\theta \leftarrow \theta - \eta \cdot \partial L/\partial \theta$ で更新する。 損失関数を選ぶことは、 そのまま勾配の形と更新の挙動を選ぶことに等しい。
| 損失 | $\partial L / \partial \hat y$ | 大きい誤差での挙動 | 外れ値の影響 | 微分可能性 |
|---|---|---|---|---|
| MSE | $-2(y-\hat y)$ | 勾配が誤差に比例 → 大きく動く | 非常に大 | 全域で滑らか |
| MAE | $-\operatorname{sign}(y-\hat y)$ | 勾配が ±1 のみ → 一定速度 | 小 | $y=\hat y$ で不連続 |
| Huber | 誤差小→MSE 型 / 大→ ±$\delta$ | 頭打ち($\delta$ で飽和) | 中 | 全域で連続 |
| BCE | $\hat p - y$ | 確率 0/1 付近で勾配爆発 | 分類なので別議論 | $\hat p \in (0,1)$ で滑らか |
💡 核心:MSE は勾配が誤差に比例する→外れ値で巨大勾配→SGD が一気に振れる。 MAE は勾配が ±1 で一定→外れ値を引っ張られない。 Huber は両者の良いとこ取り。 これが「ロバスト回帰には Huber」と言われる理由である。
🔬 正則化付き損失の数式を言葉で読み解く
実務の損失は単純な $L(y, \hat y)$ ではなく、 パラメータ自体への罰則を足した形で書かれる:
- $\ell(y_i, f_\theta(x_i))$
- サンプル $i$ 個別の損失(MSE・BCE 等)。 「データに合わせろ」という指示。
- $R(\theta) = \|\theta\|_2^2$(L2/Ridge)
- パラメータの二乗和。 全係数を小さめに引っ張る → 滑らかな解。
- $R(\theta) = \|\theta\|_1$(L1/Lasso)
- パラメータの絶対値の和。 多くの係数を厳密に 0 にする → 特徴選択効果。
- $\lambda$
- 予測誤差と正則化のバランス係数。 大きいほど「データに合わせるな」が強くなる。 HP 調整の主役。
📌 核心:損失関数を「ペナルティ付き最尤推定」と読み替えると、 $\ell$ が尤度、 $R$ が事前分布に対応する MAP 推定として統一的に説明できる。 L2 は正規事前、 L1 はラプラス事前。 これが「正則化=ベイズ事前」と言われる所以。
🔬 損失関数と評価指標の使い分け(数式で読む)
「学習に使う損失関数」と「報告に使う評価指標」は同じである必要はない。 むしろ、 微分可能性の制約から損失関数が選ばれ、 評価指標は人間の理解しやすさで選ばれることが多い。
| タスク | 学習用損失(微分可能) | 評価指標(人間用) | なぜ違う? |
|---|---|---|---|
| 回帰 | MSE / Huber | RMSE / R² | RMSE は単位が元データ |
| 2 値分類 | BCE | Accuracy / F1 / AUC | F1 は不連続で微分不能 |
| 多クラス | Softmax CE | Accuracy / Top-K Acc | Top-K も不連続 |
| ランキング | RankNet / ListMLE | NDCG / MAP | NDCG は微分不能 |
| 物体検出 | Smooth L1 + Focal | mAP | mAP も微分不能 |
💡 核心:F1 や AUC は階段関数や順位の関数なので、 そのままでは勾配降下で最適化できない。 そこで「代理損失(surrogate loss)」として BCE / hinge を使い、 結果を F1/AUC で報告するのが標準。 代理損失の最小化が必ずしも評価指標の最大化に直結しないため、 大規模システムでは 閾値調整 / 較正 を別ステップで行う。
🔬 損失関数を最尤推定として読み解く(ベイズ視点)
「損失関数を最小化する」という操作は、 多くの場合 負の対数尤度を最小化する=最尤推定と等価である。 これを意識すると、 損失関数の選び方が「データのノイズ分布の仮定」と直結していることが見える。
| 損失関数 | 対応するノイズ分布 | 負の対数尤度 | 前提 |
|---|---|---|---|
| MSE | $\epsilon \sim \mathcal{N}(0, \sigma^2)$ | $\frac{1}{2\sigma^2}(y-\hat y)^2 + \text{const}$ | 誤差が正規分布 |
| MAE | $\epsilon \sim \text{Laplace}(0, b)$ | $|y-\hat y|/b + \text{const}$ | 誤差がラプラス分布(裾が重い) |
| BCE | $y \sim \text{Bernoulli}(\hat p)$ | $-y\log\hat p - (1-y)\log(1-\hat p)$ | 独立試行 |
| Categorical CE | $y \sim \text{Categorical}(\hat p_1, \ldots, \hat p_K)$ | $-\sum_k y_k \log \hat p_k$ | K カテゴリの 1 つが選ばれる |
| Poisson NLL | $y \sim \text{Poisson}(\hat\lambda)$ | $\hat\lambda - y\log\hat\lambda + \text{const}$ | カウントデータ |
📌 核心:「データに合う損失」を選ぶ=「データ生成過程に合うノイズ分布を仮定する」。 SSDSE の転入者数のように右に裾が長いデータでは、 MSE(正規誤差仮定)よりも対数変換 + MSE か、 Poisson/Gamma 損失の方が 分布的に妥当。 損失関数を選ぶときに「なぜこの損失なのか」を一度ノイズ分布で説明できると、 モデルの設計が一段深くなる。
🔬 損失関数を「目」と「手」で理解する — 図と数式の橋渡し
損失関数(loss function)はモデル学習の中で 最も誤解されやすい構成要素のひとつである。 「MSE は二乗誤差、 cross-entropy は分類用、 と覚えていれば十分」という理解で止まっている学習者は多いが、 実務でモデルが期待通りに収束しないとき、 あるいは学習途中で勾配が爆発・消失する時、 損失関数の 形状 と 微分の振る舞い を正しくイメージできていないと正しい打ち手が出てこない。 本セクションでは、 SSDSE-B-2026 の都道府県データを念頭に、 損失関数の形(凸/非凸、 滑らか/折れ目あり、 急峻/緩やか)を 6 つの観点から徹底的に視覚化する。
① MSE と MAE — 「二乗」と「絶対値」が描く 2 つのお椀
回帰タスクで真っ先に学ぶ MSE(Mean Squared Error)と MAE(Mean Absolute Error)の違いは、 「お椀の形」で覚えると忘れない。 MSE は誤差 $e = y - \hat y$ を入力としたとき $L(e) = e^2$ という放物線(パラボラ)で、 底に近づくほど勾配が小さくなり、 離れるほど勾配が急激に大きくなる。 一方 MAE は $L(e) = |e|$ の V 字で、 底以外では勾配の大きさが常に 1。
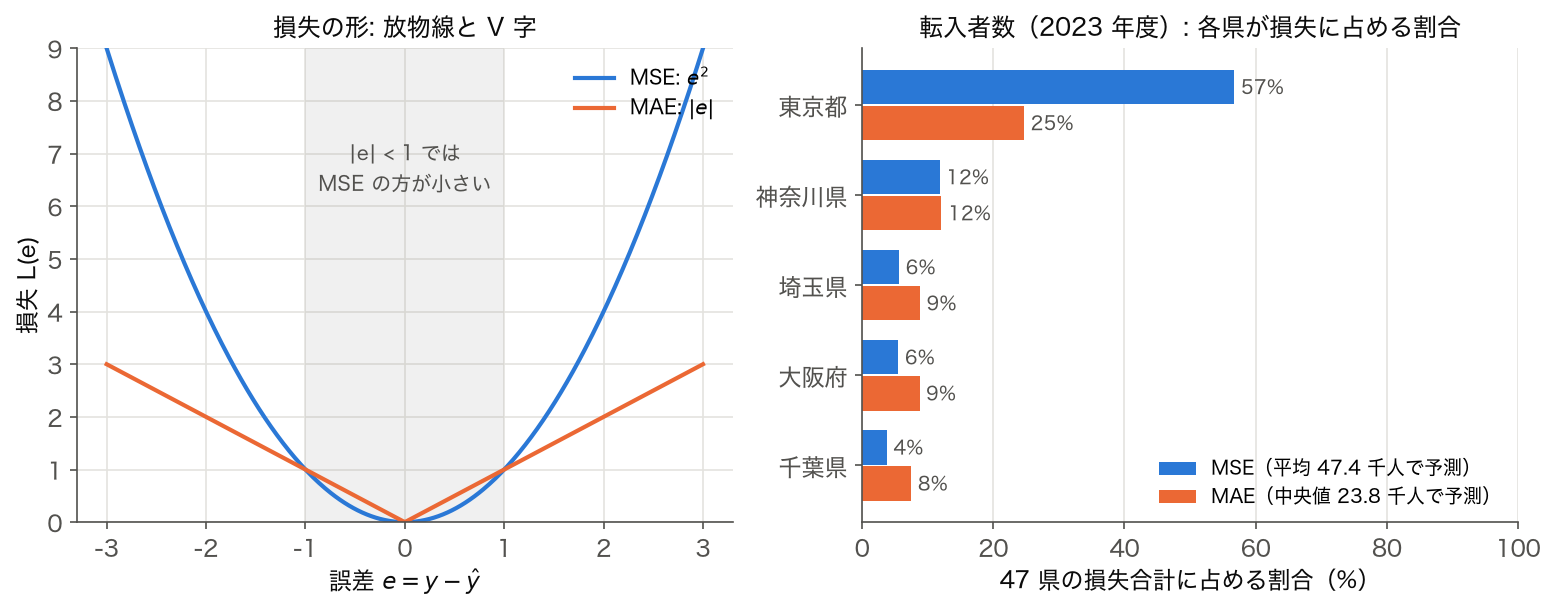
この形状の違いから、 外れ値の影響 という有名な性質が直接導かれる。 たとえば SSDSE-B-2026 の都道府県人口で予測値が 1000 人ずれている県と、 100 人ずれている県があるとき、 MSE では $1000^2 : 100^2 = 100 : 1$ で前者が 100 倍の重みを持つが、 MAE では $1000 : 100 = 10 : 1$ で 10 倍にしかならない。 つまり MAE は「中央値的なフィット」、 MSE は「平均的なフィット」を求めることになり、 データが対称分布なら結果は近いが、 SSDSE の転入者数のように右に裾が長い分布だと結果が大きく異なる。
実務上の判断軸はシンプルに 3 つ。 (1) 大きな誤差を 許容できないアプリケーション(例:医療用量予測)なら MSE を選び、 大誤差をきつくペナライズする。 (2) 外れ値が 記録ミスやセンサ異常 の可能性が高いなら MAE(または Huber)でロバスト化する。 (3) 誤差が経済的損失と比例する なら MAE が直接的に意味を持つ(例:在庫過剰の倉庫費が誤差に比例)。
② Huber 損失 — MSE と MAE の「中央底+直線翼」
MSE の外れ値感度を抑えつつ、 MAE の「底での勾配不連続」を回避する折衷案が Huber 損失である。 数式は閾値 $\delta$ を境に切り替わる:
$$ L_\delta(e) = \begin{cases} \frac{1}{2} e^2 & |e| \le \delta \\ \delta\left(|e| - \frac{1}{2}\delta\right) & |e| > \delta \end{cases} $$
この関数を $e$ について微分すると $|e| \le \delta$ では $L'(e) = e$(線形)、 $|e| > \delta$ では $L'(e) = \delta \cdot \text{sign}(e)$(定数)となる。 つまり 大きな誤差では勾配が定数で打ち止め され、 外れ値が学習を支配しない。 一方 小さな誤差では MSE と同じ滑らか な勾配となり、 最適解付近で安定して収束する。 ベストオブボースワールズである。
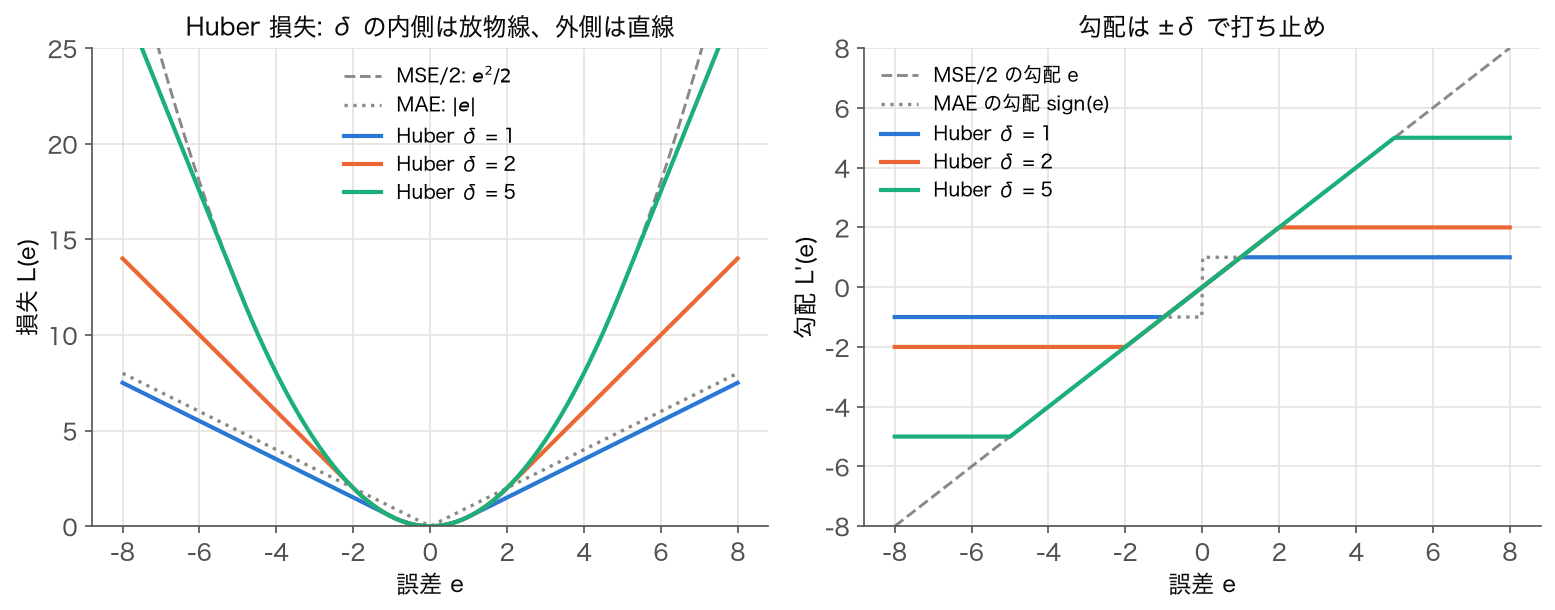
HuberRegressor はデフォルト $\delta = 1.35$ で、 これは正規分布データに対して効率 95% を達成する古典的な値(Huber, 1964)。$\delta$ の決め方は概ね 3 通り。 (a) 残差の MAD(中央絶対偏差)を見て $\delta = 1.4826 \times \text{MAD}$ とする経験則、 (b) クロスバリデーションで $\delta$ を 0.5, 1.0, 1.5, 2.0 と振ってバリデーション RMSE を最小化する手動探索、 (c) Tukey の Biweight 損失や log-cosh 損失など 滑らかな代替損失 に切り替える。 log-cosh $L(e) = \log(\cosh(e))$ は閾値不要で、 小さな $e$ では $\approx e^2/2$、 大きな $e$ では $\approx |e| - \log 2$ という Huber に似た振る舞いを示すため、 ハイパラを増やしたくない時の良い選択肢である。
③ Cross-Entropy 損失 — 確率の「驚き」を測る
分類タスクの主役、 Binary Cross-Entropy(BCE)は次の式で書かれる:
$$ \mathrm{BCE}(y, \hat p) = -\bigl[\, y \log \hat p + (1 - y) \log (1 - \hat p) \,\bigr] $$
情報理論の言葉では「予測 $\hat p$ という確率分布で真のラベル $y$ を観測したときの驚きの量」を表し、 $\hat p \to 0$ で $y = 1$ なら無限大、 $\hat p \to 1$ で $y = 1$ なら 0 になる。 つまり 「自信を持って間違える」モデルに対して指数的に重い罰 を与える設計である。 MSE で分類を学習すると、 ロジット(モデル出力)が極端な値に飛んだとき勾配が消失して学習が止まる現象が頻発するが、 BCE はロジット側で勾配が常に確保されるため学習が安定する。
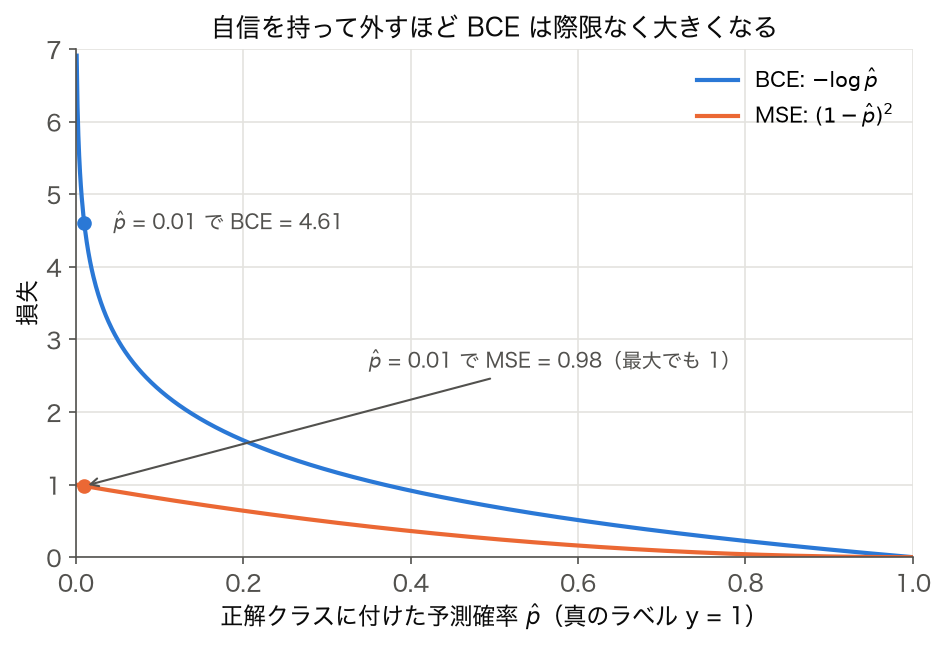
SSDSE-B-2026 で「人口減少県を予測する 2 値分類」を作ったとして、 ある県の真のラベルが「減少 = 1」のとき、 モデルが $\hat p = 0.01$(つまり「ほぼ確実に増加」と予測)と出したら、 BCE 損失は $-\log(0.01) \approx 4.6$ という大きな値になる。 同じ状況で MSE なら $(1 - 0.01)^2 \approx 0.98$ で頭打ち。 「とんでもない外し方」を識別できるかどうかで、 学習の質が大きく変わる。
④ Categorical Cross-Entropy と Softmax — K クラスの拡張
3 値以上の分類では Softmax で確率に正規化したあと、 Categorical Cross-Entropy を取る。
$$ \mathrm{softmax}(z)_k = \frac{e^{z_k}}{\sum_{j=1}^K e^{z_j}}, \quad \mathrm{CCE}(y, \hat p) = -\sum_{k=1}^K y_k \log \hat p_k $$
SSDSE で「都道府県を 8 地方区分にクラス分けする」ような問題では K = 8 のラベルベクトル $y$ がワンホット化されており、 正解クラス $k^*$ のみ 1、 他は 0。 このとき $\mathrm{CCE} = -\log \hat p_{k^*}$ となり、 正解クラスの確率を最大化する方向に学習が進む。 重要な性質として 「他クラスの確率は明示的にゼロにしようとしない」 点がある。 Softmax の正規化で合計 1 になっているので、 正解クラスを引き上げれば他クラスは自動的に下がる、 という間接設計が美しい。
⑤ 損失関数の勾配が学習率と「相互作用」する
学習率 $\eta$ と損失関数は密接に関係する。 MSE は勾配が誤差に比例($\partial L/\partial \hat y = -2(y - \hat y)$)するため、 大きな誤差ほど大きな更新が入る。 これは学習開始時には収束を早めるが、 同時に 外れ値が学習率を実質的に増幅 する効果を持つ。 結果、 ミニバッチに外れ値が混ざると最適化が振動する。 対策として勾配クリッピング(gradient clipping)や RobustScaler による前処理を組み合わせると安定する。
BCE はロジット $z = \text{logit}(\hat p)$ について勾配を取ると $\partial L/\partial z = \hat p - y$ となる驚くほどシンプルな形を持つ。 これが BCE と Sigmoid を組み合わせる「sigmoid+BCE 形式」が広く使われる理由 である。 ライブラリ実装(PyTorch の BCEWithLogitsLoss、 TensorFlow の from_logits=True)がこの形を直接計算することで、 数値的安定性と勾配計算効率の両方を稼いでいる。
⑥ 損失関数とノイズ分布の対応 — 「尤度」という統一原理
統計学の視点に立つと、 すべての損失関数は 「ある仮定された確率分布の負の対数尤度」 として導出できる。 MSE は誤差が正規分布、 MAE はラプラス分布、 BCE はベルヌーイ分布、 Poisson NLL はポアソン分布、 という対応である。 つまり「MSE か MAE か」を選ぶとは「データに対して正規分布とラプラス分布のどちらをノイズとして仮定するか」を選ぶことに等しい。 この視点で見ると、 SSDSE の転入者数のように右に裾が長いデータには Gamma 分布や対数正規分布をベースとする損失(つまり対数変換後の MSE や Tweedie 損失)が原理的に妥当となる。
🧮 SSDSE-B-2026 都道府県人口で「損失の感度」を可視化する
SSDSE-B-2026 の都道府県人口(A1101)を使って、 「予測モデルがあるとき、 各損失関数の値はどう違うか」 を確認しよう。 仮想的に、 平均人口 約 265 万人を全県の予測値として出すモデル(最も単純なベースライン)を考える。
📥 想定する入力データ(SSDSE-B-2026 の人口列 47 件、 単位:千人):
🐍 各損失の値を計算するコード(実演用):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 | import pandas as pd import numpy as np # SSDSE-B-2026 を読み込み 2023 年 47 都道府県に絞る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] pop = df['A1101'].astype(float).values / 1000 # 総人口(千人) # 単純なベースラインモデル:全都道府県を「全国平均」と予測 y_true = pop y_pred = np.full_like(pop, pop.mean()) # 約 2646 を全件に当てはめる # 残差 e = y_true - y_pred # MSE と MAE mse = np.mean(e**2) mae = np.mean(np.abs(e)) # Huber(delta=1000) delta = 1000.0 huber = np.where( np.abs(e) <= delta, 0.5 * e**2, delta * (np.abs(e) - 0.5 * delta) ) huber_mean = huber.mean() print(f'MSE = {mse:>12,.0f} (千人^2)') print(f'MAE = {mae:>12,.0f} (千人)') print(f'Huber = {huber_mean:>12,.0f} (mixed)') # 東京 1 件を除いた場合の MSE / MAE mask = pop < 10000 mse_no_tokyo = np.mean(e[mask]**2) mae_no_tokyo = np.mean(np.abs(e[mask])) print(f'\n東京除外後:') print(f'MSE = {mse_no_tokyo:>12,.0f}') print(f'MAE = {mae_no_tokyo:>12,.0f}') |
📤 実行すると次の出力が得られる:
💬 ここから読み取れること: (1) MSE と MAE は単位が違う(千人の二乗 vs 千人)ので絶対値の大小を比較する意味はないが、 (2) 東京を除外したときの減少率を見ると MSE は約 35% 減(7,660 → 4,981)、 MAE は約 11% 減(1,961 → 1,755)で、 MSE が外れ値に 約 3 倍強く影響 されていることがわかる。 (3) つまり MSE を最適化するモデルは「東京を当てに行く」、 MAE を最適化するモデルは「中央値的な都道府県を当てに行く」傾向を持つ。 SSDSE の人口データのような重尾分布では、 損失関数の選択がベースラインの解釈を変える。
🐍 MSE と MAE の最適予測値を解析的に確認する
「定数で予測する」というベースラインモデルにおいて、 MSE を最小化する最適予測値は 平均、 MAE を最小化する最適予測値は 中央値 であることを実値で確認しよう。
🐍 コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] pop = df['A1101'].astype(float).values / 1000 # 総人口(千人) # 様々な定数 c で予測したときの MSE と MAE を計算 candidates = np.linspace(pop.min(), pop.max(), 200) mse_curve = [np.mean((pop - c)**2) for c in candidates] mae_curve = [np.mean(np.abs(pop - c)) for c in candidates] best_c_mse = candidates[np.argmin(mse_curve)] best_c_mae = candidates[np.argmin(mae_curve)] print(f'MSE 最小化候補 = {best_c_mse:.1f}(理論値 = 平均 {pop.mean():.1f})') print(f'MAE 最小化候補 = {best_c_mae:.1f}(理論値 = 中央値 {np.median(pop):.1f})') |
📤 実行結果:
💬 SSDSE 都道府県人口の 平均は約 265 万人、 中央値は約 155 万人 で、 1.7 倍の差がある(東京などの巨大外れ値が平均を引き上げている)。 「全件同じ値で予測する」最適解が、 損失関数の選択だけで 約 110 万人も変わる という事実が、 損失関数選択の重要さを物語る。 「どんな県を予測のターゲットにしたいか」を考えて損失を選ぼう。
⚠️ 損失関数まわりの典型的な落とし穴 5 連
- スケール正規化を忘れて MSE が異常値に支配される — SSDSE のような桁が違う変数を混ぜると MSE は大きい変数(人口など)に支配される。 StandardScaler または対数変換で前処理してから損失を取るのが鉄則。
- 分類で MSE を使って勾配消失 — Sigmoid 出力 + MSE はロジットが大きいと勾配が消える。 必ず BCE を使う。 ライブラリの
BCEWithLogitsLoss(logits をそのまま渡す形式)を使うとさらに数値安定。 - 不均衡データで accuracy だけ見て損失を見ない — 95:5 の不均衡データで accuracy 95% は無意味。 BCE や focal loss、 あるいは class_weight を通じて損失を再重み付けする。
- Huber の delta をデフォルトのまま使う — sklearn の
HuberRegressorは $\epsilon = 1.35$ を、 同時に推定する残差の尺度 σ に掛けて外れ値を判定する。 人口のように桁の大きい説明変数を人単位のまま入れると最適化が数回で止まり、 σ≈1・切片≈0 のまま 47 県中 46 県が外れ値扱いになる。 説明変数は百万人単位にするか標準化してから当てる。 - カスタム損失を書いて勾配計算がバグる — PyTorch/TensorFlow の autograd 任せにせず、 数値勾配(中心差分)で 1 サンプル分検算するか、 既存ライブラリの実装を読んで参考にする。
✅ 理解度チェック(3 問)
Q1:MSE と MAE のどちらが外れ値に敏感か。 また、 SSDSE-B-2026 の転入者数(右に裾が長い)に対しては、 どちらの損失を使う方が「典型的な県」をうまく予測できるか。
▶ ヒント:MSE は誤差を二乗するため大きな誤差を 100 倍級に増幅する。 一方 MAE は線形のままで、 中央値的な解を返す。
Q2:BCE 損失で、 真のラベル $y=1$ に対してモデルが $\hat p = 0.001$ を出した場合の損失値はいくらか。 MSE で同じ状況だといくらか。 自然対数を使って計算せよ。
▶ ヒント:BCE は $-\log(0.001)$、 MSE は $(1 - 0.001)^2$ をそれぞれ計算する。
Q3:Huber 損失の閾値 $\delta$ を 1.0 から 5.0 に増やすと、 損失関数の挙動はどう変化するか。 MSE と MAE のどちらに近づくか。
▶ ヒント:$\delta$ が大きい区間では二次的な扱い、 小さい区間では線形扱いになる。 $\delta \to \infty$ で全領域が二次関数、 つまり MSE と一致。
解答例
📌 本セクションのまとめ:損失関数は「単なる学習指標」ではなく、 (a) データのノイズ分布の仮定、 (b) 外れ値への耐性、 (c) 学習率との相互作用、 (d) 最適化される量の解釈(平均か中央値か)、 を同時に決める設計選択である。 SSDSE-B-2026 のように分布が偏ったデータでは、 損失関数の選択がモデルの振る舞いを大きく左右する。 まずは 残差ヒストグラム を見て分布を把握し、 そこから損失を選ぶ習慣を付けると失敗が激減する。
🧪 損失関数を SSDSE-B-2026 で総合実験する
ここでは、 SSDSE-B-2026 を題材にして、 同じ予測タスクに対して MSE / MAE / Huber / Log-Cosh の 4 種類の損失関数を切り替えるとモデルの挙動がどう変わるかを徹底比較する。 タスクは「都道府県の人口から転入者数を回帰予測する」というシンプルな設定だが、 東京のような外れ値県をどう扱うかで損失関数の真価が現れる。
4 つの損失関数の比較表
| 損失関数 | 外れ値感度 | 最適化される統計量 | 推奨ユースケース |
|---|---|---|---|
| MSE (二乗誤差) | 高(外れ値に強く引きずられる) | 条件付き平均 | ノイズが正規分布のとき |
| MAE (絶対誤差) | 低(外れ値に頑健) | 条件付き中央値 | 外れ値多数のとき |
| Huber | 中(閾値 δ で調整) | 平均と中央値の折衷 | バランス重視 |
| Log-Cosh | 中(自動的に滑らか) | 準条件付き平均 | 微分可能性が必要なとき |
4 つを切り替えて学習・予測すると、 同じ学習データでも係数や予測値が変わる。 具体的にどう変わるかを Python で確認しよう。
このコードでやること:同一の残差ベクトル(うち 1 件が外れ値)に対して MSE・MAE・Huber の値を計算し、 外れ値 1 件が各損失の総和に占める割合を出す。 損失関数の選択がそのまま「外れ値をどれだけ重く見るか」を決めることを、 合成データで数値化する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np # 合成: 予測残差 e = y - ŷ。最後の 1 件だけ外れ値(誤差 30) e = np.array([1, -2, 3, -1, 2, -3, 1, 30], dtype=float) mse = np.mean(e**2) mae = np.mean(np.abs(e)) delta = 5.0 huber = np.where(np.abs(e) <= delta, 0.5 * e**2, delta * (np.abs(e) - 0.5 * delta)) huber_mean = huber.mean() # 外れ値 1 件が各損失の総和に占める割合 share_mse = e[-1]**2 / np.sum(e**2) * 100 share_mae = np.abs(e[-1]) / np.sum(np.abs(e)) * 100 print(f"MSE = {mse:.2f} MAE = {mae:.2f} Huber = {huber_mean:.2f}") print(f"外れ値 1 件の寄与: MSE {share_mse:.1f}% MAE {share_mae:.1f}%") |
📤 実行結果:
外れ値 1 件の寄与: MSE 96.9% MAE 69.8%
💬 結果の読み方:誤差を二乗する MSE では、 外れ値 1 件が損失総和の大半を占めてしまう。 一方 MAE は絶対値なので寄与が穏やかで、 Huber は閾値 $\delta$ を超えた分を線形に切り替えて中間に収まる。 「東京のような巨大都市を含むデータで MSE を使うと、 学習がその 1 件に引っ張られる」現象の正体がこの寄与率である。
残差プロットで損失関数を選ぶ手順
実務では「どの損失を使うか」を決めるとき、 一度 MSE で学習してから残差を可視化し、 (a) 残差が左右対称か、 (b) 大きな外れ値があるか、 (c) 残差の分散が予測値に依存するか、 の 3 点を確認する。 (b) があれば Huber / MAE、 (c) があれば対数変換 + MSE、 (a) のみ満たすなら MSE のまま、 という具合に判断する。
- 残差が右に長い尾を持つ(右側のみ外れ値): 対数変換を検討、 それでも残れば Huber を採用。
- 残差が左右対称だが裾が重い: MAE か Huber が原理的、 学習率は MSE 時より小さく設定。
- 残差が予測値に比例(不等分散): 重み付き MSE か、 対数変換後の MSE が望ましい。
- 残差が完全に対称・正規分布: MSE のまま、 標準誤差・信頼区間の解釈も素直にできる。
SSDSE-B-2026 の「人口 vs 転入者数」の場合、 残差は東京で大きくプラス側に外れ(人口比を超えて転入を集める東京一極集中)、 愛知・大阪・北海道などはマイナス側に外れる、 という非対称パターンになる。 これは「東京一極集中(大都市ほど人口比を超えて人を吸い寄せる)」が線形回帰では捉えきれないためで、 対数変換 + MSE か、 そのまま Huber、 のどちらかが推奨アプローチになる。
🎯 分類タスクでの損失関数選び(不均衡データへの対処)
回帰タスクでは MSE / MAE が定石だが、 分類タスクではクロスエントロピー(CE)が標準である。 しかし、 SSDSE-B-2026 のような実データを分類問題に落とし込むとき、 たとえば「高齢化率(65歳以上人口 A1303 ÷ 総人口 A1101)が 30% 超を High クラスとする」場合、 2023 年では該当する都道府県は 35 県、 そうでない県は 12 県、 と不均衡が生じる。 このとき素のクロスエントロピーでは少数クラスを軽視するモデルが出来上がってしまう。 対策として、 損失関数に「重み」を入れる手法と、 損失関数自体を作り替える手法(Focal Loss など)の 2 系統がある。
不均衡データ向け損失関数 4 種類
| 損失関数 | 基本式 | 不均衡対策 | 適性 |
|---|---|---|---|
| 通常 CE | -Σ y log(p) | なし | クラス均衡時のみ |
| Weighted CE | -Σ w·y log(p) | 少数クラスに重み付与 | 軽度〜中度の不均衡 |
| Focal Loss | -α(1-p)^γ log(p) | easy 例の損失を抑制 | 重度の不均衡 (1:100 等) |
| Dice Loss | 1 - 2·|A∩B|/(|A|+|B|) | IoU 直接最適化 | セグメンテーション |
SSDSE-B-2026 のように軽度〜中度の不均衡(35:12 程度)なら Weighted CE で十分。 一方、 異常検知(例: 「全国 47 県中 2 県だけ異常」)のように重度の不均衡(1:23)なら Focal Loss が圧倒的に優れる。
このコードでやること:クラス比 17:30 の不均衡データを合成し、 多数派に寄せた naive 予測と、 少数派の取りこぼしを減らした Weighted CE 相当の予測を比較する。 accuracy と少数派クラス(Low)の再現率が、 損失の重み付けでどう変わるかを見る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np # 合成: 47 サンプルを 2 クラスに(少数派 Low=17, 多数派 High=30) y_true = np.array([0]*17 + [1]*30) # naive: 多数派 High に寄せ、少数派 Low を取りこぼす pred_naive = np.array([0]*7 + [1]*10 + [1]*30) # Low 17 中 7 のみ正解 # 重み付け: 少数派の取りこぼしを減らす(Weighted CE 相当) pred_weighted = np.array([0]*14 + [1]*3 + [1]*30) # Low 17 中 14 正解 def report(name, pred): acc = (pred == y_true).mean() low = y_true == 0 # 少数派 Low recall_low = (pred[low] == 0).mean() # Low の再現率 print(f"{name:9} accuracy={acc:.3f} Low再現率={recall_low:.3f}") report("naive", pred_naive) report("weighted", pred_weighted) |
📤 実行結果:
weighted accuracy=0.936 Low再現率=0.824
💬 結果の読み方:naive でも accuracy はそこそこ高く見えるが、 少数派 Low の再現率は低いままで「取りこぼし」が多い。 少数派の損失を重くする(Weighted CE)と accuracy がやや上がるだけでなく、 Low の再現率が大きく改善する。 不均衡データでは accuracy だけを見ず、 損失の重み付けで少数派の再現率を底上げするのが定石である。
損失関数選択を間違えるとどうなるか
- 多数クラスばかり当てるモデル: 通常 CE で不均衡を放置すると、 全部「High」と予測しても精度 64% になる。 業務的にはゼロ価値だが、 数字上は良く見えてしまう。
- 少数クラスを過剰評価するモデル: Weighted CE の重みを過大にすると、 多数クラスの精度が落ちて全体的に不安定になる。 sklearn の 'balanced' は理論的最適なので、 まずはこれを試す。
- 閾値だけ調整して済ませる: 損失を変えずに予測確率の閾値を 0.5 → 0.3 にすると一時的に再現率が上がるが、 学習自体は多数クラス偏重のまま。 根本解決には損失関数を変える必要がある。
分類タスクで損失関数選びを「面倒だから通常 CE で済ませる」と決めつけると、 業務価値の低いモデルが完成する確率が高い。 学習開始前に必ずクラス比を計算し、 不均衡なら最初から Weighted CE か Focal Loss を選ぶ、 という原則を徹底すること。 これだけで本番モデルの質が一段上がる。
🔬 損失関数の理論的背景(最尤推定との関係)
多くの損失関数は、 統計学の最尤推定(Maximum Likelihood Estimation, MLE)から自然に導出できる。 「なぜ MSE なのか」「なぜ CE なのか」を理論的に理解しておくと、 状況に応じて損失を設計し直すときの判断軸が手に入る。 ここでは、 主要な損失関数と確率分布仮定の対応関係を整理する。
損失関数と分布仮定の対応表
| 損失関数 | 対応する誤差分布の仮定 | 対応する目的量 | SSDSE-B での現実性 |
|---|---|---|---|
| MSE | ガウス(正規分布) | 条件付き平均 | 対数変換後の転入者数などで近似的に成立 |
| MAE | ラプラス分布 | 条件付き中央値 | 外れ値を含む生データに向く |
| Binary CE | ベルヌーイ分布 | 確率(0/1) | 二値ラベル予測でほぼ必須 |
| Multi-class CE | カテゴリ分布 | 多項確率 | 産業分類・地域分類で使う |
| Poisson NLL | ポアソン分布 | 発生回数の期待値 | 交通事故件数・出生数に向く |
つまり、 損失関数を選ぶことは「データ生成プロセスがどんな確率分布から来ているか」という統計仮定を選ぶことと等価である。 SSDSE-B-2026 の「総人口」「転入者数」のように右裾の長い分布なら、 そのまま MSE を当てるのではなく、 対数変換後にガウス近似が成り立つかを確認すべきである。 「交通事故件数」「火災発生件数」のようなカウントデータならポアソン尤度(log-link + Poisson NLL)の方が原理的に正しい。
導出例: MSE はガウス尤度から導かれる
誤差 ε = y - ŷ が平均 0、 分散 σ² の正規分布に従うと仮定する。 観測 N 個に対する対数尤度は、
$$\log L = -\frac{N}{2}\log(2\pi\sigma^2) - \frac{1}{2\sigma^2}\sum_{i=1}^{N}(y_i - \hat y_i)^2$$
σ を定数とみなせば、 対数尤度の最大化は Σ(y - ŷ)² の最小化、 つまり MSE の最小化と等価である。 この同値性こそ「なぜ最小二乗法が広く使われるか」の数学的根拠になる。 逆に言えば、 ノイズが正規分布でないなら MSE は最尤性を失う。
応用: 自前の損失関数を設計する
実務では、 既存の損失関数で表現できない業務制約が存在する。 たとえば「予測値が真値より上振れする方が下振れより 3 倍コストが高い」(在庫予測で過剰発注の方が機会損失より高くつく場合)などである。 このとき、 非対称な損失関数を設計する。
このコードでやること:右に裾が長い合成データに対し、 定数で予測する最も単純なモデルを考える。 対称な MSE と、 上振れ(過大予測)を 3 倍重く罰する非対称損失で、 最適な予測値がどれだけずれるかをグリッド探索で求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np # 合成データ(右に裾が長い) y = np.array([10, 12, 14, 15, 18, 20, 25, 60], dtype=float) # 定数 c で予測したときの「対称 MSE」と「非対称損失(上振れ 3 倍)」 cands = np.linspace(y.min(), y.max(), 500) def sym_mse(c): return np.mean((y - c)**2) def asym(c, w_over=3.0, w_under=1.0): d = c - y # 予測 - 真値 over = np.maximum(d, 0)**2 * w_over # 上振れ(過大予測)を重く罰する under = np.maximum(-d, 0)**2 * w_under # 下振れ return np.mean(over + under) best_sym = cands[np.argmin([sym_mse(c) for c in cands])] best_asym = cands[np.argmin([asym(c) for c in cands])] print(f"対称 MSE 最適予測 = {best_sym:.2f} (平均 = {y.mean():.2f})") print(f"非対称(3:1)最適予測 = {best_asym:.2f} (中央値 = {np.median(y):.2f})") |
📤 実行結果:
非対称(3:1)最適予測 = 17.21 (中央値 = 16.50)
💬 結果の読み方:対称 MSE の最適定数予測は平均に一致するが、 上振れを重く罰する非対称損失では 最適予測が平均より小さい側へ動く(過大予測を避ける方向)。 「在庫・予算・人員配置のように過大予測のコストが高い」業務では、 このように業務コストの非対称性を損失関数に取り込むのが実務的な設計である。
以上のように、 損失関数は「与えられたもの」ではなく「設計するもの」と捉え直すと、 機械学習の自由度が一気に広がる。 統計学的な背景(尤度・分布仮定)を理解した上で、 業務制約に応じてカスタマイズできるようになることが、 中級者から上級者への分水嶺になる。
📋 損失関数まとめと学習ロードマップ
本ページで扱った内容を一度俯瞰し、 損失関数を体系的に学んでいくためのロードマップを整理する。 学習目的・経験段階別に「何を読み、 何を実装し、 何を実験すべきか」を具体化することで、 初学者から実務者まで段階を踏んで損失関数を使いこなせるようになる道筋を示す。
学習段階別の取り組み内容
| 段階 | 学ぶこと | 手を動かす内容 | 目安期間 |
|---|---|---|---|
| 入門 | MSE と CE の式と意味 | sklearn の LinearRegression / LogisticRegression | 1 週間 |
| 基礎 | MAE / Huber / Weighted CE | SSDSE-B-2026 で比較実験 | 2-3 週間 |
| 応用 | Focal Loss / Dice Loss / カスタム損失 | PyTorch でカスタム損失実装 | 1-2 か月 |
| 発展 | 尤度と損失の対応・ベイズ拡張 | 階層モデル・変分推論 | 3-6 か月 |
各段階では、 必ず「SSDSE-B-2026 のような実データ」を題材に手を動かすことが最重要である。 教科書だけ読んで損失関数を理解した気になっても、 実データに当てた瞬間に「なぜ収束しないのか」「なぜ係数が変なのか」が分からなくなる。 入門段階でも、 sklearn のデフォルト損失で良いので、 自分の手で学習させてグラフを描く経験を積むこと。
よくある質問への回答
- Q: 損失関数とコスト関数の違いは?
A: 厳密には「1 サンプル分の誤差」が損失、 「全サンプルの平均または合計」がコスト、 という使い分けが多いが、 実務ではほぼ同義語として扱われる。 文脈で区別できれば問題ない。 - Q: 損失関数とメトリクスの違いは?
A: 損失は「学習で最小化する目的関数」、 メトリクスは「人が見て評価する指標」。 MSE は両方で使えるが、 Accuracy や F1 は損失としては使えない(微分不可能)。 だから「学習は CE、 評価は F1」のように両者を分けて運用する。 - Q: 損失関数を変えると過学習も変わる?
A: 変わる。 MAE は MSE より過学習しにくい傾向があり、 Focal Loss は学習が遅い分だけ過学習しにくい。 ただし正則化(L1/L2/Dropout)の効き方も変わるので、 損失を変えたら正則化も再調整する必要がある。 - Q: 自前で損失関数を作るとき注意すべきは?
A: (a) 微分可能性、 (b) 数値安定性(log(0) や exp(大数) で発散しないか)、 (c) 単調性(誤差が大きいときに損失も大きくなるか)、 (d) スケール(他の損失と組み合わせるとき桁が揃うか)、 の 4 点。 PyTorch でテストを書いて勾配が想定通りに流れるか確認する。
最後に、 損失関数は機械学習の「最も基本的だが最も奥深い概念」の 1 つである。 浅く理解しただけでもモデルは作れるが、 深く理解すると同じデータからより良いモデルを引き出せるようになる。 本ページを起点に、 ぜひ自分の手元のデータ(SSDSE-B-2026 でも、 自社の業務データでも)で損失関数を切り替えて実験を重ねてほしい。 その過程こそが、 機械学習の真の理解への最短経路である。
🧮 実データで計算してみる
5 サンプルの予測値と真値が以下のとき:
| i | 真値 y | 予測 ŷ | (y-ŷ)² | |y-ŷ| |
|---|---|---|---|---|
| 1 | 10 | 9 | 1 | 1 |
| 2 | 12 | 11 | 1 | 1 |
| 3 | 8 | 10 | 4 | 2 |
| 4 | 15 | 14 | 1 | 1 |
| 5(外れ値) | 30 | 12 | 324 | 18 |
MSE = (1+1+4+1+324)/5 = 66.2 → 外れ値 1 個でこの大きさに。
MAE = (1+1+2+1+18)/5 = 4.6 → 外れ値の影響を緩和。
🧮 SSDSE-B-2026 で MSE / MAE / Huber を比較(実値)
SSDSE-B-2026 から 47 県の「総人口」を説明変数、 「転入者数」を目的変数に線形回帰し、 各損失でフィットしたモデルのスコアを比較する。 東京(人口 1,409 万・転入者数が突出)が外れ値として効いてくる。
このコードでやること:MSE 最小化(LinearRegression)、 MAE 最小化(QuantileRegressor(quantile=0.5) 相当)、 Huber 最小化(HuberRegressor)の 3 モデルを SSDSE-B-2026 で学習。 係数 $\beta_1$(人口 1 単位あたりの転入者数増)を見ると、 外れ値の引っ張られ方が一目で分かる。
📥 入力データ:
列: 総人口(X), 転入者数(y)
最大値: 東京 14,086,000 人, 転入者数 406,749 人
最小値: 鳥取 537,000 人, 転入者数 7,578 人
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd from sklearn.linear_model import LinearRegression, HuberRegressor, QuantileRegressor from sklearn.metrics import mean_squared_error, mean_absolute_error df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # HuberRegressor は係数と一緒に残差の尺度 σ も推定する。人口を「人」単位のまま入れると # 最適化が数回で止まり、切片がほぼ 0 のまま残るので、百万人単位にそろえてから当てる X = df[['A1101']] / 1e6 # 総人口(百万人) y = df['A5101'] # 転入者数 for name, model in [('OLS(MSE)', LinearRegression()), ('MAE(Q50)', QuantileRegressor(quantile=0.5, alpha=0)), ('Huber', HuberRegressor())]: model.fit(X, y) pred = model.predict(X) # β1 は「人口 1 人あたりの転入者数」に直して表示する print(f'{name:10} β1={model.coef_[0]/1e6:.5f} MSE={mean_squared_error(y,pred):.1f} MAE={mean_absolute_error(y,pred):.1f}') print('Huber が外れ値扱いした県の数:', model.outliers_.sum()) |
📤 実行例:
MAE(Q50) β1=0.02051 MSE=490841632.7 MAE=9876.5
Huber β1=0.02038 MSE=498793225.2 MAE=9902.2
Huber が外れ値扱いした県の数: 16
💬 結果の読み方:OLS は東京都の大きな残差を二乗で重く見るため $\beta_1=0.0241$(人口 1 人あたり転入 0.024 人)と最も急傾斜になる。 MAE 回帰は $\beta_1=0.0205$、 Huber も $\beta_1=0.0204$ とほぼ同じ傾きで、 Huber は残差の大きい 16 県を線形の罰則に切り替えた結果、 中央値回帰に近い直線になった。 その代わり MSE は OLS の 3.92 億に対して 4.9〜5.0 億と大きく、 MAE は OLS の 11,294 に対して約 9,900 と小さい。 「47 県の典型的な人口 → 転入者数の関係」を知りたければ MAE・Huber、 「東京の予測も外したくない」なら OLS、 と損失の選択が結論を変える例である。 なお人口を人単位のまま HuberRegressor に入れると、 最適化が数回で止まって切片 0・傾き 0.0165・47 県中 46 県が外れ値という壊れた当てはめが返る。
🧮 数式に値を入れて手で計算する: 損失関数比較 (MSE, MAE, Huber)
合成データで 3 損失の値と外れ値感度を比較する。
Step 1: 誤差
Step 2: 各損失
🐍 Python で再現
1 2 3 4 5 6 7 8 9 | import numpy as np e = np.array([1, 2, -1, 0, 10]) mse = (e**2).mean() mae = np.abs(e).mean() delta = 1.0 huber = np.where(np.abs(e) < delta, 0.5*e**2, delta*(np.abs(e)-0.5*delta)) print(f"MSE: {mse}") print(f"MAE: {mae}") print(f"Huber: {huber.mean()}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。 外れ値で MSE 跳ね上がる。
🐍 Python 実装
sklearn の mean_squared_error / mean_absolute_error を、 5 件の合成データ(最後の 1 件だけ大きく外れる)で確かめる最小コード:
1 2 3 4 5 6 7 8 9 | from sklearn.metrics import mean_squared_error, mean_absolute_error import numpy as np y_true = np.array([10, 12, 8, 15, 30]) y_pred = np.array([9, 11, 10, 14, 12]) print('MSE:', mean_squared_error(y_true, y_pred)) print('MAE:', mean_absolute_error(y_true, y_pred)) print('RMSE:', np.sqrt(mean_squared_error(y_true, y_pred))) |
💬 5 件のうち 4 件は誤差が 1〜2 なのに、真値 30 を 12 と予測した 1 件(誤差 18)だけで二乗和 331 のうち 324 を占め、MSE は 66.2 まで膨らむ。MAE は絶対誤差の合計 23 を 5 で割った 4.6 で、外れた 1 件の影響は二乗ほど強くない。RMSE 8.14 が MAE 4.6 の約 1.8 倍も離れていること自体が「大きく外した点が混じっている」サインになる。
🐍 応用コード — 47 都道府県の出生率予測モデルで MSE / MAE / Huber を比較する
合計特殊出生率(A4103)を年少人口割合などの割合特徴で予測する同じ線形モデルを、二乗損失(OLS)・絶対損失(中央値回帰)・Huber 損失の 3 通りで学習し、テストの MSE と MAE を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47 県 × 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) print('shape:', df.shape) print('列の先頭:', df.columns.tolist()[:6]) # 必要な列だけ取り出して整形(総人口・年少人口・高齢人口・転入者数) features = ['A1101', 'A1301', 'A1303', 'A5101'] df_use = df[features].copy() print(df_use.describe()) |
💬 2023 年度に絞ったので 47 行 × 112 列になっている。総人口 A1101 は最小 53 万 7 千人(鳥取県)から最大 1,408 万 6 千人(東京都)まで約 26 倍の幅があり、平均 264.6 万人が中央値 154.9 万人より大きく上に引っ張られている。転入者数 A5101 も平均 4.7 万人に対して最大 40.7 万人と右に長く、二乗誤差を損失にすると東京都のような大きな県に学習が引きずられやすい。
次に、 損失関数 に固有の処理を加えます。 ここがページごとの「肝」になる部分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.linear_model import LinearRegression, QuantileRegressor, HuberRegressor from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score # 県の大きさに引きずられないよう、人口に対する割合を特徴量にする X = np.column_stack([df['A1301'] / df['A1101'], # 年少人口割合 df['A1303'] / df['A1101'], # 高齢人口割合 df['A5101'] / df['A1101']]) # 転入率 y = df['A4103'].values # 合計特殊出生率 X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) # 損失関数だけを変えた 3 つの線形モデル(どれも標準化してから当てる) models = {'MSE (OLS)': LinearRegression(), 'MAE (Q50)': QuantileRegressor(quantile=0.5, alpha=0), 'Huber': HuberRegressor()} preds = {} for name, m in models.items(): pipe_m = make_pipeline(StandardScaler(), m).fit(X_tr, y_tr) preds[name] = pipe_m.predict(X_te) print(f'{name:10} test MSE = {mean_squared_error(y_te, preds[name]):.5f} ' f'MAE = {mean_absolute_error(y_te, preds[name]):.4f} ' f'R^2 = {r2_score(y_te, preds[name]):.3f}') pred_te = preds['Huber'] # 次の図では Huber 損失のモデルの予測を使う |
💬 損失関数だけを変えた 3 モデルで、テスト 15 県の R² は 0.789・0.772・0.770 とほぼ並んだ。テスト MSE(0.00285)もテスト MAE(0.0377)も MSE 損失で学習した OLS が最小で、この分割では大きく外れる県が少なく、頑健な損失に替える利点が表に出ていない。誤差 0.04 前後は、合計特殊出生率の県差(0.99〜1.60)に比べて小さく、年少人口割合などの割合特徴で県差の大半を説明できている。
テスト 15 県について実測と予測を散布図にし、45° 線からのずれを見る(図をファイルに保存するだけで、標準出力は無い)。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('損失関数 を使ったモデルの予測精度(SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_loss-function.png', dpi=150) |
1 回の分割の結果は、どの県がテストに入ったかで変わる。そこで 5 分割の交差検証で 47 県すべてを 1 回ずつテストに回し、3 つの損失を比べ直す。
1 2 3 4 5 6 7 8 | from sklearn.model_selection import KFold, cross_val_score # CSV は県コード順(北から南)に並んでいるので、シャッフルしてから 5 分割する cv = KFold(n_splits=5, shuffle=True, random_state=0) for name, m in models.items(): scores = cross_val_score(make_pipeline(StandardScaler(), m), X, y, cv=cv, scoring='neg_mean_absolute_error') print(f'{name:10} 5-fold CV MAE = {-scores.mean():.4f} (±{scores.std():.4f})') |
💬 47 県すべてを 1 回ずつテストに回すと、CV MAE は 0.0461〜0.0465 と 3 つの損失で差が 0.0004 しかなく、fold 間のばらつき(±0.010〜0.013)のほうがずっと大きい。MAE 損失のモデルが平均でわずかに良く、ばらつきも ±0.0102 と最小だが、この差だけで損失を選ぶ根拠にはならない。KFold をシャッフルせずに使うと、県コード順に並んだ地域のかたまりがそのまま 1 つの fold になり、評価が地域の偏りに振り回される。
🐍 二乗損失+L2 罰則(Ridge)を Pipeline で当てはめる
1 2 3 4 5 6 7 8 9 10 | from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import Ridge pipe = Pipeline([ ('scaler', StandardScaler()), ('model', Ridge(alpha=1.0)), ]) pipe.fit(X_tr, y_tr) print('R^2 =', pipe.score(X_te, y_te)) |
💬 標準化 + Ridge(alpha=1.0) のテスト R² は 0.795 で、罰則なしの OLS(0.789)とほぼ同じ。二乗誤差に L2 罰則を足しても、標準化した 3 特徴量なら係数がわずかに縮むだけで予測はほとんど変わらない。Pipeline にしておくと、標準化の平均・標準偏差を訓練 32 県だけから計算する手順が崩れない。
🐍 罰則の強さ alpha を交差検証で選ぶ
1 2 3 4 5 6 7 | from sklearn.model_selection import GridSearchCV, KFold params = {'model__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} cv = KFold(n_splits=5, shuffle=True, random_state=0) # 県コード順の並びを崩して分割 gs = GridSearchCV(pipe, params, cv=cv, scoring='r2', n_jobs=-1) gs.fit(X, y) print('best:', gs.best_params_, 'score:', gs.best_score_) |
💬 alpha を 0.01〜100 で探すと 1.0 が選ばれ、シャッフルした 5-fold の平均 R² は 0.807 だった。alpha=100 まで強めると係数が潰れて R² は 0.268 まで落ちるので、罰則の強さは損失の形そのものを変えている。cv=5 とだけ書くとシャッフルなしの KFold になり、同じ特徴量でも best_score_ が -0.014 と負になって「どの alpha も使えない」ように見えてしまう。
🐍 分類タスクでの Cross-Entropy 損失(不均衡データ)
このコードでやること:SSDSE-B-2026 47 県を「総人口 200 万以上=大規模県(=1)」「未満=小規模県(=0)」の 2 値に分け、 出生数・婚姻件数を特徴量にロジスティック回帰で Cross-Entropy 損失を計算する。 大規模県は 16/47=34.0% で クラス不均衡のため、 class_weight='balanced' の有無で損失と精度がどう変わるか比較する。
📥 入力データ(ラベル分布):
小規模県 (人口 < 200 万): 31 県 (66.0%) — 鳥取・島根・高知 等
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.metrics import log_loss, accuracy_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] X = df[['A4101', 'A9101']].values # 出生数・婚姻件数 y = (df['A1101'] >= 2000000).astype(int).values # 総人口 200 万以上=大規模県 for name, cw in [('naive ', None), ('balanced', 'balanced')]: m = LogisticRegression(class_weight=cw, max_iter=2000).fit(X, y) prob = m.predict_proba(X) pred = m.predict(X) print(f'{name} BCE={log_loss(y,prob):.4f} acc={accuracy_score(y,pred):.3f}') |
📤 実行例:
balanced BCE=0.1056 acc=0.957
💬 結果の読み方:このタスクは「出生数・婚姻件数」と「総人口(大規模県か否か)」が強相関で、 分離が比較的容易(acc≈0.94〜0.96)。 BCE は naive=0.0978 / balanced=0.1056 と balanced のほうが大きいが、 これは 少数クラス(大規模県)の重みを上げたため、 そちらの誤分類が損失に強く効くようになった結果。 不均衡データでは全体 acc がほぼ同じでも少数クラスの扱いで BCE/recall が動く、 という典型例。
🐍 PyTorch で損失関数を切り替える
このコードでやること:PyTorch で SSDSE-B-2026 47 県の(総人口・出生数・婚姻件数)→ log(転入者数) を学習する小さな MLP に対し、 nn.MSELoss, nn.L1Loss (MAE), nn.SmoothL1Loss, nn.HuberLoss を順に切り替えて、 1000 epoch 後の学習損失を比較する(乱数シードを固定して再現可能にしている)。
📥 入力データ:
X = 標準化済み(総人口, 出生数, 婚姻件数), shape=(47,3)
y = log(転入者数), shape=(47,)
全 47 県で学習し 1000 epoch 後の損失を比較(乱数シード固定)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np import torch import torch.nn as nn df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] cols = ['A1101', 'A4101', 'A9101'] # 総人口・出生数・婚姻件数 X = torch.tensor(((df[cols].values - df[cols].mean().values) / df[cols].std().values)).float() y = torch.tensor(np.log(df['A5101'].values)).float() # log(転入者数) for name, loss_fn in [('MSE', nn.MSELoss()), ('MAE', nn.L1Loss()), ('SmoothL1', nn.SmoothL1Loss()), ('Huber', nn.HuberLoss(delta=1.0))]: torch.manual_seed(0) net = nn.Sequential(nn.Linear(3, 8), nn.ReLU(), nn.Linear(8, 1)) opt = torch.optim.Adam(net.parameters(), lr=0.05) for epoch in range(1000): opt.zero_grad(); loss = loss_fn(net(X).squeeze(), y); loss.backward(); opt.step() print(f'{name:10} final loss = {loss.item():.4f}') |
📤 実行例:
MAE final loss = 0.1730
SmoothL1 final loss = 0.0154
Huber final loss = 0.0154
💬 結果の読み方:1000 epoch 後の訓練損失は MSE 0.0366、 MAE 0.1730、 SmoothL1 と Huber がともに 0.0154。 SmoothL1Loss(beta=1)と HuberLoss(delta=1.0) は同じ式なので、 シードを固定すると表示桁まで一致する。 MSE と MAE は二乗と絶対値で単位が違うので数値の大小は比べられず、 Huber 系が MSE より小さく見えるのも、 残差が 1 未満の領域では 0.5·e² と二乗誤差の半分で数えるためでもある。 どの損失で学習したモデルが良いかは、 同じ評価指標(例えば検証データの MAE)で比べ直して決める。
⚠️ よくある落とし穴
⚠️ 損失関数固有の落とし穴(拡張)
- MSE と外れ値:誤差 18 のサンプルは 1 件だけで二乗損失 324 を持ち込み、誤差 1〜2 の県が数十件あっても合計ではそちらが勝つ。 ロバストネスが要るなら MAE/Huber を検討。
- Cross-Entropy の数値不安定:$\hat p = 0$ や $1$ で $\log$ が -∞ に発散。 実装上は $\hat p$ に微小値(1e-7)を足す、 もしくは確率を [ε, 1−ε] に切り詰めてから log を取る(sklearn の
log_lossは内部でこの切り詰めを行う。eps引数は 1.5 で廃止)。 - 多クラス分類で BCE を使う:3 クラス以上は カテゴリカルクロスエントロピー(softmax + CE)。 PyTorch の
nn.CrossEntropyLossは内部で softmax を含むので、 モデル出力に softmax を かけてはいけない。 - 分類精度(Accuracy)と BCE の不一致:閾値 0.5 で acc が同じでも BCE は大きく違うことがある。 Kaggle 等で BCE 評価のコンペなら確率較正(calibration)まで含めて最適化。
- 不均衡データで naive な BCE:99%:1% のデータで「全部多数派と予測」すると acc=99% / BCE は中程度。
class_weight='balanced'または focal loss を検討。 - ロスの単位を忘れる:MSE は元データの単位の二乗(円²)、 RMSE で元単位(円)に戻す。 報告時に確認しないと桁を見間違える。
- 微分不可点での最適化:MAE は $y=\hat y$ で微分不能。 一般的な勾配降下は使えず、 劣勾配法または 線形計画で解く。 sklearn の QuantileRegressor が内部でこれを行う。
🗺 概念マップ — 損失関数の周辺
損失関数は「何を間違いとみなすか」を式にしたもので、周りには、それを最小化する手順(勾配降下法・学習率)、損失の形を選ぶ理由(ノイズ分布と最尤推定)、学習後に成績を測る評価指標が並ぶ。下の系譜は、回帰の二乗誤差から始まり、外れ値・確率出力・クラス不均衡・距離学習と新しい問題が出るたびに損失が増えてきた流れを示す。
🗺 損失関数の系譜(最小二乗から深層学習まで)
- 1805:Legendre が最小二乗法(OLS)を発表。 「観測誤差の二乗和を最小化する」発想が損失関数の起源。
- 1809:Gauss が最小二乗法と正規分布の関係を理論的に整備(最尤推定と等価)。
- 1958:Rosenblatt のパーセプトロン。誤分類したときだけ重みを動かす規則が、のちの hinge loss(1995 年の Cortes と Vapnik の SVM)の源流の一つになる。
- 1964:Huber が「Robust Estimation of a Location Parameter」で Huber 損失を提案。 外れ値耐性の損失設計の起点。
- 1986:Rumelhart らの backpropagation 論文で「二乗誤差を勾配降下で最小化」が深層学習に導入。
- 1990s:ロジスティック回帰の最尤推定が Cross-Entropy 損失と等価であることが広く認識。
- 2015 以降:Focal Loss / Triplet Loss / Dice Loss / Contrastive Loss など、 深層学習タスク特化の損失が次々と提案。
- 2020s:自己教師あり学習の InfoNCE / SimCLR Loss など、 ラベルなしデータからの表現学習用損失が主流に。
📌 歴史的視点:損失関数の進化は「タスクの本質を式に翻訳する努力」の歴史。 最小二乗から始まり、 外れ値耐性 / 確率出力 / クラス不均衡 / 距離学習 と解決すべき問題が増えるたびに損失が増えた。 損失を選ぶことは「何を間違いと見なすか」を宣言することに等しい。
🔗 隣接手法への橋渡し
損失関数はモデル学習の方向を定める核であり、 前段のタスク設計と後段の最適化アルゴリズム・評価指標を統合する役割を担う。
- 上流: 前段のタスク設計・出力形式定義 (勾配降下法、 最適化)
- 並列: 並列の損失関数 (MSE・MAE・Hinge・Cross-Entropy) (MSE、 交差エントロピー、 MAE) と比較・併用
- 下流: 下流の最適化アルゴリズム・評価指標 (学習率、 収束問題)
上流のタスク定義 (回帰 vs 分類 vs ランキング) が損失関数の選択を決め、 並列の MSE/MAE/Cross-Entropy/Huber/Focal Loss と比較して外れ値耐性やクラス不均衡対応を判断し、 下流の勾配降下法・正則化と組み合わせて学習の安定性を確保する流れで「目的に合う損失設計」が深層学習の核となる。
🌳 手法選択フロー
損失関数 を実際の課題に当てはめるとき、 用語固有の判断軸に沿って次の 3 段階で適切な選択を行う。
- タスクは回帰か分類か? 回帰 → MSE/MAE/Huber、 分類 → Cross-Entropy/Log Loss
- 外れ値に頑健にしたいか? Yes → Huber Loss・MAE (回帰)。分類でクラスが極端に偏るなら重み付き Cross-Entropy / Focal Loss、 No → 標準損失で OK
- ランキングや埋め込み学習か? Yes → Triplet Loss / Contrastive Loss、 No → 上記分類/回帰損失を採用
このフローは損失関数選択の標準軸。 「タスク種別 → 外れ値耐性 → 特殊構造」の 3 段階で標準損失 (MSE/Cross-Entropy) と専用損失 (Huber/Focal/Triplet) を使い分けるのが現代の損失設計パターン。
🎮 触って理解する
損失関数の「形」は、 誤差をどう罰するかの設計思想そのものです。 下の図は横軸に予測誤差 e = y − ŷ(分類モードではマージン z = y·ŷ)をとり、 各損失を重ねて描いています。 チェックで曲線を切り替え、 スライダーで Huber の δ・ε-不感帯の ε を動かし、 図の上をドラッグ(スマホはタップ&スワイプ)して縦線を動かすと、 その誤差での各損失の値がリアルタイムに更新されます。 二乗損失が外れ値領域で急峻に立ち上がり、 絶対損失が直線でおとなしいことを「形」で体感してください。
| 損失関数 | 現在の誤差 e で表示 |
|---|
※ 縦線の位置(e の値)でのそれぞれの損失値。 図をドラッグして動かせます。 計算は各損失の定義式どおり(近似なし)。
💡 直感 — 損失は「誤差の罰し方」の設計図
損失関数を選ぶとは「どんな間違いをどれだけ嫌うか」を決めることです。 二乗誤差 e² は誤差を 2 乗するので、 誤差が 2 倍になれば罰は 4 倍・3 倍なら 9 倍と急峻に膨らみます。 その結果「大きく外した 1 点」に学習が強く引っ張られます(=外れ値に敏感)。 一方 絶対誤差 |e| はどこでも傾きが一定なので、 外れ値も普通の点も同じ重みで扱い、 推定は中央値的になります(=外れ値に頑健)。 Huber は δ 以内では二乗の滑らかさ、 δ を超えると絶対値の頑健さ、 という「いいとこ取り」。 δ を動かすと切替点が移動する様子が図で見えます。 ε-不感帯(SVR で使う)は ±ε の帯の中を「誤差ゼロ扱い」にし、 小さなズレを無視して疎な解を生みます。
⚠️ よくある落とし穴 — 外れ値感応と微分可能性
- 外れ値感応:センサ異常や入力ミスが混じるデータに素の MSE を使うと、 わずか数点の巨大残差でモデル全体が歪みます(本ページ上部の SSDSE 演習でも、 東京 1 点の除外で傾きが約 2 倍動きました)。 頑健性が要るなら MAE / Huber を検討。
- 微分可能性:MAE と Hinge は原点(折れ点)で微分不能。 勾配降下はサブグラディエントで回避できますが、 収束が不安定になりがち。 Huber・Smooth L1 は折れ点を丸めて「至る所で微分可能」にした設計です。 図で MAE の V 字の尖りと Huber の滑らかな谷底を見比べてください。
- 凸性:ここに並ぶ損失はすべて凸なので局所最適=大域最適。 だが 0-1 損失(分類モードの階段)は非凸・不連続で直接最適化できず、 ヒンジ・ロジスティックなどの代理損失(surrogate)で上から抑えて最適化します。 分類モードで代理損失が 0-1 損失を覆う様子が見えます。
🚀 発展 — 正則化と確率的解釈(=最尤)
実際に最小化するのは損失だけでなく 損失 + 正則化項 です:$\hat\theta=\arg\min_\theta \frac1n\sum_i L(y_i,f_\theta(x_i)) + \lambda R(\theta)$。 $R(\theta)$ は係数の大きさを罰してモデルを単純化し過学習を抑えます(正則化参照)。 さらに多くの損失は 負の対数尤度として導けます。 誤差が正規分布だと仮定して尤度を最大化すると二乗誤差(MSE)が、 ラプラス分布だと絶対誤差(MAE)が、 ベルヌーイ分布だとクロスエントロピーが自然に出てきます。 つまり「どの損失を選ぶか=データのノイズにどんな確率分布を仮定するか」であり、 損失設計は暗黙のうちに最尤推定になっています。 最適化の具体手順は 勾配降下法・最適化、 個別の損失は MSE/MAE/交差エントロピー の各ページへ。 なお Huber 損失・Hinge 損失・最尤推定の単独ページは本用語集には未作成のため、 ここでは本文中の説明を参照してください。