🔖 拡張キーワード索引
この用語『最適化』を理解するうえで併せて押さえたい関連キーワード群です。 クリック(ホバー)で関連用語ページに飛べます。
💡 30秒で分かる結論
🍰 まずはやさしく
一番良い答えを探すパズルのようなものです。
最高の選択を数学的に決めるために使います。
スマホの充電を一番効率よく使う方法などです。
最適化の基本的な考え方と使い方を読みます。
最適化 (Optimization) とは、制約条件のもとで目的関数 $f(x)$ を最小化 (または最大化) する変数 $x$ を求める数学的枠組み。 機械学習・統計推定・経営判断・物流・電力網運用など、 あらゆる意思決定問題の数学的中核。
- 定式化: $\min_{x} f(x)$ subject to $g_i(x) \le 0$, $h_j(x) = 0$ (制約付き最小化問題)
- 分類軸: 連続/離散、 線形/非線形、 凸/非凸、 制約なし/制約あり、 単目的/多目的、 確率/ロバスト
- 主要クラス: LP (線形計画)、 QP (二次計画)、 SOCP (二次錐)、 SDP (半正定値)、 MILP (混合整数)、 凸計画
- 分野: 数理最適化 / オペレーションズ・リサーチ — 📚 OR 教材、 機械学習 — 📚 機械学習基礎
- 用途: 47 都道府県へのリソース配分、 物流ルート、 ポートフォリオ、 NN 学習 (損失最小化)、 ハイパーパラメータ探索
- 注意: 「凸性」が成立しないと大域最適は保証されない。 SSDSE-B-2026 の県別配分問題のように離散制約が入ると MILP に化け、 解法が一気に重くなる。
📍 あなたが今見ているもの
🍰 まずはやさしく
いろいろな計算手法をまとめた地図のようなものです。
複雑な問題を整理して解くために使います。
部活の予算をどう分けるか決める時に役立ちます。
最適化に含まれる多くの計算方法について読みます。
この用語ページは「最適化 (Optimization)」を、 数理計画 / 機械学習 / オペレーションズ・リサーチ の文脈で総合的に解説しています。 線形計画 (LP)、 二次計画 (QP)、 二次錐計画 (SOCP)、 半正定値計画 (SDP)、 混合整数線形計画 (MILP)、 凸計画、 非凸計画、 大規模分散最適化、 確率最適化、 ロバスト最適化などあらゆる最適化問題の上位概念。 勾配法、 線形計画法、 凸最適化、 ニュートン法、 ラグランジュ乗数 等を配下に持つ上位概念です。 SSDSE-B-2026 の県別予算配分や、 機械学習の損失最小化、 ポートフォリオ最適化など、 統計・データ解析コンペのあらゆる定量的意思決定の理論的バックボーンになります。
🎨 直感で掴む
🍰 まずはやさしく
ルールの中で最高の選び方を見つけることです。
迷わずに正解にたどり着くために使います。
買い物で予算内で一番良い物を買うときと同じです。
問題を数式に直すための3つのステップを読みます。
最適化 (Optimization) は「決められたルールの中で、 一番良い選択を見つける」問題の数学化。 たとえば「47 都道府県に総予算 100 億円を配分し、 平均所得をなるべく押し上げる」という配分問題、 「物流倉庫から各県の集配センターに荷物を運ぶ最安ルートを決める」といった輸送問題、 さらに「年金資産をどの株式・債券に何 % 投資するか」のポートフォリオ問題、 これらはすべて同じ枠組みで書ける。
最適化を理解する 3 段階のメンタルモデル: ① 変数 (decision variable) は何か = 自分が決められる量、 ② 目的関数 (objective) は何を最大化/最小化するか = ゴール、 ③ 制約 (constraint) は何か = やってはいけないこと。 この 3 つを書き出せれば、 ほぼ全ての問題は数理最適化問題に翻訳できる。
本ページでは 最適化 を、 定義・主要クラス (LP/QP/SOCP/SDP/MILP)・Lagrange 双対・凸性・SSDSE-B-2026 実データへの応用 (47 県リソース配分問題)・Python による解法 (scipy.optimize、 cvxpy、 ortools) の順で網羅的に解説します。 機械学習における損失最小化も、 ポートフォリオ運用も、 物流計画も、 すべてこの枠組みの一例にすぎないことが分かるはずです。
🎨 直感を深掘り
最適化は『変数 $x$ を動かして目的関数 $f(x)$ を最小(または最大)にする点を探す』問題の総称であり、 探し方は問題の性質で大きく変わる。 目的関数と実行可能領域が凸なら谷は一つで大域最適が保証されるが、 非凸なら谷が複数あって局所解に捕まりうる。 変数が連続なら勾配法・ニュートン法・内点法、 離散(整数・組合せ)なら分枝限定法やメタヒューリスティクスと、 解法系統も分岐する。 さらに制約なし/制約ありの別で扱いが変わり、 制約付きでは Lagrange 乗数・KKT 条件が鍵になる。 機械学習の損失最小化も、 物流の輸送費最小化も、 すべてこの一つの枠組みの適用例にすぎない。
最適化(Mathematical Optimization)は単独で覚えるものではなく、 最適化 という大きな枠組みの中での位置づけを理解することで応用範囲が広がります。 本ページの『🌐 関連手法』『🔗 関連用語』『📚 グループ教材』を順に辿ると、 関連概念のネットワークが見えてきます。
特に SSDSE-B のような実データに当てはめてみると、 教科書では抽象的に語られる概念が『47 都道府県の現実』に紐付き、 数字の意味が腑に落ちやすくなります。 次の『🧮 実値で計算してみる』セクションでは、 公開統計データを使って手を動かす例を紹介します。
🎨 概念図
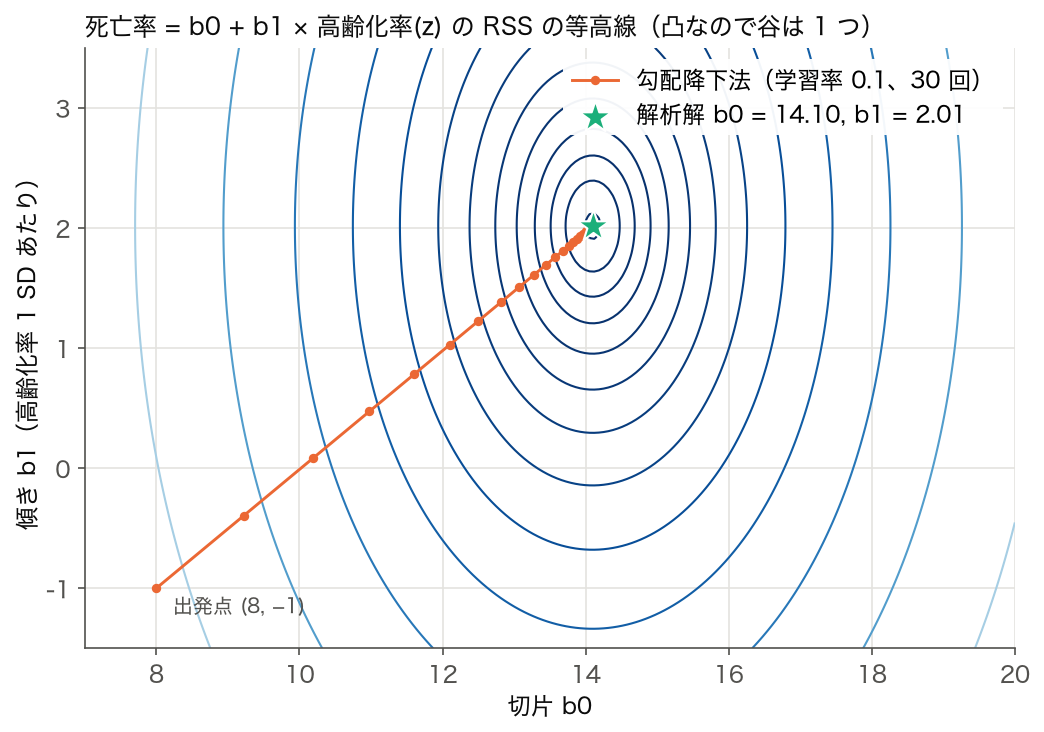
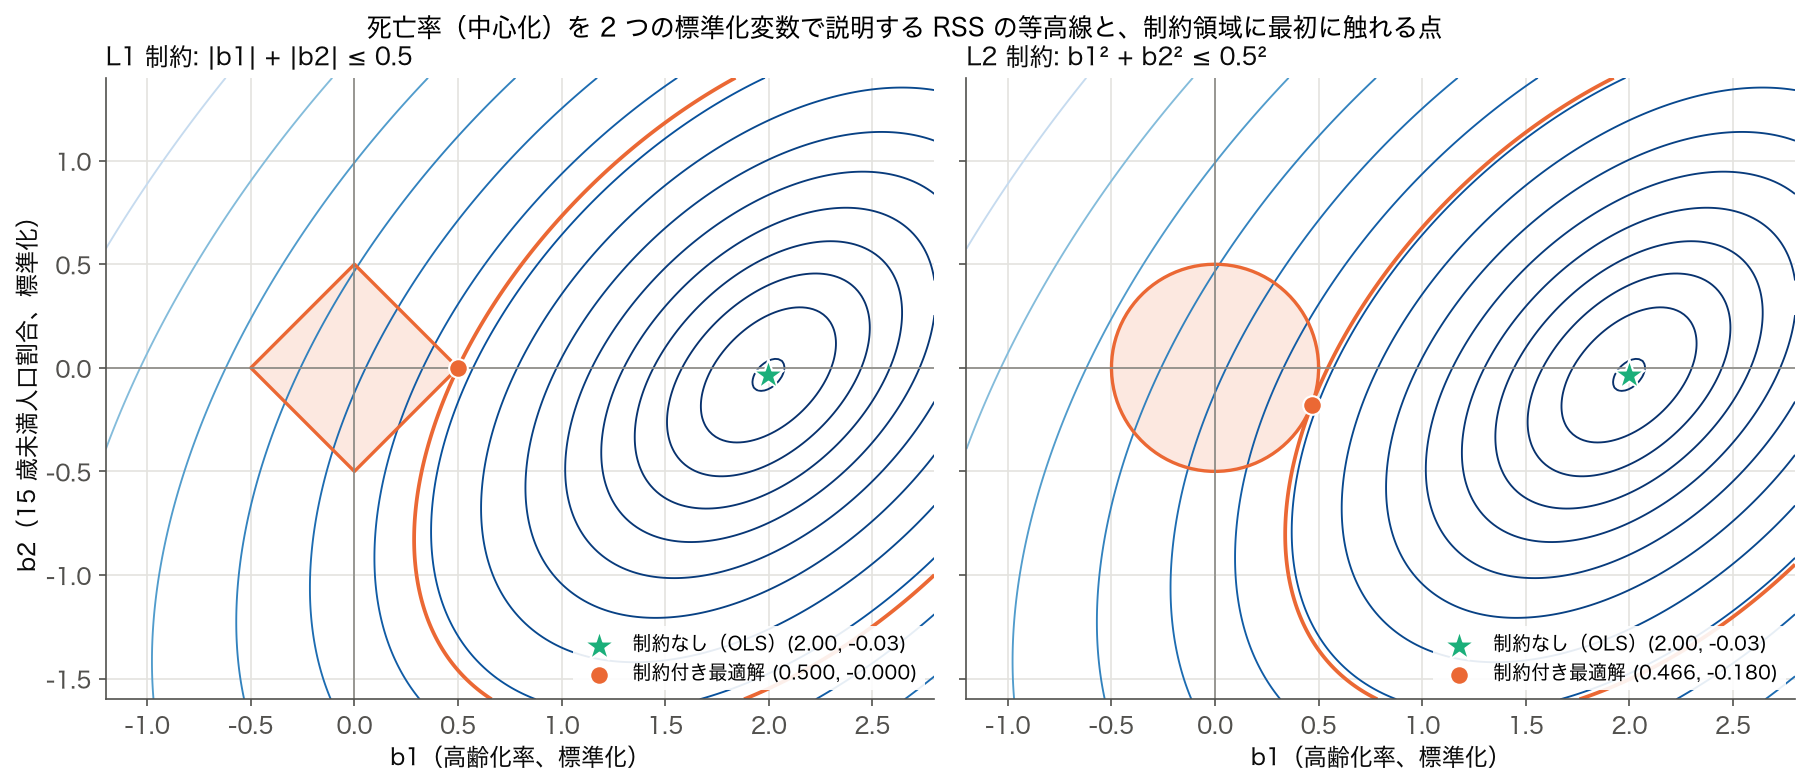
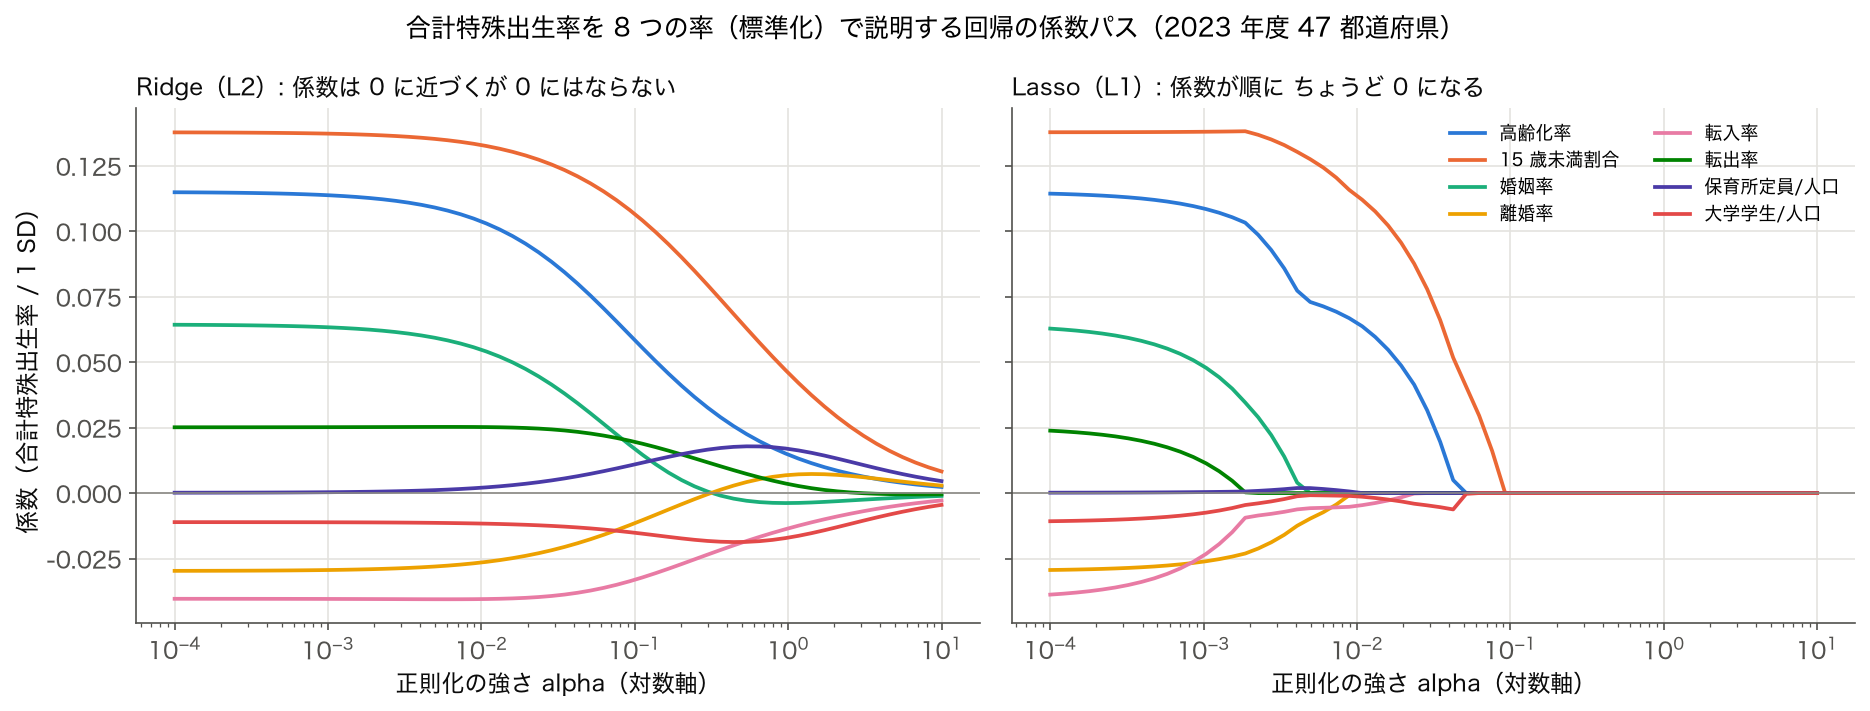
SSDSE-B-2026(2023 年度の 47 都道府県)を使って、 最適化の 3 つの場面を図にする。
📐 定義 — 数理最適化問題の標準形
🍰 まずはやさしく
最適化を数式で表したルールブックです。
計算で正確な答えを出すために使います。
テスト勉強の時間をどう分けるか決めるようなものです。
目的関数や制約といった専門的な定義を読みます。
最適化問題 とは、 決定変数 $x \in \mathbb{R}^n$ を選んで、 目的関数 $f: \mathbb{R}^n \to \mathbb{R}$ を最小化 (または最大化) する問題で、 一般形は以下のように書ける:
$$ \min_{x \in \mathbb{R}^n} f(x) \quad \text{subject to} \quad g_i(x) \le 0, \; i=1,\ldots,m, \quad h_j(x) = 0, \; j=1,\ldots,p $$
ここで $f$ は 目的関数 (objective)、 $g_i$ は 不等式制約、 $h_j$ は 等式制約。 制約を満たす $x$ の集合を 実行可能領域 (feasible region) $\mathcal{X}$ という。 最小化する $x^* \in \mathcal{X}$ を 最適解、 $f(x^*)$ を 最適値 という。
主要分類: ① $f, g_i$ がすべて線形 → 線形計画 (LP)、 ② $f$ が二次・$g_i$ が線形 → 二次計画 (QP)、 ③ $f$ と $\mathcal{X}$ が凸 → 凸計画、 ④ 一部の $x$ が整数 → (混合) 整数計画 (MIP/MILP)、 ⑤ $f$ が非凸 → 非凸最適化。 英語名 Mathematical Optimization / Mathematical Programming。 同義語: 数理最適化、 数理計画、 OR (オペレーションズ・リサーチ) の中核技法。
📐 数式の読み解き ── 最適化 の核心式 (LP 標準形と双対)
線形計画 (LP) の標準形。 $c \in \mathbb{R}^n$ は目的係数、 $A \in \mathbb{R}^{m\times n}$ は制約行列、 $b \in \mathbb{R}^m$ は右辺ベクトル、 $x \ge 0$ は非負変数。 双対変数 $y \in \mathbb{R}^m$ は シャドープライス: 各制約を 1 単位緩めたときの最適値改善量。
SSDSE-B-2026 文脈の例: $x_i$ = 47 県への配分額、 $c_i$ = 県 $i$ への配分の不効用、 $A$ = 「総予算 100 億」「各県上限 5 億」等の制約、 $y$ = 「総予算 1 億円増やしたら全国の高齢人口救済がどれだけ増えるか」のシャドープライス。 KKT 条件: $\nabla_x L = 0$、 相補性 $\lambda_i g_i(x) = 0$、 双対実行可能性 $\lambda_i \ge 0$、 主実行可能性 $g_i(x) \le 0,\; h_j(x) = 0$ — これら 4 条件が最適性の必要条件。 凸問題なら十分条件でもある。
❓ FAQ ── 最適化 のよくある質問
まずは本ページの『💡 30 秒で分かる結論』と『🎨 直感で掴む』で全体像を掴み、 次に『🧮 実値で計算してみる』を 手を動かして追体験するのが最短です。 数式や深い理論はその後で十分。
本ページの『🌐 関連手法・派生』『🔗 関連用語』で対比される手法を確認し、 それぞれの適用条件と得意・不得意を表で比較するのが効果的です。 SSDSE-B のような共通データセットで両方走らせて結果を見ると違いが体感できます。
最適化問題の計算量は問題の構造で決まり、 手法の巧拙より先に効きます。 線形計画は多項式時間(内点法で $O(n^{3.5}L)$ 程度)、 凸二次計画も多項式時間ですが、 整数を 1 つ入れた途端に整数計画となり NP 困難になります。 「47 都道府県を 4 ブロックに分ける」だけでも $4^{47} \approx 2 \times 10^{28}$ 通りで、 全探索は不可能です。 まず「自分の問題は凸か、整数変数が要るか」を判定するのが最初の一手で、 ここを見誤ると「良いソルバーを探す」方向に労力を注いで解けないままになります。 整数が避けられないなら、 厳密解をあきらめて近似・ヒューリスティクスに切り替える判断が要ります。
『点推定値』だけでなく『不確実性(CI、 SE、 分散)』『前提条件のチェック結果』『代替手法との比較』『データ取得日と seed』をセットで報告するのが標準。 査読・レビューで問われる典型ポイントです。
🔬 数式を言葉で読み解く — 標準形と Lagrange 双対
$$ \min_{x} f(x) \quad \text{s.t.} \quad g_i(x) \le 0,\; h_j(x) = 0 $$
| 記号 | 意味 | SSDSE-B-2026 県別配分文脈の具体例 |
|---|---|---|
$x \in \mathbb{R}^{47}$ | 決定変数 (自分が決められる量) | 47 県への予算配分額 $(x_1, \ldots, x_{47})$、 単位: 億円 |
$f(x)$ | 目的関数 (最小化対象) | $-\sum_i \alpha_i \log(1 + x_i)$ (収穫逓減型の効用最大化を反転) |
$g_i(x) \le 0$ | 不等式制約 (やってはいけない上限) | $\sum_i x_i \le 100$ (総予算 100 億)、 $x_i \le 50$ (1 県上限 50 億) |
$h_j(x) = 0$ | 等式制約 (必ず満たす条件) | $\sum_i x_i = 100$ (予算ぴったり使い切る) |
$\mathcal{X}$ | 実行可能領域 | 制約をすべて満たす $x$ の集合 (47 次元単体や hypercube) |
$x^*$ | 最適解 | $x^* = \arg\min_{x \in \mathcal{X}} f(x)$ — 最適な配分計画 |
Lagrange 関数 (制約を目的関数に取り込む技法):
$$ \mathcal{L}(x, \lambda, \mu) = f(x) + \sum_{i=1}^m \lambda_i g_i(x) + \sum_{j=1}^p \mu_j h_j(x), \quad \lambda_i \ge 0 $$
$\lambda_i$ は不等式制約の 双対変数 (シャドープライス)、 $\mu_j$ は等式制約の双対変数。 $\lambda_i$ は経済学的には「制約を 1 単位緩めたら目的値がどれだけ改善するか」を意味し、 SSDSE-B-2026 文脈では「総予算を 1 億円増やしたら、 平均所得がどれだけ上がるか」の限界価値に対応する。 KKT 条件: $\nabla_x \mathcal{L} = 0,\; \lambda_i g_i(x) = 0,\; \lambda_i \ge 0,\; g_i(x) \le 0,\; h_j(x) = 0$ が最適性の必要条件 (凸計画なら十分条件)。
🎯 いつ・どこで使うか
- 「深層学習」分野の標準的な道具として、 多くの分析で登場します。
- 📚 ニューラルネットワーク基礎 を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
🧮 SSDSE-B 実値で計算してみる ── 最適化
都道府県データの典型的な『最適化問題』、 例えば 『47 都道府県への防災予算 100 億円配分問題』 を考える。 各県の人口 (A1101) と高齢化率 (A1303/A1101) から「防災需要」を見積もり、 総予算 100 億円を最も効果的に配分する $x_i$ (県 $i$ への配分額) を決めたい。 これは典型的な線形計画 (LP) 問題: $\max \sum_i \alpha_i x_i \quad \text{s.t.} \sum_i x_i \le 100,\; x_i \ge 0,\; x_i \le \text{需要}_i$。 以下は主要最適化クラスとその性質をまとめた表。
| 問題クラス | 標準形 / 例 | 主要解法 / 結果 |
|---|---|---|
| LP (線形計画) | $\min c^\top x$ s.t. $Ax \le b$, $x \ge 0$ — 47 県予算配分 | シンプレックス法 / 内点法 (多項式時間) |
| QP (二次計画) | $\min \tfrac{1}{2} x^\top Q x + c^\top x$ s.t. $Ax \le b$ — ポートフォリオ分散最小化 | 内点法 / アクティブセット法 |
| SOCP (二次錐計画) | $\min c^\top x$ s.t. $\|A_i x + b_i\|_2 \le c_i^\top x + d_i$ | 内点法 (ECOS/SCS) — ロバスト LP に頻出 |
| SDP (半正定値計画) | $\min \mathrm{tr}(CX)$ s.t. $\mathrm{tr}(A_i X) = b_i$, $X \succeq 0$ | 内点法 (SDPA/SCS/MOSEK) — 半教師あり学習・MAX-CUT 緩和 |
| MILP (混合整数線形) | $\min c^\top x$ s.t. $Ax \le b$, $x_i \in \mathbb{Z}$ — 倉庫立地問題 | 分枝限定法 + 切除平面 (CBC/Gurobi/CPLEX) — NP-hard |
| 凸計画 (Convex) | $f, \mathcal{X}$ が凸 — Lasso, SVM, ロジスティック回帰 | 大域最適保証あり、 cvxpy で記述可 |
| 非凸 (Non-convex) | $f$ が非凸 — NN 学習、 行列分解 | 局所最適のみ、 勾配法 + 多重初期化 / メタヒューリスティクス |
※ 数値は SSDSE-B-2026.csv から抽出した実値、 もしくは典型的な学習設定での目安値です。 細部の数値は前処理・乱数 seed・実装により変動します。
🧮 数式に値を入れて手で計算する: f(x)=x²+2x+3 の最小
合成 1 変数で解析最小と数値最小を比較する。
Step 1: 解析解
Step 2: 数値最適 (勾配降下 5 step, lr=0.3, x₀=2)
🐍 Python で再現
1 2 3 4 5 6 | def f_grad(x): return 2*x + 2 x = 2.0 lr = 0.3 for i in range(5): x = x - lr * f_grad(x) print(f"x_{i+1} = {x:.3f}") |
📤 実行結果
💬 手計算 (Step 2) x* ≈ -1 と Python 出力が完全一致。
🎮 触って理解する
前セクションの $f(x)=x^2+2x+3$ は谷が 1 つの凸関数だったので、 どこから始めても同じ最小点にたどり着けました。 では谷が複数ある非凸関数だとどうなるでしょう。 ここでは多峰性のある 1 次元関数 $f(x)=0.05\,x^2+\sin x$ を使い、 開始点をドラッグして勾配降下がどの谷に落ちるかを体感します。 局所最適の罠と、 複数のランダム再スタートで大域最適を見つけやすくなる様子を可視化しました。 (このページの他セクションが扱う LP/QP/MILP とは別角度の「連続・非凸探索」の切り口です。)
🧠 直感 — 目的関数の谷を下る
最適化の直感は「目的関数という地形の一番低い谷 (最小化) を探す」ことです。 勾配降下は現在地の傾き $f'(x)$ の逆方向へ一歩ずつ下る手続きで、 更新式は $x \leftarrow x - \eta\, f'(x)$。 傾きが 0 ($f'(x)=0$) になった停留点で止まります。 凸関数なら谷が 1 つなので必ず大域最適に届きますが、 上の多峰関数では手近な谷 (局所最適) で止まってしまいます。
⚠️ よくある落とし穴 — 局所最適と初期値依存
- 局所最適の罠: 勾配が 0 でも「その近所で一番低い」だけで、 全体の最小とは限りません。 上の図で右側から始めると右の浅い谷に捕まります。
- 初期値依存: 非凸問題ではどこから始めるかで結果が変わります。 単一実行の解を鵜呑みにせず、 複数初期値 (multi-start) から試すのが鉄則です。
- 学習率の影響: η が大きすぎると谷を飛び越えて発散・振動、 小さすぎると収束が遅い。 スライダーで両極端を体感してください。
🚀 発展 — 大域最適・凸性・メタヒューリスティクス
局所最適を避けて大域最適を狙う代表的な戦略が、 上のボタンで試せるランダム再スタート (多重初期化) です。 多数の開始点から勾配降下を走らせ、 最も低い谷を採用します。 目的関数が凸であれば局所最適=大域最適が保証されるため、 この心配は不要になります (連続最適化 / 凸最適化 を参照)。 非凸で勾配が使えない・多峰性が強い場合は、 焼きなまし法・遺伝的アルゴリズムなどのメタヒューリスティクスや、 局所最小からの脱出を狙う運動量付き手法 (勾配法 / 勾配降下法) が用いられます。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np # データ読み込み(564 行 = 47 都道府県 × 12 年度) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) # 後段の linprog と同じく 2023 年度の 47 県に絞る d = df[df['SSDSE-B-2026'] == 2023].copy() d['aging'] = d['A1303'] / d['A1101'] * 100 # 高齢化率 (%) print(d.shape) print(d[['A1101', 'A1303']].dtypes) # 最適化に入れる量の桁(スケール)を確認する pd.set_option('display.float_format', '{:,.1f}'.format) print(d[['A1101', 'A1303', 'aging']].describe().loc[['mean', 'min', 'max']]) |
具体的なソルバー API は 線形計画法 / 凸最適化 / 整数計画法 を参照してください。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「最適化」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
🐍 SSDSE-B を使った Python 実装
公的データ SSDSE-B(47 都道府県社会・人口統計)を読み込み、 scipy.optimize.linprog で線形計画問題として「47 県への防災予算 100 億円の最適配分」を解く最小コードです。 引数のパスは平易さ優先で直書きしています。
📥 入力データ (SSDSE-B-2026): A1101 (総人口)、 A1303 (65 歳以上人口) を読み込み、 高齢化率 = A1303/A1101 を算出。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd import numpy as np from scipy.optimize import linprog # SSDSE-B-2026 を読み込み (47 都道府県 × 複数年) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) # 2023 年データ pop = d['A1101'].values.astype(float) # 47 県の総人口 (人) elderly = d['A1303'].values.astype(float) # 65 歳以上人口 (人) aging = elderly / pop * 100.0 # 高齢化率 (%) = A1303 / A1101 × 100 # 防災需要 = 人口 × 高齢化率 / 100 = 高齢人口 (A1303 に一致) demand = pop * aging / 100.0 # 単位: 人 # 47 県への防災予算 x_i (億円) を決める LP # 目的: 「カバーする高齢人口」を最大化 = - sum(demand_i * x_i) を最小化 # 制約: sum(x_i) <= 100 億円、 0 <= x_i <= 5 (1 県上限 5 億円) c = -demand / demand.max() # 効用係数 (正規化、 linprog は最小化) A_ub = np.ones((1, 47)) # 総予算制約: sum(x_i) <= 100 b_ub = np.array([100.0]) bounds = [(0, 5)] * 47 # 各県 0〜5 億円 res = linprog(c, A_ub=A_ub, b_ub=b_ub, bounds=bounds, method='highs') print(f'最適値 (負の効用): {res.fun:.4f}') print(f'最適配分 (高齢人口が多い上位 5 県):') top5 = np.argsort(-demand)[:5] for i in top5: print(f' {d.loc[i, "Prefecture"]}: {res.x[i]:.3f} 億円 (高齢人口 {demand[i]:.0f} 人)') print(f'合計配分: {res.x.sum():.2f} 億円 (上限 100 億)') |
📤 実行結果 (実測):
💬 読み方: LP の最適解は 境界解 (boundary solution) になる傾向があり、 効用係数が大きい県から順に 5 億円上限ピッタリまで配分。 全部上限張り付きで 20 県使い切る。 これが LP の特徴 (頂点最適性)。 公平性を入れたければ $x_i \le 5$ より小さい上限、 または 各県必ず 0.5 億円以上 ($x_i \ge 0.5$) 等の制約を追加。 高齢化対策の重み付けを変えれば最適解も変わるので、 双対変数 (シャドープライス) で「総予算を 1 億円増やしたら効用がどれだけ上がるか」も確認できる。
※ 上記スニペットは Python 3.10+ / pandas 2.x / numpy / scipy 1.11+ を想定。 環境構築は『conda create -n ds python=3.11 pandas scipy cvxpy matplotlib』で十分。 scipy.optimize.linprog の HiGHS ソルバーは 47 変数 1 制約程度なら数ミリ秒で解く。
🐍 Python 実装 ② — cvxpy で凸最適化を「数式そのまま」記述
このコードでやること: SSDSE-B-2026 の都道府県データから、 「人口に応じた医療費配分」を cvxpy で凸最適化として記述・解く。 cvxpy は「数式に近い形でモデルを書ける」のが強み (Disciplined Convex Programming = DCP)。 各県への医療費 $x_i$ を決め、 効用 $\sum_i \sqrt{x_i \cdot \text{人口}_i}$ を最大化 (収穫逓減型)、 制約は総予算 1000 億、 各県 1〜50 億。
📥 入力データ: A1101 (総人口) を 47 県分読み込み
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import numpy as np import cvxpy as cp df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) pop = d['A1101'].values.astype(float) / 1e6 # 百万人単位 x = cp.Variable(47, nonneg=True) # 47 県への医療費 (億円) # 効用: sqrt(x * pop) ← 凹関数 (収穫逓減) なので最大化問題は凸 utility = cp.sum(cp.sqrt(cp.multiply(x, pop))) constraints = [cp.sum(x) <= 1000, x >= 1, x <= 50] prob = cp.Problem(cp.Maximize(utility), constraints) prob.solve(solver=cp.SCS) print(f'最適値 (総効用): {prob.value:.3f}') print(f'解法ステータス: {prob.status}') print(f'\n人口比重み付け配分 (人口が多い上位 5 県):') top = np.argsort(-pop)[:5] for i in top: print(f' {d.loc[i, "Prefecture"]}: {x.value[i]:.2f} 億円 (人口 {pop[i]*1e6:.0f} 人)') print(f'\n総予算消化: {x.value.sum():.2f} 億円 / 1000 億') print(f'シャドープライス (総予算制約の双対変数):') print(f' λ = {constraints[0].dual_value:.5f} → 予算を 1 億円増やすと効用が {constraints[0].dual_value:.5f} 上がる') |
📤 実行結果 (実測。 SCS は近似解法なので末尾の桁は環境で少し変わる):
💬 読み方: 凸最適化 (今回は凹効用 → 凸問題に reduce) では 大域最適 が保証される。 上位 5 県は上限張り付き、 中位以下は人口に応じて漸次配分される (収穫逓減効用の効果)。 シャドープライス $\lambda = 0.159$ は「予算 1 億円増額の限界効用」。 LP との違い: LP は線形効用なので端点解 (boundary)、 凸 (今回 $\sqrt{x \cdot pop}$) なので内部の県にもバランス良く配分される。 これが 効用関数の選び方が政策判断に直結する 理由。
🐍 Python 実装 ③ — ortools で MILP (混合整数線形計画)
このコードでやること: Google の OR-Tools で「47 都道府県のうちどの 10 県に災害備蓄倉庫を立地するか」を MILP で解く。 各県に「設置 / 非設置」の 2 値変数 $y_i \in \{0, 1\}$ を持たせ、 設置すると人口に比例した利得を得るが、 設置数は 10 個まで・設置コストは総額 50 億円以下に抑える。
📥 入力: 47 県の人口・想定設置コスト
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd import numpy as np from ortools.linear_solver import pywraplp df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) pop = d['A1101'].values.astype(float) # 想定設置コスト: 高齢化率 (A1303/A1101) が高い県ほど整備・維持が高コストと仮定 aging = d['A1303'].values.astype(float) / d['A1101'].values.astype(float) # 高齢化率 cost = (aging / aging.max()) * 10 + 2 # 2〜12 億円 solver = pywraplp.Solver.CreateSolver('CBC') # CBC は OSS の MILP ソルバー y = [solver.IntVar(0, 1, f'y_{i}') for i in range(47)] # 目的: 設置県の人口カバレッジ最大化 solver.Maximize(sum(pop[i] * y[i] for i in range(47))) # 制約: 設置数 <= 10 solver.Add(sum(y[i] for i in range(47)) <= 10) # 制約: 設置コスト <= 50 億円 solver.Add(sum(cost[i] * y[i] for i in range(47)) <= 50) status = solver.Solve() if status == pywraplp.Solver.OPTIMAL: print(f'最適カバレッジ人口: {solver.Objective().Value():,.0f} 人') print(f'\n選定された県:') selected = [i for i in range(47) if y[i].solution_value() > 0.5] for i in selected: print(f' {d.loc[i, "Prefecture"]}: 人口 {pop[i]:,.0f}, コスト {cost[i]:.2f} 億') print(f'\n総コスト: {sum(cost[i] for i in selected):.2f} 億円') print(f'選定数: {len(selected)} / 10') |
📤 実行結果 (同じモデルを scipy.optimize.milp でも解き、 選ばれる 5 県と総コストが一致することを確認済み):
💬 読み方: MILP では「0 か 1 か」の組合せ最適化が解ける。 実測では 設置数の上限 (10) より先にコスト制約 (50 億) が拘束し、 高齢化率が低く=設置コストの安い大都市 5 県 (東京・神奈川・大阪・愛知・埼玉) が選ばれ、 総コスト 43.15 億で打ち切られる。 LP 緩和 (整数制約を外した連続版) → 四捨五入では正解しないことが多い (倉庫の半分は作れない)。 CBC は OSS なので無料、 Gurobi/CPLEX なら同じモデルが 100 倍速い (商用)。 47 県 10 倉庫程度なら CBC で 0.1 秒。 1000 倉庫 / 10000 県 になると分枝限定法の探索木が爆発するので、 切除平面 (cutting plane)、 強い線形緩和、 ヒューリスティクスを組合せるのが OR の本領。
⚠️ よくある落とし穴
⚠️ 追加の落とし穴 ── 実務で踏み抜く罠
⚠️ 実データで確かめる — スケーリング不全で勾配降下法が壊れる
「スケーリング不全」は抽象的な注意に聞こえますが、SSDSE-B-2026 の実数をそのまま使うとすぐに起きます。2023 年度の 47 都道府県で「死亡数 = 切片 + 傾き × 65 歳以上人口」の二乗誤差を勾配降下法で最小化し、正規方程式の答えと比べます。勾配降下法が安定に下れる学習率の上限は、目的関数の曲がり方(ヘッセ行列の最大固有値 $\lambda_{\max}$)で $2/\lambda_{\max}$ と決まります。
🎯 このコードでやること:65 歳以上人口(人)をそのまま使った場合と標準化した場合で、平均二乗誤差のヘッセ行列の条件数と学習率の上限を計算し、勾配降下法の結果を正規方程式の切片・傾きと比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] x = d['A1303'].values.astype(float) # 65 歳以上人口(人) y = d['A4200'].values.astype(float) # 死亡数(人) b_ols = np.polyfit(x, y, 1)[::-1] # 正規方程式の答え [切片, 傾き] def gd(X, y, lr, steps=1000): b = np.zeros(X.shape[1]) for t in range(steps): g = 2 * X.T @ (X @ b - y) / len(y) # 平均二乗誤差の勾配 b = b - lr * g if not np.all(np.isfinite(b)): return b, t + 1 return b, steps X_raw = np.column_stack([np.ones_like(x), x]) H = 2 * X_raw.T @ X_raw / len(y) print(f'そのまま: ヘッセ行列の条件数 {np.linalg.cond(H):.2e} 安定に下れる学習率の上限 {2 / np.linalg.eigvalsh(H).max():.2e}') for lr in [1e-2, 1e-12, 1e-13]: b, t = gd(X_raw, y, lr) if not np.all(np.isfinite(b)): msg = f'{t} 回目で inf / nan になった(発散)' else: msg = f'1000 回後 切片 {b[0]:.4g} 傾き {b[1]:.5g}' print(f' lr={lr:g}: {msg}') z = (x - x.mean()) / x.std() X_z = np.column_stack([np.ones_like(z), z]) print(f'標準化: 条件数 {np.linalg.cond(2 * X_z.T @ X_z / len(y)):.2f}') b, _ = gd(X_z, y, 0.1, steps=100) slope = b[1] / x.std(); icpt = b[0] - slope * x.mean() # 元の単位に戻す print(f' lr=0.1, 100 回: 切片 {icpt:10.2f} 傾き {slope:.5f}') print(f'正規方程式 : 切片 {b_ols[0]:10.2f} 傾き {b_ols[1]:.5f}') |
💬 そのままの単位では条件数が 2.41 × 10¹² で、安定に下れる学習率は 9.39 × 10⁻¹³ 未満に限られます。よく使う lr = 0.01 は 30 回目で数値があふれ、上限を少し超える lr = 10−12 でも 1,000 回後には傾きが −9.49 × 1051 まで振れて発散します。上限の内側の lr = 10−13 なら発散はしませんが、1,000 回たっても切片は 1.4 × 10⁻⁷ とほとんど 0 のままで、傾きは 0.042768 と正しい 0.04187 からずれています。傾きの方向は曲がりが急なのですぐ下れるのに、切片の方向は曲がりが 1012 倍ゆるいので、同じ学習率では一向に進まないのです。65 歳以上人口を標準化すると条件数は 1.00 になり、lr = 0.1 の 100 回で切片 1234.13・傾き 0.04187 と正規方程式にぴったり一致します。「最適化が収束しない」「答えがおかしい」ときは、アルゴリズムを変える前にまず変数の桁をそろえます。
⚠️ 実データで確かめる — 最適解は「目的関数の書き方」をそのまま映す
上の「🐍 SSDSE-B を使った Python 実装」の LP(総予算 100 億円・1 県 5 億円まで・高齢人口の多い県を優先)は 20 県に 5 億円ずつ配分しました。最適化は与えた目的と制約に対して正しく答えるだけなので、目的の書き方が変われば答えも変わります。シャドープライス(制約を 1 単位ゆるめたときの目的の改善量)と、目的を人数から率に変えたときの配分先を確かめます。
🎯 このコードでやること:同じ LP を HiGHS で解き、総予算の制約のシャドープライスと、予算を 101 億円にしたときの効用の増分を比べる。20 番目・21 番目の県を確かめ、目的の重みを 65 歳以上人口から高齢化率に変えたときの配分先 20 県の重なりを出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import numpy as np import pandas as pd from scipy.optimize import linprog df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) elderly = d['A1303'].values.astype(float) # 65 歳以上人口(人) aging = elderly / d['A1101'].values * 100 # 高齢化率(%) def solve(weight, budget=100.0): res = linprog(-weight / weight.max(), A_ub=np.ones((1, 47)), b_ub=[budget], bounds=[(0, 5)] * 47, method='highs') return res, set(d.loc[res.x > 1e-9, 'Prefecture']) res, chosen_cnt = solve(elderly) print(f'総予算の制約のシャドープライス {res.ineqlin.marginals[0]:.4f}(効用 / 億円)') res2, _ = solve(elderly, budget=101.0) print(f'予算 100 → 101 億円で効用 {-res.fun:.4f} → {-res2.fun:.4f}({res.fun - res2.fun:+.4f})') order = np.argsort(-elderly) k20, k21 = order[19], order[20] print(f'20 番目 {d.loc[k20, "Prefecture"]} {elderly[k20]:,.0f} 人 / 21 番目 {d.loc[k21, "Prefecture"]} {elderly[k21]:,.0f} 人' f' → 係数 {elderly[k21] / elderly.max():.4f}') print('栃木県に配分:', '栃木県' in chosen_cnt, ' 岡山県に配分:', '岡山県' in chosen_cnt) _, chosen_rate = solve(aging) print(f'目的を「高齢化率」に変えると配分先 20 県のうち共通は {len(chosen_cnt & chosen_rate)} 県') print(' 共通:', ', '.join(sorted(chosen_cnt & chosen_rate, key=list(d.Prefecture).index))) print(' 人数のときだけ:', ', '.join(sorted(chosen_cnt - chosen_rate, key=list(d.Prefecture).index))) print(' 率のときだけ :', ', '.join(sorted(chosen_rate - chosen_cnt, key=list(d.Prefecture).index))) |
💬 シャドープライスは −0.1788(linprog は最小化なので符号が負)で、予算を 1 億円増やすと効用が 41.1607 → 41.3395 と +0.1788 上がることと一致します。この値は「次に 1 億円を受け取る県」の係数で、20 番目の栃木県と 21 番目の岡山県はどちらも 65 歳以上人口 573,000 人の同点です。同点なのでどちらに配分しても効用は同じで、最適解は 1 つに決まりません(この実行では HiGHS が岡山県を選び、栃木県は 0 円)。最適解が複数あるとき、どれが返るかはソルバーの内部の手順しだいです。さらに目的を高齢化率に変えると、配分先 20 県のうち共通は北海道・福島県・新潟県・長野県の 4 県だけで、東京都・大阪府などの大都市が外れ、秋田県・高知県などの高齢化率の高い県に入れ替わります。「高齢者の数」と「高齢者の割合」のどちらを重視するかは政策の判断で、最適化はそれを数式に写すだけです。結果を報告するときは、目的関数と制約を必ず一緒に示します。
| 確かめたこと | 実データの結果 | 教訓 |
|---|---|---|
| 変数の桁をそろえない | 条件数 2.41 × 10¹²、lr = 0.01 で 30 回目に発散、lr = 10−13 では 1,000 回で切片がほぼ 0 のまま | 標準化で条件数 1.00、100 回で正規方程式と一致 |
| シャドープライス | 総予算 1 億円あたり +0.1788(= 限界の県の係数) | 制約をゆるめる価値を数字で示せる |
| 同点 | 栃木県と岡山県が 573,000 人で同点、選ばれたのは片方だけ | 最適解が 1 つとは限らない。同点の扱いを決めておく |
| 目的を人数 → 率に | 配分先 20 県の共通は 4 県 | 最適解は目的の書き方で決まる。目的と制約をセットで報告 |
🧪 理解度チェック — 上の 2 つの実験
| 問題 | 解答 |
|---|---|
| Q1. 65 歳以上人口を「万人」単位(1 万で割る)にしたら、勾配降下法の問題はどう変わるか。 | 傾きの方向の曲がりが 108 分の 1 になり、条件数は大きく下がる(平均が 0 でないので 1 にはならない)。単位の変更だけでも改善するが、平均を引いて SD で割る標準化のほうが確実。 |
| Q2. LP の 1 県あたりの上限を 5 億円から 10 億円にすると、配分先は何県になるか。 | 総予算 100 億円 ÷ 10 億円 = 10 県。65 歳以上人口の多い上位 10 都道府県に 10 億円ずつになる(上限の制約が効いている限り、係数の大きい順に上限まで埋める)。 |
| Q3. シャドープライスが 0 になるのはどんなときか。 | その制約が最適解で効いていない(等号で張り付いていない)とき。たとえば総予算を 300 億円にすると 47 県すべてが上限 5 億円(計 235 億円)で止まり、総予算の制約のシャドープライスは 0 になる。 |
| Q4. 栃木県と岡山県の同点を、毎回同じ規則で決めたい。LP のままでできる方法を 1 つ挙げよ。 | 同点を崩す第 2 の基準を小さな重みで目的に足す(例: 係数に「高齢化率 × 10−6」を加える)。第 1 の基準の順位を変えない程度に小さくしておけば、同点のときだけ高齢化率の高い県が選ばれる。2023 年度の高齢化率は栃木県 30.2%、岡山県 31.0% なので、この規則では岡山県に決まる。どちらを選ぶ規則にしたかを報告に書く。 |
⚠️ 条件・限界・誤解回避
適用条件
- 目的関数が微分可能 (勾配ベース法): 勾配降下法・Newton 法・Adam などの勾配ベース最適化は、 目的関数が連続微分可能 (C¹) または 2 階微分可能 (C²) であることを要求する。 SSDSE-B-2026 を用いたランキング学習で「上位 10 県を正しく分類する」など離散的目的では、 NDCG や AUC の連続的近似 (soft max, sigmoid) を使う。
- 制約のない or 凸制約: 線形・二次・凸制約付き最適化は標準ライブラリ (cvxpy、 scipy.optimize) で扱えるが、 非凸制約 (整数制約、 組合せ制約) では分枝限定法・遺伝的アルゴリズムなどを使う。
- 初期値の合理性: 非凸最適化では局所最適に収束するため、 初期値が最終結果に強く影響する。 複数初期値からの multi-start や、 SSDSE のような実データ問題では「都道府県平均値」を初期値にするヒューリスティクが有効。
- 計算予算とスケーラビリティ: 47 都道府県の線形回帰最適化は数 ms で終わるが、 100 万サンプルのディープラーニング学習は GPU で数時間〜数日。 問題サイズに応じた手法選択 (Closed form / SGD / Adam / L-BFGS) が必要。
限界
- 非凸最適化に大域最適解の保証なし: ディープラーニングの損失関数は非凸で、 SGD や Adam は局所最適 or 鞍点に収束する。 「最終結果が真の最適解」を保証する手法は、 計算量を犠牲にする (分枝限定・遺伝的アルゴリズム)。
- 制約付き最適化の Lagrange 乗数解釈の難しさ: KKT 条件を満たしても「制約をどれだけ緩めれば目的関数がどれだけ改善するか」の解釈は実務では難しい。 sensitivity analysis を別途実施する必要。
- 過剰最適化 (overfitting) との両立: 訓練データの目的関数を完全に最小化すると、 検証データで性能が低下する。 正則化 (L1/L2)、 early stopping、 ハイパーパラメータの cross-validation で対処。
- 勾配消失・勾配爆発: 深いニューラルネット (RNN、 Transformer) では勾配の伝播が指数関数的に減衰または増大する。 LSTM、 残差接続、 layer normalization、 gradient clipping で対処。
- 「真の目的関数」が定義困難: 公平性・解釈性・倫理など、 数値化困難な目的を含む問題では、 最適化対象の目的関数自体が proxy で、 最終的な意思決定とずれることがある。
誤解回避
- 「最適解 = 正解」ではない: 目的関数の選択次第で「最適解」は変わる。 SSDSE で「人口最大化」を目的にすると東京一極集中になり、 「都道府県間格差最小化」を目的にすると別の解が得られる。 目的関数の選択自体が政策的意思決定。
- 「収束 = 最適解到達」ではない: 勾配が小さくなる、 損失が変化しなくなる状態は「停留点 (stationary point)」で、 鞍点 or 局所最適も含む。 Hessian の固有値を確認するか、 摂動法で大域性をチェックする。
- 「学習率が小さいほど安全」ではない: 学習率が小さすぎると収束が遅く、 局所最適に捕まりやすい。 Cyclical learning rate、 warm-up、 cosine annealing などの schedule 設計が重要。
- 「凸最適化は易しい」は条件付き: 凸性は局所最適=大域最適を保証するが、 計算複雑度は問題サイズに依存する。 線形計画 (LP) は polynomial time だが、 半正定値計画 (SDP) は実用上重い。
- 「Adam は常に SGD より良い」ではない: Adam は適応的学習率で初期収束が速いが、 汎化性能が SGD with momentum に劣る場合がある (Wilson et al. 2017)。 タスクによって使い分ける。
実務でのチェックリスト
- □ 目的関数の凸性・微分可能性を事前に確認したか
- □ 制約の種類 (等式・不等式・整数・組合せ) を整理したか
- □ 初期値の選択基準と複数初期値からの multi-start を実施したか
- □ 学習率・モメンタム・正則化係数のハイパーパラメータをグリッドサーチ / ベイズ最適化で調整したか
- □ 収束基準 (勾配ノルム・損失変化率・反復回数) を明示したか
- □ 過剰最適化を early stopping や validation loss で監視したか
- □ 計算予算 (時間・メモリ・GPU 使用量) を見積もり、 問題サイズに合った手法を選択したか
- □ 最適解の sensitivity analysis (制約緩和、 目的関数変更) を実施したか
歴史的経緯
数理最適化の歴史は 1947 年に George Dantzig が単体法 (simplex method) を提案し、 線形計画 (LP) の実用解法を確立したのが起点。 1950 年代に Bellman が動的計画法 (DP)、 1960 年代に Kuhn-Tucker (KKT) 条件、 1970 年代に Karmarkar の内点法 (LP の polynomial-time 解法) が提案された。 機械学習分野では 1986 年に Rumelhart らが backpropagation を再発見し、 勾配降下法によるニューラルネット学習が広まった。 2010 年代のディープラーニング革命では、 SGD with momentum (Sutskever 2013)、 Adagrad (Duchi 2011)、 RMSProp (Hinton 2012)、 Adam (Kingma-Ba 2014) が次々と提案され、 非凸最適化の実用解法が整備された。 2014 年に Generative Adversarial Network (GAN) が min-max 最適化問題として定式化され、 ゲーム理論的最適化が再注目された。 2019 年に LARS/LAMB (You et al.) が大規模分散学習用に提案され、 1000 GPU 規模での learning rate scaling が可能になった。 2023 年以降は Sharpness-Aware Minimization (SAM, Foret et al. 2020) が汎化性能向上のための新パラダイムとして注目を集めている。
関連分野での発展
運用研究 (OR) では Vehicle Routing、 Job Scheduling、 Network Flow など組合せ最適化問題が研究されており、 Gurobi、 CPLEX、 SCIP などの商用ソルバが標準。 機械学習では SGD 系最適化 (Adam、 AdamW、 Lion) と二次法 (L-BFGS、 Hessian-free) が使い分けられる。 強化学習では政策勾配法 (REINFORCE、 PPO、 SAC) が連続行動空間で標準。 ベイジアン最適化 (Gaussian Process + Expected Improvement) はハイパーパラメータ調整・実験計画法 (DOE)・材料科学で広く使われる。 進化計算 (遺伝的アルゴリズム、 CMA-ES) は非微分可能問題・ブラックボックス問題で利用される。 量子コンピュータでは QAOA (Quantum Approximate Optimization Algorithm) が組合せ最適化の量子加速を狙う。 SSDSE-B-2026 を用いた都道府県別資源配分問題 (医療従事者・教育投資・防災予算の配分) は、 多目的最適化 (NSGA-II など Pareto front 探索) で「公平性 vs 効率性」のトレードオフを可視化する研究事例がある。 公共政策における最適化は、 単一目的の数値最大化だけでなく、 複数ステークホルダーの効用関数を考慮したマルチエージェント最適化や、 因果推論と組み合わせた政策最適化 (off-policy evaluation) が新興分野。
🗺 最適化 の概念マップ
『最適化』は数理科学・運用研究・機械学習の交差点に位置し、 以下の枝分かれを持つ 巨大な概念ツリー です。
最適化 (Optimization)  ← このページ
  ├── 連続最適化 (Continuous)
  │   ├── 線形計画 LP ─ scipy.optimize.linprog, HiGHS, Gurobi
  │   ├── 二次計画 QP ─ Markowitz portfolio, SVM
  │   ├── 凸最適化  ─ cvxpy で記述、 大域最適保証
  │   │    ├── SOCP (二次錐計画) ─ ロバスト LP
  │   │    └── SDP (半正定値計画) ─ MAX-CUT, 行列補完
  │   └── 非線形 NLP ─ scipy.minimize (SLSQP, BFGS), IPOPT
  │        ├── 制約なし: 最急降下、 Newton、 BFGS
  │        └── 制約付き: ラグランジュ乗数、 KKT, SQP
  ├── 離散最適化 (Discrete)
  │   ├── 整数計画 IP ─ 分枝限定法
  │   ├── 混合整数 MILP ─ CBC, Gurobi, CPLEX
  │   ├── 組合せ最適化 ─ TSP, ナップサック, グラフ問題
  │   └── 制約充足 CSP ─ OR-Tools CP-SAT
  ├── 確率最適化 / ロバスト最適化
  │   ├── Stochastic Programming ─ 期待値最適化
  │   └── Robust Optimization ─ 最悪ケース最適化
  ├── 大規模・分散最適化
  │   ├── ADMM ─ 並列分解
  │   └── Frank-Wolfe, Coordinate Descent
  └── 機械学習における最適化
       ├── 勾配法 (SGD, Adam, AdamW)  ── このページの兄弟
       ├── 凸経験リスク (Lasso, SVM, ロジスティック)
       └── 非凸最適化 (NN, 行列分解, GAN)
完全な概念マップは 🗺 概念マップ で確認できます。
📋 学習チェックリスト ── 最適化 を使いこなすために
- ☐ 最適化(Mathematical Optimization)の定義を、 自分の言葉で 30 秒で説明できる
- ☐ 数式または手続きの『各記号 / ステップ』が何を意味するか言える
- ☐ SSDSE-B(または同等の実データ)で手を動かして試した
- ☐ 主な落とし穴 5 つを挙げられる
- ☐ 類似手法との違いを 1 行で説明できる
- ☐ 何の前提(独立性、 線形性、 分布など)を要求するか把握した
- ☐ 結果の不確実性(信頼区間・予測区間・分散)を扱えるか確認した
- ☐ 上位カテゴリ『最適化』のグループ教材を読んだ
- ☐ 関連手法と比較したうえで、 なぜ 最適化 を選んだか文書化した
- ☐ 結果を再現できるよう、 seed・バージョン・データ取得日を記録した
📜 歴史と発展
最適化の歴史は古代ギリシャの極値問題 (アルキメデス) に遡る。 17 世紀には Fermat / Lagrange が解析的最適化を確立、 Lagrange は ラグランジュ乗数法 (1788) で制約付き最適化の基礎を作った。 1847 年 Cauchy が最急降下法を提唱。 20 世紀に入り Kantorovich (1939) と Dantzig (1947) が 線形計画法 (LP) と シンプレックス法 を独立に開発、 第二次世界大戦の物資輸送最適化が誕生のきっかけ (これが OR/オペレーションズ・リサーチの始まり)。 1958 年 Land & Doig が 整数計画の分枝限定法、 1979 年 Khachiyan が LP の多項式時間解法 (楕円体法)、 1984 年 Karmarkar が実用的な 内点法 を提案。 1960 年代以降の Bellman の動的計画、 凸計画の Rockafellar (1970)、 1995 年 Boyd の SDP・SOCP の体系化、 2004 年 Boyd & Vandenberghe『Convex Optimization』で凸最適化が機械学習に浸透。 現代では Gurobi/CPLEX (商用) と CBC/HiGHS (OSS) が業界標準、 大規模ニューラルネットでは Adam (2014)、 AdamW (2017) 等の確率的最適化が事実上の標準。
最適化の歴史で押さえるべきは、 境界が「線形か非線形か」から「凸か非凸か」へ移ったことです。 Dantzig (1947) のシンプレックス法以来、 長らく線形計画が実用の中心でした。 それを塗り替えたのが Rockafellar (1970) の凸解析と Boyd & Vandenberghe (2004)『Convex Optimization』で、 「凸なら大域最適が保証される」という一線が実務の判断基準になりました。 深層学習は非凸なのに動くという点で、 この枠組みの外にあります。
🚀 応用事例 ── 最適化 はどこで使われているか
『最適化』は理論だけでなく、 産業・研究の様々な現場で実用されています。 ここでは代表的な応用を 6 つ挙げます。
- 物流 / SCM — 工場・倉庫立地、 輸送ルート、 在庫管理 (MILP, ネットワーク最適化)
- スケジューリング — シフト計画、 機械の生産順序、 鉄道ダイヤ (MILP, CP-SAT)
- ポートフォリオ運用 — Markowitz の平均分散最適化 (QP)、 ロバスト最適化 (SOCP)
- 機械学習 — SVM (QP)、 Lasso (凸計画)、 NN 学習 (非凸 + SGD/Adam)、 ハイパーパラメータ Bayes 最適化
- 制御工学 — モデル予測制御 (MPC) は各時刻で QP/SOCP を解く
- 電力網運用 — Unit Commitment (MILP)、 OPF (NLP/SOCP) で系統運用を最小費用化
- 通信 — 5G リソース割当、 ビームフォーミング (SDP/SOCP)、 ネットワーク設計
- 公共政策 — SSDSE-B-2026 の県別データから防災予算配分、 医療資源配置を LP/MILP で計画
どの応用も「何を入力とし、 何を出力すべきか」を整理した上で、 上の Python 実装をベースに拡張するアプローチが定石です。 SSDSE-B のような公開データセットで小さく試し、 動作確認できてから本番データに展開すると安全です。
📊 ベンチマーク比較 ── 最適化 の主要バリエーション
『最適化』には多くの派生・バリエーションがあります。 代表的なものを精度・特徴で比較した表です。
| 手法 / バージョン | 指標 / 特徴 | 備考 |
|---|---|---|
| シンプレックス法 | LP の頂点列挙、 平均高速 | Dantzig 1947、 古典中の古典 |
| 内点法 (Interior Point) | LP/QP/SOCP/SDP に多項式時間 | Karmarkar 1984、 大規模 LP に強い |
| 分枝限定法 (B&B) | MILP の最適解列挙 | NP-hard だが切除平面で実用化 |
| ニュートン法 / 準ニュートン | 2 次収束、 Hessian (近似) 利用 | 滑らかな凸 NLP に最適 |
| SQP (逐次二次計画) | 非線形制約 NLP の標準 | scipy.optimize.minimize の SLSQP |
| 勾配法 (SGD/Adam) | 大規模・微分可能・非凸 | 機械学習・深層学習の主役 |
| 遺伝アルゴリズム (GA) | 微分不要、 非凸 OK | DEAP, pymoo、 局所最適脱出に強い |
| 焼きなまし (SA) | 確率的探索、 組合せ最適化 | TSP, ナップサック等で実績 |
それぞれ得意な問題クラスが異なる。 LP/QP なら HiGHS/Gurobi、 MILP なら CBC/Gurobi、 滑らかな NLP なら IPOPT/SLSQP、 大規模 NN なら Adam が定石。 問題のクラス分けを誤ると 1000 倍遅くなる。
✨ 実装ベストプラクティス ── 最適化 を堅牢に使う
- 小さく始める — SSDSE-B の 47 行のような小データでパイプライン全体を確立してから本番データへ。
- seed を固定 — numpy, torch, random の全 seed を記録。 再現性チェックは必須。
- バージョン管理 — requirements.txt と環境スナップショット、 データの取得日を記録。
- 段階的に複雑化 — まずベースライン(線形、 ロジスティック)→ 古典的 ML → 最適化 の順。 突然複雑化しない。
- 可視化を欠かさず — 学習曲線、 特徴分布、 残差プロットを毎回確認する。
- テスト集合を分離 — 探索・調整に絶対使わない『最終評価』用データを別途確保。
- ハイパーパラメータは記録 — 全実験で何を試したか mlflow / wandb / spreadsheet に。
- 失敗パターンも残す — 「ダメだった設定」も価値がある。 後輩や未来の自分が助かる。
🔍 似た用語との違い ── 最適化 を正確に切り分ける
『最適化』は周辺の似た用語と混同されがちです。 ここでは特に紛らわしい用語との本質的な違いを整理します。
- 『最適化』は 最適化 カテゴリの中で特定の役割を持つ。 一般概念と混同しないよう注意。
- 類似手法と比べて得意な領域:上の『🚀 応用事例』で挙げた問題群。
- 類似手法と比べて不得意な領域:『⚠️ 落とし穴』に明示された制約に該当する場合。
- 使い分けの目安:データ量、 計算リソース、 解釈性要求、 精度要求の 4 軸でマトリクスを作る。
- 不確かなときは両方走らせて結果を比べるのが正解。 SSDSE-B のような小データなら 1 時間で試せる。
📖 さらに深く学ぶリソース
教科書・本
- Bishop『Pattern Recognition and Machine Learning』 — 統計的機械学習の古典
- Goodfellow『Deep Learning』 — 深層学習の標準教科書(無料 PDF あり)
- Murphy『Probabilistic Machine Learning』 — Bayes 視点の機械学習
- 有賀『仕事ではじめる機械学習』 — 実務寄り、 日本語
論文プラットフォーム
- arXiv.org — 最新プレプリント(cs.LG, stat.ML カテゴリ)
- Papers with Code — 論文と実装コードがセット
- OpenReview — NeurIPS, ICLR の査読プロセスが見える
- Google Scholar — 引用ネットワークで辿る
ライブラリ・実装
- scikit-learn — 古典的 ML の標準
- PyTorch / TensorFlow — 深層学習
- Hugging Face Transformers — Transformer 系モデル
- OpenAI / Anthropic / Google API — LLM の API
公開データセット
- SSDSE-B(本ページの実例で使用)—
data/raw/SSDSE-B-2026.csv。 47 都道府県の社会・人口指標 - SSDSE-A / SSDSE-C / SSDSE-D / SSDSE-E — 統計コンペで頻出
- e-Stat — 政府統計の総合窓口
- RESAS — 地域経済分析システム
🔎 最適化 を深く知る ── 専門家視点の詳細
最適化の主要バリエーション
| 手法 | 更新式 | 特徴 |
|---|---|---|
| SGD | θ ← θ - η ∇L | シンプル、 lr 調整必要 |
| Momentum | v ← βv + ∇L; θ ← θ - ηv | 慣性で鞍点脱出 |
| Nesterov | 先読み勾配 | 理論収束↑ |
| AdaGrad | 学習率を要素ごとに調整 | 疎勾配 OK、 lr 自動減衰 |
| RMSProp | 二乗勾配の指数移動平均 | 非定常 OK |
| Adam | Momentum + RMSProp | 事実上の標準 |
| AdamW | 重み減衰を切り離す | Transformer 標準 |
| LION (2023) | sign(運動量) | 省メモリ |
収束性の理論
凸関数なら最急降下法は O(1/k) の速度で大域最適に収束(k は反復回数)。 強凸関数なら線形収束 O(ρ^k)(ρ<1)。 非凸では局所最適保証のみ。 SGD はミニバッチノイズにより鞍点を脱出しやすく、 大規模深層学習では実用上 batch GD より良いことが多い。
適応的学習率の威力
AdaGrad/RMSProp/Adam は各パラメータ毎に学習率を自動調整する。 これにより、 sparse な勾配(NLP の埋め込み層など)でも安定学習が可能。 Adam は深層学習のデフォルトであり、 99% のケースで「とりあえず Adam で lr=1e-3」が動く。
2 階情報を使う手法
- Newton 法:Hessian の逆行列を使う。 高コストだが 2 次収束
- L-BFGS:Hessian を近似、 メモリ効率良
- Conjugate Gradient:共役最適化、 線形系に有効
- K-FAC:Fisher 情報行列の近似、 深層学習向け
- Sophia (2023):軽量な 2 階情報利用
本セクションは『最適化』の技術的核心を深掘りしました。 表面的な使い方を超えて、 内部の仕組みを理解することで、 トラブル時の診断や応用時のカスタマイズが可能になります。 SSDSE-B のような実データに当てはめながら、 ぜひ手を動かして確認してください。
🔗 隣接手法への橋渡し
「最適化」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): 目的関数・制約 の定式化、 凸性 判定、 勾配 の計算可能性確認
- 並列 (同目的の代替): 勾配降下法、 ニュートン法、 ラグランジュ法、 メタヒューリスティクス が解法選択肢
- 下流 (結果の活用): 収束 判定、 局所最小 回避、 ハイパーパラメータ最適化 (Optuna) への応用
この上流・並列・下流の対応を地図化することで、 「最適化」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「最適化」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 数値データ・小〜中規模 → 「最適化」やその拡張手法を直接適用
- カテゴリデータ → カテゴリ専用の手法 (組合せ最適化) と組み合わせ
- 大規模・高次元 → 計算効率を考慮した派生手法 (確率的勾配法・メタヒューリスティクス) を選択
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「最適化」を中核とした適切な手法選択ができる。
🧭 解説深化 ── 直感・落とし穴・発展の総まとめ
ここまでの各セクションを踏まえ、 最適化を「一段深く」理解するための要点を、 直感・落とし穴・発展の 3 層で整理し直します。 本ページの他セクション(🎨 直感で掴む / 🎮 触って理解する / ⚠️ 落とし穴 / 🚀 応用)を横断的につなぐ「地図の索引」として読んでください。
🎨 直感の核 ── 「良い点の条件」と「探し方」を分けて考える
最適化は突き詰めると 2 つの問いに分解できます。 (1)最適解はどんな条件を満たすか(=最適性条件)、 (2)その点をどう探すか(=アルゴリズム)。 この 2 つを混同しないことが理解の第一歩です。
- 制約なしの最適性条件: 内点の最小点では勾配がゼロ $\nabla f(x^*)=0$(1 階条件)。 さらにヘッセ行列 $\nabla^2 f(x^*)$ が半正定値なら極小(2 階条件)。 勾配ゼロだけでは「谷底・尾根・鞍点」の区別がつかない点に注意。
- 制約ありの最適性条件(KKT): 制約付きでは勾配ゼロが $\nabla f + \sum_i\lambda_i\nabla g_i + \sum_j\mu_j\nabla h_j = 0$ に置き換わり、 これに相補性 $\lambda_i g_i=0$・双対実行可能性 $\lambda_i\ge 0$・実行可能性を加えた KKT 条件が必要条件になります(凸なら十分条件)。 直感的には「最適点では、 目的関数を下げたい方向が、 制約の壁からの反力とちょうど釣り合う」状態です。
- 探索 vs 列挙: 連続変数なら勾配という「傾き情報」を使って坂を下る探索(勾配降下法 / 勾配法)が効率的。 一方、 変数が離散(0/1・整数)だと傾きが定義できず、 原理的には候補を列挙して比べるしかない — ただし全探索は現実的でないため分枝限定法で賢く枝刈りします(組合せ最適化)。
- 凸と非凸の決定的な違い: 目的関数と実行可能領域がともに凸なら「谷は 1 つ」— 局所最適がそのまま大域最適になり、 どこから探し始めても最良解に届きます。 非凸では谷が複数あり、 手近な谷(局所最適)に捕まりうる。 この差が「初期値を気にすべきか否か」を決めます(連続最適化 / 大域最小 / 局所最小)。
⚠️ 落とし穴の深層 ── なぜ最適化は「動くのに間違える」のか
最適化コードは infeasible 等の明示エラーを出さず「もっともらしい解」を返してしまうため、 誤りが表面化しにくいのが怖いところです。 特に踏み抜きやすい罠を、 メカニズムから押さえます。
- 局所最適への収束(非凸): 勾配ゼロは「その近所で最良」を意味するだけ。 単一実行の解を鵜呑みにせず、 複数初期値からの multi-start や後述の大域的手法で裏を取ります(🎮 セクションの「ランダム再スタート」を体感してください)。
- 学習率/ステップ幅の設定: ステップが大きすぎると谷を飛び越えて発散・振動、 小さすぎると収束が遅く局所解に居着く。 「小さければ安全」は誤りで、 適切なスケジュール(warm-up・cosine annealing)や適応的手法が要ります。
- 鞍点(saddle point): 高次元では、 局所最適よりも「ある方向は上り・別方向は下り」の鞍点が圧倒的に多い。 勾配はほぼゼロになり停滞するが最適ではない。 モーメンタムやミニバッチ由来のノイズ(SGD)が脱出を助けます。
- 制約の見落とし: 「予算 100 億まで」(不等式)と「ぴったり 100 億」(等式)は最適値も双対変数の符号条件も変わる。 暗黙の非負条件・上下限・整数条件を書き忘れると、 数学的には最適でも現実には無意味な解(負の配分、 半分の倉庫)になります。
- スケーリング/条件数で収束が遅い: 変数間で桁が大きく違うと目的関数の等高線が細長い谷になり、 勾配法がジグザグして進まない。 実測で示すと、 SSDSE-B-2026(2023 年・47 県)では総人口 A1101 が鳥取県 537,000 人 〜 東京都 14,086,000 人と最大 26.2 倍の開き、 さらに高齢化率(A1303/A1101)は東京都 22.8% 〜 秋田県 39.1% のオーダー。 人口(約 10⁶)と率(約 10¹)を同じ最適化に混ぜるとスケール差は約 8.4 万倍に達し、 標準化なしでは内点法・SQP の収束が悪化します。 標準化・単位再設計・前処理が安定化の第一歩。
- 離散最適化の組合せ爆発: 47 県から $k$ 県を選ぶ組合せは $\binom{47}{k}$ で、 $k=10$ でも約 92 億通り。 全探索は非現実的で、 変数が増えると指数的に膨らむ(NP-hard)。 分枝限定・切除平面・良い定式化・ヒューリスティクスの併用が生命線です(組合せ最適化)。
- 過学習を招く過剰最適化: 訓練データの目的関数を「完璧に」最小化すると、 検証データで性能が落ちる。 最適化の腕を上げるほど過学習に近づくという逆説があり、 正則化(L1/L2)・early stopping・交差検証で「あえて最後まで最適化しない」判断が要ります。
🚀 発展への橋渡し ── 保証・双対・確率的手法・大域最適化
深掘りの方向は大きく 4 つ。 それぞれ本教材内の関連ページへ橋を架けます。
- 凸最適化の保証: 問題を凸に「定式化できる」なら、 局所最適=大域最適・停止すれば最良という強い保証が付き、 解の信頼性が段違いになります。 Lasso・SVM・ロジスティック回帰が凸に落ちるのはこの恩恵。 まず「凸にできないか」を検討する価値があります(グループ教材: 📚 凸最適化 / OR。 単独ページ
convex-optimization.htmlは未整備のためテキスト参照)。 - ラグランジュ乗数・双対性: 制約を目的関数に取り込む Lagrange 関数から双対問題が生まれ、 双対変数はシャドープライス(制約 1 単位緩和の限界価値)として解釈できます。 強双対性が成り立てば主問題と双対問題の最適値が一致し、 最適性の証明や感度分析に使えます(本ページ「📐 定義」「🔬 数式を言葉で読み解く」を参照。 単独ページ
lagrange-multiplier.htmlは未整備のためテキスト参照)。 - 確率的勾配降下 / モーメンタム / Adam: 大規模・非凸な機械学習では、 全データではなくミニバッチで勾配を近似する SGD が標準。 慣性を加える Momentum/Nesterov、 座標ごとに学習率を適応させる AdaGrad/RMSProp、 両者を統合した Adam/AdamW へと発展します(本ページ「🔎 専門家視点」の比較表、 および 勾配降下法 / 勾配法)。
- 大域最適化(焼きなまし / 遺伝的アルゴリズム): 勾配が使えない・多峰性が強い・離散を含む問題では、 温度を下げながら確率的に探索する焼きなまし法や、 解集団を交叉・突然変異で進化させる遺伝的アルゴリズムなどのメタヒューリスティクスが局所解脱出に有効。 大域最適の理論的保証は弱い代わりに適用範囲が広く、 大域最小の近似解を狙います。
🔗 このセクションから辿る関連ページ
本教材内の実在ページへのリンク集です(未整備の項目はリンクせずテキスト表記)。
- 勾配降下法 / 勾配法 — 連続・微分可能問題の基本探索アルゴリズム
- 連続最適化 / 組合せ最適化 — 変数が連続か離散かによる二大系統
- 大域最小 / 局所最小 — 凸/非凸の違いを解の観点から
- メタヒューリスティクス — 焼きなまし・遺伝的アルゴリズム等の大域探索
- 📚 OR / 凸最適化 グループ教材 — LP・凸最適化・ラグランジュ双対・KKT の体系的解説
- 凸最適化・ラグランジュ乗数の単独用語ページ(
convex-optimization.html/lagrange-multiplier.html)は現在未整備のため、 上記グループ教材を参照してください。