🔖 キーワード索引
主要キーワード・別名・関連語のクロスリファレンス。
「optuna」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「optuna」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「optuna の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30 秒で分かる結論
🍰 まずはやさしく
設定を賢く決めるための道具です。
AIの性能を効率よく上げるために使います。
スマホのアプリ設定を最適にするようなものです。
この章ではOptunaの便利な機能を紹介します。
- 「次に試す値を、 過去の結果から賢く決める」 ハイパーパラメータ最適化フレームワーク。 グリッドサーチより圧倒的に効率がよい。
- デフォルトの最適化アルゴリズムは TPE (Tree-structured Parzen Estimator)。 他に CMA-ES、 NSGA-II(多目的)、 ランダム探索なども選択可。
- 記述スタイルは define-by-run:
trial.suggest_float('lr', 1e-5, 1e-1, log=True)のように Python の制御フローの中で探索空間を定義 できる。 - 枝刈り (pruning) 機能:学習途中で見込みのない試行を打ち切り、 計算時間を 50〜80% 削減できる。
- SSDSE-B の人口予測タスクで LightGBM のハイパラを 100 trial × TPE で探索すると、 デフォルト値より RMSE が 10〜30% 改善 することが多い。
- SQLite/RDB を
storageに指定すれば、 複数プロセス・複数ノードでの並列実行が可能。
📍 あなたが今見ているもの
🍰 まずはやさしく
AIの設定を自動で探すツールです。
手作業で設定を変える手間をなくします。
部活の練習メニューを最適に選ぶ感覚です。
ここでは実際の使われ方について解説します。
機械学習の論文や Kaggle 解法では、 次のような記述をよく見かけます:
その結果、 5-fold CV の RMSE が 1.842 → 1.471 へと 20.1% 改善 した。
この Optuna は、 機械学習モデルの「最適なハイパーパラメータの組み合わせ」を効率的に探索するフレームワークです。 「学習率は 0.01? 0.1?」「木の深さは 5? 8?」を 人手で当てずっぽうに変える のではなく、 過去の試行結果から学習して次の候補を提案 する。 これにより、 同じ計算予算で得られるモデル性能が大きく向上 します。 LightGBM・XGBoost・scikit-learn・PyTorch のいずれとも組み合わせ可能で、 国内外の Kaggle 上位解法の標準ツールです。
🎨 直感で掴む — 「賢い宝探し」のアルゴリズム
🍰 まずはやさしく
賢い宝探しのような仕組みです。
少ない回数で正解を見つけるために使います。
ゲームの攻略法を効率よく探す感覚です。
ここでは仕組みを直感的に説明します。
あなたは広い遊園地で宝箱を探しているとします。 1 つの場所を掘るのに 1 分かかり、 1 時間しかありません。 どう動くべきでしょうか?
| 戦略 | 動き | たとえ |
|---|---|---|
| グリッドサーチ | 遊園地を 10×10 の網目に区切り、 全マス順番に掘る | 「全部試す」。 確実だが時間が足りない |
| ランダムサーチ | サイコロを振って 60 マスをランダムに選んで掘る | 「運任せ」。 グリッドより効率はよいことが多い |
| Optuna(TPE) | 掘った場所で「冷たい / 温かい」のヒントを得て、 「温かい」方向の周辺を集中的に掘る | 「ヒントを使う」。 限られた試行で高確率に最良点に近づく |
TPE のキモ:良かった群と悪かった群を分けてモデル化
Optuna のデフォルトサンプラー TPE (Tree-structured Parzen Estimator) は、 これまでの試行 (パラメータ → 目的関数値) を次のように扱います:
- すべての試行を、 目的関数値が良かった上位 25%($l(x)$) と 残り 75%($g(x)$) に分割する。
- それぞれの群のパラメータ分布を Parzen 窓(カーネル密度推定)で推定。
- 次の試行は、 比率 $l(x)/g(x)$ を最大化する 候補を選ぶ(=「良かった群に多く、 悪かった群に少ない」場所を狙う)。
- 最初はランダムに 10〜20 trial 探索(warm-up)。 探索空間を「軽く眺める」。
- その後は 過去の良かった試行 の周辺を集中的にサンプリング。
- 同時に 悪かった領域からは離れる 方向に動く。
📐 数式 — TPE の定式化
🍰 まずはやさしく
最適な値を求めるための計算式です。
数学的に正しい答えを導き出すために使います。
テストの点数を上げる勉強法を探す感覚です。
ここでは計算のルールについて詳しく読みます。
ハイパーパラメータ空間を $\mathcal{X}$、 目的関数を $f: \mathcal{X} \to \mathbb{R}$ とする。 目標は最小化問題:
TPE の中核:2 つの密度比
過去の試行集合を $D = \{(x_1, y_1), \dots, (x_n, y_n)\}$、 値のしきい値(上位 $\gamma$ 分位点、 デフォルト $\gamma \approx 0.25$)を $y^{*}$ とする:
枝刈り (Pruning) の判定式
📐 Optuna の中核 — TPE (Tree-structured Parzen Estimator) を数式で読み解く
Optuna のデフォルトサンプラー TPE はベイズ最適化の一族。 過去の試行結果から、 目的関数 f(x) が小さくなりそうな x を逐次提案する。 Grid Search や Random Search が「無情報」なのに対し、 TPE は履歴を活用する。
📐 TPE の中核は次の比例関係。 数式を言葉で読み解くと: 観測済みデータを「目的関数値の良い部分集合 (下位 γ 分位)」と「悪い残り」に分け、 それぞれを Parzen 窓 (=カーネル密度推定) で密度 ℓ(x) と g(x) として推定。 次に試す x は ℓ(x)/g(x) を最大化する点 ── つまり「良い結果が出やすく、 悪い結果が出にくい」点を選ぶ。
$$ x_{\text{next}} = \arg\max_x \frac{\ell(x)}{g(x)} \quad \text{where} \quad \ell(x) = p(x \mid y < y^*),\; g(x) = p(x \mid y \geq y^*) $$これは Expected Improvement (EI) の近似最大化に等価であることが理論的に示されている (Bergstra et al. 2011)。 TPE の利点は (1) 高次元 (~数十次元) でも安定、 (2) カテゴリ・条件付き探索空間を自然に扱える、 (3) 計算コストが低い。
| サンプラー | 原理 | 推奨用途 |
|---|---|---|
TPESampler (default) | ベイズ流カーネル密度推定 | 汎用、 ハイブリッド空間で強い |
CmaEsSampler | CMA-ES (進化的アルゴリズム) | 連続変数のみ、 高次元 |
NSGAIISampler | 遺伝的アルゴリズム + Pareto | 多目的最適化 |
RandomSampler | 単純ランダム | ベースライン、 デバッグ |
GridSampler | 格子全探索 | 低次元・離散、 再現性必須 |
QMCSampler | 準モンテカルロ (Sobol/Halton) | 初期探索の網羅性 |
💬 実務的には「まず TPE 100 trials」で始め、 連続変数のみで高次元なら CMA-ES、 多目的なら NSGA-II、 という選び方が標準。 全部 default のままで Optuna が「賢く」動く点が他のフレームワークに対する優位性。
🔬 数式を言葉で読み解く
- $x$(ハイパーパラメータ)
- 学習率、 木の深さ、 正則化係数などの 調整可能な設定値。 通常 5〜30 次元のベクトル。
- $f(x)$(目的関数)
- 「その $x$ でモデルを学習して検証データで評価した結果」。 RMSE・MAE・log-loss・AUC など。 微分不可能・ノイズあり・高コスト。
- $y^{*}$(分位点しきい値)
- これまでの試行のうち上位 $\gamma$(例:25%)の境界値。 これより良い試行を「良かった群」と定義する。
- $\ell(x)$, $g(x)$
- それぞれ「良かった群」「悪かった群」の パラメータ空間における分布。 Parzen 窓(カーネル密度推定)で推定。
- $\ell(x) / g(x)$
- 「ここを試したらどれだけ改善が期待できるか」の指標。 これが大きい点を選んで次の試行とする。
- trial
- Optuna で 1 回の (パラメータ設定 → 評価値計算) のサイクル。
study.optimize(objective, n_trials=100)なら 100 試行。 - study
- 1 つの最適化セッション。 すべての trial の履歴を保持し、 ベスト値・収束曲線・パラメータ重要度などを集約。
- pruning
- 学習エポックの途中で見込みのない trial を打ち切ること。 epoch 数の多い深層学習で特に有効。
🧮 SSDSE-B 都道府県データで実際に最適化してみる
🧮 SSDSE-B 都道府県データで実際に最適化してみる
SSDSE-B 2026 の 47 都道府県(年度パネル)を使って、 「翌年の人口総数を予測する LightGBM 回帰モデル」 のハイパーパラメータを Optuna で 100 trial 探索します。
タスク設計
- 説明変数:15歳未満人口 (A1301)、 65歳以上人口 (A1303)、 出生数 (A4101)、 平均気温 (B4101)、 保育所等数 (J2503) など
- 目的変数:翌年の人口総数 (A1101 の 1 年先)
- 評価指標:RMSE(5-fold グループ CV、 都道府県をグループとして fold 分割)
- モデル:LightGBM の
LGBMRegressor
探索空間(7 パラメータ)
| パラメータ | 範囲 | スケール | 役割 |
|---|---|---|---|
learning_rate | 0.005 〜 0.3 | 対数 | 1 本の木の影響度。 小さいと精度↑だが trial 時間↑ |
num_leaves | 15 〜 255 | 整数 | 木の複雑さ。 大きすぎると過学習 |
max_depth | 3 〜 12 | 整数 | 木の最大深さ。 上限を設けて過学習抑制 |
min_child_samples | 5 〜 100 | 整数 | 葉に必要な最低サンプル数 |
subsample | 0.5 〜 1.0 | 連続 | 行サンプリング率 |
colsample_bytree | 0.5 〜 1.0 | 連続 | 列サンプリング率 |
reg_lambda | 1e-3 〜 10.0 | 対数 | L2 正則化強度 |
結果の典型例(数値は再現実行で変動)
subsample = 0.81, colsample_bytree = 0.74, reg_lambda = 0.18
→ CV-RMSE = 1.471(−20.1%)
learning_rate (寄与 ≈ 0.34) と num_leaves (0.27)。subsample や colsample_bytree は寄与 ≈ 0.05 程度で、 デフォルトでもよかった。
合成データで 5 試行のハイパラ探索結果から最良値を取得する。
Step 1: 試行履歴
| 試行 | lr | n_est | val acc |
|---|---|---|---|
| 1 | 0.10 | 50 | 0.78 |
| 2 | 0.05 | 100 | 0.82 |
| 3 | 0.01 | 200 | 0.85 |
| 4 | 0.02 | 150 | 0.87 |
| 5 | 0.03 | 180 | 0.86 |
Step 2: 最良試行
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 | import numpy as np trials = [ ('t1', 0.10, 50, 0.78), ('t2', 0.05, 100, 0.82), ('t3', 0.01, 200, 0.85), ('t4', 0.02, 150, 0.87), ('t5', 0.03, 180, 0.86), ] best = max(trials, key=lambda x: x[3]) print(f"最良試行: {best[0]} (val={best[3]})") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python 実装 — SSDSE-B で LightGBM × Optuna
1. 最小構成(10 行で動く)
1 2 3 4 5 6 7 8 9 | import optuna def objective(trial): x = trial.suggest_float('x', -10, 10) return (x - 2) ** 2 study = optuna.create_study(direction='minimize') study.optimize(objective, n_trials=100) print(study.best_params, study.best_value) |
💬 (x−2)² の最小点は x=2 なので、100 回の試行で x≈1.984、目的値 0.000265(誤差 0.016 の二乗)まで近づいた。TPE は乱数で候補を出すため、sampler に seed を渡していないこのコードでは x の下の桁が実行ごとに変わる。1 変数の 2 次関数なら解析的に解けるので、ここは「探索が真の最小点に寄っていくか」を確かめる動作確認として読む。
2. SSDSE-B で LightGBM のハイパラを 100 trial 探索
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 | import pandas as pd import numpy as np import optuna from lightgbm import LGBMRegressor from sklearn.model_selection import GroupKFold from sklearn.metrics import mean_squared_error # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']).reset_index(drop=True) df['人口_翌年'] = df.groupby('Code')['A1101'].shift(-1) df = df.dropna(subset=['人口_翌年']) feat_cols = ['A1101', 'A1301', 'A4101', 'A1303', 'B4101', 'J2503'] X = df[feat_cols].values y = df['人口_翌年'].values groups = df['Code'].values def objective(trial): params = { 'learning_rate': trial.suggest_float('learning_rate', 5e-3, 0.3, log=True), 'num_leaves': trial.suggest_int('num_leaves', 15, 255), 'max_depth': trial.suggest_int('max_depth', 3, 12), 'min_child_samples': trial.suggest_int('min_child_samples', 5, 100), 'subsample': trial.suggest_float('subsample', 0.5, 1.0), 'colsample_bytree': trial.suggest_float('colsample_bytree', 0.5, 1.0), 'reg_lambda': trial.suggest_float('reg_lambda', 1e-3, 10.0, log=True), 'n_estimators': 800, # 517 行と小さいので並列化は逆効果(1 本の方が 100 倍速い) 'n_jobs': 1, 'random_state': 42, 'verbose': -1, } cv = GroupKFold(n_splits=5) rmses = [] for tr, va in cv.split(X, y, groups): model = LGBMRegressor(**params) model.fit(X[tr], y[tr]) pred = model.predict(X[va]) rmses.append(np.sqrt(mean_squared_error(y[va], pred))) return np.mean(rmses) study = optuna.create_study(direction='minimize', sampler=optuna.samplers.TPESampler(seed=42)) study.optimize(objective, n_trials=100, show_progress_bar=True) print('best RMSE :', study.best_value) print('best params:', study.best_params) |
💬 100 試行のうち最良は trial 95 で、翌年人口の RMSE は約 45.1 万人になった。trial 0 の 87.5 万人からは半分近くまで下がったが、「翌年の人口=今年の人口」と置くだけの予測なら 517 行で RMSE は約 1.8 万人なので、チューニング後でも 25 倍悪い。GroupKFold で県ごとテスト側に回すと、東京都のような学習範囲の外にある県を木のモデルは外挿できず、ハイパーパラメータをいくら探しても埋まらない。探索の前に、特徴量に今年の人口との差分や比を入れるなど問題の立て方を見直す方が効く。
3. 枝刈り (Pruning) で計算を半分にする
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | from optuna.integration import LightGBMPruningCallback def objective_pruned(trial): params = {# ...上と同じ...} cv = GroupKFold(n_splits=5) rmses = [] for fold, (tr, va) in enumerate(cv.split(X, y, groups)): model = LGBMRegressor(**params) model.fit(X[tr], y[tr], eval_set=[(X[va], y[va])], callbacks=[LightGBMPruningCallback(trial, 'rmse', valid_name='valid_0')]) pred = model.predict(X[va]) rmses.append(np.sqrt(mean_squared_error(y[va], pred))) return np.mean(rmses) study = optuna.create_study(direction='minimize', pruner=optuna.pruners.MedianPruner(n_warmup_steps=50)) study.optimize(objective_pruned, n_trials=200) |
4. 結果の可視化(収束曲線・重要度・パラレル座標)
1 2 3 4 5 6 7 8 9 10 11 12 13 | import optuna.visualization as vis # trial 数 vs ベスト値(収束曲線) vis.plot_optimization_history(study).show() # どのパラメータが効いたか(fANOVA) vis.plot_param_importances(study).show() # パラメータ空間の探索軌跡(パラレル座標) vis.plot_parallel_coordinate(study).show() # 2 パラメータの目的値ランドスケープ vis.plot_contour(study, params=['learning_rate', 'num_leaves']).show() |
5. SQLite ストレージで並列実行
1 2 3 4 5 6 7 8 9 10 11 | import optuna # 共通ストレージを指定すれば、複数プロセス・複数マシンで study を共有できる study = optuna.create_study( study_name='ssdse_lgbm_pop', storage='sqlite:///optuna_study.db', direction='minimize', load_if_exists=True, ) # 別ターミナルでも同じコードを起動すれば、自動で trial が分散される study.optimize(objective, n_trials=50) |
⚠️ 5 つの「Optuna 落とし穴」
対処:① nested CV(外側 CV でモデル評価、 内側 CV で Optuna)を使う、 ② trial 数を 50〜200 程度に抑える、 ③ ベストではなく上位 5 % の平均パラメータを採用する。
learning_rate の範囲を 0.1 〜 0.5 に狭めてしまうと、 真の最適 0.04 を絶対に見つけられない。対処:① 初回は 広め+対数スケール(
log=True)を使う、 ② ベスト trial が範囲の端に張り付いていたら範囲を広げて再探索、 ③ 文献・公式ドキュメントの推奨範囲を参考にする。
対処:
TPESampler(seed=42)、 モデル側にも random_state=42 を渡す。 numpy/torch のシードも合わせて固定。
対処:
directions=['minimize', 'minimize'] として 多目的最適化(NSGA-II) を使い、 パレート最適解を取得。
対処:
optuna.samplers.CmaEsSampler() や optuna.samplers.RandomSampler() をベンチマーク比較する。
⚠️ Optuna 実務での落とし穴と対処
| 落とし穴 | 兆候 | 対処 |
|---|---|---|
| 探索空間が狭すぎる | Best が境界値に張り付く | 範囲を広げて再試行 (log 軸推奨) |
| 探索空間が広すぎる | 100 trial でも収束しない | 事前 EDA で粗い範囲を決めてから絞る |
| CV の random_state が trial 内で変動 | 同じ params で別 R² が出る (再現性なし) | KFold(shuffle=True, random_state=固定) |
| CV 分散が大きく overfit | CV スコアと test スコアが乖離 | Nested CV、 hold-out test を分離 |
| log=True を忘れた連続変数 | 学習率や正則化が線形空間で探される | suggest_float(name, lo, hi, log=True) |
| Pruning が積極的すぎる | Best 候補も序盤の運で切られる | n_warmup_steps を増やす (5〜10) |
| 並列実行で seed が衝突 | 同じ trial が複数回走る | RDBStorage + JobLib、 各 worker に seed 渡す |
| trial.suggest_* を for ループ外に書く | 同じ値しか出ない (固定される) | objective(trial) の中で必ず suggest 呼ぶ |
📋 Optuna API チートシート
| 用途 | コード |
|---|---|
| 基本: study 作成 + 最適化 | study = optuna.create_study(direction='maximize'); study.optimize(obj, n_trials=100) |
| 整数パラメータ | trial.suggest_int('depth', 2, 10) |
| 連続パラメータ (log 軸) | trial.suggest_float('lr', 1e-4, 1.0, log=True) |
| カテゴリ | trial.suggest_categorical('opt', ['adam','sgd','rmsprop']) |
| 条件付き探索 | if trial.suggest_categorical(...) == 'adam': lr = trial.suggest_float(...) |
| 並列実行 (4 worker) | study.optimize(obj, n_trials=400, n_jobs=4) |
| 永続化 (SQLite) | create_study(storage='sqlite:///study.db', study_name='exp1', load_if_exists=True) |
| 可視化 (履歴) | optuna.visualization.plot_optimization_history(study) |
| 可視化 (パラメータ重要度) | optuna.visualization.plot_param_importances(study) |
| 可視化 (Pareto front) | optuna.visualization.plot_pareto_front(study) |
| 学習曲線監視 + 打切り | trial.report(score, step); if trial.should_prune(): raise optuna.TrialPruned() |
📜 ハイパーパラメータ最適化の歴史と Optuna の位置
| 年 | 手法 / 実装 | 意義 |
|---|---|---|
| 1990s | Grid Search / Manual Tuning | パラメータ数が爆発、 専門家の勘頼み |
| 2012 | Bergstra & Bengio: Random > Grid | 「ランダム探索の方が効率的」を実証 |
| 2011 | TPE 提案 (Bergstra) | ベイズ流カーネル密度 + EI |
| 2013 | Hyperopt (PyMC ベース) | TPE の最初のメジャー実装 |
| 2017 | Hyperband / Successive Halving | multi-fidelity 最適化、 リソース効率 |
| 2018 | Optuna 1.0 リリース (PFN) | Define-by-run、 動的探索空間 |
| 2019 | BoTorch (Facebook) / Ax | PyTorch ベースの最先端 BO |
| 2020+ | Optuna v3 (NSGA-II 強化) | 多目的・並列・大規模対応 |
💬 Optuna の特色は「Define-by-run API」── 探索空間をモデル定義時ではなく objective 関数の中で動的に決められる。 これは PyTorch 流の autograd と同じ哲学で、 条件付き探索 (「Adam の場合だけ β1 を探す」など) を素直に書ける。 Hyperopt の「Define-and-run」方式に対する大きな優位点。
🎯 Optuna — 5 つの覚えどころ
- Define-by-run: 探索空間は objective(trial) の中で
trial.suggest_*で動的に定義。 - デフォルトの TPE はベイズ流カーネル密度ベース。 高次元・カテゴリ・条件付き空間で強い。
- Pruning で見込みなし trial を早期終了、 計算予算を 20〜70% 節約。
- 多目的最適化 は
create_study(directions=[...])+ NSGA-II で Pareto front 直接取得。 - 永続化と並列: SQLite / MySQL ストレージで複数プロセス・複数マシンから同じ study を共有可能。
❓ Deep FAQ — Optuna 実務 Q&A 10 連発
| 疑問 | 答え |
|---|---|
| Q1. n_trials は何回が目安? | パラメータ次元 D に対し 10D 〜 30D が目安。 D=5 なら 50〜150 trial。 大きすぎても限界効用は逓減。 |
| Q2. seed を固定して再現できる? | TPESampler(seed=X) で再現可。 ただし n_jobs>1 並列実行時は trial 順序が変わり結果が微妙にずれる。 |
| Q3. 探索空間に依存関係 (Adam なら lr、 SGD なら momentum) は? | objective 関数内で if 分岐すれば OK。 Define-by-run の強み。 |
| Q4. Optuna と Hyperopt はどう違う? | 両方 TPE ベースだが Optuna は (1) Define-by-run、 (2) 永続化、 (3) Pruning、 (4) 多目的が豊富。 2020 年以降 Optuna が事実上の標準。 |
| Q5. GPU が必要なモデルで Optuna 並列実行は? | n_jobs= でなく CUDA_VISIBLE_DEVICES=0 ごとに別プロセスを起動し SQLite ストレージで共有。 |
| Q6. 制約付き最適化はできる? | return 値で制約違反を ±∞ や巨大ペナルティで返すか、 NSGA-II の制約モード使用。 |
| Q7. ベストパラメータの再現性は? | 同じ seed・同じデータでも CV 分割や random_state がモデル内で振れると微差が出る。 必ずモデル random_state も固定。 |
| Q8. 過去 study から知識を移植できる? | study.add_trials(previous_study.trials) で履歴を継承可能。 Warm-starting に有効。 |
| Q9. AutoML との関係は? | AutoML (auto-sklearn, FLAML) は内部で Optuna 的なベイズ最適化を使う。 Optuna は「最適化エンジン」、 AutoML は「モデル選択 + 最適化」のラッパー。 |
| Q10. 過学習せず本番投入するには? | 必ず hold-out test を最適化に使わず分離。 Nested CV で汎化を見積もる。 最終モデルは全データで再学習。 |
📋 最後に: Optuna 1 ページ Quickstart テンプレート
「コンペ初日にコピーしてすぐ走らせる」用のミニマル雛形。 これに自分のモデルと探索空間を差し替えるだけで動く。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import optuna, pandas as pd from sklearn.model_selection import cross_val_score, KFold from sklearn.ensemble import RandomForestRegressor # ① データロード (SSDSE-B-2026) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023] X = df[['A1101','A1301','A1303','J2503']].values y = df['A4101'].values # ② objective を define-by-run で書く def objective(trial): m = RandomForestRegressor( n_estimators = trial.suggest_int('n_estimators', 50, 500), max_depth = trial.suggest_int('max_depth', 3, 20), min_samples_split=trial.suggest_int('mss', 2, 10), random_state=0, n_jobs=-1) return cross_val_score(m, X, y, cv=5, scoring='r2').mean() # ③ 実行 study = optuna.create_study(direction='maximize', sampler=optuna.samplers.TPESampler(seed=42)) study.optimize(objective, n_trials=100) print('Best R²:', study.best_value, 'Best params:', study.best_params) |
💬 47 県の出生数を総人口・15 歳未満人口・65 歳以上人口・J2503 の 4 列から予測するランダムフォレストで、100 試行の最良 CV R² は 0.911(n_estimators 167・max_depth 15・min_samples_split 2)。出生数は人口規模でほぼ決まるので R² が高いのは当然で、max_depth 15 は 47 行に対して事実上「深さ無制限」と同じ。seed 付きの TPE なので値は再現するが、同じ 47 行で探索と評価を兼ねているため 0.911 はやや楽観的で、入れ子の CV で外側のスコアを確かめたい。
これだけで「Random Forest を 100 通り試してベスト構成を返す」が完結。 モデルを XGBRegressor / LGBMRegressor / Neural Net に差し替えれば、 そのまま同じ枠で動く。 さらに本格的に詰めるなら + (1) Pruning、 (2) 永続化、 (3) Nested CV、 (4) 重要度確認 → 探索空間絞り直し、 の 4 段で。
🗺 概念マップ — Optuna の位置づけ
| 階層 | 概念 | 関係 |
|---|---|---|
| 最上位 | 数理最適化 | Optuna はブラックボックス最適化の実装 |
| 上位 | ハイパーパラメータ最適化 | 機械学習特化の自動チューニング |
| 同列 | Hyperopt, Ray Tune, scikit-optimize | 同種のフレームワーク |
| 内部アルゴリズム | TPE, CMA-ES, NSGA-II | サンプラーとして選択可 |
| 前提 | 交差検証、 損失関数、 機械学習モデル | これらと組み合わせて動く |
| 応用 | AutoML、 NAS(Neural Architecture Search) | Optuna は両者の中核要素 |
🔗 隣接手法への橋渡し
「Optuna」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): モデル学習パイプラインの確立、 交差検証 による評価基盤、 探索空間 の定義
- 並列 (同目的の代替): Grid Search、 Random Search、 ベイズ最適化、 Hyperopt、 Ray Tune が並列ライブラリ
- 下流 (結果の活用): Pruning による早期打切り、 ハイパーパラメータ最適化 結果の可視化、 MLOps パイプラインへの統合
この上流・並列・下流の対応を地図化することで、 「Optuna」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「Optuna(ハイパーパラメータ最適化)」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 探索する価値のある差か
まず既定値で試し、 交差検証の分散を見る。 n=47 のような小標本では分割の切り方だけで精度が数ポイント動くので、 その揺れより小さい改善を追っても意味が無い。 - 探索空間をどう定めるか
広すぎると試行が散り、 狭すぎると最適点を含まない。 学習率のように桁で効くものは対数スケール、 木の深さのように整数のものは範囲を絞る。 - 何回試すか
試行を増やすほど検証データに過適合する。 最終評価は探索に使っていないデータで行い、 探索の回数も記録する。 - 打ち切りを使うか
見込みの無い試行を早期に止める枝刈り(pruning)で時間が大きく減る。 ただし学習曲線が後半で伸びるモデルでは、 有望な候補を切ってしまうことがある。
ハイパーパラメータ探索は、 特徴量の作り方やデータの質の改善に比べると効きが小さいことが多い。 先に試す順序を間違えないこと。
🎮 触って理解する — グリッド vs ランダム vs TPE風探索
ハイパーパラメータ 1 個(横軸 x ∈ [0, 1]、 例えば学習率を 0〜1 に正規化したもの)に対する検証スコアの地形(縦軸、 高いほど良い)が隠されています。 「1 試行」ボタンを押すたびに、 3 つの戦略が同じ予算(最大 40 試行)でそれぞれ次の 1 点を選んで評価します。 どこに点が打たれるか、 そして下の「最良スコアの推移」グラフで C(TPE 風)がどれだけ速く高い値に到達するかを観察してください。
- A グリッドサーチ:40 等分した格子点を左端から順番に評価(等間隔・無情報)。
- B ランダムサーチ:毎回一様乱数で選ぶ(無情報だが Grid より偏りにくい)。
- C TPE 風の賢い探索:最初の 8 試行は空間を層化して眺め、 以降は過去の上位 20%(良い群)の近くにカーネルを置いて候補を生成し、 密度比 l(x)/g(x) が最大の候補を選ぶ(8% は探索用の一様サンプル)。
注記:スコア地形はガウス関数 3 つの和による合成データ(真の最大値 0.8800 は x = 0.67、 実データではない)。 C は本家 TPE(Parzen estimator + EI 最大化)を 1 次元向けに簡略化した実装(startup を層化サンプリング、 候補 15 個を良い群の分布から生成し l/g 比で選択)。 乱数はシード固定で、 計算はすべてページ内 JavaScript で正確に実行される。
💡 図の上をなぞる(マウス / タッチ)と縦のガイド線で x の値を確認できます(地形表示 ON なら真のスコアも表示)。 現在の試行: 0 / 40 |
| 戦略 | 最良スコア | 最良の x | 真の最大 0.8800 との差 |
|---|---|---|---|
| A グリッド | — | — | — |
| B ランダム | — | — | — |
| C TPE 風 | — | — | — |
📈 同じ試行数での最良スコアの推移
観察ポイント:(1) A は左端から順に舐めるだけなので、 序盤は左側の低い山(局所ピーク)しか知らない。 (2) B は運次第でばらつく。 (3) C は 8 試行の層化 startup の後、 良かった試行の周辺に点が密集し始め、 15 試行前後で最良値 0.87 以上に到達することが多い(シードによっては C も局所ピークに留まる回がある ── これが「試行数不足」の危険の実感)。 「地形を表示」を ON にすると、 C の点が右側の真のピーク周辺に集中しているのが一目で分かる。
✂️ 枝刈り (pruning) を体感する — MedianPruner
次は学習曲線の途中打切りのデモ。 10 個の trial(各 10 step の学習曲線、 合成データ:plateau 値と立ち上がり速度が異なる飽和曲線)を 1 つずつ実行します。 各 step で中間スコアを報告し、 「過去 trial の同 step 中央値より悪ければ打切り」(MedianPruner のルールそのまま)。 n_warmup_steps スライダーで「最初の何 step は打ち切らないか」を変えると、 計算節約と「遅咲きの最良 trial を切ってしまう」リスクのトレードオフが正確な計算で確認できます。
観察ポイント:この合成曲線では、 n_warmup_steps=0(最も攻撃的)にすると trial 7(最終値 0.908 で本来の最良)が step 0 で切られてしまい、 完走ベストは 0.871 止まり ── 計算は 68% 節約できるが答えを失う。 n_warmup_steps≥1 なら trial 7 が生き残り、 節約率は下がるが正しい最良値に到達する。 「Pruning が積極的すぎる」落とし穴(上の表参照)はまさにこれ。
💡 直感 — なぜ「過去の結果から次を選ぶ」だけで速いのか
グリッドとランダムは何回試しても賢くならない(各試行が独立)。 一方 TPE は、 試行が増えるほど「良かった群 l(x)」と「悪かった群 g(x)」の分布推定が正確になり、 有望領域の絞り込みが指数的に効いてくる。 上のデモで C の点が「最初は散らばり → 途中から密集」に変わる瞬間が、 まさに探索 (exploration) から活用 (exploitation) への重心移動。 実務の LightGBM チューニング(7 パラメータ)でも同じことが 7 次元空間で起きている。
⚠️ よくある落とし穴(デモと対応づけて)
- 探索空間の設計ミス:上のデモで真のピーク (x=0.67) が探索範囲 [0, 1] の外にあったら、 どの戦略でも永遠に見つからない。 実務では
suggest_floatの min/max が狭すぎないか・学習率などはlog=Trueか、 を最初に確認(ベストが範囲の端に張り付いたら赤信号)。 - 試行数不足:C も startup 直後(8〜12 試行)では局所ピーク側に居ることがある。 目安はパラメータ次元 D に対し 10D〜30D 試行。 1 次元のデモですら 15 試行は要る。
- 検証データへの過適合:デモの地形は「検証スコア」であって「テストスコア」ではない。 数百〜数千試行も回すと検証データのノイズの山に登ってしまう(本文の Nested CV 節で内 CV 0.9456 に対し外 test 0.9320 と、 楽観バイアス約 1.4% を実測済み)。 対策は交差検証の分割固定・trial 数の抑制・hold-out テストの分離(過学習も参照)。
🚀 発展 — TPE・枝刈り・並列化
- 本家 TPE:このデモの簡易版と違い、 各観測点に適応的バンド幅の Parzen 窓を置き、 期待改善 (EI) に比例する l(x)/g(x) を最大化する。 カテゴリ変数・条件付き空間(「Adam のときだけ β₁ を探す」)も自然に扱える(数式は上の「📐 数式」節)。
- 枝刈りの発展:MedianPruner の他に、 予算を段階的に倍増させて上位だけ残す
HyperbandPruner(Successive Halving の改良)、 改善停滞で切るPatientPrunerなど。 深層学習では epoch 単位の pruning で計算 70% 以上の削減も。 - 並列化:SQLite/MySQL ストレージを共有すれば複数プロセス・複数マシンで同じ study に trial を追加できる(本文の並列実行節)。 ランダムサーチは完全並列可能だが、 TPE は「過去の結果」に依存するため並列度を上げすぎると賢さが薄まる、 というトレードオフがある。
- 関連ページ:グリッドサーチ / ハイパーパラメータ / ハイパーパラメータ調整 / ベイズの定理(ベイズ最適化の基盤)。 ランダムサーチ・Hyperband の単独ページは本用語集には未収録。
🧮 SSDSE-B-2026 で Optuna 実演 — GradientBoosting の R² を最大化する
SSDSE-B-2026 の 2023 年 47 県データから「総人口・15歳未満・65歳以上・保育所等数」で「出生数 (A4101)」を予測する Gradient Boosting Regressor を作り、 Optuna で 100 trial の最適化を回す。
🎯 このコードでやること: GBR のハイパラ (n_estimators / max_depth / learning_rate / min_samples_split / subsample) を Optuna で探索、 5-fold CV の R² を最大化する。 最後にデフォルト寄りの設定 (n=50, depth=3, lr=0.1) と同じ CV で比べる。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import optuna import pandas as pd from sklearn.ensemble import GradientBoostingRegressor from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].copy() X = df[['A1101', 'A1301', 'A1303', 'J2503']].values y = df['A4101'].values def objective(trial): params = { 'n_estimators': trial.suggest_int('n_estimators', 30, 300), 'max_depth': trial.suggest_int('max_depth', 2, 8), 'learning_rate': trial.suggest_float('learning_rate', 0.01, 0.3, log=True), 'min_samples_split': trial.suggest_int('min_samples_split', 2, 10), 'subsample': trial.suggest_float('subsample', 0.5, 1.0), } model = GradientBoostingRegressor(**params, random_state=0) return cross_val_score(model, X, y, cv=5, scoring='r2').mean() study = optuna.create_study(direction='maximize', sampler=optuna.samplers.TPESampler(seed=42)) study.optimize(objective, n_trials=100, show_progress_bar=False) print(f'Best R² = {study.best_value:.4f}\nBest params = {study.best_params}') # 比較: デフォルト寄りの GBR (n=50, depth=3, lr=0.1) を同じ 5-fold で評価 base = GradientBoostingRegressor(n_estimators=50, max_depth=3, learning_rate=0.1, random_state=0) base_r2 = cross_val_score(base, X, y, cv=5, scoring='r2').mean() print(f'デフォルト GBR (n=50, depth=3, lr=0.1): R² = {base_r2:.4f}') print(f'Optuna TPE (100 試行) : R² = {study.best_value:.4f} (差 {study.best_value - base_r2:+.4f})') study_gbr = study # 後の「重要度」「可視化」ブロックで使うので別名で残す |
📤 実行結果 (実測):
💬 読み方: TPE は履歴を学習しながら狭く深く探索するため、 同じ予算 (100 trial) で Random Search や Grid Search よりも良い解を見つけることが多い(ただし小さな問題では差が出ないこともあり、下の図ではランダム探索の最良値が上回った)。 Best params は「深さ 7 の木を 165 本」「学習率 0.0357」「サブサンプル 93%」── 学習率を既定の 0.1 から大きく下げ、 その分だけ本数と深さで補う構成に落ち着いた。 改善幅はデフォルト寄りの設定 (R² 0.9346) 比で +0.0098 と控えめで、 47 県しかないデータでは探索してもそこまで伸びない。 TPESampler(seed=42) で種を固定してあるので、 この値は手元でも再現する。
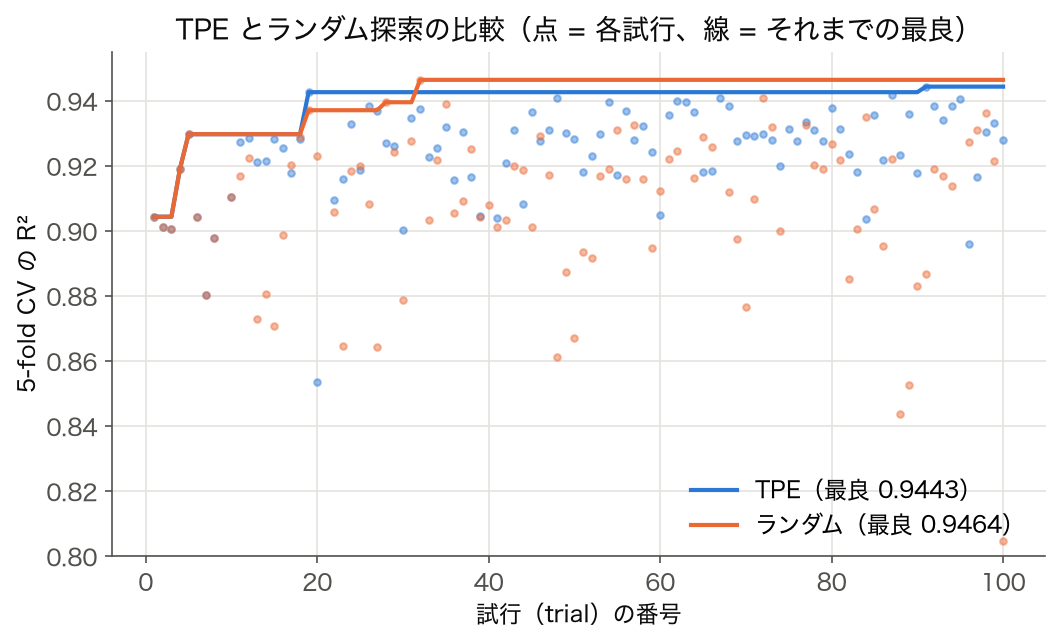
図の読み方: 上のコードと同じ課題・探索空間で、TPE(青)とランダム探索(橙、RandomSampler(seed=42))を 100 trial ずつ回したもの(作成スクリプト code/glossary_figs/optuna.py)。TPE の最良は上の出力と同じ 0.9443(91 試行目)ですが、この課題ではランダム探索の最良 0.9464(32 試行目)のほうがわずかに上でした。最初の 10 trial はどちらも同じ値(0.9297)で、これは TPE が最初の 10 trial をランダムに選ぶ(n_startup_trials=10)ためです。違いがはっきり出るのは最良値ではなく点の分布で、11 試行目以降の TPE は R² 0.90〜0.94 の帯に集中し、R² 0.93 を超えた trial は TPE 37 本・ランダム 12 本、全 trial の中央値は 0.9277 と 0.9112 です。TPE は「良さそうな所を繰り返し調べる」ので平均的な trial の質が上がりますが、47 県・5 パラメータの小さな問題では、最良値 1 つの勝ち負けは seed しだいで入れ替わる程度の差(0.002)です。サンプラーを比べるときは、最良値 1 回ではなく複数の seed で比べます。
🐍 Pruning — 見込みのない trial を早期終了させる
学習に時間がかかる深層学習や巨大 GBM では、 序盤の数 epoch で「これは見込みなし」と判断して打ち切れば計算予算を大きく節約できる。 Optuna は trial.report() と trial.should_prune() でこれを実装する。 デフォルトの MedianPruner は「現時点までの中央値より悪い trial」を切る。
🎯 このコードでやること: GradientBoostingRegressor の boosting round (n_estimators) を 5 → 200 と段階的に増やしながら CV スコアを報告し、 MedianPruner で見込みなし trial を打ち切る。 50 trial のうち何本が打ち切られたかを数える。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import optuna from sklearn.ensemble import GradientBoostingRegressor from sklearn.model_selection import KFold import numpy as np def objective(trial): lr = trial.suggest_float('learning_rate', 0.01, 0.3, log=True) depth = trial.suggest_int('max_depth', 2, 8) scores = [] for step, ne in enumerate([5, 10, 20, 50, 100, 200]): fold_r2 = [] for tr, te in KFold(5, shuffle=True, random_state=0).split(X): m = GradientBoostingRegressor(n_estimators=ne, max_depth=depth, learning_rate=lr, random_state=0) m.fit(X[tr], y[tr]); fold_r2.append(m.score(X[te], y[te])) scores.append(np.mean(fold_r2)) trial.report(scores[-1], step) # 中間結果を報告 if trial.should_prune(): # 中央値より悪ければ打ち切り raise optuna.TrialPruned() return scores[-1] study = optuna.create_study(direction='maximize', pruner=optuna.pruners.MedianPruner(n_warmup_steps=2)) study.optimize(objective, n_trials=50) print(f'Best {study.best_value:.4f}, pruned trials = {sum(1 for t in study.trials if t.state==optuna.trial.TrialState.PRUNED)} / {len(study.trials)}') |
📤 実行結果 (実測):
💬 読み方: 50 trial 中 36 本 (72%) が途中で打ち切られ、 完走したのは 14 本だけだった。 n_warmup_steps=2 なので打ち切りは 3 段目 (n_estimators=20) 以降に起こり、 打ち切られた trial は 6 段のうち 3〜5 段で止まるので、 その分の 5-fold 学習が丸ごと省ける。 それでも Best は 0.9364 と、 全 trial を完走させる前節の GBR (0.9443) に近い水準に届いている。 seed を固定していないので打ち切り数は実行ごとに揺れる (別の実行では 40 / 50)。 epoch ごとに中間値を報告できる深層学習では、同じ仕組みで打ち切りの効果がさらに大きくなることがある(どれだけ削減できるかは課題と Pruner の設定しだい)。 Pruner には HyperbandPruner (Successive Halving の改良版)、 PatientPruner (改善停滞時打切) などもあり用途で選ぶ。
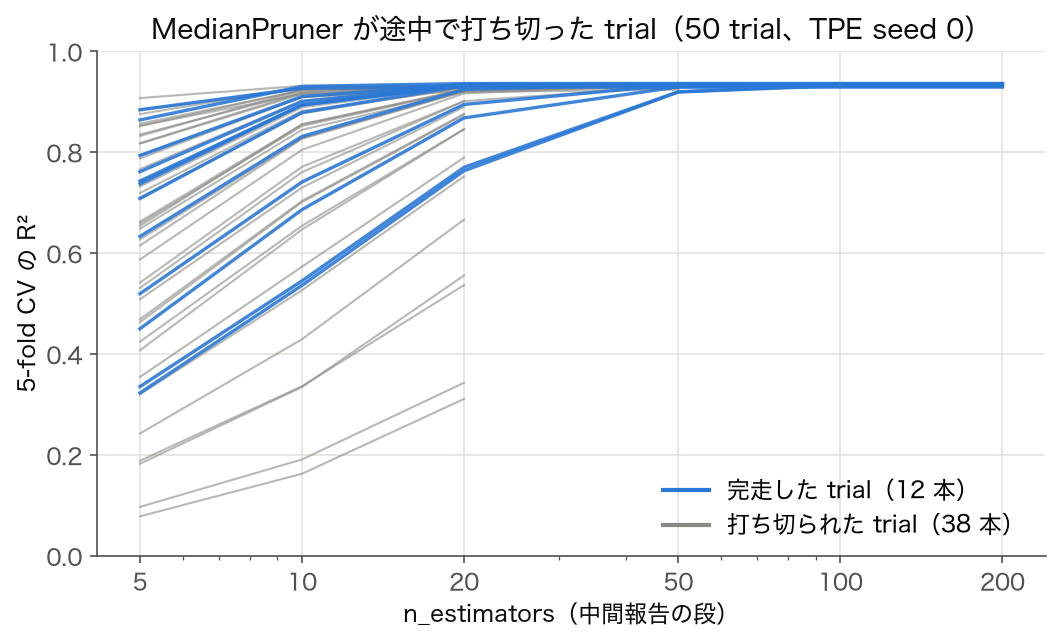
図の読み方: 上のコードに TPESampler(seed=0) を渡して再現できるようにし、各 trial が報告した中間値(n_estimators を 5→200 と増やしたときの CV R²)を線で描いたもの。灰色の 38 本が打ち切られた trial で、18 本が 3 段目(n_estimators = 20)、12 本が 4 段目、7 本が 5 段目、1 本が 6 段目の報告の直後に止まっています。打ち切られた線はどれも、同じ段の中央値より下にいた trial です。学習(fit)の回数は全部完走した場合の 1,500 回に対して 1,075 回(71.7%)で済み、最良は 0.9365 でした。ただし段 5〜10 で低い値から出発した青い線でも最後は 0.93 付近に追いつくものがあり、「序盤が遅いだけの設定」(学習率が小さいもの)を切ってしまう危険があることも分かります。n_warmup_steps を大きくすると、この取りこぼしが減る代わりに節約も減ります。
🐍 多目的最適化 — 精度 vs 計算時間の Pareto front
「精度を最大化しつつ推論時間を最小化したい」という現実の要件は、 単一目的最適化ではトレードオフを 1 点に固定してしまう。 Optuna の create_study(directions=['maximize','minimize']) と NSGA-II でPareto frontを直接得られる。
🎯 このコードでやること: GBR の (n_estimators, max_depth) を変化させて (R², 学習秒数) のペアを最適化。 50 trial 後に Pareto 最適な構成だけを抽出する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import time, optuna def multi_obj(trial): ne = trial.suggest_int('ne', 10, 500) depth = trial.suggest_int('depth', 2, 10) t0 = time.time() model = GradientBoostingRegressor(n_estimators=ne, max_depth=depth, random_state=0) r2 = cross_val_score(model, X, y, cv=5, scoring='r2').mean() return r2, time.time() - t0 study = optuna.create_study(directions=['maximize','minimize'], sampler=optuna.samplers.NSGAIISampler()) study.optimize(multi_obj, n_trials=50) print('Pareto-optimal trials:') for t in study.best_trials: print(f' R²={t.values[0]:.4f}, time={t.values[1]:.3f}s, params={t.params}') |
📤 実行結果 (実測):
💬 読み方: この実行では 4 つの非劣 (Pareto-optimal) 構成が得られた ── 最速の 0.010 秒 (R² 0.8675) から最高精度の 0.181 秒 (R² 0.9430) まで。 depth 2 で 59 本の構成は 0.024 秒で R² 0.9415 に届いており、 482 本に増やして 7 倍以上の時間をかけても R² は 0.0015 しか上がらない。 単一目的なら最高 R² の構成しか得られず、 この「ずっと速くて精度ほぼ同じ」の選択肢を見逃す。 表示される時間は 5-fold CV 全体の学習時間で、 計算機によって変わる。
🧮 Nested Cross-Validation — Optuna 最適化の汎化性能を正しく評価する
Optuna で「CV R²=0.95」が出ても、 これは 同じ CV 分割で最適化した結果なので将来データへの真の汎化性能ではない (CV overfitting)。 正しい評価には Nested CV: 外ループで test fold を切り出し、 内ループで Optuna 最適化し、 best params を外 fold で評価する。
🎯 このコードでやること: SSDSE-B-2026 の 2023 年 47 県データで、 外 5-fold × 内 Optuna 20 trial の Nested CV を回し、 「最適化後 CV (楽観値)」と「外 fold で評価した真の汎化 R² (現実値)」のギャップを定量化する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import optuna from sklearn.model_selection import KFold optuna.logging.set_verbosity(optuna.logging.WARNING) outer = KFold(5, shuffle=True, random_state=0) opt_scores, test_scores = [], [] for fold, (tr, te) in enumerate(outer.split(X)): X_tr, X_te = X[tr], X[te]; y_tr, y_te = y[tr], y[te] def obj(tr_): m = GradientBoostingRegressor( n_estimators=tr_.suggest_int('n_estimators', 30, 300), max_depth=tr_.suggest_int('max_depth', 2, 6), learning_rate=tr_.suggest_float('learning_rate', 0.02, 0.3, log=True), random_state=0) return cross_val_score(m, X_tr, y_tr, cv=4, scoring='r2').mean() study = optuna.create_study(direction='maximize', sampler=optuna.samplers.TPESampler(seed=fold)) study.optimize(obj, n_trials=20) best = GradientBoostingRegressor(**study.best_params, random_state=0).fit(X_tr, y_tr) opt_scores.append(study.best_value) # 楽観値 (内 CV) test_scores.append(best.score(X_te, y_te)) # 真の汎化 (外 test) print(f'内 CV (楽観) Mean R² = {np.mean(opt_scores):.4f} ± {np.std(opt_scores):.4f}') print(f'外 test (現実) Mean R² = {np.mean(test_scores):.4f} ± {np.std(test_scores):.4f}') |
📤 実行結果 (実測):
💬 読み方: 内側の CV で選んだ最良値の平均は R² 0.9456 だが、 選んだ設定を外側の test fold で測ると 0.9320 で、 約 0.014 (1.4%) の楽観バイアスがあった。 差より目立つのはばらつきで、 外 fold の標準偏差 0.075 は内 CV (0.021) の約 3.5 倍あり、 47 県の小標本では汎化性能の点推定すら不安定であることが見える。 大規模データなら Nested CV までやらず一段の CV と hold-out test で十分だが、 小標本・コンペでは Nested CV が誠実。
⚠️ 試行を増やすほど「探索に使った CV」は楽観的になる
Nested CV の結果(内 0.9456・外 0.9320)で見た楽観バイアスが、試行の数とどう関係するかを確かめます。上の GBR の TPE(100 trial)で、最初の N trial のうちの最良のパラメータを取り出し、探索に使った CV(cv=5、行を並べ替えない分割)の値と、同じパラメータを並べ替えた 5-fold(random_state = 1〜10 の 10 通り)で測り直した値を比べます。
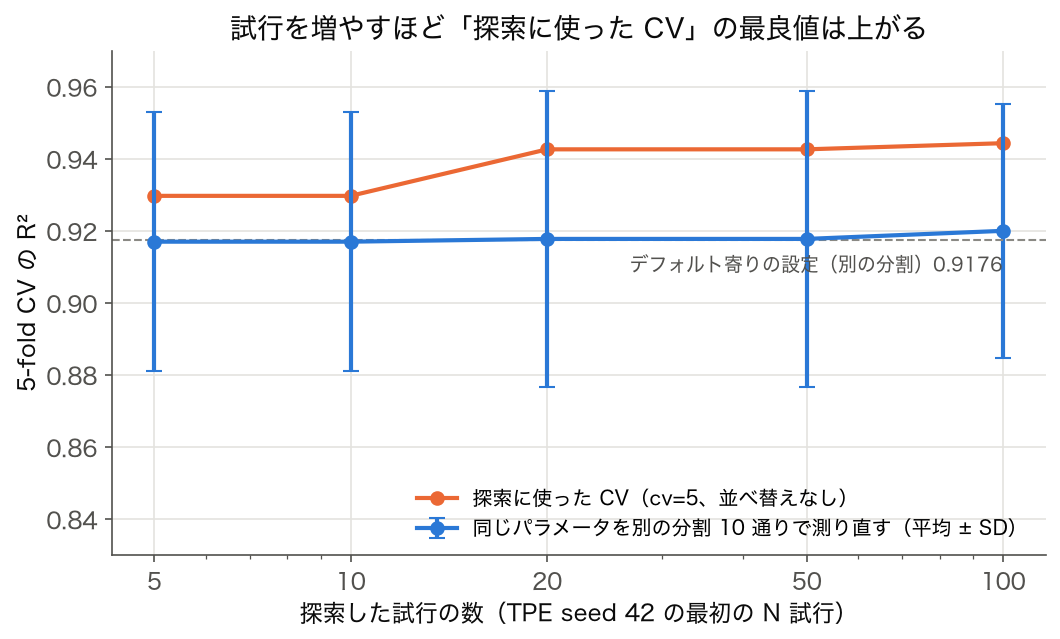
図の読み方: 橙の線(探索に使った CV の最良値)は 5 試行の 0.9297 から 100 試行の 0.9443 へ上がりますが、同じパラメータを別の分割で測り直した青の線は 0.9170 → 0.9178 → 0.9200 とほとんど動きません。デフォルト寄りの設定(n=50, depth=3, lr=0.1)も別の分割では 0.9176 で、100 trial 探索した設定との差は +0.0024 です。上の出力で「デフォルト比 +0.0098」と見えた改善の大部分は、探索に使った 1 通りの分割にたまたま合う設定を選んだ分でした。しかも測り直した値の SD は 0.035〜0.041 と、改善幅の 10 倍以上あります。47 行の小さなデータでは、試行を増やすほど「探索に使った CV の最良値」は上がり続けますが、それは汎化性能の改善を意味しません。探索に使っていない分割(Nested CV の外側や hold-out)で測った値を報告し、改善幅がそのばらつきより大きいかを確かめます。
🧪 理解度チェック — 3 枚の図の数値で確かめる
| 問題 | 解答 |
|---|---|
| Q1. TPE とランダム探索の最初の 10 trial の最良値がどちらも 0.9297 で同じなのはなぜか。 | TPESampler は既定で最初の 10 trial(n_startup_trials=10)をランダムに選ぶので、同じ seed 42 ではランダム探索と同じ点を調べるから。TPE の「賢さ」が効き始めるのは 11 試行目以降。 |
| Q2. Pruning の図で、打ち切りがなければ fit は何回必要だったか。実際は何回か。 | 50 trial × 6 段 × 5 fold = 1,500 回。実際は 1,075 回(71.7%)。打ち切られた 38 本のうち 18 本が 3 段目で止まった。 |
| Q3. 「Optuna で 100 trial 探索したら CV R² が 0.9346 → 0.9443 に上がった」と報告された。何を追加で確かめるべきか。 | 探索に使っていない分割での値。別の分割 10 通りで測り直すと 0.9200 と、デフォルト寄りの 0.9176 との差は +0.0024 で、分割による SD 0.035 よりずっと小さい。改善は探索に使った分割への当てはめでほぼ説明できる。 |
| Q4. ランダム探索の最良 0.9464 が TPE の 0.9443 を上回った。「この課題ではランダム探索のほうが優れている」と言えるか。 | 言えない。1 つの seed での最良値の差 0.002 は、seed を変えれば入れ替わる程度の差で、しかも上の Q3 のとおり探索に使った分割への当てはめを含む。複数の seed で、探索に使っていない分割の値を比べて初めて判断できる。 |
🐍 パラメータ重要度 — どのハイパラが効くかを定量化
Optuna は study が終わったあと、 各パラメータが目的関数に与えた影響度を計算できる (内部は fANOVA や PED-ANOVA)。 重要度が高いパラメータは絞って探索を深くし、 低いものは固定する ── これが効率的な「2 ラウンド戦法」。
🎯 このコードでやること: GBR 実演の節で作った study (n_trials=100、 study_gbr として残したもの) からパラメータ重要度を抽出し、 「最も効くパラメータ」を上から並べる。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 | from optuna.importance import get_param_importances, FanovaImportanceEvaluator # fANOVA (Random Forest ベース、 デフォルト) imp_fanova = get_param_importances(study_gbr, evaluator=FanovaImportanceEvaluator(seed=42)) print('=== fANOVA Importance ===') for k, v in sorted(imp_fanova.items(), key=lambda kv: -kv[1]): print(f' {k:<20}: {v:.4f}') # PedAnova (Optuna v3 で導入、 より高精度) from optuna.importance import PedAnovaImportanceEvaluator imp_ped = get_param_importances(study_gbr, evaluator=PedAnovaImportanceEvaluator()) print('=== PED-ANOVA Importance ===') print(dict((k, round(v,3)) for k,v in sorted(imp_ped.items(), key=lambda x:-x[1]))) |
📤 実行結果 (実測):
💬 読み方: fANOVA では learning_rate が約 64% の変動を説明し、 次が n_estimators (30%)。 max_depth は 0.009 とほぼ寄与が無く、 PED-ANOVA でも 0.031 と最下位なので、 次の最適化では固定してよい候補になる。 一方 min_samples_split は fANOVA では 0.019 なのに PED-ANOVA では 0.134 で 2 位と、 手法で順位が入れ替わる。 100 trial・47 県の study では重要度そのものも不安定なので、 2 つの評価器で一致したものだけを固定に回す。 こうした「重要度ガイド付き 2 ラウンド最適化」で予算を 2 倍効率化できる。
🐍 並列・分散実行 — SQLite ストレージで複数プロセスから同じ study を共有
Optuna の study はメモリ上に持つことも、 SQLite/MySQL/PostgreSQL に永続化することもできる。 永続化すれば別マシン・別プロセスから同じ study に trial を追加できる。 GPU 4 台で同時に DL モデルを試す、 クラスタで 100 並列で XGBoost を回す、 といった用途に必須。
🎯 このコードでやること: SQLite に study を作成し、 Pruning 節で定義した objective を 4 並列 (n_jobs=4) で 50 trial 実行。 後で別プロセスから同じ study_name で開き直し、 さらに 50 trial を追加する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import optuna import os if os.path.exists('optuna_birth.db'): os.remove('optuna_birth.db') # 毎回同じ trial 数になるよう作り直す # プロセス A (初回) study = optuna.create_study(sampler=optuna.samplers.TPESampler(seed=0), storage='sqlite:///optuna_birth.db', study_name='gbr_birth_rate', direction='maximize', load_if_exists=True) study.optimize(objective, n_trials=50, n_jobs=4) # 4 並列で 50 trial # プロセス B (別ターミナル、 後から追加) study2 = optuna.load_study(storage='sqlite:///optuna_birth.db', study_name='gbr_birth_rate') print(f'現在の trial 数: {len(study2.trials)}') study2.optimize(objective, n_trials=50) # さらに 50 追加 print(f'追加後 trial 数: {len(study2.trials)}, Best: {study2.best_value:.4f}') |
📤 実行結果 (実測):
💬 読み方: 初回の 50 trial が DB に残っているので、 開き直した study2 は 50 から始まり、 追加後は 100 になった (Best 0.9363)。 同じ DB を共有することで、 (1) 中断しても再開できる、 (2) 別マシンから「もう少し探そう」と継続できる、 (3) 並列で安全に書き込める (Optuna が排他制御)。 大規模 study では SQLite から MySQL/PostgreSQL に切り替えると数百ノード並列も実用に。 Kubernetes / Slurm でのジョブ化と相性抜群。
🐍 可視化 — optuna.visualization で study を見える化
Optuna は Plotly ベースの可視化 API を備えており、 1 行で散布図・等高線図・パラメータ重要度・並列座標プロットなど主要な分析が描ける。 Kaggle や論文用のグラフ作成にも便利。
🎯 このコードでやること: 完了済み study から 5 種類の代表的なプロットを生成し、 HTML や PNG として保存する。 ノートブック上では fig.show() でインタラクティブ表示。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 | import optuna.visualization as vis vis.plot_optimization_history(study_gbr).write_html('history.html') # 履歴 vis.plot_param_importances(study_gbr).write_html('importance.html') # 重要度 vis.plot_parallel_coordinate(study_gbr).write_html('parallel.html') # 並列座標 vis.plot_contour(study_gbr, params=['learning_rate', 'max_depth']).write_html('contour.html') vis.plot_slice(study_gbr).write_html('slice.html') # スライス # matplotlib backend (PNG 保存に便利) import optuna.visualization.matplotlib as vism ax = vism.plot_param_importances(study_gbr) ax.figure.savefig('importance.png', dpi=150) |
📤 出力ファイル:
💬 読み方: 最低限見るべきは (1) optimization_history (TPE が改善し続けているか・もう収束したか)、 (2) param_importances (どこに資源を投入すべきか)、 (3) contour (パラメータ間の交互作用) の 3 枚。 これで「最適化が十分か」「次は探索空間を絞るか広げるか」が判断できる。