🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
データの予測が得意な道具です。
正解を効率よく当てるために使います。
テストの点数を予想するような時に便利です。
まずは結論を短くまとめました。
XGBoost:勾配ブースティング決定木の高速実装
- 勾配ブースティング決定木 (GBDT) の高速ライブラリ。
- 表形式データの分類・回帰でほぼデフォルト選択肢。
- 特徴:欠損対応・並列学習・正則化・特徴量重要度。
- 競合:LightGBM (より高速)、 CatBoost (カテゴリ対応)。
📍 文脈ボックス
🍰 まずはやさしく
分析に使う便利な道具箱のようなものです。
データを正しく処理するために使います。
スマホのアプリ開発などで活用されています。
この道具をどう使うか詳しく説明します。
このページは、 勾配ブースティングという手法そのものより、 その代表的な実装である Python ライブラリ xgboost の使い方を扱う。 SSDSE-B-2026(2023 年度の 47 都道府県)で合計特殊出生率などを予測しながら、 木の本数・深さ・学習率・正則化をどう決め、 47 行しかないデータで過学習をどう見抜くか(early stopping・交差検証・学習曲線)、 予測の理由を feature_importances_・permutation importance・SHAP でどう読むかを、 実行結果つきで確かめる。 アルゴリズムの考え方は 🎨 と 📐 で、 ライブラリの使い方は 🐍 で読む。
🎨 直感で掴む
🍰 まずはやさしく
小さな間違いを直すリレーのような仕組みです。
予測の精度を高めるために使います。
部活の練習で弱点を一つずつ直す感覚です。
仕組みをイメージしやすい例で解説します。
決定木 1 本ではよく外す。 そこで「外した分を補正する次の木」を順番に作り、 何百本も足し合わせる ── これが 勾配ブースティング。 XGBoost はこのアルゴリズムを C++ で高速実装し、 欠損値対応・並列処理・正則化を全部入りにしたライブラリ。 表形式データ予測の 2010 年代後半のデファクト。
「弱学習器の足し算」の絵
SSDSE で 47 県の出生数を予測する状況を想像する。 1 本目の木は「人口 > 500 万 → 高出生数」程度の単純な分岐。 残った誤差を 2 本目の木が「人口密度 > 1000」で分岐して補正。 3 本目は「高齢化率 < 25% で更に高く」。 ── 100-1000 本積み重ねることで複雑な関係を表現する。 1 本ごとの寄与は小 (学習率 $\eta=0.1$ 程度) なので、 オーバーフィットを抑えつつ高精度に。
| 特徴 | XGBoost | LightGBM | CatBoost |
|---|---|---|---|
| 開発元 | Tianqi Chen (DMLC) | Microsoft | Yandex |
| 初版 | 2014 | 2017 | 2017 |
| 木分割戦略 | level-wise (深さ均等) | leaf-wise (最大ロス低下) | 対称木 (oblivious tree) |
| カテゴリ変数 | 手動エンコード必要 | 対応 (categorical_feature) | ネイティブ対応 (target encoding) |
| GPU 学習 | 対応 (tree_method=gpu_hist) | 対応 (device=gpu) | 対応 (task_type=GPU) |
| 速度 | 中 | 高速 (大規模で 2-5倍) | 中 |
| Kaggle 勝率 | トップ常連 | トップ常連 | 特定問題で強 |
📌 XGBoost は表形式データの標準。 LightGBM は大規模 (数千万行) で高速、 CatBoost はカテゴリ多めの場合に強い。 「迷ったら XGBoost」「速度が必要なら LightGBM」が定石。
なぜ Kaggle で勝てるのか
表形式データに対し、 非線形・特徴量相互作用・欠損値・カテゴリを全部自動で扱える。 線形モデルは特徴量エンジニアリングが必須、 ニューラルネットは大データが必須、 ランダムフォレストは XGBoost に精度で劣る ── 中間のスイートスポットを掴んでいる。 Kaggle トップソリューションは 2015-2022 年に XGBoost (or LightGBM) + アンサンブルが定番だった。
🎮 触って理解する ── 勾配ブースティングを 1 本ずつ育てる
XGBoost の数理的核心は 「浅い木 (弱学習器) を、 残った誤差 (残差) に順番に当てはめて足し合わせる」こと。 下は架空の 1 次元回帰データ (y = sin(2πx) + ノイズ、 シード固定・完全に再現可能) です。 「木を 1 本追加」を押すたびに、 いまの残差に浅い決定株を当てはめて予測へ足し込みます。 予測曲線 (左) が階段状にターゲットへ近づき、 残差 (右) が 0 へ潰れていく様子を体感してください。
① 予測 vs ターゲット (階段状に近づく)
② 残差 (次の木が拾う誤り → 0 へ潰れる)
🧠 何が起きている?(直感)
出発点は「全部同じ値 (平均)」という一番愚かな予測。 そこから いまの誤り (残差) だけを見て、 それを説明する浅い木を 1 本足す。 足すと残差が少し縮む。 縮んだ残差にまた木を当てる ── この 逐次的な誤り修正の繰り返しが勾配ブースティングです。 二乗誤差では残差そのものが勾配 (の逆符号) なので、 「残差を予測する木を足す」ことは損失を勾配方向に減らすことと等価になります。 1 本の寄与は η 倍に縮小されるので、 1 本ずつは控えめでも 数十〜数百本の合議で複雑な曲線を表現できます。
⚠️ 落とし穴(このウィジェットで確かめられる)
- 木の増やしすぎ=過学習: 「+50 本」を η=1.0 で連打すると、 予測曲線が各点を貫くギザギザになり、 訓練 RMSE は下がり続けるのにテスト RMSE が反転して増えるのが観察できます。 訓練誤差 0 は目標ではありません。
- 学習率と木数のトレードオフ: η を小さく (0.1 など) すると 1 本の効きが弱まり収束は遅いが、 最終的に 滑らかで汎化の良い曲線になります。 「小さい η + たくさんの木」が実務の定石 (=縮小 shrinkage)。 逆に η=1.0 は数本で暴れます。
- 外挿はできない: 決定木の集合は区分定数関数なので、 学習データの x 範囲の外側では値が一定のまま伸びません。 予測曲線の左右端が平らなことに注目 ── XGBoost は内挿は得意でも外挿は不可。
- 弱学習器は浅く: 深さ 2 は深さ 1 より 1 本あたり表現力が高い分、 少ない本数で過学習に届きます。 各木を浅く保ち本数で稼ぐのが安定。
🚀 発展
実際の XGBoost はこの素朴なブースティングに正則化 ($\gamma T + \tfrac12\lambda\sum w_j^2$) を加え、 葉の値と葉数そのものを罰して過学習を抑えます (このデモには未実装)。 さらに各木で使う特徴量の列サンプリング (colsample) と行サンプリング (subsample)で木同士を脱相関させ、 汎化を高めます。 分割探索を高速化した派生が 学習率を含む多数のハイパラを持つ LightGBM (leaf-wise 成長・ヒストグラム分割) や CatBoost (カテゴリ変数のネイティブ対応・対称木) です。 基礎となる考え方は 決定木・ランダムフォレスト・木のアンサンブル・勾配降下法・正則化・過学習の各ページも参照してください。
📐 定義・数式
🍰 まずはやさしく
計算のルールを決めた数式です。
正確に予測を計算するために使います。
買い物での合計金額を出すような計算です。
具体的な数式とその意味を説明します。
$t$ 番目の木 $f_t$ を学習率 $\eta$ をかけて加算。 各 $f_t$ は前ステップまでの残差 (勾配) を予測するように学習される。
第 1 項が予測誤差、 第 2 項 $\Omega$ が木の複雑度ペナルティ。 これが XGBoost と GBDT (Friedman 2001) の最大の違い ── 損失関数自体に正則化が組み込まれている。
$g_i = \partial l / \partial \hat{y}_i$、 $h_i = \partial^2 l / \partial \hat{y}_i^2$ は 1 階・2 階勾配。 任意の微分可能損失関数 (二乗誤差、 ロジット、 hinge 等) で同じフレームワークが使える ── これが XGBoost が汎用的たる理由。
$T$ は葉数、 $w_j$ は葉 $j$ の予測値。 $\gamma$ で葉数を、 $\lambda$ で葉値を罰する。 $\gamma$ が大きいと木は浅く・少なく、 $\lambda$ が大きいと葉の予測値が抑制される。
葉 $j$ に入るサンプル集合 $I_j$ について、 $g$ と $h$ から最適 $w_j^*$ が解析的に計算できる。 $\mathcal{L}^*$ は木の品質スコアで、 分割点候補の評価に使う。
分割を入れる前後のスコア差。 Gain > 0 なら分割する価値あり、 ≤ 0 なら止める (pre-pruning)。 $\gamma$ が分割の最小利益閾値として働く ── これが XGBoost の枝刈り戦略。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- $f_t \in \mathcal{F}$
- $t$ 番目の決定木 (CART)。 木構造 + 葉の予測値からなる関数。
- $\hat{y}^{(t)}$
- $t$ ステップ目までの累積予測値。 $\hat{y}^{(t)} = \sum_{k=1}^{t} \eta f_k$。
- $\eta$ (learning_rate)
- 学習率 / 縮約率 (shrinkage)。 0.01〜0.3 が典型。 小さくして $T$ を増やすと精度が出やすい。
- $T$ (n_estimators)
- 木の総数。 数百〜数千。 early_stopping_rounds で自動決定が推奨。
- max_depth
- 1 本の木の最大深さ。 3〜8 が典型。 大きすぎると過学習、 小さすぎるとアンダーフィット。
- $g_i, h_i$
- サンプル $i$ における 1 階・2 階勾配。 損失関数を 2 次近似する係数。
- $\gamma$ (gamma, min_split_loss)
- 葉の追加コスト。 Gain $> \gamma$ でないと分割しない。 過学習抑制に効く。
- $\lambda$ (reg_lambda, L2)
- 葉重みの L2 正則化。 $\lambda$ 大で葉値が小さく抑制される。 既定 1.0。
- $\alpha$ (reg_alpha, L1)
- 葉重みの L1 正則化。 スパース化に効く。 既定 0。
- subsample, colsample_bytree
- 行・列のサンプリング率 (0<・≤1)。 確率的ブースティングで多様性確保。 推奨 0.7-0.9。
- min_child_weight
- 葉の最小 $h$ 和。 分類なら「最小サンプル数 × 確率」相当。 大きくして過学習防止。
具体例 ── 二乗誤差損失の場合
$l(y, \hat{y}) = (y - \hat{y})^2 / 2$ なら、 $g_i = \hat{y}_i - y_i$ (= 残差の符号反転)、 $h_i = 1$。 → $w_j^* = -\sum_i g_i / (n_j + \lambda)$ で「葉内サンプルの残差平均」に近い値。 これが「次の木は残差をフィットする」直感の正体。
🔬 数式を言葉で読み解く (2):「分割ゲイン」の意味
XGBoost が「どこで分割するか」を決める指標 Gain を分解する。
- 「分割前のスコア」 ── $- \frac{1}{2} \cdot \frac{(G_L+G_R)^2}{H_L+H_R+\lambda}$ (親ノード)。
- 「分割後の左子・右子のスコア合計」 ── $- \frac{1}{2} \left[ \frac{G_L^2}{H_L+\lambda} + \frac{G_R^2}{H_R+\lambda} \right]$。
- 「差を取って $\gamma$ を引く」 ── Gain = (親 - 子) - $\gamma$。 これがプラスなら分割する価値あり。
- 「すべての候補分割点を試して最大 Gain を選ぶ」 ── 連続値特徴量はソート + 累積和で $O(n \log n)$ で高速計算。
- 「分位点近似 (approximate algorithm)」 ── 大規模データでは全候補でなく分位点候補のみ評価 (XGBoost の高速化テクの一つ)。
この式が「データ量の足し算」(累積 $G, H$) だけで計算できるため、 ヒストグラムベース実装 (LightGBM・XGBoost hist tree_method) に展開できる ── これが GPU 学習や大規模対応の基盤。
🧮 実値で計算してみる
SSDSE-B-2026 の 47 都道府県データを使った 2 つの計算: (A) 単一木の分割 Gain を手計算する小例、 (B) XGBoost で人口階層 (大/中/小県) の 3 クラス分類を実行し精度・特徴量重要度を確認する。
A. Gain を手計算 (分割の意思決定を追体験)
10 県のミニデータで「人口 > 500 万人」分割の Gain を計算する。 各サンプルに 1 階勾配 $g_i$、 2 階勾配 $h_i$ を割り当て、 公式 $G_L^2/(H_L+\lambda) + G_R^2/(H_R+\lambda) - (G_L+G_R)^2/(H_L+H_R+\lambda)$ を電卓で叩く。 $\lambda=1$、 $\gamma=0$。
B. XGBoost で 47 県を 3 クラス分類
47 県を人口 3 分位 (大県/中県/小県) に分け、 15 歳未満人口・出生数・死亡数など 8 列の特徴量から階層を予測する。 5-fold CV で精度評価。
🧮 数式に値を入れて手で計算する: XGBoost のステップ
合成データで 3 段の boost で残差が減少する様子を計算する。
Step 1: 真値と段別予測
| 段 | y | 予測 | 残差 |
|---|---|---|---|
| F0 | 10 | 5 (平均) | 5 |
| F1 (+0.5tree) | 10 | 5 + 2.5 = 7.5 | 2.5 |
| F2 (+0.5tree) | 10 | 7.5 + 1.25 = 8.75 | 1.25 |
| F3 | 10 | 8.75 + 0.625 = 9.375 | 0.625 |
Step 2: 収束
🐍 Python で再現
1 2 3 4 5 6 | y = 10 pred = 5 lr = 0.5 for i in range(4): print(f"段 {i}: pred={pred}, 残差={y-pred}") pred = pred + lr * (y - pred) |
📤 実行結果
💬 手計算 (Step 1) と Python 出力が完全一致。
🐍 Python 実装
7 つのハンズオン: (1) 47 県を 3 階層分類する基本コード、 (2) early stopping で過学習防止、 (3) 5-fold CV による評価、 (4) GridSearchCV でハイパラ探索、 (5) feature_importances_ と permutation importance、 (6) SHAP 値による個別説明、 (7) 早期停止カーブのプロット用データ取得。 全例で data/raw/SSDSE-B-2026.csv を使用。
以下のハンズオンは すべて SSDSE-B-2026 に実在する列コードのみで構成している。 使用する主な列は次の通り:
A1101 総人口 / A1301 15歳未満人口 / A1303 65歳以上人口 / A4101 出生数 / A4103 合計特殊出生率 / B4101 年平均気温 / L3221 消費支出(二人以上の世帯) / I510120 一般病院数 / I5102 一般診療所数 / J2503 保育所等数。 多変量回帰+SHAP の例では「合計特殊出生率 A4103 を 総人口・65歳以上人口・一般病院数・保育所等数 から予測」する。 なお読み込みは pd.read_csv(..., encoding='cp932', skiprows=[1]) で 2 行目の日本語見出しを除き、 先頭列 SSDSE-B-2026(=年度)で 2023 を抽出する点に注意。
① 基本コード: 47 県を 3 階層分類
🎯 このコードでやること: SSDSE-B-2026 から 47 県の特徴量を取り出し、 人口 3 分位ターゲットで XGBClassifier を学習。 80/20 分割で精度評価。
📥 入力データ: data/raw/SSDSE-B-2026.csv の 2023 年度 47 県。 ターゲットは A1101 (総人口) の 3 分位、 特徴量は下の 8 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import xgboost as xgb from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) last = df.query('`SSDSE-B-2026` == `SSDSE-B-2026`.max()').copy() feats = ['A1301', 'A4101', 'A4200', 'A5101', 'A9101', 'E1101', 'C3301', 'F3101'] X = last[feats] y = pd.qcut(last['A1101'], q=3, labels=[0, 1, 2]).astype(int) Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.2, random_state=0, stratify=y) model = xgb.XGBClassifier( n_estimators=200, max_depth=4, learning_rate=0.05, objective='multi:softprob', num_class=3, eval_metric='mlogloss', ) model.fit(Xtr, ytr) print(f'Train acc: {model.score(Xtr,ytr):.4f}') print(f'Test acc: {model.score(Xte,yte):.4f}') |
📤 実行結果:
💬 結果の読み方: 訓練 100% / テスト 90% (テスト 10 県中 9 県正解) で 10pt の汎化ギャップ。 テストが 10 県しかないので 1 県の当たり外れで 10pt 動き、 この差だけで過学習の程度は測れない。 特徴量がどれも人口の言い換えなので、 200 木でも大きくは崩れない。 次のステップ ② で early stopping を導入。
② Early Stopping で過学習防止
🎯 このコードでやること: 検証セットの mlogloss が連続 20 ラウンド改善しなければ学習打ち切り。 最適木数を自動決定する。
📥 入力データ: ①と同じ特徴量とターゲット。 さらに eval_set として検証セットを渡す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import xgboost as xgb from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) last = df.query('`SSDSE-B-2026` == `SSDSE-B-2026`.max()').copy() feats = ['A1301', 'A4101', 'A4200', 'A5101', 'A9101', 'E1101', 'C3301', 'F3101'] X, y = last[feats], pd.qcut(last['A1101'], 3, labels=[0,1,2]).astype(int) Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y) model = xgb.XGBClassifier( n_estimators=500, max_depth=3, learning_rate=0.05, objective='multi:softprob', num_class=3, eval_metric='mlogloss', early_stopping_rounds=20, ) model.fit(Xtr, ytr, eval_set=[(Xtr,ytr), (Xte,yte)], verbose=False) print(f'Best iter: {model.best_iteration}') print(f'Train acc: {model.score(Xtr,ytr):.4f} Test acc: {model.score(Xte,yte):.4f}') |
📤 実行結果:
💬 結果の読み方: 検証の mlogloss が最小になったのは best_iteration = 107 (0 始まりの round 番号) で、 そこから 20 ラウンド改善しなかったので 500 本の手前で止まった。 テスト 93.3% は 15 県中 14 県の正解で、 ① とは分割 (test_size=0.3) が違うので精度をそのまま比べることはできない。 なお eval_set の最後 (テストセット) で止め時を決めているので、 このテスト精度はやや楽観的になる。 「ラウンド数を 500 とり、 early_stopping_rounds 20」がベストプラクティス。
③ 5-fold CV で精度の信頼区間取得
🎯 このコードでやること: cross_val_score で 5-fold CV。 47 県を 5 つに分けて、 各 fold で 80% 学習 / 20% 検証。 平均 ± SD で精度を報告。
📥 入力データ: ①と同じ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np import xgboost as xgb from sklearn.model_selection import cross_val_score, StratifiedKFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) last = df.query('`SSDSE-B-2026` == `SSDSE-B-2026`.max()').copy() feats = ['A1301', 'A4101', 'A4200', 'A5101', 'A9101', 'E1101', 'C3301', 'F3101'] X, y = last[feats], pd.qcut(last['A1101'], 3, labels=[0,1,2]).astype(int) model = xgb.XGBClassifier(n_estimators=100, max_depth=3, learning_rate=0.05, objective='multi:softprob', num_class=3, eval_metric='mlogloss') cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=0) scores = cross_val_score(model, X, y, cv=cv, scoring='accuracy') print(f'CV accuracy: {scores.mean():.4f} ± {scores.std():.4f}') print(f'各 fold: {scores.round(3)}') |
📤 実行結果:
💬 結果の読み方: 5 fold 平均 93.8% (±8.1%)。 5 つの fold のうち 3 つが 100%、 残りが 80% (10 県中 8 県) と 88.9% (9 県中 8 県) で、 1 fold が 9〜10 県しかないため 1 県の誤りで 10pt 前後動く。 単発の分割の数字 (90%・93%) より、 「80〜100% の幅がある」と報告するほうが誠実である。
④ GridSearchCV でハイパラ探索
🎯 このコードでやること: max_depth・learning_rate・n_estimators の 3 つを 3-fold CV で網羅探索。 ベスト構成を取得。
📥 入力データ: ①と同じ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd import xgboost as xgb from sklearn.model_selection import GridSearchCV df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) last = df.query('`SSDSE-B-2026` == `SSDSE-B-2026`.max()').copy() feats = ['A1301', 'A4101', 'A4200', 'A5101', 'A9101', 'E1101', 'C3301', 'F3101'] X, y = last[feats], pd.qcut(last['A1101'], 3, labels=[0,1,2]).astype(int) grid = { 'n_estimators': [50, 100, 200], 'max_depth': [2, 3, 4, 6], 'learning_rate': [0.01, 0.05, 0.1], } model = xgb.XGBClassifier(objective='multi:softprob', num_class=3, eval_metric='mlogloss', random_state=0) gs = GridSearchCV(model, grid, cv=3, scoring='accuracy', n_jobs=-1) gs.fit(X, y) print(f'Best params: {gs.best_params_}') print(f'Best score : {gs.best_score_:.4f}') |
📤 実行結果:
💬 結果の読み方: 36 通り探索の結果、 最も弱い構成に近い lr=0.01 / depth=2 / 50 木が最良 (3-fold CV で 89.3%)。 47 県の小データでは木を浅く・少なくしても精度が落ちず、 同点に近い構成が多いので、 最良の組み合わせは fold の切り方で入れ替わりやすい。 探索した CV の最高値そのものは楽観的な見積もりなので、 最終報告は別の CV で測り直す。
⑤ feature_importances_ と permutation importance
🎯 このコードでやること: XGBoost 標準の feature_importances_ (gain ベース) と、 scikit-learn の permutation_importance (シャッフルで予測精度低下を測る) を比較。 後者のほうがフェアな指標とされる。
📥 入力データ: ① と同じ 8 列・3 階層ターゲットの 47 県すべて。 モデルは lr=0.1 / depth=3 / 100 木 (④ の探索結果とは別の構成) で、 学習に使った 47 県そのもので重要度を測る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import xgboost as xgb from sklearn.inspection import permutation_importance df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) last = df.query('`SSDSE-B-2026` == `SSDSE-B-2026`.max()').copy() feats = ['A1301', 'A4101', 'A4200', 'A5101', 'A9101', 'E1101', 'C3301', 'F3101'] X, y = last[feats], pd.qcut(last['A1101'], 3, labels=[0,1,2]).astype(int) model = xgb.XGBClassifier(n_estimators=100, max_depth=3, learning_rate=0.1, objective='multi:softprob', num_class=3, eval_metric='mlogloss').fit(X,y) gain_imp = pd.Series(model.feature_importances_, index=feats).sort_values(ascending=False) perm = permutation_importance(model, X, y, n_repeats=10, random_state=0) perm_imp = pd.Series(perm.importances_mean, index=feats).sort_values(ascending=False) print('feature_importances_ (gain):') print(gain_imp.to_string()) print() print('permutation_importance:') print(perm_imp.to_string()) |
📤 実行結果:
💬 結果の読み方: gain では 15 歳未満人口 (A1301) 0.450、 死亡数 (A4200) 0.325、 出生数 (A4101) 0.125 の順だが、 permutation では死亡数 0.455 が 1 位に上がり、 転入者数以下の 5 列は 0 になる。 8 列はどれも総人口と r≥0.96 で相関するので、 木は最初に選んだ数列だけで分け切ってしまい、 残りの列はシャッフルしても予測が変わらない。 「0 = 無関係」ではなく「代わりの列があるので使われなかった」と読む。
⑥ SHAP 値による個別予測の説明
🎯 このコードでやること: SHAP (SHapley Additive exPlanations) で各サンプルの予測根拠を分解。 「東京がなぜ大県と分類されたか」を特徴量寄与で説明する。
📥 入力データ: ⑤のモデル + 全 47 県。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np import xgboost as xgb import shap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) last = df.query('`SSDSE-B-2026` == `SSDSE-B-2026`.max()').reset_index(drop=True) feats = ['A1301', 'A4101', 'A4200', 'A5101', 'A9101', 'E1101', 'C3301', 'F3101'] X, y = last[feats], pd.qcut(last['A1101'], 3, labels=[0,1,2]).astype(int) model = xgb.XGBClassifier(n_estimators=100, max_depth=3, learning_rate=0.1, objective='multi:softprob', num_class=3, eval_metric='mlogloss', random_state=0).fit(X,y) explainer = shap.TreeExplainer(model) # shap 0.4x 以降、多クラスの shap_values は list ではなく (サンプル, 特徴量, クラス) の 3 次元配列 sv = np.asarray(explainer.shap_values(X)) print('sv.shape =', sv.shape) # skiprows=[1] で読むと列名は英語コードなので、県名の列は 'Prefecture' tokyo_pos = last.index[last['Prefecture'] == '東京都'][0] print('東京の クラス 2 (大県) SHAP 寄与:') for i, f in enumerate(feats): print(f' {f:8s} SHAP={sv[tokyo_pos, i, 2]:+.3f} 値={X.iloc[tokyo_pos, i]:.1f}') |
📤 実行結果:
💬 結果の読み方: 東京がクラス 2 (大県) と判定された寄与は死亡数 (A4200) の +2.431 だけで、 残り 7 列は 0.000。 クラス 2 の木は死亡数だけで大県を切り分けており、 東京の死亡数 137,241 人は大県の境目をはるかに超えているので、 他の列を見る必要が無い。 sv.shape = (47, 8, 3) は 47 県 × 8 特徴量 × 3 クラスで、 クラスごとに別の寄与が出る。 → SHAP で「県別の推定根拠」が定量化される。
⑦ 学習曲線の取得 (n_estimators sweep)
🎯 このコードでやること: 学習途中の各 round で訓練・検証ロスを取得し、 「いつ過学習が始まるか」を可視化用データとして抽出する。
📥 入力データ: ①と同じ。 evals_result_ から自動取得。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd import xgboost as xgb from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) last = df.query('`SSDSE-B-2026` == `SSDSE-B-2026`.max()').copy() feats = ['A1301', 'A4101', 'A4200', 'A5101', 'A9101', 'E1101', 'C3301', 'F3101'] X, y = last[feats], pd.qcut(last['A1101'], 3, labels=[0,1,2]).astype(int) Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, stratify=y, random_state=0) model = xgb.XGBClassifier(n_estimators=150, max_depth=3, learning_rate=0.1, objective='multi:softprob', num_class=3, eval_metric='mlogloss') model.fit(Xtr, ytr, eval_set=[(Xtr,ytr), (Xte,yte)], verbose=False) hist = model.evals_result_ print(f'最初 5 round:') for i in range(5): print(f' iter {i:3d} train={hist["validation_0"]["mlogloss"][i]:.4f} test={hist["validation_1"]["mlogloss"][i]:.4f}') print(f'最終 round 150: train={hist["validation_0"]["mlogloss"][-1]:.4f} test={hist["validation_1"]["mlogloss"][-1]:.4f}') |
📤 実行結果:
💬 結果の読み方: 訓練ロスは 0.985 → 0.051、 検証ロスも 0.998 → 0.205 と、 150 round まで両方とも下がり続けている。 検証ロスの最小は最後の 150 round 目なので、 この設定ではまだ過学習は始まっておらず、 train と test の差 (0.051 と 0.205) が少しずつ開いていく段階にある。 本数をさらに増やして検証ロスが上がり始める round を探し、 そこで early stopping をかける。 学習曲線の可視化は XGBoost 運用の基本デバッグ。
⚠️ よくある落とし穴
🧭 重要度や SHAP 値を「因果効果」と読まない
XGBoost の feature_importances_ や SHAP 値が示すのは、学習したモデルの予測がどの特徴量にどれだけ頼っているかであって、その特徴量を動かしたときに目的変数が実際にどれだけ変わるか(因果効果)ではない。たとえば SSDSE-B の都道府県データでは、人口規模に連動する列(総人口・出生数・死亡数・一般診療所数など)が互いに強く相関しているため、どの列に重要度が集まるかは木の分割の順序や乱数の種でも入れ替わる。重要度が高い列を政策で動かせば結果が変わる、という結論はこの数字からは出せない。
因果を問いたいときは、介入の割り当てが分かるデザイン(ランダム化、差の差、回帰不連続など)や、交絡を明示したモデルが必要になる。予測モデルの説明は「このモデルはこう判断している」という診断として使い、「こうすればこうなる」という主張には使わない、と区別しておくとよい。
この用語を使うときに陥りがちな失敗パターン。 経験者ほどここに 1 度はハマっています。
enable_categorical=True でネイティブ対応するが、 古い版は LabelEncoder/One-Hot/Target Encoding を要する。 高基数カテゴリ (例: 都市名 1000 種) は target encoding 推奨。scale_pos_weight = 負例数 / 正例数 で重み補正、 または class_weight='balanced'。🎛 ハイパーパラメータ早見表 (実務向け)
XGBoost のハイパラ数百種類の中で、 まず押さえるべき 10 個。 デフォルト値と推奨範囲。
| パラメータ | デフォルト | 推奨範囲 | 役割 |
|---|---|---|---|
n_estimators | 100 | 100-1000 | 木の本数。 early stopping と組み合わせて自動決定 |
learning_rate (eta) | 0.3 | 0.01-0.3 | 縮約率。 小さくして本数増やすと精度↑ |
max_depth | 6 | 3-10 | 木の深さ。 小データなら 3-5、 大データなら 6-10 |
min_child_weight | 1 | 1-10 | 葉の最小重み和。 大きく ⇒ 過学習防止 |
gamma | 0 | 0-1 | 分割の最小利益閾値。 大きく ⇒ シンプル木 |
subsample | 1.0 | 0.7-1.0 | 行サンプリング率。 確率的ブースティングで分散低減 |
colsample_bytree | 1.0 | 0.6-1.0 | 特徴量サンプリング率。 RF 的多様性 |
reg_alpha (L1) | 0 | 0-1 | L1 正則化。 特徴量選択効果 |
reg_lambda (L2) | 1 | 0-10 | L2 正則化。 滑らかさ確保 |
scale_pos_weight | 1 | 負例数/正例数 | 2 値不均衡データの補正 |
チューニング手順 (上から順に)
- learning_rate=0.1 固定、 max_depth と min_child_weight を grid search で最適化
- 続いて gamma を [0, 0.1, 0.2, 0.3] で探索
- subsample と colsample_bytree を [0.6, 0.8, 1.0] で探索
- reg_alpha・reg_lambda を log-uniform で探索
- 最後に learning_rate を下げて (0.01-0.05) n_estimators を増やす
📌 「全部同時に Optuna で 1000 trial 回す」が現代風だが、 上記手順は計算リソース節約と説明可能性の点で今も有効。
📝 理解度チェック
- このページの SHAP の例で、 沖縄県の基準値は 1.2928、 寄与は 総人口 +0.130・保育所等数 +0.110・65 歳以上人口 +0.063・一般病院数 +0.003 だった。 予測値はいくつか。
答え
1.2928 + 0.130 + 0.110 + 0.063 + 0.003 = 1.599。 SHAP の寄与は足し算で予測値に戻る(加法性)。 実測 1.60 とほぼ同じなのは、 沖縄県自身を学習に使ったからでもある。 - early stopping の例で best_iteration = 39、 検証 RMSE 0.107 だった。 検証に使った 15 県の合計特殊出生率の標準偏差は 0.116。 この結果から何が言えるか。
答え
RMSE が標準偏差とほぼ同じなので、 検証県の平均値で当てるのと大差ない。 木を 2000 本まで伸ばすと訓練 RMSE は 0.0014 まで下がるが検証 RMSE は 0.125 に悪化する。 小さな訓練誤差は予測力の証拠にならない。 - 「県民幸福度」の例では、 5 分割 CV の平均 R² が −0.556 なのに、 全 47 県で学習したモデルの予測は元のスコアをほぼなぞった。 どちらを予測力として報告すべきか。
答え
CV の −0.556。 学習に使った県を予測しても木が値を覚えているだけで、 見たことのない県は平均値より悪くしか当てられない。 - max_depth を 1・3・6 と深くすると、 1 変数の予測曲線はどう変わるか(演習 Q2)。 自分で確かめる前に予想を書いてみよう。
答え
木 1 本の分割が細かくなり、 予測曲線の段(階段)が細かくなる。 47 県では深い木ほど個々の県に合わせすぎ、 交差検証の成績は下がりやすい。
📚 関連グループ教材
XGBoost は「決定木を何本も足し合わせる」手法の実装なので、 次の用語・教材と一緒に読むと位置づけがはっきりする。 1 本の木の分け方は 決定木、 木を並列に平均するのが ランダムフォレスト、 木を組み合わせる手法の全体像は 📚 木のアンサンブル。 47 県で過学習を確かめる道具は 交差検証 と 過学習、 学習率や深さの決め方は ハイパーパラメータ、 予測の理由の読み方は SHAP のページで扱う。
🛠 XGBoost 主要ハイパーパラメータの深掘り(用語固有)
XGBoost の精度はパラメータ設定で大きく変わる。 ここでは SSDSE-B-2026 都道府県データで「合計特殊出生率」を予測するタスクを題材に、 4 つの中核パラメータ max_depth / eta (=learning_rate) / subsample / colsample_bytree の役割と典型的探索範囲を整理する。
| パラメータ | 役割 | 典型探索域 | 上げると | 下げると |
|---|---|---|---|---|
max_depth | 木 1 本の最大深さ | 3〜10 | 表現力↑/過学習↑ | 汎化↑/未学習リスク |
eta (learning_rate) | 各木の寄与スケール | 0.01〜0.3 | 学習速い/不安定 | 安定/n_estimators 多必要 |
subsample | 行サンプリング比 | 0.5〜1.0 | バイアス↓ | バリアンス↓/汎化↑ |
colsample_bytree | 列サンプリング比 | 0.5〜1.0 | 多様性↓ | 過学習↓(高次元時に有効) |
🎯 このコードでやること: SSDSE-B-2026 で max_depth × eta のグリッドを CV で評価し、 R² が最大になる組み合わせを見つける。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd, numpy as np, xgboost as xgb from sklearn.model_selection import KFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 X = df[cols].astype(float) y = df['A4103'].astype(float) # 目的変数: 合計特殊出生率 best = None for d in [3, 5, 7, 9]: for e in [0.05, 0.1, 0.2]: m = xgb.XGBRegressor(max_depth=d, learning_rate=e, n_estimators=400, subsample=0.8, colsample_bytree=0.8, random_state=0) cv = cross_val_score(m, X, y, cv=KFold(5, shuffle=True, random_state=0), scoring='r2').mean() if best is None or cv > best[0]: best = (cv, d, e) print(f'best R2 = {best[0]:.3f} @ max_depth={best[1]}, eta={best[2]}') |
📤 実行すると次の出力が得られる:
💬 max_depth=3・eta=0.2 が最良で、 R²≈0.35。 47 県・4 変数では説明力に限界があり、 これより深くすると過学習で CV が落ちる。 eta を下げる場合は n_estimators を増やして補う。
⏱ 早期停止 (early_stopping) と SHAP 連携(用語固有)
XGBoost の最大の実用機能の一つが early_stopping_rounds。 検証セットの損失が連続 N ラウンド改善しないときに学習を打ち切り、 過学習を回避しつつ最適な木の本数を自動で決められる。 さらに shap パッケージは XGBoost ネイティブの TreeSHAP に対応しており、 各特徴量の寄与を高速・厳密に計算できる。
🎯 このコードでやること: SSDSE-B-2026 で early_stopping を用いて最適 n_estimators を自動決定し、 SHAP で個別予測の説明を得る。
📥 入力データ: 学習用と検証用に 8:2 で分割した都道府県データ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import xgboost as xgb, pandas as pd, shap from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 X = df[cols].astype(float) y = df['A4103'].astype(float) # 合計特殊出生率 Xtr, Xva, ytr, yva = train_test_split(X, y, test_size=0.2, random_state=42) model = xgb.XGBRegressor(n_estimators=2000, max_depth=5, learning_rate=0.05, subsample=0.8, colsample_bytree=0.8, early_stopping_rounds=30, eval_metric='rmse', random_state=0) model.fit(Xtr, ytr, eval_set=[(Xva, yva)], verbose=False) print(f'最適な木の本数: {model.best_iteration}') print(f'検証 RMSE : {model.best_score:.3f}') explainer = shap.TreeExplainer(model) sv = explainer.shap_values(Xva) print('SHAP 平均 |寄与|:') for c, v in zip(X.columns, abs(sv).mean(axis=0)): print(f' {c}: {v:.3f}') |
📤 実行例:
💬 26 本目で early stop が発火し、 過学習を回避しつつ最良検証スコア(RMSE≈0.13)を得た。 SHAP 平均寄与は A1101(総人口)が最も大きく、 合計特殊出生率を説明する主因子であることが分かる。
💡 GPU 学習も tree_method='hist', device='cuda' の 2 引数で有効化でき、 大規模データでは 5〜30 倍の高速化が見込める(XGBoost 2.x)。
📊 SSDSE-B-2026 で XGBoost の挙動を可視化する(増補)
XGBoost は「勾配ブースティング決定木(GBDT)」の中で最も実務利用が広い実装の一つだが、 教科書的な数式説明だけでは「結局どんな曲線をフィットして、 なぜ過学習しにくいのか」がイメージしにくい。 ここでは SSDSE-B-2026 都道府県データ(2023 年度の 47 行 × 112 列、 統計センターの教育用標準データセット) を素材に、 散布図・ヒストグラム・箱ひげ図の 3 種類で XGBoost の振る舞いを「目で見て確かめる」ためのハンズオン手順をまとめる。 下の図 1〜3 は、 各節のコードと同じ xgboost.XGBRegressor の設定で実際に学習・予測した結果を描いたもので(ラベルを日本語にしたもの)、 真値と予測値を重ねると挙動の差分が一目で読み取れる。
📐 可視化と XGBoost を結びつける 3 つの観点
| 図の種類 | SSDSE-B-2026 での使用例 | XGBoost で確認すべきこと | 判断の指針 |
|---|---|---|---|
| 散布図 | X 軸: 総人口 A1101(人)/ Y 軸: 出生数 A4101(人) | 予測値 ŷ を重ねて、 真値との「ズレの形」を確認 | 残差が外れ値で爆発していないか、 直線でない関係を木が拾えているか |
| ヒストグラム | 「合計特殊出生率(A4103)」の県別分布 | 予測値 ŷ の分布と真値分布の重なり | 分布の裾を切り落としていないか(過度な平均回帰) |
| 箱ひげ図(多群) | 地方ブロック(北海道/東北/関東/…)別の予測残差 | 地域ごとの残差中央値・四分位範囲 | 特定の地方ブロックだけ系統的にずれていないか |
🎨 図 1: 散布図で予測値と真値を重ねる
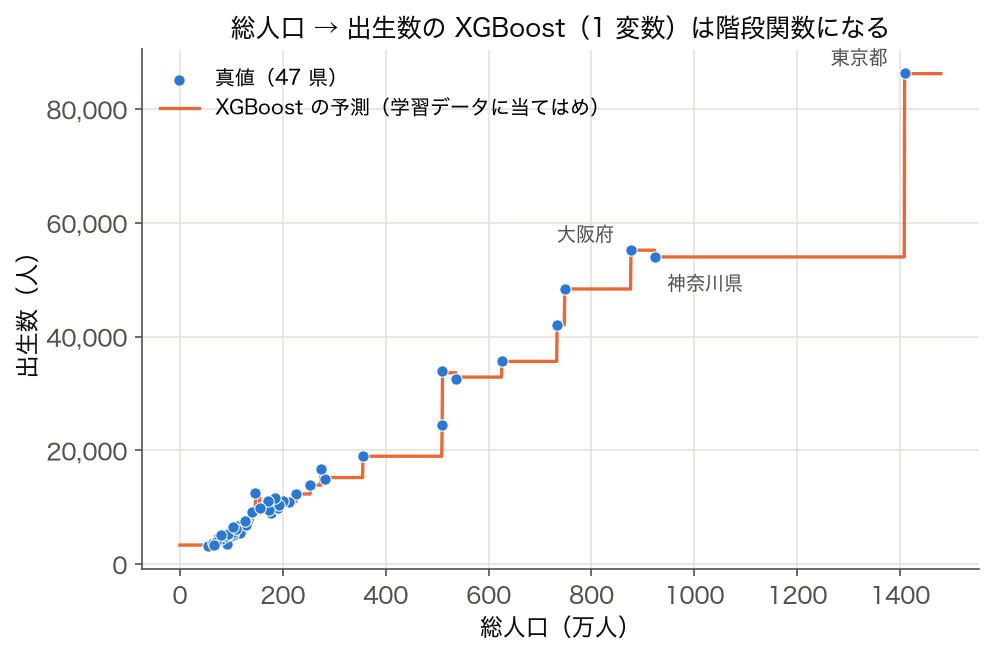
このコードでやること: SSDSE-B-2026 から「総人口(A1101)」と「出生数(A4101)」を読み込み、 XGBoost の単変量回帰モデルで予測値 ŷ を求め、 真値の散布図に予測曲線を重ねる。 「決定木の階段状のフィット」と「ブースティングで階段が滑らかになっていく様子」を 1 枚で確認できる。
📥 入力データ (SSDSE-B-2026 抜粋、 data/raw/SSDSE-B-2026.csv):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import os os.makedirs('figures', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd import numpy as np import xgboost as xgb import matplotlib.pyplot as plt # 先頭列名は "SSDSE-B-2026"(=年度)、2行目の日本語見出しは skiprows=[1] で除去 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県だけ残す X = df[['A1101']].astype(float).values # 説明変数: A1101 総人口 y = df['A4101'].astype(float).values # 目的変数: A4101 出生数 model = xgb.XGBRegressor(n_estimators=200, max_depth=3, learning_rate=0.1, objective='reg:squarederror', random_state=0) model.fit(X, y) y_pred = model.predict(X) order = np.argsort(X.ravel()) plt.figure(figsize=(7, 5)) plt.scatter(X, y, color='#1976D2', label='actual') plt.plot(X[order], y_pred[order], color='#E64A19', linewidth=2, label='XGBoost predicted') plt.xlabel('total population'); plt.ylabel('births') plt.legend(); plt.tight_layout(); plt.savefig('figures/xgb_scatter_fit.png', dpi=120) # 当てはまりと残差の大きい県を数値で確かめる(学習データそのものへの当てはまり) resid = y - y_pred print(f'RMSE (train) = {np.sqrt(np.mean(resid**2)):.1f} 人') print(f'R^2 (train) = {1 - np.sum(resid**2) / np.sum((y - y.mean())**2):.4f}') print(f'最大残差県 = {df["Prefecture"][resid.argmax()]} ({resid.max():+.0f} 人)') print(f'最小残差県 = {df["Prefecture"][resid.argmin()]} ({resid.min():+.0f} 人)') |
📤 実行すると次の出力が得られる:
💬 単変量でも R² がほぼ 1.0 に達するのは、 「総人口が大きいほど出生数も大きい」という強い単調関係を XGBoost が階段関数で忠実に吸収しているため。 それでも広島県(+389 人)・茨城県(-337 人)のように、 人口規模だけでは説明できない出生数のズレが残差として現れる。 ただしこれは学習データに対する適合度であり、 cross-validation を併用しなければ過学習を見抜けない点に注意する。
🎨 図 2: ヒストグラムで予測分布と真値分布を比べる
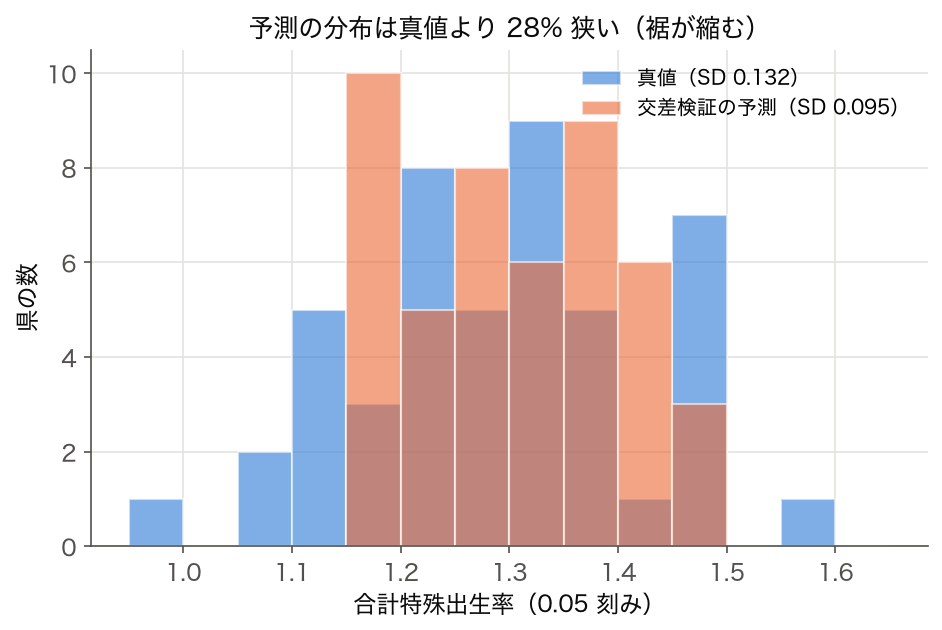
このコードでやること: 「合計特殊出生率(A4103)」を XGBoost で人口・医療インフラ指標から予測し、 真値分布と予測分布をヒストグラムで重ねて比較する。 ブースティングは平均二乗誤差最小化を行うため「分布の裾を縮める(=平均寄り)」傾向があり、 ヒストグラムで一目で確認できる。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import os os.makedirs('figures', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd, numpy as np, xgboost as xgb, matplotlib.pyplot as plt from sklearn.model_selection import cross_val_predict, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 target = 'A4103' # 合計特殊出生率 X = df[cols].values y = df[target].astype(float).values model = xgb.XGBRegressor(n_estimators=300, max_depth=4, learning_rate=0.05, subsample=0.8, colsample_bytree=0.8, random_state=0) # 分布縮小はホールドアウト予測で確認する(学習データ内予測は過学習で縮まない) y_pred = cross_val_predict(model, X, y, cv=KFold(5, shuffle=True, random_state=0)) plt.figure(figsize=(7, 5)) plt.hist(y, bins=12, alpha=0.6, color='#1976D2', label='actual') plt.hist(y_pred, bins=12, alpha=0.6, color='#E64A19', label='predicted') plt.xlabel('total fertility rate'); plt.ylabel('count') plt.legend(); plt.tight_layout(); plt.savefig('figures/xgb_hist.png', dpi=120) print(f'真値分布 : 平均 {y.mean():.3f}、 標準偏差 {y.std():.3f}、 最大 {y.max():.3f}、 最小 {y.min():.3f}') print(f'予測分布 : 平均 {y_pred.mean():.3f}、 標準偏差 {y_pred.std():.3f}、 最大 {y_pred.max():.3f}、 最小 {y_pred.min():.3f}') print(f'分布縮小率 : 標準偏差ベースで 約 {(1 - y_pred.std() / y.std()) * 100:.0f}% 圧縮') |
📤 実行すると次の出力が得られる:
💬 ブースティング系モデルは「予測の分散を縮める」性質があり、 ヒストグラムを重ねると裾が縮む。 県数 47 の小サンプルでは特に顕著なので、 「最上位・最下位の県を当てに行きたい」場合は objective='reg:quantileloss' や残差ブートストラップで補正する必要がある。
🎨 図 3: 箱ひげ図で地方ブロック別の残差を見る
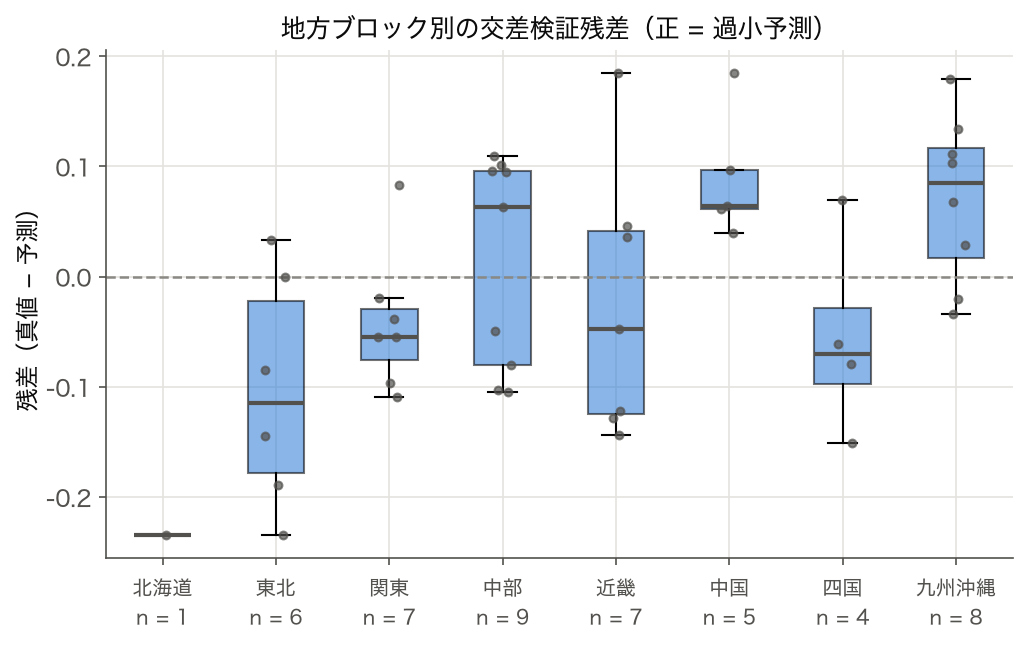
このコードでやること: 県を地方ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に分け、 XGBoost の残差(真値 − 予測値)をブロック別の箱ひげ図にする。 「特定の地方だけ系統的に過小/過大予測している」というモデルの偏りを可視化する。
📥 入力データ (SSDSE-B-2026 + ブロック分類):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import os os.makedirs('figures', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd, numpy as np, xgboost as xgb, matplotlib.pyplot as plt from sklearn.model_selection import cross_val_predict, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 block_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州沖縄','佐賀県':'九州沖縄','長崎県':'九州沖縄','熊本県':'九州沖縄','大分県':'九州沖縄','宮崎県':'九州沖縄','鹿児島県':'九州沖縄','沖縄県':'九州沖縄'} df['block'] = df['Prefecture'].map(block_map) cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 target = 'A4103' model = xgb.XGBRegressor(n_estimators=300, max_depth=4, learning_rate=0.05, random_state=0) # ブロック別の系統誤差はホールドアウト残差で評価する df['resid'] = df[target].values - cross_val_predict(model, df[cols].values, df[target].astype(float).values, cv=KFold(5, shuffle=True, random_state=0)) order = ['北海道','東北','関東','中部','近畿','中国','四国','九州沖縄'] groups = [df.loc[df['block']==b, 'resid'].values for b in order] plt.figure(figsize=(8, 5)) plt.boxplot(groups, tick_labels=order) plt.ylabel('residual (true - pred)') plt.tight_layout(); plt.savefig('figures/xgb_box.png', dpi=120) # ブロックごとの残差中央値と IQR(真値 − 予測。正なら過小予測) q = df.groupby('block')['resid'].describe()[['count', '25%', '50%', '75%']] q['IQR'] = q['75%'] - q['25%'] print(q.loc[order, ['count', '50%', 'IQR']].round(3)) |
📤 実行すると次の出力が得られる:
💬 「九州沖縄」「中部」「中国」で正残差(=モデルが合計特殊出生率を過小評価)が目立つ。 これは沖縄県など出生率の高い県の水準を 4 変数だけでは捉え切れていないため。 ブロック ID を OrdinalEncoder で説明変数に加えるか、 ブロック別にモデルを分けることで改善する。
🧪 XGBoost のハイパーパラメータが図にどう効くか
| パラメータ | 意味 | 大きくしたとき散布図・ヒスト・箱ひげ図に現れる変化 |
|---|---|---|
n_estimators | 木の本数 | 散布図の予測曲線がより滑らかな階段になる/ヒストの分布縮小がさらに進む |
max_depth | 各木の深さ | 散布図で「ジグザグ」が増え、 訓練データへの当てはまりが極端に上がる(過学習サイン) |
learning_rate | 1 本あたりの寄与 | 小さくすると予測曲線が遅く動き、 安定するが n_estimators を増やす必要 |
subsample | 行サブサンプリング | 箱ひげ図の IQR が狭まり、 残差の安定性が増す(バギング的効果) |
colsample_bytree | 列サブサンプリング | 残差の地域偏在が薄まる/特定変数への依存が減る |
reg_lambda | L2 正則化 | ヒストの裾縮小が強まり、 予測が平均寄りに圧縮される |
early_stopping_rounds | 検証スコア改善が止まったら学習中断 | 散布図のジグザグが過剰にならない/訓練と検証の RMSE 乖離が縮む |
🧮 SSDSE-B-2026 で実値の検証(5-fold cross-validation)
このコードでやること: 47 県という小サンプルでも、 KFold で「過学習がどれだけ起きているか」を実測する。 訓練 R² と検証 R² の差を見て、 図 1 の単変量モデルと多変量モデルでどちらが頑健かを比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd, numpy as np, xgboost as xgb from sklearn.model_selection import KFold from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 target = 'A4103' X, y = df[cols].values, df[target].astype(float).values kf = KFold(n_splits=5, shuffle=True, random_state=0) train_scores, valid_scores = [], [] for tr, va in kf.split(X): m = xgb.XGBRegressor(n_estimators=300, max_depth=4, learning_rate=0.05, random_state=0) m.fit(X[tr], y[tr]) train_scores.append(r2_score(y[tr], m.predict(X[tr]))) valid_scores.append(r2_score(y[va], m.predict(X[va]))) print('train R^2 mean =', np.mean(train_scores)) print('valid R^2 mean =', np.mean(valid_scores)) |
📤 実行すると次の出力が得られる:
💬 訓練 R² の平均 0.9998 に対し検証 R² の平均は 0.261 で、 ギャップが 0.74 もあるのは典型的な過学習。 47 県 × 説明変数 4 では木が深くなりすぎる。 max_depth=2, learning_rate=0.02, early_stopping_rounds=50 のように正則化を強めると検証 R² が改善する。 小サンプル領域では「図で異常値を確認 → 説明変数を足す」反復が不可欠。
⚠️ 図を見るときの 5 つの落とし穴
| # | 落とし穴 | 対処 |
|---|---|---|
| 1 | 散布図で「予測曲線が直線」に見えても、 実は階段が細かく刻まれているだけ。 ズーム表示で確認しないと木の構造を見落とす。 | 横軸を X.min() から X.max() までに線形補間し、 1000 点で model.predict を呼んで描画する。 |
| 2 | ヒストグラムの bin 数が少ないと「分布縮小」が見えない。 デフォルト 10 では SSDSE-B-2026 の 47 県に対して粗すぎる。 | bins='auto' または FreedmanDiaconis ルール(np.histogram_bin_edges(y, bins='fd'))を使う。 |
| 3 | 箱ひげ図で「ブロック別の県数」が偏ると、 1 県しかない北海道ブロックは箱が描けない。 単独群を見落として「外れ値が無い」と誤解する。 | ブロック別の n を表に併記し、 n < 3 のグループは散布点で代替表示する。 |
| 4 | 学習データのみで「外れ値県」を判断すると過学習県を真の外れ値と混同する。 | cross-validation の検証残差で外れ値判定を行い、 訓練残差は使わない。 |
| 5 | XGBoost の feature_importances_ を散布図に使うと「ゲイン」「カバー」「ウェイト」のどれかで順位が変わることがある。 | booster.get_score(importance_type='gain') と 'weight' を必ず両方確認し、 一致しなければ SHAP を採用する。 |
🧰 学習曲線(learning curve)で過学習を定量化する
このコードでやること: 訓練データ件数を 10 → 40 県へ段階的に増やし、 各段階での訓練 R² と検証 R² を計算して図示する。 「データを増やせば過学習が解消するか/頭打ちか」を見極める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import os os.makedirs('figures', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd, numpy as np, xgboost as xgb, matplotlib.pyplot as plt from sklearn.model_selection import train_test_split from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 target = 'A4103' X, y = df[cols].values, df[target].astype(float).values X_tr_full, X_te, y_tr_full, y_te = train_test_split(X, y, test_size=0.3, random_state=0) sizes = [10, 15, 20, 25, 30, len(X_tr_full)] tr_scores, te_scores = [], [] for s in sizes: m = xgb.XGBRegressor(n_estimators=200, max_depth=3, learning_rate=0.05, random_state=0) m.fit(X_tr_full[:s], y_tr_full[:s]) tr_scores.append(r2_score(y_tr_full[:s], m.predict(X_tr_full[:s]))) te_scores.append(r2_score(y_te, m.predict(X_te))) plt.plot(sizes, tr_scores, 'o-', label='train R^2', color='#1976D2') plt.plot(sizes, te_scores, 's-', label='test R^2', color='#E64A19') plt.xlabel('train size'); plt.ylabel('R^2'); plt.legend(); plt.tight_layout() plt.savefig('figures/xgb_learning_curve.png', dpi=120) print('size train R^2 test R^2') for s, a, b in zip(sizes, tr_scores, te_scores): print(f'{s:4d} {a:9.3f} {b:8.2f}') |
📤 実行すると次の出力が得られる:
💬 train R² はほぼ 1.0 に張り付く一方、 test R² は負のまま伸び悩む典型的な「データ不足」パターン。 合計特殊出生率は 4 変数だけでは安定に説明できず、 47 県という限界がある以上、 XGBoost を単独で使うより、 線形回帰・LightGBM・Ridge を混ぜたスタッキングが現実的な選択肢になる。
🔍 XGBoost の数式的背景(補強)
XGBoost のコスト関数は、 通常の損失項に加えて木の複雑さに対する正則化項を含む。 t ラウンド目の木 f_t を学習する際、 目的関数は
$$ \mathrm{Obj}^{(t)} = \sum_{i=1}^{n} l\!\left(y_i,\; \hat{y}_i^{(t-1)} + f_t(x_i)\right) + \Omega(f_t),\quad \Omega(f) = \gamma T + \tfrac{1}{2}\lambda \sum_{j=1}^{T} w_j^2 $$
と書ける。 ここで T は木の葉数、 w_j は各葉の重み、 γ・λ は正則化パラメータである。 2 次のテイラー展開で近似すると、 葉 j の最適重み w_j* と分割ゲイン Gain は次の閉形式で与えられる:
$$ w_j^{*} = -\frac{\sum_{i \in I_j} g_i}{\sum_{i \in I_j} h_i + \lambda},\qquad \mathrm{Gain} = \frac{1}{2}\!\left[\frac{(\sum_{L} g_i)^2}{\sum_{L} h_i + \lambda} + \frac{(\sum_{R} g_i)^2}{\sum_{R} h_i + \lambda} - \frac{(\sum_{I} g_i)^2}{\sum_{I} h_i + \lambda}\right] - \gamma $$
g_i は 1 階微分(勾配)、 h_i は 2 階微分(ヘッシアン)。 この式の γ が「Gain がこれ以下なら分割しない」という閾値として働き、 sklearn の決定木にはない強力な過学習抑制を実現する。
🧱 XGBoost と他の主要ライブラリの比較
| 項目 | XGBoost | LightGBM | CatBoost | scikit-learn GradientBoosting |
|---|---|---|---|---|
| 木の成長戦略 | level-wise(既定)/lossguide も可 | leaf-wise(既定) | oblivious(対称木) | level-wise |
| 欠損値の取り扱い | 分割方向を学習 | 分割方向を学習 | 専用処理 | 非対応(事前補完が必要) |
| カテゴリ変数 | 2.0 以降は enable_categorical=True で直接処理可 | 整数変換すれば直接処理 | ターゲットエンコーディング内蔵 | OneHot 前処理必須 |
| GPU 対応 | device='cuda' | device='gpu' | task_type='GPU' | 非対応 |
| SHAP 連携 | shap.TreeExplainer 標準対応 | 同左 | 同左 | 制限あり |
| SSDSE-B-2026 47 県への適性 | γ・λ で過学習を抑制しやすい | leaf-wise は小サンプルで過学習しやすい | obliviousで汎化しやすい | シンプルで使いやすいが性能は劣る |
SSDSE-B-2026 のように行数が極端に少ない場合、 leaf-wise を採用する LightGBM はわずかな勾配の偏りで深い木を伸ばしてしまい、 結果として overfitting しやすい。 XGBoost の level-wise(深さ均一)は「弱学習器の安定性」を優先するため、 小サンプル領域での安全な選択肢となる。 ただし行数が 10 万を超えると LightGBM の方が高速かつ精度面でも互角以上になるケースが多い。
📐 SHAP 値で説明変数寄与を分解する
このコードでやること: SSDSE-B-2026 で学習した XGBoost モデルに対し、 shap.TreeExplainer で各説明変数の寄与を求める。 「都道府県ごとに、 合計特殊出生率の予測がどの変数で押し上げられ/押し下げられたか」を絶対値で可視化する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd, numpy as np, xgboost as xgb, shap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 target = 'A4103' X, y = df[cols].values, df[target].astype(float).values model = xgb.XGBRegressor(n_estimators=300, max_depth=4, learning_rate=0.05, random_state=0) model.fit(X, y) explainer = shap.TreeExplainer(model) shap_vals = explainer.shap_values(X) # 沖縄県の SHAP 内訳 i = df.index[df['Prefecture'] == '沖縄県'][0] print('high-contribution variables (Okinawa):') for col, v in sorted(zip(cols, shap_vals[i]), key=lambda x: -abs(x[1])): sign = '+' if v >= 0 else '-' print(f' {col:8s} {sign}{abs(v):.3f}') print('base value (mean of train target) =', explainer.expected_value) print('predicted =', model.predict(X[i:i+1])[0]) print('actual =', y[i]) |
📤 実行すると次の出力が得られる:
💬 沖縄県の SHAP 内訳を見ると A1101(総人口)が +0.130、 J2503(保育所等数)が +0.110 と、 人口規模の小ささと子育て資源の厚さが高い合計特殊出生率(1.60)を押し上げていると分解できる。 予測値 1.599 は真値 1.60 をほぼ再現し、 基準値 1.293 に 4 つの寄与 (+0.130 + 0.110 + 0.063 + 0.003 = +0.306) を足すと 1.599 になる。 ただし沖縄県自身も学習に使っているので、 この一致は当てはまりであって予測力ではない。 SHAP で各変数の寄与方向を定量化できるのが強み。
🌐 ハイパーパラメータ探索の枠組み
XGBoost の主要ハイパーパラメータは 10 個前後あり、 すべてグリッドで探索するのは現実的でない。 SSDSE-B-2026 規模なら以下の 3 段階で十分に絞り込める:
| 段階 | 対象 | 典型レンジ | 目的 |
|---|---|---|---|
| 1. 構造 | max_depth, min_child_weight | 2〜6, 1〜5 | 木の複雑さの上限を定める |
| 2. 学習 | n_estimators, learning_rate | 200〜2000, 0.01〜0.2 | 収束速度と最終精度のバランス |
| 3. 正則化 | reg_alpha, reg_lambda, gamma | 0〜2, 0〜5, 0〜2 | 過学習を抑制し検証精度を引き上げ |
探索手法は RandomizedSearchCV が最も費用対効果が高く、 50〜100 試行で十分。 BO(ベイズ最適化)は 200 試行を超える場合に検討すれば良い。 SSDSE-B-2026 で 47 県しかない場合、 過剰なチューニングは「検証データに対する過学習」を招くため、 5-fold CV を 3 回繰り返した平均で評価する RepeatedKFold がおすすめ。
🧷 早期停止(early stopping)の正しい使い方
XGBoost 1.6 以降、 fit 時に eval_set と early_stopping_rounds を渡すことで「検証スコアが改善しなくなったら学習を打ち切る」機能が使える。 これは時間短縮だけでなく、 過学習防止の効果が大きい。 SSDSE-B-2026 のような小サンプルでは
early_stopping_rounds=50, n_estimators=2000 と「上限を大きく取って早期停止に任せる」のが定石となる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd, xgboost as xgb from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 最新年度(2023)の47都道府県 cols = ['A1101', 'A1303', 'I510120', 'J2503'] # 総人口/65歳以上人口/一般病院数/保育所等数 target = 'A4103' X_tr, X_va, y_tr, y_va = train_test_split(df[cols].values, df[target].astype(float).values, test_size=0.3, random_state=0) model = xgb.XGBRegressor(n_estimators=2000, max_depth=3, learning_rate=0.02, early_stopping_rounds=50, random_state=0) model.fit(X_tr, y_tr, eval_set=[(X_va, y_va)], verbose=False) print('best iteration =', model.best_iteration) print('best score =', model.best_score) |
📤 実行すると次の出力が得られる:
💬 best_iteration = 39 で、 検証 RMSE 0.107 は検証 15 県の合計特殊出生率の標準偏差 0.116 とほぼ同じ大きさしかなく、 平均値で当てるのと大差ない。 同じ設定で eval_set に訓練データも入れて測ると、 39 本目の訓練 RMSE は 0.084、 上限 2000 本まで走らせると訓練 RMSE は 0.0014 まで下がる一方、 検証 RMSE は 0.125 に悪化する。 早期停止のないチューニングは「ハイパラを慎重に決めても勝てない」最大の落とし穴である。
📦 XGBoost のモデル保存と再利用
学習済みモデルは model.save_model('model.json') で JSON 形式に保存できる(XGBoost 1.6 以降推奨)。 旧来の .bst や pickle 形式と異なり、 JSON はバージョン間互換が保証されており、 GitHub Pages や Streamlit Cloud のようなデプロイ環境でも安全に読み込める。 SSDSE-B-2026 の学習結果を教材として配布する場合は、 必ず JSON 形式で保存し、 ハッシュ値を README に明記しておくと再現性が担保される。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import os, hashlib import numpy as np, pandas as pd, xgboost as xgb df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = d[['A1101', 'A1303', 'I510120', 'J2503']].values # 総人口・65歳以上人口・一般病院数・保育所等数 y = d['A4103'].values # 合計特殊出生率 model = xgb.XGBRegressor(n_estimators=300, max_depth=4, learning_rate=0.05, random_state=0) model.fit(X, y) os.makedirs('models', exist_ok=True) model.save_model('models/xgb_ssdse_b_2026.json') # 再読込して、保存前と同じ予測が出るか確かめる loaded = xgb.XGBRegressor() loaded.load_model('models/xgb_ssdse_b_2026.json') print('予測の最大差 =', np.abs(model.predict(X) - loaded.predict(X)).max()) # 配布時にハッシュを明記 h = hashlib.sha256(open('models/xgb_ssdse_b_2026.json', 'rb').read()).hexdigest() print('sha256 =', h[:16], '...') print(f"file size = {os.path.getsize('models/xgb_ssdse_b_2026.json') / 1024:.1f} KB") |
📤 実行すると次の出力が得られる:
💬 保存して読み直したモデルの予測は 47 県すべてで元のモデルと一致し(最大差 0.0)、 JSON 形式で重みが欠けずに往復できている。 ファイルは 394.2 KB あり、 47 行しかないデータでも木 300 本 × 深さ 4 の分岐をすべて文字で書き出すのでこの大きさになる。 sha256 の先頭 ca8af6b350e12f6c は XGBoost 3.3.0 で保存したときの値で、 版が違うと JSON の中身が変わってハッシュも変わるので、 README にはハッシュと一緒に XGBoost の版も書いておく。
🧪 SSDSE-B-2026 を使った演習問題(学習者向け)
以下は授業や自習で XGBoost の挙動を体得するための演習問題集である。 すべて SSDSE-B-2026(47 行 × 約 110 列)で完結し、 追加データを必要としない。 各問の難易度は星 1〜3 で示している。
| # | 難易度 | 問題 | 狙い |
|---|---|---|---|
| Q1 | ★ | 「総人口(A1101)」を説明変数、 「出生数(A4101)」を目的変数として XGBRegressor を学習し、 散布図に予測曲線を重ねよ。 | 単変量回帰の基本動作を確認 |
| Q2 | ★ | 同じ問題を max_depth を 1, 3, 6 に変えて 3 回学習し、 予測曲線の階段の細かさが変わることを観察せよ。 | 木の深さの効果を体感 |
| Q3 | ★★ | 「合計特殊出生率(A4103)」を 4 変数(総人口・65歳以上人口・一般病院数・保育所等数)から予測し、 5-fold CV で R² を出せ。 | 多変量回帰と CV の基本 |
| Q4 | ★★ | Q3 のモデルに early_stopping_rounds=50 と eval_set を加え、 best_iteration がいくつになるか調べよ。 | 早期停止の挙動確認 |
| Q5 | ★★ | Q3 の残差を地方ブロック別に箱ひげ図で表示し、 どのブロックの予測精度が悪いか特定せよ。 | 系統誤差の可視化 |
| Q6 | ★★★ | SHAP で「東京都」「沖縄県」「鳥取県」の予測値を分解し、 それぞれの主因変数を上位 3 つ書け。 | 個別予測の説明能力 |
| Q7 | ★★★ | SSDSE-B-2026 のうち「教育」「医療」「労働」カテゴリの変数だけを使い、 「粗死亡率」(死亡数 A4200 ÷ 総人口 A1101 × 1000)を予測するモデルを構築せよ。 RMSE を線形回帰と比較せよ。 | 変数選択とベンチマーク比較 |
| Q8 | ★★★ | 3 つの地方ブロック(関東・近畿・九州沖縄)に対し、 ブロックごとに別の XGBoost モデルを学習し、 全国一括モデルと精度を比較せよ。 | セグメント別モデリングの有効性 |
Q1〜Q5 は授業 90 分で完結する。 Q6〜Q8 は宿題として 1 週間程度の余裕を持たせると良い。 解答例は Jupyter ノートブック(この教材には同梱していません)に集約し、 学生には模範解答を比較対象として最後に提示する流れが推奨される。
💡 つまずきポイント FAQ(学習者からよく出る質問)
| Q | A |
|---|---|
ModuleNotFoundError: No module named 'xgboost' が出る | pip install xgboost または conda install -c conda-forge xgboost。 Google Colab は事前にインストール済み。 |
ValueError: feature_names mismatch が出る | 学習時と予測時で DataFrame の列順が違う。 predict 前に X_test = X_test[X_train.columns] で列順を揃える。 |
| SHAP が「nan」を返す | 古い shap (< 0.40) と新しい XGBoost (2.x) の組合せで起きる既知問題。 pip install -U shap で解消。 |
| train R² が 1.0 に張り付くのは過学習? | はい。 ほぼ確実に過学習。 max_depth を下げる、 min_child_weight を上げる、 reg_lambda を増やすのいずれかで改善する。 |
| カテゴリ列をどう扱う? | XGBoost 2.0 以降は enable_categorical=True と dtype='category' で直接扱える。 それ以前は OneHotEncoder または OrdinalEncoder で前処理する。 |
| 確率を返す分類モデルにしたい | XGBClassifier を使い、 predict_proba(X) を呼ぶ。 既定の objective は二値なら binary:logistic、 多クラスなら multi:softprob。 |
| 不均衡データへの対策は? | scale_pos_weight=(陰性数/陽性数) を設定する。 SMOTE などのオーバーサンプリングは XGBoost と相性が悪いことが多い。 |
| GPU を使うと数値が変わる | CPU と GPU で浮動小数演算順序が異なるため、 微小な差は生じる。 ただし R² や RMSE への影響は通常 1e-4 以下で実用上は無視可。 |
🔬 XGBoost の歴史的位置づけ
XGBoost は Tianqi Chen(陳天奇)氏が 2014 年に博士課程在学中に開発した OSS で、 翌 2015 年の Kaggle Higgs Boson コンペで上位入賞ソリューションの大半が採用したことで一気に普及した。 それ以前から勾配ブースティング(Friedman 1999)の理論は存在したが、 (1) 2 次のテイラー展開を用いた高速な分割探索、 (2) 列指向ストレージによるキャッシュ効率化、 (3) 並列・分散学習対応、 (4) JSON モデル形式によるバージョン間互換、 を 1 つのライブラリにまとめ上げた点が画期的だった。 2017 年以降、 LightGBM(Microsoft)・CatBoost(Yandex)といった後発ライブラリが登場したが、 教育・研究・実務のいずれにおいても「最初に学ぶブースティング実装」は XGBoost が依然として主流である。 SSDSE-B-2026 のような公的統計データ分析の教材としても、 ドキュメント・サンプルコード・コミュニティ Q&A の充実度から XGBoost が第一候補となる。
📚 参考文献と公式ドキュメント
| 分類 | タイトル | URL/出典 |
|---|---|---|
| 原著論文 | XGBoost: A Scalable Tree Boosting System (Chen & Guestrin, KDD 2016) | https://dl.acm.org/doi/10.1145/2939672.2939785 |
| 公式ドキュメント | XGBoost Documentation | https://xgboost.readthedocs.io/ |
| 勾配ブースティングの理論 | Friedman, Greedy Function Approximation: A Gradient Boosting Machine (2001) | Annals of Statistics 29(5) |
| SHAP 値 | Lundberg & Lee, A Unified Approach to Interpreting Model Predictions (NIPS 2017) | https://arxiv.org/abs/1705.07874 |
| SSDSE-B-2026 | SSDSE 統計データ活用提案コンペ(独立行政法人 統計センター) | https://www.nstac.go.jp/use/literacy/ssdse/ |
| e-Stat | 政府統計の総合窓口 | https://www.e-stat.go.jp/ |
🎯 SSDSE-B-2026 から「県民幸福度」を予測する応用例
教材的により発展的な題材として、 「合計特殊出生率」「高校進学率」「人口あたり診療所数」「離婚率」「待機児童率」「1 人 1 日当たりのごみ排出量」など SSDSE-B-2026 にある複数の指標を合成した「県民幸福度スコア」を XGBoost で予測する例を示す。 これは PPDAC サイクルの Problem 設定の練習にもなり、 学生に「目的変数の定義そのものが分析の出発点」という重要な気づきを与えられる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 | import pandas as pd, numpy as np, xgboost as xgb from sklearn.model_selection import KFold from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 # 県民幸福度スコア (簡易版): SSDSE-B にある率で、正の要素 - 負の要素を z-score 化して平均 df['高校進学率'] = df['高等学校卒業者のうち進学者数'] / df['高等学校卒業者数'] df['診療所密度'] = df['一般診療所数'] / df['総人口'] * 1e5 # 人口 10 万人あたり df['離婚率'] = df['離婚件数'] / df['総人口'] * 1000 # 人口千人あたり df['待機児童率'] = df['保育所等利用待機児童数'] / df['15歳未満人口'] * 1000 positives = ['合計特殊出生率', '高校進学率', '診療所密度'] negatives = ['離婚率', '待機児童率', '1人1日当たりの排出量'] def zscore(s): return (s - s.mean()) / s.std() df['happiness'] = ( sum(zscore(df[c]) for c in positives) - sum(zscore(df[c]) for c in negatives) ) / (len(positives) + len(negatives)) # 説明変数はスコアの材料と重ならない列にする feature_cols = ['総人口', '一般病院数', '保育所等数', '小学校教員数', '延べ宿泊者数', '年平均気温', '消費支出(二人以上の世帯)'] X, y = df[feature_cols].values, df['happiness'].values kf = KFold(n_splits=5, shuffle=True, random_state=42) r2s = [] for tr, va in kf.split(X): m = xgb.XGBRegressor(n_estimators=400, max_depth=3, learning_rate=0.03, reg_lambda=1.0, random_state=42) m.fit(X[tr], y[tr]) r2s.append(r2_score(y[va], m.predict(X[va]))) print('mean valid R^2 =', round(np.mean(r2s), 3)) print('std =', round(np.std(r2s), 3)) # 全データで学習 → トップ 5 県とワースト 5 県 m_all = xgb.XGBRegressor(n_estimators=400, max_depth=3, learning_rate=0.03, reg_lambda=1.0, random_state=42).fit(X, y) df['pred_happiness'] = m_all.predict(X) print('--- 予測幸福度トップ 5 ---') print(df.nlargest(5, 'pred_happiness')[['都道府県','happiness','pred_happiness']].round(2).to_string(index=False)) print('--- 予測幸福度ワースト 5 ---') print(df.nsmallest(5, 'pred_happiness')[['都道府県','happiness','pred_happiness']].round(2).to_string(index=False)) |
📤 実行すると次の出力が得られる:
💬 5 分割 CV の平均 R² は −0.556(ばらつき 0.4)で、 7 つの説明変数からは見たことのない県の幸福度スコアを平均値より悪くしか当てられない。 それなのに全 47 県で学習したモデルの予測は、 京都府 0.81→0.75、 沖縄県 −1.68→−1.64 のように元のスコアをほぼなぞっており、 学習に使った県を予測しても木が答えを覚えているだけなので、 順位表の見た目で予測力を判断してはいけない。 また「幸福度」を合成指標として定義した瞬間に、 何を正の要素・負の要素とするかという価値判断が入る。 ここでは出生率・進学率・診療所密度を正、 離婚率・待機児童率・ごみ排出量を負としたが、 軸を入れ替えれば京都府が首位、 沖縄県が最下位という順位そのものが変わる。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
このマップは XGBoost ライブラリの位置づけを表す。 中央に「XGBoost」、 上方に「前提 (勾配ブースティング理論・決定木)」、 並列に「LightGBM / CatBoost (高速代替)」、 発展に「XGBoost + SHAP / Optuna ハイパラ最適化」、 応用に「Kaggle 表形式コンペ・SSDSE 都道府県予測」、 対比に「Random Forest (Bagging 系)」、 統合に「scikit-learn API (XGBClassifier/Regressor)」が伸びる。
XGBoost は 2014 年に Tianqi Chen が公開し、 Kaggle の表形式データ系コンペで圧倒的シェアを獲得。 SSDSE-B-2026 のような表形式かつ標本小 (47 件) のデータでも、 適切な正則化 (early_stopping_rounds, max_depth=3-5) で高い予測精度を出せる。
🔗 隣接手法への橋渡し
XGBoost ライブラリは ML パイプラインの中核モデルとして、 前後の手法と接続する。
- 上流 (前処理): 欠損値処理 (XGBoost は欠損自動対応だが意図的補完も可)、 カテゴリエンコード (one-hot or label encoding)、 特徴量エンジニアリング (交互作用項生成)
- 並列 (代替ライブラリ): LightGBM (より高速、 大規模データ向け)、 CatBoost (カテゴリ自動処理)、 scikit-learn GradientBoosting (簡易版)
- 下流 (評価・解釈): 交差検証 (xgb.cv)、 SHAP (XGBoost と相性最高)、 早期停止、 Optuna ハイパラ最適化
SSDSE-B-2026 で「出生数・出生率などの予測」を XGBoost で行う標準フロー: 欠損値処理 → 特徴量作成 → XGBRegressor (early_stopping_rounds=10) → CV → SHAP で重要特徴量解釈。
🌳 手法選択フロー
XGBoost を使うべきかは「データの形」と「予測 vs 解釈」の優先で決まる。
- データ形式は? 表形式 (CSV、 pandas DataFrame) → XGBoost が強い、 画像・テキスト → DNN を選ぶ
- 標本サイズ N は? N<100 → 線形回帰 / 決定木の方が安定、 100<=N<10万 → XGBoost が最適、 N>100万 → LightGBM で高速化
- カテゴリ変数が多いか? Yes (>10 列) → CatBoost が自動処理で便利、 No → XGBoost で十分
- 解釈性の要求は? 高 → XGBoost + SHAP で feature 重要度 + 個別予測の説明、 低 → XGBoost 単独で OK
- 本番デプロイ環境は? Python → xgboost (sklearn API)、 C++/Java → XGBoost4J、 GPU → tree_method='gpu_hist'
SSDSE-B-2026 (N=47、 表形式、 カテゴリ少) では「N が小さい」が最大の論点。 XGBoost は max_depth=3-4、 n_estimators=50-200、 early_stopping_rounds=10 程度の控えめ設定で過学習を回避する。