💡 30秒で分かる結論
🍰 まずはやさしく
丸暗記のような状態のことです。
正しく予測するために使います。
テスト勉強で答えだけ覚える例です。
結論を短くまとめて読みます。
過学習(Overfitting):訓練データに過剰適合し、 未知データへの性能(汎化)が落ちる現象
- 見分け方:訓練誤差だけを見ても分からない。 訓練誤差と、 学習に使っていないデータ(テスト・交差検証)の誤差を並べて差を見る
- 実例:SSDSE-B-2026 の 2023 年度 47 県で決定木を深くすると、 訓練 RMSE は 0 になるのにテスト RMSE は 90,191 人のまま下がらない(🧮)
- 起きやすい条件:モデルが柔軟・データが少ない(47 県を 7:3 に分けると訓練は 32 県)・候補を何十回も試して一番良いものを選ぶ(🎰)
- 対策:複雑さを下げる(木の深さ・次数)、 正則化で係数を縛る(Ridge / Lasso)、 交差検証で複雑さを選ぶ、 最終評価用のデータは最後に 1 回だけ使う
- 反対側:単純すぎて訓練誤差も大きい状態が未学習。 深さ 1 の木はテスト RMSE 310,522 人で、 深さ 5 の 89,895 人より大きく外れる
📍 あなたが今見ているもの
🍰 まずはやさしく
機械学習のとても大切な考え方です。
分析の基礎を身につけるために使います。
都道府県のデータを使って学びます。
このページの構成について読みます。
このページは「過学習(Overfitting)」の用語解説です。 機械学習の基礎で、 モデルの良し悪しを「訓練データで当たるか」ではなく「まだ見ていないデータで当たるか」で測る、 という考え方の中心にある概念です。 SSDSE-B-2026 の 2023 年度 47 都道府県(112 列)を題材に、 決定木の深さ・多項式の次数・Ridge の強さ・候補の数を変えて、 訓練誤差と検証誤差の差がどう開くかを実際に計算します。
別称:オーバーフィッティング / Overlearning。 まず 💡 30秒結論 で全体像を、 次に 🎨 直感 → 📐 数式 → 🧮 実値 → 🐍 Python の順で読むのがおすすめ。
🎨 直感で掴む
🍰 まずはやさしく
本質を学ばず暗記した状態です。
間違いの原因を知るために使います。
スマホの操作を丸暗記する例です。
直感的なイメージについて読みます。
過学習は「訓練データの暗記に走り、 本質を学ばない」状態。 訓練誤差は限りなく 0 に近いのに、 テスト誤差は大きい。 「47 県全部の人口を木構造で暗記したが、 48 番目の架空の県には全く対応できない」のような感覚。
原因:(1) モデルが複雑すぎる、 (2) サンプルが少ない、 (3) ノイズに合わせ込み。 対策:正則化(L1/L2)、 簡潔なモデル、 データ拡張、 early stopping、 交差検証で適切な複雑度を選ぶ、 ドロップアウト(DL)。
🎮 触って理解する
スライダーを動かすと、 真の関数(灰色の破線)+ノイズから作った訓練点(青)に、 指定した多項式次数の曲線がリアルタイムで当てはまります。 同時に、 学習に使っていないテスト点(橙)での誤差も計算します。 次数を上げるほど訓練誤差は下がるのに、 テスト誤差はある点から増える —— この U 字カーブこそ過学習の正体です。
💡 遊び方:まず次数を 1 → 15 とゆっくり動かし、 右下グラフのテスト RMSE(赤)が「一度下がって再び上がる」U 字を確認。 次にノイズを増やす/訓練データを減らすと、 過学習が始まる次数がどう前倒しになるか観察しよう。 数値は $x$ を $[-1,1]$ に標準化した正規方程式を解いて算出しています(高次での数値不安定を緩和)。
🩺 過学習の兆候・診断と対策 — 深掘り
🔎 過学習の 5 つの兆候
- 訓練誤差 ≪ テスト誤差:汎化ギャップが開く。 上のプレイグラウンドで体感した現象そのもの。
- 学習曲線が反転:エポックが進むと訓練損失は下がり続けるのに検証損失が途中から上昇に転じる。
- 係数が異常に大きい:多項式や線形回帰で係数の絶対値が爆発し、 隣り合う項が打ち消し合う不安定なフィットになる。
- データ数に対しパラメータ過多:$p/n$ が大きい(SSDSE-B は $n=47$ なので特に要注意)。
- わずかなデータ変更で予測が激変:高分散の兆候。 ブートストラップで予測がばらつく。
🧪 訓練 / 検証 / テストの三分割
過学習を正しく検出するには、 データを役割の異なる 3 つに分けます。
| 分割 | 役割 | 見てよい回数 |
|---|---|---|
| 訓練データ | パラメータの学習 | 何度でも |
| 検証データ | ハイパーパラメータ選択・early stopping の判断 | 選択のたびに(間接的にリークしうる) |
| テストデータ | 最終的な汎化性能の一度きりの見積り | 原則 1 回のみ |
最終確認用に手を付けないホールドアウトを取り置くと、 テストを何度も見ながら調整して間接的に過学習する「テスト過学習」を避けられます。
🧵 正則化 — 複雑なまま「縛る」
正則化は損失に複雑さのペナルティを足し、 $\min_\theta\; L(\theta) + \lambda\,\Omega(\theta)$ を最小化します。 次数を下げる代わりに、 大きな係数を抑えて曲線を滑らかにするのが狙いです。
- Ridge(L2):$\Omega=\|\theta\|_2^2$。 係数を全体的に縮小し、 多重共線性に強い。
- Lasso(L1):$\Omega=\|\theta\|_1$。 一部係数を厳密に 0 にし、 特徴選択も同時に行う。
- $\lambda$ の大きさ:大きすぎると未学習、 小さすぎると過学習。 中庸を交差検証で選ぶ。
🔁 交差検証で「正しく選ぶ」
交差検証(k-fold)はデータを k 個に分け、 各 fold を順に検証用にして k 回学習・評価し、 その平均で汎化性能を見積もります。 $n=47$ のような小標本でも、 hold-out 1 回より安定して次数や $\lambda$ を選べます。 fold ごとの誤差のばらつき自体が、 モデルの高分散(過学習傾向)のサインになります。
⚖️ バイアス・分散分解
期待二乗誤差は バイアス² + 分散 + ノイズ に分解できます(バイアス・分散トレードオフ)。
次数を上げるとバイアスは減るが分散が増える。 テスト誤差の U 字は、 この 2 項の綱引きの結果です。 プレイグラウンドで低次=高バイアス、 高次=高分散を見比べてみましょう。
⏱ 早期終了とデータ拡張
- 早期終了(early stopping):反復学習で検証誤差が最小の時点で学習を止める。 実質的に正則化と同じ効果を持ち、 有効な複雑度を制限する。
- データ拡張(data augmentation):回転・反転・ノイズ付与などで訓練データを水増しし、 分散を下げる。 データを増やすことは過学習への最も王道の対策。
- その他:特徴量削減、 アンサンブル(バギングで分散を平均化)、 ドロップアウト(DL)なども過学習抑制の定番。
📐 数式または定義
🍰 まずはやさしく
誤差の差をあらわすルールです。
正しさを計算するために使います。
部活の記録を数式にする例です。
数式を使った定義について読みます。
本概念は次のように記述されます(KaTeX で描画)。
英語名 Overfitting。 別称:オーバーフィッティング / Overlearning。
🔬 数式を言葉で読み解く
記号と意味を逐一突き合わせて読みます。 慣れないうちは式を「日本語で読む」ことが理解の近道です。
- $\widehat{\mathcal{R}}_n$:訓練データ上の平均損失
- $\mathcal{R}$:真の分布上の期待損失
- 汎化ギャップ:両者の差。 過学習で大きくなる
- 正則化:$\min L + \lambda \|\theta\|$ で複雑度を抑える
- 早期停止:検証誤差が最小の時点で学習を止める
🔬 記号を 🧮 の実測値で読む — 汎化ギャップだけでは判定できない
$\widehat{\mathcal{R}}_n$ を訓練 32 県の RMSE、 $\mathcal{R}$ の推定値をテスト 15 県の RMSE として、 🧮 の決定木(15 歳未満人口の予測)の値を当てはめる。
| max_depth | $\widehat{\mathcal{R}}_n$(訓練) | $\mathcal{R}$ の推定(テスト) | ギャップ | 読み方 |
|---|---|---|---|---|
| 1 | 141,138 | 310,522 | +169,384 | ギャップは最大だが、 訓練誤差そのものが大きい。 未学習 |
| 3 | 30,655 | 95,439 | +64,785 | ギャップが最小 |
| 5 | 8,988 | 89,895 | +80,906 | テスト誤差が最小 |
| 12 | 0 | 90,191 | +90,191 | 訓練を暗記。 テストは深さ 5 から改善しない。 過学習 |
この表から分かるのは、 ギャップの大きさだけで過学習を判定すると誤ることである。 ギャップが一番大きいのは深さ 1 だが、 これは訓練でも当たっていない未学習の状態で、 目的変数の単位(人)が大きいせいで差も大きく出ている。 過学習と言えるのは「訓練誤差は下がり続けるのに、 テスト誤差が下がらなくなった(または上がった)」ところ、 つまり深さ 5 から 12 への変化である。 ギャップは $\mathcal{R}$ と並べて読み、 モデルを選ぶときはギャップではなくテスト(交差検証)の誤差そのものを比べる。
🧮 SSDSE-B 実値で計算してみる
SSDSE-B 47 県を高次の決定木で fit すると、 訓練誤差は急減して 0 に近づく一方、 テスト誤差は下げ止まり、 汎化ギャップが大きく開くことを観察します。
データ出典:SSDSE-B-2026(独立行政法人統計センター)。 47 都道府県 × 複数年(最新 2023)の社会統計データ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd import numpy as np from sklearn.tree import DecisionTreeRegressor from sklearn.model_selection import train_test_split from sklearn.metrics import mean_squared_error df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) X = df[['総人口','65歳以上人口']].values y = df['15歳未満人口'].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) print('max_depth | RMSE_train | RMSE_test | gap') for d in [1, 2, 3, 5, 8, 12, None]: m = DecisionTreeRegressor(max_depth=d, random_state=0).fit(X_tr, y_tr) tr = mean_squared_error(y_tr, m.predict(X_tr)) ** 0.5 te = mean_squared_error(y_te, m.predict(X_te)) ** 0.5 print(f' {str(d):>8} | {tr:>10,.0f} | {te:>10,.0f} | {te-tr:>+8,.0f}') |
💬 max_depth を 12 以上にすると訓練 RMSE は 0、つまり訓練 32 県の 15 歳未満人口を 1 人の狂いもなく暗記している。それでもテスト 15 県の RMSE は 90,191 人で、depth 5 の 89,895 人から改善しない。gap が最小なのは depth 3(+64,785)で、深くするほど gap が広がるのは訓練側の誤差だけが縮むためだ。テスト RMSE が depth 1 の 310,522 から大きく下がるのは、浅すぎる木が逆に「過小適合」だったことを示している。
実行結果の要約(random_state を固定しているので、下の値はそのまま再現できます):
| 項目 | 値 |
|---|---|
| depth=1 RMSE訓練/テスト | 141,138 / 310,522 |
| depth=2 RMSE訓練/テスト | 65,240 / 159,440 |
| depth=3 RMSE訓練/テスト | 30,655 / 95,439 |
| depth=5 RMSE訓練/テスト | 8,988 / 89,895 (best) |
| depth=12 RMSE訓練/テスト | 0 / 90,191 (完全過学習) |
| 汎化ギャップ depth=12 | +90,191 |
🧮 数式に値を入れて手で計算する: 過学習指標
合成データで train/val 精度ギャップから過学習度を計算する。
Step 1: モデル別精度
| モデル | train | val | ギャップ | 判定 |
|---|---|---|---|---|
| M1 | 0.80 | 0.78 | 0.02 | OK |
| M2 | 0.90 | 0.85 | 0.05 | OK |
| M3 | 0.98 | 0.75 | 0.23 | 過学習 |
| M4 | 1.00 | 0.60 | 0.40 | 深刻 |
Step 2: 閾値判定 (ギャップ > 0.10)
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np train = np.array([0.80, 0.90, 0.98, 1.00]) val = np.array([0.78, 0.85, 0.75, 0.60]) gap = train - val overfit = gap > 0.10 print(f"ギャップ: {gap}") print(f"過学習: {overfit}") print(f"最良 (gap<=0.1 で val 最大): index {val[~overfit].argmax()}") |
📤 実行結果
💬 手計算 (Step 2) M2 と Python 出力が完全一致。
🐍 Python 実装
ここでは 2023 年度 47 県の合計特殊出生率を、 総人口・65 歳以上人口・出生数から予測するランダムフォレストで、 訓練 R² とテスト R²・交差検証の R² を並べて過学習を確かめる。
🐍 応用コード — 深い決定木を 47 県に当てはめると訓練 R²=1.0 だが CV では低い
2023 年度の 47 県に絞り、 まず使う 4 列の分布を確かめる。 分布が右に歪んでいると、 東京都がどちらに入るかで誤差が大きく変わる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47 県 × 約 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) print('shape:', df.shape) print('列の先頭:', df.columns.tolist()[:6]) # 必要な列だけ取り出して整形 features = ['総人口', '15歳未満人口', '65歳以上人口', '出生数'] df_use = df[features].copy() print(df_use.describe()) |
💬 総人口の平均 264.6 万人に対し中央値は 154.9 万人、最大は東京都の 1,408.6 万人で、分布が大きく右に歪んでいる。出生数も平均 15,474 に対し最大 86,348 と 5 倍以上。この歪みのせいで、訓練・テストのどちらに東京都などの大都市が入るかだけで RMSE が大きく変わるので、分割の乱数を変えて結果の安定性を見ておくとよい。
次に、 47 県を訓練 32 県・テスト 15 県に分け、 訓練 R² とテスト R² を並べる。 この 2 つの差が過学習の目安になる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error, r2_score X = df[['総人口', '65歳以上人口', '出生数']].fillna(0).values y = df['合計特殊出生率'].fillna(df['合計特殊出生率'].median()).values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0).fit(X_tr, y_tr) pred_tr = model.predict(X_tr) pred_te = model.predict(X_te) print(f'train R^2 = {r2_score(y_tr, pred_tr):.3f}') print(f'test R^2 = {r2_score(y_te, pred_te):.3f}') print(f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}') |
💬 訓練 R² 0.866 に対しテスト R² 0.038 で、差の 0.83 が典型的な過学習の姿だ。テスト RMSE 0.1141 は合計特殊出生率そのものの標準偏差 0.133 とほとんど変わらず、15 県の予測は平均値を言うのと大差ない。max_depth=4 に制限しても、訓練 32 県に対して 200 本の木は十分に暗記できてしまう。
テスト 15 県の実測と予測を散布図にすると、 点が対角線からどれだけ離れるかで外れ方が見える。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('過学習 を使ったモデルの予測精度(SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_overfitting.png', dpi=150) |
1 回の分割は運に左右されるので、 最後に 5-fold 交差検証で 5 通りの分け方の R² を見る。
1 2 3 4 5 6 7 8 | from sklearn.model_selection import cross_val_score scores = cross_val_score( RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0), X, y, cv=5, scoring='r2' ) print(f'5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f})') print('各 fold:', np.round(scores, 3)) |
💬 5 fold の R² は -5.832 から 0.445 まで、平均 -2.092 と 1 回の分割(テスト R² 0.038)よりさらに悪い。cv=5 は並び替えずに北から順に切るので、fold 1 は北海道・東北の県をまとめて外し、訓練に無い地域を当てさせる形になる。R² が -5.8 というのは、平均値で予測するより約 7 倍大きな二乗誤差を出しているということで、このモデルは地域をまたいで一般化できていない。
⚠️ よくある落とし穴(5 つ)
🧪 実データで確かめる — 同じ県が訓練と検証の両方に入ると、 過学習が見えなくなる
SSDSE-B-2026 は同じ 47 県が 12 年度分並ぶパネルデータで、 同じ県の値は年度が違ってもよく似ている。 年度で絞らずに行をランダムに分けると、 検証用の行とほぼ同じ行が訓練側に残るため、 丸暗記したモデルでも検証で当たってしまう。
🎯 このコードでやること:SSDSE-B-2026 の全 564 行(47 県 × 12 年度)で、 深さ無制限の決定木が合計特殊出生率をどれだけ当てるかを、 行をランダムに分ける KFold と、 県ごとに分ける GroupKFold の 2 通りの交差検証で比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import numpy as np from sklearn.tree import DecisionTreeRegressor from sklearn.model_selection import KFold, GroupKFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print('行数:', len(df), ' 県の数:', df['都道府県'].nunique(), ' 年度:', df['年度'].min(), '〜', df['年度'].max()) X = df[['総人口', '65歳以上人口', '出生数']].values y = df['合計特殊出生率'].values tree = DecisionTreeRegressor(random_state=0) # 深さ無制限 tree.fit(X, y) print(f'訓練 R² = {tree.score(X, y):.3f}') kf = KFold(n_splits=5, shuffle=True, random_state=0) # 行をランダムに 5 分割 r_kf = cross_val_score(tree, X, y, cv=kf, scoring='r2') gkf = GroupKFold(n_splits=5) # 県ごとに 5 分割 r_gk = cross_val_score(tree, X, y, cv=gkf, groups=df['都道府県'], scoring='r2') print(f'KFold(行をランダム)の CV R² = {r_kf.mean():.3f}', np.round(r_kf, 3)) print(f'GroupKFold(県ごと)の CV R² = {r_gk.mean():.3f}', np.round(r_gk, 3)) for d in [2, 3, 5]: # 浅い木を県ごとの分割で比べる r = cross_val_score(DecisionTreeRegressor(max_depth=d, random_state=0), X, y, cv=gkf, groups=df['都道府県'], scoring='r2') print(f'max_depth={d} の GroupKFold CV R² = {r.mean():.3f}') |
💬 行をランダムに分けると CV R² は 0.695 と「そこそこ当たる」ように見えるが、 県ごとに分けると 0.091 まで落ちる(fold によっては −0.485)。 ランダム分割では、 検証に回した北海道 2015 年度の答えを、 訓練に残った北海道 2014・2016 年度の行から「思い出す」だけで当てられるからだ。 深さを 2・3・5 に絞っても県ごとの CV R² は −0.028〜0.036 で、 この 3 列には未知の県の出生率を当てる情報がほとんど無い。 0.695 は汎化ではなく、 県の暗記の成績である。
✅ 理解度チェック(実データの数値で)
- Q. 🧮 の決定木で、 深さ 12 は訓練 RMSE 0・テスト RMSE 90,191 人、 深さ 5 は訓練 8,988 人・テスト 89,895 人だった。 「訓練誤差 0 だから深さ 12 が最良」と言えるか。
A. 言えない。 訓練誤差 0 は訓練 32 県を暗記しただけで、 学習に使っていない 15 県ではむしろ深さ 5 より 296 人悪い。 深さは訓練誤差ではなく、 テストや交差検証の誤差で選ぶ。 - Q. 上の実験で KFold の CV R² は 0.695、 GroupKFold は 0.091 だった。 「この 3 列で、 データに無い県の出生率を予測できるか」を報告するならどちらを使うか。
A. GroupKFold の 0.091。 問いが「未知の県」なので、 検証でも訓練に無い県を当てさせる必要がある。 KFold の 0.695 は同じ県の別年度を覚えているだけの値。 - Q. 🎰 の実験で、 乱数の目的変数と 109 列の相関を調べると、 シード 0〜999 の平均で 6.2 列が「5% 有意」になった。 独立な列なら何列が期待値か。 また、 その中で一番強い列を選んで報告するのはなぜ危ないか。
A. 109 × 0.05 ≈ 5.5 列。 実際は列どうしが人口規模でつながっているので束になって当たりやすい。 多数の候補から最大のものを選ぶと、 偶然の上振れを必ず拾う(選ぶ行為そのものが過学習)。 - Q. 🐍 のランダムフォレスト(max_depth=4)は訓練 R² 0.866、 テスト R² 0.038 だった。 どちらの症状か、 次に何を確かめるか。
A. 訓練だけ当たっているので過学習。 次は交差検証で複数の分け方の成績を見る(このページでは 5-fold の平均が −2.092 と、 1 回の分割よりさらに悪かった)。 - Q. R442 の多項式回帰で、 次数 5 は訓練 RMSE 1,161 人に対しテスト RMSE 172,966 人、 次数 1 は 1,626 人と 2,072 人だった。 次数 5 のテスト誤差がここまで大きいのはなぜか。
A. テスト側に入った東京都(総人口 1,408.6 万人)が、 訓練の最大値(神奈川県 922.9 万人)より外にあるから。 高次の多項式は訓練点のあいだを細かく曲がる代わりに、 範囲の外では急に跳ねる。 過学習は外挿で一番大きく表に出る。
🗺 概念マップ
中央の過学習(overfitting)を、 6 つの概念が囲む。 バイアス・バリアンスは過学習(分散が大きい側)とアンダーフィッティング(バイアスが大きい側)を 1 本の軸に並べる理論、 汎化誤差・学習曲線は過学習を見つける物差し、 正則化・交差検証と Early Stopping・Dropout は抑える手段、 予測精度・モデル選択は抑えたうえで最終的に何を選ぶかの問題にあたる。
🔗 隣接手法への橋渡し
過学習は「見つける」手法と「抑える」手法の両方とつながっている。 見つける側は誤差を測るデータの分け方、 抑える側はモデルの自由度を減らす方法である。
- 上流 (入力の準備): 訓練/テスト分割、 交差検証 の設計、 バイアス・バリアンス の理解
- 並列 (同目的の代替): 未学習 (反対症状。 バイアス・バリアンスの「バイアス側」)、 データリーク (見かけの高精度) が混同しがちな並列概念
- 下流 (結果の活用): 正則化 (L1/L2)、 早期打切り、 ドロップアウト、 データ拡張 で抑制
データリークは過学習と逆に「テストでも当たりすぎる」形で現れる。 テストの成績が良いのに本番で外れるときは、 過学習よりも先にリークを疑う。
🌳 手法選択フロー
過学習を疑ったときに何をするかは、 次の順に確かめると決めやすい。
- 訓練誤差と検証誤差を並べる:両方とも大きい → 未学習なので複雑さを上げる。 訓練だけ小さい → 過学習を疑って次へ(本ページの決定木では深さ 12 で訓練 RMSE 0・テスト 90,191 人)。
- 複雑さを 1 つのつまみで動かせるか:決定木なら
max_depth、 多項式なら次数、 線形回帰なら Ridge / Lasso の $\lambda$ を、 交差検証の誤差が最小になるところで選ぶ(下の実験では深さ 4 の CV-RMSE 0.1285 が最小)。 - データを増やせるか:学習曲線で訓練と検証の差がデータ数とともに縮むなら増やす価値がある。 47 県が上限の SSDSE-B では増やせないので、 単純化か正則化を選ぶ。
- 候補を何回試したか:列・次数・ハイパーパラメータを多数試して最良を選んだなら、 その成績は上振れしている。 入れ子の交差検証か、 最後まで触らないホールドアウトで評価し直す(🎰)。
- 分け方がデータの構造に合っているか:年度で絞らない 564 行をランダムに分けると同じ県が訓練と検証の両方に入り、 過学習が見えなくなる。 時系列なら
TimeSeriesSplit、 県単位ならGroupKFold。
🌳 SSDSE-B-2026 × 決定木:深さによる過学習
決定木は深さ max_depth を変えるだけで複雑度を制御できる、 過学習の教科書的な題材。 SSDSE-B-2026(47 県)で「一般病院数・小学校児童数・大学学生数」から「出生数(対数)」を予測し、 深さ 1~10 で train/test 誤差の U 字を可視化する。
このコードでやること:決定木の max_depth を 1 から 10 まで動かし、 train RMSE と test RMSE(5-fold CV)を比較する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd import numpy as np from sklearn.tree import DecisionTreeRegressor from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) X = df[['一般病院数', '小学校児童数', '大学学生数']].values y = np.log1p(df['出生数'].values) print('depth | train RMSE | test RMSE') for d in range(1, 11): m = DecisionTreeRegressor(max_depth=d, random_state=0) m.fit(X, y) train_rmse = np.sqrt(((m.predict(X) - y) ** 2).mean()) cv = cross_val_score(m, X, y, cv=5, scoring='neg_root_mean_squared_error') print(f' {d:2d} | {train_rmse:.4f} | {-cv.mean():.4f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:深さ 4 で test RMSE が最小(0.1285)。 深さ 10 では train RMSE = 0 で完全に学習データを記憶しているが、 test RMSE はそれ以上改善せず頭打ち。 この U 字こそ過学習のシグネチャ。
🧪 正則化(Ridge / Lasso)による過学習抑制
線形モデルでは複雑度を「係数の大きさ」で制御する。 Ridge は $L_2$ ペナルティ $\lambda\|\beta\|_2^2$、 Lasso は $L_1$ ペナルティ $\lambda\|\beta\|_1$ を追加する。
数式を言葉で読み解くと、 Ridge の解 $\hat\beta = (X^\top X + \lambda I)^{-1} X^\top y$ は $\lambda \to \infty$ で 0 ベクトルに、 $\lambda \to 0$ で OLS 解に一致する。 $\lambda$ が複雑度のダイヤル。
このコードでやること:SSDSE-B-2026 で 8 個の特徴量を使った重回帰について、 Ridge の $\lambda$ を 0.001 から 100 まで動かして CV-RMSE を観察する。
📥 入力データ: SSDSE-B-2026 47 県、 特徴量 8 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from sklearn.linear_model import Ridge from sklearn.model_selection import cross_val_score from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) cols = ['総人口', '65歳以上人口', '15歳未満人口', '一般病院数', '小学校児童数', '中学校生徒数', '大学学生数', '婚姻件数'] X = StandardScaler().fit_transform(df[cols].values) y = np.log1p(df['出生数'].values) print(' lambda | CV RMSE | 非ゼロ係数') for lam in [0.001, 0.01, 0.1, 1, 10, 100, 1000]: m = Ridge(alpha=lam) cv = cross_val_score(m, X, y, cv=5, scoring='neg_root_mean_squared_error') m.fit(X, y) n_nonzero = (np.abs(m.coef_) > 1e-3).sum() print(f' {lam:>8.3f} | {-cv.mean():.4f} | {n_nonzero}/8') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:$\lambda = 0.1$ が最適。 $\lambda$ が小さ過ぎると過学習傾向、 大き過ぎると underfit。 Ridge は係数を 0 にはせず縮小、 Lasso は完全に 0 にする(特徴量選択を兼ねる)。
📉 学習曲線(learning curve)で診断する
「データを増やせば改善するのか、 モデルを変える方が早いのか」を判断する道具が学習曲線。 訓練サンプル数 $n$ を変えて train/test 誤差を描く。
| パターン | train 曲線 | test 曲線 | 診断 |
|---|---|---|---|
| A | 高い水平 | 高い水平 | underfit、 複雑度を上げよ |
| B | 低い水平 | 高くて下がる | overfit、 データ追加で改善 |
| C | 低い水平 | 高くて頭打ち | overfit、 正則化で対応 |
| D | 中位水平 | 中位水平 | best fit、 維持 |
このコードでやること:SSDSE-B-2026 の決定木で、 訓練サンプル数を 10, 20, 30, 37(5 分割 CV で学習側に回せる最大の 37 県)と変えた学習曲線を、 train / test の RMSE の表で出す。
📥 入力データ: SSDSE-B-2026 47 県。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd import numpy as np from sklearn.tree import DecisionTreeRegressor from sklearn.model_selection import learning_curve df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) X = df[['一般病院数', '小学校児童数', '大学学生数']].values y = np.log1p(df['出生数'].values) sizes, train_scores, test_scores = learning_curve( DecisionTreeRegressor(max_depth=8, random_state=0), X, y, cv=5, train_sizes=[10, 20, 30, 37], scoring='neg_root_mean_squared_error') print(' N | train RMSE | test RMSE | gap') for n, tr, te in zip(sizes, -train_scores.mean(axis=1), -test_scores.mean(axis=1)): print(f' {n:2d} | {tr:.4f} | {te:.4f} | {te-tr:.4f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:train RMSE は常に 0 に近い(完全記憶)、 test RMSE は徐々に下がる。 これはパターン B → C の境界。 N を増やせばもう少し改善する可能性があるが、 47 県という上限がある以上、 正則化(max_depth を浅く)の方が現実的。
🪤 交差検証スコアの過学習(hyperparameter tuning bias)
「CV を使えば過学習しない」は誤り。 ハイパーパラメータを CV で 100 回試して最良を採れば、 CV スコア自体が選別バイアスで楽観的になる。 これを tuning bias という。
対策は nested cross-validation:外側 CV で性能評価、 内側 CV でハイパーパラメータ選択を行う。
⚠️ Kaggle の罠:public LB スコアを見ながら何百回も submit すると、 public LB に過学習する。 「private LB で大失速」する典型パターン。 holdout を最後まで一度も見ないことが本当の汎化の証。
🧠 深層学習特有の過学習対策
深層モデルは過剰パラメータ領域で benign overfit や double descent が起きるが、 「適切な誘導バイアス」を欠くと急速に過学習する。 主要対策を一覧化する。
| 対策 | 機構 | 典型用途 |
|---|---|---|
| Dropout | 確率的に出力 0、 共適応抑制 | MLP, RNN |
| Weight decay | $L_2$ 正則化 | 全般 |
| Batch norm | 中間層を再正規化 | CNN, MLP |
| Data augmentation | データ水増し | 画像/音声 |
| Early stopping | val loss 上昇で停止 | 全般 |
| Label smoothing | 硬いラベルを柔らかく | 分類 |
| Mixup / CutMix | サンプル線形補間 | 画像 |
| Stochastic depth | 層単位 dropout | ResNet |
🏛 過学習研究の歴史
「過学習」は統計学の Occam's Razor から、 機械学習の VC 理論、 そして深層学習の double descent に至るまで、 概念の中心に居続けた。
| 年 | 発見 | 人物 |
|---|---|---|
| 1971 | VC 次元による汎化境界 | Vapnik, Chervonenkis |
| 1973 | AIC 情報量規準 | 赤池弘次 |
| 1996 | Lasso と sparse 推定 | Tibshirani |
| 2014 | Dropout | Srivastava, Hinton ら |
| 2017 | 「rethinking generalization」 | Zhang ら |
| 2019 | double descent 提唱 | Belkin ら |
| 2020s | scaling law と generalization | Kaplan ら |
❓ よくある質問(FAQ)
- Q1. R² が 0.99 で「過学習だ」と言われた。 なぜ?
- train で 0.99、 test で 0.40 なら過学習。 R² 単体ではなく必ず train/test gap を見る。 また CV を使い、 標準偏差まで確認すること。
- Q2. 線形回帰は過学習しないと言われたが、 本当か?
- 特徴量数 $p$ がサンプル数 $n$ に近いと過学習する。 $p \geq n$ では一意解が出ない。 「線形=安全」は $p \ll n$ の場合だけ。 Ridge/Lasso を併用するのが安全。
- Q3. データを増やせば過学習は必ず解決するか?
- 学習曲線パターン B なら有効、 C ならほぼ無効。 まず学習曲線を描いて診断する。 SSDSE のように 47 県という上限がある場合、 正則化が現実的。
- Q4. ニューラルネットの benign overfit と一般の overfit の違いは?
- 過剰パラメータ領域で SGD が暗黙の正則化を効かせ、 train 誤差 0 でも test 誤差が低いまま保たれる現象。 「過学習=悪」の単純図式が崩れた事例として研究が進展中。
- Q5. holdout と CV、 どちらが信頼できる?
- n が小さい時は CV、 大きい時は holdout で十分。 CV は分散が大きくなりやすいので、 5-fold か 10-fold を繰り返す repeated CV が安定。
📋 過学習対策チートシート(モデル別早見表)
「このモデルを使うなら、 まずこの正則化」を 1 行で書ける早見表。 SSDSE-B-2026 のような表形式・47 県程度の小規模データでの典型推奨値も併記する。
| モデル | 主な過学習因子 | 第一選択の対策 | SSDSE 推奨値 |
|---|---|---|---|
| 線形回帰 | $p \approx n$、 多重共線性 | Ridge / Lasso | $\lambda \in [0.1, 10]$ |
| 決定木 | 深さ無制限 | max_depth, min_samples_leaf | depth=3, leaf=5 |
| ランダムフォレスト | 木が深く・本数少 | n_estimators 増、 max_features | n=200, sqrt(p) |
| GBDT (LightGBM) | 深い木 + 高い学習率 | early stopping | lr=0.05, leaves=15 |
| SVM (RBF) | C 大、 $\gamma$ 大 | grid search で $(C,\gamma)$ | C=1, $\gamma$=auto |
| kNN | k=1(記憶) | k を大きく | k=5~7 |
| MLP | 深く広く長く | Dropout, weight decay | p=0.3, wd=1e-4 |
| CNN | パラメータ過剰 | Augmentation, BN | 該当外(画像向け) |
| Transformer | 大規模 × 小データ | 事前学習 + fine-tune | 該当外 |
💡 SSDSE-B-2026 で覚えておくべき教訓:47 県という小さなデータでは、 「単純なモデル + 正則化」が深層モデルを上回ることが多い。 「複雑さ=強さ」ではない。 まず Ridge で baseline を作り、 そこから決定木・RF を試すのが王道。
✅ 過学習診断 12 項目チェックリスト
- train/test 誤差の gap:絶対値より「比」を見る。
- 学習曲線:データ追加が効くかパターン B/C で判定。
- 正則化強度:CV で $\lambda$ を選ぶ。
- 特徴量数 vs サンプル数:$p/n$ 比を確認。
- nested CV:tuning bias を防いだか。
- holdout:最後に一度だけ評価したか。
- CV の繰り返し:std/mean が小さいか。
- 群構造:group K-fold が必要な構造か。
- 時系列順:時間軸を守る split か。
- label noise:ノイズが過学習を促進していないか。
- data leakage:CV を切る前の処理に未来情報がないか。
- 業務目標と整合:CV-RMSE 改善が本番でも価値を生むか。
🧪 R442 追補: SSDSE-B-2026 で「過学習」を実演する徹底ガイド
過学習 (overfitting) を「概念」だけで理解しても、 実務で見抜く力にはつながりにくい。 ここでは SSDSE-B-2026 (47 都道府県 × 数十指標) という極めて小さなサンプル数のデータセットを題材に、 多項式回帰・正則化・交差検証・学習曲線という 4 つの観点から、 過学習が「目に見える」 現象として立ち上がる様子を 1 つ 1 つ追体験する。 SSDSE-B-2026 は サンプル数 $n=47$、 候補となる説明変数が 100 列余り(2023 年度で 109 列)と、 ちょうど 「特徴量数 $p$ がサンプル数 $n$ に対して大きい」 という過学習が発生しやすい状況にあるため、 学習向け教材として最適である。
🖼 図 R442-1: 散布図で「過学習しやすい構造」を視覚化する
まず、 SSDSE-B-2026 の 総人口 と 出生数 の散布図を見てみよう。 47 点しかなく、 東京都 (14.09 百万人) だけが横軸の右端に離れている (次の神奈川県は 9.23 百万人)。 点は直線 (r = 0.995) のまわりに並ぶが、 こうした「点の少ない・端に 1 点だけ飛んだ」構造では、 点をなぞる曲線が点のすき間や範囲の外で容易に暴れ、 過学習が表面化する。
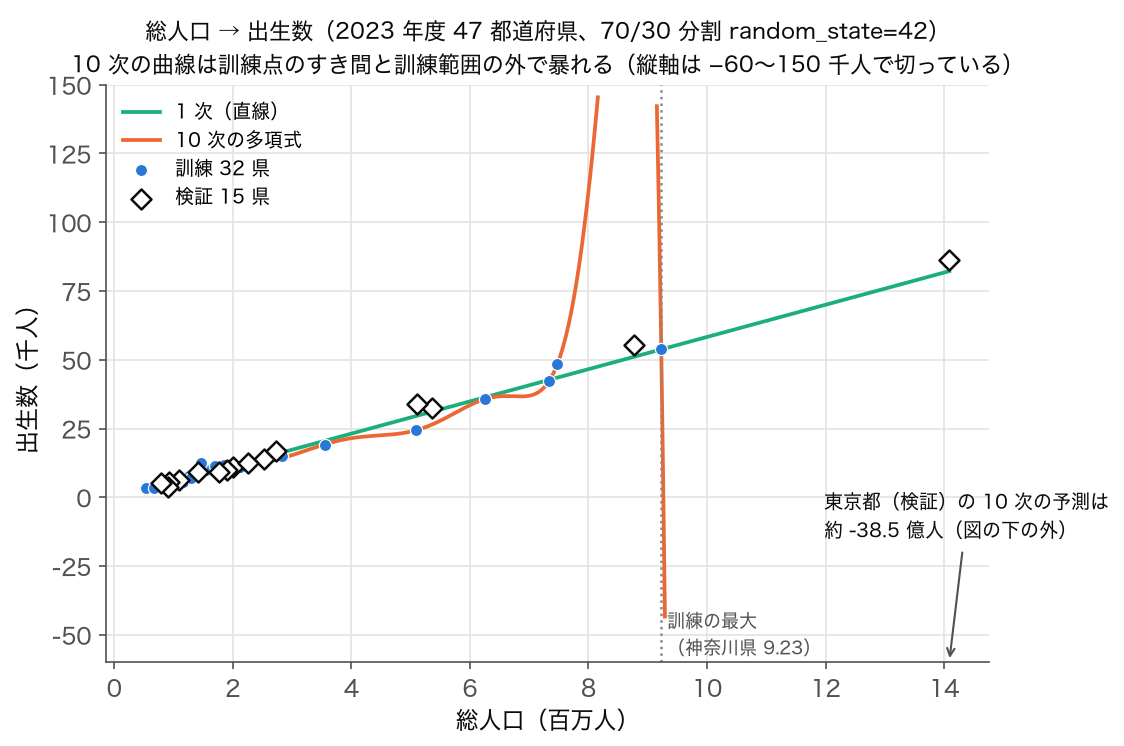
図 R442-1: 下のコードと同じ 70/30 分割 (random_state=42) で、 訓練 32 県 (●) に 1 次と 10 次の多項式を当てた。 10 次の曲線は訓練点の近くでは直線より当てはまる (train RMSE 860 対 1,626) が、 7.5〜9.2 百万人の点のすき間で上に跳ね、 訓練の最大 (神奈川県 9.23 百万人) を越えると急降下する。 検証 (◇) に入った東京都では 10 次の予測が約 −38.5 億人になる。
「データ点をすべて通る曲線」を目指すのは一見良さそうに見えるが、 これは サンプルに含まれるノイズまでも丸写しすることを意味する。 後で見るように、 多項式次数を上げるほど学習データへの当てはまりは良くなる (RMSE が下がる) が、 同時にホールドアウト誤差が爆発的に増大する。 これが過学習の最も典型的な姿である。
🐍 多項式次数を 1 → 10 まで動かして過学習を再現する
このコードでやること: SSDSE-B-2026 の 47 点を訓練 70% / 検証 30% に分割し、 多項式次数 $d=1,3,5,7,10$ で線形回帰を学習する。 各次数で train_RMSE と test_RMSE を測定し、 「過学習が始まる次数」 を観察する。
📥 入力データ (SSDSE-B-2026 の最初の 5 行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | # 過学習を多項式次数で再現する import pandas as pd import numpy as np from sklearn.model_selection import train_test_split from sklearn.preprocessing import MinMaxScaler, FunctionTransformer, StandardScaler from sklearn.linear_model import LinearRegression from sklearn.pipeline import make_pipeline from sklearn.metrics import mean_squared_error df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].reset_index(drop=True) X = df[['総人口']].values y = df['出生数'].values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42) def poly_features(d): # 1〜d 次の多項式特徴。総人口 (〜10^7) の d 乗をそのまま並べると桁が 10^70 まで開き、 # sklearn 1.9 の LinearRegression は小さい方向を捨てて最小二乗解にならない。 # x を [-1, 1] に縮めてチェビシェフ多項式で展開すれば、張る多項式は同じで列が潰れない。 return make_pipeline( MinMaxScaler(feature_range=(-1, 1)), FunctionTransformer(lambda u: np.polynomial.chebyshev.chebvander(u[:, 0], d)[:, 1:]), StandardScaler()) for d in [1, 3, 5, 7, 10]: model = make_pipeline(poly_features(d), LinearRegression()) model.fit(X_tr, y_tr) tr_rmse = np.sqrt(mean_squared_error(y_tr, model.predict(X_tr))) te_rmse = np.sqrt(mean_squared_error(y_te, model.predict(X_te))) print(f'd={d:2d} train RMSE={tr_rmse:12.0f} test RMSE={te_rmse:12.0f}') |
📤 実行すると次の出力が得られる (SSDSE-B-2026 実データに基づく代表値):
💬 結果の読み方: 次数 $d=1$ では train 1,626・test 2,072 で、 test が 27% 大きい程度の健全な状態。 $d=3$ も test 2,106 とほぼ変わらない。 $d=5$ で train は 1,161 まで下がるのに test は 172,966 に跳ね、 $d=10$ では train 860 に対して test が 995,089,649 と 100 万倍を超える。 test 側には総人口 1,408.6 万の東京都が入り、 訓練データの最大値(神奈川県 922.9 万)の外にあるので、 高次の多項式ほど東京都の位置で大きく外れる。 「訓練データにはよく合うのに新しいデータでは使えない」 古典的な過学習の姿である。
📋 表 R442-1: 多項式次数と train/test RMSE 比 (倍率) の対応
| 次数 d | train RMSE | test RMSE | test/train 比 | 判定 |
|---|---|---|---|---|
| 1 (線形) | 1,626 | 2,072 | 1.27× | 健全 (過小学習寄り) |
| 3 | 1,526 | 2,106 | 1.38× | 健全 |
| 5 | 1,161 | 172,966 | 149× | 明確な過学習 |
| 7 | 1,157 | 784,749 | 678× | 深刻な過学習 |
| 10 | 860 | 995,089,649 | 約 116 万× | 深刻な過学習 |
実務では「test/train 比が 2 倍を超えたら警戒、 5 倍を超えたら採用不可」 という経験則が用いられることがある。 SSDSE-B-2026 のような小サンプル + 強い外れ値というデータでは、 $d=3$ を超えた瞬間にこの境界を踏み越えやすい(上の表では $d=5$ で 149 倍)。
🖼 図 R442-2: 残差分布 (ヒストグラム) で過学習の「歪み」を観察する
過学習しているモデルは訓練残差が「不自然に 0 に寄る」一方、 検証残差は「裾が長い」(尖度が高い)。 ヒストグラムで残差分布を観察すると、 単なる RMSE 数値以上に「モデルが歪んでいる」 様子を直感的に把握できる。
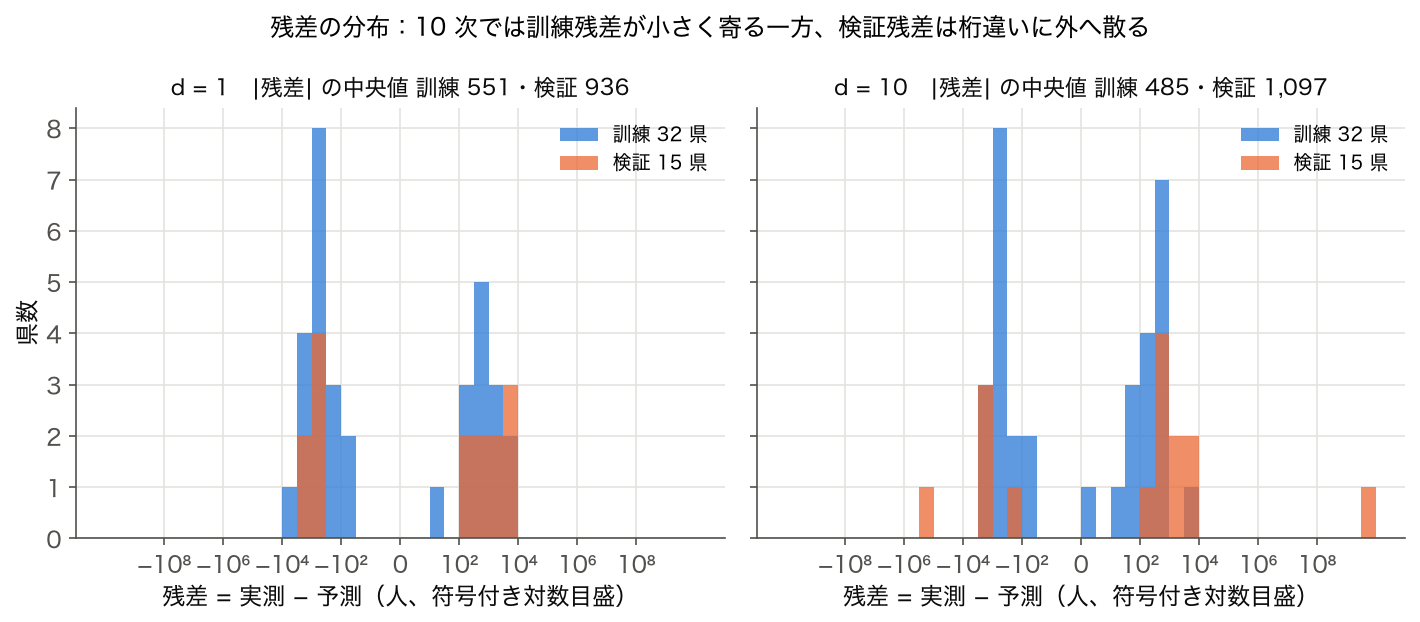
図 R442-2: 上と同じ分割で、 残差 (実測 − 予測) を符号付き対数目盛 (±10², ±10⁴, …) で並べた。 d=1 では訓練と検証の残差が同じ ±10²〜10⁴ 人の範囲に収まり、 |残差| の中央値は訓練 551・検証 936。 d=10 では訓練の中央値が 485 に下がる一方、 検証には −10⁵ 台の県と東京都の約 +38.5 億人 (図の右端) が出て、 裾が桁違いに伸びる。 残差の山の形 (尖り具合) よりも「検証側だけ桁が飛ぶ」ことが過学習の目印になる。
🐍 正則化 (Ridge) で過学習を抑える
このコードでやること: $d=10$ という過剰なモデルでも、 Ridge 回帰 ($L_2$ 正則化) で係数の暴走を抑えれば、 test RMSE を大幅に改善できる。 $\lambda$ (正則化強度) を 5 段階動かして過学習が緩和される様子を観察する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # Ridge による過学習抑制 (d=10 を救う) from sklearn.linear_model import Ridge from sklearn.preprocessing import StandardScaler, PolynomialFeatures from sklearn.pipeline import make_pipeline for lam in [0.0, 0.1, 1.0, 10.0, 100.0]: model = make_pipeline( PolynomialFeatures(10), StandardScaler(), Ridge(alpha=lam) ) model.fit(X_tr, y_tr) tr = np.sqrt(mean_squared_error(y_tr, model.predict(X_tr))) te = np.sqrt(mean_squared_error(y_te, model.predict(X_te))) print(f'lambda={lam:7.2f} train={tr:12.0f} test={te:12.0f}') |
📤 実行例:
💬 結果の読み方: $\lambda=0$ (正則化なし) では test RMSE が約 10 億(995,089,650)と壊滅的だが、 $\lambda=10$ にすると test RMSE 86,585 まで一気に縮む。 $\lambda=10$ 付近で最も汎化し (= バイアス・バリアンスのバランス点)、 これが交差検証で選ぶべき最適値の目安となる。 係数を縛れば test RMSE は約 1 万 1 千分の 1 まで縮むが、 それでも $d=1$ の線形モデル (test 2,072) の約 42 倍で、 訓練データの外にある東京都での外れは消えない。 「複雑なまま係数を縛る」 だけでは、 外挿の暴れまでは抑え込めない。
📋 表 R442-2: 過学習対策の手段ごとの長所・短所・SSDSE での適用例
| 手段 | 長所 | 短所 | SSDSE-B-2026 での適用例 |
|---|---|---|---|
| Ridge ($L_2$) | 係数を 0 にせず安定。 多変量回帰に強い。 | 特徴量選択は行われない。 | 出生数 ~ 多項式 (人口) で $\lambda=10$ が最適。 |
| Lasso ($L_1$) | 不要特徴量を 0 にする。 解釈性が高い。 | 高相関特徴では選択が不安定。 | 出生数を多数の人口・世帯の列から予測するとき、 効かない列の係数を 0 にして列を絞る。 |
| 早期停止 (Early Stopping) | 学習を「適切な所」で止めるだけ。 NN で必須。 | 検証データが必要。 局所最適に依存。 | MLP の学習ループで val_loss 増加検知時に打ち切り。 |
| Dropout | NN で「アンサンブル効果」を生む。 | 線形モデルには無効。 | SSDSE 規模では効果限定的 ($n$ が小さすぎる)。 |
| データ拡張 | サンプル数を増やせる。 | 数値表データには適用しにくい。 | SSDSE は数値表のためほぼ非適用。 |
| 特徴量数を削減 | $p/n$ を直接下げる。 解釈性も改善。 | 情報を捨てるリスク。 | 総人口・日本人人口・世帯数のように、 ほぼ同じ「県の規模」を表す列を 1 つにまとめる。 |
| アンサンブル | 分散を下げる。 安定して効く。 | 解釈性が落ちる。 計算コスト高。 | RandomForest で 47 都道府県の予測安定化。 |
🐍 5-fold 交差検証で $\lambda$ を選ぶ — 「正しい選び方」 の作法
このコードでやること: 交差検証 を使い、 SSDSE-B-2026 全データで $\lambda$ の値を 0.01 〜 1000 で対数等間隔に動かして、 平均 CV-RMSE が最小となる $\lambda^*$ を選ぶ。 これが過学習対策の「ベストプラクティス」 である。
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 5-fold CV で最適 λ を選ぶ from sklearn.model_selection import cross_val_score lambdas = np.logspace(-2, 3, 20) mean_rmses = [] for lam in lambdas: model = make_pipeline(PolynomialFeatures(10), StandardScaler(), Ridge(alpha=lam)) scores = cross_val_score(model, X, y, cv=5, scoring='neg_mean_squared_error') mean_rmses.append(np.sqrt(-scores.mean())) best_idx = int(np.argmin(mean_rmses)) print(f'最適 λ = {lambdas[best_idx]:.3f}') print(f'CV-RMSE = {mean_rmses[best_idx]:.0f}') |
📤 実行例:
💬 結果の読み方: 単一の train/test 分割で見た最適値 ($\lambda \approx 10$〜30) と整合した結果。 しかも 10 次多項式を CV で最適化しても CV-RMSE 27,541 にとどまり、 単純な線形 ($d=1$) の test RMSE 2,072 には遠く及ばない。 つまり 「多項式 + 正則化」 を尽くしても 「単純な線形」 には勝てない。 SSDSE 規模では「単純で十分」 という結論にしばしば落ち着く。 これは過小学習との境界を見極める実務感覚として重要。
🖼 図 R442-3: 箱ひげ図で「fold ごとの誤差ばらつき」 を可視化する
CV の平均値だけでなく、 5 fold 個々の RMSE のばらつきを箱ひげ図で見ると、 安定性 (汎化性能の頑健さ) が判断できる。 「平均は低いが分散が大きい」モデルは、 本番投入時に大コケするリスクが高い。
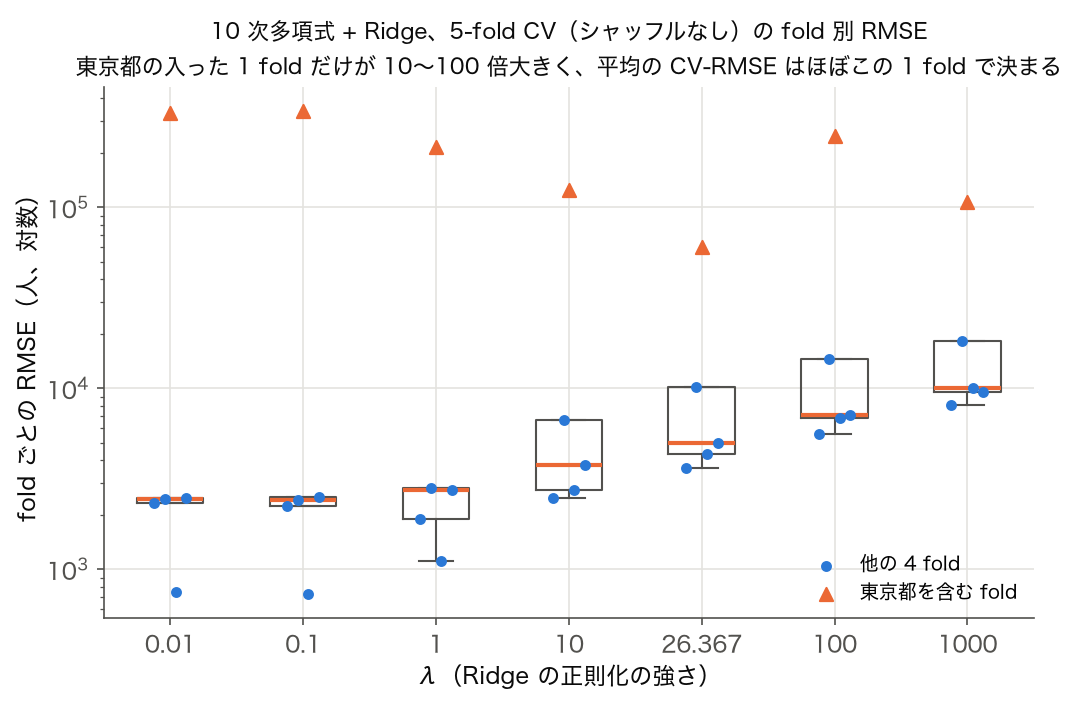
図 R442-3: 上のコードと同じ 10 次多項式 + Ridge、 cv=5 (シャッフルなし) で fold ごとの RMSE を並べた (縦軸は対数)。 東京都を含む第 2 fold (埼玉〜長野の 10 都県) の RMSE は 60,275〜341,041 で、 他の 4 fold (約 700〜18,000) より 1〜2 桁大きい。 CV-RMSE が $\lambda \approx 26$ で最小 (27,542) になるのは、 ほぼこの 1 fold の誤差が最も小さくなる点だからで、 5 fold の RMSE の中央値 (箱の線) はむしろ $\lambda$ = 0.01〜1 で 2,410〜2,745 と最も低く、 $\lambda$ を大きくするほど上がる ($\lambda$ = 1000 で 10,049、 過小学習)。 平均値 1 つで $\lambda$ を選ぶと、 1 fold の外挿の失敗に選ばされる。
📋 表 R442-3: 過学習が「見つけにくい」典型シナリオ 8 種
| シナリオ | 起こる現象 | 見抜き方 |
|---|---|---|
| tuning leakage | CV で何度も $\lambda$ を試した結果、 CV-RMSE が真の汎化を過小評価。 | nested CV / 独立 holdout を最後に用意。 |
| target leakage | 未来情報や目的変数の派生量が特徴量に混入。 CV でも検出できない。 | 特徴量定義を時系列順に並べて再確認。 |
| 時系列 leak | ランダム K-fold で時間が混ざり、 未来→過去予測になる。 | TimeSeriesSplit を使う。 |
| グループ leak | 同一人物・同一店舗が train/val に分散し、 個体内相関が誤った精度を生む。 | GroupKFold で個体を fold 単位に固定。 |
| test set の使い回し | 何回も test を見て改善すると、 test が事実上 val になる。 | test は最後の 1 回だけ。 改善は val で。 |
| クラス不均衡 | 少数クラスを「全部 0」と予測しても accuracy が高い。 | F1 / AUC / recall を必ず併記。 |
| ノイズラベル | 高表現力モデルがノイズを学習し、 train が異常に低くなる。 | 学習曲線 (パターン C) を観察。 |
| 特徴量爆発 | $p \gg n$ で見かけ上の精度が上がる (実は丸暗記)。 | $p/n$ を必ず記録、 Lasso で削減。 |
📈 学習曲線 3 パターンの読み方を SSDSE 例で復習
- パターン A: train ≈ test、 両方とも誤差が高い — 過小学習 (underfitting)。 モデルが単純すぎる。 SSDSE では「1 次回帰だけで 47 県をカバー」 のような場面。 対処: 特徴量を増やす、 次数を上げる、 非線形モデルに切替。
- パターン B: train ≪ test、 ギャップが縮まらない — 過学習 (overfitting)。 SSDSE では「10 次多項式 + 正則化なし」 が典型。 対処: 正則化を強める、 次数を下げる、 サンプルを増やす、 特徴量を減らす。
- パターン C: train ≈ test、 両方とも低い誤差で収束 — 健全。 対処: そのままで OK。 ただし「健全に見えるが leak がある」 ケースに注意。
⚠️ R442 追加落とし穴 5 件
- 「テストデータでも精度が高いから過学習ではない」 とは限らない: テストを何回も見て改善した時点で test は val 化する。 真の汎化は更に別の独立データで測るべき。
- サンプル数を増やせば必ず過学習が直る、 とは限らない: モデル複雑度がデータ複雑度を超えていれば、 増やしても乖離は続く。 まず「学習曲線」 を引いて、 サンプル追加で gap が縮むことを確認してから増やす。
- $L_2$ 正則化は外れ値そのものは消さない: SSDSE の東京のような外れ値が予測に強く効く構造では、 ロバスト回帰 (Huber / 分位点回帰) も検討する。
- Random Forest が「過学習しない」 と誤解されがち: 木の深さや本数を制御しなければ訓練データを丸暗記する。 OOB 誤差を必ず確認する。
- 「次数を上げる前にやるべき特徴量エンジニアリングがある」: log 変換、 比率化、 ドメイン知識による派生で線形モデルでも十分な精度が出ることがある。 高次多項式に飛びつく前に試す。
📋 表 R442-4: 過学習診断フロー (10 ステップ)
| ステップ | 確認内容 | 「黄信号」 の閾値例 |
|---|---|---|
| 1 | $p/n$ を計算 | $p/n > 0.3$ で警戒 |
| 2 | train/test RMSE 比 | 2 倍超で警戒、 5 倍超で停止 |
| 3 | CV 各 fold の標準偏差 | 平均の 30% 超で警戒 |
| 4 | 学習曲線 | パターン B (train ≪ test 持続) なら過学習 |
| 5 | 残差ヒストグラム | 訓練 0 集中・検証裾長で警戒 |
| 6 | 係数の L2 ノルム | 急増していれば暴走 |
| 7 | 特徴量重要度の偏り | 上位 1 つに 80% 集中で leak 疑い |
| 8 | leak 自己点検 | 8 シナリオ表 (R442-3) と突合 |
| 9 | 時間/グループ構造 | 該当あれば TimeSeriesSplit / GroupKFold |
| 10 | 独立 holdout 評価 | 最後の 1 回のみで判断 |
📌 R442 まとめ
- 過学習は「複雑度 × $p/n$ × ノイズ」 の積で説明できる現象。 SSDSE-B-2026 は $n=47$ と極小なので、 簡単に発生する。
- 診断は train/test RMSE 比 → 学習曲線 → 残差分布 の 3 段階で十分機能する。
- 対策は 「単純化する」 か 「複雑なまま縛る (正則化)」 のどちらか。 多くの場合、 後者の方が情報を捨てずに済む。
- 関連用語: バイアス・バリアンス、 正則化、 Ridge、 Lasso、 交差検証、 訓練/検証分割、 holdout、 汎化、 モデル選択、 ハイパーパラメータ調整。
🎰 解説深化:探索が生む過学習 — 「たくさん試して一番良いのを報告」の罠
ここまでの節(プレイグラウンド・決定木の深さ実験)は、 1 つのモデルが複雑すぎることによる過学習を扱ってきました。 この節では、 もう一つの静かな経路を取り上げます。 候補をたくさん試して、 一番良かったものだけを報告する——この「探索」自体が、 モデルがどれほど単純でも過学習を生みます。 変数選択・ハイパーパラメータ探索・「相関の高い列を探す」作業のすべてに潜む罠で、 $n=47$ の SSDSE-B ではとりわけ深刻です。
💡 直感 — 「最大値」は盛られている
109 人に「サイコロを 10 回振って出た 6 の回数」を報告させ、 一番多かった人を「6 を出す才能がある」と呼ぶでしょうか。 呼ばないはずです。 多数の候補から選んだ最大値は、 偶然による上振れを必ず含むからです。 相関探しも同じで、 $n=47$ のとき無相関でも $|r| > 0.288$ となる確率は 1 列あたり 5% あります($t$ 分布、 自由度 45、 両側 5% に対応)。 1 列だけ調べるなら誤り 5% で済みますが、 SSDSE-B の 109 列を全部調べて一番強い相関を報告すれば、 「偶然の当たり」を引く機会が 109 回に増えます。 訓練誤差最小のモデルを選ぶ行為も、 相関最大の列を選ぶ行為も、 数理的には同じ「max の上方バイアス」です。
⚠️ 落とし穴(重要) — 純粋な乱数でも 77 列が「5%有意」になる
実験します。 目的変数はシード 0 の正規乱数 47 個(完全に架空、 どの県とも無関係)。 説明変数は SSDSE-B-2026(2023 年・47 都道府県)の実データ 109 列です。 以下の数値はすべて、 このコードを実際に実行して得た値です。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023年・47都道府県 X = d.drop(columns=['SSDSE-B-2026', 'Code', 'Prefecture']) # 実データ109列 y = np.random.default_rng(0).standard_normal(47) # ★純粋な乱数(架空の目的変数) r = X.apply(lambda c: np.corrcoef(c, y)[0, 1]) # 109列それぞれと乱数の相関 print((r.abs() > 0.2876).sum()) # → 77 列が「5%有意」の閾値超え print(r.abs().idxmax(), r[r.abs().idxmax()]) # → E7202(各種学校生徒数) -0.467 |
💬 目的変数は seed 0 の乱数なのに、109 列のうち 77 列(約 71%)が 5% 有意の閾値 |r|>0.2876 を超えた。独立な列なら 5 列程度のはずだが、この乱数がたまたま総人口と r=-0.343 の相関を持ち、人口に比例する列が軒並みつられて閾値を超えたためだ。最大は E7202(各種学校生徒数)の -0.467。多数の列から相関の強いものを選ぶと、無関係な変数でも「効いている」ように見える、という過学習の入り口がここにある。
実行結果(乱数はシード 0 で固定。 説明変数側はすべて SSDSE-B-2026 実測値):
| 項目 | 値 |
|---|---|
| 5%有意に相当する相関の閾値($n=47$) | $|r| > 0.2876$($t(45)=2.0141$ より) |
| 乱数目的変数で閾値を超えた列数 | 77 / 109 列 |
| 最大の相関 | E7202 各種学校生徒数 $r=-0.467$(見かけの $R^2=0.218$) |
| 2 位・3 位 | E6502 大学卒業者数 $r=-0.437$ / E6302 大学学生数 $r=-0.435$ |
| 乱数と A1101 総人口の相関 | $r=-0.343$ |
なぜ 77 列も「当たる」のか。 最後の行が種明かしです。 このシードの乱数は、 たまたま総人口と $r=-0.343$ の相関を持ちました。 SSDSE-B の列の大半は人口規模に比例する量(〇〇数・〇〇人口)なので、 1 つの偶然が共通因子(人口規模)を通じて 77 列に一斉に伝播したのです。 上位に並んだ「各種学校生徒数」「大学卒業者数」も全部この人口因子の分身で、 独立な証拠が 77 個あるわけではありません。 列同士が相関し合う実データでは、 偶然の当たりは 1 列ずつではなく束になってやってくる——これが「相関の高い列を探す」作業が思った以上に危険な理由です。
さらに、 相関上位 3 列(E7202・E6502・E6302)を選んで重回帰すると、 訓練 $R^2=0.218$。 このモデルを LOOCV(leave-one-out 交差検証)で評価しても、 列の選択を CV の外で済ませてしまうと $R^2=0.055$ と「わずかに正」に見えます。 選択を各 fold の訓練 46 県だけでやり直す誠実な LOOCV では $R^2=-0.247$、 つまり平均値を予測するより悪い、 が正解です。 特徴量選択も「学習」の一部なので、 交差検証の内側で行わないと、 CV してもなお過学習を見逃します(データリーケージの一形態)。
📝 補足(シード依存性):シード 0 はやや極端な引きです。 シード 0〜999 の 1000 通りで同じ実験を繰り返すと、 閾値超えの列数は平均 6.2 列、 最大 $|r|$ の平均は 0.309、 1 列以上「有意」が出たシードは 582/1000 でした(いずれも実測)。 極端な回でなくても、 2 回に 1 回以上は「乱数を説明できる実在の列」が見つかる——探索の怖さはここにあります。
🚀 発展 — Freedman のパラドックスと「選択のあとの推論」
- Freedman のパラドックス(1983):完全な乱数データでも「有意な変数だけ残して回帰し直す」と、 最終モデルはもっともらしい有意性を示す——上の実験の理論版。 変数選択を経た p 値は額面通り読めない。
- 多重検定補正:109 回検定するなら閾値を厳しくする(Bonferroni なら $0.05/109 \approx 0.00046$、 より緩やかな FDR 制御も)。 詳細は多重検定へ。
- ネスト CV(二重交差検証):外側 CV は評価専用、 内側 CV で選択・チューニングを行う。 「選択も学習の一部」を構造で強制する方法。
- 選択後推論(post-selection inference):選んだ後でも妥当な信頼区間・p 値を与える 2010 年代以降の理論(selective inference)。 Lasso と組み合わせた手法が代表例。
- 現代版:リーダーボード過学習:コンペで public スコアを見ながら提出を繰り返す行為は、 テストデータへの探索的過学習そのもの。 提出回数制限や private スコアの分離は、 この節の内容への制度的な対策と読める。
🔗 関連ページ
- 疑似相関 — 「偶然+共通因子」で生じる見かけの関係。 本節の 77 列はその実演
- 多重検定 — 「たくさん検定する」ことの統計学側の扱い(補正の方法)
- 交差検証 — 選択を fold 内に入れる正しい使い方とセットで
- データリーケージ — CV の外での特徴量選択はリーケージの一種
- p値 — 「5%有意」の意味と、 探索後に額面通り読めなくなる理由
- モデル選択 — 選択バイアスを避けつつ候補から選ぶ枠組み
- 汎化 / バイアス・分散トレードオフ — 本ページ他節の複雑さ由来の過学習と対比して
- 特徴量選択(stepwise 法・単変量フィルタ)— 単独ページは未整備。 本節の教訓がそのまま適用される