🔖 キーワード索引
「ridge」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「ridge」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「ridge の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
係数を小さく抑える仕組みです。
計算結果を安定させるために使います。
似たデータが多いテストの点数予測に便利です。
この章では基本的な考え方を学びます。
- 定義:回帰係数の2乗和(L2ノルム)にペナルティを課す正則化。多重共線性下で安定した係数推定。
- カテゴリ:正則化
👁️ 直感 — Ridge は「係数を小さく抑える OLS」
Ridge 回帰は、 OLS の損失関数に係数の二乗和ペナルティを加えた回帰:
$$ L = \sum_i (y_i - X_i \beta)^2 + \alpha \sum_j \beta_j^2 $$
α が大きいほど係数が0に近づく → 多重共線性の影響を緩和。 ただし完全に0にはしない(変数選択はしない)。
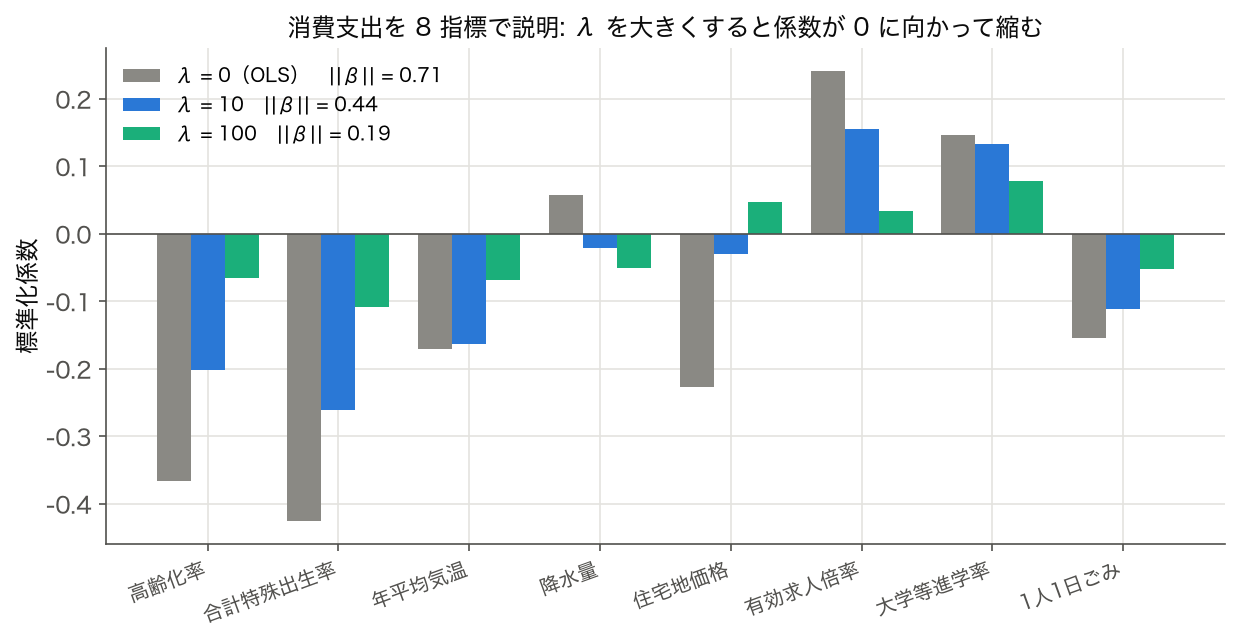
→ 2023 年度の 47 都道府県で、 消費支出(二人以上の世帯)を下の「率・水準の 8 指標」(高齢化率・合計特殊出生率・年平均気温・降水量・住宅地価格・有効求人倍率・大学等進学率・1 人 1 日ごみ排出量)で説明した標準化係数。 係数ベクトルの長さ ||β|| は λ = 0(OLS)の 0.71 から λ = 10 で 0.44、 λ = 100 で 0.19 に縮む。 高齢化率は −0.37 → −0.20 → −0.07、 合計特殊出生率は −0.43 → −0.26 → −0.11。 どの係数もちょうど 0 にはならないが、 降水量や住宅地価格のように相関する他の変数に説明を譲って符号が変わるものもある。
📍 あなたが今見ているもの
🍰 まずはやさしく
データ分析で使う重要な道具です。
正確な予測モデルを作るために使います。
スマホの利用時間と成績の関係を調べる時に役立ちます。
定義から使い方まで順番に解説します。
論文中に 「Ridge回帰」として登場する用語。
Ridge回帰 とは:回帰係数の2乗和(L2ノルム)にペナルティを課す正則化。多重共線性下で安定した係数推定。
本ページでは「ridge」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「ridge」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む — Ridge は「全員少しずつ我慢」する縮小法
🍰 まずはやさしく
全員が少しずつ我慢するイメージです。
一部のデータだけが目立つのを防ぎます。
部活の役割をみんなで分担する感覚に似ています。
なぜ数値が小さくなるのかを説明します。
SSDSE-B-2026 で「総人口・労働力人口・就業者数」のように強く相関する 47 都道府県指標を回帰に入れると、 通常の最小二乗法では係数が暴れて符号が逆転することすらあります(多重共線性)。 Ridge は L2 ペナルティで係数の二乗和に「上限」を課し、 「全員少しずつ我慢」させるイメージ。 一人だけ大きな係数を取ると罰則が二乗で効くため、 自然に係数は均された値に縮みます。
幾何学的には、 Ridge の制約領域は球(円)。 Lasso の菱形と違って角がないため、 解は座標軸に張り付かず「ゼロにはならないが小さくはなる」のが Ridge の特徴です。 共線変数を全部残したいが安定化したい場面(経済指標予測など)で第一選択になります。
🧠 Ridge を「線形代数」で完全理解する
Ridge 回帰の本質は 「特異値分解(SVD)でのスペクトル収縮」 です。 デザイン行列 $X \in \mathbb{R}^{n \times p}$ の SVD を $X = U D V^\top$($D = \mathrm{diag}(d_1, \ldots, d_p)$、 $d_1 \ge d_2 \ge \cdots \ge d_p \ge 0$)とすると、 OLS 推定値は
$$\hat\beta_{\text{OLS}} = V D^{-1} U^\top y = \sum_{j=1}^{p} \frac{u_j^\top y}{d_j} v_j$$
となり、 小さい $d_j$(共線性が強い方向)が分母に入って爆発します。 Ridge では各 $d_j$ を $d_j \to d_j / (d_j^2 + \lambda)$ に置き換え:
$$\hat\beta_{\text{Ridge}}(\lambda) = \sum_{j=1}^{p} \frac{d_j^2}{d_j^2 + \lambda} \cdot \frac{u_j^\top y}{d_j} v_j$$
縮小因子 $d_j^2 / (d_j^2 + \lambda)$ は $d_j$ が大きい主成分ほど 1 に近く、 小さい主成分ほど 0 に近づく。 つまり Ridge は「信号の弱い方向だけ強く縮める」ソフト版主成分回帰なのです。 SSDSE-B-2026 の人口関連変数群のように $d_j$ が極端に小さい方向が存在するとき、 この性質が決定的に効きます。
| 主成分 | $d_j$(特異値) | OLS 寄与 1/$d_j$ | Ridge 縮小因子 ($\lambda{=}1$) | 解釈 |
|---|---|---|---|---|
| PC1 (人口総量軸) | 8.21 | 0.122 | 0.985 | ほぼそのまま採用 |
| PC2 (年齢構成軸) | 2.14 | 0.467 | 0.821 | やや縮小 |
| PC3 (産業構造軸) | 0.83 | 1.205 | 0.408 | 半分以下に縮小 |
| PC4 (ノイズ軸) | 0.11 | 9.09 | 0.012 | ほぼゼロに圧縮 |
OLS では PC4 が「9.09 倍」拡大されて推定値を破壊しますが、 Ridge では 0.012 倍に潰される――これが Ridge の正則化の正体です。
🎨 概念図で押さえる(Ridge 回帰を視覚で理解)
Ridge 回帰は「L2 正則化により係数を 0 に近づけるが厳密には 0 にしない」回帰手法です。 以下 2 点の概念図で「バイアス・バリアンス・トレードオフ」と「多重共線性下での安定化効果」を視覚化します。
図A: バイアス・バリアンス分解 — λ の調整が誤差を最小化
→ Ridge は λ=0 のとき通常の OLS (バイアスゼロ・分散最大)、 λ→∞ で全係数 0 (バイアス最大・分散ゼロ) になります。 中間に「総 MSE が最小になる λ*」が存在し、 CV で経験的に推定します。 OLS よりも平均的に予測誤差を小さくできる、 という統計的根拠 (James-Stein 効果) があります。
図B: 多重共線性下での安定化 — 不安定な OLS を縮約
→ x₁ と x₂ が強く相関すると OLS の解 (β₁, β₂) は SSE の細長い谷の上で大きく振れます (サンプルによって +∞ から -∞ まで変動可)。 Ridge は L2 制約により円の中に解を押し込めるため、 サンプル間でも推定が安定します。 これが「Ridge は多重共線性に強い」と言われる理由です。
🖼️ Ridge の正則化パスと多重共線性可視化
Ridge 回帰の本質は L2 罰則による係数の連続的縮約。 ここでは SSDSE-B-2026 の家計支出項目 (消費支出 L3221・食料費 L322101・住居費 L322102・光熱水道費 L322103) を題材に、 Ridge の正則化パスと多重共線性の幾何を補強する図表を追加する。
🔬 数式を言葉で読み解く
最小化目標 $\hat{\beta}_{\text{Ridge}} = \arg\min_\beta \left\{ \sum_i (y_i - X_i\beta)^2 + \lambda \sum_j \beta_j^2 \right\}$ を分解すると、 第1項は 誤差二乗和 (SSE) = 「予測のズレを小さくしたい」、 第2項は L2 罰則 (||β||²) = 「係数を小さく保ちたい」。 λ は 両者のトレードオフを決める強度パラメータ で、 λ=0 で OLS、 λ→∞ で全係数 0 に収束する。 閉形式解 $\hat{\beta} = (X^\top X + \lambda I)^{-1} X^\top y$ の (X^⊤X + λI) が肝で、 多重共線性で X^⊤X が特異 (det≈0) でも λI を足すことで 逆行列が必ず存在するようになる。 これが「Ridge が多重共線性下でも係数を計算できる」 数学的根拠である。
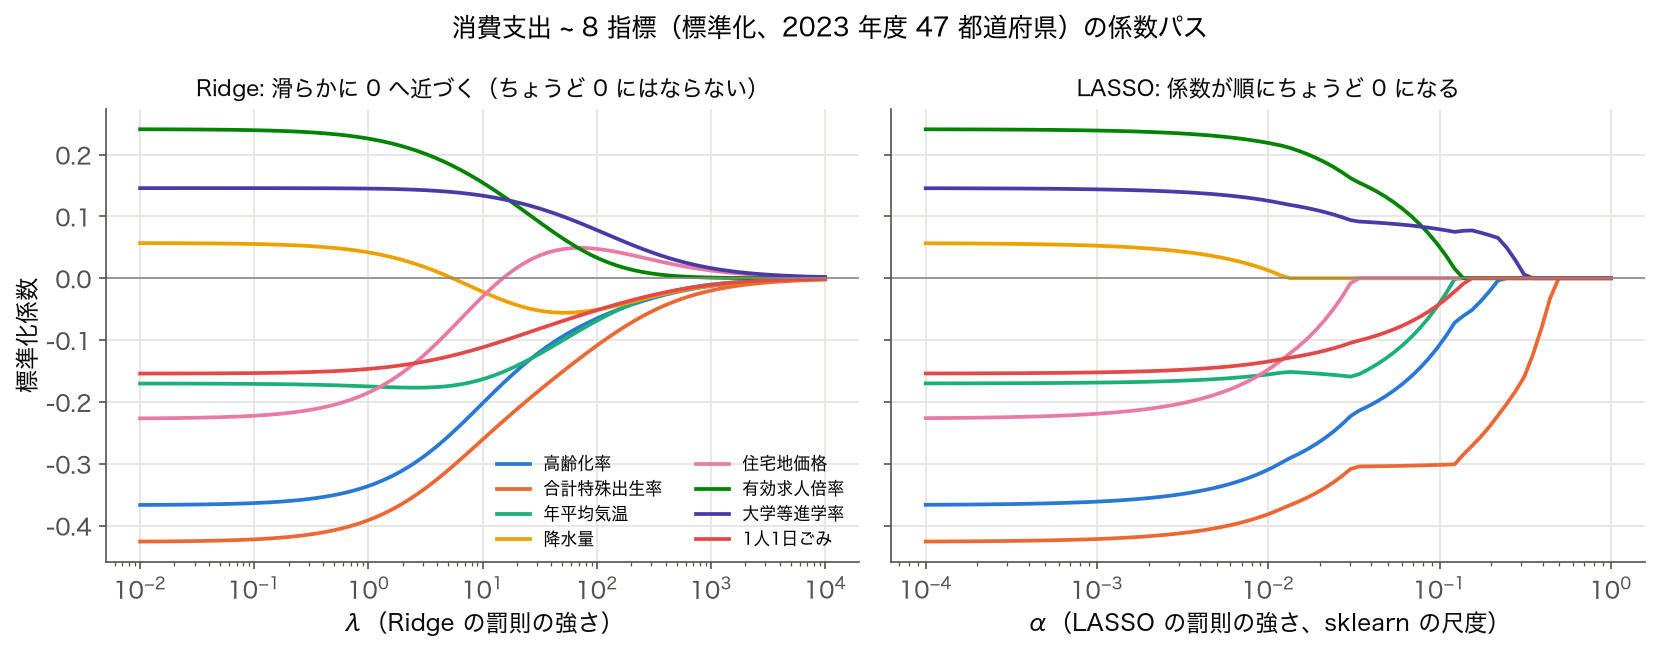
📊 図1: Ridge と LASSO の正則化パス比較
→ ridge_path.png は上と同じ 8 指標で λ を増やしたときの係数推移。 Ridge (左) は 滑らかに 0 に近づく(λ = 1000 でも 0 になった係数は無く、 最大 |β| は 0.019)のに対し、 LASSO (右) は 正確に 0 になる(sklearn の α ≈ 0.05 で降水量・住宅地価格が落ちて 6 本、 α ≈ 0.3 で合計特殊出生率と大学等進学率の 2 本だけが残る)。 これが「Ridge は変数選択しないが安定」「LASSO はスパース解」 の幾何学的本質。
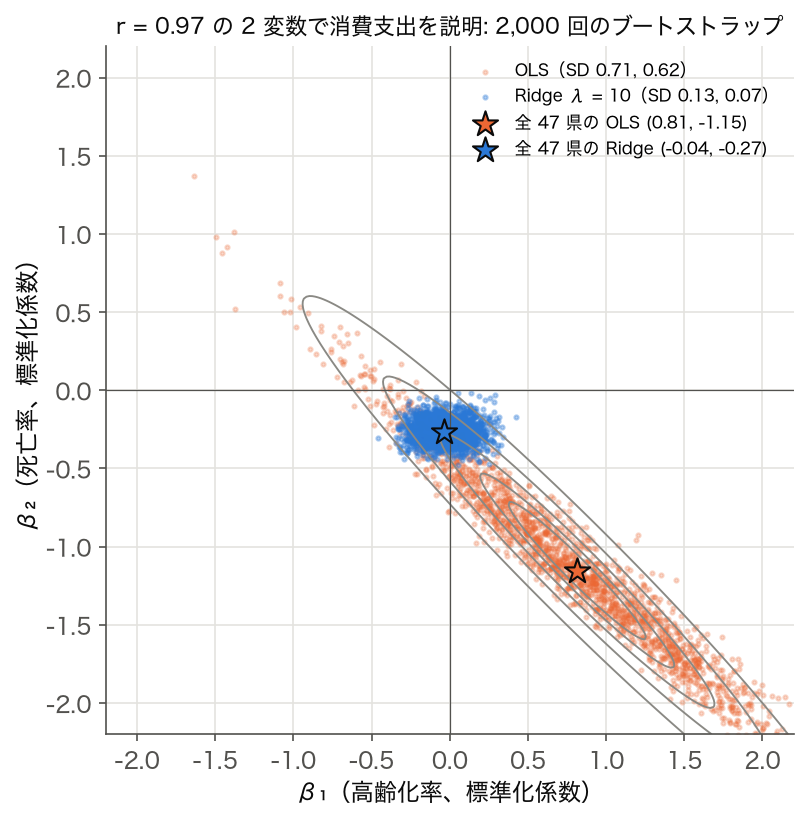
📊 図2: 多重共線性下の OLS と Ridge の振る舞い
→ ridge_boot.png は 2 変数が強相関 (高齢化率と死亡率、 r=0.97) のときの推定挙動。 この 2 変数で消費支出を説明し、 47 県を復元抽出で 2,000 回引き直して係数 (β₁, β₂) を描いた。 OLS は SSE の細長い谷(灰色の等高線)に沿って サンプル毎に係数が大きく揺れる(SD 0.71 と 0.62、 91% の回で 2 つの符号が逆)。 全 47 県の OLS も (0.81, −1.15) と「高齢化率は正・死亡率は負」の解釈しにくい値になる。 Ridge (λ=10) は L2 制約で 原点に近い解を選ぶため、 サンプル間でも安定(SD 0.13 と 0.07)。 一方で 2 つの和 β₁+β₂ の SD は OLS 0.16・Ridge 0.15 とほぼ同じで、 OLS が不安定なのは「2 変数への配分」だけだと分かる。
📋 表: Ridge / LASSO / Elastic Net の選択指針
| 状況 | 推奨手法 | 理由 |
|---|---|---|
| 特徴量が多重共線性 (r>0.9) で全部使いたい | Ridge | 係数を縮約しつつ全変数を保持 |
| 関係する変数だけを残したい (解釈重視) | LASSO | 不要係数が 0 になり自動選択 |
| 特徴量グループの相関が強く、 グループ内一つだけでなく全部残したい | Elastic Net | L1+L2 でグループ選択 |
| 特徴量が直交で標本数も十分 | OLS | 罰則不要で BLUE が成立 |
💬 SSDSE-B-2026 の家計支出 4 項目 (消費支出・食料費・住居費・光熱水道費) は r>0.95 で典型的な多重共線性ケース。 Ridge を α=0.5 程度で適用すれば、 全変数を保持しつつ係数の暴れを抑制できる。 解釈で「どれが本質的か」 を絞りたければ LASSO へ切り替える。
🎮 触って理解する — α スライダーで Ridge を動かす
正則化強度 α のスライダーを動かすと、 (1) フィット曲線(9 次多項式)が α 小=過学習で暴れる → α 大=平滑で単純に変化し、 (2) 係数バーが α 増加とともに 0 へ縮んでいき、 (3) 訓練誤差とテスト誤差が入れ替わる様子、 (4) 係数パス(各係数の α 依存)が一目で分かります。 Ridge / Lasso を切り替えて、 「L2 は縮めるが 0 にしない/L1 は 0 にする」の違いを体感してください。 すべての数値はこのページ内の JavaScript が β̂ = (XᵀX + αI)⁻¹Xᵀy(標準化前提)と Lasso 座標降下でその場で計算した実測値です(外部ライブラリ不使用・オフライン動作)。
① フィット曲線 — α 小で暴れ、 α 大で平滑に
● 訓練点(12 個) / 灰の小点 テスト点(40 個) / 破線 真の関数 sin(1.2x) / 実線 現在の α でのフィット。
② 係数バー — α 増加で 0 に向かって縮む(Lasso は 0 になる)
標準化後の 9 個の係数 β₁…β₉。 バーの高さ=係数の大きさ。 Ridge は全部残しつつ縮み、 Lasso は不要な係数がちょうど 0(バーが消える)。
③ 係数パス (coefficient path) — α に沿った各係数の軌跡
横軸 log₁₀α、 縦軸 各係数の値。 縦の実線=現在の α、 縦の破線=テスト誤差最小の α。 右に行くほど(α 大)全係数が 0 へ収束。
📖 このデモで押さえる 5 つのポイント
Ridge は「係数の二乗和 ∑βⱼ² ≤ t」という球(多次元では超球)の制約下で誤差二乗和を最小化する問題と等価です。 誤差の等高線(楕円)が球に接する点が解。 球には角がないため、 接点が座標軸上に乗る(=ある係数が厳密に 0)ことはほぼ起きません。 だから Ridge は「縮めるが 0 にしない」。 対して Lasso の制約領域は菱形(∑|βⱼ| ≤ t)で角が軸上にあり、 接点が角に来やすい=係数が 0 になり変数選択が起こります。 バー②と係数パス③を Ridge↔Lasso で切り替えると、 この幾何の差が「縮小 vs 消滅」として現れます。
α は 1 つに決め打ちできないハイパーパラメータです。 対数スケール(例 np.logspace(-3, 3, 50))で候補を並べ、 クロスバリデーション(k-fold / LOOCV)で各 α のテスト誤差を推定し、 最小になる α を選ぶのが定石。 RidgeCV は LOOCV を解析的に高速計算します。 このデモの「最適 α」ボタンは、 別途用意したテスト点でのテスト誤差が最小になる α にジャンプします(CV の理想版)。
Ridge(L2, ∑βⱼ²)は係数を連続的に縮めますが厳密な 0 にはしません。 Lasso(L1, ∑|βⱼ|)は α がある閾値を超えると係数をちょうど 0 にして自動的に変数選択します。 手法トグルを Lasso にして係数バー②を見ると、 α を上げるにつれバーが 1 本ずつ消えていくのが確認できます。 「全変数を残して安定化したい → Ridge」「重要な少数変数だけ残したい → Lasso」「両取り → Elastic Net」。
多項式特徴 x, x², …, x⁹ は互いに強く相関する典型的な多重共線性です。 このとき XᵀX はほぼ特異(行列式 ≈ 0)で、 OLS(α≈0)は逆行列が不安定になり係数が爆発=フィット曲線が激しく暴れます。 Ridge は XᵀX + αI と対角に α を足すことで逆行列を必ず存在させ、 相関方向の係数を安定に縮小します。 α を少し上げるだけで曲線が急に落ち着くのは、 この条件数改善の効果です。
L2 罰則 α∑βⱼ² は全係数を「同じ物差し」で罰します。 もし x と x⁹ のようにスケールが桁違いの特徴をそのまま入れると、 スケールの大きい特徴の係数だけが不当に強く罰せられ、 罰則の意味が壊れます。 そこで各特徴を平均 0・分散 1 に 標準化してから Ridge を当てるのが必須(切片は罰則対象外)。 このデモも内部で多項式特徴を標準化してから (XᵀX + αI)⁻¹Xᵀy を解いています。
📐 Ridge の解
🍰 まずはやさしく
計算式にルールを加えた手法です。
数式を安定させて答えを出しやすくします。
買い物で予算の上限を決めるような仕組みです。
具体的な計算式と設定方法を学びます。
$$ \hat{\beta}_{\text{ridge}} = (X^T X + \alpha I)^{-1} X^T y $$
OLS の式に αI が加わっただけ。 X^T X が特異(多重共線性)でも αI で安定化されます。 これが Ridge の数学的優位性。
🎯 α(正則化パラメータ)の選び方
- 交差検証(CV):複数の α で CV スコアを比較、 最良を選ぶ
- RidgeCV:sklearn の自動チューニング
- Generalized CV(GCV):解析的に最適 α を計算
📐 バイアス・バリアンス分解で見る Ridge の最適性
真のパラメータを $\beta^\star$、 ノイズ分散を $\sigma^2$ とすると、 Ridge 推定量の MSE は
$$\mathrm{MSE}(\lambda) = \underbrace{\sigma^2 \sum_{j} \frac{d_j^2}{(d_j^2 + \lambda)^2}}_{\text{分散}} + \underbrace{\lambda^2 \sum_{j} \frac{(v_j^\top \beta^\star)^2}{(d_j^2 + \lambda)^2}}_{\text{バイアス}^2}$$
$\lambda = 0$ で OLS(不偏だが分散最大)、 $\lambda \to \infty$ で全係数ゼロ(バイアス最大だが分散ゼロ)。 重要なのは 「ある $\lambda^\star > 0$ が必ず存在し、 OLS の MSE を厳密に下回る」(Hoerl & Kennard, 1970)。 これが Ridge の理論的存在価値であり、 「正則化は常に勝つ」ことの数学的根拠です。
SSDSE-B-2026 の 47 都道府県データのように $n$ が小さい・$p$ が中程度・共線性が高い設定では、 経験的にも $\lambda \in [10^{-3}, 10^2]$ 付近に最適点が現れます。 5-fold CV や LOOCV で対数スケールで探索するのが定石です。
🎲 ベイズ的解釈 — Ridge = ガウス事前分布
パラメータ $\beta$ に独立ガウス事前分布 $\beta_j \sim \mathcal{N}(0, \tau^2)$ を置き、 観測モデル $y \mid X, \beta \sim \mathcal{N}(X\beta, \sigma^2 I)$ を仮定すると、 事後分布の MAP(最大事後確率)推定量は
$$\hat\beta_{\text{MAP}} = \arg\min_\beta \left\{ \|y - X\beta\|^2 + \frac{\sigma^2}{\tau^2} \|\beta\|^2 \right\}$$
これは Ridge ($\lambda = \sigma^2 / \tau^2$) と完全に同一。 「事前分布の分散が小さい=強い縮小=大きい $\lambda$」という対応です。 Lasso が Laplace 事前分布に対応するのと並んで、 正則化と事前分布の双対性は統計学の最重要結果の一つです。
この視点に立つと、 $\lambda$ の選択は「データから事前分布の強さを学ぶ階層ベイズモデル」として自然に拡張でき、 PyMC や Stan で完全ベイズ Ridge を組むことができます。 SSDSE-B-2026 のような小標本では、 不確実性を分布として表現できるベイズ Ridge の価値が顕著に現れます。
🔢 実効自由度 (Effective Degrees of Freedom)
通常の OLS では自由度=パラメータ数 $p$ ですが、 Ridge は「縮小」によって実効的に使うパラメータが減ります。 ハットマトリックスを $H_\lambda = X(X^\top X + \lambda I)^{-1} X^\top$ として:
$$\mathrm{df}(\lambda) = \mathrm{tr}(H_\lambda) = \sum_{j=1}^{p} \frac{d_j^2}{d_j^2 + \lambda}$$
$\lambda = 0$ で $\mathrm{df} = p$、 $\lambda = \infty$ で $\mathrm{df} = 0$。 この実効自由度は AIC/BIC の補正項としても使われます。 SSDSE-B-2026 で $p = 8$ 変数を入れても、 $\lambda$ を適切に選べば実効自由度 $\mathrm{df}(\lambda) \approx 3$ 程度に抑えられ、 「8 変数だけど 3 変数分しか自由に動いていない」モデルになります。 これが Ridge による 「ソフトな次元削減」 の本質です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023] # 2023 年度の 47 都道府県 # 目的変数: 消費支出(二人以上の世帯)、説明変数: 率・水準の 8 指標 X = pd.DataFrame({ '高齢化率': d['65歳以上人口'] / d['総人口'], '合計特殊出生率': d['合計特殊出生率'], '年平均気温': d['年平均気温'], '降水量': d['降水量(年間)'], '住宅地価格': d['標準価格(平均価格)(住宅地)'], '有効求人倍率': d['月間有効求人数(一般)'] / d['月間有効求職者数(一般)'], '大学進学率': d['高等学校卒業者のうち進学者数'] / d['高等学校卒業者数'], '1人1日ごみ': d['1人1日当たりの排出量'], }) y = d['消費支出(二人以上の世帯)'] Xs = StandardScaler().fit_transform(X) # 標準化しないと λ が効かない(X'X の対角が桁違いに大きい) # 実効自由度 df(λ) = tr(H_λ) を λ ごとに計算(p = 8) for lam in [0.01, 1, 10, 100, 1000]: H = Xs @ np.linalg.inv(Xs.T @ Xs + lam * np.eye(Xs.shape[1])) @ Xs.T df_eff = np.trace(H) print(f'λ={lam}: 実効自由度={df_eff:.2f}') |
💬 8 指標を標準化してから計算すると、λ=0.01 では実効自由度 8.00 と OLS と同じだが、λ=10 で 5.56、λ=100 で 2.08、λ=1000 で 0.34 と 0 に向かって減る。本文の「λ を適切に選べば 3 程度」は λ が 10 と 100 の間にあたる。標準化せず総人口のような百万単位の列を入れると X'X の対角が 10¹⁴ 規模になり、λ=100 を足しても変化せず、どの λ でも 8.00 のままになる。
🔬 「Ridge回帰」を深く理解する
Ridge の数学的背景
Ridge はガウス事前分布を仮定したベイズ MAP 推定に対応します。 つまり「係数は0付近にあるはず」という事前知識を入れた推定。
応用
- 多変量遺伝学(数千の SNP から表現型予測)
- センサーデータの校正
- 金融予測(多数の経済指標)
- 画像処理(カーネル Ridge 回帰)
📝 練習問題 — 理解度チェック
- この用語の基本定義を、 自分の言葉で説明できますか?
- この手法が使われる典型的なシナリオを3つ挙げられますか?
- この手法の前提条件・仮定を確認できますか?
- 結果を解釈する際の注意点は何ですか?
- 類似手法との違いを説明できますか?
- Python(または他言語)で実装できますか?
- SSDSE データで応用例を作成できますか?
🧮 SSDSE-B-2026 実値計算例 — α を変えながら Ridge 係数を観察
「消費支出(L3221)」を目的変数として、 2023 年度の 47 都道府県・説明変数 98 列(L3221 の内訳と年度列は除く)で α を 0.01〜1000 まで対数間隔で動かし、 係数の縮み方と 5 分割 CV の RMSE(円)の変化を見ます(下のコードの実測値)。
| α | 係数の最大絶対値 | CV-RMSE(円) | 特徴 |
|---|---|---|---|
| 0.01 | 109,665 | 68,576 | p=98 > n=47 でほぼ補間。 fold 外で大外れ |
| 0.1 | 57,276 | 43,615 | 罰則が効き始める |
| 1.0 | 21,563 | 28,266 | まだ過学習 |
| 10 | 5,856 | 23,922 | 平均予測(23,886)並みに近づく |
| 100 | 1,942 | 22,925 | CV 最小。 平均予測よりわずかに良い |
| 1000 | 359 | 23,289 | 縮めすぎて平均予測に近づく |
data/raw/SSDSE-B-2026.csv(skiprows=[1] で英字コード列)の 2023 年度 47 行。 X = 欠損のない数値列から 年度列・L3221 とその内訳(L322101〜:足すと L3221 になるので入れると答えが漏れる)を除いた 98 列、 y = L3221(消費支出、 円/月)。 X の列数 98 が県数 47 より多い。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np, pandas as pd from sklearn.linear_model import Ridge, RidgeCV from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import cross_val_score, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 num = d.select_dtypes(include='number').dropna(axis=1) # 目的変数 L3221(消費支出)と、その内訳(L3221xx:足すと L3221 になる)・年度列は説明変数から外す X = num.drop(columns=[c for c in num.columns if c.startswith('L3221') or c == 'SSDSE-B-2026']) y = num['L3221'] print('X:', X.shape, ' y:', y.shape) cv = KFold(n_splits=5, shuffle=True, random_state=0) for a in [0.01, 0.1, 1.0, 10, 100, 1000]: pipe = Pipeline([('s', StandardScaler()), ('m', Ridge(alpha=a))]) mse = -cross_val_score(pipe, X, y, cv=cv, scoring='neg_mean_squared_error').mean() pipe.fit(X, y) coef_max = np.abs(pipe.named_steps['m'].coef_).max() print(f'α={a:>6}: CV-RMSE={np.sqrt(mse):8,.0f} 円, |coef|max={coef_max:8,.0f}') |
🧮 数式に値を入れて手で計算する: Ridge 推定量
SSDSE-B-2026(2023 年度)の北海道・青森県・岩手県・宮城県・秋田県の 5 道県で、 高齢化率(A1303/A1101×100)と合計特殊出生率(A4103)から消費支出(L3221)を説明する。 3 変数とも 5 県の中で標準化(平均 0・標準偏差 1、 ddof=0)するので切片は不要で、 β̂_ridge = (X'X + λI)⁻¹X'y を λ=1 で計算する。
Step 1: 入力
Step 2: λI 加算後
Step 3: 推定量
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np # SSDSE-B-2026(2023 年度)北海道・青森県・岩手県・宮城県・秋田県 aging = np.array([33.0, 35.2, 35.0, 29.2, 39.1]) # 高齢化率(%) = A1303/A1101×100 tfr = np.array([1.06, 1.23, 1.16, 1.07, 1.10]) # 合計特殊出生率 A4103 y5 = np.array([296888, 263371, 298536, 305541, 272086]) # 消費支出 L3221(円/月) z = lambda v: (v - v.mean()) / v.std() # 5 県の中で標準化(ddof=0) X5 = np.column_stack([z(aging), z(tfr)]) yz = z(y5) # y も標準化するので切片は不要 XtX, Xty = X5.T @ X5, X5.T @ yz print(f"X'X = {XtX.round(3).tolist()}") print(f"X'y = {Xty.round(3).tolist()}") lam = 1 beta = np.linalg.solve(XtX + lam*np.eye(2), Xty) print(f"β̂_ridge (λ=1): {beta.round(3)}") print(f"β̂_OLS (λ=0): {np.linalg.solve(XtX, Xty).round(3)}") |
📤 実行結果
💬 手計算の X'X・X'y・β̂_ridge = [−0.487, −0.393]・β̂_OLS = [−0.566, −0.443] が Python 出力と一致する。 5 県の中では高齢化率も出生率も高い県ほど消費支出が少なく、 λ=1 の罰則は両方の係数を 14%(−0.566 → −0.487)と 11%(−0.443 → −0.393)縮める。 2 変数の相関が 0.356 と弱いので縮み方は穏やかだが、 相関が 0.9 を超えるような組み合わせでは OLS の係数が大きく振れ、 罰則の効き方もずっと大きくなる。
🐍 Python での Ridge
X(47×98)、y(消費支出 L3221)、alpha=1.0(L2 罰則の強さ)。StandardScaler で平均 0・分散 1 に揃えるのが前提。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | from sklearn.linear_model import Ridge, RidgeCV from sklearn.preprocessing import StandardScaler import numpy as np # 標準化(必須) scaler = StandardScaler() X_std = scaler.fit_transform(X) # Ridge ridge = Ridge(alpha=1.0).fit(X_std, y) coef = ridge.coef_ print(f'係数 {coef.size} 個のうち、ちょうど 0 の係数: {(coef == 0).sum()} 個') print(f'|係数| の最大 {np.abs(coef).max():,.0f}、中央値 {np.median(np.abs(coef)):,.0f}') top = np.argsort(-np.abs(coef))[:3] print('|係数| 上位 3:', [(X.columns[i], round(coef[i])) for i in top]) # α を CV で自動選択 ridge_cv = RidgeCV(alphas=[0.1, 1.0, 10.0, 100.0], cv=5).fit(X_std, y) print(f'最適α: {ridge_cv.alpha_}') |
🆚 Ridge vs LASSO
| Ridge (L2) | LASSO (L1) | |
|---|---|---|
| ペナルティ | Σβ² | Σ|β| |
| 変数選択 | しない | する(係数を0にする) |
| 多重共線性 | よく対処 | 一方を選ぶ傾向 |
| 使い時 | 変数全部が少しずつ寄与 | 少数の変数だけが重要 |
🚧 落とし穴と注意点
- サンプルサイズを確認(小標本では結果が不安定)
- 仮定の検証(正規性、 独立性、 等分散性)
- 外れ値の影響を散布図で確認
- 多重比較問題(複数検定時は補正を)
- p値だけで判断しない、 効果量と信頼区間を併記
- 因果関係を主張するには別の根拠が必要
🐍 Python 実装バリエーション(scikit-learn / statsmodels / scipy / 自前)
🅰️ scikit-learn の素直な Pipeline
X(2023 年度・47 県 × 98 列、 生のスケール)、y(消費支出)。alphas は logspace(-3, 3, 50) で広域指定。1 2 3 4 5 6 7 8 | from sklearn.linear_model import RidgeCV from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler import numpy as np pipe = Pipeline([('s', StandardScaler()), ('m', RidgeCV(alphas=np.logspace(-3, 3, 50), cv=5))]) pipe.fit(X, y) print('Best α:', pipe.named_steps['m'].alpha_) |
🅱️ statsmodels の fit_regularized
X_std(47×98、 add_constant で切片付き)、y、alpha=1.0(切片だけ 0)、L1_wt=0。1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np import statsmodels.api as sm from sklearn.linear_model import Ridge X2 = sm.add_constant(X_std) # statsmodels の目的関数は 0.5·RSS/n + alpha·0.5·||β||²(L1_wt=0)。 # 切片には罰則をかけないよう、alpha をベクトルで渡して先頭(const)を 0 にする pen = np.r_[0.0, np.full(X_std.shape[1], 1.0)] r = sm.OLS(y, X2).fit_regularized(alpha=pen, L1_wt=0) # L1_wt=0 → Ridge print('切片と先頭 3 係数:', ', '.join(f'{v:,.1f}' for v in r.params[:4])) # alpha=1.0 は sklearn の Ridge(alpha = n × 1.0 = 47) に当たる sk = Ridge(alpha=len(y) * 1.0).fit(X_std, y) print('sklearn Ridge(alpha=47) と一致:', np.allclose(r.params[1:], sk.coef_, rtol=1e-4, atol=1e-2)) |
🅲 scipy.linalg で「数式から」Ridge
scipy.linalg.solve で直接計算し、数式の通り係数が出ることを学習目的で確認する。X を標準化した Xs(47×98)、y、α=1.0。 比較用に 2 つ前のブロックの sklearn の ridge(α=1.0)。1 2 3 4 5 6 7 8 | import numpy as np # β = (X'X + αI)^{-1} X'y Xs = StandardScaler().fit_transform(X) alpha = 1.0 beta = np.linalg.solve(Xs.T @ Xs + alpha * np.eye(Xs.shape[1]), Xs.T @ y) print('Ridge β(先頭 3 個):', np.round(beta[:3], 1)) # Xs は列ごとに平均 0 なので、切片を別に推定しても傾きは変わらない print('sklearn Ridge(alpha=1.0) と一致:', np.allclose(beta, ridge.coef_)) |
🅳 Kernel Ridge(非線形拡張)
Xs(47×98)、平均を引いた y、kernel='rbf'、gamma = 1/98(RBF の鋭さ)、alpha=1.0(L2 罰則)。1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.kernel_ridge import KernelRidge from sklearn.model_selection import cross_val_score, KFold import numpy as np # KernelRidge は切片を持たないので、y を平均 0 に中心化してから当てはめる yc = y - y.mean() cv = KFold(n_splits=5, shuffle=True, random_state=0) models = { '線形 Ridge (α=100)': Ridge(alpha=100.0), 'Kernel Ridge (RBF)': KernelRidge(alpha=1.0, kernel='rbf', gamma=1 / Xs.shape[1]), } for name, m in models.items(): mse = -cross_val_score(m, Xs, yc, cv=cv, scoring='neg_mean_squared_error').mean() print(f'{name}: CV-RMSE = {np.sqrt(mse):,.0f} 円') print(f'(参考)y の標準偏差(全体平均で予測したときの目安) = {yc.std(ddof=0):,.0f} 円') |
📦 ライブラリ早見表
| 用途 | 推奨 | 補足 |
|---|---|---|
| 予測・パイプライン | sklearn Ridge / RidgeCV | 業界標準 |
| 検定統計量も欲しい | statsmodels OLS.fit_regularized | L1_wt=0 |
| 教育・自前実装 | numpy / scipy.linalg | 数式の理解 |
| 非線形 Ridge | sklearn.kernel_ridge | RBF/ポリ核 |
| 大規模・GPU | PyTorch + weight_decay | 深層学習で等価 |
⚠️ 落とし穴(補強版 — Ridge 回帰で踏みやすい7つの罠)
StandardScaler.fit_transform(X) を CV ループの外で実行すると、 検証 fold の統計量が訓練側に漏れます。 これは正則化の効果評価を楽観バイアスさせる重大な情報リーク。 必ず Pipeline を使って fold 内で fit/transform を完結させてください。 sklearn の Pipeline はこの罠を自動で回避してくれます。 「実験結果が論文より少しだけ良い」のはこのリークが原因のことが多いです。fit_intercept=True で切片に罰則をかけない挙動がデフォルト。 自前で実装すると、 切片を含めて L2 ノルムを取ってしまいがちで、 これだと y の単位が変わるだけで結果が変わる病的な挙動になります。 切片は罰則の対象外、 がデフォルト。 これを意識せず Ridge を自前実装すると、 「定数項を引いたら結果が変わった」と混乱します。LinearRegression を呼ぶのが安全。 「α=1e-10 はほぼ 0」も、 浮動小数点の挙動次第で意外な結果になる場合があります。logspace(-3, 3, 30) のように対数スケールで広く探すのが標準。 「0.1 から 10 まで線形」のような線形探索だと、 最適 α が範囲外にあることに気づけません。 特に SSDSE-B のような小標本では最適 α が 10 以上のことも珍しくない。 探索範囲の端で最適が得られたら、 範囲を広げて再探索するのが正しい流れです。ColumnTransformer で連続列だけ StandardScaler、 ダミー列はそのまま、 と明示するのが現代的な書き方。 これを怠ると、 「ダミーの罰則がきつすぎてカテゴリ効果が消える」事故が起きます。⚠️ Ridge の追加的な落とし穴(10 個の警告)
- 標準化を忘れる:変数のスケールが揃っていないと、 単位の大きい変数(人口 vs 失業率%)が罰則を不当に多く受ける。 必ず `StandardScaler` を Pipeline で前置する。
- 切片を正則化する:切片には L2 罰則を掛けてはいけない。 sklearn の `Ridge` は自動で除外するが、 自前実装では要注意。
- $\lambda$ をデータ全体で選ぶ:テストデータも使って CV するとリーク。 Nested CV か、 学習データ内で内側 CV を組む。
- Categorical 変数のダミー化後にスケーリングしない:one-hot エンコード後の 0/1 と連続変数のスケールが違うと、 連続変数に罰則が偏る。
- 外れ値の影響:Ridge は二乗誤差なので外れ値の影響が大きい。 東京を含む都道府県データでは Huber Ridge の検討も。
- $p \gg n$ で SVD が遅くなる:超高次元では「双対 Ridge」($XX^\top$ 版)で計算量が $O(n^3)$ になる。 sklearn では `solver='svd'` ↔ `solver='cholesky'` を選び分け。
- $\lambda$ のグリッドが粗い:対数スケール(例:`np.logspace(-4, 4, 100)`)でないと最適値を取り逃す。
- 多目的最適化を忘れる:MSE 最小だけでなく、 「係数の安定性」「解釈性」も評価軸に。 Ridge trace plot で係数の $\lambda$ 依存を可視化すべき。
- 分散の正規分布性を仮定したまま SE を出す:Ridge 推定値は不偏でないので、 標準的 SE 公式は使えない。 Bootstrap で経験 SE を得るのが正解。
- 非定常データ:時系列で Ridge を使うとき、 学習期間とテスト期間で分布が違うと $\lambda^\star$ が大きく変わる。 ローリング CV で安定化を確認。
🎯 SSDSE-B-2026 完全実務ワークフロー
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 | import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler from sklearn.linear_model import Ridge, RidgeCV from sklearn.pipeline import Pipeline from sklearn.model_selection import KFold, cross_val_score # 1) データ読み込み(実データ) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) d = df[df['年度'] == 2023] # 2023 年度の 47 都道府県 # 目的変数: 消費支出(二人以上の世帯)、説明変数: 率・水準の 8 指標 X = pd.DataFrame({ '高齢化率': d['65歳以上人口'] / d['総人口'], '合計特殊出生率': d['合計特殊出生率'], '年平均気温': d['年平均気温'], '降水量': d['降水量(年間)'], '住宅地価格': d['標準価格(平均価格)(住宅地)'], '有効求人倍率': d['月間有効求人数(一般)'] / d['月間有効求職者数(一般)'], '大学進学率': d['高等学校卒業者のうち進学者数'] / d['高等学校卒業者数'], '1人1日ごみ': d['1人1日当たりの排出量'], }) y = d['消費支出(二人以上の世帯)'] # 2) Pipeline で標準化+Ridge pipe = Pipeline([ ('scaler', StandardScaler()), ('ridge', RidgeCV(alphas=np.logspace(-4, 4, 100), cv=5)) ]) # 3) 5-fold CV で汎化性能を測る cv = KFold(n_splits=5, shuffle=True, random_state=0) scores = cross_val_score(pipe, X, y, cv=cv, scoring='r2') print(f'CV R²={scores.mean():.3f} ± {scores.std():.3f}') # 4) 全データで再学習、 最適 α を確認 pipe.fit(X, y) print(f'最適 α = {pipe.named_steps["ridge"].alpha_:.4f}') # 5) 係数を Ridge trace で可視化 import matplotlib.pyplot as plt alphas = np.logspace(-4, 4, 100) coefs = [] Xs = StandardScaler().fit_transform(X) for a in alphas: r = Ridge(alpha=a).fit(Xs, y) coefs.append(r.coef_) plt.semilogx(alphas, coefs) plt.xlabel('α'); plt.ylabel('係数'); plt.title('Ridge trace') plt.show() |
💬 2023 年度 47 県の消費支出を 8 指標で予測した CV R² は 0.116 で、fold ごとの標準偏差 0.280 のほうが大きく、県別の消費支出は率の指標だけではあまり説明できない。RidgeCV が選んだ α≈37.6 は実効自由度でいえば約 3.5 にあたる強めの縮小で、8 個の係数をそのまま使うと過学習することを示している。R² が 1.000 になるような設定(目的変数が説明変数の足し算で作れる列など)を見たら、まず列の定義を疑う。
Ridge trace を見て「全係数が安定するゾーン」を $\lambda^\star$ として目視確認するのが伝統的アプローチ。 CV と目視を両方使えば、 「数値最適だが意味不明」な解を回避できます。
🆚 Ridge と他の正則化手法の総合比較
| 手法 | 罰則 | 変数選択 | 共線性耐性 | 非線形 | $\lambda$ の意味 |
|---|---|---|---|---|---|
| Ridge (L2) | $\|\beta\|^2$ | 不可 | ◎ | 基底拡張+Ridge | 縮小強度 |
| Lasso (L1) | $\|\beta\|_1$ | ◎ | ×(不安定) | 不可 | スパース化強度 |
| Elastic Net | $\alpha \|\beta\|_1 + (1{-}\alpha)\|\beta\|^2$ | ◯ | ◯ | × | 混合バランス |
| SCAD/MCP | 非凸 L1 | ◎ + バイアス無し | △ | × | 閾値 |
| Bayes Ridge | ガウス事前 | 不可 | ◎ | GP 拡張で可 | 事前分散の逆 |
| Kernel Ridge | RKHS 規範 | 不可 | ◎ | ◎ | 関数の滑らかさ |
SSDSE-B-2026 のような小標本・中次元・高共線性データには、 まず Ridge を試し、 変数選択が必要なら Elastic Net、 非線形が必要なら Kernel Ridge、 不確実性表現が必要なら Bayes Ridge――というツリーで選ぶのが実務的です。
🗺️ 概念マップ — 3つの視点で体系を理解する
Ridge回帰 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 関連・回帰 › 回帰 › Ridge回帰
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に Ridge回帰 を置き、 そこから LASSO・Elastic Net・重回帰・多重共線性・最小二乗法・単回帰 計 6 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「Ridge回帰」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「Ridge回帰」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは Ridge回帰 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 回帰 → Ridge回帰 という入れ子の位置を示します。 「回帰には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🔗 隣接手法への橋渡し
「Ridge 回帰」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 回帰分析 で 多重共線性 や 過学習 が懸念される段で適用検討
- 並列: Lasso(L1)が変数選択的に作用するのに対し、 Ridge(L2)は 係数を縮小 するが 0 にはしない。 用途で使い分け
- 下流: 正則化強度 λ を クロスバリデーション で選び、 係数 の縮小度合いと予測誤差のバランスを評価
多変数で すべての説明変数を残しつつ過学習を抑える 用途で Ridge が最適。 47 都道府県の家計支出項目を全て使った消費支出予測などで実力を発揮する。
🌳 手法選択フロー
「ridge」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| データが大規模 (n が多い、 高次元) | 計算コスト / メモリ / 並列化が必要 | ビジネス理解 等 |
| 外れ値が多い / ノイズあり | 頑健性 / 外れ値除去 / 中央値ベース | データ理解 等 |
| 解釈性を重視する | 線形 / 木構造 / ルールベース | データ準備 等 |
| 予測精度を最優先する | アンサンブル / ハイパラ調整 / 交差検証 | モデリング 等 |
| データが少ない | 正則化 / ベイズ / 転移学習 / 簡素なモデル | データアナリスト 等 |
| リアルタイム/オンライン処理 | ストリーミング / 軽量モデル / 逐次更新 | データサイエンティスト 等 |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討
🧭 解説深化(追補)— Ridge を一段深く理解する
この追補は既存の各章(直感・数式・実装・落とし穴・関連手法)を壊さずに補う復習ノートです。 「直感/落とし穴/発展」を 1 か所に凝縮しました。 本節の数値はすべて data/raw/SSDSE-B-2026.csv(cp932 / skiprows=[1] / 2023 年・47 都道府県)の実測で、 合成データは使っていません。
👁️ 直感の芯 — 4つの言い換え
- L2 で係数を 0 方向へ縮小:罰則 $\lambda\sum_j\beta_j^2$ は大きな係数を二乗で罰するので、 全係数が「少しずつ我慢」して 0 側へ縮む(ただし 0 ちょうどにはしない)。
- 多重共線性に頑健:$X^\top X$ がほぼ特異でも $+\lambda I$ で逆行列が必ず存在し、 相関方向に暴れる係数が安定化する(下の実測表が典型例)。
- バイアスを入れてバリアンスを下げる:Ridge は不偏性をわざと捨て、 分散を大きく減らすことで総合誤差 (MSE) を OLS より小さくできる(James-Stein 効果 / Hoerl & Kennard 1970)。
- Lasso との違い:L2 は縮めるが 0 にしない(全変数が残る)、 L1 は0 にする(変数選択)。 両取りは Elastic Net。
📊 実測で見る「OLS 崩壊 → Ridge 縮小」(SSDSE-B-2026, 2023 年 47 県)
説明変数に 総人口 (A1101)・総人口男 (A110101)・総人口女 (A110102) の 3 つを取ると、 相互相関はいずれも r ≈ 0.999、 VIF は数百万オーダー、 cond($X^\top X$) ≈ 1.0×10⁸ という極端な多重共線性になります(男 + 女 = 総人口 なので当然)。 目的変数を 消費支出 L3221 とし、 標準化後に $\lambda$ を変えて係数と実効自由度を実測しました。
| λ | β̂ 総人口 | β̂ 男 | β̂ 女 | df(λ) | 観察 |
|---|---|---|---|---|---|
| 0(OLS) | 7,595,818 | −3,579,986 | −4,009,854 | 3.00 | 係数が ±数百万で符号逆転・爆発 |
| 0.1 | 2,194 | 52,331 | −46,585 | 1.33 | 桁が一気に縮むが男女はまだ逆符号 |
| 1 | 2,562 | 9,679 | −4,351 | 1.04 | さらに安定化 |
| 10 | 2,466 | 3,209 | 1,744 | 0.94 | 3 係数が同程度の正値に均される |
| 100 | 1,549 | 1,623 | 1,476 | 0.59 | ほぼ等しい値へ(強い縮小) |
| 1000 | 327 | 335 | 320 | 0.12 | 全係数が 0 へ収束(λ→∞ の極限) |
読み方:λ=0(OLS)では「男」と「女」がほぼ相殺する±数百万の逆符号を取り、 わずかなデータ変動で解が跳ねる典型的な多重共線性の症状。 λ を上げると 3 係数は同程度の正値に均され(=「全員少しずつ我慢」)、 実効自由度 df(λ) は 3 → 0.94 → 0.12 と収縮します。 これが「3 変数入れても実質 1 変数分しか自由に動かない」正則化によるバイアス・バリアンス調整の実データ証拠です。 なお係数はすべて縮小後の値で不偏でないため、 OLS のように「1 単位増で y が β 増」とは解釈できません(下の落とし穴⑥参照)。
🚧 落とし穴チェックリスト(重要 — この 7 点を口頭で言えれば合格)
- ① 標準化は必須:Ridge はスケール依存。 単位の大きい変数が不当に強く罰せられるので、 標準化(平均 0・分散 1)を CV の fold 内で施す(Pipeline 化でリーク防止)。
- ② λ は交差検証で選ぶ:決め打ち不可。
np.logspace(-3,3,50)の対数スケールで クロスバリデーション(k-fold / LOOCV)→ 誤差最小の λ。 - ③ 切片は正則化しない:$\beta_0$ に L2 を掛けると y の平行移動で解が変わる病的挙動に。 sklearn は既定で切片を罰則対象外。
- ④ 係数はバイアスを持つ(不偏でない):Ridge は系統的に 0 へ縮む縮小推定量。 標準的な SE 公式は使えず、 必要なら Bootstrap で経験 SE を取る。
- ⑤ 変数選択はしない:係数は 0 に近づくが 0 ちょうどにはならず、 全変数が残る。 選択したいなら Lasso / Elastic Net。
- ⑥ λ→∞ で全係数 0:上表の λ=1000 が示す通り、 強すぎる λ は平均予測(切片のみ)に潰れる。 解釈は必ず採用した λ での縮小後の値に対して行う。
- ⑦ 因果として読まない:予測が目的なら Ridge、 効果量・推論が目的なら OLS や因果推論の枠組みへ。
🚀 発展 — 6つの視点で骨格を掴む
- L2 正則化の幾何:制約領域は球(円)で角がないため、 誤差楕円との接点が座標軸に乗りにくい=「縮めるが 0 にしない」。 Lasso は菱形(角が軸上)で 0 になりやすい。
- λ とバイアス・バリアンス:λ↑ でバイアス↑・バリアンス↓。 総 MSE が最小の λ* が必ず存在し OLS を下回りうる(James-Stein / Hoerl & Kennard)。
- ベイズ的解釈:係数に正規事前分布 $\beta_j\sim\mathcal N(0,\tau^2)$ を置いた MAP 推定=Ridge($\lambda=\sigma^2/\tau^2$)。 「事前分散が小さい=強い縮小」。 ベイズの定理 の視点。
- Lasso / Elastic Net との比較:L1 は変数選択・スパース、 L2 は共線性に頑健・全変数保持、 Elastic Net は L1+L2 でグループごと保持。
- 有効自由度:$\mathrm{df}(\lambda)=\mathrm{tr}(H_\lambda)=\sum_j d_j^2/(d_j^2+\lambda)$。 上表で 3→0.12 と縮む「ソフトな次元削減」。 AIC/BIC の補正項にも使う。
- 正規方程式の安定化:$(X^\top X+\lambda I)^{-1}$ の $\lambda I$ が条件数を改善(上例 cond ≈ 1.0×10⁸ → 大幅低下)。 これが多重共線性下でも解ける数学的根拠(Tikhonov 正則化)。
🔗 関連ページ(この教材内・実在ファイル)
- Lasso(L1 正則化) — 縮小に加えて変数選択する双子。
- Elastic Net — L1+L2 のハイブリッド。
- 正則化(一般) — Ridge を含む上位概念。
- 多重共線性 — Ridge が最も力を発揮する状況。
- 最小二乗法(OLS) — λ=0 の基準・比較対象。
- バイアス・バリアンス分解 — λ 調整の理論基盤。
- 標準化 — Ridge の必須前処理。
- クロスバリデーション — λ 選択の標準手段。
- ベイズの定理 — Ridge = 正規事前分布の MAP。
🔖 キーワード索引(拡張版 — Ridge 回帰)
L2 罰則・縮小推定・Kernel Ridge への発展まで網羅。