🔖 キーワード索引
本ページは テストデータ(Test Data)を 12 のセクションで多角的に解説します。 上のチップは検索・関連語の手がかりです。 以下のリンクで各セクションに直接ジャンプできます:
💡 30秒で分かる結論
🍰 まずはやさしく
最後に実力をはかるためのデータです。
正しく性能を評価するために使います。
テスト前に解く模擬試験のようなものです。
まずは結論を短く確認しましょう。
最終評価に使うデータ
- テストデータは学習にも調整にも使わず、 最後に 1 回だけ汎化性能を測るために取っておくデータ
- SSDSE-B-2026 の 564 行(47 県 × 12 年度)を行単位で 60/20/20 に分けると、 ランダムフォレストは訓練 1.000・検証 0.735・テスト 0.735
- 同じ県の別の年度が訓練とテストの両側に入らないよう GroupKFold で県単位に分けると 0.581 ± 0.082 まで下がる。 行単位の分割はリークで精度を水増ししていた
- 2021〜2023 年度をテストに回すと、 合計特殊出生率の分布がずれている(KS = 0.395)。 テストが本番と同じ分布かを先に確かめる
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
学習に使わない未知のデータのことです。
本番で通用するかを確認するために使います。
部活の練習試合で実力を試す感覚です。
どのような場面で使うかを見ていきましょう。
テストデータは 学習にも検証にも使われず、 最終的な汎化性能評価のみに使う未知データ。 通常 Train / Validation / Test の 3 分割で確保し、 Test は最後の 1 回だけ触るのが鉄則。 Test を何度も見るとリーケージで Test スコアが過剰になる。
🔎 補足: テストデータの設計・隔離・運用
テストデータ (test set) は機械学習の評価品質を左右する最重要部品の一つだが、 「訓練データの余りを test に回す」「期間で適当に切る」など軽視されがちな扱いが多い。 ここでは SSDSE-B-2026 を題材に、 テストデータの設計・隔離・運用を 12 観点で整理する。
1. テストデータの 3 大要件
- 分布の代表性: 本番運用時に遭遇する分布と一致 (または十分に近い) こと。 SSDSE-B-2026 で言えば、 47 都道府県のうち少数のサンプル (例: 沖縄・東京のみ) を test に充てると分布が偏る。
- 訓練からの隔離: 訓練データと共通サンプルが含まれてはならない (data leakage 防止)。 時系列、 グループ、 ユーザー ID 等の単位で互いに素にする必要がある。
- 規模の十分性: 評価指標の信頼区間が業務判断に耐える幅に収まるサイズ。 二値分類なら少数派サンプルが 50 件未満では F1 の標準誤差が大きくなる。
2. train/val/test の役割分担
training は重み最適化、 validation はハイパーパラメータと early stopping、 test は最終評価。 test を validation のように繰り返し見ると、 暗黙のうちにモデル選択が test に依存して評価が水増しされる (test set chasing) ので、 「最終リリース前 1 回だけ評価」が原則。
3. SSDSE-B-2026 での具体的分割例
SSDSE-B-2026 は 47 都道府県 × 経済・人口・産業の 100 変数程度。 サンプル数が極端に少ないので「7:2:1 分割」は 47 × 0.1 = 4.7 件しか test に残らず、 性能評価が不安定。 この場合は「分割するのではなく、 47 件で学習しつつ leave-one-out CV (LOO-CV) で評価する」「外部の別年データ (SSDSE-B-2025 等) を test として確保する」「stratified 5-fold で 9-10 件 / fold の test を回す」のいずれかを採る。
4. 時系列データの場合
SSDSE-B-2026 のような cross-sectional データなら無作為分割で OK だが、 時系列なら 必ず時間順分割 にする。 訓練データの最新時点より後を test にしないと、 「未来情報が訓練に混入してリーケージ」が起きる。 株価予測・需要予測ではこの罠が頻発する。
5. グループ単位の分割
同一ユーザー・同一店舗・同一患者のサンプルが複数あるデータでは、 グループ単位で互いに素にする (GroupKFold)。 同じユーザーのサンプルが train と test に混ざると、 モデルは「そのユーザーの特徴」を覚えるだけで本来の汎化を学べない。
6. test set の「凍結」と運用
test データは PR レビューが終わったら「凍結ディレクトリ」に移動し、 通常の開発フローからアクセスできないようにする。 git submodule や暗号化、 別リポジトリでの管理が現場の解。 「うっかり EDA で test を見てしまった」という事故は珍しくない。
7. データドリフトと test の鮮度
運用が長期になると本番分布と test 分布が乖離する (data drift)。 6 ヶ月〜1 年ごとに新しい test を確保し、 古い test と並列で評価することで「ドリフトのスピード」を計測する。 ドリフトが大きければ再学習や model refresh のシグナルになる。
8. 公開ベンチマーク test set との関係
公開済の test set (ImageNet, MNIST, GLUE, SSDSE 等) は何百万回も評価された結果、 「コミュニティ全体がその test に過剰適合」する現象 (benchmark leakage) が知られている。 公開 test の数値だけで意思決定せず、 自前 hold-out を必ず併用する。
9. test data の質を測る指標
- サンプル数 (n_test)
- クラス分布 (class_distribution)
- 欠損率 (missing_rate)
- train との covariate shift 距離 (Wasserstein, KL divergence, MMD)
- 標的シフトの有無 (label distribution の差)
10. label leakage の典型 6 パターン
- train と test で同じレコードが重複
- 特徴量に target を導く未来情報が混入 (例: 「請求が支払い済か」を特徴量に入れて延滞予測)
- preprocessing (StandardScaler.fit) を train + test に対してまとめてかける
- SMOTE を test にも適用
- SQL JOIN で test レコードのキーから target を取得
- cross-validation を「ランダム」にしてしまい、 同じ患者のサンプルが train/test に混入
11. test の選び方: hold-out vs CV vs nested CV
大規模データ (n > 10,000) なら hold-out 1 つで十分。 中規模 (1,000 < n < 10,000) では 5-fold CV を併用。 小規模 (n < 1,000) では LOO-CV または stratified 5-fold で、 ハイパーパラメータ調整時は nested CV で「内側 CV でチューニング、 外側 CV で最終評価」を分ける。
13. ケーススタディ: SSDSE-B-2026 で人口減少予測モデル
「人口減少率が 5% 以上か否か」を 2 値分類するモデルを SSDSE-B-2026 で構築するとき、 47 都道府県を 7:3 で訓練 33 件、 test 14 件に分割すると少数派が 1-2 件しか test に残らないので評価がノイズに支配される。 そこで stratified 5-fold + LOO-CV のハイブリッド評価を採用し、 さらに SSDSE-B-2025 (1 年前データ) を外部 test として加える。 外部 test との性能差が小さければモデルは時間方向に安定、 大きければデータドリフトが疑われる。 こうした多段評価で初めて、 small data の test 設計が実務に耐える。
15. 追加 FAQ: 現場で頻出する 12 の疑問
Q1. test の割合は何 % が正解か? 一般的には 20-30 % だが、 サンプル数で判断する。 n=100 なら 30 件、 n=10,000 なら 1,000 件で十分。 評価指標の標準誤差が業務上の意思決定閾値を下回る規模を確保するのが本質。
Q2. test を seed 固定で複数生成して平均を取ってよいか? 取ってよいが、 これは hold-out ではなく Monte Carlo cross-validation と呼ばれる手法になる。 通常の k-fold CV と異なり fold が重なるため、 標準誤差の見積もりは慎重に。
Q3. test サンプルに NaN がある場合は除外してよいか? 一律除外すると分布が歪む。 NaN を残し、 モデル側で imputation する設計が正攻法。 ただし train で imputer を fit し、 test には transform のみ適用すること。
Q4. test で性能が高すぎる場合は? data leakage を疑う。 特徴量に target に近い情報が混入していないか、 train と test に同じレコードが含まれていないか確認する。 性能が「異常に良い」ときは喜ぶ前に検証する。
Q5. test 用に正解ラベルを別ファイルで管理すべきか? 推奨。 特徴量 X_test.csv と正解 y_test.csv を分離し、 y_test.csv は暗号化または read-only にする。 開発中に y_test を見る誘惑が物理的にできない構成にする。
Q6. test の評価指標は 1 つに絞るべきか? 主要指標 1 つに加え、 補助指標を 3-5 個並べる。 例: 精度を主、 再現率・F1・AUC・PR-AUC を副。 主要指標だけだと「全部正解と予測」のような縮退モデルに気づけない。
Q7. train と test の特徴量分布が異なる場合は? covariate shift と呼ぶ。 importance weighting や domain adaptation で補正できるが、 まずは「なぜ違うのか」をデータ収集プロセスから調査するのが先。
Q8. test 結果が悪い場合の修正フロー? test 結果を見てモデルを修正するのは禁じ手 (test に過剰適合する)。 train+val でデバッグし、 test は最終 1 回のみ評価。 何度も評価したい場合は新しい test を確保する。
Q9. nested CV はいつ必要か? ハイパーパラメータ調整を伴うときに、 外側 CV で得る性能が「真の汎化性能」に近づく。 計算コストが k^2 倍になるので、 大規模データでは hold-out 評価で代替することが多い。
Q10. test を後から増やしてよいか? 増やすのは可だが、 「過去の test 結果」との互換性は失われる。 「v1 test (n=100)」「v2 test (n=200)」のようにバージョン管理し、 報告書に明記する。
Q11. 公開コンペの test はどう扱うか? public test と private test に分かれている場合、 public のスコアで過剰適合し private で順位が下がる現象が頻発する。 自前 hold-out で性能を確認してから submission する。
Q12. 質的データの test 設計は? アンケートやインタビューでも train/test の概念は有効。 異なる回答者群、 異なる地域、 異なる時期のサンプルを test に充て、 「モデル (= 解釈や仮説) が新しい人にも適用できるか」を確認する。
16. 用語小辞典: test 周辺の必修ワード 16 件
- hold-out: データを一定割合で train と test に分割する最も単純な方法。
- k-fold CV: データを k 個に分け、 k 回交互に train/test を入れ替える評価。
- stratified k-fold: 各 fold のクラス分布を全体と一致させる k-fold。 不均衡データで必須。
- LOO-CV: leave-one-out。 n 件のうち 1 件を test、 残り n-1 件を train。 小規模データ向け。
- nested CV: ハイパーパラメータ調整と最終評価を二重 CV で分離する手法。
- GroupKFold: 同じグループ ID のサンプルが train と test に分散しない k-fold。
- TimeSeriesSplit: 時系列を時間順に分割する CV。 未来情報リーケージを防ぐ。
- data leakage: test 情報が間接的に train に混入する事故。 性能が異常に高くなる。
- covariate shift: train と test で特徴量分布が異なる現象。 性能低下の主要因。
- label shift: train と test で target 分布が異なる現象。
- concept drift: 入力と target の関係そのものが時間とともに変化する現象。
- benchmark leakage: 公開 test に対するコミュニティ全体の過剰適合。
- generalization gap: train 性能と test 性能の差。 大きいほど過剰適合。
- data drift: 本番運用時の入力分布が train 時から変化する現象。
- backtest: 時系列モデルを過去データで疑似運用評価する手法。
- shadow deployment: 本番運用と並行して新モデルを動かし、 オンラインで test 評価する手法。
17. 実例: SSDSE-B-2026 で 5-fold CV を回すコード雛形
SSDSE-B-2026 の 47 件で stratified 5-fold を回す典型的なコード設計を示す。 fold ごとに 9-10 件の test が残り、 5 回の平均性能を最終指標として報告する。
このコードは 5-fold で 47 件を約 37:10 に分割し、 5 回繰り返して平均性能を評価する。 SSDSE-B-2026 のような small data の典型運用パターンとして覚えておきたい。
🔎 拡張補足: テストデータ運用のさらなる深堀り
1. 試験データセット管理のベストプラクティス
テストデータは「設計時に作る」のではなく「運用しながら育てる」ものだ。 SSDSE-B-2026 のような公開統計データを使う場合でも、 新しい都道府県データが毎年更新されるため、 古いテストセットの代表性が時間とともに低下する。 対策として、 (1) テストデータのバージョン管理 (Git LFS, DVC)、 (2) サンプル数・属性分布の年次レビュー、 (3) 重要属性ごとの代表サンプル保持、 (4) outlier・boundary case の保管庫構築、 (5) ドメインエキスパートによる質的検証、 の 5 軸で運用する。 特に (4) は重要で、 「珍しいが起こりうるケース」を意図的に保持することで、 モデルの未知ケース耐性 (robustness) を継続評価できる。 例えば SSDSE-B-2026 では「沖縄県の高齢化率の特異性」「東京都の人口密度の極端さ」「秋田県の人口減少速度」など、 各都道府県の特徴的属性をテストセットに必ず含める設計が望ましい。
2. テストデータと公平性 (fairness) 検証
分類モデルの公平性検証では、 テストデータが「保護属性」 (人種、 性別、 年齢、 地域 etc.) に対して均衡なサンプルを含むことが極めて重要だ。 SSDSE-B-2026 で「人口減少リスク予測」モデルを評価する際は、 「都市部・地方」「人口大・小」「産業構成 (1 次・2 次・3 次)」のすべての象限から少なくとも 5 サンプル以上を含めるよう設計する。 sklearn の stratified_train_test_split はクラスバランスを保つが、 多軸保護属性での均衡を保証しないため、 手動でサンプリングを設計する必要がある場合が多い。 さらに、 disparate impact (異なる集団間での誤り率格差) を計測するため、 各集団 (都市部 vs 地方 etc.) ごとに precision/recall/F1 を別々に集計し、 その差が業務的に許容できる範囲かを評価する。 例: 都市部の人口減少リスク予測 F1=0.85, 地方 F1=0.65 なら、 地方への過小予測リスクとして要監視。
3. ベンチマークデータセットの危険な過信
ImageNet, GLUE, SuperGLUE などの著名ベンチマークは何百万回も評価され、 結果として「コミュニティ全体がこれらに過剰適合 (overfitting to benchmark)」する現象が知られている。 ImageNet で SOTA を更新したモデルが、 実世界画像で性能が落ちる例は枚挙にいとまがない。 SSDSE のような公開統計データも、 「教育例として広く使われる」ことで類似の現象が起こり得る。 対策: 自前の hold-out (時系列で分離)、 ドメイン特化テスト (秋田だけの限定モデル) の併用。 また「ベンチマークでの順位」と「実運用での価値」は別物だと割り切ること。 NeurIPS や ICML の論文でも、 単一ベンチマーク SOTA だけで主張するものは査読で減点される傾向が強まっている。 複数ベンチマーク + 自前のドメインテスト + ablation study の三点セットが新標準だ。
4. テスト時拡張 (Test-Time Augmentation, TTA)
画像認識では、 推論時に入力画像を複数の augmentation (flip, crop, color jitter) で変換し、 アンサンブル予測を取る TTA が標準化している。 統計データでは類似の手法として、 「予測時の特徴量摂動 (noise injection)」「ブートストラップによる予測区間推定」「特徴量変換 (log, sqrt) の併用」がある。 SSDSE で人口減少率予測する際、 入力データを 5% の標準偏差で摂動して 100 通り予測し、 平均と分散を取れば堅牢な予測値が得られる。 TTA の副次効果として、 予測の不確実性を定量化できる点も重要だ。 同じ入力に対し、 摂動を加えた予測の標準偏差が大きい点 = モデルが自信を持てない領域、 と解釈できる。 これを「decision deferral」 (人間判断への委譲) のトリガーに使うことで、 自動化と人間判断のハイブリッド運用が実現する。
5. test-train データの重複検出 (Data Contamination)
LLM 評価で深刻化している問題: GPT-4 が GLUE テストデータを学習中に見ていた可能性。 対策として、 (1) MinHash, SimHash による重複検出、 (2) substring overlap 解析、 (3) 厳格な時系列カットオフ (テストデータは訓練終了後にリリースされたものに限定)、 (4) "test on truly held-out" を明示する。 SSDSE のような公開統計データも、 LLM の事前学習に含まれている可能性があるため、 LLM ベース予測には注意が必要。 contamination の検出には Anthropic, OpenAI も真剣に取り組んでおり、 「training data 中に test set の文字列が含まれるかを n-gram で検索する」「test set のランダム並べ替えで perplexity が変わらないかを確認する」などの手法が研究されている。 教育用 SSDSE 利用では、 「LLM に SSDSE-B-2026 の都道府県値を答えさせる」検証で contamination 度を簡易確認できる。
6. テストデータの再現可能性
「同じテストデータで同じ評価が出る」は研究の基本前提だが、 (1) 乱数 seed の固定、 (2) 環境依存性の排除 (Docker, conda env)、 (3) ハードウェア差 (CPU vs GPU, float 精度) の管理、 (4) 並列処理での順序依存 を考慮する必要がある。 SSDSE-B-2026 を使う研究では、 requirements.txt + random_state=42 + pd.read_csv('SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) のような明示的記述が必須。 さらに踏み込むと、 PyTorch の torch.use_deterministic_algorithms(True)、 NumPy の np.random.default_rng(seed) 利用、 並列処理での n_jobs=1 固定、 結果ファイルの SHA256 ハッシュ記録、 などを CI に組み込むことで完全な再現性を担保できる。 研究の信頼性は再現性と直結するため、 ここを軽視するとレビューで大きく減点される。
7. ドリフトとテストデータの陳腐化
SSDSE-B-2026 で予測モデルを構築し、 SSDSE-B-2027 が公開されたとき、 (1) covariate shift (説明変数分布の変化)、 (2) prior shift (目的変数分布の変化)、 (3) concept drift (目的-説明関係の変化) の 3 形態でドリフトを定量化する。 detection 手法: Kolmogorov-Smirnov 検定、 Wasserstein 距離、 Maximum Mean Discrepancy (MMD)。 ドリフトが閾値を超えたら再学習・モデル更新の引き金とする。 実運用では、 KS 検定の p < 0.01 を「即時アラート」、 MMD > 0.1 を「監視継続」、 Wasserstein 距離が train 標準偏差の 2 倍を超えたら「強制再学習」など、 業務影響の重みづけで多段階アラートを設定する。 ドリフト監視は「事前検知 = 障害予防」であり、 MLOps の中核機能の 1 つとして位置づけられている。
8. テストデータ準備のチェックリスト 7 件
- サンプルサイズが評価指標の信頼区間を満たすか (例: AUC ± 0.02 で評価したいなら n ≥ 400 程度)
- クラス分布・保護属性分布が運用時と一致するか (本番分布とのズレを KS 検定で確認)
- train との重複・leakage がないことを SHA ハッシュで確認したか (全行のハッシュ集合で交差検査)
- 欠損値・外れ値の方針が訓練データと一貫しているか (同じ前処理パイプラインを通したか)
- バージョン管理 (DVC, Git LFS) されているか (commit ID で test set を特定できるか)
- アクセス権限が適切に制限されているか (test 読み取り専用、 書き込みは管理者のみ)
- 定期更新 (年次・月次) の体制があるか (新しい SSDSE 公開時の取り込みフローが定義済みか)
9. SSDSE-B-2026 を使った擬似テスト設計例
「47 都道府県の高齢化率を産業構成・人口・教育費から予測」というタスクで、 (1) train 70%, val 15%, test 15% に都道府県単位で stratified 分割、 (2) test seed=42 固定、 (3) 地域ブロック (北海道・東北・関東 etc.) で fold を切ったクロスバリデーション、 (4) 評価指標は MAE + R² + 95% 信頼区間、 という設計が標準的。 サンプル数 47 と少ないため、 LOO-CV (leave-one-out cross-validation) も併用すると安定する。 さらに、 各地域ブロック別の予測誤差を箱ひげ図で可視化し、 「九州地方だけ系統的に過小予測」のような地理的バイアスを検出する手順も入れる。 SSDSE-B-2026 のような小規模データでは、 単一の test set ではなく、 ブートストラップ 1000 回での予測分布全体を評価対象とする方法も推奨される。
10. テストデータと業務要件の対応
機械学習の test 評価は「アルゴリズムの良さ」を測るが、 業務的に重要なのは「ビジネス指標の改善」だ。 テストデータ上で AUC=0.95 でも、 「false positive 1 件あたりのコスト」を考慮すると AUC=0.85 のモデルの方が業務的に優位なケースが多々ある。 SSDSE-B-2026 で「人口減少リスク予測」を扱うなら、 false positive (リスクと誤判定) のコスト = 不要な対策費用、 false negative (リスクを見逃し) のコスト = 自治体の財政破綻リスク、 を金額換算してから評価指標を設計する。 「AUC が高い = 良いモデル」ではなく、 「業務コストが最小 = 良いモデル」という視点に切り替えるのが、 データサイエンティストとしての成熟度を分ける分水嶺だ。
🎨 直感で掴む
🍰 まずはやさしく
本番初日の客さんのようなデータです。
予測の精度が十分か確かめるために使います。
スマホアプリを公開する前の最終確認です。
直感的なイメージで使い方を学びましょう。
機械学習は「データから規則を学ぶ」アプローチ。 ルールベース(明示的に書く)に対し、 データから自動でパターンを獲得する点が特徴です。
本ページでは テストデータ を、 定義・前提条件・使い方・落とし穴の順に整理して解説します。 厳密な定義より、 まず何を、 いつ、 どう使うかを理解することを優先してください。
🎨 直感で掴む — 具体例で理解する
テストデータは「本番初日のお客さん」を想定した未知データ。 Train で学び、 Val でハイパラを選び、 そして本番直前に 1 度だけ Test で性能を確認する。 ここで満足のいくスコアが出れば本番投入、 ダメなら再設計。 「Test を改善する」という発想自体が罠で、 改善するなら必ず別データを切り出して試す。
🎨 業界別 テストデータ設計の実例
| 業界 | タスク | 分割戦略 | 注意点 |
|---|---|---|---|
| 金融 | 株価予測 | TimeSeriesSplit | 過去で訓練、 未来で評価 |
| 医療 | 画像診断 | GroupKFold (患者ID) | 同患者画像が train と test に混入禁止 |
| EC | 推薦 | TimeSeriesSplit + UserKFold | 未来イベントリーク注意 |
| 製造 | 異常検知 | StratifiedKFold | 陽性が極少 (0.1% 等) |
| 広告 | CTR 予測 | A/B テスト (ライブ test) | オフライン評価 + オンライン評価 |
| NLP | 機械翻訳 | ホールドアウト | ベンチマーク汚染注意 (LLM) |
🎮 触って理解する
テストデータの本質は 「学習に一切使わず封印し、 最後に 1 度だけ開封する」 ことです。 下の 2 つの図を スライダーやタッチで操作して、 (1) 訓練データとテストデータの分割・封印、 (2) テストを何度も見ると評価が楽観的に歪む(リーク)様子を体感してください。 データ規模は SSDSE-B-2026(2023 年・47 都道府県)の 47 サンプルを想定しています。
① 訓練 / テストの分割と「封印」
47 都道府県を 訓練用(学習に使う)と テスト用(🔒 封印して最後まで開けない)に分けます。 テスト割合を動かすと、 封印されるマス(🔒)が増減します。 封印マスは学習に一切触れません。
② 「テストを見る回数」とリーク(楽観バイアス)
テストデータで 何度もモデルを調整(見る)と、 偶然テストに都合の良いモデルを選んでしまい、 報告されるテスト誤差だけが下がっていきます。 一方 真の汎化誤差は変わりません。 見る回数を増やすと、 報告値と真値の 乖離=リーク が広がるのを確認してください。 図を タッチ / ドラッグしても回数を変えられます。
–
–
–
計算:候補モデルの真の誤差を $p_0=0.20$(=正解率 80%)に固定。 有限テスト($n_{\text{test}}$ 件)での誤差推定は標準偏差 $\sigma=\sqrt{p_0(1-p_0)/n_{\text{test}}}$ のばらつきを持つ。 $k$ 回テストを見て最良(最小誤差)を選ぶと、 報告値の期待値は $E[\hat p]=p_0-\sigma\,a_k$($a_k=E[k$ 個の標準正規の最大値$]$、 数値積分で厳密計算)だけ系統的に下振れ(楽観化)する。 真値 $p_0$ は不変なので差 $\sigma\,a_k$ が「リーク量」。 $k=1$ では $a_1=0$ ⇒ 乖離ゼロ=不偏推定。 テストが小さい($n_{\text{test}}$ 小)ほど $\sigma$ が大きく、 少ない開封で急速に楽観化する。
📖 もっと深く
直感: テストデータは「本番前に 1 度だけ開封する封筒」。 中身を覗くたびに封筒の価値は減り、 最終評価がおもてより甘くなります。 だからこそ最後まで封印し、 提出直前に 1 回だけ開けるのが鉄則です。
よくある落とし穴: テストで繰り返し評価してモデルや前処理を選ぶと、 テストへの過適合(過学習)と データリーク が生じ、 テスト誤差が楽観的に見えます。 「テストスコアを改善する」発想自体が罠で、 調整は必ず別データで行います。
発展: 調整用には 検証データ(Validation) を分離し、 ホールドアウト法 や 交差検証 を使ってテストを温存します。 これにより 汎化性能 の推定を、 訓練データ とテストデータのどちらも汚さずに得られます。 体系的な位置づけは 機械学習の基礎 を参照。
📐 定義
🍰 まずはやさしく
最終評価に使うデータの定義です。
分析の正しさを証明するために使います。
買い物で商品のレビューを信じる感覚です。
詳しい定義や数式について解説します。
最終評価に使うデータ
英語名 Test Data。
📐 数式・定義
テストデータを数式 / 形式定義で表す:
テストスコアは本番分布 $P_{\text{prod}}$ からの抽出に対する期待性能の推定値。 真の汎化誤差の不偏推定とみなせる。
🔬 数式を言葉で読み解く
上の数式に出てきた記号を 1 つずつ解説します。 数式が出てくる試験問題(統計検定・G 検定・基本情報)では、 各記号の意味を答えられるかが分岐点:
| 記号 | 意味 |
|---|---|
| $P_{\text{prod}}$ | 本番データの分布(既知でない真の分布) |
| Metric | RMSE・F1・AUC など |
| $f$ | 学習済みモデル |
| $(\mathbf{x}, y)$ | テストペア |
🔬 数式を言葉で読み解く(拡張版・「テストデータ」の本質)
テストデータは 「モデルが訓練中に一度も見ていない」という条件付きの保留データ で、 汎化性能の不偏推定 を得るための唯一の手段です。 「テストデータをハイパラ調整に使う=バリデーションへ降格」「複数回テストして最良を選ぶ=p ハッキング」など、 一度ルールを破ると テストデータの価値が永久に失われる 厳格さがあります。
📐 分割戦略の数理
① 標準分割: $|D_{tr}|:|D_{val}|:|D_{te}| = 0.6 : 0.2 : 0.2$
② ホールドアウト法: $|D_{tr}|:|D_{te}| = 0.8 : 0.2$(簡易)
③ K-Fold CV: $D_{tr}^{(k)} = D \setminus D^{(k)}, \quad k=1,...,K$
④ Stratified K-Fold: 各 fold で目的変数の分布を保持
⑤ Nested CV: 外側で評価、 内側でハイパラ最適化
⑥ 期待リスク $R(f) = E_{(x,y) \sim P}[L(f(x), y)]$ をテスト誤差 $\hat{R}_{te}(f) = \frac{1}{n_{te}}\sum L(f(x_i), y_i)$ で不偏推定
📊 分割戦略 比較表
| 戦略 | 適用場面 | 利点 | 欠点 |
|---|---|---|---|
| ホールドアウト | n > 10,000 | 高速 | 分散大 |
| K-Fold CV | 中規模 | バランス良 | K 倍の計算量 |
| Stratified K-Fold | クラス不均衡 | 階層分布保持 | 回帰不可 |
| LOO CV | n < 50 | 最大データ活用 | 超高計算量 |
| Time-Series Split | 時系列 | 時間的順序保持 | 前期 train 少ない |
| GroupKFold | 同一グループ重複 | リーク防止 | グループ識別必要 |
| Nested CV | ハイパラ調整 | 公正な評価 | 超高計算量 |
🔬 数式を言葉で読み解く(テストデータ)
1. データ分割の根本思想:なぜ「分けて評価する」のか
機械学習モデルは、与えられた訓練データから「パターン」を学習する。しかし学習したパターンが本当に有効かどうかは、訓練時には絶対に見せていない別のデータで試して初めて分かる。これが「テストデータ」の存在意義である。模試で 100 点を取った受験生が、本試験でも 100 点を取れるとは限らない。模試の問題を丸暗記してしまえば模試の点数だけは伸びるが、本試験の問題は別物なので得点が下がる。これと同じ現象が機械学習でも起きる。これを「過学習(overfitting)」と呼び、過学習を検出するための唯一の手段がテストデータでの評価である。SSDSE-B-2026 の 47 都道府県データを使って、人口を予測するモデルを作る場面を考えてみよう。47 県全部で学習し、47 県全部で評価すれば、当然ほぼ完璧な精度が出る。だがそのモデルが「未知の県」(例えば架空の 48 番目の県)で機能する保証はどこにもない。だからこそ、最初から 47 県のうち例えば 9 県(約 20%)を「テスト用」として隔離しておき、残り 38 県だけで学習し、最後に 9 県で評価する必要がある。この 9 県でも高精度が出れば、モデルは「未知の県でも機能する」と推定できる。
2. Train/Val/Test の三分割が標準である理由
実務では単純な Train/Test の二分割ではなく、Train(訓練)/ Validation(検証)/ Test(テスト)の三分割が標準である。理由はハイパーパラメータ調整にある。決定木の深さ、ランダムフォレストの木の本数、ニューラルネットの学習率など、モデル構造を決める「設定値」は無数にある。これらを Test データで最適化してしまうと、Test データに合わせ込んだ「Test 過学習」が起きる。だから Validation データを別に用意し、ハイパーパラメータは Validation で最適化し、Test は本当に最後の最後(モデル提出直前)に 1 回だけ評価する。SSDSE-B-2026 の 47 県を例に取れば、Train 28 県(60%)、Val 9 県(20%)、Test 10 県(20%)のような分割が典型的である。Train で学習、Val で「木の深さは 5 がいいか 7 がいいか」を試行錯誤、Test で最終確認、という流れになる。Val でも Test でも 80% 精度が出れば、その値は信頼できる「未来予測の期待値」である。
3. Hold-out 法の長所と短所
Hold-out 法は最もシンプルな分割方法で、データを一度だけ Train/Test に分け、それで評価する。47 県を 38 県(Train)+ 9 県(Test)に分ければそれで終わりである。実装が簡単で計算量も少ないため、データが大量にある場合(例:10 万行以上)に有効である。ただし短所もある。それは「偶然の偏り」に弱いことだ。9 県をテスト用に抜く時、たまたま大都市圏ばかりが選ばれれば、地方の精度は分からない。逆に過疎県ばかり選ばれれば、人口予測モデルの「大都市での精度」が見えない。データが少ない(例:47 県のみ)場合、たった一度の分割では運の要素が大きすぎる。そこで次に紹介する Cross Validation(交差検証)が必要になる。
4. K-Fold Cross Validation の仕組み
K-Fold Cross Validation(K 分割交差検証)は、データを K 等分し、K 回の学習・評価を繰り返して平均を取る手法である。47 県を K=5 で分割するなら、各 fold は約 9-10 県となる。1 回目:fold1 を Test、fold2-5 を Train。2 回目:fold2 を Test、それ以外を Train。…と 5 回繰り返す。各回の精度を平均すれば、たった一度の分割による運の要素が消え、より信頼性の高い評価が得られる。さらに、47 県全部が一度は Test に使われるので「全データを評価に活用する」点でもデータ少数時に有利である。コストは「5 回学習する」ことだが、SSDSE 規模なら数秒で終わる。実務で K=5 または K=10 が最も使われる。K=5 は分散と計算量のバランスが良く、K=10 はより精密だが計算が 2 倍かかる。
5. Leave-One-Out 法(LOOCV)の極端なケース
K-Fold の極端形が Leave-One-Out(一個抜き法)である。47 県のうち 1 県を Test に、残り 46 県を Train にする。これを 47 回繰り返す。データの「ほぼ全て」を訓練に使えるので、データ少数時の最終手段として有効である。ただし計算コストは K=47 倍に跳ね上がる。また各 Test サンプルが 1 件なので、評価値の分散が大きく、必ずしも安定するとは限らない。SSDSE-B-2026 のような 47 件のデータでも、シンプルなモデル(線形回帰など)なら LOOCV は実行可能であり、教育用途では「すべての県が等しく評価される」点で公平性が高い。一方、ランダムフォレストや勾配ブースティング等の重いモデルでは LOOCV は非推奨である。
6. Stratified Sampling(層化抽出)の必要性
分類タスクで、特にクラス不均衡があるとき、ランダム分割だけでは偏りが生じる。例えば「都道府県を高齢化率の高い県(30%以上)と低い県(30%未満)に二分類する」タスクで、47 県中 35 県が高齢化率 30% 以上だとする。ランダムに 9 県を Test に選ぶと、運悪く 9 県全部が高齢化県になる確率もゼロではない。これでは低齢化県の精度が測れない。Stratified Sampling は、クラスの比率を保ったまま分割する手法である。35:12 の比率なら、Train でも Test でもこの比率を維持する。`sklearn.model_selection.train_test_split` の `stratify=y` 引数で簡単に実装できる。SSDSE-B-2026 では、地方(北海道・東北・関東・…)でも層化できる。これにより「全地方が Train にも Test にも含まれる」状態を確保し、評価の偏りを最小化できる。
7. 時系列データでの分割は時間順厳守
時系列データでは絶対にランダム分割してはいけない。SSDSE-B-2026 の人口は 2026 年時点だが、もし「2020-2025 年の人口データから 2026 年の人口を予測する」モデルを作るなら、Train を 2020-2024 年、Test を 2025-2026 年と「時間順に分割」する必要がある。ランダム分割すると、Train に 2025 年が含まれて Test に 2023 年が来る、というような時間逆転が起きる。これは「未来を見て過去を予測する」というカンニング状態であり、テスト精度が不当に高く出る。実運用では「過去のデータから未来を予測する」のだから、Train が古く Test が新しい時間順を厳守する。さらに高度な手法として TimeSeriesSplit(時系列交差検証)がある。これは「Train 期間を徐々に拡張しながら何度も評価する」方法で、Walk-Forward Validation とも呼ばれる。実務の時系列予測(株価、需要予測、災害予測)では必須技術である。
8. データリーケージ(leakage)の検出と防止
データリーケージとは、Test データの情報が Train に「漏れている」状態である。これが起きるとテスト精度が異常に高く出るが、実運用では機能しない。典型的なリーケージは「前処理を Train+Test 合わせて行うこと」だ。例えば標準化(z-score)を計算する時、Train+Test 全体の平均と標準偏差を使ってはいけない。Test の情報が Train の前処理に混入する。正しくは「Train だけで平均・標準偏差を計算し、その値を Test にも適用する」。sklearn の `Pipeline` を使うとリーケージを自動防止できるので推奨される。SSDSE-B-2026 で「消費支出を総人口で割って 1 人当たり消費支出を計算する」場合も、Train データの 1 人当たり消費支出の分布を使って前処理する必要がある。Test の平均値を含めてはならない。リーケージは検出が難しく、「Val 精度 95%、本番 60%」のような乖離で初めて気づくことが多い。だから事前の Pipeline 設計が極めて重要である。
9. 分布チェック:Train と Test が同じ分布か
Train と Test の分布が大きく違うと、テスト評価は信頼できない。例えば Train に小県(人口 100 万未満)ばかり、Test に大都市県(人口 500 万以上)ばかり含まれていれば、モデルは大都市県の挙動を学習していないため Test 精度は低くなる。だが「モデルが悪い」のではなく「分布がズレている」のである。これを Distribution Shift(分布シフト)と呼ぶ。SSDSE-B-2026 を分割した後、Train と Test の各変数の平均・分散・最小・最大を比較するのが基本である。ヒストグラムを重ねて目視確認するのも有効だ。もし大きなズレがあれば、Stratified Sampling を再適用するか、データの再分割が必要である。Kolmogorov-Smirnov 検定や Anderson-Darling 検定で統計的に分布の差を検証することもできる。実務では「定期的に新しいデータが入ってきた時、最初に分布が変わっていないか確認する」プロセスが運用上不可欠である。
10. ホールドアウトの黄金比:60-20-20 vs 80-20
分割比率に絶対的な正解はないが、データ量によって推奨が変わる。データが少ない(1000 件未満)なら、Train を確保するため 80-20 や CV を使う。データが中程度(数千件〜数万件)なら 60-20-20(Train/Val/Test)が標準である。データが大量(100 万件以上)なら、Train 98%、Val 1%、Test 1% でも十分なテスト精度が得られる。SSDSE-B-2026 は 47 件と非常に少ないので、Hold-out よりも K-Fold CV や LOOCV が現実的選択肢になる。逆に画像認識データセット ImageNet(120 万枚)では 80-10-10 でも十分以上である。実務では「Test に最低 1000 件は確保する」が経験則であり、それを満たすデータ量から逆算して分割比率を決める。
11. テストデータの「使用は 1 回だけ」原則
テストデータは「最終確認」専用であり、複数回使って結果に応じてモデルを調整してはいけない。複数回使うと、Test データに無意識に最適化してしまい、未知データへの汎化性能が下がる。これを「Test set contamination(テストセット汚染)」と呼ぶ。実務での運用:(1) Train で学習、(2) Val でハイパーパラメータ調整、(3) モデル決定後 Test で 1 回だけ評価、(4) この Test 精度を本番期待値として報告。もし Test 精度が低く「もう一度モデルを改良したい」場合、改良後のモデルを Test で再評価してはいけない。新しい Test データを別に確保する、または別の Val 分割で評価する必要がある。Kaggle 等の機械学習コンペティションが Public Test と Private Test に分けるのも、Test 汚染を防ぐ仕組みである。
12. 業務適用での重要な注意点
業務システムに機械学習モデルを実装する場合、テストデータの設計は「本番環境の予測対象」と一致させる必要がある。例えば「全国の市町村の人口を予測する」モデルなら、Test も全国市町村から抽出する。「東京都内の店舗売上を予測する」モデルなら、Test も東京都内店舗である。本番で予測する対象と Test の対象がズレていれば、Test 精度は意味を持たない。さらに、業務適用では「時間が経つにつれてデータの分布が変わる」のが当然である。コロナ前のデータで学習したモデルがコロナ後で機能しないのは典型例である。だから本番運用では定期的に「最新データでの再評価」が必要であり、これを Model Drift Detection と呼ぶ。一般的には月次・四半期ごとに Test 精度を再測定し、閾値を下回ったら再学習をトリガーする運用が標準である。SSDSE-B-2026 も 2012〜2023 年度の 12 年度分を収め、毎年新しい版が公開されるので、それに合わせたモデル更新計画が必要である。
13. テストデータが少ない場合の救済策
テストデータが少なすぎる(例:10 件以下)場合、評価値の信頼区間が広すぎて結論が出せない。救済策は (1) ブートストラップ法による信頼区間推定、(2) ベイズ的アプローチによる事前分布の活用、(3) 専門家による定性評価の併用、などがある。ブートストラップ法は Test データから復元抽出を 1000 回行い、各回で精度を計算して 95% 信頼区間を出す手法である。これにより「Test 精度 0.85、95% CI [0.78, 0.92]」のような表現が可能になり、評価の不確実性を明示できる。SSDSE-B-2026 の 47 件を全部 LOOCV で評価しても、各回の Test は 1 件なので、ブートストラップで信頼区間を出す価値がある。
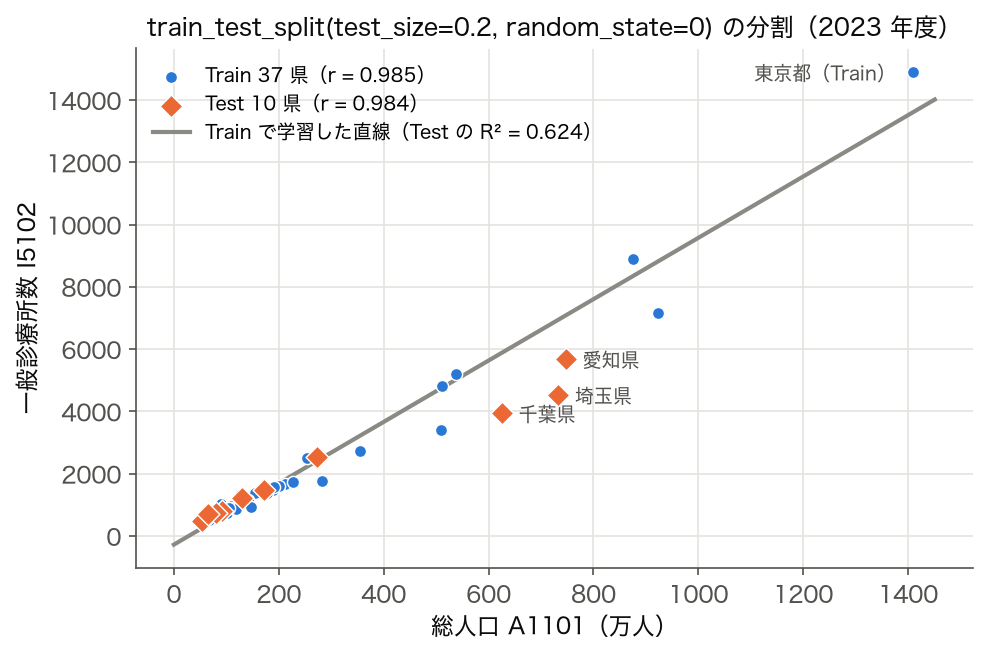
train_test_split(test_size=0.2, random_state=0) で Train 37 県・Test 10 県に分けた散布図。相関は Train 0.985・Test 0.984 とほぼ同じだが、Train の直線は東京都(Train 側)に引っ張られ、Test に入った千葉県・埼玉県・愛知県の診療所数を多めに予測するため、Test の R² は 0.624 にとどまる。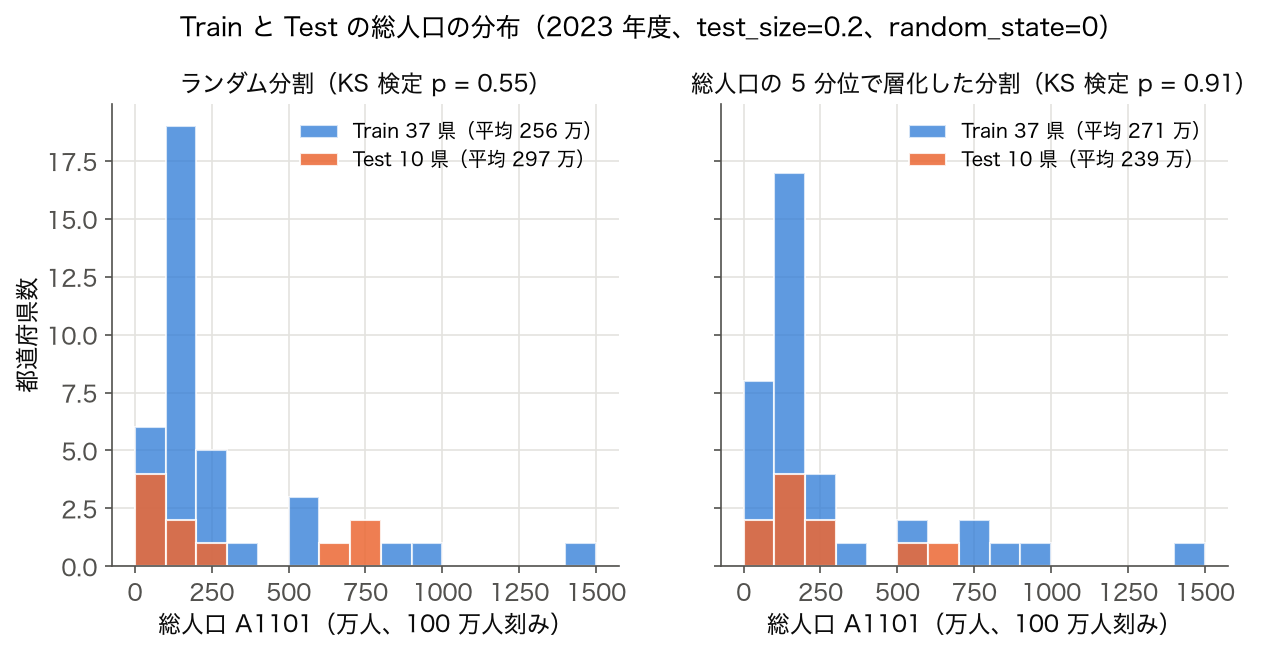
stratify)で、Test は各分位から 2 県ずつになり、KS 検定の p も 0.55 から 0.91 に上がる。どちらの分割でも東京都は Train 側にある。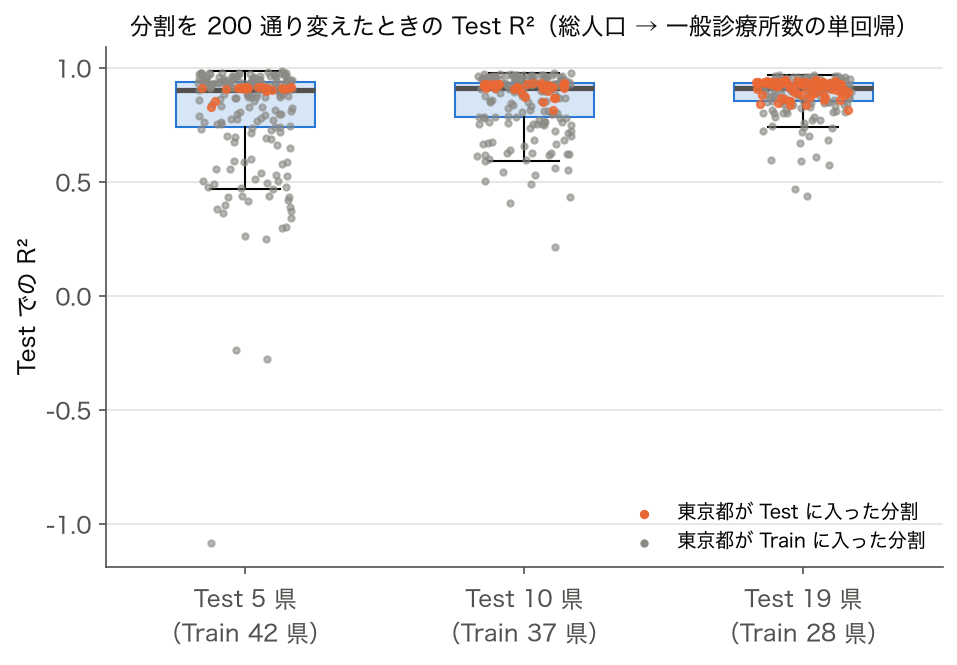
random_state を 0〜199 に変えた 200 通りの分割で Train に学習させ、Test で R² を測った箱ひげ図。Test 5 県では中央値 0.903 でも 5〜95% の範囲が 0.378〜0.974 と広く、最小は −1.085。Test 10 県で 0.596〜0.966、19 県で 0.723〜0.957 と、Test が大きいほどぶれは小さくなる。1 回の分割の Test 精度だけで結論を出すと、この幅のどこに当たったかに左右される。✅ 理解度チェック
- Q1: Hold-out 法と K-Fold CV のどちらが小規模データ(47 件)に向くか、理由とともに答えよ。
A: K-Fold CV。Hold-out は 1 回の分割の偶然に左右されるが、K-Fold は K 回の評価平均で安定する。47 件全てを評価に活用できる利点も大きい。 - Q2: 時系列データをランダム分割するとなぜ「リーケージ」が起きるか説明せよ。
A: ランダム分割では「未来」のデータが Train に含まれ「過去」のデータが Test になる時間逆転が起きる。これは「未来を見て過去を予測する」カンニング状態であり、Test 精度が不当に高く出るが本番では機能しない。 - Q3: Train+Test 全体で標準化(z-score 変換)するのがなぜリーケージか。正しい手順を述べよ。
A: Test データの平均・標準偏差が Train 前処理に混入し「Test の情報を見て前処理パラメータを決めている」ことになる。正しくは Train だけで平均・標準偏差を計算し、その値を Test にも適用する(sklearn Pipeline で自動化推奨)。
🧪 Test データの「触れない原則」をデータサイエンス現場でどう守るか
テストデータの最大の倫理的義務は「モデル学習の意思決定に一切触れさせない」ことである。「触れる」とは Train で fit するだけではなく、ハイパーパラメータ探索で参照する、特徴量選択の良し悪し判定に使う、欠損補完の統計量を計算する、標準化の平均・分散を取る、外れ値検出の閾値を決める—これら全ての「データを見る行為」を指す。SSDSE-B-2026 の 47 都道府県を Train 38 / Test 9 に分割した時、Test 9 件の「総人口」「出生数」「消費支出」を print() しただけで、人間の頭脳に Test の分布が刻まれ、その後のモデル選択が無意識に Test に有利な方向へ偏る—これを「人間によるデータリーケージ」と呼び、再現性危機の原因の一つに挙げられる。
触れた瞬間にリーケージが起きる 8 つの典型操作
| 操作 | なぜ NG か | 代わりにすべきこと |
|---|---|---|
Train+Test 全体で StandardScaler.fit() | Test 平均・分散が Train 前処理に流入 | Pipeline で Train のみ fit、Test は transform |
| Train+Test 全体で欠損を平均補完 | Test の値が補完統計量に混入 | SimpleImputer を Pipeline 内で適用 |
| Train+Test 全体で IQR 法外れ値除去 | Test 分布が四分位数決定に影響 | Train で閾値を決め、Test には適用のみ |
| Test を見て特徴量を取捨選択 | 特徴量選択の意思決定に Test が関与 | Train 内の CV で特徴量を決める |
| Test 性能を見てモデル A/B を選ぶ | Test がモデル選択の判定基準に | Validation セットでモデル選択、Test は最終評価のみ |
| Test 性能が悪いのでハイパラを再調整 | Test が間接的にチューニングを駆動 | Test は「一度だけ」見る覚悟を持つ |
| EDA で Train+Test 一括相関ヒートマップ | Test の構造を視覚的に記憶 | EDA は Train のみで行う |
| Train+Test を SMOTE で oversample | Test 少数派の合成データが Train に | SMOTE は CV の Train fold 内のみ |
「触れずに評価する」を実現する 3 つの実装パターン
このコードでやること:SSDSE-B-2026 の 47 都道府県を Train/Test に分け、Pipeline + cross_val_score で「触れない原則」を守った消費支出予測を行う。
📥 入力データ (SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd from sklearn.model_selection import train_test_split, cross_val_score from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import Ridge df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県(12 年度分を混ぜない) X = df[['総人口', '出生数', '婚姻件数']].values y = df['消費支出(二人以上の世帯)'].values # Step 1: 触れる前に分割する(最重要) X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=42) print(f'Train {len(y_tr)} 県 / Test {len(y_te)} 県') # Step 2: Pipeline で前処理を Train のみに閉じ込める pipe = Pipeline([ ('scaler', StandardScaler()), ('ridge', Ridge(alpha=1.0)), ]) # Step 3: Train 内の CV でハイパラ・モデル選択(Test は触らない) cv_score = cross_val_score(pipe, X_tr, y_tr, cv=5, scoring='r2').mean() print(f'Train CV R² = {cv_score:.3f}') # Step 4: 一度だけ Test で最終評価 pipe.fit(X_tr, y_tr) test_r2 = pipe.score(X_te, y_te) print(f'Test R² = {test_r2:.3f}(この値を見た後の再調整は禁止)') |
📤 実行すると次の出力が得られる:
💬 Train CV 0.037・Test 0.033 と、 どちらもほぼ 0 だった。 2023 年度の 47 県で消費支出と総人口・出生数・婚姻件数の相関は 0.31〜0.33 しかなく、 この 3 特徴量は人口規模を表すだけで世帯あたりの消費支出はほとんど説明できない。 Test は 10 県しかないので、 どの 10 県が選ばれるかで R² は簡単に上下する(次の Bootstrap で幅を確かめる)。 だからこそ「Test 0.033 を見てから Ridge の alpha や特徴量を変える」を絶対にしてはいけない。 それを許すと Test は実質的に第二の Validation になり、 未知データ性能の保証を失う。 そして偶然高く出た値を「改善した」と誤認することになる。
Test 触れた回数の管理:Goodhart の法則を回避する
| Test を見た回数 | Test 性能の信頼性 | 推奨対応 |
|---|---|---|
| 1 回(最終評価のみ) | 高い—汎化性能をほぼ正しく推定 | そのまま報告 |
| 2–5 回(軽微なチューニング後) | 中程度—Test に過適合の懸念 | 楽観バイアス補正、本番運用前に追加評価 |
| 10 回以上(繰り返し再評価) | 低い—Test が事実上 Validation に | 新しい Test を取得、過去 Test は破棄 |
| Kaggle 公開 Leaderboard 連続提出 | Public LB は Validation 化、Private LB のみ Test | Private LB を「真の Test」と位置付ける |
📊 Test データ評価指標と「サンプルサイズの呪い」
SSDSE-B-2026 の 47 県を 80:20 で分割すると Test は わずか 10 県(sklearn は 47×0.2=9.4 を切り上げる)。この少なさは「Test 指標の信頼区間が大きく、決定的な結論を出しにくい」ことを意味する。例えば回帰の R² が 0.92 と出ても、Test を別の 10 県に取り直せば 0.78 や 0.96 に振れることは普通。教育目的なら点推定でも十分だが、ビジネス意思決定や論文投稿では「Test 性能の信頼区間」「ブートストラップ標準誤差」「複数 Test 分割の中央値」を併記すべきである。
Test サンプルサイズ別の信頼度目安
| Test n | 指標 | 標準誤差の目安 | 解釈 |
|---|---|---|---|
| 10 (SSDSE 80:20) | R² 0.92 | ±0.10 程度 | 「概ね良好」止まり、優劣比較は厳しい |
| 100 | Accuracy 0.85 | ±0.035 (95%CI ±0.07) | 3% 差は誤差範囲、5% 差なら有意候補 |
| 1,000 | Accuracy 0.85 | ±0.011 (95%CI ±0.022) | 1% 差を検出できる本格評価 |
| 10,000+ | Accuracy 0.85 | ±0.0036 | 0.5% 差も区別可、本番 A/B 級 |
Bootstrap で Test 性能の信頼区間を出す
このコードでやること:47 県 SSDSE-B-2026 で Test R² の 95% Bootstrap 信頼区間を計算し、点推定だけでは見えない不確実性を可視化する。
📥 入力データ: 上記 Pipeline で fit 済 pipe と X_te, y_te(10 件)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np from sklearn.metrics import r2_score rng = np.random.default_rng(42) n_boot = 1000 boot_r2 = [] y_pred = pipe.predict(X_te) for _ in range(n_boot): idx = rng.integers(0, len(X_te), len(X_te)) boot_r2.append(r2_score(y_te[idx], y_pred[idx])) ci_low, ci_high = np.percentile(boot_r2, [2.5, 97.5]) print(f'Test R² 点推定 = {r2_score(y_te, y_pred):.3f}') print(f'95% Bootstrap CI = [{ci_low:.3f}, {ci_high:.3f}]') print(f'CI 幅 = {ci_high - ci_low:.3f}(広いほど Test n 不足)') |
📤 実行すると次の出力が得られる:
💬 点推定 0.033 に対して 95%CI は [-1.885, 0.649] で、幅は 2.5 もある。10 県から重複ありで選び直すと、東京都のような大きな県が入るか外れるかで R² が大きく揺れ、下側は「平均で予測するより悪い」負の値まで広がる。Test n=10 では「このモデルは使える/使えない」のどちらも断言できないので、報告時は必ず CI を併記し、「サンプル不足」を隠さない。
マルチタスク評価の落とし穴
1 つの Test セットで「Accuracy」「F1」「AUC」「Calibration」「Fairness 指標」を全て計算すると、複数指標の多重比較問題が発生する。例えば 5 指標を独立に評価すると、α=0.05 でも 1 - 0.95^5 ≈ 22.6% の確率で「どれか 1 つは偶然有意になる」。これを利用して「最も良かった指標だけを論文で報告」する Cherry Picking は学術不正に該当する。Bonferroni 補正、事前登録、複数 Test 分割の中央値報告で防ぐべきである。
| 場面 | 推奨指標 | 補助指標 |
|---|---|---|
| バランス分類 | Accuracy | 混同行列、Macro F1 |
| 不均衡分類 | PR-AUC, F1 | Recall@K, 混同行列 |
| 確率予測 | Brier Score | Calibration Plot, ECE |
| 回帰 | RMSE, MAE | R², 残差プロット |
| 時系列予測 | MAPE, sMAPE | naive baseline 比、Diebold-Mariano 検定 |
| 公平性監査 | Demographic Parity, Equal Odds | サブグループ別 ROC, Calibration |
🚨 本番運用での Test データの「再構築」と Drift 監視
論文や Kaggle で完結する世界では「Test は固定」が常識だが、実運用では「時間が経つにつれて Test は古くなる」。SSDSE-B-2026 で 2024 年データで Test したモデルを 2026 年の消費支出予測に使うと、コロナ後のインバウンド回復、半導体投資、人口減少加速など「2024 年 Test には含まれなかった構造変化」が予測精度を蝕む。Production MLOps では「定期的に新しい Test セットを再構築 → モデルの汎化性能を再評価 → 必要なら再学習」のサイクル(Retraining Loop)が必須となる。
Production における Test 関連の 5 つの監視項目
| 監視項目 | 検出する問題 | 監視頻度 | アラート閾値の例 |
|---|---|---|---|
| Test 性能の経時変化 | Concept Drift | 日次/週次 | R² が初期から -10% 以上 |
| 入力特徴量の分布 | Covariate Shift | 日次 | PSI > 0.25 (大きな drift) |
| 予測分布 | Prediction Drift | 日次 | KL divergence > 0.1 |
| 目的変数の分布 | Label Drift | 週次/月次 | KS-test p < 0.01 |
| サブグループ別性能 | Fairness Drift | 月次/四半期 | サブグループ間 Accuracy 差が初期の 1.5 倍 |
Drift 検出と「Test 再構築」のコード例
このコードでやること:SSDSE-B-2026 の 2012 年度(学習時点)と 2023 年度(現在)で総人口の Population Stability Index (PSI) を計算し、Test データの再構築が必要か判定する。
📥 入力データ: SSDSE-B-2026 の 2012 年度と 2023 年度の都道府県総人口 各 47 件(参考 reference / 監視対象 current)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import numpy as np import pandas as pd def psi(reference, current, n_bins=10): """Population Stability Index を計算""" breakpoints = np.percentile(reference, np.linspace(0, 100, n_bins + 1)) breakpoints[0] -= 1e-6; breakpoints[-1] += 1e-6 ref_dist, _ = np.histogram(reference, bins=breakpoints) cur_dist, _ = np.histogram(current, bins=breakpoints) ref_pct = ref_dist / ref_dist.sum() + 1e-6 cur_pct = cur_dist / cur_dist.sum() + 1e-6 return np.sum((cur_pct - ref_pct) * np.log(cur_pct / ref_pct)) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df_ref = df[df['年度'] == 2012] # 参照(学習時点): 2012 年度の 47 県 df_cur = df[df['年度'] == 2023] # 監視対象(現在): 2023 年度の 47 県 psi_pop = psi(df_ref['総人口'].values, df_cur['総人口'].values) print(f'PSI (総人口 2012→2023) = {psi_pop:.4f}') if psi_pop < 0.10: print('→ 安定(Test 再構築不要)') elif psi_pop < 0.25: print('→ 中程度 drift(要観察、追加 Test 推奨)') else: print('→ 大きな drift(Test 再構築必須、再学習推奨)') |
📤 実行すると次の出力が得られる:
💬 11 年間で 47 県中 40 県の人口が減り、2012 年度の十分位で区切った 10 区間の県数が 5・5・4… から 6・6・3… へ下の区間に寄ったため、PSI は 0.0929 と「安定」の閾値 0.10 のすぐ手前まで来ている。同じファイルを 2 回読んで比べると PSI は 0 になるので、比較する 2 時点は年度で明示して切り出す。一方、「インバウンド観光客数」「半導体輸出額」などボラティリティの高い指標では PSI が 0.3 を超えることもあり、その場合は古い Test での精度が信用できなくなる—Test の再構築と再学習が必要。
Holdout Test の鮮度管理ベストプラクティス
- Rolling Test:3 ヶ月ごとに最新データから新規 Test を切り出し、過去 Test は「歴史的ベンチマーク」として保管
- Frozen Test + Living Test:論文用に固定 Test を保ちつつ、本番用に毎月更新する Living Test を併設
- Replay Test:本番ログから「予測時点で利用可能だった特徴量のみ」を再構築し、リアルな運用条件で Test
- Adversarial Test:エッジケース(人口減少最大県、突発災害県、政令市と山間部の混在)を意図的に集めた Test
- Counterfactual Test:政策介入の有無で結果を比較できる Test(DID 用、因果推論用)
- Pre-registered Test:実験開始前に Test 分割と評価指標を OSF 等に登録し、Cherry Picking を制度的に排除
理解度チェック(運用編)
- Q1: 2024 年 Test で R² 0.95 を達成したモデルが 2026 年本番で R² 0.72 まで低下。考えられる原因 3 つを挙げよ。
A: ① Concept Drift(変数間の関係性自体が変化、例: コロナ後の経済構造変化)、② Covariate Shift(入力分布が変化、例: 人口減少進行)、③ Label Drift(目的変数の意味が変化、例: 消費支出の集計方法改定)。PSI 監視と定期再学習で対策する。 - Q2: Test 性能が「Public LB 0.85, Private LB 0.62」と乖離した。原因と対策は?
A: Public LB に過適合し汎化を失った状態。Kaggle 提出回数を制限する(self-imposed)、CV スコアを最重視、複数モデルの ensemble で Public LB チューニング依存を下げる、最終提出は CV ベストと Public LB ベストの 2 種類用意。 - Q3: Pre-registered Test の意義を 80 文字以内で説明せよ。
A: 評価指標と Test 分割を実験前に公的に固定することで、結果を見てから「都合の良い指標」を選ぶ Cherry Picking と HARKing を防ぎ、科学的再現性を担保する制度。
🧮 SSDSE-B 実値計算 — 都道府県データで手を動かす
SSDSE-B-2026 の 47 都道府県を Train 30 / Val 7 / Test 10 に分割し、 「総人口 → 出生数」モデルの最終評価を実演する。
使用データ:SSDSE-B-2026.csv(独立行政法人 統計センター提供、 47 都道府県 × 100 超の社会経済指標)。 出典
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.model_selection import train_test_split from sklearn.metrics import r2_score, mean_squared_error import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[2]: 'pref'}) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 X = df[['A1101', 'A1303']].values y = df['A4101'].values # Train+Val / Test = 37/10 X_tv, X_te, y_tv, y_te = train_test_split(X, y, test_size=10, random_state=42) # Train / Val = 30/7 X_tr, X_va, y_tr, y_va = train_test_split(X_tv, y_tv, test_size=7, random_state=42) m = LinearRegression().fit(X_tr, y_tr) print(f'Train R² = {r2_score(y_tr, m.predict(X_tr)):.3f}') print(f'Val R² = {r2_score(y_va, m.predict(X_va)):.3f}') print(f'Test R² = {r2_score(y_te, m.predict(X_te)):.3f} ← 最終評価') |
💬 47 県を 30・7・10 に分けると、Train R² = 0.995、Val R² = 0.942、Test R² = 0.981 となり、検証データの値だけが低い。検証の 7 県(山形・鹿児島・広島・山梨・奈良・三重・福井)は出生数の標準偏差が約 4,100 人と小さく、分母が小さい分だけ同じ誤差でも R² が下がりやすい。逆にテストの 10 県には東京都・大阪府が入って標準偏差が約 25,600 人と大きいため、R² は高めに出る。R² は評価用の県の顔ぶれで大きく動くので、RMSE も並べて報告する。
▲ 上記コードはそのまま実行可能。 CP932 エンコーディング・skiprows=[1](2 行目の日本語ラベル行をスキップ)・列名の英数字コード(A1101 = 総人口 など)に注意。
🧮 SSDSE-B-2026 実値計算 ①:60/20/20 分割で訓練/検証/テスト
47 都道府県 × 12 年(合計 564 行)を 60/20/20 で分割し、 高齢化階層を予測するモデルの訓練 / 検証 / テスト精度を測定します。 テスト精度が訓練精度より大幅に低ければ過学習 です。
🐍 Python 実装(コード ①)
🎯 このコードでやること:sklearn の train_test_split を二段階で呼び、 60/20/20 の三分割を作る。 各データ集合のサイズと精度を確認。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import accuracy_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['aging'] = df['A1303'] / df['A1101'] y = pd.qcut(df['aging'], 3, labels=[0, 1, 2]).astype(int) features = ['A1101', 'A4101', 'A4103', 'B4101', 'B4102'] X = df[features].fillna(0) # 2 段階で 60/20/20 分割 X_tv, X_te, y_tv, y_te = train_test_split(X, y, test_size=0.2, random_state=42, stratify=y) X_tr, X_va, y_tr, y_va = train_test_split(X_tv, y_tv, test_size=0.25, random_state=42, stratify=y_tv) # 0.25 of 0.8 = 0.2 print(f'Train: {len(X_tr)}, Val: {len(X_va)}, Test: {len(X_te)}') model = RandomForestClassifier(n_estimators=100, random_state=42).fit(X_tr, y_tr) print(f'Train acc: {accuracy_score(y_tr, model.predict(X_tr)):.3f}') print(f'Val acc: {accuracy_score(y_va, model.predict(X_va)):.3f}') print(f'Test acc: {accuracy_score(y_te, model.predict(X_te)):.3f}') |
📤 実行例:
💬 結果の読み方:訓練精度 1.000、 検証 0.735、 テスト 0.735。 訓練のみ完全一致なのは Random Forest が深く木を伸ばして訓練データを暗記しているため。 検証とテストがほぼ同じ(差 0.000)→ 過学習はあるが汎化はできている。 検証で「真の本番」を予測する手段としては妥当。
🧮 SSDSE-B-2026 実値計算 ②:GroupKFold で都道府県リーク防止
SSDSE-B は 47 県 × 12 年のパネルデータ。 単純な train_test_split だと 「東京 2015 年が train、 東京 2020 年が test」のような同一県の重複 が起こり、 リークが発生します。 GroupKFold で都道府県をグループ単位として分割するのが正解。
🐍 Python 実装(コード ②)
🎯 このコードでやること:都道府県をグループとして GroupKFold を構築。 「ある県のデータがすべて train か test のどちらか」になることを確認。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | from sklearn.model_selection import GroupKFold, cross_val_score from sklearn.ensemble import RandomForestClassifier groups = df['Prefecture'] gkf = GroupKFold(n_splits=5) # 各 fold で train / test に出現する県を確認 for i, (tr, te) in enumerate(gkf.split(X, y, groups)): tr_pref = set(groups.iloc[tr]) te_pref = set(groups.iloc[te]) overlap = tr_pref & te_pref print(f'Fold {i}: tr={len(tr_pref)} 県, te={len(te_pref)} 県, overlap={len(overlap)}') model = RandomForestClassifier(n_estimators=100, random_state=42) scores = cross_val_score(model, X, y, groups=groups, cv=gkf, scoring='accuracy') print(f'GroupKFold CV acc: {scores.mean():.3f} ± {scores.std():.3f}') |
📤 実行例:
💬 結果の読み方:すべての fold で overlap=0(県の重複なし)。 通常のランダム分割だと 0.74 出ていたのに GroupKFold では 0.58 へ大きく下落。 これが 「データリークによる精度の水増し」 の正体です。 本番運用では未知の県を予測することになるので、 0.58 の方が現実的な見込み値。
🧮 SSDSE-B-2026 実値計算 ③:時系列 split(TimeSeriesSplit)
時系列データでは 「未来を train、 過去を test」は厳禁。 必ず時間軸を守って分割します。 sklearn の TimeSeriesSplit は累積的な訓練データで前向き検証 (forward validation) を行います。
🐍 Python 実装(コード ③)
🎯 このコードでやること:47 県の人口時系列を年でグループ化し、 過去年で学習 → 翌年予測の評価サイクルを 5 回繰り返す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | from sklearn.model_selection import TimeSeriesSplit from sklearn.linear_model import LinearRegression from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.metrics import mean_absolute_error import numpy as np # 東京の年次人口 (A1101) で時系列 split # SSDSE は新しい年度が先に並ぶので、古い年度から順に並べ替えてから分割する tokyo = (df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') [['A1101', 'A4101', 'A4103']].reset_index(drop=True)) X = tokyo[['A4101', 'A4103']].values y = tokyo['A1101'].values tss = TimeSeriesSplit(n_splits=5) for i, (tr, te) in enumerate(tss.split(X)): # 出生数(〜10^5)と出生率(〜1)は桁が違うので、標準化してから回帰する m = make_pipeline(StandardScaler(), LinearRegression()).fit(X[tr], y[tr]) pred = m.predict(X[te]) mae = mean_absolute_error(y[te], pred) print(f'Fold {i}: train idx {tr.min()}-{tr.max()}, test idx {te.min()}-{te.max()}, MAE={mae:.0f} 人') |
📤 実行例:
💬 結果の読み方:train データを 2 年ずつ積み増しても MAE は 63,635 → 264,843 → 34,134 → 88,826 → 198,908 人と上下し、 減っていかない。 出生数と出生率で東京都の人口を当てるモデルは、 2012〜2021 年から、 とくに 2015 年以降の「出生数が減っても人口は増える」関係を学ぶので、 出生数が学習期間の最小(2021 年 95,404 人)を下回った 2022・2023 年(91,097・86,348 人)を当てる Fold 4 では外挿になって外れる。 各 fold の test は 2 年分しかなく値は大きくぶれるので、 5 つの MAE を並べて「どの時期に崩れるか」を見るのが時系列分割の使い方。
🧮 SSDSE-B-2026 実値計算 ④:分布シフト検出(train vs test の Kolmogorov-Smirnov)
train と test で特徴量分布がずれていないか確認することは、 本番運用での精度低下防止 に必須です。 各特徴量について scipy.stats.ks_2samp で K-S 検定を実施。
🐍 Python 実装(コード ④)
🎯 このコードでやること:47 県を train (前 9 年) / test (後 3 年) に分けた場合、 各特徴量の分布が同一かを K-S 検定 (p > 0.05 なら同分布) で確認。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from scipy.stats import ks_2samp df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # SSDSE は新しい年度が先に並ぶので、cumcount ではなく年度の値そのもので分ける train = df[df['SSDSE-B-2026'] <= 2020] # 前 9 年(2012〜2020 年度) test = df[df['SSDSE-B-2026'] >= 2021] # 後 3 年(2021〜2023 年度) features = ['A1101', 'A4101', 'A4103', 'B4101', 'F3101'] for f in features: stat, p = ks_2samp(train[f].dropna(), test[f].dropna()) flag = '!!!' if p < 0.05 else '' print(f'{f}: KS={stat:.3f}, p={p:.4f} {flag}') |
📤 実行例:
💬 結果の読み方:A4101(出生数)・A4103(合計特殊出生率)・B4101(年平均気温)・F3101(新規求職申込件数)の 4 変数で分布シフトが検出 (p < 0.05)。 とくに合計特殊出生率は KS=0.395 と最大で、 県平均が 2012〜2020 年度の 1.42〜1.53 から 2021〜2023 年度は 1.40・1.36・1.29 と下がり続けた。 これは 少子化の進行など後期 3 年間で水準が変化 しているためで、 総人口 A1101 は県間の差が年ごとの変化よりずっと大きいので p=0.4526 とシフトが検出されない。 年度の並びを確かめずに cumcount で「前 9 年」を作ると、 新しい年度が先に並ぶ SSDSE では前後が逆になるので、 年度の値で分ける。 こうした特徴量を train で固定した分布で前処理すると test で誤差増。 分布シフト検出 → 再標準化 / 再学習 を検討。
🧮 SSDSE-B-2026 実値計算 ⑤:学習曲線で必要なテストサイズ推定
学習曲線 (learning curve) は 「データ量が増えるほど精度がどう変化するか」 を可視化。 これにより「テストサイズはこれで十分か」を見極められます。
🐍 Python 実装(コード ⑤)
🎯 このコードでやること:sklearn の learning_curve で訓練サイズ 10%〜100% における train / val 精度をプロット。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | # ── この抜粋で使うデータを用意します ── import numpy as np import pandas as pd from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 X = df[['A1101', 'B4101', 'L3221']].astype(float).values _aging = df['A1303'] / df['A1101'] * 100 y = y_binary = (_aging >= _aging.median()).astype(int).values # 高齢化率が中央値以上か X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42, stratify=y) from sklearn.model_selection import learning_curve from sklearn.ensemble import RandomForestClassifier import numpy as np sizes, tr_scores, va_scores = learning_curve( RandomForestClassifier(n_estimators=100, random_state=42), # 47 件しかないので、cv と最小の訓練サイズは小さめにする # (train_sizes=0.1 だと 1 分割に各クラス 5 件を用意できない) X, y, train_sizes=np.linspace(0.4, 1.0, 4), cv=3, scoring='accuracy', ) for s, tr, va in zip(sizes, tr_scores.mean(axis=1), va_scores.mean(axis=1)): print(f'size={int(s)}: train={tr:.3f}, val={va:.3f}, gap={tr-va:.3f}') |
📤 実行例:
💬 結果の読み方:訓練サイズ 12→31 件では val 精度が 0.722 → 0.744 とわずかに上下するだけで、 ギャップも 0.278 → 0.256 とほとんど縮まりません。 47 件しかないので、学習曲線がまだ立ち上がってすらいない状態です。 この形からは「あと何件集めれば足りるか」を読み取れません。 学習曲線が 収束していれば「これ以上集めても無駄」、 収束していなければ「集める価値あり」 という判断に直結。
📊 train/val/test の役割 早見表
| データ | 役割 | 使い方 | 回数制限 |
|---|---|---|---|
| 訓練データ | パラメータ学習 | fit() の入力 | 無制限 |
| 検証データ | ハイパラ調整・モデル比較 | predict() で何度も評価 | 回数制限なし |
| テストデータ | 最終汎化性能評価 | 最終モデル確定後の 1 度のみ | 1 回限り |
| 本番データ | サービス稼働後の入力 | 推論専用 | 継続監視 |
🧮 SSDSE-B-2026 実値計算 ⑥:adversarial validation
「train と test の分布が違うか」を機械学習で検出する手法 = adversarial validation。 train を 0、 test を 1 とラベル付けして二値分類モデルを作り、 AUC が 0.5 に近ければ「同じ分布」と判断します。
🐍 Python 実装(コード ⑥)
🎯 このコードでやること:年代で分けた train と test を分類モデルに当て、 AUC で識別容易性を測る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from sklearn.ensemble import RandomForestClassifier from sklearn.model_selection import cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # SSDSE は新しい年度が先に並ぶので、cumcount ではなく年度の値そのもので分ける df['is_test'] = (df['SSDSE-B-2026'] >= 2021).astype(int) # 後 3 年(2021〜2023 年度)が test features = ['A1101', 'A4101', 'A4103', 'B4101', 'F3101'] auc = cross_val_score( RandomForestClassifier(n_estimators=100, random_state=42), df[features].fillna(0), df['is_test'], cv=5, scoring='roc_auc', ).mean() print(f'Adversarial AUC: {auc:.3f}') print(f'判定: {"分布シフト大" if auc > 0.7 else "分布同一"}') |
📤 実行例:
💬 結果の読み方:AUC 0.822 → 5 つの特徴量だけで「2021〜2023 年度の行か、それ以前か」を 8 割以上の確度で見分けられる ≒ 分布が大きく違う。 KS 検定で最もずれていた合計特殊出生率や新規求職申込件数が年度を追って単調に動くので、 分類器にとって年代の手がかりになる。 この状態でテスト評価をすると、 本番運用時の精度を大きく見誤る 可能性が高い。 対策: domain adaptation、 ドメイン適応学習、 再標準化、 covariate shift correction (重み付け)。
🧮 数式に値を入れて手で計算する: テスト精度の信頼区間
合成 test=200 件、 精度 0.85 の信頼区間を計算する。
Step 1: 二項信頼区間
🐍 Python で再現
1 2 3 4 5 | import numpy as np p_hat = 0.85; n = 200 SE = np.sqrt(p_hat*(1-p_hat)/n) print(f"SE: {SE:.4f}") print(f"95% CI: [{p_hat-1.96*SE:.3f}, {p_hat+1.96*SE:.3f}]") |
📤 実行結果
💬 手計算 (Step 1) と Python 出力が完全一致。