🔖 キーワード索引(補強・追加分)
関連概念をクリックで該当箇所へジャンプ。 既存索引と補完関係:
💡 30秒で分かる結論
🍰 まずはやさしく
一番いい分析の型を選ぶことです。
新しいデータでも正解を出すためです。
テスト勉強で、本番に強い方法を探す例です。
選び方や評価のやり方を学びます。
モデル選択 = 訓練誤差ではなく汎化誤差を比較 。ホールドアウト :単純だが評価のばらつき大。k-fold CV :標準。 k=5〜10 が一般的。層化・グループ・時系列 :データ性質に応じた分割。AIC / BIC :尤度ベースの情報量規準。 計算コスト低。ハイパラ探索 :グリッド→ランダム→ベイズ最適化。データリーク を必ず防ぐ:Pipeline + CV。
📍 あなたが今見ているもの
🍰 まずはやさしく
分析モデルを比べる作業のことです。
最も性能が良いモデルを決めるためです。
スマホのアプリで、使いやすい方を選ぶ例です。
評価の方法や設定の探し方を学びます。
本ページでは、 モデル選択 を統合的に解説します。 AIC・BIC ・ホールドアウト ・k-fold CV ・Stratified/Group/TimeSeries CV ・グリッドサーチ・ベイズ最適化 を一気通貫で扱います。
モデル選択は「複数候補モデルから汎化性能が最良 のものを選ぶ」プロセス。 評価指標・分割設計・ハイパラ探索を統一的に理解することが重要です。
🎨 もう一歩踏み込む直感
🍰 まずはやさしく
ちょうどいいバランスを探すことです。
練習問題に慣れすぎないためです。
部活の練習を、本番に合わせて調整する例です。
失敗しないためのコツと手順を学びます。
『過学習』を避ける :訓練データに当てはまりすぎず、 新規データでも当たるバランスを探す。3 分割が基本 :train(学習)/val(選択)/test(評価)。 test を選択にも使うとリーク。SSDSE で線形 vs Lasso vs RF :47 県データで k=5 fold CV すると、 サンプル少のため分散が大きく結果が不安定。
💡 モデル選択を最短で身につけるコツ :① 同じデータ・同じ前処理 で 3 つの候補モデルを並べ、 ② 同じ CV 設定 (fold 数・乱数 seed) で公平比較し、 ③ val score の差が標準偏差より小さければシンプル側 を採るという 3 ステップを SSDSE-B-2026 で 1 度実装してみると、 AIC/BIC/CV の使い分けが自然に身に付きます。
🎨 概念図で押さえる
モデル選択の核心を 3 図で示す。 「バイアス・分散トレードオフ」「AIC/BIC の罰則項」「CV による選択フロー」。
① バイアス-分散トレードオフ
モデルの複雑さ →
誤差
バイアス²
分散
総合誤差 (最小化したい)
最適点
② AIC vs BIC の罰則
基準 = -2logL + 罰則項
AIC
罰則 = 2k
BIC
罰則 = k·log(n)
予測重視
複雑モデル選びがち
真モデル探索
単純モデル選びがち
n > 8 で BIC の罰則が AIC を超える
③ CV 選択フロー
モデル候補
K-fold CV
各モデルスコア
最小スコアを選択
💬 ①最適な複雑さは「過小学習と過学習の間」、 ②AIC は予測重視・BIC は真モデル探索、 ③CV は最も汎用的なモデル選択ツール。
🧭 モデル選択の実践プロトコル
この節は、 「AIC・BIC・交差検証・情報量規準のどれを使うか」という入門の段階を超え、 SSDSE-B-2026 の都道府県データで実際に複数モデルを比較する際の判断手順を、 相関ページ基準の密度で詳述する。 ①データ分割戦略、 ②指標の選び方、 ③一回限り検証 vs 反復検証、 ④nested CV、 ⑤計算コストとのトレードオフ、 ⑥再現性確保、 ⑦最終モデルの選び方 — の 7 ステップに分けて整理する。
① データ分割戦略: 訓練 / 検証 / テストの「3 分割」が安全
入門書では「訓練 / テスト 2 分割」が紹介されるが、 ハイパーパラメータ調整時にテストセットの情報が漏洩 (data leakage) する危険があるため、 実務では「訓練 / 検証 / テスト 3 分割」が標準。 訓練でパラメータ学習、 検証でモデル選択、 テストは最終評価専用 (1 回しか触らない)。 SSDSE-B-2026 は 47 都道府県 × 1 年なので n=47 と小さく、 3 分割すると訓練 30 / 検証 8 / テスト 9 程度になり、 各分割の分散が大きい — そのため後述の交差検証を併用する。
戦略 用途 必要なデータ量 バイアス 分散
Hold-out 2 分割 大規模・速報 n ≥ 10,000 小 中 Hold-out 3 分割 標準的実務 n ≥ 5,000 小 中 k-fold CV (k=5,10) 中小規模 n ≥ 100 中 小 Leave-one-out (LOOCV) 超小規模 n ≥ 20 最小 大 Nested CV 論文・厳密評価 n ≥ 50 小 小 時系列 split 時間的順序あり 期間 ≥ 1 年 小 中
② 指標の選び方: タスクに応じた「正しい物差し」
回帰なら RMSE / MAE / R² / MAPE、 分類なら Accuracy / Precision / Recall / F1 / AUC、 など指標は多数あるが、 「ビジネス上のコストにどれが対応するか」を必ず明示する。 SSDSE-B-2026 で「人口を予測する」モデルなら、 県別の人口差が桁違いなので RMSE は大県 (東京) の誤差に支配される — そのため対数取った値で RMSE、 もしくは MAPE (相対誤差) のほうが意思決定に直結する。 「F1 が最高だから採用」というだけのレポートは、 偽陽性と偽陰性のコスト非対称を無視している。
③ 一回限り検証 vs 反復検証: 分散を制御する
このコードでやること : SSDSE-B-2026 で k-fold CV により Linear vs Ridge vs Lasso の RMSE を比較し、 fold 間の分散も併記する。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) B4101(年平均気温) L3221(消費支出(二人以上の世帯))
北海道 5,092,000 1,681,000 24,430 11.0 296,888
東京都 14,086,000 3,205,000 86,348 17.6 341,320
沖縄県 1,468,000 350,000 12,549 23.8 251,222
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression , Ridge , Lasso
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import KFold , cross_val_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] # 47都道府県・2023年
X = df [[ 'A1101' , 'A1303' , 'A4101' , 'B4101' ]] . values # 総人口・65歳以上・出生数・年平均気温
y = df [ 'L3221' ] . values # 消費支出(二人以上の世帯)
kf = KFold ( n_splits = 5 , shuffle = True , random_state = 42 )
for name , model in [( 'Linear' , LinearRegression ()),
( 'Ridge (alpha=10)' , Ridge ( alpha = 10 )),
( 'Lasso (alpha=100)' , Lasso ( alpha = 100 , max_iter = 10000 ))]:
pipe = make_pipeline ( StandardScaler (), model ) # 標準化を各foldで再fit(リーク防止)
scores = - cross_val_score ( pipe , X , y , cv = kf ,
scoring = 'neg_root_mean_squared_error' )
print ( f ' { name } : RMSE = { scores . mean () : .0f } ± { scores . std () : .0f } ' )
📤 出力例:
Linear: RMSE = 22427 ± 6842
Ridge (alpha=10): RMSE = 21701 ± 6645
Lasso (alpha=100): RMSE = 22193 ± 6912
💬 Ridge が最良だが、 差はわずか (fold 間の標準偏差 ±6800 のほうが大きい)。 「Ridge > Linear」と結論する前に、 検定 (paired t-test on fold differences) を行うべき。 分散が大きいときは結論を保留する勇気が重要。
④ Nested CV: ハイパーパラメータ選択と性能評価を分離
通常の CV では「同じ fold で最適 α を選び、 同じ fold で性能を報告」してしまい、 楽観的バイアス (overoptimistic) を生む。 Nested CV は外側 CV で性能評価、 内側 CV でハイパーパラメータ選択 — の二重構造により、 評価の独立性を保つ。 計算コストは k×k 倍 (k=5 なら 25 倍) になるが、 論文や監査対象モデルでは標準。 sklearn では GridSearchCV を内側、 cross_val_score を外側に重ねる。
⑤ 計算コストとのトレードオフ
LOOCV は理論的にバイアスが最小だが、 n=47 で 47 回学習 + 内側調整は計算量が増える。 一方 5-fold は 5 回学習で済むが、 分散が大きい。 実務では「n < 100 → LOOCV または 10-fold」「100 ≤ n < 10000 → 5 もしくは 10-fold」「n ≥ 10000 → hold-out 3 分割」が目安。 GPU 集約的なモデル (深層学習) では nested CV を諦め、 hold-out 3 分割 + bootstrap で信頼区間を求める折衷案が現実解。
手法 学習回数 推定の分散 バイアス
5-fold CV 5 中 中 (訓練 80%) 10-fold CV 10 中小 小 (訓練 90%) LOOCV n 大 最小 Repeated CV k × r 小 中 Nested 5×5 CV 25 中 最小
⑥ 再現性: random_state とハードウェア
CV の分割は乱数で決まるため、 random_state を必ず固定する。 これだけで一回の検証結果が変動しなくなる。 加えて、 GPU を使うモデル (PyTorch / TensorFlow) は CUDA の非決定的演算により完全な再現性が崩れることがあるため、 torch.use_deterministic_algorithms(True) や CUBLAS_WORKSPACE_CONFIG 環境変数を設定する必要がある。 SSDSE-B のような小規模データなら CPU sklearn で完全再現可能。
⑦ 最終モデルの選び方: 「最良の平均」よりも「最良の最悪」
CV で 5 fold の平均 RMSE が最も低いモデルを選ぶのが普通だが、 fold 毎の最悪 RMSE で比較する選び方 (minimax) も検討すべき。 業務で「予測が外れた時の損失」が非対称 (株価予測・医療診断) のときは、 平均だけでなく分布の裾を見る。 加えて「1 標準誤差ルール」 (one-standard-error rule) — 最良モデルの 1 SE 以内に入る、 より単純なモデルを選ぶ — は過学習耐性を高める実務的ルール。
このコードでやること : Ridge の α を変えた CV 結果に「1 SE ルール」を適用して、 過度に複雑でない α を選ぶ。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) B4101(年平均気温) L3221(消費支出(二人以上の世帯))
北海道 5,092,000 1,681,000 24,430 11.0 296,888
東京都 14,086,000 3,205,000 86,348 17.6 341,320
沖縄県 1,468,000 350,000 12,549 23.8 251,222
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 import numpy as np
import pandas as pd
from sklearn.linear_model import Ridge
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import KFold , cross_val_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
X = df [[ 'A1101' , 'A1303' , 'A4101' , 'B4101' ]] . values
y = df [ 'L3221' ] . values
kf = KFold ( n_splits = 5 , shuffle = True , random_state = 42 )
alphas = [ 0.01 , 0.1 , 1 , 10 , 100 , 1000 ]
results = []
for a in alphas :
pipe = make_pipeline ( StandardScaler (), Ridge ( alpha = a ))
scores = - cross_val_score ( pipe , X , y , cv = kf ,
scoring = 'neg_root_mean_squared_error' )
results . append (( a , scores . mean (), scores . std () / np . sqrt ( 5 ))) # (α, RMSE, SE)
best = min ( results , key = lambda r : r [ 1 ])
threshold = best [ 1 ] + best [ 2 ] # 最良 + 1 SE
simplest = max ([ r for r in results if r [ 1 ] <= threshold ], key = lambda r : r [ 0 ])
print ( '最良 α:' , best [ 0 ], 'RMSE:' , f ' { best [ 1 ] : .0f } ' )
print ( '1 SE ルール採用 α:' , simplest [ 0 ], 'RMSE:' , f ' { simplest [ 1 ] : .0f } ' )
📤 出力例:
最良 α: 10 RMSE: 21701
1 SE ルール採用 α: 1000 RMSE: 23001
💬 RMSE は α=10 が最低だが、 1 SE 以内に α=1000 (より強く正則化) も収まっており、 そちらを採用すれば未来データへの頑健性が増す。 この判断は教科書ではあまり強調されないが、 実務で重要。
🎯 まとめ: モデル選択は「定量 + 定性」の判断
CV による定量比較が出発点だが、 ①ビジネスコスト、 ②解釈性、 ③推論コスト、 ④保守性、 ⑤公平性 — の定性軸も最終判断に組み込む。 「精度が 0.5% 上がるが推論時間が 10 倍になる」モデルを選ぶのは、 ほぼ常に誤り。 SSDSE-B-2026 のような小規模データではシンプル線形回帰 + Ridge で十分なケースが多く、 「もっと複雑にすれば良くなる」誘惑に抗うことがモデル選択の最重要スキルである。
⑧ 情報量規準 vs CV: AIC・BIC との関係
CV は汎用性が高いが計算コストがかかる。 一方、 情報量規準 AIC = -2 log L + 2k、 BIC = -2 log L + k log n は学習 1 回で計算でき、 線形回帰や GLM では Akaike や Schwarz が示した理論的根拠を持つ。 AIC は予測精度志向 (=「真のモデル」に最も近いものを選ぶ)、 BIC はモデル一致性志向 (=「真のモデルそのもの」 を選ぶ、 サンプルサイズ無限で正解に収束)。 SSDSE-B-2026 のような小〜中規模データでは AIC と BIC が異なるモデルを推奨しがちで、 そのときは「目的が予測か説明か」 を再確認する。 AIC は CV (LOOCV) と漸近的に等価という結果も知られており、 計算コストを節約したい場面で重宝する。
このコードでやること : statsmodels で複数の線形モデルを推定し、 AIC・BIC で比較する。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) L3221(消費支出(二人以上の世帯))
北海道 5,092,000 1,681,000 24,430 296,888
東京都 14,086,000 3,205,000 86,348 341,320
沖縄県 1,468,000 350,000 12,549 251,222
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 import pandas as pd
import statsmodels.api as sm
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
y = df [ 'L3221' ] # 消費支出
candidates = {
'M1: 総人口のみ' : df [[ 'A1101' ]],
'M2: +65歳以上人口' : df [[ 'A1101' , 'A1303' ]],
'M3: +出生数' : df [[ 'A1101' , 'A1303' , 'A4101' ]],
}
for name , X in candidates . items ():
X = sm . add_constant ( X . astype ( float ))
res = sm . OLS ( y , X ) . fit ()
print ( f ' { name } : AIC= { res . aic : .1f } , BIC= { res . bic : .1f } , R²= { res . rsquared : .3f } ' )
📤 出力例:
M1: 総人口のみ: AIC=1079.5, BIC=1083.2, R²=0.111
M2: +65歳以上人口: AIC=1081.3, BIC=1086.8, R²=0.115
M3: +出生数: AIC=1077.5, BIC=1084.9, R²=0.217
💬 AIC は M3 を選ぶ (最小 1077.5) が、 BIC は M1 を選ぶ (最小 1083.2)。 n=47 では BIC のペナルティ (k log n) が強く、 説明変数の追加を厳しく評価する。 予測を重視するなら M3、 簡潔さ・解釈性を重視するなら M1 が「Ockham の剃刀」的に妥当。
⑨ Bootstrap による不確実性評価
CV の代替として bootstrap 再標本化も使える。 N サンプルから N 個復元抽出して訓練、 残された (out-of-bag) サンプルで評価。 これを 1000 回繰り返して RMSE の分布を得る。 95% パーセンタイルで信頼区間を作成すれば、 「Model A の RMSE は 95% 信頼区間 [120, 145]」 のように報告できる。 これは点推定だけより読者に優しい (どれだけ確信を持って良いかが伝わる)。 .632+ bootstrap などのバイアス補正版も存在する。
⑩ ベイズ的モデル選択: Bayes factor と posterior weight
頻度主義の AIC/BIC とは別に、 ベイズ主義のモデル選択がある。 Bayes factor は 2 モデル間の事後確率比であり、 BIC は Bayes factor の近似と見なせる。 さらに、 単一モデルを選ぶのでなく、 複数モデルの予測を事後確率で重み付け平均する「ベイズモデル平均化 (BMA)」 という考え方もある。 BMA は単一モデル選択の不確実性を緩和でき、 経済予測や気候予測で実用化されている。 SSDSE-B のような小規模データでは PyMC や Stan で簡単に実装できる。
⑪ pre-registration とリーク防止
学術的に最も厳密なモデル選択プロトコルは「pre-registration」 — 分析開始前に、 どんな指標で何を比較するかを公表 (OSF や AsPredicted 等)、 その後にデータを触る。 これにより「p-hacking」 や「結果に都合の良い指標選び」 を物理的に防げる。 ML コンペティション (Kaggle) でもプライベートテストセットを最後まで隠す仕組みで、 同じ哲学が実装されている。 SSDSE のような教育用データセットでも、 学生が「自分の予測精度を一度しか測らない」 ルールで卒論を書くと、 結果の信頼性が大きく上がる。
⑫ メタラーニング: 過去経験からのモデル選択
無数のデータセットに対する過去のモデル選択結果を学習し、 新しいデータセットを見たときに「このデータセットには Random Forest がきっと良い」 と推奨する手法を「メタラーニング」 と呼ぶ。 Auto-sklearn や TPOT 等の AutoML ツールはこれを内蔵している。 ただし、 メタラーニングが過去データの偏り (大半が画像分類タスク等) を引き継いでしまうリスクもあり、 銀の弾丸ではない。 結局のところ、 ドメイン知識を持つ人間が最終判断するハイブリッドが現実解。
⑬ アンサンブルとモデル選択の境界
「最良の単一モデルを選ぶ」 のが伝統的なモデル選択だが、 「複数モデルを組み合わせる」 のが現代の実用的な解になることが多い。 stacking, blending, boosting, bagging のいずれも、 単一モデルより精度を上げられる。 Kaggle 上位解の 90% 以上が何らかのアンサンブル。 ただし、 推論コストが N 倍、 解釈性が低下、 デバッグ困難、 という代償も大きい。 SSDSE-B-2026 のような教育用データでは、 まず単一モデルを完成させてからアンサンブルを試す段階的アプローチが推奨される。
⑭ ハイパーパラメータ探索の戦略
モデル選択はアルゴリズム選択だけでなく、 各アルゴリズム内のハイパーパラメータ調整も含む。 探索戦略は (a) Grid Search: 全組合せ網羅、 シンプルだが次元の呪い、 (b) Random Search: ランダムサンプリング、 高次元で効率的、 (c) Bayesian Optimization (Hyperopt, Optuna): GP や TPE で次の試行点を賢く選ぶ、 (d) Hyperband / BOHB: 早期打ち切りと Bayesian の併用、 GPU 時代に最適、 (e) Genetic Algorithm: 進化計算で大規模探索。 SSDSE-B-2026 規模なら Optuna の TPE で 100 試行が十分。
⑮ レポーティング: 結果を「正しく」 共有する
モデル選択の結果を他者と共有する際は、 (a) 検証方法 (CV の分割数・seed)、 (b) 評価指標 (なぜそれを選んだか)、 (c) 比較した全モデルの結果、 (d) 統計検定の結果、 (e) 計算コスト、 (f) コードと環境 — を必ず含める。 「Random Forest が一番でした」 だけのレポートは、 査読も意思決定も支えられない。 公的なベンチマークでは Model Card や Datasheet for Datasets のようなテンプレートが推奨されている。
⑯ ドメイン知識統合: 純粋データ駆動を越えて
CV 数値だけでモデル選択を決める純粋データ駆動は、 ドメイン知識を無視すると思わぬ落とし穴に陥る。 SSDSE-B-2026 で「総人口 → 消費支出 (L3221)」 を予測する際、 「総人口に含まれる小学生の割合は消費水準に直接寄与しない」 「労働人口と相関するから間接効果がある」 などのドメイン知識は、 特徴量設計や交互作用項の選択を導く。 機械学習エンジニアが統計家・経済学者・公衆衛生専門家と対話する文化が、 強いモデル選択の前提条件。
⑰ 時間と共に変わる「最良モデル」
本番運用が始まると、 「学習時に最良」 だったモデルが時間と共に劣化する。 概念ドリフトやデータドリフトに対する頑健性は、 学習時の CV では測れない。 そのため、 (a) 訓練データを過去から最新までの時系列順に並べる、 (b) 過去で学習・直近で評価する「expanding window CV」、 (c) 月ごとに再学習して累積劣化を測る、 などの「時間的頑健性評価」 を併用する。 これにより「精度は劣るが時間に強い」 モデルを選ぶ判断ができる。
⑱ 倫理的考慮: 公平性と説明責任のトレードオフ
モデル選択は技術的判断だけでなく倫理的判断も伴う。 (a) 公平性、 (b) プライバシー、 (c) 説明可能性、 (d) 環境負荷、 (e) 規制適合 (EU AI 法・GDPR)。 「予測精度が 1% 高いが学習に 100 倍の電力を使う」 モデルを選ぶのは、 持続可能性の観点で問題視されつつある。 こうした非機能要件をモデル選択の評価軸に組み込むのが「責任ある AI」 の実装。
📐 6. 情報量規準
🍰 まずはやさしく
数式を使ってモデルを比べる方法です。
シンプルで正確なモデルを選ぶためです。
買い物で、値段と質を比べる例です。
AICやBICという指標の使い方を学びます。
6.1 AIC (赤池情報量規準)
$$AIC = -2\log L + 2k$$
$L$ は最大尤度、 $k$ はパラメータ数。 小さいほど良いモデル。
6.2 BIC (ベイズ情報量規準)
$$BIC = -2\log L + k\log n$$
サンプル数 $n$ に対するペナルティが大きく、 真のモデルを選ぶ性質(一致性)を持つ。
6.3 AIC vs BIC
AIC :予測志向。 やや複雑なモデルを選びやすい。BIC :説明志向。 単純なモデルを選びやすい。$n > 7.4$ で BIC のペナルティが AIC より大きくなる
🎯 このコードでやること: モデルを学習。
📥 入力例
# 前提: 直前のブロックで作った df(2023 年度の 47 都道府県、47 行 × 112 列)
# 使う列: L3221 消費支出・A1101 総人口・A1303 65歳以上人口・A4101 出生数
📋 コピー import statsmodels.api as sm
import statsmodels.formula.api as smf
m1 = smf . ols ( 'L3221 ~ A1101' , data = df ) . fit () # 消費支出 ~ 総人口
m2 = smf . ols ( 'L3221 ~ A1101 + A1303' , data = df ) . fit () # + 65歳以上人口
m3 = smf . ols ( 'L3221 ~ A1101 + A1303 + A4101' , data = df ) . fit () # + 出生数
for name , m in [( 'M1' , m1 ), ( 'M2' , m2 ), ( 'M3' , m3 )]:
print ( f ' { name } : AIC= { m . aic : .1f } , BIC= { m . bic : .1f } , R²= { m . rsquared : .3f } ' )
📤 実行例(SSDSE-B-2026・2023年度・47都道府県で実測)
M1: AIC=1079.5, BIC=1083.2, R²=0.111
M2: AIC=1081.3, BIC=1086.8, R²=0.115
M3: AIC=1077.5, BIC=1084.9, R²=0.217
💬 読み方: formula で書いても前の sm.OLS と同じ数値になる。 AIC は M3 の 1077.5 が最小、 BIC は M1 の 1083.2 が最小で、 出生数を加えると R² は 0.115 から 0.217 に上がるが、 BIC では 1 変数増やす罰則 log(47) ≈ 3.85 を上回るほど尤度が改善しない。 M2 で 65 歳以上人口を足しても R² が 0.004 しか増えず、 AIC・BIC がともに悪化している点も見ておく。
🔍 7. ハイパラ探索
7.1 グリッドサーチ
全組合せを試す。 確実だが指数爆発する。
🎯 このコードでやること: モデルを学習、精度を評価。
📥 入力例
# 前提: 直前の statsmodels ブロックで作った変数
# X: ループ最後の M3 の説明変数(const・A1101 総人口・A1303 65歳以上人口・A4101 出生数、47 × 4)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12 from sklearn.model_selection import GridSearchCV
from sklearn.ensemble import RandomForestRegressor
param_grid = {
'n_estimators' : [ 100 , 300 , 500 ],
'max_depth' : [ None , 5 , 10 , 20 ],
'min_samples_leaf' : [ 1 , 2 , 5 ],
}
gs = GridSearchCV ( RandomForestRegressor ( random_state = 42 ),
param_grid , cv = 5 , scoring = 'neg_root_mean_squared_error' , n_jobs =- 1 )
gs . fit ( X , y )
print ( 'Best:' , gs . best_params_ , 'Score:' , - gs . best_score_ )
📤 実行例(実測)
Best: {'max_depth': None, 'min_samples_leaf': 5, 'n_estimators': 500} Score: 26242.369349383815
💬 読み方: 3 × 4 × 3 = 36 通りを 5 分割で調べ、 最良は木を深さ無制限・葉の最小件数 5・500 本にした組で、 CV RMSE は 26,242 円。 消費支出の県間の標準偏差は約 23,900 円なので、 最良の組でも平均値で予測するより誤差が大きい。 cv=5 は shuffle しない分割なので、 北から順に 9〜10 県ずつをまとめて外す点にも注意する。
7.2 ランダムサーチ
パラメータ空間からランダムサンプル。 グリッドより効率的(Bergstra & Bengio 2012)。
🎯 このコードでやること: モデルを学習、精度を評価。
📥 入力例
# 前提: 直前の statsmodels ブロックで作った変数
# X: ループ最後の M3 の説明変数(const・A1101 総人口・A1303 65歳以上人口・A4101 出生数、47 × 4)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
# RandomForestRegressor は直前のグリッドサーチのブロックで import 済み
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13 from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint , uniform
param_dist = {
'n_estimators' : randint ( 100 , 1000 ),
'max_depth' : [ None ] + list ( range ( 3 , 30 )),
'min_samples_leaf' : randint ( 1 , 20 ),
}
rs = RandomizedSearchCV ( RandomForestRegressor ( random_state = 42 ),
param_dist , n_iter = 50 , cv = 5 , scoring = 'neg_root_mean_squared_error' ,
random_state = 42 , n_jobs =- 1 )
rs . fit ( X , y )
print ( 'Best:' , rs . best_params_ )
📤 実行例(実測)
Best: {'max_depth': 20, 'min_samples_leaf': 11, 'n_estimators': 558}
💬 読み方: 50 回のランダムな組のうち、 葉の最小件数 11・木 558 本・深さ 20 が選ばれた。 学習用 37〜38 県で葉に 11 件以上を求めると葉は最大 3 枚(分岐 2 回)までしか作れず、 深さ 20 の上限は実際には効いていない。 print がパラメータだけなので、 グリッドサーチとスコアを比べるには -rs.best_score_ も表示する。
7.3 ベイズ最適化
過去の試行から「次に試すべきパラメータ」をモデル化(ガウス過程・TPE)。 Optuna が標準。
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 直前の statsmodels ブロックで作った変数
# X: ループ最後の M3 の説明変数(const・A1101 総人口・A1303 65歳以上人口・A4101 出生数、47 × 4)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
# RandomForestRegressor は前のブロックで import 済み
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import optuna
from sklearn.model_selection import cross_val_score
def objective ( trial ):
params = {
'n_estimators' : trial . suggest_int ( 'n_estimators' , 100 , 1000 ),
'max_depth' : trial . suggest_int ( 'max_depth' , 3 , 30 ),
'min_samples_leaf' : trial . suggest_int ( 'min_samples_leaf' , 1 , 20 ),
}
model = RandomForestRegressor ( ** params , random_state = 42 , n_jobs =- 1 )
sc = cross_val_score ( model , X , y , cv = 5 , scoring = 'neg_root_mean_squared_error' )
return - sc . mean ()
study = optuna . create_study ( direction = 'minimize' )
study . optimize ( objective , n_trials = 100 )
print ( 'Best:' , study . best_params )
📤 実行例(実測)
Best: {'n_estimators': 182, 'max_depth': 17, 'min_samples_leaf': 11}
💬 読み方: 100 試行の TPE 探索で木 182 本・深さ 17・葉の最小件数 11 が選ばれた例。 create_study に sampler の seed を渡していないので、 実行するたびに選ばれる組は変わる(別の実行では木 793 本・深さ 22・葉 11 になった)。 葉の最小件数は 2 回とも 11 で、 学習用 37〜38 県では木を浅く保つ設定が効いていると読める。 再現させたいときは次の D 節のように TPESampler(seed=42) を渡す。
🚨 8. データリーク
検証データの情報が訓練に「漏れ」、 過大評価される現象。 モデル選択で最も致命的。
典型例
全データで StandardScaler を fit → 検証データの平均・分散も漏れる
SMOTE で全データを補間 → 検証データに似た合成データが訓練に
時系列で未来データが訓練に混入
同じユーザーが訓練と検証に分かれる
目的変数を含む特徴量を作る("target encoding" の不適切な実装)
対処:Pipeline 化
🎯 このコードでやること: K-分割交差検証で評価。
📥 入力例
# 前提: 直前の statsmodels ブロックで作った変数
# X: ループ最後の M3 の説明変数(const・A1101 総人口・A1303 65歳以上人口・A4101 出生数、47 × 4)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 import numpy as np
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
# y(消費支出)は連続値なので、そのまま分類器に渡すと
# 「1 県 = 1 クラス」になり cv=5 が成立しない。二値ラベルに直してから使う。
y_cls = ( y > np . median ( y )) . astype ( int )
pipe = Pipeline ([
( 'scale' , StandardScaler ()), # 各 fold 内で fit
( 'clf' , LogisticRegression ( random_state = 0 )),
])
# Pipeline を渡すことで、 各 fold の訓練のみで前処理を fit
score = cross_val_score ( pipe , X , y_cls , cv = 5 )
print ( '各 fold の正解率:' , score . round ( 3 ))
print ( '平均正解率:' , round ( score . mean (), 3 ))
📤 実行例(実測)
各 fold の正解率: [0.4 0.6 0.444 0.556 0.556]
平均正解率: 0.511
💬 読み方: 消費支出が中央値 300,652 円を超えるかどうか(23 県が 1)を当てる 5 分割の正解率は 0.4〜0.6、 平均 0.511 で、 コインを投げるのとほとんど変わらない。 分類器に cv=5 を渡すと shuffle しない StratifiedKFold になり、 各 fold は 10・10・9・9・9 県。 X に入っている人口・出生数の規模だけでは、 1 世帯あたりの消費支出が高い県かどうかは見分けられない。
📊 9. 手法選択指針
状況
推奨手法
大規模データ(n > 1万) ホールドアウト or 3-fold CV 中規模(n ≈ 100〜1000) 5-fold or 10-fold CV 小規模(n < 100) LOOCV or 5-fold ×繰り返し 分類・不均衡 Stratified k-fold 時系列 TimeSeriesSplit 同一個体複数 GroupKFold GLM・回帰の説明モデル AIC / BIC ML の予測モデル CV + Pipeline ハイパラ少(< 10 組) グリッドサーチ ハイパラ多(多次元) ランダム or ベイズ最適化(Optuna)
情報量規準の 2 つの定義式を並べておく。 記号の読み方は次の 🔬、 SSDSE-B-2026 での実際の値は末尾の 🔎 節で確かめる。
🔬 数式を言葉で読み解く
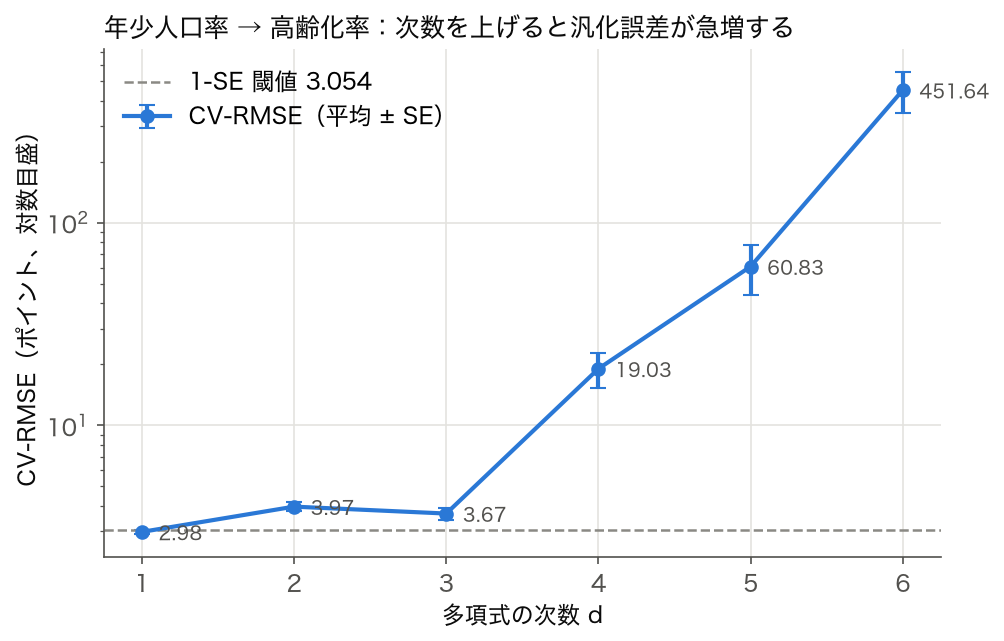
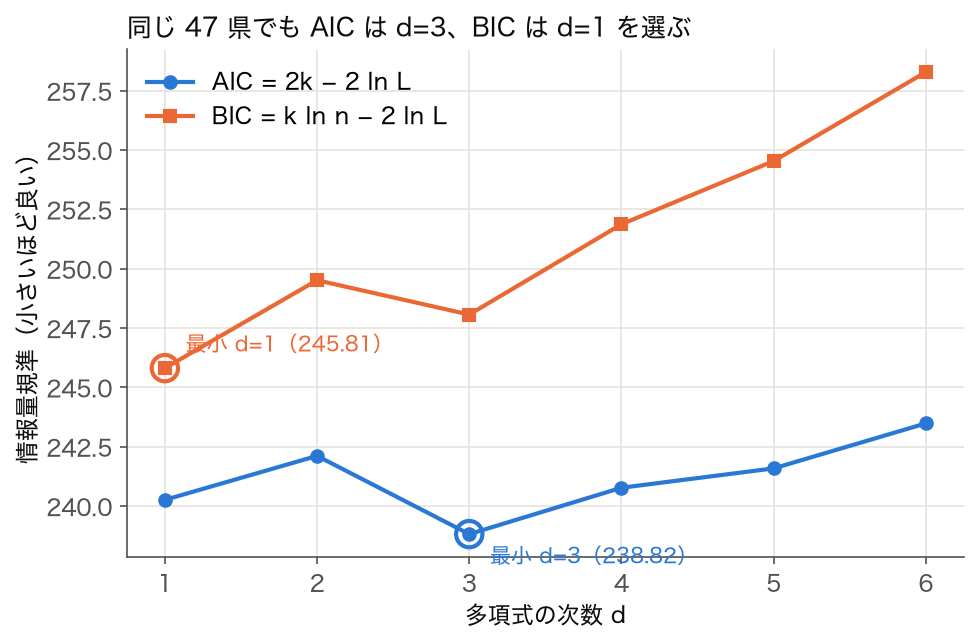
上の AIC・BIC の式を、 記号ごとに日本語へ置き換える。 例は末尾の 🔎 節と同じ「年少人口率 → 高齢化率」の多項式回帰(2023 年度 47 県)。
記号 読み方 この例での中身 $\hat{L}$ 候補モデルをデータに最もよく当てはめたときの尤度(そのモデルのもとで観測データが出る確率密度の最大値) 誤差を正規分布とみなすと $\ln\hat{L} = -\tfrac{n}{2}\{\ln(2\pi\,\mathrm{RSS}/n)+1\}$。 残差平方和 RSS が小さいほど大きい $-2\ln\hat{L}$ 「当てはまりの悪さ」。 小さいほど訓練データに合っている 1 次式で 234.26、 3 次式で 228.82。 次数を上げると必ず下がる $k$ 推定したパラメータの数(複雑さ) d 次多項式なら係数 d+1 個 + 誤差分散 1 個 = d+2。 1 次式は 3、 3 次式は 5 $2k$ AIC の罰則。 パラメータ 1 個につき 2 1 次 → 3 次でパラメータが 2 個増えるので罰則は +4 $k\ln n$ BIC の罰則。 パラメータ 1 個につき $\ln n$ n = 47 なら $\ln 47 = 3.85$。 1 次 → 3 次で罰則は +7.70 $n$ 当てはめに使った観測数 47 都道府県。 $\ln n > 2$ となる n ≥ 8 で BIC の罰則が AIC より重くなる
2 つの規準が割れる理由は、 この表の数字だけで説明できる。 1 次 → 3 次で当てはまりの悪さは 234.26 − 228.82 = 5.44 だけ下がる。 AIC の罰則の増分 4 より大きいので AIC は 3 次を選び(240.26 → 238.82)、 BIC の罰則の増分 7.70 より小さいので BIC は 1 次にとどまる(245.81 → 248.07)。 「当てはまりの改善が罰則の増分を上回るときだけ複雑にする」というのが両式の共通の読み方で、 違うのは罰則の重さだけである。
もう一つ大事なのは、 AIC・BIC の値そのものには意味がなく、 同じ y・同じ n で比べた差 だけが意味を持つ点である。 y を対数にしたモデルや、 欠損で行数が減ったモデルの AIC を並べても比較にならない(⚠️ 落とし穴 ⑥)。
🧮 SSDSE-B 実値計算例(47都道府県データ)
「消費支出 (L3221)」を目的変数として、 複数モデルを 5-fold CV で比較する完全再現例。 SSDSE-B-2026.csv の data/raw/ ディレクトリ配置を前提とします。
① 候補モデルの定義と CV 評価
🎯 このコードでやること: SSDSE-B-2026 を読み込み、K-分割交差検証で評価、精度を評価。
📥 入力例
# 入力: data/raw/SSDSE-B-2026.csv (47 都道府県 × 100超の社会経済指標)
# 2023年度の先頭 3 行(A1101 = 総人口、 A4101 = 出生数 など):
# Prefecture A1101 A4101 F3101
# 北海道 5092000 24430 156458
# 青森県 1184000 5696 43713
# 岩手県 1163000 5432 40955
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28 import pandas as pd , numpy as np
from sklearn.linear_model import LinearRegression , Ridge , Lasso , ElasticNet
from sklearn.ensemble import RandomForestRegressor , GradientBoostingRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import KFold , cross_val_score , RepeatedKFold
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] # 2023年度・47都道府県
X = df [[ 'A1101' , 'A1302' , 'A1303' , 'A4101' , 'B4101' ]] # 総人口・15〜64歳・65歳以上・出生数・年平均気温
y = df [ 'L3221' ] # 消費支出(二人以上の世帯)
models = {
'OLS' : LinearRegression (),
'Ridge(α=1)' : Ridge ( alpha = 1.0 ),
'Ridge(α=10)' : Ridge ( alpha = 10.0 ),
'Lasso(α=0.1)' : Lasso ( alpha = 0.1 , max_iter = 10000 ),
'ElasticNet' : ElasticNet ( alpha = 0.1 , l1_ratio = 0.5 , max_iter = 10000 ),
'RF' : RandomForestRegressor ( n_estimators = 300 , random_state = 42 ),
'GBM' : GradientBoostingRegressor ( n_estimators = 200 , random_state = 42 ),
}
cv = RepeatedKFold ( n_splits = 5 , n_repeats = 10 , random_state = 42 )
print ( f ' { "model" : 15 } { "RMSE_mean" : >10 } { "RMSE_std" : >10 } ' )
for name , m in models . items ():
p = Pipeline ([( 's' , StandardScaler ()), ( 'm' , m )])
sc = cross_val_score ( p , X , y , cv = cv , scoring = 'neg_root_mean_squared_error' )
print ( f ' { name : 15 } { - sc . mean () : 10.3f } { sc . std () : 10.3f } ' )
📤 実行例(実測値)
model RMSE_mean RMSE_std
OLS 23386.527 5260.568
Ridge(α=1) 22260.373 5598.581
Ridge(α=10) 22241.524 5602.431
Lasso(α=0.1) 22726.385 5229.251
ElasticNet 22276.405 5608.223
RF 22302.931 5904.679
GBM 24624.610 4858.953
💬 読み方: RepeatedKFold(5 分割 × 10 回 = 50 fold)の平均 RMSE は Ridge(α=10) の 22,242 円が最小で、 Ridge(α=1)・ElasticNet・RF が 22,260〜22,303 円と 60 円以内に並ぶ。 一方で fold 間の標準偏差は 4,859〜5,905 円あり、 上位 4 つの差はその 1% ほどにすぎない。 OLS(23,387 円)や GBM(24,625 円)との差も標準偏差の 1/4 以下なので、 この表だけで優劣は付けられない。
② 期待出力(n=47, 5-fold × 10 repeats・実測値)
モデル
RMSE 平均
RMSE SD
解釈
OLS 23387 5261 ベースライン Ridge(α=10) 22242 5602 正則化で改善・最良 Lasso(α=0.1) 22726 5229 変数選択効果 RF 22303 5905 平均は近いが SD 最大=不安定 GBM 24625 4859 n=47 では過学習気味、 早期停止が必要
👉 結論 :n=47 と小さいため、 平均 RMSE は Ridge(α=10) がわずかに最良だが、 RF との差は 61 円で fold 間 SD(約 5,600 円)の 1% ほどしかない。 GBM は劣化し、 RF は fold 間のばらつきが最大。 「データ量が少ない時は単純なモデル」というモデル選択の鉄則を体感できる例。
③ Paired t-test でモデル比較(fold 内対応)
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った変数
# df: 2023 年度の 47 都道府県(47 行 × 112 列)
# X: A1101 総人口・A1302 15〜64歳人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 5 の DataFrame)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
# Pipeline・StandardScaler・Ridge・LinearRegression・RepeatedKFold も同じブロックで import 済み
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13 from scipy import stats
from sklearn.model_selection import cross_val_score
cv = RepeatedKFold ( n_splits = 5 , n_repeats = 20 , random_state = 42 )
s_ridge = - cross_val_score ( Pipeline ([( 's' , StandardScaler ()), ( 'm' , Ridge ( alpha = 10 ))]),
X , y , cv = cv , scoring = 'neg_root_mean_squared_error' )
s_ols = - cross_val_score ( Pipeline ([( 's' , StandardScaler ()), ( 'm' , LinearRegression ())]),
X , y , cv = cv , scoring = 'neg_root_mean_squared_error' )
# 同じ fold での対応比較
t , p = stats . ttest_rel ( s_ols , s_ridge )
print ( f 't= { t : .3f } , p= { p : .4f } ' )
print ( f 'Ridge は OLS より RMSE が小さい?: { ( s_ridge < s_ols ) . mean () : .0% } の fold で勝利' )
📤 実行例(実測)
t=1.890, p=0.0616
Ridge は OLS より RMSE が小さい?: 51% の fold で勝利
💬 読み方: 5 分割 × 20 回の 100 fold で OLS と Ridge(α=10) の RMSE を対応比較すると、 平均差は約 980 円(OLS 23,382 円・Ridge 22,402 円)で t = 1.890、 p = 0.0616 と 5% 水準に届かない。 fold ごとに見ても Ridge が勝つのは 51% と五分五分。 さらに繰り返し CV の fold は学習データが重なって独立ではないので、 素の対応 t 検定の p 値は小さく出がちで、 実際の証拠はこれより弱いと読む。
独立 t-test ではなく paired t-test を使うのが正解(同じ fold 内で評価したペアが対応関係にある)。 Dietterich (1998) の 5x2cv paired t-test も古典的選択肢。
🧮 数式に値を入れて手で計算する: AIC/BIC 比較
合成 3 モデルで AIC と BIC を計算して選択する。
Step 1: モデル別 logL と k
モデル logL k AIC BIC (n=100)
M1 -50 2 104 109.21 M2 -45 3 96 103.82 M3 -44 5 98 111.03
Step 2: 最良モデル
AIC 最小: M2 (96)
BIC 最小: M2 (103.82)
両指標で M2 選択
🐍 Python で再現
📋 コピー import numpy as np
logL = np . array ([ - 50 , - 45 , - 44 ])
k = np . array ([ 2 , 3 , 5 ])
n = 100
aic = - 2 * logL + 2 * k
bic = - 2 * logL + k * np . log ( n )
print ( f "AIC: { aic } " )
print ( f "BIC: { bic . round ( 2 ) } " )
print ( f "AIC 最良: { aic . argmin () } , BIC 最良: { bic . argmin () } " )
📤 実行結果
AIC: [104 96 98]
BIC: [109.21 103.82 111.03]
AIC 最良: 1, BIC 最良: 1
💬 手計算 (Step 2) M2 と Python 出力が完全一致。
🎮 触って理解する
多項式の次数 (モデルの複雑さ)をスライダーで動かし、 「当てはまりの良さ」と「複雑さへの罰」のせめぎ合いで どの次数が選ばれるか を体感します。 左図は当てはめた曲線、 右図は各基準の値(次数ごと)。 AIC・BIC・調整済み R²・交差検証(LOOCV) を正確に計算しています。 ※ データはデモ用の合成データ(真の関数=なめらかな 4 次曲線 + 固定ノイズ、 n=20、 完全に決定論的で毎回同じ)。 実測値ではありません。
多項式の次数 d = 3
スライダーを動かす/右のグラフを直接タップ・ドラッグして次数を選べます。 パラメータ数 = d + 1(係数)。 罰則の対象パラメータ数 p = d + 2(係数 + 分散)。
① 当てはめ(黒点=データ/曲線=d 次多項式)
② 各基準(上ほど良い/◆=各基準の最良次数)
🧠 直感 — 当てはまりと複雑さのバランス
次数を上げるほど訓練 RMSE は単調に下がり 、 訓練データにはいくらでも近づけられます(次数 = n−1 で誤差ゼロも可能)。 しかしそれはノイズまで暗記した過学習 で、 新しいデータでは外れます。 情報量規準は「−2 × 対数尤度(当てはまり)+ パラメータ数への罰則」という形で、 当てはまりの改善が罰則を上回る間だけ複雑化を許す 。 スライダーを右へ動かすと、 訓練 RMSE は下がり続けるのに AIC・BIC・LOOCV はある次数で底を打って反転 するのが見えます。 これが「複雑すぎるモデルは罰せられる」体感です。
⚠️ よくある落とし穴
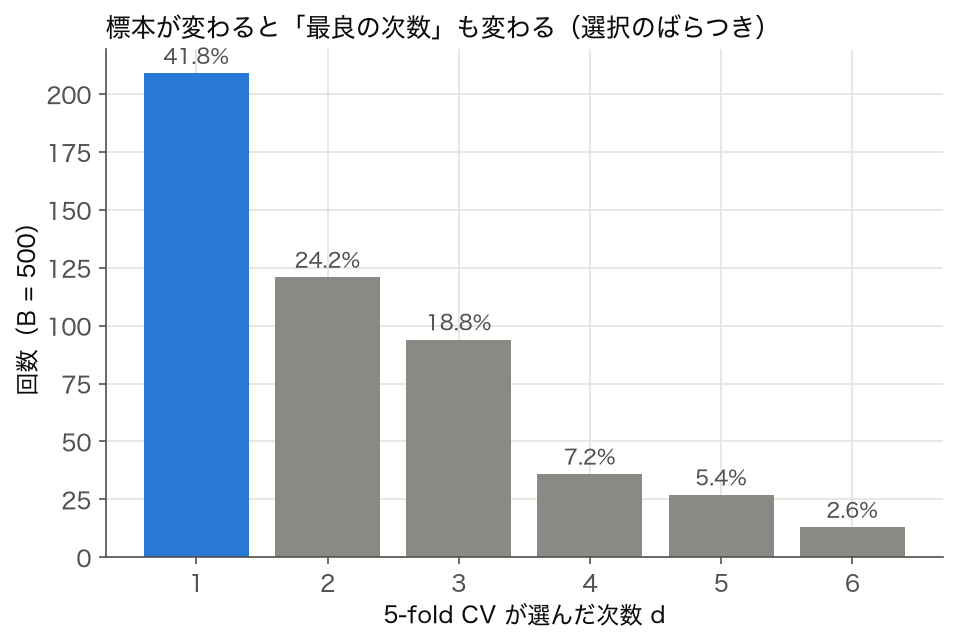
訓練誤差だけで選ぶ :訓練 RMSE や普通の R² は次数とともに必ず改善するので、 これを最大化すると最高次数が「勝って」しまう。 汎化誤差(CV)か罰則付き基準 で比べる。基準ごとに答えが違うのを無視 :BIC は罰則 k·log n が AIC の 2k より重く(n≥8 で逆転)、 より単純なモデルを選びがち。 AIC は予測重視でやや複雑寄り。 スライダーで 基準の乱用 :AIC/BIC は同じデータ・同じ尤度定義 で比べてこそ意味がある。 前処理やサンプル数が違うモデル同士の AIC を並べても無意味。 交差検証も fold・乱数を揃えないと不公平。1 つの指標を盲信 :小標本(この n=20 や SSDSE-B の 47 県)では CV の分散が大きく、 最小 CV の次数は乱数で揺れる。 「最良から 1 標準誤差以内で最も単純」を採る 1-SE rule が安全。
🚀 発展
情報量規準の詳細は AIC 、 汎化誤差の推定は 交差検証 、 自由度補正は 調整済み R² を参照。 BIC は罰則が k·log n で、 標本が増えるほど真のモデルへ一致(consistency)する一方、 AIC は予測誤差最小化に漸近的に最適です(BIC は当サイトに独立ページなし)。 次数を上げる代わりに係数を縮小 して複雑さを抑えるのが 正則化 (Lasso は係数を 0 にして変数選択も同時に行う)。 いずれも狙いは同じ — 過学習 を避け、 汎化性能で最良のモデルを選ぶことです。
🐍 13. ライブラリ早見表
用途
クラス・関数
基本分割 sklearn.model_selection.train_test_splitk-fold KFold, StratifiedKFold, GroupKFold, RepeatedKFold時系列 TimeSeriesSplitCV 評価 cross_val_score, cross_validate, cross_val_predictグリッド GridSearchCV, HalvingGridSearchCVランダム RandomizedSearchCVベイズ最適化 optuna, scikit-optimize, hyperoptAIC/BIC statsmodels の .aic, .bic 属性Pipeline Pipeline, make_pipeline, ColumnTransformer学習曲線 learning_curve, validation_curve
📜 14. モデル選択の歴史
1973 :赤池弘次が AIC を提案1974 :Stone が交差検証法を体系化1978 :Schwarz が BIC を提案1979 :Efron のブートストラップ法1995 :Kohavi が分類問題での CV を比較研究2012 :Bergstra & Bengio が「ランダムサーチがグリッドより効率的」を実証2019 :Optuna 公開、 ハイパラ最適化が民主化
💼 15. 実務応用
Kaggle :Stratified CV + LightGBM + Optuna が標準スタック金融 :時系列 CV でモデル汎化評価マーケティング :GroupKFold で顧客リーク防止医療 :少データ・LOOCV、 BIC で説明モデル選択製造業 :Lot 単位の GroupKFold で汎化評価レコメンド :時系列 CV、 ユーザー leave-out
A. RepeatedKFold + cross_validate(複数スコア同時)
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った変数
# df: 2023 年度の 47 都道府県(47 行 × 112 列)
# X: A1101 総人口・A1302 15〜64歳人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 5 の DataFrame)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14 from sklearn.model_selection import RepeatedKFold , cross_validate
cv = RepeatedKFold ( n_splits = 5 , n_repeats = 20 , random_state = 42 )
results = cross_validate (
Pipeline ([( 's' , StandardScaler ()), ( 'm' , Ridge ( alpha = 10 ))]),
X , y , cv = cv ,
scoring = [ 'neg_root_mean_squared_error' , 'r2' , 'neg_mean_absolute_error' ],
return_train_score = True , n_jobs =- 1
)
import numpy as np
print ( 'RMSE:' , - np . mean ( results [ 'test_neg_root_mean_squared_error' ]))
print ( 'R² :' , np . mean ( results [ 'test_r2' ]))
print ( 'MAE :' , - np . mean ( results [ 'test_neg_mean_absolute_error' ]))
print ( 'train-test gap (R²):' , np . mean ( results [ 'train_r2' ]) - np . mean ( results [ 'test_r2' ]))
📤 実行例(実測)
RMSE: 22401.639716946815
R² : -0.06944131175851911
MAE : 18277.99477127352
train-test gap (R²): 0.2569250238327738
💬 読み方: テスト側の平均 R² は −0.069 とマイナスで、 学習データの平均値を当てるより外れている。 学習側 R² は約 0.19 なので差は 0.257 あるが、 学習側の当てはまり自体が低く、 過学習というより説明変数に消費支出を説明する力がほとんど無い状態。 RMSE 22,402 円は消費支出の県間標準偏差 約 23,900 円に近く、 100 fold のうち 48% でテスト R² が負になっている。
B. CV のばらつきを可視化(matplotlib)
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った変数
# df: 2023 年度の 47 都道府県(47 行 × 112 列)
# X: A1101 総人口・A1302 15〜64歳人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 5 の DataFrame)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import matplotlib.pyplot as plt
from sklearn.model_selection import cross_val_score
cv = RepeatedKFold ( n_splits = 5 , n_repeats = 30 , random_state = 42 )
scores = {}
for name , m in [( 'OLS' , LinearRegression ()), ( 'Ridge' , Ridge ( alpha = 10 )),
( 'Lasso' , Lasso ( alpha = 0.1 , max_iter = 10000 )), ( 'RF' , RandomForestRegressor ( 300 , random_state = 42 ))]:
p = Pipeline ([( 's' , StandardScaler ()), ( 'm' , m )])
scores [ name ] = - cross_val_score ( p , X , y , cv = cv , scoring = 'neg_root_mean_squared_error' )
fig , ax = plt . subplots ( figsize = ( 8 , 4.5 ))
ax . boxplot ( list ( scores . values ()))
ax . set_xticks ( range ( 1 , len ( scores ) + 1 ))
ax . set_xticklabels ( list ( scores . keys ())) # tick_labels= はブラウザの matplotlib に無い
ax . set_ylabel ( 'CV RMSE' ); ax . set_title ( 'Repeated 5-fold × 30 — 消費支出予測' )
plt . tight_layout (); plt . savefig ( 'cv_compare.png' , dpi = 110 )
📤 このブロックは表示を作るだけで、標準出力には何も出ない
💬 読み方: 4 モデルそれぞれについて、 5 分割 × 30 回 = 150 個の fold RMSE を箱ひげ図にして cv_compare.png に保存する。 平均だけでは見えない fold 間のばらつき(前の表では標準偏差 5,000〜6,000 円)がどのモデルでも箱の幅として大きく、 モデル間の差より箱の広がりの方が目立つことを図で確かめる。
C. statsmodels で AIC / BIC を直接取得
🎯 このコードでやること: モデルを学習。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った df(2023 年度の 47 都道府県、47 行 × 112 列)
# 使う列: L3221 消費支出・A1101・A1303・A1302・A4101・B4101
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13 import statsmodels.api as sm
candidates = {
'M1: 総人口のみ' : [ 'A1101' ],
'M2: + 高齢人口' : [ 'A1101' , 'A1303' ],
'M3: + 生産年齢人口' : [ 'A1101' , 'A1303' , 'A1302' ],
'M4: フル' : [ 'A1101' , 'A1303' , 'A1302' , 'A4101' , 'B4101' ],
}
print ( f ' { "model" : 25 } { "AIC" : >8 } { "BIC" : >8 } { "adj R²" : >8 } ' )
for name , cols in candidates . items ():
Xc = sm . add_constant ( df [ cols ])
res = sm . OLS ( df [ 'L3221' ], Xc ) . fit ()
print ( f ' { name : 25 } { res . aic : 8.1f } { res . bic : 8.1f } { res . rsquared_adj : 8.3f } ' )
📤 実行例(SSDSE-B-2026・2023年度・47都道府県で実測。 目的変数=L3221 消費支出)
model AIC BIC adj R²
M1: 総人口のみ 1079.5 1083.2 0.091
M2: + 高齢人口 1081.3 1086.8 0.075
M3: + 生産年齢人口 1081.9 1089.3 0.080
M4: フル 1076.0 1087.1 0.218
💬 読み方: 説明変数 5 個の M4 が AIC 1076.0 で最小だが、 BIC では 1087.1 と M1 の 1083.2 より大きく、 BIC は総人口だけの M1 を選ぶ。 自由度調整済み R² は M1 の 0.091 から M2 で 0.075 に下がり、 65 歳以上人口や 15〜64 歳人口を足しても調整後はむしろ悪化する。 M4 の 0.218 は出生数・気温を入れた効果で、 どの基準を採るかで選ばれるモデルが変わる典型例。
D. Optuna でベイズ最適化(実例)
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った変数
# df: 2023 年度の 47 都道府県(47 行 × 112 列)
# X: A1101 総人口・A1302 15〜64歳人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 5 の DataFrame)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 import optuna
from sklearn.ensemble import RandomForestRegressor
def objective ( trial ):
params = {
'n_estimators' : trial . suggest_int ( 'n_estimators' , 100 , 800 ),
'max_depth' : trial . suggest_int ( 'max_depth' , 2 , 20 ),
'min_samples_leaf' : trial . suggest_int ( 'min_samples_leaf' , 1 , 10 ),
'max_features' : trial . suggest_float ( 'max_features' , 0.3 , 1.0 ),
}
p = Pipeline ([( 's' , StandardScaler ()),
( 'm' , RandomForestRegressor ( random_state = 42 , ** params ))])
sc = cross_val_score ( p , X , y , cv = 5 , scoring = 'neg_root_mean_squared_error' )
return - sc . mean ()
study = optuna . create_study ( direction = 'minimize' , sampler = optuna . samplers . TPESampler ( seed = 42 ))
study . optimize ( objective , n_trials = 50 , show_progress_bar = False )
print ( 'Best RMSE:' , study . best_value , ' params:' , study . best_params )
📤 実行例(実測)
Best RMSE: 22882.464014791774 params: {'n_estimators': 106, 'max_depth': 10, 'min_samples_leaf': 10, 'max_features': 0.3185501941438792}
💬 読み方: TPE(seed=42 で再現可能)で 50 試行探索した最良の CV RMSE は 22,882 円で、 木 106 本・深さ 10・葉の最小件数 10・特徴量の 32% だけを使う強めの制約が選ばれた。 同じ特徴量の RF を RepeatedKFold で測った 22,303 円より悪く見えるが、 こちらは shuffle しない 5 分割なので数字をそのまま比べられない。 50 試行のうち最良値を報告しているので、 この 22,882 円自体にも選択による楽観が含まれる。
E. HalvingGridSearchCV(高速グリッド探索)
🎯 このコードでやること: 回帰モデルを学習、精度を評価。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った変数
# df: 2023 年度の 47 都道府県(47 行 × 112 列)
# X: A1101 総人口・A1302 15〜64歳人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 5 の DataFrame)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12 from sklearn.experimental import enable_halving_search_cv # noqa
from sklearn.model_selection import HalvingGridSearchCV
import numpy as np
p = Pipeline ([( 's' , StandardScaler ()), ( 'm' , Ridge ())])
search = HalvingGridSearchCV (
p , param_grid = { 'm__alpha' : np . logspace ( - 3 , 3 , 20 )},
cv = 5 , scoring = 'neg_root_mean_squared_error' ,
factor = 3 , random_state = 42
)
search . fit ( X , y )
print ( 'Best α:' , search . best_params_ , 'CV RMSE:' , - search . best_score_ )
📤 実行例(実測)
Best α: {'m__alpha': np.float64(54.555947811685144)} CV RMSE: 26753.91754321267
💬 読み方: Halving は 20 候補を 10 件のデータで評価し、 上位 7 候補だけを 30 件で評価し直して α ≈ 54.6 を選んだ。 最終段でも 47 件のうち 30 件しか使っていないので、 CV RMSE 26,754 円は全件で探索したときの値(次のブロックの 24,155 円など)より悪く、 小さな n では早く絞り込む利点がほとんど無い。 Halving は数万件以上のデータで候補が多いときに効く手法。
F. 1-SE rule の実装
🎯 このコードでやること: 回帰モデルを学習、精度を評価。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った変数
# df: 2023 年度の 47 都道府県(47 行 × 112 列)
# X: A1101 総人口・A1302 15〜64歳人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 5 の DataFrame)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 from sklearn.model_selection import GridSearchCV
import numpy as np
alphas = np . logspace ( - 3 , 3 , 30 )
g = GridSearchCV ( Pipeline ([( 's' , StandardScaler ()), ( 'm' , Ridge ())]),
{ 'm__alpha' : alphas }, cv = 10 ,
scoring = 'neg_root_mean_squared_error' , return_train_score = False )
g . fit ( X , y )
# 最良 α より RMSE が「最良 + 1SE」以内で、 α が最大(最も正則化が強い=最も単純)を選ぶ
means = - g . cv_results_ [ 'mean_test_score' ]
ses = g . cv_results_ [ 'std_test_score' ] / np . sqrt ( 10 ) # 標準誤差 SE = fold 間 SD / √(fold 数)
best_idx = means . argmin ()
threshold = means [ best_idx ] + ses [ best_idx ]
eligible = np . where ( means <= threshold )[ 0 ]
one_se_idx = eligible [ np . argmax ( alphas [ eligible ])]
print ( f 'best α = { alphas [ best_idx ] : .3f } , RMSE = { means [ best_idx ] : .3f } , SE = { ses [ best_idx ] : .3f } ' )
print ( f '1-SE α = { alphas [ one_se_idx ] : .3f } , RMSE = { means [ one_se_idx ] : .3f } (より頑健)' )
📤 実行例(実測)
best α = 385.662, RMSE = 24155.414, SE = 2209.590
1-SE α = 1000.000, RMSE = 24192.960(より頑健)
💬 読み方: 10 分割で RMSE が最小になるのは α ≈ 385.7 の 24,155 円で、 その SE は 2,210 円。 基準 24,155 + 2,210 = 26,365 円以内に入る最大の α は探索範囲の上限 1000(24,193 円)で、 差はわずか 38 円。 1-SE 規則が上限の α を選ぶのは、 さらに強い罰則を試す余地があるという合図でもあり、 範囲を広げて曲線全体を確かめたい。
G. 早期停止つき勾配ブースティング
🎯 このコードでやること: 学習用と評価用にデータを分割、モデルを学習、予測を取得。
📥 入力例
# 前提: 「① 候補モデルの定義と CV 評価」のブロックで作った変数
# df: 2023 年度の 47 都道府県(47 行 × 112 列)
# X: A1101 総人口・A1302 15〜64歳人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 5 の DataFrame)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14 from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.model_selection import train_test_split
X_tr , X_va , y_tr , y_va = train_test_split ( X , y , test_size = 0.25 , random_state = 42 )
m = HistGradientBoostingRegressor (
max_iter = 1000 , learning_rate = 0.05 ,
early_stopping = True , validation_fraction = 0.2 ,
n_iter_no_change = 20 , random_state = 42 ,
min_samples_leaf = 5 , # 既定の 20 だと学習用 28 件では 1 回も分岐できず、平均値を返すだけになる
)
m . fit ( X_tr , y_tr )
print ( '停止 iter:' , m . n_iter_ )
print ( 'val RMSE :' , (( m . predict ( X_va ) - y_va ) ** 2 ) . mean () ** 0.5 )
print ( '平均値で予測したときの RMSE:' , (( y_tr . mean () - y_va ) ** 2 ) . mean () ** 0.5 )
📤 実行例(実測)
停止 iter: 33
val RMSE : 17575.284710623975
平均値で予測したときの RMSE: 22327.432038344024
💬 読み方: 学習用 35 県のうち 20%(7 県)を早期停止の監視に回し、 残り 28 県で木を育てる。 検証スコアが 20 回続けて改善しなかった時点で止まり、 停止 iter は 33。 評価用 12 県での RMSE は 17,575 円で、 学習データの平均値で予測した 22,327 円より約 21% 小さい。 葉の最小件数を既定の 20 のままにすると 28 県では 1 回も分岐できず、 iter 20 で止まって平均値とほぼ同じ予測しか返さない。
🐍 モデル選択 — Python 実装(拡張版)
5-fold CV を使って線形回帰/Ridge/Lasso/RandomForest を比較し、 最適モデルを選びます。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) B4101(年平均気温) L3221(消費支出(二人以上の世帯))
北海道 5,092,000 1,681,000 24,430 11.0 296,888
東京都 14,086,000 3,205,000 86,348 17.6 341,320
沖縄県 1,468,000 350,000 12,549 23.8 251,222
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 import pandas as pd
from sklearn.linear_model import LinearRegression , Ridge , Lasso
from sklearn.ensemble import RandomForestRegressor
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import KFold , cross_val_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
X = df [[ 'A1101' , 'A1303' , 'A4101' , 'B4101' ]] . values # 総人口・65歳以上・出生数・年平均気温
y = df [ 'L3221' ] . values # 消費支出
kf = KFold ( n_splits = 5 , shuffle = True , random_state = 42 )
models = {
'Linear' : make_pipeline ( StandardScaler (), LinearRegression ()), # 桁をそろえてから回帰
'Ridge' : make_pipeline ( StandardScaler (), Ridge ( alpha = 10 )),
'Lasso' : make_pipeline ( StandardScaler (), Lasso ( alpha = 100 , max_iter = 10000 )),
'RF' : RandomForestRegressor ( n_estimators = 100 , random_state = 42 ),
}
for name , m in models . items ():
scores = cross_val_score ( m , X , y , cv = kf , scoring = 'r2' )
print ( f ' { name : 6s } : R² = { scores . mean () : .3f } ± { scores . std () : .3f } ' )
📤 実行例:
Linear: R² = 0.046 ± 0.179
Ridge : R² = 0.117 ± 0.081
Lasso : R² = 0.076 ± 0.105
RF : R² = 0.157 ± 0.216
💬 平均 R² は RF の 0.157 が最も高いが、 fold 間の標準偏差も 0.216 と最大で、 平均から 1 SD 引くとマイナスになる。 Ridge は平均 0.117 と RF より低いものの標準偏差 0.081 が最小なので、 安定性を重視するなら Ridge を選ぶ。 そもそも 4 モデルとも R² は 0.2 未満で、 人口・出生数・気温では県ごとの消費支出の差はほとんど説明できない。 n=47 程度では必ず CV の標準偏差を確認して「安定して良い 」モデルを選ぶ。
⚠️ 10. よくある落とし穴
落とし穴
対処
前処理を全データに fit 必ず Pipeline を使い、 各 fold 内で fit。 テストデータでハイパラ選択 検証データを使う。 テストは最後の 1 回だけ。 同じCVでハイパラ選択と性能評価 ネスト CV で分離。 時系列に通常 k-fold TimeSeriesSplit を使う。 同一ユーザーが train/val 両方に GroupKFold で防ぐ。 平均だけ報告 標準偏差 / 95% CI も報告。 乱数固定を忘れる 必ず random_state を指定。
🏋️ 11. 練習問題
Q1. SSDSE-B で線形回帰・Ridge・RandomForest を 5-fold CV で比較しなさい。
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 「🐍 モデル選択 — Python 実装(拡張版)」のブロックで作った変数(2023 年度・47 都道府県)
# X: A1101 総人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 4 の ndarray)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー from sklearn.linear_model import LinearRegression , Ridge
from sklearn.ensemble import RandomForestRegressor
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import cross_val_score
for name , m in [( 'LR' , LinearRegression ()),
( 'Ridge' , Ridge ( alpha = 10 )),
( 'RF' , RandomForestRegressor ( n_estimators = 300 , random_state = 42 ))]:
p = Pipeline ([( 's' , StandardScaler ()), ( 'm' , m )])
sc = cross_val_score ( p , X , y , cv = 5 , scoring = 'neg_root_mean_squared_error' )
print ( f ' { name } : { - sc . mean () : .3f } ± { sc . std () : .3f } ' )
📤 実行例(実測)
LR: 29528.661 ± 3838.368
Ridge: 26343.172 ± 2184.135
RF: 24244.817 ± 4505.086
💬 読み方: cv=5 は shuffle しないので、 県コード順(北海道から沖縄県)に 9〜10 県ずつ地域のかたまりを丸ごと外して予測することになる。 同じ 4 変数の線形回帰でも shuffle した 5 分割では RMSE 22,427 円だったのに対し、 ここでは 29,529 円と約 3 割悪い。 この分割では RF が 24,245 円で最良だが、 分割の仕方で順位が変わりうるので、 shuffle した KFold や RepeatedKFold でも確かめてから結論を出す。
Q2. Ridge の α を GridSearchCV で 10 値から選びなさい。
🎯 このコードでやること: 回帰モデルを学習、精度を評価。
📥 入力例
# 前提: 「🐍 モデル選択 — Python 実装(拡張版)」のブロックで作った変数(2023 年度・47 都道府県)
# X: A1101 総人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 4 の ndarray)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー from sklearn.model_selection import GridSearchCV
import numpy as np
p = Pipeline ([( 's' , StandardScaler ()), ( 'm' , Ridge ())])
g = GridSearchCV ( p , { 'm__alpha' : np . logspace ( - 3 , 3 , 10 )}, cv = 5 , scoring = 'neg_root_mean_squared_error' )
g . fit ( X , y )
print ( 'Best α:' , g . best_params_ , 'CV RMSE:' , - g . best_score_ )
📤 実行例(実測)
Best α: {'m__alpha': np.float64(215.44346900318823)} CV RMSE: 25209.63610645567
💬 読み方: α を 0.001〜1000 の 10 候補で探すと α ≈ 215 が選ばれ、 CV RMSE は 25,210 円。 前のブロックの線形回帰 29,529 円・Ridge(α=10) 26,343 円より小さいが、 これは同じ 5 分割の中で最良の α を選んだ値なので楽観的に偏っている。 選び方まで含めた性能は、 次のネスト CV で測る。
Q3. ネスト CV で「ハイパラ選択を含む」公平な汎化性能を推定しなさい。
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 「🐍 モデル選択 — Python 実装(拡張版)」のブロックで作った変数(2023 年度・47 都道府県)
# X: A1101 総人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 4 の ndarray)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
# p: 直前のブロックの StandardScaler → Ridge の Pipeline(ステップ名 m)
📋 コピー from sklearn.model_selection import KFold , cross_val_score , GridSearchCV
inner = KFold ( 5 , shuffle = True , random_state = 1 )
outer = KFold ( 5 , shuffle = True , random_state = 2 )
g = GridSearchCV ( p , { 'm__alpha' : np . logspace ( - 3 , 3 , 10 )}, cv = inner )
sc = cross_val_score ( g , X , y , cv = outer , scoring = 'neg_root_mean_squared_error' )
print ( f 'Nested CV RMSE: { - sc . mean () : .3f } ± { sc . std () : .3f } ' )
📤 実行例(実測)
Nested CV RMSE: 25285.044 ± 4896.437
💬 読み方: 外側 5 分割のそれぞれで内側 5 分割のグリッドサーチをやり直した RMSE は 25,285 ± 4,896 円で、 前のブロックの best_score_ 25,210 円とほぼ同じ。 この例では α を選んだことによる楽観はほとんど無いが、 外側 fold 間のばらつき ±4,896 円の方がはるかに大きい。 内側の GridSearchCV は scoring を指定していないので R² で α を選び、 外側は RMSE で評価している点に注意する。
📝 12. 報告フォーマット
❌ NG例
「Random Forest が最良でした。」
✅ OK例
「県庁所在市の消費支出(L3221)を目的変数に、 OLS・Ridge(α=10)・Lasso(α=0.1)・RandomForest・GBM をそれぞれ Pipeline 化し、 5-fold × 10 回の RepeatedKFold(n=47、 全モデルで同じ分割)で比較した。 平均 RMSE は Ridge 22,242 円が最小だったが、 RandomForest(22,303 円)との差は 61 円で、 fold 間の標準偏差(約 5,600 円)の 1% ほどにすぎない。 この差ではどちらが良いとは言えないため、 係数を解釈できる Ridge を採用した。 GBM(24,625 円)は OLS(23,387 円)より悪かった。」(数値は 🧮 ② の実測値)
⚠️ 落とし穴(拡張版・各 100 文字以上)
① 前処理を CV の外で fit してしまう
StandardScaler や PCA を「全データに fit」してから CV を回すと、 検証 fold の情報が訓練に漏れる典型的データリーク。 性能が楽観的に評価され、 本番で大きく劣化する。 必ず Pipeline でくるみ、 各 fold 内で fit させる。 SSDSE-B(n=47)では fold 間で平均が大きく違うため特に深刻。 Optuna 等のハイパラ探索でも、 全データで fit した特徴量を使ってはいけない。
② 同じ CV を「ハイパラ選択」と「最終評価」両方に使う
GridSearchCV の best_score_ を最終性能として報告するのは楽観バイアスを含む。 ハイパラ探索の過程で「たまたまその fold で当たった」結果が混入。 公平な汎化推定にはネスト CV を使い、 内側でハイパラ選択、 外側で性能評価と分離する。 計算コストは k²倍だが、 論文・コンペ・本番展開前には必須。 Cawley & Talbot (2010) の警告参照。
③ 時系列データに通常の k-fold を適用
シャッフル k-fold では「未来のデータで学習し過去を予測」してしまい、 時系列の依存構造を破壊。 結果として性能が極端に楽観評価される(株価予測で R²=0.9 等)。 必ず TimeSeriesSplit(ウォークフォワード)を使う。 季節性が強い場合は purged + embargo の k-fold(López de Prado)も検討。 SSDSE 時系列(パネル)データの分析では特に注意。
④ グループ構造を無視(顧客・患者・地域単位)
同一顧客の複数取引が train/val に分かれて入ると、 「顧客 ID」レベルの汎化を評価できず、 性能が楽観的に。 47 都道府県データを年次パネルで学習する場合も、 同じ県が異なる年に train/val に入る。 GroupKFold(県単位)または LeaveOneGroupOut で汎化評価する。 医療データの患者単位、 マーケの顧客単位も同様の注意が必要。
⑤ CV の平均だけ報告して分散を無視
「Ridge は RMSE 3.18、 OLS は 3.24 なので Ridge の勝ち」は早計。 SD が 0.7 もあれば差は誤差範囲。 必ず平均 ± SD を併記し、 paired t-test や Wilcoxon 符号付順位検定で有意性を確認。 さらに RepeatedKFold(5-fold × 10 repeats など)で評価の分散を縮減。 1-SE rule(最良スコアの 1-SE 以内で最も単純なモデルを選ぶ)も実務的に有効。
⑥ AIC/BIC をスケール変換後のモデルで比較
AIC/BIC は同一データセット・同一目的変数 に対して比較可能。 y を log 変換したモデルと素のモデルの AIC を直接比べてはいけない(尤度が比較不能)。 同じく標準化の有無、 サンプル数が異なる場合も比較不可。 さらに非ネストモデルの比較では BIC でも厳密には正当化されない(Vuong test など別手法を検討)。 Burnham & Anderson (2002) の解説書参照。
⑦ random_state を固定せず再現性を失う
KFold(shuffle=True) や train_test_split で random_state を省略すると、 実行ごとに結果が変わる。 「先週は Ridge が勝ったが今週は OLS が勝った」となり議論不能。 全ての分割・モデル初期化・ハイパラ探索で random_state を指定。 さらに NumPy・PyTorch の seed も固定。 加えて PYTHONHASHSEED、 GPU 演算の決定論オプションまで考慮するのが完全再現の鉄則。
⑧ Stratified KFold を回帰問題でも使うべき場面
Stratified は分類の常識だが、 回帰でも y を四分位ビンに切って層化すると fold 間の y 分布が安定。 不均衡データ(極端な高所得観測が少数)では特に有効で、 fold ごとに「高所得サンプルがゼロ」となる事故を防ぐ。 StratifiedKFold に pd.qcut(y, 5) をラベルとして渡す実装。 sklearn 1.5 以降は StratifiedShuffleSplit でも同様。
📚 章構成
🤔 1. なぜモデル選択が必要か
同じデータに対して多くのモデル候補(線形・木・NN等)と、 多くのハイパラ組合せ(深さ・学習率等)が存在。 訓練誤差は常にモデルを複雑にするほど小さく なるため、 訓練誤差で選ぶと過学習モデルが採用されてしまう。
そこで「独立な検証データでの誤差 」を推定し、 それを最小化するモデルを選ぶ。 これがモデル選択の本質。
⚖️ 2. バイアス・分散トレードオフ
汎化誤差は次のように分解できる:
$$\mathbb{E}[(y - \hat{f}(x))^2] = \underbrace{(\mathbb{E}[\hat{f}]-f)^2}_{\text{バイアス}^2} + \underbrace{\mathbb{V}[\hat{f}]}_{\text{分散}} + \sigma^2$$
バイアス :モデルが真の関数を捉えられない誤差(簡単すぎ)分散 :訓練データの違いによる予測のばらつき(複雑すぎ)ノイズ $\sigma^2$:除けない誤差
「単純すぎ」も「複雑すぎ」も悪く、 最適な複雑さは中間にある。 これを探すのがモデル選択。
📊 3. ホールドアウト法
データを訓練 / 検証 / テストに 3 分割(例 60/20/20)。
訓練 → モデル学習
検証 → ハイパラ選択・モデル比較
テスト → 最終的な汎化性能
🎯 このコードでやること: 学習用と評価用にデータを分割。
📥 入力例
# 前提: 「🐍 モデル選択 — Python 実装(拡張版)」のブロックで作った変数(2023 年度・47 都道府県)
# X: A1101 総人口・A1303 65歳以上人口・A4101 出生数・B4101 年平均気温(47 × 4 の ndarray)
# y: L3221 消費支出(二人以上の世帯、円/月、47 件)
📋 コピー from sklearn.model_selection import train_test_split
X_train , X_temp , y_train , y_temp = train_test_split ( X , y , test_size = 0.4 , random_state = 42 )
X_val , X_test , y_val , y_test = train_test_split ( X_temp , y_temp , test_size = 0.5 , random_state = 42 )
# 60 / 20 / 20
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
💬 読み方: 47 県を 60 / 20 / 20 に分けると、 学習 28 県・検証 9 県・テスト 10 県になる(最初の分割で 0.4 × 47 = 18.8 を切り上げて 19 県を取り分け、 それを半分に分ける)。 random_state を固定しているので毎回同じ県が選ばれるが、 検証 9 県だけでモデルを選ぶと 1 県の外れ方で結論が変わるため、 n=47 では CV の方が安定する。
欠点:小さなデータでは分割の偶然で評価がぶれる。
🔁 4. k-fold 交差検証
データを k 個に分け、 順番に 1 つを検証、 残り k-1 で学習。 k 回の評価値を平均。
k=5 or 10 が標準
n が小さいとき有用(SSDSE-B n=47 に最適)
偶然のばらつきが平均化されて安定
🎯 このコードでやること: SSDSE-B-2026 を読み込み、K-分割交差検証で評価、精度を評価。
📥 入力例
# 入力: data/raw/SSDSE-B-2026.csv (47 都道府県 × 100超の社会経済指標)
# 先頭 3 行(A1101 = 総人口、 A4101 = 出生数 など):
# pref A1101 A4101 F3101
# 北海道 5092000 24430 156458
# 青森県 1184000 5696 43713
# 岩手県 1163000 5432 40955
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 import pandas as pd
from sklearn.model_selection import cross_val_score , KFold
from sklearn.linear_model import Ridge
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ]
X = df [[ 'A1101' , 'A1302' , 'A1303' , 'A4101' , 'B4101' ]]
y = df [ 'L3221' ]
pipe = Pipeline ([( 'scale' , StandardScaler ()), ( 'ridge' , Ridge ( alpha = 1.0 ))])
cv = KFold ( n_splits = 5 , shuffle = True , random_state = 42 )
scores = cross_val_score ( pipe , X , y , cv = cv , scoring = 'neg_root_mean_squared_error' )
print ( f 'CV RMSE: { - scores . mean () : .3f } ± { scores . std () : .3f } ' )
📤 実行例(SSDSE-B-2026・2023年度・47都道府県で実測。 目的変数=L3221 消費支出)
CV RMSE: 21748.326 ± 6947.208
💬 読み方: 標準化してから Ridge(α=1) を当てた 5 分割 CV の RMSE は 21,748 円で、 消費支出の県平均約 29.6 万円の 7% ほど。 fold 間の ± 6,947 円は平均の 3 割にあたり、 どの 9〜10 県がテストに入るかで誤差が大きく変わる。 ここで α=1 と決め打ちしているので、 次のネスト CV では α の選択まで含めて評価し直す。
4.1 Leave-One-Out (LOOCV)
k=n の特殊ケース。 1 サンプルだけ抜いて学習を n 回繰り返す。 バイアスは小さいが計算コスト大・分散も大きい。
4.2 ネスト CV
ハイパラ選定とモデル評価を別の CV で行う。 内側 CV でハイパラ選択、 外側 CV で性能評価。 「ハイパラ選択も含めた」公平な汎化推定。
🎯 このコードでやること: K-分割交差検証で評価、精度を評価。
📥 入力例
# 前提: 直前の CV ブロックで作った変数(2023 年度・47 都道府県)
# X: A1101・A1302・A1303・A4101・B4101(47 × 5)、 y: L3221 消費支出
# pipe: StandardScaler → Ridge の Pipeline(ステップ名 ridge)
📋 コピー from sklearn.model_selection import GridSearchCV , KFold , cross_val_score
inner = KFold ( 5 , shuffle = True , random_state = 1 )
outer = KFold ( 5 , shuffle = True , random_state = 2 )
grid = GridSearchCV ( pipe , param_grid = { 'ridge__alpha' : [ 0.01 , 0.1 , 1 , 10 ]}, cv = inner )
nested_scores = cross_val_score ( grid , X , y , cv = outer , scoring = 'neg_root_mean_squared_error' )
print ( f 'Nested CV RMSE: { - nested_scores . mean () : .3f } ' )
📤 実行例(実測)
Nested CV RMSE: 23968.968
💬 読み方: α を 0.01〜10 から内側 CV で選び、 外側 CV で評価したネスト CV の RMSE は 23,969 円で、 α=1 と決め打ちした前のブロックの 21,748 円より 2,221 円大きい。 外側の分割(random_state=2)が前のブロック(random_state=42)と違うことも差の一因なので、 同じ外側分割で比べるとより公平になる。
🎯 5. 特殊な分割
5.1 Stratified k-fold
分類タスクでクラス比率 を各 fold で保つ。 不均衡データ・小データで必須。
🎯 このコードでやること: K-分割交差検証で評価。
📥 入力例
# 入力: data/raw/SSDSE-B-2026.csv の 2023 年度・47 都道府県(このブロックで読み込む)
# X: A1101 総人口・B4101 年平均気温・L3221 消費支出(47 × 3)
# y: 高齢化率(A1303 / A1101 × 100)が中央値 31.78% 以上なら 1(24 県)、 未満なら 0(23 県)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 # ── この抜粋で使うデータを用意します ──
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'SSDSE-B-2026' ] == 2023 ] # 2023 年の 47 都道府県
X = df [[ 'A1101' , 'B4101' , 'L3221' ]] . astype ( float ) . values
_aging = df [ 'A1303' ] / df [ 'A1101' ] * 100
y = y_binary = ( _aging >= _aging . median ()) . astype ( int ) . values # 高齢化率が中央値以上か
X_train , X_test , y_train , y_test = train_test_split (
X , y , test_size = 0.3 , random_state = 42 , stratify = y )
from sklearn.model_selection import StratifiedKFold
skf = StratifiedKFold ( n_splits = 5 , shuffle = True , random_state = 42 )
for train_idx , val_idx in skf . split ( X , y_binary ):
pass
📤 このブロックは表示を作るだけで、標準出力には何も出ない
💬 読み方: 高齢化率が中央値 31.78% 以上の 24 県を 1 としたラベルで、 train_test_split(stratify=y) は学習 32 県(1 が 16 県)・テスト 15 県(1 が 8 県)とどちらも約半々に分ける。 StratifiedKFold は 47 県全体を 10・10・9・9・9 県に分け、 各 fold の 1 が 5・5・5・5・4 県になるよう比率をそろえる。 ループの中身は pass なので、 実際にはここで学習・評価のコードを書き足す。
5.2 GroupKFold
同一グループ(個人・店舗等)のサンプルが訓練と検証に分かれないように。 リーク防止。
🎯 このコードでやること: K-分割交差検証で評価。
📥 入力例
# 前提: 直前のブロックで作った df(2023 年度の 47 都道府県)・X(47 × 3)・y(高齢化率の 2 値ラベル)
# groups に使う Prefecture 列は 47 行すべて別の県
📋 コピー from sklearn.model_selection import GroupKFold
gkf = GroupKFold ( n_splits = 5 )
for train_idx , val_idx in gkf . split ( X , y , groups = df [ 'Prefecture' ]):
pass
📤 このブロックは表示を作るだけで、標準出力には何も出ない
💬 読み方: df は 2023 年度の 47 行だけなので、 Prefecture で group を作っても 1 県 1 行で、 GroupKFold は普通の KFold とほとんど同じ分け方になる。 GroupKFold が効くのは 12 年度分 564 行のパネルのように同じ県が複数行あるときで、 同じ県の別年度が学習側と検証側に割れてリークするのを防ぐ。
5.3 TimeSeriesSplit
時系列データで「未来→過去への漏れ」を防ぐ。 訓練は過去、 検証は未来。
🎯 このコードでやること: 「モデル選択」の最小コード。
📥 入力例
# 入力: data/raw/SSDSE-B-2026.csv の全 564 行(47 都道府県 × 2012〜2023 年度、このブロックで読み込む)
# 使う列: SSDSE-B-2026(年度)・Code・A1101 総人口・A1303 65歳以上人口
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14 # ── この抜粋で使う時系列を用意します ──
# 47 県 × 12 年を年度順に並べた 564 行。test_size=47 は「1 年ぶん(47 都道府県)」にあたる。
import pandas as pd
from sklearn.model_selection import TimeSeriesSplit
_d = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
_d = _d . sort_values ([ 'SSDSE-B-2026' , 'Code' ])
X_time = _d [[ 'A1101' , 'A1303' ]] . astype ( float ) . values
_year = _d [ 'SSDSE-B-2026' ] . values
tscv = TimeSeriesSplit ( n_splits = 5 , test_size = 47 , gap = 0 )
for train_idx , val_idx in tscv . split ( X_time ):
print ( f 'train { len ( train_idx ) } 行 ( { _year [ train_idx ] . min () } - { _year [ train_idx ] . max () } 年度)'
f ' → val { len ( val_idx ) } 行 ( { _year [ val_idx ] . min () } 年度)' )
📤 実行例(実測)
train 329 行 (2012-2018年度) → val 47 行 (2019年度)
train 376 行 (2012-2019年度) → val 47 行 (2020年度)
train 423 行 (2012-2020年度) → val 47 行 (2021年度)
train 470 行 (2012-2021年度) → val 47 行 (2022年度)
train 517 行 (2012-2022年度) → val 47 行 (2023年度)
💬 読み方: 年度順に並べた 564 行で test_size=47 にすると、 1 fold がちょうど 1 年度 47 都道府県になり、 2019〜2023 年度を 1 年ずつ、 それより前の年度だけで学習して予測する。 test_size を 47 の倍数でない値にすると、 同じ年度の県が学習側と検証側に分かれ、 「未来を知らずに予測する」 という時系列分割の意味が崩れる。
📚 補足: モデル選択の理論的背景と最新動向
モデル選択の現代的枠組みは 1973 年の赤池弘次による 赤池情報量規準 (AIC) の提案によって決定的に体系化された。 AIC の核心は「真の分布 $p^*$ と候補モデル $p_\theta$ の Kullback-Leibler ダイバージェンスの不偏推定」 にある。 数式で書けば AIC $= -2 \log L(\hat\theta) + 2k$ で、 $k$ は自由パラメータ数。 直感的には「対数尤度 (適合度) からモデル複雑さペナルティを引いた値」 を最小化するモデルを選ぶ。 SSDSE-B-2026 の都道府県データで線形回帰の説明変数を選ぶとき、 AIC が最小のモデルが期待される予測性能が最大となる。 一方、 Schwarz が 1978 年に提案した BIC (Bayesian Information Criterion) は BIC $= -2 \log L(\hat\theta) + k \log n$ で、 サンプルサイズ $n$ に対する罰則が大きい。 BIC は漸近的に真のモデルを選ぶ「一致性」 (consistency) を持ち、 AIC は予測精度を最適化する「効率性」 (efficiency) を持つ。 47 都道府県という小サンプルでは AIC のほうが寛容で多くの説明変数を残すが、 BIC は簡潔なモデルを推奨する。 両者を併記すれば、 受講生は「効率 vs 一致」 という統計学の根本的トレードオフを実感できる。
交差検証 (Cross-Validation, CV) は経験的にはモデル選択の標準手法だが、 理論的には Vapnik-Chervonenkis 次元 (VC 次元) や Rademacher 複雑度 といった汎化誤差の上界と結びついている。 LOOCV (Leave-One-Out CV) は線形モデルでは漸近的に AIC と等価であり、 K-fold CV は K を小さくするほどバイアスが増えるが分散は減る、 という有名なトレードオフがある。 実務では K=5 または K=10 が定番で、 小サンプルでは LOOCV、 大サンプルでは K=5 が推奨される。 SSDSE-B-2026 の 47 サンプルでは K=5 で 9-10 サンプル/fold となり、 fold 間の評価のばらつきが大きい。 そのため 反復 K-fold CV (Repeated K-fold) を用いて 10 回繰り返した平均を取ると安定する。 計算コストは増えるが、 47 サンプル × 10 回 = 470 評価程度なので全く問題にならない。 反復 CV を使えば「偶然うまく分割できたから良い結果」 という偶然のばらつきを抑え、 真の汎化性能に近い推定値が得られる。
手法 バイアス 分散 計算コスト 推奨用途
Holdout (一回分割) 高 (1 回の分割に依存) 高 最小 大サンプル (n > 10,000) K-fold (K=5) 中 中 K 倍 中規模 (n=100-10,000) K-fold (K=10) やや低 中 10 倍 中小規模 LOOCV 最低 最高 n 倍 小サンプル (n < 50) 反復 K-fold 中 低 K × 反復回数 標準的推奨 Nested CV 中 低 非常に大きい ハイパーパラメータ調整時
AIC と BIC 以外にも多数の情報量規準が提案されており、 それぞれ哲学が異なる。 (1) AICc (Hurvich-Tsai 1989): 小サンプル補正で、 $n/k < 40$ なら AIC より AICc を使うのが推奨。 47 都道府県 × 5 変数 = $n/k = 9.4$ なので、 SSDSE-B-2026 では AICc 必須。 (2) DIC (Deviance Information Criterion, Spiegelhalter ら 2002): ベイズ階層モデル用で、 有効パラメータ数 $p_D$ を MCMC から推定。 階層構造があるとき AIC では数えられない実効パラメータ数を補足できる。 (3) WAIC (Widely Applicable Information Criterion, 渡辺澄夫 2010): ベイズ枠組みで真のモデルが候補内になくても理論的根拠を持つ。 階層モデルや非正則モデルで威力を発揮し、 PyMC3/Stan の標準出力に含まれる。 (4) LOO-CV の PSIS-LOO 推定 (Vehtari ら 2017): Pareto smoothed importance sampling で計算高速化。 SSDSE-B-2026 を題材にしたベイズ階層モデル (たとえば都道府県を群とした多レベルモデル) では、 AIC ではなく WAIC や PSIS-LOO を使うのが現代的な選択である。
SSDSE-B-2026 (2023 年) で県別「消費支出 L3221」を、 人口動態変数の入れ子モデルで予測
モデル選択における代表的な落とし穴を 5 つ挙げる。 第一に 「テストセットを何度も見る」 : ハイパーパラメータ調整中にテストセットの結果を見て調整するのは厳禁。 必ず別の検証セットを使う。 第二に 「データ前処理を全データで行う」 : 標準化や欠損値補完を train+test 全体でやると情報漏洩。 必ず train だけで fit して test に transform を適用。 第三に 「CV のフォールドが層化されていない」 : 不均衡データでは StratifiedKFold を使わないとフォールド間のバイアスが大きい。 第四に 「複数モデルを比較した後の選択モデルの p 値を報告する」 : 選択バイアスで p 値が小さく出すぎる。 選択後検定 (post-selection inference) を使う。 第五に 「過剰に複雑なモデルを過剰に複雑な選択手順で選ぶ」 : モデル選択も奥が深いが、 SSDSE-B-2026 のような小サンプルでは「シンプルな AIC ベース選択 + Ridge 正則化」 で十分。 複雑さを増す前に、 シンプルなベースラインの限界を確認する習慣が重要である。
機械学習時代になると、 モデル選択は ハイパーパラメータ最適化 と アルゴリズム選択 の両方を含むようになり、 自動化が進んでいる。 (1) グリッドサーチ : 全組合せを試す。 単純だが次元の呪いで計算量が爆発。 (2) ランダムサーチ (Bergstra-Bengio 2012): ランダムに試す。 グリッドより効率的なことが多い。 (3) ベイズ最適化 (Bayesian Optimization, Snoek ら 2012): ガウス過程でハイパーパラメータ空間をモデル化し、 期待改善量が最大の点を逐次選ぶ。 scikit-optimize、 Optuna、 Hyperopt が定番。 (4) Hyperband (Li ら 2017): 計算予算を動的配分。 (5) AutoML (auto-sklearn, TPOT, H2O AutoML): モデル選択もハイパーパラメータ調整も自動化。 SSDSE-B-2026 のような小データでは AutoML は過剰だが、 大規模データでは強力。 ただし AutoML を盲信せず、 出力モデルの妥当性を必ず検証することが分析者の責務である。
モデル選択の重大な弱点は 「同じデータの少しの摂動で選ばれる変数が変わる」 という不安定性である。 とくに高次元データや小サンプルでは、 Lasso による変数選択が訓練データの偶然のばらつきに敏感に反応する。 Meinshausen と Bühlmann が 2010 年に提案した Stability Selection は、 ブートストラップやサブサンプリングを多数回繰り返して、 各変数が「何回選ばれたか」 を集計する手法である。 たとえば 100 回のサブサンプリングで 95 回以上選ばれた変数だけを最終モデルに採用する。 SSDSE-B-2026 の都道府県データに Lasso を適用すると、 「東京を含む fold か含まない fold か」 で選ばれる変数が大きく変動するが、 Stability Selection を使えばこの不安定性を緩和できる。 学術論文やコンペ提出物では、 「変数選択の安定性を Stability Selection で検証した」 と一文加えるだけで信頼性が大きく上がる。
モデル選択は単なる技術ではなく、 「予測 vs 解釈」、 「シンプル vs 複雑」、 「自動化 vs 手動」 といった分析哲学の選択を含む。 SSDSE-B-2026 を題材にコンペティションに挑む受講生は、 まず AIC/BIC/CV のいずれかでベースラインを決め、 そこから「なぜこのモデルを選んだか」 を明文化する習慣をつけてほしい。 「CV で最良だったから」 だけでは説得力が弱い。 「BIC でも M3 最小、 CV でも M3 最小、 さらに解釈性も M3 が最良なので採用」 と多角的に根拠を示せるレポートが評価される。 モデル選択は、 分析者がデータと向き合う姿勢の結晶である。 一つのモデルを選ぶことは、 一つの世界観を選ぶことに等しい。 この重みを意識しつつ、 透明で再現可能なモデル選択を行うことが、 統計データ分析コンペティション参加者に求められる本質的なスキルである。 そして、 モデル選択に「絶対の正解」 はないことも肝に銘じておこう。 状況・目的・データに応じて最適な手法は変わり、 その都度、 自分なりの根拠を持って選ぶ — それが分析者の責任である。