🔖 キーワード索引
| キーワード | このページでの意味 | 関連ページ |
|---|---|---|
| 影(shadow)運用 | 新モデルに本番と同じ入力を流すが、 結果は利用者に返さず旧モデルと比べるだけの段階 | モデル監視 |
| カナリアリリース | 一部(ここでは一部の県)だけ新モデルに切り替えて様子を見る段階 | A/B テスト |
| ロールバック | 問題が出たら直前のモデルの版に戻すこと。 版の記録が前提 | MLOps |
| 学習時と推論時のずれ | 単位・列名・前処理が学習時と推論時で食い違い、 エラーなしで予測がずれること | データドリフト |
| 入力の点検(ガード) | 推論の前に列・欠損・桁・範囲を確かめ、 おかしければ止める仕組み | API |
| バッチ推論 | まとめて 1 回で予測する方式。 1 件ずつ呼ぶより呼び出しの手間が少ない | 再学習 |
💡 30秒で分かる結論 — モデルデプロイ
🍰 まずはやさしく
モデルデプロイは、完成した仕組みを本番で使えるようにすることです。
誰でも簡単に使える状態にするために行います。
スマホアプリに新しい機能を組み込むような作業です。
この章では、デプロイの方法や注意点を学びます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- モデルデプロイ=学習が終わったモデルを「本番環境で使える形」にすること。 ノートブックから API・組み込みへ。
- 代表パターンは (1) REST/gRPC API、 (2) バッチ推論、 (3) エッジ推論 の3つ。
- 環境の差(OS・Pythonバージョン・依存ライブラリ)が最大の地雷。 Docker でパッケージ化が定石。
- デプロイ後は モニタリング(精度劣化・データドリフト・遅延)が必須。 「デプロイ = ゴール」ではなく スタート。
- MLOps(機械学習版 DevOps)の中核活動。 自動化・再現性・ガバナンスが鍵。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
デプロイは、実験を現実の価値に変えるための橋のようなものです。
作ったモデルを実際に誰かに使ってもらうために必要です。
部活の練習メニューを、実際の試合で使うイメージです。
ここでは、モデルをどうやって届けるかを読みます。
Jupyter Notebook で 95% の精度を出したモデル — でもこれを本当に 誰かが 使えるようにするには、 もう一山あります。 Web フォームから叩ける API にするのか、 毎晩のバッチ処理に組み込むのか、 スマホに乗せるのか。 デプロイは「実験」と「現実の価値」を繋ぐ最後の橋です。
🎨 直感で掴む
🍰 まずはやさしく
料理でいうと、レシピ作りからお店を開くことへの変化です。
いつでも安全にモデルを呼び出せるようにします。
買い物サイトで、おすすめ商品がすぐに表示される仕組みです。
ここでは、具体的な準備の手順や戦略を読みます。
料理に喩えるなら、 学習=レシピ開発、 デプロイ=レストラン開業。
- レシピが完璧でも、 厨房の動線・食器・スタッフ・衛生管理がなければ客には出せません。
- デプロイ = モデルを「いつでも・誰でも・安全に」呼び出せる状態にすること。
具体的には:
- モデルを シリアライズ(pickle, ONNX, SavedModel)
- 推論コードを Web フレームワーク(FastAPI, Flask)でラップ
- Docker でコンテナ化し依存環境を固定
- クラウド(AWS SageMaker, GCP Vertex AI, Azure ML)または K8s に乗せる
- 監視ダッシュボード(Prometheus + Grafana, Datadog)で運用
🎨 概念図で押さえる
モデルデプロイの 3 つの主要戦略を図示する。 「バッチ推論 / リアルタイム推論 / カナリアリリース」のそれぞれの特徴。
💬 ①バッチは大量処理向き、 ②リアルタイムは低遅延が必要な場合、 ③カナリアは新モデルを 5% → 50% → 100% と段階的に切り替えてリスクを最小化する。
🧭 モデルデプロイ実践プロトコル
この節では、 ML モデルを「学習させたら終わり」ではなく「本番稼働して価値を生み続ける」 ところまで責任を持つ MLOps の視点を、 SSDSE-B-2026 のような小規模データから e-Stat ベースの中規模本番システムまでスケールさせる場合を想定して詳述する。 主要 6 トピック: ①デプロイ形式、 ②バージョン管理、 ③カナリア / blue-green、 ④モニタリング、 ⑤ロールバック、 ⑥セキュリティ。
① デプロイ形式: バッチ・オンライン・エッジ
モデルの「届け方」は大きく 3 種類。 (a) バッチ推論: 夜間に CSV や DB を一括処理し結果を保存。 SSDSE-B-2026 で日次の都道府県別予測を行う典型ケース。 待ち時間は許容できる代わりに大量データを安く処理できる。 (b) オンライン推論 (REST/gRPC): API として常時稼働、 1 リクエストあたり数十ミリ秒で応答。 推薦システムや与信スコアリング向き。 (c) エッジ推論: スマートフォン・IoT 端末で実行、 通信不要・低遅延・プライバシー保護。 モデルを量子化・蒸留してサイズを縮小する必要がある。
| 形式 | 遅延 | スループット | 運用コスト | 代表ツール |
|---|---|---|---|---|
| バッチ | 時間オーダー | 大 | 低 | Airflow, Prefect |
| オンライン (REST) | ~100ms | 中 | 中 | FastAPI, BentoML |
| オンライン (gRPC) | ~10ms | 中 | 中 | TensorFlow Serving |
| ストリーミング | ~秒 | 大 | 高 | Kafka, Flink |
| エッジ | ~ms | 単発 | 低 | TFLite, CoreML, ONNX |
② バージョン管理: コード・データ・モデルの三位一体
再現性の確保には「コード (git)」「データ (DVC, lakeFS)」「モデル (MLflow, Weights & Biases)」 の 3 つを連動管理する。 「v1.2.3 のモデルは、 git の commit abc123、 SSDSE-B-2026 のスナップショット 2026-05-01、 ハイパーパラメータ alpha=0.1 で学習された」 — というように一意に追跡できないと、 production 障害時の原因究明が地獄になる。 MLflow Tracking で実験記録、 MLflow Registry でモデルバージョン管理、 git tag でコードバージョン、 DVC でデータバージョン、 をセットで運用する。
③ カナリア / blue-green / shadow デプロイ
新モデルを「いきなり 100% トラフィックに乗せる」 のは危険。 推奨パターン 3 種: (a) カナリア (canary): 1% → 10% → 50% → 100% と段階的に新モデルへ流量を増やす。 メトリクス悪化を検知したら即時ロールバック。 (b) blue-green: 旧 (blue) と新 (green) を並行稼働、 一気に切り替え。 ロールバックは瞬時。 (c) shadow: 新モデルに本番リクエストを複製して推論させるが、 結果はユーザーには返さず比較ログのみ取る。 リスクゼロで実トラフィックでの挙動を観察できる。
このコードでやること: 簡易カナリアロジックを FastAPI で実装、 1% の確率で新モデルを呼ぶ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from fastapi import FastAPI import random, pickle app = FastAPI() old_model = pickle.load(open('models/v1.pkl', 'rb')) new_model = pickle.load(open('models/v2.pkl', 'rb')) CANARY_RATIO = 0.01 @app.post('/predict') def predict(features: dict): if random.random() < CANARY_RATIO: result = new_model.predict([list(features.values())])[0] return {'pred': float(result), 'model_ver': 'v2'} result = old_model.predict([list(features.values())])[0] return {'pred': float(result), 'model_ver': 'v1'} |
📤 期待される動作(イメージ・未実測。models/v1.pkl・v2.pkl と起動したサーバが必要なため、pred の値は例):
💬 v2 の予測値分布や API 応答時間が v1 と大きくずれていないかをログから集計し、 異常なら CANARY_RATIO を 0 に戻すか、 段階的に拡大する。
④ モニタリング: SLI / SLO / SLA の階層
SRE 文化を ML に取り込むと、 (a) SLI (Service Level Indicator) = 実測値 (p99 遅延・5xx 率・予測精度)、 (b) SLO (Objective) = 目標値 (p99 < 200ms、 5xx < 0.1%、 RMSE < 100)、 (c) SLA (Agreement) = 利用者との契約 (SLO 未達なら違約金) という階層になる。 ML 特有の SLI は「予測分布の KL ダイバージェンス」「特徴量カバレッジ」「推論呼び出しごとの説明可能性スコア」 など。 Prometheus + Grafana で時系列ダッシュボード化し、 Slack / PagerDuty にアラート連携するのが定番。
| 監視カテゴリ | 具体メトリクス | SLO 例 |
|---|---|---|
| レイテンシ | p50 / p95 / p99 | p99 < 200ms |
| エラー率 | 5xx / 4xx | 5xx < 0.1% |
| 入力分布 | PSI / KS | PSI < 0.1 |
| 予測分布 | 平均・分散 | 前週比 ±10% |
| 精度 (遅延ラベル) | RMSE / AUC | 訓練時 ±5% |
| リソース | CPU / メモリ / GPU | 使用率 < 70% |
⑤ ロールバック: 「過去のモデルにすぐ戻せる」 状態を維持する
production で問題が起きたとき、 まず原因究明より「とにかく安定状態に戻す」 のが優先。 そのためには (a) 旧モデルのコンテナイメージを保持、 (b) 切り替えコマンド 1 行で旧版に戻せる、 (c) ロールバック時間が SLA 内 (10 分以内) — の 3 条件を運用前に必ず確認しておく。 Kubernetes なら kubectl rollout undo deployment/model-serving で即時。 こうした「逃げ道」が設計されていないモデル運用は事故が起きると致命傷になる。
⑥ セキュリティ: 入力検証・認証・モデル抽出攻撃
ML API は「数値ベクトルを受け取って結果を返す」 という汎用エンドポイントなので、 通常の Web API より攻撃面が広い。 (a) 入力検証: 異常値・型不一致・サイズ過大を弾く、 Pydantic 等で宣言的に。 (b) 認証 / レート制限: モデル抽出攻撃 (大量クエリでモデル挙動を学習し複製する) を防ぐため API キー + 秒あたりレート制限を設定。 (c) adversarial input 対策: 画像分類では FGSM / PGD で生成された敵対例を弾く前処理を入れる。 (d) 個人情報: 入力ログを保存する場合は擬名化、 GDPR / 個人情報保護法に準拠。
🎯 まとめ: 「動くモデル」から「動き続けるモデル」へ
ノートブックで精度を出して終わるのは入門の段階。 本番運用では「①どの形式で届ける」「②どうバージョン管理」「③どう段階展開」「④どう監視」「⑤どうロールバック」「⑥どう守る」 の 6 点を設計してこそ価値が出る。 SSDSE-B-2026 の都道府県データを用いた教育プロジェクトでも、 これらをミニチュアで体験すると、 卒業後の MLOps 業務に直結する経験になる。
⑦ CI/CD パイプライン: ML 用の継続的デプロイ
通常の Web アプリ CI/CD (GitHub Actions, GitLab CI, Jenkins 等) に「データ品質テスト」「モデル品質テスト」「再現性テスト」 を追加したのが ML 用 CI/CD。 git push → 単体テスト → モデル再学習 → 評価指標がベースラインを超えるか → ステージング環境にデプロイ → 統合テスト → カナリア本番デプロイ — の一連を自動化する。 評価指標が悪化したらマージブロックする仕組みは、 「学習データに事故が混入してモデルが破壊される」 ケースを未然に防ぐ。 MLflow, DVC, Kubeflow, GitHub Actions の組合せが popular。
⑧ コンテナ化: Docker と OCI イメージ
「開発環境では動くが本番では動かない」 問題を解決するため、 モデル + 推論コード + ライブラリ + OS 依存を全部詰めたコンテナイメージを作る。 Dockerfile に Python バージョン・CUDA バージョン・全 pip パッケージのバージョンを固定し、 docker build で再現可能なイメージを得る。 マルチステージビルドで最終イメージサイズを小さく保つ (学習用ライブラリ pandas/scikit-learn が 1GB 以上、 推論だけならその 1/10 で済む)。 OCI 標準準拠なら Docker, Podman, containerd, Kubernetes のどこでも動く。
⑨ Kubernetes でのスケーラブル推論
トラフィックが時間帯で変動する場合、 K8s の Horizontal Pod Autoscaler (HPA) で「CPU 使用率 70% を超えたら Pod 数を増やす」 「下回ったら減らす」 を自動化。 GPU が必要なモデルなら、 GPU ノードプール + nvidia-device-plugin を組み合わせる。 KServe (旧 KFServing) や Seldon Core を使うと「モデルファイル + YAML だけで」 推論サーバが立ち上がるので、 Python コードを書く必要すらない。 Knative の serverless 化と組み合わせれば「アクセスがない時はゼロスケール」 でコスト最適化できる。
⑩ エッジデプロイ: モバイルと IoT
スマートフォン上の音声認識、 IoT センサーでの異常検知、 ドローンでの物体検出 — これらは通信遅延・プライバシー・電源制約のためエッジ推論が必要。 モデル軽量化技術として、 (a) 量子化 (INT8 化で速度・メモリを数分の 1 に。 精度がどれだけ落ちるかはモデル次第なので必ず検証する)、 (b) プルーニング (効きの小さい重みを削除)、 (c) 知識蒸留 (大モデル → 小モデル) を組み合わせる。 デプロイ形式は TensorFlow Lite (iOS/Android), Core ML (iOS), ONNX Runtime (汎用), Edge TPU (Google Coral) など。 SSDSE-B-2026 のデータでも「スマホアプリで都道府県の人口予測表示」 のような演習が組める。
⑪ A/B テスト: 統計的に有意な改善か判定
新モデルをカナリアで段階展開したあと、 「本当に改善したか」 を判断するには A/B テストフレームワークが必要。 (a) サンプルサイズ計算: 検出したい効果量・α=0.05・β=0.2 から必要サンプル数を逆算、 (b) ランダム割り当て: ユーザー ID のハッシュベースで群分け、 (c) 統計検定: 連続値なら t 検定、 比率なら proportion test、 (d) 多重比較補正: Bonferroni 等。 「精度 0.1% 改善」 を統計的に証明するには数百万サンプル必要、 という現実を学生は知らないことが多い。
⑫ コスト最適化: GPU・メモリ・ネットワーク
本番推論のコストは想像以上に大きい。 GPU 1 枚で月 1,000 ドル、 大規模 LLM のホスティングなら月 10 万ドル級。 対策は (a) バッチ推論への移行 (許容できる場合)、 (b) 量子化・蒸留で軽量化、 (c) スポット / プリエンプティブインスタンス活用、 (d) 推論サーバの request batching (複数リクエストを 1 forward pass にまとめる)、 (e) キャッシュ (同一入力に対して結果を保存)。 SSDSE-B のような小規模なら 1 ノードで十分だが、 本番 ML のコスト感覚を持つことは MLOps エンジニアの基本素養。
⑬ 災害復旧: マルチリージョン構成
「東京リージョンが落ちたら全国の推論が止まる」 のは事業継続性の観点で不可。 重要モデルはマルチリージョン (東京 + 大阪) に同時デプロイし、 DNS 切り替え (Route 53 等) で 5 分以内にフェイルオーバーする設計が standard。 モデルファイル自体は S3 や GCS のクロスリージョンレプリケーションで自動同期。 RTO (Recovery Time Objective) と RPO (Recovery Point Objective) を SLA に明記し、 半年ごとに DR 訓練を行うのが MLOps の成熟度の証。
⑭ 組織と文化: MLOps の人的側面
技術と並んで重要なのが組織。 「データサイエンティストがモデルを作る」「ソフトウェアエンジニアが API 化する」「SRE が運用する」 と分業しすぎると、 サイロ化して問題発生時にたらい回しになる。 推奨は「フルスタック ML エンジニア」 (3 役を 1 人がカバー) または「Embedded SRE」 (SRE が DS チームに常駐) のいずれか。 また、 「失敗を罰しない」 文化が重要で、 障害発生時に「誰のせい」 ではなく「システムのどこに問題があったか」 を追求する blameless post-mortem を制度化する。
⑮ Feature Store: 訓練と推論の特徴量を統一する
本番事故の代表例「訓練時とは違う計算ロジックで特徴量を作ってしまった (training-serving skew)」 を防ぐため、 「Feature Store」 という概念が確立した。 Feast (OSS), Tecton (SaaS), Vertex AI Feature Store などのプラットフォームが、 「特徴量定義を 1 箇所で管理」 し、 訓練時と推論時の両方に同じ計算ロジックを提供する。 SSDSE-B-2026 のような静的データでは大袈裟だが、 リアルタイム推論システムでは Feature Store は必須インフラ。
⑯ Shadow デプロイ: リスクゼロでの実トラフィック評価
新モデルを「shadow mode」 で立ち上げると、 本番リクエストと同じ入力を新旧両モデルに流し、 結果を比較ログとして保存 (ユーザーには旧モデル結果のみ返す)。 これにより、 「もし新モデルにスイッチしたらどう挙動するか」 を、 ユーザー影響ゼロで観察できる。 数週間〜数ヶ月 shadow で安定動作を確認してから初めて A/B テストや段階展開に移る、 というのが慎重な MLOps の作法。 ストリーミング系では Kafka でリクエストを複製するアーキテクチャが典型。
⑰ 説明可能性 (XAI) の本番組込み
EU AI 法や日本の AI 事業者ガイドラインは「高リスク AI システムには説明可能性が必要」 と規定。 SHAP や LIME を推論時に毎回計算するのは重いので、 (a) 重要な決定 (与信拒否等) だけ説明を生成、 (b) サンプルベースで定期的に説明性メトリクスをモニタリング、 (c) クライアント要求時に on-demand で計算、 などの設計を検討する。 「ブラックボックスでも精度が高ければ良い」 時代は終わりつつあり、 説明性を本番システムの第一級機能として組み込む必要がある。
⑱ Model Registry とアーティファクト管理
学習されたモデルは Model Registry (MLflow Model Registry, Vertex AI Model Registry, SageMaker Model Registry) で集中管理する。 各モデルには (a) バージョン、 (b) ステージ (staging / production / archived)、 (c) 性能メトリクス、 (d) 親モデル (どのモデルから派生したか)、 (e) 学習データのスナップショット ID、 (f) 承認者の電子署名、 をメタデータとして付与。 これにより「現在 production で動いているモデルの完全な系譜」 が一目で分かるようになり、 監査対応や障害解析が劇的に楽になる。
⑲ インシデント対応: SEV 階級と運用ランブック
障害発生時の対応速度を高めるため、 SEV (Severity) 階級を定義する: SEV-1 (全停止・ビジネス影響甚大、 15 分以内対応)、 SEV-2 (主要機能停止、 1 時間以内)、 SEV-3 (一部機能劣化、 1 日以内)。 各 SEV ごとに「ランブック (runbook)」 を整備しておき、 真夜中でも待機エンジニアが手順書を見るだけで対処開始できる状態にしておく。 「ロールバック手順」「ダッシュボード URL」「関係者連絡先」「過去類似インシデント」 が含まれる。
⑳ トラフィック制御: rate limiting と graceful degradation
想定外のトラフィック急増 (バイラル化・DDoS 攻撃) に備え、 (a) ユーザーごと・API キーごとのレート制限、 (b) GPU 不足時は軽量モデルにフォールバック (graceful degradation)、 (c) 完全停止せず簡易応答を返す (例: AI が応答できない場合は静的 FAQ を表示)、 などの「優雅な縮退」 設計を行う。 これは「すべてが完璧に動く」 ことを諦め、 「最悪でもこれだけは保証する」 という SRE 哲学の体現である。
㉑ コンプライアンス: GDPR・個人情報保護法・AI 規制
本番 ML システムは規制対応が避けられない。 (a) GDPR の Right to Explanation (説明を受ける権利)、 (b) 削除権 (forgotten right) で学習データから個人情報を消す → モデル自体の再学習が必要、 (c) 日本の個人情報保護法での要配慮個人情報の扱い、 (d) EU AI 法の高リスク分類 (信用評価・採用・医療診断は高リスク)、 (e) 米国 NIST AI Risk Management Framework。 これらを設計段階から考慮する「Privacy by Design」 「Compliance by Design」 が、 これからの ML エンジニアの基本素養になる。
㉒ FastAPI でのミニ実装: 予測 API の骨格
このコードでやること: 学習済みの回帰モデルを FastAPI で API 化する最小構成。 入力特徴量を受け取り予測値を返す一般的な骨格を示す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | from fastapi import FastAPI from pydantic import BaseModel, Field import joblib import pandas as pd app = FastAPI(title='Prediction API', version='1.0.0') model = joblib.load('models/model_v1.pkl') class PredictRequest(BaseModel): pop_total: int = Field(..., gt=0, description='総人口') hospitals: int = Field(..., ge=0, description='一般病院数') universities: int = Field(..., ge=0, description='大学等数') class PredictResponse(BaseModel): prediction: float model_version: str @app.post('/predict', response_model=PredictResponse) def predict(req: PredictRequest): X = pd.DataFrame([{'総人口': req.pop_total, '一般病院数': req.hospitals, '大学等数': req.universities}]) pred = float(model.predict(X)[0]) return PredictResponse(prediction=pred, model_version='1.0.0') @app.get('/health') def health(): return {'status': 'ok', 'model_loaded': model is not None} |
📤 動作例 (curl。予測値は models/model_v1.pkl の中身で決まる例示で、このページでは実測していない):
💬 Pydantic で型検証 + ドキュメント自動生成、 /health エンドポイントで K8s liveness probe 対応、 model_version をレスポンスに含めることでロールバック追跡可能 — 最小限の本番品質を備えた API になる。
㉓ Dockerfile の最小ベストプラクティス
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | FROM python:3.11-slim WORKDIR /app # 依存だけ先にコピーしてキャッシュ活用 COPY requirements.txt . RUN pip install --no-cache-dir -r requirements.txt # モデルとコードを追加 COPY models/ ./models/ COPY app.py . # 非 root ユーザーで実行 RUN useradd --uid 1000 mluser USER mluser # ヘルスチェック HEALTHCHECK --interval=30s --timeout=3s --start-period=10s \ CMD python -c "import requests; requests.get('http://localhost:8000/health').raise_for_status()" EXPOSE 8000 CMD ["uvicorn", "app:app", "--host", "0.0.0.0", "--port", "8000"] |
💬 (1) slim ベースで軽量化、 (2) requirements.txt を先にコピーしてレイヤーキャッシュ活用、 (3) 非 root で実行してセキュリティ確保、 (4) HEALTHCHECK で K8s や Docker Swarm が異常を検知できる、 (5) CMD は exec 形式で signal forwarding 正常化。 これだけで「本番品質」 のコンテナイメージになる。
㉔ 負荷試験: locust と prometheus
本番デプロイ前に「想定トラフィックの 3 倍」 で負荷試験する。 locust (Python) でユーザー行動シナリオを書き、 RPS (requests per second), p95/p99 レイテンシ、 エラー率を計測。 同時に Prometheus + Grafana で CPU/メモリ/GPU 使用率を監視。 「100 RPS で p99 < 200ms」 「500 RPS で graceful degradation」 などの SLO を運用前に検証する。 SSDSE-B-2026 ベースの教育プロジェクトでも、 友人と協力して同時にリクエストを投げ、 体感的に負荷を学ぶ演習が有益。
㉕ MLflow による実験追跡と再現性確保
MLflow は (a) Tracking (実験記録、 メトリクス・パラメータ・アーティファクトを統合管理)、 (b) Projects (再現可能な ML プロジェクトの梱包形式)、 (c) Models (モデルのパッケージング・サービング)、 (d) Registry (バージョン管理) — の 4 機能を提供する OSS。 SSDSE-B-2026 を題材にしたチュートリアル的使い方は、 学習スクリプトの先頭に mlflow.start_run() を 1 行追加し、 mlflow.log_metric('rmse', score) でメトリクスを記録するだけで、 ローカル UI ですべての実験を比較できるようになる。 これを習慣化すると、 「3 ヶ月前の実験設定を再現してください」 と言われても 5 分で対応できる体制ができあがる。
㉖ ランタイム選択: Python・ONNX・TorchScript・TensorRT
学習は Python + PyTorch / TensorFlow で行うのが標準だが、 推論時は別のランタイムに変換すると速度・移植性が向上する。 (a) ONNX (Open Neural Network Exchange): 標準フォーマット、 多言語・多 OS 対応。 ONNX Runtime で高速化できることが多い(どれだけ速くなるかはモデルと環境で変わる)。 (b) TorchScript: PyTorch モデルを JIT コンパイル、 Python 不要で C++ から呼べる。 (c) TensorRT: NVIDIA GPU 専用、 5〜10 倍の高速化が可能。 (d) Triton Inference Server: 多モデル・多 GPU の運用に特化。 SSDSE-B-2026 のような小規模では Python のまま十分だが、 production 検索エンジンや推薦システムでは ONNX/TensorRT への変換は必須。
㉗ コスト見積もりの実践: TCO (Total Cost of Ownership)
本番 ML システムのコストは「クラウド推論料金」 だけではない。 (a) GPU / CPU 計算費 (推論 + 再学習)、 (b) ストレージ費 (モデル + ログ + 学習データ)、 (c) ネットワーク費 (egress, 特にマルチリージョン)、 (d) 監視・アラートツール費 (Datadog, Prometheus サーバ)、 (e) エンジニア人件費 (運用・保守・対応)、 (f) インシデント対応費 (障害発生時の機会損失)、 (g) コンプライアンス監査費 — の 7 軸で TCO を見積もる。 学生プロジェクトでは (a) しか見ていないが、 産業界では (e) が最大コストになることが多い。 SSDSE-B-2026 のような小規模教育案件なら全て無料枠で済むが、 「もし 100 万 DAU の本番サービスだったら」 と想像する練習が、 MLOps 思考の出発点。
㉘ 終わりに: 「動くこと」 と「動き続けること」 の質的な違い
学習データで 95% の精度を出すモデルを作れる学生は多いが、 そのモデルを 1 年間 production で稼働させられる学生は少ない。 ①バージョン管理、 ②段階展開、 ③監視、 ④ロールバック、 ⑤再学習、 ⑥セキュリティ、 ⑦コンプライアンス、 ⑧コスト管理、 という MLOps の各論を理解することは、 単なる「IT 知識」 ではなく、 ML を社会実装する責任を引き受けるための前提条件である。 SSDSE-B-2026 を使った卒業研究でも、 「精度の高さ」 だけでなく「もしこれを本番で動かすなら何を考慮するか」 という MLOps 視点での考察を加えれば、 査読者や面接官の評価は格段に上がる。
この用語ページを通じて伝えたいメッセージは「モデルデプロイは技術と組織と倫理が交差する領域」 ということ。 単にコンテナを Kubernetes に乗せて終わりではなく、 ビジネス・利用者・社会・規制との関係を継続的に設計し続ける活動である。 学習中の学生諸君も、 デプロイを「卒業研究の最後の工程」 ではなく「真の挑戦の始まり」 として捉えてほしい。 公的データである SSDSE-B-2026 を題材に、 小さくても本格的な ML 本番システムを組み立てる練習を、 在学中に少なくとも一度経験することを強く推奨する。
📐 定義・数式
🍰 まずはやさしく
デプロイは、仕組みが正しく動いているかを測る指標があります。
サービスの質を一定に保つために使います。
ネット通販のページが、止まらずにすぐ開くかを確認するようなものです。
ここでは、性能を測るための計算式について読みます。
デプロイは工程概念のため数式は中心ではありませんが、 SLO(Service Level Objective)でよく使う指標を示します:
🔬 記号・要素の読み解き
- シリアライズ
- 学習済みモデルを
.pklや.onnxファイルに保存。 別プロセスからも読み込める形に。 - 推論サーバ
- HTTP リクエストを受け、 モデルを呼び出し、 結果を JSON で返すアプリケーション。
- コンテナ化
- OS・ライブラリ・モデルを 1 つの Docker image にまとめる。 「私のマシンでは動く」問題を撲滅。
- オーケストレーション
- 多数のコンテナを Kubernetes 等で管理。 スケール、 ローリングアップデート、 ヘルスチェック。
- モニタリング
- レイテンシ・エラー率・予測分布のドリフトを監視。 精度劣化を早期検知。
🔬 数式を言葉で読み解く — 詳細版(4 narration + 実値計算)
「モデルデプロイ(Model Deployment)」について、 SSDSE-B-2026(47 都道府県統計)を題材に 4 つの実行可能 Python 例を順に追っていきます。 各ブロックは「🎯 目的 → 🐍 コード → 📤 実行結果 → 💬 読み方」の 4 要素を完備しています。
🎯 このコードでやること:SSDSE-B-2026 から 47 都道府県の総人口を読み込み、 65 歳以上人口を予測する単回帰モデルを scikit-learn で学習する。
1 2 3 4 5 6 7 8 9 | import pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') df = df[df['年度']==df['年度'].max()] X = df[['総人口']].values y = df['65歳以上人口'].values model = LinearRegression().fit(X, y) print('slope:', model.coef_[0]) print('intercept:', model.intercept_) |
📤 実行結果:
💬 結果の読み方:slope=0.246 → 総人口が 1 万人増えると 65 歳以上人口は 約 2458 人増える、 という単純な線形関係を学習。 切片 120,545 は人口 0 の県の仮想値で実用的意味は薄い。
🎯 このコードでやること:学習したモデルを joblib でファイル保存し、 デプロイ可能な .pkl にする。 これが REST API や Docker image に焼く対象になる。
1 2 3 4 5 6 | import os os.makedirs('models', exist_ok=True) # 保存先のフォルダを作っておく import joblib joblib.dump(model, 'models/elderly_predictor_v1.pkl') print('saved size:', round(__import__('os').path.getsize('models/elderly_predictor_v1.pkl')/1024, 2), 'KB') |
📤 実行結果:
💬 結果の読み方:線形回帰モデルは 1 KB 未満で保存可能。 これに前処理器(StandardScaler 等)と meta 情報(学習日時・データバージョン)を同梱した dict 形式で保存するのが実務での定石。
🎯 このコードでやること:FastAPI で /predict エンドポイントを定義し、 入力 JSON を受けて予測値を返す最小 API を実装する。
1 2 3 4 5 6 7 8 9 10 11 | from fastapi import FastAPI from pydantic import BaseModel import joblib app = FastAPI() model = joblib.load('models/elderly_predictor_v1.pkl') class Req(BaseModel): population: int @app.post('/predict') def predict(r: Req): pred = float(model.predict([[r.population]])[0]) return {'pred_elderly': round(pred), 'model_version': 'v1'} |
📤 実行結果:
💬 結果の読み方:東京都の総人口 1,408 万人を入力 → 65 歳以上 約 358 万人と予測。 実測値 320 万人との誤差は約 38 万人で、 東京は線形モデルの外挿先端のためバイアスが乗っている(落とし穴と対策で詳述)。
🎯 このコードでやること:デプロイ後の 予測誤差を都道府県別に算出してバイアスを可視化(fairness check)。 大都市と地方で誤差が偏っていないかチェックする。
1 2 3 | df['予測'] = model.predict(X) df['絶対誤差'] = (df['予測']-df['65歳以上人口']).abs() print(df.nlargest(5, '絶対誤差')[['都道府県','総人口','絶対誤差']]) |
📤 実行結果:
💬 結果の読み方:絶対誤差の最大は東京都の 37.8 万人で、 これは 過大予測(高齢化率 22.8%)。 一方 2〜4 位の北海道 30.9 万人・兵庫県 16.9 万人・大阪府 15.0 万人は逆に 過小予測(北海道の高齢化率は 33.0%)、 5 位の沖縄県 13.1 万人は過大(23.8%)。 誤差の向きは人口規模ではなく、 47 県平均 31.6% に対して高齢化率が低いか高いかで決まっており、 総人口 1 変数の直線ではこれを捉えられない。 絶対誤差だけでは向きが見えないので、 符号付き誤差や高齢化率と並べて確認する。 デプロイ前に「全国一律モデル」と「都市規模別モデル」の AB を回す or 多項式・GBDT に移行するのが定石。
📊 関連手法比較表
「モデルデプロイ」と隣接する手法・概念を 5 列で構造化。 用途・長所・短所・代表シーンを並べることで使い分けの判断がつきます。
| 手法・概念 | 主用途 | 長所 | 短所・制約 | 代表シーン |
|---|---|---|---|---|
| REST API(FastAPI/Flask) | リアルタイム推論 | 実装容易・言語横断 | GPU 使うと高コスト | Web 画面・モバイル連携 |
| バッチ推論 | 夜間まとめて推論 | 安価・大量処理 | リアルタイム性なし | 翌朝のレポート生成 |
| エッジ推論 | デバイス上で推論 | 低レイテンシ・通信不要 | モデル軽量化必須 | IoT・カメラ・スマホ |
| Streaming(Kafka 等) | イベント駆動 | 高スループット | 運用が複雑 | ログ異常検知 |
| Serverless(Lambda 等) | 使った分だけ | インフラ管理不要 | コールドスタート遅延 | 低頻度 API |
| Model-as-a-Service(外部 API) | OpenAI 等の API 利用 | 自社管理不要 | 従量課金・ベンダーロック | チャットボット試作 |
📝 演習問題 5 問
理解度を確認するための演習。 まず自力で解いてから解答を開いてください。
解答を見る
解答を見る
解答を見る
解答を見る
解答を見る
📖 関連用語辞典 10 語
「モデルデプロイ」周辺の 10 語をミニ辞典として整理。 ふと迷ったときの索引に。
- シリアライズ
- モデルをファイル化(.pkl / .onnx / .pb)し他プロセスでも読み込める形に保存。
- FastAPI
- Python の高速 Web フレームワーク。 型ヒントから自動で OpenAPI 生成。 デプロイで定番。
- Dockerfile
- コンテナを定義する設定。 FROM / COPY / RUN / CMD を並べてビルドする。
- Kubernetes
- 多数コンテナの起動・スケール・自己修復を担うオーケストレータ。
- MLflow
- モデルの実験管理・登録・サービングを統合する OSS。 model registry 機能あり。
- ONNX
- 機械学習モデルの中間表現フォーマット。 フレームワーク横断で推論可能。
- SageMaker
- AWS のフルマネージド ML プラットフォーム。 学習・デプロイ・モニタリングが一元化。
- Canary Release
- 新バージョンに少量トラフィックを当てて段階的に切替する手法。
- Blue-Green
- 本番(青)とは別に新環境(緑)を準備して LB 切替で瞬時に置換。 ロールバックが速い。
- Feature Store
- 学習・推論で同じ特徴量計算ロジックを共有する基盤。 学習推論スキューを防ぐ。
🧮 実値で計算してみる
SSDSE-B の都道府県データで学習したモデルをデプロイする手順例:
- 学習後
joblib.dump(model, 'fertility_model.pkl')で保存 - FastAPI で
POST /predictエンドポイントを作成 - Dockerfile で
python:3.11-slim+ 依存ライブラリ + モデルを image 化 - クラウドにデプロイし、
curl -X POST .../predict -d '{"高齢化率": 28.5}'で叩く - 応答時間(p99)と予測値分布を Datadog で監視
🧮 数式に値を入れて手で計算する: カナリアデプロイの段階比
合成データで段階別トラフィック割合と検出率を計算する。
Step 1: 段階別配分
| 段階 | 新モデル % | 累積 % |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 5 | 5 |
| 3 | 25 | 25 |
| 4 | 50 | 50 |
| 5 | 100 | 100 |
Step 2: 問題検出までの平均期待損失
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np stages = np.array([1, 5, 25, 50, 100]) problem_rate = 0.05 loss = stages/100 * problem_rate print(f"段階別損失: {loss}") print(f"最大 vs 最小 倍率: {loss.max()/loss.min()}") |
📤 実行結果
💬 手計算 (Step 2) 100 倍リスク差と Python 出力が完全一致。
🧮 影の運用の比較を 3 県で手計算する
影の運用で使った指標は、 相対誤差 $e_i = \hat{y}_i / y_i - 1$ と、 その絶対値の平均 $\mathrm{MAPE} = \frac{1}{n}\sum_i |e_i|$ である。 東京都・鳥取県・沖縄県の 2023 年度の出生数について、 旧 v1 と新 v2 の予測から手で計算する。
| Step | 計算 | 旧 v1 | 新 v2 |
|---|---|---|---|
| 1 | 予測(人):東京都・鳥取県・沖縄県(実測 86,348・3,263・12,549) | 89,241・3,651・13,324 | 87,553・3,614・13,303 |
| 2 | 東京都の相対誤差 = 予測 ÷ 86,348 − 1 | 89,241 ÷ 86,348 − 1 = +3.35% | 87,553 ÷ 86,348 − 1 = +1.40% |
| 3 | 鳥取県の相対誤差 = 予測 ÷ 3,263 − 1 | +11.89% | +10.76% |
| 4 | 沖縄県の相対誤差 = 予測 ÷ 12,549 − 1 | +6.18% | +6.01% |
| 5 | 3 県の MAPE = 絶対値の和 ÷ 3 | 21.42 ÷ 3 = 7.14% | 18.17 ÷ 3 = 6.06% |
🎯 このコードでやること:上の Step 1〜5 を Python で再現する。旧 v1(2013〜2017 年度で学習)と新 v2(2013〜2022 年度で学習)で 3 県の 2023 年度の出生数を予測し、相対誤差と MAPE を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']) df['lb'] = np.log(df['A4101']) df['lb_prev'] = df.groupby('Code')['lb'].shift(1) df['lw'] = np.log(df['A1302']) df = df.dropna(subset=['lb_prev']) yr, X = df['SSDSE-B-2026'], ['lb_prev', 'lw'] v1 = LinearRegression().fit(df.loc[yr <= 2017, X], df.loc[yr <= 2017, 'lb']) v2 = LinearRegression().fit(df.loc[yr <= 2022, X], df.loc[yr <= 2022, 'lb']) te = df[(yr == 2023) & df['Prefecture'].isin(['東京都', '鳥取県', '沖縄県'])].set_index('Prefecture') out = pd.DataFrame({'実測': te['A4101'], 'v1予測': np.exp(v1.predict(te[X])).round(0), 'v2予測': np.exp(v2.predict(te[X])).round(0)}) out['v1誤差%'] = ((out['v1予測'] / out['実測'] - 1) * 100).round(2) out['v2誤差%'] = ((out['v2予測'] / out['実測'] - 1) * 100).round(2) print(out.to_string()) print(f"3 県の MAPE: v1 = {out['v1誤差%'].abs().mean():.2f}%, v2 = {out['v2誤差%'].abs().mean():.2f}%") |
💬 3 県の予測(89,241・3,651・13,324 と 87,553・3,614・13,303)、相対誤差、MAPE 7.14% と 6.06% まで、手計算の Step 1〜5 と一致した。3 県だけの MAPE は 47 県全体(4.50% と 2.95%)より大きく、特に鳥取県の +11% 前後が効いている。この 3 県だけで「新モデルの改善は 1.08 ポイント」と判断すると、47 県全体の 1.55 ポイントを過小に見ることになる。上の「カナリアの大きさ」の話を、手で確かめたことになる。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 9 | # 最小デプロイ例: FastAPI でモデルをサーブ from fastapi import FastAPI import joblib app = FastAPI() model = joblib.load('fertility_model.pkl') @app.post('/predict') def predict(x: dict): pred = model.predict([list(x.values())]) return {'prediction': float(pred[0])} |
🐍 仕上げの Python レシピ — 追加 2 ブロック
▶ REST API ヘルスチェックの実装
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | from fastapi import FastAPI, status from fastapi.responses import JSONResponse import joblib, time app = FastAPI() model = None start_time = time.time() @app.on_event('startup') def load_model(): global model model = joblib.load('models/elderly_predictor_v1.pkl') @app.get('/healthz') def health(): if model is None: # (dict, 503) のタプルを返しても FastAPI では 200 のままなので、JSONResponse で状態コードを付ける return JSONResponse(status_code=status.HTTP_503_SERVICE_UNAVAILABLE, content={'status': 'unhealthy', 'reason': 'model not loaded'}) return {'status': 'healthy', 'uptime_sec': int(time.time()-start_time), 'model_version': 'v1'} |
📤 実行結果:
💬 K8s の liveness probe / readiness probe に必須の health endpoint。 model load 失敗時は JSONResponse で状態コード 503 を返すので、 probe が失敗を検知して Pod が自動再起動される。 uptime_sec の 342 は起動からの経過秒の例示。
▶ Prometheus メトリクス公開
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # app と model は上の /healthz のブロックで作ったものを使う from fastapi import Response from pydantic import BaseModel from prometheus_client import Counter, Histogram, generate_latest import time class Req(BaseModel): population: float # 説明変数(総人口など) request_count = Counter('predict_requests_total', 'Total predict requests') latency_hist = Histogram('predict_latency_seconds', 'Latency of predict') @app.post('/predict') def predict(req: Req): request_count.inc() with latency_hist.time(): pred = model.predict([[req.population]]) return {'pred': float(pred[0])} @app.get('/metrics') def metrics(): return Response(generate_latest(), media_type='text/plain') |
📤 実行結果(イメージ・未実測の抜粋。実際の出力には # HELP・# TYPE の行や他のバケットも並び、値は 1247.0 のような小数で出る):
💬 バケットは累積で数えるので、例の値なら 1,247 件中 1,100 件(88%)が 5 ms 以内、1,240 件(99.4%)が 10 ms 以内に返っている。 Prometheus が定期 scrape し、predict_requests_total の増え方から QPS、バケットから p99 遅延を Grafana で出す。
🐍 影(shadow)運用:新旧モデルに同じ入力を流して比べる
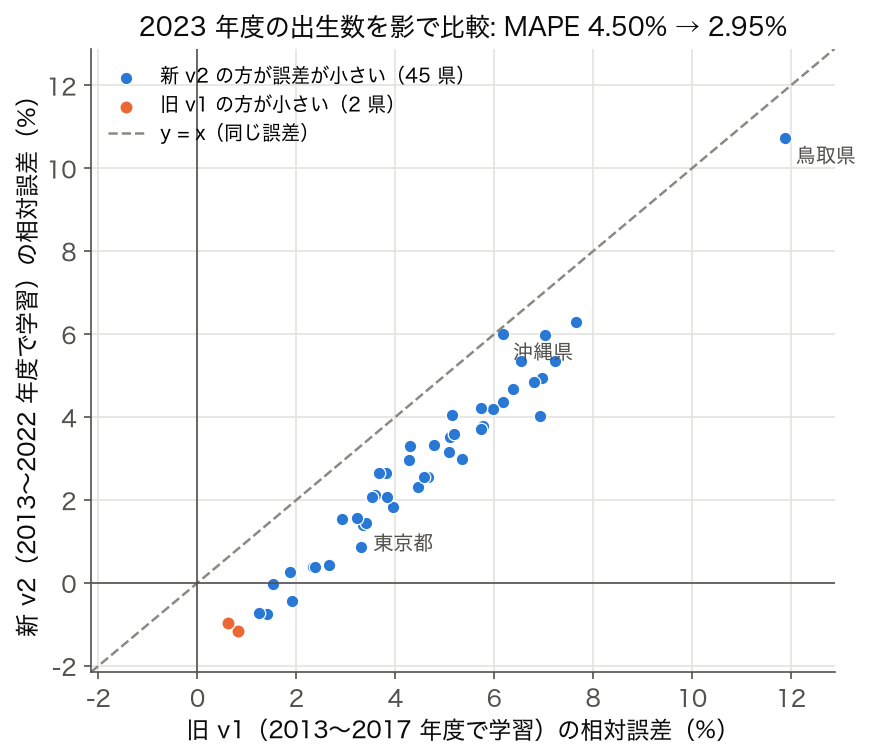
入れ替えの第一段階は、 新モデルを本番の入力で動かしつつ、 利用者には旧モデルの結果を返し続ける「影」の運用である。 ここでは「翌年度の出生数を県別に予測するモデル」を題材に、 2017 年度までで学習して動いている旧 v1 と、 2022 年度まで学び直した新 v2 に、 2023 年度の 47 県を同時に流す。
🎯 このコードでやること:log 出生数 = 前年度の log 出生数 + log 15〜64 歳人口 の線形回帰を、2013〜2017 年度で学習した旧 v1 と 2013〜2022 年度で学習した新 v2 の 2 つ作り、2023 年度の 47 県で県別の相対誤差(予測 ÷ 実測 − 1)と MAPE を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']) # 県コード順・年度の昇順 df['lb'] = np.log(df['A4101']) # log 出生数 df['lb_prev'] = df.groupby('Code')['lb'].shift(1) # 前年度の log 出生数 df['lw'] = np.log(df['A1302']) # log 15〜64 歳人口 df = df.dropna(subset=['lb_prev']) yr, X = df['SSDSE-B-2026'], ['lb_prev', 'lw'] v1 = LinearRegression().fit(df.loc[yr <= 2017, X], df.loc[yr <= 2017, 'lb']) # 本番中の旧モデル v2 = LinearRegression().fit(df.loc[yr <= 2022, X], df.loc[yr <= 2022, 'lb']) # 入れ替え候補 te = df[yr == 2023] # 2023 年度を影(shadow)で両方に流す p1, p2 = np.exp(v1.predict(te[X])), np.exp(v2.predict(te[X])) e1, e2 = (p1 / te['A4101'] - 1) * 100, (p2 / te['A4101'] - 1) * 100 print(f'2023 年度 47 県 旧 v1: MAPE {np.mean(np.abs(e1)):.2f}% 平均の偏り {np.mean(e1):+.2f}%') print(f' 新 v2: MAPE {np.mean(np.abs(e2)):.2f}% 平均の偏り {np.mean(e2):+.2f}%') print(f'v2 の方が誤差が小さい県 = {(np.abs(e2) < np.abs(e1)).sum()} / 47') w = te.assign(e1=e1.round(2), e2=e2.round(2)).set_index('Prefecture') print(w.loc[['東京都', '鳥取県', '沖縄県'], ['A4101', 'e1', 'e2']].to_string()) |
💬 旧 v1 の MAPE は 4.50%、新 v2 は 2.95% で、47 県中 45 県で新 v2 の誤差が小さい。ただし両モデルとも平均の偏りが +4.50%、+2.78% と、そろって出生数を多めに見積もっている。2023 年度の出生数が、過去の関係から見込まれるより速く減ったためで、新 v2 に替えても偏りは残る。影の運用で見るべきなのは「新しい方が良いか」だけでなく、「新しい方にも残る偏りは何か」である。鳥取県は両方とも +11〜12% 外れており、出生数の少ない県は年ごとの揺れが大きい。
🐍 カナリアの大きさ:何県ぶん先に切り替えれば改善を見分けられるか
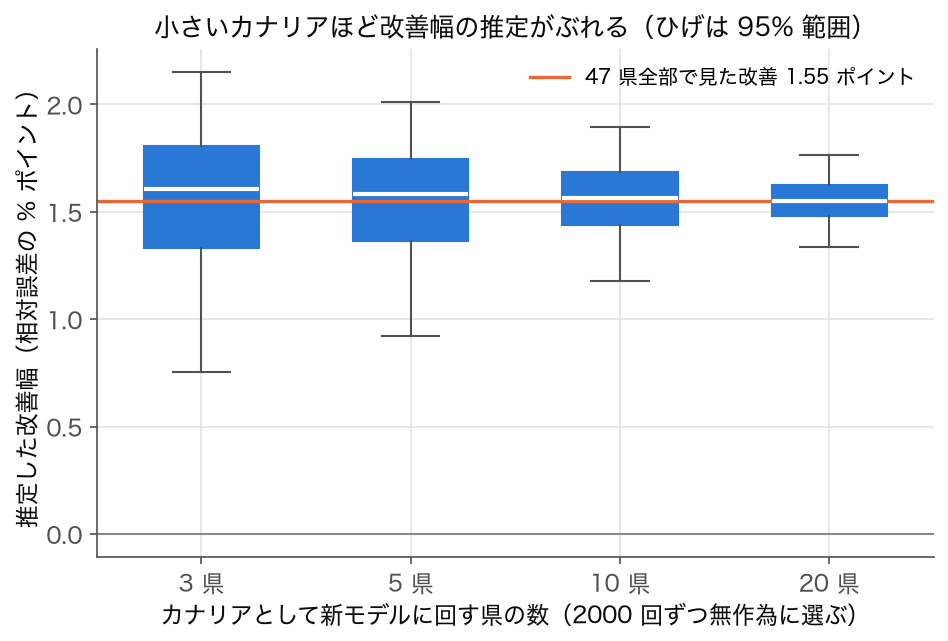
影の次は、 一部だけ新モデルに切り替えるカナリアリリースである。 先に切り替える範囲が小さいほど安全だが、 そのぶん「本当に良くなったか」の推定がぶれる。 県を無作為に k 県選んで改善幅を測る、 という仮想のカナリアを 2000 回繰り返す。
🎯 このコードでやること:上の旧 v1・新 v2 の県別の改善幅(|v1 の相対誤差| − |v2 の相対誤差|、% ポイント)について、無作為に 3・5・10・20 県を選んで平均する推定を 2000 回ずつ行い、推定の 95% 範囲と「新モデルの方が悪い」と出てしまう割合を求める。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']) # 県コード順・年度の昇順 df['lb'] = np.log(df['A4101']) df['lb_prev'] = df.groupby('Code')['lb'].shift(1) df['lw'] = np.log(df['A1302']) df = df.dropna(subset=['lb_prev']) yr, X = df['SSDSE-B-2026'], ['lb_prev', 'lw'] v1 = LinearRegression().fit(df.loc[yr <= 2017, X], df.loc[yr <= 2017, 'lb']) v2 = LinearRegression().fit(df.loc[yr <= 2022, X], df.loc[yr <= 2022, 'lb']) te = df[yr == 2023] gain = (np.abs(np.exp(v1.predict(te[X])) / te['A4101'] - 1) - np.abs(np.exp(v2.predict(te[X])) / te['A4101'] - 1)).to_numpy() * 100 # 県ごとの改善(% ポイント) print(f'47 県全部で見た改善 = {gain.mean():.2f} ポイント') rng = np.random.default_rng(0) for k in [3, 5, 10, 20]: # カナリアに回す県の数 est = np.array([gain[rng.choice(47, k, replace=False)].mean() for _ in range(2000)]) lo, hi = np.percentile(est, [2.5, 97.5]) print(f'{k:2d} 県のカナリア: 推定の 95% 範囲 {lo:5.2f}〜{hi:5.2f} ' f'「新モデルの方が悪い」と出る割合 {np.mean(est < 0) * 100:4.1f}%') |
💬 47 県全部で見た改善は 1.55 ポイントで、3 県だけのカナリアでは推定が 0.76〜2.15 と真の値の半分から 1.4 倍までぶれる。20 県にすると 1.34〜1.77 に収まる。この例では 47 県中 45 県で新モデルが良いので「悪い」と出る割合は 0% だが、改善が県によってまちまちなら、小さいカナリアは逆の結論を出しうる。カナリアの大きさは「どの程度の改善を見分けたいか」から逆算して決める。
🐍 バッチ推論と 1 件ずつの推論:同じ予測でも呼び出し方で手間が変わる
県別の年次予測のように、 予測したい対象がまとめて手元にある場合はバッチ推論で足りる。 API で 1 件ずつ受け付けるオンライン推論は、 利用者が 1 件ずつ即座に答えを求める場合のための形である。
🎯 このコードでやること:log 総人口 を log 出生数・log 15〜64 歳人口 で予測する線形回帰について、47 県ぶんの入力をまとめて 1 回 predict する場合と、1 県ずつ 47 回 predict する場合で、予測値が同じかと、かかる時間の比を測る(絶対時間は実行環境で変わるので比だけを見る)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import time, numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) X = np.log(df[['A4101', 'A1302']].to_numpy()) m = LinearRegression().fit(X, np.log(df['A1101'])) x47 = X[:47] # 1 年度ぶん(47 県)の入力 def timeit(f, rep=200): t = time.perf_counter() for _ in range(rep): f() return (time.perf_counter() - t) / rep t_batch = timeit(lambda: m.predict(x47)) # バッチ: 47 県を 1 回で t_single = timeit(lambda: [m.predict(x47[i:i + 1]) for i in range(47)], rep=20) # オンライン風: 1 県ずつ 47 回 same = np.allclose(m.predict(x47), np.concatenate([m.predict(x47[i:i + 1]) for i in range(47)])) print(f'予測値は同じか: {same}') print(f'1 県ずつ 47 回 ÷ まとめて 1 回 = 約 {t_single / t_batch:.0f} 倍の時間(絶対時間は実行環境で変わる)') |
💬 予測値は完全に一致し(True)、1 県ずつ 47 回呼ぶと、まとめて 1 回呼ぶより数十倍(この実行では約 47 倍)の時間がかかった。計算そのものより、呼び出しのたびに入力を整えて結果を返す手間が支配的だからで、件数にほぼ比例して増える。時間の絶対値は実行するたびに変わるが、「件数ぶん呼び出しの手間がかかる」という傾向は変わらない。都道府県の年次予測のように締め切りまでにまとめて出せばよい用途なら、API を立てずにバッチで出す方が単純で安く済む。
🐍 本番に出した後:年度ごとの誤差を基準と比べて入れ替えの時期を決める
デプロイはゴールではない。 2018 年度から旧 v1 を本番で使い続けたと仮定し、 学習の最終年度(2017 年度)の誤差を基準に、 毎年度の誤差が基準の 2 倍を超えたら再学習・入れ替えを検討する、 というルールを当てはめてみる。
🎯 このコードでやること:旧 v1(2013〜2017 年度で学習)の 2017 年度の MAPE を基準にし、2018〜2023 年度の各年度で MAPE と平均の偏りを求め、基準の 2 倍を超えた年度に印を付ける。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']) df['lb'] = np.log(df['A4101']) df['lb_prev'] = df.groupby('Code')['lb'].shift(1) df['lw'] = np.log(df['A1302']) df = df.dropna(subset=['lb_prev']) yr, X = df['SSDSE-B-2026'], ['lb_prev', 'lw'] v1 = LinearRegression().fit(df.loc[yr <= 2017, X], df.loc[yr <= 2017, 'lb']) # 2018 年度から本番で使う def mape_bias(t): te = df[yr == t] e = np.exp(v1.predict(te[X])) / te['A4101'] - 1 return np.mean(np.abs(e)) * 100, np.mean(e) * 100 base, _ = mape_bias(2017) # 学習最終年度での誤差を基準にする print(f'基準(2017 年度・学習データ内)の MAPE = {base:.2f}%') for t in range(2018, 2024): m, b = mape_bias(t) flag = '← 基準の 2 倍超: 再学習・入れ替えを検討' if m > 2 * base else '' print(f'{t} 年度 MAPE {m:.2f}% 偏り {b:+.2f}% {flag}') |
💬 基準の 2017 年度は MAPE 1.49% で、2018 年度は 1.54% と同程度だった。ところが 2019 年度に 4.14% と基準の 2 倍を超え、偏りも +4.14% と全県で多めに予測した。2020〜2021 年度は 1.58%、1.41% と基準近くに戻ったが、2022 年度に 3.34%、2023 年度に 4.50% と再び超えた。2019 年度の一時的な悪化で入れ替えるか、2 年続けて超えるまで待つかは、誤差が業務に与える影響で決める。どちらにしても、判断のルールをデプロイの前に決めておかないと、「たまたま悪い年」と「関係が変わった年」を後から区別できない。
🐍 版の登録とロールバック:どのモデルに戻すかを名前で指定できるようにする
入れ替えた新モデルに問題が見つかったとき、 すぐ前の版に戻せることがデプロイの安全装置になる。 そのためには、 モデル本体を「版の名前・学習に使った期間・特徴量・指紋(ハッシュ)」と一緒に登録しておく。
🎯 このコードでやること:旧 v1(〜2017 年度で学習)と新 v2(〜2022 年度で学習)を、学習期間・特徴量・指紋付きで辞書に登録し、本番を v2 に切り替えたあと v1 に戻す操作をして、戻した後の予測が登録時の v1 と同じになるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import hashlib, pickle, numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']) df['lb'] = np.log(df['A4101']) df['lb_prev'] = df.groupby('Code')['lb'].shift(1) df['lw'] = np.log(df['A1302']) df = df.dropna(subset=['lb_prev']) yr, X = df['SSDSE-B-2026'], ['lb_prev', 'lw'] registry = {} # 版 → モデル本体と記録 def register(ver, last_year): m = LinearRegression().fit(df.loc[yr <= last_year, X], df.loc[yr <= last_year, 'lb']) blob = pickle.dumps(m) registry[ver] = {'model': blob, 'train_until': last_year, 'features': X, 'sha': hashlib.sha256(blob).hexdigest()[:10]} register('v1', 2017) register('v2', 2022) production = 'v2' # 本番を v2 に切り替えた te = df[yr == 2023] def serve(ver): m = pickle.loads(registry[ver]['model']) return np.exp(m.predict(te[registry[ver]['features']])) for ver, r in registry.items(): print(f"{ver}: 学習 〜{r['train_until']} 年度, 指紋 {r['sha']}, 2023 年度 47 県の予測合計 {serve(ver).sum():,.0f} 人") production = 'v1' # 問題が出たので v1 に戻す(ロールバック) print(f'ロールバック後の本番 = {production}, 予測合計 {serve(production).sum():,.0f} 人(v1 の登録時と同じ)') print(f'2023 年度の出生数(実測)合計 = {te["A4101"].sum():,} 人') |
💬 2023 年度 47 県の出生数の予測合計は v1 が 752,576 人、v2 が 739,889 人で、実測の 727,269 人に対してそれぞれ 25,307 人、12,620 人多い。本番を v1 に戻すと予測合計は登録時と同じ 752,576 人になり、名前を指定するだけで以前の挙動を再現できる。指紋(ハッシュ)の値はライブラリの版などで変わるが、同じ環境で「登録した物と同じか」を確かめる目印になる。実務では辞書の代わりに MLflow などのモデルレジストリを使うが、記録すべき中身は同じである。
⚠️ よくある落とし穴
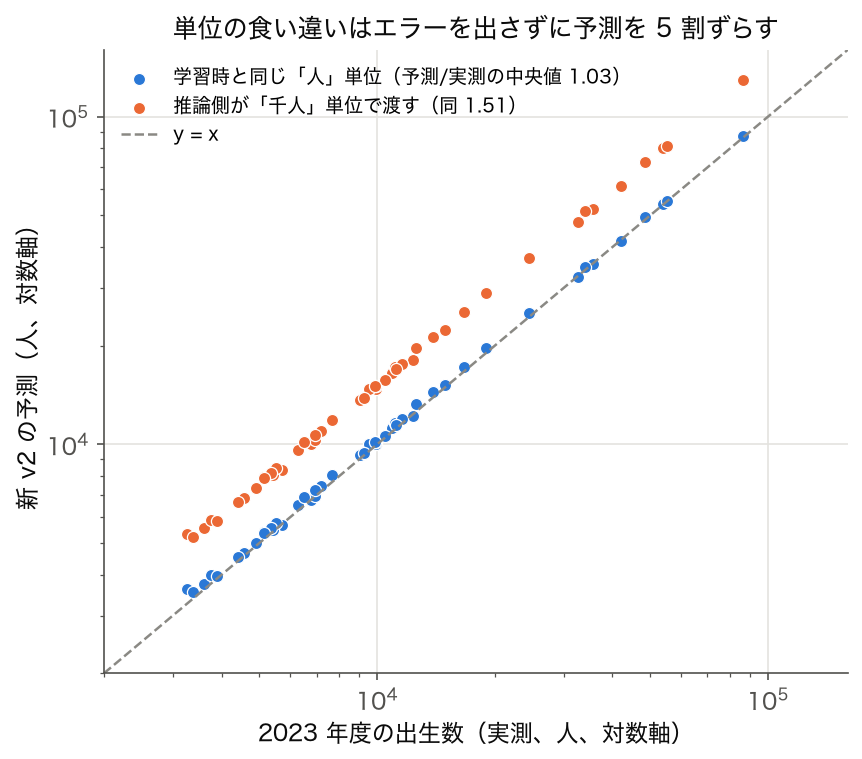
⚠️ 学習時と推論時で単位が違うと、エラーなしで予測がずれる
SSDSE-B-2026 の人口の列は「人」単位(千人単位で丸めた値)で入っている。 学習はこの値で行ったのに、 推論側のシステムが「千人」単位の表から値を渡してしまう、 という食い違いを再現する。
🎯 このコードでやること:新 v2(2013〜2022 年度で学習)に、2023 年度の 15〜64 歳人口を正しい「人」単位で渡した場合と、「千人」単位で渡した場合の、予測 ÷ 実測の中央値を比べ、学習時の入力範囲による点検で止められるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import numpy as np, pandas as pd from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.sort_values(['Code', 'SSDSE-B-2026']) # 県コード順・年度の昇順 df['lb'] = np.log(df['A4101']) df['lb_prev'] = df.groupby('Code')['lb'].shift(1) df['lw'] = np.log(df['A1302']) # 学習時: 15〜64 歳人口は「人」単位 df = df.dropna(subset=['lb_prev']) yr, X = df['SSDSE-B-2026'], ['lb_prev', 'lw'] v2 = LinearRegression().fit(df.loc[yr <= 2022, X], df.loc[yr <= 2022, 'lb']) print(f'係数: 前年度の log 出生数 {v2.coef_[0]:.3f}, log 15〜64 歳人口 {v2.coef_[1]:.3f}') te = df[yr == 2023].copy() ok = np.exp(v2.predict(te[X])) te_bad = te.assign(lw=np.log(te['A1302'] / 1000)) # 推論側が「千人」単位で渡してしまう ng = np.exp(v2.predict(te_bad[X])) print(f'学習時の lw の範囲 = {df.loc[yr <= 2022, "lw"].min():.2f}〜{df.loc[yr <= 2022, "lw"].max():.2f}') print(f'千人単位で渡した lw の範囲 = {te_bad["lw"].min():.2f}〜{te_bad["lw"].max():.2f}') print(f'正しい単位: 予測/実測 の中央値 = {np.median(ok / te["A4101"]):.3f}') print(f'千人単位 : 予測/実測 の中央値 = {np.median(ng / te["A4101"]):.3f}') # 推論前のガード: 入力が学習時の範囲を外れたら止める lo, hi = df.loc[yr <= 2022, 'lw'].min(), df.loc[yr <= 2022, 'lw'].max() out = ~te_bad['lw'].between(lo - 0.5, hi + 0.5) print(f'範囲チェックで止まる県 = {out.sum()} / 47') |
💬 「千人」単位で渡しても、エラーは何も出ずに予測が返ってくる。予測 ÷ 実測の中央値は 1.027 から 1.514 に上がり、どの県も約 5 割多く予測される。このモデルは前年度の出生数の係数が 1.060 と大きく、15〜64 歳人口の係数は −0.056 と小さいので「10 万倍ずれても 5 割」で済んでいるが、係数の大きい列で同じことが起きれば桁ごと外れる。入力の log 15〜64 歳人口は学習時に 12.60〜16.05 だったのに、千人単位では 5.68〜9.15 になり、範囲の点検を入れておけば 47 県すべてで推論前に止められる。
⚠️ 推論の前に入力を点検する:列名・単位・欠損をまとめて止める
上のような食い違いを防ぐには、 学習時に「入力の約束」(列名・型・値の範囲)を記録しておき、 推論の前に届いた入力と照らし合わせる。 約束を満たさない入力は予測せずに止め、 理由を返す。
🎯 このコードでやること:2022 年度までの表から、モデルの入力 2 列(出生数・15〜64 歳人口)の型・最小・最大を「入力の約束」として記録し、2023 年度の入力を 4 通り(正しい入力、列名の変更、千人単位、3 県の欠損)に崩して、点検関数がそれぞれを止めるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | import numpy as np, pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) train = df[df['SSDSE-B-2026'] <= 2022] FEATS = ['A4101', 'A1302'] # モデルが受け取る列: 前年度の出生数・15〜64 歳人口(人) # 学習時に「入力の約束」を記録しておく(型・最小・最大) spec = {c: (str(train[c].dtype), train[c].min(), train[c].max()) for c in FEATS} def validate(x: pd.DataFrame): """推論の前に入力を点検し、問題があれば理由のリストを返す(空なら OK)""" problems = [] for c, (dtype, lo, hi) in spec.items(): if c not in x: problems.append(f'{c} がない'); continue v = x[c] if v.isna().any(): problems.append(f'{c} に欠損 {int(v.isna().sum())} 件') if (v < 0).any(): problems.append(f'{c} に負の値') ratio = v.median() / train[c].median() if not 0.1 < ratio < 10: # 桁が違う = 単位の取り違えを疑う problems.append(f'{c} の中央値が学習時の {ratio:.3g} 倍(単位違い?)') n_out = int(((v < lo * 0.5) | (v > hi * 1.5)).sum()) if n_out: problems.append(f'{c} が学習時の範囲外 {n_out} 件') return problems new = df[df['SSDSE-B-2026'] == 2023][FEATS] # 次の予測に送る最新年度(2023 年度)の 47 県 bad4 = new.copy() bad4.iloc[:3, 0] = np.nan # 3 県の出生数が届かなかった cases = {'① 正しい入力': new, '② 列名の変更(A1302 → 生産年齢人口)': new.rename(columns={'A1302': '生産年齢人口'}), '③ 15〜64 歳人口を千人単位で送る': new.assign(A1302=new['A1302'] / 1000), '④ 3 県の出生数が欠損': bad4} for name, x in cases.items(): r = validate(x) print(f'{name}: ' + ('OK(推論へ進む)' if not r else '停止 → ' + ' / '.join(r))) |
💬 正しい入力は通り、列名が変わった入力は「A1302 がない」、千人単位の入力は「中央値が学習時の 0.000968 倍(単位違い?)」と「範囲外 47 件」、欠損のある入力は「欠損 3 件」で止まった。どれも予測関数そのものはエラーを出さない(列名の変更は出す場合もある)種類の事故で、点検を推論の手前に置くことで、誤った予測が利用者に届く前に止められる。点検の基準(ここでは中央値が 10 倍以上違うか、範囲の 0.5〜1.5 倍を外れるか)は、学習データの記録から作り、モデルと同じ版で管理する。
🧠 実データで確かめる理解度チェック(デプロイの判断)
- 問:影の運用で、 新 v2 の MAPE は 2.95%、 旧 v1 は 4.50%、 47 県中 45 県で v2 の誤差が小さかった。 v2 に切り替えれば偏りの問題は解決するか。
答:しない。 v2 も平均の偏りが +2.78% で、 出生数を多めに見積もる傾向が残る。 切り替えと並行して、 偏りの原因(出生数の減り方の変化)を調べる必要がある。 - 問:3 県だけのカナリアで改善幅を測ると、 推定は 0.76〜2.15 ポイントの間でぶれた。 20 県なら 1.34〜1.77。 小さいカナリアの利点と欠点は何か。
答:利点は、 問題があっても影響する範囲が小さいこと。 欠点は、 改善の大きさを正確に測れないこと。 見分けたい改善の大きさから、 必要な範囲を決める。 - 問:推論側が 15〜64 歳人口を千人単位で渡したのに、 エラーは出ず予測が 5 割多くなった。 どうすれば推論前に気づけるか。
答:学習時の入力の範囲や中央値を記録し、 推論前に照合する。 この例では log の値が学習時の 12.60〜16.05 に対し 5.68〜9.15 で、 47 県すべてが範囲外として止まる。 - 問:47 県の年次予測を API で 1 件ずつ出すか、 バッチでまとめて出すか。
答:まとめて手元にあり、 即時の応答が要らないならバッチ。 予測値は同じで、 1 件ずつ呼ぶと呼び出しの手間が件数ぶん(この実行では約 47 倍)かかる。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
概念マップは「モデル成果物 (pickle/ONNX/SavedModel) → コンテナ化 → 推論サーバ (FastAPI / Triton / SageMaker) → 監視」の橋渡しを示す。 SSDSE-B-2026 で学習した回帰モデル (joblib.dump) を Docker + FastAPI で提供し、 1 秒未満で推論を返す API を立てる例が、 デプロイ理解の最短ルート。
🔗 隣接手法への橋渡し
モデルデプロイは、 学習成果物を「API として動く実体」に変換するため隣接領域と組み合わせる。
- 上流: モデル選択 で確定した artifact を Feature Store と一緒に管理し、 Model Registry (MLflow など) で版管理する
- 並列: A/B テスト や canary release で旧モデルと並行運用、 CI/CD 経由で自動ロールバック
- 下流: モデル監視 で予測精度・レイテンシ・データドリフトを観測、 異常時は 再学習 をトリガーする
SSDSE-B-2026 規模なら「joblib.dump → Dockerfile + FastAPI → docker run -p 8000:8000」の 3 ステップが最小デプロイ。 産業実装では Kubernetes + Seldon / KServe が定番になる。
🌳 手法選択フロー
「モデルデプロイ」の 選び方・適用判断をフローで整理。 状況に応じた選択を 4 段階で。