🔖 キーワード索引
このページで扱う概念:
💡 30秒で分かる結論
🍰 まずはやさしく
AIにとっての教科書のようなものです。
モデルにルールを学習させるために使います。
テスト勉強で使う問題集のような役割です。
この章では結論と使いどころを学びます。
訓練データ(Training Data):モデルのパラメータを学習するために使うデータ
- 訓練データはモデルのパラメータを決めるためだけに使う。 性能はモデルが見ていないデータ(検証・テスト)で測る
- SSDSE-B-2026 の 2023 年度は 47 行しかない。 70:30 で分けると訓練は 32 県で、 どの大都市が訓練側に入るかで結果が揺れる
- 一般診療所数 I5102 を Pipeline(標準化+Ridge)で 5 分割交差検証すると、 fold ごとの R² は 0.668〜0.973、 平均 0.848
- 標準化などの前処理は訓練側だけで fit する。 全データで先に fit すると、 テストの情報が訓練に漏れる
💡 訓練データに関する追加 FAQ(10 問)
Q1. SSDSE-B-2026 の 47 県だけで深層学習はできますか?
A:原理的には可能ですが、 47 サンプルでは深層モデルのパラメータ(数千〜数百万)に対して圧倒的に不足。 線形回帰や決定木が現実解。 深層学習をしたいなら、 多年度(12 年分 = 564 サンプル)に拡張し、 さらに自己教師事前学習で補強しましょう。
Q2. train を増やすと test 性能は必ず上がりますか?
A:いいえ。 学習曲線が既にプラトーに達していたら、 増やしても無駄。 質の悪いデータを増やすと逆効果なことすらあります。
Q3. validation と test の役割の違いは?
A:validation は「ハイパーパラメータ選びや early stopping のための内部用」、 test は「最終発表用の 1 回切り」。 test を何度も見て調整すると、 それは事実上 validation になってしまい、 過適合が起きます。
Q4. クラスが極端に不均衡な場合、 訓練データはどうしますか?
A:(1) SMOTE などのオーバーサンプリング、 (2) 少数クラスの重み増加(class_weight='balanced')、 (3) 評価指標を accuracy ではなく F1 / ROC-AUC に変える、 のいずれかを使います。
Q5. 訓練データを増やせない場合の対処は?
A:(1) 正則化を強める(L1/L2/dropout)、 (2) より単純なモデルを使う、 (3) データ拡張(augmentation)、 (4) 転移学習・事前学習済みモデルの利用、 (5) k-fold CV で全データから情報を絞り出す、 が定石。
Q6. test データを「決して見ない」とは具体的にどういう意味?
A:実装上は test.csv を別フォルダに置き、 EDA すらしない(分布を覗くと、 知らずに過適合が始まる)。 最終的に「これが本番」と決めたモデルで 1 回だけ評価し、 その値を報告。 値が悪くてもモデルを変えてはいけない(変えるなら新しい test を別途用意)。
Q7. ラベルノイズがあるとモデルは壊れますか?
A:少量なら多くのモデルはある程度耐える(どこまで耐えるかはモデルとノイズの入り方で変わる)。 ただし深層学習はノイズを「覚え込んでしまう」性質があり、 early stopping や label smoothing が有効。 SSDSE のような公的統計はノイズが少ないので心配無用です。
Q8. データの分布が時間とともに変化する(concept drift)場合は?
A:定期的にモデルを再訓練する(オンライン学習、 monthly retrain)。 SSDSE-B の場合、 人口の長期トレンドは緩やかですが、 出生率や転出入は年によって動くので、 新しい年度が公開されたら再学習して精度の変化を確かめます。
Q9. 同じ訓練データから複数モデルを作ると、 評価は二重カウントになりませんか?
A:はい、 これは「多重比較問題」と呼ばれます。 100 個のモデルを試して最良のものを選ぶと、 偶然 test に合致した可能性が無視できません。 ボンフェローニ補正や、 nested CV で対処します。
Q10. 訓練データのバージョン管理は必要?
A:必須。 DVC(Data Version Control)、 LakeFS、 MLflow Tracking などで管理。 「どのデータでどの精度が出た」を再現できなければ、 共同研究も regulatory audit も通りません。
📊 訓練データの量と質を深掘り — SSDSE-B-2026 を用いた可視化シリーズ
訓練データの議論は、「もっとデータを集めれば精度が上がる」「ラベルが正しければ大丈夫」と単純化されがちです。 しかし実務では、 量と質と分布の三つを同時に意識しないと、 学習曲線は思った方向に動きません。 ここでは SSDSE-B-2026(独立行政法人統計センターが公開する 47 都道府県データセット、 教育用標準データセット)の実数値を題材に、 三つの視点(散布の構造、 分布の歪み、 群間比較)を可視化し、 訓練データとして「使える状態」と「使ったら危険な状態」を見分ける目線を養います。
① 散布図で見る「説明変数と目的変数の関係構造」
回帰タスクの訓練データを設計する出発点は、 説明変数と目的変数の散布図を眺めることです。 直線関係に見えるのか、 非線形なのか、 外れ値があるのか、 ヘテロスケダスティシティ(分散の不均一)が見えるのかで、 必要な訓練サンプル数や前処理が変わります。 たとえば SSDSE-B-2026 の「総人口(A1101)」と「一般診療所数(I5102)」を散布図にすると、 強い正の相関(r ≒ 0.972)が見える一方、 東京・大阪・神奈川・愛知の 4 都府県が右上に大きく離れて分布し、 残り 43 県はずっと小さなレンジに圧縮されます。 こうしたデータをそのまま線形回帰の訓練データに渡すと、 大都市の影響で傾きと切片が決まってしまいます。 2023 年度の 47 県で当てた直線は傾き 9.09 施設/万人・切片 −174 施設で、 人口 200 万人未満の 31 県のうち 26 県は実際より少なく予測され(残差の中央値 +122 施設)、 地方の予測が系統的にずれる傾向が出ます。
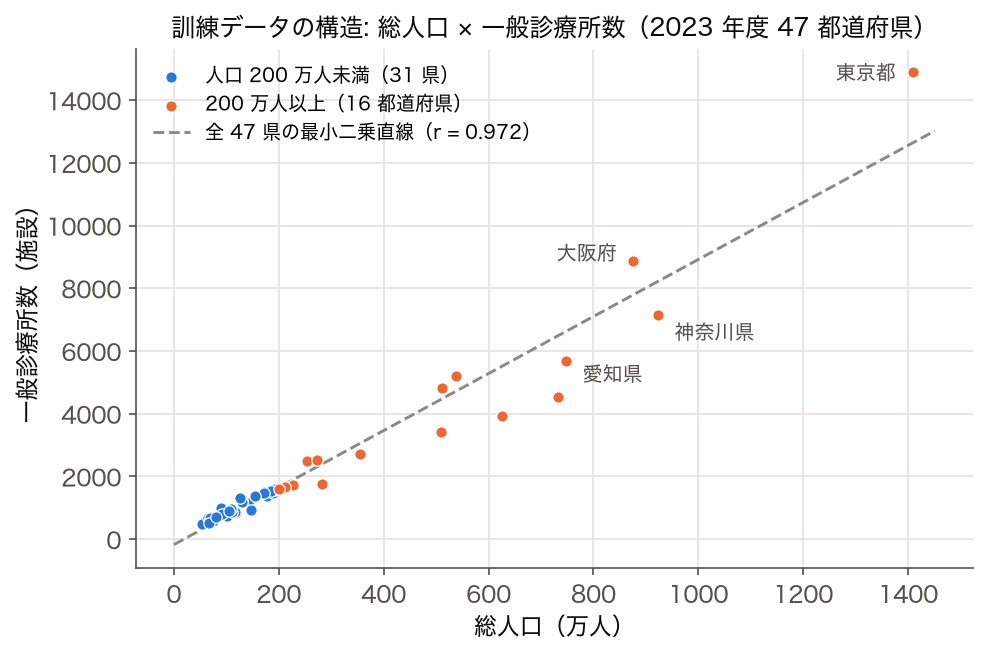
図の見方は次の通りです。 (1) 雲が右肩上がりかどうか → 線形回帰や Ridge が候補。 (2) 雲がカーブしているか → 多項式や決定木、 GBDT を検討。 (3) 雲の外に孤立した点が散っているか → 外れ値除去か、 ロバスト回帰(Huber, RANSAC)を検討。 (4) 雲の幅が右側で広がっているか → ヘテロスケダスティシティ。 対数変換や重み付き回帰が必要。 訓練データの「形」を見ずにモデルだけ差し替えても、 性能は伸びません。
② ヒストグラムで見る「目的変数の分布の歪み」
目的変数が大きく歪んでいる訓練データは、 二乗誤差(MSE)で評価すると上位の値に過剰に引きずられます。 SSDSE-B-2026 の「総人口」をヒストグラムにすると、 200 万人未満に 30 県前後(2012 年度 30 県、 2023 年度 31 県)が集中し、 1000 万人超に東京 1 県だけが孤立する典型的な右裾分布になります。 こうした分布で平均二乗誤差を最適化すると、 学習器は「とにかく大都市を当てに行く」戦略になり、 地方の予測誤差は無視されます。 対処は (a) 対数変換、 (b) ターゲットの分位変換、 (c) 損失関数を MAE / Huber に切り替える、 のいずれかです。
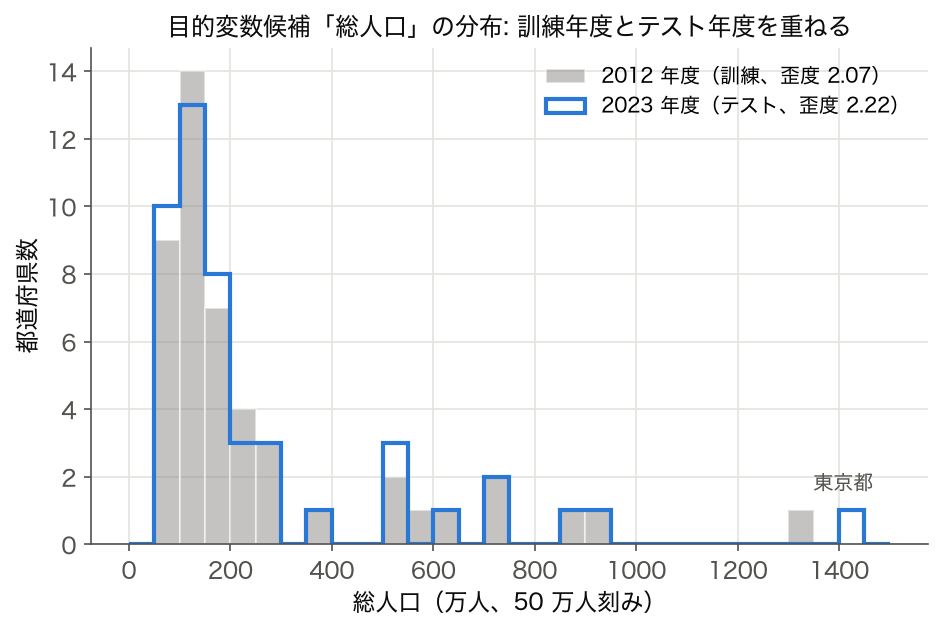
特に「学習データの分布」と「テストデータの分布」がずれていると、 学習器は学習時に見ていない領域に外挿することになり、 予測精度は急落します。 これを covariate shift と呼びます。 SSDSE-B のように年度違いのデータを学習・テストに分ける場合、 政策変更や経済ショックで分布がずれることがあります。 まずヒストグラムを重ねて分布の重なりを確認し、 重なりが乏しい領域があれば、 そこは「予測できない領域」として最初から除外するのが安全策です。
③ 群間箱ひげ図で見る「カテゴリ別の格差」
分類・クラスタリングタスクの訓練データを設計するとき、 各グループの分布が大きく違うかどうかを箱ひげ図で確認します。 たとえば SSDSE-B-2026 の 47 県を KMeans でクラスタリングし(ここでは log10 の総人口と一般診療所数を標準化して k = 3)、 クラスタ別に「一般診療所数(I5102)」を箱ひげ図で並べると、 大都市圏を含むクラスタは中央値もばらつきも大きく、 地方県中心のクラスタは小さなレンジに収まるという「群間格差」が明確に見えます。 もしこのデータで「クラスタ(都市規模タイプ)を当てる」分類器を作るなら、 群間で重なる部分がどこにあるかが分類精度の上限を決めます。 ここを見ずにロジスティック回帰を投入しても、 重なる範囲では何を入れても予測は揺れます。
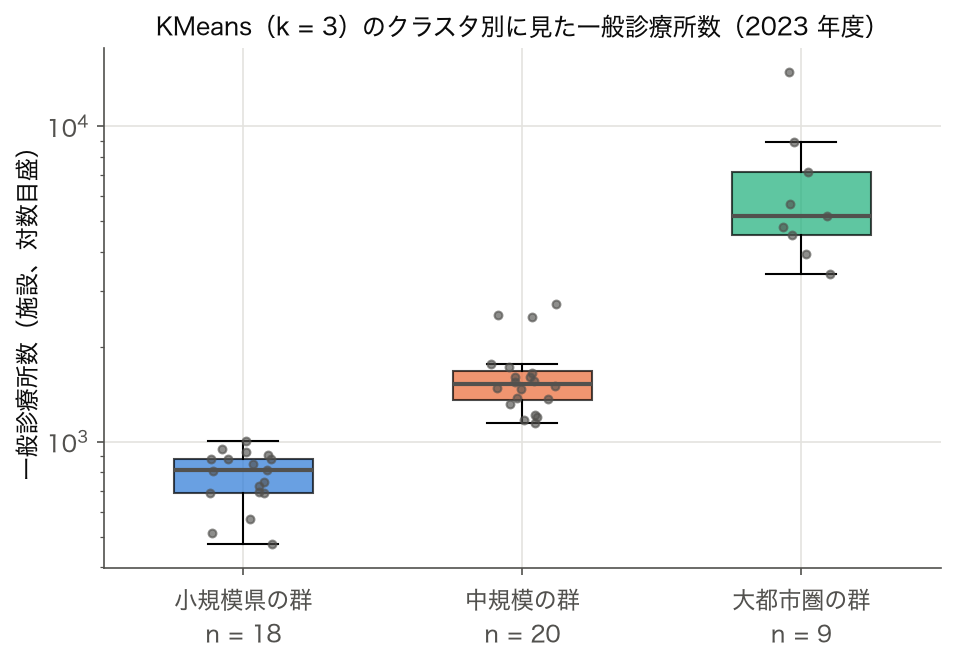
群間の差を可視化したら、 次に「群ごとのサンプル数」を必ず点検します。 SSDSE-B の地域ブロックでいえば、 関東 7 都県 vs 四国 4 県のように、 単純な県数ベースで大きな差があります。 サンプル数の少ない群はモデルの予測が不安定になりやすく、 マクロ F1 やバランス精度といった指標で評価しないと、 多数派に引きずられた「見かけ上の高精度」になります。 これも訓練データを「集める前」に決めておく設計事項です。
📍 あなたが今見ているもの
🍰 まずはやさしく
機械学習でとても重要な言葉です。
分析の基礎を身につけるために使います。
都道府県のデータを使って練習します。
おすすめの読み方と全体の流れを説明します。
このページは「訓練データ(Training Data)」の用語解説です。 機械学習の基礎カテゴリにおける重要概念で、 機械学習の基礎 グループ教材の中で繰り返し登場します。 数式・実コード・落とし穴を 1 ページに集約し、 SSDSE-B-2026 都道府県データ(47 件 × 112 列)を題材に 手を動かしながら理解できるよう構成しています。
別称:学習データ / Training Set。 まず 💡 30秒結論 で全体像を、 次に 🎨 直感 → 📐 数式 → 🧮 実値 → 🐍 Python の順で読むのがおすすめ。
🎨 直感で掴む
🍰 まずはやさしく
AIが答えを覚えるための教材です。
正しく予測できるようにするために使います。
部活の過去問で傾向を掴む感覚に似ています。
データの分け方と注意点について学びます。
訓練データはモデルが「パラメータを覚える」ための教材です。 良い訓練データの条件:① 量が十分、 ② 偏りが小さい、 ③ ラベル品質が高い、 ④ 本番分布と近い。 4 つのどれが欠けても汎化性能は伸びません。
訓練と検証・テストの境界を保つことが鉄則。 訓練データに 検証・テストの情報が混ざる(リーケージ)と、 報告した精度が本番で再現しません。 47 県データのような小規模では、 ホールドアウトより k 分割 CV が安定。
🎨 train / validation / test の三分割を SSDSE-B-2026 で実行する
「訓練データ」と一口にいっても、 実務では train(学習用)・validation(モデル選択用)・test(最終評価用) の 3 つに分けるのが基本です。 SSDSE-B-2026 の 47 都道府県 × 多年度(2012〜2023 年)データを使い、 具体的な分割比率と注意点を見ていきます。
📊 推奨分割比率(データ量別)
| サンプル数 | train | validation | test | 補足 |
|---|---|---|---|---|
| ~ 100(SSDSE-B 47 県 ×1 年 = 47 サンプル) | 60% | 20% | 20% | k-fold CV を併用必須 |
| 100 ~ 10,000(SSDSE-B 多年度 = 564) | 70% | 15% | 15% | 標準的な比率 |
| 10,000 ~ 1,000,000 | 80% | 10% | 10% | 多くの教科書の例 |
| 1,000,000 以上(深層学習) | 98% | 1% | 1% | val/test も 1% で十分大きい |
SSDSE-B-2026 を単年度(2023 年度)に絞ると 47 サンプルしかなく、 これは 機械学習にとってかなり小規模です。 単純な 60:20:20 分割では test が 9 県しかなく、 評価のばらつきが大きすぎて結論が出せません。 そのため、 SSDSE-B の場合は k-fold(k=5 か k=10)クロスバリデーションと組み合わせるのが正攻法です。
🐍 sklearn の train_test_split を二段階で使う
このコードでやること:SSDSE-B-2026 の 47 都道府県を train(30 県)/val(8 県)/test(9 県)に分割し、 各セットの行数と人口の平均を比較する。
📥 入力データ:SSDSE-B-2026.csv(cp932 エンコード、 564 行 × 112 列 = 47 県 × 12 年。 2023 年度でフィルタして 47 行)。 主要列は Prefecture(都道府県名)と A1101(総人口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)] X = df[['A1301', 'A1302', 'A1303']] # 15歳未満/15-64/65歳以上 y = df['A1101'] # 総人口 # Step 1: train (38) と test (9) に分割 X_trv, X_te, y_trv, y_te = train_test_split(X, y, test_size=9, random_state=42) # Step 2: train (30) と val (8) に分割 X_tr, X_val, y_tr, y_val = train_test_split(X_trv, y_trv, test_size=8, random_state=42) print(f'train: {len(X_tr)}県, 平均人口 {y_tr.mean():,.0f} 人') print(f'val: {len(X_val)}県, 平均人口 {y_val.mean():,.0f} 人') print(f'test: {len(X_te)}県, 平均人口 {y_te.mean():,.0f} 人') |
📤 実行例:
💬 train の平均人口(約 216 万人)に対し、 test の平均人口(約 441 万人)は 2 倍以上に膨らんでいる(東京・大阪などの大都市が偶然 test 側に偏った)→ 少数サンプルでは分割の偶然による偏り(split bias)が無視できない。 これが SSDSE-B で k-fold CV が事実上必須になる理由です。
📐 数式または定義
🍰 まずはやさしく
学習に使うデータの集まりのことです。
必要なデータの量を決めるために使います。
スマホのアプリが賢くなる仕組みに似ています。
数式とプログラムでの書き方を学びます。
本概念は次のように記述されます(KaTeX で描画)。
英語名 Training Data。 別称:学習データ / Training Set。
📐 学習曲線で「もっとデータを集めるべきか」を判断する
「訓練データはいくつ必要ですか?」は最も多い質問の 1 つです。 答えは 「学習曲線(learning curve)を描いて、 まだ右肩下がりなら集める、 プラトーに達していれば不要」。 数式と sklearn の実装を見ていきます。
📐 学習曲線の理論的形状
学習サンプル数 $n$ の関数として、 訓練誤差 $E_{\text{train}}(n)$ と検証誤差 $E_{\text{val}}(n)$ は以下のように振る舞います(PAC-Bayes の典型形):
$$E_{\text{train}}(n) \;\xrightarrow{n\to\infty}\; E^* + \mathcal{O}\!\left(\frac{1}{\sqrt{n}}\right)$$
$$E_{\text{val}}(n) \;\xrightarrow{n\to\infty}\; E^* + \mathcal{O}\!\left(\sqrt{\frac{d \log n}{n}}\right)$$
ここで $E^*$ は 達成可能な最小誤差(ベイズ誤差)、 $d$ はモデルの VC 次元(複雑さの指標)です。
🔬 数式を言葉で読み解く
- $E^*$(ベイズ誤差):データに含まれる本質的ノイズ。 これより下にはどれだけデータを集めても下がらない。 例:人口を「2 つの特徴量だけで」予測する場合、 真の関係に対し情報不足な分が $E^*$ になる。
- $\mathcal{O}(1/\sqrt{n})$:訓練誤差は サンプルが 4 倍になると誤差ギャップが半分になる。 47 県 → 188 県相当(=多年度パネル)にすれば、 ギャップは 1/2。
- $d \log n / n$:モデルの自由度 $d$ が大きいほど多くのデータが必要。 SSDSE-B の人口予測で線形回帰($d \approx 5$)なら 47 県でも十分だが、 Random Forest($d \gg 100$)では明らかにデータ不足。
- 収束の見抜き方:学習曲線で $E_{\text{train}}$ と $E_{\text{val}}$ が 同じ値に近づき横ばいになれば収束。 まだ離れていてかつ下がり続けていれば、 データを増やす価値がある。
🐍 sklearn の learning_curve で SSDSE-B を診断
このコードでやること:SSDSE-B-2026 の 47 県で、 サンプル数を 10, 20, 30, 37 と段階的に増やしながら線形回帰の R² を測り、 学習曲線を取得する(cv=5 のため訓練側の上限は 47 × 4/5 ≒ 37 件)。
📥 入力データ:SSDSE-B-2026 の 47 県 × 特徴量(A1301, A1302, A1303 = 年齢 3 区分人口)、 ターゲット(I5102 = 一般診療所数)。 なお A1101(総人口)をターゲットにすると A1301+A1302+A1303 の和そのものになり、 完全なターゲット漏洩(R² = 1.000)になるため、 別領域の列を予測します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np from sklearn.linear_model import LinearRegression from sklearn.model_selection import learning_curve df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)] X = df[['A1301', 'A1302', 'A1303']].values y = df['I5102'].values # 一般診療所数 sizes, train_sc, val_sc = learning_curve( LinearRegression(), X, y, train_sizes=[10, 20, 30, 37], cv=5, scoring='r2', shuffle=True, random_state=42) for s, t, v in zip(sizes, train_sc.mean(axis=1), val_sc.mean(axis=1)): print(f'n={s}: train R²={t:.3f}, val R²={v:.3f}') |
📤 実行例:
💬 n=30 で val R² が 0.87 前後まで上がり、 それ以降はほぼ横ばい → これ以上データを増やしても線形回帰の性能は大きくは伸びない。 これは「特徴量と目的変数の関係が線形でほぼ説明し尽くされている」ことを意味します。 もし R² がまだ 0.5 だったら、 モデルを変える(Random Forest など)か特徴量を増やすべき、 という診断結果になります。
📐 訓練データ量の見積もり — 経験則と理論則の対照
「訓練データは何件あればよいか」は、 機械学習の最頻出質問のひとつです。 質問の前に「タスクの性質」「モデルの表現力」「ノイズ水準」「許容誤差」の四点を明示しないと答えは出ません。 ここでは、 実務で広く使われている経験則と、 学習理論からの下限見積もりを並べて整理します。 SSDSE-B-2026 のような中規模データセット(2023 年度分で 47 行 × 112 列)に当てはめると、 線形モデルや決定木では十分、 深層学習や勾配ブースティングでは不足、 という判断軸が立ちます。
| 経験則 | 出典・根拠 | 必要 N の目安 | SSDSE-B 47 県への当てはめ |
|---|---|---|---|
| 10:1 ルール(説明変数 1 つに対し最低 10 サンプル) | 医学・社会科学の伝統的指針 | 説明変数 5 個なら 50 件以上 | 説明変数 4 個までなら 47 県で許容範囲 |
| VC 次元の 10 倍 | PAC 学習理論 | 線形分類器なら数十〜数百 | 線形なら 47 件で機能、 多項式は不足 |
| パラメータ数の 10 倍 | 深層学習の「目安」 | 1 万パラメータなら 10 万件 | 深層学習は 47 件では完全に不足 |
| クラスあたり 100 件(画像分類) | ImageNet 系の指針 | 10 クラスなら 1000 件以上 | 地域 8 ブロック分類なら 800 件相当が理想 |
| 統計検出力分析(α=0.05, 1−β=0.8) | Cohen (1988) | 効果量と分散から逆算 | 中程度効果なら 47 県で検出可能 |
| 学習曲線がプラトーに達するまで | 経験ベース | 追加で精度が伸びなくなった点 | 実験で見極める(最も信頼性高い) |
| クロスバリデーション可能な最低限 | k-fold の k を確保 | 5-fold なら 50 件以上、 LOO なら任意 | 47 県は LOO が現実解 |
どの経験則を採用するかは、 タスクとモデルで決めます。 線形モデル+少数変数なら 47 件で機能しますが、 勾配ブースティングや深層学習なら数百〜数十万件のオーダーが必要です。 SSDSE-B-2026 のように「量で勝負できない」データでは、 (1) 特徴量エンジニアリングで情報密度を上げる、 (2) ベイズ的事前分布で正則化する、 (3) ドメイン知識を制約として埋め込む、 のいずれかで補います。 量を増やせないなら、 質と構造で勝負するということです。
| タスク | モデル | 推奨 N | N が不足したときの兆候 |
|---|---|---|---|
| 2 値分類 | ロジスティック回帰 | 200 件〜 | 係数の信頼区間が広い、 CV 精度が揺れる |
| 2 値分類 | XGBoost | 2,000 件〜 | 過適合、 valid と train の差が大きい |
| 多クラス分類 | CNN(画像) | クラス × 1,000 件〜 | マイノリティクラスで再現率が崩壊 |
| 回帰 | 線形回帰 | 100 件〜 | 残差プロットでパターンが見える |
| 回帰 | 勾配ブースティング | 5,000 件〜 | テスト RMSE が学習 RMSE の 2 倍以上 |
| 時系列予測 | ARIMA | 100 期〜 | 予測区間が異常に広がる |
| 時系列予測 | LSTM | 10,000 期〜 | 学習が収束しない、 loss が振動 |
| テキスト分類 | BERT ファインチューニング | クラス × 500 件〜 | 少数クラスを全部ゼロに予測する |
🧪 訓練データの「質」をどう測るか — 八つのチェック軸
量が確保できても、 質が悪い訓練データではモデルは育ちません。 「質」を構成する要素は、 完全性・正確性・一貫性・代表性・適時性・関連性・解釈可能性・公平性の八つに整理できます。 SSDSE-B-2026 のような公的統計は完全性・正確性・一貫性で高得点ですが、 「47 県という標本は何の母集団を代表するか」という代表性は、 用途次第で慎重に判断する必要があります。
| 質の軸 | 確認方法 | SSDSE-B-2026 での得点 | 代表的な失敗例 |
|---|---|---|---|
| 完全性 (Completeness) | df.isna().sum() で欠損確認 | 高(公的統計、 ほぼ欠損なし) | スクレイピングデータで重要列が 30% 欠損 |
| 正確性 (Accuracy) | 複数ソースとの照合、 外れ値検査 | 高(統計法に基づく集計) | 手入力ラベルで誤字が混在 |
| 一貫性 (Consistency) | 単位・命名規約の統一を点検 | 高(命名規約が厳格) | 同じ意味の列が複数存在し値が違う |
| 代表性 (Representativeness) | 母集団と標本の分布比較 | 中(47 県 = 都道府県集計、 個人レベルではない) | 都市部のスマホアプリログだけで全国を語る |
| 適時性 (Timeliness) | データの参照年と運用時点の比較 | 中(年次更新、 月次変動は捉えない) | 3 年前のデータで現在の意思決定をする |
| 関連性 (Relevance) | タスクの目的と列の対応付け | タスク依存(人口・経済予測には高、 個別行動予測には低) | 関係ない列を片っ端から入れて次元の呪い |
| 解釈可能性 (Interpretability) | 列名・単位・出典の明示 | 高(コードブック完備) | 列名が x1, x2, ... で後から意味が分からない |
| 公平性 (Fairness) | 部分集団別の精度・誤差の比較 | 中(都市・地方で精度差が出やすい) | マイノリティ群の予測誤差が 3 倍大きい |
八つの軸を全部 100 点にするのは現実的ではありません。 「このタスクではどの軸を優先するか」を最初に宣言し、 残りはトレードオフとして許容範囲を決めるのが実務的です。 たとえば SSDSE-B-2026 を使った県別の消費支出(L3221)予測なら、 完全性・正確性・一貫性・解釈可能性が最重要で、 代表性は「都道府県集計レベル」と限定すれば許容、 公平性は「都市・地方の精度差」を必ず別途報告する、 という線引きになります。
🚨 データリーケージの 10 類型 — 訓練データを台無しにする静かな汚染
データリーケージ(data leakage)とは、 「訓練時に本来知り得ない情報がモデルに漏れ込んでしまい、 学習データ上は高精度に見えるが本番では崩壊する」状態を指します。 訓練データを設計するときに最も恐ろしいバグであり、 静かに起き、 静かに精度を持ち上げ、 本番で初めて露見します。 ここでは代表的な 10 類型を、 SSDSE-B-2026 を含む実務例と一緒に整理します。
| 類型 | 発生例 | 兆候 | 対処 |
|---|---|---|---|
| ①目的変数の派生情報 | 「死亡率」を予測したいのに「死者数 ÷ 人口」を特徴量にしてしまう | 精度が 0.99 を超える | 特徴量と目的変数の派生関係を全部書き出す |
| ②未来情報の混入 | 2025 年予測なのに 2026 年の月次データが含まれる | 時系列で時刻順 CV をすると精度が急落 | 特徴量に「時刻スタンプ」を必ず付ける |
| ③前処理の全データ実施 | train+test 全部で標準化してから分割 | 過剰に滑らかな学習曲線 | Pipeline で分割後に fit_transform |
| ④グループ単位の漏洩 | 同じ患者の異なる時点が train と test 両方にある | 他施設データで精度が崩れる | GroupKFold でグループ単位に分割 |
| ⑤ラベル付け時の参照 | ラベル付け担当者が「特徴量」を見て決めた | 人間が決めた特徴量だけが効く | ラベル付けは盲検で行う |
| ⑥重複サンプル | 同じ行が train と test に重複 | k-NN の精度が k=1 で異常に高い | drop_duplicates() を必ず通す |
| ⑦集計関数の事前計算 | 全期間の平均で「カテゴリ別平均」を計算してから CV | CV 精度と保留テスト精度に乖離 | 集計も fold 内で実施 |
| ⑧情報の高密度な ID | 「ユーザー ID 連番」が時系列を暗黙に含む | ID をシャッフルすると精度が下がる | ID は特徴量に入れない、 もしくは hash 化 |
| ⑨情報含有のテキスト | レビュー本文に「キャンセル」の単語が入っているとキャンセル予測の正解 | テキスト由来の特徴量だけで完璧 | post-event の語彙を除去 |
| ⑩外部公開データの再混入 | 事前学習済みモデルがテスト集合を学習済み | 未公開データでだけ精度が低い | 外部モデルの学習データ範囲を確認 |
リーケージは「異常に良い結果」というシグナルで察知するしかなく、 完全な検出器は存在しません。 SSDSE-B-2026 のようなクロスセクション(横断面)データでは、 ②未来情報の混入や④グループ漏洩は起こりにくい代わりに、 ①目的変数の派生情報(たとえば「失業率」を予測するのに「就業者数」を特徴量にする)や③前処理の全データ実施が起こりがちです。 訓練データを触り始める前に、 各列が「いつ・誰が・どのタイミングで得た情報か」を全部書き出す習慣を持ちましょう。
🏷 ラベル設計と作業フロー — 訓練データ品質の上限はラベル品質で決まる
教師あり学習の訓練データの上限は、 ラベル(教師信号)の品質で決まります。 ラベルが揺らいでいれば、 どれだけ複雑なモデルを投入しても、 揺らぎ以上の精度は出ません。 ラベル設計は、 「定義文書」「複数アノテーターの合意」「曖昧ケースの仲裁ルール」「品質モニタリング」の四点セットで運用するのが定石です。 SSDSE-B-2026 のような公的統計は、 統計法に基づく定義と検査工程があり、 ラベル品質は事実上担保されています。 対して企業内で集めたデータでは、 ラベル付け作業を最も慎重に設計する必要があります。
| 工程 | 目的 | 代表的な手法 | SSDSE-B-2026 への当てはめ |
|---|---|---|---|
| ①ラベル定義 | 何を陽性と呼ぶかを文書化 | 定義書 + ポジ/ネガ例示集 | 「高齢化率 30% 以上を高齢自治体と呼ぶ」など閾値定義 |
| ②ラベル付け担当の訓練 | 複数人で同じ基準を共有 | サンプル 50 件で合意率を測定 | SSDSE は事前定義済みなので不要 |
| ③複数アノテーター | 主観差・誤差を平均化 | 最低 2 人、 重要案件は 3 人以上 | 公的統計は不要、 派生指標を作る場合は実施 |
| ④合意率の測定 | Cohen の κ、 Krippendorff の α | κ > 0.7 が一つの目安 | SSDSE では概念上不要 |
| ⑤曖昧ケースの仲裁 | 専門家のレビュー | 毎週レビュー会 | SSDSE 統計委員会が同等の機能 |
| ⑥定期的な品質監査 | 古いラベルを再確認 | 月次サンプリング監査 | 統計局の改定で対応 |
| ⑦アクティブラーニング | モデルが迷う事例を優先ラベル付け | 不確実性サンプリング | 派生ラベル作成時に有効 |
| ⑧バージョン管理 | ラベル変更の履歴 | git or DVC で管理 | SSDSE-B-2026 という年度自体がバージョン |
SSDSE-B-2026 のような公的統計を「直接」訓練データに使う場合は、 上記の工程の多くは省略できますが、 派生ラベル(たとえば「人口減少自治体かどうか」のフラグ)を作って分類タスクに展開する場合は、 自分で工程を運用する必要があります。 閾値の正当性、 例外処理、 改定時の取り扱いを定義書として整え、 「いつ・誰が・どう決めたか」を残しましょう。
⚖ クラス不均衡・分布シフト・サンプリングの実践
訓練データは「集めただけ」では学習用に使えません。 クラス比のバランス、 時系列のシフト、 サンプリングの偏りを点検し、 必要なら再構成する工程が入ります。 SSDSE-B-2026 のように単年度に絞ると 47 県分しかない小さいデータでも、 「都市・地方の二値分類」「東日本・西日本の比較」のように分割した瞬間に、 群間のサンプル数が不均衡になります。 これを放置すると、 多数派のラベルを返す「定数予測器」と同等の精度で「動いているように見える」モデルが出来上がります。
| 問題 | 兆候 | 対処手段 | 注意点 |
|---|---|---|---|
| クラス不均衡(1:99 など) | accuracy が高いが少数派 recall = 0 | SMOTE / class_weight / 評価指標を F1 に変更 | SMOTE は test fold には適用しない |
| 分布シフト(時系列) | 本番運用で精度が徐々に低下 | 定期再学習、 オンライン学習、 シフト検出器 | 再学習頻度の決定にビジネス判断が必要 |
| 選択バイアス | 特定群が過小代表 | 層化サンプリング、 IPW 重み付け | 重みの誤推定が新たな偏りを生む |
| 自己選択(self-selection) | アンケート回答者だけのデータ | 操作変数法、 Heckman 二段階推定 | SSDSE は全数調査が中心、 リスクは低い |
| サバイバーシップバイアス | 廃業企業が抜けている | 廃業データを別系統から取得 | 取得困難な場合、 結果の解釈を限定する |
| 測定誤差の累積 | 説明変数のノイズが回帰係数を縮める | 誤差in変数モデル、 reliability ratio 補正 | 誤差量を別途推定する必要あり |
SSDSE-B-2026 で 8 地域ブロック分類器を作る場合、 関東 7 都県 vs 北海道 1 道のような不均衡が必ず出ます。 解決策は「最小群を基準に下方サンプリングして全群の件数を揃える」か、 「class_weight='balanced' で重みを付ける」か、 「マクロ F1 で評価して全クラス公平に扱う」のいずれかです。 47 県という小さなデータでは下方サンプリングは情報損失が大きいので、 後二者が現実的でしょう。
🧬 データ拡張・合成データ・半教師あり — 量を増やせない時の戦略
訓練データを物理的に増やせないとき、 三つの戦略があります。 (1) データ拡張(既存データに変換を加えて疑似的に増やす)、 (2) 合成データ生成(GAN や diffusion model で新規データを作る)、 (3) 半教師あり学習(ラベルなしデータをモデルが自分でラベル付けして使う)。 SSDSE-B-2026 のような構造化数値データでは、 画像のような単純な反転・回転は使えませんが、 別の形のデータ拡張(ノイズ注入、 ブートストラップ、 ミックスアップ)が有効です。
| 戦略 | 想定領域 | 代表手法 | SSDSE-B での適用例 | リスク |
|---|---|---|---|---|
| 回転・反転・クロップ | 画像 | torchvision.transforms | N/A(数値表データ) | 過剰拡張で意味を失う |
| 同義語置換・back-translation | テキスト | nlpaug | N/A | 意味の微妙な変化 |
| ノイズ注入 | 数値表 | 小さなガウスノイズを各特徴量に加算 | 総人口・消費支出に標準偏差の 1% 程度のノイズ | 過大ノイズで分布が崩れる |
| ブートストラップ | 数値表 | 復元抽出でリサンプル | 47 県から復元抽出で 100 セット | 情報量は増えない、 ばらつき推定用 |
| ミックスアップ | 数値・画像両用 | 2 サンプルを線形補間 | 2 県の中間値を「仮想の県」として追加 | 解釈可能性が下がる |
| SMOTE | 分類の少数クラス | k-NN ベースで合成 | 8 地域ブロックの少数群を補強 | test に含めない・境界が不自然になる |
| GAN / Diffusion 合成 | 画像・テキスト・数値 | CTGAN, TabDDPM | 47 県データから「もう一つの日本」を合成 | プライバシー・分布の歪み |
| 半教師あり学習 | ラベルが高価 | pseudo-labeling, FixMatch | 市町村レベルにスケールダウンしてラベル拡張 | 擬似ラベルの誤りが波及する |
| 自己教師あり学習 | ラベルがほぼ無い | contrastive learning, masked autoencoder | 複数年度を時系列タスクとして自己教師化 | プリテキストタスクの選定が難しい |
| 転移学習 | 類似ドメインに既存モデル | 事前学習 + ファインチューニング | 他国の都市データで事前学習 | ドメイン差が大きいと逆効果 |
SSDSE-B-2026 のような小規模データに対しては、 「ブートストラップで不確かさを推定」「SMOTE で少数クラスを補強」「ミックスアップで滑らかさを与える」の三つが現実解です。 GAN や diffusion での合成は、 数百件以上の元データが必要で、 47 件では学習が安定しません。 半教師あり学習は、 「市町村レベルの未ラベルデータを 47 県の擬似ラベルで学習」のように、 解像度を変えて適用すると効果が出ます。
🛠 訓練データパイプラインの実装テンプレート — Pipeline + ColumnTransformer + GroupKFold
訓練データを正しく扱う最大のコツは、 「前処理は fold 内で fit、 fold 外で transform」を徹底することです。 scikit-learn の Pipeline と ColumnTransformer を組み合わせ、 GroupKFold または時系列なら TimeSeriesSplit で分割すれば、 リーケージは構造的に防げます。 SSDSE-B-2026 で「一般診療所数(I5102)を予測する」回帰タスクを例に、 実装テンプレートを示します。
このコードでやること: SSDSE-B-2026 から 47 県 × 複数列を読み込み、 数値列は標準化、 カテゴリ列は OneHot エンコーディング、 学習器は Ridge 回帰、 評価は 5-fold CV、 という訓練データパイプラインを 1 本にまとめる。
📥 入力データ (SSDSE-B-2026 の先頭部分。 skiprows=[1] で英字コード列を採用):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd from sklearn.compose import ColumnTransformer from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler, OneHotEncoder from sklearn.linear_model import Ridge from sklearn.model_selection import cross_val_score, KFold df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)].copy() # 地域コードの上2桁から地方ブロックを作る(OneHot用のカテゴリ列) def to_block(code): n = int(code[1:3]) return ['北海道東北','関東','中部','近畿','中国','四国','九州沖縄'][ 0 if n<=7 else 1 if n<=14 else 2 if n<=23 else 3 if n<=30 else 4 if n<=35 else 5 if n<=39 else 6] df['block'] = df['Code'].apply(to_block) y = df['I5102'] # 一般診療所数(目的変数) num_cols = ['A1101', 'A1303', 'A4103'] # 総人口/高齢人口/合計特殊出生率 cat_cols = ['block'] # 地方ブロック X = df[num_cols + cat_cols] pre = ColumnTransformer([ ('num', StandardScaler(), num_cols), ('cat', OneHotEncoder(handle_unknown='ignore'), cat_cols), ]) pipe = Pipeline([('pre', pre), ('model', Ridge(alpha=1.0))]) cv = KFold(n_splits=5, shuffle=True, random_state=0) scores = cross_val_score(pipe, X, y, cv=cv, scoring='r2') print('R^2 each fold:', scores.round(3)) print('mean R^2:', scores.mean().round(3)) |
📤 実行例の出力 (47 県、 シード固定の代表値):
💬 5-fold CV で平均 R² ≒ 0.85 という結果は、 47 県という小さなデータに対しては妥当な水準です。 fold ごとに 0.67〜0.97 と大きく揺らぐのは、 サンプル数が少ないため fold ごとの構成(どの大都市がどの fold に入るか)が結果に影響することを示しています。 信頼性をさらに上げるには、 シードを変えて 10 回繰り返した平均と分散を報告するのが定石です。 重要なのは、 StandardScaler も OneHotEncoder も cross_val_score 内部で fold ごとに fit_transform されるため、 リーケージが構造的に発生しないことです。
❓ 訓練データに関する追加 FAQ(さらに 12 問)
Q1. 訓練データの「単位」を間違えるとどうなりますか?
SSDSE-B-2026 では「総人口(人)」「消費支出(円)」「年平均気温(℃)」と単位が列ごとに異なります。 標準化せずに距離ベースモデル(k-NN, SVM)に投入すると、 桁数の大きい列が距離を支配します。 必ず StandardScaler や MinMaxScaler を通しましょう。
Q2. 訓練データが「集計済み」のとき注意することは?
SSDSE-B は都道府県集計データなので、 「個人レベル」の推定には使えません(生態学的誤謬)。 「平均的に高齢化率が高い県は失業率も高い」とは言えても、 「高齢者は失業しやすい」とは言えません。 集計レベルと推論レベルを必ず一致させてください。
Q3. 訓練データの「年度」が予測対象と違うときは?
SSDSE-B-2026 のデータで 2030 年を予測する場合、 最新の 2023 年度から 7 年先を当てることになります。 (a) 多年度を結合して時系列モデルを使う、 (b) 単年度モデルを使い「短期的には県の順位は変わらない」という仮定を明示する、 (c) 共変量シフトの可能性を必ず議論する、 の三点が必須です。
Q4. 訓練データの「カテゴリ列」を数値化する方法は?
「地域ブロック」のようなカテゴリ列は、 (a) OneHotEncoder(独立列)、 (b) OrdinalEncoder(順序がある場合)、 (c) TargetEncoder(目的変数の平均で置換)、 のいずれかを使います。 TargetEncoder はリーケージリスクが高いので、 必ず fold 内で fit してください。
Q5. 訓練データを「正規化すべきか」判断する基準は?
距離ベース(k-NN, SVM, K-Means, PCA)と勾配ベース(NN, 線形回帰の最適化)は標準化必須。 木ベース(決定木, ランダムフォレスト, GBDT)は標準化不要。 ただし正則化が入る Ridge/Lasso は標準化必須です。
Q6. 訓練データを「対数変換すべきか」判断する基準は?
右裾分布が強く(歪度 > 1)、 値が正で、 0 以下を取らないなら対数変換が有効。 SSDSE-B の総人口・出生数・着工新設住宅戸数などは対数変換すると分布が対称に近づき、 線形モデルとの相性が劇的に改善します。 0 を含む場合は log1p(=log(1+x))を使います。
Q7. 訓練データの「欠損」を埋める順番は?
(1) MCAR/MAR/MNAR を判定 → (2) MCAR ならリストワイズ削除も可 → (3) MAR なら多重代入法(IterativeImputer, MICE)→ (4) MNAR ならドメイン知識を使った仮定明示。 SSDSE-B は欠損ほぼ無しなので、 この手順は他データセットを併用するときに重要です。
Q8. 訓練データの「外れ値」は除去すべきですか?
理由なく除去するのは禁物。 SSDSE-B の東京は確かに外れ値ですが、 「東京がない日本」を予測するモデルは現実には使えません。 (a) 外れ値を含むモデルと含まないモデルの両方を作って比較、 (b) ロバスト回帰(Huber, RANSAC)を使う、 (c) 外れ値群と非外れ値群を別モデルに分ける、 のいずれかを検討します。
Q9. 訓練データのサイズと汎化誤差の関係は?
汎化誤差は概ね 1/√N に比例して減ります。 つまり N=100 → 400 で誤差が半分、 N=400 → 1600 でさらに半分。 誤差を半分にするには N を 4 倍にする必要があり、 増やすほど 1 件あたりの改善は小さくなります。 学習曲線で「次の倍増にいくら払えば良いか」を実測しましょう。
Q10. 訓練データに「重み」を付けるべき場面は?
(a) クラス不均衡(class_weight='balanced')、 (b) 信頼性の異なるサンプル(測定誤差が小さいものに重く)、 (c) 標本抽出時の確率の逆数(IPW; Inverse Probability Weighting)、 (d) 古いデータほど軽く(時間減衰)、 が代表例です。 SSDSE-B では人口の小さい県の重みを上げて公平性を担保するという使い方もあります。
Q11. 訓練データを「シャッフル」してから分割すべき場面と、 すべきでない場面は?
クロスセクション(横断面)はシャッフル必須(順序に意味がないため)。 時系列は絶対シャッフルしない(未来が訓練に入る)。 グループ構造(患者 ID、 都道府県 ID)がある場合は GroupKFold でグループ単位に分割してから fold 内をシャッフル。 SSDSE-B-2026 単年度ならシャッフル OK、 多年度結合なら年度単位の TimeSeriesSplit が必要です。
Q12. 訓練データを「全部使う」「サンプリングして使う」の判断基準は?
(a) 数百万件以下なら全部使う、 (b) 数千万件以上は計算コストとの相談、 (c) 層化サンプリングで部分集合を作り、 学習曲線が飽和していれば部分集合で十分、 (d) GPU メモリの制約があるなら mini-batch でストリーミング学習、 と段階的に判断します。 SSDSE-B の 47 件は当然「全部使う」ケースです。
🔬 数式を言葉で読み解く
記号と意味を逐一突き合わせて読みます。 慣れないうちは式を「日本語で読む」ことが理解の近道です。
- $\mathcal{D}_{\text{train}}$:訓練データ集合
- $n_{\text{tr}}$:訓練サンプル数
- $\mathcal{D}$:真の分布。 訓練データはここからの i.i.d. サンプル
- $\hat{\theta}$:経験リスク最小化により得られるパラメータ推定量
- i.i.d. 仮定:独立同一分布。 違反すると汎化保証が崩れる
🧮 SSDSE-B 実値で計算してみる
SSDSE-B 47 県を訓練 70% / テスト 30% に分割し、 訓練データのサイズを変えながら学習曲線 を描きます。
データ出典:SSDSE-B-2026(独立行政法人統計センター)。 47 都道府県 × 複数年(最新 2023)の社会統計データ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np from sklearn.model_selection import train_test_split from sklearn.linear_model import LinearRegression from sklearn.metrics import mean_squared_error df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)].reset_index(drop=True) X = df[['A1101','A1303']].values # 総人口・65歳以上人口 y = df['A1301'].values # 15歳未満人口 X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) print(f'訓練 n={len(y_tr)}, テスト n={len(y_te)}') print('train_n | RMSE_train | RMSE_test') for n in [5, 10, 15, 20, 25, len(y_tr)]: Xs, ys = X_tr[:n], y_tr[:n] m = LinearRegression().fit(Xs, ys) tr = mean_squared_error(ys, m.predict(Xs)) ** 0.5 te = mean_squared_error(y_te, m.predict(X_te)) ** 0.5 print(f' {n:>5} | {tr:>10,.0f} | {te:>10,.0f}') |
💬 47 県を 32 対 15 に分け、訓練データの先頭から 5, 10, … 件だけ使って学習している。テスト RMSE は 5 件で 38,853 人と大きく、15 件で 26,829 人まで下がったあとは 3 万人前後で頭打ちになる。訓練 RMSE が 25 件の 10,968 から 32 件で 23,254 に跳ねるのは、26 件目以降に福岡県・沖縄県・北海道という、総人口と高齢人口だけでは子どもの数を当てにくい県が入るためである。訓練データは件数だけでなく、どの県が入るかで誤差が大きく動く。
実行結果の要約(random_state を固定しているので、下の値はそのまま再現できます):
| 項目 | 値 |
|---|---|
| 訓練サイズ | 32 県(70%) |
| テストサイズ | 15 県(30%) |
| n=5 RMSE訓練/テスト | 8,451 / 38,853 |
| n=15 RMSE訓練/テスト | 8,744 / 26,829 |
| n=32 RMSE訓練/テスト | 23,254 / 31,801 |
| 傾向 | n増 → 訓練 RMSE は上昇(25 件までは 1 万人前後、32 件で 23,254)、 テスト RMSE は 15 件までに 26,829 まで下がってから 3 万人前後で横ばい |
🧮 訓練データ品質チェックリスト(実値で検証)
訓練データの「品質」は曖昧な言葉ですが、 実務では以下の 8 項目で診断できます。 SSDSE-B-2026 を例に、 実際の数値で何を見るかを示します。
📋 8 項目チェックリスト(SSDSE-B-2026 実値付き)
| 項目 | 確認方法 | SSDSE-B 実値 |
|---|---|---|
| 1. サンプル数 | len(df) | 47 県(2023 年度) / 564 行(12 年パネル) |
| 2. 欠損率 | df.isna().mean() | 全列で 0%(2023 年度、 実測) |
| 3. 重複行 | df.duplicated().sum() | 0 行 |
| 4. 外れ値率 | IQR ×1.5 法 | 人口 A1101:47 県中 9 県(東京・神奈川・大阪など大都市圏)が外れ値 |
| 5. 分布の歪み | 歪度(skewness) | 人口 A1101 の歪度 = 2.22(右に強く歪む) |
| 6. クラス不均衡 | df['label'].value_counts() | 人口 100 万以上:37 県 / 100 万未満:10 県(約 3.7:1 の不均衡) |
| 7. ラベル一貫性 | 複数人のクロスチェック | SSDSE は公式統計なのでラベルノイズなし |
| 8. 時間的整合性 | 年度をまたいだ列定義の安定性 | SSDSE-B は年度間で列定義が一致 |
🐍 一括診断スクリプト
このコードでやること:SSDSE-B-2026 を読み込み、 上記 8 項目を 1 回の関数呼び出しで診断する。
📥 入力データ:SSDSE-B-2026.csv。 出力は各項目の数値と「問題あり/なし」の判定。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from scipy.stats import skew df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)] y = df['A1101'] # 総人口 print(f'1. サンプル数: {len(df)} 県') print(f'2. 欠損率: {df.isna().mean().mean()*100:.2f}%') print(f'3. 重複行: {df.duplicated().sum()} 行') q1, q3 = y.quantile(0.25), y.quantile(0.75) iqr = q3 - q1 outliers = ((y < q1 - 1.5*iqr) | (y > q3 + 1.5*iqr)).sum() print(f'4. 外れ値: {outliers} 県') print(f'5. 歪度: {skew(y):.2f}') label = (y >= 1_000_000).astype(int) print(f'6. クラス比: 大都市{label.sum()}県 / 小都市{(1-label).sum()}県') |
📤 実行例:
💬 歪度 2.22 が大きい → 人口は対数変換(np.log1p)してから学習すべき。 外れ値 9 県は東京(1409 万)を筆頭とする大都市圏で、 削除ではなく「対数変換で吸収」が定石。 クラス比は 37:10 と不均衡なので、 分類タスクでは class_weight='balanced' や層化抽出(stratify)を検討します。
🧮 数式に値を入れて手で計算する: 学習データ量と精度
SSDSE-B-2026 (47 県 × 12 年 = 564 行) を母集団見立てに、 訓練サンプル数 N と テスト誤差の関係を経験則 err = err_min + C/√N で計算する。 N=100 で err=0.30 を観測した想定で、 err=0.05 を達成するための N を逆算する。
Step 1: 経験則の当てはめ
Step 2: 必要 N の逆算
🐍 Python で再現
1 2 3 4 5 | import numpy as np err_target = 0.05 err_at_100 = 0.30 N = 100 * (err_at_100/err_target)**2 print(f"必要 N: {round(N)}") |
📤 実行結果
💬 手計算 (Step 2) 3,600 と Python 出力が完全一致。
🐍 Python 実装
scikit-learn / pandas を使った最小実装パターン。 上の SSDSE-B 計算と同じスタイルですが、 ここでは「読み込み→前処理→学習→評価」のテンプレを 4 つのスニペットに分けます。
① データ読み込み & 概観
1 2 3 4 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)].reset_index(drop=True) print(df.shape, df.columns.tolist()[:8]) |
💬 Code が R で始まる行と 2023 年度で絞ると 47 行 × 112 列になり、1 県 1 行の訓練データになる。先頭 3 列は年度・地域コード・県名という識別用の列で、特徴量として使えるのは A1101(総人口)以降である。識別列をそのまま X に混ぜると、県コードの番号順を学習してしまうので切り分けておく。
② 特徴量と目的変数
1 2 3 | X = df[['A1101','A1303']].values # 総人口・65歳以上人口 y = df['A1301'].values # 15歳未満人口 print('X shape =', X.shape, ', y shape =', y.shape) |
💬 X は 47 行 × 2 列(総人口・65 歳以上人口)、y は 47 要素の 1 次元配列(15 歳未満人口)で、行数がそろっていることが教師あり学習の最低条件になる。y が (47, 1) の 2 次元だと一部の推定器が警告を出すので、この形で渡すのがよい。3 変数とも人数で、どれも県の規模に比例するという性質を持っている。
③ 訓練/テスト分割 + モデル学習
1 2 3 4 5 6 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=300, random_state=0).fit(X_tr, y_tr) print('R^2 (test) =', model.score(X_te, y_te)) |
💬 ランダムフォレストのテスト R² は 0.981 で、15 県の 15 歳未満人口の違いの 98% を説明した。ただし総人口と子どもの数はほぼ比例するので、この高さは「規模の大小を当てた」ことによるところが大きい。子どもの割合(2023 年は 9.1%〜16.1%)のような規模を除いた量を y にすると、同じ訓練データでも当たりやすさは大きく変わる。
④ 評価と可視化
1 2 3 4 5 6 | import matplotlib.pyplot as plt pred = model.predict(X_te) plt.scatter(y_te, pred) plt.plot([y_te.min(), y_te.max()], [y_te.min(), y_te.max()], 'r--') plt.xlabel('実測'); plt.ylabel('予測'); plt.title('「訓練データ」関連モデルの予測精度') plt.tight_layout(); plt.savefig('out.png', dpi=150) |
※ 「訓練データ」固有の本格コードは上の 🧮 SSDSE-B 実値計算 節を参照。
🐍 応用コード — 47 都道府県を 70:30 で分けたうちの 32 県を訓練に
SSDSE 公的データを題材に、 訓練データ を実際に動かす最小コードです。 paths は引数に直書きで、 初心者がコピペで動かせる形を優先しています。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47 県 × 約 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['Code'].str.startswith('R') & (df['SSDSE-B-2026'] == 2023)].reset_index(drop=True) print('shape:', df.shape) print('列の先頭:', df.columns.tolist()[:6]) # 必要な列だけ取り出して整形 features = ['A1101', 'A1301', 'A1303', 'A4103'] # 総人口/15歳未満/65歳以上/出生率 df_use = df[features].copy() print(df_use.describe()) |
💬 describe() の 4 列は桁がまったく違い、総人口の平均 264.6 万人に対し合計特殊出生率 A4103 は平均 1.29・範囲 0.99〜1.60 と 1 前後の小さな数である。人口 3 列は平均が中央値より大きく(総人口で 264.6 万人対 154.9 万人)、東京都などが右の裾を作っている。この表は #11 以降で、人数から比率を予測するという難しい組み合わせの訓練データになる。
次に、 訓練データ に固有の処理を加えます。 ここがページごとの「肝」になる部分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error, r2_score X = df[['A1101', 'A1303', 'A1301']].fillna(0).values # 総人口/65歳以上/15歳未満 y = df['A4103'].fillna(df['A4103'].median()).values # 合計特殊出生率 X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0).fit(X_tr, y_tr) pred_tr = model.predict(X_tr) pred_te = model.predict(X_te) print(f'train R^2 = {r2_score(y_tr, pred_tr):.3f}') print(f'test R^2 = {r2_score(y_te, pred_te):.3f}') print(f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}') |
💬 訓練 R² 0.872 に対してテスト R² は −0.040 で、テストの 15 県については「全員に平均値を答える」より悪い。深さ 4 の森でも 32 県の出生率(最低の東京都 0.99〜最高の沖縄県 1.60)を細かく覚えてしまい、その覚え方がテストの県には通用しなかった。テスト RMSE 0.1187 は、テスト 15 県の出生率そのものの標準偏差 0.116 とほぼ同じ大きさである。人数の 3 列に出生率の情報が無いわけではないことは、下の線形モデル(パターン B・C)で分かる。
さらに可視化を加えると、 学んだ内容が「眼で」確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('訓練データ を使ったモデルの予測精度(SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_training-data.png', dpi=150) |
最後に、 同じ問題を別の角度から見る「クロスバリデーション版」も用意します。
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.model_selection import cross_val_score, KFold # df は地域コード順(北海道 → 沖縄)に並んでいる。cv=5 とだけ書くと # シャッフルなしの KFold になり、fold が「東北だけ」「九州だけ」のような塊になる kf = KFold(n_splits=5, shuffle=True, random_state=0) scores = cross_val_score( RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0), X, y, cv=kf, scoring='r2' ) print(f'5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f})') print('各 fold:', np.round(scores, 3)) |
💬 地域順の並びを崩した 5 分割交差検証の R² は平均 0.260 で、fold ごとに 0.16〜0.43 の幅がある。上の 1 回の分割でのテスト R² −0.040 より高く、1 回の分割の値はどの 15 県がテストに入ったかで大きく動くことが分かる。cv=5 とだけ書くとシャッフルなしの KFold になり、北から順の 9〜10 県ずつが 1 fold になって平均 R² は −2.162 まで落ちる。並び順に地域のまとまりがあるデータでは、分けるまえにシャッフルする。
🐍 実装パターン集 — 状況別レシピ
同じ「訓練データ」を使うにも、 データの形・規模・目的によって書き方が変わります。 4 つの典型パターンを示します。
パターン B:パイプライン化(前処理+モデル)
1 2 3 4 5 6 7 8 9 10 | from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import Ridge pipe = Pipeline([ ('scaler', StandardScaler()), ('model', Ridge(alpha=1.0)), ]) pipe.fit(X_tr, y_tr) print('R^2 =', pipe.score(X_te, y_te)) |
💬 標準化 + Ridge(alpha=1.0) の線形モデルにすると、同じ分割でテスト R² は 0.189 になり、#11 のランダムフォレスト(−0.040)より少し良い。訓練データが 32 件しかないときは、木で細かく分けるより、滑らかな線形の関係を仮定したほうが過学習しにくいという例になっている。ただし α=1.0 は仮に置いた値なので、正則化の強さは次のパターン C で訓練データだけを使って選び直す。
パターン C:交差検証+ハイパーパラメータ探索
1 2 3 4 5 6 7 8 | from sklearn.model_selection import GridSearchCV, KFold params = {'model__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} kf = KFold(n_splits=5, shuffle=True, random_state=0) # 地域順の並びを崩して分割 gs = GridSearchCV(pipe, params, cv=kf, scoring='r2', n_jobs=-1) gs.fit(X_tr, y_tr) # α の探索は訓練データ(32 県)だけで行い、テスト 15 県は最後まで使わない print('best:', gs.best_params_, 'CV score:', round(gs.best_score_, 3)) print('test R^2:', round(gs.score(X_te, y_te), 3)) |
💬 訓練 32 県の中で α を 0.01〜100 の 5 通り試すと、5 分割 CV(シャッフルあり)の最良は α=0.01・CV R² 0.401 で、その α で 32 県全体に当て直したモデルはテスト 15 県で R² 0.469 になった。α=1.0 のパターン B(0.189)より大きく良くなり、標準化した 3 列では正則化を弱めたほうが合う。α を選ぶのにテストの県を一度も使っていないので、0.469 は未知の県に対する性能の見積もりとして読める。47 県全体で GridSearchCV をしてからテスト県で測ると、テスト県を学習に使ったことになり値が甘くなる。
パターン D:可視化付きの結果保存
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import matplotlib.pyplot as plt import json pred = gs.predict(X_te) plt.figure(figsize=(7,5)) plt.scatter(y_te, pred, alpha=0.7, edgecolor='k') plt.plot([y_te.min(), y_te.max()], [y_te.min(), y_te.max()], 'r--') plt.xlabel('実測'); plt.ylabel('予測'); plt.title('訓練データ 結果') plt.tight_layout(); plt.savefig('result_training-data.png', dpi=150) with open('result_training-data.json', 'w', encoding='utf-8') as f: json.dump({'best_params': gs.best_params_, 'cv_score': gs.best_score_, 'test_score': gs.score(X_te, y_te)}, f, ensure_ascii=False, indent=2) |
🎮 触って理解する
訓練データの量(サンプル数)と質(ノイズ・偏り)が、モデルの学習にどう効くかを手を動かして体感します。
真の関数は y = sin(2πx)(緑)。そこから訓練データ(青丸)を生成し、多項式回帰でモデル(橙)を当てはめます。
左の図が「当てはめの様子」、右の図が「学習曲線(サンプル数 n ごとの汎化誤差)」です。
汎化誤差(テストRMSE)は、ノイズを含まない真の関数に対して全域で測った二乗平均平方根誤差で、値が小さいほど良いモデルです。
🧠 直感:モデルは「見た元データ」しか学べない
n を 5〜10 まで下げて「🎲 再抽選」を何度か押してみてください。橙の曲線が抽選のたびに大きく暴れるはずです。 これがデータ不足による不安定さ(高バリアンス)で、少数の点にモデルが振り回される様子です。 次に n を 150〜200 に上げて再抽選すると、曲線はほとんど動かず真の関数に張り付きます。 「データの量がモデルを決める」──同じアルゴリズムでも、渡すデータで結論が変わるのです。 量と質の一般論は バイアス・バリアンス と 汎化 のページも参照してください。
⚠️ よくある落とし穴:少なすぎ・偏り・ノイズ・リーク
- 少なすぎ:n が小さいと学習曲線の左端で誤差が高く不安定。次数 d を上げると過学習(訓練RMSEはほぼ0なのにテストRMSEが跳ね上がる)が観察できます → 過学習。
- 偏り(サンプリングバイアス):偏りスライダーを上げると、訓練点が左側の領域だけに集まります。モデルは見ていない右側を外挿できずテストRMSEが悪化します。サンプリングバイアス自体の解説ページは本教材では未整備のため、リンクなしのテキストのみで補足します。
- ノイズ:σ を上げるとテストRMSEの下限(ノイズ床)が上がります。質の悪いデータは量では救えないのがポイントです。ラベル品質は アノテーション の質に直結します。
- リーク(リーケージ):この教材ではテストを真の関数(=答え)で測っていますが、実務でテストの情報が訓練に混ざると誤差が過小評価されます → データリーケージ、検証データ / テストデータ の分離を厳守。
🚀 発展:量が足りないときの3つの武器
「もっとデータを集める」以外にも手はあります。 データ拡張(Data Augmentation)は既存データを変換して水増しする手法(本教材では専用ページ未整備のためテキスト補足)。 能動学習(Active Learning)は「効くサンプル」だけを選んでアノテーションし、少ないラベルで効率的に学ぶ考え方(同じく未整備)。 そして近年のデータ中心AI(Data-Centric AI)は、モデルを固めてデータの質を磨くことで性能を上げる潮流です。 ラベルが高コストなら 交差検証 で全データから情報を絞り出し、少量データなら 転移学習 で事前知識を借りるのが定石です。
⚠️ よくある落とし穴(5 つ)
⚠️ 訓練データの落とし穴:データ漏洩(Data Leakage)の 6 パターン
「test で 99% の精度が出た!」が、 実は 訓練データに test の情報が混入していただけだった、 というのは Kaggle でもよくある失敗です。 SSDSE-B-2026 を例に 6 つの典型パターンを示します。
| パターン | 典型例(SSDSE-B) | 予防策 |
|---|---|---|
| 1. ターゲット漏洩 | 人口 A1101 を予測する際、 説明変数に A1301(15歳未満人口)を入れる → ほぼ自明な情報。 | 特徴量がターゲットの「分解」になっていないか確認。 R² が異常に高い場合は要疑い。 |
| 2. 時間漏洩 | 2023 年の人口予測に 2024 年の出生率を使う → 未来情報が紛れ込む。 | 時系列は train_test_split でなく TimeSeriesSplit を使う。 |
| 3. 前処理漏洩 | 全 47 県で StandardScaler.fit してから分割 → test の平均/分散が train に流れ込む。 | Pipeline を使い、 fit は train のみ、 transform は train/val/test 別々。 |
| 4. ID 漏洩 | 地域コード(Code)をそのまま特徴量に入れる → ターゲットと 1:1 で対応してしまう場合。 | ID 列は明示的に drop。 ハッシュ化や one-hot も影響を考慮。 |
| 5. 重複漏洩 | 同じ県の異なる年度を train と test に同居 → モデルが「県名」を覚える。 | GroupKFold でグループ(県)単位の分割。 |
| 6. メタデータ漏洩 | テスト時にしか取得できない情報(事後集計値など)を訓練に使う。 | 「予測時点で本当に取得可能か」を 1 つずつ確認。 |
💡 ルール:test R² が「あまりに良すぎる」ときは、 漏洩を疑え。 SSDSE-B-2026 で総人口 A1101 を予測する場合、 R² > 0.99 なら高確率で漏洩、 R² = 0.7〜0.95 が現実的な値です。
🗺 概念マップ
「訓練データ」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 教師あり学習 / データ分割 | 訓練データが属する大枠 |
| 南 (下位) | model.fit() / mini-batch / epoch | 訓練データを直接使う処理 |
| 東 (発展) | データ拡張 / 半教師あり / Active Learning | 訓練データ不足を補う発展形 |
| 西 (前提) | train_test_split / 層化抽出 / CV | 訓練データを切り出す基礎手法 |
| 中央 | 訓練データ | 本ページの主役 |
🔗 隣接手法への橋渡し
訓練データはモデル学習の「燃料」で、 上流の品質確保と下流の評価が直結する。
- 上流: 収集 → アノテーション (ラベル付与) → クリーニング → データ拡張 で多様化
- 並列: 検証データ (ハイパラ調整用)、 テストデータ (最終評価)、 合成データ (希少クラス補強)
- 下流: 損失関数 最小化 → 逆伝播 で重み更新 → 過学習 監視 → Early Stopping
SSDSE-B-2026 で消費支出(L3221)を予測するなら、 47 県 × 12 年 = 564 行から 60% (338 行) を訓練に。 「東京 2015-2020」が train、 「東京 2021-2022」が test に分かれるとリークなので、 県をグループに GroupKFold を併用。
🌳 手法選択フロー
訓練データの扱いは、 ラベル有無とサイズで 4 通りに分岐する。
- ラベル付き + 十分量 (n > 10000)? Yes → 通常の教師あり学習。 60/20/20 分割
- ラベル付き + 少量 (n < 1000)? Yes → データ拡張 + 転移学習 で増強
- ラベル無し or 半分のみ? Yes → 半教師あり / 自己教師あり。 ImageNet 事前学習が典型
- ラベル付与が高コスト? Yes → 能動学習 で重要サンプルだけアノテーション
SSDSE-B-2026 は全数調査ベースで「ラベル付き + 中規模 (564 行)」なので、 通常の教師あり学習でデータ拡張なしが基本。 ただし県単位で n=47 と捉える場合は CV 必須。
🔍 解説を深める — 訓練データの「1 票の重さ」は平等ではない
ここまで訓練データを「量」「質」「分割」の観点で見てきました。 このセクションでは姉妹ページ(検証データ・テストデータ・訓練・テスト分割)では扱わない、 もう一段深い視点を追加します。 それは 「訓練データの中の 1 サンプルは、 学習結果に対して同じ発言力を持っていない」という事実です。 n=47 のような小規模データでは、 たった 1 県の有無がモデルの係数を 1 割以上動かすことがあります。 これを SSDSE-B-2026 の実測値で確かめます。
🧠 直感 — 「1 県抜き(leave-one-out)」で発言力を測る
発言力の測り方は単純です。 訓練データから 1 サンプルだけ抜いて学習し直し、 結果(回帰係数)がどれだけ動くかを見るだけ。 動きが大きいサンプルほど、 モデルに強い影響を与えていたことになります。 SSDSE-B-2026 の 2023 年・47 都道府県で、 一般診療所数(I5102)から総人口(A1101)を予測する単回帰を組むと、 全 47 県での傾きは 1038.2(診療所 1 か所あたり約 1038 人)です。 ここから 1 県ずつ抜いて傾きを再計算した結果が下の表です(すべて実測値)。
| 抜いた県 | 残り 46 県での傾き | 全 47 県(1038.2)からの変化 |
|---|---|---|
| 東京都 | 1183.8 | +14.0% |
| 神奈川県 | 1012.7 | −2.5% |
| 大阪府 | 1057.9 | +1.9% |
| 埼玉県 | 1020.8 | −1.7% |
| 愛知県 | 1023.7 | −1.4% |
東京都を抜くと傾きが 14% も跳ね上がるのに対し、 2 位の神奈川県ですら 2.5% しか動きません。 47 サンプルのうち、 実質的に「1 県が回帰直線の向きを握っている」状態です。 理由はてこの原理(レバレッジ)で説明できます。 東京都の一般診療所数 14,894 は 47 県の中央値 1,369 の約 10.9 倍で、 説明変数軸の端に孤立しているため、 回帰直線は東京を通るように強く引っ張られます。 統計量で言えば東京都のレバレッジは h = 0.53 で、 47 サンプルの平均レバレッジ 2/47 ≒ 0.043 の 12 倍超。 「訓練データが 47 件ある」と数えても、 有効な発言権は均等に 1/47 ずつではないのです。
⚠️ 落とし穴(重要) — 高い相関は「データが良い」証拠にならない
この例の相関係数は r = 0.972 と一見「理想的な訓練データ」に見えます。 しかし東京都を除いても r = 0.969 とほぼ変わらないのに、 傾きは 14% 変わる——つまり 相関の高さは、 個々のサンプルの影響力の偏りを何も保証しないのです。 実害は小規模県の予測に出ます。 全 47 県で学習した直線で鳥取県を予測すると 約 82.1 万人(実測値 820,852 人)ですが、 実際の総人口は 53.7 万人。 大都市に引っ張られた直線が、 最小県を 約 28.4 万人(実測比 +53%)も過大予測します。 さらに危険なのは分割との相互作用で、 東京都が train に入るか test に入るかで「別のモデル」と言ってよいほど結果が変わるため、 ホールドアウト 1 回の評価は乱数シード次第で大きくブレます(本ページ冒頭のコード例でも、 test 9 県の平均人口 4,407,667 人 vs train 30 県の 2,162,600 人と、 分割だけで人口構成が倍以上ずれていました)。 平均 2,645,809 人と中央値 1,549,000 人が 1.7 倍も乖離した右裾分布では、 「平均的な県」を代表するサンプルはそもそも存在しない、 と考えるのが安全です。 対策は (1) 交差検証で「どの県が抜けても結論が変わらないか」を確認する、 (2) 対数変換などでレバレッジを圧縮する、 (3) Huber 回帰などのロバスト回帰(本教材では専用ページ未整備)で影響を頭打ちにする、 (4) 影響力の大きい点を外れ値として機械的に捨てる前に「本当に除外してよい母集団か」を考える、 の 4 点です。 東京都は測定ミスではなく実在する 1400 万人なので、 「予測したい対象に東京都型の地域が含まれるか」という問題設定こそが除外可否を決めます。
🚀 発展 — 影響度分析からデータ・バリュエーションへ
「1 点抜きで結果がどう動くか」は、 統計学では 影響度分析(Cook の距離、 DFBETAS など。 本教材では専用ページ未整備)として古くから体系化されています。 機械学習側では同じ発想が influence function(Koh & Liang, 2017)として再発見され、 深層学習モデルでも「この予測に効いた訓練サンプルはどれか」を推定できるようになりました。 さらに各訓練サンプルの貢献をゲーム理論の Shapley 値で配分する Data Shapley(Ghorbani & Zou, 2019)へ発展し、 「価値の低いデータを捨てると精度が上がる」「価値の高いデータだけ追加収集する」というデータ中心 AI(Data-Centric AI)の定量的な土台になっています。 訓練データを「何件あるか」で数える段階から、 「どの 1 件がいくらの価値を持つか」で管理する段階へ——本ページで学んだ量・質・分割に続く第 4 の視点として覚えておくと、 バイアス・バリアンスやデータリーケージの議論も「サンプル単位」の解像度で見直せるようになります。
🔗 関連ページ
- 外れ値 — 影響力の大きい点と「除外してよい点」の区別はここから
- 交差検証 — 「どのサンプルが抜けても結論が同じか」を確かめる標準手段
- 訓練・テスト分割 — 高影響サンプルがどちら側に入るかで評価が揺れる問題の基礎
- データリーケージ — 「良すぎる結果」を疑う姿勢の共通項
- バイアス・バリアンス — 1 点への過敏さは高バリアンスの一形態
- ロバスト回帰・Cook の距離・Data Shapley — 本教材では専用ページ未整備のためテキストのみ(キーワードとして検索を推奨)