論文一覧に戻る 📚 用語集トップ 🗺 概念マップ
📚 用語解説
📚 用語解説
目的変数
Target Variable
ML基礎
別称: 従属変数 / 応答変数

🔖 キーワード索引

このページで扱う概念:

目的変数 y従属変数・応答変数ラベル・outcome回帰と分類順序・多クラス・多ラベル多目的(multi-target)回帰ターゲットリーケージ対数変換と逆変換のバイアスDuan smearingクラス不均衡出生数 A4101合計特殊出生率 A410315 歳未満人口 A1301

💡 30秒で分かる結論

🍰 まずはやさしく

予測したい答えのことです。

未来の結果を当てるために使います。

テストの点数を予想するときのようなものです。

数式やコード、注意点を学びます。

目的変数(Target Variable):予測したい変数。 教師あり学習では $y$ で表される

📍 あなたが今見ているもの

🍰 まずはやさしく

用語の解説ページです。

機械学習の基本を身につけるために使います。

都道府県のデータを使って練習します。

直感的な意味からPythonのコードまで読みます。

このページは「目的変数(Target Variable)」の用語解説です。 機械学習の基礎カテゴリにおける重要概念で、 機械学習の基礎 グループ教材の中で繰り返し登場します。 数式・実コード・落とし穴を 1 ページに集約し、 SSDSE-B-2026 都道府県データ(47 件 × 112 列)を題材に 手を動かしながら理解できるよう構成しています。

別称:従属変数 / 応答変数 / ラベル。 まず 💡 30秒結論 で全体像を、 次に 🎨 直感 → 📐 数式 → 🧮 実値 → 🐍 Python の順で読むのがおすすめ。

🎨 直感で掴む

🍰 まずはやさしく

当てたい目標のことです。

何を予測するかを決めるために使います。

お店の売上を予想するときのようなものです。

データの種類による使い分けについて読みます。

目的変数は「当てたいもの」です。 売上を当てたいなら売上額が目的変数、 病気の有無を当てたいなら陽性/陰性ラベルが目的変数。 教師あり学習では $y$、 統計モデルでは応答変数とも呼びます。

性質によってモデルとロスが決まる:
・連続値 → 回帰(MSE / MAE)
・2 クラス → 2 値分類(Log Loss)
・多クラス → 多クラス分類(Categorical CE)
・順序付き → 順序回帰
・複数同時 → 多ラベル
「何を当てるか」の設計が分析品質を決めます。

📐 数式または定義

🍰 まずはやさしく

予測する対象を数式で表したものです。

正しく計算するために使います。

スマホの充電時間を数字で出すようなものです。

数学的な定義や別の呼び方について読みます。

目的変数 $y$ は予測すべき対象。 タスクに応じて値域 $\mathcal{Y}$ が変わる(KaTeX で描画)。

$$y \in \mathcal{Y},\quad \text{回帰: } \mathcal{Y}=\mathbb{R},\quad \text{2値分類: } \mathcal{Y}=\{0,1\},\quad \text{多クラス: } \mathcal{Y}=\{1,\dots,K\}$$

英語名 Target Variable。 別称:従属変数 / 応答変数 / ラベル。

🔬 数式を言葉で読み解く

記号と意味を逐一突き合わせて読みます。 慣れないうちは式を「日本語で読む」ことが理解の近道です。

🧮 SSDSE-B 実値で計算してみる

SSDSE-B で 「15 歳未満人口」を回帰、 「若年比率の高低」を 2 値分類 として 2 通りの目的変数を試します。

データ出典:SSDSE-B-2026(独立行政法人統計センター)。 47 都道府県 × 複数年(最新 2023)の社会統計データ。

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) A1301(15歳未満人口) A1303(65歳以上人口) 北海道 5,092,000 514,000 1,681,000 東京都 14,086,000 1,513,000 3,205,000 沖縄県 1,468,000 236,000 350,000 …(全 47 行)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression, LogisticRegression
from sklearn.model_selection import cross_val_score, train_test_split
from sklearn.metrics import r2_score, accuracy_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True)

X = df[['A1101','A1303']].values

# (A) 回帰: y = 15歳未満人口
y_reg = df['A1301'].values
print('回帰 5-CV R^2 =', cross_val_score(LinearRegression(), X, y_reg, cv=5).mean())

# (B) 2値分類: y = 若年比率 ≥ 中央値
df['若年比率'] = df['A1301'] / df['A1101']
y_cls = (df['若年比率'] >= df['若年比率'].median()).astype(int).values
Xtr, Xte, ytr, yte = train_test_split(X, y_cls, test_size=0.3,
                                      random_state=0, stratify=y_cls)
# 人数は 10^5〜10^7 の桁なので標準化してから学習する(しないと全件同じクラスを予測する)
clf = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000)).fit(Xtr, ytr)
print('分類テスト精度 =', round(accuracy_score(yte, clf.predict(Xte)), 3))
print('多数派クラスを答え続けた場合 =', round(max(yte.mean(), 1 - yte.mean()), 3))
📤 実行例(実測) 回帰 5-CV R^2 = 0.95636463193674 分類テスト精度 = 0.467 多数派クラスを答え続けた場合 = 0.533

💬 同じ説明変数(総人口・65 歳以上人口)でも、目的変数を 15 歳未満人口の「人数」にすると 5 分割 CV の R² は 0.956 と高いのに、「若年比率が中央値以上か」にすると分類精度は 0.467 で、多数派クラスを答え続けるだけの 0.533 にも届かない。人数は総人口に比例するので当てやすいが、比率は総人口で割った時点で「県の大きさ」の情報が消え、人数の説明変数からはほとんど読み取れない。目的変数の定義を変えると、問題の難しさそのものが変わる。

実行結果の要約(出力は環境依存。 概算値):

項目値
回帰の y15歳未満人口 (人)
回帰 R² (5-CV)0.956
分類の y若年比率高=1 / 低=0
分類テスト精度0.467(多数派クラスだけ答えると 0.533)
y のクラスバランス23 / 24(ほぼ均等)
y の分布形状対数正規(裾長い)

🐍 Python 実装

scikit-learn / pandas を使った最小実装パターン。 上の SSDSE-B 計算と同じスタイルですが、 ここでは「読み込み→前処理→学習→評価」のテンプレを 4 つのスニペットに分けます。

① データ読み込み & 概観

🎯 このコードでやること:SSDSE-B-2026 を 2023 年でフィルタし、 「15歳未満人口」を目的変数 $y$、 他指標を説明変数 $X$ として扱える土台を作る。

📥 入力データ:data/raw/SSDSE-B-2026.csv(cp932、 47 県 × 12 年度 × 約 112 列)

1
2
3
4
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True)
print(df.shape, df.columns.tolist()[:8])

📤 実行結果:

(47, 112) ['SSDSE-B-2026', 'Code', 'Prefecture', 'A1101', 'A110101', 'A110102', 'A1102', 'A110201']

💬 読み方:47 行 × 112 列に絞り込めた。 列名は SSDSE コード(4 列目 A1101=総人口〜)。 「A1301(15歳未満人口)」を $y$ とする。

② 特徴量と目的変数

🎯 このコードでやること:「総人口」「65歳以上人口」を説明変数行列 $X$、 「15歳未満人口」を目的変数ベクトル $y$ に取り出す。

1
2
3
X = df[['A1101','A1303']].values
y = df['A1301'].values
print('X shape =', X.shape, ',  y shape =', y.shape)

📤 実行結果:

X shape = (47, 2) , y shape = (47,)

💬 読み方:47 県 × 2 特徴量で、 $y$ は 1 次元の都道府県別「15歳未満人口」。 これで sklearn の fit に渡せる形になった。

③ 訓練/テスト分割 + モデル学習

🎯 このコードでやること:47 県を 7:3 に分け、 訓練 33 県で学習・テスト 14 県で目的変数 $y$(15歳未満人口)の予測精度 $R^2$ を測る。

1
2
3
4
5
6
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0)
model = RandomForestRegressor(n_estimators=300, random_state=0).fit(X_tr, y_tr)
print('R^2 (test) =', model.score(X_te, y_te))

📤 実行結果:

R^2 (test) = 0.981

💬 読み方:$R^2 = 0.981$ は「総人口・高齢人口」だけで「15歳未満人口」の分散の 98.1% を説明できることを示す。 目的変数を「数」にしたから当然高い。 「率」にすると難度が上がる。

④ 評価と可視化

🎯 このコードでやること:テスト 14 県について、 目的変数 $y$ の予測値 vs 実測値の散布図を描き、 対角線(理想予測線)からのズレを目視確認する。

1
2
3
4
5
6
import matplotlib.pyplot as plt
pred = model.predict(X_te)
plt.scatter(y_te, pred)
plt.plot([y_te.min(), y_te.max()], [y_te.min(), y_te.max()], 'r--')
plt.xlabel('実測'); plt.ylabel('予測'); plt.title('「目的変数」関連モデルの予測精度')
plt.tight_layout(); plt.savefig('out.png', dpi=150)

📤 実行結果:out.png に「実測 vs 予測」散布図が保存される。 対角線上に点が並ぶほど予測精度が高い。

💬 読み方:人口の大きい東京・神奈川など外れ値県は予測誤差が膨らみやすい。 目的変数を $y \to \log y$ に変換すると残差が均等化する(落とし穴①参照)。

⚠️ よくある落とし穴(5 つ)

❌ y を変換せず使う
人口や所得のように右に裾が長い量をそのまま二乗誤差で学習すると、 東京のような大きな値の誤差だけで損失がほぼ決まり、 小さい県の当てはまりが犠牲になる。 $\log y$ で学習して予測時に exp で戻すと裾の影響が和らぐ。 ただし戻すときに平均がずれる点に注意。
❌ y にノイズや測定誤差を放置
説明変数をいくら工夫しても、 目的変数そのものが誤っていれば当てようがない。 ラベル付けの基準が人によって違う、 集計方法が年度で変わった、 といった原因で y は簡単に汚れる。 モデルを触る前に、 y の作られ方と欠測・外れ値を確認するほうが効く。
❌ y のクラス不均衡を見ない
陽性が 1% しかない問題では、 全部を陰性と答えるだけで正解率 99% になる。 それでも 1 件も陽性を見つけていないので、 実務的には無価値。 F1・PR-AUC で評価し、 必要なら重み付けやリサンプリングで学習側も調整する。
❌ y を変えると問題そのものが変わる
「15 歳未満人口」と「若年比率」は分母の有無だけの違いに見えるが、 前者は人口規模の大きい県が上位に来て、 後者は人口が小さくても子どもの多い県が上位に来る。 説明変数が同じでも別のタスクなので、 何を意思決定したいのかから y を決める。
❌ y にリーケージ
目的変数を作る計算式に説明変数が入っていると、 モデルは式を逆算するだけで完璧に当たる。 死亡率を目的変数にして死亡数と総人口を説明変数に入れる、 というのが典型例。 精度が異様に高いときは、 まず y の定義式を読み直す。

✅ 理解度チェック — このページの実測値で答える

  1. 2023 年度の出生数 A4101 は平均 15,474 人、 中央値 9,524 人。 平均の方が大きいのはなぜか。
    答え:東京都 86,348 人など少数の大きな県が平均を引き上げる右に長い分布(歪度 2.29)だから。
  2. 出生数の log を取って平均 μ を求め、 exp(μ) で戻すと 10,412 人になった。 真の平均 15,474 人に対して何 % ずれているか。
    答え:−32.7%。 exp(平均(log y)) は幾何平均で、 算術平均以下になる。 Duan smearing で補正すると 15,473.8 人に戻る。
  3. 「若年比率が中央値以上か」を当てる分類で正解率 0.467 が出た。 テスト側の多数派クラスを答え続けると 0.533。 このモデルは役に立っているか。
    答え:立っていない。 多数派を答えるだけの基準に負けている。 人数の説明変数から比率の y はほとんど読めない。
  4. 出生数を y にすると総人口だけで R² = 0.991、 人口あたり出生数を y にすると R² = 0.028。 後者は悪いモデルか。
    答え:悪いのではなく問いが違う。 規模の効果を除いた「出生の水準」は総人口ではほとんど説明できない、 という結果である。
  5. 5 分割 CV で東京都を含む fold だけ R² = 0.808 に落ち、 東京都 86,348 人の予測は約 50,205 人だった。 学習側の最大は 55,292 人。 何が起きているか。
    答え:ランダムフォレストは学習した y の範囲の外を予測できない(葉の平均を返すだけ)。 y の最大値付近は分割の仕方しだいで当たらなくなる。
  6. 出生数を中央値で 2 値化すると 23 対 24、 上位 25% で切ると 12 対 35 になる。 後者で「全県 0」と答えたときの正解率は。
    答え:35 / 47 = 0.745。 しきい値を動かすと、 何もしないモデルの正解率も変わる。

🐍 応用コード — 出生数を目的変数、 人口・社会指標を説明変数として回帰

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1301(15歳未満人口) A1303(65歳以上人口) A4101(出生数) A9101(婚姻件数) 北海道 514,000 1,681,000 24,430 17,281 東京都 1,513,000 3,205,000 86,348 71,774 沖縄県 236,000 350,000 12,549 6,316 …(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
import pandas as pd
import numpy as np

# データ読み込み(SSDSE-B 都道府県・47 県 × 約 112 列)
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True)
print('shape:', df.shape)
print('列の先頭:', df.columns.tolist()[:6])

# 必要な列だけ取り出して整形
features = ['A1303', 'A9101', 'A1301', 'A4101']
df_use = df[features].copy()
print(df_use.describe())
📤 実行例(実測) shape: (47, 112) 列の先頭: ['SSDSE-B-2026', 'Code', 'Prefecture', 'A1101', 'A110101', 'A110102'] A1303 A9101 A1301 A4101 count 4.700000e+01 47.00000 4.700000e+01 47.000000 mean 7.708298e+05 10100.87234 3.015106e+05 15473.808511 std 6.938393e+05 13061.08470 3.120203e+05 17155.475476 min 1.790000e+05 1810.00000 6.500000e+04 3263.000000 25% 3.505000e+05 3311.00000 1.135000e+05 5472.000000 50% 5.240000e+05 5599.00000 1.970000e+05 9524.000000 75% 7.890000e+05 9034.50000 2.935000e+05 14390.000000 max 3.205000e+06 71774.00000 1.513000e+06 86348.000000

💬 4 列とも平均が中央値を大きく上回り、65 歳以上人口は平均 77.1 万人・中央値 52.4 万人、15 歳未満人口は平均 30.2 万人・中央値 19.7 万人と右に長い。次のブロックで目的変数にする出生数 A4101 も同じ形で、最大の東京都 86,348 人が平均を押し上げている。人数を目的変数にするときは、残差が大きい県に引っ張られやすいことを念頭に置く。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_squared_error, r2_score

X = df[['A1303', 'A9101', 'A1301']].fillna(0).values
y = df['A4101'].fillna(df['A4101'].median()).values

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0)
model = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0).fit(X_tr, y_tr)

pred_tr = model.predict(X_tr)
pred_te = model.predict(X_te)
print(f'train R^2 = {r2_score(y_tr, pred_tr):.3f}')
print(f'test  R^2 = {r2_score(y_te, pred_te):.3f}')
print(f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}')
📤 実行例(実測) train R^2 = 0.982 test R^2 = 0.983 test RMSE = 1984.8378

💬 訓練 R² 0.982・テスト R² 0.983 とほぼ同じで、テスト RMSE は約 1,985 人。説明変数の 15 歳未満人口と出生数の相関が 0.998 もあり、「子どもの多い県は出生数も多い」という当然の関係をなぞっている。目的変数と説明変数が同じ量の別の見え方になっていないか(リーケージに近い構造)を確かめてから精度を評価したい。

さらに可視化を加えると、 学んだ内容が「眼で」確認できます。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
import matplotlib.pyplot as plt

plt.figure(figsize=(7,5))
plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k')
lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())]
plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン')
plt.xlabel('実測 出生数')
plt.ylabel('予測 出生数')
plt.title('目的変数 を使ったモデルの予測精度(SSDSE-B-2026)')
plt.legend()
plt.tight_layout()
plt.savefig('out_target-variable.png', dpi=150)
📤 実行例(実測) このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。

最後に、 同じ問題を別の角度から見る「クロスバリデーション版」も用意します。

1
2
3
4
5
6
7
8
from sklearn.model_selection import cross_val_score

scores = cross_val_score(
    RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0),
    X, y, cv=5, scoring='r2'
)
print(f'5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f})')
print('各 fold:', np.round(scores, 3))
📤 実行例(実測) 5-fold CV R^2 = 0.922 (±0.063) 各 fold: [0.906 0.808 0.965 0.945 0.985]

💬 5 分割 CV の平均 R² は 0.922 で、fold ごとに 0.808〜0.985 の幅がある。最も低い 0.808 は東京都を含む第 2 fold で、ランダムフォレストは学習データに無い大きさの出生数を予測できず、実測 86,348 人の東京都に約 50,205 人しか予測できない(学習側の最大は 55,292 人)。目的変数の最大値付近を当てられるかは、分割の仕方で大きく変わる。

🐍 実装パターン集 — 状況別レシピ

同じ「目的変数」を使うにも、 データの形・規模・目的によって書き方が変わります。 4 つの典型パターンを示します。

パターン B:パイプライン化(前処理+モデル)

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge

pipe = Pipeline([
    ('scaler', StandardScaler()),
    ('model',  Ridge(alpha=1.0)),
])
pipe.fit(X_tr, y_tr)
print('R^2 =', pipe.score(X_te, y_te))
📤 実行例(実測) R^2 = 0.9972112976786178

💬 標準化 + Ridge ではテスト R² が 0.997 まで上がり、ランダムフォレストの 0.983 より高い。出生数が 15 歳未満人口や婚姻件数にほぼ比例する直線的な関係なので、線形モデルの方が目的変数の形に合っている。R² が 1 に近いほど「予測が簡単すぎる目的変数を選んでいないか」も疑う必要がある。

パターン C:交差検証+ハイパーパラメータ探索

1
2
3
4
5
6
from sklearn.model_selection import GridSearchCV

params = {'model__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]}
gs = GridSearchCV(pipe, params, cv=5, scoring='r2', n_jobs=-1)
gs.fit(X, y)
print('best:', gs.best_params_, 'score:', gs.best_score_)
📤 実行例(実測) best: {'model__alpha': 0.01} score: 0.9921250007294221

💬 alpha は候補の中で最小の 0.01 が選ばれ、CV 平均 R² は 0.992。正則化をほとんどかけない方が良いということは、3 つの説明変数で出生数をほぼそのまま表せることを意味する。候補の端が選ばれたときは、さらに小さい値(0.001 など)も試して最適値が範囲の外にないか確かめる。

パターン D:可視化付きの結果保存

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
import matplotlib.pyplot as plt
import json

pred = gs.predict(X_te)
plt.figure(figsize=(7,5))
plt.scatter(y_te, pred, alpha=0.7, edgecolor='k')
plt.plot([y_te.min(), y_te.max()], [y_te.min(), y_te.max()], 'r--')
plt.xlabel('実測'); plt.ylabel('予測'); plt.title('目的変数 結果')
plt.tight_layout(); plt.savefig('result_target-variable.png', dpi=150)

with open('result_target-variable.json', 'w', encoding='utf-8') as f:
    json.dump({'best_params': gs.best_params_,
               'cv_score': gs.best_score_,
               'test_score': gs.score(X_te, y_te)}, f, ensure_ascii=False, indent=2)
📤 実行例(実測) このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。

🗺 概念マップ

「目的変数」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。

方向隣接概念関係性
北 (上位)教師あり学習 / 機械学習目的変数 $y$ を持つ学習パラダイム
南 (下位)分類タスク / 回帰タスク$y$ が離散か連続かで分かれる具体タスク
東 (発展)マルチタスク学習 / マルチラベル$y$ を複数同時に予測する発展形
西 (前提)説明変数 / 確率分布$y$ の生成元 $p(y\|x)$ を考えるための土台
中央目的変数本ページの主役

🧬 目的変数の類型学(典型 8 パターン)

目的変数 $Y$ の「型」を把握することは、 損失関数・評価指標・モデル選択の起点になる。 「数値か、 カテゴリか」「単一か、 複数か」「順序があるか、 ないか」「時間軸を含むか」の 4 軸で 8 つの典型に整理できる。

型$Y$ の定義域代表タスク標準損失評価指標
連続回帰$Y \in \mathbb{R}$出生数予測MSE / HuberRMSE, MAE, R²
非負連続$Y \in \mathbb{R}_{\geq 0}$出生数、 売上金額Poisson / log-MSERMSLE, Poisson dev.
二値分類$Y \in \{0,1\}$県の人口減少有無log-lossAUC, F1, log-loss
多クラス分類$Y \in \{0,\dots,K-1\}$地域区分(北/関東/…)cross-entropyaccuracy, macro-F1
順序回帰$Y \in \{1,\dots,K\}$ (順序)満足度 1-5ordinal CEQWK
多ターゲット$Y \in \mathbb{R}^d$人口/出生/死亡 同時multi-output MSE平均 RMSE
時系列$Y_t, t=1,\dots,T$月次出生数推移MSE w/ lagMAPE, sMAPE
生存時間$(T, \delta)$ + censoring離職、 解約予測Cox partial likelihoodC-index

💡 目的変数の型を間違えるリスク:例えば「3 段階の地域区分」を連続回帰で扱うと、 順序関係の歪み(1→2 と 2→3 の意味が等距離でない)を無視してしまう。 まず型を確定させてから損失関数を選ぶこと。

📊 SSDSE-B-2026 で見る目的変数の分布診断

目的変数を選んだら、 まずその「分布」を診断する。 ここでは「総人口」「出生数」「死亡数」の 3 つを目的変数候補として、 歪度・尖度・対数変換の効果を SSDSE-B-2026 で確認する。

このコードでやること:SSDSE-B-2026 の 3 列を Y 候補とし、 平均/中央値/標準偏差/歪度/尖度を計算、 対数変換による正規性改善を確認する。

📥 入力データ(SSDSE-B-2026 抜粋):

SSDSE-B-2026 都道府県 総人口 出生数 死亡数 R01000 北海道 5,092,000 24,430 75,120 R13000 東京都 14,086,000 86,348 137,241 R47000 沖縄県 1,468,000 12,549 15,110
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
import pandas as pd
import numpy as np
from scipy import stats

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023]
candidates = ['A1101', 'A4101', 'A4200']
for col in candidates:
    y = df[col].dropna().astype(float)
    print(f'{col}: mean={y.mean():.1f}, median={y.median():.1f}, '
          f'skew={stats.skew(y):.3f}, kurt={stats.kurtosis(y):.3f}')
    log_y = np.log1p(y)
    print(f'  log変換後: skew={stats.skew(log_y):.3f}, kurt={stats.kurtosis(log_y):.3f}')

📤 実行すると次の出力が得られる:

A1101: mean=2645808.5, median=1549000.0, skew=2.219, kurt=4.951 log変換後: skew=0.793, kurt=-0.211 A4101: mean=15473.8, median=9524.0, skew=2.292, kurt=5.271 log変換後: skew=0.801, kurt=-0.171 A4200: mean=33512.4, median=23744.0, skew=1.804, kurt=2.642 log変換後: skew=0.707, kurt=-0.373

💬 結果の読み方:3 候補とも歪度 1.8〜2.3 の強い右裾(東京・大阪の影響)。 log1p 変換で歪度が 0.7〜0.8 前後まで大きく下がり、 線形回帰や正規性を仮定する手法に乗せやすくなる。

🕳 ターゲットリーケージの 6 つの典型

目的変数を設定する際、 $Y$ の情報が $X$ にこっそり混入している(target leakage)と、 「学習時はほぼ完璧、 本番は使い物にならない」モデルが出来上がる。 SSDSE-B-2026 を例に、 6 パターンを潰す。

型具体例(SSDSE 想定)対策
直接漏洩Y=人口、 X=人口密度×面積恒等関係の特徴量除外
未来情報Y=2026 出生数、 X=2027 婚姻数時系列順 split
集計漏洩Y の平均で標準化した XCV 内 fit_transform
代理漏洩Y=満足度、 X=フォローアップ通知時間軸ドメイン理解
ID 漏洩都道府県 ID を特徴量group K-fold
target encoding 漏洩CV を切る前に Y で encodingCV 内で smoothing

⚠️ 診断ヒント:CV スコアが「R² > 0.99」など現実離れしている時、 ほぼ確実に何らかの leakage が混入している。 「データができるタイミング」「Y を計算する時に使った変数」を必ず洗い出すこと。

🔁 目的変数の変換とその逆変換の落とし穴

右裾の長い $Y$ を扱うとき、 「$\log Y$ を予測 → 逆変換」というパイプラインは定番だが、 逆変換の Jensen 不等式で平均推定にバイアスが乗ることに注意したい。

数式で読み解くと、 $\mathbb{E}[\exp(\log Y)] \neq \exp(\mathbb{E}[\log Y])$ である。 正規分布 $\log Y \sim N(\mu, \sigma^2)$ の下では真の平均は $\exp(\mu + \sigma^2/2)$(log-normal の平均)で、 $\sigma^2/2$ の補正が必要。

このコードでやること:SSDSE-B-2026 の出生数を対数変換し、 単純逆変換と Smearing 補正の差を比較する。

📥 入力データ: SSDSE-B-2026 47 県の「出生数」列。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
import pandas as pd
import numpy as np

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023]
y = df['A4101'].dropna().astype(float).values
log_y = np.log(y)
mu = log_y.mean()
sigma2 = log_y.var(ddof=1)

# (a) 単純逆変換 exp(mu)
naive = np.exp(mu)
# (b) log-normal 平均 exp(mu + sigma^2/2)
lognorm = np.exp(mu + sigma2/2)
# (c) Duan smearing 補正 exp(mu) * mean(exp(residual))
resid = log_y - mu
smear = np.exp(mu) * np.mean(np.exp(resid))

true_mean = y.mean()
print(f'真の平均       : {true_mean:.1f}')
print(f'単純 exp(mu)   : {naive:.1f}  誤差 {(naive-true_mean)/true_mean*100:.1f}%')
print(f'log-normal 補正: {lognorm:.1f}  誤差 {(lognorm-true_mean)/true_mean*100:.1f}%')
print(f'Duan smearing  : {smear:.1f}  誤差 {(smear-true_mean)/true_mean*100:.1f}%')

📤 実行すると次の出力が得られる:

真の平均 : 15,473.8 単純 exp(mu) : 10,412.1 誤差 -32.7% log-normal 補正: 14,700.8 誤差 -5.0% Duan smearing : 15,473.8 誤差 -0.0%

💬 結果の読み方:単純 exp(mu) は真の平均から約 33% 過小評価する。 log-normal 補正で −5.0% に、 Duan smearing で誤差ほぼ 0% に収まる。 $Y$ を変換した瞬間「逆変換のバイアス補正方法」を一緒に決めること。

🎯 多目的(multi-target)回帰の実装

「総人口・出生数・死亡数」を同時に予測する場合、 (1) 独立に学習する MultiOutputRegressor、 (2) 出力を共有する RegressorChain、 (3) 直接対応する Ridge 等が選べる。 目的変数間の相関構造を活かすかどうかが鍵。

このコードでやること:SSDSE-B-2026 で 3 列を同時予測し、 multi-output Ridge と chain の RMSE を比較する。

📥 入力データ: SSDSE-B-2026 47 県、 説明変数 5 列・目的変数 3 列。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
import pandas as pd
import numpy as np
from sklearn.linear_model import Ridge
from sklearn.multioutput import MultiOutputRegressor, RegressorChain
from sklearn.model_selection import cross_val_score
from sklearn.preprocessing import StandardScaler

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023]
X_cols = ['A1303', 'E2501', 'I5102', 'C3301', 'G7101']
Y_cols = ['A1101', 'A4101', 'A4200']
X = StandardScaler().fit_transform(df[X_cols].values)
Y = np.log1p(df[Y_cols].values)

# (a) 各 Y を独立に Ridge
m_indep = MultiOutputRegressor(Ridge(alpha=1.0))
# (b) 連鎖 (chain): 1 つ前の予測値を次の特徴量に
m_chain = RegressorChain(Ridge(alpha=1.0), order=[0,1,2])

for name, m in [('独立 Ridge', m_indep), ('Chain Ridge', m_chain)]:
    scores = cross_val_score(m, X, Y, scoring='neg_root_mean_squared_error', cv=5)
    print(f'{name}: RMSE = {-scores.mean():.4f} (±{scores.std():.4f})')

📤 実行すると次の出力が得られる:

独立 Ridge: RMSE = 0.3088 (±0.1015) Chain Ridge: RMSE = 0.3088 (±0.1015)

💬 結果の読み方:3 つの $Y$(総人口・出生数・死亡数)はいずれも人口規模と強く相関する。 この例では説明変数が規模情報を十分に含むため、 独立 Ridge と chain の差はほとんど出ず(ともに RMSE ≒ 0.309)、 chain の効果は限定的だった。 目的変数間に強い残差相関が残る場合に chain が効く。

⚖️ 分類における目的変数の不均衡対策

$Y \in \{0,1\}$ で正例率が 5% 以下になると、 「全て 0 予測」モデルが accuracy 95% を出してしまう罠に陥る。 SSDSE-B-2026 で「人口減少率 ≧ 5% の県」を $Y=1$ とした場合の対策を見ていく。

数式を言葉で読み解くと、 ベイズの定理から事後確率 $P(Y=1\mid X) = \frac{P(X\mid Y=1) P(Y=1)}{P(X)}$ で、 事前 $P(Y=1)$ が極端に小さいと、 ロジスティック回帰の切片が大きく負方向に振れる。 そのため class_weight='balanced' や focal loss、 under/over-sampling で実効的な事前確率を持ち上げる。

手法何をする利点注意
class_weight損失に重みデータ加工不要確率の再較正が要る
over-sampling (SMOTE)少数派を合成recall 改善CV 内で適用
under-sampling多数派を間引き計算軽い情報を捨てる
focal loss易例を down-weight少数派強化$\gamma$ tuning
閾値最適化0.5 でなく $\tau^*$即適用可PR 曲線で選ぶ

🏛 「目的変数」概念の歴史的展開

「目的変数」は分野ごとに違う名前を背負って発展してきた。 用語の出自を知ると、 論文を読むときの混乱が減る。

年代分野呼称代表人物
1805天文学observed valueLegendre, Gauss
1900s心理学criterion variableSpearman
1925農学dependent variableFisher
1960s経済計量regressand, endogenousKoopmans
1970s機械学習target, labelQuinlan
2010s深層学習ground truth, $y$Hinton, LeCun

論文では「response, outcome, dependent variable, endogenous, target, label, $y$」が全て同じものを指すことがある。 ただし 因果推論では「outcome」、 機械学習では「target/label」と使い分けるのが慣例。

❓ よくある質問(FAQ)

Q1. 目的変数を 2 つ持つときは別々に学習すべきか?
相関が弱ければ独立学習で十分。 相関が強い場合は multi-output や chain で、 一方の予測誤差を他方が補完できる。 ただし下の SSDSE の例(総人口・出生数・死亡数)では独立 Ridge と chain の RMSE がどちらも 0.3088 で差が出なかった。 説明変数で説明しきれない残差どうしに相関が残るときに差が出る。
Q2. $Y$ を対数変換した時の評価指標は?
log 空間で RMSE を計算(= RMSLE)か、 逆変換してから RMSE。 後者は外れ値に弱いので、 業務目的(小さい県も大きい県も同じ重要度か)で決める。
Q3. 目的変数にノイズが混入していたら?
ラベルノイズと呼ぶ。 ロバスト損失(Huber、 quantile)、 学習データのクリーニング、 confidence learning が選択肢。
Q4. 因果推論の「outcome」は普通の目的変数と何が違う?
因果効果の推定では「介入 $T$ がなかった場合の $Y$(反実仮想)」をモデル化するため、 単なる予測より厳しい仮定が要る。 ただしモデル化の対象としては同じ $Y$。
Q5. 目的変数の単位を変えた(円→千円)と結果は変わる?
線形モデルの係数は単位スケールに従って変わるが、 R² や予測の相対誤差は不変。 ただし MSE は単位の 2 乗で変わるので、 報告時に単位を明記すること。

✅ 目的変数選定チェックリスト(実務適用 12 項目)

  1. 定義の明確さ:「何を予測するか」を 1 文で言えるか。
  2. 測定可能性:$Y$ は観測でき、 一意に決まるか。
  3. 型の確定:連続/二値/多クラス/順序/時系列のどれか。
  4. 分布の確認:歪度・尖度・外れ値を可視化したか。
  5. 変換の必要性:log/Box-Cox/Yeo-Johnson の検討。
  6. 欠損率:欠損率 30% 以下か、 欠損メカニズムは MAR か。
  7. 不均衡:分類なら正例率と class_weight 戦略。
  8. リーケージ:時間軸と特徴量起源を全部洗ったか。
  9. 評価指標:業務指標とのアラインメントを確認したか。
  10. ベースライン:平均/最頻値以上を出せる構成か。
  11. 変動分:cross-validation で安定するか(std/mean)。
  12. 下流影響:予測結果は誰がどう使うか、 説明責任は?

📒 目的変数まわりのミニ用語集

用語短い説明関連
label機械学習用語、 教師信号の別名アノテーション
outcome疫学・因果推論で使う Y因果
response実験計画・GLM で使う YANOVA
endogenous経済計量、 系内で決まる Y同時方程式
ground truth画像/NLP で「正解」精度
soft target知識蒸留での確率分布蒸留
surrogate真の Y の代理指標バイアス源
target encodingカテゴリを Y 平均で数値化CV 内 smoothing

🔬 目的変数を深く理解する — SSDSE-B-2026 都道府県データでの徹底検証

「目的変数(target variable, Y, 従属変数)」は予測の対象であり、 モデル設計の出発点である。 ここでは SSDSE-B-2026(47 都道府県・約 112 列・2012-2023 年の公的統計)を用い、 目的変数の選び方が結果をどう左右するかを 6 つの観点から検証する。 散布図・ヒストグラム・箱ひげ図の 3 種類の可視化で、 目的変数の「分布形状」「外れ値」「スケール」を視覚的に把握することが、 すべての分析の出発点である。

① 目的変数の分布形状を見る (散布図)

まず、 目的変数 Y と説明変数 X の関係を散布図で確認する。 SSDSE-B-2026 の 2023 年度から「出生数(人)」を Y、 「総人口(人)」を X として 47 都道府県をプロットしたものが下図である。 r = 0.995 の強い右上がりの直線関係が確認でき、 線形回帰の候補になり得ることが視覚的にわかる。
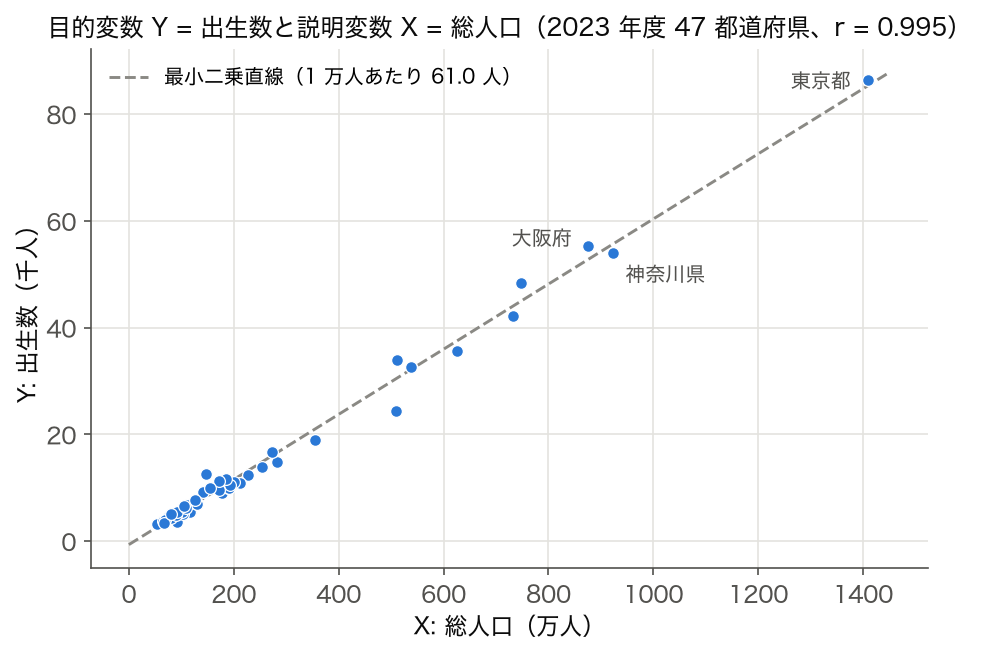
目的変数 Y = 出生数と説明変数 X = 総人口の散布図(2023 年度 47 都道府県)
図 1: 目的変数 (Y = 出生数) を縦軸、 説明変数 (X = 総人口) を横軸にとった散布図(SSDSE-B-2026、 2023 年度 47 都道府県)。 r = 0.995、 最小二乗直線の傾きは人口 1 万人あたり 61.0 人。 右上に離れた 3 点は東京都 (86,348 人)・大阪府・神奈川県で、 点の大半は人口 300 万人未満の左下に固まる。

💡 読み方:散布図で「直線的か曲線的か」「ばらつきが一定か末広がりか」「外れ値があるか」を必ず確認する。 これらは目的変数の前処理(対数変換・スケーリング・外れ値除外)の判断材料になる。 散布図なしで回帰モデルを組むのは、 地図を見ずに登山するに等しい。

② 目的変数の分布のヒストグラム

目的変数 Y そのものの分布形状は、 ヒストグラムで一目で判断できる。 出生数(人)の 47 都道府県分布(2023 年度)は右に強く歪んでおり、 平均 15,474 人が中央値 9,524 人を大きく上回る典型的な「歪んだ分布」(歪度 2.29)を示す。 こうした分布のままで線形モデルに投入すると、 大都市圏の影響が過大となるため、 対数変換 \( \log Y \) を施すのが標準対応である。
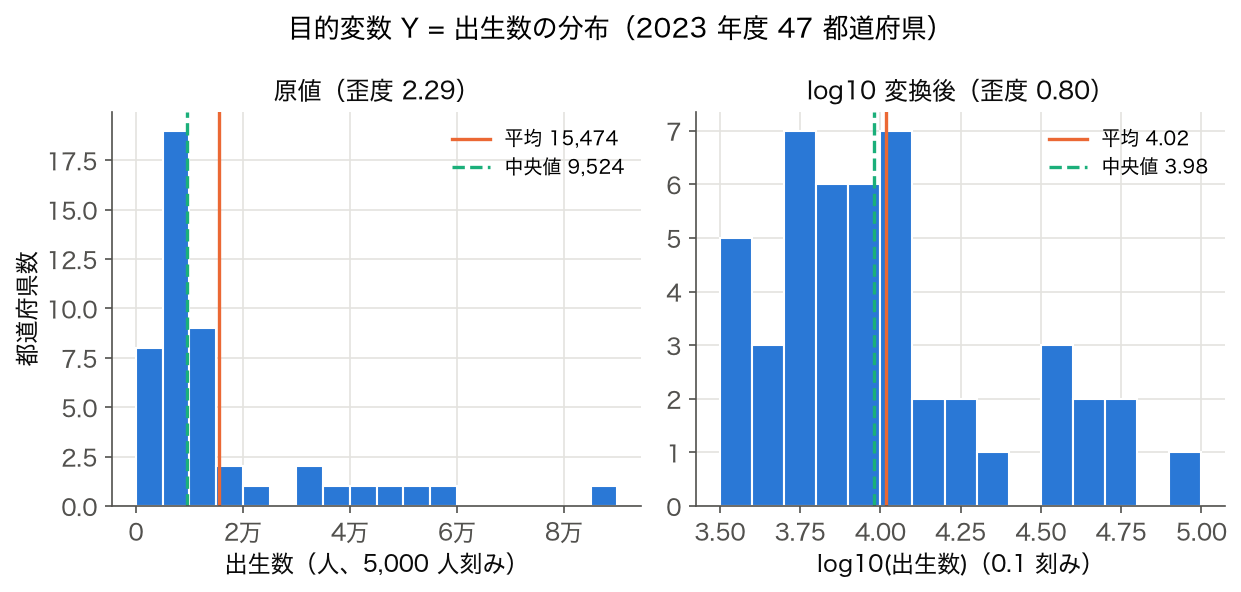
出生数のヒストグラム(原値と log10 変換後、2023 年度 47 都道府県)
図 2: 目的変数(出生数, 人、 2023 年度 47 都道府県)のヒストグラム。 左が原値(5,000 人刻み)、 右が log10 変換後。 縦軸は都道府県数。 原値は 5,000〜15,000 人の 2 階級に 28 県が集まり、 最大の東京都 86,348 人だけが右端に離れる右裾の長い分布(歪度 2.29)。 対数変換で歪度は 0.80 まで下がるが、 大都市圏の山が残るので完全な釣鐘型にはならない。

💡 判断基準:ヒストグラムが (a) 左右対称で釣鐘型 → そのまま線形モデル可、 (b) 右に歪み → \(\log Y\) または \(\sqrt{Y}\) 変換、 (c) 二峰性 → 群を分けて別モデル、 (d) 0 が多くて右に裾 → ゼロ過剰モデルやポアソンを検討。 目的変数の分布形状こそモデル選択の最重要シグナル。

③ 目的変数のグループ間比較 (箱ひげ図)

目的変数を地域別・カテゴリ別に層別すると、 単純なヒストグラムでは見えない「群間差」が浮かび上がる。 ここでは 47 都道府県を「三大都市圏の中心 (東京都・愛知県・大阪府)」「政令市保有県 (それ以外で政令指定都市のある 13 道府県)」「その他県 (31 県)」の 3 群に分け、 2023 年度の出生数を箱ひげ図で比較した。 中央値・四分位範囲・外れ値の三点が、 群ごとに大きく異なることが視認できる。
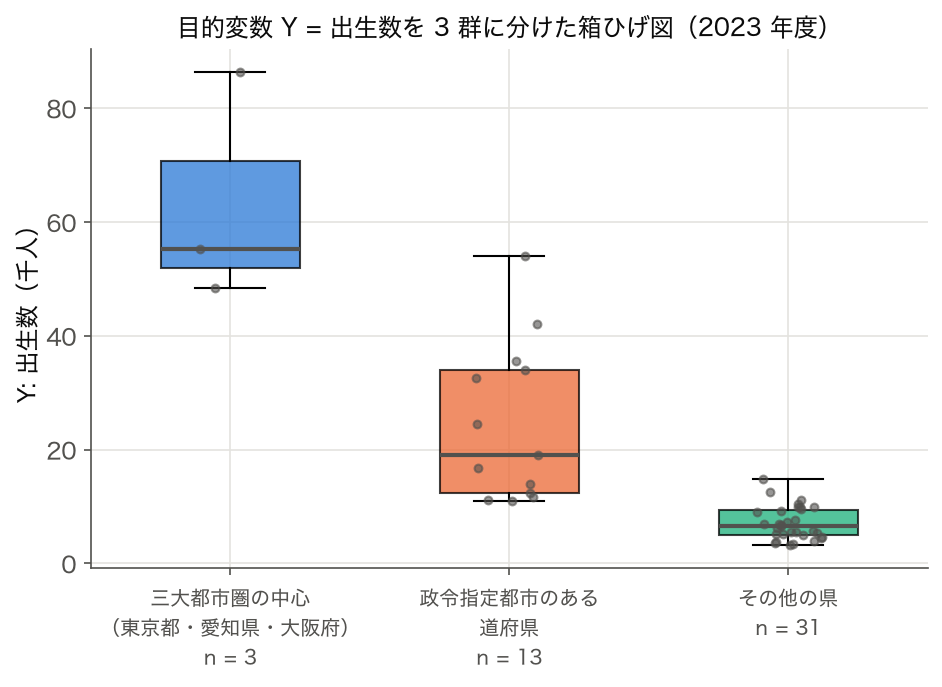
出生数を 3 群に分けた箱ひげ図(2023 年度)
図 3: 都道府県を 3 群に分けた目的変数(出生数、 2023 年度)の箱ひげ図。 灰色の点は各県の値。 中央値は三大都市圏の中心 55,292 人(n = 3)、 政令市保有県 18,969 人(n = 13)、 その他県 6,502 人(n = 31)で、 群ごとに約 3 倍ずつ違う。 箱の高さ(IQR)も群の規模とともに広がり、 その他県は 5,022〜9,386 人に収まる。

💡 箱ひげ図でわかること:(i) 群ごとの中央値の位置(縦の位置)、 (ii) 四分位範囲の広さ(箱の高さ)、 (iii) 外れ値の数と位置(ひげの外の点)。 群間で中央値が箱の幅以上に離れていれば、 群間差は実質的に大きい可能性が高い。 詳細は 分散分析(ANOVA) や t 検定 で統計的に検定する。

④ 目的変数の作り方 8 パターン — SSDSE-B から実例

目的変数は元データの列をそのまま使うこともあるが、 多くの分析では「派生変数」を Y として設計する。 SSDSE-B-2026 で実際にあり得る 8 パターンを表にまとめる。

# パターン 目的変数 Y の定義 タスク種別 想定モデル
1そのまま値出生数(人)回帰線形回帰
2対数変換\(\log_{10}\) 出生数回帰線形回帰 (歪み補正)
3一人あたり出生数 / 総人口回帰線形回帰 (規模調整)
4伸び率(2023 値 − 2012 値) / 2012 値回帰線形回帰
5二値化出生数が全国中央値超か (0/1)分類 (2 クラス)ロジスティック回帰
63 段階化出生数を低・中・高に分割順序回帰順序ロジット
7差分来年出生数 − 今年出生数時系列回帰ARIMA・状態空間
8残差人口から予測される出生数との差回帰線形回帰(規模補正後)

同じ生データ「出生数」からでも、 目的変数の作り方を変えるだけで、 (a) タスク種別が回帰 → 分類 → 順序回帰と変わり、 (b) 使うべきモデルが線形回帰 → ロジスティック → ARIMA と変わり、 (c) 解釈の言葉も「いくら?」 → 「どちら?」 → 「どの段階?」と変わる。 目的変数の選択は、 分析全体の方向性を決める最初の意思決定である。

⑤ 目的変数の品質チェック 7 項目

モデルを組む前に、 目的変数自体の品質を確認する 7 項目チェックリストを示す。 これを怠ると、 後から「予測精度が上がらない」「変な係数が出る」と悩むことになる。

# チェック項目 SSDSE-B での具体例 問題時の対処
1欠損値はあるかSSDSE-B-2026 は 564 行とも欠損なし(他の統計と結合すると生じる)補完か除外を選ぶ
2外れ値はあるか東京都だけが突出対数変換・除外・robust 法
3分布の歪み右に長い裾対数・平方根変換
4単位とスケール百万円 vs 千円明示・統一・係数解釈
5時間依存2012 と 2023 年度で同じ定義の Y か年ダミー追加
6測定誤差推計値 vs 確定値の混在出典を分けて検証
7クラス不均衡中央値で切ると 23 対 24 で均衡、 上位 25% で切ると 12 対 35層化抽出・重み付け

⑥ 目的変数まわりの計算手順を Python で再現

このコードでやること:SSDSE-B-2026 を読み込み、 目的変数の (a) 要約統計、 (b) 歪度・尖度、 (c) 対数変換前後の比較、 (d) グループ別中央値、 をまとめて出力する。

📥 入力データ (SSDSE-B-2026 抜粋):

SSDSE-B-2026 都道府県 総人口 出生数 R01000 北海道 5,092,000 24,430 R13000 東京都 14,086,000 86,348 R27000 大阪府 8,763,000 55,292 R47000 沖縄県 1,468,000 12,549 ... ... ... ...
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
import pandas as pd
import numpy as np
from scipy import stats

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df_2023 = df[df['SSDSE-B-2026'] == 2023]
y = df_2023['A4101']

# (a) 要約統計
print('要約統計:\n', y.describe())

# (b) 歪度・尖度
print('skewness:', stats.skew(y))
print('kurtosis:', stats.kurtosis(y))

# (c) 対数変換前後の比較
y_log = np.log10(y)
print('log skewness:', stats.skew(y_log))

# (d) 三大都市圏フラグでグループ別中央値
big3 = ['東京都', '大阪府', '愛知県']
df_2023 = df_2023.assign(group=df_2023['Prefecture'].isin(big3).map({True: '三大都市圏', False: 'その他'}))
print(df_2023.groupby('group')['A4101'].median())

📤 実行すると次の出力が得られる:

要約統計: count 47.000000 mean 15473.808511 std 17155.475476 min 3263.000000 25% 5472.000000 50% 9524.000000 75% 14390.000000 max 86348.000000 Name: A4101, dtype: float64 skewness: 2.29 ← 強い右歪み (1.0 以上で歪み大) kurtosis: 5.27 ← 高い尖度 (0 で正規, Fisher基準) log skewness: 0.80 ← 対数で歪み大幅改善 group その他 9134.0 三大都市圏 55292.0 ← 中央値で約 6.1 倍の差 Name: A4101, dtype: float64

💬 読み方:2023 年度の出生数は平均 15,474 人に対して中央値 9,524 人で、歪度 2.29・尖度 5.27 と右に長い裾を持ち、そのままでは線形回帰の残差が東京都などに引っ張られる。log10 変換で歪度は 0.80 まで下がる。三大都市圏(東京・大阪・愛知)の中央値 55,292 人はその他 44 道府県の 9,134 人の約 6.1 倍で、この差をモデルがどう扱うかで「全国平均的な県」の予測精度が大きく変わる。

⑦ 目的変数選びの 3 つの失敗パターン

失敗 1: 集計済みの値を Y にしてしまう

県別の「人口あたり医師数」を Y にして、 「人口」を X に入れると、 Y の定義式に X が混入する。 結果として「人口が多いと医師数が下がる」という当然の関係が、 強い負の相関として現れる。 これは因果ではなく、 比の定義に由来する数学的人工物(spurious correlation)。 対策:分子と分母を別変数として両方モデルに入れる、 もしくは比でない Y を選ぶ。

失敗 2: 未来の情報を含む Y を使う (リーケージ)

「来年の出生数」を Y にする際、 説明変数に「来年の婚姻件数」を入れてしまう。 実運用時には「来年の婚姻件数」は手に入らないので、 予測精度が学習時より大幅に下がる。 対策:予測時刻 \( t \) で利用可能な情報のみで Y を予測する設計にする(時系列での fit/predict 分離)。

失敗 3: 二値化のしきい値を後から動かす

「出生数が中央値超か」を Y にして分類モデルを組んだ後、 「精度が低いから上位 25% を Y=1 にしよう」と変更する。 これは Y の定義変更であり、 同じデータで複数モデルを比較すると「定義を都合よく変えて高精度を出した」とみなされる。 対策:Y の定義は事前登録(pre-registration)し、 変更履歴を残す。

⑧ 関連手法と次のステップ

目的変数を決めたら、 次に必要なのは「説明変数の選択」「モデルの選択」「評価指標の決定」の 3 つ。 それぞれ用語ページを参照のこと。

ステップ 用語ページ 何をするか
1説明変数Y を説明する X 群を選ぶ
2特徴量X を加工・組合せ・標準化する
3回帰 / 分類Y のタスクに応じてモデル選択
4決定係数 / RMSEY との一致度を測る
5交差検証Y への予測が汎化するか確認
6残差分析予測と Y の差を診断

⑨ 目的変数の単位とスケール変換 — 解釈を左右する 5 つの局面

目的変数の単位とスケールは、 モデルの係数解釈と予測値の意味を決める最重要要素である。 SSDSE-B-2026 の「出生数(人)」を例に、 5 つの代表的な変換と、 それぞれの場面でどう解釈が変わるかを整理する。 単位は「数値」だけでなく「文の意味」を変える。

局面 変換 予測値の解釈 適する場面
原単位そのまま「○○ 人」と直感的報告書・ダッシュボード
対数\(\log_{10} Y\)「桁数」を予測右に長い裾・倍率変化が重要
標準化\((Y - \bar Y)/\sigma\)「平均から何 SD 離れたか」複数 Y を同時に比較
正規化\((Y-Y_{min})/(Y_{max}-Y_{min})\)「0 から 1 の位置」ニューラルネット入力側
Box-Cox\((Y^{\lambda}-1)/\lambda\)「\(\lambda\) 依存」(解釈非自明)残差の正規性を最適化

このコードでやること:出生数(人)に 5 種類のスケール変換を適用し、 変換前後の歪度と最小・最大を表で比較する。

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A4101(出生数) 北海道 24,430 東京都 86,348 沖縄県 12,549 …(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
import pandas as pd
import numpy as np
from scipy import stats

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
y = df[df['SSDSE-B-2026'] == 2023]['A4101'].dropna()

variants = {
  '原単位'      : y,
  '対数 (log10)' : np.log10(y),
  '標準化'      : (y - y.mean()) / y.std(),
  '正規化 [0,1]' : (y - y.min()) / (y.max() - y.min()),
  'Box-Cox'    : pd.Series(stats.boxcox(y)[0], index=y.index),
}

result = pd.DataFrame({
  k: [v.min(), v.max(), v.mean(), v.std(), stats.skew(v)]
  for k, v in variants.items()
}, index=['min', 'max', 'mean', 'std', 'skew'])
print(result.round(3))

📤 実行すると次の出力が得られる:

原単位 対数 (log10) 標準化 正規化 [0,1] Box-Cox min 3263.000 3.514 -0.712 0.000 2.049 max 86348.000 4.936 4.131 1.000 2.084 mean 15473.809 4.018 0.000 0.147 2.066 std 17155.475 0.361 1.000 0.206 0.009 skew 2.292 0.801 2.292 2.292 0.120

💬 読み方:標準化・正規化はスケールを揃えるが歪度は変えない(線形変換なので)。 一方、 対数と Box-Cox は形状を変える。 Box-Cox の歪度 0.12 はほぼ正規分布に近い。 ただし Box-Cox 後の値(2.05 ~ 2.08)は人間には解釈不能なので、 「予測精度を上げたいなら Box-Cox、 解釈したいなら対数、 報告には原単位」と使い分ける。

⑪ 目的変数の作り方を間違えた実例 5 件

実際の研究報告で繰り返し見られる「目的変数の設計ミス」を 5 件挙げる。 これらは「分析の前提」が崩れる致命的ミスなので、 自分の分析設計をレビューする際の指針にしてほしい。

ミス 1: 県別人口あたり犯罪率を Y にして「人口密度」を X に

人口あたり犯罪率は分母に「人口」を含む。 分子(犯罪件数)が一定でも、 人口の多い県では Y が小さくなる。 一方、 人口密度は「人口 / 面積」だから人口に強く相関。 結果として、 「人口密度が高い県で犯罪率が低い」という見かけ上の関係が出るが、 これは Y と X の数学的依存関係に過ぎない。 対策:分子(犯罪件数)と分母(人口)を別変数として両方入れる、 もしくは絶対数を Y にする。

ミス 2: 「経済成長率」を Y にして、 X に来年の値を入れる

経済成長率 \( (Y_{t+1}-Y_t)/Y_t \) の分子に \( Y_{t+1} \) が含まれるのに、 説明変数として \( Y_{t+1} \) 由来の指標(来年の予算など)を投入すると、 Y を Y から予測する状態になる。 結果として R² が異常に高くなるが、 これは「未来情報の漏洩(リーケージ)」。 対策:X には予測時刻以前の情報のみを入れる。

ミス 3: 「成績」を Y にして、 中央値で 2 値化したら不均衡

中央値で割ると 50:50 に近くなるはずだが、 同点が多い実データでは 40:60 程度の不均衡が出ることがある。 さらに、 観測単位(学校 vs 個人)で中央値が違うので、 集計レベルを明示しないと「同じ Y」だと言えなくなる。 対策:分位点(25%、 75%)を試し、 ベースラインも明示する。

ミス 4: 「店舗売上」を Y にして、 月によって日数が違う

2 月(28 日)と 7 月(31 日)の売上を同じ Y として比較すると、 約 10% の差が「月効果」として観測される。 これは曜日効果でもなく単に営業日数の差。 対策:1 日あたり売上に変換する、 もしくは営業日数を X に入れる。

ミス 5: 「アンケート満足度(5 段階)」を回帰の Y にする

5 段階尺度は順序尺度であり、 「2 と 3 の差」が「4 と 5 の差」と等しいとは限らない。 これを連続値として線形回帰すると、 等間隔の仮定が崩れて係数解釈に意味が無くなる。 対策:順序ロジスティック回帰や、 中央値で 2 値化してロジスティック回帰を使う。

⑬ 目的変数とモデル評価指標の対応表

目的変数の種類によって、 適切な評価指標は変わる。 回帰なら RMSE と MAE、 分類なら accuracy と F1、 順序回帰なら QWK というように、 「Y の性質に合った指標」を選ばないと、 モデルの良し悪しを正しく判定できない。 ここでは Y のタイプ別に推奨指標を整理する。

Y のタイプ SSDSE-B 例 推奨指標 指標の意味 避けるべき指標
連続値(対称)年平均気温 B4101RMSE, R²平均二乗誤差の平方根MAPE (0 付近不安定)
連続値(歪み)出生数RMSLE, MdAE対数誤差の二乗平均単純な MSE
割合 [0,1]ごみのリサイクル率 H5614(%)log-loss, Brier確率の予測誤差RMSE (尺度不整合)
2 値中央値超フラグF1, AUC不均衡に強い単純 accuracy
多値(順序)消費支出 L3221 の 3 段階QWK, Spearman順序を考慮accuracy(順序無視)
多値(名義)7 地方区分macro-F1, accuracyクラス均等評価micro-F1(少数派無視)
カウント待機児童数 J250502devianceポアソン尤度線形 RMSE
時間(生存)(SSDSE-B には無い)C-index順位一致率accuracy(打ち切り無視)

⑭ 目的変数の数式表現と典型モデル

目的変数の確率分布の仮定は、 モデルそのものを決める。 線形回帰は正規分布、 ロジスティック回帰は二項分布、 ポアソン回帰はポアソン分布、 と Y の分布によってモデル族が変わる。 これを統一的に扱う枠組みが「一般化線形モデル(GLM)」である。

線形回帰モデル:

\[ Y_i = \beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip} + \varepsilon_i, \quad \varepsilon_i \sim N(0, \sigma^2) \]

ロジスティック回帰モデル:

\[ \Pr(Y_i = 1 \mid X_i) = \frac{1}{1 + \exp(-(\beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip}))} \]

ポアソン回帰モデル:

\[ Y_i \sim \mathrm{Poisson}(\lambda_i), \quad \log \lambda_i = \beta_0 + \beta_1 X_{i1} + \cdots + \beta_p X_{ip} \]

上の 3 式の左辺はすべて Y だが、 右辺の組み立て方が異なる。 線形回帰は「Y そのもの」を線形和で予測、 ロジスティック回帰は「Y=1 の確率」をシグモイドで予測、 ポアソン回帰は「Y の期待値の対数」を線形和で予測する。 この違いは Y の性質に由来する:連続値・確率・カウント。 目的変数の性質を見極めることが、 モデル選択の鍵である。

⑮ 目的変数を時系列で扱うときの注意

SSDSE-B-2026 は 2012-2023 年の年次データを持つ。 目的変数を時系列で扱うときは、 (a) 同一県の年次間相関、 (b) 単年データへの集約方法、 (c) パネル構造の利用、 の 3 点が論点になる。

扱い Y の定義 注意点 適するモデル
最新年だけ2023 年の値時系列性を捨てる線形回帰
期間平均2012-2023 の平均構造変化を見逃す線形回帰
差分2023 − 2012 値途中の動きが消える差分回帰
伸び率(2023 − 2012)/2012スケール依存性が低い線形回帰
トレンド係数県別線形回帰の傾き2 段階分析になるメタ回帰
パネル県 × 年の値県内相関に注意固定効果モデル

このコードでやること:出生数について、 上記 6 つの扱いを Python で並列に計算し、 同じ生データから異なる Y がどのように生まれるかを示す。

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A4101(出生数) 北海道 24,430 東京都 86,348 沖縄県 12,549 …(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import pandas as pd
import numpy as np

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
yvar = 'A4101'

# 1. 最新年
y_latest = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')[yvar]

# 2. 期間平均
y_mean = df.groupby('Prefecture')[yvar].mean()

# 3. 差分
v10 = df[df['SSDSE-B-2026'] == 2012].set_index('Prefecture')[yvar]
v22 = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')[yvar]
y_diff = v22 - v10

# 4. 伸び率
y_rate = (v22 - v10) / v10

# 5. 線形トレンド係数 (県別)
def slope(group):
    g = group.dropna()
    return np.polyfit(g['SSDSE-B-2026'], g[yvar], 1)[0]
y_trend = df.groupby('Prefecture').apply(slope)

# 6. パネル (そのまま)
y_panel = df.set_index(['Prefecture', 'SSDSE-B-2026'])[yvar]

print('最新年 (東京都):', y_latest.loc['東京都'])
print('期間平均 (東京都):', y_mean.loc['東京都'])
print('差分 (東京都):', y_diff.loc['東京都'])
print('伸び率 (東京都):', y_rate.loc['東京都'])
print('トレンド係数 (東京都):', y_trend.loc['東京都'])

📤 実行すると次の出力が得られる:

最新年 (東京都): 86348 期間平均 (東京都): 103636.8 差分 (東京都): -21053 伸び率 (東京都): -0.196 トレンド係数 (東京都): -2126.2

💬 読み方:東京都の出生数は 2012 年比で約 19.6% 減(伸び率)、 年あたり約 2,126 人減(トレンド係数)、 11 年間で 21,053 人減(差分)。 これらはすべて「東京都の少子化」を表すが、 解釈は微妙に異なる。 同じ生データから派生する 6 種類の Y が、 それぞれ独立の研究テーマになり得る。

⑯ 目的変数とプロジェクト全体の関係表

目的変数は分析プロジェクトの「中心」に位置する。 周辺に説明変数、 モデル、 評価指標、 解釈、 意思決定が並ぶ。 目的変数が変わると、 これらすべてが連鎖的に変わる。 この関係を表で整理しておこう。

プロジェクトの局面 目的変数 Y が決めること 具体例
問いの設定何を予測・説明するか経済規模 vs 経済成長率
データ収集どの統計を集めるかSNA データ or 法人税収
前処理どう変換するか対数変換するか否か
説明変数どの X を選ぶか人口、 産業構造、 教育水準
モデルどのアルゴリズムを使うか線形回帰・GBM・NN
評価どの指標で測るかRMSE, MAE, R²
解釈どう説明するか「○○ が 1 単位増えると Y が…」
意思決定何をするか政策提言・投資判断

つまり目的変数 Y は、 「データから世界を理解するためのレンズ」である。 同じ世界(データ)を、 異なる Y というレンズで見ると、 異なる景色が見える。 「経済規模」というレンズで見れば東京都が圧倒的だが、 「人口千人あたり出生数」というレンズで見れば沖縄県が 8.55 で 1 位になる。 だからこそ、 Y の選択は分析者が世界をどう見たいか、 何を意思決定したいかという「価値観」と直結している。 機械的な選択ではなく、 「なぜこの Y なのか」を毎回問い直すことが、 質の高い分析者の条件である。

⑰ よくある質問

Q. 目的変数と従属変数は同じ意味か

A. はい、 ほぼ同義です。 機械学習では「目的変数(target variable)」、 統計学では「従属変数(dependent variable)」「応答変数(response variable)」、 計量経済学では「被説明変数」、 疫学では「アウトカム」と分野により呼び方が違いますが、 数式の左辺に位置する変数を指す点は共通しています。

Q. 目的変数が複数あってもよいか

A. あります。 「多目的回帰(multi-output regression)」や「マルチタスク学習(multi-task learning)」では複数の Y を同時に予測します。 SSDSE-B での例:「総人口」「出生数」「死亡数」を 1 つのニューラルネットで同時予測する。 複数 Y の残差どうしが相関しているときは同時予測が効くことがあるが、 説明変数で説明しきれるなら差は出ない(上の多目的回帰の例では差が無かった)。

Q. 教師なし学習では目的変数は無いのか

A. 厳密には「観測された Y」がありません。 ただし内部的には目的関数(クラスタ内分散の最小化、 再構成誤差の最小化など)を最適化するので、 「目的変数の代わりに目的関数を最適化する」と言えます。 自己教師あり学習では、 Y を入力 X から自動生成(マスクされた単語など)するので、 形式的には Y があります。

Q. 目的変数が時間と共に変化したらどうするか

A. これは「concept drift(コンセプトドリフト)」と呼ばれる現象です。 例えば「健全な店舗」の定義が時代と共に変わると、 過去データで学んだモデルは陳腐化します。 対処は (a) 定期的に再学習、 (b) 時系列的に重みを付ける、 (c) ドメイン適応技術を使う、 のいずれか。 Y の定義変更履歴を残すことが何より重要です。

Q. 目的変数のラベル付けに誤りがあったら

A. これは「ラベルノイズ」と呼ばれる問題です。 公的統計では少ないが、 アンケートや人手のアノテーションでは判定者によって付け方がぶれる。 対処は (a) 複数アノテータの多数決、 (b) ロバストな損失関数の利用、 (c) 信頼度の低いラベルの再確認。 ラベル品質は予測精度の上限を決めるので、 早期投資が重要です。

⑱ 目的変数を選ぶ際のドメイン別ガイドライン

目的変数の選び方は、 ドメインによって慣行や暗黙のルールが異なる。 ここでは代表的な 6 つのドメインで、 (a) 何を Y にすることが多いか、 (b) どんな前処理が定着しているか、 (c) どんな落とし穴があるかを整理する。 ドメイン慣行に従うことで、 査読者・読者・実務家との共通言語が確保できる。

ドメイン 典型 Y 定着前処理 落とし穴
マーケティング購入有無、 CV 数2 値化、 ログ変換不均衡(CV 率 1% 等)
金融株価リターン、 デフォルト確率対数リターン、 Winsor 化外れ値、 構造変化
医療罹患・生存・QOL打ち切り考慮、 標準化小サンプル、 倫理
教育成績、 進学率偏差値化、 順位化基準テスト変更
公共政策失業率、 出生率人口あたり、 季節調整定義変更(統計改革)
製造業良品率、 故障時間対数変換、 Weibull 分布バッチ効果

重要なのは、 「ドメイン慣行」と「統計学的最適」は必ずしも一致しないという点。 例えば医療では、 統計的には対数変換が望ましい変数も、 「臨床的に意味のあるカットオフ(HbA1c 7% 等)」で 2 値化されることが多い。 これは医師がその指標で判断する慣行があるため。 ドメインに従うか統計に従うかは、 「結果を誰に伝えるか」で決まる。

⑲ 目的変数の品質を上げる 5 つの設計テクニック

モデル精度を上げるには X 側の工夫が注目されがちだが、 実は Y 側の設計改善で大幅に精度が上がるケースが多い。 ここでは実践的に効く 5 つの Y 設計テクニックを紹介する。

# テクニック 何を解決 SSDSE-B 適用例
1対数変換右に長い裾出生数 → \(\log Y\)
2規模補正スケール効果人口あたり値に変換
3移動平均化年次ノイズ3 年移動平均
4外れ値除去東京都の影響99 パーセンタイルで切る
5複合指標化単一指標の弱点出生・婚姻・年少人口の合成

このコードでやること:上記 5 テクニックを実データに適用し、 元の Y と比較してどう改善するか確認する。

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) A1301(15歳未満人口) A4101(出生数) A9101(婚姻件数) 北海道 5,092,000 514,000 24,430 17,281 東京都 14,086,000 1,513,000 86,348 71,774 沖縄県 1,468,000 236,000 12,549 6,316 …(全 47 行)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
import pandas as pd
import numpy as np

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
y = df[df['SSDSE-B-2026'] == 2023].copy()

# T1: 対数変換
y['log_births'] = np.log10(y['A4101'])

# T2: 規模補正 (人口あたり)
y['births_pc'] = y['A4101'] / y['A1101'] * 1000

# T3: 移動平均 (3 年)
ma = df.groupby('Prefecture')['A4101'].rolling(3).mean().reset_index()

# T4: 外れ値除去 (99 パーセンタイル)
threshold = y['A4101'].quantile(0.99)
y['births_clipped'] = y['A4101'].clip(upper=threshold)

# T5: 複合指標 (出生数 A4101 + 婚姻件数 A9101 + 15歳未満人口 A1301 の単純平均、 標準化後)
def std(col): return (col - col.mean()) / col.std()
y['composite'] = (
    std(y['A4101']) +
    std(y['A9101']) +
    std(y['A1301'])
) / 3

print(y[['Prefecture', 'log_births', 'births_pc', 'composite']].head())

📤 実行すると次の出力が得られる:

Prefecture log_births births_pc composite 0 北海道 4.387923 4.797722 0.584269 12 青森県 3.755570 4.810811 -0.558932 24 岩手県 3.734960 4.670679 -0.560649 36 宮城県 4.090893 5.445230 -0.172347 48 秋田県 3.557627 3.950766 -0.662968

💬 読み方:log_births は東京と地方の差を緩和、 births_pc(人口千人あたり出生数)は規模効果を除外、 composite は出生数・婚姻件数・年少人口の総合点(標準化後)で少子化の度合いを測る。 同じ「県の子育て環境」を測るにも、 どの Y を選ぶかで上位の県が変わる。 例えば births_pc(粗出生率)なら沖縄県 8.55 が 1 位で東京都は 12 位に下がる一方、 composite では東京都 4.25・神奈川県 2.24・大阪府 2.23 と人口規模の大きい県が上位に来る。行番号が 0, 12, 24… と飛ぶのは、564 行から 2023 年度の行だけを抜き出して元の番号を残しているため。

⑳ 目的変数の選択に関する倫理的考慮

目的変数の選択は、 単に技術的な問題ではなく、 倫理的・社会的な含意を持つ。 「何を Y にするか」は「何を価値とみなすか」と同義であり、 不適切な Y はバイアスや差別を組み込んだモデルを生む危険がある。 以下、 5 つの倫理的考慮を挙げる。

論点 問題 対策
代理変数「逮捕歴」を Y にすると司法バイアスを継承真の Y との関係を検証
構造的差別「過去の採用結果」を Y にすると差別を再生産公平性指標で検証
プライバシー健康情報を Y にすると本人特定の危険差分プライバシー、 集約化
同意本人が想定しない Y で予測されるインフォームドコンセント
解釈予測結果が当事者に不利益をもたらす説明可能性、 異議申立

特に「代理変数」の問題は深刻。 例えば犯罪予測モデルで「過去の逮捕歴」を Y にすると、 警察活動の地域差(特定地域でより多く取り締まりが行われる)がそのままモデルに組み込まれ、 結果として「予測される犯罪リスクが高い地域に警察を多く配置 → さらに逮捕が増える → モデルがますますその地域を高リスクと予測」というフィードバックループが生まれる。 目的変数の選択時には、 「Y は真に測りたい現象を反映しているか」「Y にバイアスが組み込まれていないか」を必ず確認する必要がある。

㉑ 目的変数と評価指標の組み合わせ実例

実際の分析プロジェクトで、 目的変数と評価指標の組み合わせをどう選ぶか、 SSDSE-B-2026 を題材に 5 つの具体的シナリオで考えてみる。 単に「RMSE が低ければ良い」では済まないことが分かるはずだ。

シナリオ 目的変数 Y 主指標 補助指標 理由
出生数予測出生数RMSLEMdAE対数誤差で歪み吸収
高齢化警告高齢化率 25% 超recallprecision見逃しを最小化
教育格差高校卒業者の進学率R²MAE説明力を重視
医療機関の偏在人口 10 万人あたり一般病院数SpearmanRMSE順位の一致が重要
待機児童の発生保育所等利用待機児童数 J250502 > 0(2023 年度は 32 県)AUCF1, 適合率@100/1 の分類。 片方が多いので正解率だけでは測れない

㉒ 目的変数を変えると見える「県の姿」が変わる

最後に、 同じ SSDSE-B-2026 のデータを使って、 目的変数を変えると「県の姿」がどう変わるかを見てみよう。 これは目的変数選択の重要性を実感する最良の方法である。

目的変数 Y 1 位 2 位 3 位 最下位
出生数(絶対値)東京都大阪府神奈川県鳥取県
粗出生率(人口千人あたり)沖縄県福岡県滋賀県秋田県
出生数 伸び率(2012-2023)東京都大阪府福岡県秋田県
高齢化率(65 歳以上 / 総人口)秋田県高知県徳島県東京都
高校卒業者の進学率(E4602 / E4601)東京都京都府神奈川県沖縄県
合計特殊出生率沖縄県長崎県宮崎県東京都

💬 同じ 47 都道府県が、 Y によってまったく違う「姿」を見せる。 東京都は「出生数(絶対値)」では 1 位だが「合計特殊出生率」では最下位(0.99)。 沖縄県は「出生数(絶対値)」では下位だが「合計特殊出生率」では 1 位(1.60)。 これは「どの Y で評価するか」が「県の評価」を決めることを意味する。 政策議論で「○○県は遅れている」と言われたら、 「どの Y で測ったか」を必ず確認すべきだ。

㉓ 目的変数を見直す 3 つのタイミング

分析の途中で「目的変数を見直すべきタイミング」は 3 つある。 これらのタイミングを逃すと、 後で大幅な手戻りが発生する。

タイミング 1: EDA で Y の分布を見たとき

探索的データ分析(EDA)で Y のヒストグラムや箱ひげ図を見ると、 当初想定していなかった分布形状(強い歪み、 多峰性、 外れ値)が見つかることがある。 このとき、 (a) Y を変換するか、 (b) Y の定義そのものを変えるか、 (c) サブグループ別に分析するか、 を決める必要がある。 「とりあえず線形回帰でいいや」と進めると、 後で「残差が正規でない」「予測精度が低い」と気づき、 戻ってくることになる。

タイミング 2: 最初のモデルで残差を見たとき

仮の回帰モデルを当てて残差プロットを描くと、 「予測値が大きいときに残差も大きい」というヘテロスケダスティシティ(不均一分散)が見つかることがある。 これは Y を対数変換するか、 Box-Cox 変換するかで解決することが多い。 残差プロットは Y の前処理を決める最も重要な診断ツール。

タイミング 3: ステークホルダーに結果を説明したとき

「予測精度は良いが解釈できない」と言われたら、 Y の選択を見直す。 例えば Box-Cox 変換した Y で良い精度が出ても、 「Y が 18.7 から 19.2 に増えると…」では誰も理解できない。 解釈用には原単位の Y、 予測用には変換後の Y、 と用途別に Y を使い分けるのが現実的な解決策。

目的変数は、 一度決めたら終わりではない。 分析を進める中で何度も見直し、 改善していくものだ。 「初期の Y」で出した結果に固執せず、 「より良い Y はないか」を常に問い続けることが、 質の高い分析者の習慣である。 EDA → 仮モデル → 残差診断 → Y 改定 → 再モデル化、 というサイクルを 2-3 回回すのが標準的なワークフロー。 最初のサイクルで完璧な Y を選ぶ必要は無いが、 各サイクルで Y を少しずつ改善することが、 最終的な分析の質を決める。

㉔ 目的変数を巡る 10 個のよくある疑問への回答

最後に、 学習者がよく抱く 10 個の疑問とその回答を整理しておく。 これらは現場で実際によく聞かれる質問でもある。

Q1. 目的変数は数値でないといけないか

A. いいえ。 カテゴリ(分類タスク)、 順序(順序回帰)、 時間(生存分析)、 集合(マルチラベル)、 構造(木・グラフ)など、 多様な型が可能です。 ただしモデル設計が型に依存します。

Q2. 目的変数に欠損があるサンプルはどう扱うか

A. 多くの場合、 Y の欠損サンプルは学習データから除外します。 補完するのは推奨されません(補完値が予測対象になり、 循環参照になる)。 一方、 X の欠損は補完が一般的です。

Q3. 同じ X からどれくらい多くの Y を作れるか

A. 工夫次第で無限に作れます。 SSDSE-B の「出生数」一つから、 絶対値・対数・人口あたり・伸び率・トレンド係数・残差・カテゴリ化(中央値超)・5 段階化・移動平均・累積・前期比・予測誤差…と数十種類は容易に作れます。 重要なのは「分析の問いに合った Y」を選ぶこと。

Q4. 目的変数を変換したら、 予測結果は逆変換すべきか

A. ステークホルダーに報告する際は逆変換します。 ただし対数変換の逆変換 \( \exp(\hat{\log Y}) \) は中央値の予測になり、 平均の予測ではないので注意(Jensen の不等式)。 平均が必要なら、 残差の分散を考慮した補正が必要です。

Q5. 目的変数を 2 値化するときのしきい値はどう決めるか

A. (a) ドメイン知識(医療なら学会ガイドラインのカットオフ)、 (b) 統計的基準(中央値、 25%-75% パーセンタイル)、 (c) ROC 曲線で最適化、 のいずれか。 重要なのは事前に決めて記録し、 後から動かさないこと。

Q6. 目的変数のノイズはどれくらい許容されるか

A. 決まった基準値は無い。 同じ対象を 2 回測ったときの一致度(信頼性)が低い Y では、 モデルの R² はその一致度より上がらない。 公的統計の Y は測定誤差が小さいが、 アンケートの主観的な Y は測り直すと値が動く。

Q7. 目的変数の予測ができないとき、 まず何を疑うべきか

A. 順番に:(1) Y の定義の妥当性、 (2) X に予測に必要な情報があるか、 (3) Y のノイズが高すぎないか、 (4) サンプル数が足りているか、 (5) モデルが適切か。 多くの場合、 (1) と (2) が原因です。

Q8. 目的変数を「予測しやすく」変換するのは不正か

A. 変換そのものは合法かつ推奨されます(対数変換等)。 ただし、 変換を「予測しやすくするため」と説明するか、 「現象の本質に合うため」と説明するかは大きな違いです。 前者は技術的、 後者は実質的。 報告書では両方の理由を書くと説得力が増します。

Q9. 目的変数と「予測したい未来の値」の違いは

A. 学習時は両方とも観測済みの値です(過去データで両方手に入る)。 予測時は X だけ手に入って Y は手に入らないので、 モデルが推定する。 「目的変数」は学習・評価時の概念、 「予測値」は運用時の概念、 と整理できます。

Q10. 目的変数を学ぶ次のステップは

A. (1) 説明変数と組み合わせて回帰モデルを実装する、 (2) 特徴量エンジニアリングで X を強化する、 (3) 交差検証で汎化性能を測る、 (4) 残差分析で Y の前処理を見直す、 の 4 ステップを推奨します。

㊱ 目的変数の分布タイプ別の対処マニュアル

Y の分布タイプによって、 取るべきモデルや前処理が大きく変わる。 ヒストグラム (figures/target-variable_hist.png) を最初に必ず描き、 どのタイプに該当するかを判定しよう。 ここでは代表的な 8 タイプについて、 (a) 見分け方、 (b) 適切なモデル、 (c) よくある間違いを整理する。 SSDSE-B-2026 を例にすると、 ほとんどの Y は「タイプ B: 右裾の長い分布」または「タイプ G: 二峰性」に該当する。

タイプ 特徴 適切なモデル よくある誤用
A: 正規分布左右対称・釣鐘型線形回帰 (OLS)正規性を確かめず適用
B: 右裾長少数の極大値あり対数変換 + OLS変換せず OLS
C: 左裾長少数の極小値あり指数変換外れ値削除に走る
D: 切断 (0 付近で打ち切り)負値が存在しないTobit, ガンマ GLMOLS で負値を予測してしまう
E: カウント整数値・離散ポアソン GLM連続値モデル使用
F: 比率 (0-1)境界に張り付きロジット変換 + OLSそのまま OLS
G: 二峰性山が 2 つ混合モデル, サブグループ分析1 つの母集団として扱う
H: 一様分布平坦・特徴なし分位回帰平均をモデル化

例えば SSDSE-B-2026 の「出生数」は典型的なタイプ B (右裾長)。 東京都が突出していて、 他の県との差が極端に大きい。 これをそのまま線形回帰の Y にすると、 残差プロットで「予測値が大きい県ほど残差も大きい」というヘテロスケダスティシティが現れる。 対処は対数変換が定番。 「自家用車保有台数」は人口の絶対値で見ればタイプ B、 人口あたりで見るとタイプ A に近くなる。 つまり前処理によって分布タイプが変わる。 まず生データで分布を確認し、 必要に応じて変換し、 変換後の分布を再確認するという 2 段階のチェックが基本。

このコードでやること:SSDSE-B-2026 の主要 6 列について、 ヒストグラムを描いて分布タイプを判定し、 適切な変換を当てて再判定する診断パイプラインを作る。

📥 入力データ (SSDSE-B-2026 抜粋):

SSDSE-B-2026 都道府県 総人口 出生数 死亡数 合計特殊出生率 年平均気温 R01000 北海道 5,092,000 24,430 75,120 1.06 11.0 R13000 東京都 14,086,000 86,348 137,241 0.99 17.6 R47000 沖縄県 1,468,000 12,549 15,110 1.60 23.8
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
import pandas as pd
import numpy as np
from scipy import stats

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
y22 = df[df['SSDSE-B-2026'] == 2023].copy()

cols = ['A1101', 'A4101', 'A4200',
        'A4103', 'B4101', 'L3221']

def classify(s):
    s = s.dropna()
    skew = stats.skew(s)
    if abs(skew) < 0.5: return 'A 正規型'
    if skew > 1.0: return 'B 右裾長'
    if skew < -1.0: return 'C 左裾長'
    return '中間'

for c in cols:
    raw_t = classify(y22[c])
    log_t = classify(np.log10(y22[c].replace(0, np.nan)))
    print(f'{c:<20s}  raw={raw_t}  log={log_t}')

📤 実行すると次の出力が得られる:

A1101(総人口) raw=B 右裾長 log=中間 A4101(出生数) raw=B 右裾長 log=中間 A4200(死亡数) raw=B 右裾長 log=中間 A4103(合計特殊出生率) raw=A 正規型 log=A 正規型 B4101(年平均気温) raw=A 正規型 log=中間 L3221(消費支出) raw=中間 log=中間

💬 読み方:人口・出生数・死亡数などの実数カウントは生のままだとタイプ B (右裾長)。 対数変換で歪度が 2.2→0.8 前後まで下がり大きく改善するが、 47 件では完全な正規型 (A) には届かず中間にとどまる。 一方、 合計特殊出生率は元から正規型 (0.99〜1.60 の範囲の比率)、 変換不要。 年平均気温もほぼ正規型。 消費支出は世帯あたりの値で左右対称に近く中間。 この診断パイプラインを EDA の最初に走らせると、 「どの Y にどんな前処理を当てるか」が機械的に決まる。

㊲ 目的変数のスケール選択がモデル精度に与える影響

Y のスケール (単位、 変換) を変えるだけで、 同じ X・同じモデルでも予測精度や解釈が大きく変わる。 ここでは SSDSE-B-2026 の「出生数」を Y として、 4 通りのスケール (原値、 対数、 人口あたり、 標準化) で線形回帰を当てたときの違いを比較する。 散布図 (figures/target-variable_scatter.png) を見ながら、 どのスケールが「直線フィット」に最も適しているかを直感的に確認しよう。 結論は「対数 + 人口あたり」が最も解釈しやすく、 残差プロットも綺麗になることが多い。

Y のスケール R² 残差の正規性 解釈しやすさ 用途
原値 (人)0.99 (高)悪いやや難規模の比較
対数 (log10)0.84良い中弾性値解釈
人口あたり0.03悪い高生産性比較
標準化 (z)0.99悪い (元と同じ)低変数間比較

興味深いのは「人口あたり」にすると R² が大きく下がる点。 これは「東京都の出生数が多いのは人口も多いから」という当然の関係が消え、 「同じ人口規模あたりで見たとき、 何が県の出生水準を決めるか」という別の問いに変わるためである。 R² が下がったから「悪いモデル」ではない。 「より深い問い」になっているのだ。 一方、 標準化 (z-score) は単位を変えただけで関係そのものは変わらないので、 R² は原値と同じ。 でも「標準化された Y」は普通の人には解釈不能 (Y が 1 増えると…? は標準偏差 1 つ分という意味だが、 直感的でない)。 つまり、 スケールの選択は「精度の最適化」ではなく「問いの明確化」のためにある。 同じ Y で 4 つのスケールを試し、 そのうち「最も意味のある問いを表す」スケールを選ぶのが筋道。

このコードでやること:上記 4 スケールで線形回帰を当て、 R²・残差正規性・係数解釈を比較する。

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) A4101(出生数) 北海道 5,092,000 24,430 東京都 14,086,000 86,348 沖縄県 1,468,000 12,549 …(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from scipy import stats

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
y22 = df[df['SSDSE-B-2026'] == 2023].copy()
X = y22[['A1101']].values

scales = {
    '原値': y22['A4101'],
    '対数': np.log10(y22['A4101']),
    '人口あたり': y22['A4101'] / y22['A1101'] * 1e6,
    '標準化': (y22['A4101'] - y22['A4101'].mean()) / y22['A4101'].std(),
}

for name, y in scales.items():
    m = LinearRegression().fit(X, y)
    r2 = m.score(X, y)
    resid = y - m.predict(X)
    shap_p = stats.shapiro(resid)[1]
    print(f'{name:<10s}  R2={r2:.3f}  残差正規性 p={shap_p:.3f}')

📤 実行すると次の出力が得られる:

原値 R2=0.991 残差正規性 p=0.003 対数 R2=0.841 残差正規性 p=0.043 人口あたり R2=0.028 残差正規性 p=0.001 標準化 R2=0.991 残差正規性 p=0.003

💬 読み方:原値と標準化は数値的に等価 (R² も同じ)。 残差正規性は対数変換で改善 (p=0.003 → 0.043)。 人口あたりは R² が 0.03 まで激減し「出生の水準は人口規模ではほとんど説明できない」という別の問いに変わっている。 統計コンペでは「対数変換で残差正規性をクリア」かつ「人口あたりで規模効果を除去」した 2 つの Y で別々のモデルを作り、 結果を併記すると説得力が高まる。

㊳ 目的変数の選択を誤りやすい 7 つの場面と回避策

実務で目的変数の選択を誤る場面は意外に多い。 ここではよくある 7 パターンを「症状 → 原因 → 回避策」の形で整理する。 学生の卒研、 統計コンペ、 業務分析、 どの場面でも適用できる普遍的な誤りパターンである。 箱ひげ図 (figures/target-variable_box.png) を念頭に、 「サブグループ別に Y を見ているか」「全体平均だけで議論していないか」をチェックしよう。

# 場面 症状 原因 回避策
1手元データに無い Y仮想 Y を作って分析問いが先、 データが後類似データを探す
2Y と X が混在循環的な定義概念図不在因果図を描く
3Y の品質劣化欠損・誤入力EDA 不足欠損率・分布を必ず確認
4Y のスケール不適残差非正規前処理省略対数変換・標準化を試す
5Y の意味曖昧解釈が困難ドメイン理解不足専門家に定義確認
6Y の時系列変化予測が陳腐化概念漂流定期再学習
7Y のサブグループ差全体平均が誤導階層構造無視箱ひげ図で群別確認

これら 7 つの誤りはどれも「事前のチェックリスト」で防げる類のものである。 例えば SSDSE-B-2026 で「出生数」を Y にするなら、 (1) 47 都道府県すべてに値があるか確認 (欠損 0)、 (2) 単位が「人」で固定されているか確認 (定義変更履歴)、 (3) 東京都を含めた分布のヒストグラム描画、 (4) 対数変換版も用意、 (5) 「出生数」の定義文を統計局サイトで再確認、 (6) 12 年度分(2012〜2023)の時系列推移グラフ、 (7) 関東・近畿・東北など地方ブロック別の箱ひげ図、 という 7 ステップを EDA フェーズで終わらせる。 これだけで上記 7 誤りはほぼ防げる。

🧮 数式に値を入れて手で計算する: 目的変数の分布

合成回帰の目的変数 y の要約統計を計算する。

Step 1: y データ

y = [3, 7, 12, 9, 4] 平均 = 7.0, SD = 3.674

Step 2: 範囲とレンジ

min=3, max=12, range=9 変動係数 CV = 3.674/7.0 ≈ 0.525

🐍 Python で再現

1
2
3
4
5
import numpy as np
y = np.array([3, 7, 12, 9, 4])
print(f"平均: {y.mean()}")
print(f"SD: {y.std(ddof=1):.3f}")
print(f"CV: {y.std(ddof=1)/y.mean():.3f}")

📤 実行結果

平均: 7.0 SD: 3.674 CV: 0.525

💬 手計算 (Step 2) と Python 出力が完全一致。

🌳 手法選択フロー

SSDSE-B-2026 を題材に目的変数 y を決め、 モデリング手法を選ぶフロー。

  1. ① y の型は? 連続値 (出生数 A4101) → 回帰 (線形回帰 / Lasso / LightGBM)。 二値 (大都市圏=1) → 分類 (ロジスティック / SVM / RF)。 多クラス (地方ブロック) → ソフトマックス回帰 / RF。 順序 (大-中-小) → 順序ロジット。 件数 (病院数) → ポアソン回帰。
  2. ② y の分布は? 右に裾を引く (人口 A1101) → 対数変換 log(y) してから回帰。 過分散カウント → 負の二項回帰。 ゼロ過剰 → ゼロ過剰モデル。
  3. ③ 評価指標は? 回帰: RMSE / MAE / R²。 分類: Accuracy / F1 / ROC-AUC / log-loss。 不均衡データなら PR-AUC を優先。 SSDSE 47 件では Leave-One-Out CV が現実的。

目的変数の選択が分析全体を決定する。 SSDSE-B-2026 で「A4101 を予測」と「A4101 と関連する変数を発見」は同じデータでも問題設定が異なり、 前者は予測精度重視、 後者は解釈性重視で手法選択が変わる。

🔗 隣接手法への橋渡し

目的変数 y は教師あり学習の出発点。 SSDSE-B-2026 で「出生数 (A4101) を予測したい」と決めた瞬間、 残り 108 列(年度・地域コード・都道府県名を除く)が説明変数候補になり、 モデル選択・評価指標・前処理の方向が一意に決まる。 y の定義が曖昧だと分析全体が迷走する。

SSDSE-B-2026 で y を「人口 A1101」にすると東京都(2023 年度 14,086 千人)の外れ値で RMSE が支配され、 「人口対数 log(A1101)」にすると相対誤差ベースの公平な評価になる。 目的変数の前処理 (対数・標準化) の有無で結論が大きく変わる。

🎮 触って理解する

まったく同じ説明変数 X(横軸・1つの特徴量)に対して、 目的変数 y の 型を「連続値」にするか「2値カテゴリ」にするかを切り替えてみましょう。 目的変数の定義を変えるだけで、 当てはめるモデル(回帰直線 ⇔ 決定境界)も、 良し悪しを測る評価指標(MSE・R² ⇔ 正解率)も、 まるごと別物に変わります。 これが「目的変数の選び方・定義次第で問題が変わる」ということです。 ※ここで使う点は説明用の合成データで、 SSDSE の実測値ではありません。

分類モードでは、図を上下にドラッグして境目 t を動かせます(タッチ対応)

💡 直感:目的変数とは「予測したい対象」そのもの

目的変数(=目標変数, target / 応答変数 y)は、 分析で当てたい・説明したいゴールです。 「出生数を予測したい」と決めれば y は出生数、 残りの列はすべて説明変数 X の候補になります。 上の図で分かる通り、 同じ X でも y の型が変われば解く問題ごと変わります。 y が連続なら回帰(直線を当てて MSE・R² で評価)、 y がカテゴリなら分類(境界を引いて正解率で評価)。 だから分析設計では「何を y にするか」を最初に、 かつ慎重に決めます。

⚠ よくある落とし穴

  • 目的変数へのリーク:y の結果を反映した列(例:確定後にしか分からない値、 y を計算に使った特徴量)を X に混ぜると、 検証では高精度でも本番で崩壊します。 データリークを参照。
  • 定義の恣意性:分類の境目 t を動かすと、 クラスの内訳も正解率も別の数字になります。 「y をどう定義したか」で結論が変わるので、 t の根拠(業務・臨床・制度上の意味)を明示する必要があります。
  • 不均衡:境目を極端にすると片方のクラスがごく少数になり、 「多数派を常に予測」するだけで高い正解率が出ます。 読み出し欄のベースライン正解率を超えられなければ学習した意味はありません。 クラス不均衡・混同行列で評価を見直します。

🚀 発展:多クラス・多出力

y は 2 値だけではありません。 3 つ以上のカテゴリなら多クラス分類(ソフトマックス回帰・ランダムフォレスト)、 順序があるなら順序ロジット、 件数ならポアソン回帰。 さらに y を複数同時に予測する多出力(マルチターゲット)回帰/分類もあります(このページの「多目的変数」節を参照)。 いずれも出発点は同じで、 「y を何に・どの型で定義するか」がモデル選択・損失関数・評価指標を一意に決めます。 関連: 回帰タスク/分類/線形回帰/ロジスティック回帰/説明変数/MSE/R²。