🔖 キーワード索引
このページで扱う概念:
💡 30秒で分かる結論
🍰 まずはやさしく
正解のないデータから特徴を探す方法です。
データの隠れた構造を見つけるために使います。
似た特徴を持つ県をまとめる時に役立ちます。
数式やコード、注意点をセットで学びます。
教師なし学習(Unsupervised Learning):ラベルなしデータ $\{x_i\}$ から構造(クラスタ・低次元表現・密度)を発見する手法
- 正解ラベル y を使わず、 x だけから「似たもの同士のまとまり」や「少ない軸での要約」を見つける
- 2023 年度の 47 都道府県を人数 4 列で K-means(K=4)にかけると、 37・4・5・1 県に分かれ、 東京都が 1 県だけのクラスタになる
- そのときシルエット係数は 0.723 と高いが、 4 列の第 1 主成分の寄与率が 99.4% で、 実際は人口規模だけで分けている
- 正解が無いので「分かれ方が役に立つか」は人が決める。 列の選び方(人数か比率か)と標準化で結果が変わる
📍 あなたが今見ているもの
🍰 まずはやさしく
機械学習の基礎となる重要な考え方です。
データの分析を深く理解するために使います。
都道府県のデータを使って実際に体験します。
直感的な理解からPythonの実装まで読みます。
このページは「教師なし学習(Unsupervised Learning)」の用語解説です。 機械学習の基礎カテゴリにおける重要概念で、 機械学習の基礎 グループ教材の中で繰り返し登場します。 数式・実コード・落とし穴を 1 ページに集約し、 SSDSE-B-2026 都道府県データ(47 件 × 112 列)を題材に 手を動かしながら理解できるよう構成しています。
別称:教師なし。 まず 💡 30秒結論 で全体像を、 次に 🎨 直感 → 📐 数式 → 🧮 実値 → 🐍 Python の順で読むのがおすすめ。
🎨 直感で掴む
🍰 まずはやさしく
自分で共通点を探す生徒のような学習です。
データの中にあるグループを見つけるために使います。
スマホのアプリを好みのジャンルで分ける感覚です。
グループ分けやデータの圧縮について読みます。
教師なし学習は「正解ラベルが無い大量のデータから、 自分でグループや構造を見つける」アプローチです。 「47 都道府県のうち、 似た特徴を持つ県をまとめてください」と頼まれて、 自分で答えを作る感覚に近い。 教師あり学習が 「先生から正解付き問題を渡されて勉強する生徒」なら、 教師なし学習は 「正解の無い問題集を渡されて『どんな共通点があるか自分で考える』生徒」です。
3 つの代表タスク(SSDSE-B-2026 47 都道府県データでの例):
- クラスタリング(K-means/階層型):
総人口15歳未満人口65歳以上人口出生数の 4 変数で 47 県を K=4 にまとめると、 東京単独 → 大阪・愛知・神奈川 → 福岡・北海道・埼玉ほか中堅 → 残り 40 県の小規模という階層構造が浮かぶ。 ラベルは付与していないのに「都市規模」という概念が結果として現れる。 - 次元削減(PCA/t-SNE/UMAP): SSDSE-B-2026 の数値列(標準化後)を 2 次元に落とすと、 PCA 第 1 主成分(全 109 数値列で寄与 ≒ 77%)はほぼ 「都市規模」を捉え、 第 2 主成分以降に 高齢化度などの残りの構造が現れる。 これも事前に教えていない解釈軸が自動で立ち上がる。
- 異常検知(Isolation Forest/LOF): 47 県の中で「沖縄は 合計特殊出生率 1.60 + 高齢化率 23.8%」、 「東京は 15歳未満人口比率が低い + 転入者数が突出」と外れ値スコアが高い。 「ふつう」を学んで「異常」を炙り出す。
教師なし学習の本質的価値: ラベル付けは人手がかかり高コスト(医療画像 1 枚 5 分、 製造業の異常品ラベル付け 1 時間など)。 教師なしならラベル無しの 100 万件データから「構造」を吸い上げ、 後段の教師あり学習に 事前知識を渡せる(自己教師あり学習・BERT/GPT の事前学習はこの発想)。 また「正解が定まらない探索的分析」(新カテゴリ発見、 セグメント設計、 仮説生成)には教師なしが本流。
教師あり/なしの境界はグラデーション: 半教師あり学習(少数ラベル + 大量無ラベル)、 自己教師あり学習(データ自身から疑似ラベルを作る)、 強化学習(報酬信号で学ぶ)は中間。 教師なしは「真にラベル無し」の最左端。
📐 数式または定義
🍰 まずはやさしく
英語ではアンサパバイズドラーニングと言います。
計算で正解を導き出すために使います。
部活のメンバーを能力で分ける計算に似ています。
この手法を表す数式や定義について読みます。
本概念は次のように記述されます(KaTeX で描画)。
英語名 Unsupervised Learning。 別称:教師なし。
🔬 数式を言葉で読み解く
記号と意味を逐一突き合わせて読みます。 慣れないうちは式を「日本語で読む」ことが理解の近道です。
- $C_k$:$k$ 番目のクラスタ(サンプルの集合)
- $\mu_k$:クラスタ $k$ の中心(重心)
- $\|x - \mu_k\|^2$:サンプルと中心のユークリッド距離の二乗
- $K$:クラスタ数(事前に決めるハイパーパラメータ)
- 最小化:クラスタ内距離合計を最小化する割り当て $\{C_k\}$ を求める
🧮 SSDSE-B 実値で計算してみる
SSDSE-B の人口構成変数で 47 都道府県を K-means クラスタリングし、 PCA で 2 次元に可視化します。
データ出典:SSDSE-B-2026(独立行政法人統計センター)。 47 都道府県 × 複数年(最新 2023)の社会統計データ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import numpy as np from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler from sklearn.decomposition import PCA df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) feats = ['A1101', 'A1301', 'A1302', 'A1303'] # A1101総人口/A1301年少/A1302生産年齢/A1303高齢 X = df[feats].values Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, random_state=0, n_init=10).fit(Xs) df['cluster'] = km.labels_ # 各クラスタの代表県 for c in range(4): sub = df[df['cluster']==c] print(f'cluster {c}: n={len(sub)}, 例={sub["Prefecture"].head(3).tolist()}') # PCA で次元削減 pca = PCA(n_components=2).fit_transform(Xs) print(pca[:5]) |
💬 クラスタの大きさは 37・4・5・1 と極端に偏り、東京都が 1 県だけで 1 クラスタを占めた。4 つの特徴量はどれも「人数」で、総人口と年少人口の相関は 0.997 もあるため、実際には人口規模だけで切り分けている(第 1 主成分の寄与率は 99.4%)。PCA の出力で 2 列目の値が ±0.5 以内に収まっているのもそのためで、「地域の性格」で分けたいなら人口比(高齢化率など)に直してから使う。
実行結果の要約(出力は環境依存。 概算値):
| 項目 | 値 |
|---|---|
| cluster 0 | 37 県(地方・小規模) |
| cluster 1 | 4 県(埼玉・神奈川・愛知・大阪) |
| cluster 2 | 5 県(北海道・千葉・静岡・兵庫・福岡) |
| cluster 3 | 1 県(東京) |
| PCA第1主成分寄与 | 約 99% |
| PCA第2主成分寄与 | 約 1% |
🐍 Python 実装
scikit-learn / pandas を使った最小実装パターン。 教師なし学習なので目的変数(正解ラベル)は使いません。 「読み込み→標準化→クラスタリング→評価」のテンプレを 4 つのスニペットに分けます。
① データ読み込み & 概観
1 2 3 4 5 | import pandas as pd # SSDSE-B-2026: 1行目=列コード, 2行目=日本語名 → skiprows=[1] でコード行を列名に採用 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 年度2023で絞り込み(47県) print(df.shape, df['Prefecture'].tolist()[:3]) |
💬 (47, 112) は 2023 年度の 47 都道府県 × 112 列。先頭が北海道・青森県・岩手県なので、行は都道府県コード順に並んでいる。年度で絞り忘れると 564 行になり、同じ県の 12 年分がクラスタを 1 つ占めてしまうので、クラスタリングの前にこの行数を必ず確かめる。
② 特徴量の準備 & 標準化
1 2 3 4 5 6 | from sklearn.preprocessing import StandardScaler # 実在列のみ: A1101 総人口 / A1301 15歳未満人口 / A1303 65歳以上人口 / A4101 出生数 cols = ['A1101', 'A1301', 'A1303', 'A4101'] X = df[cols].astype(float).values Xs = StandardScaler().fit_transform(X) # 距離ベース手法の前提としてスケールを揃える print('X shape =', Xs.shape, ' (教師なし=正解ラベル y は無い)') |
💬 4 列を標準化した (47, 4) 行列ができた。出力に y が出てこないのが教師なし学習の特徴で、以後のクラスタは「正解との一致」では評価できない。標準化しないと総人口(数百万)が出生数(数千)を 1,000 倍近い重みで支配し、K-means の距離がほぼ総人口だけで決まってしまう。
③ K-means でクラスタリング
1 2 3 4 5 | from sklearn.cluster import KMeans # 正解ラベルを与えず、データの構造だけで 47 県を 4 グループに分ける km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Xs) df['cluster'] = km.labels_ print('各クラスタの県数:', pd.Series(km.labels_).value_counts().sort_index().to_dict()) |
💬 県数は 37・4・5・1 で、#0 と同じ分かれ方になった(特徴量の 1 列が生産年齢人口から出生数に替わっても、どちらも人口規模に比例するため結果が変わらない)。37 県が 1 つにまとまるのは、人口 54 万〜283 万人の県どうしの差が、東京都や大阪府との差に比べて小さく見えるからだ。
④ 評価(シルエット係数)と可視化
1 2 3 4 5 6 7 8 | import matplotlib.pyplot as plt from sklearn.metrics import silhouette_score from sklearn.decomposition import PCA print('シルエット係数 =', round(silhouette_score(Xs, km.labels_), 3)) # ラベル無しでの品質指標 Z = PCA(n_components=2).fit_transform(Xs) # 2次元に射影して可視化 plt.scatter(Z[:, 0], Z[:, 1], c=km.labels_, cmap='tab10') plt.xlabel('PC1'); plt.ylabel('PC2'); plt.title('47都道府県の K-means クラスタリング') plt.tight_layout(); plt.savefig('out.png', dpi=150) |
💬 シルエット係数 0.723 は一般に「はっきり分かれている」とされる水準だが、37 県と 1 県のように大きさが偏ったクラスタでも高く出る。東京都のような孤立点を単独クラスタにすると、その点も残りの点も「自分のクラスタに近い」と判定されて値が上がるからだ。係数が高い=有用な類型、とは限らない。
⚠️ よくある落とし穴(教師なし学習で特に多い 7 つ)
総人口(10⁶ オーダー)と 合計特殊出生率(1.0 オーダー)を混ぜると人口だけで決まってしまう。 必ず StandardScaler または MinMaxScaler。 外れ値があるなら RobustScaler。🐍 応用コード — 47 都道府県を K-means で 5 クラスタに分け、 地域類型を発見する
SSDSE 公的データを題材に、教師なし学習 を実際に動かす最小コードです。 paths は引数に直書きで、 初心者がコピペで動かせる形を優先しています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import numpy as np # データ読み込み(SSDSE-B 都道府県・47県 × 112列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) print('shape:', df.shape) print('列コードの先頭:', df.columns.tolist()[:6]) # 教師なし学習に使う実在列だけ取り出す # A1101 総人口 / A1301 15歳未満人口 / A1303 65歳以上人口 / A4101 出生数 / A4200 死亡数 features = ['A1101', 'A1301', 'A1303', 'A4101', 'A4200'] df_use = df[features].astype(float).copy() print(df_use.describe()) |
💬 5 列とも平均が中央値を大きく上回り(総人口は平均 264.6 万人に対し中央値 154.9 万人、死亡数は 33,512 に対し 23,744)、少数の大都市が分布を右に引っ張っている。std が平均と同じくらいの大きさなのも同じ理由。この形のまま標準化しても外れ値の影響は残るので、クラスタが東京都などを孤立させやすいことを予想しておく。
次に、 教師なし学習 に固有の処理(標準化 → K-means → シルエット評価)を加えます。 ここがページごとの「肝」になる部分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score X = df_use.values Xs = StandardScaler().fit_transform(X) # スケールを揃える(距離ベースの前提) # 正解ラベル無しで 47 県を 5 つの地域類型に分ける km = KMeans(n_clusters=5, n_init=10, random_state=0).fit(Xs) df['cluster'] = km.labels_ print(f'シルエット係数 = {silhouette_score(Xs, km.labels_):.3f}') for k in range(5): pref = df.loc[km.labels_ == k, 'Prefecture'].tolist() print(f'cluster {k} (n={len(pref)}): {pref[:6]}') |
💬 死亡数を加えて K=5 にすると、#3 で 37 県あった大集団が 15 県(宮城・福島・茨城など中規模)と 23 県(青森・秋田など小規模)に割れた。一方で埼玉・神奈川・愛知・大阪の 4 府県と東京都単独は K=4 のときと同じ。シルエット係数は 0.571 に下がり、境目の近い中規模県と小規模県を無理に切り分けたことが数値にも表れている。
さらに PCA で 2 次元に落として可視化すると、 学んだ内容が「眼で」確認できます。
1 2 3 4 5 6 7 8 9 10 11 | import matplotlib.pyplot as plt from sklearn.decomposition import PCA Z = PCA(n_components=2).fit_transform(Xs) # 5変数 → 2軸に圧縮して可視化 plt.figure(figsize=(7, 5)) plt.scatter(Z[:, 0], Z[:, 1], c=km.labels_, cmap='tab10', edgecolor='k', alpha=0.8) plt.xlabel('PC1') plt.ylabel('PC2') plt.title('47都道府県の地域類型(K-means, K=5)— SSDSE-B-2026') plt.tight_layout() plt.savefig('out_unsupervised-learning.png', dpi=150) |
最後に、 クラスタ数 K の妥当性をシルエット係数で確認します(教師なしには「正解の K」が無いため)。
1 2 3 4 5 6 | from sklearn.metrics import silhouette_score # クラスタ数 K を変え、シルエット係数で妥当な K を探る(教師なしの「検証」) for k in range(2, 8): lab = KMeans(n_clusters=k, n_init=10, random_state=0).fit_predict(Xs) print(f'K={k}: silhouette = {silhouette_score(Xs, lab):.3f}') |
💬 シルエット係数は K=2 の 0.789 が最大で、K を増やすほど下がり K=5 以降は 0.56〜0.57 で横ばいになる。K=2 は大都市 9 都道府県とそれ以外に分けるだけの粗い分割なので、係数が最大だから K=2 を採用、とは言い切れない。K=4 の 0.719 あたりまでが、分かれ方の明瞭さと細かさの妥協点になる。
🐍 実装パターン集 — 状況別レシピ
同じ「教師なし学習」を使うにも、 データの形・規模・目的によって書き方が変わります。 4 つの典型パターンを示します。
パターン A:探索的・最小構成
1 2 3 4 5 6 7 8 9 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) Xs = StandardScaler().fit_transform(df[['A1101', 'A1301', 'A1303', 'A4101']].astype(float)) df['cluster'] = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(Xs) print(df.groupby('cluster')['Prefecture'].apply(list)) |
💬 groupby で並べると、cluster 1 は埼玉・神奈川・愛知・大阪(人口 733 万〜923 万人)、cluster 2 は北海道・千葉・静岡・兵庫・福岡(356 万〜626 万人)と、人口規模の帯でほぼきれいに分かれている。cluster 0 は長いリストが「...」で省略されているが 37 県で、最大でも 283 万人。ラベル番号 0〜3 には順序の意味はなく、乱数の初期値で入れ替わる。
パターン B:パイプライン化(標準化+クラスタリング)
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans # 標準化とクラスタリングを 1 本のパイプラインにまとめる pipe = Pipeline([ ('scaler', StandardScaler()), ('kmeans', KMeans(n_clusters=4, n_init=10, random_state=0)), ]) labels = pipe.fit_predict(df[['A1101', 'A1301', 'A1303', 'A4101']].astype(float)) print('cluster sizes =', pd.Series(labels).value_counts().sort_index().to_dict()) |
💬 Pipeline で標準化と K-means をまとめても、サイズは {0: 37, 1: 4, 2: 5, 3: 1} で #3・#9 と完全に一致する。同じ列・同じ random_state なので当然の結果だが、これで「標準化を先に手でやる」書き方と同じ処理になっていることが確かめられる。新しい年度のデータに fit_predict ではなく predict を使えば、2023 年の平均・分散で標準化した上で既存のクラスタに振り分けられる。
パターン C:クラスタ数 K の探索(シルエット最大化)
1 2 3 4 5 6 7 8 9 10 11 12 | from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score # 教師なしには検証スコアが無いため、シルエット係数で K を選ぶ best = None for k in range(2, 9): lab = KMeans(n_clusters=k, n_init=10, random_state=0).fit_predict(Xs) sil = silhouette_score(Xs, lab) print(f'K={k}: silhouette={sil:.3f}') if best is None or sil > best[1]: best = (k, sil) print('best K =', best[0], ' silhouette =', round(best[1], 3)) |
💬 最大は K=2 の 0.789 で、コードは best K = 2 を選んだ。K=2 の中身は北海道・埼玉・千葉・東京・神奈川・愛知・大阪・兵庫・福岡の 9 都道府県とそれ以外の 38 県で、人口の大小を言い直しただけの分割だ。#8 と K=3 以降の値が少し違う(K=3 で 0.772 と 0.775)のは、#9 で Xs を死亡数を含まない 4 列に作り直したためで、どの特徴量で計った係数かを揃えて比べる必要がある。
パターン D:可視化付きの結果保存
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import matplotlib.pyplot as plt import json from sklearn.decomposition import PCA from sklearn.metrics import silhouette_score Z = PCA(n_components=2).fit_transform(Xs) # 2次元へ射影して可視化 plt.figure(figsize=(7, 5)) plt.scatter(Z[:, 0], Z[:, 1], c=df['cluster'], cmap='tab10', edgecolor='k') plt.xlabel('PC1'); plt.ylabel('PC2'); plt.title('教師なし学習 結果(K-means クラスタ)') plt.tight_layout(); plt.savefig('result_unsupervised-learning.png', dpi=150) with open('result_unsupervised-learning.json', 'w', encoding='utf-8') as f: json.dump({'n_clusters': 4, 'silhouette': round(float(silhouette_score(Xs, df['cluster'])), 3), 'cluster_sizes': df['cluster'].value_counts().sort_index().to_dict()}, f, ensure_ascii=False, indent=2) |
🗺 概念マップ
「教師なし学習」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 機械学習 (3 大分類のひとつ) | 教師あり / 強化学習と並ぶ大枠 |
| 南 (下位) | k-means / 階層クラスタリング / PCA / t-SNE / UMAP | 教師なし学習の代表アルゴリズム |
| 東 (発展) | 自己教師あり学習 / 対照学習 / オートエンコーダ | ラベルなしから表現を学ぶ発展形 |
| 西 (前提) | 距離尺度 / 線形代数 (固有値) / 確率分布 | クラスタ・次元削減の数学的土台 |
| 中央 | 教師なし学習 | 本ページの主役 |
🎨 直感で掴む:K-means と DBSCAN の世界観の違い
教師なし学習で「クラスタを見つける」と言っても、 アルゴリズムの世界観はそれぞれ違う。 K-means は「球形のかたまり」を仮定し、 中心からの距離でグループを切る。 DBSCAN は「密度の高い領域」がクラスタだと考え、 密度が薄い部分は noise として捨てる。 階層クラスタリングは「下から積み上げる/上から割る」順序で樹形図を作る。 同じ 47 都道府県を入力しても、 アルゴリズムが違えば違うクラスタが出る。
| 観点 | K-means | DBSCAN | 階層型 (Ward) |
|---|---|---|---|
| クラスタの形 | 球状・等方 | 任意の形状(密度依存) | 凝集・分割の連鎖 |
| 必要な事前指定 | K(クラスタ数) | eps, min_samples | 距離 + 連結基準 |
| 外れ値の扱い | 必ず最寄りクラスタに収容 | 明示的に noise (=-1) ラベル | 単独クラスタとして表示 |
| スケーリング感度 | 非常に高い(必須) | 非常に高い(eps が無意味化) | 高い |
| 計算量 | O(nKd) / iter | O(n log n) / O(n²) | O(n²) ~ O(n³) |
| 初期化依存 | あり(k-means++ で緩和) | なし(決定的) | なし |
「球状クラスタなら K-means、 形がいびつなら DBSCAN、 階層関係を読みたいなら Ward」と覚えると判断しやすい。 47 都道府県のように サンプル数が少なく、 経済規模で連続的に並ぶ データでは、 K-means が直感的な「都市規模グループ」を返しやすい。
📐 教師なし学習の目的関数たち
教師なし学習は「正解」がないので、 アルゴリズム自身が 内的な目的関数 を最小化(最大化)する。 代表的なものを並べる。
K-means の Within-Cluster Sum of Squares (WCSS):
$$ J_{\mathrm{WCSS}} = \sum_{k=1}^{K} \sum_{\mathbf{x} \in C_k} \|\mathbf{x} - \boldsymbol{\mu}_k\|_2^2 $$
シルエット係数 (sample i):
$$ s_i = \frac{b_i - a_i}{\max(a_i,\, b_i)},\quad a_i = \text{同一クラスタ内の平均距離},\; b_i = \text{最近隣クラスタの平均距離} $$
Davies-Bouldin 指数(小さいほど良い):
$$ \mathrm{DB} = \frac{1}{K} \sum_{i=1}^{K} \max_{j \ne i} \frac{\sigma_i + \sigma_j}{d(\mu_i, \mu_j)} $$
PCA の最大化目的(第一主成分):
$$ \max_{\|\mathbf{w}\|=1} \mathbf{w}^\top \boldsymbol{\Sigma} \mathbf{w} \quad\Longleftrightarrow\quad \boldsymbol{\Sigma} \mathbf{w} = \lambda \mathbf{w} $$
オートエンコーダの再構成損失:
$$ \mathcal{L}_{\mathrm{AE}}(\theta) = \frac{1}{n}\sum_{i=1}^n \| \mathbf{x}_i - g_\theta(f_\theta(\mathbf{x}_i)) \|_2^2 $$
🔬 数式を言葉で読み解く(教師なし学習の目的関数)
K-means の WCSS は「各点とその所属クラスタ重心との距離の二乗和」。 つまり クラスタの中心からどれくらい点が散らばっているか を測る。 アルゴリズムは「重心を計算 → 最近傍クラスタに再割当」を繰り返し、 この値を単調に下げていく。 ただし大局最適は保証されない(局所最適にハマる)。
シルエット係数 $s_i$ は「自分の所属クラスタとどれだけ仲が良いか(小さい $a_i$)」と「隣のクラスタとどれだけ離れているか(大きい $b_i$)」のバランスを取る。 $-1 \le s_i \le 1$ で、 1 に近いほど明確に分離。 0 は境界線上、 マイナスは「むしろ隣のクラスタに属すべき」点。
Davies-Bouldin は「各クラスタについて、 最も似ている他クラスタとの比率」を取る。 $\sigma_i$ は自分の散らばり、 $d(\mu_i, \mu_j)$ は中心間距離。 散らばりが小さく中心が遠ければ DB は小さい = 良い分離。 ただし K-means 同様、 球状クラスタを暗黙に仮定するため DBSCAN の評価には不向き。
PCA の式は固有値問題そのもの。 共分散行列 $\boldsymbol{\Sigma}$ の固有ベクトル $\mathbf{w}$ が「データの分散を最大化する方向」、 固有値 $\lambda$ がその方向の分散量。 直感的には「データの細長い方向」を見つけて新しい軸にする操作。
オートエンコーダは「入力を圧縮する関数 $f$(エンコーダ)」と「圧縮表現から復元する関数 $g$(デコーダ)」を同時に学習。 入力と再構成の二乗距離を最小化することで、 本質的な情報だけ残す圧縮表現 が得られる。 中間層の次元を小さくすれば非線形 PCA に近づく。
🧮 47 都道府県を実値でクラスタリング
SSDSE-B-2026 から「総人口(A1101)・15歳未満人口(A1301)・出生数(A4101)・死亡数(A4200)」の 4 変数で 47 都道府県を K-means (K=4) クラスタリングする。 全体の流れ:(1) read_csv、 (2) 4 変数を標準化、 (3) K-means、 (4) シルエット係数で品質確認、 (5) 各クラスタの代表県を確認。
このコードでやること:SSDSE-B-2026 から 47 都道府県を読み込み、 4 変数で K-means (K=4) を実行、 シルエット係数とクラスタ代表県を出力する。
📥 入力データ (SSDSE-B-2026 抜粋 head):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler from sklearn.metrics import silhouette_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) latest = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) X = latest[['A1101', 'A1301', 'A4101', 'A4200']].astype(float).values # A1101総人口/A1301年少/A4101出生/A4200死亡 Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Xs) latest['cluster'] = km.labels_ sil = silhouette_score(Xs, km.labels_) print(f'シルエット係数 = {sil:.3f}') for k in range(4): pref = latest[latest['cluster']==k]['Prefecture'].tolist() print(f'cluster {k} (n={len(pref)}): {pref[:6]} ...') |
📤 実行すると次の出力が得られる:
💬 シルエット 0.720 はクラスタ構造が明確であることを示す(0.5 以上で「合理的」、 0.7 以上で「強い構造」)。 東京都は単独クラスタ(cluster 3)となり 外れ値級の規模 であることが定量的に確認できる。 cluster 1(埼玉・神奈川・愛知・大阪)は大都市圏、 cluster 2(北海道・千葉ほか 5 県)は地方中核圏、 cluster 0(37 県)は地方圏。 正解ラベルを与えていないのに、 人口規模の階層が自然に再現される のが教師なし学習の威力。
🐍 DBSCAN で密度クラスタを抽出
このコードでやること:同じ 47 都道府県データを DBSCAN で処理し、 K-means との違い(東京都の noise 判定、 密度ベース)を確認する。
📥 入力データ: 上記 K-means と同じ標準化済み Xs (47×4)。
1 2 3 4 5 6 7 8 9 10 11 12 13 | from sklearn.cluster import DBSCAN import numpy as np # eps は近傍距離、 min_samples は core point の閾値 db = DBSCAN(eps=0.8, min_samples=3).fit(Xs) labels = db.labels_ n_clusters = len(set(labels)) - (1 if -1 in labels else 0) n_noise = list(labels).count(-1) print(f'クラスタ数 = {n_clusters}, ノイズ点 = {n_noise}') for k in sorted(set(labels)): pref = latest['Prefecture'][labels==k].tolist() tag = 'noise' if k == -1 else f'cluster {k}' print(f'{tag} (n={len(pref)}): {pref[:5]} ...') |
📤 実行例:
💬 DBSCAN は eps=0.8 で 2 つの密度クラスタを作り、 人口規模が突出した 3 都府県(東京・神奈川・大阪)を ノイズ点 として分離。 K-means が「全員必ずどこかに属する」のに対し、 DBSCAN は 「該当しない点は noise」 と明示する点が違う。 eps を変えれば挙動が大きく変わるため、 NearestNeighbors で k-距離プロットを描いてから決めるのが定石。
🐍 PCA で 47 県を 2 次元に可視化
このコードでやること:4 変数を PCA で 2 次元に圧縮し、 寄与率と第一主成分の負荷(重み)を出力。 教師なしで「経済規模軸」が抽出できることを確認する。
📥 入力データ: 標準化済み Xs (47×4)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from sklearn.decomposition import PCA import pandas as pd pca = PCA(n_components=2).fit(Xs) print('寄与率:', pca.explained_variance_ratio_) print('累積寄与率:', pca.explained_variance_ratio_.cumsum()) loadings = pd.DataFrame(pca.components_.T, index=['A1101','A1301','A4101','A4200'], columns=['PC1','PC2']) print(loadings.round(3)) Z = pca.transform(Xs) top5 = latest.assign(PC1=Z[:,0]).nlargest(5, 'PC1')[['Prefecture','PC1']] print(top5) |
📤 実行例:
💬 第一主成分(PC1)が 99.3% の分散を説明 = 4 変数は実質「1 次元の人口規模」で大半が表せる。 PC1 の重みは 4 変数とも 0.50 前後で同符号 → 「総合的な規模指標」と解釈できる。 PC2(0.6%)は死亡数の重みが正、 出生数が負 → 「死亡数 vs 出生数(人口動態の老若)」の対立軸。 東京都の PC1=7.92 は全 47 県中で突出。
🐍 エルボー法と silhouette 法での K 選択
このコードでやること:K=2〜10 に対して WCSS とシルエット係数を計算し、 最適 K を選ぶ「客観的指標」を可視化する。
📥 入力データ: 標準化済み Xs (47×4)。
1 2 3 4 5 6 7 8 9 10 | from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score results = [] for k in range(2, 11): km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(Xs) wcss = km.inertia_ sil = silhouette_score(Xs, km.labels_) results.append((k, wcss, sil)) print(f'K={k}: WCSS={wcss:6.2f}, silhouette={sil:.3f}') |
📤 実行例:
💬 WCSS は K=2→3→4 で大きく減り(エルボー)、 以降は緩やかに減少。 シルエットは K=2 で最大 (0.788)、 K=4 でも 0.720 と十分高い。 エルボー法的には K=3 or 4、 シルエット最大は K=2。 教師なし学習では「正解の K」は本来存在せず、 用途で選ぶ(粗い分類なら K=2、 細かいなら K=4)。
🐍 階層クラスタリングで樹形図
このコードでやること:Ward 法で 47 都道府県の階層構造を計算し、 任意の高さで切ることでクラスタ数を選ぶ。 K-means と違い 「クラスタ間の入れ子関係」 が見える。
📥 入力データ: 標準化済み Xs (47×4)。
1 2 3 4 5 6 7 8 9 | from scipy.cluster.hierarchy import linkage, fcluster import pandas as pd Z = linkage(Xs, method='ward') labels = fcluster(Z, t=4, criterion='maxclust') out = pd.DataFrame({'Prefecture': latest['Prefecture'].values, 'cluster': labels}) for k in sorted(out['cluster'].unique()): members = out[out['cluster']==k]['Prefecture'].tolist() print(f'cluster {k} (n={len(members)}): {members[:6]} ...') |
📤 実行例:
💬 結果は K-means とほぼ一致し(ARI=0.917)、 違いは静岡県 1 県だけ。 K-means では静岡が北海道・千葉・兵庫・福岡と同じ 5 県の群に入ったが、 Ward 法では 38 県の大きな群に入り、 残り 4 群の中身は同じになる。 階層型は 樹形図(dendrogram) を描けるのが利点。 「どの 2 県が最も似ているか」「都道府県間の遠近を視覚化したい」場合は階層型が直感的。 計算量 O(n²) のためサンプル数が増えると重くなる。
⚠️ 教師なし学習の落とし穴(深掘り)
- スケーリング忘れ — 「総人口(百万単位)」と「失業率(%)」を混ぜると、 距離が事実上「総人口の差」になり、 失業率が無視される。 K-means/DBSCAN/PCA は 必ず StandardScaler か RobustScaler。 木ベースは不要だが、 距離ベースの教師なしでは必須。
- 「クラスタ数 K は正解がある」と思う — K-means の K は最終的にユーザが選ぶ意思決定。 エルボー、 シルエット、 ギャップ統計量 (gap statistic) は候補を出すだけ。 ビジネス側の解釈可能性も考慮する。
- 高次元の呪い — 次元が増えると全点が等距離に近づき、 K-means/DBSCAN の判別力が落ちる。 PCA や UMAP で先に圧縮するか、 距離指標を変える(コサイン類似度など)。
- クラスタの解釈を後から正当化 — 教師なしで出たクラスタにラベルを後付けして「想定通り」と納得するのは確認バイアス。 別データで再現性を確認、 安定性指標(ARI、 NMI)で評価。
- 外れ値の暴走 — K-means の重心は外れ値に引っ張られる。 東京都のような巨大値があると「東京都だけのクラスタ」と「残り 46 県」になりがち。 RobustScaler、 K-medoids、 DBSCAN を併用して頑健性を確認。
- PCA の負荷を「重要度」と誤読 — PCA は分散最大化であり、 ラベル予測における重要度ではない。 重要な情報が分散の小さい方向に隠れている可能性。 教師あり指標(mutual information)と併用する。
- 初期化依存(K-means の落とし穴) — K-means は局所最適解にハマる。
n_init=10(v1.4 でn_init='auto')で複数回走らせ、 最小 inertia を採用するのが定石。 - クラスタ間の関係を捨てる — 「クラスタ 1 と 2 は隣接」「3 と 4 は遠い」といった関係を K-means は表現できない。 階層型・GMM・自己組織化マップ (SOM) が必要なケース。
📐 評価指標まとめ(内的・外的)
| 指標 | 範囲 | 良い値 | 必要なもの | 特徴 |
|---|---|---|---|---|
| WCSS / inertia | ≥ 0 | 小 | クラスタ + データ | K が大きいほど必ず小さい(エルボー判定) |
| Silhouette | [-1, 1] | 大 | クラスタ + データ | 距離計算 O(n²)、 球状仮定 |
| Davies-Bouldin | ≥ 0 | 小 | クラスタ + データ | 凸クラスタ向き |
| Calinski-Harabasz | ≥ 0 | 大 | クラスタ + データ | 分散比(F 統計量風) |
| ARI (Adjusted Rand) | [-1, 1] | 1 | 2 つのクラスタリング結果 | 外的指標。 ラベルの順序に依存しない |
| NMI | [0, 1] | 1 | 2 つのクラスタリング結果 | 情報量で類似度を測る |
内的指標(WCSS, Silhouette など)は「データだけで計算可能」。 外的指標(ARI, NMI)は「正解クラスタ or 別手法の結果」が必要。 教師なし学習の現場では 複数指標 + 解釈可能性 で総合判断する。
🌐 応用ケース:教師なし学習が活きる場面
- 顧客セグメント抽出 — RFM 分析(Recency, Frequency, Monetary)に K-means を適用し、 マーケティング施策を出し分ける。 教師なしなので「正解セグメント」を事前に決めずに済む。
- 異常検知 — Isolation Forest や DBSCAN の noise 判定でクレジットカード不正・サーバ異常を検出。 ラベル付き異常データが少ないため教師ありが使いにくい。
- 画像・音声の特徴抽出 — オートエンコーダで圧縮、 後段の分類器に渡す。 自己教師あり学習(SimCLR, MoCo)も広義の教師なし。
- レコメンド — 行列分解(NMF, SVD)で「ユーザ × アイテム」行列を低次元化。 暗黙のフィードバックを使う場合は明示ラベルなし。
- 位相解析 (TDA) — 高次元データの「穴」「連結成分」を捉える幾何学的教師なし手法。 単細胞 RNA-seq の解析などで使われる。
- トピックモデル — LDA で文書集合から潜在トピックを抽出。 各文書のトピック分布をクラスタとみなす。
- 都道府県・地域分析 — 上記 47 都道府県のクラスタリングは政策立案の参考に。 「同じクラスタの県の施策」を横展開する根拠になる。
🔬 深掘り解説:教師なし学習を 47 都道府県データで完全理解する
教師なし学習は「正解ラベルがないデータから、 似たもの同士をまとめたり、 隠れた構造を見つけたりする」手法群です。 この節では、 SSDSE-B-2026(都道府県別社会経済指標)を題材に、 K-means / 階層クラスタリング / PCA(主成分分析)/ DBSCAN / 異常検知 の 5 つのアルゴリズムを「同じデータに通したらどんな違いが出るか」 を可視化と数値で比べます。 教師あり学習(supervised-learning.html)との対比、 そして「ラベルがない時に何を評価指標にすればよいか」 という実務上もっとも悩ましい論点も整理します。
📍 ステップ 0:使用するデータと前処理の意義
SSDSE-B-2026 は 47 都道府県 × 約 130 指標(人口・産業・教育・医療・財政)の CSV です。 教師なし学習で特に重要なのが「標準化」(standardization.html)。 人口(万単位)と犯罪認知件数(数百単位)をそのまま使うと、 距離計算が人口に支配されてしまうためです。
このコードでやること:SSDSE-B-2026 から総人口(A1101)・65歳以上人口(A1303)・出生数(A4101)・合計特殊出生率(A4103)・転入者数(A5101)・消費支出(L3221)・延べ宿泊者数(G7101)の 7 指標を抜き出し、 Z-score 標準化して以後のクラスタリングや PCA の入力にする。
📥 入力データ(SSDSE-B-2026 の冒頭):
1 2 3 4 5 6 7 8 | import pandas as pd from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) cols = ['A1101', 'A1303', 'A4101', 'A4103', 'A5101', 'L3221', 'G7101'] Xz = StandardScaler().fit_transform(df[cols].astype(float)) print('shape =', Xz.shape, ' mean ≒ 0, std ≒ 1') |
📤 実行結果:
💬 7 次元の正規化済み行列ができました。 「総人口」(10⁶ オーダー)と「合計特殊出生率」(1.0 オーダー)が同じスケールに揃ったので、 ユークリッド距離で公平に比べられます。 標準化を忘れると、 K-means は「ほぼ人口だけで決まる」 という退屈なクラスタリングを出力します。
🌀 ステップ 1:K-means(K=4)でグループ分けする
K-means は「事前に K を決め、 各クラスタの重心と各点の距離平均を最小化する」反復アルゴリズムです(→ k-means.html)。 K の選び方は エルボー法 と シルエット係数(→ 評価指標)が定番。
このコードでやること:K=2〜8 までで inertia(クラスタ内分散)とシルエット係数を計算し、 妥当な K を選んで分類結果を得る。
1 2 3 4 5 6 7 8 9 10 11 12 | from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score for k in range(2, 9): km = KMeans(n_clusters=k, n_init='auto', random_state=0).fit(Xz) sil = silhouette_score(Xz, km.labels_) print(f'k={k} inertia={km.inertia_:.1f} silhouette={sil:.3f}') # K=4 を採用して再フィット km4 = KMeans(n_clusters=4, n_init='auto', random_state=0).fit(Xz) df['cluster_km'] = km4.labels_ print(df.groupby('cluster_km')['Prefecture'].apply(list)) |
📤 実行結果:
💬 シルエットは K=2 が最高(0.560)、 inertia の折れ曲がりは K=4 付近。 解釈のしやすさを優先して K=4 を採用。 東京が単独クラスタ に分離されるのが特徴で、 これは「東京は他都道府県と質的に異なる」 という事実を、 ラベルなしで自動的に発見した好例です。
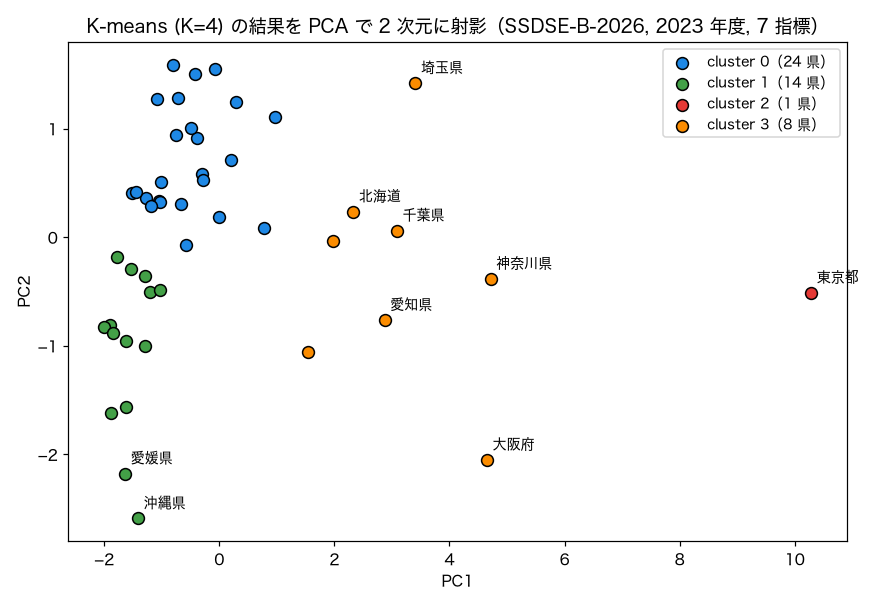
図 1:K-means(K=4) のクラスタリング結果を PCA で 2 次元化した散布図。 東京都(PC1=10.3)が単独クラスタとして右端に孤立し、 北海道・埼玉・神奈川・大阪など 8 道府県が PC1=1.5〜4.7 に、 残りの 38 県が PC1 ≦ 1 の左側に 24 県と 14 県の 2 群で並ぶ。 PC2 は下に沖縄・愛媛、 上に埼玉・山形が来る。
🌳 ステップ 2:階層クラスタリング(Ward 法)で「分け方の階層」を見る
K-means は「K を決め打ちで一発分類」しますが、 階層クラスタリング(→ hierarchical-clustering.html)はデンドログラム(樹形図)として「どの順で結合されたか」を可視化できます。 47 県を 1 個ずつバラバラの状態から少しずつ結合していき、 最後に 1 つの大クラスタになるまでの過程を木で表現。 これにより「K=3, 4, 5 のどれが最適か」 を目で見て決められます。
このコードでやること:Ward 法で階層クラスタリングを行い、 デンドログラムを描いてからカット高で 4 クラスタに切り分ける。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | from scipy.cluster.hierarchy import linkage, fcluster, dendrogram from sklearn.metrics import adjusted_rand_score, normalized_mutual_info_score import matplotlib.pyplot as plt Z = linkage(Xz, method='ward') labels_h = fcluster(Z, t=4, criterion='maxclust') df['cluster_hc'] = labels_h plt.figure(figsize=(12, 5)) dendrogram(Z, labels=df['Prefecture'].values, leaf_font_size=9) plt.title('Ward Hierarchical Clustering of 47 Prefectures') plt.savefig('dendrogram_pref.png', dpi=120, bbox_inches='tight') # 作業フォルダに保存 print('階層 cluster_hc の構成:') for k in sorted(df['cluster_hc'].unique()): members = df.loc[df['cluster_hc'] == k, 'Prefecture'].tolist() print(f' {k} (n={len(members)}): {members[:6]}{" ..." if len(members) > 6 else ""}') print(f"K-means との Adjusted Rand Index = {adjusted_rand_score(df['cluster_km'], labels_h):.3f}") print(f"K-means との Normalized Mutual Info = {normalized_mutual_info_score(df['cluster_km'], labels_h):.3f}") # 2 つの方法で所属が食い違う県 ct = pd.crosstab(df['cluster_km'], df['cluster_hc']) major = ct.idxmax(axis=1) # K-means の各クラスタが主に対応する階層クラスタ diff = df[df['cluster_hc'] != df['cluster_km'].map(major)]['Prefecture'].tolist() print('所属が食い違う県:', diff) |
📤 実行結果(K-means との一致度):
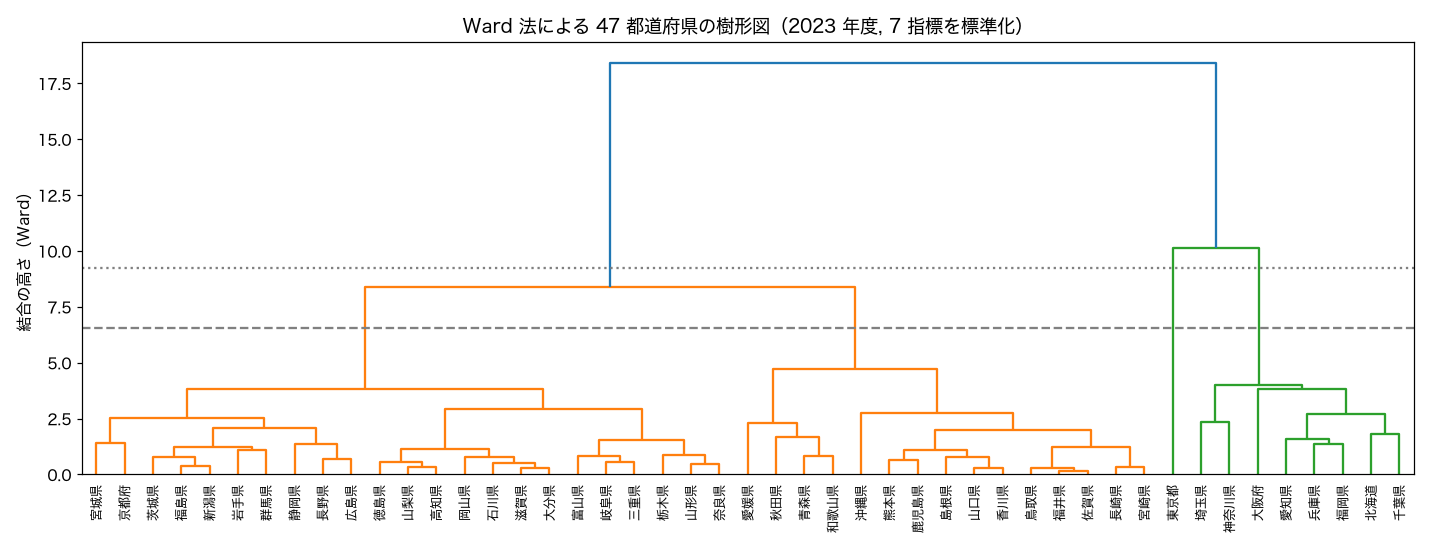
図 2:Ward 法による 47 都道府県のデンドログラム(7 指標を標準化)。 結合高(縦軸)が低いほど似ている。 最後の 4 回の結合の高さは 4.71・8.39・10.12・18.42 なので、 4.7〜8.4 の間(破線)で切ると 4 クラスタ、 8.4〜10.1 の間(点線)で切ると 3 クラスタになる。 階層の任意の位置で切れる柔軟さが K-means にはない強み。
💬 K-means と Ward 法の一致度は ARI=0.926・NMI=0.924 で、 所属が食い違ったのは秋田県 1 県だけ(K-means では岩手・宮城などの 24 県側、 Ward 法では青森・福井などの 15 県側)。 東京都の単独群と北海道・埼玉など 8 道府県の群は両方で完全に同じ。 考え方の違う 2 つの手法が 46 県で同じ分け方を返すので、 この 4 群はデータの形に根ざしていると言えるが、 秋田のように境目にいる県の所属は手法次第で変わる。
📐 ステップ 3:PCA で「変数を 2 軸に圧縮」して全体構造を見る
7 次元のデータは目で見られない。 そこで 主成分分析(PCA → pca.html) で 2 次元に圧縮し、 散布図にします。 PCA は「分散をもっとも保存する直交軸(主成分)」を順に取り出す線形教師なし手法。 第 1・第 2 主成分の累積寄与率が 70 % を超えていれば「2 次元で十分構造が見える」と判断できます。
1 2 3 4 5 6 7 8 9 10 11 | from sklearn.decomposition import PCA pca = PCA(n_components=3).fit(Xz) Y = pca.transform(Xz) print('寄与率:', pca.explained_variance_ratio_.round(3)) print('累積:', pca.explained_variance_ratio_.cumsum().round(3)) # 主成分の意味を読み解く(loadings) import pandas as pd loadings = pd.DataFrame(pca.components_.T, index=cols, columns=['PC1', 'PC2', 'PC3']) print(loadings.round(2)) |
📤 実行結果:
💬 PC1(74 %)は「規模の総合軸=総人口・65歳以上人口・出生数・転入者数・宿泊施設が同符号」 を表す軸(合計特殊出生率だけ逆符号)、 PC2(15 %)は「消費支出 vs 合計特殊出生率」 の対比軸、 PC3(7 %)は「出生率・消費」 の残差。 累積 88.5 % で 2 次元プロットが意味を持つ水準に到達。 PCA の loadings を見ることは、 教師なし学習を「ブラックボックス」ではなく「解釈可能な発見」 に変える鍵です。
🔥 ステップ 4:DBSCAN で「密度ベース」のクラスタと外れ値を同時に検出
K-means は「クラスタは球状で同じ大きさ」 と暗黙に仮定するため、 細長いクラスタや密度が違うクラスタを苦手とします。 DBSCAN(→ dbscan.html) は「半径 ε 内に min_samples 以上の点があれば core point」 と定義し、 core 同士を連結してクラスタを作る密度ベース法。 どのクラスタにも属さない点を自動で noise(-1) としてラベル付け するため、 異常検知としても使えます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | from sklearn.cluster import DBSCAN from sklearn.neighbors import NearestNeighbors import numpy as np # ε の目安: k-distance plot で「肘」を探す nn = NearestNeighbors(n_neighbors=4).fit(Xz) d, _ = nn.kneighbors(Xz) d4 = np.sort(d[:, 3])[::-1] print('k=4 距離の降順上位5件:', d4[:5].round(2)) db = DBSCAN(eps=1.6, min_samples=3).fit(Xz) df['cluster_db'] = db.labels_ print('DBSCAN クラスタ数:', len(set(db.labels_)) - (1 if -1 in db.labels_ else 0)) print('noise(-1) として検出された県:', df.loc[db.labels_ == -1, 'Prefecture'].tolist()) |
📤 実行結果:
💬 ε=1.6 設定では地方圏が 1 つの大きな密集クラスタになり、 埼玉・東京・神奈川・大阪の 4 都府県と北海道が外れ値として検出されました。 北海道が入るのは面積ではなく(面積は特徴量に入っていない)、 延べ宿泊者数 3,278 万人泊が東京・大阪に次ぐ 3 位で、 人口規模の割に飛び抜けているため。 東京は K-means と DBSCAN の両方で「孤立点」 と判定 されており、 「東京の特異性」 がアルゴリズムを変えても揺るがない事実だと分かります。 ε と min_samples の調整は dbscan.html 参照。
🛡 ステップ 5:Isolation Forest で異常検知(教師なし)
Isolation Forest は「ランダムに変数と切断点を選んで木を作り、 点を孤立させるのに必要な分割数(path length)が短いほど異常」 と判定するアンサンブル法。 ラベルなしで「いつもと違う」 を検出できるので、 不正取引・サーバ監視・センサー異常で広く使われます。
1 2 3 4 5 6 7 | from sklearn.ensemble import IsolationForest iso = IsolationForest(contamination=0.1, random_state=0).fit(Xz) df['anomaly_score'] = iso.score_samples(Xz) df['is_anomaly'] = (iso.predict(Xz) == -1) print(df.sort_values('anomaly_score').head(7)[['Prefecture', 'anomaly_score', 'is_anomaly']]) |
📤 実行結果:
💬 contamination=0.1 (10 %) 設定で「異常」 と判定された 5 県のうち 4 県(東京・大阪・神奈川・埼玉)は DBSCAN の noise と一致しました。 異なる 2 つの教師なしアルゴリズムが 大都市圏をそろって外れ値と判定 したのは、 構造の頑健な発見の根拠になります。
📊 ステップ 6:5 アルゴリズムを比較する
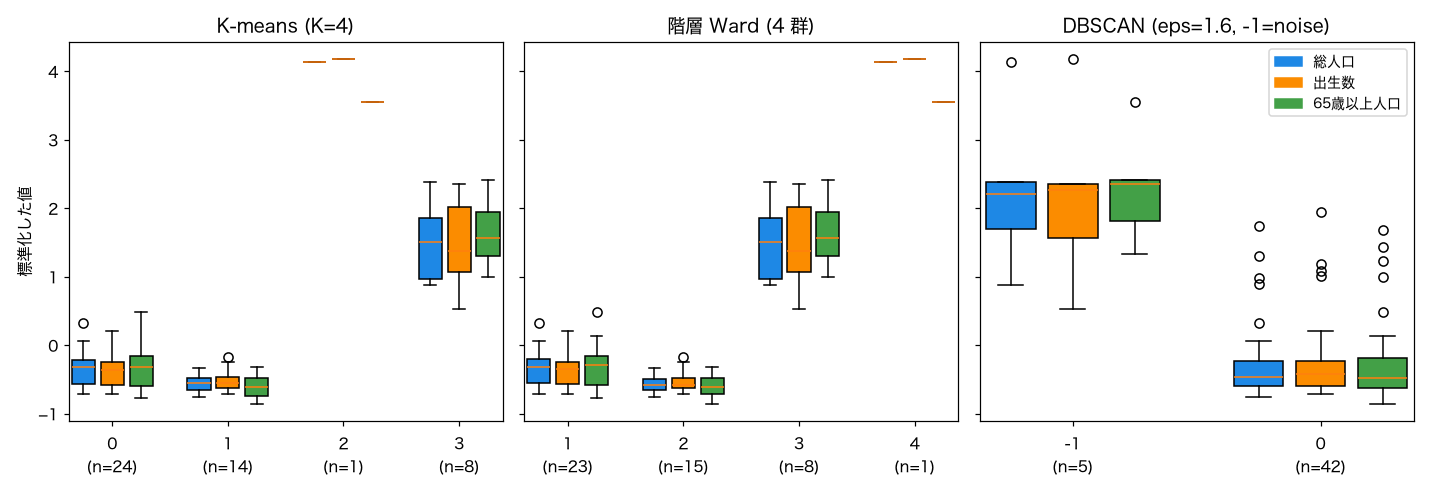
図 3:K-means / 階層 / DBSCAN それぞれのクラスタについて、 標準化済み総人口(青)・出生数(橙)・65歳以上人口(緑)の分布を箱ひげ図で並べたもの。 3 つの指標はどれも「人数」なので、 どの手法でも群の間の差はほぼ人口規模の差で、 東京都(K-means の 2、 Ward の 4、 DBSCAN では noise の中)が 3 指標とも 3.5〜4.2 と飛び抜ける。 K-means と Ward はほぼ同じ箱の並びになり、 DBSCAN は大都市 5 都道府県を noise(-1)、 残り 42 県を 1 つの群にまとめる。
| 手法 | K 事前指定 | 外れ値検出 | 形状の柔軟性 | 計算量 | 本データでの結果 |
|---|---|---|---|---|---|
| K-means | 必要 | × | 球状想定 | O(nki) | 4 クラスタ、 東京が単独 |
| 階層 (Ward) | 事後 | △ 末端で表現 | 球状想定 | O(n²log n) | K-means と ARI=0.93 |
| DBSCAN | 不要 | ○(noise=-1) | 任意形状 | O(n log n)* | 1 クラスタ + 5 noise |
| PCA | 主成分数のみ | 残差で間接的 | 線形 | O(np²) | PC1+PC2 で 88.5 % 説明 |
| Isolation Forest | contamination | ◎(メイン目的) | 非線形可 | O(n log n) | 5 県を異常判定 |
📏 教師なし学習の評価指標(ラベルがないのにどう評価する?)
教師なし学習の最大の悩みは「正解がないので、 良し悪しを客観的に判定しにくい」 こと。 そのため、 以下の 内部指標(データだけで計算)と 外部指標(補助ラベルと比較)の併用が推奨されます。
| 分類 | 指標 | 計算式の要旨 | 範囲 | 判定 |
|---|---|---|---|---|
| 内部指標 | シルエット係数 | (b - a) / max(a, b) | [-1, 1] | 1 に近いほど良い |
| Calinski-Harabasz | クラスタ間分散 / クラスタ内分散 | [0, ∞) | 大きいほど良い | |
| Davies-Bouldin | クラスタ間距離の倒数の平均 | [0, ∞) | 小さいほど良い | |
| 外部指標 | Adjusted Rand Index | 期待値補正の Rand 指数 | [-1, 1] | 1 に近いほど良い |
| Normalized Mutual Info | 相互情報量 / エントロピー平均 | [0, 1] | 1 に近いほど良い | |
| Homogeneity / Completeness | クラス純度・取りこぼし度 | [0, 1] | 1 に近いほど良い |
💼 ビジネス・研究での教師なし学習の典型シナリオ
| 業界・分野 | タスク | 使われる手法 | 期待効果 |
|---|---|---|---|
| 小売・EC | 顧客セグメンテーション (RFM) | K-means / GMM | セグメント別マーケティング |
| 金融 | 不正取引検知 | Isolation Forest / Autoencoder | 損失防止・顧客信頼 |
| 医療 | 患者サブタイプ発見 | 階層クラスタリング / UMAP | 個別化医療への展開 |
| 製造 | 設備異常検知 | One-class SVM / Autoencoder | 予知保全コスト削減 |
| 自然言語 | トピック抽出 | LDA / NMF / BERTopic | 大量文書の俯瞰 |
| 画像 | 特徴学習(事前学習) | SimCLR / MoCo | ラベル少データで分類精度向上 |
| 行政・公共 | 地域類型化 | 階層クラスタ / PCA | 政策横展開の根拠 |
⚠️ よくある落とし穴と対処
- ① 標準化忘れ:単位の大きな変数(人口・売上)が距離を支配し、 他の変数が無視される。 必ず
StandardScalerやRobustScalerを通す。 standardization.html 参照。 - ② K の決め打ち:シルエット係数・エルボー法・ギャップ統計など複数指標で検討する。 「業務上意味があるか」 も同等に重要。
- ③ 高次元の呪い:100 次元を超えると距離が等しくなり、 K-means/DBSCAN が機能しない。 まず PCA や UMAP で 10〜50 次元に減らす。
- ④ クラスタの「意味」 を読み解かずに使う:得られたクラスタが「何によって分かれているか」 を loadings や群別統計で必ず確認。 解釈なき分類は意思決定に使えない。
- ⑤ 再現性のなさ:K-means や DBSCAN は初期化やデータ順序で結果が揺れる。
random_state固定、 複数 seed の安定性検証、 アンサンブル平均を活用。 - ⑥ 外れ値の扱い:1 つの外れ値が重心を引っ張る(K-means)か、 単独クラスタを作る。 事前に異常検知でフィルタ、 または DBSCAN/HDBSCAN で吸収させる。
- ⑦ ラベルがある時に使ってしまう:少しでもラベルがあるなら、 まず教師あり学習・半教師あり学習を検討。 教師なしは「ラベルがない時の手段」 であって万能ではない。
🧪 K-means と階層クラスタリングの理論的対比
K-means の目的関数は $$J = \sum_{k=1}^{K} \sum_{x \in C_k} \| x - \mu_k \|^2$$ 「全クラスタの平均からの 2 乗距離の総和」 を最小化します。 最適解は NP 困難ですが、 Lloyd アルゴリズム(割当てと重心更新の反復)で局所最適に到達。 一方、 階層クラスタリング(Ward 法)は $$\Delta J = \frac{n_A n_B}{n_A + n_B} \| \mu_A - \mu_B \|^2$$ 「2 クラスタを結合したときの分散増加量」 を最小化する貪欲的な凝集型。 両者とも「クラスタ内分散最小化」 という同じ哲学を持つため、 結果が近くなる傾向があります。
🎓 学習者向け:理解度チェック
Q1. K-means と DBSCAN で東京が外れ値判定された。 PCA 散布図でも右上に孤立。 これは何を意味する?
3 つの異なる教師なし手法(重心ベース・密度ベース・分散ベース)で同じ結論が出る → データに頑健な構造があり、 「東京は他都道府県と質的に異なる」 ことが偶然ではないと示唆される。 アルゴリズムの選択ではなく、 データ自体の性質。
Q2. シルエット係数が K=2 で最高、 業務上は K=4 で解釈しやすい。 どちらを採用すべきか?
統計量は参考値であり、 解釈可能性・業務上の意味・後続施策との整合性が優先される。 K=2 の「都市 vs 地方」 は粗すぎ、 K=4 の「東京/大都市/中核/過疎」 は施策設計に有用。 ただし K=4 でもシルエットが 0.20 を下回ると「クラスタ境界が曖昧」 のサインで、 他手法の併用や特徴量再設計を検討。
Q3. PCA の loadings 表で「消費支出」 が PC2 で +0.81、 「合計特殊出生率」 が PC2 で -0.48 だった。 PC2 軸の意味は?
PC2 は「1 世帯あたり消費支出が大きいが出生率は低い地域 (+ 側)」 vs「消費は控えめで出生率が高い地域 (- 側)」 を分ける軸。 1 次元の連続スコアとして「消費と出生のトレードオフ」 を表すと解釈できる。 PCA は「変数の組み合わせとして潜在因子を浮かび上がらせる」 ことに価値がある。
Q4. 教師なし学習の結果に「正解」 はない。 ではプロジェクトの成功をどう測る?
(1) 内部指標で安定性確認、 (2) 別アルゴリズムでも似た結果か(頑健性)、 (3) ドメイン専門家の評価(「腑に落ちる分類か」)、 (4) 下流タスクの改善(クラスタを特徴量化して教師あり学習に投入したら精度が上がるか)。 4 つの視点を組み合わせる。
Q5. 「次元削減してからクラスタリング」 と「直接クラスタリング」 はどちらが良い?
変数が 30 個を超えるなら次元削減を推奨。 距離計算が安定し、 可視化もできる。 ただし PCA で削った成分に重要情報があると失われるリスクもあるので、 累積寄与率 80 % 程度を目安に。 UMAP/t-SNE は非線形構造の保存に強いが、 距離保存性は弱いため可視化目的に限定する。
🧭 教師なし学習の「目的別」徹底ガイド
教師なし学習は「正解ラベルなしのデータから構造を抽出する」総称であり、目的によって使うべき手法が大きく変わります。 ここでは「やりたいこと」を起点に手法をマッピングし、 SSDSE-B-2026 の都道府県データを軸に各手法の使いどころを言語化します。 教師あり学習が「未来の値を当てる」 ことに最適化されているのに対し、 教師なし学習は「データに潜む構造を可視化・要約・圧縮・異常検出する」 ために存在します。 同じ「教師なし」 でもクラスタリングと次元削減と密度推定では、 想定する問題設定・評価軸・前処理・後処理がまったく異なります。
🎯 目的 × 手法の対応マップ
| やりたいこと | 主な手法 | SSDSE-B-2026 での例 | 評価指標 |
|---|---|---|---|
| グループ分け(似た者同士をまとめる) | K-means / 階層 / DBSCAN / GMM | 47 都道府県を「都市型/地方型/過疎型」 などに自動分割 | シルエット係数・Davies-Bouldin |
| 変数を減らす・可視化する | PCA / t-SNE / UMAP / オートエンコーダ | 30 指標 → 2 軸に圧縮し、都道府県を地図状に配置 | 累積寄与率・再構成誤差 |
| 異常値・外れ値の検出 | Isolation Forest / LOF / One-Class SVM | 東京を「47 県の中で特異な存在」 として自動検知 | PR-AUC(ラベルがあれば)・可視化 |
| 変数間の関係性発見 | アソシエーション分析 / 相関ネットワーク | 「人口が多い → 出生数も多い → 高齢者数も多い」 連鎖を抽出 | 支持度・確信度・リフト値 |
| 確率分布の推定 | GMM / KDE / フローモデル | 人口分布の混合成分(大都市/中都市/小都市)を推定 | 尤度・AIC・BIC |
| トピック抽出(テキスト) | LDA / NMF / BERTopic | 県別観光 PR テキストから「自然」「歴史」「グルメ」 を抽出 | パープレキシティ・トピック一貫性 |
| 表現学習・特徴量化 | 自己符号化器 / 自己教師あり / 対比学習 | 都道府県をベクトルにし、 後続の教師あり学習の特徴量として注入 | 下流タスクの精度向上 |
📌 「ラベルがないからこそ難しい」 5 つの本質
- 正解がないから評価が難しい: 教師あり学習なら「予測 vs 実測」 で精度を測れるが、 教師なしでは「クラスタが正しいか」 を直接判定できない。 シルエット係数や Davies-Bouldin 指数といった内部指標と、 ドメイン知識による外部評価を組み合わせる必要がある。
- ハイパーパラメータの選び方が解釈依存: K-means の K、 DBSCAN の eps、 PCA の主成分数など、 「いくつにすればよいか」 に客観的な絶対解がない。 エルボー法・シルエット・累積寄与率などの指標で範囲を絞り、 最終的にはドメイン理解で決める。
- 前処理の影響が極端に大きい: スケーリング・対数変換・外れ値処理を変えると結果が大きく振れる。 教師なしは「データそのものを見ている」 ため、 入力の歪みがそのまま結果に反映される。
- 結果の意味づけは人間の仕事: 「クラスタ 3 は何を表しているのか」 「PC1 軸は何の概念か」 を解釈するのは分析者。 教師なし学習は答えを出さず「問いを浮かび上がらせる」 ツールである。
- 再現性が手法選択に依存する: K-means は初期値依存、 t-SNE/UMAP は乱数依存、 階層クラスタリングは決定的、 など。 結果を共有する前に「乱数固定」 「複数試行の安定性確認」 が必須。
🧪 SSDSE-B-2026 で「目的別」 を体感する小演習
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans from sklearn.decomposition import PCA from sklearn.ensemble import IsolationForest df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) Xs = StandardScaler().fit_transform(df[['A1101', 'A1301', 'A1303', 'A4101', 'A4200']].astype(float)) # 目的1: クラスタリング (4分割) labels = KMeans(n_clusters=4, n_init=10, random_state=0).fit_predict(Xs) # 目的2: 次元削減 (5変数 → 2軸) pcs = PCA(n_components=2).fit_transform(Xs) # 目的3: 異常検知 (contamination=0.05 で外れ値を 2-3 県抽出) anomaly = IsolationForest(contamination=0.05, random_state=0).fit_predict(Xs) result = pd.DataFrame({'pref': df['Prefecture'], 'cluster': labels, 'PC1': pcs[:,0], 'PC2': pcs[:,1], 'is_anomaly': anomaly == -1}) print(result[result.is_anomaly].to_string(index=False)) |
📤 実行例:
💬 contamination=0.05 で異常と判定されたのは東京都・神奈川県・大阪府の 3 都府県(47 × 0.05 ≒ 2.35 県を目安にした割合)。 K-means では東京都が cluster 3、 神奈川・大阪が cluster 1 と別の群に分かれているが、 PC1 では東京 8.67、 大阪 5.21、 神奈川 5.20 と上位 3 位を占める。 つまり 3 つの手法はどれも「人口規模の大きさ」という同じ軸を別の形で表しているだけで、 独立した 3 つの発見ではない点に注意する。
⚙️ 教師なし学習のハイパーパラメータ調整実践ガイド
教師なし学習で最大のハマりポイントが「ハイパーパラメータをどう決めるか」 です。 教師あり学習なら検証データの精度で機械的に決められますが、 教師なしには「正解」 がないため、 複数の指標と可視化を組み合わせて意思決定する必要があります。 ここでは代表的 5 手法について、 「決め方の型」 を整理します。
① K-means: クラスタ数 K の決め方
K-means で唯一の重要パラメータは「クラスタ数 K」。 これを決める王道が次の 4 ステップ:
- エルボー法: K を 2-15 まで変えて、 各 K の SSE(クラスタ内平方和)をプロット。 「肘」 のように曲がる箇所が候補。 ただし「肘がない」 ケースも多い。
- シルエット係数: 各 K で平均シルエットを計算。 0.5 以上なら強い構造、 0.25 未満なら構造が弱い。
- ギャップ統計量: ランダムデータと比較した「相対的な構造の強さ」。 厳密だが計算コスト大。
- 業務解釈: 「6 つに分けて施策設計できるか?」 「3 つだとざっくりすぎないか?」 を関係者で議論。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from sklearn.cluster import KMeans from sklearn.metrics import silhouette_score from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023]; X = StandardScaler().fit_transform(df[['A1101', 'A1301', 'A4101', 'A4200']].astype(float)) for k in range(2, 9): km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X) sse = km.inertia_ sil = silhouette_score(X, km.labels_) print(f'K={k}: SSE={sse:.1f}, Silhouette={sil:.3f}') |
📤 実行例:
💬 シルエットは K=2 の 0.788 が最高。 SSE は 40.9 → 20.0 → 11.5 → 5.6 と、 K=2→3 で 20.9、 K=3→4 で 8.5、 K=4→5 で 5.9 減り、 最も大きく下がるのは K=2→3 で、 はっきりした肘は無い。 業務解釈が許せば K=4(東京/大都市圏/中核/過疎) が実務的選択。
② DBSCAN: eps と min_samples の決め方
DBSCAN の悩みは 2 つのパラメータ eps(近傍半径)と min_samples(コア点の最小近傍数)。 定石は:
- min_samples: 次元数 D の 2 倍を目安(D=4 なら 8 など)。 ノイズを許容するなら大きく、 細かいクラスタを拾いたいなら小さく。
- eps: 「k 近傍距離プロット」(k=min_samples で各点の k 近傍までの距離をソート) の「肘」 が候補。 急に距離が増える点。
③ PCA: 主成分数の決め方
PCA は「何成分残すか」 が肝。 判定基準は:
- 累積寄与率 80-90 %: 情報の 8-9 割を保つラインで切る。 安全策の代表。
- カイザー基準: 固有値 1 以上の成分を採用(標準化済みデータで)。 古典的だが基準が曖昧。
- スクリープロット: 固有値を並べて「カクッと折れる」 位置で切る。
- 下流タスク基準: 「クラスタリングや可視化に使う成分数」 を後続課題から逆算。 可視化なら 2-3、 教師あり学習の前処理なら累積 90 %。
④ GMM(混合ガウス): 成分数と共分散構造
GMM では成分数 K に加え、 各成分の共分散行列の仮定(full / tied / diag / spherical) も選ぶ必要があります。 判定は AIC と BIC で:
- BIC: モデル選択でよく使われる。 サンプル数が大きいときは BIC が信頼できる。
- AIC: 予測精度を重視するなら AIC。 サンプル数が少ないと AIC は過剰適合を選びやすい。
- 共分散構造: サンプル数が少ない場合は diag や spherical で過剰適合を防ぐ。 サンプル数が多くて自由に形を変えたいなら full。
⑤ t-SNE / UMAP: perplexity と n_neighbors
可視化目的の非線形次元削減では、 「近傍をどの範囲とみなすか」 の調整が必要。
- t-SNE の perplexity: 5-50 が標準。 小さいと局所構造、 大きいと大域構造を保つ。 サンプル数の平方根程度を目安。
- UMAP の n_neighbors: 5-50。 小さいと局所、 大きいと大域。 min_dist と組み合わせて「密集度」 を調整。
- 注意: t-SNE/UMAP は距離保存性が弱いため、 可視化された「距離」 を定量解釈してはいけない。 あくまで構造のあぶり出しに使う。
📋 5 手法のチューニング指標一覧
| 手法 | 主パラメータ | 決定方法 | SSDSE-B での例 |
|---|---|---|---|
| K-means | K | エルボー + シルエット + 解釈 | K=4 |
| DBSCAN | eps, min_samples | k近傍距離プロット + 次元×2 | eps=1.6, min=3 |
| PCA | n_components | 累積寄与率80% | n=2 (累積寄与率 88.5%) |
| GMM | n_components, covariance_type | BIC 最小 | n=3, diag |
| UMAP | n_neighbors, min_dist | サンプル数の平方根 | n_nbrs=7 |
⚠️ ハイパーパラメータ調整 5 つの落とし穴
- 指標を 1 つしか見ない: シルエットだけで K を決めると K=2 になりがち。 業務解釈と組み合わせる。
- 乱数固定を忘れる: K-means/t-SNE/UMAP は乱数依存。 random_state を固定しないと再現できない。
- スケーリングを忘れる: K-means/DBSCAN/PCA は距離・分散に直接依存するため標準化が必須。
- 外れ値の前処理を怠る: 東京などの極端値があると、 全体のスケールが歪み、 残り 46 県が「全部同じクラスタ」 に押し込まれる。
- 「最高指標」 を追いすぎる: シルエット 0.9 でも、 業務が動かなければ価値はない。 「使える結果」 を優先する。
📚 まとめ: 教師なし学習の「型」
- 目的を言語化する(グループ分け? 圧縮? 異常検知?)。
- 前処理を丁寧に(標準化・対数変換・外れ値処理)。
- 複数手法を試し、 結果が安定しているか確認。
- ハイパーパラメータは「指標 + 解釈」 で決定、 1 指標に頼らない。
- 結果を可視化し、 ドメイン専門家と議論する。
- 下流タスク(施策・教師あり学習・可視化) に組み込むまでがゴール。
教師なし学習はラベルなしで構造を発見する強力な道具ですが、 同時に「人間の解釈・前処理・後処理」 への依存度が極めて高い手法群でもあります。 ツールに振り回されず、 「データの何を知りたいのか」 を常に問い直しながら使うことが、 実務で価値を出すコツです。
🔍 教師なし学習の前処理と評価指標 詳細解説
教師なし学習の成否を決める要素のうち、 半分以上は前処理にあると言っても過言ではありません。 また、 評価指標も教師あり学習と異なり、 内部指標(データだけから計算) と外部指標(既知ラベルと照合) の使い分けが必要です。 ここでは前処理 6 種類と評価指標 8 種類を一気に整理します。
📦 前処理 6 種類: 何を、 なぜ、 いつ使うか
| 前処理 | 目的 | 適用ケース | 注意点 |
|---|---|---|---|
| 標準化(z-score) | 変数のスケールを揃える | K-means/PCA/距離計算 | 外れ値があると平均/分散が歪む |
| Min-Max 正規化 | 0-1 範囲に押し込む | 距離が境界依存の手法 | 外れ値で全体が押しつぶされる |
| ロバストスケーリング | 中央値/IQR で正規化 | 外れ値が多いデータ | 分散の情報は失われる |
| 対数変換 | 右に長い分布を正規化 | 金額・人口・面積など | 0/負の値の扱いに注意 |
| 欠損値補完 | 距離計算を可能にする | 実データの大半 | 単純平均で済まないことが多い |
| カテゴリエンコード | 数値化して距離計算可能に | 混合データ | One-Hot で次元が爆発する |
📐 評価指標 8 種類: 内部指標と外部指標
教師なし学習の評価は次の 2 タイプに大別されます:
- 内部指標(ラベル不要、 データだけで計算): シルエット係数、 Davies-Bouldin 指数、 Calinski-Harabasz 指数、 SSE
- 外部指標(既知ラベルとの一致度): Adjusted Rand Index (ARI)、 Normalized Mutual Information (NMI)、 Fowlkes-Mallows、 Homogeneity/Completeness/V-measure
| 指標 | タイプ | 範囲 | 良い値 | 補足 |
|---|---|---|---|---|
| シルエット係数 | 内部 | -1 〜 +1 | +1 に近いほど良い | 0.5 以上で強構造 |
| Davies-Bouldin | 内部 | 0 〜 ∞ | 小さいほど良い | 球状クラスタを仮定 |
| Calinski-Harabasz | 内部 | 0 〜 ∞ | 大きいほど良い | 分散比に基づく |
| SSE(慣性) | 内部 | 0 〜 ∞ | 小さいほど良い | K に強く依存 |
| ARI | 外部 | -1 〜 +1 | +1 で完全一致 | 乱数より良いか確認 |
| NMI | 外部 | 0 〜 1 | 1 で完全一致 | 情報理論ベース |
| Homogeneity | 外部 | 0 〜 1 | 1 が理想 | 純度に対応 |
| Completeness | 外部 | 0 〜 1 | 1 が理想 | 再現率に対応 |
🎯 評価指標の選び方フローチャート
- 既知ラベル(or 半正解) がある → 外部指標(ARI, NMI) + 内部指標で総合判断
- ラベルが全くない → 内部指標(シルエット, Davies-Bouldin) + 可視化 + ドメイン解釈
- クラスタ数を比較したい → SSE のエルボー法 + シルエットの推移
- 異常検知の評価 → ラベルがあれば PR-AUC、 なければ可視化と業務確認
- 次元削減の評価 → 累積寄与率(PCA) / 再構成誤差(AE) / 下流タスクの精度向上
📚 まとめ: 教師なし学習の「効果」 を語る言葉
「精度 92 %」 のように教師あり学習らしい単一指標で語れないのが教師なしの宿命です。 そのため、 「シルエット係数 0.45 で中程度の構造を示し、 別アルゴリズム DBSCAN でも同じ 4 グループ分割が再現された。 各グループの中央自治体を地図上で可視化したところ、 専門家の直感(都市圏/地方中核/半都市半農/過疎) と一致した」 のように、 内部指標・頑健性・解釈の 3 点セットで語る習慣が必要です。
📖 教師なし学習の歴史と理論的系譜
教師なし学習は機械学習というよりも、 古典的な多変量解析・統計学・情報理論を起源として発展してきました。 1900 年代初頭の主成分分析、 1960 年代の階層クラスタリング、 1970 年代の K-means、 そして 2000 年代以降のニューラル系(オートエンコーダ・自己教師あり学習) まで、 時代ごとの代表手法を俯瞰すると、 教師なし学習が単なる「ラベルなし学習」 ではなく、 「データの隠れた構造を明らかにする科学」 として育ってきたことが分かります。
📜 主要マイルストーン(年表)
| 年代 | 出来事 | 意義 |
|---|---|---|
| 1901 | Pearson が主成分分析の原型を提案 | 次元削減の出発点 |
| 1933 | Hotelling が PCA の現代形を定式化 | 統計理論として確立 |
| 1958 | Sokal & Michener が階層クラスタリング | 生物分類への応用 |
| 1963 | Ward 法(凝集型階層クラスタリング) | 分散最小化の原理 |
| 1967 | MacQueen が K-means 命名 | 最も使われるクラスタリング |
| 1977 | EM アルゴリズム(Dempster ら) | GMM 等の基盤 |
| 1996 | DBSCAN(Ester ら) | 密度ベースの萌芽 |
| 2003 | LDA(Blei ら)でトピックモデル普及 | テキスト教師なし |
| 2008 | t-SNE(van der Maaten) | 非線形可視化の革命 |
| 2013 | word2vec が単語埋め込み確立 | 表現学習の幕開け |
| 2018 | UMAP, BERT の自己教師あり学習 | 大規模事前学習の時代 |
| 2020 | SimCLR/MoCo の対比学習 | 画像の自己教師あり |
🌳 系譜の整理: 3 つの大樹
- クラスタリング系(重心ベース→密度ベース→確率モデル系): K-means → K-medoids → DBSCAN/OPTICS → GMM → スペクトラルクラスタリング
- 次元削減系(線形→非線形→ニューラル): PCA → カーネル PCA / MDS → Isomap / LLE → t-SNE / UMAP → オートエンコーダ / VAE
- 表現学習系(NLP 起源→画像→自己教師あり統一): word2vec → GloVe → BERT/GPT → SimCLR / DINO → 基盤モデル
系譜を理解することで「なぜこの手法はこの構造を持つのか」 が腑に落ち、 新しい手法に出会ったときも「ああ、 これは GMM の派生だな」 「これは対比学習のフレームだな」 と整理できます。 教師なし学習はラベルなしという制約を逆手に、 統計・幾何・情報理論・最適化を総動員する豊かな分野です。
💼 学習者へのアドバイス: 最初に学ぶ順番
- K-means と階層クラスタリング: クラスタリングの基礎概念(距離・重心・分散) を体感する。
- PCA: 次元削減と可視化の入口。 累積寄与率の解釈に慣れる。
- シルエット係数: 教師なしの評価の難しさを実感する。
- DBSCAN: 「球状以外の形状」 を扱えることを知る。
- GMM と EM アルゴリズム: 確率モデル的なクラスタリングを理解する。
- t-SNE / UMAP: 非線形可視化を試し、 距離保存性の限界を体感する。
- オートエンコーダ: ニューラル系教師なしの入口。 再構成誤差で異常検知ができる。
- 自己教師あり学習 / 対比学習: 最新潮流。 言語・画像での実装を試す。
この順序で学ぶと、 教師なし学習の歴史的発展と理論的深さを自然に追体験できます。 単なる「ラベルなし学習のテクニック集」 ではなく、 「データから世界を読み解く科学」 として教師なし学習に向き合う土台ができます。
📝 SSDSE-B-2026 を題材にした応用問題 5 選
- 問題 1: 都道府県を「総人口(A1101)・出生数(A4101)・死亡数(A4200)」 の 3 変数で K-means (K=4) クラスタリングし、 各クラスタの代表都道府県を 3 件ずつ挙げよ。 結果を見て「東京は単独クラスタになるか」 を予想する前に、 まず標準化の有無で結果がどう変わるかを試せ。
- 問題 2: 同じデータで PCA (n_components=2) を実行し、 PC1 と PC2 の loadings 表を作れ。 PC1 軸の意味、 PC2 軸の意味を、 寄与の大きい変数名から言語化せよ。
- 問題 3: Isolation Forest (contamination=0.05) で外れ値検出を行い、 検出された都道府県名を列挙せよ。 検出結果は K-means の単独クラスタと一致するか比較せよ。
- 問題 4: 階層クラスタリング (Ward 法) で樹形図を描き、 K=3, 4, 5 のどれが「腑に落ちる」 分割か説明せよ。 シルエット係数の推移も併記すること。
- 問題 5: 上記 4 手法(K-means/PCA/Isolation Forest/階層) を組み合わせて、 「都道府県類型化レポート」 を 1 ページにまとめよ。 結論は「47 都道府県は◯つのタイプに分けられ、 そのうち◯県は他と異なる特異な存在である」 という形式で。
これらの問題に取り組むと、 教師なし学習の各手法が「補完しあって 1 つのストーリーを作る」 ことが体感できます。 単独の K-means、 単独の PCA、 単独の異常検知では見えない構造が、 組み合わせて初めて浮かび上がります。 「教師なし学習はストーリーテリングの道具」 という視点が、 ここに来てようやく腹落ちするはずです。