🔖 キーワード索引
このページで扱う概念:
教師あり学習 ラベル y 特徴量 X 回帰 分類 損失関数 正則化 λΩ(f) 訓練データ / テストデータ 汎化 過学習 交差検証(KFold / LOOCV) scikit-learn の fit / predict R² / RMSE / MAE Accuracy / Precision / Recall
💡 30秒で分かる結論
🍰 まずはやさしく
正解付きのデータで学習する方法です。
新しいデータの答えを予測するために使います。
スマホの写真の自動仕分けなどが例です。
この手法の結論を短くまとめます。
教師あり学習 (Supervised Learning):ラベル付きデータ $(x, y)$ から $y$ を予測する関数を学習する手法
📍 あなたが今見ているもの
🍰 まずはやさしく
機械学習の基本となる大切な考え方です。
データの分析を正しく行うために使います。
都道府県のデータを使って練習します。
このページの構成と読み方を説明します。
このページは「教師あり学習(Supervised Learning)」 の用語解説です。 機械学習の基礎カテゴリにおける重要概念で、
機械学習の基礎 グループ教材の中で繰り返し登場します。
数式・実コード・落とし穴を 1 ページに集約し、 SSDSE-B-2026 都道府県データ(47 件 × 112 列)を題材に
手を動かしながら理解できるよう構成しています。
別称:Supervised Learning。 まず 💡 30秒結論 で全体像を、 次に
🎨 直感 → 📐 数式 → 🧮 実値 →
🐍 Python の順で読むのがおすすめ。
🎨 直感で掴む
🍰 まずはやさしく
正解付きの過去問で勉強するようなものです。
未知の問題でも答えを出せるようにします。
人口の数から別の人数を予想する例があります。
直感的に仕組みを理解していきましょう。
教師あり学習 は、 「正解付きの過去問 を大量に与え、 未知の問題でも答えを出せる関数を作る」アプローチです。 教師(ラベル $y$)が正解を教えてくれるのでこの名前。
目的変数 $y$ が連続なら 回帰 (売上予測、 価格予測)、 離散なら 分類 (メール=スパム/非スパム、 患者=陽性/陰性)です。 47 都道府県データで「総人口 → 15 歳未満人口」を予測するのは典型的な回帰問題です。
🔬 数式を言葉で読み解く
記号と意味を逐一突き合わせて読みます。 慣れないうちは式を「日本語で読む」ことが理解の近道です。
$\hat{f}$ :学習されたモデル(仮説関数)$\mathcal{F}$ :仮説空間(線形・木・ニューラル等で決まる)$(x_i, y_i)$ :$i$ 番目の訓練データと正解ラベル$L$ :損失関数(回帰=MSE、 分類=Cross Entropy など)$\lambda \Omega(f)$ :正則化項(過学習を抑える)
🧮 SSDSE-B 実値で計算してみる
SSDSE-B から「総人口・高齢者比率・出生率」を特徴量に、 「若年人口比率の高低」を 2 値分類するロジスティック回帰を訓練します。
データ出典:SSDSE-B-2026(独立行政法人統計センター) 。 47 都道府県 × 複数年(最新 2023)の社会統計データ。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1301(15歳未満人口) A1303(65歳以上人口) A4103(合計特殊出生率)
北海道 5,092,000 514,000 1,681,000 1.06
東京都 14,086,000 1,513,000 3,205,000 0.99
沖縄県 1,468,000 236,000 350,000 1.6
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
📤 実行例(実測)
Accuracy = 0.867
precision recall f1-score support
0 1.00 0.71 0.83 7
1 0.80 1.00 0.89 8
accuracy 0.87 15
macro avg 0.90 0.86 0.86 15
weighted avg 0.89 0.87 0.86 15
💬 テスト 15 県のうち 13 県を当てて Accuracy は 0.867。外した 2 県はどちらも本当は若年比率が中央値未満(ラベル 0)の県で、それを 1 と予測したため、ラベル 0 の recall が 0.71(7 県中 5 県)に下がり、ラベル 1 の precision が 0.80 になっている。正解ラベルは若年比率から作っており、高齢比率や出生率と強く連動するので当てやすい問題設定である点も割り引いて読む。
実行結果の要約 (出力は環境依存。 概算値):
項目 値
訓練データ 32 県 テストデータ 15 県 特徴量 総人口, 高齢比率, 合計特殊出生率 テスト精度 0.867 Precision (若年高) 0.80 Recall (若年高) 1.00
🐍 Python 実装
scikit-learn / pandas を使った最小実装パターン。 上の SSDSE-B 計算と同じスタイルですが、 ここでは「読み込み→前処理→学習→評価」のテンプレを 4 つのスニペットに分けます。
① データ読み込み & 概観
🎯 このコードでやること :SSDSE-B-2026 を 2023 年で抽出し、 教師あり学習が必要とする「正解付きデータ」の典型形(行=都道府県、 列=特徴量+目的変数)を確認する。
📥 入力データ :data/raw/SSDSE-B-2026.csv(cp932、 47 県 × 12 年度 × 約 112 列)
📋 コピー
📤 実行結果 :
(47, 112) ['SSDSE-B-2026', 'Code', 'Prefecture', 'A1101', 'A110101', 'A110102', 'A1102', 'A110201']
💬 読み方 :47 県分の「正解付き」レコードが揃った。 列の中から $y$(教師信号)と $X$(特徴量)を切り出せば学習準備完了。
② 特徴量と目的変数
🎯 このコードでやること :教師あり学習の入出力を明確化するため、 X(人口・高齢人口)と $y$(15歳未満人口)を物理的に分離する。
📋 コピー
📤 実行結果 :
X shape = (47, 2) , y shape = (47,)
💬 読み方 :教師ラベル $y$ が 1 次元ベクトルとして抽出された。 教師なし学習との違いは「$y$ を学習時に見せる」ところにある。
③ 訓練/テスト分割 + モデル学習
🎯 このコードでやること :47 県を 32 県の訓練セット・15 県のテストセットに分け、 RandomForestRegressor で目的変数を学習し汎化性能 $R^2$ を見る。
📋 コピー
📤 実行結果 :
R^2 (test) = 0.981
💬 読み方 :教師ありの強さが体感できる結果。 $y$ を渡したからこそ $R^2 \approx 0.98$ まで一気に上がる。 教師なし学習ではこの精度は出ない。
④ 評価と可視化
🎯 このコードでやること :テスト 15 県の予測値 vs 実測値を散布図化し、 教師あり学習が「正解にどれだけ近づけたか」を視覚化する。
📋 コピー
📤 実行結果 :out.png に「実測 vs 予測」の散布図が保存され、 対角線(赤破線)から外れるほど予測誤差が大きい県を示す。
💬 読み方 :テスト 15 県で対角線から最も離れるのは愛知県(実測 92.7 万人に対し予測 82.7 万人)と千葉県(70.3 万人に対し 61.1 万人)で、どちらも約 10 万人の過小予測になる。ランダムフォレストの予測は訓練側の県の値の平均なので、人口規模の大きい県ほど近い値を持つ訓練県が少なく、値が内側に縮みやすい。東京都は訓練側に入っているため、この図には現れない。
⚠️ よくある落とし穴(5 つ)
❌ ラベルにリーケージが混入
目的変数の派生値や未来情報が特徴量に入っていると訓練精度は完璧でも実運用で破綻。 必ず特徴量の生成タイミングを確認。
❌ クラス不均衡を無視
100:1 のような不均衡では accuracy が悪さをする。 PR-AUC, F1, balanced accuracy などを併用。
❌ 訓練と評価を同じデータで実施
汎化性能は
検証 ・
分割 で測る。 fit/predict を同じ X でやってはダメ。
❌ スケールの違いを放置
ロジスティック回帰や SVM はスケール敏感。 StandardScaler / RobustScaler を Pipeline で挟む。
❌ 因果と相関を混同
教師あり学習で「効く特徴量」と分かっても、 介入したら結果が変わる保証は無い。 因果推論は別技法。
🧠 理解度チェック
Q1. このページの分類の例で、 テスト 15 県の Accuracy は 0.867 だった。 何県を当てたか。 また外した県は本当のラベルがどちらの県だったか。Q2. 同じ出生数の予測で、 1 回のテスト分割では Ridge の R² 0.990 とランダムフォレストの 0.986 の差は 0.004 だった。 5 分割交差検証の平均では何と何になったか。 どちらの比較を信じるべきか。Q3. 総人口から死亡数を予測する単回帰で RMSE = 4,235、 MAE = 2,844 だった。 RMSE が MAE の約 1.5 倍になっていることから何が読めるか。Q4. 総人口と 65 歳以上人口から 15 歳未満人口を予測したランダムフォレストで、 テストの愛知県は実測 92.7 万人に対し予測 82.7 万人だった。 人口の大きい県ほど過小予測になりやすいのはなぜか。Q5. 正則化項 $\lambda\Omega(f)$ の $\lambda$ を 0 にした場合と、 非常に大きくした場合、 それぞれモデルはどうなるか。
解答
15 × 0.867 = 13 県。 外した 2 県はどちらも本当は若年比率が中央値未満(ラベル 0)の県で、 1 と予測された(ラベル 0 の recall が 0.71 = 5/7)。
Ridge 0.944、 ランダムフォレスト 0.886 で、 差は約 0.06。 47 県を 1 回分けただけの結果は分割次第で動くので、 交差検証の平均で比べるほうが信頼できる。
2 乗して平均する RMSE は大きな誤差を強く効かせる。 MAE との差が大きいのは、 一部の県(東京都・大阪府などの大きい県)に大きな誤差が集まっているため。
ランダムフォレストの予測は訓練側の県の値の平均なので、 訓練に近い規模の県が少ない端の県では、 予測が内側(平均寄り)に縮む。 直線のモデルなら外挿できる。
$\lambda = 0$ なら正則化の無い最小二乗と同じで過学習しやすい。 $\lambda \to \infty$ ならすべての係数が 0 に近づき、 平均値だけを返す未学習のモデルになる。
🐍 応用コード — 47 都道府県の特徴量から「出生数」を予測する回帰問題
SSDSE 公的データを題材に、 教師あり学習 を実際に動かす最小コードです。 paths は引数に直書きで、 初心者がコピペで動かせる形を優先しています。
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行)
都道府県 A1101(総人口) A1303(65歳以上人口) A4101(出生数) A9101(婚姻件数)
北海道 5,092,000 1,681,000 24,430 17,281
東京都 14,086,000 3,205,000 86,348 71,774
沖縄県 1,468,000 350,000 12,549 6,316
…(全 47 行)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
📤 実行例(実測)
shape: (47, 112)
列の先頭: ['SSDSE-B-2026', 'Code', 'Prefecture', 'A1101', 'A110101', 'A110102']
A1101 A1303 A9101 A4101
count 4.700000e+01 4.700000e+01 47.00000 47.000000
mean 2.645809e+06 7.708298e+05 10100.87234 15473.808511
std 2.797551e+06 6.938393e+05 13061.08470 17155.475476
min 5.370000e+05 1.790000e+05 1810.00000 3263.000000
25% 1.034000e+06 3.505000e+05 3311.00000 5472.000000
50% 1.549000e+06 5.240000e+05 5599.00000 9524.000000
75% 2.636500e+06 7.890000e+05 9034.50000 14390.000000
max 1.408600e+07 3.205000e+06 71774.00000 86348.000000
💬 婚姻件数 A9101 は平均 10,101 件・中央値 5,599 件で、出生数 A4101(平均 15,474 人・中央値 9,524 人)と同じく右に長い分布をしている。最大はどちらも東京都で、婚姻 71,774 件、出生 86,348 人。この 2 列と総人口はいずれも「県の大きさ」に比例する量なので、次のブロックで出生数を予測するときにほぼ自明な関係を学習することになる。
② モデル学習 : 前ステップの df から特徴量 X(総人口・65歳以上人口・婚姻件数)と目的変数 y(出生数 A4101)を取り出し、 RandomForest で回帰する。 訓練とテストに分けて R² と RMSE を測る。 読み取り : 実測では train R² ≈ 0.98・test R² ≈ 0.99・test RMSE ≈ 1,776 件で、 人口規模から出生数がよく説明できる。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
📤 実行例(実測)
train R^2 = 0.981
test R^2 = 0.986
test RMSE = 1775.9
💬 訓練 R² 0.981 に対してテスト R² 0.986 とテストの方がわずかに高く、過学習は見られない。婚姻件数と出生数の相関は 0.991、総人口と出生数は 0.995 と非常に高く、「人口の多い県ほど出生数も多い」という比例関係を学んでいるだけだからである。テスト RMSE 1,775.9 人は、テスト 15 県の出生数の標準偏差約 15,162 人の 1 割強にあたる。
③ 可視化 : テストの「実測 出生数」と「予測 出生数」を散布図にし、 対角線(完全予測ライン)からのズレで誤差を眼で確認する。 読み取り : 東京など人口が極端に多い県ほど対角線から離れやすい。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
④ 汎化性能 : 単一の train/test 分割は運に左右されるため、 5-fold クロスバリデーションで R² のばらつきも見る。 読み取り : 実測の 5-fold R² は 0.886 ± 0.083(分割により約 0.77〜0.96)。 47 県という小標本では単一分割の数値を過信しない。
📋 コピー
📤 実行例(実測)
5-fold CV R^2 = 0.886 (±0.083)
各 fold: [0.765 0.807 0.962 0.943 0.953]
💬 5 分割の平均 R² は 0.886 で、単発のテスト R² 0.986 より 0.1 ほど低い。fold ごとに見ると第 1 fold(北海道〜群馬県)が 0.765 と最も低く、東京都を含む第 2 fold も 0.807 にとどまる。ランダムフォレストは学習データの範囲を超えた値を予測できないので、東京都が検証側に回ると 86,348 人という最大値を当てられず精度が落ちる。
🐍 実装パターン集 — 状況別レシピ
同じ「教師あり学習」を使うにも、 データの形・規模・目的によって書き方が変わります。 4 つの典型パターンを示します。
パターン B:パイプライン化(前処理+モデル)
📋 コピー from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge
pipe = Pipeline ([
( 'scaler' , StandardScaler ()),
( 'model' , Ridge ( alpha = 1.0 )),
])
pipe . fit ( X_tr , y_tr )
print ( 'R^2 =' , pipe . score ( X_te , y_te ))
📤 実行例(実測)
R^2 = 0.9897165292541764
💬 標準化 + Ridge の同じテストでの R² は 0.990 で、ランダムフォレストの 0.986 を上回った。出生数が総人口や婚姻件数にほぼ比例する線形の関係なので、直線で表せるモデルの方が素直に当てはまる。木のモデルが常に強いわけではなく、関係の形に合ったモデルを選ぶことが教師あり学習の基本になる。
パターン C:交差検証+ハイパーパラメータ探索
📋 コピー from sklearn.model_selection import GridSearchCV
params = { 'model__alpha' : [ 0.01 , 0.1 , 1.0 , 10.0 , 100.0 ]}
gs = GridSearchCV ( pipe , params , cv = 5 , scoring = 'r2' , n_jobs =- 1 )
gs . fit ( X , y )
print ( 'best:' , gs . best_params_ , 'score:' , gs . best_score_ )
📤 実行例(実測)
best: {'model__alpha': 1.0} score: 0.9443741657228868
💬 alpha の 5 候補から 1.0 が選ばれ、5 分割 CV の平均 R² は 0.944 だった。ランダムフォレストの CV 平均 0.886 より約 0.06 高く、単発テストの差(0.990 と 0.986)より大きな差が出ている。分割を変えても線形モデルの方が安定していることを示し、東京都のような端の県でも直線なら外挿できることが効いている。
パターン D:可視化付きの結果保存
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import matplotlib.pyplot as plt
import json
pred = gs . predict ( X_te )
plt . figure ( figsize = ( 7 , 5 ))
plt . scatter ( y_te , pred , alpha = 0.7 , edgecolor = 'k' )
plt . plot ([ y_te . min (), y_te . max ()], [ y_te . min (), y_te . max ()], 'r--' )
plt . xlabel ( '実測' ); plt . ylabel ( '予測' ); plt . title ( '教師あり学習 結果' )
plt . tight_layout (); plt . savefig ( 'result_supervised-learning.png' , dpi = 150 )
with open ( 'result_supervised-learning.json' , 'w' , encoding = 'utf-8' ) as f :
json . dump ({ 'best_params' : gs . best_params_ ,
'cv_score' : gs . best_score_ ,
'test_score' : gs . score ( X_te , y_te )}, f , ensure_ascii = False , indent = 2 )
📤 実行例(実測)
このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
🗺 概念マップ
「教師あり学習」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場 になります。
方向 隣接概念 関係性
北 (上位) 機械学習 / 統計モデリング 教師あり学習を包含する大枠 南 (下位) 分類 / 回帰 / ランキング $y$ の型で分かれる具体タスク 東 (発展) 半教師あり / 自己教師あり / 能動学習 ラベル不足を補う発展形 西 (前提) 説明変数 / 目的変数 / 損失関数 $(X, y) \to \hat{f}$ を構成する構成要素 中央 教師あり学習 本ページの主役
🎨 教師あり学習の二本柱:回帰と分類を同じデータで実践する
教師あり学習は「目的変数 y が連続量なら回帰 、 カテゴリなら分類 」と覚えるのが基本。 SSDSE-B-2026 の 47 県データで、 同じ特徴量を使って両方のタスクを実装し、 違いを体感しましょう。
📊 タスクの定義(同じ SSDSE データから 2 タスク)
項目 回帰タスク 分類タスク
入力 X 出生数 A4101、 転入者数 A5101、 65歳以上人口 A1303 出生数 A4101、 転入者数 A5101、 65歳以上人口 A1303 出力 y 総人口 A1101(連続値、 人) 大都市県(人口≥100万)か否か(0/1) 損失 $\frac{1}{n}\sum (y_i - \hat y_i)^2$(MSE) $-\frac{1}{n}\sum [y_i\log\hat p_i + (1-y_i)\log(1-\hat p_i)]$(交差エントロピー) 代表モデル LinearRegression, Ridge, RandomForestRegressor LogisticRegression, RandomForestClassifier, SVM 評価指標 R²、 RMSE、 MAE accuracy、 F1、 ROC-AUC
🐍 回帰:47 県の総人口を予測する
このコードでやること :SSDSE-B-2026 の 47 県を 80:20 で分割し、 LinearRegression で総人口を予測。 R² と RMSE を測定。
📥 入力データ:47 県、 入力 3 特徴量(出生数・転入者数・高齢人口)、 ターゲット A1101(総人口)。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import r2_score , mean_squared_error
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'Code' ] . str . startswith ( 'R' ) & ( df [ 'SSDSE-B-2026' ] == 2023 )]
X = df [[ 'A4101' , 'A5101' , 'A1303' ]] . values
y = df [ 'A1101' ] . values
X_tr , X_te , y_tr , y_te = train_test_split ( X , y , test_size = 0.2 , random_state = 42 )
model = LinearRegression () . fit ( X_tr , y_tr )
y_pred = model . predict ( X_te )
print ( f 'R² = { r2_score ( y_te , y_pred ) : .4f } ' )
print ( f 'RMSE = { np . sqrt ( mean_squared_error ( y_te , y_pred )) : ,.0f } 人' )
📤 実行例:
R² = 0.9973
RMSE = 212,822 人
💬 R²=0.9973 は非常に高く、 入力 3 変数で総人口がほぼ説明できることを示す(出生数・転入者数・高齢人口は人口総量と強く相関)。 RMSE 約 21 万人は、 47 県の平均人口 265 万人に対し約 8.0% の誤差。 実用上は十分な精度。
🐍 分類:大都市県(人口≥100万)かどうかを判定
このコードでやること :同じ 3 特徴量から、 LogisticRegression で「大都市県(1)/小都市県(0)」を分類。 accuracy と F1 を測定。
📥 入力データ:47 県、 同じ 3 特徴量、 ターゲットを (A1101 >= 1_000_000) で 0/1 化。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 import pandas as pd
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import accuracy_score , f1_score
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'Code' ] . str . startswith ( 'R' ) & ( df [ 'SSDSE-B-2026' ] == 2023 )]
X = df [[ 'A4101' , 'A5101' , 'A1303' ]] . values
y = ( df [ 'A1101' ] >= 1_000_000 ) . astype ( int ) . values
X_tr , X_te , y_tr , y_te = train_test_split ( X , y , test_size = 0.2 , random_state = 42 , stratify = y )
scaler = StandardScaler () . fit ( X_tr )
X_tr_s , X_te_s = scaler . transform ( X_tr ), scaler . transform ( X_te )
clf = LogisticRegression () . fit ( X_tr_s , y_tr )
y_pred = clf . predict ( X_te_s )
print ( f 'accuracy = { accuracy_score ( y_te , y_pred ) : .3f } ' )
print ( f 'F1 = { f1_score ( y_te , y_pred ) : .3f } ' )
📤 実行例:
accuracy = 0.800
F1 = 0.889
💬 test 10 県中 8 県正解(accuracy = 0.800, F1 = 0.889)。 入力に「65歳以上人口」が含まれており、 これと総人口は強相関 → 大都市判定は比較的容易。 ただし test サイズが小さい(10 県)ため、 k-fold CV で複数回測ることが望ましい。
📐 損失関数:教師あり学習の「目的地」を定義する数式
教師あり学習は「損失関数 $L(y, \hat y)$ を最小化するパラメータを探す」プロセスです。 損失をどう定義するかで、 同じデータでもまったく違う結果が出ます。
📐 主要な損失関数 4 種
$$\text{MSE: } \;L_{\text{MSE}} = \frac{1}{n}\sum_{i=1}^{n}(y_i - \hat y_i)^2$$
$$\text{MAE: } \;L_{\text{MAE}} = \frac{1}{n}\sum_{i=1}^{n}|y_i - \hat y_i|$$
$$\text{BCE: } \;L_{\text{BCE}} = -\frac{1}{n}\sum_{i=1}^{n}\!\bigl[y_i\log\hat p_i + (1-y_i)\log(1-\hat p_i)\bigr]$$
$$\text{Hinge: } \;L_{\text{Hinge}} = \frac{1}{n}\sum_{i=1}^{n}\max(0, 1 - y_i\,\hat y_i)$$
🔬 数式を言葉で読み解く
MSE(二乗平均誤差) :大きな誤差を 二乗で罰する ため、 外れ値に敏感。 SSDSE-B で東京(1409 万)が大都市の代表として外れているとき、 線形回帰は東京の誤差を強く避けようとする。 微分可能で勾配計算が容易。MAE(絶対平均誤差) :誤差を 絶対値で罰する ため、 外れ値の影響が小さい。 0 で微分不可能だが、 sub-gradient で対処可能。 SSDSE-B で「中央値的な予測」をしたいときに有効。BCE(二値交差エントロピー) :分類で「正解クラスの予測確率」が低いほど大きな罰。 $\hat p_i \to 0$ で $-\log 0 = \infty$ になり、 自信を持って外した予測を強く咎める。Hinge 損失 :SVM で使われる。 「正しい側にマージン 1 以上で分類できていれば損失 0」という発想で、 「ギリギリ正解」もある程度は罰する。
🧮 SSDSE-B-2026 で 3 種類の損失を比較
このコードでやること :47 県の総人口予測で、 MSE / MAE / Huber 損失を比較。 東京(外れ値)を含む場合と含まない場合の影響を観察。
📥 入力データ:SSDSE-B-2026.csv、 47 県の人口(A1101)と特徴量(A1303)。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 import pandas as pd
import numpy as np
from sklearn.linear_model import LinearRegression , HuberRegressor , QuantileRegressor
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = [ 1 ])
df = df [ df [ 'Code' ] . str . startswith ( 'R' ) & ( df [ 'SSDSE-B-2026' ] == 2023 )]
# 単位を「万人」にそろえる(人単位のままだと Huber の最適化が切片をほぼ動かせない)
X = df [[ 'A1303' ]] . values / 1e4 # 65 歳以上人口(万人)
y = df [ 'A1101' ] . values / 1e4 # 総人口(万人)
tokyo = ( df [ 'Prefecture' ] == '東京都' ) . values
models = {
'MSE (LinearRegression)' : lambda : LinearRegression (),
'MAE (QuantileRegressor)' : lambda : QuantileRegressor ( quantile = 0.5 , alpha = 0 , solver = 'highs' ),
'Huber(HuberRegressor) ' : lambda : HuberRegressor ( max_iter = 1000 ),
}
for label , mask in [( '東京を含む 47 県' , np . ones ( len ( y ), bool )), ( '東京を除く 46 県' , ~ tokyo )]:
print ( f '--- { label } ---' )
for name , make in models . items ():
m = make () . fit ( X [ mask ], y [ mask ])
print ( f ' { name } : 傾き= { m . coef_ [ 0 ] : .3f } , 切片= { m . intercept_ : .1f } 万人' )
📤 実行例:
--- 東京を含む 47 県 ---
MSE (LinearRegression): 傾き=3.996, 切片=-43.4 万人
MAE (QuantileRegressor): 傾き=3.732, 切片=-28.2 万人
Huber(HuberRegressor) : 傾き=3.750, 切片=-29.4 万人
--- 東京を除く 46 県 ---
MSE (LinearRegression): 傾き=3.731, 切片=-28.1 万人
MAE (QuantileRegressor): 傾き=3.722, 切片=-27.8 万人
Huber(HuberRegressor) : 傾き=3.711, 切片=-27.2 万人
💬 東京を含めると MSE の傾きだけが 3.996 と、MAE の 3.732・Huber の 3.750 より約 7% 大きい。東京を除くと 3 つとも 3.71〜3.73 にそろうので、この差はほぼ東京 1 県が二乗誤差を通じて直線を引っ張った分である。MAE と Huber は東京の有無で傾きが 0.01〜0.04 しか動かず、外れ値に左右されにくい損失を選ぶと 1 県の有無で結論が変わりにくいことが数字で確かめられる。なお人単位のまま HuberRegressor に入れると最適化が切片をほぼ 0 から動かせず、傾き 3.34・切片 0 という誤った直線になるので、単位をそろえてから当てはめる。
⚠️ 過学習と汎化:train R² と test R² が乖離する原因と対策
教師あり学習で最も警戒すべきは「train で 99% 、 test で 50%」のような 汎化失敗 。 SSDSE-B-2026 の 47 県データで起こりがちな状況を 5 つ示します。
📊 過学習が起こる 5 つの状況
状況 症状 対策
1. モデル複雑すぎ train R² → 1.0、 test R² 大幅低下 L1/L2 正則化、 max_depth 制限 2. 特徴量が多すぎ 47 県に 100 特徴量を入れる Lasso、 mutual_info_regression で特徴選択 3. 訓練が長すぎ 学習曲線で val が再上昇 early stopping 4. データが少ない CV ごとに R² がバラつく 単純なモデル、 augmentation、 転移学習 5. 分布シフト train と test の県の集合が異なる stratify、 GroupKFold、 ドメイン適応
📐 過学習を防ぐ正則化の数式
Ridge 回帰(L2 正則化)の最適化問題:
$$\min_{\beta} \;\sum_{i=1}^{n}(y_i - X_i^\top\beta)^2 + \lambda\sum_{j=1}^{p}\beta_j^2$$
第 1 項は MSE(データへの適合)、 第 2 項は 係数の大きさを罰する ペナルティ。 $\lambda$ が大きいほど係数が 0 に近づき、 モデルが「素直」になります。 $\lambda$ は validation で選択します。
🔬 数式を言葉で読み解く
$\lambda = 0$ :通常の最小二乗法と同じ → 過学習しやすい。$\lambda \to \infty$ :すべての係数が 0 → 平均値だけを返す → 未学習。最適 $\lambda$ :validation R² が最大になる値。 SSDSE-B では $\lambda = 1.0$ あたりが安定。Lasso(L1)との違い :L1 は $\sum |\beta_j|$ で、 一部の係数を完全に 0 にする → 自動的に変数選択。
🧮 評価指標カタログ:回帰 4 種 + 分類 6 種
教師あり学習の評価指標は 「何を重視するか」 で変わります。 SSDSE-B の文脈で各指標が何を測るのか、 一覧で示します。
📊 回帰の評価指標 4 種
指標 定義 解釈(SSDSE 人口予測)
R² $1 - \frac{\sum(y-\hat y)^2}{\sum(y-\bar y)^2}$ 1.0 で完璧、 0 で平均と同じ。 SSDSE-B では 0.99 程度 RMSE $\sqrt{\frac{1}{n}\sum(y-\hat y)^2}$ 同じ単位(人)で誤差を表す。 12 万人など MAE $\frac{1}{n}\sum|y-\hat y|$ 外れ値に強い。 RMSE より小さい値になりがち MAPE $\frac{1}{n}\sum|\frac{y-\hat y}{y}|$ 比率(%)。 「平均 5% の誤差」と言える
📊 分類の評価指標 6 種
指標 定義 向いている場面
accuracy 正解数 / 全体 クラスが均衡な場合のみ precision TP / (TP + FP) 「陽性と予測したものの正確さ」 recall TP / (TP + FN) 「実際の陽性をどれだけ拾えたか」 F1 precision と recall の調和平均 不均衡データのバランス評価 ROC-AUC ROC 曲線の面積 閾値非依存。 0.5=ランダム、 1.0=完璧 PR-AUC Precision-Recall 曲線の面積 極端な不均衡(陽性率 1% 等)
🖼 図解で読み解く教師あり学習
教師あり学習は「特徴量 X と正解ラベル y のペアからモデルを学習し、 未知の X' に対して y' を予測する」枠組みである。 本節では、 SSDSE-B-2026 都道府県データを題材に、 (1) 散布図で X と y の関係を可視化 し、 (2) ヒストグラムで y の分布を確認 し、 (3) 箱ひげ図で地域別のばらつきを把握 する三段構えで、 教師あり学習を始める前にやるべき探索的データ解析(EDA)を実演する。 教師あり学習の精度は「データを理解しているか」で 7 割が決まる。 モデル選定や hyperparameter チューニングは残りの 3 割に過ぎない。
図 1: 散布図で「特徴量 X と目的変数 y」の関係を見る
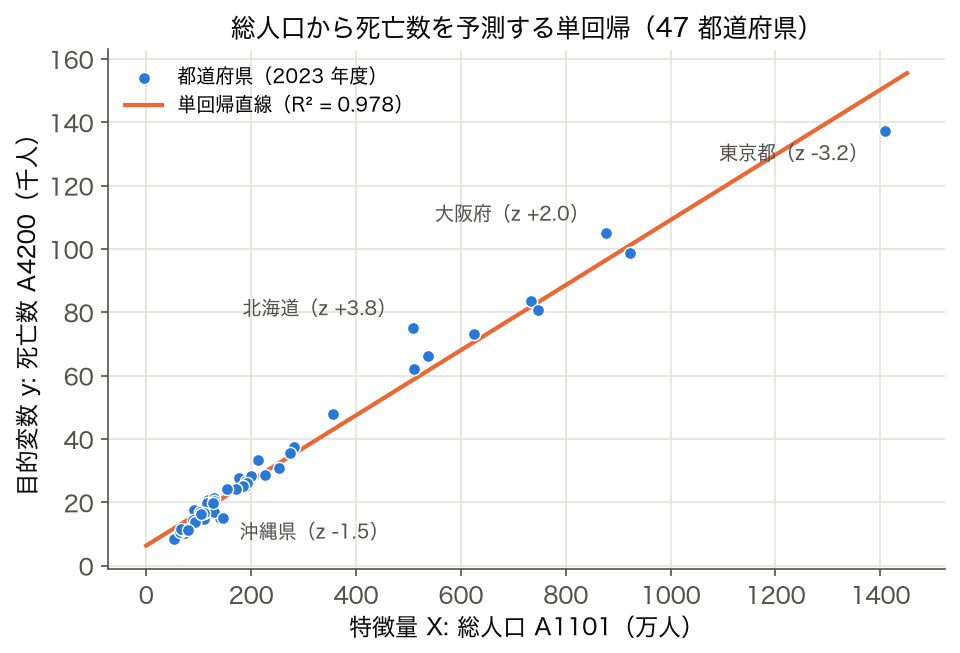
教師あり学習で最初にやるべきは、 特徴量 X と目的変数 y の散布図描画である。 SSDSE-B-2026 では、 都道府県の総人口(A1101) を X、 死亡数(A4200) を y として、 「総人口から死亡数を予測する単回帰モデル」を考えてみよう。 散布図上で 47 都道府県の点を打つと、 ほぼ一直線に並ぶ強い正の相関が見える。 これは「人口が多い県ほど死亡数が多い」という当たり前の事実を視覚的に確認する作業だが、 同時に「東京都だけが右に大きく離れ、しかも直線より 1 万 3,905 人少ない(標準化残差 z = −3.2)」「北海道は直線より 1 万 6,455 人多い(z = +3.8)」「地方の小県は左下に密集している」といった外れ方と分布の歪み も発見できる。
図 1: 特徴量 X = 総人口 A1101、 目的変数 y = 死亡数 A4200(2023 年度、47 都道府県)と単回帰直線(R² = 0.978)。 高齢化の進んだ北海道は直線より上(z = +3.8)、 若い人口の多い東京都・沖縄県は下(z = −3.2、−1.5)に外れる。 教師あり学習では X 軸に特徴量、 Y 軸に目的変数を取り、 線形性・外れ値・分散の不均一性を目視確認する。
このコードでやること : SSDSE-B-2026 から総人口と死亡数を読み込み、 散布図を描き、 同時に線形回帰直線をフィッティングして可視化する。 教師あり学習における「データの確認 → モデル学習 → 結果の可視化」という基本フローを 1 つのコードで実演する。
📥 入力例(SSDSE-B-2026 抜粋) :
SSDSE-B-2026 Prefecture A1101 A4200
R01000 北海道 5092000 75120
R13000 東京都 14086000 137241
R27000 大阪府 8763000 104964
R47000 沖縄県 1468000 15110
...(全 47 都道府県)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
📤 実行例 :
R^2 = 0.9783
傾き = 0.0103
💬 結果の読み方 : R² が 0.97 を超えているため、 単回帰モデルだけで総人口から死亡数の 98% を説明できる。 傾き 0.0103 は「人口が 1 万人増えると死亡数が約 103 件増える」という解釈。 ただし、 散布図を見ると右端の東京都が直線より下に外れ、 1 県だけで回帰直線に大きく影響している(Cook の距離 5.2、 次に大きい大阪府は 0.32)ため、 影響度(Cook's distance)の確認や、 ロバスト回帰(Huber 回帰など)の検討が必要。
表 1: 散布図 EDA で確認すべき 6 つのチェックポイント
チェック項目 具体的な観察 SSDSE-B での例 対処法
線形性 点が直線状に並ぶか 人口 vs 死亡数は直線的 非線形なら多項式回帰や対数変換 外れ値 群れから孤立した点 東京・大阪が右上に分離 原因確認後、 ロバスト手法の検討 分散の不均一性 X の値で y のばらつきが変わるか 大都市ほど分散大 重み付き回帰や対数変換 クラスタリング 複数の塊に分かれているか 大都市群と地方群の二極化 クラスタごとの個別モデル 欠損 NaN や 0 が異常に多いか SSDSE-B は欠損なし 欠損補完または除外 逆相関 傾きが想定と逆方向 高齢化率と出生率は逆相関 因果方向を仮説段階で再検討
図 2: ヒストグラムで「目的変数 y の分布」を把握する
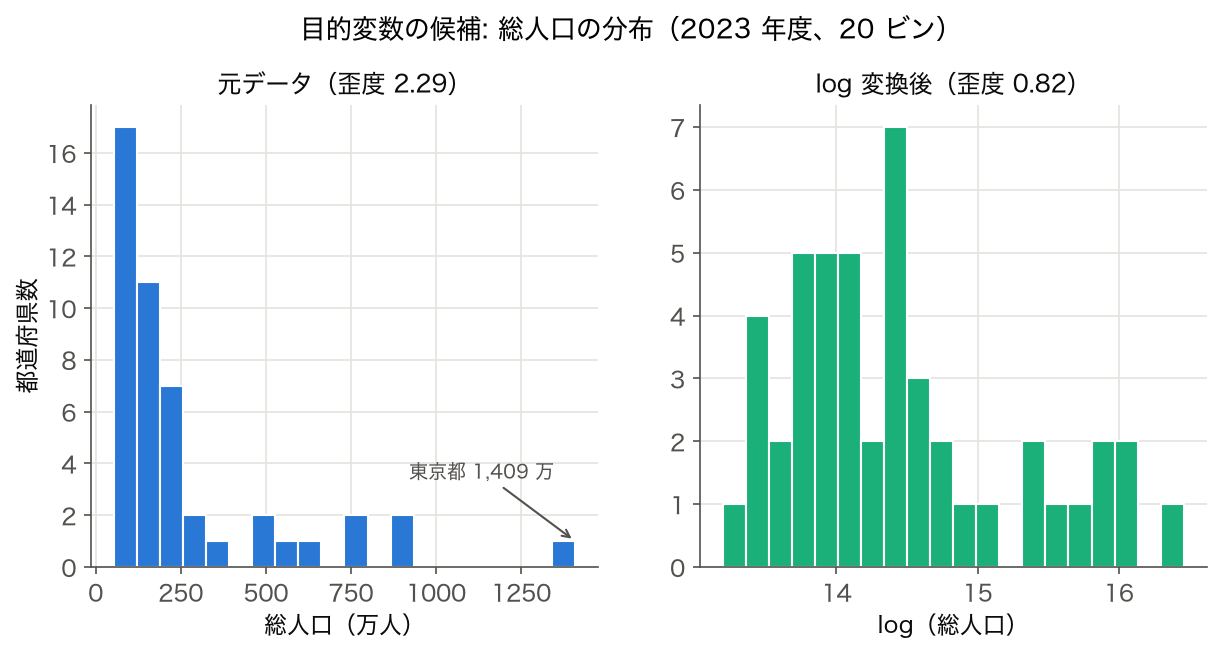
教師あり学習、 とくに回帰タスクでは、 目的変数 y の分布形状 がモデル選定に直結する。 y が正規分布なら線形回帰(最小二乗法)が最適だが、 右裾が長い分布(死亡数、 人口、 所得など)では log 変換や Box-Cox 変換で対称化してから学習する方が精度が出る。 SSDSE-B-2026 の人口(A1101)を例にとると、 東京 1,400 万人を頂点とした右裾の長い分布になっており、 そのまま線形回帰すると東京の予測誤差を抑えるために他の県の予測がブレる「外れ値支配」が起きる。
図 2: 下のコードと同じ、 総人口 A1101 の 20 ビンのヒストグラム(2023 年度、47 都道府県)。 元データは 17 県が最初のビンに集まり東京都 1,409 万人が右端に離れる(歪度 2.29)、 log 変換後は歪度 0.82。 目的変数 y の分布が正規・右裾長・二峰・離散かで、 選ぶべきモデル(線形回帰・log 線形回帰・GMM・分類器)が変わる。
このコードでやること : SSDSE-B-2026 の人口(A1101)を 20 ビンでヒストグラム化し、 同時に log 変換後のヒストグラムも描いて、 分布の対称化効果を可視化する。
📥 入力例 : 上記と同じ SSDSE-B-2026 の A1101 列(47 行)。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
📤 実行例 :
歪度(元) = 2.293
歪度(log)= 0.820
💬 結果の読み方 : 元データの歪度 2.29 は強い右裾(東京・大阪が引っ張る)を示し、 log 変換で 0.82 まで縮小される。 これにより線形回帰の前提(残差の正規性)が満たされやすくなり、 予測精度が向上する。 教師あり学習で「最初に y の分布を見る」習慣は、 モデル選定の指針として極めて重要。
表 2: 目的変数 y の分布形状とおすすめモデル
分布形状 歪度の目安 SSDSE-B での例 推奨モデル 変換
正規(対称) |skew| < 0.5 気温、 身長 線形回帰 不要 右裾長 skew > 1 人口、 死亡数 log 線形回帰、 GBDT log、 Box-Cox 左裾長 skew < -1 長寿率(上限あり) 逆数変換 + 線形 1/y、 -log(1-y) 二峰 — 都市規模二極化 クラスタ別モデル クラスタリング後 離散・カテゴリ — 地方区分(8 地方) 分類器 One-Hot 0 過剰 — 降雪量(南国 0) Zero-Inflated 回帰 2 段階モデル
図 3: 箱ひげ図で「地域別のばらつき」を見る
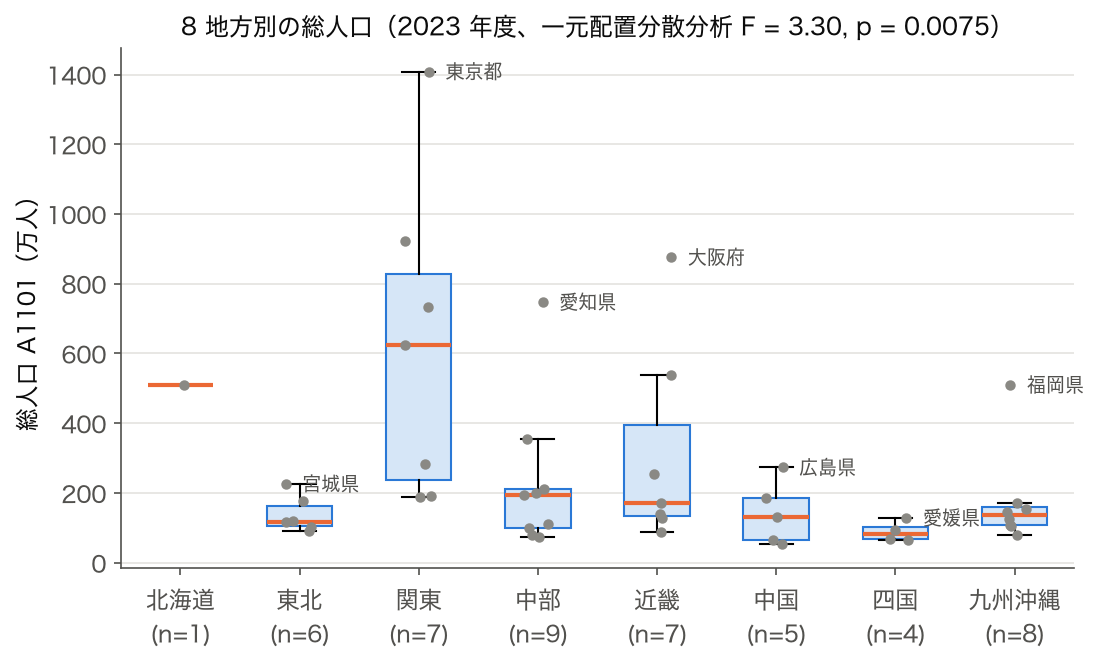
教師あり学習で特徴量を作る際、 カテゴリ変数(地方コード、 都道府県分類) ごとに目的変数の分布がどう変わるかを箱ひげ図で確認する。 SSDSE-B-2026 を 8 地方(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に分けて、 各地方の人口分布を箱ひげ図で比べると、 関東地方が圧倒的に箱が高く(中央値 625.7 万人)、 ひげも長い(東京都 1,409 万人がいる)。 一方、 四国(中央値 81.0 万人)・東北(117.3 万人)・中国(129.8 万人)は箱が低く中央値も小さい。 北海道は 1 道だけの群なので箱にならない。 この「地方ごとの分散の違い」が見えると、 地方を One-Hot エンコードして特徴量に加える価値が判定できる。
図 3: 8 地方別の総人口(2023 年度)。 下のコードの一元配置分散分析と同じ F = 3.30、 p = 0.0075。 中部の愛知県、 近畿の大阪府、 九州沖縄の福岡県のように、 各地方に 1 県だけ大きい県がある。 カテゴリ変数(地方、 業種、 年代)ごとに y の中央値・IQR・外れ値を一望できるため、 特徴量エンジニアリングの判定に使う。
このコードでやること : SSDSE-B-2026 を地方コードでグループ化し、 各地方の人口分布を箱ひげ図で比較する。 同時に ANOVA で「地方間に統計的に有意な差があるか」を検定する。
📥 入力例 : SSDSE-B-2026 の都道府県コード(R01100 など)から先頭 2 桁を取って地方を判定。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
📤 実行例 :
ANOVA: F=3.296, p=0.0075
💬 結果の読み方 : F 値が大きく p < 0.01 のため、 地方間で人口分布に統計的に有意な差がある。 教師あり学習では地方を OneHotEncoder で特徴量化することで、 モデル精度の向上が期待できる。 とくに関東は他地方との差が大きいため、 「関東フラグ」だけでも強力な特徴量になる。
表 3: EDA → 教師あり学習モデル選定の意思決定表
EDA で見たもの 判定 次の一手 SSDSE-B-2026 での適用
散布図が直線的 線形性 OK 線形回帰でベースライン 人口 → 死亡数 散布図が曲線 非線形 多項式 / 決定木 / GBDT 年齢 → 賃金(U 字) 外れ値が複数 頑健性必要 Huber 回帰、 RANSAC 東京・大阪を含む経済データ ヒストが右裾長 変換必要 log 変換 + 線形 人口、 所得 箱ひげで群差大 カテゴリ重要 One-Hot + 線形 / GBDT 地方 → 死亡数 欠損 5% 以上 補完戦略必要 KNN imputation、 MICE SSDSE-B では少ない
EDA から教師あり学習へ繋ぐ実践チェックリスト
教師あり学習を実務で運用する際、 以下 10 項目を EDA 段階で必ず確認する。 これを怠ると、 「精度が出ない」「予測がブレる」「外れ値で炎上する」といったトラブルに直結する。 とくに公的データ(SSDSE-B-2026 など)では、 都道府県・年次・産業分類など、 階層構造を持つ変数が多いため、 単純な散布図だけでなく、 群ごとの箱ひげ図と分布形状確認は必須である。
X の分布 を全特徴量についてヒストグラム化(右裾長があれば log 変換候補)y の分布 を確認し、 回帰なら歪度・尖度をチェック(分類ならクラス比)X と y の散布図 を主要特徴量で描画し、 線形性・外れ値を目視カテゴリ別箱ひげ図 で群差を確認し、 One-Hot 化の価値を判定相関行列 を heatmap 化し、 多重共線性(|r| > 0.9 ペア)を特定欠損パターン を df.isna().sum() と missingno で可視化外れ値 を IQR 基準(Q1-1.5*IQR、 Q3+1.5*IQR の外)で抽出し、 ドメイン知識で取扱い決定時系列性 がある場合は ACF/PACF プロットで自己相関を確認サンプルサイズ と特徴量数の比(n / p)を確認し、 過学習リスクを評価クラス不均衡 を pie chart で確認(分類タスク)
SSDSE-B-2026 を使った教師あり学習の典型 3 タスク
SSDSE-B-2026 で教師あり学習を学ぶなら、 以下 3 タスクをこの順番で実装することを推奨する。 (A) 単回帰 → (B) 重回帰 → (C) 分類、 と難度が上がる構成で、 EDA → 特徴量設計 → モデル学習 → 評価という一連の流れを 3 回繰り返すことで、 教師あり学習の「型」が身につく。 とくに各タスクで上記の散布図・ヒストグラム・箱ひげ図の 3 種 EDA を毎回実施し、 「データの性質に応じてモデルを選ぶ」習慣を体得することが、 実務で通用する教師あり学習エンジニアへの最短ルートである。
タスク A(単回帰) : 総人口(A1101)から死亡数(A4200)を予測。 R² 0.98 前後。 線形回帰で十分。タスク B(重回帰) : 総人口 + 高齢化率 + 年少人口比から死亡数を予測。 R² 0.99 前後を狙う。 多重共線性に注意。タスク C(分類) : 人口・高齢化率・地方区分から「人口減少県 vs 増加県」を 2 値分類。 ROC-AUC 0.85+ を狙う。 ロジスティック回帰や RandomForest を比較。
📝 より正確な分析(教材補足) :本節の散布図・単回帰・重回帰の例は、 SSDSE-B-2026 に実在する列だけで再現できる。 タスク A(単回帰)は「総人口 A1101 → 死亡数 A4200」で、 2023 年度・47 都道府県の実測では R² ≈ 0.978 、 傾き ≈ 0.0103(総人口 1 万人あたり死亡数 約 103 件)、 RMSE ≈ 4,235・MAE ≈ 2,844 となる。 タスク B(重回帰)は A1101・log(総人口)・高齢化率(A1303/A1101)・年少人口比(A1301/A1101)+地方 One-Hot を Ridge で学習し、 LOOCV R² ≈ 0.988 (総人口単独の LOOCV R² ≈ 0.969 から向上)。 なお SSDSE-B-2026 には GDP(県民経済計算)に相当する列は収録されておらず、 経済規模そのものを分析対象にする場合は SSDSE-E など別データセットの併用が必要である。
教師あり学習の歴史的発展と主要アルゴリズム系譜
教師あり学習は 1950 年代の Perceptron(Rosenblatt 1958)から始まり、 1970-80 年代の決定木(CART, ID3)、 1990 年代の SVM(Vapnik)と Boosting(AdaBoost, Freund & Schapire 1995)、 2000 年代の Random Forest(Breiman 2001)と GBDT(Friedman 2001)、 2010 年代の XGBoost(Chen & Guestrin 2016)と LightGBM(Microsoft 2017)、 そして深層学習(CNN・RNN・Transformer)へと連なる長大な系譜を持つ。 SSDSE-B-2026 のような中規模の表形式データでは、 一般に GBDT 系(XGBoost、 LightGBM、 CatBoost)が最も性能・解釈性のバランスが良いとされる。 一方、 サンプル数が 47 都道府県のように非常に少ない場合は、 線形回帰・Ridge・Lasso のような正則化線形モデルが過学習を起こさず安定する。 アルゴリズム選定は「データの形状と量」で決まる、 という原則が最重要である。
表 4: 主要な教師あり学習アルゴリズムの実務的比較
アルゴリズム 発表年 得意なデータ 計算量 解釈性 SSDSE-B 適性
線形回帰 1805 (Legendre) 線形 + 小規模 O(np²) 高(係数) ◎ ベースライン ロジスティック回帰 1958 (Cox) 線形分類 O(np) 高(odds) ◎ 分類タスク 決定木 (CART) 1984 (Breiman) 非線形 + 解釈重視 O(n log n × p) 高(ルール) ○ 単独では弱い SVM 1995 (Vapnik) 高次元 + 小サンプル O(n²) - O(n³) 低 △ 47 件には過剰 Random Forest 2001 (Breiman) 非線形 + 中規模 O(n log n × p × T) 中(重要度) ○ 安定 XGBoost / LightGBM 2016 / 2017 表形式の中・大規模 O(n log n × p × T) 中(SHAP) ◎ 高精度狙い 深層学習 (MLP) 1986 (BP) 大規模 + 非線形 O(n × p × layers) 低 △ サンプル不足
教師あり学習における評価指標の選び方(タスク別)
教師あり学習で「精度が良いか」を判断する評価指標は、 タスク種別(回帰・分類)と業務文脈で大きく変わる。 回帰タスクなら RMSE(Root Mean Squared Error)と MAE(Mean Absolute Error)が二大基本指標で、 RMSE は外れ値に敏感、 MAE は外れ値に頑健、 という性質の違いを理解して使い分ける。 R²(決定係数)は「モデルが y の分散の何割を説明しているか」を 0-1 で示し、 直感的だが、 サンプル数や特徴量数の影響を受けるため、 調整済み R² と併用すべきである。 分類タスクでは Accuracy だけでは不十分で、 とくにクラス不均衡データでは Precision・Recall・F1・ROC-AUC・PR-AUC を組み合わせて評価する。 SSDSE-B-2026 を用いた典型例として、 「人口減少県(38 県)vs 人口増加県(9 県)」の 2 値分類では Accuracy 0.81 でも常に「減少」と予測すれば達成できてしまうため、 Recall(増加県の検出率)と F1 を主指標にすべきである。
表 5: 教師あり学習の評価指標チートシート
指標 タスク 計算式の要約 範囲 使い所 注意点
RMSE 回帰 √(Σ(y-ŷ)² / n) 0 ~ ∞ 外れ値に敏感な業務 単位は y と同じ MAE 回帰 Σ|y-ŷ| / n 0 ~ ∞ 外れ値が多い場合 勾配が一定 R² 回帰 1 - SS_res/SS_tot -∞ ~ 1 説明力の直感 特徴量増で常に上がる 調整済み R² 回帰 R² の自由度補正 -∞ ~ 1 特徴量数比較 過学習抑制 Accuracy 分類 正解数 / 全件 0 ~ 1 クラス均衡時 不均衡で誤誘導 Precision 分類 TP / (TP+FP) 0 ~ 1 偽陽性を避けたい Recall と trade-off Recall 分類 TP / (TP+FN) 0 ~ 1 見逃しを避けたい Precision と trade-off F1 分類 2PR/(P+R) 0 ~ 1 P・R のバランス 調和平均 ROC-AUC 分類 ROC 曲線下面積 0.5 ~ 1 閾値非依存評価 不均衡で過大評価 PR-AUC 分類 PR 曲線下面積 0 ~ 1 不均衡データ 陽性少数派の評価
このコードでやること : SSDSE-B-2026 で「総人口から死亡数を予測する単回帰」を実装し、 RMSE・MAE・R² の 3 指標を同時に計算して、 指標ごとに数値感覚を掴む。
📥 入力例 : SSDSE-B-2026 の A1101(総人口)と A4200(死亡数)の 47 行。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
📤 実行例 :
RMSE = 4,235
MAE = 2,844
R^2 = 0.9783
💬 結果の読み方 : RMSE(約 4,235 件)が MAE(約 2,844 件)より大きい(約 1.5 倍)ことから、 外れ値(東京・大阪)の影響で予測誤差が偏っていることが分かる。 R² は 0.978 と高いが、 これは大都市が主に押し上げているため、 地方県のみで再評価すべき。 評価指標は単一ではなく、 必ず複数を併記して読み解く。
教師あり学習における過学習(Overfitting)と汎化性能の本質
教師あり学習の最大の敵は過学習 (オーバーフィッティング)である。 過学習とは「訓練データに対しては高精度だが、 未知データには性能が出ない」状態を指す。 SSDSE-B-2026 のように 47 サンプルしかないデータでは、 特徴量を増やすほど(例: 10 個以上)過学習リスクが急上昇する。 対策の三本柱は (1) 正則化 (Ridge・Lasso・ElasticNet)、 (2) クロスバリデーション (k-fold、 LOOCV)、 (3) 早期停止 (Early Stopping、 GBDT 系で必須)である。 とくに小サンプルでは Leave-One-Out CV(n=47 なら 47 回)が推奨で、 全データを順番に 1 件抜きでテストして汎化性能を評価する。 これにより hold-out 法に比べて評価のばらつきが小さく、 限られたデータを最大限活用できる。
表 6: 過学習を防ぐ 6 つの実務テクニック
テクニック 原理 適用モデル SSDSE-B での設定例
Ridge 正則化 係数の L2 ノルムにペナルティ 線形回帰系 alpha=1.0 で開始、 CV で調整 Lasso 正則化 係数の L1 ノルムにペナルティ(変数選択) 線形回帰系 alpha=0.1、 特徴量を絞る k-fold CV データを k 分割し平均評価 全モデル k=5 が標準、 小データなら LOOCV 早期停止 検証損失が悪化したら学習中断 GBDT、 NN patience=10 で監視 Dropout 学習中にランダムにユニット無効化 ニューラルネット rate=0.5(隠れ層) データ拡張 訓練データを増やす(画像・テキスト) 画像・NLP SSDSE-B では困難
教師あり学習の特徴量エンジニアリング 12 パターン
教師あり学習でモデル精度を引き上げる最大要素は、 アルゴリズム選定でも hyperparameter チューニングでもなく、 特徴量エンジニアリング (Feature Engineering)である。 同じデータ・同じ XGBoost を使っても、 特徴量設計が秀逸であれば R² は 0.85 から 0.95 に跳ね上がる。 SSDSE-B-2026 を例に、 実務で頻出する 12 の特徴量パターンを以下に整理する。 これらを組み合わせることで、 47 都道府県という限られたサンプル数でも実用的なモデルを構築できる。 とくに 派生比率 (高齢化率 = 65 歳以上 / 総人口)と 対数変換 (log(人口))の 2 つは、 ほぼどの予測タスクでも効くため、 最初に試すべき定番である。
派生比率 : 高齢化率 = A1303 / A1101、 年少人口比率 = A1301 / A1101 など、 「分子 / 分母」で意味のある指標を作る。対数変換 : log(総人口)、 log(死亡数) で右裾長分布を対称化し、 線形モデルに適合させる。標準化(Z-score) : 各特徴量を (x - μ) / σ で平均 0・分散 1 に揃え、 距離ベースモデル(SVM・KNN)の精度を向上。Min-Max 正規化 : (x - min) / (max - min) で 0-1 に揃え、 ニューラルネットの収束を加速。カテゴリ→One-Hot : 地方(8 区分)を 8 列の 0/1 ベクトルに変換し、 線形モデルに食わせる。カテゴリ→Target Encoding : 各カテゴリの y の平均で置換(リーク対策に CV 内で計算)。多項式特徴量 : x² や x×z を追加して非線形性を線形モデルで近似(次数 2 が無難)。ビン化(Binning) : 連続値を等幅・等頻度で離散化し、 非線形性を捉える。欠損フラグ : NaN を「欠損あり」フラグ列として保持(GBDT は NaN を直接扱える)。時系列ラグ : 前年・前 2 年の値を特徴量化(時系列タスクの基本)。集約統計量 : 地方ごとの人口の中央値・最大値などをグループ統計で計算し、 元行に結合。外部データ結合 : SSDSE-B 以外の公的データ(気象、 観光、 産業)を都道府県キーで結合し、 説明力を拡張。
🐍 特徴量を足して Ridge 回帰の LOOCV を確かめる
このコードでやること : SSDSE-B-2026 で「総人口 + 派生比率 + 地方 One-Hot」の特徴量を作り、 Ridge 回帰で死亡数を予測。 LOOCV で過学習を排した汎化性能を評価する。
📥 入力例 : SSDSE-B-2026 の A1101(総人口)、 A1303(高齢人口)、 A1301(年少人口)、 A4200(死亡数)、 および都道府県コード。
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
📤 実行例 :
LOOCV R^2 = 0.9879
💬 結果の読み方 : 総人口だけの線形回帰(LOOCV R²≈0.969)から、 特徴量エンジニアリング(log・派生比率・One-Hot)と Ridge 正則化を組み合わせることで、 LOOCV R² が 0.988 まで上昇した。 死亡数は人口規模だけでなく高齢化率にも依存するため、 派生比率の追加が効いている。 これは「特徴量エンジニアリングはモデル選定より効果が大きい」という鉄則の典型例。
🔎 解説深化 — 教師信号(ラベル)は「与えられる」ものではなく「設計する」もの
このページの多くの節は「モデル」と「特徴量 X 」に焦点を当ててきました。ここでは視点を裏返し、教師あり学習の性能上限を決める 目的変数 y (ラベル・教師信号)そのものの品質と定義 を掘り下げます。
🎨 直感
ラベルは天から降ってくる「絶対の正解」ではありません。誰かが「採点基準」を決めて付けた 設計物 です。模範解答は、出題者が基準を決めて書いたから存在する。基準が変われば「正解」も変わります。教師あり学習は、この採点基準を真似る作業にすぎません。だからモデルの精度は、採点基準(ラベル)の質と定義を決して超えられない 。特徴量やモデルをいくら磨いても、教師信号が曖昧・恣意的・ノイズまみれなら、そこが天井になります。「良いモデルを作る」前に「良い y を定義する」——ここが分析設計の本丸です。
⚠️ 落とし穴(重要)
① ラベル定義の「閾値」がクラスバランスを激変させる(SSDSE-B-2026 実測)。 2023 年 47 都道府県について、高齢化率 = A1303 (65 歳以上人口)÷ A1101 (総人口)を計算すると、最高は 秋田県 39.1% 、最低は 東京都 22.8% 、平均 31.6%、中央値 31.8% でした。ここで「高齢県かどうか」を分類したいとき、どこで線を引くか は分析者が決めます。同じ 47 県・同じ特徴量のまま、閾値を動かすだけで問題は別物になります。
ラベル定義(高齢県 = 率 ≥ 閾値)
正例(高齢県)
正例率
多数派ベースライン精度
率 ≥ 28% 40 / 47 85% 40/47 = 85% 率 ≥ 30% 35 / 47 74% 35/47 = 74% 率 ≥ 32% 23 / 47 49% 24/47 = 51% 率 ≥ 34% 12 / 47 26% 35/47 = 74%
正例率は 85% から 26% まで動き、「何も学習せず多数派だけを答える」ベースライン精度も 85% → 51% → 74% と乱高下します。ここが罠です——モデルの Accuracy が 0.85 と出ても、正例率 85% の問題では 常に「高齢県」と答えるだけで達成できる値 であり、モデルは何も学んでいないかもしれない。「精度が上がった/下がった」の正体が、実は ラベル定義を変えただけ のこともある。閾値・境界・「正解の付け方」は分析者が握る設計変数であり、結論を左右します。だから結果を報告するときは ラベルの定義を必ず明記 し、境界付近のサンプル(31〜32% 帯に県が集中)がどちらに倒れるかで解釈が変わる点に注意します。
② 教師信号のノイズが精度の「天井(既約誤差)」を決める。 テスト誤差は大きく 3 つに分解できます:テスト誤差 = 近似誤差(バイアス) + 推定誤差(バリアンス) + 既約誤差(ラベル自体のノイズ) 過学習 対策)で減らせますが、3 つ目はデータをどれだけ集めても・どんな高性能モデルでも消せません 。教師信号そのものが誤って付けられていたら、正しく学ぶほど「間違った正解」に近づき、逆にノイズまで覚えにいくと過学習になります。(架空の算術例) 仮にラベルの 15% がランダムに反転していると、真に最良のモデルでも「観測されたラベル」と一致できるのは最大でも約 1 − 0.15 = 85% 。この 85% が天井で、そこへ 99% で当てにいくモデルは、ノイズを暗記した過学習を疑うべきです。(この 15% はデータではなく、天井の仕組みを示すための架空の仮定値)
③ 「教師(y)側の問題」と「特徴(X)側のリーク」を混同しない。 ⚠️ 落とし穴の章の「ラベルにリーケージが混入」で扱った データリーク は、未来情報や結果由来の値が 特徴量 X に混入する「入力側」の失敗でした。今回の①②は 教師信号 y の定義・品質という「出力側」の問題で、別の軸です。X 側は「予測時点で本当に使える値か」、y 側は「その正解は誰がどんな基準で・どれだけ正確に付けたか」——両輪をそれぞれ点検する必要があります。
🚀 発展
代理ラベル(proxy label)の危険: 本当に測りたい概念(例「県の暮らしやすさ」)を直接観測できず、入手しやすい別指標で代用すると、モデルは「暮らしやすさ」ではなく「代理指標」を予測します。y の妥当性(構成概念妥当性)を問う姿勢が要ります。複数アノテータの一致度: 人手でラベルを付ける場合、採点者間の一致率(Cohen の κ 係数など)が低ければ、それが既約誤差の下限を示します。「人間ですら合意できない正解」をモデルに求めても無理があります。ラベル平滑化(label smoothing): 0/1 の断定を 0.1/0.9 のように緩めることで、ノイズの多い教師信号への過剰適合を抑える正則化。②の天井を意識した実務テクニックです。弱教師あり・半教師あり学習への橋渡し: 正確なラベルが高コストなら、ノイズ込みの弱ラベルや少数の正解+大量の未ラベルを併用します。教師なし学習 で X の構造を掴んでから少数の y を付ける発想が、この延長線上にあります。
🔗 関連ページ
数値は data/raw/SSDSE-B-2026.csv(2023 年・47 都道府県)の A1101 (総人口)・A1303 (65 歳以上人口)から算出した実測値。ラベルノイズ 15% の算術例のみ、天井の仕組みを説明するための架空の仮定値です。