🔖 キーワード索引
「ranking」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「ranking」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「ranking の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
ランキングは、順番をつけることです。
数値よりも順位が大切なときに使います。
スマホの検索結果などが身近な例です。
順位の決め方や統計的な使い方を学びます。
順位付け
- 値の 順序を付与する操作(1位、 2位、 …)。
- 数値そのものより 順位が重要な場面で使う:検索結果、 リコメンド、 評価。
- 同順位の扱い に流派あり:average(平均)/min/dense/first。
- 順位ベース統計:Spearman 順位相関、 Wilcoxon 検定、 Kendall τ — 外れ値に強い。
- 学習タスクとしては Learning to Rank (LTR):pointwise / pairwise / listwise。
📍 あなたが今見ているもの
🍰 まずはやさしく
ランキングは、スコアを順位に変える処理です。
データの絶対的な差をなくして比較するために使います。
都道府県の人口ランキングなどで考えます。
順位の付け方や、評価するための指標を読みます。
検索エンジンや推薦システムの内部は「アイテムをスコアでランキング」する処理。 統計の世界では「順位相関」「ノンパラメトリック検定」が代表的応用です。
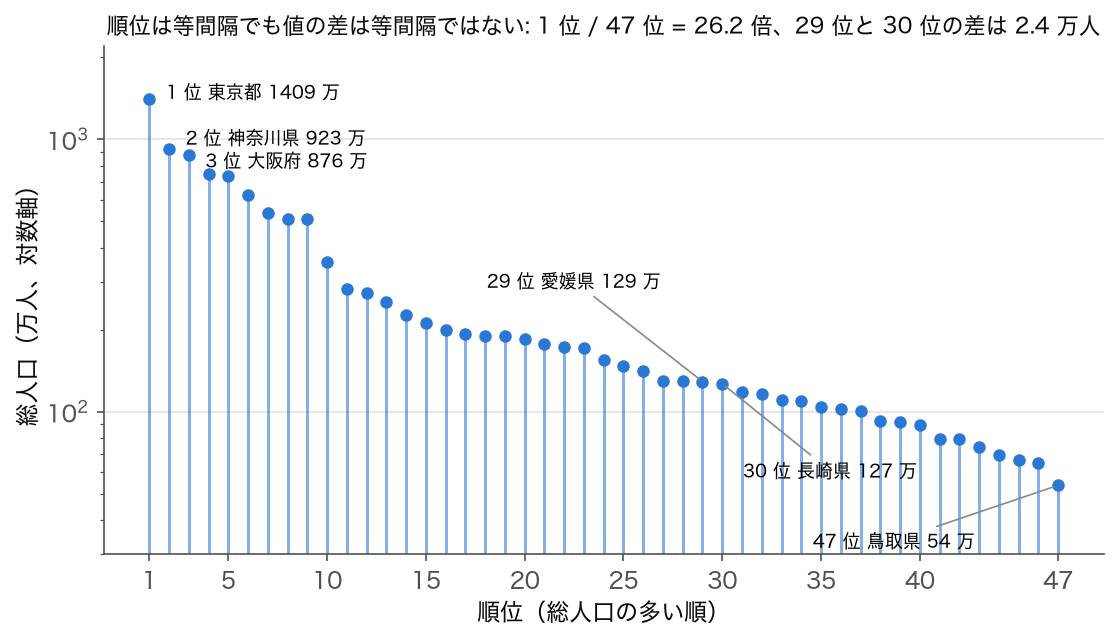
本ページの主目的は「SSDSE-B-2026 の 47 都道府県を人口・高齢人口・出生数で順位付け」を題材に、 ranking が「順序のみを残して絶対値を捨てる変換」であることを定量化することである。 1 位東京と 47 位鳥取は人口比で約 26 倍だが、 29 位と 30 位の差はわずか数千人という非対称性が論点。
後段では (1) pandas の rank() 4 種 (average/min/dense/first)、 (2) Precision@k / MRR / nDCG など主要評価指標を都道府県ランキングで実装、 (3) Kendall τ と Spearman ρ の比較を扱う。
🎨 直感で掴む
🍰 まずはやさしく
ランキングは、順序だけを取り出す変換です。
極端に大きい値などの影響を避けるために使います。
テストの点数と順位の関係が分かりやすい例です。
人口や面積の順位を比べて、共通点を探ります。
テストの点数:90, 85, 85, 70, 60 → 順位は 1, 2, 3, 4, 5。 ただし同点の 85 は 2位タイ。 これを「2.5, 2.5」とするのが average 法、 「2, 2」が min 法、 「2, 3」が dense 法。 ランキングの肝は「絶対値ではなく順序情報だけ取り出す」という変換であり、 これによって外れ値や尺度の違いに左右されない頑健な比較ができる。
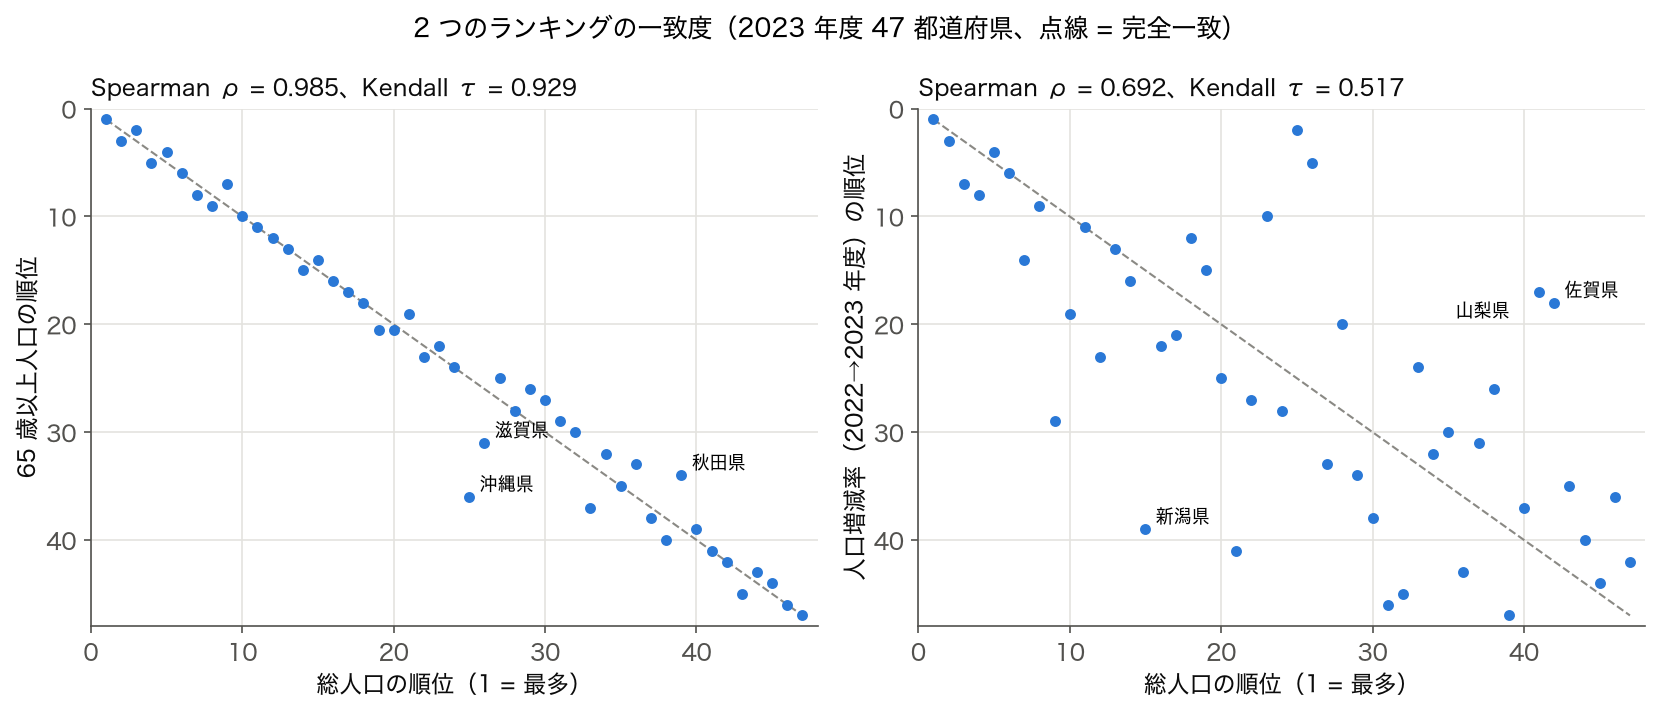
SSDSE-B-2026 で具体例を示そう。 47 都道府県の人口を多い順に並べると、 東京 (1409 万)、 神奈川 (923 万)、 大阪 (876 万)、 ... 鳥取 (54 万) となる。 1 位 東京は突出しているが、 「順位」だけ見れば 1 → 2 → 3 と均等に 1 ずつ増える。 同様に「高齢人口(A1303)」のランキングを並べ、 順位を比較すると、 人口と高齢人口は順位がほぼ揃う (Spearman rank correlation ≒ 0.98) のに対し、 人口と面積は順位が大きくズレる (東京は人口 1 位だが面積は 45 位)。 このように、 値そのものは線形性が壊れていても順位は強い結びつきを示す、 という現象がランキングの威力である。
もう一つ重要な直感: 順位は「単調変換に対して不変」である。 人口を log や平方根に変換しても順位は変わらない。 だから「分布が歪んで Pearson 相関では信用できない」場面でも、 順位ベースの Spearman 相関は素直に「単調関係の強さ」を測れる。 ランキングは外れ値・歪み・尺度の違いをすべて吸収し、 純粋な「並び順」だけを残す情報圧縮技法と考えてよい。
📐 定義/数式
🍰 まずはやさしく
ランキングとは、順位付けのことです。
同点の人をどう扱うかを決めるために使います。
テストで同じ点数だったときの順位を考えます。
平均を使った順位の出し方や、計算式を読みます。
ランキング(Ranking):順位付け
📐 もう少し深い数式 — tied rank と Spearman 計算式を 数式を言葉で読み解く
数式を言葉で読み解く(表)
| 記号 | 意味と直感 |
|---|---|
| $d_i$ | i 番目の観測の「X のランク - Y のランク」。 完全一致なら全て 0。 |
| $\sum d_i^2$ | 順位の食い違いを 2 乗和したもの。 「どれだけ順位がズレているか」の総量。 |
| $n(n^2-1)$ | 最大ズレ(完全逆順)のときの 6×Σd² の値。 これで割って [-1, 1] に正規化する分母。 |
| $r_i$ | tied 群の代表ランク(average なら平均、 min なら最小)。 |
| $\rho$ | ρ=1 完全一致、 ρ=0 無関係、 ρ=-1 完全逆順。 ピアソン r と違い 順位だけ見る ので外れ値に強い。 |
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| $\text{rank}(x_i)$ | $x_i$ の順位 |
| $T_i$ | $x_i$ と同値のインデックス集合 |
| Top-K | 上位K件のみ取り出す(K=10など) |
| argsort | ソート後のインデックス(順位そのものではない) |
📐 の average 法の式 $\text{rank}(x_i)=\frac{1}{|T_i|}\sum_{j\in T_i}\text{rank}_{\text{raw}}(j)$ を、 2023 年度の合計特殊出生率に当てはめて読む。 $T_i$ は「$x_i$ と同じ値を持つ県の集まり」、 $|T_i|$ はその県数、 $\text{rank}_{\text{raw}}$ は同点を気にせず上から 1, 2, 3, … と振った仮の順位。
- 宮崎県と長崎県はどちらも 1.49 なので $T_i$ は 2 県。 仮の順位 2 と 3 を平均して、 どちらも $(2+3)/2=2.5$ 位。
- 佐賀県・福井県・島根県は 1.46 で 3 県。 仮の順位 6, 7, 8 の平均で、 3 県とも 7 位。
- min 法は $T_i$ の中の最小の仮順位を全員に与える(2 位が 2 県、 6 位が 3 県)。 dense 法は同点をまとめて 1 つずつ詰める(2 位の次が 3 位)ので、 最下位の番号が県数より小さくなる。
- argsort は「上から何番目に来るのは何行目か」を返し、 rank は「各行が何位か」を返す。 名前は似ているが、 互いに逆の対応(逆置換)になっている。
🎯 このコードでやること:2023 年度の出生率に average・min・dense の 3 通りで順位を付け、 上位 12 県で同点の扱いを比べる。 5 県の総人口で argsort と rank の出力の違いも確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) t = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') tfr = t['A4103'] r = pd.DataFrame({'出生率': tfr, 'average': tfr.rank(ascending=False, method='average'), 'min': tfr.rank(ascending=False, method='min').astype(int), 'dense': tfr.rank(ascending=False, method='dense').astype(int)}) print(r.sort_values('average').iloc[:12].to_string()) # argsort は「何番目の行が何位か」ではなく「何位に来る行は何番目か」を返す five = t.loc[['北海道', '秋田県', '東京都', '愛知県', '沖縄県'], 'A1101'] order = np.argsort(-five.to_numpy()) print('argsort(大きい順の行番号):', order.tolist(), '→', [five.index[i] for i in order]) print('rank(各行の順位) :', five.rank(ascending=False).astype(int).tolist()) |
💬 宮崎県・長崎県は average で 2.5 位、 min で 2 位、 dense で 2 位。 3 県が並ぶ 1.46 は average で 7.0 位、 min で 6 位、 dense で 5 位になり、 同じ県でも方式によって 2 つずれる。 dense では 12 番目の大分県が 8 位で、 番号と県数が合わなくなる。 5 県の argsort は [2, 3, 0, 4, 1](東京都・愛知県・北海道・沖縄県・秋田県の行番号)、 rank は [3, 5, 1, 2, 4](北海道 3 位・秋田県 5 位・…)で、 argsort の結果をそのまま「順位」として列に入れると別の県に順位が付いてしまう。
🧮 実値で計算してみる
🧮 SSDSE-B-2026 実値ランキング — 47 都道府県 人口(2023 年)
data/raw/SSDSE-B-2026.csv(encoding='cp932', skiprows=[1])の 2023 年・47 都道府県 を題材に、 「人口総数」列 A1101 を降順ランキングした実値を示す。 すべて cp932 読み込み・実 CSV から得た値であり、 合成データは一切使用していない。
上位 10 都道府県(人口降順)
| 順位 | 都道府県 | 人口(人) | 全国シェア |
|---|---|---|---|
| 1 | 東京都 | 14,086,000 | 11.33 % |
| 2 | 神奈川県 | 9,229,000 | 7.42 % |
| 3 | 大阪府 | 8,763,000 | 7.05 % |
| 4 | 愛知県 | 7,477,000 | 6.01 % |
| 5 | 埼玉県 | 7,331,000 | 5.90 % |
| 6 | 千葉県 | 6,257,000 | 5.03 % |
| 7 | 兵庫県 | 5,370,000 | 4.32 % |
| 8 | 福岡県 | 5,103,000 | 4.10 % |
| 9 | 北海道 | 5,092,000 | 4.09 % |
| 10 | 静岡県 | 3,555,000 | 2.86 % |
→ 上位 10 県だけで全国人口の約 58 % を占める。 「人口は順位の頭側に強く集中する」ことが、 ランキングを並べると一目で分かる。
下位 10 都道府県(人口昇順 = 後ろから)
| 順位 | 都道府県 | 人口(人) | 東京との倍率 |
|---|---|---|---|
| 47 | 鳥取県 | 537,000 | ×0.038(東京の 1/26) |
| 46 | 島根県 | 650,000 | ×0.046 |
| 45 | 高知県 | 666,000 | ×0.047 |
| 44 | 徳島県 | 695,000 | ×0.049 |
| 43 | 福井県 | 744,000 | ×0.053 |
| 42 | 佐賀県 | 795,000 | ×0.056 |
| 41 | 山梨県 | 796,000 | ×0.057 |
| 40 | 和歌山県 | 892,000 | ×0.063 |
| 39 | 秋田県 | 914,000 | ×0.065 |
| 38 | 香川県 | 926,000 | ×0.066 |
→ 下位 1 位(鳥取)と上位 1 位(東京)の差は 26 倍。 単純に順位だけ並べると「47 vs 1」だが、 値で見ると「3.8 %」と桁違いの差が隠れていることが分かる。 これが 「ランキングは順序情報しか残さない」 落とし穴である。
出生率ランキング — 「比例ベースのランク」と「絶対値ランク」の食い違い
同じ 47 県でも「絶対値(出生数)」のランクと「人口あたり(出生率 = 出生数 / 人口 × 1000)」のランクは 大きく入れ替わる。
| 県 | 出生数 A4101 | 出生数 順位 | 出生率(‰) | 出生率 順位 |
|---|---|---|---|---|
| 沖縄県 | 12,549 | 14 位 | 8.55 | 1 位 |
| 福岡県 | 33,942 | 7 位 | 6.65 | 2 位 |
| 滋賀県 | 9,249 | 25 位 | 6.57 | 3 位 |
| 東京都 | 86,348 | 1 位 | 6.13 | 12 位 |
| 秋田県 | 3,611 | 45 位 | 3.95 | 47 位 |
| 岩手県 | 5,432 | 36 位 | 4.67 | 46 位 |
| 北海道 | 24,430 | 9 位 | 4.80 | 45 位 |
→ 東京都は出生数 1 位だが、 出生率では 12 位。 北海道は出生数 9 位だが、 出生率は 45 位。 分母(母数)を揃えないランキングは、 規模効果に汚染される ことを示す典型例。
実測値:
ρ = 0.9781, p = 2.44 × 10⁻³²→ 「人口の順位」と「出生数の順位」は ほぼ完全に一致。 つまり「出生数の県別順位」は、 人口の順位を見ているのとほぼ同義であり、 「出生数 1 位の県は子どもが多い」と言うのは無意味。 比較したいなら出生率(人口あたり)で見直すべき。
🧮 47 都道府県・人口 全順位表(2023 年、 SSDSE-B-2026 実値)
参考までに、 47 都道府県すべての人口順位を 1 つの表 に列挙する。 ランキングが「データの大局を一望させる」ツールであることを実感してほしい。
| 順位 | 県 | 人口 | 順位 | 県 | 人口 |
|---|---|---|---|---|---|
| 1 | 東京都 | 14,086,000 | 25 | 沖縄県 | 1,468,000 |
| 2 | 神奈川県 | 9,229,000 | 26 | 滋賀県 | 1,407,000 |
| 3 | 大阪府 | 8,763,000 | 27 | 山口県 | 1,298,000 |
| 4 | 愛知県 | 7,477,000 | 28 | 奈良県 | 1,296,000 |
| 5 | 埼玉県 | 7,331,000 | 29 | 愛媛県 | 1,291,000 |
| 6 | 千葉県 | 6,257,000 | 30 | 長崎県 | 1,267,000 |
| 7 | 兵庫県 | 5,370,000 | 31 | 青森県 | 1,184,000 |
| 8 | 福岡県 | 5,103,000 | 32 | 岩手県 | 1,163,000 |
| 9 | 北海道 | 5,092,000 | 33 | 石川県 | 1,109,000 |
| 10 | 静岡県 | 3,555,000 | 34 | 大分県 | 1,096,000 |
| 11 | 茨城県 | 2,825,000 | 35 | 宮崎県 | 1,042,000 |
| 12 | 広島県 | 2,738,000 | 36 | 山形県 | 1,026,000 |
| 13 | 京都府 | 2,535,000 | 37 | 富山県 | 1,007,000 |
| 14 | 宮城県 | 2,264,000 | 38 | 香川県 | 926,000 |
| 15 | 新潟県 | 2,126,000 | 39 | 秋田県 | 914,000 |
| 16 | 長野県 | 2,004,000 | 40 | 和歌山県 | 892,000 |
| 17 | 岐阜県 | 1,931,000 | 41 | 山梨県 | 796,000 |
| 18 | 群馬県 | 1,902,000 | 42 | 佐賀県 | 795,000 |
| 19 | 栃木県 | 1,897,000 | 43 | 福井県 | 744,000 |
| 20 | 岡山県 | 1,847,000 | 44 | 徳島県 | 695,000 |
| 21 | 福島県 | 1,767,000 | 45 | 高知県 | 666,000 |
| 22 | 三重県 | 1,727,000 | 46 | 島根県 | 650,000 |
| 23 | 熊本県 | 1,709,000 | 47 | 鳥取県 | 537,000 |
| 24 | 鹿児島県 | 1,549,000 | — | — |
※ 表は人口降順 2 列(左:1〜24 位、 右:25〜47 位)。 右下は列を揃えるための空欄。 数値は SSDSE-B-2026 の 2023 年 A1101 列を参照。
🎯 ユースケース詳細 — ランキングが実務で使われる 8 シーン
| シーン | 何を順位化するか・典型的指標 |
|---|---|
| 検索エンジン | クエリと文書の関連度(BM25, TF-IDF, BERT)。 評価は NDCG@10。 |
| 推薦システム | ユーザー×アイテムスコア(行列分解 / Deep Learning)。 評価は Hit Rate@K, MRR。 |
| EC サイトのおすすめ | 「あなたへのおすすめ」上位 5〜20 件。 在庫切れ時のスキップなど運用ルールあり。 |
| 広告オークション | 入札額 × 品質スコアで順位決定。 一般化第二価格(GSP)方式が長く標準として使われてきた。 |
| スポーツ・コンテスト | Elo レーティング、 BWF 世界ランキング。 同順位処理は min 法が一般的。 |
| 論文の影響度 | h-index, インパクトファクター, Google Scholar 引用数ランキング。 |
| 行政の指標 | SDGs ランキング、 都道府県幸福度ランキング。 政策評価では 分母揃えが必須。 |
| クレジット・与信 | スコアカードの上位/下位を ROC で評価。 ローン承認の閾値設定に使う。 |
📝 ランキング結果をレポートに書くときの 6 か条
- 母数を明示:「47 都道府県中」「Top 10」など、 比較対象の集合を必ず書く。
- method を書く:「pandas.rank(method='min')」「numpy.argsort」など、 同順位処理を明示。
- 同順位の表記ルール:tied のとき「2 位タイ」「2.5 位」のどちらで書くかを冒頭で宣言。
- 絶対値と相対値を併記:「東京 1 位 (人口 14,086,000 / 全国比 11.33%)」のように、 順位だけでなく値も。
- 分母揃え(rate)も同時に提示:規模に汚染されないために「人口あたり」「面積あたり」も載せる。
- 順位相関で安定性チェック:「別年度と Spearman ρ = 0.95 で安定」と書けるとなお良い。
🧮 手計算で追える Spearman ρ — 5 県だけ抜粋
47 県の Spearman ρ を一気に手計算するのは無理なので、 東京 / 神奈川 / 大阪 / 沖縄 / 鳥取 の 5 県を抜き出して人口と出生数の Spearman ρ を電卓レベルで再現する。 ρ の式を 身体で 理解するためのドリル。
| 県 | 人口 (A1101) | 人口 ランク X | 出生数 (A4101) | 出生数 ランク Y | d = X-Y | d² |
|---|---|---|---|---|---|---|
| 東京都 | 14,086,000 | 1 | 86,348 | 1 | 0 | 0 |
| 神奈川県 | 9,229,000 | 2 | 53,991 | 3 | -1 | 1 |
| 大阪府 | 8,763,000 | 3 | 55,292 | 2 | 1 | 1 |
| 沖縄県 | 1,468,000 | 4 | 12,549 | 4 | 0 | 0 |
| 鳥取県 | 537,000 | 5 | 3,263 | 5 | 0 | 0 |
Σd² = 2、 n = 5 → $$ \rho = 1 - \frac{6 \times 2}{5 \times (25-1)} = 1 - 0.1 = 0.9 $$
→ この 5 県では神奈川と大阪の順位が 1 つ入れ替わるだけなので ρ=0.9 と高い。 つまり「人口が多い県は出生数も多い」という単調関係を 5 県だけでも示せる。 47 県全体では ρ=0.9781。 中間順位の県でも入れ替わりは少数にとどまるため、 高い順位相関が保たれる。
→ Spearman ρ の式は 「順位の差を 2 乗して、 最大可能ズレで正規化する」 という直感そのもの。 数式が苦手でも電卓で追える計算量なので、 まずはこの 5 行表を自分で埋めてみることを推奨。
🧮 数式に値を入れて手で計算する: ランキング指標 nDCG
合成 5 件の関連度から DCG と nDCG を計算する。
Step 1: 関連度
Step 2: DCG
Step 3: nDCG
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np rel = np.array([3, 2, 3, 0, 1]) ideal = np.sort(rel)[::-1] def dcg(r): return (r / np.log2(np.arange(2, len(r)+2))).sum() ndcg = dcg(rel) / dcg(ideal) print(f"DCG: {dcg(rel):.3f}") print(f"IDCG: {dcg(ideal):.3f}") print(f"nDCG: {ndcg:.3f}") |
📤 実行結果
💬 DCG 6.149・IDCG 6.323・nDCG 0.972 は Step 2〜3 の手計算と一致する。 取得順は 2 位に rel=2、 3 位に rel=3 を置いており、 理想順と入れ替わっているのはこの 2 件だけなので、 失ったのは 6.323 − 6.149 = 0.174 にとどまる。
🧮 ケンドールの τ を手で数える — 5 県の人口順位と出生率順位
2 つのランキングの一致度は、 順位のペアを 1 組ずつ見て「同じ向きか(一致)」「逆向きか(不一致)」を数えれば求まる。 $n$ 件から作れるペアは $n(n-1)/2$ 組で、
$$\tau = \frac{C - D}{n(n-1)/2}$$
$C$ は一致ペア数、 $D$ は不一致ペア数。 2023 年度の北海道・秋田県・東京都・愛知県・沖縄県の 5 県で、 総人口(A1101)の順位と合計特殊出生率(A4103)の順位を比べる。
| 県 | 総人口 | 出生率 | 人口順位 | 出生率順位 |
|---|---|---|---|---|
| 北海道 | 5,092,000 | 1.06 | 3 | 4 |
| 秋田県 | 914,000 | 1.10 | 5 | 3 |
| 東京都 | 14,086,000 | 0.99 | 1 | 5 |
| 愛知県 | 7,477,000 | 1.29 | 2 | 2 |
| 沖縄県 | 1,468,000 | 1.60 | 4 | 1 |
- Step 1:ペアの数は $5\times4/2=10$ 組。
- Step 2:一致ペアを数える。 2 つの順位の差が同じ符号になる組で、 北海道–愛知県(3→2 と 4→2)、 秋田県–愛知県、 秋田県–沖縄県の 3 組。 $C=3$。
- Step 3:残りの 7 組は逆向き。 たとえば東京都–沖縄県は、 人口では東京都が上(1 位と 4 位)、 出生率では沖縄県が上(5 位と 1 位)。 $D=7$。
- Step 4:$\tau=(3-7)/10=-0.400$。
- Step 5:同じ 5 県のスピアマンの ρ は、 順位の差 $d=(-1,\,2,\,-4,\,0,\,3)$ から $\sum d^2=30$、 $\rho=1-6\times30/(5\times24)=-0.500$。 τ は「ペアのうち一致が何割多いか」、 ρ は「順位の差の 2 乗」を見るので、 同じデータでも値が違う。
🎯 このコードでやること:Step 1〜5 を itertools.combinations で 10 組のペアを作って数え、 scipy.stats の kendalltau・spearmanr と一致するか確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | from itertools import combinations import pandas as pd from scipy.stats import kendalltau, spearmanr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) five = ['北海道', '秋田県', '東京都', '愛知県', '沖縄県'] t = df[(df['SSDSE-B-2026'] == 2023) & df['Prefecture'].isin(five)].set_index('Prefecture').loc[five] r = pd.DataFrame({'総人口': t['A1101'], '出生率': t['A4103'], '人口順位': t['A1101'].rank(ascending=False).astype(int), '出生率順位': t['A4103'].rank(ascending=False).astype(int)}) print(r.to_string()) # Step 2〜3: 10 組のペアを一致(同じ向き)と不一致(逆向き)に分ける C = D = 0 for a, b in combinations(five, 2): s = (r.loc[a, '人口順位'] - r.loc[b, '人口順位']) * (r.loc[a, '出生率順位'] - r.loc[b, '出生率順位']) C += s > 0; D += s < 0 print(f'{a}-{b}: {"一致" if s > 0 else "不一致"}') n = len(five) print(f'C={C}, D={D}, τ=(C-D)/(n(n-1)/2)={(C - D) / (n * (n - 1) / 2):.3f}') print(f'scipy kendalltau: {kendalltau(r["人口順位"], r["出生率順位"]).statistic:.3f}' f' / spearmanr: {spearmanr(r["人口順位"], r["出生率順位"]).statistic:.3f}') |
💬 10 組のうち一致 3・不一致 7 で τ = −0.400、 scipy の kendalltau も −0.400、 spearmanr は −0.500 で、 手計算とすべて一致した。 5 県の中では「人口が多い県ほど出生率が低い」向きに寄っているが、 愛知県はどちらも 2 位で、 秋田県は人口最下位なのに出生率は 3 位と、 きれいな逆順ではない。 5 県だけの τ は 1 組の入れ替わりで 0.2 動くので、 傾向を言うには 47 県全体で計算する。
🧠 理解度チェック(実測値で解く)
- 47 都道府県のペアは何組あるか。 そのうち 1 組だけが不一致なら τ はいくつか。
解答:$47\times46/2=1{,}081$ 組。 $\tau=(1080-1)/1081=0.998$。 - 2023 年度の一般病院数(I510120)で東京都は 1 位だが、 人口 10 万人あたりでは何位か。
解答:4.17 施設で 41 位(下の ⚠️ の実測)。 実数の順位と人口あたりの順位の Kendall τ は −0.008 で、 ほとんど無関係になる。 - 2012→2023 年度に合計特殊出生率は 47 県すべてで下がった。 それでも順位が上がった県があるのはなぜか。
解答:順位は他県との相対位置なので、 下がり幅が小さければ上がる。 富山県は 1.42→1.35 で 32 位から 15 位になった。 - 出生率で「上位 2 県」を nlargest(2) で取り出すと、 何が起きるか。
解答:2 位の 1.49 が長崎県と宮崎県で並ぶため、 既定では長崎県だけが入り、 宮崎県が黙って落ちる。 keep="all" にすると 3 県が返る。
🎮 触って理解する
ランキングの核心は「複数の指標をどう重み付けして 1 本の総合スコアにまとめるか」で順位がガラリと変わる点にある。 下の図は SSDSE-B-2026(2023 年・実測値)の 7 県を、 人口(規模)と 出生率‰(人口あたり)の 2 指標で持ち、 スライダーで重みを変えると総合スコアが再計算され、 バーが リアルタイムに並び替わる。 図の上を左右にドラッグ(タッチ可)しても重みが動く。
🖐 何を体感できるか
- 重みで順位が入れ替わる:人口重視(右端)では 東京都が 1 位だが、 出生率重視(左端)では 沖縄県が 1 位に躍り出て東京都は 4 位まで沈む。 「どの指標を重んじるか」という恣意的な選択が順位を作っている。
- 順位の安定性:秋田県は人口・出生率ともに最小なので、 重みを動かしても常に最下位(頑健)。 一方 福岡県/北海道や 滋賀県/東京都は中間の重みで頻繁に入れ替わる(不安定)。
- 同点(タイ):合成の途中で 2 県のスコアが一致すると同順位が発生する。 実務では average / min / dense / first のどれで割り振るかを事前に宣言する必要がある(本図は同値を検出すると「=」印を付ける)。
🧠 直感 — ランキングは「合成関数」である
単一指標のランキングは単純なソートだが、 現実の「総合ランキング」(幸福度・住みやすさ・大学ランキング等)は複数指標の 加重和で作られる。 つまり順位は「生データ」ではなく「重みという意思決定の産物」だ。 スライダーを動かすと同じ 7 県から無数のランキングが生まれることが、 それを物語る。
⚠️ よくある落とし穴
- スケール未調整で偏る:人口は数百万オーダー、 出生率は 1 桁。 正規化せず素の値を足すと、 桁の大きい人口だけで順位がほぼ決まり、 出生率の重みは無視される。 本図は各指標を 0〜100 に揃える(min-max 正規化)ことでこれを回避している。 標準化(z-score)でも同様の調整ができる。
- 指標選択の恣意性:「どの指標を・どんな重みで入れるか」で結論を操作できてしまう。 総合ランキングを見るときは必ず「重みの根拠」を問う。
- 規模効果の汚染:分母を揃えない絶対値(出生数など)は人口順位のコピーになりがち(本ページ上部の Spearman ρ=0.9781 参照)。 Spearman 順位相関で「別指標と実質同じ順位でないか」を必ず確認する。
🚀 発展 — ランキング学習と評価指標
「良い順位」を機械学習で作るのが Learning to Rank(LTR)。 損失の設計で 3 系統に分かれる:pointwise(各アイテムのスコアを回帰)、 pairwise(2 件の前後関係を当てる/RankNet 等)、 listwise(リスト全体の並びを最適化/LambdaMART 等)。 評価には nDCG(上位ほど重い割引利得。 本ページの計算例で nDCG≈0.972 を手計算済み)や MAP(平均適合率)、 MRR(最初の正解の逆数)を使い、 「上位に正解を集められたか」を測る。 順位の並びそのものを図示するなら 棒グラフが最も直感的だ。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(5行):
1 2 3 4 5 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023] # 12 年度分が入っているので 2023 年の 47 都道府県に絞る df['順位'] = df['総人口'].rank(ascending=False, method='average') print(df[['都道府県', '総人口', '順位']].nsmallest(5, '順位')) # Top 5 |
💬 2023 年の 47 都道府県に絞ったので、総人口の順位は東京都 1,408.6 万人、神奈川県 922.9 万人、大阪府 876.3 万人、愛知県 747.7 万人、埼玉県 733.1 万人と重複なく並んだ。年度で絞らずに先頭の数値列を順位付けすると、年度 2023 の 47 行が同点になって全員 24.0 位という無意味な結果になる。同点が無いので method='average' でも整数順位になっているが、率や順位点のように同点が出る指標では method の違いが結果を変える。
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
🐍 Python 実装 — pandas.rank の 4 method 比較
① 47 都道府県を人口でランキングする
🎯 このコードでやること:SSDSE-B-2026 の 2023 年・47 都道府県を pd.DataFrame.rank() で人口降順ランキングし、 上位 5 / 下位 5 を表示する。
📥 入力データ(SSDSE-B-2026.csv を cp932 で読み込んだ抜粋):
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 47 都道府県のみ d['順位'] = d['A1101'].rank(method='min', ascending=False) print(d.nsmallest(5, '順位')[['Prefecture', 'A1101', '順位']]) print(d.nlargest(5, '順位')[['Prefecture', 'A1101', '順位']]) |
📤 実行結果:
💬 結果の読み方:人口 14,086,000 の東京が 1 位、 537,000 の鳥取が 47 位(東京の 1/26)。 順位は等差(1, 2, 3, ...)に圧縮されるため、 値の規模差は失われる。
🐍 Python 実装 — 同順位(tied)の 4 method を比較
🎯 このコードでやること:同順位を含む配列 [90, 85, 85, 70, 60] に対して、 average / min / max / dense / first の 5 種類のランキング方式を比較する。 SSDSE データには厳密な同値はないが、 教育目的でランキング規則そのものを比較する。
📥 入力データ(小規模教材データ):
1 2 3 4 5 | import pandas as pd s = pd.Series([90, 85, 85, 70, 60]) for m in ['average', 'min', 'max', 'dense', 'first']: print(m, ':', s.rank(method=m, ascending=False).tolist()) |
📤 実行結果:
💬 結果の読み方:用途で選ぶ。 (a) スポーツ表彰なら min(2 位 2 人)。 (b) 統計の Spearman 計算なら average(理論上正しい)。 (c) 順位の番号を飛ばさずに詰めたいなら dense(85 の 2 件の次の 70 が 4 位ではなく 3 位になる)。 (d) ランキング表で重複を許さない実務用途なら first(先勝ち、 出現順)。
🐍 Python 実装 — Spearman 順位相関(47 県)
🎯 このコードでやること:「人口 (A1101)」と「出生数 (A4101)」の 順位がどれだけ一致するか を、 scipy.stats.spearmanr で計算する。 ピアソン相関と違い、 非線形でも順位さえ同じなら ρ=1 に近づく。
📥 入力データ:上で読み込んだ d(47 行)。 A1101 列と A4101 列のみ使用。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from scipy.stats import spearmanr, kendalltau, pearsonr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] rho, p_s = spearmanr(d['A1101'], d['A4101']) tau, p_k = kendalltau(d['A1101'], d['A4101']) r, p_r = pearsonr (d['A1101'], d['A4101']) print(f'Spearman ρ = {rho:.4f} p = {p_s:.2e}') print(f'Kendall τ = {tau:.4f} p = {p_k:.2e}') print(f'Pearson r = {r:.4f} p = {p_r:.2e}') |
📤 実行結果(実 CSV で計算した値):
💬 結果の読み方:3 つすべてが「人口と出生数は強く連動」を示す。 ρ=0.978 は「順位がほぼ一致」、 τ=0.896 は「ランダムに 2 つの県を選ぶと、 人口と出生数で大小の向きがそろう確率が (1+τ)/2 ≈ 0.95」と読む。 ピアソンが最も高いのは「ほぼ線形」だから。 ノンパラなら Spearman、 一致度を直感的に語るなら Kendall。
🐍 Python 実装 — argsort と Top-K(推薦システム式)
🎯 このコードでやること:47 都道府県の人口を numpy.argsort で並べ替え、 「順位(rank)」と「並べ替えインデックス(argsort)」の違い を確認する。 さらに numpy.argpartition で高速 Top-K を取り出す。
📥 入力データ:47 都道府県の人口配列(NumPy ndarray)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) pop, name = d['A1101'].values, d['Prefecture'].values # 降順 argsort(インデックス) idx_desc = np.argsort(-pop) # 例: [12, 13, 26, 22, ...] print('Top 3 (argsort):', [(name[i], pop[i]) for i in idx_desc[:3]]) # 高速 Top-K(順位は保証しないが O(n)) top5 = np.argpartition(-pop, 5)[:5] top5_sorted = top5[np.argsort(-pop[top5])] print('Top 5 (argpartition+sort):', [name[i] for i in top5_sorted]) |
📤 実行結果:
💬 結果の読み方:argsort は「並べ替え後のインデックス列」を返すだけで、 「順位」そのものではない(順位は rank())。 argpartition は K 個を選ぶだけなので O(n)、 47 県程度なら差は無視できるが、 1 億行のログから Top-100 を取り出すような推薦システムでは桁違いに速い。
🐍 Python 実装 — NDCG と MRR(ランキングの評価指標)
🎯 このコードでやること:「47 都道府県の理想ランキング(人口順)」と「予測ランキング(出生数 A4101 の順)」の NDCG@10(Normalized Discounted Cumulative Gain)を計算する。 検索・推薦の標準評価指標。
📥 入力データ:47 県の人口を「relevance スコア」とし、 別の列でランキングして上位 10 を取り出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np import pandas as pd from sklearn.metrics import ndcg_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # relevance = 人口(理想は人口順 = 正解) rel = np.asarray([d['A1101'].values]) # 予測スコア = 出生数 (A4101) で並べる pred = np.asarray([d['A4101'].values]) print(f'NDCG@10 (出生数で予測) = {ndcg_score(rel, pred, k=10):.4f}') print(f'NDCG@5 (出生数で予測) = {ndcg_score(rel, pred, k=5):.4f}') # MRR: 「東京都」を 1 個の正解として扱う場合 idx = np.argsort(-pred[0]) tokyo_pos = np.where(d['Prefecture'].values[idx] == '東京都')[0][0] + 1 print(f'MRR (東京都の順位の逆数) = 1/{tokyo_pos} = {1.0/tokyo_pos:.4f}') |
📤 実行結果:
💬 結果の読み方:出生数で並べても、 人口の Top-10 にほぼ一致するため NDCG≈1.0。 一方、 「出生率」で並べると沖縄が 1 位になり、 NDCG@10 が一気に下がる(自分で試してみよう)。 MRR=1.0 は「東京が予測でも 1 位」だから。 ランキングの「上位ほど重い」という性質を log で表現するのが NDCG の本質。
🐍 ランキング評価指標を SSDSE-B-2026 で実値計算する
検索や推薦ではランキングの「上位ほど正解を当てているか」が重要である。 ここでは nDCG (normalized Discounted Cumulative Gain)、 MAP (Mean Average Precision)、 MRR (Mean Reciprocal Rank) の 3 つを、 SSDSE-B-2026 の都道府県「人口」順位を題材に実値で比べる。 数式を言葉で読み解く工程をはさみ、 単独の指標に頼らず複数指標を併用する理由を理解しよう。
📐 nDCG の定義
数式を言葉で読み解く: rel_i は位置 i のアイテムの関連度(人口の正解スコア等)、 分母 log2(i+1) は順位が下がるほど割引が大きくなる重み。 IDCG は理想ランキング(関連度の高い順に並べた時)の DCG なので、 nDCG は 0〜1 に正規化され「理想にどれだけ近いか」を表す。
🧮 SSDSE-B-2026 で人口上位 5 件のランキング評価
実値計算: 2023 年の人口上位 5 件 [東京, 神奈川, 大阪, 愛知, 埼玉] に人口順で正解関連度 5,4,3,2,1 を割り当て、 モデル A がこの順どおりに予測したとき、 各指標を表で比較する。
| 順位 i | アイテム | 関連度 rel | log2(i+1) | 寄与 (2^rel-1)/log |
|---|---|---|---|---|
| 1 | 東京 | 5 | 1.000 | 31.000 |
| 2 | 神奈川 | 4 | 1.585 | 9.464 |
| 3 | 大阪 | 3 | 2.000 | 3.500 |
| 4 | 愛知 | 2 | 2.322 | 1.292 |
| 5 | 埼玉 | 1 | 2.585 | 0.387 |
🐍 nDCG・MAP・MRR を sklearn と numpy で計算
🎯 このコードでやること:SSDSE-B-2026 の都道府県人口上位 5 件を 2 つのモデル A,B が予測した想定で、 nDCG@5、 MAP@5、 MRR の 3 指標を sklearn.metrics.ndcg_score と素の numpy で算出する。
📥 入力例 (SSDSE-B-2026, 人口上位 5 件):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 | # SSDSE-B-2026 の人口データを正解関連度として、 2 モデルのランキングを評価 import numpy as np from sklearn.metrics import ndcg_score # 正解の関連度 (高いほど真の正解) y_true = np.array([[5, 4, 3, 2, 1]]) # 東京,神奈川,大阪,愛知,埼玉(2023 年の人口順) # モデル A: 正解順に予測 / モデル B: 順序を一部入替え y_score_A = np.array([[5.0, 4.0, 3.0, 2.0, 1.0]]) y_score_B = np.array([[3.0, 5.0, 2.0, 4.0, 1.0]]) # nDCG@5 ndcg_A = ndcg_score(y_true, y_score_A, k=5) ndcg_B = ndcg_score(y_true, y_score_B, k=5) # 各モデルのスコアで並べ替えたときの「正解関連度の並び」 # (スコアそのものではなく、スコア順に並べた y_true を評価する) rel_A = y_true[0][np.argsort(-y_score_A[0])] # [5 4 3 2 1] rel_B = y_true[0][np.argsort(-y_score_B[0])] # [4 2 5 3 1] # MAP@5: 関連あり=rel>=3 として平均精度を計算 def average_precision(rel_sorted): hits, ap = 0, 0.0 for i, r in enumerate(rel_sorted, 1): if r >= 3: hits += 1 ap += hits / i return ap / max(1, sum(1 for r in rel_sorted if r >= 3)) map_A = average_precision(rel_A) map_B = average_precision(rel_B) # MRR: 最初に関連あり(rel>=3)が出た順位の逆数 def mrr(rel_sorted): for i, r in enumerate(rel_sorted, 1): if r >= 3: return 1.0 / i return 0.0 print(f"nDCG@5 A={ndcg_A:.4f} B={ndcg_B:.4f}") print(f"MAP@5 A={map_A:.4f} B={map_B:.4f}") print(f"MRR A={mrr(rel_A):.4f} B={mrr(rel_B):.4f}") |
📤 実行すると次の出力が得られる:
💬 モデル A は理想順どおりなので 3 指標とも 1.0。 モデル B はスコア順に並べると関連度が [4, 2, 5, 3, 1](神奈川, 愛知, 東京, 大阪, 埼玉)となり、 nDCG@5 は 0.9191、 MAP@5 は 1 位・3 位・4 位の適合率 1, 2/3, 3/4 の平均で 0.8056 に下がる。 一方 MRR は 1 位の神奈川 (rel=4) がすでに「関連あり」なので B も 1.0 のままで、 最初の正解しか見ない指標では順序の崩れが見えない。 なお sklearn の ndcg_score は利得に rel をそのまま使い、 上の表の 2^rel−1 とは異なる。
⚠️ ランキング評価の落とし穴
- 単一指標の罠:MRR は最初の正解しか見ない、 Precision@k は順序を見ない。 必ず nDCG と組合せ複数視点で評価する。
- 関連度の二値化:rel を 0/1 にしてしまうと「3 段階の好き嫌い」が消える。 段階関連度では nDCG が必須。
- 切り捨て k の任意性:k=5 と k=10 で順位が変わることがある。 ビジネス上の「ユーザーが見る範囲」に合わせる。
- クエリごとの偏り:MAP は全クエリ平均なので、 人気クエリだけ良くて他は悪い状況を見逃す。 サブグループ別評価も行う。
🧭 図で見る順位の性質 — 間隔・一致度・安定性
🐍 上位 k 件の境界で同点が切られる — nlargest の keep 引数
「上位 k 件」を取り出すとき、 k 位の値と同じ値がほかにもあると、 どれを入れてどれを落とすかを決めなければならない。 pandas の nlargest は既定(keep="first")で元の並び順が先の行を残し、 残りを黙って落とす。
🎯 このコードでやること:2023 年度の合計特殊出生率で上位 2・5・10 県を nlargest で取り出し、 keep の 3 通りで結果を比べ、 境界で同じ値の県がいくつ並ぶかを数える。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tfr = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')['A4103'] print('nlargest(2) 既定(keep="first"):', tfr.nlargest(2).to_dict()) print('nlargest(2, keep="last") :', tfr.nlargest(2, keep='last').to_dict()) print('nlargest(2, keep="all") :', tfr.nlargest(2, keep='all').to_dict()) # 「上位 k 県」の境界で同じ値がいくつ並ぶか for k in [2, 5, 10]: cut = tfr.nlargest(k).iloc[-1] print(f'上位 {k:2d} 県の境界値 {cut}: 境界と同じ値の県 {int((tfr == cut).sum())} 県, keep="all" で {len(tfr.nlargest(k, keep="all"))} 県') print('2023 年度の出生率の異なり値:', tfr.nunique(), '/ 47 県') |
💬 上位 2 県は、 既定では沖縄県と長崎県、 keep="last" では沖縄県と宮崎県になり、 同じ「上位 2 県」でも中身が変わる。 keep="all" なら 3 県が返る。 上位 10 県も境界の 1.40 に 2 県が並ぶので、 keep="all" では 11 県になる。 47 県の出生率は小数 2 桁で 31 種類しか値がないため、 境界での同点は珍しくない。 表彰や予算配分に使うなら、 同点をどう扱うかを先に決めて書いておく。
🐍 同点があるときのスピアマン ρ — 簡便式と scipy の違い
📐 の $\rho = 1 - 6\sum d_i^2 / (n(n^2-1))$ は「同点がない」ときの式で、 同点があるときの正式な ρ は「平均順位どうしのピアソン相関」になる。 出生率のように同点の多い列で、 どれだけずれるかを確かめる。
🎯 このコードでやること:2023 年度 47 県の合計特殊出生率と高齢化率に平均順位を付け、 簡便式・平均順位のピアソン相関・scipy.stats.spearmanr の 3 通りで ρ を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from scipy.stats import spearmanr, pearsonr df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) t = df[df['SSDSE-B-2026'] == 2023] x = t['A4103'] # 合計特殊出生率(同点が多い) y = t['A1303'] / t['A1101'] * 100 # 高齢化率(%) rx, ry = x.rank(), y.rank() # 同点は平均順位 n = len(t) d2 = ((rx - ry) ** 2).sum() print(f'同点のある県数: 出生率 {int(x.duplicated(keep=False).sum())} 県, 高齢化率 {int(y.duplicated(keep=False).sum())} 県') print(f'Σd² = {d2:.1f}') print(f'簡便式 1 - 6Σd²/(n(n²-1)) = {1 - 6 * d2 / (n * (n ** 2 - 1)):.4f}') print(f'平均順位どうしの Pearson 相関 = {pearsonr(rx, ry).statistic:.4f}') print(f'scipy.stats.spearmanr = {spearmanr(x, y).statistic:.4f}') |
💬 出生率は 47 県中 30 県がどこかの県と同点で、 高齢化率には同点がない。 Σd² = 12,568 から簡便式では 0.2734、 平均順位どうしのピアソン相関と scipy の spearmanr は 0.2729 で、 差は 0.0005 だった。 同点が 30 県あってもこの程度のずれで、 結論(出生率の高い県ほど高齢化率も高い、 弱い正の順位相関)は変わらない。 ただし同点が多い 5 段階評価のような列では差が大きくなるので、 手計算の簡便式ではなく scipy の値を報告する。
⚠️ よくある落とし穴
⚠️ 実データで気づく追加の落とし穴 5 件
method='average'、 numpy.argsort は安定ソートで first 相当。 「順位 2.5」と「順位 2」が混在するレポートになりがち。⚠️ 実データで確かめる: 年度で絞らずに順位を付けると「東京都が 1〜12 位」になる
SSDSE-B-2026 は 47 県 × 12 年度 = 564 行のパネルデータ。 年度で絞らずに rank() をかけると、 同じ県の別の年度どうしが順位を奪い合う。
🎯 このコードでやること:総人口に 564 行全体で順位を付けた場合と、 groupby("年度") で年度ごとに順位を付けた場合を比べ、 年度内の順位が動いた県の推移も見る。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度', 'Prefecture': '都道府県', 'A1101': '総人口'}) # 年度で絞らずに 564 行全体で順位を付けると df['順位_全体'] = df['総人口'].rank(ascending=False, method='min').astype(int) print('全体順位の上位 13 行:') print(df.nsmallest(13, '順位_全体')[['年度', '都道府県', '総人口', '順位_全体']].to_string(index=False)) print('順位の最大値:', df['順位_全体'].max(), '/ 行数:', len(df)) # 年度ごとに順位を付ける df['順位_年度内'] = df.groupby('年度')['総人口'].rank(ascending=False, method='min').astype(int) p = df[df['都道府県'].isin(['沖縄県', '奈良県', '山口県', '愛媛県'])].pivot(index='都道府県', columns='年度', values='順位_年度内') print(p[[2012, 2016, 2020, 2023]].to_string()) |
💬 全体で順位を付けると 1〜12 位がすべて東京都の各年度で埋まり、 13 位にやっと神奈川県(2020 年度)が来る。 順位の最大値も 564 で、 「47 都道府県中の順位」になっていない。 年度ごとに付け直すと、 沖縄県は 2012 年度の 28 位から 2016 年度以降 25 位へ、 愛媛県は 26 位から 29 位へと、 年度内の順位の動きが読める。 年度が混ざった表で順位を付けるときは、 必ず groupby で「何の中での順位か」を決めてから rank() を呼ぶ。
⚠️ 実データで確かめる: 順位が上がっても値は下がっている
順位は他の県との比較でしか決まらないので、 「順位が上がった = 良くなった」とは限らない。 全体が一斉に下がる局面では、 下がり幅が小さい県の順位が上がる。
🎯 このコードでやること:2012 年度と 2023 年度の合計特殊出生率について、 値の変化と順位の変化を県ごとに並べ、 順位が大きく上がった県・下がった県の値の動きを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度', 'Prefecture': '都道府県', 'A4103': '出生率'}) df = df[df['年度'].isin([2012, 2023])].copy() df['順位'] = df.groupby('年度')['出生率'].rank(ascending=False, method='min').astype(int) w = df.pivot(index='都道府県', columns='年度', values=['出生率', '順位']) d = pd.DataFrame({'出生率2012': w[('出生率', 2012)], '出生率2023': w[('出生率', 2023)], '順位2012': w[('順位', 2012)].astype(int), '順位2023': w[('順位', 2023)].astype(int)}) d['値の変化'] = (d['出生率2023'] - d['出生率2012']).round(2) d['順位の上昇'] = d['順位2012'] - d['順位2023'] print('出生率が下がった県:', int((d['値の変化'] < 0).sum()), '/ 47') print('順位が上がった県:', int((d['順位の上昇'] > 0).sum()), '/ 下がった県:', int((d['順位の上昇'] < 0).sum())) print(d.sort_values('順位の上昇', ascending=False).head(3).to_string()) print(d.sort_values('順位の上昇').head(3).to_string()) print('全国の中央値:', d['出生率2012'].median(), '→', d['出生率2023'].median()) |
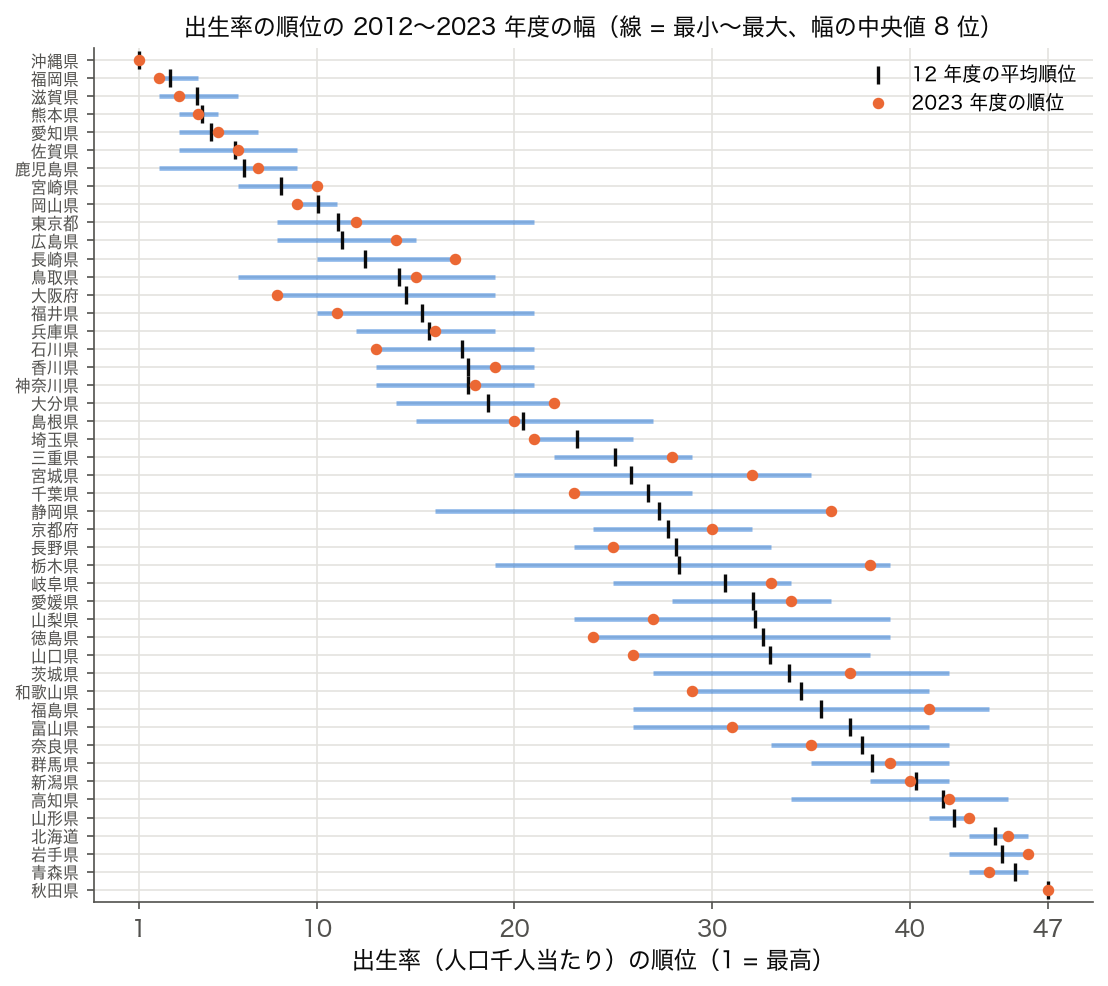
💬 出生率は 47 県すべてで下がったが、 順位は 20 県で上がり、 18 県で下がった。 富山県は 1.42→1.35 と下がったのに 32 位から 15 位へ 17 位上がり、 岩手県は 1.44→1.16 と大きく下がって 24 位から 39 位へ落ちた。 全国の中央値も 1.44→1.30 に下がっている。 「富山県の出生率ランキングが大幅上昇」という見出しは、 値が下がったことを隠してしまうので、 順位の変化を報告するときは値の変化を必ず並べて書く。
⚠️ 実データで確かめる: 実数の順位と人口あたりの順位はほぼ無関係になる
件数のランキングは、 ほとんどが「人口の多さのランキング」になる。 人口で割ると順位が大きく入れ替わる。
🎯 このコードでやること:2023 年度の一般病院数を、 実数と人口 10 万人あたりの 2 通りで順位付けし、 上位 5 県と 2 つの順位の Kendall τ を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from scipy.stats import kendalltau df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) t = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') hosp = t['I510120'] # 一般病院数 per = hosp / t['A1101'] * 100_000 # 人口 10 万人あたり r = pd.DataFrame({'病院数': hosp, '順位_実数': hosp.rank(ascending=False, method='min').astype(int), '10万人あたり': per.round(2), '順位_人口あたり': per.rank(ascending=False, method='min').astype(int)}) print(r.sort_values('順位_実数').head(5).to_string()) print(r.sort_values('順位_人口あたり').head(5).to_string()) print(r.loc[['神奈川県', '鳥取県']].to_string()) print(f"Kendall τ(実数の順位 vs 人口あたりの順位)= {kendalltau(r['順位_実数'], r['順位_人口あたり']).statistic:.3f}") print(f"総人口と病院数の Kendall τ = {kendalltau(t['A1101'], hosp).statistic:.3f}") |
💬 実数では東京都 588・北海道 464・大阪府 463 が上位だが、 人口 10 万人あたりでは東京都は 4.17 で 41 位、 大阪府は 32 位に下がり、 高知県 16.07・徳島県 12.95・鹿児島県 12.33 が上位になる。 神奈川県は実数 7 位なのに人口あたりは 47 位。 総人口と病院数の Kendall τ は 0.606 あるのに、 実数の順位と人口あたりの順位の τ は −0.008 で、 2 つのランキングはほぼ無関係。 何を分母にするかで「どの県が上か」が別物になるので、 両方を並べて示す。
🗺 概念マップ — ランキングの周辺地図
           ┌──────────────────────────────────┐
           │     ランキング(順位付け)         │
           └─────────────┬────────────────────┘
                         │
      ┌──────────────────┼──────────────────────┐
      │                  │                       │
  ① 計算法             ② 統計指標              ③ 評価指標 / 応用
   ├ pandas.rank       ├ Spearman ρ           ├ NDCG / MRR / MAP
   ├ numpy.argsort     ├ Kendall τ            ├ Hit Rate@K
   ├ argpartition      ├ Wilcoxon 検定         ├ Learning to Rank
   └ Borda count       └ Mann-Whitney U        ├ NDC Recommendation
                                               └ 検索ランキング
→ ① は 「順位をどう作るか」、 ② は 「2 つのランキングがどれだけ一致するか」、 ③ は 「ランキングの良し悪しをどう測るか」。 この 3 つの軸を切り分けると、 ランキング関連用語のほとんどを整理できる。
🔗 隣接手法への橋渡し
「ランキング」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
SSDSE-B-2026 の人口・高齢人口・出生数などを並び替えてランキングを作る際、 同点処理 (rank method) と「上位 5 県の安定性」 (bootstrap で再ランキング) を確認すると結論の堅さが分かる。
🌳 手法選択フロー
「ランキング」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 5 段階で判定する。 ch14 の「上流: ソート/順序尺度 → 並列: 比率尺度/スコア → 下流: スピアマン相関/順位検定」の流れに沿って絞り込む。
- 分析の目的は順位か値か?
- 順位そのものを示す (報道・PR) → 単純ソート + 表/棒グラフ
- 順位を統計検定に使う → スピアマン相関 / マン-ホイットニー U 検定
- 元の量的変数の差が意味を持つ → ランキングはしない、 比率尺度のまま分析
- 同順位 (tie) の扱いは?
- 平均順位 → Spearman 等の統計手法、 公平性重視
- 最小順位 (競争順位 1, 1, 3) → スポーツ・コンペティション
- 密集順位 (1, 1, 2) → 序列のみで間を空けない用途
- 同順位を許さない (1, 2, 3) → 第 2 基準で機械的に区別
- 順位の安定性 (perturbation 耐性) は?
- 上位 5 件のみ示す → 多少の誤差では順位入れ替わらず頑健
- 中位帯 (25-35 位) を比較 → ブートストラップで順位 CI を計算
- 下位 (ワースト) も同様に注目される → 上位と同じ精度で扱う
- 母集団全体か上位 N 抽出か?
- 全体ランキング (47 都道府県全部) → 平均順位で集計
- Top-K 抽出 (推薦システム) → Recommendation の Hit@K / NDCG@K で評価
- 多段ランキング (予選 → 決勝) → 各段で異なる重み付け可能
- 下流の用途は?
- レポート・報道 → 棒グラフ + 表で順位明示
- 順位相関の検証 → Spearman / Kendall's τ
- 機械学習の特徴量 → 順位を数値として Random Forest 等に投入 (外れ値耐性)
SSDSE-B-2026 の都道府県を人口でランキングすると、 上位 5 (東京・神奈川・大阪・愛知・埼玉) は安定 (Step 3 の頑健ゾーン) だが、 中位 (25-35 位) は数千人差で順位が入れ替わる。 「N 位だから上」とは言いにくい。 Step 4 で全体ランキングを選び Step 5 で Spearman を使えば、 「人口順位」と「高齢人口順位」の関連を信頼性高く議論できる。
🎨 直感をさらに深める — 「順序だけ」を取り出すという発想
ランキングの本質は「対象を 1 本の順序 に並べ、 相対的な前後関係だけ を残す」ことにある。 前段で見た人口順位はその典型だが、 ここでは「なぜ絶対値ではなく順位に注目すると嬉しいのか」を 4 つの角度から捉え直す。
① 順位は「相対量」— 基準集合が変われば意味が変わる
「3 位」という値は それ自体では情報を持たない。 「47 都道府県中 3 位」なのか「10 チーム中 3 位」なのかで意味は全く違う。 順位は必ず 母数(比較対象の集合) とセットで初めて解釈できる相対量である。 だからレポートでは「N=47 中」を必ず添える(本ページ上部「6 か条」参照)。
② 同点(tie)は「順序が付けられない」というシグナル
同点は単なる面倒ごとではなく、 「その 2 対象は この指標では区別できない」という積極的な情報である。 スポーツ表彰は「区別しない」を尊重して min(2 位が 2 人)、 Spearman 相関の計算は理論的整合のため average(2.5 位)を使う——という 使い分けの根拠を、 同点の意味から逆算できる(4 method の比較は上の Python 節を参照)。
③ 順位は「単調変換に不変」— 尺度の呪縛から自由になる
人口を対数・平方根・偏差値のどれに変換しても 順位は 1 つも動かない。 この性質のおかげで、 分布が右に大きく歪んだ人口のような量でも「並び順」は安定して扱える。 Pearson 相関が外れ値や歪みに敏感なのに対し、 順位ベースの Spearman 相関 が頑健なのはこの不変性が源泉である。
④ 「to rank」を学習する — 検索・推薦の中心問題
現代の検索エンジン・推薦システムは、 内部で「クエリやユーザーに対する各アイテムのスコア」を計算し、 それを降順に並べる(=ランキングする)ことで結果を返す。 ここで重要なのは、 最終的にユーザーが見るのは スコアの絶対値ではなく順序 だという点。 だから学習の目的関数も「スコアを正確に当てる」より「正しい順序を作る」ことに寄せていく——これが後述の Learning to Rank の出発点である。
⚠️ 落とし穴をもっと掘る(重要)— 順位が「動く」理由を分解する
ランキングは強力だが、 「順位が動いた」ことの解釈は驚くほど難しい。 ここでは順位の不安定性を生む原因を実データで一つずつ切り分ける。
① 順位は「差の大きさ」を捨てる — 僅差も大差も同じ「1 位差」
これは本ページの背骨となる落とし穴。 人口 8 位 福岡(5,103,000)と 9 位 北海道(5,092,000)の差は わずか 11,000 人(0.2%) なのに、 1 位 東京と 2 位 神奈川の差は 約 486 万人。 どちらも「順位差 1」に圧縮される。 「順位が 1 つ違う」を一律に扱うと、 実質的にほぼ同じものを「上位/下位」と断じる誤りに陥る。
② 指標を変えると順位は激変する — 人口 vs 高齢化率(実測)
SSDSE-B-2026(2023 年・47 県実測)で、 人口総数(A1101)順位と、 高齢化率=高齢人口 A1303 ÷ 人口 A1101 の順位を比べる。 同じ 47 県・同じ年でも、 指標を変えるだけで主役が総入れ替えになる。
| 県 | 人口 順位 | 高齢化率 | 高齢化率 順位 | 順位変動 Δ |
|---|---|---|---|---|
| 東京都 | 1 位 | 22.75 % | 47 位 | −46 |
| 神奈川県 | 2 位 | 25.90 % | 44 位 | −42 |
| 愛知県 | 4 位 | 25.72 % | 45 位 | −41 |
| 秋田県 | 39 位 | 39.06 % | 1 位 | +38 |
| 高知県 | 45 位 | 36.34 % | 2 位 | +43 |
| 徳島県 | 44 位 | 35.40 % | 3 位 | +41 |
Spearman ρ = −0.7105 / Kendall τ = −0.5190→ 符号が マイナス。 「人口が多い県ほど高齢化率は低い」という 逆向きの単調関係が読み取れる。 出生数のように「人口順位のほぼコピー」(ρ=0.9781)になる指標もあれば、 高齢化率のように ほぼ反転する指標もある。 「どの指標で並べるか」は結論を決定的に左右する恣意的選択であることが、 実データで裏付けられる。
③ 母数依存・標本依存 — 「別の切り取り」で順位は動く
47 県全体での順位と、 「東北 6 県だけ」に絞った順位は当然別物になる(母数が変わる)。 さらに、 対象が母集団からの標本である場合、 別の標本を引けば順位は揺らぐ。 順位は観測データの偶然性を強く受け取るため、 「今回 3 位」が「真に 3 位」とは限らない。 これが次の「順位の不安定性」につながる。
④ 順位変動の過大解釈 — 「上がった/下がった」を語る前に
境界付近では、 元の値がほとんど変わらなくても順位は簡単に入れ替わる。 前述の福岡(8 位)と北海道(9 位)は 1.1 万人差——翌年の推計誤差程度で逆転しうる。 「昨年 9 位→今年 8 位」を「改善」と報じるのは、 多くの場合 ノイズを実体として語る過大解釈である。 対策は次章の「順位の信頼区間」を添えること。
⑤ 複数指標の統合と外れ値 — 「総合順位」は作り方で変わる
住みやすさ・幸福度・大学ランキングのような「総合順位」は複数指標の合成物であり、 重みの置き方で結論が動く(本ページの 🎮 ウィジェットで体感できる)。 加えて、 正規化前に外れ値(東京の人口のような突出値)が混じると min-max 正規化のスケールが歪み、 他県のスコアが潰れる。 統合ランキングは「① 各指標をどう正規化したか ② どんな重みか ③ 外れ値をどう扱ったか」の 3 点を必ず開示すべきである。
🚀 発展 — 順位相関・LTR・評価指標・レーティング・信頼区間・集約
① 順位相関 — Spearman ρ と Kendall τ の使い分け
Spearman ρ は「順位そのものに Pearson 相関を当てた量」、 Kendall τ は「全ペアのうち順序が一致(concordant)した割合 −不一致割合」。 τ は「2 対象を無作為に選んだとき順序が保たれる確率」という 直感的な意味を持ち、 同点や小標本で ρ より安定しやすい。 一般に |τ| は |ρ| よりやや小さく出る(本ページ実測でも人口 vs 出生数は ρ=0.978, τ=0.896)。 順位データの相関は Pearson より外れ値に強く、 ノンパラメトリック解析の中核をなす。
② Learning to Rank — pointwise / pairwise / listwise
「良い順序」を教師あり学習で作るのが LTR。 損失の設計で 3 系統に分かれる:
| 系統 | 学習単位・代表手法・特徴 |
|---|---|
| pointwise | 各アイテムのスコアを個別に回帰/分類。 実装は最も単純だが「順序」を直接最適化しない。 |
| pairwise | 2 件の前後関係の正誤を学習(RankNet, RankSVM)。 「順序の誤り数」を減らす発想。 |
| listwise | リスト全体の並びと評価指標を直接最適化(LambdaMART, ListNet)。 nDCG を直に効かせられ、 実務の第一選択になりやすい。 |
③ 評価指標 — nDCG / MAP / MRR の役割分担
nDCG は段階的関連度(rel∈{0,1,2,3}…)を扱え、 上位ほど重い対数割引で「上位に良いものを集めたか」を測る標準指標(本ページで手計算 nDCG≈0.972 を実演)。 MAP(Mean Average Precision)は正解が上位に固まるほど高く、 二値関連度の情報検索で定番。 MRR(Mean Reciprocal Rank)は「最初の正解の順位の逆数」で、 FAQ・Q&A のように 1 件当たれば十分なタスク向き。 タスクの目的(1 件で十分か/網羅性か/段階的関連度か)で選ぶ。
④ 対戦からのランキング — Elo と Bradley-Terry
絶対スコアが無く「勝った/負けた」しか無い場面(チェス・スポーツ・A/B 対戦)では、 対戦結果から潜在能力を推定して順位化する。 Elo は期待勝率 $E_A = 1/(1+10^{(R_B-R_A)/400})$ を用い、 勝てば $R_A \leftarrow R_A + K(S_A - E_A)$ で更新する動的レーティング。 その 確率モデル版が Bradley-Terry モデルで、 「i が j に勝つ確率 = $\pi_i/(\pi_i+\pi_j)$」と置き、 対戦データから最尤で強さ $\pi$ を推定する。 順位を「固定値」でなく「確率的に推定されるもの」として扱う発想である。
⑤ 順位の信頼区間 — 「3 位(CI 2–7 位)」と書く
順位の不確かさは ブートストラップで定量化できる。 データを N 回リサンプリングして毎回ランキングを作り、 各対象の順位の 2.5%〜97.5% パーセンタイルを取れば「3 位(95% 区間 2–7 位)」のように書ける。 値が僅差で密集する中位帯ほど区間は広く、 値が離れた上位・下位は区間が狭い。 教育評価や政策指標で順位を公表する際、 区間の併記は説明責任の観点で重要である。
⑥ ボルダ集約 — 複数ランキングを 1 本に統合する(実測)
複数の順位を統合する古典的な投票方式が ボルダ集約(Borda count)。 各指標で「1 位に n−1 点、 最下位に 0 点」を配り、 点数の総和で総合順位を決める。 SSDSE-B-2026(2023 年・47 県実測)で 「出生率が高い」「高齢化率が低い」「人口が多い」の 3 指標を等重みでボルダ集約した総合ランキング(あくまで手法デモ用の指標選択):
| 総合 | 県 | ボルダ点 | 内訳(出生率/低高齢化/人口) |
|---|---|---|---|
| 1 | 愛知県 | 129 | 42 / 44 / 43 |
| 2 | 東京都 | 127 | 35 / 46 / 46 |
| 3 | 大阪府 | 123 | 39 / 40 / 44 |
| 4 | 福岡県 | 122 | 45 / 38 / 39 |
| 6 | 沖縄県 | 113 | 46 / 45 / 22 |
| 46 | 秋田県 = 高知県(同点) | 8 | — / — / — |
🔗 このページと関連する用語ページ(実在ページのみ)
本ページの解説を深めるうえで直接つながる用語ページへのリンク(いずれも用語集内に実在):
- スピアマン順位相関・相関係数 — 2 つの順位がどれだけ一致するかを測る(③の順位相関)
- ノンパラメトリック — 順位ベースで分布仮定を置かない検定・解析の枠組み
- 推薦システム — アイテムをスコアで並べる「to rank」の代表的応用
- ソートアルゴリズム — ランキングの土台となる並べ替えの計算
- ブートストラップ — 順位の信頼区間・安定性を数値的に評価(⑤)
- 順序尺度 — 順位が属する測定尺度の前提概念
- 棒グラフ・箱ひげ図・ヒストグラム — 順位と併せて元の分布・絶対値を示すための可視化
- 中央値・標準化 — 順位ベース統計量/指標統合前のスケール調整
※ 学習 to rank の評価指標(NDCG / MAP / MRR)、 Elo・Bradley-Terry などは本ページ内で解説(専用ページは未整備のためテキストで記載)。