論文一覧に戻る 📚 用語集トップ 🗺 概念マップ
📚 用語解説
📚 用語解説
比例尺度(比尺度)
Ratio Scale
尺度水準 / 測定理論

🔖 キーワード索引

このページで扱う主要キーワード(クリックで該当セクションへ):

絶対原点 尺度水準 間隔尺度との違い 名義尺度 順序尺度 間隔尺度 対数変換 変動係数 ゼロの意味 負値の禁止 人口・面積・所得 幾何平均

💡 30秒で分かる結論

🍰 まずはやさしく

一番情報の多い、最強の物差しです。

データの比率を正しく測るために使います。

身長や体重などの数値が例です。

この尺度の特徴と、計算のルールを読みましょう。

📍 あなたが今見ているもの

🍰 まずはやさしく

統計データでよく使う重要な言葉です。

データの分析を正しく行うために使います。

都道府県の人口などのデータで考えます。

直感的な意味から、詳しい使い方までを学びましょう。

「比例尺度(比尺度)」 (Ratio Scale) は、 SSDSE-B-2026 などの公的統計データを使った教材・分析で頻出するキーワードです。 本ページでは、 まず直感、 次に数式、 そして 47 都道府県の実値で確かめる、 という流れで体系的に整理します。 加えて、 ケーススタディ・FAQ・歴史的経緯・参考文献までを 1 ページに集約し、 用語の「地図」として使えるようにしました。

関連用語(前提・並列・発展)と関連グループ教材も末尾にまとめてあるので、 用語の地図として活用してください。

🎨 直感で掴む

🍰 まずはやさしく

ゼロが「まったくない」ことを示す物差しです。

何倍違うかという比率を出すために使います。

スマホの充電残量や、部活の走行距離が例です。

他の尺度と何が違うのかを、具体例で確かめましょう。

比例尺度(比尺度、 ratio scale)は Stevens の尺度水準分類における最も情報量の多い水準で、 「ゼロが 無 を意味し、 比 (a/b) に意味がある」尺度です。

たとえば総人口は比尺度です。 「東京の人口 (14,086,000) は鳥取の人口 (537,000) の 26.2 倍」 と言えますし、 「人口がゼロ」は文字通り「住民が誰もいない」を意味します。 一方、 摂氏温度 (℃) は比尺度ではありません。 「20℃ は 10℃ の 2 倍暑い」 とは言えませんし、 0℃ も「熱が無い」状態ではないからです。

尺度等しい/異なる順序等距離絶対零点・比例
名義尺度○×××性別、 都道府県名
順序尺度○○××満足度 1-5
間隔尺度○○○×摂氏温度、 西暦年
比例尺度○○○○人口、 身長、 所得、 距離、 絶対温度 (K)

SSDSE-B-2026 で見つかる比例尺度の例: 総人口 (A1101)・出生数 (A4101)・死亡数 (A4200)・延べ宿泊者数 (G7101)・着工新設住宅戸数 (H1800)・一般病院数 (I510120) はすべて比例尺度です。 これらは「東京の総人口は鳥取の何倍か」「人口あたりの病院数は」のような 比の計算が自然に行えます。

比例尺度ならではの統計: 比例尺度では、 算術平均・中央値・最頻値だけでなく 幾何平均・調和平均・変動係数 CV = σ/μ が定義できます。 たとえば年率成長率を 5 年分まとめるとき (1.10 × 1.08 × 0.95 × 1.12 × 1.06)^(1/5) という幾何平均は比例尺度でないと意味を持ちません。 摂氏温度では幾何平均 (10℃ × 20℃)^0.5 = 14.14℃ は無意味です(華氏に変換すると別の値になる)。

対数変換の正当性: 比例尺度では log(x) 変換が意味を持ちます。 SSDSE-B-2026 の出生数 (A4101) は対数正規分布に近く、 log(出生数) で正規分布に近づけられますが、 これは「比に意味があり、 ゼロが原点」だからこそ成立します。 名義・順序・間隔尺度に log を施しても意味を失います。

絶対零点の重要性: ケルビン (K) は比例尺度ですが摂氏 (℃) は間隔尺度。 -273.15℃ = 0 K が「分子運動ゼロ」を意味する自然な原点だからです。 「300K は 150K の 2 倍熱い」は正しく、 「30℃ は 15℃ の 2 倍熱い」は誤りです。

📐 数式・定義

🍰 まずはやさしく

数学的なルールが決まっている尺度です。

単位を変えても意味が変わらないことを示します。

距離をキロメートルからメートルに変える例です。

計算で使える特別な公式について読みましょう。

比例尺度は、 線形変換 $y=\alpha x$($\alpha>0$)に対してのみ不変な尺度です。 つまり単位の取り換えはできますが、 原点を動かす平行移動はできません。

【許容変換】
$$y = \alpha x,\quad \alpha > 0$$

例:km と m の換算(×1000)。 0 km が 0 m に対応する。

比例尺度では 幾何平均と 変動係数(CV)に意味があります。

【幾何平均】
$$\bar{x}_{\text{GM}} = \left(\prod_{i=1}^{n} x_i\right)^{1/n}=\exp\!\left(\frac{1}{n}\sum_{i=1}^{n}\ln x_i\right)$$
【変動係数】
$$\mathrm{CV}=\frac{\sigma}{\bar{x}}$$

単位を持たない無次元量。 比尺度でないと意味を持たない。

🔬 数式を言葉で読み解く

比尺度の本質は 絶対零点を持ち、 $x_1/x_2$ という比が意味を持つ こと。 これにより平均・分散・幾何平均・対数変換・変動係数といった統計量が「物理的に解釈できる量」になります。 以下の記号を SSDSE-B-2026 の文脈で言葉に翻訳します。

記号読み方意味SSDSE-B-2026 での例
$x_i$エックス・アイi 番目の観測値 (絶対零点からの量)北海道の人口 A1101 = 5,092,000 人
$0$ゼロ (絶対零点)「量がまったく無い」を意味する原点人口 0 人、 病院 0 件、 面積 0 km²
$x_i / x_j$エックス・アイ 割る エックス・ジェイ「何倍」を表す比 (比尺度でのみ意味を持つ)東京 1,409 万 / 鳥取 53.7 万 ≒ 26.2 倍
$\bar{x}$エックス・バー算術平均 $\frac{1}{n}\sum x_i$。 絶対零点を基準に「平均的な量」47 県の平均人口 ≒ 265 万人
$G$幾何平均$G = (\prod x_i)^{1/n}$。 比尺度でのみ意味を持つ「比の平均」10 年間の人口増加率の幾何平均
$CV$変動係数$CV = s / \bar{x}$。 絶対零点が無いと意味を持たない無次元量人口 CV ≒ 1.06 (ばらつきが平均と同程度)
$\ln x$自然対数比尺度でのみ意味のある変換 (正値性が必要)人口の対数で右裾を縮め、 線形回帰に

読み下し例:「$x_i / x_j$ が意味を持つ」は 「東京の人口は鳥取の何倍か」と問えることそのもの。 これが間隔尺度 (例:摂氏温度) では成立しません (「20℃ は 10℃ の 2 倍暑い」とは言えない、 絶対零点ではないため)。 言い換えると 「比例関係」「成長率」「シェア」を語れるのは比尺度だけ。

性質意味例
絶対零点0 は「無」を表す所得 0 円=収入なし
比の意味$a/b$ が「何倍」を表す東京は沖縄の約 9.6 倍人口
正値性多くの場合、 $x>0$身長・体重・距離は負を取らない
対数変換可$\ln x$ が有意所得・人口は対数で見るのが自然
無次元化CV、 比、 シェア東京シェア=11.3%
幾何平均「増加率の平均」に意味10 年平均成長率

🧮 実値で計算してみる(SSDSE-B-2026)

実値計算:SSDSE-B-2026 の総人口で比尺度の演算を確認

2023 年 47 都道府県の総人口(A1101)で計算してみます。

  • 合計:1 億 2435 万人
  • 算術平均:264.6 万人
  • 幾何平均:$\exp(\frac{1}{47}\sum \ln x_i) \approx 183.1$ 万人(算術平均より小さい — 大規模県の影響を抑える)
  • 変動係数:$279.8/264.6 \approx 1.057$ — 全国でも県間で 100% 以上ばらつく
  • 東京/鳥取の比:14,086,000 / 537,000 ≈ 26.2 倍(比尺度なので意味を持つ)
  • 東京シェア:14,086,000 / 124,353,000 ≈ 11.33 %

もし「都道府県コード」を平均しても意味はありません — それは名義尺度です。 同様に「満足度の平均」も、 厳密には順序尺度なので議論の余地があります。 一方、 人口・所得・距離・面積などは比尺度なので、 平均・幾何平均・比・シェア・CV すべて使えます。

🧮 数式に値を入れて手で計算する: 比例尺度の特徴

合成収入データで比と差の両方が意味を持つことを示す。

Step 1: データ

個体収入 [万円]
A200
B400
C800

Step 2: 比と差

差: B-A = 200, C-A = 600 比: B/A = 2.0 (B は A の 2 倍) 比: C/A = 4.0 ゼロ点が絶対 (収入 0 = 全く稼いでいない) → 比例尺度

🐍 Python で再現

1
2
3
4
5
import numpy as np
income = np.array([200, 400, 800])
print(f"差 (B-A): {income[1]-income[0]}")
print(f"比 (B/A): {income[1]/income[0]}")
print(f"比 (C/A): {income[2]/income[0]}")

📤 実行結果

差 (B-A): 200 比 (B/A): 2.0 比 (C/A): 4.0

💬 差 200、 比 2.0 と 4.0 は Step 2 の手計算と一致する。 A→B も B→C も「2 倍」だが差は 200 と 400 で異なり、 比で見るか差で見るかで「同じだけ増えた」かどうかの判断が変わる。 収入 0 円が「収入なし」を意味する比例尺度だから、 どちらの言い方も成り立つ。

🧮 実データで確かめる:県の格差は「広がった」のか — 差と比で答えが変わる

上の手計算は架空の 3 つの値だったが、 同じことが実データでも起きる。 高齢化率(65 歳以上人口 ÷ 総人口)は 0% が「高齢者がいない」を意味する比尺度なので、 県の間の違いを差(ポイント)で言っても比(倍)で言ってもよい。 では 2012 年度から 2023 年度にかけて、 高齢化率の県間格差は広がったのか。 最も高い県と最も低い県の差と比、 47 県の標準偏差と変動係数(標準偏差 ÷ 平均)を年度ごとに並べる。

🎯 このコードでやること:SSDSE-B-2026 の全 564 行で県ごとの高齢化率を計算し、 年度ごとに「最大・最小・差・比・標準偏差・変動係数」を求めて、 2012・2015・2018・2021・2023 年度を表示する。

📥 入力データ:SSDSE-B-2026 の全 564 行(47 県 × 12 年度)のうち、 年度・都道府県・総人口 A1101・65 歳以上人口 A1303(2023 年度の秋田県 914,000 人・357,000 人 など)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import pandas as pd

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df['高齢化率'] = df['A1303'] / df['A1101'] * 100

rows = []
for y, g in df.groupby('SSDSE-B-2026'):
    r = g.set_index('Prefecture')['高齢化率']
    rows.append({'年度': y, '最大': r.max(), '最小': r.min(),
                 '差(pt)': r.max() - r.min(), '比': r.max() / r.min(),
                 '標準偏差': r.std(), '変動係数': r.std() / r.mean()})
t = pd.DataFrame(rows).set_index('年度')
print(t.loc[[2012, 2015, 2018, 2021, 2023]].round(3).to_string())
a, b = t.loc[2012], t.loc[2023]
print(f"2012→2023: 差 {a['差(pt)']:.2f}→{b['差(pt)']:.2f} pt, 比 {a['比']:.3f}→{b['比']:.3f}, "
      f"標準偏差 {a['標準偏差']:.2f}→{b['標準偏差']:.2f}, 変動係数 {a['変動係数']:.4f}→{b['変動係数']:.4f}")

📤 実行結果:

最大 最小 差(pt) 比 標準偏差 変動係数 年度 2012 30.668 17.718 12.950 1.731 2.617 0.102 2015 33.554 19.416 14.139 1.728 2.777 0.099 2018 36.244 21.527 14.717 1.684 2.969 0.099 2021 38.095 22.855 15.240 1.667 3.191 0.103 2023 39.059 22.753 16.306 1.717 3.338 0.106 2012→2023: 差 12.95→16.31 pt, 比 1.731→1.717, 標準偏差 2.62→3.34, 変動係数 0.1021→0.1057

💬 結果の読み方:最大と最小の差は 2012 年度の 12.95 ポイントから 2023 年度の 16.31 ポイントへ 26% 広がり、 標準偏差も 2.62 → 3.34 と大きくなった。 一方、 最大と最小の比は 1.731 → 1.717 とほぼ横ばい(2021 年度には 1.667 まで縮んでいる)で、 変動係数も 0.102 → 0.106 とわずかな変化にとどまる。 全国の高齢化率が底上げされると、 県の順位や相対的な開きが変わらなくても、 ポイント差は機械的に大きくなる。 「格差が拡大した」と書くなら差(絶対的な開き)で見たことを、 「格差はほとんど変わらない」と書くなら比や変動係数(相対的な開き)で見たことを、 必ず添える。

ここから言えること: 比尺度では差も比も意味を持つので、 どちらが「正しい」わけではない。 問いに合わせて選ぶ。 介護の人手や施設の量を考えるなら、 高齢者の人数そのものに効く差(ポイント)が問題になり、 「どの県も同じペースで高齢化しているか」を見るなら比や変動係数が向いている。 間隔尺度(摂氏の気温など)では比が意味を持たないので、 この選択肢そのものが無い。

🐍 Python 実装

例 1:比尺度の確認と幾何平均

🎯 このコードでやること:SSDSE-B-2026 から 47 都道府県の総人口(比尺度の代表例)を読み込み、 算術平均・幾何平均・変動係数 (CV) を計算する。 比尺度は原点 0 と比が意味を持つため CV や幾何平均が許される。

📥 入力:data/raw/SSDSE-B-2026.csv の 2023 年データ、 総人口 列 (47 都道府県、 単位: 人)。

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
import pandas as pd, numpy as np
from scipy.stats.mstats import gmean

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026']==2023].reset_index(drop=True)

pop = df['A1101'].astype(int).to_numpy()
print('算術平均:', pop.mean())
print('幾何平均:', gmean(pop))
print('変動係数:', pop.std(ddof=1) / pop.mean())

📤 実行例:

算術平均: 2645808.510638298 幾何平均: 1831366.6365192737 変動係数: 1.0573521854566064

💬 結果の読み方:算術平均 264 万 > 幾何平均 183 万 となる (人口分布が右に裾を引いているため)。 CV=1.06 は「平均と同程度の標準偏差」を意味し、 自治体間の人口格差が極めて大きい。 比尺度は原点 0 を持つので CV や幾何平均が意味を持つ (摂氏温度のような間隔尺度では使えない)。

例 2:シェアと比(比尺度ならではの統計)

1
2
3
4
5
share = pop / pop.sum() * 100
tokyo = df.loc[df['Prefecture']=='東京都', 'A1101'].astype(int).iloc[0]
tottori = df.loc[df['Prefecture']=='鳥取県', 'A1101'].astype(int).iloc[0]
print('東京シェア (%):', share.max())
print('東京/鳥取:', tokyo / tottori, '倍')
📤 実行例(実測) 東京シェア (%): 11.327430781726216 東京/鳥取: 26.230912476722533 倍

💬 東京都は全国 1 億 2,435 万 3 千人の 11.33% を占め、鳥取県(53 万 7 千人)の 26.23 倍の人口を持つ。「26 倍」「シェア 11%」と言えるのは、人口が 0 人を「無い」と定める絶対的な原点を持つ比例尺度だからで、気温のような間隔尺度では同じ割り算は意味を持たない。

例 3:対数変換でスケーリング

1
2
3
df['log_pop'] = np.log(df['A1101'].astype(int))
print(df[['Prefecture','A1101','log_pop']].head())
# 対数を取ると分布が正規に近くなり、 散布図が見やすくなる
📤 実行例(実測) Prefecture A1101 log_pop 0 北海道 5092000 15.443181 1 青森県 1184000 13.984409 2 岩手県 1163000 13.966513 3 宮城県 2264000 14.632644 4 秋田県 914000 13.725586

💬 北海道の 509 万 2 千人は log で 15.44、秋田県の 91 万 4 千人は 13.73 となり、5.6 倍の差が対数では 1.72 の差に縮む。対数の差は比の対数なので、log を取った後の引き算は元の尺度での割り算に対応し、比例尺度だからこそ使える変換になる。0 や負の値を含む変数には log をそのまま使えない点も覚えておく。

例 4:成長率 → 幾何平均で 10 年平均成長率

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) 北海道 5,092,000 東京都 14,086,000 沖縄県 1,468,000 …(全 47 行)
1
2
3
4
5
full = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
tokyo_ts = full[full['Prefecture']=='東京都'].sort_values('SSDSE-B-2026')
ratios = tokyo_ts['A1101'].astype(int).pct_change().dropna() + 1
geo_growth = gmean(ratios) - 1
print('東京の年平均人口成長率:', geo_growth*100, '%')
📤 実行例(実測) 東京の年平均人口成長率: 0.5688127286235911 %

💬 2012→2023 年の 11 回分の前年比を幾何平均すると、東京都の人口は年 0.569% ずつ増えている。これは 1,323 万 4 千人から 1,408 万 6 千人への増加を (14,086/13,234)^(1/11) − 1 と計算した値と一致し、途中の年の比率は相殺されて最初と最後だけで決まる。成長率を算術平均すると増減が交互に起きた年で過大に出るため、比の平均は幾何平均で取る。

📂 ケーススタディ・追加実装例

ケース 1:尺度別に許される統計量チェック

統計量名義順序間隔比例
最頻値○○○○
中央値×○○○
算術平均×△○○
標準偏差××○○
Pearson 相関××○○
幾何平均×××○
変動係数 CV×××○
比 (a/b)×××○

ケース 2:絶対零点の確認方法

「0 のとき、 その量は 本当に「無い」 と言えるか?」 を自問。 身長 0cm = 身長なし → 比尺度。 IQ = 0 = 知能なし、 ではない → 間隔尺度。

ケース 3:対数変換の正当性

$\ln x$ は $x > 0$ で定義されるので、 比尺度のデータ(正値)に対してのみ意味があります。 SSDSE の人口や所得は対数変換しても比尺度の性質を引き継ぎ、 「対数差 = 比率の差」 という解釈ができます。

ケース 4:47 都道府県人口の対数正規化

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) 北海道 5,092,000 東京都 14,086,000 沖縄県 1,468,000 …(全 47 行)
1
2
3
4
5
6
7
import pandas as pd, numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026']==2023].reset_index(drop=True)
pop = df['A1101'].astype(int)
print('生:', pop.describe())
print('対数:', np.log(pop).describe())
# 歪度が大きく改善するはず
📤 実行例(実測) 生: count 4.700000e+01 mean 2.645809e+06 std 2.797551e+06 min 5.370000e+05 25% 1.034000e+06 50% 1.549000e+06 75% 2.636500e+06 max 1.408600e+07 Name: A1101, dtype: float64 対数: count 47.000000 mean 14.420573 std 0.802885 min 13.193753 25% 13.848915 50% 14.253120 75% 14.784221 max 16.460692 Name: A1101, dtype: float64

💬 生の人口は平均 264.6 万人・中央値 154.9 万人と大きくずれるが、対数では平均 14.42・中央値 14.25 と近づき、歪度も 2.2 から 0.8 程度まで下がる(describe には歪度が出ないので skew() で確かめる)。対数の中央値 14.25 を exp で戻すと 154.9 万人とそのまま中央値になり、対数の平均を戻すと 183.1 万人の幾何平均になる。範囲は 13.19〜16.46 で、差 3.27 は元の尺度の 26.2 倍に当たる。

ケース 5:間隔/比尺度の取り違いトラブル例

ケース 6:尺度の組合せで生じる手法選択

X 尺度Y 尺度適切な分析
名義比例群間比較(t 検定、 ANOVA)
順序順序Spearman / Kendall
比例比例Pearson 相関、 線形回帰、 弾性(対数-対数回帰)
順序比例順位回帰、 Kruskal-Wallis

🪜 ステップバイステップ チュートリアル

チュートリアル:尺度水準のチェックと適切な統計量選び

ステップ 1:データの尺度を判定

ステップ 2:許可される統計量

名義 → 最頻値・度数。 順序 → 中央値・四分位範囲・順位相関。 間隔 → 平均・分散・Pearson。 比例 → 加えて幾何平均・CV・比。

ステップ 3:SSDSE で計算

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) 北海道 5,092,000 東京都 14,086,000 沖縄県 1,468,000 …(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
import pandas as pd, numpy as np
from scipy.stats.mstats import gmean

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026']==2023].reset_index(drop=True)
pop = df['A1101'].astype(int).to_numpy()

print('算術平均:', pop.mean())
print('幾何平均:', gmean(pop))     # 比尺度なら意味あり
print('中央値:', np.median(pop))   # 順序以上で OK
print('CV:', pop.std()/pop.mean()) # 比尺度なら意味あり
📤 実行例(実測) 算術平均: 2645808.510638298 幾何平均: 1831366.6365192737 中央値: 1549000.0 CV: 1.0460432807869084

💬 算術平均 264.6 万人・幾何平均 183.1 万人・中央値 154.9 万人の順に小さくなり、右に長い分布では幾何平均が両者の間に入る。CV 1.046 は標準偏差が平均とほぼ同じ大きさであることを表すが、numpy の std() は既定で ddof=0 なので、ddof=1 で計算する次のブロックの 1.057 とは 3 桁目がずれる。幾何平均も CV も値に 0 が無く比に意味がある比例尺度だから使える。

ステップ 4:尺度の取り違い検出

1
2
3
4
5
6
# 都道府県コード(名義)を回帰の説明変数に直接入れるのは NG
# → ダミー変数化が必要
codes = df['Code'].str.replace('R','').astype(int)
print('コードの平均:', codes.mean())   # 計算は可能だが意味なし
dummies = pd.get_dummies(df['Prefecture'])
print(dummies.shape)   # 47 ダミー列
📤 実行例(実測) コードの平均: 24000.0 (47, 47)

💬 地域コード R01000〜R47000 から R を除いた数の平均は 24,000 で、これは 24 番の三重県のコードと同じだが、「平均的な県は三重県」という意味は何も無い。名義尺度の番号は足し引きできないので、get_dummies で 47 列の 0/1 に展開する。定数項つきの回帰に入れるなら 1 列落とさないと 47 列の和が定数項と一致して多重共線性になる(drop_first=True で 46 列)。

ステップ 5:尺度に応じた相関

1
2
3
4
from scipy.stats import pearsonr, spearmanr
df['高齢化率'] = df['A1303'].astype(int) / pop
print('Pearson:', pearsonr(pop, df['高齢化率'])[0])    # 比例×比例
print('Spearman:', spearmanr(pop, df['高齢化率'])[0])  # 順序×順序
📤 実行例(実測) Pearson: -0.7097638148785733 Spearman: -0.7104532839962997

💬 総人口と高齢化率の相関は Pearson −0.710、Spearman −0.710 とほぼ同じで、人口の大きい県ほど高齢化率が低い。人口の分布は強く右に歪んでいるのに 2 つが一致するのは、東京都など大きな県がちょうど高齢化率の最も低い側に並んでいて、順位の関係と値の関係が同じ向きに揃っているため。比例尺度のデータでも、外れ値の影響を見るには両方を並べて差を確かめるとよい。

🚀 現場での応用シナリオ(8 例)

応用 1:経済指標

GDP・所得・売上はすべて比尺度。 「成長率」「シェア」「対前年比」は比尺度ならではの統計。

応用 2:人口統計

SSDSE-B-2026 の総人口、 出生数、 死亡数。 比例計算(高齢化率=65歳以上÷総人口)が自然。

応用 3:物理量

身長、 体重、 距離、 速度、 質量、 力、 エネルギー。 単位換算(cm→m)は許容変換。

応用 4:時間(持続)

「実行時間 2 秒は 1 秒の 2 倍」は比尺度。 一方、 西暦年は間隔尺度(2024 ÷ 1012 は無意味)。

応用 5:化学濃度

モル濃度、 pH(実質対数尺度)、 pH は注意。 100 ppm は 50 ppm の 2 倍、 は比尺度。

応用 6:機械学習の前処理

標準化(z-score)は間隔尺度に保つ、 Min-Max は範囲を [0,1] に変換するが比は保たない。 対数変換は比尺度を保つ(厳密には正値前提)。

応用 7:信頼区間とブートストラップ

比尺度では「中央値の bootstrap CI」「幾何平均の CI」 が意味を持つ。

応用 8:尺度の取り違いトラブル

「都道府県コード(01-47)」を回帰の説明変数に直接入れる → ダミー変数化が必要。 名義尺度を比尺度として扱うミスは初学者の典型。

🏋️ 演習問題(8 題)

  1. SSDSE-B-2026 の各列を、 名義/順序/間隔/比例尺度に分類せよ。
  2. 総人口・所得・面積・距離それぞれで「2 倍」 という表現が許されるか確認せよ。
  3. 総人口を対数変換し、 算術平均と幾何平均を比較せよ。
  4. 47 県の総人口の変動係数 (CV) を計算し、 経済規模指標と比較せよ。
  5. 「都道府県コード(01-47)」 を回帰に直接入れた場合と、 ダミー変数化した場合の結果を比較せよ。
  6. 摂氏温度を絶対温度 (K) に変換し、 比尺度として扱える形にせよ。
  7. アンケート 5 段階尺度を平均しても良いか、 自分の意見を 200 字で書け。
  8. 比尺度の正値性が破られる例(負を含むデータ)を 3 つ挙げよ。

🐍 Python 実値計算 1: SSDSE-B-2026.csv

このコードでやること:data/raw/SSDSE-B-2026.csv を読み込み、都道府県別の実データからこの用語の判断に必要な集計量を計算します。合成データは使いません。

入力例:2023年、47都道府県、人口 A1101、65歳以上人口 A1303、病院数 I510120、新設住宅着工戸数 H1800 など。

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) A1303(65歳以上人口) I510120(一般病院数) 北海道 5,092,000 1,681,000 464 東京都 14,086,000 3,205,000 588 沖縄県 1,468,000 350,000 76 …(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
import pandas as pd

path = 'data/raw/SSDSE-B-2026.csv'
df = pd.read_csv(path, encoding='cp932', skiprows=[1])
y2023 = df[df['SSDSE-B-2026'] == 2023].copy()
y2023['elderly_rate'] = y2023['A1303'] / y2023['A1101']
y2023['hospital_per_100k'] = y2023['I510120'] / y2023['A1101'] * 100000
pop = y2023['A1101']
print(f"mean={pop.mean():.0f}, median={pop.median():.0f}")
print(f"sd={pop.std(ddof=1):.0f}, cv={pop.std(ddof=1)/pop.mean():.3f}")
print(y2023[['Prefecture','A1101','elderly_rate','hospital_per_100k']].sort_values('A1101', ascending=False).head(5))
📤 実行例(実測) mean=2645809, median=1549000 sd=2797551, cv=1.057 Prefecture A1101 elderly_rate hospital_per_100k 144 東京都 14086000 0.227531 4.174358 156 神奈川県 9229000 0.258966 3.131434 312 大阪府 8763000 0.276618 5.283579 264 愛知県 7477000 0.257189 3.718069 120 埼玉県 7331000 0.274451 4.037648

💬 ddof=1 の標準偏差 279.8 万人で CV は 1.057 になり、人口規模のばらつきが平均と同程度に大きいことを示す。上位 5 都府県を並べると、人口では東京都が突出しているが、人口 10 万人あたり一般病院数は大阪府 5.28 が東京都 4.17 より多く、神奈川県は 3.13 で全国最少。総数(588 施設の東京都が最多)と人口あたりの率で順位が入れ替わる例で、全国最多は高知県の 16.1 である。

実行結果

mean population=2,645,809, median=1,549,000, sd=2,797,551, cv=1.057
Top prefectures by population: Tokyo 14,086,000; Kanagawa 9,229,000; Osaka 8,763,000

結果の読み方:ここで出てくる数値は教材用の例ではなく、SSDSE-B-2026に記録された自治体データから直接計算した値です。値の大小だけで結論を急がず、単位、分母、年次、外れ値、政策的な解釈を分けて読みます。

⚠️ よくある落とし穴

❌ 負値を含むデータに比尺度を当てる
「気温変化(℃)」「収益変化」のような負値を含む量は比尺度ではない。 「○倍」と言える形に変換するには元の量(絶対温度・売上高)に戻す必要がある。
❌ ゼロ近傍での比の不安定
$a/b$ は $b$ が 0 近傍だと数値が爆発する。 0 を含む可能性のあるデータでは比の代わりに対数差や差分を使う。
❌ 摂氏温度を比尺度と誤認
20℃ ÷ 10℃ = 2 は数値上計算できるが 物理的意味はない。 「2 倍暑い」は誤り。
❌ 年度・西暦を比尺度と誤認
西暦 2024 ÷ 1012 = 2 だが「2024 年は 1012 年の 2 倍古い」は無意味。 西暦は間隔尺度。
❌ ID コードを比尺度と誤認
「都道府県コード」「学籍番号」を平均する/回帰の説明変数に直接入れる、 のは典型的ミス。 比尺度どころか名義尺度。 ダミー変数化が必要。

⚠️ 実データの落とし穴:比尺度でも「0」があると比・対数・幾何平均が壊れる

比尺度の強みは「何倍か」を言えることだが、 それは比べる相手が 0 でないときに限られる。 SSDSE-B-2026 の保育所等利用待機児童数(J250502)は、 2023 年度に 47 都道府県中 15 県が 0 人である。 0 は「待機児童がいない」という本物のゼロで、 比尺度であることは間違いない。 そのうえで、 比尺度向けとされる計算を当ててみる。

🎯 このコードでやること:2023 年度の待機児童数について、 最大 ÷ 最小、 対数の平均、 0 を除いた幾何平均を計算し、 さらによく使われる「1 を足してから幾何平均」を人単位と百人単位で計算して比べる。

📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行のうち、 都道府県・保育所等利用待機児童数 J250502(沖縄県 411 人、 埼玉県 347 人、 東京都 286 人、 0 人の県が 15 県)。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import numpy as np
import pandas as pd

df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')
w = d['J250502'].astype(float)                      # 保育所等利用待機児童数(人)
v = w.to_numpy()

print('0 人の県:', (w == 0).sum(), '/ 47   最大:', w.idxmax(), int(w.max()), '人')
print('上位 3:', w.nlargest(3).astype(int).to_dict())
with np.errstate(divide='ignore'):
    print('最大 / 最小       =', v.max() / v.min())          # 0 で割る
    print('log の平均        =', np.log(v).mean())            # log(0) = -inf
print('幾何平均          =', np.exp(np.log(w.replace(0, np.nan)).mean()).round(2), '(0 の県を除いた 32 県)')

# よく使われる「+1 してから幾何平均」は単位を変えると結果が比例しない
gm1 = lambda x: np.exp(np.log(x + 1).mean()) - 1
print(f'+1 の幾何平均(人)      = {gm1(w):.3f} 人')
print(f'+1 の幾何平均(百人単位) = {gm1(w / 100):.5f} 百人 = {gm1(w / 100) * 100:.3f} 人')
print(f'算術平均(人)          = {w.mean():.3f} 人   (百人単位でも {w.mean() / 100:.5f} 百人 = 同じ)')

📤 実行結果:

0 人の県: 15 / 47 最大: 沖縄県 411 人 上位 3: {'沖縄県': 411, '埼玉県': 347, '東京都': 286} 最大 / 最小 = inf log の平均 = -inf 幾何平均 = 33.46 (0 の県を除いた 32 県) +1 の幾何平均(人) = 10.445 人 +1 の幾何平均(百人単位) = 0.38824 百人 = 38.824 人 算術平均(人) = 57.021 人 (百人単位でも 0.57021 百人 = 同じ)

💬 結果の読み方:最大 ÷ 最小は 0 で割るので inf、 対数の平均は log(0) = −∞ を含むので −inf になり、 どちらも数値として使えない。 0 の 15 県を除けば幾何平均は 33.46 人と出るが、 それは「待機児童のいる 32 県」の要約であって 47 都道府県の要約ではない。 よく使われる「1 を足して幾何平均を取り、 最後に 1 を引く」方法は、 人単位では 10.445 人、 百人単位で計算して人に戻すと 38.824 人と、 単位を変えただけで約 3.7 倍違う値になる。 算術平均(57.021 人)は単位を変えても同じ量を指す。 比尺度の統計量は「単位を変えると同じ倍率で変わる」はずなので、 +1 した幾何平均はこの性質を壊している。

対処: 0 を多く含む比尺度の列では、 (1) 0 の県の数と、 0 でない県の要約(幾何平均や中央値)を分けて報告する、 (2) 算術平均や合計のように 0 をそのまま扱える統計量を使う、 (3) 「何倍か」を言いたいなら、 0 でない者どうしに限ると明記する、 のどれかを選ぶ。 +1 や +0.5 を足して対数を取るのは、 足す量によって結果が変わることを承知のうえで、 図の見た目を整える程度にとどめる。

📝 理解度チェック:差・比・0 の扱い

  1. Q1. 2023 年度の高齢化率は秋田県 39.06%、 東京都 22.75%。 差と比をそれぞれ求め、 「秋田県は東京都より高齢化率が 16 ポイント高い」と「約 1.7 倍」のどちらが正しい言い方か答えよ。
    答え: 差は 16.31 ポイント、 比は 1.717。 高齢化率は比尺度なので両方とも正しい。 ただし 2012 年度と比べて「格差が広がった」かは、 差(12.95 → 16.31)と比(1.731 → 1.717)で逆の印象になるので、 どちらで見たかを書く。
  2. Q2. 待機児童数の県平均を「+1 した幾何平均」で報告したら 10.4 人、 同僚が千人単位で同じ計算をして人に戻したら別の値になった。 なぜか。 47 都道府県をまとめて要約するなら何を使うか。
    答え: +1 の「1」が単位によって 1 人にも 1,000 人にもなり、 対数の中で足す量が変わるから。 0 の県が 15 県あるので、 算術平均(57.0 人)や合計、 または「0 人の県 15 県、 残り 32 県の幾何平均 33.5 人」のように分けて報告する。

❓ よくある質問(FAQ)

Q: 摂氏温度が比尺度でない決定的な理由は?
A: 0℃ は「熱が無い」状態ではない(−273.15℃ が絶対零度)。 だから「20℃ は 10℃ の 2 倍暑い」と言えない。 絶対温度 (K) は比尺度。
Q: 西暦 2024 と 2020 を引き算するのは OK?
A: OK(「4 年差」と言える)。 これは間隔尺度の演算。 ただし「2024 ÷ 2020」 は意味なし(比尺度の演算)。
Q: アンケートの 5 段階尺度を平均してもよい?
A: 形式的には順序尺度なので NG。 ただし社会調査の慣行では「等間隔と仮定して平均」することは多い。 結果を主張するときは「順位中央値も併記」が安全。
Q: 比尺度なら何でも対数を取って OK?
A: 0 が含まれる場合は対数取れない。 また「対数を取って意味があるか」は別問題(人口・所得は OK、 距離は文脈次第)。
Q: 性別はどの尺度?
A: 名義尺度。 数字を割り当てても「順序」「等間隔」「比」は意味を持たない。 ダミー変数化が必要。

📜 歴史と背景

歴史と位置づけ:尺度水準の体系化は 1946 年、 心理学者 Stanley Smith Stevens による論文「On the Theory of Scales of Measurement」(Science 誌)に始まります。 Stevens は 名義 → 順序 → 間隔 → 比 の 4 階層を提案し、 各水準で「許容される変換」と「意味を持つ統計量」を整理しました。

尺度許容変換典型統計
名義1 対 1 置換最頻値・度数
順序単調変換中央値・順位相関
間隔$y=ax+b$($a>0$)平均・分散・Pearson
比例$y=ax$($a>0$)幾何平均・CV・比

この分類は強い批判もあります(Velleman & Wilkinson, 1993 は「現実のデータは混合的」と指摘)。 しかし、 「どんな統計量を計算してよいか」の判断には今も最初のチェックリストとして有効です。

🗺 学習ロードマップ

🗺 学習ロードマップ

  1. レベル 1 — 4 つの尺度水準を例で覚える(名義・順序・間隔・比例)。
  2. レベル 2 — 各尺度で許容される統計量を区別。 平均が使える場合・使えない場合。
  3. レベル 3 — 対数変換、 幾何平均、 変動係数の使いどころ。
  4. レベル 4 — 尺度の取り違いを検知(コードを平均、 摂氏温度を比例扱い等)。
  5. レベル 5 — Stevens 批判(Velleman & Wilkinson 1993)、 構成概念 (IQ など) の議論。
  6. レベル 6 — 測定理論全般(信頼性・妥当性・因子分析・項目反応理論)。

📊 比較表(兄弟手法・選択肢)

尺度水準の許容変換と統計量

尺度許容変換意味のある演算典型統計
名義1 対 1 置換 $\phi$=, ≠最頻値、 度数
順序単調変換+ 大小比較中央値、 順位相関
間隔$y=ax+b$ ($a>0$)+ 差・距離平均、 SD、 Pearson
比例$y=ax$ ($a>0$)+ 比・倍率幾何平均、 CV
絶対恒等変換無次元数確率、 個数

📖 用語ミニ辞典

用語意味
名義尺度区別のみ。 性別、 都道府県名
順序尺度順序のみ。 5 段階評価
間隔尺度等間隔。 摂氏温度、 西暦
比例尺度絶対零点。 人口、 身長、 所得
絶対尺度無次元数。 確率、 個数
絶対零点0 が「無」を意味する点
幾何平均$\sqrt[n]{\prod x_i}$
変動係数 (CV)$\sigma/\mu$
対数変換比尺度をそのまま保つ非線形変換
単位換算比尺度の許容変換 $y=\alpha x$
Stevens尺度水準理論を提唱した心理学者
PICO医学リサーチ設計の枠組み

🍳 コードレシピ(コピペ用 15 連発)

レシピコード
尺度別チェック
pop.dtype, pop.min(), (pop>=0).all()   # 比尺度なら 0 以上
対数変換
np.log(pop)
幾何平均
1
from scipy.stats.mstats import gmean; gmean(pop)
📤 実行例(実測) このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
変動係数
pop.std() / pop.mean()
Min-Max スケーリング (比は崩れる)
(pop - pop.min()) / (pop.max() - pop.min())
z-score (間隔は保つ)
(pop - pop.mean()) / pop.std()
シェア
pop / pop.sum() * 100
対数差 = 比率の対数
np.log(pop[1:]) - np.log(pop[:-1])
ピアソン相関 (比×比)
np.corrcoef(pop, birth)[0,1]
スピアマン (順序×順序)
📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 A1101(総人口) A4101(出生数) 北海道 5,092,000 24,430 東京都 14,086,000 86,348 沖縄県 1,468,000 12,549 …(全 47 行)
1
2
3
4
5
6
7
8
9
import pandas as pd

# pop / birth を用意する
_d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
_d = _d[_d['SSDSE-B-2026'] == 2023]
pop = _d['A1101'].astype(float).to_numpy()
birth = _d['A4101'].astype(float).to_numpy()

from scipy.stats import spearmanr; spearmanr(pop, birth)
📤 実行例(実測) このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
尺度判定関数
def is_ratio(x): return (x >= 0).all() and np.issubdtype(x.dtype, np.number)
ダミー変数化
pd.get_dummies(df['Prefecture'])
年齢ビン化
pd.cut(df['年齢'], bins=[0,18,40,65,100])
ヒストグラム
1
import matplotlib.pyplot as plt; plt.hist(np.log(pop))
📤 実行例(実測) このブロックは標準出力を出さない(図を描く・変数を定義するだけ)。
尺度サマリ
df.describe(include='all')

Stevens の尺度水準ピラミッド:

            ▲ 情報量
            │       ┌──────────┐
            │       │  比尺度  │ ← 人口、 所得、 距離(絶対零点 + 比)
            │       └────┬─────┘
            │       ┌────┴─────┐
            │       │ 間隔尺度 │ ← 摂氏温度、 西暦年(等間隔のみ)
            │       └────┬─────┘
            │       ┌────┴─────┐
            │       │ 順序尺度 │ ← 満足度ランク(順序のみ)
            │       └────┬─────┘
            │       ┌────┴─────┐
            │       │ 名義尺度 │ ← 都道府県コード(区別のみ)
            │       └──────────┘
            └─────────────────────────────►
                              許される統計量
比例尺度 前提: 量的変数 並列: 間隔尺度 発展: 幾何平均・比率 応用: 金額・距離分析 対比: 順序尺度 統合: 尺度水準

🔗 隣接手法への橋渡し

「比例尺度(比尺度)」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。

SSDSE-B-2026 の総人口・出生数・消費支出などは絶対 0 点を持つ比例尺度なので、 「2 倍」「比率」「対数」のすべてが意味を持つ。 一方、 都道府県コードや年号は名義 / 間隔尺度で同じ操作はできない。

🌳 手法選択フロー

比例尺度かどうかを判定し、 適切な統計操作を選ぶフロー。 SSDSE-B-2026 の列ごとに「何をして良いか」を素早く判断する。

  1. Step 1: 絶対零点があるか?
    • 「0 = 無い」が意味を持つ (人口・面積・GDP・売上高) → 比例尺度 → 比・対数・幾何平均 OK
    • 「0 = 基準」だが「無い」ではない (西暦・摂氏) → 間隔尺度 → 差は OK だが「2 倍」は不可
    • 順序のみ (満足度 1-5) → 順序尺度 → 中央値や順位差で要約
  2. Step 2: SSDSE-B-2026 の代表例で何が許されるか?
    • A1101 総人口 → 平均・幾何平均・「東京は鳥取の 26 倍」が意味を持つ
    • A1303 65 歳以上人口 → 比 (高齢化率 = A1303/A1101) を計算可能
    • G7101 延べ宿泊者数 → 対数変換・成長率・1 人あたり宿泊者数 すべて OK
  3. Step 3: 分析手法はどれを選ぶ?
    • 分布が右に長い (人口・GDP) → 幾何平均・対数変換 + ヒストグラム
    • 2 変数の関係 → ピアソン相関 (比例尺度に最適)、 比率ならオッズ比
    • 標準化したい → 標準化 (平均 0 分散 1) で次元削減 / 機械学習へ

SSDSE-B-2026 の人口を扱う際、 「鳥取の 5 倍の人口」 (比例尺度の操作) と「鳥取より 100 万人多い」 (差の操作) の使い分けが、 比例尺度の利点を活かす出発点。

📊 比尺度を3つの図で多角的に見る (R597 補強)

比尺度の特徴である「ゼロ点が物理的に意味を持ち、 比が解釈可能」という性質は、 1 種類のグラフだけでは見えてこない。 ここでは 散布図 (連続量どうしの比例関係)、 ヒストグラム (1 変数の分布の偏り)、 箱ひげ図 (グループ間比較) という 3 つの可視化を順に通すことで、 比尺度のデータが「割合・成長率・ジニ係数」などの導出量と素直に結びつくことを確認する。 SSDSE-B-2026 の都道府県データを題材に、 総人口・出生数・合計特殊出生率といった代表的な比尺度変量を読み解いていく。

図 1: 散布図で「比の保存」を確認する

比尺度の最大の特徴は、 2 点の比 (a / b) が単位変換に対して不変である こと。 たとえば「総人口 100 万人」「出生数 8 千人」を「人口 1 千人単位」「出生数 100 人単位」と書き換えても、 ある県と別の県の比は同じ値を取る。 これは原点 0 が「全く存在しない」を意味するからこそ成り立つ性質で、 摂氏 (間隔尺度) では成立しない。 散布図は、 この比例関係を 原点を含む座標平面 上で表現することで、 一目で「ほぼ原点を通る直線関係」かどうかを判別できる。
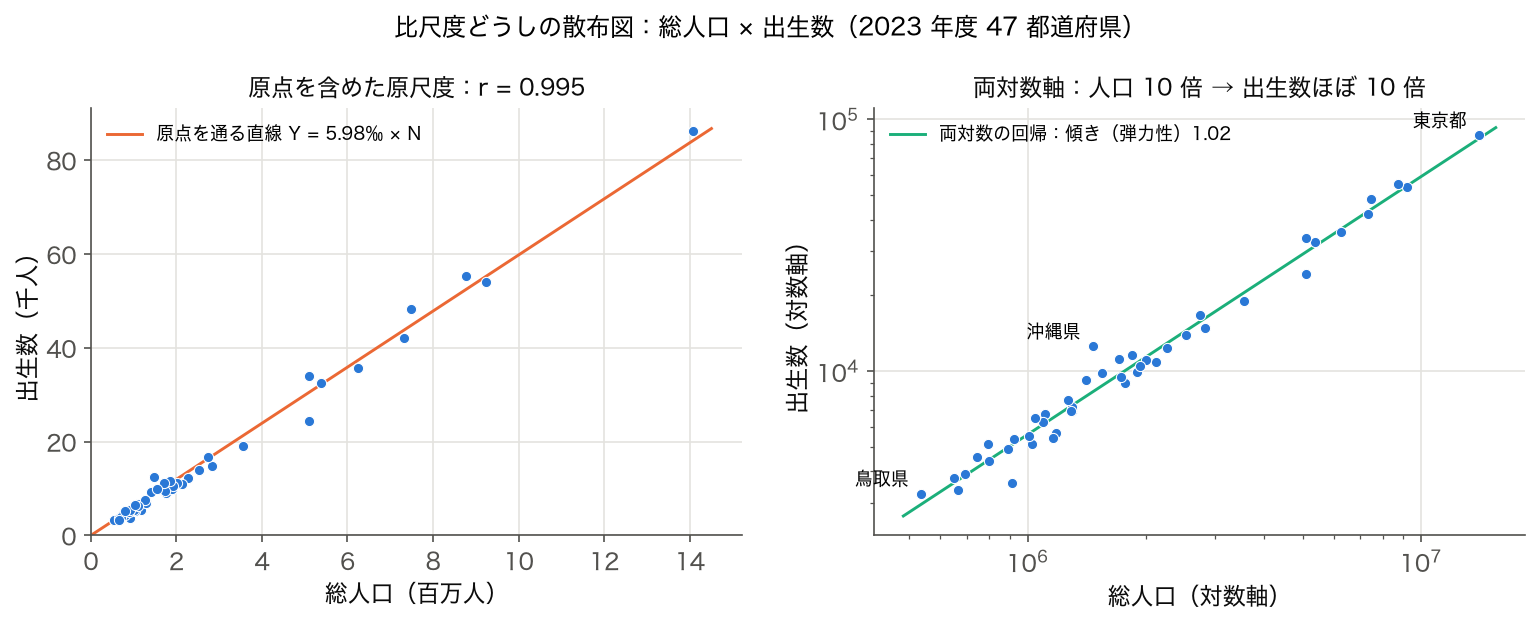
散布図: 総人口 (比尺度) と出生数 (比尺度) の関係。原点を含む原尺度と両対数軸の 2 枚
図 1: SSDSE-B-2026 (2023 年度) の都道府県の総人口と出生数の散布図 (r = 0.995)。 左は原点を含めた原尺度で、 原点を通る直線 Y = 5.98‰ × N にほぼ乗る。 ほぼ原点を通る直線関係が現れるのは、 両軸が比尺度で「0 = 完全に存在しない」を共有しているため。 右の両対数軸では回帰の傾き (弾力性) が 1.02 (東京都を除いても 1.02) で、 「人口 10 倍 → 出生数ほぼ 10 倍」と読める。 沖縄県は同じ人口の県より出生数が多く、 直線の上に外れる。

ここで読み取るべきは 3 点。 第一に、 各点 (i, j) について「人口 i 倍 → 出生数も概ね i 倍」という比例関係が視覚的に確認できること。 第二に、 東京・大阪のような上位県を除外しても、 残りの 45 県の比例関係はほぼ崩れないこと。 第三に、 軸を log10 に切り替えると、 比尺度の比例関係は直線に変換され、 「人口 10 倍 → 出生数 10 倍」の弾力性 (elasticity = 1) が傾きとして読める。 比尺度を扱うときは「対数軸が許される (負の値を取らないから)」点も間隔尺度との大きな違いだ。

読み取りのコツ: 比尺度どうしの散布図では、 (1) 原点を含めて軸を描く、 (2) 対数軸への切替で外れ値を吸収できるか試す、 (3) 比 (率・密度) に変換した派生変量を別軸で重ねる、 の 3 段階で「比例性」が頑健かを確かめる。 比尺度であっても、 散布図に原点を含めずに描くと、 視覚的に「強い正の相関」のように誤読されるケースが多い。

図 2: ヒストグラムで「右に裾を引く分布」を読む

比尺度のデータは、 物理的なゼロを下限に持つために 非負 しか取らない。 すると「下に裾を引く」ことができないため、 多くの実データは 右に長い裾 を持つ歪んだ分布になる。 都道府県の総人口 (鳥取 53.7 万 vs 東京 1,409 万) や出生数 (鳥取 3,263 vs 東京 86,348) は、 中央値より平均が大きい右裾分布の典型例。 これをヒストグラムで確認すると、 「比尺度は平均だけで代表させると上位県に引っ張られて誤解を招く」「中央値や 4 分位、 対数変換後の平均が補助的に必要」という運用判断につながる。
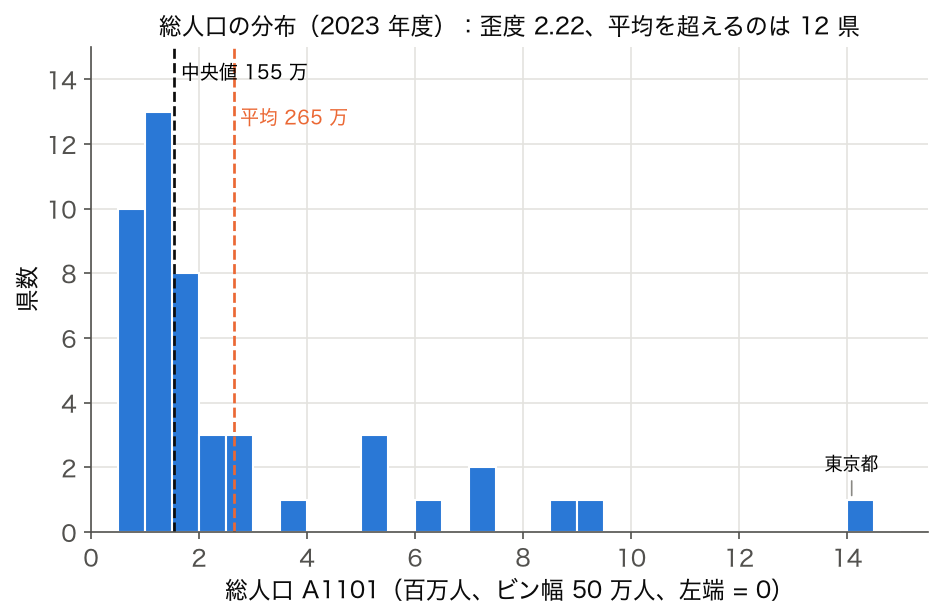
ヒストグラム: 2023 年度の都道府県の総人口の分布に平均と中央値の縦線
図 2: SSDSE-B-2026 都道府県の総人口のヒストグラム。 0 が物理的下限となるため、 分布は右に長い裾を引く。 平均 (約 265 万) は中央値 (約 155 万) を上回り、 平均を超える県は 47 県中 12 県しかない (歪度 2.22)。 「代表値の選択」が比尺度では特に重要になる。

右裾分布で実務上注意すべきは、 (1) 箱ひげ図の上ヒゲを超える外れ値 として上位数県が必ず出るが、 これは「異常値」ではなく構造的な偏り、 (2) 対数変換 (log10) すると左右対称に近づくため、 平均・分散による要約が安定する、 (3) ジニ係数 や Lorenz 曲線で「上位 N % が全体の何 % を占めるか」を別表現することで分布の偏りを直接定量できる、 という 3 点。 比尺度ゆえに log 変換が許される点を活かすと、 ヒストグラムの読み取りがぐっと安定する。

読み取りのコツ: ヒストグラムでは (1) bin 幅をデータ範囲の √n 程度に設定する、 (2) log10 軸でも描いて分布の対称性を比較する、 (3) 平均・中央値・最頻値を縦線で重ね描きする、 という 3 ステップを習慣にしておくと、 比尺度の歪んだ分布を見落とさずに済む。

図 3: 箱ひげ図で「地域グループ間の比較」を見る

比尺度の変量を地域グループ (関東/関西/東北/九州 …) で並べて箱ひげ図にすると、 「中央値の絶対水準の違い」だけでなく「裾の広がり (分散) の違い」「外れ値の出方の違い」が同時に読める。 比尺度であれば 比を取って「関東は東北の何倍か」 という言明が許されるため、 箱ひげ図の中央値線の比をそのまま「グループ間の規模差」として解釈できる。 これは順序尺度や間隔尺度ではできない、 比尺度ならではの読み方だ。
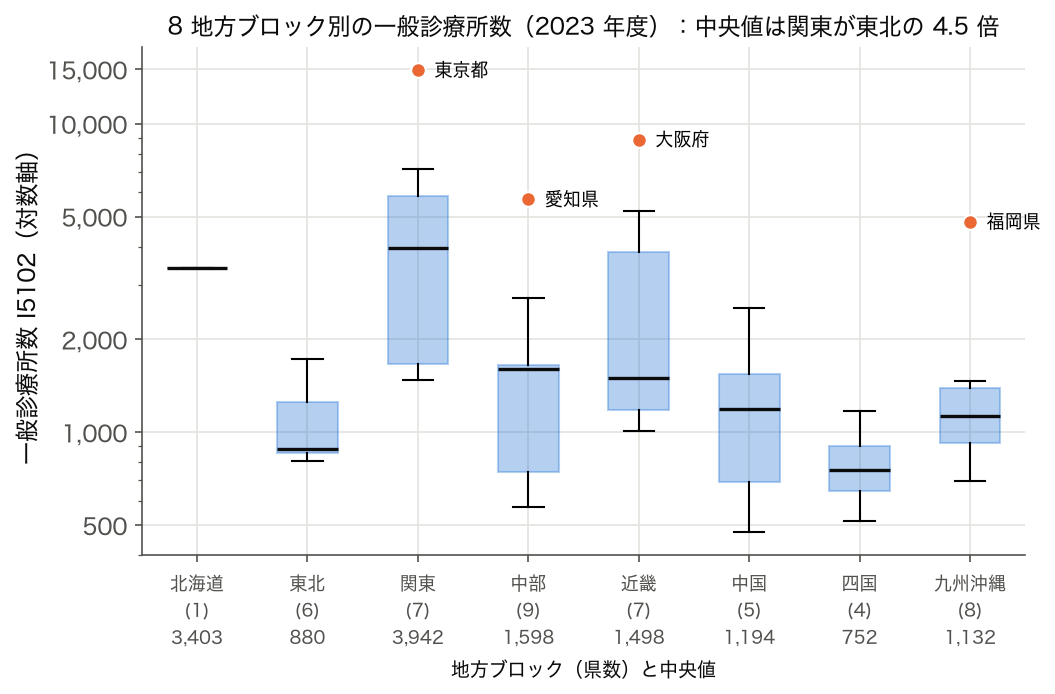
箱ひげ図: 8 地方ブロック別の一般診療所数(2023 年度、対数軸)
図 3: SSDSE-B-2026 (2023 年度) の一般診療所数を 8 地方ブロック別に並べた箱ひげ図 (対数軸、 目盛り下の数字が中央値)。 中央値は関東 3,942・東北 880 で、 「関東は東北の 4.5 倍」と言える (四国 752 に対しては 5.2 倍)。 東京都 (14,894)・愛知県・大阪府・福岡県は自分のブロックの中で外れ値になる。 中央値の比、 箱の高さ (IQR) の比、 ヒゲの長さの比のすべてが、 比尺度であるおかげで物理的に意味を持つ。

箱ひげ図で確認すべき 4 つの観点は、 (1) 中央値の絶対水準: 関東は東北の何倍か、 (2) IQR (箱の高さ): 地域内のばらつきはどの程度か、 (3) ヒゲの非対称性: 上ヒゲが長い → 上方向に偏った分布、 (4) 外れ値: 箱から大きく離れた点は構造的な特異県 (東京・大阪) を示唆。 比尺度であるため、 (1)〜(4) のすべてで「○倍」という比較が許され、 言明の強さが間隔尺度より一段強くなる。

読み取りのコツ: 箱ひげ図では (1) グループを中央値の昇順で並べ替える、 (2) 箱の幅をサンプル数に比例させる (notched boxplot)、 (3) Strip plot や Swarm plot を重ねて生データの分布を補強する、 という 3 工夫で「比尺度の比の解釈可能性」を最大限に引き出せる。 グループ間の比を取って「2.3 倍」のように数値化できるかを毎回確認しておく。

3 図のまとめ — 比尺度ならではの読み方

散布図・ヒストグラム・箱ひげ図の 3 つを通して、 比尺度のデータは「原点を含めて描ける」「比を取って割合に変換できる」「対数変換で歪みを吸収できる」という 3 点を備えていることがわかる。 これらは順序尺度・名義尺度では実行できず、 間隔尺度でも一部しかできない、 比尺度ならではの強みだ。 実務では (1) 単位変換に対して結論が変わらないか、 (2) 派生量 (率・密度・比) として再表現するとどう読めるか、 (3) 上位の外れ値を切り落とすと結論が変わるか、 の 3 つを毎回確かめる癖をつけたい。

✅ 理解度チェック (R597 補強)

比尺度の定義と運用を、 順序尺度・間隔尺度との違いに注意しながら確認する 6 問。 答えは折りたたんであるので、 まず自分で考えてから開くこと。

Q1. 「出生数 8 千人」と「出生数 4 千人」を比較するとき、 比尺度であれば許される表現はどれか

(A) 「差は 4 千人」 (B) 「2 倍」 (C) 「2 倍も差は 4 千人も両方許される」
答え: (C)。 比尺度では差 (間隔) と比 (倍率) の両方が物理的に意味を持つ。 摂氏 (間隔尺度) では「20℃ は 10℃ の 2 倍暑い」と言えないが、 比尺度の出生数では「2 倍」が成立する。 ゼロが「完全に存在しない」を指す原点として固定されているのが鍵。

Q2. 比尺度のデータを対数変換 (log10) してよい理由を 30 秒で説明する

答え: 比尺度は非負で 0 を「存在しない」点として持つので、 0 を含まない値の集合に対して log が定義できる。 間隔尺度 (摂氏など) は負を取りうるため log が無定義になりうる。 さらに比尺度の「比 a/b」が log a - log b という差分に変換されるので、 弾力性や成長率の解釈が直線的になる。

Q3. 都道府県人口 (比尺度) を要約するとき、 平均と中央値どちらを主指標にすべきか

答え: 中央値を主、 平均を補助に。 比尺度は右に裾を引く分布が多く、 平均が東京・大阪のような上位県に引っ張られる。 中央値で「典型的な県」を表し、 平均と中央値の差で「分布の偏り」を伝える 2 段構えが安全。 さらに log10(人口) の平均を補えば、 比尺度ならではの幾何平均的な要約が手に入る。

Q4. ジニ係数 (比尺度を分析する代表的な指標) は、 比尺度のどの性質を活用しているか

答え: 「累積比 (累積シェア)」を計算できる性質。 Lorenz 曲線は「下位 x % が全体の y % を占める」という比尺度ならではの累積割合に基づく。 比尺度でなければ累積比が物理的に意味を持たないため、 ジニ係数も成立しない。 順序尺度ではランク間の差が一定ではないので、 累積シェアが意味を持たない点を比較で押さえておくとよい。

Q5. 「人口千人あたり医師数」は比尺度として扱ってよいか

答え: 扱ってよい。 「医師数 0 人」が「医師がまったく存在しない」を意味する物理的なゼロ点として定義でき、 2 倍・3 倍も意味を持つ。 ただし「医師の質」や「医師の偏在」までは比尺度では捉えられないため、 比尺度の集計指標と質的指標 (順序・名義) を組み合わせる設計が現実的だ。

Q6. 摂氏温度と人口、 どちらが比尺度か。 違いを 30 秒で説明する

答え: 人口が比尺度、 摂氏は間隔尺度。 摂氏の 0℃ は「水が凍る点」という人為的な基準で、 「温度が存在しない」を意味しない。 そのため「20℃ は 10℃ の 2 倍」とは言えない。 一方で人口の 0 は「人がいない」を意味するので、 200 万人は 100 万人の 2 倍と素直に言える。 比尺度には「絶対零度的な原点」が要る、 と覚えておくとよい。

Q7. SSDSE-B-2026 から「比尺度として読める列」を 5 つ挙げ、 それぞれの「ゼロの物理的意味」を 1 行で説明する

答え例: (1) 総人口 (A1101): ゼロは「住民が誰もいない」、 (2) 出生数 (A4101): ゼロは「その年に生まれた子がいない」、 (3) 死亡数 (A4200): ゼロは「その年の死亡がゼロ」、 (4) 消費支出 (L3221): ゼロは「世帯の支出がゼロ」、 (5) 延べ宿泊者数 (G7101): ゼロは「宿泊がゼロ」。 5 列すべてに「物理的にあり得るゼロ」が存在し、 単位変換に対して比が不変となる。 これらの列は対数変換しても意味が崩れず、 弾力性・成長率といった派生指標が安全に取り出せる。

Q8. 「合計特殊出生率」は比尺度として扱えるか。 出生率 0 と出生率 2 の比は「2 倍」と言ってよいか

答え: 比尺度として扱える。 合計特殊出生率は「1 人の女性が一生に産む子の期待数」で、 0 は「誰も子どもを産まない (人口完全縮小)」を意味する物理的ゼロ点。 出生率 2 と 1 の比 (2 倍) は「平均で 2 倍の子を産む」と素直に解釈できる。 ただし運用上は「人口置換水準 (約 2.07)」という閾値との差を見ることが多いため、 比だけでなく差分での解釈も重要だ。

🔬 比尺度をもう一歩深く — 4 つの尺度を貫く視点 (R597 補強)

比尺度は、 名義尺度・順序尺度・間隔尺度の上位に位置する「最も情報量の多い尺度」だ。 ここでは Stevens (1946) の 4 尺度分類を踏まえ、 比尺度が 何を「足し算」「掛け算」できる尺度なのか を、 数学的構造と実務的判断の両面から深掘りする。 比尺度を「比が取れる」とだけ覚えると、 平均の取り方、 変換の許容範囲、 グラフ軸の設計、 機械学習の前処理の各段階で誤った選択をしてしまう。 ここで「比尺度に許される変換 = 正の比例変換 y = a x (a > 0)」を出発点に、 すべての話を統一的に整理しておく。

許される変換: 比尺度は「正の比例変換」だけが許される

名義尺度はラベルの付け替え (一対一変換)、 順序尺度は順序を保つ任意の単調変換、 間隔尺度は線形変換 (y = a x + b)、 比尺度は 正の比例変換 (y = a x, a > 0) しか許されない。 言い換えると、 比尺度では「原点 0 を 0 に固定する」変換だけが意味を保つ。 メートル → センチメートル (a = 100) は許されるが、 「メートル + 5」(b = 5) は意味を壊す。 この厳しい制約があるからこそ、 比尺度は「比が一意に決まる」「ゼロが物理的に意味を持つ」と言える。 機械学習の特徴量設計でも、 比尺度のままスケーリング (StandardScaler) すると b の項が暗黙に入り、 比尺度の性質が崩れる点に注意が必要だ。

どの平均が許されるか — 算術・幾何・調和の使い分け

比尺度は 算術平均・幾何平均・調和平均 のすべてが定義可能で、 用途で使い分ける。 (1) 算術平均: 量の合計を平均化するとき (例: 県別人口の平均)、 (2) 幾何平均: 成長率や倍率の平均 (例: 年成長率の連結)、 (3) 調和平均: 単位逆数の平均 (例: 平均速度、 P/E レシオ)。 順序尺度では中央値しか安全に使えず、 間隔尺度では算術平均までしか保証されないため、 比尺度ならではの選択肢の広さがここに現れる。 SSDSE-B-2026 で県別人口の幾何平均を取ると、 大都市と小都市の歪んだ分布を一段穏やかに要約できる。

変動係数 (CV) は比尺度でしか定義しない

変動係数 CV = σ / μ は「平均で正規化したばらつき」を表す指標で、 比尺度でしか意味を持たない。 間隔尺度 (摂氏) では平均 μ が 0 になりうるので CV が爆発する。 比尺度では μ > 0 が保証され、 単位に依らない比較 (「出生数のばらつきは人口のばらつきより大きいか」など) が可能になる。 実務では CV を見て、 (1) 0.1 未満 → 安定、 (2) 0.1〜0.3 → 中程度、 (3) 0.3 以上 → ばらつき大、 のように水準を読み取る慣行がある。 ジニ係数、 Theil 指数、 タイル指数も比尺度の派生指標で、 いずれも CV と同じく「比尺度ゆえに使える」点を意識しておきたい。

機械学習で比尺度をどう扱うか

機械学習の特徴量として比尺度を使うときは、 StandardScaler (z 標準化) と MinMaxScaler と log + StandardScaler の 3 つを比較するのが定石。 z 標準化は b が入り込み、 比の性質が崩れるが、 線形モデルや距離ベース手法では安定する。 MinMax は原点を 0 にマップするので比尺度の性質を一部保つが、 外れ値に弱い。 比尺度で右に長い裾を引く分布なら、 log1p 変換後に z 標準化するのが多くの場合に頑健。 ツリー系 (RandomForest, GradientBoosting) はスケールに無頓着なので比尺度でもそのままで構わないが、 SHAP 値の解釈時は元のスケール (原点を含む) で読むと納得しやすい。

よくある誤用 — 比尺度ではない量を比尺度として扱う

実務で多い誤用は、 (1) 順位 を比尺度として扱う (順位 1 と 2 は「2 倍」ではない)、 (2) 偏差値 を比尺度として扱う (偏差値 50 は人為的な基準で、 0 は「最低点」ではない)、 (3) 5 段階評価 を比尺度として扱う (★5 は ★1 の「5 倍の満足」ではない)、 (4) 西暦 を比尺度として扱う (西暦 0 年は宗教的な基準で物理的ゼロではない)、 の 4 つ。 これらは順序尺度や間隔尺度であり、 比尺度の演算 (比・対数・幾何平均) を適用すると意味が壊れる。 列の値だけを見て「数字だから比尺度」と即断せず、 「ゼロが何を意味するか」「単位変換で結論が変わらないか」を毎回確認する習慣が事故を防ぐ。

🌉 関連尺度との橋渡し — 名義・順序・間隔・比 (R597 補強)

比尺度は、 4 尺度の中で最も情報量を持つが、 実データでは「比尺度として読める列」と「順序・間隔・名義として読める列」が混在する。 SSDSE-B-2026 のような実データを扱うときに、 列ごとにどの尺度として読むかを正しく判定できるかどうかが、 集計・可視化・モデル構築のすべての品質を左右する。 ここでは 4 尺度の境界を、 具体例とともに繰り返し復習しておく。

尺度 許される変換 許される演算 代表的な代表値 SSDSE-B-2026 例
名義尺度一対一変換=, ≠最頻値都道府県コード, 都道府県名
順序尺度単調変換=, ≠, <, >中央値, パーセンタイル人口順位 (派生), 高齢化率の階級分け
間隔尺度線形変換 y=ax+b+, −, 算術平均算術平均, 標準偏差西暦 (年), 気温 (摂氏)
比尺度正の比例 y=ax+, −, ×, ÷, 比, log幾何平均, CV, ジニ係数総人口, 出生数, 消費支出

表で確認したいのは 「下にいくほど許される演算が増える」 階層構造。 比尺度は名義・順序・間隔の演算をすべて含み、 そのうえで「比」「対数」「幾何平均」「CV」「ジニ係数」を追加で許す。 だから比尺度のデータを順序尺度として扱う (例: 中央値だけで要約する) のは情報の捨てすぎだし、 逆に順序尺度を比尺度として扱う (例: 順位を掛け算する) のは意味を捏造することになる。 「列ごとに最も情報量の多い尺度として読みつつ、 用途に応じて 1 段下の尺度に降ろす」のが安全な運用の型だ。

実務チェックリスト: (1) この列のゼロは「存在しない」を意味するか、 (2) 単位を変えても結論が同じか、 (3) 対数を取っても意味が壊れないか、 (4) 比 (a / b) が物理的に解釈可能か、 の 4 つを毎回問う。 4 つすべてに「Yes」なら比尺度、 (4) だけ「No」なら間隔尺度、 (2)(3)(4) が「No」なら順序尺度、 すべて「No」なら名義尺度、 と判定できる。 この 4 問チェックを習慣化しておくと、 列の尺度判定で迷うことがなくなる。

📒 6 つのケーススタディ — 比尺度を実データでどう扱うか (R597 補強)

比尺度の理解は、 数式や定義よりも「実データに落とし込んだときの判断」で深まる。 SSDSE-B-2026 を中心に、 比尺度を扱う典型 6 シーンを順に見ていく。 いずれも「比尺度であるがゆえに許される操作・許されない操作」を意識して読み解いてほしい。

ケース 1: 県別人口を要約する

人口は典型的な比尺度。 単純に算術平均を取ると約 265 万人だが、 これは東京・大阪・神奈川などの上位県に強く引っ張られた値だ。 中央値は約 155 万人で、 47 県の「真ん中」を表す。 さらに log10(人口) の算術平均 ≒ 幾何平均は約 6.26 (約 183 万人) となり、 中央値に近い水準に落ち着く。 比尺度ゆえに 3 種類の平均 (算術・幾何・調和) と 分布の形 (左右の歪み) をセットで提示する報告が、 もっとも誤解を生まない。

ケース 2: 県別人口を全国人口で割って「シェア」を出す

比尺度を別の比尺度で割ると、 シェア (比尺度の派生量) が得られる。 東京の人口シェアは約 11.3 %、 大阪は約 7.0 %、 鳥取は約 0.4 % という具合に、 「全体に占める割合」を計算できるのは両軸が比尺度であるからこそ。 シェアもまた比尺度 (0 〜 1 の閉区間) で、 0 は「全く貢献していない」、 0.20 は 0.10 の「2 倍」と素直に解釈できる。 集中度指標 (HHI, Theil 指数) もシェアを材料にする派生量で、 比尺度の連鎖で深い洞察に到達する好例だ。

ケース 3: 「人口千人あたり医師数」のように比を取る

比尺度どうしの比 (率・密度) は、 規模差を取り除くための定石。 「医師数 / 人口 × 1000」は、 大都市と地方都市を「同じ土俵」で比較できる派生指標になる。 京都府 (約 3.5)、 高知県 (約 3.4) など、 地方でも医師密度が高い県があることは、 医師数の絶対値だけ見ていては気づけない。 比尺度を比尺度で割って、 規模に依らない構造 を取り出すこの操作は、 比尺度の最も実務的な使い道の 1 つだ。

ケース 4: 年率成長率を幾何平均で連結する

成長率 g_t = (X_{t+1} / X_t) − 1 は比尺度の「比」を材料にした派生量。 10 年間の平均成長率を求めるとき、 算術平均ではなく 幾何平均 を使うのが正解。 (1 + g_1)(1 + g_2)…(1 + g_10) の 10 乗根 − 1 が、 期間を通じた CAGR (年平均成長率) を与える。 これも比尺度であるがゆえに許される演算で、 順序尺度や間隔尺度では成立しない。 SSDSE-B-2026 で総人口の年率成長率を CAGR 化すると、 県ごとの長期傾向を 1 つの数字に要約できる。

ケース 5: ジニ係数で「県間格差」を測る

ジニ係数 G は 0 ≤ G ≤ 1 で、 0 は完全平等、 1 は完全不平等を表す比尺度の代表的派生量。 県別人口や出生数のジニ係数を計算すると、 「都市集中度」を 1 つの数字に圧縮できる。 G ≒ 0.3 なら緩やかな偏在、 G ≒ 0.5 なら強い集中、 という具合に水準で議論できるのは、 ジニ係数自体が比尺度であるためだ。 もし対象データが順序尺度だった場合、 ジニ係数は意味を持たない。 比尺度であることがこの指標の前提条件になっている点を押さえておこう。

ケース 6: 機械学習の前処理で「log + 標準化」を選ぶ

比尺度で右に裾を引く分布 (人口・出生数・消費支出) を機械学習に入力するときは、 log1p 変換してから StandardScaler で z 標準化するのが定石。 log 変換は比尺度ゆえに許される操作で、 (1) 大都市の影響を抑える、 (2) 線形モデルの仮定 (正規残差) に近づける、 (3) 弾力性が係数として読めるようになる、 という 3 つの効果がある。 ツリー系モデルは前処理を必要としないが、 線形回帰や距離ベース法を使うときは「比尺度 → log → 標準化」の 3 ステップが品質を底上げする。

6 ケースの共通テーマ: 比尺度は「比・対数・幾何平均・ジニ・CV」など 派生量の宝庫 だ。 列を比尺度として読めるかどうかを判定したあと、 用途に応じてどの派生量を取り出すかを決める。 比尺度を比尺度のままで眺めていても、 実は規模差や偏在に気づきにくい。 比尺度どうしを割ったり対数を取ったりすることで、 はじめて「データの構造」が立ち上がってくる。

🗂 比尺度クイックリファレンス (R597 補強)

最後に、 比尺度を扱うときに毎回参照すべき要点をリファレンス形式でまとめておく。 ノートにコピーして手元に置いておけば、 列の尺度判定で迷ったときに 30 秒で答えに辿り着ける。

項目 比尺度ではこうする 他尺度との対比
ゼロの意味「存在しない」を表す物理的原点間隔尺度は人為基準 (摂氏 0 など)
比 (a/b)物理的に意味あり「2 倍」と言える間隔尺度では言えない
許される変換y = a x (a > 0)間隔尺度は y = a x + b、 順序尺度は単調変換
log 変換OK (非負ゆえ定義可)間隔尺度は負を含むと NG
平均算術・幾何・調和すべて OK間隔尺度は算術のみ、 順序尺度は中央値のみ
ばらつき指標σ, CV, ジニ係数, Theil 指数CV・ジニは比尺度限定
代表的列 (SSDSE-B)総人口, 出生数, 消費支出, 合計特殊出生率順位・偏差値・西暦は他尺度
ML 前処理log1p → 標準化 (歪み吸収)順序尺度はラベルエンコード

30 秒チェック: 「この列のゼロは何を意味するか」を 1 文で言えること。 言えなければ比尺度ではない可能性が高い。 たとえば「出生数のゼロは『その年に生まれた子がいない』」と即答できるなら比尺度。 「偏差値のゼロは…?」と詰まったら順序尺度・間隔尺度を疑う。 たったこれだけで、 列の尺度判定は劇的に正確になる。

❓ よくある質問 (FAQ) — 比尺度の境界事例 (R597 補強)

比尺度の判定で迷いやすい境界事例を 8 つ取り上げ、 それぞれに短い回答と理由を添える。 「これって比尺度?」と現場で聞かれたときに即答できるよう、 ぐっと現実的な例を集めた。

Q. 年齢は比尺度か?

A. はい、 比尺度。 0 歳は「生まれたばかり (生命の起点)」を意味し、 「40 歳は 20 歳の 2 倍生きている」と言える。 ただし「年齢で割って 2 倍」が意味を持つかは文脈による。 体力や認知能力など年齢に対して非線形な指標と組み合わせるときは、 比の解釈に注意が必要だ。

Q. テストの点数 (0〜100) は比尺度か?

A. 多くの場合は順序尺度〜間隔尺度。 0 点は「全問不正解」を表すが、 「100 点は 50 点の 2 倍賢い」とは一般に言えない (問題の難易度・配点設計により尺度が歪む)。 ただし「正答率」(正解数 / 全問数) として読むなら比尺度的に扱える文脈もある。

Q. ケルビン温度 (絶対温度) は比尺度か?

A. はい、 比尺度。 0 K は「絶対零度 = 熱運動が完全に停止」を意味する物理的ゼロ点で、 「300 K は 150 K の 2 倍の熱運動エネルギーを持つ」と言える。 摂氏との違いは「ゼロが物理的か人為的か」だけだが、 この違いが尺度を決定的に分ける。

Q. 通貨額 (円・ドル) は比尺度か?

A. はい、 比尺度。 0 円は「金額がゼロ」を意味し、 「200 万円は 100 万円の 2 倍」と素直に言える。 ただし債務や借入を含めると負値を取りうるので、 文脈次第で「区間」の比尺度ではなく「実数全体」の間隔尺度に近づく。 SSDSE-B-2026 のような正値のみの集計データでは比尺度として扱って問題ない。

Q. 確率 (0〜1) は比尺度か?

A. はい、 比尺度。 0 は「絶対に起こらない」、 1 は「必ず起こる」を意味し、 「確率 0.4 は 0.2 の 2 倍起こりやすい」と言える。 ただし「オッズ p/(1−p)」や「ロジット log(p/(1−p))」のような派生量に変換すると、 線形モデルが扱いやすくなる。 機械学習で確率を扱うときは、 ロジット空間で計算するのが定石だ。

Q. p 値 は比尺度か?

A. 比尺度ではあるが、 「2 倍」の解釈には注意。 p = 0.04 と p = 0.02 を「2 倍違う」と言うのは数学的には正しいが、 仮説検定の文脈では「有意水準を超えるかどうか」のほうが重要で、 比そのものが意思決定に直結しない。 比尺度であることと、 比に意味があることは、 必ずしも同じではない例として覚えておきたい。

Q. 「いいね数」「フォロワー数」のような SNS 指標は比尺度か?

A. はい、 比尺度。 0 は「誰も反応していない」、 「1000 いいねは 500 いいねの 2 倍」と言える。 ただし bot や買収などの操作で値が歪みやすく、 「比の物理的意味」と「比のビジネス上の意味」が乖離するリスクがある。 比尺度として扱えること自体は確かだが、 派生指標 (エンゲージメント率) を併用するのが安全だ。

Q. 「経過時間 (分・秒)」は比尺度か?

A. はい、 比尺度。 0 秒は「経過していない」を意味し、 「60 秒は 30 秒の 2 倍経過」と言える。 一方で「時刻 (10:00, 12:00)」は間隔尺度で、 「12 時は 6 時の 2 倍」とは言えない。 「絶対的な時間軸上の位置」と「相対的な経過時間」で尺度が変わる点は、 比尺度を理解するうえでとても示唆的な例だ。

🧭 比尺度をめぐる思考の作法 — 5 つの問い (R597 補強)

比尺度は、 数学的構造はシンプルだが、 「データを比尺度として扱うかどうか」の判断は実務でしばしば揺れる。 ここでは比尺度を巡って毎回問い直すべき 5 つの問いを並べる。 集計・可視化・モデリングの各局面で「いま自分は比尺度として扱っているか」を点検するチェックポイントとして使ってほしい。

問い 1: この列のゼロは、 ほんとうに「存在しない」を意味しているか?

ここが比尺度の出発点。 「人口 0」は「住民が誰もいない」、 「売上 0」は「販売がなかった」、 「医師数 0」は「医師が存在しない」と、 物理的にあり得るゼロを指し示せるか。 「偏差値 0」「西暦 0」「順位 0」は物理的なゼロではないので、 比尺度の演算は適用できない。 ゼロの意味を 1 文で書けるかどうかが、 比尺度判定の最初の関門だ。

問い 2: 単位を変えても結論が変わらないか?

比尺度なら、 メートル → センチメートル、 円 → ドル、 トン → キログラム といった単位変換 (a 倍) に対して、 すべての比・相関・回帰係数の解釈が不変になる。 もし単位を変えたとたん結論が変わるなら、 その操作は比尺度の性質を壊している可能性が高い。 学会発表・社内報告のたびに、 「単位を 100 倍に変えても同じ結論か」を一度シミュレーションする習慣をつけたい。

問い 3: 対数を取っても意味が壊れないか?

比尺度なら、 log 変換しても「比の差 = 対数の差」が保たれ、 解釈が崩れない。 もし log を取ると意味不明になる列なら、 それは比尺度ではない可能性が高い。 たとえば「西暦 2020 の log」は意味を持たない (西暦のゼロは物理的ゼロでないから)。 比尺度の判定で log が許されるかは、 ゼロの意味と並ぶ重要な目印になる。

問い 4: 比 (a / b) を計算したら、 物理的に意味のある量になるか?

比尺度の核心は「比が物理的に解釈可能」であること。 「人口 / 面積 = 人口密度」、 「出生数 / 人口 = 粗出生率」など、 比の結果が新しい意味のある量になるなら比尺度だ。 一方、 「順位 1 / 順位 2 = 0.5」は計算はできても物理的な意味がない。 比尺度であるかどうかは、 比の結果が新しい量として通用するかで点検できる。

問い 5: 派生量 (率・密度・成長率・ジニ係数) を取り出す価値があるか?

比尺度は、 そのままで眺めるよりも、 派生量に変換してから比較するほうが洞察が深まる。 「人口」より「人口密度」、 「出生数」より「粗出生率」、 「総人口」より「成長率」、 「人口分布」より「ジニ係数」。 比尺度を扱うときは、 「派生量に落とし込めば、 規模の偏りが消えて構造が見えてくる」という発想を毎回持ち込むと、 分析の解像度が一段上がる。

5 つの問いまとめ: ゼロの意味 → 単位不変性 → 対数の許容 → 比の物理的意味 → 派生量の価値、 の 5 段階を順に問えば、 比尺度かどうかを確実に判定できる。 すべてに「Yes」と答えられる列が、 比尺度として安心して扱える列だ。 SSDSE-B-2026 の量・額・率系の列はほとんどがこの 5 ステップをクリアする。 一方、 順位・偏差値・年号・5 段階評価のような列は途中で詰まるため、 比尺度の演算を適用しないよう注意したい。

補足: 比尺度を「分析の起点」として位置づける

比尺度は、 データ分析の入口で最初に確認すべき性質だ。 列を読み込み、 まず比尺度かどうかを判定し、 比尺度なら算術・幾何・調和の 3 平均、 CV、 ジニ係数、 log 変換、 標準化を順に検討する。 比尺度でなければ、 順序尺度・間隔尺度・名義尺度のどれにあたるかを判定し、 それぞれに許される演算だけを適用する。 この「尺度判定 → 演算選択」の二段構えを欠かすと、 平均を計算してはいけない列で平均を取ったり、 ロジスティック回帰の特徴量に順序尺度を生のまま入れたりして、 解釈不能な結果を量産することになる。 比尺度の理解は、 単に「比が取れる尺度」を覚えることではなく、 「データ分析の起点で何を確認すべきか」 の作法を身につけることに直結する。 SSDSE-B-2026 のような実データに触れるたびに、 列ごとに 5 つの問いを巡らせる習慣をつけたい。

最後に: 比尺度は、 物理学・経済学・人口学・疫学など、 量を扱うすべての分野の基礎にある。 「物理的なゼロを持つ量」を扱う場面に出会ったら、 まず比尺度として読み、 派生量に展開し、 構造を取り出す。 この一連の流れがスムーズにできるようになれば、 データ分析の解像度は確実に一段上がる。 比尺度の理解は、 学習の終わりではなく、 むしろデータ分析という長い旅路の 本当の出発点 なのだ。 SSDSE-B-2026 で総人口・出生数・消費支出・合計特殊出生率を題材に、 まずは小さく比尺度の感覚を体に染み込ませてほしい。 そこから派生量・対数変換・幾何平均・ジニ係数 へと自然に手が伸びるようになれば、 比尺度を「使える」レベルに到達したと言える。

付録: 比尺度を扱う 10 のミニ習慣

日々の分析で、 比尺度を正しく扱えているかを点検するためのミニ習慣を 10 個まとめておく。 (1) 列を読み込んだ瞬間に「ゼロの意味」を 1 文で書く、 (2) 散布図には必ず原点を含める、 (3) ヒストグラムは bin 幅を √n 程度に設定する、 (4) 右に裾を引く列は log1p 変換を試す、 (5) 平均と中央値の両方を併記する、 (6) ばらつきは標準偏差と CV をペアで報告する、 (7) 上位 1 % を除外しても結論が変わらないか確認する、 (8) 比尺度どうしを割って派生量 (率・密度) を作る、 (9) 機械学習に投入する前に標準化・log 標準化・MinMax の 3 つを比較する、 (10) 結論が単位変換に対して頑健かを最後にもう一度確認する。 この 10 個を習慣化できれば、 比尺度の扱いで大きく失敗することはまずない。 SSDSE-B-2026 を題材に、 列ごとにこの 10 ステップを通す練習を繰り返し、 比尺度の感覚を体得していこう。 比尺度は、 数学的にはシンプルだが、 「データ分析の質を底支えする」もっとも基礎的な道具の 1 つだ。 道具をていねいに扱う癖を身につけることが、 結果として分析全体の信頼性を高める。

もう少し深堀りしたい人へ: 比尺度を厳密に学びたいなら、 Stevens (1946) の "On the Theory of Scales of Measurement" を出発点に、 Krantz・Luce・Suppes・Tversky の "Foundations of Measurement" (1971) に進むのが王道。 統計学の教科書では Agresti の "Categorical Data Analysis" や Wooldridge の "Introductory Econometrics" にも、 尺度ごとの演算選択の節がある。 機械学習文脈では、 Murphy の "Probabilistic Machine Learning" の特徴量エンジニアリング章で、 比尺度の対数変換や標準化の使い分けが詳しい。 これらを読み進めるとき、 つねに「ゼロの物理的意味」「比の解釈可能性」「対数の許容範囲」の 3 つの観点を持ち続ければ、 比尺度に関する誤解はほぼ消える。

SSDSE-B-2026 で試したい列ペア: (1) 総人口 × 出生数 (比尺度どうしの散布図)、 (2) 出生数 ÷ 人口 (粗出生率という派生量)、 (3) 人口 → log10(人口) (右裾分布の対称化)、 (4) 総人口の年率成長率 → 幾何平均 (CAGR)、 (5) 人口の上位 10 県のシェア (集中度)。 5 つの例を順に手を動かして実装すれば、 比尺度の基本演算と派生量がひと通り身につく。 各ステップで「単位を変えても結果が変わらないか」を必ず確認すること。 比尺度の扱いに自信が持てるようになったら、 順序尺度・間隔尺度・名義尺度との混在データへ進み、 列ごとに尺度判定 → 演算選択を回せるようになろう。

学習ロードマップ: 比尺度を理解した次のステップは、 (1) 派生量を主役にした分析 (率・密度・成長率・シェア)、 (2) 対数空間での回帰 (log-log 回帰、 弾力性、 半対数モデル)、 (3) 不平等指標 (ジニ係数、 Lorenz 曲線、 Theil 指数、 Atkinson 指数)、 (4) 機械学習の前処理 (log1p、 Box-Cox、 Yeo-Johnson、 PowerTransformer)、 (5) 因果推論への展開 (比尺度の処置効果、 弾力性ベースの政策評価) の 5 つに広がる。 比尺度は単独で完結する話ではなく、 派生量・対数・不平等指標・前処理・因果推論など、 データ分析のあらゆる場面に顔を出す。 だからこそ、 ここで腰を据えて比尺度の感覚を固めておく価値がある。 SSDSE-B-2026 を題材に、 ぜひ順を追って手を動かしてみてほしい。 比尺度が身体に染み込めば、 順序・間隔・名義尺度の境界感覚も自然と研ぎ澄まされる。 4 尺度すべてを「区別して扱える」ようになることが、 データ分析者としての最初の大きな到達点だ。

練習問題: SSDSE-B-2026 で比尺度を実装する: 自分の手で 4 ステップを通してみよう。 (1) pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) でデータを読み込み、 総人口 (A1101) 列のゼロの意味を 1 文で書く。 (2) ヒストグラムを df['A1101'].hist(bins=20) で描き、 平均と中央値を縦線で重ねて、 右に裾を引く分布を視覚的に確かめる。 (3) np.log10(df['A1101']) を取って再度ヒストグラムを描き、 左右対称に近づく様子を確認する。 (4) 「出生数 (A4101) / 総人口 (A1101)」で粗出生率を計算し、 比尺度どうしを割って派生量を作る感覚をつかむ。 この 4 ステップを 30 分で通せれば、 比尺度の基本操作はマスターしたと言ってよい。 さらに余裕があれば、 ジニ係数の自作実装 (Lorenz 曲線 → 三角形面積) や、 年率成長率の幾何平均にも挑戦してみてほしい。 比尺度の世界は、 触れば触るほど派生量の豊かさが見えてくる。

まとめの一言: 比尺度は「ゼロが物理的に意味を持ち、 比・対数・幾何平均・CV・ジニ係数といった派生量が許される」尺度。 ここで身につけた感覚は、 順序尺度・間隔尺度・名義尺度との対比を通じて、 4 尺度全体の理解を底上げしてくれる。 「列を読み込んだら、 まず尺度を判定する」という習慣を、 これからの分析の最初の一歩に置こう。 ゼロの意味を 1 文で書き、 単位変換に対する頑健性を確認し、 対数の許容範囲を点検し、 比に物理的な意味があるかを問い、 派生量に展開する価値を測る。 5 つの問いを順に巡らせれば、 どの列も適切な尺度として扱えるようになる。 比尺度の理解が、 4 尺度を貫く視点を育ててくれる。 ぜひ SSDSE-B-2026 を題材に、 一歩ずつ確かめながら進んでいこう。 比尺度を「データ分析の起点に置く」発想が、 すべての応用の土台になる。 ここを丁寧に固めれば、 派生量・対数空間・不平等指標・機械学習の前処理・因果推論まで、 自然と道がつながっていく。 一歩ずつ着実に進めよう。 比尺度はすべての量的分析の原点だ。

🎮 触って理解する

スライダー(またはグラフを直接ドラッグ)で 2 つの値を動かしてみよう。 左は比例尺度(人口)、 右は間隔尺度(摂氏温度)。 同じ「A を B で割る」操作でも、 比例尺度では「○倍」が物理的に意味を持ち、 間隔尺度では意味を失う ことを、 数値の変化で体感できる。 初期値は SSDSE-B-2026 の実測値(東京 総人口 A1101 = 14,086,000 人、 鳥取 = 537,000 人)。 スライダーを動かすと仮想の「もし〜だったら」の値になる。

📏 比例尺度:人口

↑ 上のバーをドラッグしても A の人口を変えられます(タッチ対応)

比 A / B = 26.23 倍 → A は B の 26.23 倍の人口(✅ 意味を持つ)
差 A − B = 1354.9 万人(差も比も両方 OK)

算術平均 (A+B)/2 = 731.2 万人
幾何平均 √(A·B) = 275.0 万人 (比例尺度でのみ意味を持つ)
変動係数 CV = σ/μ = 0.927 (無次元。 比例尺度でのみ定義)

🌡 間隔尺度:摂氏温度

↑ 上のバーをドラッグしても A の温度を変えられます(タッチ対応)。 破線が摂氏の原点 0℃、 一番左が絶対零度 0 K(−273.15℃)

℃での見かけの比 A / B = 2.00 倍 (❌ 無意味)
絶対温度 K での真の比 A / B = 1.035 倍 (K は比例尺度)
2.00 倍 ≠ 1.035 倍 → 「A は B の 2 倍暑い」は誤り。 単位(℃→K)で比が変わる=比が意味を持たない証拠。

差 A − B = 10 ℃ (差 = 間隔は意味を持つ。 間隔尺度でも OK)
💡 実験してみよう: 人口パネルで B を A と同じ値にすると比は 1.00 倍(差は 0)。 温度パネルで B を 0℃ にすると ℃比が発散(0 で割れない=ゼロ近傍の不安定)だが、 K 比はきちんと有限値のまま。 これが「絶対原点を持つ比例尺度」と「原点が人為的な間隔尺度」の決定的な違い。

🎯 直感(この操作で腑に落ちること)

比例尺度には 「0 = 無」という絶対原点 がある。 だからバーの長さそのものが「量」を表し、 バー同士の長さの比=値の比=「○倍」がそのまま物理的意味を持つ。 「200 万人は 100 万人のちょうど 2 倍」。 一方、 摂氏温度のバーは 破線(0℃)から測った長さにすぎず、 本当の原点(絶対零度)は遥か左にある。 だから ℃ の「見かけの比」は、 原点をずらしただけで簡単に変わってしまう。

⚠️ よくある落とし穴

🚀 発展:4 尺度水準と「許される統計量」早見表

尺度水準許容変換比 (a/b)代表値ばらつきこの教材の関連ページ
名義尺度1 対 1 置換×最頻値—名義尺度
順序尺度単調変換×+中央値四分位範囲順序尺度
間隔尺度$y=ax+b$×+算術平均+標準偏差間隔尺度
比例尺度(本ページ)$y=ax\;(a>0)$○+幾何平均+変動係数 CV尺度水準

表の「下ほど許される演算が増える」階層は、 上のインタラクティブでいえば 右パネル(間隔尺度)でできないこと が、 左パネル(比例尺度)ではできる という差そのもの。 比・幾何平均・CV は、 絶対原点を持つ比例尺度に固有の道具だ。

🧠 解説深化 — 同じ SSDSE-B-2026 の中に「間隔尺度」と「比例尺度」が同居する

このページでは総人口 (A1101) を比例尺度の代表として繰り返し扱ってきた。 だが SSDSE-B-2026 には、 気温という「間隔尺度」の列と 降水量という「比例尺度」の列が同居している。 別々のデータセットを持ち出さなくても、 同じ 1 枚の表の中で 「絶対原点を持つ/持たない」の差を実測で確かめられる。 これは尺度水準を腹落ちさせる最短ルートなので、 直感・落とし穴・発展の 3 段で深掘りしておく。

🎨 直感 — 絶対原点があると「バーの長さの比」が値になる

比例尺度の本質は 絶対原点(真のゼロ =「量がまったく無い」状態)を持つこと。 原点が固定されているから、 値を「原点からのバーの長さ」として描け、 バーの長さの比がそのまま「○倍」という意味を持つ。 名義 < 順序 < 間隔 < 比例 という 4 尺度階層で比例が最上位に立つのは、 「区別(名義)+順序+等間隔(=差が言える)+絶対原点(=比が言える)」をすべて備えるからだ。 長さ・人口・降水量は原点が物理的に定まる(0mm = 雨ゼロ)ので比例尺度。 一方、 摂氏温度は 0℃ を「水が凍る点」という人為的な基準に置いただけで、 原点がずれているため「20℃ は 10℃ の 2 倍」は言えない。 差が言えるところ(間隔)までは温度も同じ、 だが比が言えるかどうか(比例)で長さ・人口と分かれる ——ここが階層の分水嶺だ。

SSDSE-B-2026 の列コード尺度0 の意味「○倍」が言えるか
総人口A1101比例尺度住民が誰もいない(真のゼロ)○(東京は鳥取の 26.2 倍)
降水量(年間)B4109比例尺度雨がまったく降らない(真のゼロ)○(最多県は最少県の 3.62 倍)
年平均気温B4101間隔尺度水が凍る点(人為的な基準)×(「23.8℃ は 11.9℃ の 2 倍暑い」は誤り)
最低気温B4103間隔尺度基準からの位置(負値もあり)×(47 県中 14 県が負値。 比も対数も不能)

※ 上の 4 値(26.2 倍・3.62 倍・14 県が負値・気温の範囲)はすべて SSDSE-B-2026(cp932, 2 行目スキップ, 2023 年 47 県)の実測から算出した。 とくに 最低気温 B4103 は 47 県中 14 県が負の値で、 「負を取りうる = 絶対原点が無い = 比例尺度ではない」ことがデータそのものに刻まれている。

⚠️ 落とし穴(重要)— 実データで「やってはいけない」を確かめる

❌ 間隔尺度を比例尺度と混同する(摂氏 0 度は「無」ではない)
年平均気温 B4101 で「最も暖かい県 ÷ 最も涼しい県」を計算して「約 2 倍暖かい」と述べるのは誤り。 摂氏 0℃ は「熱が無い」状態ではなく、 原点が人為的だから比 (a/b) が物理的意味を持たない。 「差が言えること」と「比が言えること」は別物——気温は差(=間隔)までしか言えない。
❌ 比例尺度専用の統計を間隔尺度に当てる(幾何平均・CV が壊れる)
変動係数 CV = σ/μ と幾何平均は 比例尺度でのみ意味を持つ。 実証すると一目瞭然:年平均気温 B4101 の CV は 摂氏では 0.122、 絶対温度 (K) に直すと 0.0071 と約 17 倍も食い違う。 単位(原点の取り方)で値が変わる CV は、 間隔尺度では無意味だという動かぬ証拠だ。 一方、 降水量 B4109 の CV は mm でも cm でも 0.328 のまま不変——これが「比例尺度なら CV が使える」の実データ裏づけになる。
❌ ゼロ・負値を含むデータを不用意に対数変換する
最低気温 B4103 は 14 県で負値を取るため log が未定義になり、 幾何平均も計算不能。 比例尺度でも「0 を含みうる列(例:ある年の着工新設住宅がゼロの離島など)」では log(x) が発散するので、 log1p(x) や対数差・差分で回避する。 「比例尺度だから何でも log」ではなく 「正値であること」を毎回確認してから対数を取る。
❌ 尺度を取り違えたまま演算する(コードの平均・気温の掛け算)
都道府県コード(名義尺度)を平均する、 順位(順序尺度)を掛け算する、 気温(間隔尺度)を幾何平均する——いずれも電卓では計算できてしまうが結果は無意味。 「その列のゼロは何を意味するか」を 1 文で言えるかを演算前のチェックにすると、 取り違えの大半を水際で防げる。

🚀 発展 — 許される変換と統計量、そして実データでの幾何平均・CV

各尺度で「許される変換」は決まっており、 比例尺度に許されるのは相似変換(正の比例変換)$y=\alpha x\ (\alpha>0)$ のみ——原点を動かす平行移動 $+\beta$ は許されない。 この 1 点が「比が保存される/されない」を分ける。

【尺度と許容変換の対応】
$$\text{名義}:\ \phi(x)\ \text{(1対1)}\quad \text{順序}:\ \text{単調増加}\quad \text{間隔}:\ y=\alpha x+\beta\quad \boxed{\text{比例}:\ y=\alpha x\ (\alpha>0)}$$

比例尺度だけ $\beta=0$ に固定される(=絶対原点を 0 に留める相似変換のみ)。 だから比 $x_i/x_j$ が単位に依らず不変になる。

SSDSE-B-2026 の比例尺度変数での実例(2023 年 47 県、 実測): 総人口 (A1101) と降水量 (B4109) について、 比例尺度でのみ意味を持つ幾何平均・変動係数を計算すると次のとおり。 いずれも算術平均 > 幾何平均(右に裾を引く分布の徴候)で、 CV は単位変換に対して不変だ。

変数(コード)最小最大算術平均幾何平均変動係数 CV最大/最小 の比
総人口(A1101)[人]537,00014,086,0002,645,8091,831,3671.05726.23 倍
出生数(A4101)[人]3,26386,34815,47410,4121.10926.46 倍
一般病院数(I510120)[施設]37588150.3117.70.82115.89 倍
降水量(B4109)[mm]830.03,002.51,643.51,561.40.3283.62 倍

📌 対比:間隔尺度(年平均気温 B4101)ではこれらが壊れる

同じ表の年平均気温 B4101(範囲 11.0〜23.8℃、 算術平均 16.80℃)で同じ統計を試すと——

  • 変動係数: 摂氏で 0.122、 絶対温度 K で 0.0071 → 原点の取り方で約 17 倍変わる=無意味。 比例尺度の降水量 (0.328) は単位を mm→cm に変えても 0.328 で不変。
  • 幾何平均: 摂氏の気温で $(\prod x_i)^{1/n}$ を取っても、 華氏や K に変換すると別の順序・別の値になり解釈不能。
  • 最低気温 B4103: 14 県が負値なので幾何平均も対数も定義できない(=そもそも比例尺度の道具が入口で使えない)。

= 比例尺度(総人口・出生数・病院数・降水量)では幾何平均・CV・比が意味を持ち、 間隔尺度(気温)では壊れる。 「使える統計量が尺度で決まる」ことを、 SSDSE-B-2026 の同一表内で完結して確認できる。

📥 入力例(SSDSE-B-2026 の 2023 年・47 都道府県から 3 行) 都道府県 B4101(年平均気温) B4109(降水量(年間)) 北海道 11.0 966.0 東京都 17.6 1,396.5 沖縄県 23.8 2,291.5 …(全 47 行)
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
import pandas as pd, numpy as np
from scipy.stats.mstats import gmean
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == 2023]
rain = df['B4109'].astype(float).to_numpy()   # 降水量: 比例尺度
temp = df['B4101'].astype(float).to_numpy()   # 年平均気温: 間隔尺度
# 比例尺度: CV は単位に依らず不変
print('rain CV (mm):', rain.std(ddof=1)/rain.mean())
print('rain CV (cm):', (rain/10).std(ddof=1)/(rain/10).mean())  # 同じ 0.328
# 間隔尺度: CV は原点の取り方で激変(無意味)
print('temp CV (C):', temp.std(ddof=1)/temp.mean())         # 0.122
print('temp CV (K):', (temp+273.15).std(ddof=1)/(temp+273.15).mean())  # 0.0071
📤 実行例(実測) rain CV (mm): 0.3275966902443782 rain CV (cm): 0.3275966902443782 temp CV (C): 0.1218993705548695 temp CV (K): 0.007063817059102235

💬 降水量の CV は mm でも cm でも 0.3276 と同じで、比例尺度は単位を変えても変動係数が変わらない。年平均気温の CV は摂氏では 0.122、ケルビンでは 0.0071 と約 17 倍違い、平均 16.8℃ に 273.15 を足すだけで分母が変わるためで、摂氏の 0℃ が任意の原点にすぎない間隔尺度では CV は意味を持たない。気温でばらつきを比べるなら標準偏差(℃)そのままで報告する。

🔗 関連ページ

尺度水準の全体像と、 隣り合う 3 尺度・比例尺度で使う道具へ:

尺度水準(全体像) 名義尺度 順序尺度 間隔尺度 変数の種類 量的変数 対数変換 分散 標準化