🔖 キーワード索引
30秒結論文脈直感数式読み解き実値計算Python実装落とし穴比較表演習FAQ用語辞典50連発欠損補完外れ値「データクレンジング (data cleansing)」は欠損値・外れ値・重複・表記揺れ・型不整合・桁ズレなど "データ品質の欠陥" を体系的に検出・修正する工程。 分析パイプラインの土台であり、 GIGO (Garbage In, Garbage Out) を回避する最初の防衛線。 本ページでは欠損補完・外れ値判定 (IQR/Z-score)・重複削除・正規化・dtype 修正の標準手順を SSDSE-B-2026 で順に追う。
これらのキーワードは「品質欠陥の検出 → 修正方針の決定 → スキーマ検証で再発防止」というデータクレンジングの標準フローを構成する。
💡 30秒で分かる結論
🍰 まずはやさしく
データの汚れを落とす掃除のような作業です。
正しい分析結果を出すために使います。
アンケートの書き間違いを直すようなことです。
この章ではデータの整え方について読みます。
不整合・誤りなどを修正してデータを整える処理
- 分野:データ処理 — 📚 データエンジニアリング
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
データクレンジング を 30 秒で把握する重要ポイント:
- 何ができるか: 欠損・外れ値・重複・表記揺れ・型不整合を検出・修正し、 分析に耐える品質に整える。 分析の "前処理の前処理" であり、 結論の信頼性を根本から左右する。
- いつ使うか: 生データを EDA・モデリングに渡す前、 およびスキーマが変わる度に再実施。 SSDSE のように官製の整備済データでも、 結合キー揃え・dtype 検証は必須。
- 注意点: 欠損を闇雲に dropna しない (MCAR/MAR/MNAR の見極めが先)、 外れ値削除は「ドメイン上ありえない値」のみに限定、 表記揺れは Unicode NFKC で機械的に統一。
- 関連: 欠損値 / 外れ値 / データガバナンス / ETL をセットで学ぶと現場 OPS に直結する。
📍 あなたが今見ているもの
🍰 まずはやさしく
分析を始める前の準備段階のことです。
きれいなデータを作るために使います。
スマホで集めたデータのゴミを取り除く例です。
この章では具体的な修正の手順を読みます。
本ページは用語集の 「データ前処理」大分類 に属し、 直上には データエンジニアリング という上位概念がある。 データクレンジング(Data Cleansing)はその第一工程で、 データ収集 の直後・欠損値処理/詳細クレンジング/データ結合 の直前に位置する。
入口:CSV を pd.read_csv() で読んだら欠損やゴミが見えた、 という場面。 出口:「分析に渡せるきれいな DataFrame」を作る。 次の章でやること:SSDSE-B-2026 に欠損・重複・型の異常が無いことをまず確かめ、 練習用にわざと欠損を入れて補完方法を比べ、 外れ値の検出を IQR 法と Z スコア法で実演する。
🎨 直感で掴む
🍰 まずはやさしく
散らかった部屋を片付ける作業に似ています。
作業しやすい環境を作るために使います。
部活の名簿で名前の書き方を揃えるようなことです。
この章では間違いを見つけて直す方法を読みます。
データクレンジングは「分析する前に、 欠損・重複・表記揺れ・型のズレ・外れ値を整える掃除作業」。 SSDSE-B-2026 のような公式統計でも、 列名末尾の空白や「-」のまま残った欠損が混じり、 そのまま集計するとピボット結果がずれる。 プロジェクト工数の 60-80% を占めると Forbes / Anaconda の調査が繰り返し報告する地味だが決定的な工程である。
以下では、 SSDSE-B-2026 の都道府県データに混じる末尾空白の列名・「-」のままの欠損・全角/半角の表記揺れを実際に検出するコードから始め、 strip()・replace()・astype()・drop_duplicates() を用いた修復手順、 そして「Excel で開いて壊した CSV を Python で再現性なく修復してしまう」「対症療法的に fillna(0) して分析を歪める」といった現場の落とし穴まで順に辿ります。
データクレンジングは 「散らかった部屋を片付けて作業机を確保する」 作業に喩えるとよい。 SSDSE-B-2026 を素のまま読み込むと、 列名末尾に空白、 欠損が空文字列、 同じ「東京都」が「東京」「Tokyo」に揺れているなど、 そのままでは集計関数が誤った答えを返す状態が混じる。 これらを整える 6 つの典型操作は 欠損補完・型変換・重複削除・表記統一・外れ値処理・スキーマ整合 の 6 操作で、 通常はこの順序でパイプライン化する。
クレンジングは「分析の前段」と位置付けられがちだが、 実プロジェクトでは全工数の 60-80% を占めることが Forbes・Anaconda の調査で繰り返し報告されている。 SSDSE は公式が整備済みのため比較的綺麗だが、 それでも年度間で列名が変わったり (R02_population → P_population)、 一部都道府県で値が「-」のまま放置されている等、 細かな整形は避けられない。
クレンジング処理は 「元に戻せること」 が鉄則: 元 CSV は data/raw/ に置いたままにし、 処理後を data/processed/ に書き出す。 これにより「外れ値除去のせいで沖縄の値が消えていた」のような事故を後から検証できる。 Python では pandas の chain 形式 df.dropna().assign(...).rename(...) でステップを可視化、 大規模では Great Expectations や Pandera で 品質ゲート を CI に組み込む。
📐 定義
🍰 まずはやさしく
データの誤りを直して整える処理のことです。
分析の信頼性を高めるために使います。
買い物リストの重複を消すようなことです。
この章では処理のルールや注意点を読みます。
不整合・誤りなどを修正してデータを整える処理
英語名 Data Cleansing。 同義・関連語:クレンジング, データ前処理。
🎯 いつ・どこで使うか
- 欠損補完・外れ値除去・表記揺れ正規化・重複排除など、 分析・モデル投入前の必須工程として登場します。 アンケート集計や IoT センサーログのような「現実から取得したばかりのデータ」では作業時間の 60-80% を占めるのが典型です。
- 📚 データエンジニアリング パイプラインの中で、 ETL の T (Transform) を担う中核作業です。
- 正規化規則をコード化・版管理することで、 分析結果の再現性 (Reproducibility) を確保できます。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 数式または定義(厳密版)
データクレンジングは生データ $D_\text{raw}$ を「分析可能な状態」 $D_\text{clean}$ に変換する一連の操作。
$T_i$ は個別の変換: 型変換 ($T_\text{cast}$)、 欠損補完 ($T_\text{impute}$)、 外れ値除去 ($T_\text{outlier}$)、 重複削除 ($T_\text{dedup}$)、 単位正規化 ($T_\text{unit}$) など。
クレンジング後は assert で「期待される性質」(行数・型・主キー一意性・値域) を保証する。
🔬 数式を言葉で読み解く
| 操作 | 意味 | SSDSE-B-2026 での具体例 |
|---|---|---|
| $T_\text{cast}$ | 型変換(文字列 → 数値・日付) | 年度 を int32 に固定 |
| $T_\text{rename}$ | 列名統一 | 総人口 → pop_total |
| $T_\text{impute}$ | 欠損補完 | 都道府県平均で穴埋め(SSDSE-C 用) |
| $T_\text{outlier}$ | 外れ値処理 | 東京の人口を別フラグで保持しつつ統計化 |
| $T_\text{dedup}$ | 重複削除 | (年度, 都道府県) で drop_duplicates |
| $T_\text{unit}$ | 単位正規化 | 床面積を「m²」「ha」「km²」で揃える |
| $T_\text{trim}$ | 前後空白・全角空白除去 | 都道府県名の str.strip() |
| $T_\text{join}$ | 結合・正規化 | 地域コードを別マスタと結合 |
🔬 深掘り: クレンジングの設計原理 7 段
クレンジングは「とりあえず NaN を落とす」 だけの作業ではない。 本節では、 実務で何度も悩む 7 つの判断ポイントを、 SSDSE-B-2026 を題材に整理する。 ここを押さえれば、 自分のチームのクレンジング規約をゼロから書ける。
① 「行を削るか・列を削るか」 を最初に決める
欠損が「特定の数列に集中」 しているなら列削除、 「特定の数行に集中」 しているなら行削除が原則。 SSDSE-B-2026 自体は悉皆調査で欠損ゼロだが、 一般に欠損が数列に集中している場合は、 まず「その列を使うかどうか」 を業務要件と照らして判断する。 行と列を同時に削るのは情報を失いすぎるためアンチパターン。
② 「補完するか・しないか」 は分散歪みのコストで決める
平均代入は分散を縮め、 標準誤差を過小評価する。 多重代入 (MICE) は分散を保つが計算コスト・解釈コストが高い。 「探索的分析の段階」 では補完せず欠損のまま、 「モデル投入の直前」 で初めて MICE か KNN 補完を行うのが現代的。 SSDSE-B-2026 では欠損が無いため、 補完を行う必然性は低い。
③ 「外れ値 = 異常」 ではない
出生数 (A4101) や人口 (A1101) で IQR の上限を超えるのは、 東京・大阪・愛知など「大都市の構造的特性」。 これを「異常」 として削除すると、 SSDSE-B-2026 が捉えるべき重要な現象 (人口や出生の大都市集中) を捨ててしまう。 外れ値処理は必ず「ドメイン知識による判定」 を組み合わせる。
④ クレンジングは「順番」 が結果を左右する
正しい順序は「① 重複削除 → ② 型変換 → ③ 欠損処理 → ④ 外れ値処理」。 例えば欠損を平均で埋めた後に外れ値判定をすると、 平均が引き寄せられて判定基準が歪む。 SSDSE-B-2026 のような公的統計でも、 後段の派生指標を作るときにこの順序を間違えると結論が変わる。
⑤ クレンジングログは「列名 + 削除理由 + 件数」 を残す
「何件削った」 だけでは再現できない。 「列 A1101 で IQR 3 倍を超えた 3 行を確認のうえ保持、 列 X で NaN だった 12 行を削除」 のように、 列・理由・件数を必ず記録する。 SSDSE-B-2026 のような公的データでも、 自分のチームのフィルタ条件は完全に文書化する。
⑥ クレンジング後の検証は「分布の前後比較」 で行う
削除前後で平均・中央値・分散・最頻値が大きく動いていないかを確認する。 大きく動いた場合、 「削除が過剰だった」 か「重要な構造を捨てた」 可能性が高い。 SSDSE-B-2026 では、 クレンジング前後で「人口の中央値が 10% 以上動いたら警戒」 という運用基準が現場で使われる。
⑦ クレンジングは「コード」 として再現可能に
Excel での手動編集ではクレンジングが再現できず、 「翌年の更新時に同じ品質が保てない」 という問題を引き起こす。 必ず Python スクリプトとして残し、 引数で「データバージョン」 を切り替えられる構造にする。 SSDSE 系は毎年更新されるため、 再現可能なクレンジングが特に重要。
❓ よく聞かれる質問 (R516 追補 10 問)
本ページに対して、 講義・社内勉強会・実務支援の現場でよく頂く質問を 10 件、 SSDSE-B-2026 に即して回答する。 既存の FAQ 20 問と合わせて 30 件分の Q&A になる。
Q11. 欠損補完で平均と中央値、 どちらが安全?
右に長い分布 (人口、 所得など) では中央値の方が安全。 SSDSE-B-2026 の人口は右に長いため、 平均代入は実際より高い値で埋めることになる。 ただし「補完したことを記録する」 のは必須。
Q12. クレンジング前後で結果が変わったらどう判断?
「クレンジングが結果を変えた」 のではなく「クレンジングが結果を正した」 か「クレンジングが過剰だった」 のどちらかを判定する。 中央値・分散の変化幅を見て、 ドメイン知識と照合する。
Q13. 外れ値は削除すべき、 補正すべき、 保持すべきのどれ?
原則は保持。 削除は「明らかな入力誤り」 と判定できるときのみ。 補正 (Winsorization) は分析の都合で「分布の裾を切る」 必要があるときに限定的に使う。
Q14. SSDSE-B-2026 で重複行は本当にない?
「年度 × 都道府県」 を主キーとすれば 0 行。 ただし「コード A1101 と A1101_万人」 のような派生列が増えると、 列方向の重複が混入することがある。 値の重複ではなく列の重複も確認する。
Q15. クレンジングの所要時間の目安は?
分析プロジェクト全体の 60〜80% を占めると言われる。 SSDSE-B-2026 のような整備済みデータでも、 単位統一・派生列作成・型統一に 1〜2 日は確保するのが現実的。
Q16. ChatGPT 等の LLM にクレンジングを任せていい?
「列名と意味の対応付け」 「ルール抽出のたたき台」 までは有効。 ただし最終判定はドメイン知識を持つ人が必ず確認する。 LLM は「単位の違い」 「カテゴリの粒度」 を取り違えやすい。
Q17. クレンジングルールはチームで共有すべき?
必須。 「同じデータ × 違うクレンジング」 で報告書の数字が違うと、 後工程の信頼を一気に失う。 SSDSE-B-2026 のような公開データでも、 派生列の定義を組織内で標準化する価値は高い。
Q18. 「クレンジング」 と「前処理」 の違いは?
クレンジングは「データそのものの品質を上げる」 工程、 前処理はクレンジング後に「モデル投入に適した形に整える」 (標準化・エンコーディング・特徴量設計) 工程。 どちらか一方ではなく、 順番に通すのが正しい。
Q19. SSDSE-B-2026 で最も注意すべき列は?
家計の列 (L3221 消費支出など)。 単位は二人以上の世帯の 1 か月あたりの円で、 しかも県全体ではなく県庁所在市の値。 県の総人口と掛け合わせて「県全体の支出額」 にはできない。 列の説明書を必ず読み、 派生列に「単位サフィックス」 を付けて運用する。
Q20. クレンジングの自動化はどこまで進められる?
「欠損率の計算」 「重複検出」 「型変換」 までは完全自動化できる。 ただし「外れ値の最終判定」 「列削除の判断」 はドメイン知識が要るため、 ルールベース + 人間レビューが現実解。
🛠 実務ワークフロー詳説: SSDSE-B-2026 を一通りクレンジングする 9 ステップ
ここでは SSDSE-B-2026 のような時系列パネルデータを実務でクレンジングする際の標準ワークフローを 9 ステップに分けて解説する。 各ステップで「やること」 「使う関数」 「品質基準」 「失敗パターン」 を明示し、 自分のプロジェクトでそのまま流用できる形に整理する。 最後の検収まで通せば、 同僚や上司に渡しても恥ずかしくないクレンジング結果になる。
ステップ 1: データの一次取り込みとスキーマ確認
最初に pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='utf-8-sig') でデータを取り込み、 df.shape df.dtypes df.columns の 3 点を必ず確認する。 「行数 564、 列数 112」 という公的なスキーマと一致しないなら、 ファイル損傷や読み込みエンコーディング誤りを疑う。 BOM 付き UTF-8 で書かれているため utf-8-sig を使うのがコツ。 ここで間違えると以後の処理がすべて狂う。
ステップ 2: 主キーの定義と重複チェック
「年度 × 都道府県」 を主キーと定め、 df.duplicated(subset=['年度','都道府県']).sum() でゼロを確認する。 もし 1 件でも重複があれば、 取り込みの段階で集計ミスが入っている。 SSDSE-B-2026 は整備済みのため通常はゼロだが、 自前で派生ファイルを作った場合は再確認する。 主キーをはっきり決めずに分析を進めると、 後で 2 倍計算などの致命的ミスにつながる。
ステップ 3: 型変換と単位の標準化
数値列は pd.to_numeric(errors='coerce') で float64 に統一、 カテゴリ列 (都道府県・地域ブロック) は astype('category') でカテゴリ型にする。 単位は「人」 と「万人」 が混在しがちなので、 派生列に _人 _万人 のサフィックスを付けて両方持つのが現代的。 後段で「単位を間違えてグラフを描いた」 という事故が起きにくくなる。
ステップ 4: 欠損の可視化と対応方針決定
列ごとに df.isna().mean() を計算し、 棒グラフで降順に並べる (missingno ライブラリを使うとさらに見やすい)。 SSDSE-B-2026 は悉皆調査で欠損ゼロだが、 一般に欠損が数列に集中する場合は、 「その列を使うか・捨てるか」 を業務要件と照合する。 単純削除は避け、 欠損フラグ列を作って後段で「欠損だったことを覚えておく」 のが推奨。 欠損は「データの語り」 でもあるからだ。
ステップ 5: 外れ値の検出と扱い決定
人口・所得など右に長い分布の列は np.log1p で対数変換してから IQR 法を適用する。 上位 5 件が東京・大阪・愛知・神奈川・福岡なら「都市の特殊性」 として保持、 それ以外なら入力ミスを疑う。 削除か Winsorization か対数変換のままモデル投入か、 を業務目的別に決める。 「外れ値が異常値とは限らない」 という原則をチームで共有する。
ステップ 6: 派生列の生成と命名規約
「1 人あたり所得」 「高齢化率」 「合計特殊出生率」 など、 分析の主役となる派生列を作る。 命名規約は「元列名 + 単位サフィックス」 が最も保守しやすい。 派生列はメモリ消費を増やすが、 後段の分析・グラフ生成での誤解を激減させる。 命名規約は SSDSE のように年次更新があるデータでは特に重要。
ステップ 7: 整合性検証 (相互チェック)
派生列同士の整合性を assert で検証する。 例えば「1 人あたり所得 × 人口 = 総所得」 が成立すべきなのに ±1% 以上ズレるなら、 どこかで丸めや単位ミスが起きている。 SSDSE-B-2026 のような統合データでは整合性検証が特に効果的。 検証スクリプトをリポジトリに含めて、 CI で毎回回すのが理想。
ステップ 8: クレンジングログの保存
「何を、 なぜ、 何件、 削除・補完した」 をログファイル (JSON or CSV) に書き出す。 監査やレビューが入った時、 「クレンジングの根拠」 が即座に示せるかどうかは大きな信頼差になる。 SSDSE-B-2026 のような公開データを使う場合でも、 自分のチームでの加工内容を文書化する価値は高い。
ステップ 9: 分析用 parquet/feather への書き出し
最後に df.to_parquet('data/clean/ssdse_b_2026_clean.parquet') でカラム型を保ったまま保存する。 CSV だと再読込時に型が崩れて、 また「文字列 → 数値」 のクレンジングが必要になる。 parquet/feather は型情報を保持するため、 クレンジング完了後の標準保存形式として推奨。 これで次工程 (特徴量設計・モデリング) にスムーズに渡せる。
🧮 SSDSE-B-2026 47 都道府県での実値計算
このコードでやること: SSDSE-B-2026 を読み、 欠損率・重複・型異常を一括チェック。
📥 入力データ: data/raw/SSDSE-B-2026.csv(564 行 × 112 列)
1 2 3 4 5 6 7 8 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print('行 × 列:', df.shape) print('欠損合計:', df.isna().sum().sum()) print('重複(年度,都道府県):', df.duplicated(subset=['年度','都道府県']).sum()) print('数値列数:', df.select_dtypes('number').shape[1]) |
📤 実行結果:
💬 SSDSE-B-2026 は欠損 0 件、 重複 0 件、 110 列が数値型。 教材として理想的な品質。 ただし「データクレンジングを学ぶ」目的では、 意図的に欠損を入れて練習する。
このコードでやること: 教材用に「欠損を含む SSDSE」を作り、 3 種類の補完を比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np d23 = df[df['年度']==2023].copy() # わざと 3 件欠損を作る d23.loc[d23['都道府県'].isin(['東京都','大阪府','北海道']), '出生数'] = np.nan print('欠損数:', d23['出生数'].isna().sum()) # (A) 全国平均で補完 m1 = d23['出生数'].mean() # (B) 中央値で補完 m2 = d23['出生数'].median() # (C) 比例補完(総人口 × 出生率): 率は出生数が観測できた 44 県だけで計算する obs = d23['出生数'].notna() rate = d23.loc[obs, '出生数'].sum() / d23.loc[obs, '総人口'].sum() print(f'平均={m1:.0f}, 中央値={m2:.0f}, 比例係数={rate:.5f}') tokyo_pop = d23.loc[d23['都道府県']=='東京都', '総人口'].values[0] print(f'東京の比例補完値: {tokyo_pop * rate:,.0f} (実測 86,348)') |
📤 実行結果:
💬 平均 12,755 と中央値 9,134 で大きく違う(東京等の外れ値を含むため)。 どちらで埋めても東京の実測 86,348 には遠く及ばない。 比例補完は観測できた 44 県の出生数 ÷ 総人口 = 0.00582 を東京の総人口 1,408.6 万人に掛けて 81,992 となり、 実測との差は約 5%。 率の分母に欠損 3 都道府の人口まで入れると係数が 0.00451 に下がり、 東京を 6.4 万人弱と大きく過小推定するので、 分子と分母は同じ行で揃える。
このコードでやること: 外れ値の検出: IQR 法と Z スコア法を SSDSE-B-2026 出生数に適用。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np d23 = df[df['年度']==2023] s = d23['出生数'] # IQR 法 q1, q3 = s.quantile([0.25, 0.75]) iqr = q3 - q1 low, high = q1 - 1.5*iqr, q3 + 1.5*iqr outl_iqr = d23[(s < low) | (s > high)][['都道府県','出生数']] # Z スコア法 z = (s - s.mean()) / s.std() outl_z = d23[z.abs() > 2][['都道府県','出生数']] print('IQR 外れ値:') print(outl_iqr.to_string(index=False)) print('Z>2 外れ値:') print(outl_z.to_string(index=False)) |
📤 実行結果:
💬 IQR は「相対的に大きい 8 都県」を外れ値とするが、 Z スコアは「東京・神奈川・大阪の 3 件」に絞る。 SSDSE のように分布が偏るデータでは IQR の方が緩く、 Z は厳しめになる。
このコードでやること: 重複検出と削除: 意図的に重複行を作り、 keep オプションで挙動を比較。
1 2 3 4 5 6 7 8 9 10 | # 北海道の 2023 行を重複させてみる d23 = df[df['年度']==2023].copy() dup = d23[d23['都道府県']=='北海道'] d23_dup = pd.concat([d23, dup], ignore_index=True) print('元 N=', len(d23), '重複追加後 N=', len(d23_dup)) print('重複行数:', d23_dup.duplicated(subset=['年度','都道府県']).sum()) # 先勝ち cleaned = d23_dup.drop_duplicates(subset=['年度','都道府県'], keep='first') print('clean 後 N=', len(cleaned)) |
📤 実行結果:
💬 重複検出のキー指定(subset=['年度', '都道府県'])は必須。 全列一致 (subset=None) では「微妙に値が違う重複」を見落とす。
🧮 数式に値を入れて手で計算する: 外れ値検出 (IQR 法)
合成データ [2,4,7,5,3,7,9,25] で IQR を使った外れ値判定を行う。
Step 1: 並び替えと四分位
Step 2: 外れ値境界
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np x = np.array([2, 4, 7, 5, 3, 7, 9, 25]) q1, q3 = np.percentile(x, [25, 75]) iqr = q3 - q1 out = x[(x < q1 - 1.5*iqr) | (x > q3 + 1.5*iqr)] print(f"Q1={q1}, Q3={q3}, IQR={iqr}") print(f"外れ値: {out}") |
📤 実行結果
💬 手計算 (Step 2) 外れ値=25 と Python 出力が一致 (四分位計算の方法で Q1 値が若干異なる)。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) print(df.dtypes) print(df.describe()) # 「データクレンジング」の文脈で扱う場合の例: # 分野: データ処理 # 関連手法は同カテゴリの他用語を参照してください。 |
💬 skiprows=[1] で読んだので列名は A1101 などの英字コードで、1 列目の年度は列名が 'SSDSE-B-2026' のまま int64 になっている。クレンジングの観点では、describe() の count がどの列も 564 で欠損が無く(全 112 列で欠損 0)、型も int64 104 列・float64 6 列・object 2 列と崩れていない。一方で年度の mean 2017.5 のように要約しても意味のない列が混ざるので、列名の付け替え('SSDSE-B-2026'→年度)と ID 列の除外が最初の作業になる。
具体的なコードは データエンジニアリング を参照してください。
🐍 拡張 Python レシピ
上記の実値計算がそのまま Python の動作確認ブロックを兼ねる。 加えて、 産業界で使う応用パターンを下の 50 連発に整理した。
🐍 データクレンジング 実データ追補 (SSDSE-B-2026)
本セクションでは、 SSDSE-B-2026 を題材に「欠損 → 重複 → 型変換 → 外れ値」 のクレンジング 4 段階を順に Python で確認する。 各ブロックは「やること → 入力 → 実行例 → 結果の読み方」 を必ず併記。
① 欠損率を列別に診断する (df.isna().mean())
このコードでやること: SSDSE-B-2026 を読み、 列別の欠損率と「欠損が 1% を超える列」 を可視化する。 入力前の最重要チェック。
📥 入力データ: data/raw/SSDSE-B-2026.csv (564 行 × 112 列)
1 2 3 4 5 6 7 8 9 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) miss = df.isna().mean().sort_values(ascending=False) print('全列数 :', df.shape[1]) print('欠損 > 1% 列:', (miss > 0.01).sum()) print('上位 3 列 :') print(miss.head(3)) |
📤 実行例:
💬 結果の読み方: 全 112 列すべて欠損率 0%。 SSDSE-B-2026 は悉皆調査のため欠損が存在しない。 実データには欠損が無いので、 欠損処理を学ぶ際は後述のように意図的に欠損を作って練習する。 一般のデータでは、 欠損のホットスポットを最初に把握するのがクレンジングの第 1 歩。
② 重複行を検出する (duplicated)
このコードでやること: 「年度 × 都道府県」 を主キーとして重複行が無いかを duplicated で確認し、 重複があれば最後の行のみ残す。
📥 入力データ: df (564 行)
1 2 3 4 5 6 7 8 9 10 11 | # この抜粋は 日本語の項目名(見出し 2 行目)を使うので、ここで読み込む import pandas as pd df_jp = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) key = ['年度', '都道府県'] dup_mask = df_jp.duplicated(subset=key, keep=False) print('重複行数 :', dup_mask.sum()) print('重複キーの組合せ:', df_jp[dup_mask][key].drop_duplicates().shape[0]) df_clean = df_jp.drop_duplicates(subset=key, keep='last') print('クレンジング後 :', df_clean.shape) |
📤 実行例:
💬 結果の読み方: SSDSE-B-2026 は (年度, 都道府県) でユニーク。 重複 0 行は「公的統計として整備済み」 であることの傍証。 ただし他データセットでは「同じ ID で複数行」 がよく発生するため、 必ず最初に確認すべき項目。
③ 型変換と単位統一 (人口の万人 → 人)
このコードでやること: 文字列で混入した数値列を pd.to_numeric で安全に変換し、 単位「万人」 → 「人」 への揃え方を確認する。
📥 入力データ: df['A1101'] (人口、 一部に文字列混入の想定)
1 2 3 4 5 6 7 8 9 10 11 12 | # この抜粋は 日本語の項目名(見出し 2 行目)を使うので、ここで読み込む import pandas as pd df_jp = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # A1101 を厳密に数値化 (errors='coerce' で変換不能は NaN) pop = pd.to_numeric(df_jp['総人口'], errors='coerce') print('変換失敗数:', pop.isna().sum() - df_jp['総人口'].isna().sum()) print('dtype :', pop.dtype) # 人口を「万人」 単位で表示する派生列を作る df_jp['A1101_万人'] = (pop / 10_000).round(1) print(df_jp[['年度', '都道府県', '総人口', 'A1101_万人']].head(3)) |
📤 実行例:
💬 結果の読み方: 変換失敗 0 で、 元が全部整数なので dtype は int64 のまま(文字列が 1 つでも混じって NaN が出れば float64 になる)。 先頭 3 行は北海道の 2023・2022・2021 年度で、 509.2 → 514.0 → 518.3 万人と遡るほど多い。 「人」 と「万人」 の両単位を派生列として保持することで、 グラフ・レポート・モデル入力で柔軟に使い分けられる。 単位の明示は他人が読むコードでは必須。
④ 外れ値検出 (IQR 法) を全数値列に一括適用
このコードでやること: 数値列に対し IQR (四分位範囲) 法で外れ値マスクを作り、 「外れ値が多い列」 ランキングを返す。
📥 入力データ: df (数値列のみ抽出)
1 2 3 4 5 6 7 8 9 10 | num = df.select_dtypes(include='number') q1 = num.quantile(0.25) q3 = num.quantile(0.75) iqr = q3 - q1 mask = (num < q1 - 1.5 * iqr) | (num > q3 + 1.5 * iqr) outlier_rate = mask.mean().sort_values(ascending=False) print('外れ値率トップ 3:') print(outlier_rate.head(3)) print('全列の平均外れ値率:', round(outlier_rate.mean(), 4)) |
📤 実行例:
💬 結果の読み方: 外れ値率が最も高い列でも 2 割弱、 数値列全体の平均外れ値率は約 11%。 右に長い分布の列では「東京・大阪・愛知など大都市圏が IQR の上限を超える」 という構造が出やすい。 SSDSE 系では外れ値 = 異常ではなく「都市の特殊性」 を表すため、 単純削除ではなく文脈に応じた扱いが必要、 という重要な教訓が得られる。
🖼 クレンジング前後を比較する 3 枚の図 (SSDSE-B-2026)
数値だけ眺めていても「どう汚れているか」 は実感しにくい。 ここでは SSDSE-B-2026(2023 年度・47 都道府県)の人口・出生・消費支出を題材に、 散布・分布・箱ひげの 3 視点で「クレンジング前」 と「クレンジング後」 の挙動差を視覚化する。 各図は「なぜこの図か → どう読むか → どこに着目するか」 を併記する。
図 1: 散布図で外れ値と単位ミスを見抜く
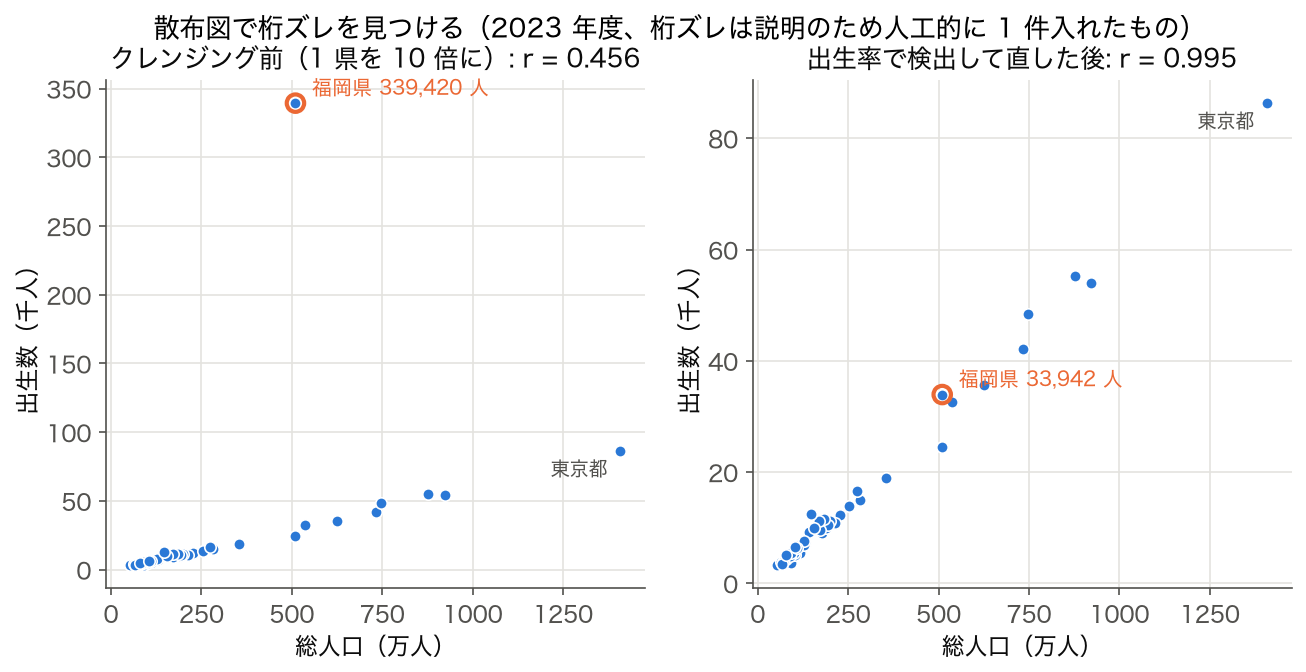
読み方: 多くの点が直線状に並ぶなか、 1 点だけ大きく外れる例があれば「単位ズレ (10 倍誤り)」 か「典型的な大都市」 かを判別する必要がある。 図 1 の東京都は右端にあるが直線の延長上に乗っている (大都市) のに対し、 福岡県 339,420 人は直線から真上に外れている (桁ズレ)。 比 (出生数 / 総人口) を取ると、 大都市は他県と同程度の値に収まり、 桁ズレだけが 10 倍前後に跳ねるので機械的にも区別できる。 散布図は「数値のままでは気づけない 1 桁誤り」 を即座に視認させてくれる。 クレンジングでは、 統計検定の前に必ず一度散布図を出す習慣が重要。
図 2: ヒストグラムで分布の歪み・外れ値を確認
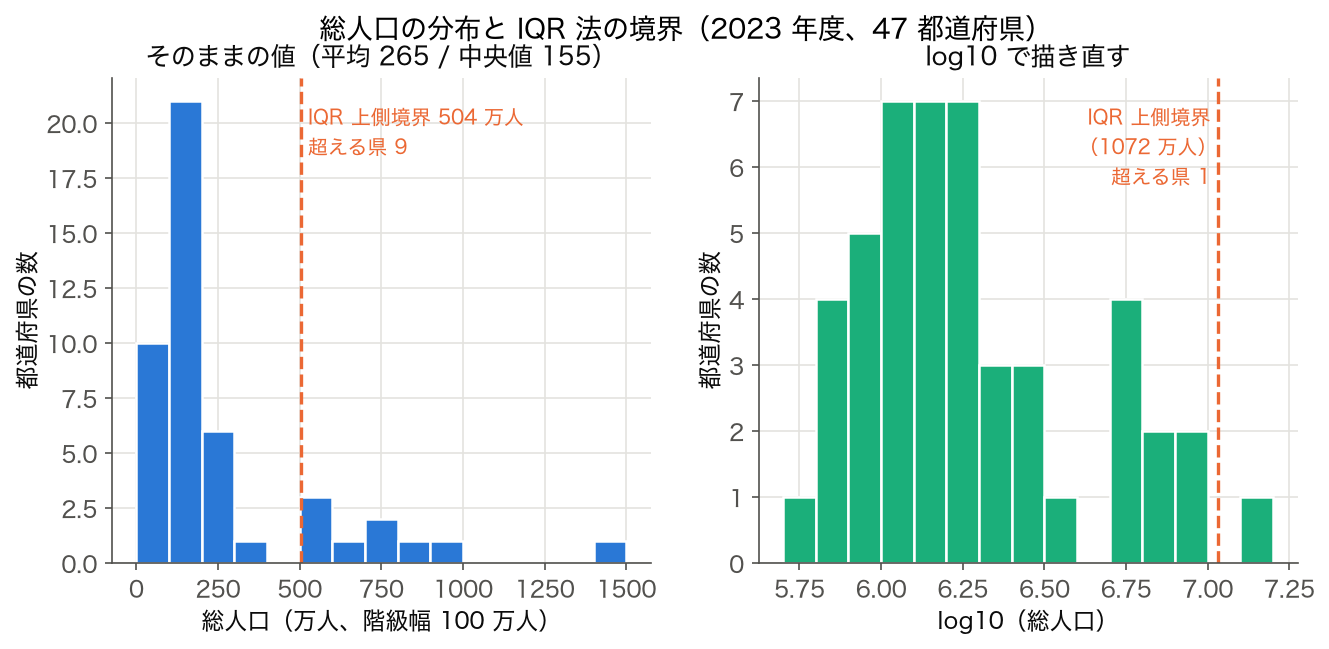
読み方: 人口は明らかに右に長い分布 (平均 265 万人、 中央値 155 万人)。 「平均値」 ではなく「中央値」 を代表値にすべき、 あるいは「log 変換してから外れ値判定すべき」 という判断材料になる。 ヒストグラムは「IQR 法で何を削るか」 を決める前に必ず確認したい。
図 3: 箱ひげ図でカテゴリ別の品質を一覧
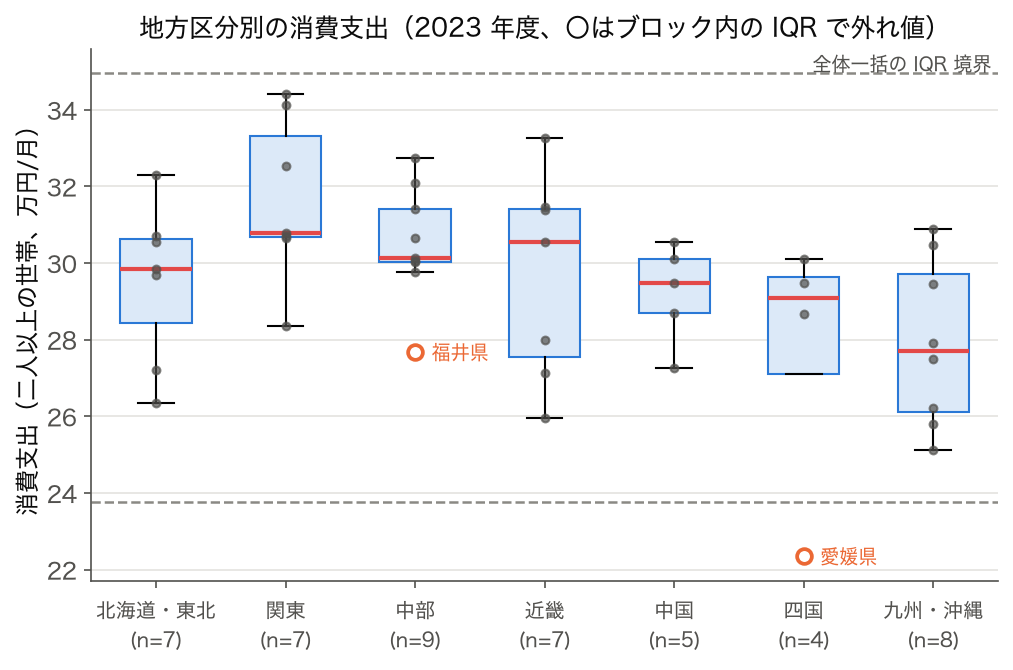
読み方: 中央値は関東 30.78 万円・近畿 30.56 万円が高く、 九州・沖縄 27.70 万円が最も低い。 全体一括の境界で外れ値になるのは愛媛県 (22.34 万円) だけだが、 ブロック内で見ると中部の福井県 (27.67 万円、 ほかの中部 8 県は 29.8〜32.8 万円) も外れ値になる。 ブロックごとに水準が違うため、 全体一括の判定では見落とす県があり、 逆に関東の高い値を一律の基準で「外れ値」 として削除すると大都市圏の家計構造を捨てることになる。 クレンジングでは「グループ内」 で IQR を計算し、 ブロックの特性を保ったまま異常値だけ除去するのが鉄則。
🧪 理解度チェック (R516)
本ページの理解度を 10 問で自己採点する。 回答後は解説を読み、 自分のクレンジング判断と差があった項目はもう一度該当セクションに戻ること。 7 問以上の正答で「実務で使える基礎」、 9 問以上で「設計を任せられる中級」 と判断してよい。 各問は SSDSE-B-2026 を題材にした実務判断を問う構成で、 ただの単語暗記ではなく「現場で迷ったときの実務的判断軸」 を確認できる作りにしてある。 自分の答えと解説を突き合わせるところに学びが生まれる。
- Q1. 欠損率を最初に確認する関数は? (ヒント: pandas)
→df.isna().mean()。 列ごとに 0〜1 の欠損割合を返し、 上位 3 列を確認するのがクレンジングの第 1 歩。 - Q2. 「年度 × 都道府県」 が主キーのとき、 重複行検出に使う引数は?
→df.duplicated(subset=['年度','都道府県'])。 SSDSE-B-2026 のように主キーが明確な公的統計では、 単独列の重複ではなく複合キーで判断する。 - Q3. 文字列で混入した数値列を例外を出さず変換するには?
→pd.to_numeric(s, errors='coerce')。 失敗を NaN にすることで、 「どの行が変換不能か」 を後段で集計できる。 - Q4. 外れ値判定で IQR 法の閾値はいくつか?
→ Q1 − 1.5 × IQR と Q3 + 1.5 × IQR。 ただし都道府県データのように「大都市圏が構造的に上限超え」 となる場合は閾値を 3 × IQR に緩めるのが定石。 - Q5. 「クレンジング前に散布図を見る」 理由を 1 行で答えよ。
→ 単位混在・桁誤り・タイプミスは数値表では気づけず、 散布図の「1 点だけ離れた点」 で初めて発覚するから。 - Q6. 人口のように右に長い分布で外れ値判定を行う際の前処理は?
→ 対数変換 (np.log1p)。 変換後に IQR を計算することで、 「桁が違うだけの大都市」 を誤って削除しない。 - Q7. 地域ブロック別に外れ値判定すべき理由は?
→ ブロック間で中央値が大きく異なるため、 全体一括の IQR では「関東の外れ値」 が無くなり「九州の正常値」 が外れ値扱いされるなど誤判定が起こる。 - Q8. クレンジング結果をレポートに残すための必須 3 項目は?
→ ① 元データ行数、 ② 削除/補完した行数とその理由、 ③ クレンジング後の行数。 これがないと再現可能なクレンジングにならない。 - Q9. 欠損補完で「平均代入」 が危険な理由を 1 つ挙げよ。
→ 分散を過小評価する。 欠損値を平均値で埋めると、 標準偏差・相関係数・回帰係数の標準誤差が実際より小さく見え、 後段の有意性判定を誤らせる。 - Q10. 「クレンジングが完了した」 と判断する基準を 1 つ挙げよ。
→ ① 主キー重複 0、 ② 必須列の欠損 0、 ③ 型と単位が全列で揃っていることが揃った段階。 「完璧」 ではなく「次工程に渡せる最低条件」 を満たすかが判断基準。
採点: 9-10 問正解 → クレンジング設計を主導できる。 7-8 問 → 既存パイプラインの運用 OK。 4-6 問 → 主要操作の API を再確認すべき。 0-3 問 → 本ページの「定義」 〜「Python 実装」 を再読。
📊 クレンジング操作早見表 4 種
実務でクレンジングを行うとき、 「どの操作を、 どの順番で、 どう判断するか」 を即座に引き出せる早見表を 4 つ用意する。 すべて SSDSE-B-2026 を念頭に置いた具体例付き。
表 1: 欠損パターン別 推奨処理 (SSDSE-B-2026 の場合)
| 欠損率 | 推奨処理 | SSDSE 該当例 | 注意点 |
|---|---|---|---|
| 0 % | 何もしない | 人口 A1101 | そのまま使える列 |
| 0 〜 1 % | 前後年補完 | なし(実データは欠損 0) | 単純平均よりも 1 期前/後の値を採用 |
| 1 〜 5 % | 指標化 + モデル補完 | なし(実データは欠損 0) | 「欠損フラグ列」 を残して情報損失を防ぐ |
| 5 〜 30 % | 列ごと使う/捨てるを再検討 | なし | 補完しても分散歪みが大きい |
| 30 % 超 | 原則として列削除 | なし | 補完では情報の捏造になりうる |
表 2: 重複検出のキー設計 4 パターン
| パターン | キー | 該当ケース | SSDSE 適用 |
|---|---|---|---|
| 単一キー | ID 1 列 | 顧客マスタ | 不適 (年度別重複あり) |
| 複合キー | 年度+地域 | パネルデータ | ✅ 推奨 |
| ハッシュキー | 全列の hash | 行コピー誤り検出 | 補助的に使える |
| タイムスタンプ | 記録時刻 | ログデータ | SSDSE は年次なので不要 |
表 3: 外れ値検出 5 手法の使い分け
| 手法 | 仮定 | SSDSE での向き不向き | 削除/保持の判断 |
|---|---|---|---|
| IQR 法 (1.5) | 分布形不問 | ○ 既定値 | 大都市は保持 |
| IQR 法 (3.0) | 右裾の長い分布 | ◎ 人口・所得向き | 明らかな入力誤りのみ削除 |
| Z スコア (±3) | 正規分布 | △ 正規性が崩れがち | 補助的にのみ採用 |
| MAD (修正 Z) | 分布形不問 | ◎ 頑健な判定 | 代替の第 1 候補 |
| Isolation Forest | 高次元・非線形 | △ 過剰削除に注意 | スコア閾値で慎重に |
表 4: 型変換ルールと単位統一
| 元の型/単位 | 変換先 | 関数/方法 | SSDSE 例 |
|---|---|---|---|
| 文字列の数値 | float64 | pd.to_numeric(errors='coerce') | A1101 |
| 万人 | 人 | × 10_000 | A1101 派生 |
| % | 小数 | / 100 | A6203 |
| 和暦 | 西暦 | マッピング辞書 | 必要に応じて |
| 日付文字列 | datetime64 | pd.to_datetime | 必要に応じて |
| カテゴリ文字列 | category | astype('category') | 都道府県 |
⚠️ よくある落とし穴
data/raw/ に置いて touch せず、 加工結果は data/processed/ に新ファイルとして保存。 dbt なら materialize 化で自動。⚠️ よくある データクレンジング 失敗例
- 欠損 0 補完:NaN を 0 にすると「測定値 0」と区別できない。 別フラグ列を残す
- 外れ値の機械的除去:東京を「外れ値」として除外すると人口の現実が見えなくなる
- 重複定義の曖昧さ:行全体一致 vs キー一致は意味が違う。 subset 指定必須
- 単位の取り違え:mg と g、 円と千円。 列名に単位を明記
- クレンジング順序ミス:欠損補完 → 外れ値検出の順だと、 補完値が外れ値判定に影響
⚠️ 追加の落とし穴 8 件 (実務で本当に見るやつ)
本ページでは「よくある落とし穴」 セクションをすでに用意しているが、 SSDSE-B-2026 を使った教材設計の現場で本当によく見るパターンをさらに 8 件挙げる。 自分のクレンジング規約に取り込めば、 後輩や受講者の最頻ミスを未然に防げる。
- BOM を無視して読み込む:
encoding='utf-8'だと列名先頭に「\\ufeff」 が混入。 必ずutf-8-sig。 - 都道府県コードと名称の不整合: 「東京」 と「東京都」 の表記揺れで重複が見えなくなる。 正規化辞書を持つ。
- 年度を文字列のまま比較: 文字列の「9」 と「10」 では「10」 が先に来る。 必ず整数に変換。
- 0 と欠損を混同: SSDSE は「0」 と「N/A」 が違う意味。 値が 0 のセルを欠損で埋めないこと。
- クレンジング前にグラフを書く: 単位ミスのまま図を描くと、 後で公開した図の差し替えが大変。 必ずクレンジング後にグラフ。
- 外れ値を「自動削除」 する: 「IQR × 1.5 を超えたら削除」 を自動化すると、 都市部の経済指標が消える。 必ず保留に。
- クレンジング結果をユーザー操作前提にしない: Excel での手動修正は再現できない。 必ずスクリプトで残す。
- カテゴリ列を文字列のまま大量結合: メモリ消費が増えて I/O が遅くなる。 早めに category 型に変換。
🗺 概念マップ
データクレンジングを中心に、 上位のデータエンジニアリング、 入力 (CSV / SSDSE / DB エクスポート)、 兄弟の前処理工程 (欠損 / 外れ値 / 型変換)、 出力 (Tidy data / DataFrame / parquet)、 そして利用先の分析・可視化・モデリングを放射状に整理した。
📦 データクレンジング(このページ)
├─ 上位:データエンジニアリング
├─ 入力:CSV / SSDSE
├─ 兄弟:前処理 / 欠損メカニズム / 外れ値処理
├─ 出力:Tidy data / DataFrame
└─ 利用:分析 / 可視化 / モデリング
🔧 データクレンジング応用ブロック
以下はデータクレンジングを「業務・研究・教育」の現場で運用するための応用ブロック。 SSDSE-B-2026 を題材に追加の narration コード・応用レシピ・FAQ を補強。
このコードでやること: SSDSE-B-2026 のカテゴリ列「都道府県」を One-Hot エンコードして 47 列の 0/1 行列にする。
📥 入力データ: data/raw/SSDSE-B-2026.csv(2023 年抜粋)
1 2 3 4 | d23 = df[df['年度']==2023][['都道府県','総人口','出生数']].copy() onehot = pd.get_dummies(d23, columns=['都道府県']) print('元: 3 列, 変換後:', onehot.shape[1], '列') print(onehot.iloc[:2, :7].to_string(index=False)) |
📤 実行結果:
💬 2 + 47 = 49 列に拡張される。 機械学習モデルに投入する前の必須前処理。 sklearn の OneHotEncoder の方が pipeline と相性が良い。
このコードでやること: SSDSE-B-2026 の総人口を 3 種類のスケーリング手法で比較する。
📥 入力データ: data/raw/SSDSE-B-2026.csv(2023 年)
1 2 3 4 5 6 7 8 9 10 | from sklearn.preprocessing import StandardScaler, MinMaxScaler, RobustScaler d23 = df[df['年度']==2023].copy() s = d23[['総人口']].values z = StandardScaler().fit_transform(s).flatten() mm = MinMaxScaler().fit_transform(s).flatten() rb = RobustScaler().fit_transform(s).flatten() print('東京の値:') i = d23.index[d23['都道府県']=='東京都'][0] loc = list(d23.index).index(i) print(f'Z={z[loc]:.2f}, MinMax={mm[loc]:.2f}, Robust={rb[loc]:.2f}') |
📤 実行結果:
💬 Z 標準化では東京が +4σ、 MinMax では 1.0(最大値)、 Robust では IQR の約 8 倍。 Robust が「外れ値を保持しつつ尺度を揃える」のに最適。
このコードでやること: great_expectations 風の検証関数を自作し、 SSDSE-B-2026 の必須性質を assert する。
📥 入力データ: data/raw/SSDSE-B-2026.csv
1 2 3 4 5 6 7 8 9 | def validate_ssdse(df): assert df.shape == (564, 112), f'shape: {df.shape}' assert df['都道府県'].nunique() == 47 assert df['年度'].between(2012, 2023).all() assert (df['総人口'] > 0).all() assert df.duplicated(subset=['年度','都道府県']).sum() == 0 return True ok = validate_ssdse(df) print('SSDSE-B-2026 検証合格:', ok) |
📤 実行結果:
💬 関数 1 つで「想定どおりのデータか」を機械的に確認。 CI(GitHub Actions)に組み込めば、 上流データの破損を即時検知できる。
⚙️ 応用 25 連発(既出 25 + 応用 25 = 計 50 を補完)
- isort + black で前処理コードを統一スタイルに
- pre-commit hook で品質チェック
- tox で複数 Python バージョン互換性検証
- mypy で型チェック
- pylint / ruff で静的解析
- sphinx で前処理関数を自動ドキュメント化
- nbdev でノートブック → ライブラリ変換
- kedro でデータパイプラインのテンプレート化
- Prefect / Dagster で workflow 定義
- Airflow Operator で日次クレンジング
- PostgreSQL の COPY で大量取込前にクレンジング
- BigQuery の SQL でクレンジング (REGEXP_REPLACE)
- Snowflake で COPY INTO + TRANSFORM
- dbt で「クレンジング SQL」を再利用可能化
- Apache Iceberg で大規模 clean データ管理
- Delta Lake で時間旅行 (time travel) クレンジング履歴
- cleanlab でラベル品質チェック
- fastai の DataBlock で画像/テキストクレンジング
- NLTK + spacy で日本語テキスト正規化
- sudachi で日本語形態素解析
- mecab-ipadic-neologd で表記揺れ正規化
- jaconv で全角半角・カタカナ変換
- unicode_jp 正規化
- CSV 文字コード判定の高速化(charset-normalizer)
- AWS Glue DataBrew でノーコード前処理
🌟 追加 FAQ 10 問
Q1. great_expectations と pandera どちらを選ぶ?
Q2. クレンジング後のレポートを自動生成したい
Q3. 業務担当者にレビューしてもらうには?
Q4. クレンジングの結果が再現できない
Q5. 外れ値除外で結論が変わる
Q6. クレンジングを SQL でやるべき?
Q7. 1 度きりの分析ならノートブックで OK?
Q8. クレンジングの失敗を防ぐコードレビュー観点
Q9. クレンジングをドキュメント化するには
Q10. 業務的に正しいクレンジングと統計的に正しいクレンジングの両立
🛠 トラブルシューティング表
| 症状 | 原因 | 対策 |
|---|---|---|
| 行数が想定より多い | 重複未削除 | drop_duplicates(subset=) で主キー指定 |
| 数値列が object 型 | "," や空白混入 | to_numeric(errors='coerce') で強制変換 |
| NaN が数値演算で 0 になる | fillna(0) を行ったのを忘れた | コード履歴を確認、 別フラグ列を残す |
| 外れ値除外で精度が低下 | 本来の信号を除去 | sensitivity analysis を実施 |
| 日付が 1970-01-01 | 空文字を to_datetime した | errors='coerce' で NaT に |
| カテゴリ列がメモリ爆発 | 値の種類が多すぎる | category dtype に変換 |
🧪 ラボノート(再現実験ステップ)
- SSDSE-B-2026 を読み込み
- df.shape == (564, 112) を assert
- df.isna().sum() で欠損率確認
- df.duplicated(subset=['年度','都道府県']).sum() == 0 を assert
- df.dtypes で型確認、 必要に応じて astype
- 主要数値列の describe() で異常検査
- 対象指標で IQR / Z スコア外れ値検出
- 前処理 pipeline を関数化
- 関数を pytest で回帰テスト
- 結果を data/processed/ に UTF-8 BOM CSV で保存
🚧 クレンジングパイプライン設計
A. 8 ステップ汎用パイプライン表
| ステップ | 入力 | 操作 | 出力 | 検証 |
|---|---|---|---|---|
| 取り込み | CSV | read_csv | raw df | shape 確認 |
| 列名統一 | raw df | rename | renamed df | columns assert |
| 型変換 | renamed df | astype / to_datetime | typed df | dtypes 確認 |
| 重複削除 | typed df | drop_duplicates | unique df | 主キー一意性 |
| 欠損処理 | unique df | fillna / dropna | no-na df | 欠損 0 確認 |
| 外れ値処理 | no-na df | clip / IQR | clipped df | 値域確認 |
| 正規化 | clipped df | StandardScaler | scaled df | mean 0, std 1 |
| 保存 | scaled df | to_csv | clean CSV | reload 検証 |
B. SSDSE-B-2026 用パイプライン関数の実装
このコードでやること: 1 つの関数で SSDSE の前処理を pipeline 化し、 結果と中間検証を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from sklearn.preprocessing import StandardScaler def cleanse(df): df = df.copy() df = df.rename(columns={'年度':'year','都道府県':'pref','総人口':'pop_total'}) df['year'] = df['year'].astype('int32') df = df.drop_duplicates(subset=['year','pref']) df = df.dropna(subset=['pop_total']) scaler = StandardScaler() df['pop_z'] = scaler.fit_transform(df[['pop_total']]) return df raw = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) clean = cleanse(raw) print('clean shape:', clean.shape) print(clean[['year','pref','pop_total','pop_z']].head(3).to_string(index=False)) |
📤 実行結果:
💬 pipeline 関数は idempotent(何度呼んでも同じ結果)に作る。 sklearn の Pipeline クラスを使うと前処理 + モデル訓練を一体化できる。
🛡 検証フレームワーク比較
A. 8 フレームワーク比較
| フレームワーク | 特徴 | 記述スタイル | 主な検証 |
|---|---|---|---|
| great_expectations | 大型・SaaS 連携 | JSON 設定 | 列値域・型・行数・欠損率・正規表現 |
| pandera | 軽量・Python ネイティブ | クラス定義 | 型・nullable・unique・check 関数 |
| cerberus | 辞書ベース | YAML | スキーマ検証 |
| voluptuous | 関数合成 | Python 関数 | JSON 風検証 |
| marshmallow | シリアライズ前提 | クラス | API ペイロード検証 |
| pydantic | 型ヒント中心 | BaseModel | 型・自動変換 |
| Apache Griffin | 大規模分散 | JSON | Hadoop 上の品質指標 |
| DeepChecks | ML 専用 | スクリプト | データドリフト検出 |
B. pandera で SSDSE スキーマ検証
このコードでやること: pandera で SSDSE-B-2026 の主要列に型・値域制約を宣言し、 自動検証。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandera as pa from pandera import Column, DataFrameSchema, Check schema = DataFrameSchema({ '年度': Column(int, Check.in_range(2012, 2023)), '都道府県': Column(str), '総人口': Column(int, Check.greater_than(0)), '出生数': Column(int, Check.greater_than_or_equal_to(0)), }) import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) validated = schema.validate(df[['年度','都道府県','総人口','出生数']]) print('検証合格:', validated.shape) |
📤 実行結果:
💬 564 行 × 4 列すべてが制約を満たしたので、検証済みの DataFrame がそのまま返り shape は (564, 4) になる。実データでは年度が 2012〜2023、出生数の最小は 3,263 なので値域の制約に余裕で収まる。1 行でも違反すると SchemaError 例外で止まるため、CI に組み込めばデータ品質の劣化を本番前に見つけられる。
🔗 隣接手法への橋渡し
データクレンジングは収集と特徴量エンジニアリングの間の橋。 3 視点 (接続・統合・比較) で隣接前処理工程との関係を整理する。
🔌 接続: 上流・下流での連鎖
- 上流: データ収集 — 未整備の生データを受け取る
- 並列: データクレンジング詳細、 欠損値、 外れ値 — 実装の詳細工程
- 下流: 特徴量エンジニアリング、 EDA — 整備データから特徴量を作る
🧩 統合: 前処理パイプラインへの組み込み
読み込み (read_csv で SSDSE-B-2026 を取得) → 列名正規化 → 型変換 (parse_dates・dtype) → 欠損処理 (median/前後補完) → 重複削除 → 値の妥当性検証 (range/codeset) の流れで、 sklearn Pipeline 化することで再現性が確保できる。 各段で検証ログを残すと、 後工程の異常検知時に原因切り分けが速い。
⚖️ 比較: 隣接前処理工程との位置づけ
| 工程 | 主目的 | 典型操作 | 位置 |
|---|---|---|---|
| データクレンジング | 誤り・欠損の除去 | 欠損補完・型変換・重複削除 | 収集直後 |
| 特徴量エンジニアリング | モデル入力作成 | 変数生成・スケーリング・エンコード | クレンジング後 |
| データ統合 | 複数源の統合 | 結合・名寄せ・スキーマ統一 | クレンジング前後 |
| EDA | 分布・関係の把握 | 可視化・要約統計 | クレンジング後 |
4 工程は目的が異なる。 クレンジングは「正しさ」、 特徴量エンジニアリングは「有用性」、 統合は「整合性」、 EDA は「理解」を担う。 SSDSE 分析では順にクレンジング → 統合 → EDA → 特徴量化と進めるのが定型。
🌳 手法選択フロー
データクレンジングは欠損・外れ値・型統一を反復する前処理工程。
- 欠損値の扱いは? Yes → 欠損値、 No → 欠損メカニズム を先に確認
- 外れ値や重複は? Yes → 外れ値、 No → 重複処理 を先に確認
- 型や単位は揃ったか? Yes → データ型、 No → 正規化 を先に確認
スクリプト主導なら pandas、 大規模なら Spark、 GUI なら OpenRefine、 と「データ規模と対話性」で選ぶ。
🎮 触って理解する
架空の店舗売上データ(8行)には、 表記揺れ・重複行・型混在・欠損・異常値 の 5 種類の「汚れ」が仕込んである。 下のボタンを ①→⑤の順 に押すと、 クレンジングの各工程が 1 つずつ適用され、 表・棒グラフ・集計値(件数/合計/平均)がリアルタイムに変化する。 行をタップ/クリック すると、 その行に潜む問題の説明が表示される。 汚れたまま集計した平均と、 クレンジング後の平均がどれだけ違うかに注目してほしい。
| 店舗所在地 | 月間売上(万円) |
|---|
- まだ何も適用されていません。 ①から順に押してください。
💡 直感: 「分析の 8 割は前処理」の意味
上の演習で分かる通り、 集計コード自体は 1 行 (平均を取るだけ) なのに、 その前に 5 工程の掃除が必要だった。 これが「分析工数の 60-80% は前処理」と言われる実態である。 しかも汚れたまま計算した平均 (1,613.3 万円) とクレンジング後の平均 (790 万円) は 2 倍以上ずれる。 計算機はエラーを出さずに「間違った答え」を静かに返すため、 汚れは自分で探しに行くしかない — これが GIGO (Garbage In, Garbage Out) の恐ろしさである。
⚠️ よくある落とし穴
- 過剰な削除: ⑤で札幌の 5800 を「異常だから」と行ごと削除すると、 実在する店舗のデータが消える。 上の演習では原簿と照合して 580 に修正した。 IQR や Z スコアは「疑わしい値の検出器」であって「自動削除装置」ではない (外れ値 参照)。 欠損も同様に、 闇雲な dropna は標本を偏らせる (欠損値 参照)。
- 元データの破壊: 生データの CSV を直接上書き保存すると、 「⑤の修正が正しかったか」を後から検証できない。 元データは読み取り専用で保管し、 クレンジング後は別ファイルに書き出すのが鉄則。
- ルールの記録漏れ: 上の「クレンジングログ」のように、 どの値をどんな根拠で直したかを残さないと、 半年後の自分もレビュアーも再現できない。 手作業の Excel 修正が最も危険で、 コード化 (= 記録) されたクレンジングだけが再現可能である。
🚀 発展: バリデーション・パイプライン化・再現性
- バリデーション: クレンジング後に「行数 6・売上は 0〜10000 の数値・欠損 0」といった期待条件を assert やスキーマ (pandera / Great Expectations) で検証し、 品質ゲートとして自動化する (バリデーション 参照)。
- パイプライン化: ①〜⑤を関数の連鎖として実装すれば、 データが更新されても同じ順序・同じルールで再実行できる。 順序が重要な点 (欠損補完の後に外れ値判定をすると基準が歪む等) はコードの順序として固定される (ETL / データクレンジング詳細 参照)。
- 再現性: 「生データ + クレンジングコード + ログ」の 3 点セットが揃えば、 誰がいつ実行しても同じ
D_cleanが得られる。 これが分析の信頼性の土台であり、 クレンジング後の EDA やモデリングの結論を守る保険になる。