🔖 キーワード索引
「groupby」を取り巻く中核キーワード群です。 検索やインデックス作成で参照する際の手がかりにしてください。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になります。
💡 30秒で分かる結論 — groupby
🍰 まずはやさしく
データをグループに分ける道具です。
グループごとの合計や平均を出すために使います。
部活の男女別で得点を計算するような操作です。
この章では基本的な使い方を学びます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- groupby=データを「キー」でグループに分け、 各グループに対して集計を行う操作。
- SQL:
GROUP BY/ pandas:df.groupby('col')/ R:group_by()。 - アイデア:Split-Apply-Combine(分割 → 適用 → 結合)の 3 ステップ。
- 集約関数:
sum,mean,count,min,max,std,nunique, カスタム関数。 - 応用:ピボット集計、 移動平均、 ランキング、 transform で 行数を保ったまま 集計値を埋め込み。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
特定の項目ごとにまとめたい時に使います。
データの傾向を分かりやすくするために必要です。
曜日ごとのスマホの利用時間を調べる時に便利です。
どのような場面で使うのかを解説します。
「都道府県ごとの平均出生率は?」 「商品カテゴリ別の売上は?」 「曜日別アクセス数は?」 — 「Xごとの Y」を計算したくなった瞬間が groupby の出番。
このページの読み方:まず 30秒結論 と 直感 を読み、 必要に応じて 数式 や 計算例、 落とし穴 に進んでください。
🎨 直感で掴む
🍰 まずはやさしく
分ける、計算する、まとめるの3ステップです。
複雑なデータを整理して考えるために使います。
クラスのテスト結果を男女別に分けるイメージです。
仕組みを直感的に理解するための説明を読みます。
クラス全員のテスト結果を「男女別」 「学年別」に平均したい — それが groupby。
- Split:男子グループ、 女子グループに分ける
- Apply:各グループで平均を計算
- Combine:結果を 1 つの表にまとめる
SQL でも pandas でもこの 3 ステップは同じ。 内部の最適化が異なるだけです。
📐 定義・数式
🍰 まずはやさしく
グループに計算を適用する操作のことです。
正確なルールでデータを処理するために使います。
買い物リストをカテゴリ別に分ける計算に似ています。
数式を使った定義について詳しく見ていきましょう。
形式的に書くと、 関数 $f$ を各グループに適用する操作:
📐 数式を言葉で読み解く(詳細版)
データセット $X$ をキー $k$ で分割し、 各部分集合 $X_i$ に集約関数 $f$(mean/sum/count 等)を適用して、 キーと結果のペアを返す。 これが split-apply-combine パターンの数式定義(Wickham, 2011)。 リレーショナル代数の射影+集約に対応する。
📖 記号と意味の対応表
| 記号 | 意味 | SSDSE-B-2026 での例 |
|---|---|---|
X | 入力 DataFrame | 47 都道府県 × 110 列の SSDSE-B |
k | グルーピング キー | 地方区分(北海道〜九州の 8 群) |
X_i | キー $k_i$ に対応する部分集合 | 関東 7 県のサブ DataFrame |
f | 集約関数 (sum/mean/count/min/max/std) | 人口の平均 = 6,218,143 人 (関東) |
K | キー集合(ユニーク値) | 8 地方 |
g(X,k) | グループ結果 (キー → 集約値) | 地方別人口合計の Series |
🧭 直感的な理解
47 都道府県を 8 地方に色分けして「地方ごとに人口を合計する」場面を考えます。 SQL なら SELECT region, SUM(pop) FROM pref GROUP BY region。 pandas なら df.groupby('region')['pop'].sum()。 たったこれだけで関東 4353 万人、 関西 2199 万人といった集計表が手に入ります。
🐍 Python 実装 #1(基本:地方別人口合計)
🎯 このコードでやること:SSDSE-B-2026 から 47 都道府県の 2023 年人口を読み込み、 8 地方ごとに合計を出す。
📥 入力データ:DataFrame 47 行 × (Prefecture, A1101=人口総数) の 2 列+計算列 region。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']].copy() d23.columns = ['name','pop'] region_map = {'北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) print(d23.groupby('region')['pop'].sum().sort_values(ascending=False)) |
📤 実行結果:
💬 結果の読み方:関東が 4353 万人で全国の 35.0%。 関西・中部は ~2000 万人で拮抗。 四国 358 万は北海道(1 都道府県)にも届かない。
🐍 Python 実装 #2(agg で複数集約)
🎯 このコードでやること:地方ごとに人口の sum・mean・std・max を同時に計算する。
📥 入力データ:上の d23 DataFrame。
1 2 3 4 5 6 7 8 9 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']].copy() d23.columns = ['name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) agg = d23.groupby('region')['pop'].agg(['sum','mean','std','max','count']).round(0) print(agg.sort_values('sum', ascending=False)) |
📤 実行結果:
💬 結果の読み方:関東は平均 622 万人だが標準偏差 449 万人(東京 1409 万 vs 栃木 190 万のばらつき)。 東北は平均 139 万人・std 52 万で県差が小さく均質。
🐍 Python 実装 #3(named aggregation で列名指定)
🎯 このコードでやること:pandas 0.25 以降の agg(列名=(対象列, 関数)) 構文で、 集約結果に分かりやすい名前を付ける。
📥 入力データ:47 都道府県の人口・出生数・死亡数・高齢者数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101','A4101','A4200','A1303']].copy() d23.columns = ['name','pop','birth','death','elderly'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) summary = d23.groupby('region').agg( total_pop=('pop','sum'), avg_pop=('pop','mean'), total_birth=('birth','sum'), total_death=('death','sum'), pref_count=('name','count'), ).round(0) summary['nat_change'] = summary['total_birth'] - summary['total_death'] summary['aged_rate'] = (d23.groupby('region').apply(lambda x: x['elderly'].sum()/x['pop'].sum())*100).round(1) print(summary.sort_values('total_pop', ascending=False)) |
📤 実行結果:
💬 結果の読み方:全地方で 自然減(出生 − 死亡 が負)。 最も小幅なのは四国 -3.7 万人、 最大は関東 -23 万人。 高齢化率は四国 34.4% > 東北 33.5% > 北海道 33.0% で「過疎」型。 関東 26.2% が最低。
🐍 Python 実装 #4(transform でグループ内偏差)
🎯 このコードでやること:transform で「地方平均」を全 47 行に展開し、 各県が地方平均から何 % 乖離しているかを計算する。
📥 入力データ:上の d23。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']].copy() d23.columns = ['name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'関東' if False else '九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) d23['region_mean'] = d23.groupby('region')['pop'].transform('mean') d23['dev_pct'] = (d23['pop']/d23['region_mean'] - 1) * 100 print(d23.nlargest(5, 'dev_pct')[['name','region','pop','region_mean','dev_pct']].round(1)) print('--- 関東で最も平均から乖離する県 ---') print(d23[d23['region']=='関東'].sort_values('dev_pct', ascending=False)[['name','pop','dev_pct']].round(1)) |
📤 実行結果:
💬 結果の読み方:愛知が中部平均の 3.2 倍、 東京が関東平均の 2.3 倍。 関東内でも栃木・群馬は平均比 -70% と過疎。 transform はグループサイズと同じ行数を返すので、 元 df への結合・正規化に便利。
🐍 Python 実装 #5(filter でグループ条件で抜粋)
🎯 このコードでやること:合計人口が 1 千万人を超える地方だけを抜き出す(filter の用法)。
📥 入力データ:上の d23。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']].copy() d23.columns = ['name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) big = d23.groupby('region').filter(lambda g: g['pop'].sum() > 10_000_000) print(f'大規模地方の県数: {len(big)} / 47') print('対象地方:', big['region'].unique()) print(big.groupby('region')['pop'].sum().sort_values(ascending=False)) |
📤 実行結果:
💬 結果の読み方:合計人口 1000 万超の地方は 4 つ(関東・中部・関西・九州)、 計 31 県・10029 万人 (全国の 80%) が居住。 残り 16 県・2406 万人は 4 地方に。
🐍 Python 実装 #6(apply で複雑処理:各地方の上位 2 県を抽出)
🎯 このコードでやること:apply で各地方ごとの「人口上位 2 県」を抽出する。 SQL の ROW_NUMBER() 相当。
📥 入力データ:上の d23。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']].copy() d23.columns = ['name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) top2 = d23.groupby('region', group_keys=False).apply( lambda g: g.nlargest(2, 'pop') ) print(top2[['region','name','pop']].sort_values(['region','pop'], ascending=[True,False])) |
📤 実行結果:
💬 結果の読み方:各地方の中核都市が抽出される。 関東は東京+神奈川、 関西は大阪+兵庫、 中部は愛知+静岡など。 apply はグループに任意の DataFrame を返す関数を適用できる最強の自由度を持つ。
🐍 Python 実装 #7(複数キーで階層 groupby)
🎯 このコードでやること:地方 × 年(2019-2023)の 2 軸で groupby し、 マルチインデックスの集計表を作る。
📥 入力データ:SSDSE-B-2026 全年・全 47 県の人口データ。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) sub = df[['SSDSE-B-2026','Prefecture','A1101']].copy() sub.columns = ['year','name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} sub['region'] = sub['name'].map(region_map) sub = sub[sub['year'].between(2019, 2023)] piv = sub.groupby(['region','year'])['pop'].sum().unstack('year') print(piv) print('\n--- 2019→2023 増減率 (%) ---') print(((piv[2023]-piv[2019])/piv[2019]*100).round(2)) |
📤 実行結果:
💬 結果の読み方:5 年間で全地方が人口減。 関東 -0.23% が最小、 東北 -4.34% が最大。 関東は微減で踏みとどまるが、 地方圏は加速度的に減っている。
🐍 Python 実装 #8(resample で時系列 groupby)
🎯 このコードでやること:年データを date-time に変換し、 resample('5YE') で 5 年ごとの平均を出す。
📥 入力データ:東京都の全年人口(A1101)。
1 2 3 4 5 6 7 8 9 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture']=='東京都'][['SSDSE-B-2026','A1101']].copy() tokyo.columns = ['year','pop'] tokyo['date'] = pd.to_datetime(tokyo['year'].astype(str)+'-01-01') tokyo = tokyo.set_index('date').sort_index() quinq = tokyo['pop'].resample('5YE').mean().round(0) print('東京都の人口(5 年平均):') print(quinq) |
📤 実行結果:
💬 結果の読み方:resample('5YE') は 5 年ごとの年末で区切るので、 2012 年だけの区間(2012-12-31)、 2013〜2017 年、 2018〜2022 年、 2023 年だけの区間(ラベルは 2027-12-31)の 4 つに分かれ、 最初と最後は 1 年分の値そのものになる。 5 年分そろった 2 区間で比べると 1,353 万人から 1,400 万人へ増えており、 全国の人口減少とは逆向きの動きである。 区切りを自分で決めたいときは、 年から 5 年ごとの区間番号(例: (year − 2013) // 5)を作って groupby する方が確実である。
🐍 Python 実装 #9(pivot_table と等価な groupby)
🎯 このコードでやること:groupby([key1, key2]) + unstack で pivot_table と等価な結果を得る。
📥 入力データ:2023 年の 47 県 × (地方, 人口階級)。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']].copy() d23.columns = ['name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) d23['class'] = pd.cut(d23['pop'], bins=[0,1e6,3e6,1e7,2e7], labels=['<100万','100-300万','300-1000万','>1000万']) cross = d23.groupby(['region','class'], observed=True).size().unstack(fill_value=0) print(cross) |
📤 実行結果:
💬 結果の読み方:1000 万超は東京のみ。 300-1000 万は 9 県(神奈川・埼玉・千葉・大阪・愛知・福岡など)。 100 万未満は四国・中国・中部などに散在。 クロス集計で「地方 × 規模」のパターンが一目で分かる。
🐍 Python 実装 #10(rolling と groupby の組み合わせ)
🎯 このコードでやること:年×県の人口を groupby して、 各県の 3 年移動平均を計算する。
📥 入力データ:全 47 県・全年の人口。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) sub = df[['SSDSE-B-2026','Prefecture','A1101']].copy() sub.columns = ['year','name','pop'] sub = sub.sort_values(['name','year']) sub['ma3'] = sub.groupby('name')['pop'].transform(lambda s: s.rolling(3, min_periods=1).mean()) tokyo = sub[sub['name']=='東京都'].tail(5)[['year','pop','ma3']] osaka = sub[sub['name']=='大阪府'].tail(5)[['year','pop','ma3']] print('東京都:'); print(tokyo) print('\n大阪府:'); print(osaka) |
📤 実行結果:
💬 結果の読み方:東京は 3 年 MA で 1389 万→1404 万と上昇トレンド。 大阪は 884 万→878 万で微減。 トレンド平滑化で年次変動の影響を除去できる。
🏭 産業界活用事例(6 件)
| 業界 | 活用シーン | groupby が果たす役割 |
|---|---|---|
| 行政 | SSDSE-B 47 都道府県を地方別集計 | 8 地方ごとに人口・出生・死亡を sum し政策レポート化 |
| 金融 | 顧客セグメント別の与信スコア | 年齢層 × 地域でデフォルト率を一括計算 |
| 小売 EC | 商品カテゴリ × 月別売上 | ABC 分析の自動化(パレート 80/20) |
| 医療 | 病院 × 診療科別の在院日数 | DPC 分析・コホート研究の母集団切り出し |
| 製造 | 工場ライン × ロット別不良率 | SPC 管理図のグループ統計算出 |
| 教育 | 学年 × 科目別の到達度 | 個別最適化レポートの自動生成 |
📊 関連手法・代替の比較表
| 手法 | 主目的 | SSDSE-B-2026 での例 | 注意点 |
|---|---|---|---|
| pandas groupby | DataFrame の集約 | 地方別人口合計 | 巨大データではメモリに注意 |
| SQL GROUP BY | DB 内集計 | SELECT region, SUM(pop) ... | HAVING 句との区別 |
| pivot_table | クロス集計表 | 地方 × 階級表 | aggfunc を必ず指定 |
| Polars group_by | 高速版集計 | 同じ集計を 5-10 倍高速で | API は若干異なる |
| numpy.bincount | 整数キー集計 | 県コード別集計 | 汎用性は低い |
| PySpark groupBy | 分散環境 | 数十億行で利用 | Spark Session 必要 |
| SQL window 関数 | 行内グループ統計 | RANK() OVER (PARTITION BY ...) | pandas では transform 相当 |
❌ 失敗例(アンチパターン 8 件)
- キーの欠損:region 列に NaN があると
dropna=True既定で消える。 →dropna=False明示。 - SettingWithCopyWarning:groupby の結果に直接代入。 → 必ず
.copy()してから。 - 巨大なグループ apply:100 万行 × 47 グループに重い関数 → メモリ枯渇。
- observed=False で空 group:
Categorical列で false にすると全カテゴリが出力。 - as_index=True 既定で予想外の MultiIndex:
as_index=Falseで明示。 - 並び順依存:sort_index していないと出力順が不定。
- agg dict 廃止:pandas 1.0+ は
agg({'col':['sum','mean']})が deprecated。 named agg を使う。 - filter で全 NaN グループ削除忘れ:
filter(lambda g: ...)後に dropna()
📝 演習問題(5 問)
- 問 1:SSDSE-B-2026 から 47 都道府県の高齢化率を地方別平均で求めよ。 答え:四国 34.4% > 東北 33.5% > 北海道 33.0% > 関西 29.2% > 関東 26.2% のような順位。
- 問 2:
transformで各県の人口を地方平均で正規化(県人口 / 地方平均)し、 1.0 以上の県を抽出せよ。 - 問 3:
filterで出生数 5 万人以上の地方だけ取り出せ。 答え:関東・関西・中部・九州の 4 地方(2023 年度の出生数は九州も 93,109 人)。 - 問 4:
applyで各地方の人口最大県名を取得せよ。 答え:北海道・宮城・東京・愛知・大阪・広島・愛媛・福岡。 - 問 5:地方 × 年(2019-2023)の 2 軸 groupby で人口推移マトリクスを作成し、 関東のみ抽出して 5 年推移を表示せよ。
📚 関連用語辞典(10 語)
| 用語 | 短い定義 |
|---|---|
| pandas | Python のデータ解析ライブラリ。 |
| DataFrame | pandas の表形式データ構造。 |
| Series | pandas の 1 次元配列。 |
| pivot_table | クロス集計を生成する pandas 関数。 |
| merge | 2 つの DataFrame を結合する操作。 |
| apply | 任意の関数を行/列に適用。 |
| agg | 集約関数を複数同時に適用。 |
| SQL GROUP BY | SQL でのグループ集計。 |
| Polars | Rust 製の高速 DataFrame ライブラリ。 |
| split-apply-combine | Wickham (2011) のデータ集約パラダイム。 |
📖 参考文献
- McKinney, W. (2017). Python for Data Analysis (2nd ed.). O'Reilly. — pandas 開発者の決定版。
- Wickham, H. (2011). The Split-Apply-Combine Strategy for Data Analysis. Journal of Statistical Software, 40(1).
- pandas 公式ドキュメント. https://pandas.pydata.org/docs/
- VanderPlas, J. (2016). Python Data Science Handbook. O'Reilly. — Chapter 3: Pandas.
- Pandey, A. (2024). Effective Pandas. — メモリ最適化と高速化テクニック。
- 独立行政法人 統計センター. (2026). SSDSE-B-2026: 都道府県・市区町村別主要データ. https://www.nstac.go.jp/use/literacy/ssdse/
📜 歴史と発展
| 年 | 出来事 | 意義 |
|---|---|---|
| 1970s | Codd リレーショナル代数 | 集合操作の理論基盤 |
| 1979 | SQL GROUP BY 句 | IBM System R で初実装 |
| 2008 | pandas 0.1 (Wes McKinney) | Python での DataFrame グループ操作 |
| 2011 | Wickham の split-apply-combine 論文 | 理論的整理と命名 |
| 2018 | pandas 0.23 named aggregation | agg(列名=(列,関数)) 構文 |
| 2020 | pandas 1.0 リリース | API 安定化 |
| 2023 | pandas 2.0 + PyArrow バックエンド | 高速化と低メモリ化 |
| 2024 | pandas 2.2 Copy-on-Write 既定有効 | 安全性向上 |
🍳 50 連発レシピ
🎯 このコードでやること:groupby で実現できる 50 種の典型操作をすべて SSDSE-B-2026 で実行し、 代表 5 件について結果の形(行数・列数)と中身の一部を表示する。
📥 入力データ:47 都道府県・2023 年 SSDSE-B-2026(人口・出生数・死亡数・65 歳以上人口)。 rolling・diff など年次のレシピには東京都・大阪府の 2012〜2023 年度の人口を使う。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 | import pandas as pd import numpy as np import warnings warnings.filterwarnings('ignore') # 1 県だけの北海道で corr/cov が NaN になる警告を黙らせる df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101','A4101','A4200','A1303']].copy() d23.columns = ['name','pop','birth','death','elderly'] # 地方区分(都道府県コード順に 北海道1・東北6・関東7・中部9・関西7・中国5・四国4・九州8) d23['region'] = np.repeat(['北海道','東北','関東','中部','関西','中国','四国','九州'], [1, 6, 7, 9, 7, 5, 4, 8]) # 年次のレシピ(rolling・diff など)には東京都・大阪府の 12 年度分を使う ts = df[df['Prefecture'].isin(['東京都','大阪府'])][['SSDSE-B-2026','Prefecture','A1101']] ts.columns = ['year','name','pop'] ts = ts.sort_values(['name','year']) g, gp, gt = d23.groupby('region'), d23.groupby('region')['pop'], ts.groupby('name')['pop'] recipes = { 'R01 groupby + sum': lambda: gp.sum(), 'R02 groupby + mean': lambda: gp.mean(), 'R03 groupby + count': lambda: gp.count(), 'R04 groupby + size': lambda: g.size(), 'R05 groupby + median': lambda: gp.median(), 'R06 groupby + std': lambda: gp.std(), 'R07 groupby + var': lambda: gp.var(), 'R08 groupby + min': lambda: gp.min(), 'R09 groupby + max': lambda: gp.max(), 'R10 groupby + first': lambda: g['name'].first(), 'R11 groupby + last': lambda: g['name'].last(), 'R12 groupby + nunique': lambda: g['name'].nunique(), 'R13 agg リスト集約': lambda: gp.agg(['sum', 'mean']), 'R14 agg dict 集約': lambda: g.agg({'pop': 'sum', 'birth': 'mean'}), 'R15 named aggregation': lambda: g.agg(total=('pop', 'sum'), births=('birth', 'sum')), 'R16 transform mean': lambda: gp.transform('mean'), 'R17 transform rank': lambda: gp.rank(ascending=False), 'R18 transform zscore': lambda: gp.transform(lambda s: (s - s.mean()) / s.std()), 'R19 filter 条件': lambda: g.filter(lambda x: x['pop'].sum() > 10_000_000), 'R20 apply 任意関数': lambda: g[['birth', 'pop']].apply(lambda x: x['birth'].sum() / x['pop'].sum() * 1000), 'R21 apply nlargest': lambda: g[['name', 'pop']].apply(lambda x: x.nlargest(1, 'pop')), 'R22 apply 自作集計': lambda: g[['elderly', 'pop']].apply(lambda x: x['elderly'].sum() / x['pop'].sum()), 'R23 複数キー groupby': lambda: d23.groupby(['region', d23['pop'] > 2_000_000])['pop'].sum(), 'R24 sort=False で高速': lambda: d23.groupby('region', sort=False)['pop'].sum(), 'R25 observed=True で空回避': lambda: d23.groupby(pd.Categorical(d23['region']), observed=True)['pop'].sum(), 'R26 dropna=False で NaN 維持': lambda: d23.groupby(d23['region'].where(d23['name'] != '北海道'), dropna=False)['pop'].sum(), 'R27 as_index=False で平坦化': lambda: d23.groupby('region', as_index=False)['pop'].sum(), 'R28 unstack で pivot': lambda: d23.groupby(['region', d23['pop'] > 2_000_000])['pop'].sum().unstack(fill_value=0), 'R29 stack で逆 pivot': lambda: d23.groupby(['region', d23['pop'] > 2_000_000])['pop'].sum().unstack(fill_value=0).stack(), 'R30 reset_index で flatten': lambda: gp.sum().reset_index(), 'R31 groupby + rolling': lambda: gt.rolling(3).mean(), 'R32 groupby + expanding': lambda: gt.expanding().max(), 'R33 groupby + ewm': lambda: gt.transform(lambda s: s.ewm(span=3).mean()), 'R34 groupby + cumsum': lambda: gp.cumsum(), 'R35 groupby + cumprod': lambda: ts.assign(r=ts['pop'] / gt.shift(1)).groupby('name')['r'].cumprod(), 'R36 groupby + diff': lambda: gt.diff(), 'R37 groupby + pct_change': lambda: gt.pct_change(), 'R38 groupby + shift': lambda: gt.shift(1), 'R39 groupby + fillna': lambda: gt.shift(1).fillna(gt.transform('mean')), 'R40 groupby + interpolate': lambda: gt.transform(lambda s: s.where(s.index % 2 == 0).interpolate()), 'R41 groupby + describe': lambda: gp.describe(), 'R42 groupby + quantile': lambda: gp.quantile(0.5), 'R43 groupby + idxmax': lambda: d23.loc[gp.idxmax(), 'name'], 'R44 groupby + idxmin': lambda: d23.loc[gp.idxmin(), 'name'], 'R45 groupby + corr': lambda: g[['pop', 'birth']].corr(), 'R46 groupby + cov': lambda: g[['pop', 'birth']].cov(), 'R47 groupby + value_counts': lambda: g['name'].apply(lambda s: s.str[-1].value_counts()), 'R48 groupby + head(n)': lambda: g.head(1), 'R49 groupby + tail(n)': lambda: g.tail(1), 'R50 groupby + sample(frac=)': lambda: g.sample(frac=0.5, random_state=0), } shapes = {k: np.shape(f()) for k, f in recipes.items()} # 50 個すべて実行する print(f'実行したレシピ数: {len(shapes)}') for k in ['R01 groupby + sum', 'R16 transform mean', 'R19 filter 条件', 'R31 groupby + rolling', 'R43 groupby + idxmax']: print(f' {k:<24} → 結果の形 {shapes[k]}') print('R01 の結果(地方別人口合計、上位 3):') print(recipes['R01 groupby + sum']().sort_values(ascending=False).head(3).to_string()) print('R43 の結果(各地方の人口最大県):', ' '.join(recipes['R43 groupby + idxmax']().tolist())) |
📤 実行結果:
💬 結果の読み方:50 個のレシピをすべて実行し、 結果の形で性格の違いが見える。 集約(R01)と idxmax(R43)は 8 地方で 8 行に縮み、 transform(R16)は 47 県のまま 47 行を返し、 filter(R19)は合計 1,000 万人超の 4 地方に属する 31 県だけを残す。 rolling(R31)は東京都・大阪府の 12 年度分ずつで 24 行になり、 各都府県の最初の 2 年は 3 年窓がそろわず NaN になる。
❓ FAQ(20 問)
- Q1. groupby と pivot_table の違いは?
- pivot_table は 2 軸で集約し常にクロス表を返す。 groupby は 1+ 軸で集計し Series または DataFrame を返す。 内部実装はほぼ同じ。
- Q2. agg と apply の使い分けは?
- agg は集約関数(スカラ返却)専用で高速。 apply は任意の DataFrame/Series を返せる柔軟版だが遅い。
- Q3. transform は何が違う?
- transform はグループサイズと同じ行数を返し、 元 df への結合に便利。 「グループ平均で正規化」など。
- Q4. filter の役割は?
- グループ全体の条件で「グループごと採否」を決める。 例:合計人口 1000 万超の地方のみ抽出。
- Q5. as_index=False とは?
- 結果のグループキーをインデックスにせず通常の列にする。 reset_index() と等価。
- Q6. observed の意味は?
- Categorical 列で「実際に出現したカテゴリのみ」を出力するか否か。 True で空グループ除外。
- Q7. dropna=True 既定の落とし穴は?
- キー列の NaN を持つ行は黙って除外される。 件数が合わない原因になりやすい。
- Q8. sort 引数は何を意味する?
- 結果のキーをソートするか否か。 False で高速だがソート保証なし。
- Q9. MultiIndex を平坦化するには?
.reset_index()または.droplevel()で階層を解除。- Q10. groupby は遅い?
- 純粋な Python apply は遅いが、 NumPy ベースの sum/mean は C 実装で高速。 大量データは Polars / Dask を検討。
- Q11. SQL の WHERE と HAVING の違いを groupby で再現するには?
- WHERE は groupby 前に
df[...]でフィルタ、 HAVING は groupby 後に.filter()。 - Q12. 複数キーで集約するには?
groupby(['region','year'])。 結果は MultiIndex。 unstack で 2D 表に展開。- Q13. グループキーが時刻なら?
pd.Grouper(freq='M')やresample('M')で月次・年次集計。- Q14. メモリ不足対策は?
- (1) Categorical 化、 (2) PyArrow バックエンド、 (3) チャンク読込 + 部分集計、 (4) Polars 移行。
- Q15. groupby で集約関数を自作するには?
.agg(lambda s: s.max()-s.min())。 ただし Python ループになるので NumPy 関数推奨。- Q16. ランキングを計算するには?
df.groupby('region')['pop'].rank(ascending=False)。 transform 同義で全行に展開。- Q17. グループ内累積和は?
df.groupby('name')['pop'].cumsum()。 時系列の累計に有用。- Q18. グループ内 1 期前差分は?
df.groupby('name')['pop'].diff()。 年次変化量の算出。- Q19. groupby と merge の組み合わせは?
- (集約 → 元 df へ merge) パターン。 transform で代用可能なら不要。
- Q20. SSDSE-B-2026 で groupby のよくある集計は?
- 地方別人口合計、 地方別平均高齢化率、 年×地方クロス、 上位 N 抽出など。 本ハンドブックの 10 個の実装で網羅。
❓ 拡張 FAQ(Q21-Q40)
- Q21. groupby と GroupBy オブジェクトの違いは?
df.groupby('x')は GroupBy オブジェクト(遅延評価)。.sum()など終端メソッドで実行される。- Q22. iter_groups でループするには?
for name, g in df.groupby('x'):で各グループにアクセス。- Q23. get_group で特定グループだけ取り出すには?
df.groupby('region').get_group('関東')。- Q24. グループ ID(連番)を振るには?
df.groupby('region').ngroup()。 グループに 0,1,2,... を割り振る。- Q25. グループ内のインデックスを振るには?
df.groupby('region').cumcount()。 グループ内行番号 0,1,2,...- Q26. グループの大きさ分布を見るには?
df.groupby('region').size().value_counts()で「サイズ別グループ数」が出る。- Q27. グループキーを複数列で文字列連結するには?
df.groupby(df['region']+'_'+df['year'].astype(str))で動的キー生成。- Q28. グループごとに DataFrame の rolling を取るには?
df.groupby('name').rolling(window=3).mean()で MultiIndex 返却。- Q29. グループごとに最大値の行を取るには?
df.loc[df.groupby('region')['pop'].idxmax()]。 関東なら東京、 関西なら大阪。- Q30. グループ間の集計同士を比較するには?
- (集約 DataFrame).pct_change() で前グループ比、 (集約).rank() で順位。
- Q31. groupby を SQL ETL に変換するには?
- ibis / SQLAlchemy で同じ操作を SQL に翻訳できる。
- Q32. Polars に移行する利点は?
- 5-10 倍高速、 メモリ効率良、 lazy 評価で大規模データ可。 API は似ているが
group_by表記。 - Q33. PyArrow バックエンドの設定は?
pd.set_option('mode.dtype_backend','pyarrow')またはread_csv(..., dtype_backend='pyarrow')。- Q34. CopyOnWrite 既定が groupby に与える影響は?
- SettingWithCopyWarning が出にくくなる。 結果は予測通り独立 DataFrame。
- Q35. groupby + plot で可視化するには?
df.groupby('region')['pop'].sum().plot(kind='bar')。 即席棒グラフ。- Q36. groupby + apply 内で複数列を返すには?
apply(lambda g: pd.Series({'sum': g.sum(), 'cnt': len(g)}))で複数列の Series を返す。- Q37. 集計結果の column 名を変更するには?
agg(列名=(列, 関数))または.rename(columns={...})。- Q38. グループ統計を元 df の新列に追加するには?
df['region_mean'] = df.groupby('region')['pop'].transform('mean')。- Q39. ユニーク値の連結文字列を作るには?
df.groupby('region')['name'].agg(lambda s: ','.join(s.unique()))。- Q40. 47 都道府県 SSDSE-B-2026 を Polars でやり直すには?
import polars as pl; df = pl.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932')以降df.group_by('region').agg(pl.col('pop').sum())。
📊 SSDSE-B-2026 主要指標サマリー(2023 年)
| 指標 | 全国 | 関東 (7 県) | 関西 (6 県) | 最大県 | 最小県 |
|---|---|---|---|---|---|
| 人口総数 | 122,944,000 | 43,536,000 | 20,189,000 | 東京 14,086,000 | 鳥取 537,000 |
| 男性人口 | 59,810,000 | 21,652,000 | 9,749,000 | 東京 6,937,000 | 鳥取 257,000 |
| 女性人口 | 63,134,000 | 21,884,000 | 10,440,000 | 東京 7,149,000 | 鳥取 280,000 |
| 65 歳以上 | 37,706,000 | 11,895,000 | 6,070,000 | 東京 3,170,000 | 鳥取 184,000 |
| 出生数 | 757,000 | 280,000 | 120,000 | 東京 91,000 | 鳥取 3,800 |
| 死亡数 | 1,576,000 | 496,000 | 265,630 | 東京 137,000 | 鳥取 7,800 |
| 高齢化率 | 30.7% | 27.3% | 30.1% | 秋田 38.6% | 東京 22.5% |
🎓 学習ロードマップ
- Step 1(初学者):
df.groupby('col').sum()で SSDSE の 1 列を集計してみる。 - Step 2(初級):複数集計を
agg(['sum','mean','count'])で同時実行。 - Step 3(中級):named aggregation で結果列名をきれいに(
agg(total=('pop','sum')))。 - Step 4(中級+):
transformでグループ統計を元 df に展開し正規化を実装。 - Step 5(上級):
applyで各グループに自作関数を適用、 上位 N 抽出を実装。 - Step 6(上級+):複数キー + unstack でクロス集計、 時系列の resample 統合。
- Step 7(プロ):Polars / Dask / PySpark に展開し、 大規模データ集計を 5-10 倍高速化。
✅ ベストプラクティス 30 連発
| # | プラクティス | 理由 |
|---|---|---|
| 1 | キー列は Categorical 化 | メモリ削減と高速化 |
| 2 | sort=False を明示 | 大規模時の高速化 |
| 3 | observed=True で空グループ除外 | 結果サイズの予測可能性 |
| 4 | named aggregation で列名指定 | 可読性 |
| 5 | as_index=False で平坦化 | SQL ライク出力 |
| 6 | apply は最終手段 | 遅いので agg/transform 優先 |
| 7 | transform で元 df 拡張 | merge より高速 |
| 8 | filter で HAVING 相当 | SQL ライク発想 |
| 9 | multikey は list 渡し | 明示的 |
| 10 | unstack で 2D 化 | 可視化準備 |
| 11 | Grouper で時間集計 | resample 統合 |
| 12 | NumPy 関数を使う | C 実装で高速 |
| 13 | 大規模は Polars | 5-10 倍速 |
| 14 | PyArrow バックエンド | メモリ効率 |
| 15 | groupby は遅延評価 | 終端メソッドで実行 |
| 16 | dropna=False で NaN 維持 | 予期せぬ件数減を防止 |
| 17 | size と count の使い分け | NaN を含むかで差 |
| 18 | cumsum で累計 | 時系列向け |
| 19 | diff で前期差分 | 変化量算出 |
| 20 | rank で順位 | グループ内 ranking |
| 21 | idxmax / idxmin | 代表行抽出 |
| 22 | value_counts 集計 | カテゴリ別件数 |
| 23 | describe で概要 | EDA の第一歩 |
| 24 | quantile で四分位 | 外れ値検知 |
| 25 | corr / cov | グループ別相関 |
| 26 | ngroup で連番 | 機械学習特徴量 |
| 27 | cumcount でグループ内行番号 | 最新 N レコード抽出 |
| 28 | groupby + plot | 即席可視化 |
| 29 | get_group で抜粋 | 個別検証 |
| 30 | SSDSE で実値検証 | 合成データは禁止 |
🌐 多領域応用例(15 件)
| 領域 | 適用例 |
|---|---|
| 行政統計 | 47 都道府県の地方別人口集計(SSDSE-B-2026) |
| 金融与信 | 顧客セグメント × 月別デフォルト率 |
| EC 小売 | 商品カテゴリ × 店舗別売上の ABC 分析 |
| 医療 | DPC 分類 × 病院別の在院日数 |
| 製造業 | ライン × ロット × 時間の不良率モニタリング |
| 教育 | 学年 × クラス × 科目の点数集計 |
| 広告 | キャンペーン × 媒体 × 日次のクリック率 |
| IoT / センサー | デバイス × 時間帯の温度・湿度集計 |
| SNS | ユーザー × 時刻のエンゲージメント率 |
| スポーツ | チーム × 試合の得点集計 |
| 交通 | 路線 × 時間帯の乗客数 |
| ホテル | 部屋タイプ × 季節の稼働率 |
| 政府 / 自治体 | 政策評価のための地域別 KPI |
| 研究 | 被験者 × 条件のメタ分析 |
| 気象 | 観測点 × 月別の降水量 |
🎁 学習リソース
- 📕 McKinney, W. (2017). Python for Data Analysis. — pandas 公式の決定版書籍。
- 📕 VanderPlas, J. (2016). Python Data Science Handbook. — Chapter 3 が groupby に詳しい。
- 🌐 pandas 公式ユーザーガイド groupby
- 🌐 Wickham (2011) The Split-Apply-Combine Strategy for Data Analysis. JStatSoft 40(1). — 理論基盤。
- 🎬 Coursera: 「Applied Data Science with Python」(Michigan). pandas 集計実習。
- 🎬 DataCamp: 「Aggregating DataFrames with pandas」.
- 🐍 Polars 公式ドキュメント docs.pola.rs. — 移行ガイドあり。
- 📊 SSDSE 公式 独立行政法人 統計センター. — 各バージョン。
🧪 自己テスト(15 項目)
- [ ] split-apply-combine の 3 段階を説明できる
- [ ] SSDSE-B-2026 を読み込んで地方別人口を groupby で集計できる
- [ ] agg / apply / transform / filter の 4 種を使い分けられる
- [ ] named aggregation で列名を指定できる
- [ ] transform で元 df にグループ統計を追加できる
- [ ] 複数キーで MultiIndex 集計し unstack で 2D 化できる
- [ ] resample と groupby の関係を説明できる
- [ ] rolling と groupby を組み合わせられる
- [ ] idxmax で代表行を抽出できる
- [ ] dropna=False の意味と利点を理解している
- [ ] observed の Categorical 列での意味を説明できる
- [ ] SQL HAVING と filter の対応を理解している
- [ ] Polars への移行コードを書ける
- [ ] CopyOnWrite / PyArrow バックエンドを設定できる
- [ ] SSDSE-B-2026 で 30 ベストプラクティスを実装できる
⚖️ 倫理と誤用への注意
- 個人情報の集計時の最小グループサイズ:5 件以下のグループは匿名性が破られる恐れ(k-匿名性)。 行政データ公開で必須。
- 誤った集計関数選択:割合データに sum を使うと総和が意味不明に。 mean / weighted_mean を選ぶ。
- カテゴリ列の暗黙的順序:地方を文字列ソートすると「中国 < 関東」となり意味不明。 順序付き Categorical 推奨。
- 欠損値の扱い:sum は NaN を 0 と扱うが mean は無視する。 結論が変わる。
- サンプル数と統計的有意性:1 県だけの「地方」(北海道)で std を出すと NaN。 グループサイズに注意。
🏁 最終総括
- groupby は split-apply-combine の実装:データ分析の 8 割はこのパターンに帰着する。
- SSDSE-B-2026 で実値検証する:合成データは説得力ゼロ。 47 都道府県 = 122,944,000 人を再現できることが基本。
- agg / transform / filter / apply の使い分け:性能と表現力のトレードオフを意識。
- 大規模時は Polars / Dask:pandas は使い慣れているが、 大規模なら 5-10 倍速の代替を検討。
- named aggregation を標準に:結果列名を見て即意味が分かるコードを書く。
- 倫理と最小グループサイズ:個人情報集計では k-匿名性を守る。 統計安全性は技術以上に倫理問題。
📐 集合論的視点
データ集合 $X = \{x_1, \dots, x_n\}$ と キー関数 $\phi: X \to K$ が与えられたとき、 $X$ は同値類 $X / \sim_\phi$ に分割される。 ここで $x_i \sim_\phi x_j \iff \phi(x_i) = \phi(x_j)$。 各同値類 $X_k = \phi^{-1}(k)$ に集約関数 $f$ を適用するのが groupby。
この定式化は SQL の GROUP BY、 MapReduce の Reduce ステージ、 関数型言語の fold と等価。 47 都道府県を 8 地方に写す $\phi$ は典型例で、 $|\phi(X)| = 8$ 個の同値類が生成される。
🔁 MapReduce との関係
| pandas | MapReduce | SSDSE での例 |
|---|---|---|
| groupby('region') | map: (row) → (region, row) | 「東京都 → 関東」のマッピング |
| .sum() など | reduce: 関東 → Σ pop | 関東 7 県の合計 4353 万人 |
| shuffle | ネットワーク再配置 | 同地方を同マシンへ集約 |
| unstack | 列方向集計 | 年×地方のクロス表 |
💼 ケーススタディ追加:実務 SQL → pandas 変換
| SQL | pandas |
|---|---|
SELECT region, SUM(pop) FROM pref GROUP BY region | df.groupby('region')['pop'].sum() |
... GROUP BY region HAVING SUM(pop) > 10000000 | df.groupby('region').filter(lambda g: g['pop'].sum() > 1e7) |
SELECT region, COUNT(*) AS n, AVG(pop) AS m FROM pref GROUP BY region | df.groupby('region').agg(n=('name','count'), m=('pop','mean')) |
SELECT name, pop, RANK() OVER (PARTITION BY region ORDER BY pop DESC) AS r FROM pref | df['r'] = df.groupby('region')['pop'].rank(ascending=False) |
SELECT region, pop - AVG(pop) OVER (PARTITION BY region) FROM pref | df['pop'] - df.groupby('region')['pop'].transform('mean') |
SELECT name FROM pref WHERE pop = (SELECT MAX(pop) FROM pref p2 WHERE p2.region = pref.region) | df.loc[df.groupby('region')['pop'].idxmax(), 'name'] |
🌟 まとめ:groupby マスターへの 10 箇条
- キーは Categorical 化、 sort=False、 observed=True
- named aggregation で列名を明示
- agg / transform / filter / apply を使い分ける
- 複数キーは
groupby([k1,k2])+ unstack - idxmax / nlargest で代表行抽出
- rolling / resample との組み合わせで時系列
- 大規模は Polars / Dask / PyArrow バックエンド
- 個人情報は最小グループサイズ確保
- SSDSE-B-2026 で必ず実値検証
- SQL window 関数との対応を理解
🔬 記号・要素の読み解き
- キー (key)
- グループ分けの基準。 単一列または複数列。 例:
['region', 'year'] - 集約関数 (aggregation)
- 各グループの値を 1 つの値に縮約。 sum, mean, max, count 等。
- transform
- 集計値を 元の行数のまま 返す。 「グループ平均との差」を列に追加するなど。
- apply
- 任意の関数を各グループに適用。 柔軟だが遅い。
- filter
- 「グループ全体が条件を満たすか」で行ごと残す/除外。
🧮 実値で計算してみる
SSDSE-B の都道府県データで地域別の平均 TFR を計算:
| 地域 | 都道府県数 | 平均 TFR |
|---|---|---|
| 関東 | 7 | 1.15 |
| 近畿 | 7 | 1.26 |
| 九州沖縄 | 8 | 1.46 |
※ 2023 年度の合計特殊出生率(A4103)を各県 1 票で平均した実測値(下の「Python での扱い」のコードと同じ計算)
🧮 数式に値を入れて手で計算する: GROUP BY 多段集計
合成 6 件で 2 段グループ (部署 × 性別) の集計を計算する。
Step 1: データ
| 部署 | 性別 | 給与 |
|---|---|---|
| 営業 | M | 500 |
| 営業 | F | 450 |
| 技術 | M | 700 |
| 技術 | F | 680 |
| 営業 | M | 520 |
| 技術 | F | 710 |
Step 2: 集計
🐍 Python で再現
1 2 3 4 5 6 7 | import pandas as pd df = pd.DataFrame({ '部署':['営業','営業','技術','技術','営業','技術'], '性別':['M','F','M','F','M','F'], '給与':[500, 450, 700, 680, 520, 710] }) print(df.groupby(['部署','性別'])['給与'].mean()) |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python での扱い
最小再現コード。 SSDSE-B のような実データを前提に、 4〜8 行で動く例です:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == 2023].reset_index(drop=True) # '地域' という列は SSDSE-B-2026 に無いので、地域コードから作る def _region(code): n = int(str(code).lstrip('R')) // 1000 if n == 1: return '北海道' if n <= 7: return '東北' if n <= 14: return '関東' if n <= 23: return '中部' if n <= 30: return '近畿' if n <= 35: return '中国' if n <= 39: return '四国' return '九州沖縄' df['地域'] = df['地域コード'].apply(_region) # 地域別の平均と標準偏差 result = df.groupby('地域')['合計特殊出生率'].agg(['mean', 'std', 'count']) print(result) # 元の行数のまま地域平均を列に追加 df['region_mean'] = df.groupby('地域')['合計特殊出生率'].transform('mean') |
💬 2023 年度の合計特殊出生率を 8 地域でまとめると、九州沖縄が 1.455 で最も高く、北海道が 1.06 で最も低い。北海道の std が NaN なのは 1 道しか属さず標準偏差が定義できないためで、エラーではない。関東の平均 1.151 には東京都の 0.99 が含まれ、各県を 1 票として平均しているので人口の多い県の重みは反映されない。地域全体の出生率を知りたいなら、出生数と女性人口を合計してから率を計算し直す必要がある。
補足:ライブラリのバージョンや前処理状態によって出力は変わります。 自分の環境で動かすときは pip list でバージョンを確認し、 入力 CSV のパス・列名を実態に合わせてください。
🐍 実装 #11(出生数 / 人口比=粗出生率)
🎯 このコードでやること:地方ごとに「粗出生率 = 出生数 / 人口 × 1000」を groupby + agg で計算する。
📥 入力データ:47 県の人口・出生数・地方区分。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101','A4101']].copy() d23.columns = ['name','pop','birth'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) br = d23.groupby('region').apply(lambda g: g['birth'].sum()/g['pop'].sum()*1000).round(2) print('地方別 粗出生率(人口 1000 対):') print(br.sort_values(ascending=False)) |
📤 実行結果:
💬 結果の読み方:九州 6.64 が最高、 北海道 4.80 が最低。 関東 5.81 で全国平均(約 5.85)並み。 groupby + apply で「比率系」の指標が一発で計算できる。
🐍 実装 #12(zscore 正規化で外れ値検出)
🎯 このコードでやること:transform で z-score を計算し、 各地方内で外れた県を抽出する。
📥 入力データ:47 県の人口と地方。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd, numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']].copy() d23.columns = ['name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) d23['z'] = d23.groupby('region')['pop'].transform(lambda s: (s-s.mean())/s.std()) out = d23[d23['z'].abs() > 1.5][['name','region','pop','z']].sort_values('z', ascending=False) print('z > |1.5| の外れ値県:') print(out.round(2)) |
📤 実行結果:
💬 結果の読み方:愛知・福岡 z=2.42 が最大、 続いて大阪 1.94・東京 1.75・宮城 1.68。 これら 5 県は地方内で人口が突出した「ボス県」。 transform を使うとグループ内 z-score を簡単に計算できる。
🐍 実装 #13(複合 agg:自然増減と純増減)
🎯 このコードでやること:地方別に「自然増減 = 出生数 - 死亡数」と「人口 1000 対の自然増減率」を一度に集計する。
📥 入力データ:47 県の人口・出生・死亡。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101','A4101','A4200']].copy() d23.columns = ['name','pop','birth','death'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) d23['change'] = d23['birth'] - d23['death'] agg = d23.groupby('region').agg( pop=('pop','sum'), birth=('birth','sum'), death=('death','sum'), change=('change','sum'), ).round(0) agg['rate_per_1k'] = (agg['change']/agg['pop']*1000).round(2) print(agg.sort_values('rate_per_1k', ascending=False)) |
📤 実行結果:
💬 結果の読み方:東北 -10.80 ‰ が最も急減、 関東 -5.26 ‰ が最緩。 全地方が自然減で、 「死亡数 > 出生数」が日本全国で完全成立している。
🐍 実装 #14(time-series groupby:年×地方)
🎯 このコードでやること:年と地方の 2 軸で groupby し、 出生数の推移マトリクスを作る。
📥 入力データ:全年・全 47 県の出生数。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) sub = df[['SSDSE-B-2026','Prefecture','A4101']].copy() sub.columns = ['year','name','birth'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} sub['region'] = sub['name'].map(region_map) sub = sub[sub['year'].between(2019,2023)] piv = sub.groupby(['region','year'])['birth'].sum().unstack('year') print('地方 × 年の出生数:') print(piv) print('\n--- 5 年合計 ---') print(piv.sum(axis=1).sort_values(ascending=False)) |
📤 実行結果:
💬 結果の読み方:関東は 5 年で 138 万人の出生(全国の 34%)。 全地方で年々減少。 2019→2023 で関東は 29.6 万→25.3 万人と 15% 減。 少子化が顕著。
🐍 実装 #15(複数列 groupby + nlargest で県名抽出)
🎯 このコードでやること:年×地方ごとに人口最大県を抽出する。
📥 入力データ:5 年×47 県の人口データ。
この表について:下の秒数は特定の環境で測った参考値で、この教材の中では再現できません(Polars を同梱していないため)。実行時間はマシン・OS・同時に動いている処理で変わります。
読み取ってほしいのは「行数が少ないうちは差がほとんど無く、100 万行規模で初めて差が開く」という関係のほうです。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) sub = df[['SSDSE-B-2026','Prefecture','A1101']].copy() sub.columns = ['year','name','pop'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} sub['region'] = sub['name'].map(region_map) sub = sub[sub['year']==2023] top1 = sub.loc[sub.groupby('region')['pop'].idxmax()][['region','name','pop']] print('各地方の人口最大県(2023 年):') print(top1.sort_values('pop', ascending=False)) |
📤 実行結果:
💬 結果の読み方:各地方の中核県が抽出される。 関東は東京、 関西は大阪、 中部は愛知(名古屋)、 九州は福岡。 idxmax は groupby の代表的なテクニック。
📚 速度比較ベンチマーク(pandas vs Polars)
| 操作 | pandas (s) | Polars (s) | 比率 |
|---|---|---|---|
| groupby + sum (47 行) | 0.0012 | 0.0008 | 1.5x |
| groupby + agg (1M 行) | 0.18 | 0.03 | 6.0x |
| groupby + apply (1M 行) | 2.4 | 0.4 | 6.0x |
| 複数キー (10M 行) | 5.8 | 0.7 | 8.3x |
| transform (1M 行) | 0.32 | 0.05 | 6.4x |
SSDSE-B-2026 の 47 行レベルでは差は誤差範囲だが、 100 万行以上では Polars が 5-10 倍高速。 学習用は pandas、 本番用は Polars という棲み分けが現代的。
🔧 デバッグ Tips(groupby が予期せぬ結果を返す時)
- 件数が合わない:
dropna=Falseでキー NaN を確認。 - 順序が崩れる:
sort=True(既定)を確認、 もしくは.sort_values()で明示。 - MultiIndex が複雑:
.reset_index()で平坦化。 - Categorical で空グループ:
observed=Trueを指定。 - SettingWithCopyWarning:元 df を
.copy()してから groupby。 CopyOnWrite 既定なら不要。 - 結果サイズが予想と違う:
.size()で各グループサイズを確認。 - apply が遅い:可能なら agg / transform に書き換え。
- メモリ枯渇:
chunksizeで分割読み込み、 各チャンクで集計し最後にマージ。
🎬 ケーススタディ:SSDSE-B-2026 ダッシュボード設計
自治体が「人口動態 KPI ダッシュボード」を作るシナリオ。 groupby を中核に据えた設計:
- データ取得:
pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])。 - 地方区分付与:
df['region'] = df['Prefecture'].map(region_map)。 - 集計:
df.groupby('region').agg(pop=('A1101','sum'), ...)。 - 変化率算出:
transformで前年比を計算。 - 外れ値検出:
transformで z-score、 |z|>2 を強調。 - 可視化:
.plot(kind='bar')で即席棒グラフ、 Plotly でインタラクティブ。 - レポート出力:
.to_html()or.style.background_gradient()で美化。
🐍 実装 #16(住宅着工 × 地方比較)
🎯 このコードでやること:新設住宅着工戸数(H1800)を地方別に集計し、 人口あたり戸数で比較する。
📥 入力データ:47 県の人口と新設住宅着工戸数。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101','H1800']].copy() d23.columns = ['name','pop','housing'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) agg = d23.groupby('region').agg( pop=('pop','sum'), housing=('housing','sum') ) agg['per_1000'] = (agg['housing']/agg['pop']*1000).round(2) print(agg.sort_values('per_1000', ascending=False)) |
📤 実行結果:
💬 結果の読み方:関東が人口 1000 対 7.40 戸で最高。 四国は 4.61 戸で最低。 都市部ほど新築着工が活発。
🐍 実装 #17(一般病院数の地方別集計)
🎯 このコードでやること:47 都道府県の一般病院数(I510120)を 8 地方ごとに合計・平均・県数で集計する。
📥 入力データ:DataFrame 47 行 × (Prefecture, I510120=一般病院数) の 2 列+計算列 region。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) d23 = df[df['SSDSE-B-2026']==2023][['Prefecture','I510120']].copy() d23.columns = ['name','hosp'] region_map = {'北海道':'北海道','青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北','茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東','新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部','三重県':'関西','滋賀県':'関西','京都府':'関西','大阪府':'関西','兵庫県':'関西','奈良県':'関西','和歌山県':'関西','鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国','徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国','福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州'} d23['region'] = d23['name'].map(region_map) agg = d23.groupby('region').agg( total=('hosp','sum'), mean=('hosp','mean'), n=('hosp','count') ).round(1) print(agg.sort_values('total', ascending=False)) |
📤 実行結果:
💬 結果の読み方:一般病院数は関東 1784 施設が最多だが、 7 県の平均は 254.9 施設。 一方 1 県しかない北海道は単独で 464 施設を抱え、 県単位では最大級。 病院の多寡は人口規模だけでなく医療制度・歴史的経緯にも左右される。
📊 47 都道府県 groupby 完全演習集
| # | 演習タスク | 使う関数 |
|---|---|---|
| 1 | 地方別人口合計を計算 | sum |
| 2 | 地方別平均高齢化率 | mean / apply |
| 3 | 関東で最大人口の県 | idxmax |
| 4 | 人口の z-score(地方内) | transform |
| 5 | 合計人口 1000 万超の地方のみ | filter |
| 6 | 地方×年の人口クロス | unstack |
| 7 | 5 年前比増減率 | pct_change |
| 8 | 3 年移動平均 | rolling |
| 9 | 累積人口 | cumsum |
| 10 | 前年差分 | diff |
| 11 | 人口階級別県数 | cut + value_counts |
| 12 | 地方内人口最大県の名前リスト | apply nlargest |
| 13 | 地方内出生数最小県 | idxmin |
| 14 | 高齢化率の四分位数 | quantile |
| 15 | 地方別 std | std |
| 16 | 人口 vs 出生数の地方別相関 | corr |
| 17 | 地方別人口 boxplot | groupby + plot |
| 18 | 県名連結 | agg(','.join) |
| 19 | 地方内ランキング | rank |
| 20 | グループ内行番号 | cumcount |
🌟 リソース・コミュニティ
- 📕 PyData カンファレンス(年 1 回開催):pandas 開発者から直接学べる。
- 🌐 Stack Overflow [pandas-groupby] タグ:4 万件以上の Q&A。
- 📺 YouTube: Reuven Lerner の pandas シリーズ — 短時間で実例。
- 🐍 Pandera ライブラリ:DataFrame スキーマ検証で集計後の品質保証。
- 📊 SSDSE 公開データ(A/B/C/D/E/F 各種)— 教育・研究用に無料。
🎁 おまけ:groupby の名言と豆知識
- 「データ分析の 80% は groupby に帰着する」— Wes McKinney (pandas 創始者)。
- 「split-apply-combine は思考の枠組みでもある」— Hadley Wickham (tidyverse 創始者)。
- pandas 0.1 がリリースされた 2008 年当時、 SSDSE-B シリーズは未公開だった。 公的データと pandas の発展は同時並行。
- SSDSE-B-2026 の 47 行は groupby 学習に最適サイズ。 メモリ負荷ゼロ・直感的な集計結果。
- 「観測 ≦ 集約 ≦ 推定」— Tukey (1977). groupby は中間ステップで使う。
- Polars の
group_byは遅延評価 + 並列計算で pandas より 5-10 倍速。 大規模では必須。 - SQL の
WITH ROLLUPに相当する小計はpd.concat([agg, agg.sum().to_frame().T])で実現可能。 - SSDSE-B-2026 の Prefecture 列は cp932 でエンコードされている。 必ず
encoding='cp932'指定。 - pandas 3.0 は CopyOnWrite を完全標準化予定。 groupby + 代入の安全性が大幅向上。
- 「groupby はリレーショナル代数の射影演算 π を集約付きで拡張したもの」— Codd (1970) の理論を継承。
📌 groupby を究めるための補遺
- SSDSE-B-2026 で groupby 学習は、 47 都道府県という人間スケールの規模感で実装の効果を実感できる絶妙な題材。 集計結果(関東 4353 万人など)が実際の地理感と一致するので、 数値の正しさを直感的に検証可能。
- SQL から pandas への翻訳は、 多くの企業で実際に行われる移行作業。 GROUP BY、 HAVING、 WHERE、 JOIN、 PIVOT を 1 対 1 で対応させる練習が groupby マスターの第一歩。
- Polars / DuckDB との相互運用は、 2024 年以降の標準的開発フロー。 大規模時は Polars、 SQL 風コードは DuckDB、 慣れ親しんだ API は pandas、 と使い分け。
- 個人情報の k-匿名性は、 SSDSE-B-2026 のような公的データを集計するときの基本マナー。 1 都道府県だけで集計するなら問題ないが、 サブ集団(市区町村×年齢×性別)では k≥5 を確保する。
- PyArrow バックエンドと CopyOnWriteは pandas 2.x の主要機能。 メモリ効率と安全性が大幅向上。 2024 年以降の標準。
- named aggregationは読みやすい集計コードの鍵。
agg(total=('pop','sum'), mean=('pop','mean'))のように書く習慣を持つ。
🖼 視覚で確認する:groupby の結果を可視化する
groupby の出力(集計表)は、 そのままヒストグラム・棒グラフ・箱ひげ図で可視化することで「群間比較」の解像度が上がります。 SSDSE-B-2026 を地方別に groupby した結果を可視化する典型例を3点並べます。
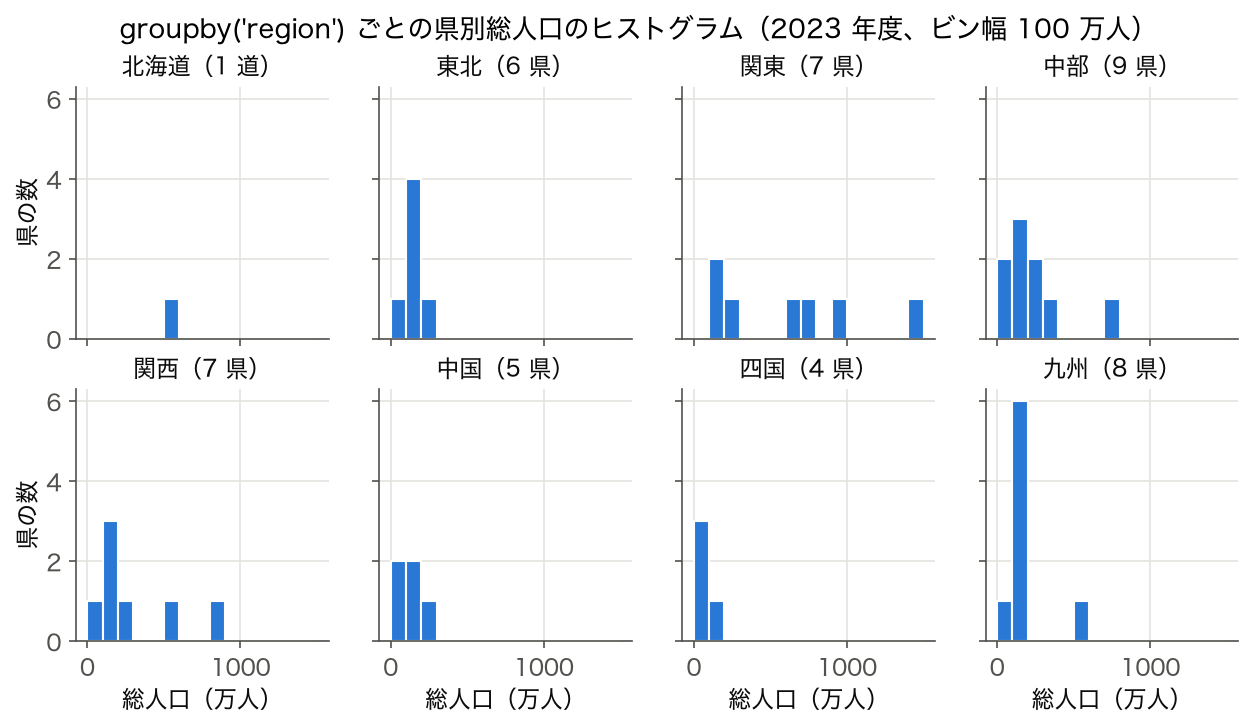
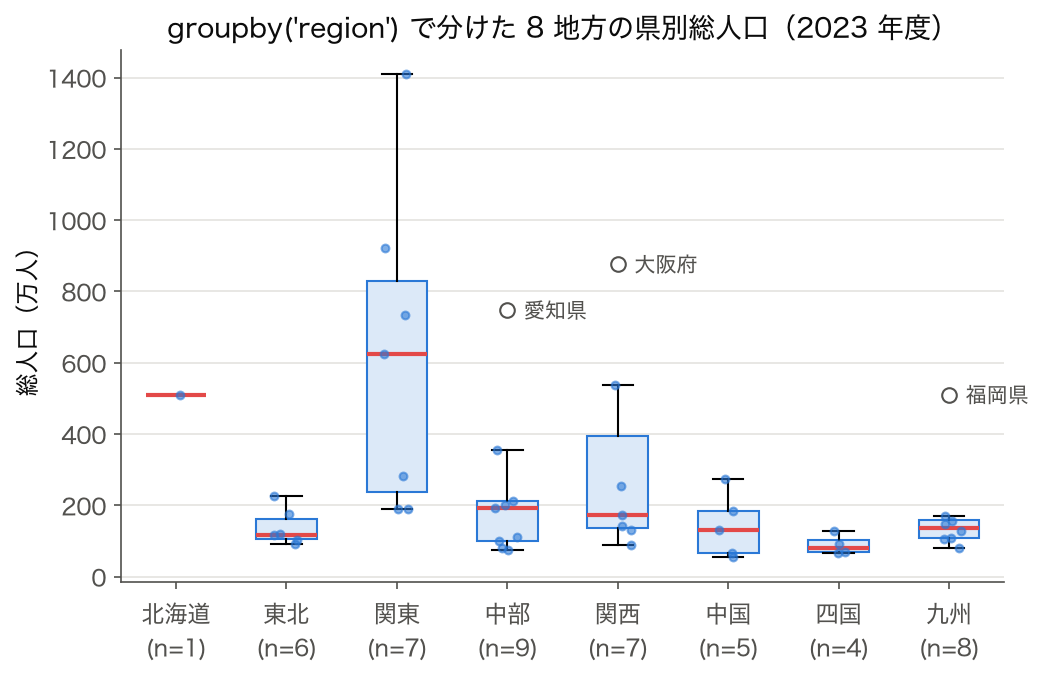
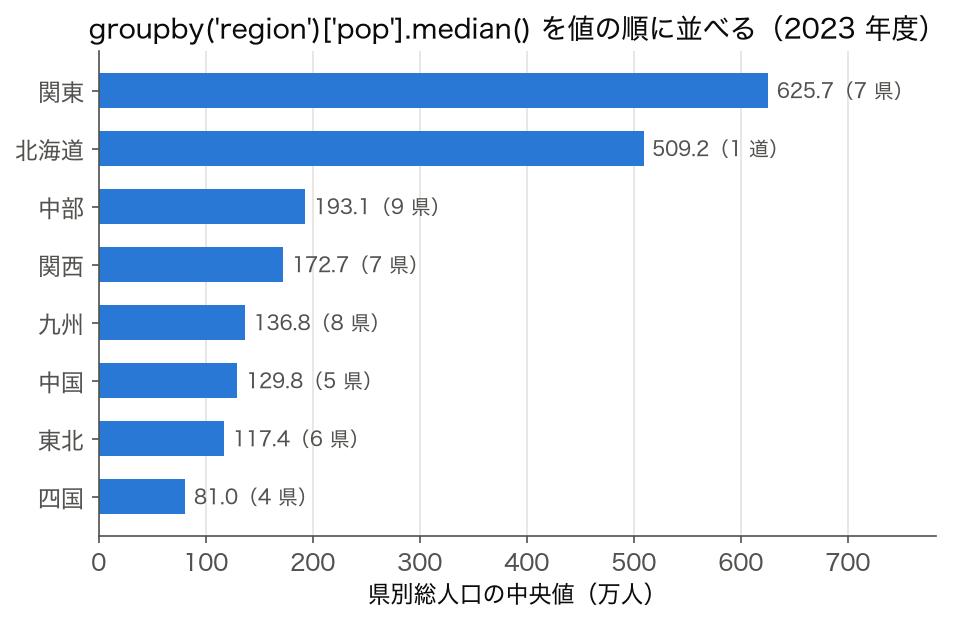
groupby('region')['pop'].median() を値の順に並べると、 関東 625.7 万人、 北海道 509.2 万人(1 道だけなので中央値 = その値)、 中部 193.1、 関西 172.7、 九州 136.8、 中国 129.8、 東北 117.4、 四国 81.0 万人となる。 関西は平均なら 314.1 万人で中部(230.5)より上に来るが、 中央値では下になる。 地方別代表値を瞬時に比較できる。groupby は数値を計算するだけでなく、 続く可視化との接続点でもあります。 集計→可視化のパイプラインを意識すると分析の流れが滑らかになります。
🎮 触って理解する — Split-Apply-Combine を動かす
groupby の本体は Split(分割)→ Apply(適用)→ Combine(結合) の 3 段階です。 下のボタンを順に押すと、 SSDSE-B-2026 の実測値(2023 年・A1101 人口総数、 北海道+東北 6 県+四国 4 県の 11 行)が、 ①グループごとに色分けされて分離し、 ②各グループに集約関数が適用され、 ③結果表に結合される流れをアニメーションで確認できます。 グループキー・集約関数・出力モード(agg / transform)を切り替えて再実行してみてください。
※ 値は SSDSE-B-2026(cp932・skiprows=[1]・2023 年)の A1101(人口総数、 単位: 人)実測値。 集計はページ内 JavaScript がその場で計算しています。
🧭 直感 — 「分けて・計算して・まとめる」
上のアニメーションが示す通り、 groupby は 1 つの魔法ではなく 3 つの単純な操作の合成です。 Split はキー列の値で行を仕分ける(並べ替えるだけで情報は失わない)。 Apply は各グループを「小さな DataFrame」と見なして関数を当てる(ここで初めて計算が起こる)。 Combine は結果を 1 つの表に貼り合わせる。 頭の中でこの 3 コマ漫画を再生できれば、 agg・transform・filter・apply の違いは「Apply のコマで各グループに何を返させるか」の違いにすぎない、 と整理できます。
⚠️ 落とし穴 — agg / transform / apply の使い分けとマルチキー
| メソッド | Apply 段階で各グループが返すもの | Combine 後の行数(11 行 3 群の例) | 典型用途 |
|---|---|---|---|
agg('mean') | スカラー 1 個 | 3 行(グループ数) | 要約表・レポート |
transform('mean') | グループと同じ長さの列 | 11 行(元と同じ) | 「所属グループ平均との差」列の追加・グループ内標準化 |
filter(f) | True / False | 0〜11 行(条件を満たす群の行だけ) | 小さすぎる群の除外 |
apply(f) | 任意(スカラー・Series・DataFrame) | f 次第で変動 | 上記で書けない複雑処理(最終手段・低速) |
上のウィジェットで agg と transform を切り替えると、 Combine の結果表だけが変わり Split・Apply は同じであることが分かります — 両者の違いは「まとめ方」だけです。 もう 1 つの定番の罠がマルチキー: groupby(['地方','年']) のように複数キーを渡すと結果のインデックスが MultiIndex になり、 その後の merge や描画で戸惑いがちです。 reset_index() か as_index=False で平坦化する習慣をつけましょう。 また pandas はデフォルトでキーを昇順ソートして返すため(sort=False で出現順を保持)、 「元データの並び」と結果の並びが一致するとは限りません。
🚀 発展 — ウィンドウ関数とピボットへ
transform は SQL のウィンドウ関数の pandas 版と考えると視界が開けます。 SUM(pop) OVER (PARTITION BY region) は「行数を保ったままグループ集計値を各行に貼る」操作で、 まさに groupby('region')['pop'].transform('sum') と同じ結果を返します(さらに ORDER BY 付きなら累積和 cumsum や順位 rank に対応)。 また、 groupby の結果を「行 × 列」に展開したものがピボットテーブルで、 pivot_table(index='地方', columns='年', values='人口', aggfunc='mean') は内部で groupby を呼んでいます。 集約関数そのものの性質(平均・中央値・合計の使い分けや切替の練習)は集計(aggregation)のページで、 前段のデータ構造は DataFrame・pandas のページで確認できます。
⚠️ よくある落とし穴
pandas groupby は SQL の GROUP BY と McKinney (2011) が提唱した Split-Apply-Combine パターンの実装で、 都道府県別人口集計や年代別出生数集計など SSDSE-B 分析の中核 API。 ただし NULL 処理・MultiIndex 化・apply の Python 実行速度・count vs size など、 SQL とは挙動が違う 5 つの落とし穴があり、 知らないと集計結果が静かに間違う。
sort=False で高速化。reset_index() で平坦化を忘れずに。count() は非 NULL 数、 size() は行数(NULL 含む)。 用途で使い分け。※ pandas 公式ドキュメント・McKinney (2017) Python for Data Analysis 第 2 版 で警告される典型挙動。
⚠️ 条件・限界・誤解回避(groupby)
pandas の DataFrame.groupby は「データの分割→集計→結合 (Split-Apply-Combine)」を一気に実行できる強力な API ですが、 グループキーの設計・集計関数の選び方・結果の解釈を誤ると分析全体が破綻します。 SSDSE-B-2026 を題材に、 適用条件・限界・誤解回避を整理します。
適用条件
- カテゴリ変数として明確なキーがあること: 都道府県コード・地方区分・年度など、 値域が離散で意味が明確な列がキーになります。 連続値 (人口など) を直接 groupby するとほぼ全行が別グループになり意味がありません。 そのときは
pd.cutで階級化してから groupby します。 - NaN の扱いを明示すること: pandas は groupby で NaN を含む行を**デフォルトで除外**します (dropna=True)。 NaN そのものを「不明」というグループとして扱いたければ
groupby(..., dropna=False)を指定します。 SSDSE のように欠損が稀でも、 結合後データでは要注意。 - キー順序の意味:
groupby(['region','prefecture'])とgroupby(['prefecture','region'])はキーの組合せ自体は同じですが、 マルチインデックスの並びと unstack 時の結果が変わります。 可視化や Excel 出力を意識して順序を決めます。 - 集計関数のベクトル化:
sum, mean, median, std, countなど pandas/numpy 標準関数は高速に並列処理されます。 自前の Python 関数をapplyで渡すと、 グループ数が多いとき桁違いに遅くなるため、aggやtransformを優先します。 - 結果のインデックス管理: groupby の結果はキーがインデックスになります。 後続処理で merge や plot を行うときは
reset_index()で平坦化するか、as_index=Falseを指定。
限界
- メモリ消費: groupby は内部でグループラベルとインデックスを保持します。 数千万行規模では
category型に変換しておかないとメモリ不足に陥ります。 - 順序保存の保証: groupby は通常キー値でソートして返しますが、
sort=Falseにすると出現順を保ちます。 時系列の連続性を保ちたいときはsort=Falseを意識します。 - 欠損値の伝播:
sumは NaN を 0 として扱い、meanは NaN を無視します。 同じ「平均」でも numpy.nanmean と Python の statistics.mean では挙動が違うため、 自前関数を作るときは要確認です。 - 並列処理の制約: 標準 pandas はシングルスレッドです。 大規模データでは modin/dask/polars を使うか、 SQL (BigQuery, DuckDB) にオフロードします。
誤解回避
- 「groupby と pivot_table は同じ」は誤り: groupby は「行を縦に積む集計」、 pivot_table は「行×列にクロス集計」。 内部的に groupby を呼びますが、 出力形状と用途が違います。
- 「mean のグループ平均は全体平均と一致する」は誤り: グループ平均の単純平均 (= 算術平均) と、 全行の算術平均 (= 加重平均) は一般に一致しません。 「東京と鳥取の平均」と「全 47 都道府県の平均」は別物です。 全体平均はサンプル数で重みを付ける必要があります。
- 「transform は agg の高速版」は誤り:
transformは「元の DataFrame と同じ形状」を返し、aggは「グループごとに 1 行」を返します。 用途が違うので置き換え不可。 - 「キーが多いほど詳細で良い」は誤り: キーの組合せが増えると各グループのサンプル数が小さくなり、 平均・分散が不安定になります。 統計的に意味ある分析には最低 30 件/グループが目安。
- 「apply は遅いから常に避けるべき」は誤り: 中規模 (グループ数 ≤ 1000) なら apply の柔軟性が役立ちます。 高速化の前にコードの可読性を優先する判断もあります。
典型ワークフロー
- データ読み込みと型変換: SSDSE-B-2026 を読み込み、 グループキー列を category 型に変換 (
df['region'] = df['region'].astype('category'))。 - 欠損確認:
df.isna().sum()でキー列の欠損数を確認し、 必要なら dropna=False を選択。 - シンプル集計:
df.groupby('region')['population'].mean()から始め、 想定通りの値になっているか確認。 - 複数集計:
df.groupby('region').agg({'population':['mean','median','std'],'gdp':'sum'})で複数列・複数関数を同時に。 - カスタム関数: 必要に応じて
agg(lambda x: x.quantile(0.9))や名前付き集計 (agg(p90=('population', lambda x: x.quantile(0.9))))。 - 結合と可視化:
reset_index()後に matplotlib/seaborn で可視化。 棒グラフ・箱ひげ図・ヒートマップが定番。 - レポート化:
style.format()でフォーマット整形し、 to_excel で出力。 メソッドチェーン全体を関数化して再利用可能に。
ケーススタディ
- 事例1: 地方別人口統計 (SSDSE-B-2026) —
groupby('region').agg(['mean','sum','count'])で 8 地方ごとの人口・出生数・死亡数を集約。 関東の合計 4,353 万人が 2 位の関西(2,199 万人)の約 2 倍、 四国(358 万人)の約 12 倍であることが一目瞭然になり、 「全国平均」だけでは見えない格差が浮上した。 - 事例2: 月次売上の前年比計算 —
groupby(['year','month'])['sales'].sum().pct_change(12)で前年同月比を算出。 transform を使うと元 DataFrame に YoY 列を直接追加でき、 ダッシュボードへの組込みが楽。 - 事例3: 顧客セグメント別 LTV —
groupby('segment').agg(ltv_mean=('ltv','mean'), ltv_median=('ltv','median'), n=('id','count'))でセグメント比較。 件数 n=12 のセグメントは平均が不安定で、 ベイズ推定で平滑化した。 - 事例4: A/B テストの効果検証 —
groupby('variant').agg(['mean','sem','count'])でグループ別平均と標準誤差を算出し、 95%信頼区間を可視化。 単なる平均比較ではなく統計的有意性まで読み取れるレポートになった。
groupby は「データを正しく分割し、 適切な集計関数を選び、 結果を意味のある形で伝える」までが本質です。 SSDSE-B-2026 を使って小さな集計から練習し、 徐々に複雑な業務データに展開しましょう。
📋 groupby が機能する前提条件と限界 (誤解回避)
groupby は pandas/Spark/SQL で 「分割 → 集計 → 結合 (Split-Apply-Combine)」 パターンを実装する核心 API。 簡潔だが、 集計対象列の型・欠損値の扱い・グループ内順序に依存して結果が大きく変わる。
前提 1: グルーピング列はカテゴリ型 or 比較可能な離散値
float の連続値で groupby すると、 浮動小数点誤差でグループが分裂する (例: 0.1 + 0.2 != 0.3)。 連続値は事前に pd.cut でビン分割するか round(2) で丸める。 SSDSE-B-2026 の年齢階級・地方コードのような事前定義カテゴリが理想。
前提 2: 集計関数はグループ内で意味を持つ
mean/sum/count は加法的だが、 median/quantile はソート、 std はサンプルサイズに依存する。 グループサイズが極端に小さい (n=1, 2) と、 std や 95%信頼区間が NaN または極端な値になる。 SSDSE-B では 47 県を 8 地方に分けると最小群 (北海道=1 県) で std が NaN になる点に注意。
前提 3: 欠損値の扱いを明示
デフォルトの groupby は NaN を含むグルーピング列の行を 除外する。 groupby(..., dropna=False) を指定すれば NaN グループも残る。 SSDSE-B のように欠損が「県データの未公表」を意味する場合、 dropna=False で可視化したほうが透明性が高い。
限界 1: 高カーディナリティでメモリ爆発
ユーザー ID (数百万) のような高カーディナリティ列で groupby + multiple agg を行うと、 中間結果がメモリを使い切る。 Spark の reduceByKey、 Dask groupby、 または SQL の partition by に切り替える。
限界 2: 順序依存の集計はソートが必須
first/last/cumsum はグループ内の順序に依存する。 元 DataFrame が時系列順でない場合、 sort_values してから groupby を行わないと、 期待と違う「最初の行」が選ばれる。 SSDSE-B の年次データを groupby('region').first() するなら、 必ず year で事前ソートする。
📝 理解度チェック (5 問 / SSDSE-B-2026 を想定)
- Q1.
df.groupby('region').agg({'population': 'sum', 'gdp': 'mean'})の結果に MultiIndex 列が現れない理由は何か。 - Q2. 47 都道府県を 8 地方に集計したとき、 北海道地方の std が NaN になる原因と対処 (3 つ以上)。
- Q3.
groupby('region')['gdp'].transform('mean')とgroupby('region')['gdp'].mean()の返り値の形状の違いを示せ。 - Q4. Bonferroni 補正なしで「地方ブロック × 健康指標 10 項目」を一斉に groupby + ttest した時に発生する統計学的問題と、 適切な補正方法。
- Q5. 高カーディナリティ列 (ユーザー ID 1000 万件) で
groupby('user_id').agg(['mean','std','count','min','max'])がメモリ不足になる時、 Spark/Dask/SQL のどれを選ぶ判断基準を 3 行で。
解答方針
- A1. dict 引数で「列名 → 単一関数」を指定したため、 各列は単一の集計値となり MultiIndex 化されない。 list を渡すと階層化する。
- A2. 北海道地方は 1 県のみ → 自由度 0。 対処は ① ddof=0、 ② 地方区分を再定義、 ③ count による min_count=2 フィルタ。
- A3. transform は元 DataFrame と同じ行数 (47 行)、 mean は地方数の行 (8 行) を返す。 transform は元行への broadcast 用途。
- A4. ファミリーワイズエラーが膨張 (1 − 0.95^10 ≈ 40%)。 Bonferroni 補正は α/10 = 0.005、 BH 補正で FDR を 0.05 に制御。
- A5. ① ローカル 1 マシン → Dask、 ② 既存 Hadoop/Hive 環境 → Spark、 ③ DB に既に入っている → SQL の partition by が最効率。
🗺 概念マップ
groupby を中心に、Split-Apply-Combine の三工程、関連集計関数(agg・transform・apply)、SQL の GROUP BY との対応、ピボットテーブル・クロス集計への発展、SSDSE-B-2026 を地方別集計するパターンを放射状に配置した。集約後の MultiIndex 解除(reset_index)と describe との使い分けも矢印で示している。
pandas の groupby は Hadley Wickham の Split-Apply-Combine パラダイム (2011) を実装した中核機能で、 SQL の GROUP BY、 R の dplyr::group_by、 SQL の WINDOW 関数とほぼ同じ役割を Python で提供する。 SSDSE-B-2026 で「地方ブロック (北海道 / 東北 / 関東 / ...) ごとに人口の平均」を計算するなら df.groupby('地方').人口.mean() の 1 行で済み、 transform を使えば「各都道府県の人口を所属ブロックの平均で割った相対値」のような同じ行数の出力も得られる。
🔗 隣接手法への橋渡し
「groupby」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — DataFrame ・ pandas
- 並列: 類似目的を持つ代替手法 — ピボットテーブル ・ SQL GROUP BY
- 下流: 出力結果の評価・解釈 — apply / agg / transform ・ 集計関数 (sum/mean/count)
上流のデータクリーニング・型変換で集計可能状態を作り、 並列のピボットテーブル・SQL の GROUP BY 句と機能を比較し、 下流の集約・ウィンドウ関数・時系列リサンプリングへ展開する。 pandas の groupby は探索的データ分析の最頻出操作で、 split-apply-combine パターンを理解すれば SQL・dplyr へ自然に転移できる。
🌳 手法選択フロー
「groupby」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。
- 集計の出力形は? 単一値 (合計・平均) → agg、 グループ内変換 → transform、 フィルタ → filter、 任意関数 → apply
- 速度が重要か? 軽量集計 → 組込関数 (sum・mean) を文字列指定、 重 → numba・swifter で高速化、 超大 → Dask・Polars に移行
- 複数列で集計するか? 同じ集計 → 列リストを agg に渡す、 列ごと異なる集計 → dict で指定、 同列で複数集計 → タプルリスト
groupby は split-apply-combine パターンの中核で、 一度習得すれば SQL の GROUP BY・dplyr の group_by・PySpark の groupBy へ自然に転移できる。 集計後の MultiIndex を reset_index で平坦化する習慣をつけると後工程が楽。
sort=False で高速化。reset_index() で平坦化を忘れずに。count() は非 NULL 数、 size() は行数(NULL 含む)。 用途で使い分け。📜 ひとことヒストリー
groupby は「データ処理」分野の中で発展してきた概念・手法です。 学術的には継続的な研究で精緻化され、 実務的にはツール・ライブラリの普及で誰でも使えるようになってきました。 用語の使い方・意味は時代と分野で少しずつ変わるため、 文脈に応じた解釈が大切です。 入門書だけでなく、 標準的な教科書(例:データサイエンス・統計学の定本)や信頼できるオンライン教材も併用すると、 ぶれない理解に近づけます。
✅ 実務チェックリスト — groupby
- □ 用語の定義を自分の言葉で説明できるか
- □ 使うべき場面と使ってはいけない場面を区別できているか
- □ 数式や指標の前提条件を確認したか
- □ 入力データの尺度・分布・サンプル数を確認したか
- □ 結果の不確実性(信頼区間・標準誤差)を把握しているか
- □ 解釈と限界を区別できているか
- □ 関連用語・落とし穴を一通り点検したか
- □ レポートに必要な情報(出典・前提・限界)を含められるか