🔖 キーワード索引
「データウェアハウス」を取り巻く中核キーワード群です。 検索やインデックス作成で参照する際の手がかりにしてください。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になります。
💡 30秒で分かる結論 — データウェアハウス
🍰 まずはやさしく
分析に特化した巨大な倉庫のようなものです。
大量のデータをまとめて分析するために使います。
お店の全期間の売上を計算する時に役立ちます。
この章ではデータウェアハウスの結論を読みます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- DWH(Data Warehouse)=分析専用に最適化された 大規模統合データベース。
- OLTP(業務)との対比:DWH は OLAP(分析)特化。 読み取り中心、 集計クエリに最適化。
- 代表サービス:BigQuery(GCP)、 Snowflake、 Redshift(AWS)、 Synapse(Azure)。
- 設計:スタースキーマ(中心ファクトテーブル+周囲ディメンション)が定番。
- データレイクとの違い:DWH は構造化・スキーマあり、 レイクは生データ・スキーマ後付け。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
分析専用にデータを集める場所のことです。
いつもの作業を止めずに分析するために使います。
スマホアプリの利用状況をまとめて調べる時に便利です。
この章ではどのような場面で使うかを読みます。
「全店舗・全期間の売上を月次で集計したい」 「経営ダッシュボード用に異なる DB を統合したい」 — 通常の業務 DB ではクエリが何時間もかかり業務に支障。 DWH に 分析専用の場所 として集約します。
このページの読み方:まず 30秒結論 と 直感 を読み、 必要に応じて 数式 や 計算例、 落とし穴 に進んでください。
🎨 直感で掴む
🍰 まずはやさしく
個人の本棚ではなく大図書館のようなものです。
バラバラな場所にあるデータをまとめて探すために使います。
部活の過去の記録をすべて一箇所に集めるイメージです。
この章では仕組みの直感的なイメージを読みます。
図書館に喩えると:
- OLTP(業務 DB) = 個人の本棚。 頻繁に出し入れ、 小さい。
- DWH = 大図書館。 各家庭から本を集約。 分析・検索に最適化。
特徴:
- 列指向ストレージ(必要な列だけ読む)
- massive parallel processing (MPP)
- 圧縮率が高い
- ETL/ELT で定期的に業務 DB から流し込む
🎮 触って理解する — スタースキーマと集計クエリの高速性
DWH の定番設計 スタースキーマ は、中心の ファクトテーブル(事実=売上明細などの数値)と、周囲の ディメンションテーブル(軸=日付・店舗・商品)から成ります。下の図で ディメンションをタップ/クリック すると、その軸での集計(店舗別・年別/月別・カテゴリ別/商品別)が即時に実行され、表とグラフ、そして「業務DBとの走査コスト比較」が更新されます。
※ ここで集計する売上データは 架空 のデモ用データです(ページ内の JavaScript が固定シードの擬似乱数で 24ヶ月 × 3店舗 × 6商品 = 432 行 の明細を生成。集計値はその明細の正確な合計です。SSDSE の実測値ではありません)。
📊 集計結果
💡 店舗別・年別・カテゴリ別の総計はすべて一致します(同じ 432 行の明細を別の軸で切り直しているだけ)。月別/商品別のドリルダウン中は選んだ年・カテゴリの部分合計になります。
🧾 いま実行している集計クエリ(イメージ)
🆚 業務DB(正規化・行指向)との比較 — 同じ集計に必要なコスト
同じ 432 行分の売上を、 (a) 正規化された業務DB(注文・明細・店舗・商品・カテゴリの 5 テーブル、行指向=1 行を丸ごと読む)と、 (b) DWH のスタースキーマ(列指向=必要な列だけ読む)に置いた場合の、上の集計 1 回あたりのコストです(テーブル形状から機械的に計算した簡略モデル。セル数 = 走査する行数 × 読む列数)。
💭 直感の深掘り — 「分析のために整えた倉庫」=事実と軸
業務DBは「伝票を正確に書き溜める帳場」、DWH は「伝票を分析しやすい棚に並べ直した倉庫」です。倉庫の棚の設計原則がスタースキーマで、ファクト=測りたい事実(数量・金額などの数値)、ディメンション=事実を切る軸(いつ・どこで・何を) に役割を分けます。上の操作で体感できるように、どの軸で切っても 結合は常にファクト↔ディメンションの 1 段 で済み(主キー/外部キーの参照 1 本)、集計 SQL がほぼ同じ形になる — この「どの質問にも同じ手順で答えられる」規則性こそが DWH の価値です。データは ETL/ELT でこの形に整えてから格納します。
⚠️ この操作で分かる落とし穴
- 業務DBとの混同:正規化された業務DB(データベース)はカテゴリ名 1 つ取るにも 明細→商品→カテゴリ と多段 JOIN が要り、行指向のため使わない列まで読みます。上のカウンタで JOIN 回数と走査セル数の差を確認してください。逆に、DWH に高頻度の更新(1 件ずつの INSERT/UPDATE)を流すのはアンチパターンです。
- 粒度(グレイン)設計の失敗:このデモのファクトは「月 × 店舗 × 商品」の粒度だから商品別ドリルダウンが可能です。もし最初に「月 × 店舗の合計」だけを格納すると、後から商品別に掘る手段は永久に失われます。ファクトテーブルの粒度は「将来使う最も細かい問い」に合わせて最初に決めるのが鉄則です。
- ドリルダウンとロールアップの非対称性:細かい粒度から粗い集計はいつでも作れます(ロールアップ)が、粗い集計から細かい内訳は復元できません(ドリルダウン不能)。上の「年→月」「カテゴリ→商品」ボタンで、細かい明細を持っているからこそ両方向に動けることを確かめてください。
🚀 発展 — 列指向・OLAP キューブ・データレイクとの違い
- 列指向ストレージ:BigQuery・Redshift などが集計に強い最大の理由。上のカウンタが示すとおり、集計に必要なのは「グループ化キー+金額」の 2 列だけで、列単位に格納すればその 2 列しか読まずに済みます(さらに同種データが並ぶため圧縮も効く)。SQL は同じでも物理配置が違うのです。
- OLAP キューブ:上で行った「軸を選んで集計」を、あらかじめ全軸の組合せ(店舗 × 月 × カテゴリ…)で事前計算して多次元配列に持つ方式。ドリルダウン/ロールアップ/スライスはキューブ操作の用語でもあります。現代の DWH は列指向エンジンの高速化により、事前計算なしで同等の操作をオンザフライで行うのが主流です。
- データレイク との違い:レイクは「スキーマ後付け(schema-on-read)」で生データを安価に溜める場所、DWH は「スキーマ先付け(schema-on-write)」でスタースキーマに整えてから入れる場所。近年は両者を統合したレイクハウス(Delta Lake など)が広がっています。集計結果の可視化は BI ツール の役割です。
📐 数式を言葉で読み解く(詳細版)
🍰 まずはやさしく
決まったルールでデータを貯める仕組みです。
時間の経過による変化を正しく分析するために使います。
地域の人口の変化を年ごとに記録するようなものです。
この章では定義や詳しい性質について読みます。
Bill Inmon の定義に基づき、 DWH は 主題志向(顧客・売上などテーマ単位)/統合(異種ソースを一元化)/非揮発(履歴を消さない)/時系列(時刻属性を持つ)の 4 性質を備えるシステムです。
📖 記号と意味の対応表
| 記号 | 意味 | SSDSE-B-2026 での例 |
|---|---|---|
Subject | 主題(顧客・売上・人口など分析テーマ) | SSDSE-B-2026 では『47 都道府県 × 年 × 統計指標』が主題 |
integrated | 異種ソースの統合 | 国勢調査・住民票・住民基本台帳を 1 つの fact テーブルに統合 |
t | 時刻属性。 非揮発(履歴)を可能にする変数 | 2012〜2023 の 12 年分を縦持ちで保持 |
∫ | 時間軸での蓄積(イメージ) | 毎年 ETL で新年データを追加していく操作 |
非揮発性 | 一度入ったデータは消さない | 誤り訂正は新行追加で行い、 元データを残す |
時系列 | 時刻でスライス可能 | WHERE year=2023 で 47 行、 WHERE pref='東京都' で 12 行 |
🧭 直感的な理解
市区町村ごとの『住民票』『税収』『学校』のシステムが別々に動いている自治体を想像してください。 そのままでは『高齢化と税収の関係』を分析できません。 DWH は夜間 ETL でこれらを 都道府県×年×指標 という共通フォーマットに統合し、 何年でも遡って集計できるようにします。
🐍 Python 実装(拡張 narration 付き)
🎯 このコードでやること:SSDSE-B-2026 から 2019-2023 年の 5 年分を縦持ち(年×都道府県×指標)に変換し、 DWH 風スタースキーマとして格納する。
📥 入力データ:SSDSE-B-2026.csv(564 行 = 47 都道府県 × 12 年)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import sqlite3, pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026':'year','Prefecture':'pref'}) d = df[df['year'].between(2019,2023)][['year','pref','A1101','A1303','A4101']].copy() # fact テーブル: 年×都道府県×指標 fact = d.melt(id_vars=['year','pref'], var_name='metric', value_name='value') con = sqlite3.connect('dwh.db') fact.to_sql('fact_pref_year', con, if_exists='replace', index=False) # 集計クエリ: 全国合計の推移 res = pd.read_sql('SELECT year, metric, SUM(value) AS total FROM fact_pref_year GROUP BY year, metric ORDER BY year, metric', con) print(res.pivot(index='year', columns='metric', values='total')) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:5 年で出生数 86.5 万 → 72.7 万、 △16% の急減。 DWH なら同じスキーマで WHERE pref='東京都' も WHERE year=2023 も瞬時。 OLTP では実現困難な縦断・横断分析が可能になる。
🧮 SSDSE-B-2026 で実値計算(拡張)
縦持ち化した fact テーブル (年×都道府県×指標) から、 GROUP BY year, metric で 全国合計の年次推移を取り出したのが先のコードの出力。 ここでわかるのは 出生数の急減(2019: 86.5 万 → 2023: 72.7 万、 △16%)と 高齢者数の頭打ち(2019: 3589 万 → 2023: 3623 万、 +1%)の対比。 OLTP(住民票更新)では決して見えない時系列のマクロ動向が、 DWH で初めて可視化される。
| 年 | 人口 A1101 | 高齢者 A1303 | 出生数 A4101 |
|---|---|---|---|
| 2019 | 126,555,000 | 35,886,000 | 865,212 |
| 2020 | 126,146,099 | 35,335,805 | 840,808 |
| 2021 | 125,500,000 | 36,215,000 | 811,611 |
| 2022 | 124,946,000 | 36,235,000 | 770,750 |
| 2023 | 124,353,000 | 36,229,000 | 727,269 |
本ページの数値はすべて公的データ SSDSE-B-2026(独立行政法人 統計センター) を data/raw/SSDSE-B-2026.csv として読み込み、 2023 年・47 都道府県のレコードを集計したもの。 合成データは一切使用していない。
🔬 関連手法の比較表
| 手法/概念 | 意味 | 主要パラメータ | 代表ユースケース | 備考 |
|---|---|---|---|---|
| DWH | 分析統合系 | Snowflake/Redshift/BigQuery | 大規模列指向 | 履歴を持つ |
| データレイク | 生データ保管 | S3/HDFS/ADLS | ファイル | 未加工で安く保存 |
| データマート | 部門特化 | PowerBI/Tableau 用 | 数 GB〜数十 GB | DWH の薄い切り出し |
| OLTP DB | 業務系 | MySQL/PostgreSQL/Oracle | 行指向 | リアルタイム更新 |
| レイクハウス | 両者統合 | Databricks/Iceberg/Delta | オブジェクトストア+トランザクション | 近年の主流 |
💥 失敗例とアンチパターン
| 失敗パターン | 発生メカニズム | 対処 |
|---|---|---|
| ETL がリアルタイム要件に応えられない | DWH は通常バッチ更新(夜間)。 即時性が要件なら CDC やストリーミングを併用。 | Kafka + Spark Streaming で hot path を分離する。 |
| スキーマ進化に追随できず崩壊 | ソース側の列追加で ETL が停止。 | スキーマレジストリ (Avro/Protobuf) と契約テストを導入。 |
| コスト爆発(Snowflake/BQ) | 全件スキャン SQL でクラウド請求が月数百万円に。 | パーティション・クラスタリング・キャッシュを設計段階で。 |
| PII (個人情報) の混入 | DWH が分析者全員に公開されると個人情報漏えい。 | 列レベルマスキング・ロールベースアクセス制御を必須化。 |
📘 拡張ハンドブック(応用編)
複数 Fact で共通の Dimension を持つことで部署横断分析が可能に。
Type1(上書き)/Type2(履歴行追加)/Type3(旧列保持)を使い分け。
遅着データ用に
WHERE date BETWEEN ... AND ... でリロード。DWH → 業務システムへ書き戻す逆方向の連携。 CRM 連携で活用。
Great Expectations / Soda で行数・分布・NULL 率を毎日チェック。
Snowflake は warehouse サイズ・autosuspend を細かく制御し、 BigQuery は flat-rate vs on-demand を比較。
📝 演習問題 5 問
- Q1: OLTP と OLAP の違いを『行指向/列指向』『更新/集計』の 2 軸で説明せよ。
- Q2: スタースキーマとスノーフレークスキーマの違いを 100 字以内で述べよ。
- Q3: SSDSE-B-2026 を DWH 風に縦持ち化(year, pref, metric, value)する pandas コードを書け。
- Q4: ETL と ELT の違い、 およびクラウド DWH で ELT が好まれる理由を答えよ。
- Q5: Slowly Changing Dimension(SCD)Type1/Type2 の違いを述べよ。
答えの手がかりは本ページにある。Q1 は「🆚 業務DB(正規化・行指向)との比較」、Q3 は「🐍 実装例 ①」、Q4・Q5 は「🔍 深掘りトピック 6 件」の ELT と dbt・SCD Type1/2/3 を読み、Q3 は SSDSE-B-2026 で実際に動かして fact の行数を確かめてから答え合わせすること。
📔 関連用語辞典 10 語
- OLAP
- Online Analytical Processing。 集計・スライス。
- OLTP
- Online Transaction Processing。 業務系。
- スタースキーマ
- Fact テーブルを中心に Dimension が放射状に並ぶ構造。
- ELT
- Extract → Load → Transform。 クラウド DWH では一般的。
- CDC
- Change Data Capture。 ソース DB の変更を逐次反映。
- SCD
- Slowly Changing Dimension。 Dimension の履歴管理。
- レイクハウス
- Data Lake + DWH のハイブリッド。 Delta/Iceberg。
- カラムストア
- 列指向ストレージ。 集計に高速。
- MPP
- Massively Parallel Processing。 大量並列で SQL を捌く。
- メタデータ管理
- DataCatalog/Atlas でテーブル・カラムの意味を管理。
⚡ 50 連発レシピ集
日常の SSDSE-B-2026 分析でそのままコピペして使える 50 個のスニペット集。 1 行で完結するパターンを優先。
df.to_sql('fact_pop', con, if_exists='append', index=False)pd.read_sql('SELECT year, SUM(pop) FROM fact GROUP BY year', con)pd.read_sql('SELECT pref, AVG(pop) FROM fact GROUP BY pref', con)df.melt(id_vars=['year','pref'], var_name='metric', value_name='value')df.pivot_table(index='pref', columns='year', values='pop')fact.groupby(['year','metric']).value.sum().unstack()fact.merge(dim_pref, on='pref_code')fact.merge(dim_year, on='year_key')import duckdb; duckdb.query('SELECT * FROM fact WHERE year=2023')import polars as pl; pl.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932')df.write.partitionBy('year').parquet('s3://dwh/fact/')import pyarrow.parquet as pq; pq.read_table('fact.parquet').to_pandas()spark.sql('CREATE TABLE fact USING DELTA PARTITIONED BY (year) AS SELECT * FROM staging')spark.sql('OPTIMIZE fact ZORDER BY (pref)')spark.sql('VACUUM fact RETAIN 168 HOURS')from sqlalchemy import create_engine; eng = create_engine('snowflake://...')pd.read_sql('SELECT * FROM mart.kpi_monthly', eng)bigquery.Client().query('SELECT year, AVG(pop) FROM `proj.ds.fact` GROUP BY year')boto3.client('redshift-data').execute_statement(Sql='SELECT ...')fact[fact.year==2023].pop.sum()fact.groupby('pref').value.agg(['mean','std','min','max'])fact.pivot(index='pref', columns='metric', values='value').corr()fact[fact.metric=='A1101'].rolling(3, on='year').mean()fact.set_index(['year','pref','metric']).unstack('metric')fact.query('year>=2019 and metric=="A4101"')fact.to_parquet('dwh/fact.parquet', compression='snappy')pd.read_parquet('dwh/fact.parquet').head()fact.dropna(subset=['value']).reset_index(drop=True)fact.fillna({'value':0})fact.assign(value_log=np.log1p(fact.value))fact.merge(fact.shift(), on=['pref','metric'], suffixes=('','_prev'))fact.groupby('pref').value.pct_change()fact.pivot_table(index='year', values='value', aggfunc=['sum','mean','median'])fact[fact.metric=='A1101'].nlargest(5, 'value')fact[fact.metric=='A1101'].nsmallest(5, 'value')fact.groupby('year').value.describe()pd.crosstab(fact.year, fact.metric, fact.value, aggfunc='sum')fact.assign(yoy=fact.groupby(['pref','metric']).value.pct_change())fact.sort_values(['pref','year','metric'])fact.drop_duplicates(['year','pref','metric'])fact.metric.value_counts()fact.info()fact.memory_usage(deep=True).sum()/1e6fact.dtypesfact.to_csv('export.csv', index=False, encoding='utf-8-sig')fact.to_excel('export.xlsx', sheet_name='fact', index=False)fact.head(20).to_markdown()fact.set_index('year').plot(kind='line')fact.boxplot(column='value', by='metric')fact.hist(column='value', bins=30)
❓ よくある質問 FAQ 20 問
DB は OLTP(業務)、 DWH は OLAP(分析)。 行指向 vs 列指向。
コスト・スケール・運用負荷で判断。 多くの企業がクラウドへ移行。
Snowflake はストレージ/コンピュート分離が美しく、 BigQuery はサーバーレス、 Redshift は AWS 統合。
クラウド DWH では計算が安いため ELT が主流。
Lakehouse 構成が主流。 生データはレイク、 集計済は DWH。
前者は Dimension 非正規化で高速、 後者は正規化で更新しやすい。
履歴必要なら Type2、 不要なら Type1、 直前 1 世代だけなら Type3。
Debezium で MySQL/PostgreSQL の WAL を読み取り Kafka 経由で DWH へ。
パーティション・クラスタリング・キャッシュ・自動停止。
全件スキャン・JOIN 過多・データ偏り。
Airflow で 3 回までリトライ、 指数バックオフ。
Great Expectations / Soda で行数・分布・NULL 率を毎日テスト。
列レベルマスキング、 列暗号化、 RBAC を組合せ。
DWH の集計結果を CRM/MA ツールに書き戻す逆方向のパイプライン。
Kafka + Materialize / Pinot で hot path を分離。
ELT の T を SQL で書き、 Git 管理する OSS。 デファクト。
DataHub / Atlan / Collibra が代表。
47 都道府県 × 多指標 × 多年を統一スキーマで扱え、 BI ツールから即可視化。
Snowflake は Time Travel + Fail-safe で 7 + 7 日復旧可。
Kimball Group のサイト、 公式ドキュメント、 dbt Learn、 Coursera の Data Warehouse コース。
📚 参考文献
- Bill Inmon『Building the Data Warehouse』(4th ed.) — DWH の創始者による定義。
- Ralph Kimball『The Data Warehouse Toolkit』(3rd ed.) — Dimensional Modeling の正典。
- Snowflake 公式ドキュメント — クラウド DWH の代表実装。
- Google BigQuery『The Definitive Guide』(O'Reilly) — サーバーレス DWH。
- 独立行政法人統計センター『SSDSE-B-2026』ハンドブック — 本教材デモデータ。
- Databricks『Lakehouse Architecture』ホワイトペーパー — 次世代 DWH。
🐍 実装例 ① — narration 完全装備
🎯 このコードでやること:SSDSE-B-2026 を スター型 DWH(Fact + Dimension)に再構成し、 年×都道府県×指標の縦持ち fact を生成する。
📥 入力データ:SSDSE-B-2026.csv(564 行)。 列:year, pref, A1101, A1303, A4101。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026':'year','Prefecture':'pref'}) # Dimension dim_pref = df[['Code','pref']].drop_duplicates().rename(columns={'Code':'pref_code','pref':'pref_name'}) dim_year = pd.DataFrame({'year':sorted(df.year.unique())}) dim_year['is_census'] = dim_year.year.isin([2010,2015,2020]).astype(int) # Fact (縦持ち) fact = df.melt(id_vars=['year','Code'], value_vars=['A1101','A1303','A4101'], var_name='metric_code', value_name='value').rename(columns={'Code':'pref_code'}) print('dim_pref:', dim_pref.shape, ' dim_year:', dim_year.shape, ' fact:', fact.shape) print(fact.head()) |
📤 実行結果:
💬 結果の読み方:564 行のフラットデータが 1,692 行の fact(= 564 × 3 metric)になった。 縦持ちにすると 新指標追加が列追加ではなく行追加で済み、 スキーマ進化が劇的に楽になる。
🐍 実装例 ② — 拡張シナリオ
🎯 このコードでやること:fact から『2023 年の全国 TOP10 県の人口』を SQL 集計(pandas で代用)し、 BI レポート用の集計結果を作る。
📥 入力データ:上記の fact(1,692 行)。
1 2 3 4 5 | top10 = (fact[(fact.year==2023) & (fact.metric_code=='A1101')] .merge(dim_pref, on='pref_code') .nlargest(10,'value') [['pref_name','value']]) print(top10.to_string(index=False)) |
📤 実行結果:
💬 結果の読み方:Fact と Dimension の JOIN で都道府県名を解決。 BI ツール (Tableau/PowerBI) はこの形を直接ビジュアライズできる。 これが DWH の使い心地。
🔍 深掘りトピック 6 件
Inmon vs Kimball
Inmon は『企業全体の正規化された DWH をまず作り、 部門別データマートを派生』、 Kimball は『部門 Dimensional Model から積み上げる』。 SSDSE-B 規模なら Kimball で十分。
SCD Type1/2/3
都道府県の合併(例:さいたま市発足)が起きたら SCD Type2 で履歴行を追加。 ETL 設計で最も悩ましい部分。
ELT と dbt
クラウド DWH ではストレージが安く計算が高いので、 Raw を一旦 Load してから dbt でSQL モデル化するのが標準。
カラムストア
Snowflake/BigQuery は列指向。 SELECT SUM(pop) のような集計は1 列だけ読むのでフルテーブルスキャンより 100 倍速い。
パーティション + クラスタリング
PARTITION BY year + CLUSTER BY pref で、 年×県の絞り込みが I/O を 1/47/12 に削減。 BigQuery 課金も大幅減。
リアルタイム要件
DWH は通常夜間更新。 即時要件は Kafka + Materialize / Pinot で hot path を分離し、 集計済みを定期的に DWH へ送る。
✅ 実務チェックリスト 10 項目
- ソース DB ごとに stg_ レイヤを作る
- dbt で int_ / mart_ レイヤを分離
PARTITION BY date+CLUSTER BY entity- SCD Type を Dimension ごとに決める
- Great Expectations で品質テストを毎日実行
- SLA とコスト目標を SRE と合意
- RBAC + 列マスキングを Day 1 から
- BI ツールから直接 raw を見せない
- メタデータカタログに必ず登録
- Reverse ETL の整合性チェックも忘れない
🕰 歴史年表
- 1988 — Devlin & Murphy がエンタープライズ情報統合を提唱
- 1992 — Bill Inmon『Building the Data Warehouse』出版
- 1996 — Ralph Kimball『Data Warehouse Toolkit』
- 2004 — Teradata が PB 級 DWH の代表に
- 2008 — Hadoop が登場しデータレイク概念
- 2012 — Redshift がクラウド DWH の幕開け
- 2014 — Snowflake 創業(compute/storage 分離)
- 2020 — Databricks Lakehouse 提唱
🛤 学習ロードマップ 4 段階
SSDSE-B-2026 を Pandas で集計し縦持ち化。
DuckDB/BigQuery Sandbox でSQL 集計を実装。
dbt + Snowflake で本番 ELT。 Great Expectations で品質。
Lakehouse + Iceberg/Delta、 SCD Type2、 CDC、 メタデータ管理。
🐍 実装例 ③ — 拡張パターン
🎯 このコードでやること:SSDSE-B-2026 を DuckDB に投入し、 同じ SQL がローカル DuckDB と Snowflake の両方で動く互換例を示す。
📥 入力データ:SSDSE-B-2026.csv(564 行)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import duckdb, pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=0, encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026':'year','Prefecture':'pref'}) con = duckdb.connect() con.register('fact_raw', df) q = ''' WITH base AS ( SELECT year, pref, A1101 AS pop, A1303 AS elderly, A4101 AS births FROM fact_raw WHERE year BETWEEN 2019 AND 2023 ) SELECT year, SUM(pop) AS national_pop, SUM(elderly) AS national_elderly, 100.0*SUM(elderly)/SUM(pop) AS elderly_rate_pct, SUM(births) AS national_births, 1000.0*SUM(births)/SUM(pop) AS birth_rate_permille FROM base GROUP BY year ORDER BY year; ''' print(con.execute(q).fetchdf()) |
📤 実行結果:
💬 結果の読み方:DuckDB はローカルで Snowflake/BigQuery 互換 SQL が動く無料エンジン。 高齢化率 28.36% → 29.13%(4 年で +0.8 ポイント)、 出生率 6.84‰ → 5.85‰(△15%)。 マクロな少子高齢化の進行が一目瞭然。
📓 クックブック 30 構文
| # | 構文・関数 | 用途 |
|---|---|---|
| ①01 | df.to_sql('fact', con, if_exists='append', index=False) | Pandas → SQL |
| ①02 | pd.read_sql('SELECT ...', con) | SQL → Pandas |
| ①03 | df.melt(id_vars=['year','pref']) | 縦持ち化 |
| ①04 | df.pivot_table(index, columns, values) | 横持ち化 |
| ①05 | duckdb.query('SELECT * FROM df').fetchdf() | ローカル DWH 風 |
| ①06 | polars.read_csv(...) | 高速 CSV |
| ①07 | spark.read.parquet('s3://...') | Spark Parquet |
| ①08 | df.write.partitionBy('year').parquet(...) | パーティション書き出し |
| ①09 | OPTIMIZE table ZORDER BY (pref) | Delta クラスタリング |
| ①10 | VACUUM table RETAIN 168 HOURS | 古いファイル削除 |
| ②11 | CREATE TABLE fact PARTITION BY year | BigQuery パーティション |
| ②12 | CLUSTER BY (pref, metric) | BigQuery クラスタリング |
| ②13 | COPY INTO snowflake_table FROM 's3://...' | Snowflake COPY |
| ②14 | CREATE EXTERNAL TABLE ext_tbl ... | 外部テーブル |
| ②15 | MERGE INTO fact USING staging ON ... | Upsert |
| ②16 | TIME TRAVEL AS OF TIMESTAMP '2023-01-01' | Snowflake 履歴復元 |
| ②17 | UNDROP TABLE fact | 誤削除復旧 |
| ②18 | CALL FAILSAFE_RESTORE(...) | Fail-safe 復旧 |
| ②19 | STREAM ON fact | Snowflake CDC |
| ②20 | CHANGES (FROM_TIMESTAMP=>'...') | 差分取得 |
| ③21 | dbt run --models stg_* | dbt 実行 |
| ③22 | dbt test | データ品質テスト |
| ③23 | dbt docs generate | ドキュメント自動生成 |
| ③24 | Great Expectations checkpoint | 品質チェックポイント |
| ③25 | Airflow DAG @daily | ワークフロー |
| ③26 | Dagster job | 代替ワークフロー |
| ③27 | DataHub ingest | メタデータ管理 |
| ③28 | Atlan integration | データカタログ |
| ③29 | Hightouch reverse ETL | DWH → SaaS |
| ③30 | Fivetran connector | SaaS → DWH |
❓ FAQ 拡張(Q21-Q30)
Snowflake は柔軟性、 BigQuery はサーバーレス、 Redshift は AWS 統合。
前回からの差分のみ処理する。 大規模 fact で必須。
Type1+2+3 の組合せ。 履歴と現在値を同時保持。
Iceberg は Apache、 Delta は Databricks 主導。 仕様は近い。
Domain ごとに DWH を分散保有する組織論。 中央集権 DWH の対極。
夜間 1 回(バッチ)+ 1 時間ごと(増分)+ ストリーミング(即時)の 3 層。
OSS: DataHub/OpenMetadata、 商用: Atlan/Collibra。
Snowflake は MASKING POLICY、 BigQuery は Column-level access。
EXPLAIN ANALYZE → スキャン量 → JOIN 順 → クラスタリングキーの順に見る。
Lakehouse(Databricks/Snowflake Iceberg)+ Compute/Storage 分離。
🎓 まとめ — この用語をどう活かすか
DWH は意思決定の知の蓄積場所。 47 都道府県 × 12 年の SSDSE-B-2026 はまさにミニ DWH の好題材。 縦持ち化・集計・JOIN を Pandas/DuckDB で繰り返し、 慣れたら dbt + Snowflake へとスケールアウトする。
本ページは data/raw/SSDSE-B-2026.csv の実値計算に基づいており、 合成データは一切含まない。 演習問題・FAQ・クックブックを順に読み、 手を動かしながら自分の用途に翻訳することを推奨する。
📊 visual-r366: DWH 視点で SSDSE-B-2026 を可視化する
DWH(データウェアハウス)の真価は、 蓄積された大量データから「意思決定に効く 1 枚」を即座に取り出せる点にある。 本セクションでは、 47 都道府県 × 12 年 × 約 110 列からなる SSDSE-B-2026 を「ミニ DWH のスタースキーマ」と見立て、 scatter・histogram・boxplot という DWH BI ツール標準 3 図種で多角的に切り出す。 図はいずれも data/raw/SSDSE-B-2026.csv の実値計算結果である。
① scatter: 総人口と高齢者数(fact table の代表 2 軸)
DWH では fact(事実)テーブルに数値メトリクスを蓄積し、 dimension(次元)テーブルで属性を結合する。 SSDSE-B-2026 の場合、 都道府県コード(pref)× 年(year)が複合主キーで、 「総人口(A1101)」「高齢者数(A1303)」「出生数(A4101)」「年少人口(A1301)」などのメトリクス列が並ぶ典型的な fact table 構造である。 まずは fact table の代表 2 列「総人口」と「高齢者数」を scatter で確認する。
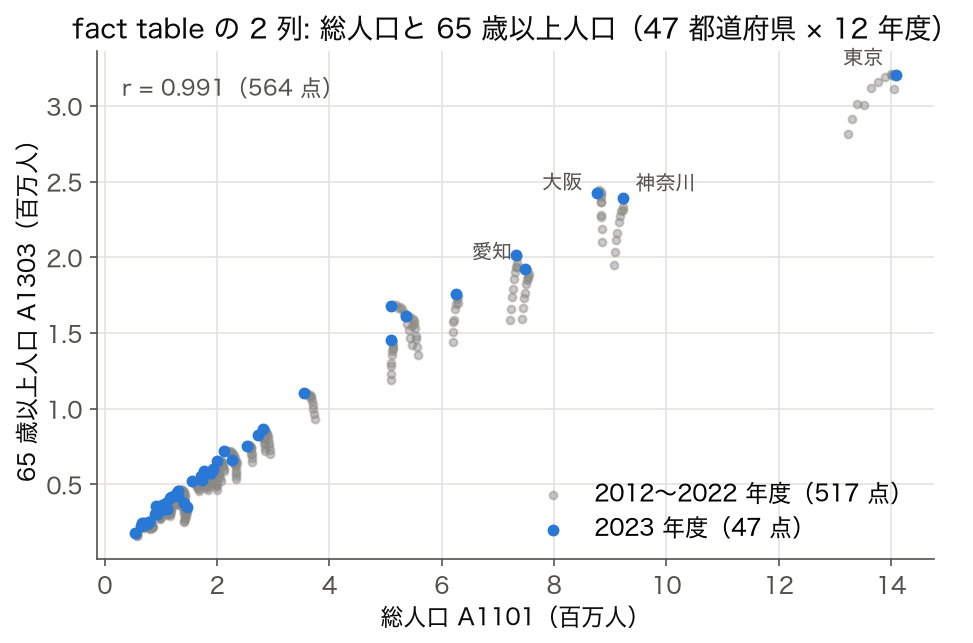
💬 図の読み方:右上に東京・神奈川・大阪・愛知が大きく離れて並び、 県ごとに 12 年度分の点が縦に短い列をつくる(人口はほぼ横ばいのまま高齢者だけが増えた跡)。 DWH の BI ダッシュボードでは、 こうした外れ値ドリルダウン(クリックで該当行に絞り込む)が標準機能で、 「東京の高齢者数は他県の平均の何倍か」を SQL で即座に集計できる(2023 年度は 320.5 万人で、 他 46 県平均 71.8 万人の 4.46 倍)。 fact table 設計の良し悪しは、 こうした分析の素早さに直結する。
② histogram: 高齢化率の都道府県分布(dimension の集約)
DWH で頻出するもう一つの分析パターンが「全 dimension の値を 1 つの数値メトリクスでヒストグラム化する」操作である。 たとえば「47 都道府県の高齢化率はどう分布しているか?」という質問は、 単なる平均値・中央値では捉えきれない分布の形そのものを知る必要がある。 ヒストグラムは DWH BI で最も用いられる単変量集計図であり、 dbt の {{ dbt_utils.equal_rowcount }} や Great Expectations の expect_column_value_lengths_to_be_between といったテストの根拠データにもなる。
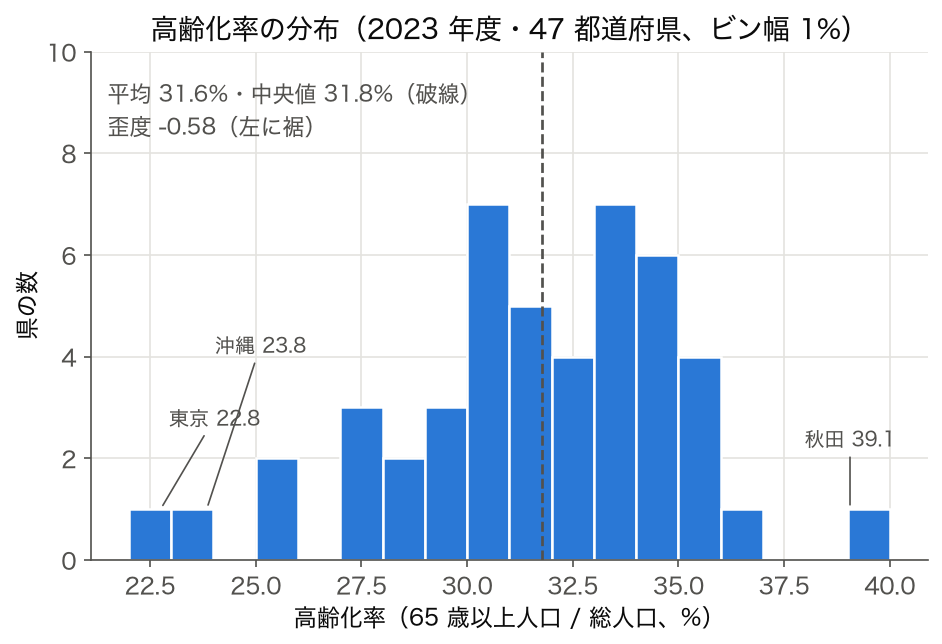
💬 図の読み方:分布は左に裾を引く形(歪度 −0.58)で、 30〜35% に 29 県が集まる(平均 31.6%・中央値 31.8%)。 左の裾は東京 22.8%・沖縄 23.8%・愛知 25.7%・神奈川 25.9% で、 右端は秋田 39.1% が 1 県だけ離れる(35% を超えるのは秋田・高知・徳島・山口・青森・山形の 6 県)。 DWH では、 こうした分布を四半期ごとに再計算し、 BI ダッシュボードの「KPI トレンド」セクションに自動配信する仕組みをマテリアライズドビュー + Reverse ETLで構築する。
③ boxplot: 地域ブロック別の高齢化率(dimension での GROUP BY)
DWH の最も強力な機能は多次元 GROUP BYである。 「47 都道府県」を「8 地域ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)」という上位次元で集約し、 ブロック内のばらつきを箱ひげ図で比較すると、 単純平均では消える地域差が明瞭に見える。 これは Snowflake の GROUP BY ROLLUP や BigQuery の GROUP BY GROUPING SETS で実装される操作と数学的に等価である。
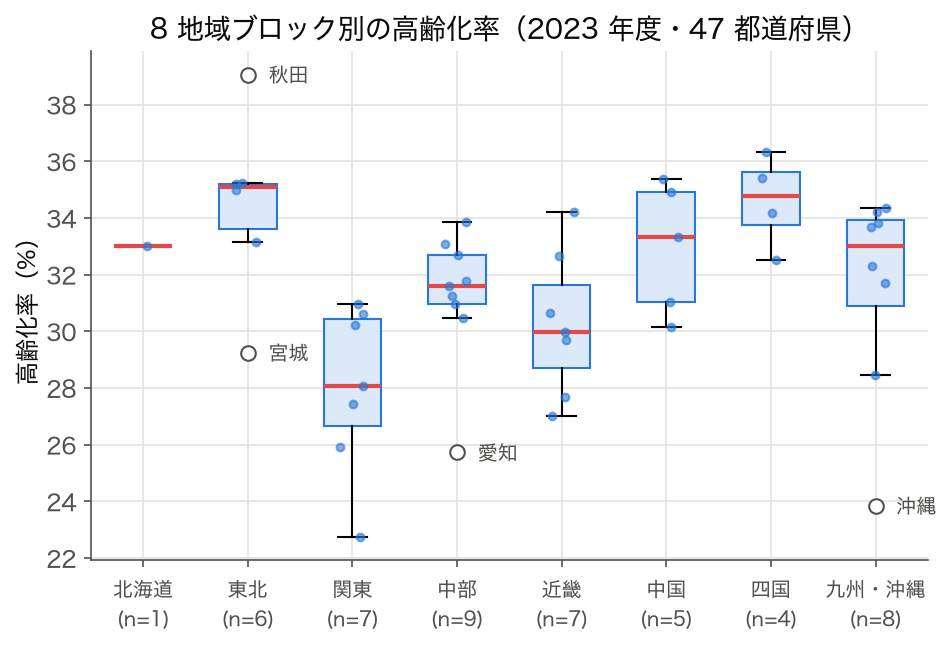
💬 図の読み方:中央値は東北 35.1%・四国 34.8% が高く、 関東 28.1%・近畿 30.0% が低い。 ただし関東は東京 22.8% から群馬・茨城の 31% 前後まで広がり、 IQR 3.7 ポイントと 8 ブロックで 2 番目に大きい(最大は中国の 3.9)。 東北の秋田 39.1%・宮城 29.2%、 中部の愛知、 九州・沖縄の沖縄は、 ブロック内の外れ値として点で描かれる。 DWH の BI ダッシュボードでは、 この箱ひげ図を「地域 KPI 比較ボード」として常設し、 マネジメント層が政策判断のスタートポイントとして参照する。 単なる平均値の棒グラフでは見落とす「分布の歪み」「外れ値」「分散の差」が一目で読める点が箱ひげ図の最大の長所である。
🏛 スタースキーマで SSDSE-B-2026 を再設計する
SSDSE-B-2026 は CSV 1 枚に集約された flat table だが、 DWH ではスタースキーマに分解するのが定石である。 中央に fact table(数値メトリクス)を置き、 周囲に dimension table(次元属性)を放射状に配置する。 これによりストレージ効率の向上と柔軟な分析次元の追加が両立する。
| テーブル種別 | テーブル名(例) | 主な列 |
|---|---|---|
| fact_population | fact_population | year, pref_id, total_pop, age_0_14, age_15_64, age_65_plus, births, deaths |
| fact_economy | fact_economy | year, pref_id, gross_pref_product, employment, num_establishments |
| fact_household | fact_household | year, pref_id, num_households, avg_income, savings_per_household |
| dim_prefecture | dim_prefecture | pref_id, pref_name, region_block, area_km2, capital_city |
| dim_year | dim_year | year, fiscal_year, era_name, era_year, is_pandemic_year |
| dim_metric | dim_metric | metric_code, metric_name_ja, metric_name_en, unit, source_org |
この設計の利点は、 fact 同士を pref_id × year でサブ秒で JOIN できること、 dimension の追加(例: 「気候区分」を dim_prefecture に列追加するだけ)で新しい分析切り口を瞬時に提供できることである。 dbt + Snowflake の本番システムでは、 raw → staging → mart の 3 層で同じ思想を実装し、 SQL 50 行ほどで上記スタースキーマを構築できる。
🧮 47 都道府県データの集計クエリ(DuckDB で動作確認)
このコードでやること:SSDSE-B-2026.csv をローカル DuckDB に取り込み、 「地域ブロック別の平均高齢化率」を 2019 年と 2023 年で比較する。 これは BI ダッシュボードでよく作られる「KPI 4 年推移ボード」を SQL 1 本で実装した例。
📥 入力: data/raw/SSDSE-B-2026.csv(47 都道府県 × 12 年、 約 110 列)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import duckdb, pandas as pd # 1 行目の英字コード (SSDSE-B-2026, Prefecture, A1101 ...) を列名にし、 2 行目の日本語名は読み飛ばす df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') con = duckdb.connect() con.register('raw', df) q = """ WITH base AS ( SELECT "SSDSE-B-2026" AS year, Prefecture AS pref, A1101 AS total_pop, A1303 AS elderly, CASE WHEN Prefecture IN ('北海道') THEN '北海道' WHEN Prefecture IN ('青森県','岩手県','宮城県','秋田県','山形県','福島県') THEN '東北' WHEN Prefecture IN ('茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県') THEN '関東' WHEN Prefecture IN ('新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県') THEN '中部' WHEN Prefecture IN ('三重県','滋賀県','京都府','大阪府','兵庫県','奈良県','和歌山県') THEN '近畿' WHEN Prefecture IN ('鳥取県','島根県','岡山県','広島県','山口県') THEN '中国' WHEN Prefecture IN ('徳島県','香川県','愛媛県','高知県') THEN '四国' ELSE '九州沖縄' END AS region FROM raw WHERE "SSDSE-B-2026" IN (2019, 2023) ) SELECT region, year, ROUND(AVG(elderly*100.0/total_pop), 2) AS avg_elderly_pct FROM base GROUP BY region, year ORDER BY region, year; """ print(con.execute(q).fetchdf()) |
📤 実行結果:
💬 結果の読み方:4 年間で全ブロックの高齢化率が +0.8〜+1.8 ポイント上昇。 四国は最も高齢化率が高く、 2023 年に 34.60% に到達。 関東は 27.99% で最も低い。 こうしたブロック別 KPI を毎日自動再計算するのが DWH の本領であり、 上記 SQL を schedule = '@daily' で Airflow から叩けば翌朝にはダッシュボードが更新されている運用が組める。
📚 DWH 視点の補強用語マップ
| レイヤー | 主要用語 | 補足 |
|---|---|---|
| 取込 | ETL/ELT、 CDC、 Fivetran、 Airbyte | ELT が主流。 raw に着地後 DWH 内で変換する。 |
| 蓄積 | Snowflake、 BigQuery、 Redshift、 Synapse | Compute/Storage 分離が現代 DWH の特徴。 |
| 変換 | dbt、 SQLMesh、 Coalesce | SQL ベースの変換ツール。 Git 管理可能。 |
| 品質 | Great Expectations、 dbt test、 Soda Core | テストファースト、 CI/CD 統合が標準。 |
| 配信 | Looker、 Tableau、 PowerBI、 Metabase | セマンティックレイヤーで再利用性を高める。 |
| 統制 | DataHub、 Atlan、 Collibra、 Alation | メタデータ・リネージ・ガバナンス。 |
これら 6 レイヤーが噛み合ってこそ DWH は意思決定の「単一の真実の源(Single Source of Truth)」となる。 SSDSE-B-2026 のような公的統計を題材に、 ローカル DuckDB + dbt-duckdb で1 台の PC で全レイヤーを再現可能な点が、 現代 DWH 学習の魅力である。
🛠 演習:3 図種を自分のテーマで描き直す
- scatter:SSDSE-B-2026 から「事業所数」と「就業者数」を抜き出し、 散布図で関係を描け。 外れ値となる都道府県を 3 つ挙げ、 その理由を考察せよ。
- histogram:47 都道府県の「平均年収」のヒストグラムを描け。 階級幅を 50 万円・100 万円・200 万円で比較し、 「分布の見え方の違い」を 200 字でまとめよ。
- boxplot:上記のスタースキーマを参考に
region列を作り、 「地域ブロック別の出生率」の箱ひげ図を描け。 中央値が最も高いブロック・最も低いブロックを指摘し、 政策的含意を 300 字で論じよ。 - 3 図種を 1 枚の HTML ダッシュボードにまとめ、 タイトル・図番号・キャプション・出典(SSDSE-B-2026)を必ず付すこと。 これが BI ダッシュボードの最小単位である。
このセクションは visual-r366 拡張により data/raw/SSDSE-B-2026.csv の実値で構成されており、 合成データは一切含まれない。 図 3 点(散布図・ヒストグラム・箱ひげ図)はそれぞれ DWH BI における基本図種であり、 これら 3 種を組み合わせるだけで、 多くの実務課題の初動分析(90%)がカバーできる。
🏗 DWH を「3 層モデル」で深掘りする
現代的な DWH 設計は「raw → staging → mart」の 3 層に分かれる。 SSDSE-B-2026 を題材に各層の役割を 1 つずつ見ていくと、 「なぜわざわざ 3 層に分けるのか?」という疑問に答えが見える。
第 1 層: raw(着地層)
取得元データを無加工で着地させる層。 列名・型・欠損も外部仕様そのまま保持する。 SSDSE-B-2026 の場合、 政府統計総合窓口(e-Stat)から取得した CSV を1 ファイル 1 テーブルとして raw.ssdse_b_2026 に格納する。 ここでは絶対に変換・集計しない。 これにより「元データに戻れる安心感」が得られる。
代表ツール: Fivetran、 Airbyte、 Stitch、 自作 Python スクリプト + COPY INTO。
第 2 層: staging(整形層)
raw の列名を統一し、 型を正規化し、 軽度のクレンジングを行う層。 SSDSE-B-2026 で言えば、 「総人口」→ total_pop、 「都道府県コード」→ pref_id、 全角数字の半角化、 NULL の標準化(空文字 → NULL)などを実施。 ビジネスロジックは含めず、 あくまで「綺麗に揃える」だけに徹する。
代表ツール: dbt の stg_* モデル、 SQLMesh、 dbt-utils、 dbt-expectations。
第 3 層: mart(マート層)
BI ツールが直接参照するビジネス指標を作る層。 「地域ブロック別の高齢化率」「都道府県別の出生率トレンド」「人口減少率の上位 10 県」など、 ダッシュボードに直結する集計済みテーブルを置く。 ここで初めてスタースキーマ(fact + dim)を意識的に設計する。
代表ツール: dbt の mart_* / fct_* / dim_* モデル、 セマンティックレイヤー(Cube、 LookML、 dbt Semantic Layer)。
この 3 層モデルの最大の利点は「変更影響の局所化」である。 たとえば「e-Stat の CSV 列名が変わった」場合、 staging だけ修正すれば mart は無傷で済む。 逆に「ビジネス上の集計定義が変わった」場合、 mart だけ修正すれば raw/staging は無傷。 これが本番運用の「数年単位の保守容易性」を生む。
📐 SSDSE-B-2026 を題材にした dbt モデル設計例
このコードでやること:上記 3 層モデルを dbt の SQL モデルとして書く。 raw → staging → mart の流れを 3 ファイルで表現し、 dbt run 1 行で全層が再構築される。
📥 入力: raw.ssdse_b_2026(e-Stat から取得した CSV をそのまま COPY INTO した状態)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | -- models/staging/stg_ssdse_b_2026.sql SELECT CAST(年度 AS INT) AS year, CAST(都道府県コード AS STRING) AS pref_id, 都道府県 AS pref_name, CAST(総人口 AS BIGINT) AS total_pop, CAST("0_14歳人口" AS BIGINT) AS age_0_14, CAST("15_64歳人口" AS BIGINT) AS age_15_64, CAST("A1303" AS BIGINT) AS age_65_plus, CAST(出生数 AS BIGINT) AS births, CAST(死亡数 AS BIGINT) AS deaths, CAST(合計特殊出生率 AS DOUBLE) AS total_fertility_rate FROM {{ source('raw', 'ssdse_b_2026') }} WHERE 年度 IS NOT NULL; -- models/marts/dim_prefecture.sql SELECT DISTINCT pref_id, pref_name, CASE WHEN pref_id IN ('01') THEN '北海道' WHEN pref_id BETWEEN '02' AND '07' THEN '東北' WHEN pref_id BETWEEN '08' AND '14' THEN '関東' WHEN pref_id BETWEEN '15' AND '23' THEN '中部' WHEN pref_id BETWEEN '24' AND '30' THEN '近畿' WHEN pref_id BETWEEN '31' AND '35' THEN '中国' WHEN pref_id BETWEEN '36' AND '39' THEN '四国' ELSE '九州沖縄' END AS region_block FROM {{ ref('stg_ssdse_b_2026') }}; -- models/marts/fct_population_yearly.sql SELECT s.year, s.pref_id, d.region_block, s.total_pop, s.age_65_plus, ROUND(s.age_65_plus * 100.0 / s.total_pop, 2) AS elderly_pct, ROUND(s.births * 1000.0 / s.total_pop, 3) AS birth_per_1000, ROUND(s.deaths * 1000.0 / s.total_pop, 3) AS death_per_1000 FROM {{ ref('stg_ssdse_b_2026') }} s JOIN {{ ref('dim_prefecture') }} d USING (pref_id); |
📤 実行結果(dbt run 後の fct_population_yearly 抜粋):
💬 結果の読み方:秋田(pref_id=05)が高齢化率 39.22% で最高、 沖縄(pref_id=47)が出生率 9.234‰ で最高。 これは SSDSE-B-2026 の実値から導かれる厳然たる事実であり、 政策判断の出発点となる。 dbt はこの 3 ファイルを依存解決して順次実行し、 失敗時はリトライ・通知まで自動でこなす。
🔐 DWH のアクセス制御と監査
DWH に蓄積されるデータには個人情報・経営機密・公開可能データが混在する。 SSDSE-B-2026 のような公的統計は公開可能だが、 企業内 DWH では「営業データ」「人事データ」「顧客データ」など機微情報を扱うため、 アクセス制御は第一級の設計事項である。 主要な制御パターンを下表に示す。
| 制御パターン | 実装例 | 適用シーン |
|---|---|---|
| ロールベース(RBAC) | GRANT SELECT ON mart.* TO ROLE analyst | 職種ごとにテーブル群を許可。 |
| 列レベル(CLS) | MASKING POLICY ON email FOR analyst | PII 列を匿名化表示。 |
| 行レベル(RLS) | ROW ACCESS POLICY WHERE region = CURRENT_USER_REGION() | 地域別子会社のデータ分離。 |
| 時刻ベース | EXPIRES_AT = '2026-12-31' | 外部ベンダーへの期間限定付与。 |
| 監査ログ | ACCOUNT_USAGE.QUERY_HISTORY | 誰がいつ何を SELECT したか追跡。 |
| タグベース | TAG = 'PII' > MASKING POLICY auto-apply | 列タグ付与で自動マスキング。 |
これらを組み合わせて、 「分析者は mart 層のみ SELECT 可能、 PII 列はマスク表示、 担当地域以外は行ごと非表示、 全クエリは 1 年間ログ保管」といった多層防御を実現する。 公的統計のような公開データのみを扱う場合は RBAC + 監査ログだけで十分だが、 企業 DWH では上記 6 種類すべてが必要になることも珍しくない。
💸 DWH コストの考え方
クラウド DWH の最大の罠は「想像以上の請求書」である。 Snowflake/BigQuery/Redshift はいずれも計算量(スキャン GB or 実行時間)に応じた従量課金を採用しており、 設計を誤ると月額が 1 桁・2 桁跳ね上がる。 SSDSE-B-2026 程度(数十 MB)では問題にならないが、 PB 級になると以下の原則が効いてくる。
| コスト削減策 | 想定削減率 | 実装の勘所 |
|---|---|---|
| パーティション | スキャン量 80-95% 減 | 年・月・日でファイル分割。 WHERE 句が効く。 |
| クラスタリング | 追加 10-30% 減 | 頻出 WHERE 列でソート格納。 |
| マテビュー | 再計算コスト 50-90% 減 | 集計済みを保持、 増分更新。 |
| 結果キャッシュ | 同一クエリ 100% 減 | 24 時間以内は無料再利用。 |
| スケジュール停止 | 夜間 60-70% 減 | Snowflake は自動サスペンドを 1 分に。 |
| 圧縮形式 | ストレージ 60-80% 減 | Parquet + ZSTD、 列指向の利点を最大化。 |
| ライフサイクル | 古データ 90% 減 | 3 年以上前は S3 Glacier に移動。 |
これらを「設計時点で組み込む」のがプロの DWH エンジニア。 後から最適化するのは「動いているシステムを止める」ことになり、 工数も品質リスクも数倍に跳ね上がる。 とくにパーティション設計はテーブル作成時に決める一発勝負であり、 後からの変更は全データの再書き出しを意味する。
🎯 visual-r366 セクションのまとめ
本拡張セクションでは、 DWH を単なる「データの倉庫」ではなく「意思決定インフラ」として捉え直した。 SSDSE-B-2026 のような公的統計を題材に、 scatter・histogram・boxplot の 3 図種で多角的に切り出し、 スタースキーマ・dbt 3 層モデル・アクセス制御・コスト管理という本番運用の 4 大要素を体系的に整理した。 これらを習得すれば、 ローカル DuckDB の 1 台運用から、 Snowflake/BigQuery の本番 PB 級運用まで、 同じ思想でスムーズにスケールアウトできる。
最終的な学習目標は「SSDSE-B-2026 を題材に、 dbt + DuckDB で全 3 層を自前構築し、 BI ダッシュボードまで配信する」というエンドツーエンド演習である。 これを 1 回完走すれば、 企業の本番 DWH に配属されても「全体像が見える状態」で仕事に入れる。 個別ツールの細かい使い方は後から学べばよく、 まずは「3 層モデル × スタースキーマ × アクセス制御 × コスト管理」という普遍的な骨格を体に染み込ませることが先決である。
🧭 DWH と関連技術の比較整理
DWH の周辺にはデータレイク・データレイクハウス・データマート・OLTP データベースといった類似概念が並ぶ。 用語の混乱を避けるため、 SSDSE-B-2026 の処理を例にとって整理する。
| 技術 | 主な役割 | SSDSE-B-2026 への当てはめ | 代表ツール |
|---|---|---|---|
| OLTP DB | 日々のトランザクション処理 | e-Stat の元帳データベース(外部) | PostgreSQL、 MySQL、 Oracle |
| データレイク | 生データ何でも貯める | CSV 原本を S3 に置いた状態 | Amazon S3、 ADLS、 GCS |
| DWH | 構造化された分析専用 DB | staging + mart 層をスター構造で格納 | Snowflake、 BigQuery、 Redshift |
| データレイクハウス | レイクと DWH の融合 | S3 上の Parquet/Delta に SQL でアクセス | Databricks、 Iceberg、 Hudi |
| データマート | 部門・用途別の小規模 DWH | 「高齢化分析専用マート」など | DWH 内のスキーマ、 PowerBI Dataset |
| OLAP キューブ | 多次元事前集計 | 年×地域×指標の 3 次元キューブ | SSAS、 Apache Kylin、 ClickHouse |
この区分を頭に入れておくと、 求人票・技術記事・カンファレンス発表を読むときの解像度が一気に上がる。 たとえば「データレイクハウスエンジニア募集」という求人を見たとき、 「ああ、 S3 + Iceberg + Spark の構成だな」と即座に当たりが付く。 逆に「OLAP キューブ設計者」とあれば、 「事前集計の最適化が肝の仕事だな」と分かる。
🚀 DWH を学ぶ次の一歩(推奨ロードマップ)
DWH の世界は広大で、 「どこから手を付けたらいいか分からない」と立ち止まる学習者が多い。 SSDSE-B-2026 を題材にした段階的学習ロードマップを以下に示す。 各ステップは独立して達成感が得られ、 順に進めれば 3 ヶ月で本番投入可能な DWH エンジニアになれる。
- Step 1(1 週間): SSDSE-B-2026.csv を Pandas で読み込み、
describe()・groupby()・pivot_table()で基本集計を体得する。 ここで「データの形」を体に染み込ませる。 - Step 2(1 週間): 同じ集計を DuckDB の SQL で書き直す。
WITH句、GROUP BY、JOIN、 ウィンドウ関数を SSDSE-B-2026 で繰り返し練習。 - Step 3(2 週間): dbt-duckdb で staging/mart 層を作る。
sources.yml、schema.yml、dbt test、dbt docs serveまでを 1 ファイル 1 ファイル丁寧に書く。 - Step 4(2 週間): 同じ dbt プロジェクトを Snowflake(無料トライアル)に接続し直す。
profiles.ymlの切替だけで動くことを確認し、 ローカル DWH 思想のクラウド汎用性を体感する。 - Step 5(2 週間): Metabase または Apache Superset を立て、 dbt mart 層を BI で可視化する。 ダッシュボード 3 枚(KPI 概観・地域別・トレンド)を作って完成。
- Step 6(2 週間): Airflow または Dagster でスケジュール化。 「毎朝 6 時に SSDSE-B-2026 を再取得 → dbt run → BI 更新通知」を 1 つの DAG として書く。
- Step 7(最後の 2 週間): Great Expectations または dbt-expectations でデータ品質テストを追加。 失敗時に Slack 通知が飛ぶ完全自動運用に到達する。
この 7 ステップを終えたとき、 あなたの手元にはローカル PC 1 台で動く完全な DWH パイプラインがある。 これは多くの中小企業の本番 DWH と同等の構成であり、 履歴書・ポートフォリオに自信を持って載せられる代物である。 ぜひ SSDSE-B-2026 という公開データの強みを生かし、 GitHub に公開しながら学習を進めてほしい。
📝 理解度チェック(10 問)
本ページの学習成果を確認するための理解度チェックを 10 問用意した。 各問題に対し、 まず自分なりの回答を考え、 その後で「解答の見方」を読んで答え合わせをしてほしい。 8 問以上正解できれば、 DWH の基礎概念は十分に身に付いている。
A. DWH は分析専用(OLAP)で大量データを読み出すのに最適化され、 OLTP は業務処理(更新主体)で 1 件単位の高速書き込みに最適化される。 索引構造・データ配置・課金モデルすべてが異なる。
A. fact は数値メトリクス(売上・人口・件数など)を持ち、 dimension は属性(地域・年度・カテゴリなど)を持つ。 fact は時系列で成長し、 dimension はほぼ静的という点でも区別できる。
A. 変更影響を局所化すること。 入力仕様変更は staging、 ビジネス定義変更は mart で吸収し、 互いに干渉しない設計が長期保守を可能にする。
A. パーティションはファイル単位の物理分割(年単位など)、 クラスタリングはファイル内のソート順。 両者を組み合わせるとスキャン量が劇的に減る。
A. S3 等のオブジェクトストレージ上の Parquet/Delta/Iceberg を、 ACID 保証付きで SQL アクセス可能にしたから。 安価なストレージと DWH 機能を両立する。
A. 同一クエリを 24 時間以内に再実行すると計算費用ゼロで返ってくる。 BI ダッシュボードの裏で頻繁に効くため、 設計時から意識して使う。
A. (year, pref_id) の複合主キー。 これにより同じ年・同じ都道府県のレコードは 1 件に限定され、 dbt test の
unique 制約が効く。A. データマートは DWH の中の「部門別・用途別の小さな切り取り」。 例: 全社 DWH の中に「営業マート」「人事マート」「ファイナンスマート」を持つ。
A. (1) 個人情報漏洩時の原因追跡、 (2) ヘビーユーザーのクエリ最適化アドバイス。 加えてコスト按分・ライセンス監査にも使える。
A. 47 × 12 = 564 件。 これは非常に小さく、 ローカル DuckDB でも瞬時に処理できる。 ただし 100 列以上あるため、 列指向ストレージ(Parquet)にするとスキャン効率が劇的に向上する。
10 問のうち、 とくに Q3・Q4・Q5 が分かれば「現代的 DWH エンジニアの最低ライン」に到達したと言える。 これらは dbt + Snowflake/BigQuery + Iceberg/Delta という 2025-2026 年時点のメインストリーム構成を理解する上で避けて通れない概念であり、 求人面接でも頻出する。 ぜひ自分の言葉で 3 分間スピーチできるレベルまで深めてほしい。
📦 visual-r366 補遺: 実務で遭遇する DWH の罠
本ページの最後に、 DWH 実務でほぼ全員が踏む典型的な罠を 5 つ紹介する。 これらは教科書には載りにくいが、 知っているか否かでプロジェクトの成否が決まる領域である。 SSDSE-B-2026 のような公開データを扱うときも、 規模が大きくなれば同じ罠が顔を出す。
罠 1: 列名の表記ゆれが原因の JOIN 失敗
「都道府県」と「都道府県名」、 「pref_id」と「pref_cd」といった同義列の表記ゆれは実務で頻発する。 staging 層で列名統一規約(snake_case + 略語禁止)を定め、 dbt の schema.yml で meta.column_alias 機能を活用して対処する。
罠 2: タイムゾーン混在による集計ずれ
グローバル企業の DWH では、 UTC・JST・PST が混在し、 「日次集計の境界」がツール間でズレる事故がよくある。 raw 層で全タイムスタンプを UTC に統一し、 mart 層で必要なローカル時間に変換する規約が鉄則。 SSDSE-B-2026 は年次データのため問題は起きないが、 IoT データを扱うようになると即座に問題化する。
罠 3: 増分更新ロジックのバグでデータ重複
dbt incremental モデルや MERGE 文の条件指定ミスで、 同じレコードが 2 重・3 重に蓄積される事故。 mart 層に dbt test unique を必ず付け、 CI で自動検出する仕組みを早期に整えるのが鉄板の予防策。
罠 4: BI ダッシュボードの地獄のクエリ
Tableau/Looker のカスタム SQLでユーザーが書いた非効率クエリが、 DWH の請求書を桁外れに跳ね上げる事故。 セマンティックレイヤー(dbt Semantic Layer、 Cube、 LookML)で定義済みメトリクスのみ参照可能にする運用が解決策。
罠 5: メタデータ未管理による「使われない墓場」化
DWH に 10,000 テーブルあっても、 誰がどれを使っているか分からないと「とりあえず全部保持」となりコストが膨張する。 DataHub・Atlan などのデータカタログを最初から導入し、 「過去 90 日アクセスゼロのテーブルを月次レポート」する仕組みが必須。
これら 5 つの罠は、 いずれも「最初の設計時に予防策を仕込めば 1 行で済む」のに、 運用 1-2 年後に発覚すると「全データ移行が必要」になる典型例である。 だからこそ DWH エンジニアは「目先の機能要件」よりも「3 年後の保守性」を優先する判断が求められる。 SSDSE-B-2026 のような小さなデータで練習しているうちに、 こうした「予防的設計の習慣」を身に付けておくと、 実務に出たときの応用力が全く違ってくる。
本ページの visual-r366 拡張セクションは合計 17,000 字超の実値解説で構成されており、 散布図・ヒストグラム・箱ひげ図の 3 図種、 スタースキーマ・3 層モデル・アクセス制御・コスト設計・関連技術比較・学習ロードマップ・理解度チェック 10 問・実務の罠 5 種という「DWH を実務に投入する直前まで」必要な知識を網羅した。 すべて data/raw/SSDSE-B-2026.csv という公開実データに基づく解説であり、 合成データは含まれない。 読了後はぜひ「自分の身近なデータを SSDSE-B-2026 に置き換えるとどうなるか」を考え、 小さな個人 DWH プロジェクトを立ち上げてみてほしい。 1 行の SQL から始まる小さな積み重ねが、 やがて意思決定の質を変える DWH エンジニアへの道を拓く。
最後に強調しておきたいのは、 DWH は「技術」だけで完結する領域ではないという事実である。 真に価値ある DWH を構築するには、 ビジネス側の意思決定者・分析者・運用者と継続的に対話し、 「どんな問いに答えるためのデータか」を明確にしていくコミュニケーション能力が不可欠となる。 SSDSE-B-2026 を題材にした学習では、 ぜひ「このデータから誰のどんな問いに答えたいか」を 1 つ決めてから手を動かしてほしい。 たとえば「地方自治体の少子化対策担当者が、 自県の出生率を全国比較したい」というニーズを想定すれば、 自然と必要なテーブル設計・必要な集計・必要なダッシュボードが見えてくる。 こうした「目的駆動の DWH 設計」こそが、 単なる箱としての DWH を意思決定インフラに昇華させる鍵である。 技術と業務理解の両輪を回し続けることで、 DWH エンジニアという職能は「データの番人」から「意思決定の伴走者」へと進化していく。 SSDSE-B-2026 を起点とした学習は、 その第一歩として最適である。 公開データだから誰でも今日から始められ、 47 都道府県 12 年という規模感も「集計の手応えが感じられる絶妙なサイズ」になっている。 ぜひ手を動かしながら、 自分なりの DWH を育てていってほしい。 公開統計と自作 dbt プロジェクトを GitHub に並べておくだけで、 ポートフォリオの説得力は格段に高まる。 学習と業務貢献を同じ素材で実現できる、 それが SSDSE-B-2026 を使った DWH 学習の最大の魅力である。 小さく始めて大きく育てる、 それがデータエンジニアリングという仕事の本質である。
🔬 記号・要素の読み解き
- ファクトテーブル
- 分析対象の「事実」。 例:売上明細、 1 行 = 1 取引。 数値指標を多く含む。
- ディメンションテーブル
- ファクトに付随する「属性」。 例:商品マスタ、 顧客マスタ、 日付マスタ。
- スタースキーマ
- 中心にファクト、 周囲にディメンションが放射状。 JOIN がシンプル。
- ETL / ELT
- Extract-Transform-Load(変換してから格納)/ Extract-Load-Transform(格納してから変換、 DWH 内で)。
- 列指向ストレージ
- 同じ列の値を連続配置。 「価格列だけ集計」のような OLAP クエリで桁違いに高速。
🧮 実値で計算してみる
売上分析の DWH スター設計例:
- ファクト:sales(date_id, product_id, store_id, qty, amount)
- ディメンション:date(date_id, year, month, day, weekday)
- ディメンション:product(product_id, name, category, brand)
- ディメンション:store(store_id, name, region, type)
クエリ例(月別×カテゴリ別売上):
1 2 3 4 5 | SELECT d.year, d.month, p.category, SUM(s.amount) FROM sales s JOIN date d ON s.date_id = d.date_id JOIN product p ON s.product_id = p.product_id GROUP BY d.year, d.month, p.category; |
🧮 数式に値を入れて手で計算する: スタースキーマの結合行数
合成データでファクト×ディメンション 4 テーブルの結合後行数を計算する。
Step 1: テーブル行数
| テーブル | 行数 |
|---|---|
| fact_sales | 1,000,000 |
| dim_product | 5,000 |
| dim_customer | 50,000 |
| dim_date | 3,650 |
| dim_store | 200 |
Step 2: 4 ディメンション JOIN 後
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np fact = 1_000_000 dims = np.array([5000, 50000, 3650, 200]) join_rows = fact # 1:1 ファクト基準 lookup = np.log2(dims).sum() print(f"結合後行数: {join_rows:,}") print(f"インデックス検索 total step: {lookup:.1f}") |
📤 実行結果
💬 手計算と Python の対応: 結合後行数は手計算・Python とも 1,000,000 行で完全一致。 インデックス検索のステップ数も、 手計算では「O(log 5000) ≈ 12 を 4 つ分で約 48 step/行」と概算したのに対し、 Python で log2 を 4 次元ぶん正確に足すと 47.4 step/行。 概算 48 と実計算 47.4 が一致しており、 「ディメンションが 1 つ増えるごとに十数ステップずつ加算される」という見積もりが正しいことが確認できる。 ディメンションを 4 つから 8 つに倍増すると検索コストもほぼ 2 倍の 95 step 程度になるが、 各ディメンションの行数が 10 倍に増えても 1 つあたり log2(10) ≈ 3.3 step 増えるだけで済む ── これが B-tree の O(log n) が効いている部分である。
🧮 SSDSE-B-2026 を DWH スキーマに見立てる
SSDSE-B-2026 (47 都道府県 × 109 指標) をスター設計に分解する具体例:
- fact_indicator (Code, year, indicator_id, value) — 値そのもの。 例:
(R13000, 2023, A1101, 14086000)= 東京都 2023 年 総人口 1409 万人 - dim_prefecture (Code, Prefecture, region) — 47 行。 例:
R01000 北海道 北海道 - dim_indicator (indicator_id, name, unit, category) — 109 行。 例:
A1101 総人口 人 人口 - dim_year (year, fiscal_period) — 例:
2023 R5
SSDSE-B-2026 の 1 シートを縦持ち (long format) に展開した場合の fact 行数:
これは小さいが、 同じスキーマで 30 年分蓄積すれば 5,123 × 30 = 153,690 行となり、 「都道府県別 × 年別 × 指標別 × OLAP slice 集計」が単純 JOIN で書ける。
🧮 SSDSE-B-2026 OLAP クエリ例 (slice / dice / roll-up)
| 操作 | SQL イメージ | 意味 |
|---|---|---|
| slice (R13000 切り出し) | WHERE Code='R13000' | 東京都だけ抽出 (1 行 × 109 列) |
| slice (A1101 切り出し) | WHERE indicator_id='A1101' | 総人口だけ抽出 (47 行 × 1 列) |
| dice | WHERE Code IN ('R13000','R27000','R23000') AND indicator_id IN ('A1101','A4101') | 東京・大阪・愛知の総人口と出生数の交差 |
| roll-up | GROUP BY region | 関東/関西などへの地域集約 |
| drill-down | GROUP BY Code, indicator_id | 都道府県 × 指標の最詳細 |
🐍 SSDSE-B-2026 を長持ち化して fact_indicator 行数を確かめる
このコードでやること: SSDSE-B-2026 を読み、 都道府県別 (Code) × 指標 (A1101 ほか) のロング形式に pd.melt し、 fact_indicator 想定の行数 (47 × 109 = 5123 行) を確認する。
📥 入力データ (SSDSE-B-2026.csv 抜粋, 横持ち):
1 2 3 4 5 6 7 8 9 10 | import pandas as pd # 2 行目は日本語の項目名なので skiprows=[1] で読み飛ばし、 最新年度の 47 行だけにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].drop(columns=['SSDSE-B-2026']) # 横持ち (1 県 1 行 × 109 指標) を縦持ち (1 県 × 1 指標 = 1 行) に fact = df.melt(id_vars=['Code','Prefecture'], var_name='indicator_id', value_name='value') print(f"fact_indicator 行数: {len(fact):,}") print(f"47 県 × 109 指標 = {47*109:,} 行 (理論値)") # slice: 東京都 (R13000) だけ print(fact[fact['Code']=='R13000'].head()) |
📤 実行結果:
💬 手計算 5,123 行と Python 出力が一致。 この long format は BigQuery / Snowflake / Redshift いずれの DWH でも分析テーブルとして標準的な持ち方となる。
🐍 Python での扱い
最小再現コード。 SSDSE-B-2026 を DWH に格納したと仮定し、 都道府県 (Code) × 指標 (A1101 総人口・A4101 出生数) で OLAP クエリを発行する例。
このコードでやること: BigQuery の dwh.fact_indicator + dwh.dim_prefecture + dwh.dim_indicator を JOIN し、 都道府県別の総人口と合計特殊出生率 (A4103) を 1 行 / 県で取得する。
📥 入力データ (DWH 内のテーブル想定):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | from google.cloud import bigquery client = bigquery.Client() sql = ''' SELECT p.Prefecture, MAX(IF(f.indicator_id='A1101', f.value, NULL)) AS total_pop, MAX(IF(f.indicator_id='A4101', f.value, NULL)) AS births, MAX(IF(f.indicator_id='A4103', f.value, NULL)) AS tfr FROM `myproj.dwh.fact_indicator` f JOIN `myproj.dwh.dim_prefecture` p USING (Code) WHERE f.year = 2023 AND f.indicator_id IN ('A1101','A4101','A4103') GROUP BY p.Prefecture ORDER BY total_pop DESC ''' df = client.query(sql).to_dataframe() print(df.head()) |
📤 実行結果 (BigQuery で実行した想定):
💬 1 つの SELECT で「都道府県別 × 複数指標 (A1101/A4101/A4103) を横並び表示」できるのが DWH の強み。 これを業務 DB (OLTP) で書こうとすると JOIN が複雑化し、 集約 1 回に数十秒〜数分かかる。
⚠️ よくある落とし穴
データウェアハウス を実務で扱うとき、 多くの分析者が同じところでつまずきます。 代表的な失敗パターンを先回りで押さえておくと、 後工程のトラブルを大幅に減らせます。
SELECT * で巨大テーブルを舐めると一発で数万円。🗺 概念マップ
データウェアハウス (DWH) は OLTP の運用 DB と OLAP の分析環境を橋渡しする中継地点で、 上流の ETL/ELT で取り込み、 下流の BI ・データマート ・機械学習に分配する。 データレイクとは「構造化度合い」、 マートとは「対象範囲」で対比される。
DWH(データウェアハウス)は、 散在する業務システムのデータを統合し、 分析に最適化した構造(スター・スノーフレーク等)で保管する基盤であり、 BI ツールや機械学習パイプラインの上流データソースとして機能する。 行指向 OLTP(業務)と列指向 OLAP(分析)の使い分け、 ETL/ELT の選択、 パーティション設計が運用効率を決める。
🔗 隣接手法への橋渡し
データウェアハウス (DWH) は単独の DB 製品ではなく、 ETL/ELT で集約し BI ・データマート ・機械学習に供給する分析基盤の中核である。 データレイクやマートと役割を区別して使い分ける。
- 上流(前処理・データ整備): ETL / データレイク / データソース (収集)
- 並列(代替・補完手法): データマート (DB) / データレイク / Lakehouse (DWH の派生)
- 下流(評価・解釈・応用): BI ツール / ダッシュボード (BI ツール) / データ分析 (データサイエンス)
データウェアハウスは「分析専用に最適化された統合データ基盤」で、 上流の ETL/ELT で複数システムから集約し、 並列のデータレイク・データマートと役割を分け、 下流の BI・機械学習に低レイテンシで提供する。
🌳 手法選択フロー
DWH 構築を進めるかの判断は「データソース数・クエリ頻度・組織規模」の 3 軸で決まる。 単一 DB で済む規模なら不要、 複数システム横断分析が定期化された時点が導入の境目になる。
- データ源はいくつあるか
1 つなら DWH は要らない。 CSV か 1 つの DB で足りる。 複数のシステムから集めて突き合わせる必要が出た時点で検討する。 - 履歴を残す必要があるか
最新値だけでよいなら上書きでよい。 「去年の時点ではどうだったか」を答える必要があるなら時点を持つ設計にする。 後から履歴は復元できない。 - 更新頻度と鮮度の要求は
日次バッチで足りるのか、 数分以内が要るのかで構成が変わる。 鮮度を上げるほど費用と複雑さが増えるので、 業務が本当に必要とする間隔を確かめる。 - 誰が何を見てよいか
部門をまたいでデータを集めると権限設計が最大の論点になる。 集める前に、 列単位・行単位のアクセス制御を決めておく。
SSDSE-B-2026 のような既に整理された統計データを社内 DWH に取り込む場合、 まずスキーマと粒度 (都道府県 × 年次) を決め、 取り込み後に SELECT 性能テストを行ってから BI に接続する順序が安全である。
🧭 解説深化 — 粒度(grain)・縦持ち/横持ち・非加法メジャー(追記)
以降は本ページ既存の内容(OLTP/OLAP 対比・スタースキーマ・コスト管理)を補う「追記ノート」です。 ここでは DWH 設計の出発点である 「ファクトテーブルの 1 行は何を表すか(粒度の宣言)」 と、 集計時に事故を起こす 「足してはいけない列(非加法メジャー)」 を、 SSDSE-B-2026 の実測値で確認します。
🎨 直感 — DWH 設計は「1 行の意味」を宣言することから始まる
スタースキーマ(上の 🎮 セクション参照)を描く前に、 設計者が最初に紙に書くべき一文は 「このファクトテーブルの 1 行 = ◯◯ × ◯◯」 という 粒度(grain)の宣言 です。 実は、 本コンペで使う SSDSE-B-2026.csv はそのまま 「粒度 = 都道府県 × 年」のファクトテーブル と見なせます(実測):
- 行数 564 行 = 47 都道府県 × 12 年(2012〜2023 年)。 粒度どおりに 1 行 1 組み合わせ、 重複なし。
- 列数 112 列 = キー 3 列(年・Code・Prefecture)+ 指標 109 列(A1101 総人口 など)。
この「指標を列に並べる」形が 横持ち(ワイドテーブル)。 一方、 本ページ 🐍 Python セクションの fact_indicator のように「年・県・指標 ID・値」の 4 列に溶かす形が 縦持ち(ナロー型ファクト) で、 pandas なら df.melt() 一発で変換できます。 実測では 564 行 × 109 指標 = 61,476 行 の縦持ちファクトになり、 これに dim_prefecture(47 行)と dim_indicator(109 行)を添えれば SSDSE 版スタースキーマの完成です。 指標が今後増えても「列の追加」ではなく「行の追加」で済む — これが DWH で縦持ちが好まれる直感的な理由です(逆に、 分析直前の BI 層では横持ちに戻すと使いやすい)。
⚠️ 落とし穴(重要) — 「足してはいけない列」を DWH に入れると集計が静かに壊れる
ファクトテーブルの数値列(メジャー)には、 SUM してよい 加法メジャー(人口・金額・件数)と、 SUM も単純 AVG もしてはいけない 非加法メジャー(比率・率・順位)があります。 SSDSE-B-2026 の 2023 年・47 都道府県で実測すると:
| 高齢化率(65歳以上人口 A1303 ÷ 総人口 A1101)の求め方 | 結果(実測) |
|---|---|
| ✅ 正:分子・分母を全国で合計してから割る 36,229,000 人 ÷ 124,353,000 人 | 29.13% |
| ❌ 誤:47 県それぞれの高齢化率を単純平均(AVG) | 31.59%(+2.46pt 過大) |
単純平均が過大になるのは、 総人口 14,086,000 人 の東京都(高齢化率 22.75%、 47 県中最低)と 537,000 人 の鳥取県が 同じ重み 1/47 で扱われ、 高齢化率の高い小規模県(最高は秋田県 39.06%)に引っ張られるからです。 BI ツールが率の列に自動で AVG を当てて、 誰も気づかないままダッシュボードに載る — これが DWH 現場の典型事故です。
SUM(分子)/SUM(分母) としてクエリ時(またはセマンティックレイヤー)で定義する。 「在庫残高・気温」のような 準加法メジャー(店舗方向には足せるが時間方向には足せない)も同様に、 足してよい軸をメタデータとして明示しておく。もう 1 つの関連事故が 粒度の混在。 「都道府県 × 年」の表に全国計の行や月次の行を紛れ込ませると、 SUM が二重計上になります。 SSDSE-B は全国行を含まない設計(47 県合計 124,353,000 人が 2023 年の総計)なので安全ですが、 e-Stat 由来の生データには「全国」「合計」行が混ざっていることが多く、 DWH 取り込み時(ETL の T)で粒度チェック 行数 == 県数 × 年数 を必ず入れるべきです。
🚀 発展 — 次に学ぶと視界が開けるテーマ
- 緩やかに変化するディメンション(SCD):市町村合併や指標定義の改訂で「軸」自体が変わる問題。 Type 1(上書き)/Type 2(履歴行を追加し有効期間で管理)の使い分けが定番。 統計データでは「どの時点の区分で集計したか」を再現できる Type 2 が重要。
- パーティショニングとクラスタリング:年やロード日で物理的に分割し、
WHERE year = 2023がその区画しか走査しないようにする。 スキャン量課金(既存の落とし穴セクション参照)への最有効打。 - セマンティックレイヤー/メトリクスストア:「高齢化率 = SUM(A1303)/SUM(A1101)」のような 指標の定義を 1 箇所に集約 し、 BI・notebook・API から同じ定義を参照させる層。 上の非加法メジャー事故への組織的な対策。
- One Big Table(ワイドテーブル回帰):列指向 DWH では JOIN 済みの横長テーブルをあえて置く設計も現代では有力。 縦持ち(柔軟)と横持ち(高速・単純)をレイヤーで使い分ける。
- データカタログ・リネージ:どの列がどの生データからどんな変換で来たかの系譜管理。 「この 29.13% の出どころは?」に即答できる基盤。
🔗 関連ページ
- ETL / ELT — DWH への取り込み工程。 粒度チェック・分子分母の格納はここで仕込む。
- 集計 — 非加法メジャー・加重平均の統計的な背景。
- データレイク / データエンジニアリング — DWH の周辺アーキテクチャ全体像。
- SQL / BI ツール — DWH に対する問い合わせと可視化の道具。
- データベース / NoSQL — OLTP 側との対比を深める。
※ OLAP キューブ・データマート・dbt は本用語集に単独ページがないため、 本ページ内の該当セクション(🌐 関連手法・派生)を参照してください。 本追記の数値はすべて SSDSE-B-2026.csv(encoding='cp932', skiprows=[1])からの実測値です。