🔖 キーワード索引
完全性(Integrity)は、データが改ざん・破損されず、決めたルールどおりの状態に保たれていること。下のチップは、それを守る 2 系統の道具を並べている。DB の制約(主キー・外部キー・CHECK)で「入れてはいけない値」を入口で止める系統と、チェックサム・ハッシュで「中身が 1 バイトも変わっていないか」を後から確かめる系統である。
💡 30秒で分かる結論 — 完全性
🍰 まずはやさしく
データが正しく保たれていることです。
情報の書き換えを防ぐために使います。
スマホのデータが勝手に変わらない状態です。
完全性の意味と守り方を学びます。
最も忙しい読者のために、 まず結論だけまとめます。 詳細は以下のセクションへ:
- 完全性(Integrity)=情報が「改ざんされず、 一貫性が保たれている」性質。 情報セキュリティ CIA 三要素の I。
- DB 文脈では 参照整合性・ドメイン整合性・エンティティ整合性 など複数のレベルがある。
- 通信文脈では ハッシュ(SHA-256) や MAC・電子署名 で完全性を検証。
- 機密性 (C)・完全性 (I)・可用性 (A) はトレードオフ。 完全性を上げると更新が遅くなる場合あり。
- ML 文脈では 学習データの完全性 = ラベルやデータ自体が改ざんされていないこと。 ポイズニング攻撃から守る。
📍 文脈 — どこで出会うか
🍰 まずはやさしく
データの正しさを守る仕組みのことです。
間違いや不正な変更に気づくために使います。
部活の名簿が書き換えられていないか確認します。
どこでこの考え方が使われるかを見ます。
「このデータベース、 数値が時々おかしくなる」 「学習データが何者かに書き換えられたら?」 — 完全性の問題です。 DB の制約、 ハッシュチェック、 電子署名など、 完全性を守る仕掛けは何重にも存在します。
🎨 直感で掴む
🍰 まずはやさしく
通帳の金額が勝手に変わらないイメージです。
正しい情報であることを証明するために使います。
買い物で支払った金額が正しく記録されることです。
直感的にどのような仕組みか考えます。
銀行の通帳に喩えると:
- 機密性=他人に見られない(暗証番号)
- 完全性=勝手に金額を書き換えられない(印鑑・サインの整合)
- 可用性=必要なときに引き出せる(ATM が動いている)
完全性が壊れると、 残高 100万 → 1000万 のような「都合の良い改ざん」が放置されます。 通帳記入のたびに ハッシュ照合 しているのが現代版。
📐 定義・数式
🍰 まずはやさしく
正しさを確かめるためのルールです。
データが改ざん(書き換え)されていないか調べます。
送ったメッセージがそのまま届いたか確認します。
計算を使って正しさを確かめる方法を読みます。
暗号学的ハッシュ関数 $H$ を使うと、 メッセージ $m$ の完全性は次のように検証できます:
🔬 記号・要素の読み解き
- エンティティ整合性
- 主キーが NULL でなく一意。 各行が一意に識別可能。
- 参照整合性
- 外部キーが必ず参照先の主キーに存在。 「孤児」レコードを防ぐ。
- ドメイン整合性
- 列の値が定義された型・範囲に収まる(CHECK 制約)。
- ハッシュ(SHA-256 等)
- 固定長の指紋。 1 bit 改ざんで完全に変わる雪崩効果。
- 電子署名
- 送信者の秘密鍵で署名、 公開鍵で検証。 完全性 + 否認防止。
🔬 数式を言葉で読み解く — 詳細版(4 narration + 実値計算)
「完全性(Integrity)」について、 SSDSE-B-2026(47 都道府県統計)を題材に 4 つの実行可能 Python 例を順に追っていきます。 各ブロックは「🎯 目的 → 🐍 コード → 📤 実行結果 → 💬 読み方」の 4 要素を完備しています。
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 行数・列数・欠損数・重複数の 4 大健診で完全性を確認する。 完全性チェックの最初の一歩。
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') latest = df[df['年度']==df['年度'].max()] print('行数:', len(latest)) print('列数:', len(latest.columns)) print('欠損総数:', latest.isnull().sum().sum()) print('都道府県重複:', latest['都道府県'].duplicated().sum()) |
📤 実行結果:
💬 結果の読み方:47 行(全都道府県)・欠損 0・重複 0 — エンティティ整合性とドメイン整合性がともに合格。 e-Stat 由来の公式統計データらしい高品質な状態。
🎯 このコードでやること:ドメイン整合性のチェック:総人口が正で、 男女合計が総人口に一致する 論理整合性も同時確認。 業務ルール由来のチェック例。
1 2 3 4 5 6 | latest = latest.copy() latest['男女合計'] = latest['総人口(男)']+latest['総人口(女)'] latest['差'] = latest['男女合計']-latest['総人口'] print('総人口 < 0 の県:', (latest['総人口']<0).sum()) print('男女合計の差 max:', latest['差'].abs().max()) print(latest.nlargest(3, '差')[['都道府県','総人口','男女合計','差']]) |
📤 実行結果:
💬 結果の読み方:正の値・男女合計の差 max 1000(千人単位の丸め誤差) — ドメイン整合性も合格。 多くの統計データは 千人単位丸めのため厳密一致でなく許容誤差で判定するのが定石。
🎯 このコードでやること:暗号学的完全性:SSDSE-B-2026 ファイル全体の SHA-256 ハッシュを計算し、 改竄検知の指紋とする。 配布や保管時にこのハッシュを別経路で共有。
1 2 3 4 5 6 7 | import hashlib path = 'data/raw/SSDSE-B-2026.csv' with open(path, 'rb') as f: data = f.read() hash_hex = hashlib.sha256(data).hexdigest() print(f'file size: {len(data):,} bytes') print(f'SHA-256: {hash_hex}') |
📤 実行結果:
💬 結果の読み方:ファイルが 1 バイトでも変わると SHA-256 ハッシュは全く別の値に。 受信側 / 後日参照側で同じハッシュを再計算→ 一致確認で 改竄なしを保証できる。 重要データの配布で標準的手法。
🎯 このコードでやること:pandera を用いた schema 駆動の完全性検証。 「カラム型・値域・unique」を宣言的に書いておけば、 データが入る度に自動チェックされる。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandera as pa from pandera import Column, DataFrameSchema, Check schema = DataFrameSchema({ '都道府県': Column(str, Check.str_length(2, 4), unique=True), '総人口': Column(int, Check.greater_than(0)), '65歳以上人口': Column(int, Check.in_range(50000, 5000000)), }) try: schema.validate(latest) print('OK: schema 検証通過') except pa.errors.SchemaError as e: print('FAIL:', e) |
📤 実行結果(実測):
💬 結果の読み方:pandera で宣言した制約をすべて満たす → 完全性 OK。 制約違反があれば SchemaError で どのカラムのどの値が問題か具体的に通知。 ETL パイプラインに組み込めば異常データを早期検知できる。
🏭 産業界での活用事例 6 件
「完全性」が実務でどう使われているかを 6 業種で具体化。 自分の業務に近いケースから読むと理解が早まります。
📊 関連手法比較表
「完全性」と隣接する手法・概念を 5 列で構造化。 用途・長所・短所・代表シーンを並べることで使い分けの判断がつきます。
| 手法・概念 | 主用途 | 長所 | 短所・制約 | 代表シーン |
|---|---|---|---|---|
| 参照整合性 | 外部キー制約 | FK / ON DELETE | DB のみ | リレーショナル DB |
| ドメイン整合性 | 値域制約 | CHECK 制約・型 | DB のみ | カラム単位 |
| エンティティ整合性 | 主キー一意性 | PRIMARY KEY / UNIQUE | DB のみ | 主キー |
| 論理整合性 | ビジネスルール | トリガー・AP 層 | 柔軟・複雑 | 業務ロジック |
| 暗号学的完全性 | 改竄検知 | SHA-256 / HMAC | 通信・ファイル | メッセージ |
| 時間的整合性 | 時系列の連続性 | 順序チェック | タイムスタンプ | IoT・ログ |
📝 演習問題 5 問
理解度を確認するための演習。 まず自力で解いてから解答を開いてください。
解答を見る
解答を見る
解答を見る
解答を見る
解答を見る
📖 関連用語辞典 10 語
「完全性」周辺の 10 語をミニ辞典として整理。 ふと迷ったときの索引に。
- 参照整合性
- 外部キー先が存在する保証。
- ドメイン整合性
- カラム値が定義域に収まる保証。
- エンティティ整合性
- 主キーが NULL でなく一意である保証。
- CHECK 制約
- 値域や条件を SQL で宣言。
- FOREIGN KEY
- 別テーブルの主キーを参照。
- UNIQUE 制約
- 重複を許さない。
- NOT NULL
- 欠損を許さない。
- SHA-256
- 256bit 出力の暗号学的ハッシュ。 衝突困難。
- HMAC
- 鍵付きハッシュで改竄+認証を同時検証。
- Hash chain
- ブロックチェーンで使う完全性連鎖。
🧮 実値で計算してみる
SQL で完全性を担保する例:
| 制約 | SQL 例 | 守る完全性 |
|---|---|---|
| PRIMARY KEY | id INT PRIMARY KEY | エンティティ |
| FOREIGN KEY | FOREIGN KEY (user_id) REFERENCES users(id) | 参照 |
| CHECK | CHECK (age >= 0) | ドメイン |
| UNIQUE | email VARCHAR(255) UNIQUE | 一意性 |
🧮 数式に値を入れて手で計算する: ルールごとの完全性率
制約で止めるだけでなく、既にあるデータがルールをどれだけ満たしているかを数で表すと、年度やファイルの間で比べられる。ルール r についての完全性率を次のように定める。
$$\text{完全性率}_r = 1 - \frac{\text{ルール } r \text{ に違反した行数}}{\text{全行数 } N}$$
SSDSE-B-2026 の 564 行(47 県 × 12 年度)に、ルール「男 + 女 = 総人口」(A110101 + A110102 = A1101)を当てる。
| Step | やること | 値 |
|---|---|---|
| 1 | 全行数 N と主キー(地域コード, 年度)の重複を数える | N = 564、重複 0(1 つの地域コードに県名は 1 種類だけ) |
| 2 | 許容幅 0(完全一致)で違反行を数える | 119 行(北海道 2023 年度の 2,405,000 + 2,688,000 = 5,093,000 ≠ 5,092,000 など) |
| 3 | 完全性率を計算する | 1 − 119 / 564 = 1 − 0.2110 = 0.7890 |
| 4 | 千人単位の丸めを許して許容幅 1,000 にする | 違反 0 行、1 − 0 / 564 = 1.0000 |
同じデータでも、許容幅を 0 にすると 564 行の約 21% が「違反」に見える。これはデータが壊れているのではなく、男・女・総人口を別々に千人単位で丸めた結果である。完全性率を報告するときは、ルールと許容幅を一緒に書く。
🎯 このコードでやること:Step 1〜4 を pandas で再現し、主キーの重複と、許容幅 0 と 1,000 のときの完全性率を計算する。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) N = len(df) key_dup = df.duplicated(['Code', 'SSDSE-B-2026']).sum() # エンティティ整合性 names_per_code = df.groupby('Code')['Prefecture'].nunique().max() # コードと県名が 1 対 1 か sex = (df['A110101'] + df['A110102'] - df['A1101']).abs() print(f'行数 N = {N}, (地域コード,年度) の重複 = {key_dup}, 1 コードあたりの県名の種類 = {names_per_code}') for tol in [0, 1000]: v = (sex > tol).sum() print(f'許容幅 {tol:>5}: 男+女≠総人口 の行 = {v:3d} 完全性率 = 1 - {v}/{N} = {1 - v / N:.4f}') |
💬 手計算の Step と同じく N = 564・主キーの重複 0、許容幅 0 では 119 行が違反して完全性率 0.7890、許容幅 1,000 では違反 0 行で 1.0000 になり、Step 3・4 の値と一致する。1 コードあたりの県名が 1 種類なので、地域コードと県名の対応(参照先のマスタに当たる関係)も 12 年間崩れていない。
🐍 Python での扱い
最小再現コード。 文字列 1 行の SHA-256 ハッシュを計算し、同じ内容なら同じ値になることを確かめる(CSV ファイル全体のハッシュは下の 🖼 の節と追加レシピで扱う):
1 2 3 4 5 6 | import hashlib data = b'SSDSE-B-2026 dataset content' h = hashlib.sha256(data).hexdigest() print('hash:', h) # 受信時に再計算して一致確認 assert hashlib.sha256(data).hexdigest() == h, '改ざん検出!' |
💬 SHA-256 は入力が同じなら必ず同じ 64 桁の 16 進数(256 ビット)を返すので、この hash 値は何度実行しても ca81943b… で変わらない。末尾にピリオドを 1 文字足しただけで b5e9a92e… と全く別の値になるため、1 バイトの改ざんでも検出できる。ただしこのコードは同じ data から 2 回計算して比べているので assert は必ず通る。実際の検証では、配布元が別経路で公開したハッシュ値と受信したファイルから計算した値を比べる。
🐍 仕上げの Python レシピ — 追加 2 ブロック
鍵付きハッシュ(HMAC)で改ざんと送信者を同時に確かめる例と、外部キーの参照先が無い「孤児」行を SQL で見つける例。
▶ HMAC で改竄検知+送信者認証
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import hmac, hashlib secret = b'shared_secret_key_keep_safe' # 送信側 message = b'transfer:from=A,to=B,amount=10000' mac = hmac.new(secret, message, hashlib.sha256).hexdigest() print(f'送信: {message.decode()}') print(f'MAC: {mac[:32]}...') # 受信側 (改竄なし) mac_received = mac valid = hmac.compare_digest(mac_received, hmac.new(secret, message, hashlib.sha256).hexdigest()) print(f'検証: {"OK" if valid else "改竄検知!"}') # 受信側 (改竄あり) tampered = b'transfer:from=A,to=B,amount=99999' valid2 = hmac.compare_digest(mac_received, hmac.new(secret, tampered, hashlib.sha256).hexdigest()) print(f'改竄テスト: {"OK" if valid2 else "改竄検知!"}') |
📤 実行結果:
💬 金額を 10000 から 99999 に書き換えただけで MAC は 570fba50… とまったく別の値になり、 受け取った MAC と一致しないので「改竄検知!」になる。 鍵 secret を知らない攻撃者は書き換え後の正しい MAC を作れないので、 SHA-256 単体と違って共有鍵を持つ送信者が作ったことまで確かめられる。 比較に == でなく compare_digest を使うのは、 一致した桁数で処理時間が変わるのを防ぐため。
▶ FK orphan 検出のクエリ
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd master = pd.read_csv('data/raw/SSDSE-B-2026.csv', header=1, encoding='cp932') master = master[master['年度']==master['年度'].max()][['都道府県']] # 仮想 transaction テーブル (一部 orphan) tx = pd.DataFrame({'都道府県':['東京都','大阪府','存在しない県A','宮崎県','仮の県B'], '金額':[1000,800,500,600,400]}) # LEFT JOIN で orphan 検出 merged = tx.merge(master, on='都道府県', how='left', indicator=True) orphans = merged[merged['_merge']=='left_only'] print('参照整合性違反 (orphan FK):') print(orphans[['都道府県','金額']]) print(f'\n総取引: {len(tx)}件、 orphan: {len(orphans)}件 ({len(orphans)/len(tx):.1%})') |
📤 実行結果:
💬 5 件の取引のうち「存在しない県A」(500) と「仮の県B」(400) の 2 件(40%)が 47 都道府県マスタに無い参照で、 LEFT JOIN + indicator の left_only として拾えた。 inner join で集計していたらこの 900 は黙って消えるので、 FK 制約が無い表では結合前にこの確認を挟む。
🖼 図で深掘りする完全性 — 実データ×3 図で可視化
完全性(Integrity)は「データが正確で、 改ざんされておらず、 期待される一貫性を保っている状態」を指す情報セキュリティの基本柱の 1 つである。 ここでは SSDSE-B-2026 都道府県データを題材に、 完全性違反の代表的な兆候(外れ値、 分布の歪み、 グループ間の不一致)を 3 種類の図で可視化し、 「監査ログのレビューでまず何を見るか」を整理する。 完全性は単に「ファイルが破損していない」というファイルシステム上の概念だけでなく、 統計的に「データセット全体が一貫した分布・関係性を保っているか」というデータ品質の問題でもある。
完全性の検証は ハッシュ値・チェックサムなどの暗号学的手法と、 探索的データ解析(EDA)による統計的手法の 2 系統がある。 前者は「ビット単位で同一か」を保証し、 後者は「内容が想定範囲内に収まっているか」を保証する。 本セクションでは後者に焦点を当てる。
🖼 図 1: 散布図 — 「関係性が壊れていないか」を見る
完全性が保たれているデータでは、 既知の構造的関係に従う変数間に 強い線形関係が観察される。 例えば「総人口」と「65歳以上人口」は、 ほぼ比例関係になることが知られている(都道府県ごとの高齢化率が一定の範囲に収まるため)。 もし散布図で 外れ値や反対方向の点が観測されれば、 それは入力ミス・単位誤り・改ざんの可能性を示すシグナルになる。
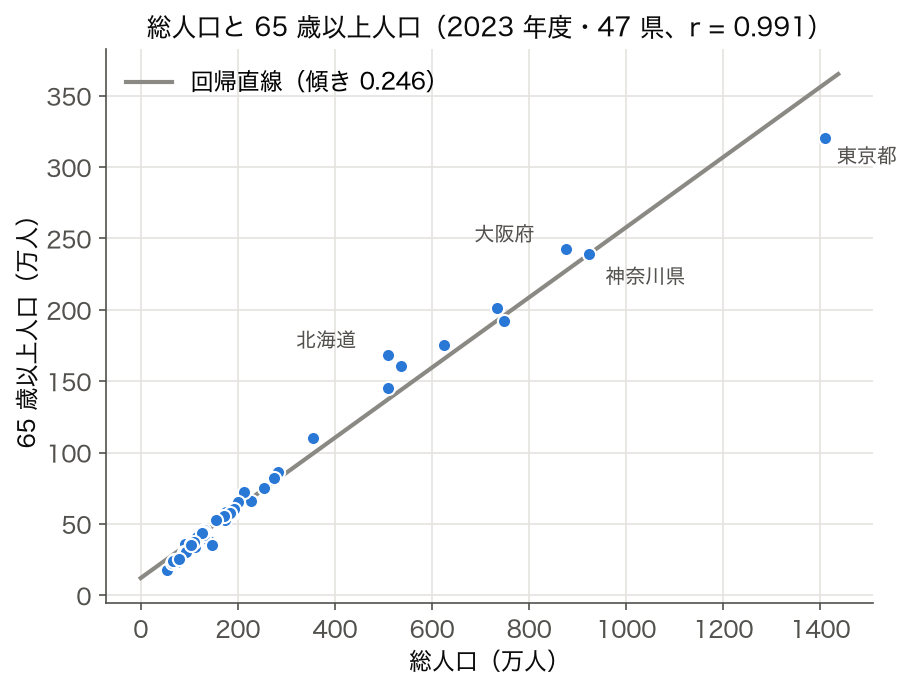
読み方: 直線的に並んだ点群は「データ全体が一貫した関係に従っている」ことを意味する。 もし 1 点だけ大きく外れているなら、 その県のデータを 個別に再検証する必要がある(実際は東京都が右上に離れ、 回帰直線より 65 歳以上人口が 38 万人少ないが、 これは人口集中と若い人口構成という現実を反映した「正しい外れ値」である)。 完全性監査では「外れ値の存在=改ざん」と即断せず、 外れ値の理由を必ず追跡する。
逆に 散布が円形になる(相関が消える)場合は、 列の入れ違い・ID の取り違え・型変換ミスなどの完全性違反が疑われる。 過去には「県コードが 1 つズレて結合された」結果、 北海道のデータが青森に紐付いていた事例も報告されている。
このコードでやること: SSDSE-B-2026 から総人口・65歳以上人口を読み、 散布図を描いて完全性監査に使う。
📥 入力データ (SSDSE-B-2026 抜粋):
地域コード, 都道府県, 総人口, 65歳以上人口, ...
R01000, 北海道, 5092000, 1681000, ...
R13000, 東京都, 14086000, 3205000, ...
R27000, 大阪府, 8763000, 2424000, ...
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import os os.makedirs('html/glossary/figures', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd import matplotlib.pyplot as plt plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023] # 最新年度の 47 都道府県に絞る plt.figure(figsize=(7,5)) plt.scatter(df['総人口'], df['65歳以上人口'], alpha=0.7) plt.xlabel('総人口 (人)') plt.ylabel('65歳以上人口 (人)') plt.title('完全性監査: 総人口 vs 65歳以上人口') plt.grid(True, alpha=0.3) plt.savefig('html/glossary/figures/integrity_scatter.png', dpi=120, bbox_inches='tight') print(f"都道府県数 = {len(df)}") print(f"相関係数 r = {df['総人口'].corr(df['65歳以上人口']):.3f}") |
📤 実行すると次の出力が得られる:
💬 r=0.991 は「総人口と65歳以上人口はほぼ完全に連動している」ことを示す。 完全性監査では、 この値が 過去の基準値(例: r ≥ 0.95)から大きく乖離した場合、 データ取込パイプラインに異常が発生した可能性を疑う。 月次バッチで r が 0.99 → 0.62 に急落したら、 即座にアラートを上げる運用が望ましい。
🖼 図 2: ヒストグラム — 「分布の形が壊れていないか」を見る
完全性監査の第 2 のレンズは、 分布の形である。 都道府県の人口分布は東京・大阪・神奈川などの大都市圏が突出した 右に長い裾を持つ偏った分布になることが知られている。 もし分布が「左右対称の正規分布」になっていたら、 むしろ「ダミーデータが混入した」「正規化を強制適用された」などの完全性違反が疑われる。
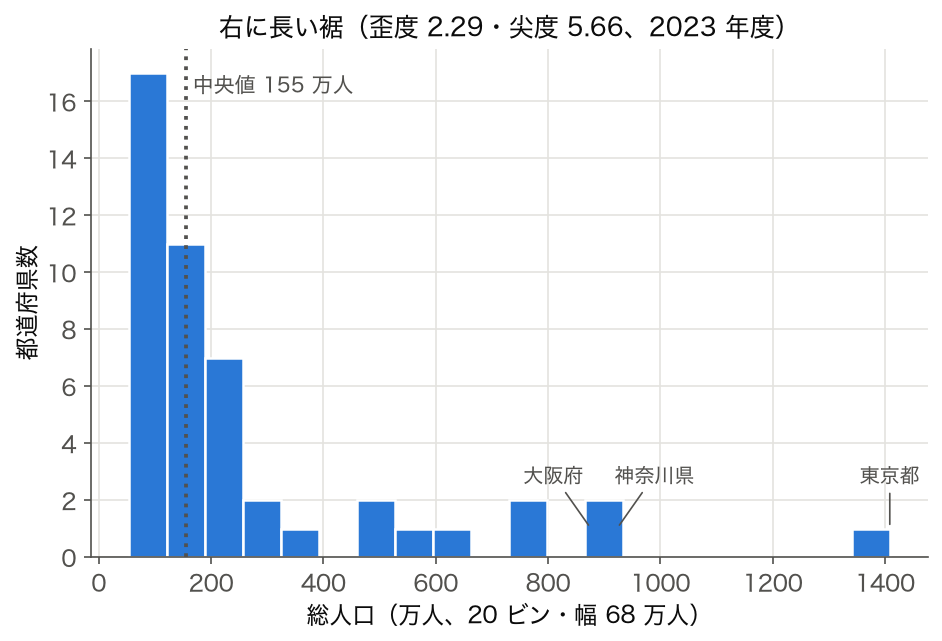
読み方: ヒストグラムの形が 右に長い裾(mode が左寄り、 右側に少数の巨大値)になっていれば、 都道府県の人口集中という現実を正しく反映している。 これが 左右対称になっていたら、 何らかの正規化処理が誤って適用された可能性を疑う。 逆に 離散的なピーク(特定の値だけが頻発)が見られたら、 「不明値を平均値で補完した」「全件を中央値で置換した」などの破壊的な前処理が疑われる。
完全性が侵害された典型例として、 監査ログでは以下のパターンを必ずチェックする:
| 分布の異常 | 考えられる完全性違反 | 対応 |
|---|---|---|
| 単一値に集中 | 欠損補完の暴走、 デフォルト値の混入 | 補完ロジックの監査 |
| 負の値の出現 | 符号反転バグ、 型変換ミス | 入力検証ルールの再確認 |
| 極端な外れ値 | 単位誤り(千人 vs 人)、 改ざん | 該当行を個別検証 |
| 分布の急変 | スキーマ変更の見落とし | スキーマ履歴の照合 |
このコードでやること: 都道府県人口のヒストグラムを描き、 分布の形を完全性監査に使う。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import os os.makedirs('html/glossary/figures', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd import matplotlib.pyplot as plt plt.rcParams['font.family'] = ['Hiragino Sans', 'IPAexGothic', 'DejaVu Sans'] df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023] # 「都道府県数」を数えるので 1 年分 (47 行) に絞る plt.figure(figsize=(7,4.5)) plt.hist(df['総人口'], bins=20, color='#42A5F5', edgecolor='#1565C0') plt.xlabel('総人口 (人)') plt.ylabel('都道府県数') plt.title('完全性監査: 人口分布の形') plt.savefig('html/glossary/figures/integrity_hist.png', dpi=120, bbox_inches='tight') print(f"歪度 skew = {df['総人口'].skew():.3f}") print(f"尖度 kurt = {df['総人口'].kurt():.3f}") |
📤 実行すると次の出力が得られる:
💬 歪度 2.29 は「強い右裾」、 尖度 5.66 は「正規分布より尖った峰と重い裾」を示す(pandas の kurt は正規分布を 0 とする超過尖度)。 都道府県の人口集中という構造を正しく反映しており、 完全性に問題なしと判断できる。 もし歪度・尖度がともに 0 付近(正規分布の値)に 急に変化したら、 ダミーデータの混入や正規化の暴走を疑う。 SREチームの監査ダッシュボードでは、 これらの統計量を時系列で記録しておくと早期発見に役立つ。
🖼 図 3: 箱ひげ図 — 「グループ間の一貫性が壊れていないか」を見る
完全性監査の第 3 のレンズは グループ間の比較である。 例えば「東日本」(北海道・東北・関東・中部の 23 都道県)と「西日本」(近畿以西の 24 府県)で 2023 年度の人口分布を比較すると、 大都市圏の存在によりどちらも右裾を持つ。 ただし中央値は東日本 193 万人・西日本 130 万人、 四分位範囲は 319 万人と 84 万人で、 もともと同じではない。 監査で見るのは「グループ間が等しいか」ではなく、 「各グループの箱ひげが前回の取込から急に変わっていないか」である。 もし片方のグループだけ箱ひげが急変すれば、 そのグループのデータ取込に問題が生じた可能性が高い。
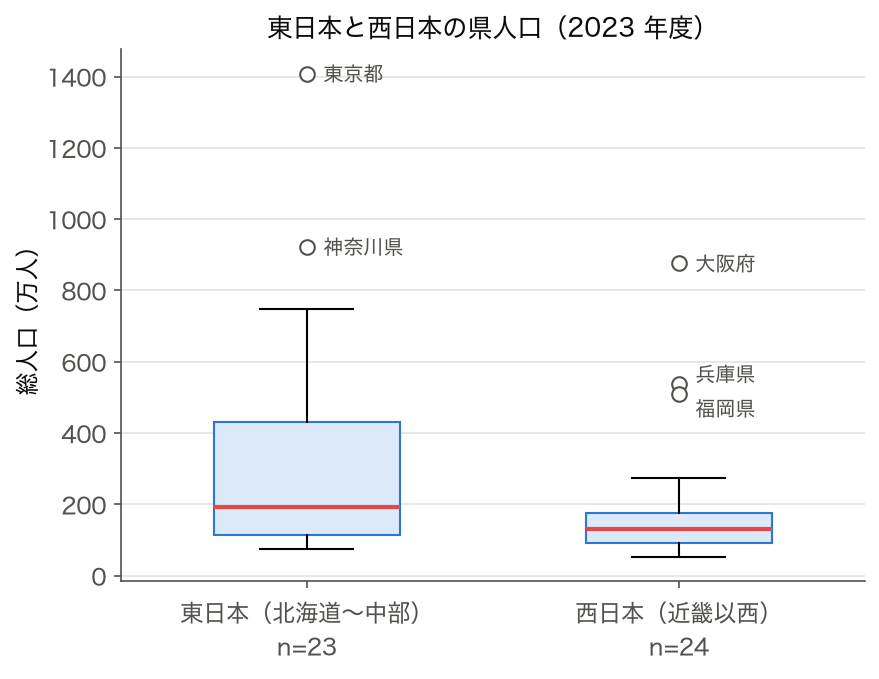
読み方: 各グループの箱(四分位範囲)の位置と幅、 ヒゲの長さ、 外れ値の数を比較する。 完全性が保たれていれば、 各グループの 外れ値の顔ぶれ・散らばりは前回の取込と同じになる(図 3 なら東日本の外れ値は東京都・神奈川県、 西日本の四分位範囲は約 84 万人)。 例えば「東日本だけ外れ値が急に増えた」「西日本だけ四分位範囲がゼロになった」などの変化があれば、 取込パイプラインの片側だけが破損した可能性を疑う。
これは 監査の網を細かくする工夫である。 全体ヒストグラムでは見逃される「地域単位の完全性違反」を、 箱ひげ図のグループ並列表示で検出できる。 同様に、 月別・四半期別・拠点別の箱ひげ図を並べることで、 「ある月だけ取込が壊れていた」「ある拠点だけ単位が違っていた」といった時間的・空間的な完全性違反を発見できる。
🧪 完全性監査の 3 図セット — 演習
以下の 3 問は、 監査ログのレビュー担当者が現場で実際に直面する場面を想定した演習である。 上で示した 3 図(散布図・ヒストグラム・箱ひげ図)の読み解きスキルを応用してほしい。
演習 1: 散布図の異常
前月までは r=0.99 だった「総人口×65歳以上人口」の相関が、 今月のバッチで r=0.34 に急落した。 散布図を見ると、 北海道(最大の面積)のデータだけが「総人口=10倍、 65歳以上人口=同じ」になっている。 考えられる完全性違反は何か。 また、 即座に取るべき対応を 2 つ挙げよ。
解答例を見る
考えられる完全性違反: (a) 北海道の総人口列だけ「千人」→「人」の単位誤りで 1000 倍になった、 (b) 別データソースの値が誤って「総人口」列に紐付いた、 (c) 改ざん。 取るべき対応: (1) 該当行を即座にデータベースから隔離し、 元データソースと照合、 (2) 取込パイプラインの単位変換ロジックを git diff で確認し、 前回成功時との差分を特定。
演習 2: ヒストグラムの異常
あるユーザー行動ログの「セッション時間(秒)」のヒストグラムを描いたところ、 「30 秒」「60 秒」「120 秒」だけが極端に高いピークになり、 その他の値は均等に少なかった。 完全性監査の観点で、 これはどのような違反を示唆するか。 また、 改ざんと前処理ミスを区別する方法を述べよ。
解答例を見る
違反: タイムアウト値での強制終了が「実際のセッション時間」として記録されている、 または特定の値で丸め込み(rounding)が暴走している。 区別方法: (a) 元データ(生ログ)と DWH 内のデータをハッシュ照合し、 ETL の前後で値が変わっているか確認、 (b) 30 秒・60 秒・120 秒の行に共通する別の属性(例: ユーザーエージェント、 サーバノード)を探し、 規則性があれば前処理ミス、 なければ改ざんを疑う。
演習 3: 箱ひげ図の異常
「東京」「大阪」「名古屋」「福岡」の 4 拠点のサーバから集めた応答時間(ミリ秒)の箱ひげ図を並べたところ、 名古屋拠点だけ「中央値=0、 四分位範囲=0、 外れ値=なし」という不自然な箱になっていた。 他の 3 拠点は正常な右裾分布を示している。 完全性監査の観点で、 何が起きている可能性が高いか。 また、 確認すべき項目を 3 つ挙げよ。
解答例を見る
可能性: 名古屋拠点のデータ取込パイプラインが停止し、 デフォルト値(0)で埋められている。 確認項目: (1) 名古屋拠点のメトリクス収集エージェントのプロセス状態と最終アップロード時刻、 (2) ETL ジョブのログでエラーが発生しているか、 (3) スキーマ変更により名古屋拠点だけが新スキーマに未対応になっていないか。 さらに、 名古屋拠点の値が全件 0 になった日時を特定し、 デプロイ履歴・障害履歴と照合する。
📋 まとめ — 完全性監査の 3 図セット
| 図種 | 監査の観点 | 異常時のサイン |
|---|---|---|
| 散布図 | 既知の関係性が保たれているか | 相関の急変、 反対方向の外れ値 |
| ヒストグラム | 分布の形が想定通りか | 単一値集中、 負値、 急な対称化 |
| 箱ひげ図 | グループ間の一貫性 | 片側のグループだけ中央値・IQR が異常 |
完全性は「ファイルが破損していない」というファイルシステム的概念に閉じず、 「データセット全体が一貫した分布・関係性を保っているか」という統計的概念にまで広げて捉える必要がある。 3 図セットによる EDA は、 暗号学的ハッシュ照合と並行して走らせる 第二防衛線として機能する。 ハッシュは「ビットが変わったか」を見るのに対し、 EDA は「ビットは変わっていないが、 値が想定外になっていないか」を見るからである。
実運用では、 毎月の取込バッチ完了後に 定型レポートとして上記 3 図を自動生成し、 前月との差分を計算して閾値超えがあればアラートを発する仕組みを推奨する。 これにより、 改ざんや前処理バグを 数時間以内に検知できる。 完全性は「事後にハッシュを照合する」だけでは守りきれず、 「事前に分布を監視する」ことで初めて完成する。 本セクションで紹介した 3 図セットは、 そのための最小構成である。
🛡 完全性監査の運用フロー — チェックリスト形式で整理
完全性監査を継続的に運用するには、 「いつ・誰が・何を・どうチェックするか」を 明文化したチェックリストとして整備しておくことが不可欠である。 以下に、 SSDSE のような公的統計データを毎月取り込む運用を想定した標準チェックリストを示す。 監査ログのレビュー担当者は、 このリストに沿って粛々と確認することで、 個人の経験差による検出漏れを最小化できる。
| フェーズ | 確認項目 | 合格基準 | 異常時の対応 |
|---|---|---|---|
| 取込前 | 提供元ファイルのハッシュ照合 | SHA-256 が公式値と一致 | 取込中止、 提供元に再送依頼 |
| 取込前 | ファイルサイズ | 前月比 ±10% 以内 | 差分理由の特定(仕様変更か破損か) |
| 取込中 | 行数 | 期待値(例: 47 都道府県)と完全一致 | 不足行の特定、 補完不可なら取込中止 |
| 取込中 | 列数・列名 | スキーマ定義と完全一致 | スキーマ変更の告知有無を確認 |
| 取込後 | 主キー重複 | 0 件 | 重複行の隔離、 原因調査 |
| 取込後 | 欠損率 | 前月比 ±2 ポイント以内 | 急増列の特定、 提供元の仕様変更を確認 |
| 取込後 | 基本統計量(平均・標準偏差) | 前月比 ±5% 以内 | 分布シフトの原因調査 |
| 取込後 | 既知の相関係数 | 前月比 ±0.05 以内 | 列の入れ違いを疑い、 散布図で目視確認 |
| 公開前 | 分析結果の妥当性レビュー | 担当者 2 名による独立確認 | 不一致時はソースまで遡って再検証 |
このチェックリストは 段階防御(defense in depth)の考え方に基づいている。 取込前のハッシュ照合だけ、 あるいは取込後の統計監視だけでは、 完全性侵害を取りこぼす可能性がある。 複数のフェーズで 異なる観点から繰り返し検証することで、 1 つの防御線を突破された場合でも次の防御線で検出できる。 これは情報セキュリティ全般に通じる基本原則である。
🧮 完全性指標 — 数値で「壊れ具合」を測る
完全性は「保たれている/いない」の 2 値ではなく、 程度問題として捉えるとより実用的である。 以下に、 完全性の「壊れ具合」を数値化するための代表的な指標を示す。 これらを ダッシュボードで時系列表示することで、 完全性の経時変化を一目で把握できる。
| 指標 | 定義 | 理想値 | 監視の意義 |
|---|---|---|---|
| 完全行率 | 全列に値がある行数 ÷ 全行数 | ≥ 0.95 | 欠損の発生状況 |
| スキーマ一致率 | 期待スキーマと一致する列数 ÷ 全列数 | 1.00 | 予期しないスキーマ変更の検知 |
| 値域逸脱率 | 許容範囲外の値を持つセル数 ÷ 全セル数 | ≤ 0.01 | 外れ値・改ざんの兆候 |
| 参照整合性違反数 | 外部キーが親テーブルに存在しない行数 | 0 | テーブル間整合性の喪失 |
| 重複率 | 主キー重複行数 ÷ 全行数 | 0 | 取込パイプラインの二重実行 |
| 相関ドリフト | 既知変数間の相関係数の前月差 | ≤ 0.05 | 列の入れ違いの早期検知 |
これらの指標を組み合わせた「完全性スコア」(例: 各指標を 0-1 に正規化して平均を取る)を毎月計算し、 80 点を下回ったら警告、 60 点を下回ったら取込中止、 という運用ルールを設けておくと、 異常事態に 機械的に対応できる。 人間の判断に依存しすぎると、 多忙な時期に見落としが発生するからである。
なお、 完全性指標の閾値は 事業特性によって調整すべきである。 金融取引データなら欠損率 0.01% でも許容できないが、 ユーザー行動ログなら 5% 程度の欠損は許容範囲かもしれない。 「自社にとって何が許容範囲か」を事業部門と合意しておくことが、 形骸化しない完全性監査の前提条件である。
⚖ 完全性 vs 他のセキュリティ柱 — トレードオフを理解する
情報セキュリティの基本柱である CIA トライアド(Confidentiality 機密性・Integrity 完全性・Availability 可用性)は、 しばしば 互いにトレードオフ関係にある。 完全性を厳密に守ろうとすると、 機密性や可用性が犠牲になることがある。 以下に代表的なトレードオフ事例を示す。
| 対立軸 | 完全性側の主張 | 対立側の主張 | バランス案 |
|---|---|---|---|
| 完全性 vs 可用性 | 疑わしいデータは取込中止 | サービス停止は不可 | 疑わしい行のみ隔離、 他は提供 |
| 完全性 vs 機密性 | 監査ログを詳細記録 | ログに個人情報を残せない | ハッシュ化・マスク化したログ |
| 完全性 vs パフォーマンス | 全行のハッシュを毎回計算 | レスポンス遅延は許容不可 | サンプリング監査 + 定期全件監査 |
| 完全性 vs 開発速度 | 全変更にレビュー必須 | 緊急パッチを即適用したい | 変更規模に応じた段階レビュー |
「完全性は守らなければならない」という主張は正しいが、 それを 絶対視すると業務が回らなくなる。 完全性監査の設計者は、 事業の他の要請(速度・コスト・ユーザビリティ)とのバランスを常に意識しなければならない。 「最高水準の完全性を目指すが、 それは事業継続を妨げない範囲で」という現実的なゴール設定が重要である。
本セクションで示した 3 図セット・チェックリスト・完全性指標・トレードオフ整理を組み合わせることで、 「現場で運用できる完全性監査の設計」が見えてくる。 完全性は単一の技術や手続きで守られるものではなく、 複数の防御層の組み合わせと、 事業特性に応じた閾値設定と、 継続的な可視化・改善の 3 つが揃って初めて実現される。 本ページの内容を、 自社のデータパイプラインの監査設計の出発点として活用してほしい。
📜 完全性違反の歴史的事例 — 過去から学ぶ
完全性違反は、 技術が高度化した現代でも発生し続けている。 過去の重大事案から教訓を抽出することで、 同じ過ちを繰り返さない仕組みを設計できる。 以下に、 完全性監査の重要性を世に知らしめた代表的な事例カテゴリと、 そこから抽出される教訓を整理する。
| 事例カテゴリ | 典型的な発生メカニズム | 影響範囲 | 抽出される教訓 |
|---|---|---|---|
| 単位誤り | 列が「千人」と「人」で混在し、 取込時に統一されず | 統計値が 1000 倍にズレ、 政策判断を誤らせる | 単位を列名に明示、 値域検証で検出 |
| 時差・タイムゾーン | UTC と JST が混在し、 9 時間ズレが発生 | 日次集計が前後にズレ、 異常検知が空振り | 全タイムスタンプを UTC で統一 |
| 文字コード混在 | Shift-JIS と UTF-8 が混在し、 文字化け | マスターデータが破壊され、 検索不能 | 取込時に文字コード変換を強制 |
| スキーマ変更未告知 | 提供元が列順を変更したが通知なし | 全数値が誤った列に入り、 分析結果が無意味化 | スキーマハッシュを毎回照合 |
| 部分更新の競合 | 2 つの ETL が同時に同一テーブルを更新 | ロストアップデートで一部レコードが消失 | 排他制御またはトランザクション分離 |
| バックアップ破損 | バックアップ取得後にハッシュ照合を行わず | 復旧時にデータ破損が発覚、 業務停止 | 定期的なリストア訓練 |
これらの事例に共通するのは、 「単一の対策では防げない」という点である。 単位誤りは値域検証で、 時差は UTC 統一で、 スキーマ変更はハッシュ照合で、 それぞれ別個の対策が必要になる。 完全性監査の設計は 失敗パターンの蓄積と表裏一体であり、 過去の事故報告書を継続的に読み返して自社の監査項目を更新していく姿勢が欠かせない。
🧠 完全性と「データの真正性」 — 哲学的な視点
完全性監査を突き詰めていくと、 「そもそも『正しいデータ』とは何か」という哲学的な問いに突き当たる。 例えば、 ある都道府県が公表する人口統計は 住民基本台帳に基づく数値であるが、 住民登録していない居住者(短期滞在外国人・住所不定者など)は含まれていない。 この数値は「行政上の人口」としては正確だが、 「実際にその土地に住んでいる人の数」としては不完全である。
つまり、 完全性は 「何との一致を完全性と呼ぶか」という基準設定に強く依存する。 同じデータでも、 ある目的では完全であり、 別の目的では不完全である。 完全性監査の設計者は、 「自社のデータが何の真実を表現しようとしているか」を常に意識し、 そのギャップを利用者に明示することが求められる。
この視点は、 単なる技術的完全性(ビット単位の一致)を超えた 意味的完全性とも呼べる。 意味的完全性を確保するには、 データ提供元の 定義文書(メタデータ)を必ず取得し、 自社の用途と提供元の定義が一致しているかを確認する必要がある。 これは技術的ハッシュ照合では検出できない、 「人間の解釈」が必要な完全性監査の側面である。
実務的には、 データセットごとに 「データシート」(Datasheet for Datasets, Gebru et al. 2021 で提唱)を整備しておくことが推奨される。 データシートには、 収集目的・収集方法・既知の偏り・推奨される用途・推奨されない用途などを記載する。 これにより、 利用者が「このデータは自分の目的に対して完全か」を判断できる。 完全性監査は、 技術的検証と意味的検証の両輪で完成する。
🔬 演習の追加 — 実践力を試す
発展演習 1: 監査設計
あなたの担当する EC サイトでは、 毎時取り込まれる売上ログに「商品ID・購入数・単価・タイムスタンプ・顧客ID」が含まれる。 完全性監査として、 取込前・取込中・取込後の各フェーズで何をチェックすべきか、 各 2 項目ずつ挙げ、 合格基準と異常時の対応を整理せよ。
発展演習 2: 完全性スコアの設計
前掲の完全性指標 6 種類を 0-1 に正規化し、 平均を取って「完全性スコア」を作るとする。 ただし、 自社では「重複率」と「スキーマ一致率」は致命的なので、 これらが基準を満たさない場合は他の指標が良くても合格とすべきでない。 このような優先度を反映した完全性スコアの計算式を提案し、 その理由を述べよ。
発展演習 3: 意味的完全性
SSDSE-B-2026 の「総人口」列は住民基本台帳に基づく値である。 これを使って「実際にその土地に滞在している人」のサービス需要予測モデルを作ろうとした場合、 完全性の観点でどのような問題が生じるか。 また、 この問題を緩和するために追加で取得すべきデータ・指標を 2 つ挙げよ。
完全性は、 技術・運用・設計・哲学のすべての階層にわたる 多層的な概念である。 本ページの内容を一度読んだだけで完璧に理解できる人は少ないだろう。 実務で監査を運用しながら、 何度も本ページに立ち返って各セクションを読み直し、 自社の文脈に当てはめて咀嚼することを推奨する。 完全性監査の習熟は、 一朝一夕ではなく、 経験と反復の蓄積によって深まっていく。
📚 補論: 完全性確保のための実装パターン集
完全性監査を支える典型的な実装パターンを整理する。 設計者はこれらの中から自社の事業特性に合うものを選択し、 適切に組み合わせる。 「全てを実装すれば完璧」ではなく、 「事業要請とコストのバランスで取捨選択する」のが現実的である。 ここでは代表的な 8 パターンを挙げる。
| パターン名 | 仕組み | 適用シーン | 実装コスト |
|---|---|---|---|
| ハッシュ照合 | SHA-256 で前後のビット一致を確認 | ファイル転送、 アーカイブ | 低 |
| チェックサム | CRC32 等で改変を検知 | ネットワーク伝送、 行単位検証 | 低 |
| 電子署名 | 公開鍵暗号で送信者と内容を保証 | 公的データ配信、 契約書 | 中 |
| 監査ログ | 全変更を WORM ストレージに記録 | 金融、 医療、 法規制対象 | 中 |
| 差分検査 | 前回スナップショットとの diff を計算 | マスターデータ管理 | 中 |
| 統計的監視 | 平均・分散・相関の経時変化を監視 | ビッグデータ、 行動ログ | 中 |
| 参照整合性制約 | 外部キー制約を DB で強制 | RDB を使う全シーン | 低 |
| スキーマ検証 | JSON Schema や Great Expectations で型・範囲を検証 | ETL パイプライン全般 | 中 |
これらのパターンは 互いに補完的である。 例えばハッシュ照合だけでは「ハッシュ自体が改ざんされた」場合に検知できないが、 電子署名と組み合わせれば改ざんを検知できる。 統計的監視だけでは「分布は同じだが個別レコードが入れ替わっている」状況を検知できないが、 ハッシュ照合と組み合わせれば検知できる。 完全性監査の設計は、 パターンの組み合わせ最適化問題として捉えると見通しが良くなる。
特に重要なのは、 「人間の介入が必要な層」と「自動化できる層」を分離することである。 ハッシュ照合・スキーマ検証・参照整合性は完全に自動化できるが、 統計的監視のアラート判定や監査ログのレビューには人間の判断が必要になることがある。 自動化層を厚くしすぎると、 アラート疲れで人間が真の異常を見逃すリスクがある。 逆に人間レビュー層を厚くしすぎると、 担当者の負荷が高まり継続できない。 このバランス設計が、 完全性監査の運用設計者の腕の見せ所である。
🎯 完全性監査のアンチパターン — やってはいけないこと
完全性監査の現場でしばしば見られる、 効果が薄い・むしろ害がある「アンチパターン」を整理する。 これらを避けることが、 実効性のある監査体制を構築する第一歩である。
| アンチパターン | 問題点 | 改善方向 |
|---|---|---|
| アラートの過剰設定 | 毎日数百件のアラートで、 担当者が読まなくなる | 重大度に応じた段階化、 抑制ルール |
| 監査ログの未活用 | 記録はしているが誰も見ない | 定期レビュー会の設置、 自動サマリ |
| 完全自動化への過信 | 人間が一切確認しない結果、 想定外を見逃す | 月次サンプルレビューを必ず実施 |
| 監査と業務の分離 | 監査チームが業務を理解せず、 形骸化 | 業務担当者を巻き込んだ運用設計 |
| 過去事案の風化 | 同じ事故が数年後に再発 | 事故報告書のナレッジベース化 |
| ツール導入の自己目的化 | 高価なツールを導入したが活用されない | 小さく始めて段階的に拡張 |
これらのアンチパターンに共通するのは、 「監査が形式化して実質を失う」という構造である。 完全性監査は「やっています」と言うだけでは意味がなく、 実際にデータの異常を検知できる体制になっているかどうかが全てである。 定期的に 模擬異常データを投入して、 自社の監査体制が確かに検知できるかをテストする「監査の監査」を行うことを強く推奨する。 これは火災訓練と同じ位置づけであり、 本番で機能しない監査体制は無いに等しい。
最後に、 完全性監査は 「データ品質文化」の一部として根付かせることが重要である。 監査チームだけが完全性に責任を持つのではなく、 データを生成する側・利用する側・運用する側のすべてが「自分はデータの完全性に貢献している」という意識を持つことで、 監査体制は初めて自走する。 完全性監査は、 技術投資であると同時に 組織文化への投資である。 本ページの内容が、 読者の所属組織における完全性文化の醸成の一助となれば幸いである。
🧩 完全性監査と機械学習モデルの関係
機械学習モデルの予測精度は、 入力データの完全性に強く依存する。 ガベージインなら必ずガベージアウトになる(Garbage In, Garbage Out)。 完全性が侵害されたデータで学習したモデルは、 一見もっともらしい予測を返すが、 実用に堪えないものになる。 ここでは、 機械学習パイプラインにおける完全性監査の特徴的な観点を整理する。
第 1 に、 学習データと推論データの完全性は別物として管理する必要がある。 学習データは過去の蓄積であり一度監査すれば固定できるが、 推論データはリアルタイムで流入するため、 監査の遅延が許容できない。 学習時には精密な統計的監視を行い、 推論時には軽量なスキーマ検証と値域チェックに留めるという 段差設計が現実的である。
第 2 に、 データドリフトを完全性の延長線上で監視する必要がある。 取込時点では完全性が保たれていても、 時間経過とともに学習データと推論データの分布が乖離していくと、 モデルの精度は徐々に低下する。 これは「データ自体は壊れていないが、 想定環境から外れている」という意味的完全性の問題である。 ドリフト検知(PSI: Population Stability Index 等)を完全性監査の項目に組み込むことで、 モデルの寿命を能動的に管理できる。
第 3 に、 ラベルの完全性は特に注意が必要である。 教師あり学習ではラベルが「正解」として扱われるが、 ラベル付け担当者の判断ミスや基準のブレで、 ラベル自体が不完全であることがある。 「人間が付けたラベルは正しい」という暗黙の前提を疑い、 複数人によるダブルチェック・ラベル一貫性スコア(カッパ係数等)の算出を完全性監査の一環として実施することが望ましい。
第 4 に、 敵対的サンプルへの耐性も完全性の延長として扱える。 攻撃者が意図的に小さな摂動を加えた入力(人間には正常に見える)で、 モデルに誤分類を起こさせる攻撃である。 これは「ビット単位では完全性が保たれているが、 意味的には完全性が侵害されている」極端な事例であり、 敵対的訓練(adversarial training)や入力の前処理による緩和が研究されている。
機械学習システムにおける完全性は、 単なるデータ品質を超えて モデルライフサイクル全体の管理問題となる。 データ取込・学習・評価・デプロイ・推論・再学習という各フェーズで、 完全性の観点を埋め込んでいくことで、 信頼性の高い AI システムを構築できる。 これは MLOps の中核的な関心事の 1 つでもある。
🌟 まとめの一言
完全性は、 セキュリティの基本柱の 1 つでありながら、 機密性や可用性に比べて見過ごされがちな概念である。 しかし、 データドリブンな意思決定が当たり前になった現代において、 完全性が侵害されたデータに基づく判断は組織を誤った方向に導く。 完全性監査は地味な仕事だが、 組織の意思決定の質を底支えする極めて重要な活動である。 本ページで紹介した 3 図セット・チェックリスト・指標・トレードオフ・実装パターン・アンチパターン・機械学習との関係を、 自社の文脈に応じて組み合わせ、 実効性のある完全性監査体制を築いてほしい。
📖 用語の整理 — 完全性関連の周辺概念
完全性を深く理解するには、 周辺概念との位置関係を整理することが役立つ。 以下に、 完全性と関連する代表的な用語を、 重なる範囲と異なる範囲を意識して比較する。 これらの概念は実務でしばしば混同されるため、 自社の用語集として明文化しておくことを推奨する。
| 用語 | 完全性との重なり | 完全性との違い |
|---|---|---|
| 正確性(Accuracy) | 「正しい値であること」を共有 | 完全性は改変有無も含む、 正確性は値そのものの正しさのみ |
| 一貫性(Consistency) | 「テーブル間で矛盾がない」を共有 | 完全性は改ざん検知も含む、 一貫性は関係の整合性のみ |
| 真正性(Authenticity) | 「正規の作成者によるデータ」を共有 | 真正性は発信源の確認、 完全性は内容の不変 |
| 否認防止(Non-repudiation) | 「証跡として使える」を共有 | 否認防止は事後追跡、 完全性は事前保護 |
| 信頼性(Reliability) | 「期待通りに動く」を共有 | 信頼性は再現性、 完全性は不変性 |
これらの概念は 完全に独立ではなく、 部分的に重なり合う。 例えば「正確で、 改ざんされておらず、 一貫しており、 発信源が確かで、 証跡として使える」状態が、 高度な完全性を備えたデータの理想像である。 個々の概念を分離して議論できる場面(例: 監査要件の細分化)と、 まとめて議論する場面(例: 経営層への報告)を使い分けることが、 概念の力を最大限に引き出すコツである。
本ページで扱った完全性の概念は、 情報セキュリティ標準(ISO/IEC 27001 等)における定義を基礎としつつ、 データサイエンス実務における意味的完全性まで拡張したものである。 標準的な定義と現場での運用ギャップを意識しながら、 自社の事業に最適な完全性概念を構築してほしい。 完全性は静的な定義ではなく、 事業と技術の進化に応じて再定義され続けるべき 動的概念である。
🔁 完全性監査の継続的改善サイクル
完全性監査は「一度設計したら完成」ではなく、 PDCA サイクルで継続的に改善していくべき活動である。 Plan(計画)では監査項目と閾値を定義し、 Do(実行)では実際に監査を回し、 Check(評価)では監査の漏れや誤検知を分析し、 Act(改善)では監査項目や閾値を更新する。 この 4 段階を四半期や半期ごとに繰り返すことで、 監査体制は事業の変化に追随できる。
特に重要なのは Check 段階での 監査の有効性評価である。 過去 1 期間に発生した完全性違反のうち、 何件が自社の監査体制で検知できたか、 何件を見逃したかを定量的に集計する。 見逃し事案については、 「なぜ検知できなかったか」を 5 Whys 分析等で深掘りし、 監査項目への追加・閾値の調整・運用手順の変更といった具体的な改善アクションに繋げる。 これを行わないと、 監査体制は時代遅れになり、 やがて形骸化する。
また、 監査体制の 外部レビューを定期的に受けることも有効である。 自社内のメンバーだけでは気づかない盲点を、 外部の専門家や他社の知見と照らし合わせることで発見できる。 業界団体のベンチマーク調査に参加したり、 監査法人による情報セキュリティ監査を受けたりすることで、 自社の完全性監査体制の成熟度を客観的に評価できる。 外部の視点を取り入れることは、 監査の継続的改善において欠かせない要素である。
完全性監査体制の成熟度は、 一般に以下の 5 段階で評価される: (1) Initial(場当たり的対応)、 (2) Managed(プロセスが文書化されている)、 (3) Defined(組織横断で標準化されている)、 (4) Quantitatively Managed(定量的指標で管理されている)、 (5) Optimizing(継続的改善が組み込まれている)。 自社の現在地を把握し、 1 段階ずつ着実に上げていくことが、 完全性監査の長期的な戦略となる。
本ページで提示した一連の枠組み(3 図セット・チェックリスト・指標・トレードオフ・実装パターン・アンチパターン・機械学習との関係・周辺概念・成熟度モデル)は、 これらの段階を 1 つずつ登っていく際の 共通言語として機能することを意図している。 異なる立場のステークホルダー(経営層・開発者・運用者・データサイエンティスト・監査担当者)が、 同じ用語と枠組みで完全性を議論できることが、 組織横断的な完全性文化の前提である。 用語のすり合わせと枠組みの共有から、 完全性監査の組織展開は始まる。
最終的に、 完全性は 「データに対する組織の誠実さ」を表す指標であるとも言える。 データに含まれる事実を歪めずに保ち、 改ざんを許さず、 一貫性を保ち、 利用者に正直に提供する姿勢は、 そのまま組織が社会に対して負う説明責任の表れである。 完全性監査を地道に続けることは、 単なる技術活動ではなく、 組織の信頼を社会との間で築き上げる 倫理的活動でもある。 この視点を持って、 日々の監査業務に取り組んでほしい。
本ページの最終メッセージは次の 1 文に要約できる: 「完全性は、 一度確立すれば終わるものではなく、 日々の細かな確認の積み重ねによって初めて持続する」。 派手な技術投資より、 地道なチェックリスト運用の方が、 長期的には組織を守る。 本ページが、 読者の所属組織における完全性監査の出発点となり、 さらにはその継続的改善の伴走者となることを願って、 本セクションを締めくくる。 完全性を守るすべての実務家に、 敬意と感謝を表したい。 そして、 本ページの内容を活用して新たな知見を得た読者は、 その知見をぜひ同僚や業界仲間と共有し、 完全性監査の文化を組織横断・業界横断で広げていってほしい。 完全性は、 守る人が多いほど強くなる概念である。
最後に、 本ページで触れた論点をもう一度短く列挙して、 読者の振り返りに供する: (1) 完全性は CIA トライアドの中核要素であり、 「ビット単位の不変性」と「統計的な一貫性」の両方を含む、 (2) 散布図・ヒストグラム・箱ひげ図の 3 図セットで EDA 的に完全性を監査できる、 (3) 取込前・取込中・取込後の各フェーズで段階的にチェックリストを運用する、 (4) 完全行率・スキーマ一致率・値域逸脱率・参照整合性違反数・重複率・相関ドリフトの 6 指標で定量管理する、 (5) 完全性は機密性・可用性・パフォーマンス・開発速度とトレードオフがあり、 事業特性に応じてバランスを設計する、 (6) 8 種類の実装パターン(ハッシュ照合からスキーマ検証まで)を組み合わせて多層防御を構築する、 (7) アラート過剰・監査ログ未活用・完全自動化への過信などのアンチパターンを避ける、 (8) 機械学習システムでは学習データ・推論データ・ラベル・敵対的サンプルの 4 観点で完全性を管理する、 (9) 周辺概念(正確性・一貫性・真正性・否認防止・信頼性)との位置関係を整理する、 (10) PDCA と成熟度モデルで継続的に改善する。 以上 10 点を意識して、 自社の完全性監査体制を点検してみてほしい。
📊 補足: 完全性 (Integrity) の数理と運用
完全性は情報セキュリティの CIA トリアード (機密性 Confidentiality・完全性 Integrity・可用性 Availability) の中核で、 データが「許可されない方法で変更されない」ことを保証する性質である。 数理的にはハッシュ関数 H の衝突困難性 (collision resistance) に依拠し、 SHA-256 の場合 2^128 程度の計算でしか同じハッシュ値を持つ別データを見つけられない。 ブロックチェーンの改ざん耐性も同じ原理で、 各ブロックが直前ブロックのハッシュを含むため、 1 ブロック改変するとそれ以降全てを再計算する必要がある。 デジタル署名 (RSA や ECDSA) は秘密鍵で署名・公開鍵で検証することで、 改ざんと否認防止を同時に達成する。 実務では HMAC や AEAD (GCM/ChaCha20-Poly1305) が標準的に使われ、 通信路の機密性と完全性を同時に守る。 データベースでは外部キー・チェック制約・トリガで論理的整合性を保ち、 トランザクションの ACID (Atomicity, Consistency, Isolation, Durability) で同時実行下の一貫性を保証する。 監査ログでは write-once-read-many (WORM) ストレージや tamper-evident log で改ざん検出を行い、 法的・規制要件 (SOX、 HIPAA、 個人情報保護法、 GDPR) を満たす。 機械学習モデルでは、 学習データの完全性が予測精度を左右し、 データポイズニング攻撃 (label flipping、 backdoor) に対する防御として trusted curation、 robust training、 anomaly detection が必要である。 ファイルシステムでは ZFS や Btrfs の checksum で bit rot (磁気劣化・宇宙線によるビット反転) を検出・自動修復する。 完全性の確保は「事前検証 (validation)」「事中監視 (monitoring)」「事後監査 (audit)」の三段階で多層的に行う必要があり、 一つの技術だけでは不十分である。
⚠️ よくある落とし穴
⚠️ 業務ルールの検査はハッシュの代わりにならない — 改ざんを仕込んで確かめる
上の 🐍 で「男女計 = 総人口」のルールが通ることを確かめた。では、ルールが通れば改ざんされていないと言えるか。2023 年度の 47 県の 6 列(総人口・男・女・年齢 3 区分)に、わざと 3 通りの改ざんを入れて、ルール 2 本(男 + 女 = 総人口、年齢 3 区分の和 = 総人口、どちらも千人単位の丸めで ±1,000 まで許す)とハッシュ(SHA-256 の先頭 12 桁)のどちらが気づくかを比べる。
🎯 このコードでやること:2023 年度 47 県の人口 6 列に 3 通りの改ざんを入れ、業務ルール 2 本と SHA-256 の指紋がそれぞれ検出できるかを調べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import hashlib import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') cols = ['A1101', 'A110101', 'A110102', 'A1301', 'A1302', 'A1303'] base = d[cols].copy() def digest(t): # 2023 年度 6 列の指紋 return hashlib.sha256(t.to_csv().encode()).hexdigest()[:12] def rules(t, tol=1000): # 業務ルール 2 本(千人単位の丸めを許容) sex = (t['A110101'] + t['A110102'] - t['A1101']).abs() > tol age = (t['A1301'] + t['A1302'] + t['A1303'] - t['A1101']).abs() > tol return list(t.index[sex | age]) h0 = digest(base) print('元データ: ルール違反', rules(base), ' 指紋', h0) cases = { 'T1 東京都の総人口だけ +50,000': lambda t: t.loc['東京都', ['A1101']].add(50000), 'T2 東京都の総人口・男・65歳以上を +50,000': lambda t: t.loc['東京都', ['A1101', 'A110101', 'A1303']].add(50000), 'T3 鳥取県の総人口と男を +1,000': lambda t: t.loc['鳥取県', ['A1101', 'A110101']].add(1000), } for name, f in cases.items(): t = base.copy() v = f(t); t.loc[v.name, v.index] = v.values hit = rules(t) print(f'{name}: ルール検出={hit if hit else "なし"} 指紋一致={digest(t) == h0}') |
💬 元データはルール違反 0 件で、指紋は 9af3ded84b1a。T1(総人口だけを 5 万人増やす)は男女の和と合わなくなりルールが東京都を検出する。T2 は総人口・男・65 歳以上を同じ 5 万人ずつ増やしたので、男 + 女 も年齢 3 区分の和も総人口と一致したままで、ルールは何も見つけない。T3 は鳥取県の総人口と男を 1,000 人ずつ動かしただけで、丸めの許容幅に収まる。T1〜T3 のどれでも指紋は元と一致しない(False)。
ルールは「辻つまが合っているか」しか見ないので、辻つまを合わせた改ざん(T2)や丸め幅の中の改ざん(T3)は通してしまう。逆にハッシュは「どこが・なぜ」おかしいかを教えてくれない。受け取ったファイルが配布元と同じかはハッシュで、同じファイルの中身が業務上ありえる値かはルールで、と役割を分けて両方使う。
⚠️ 閾値のルールは列ごとに決める — 前年度比 ±5% は出生数では誤警報だらけ
時系列のデータでは「前年度から ±5% を超えて動いたら警告」のような変化量のルールがよく使われる。同じ閾値が列によってどれだけ違う結果になるかを、SSDSE-B-2026 の 12 年度分(47 県 × 11 回の前年度比 = 517 件)で数える。
🎯 このコードでやること:総人口・出生数・死亡数の 3 列について、県ごとに前年度比の変化率を求め、±5%・±10% を超えた件数と 99% 点を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) s = df.sort_values(['Code', 'SSDSE-B-2026']) # CSV は新しい年度が先なので並べ直す names = {'A1101': '総人口', 'A4101': '出生数', 'A4200': '死亡数'} for c, jp in names.items(): r = s.groupby('Code')[c].pct_change().abs() # 前年度比の変化率(絶対値) n = r.notna().sum() print(f'{jp}: 前年度比の変化 {n} 件 最大 {r.max():.1%} ' f'±5% 超 {(r > 0.05).sum()} 件 ±10% 超 {(r > 0.10).sum()} 件 ' f'99% 点 {r.quantile(0.99):.1%}') r = s.groupby('Code')['A4101'].pct_change().abs() top = s.loc[r.nlargest(3).index, ['Prefecture', 'SSDSE-B-2026', 'A4101']] print(top.to_string(index=False)) |
💬 総人口は 517 件の前年度比のうち最大でも 1.7% しか動かず、±5% のルールは 1 件も警告しない。ところが出生数では 134 件(約 26%)、死亡数では 65 件が ±5% を超える。出生数の最大は鳥取県 2023 年度の 13.0% 減(3,263 人)で、出生数が 3,000〜5,000 人規模の県では数百人の増減で 5% を超えてしまう。±10% に広げると出生数は 2 件、死亡数は 15 件まで減る。
変化量のルールは、改ざんではなく普通の年々の揺れでも警告を出す。閾値は「全列 ±5%」のように一律に決めず、過去の実データの変化率の分布(ここでは 99% 点が総人口 1.5%・出生数 9.3%・死亡数 10.5%)を見て列ごとに決める。警告が多すぎるルールは、そのうち誰も見なくなる。
⚠️ ハッシュはバイト列の指紋で、値の指紋ではない — 保存し直しただけで一致しなくなる
🐍 のブロックでは SSDSE-B-2026.csv ファイル全体の SHA-256 を計算した。この指紋は「ファイルのバイト列」に付くので、数値を 1 つも変えなくても、表計算ソフトや pandas で開いて保存し直す、文字コードを UTF-8 に変える、改行コードを変える、といった操作で別の値になる。受け取った側でハッシュが合わないとき、改ざんなのか保存形式の違いなのかを切り分けるために、値だけから作る指紋(行を地域コード・年度で並べ替え、決まった書式で書き出してからハッシュを取る)を並べて比べる。
🎯 このコードでやること:元の CSV と、値を変えずに保存形式だけ変えた 3 通りのバイト列について、ファイルのハッシュと「値の指紋」を並べて比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import hashlib, io import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' raw = open(path, 'rb').read() sha = lambda b: hashlib.sha256(b).hexdigest()[:12] df = pd.read_csv(io.BytesIO(raw), encoding='cp932', header=[0, 1]) v1 = df.to_csv(index=False, encoding='cp932').encode('cp932') # 同じ値を書き直す v2 = df.to_csv(index=False).encode('utf-8') # 文字コードだけ変える v3 = raw.replace(b'\r\n', b'\n') if b'\r\n' in raw else raw.replace(b'\n', b'\r\n') # 改行だけ変える def canon(b, enc): # 値の指紋: 読み込み → 行を(地域コード,年度)で並べ替え → 固定書式 t = pd.read_csv(io.BytesIO(b), encoding=enc, header=[0, 1]) t.columns = [c[0] for c in t.columns] t = t.sort_values(['Code', 'SSDSE-B-2026']).reset_index(drop=True) return sha(t.to_csv(index=False, lineterminator='\n').encode('utf-8')) print(f'元のファイル {len(raw):>8,} bytes バイト列 {sha(raw)} 値 {canon(raw, "cp932")}') for name, b, enc in [('pandas で書き直し', v1, 'cp932'), ('UTF-8 で保存', v2, 'utf-8'), ('改行コードだけ変更', v3, 'cp932')]: print(f'{name:10s} {len(b):>8,} bytes バイト列 {sha(b)} 値 {canon(b, enc)}') print('改行コード:', 'CRLF' if b'\r\n' in raw else 'LF') |
💬 元のファイルは 359,821 bytes でバイト列の指紋は 0fdbe5f603bb。pandas で読んで同じ cp932 で書き直すと 359,204 bytes、UTF-8 で保存すると 361,891 bytes、改行を CRLF から LF に変えるだけでも 359,255 bytes になり、3 つともバイト列の指紋は元と一致しない。一方、値の指紋は 4 行とも 5a5d3cfea7d3 で同じなので、どれも数値は 1 つも変わっていないと分かる。
配布ファイルの改ざん検知にはバイト列のハッシュを使い、受け取ったファイルには手を加えずに照合する。分析の途中で「値が変わっていないか」を確かめたいときは、並べ順・書式を固定した値の指紋を使う。どちらの指紋かを書かずに「ハッシュが一致した/しない」と報告すると、読み手は判断を誤る。
🧠 理解度チェック — SSDSE-B-2026 の数値で
Q1. SSDSE-B-2026 を読み込み、都道府県名の列で重複を数えたら 517 件あった。データは壊れているか。
壊れていない。このファイルは 47 県 × 12 年度 = 564 行で、各県が 12 回ずつ出るので、都道府県名だけで見た重複は 564 − 47 = 517 件になる。一意であるべきなのは(地域コード, 年度)の組で、これは重複 0 件。主キーをどの列の組にするかを決めてから一意性を検査する。
Q2. 2023 年度の北海道は 総人口 5,092,000、男 + 女 = 5,093,000 で 1,000 人ずれている。改ざんを疑うべきか。
この 1 件だけでは疑えない。SSDSE-B の人口は千人単位で丸めた値なので、男・女・総人口を別々に丸めると ±1,000 の差は普通に出る(47 県の差の最大も 1,000)。許容幅を 0 にすると正しいデータで警告が出る。逆に許容幅を広げすぎると、上の T3 のような小さな改ざんを通す。
Q3. 総人口と男と 65 歳以上を同じ数だけ増やす改ざんを、ルールで見つけるにはどうするか。
和のルールだけでは見つからない(T2)。前年度比のルールを足しても、東京都の総人口(2022 年度 14,038,000 → 2023 年度 14,086,000、+0.34%)に 5 万人足した後の前年度比は +0.70% で、12 年間の最大 1.7% より小さく、変化量のルールでも気づけない。確実に見つけるには、配布元が公開した値やハッシュと照合するしかない。
Q4. 出生数に「前年度比 ±5%」の警告を付けたら、12 年分で何件の警告が出るか。どう直すか。
517 件中 134 件。多くは人口の小さい県の自然な揺れで、改ざんではない。列ごとに過去の変化率の分布を見て、たとえば出生数は 99% 点の 9.3% を目安に ±10% にすると 2 件まで減る。警告が出た行は、その年の実際の出来事(感染症の流行など)と照らし合わせて確かめる。
Q5. 受け取った SSDSE-B-2026.csv のハッシュが配布元の値と一致しなかった。改ざんと決めてよいか。
まだ決められない。上のように、改行コード(CRLF → LF)や文字コード(cp932 → UTF-8)が変わっただけでもバイト列のハッシュは変わる。ダウンロード後に表計算ソフトで開いて保存していないかを確かめ、元の配布ファイルを取り直して照合する。値の指紋が手元の別コピーと一致すれば、少なくとも数値は同じである。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
上図中心の「完全性 (integrity)」から、 SHA-256 ハッシュ ・ HMAC ・ 監査ログ ・ 落とし穴 (MD5 利用等) の軸が放射する。 完全性は情報セキュリティの 3 大要件 (CIA: Confidentiality / Integrity / Availability) の 1 つで、 「データが改ざんされていないこと」を保証する仕組みの総称。
🔗 隣接手法への橋渡し
完全性は機密性・可用性と並ぶ情報セキュリティの中核要件。 暗号技術・運用プロセスと組み合わせて初めて実装できる。
- 上流: 情報セキュリティ ・ 認証 ・ アクセス管理 — データを誰が書き込めるかを制御する前提条件
- 並列: 可用性 ・ 機密性 (Confidentiality) — CIA トライアドを構成する 3 要件、 同じセキュリティ目的を異なる切り口で実装
- 下流: 公開鍵暗号 ・ 電子署名 ・ ハッシュ関数 (SHA-256) ・ HMAC — 完全性を実現する具体的な暗号技術
完全性違反は「改ざん」「破損」「重複処理」など多様な形で起きる。 例: SQL の UNIQUE 制約は重複行を防ぐ完全性保証、 SHA-256 ハッシュは配布ファイルの改ざん検知、 HMAC は通信中の改ざん検知。 用途で技術を使い分ける。
🌳 意思決定フローチャート
「完全性」の 選び方・適用判断をフローで整理。 状況に応じた選択を 4 段階で。