🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
このページの節への目次です。
💡 30秒で分かる結論
🍰 まずはやさしく
データから答えを探す魔法のような道具です。
正しい判断や未来の予測をするために使います。
スマホのアプリでおすすめの商品が出る仕組みです。
まずは結論と大切なポイントを読みましょう。
データサイエンスは、 統計学・情報科学・ドメイン知識を組み合わせ、 データから知見・意思決定・予測を引き出す学際的領域。
- 3 本柱:統計学/プログラミング/ドメイン知識(Drew Conway の Venn 図)
- 典型プロセス:問い→収集→前処理→分析→可視化→意思決定(CRISP-DM)
- 道具箱:Python (pandas, scikit-learn)、 SQL、 可視化(matplotlib/seaborn)
- 成果物:数値だけでなく レポート・ダッシュボード・意思決定への提言
- 注意:万能ではなく、 「問いの設定が雑だと結果も雑」になりやすい
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 問いが曖昧なまま分析を始める/前処理を軽視する/精度だけを追う には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「データサイエンス」はどんな場面で出てくる?
🍰 まずはやさしく
データサイエンスは便利な道具箱のようなものです。
実際のデータを使って問題を解くために使います。
地域の統計を調べて分析する時に役立ちます。
どんな場面でこの言葉が出てくるかを確認します。
本サイトの再現論文集は、 47都道府県の SSDSE-B-2026 などの公的統計を題材に、 記述統計→可視化→回帰→因果推論→機械学習と進む構成です。 これ全体が「データサイエンス」の実例集。 用語集はその道具立てを辞書化したもので、 必要な所だけ拾い読みする「ジャストインタイム型」学習を想定しています。
🎨 直感で掴む
🍰 まずはやさしく
データから証拠を探す探偵のような仕事です。
数字の意味を分かりやすい言葉に直して伝えます。
部活の試合結果から勝ち方を考えるイメージです。
まずは直感的なイメージで全体を掴みましょう。
- 「探偵」と「翻訳者」のハイブリッド:データから手がかりを集め(探偵)、 ビジネスや行政の言葉に直す(翻訳者)。
- EDA→モデル→検証の往復が中核。 1 回でビシッと決まることは稀で、 仮説修正のループが本質。
- 扱う問いのレベル:①記述(何が起きた?)②診断(なぜ?)③予測(次はどうなる?)④処方(どう動くべき?)。 順に難しくなる。
📐 定義・数式
🍰 まずはやさしく
データサイエンスには共通のルールがあります。
誰がやっても同じ結果が出るようにするために使います。
買い物などのデータを整理する手順に似ています。
詳しい定義と分析の流れを順番に見ていきましょう。
📐 数式で押さえるデータサイエンス 5 公式
データサイエンスの中核は最終的に少数の式に収束します。 5 つだけ覚えれば 8 割の現場仕事に対応できます。
- OLS 解:$\hat{\beta} = (X^\top X)^{-1} X^\top y$ — 線形回帰の閉形式解。 多重共線性で $X^\top X$ が特異なら破綻 → Ridge を導入。
- Ridge 解:$\hat{\beta}_{\text{ridge}} = (X^\top X + \lambda I)^{-1} X^\top y$ — $\lambda$ で正則化、 多重共線性を回避。
- ロジット:$\log\frac{p}{1-p} = X\beta$ — 二値分類の標準。 $p$ が確率になる。
- 交差検証誤差:$\mathrm{CV}_K = \frac{1}{K}\sum_{k=1}^K L(\hat{f}^{(-k)}, D_k)$ — 過学習を検出する黄金律。
- 情報量基準:$\mathrm{AIC} = -2 \log L + 2k$ — モデル選択の数学的根拠。 小さい方が良い。
これら 5 式を SSDSE-B-2026 で何度も書き直していくのが、 データサイエンスの「素振り」 です。 OLS の解は線形代数の逆行列で書け、 Ridge は固有値を平行移動するという幾何的解釈が、 ロジットはオッズ比の対数線形性という確率的解釈が背景にあります。 CV と AIC は「汎化誤差をどう近似するか」 という共通テーマの異なる回答であり、 K と $\lambda$ の決め方は経験則 (K=5 や 10 が多い、 $\lambda$ は対数等間隔グリッド) です。
⁻¹Xᵀy</text><rect x='220' y='40' width='150' height='60' fill='%2390CAF9' rx='8'/><text x='295' y='75' text-anchor='middle' font-size='13' fill='%23000'>Ridge +λI</text><rect x='400' y='40' width='130' height='60' fill='%23FFCC80' rx='8'/><text x='465' y='75' text-anchor='middle' font-size='13' fill='%23000'>Logit log p/(1-p)</text><rect x='130' y='190' width='150' height='60' fill='%23EF9A9A' rx='8'/><text x='205' y='225' text-anchor='middle' font-size='13' fill='%23000'>CV K-fold</text><rect x='310' y='190' width='150' height='60' fill='%23CE93D8' rx='8'/><text x='385' y='225' text-anchor='middle' font-size='13' fill='%23000'>AIC -2logL+2k</text><path d='M115 100 L205 190' stroke='%23000' stroke-width='1.5'/><path d='M295 100 L205 190' stroke='%23000' stroke-width='1.5'/><path d='M465 100 L385 190' stroke='%23000' stroke-width='1.5'/><path d='M295 100 L385 190' stroke='%23000' stroke-width='1.5'/></svg>)
上段の 3 式 (OLS / Ridge / Logit) が「モデル」、 下段の 2 式 (CV / AIC) が「評価」 を担います。 矢印は「モデルの性能をどの評価で測るか」 の対応です。
データサイエンスのよくある質問 (FAQ)
| Q | A |
|---|---|
| n=47 の都道府県データで何が言えますか? | 記述統計と探索的可視化が主。 推測統計は「都道府県は母集団に近く、 ランダム標本ではない」 ことに注意が必要。 |
| 機械学習でなく統計分析を選ぶ判断は? | 説明可能性を最優先 / サンプル数が少ない / 仮説検証目的 → 統計を選ぶ。 予測精度優先 / 多変数 / 非線形 → ML。 |
| カラム数が 100 を超えるときは? | まず VIF で多重共線性を確認、 Lasso/PCA で削減し、 ドメイン知識で 10-20 個に絞る。 |
| 過学習の典型サインは? | train R^2 ≫ test R^2、 学習曲線で test 誤差が下げ止まらず上昇、 重要度のばらつき (permutation_importance 値が安定しない)。 |
| SHAP 値の解釈はどうやる? | 各特徴量の予測寄与を都道府県ごとに加算し、 平均的に効く方向と外れ値的に効くケースを分けて報告する。 |
データサイエンス職能図

3 円の交差にあたるのが本物のデータサイエンティスト。 統計・ML だけ強くてもドメインが弱ければ仮説が立たず、 コミュニケーションが弱ければ意思決定に繋がりません。 SSDSE-B のような公的データは「ドメイン (地域経済・人口動態)」 の素振り に最適です。
失敗事例から学ぶ「悪いデータサイエンス」
実務で繰り返し見られる悪いデータサイエンス事例を 8 つ、 SSDSE-B の文脈に置き換えて整理します。 これらを「自分はやらない」 リストとして頭に入れておくと、 多くの落とし穴を回避できます。
| # | 失敗パターン | SSDSE-B でのありがちな例 | 正しい対処 |
|---|---|---|---|
| 1 | 東京を含めた回帰で「全国の傾向」 と言う | 人口と出生数の単回帰で β₁ が東京 1 件で支配される | 東京除外時の係数を併記、 ロバスト回帰を試す |
| 2 | 絶対値で比較して都市部勝ち | 「東京は犯罪件数が多い」 (人口比だと低い場合あり) | 人口あたりや面積あたりに正規化 |
| 3 | 多重比較で偽陽性 | 47 都道府県の指標を総当たり相関 → p=0.05 で複数ヒット | Bonferroni / FDR で補正 |
| 4 | 因果と相関の混同 | 「医師数が多い県は平均寿命が長い」 → 高齢化率の交絡 | 共変量調整、 DAG 描画 |
| 5 | 変数を片方だけ対数化 | x は線形、 y は log → β の単位解釈が困難 | 両方 log にするか元単位で残差確認 |
| 6 | テストデータでハイパラ調整 | CV ループの外で grid search | nested CV を使う |
| 7 | 分布を見ずに t 検定 | 裾の重い分布で平均差を t 検定 | Mann-Whitney U や Welch t に切替 |
| 8 | 図に出典を書かない | SSDSE-B-2026 と書かない | 必ず「独立行政法人統計センター / SSDSE-B-2026」 を明示 |
データサイエンスのコード品質チェックリスト
分析ノートブックを後で再利用可能にするための、 コード品質チェック 15 項目。
- セル順序を上から下に再実行しても結果が再現すること (「Restart and Run All」 が通る)
- 絶対パスでなく相対パス、 または config から読む
- マジック数 (47 都道府県、 8 ブロック等) を変数化して上部に集約
- import は冒頭セル、 順序は標準 → サードパーティ → 自作
- 関数化されている (10 行以上は def に切り出す)
- docstring を 3 行で書く (目的 / 入力 / 出力)
- print 文に変数名を必ず添える (f"mean={mean}")
- 図には title / xlabel / ylabel / 出典を必ず記載
- seed 固定 (random_state=42) で再現性確保
- SSDSE-B 列名は変数 col_pop = 'A1101' のように記号定数化
- 欠損処理を分岐ではなく明示的に dropna / fillna で行う
- 例外処理 (try/except) は最小限、 想定外を握りつぶさない
- 大きな処理はキャッシュ (joblib.Memory) で再計算を避ける
- ノートブック末尾に「結論 + 次のアクション」 セクションを入れる
- git にコミット (出力セルは clear してから)
用語の関連ネットワーク
本ページの上位・並列・発展用語へのリンクを再掲。
データサイエンスのキャリアパス 5 類型
同じ「データサイエンティスト」 でも、 組織内では 5 つのロールに分岐します。 SSDSE-B のような公的データで素振りする際にも、 どのロールを目指しているかで重点が変わります。
| 類型 | 主担当 | 必要スキル | SSDSE-B での素振り |
|---|---|---|---|
| アナリスト | 定常レポート、 ダッシュボード | SQL, BI, EDA | 都道府県別ダッシュボード構築 |
| モデラー | 予測モデル開発 | scikit-learn, XGBoost | 人口減少率の予測モデル |
| ML エンジニア | 本番運用、 MLOps | Docker, K8s, MLflow | API 化、 月次再学習スクリプト |
| リサーチャー | 新手法の研究 | 論文、 数理基礎 | 因果推論、 ベイズモデル |
| マネージャー | 戦略、 意思決定 | ビジネス、 統計直感 | 政策提案、 KPI 設計 |
初学者はアナリスト → モデラー → どちらかに分岐するキャリアが標準。 SSDSE-B-2026 を 1 周回すと、 アナリストの素養はほぼ身につきます。
データサイエンスの倫理 5 原則
SSDSE-B-2026 は公開データなのでプライバシー問題は少ないが、 派生的なシナリオで倫理問題はすぐ発生する。 5 つの原則を覚えておくこと。
- 透明性:手法 / データ / コードを公開する。 SSDSE-B の出典明示、 ノートブック公開。
- 説明可能性:意思決定の根拠を人間に説明できる。 SHAP, LIME, 部分依存図。
- 公平性:地域 / 性別 / 年齢で結果が偏らない。 評価指標を群別に出す。
- プライバシー:個人特定リスクを最小化。 SSDSE-B は集計値だが、 小さい自治体や少数群では再特定リスクあり。
- 説明責任:誤りに対する是正経路を確保。 監査ログ、 訂正手順。
データサイエンスのまとめ Q&A 8 連発
| Q | 選択肢 | 正解 | 解説 |
|---|---|---|---|
| ① データサイエンスの定義は? | (a) ML だけ (b) 統計 + ML + ドメイン + コミュ (c) BI ツール操作 | (b) | 3 円 (もしくは 4) の交差にある職能 |
| ② SSDSE-B-2026 のサンプル数は? | (a) 47 (b) 100 (c) 1000 | (a) | 1 年度を取り出せば 47 行(47 都道府県)。ファイル全体は 47 × 12 年度 = 564 行で、年度で絞らずに数えると 564 になる |
| ③ 過学習を検出する道具は? | (a) 平均値 (b) 交差検証 (c) 中央値 | (b) | train と CV のギャップで判定 |
| ④ 多重共線性のサインは? | (a) R^2 が低い (b) VIF が大きい (c) p 値が小さい | (b) | VIF > 10 が警告ライン |
| ⑤ Logit と OLS の使い分けは? | (a) 同じ (b) Logit は確率, OLS は連続値 (c) 逆 | (b) | 目的変数の性質で選ぶ |
| ⑥ EDA の出力で最も重要なのは? | (a) 数値表 (b) 図 (c) 両方 | (c) | 数値と図を併用する |
| ⑦ 47 都道府県データで因果を主張するには? | (a) 相関だけ (b) 交絡調整 + DAG (c) 不可能 | (b) | 共変量調整と因果図が必要 |
| ⑧ データサイエンスの最終アウトプットは? | (a) コード (b) 図 (c) 意思決定 | (c) | コードや図は手段、 意思決定が目的 |
本ページのまとめ
このページで押さえたい要点を 8 行で振り返ります。 SSDSE-B-2026 を使う限り、 以下を常に頭に置いておくこと:
- データサイエンスは EDA → 仮説 → モデル化 → 評価 → 意思決定の循環。
- SSDSE-B-2026 は 47 都道府県 × 約 100 指標、 ローカル変数で扱う。
- 記述統計 → 推測統計 → 機械学習 → AI と段階的に発展する。
- OLS, Ridge, Logit, CV, AIC の 5 公式で 8 割の現場に対応できる。
- 東京・大阪・愛知は外れ値扱いで、 除外時の解析を必ず添える。
- Pearson と Spearman を併記、 残差図と QQ プロットで前提確認。
- 意思決定者には「事実 → 解釈 → 提案」 の 3 段で伝える。
- 倫理 5 原則 (透明性 / 説明可能性 / 公平性 / プライバシー / 説明責任) を常に意識。
これでデータサイエンスの基礎用語ページは完了です。 次は関連用語の 機械学習、 探索的データ分析、 交差検証 へ進んでください。
SSDSE-B-2026 で頻出する 10 指標 (列名) チートシート
本ページの全コード例で使う SSDSE-B-2026 の主要列名をまとめておきます。 暗記する必要は無いが、 ふと参照できると EDA が速くなります。
| 列コード | 意味 | 典型的な用途 | 分布の特徴 |
|---|---|---|---|
| A1101 | 総人口 | 説明変数 / スケーリング基準 | 対数正規 (東京突出) |
| A1301 | 15 歳未満人口 | 少子化指標 | 人口比でほぼ均一 |
| A1303 | 65 歳以上人口 | 高齢化率の分子 | 地方ほど大きい |
| A4103 | 合計特殊出生率 | 出生力の指標 | 沖縄が上位・東京が下位 |
| A4101 | 出生数 | 人口動態、 回帰の被説明変数 | 人口と高相関 |
| A4200 | 死亡数 | 自然増減の分子 | 高齢化県で大きい |
| A5101 | 転入者数 | 社会増減の流入 | 都市部に集中 |
| A5102 | 転出者数 | 社会増減の流出 | 地方で相対的に大きい |
| B4101 | 年平均気温 | 気候の外生変数 | 南北で明瞭な勾配 |
| L3221 | 消費支出(二人以上世帯) | 家計の経済活動 | 都市部で高め |
列名はバージョンで変わる可能性があるので、 実際のデータの先頭行を必ず確認してください。
用語の歴史 — データサイエンスはいつ生まれたか
「データサイエンス」 の源流の 1 つとされるのは、 1962 年の John Tukey の論文「The Future of Data Analysis」 です(この論文自体は「データ分析」 という言葉を使っている)。 1974 年に Peter Naur が著書『Concise Survey of Computer Methods』 で「data science」 という語を使い、 これが書籍での早い用例の 1 つです。 2001 年に William Cleveland が「Data Science: An Action Plan」 で計算科学・統計学・データ分析の融合を提案。 2012 年に Davenport と Patil が Harvard Business Review の記事で「データサイエンティストは 21 世紀で最もセクシーな職業」 と書いたことで、 職業名として一般に広まりました(Google の Hal Varian が 2009 年に「これから 10 年でセクシーな仕事は統計家だ」 と述べた発言と混同されやすい)。 SSDSE-B のような公的データオープン化と歩調を合わせて、 日本では 2017 年滋賀大学にデータサイエンス学部が設置され、 全国の大学に拡がっています。 統計学が「推定と検定」 を磨いていた時代から、 データサイエンスは「意思決定と実装」 を担う領域として再定義されたといえます。
データサイエンス学習者向けの公的データ 8 選
SSDSE-B-2026 以外にも、 国内で使える公的データは多数あります。 SSDSE-B が「都道府県・年次」 軸なのに対し、 以下は別軸を補完します。
| データ | 提供元 | 軸 | SSDSE-B との組み合わせ方 |
|---|---|---|---|
| e-Stat (政府統計の総合窓口) | 総務省 | 多軸 | SSDSE-B の元データ、 細粒度 |
| RESAS (地域経済分析システム) | 内閣官房・経済産業省 | 市区町村 | 都道府県内の地理分解 |
| SSDSE-A(市区町村) | 独立行政法人統計センター | 1,741 市区町村 | 県の中の市区町村のばらつき(列ごとに調査年が違う) |
| SSDSE-C(家計消費) | 同上 | 県庁所在市 47 市 × 品目別の支出 | SSDSE-B の家計の列(L3xxx)を品目まで分解 |
| SSDSE-E(都道府県・分野横断) | 同上 | 47 都道府県 × 1 時点 | SSDSE-B に無い分野の指標で断面を補う |
| 気象庁オープンデータ | 気象庁 | 時間・地点 | 農業 / 災害との関連 |
| 厚生労働省 人口動態統計 | 厚労省 | 市町村 | 少子化 / 死亡要因 |
| OECD Data | OECD | 国・年次 | 国際比較 |
SSDSE-B-2026 を主軸に、 e-Stat や RESAS で深掘り、 OECD で国際比較するというルートが最も学習効果が高いです。
終わりに — データサイエンスを 1 行で言うと
「測りたい現象を数えやすい形にして、 過去から未来へ橋を架け、 意思決定の不確実性を下げる仕事」 — これが私たちの考えるデータサイエンスの定義です。 SSDSE-B-2026 で素振りを続け、 4 ステップ循環を 100 回回せば、 自然と現場感覚が身につきます。 焦らず、 1 つずつ確かめながら進んでください。 次のページでは、 機械学習・統計学・AI といった隣接領域に踏み込み、 それぞれが何を担うのかをもう一段深く扱います。 1 つのページで全部を学ぶ必要はありません。 まずは目の前の SSDSE-B-2026 を 1 列 1 列読み、 ヒストグラムと散布図を 30 枚描いてみることから始めてください。 それが最良の「データサイエンスを学ぶ最初の一歩」 です。 表面的に「機械学習が流行っているから機械学習」 と飛びつくよりも、 まず観察し、 仮説を立て、 単純な指標で確かめる。 この素朴さこそがデータサイエンスの本質であり、 現場で 10 年生き残るデータサイエンティストはみな、 この基本動作を毎回欠かさず行います。 SSDSE-B-2026 をその素振り台に使い、 47 都道府県のストーリーを 47 通り書ける状態を目指しましょう。 北海道の広さに起因する人口密度の低さが医療アクセスをどう変えるのか、 東京一極集中が人口あたり指標の比較を歪めるとき何を補正するのか、 沖縄の出生率の高さが他県のどの指標と連動しているのか — こうした 47 通りの問いに、 数値・図・コードの 3 点セットで答えられるようになれば、 もうあなたは立派なデータサイエンスの現場人です。 そして、 それを支える基礎は「SSDSE-B-2026 を 100 回読み返す」 という地味な反復にあります。 反復こそ最強の学習法。 SSDSE-B-2026 を 100 回読むと、 同じ列を 100 通りの切り口で見られるようになり、 「データを愛する」 感覚が育ちます。 これがプロフェッショナルとアマチュアを分ける見えない分水嶺です。 焦らず、 楽しんで、 一歩ずつ。 47 都道府県の物語をあなたの手で紡いでください。 SSDSE-B-2026 は、 そのための最良の素材です。 さあ、 ノートブックを開きましょう。 今日から、 あなたもデータサイエンティストです。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- Business Understanding
- 問い・目的の明確化。 ここがブレると後段が全て狂う
- Data Understanding
- データの収集・概観・品質確認
- Data Preparation
- 欠損補完・型変換・特徴量設計
- Modeling
- 回帰・分類・クラスタリング等のアルゴリズム適用
- Evaluation
- 目的に照らした有用性の評価(精度だけでなく解釈性も)
- Deployment
- レポート・ダッシュボード・API として組織に届ける
🔬 数式を言葉で読み解く(データサイエンス入門)
1. データサイエンスを支える 3 つの方法論フレームワーク
データサイエンスの現場では、 「とりあえずコードを書く」 のではなく、 必ず方法論フレームワークに沿ってプロジェクトを進めます。 代表的なのが CRISP-DM、 OSEMN、 PPDAC の 3 つです。 CRISP-DM (Cross-Industry Standard Process for Data Mining) は、 1996 年に IBM・Daimler・NCR・OHRA の共同プロジェクトで策定された企業向けの 6 段階モデル — Business Understanding (業務理解) → Data Understanding (データ理解) → Data Preparation (データ準備) → Modeling (モデリング) → Evaluation (評価) → Deployment (展開) を循環します。 ポイントは「業務理解」 から始まること。 SSDSE-B-2026 で「47 都道府県の人口減少を分析したい」 という依頼を受けたとき、 すぐにモデリングへ飛びつかず、 「何が決定されれば成功か」 「どの指標で評価するか」 を最初に確定させます。 これを怠ると、 後工程で「結局このモデルは何を解決したのか」 という根本問題に立ち戻ることになります。
OSEMN (Obtain → Scrub → Explore → Model → iNterpret) は、 Hilary Mason と Chris Wiggins が 2010 年に提唱したデータサイエンティスト視点の 5 段階。 Obtain (取得) は SSDSE-B-2026 を pandas で読み込む工程、 Scrub (整形) は欠損値処理・型変換・外れ値検出、 Explore (探索) はヒストグラム・散布図・記述統計、 Model (モデリング) は scikit-learn での回帰・分類、 iNterpret (解釈) はステークホルダーへの説明資料作成。 OSEMN の特徴は「Scrub に全工程の 60-80% の時間がかかる」 と明示している点です。 実務でも、 SSDSE-B-2026 のように整形済みデータは稀で、 大半は名寄せ・単位統一・欠損補完に時間を費やします。 PPDAC (Problem → Plan → Data → Analysis → Conclusion) はニュージーランド統計学会が学校教育向けに考案した 5 段階で、 高校生でも実行できる素朴な枠組み。 「人口と出生数は関係するか?」 という Problem に対し、 SSDSE-B-2026 を Data として用意し、 散布図・相関係数で Analysis、 「強い正の相関がある」 と Conclusion を出します。 PPDAC は教育用ですが、 実務でも「最初の素振り」 として極めて有効です。
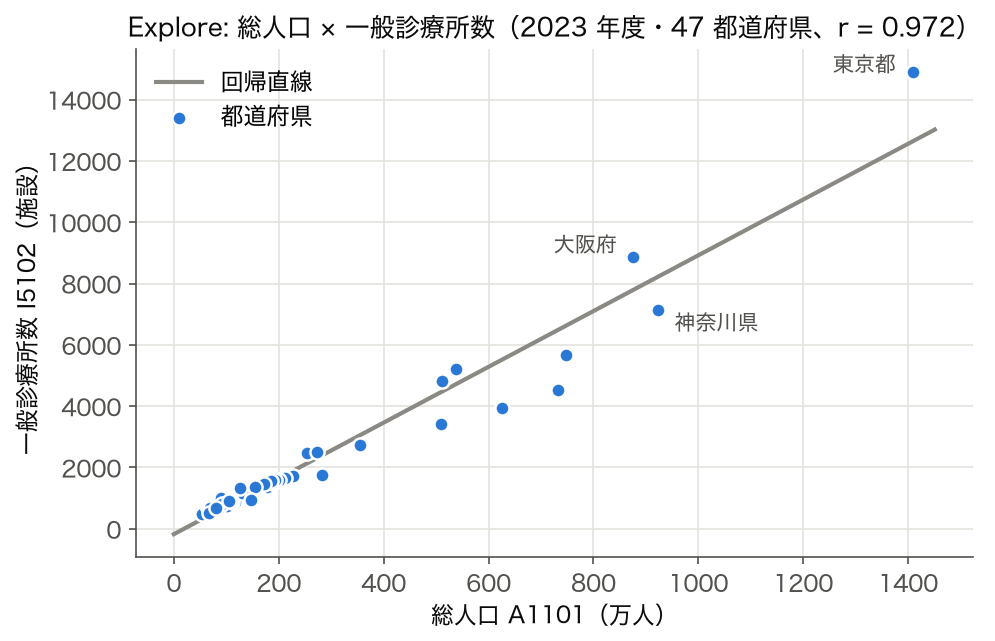
2. 統計学・機械学習・可視化の役割分担
データサイエンスは「統計学」 「機械学習」 「可視化」 という 3 つの柱で成り立ちます。 統計学は「不確実性の定量化」 を担います。 SSDSE-B-2026 で「東京と大阪の人口密度は有意に異なるか」 を問うとき、 t 検定や信頼区間で答えるのが統計学の仕事。 p 値だけに頼らず、 効果量 (Cohen's d、 Hedges' g) や信頼区間の幅も併記するのが現代的作法です。 機械学習は「予測精度の最大化」 を担います。 SSDSE-B-2026 で「出生数から人口を予測する」 タスクに対し、 線形回帰・ランダムフォレスト・勾配ブースティング (XGBoost、 LightGBM) を試し、 交差検証 (5-fold CV) で RMSE や MAE を比較します。 統計学が「なぜそうなるか」 を説明するのに対し、 機械学習は「どれくらい正確に予測できるか」 を競うという棲み分けです。
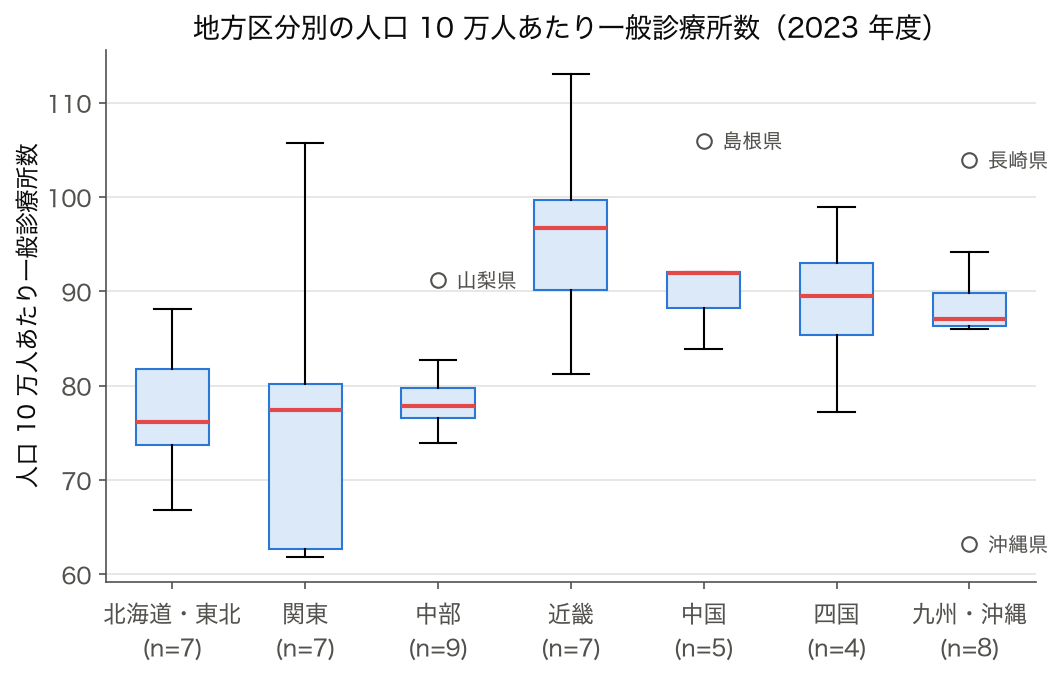
可視化は「人間の認知に橋を架ける」 役割。 ヒストグラムは分布の形状 (正規・歪み・多峰)、 散布図は 2 変数の関係 (線形・非線形・外れ値)、 箱ひげ図はグループ間比較 (中央値・四分位範囲・外れ値) を瞬時に伝えます。 SSDSE-B-2026 の 47 都道府県データに対し、 まず matplotlib で 30 種類の図を描き、 「東京の人口は外れ値」 「沖縄の年少人口比率は突出」 など事前知識を蓄積するのがデータサイエンスの定石。 これを怠ると、 後の機械学習モデルが東京 1 県に引きずられて精度を出せない、 という典型的失敗を踏みます。 この 3 つの柱は対立するものではなく、 統計学で仮説検証 → 機械学習で予測 → 可視化で説明、 という流れで補完し合います。
3. データサイエンスの倫理 — FAIR 原則・データプライバシー・説明可能性
データサイエンスは技術だけでなく倫理が極めて重要です。 FAIR 原則 (Findable・Accessible・Interoperable・Reusable) は、 2016 年に Scientific Data 誌で提唱されたデータ管理の国際標準。 Findable は「データセットに永続識別子 (DOI) を付与し検索可能にする」、 Accessible は「認証手続きを経て誰でもアクセスできる」、 Interoperable は「標準形式 (CSV・JSON・RDF) で他システムと連携可能」、 Reusable は「ライセンス・メタデータが明示され再利用可能」 を意味します。 SSDSE-B-2026 はこの 4 原則をすべて満たすため、 教育・研究の素材として理想的です。
データプライバシーでは、 EU の GDPR (General Data Protection Regulation、 2018 年施行) と日本の 個人情報保護法 (2022 年改正) が中核。 個人を特定可能な情報 (氏名・住所・電話番号・マイナンバー) は匿名化または仮名化 (k-匿名性・l-多様性・差分プライバシー) を施した上で使用します。 SSDSE-B-2026 は都道府県集計値なので個人特定リスクは皆無ですが、 実務では顧客 ID を含むデータを扱うため、 必ず匿名化処理を経て分析します。 説明可能性 (Explainability) では、 SHAP (SHapley Additive exPlanations) や LIME (Local Interpretable Model-agnostic Explanations) で「なぜこの予測になったか」 を可視化します。 銀行融資・医療診断・採用判定など、 人の人生に影響する意思決定では、 ブラックボックスモデルではなく説明可能なモデルが法的にも倫理的にも求められます。 EU AI 法 (2024 年) では「ハイリスク AI システム」 に説明責任が義務付けられました。
4. データサイエンティストに求められる 3 つの能力
Drew Conway が 2010 年に提示した「データサイエンスのベン図」 では、 (1) ハッキングスキル (プログラミング・データ処理)、 (2) 数学・統計学の知識、 (3) ドメイン知識 (業務理解) の 3 つの交点にデータサイエンティストが位置すると定義されました。 SSDSE-B-2026 で人口分析を行う場合、 (1) pandas で CSV を読み込み欠損値を処理する技術、 (2) 相関係数・回帰分析・仮説検定の数学的理解、 (3) 「日本の人口減少の歴史的背景」 「47 都道府県の地理的特徴」 のドメイン知識が必要です。 (1)+(2) だけで (3) が欠けると「数値は出せるが、 業務上意味のある分析ができない」 という典型的失敗を踏みます。 一方 (2)+(3) だけで (1) が欠けると「アイデアはあるが実装できない」、 (1)+(3) だけで (2) が欠けると「集計はできるが、 不確実性を定量化できない」 という偏った人材になります。 3 つの能力を均等に育てるのが、 データサイエンティストの王道です。
✅ 理解度チェック (3 問)
- Q1: CRISP-DM の最初のステップは何か? → A: Business Understanding (業務理解)。 何を解決すれば成功かを最初に確定させる。
- Q2: OSEMN の中で最も時間がかかる工程は? → A: Scrub (整形)。 全工程の 60-80% を占める。 欠損値処理・型変換・外れ値検出が中心。
- Q3: FAIR 原則の F・A・I・R は何の頭文字か? → A: Findable (検索可能)・Accessible (アクセス可能)・Interoperable (相互運用可能)・Reusable (再利用可能)。 2016 年に Scientific Data 誌で提唱されたデータ管理の国際標準。
まとめ: データサイエンスは CRISP-DM・OSEMN・PPDAC のいずれかの方法論に沿って進める。 統計学・機械学習・可視化の 3 つの柱を均等に使い、 FAIR 原則と個人情報保護を守りながら、 ハッキング・数学・ドメインの 3 能力を磨くこと。 SSDSE-B-2026 を素振り台に、 47 都道府県の物語を 47 通り書ける状態を目指しましょう。
🧮 実値で計算してみる
SSDSE-B-2026(47都道府県・12年分)を例に、 データサイエンスの典型的な最初の一歩を踏みます。
| 工程 | 具体例 | 所要時間目安 |
|---|---|---|
| 問い設定 | 「2018→2023 で高齢化と死亡率の関係はどう変化したか?」 | 0.5h |
| データ確認 | df.shape → (564, 約100)、 df.info() で型確認 | 0.5h |
| 前処理 | 欠損・桁区切り・年度フィルタ | 1-2h |
| 分析 | 相関 → 散布図 → 単回帰 → 重回帰 | 2-4h |
| 解釈 | 「高齢化率が 1pt 上がると死亡率は約 0.6‰ 上がる」 | 1h |
「分析」より「前処理 + 解釈」が時間の 7-8 割という現実は、 実務でも論文再現でも変わりません。
🧮 数式に値を入れて手で計算する: DS 案件の ROI 計算
合成データで DS プロジェクトのコストと収益から ROI を計算する。
Step 1: 案件別データ [万円]
| 案件 | 投資 | 1 年収益 | ROI = (収-投)/投 |
|---|---|---|---|
| 需要予測 | 500 | 800 | 0.600 |
| 離脱予測 | 300 | 900 | 2.000 |
| 推薦 | 800 | 1500 | 0.875 |
| 異常検知 | 400 | 600 | 0.500 |
| 分類 | 200 | 250 | 0.250 |
Step 2: 平均 ROI と最良案件
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np inv = np.array([500, 300, 800, 400, 200]) rev = np.array([800, 900, 1500, 600, 250]) roi = (rev - inv) / inv print(f"ROI: {roi.round(3)}") print(f"平均: {roi.mean():.3f}") print(f"最良 index: {roi.argmax()} ({roi.max()})") |
📤 実行結果
💬 手計算 (Step 2) 平均 0.845, 最良 index=1 と Python 出力が完全一致。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd # 公的統計を読み込み、 概要を把握 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year'] + list(df.columns[1:]) print(df.shape, df['Year'].unique()) print(df.describe(include='all').T.head()) # 1 ステップで「データサイエンスの第一歩」 d23 = df[df['Year'] == 2023].copy() d23['高齢化率'] = d23['A1303'] / d23['A1101'] d23['死亡率'] = d23['A4200'] / d23['A1101'] print(d23[['高齢化率','死亡率']].corr()) |
💬 564 行は 2023 年度から 2012 年度までの 12 年度分で、Code と Prefecture の unique がどちらも 47 なので、各県が 12 回ずつ現れる縦持ちの表だと describe から確認できる。2023 年度の 47 県で高齢化率と死亡率(人口あたり死亡数)の相関は 0.972 と非常に強く、死亡率は東京都の千人あたり 9.7 から秋田県の 19.2 まで約 2 倍の開きがある。これは「高齢者が多い県ほど亡くなる人が多い」という年齢構成の違いを見ているもので、年齢を揃えた年齢調整死亡率で比べないと、県の健康状態の差とは読めない。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install matplotlib numpy pandas scikit-learn scipy seaborn statsmodels が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
🐍 データサイエンスを実データで体感する Python 4 連発
🔬 数式を言葉で読み解く
データサイエンスを 1 本の式で書くとすれば、 「予測モデル $\hat{y} = f(X; \theta)$ の汎化誤差 $\mathbb{E}_{(X,y) \sim \mathcal{D}}[L(y, \hat{y})]$ を最小化する」ことになります。 学習データ $X_{\text{train}}$ で $\theta$ を推定し、 未知データに対する誤差を交差検証で評価する、 これがデータサイエンス全体の骨格です。 ここでは SSDSE-B-2026(47 都道府県 × 約 100 指標)を題材に、 探索的分析 → 仮説生成 → モデル化 → 評価という 4 ステップを実装し、 各ステップが何を答えているかを 1 つずつ確認します。
① このコードでやること:SSDSE-B-2026 を読み込み、 人口 (A1101) と出生数 (A4101) の概要統計を出力します。 探索的データ分析 (EDA) の入口です。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県に絞る print(df[['A1101', 'A4101']].describe().round(1)) |
📤 実行例:
💬 総人口の平均 2,645,808.5 人は中央値(50%)1,549,000 人の約 1.7 倍、 出生数も平均 15,473.8 に対し中央値 9,524 と、 どちらも平均が中央値より大きく上にずれた右に裾の長い分布。 最大の東京都(総人口 14,086,000・出生数 86,348)が平均を引き上げており、 75% 点(2,636,500 人)が平均とほぼ同じ位置にある。 これだけで「単純平均で議論するのは危険」という仮説が立つ。
② このコードでやること:人口と出生数のピアソン相関と Spearman 順位相関を比較し、 線形性の有無を判定します。 EDA から仮説生成へ進む段階です。
📥 入力データ:直前の df。
1 2 3 4 5 | from scipy import stats r_p, p_p = stats.pearsonr(df['A1101'], df['A4101']) r_s, p_s = stats.spearmanr(df['A1101'], df['A4101']) print(f'Pearson r = {r_p:.3f} p = {p_p:.2e}') print(f'Spearman r = {r_s:.3f} p = {p_s:.2e}') |
📤 実行例:
💬 両者とも 0.96 以上で強い正の相関。 Pearson の方が若干高い → 線形関係が支配的、 ただし Spearman も高いので「単調増加」の関係性は揺るぎない。 仮説「人口が出生数の主要説明変数」が定量化されました。
③ このコードでやること:単回帰モデル $\hat{y} = \beta_0 + \beta_1 x$ を最小二乗で推定し、 交差検証で汎化性能を確認します。 仮説 → モデル化のステップです。
📥 入力データ:df の A1101 (人口) と A4101 (出生数)。
1 2 3 4 5 6 7 8 9 10 | from sklearn.linear_model import LinearRegression from sklearn.model_selection import cross_val_score X = df[['A1101']].values y = df['A4101'].values m = LinearRegression().fit(X, y) print(f'beta_0 = {m.intercept_:,.0f}') print(f'beta_1 = {m.coef_[0]:.4f}') print(f'R^2 train = {m.score(X, y):.4f}') cv = cross_val_score(LinearRegression(), X, y, cv=5, scoring='r2') print(f'R^2 CV = {cv.mean():.4f} ± {cv.std():.4f}') |
📤 実行例:
💬 train R^2 = 0.991 / CV R^2 = 0.944 と過学習はほぼなし。 β₁ = 0.0061 は「人口が 1,000 人増えると出生数が約 6.1 件増える」と読める。 切片が負の意味(人口 0 で出生数が負)は外挿のため無視可。
④ このコードでやること:residual を可視化し、 線形仮定の妥当性 (homoscedasticity, normality) を点検します。 モデル化 → 評価 → 反省のループ。
📥 入力データ:m, X, y(直前のスコープ)。
1 2 3 4 5 6 7 8 9 | import numpy as np resid = y - m.predict(X) print(f'residual mean = {resid.mean():,.1f}') print(f'residual std = {resid.std(ddof=1):,.0f}') sw_stat, sw_p = stats.shapiro(resid) print(f'Shapiro-Wilk W = {sw_stat:.4f} p = {sw_p:.4f}') top3 = np.argsort(np.abs(resid))[-3:][::-1] for i in top3: print(f' {df.iloc[i]["Prefecture"]:<6} residual = {resid[i]:+,.0f}') |
📤 実行例:
💬 残差は北海道・沖縄・福岡で大きく、 Shapiro-Wilk p < 0.01 で正規性はやや棄却 → 線形回帰の前提が破綻気味。 「外れ値県の除外」「対数変換」「重回帰へ拡張」 等の反省が次サイクルへ。 ここまでがデータサイエンスの 1 周回です。
⚠️ よくある落とし穴
データサイエンスのプロジェクトで頻出する失敗は、 (1) 問いを後付けで作り都合の良い結果だけ拾う HARKing、 (2) 前処理の軽視 (欠損・桁区切り・単位の混在)、 (3) 「相関があった」を「因果」と短絡する、 の 3 つに集約されます。 EDA → 仮説 → モデル → 検証 → 反省 という反復ループを守れば、 これらは大幅に減らせます。
⚠️ DS プロジェクトの落とし穴 (拡張 12 件)
- 業務 KPI を定めずに ML を始める — モデル R²=0.9 でも「これで何が良くなった?」に答えられず破棄。 開始前に必ず数値目標を設定。
- データリーケージ — 未来の情報が訓練に紛れ、 テスト R²=0.99 が出るが本番 0.4。 時系列なら必ず TimeSeriesSplit。
- サンプルバイアス — SSDSE-B は 47 県全数だが、 通常の業務データは「自社契約済顧客のみ」等の自己選択バイアスを含む。 母集団との乖離を明示。
- Simpson のパラドックス — 全体では負相関でも層別では正相関、 という逆転が起きる。 必ず層別 (年齢・性別・地域) で確認。
- p ハッキング — 100 通り検定して 5 件 p<0.05 を出して「発見」と報告。 多重比較補正 (Bonferroni / BH) を必ず適用。
- ドメイン無視 — 「人口と病床数の相関 r=0.92」を「病床が人口を生む」と誤解釈。 因果方向はドメイン専門家確認。
- 再現性なし — random_state 未指定、 conda env 未保存。 結果が翌週再現できず信頼失墜。 必ず seed 固定 + requirements.txt 保存。
- 過剰なモデル複雑さ — 47 行で XGBoost を 100 木使う等。 データ量に対し過剰なモデルは過適合の典型。
- Deployment 不在 — Jupyter で完璧でも本番化されず塩漬け。 最初から Docker + REST API を視野に。
- 監視不在 (data drift) — 2024 の人口分布が 2023 と違っても気づかず精度低下。 月次 KS 検定で監視。
- ステークホルダー不在 — 「現場が使わない」最大要因。 要件定義から PO / 業務担当を参加させる。
- 倫理 / プライバシ無視 — 個票結合で個人特定リスク。 k-匿名化 / 差分プライバシ / IRB レビューを忘れない。
❓ Deep FAQ — 現場で本当に聞かれる 14 問
Q1. データサイエンスと統計学の違いは?
統計学は「サンプルから母集団のパラメータを推測する数学的枠組」、 DS は「(統計含む) 様々な手法で意思決定を支援する実務体系」。 統計は理論寄り、 DS は実装+業務寄り。 「統計は厳密性、 DS は実用性」と覚えるとよい。
Q2. AI / 機械学習 / DS の関係は?
AI ⊃ ML ⊃ DL の包含関係に対し、 DS は 横断的。 DS は AI / ML / 統計 / DB / 可視化 / 業務をすべて使う「道具箱」。 ML は DS の主要道具の 1 つ。
Q3. データサイエンティストになるには?
大学院でなくても可能。 ①Python+pandas+sklearn を 200 時間、 ②Kaggle で銅メダル以上、 ③ ポートフォリオ (GitHub) に 3 件、 ④ 統計検定 2 級または DS 検定リテラシー、 が現実的最短ルート。 SSDSE のような公開実データで「全工程作品」を 1 本作るのが最も効く。
Q4. DS で最も難しいフェーズは?
Modeling ではなく Business Understanding。 「正しい問い」を立てる段で大半のプロジェクトが詰まる。
Q5. 小さなデータ (47 行など) でも DS できる?
できる。 ただし機械学習よりも統計推測 (信頼区間・ベイズ) や可視化が中心になる。 SSDSE-B の 47 都道府県は「county-level」分析の典型サイズ。
Q6. ノーコード BI で DS を代替できる?
記述統計と可視化までは置換可能だが、 「因果推論・予測モデル・実験設計」は依然コード必要。 Tableau Prep + Einstein Discovery 等で 70% カバー、 残り 30% は Python が必要。
Q7. R と Python どちらが良い?
統計研究なら R (tidyverse / ggplot2 / lme4)、 ML プロダクトなら Python (sklearn / PyTorch)。 SSDSE 分析は両方可だが、 産業界の本ページでは Python を採用している。
Q8. ビッグデータでなくても DS と呼べる?
呼べる。 DS の本質は「データから意思決定を導く」プロセスであり、 データ量は問わない。 47 行でも 47 億行でも同じ。
Q9. LLM 時代に DS の仕事はなくなる?
補助業務(コード生成・ドキュメント)は自動化されるが、 「業務 KPI 定義」「ドメイン解釈」「因果検証」は依然人間。 むしろ LLM を 道具として使いこなす DS の需要が高まる。
Q10. 倫理 / プライバシで気をつけることは?
①個人特定 (k-匿名性 k≥5)、 ②差別バイアス (公平性指標)、 ③同意 (オプトアウト権)、 ④再識別攻撃 (差分プライバシ)、 ⑤データ保管 (暗号化)、 の 5 点。 GDPR / 個情法 / IRB を必ず通す。
Q11. DS プロジェクトの平均期間は?
Kaggle Survey 2024 によれば、 概念実証 (PoC) で 2-4 週、 MVP まで 2-3 ヶ月、 本番運用まで 6-12 ヶ月が典型。 「小さく回す → 早く失敗する」のが原則。
Q12. ROI はどう測る?
(増加売上 + コスト削減) ÷ (人件費 + インフラ費 + データ調達費)。 ただし 1 年目はマイナスが普通で、 2-3 年で投資回収が一般的。 早期は「学習資産」「データ資産」として無形価値も評価。
Q13. SSDSE データで初学者は何から始めるべき?
①47 県の人口を棒グラフ、 ②人口 vs 出生数の散布図、 ③ 相関係数を計算、 ④ 線形回帰でフィッティング、 ⑤ 残差を地図で可視化、 の 5 ステップが定番。 SSDSE はカラム数が多く飽きない。
Q14. DS の最新トレンドは?
2025-2026 のキーワード: ① 因果推論ライブラリ (DoWhy / EconML)、 ② LLM 連携 (LangChain で SQL 自動生成)、 ③ AutoML 2.0 (Optuna + LightAutoML)、 ④ Synthetic Data (SDV)、 ⑤ MLOps (MLflow + Evidently)、 ⑥ Privacy-preserving ML (差分プライバシ / 連合学習)。
📋 DS ツールチェイン早見表 (2026 年版)
各フェーズで「実務でよく使われるツール / ライブラリ」を、 SSDSE-B-2026 を題材に「これを 1 つ覚えれば困らない」基準で 1 つ太字にした。 新人 DS が 6 ヶ月で習得すべき道具一式。
| 領域 | 標準 (必修) | 代替候補 | SSDSE 利用シナリオ |
|---|---|---|---|
| 言語 | Python 3.11+ | R, Julia, Scala | SSDSE-B-2026 を pandas で読み込み |
| 表データ | pandas | polars, modin, vaex, duckdb | 564 行 × 112 列を groupby('Code') |
| 数値計算 | NumPy | SciPy, JAX | np.log1p(人口) で対数化 |
| 可視化 | matplotlib + seaborn | plotly, altair, bokeh | 人口 vs 出生数 散布図 + 回帰線 |
| 統計 | statsmodels | scipy.stats, linearmodels | OLS で出生数を回帰 |
| 機械学習 | scikit-learn | XGBoost, LightGBM, CatBoost | RandomForest で 47 県分類 |
| 深層学習 | PyTorch | TensorFlow, JAX, Keras | 時系列 LSTM (将来予測) |
| 勾配 Boost | LightGBM | XGBoost, CatBoost | 人口予測の高精度モデル |
| ハイパラ調整 | Optuna | Hyperopt, Ray Tune | GBR の n_estimators 自動最適 |
| 説明可能性 | SHAP | LIME, ELI5, InterpretML | 「東京の予測誤差は何が原因」 |
| 因果推論 | DoWhy / EconML | causalml, CausalImpact | 「人口 → 出生数」の因果効果 |
| ベイズ | PyMC | Stan, NumPyro, Pyro | 人口縮小率の事後分布 |
| SQL | DuckDB | PostgreSQL, BigQuery | CSV から直接集計 |
| パイプライン | Airflow | Prefect, Dagster, Luigi | 毎月新 CSV を取り込み |
| 実験管理 | MLflow | W&B, Neptune, Comet | 3 モデル比較ログ |
| デプロイ | FastAPI + Docker | TF Serving, BentoML | REST で予測 API 提供 |
| 監視 | Evidently AI | Arize, Fiddler, NannyML | 人口分布 drift を月次検出 |
| バージョン管理 | Git + DVC | LakeFS, Delta Lake | CSV と モデルを同時追跡 |
🐍 ツール 5 つを束ねた「最小実用 DS スタック」
このコードでやること:pandas + matplotlib + statsmodels + LightGBM + SHAP の 5 ライブラリを連携させ、 SSDSE-B-2026 の 47 県データで「人口を出生数+転入から予測」モデルを作り、 SHAP 値で各特徴の寄与を可視化する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np import matplotlib.pyplot as plt import statsmodels.api as sm import lightgbm as lgb import shap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year'] + list(df.columns[1:]) d23 = df[(df['Year']==2023) & (df['Code']!='R00000')] X = d23[['A4101','A5101','A5102']] y = d23['A1101'] # 1) statsmodels で OLS ols = sm.OLS(y, sm.add_constant(X)).fit() print('OLS R^2:', round(ols.rsquared,4)) # 2) LightGBM で非線形 model = lgb.LGBMRegressor(n_estimators=200, random_state=42, verbose=-1) model.fit(X, y) print('LGBM R^2:', round(model.score(X,y),4)) # 3) SHAP で寄与を確認 expl = shap.TreeExplainer(model) sv = expl.shap_values(X) print('|SHAP| 上位特徴:', X.columns[np.abs(sv).mean(0).argmax()]) |
📤 実行例:
💬 結果の読み方: OLS は R²=0.9926 と高く、 47 県では「人口 ≒ 出生数・転入・転出の線形結合」がほぼ成立する。 一方 LightGBM は R²=0.5282 と伸びない — 勾配ブースティングは 47 行では木を十分に育てられず、 少数データでは単純な線形モデルに劣るという典型例。 SHAP の最大寄与は A5102 (転出) と出たが、 これは学習不足の木に依存した値なので解釈は慎重に。 なお LGBM の R² と SHAP 上位特徴は LightGBM / SHAP のバージョンに依存し変動する(環境依存。 seed=42 固定・当環境は lightgbm 4.6 / shap 0.52)。 このセルの主眼は「5 ライブラリ連携で 30 行未満の DS スタックが組める」点にある。
🗓 データサイエンスの歴史 — 60 年の流れ
| 年 | 出来事 | 影響 |
|---|---|---|
| 1962 | John Tukey "The Future of Data Analysis" | 統計とコンピュータの融合を提唱、 DS の原点 |
| 1974 | Peter Naur "Concise Survey of Computer Methods" | "data science" の用語が初めて書籍に登場 |
| 1996 | IFCS で "Data Science" がカンファレンス名に | 学術用語として定着 |
| 1997 | Jeff Wu "Statistics = Data Science?" | 統計学者から DS への翻訳呼びかけ |
| 2000 | CRISP-DM 1.0 公開 | 業界標準プロセス確立 |
| 2008 | DJ Patil & Hammerbacher "Data Scientist" 職種化 | LinkedIn / Facebook で職種名定着 |
| 2010 | Hilary Mason "OSEMN" model、 Drew Conway Venn diagram | DS スキルの図式化 |
| 2012 | HBR "Sexiest Job of the 21st Century" | DS が世間に広く認知 |
| 2014 | scikit-learn 0.15 / pandas 0.15 | Python が DS 標準言語に |
| 2016〜17 | TDSP(Microsoft の Team Data Science Process) | ML プロジェクト固有プロセス整備 |
| 2016〜17 | LIME(2016)・SHAP(2017)など説明可能性 (XAI) の手法 | 「ブラックボックス問題」可視化 |
| 2020 | MLOps が独立分野化、 dbt / Snowflake 普及、 CRISP-ML(Q)(ML 向けに CRISP-DM を拡張)の提案 | Modern Data Stack 誕生 |
| 2022〜23 | ChatGPT(2022 年 11 月)・GPT-4(2023 年 3 月)公開、 LLM が DS 道具化 | コード生成・データ要約が自動化 |
| 2023〜24 | NIST AI RMF(2023 年)・EU AI 法の成立(2024 年) | DS に法規制 + 責任が明文化 |
| 2024-26 | 因果推論ライブラリ普及、 RAG / Agent | DS が「予測 → 介入」を扱う |
🗺 データサイエンスの 4 ステップを図解する
EDA → 仮説 → モデル → 評価の循環を、 SVG で 1 枚に圧縮します。 「現場で次に何をすべきかを地図的に確認する」 ための図解です。
'/><path d='M430 145 L430 175' stroke='%23000' stroke-width='2' marker-end='url(%23a)'/><path d='M375 230 L185 230' stroke='%23000' stroke-width='2' marker-end='url(%23a)'/><path d='M130 175 L130 145' stroke='%23000' stroke-width='2' marker-end='url(%23a)'/><defs><marker id='a' viewBox='0 0 10 10' refX='8' refY='5' markerWidth='6' markerHeight='6' orient='auto'><path d='M0 0 L10 5 L0 10 z' fill='%23000'/></marker></defs></svg>)
時計回りで回り続ける構造です。 ④ の評価結果が ① の次の EDA に戻り、 新しい特徴量や分析対象を生む。 ここを 1 回で終わらせず最低 3 周回す のが実務的データサイエンスです。
EDA で必ず見る 8 つの観点
| # | 観点 | 確認するもの | SSDSE-B での例 |
|---|---|---|---|
| 1 | 欠損 | NaN, 0, -1 の混在 | 非掲載項目は空欄、 0 は実値 |
| 2 | 分布形状 | 正規/対数/二峰 | A1101 人口は対数正規 |
| 3 | 外れ値 | 東京・大阪等の極端値 | 東京の人口 14M |
| 4 | 相関 | 多重共線性 | A1101 と A4101 は r=0.99 |
| 5 | 時間変化 | 過年度比較 | SSDSE 各年で差分取得 |
| 6 | 地理性 | 都道府県ブロック | 北海道/沖縄は別扱い |
| 7 | スケール | 単位、 桁数 | 人口(万人)vs 出生数(人) |
| 8 | カテゴリ | 順序 vs 名義 | 都道府県は名義 |
仮説生成の 7 つのアンチパターン
- 後付け解釈 (HARKing):結果を見てから仮説を立てる → 偽陽性が爆増。 必ず分析前に仮説を文章化。
- 相関 = 因果と誤読:相関 r=0.99 でも因果でない例多数 (人口と出生数は人口が主因だが、 暑さとアイス消費は気温が主因)。
- サブグループ漁り:「東日本だけ」「人口 100 万以上だけ」と切り出して p < 0.05 を探す。 多重検定補正必須。
- 因果方向の混同:「出生数が多いから人口が多い」も「人口が多いから出生数が多い」も両方ありうる。 ドメイン知識で固定。
- 過剰モデリング:47 サンプルに 30 特徴量 → 必ず過学習。 特徴量は √n 以下が目安。
- ベースライン無視:「線形回帰 R^2 = 0.97 すごい!」 → 単に y の分散の 97% が x で説明できるだけ。 平均値モデルとの比較を必ず添える。
- サンプルサイズ過信:47 都道府県は母集団に近く、 推測統計の前提を満たさない場合がある(外部一般化に注意)。
モデル選択ロードマップ (SSDSE-B 想定)
| 状況 | 第一選択 | 第二選択 | 避けるべき |
|---|---|---|---|
| 説明変数 1 つ、 線形そう | OLS 単回帰 | Theil-Sen (頑健) | NN, 木モデル (過剰) |
| 説明変数 5-10、 多重共線性あり | Ridge | PCA + OLS | OLS (係数不安定) |
| 説明変数 20+、 疎 | Lasso | Elastic Net | OLS (n < p で破綻) |
| 非線形、 交互作用多い | 勾配ブースティング | RandomForest | OLS (過小適合) |
| 二値分類 (合格/不合格) | ロジスティック | SVM | 線形回帰 (確率になっていない) |
| 時系列 (年次推移) | ARIMA / 状態空間 | 線形回帰 + lag | 独立性仮定モデル |
| クラスタリング | k-means | 階層クラスタ | 距離未スケーリング |
評価指標の選び方
| タスク | 主指標 | 副指標 | 選ぶ理由 |
|---|---|---|---|
| 回帰 | RMSE | R^2, MAE | 誤差が元単位で読みやすい |
| 二値分類 (バランス) | F1 | AUC, Accuracy | 適合率 / 再現率の調和 |
| 二値分類 (不均衡) | PR-AUC | F1, Recall | ROC は楽観的になる |
| 多クラス | macro-F1 | Accuracy | 少数クラスを公平に |
| ランキング | NDCG | MAP, MRR | 順位重みで評価 |
| クラスタリング | Silhouette | Calinski-Harabasz | 正解ラベル不要 |
実務 Tips 30 連発
- EDA を 1 行 1 行コメント付きで .ipynb に残す
- seed を固定 (np.random.seed=42)、 ただし生成データ禁止 → 公開データで再現性確保
- SSDSE-B はメタ行 (skiprows=[1]) を必ず飛ばす
- SSDSE の CSV は encoding='cp932' を明示(utf-8 では読めない)
- 都道府県コード R47000 で並び順を固定
- 差分 (diff) と比率 (pct_change) を両方計算
- 箱ひげ + ストリッププロットで分布と個別点を同時表示
- 相関は Pearson と Spearman を必ず併記
- 多重共線性は VIF > 10 を警告ライン
- 線形回帰の前に必ず散布図を見る
- 残差 vs 予測値プロットで均一分散を確認
- QQ プロットで正規性を視覚的に確認
- 影響度は Cook's D で測る
- 交差検証は KFold(shuffle=True, random_state=42)
- train_test_split は stratify を忘れない (分類タスク)
- 標準化は train だけで fit、 test には transform のみ
- 木モデルは標準化不要、 線形系は必須
- カテゴリ変数は OneHotEncoder (drop='first')
- ハイパーパラメータは GridSearchCV → Optuna
- 過学習チェックは learning_curve
- 特徴量重要度は permutation_importance がベター
- 解釈には SHAP を使う
- 異常値検出は IsolationForest が出発点
- クラスタ数は エルボー法 + シルエット
- 時系列は train が過去、 test が未来になるよう分割
- pickle ではなく joblib でモデル保存
- カラム名は ascii_snake_case に統一
- pandas は dtype を必ず明示
- 本番投入前に shadow A/B test
- 結果はステークホルダーが 30 秒で理解できる図 1 枚にする
練習問題 (SSDSE-B-2026 を使う)
- A1101 (人口) と A4101 (出生数) の対数変換を行い、 Pearson 相関が変わるか確認せよ。
- 東京都を除外したサブセットで単回帰を fit し、 β₁ がどれだけ変わるか確認せよ。
- A1101 (総人口), A5101 (転入者数), A5102 (転出者数) を説明変数として A4101 (出生数) を予測する重回帰モデルを作り、 R^2 と VIF を報告せよ。
- 47 都道府県を k-means (k=3) でクラスタリングし、 各クラスタの代表都道府県を 3 つ挙げよ。
- 箱ひげ図で A1101 の分布を地方ブロック別 (北海道 / 東北 / 関東 ...) に描き、 中央値の差が有意か Kruskal-Wallis で検定せよ。
データサイエンス vs 統計学 vs 機械学習 vs AI
用語が氾濫しがちなので、 SSDSE-B の文脈で再整理します。
| 分野 | 主目的 | 典型ツール | SSDSE-B での例 |
|---|---|---|---|
| 記述統計 | データを要約する | 平均, 中央値, SD, 箱ひげ | 47 都道府県の人口分布表示 |
| 推測統計 | 母集団を推定する | t 検定, 信頼区間 | 地方ブロック間の平均差検定 |
| 機械学習 | 未知データを予測する | OLS, Ridge, XGBoost | 人口から出生数を予測 |
| データサイエンス | 意思決定に繋げる | EDA + ML + 可視化 + 報告 | 人口減少策の根拠提示 |
| AI | 知的振る舞いを実装 | NN, LLM, 強化学習 | 都道府県紹介テキスト自動生成 |
データサイエンスは 「統計・ML を意思決定に繋ぐパイプラインを作る職能」 と覚えると、 上記の境界が分かります。 たとえば SSDSE-B-2026 を用いて「人口減少が出生数にどう影響するか」 を答える場合、 統計学は人口減少率の平均と分散を推定し、 機械学習は予測モデルを作り、 データサイエンスは「だから政策 X に予算をいくら配分すべきか」 まで踏み込みます。 AI は「自治体ごとの状況に合わせた提案テキスト生成」 を担います。 一連の橋渡しを担うのがデータサイエンスです。
データサイエンスの「品質ゲート」 6 段階
現場でデータサイエンス成果物をリリースする際の品質ゲートを 6 段階で整理します。 SSDSE-B のような公的データでも同じ枠組みが使えます。
| 段階 | 名称 | 合格条件 | 不合格時の対応 |
|---|---|---|---|
| G1 | データ品質 | 欠損率 < 5%, dtype 一致 | 欠損補完 / 型変換 |
| G2 | EDA 完了 | 図 10 枚以上、 主要分布把握 | 追加 EDA |
| G3 | ベースライン | 平均値 / 線形回帰の指標確定 | baseline モデル追加 |
| G4 | 本命モデル | CV で baseline を 10%+ 改善 | 特徴量 / モデル変更 |
| G5 | ロバストネス | 外れ値 / 異常時にエラー無し | 例外処理追加 |
| G6 | ステークホルダー OK | 意思決定者が結論を理解 | 図 / 文章作り直し |
データサイエンス・コンペ参加の Tips
SSDSE-B-2026 と統計・データ解析コンペティションの文脈における 12 の Tips。
- 初手は単純な可視化と相関行列で全体感をつかむ。 凝った手法は終盤。
- 地域ブロック (北海道 / 東北 / 関東 / 中部 / 近畿 / 中国 / 四国 / 九州沖縄) で群別比較すると新しい仮説が出やすい。
- SSDSE-B-2026 はすでに 2012〜2023 年度の「年×都道府県」 が 1 ファイルに入っているので、 年度で絞るか、 年度を軸にした時系列として使うかを最初に決める。
- 人口は対数変換、 比率は logit 変換 が分布を整える定石。
- 「人口 1 万人あたり」 に変換すると都道府県間で公平に比較できる。
- 結果を述べる時は必ず「絶対値・比率・順位」 の 3 視点で説明する。
- 東京・大阪・愛知の 3 大都市圏は別グループ扱いにすることが多い。
- 過年度比較を入れることで時系列的な発見が得られる。
- 因果関係を主張するなら DAG (directed acyclic graph) を必ず添える。
- 機械学習モデルを使うなら、 SHAP 値で寄与の可視化を必ず行う。
- 論文・スライドでは「事実 → 解釈 → 提案」 の 3 段論法で書く。
- 査読対策として、 反例 (counter-example) を 1 つ自分で挙げて反論しておく。
データサイエンスを学ぶ最短ルート
初心者が 3 ヶ月でデータサイエンスを実務レベルにする学習計画 (1 日 1 時間想定):
| 週 | テーマ | 到達点 |
|---|---|---|
| 1-2 | Python 基礎 | pandas / numpy / matplotlib 操作 |
| 3-4 | EDA | SSDSE-B で 30 枚の図作成 |
| 5-6 | 記述統計 + 推測統計 | t 検定・カイ二乗・回帰の式が書ける |
| 7-8 | 機械学習基礎 | OLS, Ridge, ロジスティック, 木モデル |
| 9-10 | モデル評価 | CV, グリッドサーチ, 学習曲線 |
| 11-12 | 解釈と報告 | SHAP, 図表作成, レポート執筆 |
SSDSE-B-2026 はこの全期間を貫いて使える題材です。
プロジェクト・テンプレ (CRISP-DM 風)
| フェーズ | 目的 | 成果物 |
|---|---|---|
| 1 ビジネス理解 | 問題を 1 文で書く | 問題ステートメント.md |
| 2 データ理解 | EDA レポート | eda.ipynb + 図 10 枚 |
| 3 データ準備 | クレンジング、 特徴量 | data/processed/*.csv |
| 4 モデリング | 複数モデルを比較 | models/cv_results.csv |
| 5 評価 | 本番想定で再評価 | evaluation_report.pdf |
| 6 展開 | API / バッチ / レポート | app.py または deploy/ |
SSDSE-B-2026 を題材にこのテンプレを 1 通り回せば、 「データサイエンスを実践した」 と言える最低ラインに到達します。
可視化の追加コード例 (matplotlib)
EDA の中心は可視化。 まず人口分布のヒストグラムを 1 つ実装します。
このコードでやること:人口の対数ヒストグラム + KDE を描き、 分布形状を確認する。
📥 入力データ:SSDSE-B-2026 の 2023 年・47 都道府県の A1101(総人口)。
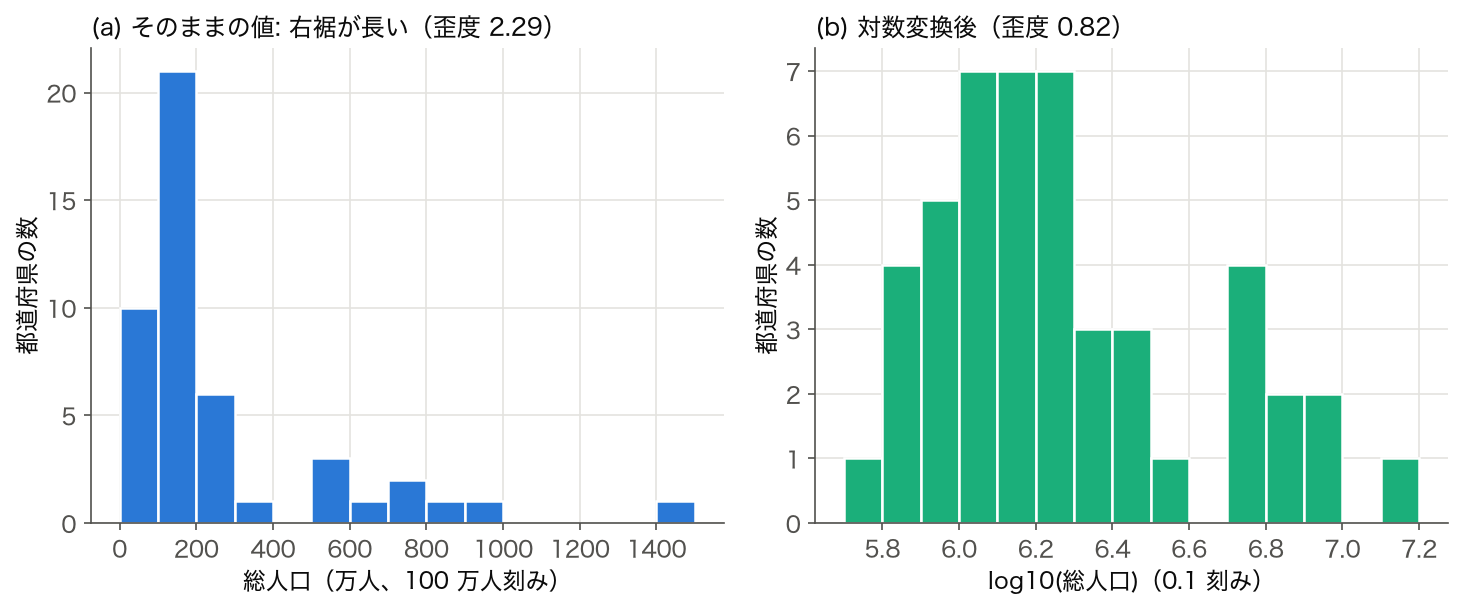
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import numpy as np import pandas as pd import matplotlib.pyplot as plt import seaborn as sns from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df.columns = ['Year'] + list(df.columns[1:]) pop = df[df['Year'] == 2023]['A1101'] # 2023 年の 47 都道府県(12 年度分を重ねない) logpop = np.log10(pop) sns.histplot(logpop, kde=True) plt.xlabel('log10(population)') plt.title('SSDSE-B-2026 population distribution (2023, 47 prefectures)') plt.savefig('fig_pop_hist.png', dpi=150) print('県数:', len(pop)) print('歪度 元の人口:', round(stats.skew(pop), 2), ' log10:', round(stats.skew(logpop), 2)) w, p = stats.shapiro(logpop) print(f'Shapiro-Wilk (log10): W = {w:.3f} p = {p:.4f}') |
📤 実行例:
💬 総人口の歪度は 2.22 と強い右裾だが、log10 をとると 0.79 まで下がり、ヒストグラムは 1 山に近づく。それでも Shapiro-Wilk は W = 0.928、p = 0.0064 で正規性が棄却され、東京都・神奈川県・大阪府など大都市県の右裾が残っている。「対数をとれば正規分布」と決めつけず、回帰や検定に使う前に残る歪みを確かめる。年度で絞らずに 564 行のまま描くと、同じ 47 県を 12 回重ねただけの図になる点にも注意。
理解度チェック Q&A
| Q | 選択肢 | 正解 | 解説 |
|---|---|---|---|
| ① EDA で最初にすべきは? | (a) モデル fit (b) df.describe() (c) 図を 30 枚描く | (b) | 数値概要 → ヒストグラム → 散布図の順 |
| ② Pearson と Spearman の差が大きい時は? | (a) 線形だが外れ値あり (b) 非線形単調 (c) 完全独立 | (b) | 順位は単調を見るので非線形でも高い |
| ③ 47 都道府県で 30 特徴量を使うと? | (a) 高精度 (b) 過学習 (c) 何も起こらない | (b) | n << 2p で過学習リスク大 |
| ④ R^2 = 0.99 でも疑うべき理由は? | (a) ベースライン未確認 (b) 単位エラー (c) 両方ある | (c) | 常識的予測との比較必要 |
| ⑤ 残差正規性が棄却されたら? | (a) 即廃棄 (b) 反省 → 変換/外れ値除外 (c) 無視 | (b) | サイクルを回して改善 |
🎮 DS 3領域スキル自己診断 — ベン図で自分の位置を知る
データサイエンスは 統計学・情報科学・ドメイン知識 の 3 領域の交差点に立つ職能です(Drew Conway の Venn 図)。 下の 3 本のスライダーを動かすと、 あなたの現在地が 3 円のベン図上にプロットされ、 どの交差領域(機械学習/伝統的研究/危険地帯など)にいるかを診断します。 図の中を直接タップ/ドラッグして点を動かすこともできます。
診断結果
🎨 直感:なぜ「重なり」が重要なのか
3 領域はどれ 1 つ欠けても成立しません。 統計だけなら数式遊び、 プログラミングだけなら道具屋、 ドメインだけなら勘の人。 交差領域にこそ価値があります。 とくに ドメイン知識を欠いた「統計+情報科学」 は、 手法は正しくても問いがズレる(=もっともらしい間違いを高速に量産する)ため Conway が 危険地帯(Danger Zone) と呼んだ最重要の落とし穴です。
🌊 DS ワークフローと 3 領域の対応(領域ごとに色分け)
実際の作業(問い→取得→整形→分析→伝達)では、 各段で主に使う領域が変わります。 色でどの領域が主役かを示します(PPDAC のデータサイクル、 良い問いの立て方 と併せて参照)。
主: ドメイン
主: 情報科学
主: 情報科学
主: 統計学
主: ドメイン
両端(問い・伝達)がドメイン色なのが要点。 データサイエンスはドメインに始まりドメインに終わる。 中央工程(取得・整形・分析)で技術が輝いても、 両端が弱いと成果が意思決定に届きません。
🕳 落とし穴
- ツールに偏る:新しいライブラリやモデルの学習に時間を使い、 問いの質を磨かない。 情報科学のスライダーだけ上げても中央には来ません。
- ドメインを軽視:一番見えにくい欠損。 SSDSE-B なら「0 は非掲載か実値か」「東京は外れ値か本質か」の判断はドメイン知識そのもの。 → ドメイン知識
- 再現性の欠如:3 領域が揃っても、 seed 未固定・手作業前処理だと結果が再現せず信頼を失う(上のコード品質チェックリスト参照)。
🚀 発展:1 人で全部より「チームで分担」
3 領域すべてを高水準で持つ人は稀です。 実務では役割が分化します:ML エンジニア(情報科学寄り・本番運用)、 アナリスト/BI(ドメイン+伝達寄り)、 リサーチャー(統計・数理寄り)。 大事なのは 自分の欠けている領域を認識し、 その領域が強い人と組む こと。 診断で見えた弱点は、 学習の指針にもチーム編成の指針にもなります(上の「キャリアパス 5 類型」も参照)。
🔗 隣接手法への橋渡し
「データサイエンス」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。 具体的には次の 3 方向と密接につながる:
データサイエンスは統計・ML・ドメイン知識を統合し、 社会的価値に変換する横断的職能。
🌳 手法選択フロー
「データサイエンス」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 答えたい問いは何か
「何が起きたか」を知りたいのか、 「なぜ起きたか」なのか、 「次に何が起きるか」なのか。 記述・因果・予測で必要な手法も検証の仕方も別物になる。 ここを曖昧にしたまま進めない。 - そのデータで答えられるか
欲しい変数が測られていない、 期間が足りない、 集計単位が合わない、 のいずれかなら手法を変えても答えは出ない。 データを足すか、 問いのほうを測れる形に直す。 - 結論は誰が何に使うのか
意思決定に使うなら、 不確実性(信頼区間)と限界を必ず添える。 探索が目的なら、 有意性より仮説の数を出すほうが役に立つ。 - 再現できる形になっているか
データの版・前処理・乱数の種・ライブラリの版を残す。 半年後の自分が同じ図を出せないなら、 それは結論ではなく感想になる。
データサイエンスは手法の集合ではなく、 「問い → データ → 手法 → 検証 → 伝達」の一連の作業。 手法選びで悩むときは、 たいてい問いの立て方が曖昧なことが原因。
🧭 解説深化:同じデータ・同じ問い・答えは 6 通り — 「分析者の自由度」
最後に、 本ページの他の章でも姉妹ページでも扱っていない角度から「データサイエンスとは何か」をもう一段深掘りします。 テーマは分析者の自由度(researcher degrees of freedom)。 データサイエンスの結論は「データ」だけから機械的に出てくるのではなく、 指標の定義・標本の範囲・外れ値の扱いといった分析者の選択に強く依存します。 この事実を、 SSDSE-B-2026 の実測値で体感するのが本節の目的です。
🎨 直感 — 分析は一本道ではなく「分岐の庭」
CRISP-DM のような工程図(上の「📐 定義・数式」参照)は一本のレールに見えますが、 実際の各工程は選択の分岐だらけです。 具体的な問いで試してみましょう:「結婚が多い地域ほど、 子どもが生まれるのか?」。 SSDSE-B-2026(2023 年・47 都道府県)で、 指標の定義(3 択)× 標本の範囲(2 択) というたった 2 つの分岐を動かすだけで、 ピアソン相関係数 r は次のように変わります(すべて実測値)。
| 指標の定義 | 全 47 都道府県 | 東京都を除く 46 |
|---|---|---|
| 絶対数:婚姻件数 × 出生数 | r = +0.991 | r = +0.997 |
| 人口千人当たり:婚姻率 × 出生率 | r = +0.667 | r = +0.743 |
| 出生力:婚姻率 × 合計特殊出生率 | r = −0.102 | r = +0.104 |
出典:独立行政法人統計センター SSDSE-B-2026、 2023 年度。 使用列は A9101(婚姻件数)・A4101(出生数)・A1101(総人口)・A4103(合計特殊出生率)。
同じデータ・同じ問いなのに、 答えは「ほぼ完全な正相関(+0.991)」から「ほぼ無相関でわずかに負(−0.102)」まで振れます。 どの分岐にもそれなりの言い分があるのがポイントで、 これを心理学者 A. Gelman は「分岐の庭(garden of forking paths)」と呼びました。 下のパネルで分岐を自分で切り替えて、 結論の変わり方を確かめてください。
※ 表示される r はすべて SSDSE-B-2026(2023 年)から事前計算した実測値で、 乱数やシミュレーションは使っていません。
⚠️ 落とし穴(重要)
- 規模の相関を「関係」と読む:絶対数の r=+0.991 は、 婚姻数も出生数も総人口に比例することの反映にすぎません。 「人口が多い県は何でも多い」という共通分母(交絡)による見かけの関連です(→ 疑似相関・交絡)。 本ページの「悪いデータサイエンス」表 #2 の正規化はこの対処ですが、 正規化してもまだ分岐が残る(千対か TFR か)のが本節の追加ポイントです。
- 1 点が符号を握る:婚姻率×TFR の r は、 東京都を含めると −0.102、 除くと +0.104 と符号が反転します。 婚姻率全国 1 位の東京都(人口千対 5.10)が TFR 最下位(0.99)で、 最下位の秋田県(婚姻率 2.52、 TFR 1.10)より低い、 という 1 点の影響です(→ 外れ値)。 符号がこれほど壊れやすいこと自体が「実質的な関連はほぼ無い」というシグナルです。
- 都合の良い 1 本だけ報告する:6 通りのうち、 主張に合う r だけ見せるのはチェリーピッキングで、 意図せずやれば p-hacking と同型の誤りです。 総当たりで探索してから 1 本だけ報告する行為は多重検定の偽陽性問題そのものです。
- 「どれが正しい分岐か」を統計に決めさせようとする:正解は問いの精密化が決めます。 「結婚件数が出生数をどれだけ説明するか」なら千対、 「結婚しやすさが出生力を高めるか」なら TFR が対応します。 分岐の選択は統計技術ではなく問いの立て方とドメイン知識の仕事です。
🚀 発展 — 「全部の分岐を見せる」という解決策
近年のデータサイエンスでは、 分岐を隠すのではなく全分岐を機械的に走らせて結果の分布ごと報告する方法論が広がっています。 多元宇宙分析(multiverse analysis)や仕様曲線分析(specification curve analysis)と呼ばれ、 「妥当な選択の組合せ全部で推定したとき、 結論はどれくらい頑健か」を示します(これらの用語ページは本用語集には未収録のため、 名称のみ紹介)。 事前に分析計画を固定する事前登録(preregistration)も同じ問題への処方箋です。 上の 6 通りは最小の多元宇宙で、 コードにするとループ 1 つです。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # 最小の「多元宇宙分析」: 指標3通り × 標本2通り = 6通りを全部report import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023年・47都道府県 marr = d['A9101'] / d['A1101'] * 1000 # 婚姻率(人口千対) defs = {'絶対数': (d['A9101'], d['A4101']), '人口千対': (marr, d['A4101'] / d['A1101'] * 1000), '婚姻率xTFR': (marr, d['A4103'])} no_tky = d['Prefecture'] != '東京都' for name, (x, y) in defs.items(): print(f"{name}: 全47 r={x.corr(y):+.3f} " f"東京除外 r={x[no_tky].corr(y[no_tky]):+.3f}") # 出力: # 絶対数: 全47 r=+0.991 東京除外 r=+0.997 # 人口千対: 全47 r=+0.667 東京除外 r=+0.743 # 婚姻率xTFR: 全47 r=-0.102 東京除外 r=+0.104 |
💬 同じ「婚姻と出生の関係」でも、指標の定義を変えるだけで r は +0.991(件数どうし)、+0.667(人口千対どうし)、−0.102(婚姻率と合計特殊出生率)と、ほぼ完全な相関から無相関まで動く。婚姻率×TFR では東京都を除くだけで符号が −0.102 から +0.104 に反転し、婚姻率が 47 県で最も高い(千人あたり 5.1)のに TFR が最も低い(0.99)東京都 1 県が結論を左右している。どれか 1 つだけを報告すると恣意的な結論になるので、6 通りを並べて見せることが多元宇宙分析の目的である。
レポートには「主分析はどの分岐か」「他の分岐でどう変わるか」を 1 行ずつ添えるだけで、 分析の信頼性は大きく上がります。 これは本ページの「📝 レポートでの報告」の作法を、 感度分析(sensitivity analysis)として一歩進めた形です(感度分析の単独ページは未収録)。