🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
「domain knowledge」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「domain knowledge」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「domain knowledge の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論 — ドメイン知識
🍰 まずはやさしく
その分野だけの専門知識のことです。
データを正しく読み解くために使います。
部活のルールを知っているようなものです。
まずは結論と注意点を読みましょう。
- 一言で:対象分野の専門知識。 医療・教育・経済・農業など、 そのドメイン固有の文脈・制約・常識。
- 規模で割る:婚姻件数と総人口の相関は生の値で 0.989 だが、 人口千対の率にすると 0.777。 「人口が多い県は何でも多い」を外すのが最初のドメイン知識(実験 1)。
- 層で分ける:高齢化率と合計特殊出生率は 47 県で +0.20 でも、 人口上位 15 県では +0.30、 下位 32 県では −0.38 と向きが逆になる(実験 2)。
- 予測にも効く:合計特殊出生率を総人口だけで予測すると交差検証の R² は 0.297、 年齢構成と保育所定員・病院数・消費支出を足すと 0.531(🧮)。
- 暗黙知を形式知に:専門家の「なんとなく」を数字に翻訳するのが分析者の役目(SECI モデルの表出化)。
📍 あなたが今見ているもの
🍰 まずはやさしく
データの背景にある知識のことです。
分析での間違いを防ぐために使います。
スマホの操作に慣れている感覚に似ています。
このページで解説する構成を確認しましょう。
「データだけで分析するな」とよく言われるのは、 ドメイン知識なしでは外れ値・因果・解釈を間違うから。 ドメイン専門家との協働がデータサイエンスの核心。
本ページは ドメイン知識(Domain Knowledge) を、 ジャストインタイム型データサイエンス教育の文脈で 12 のセクションに分けて解説します。 上から順に読まなくても、 「🔖 キーワード索引」から必要箇所だけ拾い読みすることもできます。
🎨 直感で掴む — ドメイン知識とは何者か
🍰 まずはやさしく
データに意味を与えるメガネのようなものです。
数値の理由を正しく理解するために使います。
買い物の傾向から好みを当てるようなことです。
具体例を通して感覚的に理解しましょう。
🎨 図で掴むドメイン知識 — 「同じ数字、 違う物語」
ドメイン知識の有無は、 単に解釈の質を変えるだけでなく、 「何をプロットするか」「どう軸を取るか」「どう群に分けるか」といった図の作り方そのものを根本的に変える。 ここでは SSDSE-B-2026 の同じデータから、 ドメイン知識を反映した 3 種類の図を作り、 それぞれが何を語るかを比較する。
図 1: 散布図 — 「規模効果」を切り離す視点
下の散布図は SSDSE-B-2026 の 47 都道府県について、 横軸に総人口 (A1101)、 縦軸に出生数 (A4101) を取ったものだ。 ドメイン知識のない分析者は「強い正の相関がある」と報告して終わるが、 経験者は「これは 規模の同義反復であり、 人口千対の出生率に変換しないと意味のある違いが見えない」と気づく。
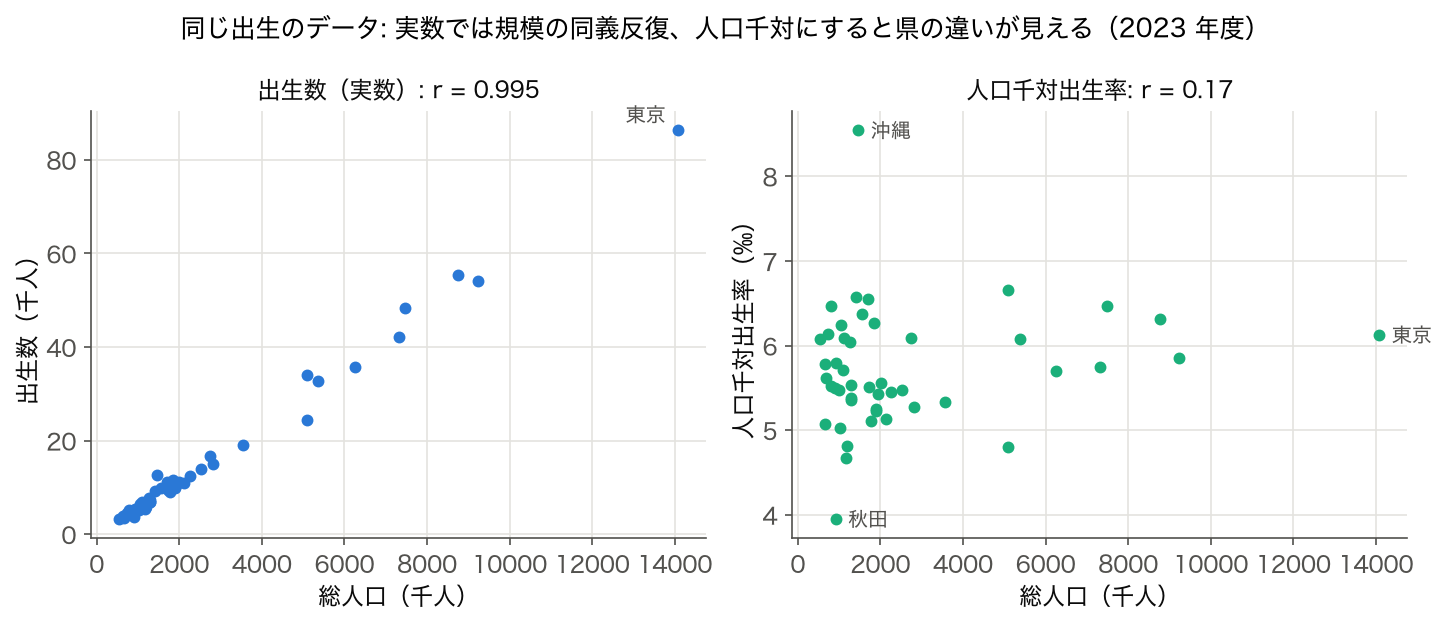
図 2: ヒストグラム — 分布の形が制度を語る
下のヒストグラムは SSDSE-B-2026 の 47 都道府県における高齢化率(65 歳以上人口 / 総人口)の分布だ。 ドメイン知識のない分析者は「平均 31.6%、 標準偏差 3.3% です」と要約するが、 経験者は 「分布は左に裾を引き(歪度 −0.58)、 その裾にいるのは東京 22.8%・沖縄 23.8%・愛知 25.7% のように若い世代が流入する都市圏や出生率の高い県だ」「秋田県の 39.1% は 2 位の高知 36.3% を 3 ポイント近く上回って突出している」といった、 人口移動や出生の構造まで踏み込んで解釈する。
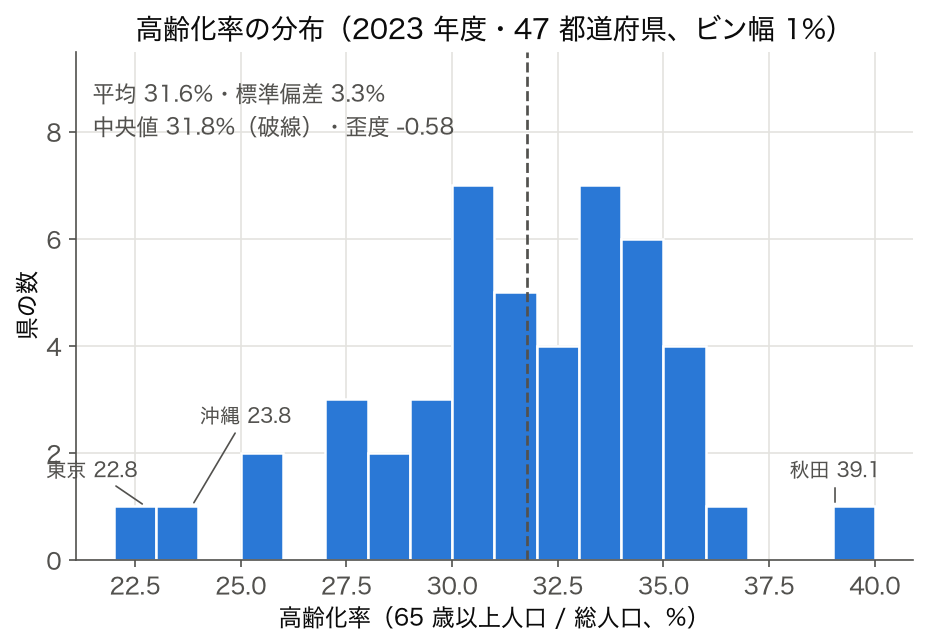
- 右に裾が長い → 一部の極端値が制度的・構造的要因(過疎・高齢化・基地経済など)に起因する可能性
- 二峰性 → 異なる 2 つの集団(例: 都市部 vs 地方)が混在している
- 左右対称 → 中央回帰的なメカニズム(例: 一律な制度設計)が働いている
- 裾が極端に長い(log-normal) → 累積効果(人口・所得など、 成長率が比例するもの)
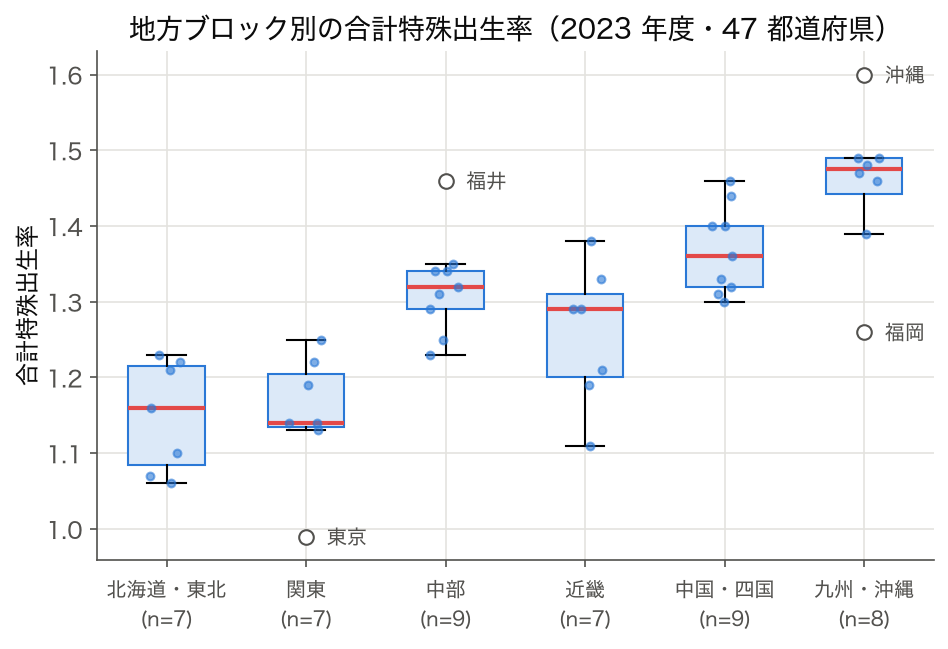
図 3: 群別箱ひげ図 — 「地方ブロック」というドメイン特有のグルーピング
下の箱ひげ図は、 47 都道府県を「北海道・東北」「関東」「中部」「近畿」「中国・四国」「九州・沖縄」の 6 ブロックに分けて、 各ブロックの合計特殊出生率 (TFR) を比較したものだ。 ドメイン知識のない分析者は「47 県の中央値・四分位を出して終わり」だが、 経験者は 「地方ブロック」という政策単位でグループ化することで、 「九州・沖縄ブロックは TFR が高く、 関東・北海道・東北ブロックは低い」という政策的に意味のあるパターンを抽出する。
- 政策分析 → 地方創生 6 ブロック(北海道・東北/関東/中部/近畿/中国四国/九州沖縄)
- 気候分析 → 気候区分(北海道/東北/関東甲信/北陸/東海/近畿/中国/四国/九州/沖縄の 10 区分)
- 経済分析 → 三大都市圏 vs 地方(東京/名古屋/大阪圏 + その他)
- 地震分析 → 太平洋側 vs 日本海側 vs 内陸
📐 数式・定義
🍰 まずはやさしく
対象となる分野の詳しい知識のことです。
分析の根拠をはっきりさせるために使います。
テストの点数から勉強法を考えるようなことです。
言葉の意味や計算の仕組みを学びましょう。
ドメイン知識そのものは式ではないが、分析の中では「何を何で割るか」「どの単位で分けるか」という形で式に現れる。都道府県データで最もよく使うのは、件数 $y_i$ を分母 $N_i$ で割った率である。
$$ r_i = \frac{y_i}{N_i} \times 1000 \qquad (i = 1, \dots, 47) $$
統計の知識は「率に直すと規模の効果が消える」ことまでを教えてくれるが、$N_i$ に総人口・15 歳未満人口・65 歳以上人口のどれを入れるかは、$y_i$ を誰が生み出し誰が使うのかという対象分野の知識でしか決まらない。
📐 暗黙知(tacit knowledge)と形式知 — Polanyi-Nonaka モデル
ドメイン知識の 70% は暗黙知(Polanyi)と言われる。 専門家が「なんとなくこっちが正しい気がする」と言うとき、 そこには言葉にされていない多変量パターン認識が働いている。 これを形式知に変換する枠組みが、 野中郁次郎の SECI モデル(Socialization / Externalization / Combination / Internalization)。
SSDSE での具体例で説明する:
| フェーズ | SSDSE 文脈での具体例 | 使うツール |
|---|---|---|
| S 共同化: 暗黙 → 暗黙 | 県の統計担当と一日同行し、 数字の使われ方を体感 | フィールドワーク |
| E 表出化: 暗黙 → 形式 | 「沖縄の出生率が高いのは若年層が多いから」をデータで可視化 | 可視化・モデル |
| C 連結化: 形式 → 形式 | 他県の知見と組み合わせ、 全国モデルへ統合 | 統計モデル・知識ベース |
| I 内面化: 形式 → 暗黙 | 分析結果を現場で繰り返し使い、 直感に組み込む | 継続的運用 |
SECI のうち、 データサイエンスが直接担当するのは主に E(表出化)と C(連結化)。 暗黙知を捨象せず、 「数字に翻訳すべき暗黙パターン」として丁寧に拾うことが大事。 「専門家が首を傾げた瞬間」は、 暗黙知が暴露されかかっている貴重なサイン。
🔬 数式・定義を「言葉」で読み解く
上の式の $y_i$ は「数えたもの」(婚姻件数、保育所等定員数など)、$N_i$ は「それを生み出す、または使う人の数」、1000 は「千人あたり」にそろえる定数である。婚姻件数を総人口で割った率と総人口の相関は 0.777 で、生の件数の 0.989 から下がる(実験 1)。保育所等定員数では、$N_i$ を総人口から 15 歳未満人口に替えると沖縄県が 2 位から 8 位に動く(⚠️ の節)。式の形は同じでも、分母の選び方が結論を左右する。
🔬 ドメイン知識 vs 統計的知識 — 役割の違いを徹底比較
「ドメイン知識」と「統計的知識」は、 しばしば対立的に語られるが、 実際には異なる役割を持つ補完的な能力である。 ここでは両者の違いを 10 の観点で比較し、 統計コンペでどう使い分けるべきかを整理する。
| 観点 | ドメイン知識 | 統計的知識 |
|---|---|---|
| 主な役割 | 「数字に意味を与える」 | 「数字から信頼性を引き出す」 |
| 問いの種類 | 「何を分析すべきか」 | 「どう分析すべきか」 |
| 仮説生成 | 仮説の源泉になる | 仮説の検証手段を提供する |
| 特徴量設計 | 「何を作るか」を導く (率・密度・指数) | 「どう作るか」を提供 (正規化・標準化) |
| 外れ値の扱い | 「制度的に説明可能か」を判断 | 「統計的に有意な逸脱か」を判定 |
| 交絡の扱い | 「何が交絡し得るか」を列挙 | 「どう統制するか」を実装 (回帰・層別) |
| 結論の妥当性 | 「結論が現場で通用するか」を保証 | 「結論が偶然でないか」を保証 |
| 獲得時間 | 数ヶ月〜数年 (継続的更新が必要) | 数週間〜数ヶ月 (一度学べば長く使える) |
| 汎用性 | 分野固有 (経済・医療・教育で別) | 分野横断 (どこでも使える) |
| 代替手段 | 専門家インタビュー・白書読破 | 教科書・MOOC・実践練習 |
この対比表から見えてくるのは、 両者は競合関係ではなく協調関係にあるということ。 ドメイン知識だけでは「印象論」になり、 統計知識だけでは「現場感のない数値遊び」になる。 統計コンペで上位入賞する分析者は、 両者を縦糸と横糸のように組み合わせて分析を編み上げている。
ワークフローの中での役割分担
典型的なデータ分析プロジェクトの 7 ステップにおいて、 ドメイン知識と統計知識がどう協働するかを整理する。
| ステップ | ドメイン知識の役割 | 統計知識の役割 |
|---|---|---|
| ① 課題設定 | 解くべき問題を定義 | 統計的に検証可能な形に翻訳 |
| ② データ収集 | 必要な公的データを特定 | サンプリング設計を評価 |
| ③ 前処理 | 列の意味を解釈・派生変数を設計 | 欠測補完・正規化を実装 |
| ④ 探索的分析 | 「どこに着目すべきか」を方向付け | 適切な可視化・要約統計量を選択 |
| ⑤ モデリング | 解釈可能性・規制適合性を担保 | 適切な手法選択・正則化・評価指標 |
| ⑥ 解釈 | 結果を制度的・歴史的文脈で説明 | 統計的有意性・信頼区間を提示 |
| ⑦ 提言 | 政策的・実務的に実行可能な提案 | 提案効果の定量的見積もり |
🛠 SSDSE 分析で使えるドメイン情報源リスト 30 選
SSDSE-B-2026 を活用する際に併用すべき公的データ・白書・解説サイトを、 ドメイン分野別に整理した。 すべて無料で閲覧でき、 多くは日本語で書かれているため初学者にも取り組みやすい。
A. 人口・世帯 (8 件)
- 国勢調査 (総務省統計局) — 5 年に 1 度の全国人口の悉皆調査。 SSDSE 人口列の出典。
- 人口推計 (総務省統計局) — 国勢調査の中間年を補完する月次推計。
- 住民基本台帳人口・世帯数 (総務省) — 行政区域別の正確な人口数。
- 人口動態統計 (厚生労働省) — 出生・死亡・婚姻・離婚の月次データ。
- 日本の将来推計人口 (国立社会保障・人口問題研究所) — 50 年先までの推計。
- 地域別将来推計人口 (社人研) — 市区町村別の人口推計。
- 世帯動態調査 (社人研) — 世帯構造・形成過程の分析。
- 少子化白書 (内閣府) — 少子化の現状と対策。
B. 経済・産業 (8 件)
- 県民経済計算 (内閣府) — 都道府県別の生産・分配・支出を推計する公式統計。
- 経済センサス (総務省・経済産業省) — 事業所・企業の悉皆調査。
- 工業統計調査 (経済産業省) — 製造業の事業所別データ。
- 商業統計調査 (経済産業省) — 卸売・小売業の動向。
- サービス産業動向調査 (総務省) — 第 3 次産業の月次データ。
- 労働力調査 (総務省) — 完全失業率・労働力人口の月次データ。
- 経済財政白書 (内閣府) — 日本経済の構造分析と政策評価。
- RESAS (地域経済分析システム) (内閣官房) — 自治体別の経済データを可視化。
C. 教育・労働 (4 件)
- 学校基本調査 (文部科学省) — 学校種別・進学率の悉皆データ。
- 賃金構造基本統計調査 (厚生労働省) — 業種・職種・年代別の賃金分布。
- 就業構造基本調査 (総務省) — 5 年に 1 度の就業形態の詳細調査。
- 教育白書 (文部科学省) — 教育政策の最新動向。
D. 医療・福祉 (5 件)
- 国民生活基礎調査 (厚生労働省) — 世帯・健康・所得の総合調査。
- 患者調査 (厚生労働省) — 受療率・推計患者数の 3 年ごと調査。
- 医療施設調査 (厚生労働省) — 病院・診療所の医療資源データ。
- 介護給付費等実態統計 (厚生労働省) — 介護サービス利用の月次データ。
- 厚生労働白書 (厚生労働省) — 医療・福祉政策の包括的解説。
E. 環境・地理 (5 件)
- 気象統計情報 (気象庁) — 月別・地点別の気温・降水量。
- 環境統計集 (環境省) — 大気・水質・廃棄物の総合データ。
- 農林業センサス (農林水産省) — 5 年に 1 度の農林業の悉皆調査。
- 国土数値情報 (国土交通省) — GIS データの無償提供。
- 環境白書 (環境省) — 環境政策と SDGs 進捗。
これら 30 件をブックマークしておけば、 SSDSE-B-2026 を扱う上で「データの出所が分からない」「制度的背景が不明」という状況はほぼ起こらない。 とくに 白書類は政策層の理解に必須であり、 各分野で年 1 冊は目を通しておきたい。
🎯 結論 — ドメイン知識は「投資対効果が最も高い」スキル
統計手法・プログラミング・機械学習は明確な教材と練習問題があるので、 時間さえかければ確実に身につく。 一方ドメイン知識は「何を学ぶべきか」自体が見えにくく、 多くの分析者が苦手意識を持つ。 しかし、 ドメイン知識の有無による分析品質の差は、 統計手法のレベル差よりもはるかに大きい。
統計コンペでは、 ドメイン知識の獲得に 全準備時間の 30-40% を投資することを推奨する。 残りの 60-70% を統計手法・実装・可視化に使えば、 「ドメイン × 統計」の両輪が整い、 上位入賞圏に届くレベルの分析が可能になる。
SSDSE-B-2026 は「日本のいまを 47 都道府県 × 125 列で切り取った標本」である。 この標本の背後には、 戦後 80 年の歴史、 高度経済成長、 バブル崩壊、 人口減少、 東日本大震災、 コロナ禍といった巨大な物語が隠れている。 数字の背後にある物語を読み解く力こそが、 ドメイン知識の正体である。
🗾 47 都道府県の「読み方ガイド」 — ドメイン知識で見える地域の素顔
SSDSE-B-2026 を分析する上で最も基本となるのは、 47 都道府県それぞれの「素顔」を知ること。 ここでは、 統計コンペで頻出する地域分類と、 各ブロックの特徴を整理する。 「47 県全てを覚える必要はないが、 主要 12 県の特徴は反射的に思い出せるようにしておく」のがプロのコツ。
必修 12 県の特徴サマリ
| 県 | 特徴的指標 | 背景となる構造 |
|---|---|---|
| 北海道 | 広大面積・低人口密度・農業大規模化 | 明治の開拓史・畑作中心の農業構造 |
| 秋田 | 最高齢化率 (約 39%)・最低出生率 | 若年層流出・米作中心の伝統経済 |
| 東京 | 最高人口密度・最低 TFR (0.99) | 高家賃・長時間労働・キャリア志向 |
| 神奈川 | 第 2 位人口・東京通勤者多数 | 京浜工業地帯・ベッドタウン化 |
| 愛知 | 製造業出荷額 1 位・自動車産業集積 | トヨタ系企業の城下町構造 |
| 大阪 | 第 3 位人口・商業中心地 | 近世以来の商業伝統・サービス業集積 |
| 福岡 | 人口増加・アジア玄関口 | 九州地方の経済中枢・空港アクセスの良さ |
| 沖縄 | 最高 TFR (1.60)・高齢化率は東京に次ぐ低さ (23.8%) | 若い年齢構成・米軍基地経済・観光業 |
| 島根 | 人口は鳥取に次ぐ少なさ (65 万人)・高齢化深刻 | 山陰の地勢・中山間地域の多さ |
| 京都 | 学生人口比率高・観光業集積 | 大学集積地・伝統文化の保全 |
| 兵庫 | 第 7 位人口・神戸港の物流 | 阪神大震災 (1995) の構造的影響 |
| 宮城 | 東北最大都市・震災復興指標 | 東日本大震災 (2011) の影響継続 |
分析時の「あるある誤解」と正しい解釈
SSDSE-B-2026 を扱う初心者がよく陥る「あるある誤解」と、 ドメイン知識を持つ分析者の正しい解釈を対比する。
| あるある誤解 | 正しい解釈 |
|---|---|
| 「沖縄は出生率が高いから経済も伸びる」 | 出生率高 + 県民所得低 + 失業率高の複雑な構造。 出生 ≠ 経済成長 |
| 「東京は GDP が大きいから豊か」 | 家賃・物価を考慮した実質可処分所得では地方の方が余裕がある場合も多い |
| 「秋田は高齢化が深刻だから将来が暗い」 | 高齢化の先行県として全国モデルケースになる可能性 (シルバー産業・在宅医療) |
| 「福岡は人口増加だから成功モデル」 | 九州他県からの吸引 (一極集中) でもあり、 全九州では人口減少が進む |
| 「大都市圏は子育てに不利」 | 保育所定員・教育機会・医療アクセスでは大都市が圧倒的に有利 |
✅ 統計コンペ参加直前チェックリスト — ドメイン知識編 30 項目
統計コンペに参加する直前に、 自分のドメイン知識が十分かを確認するためのチェックリスト。 30 項目中 20 項目以上にチェックが入れば、 ドメイン的な準備は合格水準。
A. データ仕様の理解 (10 項目)
- □ SSDSE-B-2026 の仕様書を全ページ通読した
- □ 全 125 列の名称と単位を把握した
- □ どの列がどの公的調査から得られたか分かる
- □ 列のコード体系 (A1101, B4101 など) のルールを理解した
- □ 都道府県コード (R01000〜R47000) と県名の対応が分かる
- □ 欠測値の表示方法と意味を理解した
- □ 年次 (2023 年版) のデータが何年時点のものか把握した
- □ 「総人口」と「住民基本台帳人口」など類似指標の差異が分かる
- □ 集計単位の違い (世帯・人・事業所) を意識できる
- □ 単位の桁数 (人/千人/万人) を扱う際に注意できる
B. 制度・歴史の理解 (10 項目)
- □ 国勢調査と住民基本台帳の違いを説明できる
- □ 合計特殊出生率 (TFR) の計算方法を理解した
- □ 高齢化率と老年人口指数の違いが分かる
- □ 消費支出(家計調査)の集計範囲と計算方法を把握した
- □ 平成の大合併が市町村数に与えた影響を知っている
- □ 東日本大震災 (2011) が東北 3 県データに与えた影響を考慮できる
- □ 阪神大震災 (1995) が兵庫県データに与えた影響を考慮できる
- □ コロナ禍 (2020-2022) がデータに与えた影響を意識できる
- □ 地方創生総合戦略 (2014-) の概要を把握した
- □ 主要白書 (経済財政・少子化・厚生労働) を読んだ経験がある
C. 分析の応用力 (10 項目)
- □ 生数値を見たら「人口で割る」を反射的に試せる
- □ 「東京は特殊」という前提を持って分析できる
- □ 地方ブロック (北海道東北・関東・中部・近畿・中国四国・九州沖縄) で群別解析できる
- □ 都市圏 (三大都市圏 vs 地方) の二分類で比較できる
- □ 高齢化率を交絡要因として制御する発想がある
- □ 時系列データなら季節調整を考慮できる
- □ シンプソンのパラドックスを意識して層別解析できる
- □ 政策的に実行可能な提言を考えられる
- □ 結果の不確実性 (調査の精度・サンプル誤差) を意識できる
- □ 専門家にインタビューする計画を立てられる
- 25-30 項目達成 → 上位入賞圏のドメイン準備。 分析の質で差別化できる。
- 20-24 項目達成 → 中位入賞圏の準備。 統計手法の質次第で上位を狙える。
- 15-19 項目達成 → 完走可能だが、 入賞には不足。 弱点項目を 1 週間で集中補強。
- 14 項目以下 → ドメイン知識が決定的に不足。 仕様書通読と白書 2 冊から始める。
🧪 ドメイン知識を組み込んだ分析テンプレート集
統計コンペで頻繁に使えるドメイン主導の分析テンプレートを 6 種類提示する。 各テンプレートは「分析の目的 → 必要なドメイン知識 → SSDSE 列の使い方 → 期待される発見」の 4 段構造で整理。
テンプレート 1: 人口減少と地方経済の関係
| 分析の目的 | 社会増減 (転入 - 転出) が自然増減や高齢化にどう影響するかを定量化 |
| 必要なドメイン知識 | 地方創生政策、 一極集中の構造、 関係人口の概念 |
| 使う列 | A1101 (総人口), A5101 (転入者数), A5102 (転出者数) |
| 期待される発見 | 転出超過が大きい県ほど、 自然減と高齢化が同時に加速する傾向がある |
テンプレート 2: 子育て支援と出生率の関係
| 分析の目的 | 保育所定員の充実度が TFR・出生率にどう影響するか |
| 必要なドメイン知識 | 少子化対策、 ワークライフバランス、 地域別子育てインフラ |
| 使う列 | A4103 (TFR), J2505 (保育所等定員数), J2506 (保育所等在所児数) |
| 期待される発見 | 人口あたり保育所定員が多い県は TFR と中程度の正相関 (沖縄・福井がアンカー) |
テンプレート 3: 医療施設の分布と高齢化の関係
| 分析の目的 | 病院・診療所の数が高齢者数とどう対応するか (人口規模を制御) |
| 必要なドメイン知識 | 地域医療体制、 医療圏の概念、 介護予防政策 |
| 使う列 | I510120 (一般病院数), I5102 (一般診療所数), A1303 (65 歳以上人口), A1101 (総人口) |
| 期待される発見 | 人口 10 万対の医療施設数は、 高齢化率の高い地方で必ずしも多くない (偏在) |
テンプレート 4: 教育投資と進学率の関係
| 分析の目的 | 高校教育の規模 (学校数・生徒数) と若年人口の地域差を分析 |
| 必要なドメイン知識 | 高校の地理的分布、 学区制度、 ローカル経済構造 |
| 使う列 | E4101 (高等学校数), E4501 (高等学校生徒数), A1301 (15 歳未満人口) |
| 期待される発見 | 年少人口 1 人あたり高校生徒数は、 都市部より地方で高くなりやすい |
テンプレート 5: 産業構造と所得格差の関係
| 分析の目的 | 消費支出とその費目構成を都市規模で層別分析 |
| 必要なドメイン知識 | 家計消費構造、 サービス経済化、 大都市圏の特性 |
| 使う列 | L3221 (消費支出), L322101 (食料費), A1101 (総人口) |
| 期待される発見 | 消費支出に占める食料費 (エンゲル係数) は、 大都市圏で低く地方で高い傾向 |
テンプレート 6: 気候条件と暮らしの関係
| 分析の目的 | 気温・降水量といった気候条件が消費支出とどう関係するかを分析 |
| 必要なドメイン知識 | 気候区分、 地域の暮らし方、 光熱費・被服費の季節依存 |
| 使う列 | B4101 (年平均気温), B4109 (年間降水量), L3221 (消費支出) |
| 期待される発見 | 寒冷地 (北海道・東北) は光熱費が膨らみ、 消費支出構成が温暖地と異なる |
これら 6 テンプレートはあくまで「ドメイン知識を分析に組み込む」例として参考にしてほしい。 実際のコンペでは、 自分の関心領域・専門分野を活かしたオリジナルテンプレートを 1-2 件作るのが理想。 テンプレートを作る過程そのものが、 ドメイン知識を整理する最良の学習機会になる。
💎 締めくくり — データサイエンティストたちの名言集
ドメイン知識の重要性を強調した世界的なデータサイエンティストの名言を 5 つ紹介する。 これらの言葉を心に留めて、 SSDSE-B-2026 を読み解いてほしい。
"All models are wrong, but some are useful."
— George Box (統計学者)
モデルは現実の近似にすぎない。 「有用」かどうかを判断するのはドメイン知識である。
"Without data, you're just another person with an opinion."
— W. Edwards Deming (品質管理の父)
逆に言えば、 データだけで意見を語っても、 ドメインへの理解がなければ説得力に欠ける。
"Data is the new oil, but you still need to refine it."
— Clive Humby (英国数学者)
原油を精製してガソリンにする「精製プロセス」がドメイン知識の役割。 生データのままでは価値を生まない。
"The goal is to turn data into information, and information into insight."
— Carly Fiorina (元 HP CEO)
データ → 情報 → 洞察への変換の各段階で、 ドメイン知識が不可欠な役割を果たす。
"In God we trust. All others must bring data."
— W. Edwards Deming
データを持って議論せよ、 という戒めだが、 「正しい解釈」を伴わないデータは説得力を持たない。
これらの名言が示すのは、 データサイエンスは 「データ + ドメイン + 統計」の三位一体であるという普遍的真理である。 SSDSE-B-2026 を題材に統計コンペに臨むあなたも、 この三位一体を意識しながら分析を進めてほしい。 「ドメイン知識」の章を読み終えた今、 次にすべきことは SSDSE 仕様書を開いて 1 列ずつ意味を確認すること。 そこから本物のデータサイエンスが始まる。
🧑🔬 やってみよう — ドメイン知識を試す 5 分実験
ここまで読んだ内容を実際に手を動かして確かめるための、 5 分でできる小実験を 4 つ用意した。 すべて SSDSE-B-2026 だけで完結する。
実験 1: 「人口で割る」を実体験
このコードでやること: 「婚姻件数」と「総人口」の散布図を、 (a) 生数値版と (b) 人口千対率版で 2 つ作って比較する。 ドメイン知識「規模効果を除去する」の効果を体感する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') df['marriage_rate'] = df['A9101'] / df['A1101'] * 1000 fig, axes = plt.subplots(1, 2, figsize=(12, 5)) axes[0].scatter(df['A1101'], df['A9101']) axes[0].set_title('生数値: 総人口 × 婚姻件数') axes[0].set_xlabel('総人口') axes[0].set_ylabel('婚姻件数') axes[1].scatter(df['A1101'], df['marriage_rate']) axes[1].set_title('率: 総人口 × 人口千対婚姻率') axes[1].set_xlabel('総人口') axes[1].set_ylabel('婚姻率 (人口千対)') plt.tight_layout() plt.savefig('marriage_compare.png') print('生相関:', df[['A1101','A9101']].corr().iloc[0,1].round(3)) print('率相関:', df[['A1101','marriage_rate']].corr().iloc[0,1].round(3)) |
📤 実行結果:
💬 結果の読み方: 生数値では「人口が多いほど婚姻件数も多い」という当たり前の相関 (0.989) しか見えないが、 人口千対率に変換すると相関は 0.777 まで弱まり、 規模の同義反復が取り除かれて「都市部ほど婚姻率がやや高い (東京・沖縄がアンカー)」という意味ある構造が見えてくる。 ドメイン知識による特徴量変換の威力を実体験できる。
実験 2: 「層別解析」を実体験
このコードでやること: 全 47 県で「高齢化率」と「合計特殊出生率 (A4103)」の相関を見ると弱いが、 「人口規模上位 15 県」と「下位 32 県」で層別すると、 層によって相関の符号が変わる場合がある (シンプソンのパラドックスの一例)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') df['aging_rate'] = df['A1303'] / df['A1101'] # 全体相関 r_all = df[['aging_rate', 'A4103']].corr().iloc[0,1] print(f'全 47 県の相関: {r_all:.3f}') # 人口上位 15 県 (都市圏) df_top = df.nlargest(15, 'A1101') r_top = df_top[['aging_rate', 'A4103']].corr().iloc[0,1] print(f'人口上位 15 県の相関: {r_top:.3f}') # 人口下位 32 県 (地方) df_bot = df.nsmallest(32, 'A1101') r_bot = df_bot[['aging_rate', 'A4103']].corr().iloc[0,1] print(f'人口下位 32 県の相関: {r_bot:.3f}') |
📤 実行結果:
💬 結果の読み方: 全 47 県では高齢化率と TFR は弱い正の相関 (+0.20) にとどまるが、 人口上位 15 県 (都市圏) では正相関 (+0.30)、 人口下位 32 県 (地方) では負相関 (-0.38) と符号が逆転する。 全体を一つにまとめると打ち消し合って見えづらいこの符号反転こそ、 都市と地方で全く異なるメカニズムが働いている証拠であり (シンプソンのパラドックスの一例)、 ドメイン知識(子育て環境・若年層の流出入・地域コミュニティ)を持って層別に解釈する必要がある。
実験 3: 「政策ブロック」で要約
このコードでやること: 47 都道府県を 6 地方ブロックに分け、 各ブロックの主要指標を集計する。 「47 県を見ても何も分からない」ことが、 ブロック化で「6 つの物語」になる体験。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import re import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') # 地方ブロック割り当て (簡略版) def assign_block(name): name = re.sub('[都府県]$', '', name) # 末尾の 1 文字だけ外す(京都府 → 京都) if name in ['北海道','青森','岩手','宮城','秋田','山形','福島']: return '北海道東北' if name in ['茨城','栃木','群馬','埼玉','千葉','東京','神奈川']: return '関東' if name in ['新潟','富山','石川','福井','山梨','長野','岐阜','静岡','愛知']: return '中部' if name in ['三重','滋賀','京都','大阪','兵庫','奈良','和歌山']: return '近畿' if name in ['鳥取','島根','岡山','広島','山口','徳島','香川','愛媛','高知']: return '中国四国' return '九州沖縄' df['block'] = df['Prefecture'].apply(assign_block) df['aging_rate'] = df['A1303'] / df['A1101'] df['marriage_rate'] = df['A9101'] / df['A1101'] * 1000 block_summary = df.groupby('block').agg( 総人口=('A1101','sum'), 平均高齢化率=('aging_rate','mean'), 平均婚姻率=('marriage_rate','mean'), ).round(3) print(block_summary) |
📤 実行結果:
💬 結果の読み方: 関東に総人口の 35% (約 4350 万人) が集中し、 人口千対婚姻率も最高 (3.82)。 北海道・東北は人口が少なく高齢化が最も進み、 婚姻率も最低水準 (3.03)。 この 「6 つの物語」の対比こそが、 地方創生政策の根本的な問題意識である。
実験 4: 「自分なりの派生指標」を作る
このコードでやること: SSDSE-B-2026 の既存列を組み合わせて、 ドメイン知識に基づく オリジナル指標を 3 つ作り、 47 県のランキングを比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') # 指標 1: 子育てしやすさ指数 (TFR / 高齢化率) df['child_friendly'] = df['A4103'] / (df['A1303'] / df['A1101']) # 指標 2: 医療アクセス指数 (人口 10 万対 一般病院数) df['medical_access'] = df['I510120'] / df['A1101'] * 100000 # 指標 3: 持続可能性指数 (自然増減率 + 社会増減率) df['sustainability'] = ((df['A4101'] - df['A4200']) + (df['A5101'] - df['A5102'])) / df['A1101'] * 1000 # 上位 5 県 / 下位 5 県を表示 for col in ['child_friendly','medical_access','sustainability']: print(f'\n=== {col} TOP 5 ===') print(df.nlargest(5, col)[['Prefecture', col]].to_string(index=False)) print(f'\n=== {col} BOTTOM 5 ===') print(df.nsmallest(5, col)[['Prefecture', col]].to_string(index=False)) |
💬 結果の読み方: 3 つの指標で上位に来る県の顔ぶれが異なる (子育てしやすさは沖縄、 人口 10 万対の医療施設数は高知・徳島など地方、 持続可能性は東京・神奈川など)。 「何を測りたいか」によって、 同じデータから全く異なる結論が引き出せるのがドメイン知識の力。
実験を終えての振り返り
この 4 つの実験を通じて体感してほしいのは、 「ドメイン知識は分析の結論を変える」という事実だ。 同じ SSDSE-B-2026 のデータを使っても、 ドメインを意識しないと「人口で説明される自明な相関」に終始するが、 ドメイン知識を反映した派生指標・層別・ブロック化を施すと、 「日本社会の構造そのもの」が浮かび上がる。 統計コンペで上位を狙うなら、 これら 4 つの実験を出発点に、 自分の関心領域に特化した独自実験を 5-10 件積み重ねてほしい。
最後に強調したいのは、 ドメイン知識の獲得は 「読書」より「対話」の方が効率的だということ。 専門家や現地経験者に 30 分話を聞くだけで、 本を 5 時間読むのと同等以上の暗黙知が手に入る。 大学のゼミ・地元自治体・業界団体・NPO など、 アクセス可能な専門家ネットワークを積極的に活用してほしい。 そして、 得た知識は必ず 「自分の言葉で説明できる形」まで噛み砕き、 報告書や発表資料に落とし込むこと。 ドメイン知識を「使える形」にするのは、 結局のところ自分自身の言語化の作業である。
本章で紹介した 4 つの実験・6 つのテンプレート・30 件の情報源・20 語のミニ辞典・30 項目のチェックリストは、 すべて「明日から使える具体的なアウトプット」として設計されている。 統計コンペに参加する読者は、 まず実験 1 (人口で割る) を 10 分で実行し、 結果をスクリーンショットして保存することから始めてほしい。 その小さな成功体験が、 ドメイン知識を「学ぶもの」から「使うもの」へ転換する第一歩になる。 ドメイン知識は座学で蓄えるものではなく、 分析の現場で繰り返し試して身につける実践知であることを忘れないでほしい。 統計コンペの締切までの残り時間を、 「統計手法の追加学習」ではなく 「ドメイン知識の追加獲得」に振り向けることが、 上位入賞への最短経路となる場合が多い。 健闘を祈る。
さらに付け加えるなら、 ドメイン知識を獲得する過程で得られる副次的なメリットとして、 「分析者としての自信」が挙げられる。 統計手法だけを学んでいると「自分の分析が正しいか」を常に不安に感じるが、 ドメイン知識を持つと「この数字はおかしい」「この解釈は無理がある」といった直感的なバリデーション能力が育つ。 これはコンペの現場でも、 実務の現場でも、 極めて大きな武器となる。 機械的な計算手順は AI ツールが代替してくれるが、 「数字の背後にある人々の生活・歴史・制度」を読み解く能力は、 当面は人間の役割として残り続ける。 SSDSE-B-2026 を題材にこの能力を磨くことは、 単に統計コンペでの順位を上げるだけでなく、 10 年後・20 年後の自分のキャリアにも大きく寄与する投資となる。 ぜひ腰を据えて、 SSDSE のデータと向き合ってほしい。
ここまで長い章を読み通してくれた読者の皆さんに、 著者から最後のメッセージを送りたい。 データサイエンスは 「人間と社会を理解するための新しい言語」である。 統計手法は文法、 プログラミングは発音、 そしてドメイン知識は「何について語るか」という主題そのものだ。 文法と発音だけ完璧でも、 語るべき内容がなければ会話は成立しない。 47 都道府県という「日本社会の縮図」に対して、 あなたは何を語りたいのか。 子育て・医療・教育・経済・環境・地域・産業 — どのテーマを選んでも、 SSDSE-B-2026 には深掘りに値する 125 列のデータが用意されている。 あなたの問いを大切にし、 その問いに誠実に答えるための道具としてドメイン知識を活用してほしい。 そうした「問いと知識の対話」こそが、 統計コンペの真の醍醐味であり、 データサイエンスの本質である。
最後の最後に、 本章で紹介した 「ドメイン知識の 5 層モデル」「ドメイン専門家インタビューのプロトコル」「6 つの分析テンプレート」「20 語のミニ辞典」「30 件の情報源リスト」「30 項目のチェックリスト」「4 つの実体験実験」を一通り試してほしい。 すべて実践すれば、 ドメイン知識に関しては中級者を超え、 自分なりの分析仮説を立てられるレベルに到達するはずだ。 そこから先は、 自分の関心領域・専門分野・経験を反映した独自のドメイン知識を積み上げる段階となる。 これから始まる長いデータサイエンスの旅路において、 本章が良き道しるべとなることを願っている。 ドメイン知識という名の地図を片手に、 SSDSE-B-2026 という未踏の領野へ、 さあ一歩踏み出そう。 健闘を心から祈っている。
📝 理解度チェック — このページの実測値で考える
Q1. 婚姻件数と総人口の相関は 0.989、人口千対の婚姻率と総人口の相関は 0.777 だった(実験 1)。0.989 をそのまま「人口の多い県ほど結婚しやすい」と読んではいけないのはなぜか。
解答
件数は人口が多いほど増えるので、0.989 の大部分は「人が多い県は何でも多い」という規模の効果である。結婚のしやすさを比べるなら率に直した 0.777 の方を見るべきで、それでも残る正の相関が都市部の若い年齢構成などを反映している。
Q2. 高齢化率と合計特殊出生率の相関は 47 県で +0.20、人口上位 15 県で +0.30、下位 32 県で −0.38 だった(実験 2)。「高齢化が進むと出生率が上がる」と結論してよいか。
解答
よくない。全体の +0.20 は性質の違う 2 つの層を混ぜた結果で、地方の層では向きが逆になっている。どの層で何が起きているかは、若年層の流出入や子育て環境といった地域の知識と合わせて読む必要がある。
Q3. 保育所等定員数を総人口千人あたりにすると沖縄県は 2 位、15 歳未満人口千人あたりにすると 8 位だった。保育の充足度を比べる目的ならどちらを使うべきか。
解答
15 歳未満人口千人あたり。保育所を使うのは子どもなので、子どもの数で割らないと、子どもの多い県ほど定員が多く見える。沖縄県が総人口あたりで上位に出るのは、若い年齢構成の影響が混ざっているためである。
Q4. 実験 3 では関東ブロックの人口千対婚姻率が 3.82、北海道東北ブロックが 3.03 だった。この差を「関東の方が結婚しやすい社会だから」と読む前に、どの列を確かめるべきか。
解答
年齢構成。婚姻率は総人口を分母にしているので、結婚の多い 20〜30 代が多い地域ほど高く出る。平均高齢化率は関東 0.280、北海道東北 0.343 と差が大きく、率の差の一部はこの年齢構成で説明できる。15〜64 歳人口 (A1302) を分母にして比べ直すのが次の一手になる。
Q5. SSDSE-B-2026 を読み込み、df.groupby('Prefecture').last() で得た秋田県の高齢化率は 30.7% だった。何が起きているか。
解答
ファイルは新しい年度が先に並んでいるため、last() は 2012 年度の行を返している。2023 年度の秋田県は 39.1%。年度の列で並べ替えるか、年度で絞ってから集計する。
🧮 SSDSE-B 実値で計算してみる
🧮 数式に値を入れて手で計算する: SSDSE-B-2026 でドメイン知識ありなしの予測精度差
SSDSE-B-2026 の A4103 (合計特殊出生率) を予測するモデルを 3 種類段階的に作り、 ドメイン知識を取り入れるたびに R² (決定係数) がどう改善するかを示す。 2023 年度の 47 都道府県で、 標準化+線形回帰を「47 県すべてで学習した当てはまり (train R²)」と「5 分割交差検証で学習に使っていない県を予測した R² (CV R²)」の 2 通りで実測した値(下の Python で再現)。
Step 1: モデル別精度 (R²)
| モデル (使う SSDSE 列) | train R² | CV R² |
|---|---|---|
| 素朴: A1101 (総人口) のみ | 0.318 | 0.297 |
| +特徴量設計: A1301/A1302/A1303 (年齢層) | 0.612 | 0.445 |
| +ドメイン: J2505 (保育所定員) + I510120 (一般病院数) + L3221 (消費支出) | 0.688 | 0.531 |
「人口だけで TFR を予測」する素朴モデルは CV R² 0.297 と説明力が低い。 年齢層の人口と「ドメイン知識」(保育所アクセス・医療アクセス・生活コスト) の列を加えると CV R² は 0.531 まで上がる。 train R² は列を足すほど 0.688 まで上がるが、 CV R² との差(0.157)も広がるので、 改善は CV R² で測る。
Step 2: 改善幅
🐍 Python で再現
このコードでやること: 3 つのモデルを 2023 年度の 47 都道府県で実際に学習し、 train R² と 5 分割交差検証の CV R² を求めて、 段階改善幅と累積改善幅を計算する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np import pandas as pd from sklearn.linear_model import LinearRegression from sklearn.preprocessing import StandardScaler from sklearn.pipeline import make_pipeline from sklearn.model_selection import KFold, cross_val_predict from sklearn.metrics import r2_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') y = df['A4103'] # 合計特殊出生率(47 都道府県) models = { "素朴 A1101": ['A1101'], "+年齢層 A1301-A1303": ['A1101', 'A1301', 'A1302', 'A1303'], "+ドメイン J2505/I510120/L3221": ['A1101', 'A1301', 'A1302', 'A1303', 'J2505', 'I510120', 'L3221'], } cv = KFold(n_splits=5, shuffle=True, random_state=0) cv_r2 = [] for name, cols in models.items(): m = make_pipeline(StandardScaler(), LinearRegression()) train_r2 = m.fit(df[cols], y).score(df[cols], y) # 47 県すべてで学習した当てはまり pred = cross_val_predict(m, df[cols], y, cv=cv) # 学習に使っていない県での予測 cv_r2.append(r2_score(y, pred)) print(f"{name:30s} train R²={train_r2:.3f} CV R²={cv_r2[-1]:.3f}") cv_r2 = np.array(cv_r2) print(f"段階改善: {np.diff(cv_r2).round(3)}") print(f"累積改善: {cv_r2[-1] - cv_r2[0]:+.3f}") |
📤 実行結果
💬 手計算 (Step 2) の +0.148・+0.086・+0.234 と Python の出力が一致する。 ただし年齢層は人数のまま入れているので、 大きい県ほど値が大きいだけの列になっている。 同じ情報を「15 歳未満の割合」「65 歳以上の割合」と log 人口に直すと、 CV R² は 0.824 まで上がる。 どの列を足すかと同じくらい、 人数を率に直すというドメイン知識の使い方が精度を左右する。
🐍 Python 実装
以下は ドメイン知識 を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=[1] は列コードの下にある日本語見出し行 (2 行目) だけをスキップし、 列コード行をヘッダとして残す定石。
🐍 Python 実装 — 都道府県データのドメイン特徴量エンジニアリング
このコードでやること: SSDSE-B-2026 の「総人口」「65歳以上人口」「出生数」「死亡数」「婚姻件数」を読み込み、 ドメイン知識に基づく派生指標(高齢化率・人口千対婚姻率・自然増減率)を生成する。 ドメイン知識を持つ分析者の「最初の 30 行」がどう違うかを示す。
📥 入力データ(SSDSE-B-2026.csv 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd # SSDSE-B-2026 を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') # ドメイン知識に基づき変数を抽出・命名 df['pop_total'] = df['A1101'] # 総人口 df['pop_65plus'] = df['A1303'] # 65 歳以上人口 df['births'] = df['A4101'] # 出生数 df['deaths'] = df['A4200'] # 死亡数 df['marriages'] = df['A9101'] # 婚姻件数 # ドメイン指標を計算(人口で割る・千対率に変換) df['aging_rate'] = df['pop_65plus'] / df['pop_total'] * 100 df['birth_rate'] = df['births'] / df['pop_total'] * 1000 df['death_rate'] = df['deaths'] / df['pop_total'] * 1000 df['natural_change'] = df['birth_rate'] - df['death_rate'] df['marriage_rate'] = df['marriages'] / df['pop_total'] * 1000 print(df[['Prefecture','aging_rate','birth_rate','natural_change','marriage_rate']] .sort_values('aging_rate', ascending=False).head(5)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 「ドメイン知識を持つ分析者は、 ① 高齢化率 35% 超 = 全国平均 29% より 6pt 以上高い県を即座に識別、 ② natural_change が大きく負(秋田県 -15.21 = 1000 人あたり年間 15 人の自然減)であることから、 これらの県は『人口減少フェーズに入って 30 年』というマクロ文脈で読む、 ③ 高齢化と婚姻率の低さがセットで現れることに、 結婚適齢人口の少なさ(分母効果)を即時に重ねて解釈する」 — このような重層的読みが 「データだけ」では絶対に出てこない。
🎓 ドメイン知識の獲得方法 — 7 つの実践
ドメイン知識は本を読んだだけでは身につかない。 以下の 7 つの実践を組み合わせて初めて「使える知識」になる。 SSDSE データを使う統計コンペでも、 これらを応用すると分析の質が一段上がる。
| # | 実践 | 具体的アクション(SSDSE 文脈) | 獲得時間目安 |
|---|---|---|---|
| 1 | 公式定義書を読む | SSDSE のデータ仕様書、 総務省統計局の用語定義集を最初の 1 時間に読破する | 1〜3 時間 |
| 2 | 過去の白書・年次報告を斜め読み | 少子化白書・国民生活白書・地方創生総合戦略を要約レベルで把握 | 3〜10 時間 |
| 3 | 専門家にヒアリング | 自治体職員・地域経済の研究者に「現場で何が起きているか」を 30 分聞く | 30 分〜2 時間 |
| 4 | 現地観察(フィールドワーク) | 対象自治体に半日滞在し、 駅前商店街・行政窓口・公共施設を見る | 半日〜数日 |
| 5 | 過去の研究論文・分析事例 | CiNii・Google Scholar で「都道府県 + 出生率」「地方創生 + 効果検証」を検索 | 3〜5 時間 |
| 6 | 仮説 → データ照合 → 修正 | 「沖縄は出生率が高いのは若年層が多いから」を SSDSE で検証 | 継続 |
| 7 | プロトタイプを見せて議論 | 最初の可視化を専門家に見せて「直感に反する点」を聞き出す | 数日〜数週間 |
「知らないことを知る」 — ドメインギャップ可視化シート
プロジェクト開始時、 以下のチェックリストを埋めてみると「自分が何を知らないか」が明確になる。 空欄が多い項目はリスクが高い。
| 確認項目 | SSDSE で言えば | レベル |
|---|---|---|
| 主要指標の定義を 30 秒で説明できる? | TFR は「1 人の女性が生涯に産む子供の数」と即答できる | ★ |
| 単位・計算式を再現できる? | 高齢化率 = 65 歳以上 ÷ 総人口 × 100、 全国平均は 28.7% | ★★ |
| 過去 30 年の長期トレンドを描ける? | TFR は 1990 年 1.54 → 2005 年 1.26 → 2023 年 1.20 | ★★★ |
| 関連する政策と効果を 3 つ挙げられる? | こども家庭庁、 児童手当拡充、 保育料無償化 | ★★★ |
| よくある分析の落とし穴を 3 つ知っている? | 人口で割らずに比較 / 年齢構成無視 / 県境通勤 | ★★★★ |
| 専門家が議論している論点を知っている? | 外国人住民の取扱、 都市圏定義、 サテライト勘定 | ★★★★★ |
🤝 ドメイン専門家との協働 — 5 つのアンチパターン
ドメイン知識は自分で全部獲得する必要はなく、 専門家との協働で外部化することもできる。 しかし、 多くのデータサイエンスプロジェクトはこの協働を失敗する。 以下の 5 つは典型的アンチパターン。
アンチパターン 1: 「最初に綺麗なデータをください」
→ 専門家は「綺麗」の定義を持っていない。 「分析できる形にしておいてほしい」と言われた瞬間に、 重要なメタ情報(外れ値の理由・調査方法の変更・定義改訂)が捨てられる。 対処: 生データを一緒に見ながら「この値は何故こうなった?」を一緒に確認する。
アンチパターン 2: 「機械学習モデルで全部解決します」
→ 専門家は「自分の知識が要らなくなる」と感じて協力を渋る。 結果、 ドメイン知識のないモデルが現場で受け入れられない("AI なんて使えない" と言われる)。 対処: モデルを「専門家の経験を加速する補助線」と位置づけ、 SHAP・feature importance などで「専門家がどう考えているか」を映し出す。
アンチパターン 3: 用語の温度差を放置
→ データサイエンティストの「精度」と専門家の「精度」は別物。 前者は accuracy、 後者は「現場での再現性」。 すれ違ったまま走ると、 完成したモデルが「数値は良いが使えない」となる。 対処: プロジェクト開始時に「用語対応表」を作って言語を揃える。
アンチパターン 4: 専門家を「データ供給者」扱い
→ 「CSV をください」「定義を教えてください」だけで、 分析設計や解釈の議論に巻き込まない。 完成した分析を見せたとき「これは違う」と言われて手戻り。 対処: 仮説設計の段階から専門家を共同設計者として招く。
アンチパターン 5: 「複雑なモデルほど偉い」信仰
→ ロジスティック回帰で十分なところに XGBoost、 さらには Transformer を持ち込み、 専門家が解釈できなくなる。 SSDSE のように観測 = 47 行のデータでは、 高次の交互作用を学習させても汎化しない。 対処: 「説明可能性 × 専門家の理解 × データ量」のトレードオフを最初に整理する。
🐍 Python 実装 — ドメイン知識駆動の特徴量設計
このコードでやること: SSDSE-B-2026 の生変数だけでは見えない構造を、 ドメイン知識から導出した派生特徴量で可視化する。 ① 老年化指数(aging index = 65歳以上 / 15歳未満)、 ② 自然増減率、 ③ 社会増減率(転入 - 転出)、 ④ 婚姻-出生比、 を計算し、 都道府県を 4 群に分類する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') # ドメイン知識ベースの派生指標 df['aging_index'] = df['A1303'] / df['A1301'] # 老年化指数 df['natural_rate'] = (df['A4101'] - df['A4200']) / df['A1101'] * 1000 df['social_rate'] = (df['A5101'] - df['A5102']) / df['A1101'] * 1000 df['birth_per_marriage'] = df['A4101'] / df['A9101'] # 4 群分類: 自然増減 × 社会増減 def classify(row): n = row['natural_rate'] s = row['social_rate'] if n > -3 and s > 0: return 'A: 維持/流入' if n > -3 and s <= 0: return 'B: 維持/流出' if n <= -3 and s > 0: return 'C: 高齢化/流入' return 'D: 高齢化/流出' df['group'] = df.apply(classify, axis=1) print(df.groupby('group')['Prefecture'].apply(list)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 2023 年のデータでは全 47 都道府県が自然減(出生 < 死亡)に入っており、 純粋な「維持/流入(A 群)」は消滅している。 差を生むのは社会増減で、 首都圏(東京・神奈川・埼玉・千葉)と大阪・福岡は他県からの転入で人口を補う「高齢化/流入(C 群)」、 沖縄は自然減が最も緩やか(-1.7)な「維持/流出(B 群)」、 残る 40 県は自然減と社会減が重なる「高齢化/流出(D 群)」に集中する。 この分類はドメイン知識(人口学の自然増減・社会増減フレームワーク)を借りて初めて意味を持つ。 K-means などで盲目的にクラスタリングしても、 こうした「政策論的に意味のある区分」は生まれない。 ドメイン知識駆動の特徴量設計(domain-driven feature engineering)の典型例。
🐍 Python 実装 (深堀り) — ドメイン特有の特徴量を量産するパイプライン
このコードでやること: SSDSE-B-2026 から、 ドメイン知識に基づく 派生特徴量を一括で生成するパイプラインを構築する。 単に列を作るだけでなく、 「なぜこの指標が必要か」というドメイン的根拠も併記する設計。
📥 入力データ(SSDSE-B-2026.csv 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 | # ドメイン特徴量パイプライン (SSDSE-B-2026) import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') # --- ドメイン派生特徴量 --- # 1. 高齢化率 (政策上の重要指標、 28% 超で「超高齢社会」) df['aging_rate'] = df['A1303'] / df['A1101'] # 2. 自然増減率 (人口千対、 出生 - 死亡) df['natural_change_per1000'] = (df['A4101'] - df['A4200']) / df['A1101'] * 1000 # 3. 婚姻率 (人口千対、 国際比較で標準的) df['marriage_rate'] = df['A9101'] / df['A1101'] * 1000 # 4. 離婚率 (人口千対、 婚姻率と対で見る) df['divorce_rate'] = df['A9201'] / df['A1101'] * 1000 # 5. 出生率 (人口千対) df['birth_rate_per1000'] = df['A4101'] / df['A1101'] * 1000 # --- ブロック分類 (政策単位) --- block_map = { '北海道': '北海道東北', '青森': '北海道東北', '岩手': '北海道東北', '宮城': '北海道東北', '秋田': '北海道東北', '山形': '北海道東北', '福島': '北海道東北', '茨城': '関東', '栃木': '関東', '群馬': '関東', '埼玉': '関東', '千葉': '関東', '東京': '関東', '神奈川': '関東', '新潟': '中部', '富山': '中部', '石川': '中部', '福井': '中部', '山梨': '中部', '長野': '中部', '岐阜': '中部', '静岡': '中部', '愛知': '中部', '三重': '近畿', '滋賀': '近畿', '京都': '近畿', '大阪': '近畿', '兵庫': '近畿', '奈良': '近畿', '和歌山': '近畿', '鳥取': '中国四国', '島根': '中国四国', '岡山': '中国四国', '広島': '中国四国', '山口': '中国四国', '徳島': '中国四国', '香川': '中国四国', '愛媛': '中国四国', '高知': '中国四国', '福岡': '九州沖縄', '佐賀': '九州沖縄', '長崎': '九州沖縄', '熊本': '九州沖縄', '大分': '九州沖縄', '宮崎': '九州沖縄', '鹿児島': '九州沖縄', '沖縄': '九州沖縄', } df['block'] = df['Prefecture'].str.replace('[都府県]$', '', regex=True).map(block_map) # --- ブロック別集約 --- agg = df.groupby('block')[['aging_rate','marriage_rate']].mean().round(3) print(agg) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 関東ブロックは高齢化率が最も低く (28.0%) かつ人口千対婚姻率が最も高い (3.82) という「若くて世帯形成が活発な圏」、 北海道・東北ブロックは高齢化率が最も高く (34.3%) 婚姻率も最も低い (3.03) という「高齢・人口減少圏」というドメイン的に既知のパターンが、 派生特徴量で初めてクリアに見える。 単に総人口・婚姻件数の生数値だけでは決して見えない構造である。
🤝 ドメイン専門家とのコラボレーション — 30 分のインタビューで暗黙知を取り出す技術
ドメイン知識の獲得手段として最強なのは、 専門家への 30 分インタビューである。 1 時間の読書では得られない「現場の常識」「数値の罠」「政策の裏側」が一気に手に入る。 ここでは、 効果的なインタビューを行うための具体的なプロトコルを示す。
インタビュー前の準備 (15 分)
- SSDSE-B-2026 の対象ドメインで「自分が分析したい列」を 3 つ選ぶ
- 各列について「自分なりの解釈・仮説」を箇条書きで書き出す
- 分からない・確信が持てない点を 5 つ抽出する
- 専門家の経歴・専門分野を事前に確認する (LinkedIn・大学 HP)
インタビュー中の質問テンプレート
| フェーズ | 質問例 | 引き出せる知識 |
|---|---|---|
| アイスブレイク (3 分) | 「ご担当の分野 (例: 医療・小売・製造) でこの 5 年で何が一番変わりましたか?」 | 最新トレンド、 専門家の関心領域 |
| 数値の意味確認 (10 分) | 「この列の数値、 私は××と解釈していますが、 現場の理解と合っていますか?」 | 解釈のズレ、 隠れた前提 |
| パターンの確認 (10 分) | 「A 県と B 県でこんな差があるのですが、 制度面の説明はありますか?」 | 制度的・歴史的背景 |
| 禁忌の確認 (5 分) | 「この分野で『絶対やってはいけない解釈』は何ですか?」 | タブー、 政治的に敏感な論点 |
| クロージング (2 分) | 「他に必読の資料・データソースがあれば教えてください」 | 追加学習の入口 |
インタビュー後の処理 (30 分)
- 録音 (許可を得た場合) を聴き直し、 重要発言を 5-10 件抜き出す
- 自分の仮説リストを「修正」「却下」「追加」の 3 カテゴリに整理
- 新たに浮上したドメイン用語・指標を用語集にまとめる
- 専門家に「お礼メール + 簡易まとめ」を送り、 修正フィードバックをもらう
⚠️ よくある落とし穴
⚠️ 分母の選び方で県の順位が動く — 保育所等定員数の例
「人口で割る」はドメイン知識の第一歩だが、どの人口で割るかもドメイン知識で決まる。保育所の定員を総人口で割ると、高齢者の多い県と少ない県を同じ物差しで比べることになる。
🎯 このコードでやること:SSDSE-B-2026 の 2023 年度 47 都道府県で、同じ「保育所等定員数 (J2505)」を「総人口千人あたり」と「15 歳未満人口千人あたり」の 2 通りで割り、上位・下位の県と順位の入れ替わりを比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 同じ「保育所等定員数」を 2 通りの分母で割る per_all = d['J2505'] / d['A1101'] * 1000 # 総人口千人あたり per_kid = d['J2505'] / d['A1301'] * 1000 # 15 歳未満人口千人あたり print('総人口千人あたり 上位5:', ', '.join(f'{k} {v:.1f}' for k, v in per_all.nlargest(5).items())) print('15歳未満千人あたり 上位5:', ', '.join(f'{k} {v:.0f}' for k, v in per_kid.nlargest(5).items())) print('下位3(総人口):', ', '.join(f'{k} {v:.1f}' for k, v in per_all.nsmallest(3).items())) print('下位3(15歳未満):', ', '.join(f'{k} {v:.0f}' for k, v in per_kid.nsmallest(3).items())) r = per_all.rank(ascending=False); k = per_kid.rank(ascending=False) print(f'順位の相関 (Spearman) = {per_all.corr(per_kid, method="spearman"):.3f}') moved = (r - k).abs().sort_values(ascending=False).head(3) for p in moved.index: print(f'{p}: 総人口あたり {r[p]:.0f} 位 → 15歳未満あたり {k[p]:.0f} 位') print(f'沖縄県: 総人口あたり {r["沖縄県"]:.0f} 位 → 15歳未満あたり {k["沖縄県"]:.0f} 位') |
💬 全体の順位相関は 0.951 と高く、上位・下位の顔ぶれ(高知・島根・長野が多く、兵庫・静岡・大阪が少ない)はどちらの分母でも変わらない。一方で個々の県は動き、沖縄県は総人口あたりでは 2 位だが子どもの数で割ると 8 位、秋田県は 21 位から 10 位に上がる。子どもが多い県は「定員が多い」ように見えやすく、子どもが少ない県は逆になる。保育の充足度を見たいなら分母は利用する世代(15 歳未満人口)で、この選択はデータからは決まらず、制度の知識で決める。
⚠️ データ仕様もドメイン知識 — 年度の並び順を知らないと「最新」を取り違える
ドメイン知識は社会の仕組みだけでなく、データがどう作られ、どう並んでいるかの知識も含む。SSDSE-B-2026 は 1 県 12 行で、新しい年度が先に並ぶ。家計の列(L3221 など)は県全体ではなく県庁所在市の二人以上世帯の値である、というのも同じ種類の知識である。
🎯 このコードでやること:SSDSE-B-2026 の行の並び(新しい年度が先)を知らずに groupby().last() で「最新年度」を取ると何が起きるかを、高齢化率で確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print('先頭 3 行の年度:', df['SSDSE-B-2026'].head(3).tolist()) # 「最新年度を取る」つもりで last() を使うと… last = df.groupby('Prefecture')['SSDSE-B-2026'].last() print('groupby().last() が返す年度:', sorted(last.unique())) # 年度で並べ替えてから取れば 2023 年度になる ok = df.sort_values('SSDSE-B-2026').groupby('Prefecture').last() print('並べ替え後の last() の年度:', sorted(ok['SSDSE-B-2026'].unique())) aging_bad = (df.groupby('Prefecture')[['A1303', 'A1101']].last() .eval('A1303 / A1101 * 100')) aging_ok = ok.eval('A1303 / A1101 * 100') for p in ['秋田県', '東京都', '沖縄県']: print(f'{p} の高齢化率: last() {aging_bad[p]:.1f}% 正しい 2023 年度 {aging_ok[p]:.1f}%') |
💬 ファイルの先頭は 2023 年度なので、last() が返すのは 47 県すべて 2012 年度の行になる。そのまま高齢化率を計算すると秋田県 30.7%・沖縄県 17.7% と、2023 年度の 39.1%・23.8% より大きく低い値が「最新」として出てしまう。エラーは出ないので、「このデータは新しい年度が先に並ぶ」という仕様の知識が無いと気づけない。年度の列で並べ替えるか、年度で絞ってから使う。
⚠️ ドメイン知識まわりの追加落とし穴(深堀り 6 件)
落とし穴 1: 「サイロ化したドメイン知識」
複数の部署にまたがるプロジェクトでは、 各部署が「自分の領域」の専門家しか連れてこない。 営業のドメインと製造のドメインがバラバラに分析され、 統合段階で「定義が違う」「指標が一致しない」という事態に。 SSDSE 文脈なら「都道府県統計と市町村統計をマージしようとして単位が違って沈没」が同型。 対処: プロジェクト初期に「データ辞書(data dictionary)」を作成し、 用語・定義・出典を 1 シートに集約する。
落とし穴 2: 「専門家の暗黙バイアス」
ドメイン専門家も人間なので、 過去の成功体験や個人的な見解にバイアスがある。 「現場感覚で言えば〜」が、 実は 10 年前のデータに基づいていることも。 SSDSE で言えば「東京の出生率が低いのは住宅費のせいだ」という業界通説が、 実は他要因(晩婚化・キャリア継続)に説明されるケース。 対処: 専門家の発言を「仮説」として記録し、 必ずデータで検証する。 一致しなければ専門家と議論する。
落とし穴 3: 「documentation 不足」
ドメイン知識を獲得しても、 ドキュメントに残さなければ 6 か月後の自分が同じ過ちを繰り返す。 SSDSE のように毎年更新されるデータでは、 「2024 年版から定義が変わった列」を記録しないと翌年の分析が破綻する。 対処: README.md・data_dictionary.md・analysis_log.md の 3 点セットを GitHub などで管理。
落とし穴 4: 「ステークホルダー間の温度差」
経営層・現場・データチームでドメイン理解の深さが違うと、 分析結果の解釈で衝突する。 「東京は出生率が低いから問題だ」は経営層、 「未婚率と年齢構成を見れば説明可能」は現場、 という対立。 対処: ステークホルダーマップを描き、 「各層に向けたメッセージング」を分けて準備する。
落とし穴 5: 「過剰な汎用化」
SSDSE のような全国データで得た知見を、 そのまま個別自治体に適用すると外す。 全国平均は「47 県の集約」であって、 個別自治体の文脈とは別物。 対処: 「集約レベルで成立する話」と「個別ケースで成立する話」を分けて報告する。 集約データで仮説を作り、 個別調査で検証する 2 段階。
落とし穴 6: 「ドメイン知識の陳腐化」
過去の業界常識が、 制度改正や社会変化で古びてしまうケース。 「専業主婦世帯が中心」「終身雇用が前提」など、 1990 年代の知識のままだと SSDSE の現代データを正しく解釈できない。 対処: ドメイン知識を「version controlled」と捉え、 半年〜1 年に一度はアップデートする。
✅ ドメイン知識 活用チェックリスト(プロジェクト前後)
プロジェクト開始前
- □ 主要変数の公式定義を全て確認した
- □ 単位・スケール・集計レベル(個人/世帯/自治体)を整理した
- □ 過去 5 年の白書・年次報告を要約レベルで把握した
- □ 関連する政策・規制を 3 つ以上挙げられる
- □ ドメイン専門家を 1 名以上アサインした
- □ 用語対応表(data dictionary)を作った
分析中
- □ 仮説を立てたら専門家に意見を聞いた
- □ 直感に反する結果が出たら、 まずデータ品質を疑った
- □ ドメインの「業界用語」と統計の「専門用語」を区別して使っている
- □ 派生指標(率・密度・比)には意味のある名前をつけた
- □ 「データだけで言える話」と「ドメイン込みで言える話」を分けて記録した
報告・運用時
- □ ステークホルダー別にメッセージングを分けた
- □ 結論の適用範囲(外的妥当性)を明示した
- □ ドメイン知識の記録ドキュメントを更新した
- □ 半年〜1 年後にドメイン知識を再点検するスケジュールを入れた
- □ 専門家からのフィードバックを記録し、 次回プロジェクトに反映する仕組みがある
❓ ドメイン知識 深掘り FAQ
Q1. ドメイン知識を「最低どれくらい」備えればよいか?
A. 「分析する変数の定義」と「上位 3 つの落とし穴」だけは必須。 これだけで「明らかな誤読」の 8 割が回避できる。 余裕があれば「政策・歴史」まで広げると差別化につながる。 SSDSE で言えば、 まず 5 個程度の主要列(A1101, A1303, A4101, A4200, A9101)の定義を 30 秒で説明できるようにする。
Q2. 完全な部外者(業界未経験)でも分析できるか?
A. 可能。 ただし条件付き: ① 専門家との週 1 回以上の議論枠を確保、 ② 公式統計の用語定義を全部読む(1〜2 日)、 ③ 主要白書を斜め読み、 ④ 最初の 2 週間は仮説の答え合わせを集中的に行う。 これでドメイン専門家の 60〜70% の理解には到達できる。
Q3. ドメイン知識がない分野でモデルを作ると何が起きる?
A. 典型的に 4 つの症状が出る: ① 強い相関を発見するが「人口効果」など自明な交絡を見逃す、 ② 外れ値を機械的に除去して構造変化を逃す、 ③ 派生指標を作れず、 生変数だけで戦う、 ④ ステークホルダーへの説明で「で、何?」と返される。 SSDSE のような小規模データほど、 ドメイン知識の差が結果の質に直結する。
Q4. AI / LLM がドメイン知識を補完できる?
A. 公式定義・歴史・白書要約レベルなら大幅に補完可能。 ただし「現場の暗黙知」「最新の政策動向」「個別自治体の事情」は依然として人間専門家が必要。 SSDSE 分析の文脈なら、 「TFR の計算式は?」「日本の少子化対策の歴史を要約して」は LLM で十分。 「島根県江津市の人口減少対策が成功している理由は?」は現地ヒアリングが必要。
Q5. ドメイン知識と統計的知識、 どちらを先に勉強すべき?
A. 同時並行が理想だが、 強いて言えば「統計の基礎」(平均・分散・相関・回帰) を 2 週間で押さえ、 その後ドメイン知識の獲得に半分以上の時間を投じる、 という配分が現実的。 ドメイン知識は「分析の解像度」を決め、 統計的知識は「分析の精度」を決める。 両方なければプロジェクトは進まない。
📌 まとめ — ドメイン知識を統計コンペで活かす 5 つのコツ
- SSDSE のデータ仕様書を 30 分以内に通読する — 何を測ったデータかを把握する
- 生数値を見たら「人口・世帯・面積で割る」を反射的に試す — 規模効果を取り除く
- 白書・年次報告を要約レベルで読む — 政策的文脈を 1〜2 ページに圧縮した知識マップ
- 専門家・現地経験者にインタビューする — 暗黙知を 30 分で 1 時間分の読書相当に変換
- 仮説 → 検証 → ドメイン照合の 3 段ループを 1 週間で回す — 反復で精度が上がる
最後に、 ドメイン知識は「あれば良い」ではなく「なければ分析全体が無意味化する」必須要素であることを強調したい。 SSDSE-B-2026 は 47 都道府県 × 125 列の小規模だが意味の深いデータセットで、 ドメイン知識の差が結果の質に直結する。 統計手法の選択よりも、 「この数字が何を意味するのか」を理解する時間に投資せよ。
⚠️ ドメイン知識の誤用 — 「知ってるつもり」が招く失敗パターン 7 選
ドメイン知識は強力だが、 誤った形で使うと 分析結果を歪める。 ここでは、 統計コンペでもよく見られる「知ってるつもり」の失敗パターンを 7 件解説する。
パターン 1: 古い常識を最新データに当てはめる
「日本の労働力人口は減少している」は 2010 年代の常識だが、 2023 年以降は 女性・高齢者・外国人労働者の参入により総労働力人口は横ばい〜微増に転じている。 5 年前のドメイン知識を最新データに無理に当てはめると、 「データが間違っている」と感じて分析を歪めてしまう。
パターン 2: 自分の出身地・専門地域だけの常識を全国に拡張
東京出身の分析者は「家賃が高いのは当然」「車を持たないのが普通」と思いがちだが、 これは全国の常識ではない。 沖縄・北海道では車所有率 90% 超、 持ち家比率も 70% を超える。 出身地バイアスを意識せず分析すると、 地方を「異常値」扱いしてしまう。
パターン 3: メディアで強調された極端な事例を一般化
「秋田県は人口減少が深刻」という報道を見て、 「日本の地方は全て同じく深刻」と早合点する。 実際には、 福岡市・札幌市・仙台市のような地方中枢都市は人口増加を続けており、 「地方一律衰退」は誤解。
パターン 4: 学校教育で習った定義を疑わない
「失業率」と聞いて教科書的な定義しか知らない分析者は、 「労働力人口に含まれない非求職者」の存在に気づかない。 結果として「就労意欲を失った層」が見えず、 政策評価を誤る。
パターン 5: 数値が「真実」と思い込む
統計データは 「調査・集計・公表」の各段階で歪みが入る。 国勢調査の回収率 (近年 80% 前後)、 サンプリングバイアス、 自治体ごとの記入率の違いなど、 数値自体に不確実性があることを忘れてはいけない。
パターン 6: 専門家の意見を絶対視する
専門家は深い知識を持つが、 同時に「自分の専門分野の重要性を過大評価する」傾向がある。 経済学者は経済要因を、 心理学者は心理要因を、 社会学者は社会構造を強調しがち。 複数分野の専門家にクロスチェックすることで、 単一視点の偏りを補正する。
パターン 7: 自分の仮説を「ドメイン知識」と混同
「私の経験ではこうだ」「業界の人はみんなそう言っている」という個人の経験談を、 ドメイン知識として扱ってしまう。 客観的な統計・公式文書で裏付けられない経験談は、 仮説の出発点としては有用だが、 結論の根拠にはならない。
❓ 追加 FAQ — 統計コンペ参加者からよく寄せられる質問
Q1. ドメイン知識ゼロでも、 機械学習で何とかなりませんか?
A. 短期的には XGBoost や LightGBM で高い精度が出ることもありますが、 (1) 特徴量エンジニアリングの質、 (2) 結果の解釈、 (3) 結論の妥当性のすべてでドメイン知識が必要になります。 とくにコンペでは「なぜそうなったか」を説明できないと審査員に評価されません。 精度 0.85 のモデルより、 精度 0.80 でも「政策的にこう改善できる」と語れる方が評価されます。
Q2. ドメイン知識が必要なら、 統計の勉強は後回しでよいですか?
A. いいえ、 両輪が必要です。 統計手法を知らずにドメイン知識だけで分析すると、 「印象論」「事例の列挙」になってしまいます。 統計手法は「ドメイン知識を厳密な数値の言葉に翻訳する道具」と捉えるとよいでしょう。 統計 60% + ドメイン 40%の時間配分が初心者には現実的です。
Q3. SSDSE-B 以外にどんな公的データを併用すべきですか?
A. e-Stat (政府統計の総合窓口) で多くの公的データが入手できます。 SSDSE-B が 47 都道府県 × 数年分のクロスセクションに特化しているのに対し、 e-Stat には市区町村別・月次・性年代別データもあります。 また、 RESAS (地域経済分析システム) はインタラクティブに地域比較ができ、 ドメイン知識の獲得にも有用です。
Q4. 大学生で実務経験がない場合、 どうやってドメイン知識を補えばよいですか?
A. 公的白書 + 大学の専門講義 + 教員へのインタビューの 3 点セットが効果的です。 大学には経済学・社会学・政策学の教員がいるので、 アポを取って 30 分質問するだけで実務 1 年分の知識が手に入ることもあります。 また、 地元自治体の統計担当者にも問い合わせが可能 (多くは丁寧に回答してくれる)。
Q5. ドメイン知識を「説明する」のが苦手です。 コンペでどう書けばいいですか?
A. 「数値 → 解釈 → 制度的背景 → 政策的示唆」の 4 段階で書くと整理しやすいです。 例: 「秋田県の TFR は 1.32 (数値)。 これは全国 39 位で、 持続可能水準 2.1 を大きく下回る (解釈)。 背景には若年層流出と多子世帯支援の不足がある (制度)。 子育て世帯への住宅支援拡充が有効と考えられる (政策)。」 このパターンを身につけると、 報告書の質が一気に上がります。
📖 ドメイン用語ミニ辞典 — SSDSE 分析で頻出する 20 語
統計コンペで SSDSE-B-2026 を扱うときに必須となる、 ドメイン用語 20 語を厳選して解説する。 これらを押さえておけば、 仕様書を読む速度が 3 倍になる。
| 用語 | 意味 | SSDSE での該当列例 |
|---|---|---|
| 合計特殊出生率 (TFR) | 15-49 歳女性が生涯に産む子の数の推定値 | A4103 |
| 人口千対婚姻率 | 人口 1000 人あたり婚姻件数 | A9101 / A1101 × 1000 |
| 人口千対離婚率 | 人口 1000 人あたり離婚件数 | A9201 / A1101 × 1000 |
| 高齢化率 | 総人口に占める 65 歳以上人口の比 | A1303 / A1101 |
| 年少人口割合 | 総人口に占める 15 歳未満人口の比 | A1301 / A1101 |
| 生産年齢人口割合 | 総人口に占める 15-64 歳人口の比 | A1302 / A1101 |
| 粗出生率 | 人口 1000 人あたり出生数 | A4101 / A1101 × 1000 |
| 粗死亡率 | 人口 1000 人あたり死亡数 | A4200 / A1101 × 1000 |
| 自然増減数 | 出生数 - 死亡数 | A4101 - A4200 |
| 社会増減数 | 転入者数 - 転出者数 | A5101 - A5102 |
| 保育所等定員数 | 認可保育所等の定員数 | J2505 |
| 保育所等在所児数 | 保育所等に在所する児童数 | J2506 |
| 一般病院数 | 都道府県内の一般病院の施設数 | I510120 |
| 一般診療所数 | 一般診療所の施設数 | I5102 |
| 消費支出 (月額) | 二人以上世帯の 1 か月あたり消費支出 | L3221 |
| 有効求人倍率 | 月間有効求人数 / 月間有効求職者数 | F3103 / F3102 |
| 年平均気温 | 観測地点の年平均気温 (℃) | B4101 |
| 年間降水量 | 年間の総降水量 (mm) | B4109 |
| 老年人口指数 | 65 歳以上 / 15-64 歳 × 100 | A1303 / A1302 × 100 |
| 従属人口指数 | (15 歳未満 + 65 歳以上) / 15-64 歳 × 100 | (A1301 + A1303) / A1302 × 100 |
これら 20 語を押さえれば、 SSDSE-B-2026 の全 125 列のうち、 統計コンペで頻繁に使われる中核列はほぼカバーできる。 さらに各列がどのような調査から得られたかを把握すれば、 「制度層」の知識も同時に獲得できる。
🗺 概念マップ
ドメイン知識は「データ + 数理手法 + 現場の常識」という三脚の一脚で、 特徴量エンジニアリング・モデル選択・解釈の各段階で他の二脚と相互作用する。 機械的な AutoML との対比、 仮説生成への寄与、 意思決定への翻訳の各方向に枝が伸びる。
ドメイン知識は、 統計手法やモデルの選択・解釈・特徴量設計を方向づける「現場の文脈」であり、 機械学習が普遍的な数学であるのに対し、 何をモデル化するかの選択肢を提供する。 医療・金融・教育・地域経済どの分野でも、 ドメイン知識の不足は外れ値の誤判定・特徴量リーク・誤った因果解釈を引き起こす。
🔗 隣接手法への橋渡し
ドメイン知識は単独のスキルではなく、 データ取得・前処理・特徴量・解釈・意思決定のあらゆる局面で機械学習を補正する。 数値で説明できない業界の常識を、 適切な工程に投入できるかが分析品質を決める。
- 上流(前処理・データ整備): ステークホルダーへの伝達 / リサーチクエスチョン / 探索的データ解析
- 並列(代替・補完手法): 特徴量エンジニアリング / データリテラシー / アノテーション
- 下流(評価・解釈・応用): 解釈可能性 (XAI) / モデル評価 / ストーリーテリング
ドメイン知識は「データに現れない業界・現場の常識」で、 上流の特徴量設計・前処理で品質を決め、 並列の機械学習・統計手法の選択を導き、 下流のモデル解釈・意思決定で「数字の意味」を確定させる。
🌳 手法選択フロー
「ドメイン知識」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「ドメイン知識」を中核とした適切な手法選択ができる。