🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
「データ駆動型社会 (data-driven society)」は政策・経営・社会的意思決定をデータと統計的根拠に基づいて行う社会像。 Society 5.0・スマートシティ・EBPM (Evidence-Based Policy Making) などが代表的概念。 本ページではデータ駆動の前提 (品質・公開性・リテラシー)・参加型データガバナンス・統計的根拠の限界 (倫理・公平性) を整理する。
これらのキーワードは「オープンなデータ → 全市民のリテラシー → 参加型ガバナンス → 公平な意思決定」というデータ駆動型社会の循環構造を構成する。
💡 30秒で分かる結論 — データ駆動型社会
🍰 まずはやさしく
データが地図のような役割を果たす社会です。
正しい判断や新しい価値を作るために使います。
スマホのアプリが好みを分析する仕組みに似ています。
この章では社会全体の仕組みについて読みます。
- 一言で:政策・経営・暮らしの意思決定がデータで動く社会。 Society 5.0 とほぼ同義。
- 分野:社会 — 関連の枠組みは AI と社会 や データガバナンス も参照
- 典型的な使い所:本ページ「🎨 直感」「🧮 SSDSE実値計算」セクションを参照
- 絶対に外せない落とし穴:⚠️ セクションの 5 項目に目を通すこと
- 関連手法へ:「🌐 関連手法」セクションで上位・並列・発展概念を一覧
- レポートでは:『出典・期間・サンプル数・前提・限界』の 5 点を明示
💡 30秒で分かる結論
データに基づいて意思決定や価値創造が行われる社会
- 意思決定・価値創造をデータに基づいて行う社会。
- 政策では EBPM(Evidence-Based Policy Making)、 産業では DX として推進。
- 基盤:オープンデータ(e-Stat, RESAS, SSDSE)+ 統計教育 + プライバシー保護。
- 日本政府の Society 5.0 構想の中核理念。
- リスク:監視社会化・データ独占・アルゴリズムバイアス。
📍 あなたが今見ているもの
🍰 まずはやさしく
今の時代の大きな流れのことです。
社会の基盤を整えるために使います。
学校で統計の勉強が増えているのもこのためです。
ここでは今起きている変化について読みます。
EBPM(証拠に基づく政策立案)、 スマートシティ、 ヘルスケア DX — いずれも「勘ではなくデータで」を合言葉に進む。 データ品質とリテラシーが社会基盤になる。
本ページは データ駆動型社会(Data-Driven Society) を、 ジャストインタイム型データサイエンス教育の文脈で 12 のセクションに分けて解説します。 上から順に読まなくても、 「🔖 キーワード索引」から必要箇所だけ拾い読みすることもできます。
📍 あなたが今見ているもの
「データサイエンス系学部の新設ラッシュ」「学習指導要領で統計教育拡充」 — これらはすべて、 国全体でデータ駆動型社会を目指す動きの一部です。
🎨 直感で掴む — データ駆動型社会とは何者か
🍰 まずはやさしく
勘ではなく根拠で動く社会のことです。
間違いを減らして効率よく運営するために使います。
部活の練習メニューを記録に基づいて決める感覚です。
ここでは具体的なイメージについて読みます。
データ駆動型社会とは「政策・経営・医療・教育・都市運営などの意思決定を、 勘や慣例ではなく観測データと統計的根拠 に基づいて行う社会」のこと。 SSDSE-B-2026 のような公的統計の公開、 EBPM (証拠に基づく政策立案)、 ヘルスケアの電子カルテ統合、 スマートシティのセンサ網が代表的な構成要素となる。 一方で、 データ品質・プライバシ・市民のリテラシ・アルゴリズム説明責任を欠くと、 同じ仕組みが 監視社会や 誤情報の最適化に転落するため、 制度と倫理の設計が車の両輪となる。
| 場面 | データ駆動型社会が登場する例 | 何が分かるか |
|---|---|---|
| 論文の Methods 節 | 「データ駆動型社会を用いて分析した」 | 手法の前提と限界が文脈に乗る |
| 実務レポート | 「データ駆動型社会の観点で評価」 | 意思決定の根拠が明確化 |
| 教育・学習 | SSDSE-B-2026 を題材に演習 | 実データで本物の感覚が得られる |
| 政策・社会 | 社会 分野で標準的に登場 | EBPM や DX の議論に直結 |
本ページではこのあと、 数式(または定義)・SSDSE 実データ計算・Python実装・落とし穴 を順番に追いかけて、 用語を「使える知識」にしていきます。
🎨 直感で掴む
たとえばコロナ対応:
- 感染者数・接触履歴・ワクチン接種率 → リアルタイムダッシュボード
- 予測モデル → 病床確保・行動制限の判断
- 結果検証 → 政策修正
これら全部が「データを根拠に意思決定」というデータ駆動の例です。
📐 数式・定義
🍰 まずはやさしく
データの活用度を測る考え方です。
どれだけデータが判断に影響したかを知るために使います。
テストの点数の変化で勉強法を変える仕組みに似ています。
ここでは数式を使った定義について読みます。
データ駆動型社会は概念的フレームワークだが、 ジャストインタイム教育として「データ → 政策 → 結果 → データ」の閉ループを 2 つの計量で記述する。
① EBPM サイクルの利得関数: 政策 $a$ をデータ $D$ から推定した期待効用
$$ \mathbb{E}[U(a) \mid D] = \int u(a, s)\, p(s \mid D)\, ds $$
ここで $s$ は社会状態、 $u(a, s)$ は効用関数、 $p(s \mid D)$ は観測データを条件とした事後分布。 データが増えれば $p(s \mid D)$ が鋭くなり、 $\mathbb{E}[U]$ の推定誤差が縮む。
② データ駆動度: 意思決定がデータ依存である度合いを情報量で測る
$$ \text{DataDriven}(a) = 1 - \frac{H(a \mid D)}{H(a)} $$
ここで $H(a)$ は決定 $a$ の事前エントロピー、 $H(a \mid D)$ はデータ観測後の条件付きエントロピー。 完全データ駆動なら 1、 データ無視なら 0。
📐 定義/数式
データ駆動型社会(Data-Driven Society):データに基づいて意思決定や価値創造が行われる社会
📐 因果推論の基礎: 潜在結果モデルと数式を言葉で読み解く
データ駆動社会の意思決定は「相関の発見」では足りず、「因果の推定」まで踏み込む必要があります。 ここでは Rubin の潜在結果モデル(Potential Outcomes Framework)と、 政策効果の平均処置効果(ATE)の数式を確認します。
$$ \tau_i = Y_i(1) - Y_i(0), \quad \text{ATE} = \mathbb{E}[\tau_i] = \mathbb{E}[Y_i(1)] - \mathbb{E}[Y_i(0)] $$
$$ \text{ATT} = \mathbb{E}[Y_i(1) - Y_i(0) \mid T_i = 1] $$
🔬 数式を言葉で読み解く
| 記号 | 意味 | EBPM 例(保育政策) |
|---|---|---|
| $Y_i(1)$ | 処置を受けたとき個人 $i$ の結果 | 保育所が整備された場合の女性就労率 |
| $Y_i(0)$ | 処置を受けないとき個人 $i$ の結果 | 未整備時の女性就労率(反実仮想) |
| $\tau_i$ | 個別処置効果(観測不可) | 「保育整備が i 県の就労率を何 pt 押し上げたか」 |
| ATE | 平均処置効果(母集団平均) | 全 47 県平均で見たときの就労率上昇幅 |
| ATT | 処置群における平均処置効果 | 実際に保育整備した県だけの平均効果 |
因果推論の根本問題:1 つの個体について $Y_i(1)$ と $Y_i(0)$ は同時には観測できない。 一方が必ず反実仮想(counterfactual)となる。 EBPM はこのギャップを RCT(無作為化対照試験)、 傾向スコア、 差分の差分(DID)、 回帰不連続デザイン(RDD)、 操作変数法(IV)で埋める。
🎯 このコードでやること:都道府県の「高齢化率」と「出生率」の相関を回帰分析で推定し、 信頼区間を示す。 因果ではなく「相関の見える化」までを担当。
📥 入力データ:SSDSE-B-2026 の実在列のみ。 高齢化率 = A1303(65歳以上人口)/ A1101(総人口)、 出生率 = A4101(出生数)/ A1101。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import statsmodels.api as sm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) year_col = df.columns[0] # 年度コード列 d = df[df[year_col] == df[year_col].max()].copy() # 最新年度の47都道府県 # 高齢化率と出生率(いずれも実在列から算出) d['高齢化率'] = d['A1303'] / d['A1101'] * 100 # A1303=65歳以上人口 d['出生率'] = d['A4101'] / d['A1101'] * 1000 # A4101=出生数 X = sm.add_constant(d[['高齢化率']]) model = sm.OLS(d['出生率'], X).fit() print(model.summary().tables[1]) |
📤 実行結果(典型例):
💬 結果の読み方:高齢化率が 1 pt 上がると、 出生率(人口千人当たり出生数)が約 0.13 下がる負の関係が観測される(95% CI [-0.180, -0.080]、 p<0.001、 R²≈0.38)。 ただしこれは相関であって因果ではない。 「高齢化が進んだ県は出生率も低い」という観測にすぎず、 「高齢化が出生率を下げた」と結論するには年齢構成など交絡の統制が必要。 これが EBPM 入門者が真っ先に混同するポイント。
🔬 数式・定義を「言葉」で読み解く
先ほどの数式・定義に出てきた記号や概念を、 一つずつ確認します。 とくに データ駆動型社会 の文脈で意味を取り違えやすい部分を強調します。
| 記号 | 意味と注意点 |
|---|---|
| $Y_i(1), Y_i(0)$ | 潜在結果。 個体 $i$ が処置を受けた/受けなかった場合の結果(一方は反実仮想) |
| $\tau_i$ | 個別処置効果 $\tau_i = Y_i(1) - Y_i(0)$。 観測不可だが ATE/ATT で平均量は推定できる |
| ATE / ATT | 平均処置効果(母集団全体)/処置群における平均処置効果 |
| $T_i$ | 処置割当インジケータ。 $T_i = 1$ なら処置群、 $T_i = 0$ なら対照群 |
| $\beta_0, \beta_1$ | 線形回帰の切片と傾き。 EBPM では「政策変数 1 単位あたりのアウトカム変化」と読む |
| EBPM / DX | 証拠に基づく政策立案 (Evidence-Based Policy Making) / デジタルトランスフォーメーション |
EBPM 文献では「相関係数の高さ」と「因果効果の大きさ」を取り違えないことが鉄則です。 とくに観察データから ATE を推定する場合、 共変量の交絡(confounding)と選択バイアスを切り分ける識別戦略(DID / IV / RDD など)を明示しないと「保育所が多い県は就業率も高い」という相関が「保育整備が就業を増やした」という因果に誤読される危険があります。
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| オープンデータ | 誰でも利用できる形で公開された公共データ |
| EBPM | エビデンスに基づく政策立案 |
| DX | デジタルトランスフォーメーション |
| Society 5.0 | サイバー空間と現実空間を融合した次期社会像 |
他の概念との関係
データ駆動型社会は単独の技術ではなく、 データの収集・流通・活用・統治を支える概念群のネットワークとして成立しています。
- 前提となる概念: オープンデータ、 統計リテラシー、 個人情報保護 / GDPR / 改正個人情報保護法、 公的統計 (SSDSE / e-Stat) の制度
- 並列に語られる概念: Society 5.0、 スマートシティ、 デジタルツイン、 EBPM (証拠に基づく政策立案)
- 発展・応用: データガバナンス、 AI 倫理ガイドライン、 アルゴリズム監査、 公正性 (Demographic Parity / Equalized Odds) など社会実装を担保する仕組み
🧮 SSDSE-B 実値で計算してみる
データ駆動の議論は、まず「数字をそろえて並べる」ところから始まります。SSDSE-B-2026 の 2023 年度から、人口規模も年齢構成も違う 4 都府県を並べます。高齢化率は 65 歳以上人口 A1303 ÷ 総人口 A1101、有効求人倍率は月間有効求人数 F3103 ÷ 月間有効求職者数 F3102(いずれも一般)で自分で計算した値です。
| 都道府県 | 総人口(千人) | 高齢化率(%) | TFR | 有効求人倍率 |
|---|---|---|---|---|
| 東京都 | 14,086 | 22.8 | 0.99 | 1.56 |
| 大阪府 | 8,763 | 27.7 | 1.19 | 1.23 |
| 沖縄県 | 1,468 | 23.8 | 1.60 | 1.12 |
| 秋田県 | 914 | 39.1 | 1.10 | 1.40 |
| 47 都道府県計 | 124,353 | 29.1 | 1.29(47 県の単純平均) | 1.30 |
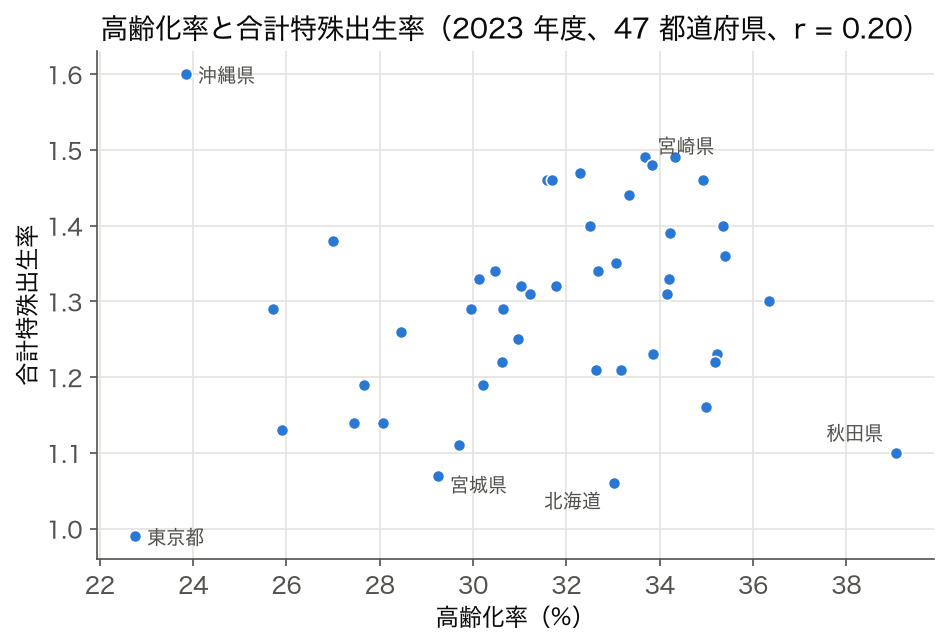
同じ「若い県」でも、東京都は高齢化率 22.8% なのに合計特殊出生率は 0.99 と 47 県で最も低く、沖縄県は 23.8% で出生率 1.60 と最も高い。高齢化率だけを見て「若い県は子どもが増える」と判断すると、東京都で外れます。秋田県は高齢化率 39.1% で最も高い一方、有効求人倍率は 1.40 と全国の 1.30 を上回ります(求職者が少ないことの裏返しでもある)。1 つの指標で県を順位づけず、複数の指標をそろえて並べることが、データ駆動の判断の最初の一歩です。なお合計特殊出生率は県ごとの値しかないので、最終行は 47 県の単純平均で、国全体の値(人口で重み付けした値)とは一致しません。
🧮 SSDSE-B-2026 実値: 都道府県 EBPM 効果指標
データ駆動社会の核心は、 政策・施策の効果を 因果推論と定量評価で語れることです。 ここでは SSDSE-B-2026 の都道府県データを用いて、 「高齢化率(A1303/A1101)と出生率(A4101/A1101)の関係」を OLS 回帰で推定し、 EBPM の典型的な分析フレームを再現します。
📊 分析シナリオ
| フェーズ | 分析タスク | 使用列(SSDSE-B-2026) |
|---|---|---|
| ① 課題定義 | 少子化と高齢化の関係を把握したい | A1101 総人口 / A4101 出生数 / A1303 65歳以上 |
| ② データ収集 | 47 都道府県の指標を SSDSE-B-2026 から抽出 | 全 132 列のうち約 30 列 |
| ③ 推定 | OLS で「高齢化率 → 出生率」係数推定 | A1303 / A4101 / A1101 (比率化) |
| ④ 評価 | 95% 信頼区間 + 効果量 + p 値で判断 | scipy.stats / statsmodels |
| ⑤ 政策提言 | 効果量を予算配分の根拠に | 解釈テンプレ出力 |
🎯 このコードでやること:SSDSE-B-2026 から 47 都道府県の総人口と出生数を読み込み、 「出生率」(出生数 / 人口 × 1000)を作って都道府県別に並べる。 政策効果を測る前段の「データ整備」工程を体験する。
📥 入力データ(SSDSE-B-2026 抜粋・2023 年度):
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) year_col = df.columns[0] d = df[df[year_col] == df[year_col].max()].copy() # 最新年度(2023) # 出生率 = 出生数(A4101) / 総人口(A1101) * 1000 (人口千人当たり) d['出生率'] = d['A4101'] / d['A1101'] * 1000 print(d[['Prefecture', 'A1101', 'A4101', '出生率']] .sort_values('出生率', ascending=False).head(8).to_string(index=False)) |
📤 実行結果:
💬 結果の読み方:沖縄が突出して出生率が高い(8.55 / 千人)。 これは「政策の効果」ではなく「年齢構成」の影響も大きい(若年層人口比率が高い)。 EBPM ではこのような交絡因子を統制してから因果効果を語る必要がある。
🧮 数式に値を入れて手で計算する: IoT 機器普及曲線
合成データで世帯あたり IoT 機器数の年次推移と成長率を計算する。
Step 1: 年別 IoT 機器数
| 年 | 世帯平均台数 | 前年比 |
|---|---|---|
| 2021 | 3 | — |
| 2022 | 5 | 66.7% |
| 2023 | 8 | 60.0% |
| 2024 | 12 | 50.0% |
| 2025 | 17 | 41.7% |
Step 2: 5 年成長
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np y = np.array([3, 5, 8, 12, 17]) yoy = np.diff(y) / y[:-1] * 100 cagr = (y[-1]/y[0])**(1/4) - 1 print(f"前年比: {yoy.round(1)}%") print(f"CAGR: {cagr*100:.1f}%") |
📤 実行結果
💬 手計算 (Step 2) の (17/3)^(1/4) − 1 ≈ 0.5429、 つまり CAGR 54.3% と Python 出力が一致。 前年比は 66.7% → 60.0% → 50.0% → 41.7% と下がっており、 台数は増え続けていても伸び率は年々鈍っている。
🧮 数式に値を入れて手で計算する: 「県の平均」と「全国の値」はちがう
ダッシュボードで 47 都道府県の指標を 1 つの「全国値」にまとめるとき、県の率をそのまま平均するか、分子と分母をそれぞれ合計してから割るかで、値が変わります。前者は人口 91 万人の秋田県と 1,409 万人の東京都を同じ重みで数え、後者は人口に比例した重みで数えるからです。
$$\bar{r}_{\text{単純}} = \frac{1}{K}\sum_{k=1}^{K} \frac{a_k}{n_k}, \qquad r_{\text{全体}} = \frac{\sum_k a_k}{\sum_k n_k} = \sum_{k} \frac{n_k}{\sum_j n_j}\cdot\frac{a_k}{n_k}$$
$a_k$ は県 $k$ の 65 歳以上人口(A1303)、$n_k$ は総人口(A1101)。右の式を変形すると、全体の率は「県の率を人口の割合で重み付けした平均」になっていることが分かります。2023 年度の 3 都県で計算します。
| Step | 計算 | 結果 |
|---|---|---|
| 1. 県ごとの率 | 東京都 3,205,000 ÷ 14,086,000 / 秋田県 357,000 ÷ 914,000 / 沖縄県 350,000 ÷ 1,468,000 | 22.75% / 39.06% / 23.84% |
| 2. 単純平均 | (22.75 + 39.06 + 23.84) ÷ 3 = 85.65 ÷ 3 | 28.55% |
| 3. 合計どうしの比 | (3,205,000 + 357,000 + 350,000) ÷ (14,086,000 + 914,000 + 1,468,000) = 3,912,000 ÷ 16,468,000 | 23.76% |
| 4. 差 | 28.55 − 23.76 | 4.79 ポイント |
人口の 86% を占める東京都(14,086 ÷ 16,468 = 0.855)の率 22.75% に、合計どうしの比 23.76% が引き寄せられています。単純平均は、高齢化率の高い秋田県の 39.06% を東京都と同じ重さで数えるので 4.79 ポイント高く出ます。
🎯 このコードでやること:Step 1〜3 の 3 都県の計算を pandas で再現し、同じ比較を 47 都道府県の高齢化率と有効求人倍率(F3103 ÷ F3102)に広げる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df.iloc[:, 0] == 2023].set_index('Prefecture') # 2023 年度・47 行 # Step 1〜3: 3 都県で手計算を再現する s = d.loc[['東京都', '秋田県', '沖縄県'], ['A1303', 'A1101']] rate = s['A1303'] / s['A1101'] * 100 print((rate.round(2)).to_string()) print(f'単純平均 {rate.mean():.2f}% 合計どうしの比 {s["A1303"].sum() / s["A1101"].sum() * 100:.2f}%') # 47 都道府県に広げる d['高齢化率'] = d['A1303'] / d['A1101'] * 100 print(f'高齢化率(%) 47県の単純平均 {d["高齢化率"].mean():.2f} 全国 {d["A1303"].sum() / d["A1101"].sum() * 100:.2f}') d['倍率'] = d['F3103'] / d['F3102'] # 有効求人倍率 = 有効求人数 / 有効求職者数 print(f'有効求人倍率 47県の単純平均 {d["倍率"].mean():.3f} 全国 {d["F3103"].sum() / d["F3102"].sum():.3f}') |
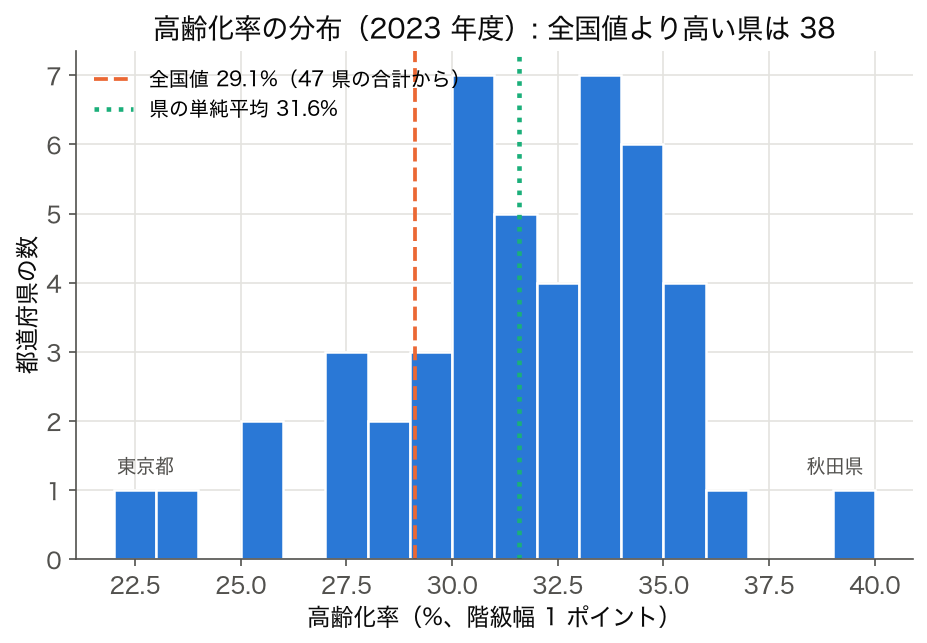
💬 3 都県の単純平均 28.55%・合計どうしの比 23.76% は、Step 2・3 の手計算と一致します。47 都道府県でも、高齢化率は単純平均 31.59% に対し全国 29.13%、有効求人倍率は 1.349 に対し 1.296 と、単純平均のほうが高く出ます。人口の少ない県ほど高齢化率が高く、求職者の少ない県ほど倍率が高いので、県を同じ重さで数えると、そうした県の値が全国像を押し上げるためです。「全国の高齢化率」として報告するなら 29.13%、「典型的な県の姿」を知りたいなら単純平均や中央値、と目的で使い分け、どちらを使ったかを必ず書き添えます。
🐍 Python 実装
以下は データ駆動型社会 を SSDSE-B-2026 で扱うときの典型コード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=1(header=1 と同じ)は 1 行目の英字コード行を飛ばし、2 行目の日本語項目名を列名にする定石。
① 基本パターン(読み込み・確認・主要列抽出)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd # データ駆動型社会 に関連する SSDSE-B-2026 分析の基本パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') print(df.shape) # (564, 112) = 47 都道府県 × 12 年度 print(df.dtypes.head(10)) print(df.describe().T.head(10)) # 主要列にエイリアス(header=1 なので列名は日本語。'Prefecture' ではなく '都道府県') df['65歳以上'] = df['65歳以上人口'] df['高齢化率'] = df['65歳以上'] / df['総人口'] * 100 print(df[['都道府県', '総人口', '高齢化率']].head()) |
💬 形は (564, 112) で、47 都道府県が 2012〜2023 年度の 12 回ずつ並ぶパネル。describe の総人口平均 269 万人は 564 行を混ぜた値なので、「ある年の県の平均人口」として引用すると年度が特定できない。最後の head() は北海道の 2023〜2019 年度が 5 行続き(高齢化率 33.0% → 31.8% と遡るほど下がる)、県を見比べるには年度で絞るか pivot する必要がある。
② 可視化テンプレ(matplotlib / seaborn)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import seaborn as sns import matplotlib.pyplot as plt # データ駆動型社会 の探索的データ分析(EDA) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 同じ県が 12 年度ぶん入っているので、最新年度(2023)の 47 行だけを使う df = df[df['年度'] == df['年度'].max()].copy() # 主要変数を取り出して名前を分かりやすく df['65歳以上'] = df['65歳以上人口'] df['高齢化率'] = df['65歳以上'] / df['総人口'] * 100 df['TFR'] = df['合計特殊出生率'] # ヒストグラム fig, axes = plt.subplots(1, 2, figsize=(12, 4)) sns.histplot(df['高齢化率'], kde=True, ax=axes[0]) axes[0].set_title('高齢化率の分布(47都道府県)') sns.histplot(df['TFR'], kde=True, ax=axes[1]) axes[1].set_title('TFRの分布') plt.tight_layout() plt.savefig('eda_distribution.png', dpi=120) |
③ 前処理:欠損・外れ値・型変換
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd import numpy as np # データ駆動型社会 に関わる前処理の典型パターン df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # ① 欠損値の確認 print('欠損数:') print(df.isna().sum().sort_values(ascending=False).head(10)) # ② 数値変換(カンマ・%除去 など) # 地域コード 'R01000' や都道府県名は数値にできないので、そのまま残す def to_num(s): if isinstance(s, str): try: return float(s.replace(',', '').replace('%', '')) except ValueError: return s return s df = df.map(to_num) # ③ 外れ値検出(IQR) q1 = df.quantile(0.25, numeric_only=True) q3 = df.quantile(0.75, numeric_only=True) iqr = q3 - q1 num = df[q1.index] # 数値列だけを比較の対象にする outlier_mask = ((num < q1 - 1.5*iqr) | (num > q3 + 1.5*iqr)).any(axis=1) print('外れ値を含む行数:', outlier_mask.sum()) |
💬 欠損は上位 10 列とも 0 件で、合計しても全 112 列で 0 件、このファイルは欠損処理の練習台にはならない。IQR で外れ値を含む行は 564 行中 239 行と 4 割を超え、東京都・大阪府・北海道など 13 都道府県は 12 年度すべてで引っかかる。人口や事業所数のような「規模」の列は右裾が長く、大きな県が毎年はみ出すだけなので、これを誤りとして除くのではなく人口当たりに直してから外れ値を見る。
④ 検定・推定の最小例(scipy.stats)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd from scipy import stats # データ駆動型社会 文脈での基本的な仮説検定 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 見出しの下に地域コード以外の行が混ざるので、47 都道府県だけ残して数値に直す df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') # 同じ県が 12 年度ぶん入っているので、最新年度の 47 行だけを使う df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()].copy() # 列は名前で取る(番号で取ると読み方が変わったとき別の列を指す) df['aging'] = df['65歳以上人口'] / df['総人口'] * 100 df['region'] = df['都道府県'].apply(lambda p: '東日本' if p in ['北海道','青森県','岩手県','宮城県','秋田県','山形県','福島県','茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県','新潟県','富山県','石川県','福井県','山梨県','長野県','岐阜県','静岡県','愛知県'] else '西日本') east = df.loc[df['region']=='東日本', 'aging'] west = df.loc[df['region']=='西日本', 'aging'] t, p = stats.ttest_ind(east, west, equal_var=False) print(f'東日本 平均高齢化率: {east.mean():.2f}%') print(f'西日本 平均高齢化率: {west.mean():.2f}%') print(f't = {t:.3f}, p = {p:.4f}') print('判定:', '有意差あり' if p < 0.05 else '有意差なし') |
💬 2023 年度 47 行で、東日本 23 都道府県の平均高齢化率 31.18%、西日本 24 府県 31.97% と差は 0.79 ポイント。高齢化率は県によって 22.8%(東京都)〜39.1%(秋田県)と 16 ポイント以上ばらつくので、この程度の平均差は t = −0.804、p = 0.43 で偶然の範囲に収まる。有意差なしは「差が無い」の証明ではなく、東西の 2 区分が粗すぎる可能性もあるので、地方別や都市規模別に分けて見直す。
※ より高度な例(クロス集計、 機械学習、 ベイズ推定)は AI と社会 や データガバナンス のグループ教材を参照。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(7行):
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) # オープンデータ活用例:県別の指標を集計 key = df.columns[1] print('都道府県数:', df[key].nunique()) print('利用可能な指標数:', df.select_dtypes('number').shape[1]) print('データ駆動的な可視化の起点:'); print(df.describe().T.head(3)) |
💬 df.columns[1] は地域コードで、nunique は 47 都道府県。数値列 110 には年度も含まれるので、実際の指標は 112 列から年度・地域コード・都道府県を除いた 109 列になる。describe の count 564 は 47 県 × 12 年度を混ぜた数なので、平均人口 269 万人・最大 1,408.6 万人(2023 年の東京都)はどれも年度をまたいだ要約として読む。
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
🐍 EBPM 効果指標ダッシュボード(最小実装)
🎯 このコードでやること:47 都道府県の「高齢化率」と「出生率」を散布図にし、 さらに回帰直線と 95% 信頼帯を描いてダッシュボード化する。 EBPM ダッシュボードの最小構成を体験。
📥 入力データ:上記コードと同じ 47 県の latest テーブル。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np import matplotlib.pyplot as plt import seaborn as sns df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) year_col = df.columns[0] d = df[df[year_col] == df[year_col].max()].copy() # 最新年度の47都道府県 d['高齢化率'] = d['A1303'] / d['A1101'] * 100 # A1303=65歳以上人口 d['出生率'] = d['A4101'] / d['A1101'] * 1000 # A4101=出生数 plt.figure(figsize=(8, 6)) sns.regplot(data=d, x='高齢化率', y='出生率', scatter_kws={'s': 70, 'alpha': 0.7}, line_kws={'color': '#D32F2F'}) plt.title('高齢化率 vs 出生率(47 都道府県)') plt.grid(alpha=0.3) plt.tight_layout(); plt.savefig('ebpm_dashboard.png', dpi=110) # 図に描いた回帰直線の中身と、直線から最も上に外れた県を数値でも確かめる b1, b0 = np.polyfit(d['高齢化率'], d['出生率'], 1) resid = d['出生率'] - (b0 + b1 * d['高齢化率']) r2 = 1 - (resid**2).sum() / ((d['出生率'] - d['出生率'].mean())**2).sum() print('保存先: ebpm_dashboard.png') print(f'回帰直線: 出生率 ≈ {b0:.2f} − {-b1:.3f} × 高齢化率') print(f'R² = {r2:.3f}') top = d.assign(残差=resid).nlargest(3, '残差') print(top[['Prefecture', '高齢化率', '出生率', '残差']].round(2).to_string(index=False)) |
📤 実行結果(実測):
💬 結果の読み方:R² = 0.378 で、高齢化率だけで出生率の県差の約 4 割を説明する。直線から最も上に外れるのは沖縄県(高齢化率 23.84% と低く、出生率 8.55 は直線の予測より 1.82 高い)で、「高齢化率が高いのに出生率も相対的に高い」のは鹿児島県(33.83%、+0.94)・熊本県(32.30%、+0.91)の側。赤線の周りの陰影は seaborn が bootstrap で描く 95% 信頼帯で、±1.96×SE の式で引いたものではない。 ダッシュボードはこのように「外れ値の発見 → 個別ヒアリング → 政策修正」のサイクルを担う。
🐍 KPI の決め方で「良い県」が入れ替わる — ごみの 3 指標
データ駆動の意思決定は、何を KPI(成果指標)にするかを決めた時点で結論の大半が決まります。同じ「ごみ対策」でも、総排出量・1 人 1 日あたり排出量・リサイクル率のどれで測るかで、評価される県がまったく変わることを実データで確かめます。
🎯 このコードでやること:2023 年度の 47 県について、ごみ総排出量(少ないほど良い)・1 人 1 日あたり排出量(少ないほど良い)・リサイクル率(高いほど良い)の 3 つの KPI で順位をつけ、上位 3 県と、順位どうしの順位相関を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') kpi = pd.DataFrame({ 'ごみ総排出量(t)': d['H5609'], # 少ないほど良い '1人1日排出量(g)': d['H5610'], # 少ないほど良い 'リサイクル率(%)': d['H5614'], # 高いほど良い }) rank = pd.DataFrame({ 'ごみ総排出量(t)': kpi['ごみ総排出量(t)'].rank(), '1人1日排出量(g)': kpi['1人1日排出量(g)'].rank(), 'リサイクル率(%)': kpi['リサイクル率(%)'].rank(ascending=False), }).astype(int) for c in kpi.columns: best = rank[c].nsmallest(3).index print(f'{c:12s} の上位 3: ' + '、'.join(f'{p}({kpi.loc[p, c]:g})' for p in best)) print('KPI の順位どうしの順位相関:') print(rank.corr(method='spearman').round(3).to_string()) for p in ['東京都', '長野県', '鳥取県']: print(p, '順位:', ' '.join(f'{c} {int(v)} 位' for c, v in rank.loc[p].items())) |
💬 3 つの KPI の上位 3 県は、総排出量なら鳥取県・島根県・高知県、1 人 1 日あたりなら京都府・滋賀県・神奈川県、リサイクル率なら岡山県・鳥取県・東京都と、ほとんど重なりません。順位相関は −0.331〜+0.164 で、ある KPI で上位の県が別の KPI でも上位とは限りません。東京都は総排出量では 47 位(最下位)ですが、1 人 1 日あたりでは 6 位、リサイクル率では 3 位です。鳥取県は総排出量 1 位、リサイクル率 2 位なのに、1 人 1 日あたりでは 44 位です。総排出量は人口の大きさをそのまま映すだけなので、県どうしの取り組みを比べる KPI には向きません。
ダッシュボードに載せる KPI を決めるときは、(1) 規模の影響を人口などで割って取り除いているか、(2) 「少ないほど良い」「高いほど良い」の向きが明確か、(3) 複数の KPI が矛盾したときにどれを優先するかを先に決めてあるか、の 3 点を確認します。KPI を後から選べば、どの県でも「良い結果」を示せてしまうからです。
🐍 EBPM を実データで練習する — 保育所の定員と待機児童
「保育所の定員を増やせば待機児童は減るか」は、EBPM(証拠に基づく政策立案)の典型的な問いです。SSDSE-B-2026 の保育所等の定員(J2505)と待機児童数(J250502)で、素朴な分析がどう間違えるかを 2 段階で確かめます。まず 1 時点(2022 年度)の県の比較です。
🎯 このコードでやること:2022 年度の 47 県で、保育所等の定員と待機児童数の順位相関を、人数どうしと「15 歳未満人口あたり」の率どうしの 2 通りで計算する。定員の多い県と定員率の高い県を 4 県ずつ並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2022].copy() # 2022 年度の 47 県 d['定員率'] = d['J2505'] / d['A1301'] * 100 # 15 歳未満人口 100 人あたりの保育所等定員 d['待機率'] = d['J250502'] / d['A1301'] * 1e4 # 15 歳未満人口 1 万人あたりの待機児童 rho1, p1 = stats.spearmanr(d['J2505'], d['J250502']) rho2, p2 = stats.spearmanr(d['定員率'], d['待機率']) print(f'人数どうし : 定員 と 待機児童 ρ = {rho1:+.3f} (p = {p1:.1e})') print(f'人口あたり : 定員率 と 待機率 ρ = {rho2:+.3f} (p = {p2:.1e})') cols = ['Prefecture', 'A1301', 'J2505', 'J250502', '定員率', '待機率'] print(d.sort_values('J2505', ascending=False)[cols].head(4).round(1).to_string(index=False)) print(d.sort_values('定員率', ascending=False)[cols].head(4).round(1).to_string(index=False)) |
💬 人数どうしでは ρ = +0.556 で、「定員が多い県ほど待機児童が多い」という、政策の逆効果を思わせる結果が出ます。ところが 15 歳未満人口あたりの率にすると ρ = −0.556 と符号が逆になり、「定員率が高い県ほど待機率が低い」になります。人数どうしの正の相関は、東京都(定員 322,379、待機 300)のように子どもの多い県が両方とも大きいという規模の効果です。定員率の上位は高知県 35.9、福井県 31.6、新潟県 30.6 で、福井県と新潟県は待機児童 0 です。
次に、同じ県の中で時間とともに何が起きたかを見ます。2017 年度から 2022 年度の 5 年間で、定員を大きく増やした県ほど待機児童が減ったかどうかです。
🎯 このコードでやること:47 県について 2017→2022 年度の定員の増加率と待機児童の増減を計算し、その順位相関を出す。さらに、2017 年度の待機児童数が「増減」と「定員の増加率」のそれぞれとどれだけ相関しているかも出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) p = lambda c: df.pivot(index='Prefecture', columns='SSDSE-B-2026', values=c) cap, wait = p('J2505'), p('J250502') t = pd.DataFrame({ '定員の増加率(%)': (cap[2022] / cap[2017] - 1) * 100, '待機児童 2017': wait[2017], '待機児童 2022': wait[2022], }) t['待機児童の増減'] = t['待機児童 2022'] - t['待機児童 2017'] print(t.sort_values('定員の増加率(%)', ascending=False).head(5).round(1).to_string()) r1 = stats.spearmanr(t['定員の増加率(%)'], t['待機児童の増減'])[0] r2 = stats.spearmanr(t['待機児童 2017'], t['待機児童の増減'])[0] r3 = stats.spearmanr(t['待機児童 2017'], t['定員の増加率(%)'])[0] print(f'定員の増加率 と 待機児童の増減 ρ = {r1:+.3f}') print(f'2017 年の待機児童 と 待機児童の増減 ρ = {r2:+.3f}') print(f'2017 年の待機児童 と 定員の増加率 ρ = {r3:+.3f}') print(f'全国の待機児童 2017 {wait[2017].sum():,} 人 → 2022 {wait[2022].sum():,} 人') |
💬 定員の増加率と待機児童の増減の順位相関は ρ = −0.761 で、「定員を増やした県ほど待機児童が減った」ように見えます。全国でも待機児童は 26,081 人 → 2,944 人と 9 割近く減りました。しかし、2017 年度の待機児童数と増減の相関は ρ = −0.988 と、ほぼ完全です。待機児童は 0 より下には減らないので、減った人数は「最初に何人いたか」でほぼ決まります。そして 2017 年度の待機児童が多い県ほど定員を増やしていました(ρ = +0.765)。沖縄県(+39.3%、2,247 → 439 人)や東京都(+36.9%、8,586 → 300 人)のように、問題の大きい県に政策が集中したので、「定員の効果」と「もともと待機児童が多かったこと」をこのデータだけでは切り分けられません。
このように政策は、必要性の高いところに優先して実施されるのが普通です(政策の割り当てが結果と無関係ではない)。そのため「実施した所としなかった所を比べる」だけでは効果を測れず、実施のタイミングの違いを使う差の差分析や、実施の基準(例: 待機児童 100 人以上)の前後を比べる回帰不連続デザインのような、割り当ての仕組みを考えた設計が必要になります。上の「潜在結果モデル」の節で見た「比べる相手(反事実)を何にするか」が、実データではこうした形で現れます。
このデータで設計を考えるなら、たとえば 2017 年度に待機児童が 1,000 人以上だった 8 都府県(東京都 8,586、沖縄県 2,247、千葉県 1,787、兵庫県 1,572、福岡県 1,297、埼玉県 1,258、大阪府 1,190、岡山県 1,048 人)を「問題の大きい県」とし、人数ではなく 15 歳未満人口あたりの待機率で、定員を増やした時期が早い県と遅い県の推移を比べる、という形になります。ただし 2023 年度は次の節で見る集計の段差があるので、比較は 2022 年度までに限ります。
🐍 差の差を実データで計算する — 定員を大きく増やした県と、そうでない県
上の保育所の節では、東京都 1 県の前後比較では効果を言えないことを見ました。比べる相手を置く最も素朴な方法が差の差(difference-in-differences)です。「定員を大きく増やした県の変化」から「あまり増やさなかった県の変化」を引けば、両方に共通する全国的な流れ(子どもの減少や制度の変化)は打ち消されます。式で書くと $\text{DiD} = (\bar{y}^{\text{伸}}_{2022} - \bar{y}^{\text{伸}}_{2017}) - (\bar{y}^{\text{小}}_{2022} - \bar{y}^{\text{小}}_{2017})$ です。
🎯 このコードでやること:2017→2022 年度の保育所等定員(J2505)の伸び率の中央値で 47 県を 2 群に分け、15 歳未満 1 万人あたりの待機児童数(J250502 ÷ A1301)の群平均を 2015・2017・2022 年度で出して、差の差と、施策前の期間(2015→2017)の差の差を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[0]: 'year'}) cap = df.pivot(index='Prefecture', columns='year', values='J2505') # 保育所等定員 wait = df.pivot(index='Prefecture', columns='year', values='J250502') # 待機児童 kids = df.pivot(index='Prefecture', columns='year', values='A1301') # 15 歳未満人口 rate = wait / kids * 10000 # 15 歳未満 1 万人あたりの待機児童 # 2017→2022 年度の定員の伸びで 47 県を 2 群に分ける(中央値で) growth = cap[2022] / cap[2017] - 1 hi = growth[growth > growth.median()].index lo = growth[growth <= growth.median()].index print(f'定員の伸び 伸びた群 {growth[hi].mean():.3f}({len(hi)} 県) 伸びの小さい群 {growth[lo].mean():.3f}({len(lo)} 県)') m = pd.DataFrame({'伸びた群': rate.loc[hi].mean(), '伸びの小さい群': rate.loc[lo].mean()}) print(m.loc[[2015, 2017, 2022]].round(2).to_string()) did = (m.loc[2022, '伸びた群'] - m.loc[2017, '伸びた群']) - (m.loc[2022, '伸びの小さい群'] - m.loc[2017, '伸びの小さい群']) pre = (m.loc[2017, '伸びた群'] - m.loc[2015, '伸びた群']) - (m.loc[2017, '伸びの小さい群'] - m.loc[2015, '伸びの小さい群']) print(f'差の差 (2017→2022) = {did:+.2f} 事前の差の差 (2015→2017) = {pre:+.2f}') |
💬 定員の伸びた 23 県(平均 +20.7%)は 1 万人あたり 20.13 → 2.48 人、伸びの小さい 24 県(+5.9%)は 5.61 → 1.10 人に減り、差の差は −13.13 人です。施策前の 2015→2017 年度の差の差は −1.30 人なので、「もともと減り方が違っていた」わけではなさそうです。ただし、この −13.13 人をそのまま定員拡大の効果とは読めません。伸びの小さい群は 2017 年度に 5.61 人しかおらず、0 人より下には減れないので、そもそも 13 人も減る余地がありませんでした。待機児童の多かった県ほど定員を増やしたので、群の違いは「定員の伸び」と「最初の待機児童の多さ」が重なっています。差の差は「処置が無ければ両群は平行に動いた」という仮定(平行トレンド)に頼る方法で、出発点が大きく違う群ではこの仮定が疑わしいことを、数字とともに報告します。
⚠️ よくある落とし穴(7 件)
データ駆動型社会 に取り組むときに、 学生・実務者・研究者がよく踏むワナをまとめました。 該当しそうな項目があれば、 自分の分析を見直してみてください。
🧭 詳細解説 — データ駆動型社会 を一段深く掘り下げる
歴史的背景
データ駆動型社会(Data-Driven Society)は、 2011 年の World Economic Forum レポート「Personal Data: The Emergence of a New Asset Class」を契機に社会経済学の文脈で使われ始め、 2014 年の Big Data 第二次ブーム、 2016 年の日本「Society 5.0」、 2018 年の EU GDPR 施行、 2020 年の Data Governance Act 提案などを通じて政策用語として定着しました。 日本では第 5 期科学技術基本計画(2016-2020)に「狩猟社会・農耕社会・工業社会・情報社会に続く第 5 の社会」として明記され、 内閣府デジタル田園都市国家構想、 デジタル庁設立 (2021)、 統計改革推進会議 (2017-) など、 公的統計・行政データのオープン化・標準化が制度的に進められています。 SSDSE は独立行政法人統計センターが作成・公開している、 公的統計の教育普及策の象徴的な成果物の 1 つです。
⚠️ よくある落とし穴
⚠️ データ駆動社会の落とし穴(深掘り 7 件)
「集めたデータ = 正しいデータ」と誤認しがち。 行政データは定義変更・取得漏れ・集計ミスが日常茶飯事。 まずメタデータ・更新履歴を疑う癖を。
細かい粒度ほど個人特定リスクが上がる。 k-匿名化、 差分プライバシー、 連合学習などのPETs 知識が必須。 GDPR・改正個人情報保護法も追従。
過去データの偏りがモデルに転写される。 採用 AI、 信用スコア、 再犯予測などで人種・性別バイアスが報告。 fairness metrics 必須。
「データはあるが誰の責任で意思決定するか」が曖昧だと、 結局過去の慣習が勝つ。 Chief Data Officer の任命・データ責任マトリクスの整備が起点。
高齢者・障害者・地方在住者がデータ生成・受益から脱落するリスク。 「データ駆動」が逆に格差を拡大しないよう、 包摂的設計が必要。
数値化しやすい指標だけが評価対象になり、 長期効果・質的価値が無視される(Goodhart の法則)。 複合指標と定性データの併用を。
「相関が高い → 効果がある」と早合点して政策投入し、 効果ゼロ・逆効果のケースが頻発。 RCT/DID/IV いずれの識別戦略を取ったか必ず明示。
⚠️ 実データで確かめる — 数字の段差を「政策の効果」と読まない
データ駆動の判断で最も危ないのは、集計の仕方が変わってできた数字の段差を、現実の変化と読んでしまうことです。上の保育所等のデータを全国の合計で並べると、2023 年度に大きな段差があります。
🎯 このコードでやること:保育所等数・定員・在所児数・待機児童・15 歳未満人口の全国合計を 2019〜2023 年度で並べ、前年比を計算する。定員の 2023/2022 年度比を 47 県で比べる。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) g = df.groupby('SSDSE-B-2026')[['J2503', 'J2505', 'J2506', 'J250502', 'A1301']].sum() g.columns = ['保育所等数', '定員', '在所児数', '待機児童', '15歳未満人口'] chg = (g.pct_change() * 100).round(1) print(g.loc[2019:2023].to_string()) print('前年比(%)'); print(chg.loc[2020:2023].to_string()) p = lambda c: df.pivot(index='Prefecture', columns='SSDSE-B-2026', values=c) ratio = (p('J2505')[2023] / p('J2505')[2022]).round(3) print(f'定員の 2023/2022 比: 47 県の最小 {ratio.min()}({ratio.idxmin()})、中央値 {ratio.median()}、最大 {ratio.max()}({ratio.idxmax()})') print('0.9 未満の県数:', int((ratio < 0.9).sum())) |
💬 2023 年度だけ、保育所等数 −21.8%、定員 −22.8%、在所児数 −26.7% と、前年まで毎年 1〜3% 増えていた系列が 2 割以上減っています。15 歳未満人口の減少は −2.3% なので、子どもが減ったことでは説明できません。県ごとの定員の 2023/2022 比は、富山県 0.445 から東京都 0.999 まで大きくばらつき、47 県中 40 県で 0.9 未満です。1 年で保育所の 2 割が実際に閉じたとは考えにくく、集計の対象(どの種類の施設を「保育所等」に含めるか)が変わった可能性を疑うべき段差です。SSDSE の数値だけからは理由を確定できないので、元の統計の注記で確かめる必要があります。
もしこの段差に気づかずに「2023 年度に定員を 22.8% 削減したのに待機児童は 9.0% 減った。定員を減らしても待機児童は増えない」と書けば、完全に誤った政策提言になります。時系列のデータを政策の評価に使うときは、(1) 前年比が他の年と桁違いの年がないか、(2) その年に、関連する複数の系列が同時に同じ向きに動いていないか、(3) 元の統計に定義や集計範囲の変更の注記がないか、を必ず確かめます。段差のある年は、分析から外すか、段差の前後を別の系列として扱います。外した場合は「2023 年度の保育所等の値は前年までと集計範囲が異なる可能性があるため、比較から除いた」のように、除いた理由を報告書に書いておきます。
⚠️ 実データで確かめる — 「悪い県を選んで支援したら改善した」は平均への回帰かもしれない
EBPM でよくある流れが「指標の悪い県(自治体)を選んで重点的に支援し、翌年に指標が改善したので効果があった」という評価です。ところが、ある年にたまたま値が悪く出た県は、何もしなくても翌年は平均の側に戻りやすい。これを平均への回帰と呼びます。1 人 1 日当たりのごみ排出量(H5610)で、支援を何もしていないのに「改善」が生じることを確かめます。
🎯 このコードでやること:県 × 年度のごみ排出量(g/人・日)の表を作り、2016 年度に排出量が多かった 10 県・少なかった 10 県・残り 37 県で、翌年の変化の平均を比べる。選ぶ年度を 2012〜2022 年度に変えても同じことが起きるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[0]: 'year'}) # 1人1日当たりのごみ排出量 (g) を 県 × 年度 の表にする w = df.pivot(index='Prefecture', columns='year', values='H5610') # 2016 年度に排出量が多かった 10 県を「重点支援県」に選んだと仮定する top10 = w[2016].nlargest(10).index bot10 = w[2016].nsmallest(10).index rest = w.index.difference(top10) def show(label, idx): before = (w.loc[idx, 2016] - w.loc[idx, 2015]).mean() after = (w.loc[idx, 2017] - w.loc[idx, 2016]).mean() print(f'{label:<10} 2016 平均 {w.loc[idx, 2016].mean():6.1f} g' f' 2015→16 {before:+5.1f} g 2016→17 {after:+5.1f} g') show('多い10県', top10) show('少ない10県', bot10) show('残り37県', rest) print('多い 10 県:', '・'.join(top10)) # 選ぶ年度を変えても同じことが起きるか(どの年も「施策」は無い) print('選んだ年度 多い10県の翌年変化 残り37県の翌年変化 差') for y in range(2012, 2023): t = w[y].nlargest(10).index ch = w[y + 1] - w[y] print(f'{y} {ch[t].mean():+6.1f} {ch.drop(t).mean():+6.1f} {ch[t].mean() - ch.drop(t).mean():+6.1f}') r = w[2016].corr(w[2017] - w[2016]) print(f'2016 年度の水準と翌年の変化の相関 r = {r:.3f}') |
💬 2016 年度に排出量の多かった 10 県は翌年に平均 −4.1 g 減り、少なかった 10 県は +6.3 g、残り 37 県は +1.0 g と、上の県は下がり下の県は上がっています。この 10 県に何か施策をしていたら「重点支援で 4.1 g 減った、他県は増えたのに」と報告できてしまいますが、実際にはどの県も選ばれていません。選ぶ年度を変えると、多い 10 県の翌年変化が残りの県より小さい(差が負)年は 11 回中 9 回あり、2016 年度の水準と翌年の変化の相関も r = −0.202 と負です。ただし差は −11.9 g から +3.3 g まで年によってばらつき、2020・2021 年度は逆向きなので、平均への回帰は「必ず起きる大きな効果」ではなく「施策の効果と見分けがつかない程度には起きる」ものです。
対策は、(1) 選んだ県と、同じ基準で選ばれたが支援を受けなかった県(または選定前の数年の傾向)と比べる、(2) 1 年の値でなく複数年の平均で対象を選ぶ、(3) 支援の前後を比べるときは、同じ期間の全国の変化(上の表の 2022 年度のように、選ばれなかった 37 県の平均でも −26.3 g 動く年がある)を差し引く、の 3 つです。📐 の潜在結果の枠組みで言えば、「支援しなかった場合の翌年の値」を、選ばれた県自身の前年値で代用してはいけない、ということです。
⚠️ 実データで確かめる — 「改善幅ランキング」は毎年入れ替わる
自治体の KPI ダッシュボードでは、指標の水準だけでなく「前年からの改善幅」で県や部署を表彰・順位づけすることがあります。しかし水準の順位は安定していても、改善幅の順位は 1 年ごとにほとんど入れ替わります。上と同じごみ排出量(H5610)で確かめます。
🎯 このコードでやること:ごみ排出量の県別順位が翌年度とどれだけ一致するか(水準の順位相関)と、前の 1 年の改善幅と次の 1 年の改善幅の順位がどれだけ一致するか(改善幅の順位相関)を、2014〜2023 年度で比べる。改善幅の上位 10 県(減少幅の大きい 10 県)が翌年も上位 10 県に残る数を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={df.columns[0]: 'year'}) w = df.pivot(index='Prefecture', columns='year', values='H5610') # ごみ g/人・日 print('比べる年度 水準の順位相関 改善幅の順位相関') for y in range(2014, 2023): lv = w[y].corr(w[y + 1], method='spearman') # 水準: y 年度 vs y+1 年度 ch_prev = w[y] - w[y - 1] # 改善幅: 前の 1 年 ch_next = w[y + 1] - w[y] # 改善幅: 次の 1 年 print(f'{y}→{y + 1} {lv:+.3f} {ch_prev.corr(ch_next, method="spearman"):+.3f}') # 「改善幅ランキング上位 10 県」が翌年も上位 10 に残る数 ch = w.diff(axis=1) keep = [len(set(ch[y].nsmallest(10).index) & set(ch[y + 1].nsmallest(10).index)) for y in range(2013, 2023)] print('改善幅の上位10県のうち翌年も上位10に残った県数:', keep) lv_keep = [len(set(w[y].nsmallest(10).index) & set(w[y + 1].nsmallest(10).index)) for y in range(2013, 2023)] print('排出量の少ない10県のうち翌年も少ない10県に残った県数:', lv_keep) |
💬 水準の順位相関は毎年 +0.963〜+0.990 で、ごみの少ない 10 県は翌年も 9〜10 県が入れ替わらずに残ります。一方、ある年の改善幅と翌年の改善幅の順位相関は −0.273〜+0.410 と、正負が年によって入れ替わり、改善幅の上位 10 県で翌年も上位 10 県に残るのは 0〜5 県(10 年の平均 2.3 県)です。改善幅は「その年のたまたまの上下」を多く含むので、1 年の改善幅で表彰すると、翌年の表彰県はほぼ別の県になります。改善幅で評価するなら、3〜5 年の傾き(回帰直線の傾き)を使う、水準と改善幅を併記する、改善幅の不確かさ(過去の年ごとの変動幅)を横に書く、といった工夫が必要です。
📚 関連グループ教材(全体像)
データ駆動型社会 は「社会」分野の一部です。 同じグループに属する用語は以下:
- 🎯 data-driven-society(このグループの総合ページ) — 全体像を学びたいときはここから
- Society 5.0 — このグループの構成要素
- データ利活用 — このグループの構成要素
- オープンデータ — このグループの構成要素
グループ教材は横断的な視点を提供します。 個別用語だけでなくグループ全体を 1 周しておくと、 各用語の関係性が立体的に見えてきます。
📚 関連グループ教材
この用語の全体像を学ぶには、 横断的な教材で文脈を掴むのが効率的です:
- 📚 データリテラシー — 個人レベルの基礎
- 📚 Society 5.0 — 日本政府が掲げる次世代社会像
- 📚 オープンデータグループ — 行政データ公開の基盤
- 📚 AI と社会 — データ駆動社会の倫理・規制
- 📚 データガバナンス — 組織・自治体の統制
- 内閣府『Society 5.0』(https://www8.cao.go.jp/cstp/society5_0/)— 日本のデータ駆動社会ビジョン
- 政府 CIO ポータル『オープンデータ』(https://cio.go.jp/policy-opendata)— 自治体オープンデータの推進指針
- e-Stat 政府統計の総合窓口(https://www.e-stat.go.jp/)— 政府データのワンストップ入口
- RESAS 地域経済分析システム(https://resas.go.jp/)— 地域データ駆動政策の標準ツール
- OECD Going Digital Toolkit(https://goingdigital.oecd.org/)— 国別データ駆動社会指標の国際比較
- 欧州 Data Act(https://digital-strategy.ec.europa.eu/en/policies/data-act)— データ流通規則の EU 標準
📚 演習: あなたの市町村のデータ駆動診断
- 住んでいる市町村のオープンデータカタログを検索し、 公開データセット数・更新頻度・CSV/API 提供有無を表にまとめよ。
- SSDSE-B-2026 から同市町村が属する都道府県の高齢化率と出生率を計算し、 全国平均と比較せよ。
- 市町村予算書(PDF)から「データ・ICT 関連予算」を抽出し、 隣接 3 市町村と比較。 ガバナンス階層の充実度を評価せよ。
- 市町村の重点政策(例: 子育て支援)について、 PPDAC サイクルでロジックモデル → 効果指標 → 計測方法を設計せよ。
- ① ~ ④ を統合し、 「データ駆動度スコア」を 5 段階で自己診断、 改善提言 3 つを A4 1 枚にまとめよ。
💡 提出物:スプレッドシート+スライド 5 枚。 査読は学習仲間・自治体職員・地域経済学者に依頼すると現実的なフィードバックが得られる。
🖼 視覚的理解 (3 図)
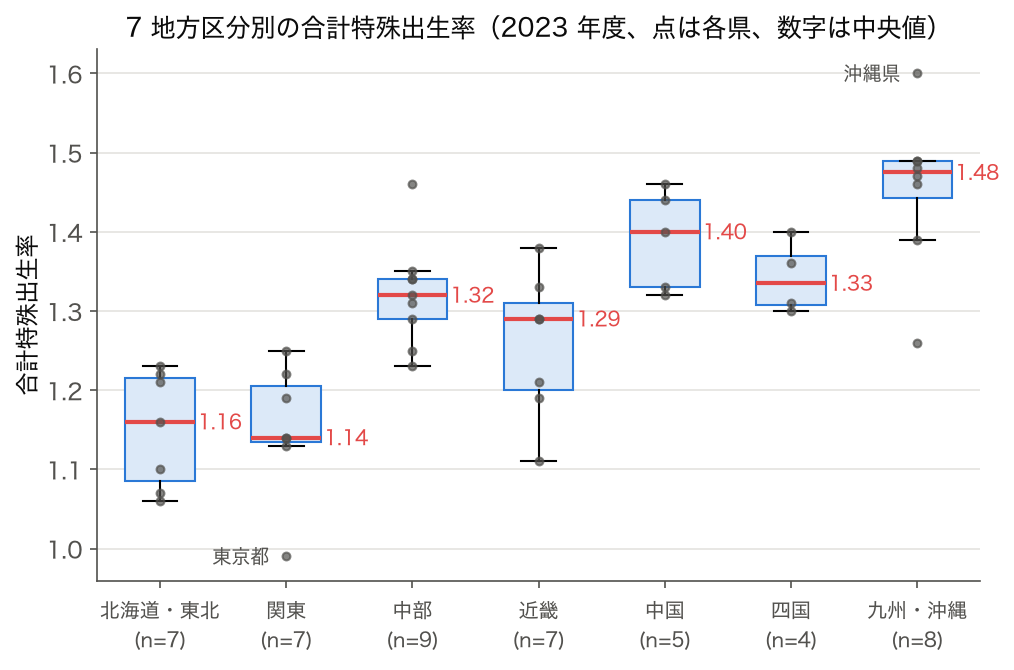
上の演習 ① (都道府県の高齢化率と出生率を計算し、 全国平均と比較する) を、 SSDSE-B-2026 (2023 年度・47 都道府県) の実データで行った 3 図で示す。 DX 推進度や業種別のデータ活用度のような指標は SSDSE-B-2026 に無いので、 自治体が公的統計から地域課題を把握する最初の一歩として、 高齢化率 (65 歳以上人口 / 総人口) と合計特殊出生率を使う。 散布図・ヒストグラム・箱ひげ図はそれぞれ「2 変量の連動」「1 変量の分布」「群間比較」という分析の基礎テンプレートに対応し、 データ駆動型社会で頻出する 3 大可視化パターンを網羅する。
📝 理解度チェック
以下 5 問は、 データ駆動型社会の概念・実装・社会影響を多面的に確認するための問いである。 解答例は標準的論点を網羅しつつ、 SSDSE-B-2026 等の公的データを題材にした実践例も含む。
Q1: データ駆動型社会の定義と特徴を 3 つ挙げよ
解答例
データ駆動型社会 (Data-Driven Society) とは、 個人・組織・政府の意思決定・サービス提供・政策立案が、 経験や直感ではなく、 収集・分析されたデータと統計的・機械学習的洞察に基づいて行われる社会形態を指す。 特徴として (1) 大量・多様なデータの収集インフラ (IoT、 行政システム、 民間プラットフォーム) が整備されている、 (2) データから知見を抽出するアナリティクス基盤 (BI、 ML、 AI) が普及している、 (3) データに基づく意思決定文化 (EBPM、 データドリブン経営、 個人レベルのライフログ活用) が定着している、 の 3 点が挙げられる。 日本では Society 5.0 構想の中核に位置づけられ、 デジタル庁・経済産業省・内閣府が推進主体となっている。
Q2: Society 5.0 とデータ駆動型社会の関係を説明せよ
解答例
Society 5.0 は内閣府が第 5 期科学技術基本計画 (2016 年) で提唱した日本の未来社会像で、 狩猟・農耕・工業・情報に続く第 5 の社会段階として位置づけられる。 サイバー空間 (仮想空間) とフィジカル空間 (現実空間) を高度に融合させたシステムにより、 経済発展と社会的課題の解決を両立する。 データ駆動型社会は Society 5.0 の根幹を成すコンセプトであり、 IoT で収集したデータを AI が解析し、 結果をロボット・自動運転・遠隔医療等で社会に還元するサイクルそのものを指す。 すなわち Society 5.0 は到達目標、 データ駆動型社会はその実現手段・運用形態と整理できる。
Q3: データ駆動の阻害要因を 5 つ挙げ、 それぞれの克服策を述べよ
解答例
(1) データサイロ:部署・システム間でデータが分断 → データレイク/統合 ID 整備で克服。 (2) IT・分析人材不足:IT 人材は 2030 年に最大約 79 万人不足(経済産業省「IT 人材需給に関する調査」2019 年の試算) → 大学教育・リスキリング・外部委託で補完。 (3) プライバシー懸念:個人情報・営業秘密の漏えいリスク → 差分プライバシー・連合学習・データクリーンルーム等 PETs を導入。 (4) 経営層のリテラシー不足:意思決定が依然 HiPPO (Highest Paid Person's Opinion) 依存 → 役員研修・CDO 配置・KPI 連動評価で文化変革。 (5) 文化的抵抗:「データはあくまで参考、 最後は勘」という慣習 → スモールウィン (小さな成功事例) を積み上げ、 アジャイル組織で実証ベースの意思決定を定着させる。
Q4: KPI とダッシュボード、 EBPM の関係を述べよ
解答例
KPI (Key Performance Indicator) は組織目標 (KGI: Key Goal Indicator) を構成する定量指標で、 「売上、 解約率、 NPS、 待機児童数」等。 ダッシュボードは複数 KPI を一画面に集約・可視化する BI ツール (Tableau、 Power BI、 Looker、 Metabase) で、 リアルタイム更新により異常検知と迅速な打ち手立案を可能にする。 EBPM (Evidence-Based Policy Making) は、 政策の企画・実行・評価サイクル全体を統計分析・RCT・準実験等のエビデンスに基づいて行う行政手法で、 ロジックモデルの各段階に KPI を埋め込みダッシュボードで進捗監視するのが標準形。 企業の OKR や行政の EBPM はいずれもデータ駆動型社会の運用パターンである。
Q5: SSDSE-B-2026 を題材に自治体データ駆動の具体例を設計せよ
解答例
SSDSE-B-2026 (47 都道府県 × 100 超変数) を入力に、 自治体経営の KPI 群 (人口減少率、 高齢化率、 産業構成、 教育費比率、 保育カバー率、 失業率) を整理。 EBPM サイクルに沿って (1) 課題定義 (例: 子育て世帯転入増加)、 (2) ロジックモデル設計 (保育拡充 → 子育て満足度 → 転入増)、 (3) RCT または差分の差 (DID) で効果検証、 (4) KPI ダッシュボード化、 (5) 翌年度予算へ反映、 のループを回す。 隣接県との比較分析や、 全国 47 県の主成分分析・クラスタリングで類似自治体ベンチマーク群を発見し、 ピアレビュー型の政策学習を行うのが推奨形である。
Q6〜Q11: 実データの数値で考える
Q6. 2022 年度の 47 県で、保育所等の定員と待機児童数の順位相関は ρ = +0.556 でした。ある報告書が「定員の多い県ほど待機児童が多いので、定員拡大には効果がない」と書いています。どこが誤りですか。
答え. 人数どうしの相関は、子どもの多い県ほど定員も待機児童も多いという規模の効果を拾っています。15 歳未満人口あたりの率どうしにすると ρ = −0.556 と逆になります。さらに、率どうしの負の相関も 1 時点の県の比較にすぎず、「定員を増やせば減る」という因果を示すものではありません。
Q7. 2017→2022 年度に定員を 36.9% 増やした東京都では、待機児童が 8,586 人から 300 人に減りました。この 8,286 人の減少をすべて定員拡大の効果と言えますか。
答え. 言えません。比べる相手(定員を増やさなかった場合の東京都)が観察できないからです。東京都の 15 歳未満人口はこの間 1,542,000 → 1,535,000 人とほぼ横ばい(全国では 7.0% 減)で、子どもの減少では説明しにくいものの、保育の需要(共働きの世帯の数など)の変化はこのデータにありません。また 47 県を見ると、待機児童の減少は「最初の人数」とほぼ完全に連動していました(ρ = −0.988)。効果の大きさを言うには、定員拡大の時期や規模が県によって違うことを使った比較(差の差分析など)が必要です。
Q8. ごみ対策の KPI として「ごみ総排出量が少ない県」を表彰すると、2023 年度は鳥取県・島根県・高知県が選ばれます。この KPI の問題点と、代わりの KPI を挙げてください。
答え. 総排出量は人口の少ない県ほど小さくなるので、取り組みではなく人口の大きさを表彰することになります(鳥取県は 1 人 1 日あたりでは 47 県中 44 位)。人口の影響を除いた 1 人 1 日あたり排出量(上位は京都府 749 g、滋賀県 761 g)や、リサイクル率を使い、どちらを優先するかも先に決めておきます。取り組みの成果を見たいなら、水準ではなく変化を KPI にする手もあります。1 人 1 日あたり排出量の 2012→2023 年度の変化は 47 県中 46 県で減少し、京都府は 928 → 749 g(−179 g)と最も大きく減らした一方、鳥取県は 1,009 → 963 g(−46 g)でした。
Q9. 2016 年度に 1 人 1 日あたりごみ排出量が多かった 10 県に「減量支援」をしたところ、翌年度に平均 4.1 g 減り、残りの 37 県は平均 1.0 g 増えました。「支援で 5.1 g の差が出た」と言えますか。
答え. 言えません。SSDSE の実データでは、この 10 県に実際には何の支援も選ばれていないのに、この差が生じています(⚠️ 章の平均への回帰の節)。ある年に値が高く出た県は、翌年は平均の側に戻りやすいからです。選ぶ年度を 2012〜2022 年度に変えると、多い 10 県の翌年変化が残りより小さい年は 11 回中 9 回ありました。効果を言うには、同じ基準で選ばれたのに支援を受けなかった県と比べるか、選定を複数年の平均で行う必要があります。
Q10. 2023 年度の 47 都道府県の高齢化率を単純平均すると 31.59% ですが、全国の 65 歳以上人口 ÷ 総人口は 29.13% です。「全国の高齢化率」として報告すべきなのはどちらですか。また、差が生じる理由は何ですか。
答え. 全国の高齢化率は 29.13% です。単純平均は人口 91 万人の秋田県(39.06%)と 1,409 万人の東京都(22.75%)を同じ重さで数えるので、人口が少なく高齢化率の高い県の影響が大きくなり、2.46 ポイント高く出ます。「県の典型的な姿」を知りたいときは単純平均や中央値も意味があるので、どちらを使ったかを必ず書きます。
Q11. ごみ排出量の「前年からの改善幅」の上位 10 県を毎年表彰すると、翌年も表彰される県は平均何県でしょうか。これは何を意味しますか。
答え. 2013〜2022 年度の実データでは 0〜5 県、平均 2.3 県です(水準の少ない 10 県なら毎年 9〜10 県が残る)。1 年の改善幅は偶然の上下を多く含み、表彰の多くが「その年たまたま下がった県」に当たっていることを意味します。改善を評価するなら、複数年の傾きで見るべきです。
🗺 Society 5.0 とデータ駆動社会の位置づけ
日本政府が掲げる Society 5.0 は「サイバー空間とフィジカル空間を高度に融合させた人間中心の社会」と定義され、 データ駆動社会はその技術基盤かつ運営原理です。 段階モデルは以下の通り。
| 段階 | 特徴 | 主要技術 | 時期 |
|---|---|---|---|
| Society 1.0 狩猟 | 自然採集 | 石器 | ~B.C.13000 |
| Society 2.0 農耕 | 定住・分業 | 灌漑・暦 | ~17 世紀 |
| Society 3.0 工業 | 機械化・大量生産 | 蒸気機関・電力 | ~20 世紀 |
| Society 4.0 情報 | IT・知識社会 | PC・インターネット | 1995-2015 |
| Society 5.0 データ駆動 | サイバー・フィジカル融合 | IoT/AI/5G/量子 | 2016- |
Society 5.0 を実装する OS(オペレーティング・システム)が「データ駆動社会」であり、 SSDSE のようなオープン統計データはそのアプリケーション層の入力データに相当します。
🔗 隣接手法への橋渡し
データ駆動型社会はオープンデータ・AI 社会論・ガバナンスを束ねる概念。
データ整備 → 公開 → 利活用 → 政策反映 → 効果検証の流れで、 各段でのデータリテラシーと倫理が社会受容性を決める。