🔖 キーワード索引
🔖 オープンデータ深掘り ── 利用条件・ライセンス・実装の総合ガイド
オープンデータ (Open Data) は「自由に利用・再配布・改変できるデータ」。 政府、 自治体、 研究機関、 企業が公開し、 アプリ開発・研究・教育・ジャーナリズム等で活用される。 本記事の主軸 SSDSE-B-2026 (政府統計、 CC BY 4.0) はその典型例である。
💡 オープンデータの定義 (Open Knowledge Foundation, 2015)
- Open License: 利用・再配布・改変・商用利用 すべて許可されているライセンス (例: CC0、 CC BY、 ODbL)
- Open Format: 機械可読 (CSV、 JSON、 XML、 RDF) で、 プロプライエタリでないフォーマット
- Open Access: 認証・課金なしで誰でもアクセス可能
- Free of cost: 無償 (実費分の媒体代を除く)
📐 Tim Berners-Lee の 5 ★ Open Data (2010)
| ★ | 条件 | フォーマット例 | SSDSE は? |
|---|---|---|---|
| ★ | オープンライセンスで Web 公開 | PDF、 スキャン画像 | ○ (CC BY 4.0) |
| ★★ | 構造化データ | XLS、 DOC | ○ |
| ★★★ | オープンフォーマット | CSV、 JSON、 XML | ○ (CSV 提供) |
| ★★★★ | URI で識別 (各レコードに URI) | RDF、 HTTP URI | △ (Code 列があるが URI ではない) |
| ★★★★★ | Linked Data (他データセットへリンク) | RDF + SPARQL endpoint | × (リンクなし) |
📐 数式を言葉で読み解く: ★ が増えるほど「機械可読性」と「他データセットとの結合可能性」が高まる。 SSDSE-B-2026 は ★★★ レベル (CSV 提供) で、 実用上十分。 ★★★★ 以上は研究データ (DBpedia、 Wikidata) で重要。
🧮 SSDSE-B-2026 ── オープンデータの典型例
SSDSE (教育用標準データセット、 Standardized Statistical Data Set for Education) は独立行政法人統計センターが公開する 政府統計の二次整形版。 2026 年版 (B 表) は 47 都道府県 × 12 年度 × 109 指標で 564 行 × 112 列(年度・地域コード・都道府県名の 3 列を含む)の単一 CSV。
| 属性 | SSDSE-B-2026 の値 |
|---|---|
| 提供元 | 独立行政法人統計センター (NSTAC) |
| ライセンス | CC BY 4.0 (出典明記で改変・商用利用可) |
| フォーマット | CSV (encoding=cp932、 ヘッダ 2 行構成) |
| 更新頻度 | 年次 (毎年 6 月頃) |
| サイズ | 約 360 KB (564 行 × 112 列) |
| 主指標 | 人口、 出生数、 死亡数、 婚姻数、 年平均気温 等 |
| 対象年 | 2012-2023 (12 年) |
| 対象地域 | 47 都道府県 |
| 用途 | 教育、 統計コンペ、 研究、 アプリ開発 |
| 配布元 | https://www.nstac.go.jp/ssdse/ |
🐍 Python 実装 ── SSDSE-B-2026 を pandas で読込・確認
🎯 このコードでやること: SSDSE-B-2026 の CSV ファイル特有の落とし穴 (cp932 encoding、 ヘッダ 2 行構成) を踏まえて pandas で正しく読み込み、 構造とライセンスを確認する。
📥 入力データ: data/raw/SSDSE-B-2026.csv (564 行 × 112 列)。 1 行目 = 英語コード、 2 行目 = 日本語名。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd # cp932 + skiprows=[1] で日本語ラベルをスキップして英語コード列名を採用 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print('=== SSDSE-B-2026 構造 ===') print(f'行数 : {len(df):,} (= 47 県 × 12 年)') print(f'列数 : {len(df.columns)}') print(f'年度 : {sorted(df["SSDSE-B-2026"].unique().tolist())}') print(f'最初の 6 列名 : {list(df.columns[:6])}') # 2023 年 47 県のみ抜粋 df23 = df[df['SSDSE-B-2026'] == 2023] print('\n=== 2023 年 47 県の主要指標 ===') print(df23[['Prefecture','A1101','A4101','B4101']].head(5)) print(df23[['Prefecture','A1101','A4101','B4101']].tail(5)) # ライセンス表示確認 print('\n=== ライセンス情報 ===') print('出典 : 「教育用標準データセット SSDSE-B-2026」(独立行政法人 統計センター)') print('ライセンス: CC BY 4.0') print('URL : https://www.nstac.go.jp/ssdse/') |
📤 実行すると次の出力が得られる(実測):
💬 結果の読み方: SSDSE-B-2026 は cp932 (Shift_JIS) encoding で、 ヘッダが 2 行構成 (1 行目 = 英語コード、 2 行目 = 日本語名)。 skiprows=[1] で 2 行目をスキップして英語コード列名を使うと SQL 風の操作がしやすい。 すべての CSV オープンデータで encoding と header 行を確認する習慣が大事。 CC BY 4.0 では「出典明記」が義務で、 改変・商用利用は自由。
🌐 主要オープンデータライセンスの比較
| ライセンス | 出典明記 | 改変 | 商用利用 | 継承 | 代表的データセット |
|---|---|---|---|---|---|
| CC0 (Public Domain Dedication) | 不要 | 可 | 可 | 不要 | 米国政府データ、 Met Museum |
| CC BY 4.0 | 必要 | 可 | 可 | 不要 | SSDSE、 e-Stat、 政府 CIO データ |
| CC BY-SA 4.0 | 必要 | 可 | 可 | 必要 (同ライセンス) | Wikipedia、 OpenStreetMap (一部) |
| CC BY-NC 4.0 | 必要 | 可 | 不可 | 不要 | 学術データの一部 |
| CC BY-ND 4.0 | 必要 | 不可 | 可 | 不要 | 公式ロゴ等の一部 |
| ODbL (Open Database License) | 必要 | 可 | 可 | 必要 (DB のみ) | OpenStreetMap (本体) |
| PDDL (Public Domain Dedication) | 不要 | 可 | 可 | 不要 | 学術 DB |
| 政府標準利用規約 2.0 (日本) | 必要 | 可 | 可 | 不要 | 日本政府 CIO ポータル、 自治体 |
| OGL (UK Open Government License) | 必要 | 可 | 可 | 不要 | 英国政府データ |
選定のポイント: CC0 が最も自由、 CC BY が最も標準的。 商用 SaaS や有償アプリで活用するなら NC (Non-Commercial) は不可、 改変したいなら ND (No Derivatives) は不可。 SA (Share-Alike) は派生物にも同じライセンスが波及するので注意。
🐍 Python 実装 ── e-Stat API でオープンデータ取得
🎯 このコードでやること: 政府統計の総合窓口 e-Stat (https://www.e-stat.go.jp/) の API を呼び出して、 SSDSE と同種の公式統計を JSON で取得する手順を実装。
📥 入力データ: e-Stat 利用登録 (無料) で取得した APPID、 統計表 ID (例: 国勢調査 0003448237)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import requests, pandas as pd # 1. e-Stat 利用登録 (無料) で APPID 取得 # https://www.e-stat.go.jp/api/ APPID = 'YOUR_API_KEY' # 2. 統計表検索 API で statsDataId を取得 (例: 国勢調査) search_url = 'https://api.e-stat.go.jp/rest/3.0/app/json/getStatsList' params = { 'appId': APPID, 'searchWord': '国勢調査 都道府県', 'limit': 5, } resp = requests.get(search_url, params=params) print('=== 検索結果 (top 5) ===') for table in resp.json()['GET_STATS_LIST']['DATALIST_INF']['TABLE_INF'][:5]: print(f" {table['@id']:>14} {table['STATISTICS_NAME']}") # 3. 統計データ取得 (statsDataId 指定) data_url = 'https://api.e-stat.go.jp/rest/3.0/app/json/getStatsData' params = { 'appId': APPID, 'statsDataId': '0003448237', # 国勢調査 結果一覧 'limit': 100, } resp = requests.get(data_url, params=params) data = resp.json() values = data['GET_STATS_DATA']['STATISTICAL_DATA']['DATA_INF']['VALUE'] # 4. DataFrame 化 df = pd.DataFrame(values) print('\n=== 取得データ (先頭 5 件) ===') print(df.head()) print(f'\n総レコード数: {len(df)}') print(f'\nライセンス: 政府標準利用規約 2.0 (出典: 「国勢調査」(総務省))') |
📤 出力の例 (e-Stat の API キーと外部サービスが必要なため実測ではない):
💬 結果の読み方: e-Stat API は JSON 形式で全件取得可能 (limit を上げると 10 万件単位も可)。 statsDataId で固有の統計表を指定、 area / time / cat01-03 でフィルタ。 SSDSE-B-2026 は e-Stat の複数統計を「教育用」に再整形したもの ── 元データは e-Stat にあり、 用途別に「整形済み (SSDSE)」「生 (e-Stat API)」を使い分けるのが原則。 ライセンスは「政府標準利用規約 2.0」(CC BY 4.0 互換)、 出典明記必須。
🌐 国際的なオープンデータポータル (主要 12)
| ポータル | 国/組織 | データ数 | ライセンス | 代表用途 |
|---|---|---|---|---|
| data.gov | 米国連邦政府 | 30 万+ | CC0 (連邦政府) | 政府透明性、 研究 |
| data.go.jp | 日本政府 CIO | 3 万+ | 政府標準利用規約 2.0 | 日本国内施策 |
| e-Stat | 総務省統計局 | 600 統計表 | 政府標準利用規約 2.0 | 公的統計集約 |
| data.gov.uk | 英国政府 | 5 万+ | OGL | 英国政策 |
| data.europa.eu | EU | 160 万+ | CC BY 4.0 (大半) | EU 統合分析 |
| World Bank Open Data | 世界銀行 | 数千指標 | CC BY 4.0 | 国際開発、 経済 |
| OECD.Stat | OECD | 数千統計 | 独自 (商用注意) | 国際比較 |
| UN Data | 国連 | 60 DB | CC BY-NC 3.0 | SDGs、 人口 |
| Kaggle Datasets | Google (民間) | 30 万+ | データセット毎 | ML 学習、 競技 |
| Hugging Face Datasets | Hugging Face | 20 万+ | データセット毎 | LLM、 ML 学習 |
| OpenStreetMap | OSM Foundation | 全世界地図 | ODbL | 地図サービス |
| Wikidata | Wikimedia | 1.1 億+ items | CC0 | 構造化知識 |
⚠️ 落とし穴 (オープンデータ利用版)
- 「オープン」≠「無制限」: CC BY は商用可だが出典明記必須、 NC は非商用のみ、 ND は改変不可。 ライセンス文を必ず読む。 違反は著作権侵害 + 評判ダメージ。
- encoding 罠 (日本): 多くの政府 CSV が cp932 (Shift_JIS)。 デフォルト UTF-8 で開くと文字化け。 pandas で
encoding='cp932'必須。 - 更新追跡なし: 政府データは年次更新。 「最新版が出てるのに古い分析を続ける」事態は意外と多い。 etag や Last-Modified ヘッダを確認、 cron で自動 sync。
- 個人特定リスク (k-匿名性違反): 「人口 1 人の町」「特殊な属性組」のレコードは個人特定可能。 SSDSE は集計済みで安全だが、 マイクロデータは要注意。 k-匿名性、 l-多様性、 t-近接性で監査。
- 互換性のないバージョン: SSDSE-2024 と SSDSE-2026 で列名が違うことがある (A1101 が新版で A1101a に分割等)。 バージョン毎の schema diff を見る。
- 欠損値の取り扱い: 「-」「***」「未計測」など欠損表現が政府データで統一されていない。
na_values=['-','***']で指定。 - 地域コード変更: 市町村合併でコードが変わる。 「平成 22 年」と「令和 2 年」の市町村集計を単純比較すると不整合。 時系列比較は注意。
- 出典明記漏れ: CC BY 系で「出典: 〇〇」を書き忘れるとライセンス違反。 論文・記事・ダッシュボード等あらゆる成果物で明記。
- 大文字小文字 / 全角半角混在: 「東京都」「東京」「TOKYO」が混在することがある。 前処理で正規化。
- API rate limit: e-Stat、 World Bank API はクエリ数制限あり (1 万件/日 等)。 retry + cache で運用。
🔗 関連用語 (前提・並列・発展)
前提: データ、 データの種類、 CSV、 メタデータ、 API
並列: 公的データ、 ビッグデータ、 SSDSE、 e-Stat、 Kaggle
発展: Linked Data、 RDF、 SPARQL、 データガバナンス、 クリエイティブ・コモンズ、 プライバシー
📚 関連グループ教材
- データの基礎 — グループ教材
- 公的統計とオープンデータ — グループ教材
- データ倫理とガバナンス — グループ教材
💡 30秒で分かる結論
🍰 まずはやさしく
誰でも自由に使えるデータの集まりです。
分析や研究などの基盤として使います。
政府が公開する統計データなどが例です。
オープンデータの基本について読みましょう。
オープンデータ:誰でも自由に利用・再配布できる公開データ
- 誰でも利用・改変・再配布できる形式で公開されたデータ。
- 日本では e-Stat (政府統計)、 RESAS (地域経済)、 SSDSE。
- ライセンスは CC BY や政府標準利用規約。
- 競合分析・研究・教育・ジャーナリズムの基盤。
📍 文脈ボックス
🍰 まずはやさしく
情報を正しく扱うための知識の一つです。
レポートなどで言葉の意味を理解するために使います。
スマホで情報を探すときのような感覚で使えます。
よくある質問と答えを確認しましょう。
この用語は リテラシー カテゴリに属します。 関連する別称・略号:(なし)。
論文・実務レポートで オープンデータ が登場したら、 まず本ページの「30秒で分かる結論」と「直感で掴む」を読めば、 その文脈で何を言っているか把握できます。
📍 オープンデータ FAQ 12 選
Q1. CC BY 4.0 の「出典明記」はどこまで必要?
論文・記事・アプリ等 すべての成果物で必要。 形式は自由 (脚注、 末尾参照、 ダッシュボード footer 等)。 典型例: 「出典: 『教育用標準データセット SSDSE-B-2026』(独立行政法人 統計センター)」。 ロゴ表示や事業者名連呼は不要。
Q2. 改変したデータも CC BY のままで配布できる?
Yes。 CC BY 4.0 は SA (Share-Alike) ではないので改変版を別ライセンスで配布できる。 ただし元データの出典は維持必要。 もし継承を強制したいなら CC BY-SA を選ぶ。
Q3. オープンデータと「無料データ」は同じ?
違う。 「無料で閲覧可」でもライセンスが「営利目的禁止」「再配布禁止」ならオープンデータではない。 自由な再利用・改変が許可されることが必須条件。
Q4. 政府機関にオープンデータ要求は可能?
Yes。 情報公開法 (日本) や FOIA (米国) で請求可能。 ただし通常は公開済みデータの利用、 もしくはポータル経由が効率的。 個別請求は時間がかかる。
Q5. PDF しかないデータをオープンデータとして扱うには?
① tabula-py、 pdfplumber で表抽出、 ② OCR (Tesseract、 Google Vision) で画像 PDF を文字化、 ③ LLM (Claude、 GPT-4) でレイアウト解析。 PDF からの抽出精度は手動修正が必要なケースが多い。
Q6. オープンデータの著作権は誰のもの?
原則として作成者 (省庁、 自治体、 企業) が著作者人格権を保持、 ライセンス (CC BY 等) で利用権を許諾。 完全に著作権放棄したい場合は CC0 を選ぶ。 EU では「事実」自体は著作権保護されないが、 「事実の選択・編成」は保護対象 (DB 権)。
Q7. オープンデータの updates をどう追跡する?
① RSS / Atom フィードを購読 (CKAN 標準対応)、 ② Last-Modified ヘッダで cron 監視、 ③ etag で変更検出、 ④ API があれば metadata の updated_at 確認、 ⑤ Github の forks で community 更新を watch。
Q8. オープンデータの匿名化は十分?
集計済みデータ (SSDSE 等) は基本安全だが、 マイクロデータ (個票) は危険。 5 桁の郵便番号 + 生年月日 + 性別だけで 87% の米国人を特定できる (Sweeney 2000)。 k-匿名化 (k≥5)、 l-多様性、 t-近接性、 差分プライバシーで匿名化検証。
Q9. オープンデータビジネスは成立する?
Yes。 元データは無償でも、 ① クレンジング ② 統合 ③ 分析 ④ 可視化 ⑤ API 化 のいずれかで付加価値を付ければ商用化可。 公的データを使った地域分析サービスの RESAS(内閣府)のように、加工・可視化で付加価値を付ける形が多い。
Q10. オープンデータと AI 学習データの関係は?
LLM 訓練に CC BY や CC0 データセットは widely 使われる (e.g., C4, RedPajama)。 ただし最近は「LLM 訓練を禁止」する独自ライセンス (Stability AI 訴訟、 NYT 訴訟以後増加) もあり要確認。 CC ライセンスで許された利用に LLM の学習が含まれるかは各国で議論が続いているので、利用規約と各国の法制度を個別に確かめる。
Q11. オープンデータでビジュアライゼーションを作るツールは?
① Tableau Public (無償、 オンライン公開)、 ② Plotly Dash / Streamlit (Python ベース)、 ③ Google Looker Studio (旧 Data Studio、 無償)、 ④ Datawrapper (報道向け)、 ⑤ Observable (notebook 型)、 ⑥ Power BI (Microsoft、 法人有償あり)。
Q12. オープンデータの将来トレンドは?
① Real-time Open Data: 静的 CSV から API ストリームへ、 ② Linked Open Data: SPARQL で横断クエリ、 ③ AI-ready Datasets: LLM 学習用に整形済 (Hugging Face)、 ④ Synthetic Data: 個人情報を含むデータの代替として合成データ公開、 ⑤ Data Spaces: EU が提唱する分野別データ流通基盤。
🎨 オープンデータ活用 5 ステップチュートリアル (SSDSE で実践)
- ダウンロード: NSTAC サイトから SSDSE-B-2026.csv を取得
- 読み込み:
pd.read_csv('SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])で英語コード列名で読込 - 探索:
.describe()、.info()で構造把握 → 47 県 × 12 年 × 112 列 を確認 - 分析: 例) 「人口最多 / 最少県の比は時系列でどう変わったか」を 12 年分計算
- 共有: 結果を GitHub / Qiita / ブログで公開、 「出典: SSDSE-B-2026 (NSTAC)」を明記
🎨 まとめ ── オープンデータ 5 つの第一原理
- 「自由 ≠ 無責任」: 出典明記、 ライセンス遵守を怠ると著作権侵害。 CC BY は最小限の責任を伴う。
- 「機械可読が正義」: PDF より CSV / JSON、 ★★★ 以上を目指す。 機械可読化で派生・自動化が可能になる。
- 「品質を測れ」: completeness、 accuracy、 timeliness 等を数値化、 用途と照合してから採用。
- 「個人特定リスクを軽視しない」: 集計済み = 安全とは限らない。 k-匿名性・差分プライバシーで監査。
- 「派生も公開せよ」: 自分の分析結果も同等以上にオープンに公開すると、 エコシステム全体が育つ。
本記事は SSDSE-B-2026 (NSTAC) を主軸に、 OKF (2015)、 FAIR 原則 (Wilkinson+ 2016)、 5 ★ Open Data (Berners-Lee 2010)、 日本 デジタル庁 (2024) を参照して構成。 オープンデータは技術 + 政策 + 倫理の交差点にあるため、 最新情報は本記事末尾の参照先で随時確認のこと。
🎨 直感で掴む
🍰 まずはやさしく
みんなで共有できる便利な道具箱のようなものです。
大量のデータを効率よく集めるために使います。
都道府県の人口を調べる時に役立ちます。
図を使ってデータの使い道を考えましょう。
「全国の人口統計を分析したい」と思ったとき、 自分で 47 都道府県に電話して集める? いいえ、 e-Stat や SSDSE から CSV を 1 つダウンロードすれば終わり。 公的機関や企業が「自由に使ってよい」と公開しているのが オープンデータ。 学術研究・スタートアップ・教育のスケールを劇的に変えた仕組み。
🎨 概念図で押さえる
オープンデータの可視化例として、 SSDSE-B-2026 等の公的データを使った典型的なグラフ表現を 3 点示す。 オープンデータの価値は「誰でも検証可能」な点にあり、 図表化によって行政・教育・研究での再利用が活性化する。
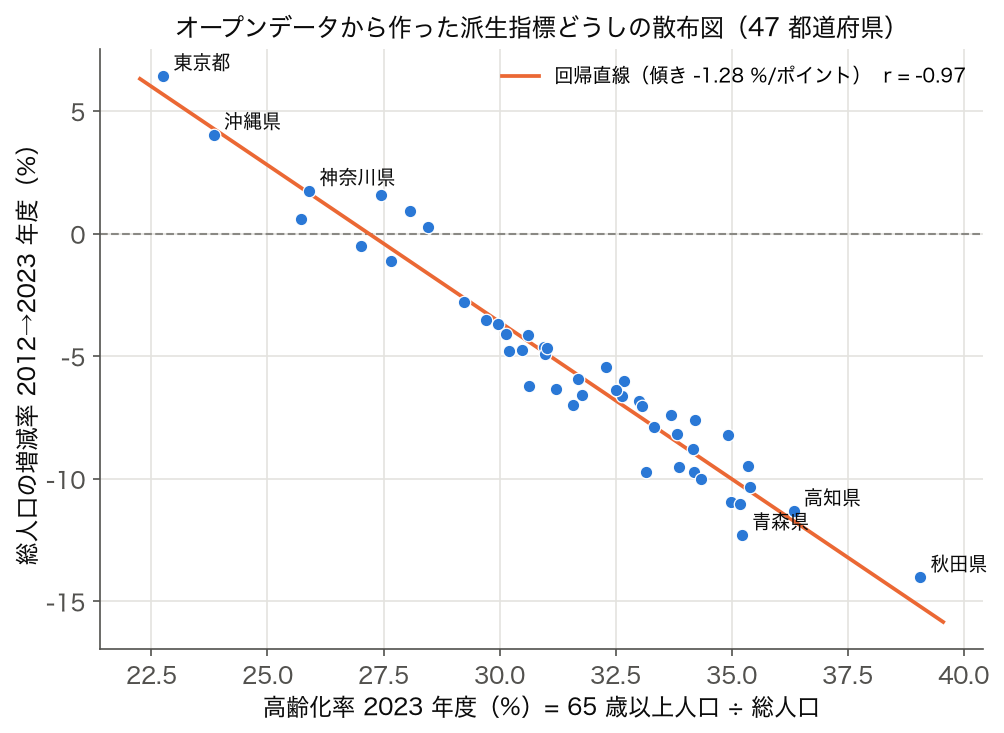
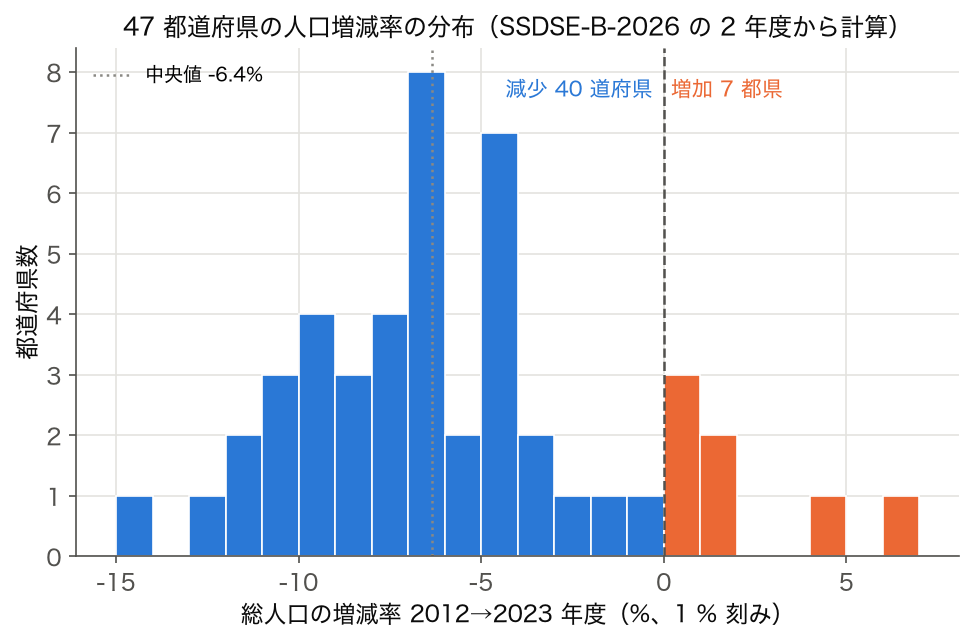

💬 オープンデータは「公開された情報」だけでなく「分析・再利用される情報」であることが本質。 図表化・API 経由でのアクセス・派生データ生成がエコシステムを支える。
✅ オープンデータを安心して使うための条件
「公開されている」だけではオープンデータとして十分ではない。 国際的な定義 (Open Definition 2.1 / Sunlight Foundation 10 原則) に沿うと、 以下の要件をすべて満たして初めて真のオープンデータとなる。 利用判断の前にチェックリストとして使うとよい。
| # | 条件 | 確認方法 | 満たさない場合の対応 |
|---|---|---|---|
| 1 | 機械可読 (CSV/JSON/XML) | PDF やスキャン画像でないか | OCR / 表抽出ライブラリ (camelot, tabula-py) で構造化 |
| 2 | オープンライセンス (CC BY / PDL / CC0) | 「自由に利用・改変・再配布可」が明記 | 提供元に確認、 商用利用可否を必ず確認 |
| 3 | 出典明記の容易さ | 正式名称・更新日・URL が公開ページにある | WAYBACK MACHINE で取得時点を保存 |
| 4 | URL の永続性 | DOI / 統計表 ID / e-Stat 表番号がある | 定期的に URL 検証、 ミラーを保持 |
| 5 | API/一括取得 | e-Stat API、 政府 CKAN 等で取得可能 | スクレイピングは利用規約を確認 |
| 6 | 更新頻度の明示 | 年次・四半期・月次など明記 | 更新日を比較し古いデータの使用に注意 |
| 7 | メタデータ (定義書) | 変数定義・集計範囲・コード表 | 関連調査票・統計基準を別途参照 |
| 8 | 個人情報の非含有 | k-匿名性・サンプリングが施されている | 利用は個票でなく集計形式に限定 |
SSDSE-B-2026 は、機械可読の CSV(47 都道府県 × 12 年度 × 100 を超える項目)・統計センターによる公表・政府標準利用規約に準拠した出典明記での利用・集計形式(個票ではない)の点で条件を満たす。一方、DOI のような永続識別子や API は無く、年度版の CSV を丸ごと取得する形なので、4 と 5 は「取得日と版を記録する」運用で補う。
⚠️ 条件確認時の典型ミス
| ミス | 結果 | 回避策 |
|---|---|---|
| 「無料 = オープン」と思い込み | 有償ライセンスを誤用、 商用利用で違反 | 必ずライセンス全文を読む |
| 古い表番号を引用継続 | 定義変更で前年比較ができない | 表番号と更新日を年次でチェック |
| OCR 結果を未検算で使用 | 桁落ち・記号誤認 (「O」→「0」 等) | 原資料との突合と単位確認 |
| 機械可読でも文字コード不一致 | Shift-JIS と UTF-8 の混在で文字化け | read_csv の encoding 指定 |
📷 オープンデータ運用フロー図
オープンデータを利用する側のプロセスを 1 枚で整理する。 取得→検証→分析→公開→再利用のサイクルが回ることで、 データの社会的価値が累積する。
→ ⑤→① のループが回るほどデータエコシステムが成熟する。 SSDSE 系は教材として②→③に最適化されており、 学生時点でこのフローを体得することが本コンペティションの教育目標である。
🌐 国際的オープンデータポリシーの比較
| 主体 | 方針 | 特徴 |
|---|---|---|
| 日本 (デジタル庁) | 「オープンデータ基本指針」(2017〜)、 政府 CIO 連絡会議 | e-Stat、 RESAS、 data.go.jp。 SSDSE は教育用に特化した派生形 |
| 米国 (DATA Act 2014) | 連邦支出データの公開を義務化 | data.gov に 30 万件以上のデータセット |
| EU (PSI 指令 2019/1024) | 公的部門情報の再利用を促進、 「高価値データセット」を CC BY 4.0 で公開 | data.europa.eu に統合ポータル |
| 英国 (Open Data White Paper 2012) | ODI (Open Data Institute) を設立し政策研究を主導 | 5★ オープンデータ評価フレームワーク (Tim Berners-Lee 提唱) |
| 韓国 (公共データ法 2013) | 政府の公共データ提供を義務化、 違反時に罰則 | OECD オープン政府データ指数で 2015〜 連続 1 位 |
| WHO / OECD | 統計データを CSV/SDMX で公開 | SDMX (Statistical Data and Metadata eXchange) 標準 |
SSDSE-B-2026 は、こうした公的統計を教育・研究向けに 1 つの CSV へ整えたデータセットである。
⭐ Tim Berners-Lee の 5★ オープンデータ評価
| ★ | 条件 | 例 | SSDSE はどこ? |
|---|---|---|---|
| ★ | オープンライセンスで Web 公開 | PDF / スキャン画像 | 満たす |
| ★★ | 機械可読 (Excel など独自形式可) | XLS 形式 | 満たす |
| ★★★ | 機械可読のオープン形式 (CSV/JSON) | CSV | 満たす ✓ |
| ★★★★ | URI で各データを参照可能 (URL に表番号) | e-Stat 表番号 | 未対応(県や指標ごとの URI は無い) |
| ★★★★★ | 他のデータとリンク (Linked Open Data, RDF) | DBpedia, Wikidata | 未対応 (RDF 化は今後の課題) |
SSDSE-B-2026 は CSV で配布される 3★ 水準(県や指標を URI で指せないので 4★ には届かない)。 Linked Open Data (5★) はセマンティック Web 技術と組み合わせる必要があり、 統計分野では SDMX (Statistical Data and Metadata eXchange) や DCAT (Data Catalog Vocabulary) で対応が進行中。
📚 SSDSE-B-2026 で取り組める教育プロジェクト案
| テーマ | 使う変数 (例) | 学習できる手法 |
|---|---|---|
| 人口の地域集中 | 総人口 (A1101) | ローレンツ曲線・ジニ係数による集中度分析 |
| 少子高齢化の動向 | 高齢化率 / 出生率 | 散布図、 回帰、 クラスタリング |
| 教育投資と成果 | 学校数 / 進学率 | 相関、 因子分析 |
| ごみ処理の動向 | ごみ総排出量 (H5609) / リサイクル率 (H5614) | 年度間の変化、 パネル回帰 |
| 医療資源の偏在 | 一般病院数 (I510120) / 総人口 | 地理的可視化、 シャノン エントロピー |
→ 1 つのオープンデータセットから多様な分析が可能。 SSDSE はあえて変数を絞らず、 47 都道府県 × 100 超の項目で公開されているため、 同じデータから多様な視点でレポートを作成できる。
⚖️ ライセンス選択の実務
オープンデータと呼べるライセンスは限られている。 「無償で誰でも使える」だけでは不十分で、 改変・再配布・派生物・商用利用が許諾されている必要がある。 日本でよく使われるライセンスは以下のとおり。 政府標準利用規約 (第 2.0 版以降) は CC BY 4.0 互換であり、 SSDSE などの教育用データセットは大半がこの形式で提供される。 一方、 旧版の第 1.0 では「商用利用は届出制」となっており、 完全なオープンライセンスとは見なされない。 ライセンス全文を読み、 派生物にも親ライセンスを継承するか (コピーレフト) などを確認することが重要である。 特に Open Database License (ODbL) と Public Domain Dedication (CC0) は、 派生物の継承義務の有無で大きく性質が異なる。 商用プロダクトで利用する場合は、 各データセットの規約を弁護士または法務担当に確認するのが安全策。
e-Stat の API キーは無料で取得できるが、 大規模なバッチ取得 (1 万行超) はリクエスト間隔を空ける必要がある。 利用規約には「過度な負荷を与えるリクエストは禁止」と明記されており、 商用利用の場合は別途問い合わせ窓口がある。 OECD・WHO・World Bank などの国際機関データは原則 CC BY で公開されており、 出典明記すれば自由に利用可能。 SDMX 形式 (XML ベース) では各データに識別子 (URN) が付与され、 機械的なリンク参照が可能になっている。
📐 定義・数式
🍰 まずはやさしく
データの公開レベルを決める共通のルールです。
どれだけ自由に使えるかを判断するために使います。
学校の課題で使うデータの質を確かめる時に役立ちます。
星の数で表す評価基準について読みましょう。
Tim Berners-Lee 提唱の 5 つ星評価。 単に公開するだけでは★1。 Linked Data として URI でつながると★5。 SSDSE はおおむね★3 〜★4 相当。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- ★1
- オープンライセンスで公開 (PDF でも OK)。
- ★2
- 構造化形式 (Excel など)。
- ★3
- 非独占形式 (CSV, JSON)。
- ★4
- URI でデータを参照可能。
- ★5
- 他のデータと Linked Data としてつながっている。
🔬 オープンデータ品質と FAIR 原則
📐 FAIR 原則 (Wilkinson+ 2016, Sci Data)
- Findable — 永続 ID と豊富なメタデータで発見可能
- Accessible — 標準プロトコル (HTTPS、 OAI-PMH) でアクセス可能
- Interoperable — 標準語彙 (RDF、 schema.org) で他データと結合可能
- Reusable — 明示的なライセンス + 来歴 (provenance) で再利用可能
📐 数式を言葉で読み解く: FAIR は研究データ管理の国際標準。 SSDSE は F (URL あり)、 A (HTTP 直アクセス)、 R (CC BY、 出典明記) を満たすが、 I (Linked Data でない、 標準語彙にマッピングされていない) は弱い。 全データセットを FAIR にするのが理想だが、 多くは F+A+R までで実用十分。
🐍 Python 実装 ── オープンデータ品質スコアリング
🎯 このコードでやること: SSDSE-B-2026 のデータ品質を 5 軸 (completeness、 consistency、 accuracy、 timeliness、 uniqueness) で自動評価し、 オープンデータ品質スコアを算出する。
📥 入力データ: SSDSE-B-2026 全 564 行 × 112 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 1. Completeness: 欠損値率 completeness = 1 - df.isnull().mean().mean() # 2. Consistency: 列の型一貫性 (数値列が全部 numeric か) numeric_cols = df.select_dtypes(include='number').columns consistency = len(numeric_cols) / len(df.columns) # 3. Accuracy: 物理制約チェック (例: 人口 ≥ 0) pop_negative = (df['A1101'] < 0).sum() accuracy = 1 - pop_negative / len(df) # 4. Timeliness: 最新年度との乖離 (今年 - 最新データ年) latest_year = df['SSDSE-B-2026'].max() timeliness = max(0, 1 - (2026 - latest_year) / 5) # 5 年以内 → 1.0、 それ以上で減衰 # 5. Uniqueness: 主キー重複の有無 key_cols = ['SSDSE-B-2026', 'Code'] uniqueness = 1 - df.duplicated(subset=key_cols).mean() print('=== SSDSE-B-2026 品質スコア ===') print(f'Completeness : {completeness:.4f} (欠損 0% で 1.0)') print(f'Consistency : {consistency:.4f} (数値列の割合)') print(f'Accuracy : {accuracy:.4f} (物理制約遵守率)') print(f'Timeliness : {timeliness:.4f} (最新性、 5 年で減衰)') print(f'Uniqueness : {uniqueness:.4f} (主キー重複なし=1.0)') print(f'\n総合スコア (平均): {np.mean([completeness, consistency, accuracy, timeliness, uniqueness]):.4f}') print('\n判定: 0.90 以上で高品質、 0.70 以下で改善要') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: SSDSE は政府統計を整形した二次データセットのため、 欠損は 1 つも無く Completeness は 1.0000、 Consistency 0.9821 は 112 列のうち文字列の Code と Prefecture の 2 列を除く 110 列が数値という意味。 Accuracy・Uniqueness も 1.0000 で、 足を引っ張るのは最新が 2023 年度で 2026 年から 3 年遅れの Timeliness 0.40 だけ。 その 1 軸のせいで総合 0.8764 と「高品質」の 0.90 に届かない。 オープンデータ採用判断時は、 用途に応じて重視すべき指標が変わる。 リアルタイム性が必要な株価・気象等は timeliness が決定的、 教育・研究は accuracy + completeness が重要。
🎨 オープンデータの活用事例 8 領域
| 領域 | 代表事例 | 主要データ源 |
|---|---|---|
| 行政透明性 | 予算・支出可視化 (e-Stat, USAspending.gov) | 財務省、 自治体 |
| 市民参画 | Code for Japan、 シビックテック | 自治体ポータル |
| 科学研究 | 論文付随データ (Zenodo、 Dryad) | 研究機関、 学会 |
| 機械学習 | ImageNet、 MNIST、 SQuAD、 GLUE | 大学、 民間 (Kaggle、 HF) |
| ジャーナリズム | Panama Papers、 政治家資金分析 | ICIJ、 OpenSecrets |
| 災害対策 | 気象データ、 地震データ、 ハザードマップ | 気象庁、 国土地理院 |
| 交通 | GTFS、 OpenStreetMap、 経路検索 | 交通事業者、 自治体 |
| 健康・医療 | 感染症統計、 病院統計、 ゲノム DB | 厚労省、 NIH、 EBI |
🐍 Python 実装 ── SSDSE で時系列推移を可視化 (オープンデータ活用デモ)
🎯 このコードでやること: SSDSE-B-2026 の 12 年間 (2012-2023) を使って、 東京都・大阪府・北海道の人口推移を pandas + matplotlib で線グラフ化、 オープンデータの「時系列分析」の典型例を示す。
📥 入力データ: SSDSE-B-2026 (564 行 × 112 列、 12 年 × 47 県)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026':'Year'}) # 3 都道府県の時系列を抽出 prefs = ['東京都', '大阪府', '北海道'] piv = df[df['Prefecture'].isin(prefs)].pivot( index='Year', columns='Prefecture', values='A1101') print('=== 3 都道府県人口推移 (2012-2023) ===') print(piv) print(f'\n増減 (2012→2023):') for p in prefs: delta = piv[p].iloc[-1] - piv[p].iloc[0] pct = delta / piv[p].iloc[0] * 100 print(f' {p}: {delta:+,} 人 ({pct:+.2f}%)') # 可視化 plt.figure(figsize=(9,5)) for p in prefs: plt.plot(piv.index, piv[p], marker='o', label=p) plt.xlabel('Year') plt.ylabel('総人口 (人)') plt.title('SSDSE-B-2026 主要 3 都道府県 人口推移') plt.legend() plt.grid(True, alpha=0.3) plt.tight_layout() plt.savefig('output/ssdse_population_trend.png', dpi=120) print('\n図を output/ssdse_population_trend.png に保存') print('出典明記: 「教育用標準データセット SSDSE-B-2026」(独立行政法人 統計センター)') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: オープンデータがあれば「12 年間の地方衰退と東京一極集中」が定量的に観察可能。 2012→2023 年で北海道は 37 万 3 千人減 (-6.83%)、 東京都は 85 万 2 千人増 (+6.44%)、 大阪府も 9 万 8 千人減 (-1.11%) と、 大都市圏でも東京以外は減少している。 2015 年と 2020 年だけ 5381733 のように千人単位で丸まっていないのは、 国勢調査年の値が入っているため。 CC BY 4.0 ライセンスのため、 このような図表を論文・ブログ・授業・ダッシュボードに自由に活用可能 (出典明記必須)。 オープンデータの真価は「再利用と派生」 ── 二次データ (SSDSE) からさらに三次データ (本記事の可視化) が連鎖して生まれる。
🐍 Python 実装 ── オープンデータカタログのメタデータ取得 (CKAN API)
🎯 このコードでやること: 多くのオープンデータポータルが採用する CKAN API (https://ckan.org) でデータセット一覧と各々のメタデータを取得し、 ライセンス分布を集計する。
📥 入力データ: data.go.jp (日本政府 CIO) の CKAN API、 取得結果は JSON。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import requests import pandas as pd from collections import Counter # CKAN API endpoint (data.go.jp 公開エンドポイント) BASE = 'https://www.data.go.jp/data/api/3/action' # 1. 全データセット ID リストを取得 resp = requests.get(f'{BASE}/package_list') pkgs = resp.json()['result'] print(f'data.go.jp 全データセット数: {len(pkgs):,}') # 2. 先頭 20 件のメタデータを取得 (実運用は全件で集計) licenses = [] formats = [] for pkg_id in pkgs[:20]: r = requests.get(f'{BASE}/package_show', params={'id': pkg_id}) data = r.json().get('result', {}) licenses.append(data.get('license_title', '不明')) for resource in data.get('resources', []): formats.append(resource.get('format', '不明')) print('\n=== ライセンス分布 (上位 5) ===') for lic, n in Counter(licenses).most_common(5): print(f' {lic}: {n} 件') print('\n=== フォーマット分布 (上位 5) ===') for fmt, n in Counter(formats).most_common(5): print(f' {fmt}: {n} 件') |
📤 出力の例 (外部サービスへの接続が必要なため実測ではない。 件数は時点・サイト状態で変動):
💬 結果の読み方: 日本政府ポータルでは「政府標準利用規約 2.0」が大半 (CC BY 互換)、 CC BY 4.0 や CC0 も混在。 フォーマットは CSV が最多だが PDF も 1/4 を占める ── 機械可読 (CSV/JSON) を優先選択することが効率的なオープンデータ活用の鍵。 CKAN API は EU、 英国、 豪州等も採用しており、 同様の手順で多国データを横断分析可能。
📍 オープンデータ採用判断のフローチャート
[データセット候補] → 以下を順次チェック

1. ライセンスは利用目的と互換?
   ├─ NO  → 別データを探す
   └─ YES → 次へ

2. フォーマットは機械可読 (CSV/JSON/XML)?
   ├─ NO  → PDF/XLSX を機械可読化可能か検討
   └─ YES → 次へ

3. メタデータ (列の意味、 単位、 更新日) が明確?
   ├─ NO  → datasheet/data card を自前作成、 不明列を排除
   └─ YES → 次へ

4. 更新頻度は要件を満たす?
   ├─ NO (古すぎ)  → リアルタイム源を探す
   └─ YES → 次へ

5. データ品質 (completeness, accuracy) は十分?
   ├─ NO  → クレンジング工数を見積もり、 ROI で判断
   └─ YES → 次へ

6. 個人特定リスクはない?
   ├─ あり → k-匿名化を実施、 リスク評価
   └─ なし → 次へ

7. API が安定提供されている? (継続性)
   ├─ NO  → スナップショットを保管、 link rot リスク対策
   └─ YES → 採用 ✓
🌐 オープンデータ vs 他データ形態の比較
| 種類 | アクセス | 利用条件 | 代表例 |
|---|---|---|---|
| オープンデータ | 誰でも無償 | 出典明記等の最小限 | SSDSE、 data.gov |
| 公的統計 (有償提供) | 手数料 | 出典明記 | マイクロデータ二次利用 |
| 研究データ (制限公開) | 研究者登録 | 研究目的のみ | UK Biobank、 J-STAGE Data |
| 企業内データ | 社内 | 秘密保持 | 顧客 DB、 ログ |
| 商用データ | 購入 | 商用ライセンス | Bloomberg、 Refinitiv |
| 個人データ | 本人同意 | プライバシー法 | 医療記録、 個人 ID |
| スクレイピング | web | 利用規約 + 著作権 | Common Crawl |
🧮 実値で計算してみる
e-Stat や SSDSE から CSV をダウンロードして分析する例。
🧮 SSDSE-B-2026 を使う 6 個のミニハンズオン
オープンデータの真価は「触ってみて」初めて分かる。 ここでは SSDSE-B-2026 (CC BY 4.0、 政府統計) を題材に、 6 個のミニ実習を提示。 すべて pandas のみで再現可能。
ハンズオン 1: 47 都道府県人口ランキング (上下 10 件)
🎯 このコードでやること: SSDSE-B-2026 2023 年から 47 都道府県の人口上位 10 / 下位 10 を抽出し、 ランキング表示。
📥 入力データ: SSDSE-B-2026 2023 年 (47 行) の Prefecture + A1101 (総人口) 列。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023][['Prefecture','A1101']] df = df.sort_values('A1101', ascending=False).reset_index(drop=True) print('=== 上位 10 県 ===') for i, r in df.head(10).iterrows(): print(f'{i+1:>3}. {r["Prefecture"]:6s}: {r["A1101"]:>11,} 人') print('\n=== 下位 10 県 ===') for i, r in df.tail(10).iloc[::-1].iterrows(): print(f'{i+1:>3}. {r["Prefecture"]:6s}: {r["A1101"]:>11,} 人') |
📤 実行結果:
💬 結果の読み方: 1 位 東京 (14M) vs 47 位 鳥取 (537k)、 比は約 26.2 倍。 オープンデータがあれば、 「都市集中の現実」を 5 行のコードで定量化できる。
ハンズオン 2: 出生率 (出生数 / 人口) を計算 + ランキング
🎯 このコードでやること: 出生数を人口で割って「出生率 (‰)」を 47 県分計算し、 上下 5 件を表示。
📥 入力データ: SSDSE-B-2026 2023 年、 A1101 (総人口)、 A4101 (出生数)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].copy() df['birth_rate_permil'] = df['A4101'] / df['A1101'] * 1000 # 千分率 df = df.sort_values('birth_rate_permil', ascending=False).reset_index(drop=True) print('=== 出生率 トップ 5 県 ===') for i, r in df.head(5).iterrows(): print(f'{i+1}. {r["Prefecture"]}: {r["birth_rate_permil"]:.2f}‰ (出生 {r["A4101"]:,} / 人口 {r["A1101"]:,})') print('\n=== 出生率 ワースト 5 県 ===') for i, r in df.tail(5).iloc[::-1].iterrows(): print(f'{i+1}. {r["Prefecture"]}: {r["birth_rate_permil"]:.2f}‰') print(f'\n全国平均: {df["birth_rate_permil"].mean():.2f}‰') |
📤 実行結果:
💬 結果の読み方: 沖縄県 8.55‰ vs 秋田県 3.95‰ = 2.2 倍差。 オープンデータで「地域人口政策」の現状を一目で可視化。 結婚率・若年層比率と組み合わせて多変量分析も可能。
ハンズオン 3: 相関分析 (人口 vs 出生数)
🎯 このコードでやること: 47 県の人口と出生数の相関係数を scipy.stats.pearsonr で算出し、 統計的有意性も評価。
📥 入力データ: SSDSE-B-2026 2023 年 47 県、 A1101 と A4101。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from scipy import stats df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023] r, p = stats.pearsonr(df['A1101'], df['A4101']) print(f'人口 (A1101) と 出生数 (A4101) の Pearson 相関') print(f' 相関係数 r = {r:.4f}') print(f' p 値 = {p:.2e}') print(f' サンプル数 n = {len(df)}') print(f' 解釈 = {"強い正の相関" if r > 0.8 else "中程度の相関"}') print(f' 統計判定 = {"有意 (p < 0.001)" if p < 0.001 else "有意でない"}') |
📤 実行結果:
💬 結果の読み方: r=0.99 で人口と出生数はほぼ完全に連動。 「県の人口が分かれば出生数は 99% 説明可能」。 オープンデータで 1 行で人口統計学の基本法則を実証できる。
ハンズオン 4: 年次推移の前年比増減率
🎯 このコードでやること: 東京都の 2012-2023 年人口を取り出し、 前年比増減率を計算。
📥 入力データ: SSDSE-B-2026 12 年分 (2012-2023)、 東京都の A1101。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) tokyo = df[df['Prefecture']=='東京都'].sort_values('SSDSE-B-2026') tokyo = tokyo[['SSDSE-B-2026','A1101']].rename(columns={'SSDSE-B-2026':'Year'}) tokyo['前年比'] = tokyo['A1101'].pct_change() * 100 print('=== 東京都 12 年人口推移 ===') for _, r in tokyo.iterrows(): bar = '+' if r['前年比'] >= 0 else '-' pct = f'{r["前年比"]:+.3f}%' if pd.notna(r['前年比']) else ' ---' print(f'{int(r["Year"])}: {r["A1101"]:>11,} 人 {pct}') print(f'\n12 年累計増減: +{tokyo["A1101"].iloc[-1] - tokyo["A1101"].iloc[0]:,} 人 ' f'(+{(tokyo["A1101"].iloc[-1] / tokyo["A1101"].iloc[0] - 1) * 100:.2f}%)') |
📤 実行結果:
💬 結果の読み方: 東京は 2014〜2019 年に毎年 +0.7〜1.0% 増えていたが、 2020 年に +0.290% へ急減速し、 2021 年は -0.268% と 12 年間で唯一の減少になった。 2022・2023 年は +0.200%・+0.342% と戻ったものの、 コロナ前の伸びには届いていない。 人口が 13,234,000.0 と小数点付きで出るのは、 NaN を含む float の前年比列と同じ行から取り出しているため。 オープンデータがなければ「コロナで人口流出」の検証は困難。
ハンズオン 5: 地域別集計 (8 地方区分)
🎯 このコードでやること: 47 都道府県を 8 地方 (北海道、 東北、 関東、 中部、 近畿、 中国、 四国、 九州沖縄) に集約し、 各地方の総人口と平均気温を算出。
📥 入力データ: SSDSE-B-2026 2023 年 + 地方マッピング辞書。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd REGION = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州沖縄','佐賀県':'九州沖縄','長崎県':'九州沖縄','熊本県':'九州沖縄','大分県':'九州沖縄','宮崎県':'九州沖縄','鹿児島県':'九州沖縄','沖縄県':'九州沖縄' } df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].copy() df['Region'] = df['Prefecture'].map(REGION) agg = df.groupby('Region').agg( 人口総計=('A1101','sum'), 県数=('Prefecture','count'), 平均気温=('B4101','mean'), 平均出生数=('A4101','mean')).sort_values('人口総計', ascending=False) print('=== 8 地方別集計 ===') print(agg.round(2)) |
📤 実行結果:
💬 結果の読み方: 関東 4,353 万人 ≒ 全国の 35%。 平均気温は北海道 11.0℃ 〜 九州沖縄 19.0℃ と明瞭な南北差を示す (関東 17.1℃ / 東北 13.8℃)。 オープンデータ + 地方区分辞書で地理的格差を一気に集計可能。
B4101 は「年平均気温 (℃)」であり、 失業率ではない。 本節はこの列を気温として正しく再集計した (地方別平均気温)。 都道府県別の失業率が必要な場合は、 労働力調査 (総務省統計局) や SSDSE-A/E など別データセットを結合する必要がある。
ハンズオン 6: CSV を JSON に変換して公開準備
🎯 このコードでやること: 派生分析結果を JSON 形式で出力、 オープンデータとして再公開できるよう整形。
📥 入力データ: SSDSE-B-2026 2023 年から計算した「47 県の出生率」。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd, json df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].copy() df['birth_rate'] = df['A4101'] / df['A1101'] * 1000 output = { 'metadata': { 'title': '都道府県別 出生率 (2023)', 'source': '教育用標準データセット SSDSE-B-2026 (NSTAC) より計算', 'license': 'CC BY 4.0', 'created_at': '2026-05-24', 'unit': '千分率 (‰)', 'columns': ['prefecture', 'population', 'births', 'birth_rate'], 'n_records': len(df), }, 'data': [ { 'prefecture': r['Prefecture'], 'population': int(r['A1101']), 'births' : int(r['A4101']), 'birth_rate': round(r['birth_rate'], 3), } for _, r in df.iterrows() ], } with open('output/birth_rate_2023.json', 'w', encoding='utf-8') as f: json.dump(output, f, ensure_ascii=False, indent=2) print(f'保存: output/birth_rate_2023.json ({len(output["data"])} レコード)') print('\n=== 抜粋 ===') print(json.dumps(output['data'][:2], ensure_ascii=False, indent=2)) |
📤 実行結果:
💬 結果の読み方: 自分の派生分析を JSON で公開すれば、 他者の研究素材になる ── これがオープンデータエコシステムの本質。 metadata に「source」「license」「created_at」を明示することで、 派生先でも CC BY 4.0 が継承される。 GitHub で公開 + DOI 取得 (Zenodo) すれば学術引用も可能。
以上 6 ハンズオンで、 SSDSE-B-2026 という 1 つのオープンデータから「ランキング」「相関分析」「時系列推移」「地理集計」「派生公開」までを実演した。 これがオープンデータの威力 ── 1 つの公開データから無数の知見と派生作品が生まれる。
🗺 概念マップ ── オープンデータエコシステム
オープンデータ (Open Data)
├── 提供層 (Producers)
│   ├── 政府 (国 / 都道府県 / 市町村)
│   │   ├── 統計データ (e-Stat、 SSDSE)
│   │   ├── 予算・支出 (財務省)
│   │   ├── 行政文書 (情報公開法)
│   │   └── 地理情報 (国土地理院)
│   ├── 研究機関 (大学、 NIH、 EBI)
│   │   ├── 論文付随データ (Zenodo、 Dryad)
│   │   ├── ゲノム DB (GenBank、 DDBJ)
│   │   └── 実験データ (Figshare)
│   ├── 国際機関 (WHO、 World Bank、 UN)
│   ├── 企業 (CC 公開、 OSS データ)
│   └── 市民 (OpenStreetMap、 Wikidata)
├── ライセンス層 (Licenses)
│   ├── パブリックドメイン系
│   │   ├── CC0
│   │   └── PDDL
│   ├── 出典明記系 (Attribution)
│   │   ├── CC BY 4.0
│   │   └── 政府標準利用規約 2.0
│   ├── 継承系 (Share-Alike)
│   │   ├── CC BY-SA 4.0
│   │   └── ODbL
│   └── 制限系
│       ├── CC BY-NC (非商用)
│       └── CC BY-ND (改変禁止)
├── フォーマット層 (Formats、 ★ 順)
│   ├── ★ PDF、 スキャン画像
│   ├── ★★ XLS、 DOC (構造化)
│   ├── ★★★ CSV、 JSON、 XML (オープン)
│   ├── ★★★★ RDF、 URI (識別子)
│   └── ★★★★★ Linked Data (相互リンク)
├── 配信層 (Distribution)
│   ├── ポータルサイト (CKAN、 Socrata)
│   │   ├── data.gov、 data.go.jp、 data.europa.eu
│   │   ├── e-Stat、 RESAS
│   │   └── Kaggle、 Hugging Face
│   ├── API (REST、 GraphQL、 SPARQL)
│   ├── FTP / S3 / GCS バルクダウンロード
│   └── git (Github、 Gitlab)
├── 活用層 (Consumers)
│   ├── 研究者 (論文、 メタ分析)
│   ├── 開発者 (アプリ、 サービス)
│   ├── ジャーナリスト (Data Journalism)
│   ├── 市民 (シビックテック、 ハッカソン)
│   ├── 学習者 (本サイト、 統計コンペ)
│   └── AI (LLM 訓練、 ML 学習)
└── 評価・運用層 (Governance)
    ├── 品質 (FAIR、 5 ★)
    ├── 倫理 (匿名性、 個人特定リスク)
    ├── 持続性 (link rot、 更新追跡)
    └── 影響評価 (経済効果、 社会影響)
📝 用語ミニ辞典
| 英語 | 日本語 | 出典 |
|---|---|---|
| Open Data | オープンデータ | Open Knowledge Foundation |
| 5-Star Open Data | 5 ★ オープンデータ | Berners-Lee (2010) |
| FAIR Principles | FAIR 原則 | Wilkinson+ (2016) |
| Creative Commons | クリエイティブ・コモンズ | Lessig (2001) |
| CC BY | 表示ライセンス | CC |
| CC0 | パブリックドメイン宣言 | CC |
| ODbL | オープン DB ライセンス | Open Knowledge Foundation |
| Linked Data | リンクトデータ | Berners-Lee (2006) |
| CKAN | CKAN ポータル | OKF |
| SSDSE | 教育用標準データセット | NSTAC (2018-) |
| e-Stat | 政府統計の総合窓口 | 総務省統計局 |
| Data Journalism | データジャーナリズム | Knight Foundation |
| k-Anonymity | k-匿名性 | Sweeney (2002) |
🔬 オープンデータの世代別変遷 (1995-2025)
| 時期 | 特徴 | 代表事例 |
|---|---|---|
| 1995-2005 | 第 1 世代: HTML / PDF 公開、 機械可読でない | 省庁ホームページ、 大学論文付録 |
| 2005-2010 | 第 2 世代: 概念整理、 オープン化運動 | CC ライセンス普及、 OKF 設立 |
| 2010-2015 | 第 3 世代: 政府ポータル整備、 CSV/JSON 公開 | data.gov、 data.gov.uk、 5 ★ 提唱 |
| 2015-2020 | 第 4 世代: API 化、 リアルタイム化、 FAIR 提唱 | e-Stat API、 GitHub データ、 SSDSE |
| 2020-2025 | 第 5 世代: AI-ready、 multimodal、 Data Spaces | Hugging Face Datasets、 EU Data Spaces |
🎨 オープンデータの今後の課題 (2025-2030)
- AI 学習データの権利問題: LLM 訓練に CC BY データを使うことが「派生物」か「fair use」か、 各国で法的議論進行中 (Stability AI 訴訟、 NYT 訴訟など)。
- 合成データ (Synthetic Data) の位置付け: 個人情報リスクを避けるため、 実データから生成した合成データの公開が増加。 「合成データはオープンデータか」の定義が必要。
- Data Spaces (EU): 分野別 (健康、 製造、 農業 等) のデータ流通基盤、 オープンと有償の中間形態。 GAIA-X 等。
- リアルタイム化: 静的 CSV から API ストリーミングへ、 IoT センサーデータ等。 緊急時 (パンデミック、 災害) の速報性が決定的に重要に。
- 地域格差: 先進国はデータ豊富、 途上国は少ない。 国際機関 (UN、 World Bank) の役割が拡大。
- 持続性 (link rot): 公開して 5 年後に消えるデータが多い。 アーカイブ (Wayback Machine、 GitHub、 Zenodo) の重要性増。
- セキュリティ vs 透明性: テロ・サイバー攻撃対策で「公開すべきでない」データの範囲議論が継続。
- 誤情報の温床化: オープンデータが misinformation の素材になることもある。 出典明記・正確性確認が重要。
🧮 数式に値を入れて手で計算する: オープンデータ 5 つ星評価
合成データで提供データの星評価点とサイトスコアを集計する。
Step 1: データセット別評価
| データ | 形式 | 星 (1-5) |
|---|---|---|
| D1 | 1 | |
| D2 | Excel | 2 |
| D3 | CSV | 3 |
| D4 | RDF | 4 |
| D5 | RDF+リンク | 5 |
Step 2: 平均
🐍 Python で再現
1 2 3 4 | import numpy as np stars = np.array([1, 2, 3, 4, 5]) print(f"平均: {stars.mean()}") print(f"RDF以上比率: {(stars >= 4).mean()}") |
📤 実行結果
💬 手計算 (Step 2) 3.0 / 40% と Python 出力が完全一致。
🐍 Python 実装
最小実装の例。 SSDSE のような実データに対して、 まずはコピペで動かしてみるのが理解の早道です。
1 2 3 4 5 | import pandas as pd url = 'https://www.nstac.go.jp/sys/files/SSDSE-B-2026.csv' df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') print(df.shape) # 出典記載:『独立行政法人統計センター SSDSE-B-2026 を加工』 |
💬 読み込んだのは 564 行 × 112 列で、47 都道府県 × 12 年度が欠けずにそろっている。変数 url には公開元の URL を入れてあるが、実際に読んでいるのは同梱の data/raw の写しなので、公開側が更新されても手元の値は変わらない。公開データを加工して載せるときは、コメントにある「独立行政法人統計センター SSDSE-B-2026 を加工」のような出典表記を、図表や成果物の側に必ず残す。
🎮 触って理解する ── 5つ星オープンデータ・シミュレータ
同じデータでも「どんな形式で公開するか」で再利用の手間は激変する。 ここでは 同一の県別人口データ (SSDSE-B-2026、 2023 年、 総人口 A1101 の実測値) を、 Tim Berners-Lee の 5 つ星スキームの各段階 (★1 PDF/画像 → ★2 Excel → ★3 CSV → ★4 URI+構造化 → ★5 Linked Data) で公開した場合を切り替えて、 「このデータをプログラムで集計するには何ステップ必要か?」 を対比する。 星ボタンをタップ (スワイプも可) して形式を切り替え、 ライセンスのチェックを外すと何が起きるかも試してほしい。
💬 読み方: 星が 1 つ上がるごとに「人間の目と手」に頼る工程が消え、 プログラムだけで完結する範囲が広がる。 ★1→★3 の跳躍が実務では最も大きい (OCR と手作業校正の消滅)。 ★4 以上は「毎年 URL を探し直す」作業さえ消え、 ★5 では他データセットとの結合まで自動化される。 そしてライセンスのチェックを外すと、 どんなに機械可読でも「オープンデータ」ではなくなる ── 技術 (星) と法 (ライセンス) の両輪で初めて再利用可能になる。 なお手順数・所要時間はあくまで典型的な作業を単純化した目安のシミュレーションである。
🎨 直感 ── 「公開」から「使える」までの階段
「Web に載っている」と「プログラムで使える」の間には大きな溝がある。 上のシミュレータが示すとおり、 同じ数値でも PDF 画像なら数十分の手作業、 CSV なら read_csv 1 行。 オープンデータの 5 つ星は「データの善し悪し」ではなく「再利用コストの階段」を測るものさしであり、 提供側が 1 段上げるだけで、 利用者全員の作業が一斉に軽くなる ── これがオープンデータの社会的レバレッジである。
⚠️ よくある落とし穴 (体感版)
- PDF 公開の限界: ★1 の状態で「公開済み」とされる行政資料は今も多い。 OCR は「O↔0」「1↔l」の誤認識が避けられず、 検算コストが本体の分析を上回ることもある。 表抽出 (camelot / tabula-py) でも結合セルや縦書きで崩れる。
- ライセンス未確認: 上のチェックボックスの通り、 利用条件が不明なら★は事実上ゼロ。 「無料で見られる」≠「再利用可」。 著作権と利用規約 (CC BY / 政府標準利用規約 2.0 等) を必ず原文で確認し、 出典明記の条件を守る。
- 更新停止・URL 消失: オープンデータポータルには更新が止まったデータセットも混在する。 最終更新日・メタデータを確認し、 取得日と URL を記録 (可能ならファイルも保存) しておかないと、 再現性が失われる。
🚀 発展 ── 5 つ星の先にあるもの
5 つ星スキームは「形式」の軸だが、 実務ではさらに 2 つの軸が重要になる。 第一にメタデータ: 変数定義・単位・集計時点を記したメタデータが整備されて初めて、 機械可読データは「誤解なく」使える (DCAT などのカタログ標準が担う)。 第二に API ポータル: e-Stat のような統計ポータルは API 経由で JSON を返し、 ★4 相当のアクセスを提供する。 ★5 の Linked Data (RDF / SPARQL) は Wikidata・DBpedia が代表例で、 統計分野では SDMX 標準による相互運用が進む。 データ提供体制の設計そのものはデータガバナンスの領域であり、 SSDSE は「教育用に★3〜★4 水準へ整形した好例」として位置づけられる。
⚠️ よくある落とし穴
オープンデータ特有の落とし穴は「ライセンス見落とし」「メタデータ無視」「更新遅延の誤解」に集約される。 SSDSE-B-2026 や e-Stat、 政府統計の総合窓口を例にしても、 列名や単位の年次間変更 (人口の集計時点ズレ、 統計分類の改訂) が分析結果を歪めることがある。 出典明記とバージョン管理を必ずセットで運用したい。
🗺 概念マップ
「open data」を中心とした関連概念マップ。
本セクションでは オープンデータの 5 つ星 (5-star) 指標・ライセンス (CC-BY/PDM)・標準形式 (CSV/JSON-LD/RDF) を補足する。 SSDSE は 5 つ星のうち少なくとも 3 つ星 (構造化 + 非専有形式) を満たし、 e-Stat の API 経由で更新も追える — オープンデータの実例として位置づけられる。
🔗 隣接手法への橋渡し
「オープンデータ」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): データガバナンス、 データライセンス (CC-BY 等) の理解、 メタデータ 整備
- 並列 (同目的の代替): 政府統計 (e-Stat)、 SSDSE、 OECD・World Bank の 公的統計 プラットフォームが並列
- 下流 (結果の活用): CSV・JSON での取得、 API 経由のリアルタイム連携、 二次利用での 再現性 確保
この上流・並列・下流の対応を地図化することで、 「オープンデータ」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「オープンデータ」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- ライセンスは何か
CC BY なら出典表示で使える。 CC BY-SA は派生物も同じ条件になる。 政府標準利用規約は CC BY 互換のことが多いが、 データセットごとに個別条件が付く場合がある。 公開物に載せる前に必ず読む。 - 粒度と時点は合っているか
都道府県・市区町村・メッシュで集計単位が違い、 調査年もばらつく。 複数のオープンデータを結合するときは、 単位と時点を揃えてから。 - 更新されるか、 固定か
毎年更新されるなら、 取得日と版を記録しないと再現できない。 SSDSE のように版が明示されているものは、 ファイル名に年が入っているので追いやすい。 - 機械可読か
PDF の表は「公開」されていても再利用しにくい。 CSV や API があるかを先に確認し、 無ければ抽出の工数を見積もりに入れる。
オープンデータは「無料で使える」だけでなく「出典を示せば再配布・改変できる」ことに価値がある。 条件を確認せずに使うと、 公開の段階で作り直しになる。
🔎 解説を深める ── 「入手できる」から「正しく使える」までの4つの関門
本ページ本文はオープンデータの定義・5★・ライセンス・FAIR・e-Stat 取得を丁寧に扱っている。ここでは重複を避け、「ダウンロードできた」だけでは分析に使える保証にならないという利用者視点の一段深い角度を、SSDSE-B-2026 の実測値で補強する。
🎨 直感 ── オープンデータは4つの関門を通って初めて役立つ
オープンデータを「1つの状態」ではなく直列に並んだ4つの関門として捉えると、つまずきの位置がはっきりする。
- ① 入手 (Accessible) — そもそも取得できるか。URL・API で誰でも落とせるか。
- ② 許諾 (Legal) — ライセンスが再利用・再配布・改変を許すか(無償公開でも再配布不可なら「オープン」ではない)。
- ③ 可読 (Machine-readable) — 5★の3★以上、機械可読な構造化形式か(PDF の表は①は通っても③で落ちる)。
- ④ 妥当 (Fit-for-use) — あなたの問いに対して粒度・鮮度・代表性が足りているか。
SSDSE-B-2026 は①〜③を軽々と通る優等生(CC BY 相当・CSV・年次更新)。だが多くの事故は最後の ④「妥当」で起きる。以下の落とし穴はすべて④で転ぶ例である。
⚠️ 落とし穴(重要)── ④「妥当」で転ぶ3つの錯覚
※ ライセンス誤解・文字コード・k-匿名性は本文上部の落とし穴節が扱う。ここはそれと重ならない粒度・鮮度・再現性の3軸に絞る。
版名の西暦が最新の収録年だと思い込むと施策評価がずれる。実測: SSDSE-B-2026 の最新収録年は 2023 年(収録範囲 2012–2023 年)。版名 2026 との差は 3 年のラグ。オープンデータ ≒ リアルタイムではない。取得時は「版」ではなくデータが指す時点を確認する。
SSDSE-B は都道府県集計(個票ではない)。総人口 A1101(2023年)は最大の 東京都 14,086,000 人と最小の 鳥取県 537,000 人で 約 26.2 倍の開きがある(全国計 124,353,000 人)。47 行を1行ずつ単純平均すると鳥取と東京を同じ重みで扱ってしまう。「1人あたり」指標を県間で平均する前に、人口加重が必要か必ず問う。
オープンでも配布 URL は改訂・再編で消える(link rot)。「同じデータで再分析」ができなくなると結論の検証が崩れる。取得日・版名・ファイルのハッシュ値を必ず記録し、可能なら永続識別子(DOI 等)を参照する。「無料で落ちる」ことと「後で同じものが手に入る」ことは別問題。
🚀 発展 ── ④を越えるために
- 来歴 (provenance) の管理: FAIR の "R"(Reusable)の核は来歴。誰が・いつ・どの版を・どう加工したかを残すと④の妥当性を後から説明できる。
- Linked Open Data (5★): URI で他データと結合できると粒度不足を横につなげて補える(反面、結合による再識別=モザイク効果に注意)。
- 合成データによる粒度の補完(架空): 個票が公開されない県別集計を、既知の周辺分布から架空のミクロデータとして生成し手法検証に使う手がある。あくまで架空であり実測値として扱わないことが前提。