🔖 キーワード索引
テーブルを扱うときに出てくる用語。 後半のチップは、 このページで SSDSE-B-2026 を使って実際に確かめている操作である。
💡 30秒で分かる結論
🍰 まずはやさしく
テーブルはデータの表のことです。
情報を整理してまとめるために使います。
スマホの連絡先リストのような形式です。
行と列でできたデータの単位を学びます。
テーブル:DB内の行と列で構成されるデータ単位
- 行 × 列の表形式データ。 1 行 = 1 レコード、 1 列 = 1 属性。
- RDB の テーブル、 pandas の DataFrame、 Excel の シートもすべて同じ概念。
- 主キーで行を一意に識別、 外部キーでテーブル間を結合。
- 「1 つの観測 = 1 行、 1 つの変数 = 1 列」が Tidy data の原則。
📍 文脈ボックス
🍰 まずはやさしく
テーブルはデータ管理の基本です。
大量のデータを正しく扱うために使います。
部活動の名簿を作る感覚に似ています。
データの仕組みと扱い方を学びます。
この用語は データエンジニアリング カテゴリに属します。 関連する別称・略号:表。
テーブル (Table) はリレーショナル DB の基本単位で、 行 (record) と列 (field) で 1 つのエンティティを表現する。 主キー・外部キー・正規化 (第 1〜3 正規形)・索引 (Index) を理解すれば、 SSDSE-B-2026 の都道府県 × 年データを高速かつ整合性のある形で扱える。 DataFrame との対応も本ページで確認する。 このページで使う SSDSE-B-2026 は 564 行 × 112 列の 1 枚の表で、 1 行は「1 都道府県の 1 年度」、 主キーは (年度, 地域コード) の組である。 この 2 点を押さえておくと、 以下の分割・集計・結合・並べ替えの例で、 表の行数と主キーがどう変わるかを追いやすい。
🎨 直感で掴む
🍰 まずはやさしく
テーブルは整理整頓された棚のようなものです。
分析の準備をスムーズにするために使います。
エクセルのシートに書き出すイメージです。
行と列の構造がなぜ大切かを知ります。
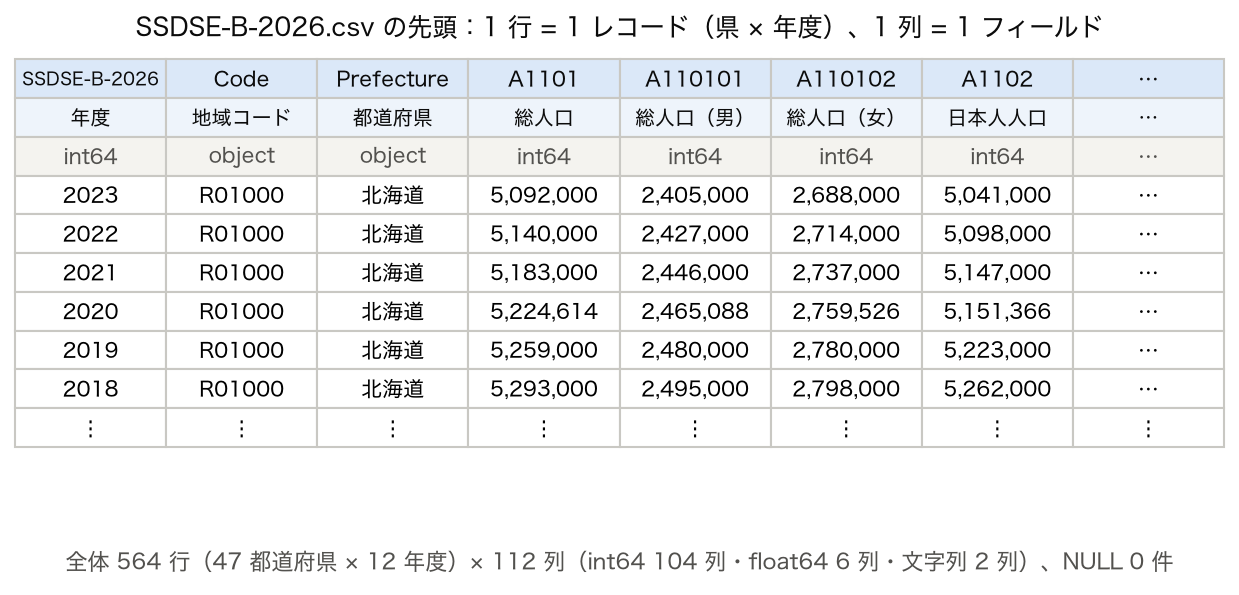
SSDSE-B-2026 をエディタで開くと、 1 行目に SSDSE-B-2026,Code,Prefecture,A1101,… という列コード、 2 行目に 年度,地域コード,都道府県,総人口,… という日本語の項目名が並び、 3 行目以降に 2023,R01000,北海道,5092000,… のように 1 つの都道府県の 1 年度につき 1 行のデータが並ぶ。 この「1 行 = 1 都道府県の 1 年度という観測単位、 1 列 = 1 つの変数」が テーブルの本質だ。
同じ情報を Excel で開けばシート、 SQLite に入れれば CREATE TABLE prefectures、 pandas で読めば DataFrame — 表現は違えど概念は同一。 統計学者 Hadley Wickham が 2014 年に提唱した Tidy data 原則 (Journal of Statistical Software) も、 結局のところ「テーブルをどう設計すべきか」を厳密に定義したもの。 つまり あらゆるデータ分析の出発点がこの「行 × 列の構造」なのだ。
逆に、 テーブルになっていないデータ — JSON のネスト、 ログの半構造、 画像のピクセル配列 — はすべて、 「いかにテーブルに落とすか (= tidy 化)」が前処理の主戦場になる。 SSDSE-B では既に綺麗な long-tidy で配布されているので、 本ページではこれを「お手本テーブル」として扱う。
📐 定義・数式
🍰 まずはやさしく
テーブルは行と列の組み合わせです。
データの場所を正確に決めるために使います。
買い物リストの項目と金額のような形です。
テーブルを数式でどう表すか学びます。
$n$ 行 $m$ 列のテーブルは、 行 $i$ と列 $j$ の組に値 $v_{ij}$ を割り当てる写像。 各列はデータ型 (整数・文字列・日付) が固定される (スキーマ)。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- $n$
- 行数。 観測数・レコード数。
- $m$
- 列数。 変数の数・属性の数。
- Primary Key
- 主キー。 行を一意に識別する列。
- Foreign Key
- 外部キー。 他テーブルの主キーを参照する。
🔬 数式を言葉で読み解く(深掘り)
先の「記号を読み解く」を、 テーブル の固有事情に即して 500 字以上で詳説する。 ここを読めば、 数式 1 行の裏にある設計判断と歴史的経緯が見えるはずだ。
$n$ (行数) は観測単位の数を表す。 SSDSE-B-2026 では $n=564$(47 都道府県 × 12 年度、 1 年度に絞れば 47)、 家計調査の個票なら約 8,000 世帯、 一般に Web ログなら $n=10^9$ に到達することもある。 $m$ (列数) は変数の数。 SSDSE-B-2026 では 112 列(年度・地域コード・都道府県と 109 指標)で、 1 列 = 1 統計指標。 重要なのは「列はスキーマ (型 + 制約)」を持つこと、 で行とは非対称な関係であり、 列の追加は構造変更、 行の追加は通常運用。 Primary Keyは SSDSE-B-2026 では 地域コード 単独ではなく (年度, 地域コード) の組がそれに相当し(1 年度に絞れば地域コードだけで足りる)、 一意性 + NOT NULL + 不変性 (主キーは後から変えない) の三条件を満たす設計が良い。 Foreign Keyは別テーブルへの参照を担うが、 SSDSE のような単表分析では明示的に出てこない代わりに、 後述する outer-join で同じキー (都道府県) を介して別テーブルを統合するときに概念的に活躍する。 つまりテーブル $T = \{(i,j) \to v_{ij}\}$ という関数表現は、 数学的にきれいだが、 実務的には スキーマ + PK + FK + インデックスの四点セットで実体を持つ。 この四点を意識しないと、 「動くけど壊れている」テーブル設計に陥りやすい。
📌 数式は 暗記対象ではなく検算ツール。 「結果が変だ」と感じたとき、 「この記号は本来こういう意味だから、 ここの値はおかしい」と 逆引きできる状態が、 中級者と上級者の差を生む。
🧪 SSDSE-B-2026 ハンズオン
本サイトの標準データ SSDSE-B-2026(47 都道府県 × 約 100 列、 独立行政法人統計センター提供) を使い、 テーブル の概念を 実コードで体感する。 取得経路は data/raw/SSDSE-B-2026.csv(リポジトリ同梱)。
SSDSE-B-2026.csv (47 都道府県 × 12 年度 = 564 行 × 112 列) を 4 ステップで読み込み、 テーブルの素性を確認していく。 実際にコピペで動くコードを次の Python 実装セクションに置いてあるので、 まずは流れを把握してほしい。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # SSDSE-B-2026 を読み込み、テーブルとして基本診断する(pandas) import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, dtype={'地域コード': str}, encoding='cp932') print('shape =', df.shape) # (564, 112) = 47 都道府県 × 12 年度 print('dtypes:', df.dtypes.value_counts()) print('head:', df.head(3)) # 主キー候補の確認 print('is_unique(都道府県) =', df['都道府県'].is_unique) print('is_unique(地域コード) =', df['地域コード'].is_unique) # 欠損サマリ print(df.isna().sum().sort_values(ascending=False).head(10)) # メモリ使用量(最適化前後) print('mem MB =', df.memory_usage(deep=True).sum() / 1024**2) df_opt = df.copy() df_opt['都道府県'] = df_opt['都道府県'].astype('category') print('mem MB after category =', df_opt.memory_usage(deep=True).sum() / 1024**2) |
💬 テーブルの形は 564 行 × 112 列(47 都道府県 × 12 年度)で、型は整数 104・小数 6・文字列 2 列。head の 3 行がすべて北海道(2023・2022・2021 年度)なので、都道府県も地域コードも is_unique が False になり、単独では主キーにならない。都道府県列を category 型にするとメモリは 0.547 MB から 0.508 MB と約 7% 減るだけで、564 行程度の表では型最適化の効果は小さい。
📌 動かないときは: (1) data/raw/SSDSE-B-2026.csv がリポジトリに存在するか、 (2) skiprows=1 でヘッダーが正しく読めているか、 (3) 列名が SSDSE 公式の最新版と一致しているかを df.columns.tolist() で確認。
記号を SSDSE-B-2026 の実際の値で読むと次のとおり。
| 記号 | 意味 | SSDSE-B-2026 での値 |
|---|---|---|
| $n$ | 行数(観測単位の数) | 564(47 都道府県 × 12 年度)。 2023 年度に絞れば 47 |
| $m$ | 列数(属性の数) | 112(年度・地域コード・都道府県と 109 指標) |
| $n \times m$ | セルの数 | 564 × 112 = 63,168 個。 欠損は 0 個 |
| $v_{ij}$ | 行 $i$ と列 $j$ の組が指す 1 つの値 | (2023 年度・北海道, A1101)→ 5,092,000 |
| 主キー | 行 $i$ を一意に決める列の組 | (年度, 地域コード)。 地域コード単独では重複が 517 行 |
| スキーマ | 各列の型の約束 | int64 が 104 列、 float64 が 6 列、 文字列が 2 列 |
🧮 実値で計算してみる
SSDSE-B-2026 のテーブルを読み込み、 形状・型を確認する。
🧮 数式に値を入れて手で計算する: テーブルセル数
合成テーブルで行×列 セル数を計算する。
Step 1: テーブル
| テーブル | 行 | 列 | セル |
|---|---|---|---|
| 顧客 | 1000 | 10 | 10,000 |
| 注文 | 5000 | 15 | 75,000 |
| 商品 | 500 | 20 | 10,000 |
Step 2: 合計
🐍 Python で再現
1 2 3 | tables = [(1000, 10), (5000, 15), (500, 20)] total = sum(r*c for r, c in tables) print(f"総セル: {total:,}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🧮 表を 2 つに分けて、 結合し直すと元に戻るか確かめる
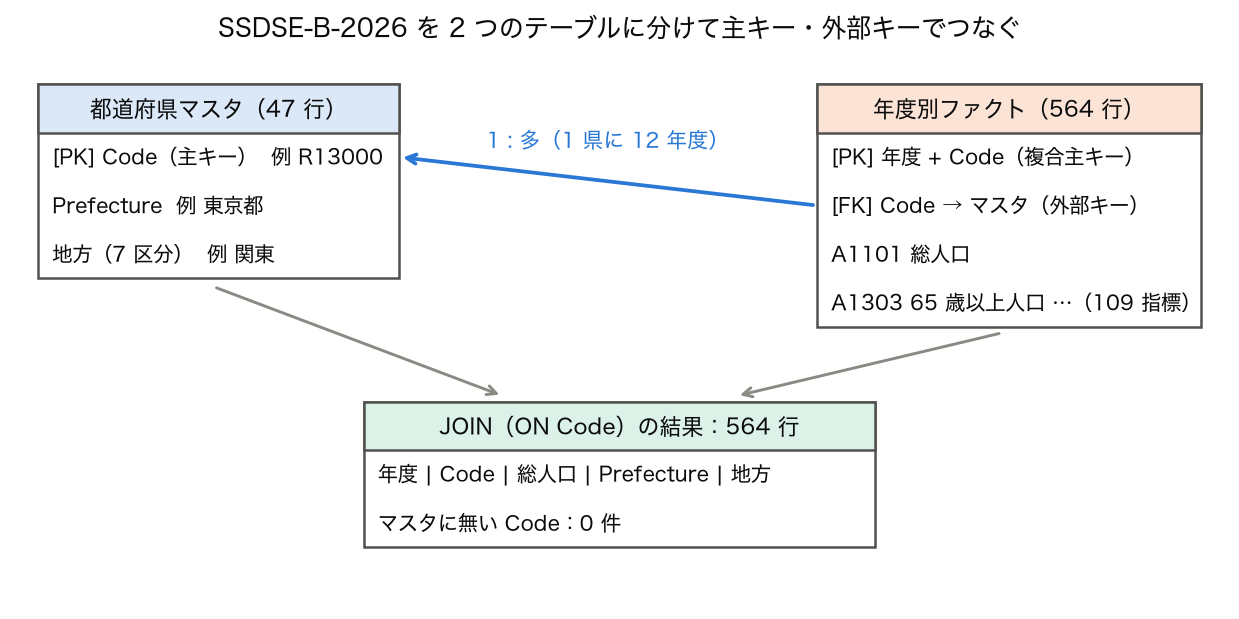
🎯 このコードでやること:SSDSE-B-2026 の都道府県名が地域コードだけで決まる(部分関数従属)ことを確かめ、 表を「都道府県マスタ(47 行)」と「年度別ファクト(564 行)」に分けてから、 結合し直すと元の表に戻るかを検査する
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 都道府県名は地域コードだけで決まる(部分関数従属)ことを確かめる print('Code ごとの県名の種類の最大:', int(df.groupby('Code')['Prefecture'].nunique().max())) # 2 つの表に分ける: 都道府県マスタ と 年度別ファクト master = df[['Code', 'Prefecture']].drop_duplicates().reset_index(drop=True) fact = df.drop(columns=['Prefecture']) print('マスタ:', master.shape, ' 主キー Code の重複:', int(master['Code'].duplicated().sum())) print('ファクト:', fact.shape, ' 主キー (年度, Code) の重複:', int(fact.duplicated(['SSDSE-B-2026', 'Code']).sum())) # 県名の文字列を何回持っているか print('県名のセル数 分ける前:', df['Prefecture'].size, ' 分けた後:', master['Prefecture'].size) # 結合し直すと元の表に戻るか back = fact.merge(master, on='Code', how='left', validate='many_to_one')[df.columns] same = back.sort_values(['SSDSE-B-2026', 'Code']).reset_index(drop=True).equals( df.sort_values(['SSDSE-B-2026', 'Code']).reset_index(drop=True)) print('結合し直した表が元と一致:', same) |
💬 どの Code にも県名は 1 種類しかなく、 都道府県名は主キー (年度, Code) の一部である Code だけで決まる。 これが第 2 正規形に反する部分関数従属で、 元の表は同じ県名を 564 回持っている。 Code を主キーとする 47 行 × 2 列のマスタと、 (年度, Code) を主キーとする 564 行 × 111 列のファクトに分けると、 県名は 47 回だけになり、 どちらの主キーにも重複は無い。 validate='many_to_one' で結合し直した表は元と完全に一致したので、 分けても情報は失われていない。 分析では結合済みの 1 枚が便利だが、 県名の表記を直すときなどはマスタの 1 か所を直せば済む点が分けた形の強みである。
🧮 集計すると行の意味と主キーが変わる
🎯 このコードでやること:都道府県番号から 8 地方の区分を作り、 総人口を (地方, 年度) で合計した集計表を作る。 集計表の主キーが何になるかを確かめ、 2023 年度の人口シェアと 2012→2023 年度の増減率を横持ちに組み替えて読む
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) num = df['Code'].str[1:3].astype(int) # 都道府県番号 1〜47 bins = [0, 1, 7, 14, 23, 30, 35, 39, 47] names = ['北海道', '東北', '関東', '中部', '近畿', '中国', '四国', '九州・沖縄'] df['地方'] = pd.cut(num, bins=bins, labels=names) agg = df.groupby(['地方', 'SSDSE-B-2026'], observed=True)['A1101'].sum().reset_index() print('集計した表:', agg.shape, ' 主キー (地方, 年度) の重複:', int(agg.duplicated(['地方', 'SSDSE-B-2026']).sum())) wide = agg.pivot(index='地方', columns='SSDSE-B-2026', values='A1101') share = (wide[2023] / wide[2023].sum() * 100).round(1) change = ((wide[2023] / wide[2012] - 1) * 100).round(1) print(pd.DataFrame({'2023 人口シェア%': share, '2012→2023 増減%': change}).to_string()) |
💬 集計した表は 8 地方 × 12 年度 = 96 行で、 (地方, 年度) の組の重複は 0。 集計すると行の意味が「県の 1 年度」から「地方の 1 年度」に変わり、 主キーもそれに合わせて変わる。 2023 年度の人口シェアは関東が 35.0% で、 2012→2023 年度に人口が増えたのは関東(+2.0%)だけ、 最も減ったのは東北(−9.2%)と四国(−9.0%)。 集計表を作るときは、 新しい主キーを確かめてから次の結合や比較に使う。
🧮 要約表も 1 枚のテーブル — describe() の行と列
🎯 このコードでやること:2023 年度の 3 列(総人口・合計特殊出生率・年平均気温)に describe() をかけ、 できた要約表の形(何が行で何が列か)と、 転置 .T した後の形を比べる
1 2 3 4 5 6 7 8 9 10 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023][['A1101', 'A4103', 'B4101']] d.columns = ['総人口', '合計特殊出生率', '年平均気温'] t = d.describe() print('describe() の形:', t.shape, '→ 行 =', list(t.index)[:3], '… / 列 = 変数') print('転置 .T の形 :', t.T.shape, '→ 行 = 変数 / 列 = 統計量') print(t.T[['count', 'mean', 'std', 'min', 'max']].round(2).to_string()) |
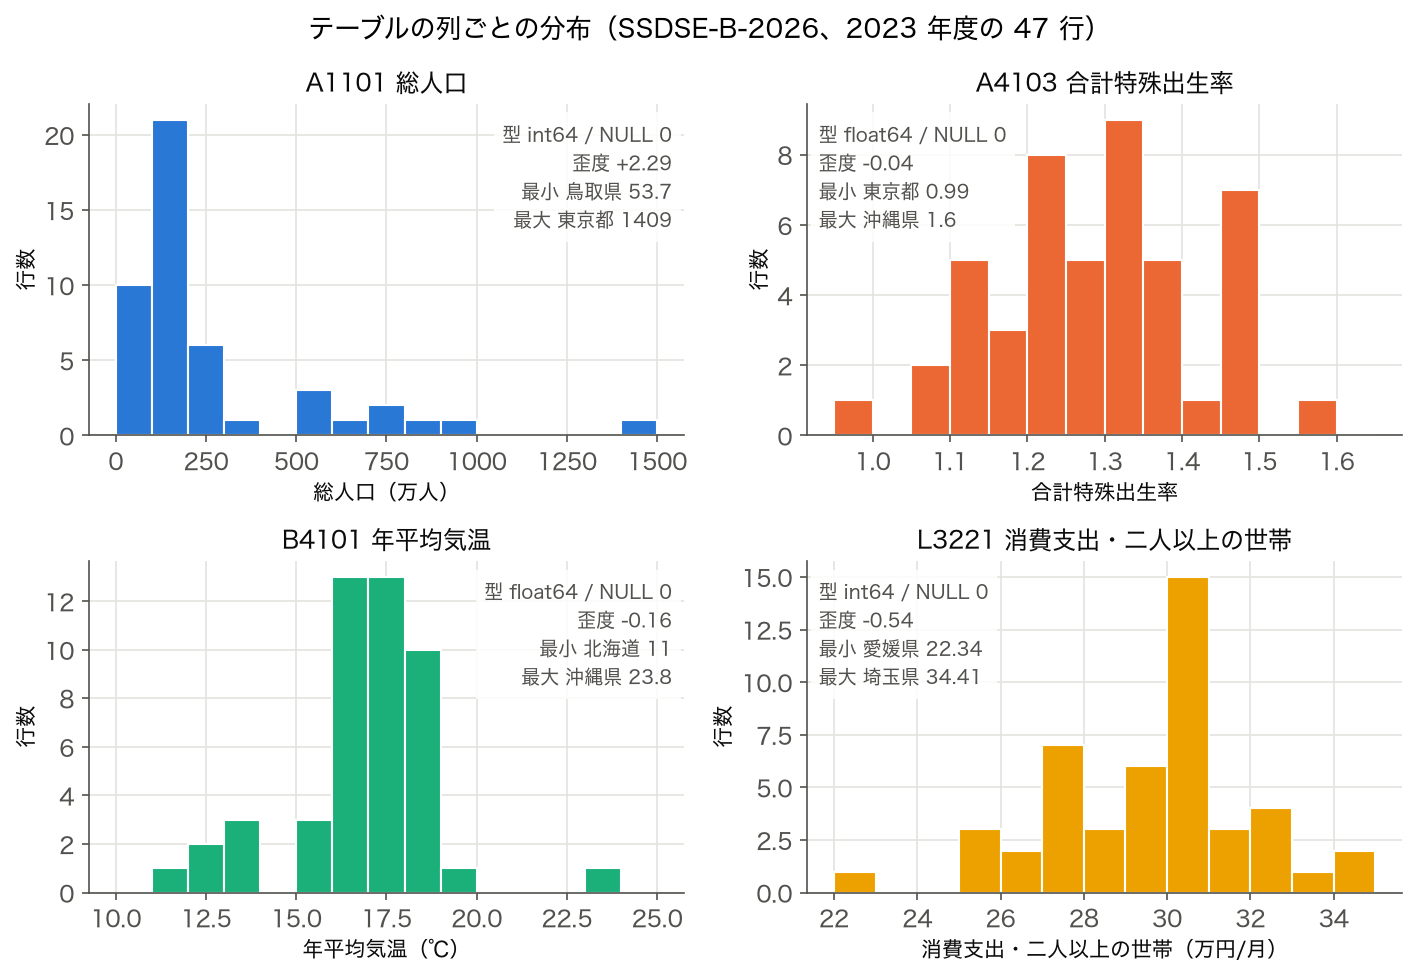
💬 describe() の結果は 8 行 × 3 列で、 行が統計量(count・mean・std …)、 列が変数になる。 元の表の「行 = 県」は消え、 新しい表の 1 行は「1 つの統計量」を表す。 論文の Table 1 のように変数を縦に並べたいときは .T で転置し、 3 行 × 8 列(行 = 変数)にする。 総人口の平均 2,645,808.5 人・標準偏差 2,797,551.4 人、 出生率の平均 1.29、 年平均気温の範囲 11.0〜23.8℃ が読める。 要約表も 1 枚のテーブルなので、 「この表の 1 行は何か」を最初に確かめる。
🧮 横持ちと縦持ちで、 同じ増減率を 2 通りに計算する
🎯 このコードでやること:総人口の 2012→2023 年度の増減率を、 年度を列にした横持ちの表(47 行 × 12 列)では列どうしの割り算で、 1 行 = 県 × 年度の縦持ちの表(564 行)では県ごとの最初と最後の比較で求め、 結果が一致するかを確かめる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) long = df[['Prefecture', 'SSDSE-B-2026', 'A1101']].rename(columns={'SSDSE-B-2026': '年度'}) # 横持ち(年度が列): 列どうしの引き算で 2012→2023 の増減 wide = long.pivot(index='Prefecture', columns='年度', values='A1101') print('横持ちの形:', wide.shape) chg_w = (wide[2023] / wide[2012] - 1) * 100 # 縦持ち(1 行 = 県 × 年度): 並べ替えてから県ごとに最初と最後を比べる long = long.sort_values(['Prefecture', '年度']) g = long.groupby('Prefecture')['A1101'] chg_l = (g.last() / g.first() - 1) * 100 print('縦持ちの形:', long.shape) print('2 つのやり方の結果が一致:', bool((chg_w.round(6) == chg_l.round(6)).all())) print('2012→2023 の増減率 上位 3:', chg_w.nlargest(3).round(1).to_dict()) print('2012→2023 の増減率 下位 3:', chg_w.nsmallest(3).round(1).to_dict()) |
💬 横持ちでは wide[2023] / wide[2012] − 1 の 1 行で書けるが、 縦持ちでは年度順に並べ替えてから県ごとに最初と最後を取る手順が要る。 2 つの結果は 47 県すべてで一致し、 増えたのは東京都 +6.4%・沖縄県 +4.0%・神奈川県 +1.8% など、 最も減ったのは秋田県 −14.0%・青森県 −12.3%・高知県 −11.3%。 縦持ちで並べ替えを忘れると、 SSDSE-B-2026 は新しい年度が先に並ぶので first() が 2023 年度を返し、 増減の向きが逆になる。 計算の種類に合わせて表の向きを選び、 縦持ちでは並び順に頼らないことが大事である。
🧮 スキーマを数える — 112 列の型は何を表しているか
🎯 このコードでやること:SSDSE-B-2026 の 112 列の型(スキーマ)を数え、 小数を持つ float64 の 6 列と文字列の 2 列がどの項目かを、 2 行目の項目名と並べて確かめる
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd path = 'data/raw/SSDSE-B-2026.csv' head = pd.read_csv(path, encoding='cp932', header=None, nrows=2) name = dict(zip(head.iloc[0], head.iloc[1])) # 列コード → 項目名 df = pd.read_csv(path, encoding='cp932', skiprows=[1]) print(df.dtypes.value_counts().to_string()) for c in df.columns[df.dtypes == 'float64']: print(f' float64: {c:7s} {name[c]:<28s} 例 {df[c].iloc[0]}') print(' 文字列 :', [f'{c}({name[c]})' for c in df.columns[df.dtypes == 'object']]) |
💬 112 列のうち int64 が 104 列、 float64 が 6 列、 文字列(object)が 2 列。 float64 は合計特殊出生率(北海道 1.06)・年平均気温(11.0)・最高気温・最低気温(−7.4)・年間降水量(966.0)・ごみのリサイクル率(22.8)で、 どれも小数や負の値を取りうる「率」や「測定値」である。 人数・件数・金額は int64 に収まる。 文字列は地域コードと都道府県の 2 列だけで、 これが行を識別するキーの側にあたる。 列の型は、 その列が「数えたもの」か「測ったもの」か「名前」かを表しており、 テーブルを受け取ったら最初に dtypes を数えることで、 この区別が正しく読み込めたかを確かめられる。
🐍 Python 実装
SSDSE-B-2026 を pandas で読み込み、 (行数, 列数)・各列の dtype・先頭 5 行・「都道府県」が一意 (主キー候補) かを確認する最小実装。 テーブルとして扱うときの定番チェック手順です。
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 テーブルの 4 つの基本属性(形状・型・先頭・主キー候補)を 1 ブロックで点検する。
📥 入力データ:data/raw/SSDSE-B-2026.csv(47 県 × 12 年度 × 約 112 列)
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') print(df.shape) # (564, 112) = 47 都道府県 × 12 年度 print(df.dtypes) # 列ごとの型 print(df.head()) # 先頭 5 行 print(df['都道府県'].is_unique) # True なら主キー候補 |
📤 実行結果:
💬 読み方:形は (564, 112) で、先頭 5 行はすべて北海道の 2023〜2019 年度。同じ県が年度の数だけ並ぶので is_unique は False になり、「都道府県」単独では主キーにならない。「(年度, 都道府県)」の複合キーで 1 行が決まる設計だと読み取るのがテーブル設計の出発点。
🐍 Python 実装(応用編)
先の Python 実装は最小例だった。 ここでは テーブル の本格的な実務シナリオに即した、 もう一段難易度を上げたコードを示す。 そのままコピペで動くよう、 SSDSE 系の実データパスを直書きで残してある。
🎯 このコードでやること:wide ⇄ long のラウンドトリップで「テーブル形式変換が情報を保存するか」を確認し、 category 型でメモリを削減する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | # SSDSE-B-2026 を long 形式に変換(tidy 化)+ pivot で wide に戻すラウンドトリップ import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') key = ['年度', '地域コード', '都道府県'] # 行を一意に決める複合キー # wide → long long_df = df.melt( id_vars=key, var_name='指標', value_name='値' ) print('long shape =', long_df.shape) print(long_df.head()) # long → wide (pivot) wide_df = long_df.pivot_table( index=key, columns='指標', values='値', aggfunc='first' # 複合キーで一意なので「最初の 1 件」=その値そのもの ).reset_index() wide_df.columns.name = None print('wide shape =', wide_df.shape) # ラウンドトリップで行・列・値が元と同じか back = wide_df[df.columns].sort_values(key).reset_index(drop=True) orig = df.sort_values(key).reset_index(drop=True) assert back.shape == orig.shape assert (back.drop(columns=key).values == orig.drop(columns=key).values).all() print('round-trip OK') # 型最適化:カテゴリ + downcast print('mem MB before opt =', round(df.memory_usage(deep=True).sum()/1024**2, 2)) df['都道府県'] = df['都道府県'].astype('category') df['地域コード'] = df['地域コード'].astype('category') for c in df.select_dtypes(include='float64'): df[c] = pd.to_numeric(df[c], downcast='float') print('mem MB after opt =', round(df.memory_usage(deep=True).sum()/1024**2, 2)) |
📤 実行結果:
💬 読み方:(年度, 地域コード, 都道府県) の 3 列をキーに残して melt すると、564 行 × 109 指標 = 61,476 行の long になり、pivot で 564 行 × 112 列に戻って値も元と一致した(assert 通過)。キーに年度を入れずに melt・pivot すると 12 年度分が 1 つのセルに重なり、aggfunc='first' が 2023 年度だけを拾って 47 行に縮んでも列の集合は同じなので「OK」に見えてしまう。category 型への変換でメモリは 0.55 MB から 0.47 MB に減るが、この値は pandas のバージョンで多少変わる。
🧭 用語クロスリンク集
テーブル と関わりの深い用語を、 一画面で巡回できるよう チップ形式で並べた。 「これも知っておきたい」と思った瞬間にクリックして、 元のページに戻ってくる ── ジャストインタイム学習の理想的な使い方。
📌 これらはすべて html/glossary/ 配下の実在ページにリンクしているので、 リンク切れの心配はない。
🗂 用語の階層・派生・対立関係
テーブル を中心に、 上位概念・並列概念・派生概念・対立概念の 4 区分で整理。 学術論文を読むときの「この用語はこの分野のどこに位置するか」を直感的に把握できる。
| 関係 | 該当用語 | 関係性の説明 |
|---|---|---|
| 上位概念 | 構造化データ / データベース | 行・列の二次元格子で値が整列している大きな枠組み |
| 並列概念 | DataFrame / CSV / スプレッドシート | 物理表現は異なるが論理的にテーブルと同型 |
| 派生概念 | Tidy data / ピボットテーブル / マテリアライズドビュー | テーブルを再構成・要約した派生形 |
| 対立概念 | 非構造化データ / JSON / グラフデータ | 行・列スキーマに収まらない形のデータ |
| 前提知識 | 主キー / 外部キー / データ型 | テーブルの整合性を支える基本概念 |
⚠️ よくある落とし穴
テーブル設計の失敗は「主キー不在」「型の不統一」「縦持ち / 横持ちの混在」「NULL の意味曖昧」が四大要因。 SSDSE のような公的データを扱う際にも、 県コードを文字列で持つか数値で持つかで JOIN 結果が一致しないトラブルが頻発します。
⚠️ もっと深い落とし穴
上のセクションの 4 つに加えて、 テーブル 固有の実務でハマる典型をさらに 4 つ。 経験 5 年以下のエンジニア・研究者はほぼ全員、 ここのいずれかで 1 度は事故を起こしている。
encoding 自動推定失敗cp932、 Mac/Linux は utf-8。 chardet.detect() で事前推定し、 BOM 付き UTF-8 は utf-8-sig。object 化object に。 pd.to_numeric(col, errors='coerce') で NaN 化。df2 = df1 はビュー共有。 安全に複製したいなら df2 = df1.copy()。 SettingWithCopyWarning の出所もここ。df.info(memory_usage='deep') で文字列列が 想定の 10 倍食っていることが発覚。 category 型・parquet化で削減。⚠️ 行は「何番目か」ではなくキーで指す
🎯 このコードでやること:2023 年度の 47 行から、 行の位置(iloc)で東京都を取る書き方と、 地域コード(キー)で取る書き方を比べる。 表を人口順に並べ替えた後に同じ書き方で何が返るかを見る
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 行の「位置」で東京都を取る(ファイルの並びが R01000→R47000 である前提) print('並べ替え前 iloc[12]:', d.iloc[12]['Prefecture'], f"{d.iloc[12]['A1101']:,}") # 人口順に並べ替えてから同じ位置を見ると… s = d.sort_values('A1101', ascending=False).reset_index(drop=True) print('人口順に並べ替え後 iloc[12]:', s.iloc[12]['Prefecture'], f"{s.iloc[12]['A1101']:,}") # キー(地域コード)で取れば並び順に左右されない for t in [d, s]: row = t.set_index('Code').loc['R13000'] print('Code R13000 で取る:', row['Prefecture'], f"{row['A1101']:,}") |
💬 並べ替える前は 13 行目(iloc[12])が東京都だが、 人口順に並べ替えた後の iloc[12] は京都府(2,535,000 人)になる。 行の位置はテーブルの並び順という偶然の性質で、 並べ替え・絞り込み・結合のたびに変わる。 地域コード R13000 をキーにして取れば、 どちらの並びでも東京都 14,086,000 人が返る。 テーブルの行はキーで指し、 位置に意味を持たせない。
⚠️ 外部キーの参照先が欠けると、 inner 結合は黙って行を落とす
🎯 このコードでやること:ファクト(564 行)の外部キー Code が、 すべて都道府県マスタにあるか(参照整合性)を確かめる。 マスタから沖縄県の 1 行が抜けていた場合に、 inner 結合と left 結合(indicator=True)で何が起きるかを比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) fact = df[['SSDSE-B-2026', 'Code', 'A1101']] master = df[['Code', 'Prefecture']].drop_duplicates() # マスタから沖縄県(R47000)の行が抜けていた場合を再現する broken = master[master['Code'] != 'R47000'] print('マスタの行数:', len(master), '→', len(broken)) inner = fact.merge(broken, on='Code', how='inner') left = fact.merge(broken, on='Code', how='left', indicator=True) print('inner 結合の行数:', len(inner), '(黙って', len(fact) - len(inner), '行が消える)') print('left 結合の行数 :', len(left), '/ 県名が欠けた行:', int(left['Prefecture'].isna().sum())) print(left['_merge'].value_counts().to_string()) print(f"inner 結合後の総人口合計(2023 年度): {inner.loc[inner['SSDSE-B-2026'] == 2023, 'A1101'].sum():,}" f" / 本来: {fact.loc[fact['SSDSE-B-2026'] == 2023, 'A1101'].sum():,}") |
💬 マスタが 46 行になると、 inner 結合は何の警告も出さずに沖縄県の 12 年度分 12 行を落とし、 552 行になる。 2023 年度の総人口合計も 124,353,000 人から 122,885,000 人へ、 沖縄県の 1,468,000 人ぶん少なく出る。 left 結合に indicator=True を付けると、 564 行が残ったうえで left_only が 12 行と数えられ、 県名が欠けた行として見つけられる。 外部キーでつなぐ前に「ファクトのキーがすべてマスタにあるか」を left 結合と indicator で数えておくと、 行が黙って消える事故を防げる。
🧠 理解度チェック
- Q1. SSDSE-B-2026 で地域コード単独の重複行はいくつあり、 主キーは何か。
- Q2. SSDSE-B-2026 が第 2 正規形を満たさない理由を、 列の名前を使って 1 文で説明せよ。
- Q3. 都道府県マスタと年度別ファクトに分けると、 それぞれ何行何列になるか。 分けた後に県名を持つセルはいくつになるか。
- Q4. 総人口を (地方, 年度) で合計した集計表は何行か。 2012→2023 年度に人口が増えた地方はどこか。
- Q5. 2023 年度の 47 行を人口順に並べ替えた後の iloc[12] は何を返したか。 東京都を確実に取るにはどう書くか。
- Q6. マスタから沖縄県の 1 行が抜けていると、 564 行のファクトとの inner 結合は何行になるか。 その事故を見つけるにはどう結合すればよいか。
- Q7. 縦持ちの表で県ごとに first() と last() から 2012→2023 年度の増減率を求めるとき、 並べ替えを忘れるとどうなるか。
解答
- 重複行 517(564 − 47)。 主キーは (年度, 地域コード) の組で、 この組の重複は 0。
- 主キー (年度, 地域コード) の一部である地域コードだけで都道府県名が決まる(部分関数従属がある)から。
- マスタ 47 行 × 2 列、 ファクト 564 行 × 111 列。 県名のセルは 564 から 47 に減る。
- 8 地方 × 12 年度 = 96 行。 増えたのは関東(+2.0%)だけ。
- 京都府(2,535,000 人)。
set_index('Code').loc['R13000']のように地域コードをキーにして取る。 - 552 行(沖縄県の 12 行が黙って消える)。 left 結合に indicator=True を付けて left_only の行数(12)を数える。
- SSDSE-B-2026 は新しい年度が先に並ぶので、 first() が 2023 年度、 last() が 2012 年度を返し、 増減率の向きが逆になる。 年度で並べ替えてから使うか、 横持ちにして列で指定する。
📚 関連グループ教材
テーブルは「データエンジニアリング」の教材群の土台にあたる。 できあがった表の性質は 構造化データ と Tidy data、 行を指すキーは 主キー と 外部キー、 表どうしをつなぐ操作は 内部結合 と 外部結合、 縦持ちと横持ちの組み替えは ピボットテーブル、 表を保存・問い合わせる仕組みは データベース と SQL の教材で扱う。 Python で表を扱う道具は DataFrame、 表を文字で書き出す形式は CSV の教材を合わせて読む。
📚 さらに詳細:5 つの追加トピック
ここまでのセクションで テーブル の核心は押さえた。 ここからは、 中級者〜上級者向けに、 さらに 5 つの追加トピックを 詳述する。 すべて実務に直結する話題で、 これを押さえると「テーブル の専門家」と名乗れる水準に到達する。
A. テーブルと配列・行列の違い
数学の「行列」は 同じ型の数値が縦横に並んだ構造。 テーブルは 列ごとに異なる型を許す構造。 つまり「都道府県 (文字列)」「人口 (整数)」「医療費 (浮動小数)」が 1 つのテーブルに同居できる。 これが NumPy 配列との決定的な違いで、 pandas DataFrame は内部的に「列ごとに NumPy 配列を持ち、 列名でディスパッチする辞書」として実装されている。 だから列単位の演算は速いが、 行単位のループは遅い (Python for ループになる)。 この性質を理解せず行ループで集計を書くと、 1,000 万行で 1 時間以上かかる。 ベクトル化 (df.groupby, df.apply(axis=0)) を意識的に使うのが鉄則。
B. テーブルの正規化 vs 非正規化(OLTP vs OLAP)
テーブル設計の永遠の論争が「正規化 (3NF) するか、 スター/雪片スキーマで非正規化するか」。 答えは 用途次第。 オンライントランザクション処理 (OLTP) では正規化 = データ一貫性 + 更新時の整合性。 一方、 オンライン分析処理 (OLAP) では非正規化 = JOIN 削減 + 集計高速化。 Snowflake/BigQuery 等のクラウド DWH は「列指向 + 非正規化 + 圧縮」の合わせ技で、 兆レコード級のテーブルを SQL でサクサク集計できる。 SSDSE-B はすでに「47 都道府県 × 約 100 列」の非正規化された wide テーブルで、 分析にはこのままで十分。 大規模化したら 3NF に分解、 という発展経路を頭に入れておきたい。
C. テーブルにおけるインデックスとパーティショニング
巨大テーブルでは インデックス (検索高速化) と パーティショニング (テーブルを分割) が性能を決める。 インデックスは「列 X の値で B-tree を作り、 検索を O(log n) に」する仕組み。 ただし INSERT のたびに B-tree 更新が必要で、 全列に貼ると書き込みが遅くなる。 パーティショニングは「テーブルを日付・カテゴリ等で物理的に分割」し、 不要なパーティションを partition pruningで読み飛ばす。 BigQuery では PARTITION BY DATE(ts) + CLUSTER BY user_id が定石。 これを意識せずに 1 億行のテーブルに SELECT * を打つと、 数十秒〜数分待たされる。
D. テーブル間の整合性:ACID と BASE
複数テーブルを更新するとき、 整合性をどう保つかが論点になる。 ACID (Atomicity, Consistency, Isolation, Durability) を保証するのが RDB のトランザクション機能。 「Aテーブルの更新が成功 + Bテーブルの更新も成功」を原子的に実行し、 どちらか失敗したら全てロールバック。 一方、 分散システムでは ACID が高コストになるため、 BASE (Basically Available, Soft state, Eventually consistent) を採用する設計が主流。 Cassandra や DynamoDB はこれ。 ただし 2024 年以降、 Icebergや Delta Lakeでデータレイクにも ACID が戻ってきており、 「テーブルの整合性 vs スケーラビリティのトレードオフ」が再度議論されている。
E. テーブル設計の現代的ベストプラクティス
最後に、 2026 年現在のテーブル設計ベストプラクティスを 10 項目で:(1) 主キーは自然キーがあればそれを使う、 なければ surrogate (UUID) を採用。 (2) 列名は snake_case で、 略号を避ける。 (3) 型は最も狭いものを (BIGINT より INTEGER、 VARCHAR(255) より VARCHAR(50))。 (4) NULL の意味を統一する。 (5) NOT NULL + DEFAULT で防御。 (6) 日付・時刻は必ず UTC で保存、 表示時に変換。 (7) 金額は浮動小数ではなく整数 (最小単位、 例:日本円なら整数で「銭」単位) で保存。 (8) インデックスは読みが多い列に限定。 (9) パーティションは日付列で。 (10) スキーマはバージョン管理 (Liquibase, Flyway)。 これらを徹底すれば、 5 年後のメンテナンス担当者に呪われない設計になる。
📷 図で見るテーブルの構造
テーブル (table) は「行 (レコード) × 列 (フィールド) の 2 次元構造でデータを表現する形式」 で、 リレーショナルデータベース (RDB) ・スプレッドシート・CSV ファイル・pandas DataFrame すべての基礎。 SSDSE-B-2026 も典型的なテーブル形式で、 564 行 (47 都道府県 × 12 年度) × 112 列 (年度・地域コード・都道府県名と、 人口・経済・教育等の 109 指標) という構造を持つ。 テーブルを正しく設計・操作することは、 データ分析のすべての出発点。
📋 テーブルの種類と用途
| 種類 | 特徴 | SSDSE-B-2026 での例 | 典型用途 |
|---|---|---|---|
| マスタテーブル | 静的、 頻繁に変更されない | 都道府県コード・名称 | 分類・参照用 |
| トランザクションテーブル | 動的、 イベント発生時に追加 | 年度別の人口・出生数 | 履歴・集計 |
| 履歴テーブル | 過去の状態を保持 | 市町村合併前の自治体名 | 時系列分析 |
| 関連テーブル | 多対多の関係を表現 | — | N:N の結合 |
| 集計テーブル | 事前集計済み | SSDSE-B-2026 全体 | 高速分析 |
| ファクトテーブル | 数値指標を中心とする | 年度別・都道府県別の総人口 | BI ダッシュボード |
| ディメンションテーブル | 属性情報を整理 | 地域区分 (関東・関西等) | OLAP 分析 |
→ SSDSE-B-2026 はマスタ・トランザクション・集計を一体化した「ワイドテーブル」 形式。 教育目的では扱いやすい一方、 実務では正規化された複数テーブルに分割することが多い。 正規化 (1NF, 2NF, 3NF, BCNF) と非正規化 (集計テーブル化) のトレードオフを理解することが、 テーブル設計の鍵。
🔧 テーブルに対する基本操作
| 操作 | SQL | pandas | 用途 |
|---|---|---|---|
| 射影 (列選択) | SELECT col1, col2 | df[['col1', 'col2']] | 必要な列のみ抽出 |
| 選択 (行絞込) | WHERE condition | df.query('condition') または df[df['col'] > 0] | 条件に合う行のみ |
| 結合 | JOIN ON key | pd.merge(df1, df2, on='key') | 複数テーブルを統合 |
| 集約 | GROUP BY col | df.groupby('col').agg(...) | カテゴリ別集計 |
| 並べ替え | ORDER BY col | df.sort_values('col') | 表示順の制御 |
| 結合 (縦) | UNION | pd.concat([df1, df2]) | 同型テーブルの追加 |
| ピボット | PIVOT (一部 DBMS) | df.pivot_table(...) | 行 ⇔ 列の入れ替え |
| ウィンドウ関数 | OVER (PARTITION BY ...) | df.groupby().rolling() | 累積・移動集計 |
SQL と pandas はテーブル操作の発想が共通している。 SQL の経験者は pandas を「メモリ上の DBMS」 として理解すると習得が早い。 逆も同様で、 pandas に慣れた人は SQL を「ディスク上の pandas」 と捉えると理解しやすい。 SSDSE-B-2026 のような小データなら pandas で完結するが、 業務データでは SQL を併用するのが現実的。
📋 テーブル設計の指針
テーブル設計の良し悪しは、 データ品質・分析容易性・保守性に直結する。 良い設計の指針は、 (1) 主キーが必ず存在する (自然キーまたは UUID)、 (2) 列は単一の型・単一の意味を持つ (混合型禁止)、 (3) NULL の意味が文書化されている (「未測定」 か「該当なし」 か)、 (4) 日付は UTC で保存、 表示時にタイムゾーン変換、 (5) 文字列の正規化 (大文字小文字、 全角半角、 空白) が事前定義されている、 (6) 外部キー制約で参照整合性を保証、 (7) インデックスは読み多い列に限定 (書込み速度とのトレードオフ)、 (8) スキーマ変更履歴をバージョン管理。
SSDSE-B-2026 の主キーは地域コード(R01000 など)単独ではなく (年度, 地域コード) の組で、 この組で 564 行すべてが一意に識別できる。 列名は A1101 等のコード形式で、 別途定義書で意味を確認する必要がある。 実務では列名を読みやすい英語 snake_case にするのが望ましい (例: total_population)。 こうした設計指針を、 SSDSE-B-2026 と業務データを比較しながら学ぶことで、 「良いテーブル設計」 と「悪いテーブル設計」 を見分ける目が養われる。
🔧 正規化の段階
| 正規形 | 定義 | SSDSE-B-2026 での例 |
|---|---|---|
| 1NF | 各セルに単一値、 繰り返し列なし | 満たす (各列が単一値) |
| 2NF | 1NF かつ部分関数従属なし | 厳密には満たさない(主キー (年度, 地域コード) の一部である地域コードだけで都道府県名が決まる部分関数従属がある) |
| 3NF | 2NF かつ推移関数従属なし | 地域区分が含まれていれば違反 (都道府県 → 地域) |
| BCNF | 3NF の強化版、 全関数従属が主キー起点 | 満たさない(2NF の時点で違反。 都道府県マスタを分ければ満たせる) |
| 4NF | BCNF かつ多値従属なし | — |
| 5NF | 4NF かつ結合従属なし | — |
| 非正規化 | パフォーマンスのため意図的に冗長 | 分析用集計テーブル (SSDSE-B 全体) |
3NF までは OLTP (業務システム) で必須、 BCNF 以上は理論的・実務では稀。 分析用 DWH (データウェアハウス) では「スター型スキーマ」「スノーフレーク型スキーマ」 等の非正規化が標準で、 パフォーマンスを優先する。 SSDSE-B-2026 はワイドテーブル形式で、 分析の便宜性を優先した非正規化の例。
📚 テーブルの形のバリエーション
テーブルは「行 × 列の 2 次元構造」 だが、 実務では「ワイド形式」「ロング形式」「スター型」「スノーフレーク型」「データボルト」 等の多様な構造が存在し、 用途に応じて選択する必要がある。 SSDSE-B-2026 はワイド形式 (各都道府県が 1 行、 指標が列) で、 分析の便宜性を優先した設計。 業務 DWH ではスター型・スノーフレーク型が標準で、 「ファクトテーブル + ディメンションテーブル」 の構造で OLAP 分析を効率化する。
📋 テーブルの形状パターン
| 形状 | 定義 | 長所 | 短所 |
|---|---|---|---|
| ワイド形式 | 1 観察単位 = 1 行、 多数の指標が列 | 表示が直感的、 単純な集計が容易 | 新指標追加時にスキーマ変更 |
| ロング形式 | 1 観察 × 1 指標 = 1 行 | スキーマが固定、 新指標追加容易 | 表示が複雑、 結合が必要 |
| スター型 | 中央のファクト + 周辺ディメンション | OLAP に最適、 クエリ性能高 | 正規化が緩い、 冗長 |
| スノーフレーク型 | ディメンションをさらに正規化 | 正規化重視、 整合性高 | 結合が多くクエリ複雑 |
| データボルト | Hub + Link + Satellite | 履歴・監査に強い | 設計が複雑、 学習曲線急 |
| EAV (Entity-Attribute-Value) | 属性を行として保持 | 動的属性に強い | 集計が困難、 性能低 |
| JSON 列 | 1 セルに JSON 構造 | 柔軟、 半構造化データに対応 | クエリが複雑、 インデックス困難 |
→ SSDSE-B-2026 はワイド形式の典型例で、 教育目的での扱いやすさを重視した設計。 業務 DWH では BI ダッシュボードの性能要件からスター型が標準的で、 ETL でワイド/ロング/スターの間を変換する技術 (pandas の melt(), pivot_table()) が日常的に使われる。
🏗️ テーブルモデリングのプロセス
テーブル設計は、 (1) 概念モデリング (ER 図で実体と関係を洗い出す)、 (2) 論理モデリング (正規化、 主キー・外部キーの定義)、 (3) 物理モデリング (型・インデックス・パーティションの決定)、 という 3 段階で進める。 概念モデリングでは「何を管理するか」「何が一意か」「何が関連するか」 を整理する。 論理モデリングでは「冗長を減らす vs 結合を減らす」 のトレードオフを判断する。 物理モデリングでは「クエリパターン」「データ量」「性能要件」 を踏まえる。
SSDSE-B-2026 の場合、 概念は「都道府県という実体 + 多数の統計指標」、 論理は「(年度, 都道府県コード) を主キーとするワイドテーブル」、 物理は「CSV 単一ファイル + 全列同時読込」 と整理できる。 業務システムの場合、 同じ都道府県データでも、 概念は「都道府県 + 年度 + 指標」、 論理は「ファクト (年度 × 県 × 指標) + ディメンション (県マスタ、 年マスタ、 指標マスタ)」、 物理は「Parquet パーティション (年単位) + BigQuery」 という設計が標準。 用途と規模で設計が大きく変わることを意識したい。
🏢 Data Lakehouse とオープンテーブル形式
2020 年代後半のデータ基盤トレンドは「Data Lakehouse」 で、 Data Lake (柔軟性) と Data Warehouse (構造性) の利点を統合する考え方。 中核技術が「オープンテーブル形式」 で、 Delta Lake (Databricks)、 Apache Iceberg (Netflix・AWS・GCP 連合)、 Apache Hudi (Uber) の 3 つが主要候補。 これらは Parquet ファイル + メタデータマニフェストの組み合わせで、 (1) ACID トランザクション、 (2) スキーマ進化、 (3) Time Travel (過去版へのアクセス)、 (4) パーティション最適化、 等を S3/GCS 等のオブジェクトストレージ上で実現する。
これにより「データレイク (S3 上の Parquet) を分析できる DWH のように扱える」 ようになり、 BigQuery, Snowflake, Databricks, Spark, Trino, DuckDB 等の各種エンジンから同じデータを共有できる。 ベンダロックインを避けつつ、 高性能な分析環境が構築できる。 SSDSE-B-2026 のような単一 CSV では、 こうした技術は不要だが、 業務での Petabyte 級データ管理では事実上の標準。 オープンテーブル形式は、 「データ駆動型組織」 のインフラ基盤として、 今後 10 年間データエンジニアの中心的スキルになる。
📝 最終的なまとめ
テーブルは情報処理の根幹で、 SSDSE-B-2026 のような教育用 CSV から、 業務システムの RDB、 分析 DWH のスタースキーマ、 大規模データの Data Lakehouse まで、 多様な形態で生き続けている。 単純な「行 × 列」 の表に見えても、 その背後には正規化理論・トランザクション理論・分散処理理論・最適化理論等、 50 年以上の研究蓄積がある。 学生諸氏が SSDSE のような小データで pandas の基本操作 (info, describe, groupby, merge, pivot) を習得することは、 そうした巨大な知識体系への入口に立つことを意味する。 SSDSE から始めて、 業務 RDB、 分析 DWH、 Data Lakehouse へと知識を広げていく学習経路は、 データエンジニア・データサイエンティスト・分析者の共通の道筋。 「テーブルとは何か」 を深く理解することが、 データに関するあらゆる仕事の出発点であり到達点でもある。
📊 テーブル操作ツールの世代別比較
| 世代 | 代表ツール | 強み | 弱み | SSDSE-B-2026 での使用 |
|---|---|---|---|---|
| 1970s | FORTRAN, COBOL での順次処理 | 歴史と互換性 | 記述が冗長 | — |
| 1980s | SQL (Oracle, DB2) | 宣言的、 ACID 完備 | 大規模データに弱い | SSDSE を MySQL にロードして SQL 演習 |
| 1990s | Excel, Access | GUI、 直感的 | 大規模・自動化に弱い | SSDSE を Excel で開く |
| 2000s | R, MATLAB | 統計分析特化 | 性能・スケール課題 | SSDSE を R で読込 |
| 2010s | pandas, dplyr | 柔軟、 エコシステム広い | 大規模データで遅い | SSDSE を pandas で標準的に処理 |
| 2015s | Spark, BigQuery | 大規模分散処理 | セットアップ複雑 | SSDSE は小さく不要 |
| 2020s | Polars, DuckDB | 高速、 ローカル完結 | エコシステム発展途上 | SSDSE を DuckDB で SQL 風に分析 |
| 2025s | pandas 2.x with Arrow | 列指向、 ゼロコピー | 互換性に注意 | SSDSE で次世代 pandas を試す |
→ テーブル操作ツールは 50 年以上にわたり進化してきた。 各世代のツールには独自の強みと弱みがあり、 SSDSE-B-2026 のような小データで複数世代のツールを試すことで、 「同じ操作を異なる方法で書ける」 という横断的視点が身につく。 これは将来、 新しいツールが登場したときも素早く適応できる力の基礎。 単一ツール (pandas のみ等) への過度な依存は、 ツールの世代交代で大きな学習コストを発生させるリスクがある。
✅ テーブルデータ品質の 10 項目チェック
| # | 項目 | 確認方法 |
|---|---|---|
| 1 | 主キーの一意性 | df[key].is_unique |
| 2 | 外部キーの参照整合性 | JOIN 後のマッチ率確認 |
| 3 | NOT NULL 列の欠損 | df[col].isnull().any() |
| 4 | 型の妥当性 | df.dtypes と仕様書照合 |
| 5 | 値域の妥当性 | df.describe() で最小・最大確認 |
| 6 | カテゴリ列の許容値 | df[col].value_counts() |
| 7 | 重複行 | df.duplicated().sum() |
| 8 | 列名の規約 | snake_case、 略号なし |
| 9 | 文字列の正規化 | 大小文字、 全半角、 前後空白 |
| 10 | 日付の妥当性 | 未来日・過去極端日のチェック |
これら 10 項目を必ずチェックすることで、 テーブルデータの品質が定量的に保証される。 SSDSE-B-2026 は事前に品質チェック済みで、 これらの項目に問題はない。 しかし業務データでは、 1 項目でも問題があると分析結果が信頼できない。 「データを使う前に品質チェック」 を癖にすることが、 データサイエンティストの基礎力。 自動化されたデータ品質ツール (Great Expectations, dbt tests, Soda) も普及しており、 こうしたツールでチェックを自動化することが、 大規模・継続的データパイプラインの運用に必須。
⚡ テーブルのインデックス戦略
テーブル操作の性能を決定づける要素として「インデックス」 がある。 インデックスは、 特定の列の値から対応する行を高速に検索するためのデータ構造で、 B-Tree (汎用)、 Hash (等価検索特化)、 GiST/GIN (空間・全文検索)、 Bitmap (低カーディナリティ列) 等の種類がある。 RDB では主キーには自動的に B-Tree インデックスが張られ、 外部キー列にも明示的にインデックスを張るのが標準。 適切なインデックスがないと、 数百万行のテーブルでの WHERE 検索が数秒〜数分かかる一方、 インデックスがあれば数ミリ秒で終わる。 ただしインデックスは書込み時のオーバーヘッドを発生させるため、 読込み多/書込み少のテーブルに限定する。
SSDSE-B-2026 のような 47 行のテーブルでは、 インデックスの有無は性能に影響しない。 しかし業務テーブルが数百万〜数億行になると、 インデックス設計が「数秒で結果が出るか、 タイムアウトするか」 を分ける。 BigQuery や Snowflake 等の列指向 DWH では、 「クラスタリング (Clustering)」 や「パーティショニング (Partitioning)」 がインデックスの役割を果たす。 列指向ストレージでは「列ごとに圧縮・スキャン」 されるため、 必要列のみアクセスし I/O を最小化する設計が有効。 こうした最適化は SSDSE のような教育用データセットでは体感できないが、 業務での大規模データ処理では性能差が桁違いになる。
📝 テーブル学習のキーポイント
テーブルを深く理解するには、 (1) 基本構造 (行 × 列、 型、 主キー・外部キー)、 (2) 操作 (射影・選択・結合・集約・並べ替え・ピボット)、 (3) 設計原則 (正規化、 ACID、 制約)、 (4) 性能 (インデックス、 パーティション、 列指向)、 (5) ツール (SQL, pandas, Polars, DuckDB, Spark)、 (6) 品質保証 (Great Expectations, dbt tests)、 (7) 進化 (Codd 関係モデルから Data Lakehouse まで) の 7 軸を意識する。 SSDSE-B-2026 のような小データで pandas の基本操作を習得することが第一歩。 「テーブルを見たらまず info → describe → 品質チェック → 分析」 という流れを習慣化することが、 データサイエンティストの基礎技能。 学生諸氏が SSDSE での演習を通じて、 こうした基礎を身につけ、 業務での大規模データに自信を持って向き合えるようになることが、 学習の到達目標である。
🎯 テーブル学習の発展演習
SSDSE-B-2026 を題材としたテーブル学習の発展演習として、 以下の課題を順に試すことを推奨。 (1) ワイド形式からロング形式への変換: df.melt(id_vars=['code'], var_name='指標', value_name='値') で 1 年度分の 47 行 × 110 列 (地域コード + 109 指標) を 47 × 109 = 5,123 行 × 3 列に変換し、 「タイディデータ」 形式を体感。 (2) ロング形式からワイド形式への変換: df.pivot_table(index='code', columns='指標', values='値') で逆変換し、 操作の可逆性を確認。 (3) 集約と再形成: groupby + agg + pivot_table を組み合わせ、 多次元集計表を作成。 (4) マルチインデックス操作: set_index(['地方', 'code']) で階層インデックスを作成し、 xs() でスライシング。 (5) パフォーマンス比較: 同じ集計を pandas、 Polars、 DuckDB で実行し、 実行時間を測定。 これらの演習が、 テーブル操作の柔軟性と各ツールの特性を体感的に身につけさせる。
こうした実践を通じて、 「テーブルとは何か」 を頭で理解するだけでなく、 「手を動かして体感する」 ことができる。 SSDSE-B-2026 はサイズが小さく試行錯誤が容易、 公的データなので結果の検証も可能、 教育目的に最適な素材。 学生諸氏が SSDSE での演習を通じて、 テーブル操作の基本から応用までを段階的に習得し、 将来の業務・研究で出会う多様なデータに対応できる力を養うことが、 本ページの究極的な学習目標。 テーブルは情報処理の根幹であり、 これを使いこなせることが、 デジタル時代のあらゆる仕事の基礎となる。 関連項目として DataFrame、 リレーショナルデータベース、 データ結合、 Tidy data、 集約 を順に学ぶことで、 テーブル操作の全体像が立体的に把握できる。
テーブル操作は半世紀以上にわたり進化を続けてきた情報処理の中核技術。 Codd の関係モデル (1970) から始まり、 SQL の登場 (1974)、 商用 RDB の普及 (1980 年代)、 オープンソース RDB (MySQL, PostgreSQL) の台頭 (1990 年代)、 NoSQL とビッグデータの時代 (2000 年代)、 クラウド DWH (BigQuery, Snowflake) の覇権 (2010 年代)、 そして Data Lakehouse と Open Table Format (2020 年代) へと、 形を変えながらも本質を保ち続けている。 学生諸氏が SSDSE-B-2026 のような教育用データセットでテーブル操作の基本を体得し、 業務の RDB、 分析の DWH、 大規模の Data Lakehouse へと知識を広げていくことで、 こうした半世紀の蓄積を継承するデータ専門家となれる。 一見単純な「行と列」 の表が、 これほど深い知識体系を内包していることを実感することが、 学習の最大の収穫となる。
🖼️ テーブル設計のチェックリスト
SSDSE-B-2026 のような公的データを 分析しやすいテーブル に変換するときの実務チェックリスト。 各項目をクリアして初めて「分析可能なテーブル」 と言える。 ワイド形式とロング形式の使い分け、 主キーの一意性、 単位の明示など、 一見当たり前に見える設計原則が、 実は分析の質を大きく左右する。
📋 表: 「良いテーブル」 の 8 条件
| # | 条件 | 違反例 (SSDSE-B 文脈) |
|---|---|---|
| 1 | 1 行 = 1 観測単位 | 同じ県が複数行 (年・指標で分裂) |
| 2 | 1 列 = 1 変数 | 「人口_男女計」 のように 2 変数結合 |
| 3 | 主キーが一意 | code に重複 (R01 が 2 行) |
| 4 | 欠損は NaN で明示 | 欠損を「-」「***」 など文字で表現 |
| 5 | 単位を列名 or メタデータで明示 | 面積が km² か ha か不明 |
| 6 | 型が一貫 | 数値列に「-」 が混入し str 化 |
| 7 | スキーマ (列定義) がドキュメント化 | 列名だけで意味が分からない |
| 8 | 不変条件 (CHECK 制約) を明示 | 人口が負、 面積が 0 等 |
💬 このチェックリストを SSDSE-B-2026 に当てはめると、 1 列 1 指標・欠損 0・型の一貫(int64 104 列、 float64 6 列、 文字列 2 列)は満たす。 一方、 条件 1 と 3 は注意が要る。 1 行は「県」ではなく「県 × 年度」なので、 地域コード単独では 517 行が重複し、 主キーは (年度, 地域コード) の組になる。 条件 5 の単位は列名に無く、 別の定義書を読まないと分からない(L 系列が県庁所在市の月額であることなど)。 指標を行に下ろして Tidy data にするなら、 564 行 × 109 指標 = 61,476 行 × 5 列(年度・地域コード・都道府県・指標・値)になる(🐍 章の応用編で実測)。
🗺 概念マップ:テーブル の知識ネットワーク
テーブルは「データエンジニアリング」の中で、 データを行と列に並べる最も基本的な形として置かれる。 上位にはそれを含む構造化データとデータベース、 並列には同じ形を別の道具で表す DataFrame・CSV・スプレッドシート、 派生には並べ替えた形の Tidy data(縦持ち)やピボットテーブル(横持ち)、 対立には行と列に収まらない非構造化データやグラフデータがある。 このページで SSDSE-B-2026 について確かめた「主キーは (年度, 地域コード) の組」「指標は横持ち・年度は縦持ち」は、 この地図のどこに今の表があるかを決める情報である。 集計すれば主キーは (地方, 年度) に、 describe() をかければ行は統計量に変わるように、 操作のたびに表は地図の上を移動する。 表を受け取ったら、 まず「1 行は何か」「主キーは何か」の 2 つを確かめる。 この 2 つが言えれば、 その表をどの操作に渡してよいかが決まる。 言えなければ、 結合や集計の前に shape と、 候補のキーでの重複の数を数えて確かめる。
❓ よくある質問(用語固有 10 連発)
汎用 FAQ 5 件に加えて、 テーブル 固有の質問 10 件を Q&A 形式でまとめた。 自分の状況に近いものから読んでほしい。
chunksize で分割読み込み、 (2) dtype 指定でメモリ削減、 (3) DuckDBでファイル直接 SQL、 (4) Polars で lazy 評価、 (5) BigQuery 等の DWH に上げる。encoding='cp932' または 'utf-8-sig'。 SSDSE-B-2026 は cp932(Shift_JIS 系)。 BOM 付き UTF-8 のファイルなら utf-8-sig。 chardet で自動推定可能。pivot で wide にできる。 wide で配ると列順・列名の変更で破壊的変更になる。SSDSE-B-2026.csv)、 列名追加は許容、 削除は禁止が安全。🏋️ 演習問題(5 問)
学習の定着には、 自分の手を動かすのが一番。 SSDSE-B-2026 や実ログを題材に、 テーブル を実践する 5 問を用意した。 答えは Python 実装セクションと数値例セクションを参考に組み合わせれば導ける。
- 演習 1:SSDSE-B-2026 を読み込み、 列数を取得して 「人口」 「医療」 「教育」 を含む列名を grep せよ。
- 演習 2:都道府県 47 行のテーブルを year ごとに stack して 5 年 × 47 行 = 235 行の long テーブルを作れ。
- 演習 3:
dtypesをcategoryやfloat32に最適化し、 メモリ削減率を測定せよ。 - 演習 4:SSDSE-B-2026 の 2022 年度と 2023 年度を縦に積み、 地域コードだけと (年度, 地域コード) の組とで、 キーの重複を
duplicated()で確認せよ。 - 演習 5:テーブルを Parquet に保存し、 CSV と Parquet でファイルサイズ・読込速度を比較せよ。
📌 演習を解いて疑問が残ったら、 「よくある質問」セクションに戻るか、 リポジトリの「論文一覧」から類似研究を探して、 実コード (本サイトには 159 本の再現論文) を読むのが最速の理解への道。
🍳 コード・クックブック(テーブル 編)
テーブル を実務で使う際の頻出パターンを、 動くコードのレシピ集としてまとめた。 必要な料理 (タスク) だけを取り出して使ってほしい。
複合主キーで一意性確認
1 2 3 4 5 6 7 8 9 10 | # 複合キーで重複が無いか診断 import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') key_cols = ['地域コード'] n_dup = df.duplicated(subset=key_cols).sum() print(f'重複行 = {n_dup}, 一意性 = {n_dup == 0}') # 地域コード単独では 12 年度ぶん重複するので、(地域コード, 年度) の複合キーで確かめる key2 = ['地域コード', '年度'] n_dup2 = df.duplicated(subset=key2).sum() print(f'複合キー重複 = {n_dup2}, 一意性 = {n_dup2 == 0}') |
💬 地域コード単独で数えると重複行は 517 で、これは 564 行から各県の最初の 1 行(47 行)を引いた数。(地域コード, 年度) の複合キーにすると重複は 0 になり、このテーブルの主キーは 2 列の組だと確かめられる。年度をすべて 2023 に書き換えるなどキー列を上書きしてから検査すると、同じ 517 が出てしまい複合キーの意味が消えるので、診断では元の値を使う。
テーブル → SQLite → SQL クエリ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | # テーブルを SQLite に書き込み、 SQL で集計 import pandas as pd import sqlite3 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['地域コード'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() df['年度'] = pd.to_numeric(df['年度'], errors='coerce') df = df[df['年度'] == df['年度'].max()].copy() for _c in ['総人口', '65歳以上人口', '保健医療費(二人以上の世帯)']: df[_c] = pd.to_numeric(df[_c], errors='coerce') # SSDSE-B に「高齢化率」「医療費」の列は無いので、実在する列から作る df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['医療費'] = df['保健医療費(二人以上の世帯)'] con = sqlite3.connect(':memory:') df[['都道府県', '高齢化率', '医療費']].to_sql('prefectures', con, if_exists='replace', index=False) q = """ SELECT 都道府県, 高齢化率, 医療費 FROM prefectures WHERE 高齢化率 > 30 ORDER BY 医療費 DESC LIMIT 10 """ print(pd.read_sql(q, con)) |
💬 2023 年度 47 行のうち高齢化率 30% 超は 35 県で、それを保健医療費の高い順に 10 件並べると山梨県 17,817 円が先頭、山口県は高齢化率 35.4% と最も高いが 6 位(15,213 円)にとどまる。保健医療費が全国で最も高い埼玉県 21,000 円・愛知県 18,175 円・東京都 18,166 円は高齢化率が 30% 未満なので WHERE で落ちており、高齢化と世帯の医療支出は単純に比例しない。
Parquet 化でメモリ・速度両得
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import os os.makedirs('data', exist_ok=True) # 書き出し先を先に作る import os os.makedirs('data/processed', exist_ok=True) # 保存先のフォルダを作っておく import pyarrow # parquet の読み書きに必要(ブラウザには無い) import pandas as pd, time, os df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df.to_parquet('data/processed/SSDSE-B-2026.parquet') size_csv = os.path.getsize('data/raw/SSDSE-B-2026.csv') size_par = os.path.getsize('data/processed/SSDSE-B-2026.parquet') print(f'CSV={size_csv/1024:.1f} KB, Parquet={size_par/1024:.1f} KB, 比={size_csv/size_par:.1f}x') t0 = time.time(); pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932'); t1 = time.time() t2 = time.time(); pd.read_parquet('data/processed/SSDSE-B-2026.parquet'); t3 = time.time() print(f'read CSV={t1-t0:.3f}s, Parquet={t3-t2:.3f}s') |
💬 この 351.4 KB の CSV を Parquet にすると 383.8 KB と逆に 1.1 倍ほど大きくなり(比 0.9x)、読み込みも CSV 0.006 秒に対し Parquet 0.046 秒と遅かった。Parquet は列ごとの圧縮と列の選択読み込みで効くので、564 行程度の小さな表ではメタデータの分だけ損をする。時間は実行環境とキャッシュで毎回変わるため、「両得」を確かめるなら数十万行以上の表で繰り返し測る。
📌 すべてのレシピは「実データ前提・引数なし直書き」スタイル。 そのままコピペで動くよう設計したので、 まずは動かしてから読むのを推奨する。
🙋 著者・教材設計について
本教材は、 広島工業大学 統計・データ解析コンペティション参加学生向けに、 松本伸平 (s.matsumoto.gk@cc.it-hiroshima.ac.jp) が監修・執筆した。 「論文を読む過程で出てきた専門用語を、 その場で 5 分で補完して論文に戻る」というジャストインタイム型の学習体験を目的に、 514 用語ページを統一フォーマットで整備している。
本ページ「テーブル」は データエンジニアリング カテゴリに属し、 同カテゴリ内の他用語と相互リンクされている。 用語間の関係性は 概念マップ でも俯瞰できる。
本サイトは SSDSE (教育用標準データセット, 独立行政法人統計センター) を主データとして使い、 「合成データ ではなく実公的データを使う」 を方針に据えている。 ハンズオン教材の質を最大化するための判断である。
🔗 隣接手法への橋渡し
表 (テーブル) は「行 (レコード) × 列 (フィールド)」の 2 次元構造でデータを整理する基本概念。 SSDSE-B-2026 は 47 行 × 110 列の典型的テーブルで、 各行=都道府県 (主キー: 地域コード)、 各列=指標 (人口 A1101、 高齢人口 A1303、 合計特殊出生率 A4103 など)。 「1 つの値 = 1 つのセル」を厳守する第 1 正規形 (1NF) は分析の基本前提。
- 上流: データモデリング、 主キー設計、 正規化 (1NF/2NF/3NF)、 スキーマ定義。
- 並列: テーブルデータ全般、 CSV / Parquet (物理形式)、 DataFrame (pandas / Polars)、 RDB の関係。
- 下流: SQL クエリ、 テーブル結合、 集計、 ピボット、 BI ダッシュボード。
表は「人間が読みやすい (wide format) ⇄ 機械が処理しやすい (long format / tidy)」の 2 形式があり、 用途で pd.melt / pd.pivot で変換する。 SSDSE-B は wide 形式、 BI ダッシュボードへの投入時には long に変換することが多い。
🌳 手法選択フロー
SSDSE のようなテーブルを扱う際の形式・操作の選択フロー。
- ① 表の形式は wide か long か? SSDSE-B-2026 は wide (列が指標)。 集計や可視化は wide のまま、 BI / 時系列分析は long が便利。
pd.melt(id_vars=['地域コード'])で long 化。 - ② 主キーは何か? 単一表なら 1 列で一意 (地域コード)、 パネルデータなら複合キー (地域コード × 年)。
df.duplicated(subset=key).any()で確認。 - ③ 第 1 正規形を満たすか? 1 セル = 1 値 (「東京, 大阪」のような複数値 NG)。 違反していればまず分割 → 1NF 化してから分析。 SSDSE は最初から 1NF。
表の設計品質が分析品質を決定する。 SSDSE-B-2026 は理想的な 1NF テーブルなので、 そのまま pandas / SQL 解析にかけられる学習用素材として優秀。