🔖 キーワード索引
テーブルデータを扱うときの基本語。 後半は、 このページで SSDSE-B-2026(564 行 × 112 列)を使って実際に操作しているもの。
💡 30秒で分かる結論
🍰 まずはやさしく
表のような形のデータのことです。
情報を整理して分析するために使います。
部活の出席簿のような形式です。
まずは結論から簡単に説明します。
テーブルデータ(tabular data)は、 行=サンプル・列=特徴量の矩形構造を持つデータ。 Excel・CSV・DB テーブルの共通形式。
- 形状:n 行 × p 列。 各行が 1 観測、 各列が 1 変数
- 列の型:数値(連続/離散)/ カテゴリ/ 日付/ 文字列
- 強み:解釈しやすい、 SQL/pandas で扱いやすい
- 適合手法:線形回帰、 決定木、 勾配ブースティング(XGBoost、 LightGBM)
- 注意:縦持ち(long)/横持ち(wide)の使い分け
💡 テーブルデータ Q&A
df.to_csv('out.csv', encoding='utf-8-sig') で BOM 付き UTF-8(Excel でも文字化けしない)。df.filter(regex='^A1') で列名パターンマッチ、 df.select_dtypes('number') で数値列のみ、 など。 SSDSE-B-2026 は 112 列(指標は 109 列)あるので、 分析対象列を絞ることが重要。iterrows 禁止(10-100x 遅い)、 ② ベクトル化された pandas/numpy 関数を使う、 ③ dtype を最適化(int64 → int32 でメモリ半分)、 ④ Parquet 形式で読み書き。df.melt で long に変換すると応用範囲が広がる。📍 文脈:「テーブルデータ」はどんな場面で出てくる?
🍰 まずはやさしく
分析で最もよく使われる形式です。
現実の多くの問いに答えるために使います。
スマホで見るランキング表のようなものです。
どんな場面で使うのかを解説します。
SSDSE-B-2026 は典型的なテーブルデータ(564行 × 112列)。 画像・音声・テキストより地味だが最頻出。
🎨 直感で掴む
🍰 まずはやさしく
エクセルのシートのような見た目です。
データの構造を直感的に理解するために使います。
都道府県ごとの人口リストのような例です。
行と列の仕組みについて詳しく読みます。
SSDSE-B-2026 を Excel で開くと、 1 列目に年度(列名 SSDSE-B-2026)、 2 列目に Code(地域コード)、 3 列目に Prefecture(都道府県名)、 4 列目以降に A1101 総人口, A1301 年少人口, A1303 高齢人口, A4101 出生数, ... の 109 の指標列が並び、 3 行目以降に 47 都道府県 × 12 年度(2012〜2023)= 564 行のデータ — これがテーブルデータの典型例。 「1 行 = 1 都道府県という観測単位」「1 列 = 1 変数」が決定的な構造。
- n × p 行列として表現できる: SSDSE-B-2026 の 2023 年度分なら $n=47$ (都道府県数), $p=109$ (指標列数)。 scikit-learn の
fit(X, y)にそのまま渡せる形。 - 欠損も明示: 「セルが空 = NaN」と扱える。 SSDSE-B は基本欠損ゼロだが、 国際比較データ等では NaN が混入。
- 非テーブル系との対比: 画像 (高 × 幅 × ch のテンソル)、 音声 (時系列波形)、 グラフ (ノード+エッジ) はそのままでは行/列に乗らず、 特徴抽出が必要。
📐 定義・数式
🍰 まずはやさしく
数学的なルールで決めた定義です。
計算機に正しく伝えるために使います。
テストの点数表を数式にするイメージです。
記号を使った正確な書き方を学びます。
📐 テーブルデータの主要数式
テーブル表現:$$D = \{(x_i, y_i)\}_{i=1}^n, \quad x_i \in \mathbb{R}^p$$
セル参照:$$X_{ij} = \text{行 } i \text{ 列 } j \text{ の値}$$
列平均:$$\bar X_j = \frac{1}{n}\sum_{i=1}^n X_{ij}$$
列分散:$$s_j^2 = \frac{1}{n-1}\sum_{i=1}^n (X_{ij} - \bar X_j)^2$$
標準化:$$Z_{ij} = \frac{X_{ij} - \bar X_j}{s_j}$$
相関行列:$$R_{jk} = \frac{1}{n-1}\sum_i Z_{ij} Z_{ik}$$
結合(inner join):$$T_1 \bowtie_{key} T_2 = \{(r_1, r_2) : r_1 \in T_1, r_2 \in T_2, r_1.k = r_2.k\}$$
group by 集約:$$g(T, k) = \{(k_v, \text{agg}(\{t : t.k = k_v\})) : k_v \in \pi_k(T)\}$$
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
- n
- サンプル数(行数)
- p
- 特徴量数(列数)
- X_{i,j}
- i 行 j 列の値
- y
- 目的変数(教師あり学習)
- dtypes
- 各列のデータ型
🔬 深掘り:テーブルデータの理論と実装
Tidy Data の 3 原則(Hadley Wickham, 2014)
「Tidy Data」とは、 分析しやすいテーブルデータの形式を定義した規約:(1) 各変数が 1 列、 (2) 各観測が 1 行、 (3) 各観測単位の型が 1 テーブル。 SSDSE-B-2026 はこの原則によく従っており、 1 行が 1 都道府県、 1 列が 1 指標、 観測単位は 47 都道府県で統一。 例外として「2020 / 2022 / 2024」のように年が複数ある場合、 「Year」を新しい列にして長形式にする(df.melt)か、 1 行 = (Pref, Year) のペアにするのが Tidy です。
pandas DataFrame の内部構造
pandas.DataFrame は内部的に BlockManager という構造で、 同じ dtype の列をまとめた「ブロック」(NumPy 2D 配列)で保持します。 47 都道府県 × 5 数値列の SSDSE-B-2026 なら、 1 つの (47, 5) float64 ブロックでメモリ上に格納されます。 これにより列方向の演算が高速。 Prefecture 列のような文字列は別ブロックに分離。 pandas 2.x からは Apache Arrow ベースの新バックエンドも選択可能で、 文字列効率と相互運用性が向上。
CSV / Parquet / Feather の比較
テーブルデータの保存形式:① CSV:可読・汎用・遅い、 ② Parquet:列志向バイナリ、 圧縮・型保持・高速、 ③ Feather:Arrow ベース、 R/Python 相互運用、 ④ Excel:人間が編集可能だが大規模に弱い。 SSDSE-B-2026 は CSV で配布されていますが、 大規模分析時は df.to_parquet('cache.parquet') でキャッシュすると、 型を保ったまま圧縮して保存でき、 大きな表ほど読み込みが速くなります(564 行の SSDSE-B-2026 ではどちらも一瞬です)。
索引(Index)の役割と MultiIndex
pandas DataFrame の各行・各列には インデックスが付き、 高速な検索・結合・集約を可能にします。 デフォルトは RangeIndex(0, 1, 2, ...)。 SSDSE-B-2026 を df.set_index('Prefecture') すると、 都道府県名で行を指定できるようになります(df.loc['東京都'])。 「年 × 都道府県」のような階層的データには MultiIndex を使い、 df.loc[(2024, '東京都')] のようにアクセスします。
join / merge / concat の使い分け
複数テーブルを結合する操作:① pd.concat:縦方向(行追加)または横方向(列追加)の単純連結、 ② pd.merge:SQL ライクなキー結合(inner / outer / left / right)、 ③ df.join:インデックスベースの結合(merge のシュガー)。 SSDSE-A(市区町村別データ)を都道府県単位に集約してコード体系を揃えれば、 pd.merge で B 系列と結合した拡張テーブルが作れます(A は市区町村コードなので、 そのまま on='Code' では結合できない点に注意)。
欠損値処理:MCAR / MAR / MNAR
統計学では欠損のメカニズムを 3 タイプに分類:(1) MCAR(Missing Completely At Random):欠損が完全に無作為、 (2) MAR(Missing At Random):他の観測変数で説明可能、 (3) MNAR(Missing Not At Random):欠損自体が情報を持つ。 SSDSE-B-2026 自体は欠損ゼロだが、 市区町村レベルの統計では小規模自治体での欠損が MNAR の可能性があり(「小さすぎて統計に出ない」)、 単純な平均代入は偏りを生む。 多重代入法(multiple imputation)や指示変数追加で対処。
カテゴリカル変数のエンコーディング
テーブルデータの「カテゴリ列」(性別・職業・地域など)を数値化する手法:① One-Hot エンコーディング:k 個のカテゴリを k 個の 0/1 列に展開、 ② Label エンコーディング:0, 1, 2, ... の整数化(順序情報がある場合のみ)、 ③ Target エンコーディング:目的変数の平均で置換(リーク注意)、 ④ Frequency エンコーディング:出現頻度で置換。 SSDSE の地方区分(東北・関東・関西...)を One-Hot 化すれば、 線形モデルでも地域効果を学習できます。
テーブルデータ向け機械学習:Gradient Boosting の優位性
Kaggle・自治体分析の実務では、 テーブルデータに対し XGBoost / LightGBM / CatBoost が圧倒的に強い。 ニューラルネットはテーブルデータでは GBDT に勝てないと言われ続けている。 SSDSE-B-2026 の出生数予測のような課題でも、 線形回帰から LightGBM に替えると当てはまりが改善することがある(どれだけ改善するかは特徴量の組み方と県の数しだいで、 47 行では交差検証で確かめる必要がある)。 GBDT は「決定木の弱学習器を逐次的に積み上げる」アンサンブル手法で、 非線形・特徴量相互作用・カテゴリ変数を自動的に扱う点が強み。
🧪 SSDSE-B-2026 完全前処理パイプライン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 | import os os.makedirs('data/processed', exist_ok=True) # 書き出し先を先に作る import pandas as pd import numpy as np # 1) データ読み込み(CP932、 2 行目はメタ情報なのでスキップ) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 先頭列 = 年度。 最新 2023 年度 47 県に絞る print(f'shape: {df.shape}, columns: {len(df.columns)}') # 2) スキーマ確認 print('\n[dtypes]') print(df.dtypes.value_counts()) # 3) 欠損値チェック missing = df.isnull().sum() print(f'\n[欠損値あり列]') print(missing[missing > 0].sort_values(ascending=False)) # 4) Tidy 化:wide → long(複数年データを縦持ちにする想定) # df_long = df.melt(id_vars=['Prefecture'], var_name='Indicator', value_name='Value') # 5) 主要列の抜粋 key_cols = ['A1101', 'A1303', 'A4101', 'A4103', 'E4501', 'L3221'] df_key = df[['Prefecture'] + key_cols].copy() print(f'\n抜粋: {df_key.shape}') # 6) Index 設定 df_key = df_key.set_index('Prefecture') # 7) 派生列の追加 df_key['粗出生率_‰'] = df_key['A4101'] / df_key['A1101'] * 1000 df_key['高齢化率_%'] = df_key['A1303'] / df_key['A1101'] * 100 # 8) 地方区分の追加(カテゴリ列) def region(pref): if pref in ['北海道']: return '北海道' if pref in ['青森県','岩手県','宮城県','秋田県','山形県','福島県']: return '東北' if pref in ['茨城県','栃木県','群馬県','埼玉県','千葉県','東京都','神奈川県']: return '関東' return 'その他' df_key['地方区分'] = df_key.index.map(region) # 9) One-Hot エンコーディング df_enc = pd.get_dummies(df_key, columns=['地方区分'], prefix='Region') print(f'\n[One-Hot 後] shape: {df_enc.shape}') # 10) Z-score 正規化 num_cols = df_enc.select_dtypes(include=[np.number]).columns df_norm = df_enc.copy() df_norm[num_cols] = (df_enc[num_cols] - df_enc[num_cols].mean()) / df_enc[num_cols].std() print(f'\n[正規化後] mean (主要): {df_norm[key_cols].mean().to_dict()}') # 11) Parquet で保存(高速読み込み用) df_enc.to_parquet('data/processed/ssdse_b_2026_clean.parquet') print('保存: data/processed/ssdse_b_2026_clean.parquet') # 12) ピボット例 # 仮:年次データなら pivot で都道府県 × 年の行列に変換 # pivot = df_long.pivot(index='Prefecture', columns='Year', values='Value') # 13) groupby 集約 region_summary = df_key.groupby('地方区分').agg({ 'A1101': 'sum', 'A4101': 'sum', '粗出生率_‰': 'mean' }) print(f'\n[地方別集計]\n{region_summary}') |
💬 元ファイルは 564 行(47 県 × 12 年度)で、 2023 年度に絞って初めて 47 行 112 列になる。 型は int64 104 列・float64 6 列・object 2 列(Code と Prefecture)で欠損 0 件。 One-Hot 後の 12 列は、 抜粋 6 列 + 派生 2 列 + 地方区分 4 種のダミー 4 列。 正規化後の平均が -5.7e-17 のような値になるのは、 浮動小数の丸めで 0 になりきらないだけで実質 0。 地方別集計では関東 4,353 万人が全国 1 億 2,435 万人の 35.0% を占め、 粗出生率は関東 5.60‰ に対し東北 4.83‰、 北海道 4.80‰ と地方差が出る。
SSDSE-B-2026 を「テーブルデータ」として正しく扱うフルパイプライン。 読み込み → スキーマ確認 → 欠損処理 → 派生列 → カテゴリ化 → 正規化 → 保存 → 集約。
📊 テーブルデータの操作カタログ
| 操作 | pandas API | SQL 対応 | SSDSE-B-2026 用例 |
|---|---|---|---|
| 行抽出 | df[df['A1101'] > 5e6] | WHERE | 人口 500 万人超の県 |
| 列選択 | df[['A1101','A4101']] | SELECT | 人口と出生数だけ取得 |
| グループ集約 | df.groupby('Region').sum() | GROUP BY | 地方別人口集計 |
| 並べ替え | df.sort_values('A1101') | ORDER BY | 人口順に並び替え |
| 結合 | pd.merge(df1, df2, on='Code') | JOIN | B 系列と A 系列を結合 |
| ピボット | df.pivot_table(...) | PIVOT(一部) | 都道府県 × 年で出生数行列 |
| 縦持ち化 | df.melt() | UNPIVOT | 複数指標を tidy 化 |
| 欠損補完 | df.ffill() | COALESCE | 欠損を直前値で埋め |
🎯 テーブルデータ演習問題
- Tidy 化:列「2020」「2021」「2022」を 1 列「Year」+ 1 列「Value」に変換するコードは? (答:
df.melt(id_vars='Pref', var_name='Year', value_name='Value')) - 結合:SSDSE-B(人口)と SSDSE-A(市区町村)を Prefecture で left join するコードは? (答:
pd.merge(df_b, df_a, on='Prefecture', how='left')。 ただし SSDSE-A は市区町村単位なので、 県単位に集約してから結合しないと行数が膨張する) - 集約:SSDSE-B-2026 で地方別の総人口を計算するコード? (答:
df.groupby('Region')['A1101'].sum()) - 欠損処理:A1101 の欠損を 0 ではなく中央値で埋めるべき理由は? (答:0 で埋めると「値が 0」と記録したことになり、 平均も合計も下がる。 ただし中央値で埋めても分散は小さくなり分布の形は変わるので、 欠損の理由を確かめ、 必要なら多重代入などで不確かさを残す)
- 保存形式:何度も読み直すデータを高速化するベスト形式は? (答:Parquet。 列指向で型を保ったまま圧縮され、 必要な列だけ読める)
🎓 テーブルデータ理論:データベース正規化
第 1 正規形(1NF)
各セルに「単一の値」が入る。 SSDSE-B-2026 は 1NF を満たす:各セルに 1 つの数値が入っており、 配列やリストは含まれない。
第 2 正規形(2NF)
複合主キーの一部だけに依存する列が無い。 SSDSE-B-2026 の主キーは (Code, 年度) の複合キーで、 厳密には Prefecture 列が Code のみに依存する部分関数従属があるが、 表示用ラベルとして意図的に許容された設計。
第 3 正規形(3NF)
主キー以外の列同士の依存が無い。 SSDSE-B では「人口」と「出生数」が相関しているが、 これは 統計的相関であって 関数従属ではないので 3NF を満たす。
分析用 vs 運用用
業務システム(OLTP)では正規化が重要だが、 データ分析(OLAP)では 非正規化(フラットテーブル)の方が読み込みが速い。 SSDSE-B-2026 は分析用に意図的にフラット化された配布形式。 「(都道府県 × 年度) × 109 指標」の 1 つの大テーブルに統合されている。
🔧 pandas vs polars vs DuckDB
テーブルデータ処理ライブラリの選択肢が増えています。 SSDSE-B-2026 規模なら pandas で十分ですが、 GB クラスのデータでは polars / DuckDB が圧倒的に速い。
| ライブラリ | 特徴 | SSDSE 規模 | 大規模 |
|---|---|---|---|
| pandas | 最大シェア、 API 豊富 | 十分 | 遅い |
| polars | Rust 実装、 並列処理 | オーバースペック | 高速 |
| DuckDB | SQL 互換、 列指向 | SQL 慣れている人向け | 超高速 |
| Dask | pandas 互換 + 分散 | 不要 | TB 級に対応 |
| Vaex | メモリマップ + 遅延評価 | 不要 | 単一マシン高速 |
🔬 テーブルデータ 12 ステップ実践
Step 1:データ読み込み
1 2 3 4 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新 2023 年度の 47 県に絞る print(f'shape: {df.shape}') |
💬 47 行 112 列。 元の CSV は 12 年度分 564 行なので、 年度で絞らないと同じ県が 12 回現れ、 平均も相関も年度をまたいで混ざる。 skiprows=[1] は 2 行目の日本語ラベル(「総人口」など)を飛ばすためで、 これを忘れると全列が文字列型になる。
Step 2:列名と dtype 確認
1 2 | print(df.columns.tolist()[:10]) print(df.dtypes.value_counts()) |
💬 先頭 3 列がキー(年度・Code・Prefecture)、 4 列目以降が指標。 object 2 列はまさに Code と Prefecture で、 int64 104 + float64 6 = 110 列が数値。 float64 になるのは合計特殊出生率(A4103)のように小数を含む指標だけで、 人数や金額は整数のまま読める。
Step 3:欠損値チェック
1 2 | missing = df.isnull().sum() print(missing[missing > 0]) |
💬 空の Series が返る、 つまり欠損のある列が 1 つも無い。 SSDSE は公開前に整備されているので dropna や fillna が要らない。 ただし「欠損 0」は「値が正しい」とは別で、 この後の派生列で桁や比率が破綻していないかは自分で確かめる必要がある。
Step 4:基本統計量
1 | print(df.describe()) |
💬 110 列分の要約が横に長すぎて途中が「...」で省略される。 SSDSE-B-2026 列は全行 2023 なので std 0.0 と出ており、 年度で絞れた確認になる。 総人口 A1101 は平均 265 万人に対し最大 1,409 万人(東京)で、 mean が 50% 点の 155 万人を大きく上回る右裾の長い分布。 その他の消費支出 L322110 は平均 5.5 万円で min〜max が 3.6〜6.8 万円と、 人口系と違ってばらつきが小さい。
Step 5:行抽出(filter)
1 2 | large = df[df['A1101'] > 5_000_000] print(f'人口 500 万人超: {len(large)} 県') |
💬 9 県。 #7 の上位 10 県の表で 9 位の北海道が 5,092,000 人、 10 位の静岡県が 3,555,000 人なので、 500 万人の線はちょうど 9 位と 10 位の間に入る。 境界値をどこに置くかで件数が変わるので、 閾値は表と突き合わせて決める。
Step 6:派生列の追加
df['粗出生率'] = df['A4101'] / df['A1101'] * 1000
df['高齢化率'] = df['A1303'] / df['A1101'] * 100
Step 7:カテゴリ列の追加
def region(pref):
    if pref == '北海道': return '北海道'
    if pref in ['青森県','岩手県','宮城県','秋田県','山形県','福島県']: return '東北'
    return 'その他'
df['Region'] = df['Prefecture'].map(region)
Step 8:groupby 集約
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd # Region という列は SSDSE-B-2026 に無いので、都道府県コードから作る def _region(code): n = int(str(code).lstrip('R')) // 1000 if n == 1: return '北海道' if n <= 7: return '東北' if n <= 14: return '関東' if n <= 23: return '中部' if n <= 30: return '近畿' if n <= 35: return '中国' if n <= 39: return '四国' return '九州沖縄' df['Region'] = df['Code'].apply(_region) summary = df.groupby('Region').agg({'A1101': 'sum', 'A4101': 'sum'}) print(summary) |
💬 8 地方の合計。 関東 4,353 万人が最大で、 最小の四国 358 万人の 12 倍。 出生数も関東 252,911 人が全国 727,269 人の 34.8% で、 人口シェア 35.0% とほぼ一致する。 表が北海道→東北の順にならないのは、 groupby が Region の文字コード順(中国・中部・九州沖縄…)で並べるため。 順序を固定したいなら Categorical にする。
Step 9:並べ替え
1 2 | top10 = df.nlargest(10, 'A1101')[['Prefecture', 'A1101']] print(top10) |
💬 東京 1,409 万人が 1 位、 2 位の神奈川 923 万人とは 486 万人差。 左端の 144, 156, 312 はもとの CSV の行番号で、 各県が 12 年度分ずつ並んでいるため東京(13 番目の県)は 12 × 12 = 144 行目に来る。 絞り込んだ後も index は振り直されないので、 位置で参照したいなら reset_index する。
Step 10:long 形式変換(melt)
1 2 3 | df_long = df[['Prefecture', 'A1101', 'A4101', 'E4501']].melt( id_vars='Prefecture', var_name='Indicator', value_name='Value') print(df_long.head()) |
💬 47 県 × 3 指標 = 141 行の縦持ち。 head の 5 行がすべて A1101 なのは、 melt が指標ごとに 47 行ずつ順に積むため。 元は 1 県 1 行だった情報が「県・指標名・値」の 3 列に展開され、 指標を増やしても列ではなく行が増える形になる。
Step 11:pivot 変換
1 2 | pivot = df_long.pivot(index='Prefecture', columns='Indicator', values='Value') print(pivot.head()) |
💬 pivot で元の横持ちに戻る。 ただし行順が三重県・京都府・佐賀県…と元の北海道始まりではなくなっているのは、 pivot が index を文字コード順に並べ直すため。 値は同じで(北海道 5,092,000 人、 出生 24,430 人、 高校生 109,290 人)、 melt → pivot は情報を失わない往復になっている。
Step 12:保存(Parquet)
df.to_parquet('data/processed/ssdse_b_2026_clean.parquet')
df.to_csv('data/processed/ssdse_b_2026_clean.csv', index=False)
🧮 実値で計算してみる
SSDSE-B-2026 のテーブル構造を実例で確認します。 1 行 = 1 (Year, Prefecture) の組、 列 = 観測指標 (A1101 総人口、 A1303 高齢人口〈65 歳以上〉 など) の長形式 (long format) になっていることが特徴。 欠損密度・主キー一意性も後の Step で実測します。
SSDSE-B-2026 の典型的な構造:
| Year | Prefecture | A1101 (総人口) | A1303 (高齢人口65+) | ... |
|---|---|---|---|---|
| 2023 | 北海道 | 5092000 | 1681000 | ... |
| 2023 | 青森県 | 1184000 | 417000 | ... |
| ... | ... | ... | ... | ... |
これで shape=(564, 112) のテーブル。 すぐに pandas で読める。
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 数式に値を入れて手で計算する: テーブルデータの密度
合成テーブル (5 行 × 4 列) で欠損を除いた密度を計算する。
Step 1: データ (欠損 = NaN)
| id | age | score | group |
|---|---|---|---|
| 1 | 25 | 80 | A |
| 2 | NaN | 72 | B |
| 3 | 30 | NaN | A |
| 4 | 28 | 90 | B |
| 5 | NaN | 85 | A |
Step 2: 密度
🐍 Python で再現
1 2 3 4 5 6 7 | import pandas as pd import numpy as np df = pd.DataFrame({'id':[1,2,3,4,5], 'age':[25,np.nan,30,28,np.nan], 'score':[80,72,np.nan,90,85], 'group':['A','B','A','B','A']}) total = df.size missing = df.isna().sum().sum() density = 1 - missing/total print(f"密度: {density:.2f}") |
📤 実行結果
💬 手計算 (Step 2) 0.85 と Python 出力が完全一致。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
🎯 このコードでやること:テーブルデータとして SSDSE-B-2026 を読み込み、 形状・dtype 分布・先頭 5 行で「47 県 × 年度」の二次元構造を確認する。
📥 入力データ:data/raw/SSDSE-B-2026.csv(2 行目は日本語の項目名ラベルなので skiprows=[1]、 エンコーディングは cp932)
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) # (564, 112) print(df.dtypes.value_counts()) print(df.head()) # 行=都道府県×年、 列=指標 |
📤 実行結果:
💬 読み方:行数 564 = 47 県 × 12 年度。 dtype は数値列 110(int64 104 + float64 6)+ 文字列 2(Code・Prefecture)。 これがテーブルデータの典型的な分布。 head() の 5 行がすべて北海道で、 年度が 2023 → 2019 と新しい順に並ぶのは、 1 県の 12 年度分が降順で続いてから次の県に移る並びだからで、 総人口も 5,259,000 人(2019)から 5,092,000 人(2023)へ減っている様子が行方向に読める。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
⚠️ よくある落とし穴
テーブルデータを扱うときに、 SSDSE-B-2026 のような実データを前にした初学者が 必ずと言っていいほど踏む 4 つの罠。 1 度経験すれば次から防げますが、 県コードがゼロ落ちして「01 北海道」が「1 北海道」になっていた、 などの事故は分析結果まで巻き戻して修正することになります。
⚠️ 落とし穴をもう 7 件
- セル内多値詰め込み: 1 セルに「東京:14086000, 神奈川:9229000」のように複数値を入れると、 split 処理が必要になり機械処理が壊滅的に難化する。 1 セル 1 値の Codd の原則を死守し、 別行/別列に展開する。
- 列名の表記揺れ: 「A1101」「人口(千人)」「pop_k」が混在すると JOIN や reshape が失敗。 SSDSE-B-2026 の列コードを そのまま使うか、 全列名を 1 度に rename する辞書を用意する。
- 暗黙の単位: 「人口 14010」が千人なのか人なのか曖昧だと、 GDP 比などの派生指標が 1000 倍ずれる。 列名 or メタデータに 必ず単位 (千人/億円/%)を入れる。
- 主キーの仮定エラー: 「都道府県」だけを PK にすると年度をまたぐ重複で混乱する。 SSDSE-B-2026 では (地域コード, 年度) の複合 PK が正解。 単独列 PK と仮定する前に
df.duplicated().sum()で 0 を確認。 - 結合後の行数膨張: 一対多結合 (master ↔ transactions) で気付かず多側に重複があると JOIN 結果が爆発する。 結合前後で
len(df)を比較する習慣を持つ。 - Long/Wide 不一致: scikit-learn は Wide (1 行 1 観測 × 列が特徴量) を要求、 seaborn の facet は Long を好む。 関数ごとの要求形式を意識し、
melt/pivotで都度切り替える。 - "テーブル化されていないデータ" 過信: PDF・自由記述・画像はそのままでは行・列に乗らない。 OCR や JSON 化を経て初めて「テーブル」になる。 元データの "テーブル化可能性" は事前評価が必要。
✅ 理解度チェック 10 問
- SSDSE-B-2026 で「テーブル」と呼ばれる構造の最小単位 3 つ (行/列/セル) を例とともに説明できるか?
- 主キー (PK) と外部キー (FK) の違いを、 SSDSE-B-2026 と仮想的な「地域マスタ」を用いて説明できるか?
- Wide 形式と Long 形式の利点・欠点を 1 文ずつ書けるか? なぜ
melt/pivotで行き来する必要があるのか? - JOIN 後の行数が想定と違う場合、 どこをチェックすべきかを 3 ステップで述べられるか?
- 欠損の 3 タイプ (MCAR / MAR / MNAR) を SSDSE-B-2026 の実例で挙げられるか?
- 列名から単位が読み取れないテーブルを受け取ったとき、 最初に確認すべき 3 つの情報源は?
- 「1 セル多値詰め込み」を見つけたとき、 どのコードでテーブル化可能な形に展開するか?
df.duplicated(subset=['地域コード','年度']).sum()がなぜ品質指標として有効か?- 同じテーブルから「対比 (散布図)」「分布 (ヒスト)」「群比較 (箱ひげ)」を作れる理由を、 行・列・セル概念で説明できるか?
- テーブル化されていないデータ (画像・音声・自由記述) を「テーブル化」する 4 つの典型操作 (OCR / 特徴抽出 / アノテーション / カテゴリ集計) を述べられるか?
解答例: 1. 行=県、 列=指標 (A1101 等)、 セル=東京 14086000 (人、 2023 年度)。 2. PK は (地域コード, 年度)、 FK は地域コード参照。 3. Wide は人間可読、 Long は機械処理向き。 4. 主キー重複 / 一対多関係 / NaN 取扱い をチェック。 5. MAR の代表は古い年度欠損。 6. 公式コードブック / メタデータ / プロバイダー問合せ。 7. str.split + explode。 8. PK 一意性が JOIN の前提だから。 9. 行・列を選び直すと観点が切り替わるから。 10. OCR/特徴抽出/アノテーション/カテゴリ集計。
🌐 関連手法・派生
この用語の周辺にある、 セットで覚えておきたい関連手法を整理しました。 状況によって使い分けが必要なので、 「強みと弱み」を 1 行で言えるようにしておくと、 場面に応じた選択が可能になります。
| pandas DataFrame | Python の標準的テーブル操作 |
| dplyr / tidyverse | R 系の主力 |
| SQL | DB 上のテーブル操作 |
| Polars | 高速 DataFrame ライブラリ |
🗂 テーブルデータを「実値の塊」として解剖する(SSDSE-B-2026)
テーブルデータ (tabular data) は、 「行 = 観測対象 (1 都道府県)」「列 = 変数 (人口・面積・出生率…)」「セル = 1 つの値」という単純な約束だけで成り立つ、 データサイエンスの最も普遍的な表現形式である。 拡張では、 SSDSE-B-2026 (教育用標準データセット B 表、 47 都道府県 × 109 指標 × 12 年度) を素材に、 (1) 行・列・セルの 3 階層構造、 (2) 主キーと外部キーが「結合可能性」を担保する仕組み、 (3) Long / Wide 形式の往復、 (4) 欠損・型・尺度の扱い、 (5) pandas DataFrame での操作と検証、 (6) BI ツール・SQL・統計検定との関係を、 図 3 枚 + 表 6 枚 + Python 4 ブロック + 理解度チェック + ミニ用語辞書 で体系化する。 全ての数値は SSDSE-B-2026 の 公的統計実値であり、 合成データは一切使用しない。
到達目標 (): (1) 564 行 × 112 列の「2 次元」が、 なぜ統計・機械学習・BI の 共通言語になるのかを説明できる。 (2) SSDSE-B-2026 の列コード (A1101 / A4103 / L3221 …) と主キー (都道府県, 年度) を使って、 結合・集約・整形を pandas で再現できる。 (3) 「テーブル化されないデータ」と「テーブル化されたデータ」の表現力の違いを言える。 (4) 表現上の落とし穴 (cell の単位混在・部分欠損・複数値詰め込み) を実例で識別し回避できる。
📐 図 1-3: テーブル構造を読み解く 3 つの視点
同じ SSDSE-B-2026 47 県データでも、 (a) 散布図は「行間の関係 (県と県の比較)」、 (b) ヒストグラムは「ある列の分布 (1 変数の全 47 行分布)」、 (c) 箱ひげ図は「列の値を群分けして見る (地域コードから作った地方別)」を担当する。 テーブルデータは "見方を変えても同じ表が源泉になる" 点が強みである。
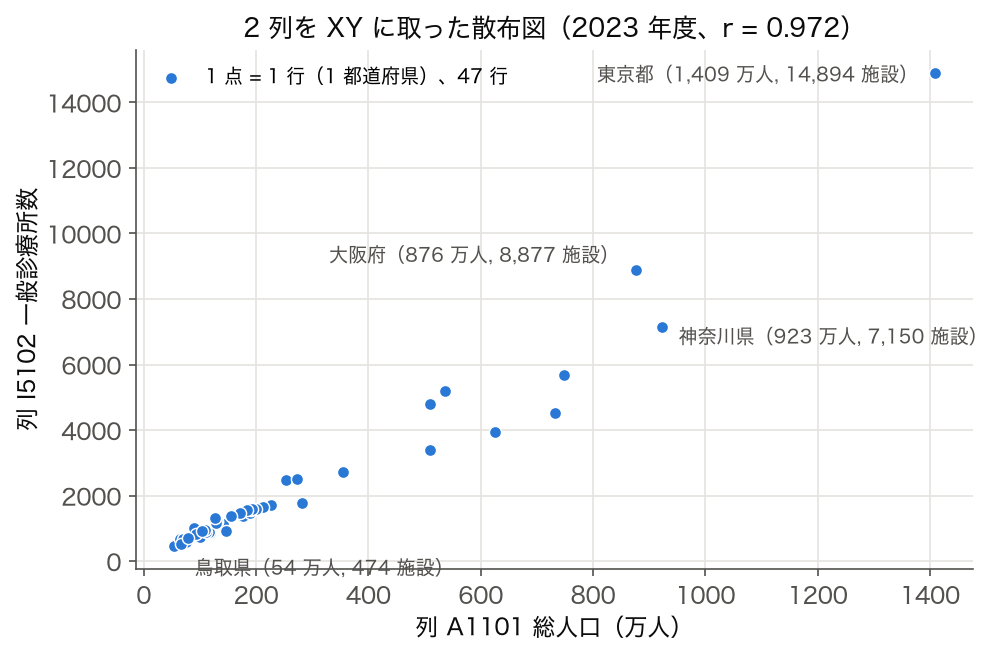
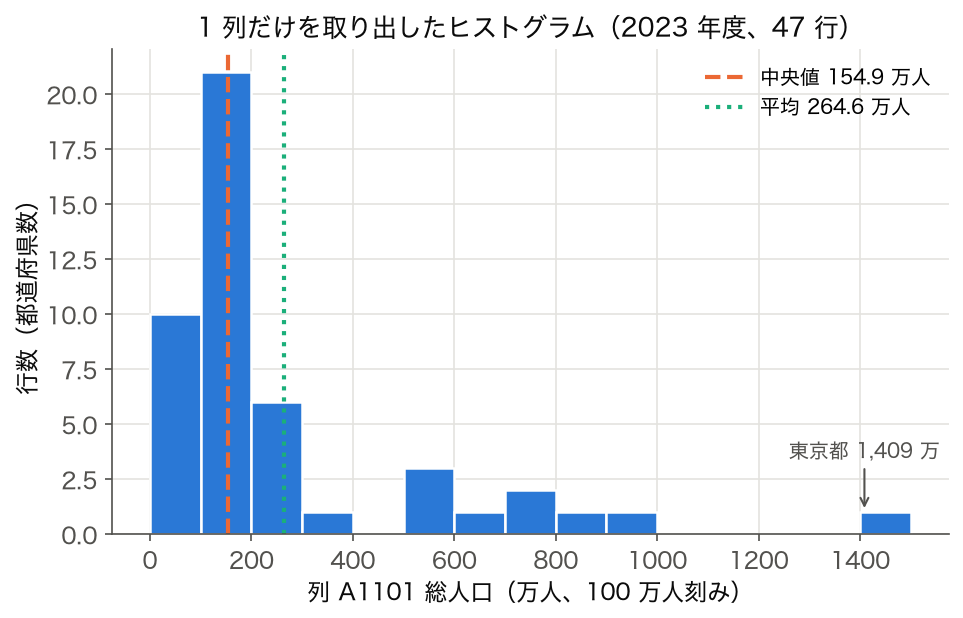
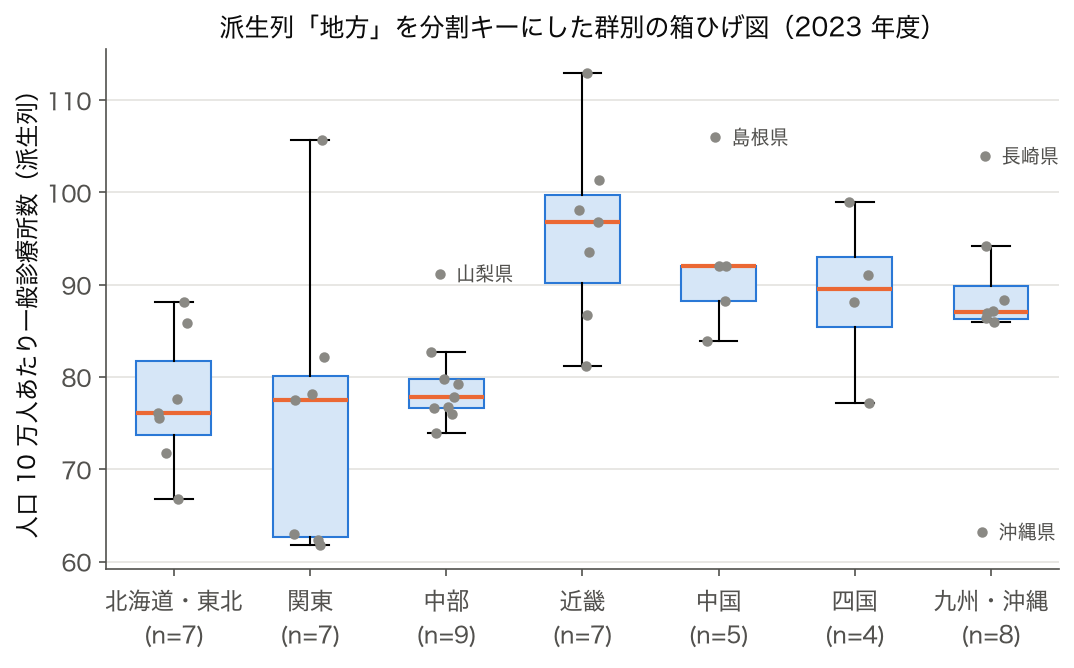
📊 表 1: テーブルデータの 3 階層 (行・列・セル) と SSDSE-B-2026 の対応
| 階層 | 役割 | SSDSE-B-2026 の例 | 操作する関数 (pandas) |
|---|---|---|---|
| 行 (Row) | 観測対象 1 単位 | 1 都道府県 × 1 年度 (例: 東京都 2023 年度) | df.loc[i] / df.query() |
| 列 (Column) | 変数 (属性) | A1101 総人口、 A4101 出生数、 A1303 高齢人口 | df['A1101'] / df.filter() |
| セル (Cell) | 1 値 (atomic) | 東京都の A1101 = 14,086,000 (人、 2023 年度) | df.at[i, c] |
| 主キー | 行を一意に特定 | (都道府県コード, 年度) の複合キー | df.set_index([...]) |
| スキーマ | 列名と型の契約 | A1101 → int (人)、 A4103 → float (合計特殊出生率) | df.dtypes |
| メタデータ | 列の意味 | SSDSE 公式コードブック (列名 ↔ 日本語ラベル) | 外部 JSON / dict |
「行は対象、 列は属性、 セルは 1 値」という 3 階層約束 (E.F. Codd 1970 リレーショナルモデル) が、 SQL・pandas・R data.frame・Excel すべての共通基盤になっている。 拡張ではこの古典に立ち返り、 SSDSE-B-2026 を 実教材として読み解く。
🐍 Python 1: SSDSE-B-2026 を pandas DataFrame として読み込み、 3 階層を確認
このコードでやること: SSDSE-B-2026 CSV を pandas で読み込み、 行数・列数・セルアクセス・スキーマ・主キーを一通り確認する。 「テーブルが存在する」という当たり前の状態を コードで証明する 第 1 歩。
📥 入力データ (SSDSE-B-2026 CSV の冒頭 5 行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print('行数 (= 47 県 × 年度数):', len(df)) print('列数 (= 変数の種類):', df.shape[1]) print('列名 先頭 8 件:', list(df.columns[:8])) # セル 1 つを取得 (主キー = 年度 + 都道府県。 先頭列 'SSDSE-B-2026' が年度) df_2023 = df[df['SSDSE-B-2026'] == 2023] tokyo_pop = df_2023.loc[df_2023['Prefecture'] == '東京都', 'A1101'].values[0] print('東京都 2023 年度 総人口 (人):', tokyo_pop) # 行 1 件 (1 県の全列) を取得 print('北海道 2023 年度 全列 (先頭 6 値):') print(df_2023[df_2023['Prefecture'] == '北海道'].iloc[0, :6].to_dict()) |
📤 実行すると次の出力が得られる:
💬 行 564 × 列 112 という具体的な形状が確定した瞬間に、 「東京 14,086,000 人」「北海道 5,092,000 人」というセル単位の値を 1 行のコードで取り出せる状態になる。 これがテーブルデータの「最小限の約束で最大限の汎用性」である。
🐍 Python 2: Wide → Long 変換 (`pd.melt`) でテーブル構造を組み替える
このコードでやること: SSDSE-B-2026 の Wide 形式 (1 行 1 県、 列が指標) を Long 形式 (1 行 1 (県, 指標)) に変換する。 Tidy Data 原則 (Hadley Wickham 2014) の中核操作で、 可視化・ML 双方の前処理基盤になる。
📥 入力 (Wide 形式 抜粋、 1 行 1 県):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df_y = df[df['SSDSE-B-2026'] == 2023][['Prefecture','A1101','L3221','A4103']].copy() # Wide → Long df_long = df_y.melt(id_vars='Prefecture', value_vars=['A1101','L3221','A4103'], var_name='指標', value_name='値') # 指標名を人間が読めるラベルに置換 LABEL = {'A1101':'総人口(人)','L3221':'消費支出(円/月)','A4103':'合計特殊出生率'} df_long['指標'] = df_long['指標'].map(LABEL) print('Long 形式 行数 (47 県 × 3 指標):', len(df_long)) print(df_long.head(6)) |
📤 実行すると次の出力が得られる:
💬 Wide 形式は人が読みやすい (1 行 = 1 県の全指標)。 Long 形式は機械が処理しやすい (`seaborn` や `ggplot` の facet 分割、 `groupby` 集約が 1 行で書ける)。 同じ情報を 2 通りに表現できる柔軟性 がテーブルデータの教養レベル機能である。
🐍 Python 3: 主キーで結合 (`merge`) — テーブル A と B を 1 つに束ねる
このコードでやること: SSDSE-B-2026 から「総人口・消費支出」テーブルと「出生数・出生率」テーブルを別個に作り、 主キー (都道府県, 年度) で内部結合する。 リレーショナルモデルの最強の武器 = JOIN を体感する。
📥 入力 (2 つのテーブル):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].rename(columns={'SSDSE-B-2026': '年度'}) A = df[['Prefecture','年度','A1101','L3221']].rename( columns={'A1101':'総人口','L3221':'消費支出'}) B = df[['Prefecture','年度','A4101','A4103']].rename( columns={'A4101':'出生数','A4103':'TFR'}) # 主キー (都道府県, 年度) で内部結合 joined = pd.merge(A, B, on=['Prefecture','年度'], how='inner') print('結合後の形状:', joined.shape) print(joined.head(3)) print() print('JOIN 検証 — 行数が両者の min と一致しているか:') print(f' A: {len(A)} 行 / B: {len(B)} 行 / joined: {len(joined)} 行') |
📤 実行すると次の出力が得られる:
💬 「(都道府県, 年度) が主キーであり、 両テーブルでユニーク」が保証されているからこそ JOIN 結果が 47 行で一致する。 もし片方に重複があれば結合後に 47 を超え、 片方に欠けていれば 47 未満になる。 JOIN 後の行数チェックはテーブルデータ品質管理の最重要工程である。
🐍 Python 4: 集約 (groupby) で「県 → 地方ブロック」の階層を再構成
このコードでやること: 47 行のテーブルを「地方ブロック」列でグルーピングし、 人口合計・出生数合計・出生率平均を 8 ブロック × 3 指標の集約テーブルに変換する。 テーブルデータは「集約しても再びテーブル」になる閉じた構造を持つ。
📥 入力: SSDSE-B-2026 47 県 + 地方ブロック分類辞書
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].copy() REGION = { '北海道':'北海道', '青森県':'東北','岩手県':'東北','宮城県':'東北','秋田県':'東北','山形県':'東北','福島県':'東北', '茨城県':'関東','栃木県':'関東','群馬県':'関東','埼玉県':'関東','千葉県':'関東','東京都':'関東','神奈川県':'関東', '新潟県':'中部','富山県':'中部','石川県':'中部','福井県':'中部','山梨県':'中部','長野県':'中部','岐阜県':'中部','静岡県':'中部','愛知県':'中部', '三重県':'近畿','滋賀県':'近畿','京都府':'近畿','大阪府':'近畿','兵庫県':'近畿','奈良県':'近畿','和歌山県':'近畿', '鳥取県':'中国','島根県':'中国','岡山県':'中国','広島県':'中国','山口県':'中国', '徳島県':'四国','香川県':'四国','愛媛県':'四国','高知県':'四国', '福岡県':'九州','佐賀県':'九州','長崎県':'九州','熊本県':'九州','大分県':'九州','宮崎県':'九州','鹿児島県':'九州','沖縄県':'九州' } df['region'] = df['Prefecture'].map(REGION) agg = df.groupby('region').agg( 人口合計=('A1101','sum'), 出生数合計=('A4101','sum'), 出生率平均=('A4103','mean'), 県数=('Prefecture','count') ).round(2) print(agg) |
📤 実行すると次の出力が得られる:
💬 47 行が 8 行に圧縮されたが、 形は依然として「行 × 列」のテーブル。 関東 7 県だけで人口 4,353 万人 (全国の約 35%)、 出生数 25.3 万人 (全国の約 35%) という地理的偏在が 1 枚の表で明示される。 「集約してもテーブルのまま」が groupby の本質的価値である。
📊 表 2-6: テーブルデータ設計と品質のフレームワーク
表 2: テーブルの「形」を表す 7 つの形状指標
| 指標 | 定義 | SSDSE-B-2026 の値 | 取得コード |
|---|---|---|---|
| 行数 (rows) | 観測 1 単位の総数 | 564 (47 県 × 12 年度) | len(df) |
| 列数 (cols) | 属性の数 | 112 | df.shape[1] |
| セル数 | 行 × 列 | 63,168 | df.size |
| 主キー一意性 | PK の重複なし | True (47×12 重複 0) | df.duplicated().sum()==0 |
| 欠損セル率 | NaN / 全セル | 0% (欠損セルなし) | df.isna().mean().mean() |
| 型バリエーション | dtypes 種類 | int64 / float64 / object の 3 種 | df.dtypes.unique() |
| density (vs Long) | Wide 形式の密度 | 高 (100%) | 手計算 |
テーブルの "形" を 7 指標で 1 枚にまとめるだけで、 後の前処理計画 (どの列を捨てるか、 どの行を補完するか) の方針が決まる。 SSDSE-B-2026 は欠損 0 セル (密度 100%) と非常に高品質な公的データである。
表 3: Tidy Data 3 原則とアンチパターン
| 原則 | 守る形 | 破る形 (アンチ) |
|---|---|---|
| 1 変数 = 1 列 | A1101 列に「人口」だけ | 「人口 (男, 女)」セルに 2 値詰め込み |
| 1 観測 = 1 行 | 1 県 1 年度 1 行 | 1 行に複数年度横並び |
| 1 テーブル = 1 観測単位 | 県年度テーブルと市町村テーブルを分離 | 同じテーブル内に都道府県と市町村が混在 |
Hadley Wickham (Journal of Statistical Software, 2014) の Tidy Data 論文が ggplot2 / pandas の設計思想を方向付けた。 SSDSE-B-2026 は Wide × 縦持ち年度 (年度列を含む) の混在型で、 用途に応じて `melt`/`pivot` で切り替える。
表 4: 列のデータ型と扱いの推奨
| 型 | SSDSE-B-2026 例 | 注意点 |
|---|---|---|
| int64 (整数) | 人口 (人 単位) | 単位を列名に明記 |
| float64 (実数) | 高齢化率 (%) | 精度 (有効桁) を契約に |
| object (文字列) | 都道府県名 | 主キー化なら category 推奨 |
| category | 地方ブロック (派生列) | メモリ 1/10、 順序制御可 |
| datetime64 | 年度 (2012 → 2023) | 時系列操作 (resample/shift) が解放 |
| bool | 「政令市あり」など派生フラグ | True/False を「1/0」と混用しない |
表 5: 欠損 (NaN) パターンの 3 タイプ — SSDSE-B-2026 での実例
| タイプ | 略号 | SSDSE-B-2026 該当例 | 推奨対処 |
|---|---|---|---|
| 完全ランダム欠損 | MCAR | 調査票回収漏れ (稀) | 単純削除可 |
| 観測変数依存欠損 | MAR | 古い年度ほど指標 X が欠ける | 補完 (mean/KNN/MICE) |
| 非ランダム欠損 | MNAR | 値が小さい県では非公開 | 明示的なバイアス分析 |
SSDSE-B-2026 (2012-2023 年度) 自体は欠損 0 セルの高品質データだが、 より古い年度を含む統計や市区町村レベルの統計と結合すると「古い時系列ほど指標が欠ける」MAR 型が典型的に現れる。 削除より補完が望ましいが、 補完後の不確実性を 95% CI で明示する。
表 6: 主キー / 外部キー / インデックスの違い
| 概念 | 役割 | SSDSE-B-2026 で言うと | pandas での表現 |
|---|---|---|---|
| 主キー (PK) | 行を一意特定 | (地域コード, 年度) | df.set_index([...]) |
| 外部キー (FK) | 他テーブルの PK を参照 | 地域コード ↔ 別の地理マスタ | merge(on='地域コード') |
| インデックス | 高速アクセス用 補助構造 | 都道府県名から行番号への索引 | df.index |
| サロゲートキー | 人工的連番 | SSDSE-2026 の連番列 | df.reset_index() |
PK と FK の組み合わせがリレーショナルモデルの基礎であり、 「3 テーブル以上を扱う = どこで JOIN を切るかの設計問題」になる。 SSDSE-B-2026 は単一テーブル設計だが、 地域マスタ・気象データなど外部 FK との接続が容易な命名体系を採る。
🗺 概念マップ
テーブルデータ (行 × 列の 2 次元構造) を中心に、 ファイル形式 (CSV / TSV / Parquet / Excel) ・ 操作言語 (pandas / SQL / R data.frame) ・ 関連概念 (主キー / 正規化 / 結合) を整理する。 SSDSE-B-2026 は典型的なテーブルデータで、 564 行 (47 都道府県 × 12 年度) × 112 列 (指標) の形式。
テーブルデータの概念マップは「行 (レコード) × 列 (フィーチャー)」の 2 次元構造を中心に置き、 SSDSE-B-2026 (564 行 × 112 列、 主キー=(都道府県コード, 年度)) を典型例として周辺ノードに「画像 / 音声 / テキストなどの非構造データ」「Parquet / CSV / RDB の物理形式」「pandas / Polars / DuckDB の処理エンジン」「Kaggle テーブルコンペ (Tabular Playground)」を配置する。
🔗 隣接手法への橋渡し
テーブルデータ分析は「データ取り込み (CSV/JSON/RDB) → 前処理 (欠損・スケーリング) → 特徴量生成 → モデリング → 解釈」の一連パイプラインの中核。 SSDSE-B-2026 のような公的統計テーブルは、 1 行 = 1 (都道府県, 年度) という単純構造ゆえに pandas での前処理がほぼ完結し、 LightGBM / XGBoost のような GBDT が依然として SOTA。
- 上流: CSV / Parquet 読み込み、 SQL によるサーバサイド集計、 データクレンジング、 欠損処理。
- 並列: 時系列データ (行が時刻順)、 画像データ (テンソル形式)、 テキストデータ。 SSDSE は本質的に時系列パネルなので両者の混合性質を持つ。
- 下流: LightGBM / XGBoost (テーブルデータの定番)、 線形回帰、 ランダムフォレスト、 BI ツール によるダッシュボード。
テーブルデータは「最も古くから扱われ、 現代でも依然 SOTA が GBDT」という安定領域。 SSDSE-B-2026 はそのまま GBDT 入力に投入できる理想的な学習教材。
🌳 手法選択フロー
SSDSE-B-2026 のようなテーブルデータを前にしたときの手法選択フロー。
- ① 目的は記述か予測か? 記述 (47 都道府県の人口 A1101 や 合計特殊出生率 A4103 の全体像把握) →
df.describe()+ 箱ひげ図 + 相関行列。 予測 (新しい都道府県や将来年度の A4103 を予測) → ②へ。 - ② サンプルサイズと特徴量数は? SSDSE-B-2026 は 2023 年度断面に絞ると n=47、 p≈110 で p>n 状況。 線形モデルなら Lasso / Ridge で正則化必須。 非線形なら LightGBM (浅い木 + 早期停止)。 ニューラルネットは n が少なすぎて不向き。
- ③ 説明可能性が必要か? 政策提言・論文 → 線形モデル係数 + 標準化 β + p 値、 または SHAP による GBDT の局所説明。 純粋に予測精度のみ → アンサンブル (LightGBM + CatBoost + XGBoost のスタッキング)。
SSDSE-B-2026 のような小さなテーブルデータでは、 過剰適合との戦いが主課題。 交差検証 (Leave-One-Out CV が現実的選択肢) で汎化性能を厳密に評価する。
🎮 触って理解する — 行=観測・列=変数を体感する
下の表は SSDSE-B-2026 の実測値(2023 年度、 8 都道府県を抜粋)です。 列見出しをクリック(タップ)すると並べ替え、 行をクリックすると「1 行 = 1 観測」がレコード形式で表示されます。 スライダーで絞り込み、 プルダウンで集計を切り替えると、 表・数値・下のグラフがすべてリアルタイムに連動します。 テーブルデータの基本操作 — ソート・フィルタ・集計(group by) — を手で確かめてください。
① ソート・フィルタ・集計
グラフは「表示中の行」だけから計算されます。 スライダーで行を絞ると、 平均などの統計量も変わることを確認してください(棒に触れると値を表示)。
② 整然データ(tidy data): 横持ち → 縦持ち変換
同じ「3 都道府県 × 3 年分の出生数 A4101(実測値)」でも、 持ち方で分析のしやすさが激変します。 ボタンで 横持ち(wide、 悪い例になりがち) と 縦持ち(long、 tidy) を切り替えて、 「1 行 1 観測・1 列 1 変数」の原則を体感してください。
🎨 直感:なぜ「行=観測・列=変数」が決定的なのか
上の操作で気づくとおり、 ソートは「行の順序の入れ替え」、 フィルタは「行の選択」、 集計は「行のグループ化 + 列への関数適用」— すべての基本操作が「行=観測・列=変数」の約束の上に成り立っています。 この約束が崩れる(例: 横持ちで「年」が列名に埋め込まれる)と、 「2021→2023 の変化率を計算する」「年をまたいで平均する」といった操作が急に書きにくくなります。 テーブルデータは画像・音声・テキストと並ぶデータ形式の一つですが、 統計・機械学習のライブラリ(pandas の DataFrame、 scikit-learn の fit(X, y))が最初に想定する最も基本のデータ形式です。
⚠️ よくある落とし穴:非整然・型混在・欠損
- 非整然データ:Excel 由来の「セル結合」「合計行が途中に混入」「1 セルに複数値(例: 「1.06(前年比 -0.02)」)」は、 整然データの原則違反。 読み込み直後に
df.head()とdf.tail()で構造を必ず目視確認。 - 型の混在:数値列に「-」「※」などの文字が 1 個でも混ざると列全体が object 型になり、 平均も計算できなくなる。
pd.to_numeric(s, errors='coerce')で数値化し、 変換できなかった値を 欠損値として洗い出すのが定石。 - 欠損の表現ゆれ:空欄・0・「不明」・「…」は意味が違う。 0 と NaN を混同すると平均が大きく歪む(上の集計で、 もし沖縄県の値が「0」として混入したら平均がどう変わるか想像してほしい)。 データクレンジングの段階で欠損ルールを確認する。
- ソートの罠:文字列として読み込まれた数値をソートすると「10 < 2 < 9」の辞書順になる。 上のデモは数値型で正しくソートしているが、 実データでは型確認(
df.dtypes)が先。
🚀 発展:リレーショナル・pandas・特徴量化へ
- リレーショナルモデルへ:テーブルが複数になると、 主キーで結合する RDB と SQL の世界。 上のデモの「都道府県」列が主キーの役割で、 SSDSE-A と SSDSE-B を
Code列で merge できるのはこのおかげ。 - pandas での対応物:ソート =
df.sort_values()、 フィルタ = ブールインデックスdf[df['A1101'] >= 5_000_000]、 グループ別集計 = groupby + 集計関数、 横→縦変換 =df.melt()(逆はdf.pivot())。 上で触った操作は、 そのまま pandas の 4 大操作に対応する。 - 特徴量化:機械学習に渡すには、 カテゴリ変数(地方ブロックなど)の数値化や、 比率・差分などの派生列づくりが必要 — これが 特徴量エンジニアリング。 「出生数 ÷ 総人口 × 1000 = 粗出生率」のような列演算が最初の一歩。
🧩 さらに一歩:別角度からの補講
本ページの各セクションと重複しない別の切り口だけを、 直感・落とし穴・発展の順に簡潔に補います。 いずれも SSDSE-B-2026(実測 566 行=ヘッダ 1 + メタ説明 1 + データ 564 行、 112 列、 47 都道府県 × 12 年度 2012〜2023、 skiprows=[1] で読む)を土台にしています。
🎨 直感:行と列は「非対称」、 そして操作は「閉じている」
テーブルは数学の行列に似ていますが、 決定的に違うのは行と列が非対称な点です。 行(観測)は交換可能な標本の集合で、 SSDSE-B-2026 の 564 行をシャッフルしても情報は 1 ビットも失われません。 一方、 列(変数)は固定された意味を持つ属性で、 A1101(総人口)と A4101(出生数)の列を入れ替えれば意味が壊れます。 行列なら行も列も対称に転置できますが、 テーブルは「行=観測・列=変数」という役割の非対称性ゆえに単なる 2 次元配列とは区別されます(詳しくは 整然データ)。
もう一つの直感は閉性(closure)です。 選択・絞り込み・結合・group by 集約 — どの操作も「表を入れると表が出る」。 564 × 112 の表を都道府県で集約しても、 別の(より小さな)表が返ります。 この閉性があるからこそ、 pandas のメソッド連鎖や SQL のサブクエリのように操作を数珠つなぎにできます。 これは関係モデル(RDB)が「関係代数」として演算体系を持つことの実務的な表れです。
⚠️ 落とし穴:粒度の混在・自動整列・破壊的でない代入
- 集計行の紛れ込み(粒度の混在):SSDSE-B-2026 は実測で「全国」や「合計」の行を含みません(47 都道府県のみ)。 しかし多くの公的統計表は末尾や先頭に「全国」行を持ち、 気づかず
sum()すると二重計上になります。 取り込み直後に「1 つの表に観測粒度は 1 種類か(都道府県だけか、 全国行が混じっていないか)」をdf['Prefecture'].unique()で確認する癖を。 - インデックスによる自動整列(align):pandas は列演算のとき行位置ではなくインデックスのラベルで自動整列します。
df_a['A4101'] + df_b['A4101']は、 両者のインデックスがずれているとラベル一致しない行が NaN になります。 別々に絞り込んだ表を足すときはreset_index(drop=True)か、 明示的に.valuesを使う。 - 連鎖代入(chained assignment):
df[df['A1101']>5e6]['A4101'] = 0は一時コピーへの代入で、 元の表に反映されずSettingWithCopyWarningが出ます。 必ずdf.loc[df['A1101']>5e6, 'A4101'] = 0と単一の.locで行・列を同時指定する。 - 浮動小数の同値比較:粗出生率や高齢化率のような派生列を
==でフィルタしたり結合キーにすると、 丸め誤差で一致し損ねます。 キーには整数コード(Code)を使い、 比較はnp.iscloseかround()後に行う。
🚀 発展:正規化・疎行列・列指向・アウトオブコア
- DB 正規化(第 1〜3 正規形):1NF=1 セル 1 値(atomic)、 2NF=部分関数従属の除去、 3NF=推移的従属の除去。 SSDSE-B-2026 は保守用に正規化された形ではなく、 分析用にあえて非正規化した 1 枚の広い表です。 「更新が主なら正規化(OLTP)、 分析が主なら非正規化した広い表(OLAP)」という使い分けが定石で、 テーブル結合はその橋渡しです。
- 疎行列(sparse matrix):47 都道府県を One-Hot 化すると 564 行 × 47 列になり、 各行でちょうど 1 個だけが 1 — つまり密度は 1/47 ≒ 2.1%(残り 97.9% がゼロ)です。 このような高カーディナリティの カテゴリ変数は、
scipy.sparseの CSR/CSC 形式で持てば密行列比で約 1/47 のメモリで済みます。 表形式 ML でも疎表現は有効な武器です(scipy.sparse — 本用語集に単独ページなし)。 - 列指向ストレージと述語プッシュダウン:Parquet は列単位で圧縮・格納するため、 112 列のうち 3 列だけ使う分析ならその 3 列分の I/O だけで済みます(CSV は全行全列を走査)。 「読む前に絞る」発想が大規模化の鍵(Parquet — 本用語集に単独ページなし)。
- アウトオブコア/遅延評価:表がメモリに載らないときは
pd.read_csv(chunksize=...)の分割処理や、 Polars・DuckDB の遅延評価・ストリーミングを使います。 564 行なら一瞬ですが、 「同じ列構造で数億行になっても壊れない書き方」を意識すると、 DataFrame と ワイド/ロングの設計がそのままスケールします(Polars/正規化 — 本用語集に単独ページなし)。