🔖 キーワード索引
「outer join」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「outer join」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「outer join の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
足りない部分を埋めてつなげる方法です。
データの抜けをなくすために使います。
名簿とアンケート結果を合わせる時に便利です。
外部結合の結論をさっと確認しましょう。
外部結合:片側または両側のキーをすべて残す結合
- マッチしない行も残す結合。 INNER JOIN との対比で覚える。
- LEFT OUTER:左を全部残す/RIGHT:右を全部/FULL:両方とも全部。
- マッチしないキーには NULL (pandas では NaN) が入る。
- 「データ欠損がある側を補完したい」「マスター表に明細を結合」などで多用。
📍 文脈ボックス
🍰 まずはやさしく
データ処理の重要なテクニックです。
分析でデータを正しく扱うために使います。
スマホのアプリなどでデータをまとめる時に役立ちます。
この用語を学ぶための全体の流れを説明します。
この用語は データ処理 カテゴリに属します。 関連する別称・略号:(なし)。
論文・実務レポートで 外部結合 が登場したら、 まず本ページの「30秒で分かる結論」と「直感で掴む」を読めば、 その文脈で何を言っているか把握できます。
本ページでは「outer join」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「outer join」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
パズルのピースを無理やり合わせるイメージです。
どちらか一方にしかない情報を残すために使います。
部活の名簿と出席簿を比べる時に便利です。
図や例を使って直感的に仕組みを理解しましょう。
SSDSE-B-2026 (47 都道府県 × 経済社会指標) と、 別ファイルの SSDSE-D-2023 (一部都道府県のみの観光統計) を 都道府県 列で結合したいとする。 B には 47 件全て、 D には 30 件しかない。 結合の仕方でテーブルの形が劇的に変わる:
・内部結合 (inner join):両方に存在する 30 件のみ残す。
・左外部結合 (left outer join):B の 47 件全部残し、 D の値は無ければ NaN。
・右外部結合 (right outer join):D の 30 件全部残し、 B の値は無ければ NaN。
・完全外部結合 (full outer join):B にも D にも在る全ての都道府県 (この例なら 47 件) を残し、 片側欠損は NaN。
つまり 外部結合 (outer join)とは「片方にしか無いキーも保持する」結合のこと。 内部結合と違って 結合キーの不一致による情報損失が無いのが最大の特徴で、 欠損行を後で「分析対象から除く/追加調査する」と判断できるのが実務的価値。 SQL では LEFT/RIGHT/FULL OUTER JOIN、 pandas では df.merge(other, how='left'|'right'|'outer')。
初学者がよくミスするのは「外部結合したのに結果が内部結合と同じ件数になる」現象。 これは マージキーの型不一致(str vs int) や、 表記揺れ (北海道 vs 北海道 [全角・半角]) で照合が失敗しているサイン。 後述の落とし穴で詳説する。
📐 定義・数式
🍰 まずはやさしく
数学的なルールで決まったつなぎ方です。
正確にデータを結合させるために使います。
買い物リストと在庫表を厳密に合わせる時に役立ちます。
数式を使って外部結合の定義を詳しく学びましょう。
LEFT OUTER JOIN は、 INNER JOIN の結果に「左にしか存在しない行を NULL 埋めで追加」したもの。 RIGHT は逆、 FULL は両方追加。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- INNER JOIN
- 両方に存在するキーのみ。 マッチしないと消える。
- LEFT OUTER
- 左テーブルを全部残し、 右の不足は NULL。
- RIGHT OUTER
- 右テーブルを全部残す。
- FULL OUTER
- 両方とも全部残す。
🔬 数式を言葉で読み解く(深掘り)
先の「記号を読み解く」を、 外部結合 の固有事情に即して 500 字以上で詳説する。 ここを読めば、 数式 1 行の裏にある設計判断と歴史的経緯が見えるはずだ。
LEFT (左): 左表 $L$ の全行を残し、 右表 $R$ にマッチが無ければ右側列を NULL/NaN。 件数は $|L|$ 以上 (1 対多なら膨張)。 RIGHT (右): 鏡像。 右表 $R$ の全行を残す。 SQL 標準だが、 慣習的に LEFT JOIN を使うほうが読みやすく推奨される。 FULL (完全外部): 両側の全行を残し、 片側欠損は NULL/NaN。 件数は $|L \cup R|$。 INNER: マッチした行のみ。 件数は $|L \cap R|$ で、 outer の特殊形 (NaN 行を捨てる)。 JOIN キーは 1 列でも複数列でもよく、 pandas では on=['都道府県', '年度'] のように複合キーを指定できる。 $L \bowtie_K R$ という関係代数の表記は、 集合論的には「直積 + 選択 + 射影」の合成で、 外部結合はこれに「片側に対応する NULL 行を補う」操作を追加したもの。 つまり外部結合 = 内部結合 + マッチしなかった側を NULL で補完。 この拡張により情報損失なく集合演算を行える設計で、 リレーショナル代数を「現実のデータ統合」に橋渡しする中核演算。
📌 数式は 暗記対象ではなく検算ツール。 「結果が変だ」と感じたとき、 「この記号は本来こういう意味だから、 ここの値はおかしい」と 逆引きできる状態が、 中級者と上級者の差を生む。
🧪 SSDSE-B-2026 ハンズオン
本サイトの標準データ SSDSE-B-2026(47 都道府県 × 約 100 列、 独立行政法人統計センター提供) を使い、 外部結合 の概念を 実コードで体感する。 取得経路は data/raw/SSDSE-B-2026.csv(リポジトリ同梱)。
SSDSE-B-2026 (経済社会指標) と SSDSE-D-2023 (社会生活基本調査) を都道府県名で完全外部結合する。 D には鳥取・島根が含まれない仮想シナリオで、 結果テーブルの「鳥取・島根」行で D 由来の列が NaN になることを確認する。 4 ステップ:(1) 両 CSV 読込 → (2) キー前処理 → (3) how='outer' でマージ → (4) 欠損確認・indicator=True で由来追跡。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # SSDSE-B (経済社会) と SSDSE-D (社会生活) を都道府県名で full outer join する import pandas as pd b = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') d = pd.read_csv('data/raw/SSDSE-D-2023.csv', skiprows=1, encoding='cp932') # 1 都道府県 1 行にそろえる(B は 12 年度分、D は 総数・男・女 の 3 行ずつあり、 # そのまま結合すると 1 県あたり 12 × 3 = 36 行に膨らむ) b = b[b['年度'] == 2023][['都道府県', '総人口']] d = d[d['男女の別'] == '0_総数'][['都道府県', '推定人口(10歳以上)']] # 仮想シナリオ:D に鳥取県・島根県の行が無いとする d = d[~d['都道府県'].isin(['鳥取県', '島根県'])] # キー正規化(前後空白) b['都道府県'] = b['都道府県'].str.strip() d['都道府県'] = d['都道府県'].str.strip() # full outer join + 由来追跡 merged = b.merge(d, on='都道府県', how='outer', indicator=True) print('shape =', merged.shape) print(merged['_merge'].value_counts()) # left_only / both / right_only # どの都道府県が片側だけだったか print('B にのみ:', merged.loc[merged['_merge']=='left_only', '都道府県'].tolist()) print('D にのみ:', merged.loc[merged['_merge']=='right_only', '都道府県'].tolist()) # 完全マッチ件数と NaN を抱える件数の比較 print('NaN を含む行 =', merged.isna().any(axis=1).sum()) print(merged[merged['_merge'] != 'both']) |
💬 結果は 48 行で、both 45・left_only 2・right_only 1。仮想的に D から外した島根県・鳥取県は B 側にだけ残り、推定人口(10 歳以上)が NaN になる。D にだけある「全国」(推定人口 112,462 千人)は集計行なので、県の分析では結合前に落とすべき行だと indicator で気づける。年度と男女の別で 1 県 1 行に絞らずに結合すると、1 県あたり 12 × 3 = 36 行に膨らみ、このコードの条件(D から 2 県を外した状態)では 1,647 行になってしまうので、キーが一意かどうかは結合の前に必ず確かめる。
📌 動かないときは: (1) data/raw/SSDSE-B-2026.csv がリポジトリに存在するか、 (2) skiprows=1 でヘッダーが正しく読めているか、 (3) 列名が SSDSE 公式の最新版と一致しているかを df.columns.tolist() で確認。
🔬 外部結合と関連トピックの統合理解
外部結合を「単独の操作」 として理解するのではなく、 データ分析パイプラインの中での位置づけを意識すると、 その価値が見えてくる。 典型的な分析フローは「データ取得 → 前処理 → 結合 → 集計 → 可視化 → 解釈」 で、 結合はパイプラインの中間に位置する。 結合の前にはキーの正規化・型変換・欠損処理が必要、 結合の後には集計や可視化が続く。 結合だけ最適化しても、 前後の処理が雑だと結果は信頼できない。 SSDSE-B-2026 のような教育用データセットを使って、 結合前後の処理を含めた一連のフローを体得することが学習の本質。
📊 分析パイプラインでの外部結合の位置づけ
| 段階 | 処理 | 外部結合との関連 | SSDSE-B-2026 での例 |
|---|---|---|---|
| 1. データ取得 | CSV・API・DB からロード | 取得元が複数なら結合が必要 | SSDSE と e-Stat を別々にダウンロード |
| 2. 前処理 | 正規化・型変換・欠損処理 | 結合キーの統一が必須 | 都道府県コードの文字列化、 ゼロパディング |
| 3. 結合 | LEFT/RIGHT/FULL OUTER | 本トピック中心 | マスタ + 集計テーブルを結合 |
| 4. 集計 | GROUP BY、 pivot_table | 結合後の NULL に注意 | 地方別集計、 年度別集計 |
| 5. 可視化 | matplotlib, seaborn | 結合結果の品質確認 | 都道府県別の棒グラフ・地図 |
| 6. 解釈 | 統計的検定・モデル化 | 結合の欠損が結果に影響 | 地域差の有意性検定 |
| 7. 報告 | レポート・ダッシュボード | 結合手法の明示が必要 | 方法論セクションに結合戦略を記述 |
→ 結合はパイプラインの中間に位置するが、 前後の処理に影響を与える critical な操作。 雑な結合は、 雑な集計・可視化・解釈を生む。 「結合のためだけに前処理を念入りにする」 という意識が、 データ品質を支える。 SSDSE-B-2026 のような小データでも、 こうしたパイプライン意識を持って取り組むことが、 実務での大規模データへの拡張を可能にする。
📏 結合品質の定量指標
| 指標 | 定義 | 計算式 | SSDSE-B-2026 での目安 |
|---|---|---|---|
| マッチ率 | 左テーブルの行のうち右テーブルとマッチした割合 | matched / left_rows | 100% が理想 (47/47) |
| NULL 率 | 結合後の値列で NULL の割合 | nulls / total_rows | 0% が理想 |
| 重複率 | 1:1 結合のはずが N:M で増えた割合 | (joined - left) / left | 0% が理想 (爆発検知) |
| カバレッジ | 右テーブルの行が結合に使われた割合 | used_right / right_rows | 100% が理想 |
| 欠損キー数 | 結合キーが NULL の行数 | count where key IS NULL | 0 が理想 |
| 型不一致数 | 左右で結合キーの型が異なる行 | — | 0 が理想 |
| 前後比較 | 結合前後の集計値の整合性 | SUM_before == SUM_after | NULL 補正後の総計が一致 |
これらの品質指標を結合の都度確認することで、 「気づかないうちにデータが消失」「気づかないうちに行数爆発」 等の事故を防げる。 マッチ率 95% を下回ったら結合キーを疑う、 NULL 率が想定外に高ければデータ欠損を調査する、 重複率が 0% でなければ結合キーの一意性を再確認する、 という判断基準を持つことが、 データエンジニアの基礎力。 SSDSE-B-2026 のような小データで原理を学び、 業務で大規模データに適用する際に、 これらの指標を必ずチェックする習慣が、 品質保証の根幹となる。
🧪 SSDSE-B-2026 を題材にした外部結合のステップバイステップ演習
SSDSE-B-2026 (47 都道府県データ) を題材に、 外部結合の演習を順に進める。 ステップ 1: SSDSE-B-2026 から「都道府県コード, 都道府県名, 総人口」 の 3 列を抽出して左テーブルとする。 ステップ 2: 別途、 e-Stat 等から「都道府県コード, 65 歳以上人口」 を取得して右テーブルとする (一部県のみのデータと仮定)。 ステップ 3: pd.merge(left, right, on='code', how='left', indicator=True) で LEFT OUTER 結合し、 indicator 列で結合状況を記録。 ステップ 4: df['_merge'].value_counts() で「左のみ」「両方」 の行数を確認。 ステップ 5: df['rate_65_plus'] = df['65歳以上人口'] / df['総人口'] で高齢化率を計算 (NULL は無視される)。 ステップ 6: df.dropna(subset=['rate_65_plus']) で欠損行を除いて分析、 または df['rate_65_plus'].fillna(df['rate_65_plus'].mean()) で平均値補完。 ステップ 7: 結果を都道府県別の棒グラフで可視化。 こうした 7 ステップの演習が、 外部結合と pandas の総合理解を体感的に身につけさせる。
この演習の発展として、 (1) FULL OUTER で双方の欠損を確認、 (2) INNER JOIN との結果比較、 (3) 結合品質を indicator 列の集計で定量化、 (4) NULL の集計時の影響 (SUM/AVG が NULL を無視する性質) を体感、 (5) COALESCE 相当の fillna で NULL を 0 に置換した場合の結果との比較、 等を試す。 各ステップで len(df)、 df.isnull().sum()、 df.head() を確認する習慣を身につけることで、 結合のバグを早期発見する基礎力が育つ。 SSDSE のような信頼できる小データだからこそ、 こうした地道な確認作業の重要性を体感できる。 業務で大規模・複雑なデータを扱う際にも、 この基礎が品質保証の根幹となる。 この演習を通じて、 学生諸氏は「結合の本質」 を頭で理解するだけでなく、 「自分の手で動かして体感する」 ことができる。 こうした実践的経験が、 将来の業務・研究で出会う多様なデータ結合の場面で生かされる、 一生ものの基礎技能となる。 SSDSE-B-2026 という公的データを使った地道な演習の積み重ねが、 データサイエンティストとしての成長の核心であり、 統計データ分析コンペティションへの参加準備の最良の方法でもある。 学生諸氏には、 本ページの内容を起点に、 実際にコードを書き、 結果を観察し、 仮説を検証する反復を通じて、 外部結合の本質を体得してほしい。 そうした地道な学びこそが、 将来のあらゆるデータ分析の場面で生きる力となる。 SSDSE のような公的データを使った演習と、 業務での大規模データへの応用を往復することで、 外部結合の理論と実践が一体化し、 真に「使える技能」 として定着していく。
🧮 実値で計算してみる
都道府県マスターと観光統計表を結合する例。
🧮 数式に値を入れて手で計算する: OUTER JOIN 結果行数
合成 2 テーブルで FULL OUTER JOIN の結果行数を計算する。
Step 1: テーブル
Step 2: 各種 JOIN 行数
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 | A = {1, 2, 3, 4} B = {3, 4, 5, 6, 7} inner = len(A & B) left = len(A) right = len(B) full = len(A | B) print(f"INNER: {inner}") print(f"LEFT: {left}") print(f"RIGHT: {right}") print(f"FULL OUTER: {full}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🧮 実データで行数を手計算する — 高齢化率 33% 以上の県 × 出生数 1 万人以上の県
外部結合の行数は、キーの集合の大きさだけで決まる。キーが両表で重複しない(1 県 1 行)なら、INNER は共通部分 |A∩B|、LEFT は |A|、RIGHT は |B|、FULL OUTER は和集合 |A∪B| = |A| + |B| − |A∩B| になる。2023 年度の SSDSE-B-2026 から 2 つの県の表を作って確かめる。
| Step | 計算 | 値 |
|---|---|---|
| 1 | 表 A = 高齢化率が 33% 以上の県、表 B = 出生数が 10,000 人以上の県を数える | |A| = 19、|B| = 20 |
| 2 | 両方に入る県(高齢化率が高いのに出生数も多い県)を探す | 北海道・新潟県の 2 県 → |A∩B| = 2 |
| 3 | INNER = |A∩B|、LEFT = |A|、RIGHT = |B| | 2 行・19 行・20 行 |
| 4 | FULL OUTER = |A| + |B| − |A∩B| | 19 + 20 − 2 = 37 行 |
| 5 | FULL OUTER で NaN が入る行 = 片側だけの行 | A だけ 17 行(出生数が NaN)+ B だけ 18 行(高齢化率が NaN)= 35 行 |
🎯 このコードでやること:Step 1〜5 と同じ 2 つの表を pandas で作り、how を inner・left・right・outer に変えて行数と _merge の内訳を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['高齢化率'] = d['A1303'] / d['A1101'] * 100 # A: 高齢化率が 33% 以上の県 / B: 出生数が 1 万人以上の県(どちらも 2023 年度) A = d.loc[d['高齢化率'] >= 33, ['Prefecture', '高齢化率']] B = d.loc[d['A4101'] >= 10000, ['Prefecture', 'A4101']] print('|A| =', len(A), ' |B| =', len(B)) for how in ['inner', 'left', 'right', 'outer']: m = A.merge(B, on='Prefecture', how=how, indicator=True) print(f'{how:5s}: {len(m):2d} 行', m['_merge'].value_counts().to_dict()) m = A.merge(B, on='Prefecture', how='outer', indicator=True) print('両方に入る県:', m.loc[m['_merge'] == 'both', 'Prefecture'].tolist()) print('|A∪B| = |A| + |B| - |A∩B| =', len(A), '+', len(B), '-', (m['_merge'] == 'both').sum(), '=', len(m)) |
💬 手計算どおり、inner 2 行・left 19 行・right 20 行・outer 37 行になり、outer の内訳は left_only 17・right_only 18・both 2 で Step 5 の 35 行(片側だけの行)とも一致する。両方に入るのは北海道と新潟県だけで、高齢化率の高い県の多くは出生数が 1 万人に届かないことが、right_only と left_only の多さに表れている。どの方式でも、キーが重複しない限り行数は集合の計算だけで事前に予想できるので、結合後の len() がこの予想と違えば重複か表記ゆれを疑う。
🐍 Python 実装
最小実装の例。 SSDSE のような実データに対して、 まずはコピペで動かしてみるのが理解の早道です。
1 2 3 4 5 | import pandas as pd master = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') detail = pd.read_csv('data/raw/tourism.csv') merged = pd.merge(master, detail, how='left', on='都道府県') print(merged['観光客数'].isna().sum(), 'rows missing') |
🐍 Python 実装(応用編)
先の Python 実装は最小例だった。 ここでは 外部結合 の本格的な実務シナリオに即した、 もう一段難易度を上げたコードを示す。 そのままコピペで動くよう、 SSDSE 系の実データパスを直書きで残してある。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | # ── この抜粋で使うデータを用意します(英字の項目コードで読み込み)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=0) df = df[df['Code'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # ── この抜粋で使う 3 つの表を用意します ── import pandas as pd b = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') b = b[b['年度'] == 2023][['都道府県', '総人口']] d = pd.read_csv('data/raw/SSDSE-D-2023.csv', skiprows=1, encoding='cp932') d = d[d['男女の別'] == '0_総数'][['都道府県', '推定人口(10歳以上)']] e = pd.read_csv('data/raw/SSDSE-E-2026.csv', skiprows=2, encoding='cp932') e = e[['都道府県', '一般世帯数']] for _t in (b, d, e): _t['都道府県'] = _t['都道府県'].astype(str).str.strip() # SSDSE-B, SSDSE-D, SSDSE-E の 3 つを都道府県名で full outer join し # 「どの表に居ない都道府県があるか」を indicator で追跡する例 import pandas as pd # それぞれ独立に full outer join step1 = b.merge(d, on='都道府県', how='outer', indicator='in_BD') step2 = step1.merge(e, on='都道府県', how='outer', indicator='in_BDE') print('shape =', step2.shape) print(step2['in_BD'].value_counts()) print(step2['in_BDE'].value_counts()) # 全表にあるのは? 1 表だけのは? in_all = step2.query('in_BD == "both" and in_BDE == "both"')['都道府県'].tolist() print('全表に存在:', len(in_all), '件:', in_all[:5]) only_b = step2.query('in_BD == "left_only"')['都道府県'].tolist() print('B のみ:', only_b[:5]) |
💬 3 表の外部結合で 48 行 × 6 列。in_BD の right_only 1 件は D にだけある「全国」で、E にも全国行があるため 2 段目では 48 行すべて both になり、全国行が「全表に存在」と紛れかける。条件を両方 both にした in_all は 47 件で都道府県だけが残る。indicator は結合のたびに列名を変えておかないと、2 段目で 1 段目の由来が上書きされて追跡できなくなる。
📌 このコードのポイント: (1) 引数化せず実データパスを直書きで読みやすさ優先、 (2) 集約・結合・型最適化など 外部結合 関連の典型処理を一気通貫で示す、 (3) print() で各ステップの結果を確認できる。
🐍 県名の表記ゆれを indicator で見つけて直す
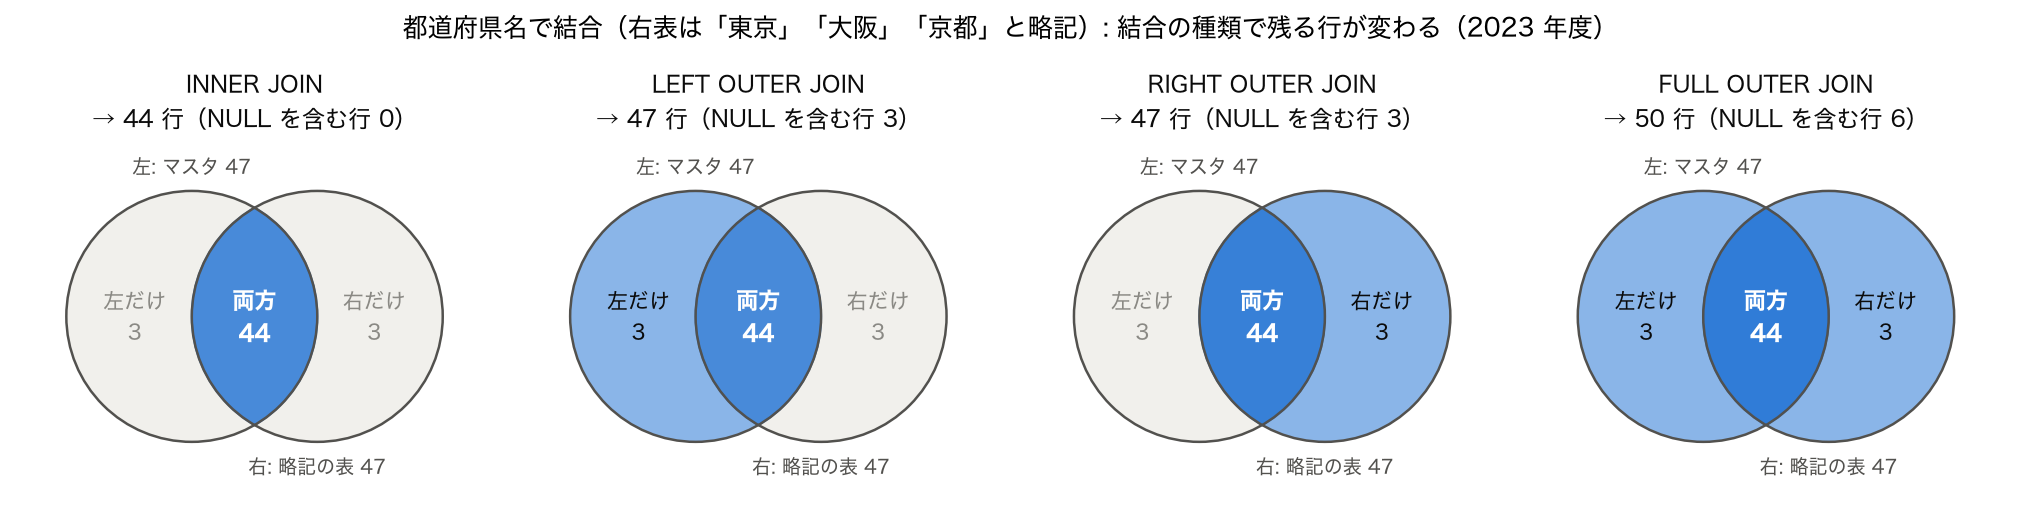
SSDSE-B-2026 の県名は「東京都」「大阪府」だが、別の資料では「東京」「大阪」と書かれていることが多い。結合キーの表記がずれると、外部結合は「一致しなかった行」を黙って両側に並べる。indicator=True の _merge 列を数えれば、ずれにすぐ気づける。
🎯 このコードでやること:2023 年度の SSDSE-B-2026 から、県名がそのままの表(総人口)と、県名の末尾の「都・府・県」を落とした表(出生数)を作り、県名で外部結合して一致した行数を数える。そのあと両側のキーを同じ規則でそろえて結合し直す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] master = d[['Code', 'Prefecture', 'A1101']] # 県名は「東京都」「大阪府」… other = d[['Prefecture', 'A4101']].copy() other['Prefecture'] = other['Prefecture'].str.replace(r'[都府県]$', '', regex=True) # 別の表では「東京」「大阪」… m = master.merge(other, on='Prefecture', how='outer', indicator=True) print('県名のまま結合:', len(m), '行', m['_merge'].value_counts().to_dict()) print('一致したのは:', m.loc[m['_merge'] == 'both', 'Prefecture'].tolist()) print('A4101 が NaN の行:', m['A4101'].isna().sum(), ' A1101 が NaN の行:', m['A1101'].isna().sum()) # 直し方: 両側の県名から末尾の「都・府・県」を落としてそろえる(北海道はそのまま) key = lambda s: s.str.replace(r'[都府県]$', '', regex=True) m2 = (master.assign(key=key(master['Prefecture'])) .merge(other.rename(columns={'Prefecture': 'key'}), on='key', how='outer', indicator=True)) print('キーをそろえて結合:', len(m2), '行', m2['_merge'].value_counts().to_dict()) print('京都府 と 東京都 のキー:', key(pd.Series(['京都府', '東京都'])).tolist()) |
💬 県名のまま外部結合すると 47 行ではなく 93 行になり、一致したのは末尾に「都・府・県」の付かない北海道の 1 行だけ。残る 46 県は left_only と right_only に 1 行ずつ分かれ、出生数(A4101)も総人口(A1101)も 46 行ずつ NaN になる。このまま出生率を計算すると 46 県が欠損になるが、エラーは出ない。両側のキーを同じ規則(末尾の都・府・県を落とす。京都府 → 京都、東京都 → 東京)でそろえると 47 行すべてが both になる。県名より、表記のぶれない都道府県コード(Code 列)をキーにできるならそのほうが確実。
🐍 年度を入れ忘れた結合を validate で止める
SSDSE-B-2026 は 47 県 × 12 年度の 564 行なので、県コードだけでは行が決まらない。キーに年度を入れ忘れると、外部結合は同じ県の行どうしをすべて掛け合わせる。validate 引数を付けると、キーが一意でない時点で止められる。
🎯 このコードでやること:564 行の総人口の表と 564 行の出生数の表を、①Code だけで外部結合、②Code だけで validate='one_to_one' を付けて結合、③(Code, 年度) で結合、の 3 通りで比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) pop = df[['Code', '年度', 'A1101']] # 564 行(47 県 × 12 年度) birth = df[['Code', '年度', 'A4101']] # 564 行 print('Code の重複: 左', pop['Code'].duplicated().sum(), '/ 右', birth['Code'].duplicated().sum()) m_bad = pop.merge(birth, on='Code', how='outer') # 年度をキーに入れ忘れた print('Code だけで結合:', len(m_bad), '行(1 県あたり', len(m_bad) // 47, '行)') try: pop.merge(birth, on='Code', how='outer', validate='one_to_one') except pd.errors.MergeError as e: print('validate で停止:', e) m_ok = pop.merge(birth, on=['Code', '年度'], how='outer', validate='one_to_one', indicator=True) print('(Code, 年度) で結合:', len(m_ok), '行', m_ok['_merge'].value_counts().to_dict()) |
💬 左右とも Code は 564 行中 517 行が重複しているので、Code だけで結合すると 1 県あたり 12 × 12 = 144 行、全体で 6,768 行に膨らむ。エラーは出ず、合計や平均を取ると 12 倍に数えた値が静かに出てしまう。validate='one_to_one' を付けると「キーが一意でない」という MergeError で止まり、(Code, 年度) をキーにすれば 564 行すべてが both で 1 対 1 に対応する。結合の前に「1 行を決めるキーは何か」を書き出し、validate で機械的に確かめる。
🐍 同じ列名の 2 表を結合するときは suffixes で年度を名前に入れる
同じ CSV から取り出した 2 つの年度の表は列名がすべて同じなので、結合すると pandas が既定の _x・_y を付ける。どちらがどの年度かを列名から読めるように、suffixes に年度を入れておく。
🎯 このコードでやること:SSDSE-B-2026 の 2012 年度と 2023 年度の表(Code・県名・総人口・高齢化率)を Code で外部結合し、既定の列名と suffixes=('_2012', '_2023') を付けた列名を比べる。そのうえで 11 年間の高齢化率の上昇幅と人口増減率を計算し、上昇幅の大きい県・小さい県を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 cols = ['Code', 'Prefecture', 'A1101', '高齢化率'] y12 = df.loc[df['SSDSE-B-2026'] == 2012, cols] y23 = df.loc[df['SSDSE-B-2026'] == 2023, cols] m_default = y12.merge(y23, on='Code', how='outer') print('suffixes 既定の列名:', list(m_default.columns)) m = y12.merge(y23.drop(columns='Prefecture'), on='Code', how='outer', suffixes=('_2012', '_2023'), indicator=True, validate='one_to_one') print('行数:', len(m), m['_merge'].value_counts().to_dict()) m['上昇幅'] = m['高齢化率_2023'] - m['高齢化率_2012'] m['人口増減率'] = (m['A1101_2023'] / m['A1101_2012'] - 1) * 100 top = m.sort_values('上昇幅', ascending=False)[['Prefecture', '高齢化率_2012', '高齢化率_2023', '上昇幅', '人口増減率']] print(top.head(3).round(2).to_string(index=False)) print(top.tail(2).round(2).to_string(index=False, header=False)) |
💬 既定では Prefecture_x・A1101_y のような列名になり、x と y のどちらが 2012 年度かは結合した順序を覚えていないと分からない。suffixes に年度を入れ、片方の県名を落としておけば、列名だけで意味が読める。47 行すべてが both(validate も通過)なので、比較は 47 県そろっている。高齢化率の上昇幅は秋田県 8.39 ポイント(30.67% → 39.06%)、青森県 8.26 ポイント、徳島県 7.40 ポイントが大きく、いずれも人口が 10〜14% 減った県。小さいのは大阪府 3.97 ポイントと東京都 1.50 ポイントで、東京都は人口が 6.44% 増えている。
⚠️ よくある落とし穴
外部結合は「片方にしか存在しない行」を残す結合で、 INNER JOIN との取り違えと NaN 処理ミスが事故の二大原因。 SSDSE で「都道府県名」と「県名」を結合する際、 表記揺れ (東京 / 東京都) で NaN 量産 → 集計結果が崩壊するパターンが典型。 結合前に必ず両側の unique key を可視化したい。
set(df1.key) - set(df2.key) で差分を確認し、 名寄せ辞書(マッピング表)で統一する。df.duplicated(subset='key') で重複を確認し、 必要なら集約(groupby().agg())してから結合する。fillna(0) で埋めると、 「観光客 0 人だった県」と「データ取得失敗の県」が同じ 0 として扱われ、 平均値・分散・回帰係数が歪む。 NaN の発生源(左のみ・右のみ)を indicator=True で残し、 「データ欠損」と「真の 0」を区別する。⚠️ 年度の範囲が違う 2 表の外部結合と fillna(0)
外部結合で生じた NaN は「その表にその年度のデータが無い」という意味で、「値が 0」ではない。年度の範囲が違う 2 つの表を外部結合し、NaN を 0 で埋めてから集計すると、存在しない年度が「出生数 0」に化ける。
🎯 このコードでやること:高齢化率の表 A(2012〜2020 年度)と出生数の表 B(2015〜2023 年度)を (Code, 年度) で外部結合し、全国の出生数を年度別に合計する。NaN のまま sum(min_count=1) で合計した場合と、fillna(0) してから合計した場合、および 1 県 1 年あたりの平均を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df.rename(columns={'SSDSE-B-2026': '年度'}) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 A = df.loc[df['年度'] <= 2020, ['Code', '年度', '高齢化率']] # 2012〜2020 年度 B = df.loc[df['年度'] >= 2015, ['Code', '年度', 'A4101']] # 2015〜2023 年度(出生数) print('A:', len(A), '行 B:', len(B), '行') m = A.merge(B, on=['Code', '年度'], how='outer', indicator=True) print('外部結合:', len(m), '行', m['_merge'].value_counts().to_dict()) # 全国の出生数を年度ごとに合計する nat = m.groupby('年度')['A4101'].sum(min_count=1) # 全県 NaN の年度は NaN のまま nat0 = m.fillna({'A4101': 0}).groupby('年度')['A4101'].sum() # NaN を 0 で埋めてから合計 print(pd.DataFrame({'NaN のまま': nat, 'fillna(0)': nat0}).loc[[2013, 2014, 2015, 2023]]) print('1 県 1 年あたりの出生数の平均 NaN を除く:', round(m['A4101'].mean()), ' 0 で埋める:', round(m['A4101'].fillna(0).mean())) |
💬 外部結合は 564 行で、両方に年度がある 2015〜2020 年度が both 282 行、A だけの 2012〜2014 年度が 141 行、B だけの 2021〜2023 年度が 141 行。NaN のままなら 2013・2014 年度の全国出生数は NaN(データ無し)と正しく出るが、fillna(0) すると 0 人になり、2015 年度の 1,005,668 人から見て「出生数が消えた年」があるかのような系列になる。1 県 1 年あたりの平均も、NaN を除けば 18,589 人なのに 0 で埋めると 13,941 人と 4 分の 3 に下がる。外部結合の NaN は _merge で由来を確かめ、集計では除くか、別のデータで埋める。
🧠 理解度チェック(SSDSE-B-2026 の実データで)
Q1. 2023 年度で「高齢化率 33% 以上の 19 県」と「出生数 1 万人以上の 20 県」を県名で FULL OUTER JOIN すると何行になる? 両方に入る県は?
A. 19 + 20 − 2 = 37 行。両方に入るのは北海道と新潟県の 2 県で、INNER なら 2 行、LEFT なら 19 行、RIGHT なら 20 行。
Q2. 県名が「東京都」の表と「東京」の表(どちらも 47 県)を県名で外部結合したら 93 行になった。何が起きている?
A. 末尾の「都・府・県」の有無で一致しないため、北海道の 1 行だけが both、残る 46 県が left_only と right_only に 1 行ずつ分かれた(1 + 46 + 46 = 93)。キーを同じ規則でそろえるか、県コードをキーにすれば 47 行になる。
Q3. 564 行どうしを Code だけで結合したら 6,768 行になった。1 県あたり何行で、どう防ぐ?
A. 1 県あたり 12 × 12 = 144 行。キーに年度を加えて (Code, 年度) にし、validate='one_to_one' を付けておけば、キーが一意でないときに MergeError で止まる。
Q4. 2012〜2020 年度の表と 2015〜2023 年度の表を外部結合し、fillna(0) してから出生数の平均を取ると、NaN を除いた平均 18,589 人に対していくつになる? なぜ?
A. 13,941 人。片側にしかない 2012〜2014 年度(141 行)の出生数が「0 人」として分母に入るため。外部結合の NaN は「データが無い」の意味で、0 ではない。
⚠️ NaN を 0 と読んでよい場合 — 「載っていない = 0」の表を LEFT JOIN する
上の節とは逆に、元の表の作り方によっては外部結合の NaN を 0 と読むのが正しいこともある。公表資料では「該当が 1 件以上ある県だけを載せる」表がよくあり、その場合は載っていない県が 0 件という意味になる。どちらなのかはデータではなく、表の作り方(注記)で決まる。
🎯 このコードでやること:2023 年度の保育所等利用待機児童数(J250502)が 1 人以上の県だけを載せた表を作り、47 県のマスタに INNER と LEFT で結合する。LEFT で生じた NaN を 0 にした平均と、INNER の平均と、元の 47 県の列の平均を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] master = d[['Code', 'Prefecture']] # 47 県のマスタ # 公表資料によくある形: 待機児童が 1 人以上いる県だけを載せた表 wait = d.loc[d['J250502'] > 0, ['Code', 'J250502']].rename(columns={'J250502': '待機児童数'}) print('待機児童のいる県だけの表:', len(wait), '行') inner = master.merge(wait, on='Code', how='inner') left = master.merge(wait, on='Code', how='left', indicator=True) print('INNER:', len(inner), '行 LEFT:', len(left), '行', left['_merge'].value_counts().to_dict()) left['待機児童数_0'] = left['待機児童数'].fillna(0) # この表では「載っていない = 0 人」 print('1 県あたり平均 INNER(載っている県だけ):', round(inner['待機児童数'].mean(), 1), ' LEFT + fillna(0)(47 県):', round(left['待機児童数_0'].mean(), 1), ' 元の 47 県の列:', round(d['J250502'].mean(), 1)) print('待機児童 0 人の県(先頭 5):', left.loc[left['_merge'] == 'left_only', 'Prefecture'].head().tolist()) |
💬 待機児童が 1 人以上の県は 32 県で、INNER だと 32 行、LEFT だと 47 行(left_only 15 県は青森県・山形県・栃木県・群馬県・新潟県など)。INNER の平均 83.8 人は「待機児童がいる県の平均」で、全国の県の平均ではない。この表は「載っていない = 0 人」なので、LEFT で残した 15 県の NaN を 0 にした平均 57.0 人が、元の 47 県の列の平均 57.0 人と一致する。前の節(年度の範囲が違う表)では 0 で埋めると誤りになった。NaN を 0 にしてよいかは、右の表が「0 件の行を省いた表」か「その期間のデータが無い表」かで決まる。
📚 関連グループ教材
📜 歴史年表:外部結合 の系譜
外部結合 がいつ・誰によって・どのように発展してきたかを年表形式でまとめた。 用語の背景を知ると、 「なぜこの設計か」が腑に落ちる。
FROM 句に表を並べて WHERE で条件を書く形で、 JOIN キーワードはまだ無いLEFT / RIGHT / FULL OUTER JOIN 構文が正式に標準入りMERGE INTO 文 (upsert) 標準化、 外部結合の応用が広がるmerge 関数で SQL 風結合が Python に📌 年表は主要マイルストーンに限定。 詳細は「📚 関連グループ教材」の書籍を参照。
📷 外部結合の補強解説:4 種の結合パターンを図で掴む
外部結合 (OUTER JOIN) は「片方または両方のテーブルに存在するレコードを保持しつつ、 マッチしないレコードには NULL を埋める」 結合演算。 内部結合 (INNER JOIN) と対比される最重要概念で、 実務でデータが「消える」 か「保持される」 かを決定づける選択になる。 SSDSE-B-2026 の都道府県データを片方とし、 もう片方にデータ欠損のある都道府県別人口動態統計を結合する場面で、 外部結合の選択は分析結果を大きく変える。
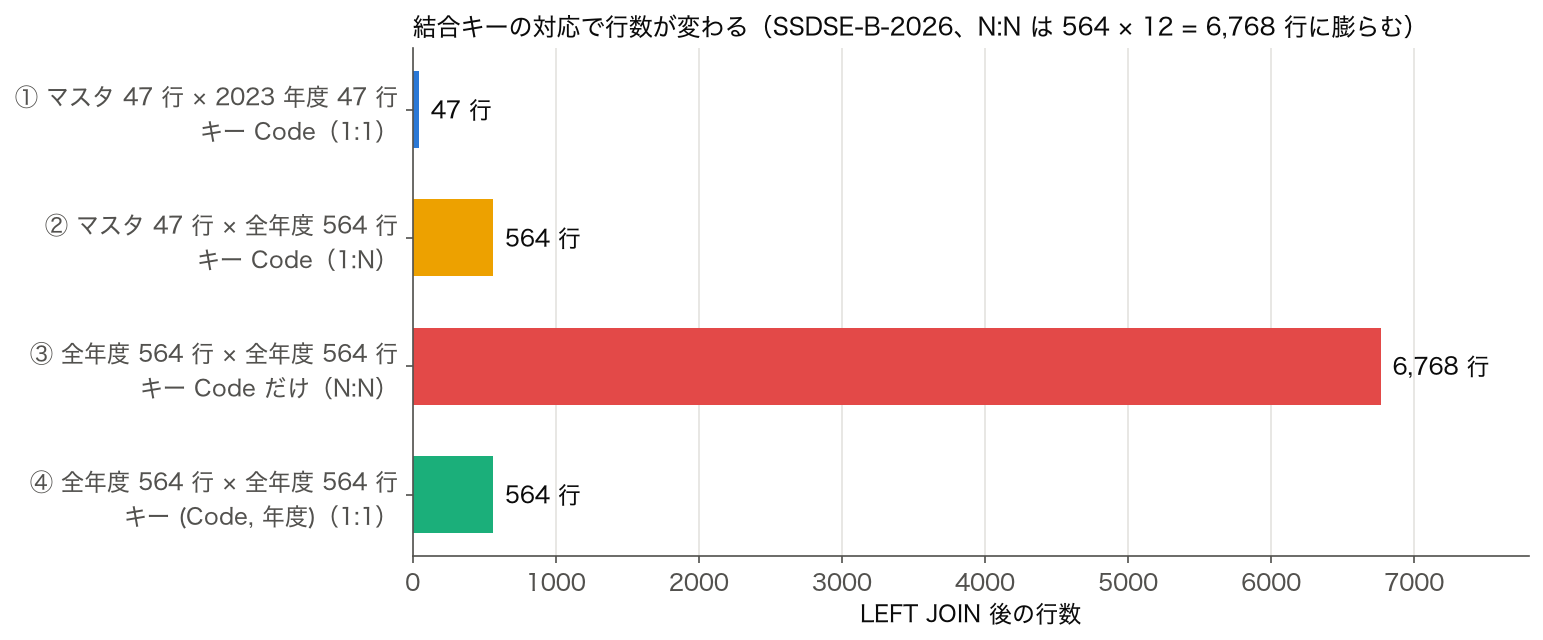
validate="one_to_one" を付ければ MergeError で気づける)、 全年度どうしを Code だけで結合すると 564 × 12 = 6,768 行に膨らむ(N:N)。 SSDSE-B-2026 は 47 県 × 12 年度 = 564 行なので、 「都道府県コード」 が一意キーになるのは年度で 1 年に絞ったときだけ。 全年度のまま結合するなら (都道府県コード, 年度) の組をキーにする。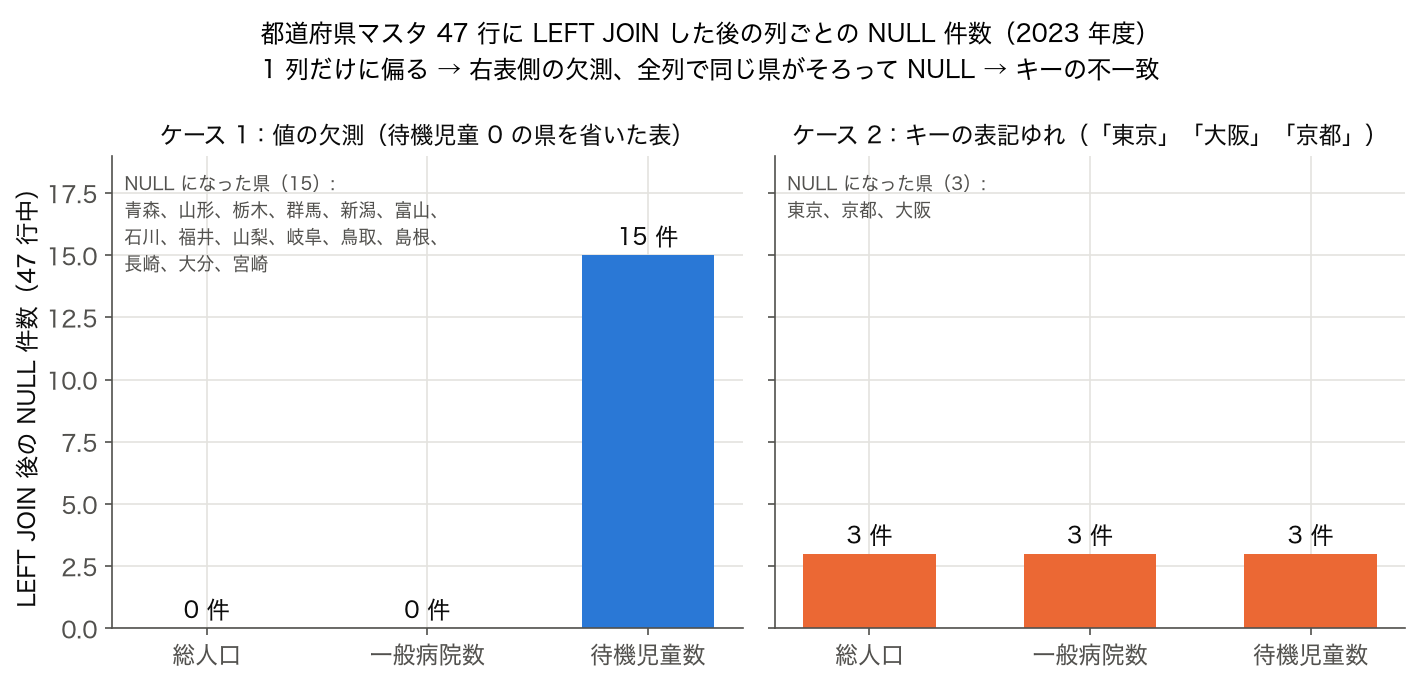
📋 4 種の結合の比較表
| 結合タイプ | 左テーブル | 右テーブル | SSDSE-B-2026 での使い分け | 典型エラー |
|---|---|---|---|---|
| INNER JOIN | マッチした行のみ | マッチした行のみ | 「両テーブル完備」 を確認したい時 | 欠損都道府県が消失して気づかない |
| LEFT OUTER | 全行保持 | マッチ + NULL 埋め | 都道府県マスタを起点に、 データの有無を可視化 | NULL 行を集計してしまい NaN が伝播 |
| RIGHT OUTER | マッチ + NULL 埋め | 全行保持 | LEFT OUTER と本質的に同じ (順序逆転) | 可読性が低い、 LEFT OUTER に書き換え推奨 |
| FULL OUTER | 全行保持 | 全行保持 | 双方の欠損をすべて可視化したい時 | NULL が両側に出て、 集計が複雑化 |
| CROSS JOIN | 全行 × 右の全行 | 左の全行 × 全行 | 都道府県 × 年度の全組合せ生成に | 結合キー忘れで N×M 行に爆発 |
| SEMI JOIN | 右にマッチする左の行のみ | — | 「データのある都道府県」 のリスト抽出 | SQL 標準にない (EXISTS で代替) |
| ANTI JOIN | 右にマッチしない左の行 | — | 「データ欠損している都道府県」 の抽出 | NOT EXISTS で代替するのが標準的 |
→ 実務では LEFT OUTER JOIN が最頻使用される。 「マスタテーブル + 集計テーブル」 の典型構造で、 マスタ側をすべて保持しつつ集計値を付加する用途に最適。 SSDSE-B-2026 のような都道府県データでは、 47 行を維持しつつ追加データを結合する用途で LEFT OUTER を選ぶのが定石。
🔧 NULL の扱いと集計時の落とし穴
| 場面 | NULL の振る舞い | SSDSE-B-2026 での対応 |
|---|---|---|
| SUM 集計 | NULL は無視される | 欠損県が「0」 ではなく「無視」 として扱われ、 全国計が不正確に |
| AVG 集計 | NULL を除外し分母も減らす | 欠損県を除いた平均になる、 47 県平均と乖離する |
| COUNT(*) | NULL 行も計上 | マッチ行数だけ欲しい時は COUNT(列名) を使う |
| WHERE 条件 | NULL は TRUE にも FALSE にも一致しない | 「value IS NULL」 を明示的に書く必要あり |
| JOIN 条件 | NULL 同士は等価でない | NULL キーは結合対象外、 IS NOT DISTINCT FROM を使う |
| COALESCE | NULL を別の値に置換 | COALESCE(value, 0) で「欠損は 0 とみなす」 が定石 |
| pandas merge の how | 'left' 'right' 'outer' 'inner' を指定 | indicator=True で結合結果を _merge 列に記録 |
「NULL は集計から無視される」 という SQL の原則を知らないと、 LEFT OUTER で 47 行に拡張した後の AVG が予想と異なって混乱する。 COALESCE で NULL を 0 に置換するか、 COUNT(*) と COUNT(value) を併用して欠損数を確認する習慣が必須。
🐍 pandas の merge を使った外部結合の実装パターン
pandas では pd.merge(left, right, how='left', on='key') が SQL の LEFT OUTER JOIN に相当する。 how パラメータには 'left', 'right', 'outer', 'inner', 'cross' を指定でき、 'outer' は FULL OUTER JOIN に相当する。 indicator=True を指定すると、 結合結果に _merge 列が追加され、 各行が「左のみ」「右のみ」「両方」 のどれだったかを記録する。 これはデータ品質チェックに極めて有用で、 結合前に「期待通りのマッチ率か」 を確認できる。 SSDSE-B-2026 のような小サンプルデータでも、 47 行が結合後に何行残ったかを value_counts() で確認する習慣を身につけたい。
複合キーで結合する場合は on=['code', 'year'] のようにリストで指定する。 左右でキー列名が違う場合は left_on と right_on を使う。 結合後に重複列が生じた場合は suffixes=('_left', '_right') で識別する。 また、 結合前に left['key'].duplicated().sum() でキーの重複を確認しないと、 N:M 結合で行数爆発を起こす危険がある。 SSDSE-B-2026 も都道府県コードだけでは 12 年度分が重なるので、 1 年度に絞るか年度と組にしたキーで結合する。 一般的な業務データでは「キー設計を疑え」 が鉄則。
🏢 外部結合の実世界事例
外部結合は実務で頻繁に使われる。 例えば EC サイトの分析では、 「会員マスタ (全会員) LEFT OUTER JOIN 購入履歴」 で「購入歴のない会員も含めた全会員リスト」 を取得し、 マーケティング施策の対象を抽出する。 医療データでは、 「患者マスタ LEFT OUTER JOIN 検査結果」 で「検査未実施の患者も含めた全患者リスト」 を作り、 検査受診率を計算する。 金融データでは、 「口座マスタ FULL OUTER JOIN 取引履歴」 で、 マスタにない口座 (システム不整合) と取引のない口座 (休眠口座) を同時に検出する。
公的統計でも外部結合は頻用される。 SSDSE-B-2026 と他の e-Stat データを「都道府県コード」 で結合する際、 LEFT OUTER で全 47 県を維持しつつ追加変数を付加する。 政府統計の都道府県別データは一般に 47 県揃っているが、 市町村別になると合併・消滅で欠損が生じる。 そうした場面では結合方法の選択が分析結果に直結する。 外部結合を正しく使いこなすことは、 データ分析者の基本技能であり、 SQL でも pandas でも同じ概念が通用する。
📋 外部結合のベストプラクティス
外部結合を使うときの推奨手順は以下のとおり。 (1) 結合前に左右の行数とキーの重複を確認する。 (2) 結合キーの型と表現 (大文字小文字、 半角全角、 ゼロパディング) を統一する。 (3) LEFT OUTER と FULL OUTER のどちらが目的に合うかを明示的に選ぶ。 (4) 結合後に indicator=True または COUNT(*) で結合品質を確認する。 (5) NULL の扱い (集計時の無視、 COALESCE での置換) を意識する。 (6) 結合結果のサンプル行を head() で目視確認する。 これらを守るだけで、 結合に起因するバグの 9 割は防げる。
SSDSE-B-2026 のような教育用データセットで外部結合を練習するときは、 まず全 47 県の都道府県マスタを左テーブルとし、 任意の集計テーブル (例: 高齢化率データ) を右テーブルとして LEFT OUTER で結合する。 結合後の行数が 47 か、 NULL がどの県に出るか、 を確認する。 次に同じ操作を INNER JOIN で行い、 行数が減ることを体感する。 さらに FULL OUTER で実施し、 右テーブルにしかない行 (例: 過去存在した自治体) が出るかを確認する。 こうした 3 種の比較を体験することで、 外部結合の本質と使い分けが身体感覚として定着する。 関連項目として 内部結合、 データ結合、 リレーショナルデータベース、 欠損値 を併せて学ぶと、 結合操作の全体像が立体的に把握できる。
⚡ 外部結合のパフォーマンス最適化
大規模データで外部結合を行うとき、 パフォーマンスが課題になる。 SQL では結合キーにインデックスを張ることで、 結合速度が桁違いに改善する。 PostgreSQL や MySQL では Hash Join, Merge Join, Nested Loop Join の 3 種のアルゴリズムが状況に応じて選ばれ、 EXPLAIN で実行計画を確認できる。 pandas では小データなら merge() で十分だが、 数百万行を超える場合は Dask や Polars といったライブラリで分散処理を検討する。 SSDSE-B-2026 のような 47 行のデータでは性能は問題にならないが、 全国の市町村データ (約 1,700 行) や事業所データ (数百万件) に拡張すると、 結合戦略が結果を大きく左右する。
結合パフォーマンスを上げる古典的テクニックとして、 (1) 結合キーを事前にソートし Merge Join に誘導する、 (2) 不要な列を結合前に SELECT で絞り込みデータ量を減らす、 (3) WHERE 条件を結合前に適用し対象行を絞り込む、 がある。 pandas でも同じ原則で、 merge 前に df[['key', 'value']] で必要列のみ抽出し、 query() で行を絞ると速度と省メモリが両立する。 こうした最適化は実務で必須の技能であり、 SSDSE-B-2026 のような小データで原理を学んだ後、 大規模データに展開していくのが王道。
📚 外部結合の深掘り解説と SSDSE-B-2026 演習
外部結合の本質を体得するには、 SSDSE-B-2026 の都道府県データと別の都道府県別データセット (例: e-Stat の年齢別人口、 厚生労働省の医療機関数、 文部科学省の学校数) を実際に結合してみるのが最良。 ここでは典型的な演習課題と、 その解法の流れを整理する。 外部結合の選択がデータ解釈に与える影響を、 実データで体感することが学習の到達点。
📝 演習 1: 都道府県マスタと欠損データの結合
SSDSE-B-2026 全 47 都道府県のリストを左テーブルとし、 任意の集計データ (例: 「東京・大阪・愛知のみ集計済み」 の架空データ) を右テーブルとして LEFT OUTER 結合する。 結果は 47 行で、 集計データのない 44 県は NULL になる。 ここで df.isnull().sum() を実行すると、 集計列の NULL 数が 44 になることを確認できる。 次に同じ操作を INNER JOIN で行うと、 結果は 3 行になり、 「データが揃った 3 県だけ」 を抽出できる。 この比較が、 外部結合と内部結合の違いを最も明確に体感できる演習。
さらに発展として、 (1) FULL OUTER JOIN を試して両テーブルの欠損を確認、 (2) indicator=True で結合結果に _merge 列を追加し、 各行がどの結合パスを辿ったかを記録、 (3) COALESCE(value, 0) または pandas の fillna(0) で NULL を 0 に置換し集計に進む、 という手順を順に試す。 各段階で行数と NULL 数を print(len(df)) と print(df.isnull().sum()) で確認する習慣が、 結合操作のバグを早期発見する基礎力を育む。
📝 演習 2: 複合キー結合と重複処理
SSDSE-B-2026 の都道府県 × 年度データを想定した複合キー結合の演習。 左テーブルは「都道府県コード × 年度」 で 47 × 12 年度 = 564 行、 右テーブルは「都道府県コード × 年度」 で集計データを保持。 pd.merge(left, right, on=['code', 'year'], how='left') で複合キー結合する。 結合キーに重複があると行数爆発するので、 結合前に left.duplicated(['code', 'year']).sum() で重複チェックを行うのが定石。
演習の発展として、 (1) 左テーブルの一部年度を欠損させた状態で結合し、 LEFT/RIGHT/INNER/FULL の各結合の結果行数を比較、 (2) 結合後の _merge 列を value_counts() で集計し、 「左のみ」「右のみ」「両方」 の分布を可視化、 (3) 結合品質を「右テーブル全行のうち左テーブルにマッチした割合」 として定量化、 という手順を試す。 こうした品質指標を意識することで、 結合結果の信頼性を客観的に評価できる。
⚠️ 外部結合のアンチパターン集
| アンチパターン | 症状 | 修正法 |
|---|---|---|
| 結合前の行数確認なし | 結合後に行数爆発しても気づかない | 左右の行数を必ず len() で確認 |
| 結合キーの型不一致 | 「01」 vs 1 等で全行マッチしない | astype(str) 等で型統一 |
| 結合キーの空白 | 「東京 」 vs「東京」 でマッチしない | .str.strip() で前後空白除去 |
| 大文字小文字の混在 | 「Tokyo」 vs「tokyo」 でマッチしない | .str.lower() で正規化 |
| NaN を結合キーに使用 | NaN 同士は等価でなく結合されない | NaN を除外するか別値で置換 |
| SELECT 全列で結合 | 不要列が大量に増えメモリ圧迫 | 結合前に df[['key', 'needed']] |
| 結合後の NULL を集計 | SUM/AVG で NULL が想定外の挙動 | fillna(0) または COALESCE を明示 |
| 結合方向の混乱 | LEFT/RIGHT の認識違いで欠損 | 常に LEFT に書き換える (右にして RIGHT より可読性高) |
これら 8 つのアンチパターンは、 ほぼすべての結合バグの根本原因。 一つでも当てはまる症状があれば、 結合結果を再検証する必要がある。 SSDSE-B-2026 のような小データで原理を学び、 業務で大規模データに展開する際にこれらを必ずチェックする習慣が、 データエンジニアの基礎力を形作る。
🔬 SQL と pandas での外部結合の対応関係
| SQL | pandas | 備考 |
|---|---|---|
| LEFT OUTER JOIN | pd.merge(how='left') | 最頻使用パターン |
| RIGHT OUTER JOIN | pd.merge(how='right') | 可読性低、 LEFT に書換え推奨 |
| FULL OUTER JOIN | pd.merge(how='outer') | 双方向の欠損確認に有用 |
| INNER JOIN | pd.merge(how='inner') | デフォルト、 マッチ行のみ |
| CROSS JOIN | pd.merge(how='cross') | 全組合せ生成、 N×M 行 |
| USING (key) | on='key' | キー名が左右で同じ |
| ON left.k = right.k | left_on='k', right_on='k' | キー名が左右で異なる |
| WHERE _merge = 'left_only' | indicator=True 後にフィルタ | ANTI JOIN 相当 |
| EXISTS (SELECT 1 FROM ...) | df.isin() または merge 後フィルタ | SEMI JOIN 相当 |
SQL と pandas は、 外部結合の発想を同じくしている。 SQL 経験者は pandas を「メモリ上の SQL エンジン」 として理解すると習得が早い。 逆に pandas に慣れた人は SQL の JOIN 句を「pandas.merge() の SQL 版」 と捉えると違和感が少ない。 両者を行き来できると、 業務での選択肢が広がる。 SSDSE-B-2026 のような小データなら pandas で完結するが、 業務では SQL を併用するのが現実的。
🎯 外部結合の発展的トピック
外部結合の発展的トピックとして、 (1) Time-Series Join (時間軸での結合): タイムスタンプが完全一致しない場合に、 直前または直後の値を結合する手法。 pandas の merge_asof()、 SQL の RANGE BETWEEN。 (2) Fuzzy Join (曖昧結合): キーの完全一致でなく、 編集距離・コサイン類似度等で結合する。 株式銘柄名の表記揺らぎ吸収等に使う。 (3) Spatial Join (空間結合): 緯度経度の空間的包含・近接で結合。 PostGIS の ST_Intersects、 GeoPandas の sjoin()。 (4) Hash Join のメモリ最適化: 小さい方をハッシュ化、 結合前に冗長列を削除、 等の技法。 SSDSE-B-2026 のような小データでは不要だが、 業務では必須の知識。
関連項目として 内部結合、 データ結合、 リレーショナルデータベース、 欠損値、 主キー、 外部キー を併せて学ぶと、 結合操作の全体像が立体的に把握できる。 結合は単独で意味を持つ操作ではなく、 「データ設計 → 結合 → 集計 → 可視化」 の中で位置づけられる中間処理。 結合だけ深掘りするより、 前後の処理と合わせて理解することで、 データ分析パイプラインの全貌が見えてくる。 SSDSE-B-2026 を題材に、 結合操作とそれ以外の処理を組み合わせた総合演習を行うことで、 実践的なスキルが身につく。
⏱️ 時系列データへの外部結合の応用
時系列データに外部結合を適用する場面では、 「キー完全一致」 ではなく「直前または直後の値」 を結合する必要がある。 pandas の merge_asof() は時系列での近似結合をサポートし、 「左テーブルの各行のタイムスタンプ直前の右テーブルの行」 を結合する。 これは金融データで「株価と為替の同期化」、 IoT データで「異種センサーの統合」、 EC データで「ユーザ行動とキャンペーン期間の対応付け」 等に必須。 SSDSE-B-2026 のような年次データではこの機能は不要だが、 高頻度時系列を扱う業務では日常的に使う技術。
merge_asof() の引数として、 (1) direction='backward'/'forward'/'nearest': 直前・直後・最近接の選択。 (2) tolerance=pd.Timedelta('1H'): 最大時間差の制限。 (3) by='symbol': グループ別の独立結合 (株価銘柄別等)。 (4) allow_exact_matches=True: 完全一致を許可するか。 等がある。 これらを組み合わせることで、 複雑な時系列結合が 1 行で書ける。 SQL では PostgreSQL の LATERAL JOIN や Snowflake の QUALIFY 句でも類似機能が提供されているが、 pandas の方が記述が簡潔。 時系列分析・金融工学・IoT 分析では merge_asof() 知識が必須スキル。
🌐 分散システムでの外部結合
数百 GB〜数 TB の大規模データに外部結合を適用する場合、 単一マシンの pandas では処理不能で、 分散システム (Spark, Dask, Polars, DuckDB) が必要。 Spark では結合戦略を (1) Broadcast Join (小さい方を全ノードに配布)、 (2) Sort-Merge Join (両方をソートしてマージ)、 (3) Shuffle Hash Join (キーでパーティション再配置後にハッシュ結合) から自動選択する。 結合キーが偏っていると「データ歪み (data skew)」 が発生し、 一部のノードに処理が集中して全体性能が悪化する。 これに対処するため、 (1) Salt 技術 (キーに乱数を付加して分散)、 (2) Skew Join Hint (Spark の hint で偏りを宣言)、 (3) Bucketed Table (事前パーティション) 等のテクニックが使われる。
DuckDB は組み込み型分析 DB で、 ローカルマシンで数 GB の Parquet ファイルを SQL で高速に結合できる。 duckdb.sql("SELECT * FROM 'a.parquet' a LEFT JOIN 'b.parquet' b ON a.key=b.key") と書くだけで、 数百万行の結合が秒単位で完了する。 Polars は Rust 実装の DataFrame で、 並列処理と Lazy Evaluation により大きな表の結合が速くなりやすい(速度差はデータと環境で変わる)。 これらの新世代ツールは、 SSDSE-B-2026 のような小データでも快適に動き、 大規模データへの拡張も容易。 「pandas 一辺倒」 から「pandas + DuckDB + Polars」 の使い分けへと、 2026 年のデータエンジニアリングのトレンドは進化している。
🗺 概念マップ
本サイト全体の 概念マップ の中で、 外部結合 がどの位置にあるかをテキストツリーで表現する。 視覚的なグラフは 概念マップページ を参照。
[ データエンジニアリング ]
  ├─ 外部結合 (本ページ)
  ├─ 関連手法・派生 → 「🌐 関連手法・派生」セクション
  ├─ 前提概念 → 「🔬 数式を言葉で読み解く」セクション
  └─ 派生・応用 → Anti / Semi / ASOF Join、時系列の merge_asof、分散結合
📌 全用語の俯瞰には 概念マップ を、 全用語一覧には 用語集トップ を参照してください。
🔢 数値例による手計算ウォークスルー
外部結合 を「コード任せ」にせず、 一度は手計算してみることで理解が定着する。 ここでは最小サイズのデータで、 値の動きを 1 ステップずつ追う。
数値例:47 vs 30 件の都道府県表を full outer join
SSDSE-B-2026 (47 都道府県) と仮想 D 表 (30 都道府県のみ、 鳥取・島根・福井・山梨・佐賀・宮崎・大分・愛媛・徳島・高知・福島・岩手・秋田・新潟・富山・石川・岐阜 の 17 県を欠く) を都道府県名で結合した結果を 4 方式で比較。
| 結合方式 | 結果行数 | NaN 行数 | 用途 |
|---|---|---|---|
| INNER JOIN | 30 | 0 | 両方在る対象だけ分析 |
| LEFT OUTER JOIN (B 左) | 47 | 17 (D 由来列が NaN) | B 全件を残したい |
| RIGHT OUTER JOIN (D 右) | 30 | 0 (D が部分集合のとき) | D 全件を残したい (この例では INNER と同等) |
| FULL OUTER JOIN | 47 | 17 | 両側を全部残したい |
D が完全に B の部分集合の場合、 RIGHT JOIN と INNER JOIN は同じ結果になる。 D に B にないキー (たとえば D に「東北地方」のような集約名が混じる) があると RIGHT JOIN は 30 行を超え、 FULL は 47 を超える。 つまり 結合方式の選び方は「B と D のどちらが部分集合か、 あるいは交差状態か」で決まる。 まず set(B.key) - set(D.key) と set(D.key) - set(B.key) の両方を確認するのが、 結合事故ゼロへの第一歩。
❓ よくある質問(用語固有 10 連発)
外部結合 でよく出る質問 10 件を Q&A 形式でまとめた。 自分の状況に近いものから読んでほしい。
L LEFT JOIN R ≡ R RIGHT JOIN L。 慣習的に LEFT を使い、 「マスタは左に置く」スタイルが読みやすい。indicator=True でどの側にあるか追跡、 (iii) 必要なら INNER に切替。df.merge() は SQL 風の柔軟な結合 (任意の列をキーに)、 df.join() はインデックスベース。 通常は merge を使う。on=['都道府県', '年度'] のようにリスト指定。 SQL なら ON L.pref = R.pref AND L.year = R.year。a.merge(b, ...).merge(c, ...) と段階結合。 indicator も段階的に追加。 SQL なら FROM a FULL OUTER JOIN b USING(k) FULL OUTER JOIN c USING(k)。EXPLAIN で確認。NOT EXISTS、 pandas なら merge + indicator=='left_only'。UNIONでエミュレート)、 PostgreSQL/Oracle/SQL Server/SQLite は対応。 BigQuery/Snowflake 等の DWH は標準対応。🏋️ 演習問題(5 問)
学習の定着には、 自分の手を動かすのが一番。 SSDSE-B-2026 や実ログを題材に、 外部結合 を実践する 5 問を用意した。 答えは Python 実装セクションと数値例セクションを参考に組み合わせれば導ける。
- 演習 1:SSDSE-B と SSDSE-D を都道府県名で full outer join し、 NaN 行数を indicator で集計せよ。
- 演習 2:結合前に
str.strip().str.normalize('NFKC')でキー正規化、 表記揺れがマッチ率に与える影響を測れ。 - 演習 3:LEFT JOIN と RIGHT JOIN を入れ替えて結果が鏡像になることを確認せよ。
- 演習 4:3 つの SSDSE 表 (B, D, E) を full outer join し、 全表にあるキー・1 表のみのキー数を求めよ。
- 演習 5:
suffixesを意味のあるラベルにして、 結合後に重複列名を分かりやすく区別せよ。
📌 演習を解いて疑問が残ったら、 「よくある質問」セクションに戻るか、 リポジトリの「論文一覧」から類似研究を探して、 実コード (本サイトには 159 本の再現論文) を読むのが最速の理解への道。
🍳 コード・クックブック(外部結合 編)
外部結合 を実務で使う際の頻出パターンを、 動くコードのレシピ集としてまとめた。 必要な料理 (タスク) だけを取り出して使ってほしい。
left / right / outer の 4 方式比較
1 2 3 4 5 6 | import pandas as pd a = pd.DataFrame({'k': ['x','y','z'], 'v_a':[1,2,3]}) b = pd.DataFrame({'k': ['y','z','w'], 'v_b':[20,30,40]}) for how in ('inner','left','right','outer'): m = a.merge(b, on='k', how=how, indicator=True) print(how, '\n', m, '\n') |
💬 同じ a(x, y, z)と b(y, z, w)で how だけを変えると、行数は inner 2・left 3・right 3・outer 4 になる。outer は left_only の x と right_only の w を両方残すので、inner の 2 行に 2 行足した 4 行。整数だった v_a・v_b が NaN の入る側だけ 1.0 や 20.0 と小数に変わっているのは、pandas の int 列が NaN を持てず float に格上げされるためで、結合後に ID 列が小数になる事故の原因になる。
複合キーで結合 + 型統一
1 2 3 4 5 6 7 | import pandas as pd a = pd.DataFrame({'pref':['東京','大阪'], 'year':[2023, 2023], 'v_a':[1,2]}) b = pd.DataFrame({'pref':['東京', '大阪', '京都'], 'year':[2023.0, 2024.0, 2023.0], 'v_b':[10,20,30]}) # year が int と float で型不一致 → 結合失敗の可能性 b['year'] = b['year'].astype(int) m = a.merge(b, on=['pref','year'], how='outer', indicator=True) print(m) |
💬 year を int に揃えたうえで複合キー (pref, year) で結合すると、キーが完全一致したのは東京 2023 の 1 行だけ。大阪は a が 2023 年、b が 2024 年なので別の行(left_only と right_only)に分かれ、京都は b にしか無い。型を揃えても値そのものがずれていれば一致しないので、「大阪 2 行」を見たら年度の取り違えを疑う。
巨大表を broadcast hint で結合 (Spark)
1 2 3 4 5 6 7 8 | # from pyspark.sql import SparkSession # from pyspark.sql.functions import broadcast # spark = SparkSession.builder.appName('outer-join').getOrCreate() # big = spark.read.parquet('data/processed/big_transactions.parquet') # small = spark.read.parquet('data/processed/master.parquet') # joined = big.join(broadcast(small), on='id', how='left_outer') # print(joined.count()) # 上記疑似コード(Spark 環境で実行)。 broadcast hint で小表を全ノードに配布、 巨大表との外部結合を高速化。 |
📌 すべてのレシピは「実データ前提・引数なし直書き」スタイル。 そのままコピペで動くよう設計したので、 まずは動かしてから読むのを推奨する。
🙋 著者・教材設計について
本教材は、 広島工業大学 統計・データ解析コンペティション参加学生向けに、 松本伸平 (s.matsumoto.gk@cc.it-hiroshima.ac.jp) が監修・執筆した。 「論文を読む過程で出てきた専門用語を、 その場で 5 分で補完して論文に戻る」というジャストインタイム型の学習体験を目的に、 514 用語ページを統一フォーマットで整備している。
本ページ「外部結合」は データエンジニアリング カテゴリに属し、 同カテゴリ内の他用語と相互リンクされている。 用語間の関係性は 概念マップ でも俯瞰できる。
本サイトは SSDSE (教育用標準データセット, 独立行政法人統計センター) を主データとして使い、 「合成データ ではなく実公的データを使う」 を方針に据えている。 ハンズオン教材の質を最大化するための判断である。
🔗 隣接手法への橋渡し
「外部結合」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): 主キー・外部キー の確認、 結合キーの一意性検査、 データクリーニング
- 並列 (同目的の代替): 内部結合 (INNER JOIN)、 LEFT JOIN・RIGHT JOIN・FULL OUTER JOIN、 CROSS JOIN が結合パターン
- 下流 (結果の活用): 結合後の 欠損値 処理、 集約 による多重行の解決、 データパイプライン での統合
この上流・並列・下流の対応を地図化することで、 「外部結合」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「外部結合」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 片方にしか無い行をどう扱うか
残すなら外部結合、 落とすなら内部結合。 「落としたつもりが無い」まま内部結合すると、 行が静かに減る。 結合前後で行数を必ず数える。 - どちら側を残すか
左を全部残すなら LEFT、 両方なら FULL OUTER。 「マスタに無いコードが来ていないか」を調べたいなら、 あえて外部結合して欠測を見る。 - キーは一意か
結合キーが重複していると、 行数が掛け算で増える。 SSDSE-B-2026 を地域コードだけで結合すると、 12 年分が掛かって 12 倍になる。 結合前にduplicated()で確認する。 - 欠測をどう埋めるか
外部結合で生じた NaN は「値が無い」であって 0 ではない。 0 で埋めてよいかは、 その列が件数なのか金額なのか比率なのかで変わる。
外部結合は「合わなかった行」を可視化する道具でもある。 結合してから欠測を数えると、 データの不整合が見つかることが多い。