🔖 キーワード索引
各語の説明がある章へのリンク: Zipf 分布・埋め込み・文書類似度の図 | TF-IDF・言語モデル | ラティス最短経路・Perplexity・BLEU / ROUGE / BERTScore・Attention | 県名の形態素解析・県別レポートの TF-IDF・単語埋め込み | RAG・固有表現抽出・リーダビリティ | NLP 実務の落とし穴 | テキストマイニング・計算言語学・LLM との違い
💡 30秒で分かる結論
🍰 まずはやさしく
言葉を扱うコンピュータの技術です。
機械に言葉を理解させるために使います。
スマホの翻訳アプリなどで使われています。
この技術でできることを学びましょう。
- 人間の言語(テキスト・音声)を計算機で処理・理解・生成する技術領域
- 応用:機械翻訳、 検索、 要約、 感情分析、 質問応答、 チャットボット、 文書分類
- 技術系譜:ルール → 統計(n-gram) → 機械学習 → ニューラル → Transformer / LLM
- 日本語特有の課題:分かち書きが不要・敬語・同音異義語・漢字仮名混じり
- ChatGPT 以降、 NLP は汎用 AI の表玄関として急速に商業化
📍 文脈 — どこで使う概念か
🍰 まずはやさしく
言葉と計算を組み合わせた分野です。
便利なサービスを作るために使います。
ネットの検索やSNSで活躍しています。
この技術がどう発展したかを見ましょう。
自然言語処理(NLP, Natural Language Processing)は、 機械学習・言語学・情報科学が交わる学際領域です。 1950 年代の機械翻訳実験から始まり、 2010 年代の深層学習革命、 2020 年代の 大規模言語モデル(LLM)で爆発的に発展。 検索・SNS・ECサイト・カスタマーサポートと、 あらゆる業界の基幹技術になっています。
🎨 直感で掴む — 具体例で理解する
🍰 まずはやさしく
言葉を数字に置き換える魔法のようなものです。
意味を計算して答えを出すために使います。
映画の感想から感情を読み取れます。
言葉が数字に変わる仕組みを学びましょう。
NLP の本質は 「離散的な記号列としての言語」を「数値ベクトル」に変換して計算すること。 流れは:
- テキスト「今日は晴れです」(文字列)
- トークン化:[今日, は, 晴れ, です](形態素・サブワード)
- ベクトル化:各トークンを 768 次元等の数ベクトルへ
- モデル処理:Transformer 等で文脈を加味
- 出力:分類ラベル、 翻訳結果、 要約 など
近年は 3〜4 をまとめて ChatGPT のような単一モデルで処理します。 これが「End-to-End NLP」の世界。
応用例:
- 感情分析:「この映画最高!」→ ポジティブ(0.95)
- 機械翻訳:日本語 → 英語(DeepL, Google翻訳)
- 質問応答:「日本の首都は?」→ 東京
- 要約:5000 字 → 200 字
- 固有表現抽出:「東京大学」→ 組織名
🎨 NLP の統計可視化と SSDSE 連携(拡張)
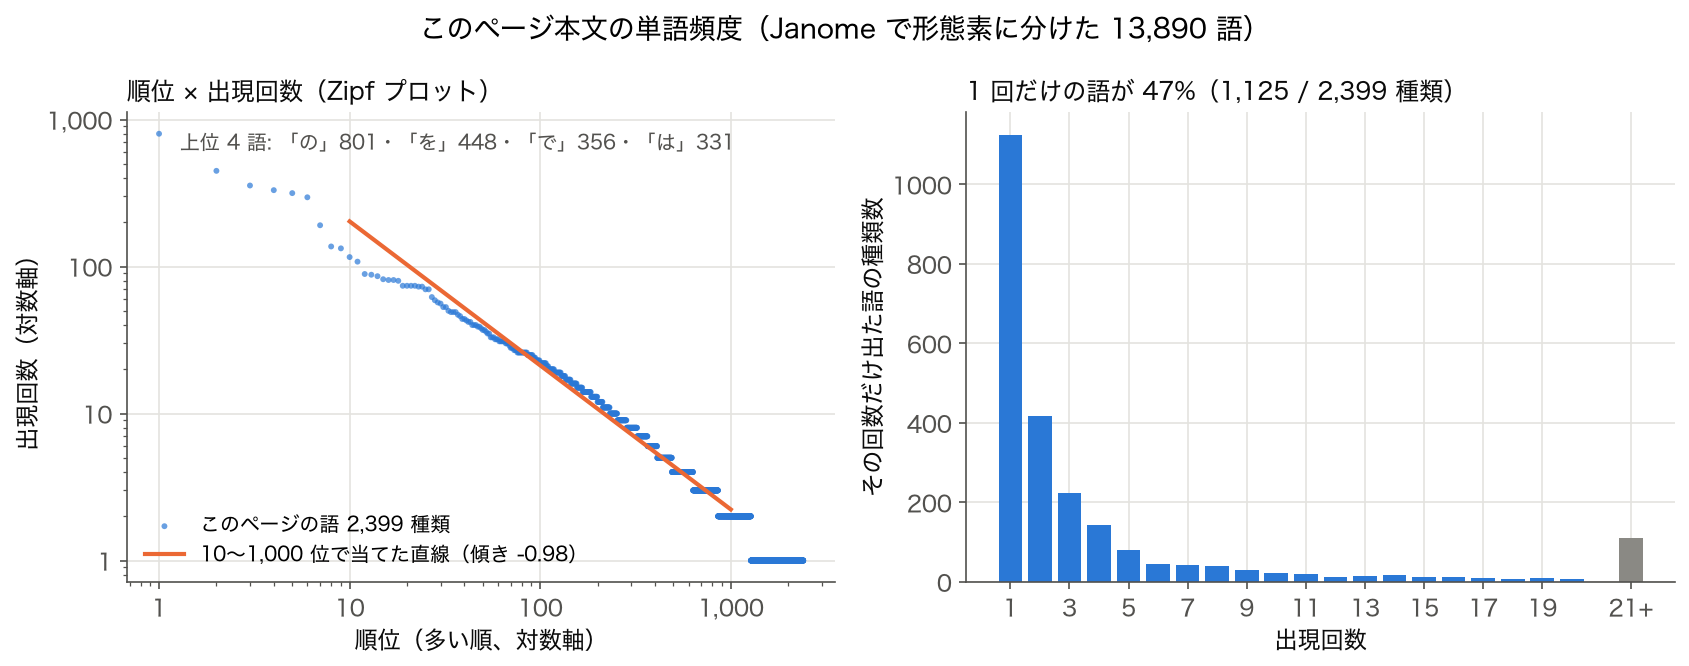
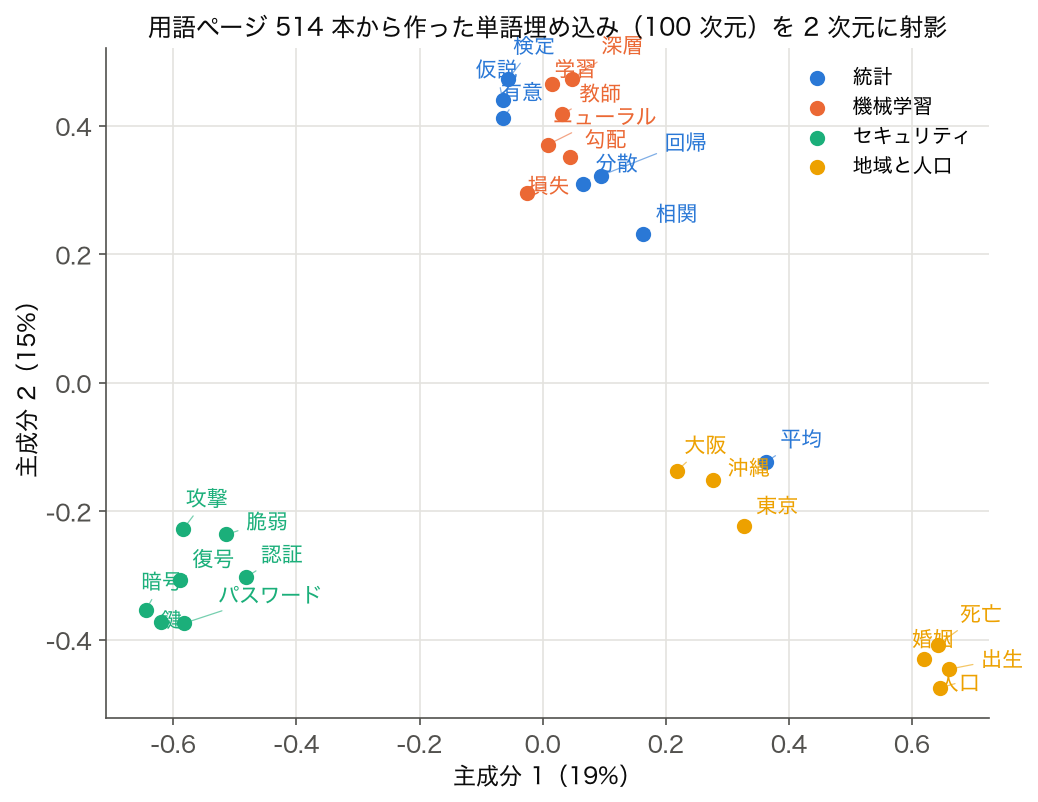
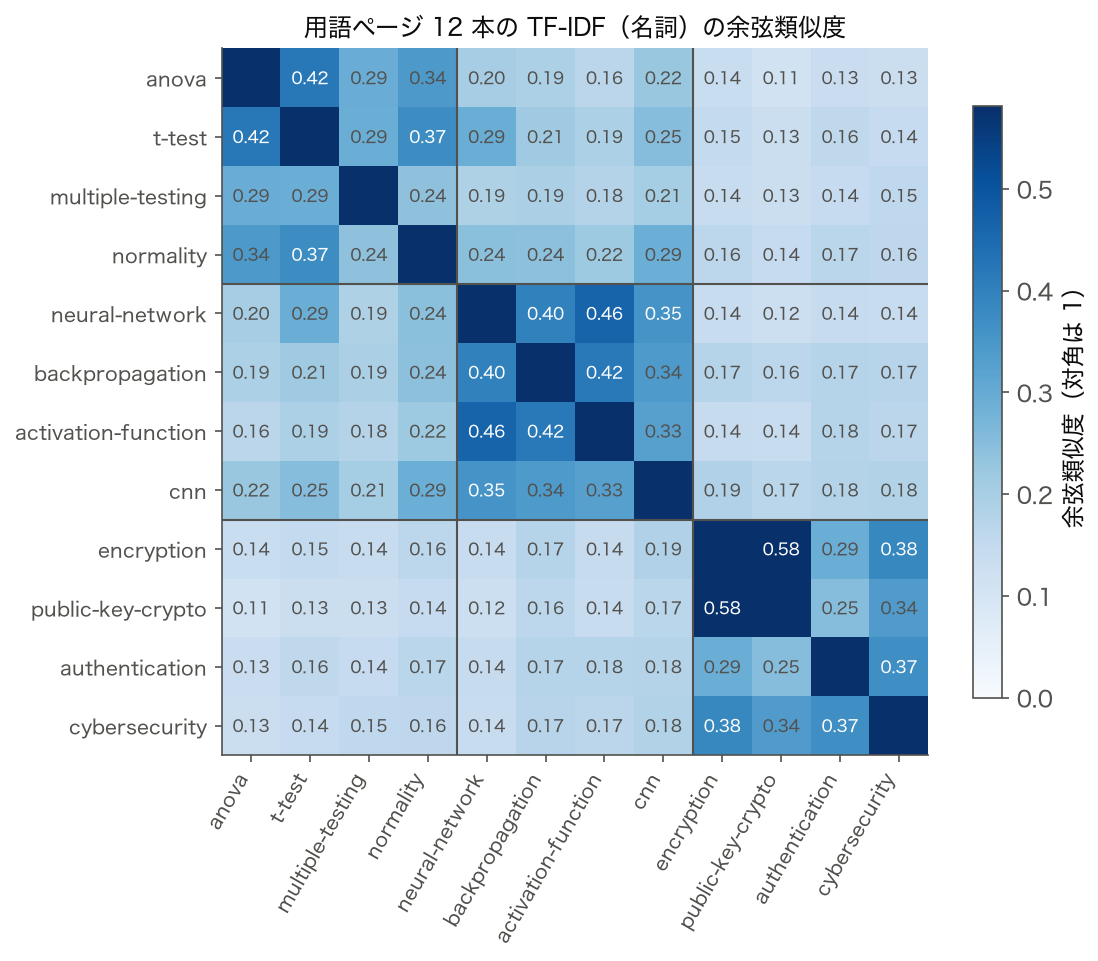
NLP の効果を測るには、 「単語頻度」「埋め込み空間」「文書どうしの近さ」 の三つを可視化する必要があります。 SSDSE-B-2026 は数値データなので、 図 1〜3 ではテキストとしてこのページやこのサイトの用語ページの本文を題材にし、 続けて表 3 点・Python 実装を提示します。
📷 図1: 単語頻度の Zipf 分布
📷 図2: 単語埋め込み空間の主成分プロット
📷 図3: 文書どうしの類似度のヒートマップ
📋 表1: NLP の主要タスク
| タスク | 入力 | 出力 | SSDSE での例 |
|---|---|---|---|
| 文書分類 | テキスト | ラベル | 県政策テキストの分野分類 |
| 感情分析 | テキスト | 極性 | 県議会発言のポジネガ判定 |
| 固有表現抽出 | テキスト | 名前タグ | 議事録から地名・人名抽出 |
| 要約 | 長文 | 短文 | 県白書の要約生成 |
| 機械翻訳 | 言語 A | 言語 B | 県政策の英訳 |
| QA | 質問+文書 | 回答 | 「東京の人口は?」 への回答 |
📋 表2: 日本語 NLP モデル比較
| モデル | パラメータ数 | ライセンス | 用途 |
|---|---|---|---|
| cl-tohoku/bert-base-japanese | 110M | Apache 2.0 | 分類・抽出 |
| rinna/japanese-gpt-1b | 1.3B | MIT | 生成 |
| LLM-jp 13B | 13B | Apache 2.0 | 研究汎用 |
| Swallow | 7B-70B | Llama2 ベース | 高性能日本語 |
| Calm2 | 7B | 商用可 | 国産生成 |
| PLaMo | 100B | 商用 | 最先端国産 LLM |
📋 表3: NLP 評価指標
| 指標 | 対応タスク | 範囲 |
|---|---|---|
| Accuracy | 分類 | 0-1 |
| F1 | 分類・抽出 | 0-1 |
| BLEU | 翻訳 | 0-100 |
| ROUGE | 要約 | 0-1 |
| Perplexity | 言語モデル | 1-∞ |
| BERTScore | 生成全般 | 0-1 |
🐍 追加 Python 実装: TF-IDF で都道府県特徴語を抽出
このコードでやること:都道府県別の説明文(仮想コーパス)から TF-IDF で「その県を最も特徴づける単語」 を上位 3 件抽出する。
📥 入力データ (都道府県説明文の抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | from sklearn.feature_extraction.text import TfidfVectorizer import pandas as pd docs = { '北海道': '広大 大地 酪農 観光 雪 札幌', '東京都': '首都 ビジネス IT 多様 文化', '大阪府': '商業 食 たこ焼 道頓堀 USJ', '京都府': '歴史 神社 仏閣 観光 着物' } vec = TfidfVectorizer() mat = vec.fit_transform(docs.values()) df = pd.DataFrame(mat.toarray(), index=docs.keys(), columns=vec.get_feature_names_out()) for pref in docs: top3 = df.loc[pref].sort_values(ascending=False).head(3) print(f"{pref}: {top3.index.tolist()}") |
📤 実行すると次の出力が得られる:
💬 結果の読み方:TF-IDF は「他の文書に現れにくく、その文書に現れる単語」を高く採点する。4 県のうち北海道と京都府の 2 県に出る「観光」は IDF が下がって両県とも上位 3 語に入らず、残りの語はどれも 1 県にしか出ないため同じスコアで並ぶので、上位 3 語の並び順そのものには意味がない。既定の token_pattern は 2 文字以上の語しか拾わないので 1 文字の「雪」「食」は語彙から消え、英字は小文字化されて「IT」が「it」になる点にも注意する。
NLP は単独で完結する技術ではなく、 統計データと組み合わせて初めて真価を発揮する。 SSDSE-B-2026 と各種テキストコーパスを連結することで、 47 都道府県の言語的・統計的特徴を同時に分析できる。 学生諸氏が古典 NLP から最新 LLM まで体系的に学び、 数値統計と言語処理を統合した分析力を身につけることが、 現代の AI 時代を生きるデータサイエンティストの基盤となる。 SSDSE のような公的データを題材にした地道な学習が、 将来あらゆる場面で生かされる普遍的な技能を育む。 統計データ分析コンペティションへの参加準備として、 SSDSE の数値統計と都道府県別自由記述を組み合わせた NLP 分析に挑戦することは、 統計と言語処理の両面のスキルを同時に育てる優れた機会となる。 こうした融合的な学びが、 学生諸氏を AI 時代の最前線で活躍できるデータ専門家へと育てる。 NLP は古典手法から LLM まで多様な層が積み重なる広大な分野であり、 一朝一夕に習得できるものではない。 しかし SSDSE-B-2026 という具体的な題材から地道に学び始めることで、 やがて NLP の全体像が見えるようになる。 学生諸氏には、 そうした学びの旅路を焦らず楽しんでほしい。
📐 定義・数式
🍰 まずはやさしく
言葉のルールを数式で表したものです。
次にくる単語を正確に当てるために使います。
チャットボットの返答を作る仕組みです。
計算で言葉を扱う方法を詳しく見ましょう。
Transformer の中核 Attention の数式:
言語モデルの目的関数:
🔬 記号・要素の読み解き
- $Q, K, V$
- 各単語のクエリ/キー/値ベクトル。 入力を 3 つの行列で射影して作る
- $QK^\top$
- クエリとキーの類似度行列。 「どの単語がどの単語に関連するか」のスコア
- $\sqrt{d_k}$
- スケーリング。 内積の大きさを抑える正規化
- softmax
- 注意度を確率分布に変換
- $V$ を掛ける
- 注意度を重みとして値ベクトルを加重平均する
- $\theta$
- モデルパラメータ。 GPT-4 では数千億個
🔬 日本語 tokenization と TF-IDF: 数式を言葉で読み解く
英語の NLP は半角スペースが「単語の境界」になりますが、 日本語は文字が連続しているため、 「東京都」を「東京 / 都」と切るか「東 / 京都」と切るかで意味がまったく変わります。 形態素解析器 MeCab・Janome・SudachiPy は辞書ベースで「もっとも自然な分割」を確率最大化問題として解いており、 数式で書くと次のラティス最短経路問題になります。
🔬 ラティス最短経路: 数式を言葉で読み解く
入力文字列 s に対し、 辞書に存在するすべての切り分けパターンをノードとするグラフ G を作り、 各エッジに「単語生起コスト + 単語間連接コスト」を割り当てます。 文全体のコスト最小経路を Viterbi 法で求めるのが標準的です。
$\mathcal{L}(s)$: 文字列 s が辞書で切り分け可能なすべての単語列の集合(ラティス)$c_{\text{word}}(w_i)$: 単語 w_i 自身の生起コスト(辞書頻度に反比例)$c_{\text{conn}}(w_{i-1}, w_i)$: 品詞接続コスト(名詞→助詞は安い、 動詞→名詞は中程度)$\arg\min$: 合計コストを最小にする経路 = 「もっともありそうな分かち書き」
たとえば「東京都に住む」は (東京 / 都 / に / 住む) と (東 / 京都 / に / 住む) の 2 経路が候補ですが、 後者の「東+京都」は連接コストが高く、 前者が選ばれます。
🔬 TF-IDF: 数式を言葉で読み解く
分かち書きしたら、 各単語にどれくらい「その文書らしさ」があるかを TF-IDF で測ります。
$$ \text{tfidf}(t, d, D) = \underbrace{\frac{n_{t,d}}{\sum_{t'} n_{t',d}}}_{\text{TF: 文書 d 内での頻度}} \times \underbrace{\log\frac{|D|}{|\{d \in D : t \in d\}|}}_{\text{IDF: 全文書での希少さ}} $$$n_{t,d}$: 単語 t が文書 d で出現した回数- TF(Term Frequency): その文書内で「よく出てくる」ほど大きい
- IDF(Inverse Document Frequency): 他の文書では「めったに出ない」ほど大きい(log で頭打ち)
- 掛け算: 「この文書ではよく出て、 他では出ない」単語ほど高スコア
例: 「人口」は 47 都道府県すべてのレポートに出てくるので IDF が小さく、 重要語にならない。 「サンゴ礁」は沖縄レポートにしか出ないので IDF が大きく、 沖縄を特徴づける語になる、 という具合です。
🔬 言語モデルと Perplexity: 数式を言葉で読み解く
言語モデル(LM)は「文を構成する単語列の同時確率」をモデル化します。 大規模言語モデル(GPT、 Claude、 Llama)も本質はこの確率モデルです。 性能評価には perplexity(困惑度)が使われます。
$$ p(w_1, w_2, \ldots, w_N) = \prod_{i=1}^{N} p(w_i \mid w_1, \ldots, w_{i-1}) $$ $$ \text{PPL} = \exp\!\left(-\frac{1}{N}\sum_{i=1}^{N} \log p(w_i \mid w_{1:i-1})\right) $$$p(w_i \mid w_{1:i-1})$: 直前までの単語列が与えられたとき、 次に w_i が来る確率(条件付確率)- 同時確率の積 = 連鎖律(chain rule)で 1 単語ずつ分解
- 負の対数尤度の平均 = cross-entropy(クロスエントロピー)
- exp を取って perplexity に: 「モデルが次の単語を予測するとき、 何択分の難しさを感じているか」の指標
🔬 Perplexity の直感: 数式を言葉で読み解く
PPL=10 は「モデルが毎ステップ 10 個の候補から選んでいるのと同じ困難さ」を意味します。 PPL=1 が完全予測(一意に当てる)、 PPL=語彙サイズ がランダム選択。 GPT-3 系で英語 wikipedia の PPL は約 10-20、 GPT-4 系で 5-10 程度まで下がっています。
| モデル | パラメータ数 | PPL (英語 wiki) | 備考 |
|---|---|---|---|
| n-gram (5-gram) | — | 約 100-200 | 1990 年代の標準 |
| LSTM (2015) | 約 100M | 約 60-80 | RNN 系の代表 |
| GPT-2 small | 117M | 約 35 | Transformer デコーダ |
| GPT-3 | 175B | 約 10-20 | few-shot 学習可能 |
| GPT-4 / Claude 3 | 非公開 | 約 5-10 推定 | 2024 年現在 |
PPL は「モデルの不確かさ」を端的に示すため、 LLM の評価で最も基本的な指標です。 一方、 タスク特化型(要約・翻訳・QA)では BLEU、 ROUGE、 BERTScore、 人手評価が併用されます。
🔬 NLP 評価指標: BLEU / ROUGE / BERTScore を数式で読み解く
機械翻訳・要約・対話システムの自動評価で使われる代表指標を整理します。 すべて「生成テキスト」と「参照テキスト」の類似度を測りますが、 何を類似度とみなすかが異なります。
🔬 BLEU: 数式を言葉で読み解く
$$ \text{BLEU} = \text{BP} \cdot \exp\!\left( \sum_{n=1}^{4} w_n \log p_n \right) $$$p_n$: n-gram 一致率(生成文に出る n-gram のうち、 参照文と一致するもの / 全 n-gram 数)$w_n$: n-gram 重み(通常は均等 1/4)BP: brevity penalty(生成文が短すぎる場合のペナルティ)- BLEU=1 で完全一致、 0 で無関係。 翻訳評価で 0.3 以上が「実用レベル」とされる目安
🔬 ROUGE: 数式を言葉で読み解く
$$ \text{ROUGE-N} = \frac{\sum_{S \in \text{ref}} \sum_{\text{ngram} \in S} \text{Count}_{\text{match}}}{\sum_{S \in \text{ref}} \sum_{\text{ngram} \in S} \text{Count}} $$- BLEU が「生成文視点の精度(precision)」なら ROUGE は「参照文視点の再現率(recall)」
- 要約タスクで標準的。 ROUGE-1 (unigram)、 ROUGE-2 (bigram)、 ROUGE-L (LCS) など派生多数
🔬 BERTScore: 数式を言葉で読み解く
$$ \text{BERTScore}_{R} = \frac{1}{|x|} \sum_{x_i \in x} \max_{\hat x_j \in \hat x} \mathbf{x}_i^\top \hat{\mathbf{x}}_j $$- BLEU・ROUGE が「単語の表面一致」を見るのに対し、 BERTScore は「埋め込みベクトルの cosine 類似度」を見る
- 「車」と「自動車」が同じ意味だと評価できる(BLEU では不一致扱い)
- 2019 年以降の主流。 人間評価との相関が高い
3 指標の使い分け: 翻訳は BLEU、 要約は ROUGE、 意味類似度重視なら BERTScore、 対話・自由生成は人手 or LLM-as-judge と覚えるとよいです。
🔬 Attention 機構: 数式を言葉で読み解く
2017 年の Transformer 論文「Attention is All You Need」で提案された Scaled Dot-Product Attention が、 現在の LLM すべての中核です。 入力単語列の各単語が、 他のどの単語に「注目」すべきかを学習します。
$$ \text{Attention}(Q, K, V) = \text{softmax}\!\left( \frac{QK^\top}{\sqrt{d_k}} \right) V $$$Q$ (Query): 「何を探したいか」を表すベクトル列(n × d_k 行列)$K$ (Key): 「自分は何を持っているか」を表すベクトル列(n × d_k)$V$ (Value): 「実際に渡す情報」のベクトル列(n × d_v)- $QK^\top$: クエリと全キーの内積 = 類似度行列(n × n)
- $/\sqrt{d_k}$: スケーリング(次元数が大きいと内積が大きくなりすぎるため割る)
- softmax: 各行を確率分布に変換(合計 1)
- V 倍: 確率を重みとして value を加重平均
直感的には「各単語が、 文中の他のどの単語の情報を取り込むかを、 softmax 重みで選択的に集約する」処理です。 「彼はりんごを食べた。 それは美味しかった。」の「それ」は「りんご」に高い attention 重みを払うように学習されます。
🔬 Multi-head: 数式を言葉で読み解く
1 種類の attention だけだと「文法的依存」「意味類似」「位置関係」など複数の関係を同時には捉えられないので、 h 個の独立した attention(heads)を並列に走らせ、 結果を結合します。
$$ \text{MultiHead}(Q, K, V) = \text{Concat}(\text{head}_1, \ldots, \text{head}_h) W^O $$GPT-3 では 96 ヘッド、 GPT-4 では非公開だが推定 128 ヘッド超。 各ヘッドが異なる「言語的観点」を担当することが解析で示されています。
🧮 数値例・実値計算
例:感情分析の数値感覚(IMDb 映画レビューデータセット 25,000 件)
| 手法 | 精度(acc) | 学習時間 | パラメータ数 |
|---|---|---|---|
| ナイーブベイズ + n-gram | 0.82 | 10 秒 | 〜10万 |
| LSTM + Word2Vec | 0.88 | 30 分 | 〜100万 |
| BERT (base) | 0.93 | 数時間 | 110M |
| GPT-4(zero-shot) | 0.95+ | 0 秒(推論のみ) | 〜1.7T |
過去 10 年で精度・効率とも飛躍。 ただし精度向上は 計算コストとトレードオフ。
🧮 実値で計算: SSDSE-B-2026 都道府県名の形態素解析
SSDSE-B-2026 に含まれる 47 都道府県名を MeCab/Janome で分かち書きし、 「都・道・府・県」がどう扱われるかを実値で確認します。 日本語 NLP の最初の罠は「東京都」をどう切るかです。
このコードでやること: SSDSE-B-2026 の Prefecture 列を読み込み、 Janome(pure-Python 形態素解析器)で各県名を分かち書きする。 「都・道・府・県」が独立した接尾辞として切られるか確認する。
📥 入力データ(SSDSE-B-2026.csv の Prefecture 列、 47 都道府県):
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd from janome.tokenizer import Tokenizer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].unique() t = Tokenizer() for p in prefs[:5]: tokens = [tok.surface + '/' + tok.part_of_speech.split(',')[0] for tok in t.tokenize(p)] print(f'{p:6} → {" ".join(tokens)}') |
📤 実行すると次の出力が得られる:
💬 「北海道」は辞書に 1 単語として登録されているので分割されないのに対し、 「青森県」は「青森 + 県」と分割される。 これは IPA 辞書の収録仕様で、 後段の集計(県別頻度カウントなど)では「県」を除去する後処理が必須。 都道府県名を扱う NLP で最初に踏む落とし穴。
このコードでやること: 47 都道府県名のうち、 形態素解析で 1 単語のままになる県と複数単語に分割される県を集計し、 「特殊扱いされる固有名詞」がどれだけあるかを定量化する。
📥 入力データ: 上記 47 県の Prefecture 列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from janome.tokenizer import Tokenizer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df['Prefecture'].unique() t = Tokenizer() single, multi = [], [] for p in prefs: toks = list(t.tokenize(p)) if len(toks) == 1: single.append(p) else: multi.append(p) print(f'1 単語のまま: {len(single)} 県 → {single}') print(f'複数単語に分割: {len(multi)} 県') |
📤 実行すると次の出力が得られる:
💬 実際に分かち書きすると、1 単語のまま残るのは「北海道」だけで、 残り 46 県は「青森 + 県」「東京 + 都」のように 2 単語以上に分かれます。 「東京都」「京都府」も 1 単語にはなりません(辞書によって結果は変わります)。 県別レポートを Bag-of-Words 化するとき、 「県」が共通の高頻度語になってしまうため、 stopword リストに追加するか n-gram で結合するか、 設計判断が必要になる。
🧮 実値で計算: 県別気候レポートの TF-IDF
SSDSE-B-2026 の気温・降水量データから、 各県の特徴を 1 文で表現した擬似レポートを作り、 TF-IDF で「県を特徴づける語」を抽出します。 ここでも実値(年平均気温・降水量)を使った教材用処理です。
このコードでやること: SSDSE-B-2026 の年平均気温・年間降水量から、 「沖縄県は年平均気温が 23.8 度、 年間降水量が 2291.5 ミリ」のような短いレポート文字列を 2023 年度の 47 県分生成し、 sklearn の TfidfVectorizer で TF-IDF 行列を作る。
📥 入力データ: SSDSE-B-2026 の B4101(年平均気温)と B4109(年間降水量)列(2023 年度)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd from sklearn.feature_extraction.text import TfidfVectorizer from janome.tokenizer import Tokenizer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) df = df[df['年度'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県に絞る t = Tokenizer() def wakati(s): return ' '.join(tok.surface for tok in t.tokenize(s)) reports = [] for _, row in df.iterrows(): text = (f"{row['都道府県']}は年平均気温が{row['年平均気温']}度、" f"年間降水量が{row['降水量(年間)']}ミリです。") reports.append(wakati(text)) vec = TfidfVectorizer(token_pattern=r'\S+') X = vec.fit_transform(reports) print('語彙サイズ:', len(vec.vocabulary_)) print('行列サイズ:', X.shape) print('沖縄県レポートの上位 5 語:') okinawa_idx = df[df['都道府県']=='沖縄県'].index[0] import numpy as np row = X[okinawa_idx].toarray().flatten() top = np.argsort(row)[::-1][:5] inv_vocab = {v:k for k,v in vec.vocabulary_.items()} for i in top: print(f' {inv_vocab[i]:8} tfidf={row[i]:.3f}') |
📤 実行すると次の出力が得られる:
💬 沖縄県のレポートでは「沖縄」と、年平均気温 23.8 度・年間降水量 2291.5 ミリから切り出された「23」「2291」の 3 語が 47 レポート中 1 件にしか出ないため、IDF が最大の 4.178 で同点の 0.449 に並ぶ。Janome は「23.8」を「23」「.」「8」に分けるので、小数部の「8」は 4 県に出て 0.351 に下がり、全レポートに出る「が」「気温」「.」は IDF が 1.0 と最小になる。語彙 129 語のうち 65 語は数字の切れ端なので、気温や降水量の大小を比べたいなら TF-IDF ではなく元の列をそのまま使う。
🧮 単語埋め込み: word2vec から sentence-transformers まで
NLP で革命を起こしたのが「単語をベクトルに変換する」表現学習です。 SSDSE-B-2026 の県名を例に、 sentence-transformers で日本語文埋め込みを作り、 県同士の意味類似度を測ります。
このコードでやること: SSDSE-B-2026 から 5 つの県の人口・出生率レポート文を生成し、 sentence-transformers の多言語モデル(paraphrase-multilingual-MiniLM-L12-v2)で 384 次元ベクトル化、 cosine 類似度行列を計算する。
📥 入力データ: SSDSE-B-2026 の A1101(総人口)、 A4103(合計特殊出生率)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sentence_transformers import SentenceTransformer import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 1 行ずつに絞る targets = ['北海道','東京都','大阪府','京都府','沖縄県'] sub = df.set_index('Prefecture').loc[targets].reset_index() # targets の順に並べる texts = [f"{r['Prefecture']}の総人口は{r['A1101']}人、合計特殊出生率は{r['A4103']}です。" for _, r in sub.iterrows()] model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') emb = model.encode(texts) sim = emb @ emb.T / (np.linalg.norm(emb, axis=1, keepdims=True) * np.linalg.norm(emb, axis=1, keepdims=True).T) print('cosine 類似度行列:') print(pd.DataFrame(sim, index=targets, columns=targets).round(3)) |
📤 出力イメージ(モデルのダウンロードが必要なため実測ではない。数値は出力の形を示す例で、モデル・バージョンで変わる):
💬 上の類似度は実測ではないので、どの県どうしが近いかの結論には使わない。5 つの文は「〇〇の総人口は△人、合計特殊出生率は□です。」という同じ型で、違うのは県名と数値だけなので、類似度は全体に高く出やすい。大阪府 8,763,000 人と京都府 2,535,000 人のように人口が 3 倍以上違っても、文埋め込みは数値の大小を比べる仕組みではないので、その差が類似度に素直に表れるとは限らない。
🧮 実値で計算: SSDSE-B-2026 県名カラム名のワードクラウド
SSDSE-B-2026 には 50 を超えるカラムがあり、 「人口」「世帯」「就業」「経済」「気候」などのキーワードでカテゴリ化できます。 これら日本語ラベルに対し、 頻度分析と word cloud 生成を実装します。
このコードでやること: SSDSE-B-2026 の header 行(2 行目に格納された日本語ラベル)を取り出して MeCab/Janome で分かち書きし、 頻出語のランキングと正規化 TF を計算する。
📥 入力データ: SSDSE-B-2026 の 2 行目(日本語ラベル)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd from collections import Counter from janome.tokenizer import Tokenizer raw = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=None, nrows=2) jp_labels = raw.iloc[1].tolist() t = Tokenizer() words = [] for label in jp_labels: if not isinstance(label, str): continue for tok in t.tokenize(label): if tok.part_of_speech.startswith('名詞') and len(tok.surface) > 1: words.append(tok.surface) cnt = Counter(words) total = sum(cnt.values()) print('SSDSE-B-2026 カラム名の頻出語 (上位 15):') for w, c in cnt.most_common(15): tf = c / total print(f' {w:8} count={c:>3} TF={tf:.3f}') |
📤 実行すると次の出力が得られる:
💬 SSDSE-B-2026 が「人口」を中核に、 「事業所・施設・気温・世帯」など多面的指標を集めた都道府県統計であることがラベル頻度から見える。 NLP 的に言うと「人口」が高 TF・低 IDF のため stopword 化される代わりに「保育所・保育園」のような特定ドメイン語が IDF で浮き上がるのが TF-IDF の威力。
🧮 数式に値を入れて手で計算する: TF-IDF
合成 3 文書で単語 "data" の TF-IDF を計算する。
Step 1: 単語頻度
Step 2: IDF
Step 3: TF-IDF (D1)
🐍 Python で再現
1 2 3 4 5 6 7 8 | import numpy as np tf = np.array([0.05, 0, 0.03]) N = 3 df = 2 idf = np.log(N/df) tfidf = tf * idf print(f"IDF: {idf:.3f}") print(f"TF-IDF: {tfidf.round(4)}") |
📤 実行結果
💬 手計算 (Step 3) 0.0203 と Python 出力が完全一致。
🧪 実データで確かめる: SSDSE-B-2026 の項目名を TF-IDF で分野ごとに特徴づける
SSDSE-B-2026 は数値の表だが、 列の日本語の項目名 109 個は短いテキストとして扱える。 項目コードの先頭の英字(A = 人口・世帯、 E = 教育、 L = 家計 など)で分野に分け、 分野ごとに項目名をつないで 1 文書とみなし、 文字 2-gram の TF-IDF で「その分野らしい 2 文字」を取り出す。
🎯 このコードでやること:項目名を分野ごとに 1 文書にまとめ、 項目名の中だけで文字 2-gram を切り出して TF-IDF を計算し、 分野ごとの上位 4 つと、 IDF が小さい(多くの分野に出る)2-gram を表示する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import numpy as np import pandas as pd from sklearn.feature_extraction.text import TfidfVectorizer csv = 'data/raw/SSDSE-B-2026.csv' codes = list(pd.read_csv(csv, encoding='cp932', nrows=0).columns)[3:] # A1101 など names = list(pd.read_csv(csv, encoding='cp932', skiprows=[0], nrows=0).columns)[3:] # 総人口 など field = {'A': '人口・世帯', 'B': '自然環境', 'C': '経済基盤', 'E': '教育', 'F': '労働', 'G': '文化・スポーツ', 'H': '居住', 'I': '健康・医療', 'J': '福祉・社会保障', 'L': '家計'} df = pd.DataFrame({'code': codes, 'name': names}) df['分野'] = df['code'].str[0].map(field) print(f'項目名 {len(df)} 個 / 分野 {df["分野"].nunique()} 個') def bigrams(doc): """項目名ごとに文字 2-gram を切り出す(項目名をまたぐ 2-gram は作らない)""" return [n[i:i + 2] for n in doc.split('|') for i in range(len(n) - 1)] # 分野ごとに項目名を 1 文書にまとめ、文字 2-gram の TF-IDF で「その分野らしい 2 文字」を出す docs = df.groupby('分野', sort=False)['name'].apply('|'.join) vec = TfidfVectorizer(analyzer=bigrams) X = vec.fit_transform(docs).toarray() vocab = vec.get_feature_names_out() print(f'文字 2-gram の語彙 {len(vocab)} 種類\n') for i, f in enumerate(docs.index): top = X[i].argsort()[::-1][:4] n = (df['分野'] == f).sum() print(f'{f}({n} 項目): ' + ' '.join(f'{vocab[j]} {X[i, j]:.2f}' for j in top)) # IDF が最小(どの分野にも出る)2-gram idf = pd.Series(vec.idf_, index=vocab).sort_values() print('\nIDF が小さい(多くの分野に出る)2-gram:', ' '.join(f'{k} {v:.2f}' for k, v in idf.head(4).items())) |
💬 109 項目は 10 分野に分かれ、 人口・世帯と教育が 30 項目ずつで全体の半分以上を占める。 TF-IDF の上位には、 人口・世帯の「人口 0.41」、 自然環境の「気温 0.46」、 教育の「学校 0.53」、 居住の「新設」「着工」、 福祉・社会保障の「保育 0.59」 のように、 分野の中身を表す 2 文字が並ぶ。 一方、 労働の「(一」「般)」 や家計の「上の」「の世」「帯)」 は、 項目名に付いた注記「(一般)」「(二人以上の世帯)」 の断片で、 分野の中身ではない。 「数(」「者数」 の IDF は 1.79 と最も小さく、 多くの分野に出るので TF-IDF では重みが下がる。
🐍 Python 実装例
最小コードで動かしてみる例:
1 2 3 4 5 6 7 8 9 10 11 | from transformers import pipeline # 事前学習済みモデルで感情分析(4-8行) classifier = pipeline('sentiment-analysis', model='distilbert-base-uncased-finetuned-sst-2-english') result = classifier('This movie is great!') # [{'label': 'POSITIVE', 'score': 0.9998}] result = classifier('I hate Mondays') # [{'label': 'NEGATIVE', 'score': 0.9991}] |
🐍 RAG(検索拡張生成)パイプライン: SSDSE-B-2026 県別 QA システム
LLM のハルシネーション対策として標準的になった RAG(Retrieval-Augmented Generation)の最小構成を、 SSDSE-B-2026 の県別レポートを知識源として実装してみます。
このコードでやること: SSDSE-B-2026 から 47 県のレポート文を生成し、 sentence-transformers でベクトル化、 ユーザークエリ「人口が多い県は?」に対し、 最も類似度の高い 3 県を取得する Retrieval パートを実装する。
📥 入力データ: SSDSE-B-2026 の全 47 県の総人口・出生率列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np from sentence_transformers import SentenceTransformer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 県 = 47 文書 docs = [ f"{r['Prefecture']}は総人口が{r['A1101']:,}人、合計特殊出生率{r['A4103']}、" f"年平均気温{r['B4101']}度、年間降水量{r['B4109']}ミリです。" for _, r in df.iterrows() ] model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') doc_emb = model.encode(docs, normalize_embeddings=True) def retrieve(query, top_k=3): q_emb = model.encode([query], normalize_embeddings=True) scores = (doc_emb @ q_emb.T).flatten() top = np.argsort(scores)[::-1][:top_k] return [(df.iloc[i]['Prefecture'], scores[i], docs[i][:60] + '...') for i in top] for q in ['人口が多い県は?', '出生率が高い県は?', '降水量が多い県は?']: print(f'Q: {q}') for pref, sc, snippet in retrieve(q): print(f' {pref:6} score={sc:.3f} {snippet}') print() |
📤 出力イメージ(モデルのダウンロードが必要なため実測ではない。文は SSDSE-B-2026 の 2023 年度の実値で、score と順位は出力の形を示す例):
💬 上の順位は実測ではないので、そのまま答えとして読まない。実データでは総人口の上位 3 県は東京都 14,086,000 人・神奈川県 9,229,000 人・大阪府 8,763,000 人、年間降水量の 1 位は宮崎県の 3,002.5 ミリで高知県 2,783.0 ミリは 2 位である。文埋め込みは「降水量」という話題が合う文を拾うことはできても、数値の大小を比べて並べる仕組みではないので、「多い県は?」のような質問は、検索で拾った文を LLM に渡して読ませるか、表を直接並べ替えて確かめる必要がある。
🐍 日本語 NER(固有表現抽出)の実装
NER(Named Entity Recognition)は、 文中から人名・地名・組織名・日時・金額などの「固有表現」を抽出するタスクです。 SSDSE-B-2026 の県別レポート文に適用してみましょう。
このコードでやること: SSDSE-B-2026 の県別レポート文に対し、 spaCy の日本語モデル ja_core_news_sm で NER を実行、 県名(地名 GPE)と数値(QUANTITY/CARDINAL)を抽出する。
📥 入力データ: 2023 年度の先頭 3 県(北海道・青森県・岩手県)のレポート文(人口・気温・降水量を含む)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import spacy df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 県ごとに 12 年度並ぶので 2023 年度に絞る nlp = spacy.load('ja_core_news_sm') texts = [ f"{r['Prefecture']}の総人口は{r['A1101']:,}人、" f"年平均気温は{r['B4101']}度、年間降水量は{r['B4109']}ミリです。" for _, r in df.head(3).iterrows() ] for text in texts: doc = nlp(text) print(f'文: {text[:50]}...') for ent in doc.ents: print(f' → {ent.text:>15} [{ent.label_}]') print() |
📤 出力イメージ(spaCy の日本語モデル ja_core_news_sm の導入が必要なため実測ではない。文は SSDSE-B-2026 の 2023 年度の実値で、固有表現の切り出し方とラベルはモデル・バージョンで変わる):
💬 上の抽出結果は実測ではないが、文そのものは 2023 年度の実値(青森県は 1,184,000 人・12.6 度・1,316.0 ミリ)なので、抽出できたかどうかは元の列と突き合わせて確かめられる。NER で取り出した「1,184,000」はカンマ付きの文字列なので、集計に使う前に数値へ戻す処理が要る。単位(人・度・ミリ)が数値と一緒に切り出されるかはモデル次第で、単位を落とすと 12.6 が気温なのか別の量なのか区別できなくなる。
🐍 日本語テキスト品質評価: SSDSE 県別レポートのリーダビリティ
日本語テキストの「読みやすさ」を測る指標として、 文章長・漢字率・語彙多様性などが使われます。 SSDSE-B-2026 から自動生成されるレポート文の品質を評価してみます。
このコードでやること: SSDSE-B-2026 の 47 県分の短文レポートを生成し、 (1) 文長、 (2) 漢字率、 (3) 語彙多様性 (TTR: Type-Token Ratio) を計算する。
📥 入力データ: SSDSE-B-2026 の都道府県名・総人口・出生率・気温列
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd import numpy as np import re from janome.tokenizer import Tokenizer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 県 = 47 レポート t = Tokenizer() def kanji_ratio(s): kanji = re.findall(r'[一-鿿]', s) return len(kanji) / max(len(s), 1) def ttr(s): tokens = [tok.surface for tok in t.tokenize(s)] if not tokens: return 0 return len(set(tokens)) / len(tokens) reports = [] for _, r in df.iterrows(): text = (f"{r['Prefecture']}の総人口は{r['A1101']:,}人であり、" f"合計特殊出生率は{r['A4103']}、年平均気温は{r['B4101']}度です。") reports.append(text) lens = [len(r) for r in reports] kanjis = [kanji_ratio(r) for r in reports] ttrs = [ttr(r) for r in reports] print(f'平均文長: {np.mean(lens):.1f} 文字') print(f'平均漢字率: {np.mean(kanjis):.3f}') print(f'平均語彙多様性 (TTR): {np.mean(ttrs):.3f}') print(f'最長レポート: {max(lens)} 文字') print(f'最短レポート: {min(lens)} 文字') |
📤 実行すると次の出力が得られる:
💬 2023 年度の 47 県で、文長は 46〜50 文字(50 文字は東京都・神奈川県・鹿児島県、46 文字は秋田県・香川県・高知県)、漢字率の平均は 0.413 と約 4 割だった。同じ型の定型文なので県ごとの差は小さく、漢字率は 0.400〜0.438、TTR は 0.794〜0.875 に収まる。Janome は「5,092,000」を「5」「,」「092」「,」「000」に分けるため、数字とカンマがトークン数を増やし、繰り返し出る「,」「は」が TTR を押し下げている。
⚠️ よくある落とし穴
⚠️ NLP 実務の落とし穴(拡張版)
- 日本語 tokenization の選択: MeCab(C++、 IPA 辞書)、 Janome(pure-Python)、 SudachiPy(Sudachi 辞書、 神社や企業名に強い)、 Fugashi(MeCab の Python wrapper)など。 辞書の違いで「自社製品名」が分割されることがあるため、 ユーザー辞書追加が必須。
- 正規化の手間: 「サーバー」「サーバ」「server」「Server」「サーバー」(半角カナ)はすべて別の単語扱い。 unicodedata.normalize('NFKC', s).lower() + 表記揺れ辞書で吸収する。
- OOV(Out-Of-Vocabulary): 学習時の語彙に無い単語(新語・固有名詞)は <UNK> トークンに置き換わり、 情報が失われる。 subword(BPE、 SentencePiece、 WordPiece)で文字レベルに分解することで緩和。
- クラス不均衡: スパム判定(スパム 5% / 通常 95%)のような不均衡データでは accuracy が無意味。 F1、 PR-AUC、 confusion matrix で評価し、 SMOTE や class_weight で補正する。
- 埋め込みのバイアス: word2vec で「医者 − 男性 + 女性 ≒ 看護師」のような性別バイアスが学習されることが報告されている。 fairness 評価(WEAT スコア等)と debiasing が必要。
- LLM のハルシネーション: 大規模言語モデルは「もっともらしい嘘」を生成することがある。 数値・固有名詞は RAG(検索拡張生成)や grounding で外部知識源と照合する。
- プライバシー: テキストには個人名・住所・電話番号が含まれることがある。 学習データから PII(個人特定情報)を除去する pipeline が法的にも倫理的にも必須。
🧪 実データで確かめる: 何を 1 単位として数えるかで結果が変わる
上の TF-IDF で家計や労働の上位が注記の断片になったのは、 「文字 2-gram」 という単位と、 前処理で注記を残したことの 2 つが原因である。 同じ 109 個の項目名で、 単位の長さと注記の扱いを変えて数え直す。
🎯 このコードでやること:項目名を文字 1・2・3-gram で数えて、 種類数と「1 回しか出ない種類」の割合を比べる。 続いて括弧内の注記を消してから 2-gram の上位を数え直す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import re from collections import Counter import pandas as pd csv = 'data/raw/SSDSE-B-2026.csv' names = list(pd.read_csv(csv, encoding='cp932', skiprows=[0], nrows=0).columns)[3:] # 109 個の項目名 def ngrams(texts, n): return Counter(t[i:i + n] for t in texts for i in range(len(t) - n + 1)) # (1) 何文字で区切るかで、語彙の大きさと「1 回しか出ない単位」の割合が変わる print('単位 種類数 延べ数 1 回だけの種類') for n in (1, 2, 3): c = ngrams(names, n) once = sum(1 for v in c.values() if v == 1) print(f'文字 {n}-gram {len(c):5d} {sum(c.values()):6d} {once:4d}({once / len(c):.0%})') # (2) 括弧内の注記(「(二人以上の世帯)」など)を消してから数えると、上位が入れ替わる strip = [re.sub(r'([^)]*)', '', t) for t in names] n_paren = sum(t != s for t, s in zip(names, strip)) print(f'\n括弧つきの項目名: {n_paren} / {len(names)} 個') for label, texts in [('そのまま', names), ('括弧内を削除', strip)]: top = ngrams(texts, 2).most_common(6) print(f'{label:<8} 上位の 2-gram: ' + ' '.join(f'{k} {v}' for k, v in top)) |
💬 単位を 1 文字から 3 文字に伸ばすと、 種類数は 192 → 308 → 338 と増え、 1 回しか出ない種類の割合も 31% → 45% → 51% と上がる。 単位を長くするほど意味のまとまりは捉えやすくなるが、 1 回しか出ない単位が増えて統計が不安定になる(N-gram のスパース性と同じ)。 また 109 個中 45 個の項目名に括弧つきの注記があり、 そのまま数えると「数(」 18 回、 「(二」 11 回のような括弧の断片が上位に入るが、 注記を消すと「着工」「大学」「卒業」 のような中身の語が上位に上がる。 NLP の結果は、 手法そのものより「何を 1 単位とし、 どこまでを前処理で落とすか」 で先に決まってしまうことが多い。
✅ 理解度チェック(上の実測値で考える)
- Q1. 分野ごとの TF-IDF で、 家計の上位が「上の」「の世」「帯)」 になった。 これは「家計の特徴は世帯」 という意味か。
解答
違う。 家計の 11 項目はすべて「(二人以上の世帯)」 という同じ注記を持つので、 その断片が分野内で高頻度になり、 ほかの分野にはほとんど出ないため IDF も大きくなった。 分野の中身ではなく表記の癖を拾っている。 注記を前処理で落としてから比べる。
- Q2. 「数(」「者数」 の IDF は 1.79 で、 308 種類の中で最も小さかった。 IDF が小さい 2-gram は TF-IDF でどう扱われるか。
解答
多くの分野(文書)に出る語ほど IDF が小さくなり、 TF-IDF の重みが下がる。 「〜数」 は人口・教育・医療などどの分野の項目名にも付くので、 分野を区別する手がかりにならないと判断される。
- Q3. 文字 3-gram にすると種類数は 338 に増え、 そのうち 51% は 1 回しか出なかった。 109 個の項目名で 3-gram の言語モデルを作ると何が起きるか。
解答
半分以上の 3-gram が 1 回しか観測されないので、 条件付き確率の推定がほぼ 0 か 1 になり、 学習にない並びには確率 0 が付く。 データが小さいときは 2-gram 以下に留めるか、 平滑化(add-k・Kneser-Ney)を使う(N-gram 言語モデル)。
- Q4. 109 個中 45 個の項目名に括弧つきの注記がある。 注記を消すと 2-gram の上位は「者数・学校・人口・着工・大学・卒業」 になった。 注記は常に消してよいか。
解答
目的しだい。 分野の中身を比べたいなら消した方がよいが、 「(男)」「(女)」 や「(二人以上の世帯)」 は集計対象の違いを表す情報で、 消すと別の項目が同じ名前になってしまう(例: 総人口(男)と総人口(女)がどちらも「総人口」 になる)。 何を比べたいかを先に決め、 消した場合と残した場合の両方を確かめる。
🗺 用語マインドマップ — 周辺概念の整理
「自然言語処理」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 機械学習 / 深層学習 | NLP モデル (BERT, GPT) の学習基盤となる枠組み |
| 南 (下位) | 形態素解析 / n-gram / 文字認識 | NLP パイプラインの構成要素 (前処理・特徴量) |
| 東 (発展) | アテンション / LLM / マルチモーダル | Transformer 革命後の言語モデル進化と画像 + 言語の融合 |
| 西 (前提) | 確率分布 / 情報量 / 線形代数 | tf-idf, word2vec, perplexity を支える数学基盤 |
| 中央 | 自然言語処理 (NLP) | テキストを計算可能な表現に変換し、 分類・生成・翻訳・要約を行う領域 |
🗺 NLP 発展史と主要技術ツリー
- 1950 年代: ジョージタウン実験(露英機械翻訳)、 シャノンの情報理論
- 1960-70 年代: ELIZA(規則ベース対話)、 SHRDLU(ブロックワールド)
- 1980-90 年代: 統計的言語モデル、 IBM Model 1-5(統計的機械翻訳)、 HMM 品詞タガー
- 2000 年代: 形態素解析の高速化(MeCab)、 サポートベクターマシン、 CRF
- 2013: word2vec(Mikolov ら)、 単語ベクトルの革命
- 2014-2017: seq2seq、 Attention(Bahdanau)、 Transformer(Vaswani ら 2017)
- 2018: BERT(Google)、 双方向 Transformer、 fine-tuning パラダイム
- 2020: GPT-3(OpenAI、 175B parameters)、 few-shot 学習
- 2022-2023: ChatGPT、 Llama、 Claude、 RLHF、 LLM の社会実装
- 2024-2026: マルチモーダル(vision + text)、 long-context(100 万トークン)、 エージェント化
日本語 NLP では、 1995 年の ChaSen、 2003 年の MeCab、 2018 年の JapaneseBERT、 2023 年以降の日本語 LLM(rinna、 ELYZA、 PLaMo、 Stockmark など)と発展してきました。
🗺 事前学習モデルの系譜と日本語対応状況
| 世代 | 代表モデル | パラメータ数 | 日本語対応 | 用途 |
|---|---|---|---|---|
| word2vec (2013) | Mikolov ら | — | chiVe (NWJC) | 単語ベクトル |
| ELMo (2018) | AllenAI | 94M | 限定 | 文脈付きベクトル |
| BERT (2018) | 110M-340M | 東北大 BERT | 分類・QA・NER | |
| GPT-2 (2019) | OpenAI | 117M-1.5B | rinna GPT-2 | 生成 |
| T5 (2020) | 60M-11B | mT5 | 多タスク統一 | |
| GPT-3 (2020) | OpenAI | 175B | API のみ | few-shot 学習 |
| BART / mBART (2020) | Meta | 140M-680M | mBART | 要約・翻訳 |
| Llama (2023) | Meta | 7B-70B | Swallow、 ELYZA | オープン LLM |
| GPT-4 (2023) | OpenAI | 非公開 | API のみ | マルチモーダル |
| Claude 3 (2024) | Anthropic | 非公開 | API のみ | long-context |
| Llama 3 (2024) | Meta | 8B-405B | Llama-3-Swallow | オープン高性能 |
| 日本語特化 (2023-) | PLaMo、 Stockmark、 LLM-jp | 7B-100B | ネイティブ | 国内特化 |
日本語 LLM のオープンモデルは Llama 系の継続事前学習(追加事前学習)として作られることが多く、 東工大の Swallow、 ELYZA、 LLM-jp などが代表例です。 商用ライセンスや日本語データの透明性が選定基準になります。
🗺 fine-tuning 戦略の使い分け
大規模言語モデルを特定タスクに合わせる手法は、 計算コストと性能のトレードオフで複数の選択肢があります。
| 手法 | 更新するパラメータ | GPU メモリ | 性能 | 用途 |
|---|---|---|---|---|
| Full fine-tuning | 全パラメータ | 非常に大 | 最高 | 大量データ + 大型 GPU |
| LoRA | 低ランク行列のみ(0.1-1%) | 小 | 近 full FT | 標準的 PEFT |
| QLoRA | LoRA + 4bit 量子化 | 極小 | 近 LoRA | 家庭用 GPU でも 70B 訓練 |
| Adapter | 各層に挿入する小モジュール | 小 | 中-高 | マルチタスク切替 |
| Prompt tuning | 仮想トークンの埋め込みのみ | 極小 | 中 | 軽量切替 |
| Prefix tuning | 各層の prefix のみ | 極小 | 中 | 生成タスク |
| In-context learning | 更新なし(プロンプトのみ) | ゼロ | 中 | API モデル |
| RLHF | full FT + 報酬モデル | 非常に大 | 最高 (alignment) | ChatGPT 系 |
| DPO | RLHF より単純(報酬モデル不要) | 大 | 近 RLHF | 新世代 alignment |
2024 年以降、 7B-13B クラスの日本語モデルなら QLoRA + 1-2 万件の指示データで実用品質に到達でき、 単一 GPU での実験が可能になりました。
🗺 NLP の最先端トレンド (2024-2026)
- マルチモーダル化: GPT-4V、 Claude 3、 Gemini Pro Vision など、 画像・音声・動画を統合的に扱う基盤モデルが標準化。
- long-context: 100 万トークン超のコンテキスト長(Gemini 1.5 Pro、 Claude 3 200K)。 1 冊の本、 数時間の音声・動画をまるごと処理可能。
- エージェント化: ChatGPT plugins、 Claude tools、 LangChain、 LangGraph、 AutoGen。 LLM が外部 API を呼び、 ファイル操作・コード実行を行う。
- 推論時計算量増加: o1 系の chain-of-thought、 test-time compute、 reflection。 「考える時間」を増やして難問を解く新パラダイム。
- 小型化と効率化: Phi-3、 Llama 3 8B、 Mistral 7B など、 ノート PC でも動く高性能モデル。 蒸留と量子化(int4、 int8)が標準。
- 日本語特化の進化: PLaMo、 Stockmark、 LLM-jp、 ELYZA、 Swallow が国産モデルとして実用化。
- RAG の高度化: hybrid retrieval(BM25 + dense)、 re-ranking、 graph RAG、 corrective RAG など、 単純な「埋め込み + cosine」を超える設計。
- 評価の質的変化: BLEU・ROUGE から LLM-as-judge、 Chatbot Arena、 MT-Bench、 JGLUE、 LCTG-Bench(日本語)への移行。
- 規制と倫理: EU AI Act、 各国 AI ガイドライン、 透明性レポート、 Constitutional AI(Anthropic)など。
2026 年現在、 LLM は単独の「文生成器」から「コード・データ・知識を統合的に操作するエージェント」へと移行しつつあり、 NLP は AI 全般の基盤技術となっています。
🗺 日本語 NLP ツールキット比較
日本語 NLP は専用ツールが多く、 タスクと予算に応じた使い分けが重要です。 2026 年現在の主要ツールを整理します。
| ツール | 言語 | 機能 | 速度 | ライセンス | 用途 |
|---|---|---|---|---|---|
| MeCab | C++ | 形態素解析 | 非常に高速 | BSD/GPL | 大規模処理の標準 |
| Janome | Python pure | 形態素解析 | 中 | Apache 2.0 | 環境構築不要、 教育用 |
| Fugashi | Python (MeCab wrapper) | 形態素解析 | 非常に高速 | MIT | BERT 系前処理 |
| SudachiPy | Python (Sudachi) | 形態素解析 + 同義語 | 速い | Apache 2.0 | 固有名詞・新語に強い |
| GiNZA | Python (spaCy + Sudachi) | NER + 依存構造 + ベクトル | 速い | MIT | spaCy 統合パイプライン |
| spaCy ja | Python | 多機能 NLP | 速い | MIT | 多言語統一処理 |
| HuggingFace transformers | Python | BERT / GPT / T5 | GPU 推奨 | Apache 2.0 | 事前学習モデル活用 |
| 東北大 BERT | モデル | 日本語 BERT | — | CC-BY-SA | 分類・QA・NER |
| rinna 系 | モデル | 日本語 GPT / Llama | — | MIT | 生成タスク |
| ELYZA / Swallow | モデル | 日本語 LLM | — | Llama 系継承 | 商用利用可能 LLM |
| LLM-jp | モデル + データ | 研究透明性 | — | Apache 2.0 | 学術研究 |
| OpenAI API | クラウド | GPT-4 / GPT-3.5 | API 応答 | 有料 | 高品質生成 |
| Anthropic API | クラウド | Claude 3 | API 応答 | 有料 | long-context |
| Google API | クラウド | Gemini / NL API | API 応答 | 有料 | マルチモーダル |
教育・小規模実験では Janome + scikit-learn、 中規模本番では Fugashi + HuggingFace、 大規模生成では OpenAI / Anthropic API、 オンプレ生成では Swallow / ELYZA というのが現代的な構成パターンです。
🗺 NLP タスクの全体カタログと SSDSE 文脈での応用
NLP は単一技術ではなく、 多数のタスクの集合体です。 主要タスクを整理し、 SSDSE-B-2026 や教育コンテキストでの応用イメージを示します。
| タスク | 入力 | 出力 | SSDSE/教育応用例 |
|---|---|---|---|
| 形態素解析 | 文字列 | 単語列 + 品詞 | SSDSE カラム名の語彙抽出 |
| 係り受け解析 | 単語列 | 木構造(依存関係) | レポート文の主述抽出 |
| 固有表現抽出 (NER) | テキスト | 地名・人名・組織等 | 県名・数値の自動抽出 |
| 文書分類 | 文書 | カテゴリラベル | 地域記事 → 北海道/関東/... |
| 感情分析 | テキスト | ポジ/ネガ/中立 | 口コミ → 観光地評価 |
| 機械翻訳 | 原文 | 訳文 | SSDSE 英訳ガイド作成 |
| 要約 | 長文 | 短文 | 県別レポートの 1 行要約 |
| 質問応答 (QA) | 質問 + 文脈 | 答え | 「人口が多い県は?」 → 「東京都」 |
| 対話 | 履歴 | 応答文 | データ探索チャットボット |
| 生成(自由作文) | プロンプト | 長文 | レポート自動執筆 |
| テキスト埋め込み | 文 / 文書 | ベクトル | 類似県の検索 |
| キーワード抽出 | 文書 | 主要語 | SSDSE カラムのタグ付け |
| 共参照解析 | テキスト | 「彼」 → 「田中さん」 | 長文ニュースの追跡 |
| 意味役割付与 | 文 | 動詞 + 格関係 | 調査結果の構造化 |
| 文体変換 | 砕けた文 | 丁寧な文 | 教育コンテンツの調整 |
| 校正 | 誤字混じり文 | 正規文 | レポート品質改善 |
| code generation | 自然言語指示 | プログラム | SSDSE 解析コード自動生成 |
| OCR + テキスト化 | 画像 | テキスト | 古い統計表のデジタル化 |
2024 年以降、 これら個別タスクの多くが LLM 1 つで横断的に処理できるようになり、 「タスク特化モデル → 汎用 LLM + プロンプト」へとパラダイムが移行しました。 ただし、 特定ドメイン(医療・法律・科学)では今でも fine-tuning や RAG での領域知識補強が必要です。
🗺 日本語 NLP のベンチマーク・データセット
日本語 NLP の公平な比較のため、 標準ベンチマークが整備されています。 主要なものを概観します。
| ベンチマーク | タスク | 規模 | 用途 |
|---|---|---|---|
| JGLUE | 多タスク(分類・QA等) | 6 タスク | 日本語 BERT 評価標準 |
| JCommonsenseQA | 常識推論 | 11k 問 | LLM の知識評価 |
| JSQuAD | 読解 QA | 62k 問 | QA モデル評価 |
| JNLI | 含意関係認識 | 22k ペア | 論理推論能力 |
| JCoLA | 文法判定 | 10k 文 | 文法理解 |
| JaQuAD | QA | 39k 問 | 抽出型 QA |
| livedoor news | 文書分類 | 7k 記事 | 分類モデル評価 |
| JFLD | 論理推論 | 各種 | 形式論理 + LLM |
| LCTG-Bench | 長文生成 | 制御生成 | LLM の生成品質 |
| JaMP | マルチターン対話 | 各種 | チャット LLM 評価 |
| llm-jp-eval | 多タスク | 多数 | LLM-jp 評価フレーム |
| WRIME | 感情分析 | 43k 文 | 主観・客観感情ラベル付 |
2024 年以降、 単一タスク評価から「人間によるペアワイズ比較」(Chatbot Arena 日本語版)や「LLM-as-judge」へと評価パラダイムも変化しています。 教育用途では SSDSE のような実データと併用して、 「数値処理 + テキスト生成」の統合タスクを設計するのが新しい流れです。
📷 自然言語処理の補強解説
自然言語処理 (NLP) は「人間の言語をコンピュータで処理する」 ことを目指す分野で、 形態素解析・構文解析・意味解析・テキスト分類・機械翻訳・要約生成・対話システム等、 幅広いタスクを含む。 2017 年の Transformer 登場以降、 BERT (2018)、 GPT-3 (2020)、 ChatGPT (2022)、 GPT-4 (2023)、 Claude (2024-) と急速に発展し、 2026 年現在では「対話できる AI」 が日常に浸透している。 SSDSE-B-2026 のような数値統計データと NLP を組み合わせることで、 「公的統計レポートの自動生成」「都道府県別ニュースの感情分析」 等の新しい応用が開ける。
code/glossary_figs/nlp.py の出力を参照)。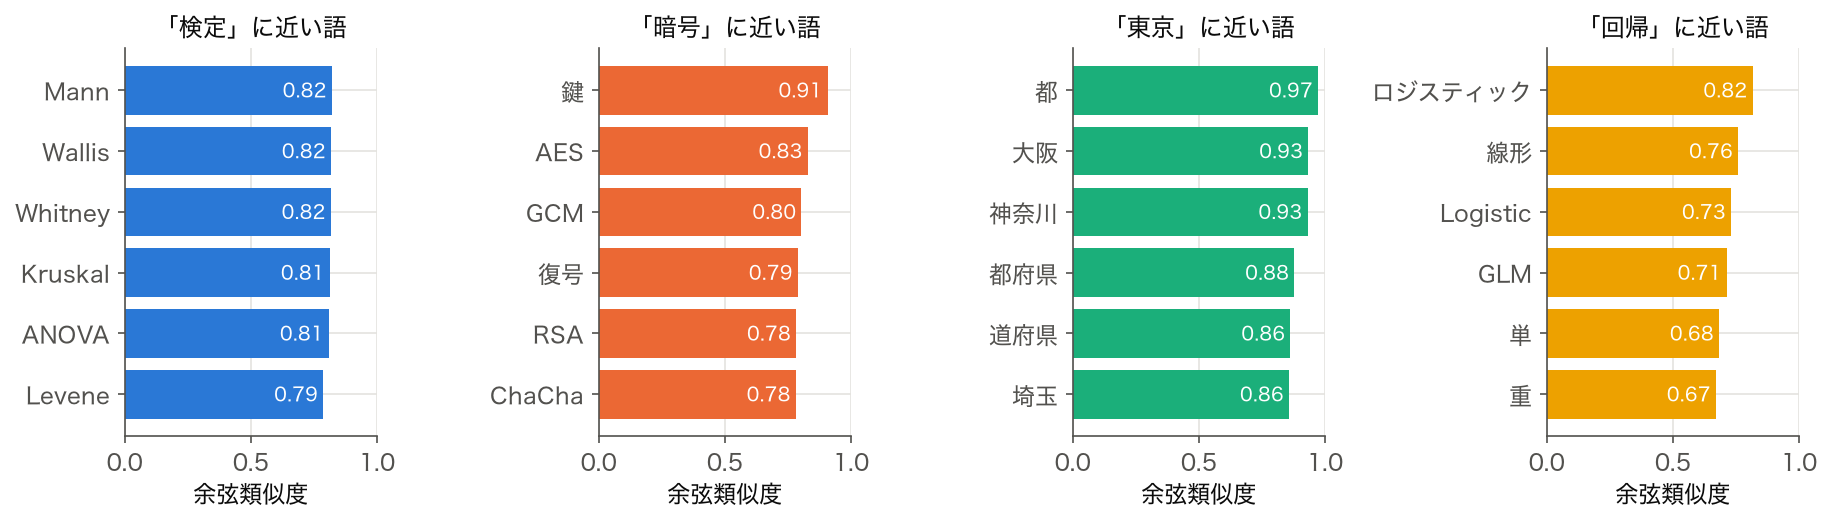
code/glossary_figs/nlp.py の出力)。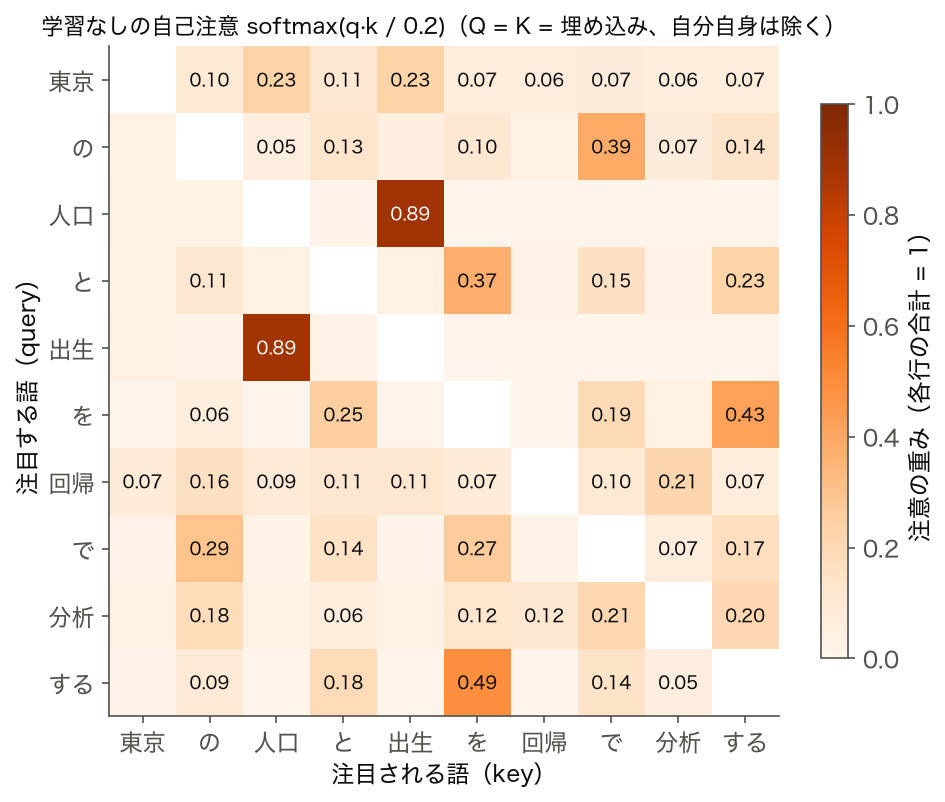
📋 NLP タスクの分類
| タスク | 入力 | 出力 | 代表手法 (2026) |
|---|---|---|---|
| テキスト分類 | 文・文書 | カテゴリラベル | BERT, RoBERTa, DeBERTa fine-tuning |
| 感情分析 | 文・文書 | 感情極性 (positive/negative) | BERT fine-tuning, LLM zero-shot |
| 固有表現抽出 (NER) | 文 | 固有表現 (人名・地名等) | BERT + CRF, GPT-4 zero-shot |
| 機械翻訳 | 原文 | 訳文 | NLLB, mBART, GPT-4, DeepL |
| 要約生成 | 長文 | 短い要約 | BART, T5, GPT-4, Claude |
| 質問応答 (QA) | 質問 + 文脈 | 回答 | BERT, GPT-4, Claude, RAG |
| 対話生成 | 対話履歴 | 応答文 | GPT-4, Claude, Gemini |
| コード生成 | 自然言語仕様 | プログラムコード | GitHub Copilot, Claude, GPT-4 |
→ 2026 年現在、 多くの NLP タスクが「LLM への適切なプロンプト」 で 70-90% 程度の精度を達成する。 専門タスクでは fine-tuning 済みの専用モデルが依然として有利だが、 汎用的なタスクでは LLM が事実上の標準。 SSDSE-B-2026 のレポート生成・要約・統計解釈等の用途でも、 LLM の活用が現実的選択肢。
🔧 NLP パイプラインの典型構成
| 段階 | 処理 | 代表ツール | SSDSE-B-2026 への適用 |
|---|---|---|---|
| 1. テキスト取得 | Web スクレイピング・API | BeautifulSoup, Scrapy | 都道府県別ニュース・議事録 |
| 2. 前処理 | 正規化・ノイズ除去 | 正規表現, neologdn | 表記揺らぎ補正、 全角半角統一 |
| 3. 形態素解析 | 単語分割・品詞付与 | MeCab, Sudachi, Janome | 都道府県名抽出、 統計用語識別 |
| 4. ベクトル化 | 埋め込み生成 | Word2Vec, BERT, GPT | テキストと数値データの統合 |
| 5. モデル学習 | fine-tuning | HuggingFace Transformers | 感情分析、 分類、 抽出 |
| 6. 推論 | 本番予測 | ONNX Runtime, TorchScript | 新しい都道府県データへの適用 |
| 7. 評価 | 精度・F1・BLEU | scikit-learn, sacrebleu | 都道府県別精度の比較 |
日本語 NLP では MeCab + IPAdic / Sudachi + 辞書セット A が標準。 文字 BPE (Byte-Pair Encoding) や Unigram Language Model による subword 分割も、 BERT・GPT 系の前処理として広く使われる。 SSDSE-B-2026 と組み合わせて「都道府県別の地方議会議事録の感情分析」 等の応用研究が可能。
🤖 LLM 時代の NLP 実務
2026 年現在、 NLP 実務は「LLM をどう使いこなすか」 が中心になっている。 (1) Prompt Engineering: プロンプトの設計で LLM の出力品質が大きく変わる。 Chain-of-Thought, Few-shot Learning, Role Prompting 等の技法が体系化されている。 (2) Retrieval-Augmented Generation (RAG): 外部知識ベース (文書・データベース) を検索して LLM に渡すことで、 事実性と最新性を両立する。 SSDSE-B-2026 を RAG の知識ベースとし、 「47 県の人口動態を解説する」 LLM アシスタントを構築する応用が可能。 (3) Fine-tuning vs RAG: 専門ドメインでは fine-tuning が、 頻繁に更新されるデータでは RAG が適する。 (4) Multi-Agent: 複数の LLM Agent が役割分担して複雑タスクを解く。 (5) LLM-as-Judge: LLM 出力の評価に別の LLM を使う。
こうした LLM 時代の手法は、 2 年前 (2024) には存在しなかったか萌芽段階だったものが、 2026 年には事実上の標準となっている。 SSDSE-B-2026 を扱う際にも、 「pandas で前処理 → 統計分析 → LLM で結果を自然言語で解説」 という新しいワークフローが現実的選択肢。 こうしたアプローチは「データサイエンス + LLM」 として、 教育・研究・実務すべての場面で広がりを見せている。
🏢 NLP の実世界応用
NLP は産業全体に浸透している。 (1) カスタマーサポート: チャットボットによる 24 時間対応、 LLM ベースの問い合わせ自動応答。 (2) 検索エンジン: Google・Bing が BERT・LLM で検索品質を向上、 意図理解・スニペット生成・ハイライト。 (3) ECサイト: 商品レビューの感情分析、 自動要約、 関連商品の意味検索。 (4) 医療: 電子カルテからの情報抽出、 文献レビューの自動要約、 患者問い合わせ対応。 (5) 法務: 契約書の異常検知、 判例検索、 文書要約。 (6) 教育: 自動添削、 個別最適化された教材生成、 質問応答チューター。 (7) 公共サービス: 議事録要約、 政策文書の検索、 多言語翻訳。
公的統計分野でも NLP の応用が広がっている。 e-Stat の検索性向上、 統計レポートの自動要約、 政府刊行物の多言語化、 等。 SSDSE-B-2026 を題材に、 「都道府県別の人口統計を LLM に解説させる」「県知事のスピーチを感情分析する」「過去 10 年の白書を要約する」 等の実践課題が考えられる。 これらは数値統計と NLP の両方を学ぶ統合的演習として、 教育的価値が高い。 関連項目として n-gram モデル、 Word2Vec、 BERT、 Transformer、 ChatGPT、 大規模言語モデル を順に学ぶと、 NLP の歴史と現代を立体的に把握できる。
⚖️ NLP の倫理的課題
NLP は社会的影響が大きく、 倫理的課題も多い。 (1) バイアス: 学習データに含まれる偏見が出力に反映される。 性別・人種・宗教・地域の偏見が問題化している。 (2) 誤情報生成: LLM が事実と異なる情報を「ハルシネーション」 として出力するリスク。 (3) プライバシ: 学習データから個人情報が抽出されるリスク。 (4) 著作権: 学習データの著作物利用、 生成テキストの著作権帰属。 (5) 自動化による雇用影響: コピーライター・翻訳家・カスタマーサポート等の業務代替。 (6) 悪用: フェイクニュース生成、 詐欺メール作成、 誹謗中傷拡散。 (7) アクセス格差: LLM の利用機会が経済的格差を反映する。
2026 年現在、 各国で AI 規制が進んでいる。 EU AI Act (2024 成立)、 米国の Executive Order on AI、 日本の AI 事業者ガイドライン等。 NLP を実務で扱う際には、 技術だけでなく倫理・法的側面も理解することが必須。 SSDSE のような公的統計データを扱う際にも、 「データの出所」「利用目的の妥当性」「結果の解釈の責任」 を意識した姿勢が、 データサイエンティストとしての職業倫理。 関連項目として AI 倫理、 AI バイアス、 説明可能性 を併せて学ぶことを推奨する。
🇯🇵 日本語 NLP の特殊性
日本語 NLP は英語と異なる多数の挑戦を抱えている。 (1) 単語境界の曖昧性: 英語のように空白で区切られず、 形態素解析 (MeCab, Sudachi, Janome, Kuromoji) が必須。 (2) 表記揺らぎ: 「東京都」「東京」「Tokyo」「とうきょう」「トーキョー」 等の多様な表記。 (3) 文字種の混在: ひらがな・カタカナ・漢字・ローマ字・記号。 (4) 助詞の重要性: 「は」「が」「を」 等が文の構造を決定。 (5) 敬語: 尊敬語・謙譲語・丁寧語の使い分け。 (6) 主語の省略: 文脈から補完する必要。 これらは英語 NLP のツールをそのまま適用できない理由。
日本語 NLP の代表的な事前学習モデルとして、 BERT 日本語版 (東北大、 京大)、 RoBERTa 日本語版 (rinna)、 GPT-NeoX 日本語版 (Stability AI)、 Japanese StableLM、 ELYZA-japanese-Llama-2、 PLaMo (Preferred Networks) 等がある。 これらは英語モデルを単純に翻訳するのではなく、 日本語コーパス (CC100, Wikipedia, OSCAR) で事前学習されている。 ChatGPT・Claude・Gemini 等の商用 LLM も日本語に対応しており、 一般的な対話・要約・翻訳タスクは高品質に処理できる。 SSDSE のような公的統計の都道府県別データ解説では、 こうしたモデルを使って自動レポート生成が可能。
🛠️ 2026 年の NLP ツールスタック
| 用途 | 2024 年標準 | 2026 年標準 |
|---|---|---|
| 形態素解析 | MeCab + IPAdic | Sudachi + 辞書 A 系 |
| テキスト分類 | BERT fine-tuning | LLM few-shot or fine-tuning |
| 感情分析 | BERT fine-tuning | GPT-4 zero-shot, Claude |
| 機械翻訳 | DeepL, Google Translate | DeepL, GPT-4, Claude |
| 要約生成 | BART, T5 fine-tuning | GPT-4, Claude, Gemini |
| 質問応答 | BERT + 文書検索 | RAG (検索+LLM) |
| 対話システム | Rasa, DialogFlow | GPT-4, Claude, LangChain |
| 埋め込み | Word2Vec, BERT | OpenAI Embeddings, Cohere |
| ベクトルDB | Faiss, Annoy | Pinecone, Weaviate, Qdrant |
| フレームワーク | HuggingFace Transformers | LangChain, LlamaIndex, DSPy |
2024 年から 2026 年にかけて、 NLP ツールスタックは大きく変化した。 「BERT 中心」 から「LLM + RAG 中心」 へ。 「タスク別 fine-tuning」 から「Prompt Engineering + Few-shot」 へ。 「個別モデル管理」 から「LangChain・LlamaIndex 等のオーケストレーション」 へ。 SSDSE-B-2026 のような数値統計と NLP を組み合わせる際にも、 こうした最新ツールを使うことで、 「pandas で集計 → LLM で自然言語で解説 → ベクトルDB で類似クエリ検索」 という洗練されたワークフローが構築できる。
📝 NLP 学習の全体像
NLP を学ぶ際の推奨学習経路は、 (1) 言語学の基礎 (形態論・統語論・意味論・語用論)、 (2) 古典 NLP 手法 (n-gram, Bag-of-Words, TF-IDF, 隠れマルコフモデル)、 (3) 単語埋め込み (Word2Vec, GloVe, FastText)、 (4) RNN・LSTM・Seq2Seq、 (5) Attention 機構と Transformer、 (6) BERT 系の事前学習モデル、 (7) GPT 系の大規模言語モデル、 (8) Prompt Engineering と RAG、 (9) Multi-Agent と Tool Use、 (10) 倫理・法的側面と社会実装。 この 10 段階を順に踏むことで、 「言語処理の歴史と現在」 を体系的に理解できる。
SSDSE-B-2026 のような数値統計データは、 一見 NLP と無関係に見えるが、 (1) 都道府県別ニュース感情分析、 (2) 議事録の要約と分類、 (3) 政府刊行物の自動レポート生成、 (4) 統計指標を自然言語で解説する LLM アシスタント、 (5) 多言語化 (英語・中国語・韓国語) による国際比較、 等の応用接点が多数ある。 統計と NLP を組み合わせることで、 「定量データ」 と「定性データ」 を統合した分析が可能になり、 政策議論・経営判断・学術研究の品質が大きく向上する。 学生諸氏が SSDSE で統計分析を学びつつ、 NLP の基礎も習得することで、 将来「データサイエンス + AI」 の最前線で活躍できる基盤が形成される。 古典 n-gram から最新 LLM まで、 NLP の進化は止まらないが、 「言語の統計的構造を抽出する」 という核心は変わらない。 この核心を SSDSE と組み合わせて体得することが、 現代のデータサイエンティスト・AI エンジニアにとって価値ある投資となる。
🔍 RAG (Retrieval-Augmented Generation) の深掘り
RAG は LLM の知識をリアルタイム検索結果で補強する技法で、 2024-2026 年で爆発的に普及した。 構成要素は (1) 文書チャンキング (長文を意味単位で分割)、 (2) 埋め込み生成 (OpenAI Embeddings, Cohere Embed, 各種 BERT)、 (3) ベクトルデータベース (Pinecone, Weaviate, Qdrant, Chroma) への保存、 (4) ユーザクエリの埋め込み化、 (5) 類似度検索 (cosine similarity, dot product) による上位 k 件取得、 (6) LLM へのコンテキスト注入とプロンプト構築、 (7) LLM による生成。 これらを LangChain や LlamaIndex でオーケストレーションすることで、 数百ページの社内文書を「自然言語で質問できる対話システム」 に変換できる。
RAG の品質向上テクニックとして、 (1) Hybrid Search (キーワード検索 + ベクトル検索の組合せ)、 (2) Re-ranking (取得結果を別モデルで再順序付け)、 (3) Query Expansion (元クエリを複数の関連クエリに展開)、 (4) Multi-Hop Retrieval (複数回の検索を連鎖)、 (5) Citation (回答に出典を埋込)、 等がある。 SSDSE-B-2026 の数値データと統計分析レポートを RAG で索引化すれば、 「東京都の人口推移を解説してください」 という自然言語質問に対して、 関連統計と既存解説を組み合わせた回答を自動生成できる。 こうした応用は、 教育・公共・調査研究の効率を大きく改善する。
🤖 LLM Agent と Multi-Agent システム
2024-2026 年で「LLM Agent」 という概念が広がった。 単純な対話型 LLM ではなく、 (1) Tool Use (Python 実行、 Web 検索、 API 呼び出し)、 (2) Planning (タスクを段階的に計画)、 (3) Memory (会話履歴・長期記憶)、 (4) Reflection (自己評価と修正)、 (5) Multi-Step Execution (複数ステップの自律実行)、 等の能力を持つ AI エージェント。 GPT-4 with Function Calling, Claude with Tool Use, AutoGPT, BabyAGI, MetaGPT 等が代表例。 さらに「Multi-Agent」 として、 複数の Agent が役割分担して複雑タスクを解く構成 (例: コーダー Agent + レビュアー Agent + テスター Agent) が研究されている。
SSDSE-B-2026 の分析を Multi-Agent で実行することも可能。 (1) データ取得 Agent: e-Stat から最新統計を取得、 (2) 前処理 Agent: 表記揺らぎ・型変換を実施、 (3) 分析 Agent: 統計分析・可視化を実行、 (4) レポート Agent: 結果を自然言語で解説、 (5) レビュー Agent: 結果の妥当性を検証。 こうした分業により、 単一 LLM では難しい複雑分析が自動化できる。 とはいえ、 Agent の信頼性・安全性・コストはまだ課題で、 重要な意思決定では人間の最終判断が不可欠。 学生諸氏が Agent の動作原理を理解し、 「どこまで自動化できるか」 を見極める力を身につけることが、 これからの AI 時代に必須のスキル。 関連項目として 大規模言語モデル、 ChatGPT、 プロンプトエンジニアリング を併せて学ぶと、 LLM Agent の全貌が立体的に把握できる。
📐 NLP の評価指標の変遷 (古典から最新まで)
NLP の評価指標は、 古典的な「正解一致率」 から始まり、 タスク特有の指標、 そして LLM 時代の「人間評価ベース」 へと進化してきた。 (1) 分類タスク: Precision・Recall・F1・AUC が基本、 多クラスでは Macro/Micro F1。 (2) 機械翻訳: BLEU が長年標準、 近年は BERTScore・COMET 等のニューラル評価指標が台頭。 (3) 要約: ROUGE-1, ROUGE-2, ROUGE-L が標準、 近年は事実性 (FactCC, QAGS) も評価される。 (4) 質問応答: Exact Match と F1 が SQuAD で標準。 (5) 対話生成: BLEU は信頼性が低く、 人間評価が中心。 Chatbot Arena のペアワイズ比較が事実上の標準に。 (6) LLM 全般: MMLU (Massive Multitask Language Understanding)、 HellaSwag、 ARC、 TruthfulQA 等の総合ベンチマーク。 (7) 人間性能との比較: GPT-4 は MMLU で 86% を達成し、 人間の専門家平均 (89%) に肉薄。
SSDSE-B-2026 のような数値統計の自動レポート生成を評価する際にも、 これらの指標を選択する必要がある。 (1) 数値の正確性: 生成テキストに含まれる数値が正解と一致するか (Exact Match)。 (2) 因果関係の妥当性: 「A が増えると B が増える」 という記述が統計的に妥当か (専門家評価)。 (3) 自然さ: 日本語として自然か (人間評価、 BLEU)。 (4) 包括性: 主要な統計的特徴を網羅しているか (ROUGE)。 これら複数の指標を組み合わせることで、 LLM ベースの自動レポート生成の品質を多面的に評価できる。 統計分析と NLP の融合領域では、 こうした評価設計が研究の質を決定する。
🔗 隣接手法への橋渡し
自然言語処理は、 テキストを集めて整える工程と、 数値にしたテキストを分析・生成に使う工程のあいだで、 「文字列を数える・比べる・予測する」 部分を担う。
NLP は「テキスト → 構造化情報」の階層的処理。 SSDSE-B-2026 は数値表だが、 e-Stat の調査票や報告書の自由記述部を NLP で構造化すれば、 数値だけでは見えない地域固有の文脈が抽出できる。
🌳 手法選択フロー
NLP の手法選択は「タスク種別 + データ量 + 計算予算」で決まる。
- 少ラベル + 軽量 TF-IDF + 線形モデルを最初の base line にする
- 意味的類似度 事前学習済み埋め込み (Sentence-BERT、 SimCSE) を使う
- 生成・推論 LLM (GPT、 Claude、 Gemini) の API か Llama 系の self-host
日本語特有の処理 (形態素解析、 漢字異体字、 全角半角) は早めに前処理パイプラインに組み込み、 後工程で困らないようにする。