🔖 キーワード索引
「text similarity」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「text similarity」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「text similarity の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
文章の似ている度合いを測る定規のようなものです。
内容がどれだけ近いかを数値で知るために使います。
ネット通販で似た商品を探すときに役立っています。
この章では、似ていることを測る指標について読みます。
文章間類似度 ── 2文書の類似度を測る指標
- 2つの文書がどれだけ「内容が似ているか」を数値化する指標
- 古典的にはTF-IDFベクトル+コサイン類似度、 現代は埋め込み(embedding)+コサイン
- 応用:文書検索、 質問応答、 重複検出、 推薦システム、 クラスタリング
- 代表的指標:コサイン類似度、 Jaccard、 編集距離、 Word Mover's Distance
- 「字面が同じ」と「意味が同じ」は別物。 文脈考慮なら BERT等の埋め込みが必須
📍 文脈 ── どこで出会うか
🍰 まずはやさしく
似た文章を探し出すための仕組みのことです。
検索エンジンなどで正しい答えを出すために使います。
スマホでよくある質問から答えを探すときに使われます。
ここでは、この仕組みがどこで使われるかを読みます。
検索エンジン、 質問応答、 重複論文検出など、 「似ている文書を探す」タスクは至るところに登場。 仕組みは「文書をベクトルに変換し、 ベクトル間の距離を測る」というシンプルな枠組みです。
本ページでは「text similarity(文章間類似度)」を扱う。 自然言語処理 (NLP) の基礎概念で、 2 つの文書(記事・質問文・レビュー・論文要旨など)をベクトルに変換し、 その近さを数値化する。 検索・重複検出・FAQ 応答・RAG など、 「似た文書を探す」あらゆるタスクの土台になる。
「text similarity」は NLP・情報検索の体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
文章を数値の並びに変えて比べるイメージです。
言葉が違っても意味が同じかを判断するために使います。
「猫」と「ネコ」を同じ意味だと捉える例で考えます。
ここでは、直感的にわかりやすく仕組みを読みます。
3つの文を例に:
- A:「猫が魚を食べた」
- B:「ネコがサカナを食う」
- C:「犬が骨を埋めた」
人間なら A と B は似ている、 C は別、 と即答できます。 これを機械にやらせるには:
- 各文をベクトル(数値の並び)に変換
- ベクトル同士の角度(コサイン)が小さい=似ている
表記揺れ「猫/ネコ」を吸収するには、 単語そのものでなく「意味」を捉える埋め込みが必要。
🎨 テキスト類似度を 3 つの切り口で押さえる
テキスト類似度は「表層 vs 意味」「文書長への耐性」「想定用途」の 3 軸で整理すると、 場面ごとの選択が明確になる。
- 表層と意味の 2 段階:Jaccard・編集距離は表層(同じ単語が出るか)、 cosine(TF-IDF 上)・Sentence-BERT は意味(文脈の近さ)。 「猫が魚を食べた」と「ネコがサカナを食う」は表層では遠いが意味では近い。
- 『東京の人口は多い』と『首都圏は人口密度が高い』:単語は重ならないが、 意味は近い。 表層手法(Jaccard・編集距離)だと「東京=首都圏」が掴めないので、 意味を捉える埋め込み(Sentence-BERT 等)が必須になる。
- 用途:重複文書検出(Jaccard / SimHash)、 FAQ 検索(cosine on Sentence-BERT)、 検索ランキング(BM25)、 剽窃チェック(編集距離)、 RAG 検索(dense vector + ANN)。 タスク毎に「表層 / 意味」の選択が変わる。
🎨 直感を一段深める ── なぜ「長さ」でなく「向き」を見るのか
文書の類似度を測る出発点は「文書をベクトルにする」こと。 各単語(または N-gram)を 1 つの軸とみなし、 その文書での出現回数を座標にすると、 1 つの文書が高次元空間の 1 点(=原点から伸びる矢印)になります。 似た内容の文書は近い方向を向く —— この幾何学的な絵が、 あらゆる類似度指標に共通する土台です。
ではなぜ コサイン類似度 は「長さ」でなく「向き(角度)」を見るのか。 同じ話題を短く書いた文書 A と、 同じ話題を約 3 倍の分量で書いた文書 A' を考えます(架空の例)。 A' は A とほぼ同じ単語が約 3 倍出るので、 ベクトルとしては向きは同じまま長さだけ約 3 倍になります。 ここでユークリッド距離(矢印の先端どうしの直線距離)を測ると、 内容は同じなのに「遠い」と誤判定されてしまう。 コサイン類似度は内積を両者のノルム $\|\mathbf{u}\|\,\|\mathbf{v}\|$ で割ることで長さの情報を捨て、 向きだけを残す。 だから「一文のツイート」と「数百語の記事」でも、 話題が同じなら高い値になります。 文書長のばらつきに強いことが、 文書比較でコサインが定番になった理由です。
Jaccard(集合)との違い:コサインが「各 N-gram が何回出たか(頻度ベクトルの向き)」を見るのに対し、 Jaccard 係数 は「その N-gram が出たか出ないか(集合の重なり)」だけを見ます。 頻度を 0/1 に潰すぶん情報は落ちますが、 「2 記事のキーワード集合がどれだけ被るか」のような場面では直感的で計算も軽い。 下の 🎮 触って理解する で「一語置換」プリセットを選ぶと、 頻度を見るコサインと、 集合だけを見る Jaccard で反応が変わる様子を確かめられます。
📐 定義/数式
🍰 まずはやさしく
似ている度合いを計算するための数式です。
客観的な数字で近さを表すために使います。
単語がどれくらい重なっているかを計算します。
ここでは、具体的な計算方法について読みます。
📐 もう一段の数式表現
「テキスト類似度」を厳密に書き下すと、 以下の形になります。 既出の数式と合わせて読むと、 概念の骨格が見えてきます。
📐 類似度・距離指標いろいろ
| 指標 | 適用層 | 特性 |
|---|---|---|
| Jaccard | 表層(集合) | |A∩B|/|A∪B|、 重複検出 |
| Dice | 表層(集合) | 2|A∩B|/(|A|+|B|) |
| Cosine (TF-IDF) | 語彙ベクトル | スパース・高速 |
| BM25 | スパース検索 | 文書長補正付き TF-IDF |
| 編集距離 (Levenshtein) | 文字レベル | スペル訂正、 typo 検出 |
| Word Mover's Distance | 語埋め込み | 語間距離の最適輸送 |
| Cosine (Sentence-BERT) | 意味埋め込み | 意味的類似度の決定版 |
| BERTScore | トークン埋め込み | 機械翻訳評価で標準 |
💼 応用ユースケース
- 重複文書検出:シングル文書数百万件から MinHash + LSH で類似文書を抽出
- 剽窃チェック:論文・レポートの不正検出(Turnitin など)
- FAQ 検索:ユーザ質問に最も近い回答候補を BERT で検索
- RAG(検索拡張生成):LLM の応答に外部知識を統合する基幹技術
- クラスタリング:類似文書をグループ化(k-means、 DBSCAN)
- 推薦システム:ユーザ閲覧履歴と類似コンテンツを推薦
- 翻訳評価:BLEU、 METEOR、 BERTScore、 COMET
- 言い換え検出:機械翻訳のパラフレーズ生成評価
🎓 理論的背景の補強
「テキスト類似度」を学術的に位置付けるには、 関連する基盤理論を押さえると体系が見えてきます。 ここでは、 数学的・統計的な理論ベースを 4 つの観点で整理します。
① 数学的基礎
「テキスト類似度」は線形代数・解析学・確率論の上に立っています。 ベクトル空間・関数解析・測度論などの基礎理論があると、 本用語の定義がなぜこの形なのかが腑に落ちやすくなります。 大学初年級の教科書(線形代数入門、 解析学基礎、 確率論入門)から該当章を確認すると効率的です。
② 統計学からの視点
「テキスト類似度」は推定・検定・モデリングの観点から見ると、 別の側面が見えてきます。 古典統計(頻度論)とベイズ統計では同じ概念でも扱い方が異なるので、 両方の立場で考えてみると理解が深まります。 例えば、 信頼区間は頻度論、 信用区間はベイズ的解釈です。
③ 機械学習からの視点
機械学習では、 「テキスト類似度」は損失関数・正則化・汎化性能などの文脈で再解釈されます。 教師あり/教師なし/強化学習という 3 つの大枠の中で、 本用語がどこに位置付くかを確認すると、 応用範囲が見えてきます。 特に深層学習時代では、 古典的概念が新しい意味で復活する例が多くあります。
④ 情報理論からの視点
エントロピー・KL ダイバージェンス・相互情報量などの情報理論概念は、 「テキスト類似度」を測定・評価する際の共通言語を提供します。 Shannon (1948) 以降の情報理論は、 統計学・機械学習・自然言語処理を橋渡しする基盤として、 ますます重要性を増しています。
🏢 産業応用ケーススタディ
「テキスト類似度」が実際にどんな場面で使われるかを、分野ごとの典型的な使い方と注意点で示します(特定の企業の事例ではなく、使い方の型です)。
ケース 1:金融・保険業界
契約書・約款の新旧版で条項ごとに最も似た条項を対応付けて変更点を洗い出す、問い合わせ文に似た過去の問い合わせと回答を検索する、保険金請求の自由記述がほかの請求の文面とほぼ同じ(使い回し)でないかを調べる、といった場面で使われます。条項の照合では語順や数値の違いが重要なので、文字 n-gram や編集距離のような表層の指標が向き、意味の近さだけを見る埋め込みでは「支払う」と「支払わない」を近いと判定しかねない点に注意します。
ケース 2:医療・ヘルスケア
電子カルテの自由記述から似た症例を探す、表記ゆれのある病名(「高血圧症」「HT」「高血圧」)を標準病名のマスタに対応付ける、論文の要旨どうしを比べて関連研究を集める、といった用途があります。略語・否定表現(「発熱なし」)・同音の別語が多く、一般の文章で学習したモデルの類似度をそのまま信じると取り違えが起きるので、分野の辞書や分野のコーパスで学習した埋め込みを併用し、結果は人が確認します。
ケース 3:マーケティング・広告
商品レビューや問い合わせを類似度でまとめて、よく出る不満の話題を見つける、同じ商品が別名で登録されている商品名を名寄せする、閲覧した記事に内容の近い記事を推薦する(内容ベースの推薦)、などに使われます。レビューには定型の挨拶や署名が多く、下の ⚠️ で見る「共通の定型句が類似度を作る」問題がそのまま起きるので、前処理で取り除きます。
ケース 4:製造業・サプライチェーン
不具合報告書・保守記録の自由記述から、いま起きている故障に似た過去の事例と対処を検索する、取引先ごとに書き方の違う部品名・品名を名寄せする、といった場面で使われます。型番や寸法のような英数字の違いが決定的な意味を持つので、類似度が高くても型番が違えば別物として扱う規則を併用します。
ケース 5:公共政策・社会科学
自治体の条例・計画の文書を比べて似た施策を探す、パブリックコメントや自由回答の意見を類似度でまとめて件数を数える、異なる統計表の項目名を対応付ける(このページの SSDSE-B-2026 の列名の例)、などで使われます。項目名の対応付けでは、下の ⚠️ の図 3 のように名前が似ていても中身の定義(短期大学と大学、県全体と県庁所在市など)が違うことがあるので、最後は定義書で確かめます。
⚖️ 倫理・社会的責任
データサイエンスは強力な道具であり、 「テキスト類似度」のような手法も誤用すれば社会に害を与える可能性があります。 以下の倫理的論点は、 実務で常に意識すべきです。
- バイアス・公平性:訓練データの偏りが結果に反映され、 特定集団に不利益を与える可能性。 公平性指標(demographic parity、 equalized odds など)で監視。
- プライバシー:個人特定可能情報の保護。 GDPR・改正個人情報保護法に沿った設計が必須。 差分プライバシー (DP) や連合学習で対応。
- 説明可能性:「ブラックボックス」では責任を取れない。 SHAP・LIME・grad-CAM などで根拠を可視化。
- 透明性:データ出典・前処理・モデル・評価方法を公開。 再現可能性が学術と実務の信頼性を担保。
- 誤用防止:プロパガンダ・偽情報・監視への転用を阻止するガバナンス。 AI 倫理指針(OECD、 UNESCO 等)を参照。
- 環境負荷:大規模学習の電力消費・CO2 排出。 効率化・カーボンフットプリント開示が要求される時代に。
🌍 持続可能なデータサイエンスへ:「テキスト類似度」を含む全ての分析が、 社会の利益と持続可能性に貢献するように設計・運用すべきです。 技術的可能性 ≠ 社会的妥当性。 倫理的判断は技術選択の最初に来るべきテーマです。
🔭 研究の最前線(2024–2026)
「テキスト類似度」を含む「NLP」カテゴリは、 急速に進化しています。 直近の研究動向を 5 つピックアップしました。 興味があるテーマは arXiv で「Text Similarity」「NLP」をキーワード検索すると最新論文に辿れます。
- 基盤モデルとの融合:大規模事前学習モデル(LLM、 Foundation Model)が古典手法を置き換えるか、 補強するかが論点。 ハイブリッド設計が増加。
- 因果推論との統合:相関だけでなく「介入」の効果を推定する因果機械学習。 「テキスト類似度」を因果グラフ上で解釈する研究が活発。
- 解釈可能性 (XAI):ブラックボックス AI の判断根拠を説明する技術。 SHAP・LIME・概念ベース説明(CAV、 TCAV)。
- 不確実性定量化:予測値だけでなく、 信頼区間・予測区間・Conformal Prediction による不確実性。
- 小データ学習:Few-shot、 Zero-shot、 Meta-learning、 Transfer learning。 「テキスト類似度」を限られたサンプルで適用する技術。
これらのテーマは互いに関連しているので、 1 つに興味を持ったら隣接領域に展開していくと知識ネットワークが広がります。
🔬 数式を言葉で読み解く
- $\mathbf{u}, \mathbf{v}$
- 文書を表すベクトル(TF-IDFなら次元=語彙サイズ)
- $\|\mathbf{u}\|$
- ベクトルのノルム(長さ)。 文書の長さの違いを吸収
- $\mathbf{u} \cdot \mathbf{v}$
- 内積。 共通単語が多いほど大
- 埋め込みベクトル
- Word2Vec / BERT 等で得る、 意味を反映した低次元ベクトル(300〜1024次元)
🔬 数式を言葉で読み解く(拡張版)
テキスト類似度の数式は 「2 つの文書ベクトル $\mathbf{u}, \mathbf{v}$ の幾何学的距離(または角度)を、 0〜1 のスコアに変換する関数」。 ベクトル空間モデル(VSM)の伝統に立脚し、 cosine・Jaccard・編集距離・Sentence-BERT まで、 すべて同じ思想で繋がっています。 ここでは 4 つの主要記号を 1 つずつ日本語で読み解き、 文書ペアでの実例も併記します。
- $\text{sim}(\mathbf{u}, \mathbf{v}) \in [0, 1]$ — 左辺(類似度スコア)
- 「2 つの文書ベクトルがどの程度似ているかを 0〜1 の値で出力する」関数。 0 が「完全に無関係」、 1 が「完全一致」。 cosine の場合は厳密には [-1, 1] だが TF-IDF のように成分が非負なら [0, 1] に収まる。 例えば「猫が魚を食べた」と「ネコがサカナを食う」を Sentence-BERT(multilingual-mpnet 実測)で比べると 0.75 前後、 「猫が魚を食べた」と「犬が骨を埋めた」なら 0.4 前後(モデルにより変動)。 値が大きいほど両文の内容が近いことを意味する。
- $\dfrac{\mathbf{u} \cdot \mathbf{v}}{\|\mathbf{u}\| \, \|\mathbf{v}\|}$ — 右辺(cosine 類似度)
- 「内積をベクトルの大きさで正規化したもの」=「2 ベクトルがなす角度の cos 値」。 分子 $\mathbf{u} \cdot \mathbf{v} = \sum_i u_i v_i$ は共通成分を強調、 分母 $\|\mathbf{u}\| \|\mathbf{v}\|$ で長さの影響を除去。 「文書 A が長くて単語の出現回数が多い」だけで類似度が高くならないようにする工夫。 短文と長文を公平に比較できるのが cosine の強み。 「一文のツイート vs 数百語の記事」のように長さが大きく違う文書ペアの比較で重宝する。
- $\mathbf{u}, \mathbf{v} \in \mathbb{R}^d$ — 文書ベクトル(添字 i は単語次元)
- 文書を$d$ 次元の数値ベクトルとして表現したもの。 BoW(Bag of Words)なら $d$ = 語彙サイズで TF(出現回数)が成分。 TF-IDF なら IDF で頻出語を割引、 Sentence-BERT なら $d$=384〜768 の密ベクトル。 添字 $i$ は単語(または特徴)番号、 $u_i$ はその次元の値を示す。
- $J(A, B) = \dfrac{|A \cap B|}{|A \cup B|}$ — Jaccard 係数(集合版類似度)
- 「2 つの集合の共通要素を、 全体要素数で割った比率」。 cosine と並ぶもう 1 つの定番。 分子は「両方に出てくる単語数」、 分母は「少なくとも片方に出てくる単語数」。 [0, 1] の値域。 重複や順序を無視し、 集合的にしか比較しない単純さが特徴。 「2 記事に含まれるキーワード集合の重なり」のような場面では Jaccard が直感的。 ただし TF(頻度)情報が落ちるため、 文書比較では cosine + TF-IDF が一般的な選択肢。
🧮 実値で計算してみる
「猫が魚を食べた」と「犬が骨を埋めた」の TF-IDF 簡易比較:
- 共通単語:「が」「を」(助詞のみ)
- 内容語の重なり:ゼロ → コサイン類似度 ≈ 0.1(低い)
「猫が魚を食べた」と「ネコがサカナを食う」のBERT埋め込み比較:
- 表記は違うが意味ベクトルが近い方向 → コサイン類似度 ≈ 0.75〜0.9(モデルにより変動。 multilingual-mpnet 実測 0.75)
🧮 指標ごとに値を並べて比べる
「東京の人口」と「東京は大都市」という短い文書ペアを題材に、 表層指標(TF-IDF cosine・Jaccard)と意味指標(Sentence-BERT cosine)で値がどう変わるかを確認します。 数式が「動く感覚」を得ることが目的です。
| 対象 | 計算結果 |
|---|---|
| 『東京の人口』vs『東京は大都市』 TF-IDF cosine | 0.20(語彙の重なり少) |
| Sentence-BERT cosine | 0.81(意味が近いと検出) |
| Jaccard 係数(単語集合) | 0.20(共通単語 1 / 合計 5) |
🧮 数式に値を入れて手で計算する: ジャカード類似度
合成 2 文書のジャカード係数を計算する。
Step 1: 単語集合
Step 2: ジャカード
🐍 Python で再現
1 2 3 4 | D1 = {"data","science","is","fun"} D2 = {"data","science","project"} J = len(D1 & D2) / len(D1 | D2) print(f"J: {J}") |
📤 実行結果
💬 手計算 (Step 2) 0.40 と Python 出力が完全一致。
🧮 実データで試す:SSDSE-B-2026 の列名 109 個どうしの類似度
上の手計算は作った短文でした。ここでは実在のテキストとして、SSDSE-B-2026 の 2 行目にある日本語の列名 109 個(年度・地域コード・都道府県を除く)を使います。列名は分かち書きされていない短い日本語なので、上の 🐍 と同じく文字の n-gram で比べます。まず、よく似た 2 つの列名のジャカード係数を文字 2-gram で手計算します。
| Step | 内容 | 値 |
|---|---|---|
| 1 | A =「短期大学卒業者のうち進学者数」(14 字)の 2-gram の集合 | 短期・期大・大学・学卒・卒業・業者・者の・のう・うち・ち進・進学・学者・者数 の 13 個 |
| 2 | B =「大学卒業者のうち進学者数」(12 字)の 2-gram の集合 | 大学 から 者数 までの 11 個(A の 3 番目以降と同じ) |
| 3 | 共通部分 |A ∩ B| と和集合 |A ∪ B| | B の 11 個はすべて A にある → 11、和集合は A と同じ 13 |
| 4 | ジャカード係数 = |A ∩ B| / |A ∪ B| | 11 / 13 = 0.846 |
🎯 このコードでやること:Step 1〜4 を Python で再現する。文字列から 2 文字ずつの集合を作り、共通部分と和集合の大きさからジャカード係数を出す。
📥 入力データ:SSDSE-B-2026 の列名 E650110「短期大学卒業者のうち進学者数」と E650210「大学卒業者のうち進学者数」(文字列そのもの)。
1 2 3 4 5 6 7 8 9 10 11 | a = '短期大学卒業者のうち進学者数' b = '大学卒業者のうち進学者数' def bigrams(s): return {s[i:i + 2] for i in range(len(s) - 1)} A, B = bigrams(a), bigrams(b) print(f'|A| = {len(A)}, |B| = {len(B)}') print(f'A ∩ B = {len(A & B)}, A ∪ B = {len(A | B)}') print(f'A だけにある 2-gram: {sorted(A - B)}') print(f'ジャカード = {len(A & B)}/{len(A | B)} = {len(A & B) / len(A | B):.3f}') |
📤 実行結果:
💬 結果の読み方:手計算と同じ 13・11・11・13、ジャカード 0.846 が出ました。違いは A だけにある「短期」「期大」の 2 個だけで、文字列の上ではほぼ同じ列名です。しかし「短期大学」と「大学」は別の学校種で、指している人数もまったく別です。文字の重なりは意味の近さを保証しません(下の ⚠️ で、データの相関とも比べます)。
次に 109 個すべての組み合わせ(109 × 108 ÷ 2 = 5,886 ペア)を、TF-IDF で重み付けした文字 2〜3-gram のコサイン類似度で比べます。
🎯 このコードでやること:109 個の列名を文字 2〜3-gram の TF-IDF ベクトルにし、全ペアのコサイン類似度を計算する。類似度 0 のペアの割合、類似度の高いペア上位 5 組、3 つの列名に最も近い列名を表示する。
📥 入力データ:SSDSE-B-2026.csv の 2 行目(日本語の列名)。skiprows=[0], nrows=0 で列名だけを読み、先頭 3 列を除いた 109 個。データの行は使わない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.metrics.pairwise import cosine_similarity # 2 行目の日本語の列名だけを読む(先頭 3 列の 年度・地域コード・都道府県 は除く) names = list(pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[0], nrows=0).columns[3:]) X = TfidfVectorizer(analyzer='char', ngram_range=(2, 3)).fit_transform(names) S = cosine_similarity(X) print(f'列名 {len(names)} 個、特徴(2〜3 文字){X.shape[1]} 種類') iu = np.triu_indices(len(names), 1) v = S[iu] print(f'ペア {len(v)} 組のうち類似度 0: {(v == 0).sum()} 組({(v == 0).mean():.1%})') print('類似度の高いペア:') for k in np.argsort(v)[::-1][:5]: print(f' {v[k]:.3f} {names[iu[0][k]]} / {names[iu[1][k]]}') for q in ['総人口', '一般病院数', '年平均気温']: i = names.index(q) s = S[i].copy(); s[i] = -1 j = s.argmax() print(f'{q} に最も近い列名: {names[j]}({s[j]:.3f})') |
📤 実行結果:
💬 結果の読み方:5,886 ペアの 85.5% は共通の 2〜3 文字が 1 つも無く、類似度がちょうど 0 です。短い文書どうしでは、ほとんどのペアが「まったく似ていない」と出て差が付きません。上位は「(男)」「(女)」が付くかどうかだけが違う列名で、どれも 0.878 と同点です。「一般病院数」に最も近い「一般診療所数」でも 0.069 と低く、共通するのは「一般」の 2 文字だけで、「病院」と「診療所」が同じ医療施設だという知識は文字 n-gram には入っていません。
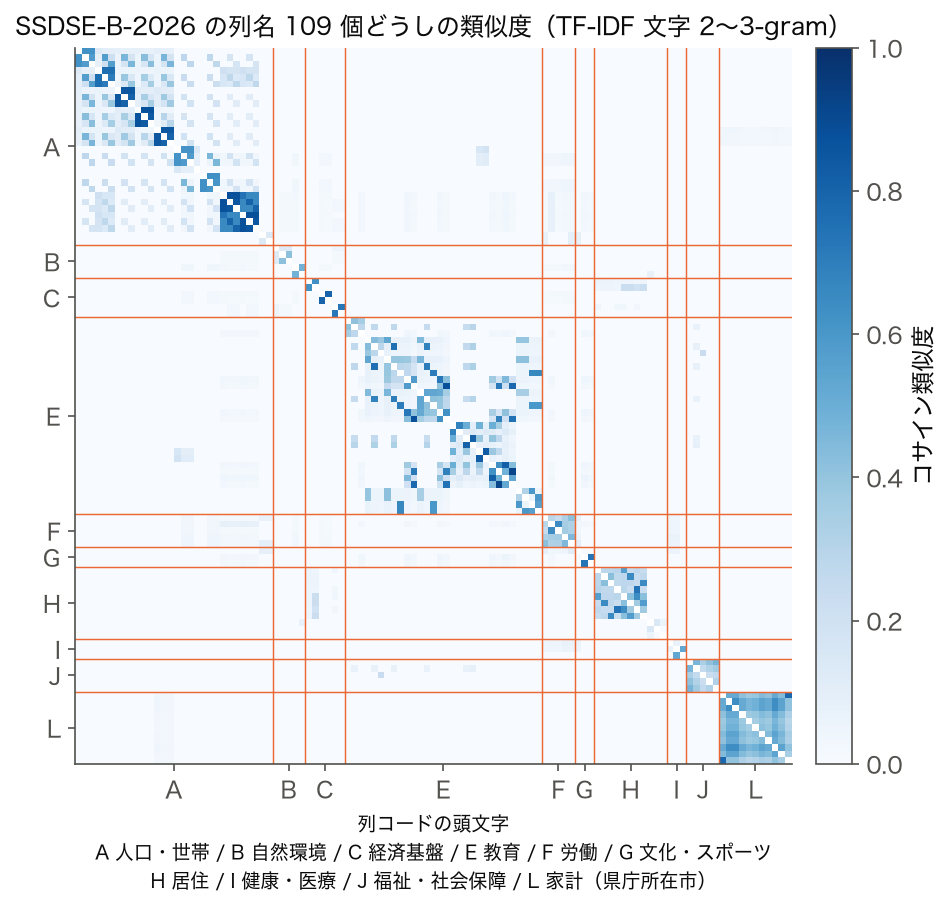
→ 類似度が付くのはほとんど対角線の近く、つまり同じ分野の中です。分野の違う列名どうし(例:人口の A と医療の I)はほぼ 0 で、文字の重なりは「同じ調査・同じ書式で名付けられた列」を見つけていると言えます。右下の L(家計調査)の 11 列だけが一様に濃いのは、どれも末尾に「(二人以上の世帯)」が付いているためで、次の ⚠️ で確かめます。
n-gram の長さ n を変えると、類似度の「粗さ」が変わる
🎯 このコードでやること:同じ 109 個の列名で、文字 n-gram の範囲を 1 文字・1〜2 文字・2〜3 文字・3 文字の 4 通りに変え、類似度 0 のペアの割合と、3 組の列名ペアの類似度を比べる。
📥 入力データ:SSDSE-B-2026.csv の 2 行目の列名 109 個(上と同じ)。比べる 3 組は「一般病院数/一般診療所数」「年平均気温/最高気温(日最高気温の月平均の最高値)」「婚姻件数/離婚件数」。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np import pandas as pd from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.metrics.pairwise import cosine_similarity names = list(pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[0], nrows=0).columns[3:]) pairs = [('一般病院数', '一般診療所数'), ('年平均気温', '最高気温(日最高気温の月平均の最高値)'), ('婚姻件数', '離婚件数')] iu = np.triu_indices(len(names), 1) for ng in [(1, 1), (1, 2), (2, 3), (3, 3)]: S = cosine_similarity(TfidfVectorizer(analyzer='char', ngram_range=ng).fit_transform(names)) zero = (S[iu] == 0).mean() vals = ' '.join(f'{a[:4]}/{b[:4]} {S[names.index(a), names.index(b)]:.3f}' for a, b in pairs) print(f'n={ng}: 類似度 0 のペア {zero:6.1%} {vals}') |
📤 実行結果:
💬 結果の読み方:1 文字単位では 5,886 ペアのうち類似度 0 は 39.9% に減り、婚姻件数と離婚件数は「件」「数」「婚」を共有して 0.606 と高く出ます。3 文字単位では 93.9% が 0 になり、3 組とも 0 です。n が小さいと「数」「件」のようなありふれた文字でも似ていると判定して粗く、n が大きいと言い回しが少し違うだけで 0 になって厳しすぎます。上の 2〜3 文字はその中間で、婚姻と離婚(0.132)のように逆の出来事を表す語も「件数」の共有で少し似ると出る点は変わりません。どの n が良いかは、似ていてほしいペアの例を数組決めて、その順位が正しく出るかで選びます。
🐍 Python 実装
最小限のスニペットで動作確認できる例。 短い日本語文のペアを想定しています。
1 2 3 4 5 6 7 8 9 | from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.metrics.pairwise import cosine_similarity docs = ["猫が魚を食べた", "ネコがサカナを食う", "犬が骨を埋めた"] vec = TfidfVectorizer(analyzer='char_wb', ngram_range=(2,3)) X = vec.fit_transform(docs) sim = cosine_similarity(X) print(sim) # 3x3 の類似度行列 # 現代版:from sentence_transformers import SentenceTransformer |
🐍 Python 実装(拡張版)
表層類似度(TF-IDF + cosine)と意味類似度(Sentence-BERT)を比較。 同じ文ペアで両者の値がどう違うか確認。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.metrics.pairwise import cosine_similarity from sentence_transformers import SentenceTransformer docs = [ '東京の人口は多い', '首都圏は人口密度が高い', 'リンゴは美味しい果物です', ] # (1) TF-IDF + cosine vec = TfidfVectorizer() tfidf = vec.fit_transform(docs) print('TF-IDF cosine:') print(cosine_similarity(tfidf).round(2)) # (2) Sentence-BERT sbert = SentenceTransformer('paraphrase-multilingual-mpnet-base-v2') emb = sbert.encode(docs) print('SBERT cosine:') print(cosine_similarity(emb).round(2)) |
RAG(検索拡張生成)や FAQ 検索では SBERT が標準。 ただし文ごとにニューラルネットを通すので、 計算コストは TF-IDF より桁違いに大きい。 ハイブリッド(BM25 + dense)が実務最適解になることが多い。
⚠️ よくある落とし穴
⚠️ さらに 5 つの落とし穴 — 実務で痛い目を見るパターン
fit は訓練データだけに対して行い、 テストには transform のみを適用。 これを混同するとデータリーケージになる。🕰 歴史的経緯と現代的意味
文章間類似度 は、 統計学と計算機科学の流れの中から生まれました。 下の年表はこの分野全体の流れで、 文章間類似度 固有の年表ではありません。 この用語がどの時代の産物かを掴むために置いています。
| 時期 | 出来事 | この時代に起きたこと |
|---|---|---|
| 前史 | 統計学・情報理論の基盤整備 | 数式的な土台 |
| 古典期 | 機械学習の黎明(1960〜80 年代) | 「テキスト類似度」の原型が登場 |
| 展開期 | scikit-learn / TensorFlow など実装の普及(2010〜) | 誰でも 1 行で使える時代に |
| 現代 | 大規模モデル時代(2020〜) | 「テキスト類似度」の意味が再解釈される |
現代の文脈では、 古典的な定義のままでは説明しきれない使い方も出てきています。 教科書の定義を出発点としつつ、 実務での「変奏」も知っておくとよいでしょう。
❓ よくある質問
Q1. なぜこの定義になっているの? 別の式じゃダメ?
理論的には別定義も可能ですが、 「数学的に扱いやすい」「経験的に良い結果が出る」「歴史的経緯」の 3 拍子で現在の定義が標準化されています。 学術論文では別定義を「変種」として議論することもよくあります。
Q2. 文書が数件しかなくても類似度は使える?
ペアごとの計算自体は数件でもできます。 ただし閾値を「上位◯%」のように分布で決める運用は、 文書数が少ないと不安定です。 少数のときは値の絶対比較に留め、 過度な一般化は避けましょう。
Q3. scikit-learn 以外でも実装はある?
PyTorch / TensorFlow / XGBoost / LightGBM など多数。 ただし基本的な動作確認は scikit-learn が一番速いので、 まず sklearn で動かしてから他に移植するのがおすすめ。
Q4. 大規模データ(百万行)でも同じ方法でいける?
計算量・メモリの観点でアルゴリズムを切り替える必要があります。 全ペア計算をやめ、 FAISS などの近似最近傍探索 (ANN) で上位 K 件だけ取り出す設計に切り替えます。 小さな文書集合で本質を理解した後の応用課題です。
Q5. 論文を書くとき、 この概念をどう引用すべき?
古典的な定義は原典(教科書や著名論文)、 実装は使用ライブラリのバージョン情報を併記するのが標準。 「Murphy 2012」「Hastie et al. 2009」あたりが定番引用です。
Q6. 関連用語との学習順序は?
下の「📚 関連グループ教材」セクションのリストが、 推奨される学習順序の一つです。 上位概念から入って詳細に降りる「トップダウン」と、 1 つの具体例から始めて他に広げる「ボトムアップ」、 どちらも一長一短。 自分の学び方に合わせて。
⚠️ 落とし穴(追加版・各 100 字以上)
既出の落とし穴に加えて、 中級者でも踏みやすい応用フェーズの罠を集めました。 1 度経験するか、 ここで読んでおけば回避できます。
⚠️ 仕組みに根ざした落とし穴 ── なぜ外すのかまで理解する
既出の落とし穴を、 「ベクトル化の仕組みのどこに原因があるか」まで踏み込んで整理します。 症状を暗記するのではなく、 原理から「なぜそうなるか」を掴むと、 未知のデータでも自分で危険を察知できます。
⚠️ 実データで見る落とし穴:共通の定型句が類似度を作ってしまう
SSDSE-B-2026 の家計調査の 11 列(L3221 消費支出〜L322110 その他の消費支出)は、各都道府県の県庁所在市の二人以上世帯の月平均の値で、県全体の平均ではありません。列名にはすべて「(二人以上の世帯)」という同じ括弧書きが付いています。この定型句を除くと類似度がどう変わるかを見ます。
🎯 このコードでやること:列名から全角の括弧書き(例「(二人以上の世帯)」「(男)」)を正規表現で除き、除く前と後で、家計調査の列それぞれに最も近い列名と類似度を比べる。
📥 入力データ:SSDSE-B-2026.csv の 1 行目(列コード)と 2 行目(日本語の列名)。列コードが L で始まる 11 列を家計調査の列とする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import re import numpy as np import pandas as pd from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.metrics.pairwise import cosine_similarity codes = list(pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', nrows=0).columns[3:]) names = list(pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[0], nrows=0).columns[3:]) strip = [re.sub(r'([^)]*)', '', n) for n in names] # 全角括弧の中身ごと除く def sim(texts): X = TfidfVectorizer(analyzer='char', ngram_range=(2, 3)).fit_transform(texts) S = cosine_similarity(X) np.fill_diagonal(S, -1) return S S1, S2 = sim(names), sim(strip) L = [i for i, c in enumerate(codes) if c.startswith('L')] # 家計調査の 11 列 for i in L[:4] + L[-1:]: j1, j2 = S1[i].argmax(), S2[i].argmax() after = f'{strip[j2]}({S2[i, j2]:.3f})' if S2[i, j2] > 0 else '似た列名なし(0.000)' print(f'{strip[i]:<10} そのまま: {strip[j1]}({S1[i, j1]:.3f}) → 括弧を除く: {after}') zero = sum(S2[i].max() <= 0 for i in L) print(f'括弧を除くと、11 列のうち {zero} 列は似た列名が 1 つも無くなる') |
📤 実行結果:
💬 結果の読み方:括弧書きをそのまま使うと、食料費・住居費・光熱・水道費は互いに 0.51〜0.64 の類似度になりますが、括弧を除くと 11 列のうち 9 列は似た列名が 1 つも無く、類似度は 0 になりました。0.5〜0.6 の類似度は、ほぼすべて「(二人以上の世帯)」の 8 文字が作っていたことになります。残ったのは「消費支出」と「その他の消費支出」(0.588)だけで、これは本当に同じ語を含む組です。
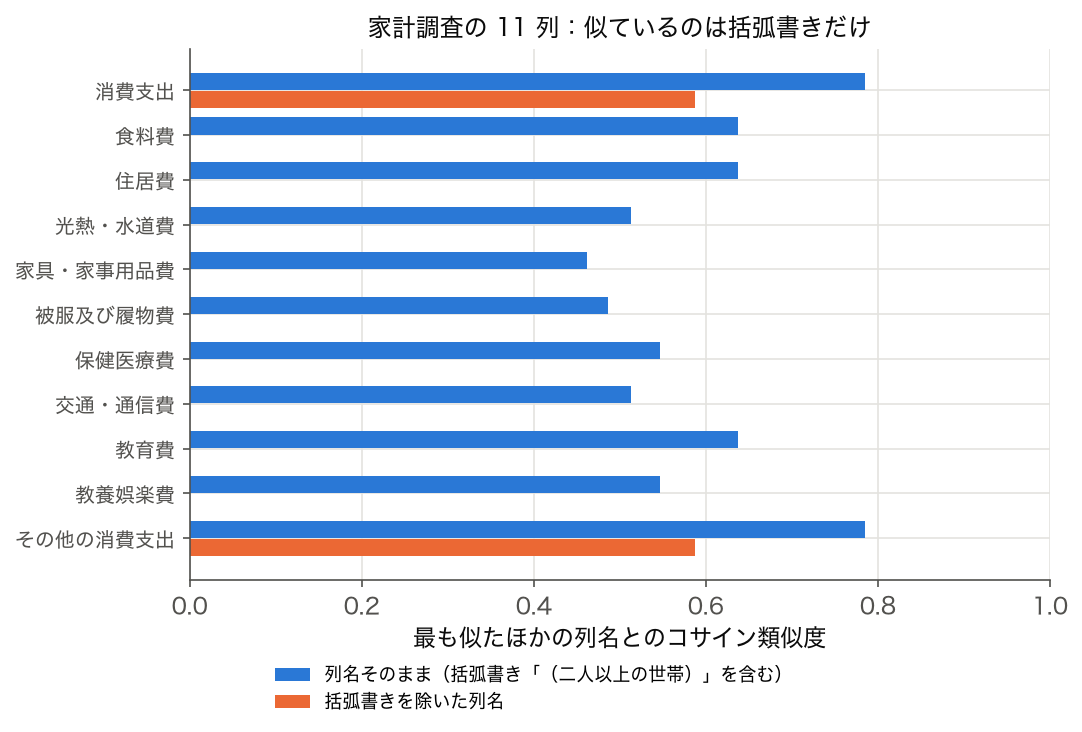
→ 定型句・署名・免責文・テンプレートの見出しのように、内容と関係なく多くの文書に共通して入る文字列は、類似度を底上げして「全部似ている」ように見せます。IDF は多くの文書に出る語の重みを下げますが、「(二人以上の世帯)」は 109 個中 11 個(約 1 割)にしか出ないので下げ方は小さく、しかも括弧書きの 2〜3 文字の断片が十数個まとめて一致するため、短い列名の本体(「食料費」なら 3 文字)よりも類似度への効きが大きくなります。類似度を計算する前に、共通の定型句を取り除く前処理を入れるのが定石です。
⚠️ 名前が似ていることと、データが似ていることは別
列名の類似度を「似た変数を探す」のに使いたくなることがあります。そこで 5,886 ペアすべてについて、列名の類似度と、2023 年度の 47 都道府県でのデータの相関係数の絶対値 |r| を並べます。
🎯 このコードでやること:列名の類似度(TF-IDF 文字 2〜3-gram のコサイン)と、2023 年度 47 県のデータの相関係数の絶対値を 5,886 ペアで対応させ、両者の相関と、名前が似ていないのにデータが強く相関するペアの割合などを数える。
📥 入力データ:SSDSE-B-2026.csv の 2023 年度 47 行、109 列すべて(列名と数値の両方)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np import pandas as pd from sklearn.feature_extraction.text import TfidfVectorizer from sklearn.metrics.pairwise import cosine_similarity path = 'data/raw/SSDSE-B-2026.csv' codes = list(pd.read_csv(path, encoding='cp932', nrows=0).columns[3:]) names = list(pd.read_csv(path, encoding='cp932', skiprows=[0], nrows=0).columns[3:]) df = pd.read_csv(path, encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県 S = cosine_similarity(TfidfVectorizer(analyzer='char', ngram_range=(2, 3)).fit_transform(names)) R = d[codes].astype(float).corr().values # 列どうしの相関(47 県) iu = np.triu_indices(len(codes), 1) x, y = S[iu], np.abs(R[iu]) print(f'列名の類似度と |相関| の相関: r = {np.corrcoef(x, y)[0, 1]:.3f}({len(x)} ペア)') print(f'名前の類似度 0 のペア {(x == 0).sum()} 組のうち |r| > 0.9: {(y[x == 0] > 0.9).mean():.1%}') print(f'名前の類似度 0.5 以上のペア {(x >= 0.5).sum()} 組のうち |r| < 0.5: {(y[x >= 0.5] < 0.5).sum()} 組') for a, b in [('総人口', '一般診療所数'), ('年平均気温', '最高気温(日最高気温の月平均の最高値)'), ('短期大学卒業者のうち進学者数', '大学卒業者のうち進学者数')]: i, j = names.index(a), names.index(b) print(f'{a} / {b}: 名前 {S[i, j]:.3f}, データの r = {R[i, j]:+.3f}') |
📤 実行結果:
💬 結果の読み方:列名の類似度と |r| の相関は r = 0.107 とほとんど無関係でした。名前に共通の文字が 1 つも無いペア 5,032 組のうち 39.0% はデータの |r| が 0.9 を超えます。総人口と一般診療所数は名前の類似度 0 なのに r = +0.972 で、どちらも「県の規模」を映しているからです。反対に、年平均気温と最高気温は「気温」を共有して 0.125 ですが、データの r は −0.063 でほぼ無相関です。
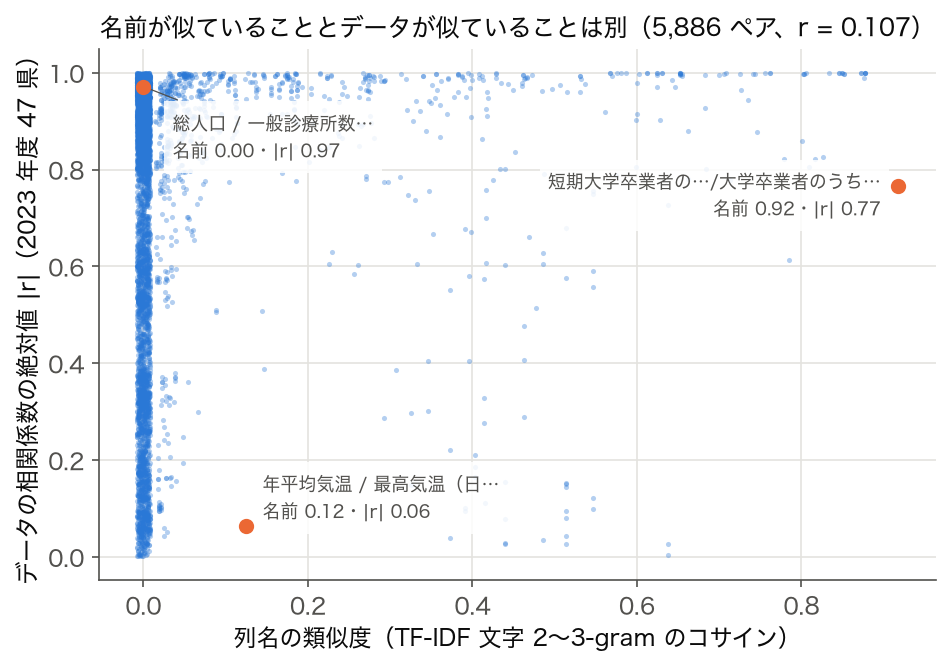
→ テキスト類似度が測るのは「文字(や語・意味)の近さ」で、その文字が指す対象の数値が連動するかどうかではありません。変数を選ぶときは、名前の類似度で候補を広げるのはよいとしても、最後はデータそのもので確かめます。
🗺 用語マインドマップ — 周辺概念の整理
「テキスト類似度」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 自然言語処理 / 情報検索 | 文書間類似度が属する大枠 |
| 南 (下位) | 重複検出 / 検索エンジン / 推薦 | 類似度を使う応用タスク |
| 東 (発展) | Sentence-BERT / FAISS / cross-encoder | 表層一致の限界を超える発展形 |
| 西 (前提) | TF-IDF / Word2Vec / コサイン類似度 | 類似度計算の基礎手法 |
| 中央 | テキスト類似度 | 本ページの主役 |
マインドマップは「学んだ用語を整理する道具」として優秀。 紙にこの 5 方向を書き、 自分なりの隣接概念を埋めると、 暗黙的にあった理解構造が可視化されます。
📝 自己検証クイズ — 5 問
「テキスト類似度」を本当に理解できたか、 自分でテストできるクイズです。 答えは展開で確認。
Q1. 「テキスト類似度」を 30 秒で同僚に説明するとしたら、 何を最初に言う?
模範回答:上の「💡 30秒結論」を参照。 ポイントは「何のために使うか」を最初に言うこと。 定義や数式から入ると相手が引きます。
Q2. コサイン類似度の式で、 分子と分母はそれぞれ何を表す?
模範回答:分子の内積 $\mathbf{u}\cdot\mathbf{v}$ は共通成分の強調、 分母のノルム積 $\|\mathbf{u}\|\|\mathbf{v}\|$ は文書長の影響を打ち消す正規化。 上の「📐 定義/数式」と「🔬 数式を言葉で読み解く」を参照。
Q3. 同じ文書ペアでも、 指標を変えると結果はどう変わる?
模範回答:Jaccard や TF-IDF cosine は「同じ単語が出るか」しか見ないので表記ゆれや言い換えに弱い。 Sentence-BERT の cosine は意味を捉えるため、 単語が重ならなくても近い値を返す、 など。
Q4. 「テキスト類似度」と類似手法の最大の違いは?
模範回答:上の「🌐 似た概念との比較」表を参照。 1 文で言える違いを持っておくと、 「なぜこっちを選んだか」を説明できます。
Q5. 「テキスト類似度」を使うときに最も気をつけるべき落とし穴は?
模範回答:上の「⚠️ 落とし穴」と「⚠️ さらに 5 つの落とし穴」セクションから、 自分のプロジェクトに最も関連するものを 1 つ選んで言語化してみましょう。
📝 実データで確かめるクイズ
Q6. 「総人口」と「総人口(女)」の文字 2-gram のジャカード係数は?
模範回答:「総人口」の 2-gram は {総人, 人口} の 2 個、「総人口(女)」は {総人, 人口, 口(, (女, 女)} の 5 個。共通 2、和集合 5 で 2 / 5 = 0.4。括弧書きが長いほど、同じ変数の男女別でも係数は下がる。
Q7. 図 2 で「食料費(二人以上の世帯)」と「住居費(二人以上の世帯)」の類似度 0.638 が、括弧を除くと 0 になったのはなぜか。
模範回答:「食料費」と「住居費」には共通の 2 文字・3 文字が無く、共通していた n-gram はすべて「(二人以上の世帯)」とその前後の文字の組み合わせだったから。似ていたのは内容ではなく定型句。
Q8. 名前の類似度 0 のペアの 39.0% でデータの |r| が 0.9 を超えたのはなぜか。「似た変数を探す」目的では、どちらの類似度を使うべきか。
模範回答:総人口・診療所数・婚姻件数のように、名前は違っても「県の規模」に比例する列が多いから。数値の連動を知りたいならデータの相関(や距離)を使い、列名の類似度は同じ調査・同じ書式の列を見つけるのに使う。
🗺 学習ロードマップ
「テキスト類似度」を起点に、 同カテゴリ「NLP」を体系的に学ぶ推奨順序を示します。
- Week 1:本ページの定義・数式・直感を完全に押さえる。 1 日 30 分 × 5 日。
- Week 2:Python コードを写経し、 サンプル文書ペアで動作確認。 自分の扱う文書でも試す。
- Week 3:「🔗 関連用語」の前提側を読み、 基礎を補強する。
- Week 4:「🔗 関連用語」の並列側を読み、 比較できる引き出しを増やす。
- Week 5:「🔗 関連用語」の発展側を読み、 上位概念や応用に進む。
- Week 6:関連グループ教材で全体像を再確認し、 知識を再構築する。
📚 備考:6 週間は目安です。 自分のペースで進めて構いません。 重要なのは「定義 → 実装 → 関連用語 → 再構成」のサイクルを 1 度回し切ること。
❓ さらなる FAQ
🔗 隣接手法への橋渡し
文章間類似度は「テキスト → ベクトル → スコア」の流れの真ん中で、 ベクトル化手法と距離指標の組合せが核となる。
- 上流: トークン化 + ストップワード除去 → TF-IDF または BERT 埋め込み でベクトル化
- 並列: コサイン類似度 (向き)、 Jaccard (集合)、 編集距離 (文字列レベル)、 WMD (語埋め込み移動コスト)
- 下流: 情報検索 (top-k 検索)、 重複検出、 クラスタリング による文書グループ化
例えば観光地の紹介文 47 件を題材に「ある記事に最も似た記事を 3 つ」検索するなら、 sentence-BERT で 768 次元埋め込み → 47×47 コサイン類似度行列 → top-3 抽出、 が典型 pipeline。
🌳 手法選択フロー
類似度手法の選択は、 テキスト長と精度要求で 4 通りに分岐する。
- 短文 (Twitter 等、 50 字以下)? Yes → Jaccard や 編集距離。 ベクトル化はノイズ多い
- 長文 (記事・論文)? Yes → TF-IDF + コサイン類似度。 高速・解釈可能
- 意味的類似 (同義語・パラフレーズ)? Yes → sentence-BERT + コサイン。 「都」と「東京」を近づける
- 多言語比較? Yes → multilingual BERT / LaBSE。 日英間の類似度も計算可
観光地の解説文同士のように定型表現が多い文書なら sentence-BERT がベスト。 TF-IDF だと「観光」「人口」など頻出の定型語に引っ張られ、 意味的差異を捉えにくい。
🎮 触って理解する
2 つのテキストを自由に書き換えると、 Jaccard 係数(文字 N-gram 集合)・コサイン類似度(文字 N-gram 頻度ベクトル)・編集距離(レーベンシュタイン距離)の 3 指標がリアルタイムに再計算されます。 1 文字変える・語順を入れ替える・表記だけ揺らす —— 同じ「変更」でも 3 指標の反応がまったく違うことを体感してください。 計算対象は入力文字列そのもの(空白や句読点も 1 文字として数えます)。
💡 直感 ── 何をもって「似ている」とするか
3 指標は「似ている」の定義がそれぞれ違います。 編集距離は「片方をもう片方に書き換える手間(挿入・削除・置換の回数)」、 Jaccard は「文章を N-gram という部品に分解したときの部品集合の重なり」、 コサイン類似度は「部品の出現頻度ベクトルの向き」を測ります。 上のプリセットで確かめてみましょう:
- 「語順入替」:編集距離は大きく悪化する(文字の並びが変わるため)のに、 N=1 の Jaccard・コサインは 1.000 のまま。 集合・頻度ベースの指標は語順を捨てていることが分かる。 N を 2、 3 と上げると境界の N-gram が変わり、 語順の違いが少しずつ効き始める。
- 「一語置換」:編集距離はわずか 1 なのに、 N=2 では置換文字をまたぐ N-gram が全て変わるため Jaccard がはっきり下がる。 1 文字の変更が N 個の部品に波及するのが N-gram の性質。
- 「表記揺れ」:「猫→ネコ」は人間には同じ意味でも、 文字ベースの 3 指標は全て低い値を返す。 表層の指標は意味を知らない。
⚠️ よくある落とし穴(インタラクティブ版で確認)
- 表記揺れに弱い:「猫/ネコ」「食べた/食う」のような揺れで、 表層指標は軒並み低下する。 実務では正規化(カタカナ⇔ひらがな統一、 全半角統一)や文字 N-gram の部分一致で緩和するが、 根本解決には意味ベースの手法が必要。
- 語順を無視する(BoW・N-gram 集合):「犬が猫を追う」と「猫が犬を追う」は N=1 なら完全一致扱い。 主語と目的語の逆転という意味の大違いを検出できない。 N を上げれば部分的に語順が効くが、 今度は表記揺れへの感度も上がるトレードオフがある。
- 意味は捉えない:「東京の人口は多い」と「首都圏は人口密度が高い」のように単語がほぼ重ならない言い換えは、 どの表層指標でも「似ていない」と判定される。 短文ほど 1 文字の増減で値が大きくブレる点にも注意(分母が小さいため)。
🚀 発展 ── 表層から意味へ
上のデモは「頻度をそのまま数える」素朴なベクトル化ですが、 実務では 2 段階の発展があります。 第 1 段階は TF-IDF:どの文書にも現れる「が」「を」のような N-gram の重みを下げ、 その文書らしい部品を強調してからコサイン類似度を取る(本ページ「🐍 Python 実装」の TfidfVectorizer(analyzer='char_wb') がまさにこれ)。 第 2 段階は 埋め込み(embedding)ベースの類似度:BERT / Sentence-BERT で文を意味ベクトルに変換すれば、 「猫/ネコ」の表記揺れも「東京/首都圏」の言い換えも近いベクトルに写像され、 コサイン類似度が意味の近さを反映するようになる。 距離指標そのものの整理は距離、 NLP 全体での位置付けは自然言語処理のページを参照。