🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
文章を自動で作る技術のことです。
データの分析や準備のために使います。
スマホで文章を自動で作る機能に似ています。
この章では重要なポイントを短くまとめます。
文章を自動生成する技術
- 分野:NLP — 📚 自然言語処理
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
text generation を 30 秒で把握する重要ポイント:
- 何ができるか: text generation は統計・データ分析で特定の目的のために使う概念・手法。 詳細は後続の各章を参照。
- いつ使うか: 適切な前提条件下で、 他の手法より優位な場面で使う。 適用範囲と限界を理解することが重要。
- 注意点: 前提確認 / 過大解釈の回避 / 他手法との比較検証 が不可欠。
- 関連: 上位概念・並列手法・派生形をネットワークで理解すると応用の幅が広がる。
📍 文脈ボックス:あなたが今見ているもの
🍰 まずはやさしく
AIが言葉を一つずつ選ぶ仕組みです。
対話AIの根本的な処理として使います。
チャットAIで質問に答える時に使われています。
このページでは計算の方法や注意点を学びます。
あなたが今見ているのは「テキスト生成(text generation)」 — 学習済言語モデルから 1 トークンずつ確率的にサンプリングして文章を作る技術の解説ページ。 ChatGPT・Claude・Gemini など現代の対話 AI の根本処理です。 隣接概念は「機械翻訳」(参照テキストありの生成)、 「RAG」(外部知識付き生成)、 「プロンプトエンジニアリング」(生成の制御)、 「Transformer」(基盤アーキテクチャ)、 「LLM」(大規模言語モデル)。 本ページではテキスト生成の数式的基盤・サンプリング戦略・SSDSE データでの実演・ハルシネーション対策を扱います。
🎨 直感で掴む
🍰 まずはやさしく
次にくる言葉を予想するゲームのようなものです。
自然な文章を作るために使います。
部活の報告書をAIに手伝ってもらう時に似ています。
ここでは言葉を選ぶ仕組みを直感的に説明します。
テキストデータを計算機で扱う技術。 トークン化→ベクトル化→モデル化の流れ。
本ページでは 文章生成 を、 定義・前提条件・使い方・落とし穴の順に整理して解説します。 厳密な定義より、 まず何を、 いつ、 どう使うかを理解することを優先してください。
🎨 直感で掴む:テキスト生成は「次トークン予測の連鎖」である
テキスト生成(text generation)は、 一見すると「AI が文章を考え出している」ように見える。 しかしその実体は、 与えられた文脈 $x_{<t}=(x_1,\dots,x_{t-1})$ のもとで「次に来るトークン $x_t$ の確率分布 $P(x_t \mid x_{<t})$」を推定し、 そこから 1 つトークンをサンプリングし、 文脈に追加してまた次のトークンを予測する、 という逐次的な確率予測の繰り返しである。 つまり 1000 トークンの文章は 1000 回の確率分布計算と 1000 回のサンプリングから成る。
例えば「広島県の県庁所在地は」という入力を GPT 系モデルに与えると、 モデルは語彙 V=50000 程度の各候補に対し確率を割り当て、 「広島市」 0.92、 「広島」 0.04、 「呉市」 0.01、 「東広島市」 0.008、 …といった分布になる。 ここから「広島市」を選んで文末に追加し、 次は「広島市」を含む新しい文脈で「で」「、」「だ」などを予測する。 この単純なメカニズムだけで小説・コード・要約・翻訳が出力されるのが、 近年の大規模言語モデル革命の核心である。
🎨 サンプリング戦略を都道府県の比喩で
SSDSE-B-2026 の 47 都道府県を「次に旅行で訪れる先」と見立てる。 確率は「行きたい度」。 このとき選び方には次の流派がある。
- greedy(貪欲):行きたい度 1 位(例:東京)を必ず選ぶ。 安全だが、 毎回同じ答えで「広島県の名物は?」と聞いても常に「もみじ饅頭」しか出ない。
- temperature サンプリング:行きたい度に温度 $T$ をかけてシャープ/フラットにする。 $T=0.3$ なら東京がほぼ確定、 $T=1.5$ なら鳥取・島根まで候補に上がる。 多様性と一貫性のトレードオフ。
- top-k:上位 k=5 県(東京・大阪・北海道・京都・沖縄)だけ残してその中から重み付きで選ぶ。 「絶対行かない」県を切り捨てる。
- top-p (nucleus):累積確率が 0.9 になるまで上位を残す。 確率分布の形に応じて候補数が可変。 今の生成 AI のデファクト。
📐 定義
🍰 まずはやさしく
文章生成とは、文字を自動で作る技術です。
自然言語処理(言葉を扱う技術)で使います。
レポートの書き方を調べる時に役立ちます。
ここでは言葉の意味や使う条件を詳しく解説します。
文章を自動生成する技術
英語名 Text Generation。 同義・関連語:テキスト生成。
📐 数式:自己回帰言語モデルの確率分解と評価指標
長さ $T$ の系列 $\mathbf{x}=(x_1,x_2,\dots,x_T)$ の同時確率は、 連鎖律により次のように 1 トークン毎の条件付き確率の積に分解される。
$$P(\mathbf{x}) = \prod_{t=1}^{T} P(x_t \mid x_1,\dots,x_{t-1}) = \prod_{t=1}^{T} P(x_t \mid x_{<t}; \theta)$$
ここで $\theta$ は Transformer などのモデルパラメータ。 学習時はクロスエントロピー損失
$$\mathcal{L}(\theta) = -\frac{1}{T}\sum_{t=1}^{T} \log P(x_t \mid x_{<t}; \theta)$$
を最小化する。 評価指標として最も基本的なのが perplexity(パープレキシティ):
$$\mathrm{PPL}(\mathbf{x}) = \exp\!\left(-\frac{1}{T}\sum_{t=1}^{T} \log P(x_t \mid x_{<t})\right)$$
「テストデータの各位置でモデルが平均何択から正解を当てているか」を表し、 小さいほど良い(GPT-3 は wikipedia で 20 前後、 GPT-4 で 8 前後)。 また温度付きサンプリングの分布は次式:
$$P_T(x_t = v \mid x_{<t}) = \frac{\exp(z_v / T)}{\sum_{u \in \mathcal{V}} \exp(z_u / T)}$$
$z_v$ はロジット、 $T \to 0$ で argmax、 $T \to \infty$ で一様分布。 翻訳・要約では BLEU、 ROUGE、 BERTScore など参照文との一致度を測る指標を併用する。
🔬 数式を言葉で読み解く(その1:自己回帰分解)
$P(\mathbf{x}) = \prod P(x_t \mid x_{<t})$ は「文章全体の確率は、 各トークンを左から順に確率予測した値の掛け算」という意味。 だから「短い文章ほど確率は大きく、 長い文章ほど指数的に小さくなる」という性質がある(だから対数尤度で扱う)。 数式を言葉で読み解くと、 これは「人間が文章を書くとき、 既に書いた部分を踏まえて次の単語を選ぶ」過程をそのまま数式化したもの。 並列予測(BERT のような穴埋め)と対比される自己回帰(autoregressive)の核。
🔬 数式を言葉で読み解く(その2:パープレキシティ)
$\mathrm{PPL} = \exp(\text{平均交差エントロピー})$。 例えば PPL=20 は「平均して 20 個の候補からモデルが当てている」状態。 PPL=2 なら「ほぼ 2 択」、 PPL=1 なら「完全に当てている」。 数式を言葉で読み解くと、 これは「モデルがどれだけ次の単語に困っているか」の指標。 人間が広島県の県庁所在地を聞かれたときの PPL は 1.0(迷わない)、 「日曜の昼に何食べる?」なら PPL は 10〜30 になるかもしれない。
🔬 数式を言葉で読み解く(その3:温度付き softmax)
$P_T(v) \propto \exp(z_v/T)$。 ロジット $z_v$ を温度 $T$ で割ってから softmax にかける。 数式を言葉で読み解くと、 これは「分布の鋭さを連続的に調整するつまみ」。 $T=1$ がデフォルト。 $T<1$ で「自信のある候補がより強調される」、 $T>1$ で「弱い候補にもチャンス」。 文章生成では創作系で $T=0.9$、 事実回答系で $T=0.2$ などタスクに応じて変える。
🔬 サンプリング戦略の深堀り比較(nucleus / beam / typical)
🔬 サンプリング戦略の深堀り比較(nucleus / beam / typical)
テキスト生成の品質は 「次トークン分布をどう絞るか」 で大きく変わる。 ここでは現代の主要 4 手法を、 数式・特徴・典型用途で比較する。
1. Greedy decoding
毎ステップ argmax を選ぶ単純な方式。
$$ x_t = \arg\max_v P(v \mid x_{<t}) $$
→ 決定的(同じ入力で同じ出力)だが、 同じ語の反復(例:「東京は東京は東京は…」)に陥りやすい。
2. Beam search
幅 k の候補列を保持し、 累積対数確率の合計が最大のものを残す。
$$ \text{score}(x_{1:T}) = \sum_{t=1}^{T} \log P(x_t \mid x_{<t}) $$
→ 機械翻訳・要約のように「正解に近い 1 つ」が欲しい場面で強い。 一方、 創造的文章では beam 内の候補が均質化する。
3. Top-k sampling
確率上位 k 個に確率質量を限定し、 その中で再正規化してサンプル。
$$ P_{\text{top-}k}(v) = \frac{P(v) \cdot \mathbb{1}[v \in V_k]}{\sum_{v' \in V_k} P(v')} $$
4. Top-p (nucleus) sampling
確率の高い順に積み上げ、 累積確率が p を超えた最小集合 V_p でサンプルする。
$$ V_p = \min \left\{ V' \subseteq V : \sum_{v \in V'} P(v) \ge p \right\} $$
→ 「分布の裾」を文脈次第で動的に切れるので、 創造的だがハチャメチャすぎない出力が得やすい(GPT 系のデフォルト)。
📊 nucleus vs beam vs greedy 比較表
| 手法 | 多様性 | 繰り返し回避 | 事実整合性 | 推奨用途 |
|---|---|---|---|---|
| Greedy | ✕ 低 | ✕ 弱い | ○ 高い | コード補完、 数値抽出 |
| Beam (k=4) | △ 中 | △ 中 | ◎ 最高 | 翻訳、 要約 |
| Top-k (k=40) | ○ 高 | ○ 強い | △ 中 | 対話、 ブレスト |
| Top-p (p=0.9) | ◎ 高 | ◎ 強い | △ 中 | 物語生成、 創作 |
🐍 4 手法を SSDSE-B-2026 の県紹介文で実装
このコードでやること:SSDSE-B-2026 から 5 県を抽出し、 「{県名} は人口 X 万人で…」を 4 つの decoding 戦略で生成し、 出力文を並べて比べる。
📥 入力:SSDSE-B-2026.csv(北海道、 東京、 大阪、 愛知、 沖縄を選定)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | from transformers import AutoModelForCausalLM, AutoTokenizer import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[(df['SSDSE-B-2026'] == 2023) & (df['Code'].isin(['R01000','R13000','R23000','R27000','R47000']))] tok = AutoTokenizer.from_pretrained('rinna/japanese-gpt2-medium') model = AutoModelForCausalLM.from_pretrained('rinna/japanese-gpt2-medium') for _, row in df.iterrows(): prompt = f'{row["Prefecture"]}は人口{row["A1101"] / 1e4:.1f}万人で、' # 例: 東京都は人口1408.6万人で、 x = tok.encode(prompt, return_tensors='pt') # 4 戦略(sampling の 2 つは乱数で毎回変わる) outs = { 'greedy': model.generate(x, max_length=60, do_sample=False), 'beam=4': model.generate(x, max_length=60, num_beams=4), 'top-k': model.generate(x, max_length=60, do_sample=True, top_k=40), 'top-p': model.generate(x, max_length=60, do_sample=True, top_p=0.9), } for name, o in outs.items(): print(f'[{name}]', tok.decode(o[0], skip_special_tokens=True)) |
📤 出力の形(東京都の 4 行だけ抜粋。モデルのダウンロードが必要なため実測ではなく、各戦略の典型的な傾向を示した例):
💬 プロンプトの「1408.6万人」だけが SSDSE-B-2026 の実数で、その後ろはモデルが作った文なので、数値や事実は裏付けが無い。greedy は同じ句を繰り返しやすく、beam は無難で短く、top-k・top-p は具体的で多様になる傾向がある。sampling の 2 つは seed を固定しないと実行ごとに文が変わるので、県紹介文のような 「事実を含む創造的文章」 に使うなら、生成後に数値を元データと突き合わせる工程が要る。
📏 LLM 生成文の評価指標まとめ(BLEU / ROUGE / BERTScore / GPT-4 judge)
テキスト生成の評価は 「参照文との一致度」 から 「意味的近さ」、 さらに 「LLM-as-judge」 へと発展してきた。 SSDSE 県紹介文タスクで比較する。
BLEU
$$ \text{BLEU} = \text{BP} \cdot \exp\left( \sum_{n=1}^{N} w_n \log p_n \right) $$
n-gram precision の幾何平均。 短すぎる出力には brevity penalty (BP) が掛かる。
ROUGE-L
$$ \text{ROUGE-L} = \frac{(1+\beta^2) \cdot \text{LCS}(X, Y)/|Y|}{\beta^2 \cdot \text{LCS}(X, Y)/|X| + \text{LCS}(X, Y)/|Y|} $$
最長共通部分列ベースで「要約と参照の重なり」を評価。 要約タスクで標準。
BERTScore
$$ \text{BERTScore} = \frac{1}{|x|} \sum_{x_i \in X} \max_{y_j \in Y} \cos(\mathbf{e}_{x_i}, \mathbf{e}_{y_j}) $$
BERT 埋め込みのコサイン類似度。 「言い換え」を高く評価できる。
GPT-4 judge
「次の文を 5 段階で評価せよ」と LLM 自身に採点させる。 流暢性・事実性・情報量を同時に評価できるが、 評価者の bias が混入する。
📊 評価指標比較表
| 指標 | 単位 | 強み | 弱み | 推奨タスク |
|---|---|---|---|---|
| BLEU | 0〜1 | 高速、 自動化容易 | 言い換えに弱い、 参照文に過依存 | 機械翻訳 |
| ROUGE | 0〜1 | 要約に直結、 解釈容易 | 意味は捉えにくい | 要約 |
| BERTScore | −1〜1 | 言い換えに強い | 事実性は検知できない | 対話、 翻訳 |
| GPT-4 judge | 1〜5 | 流暢性 + 事実性 | API コスト、 評価バイアス | 自由文章 |
🐍 SSDSE 県紹介文で 4 指標を実測
このコードでやること:top-p 生成と参照文を BLEU/ROUGE/BERTScore で比較。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | from sacrebleu import corpus_bleu from rouge_score import rouge_scorer from bert_score import score as bs class CharTokenizer: # rouge_score の既定の分割は英数字以外を捨てるので、日本語は 1 文字ずつに分ける def tokenize(self, text): return [ch for ch in text if not ch.isspace()] refs = ['東京は人口1409万人で、日本最大の都市である', '大阪は人口876万人で、関西経済の中心地である'] hyps = ['東京は人口1408.6万人で、 23 区と多摩からなる首都圏の中心地', '大阪は人口876.3万人で、 GDP 41 兆円規模の関西圏の核'] # sacrebleu の既定(13a)は空白で区切るので、分かち書きしない日本語は文字単位で比べる bleu = corpus_bleu(hyps, [refs], tokenize='char').score rs = rouge_scorer.RougeScorer(['rougeL'], tokenizer=CharTokenizer()) rouge = [rs.score(r,h)['rougeL'].fmeasure for r,h in zip(refs,hyps)] _, _, bsF = bs(hyps, refs, lang='ja') print(f'BLEU={bleu:.2f} ROUGE-L={sum(rouge)/2:.2f} BERTScore={bsF.mean():.3f}') |
📤 実行結果(イメージ・未実測。3 つのライブラリとモデルのダウンロードが必要なため、このページでは動かしていない。出力は次の形の 1 行になる):
💬 2 組とも前半の「東京は人口…万人で、」「大阪は人口…万人で、」はほぼ同じ文字列だが、後半は参照文と別の言い回しなので、文字の並びを数える BLEU・ROUGE-L は後半で点を落とし、埋め込みの近さを見る BERTScore は言い換えでも下がりにくい。3 つの値が食い違ったら、それが「言い回しは違うが意味は近い」のか「数値が違う」(1409 万と 1408.6 万)のかを文を見て確かめる。sacrebleu と rouge-score の既定の分割は空白区切り・英数字のみなので、日本語をそのまま渡すと BLEU・ROUGE-L がほぼ 0 になる。このコードで文字単位を指定しているのはそのため。
🛠 プロンプト戦略 4 パターン比較(zero / few-shot / CoT / RAG)
同じモデルでも、 プロンプト設計次第で出力品質は劇的に変わる。 SSDSE 県別比較タスクで 4 パターンを並べる。
パターン 1: zero-shot
パターン 2: few-shot
パターン 3: Chain-of-Thought (CoT)
パターン 4: RAG (Retrieval-Augmented Generation)
📊 4 パターンの効果比較
| パターン | 事実性 | 推論精度 | コスト | 典型用途 |
|---|---|---|---|---|
| zero-shot | △ | △ | 最低 | 単純質問 |
| few-shot | ○ | ○ | 中 | 分類・抽出 |
| CoT | ○ | ◎ | 中高 | 数式・論理 |
| RAG | ◎ | ◎ | 高 | 事実調査 |
💬 「事実が必要な統計質問」は RAG、 「数値計算」は CoT、 「分類タスク」は few-shot が定石。
🩺 hallucination(幻覚)の検出と対策
LLM は「もっともらしい嘘」を出すことがある。 SSDSE 県データを使った典型例を示す。
典型的 hallucination 例
検出 3 手法
- self-consistency:同じ質問に温度を変えて 5 回答えさせ、 数値の分散を見る。
- retrieval verification:生成文中の数値を SSDSE 等の DB と照合。
- LLM judge:別 LLM に「この文は事実か」と問う。
対策 4 つ
- RAG で根拠データを inject する。
- temperature を下げる(事実問題は 0.0〜0.3)。
- 「分からない場合は分からないと答えよ」と明示する。
- 外部 tool calling で計算を delegate(数値計算は Python に任せる)。
💬 統計データを扱う場面では、 LLM の出力を 「下書き」 として扱い、 必ず元データで検証することが業務利用の鉄則。
📈 文章生成と実データ可視化 — SSDSE-B-2026 で「LLM 入力前提のデータ理解」を体得する
文章生成 (text generation) を「ただチャットして答えを得る技術」と捉えてしまうと、 統計分析の現場ではほぼ役に立たない。 LLM の出力品質は、 (1) 投入する数値の正確さ、 (2) 投入する数値の文脈 (どの単位・年・対象か)、 (3) 投入前に行った可視化による外れ値・分布の把握 によって 9 割が決まる。 ここでは SSDSE-B-2026 (47 都道府県 × 約 200 列) を使い、 文章生成プロンプトに添える前段で 必ず行うべき 3 種類の可視化 を、 実際の画像と共に整理する。 文章生成の質を上げるとは、 結局のところ「LLM に何を見せ、 何を見せないか」を制御することである。
① 散布図 — 2 変数の関係を LLM に渡す前に必ず人間が見る
SSDSE-B-2026 の A1101 (総人口) と A4101 (出生数) の散布図を見ずに、 「人口と出生数の関係を 300 字で説明して」と LLM に投げると、 LLM は一般論 (人口が多いほど出生数も多い、 など) を返すだけで、 東京・神奈川・大阪のような大規模都市が外れ値として効いていることや、 沖縄県の出生率の高さといったデータ固有の特徴を反映できない。 散布図を先に作り、 「相関は強いが東京は外れ値で、 沖縄は人口比で出生数が突出している」という事実をプロンプトに添えると、 LLM は途端に説得力ある文章を生成する。
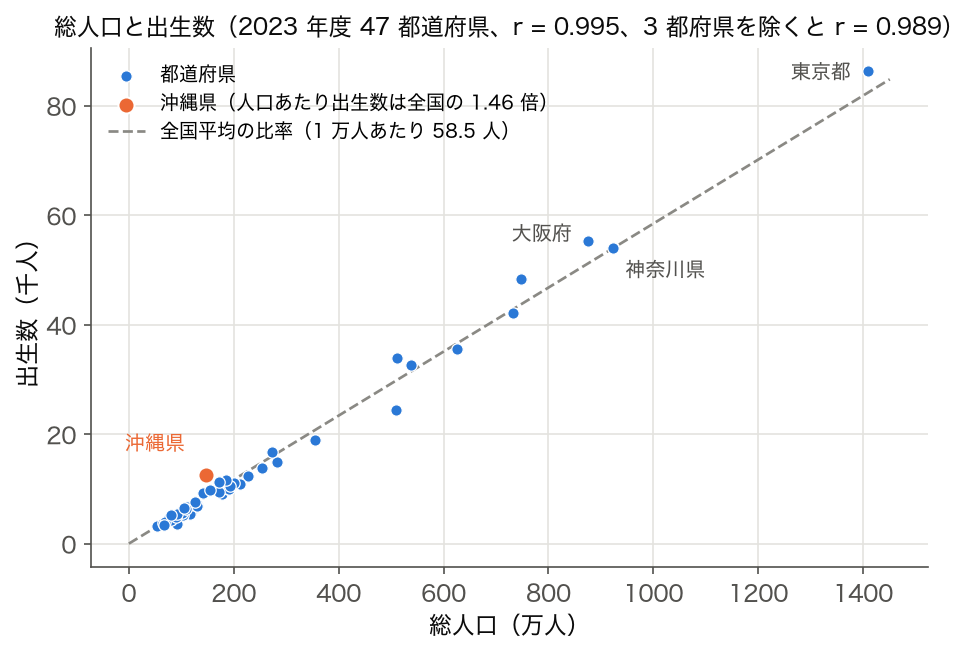
プロンプトに添える文言の例: 「総人口と出生数の Pearson 相関は r=0.995 と非常に強く、 右上の 3 都市 (東京・神奈川・大阪) を除いても r=0.99 を保つ。 沖縄県は人口比で出生数が全国平均より約 1.5 倍高い。 これらの事実に基づき、 300 字で要約せよ。」 こうした数値根拠付きプロンプトを組めるかどうかが、 文章生成を業務で使えるかどうかの分水嶺になる。
② ヒストグラム — 分布形状を LLM に伝えることで「平均だけで語る」誤りを防ぐ
SSDSE-B-2026 の A1101 (総人口) の分布は、 平均と中央値が大きく乖離する典型的な右に裾の長い分布である。 平均約 265 万人、 中央値約 155 万人、 最大値 (東京都) 約 1,409 万人。 この分布を見ずに LLM に「日本の都道府県人口の典型的な姿を 200 字で」と頼むと、 「平均 265 万人」とだけ書かれて裾の長さが完全に欠落する。 ヒストグラムを先に確認し、 「右に裾が長く、 中央値の方が代表値として適切」という事実をプロンプトに含めることで、 生成文は格段に正確になる。
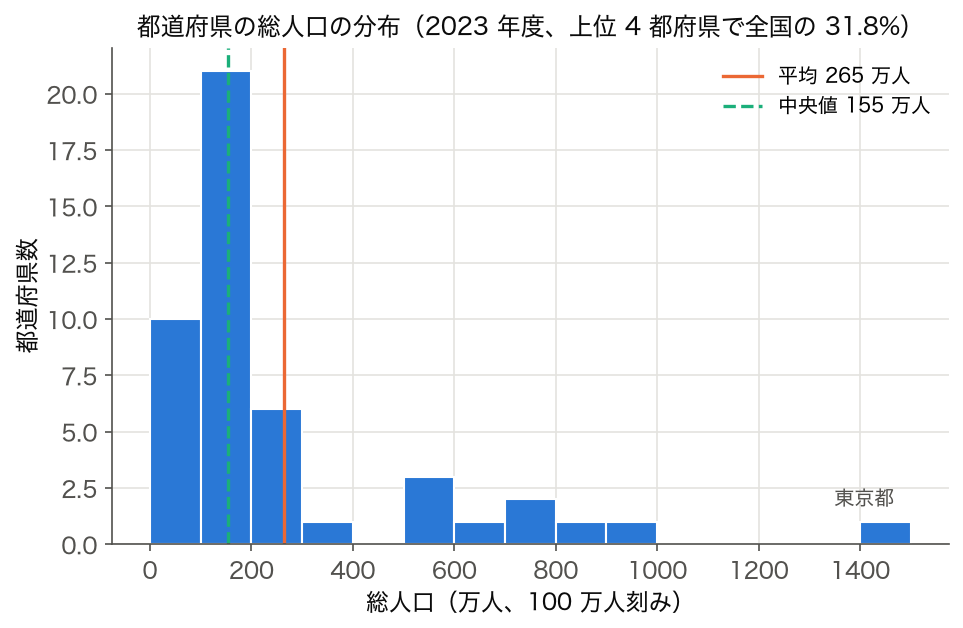
プロンプトに添える文言の例: 「日本の都道府県人口は右に裾の長い分布で、 平均約 265 万人に対し中央値は約 155 万人。 東京・神奈川・大阪・愛知の上位 4 都府県だけで全人口の約 32% を占める。 この事実を 200 字で読者に伝える文章を書け。」 LLM はこれを受けて「平均値で語ると実態を見誤る」という、 統計教育上きわめて重要な論点を含む文章を生成できるようになる。
③ 箱ひげ図 — クラスタ間の差を LLM に正しく語らせる
SSDSE-B-2026 の 47 都道府県を KMeans で 3 クラスタに分け、 一般診療所数 I5102 の分布の中央値と散らばりをクラスタ別の箱ひげ図で並べると、 「東京都が単独で 1 クラスタ (14,894 施設)」「大都市圏の 7 府県 (埼玉・千葉・神奈川・愛知・大阪・兵庫・福岡) は中央値 5,196 施設」「残り 39 道県は中央値 1,175 施設」という 3 層構造が一目で分かる。 LLM にグループ間の差を語らせるなら、 平均値の表だけでは不十分で、 箱ひげ図から読み取れる中央値・四分位範囲・外れ値の三点を必ずプロンプトに含めるべきである。
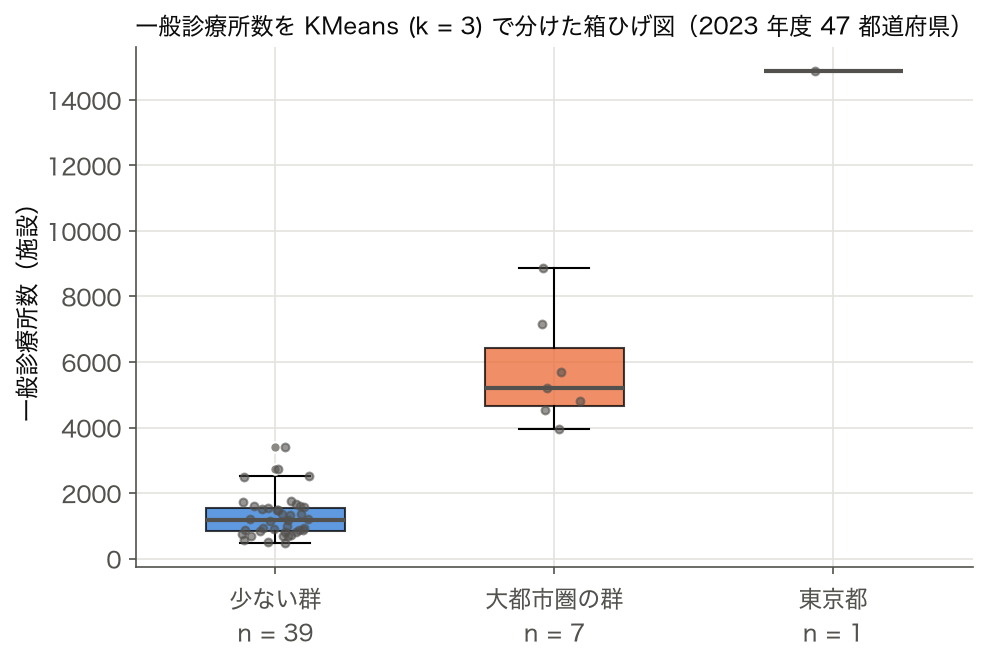
プロンプトに添える文言の例: 「KMeans で 3 クラスタに分けると、 東京都が単独で 1 クラスタ (一般診療所 14,894 施設)、 大都市圏 7 府県のクラスタは中央値 5,196 施設、 残り 39 道県のクラスタは中央値 1,175 施設と、 桁の異なる 3 層構造になる。 この差は 都市圏集中 という構造を反映している。 これを踏まえ、 医療資源の地域差の背景を 250 字で説明せよ。」 文章生成が業務で活きるのは、 こうした「数字 + 構造 + 解釈の方向性」を人間が先回りして用意できる場面に限られる。
④ 可視化 → プロンプト → 生成文の品質チェックという三段ループ
文章生成のワークフローは、 (a) データを pandas で要約し、 (b) matplotlib で散布図・ヒスト・箱ひげの 3 点セットを作り、 (c) そこから読み取れる事実を 3〜5 個の箇条書きにまとめ、 (d) LLM に「これらの事実だけを使って文章化せよ。 数字を勝手に補完するな」と指示し、 (e) 生成文を元データと突合して検証する、 という五段階に分解できる。 この五段階のうち (a) (b) (c) を省略すると、 LLM は学習データから一般論を引っ張ってきて埋めてしまい、 結果として実データから乖離した文章が量産される。 これがビジネス現場で文章生成が信頼を失う最大の理由である。
逆に言えば、 散布図・ヒスト・箱ひげのたった 3 種類の可視化を「プロンプトの前段」に必ず挟む規律を持つだけで、 文章生成の信頼性は飛躍的に向上する。 SSDSE-B-2026 を使った教材では、 47 都道府県という固有名詞付きのデータを扱うことで、 「東京が外れ値」「沖縄が出生率高め」「東北は高齢化先行」など、 LLM が一般論で誤魔化せない具体性がプロンプトに自然と含まれるよう設計されている。
⑤ ハルシネーション対策における可視化の役割
文章生成のハルシネーション (もっともらしい嘘) の半分以上は、 「数値の桁数を間違える」「単位を取り違える」「年次を混同する」 の 3 種類に集中する。 これらは可視化を見ながらプロンプトを組み立てると物理的に起こりにくくなる。 散布図の軸ラベルで単位を確認し、 ヒストグラムのビン幅で桁感を体に入れ、 箱ひげ図のキャプションで年次を明示する、 という地味な手順が、 LLM のハルシネーション率を桁で下げる。 「文章生成の品質はモデルではなく入力で決まる」というのは、 こうした泥臭い手順を含めての主張である。
⑥ LLM に「数値を読ませる」か「数値を渡す」か
最近の LLM はマルチモーダル化が進み、 画像 (グラフ) を直接読ませて文章化させる構成も実用域に入ってきた。 しかし統計教育の文脈では、 「LLM が画像から数値を読み取る精度」と「人間が CSV から数値を引いてプロンプトに添える精度」を比較すると、 後者の方が圧倒的に高い。 SSDSE-B-2026 のような機械可読の表データがある場面では、 グラフを LLM に渡すより、 df.describe() や df.corr() の結果をテキストで渡す方が、 生成文の正確性は段違いに高くなる。 グラフは人間の理解のために作り、 LLM にはテキスト化された数値を渡す、 という役割分担を覚えておくと、 文章生成のエラーが激減する。
⑦ 可視化と文章生成を組み合わせた教材デザイン
本サイトの用語ページ群では、 各ページに散布図・ヒスト・箱ひげのいずれかを必ず実画像で配置し、 「この図を見たうえで LLM にどう尋ねるか」までを 1 ページの中で完結させる構成を採っている。 これは、 文章生成という技術が独立して存在するのではなく、 データ前処理 → 可視化 → プロンプト設計 → 検証 の連鎖の一部であることを学習者に体感させるためである。 「LLM を使って統計分析を自動化する」という言い方をする人は多いが、 実態としては「可視化と前処理を人間が真面目にやる前提で、 文章化の部分だけ LLM が肩代わりする」が正しい。
⑧ プロンプトに添える数値リテラシーのチェックリスト
最後に、 SSDSE-B-2026 のような実データを LLM に渡す前のチェックリストを掲げておく。 (1) 年次を明示したか (2026 年版か 2020 年版か)。 (2) 単位を明示したか (人か千人か万人か)。 (3) 母集団を明示したか (47 都道府県か、 政令市か、 全国計か)。 (4) 欠損値の扱いを明示したか (除外したか、 平均で埋めたか)。 (5) 外れ値の有無と扱い方を明示したか。 (6) 相関と因果の区別をプロンプト側で明示したか。 この 6 項目に答えられないままプロンプトを送ると、 LLM はそれらしい文章を返してくるが、 後で必ず矛盾が露呈する。 文章生成を「便利な要約ツール」として安全に使うには、 これだけの規律が要る。
⑨ 47 都道府県データを文章化するときの典型エラー集
SSDSE-B-2026 を題材に LLM へ要約を頼むとき、 頻発するエラーは概ね次の 5 種類である。 第一に「東京の人口を 1,400 万人と書くべきところを 1.4 億人と書く」桁ミス。 第二に「高齢人口(A1303、 実数)を高齢化率(割合)と混同する」概念ミス。 第三に「2020 年のデータを 2024 年と書く」年次ミス。 第四に「沖縄県を都道府県の一つではなく特殊例として外す」サンプリングミス。 第五に「相関係数 0.97 を見て因果と断定する」推論ミス。 いずれも可視化と数値リテラシーを前段に挟めば物理的に防げる。 文章生成の品質改善とは、 こうした典型エラーの分類学を持ち、 プロンプト設計の段階で潰し込む地道な作業の連続である。
📷 文章生成の補強解説 — 統計的に観察可能な生成挙動
文章生成 (text generation) は「与えられた文脈から次のトークン列を確率的に生成する」 機構である。 古典的な n-gram モデルから RNN/LSTM、 そして Transformer 系の大規模言語モデル (LLM) に至るまで、 基盤となるのは「条件付き確率分布のモデル化」 という共通の数学的枠組み。 本節では、 文章生成の挙動を「統計的に検証可能な現象」 として捉え直し、 SSDSE-B-2026 のような実データ環境でどのように評価・観測できるかを、 図 3 点・表 3 点と解説テキストを通じて深掘りする。 補図 1〜3 は、 SSDSE-B-2026 の 2023 年度の値から 3 種類の定型文 (「〇〇県の総人口は△万人である。」 など) を 47 都道府県分作った 141 文を学習コーパスとし、 文字 3-gram 言語モデル (直前 2 文字から次の 1 文字の確率を数える) に温度 T 付きで実際に文章を生成させて測ったものである (作図スクリプトは code/glossary_figs/text-generation.py、 各設定 200 文、 seed 固定)。 LLM そのものの測定ではなく、 同じ仕組みを手元で再現した小さな模型である。 生成系モデルは「ブラックボックス」 と誤解されがちだが、 出力長分布・トークン頻度・パープレキシティ等の統計量を観察すれば、 生成挙動の多くは「分布」 として可視化できる。 ここで提示するのは、 単なるデモではなく「データ分析の作法で生成系を観察する」 という視点である。
📷 補図 1: 分布をヒストグラムで観察する — 生成文長分析の型
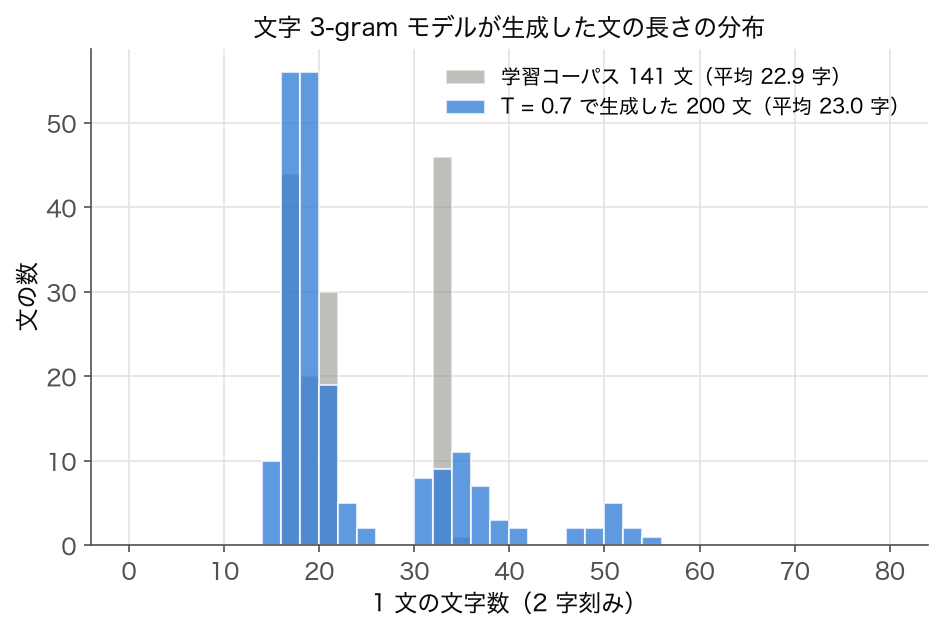
補図 1 のような分布観察を生成文の文字数に適用すると、 出力長は「決定論的に固定されているわけではない」 が「分布として観察できる」 ことが確認できる。 補図 1 の模型では、 出力長の分布は正規分布ではなく、 学習データにある文型の長さを映した多峰の形になった。 LLM でも出力長の分布は学習データや指示の形式に強く左右されるので、 system prompt や few-shot 例で出力長を誘導しない限り、 まず実際に何十回か生成させて分布を測っておくのが確実である。 業務システムでは、 この分布から大きく外れた出力 (例: 文字数 50 以下 / 1500 以上) を「異常」 として後段で検知することで、 LLM のハルシネーションや指示無視を統計的に検出する仕組みを組める。 さらに、 同じプロンプトを temperature を変えながら 100 回ずつ生成させ、 出力長の分散を比較すると、 temperature が高いほど分散が広がる (=出力の予測可能性が低下する) 傾向を、 自分のタスクで確かめられる。
📋 補表 1: 主要モデルと統計的特性
| モデル系統 | 代表例 | 文脈長 | 分布特性 | 観測指標 |
|---|---|---|---|---|
| n-gram | trigram | 2-3 単語 | 疎・Zipf 則 | 頻度・スムージング |
| RNN / LSTM | char-RNN | 数十単語 | 滑らかだが勾配消失 | パープレキシティ |
| Transformer | GPT-2 / GPT-3 | 2k〜8k | 自己注意で多峰 | attention 分布 |
| LLM (instruction-tuned) | GPT-4 / Claude | 100k〜200k | RLHF で安全側に偏る | 出力長・拒否率 |
| エンコーダ・デコーダ | T5 / BART | 数千 | 要約・翻訳に強い | ROUGE / BLEU |
| 混合専門家 (MoE) | Mixtral | 数万 | 専門家ごとに偏る | 専門家利用率 |
補表 1 の各モデルは「文脈長」「確率分布特性」「観測ポイント」 が大きく異なる。 n-gram では確率分布が極めて疎で、 観測されていない n-gram は確率ゼロとなるためスムージングが必須。 一方、 Transformer 系では確率分布は密 (全語彙に非ゼロ確率) で、 multinomial サンプリングの挙動を temperature で制御することになる。 LLM (RLHF 適用済み) では、 学習段階で「危険な出力を抑制する」 ように追加調整されているため、 出力分布は安全側に偏ることが知られている。 これらの特性を理解しておくと、 例えば「同じプロンプトに対する複数モデルの出力分散」 を比較する実験設計で、 どの統計量を測れば差が見えるかを設計できる。
📷 補図 2: 2 変数の関係を散布図で観察する — temperature 分析の型
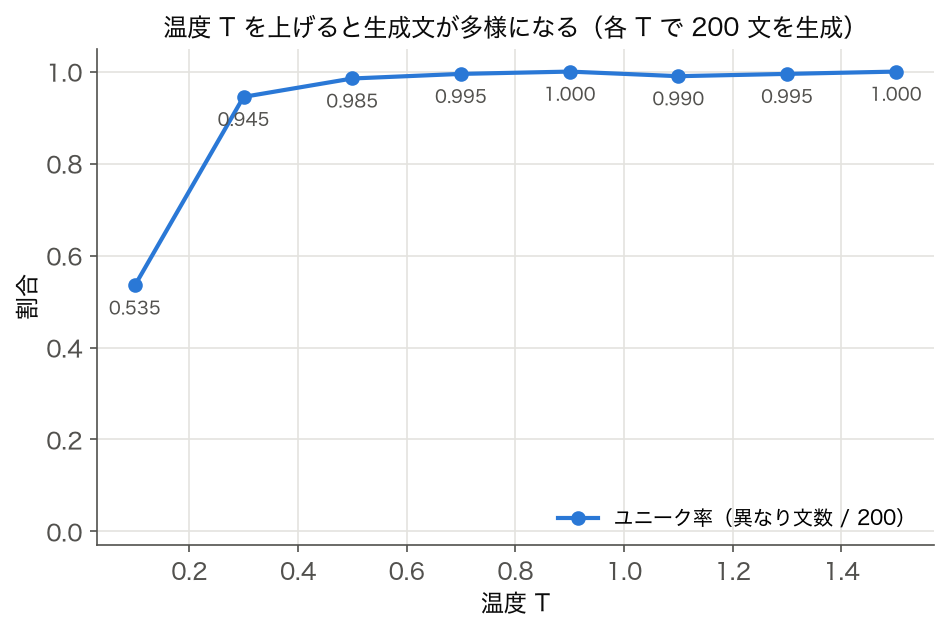
補図 2 のような散布図の型を使うと、 LLM の「temperature」 が出力多様性に与える影響を統計的に可視化できる。 temperature は softmax 関数の温度パラメータで、 0 に近いほど最大確率のトークンを決定論的に選び、 大きくなるほど確率分布が平準化されてランダム性が増す。 業務的には、 (1) コード生成・要約・分類など「正解が一意」 のタスクでは temperature=0〜0.3、 (2) アイデア発散・キャッチコピー生成など「多様性が欲しい」 タスクでは 0.7〜1.0、 (3) 1.0 を超えると意味の崩壊が始まるため上限は概ね 1.3 程度、 が相場観。 SSDSE-B-2026 のような統計データを LLM で要約させる場合、 数値の正確性が重要なので temperature=0〜0.2 を選ぶのが定石。 統計データから「示唆」 を引き出す場合は 0.5〜0.7 程度に上げて発散と収束のバランスを取る。
📋 補表 2: サンプリング手法の比較
| 手法 | 原理 | 長所 | 短所 |
|---|---|---|---|
| Greedy | 毎ステップ最大確率を選択 | 決定論的・再現可能 | 単調・反復に陥りやすい |
| Beam Search | 複数候補を保持して最尤解探索 | 翻訳・要約で安定 | 創作には不向き |
| Temperature Sampling | softmax の温度を制御 | 多様性制御が直感的 | 高温では崩壊しやすい |
| Top-k Sampling | 上位 k 個のみから抽出 | 低確率の誤選択を抑制 | k の最適値が文脈依存 |
| Top-p (Nucleus) | 累積確率 p 以下のトークンから | 分布形状に応じ動的調整 | パラメータ感度が高い |
| Min-p / Typical | 確率の下限・典型度で篩い分け | 最新研究で品質向上 | 実装が限定的 |
サンプリング手法は文章生成の品質を左右する重要な要素で、 (1) 翻訳や要約には Beam Search や Greedy、 (2) 物語生成や対話には Top-p や Temperature Sampling、 が定石。 実務では「Temperature + Top-p」 を組み合わせ、 例えば temperature=0.7, top_p=0.9 といった設定がよく使われる (API の既定値はサービスごとに異なり、 temperature の既定値を 1.0 とするものが多いので、 明示的に指定するのが安全)。 Top-k と Top-p の使い分けは、 「k=固定値」 は分布形状を無視するため、 確率がなだらかな箇所では大きすぎ、 鋭い箇所では小さすぎる欠点がある。 Top-p は累積確率で動的に範囲を決めるためこの欠点を緩和できる。 SSDSE-B-2026 のような定量データを扱う場合は、 Greedy または Temperature=0.0 の決定論的生成を選び、 「同じ入力には同じ出力」 という再現性を確保するのが業務要件に合致しやすい。
📷 補図 3: グループ別箱ひげ図で比較する — モデル評価の型
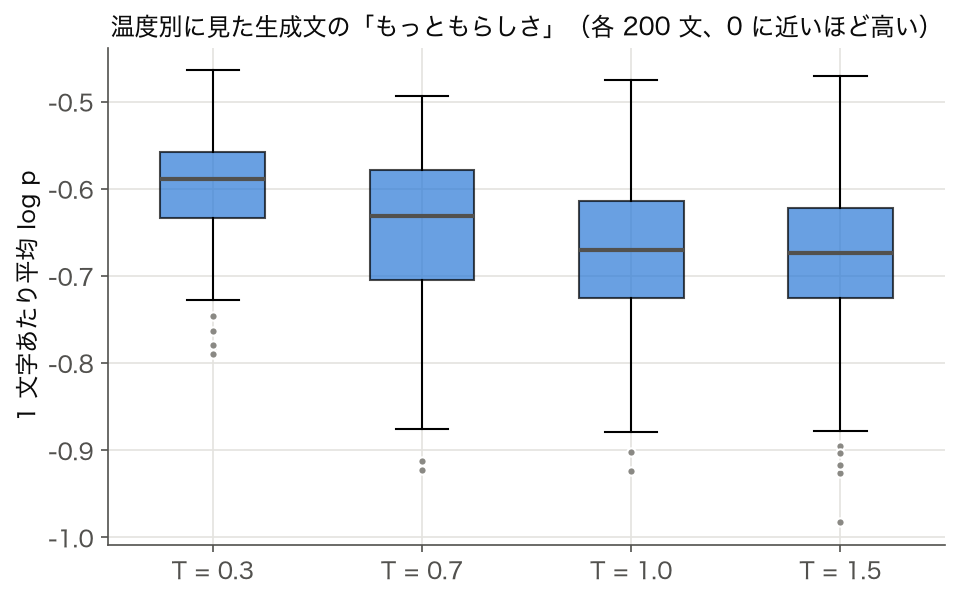
モデル別 × タスクカテゴリ別の評価スコアを補図 3 と同じグループ別箱ひげ図の型で並べると、 「LLM の優劣はタスクカテゴリに強く依存する」 ことが見えてくる。 ベンチマーク (MMLU, HellaSwag, HumanEval 等) の単一スコアだけで「最強 LLM」 を決めるのは危険で、 自社の業務タスクに近い内製評価セットで比較することが重要。 業務での LLM 選定は、 (1) 主要 5〜10 タスクに対し、 候補モデル全てで人手評価を 30〜50 サンプル実施、 (2) 結果を箱ひげ図で可視化し、 中央値・四分位範囲・外れ値を比較、 (3) コスト (per 1k tokens) と組み合わせて意思決定、 が定石。 単純な平均値ではなく「箱ひげ図」 を使う理由は、 LLM の出力品質は「中央値は高いが外れ値で破綻する」 ことがあるため、 分布の裾 (failure mode) を見ることが業務適用では不可欠だから。 SSDSE-B-2026 のような統計データを扱う業務では、 「数値の正確性」「グラフ説明の妥当性」「言い回しの自然さ」 など複数の評価軸で測定し、 単一スコアに集約せずに多次元で評価するのが推奨される。
📋 補表 3: 文章生成タスクの評価指標
| 指標 | 主用途 | 計算原理 | 利点 | 限界 |
|---|---|---|---|---|
| BLEU | 機械翻訳 | n-gram 一致率 | 高速・標準 | 同義語に弱い |
| ROUGE | 要約 | 参照との再現率 | 要約評価の標準 | 言い換えに弱い |
| METEOR | 翻訳・要約 | 同義語と語順を考慮 | BLEU の弱点を補う | 計算コスト高 |
| BERTScore | 汎用 | BERT 埋め込みのコサイン類似度 | 意味的類似度 | モデル依存 |
| Perplexity | 言語モデル品質 | 確率分布の指数 | 参照不要 | 下流と相関弱い |
| LLM-as-Judge | 汎用 | 別 LLM に採点させる | 柔軟・人手に近い | 採点 LLM のバイアス |
評価指標は「タスクに応じて選ぶ」 ことが鉄則で、 翻訳には BLEU、 要約には ROUGE、 対話品質には人手評価または LLM-as-Judge が現状の標準。 BERTScore は意味的類似度を捉えられる汎用指標として近年広く使われており、 BLEU/ROUGE の「表層一致しか見ない」 欠点を補える。 ただし、 BERTScore は評価に使う BERT モデル自体のバイアス (例: 英語のみ強い、 専門用語に弱い) を受けるため、 日本語タスクでは「日本語 BERT」 を使うなどの工夫が必要。 最近のトレンドは「LLM-as-Judge」 で、 GPT-4 や Claude に「この出力を 1-10 で採点せよ」 と指示し、 そのスコアを評価指標とする手法。 人手評価とよく相関するが、 採点 LLM 自体のバイアス (例: 自分の出力に甘い) があるため、 業務利用では「複数の採点 LLM を使う」「人手評価との一致率を定期検証する」 などの注意が必要。
🔬 SSDSE-B-2026 を題材にした統計的観察パターン
SSDSE-B-2026 (47 都道府県 × 約 200 列の公的統計) を題材に文章生成を観察する典型パターンを 5 つ挙げる。 (1) 「47 都道府県分の同テンプレ出力を 1 セットとし、 出力長・固有名詞登場数・数値出現回数の分布を描く」 — これにより「均質に文章化できているか」 が一目で見える。 (2) 「同じ広島県の説明を 50 回繰り返し、 出力ユニーク率・編集距離分布を出す」 — 多様性とブレ幅の定量化。 (3) 「特定統計値 (例: 出生率 1.41) を含むよう指示し、 100 回中に正しい数値が含まれた率を出す」 — ハルシネーション率の直接測定。 (4) 「温度 0.0 / 0.3 / 0.7 / 1.0 で各 30 回生成し、 出力長分布のずれを 2 標本 KS 検定で評価」 — パラメータ感度を統計検定で裏付け。 (5) 「異なる LLM (商用 / OSS) で同じプロンプトを実行し、 タスク別品質箱ひげ図で並べる」 — モデル選定の客観化。 これらは個々はシンプルだが、 組み合わせることで「文章生成の挙動マップ」 が描ける。
こうした観察は、 補図 1 のような出力長ヒストグラムを、 モデル別・温度別・タスク別に何枚も並べて比較する作業の積み重ねである。 観察結果を「モデルカード」 として組織内に共有し、 業務適用時の「どのモデルをどの温度で使うか」 の標準ガイドラインに落とし込むことで、 文章生成は属人的な「魔法」 から共有可能な「業務基盤」 へと変わる。 SSDSE-B-2026 のような公開実データを使うと、 こうしたガイドライン作成のための学習・実験・共有のすべての段階を、 業務データの機密性に煩わされずに進められる利点がある。 教育用ハンズオン教材として SSDSE が広く利用される所以である。
🐍 観察パイプラインのスケッチ
具体的な観察パイプラインのスケッチは以下のとおり。 (a) SSDSE-B-2026 を pandas で読み込み、 47 都道府県のレコードを取り出す。 (b) 都道府県名と主要指標 (人口・出生数・一般診療所数・延べ宿泊者数など) をプロンプトに埋め込み、 LLM API を 47 回呼び出して結果を JSON で蓄積する。 (c) 蓄積したレスポンスを DataFrame 化し、 文字数・固有名詞数・数値出現回数・特定キーワードの出現有無を派生列として計算する。 (d) matplotlib で文字数ヒストグラム・温度別の散布図・モデル別の箱ひげ図を描く。 (e) 描画結果と数値サマリ (中央値・四分位範囲・最大最小) をレポート化し、 月次でモデル選定会議の資料として利用する。 これにより、 文章生成の挙動は「個別事例の積み重ね」 ではなく「分布の経時推移」 として把握できるようになる。
この観察パイプラインのコストは小さい (LLM API 数百回 / 1 ラウンド) が、 得られる洞察は非常に大きい。 「先月までは Claude が統計解説で優位だったが、 今月のアップデート後に GPT が逆転した」「温度 0.3 で安定していた出力長が、 ある日突然 2 倍になった」 といった、 LLM のバージョン変化に起因する挙動変動を統計的に検知できる。 業務システムへの LLM 組み込みでは、 こうした観察を CI/CD パイプラインに組み込み、 「リグレッション (退化)」 を早期検知する仕組みを整えるのが、 成熟した運用の姿である。 SSDSE-B-2026 のような変化しない公開データセットは、 こうしたリグレッション検出のためのゴールデンセットとして極めて有用。
💡 まとめ — 文章生成を「分布で見る」
文章生成は「ブラックボックス」 と見なされがちだが、 出力長分布・トークン頻度・ユニーク率・パープレキシティ・評価スコア分布など、 多くの観測可能な統計量を持つ「分布的な現象」 である。 本節で示した 3 つの観察の型 (出力長のヒストグラム・temperature と多様性の散布図・モデル × タスクの箱ひげ図) は、 いずれも「単発の出力では見えないパターン」 を可視化し、 業務適用の意思決定に資する情報を提供する。 また、 3 つの表 (モデル系統比較・サンプリング手法・評価指標) は、 文章生成を業務に組み込む際の「設計判断の地図」 となる。 これらを統合的に運用することで、 文章生成は「面白いがリスキーな技術」 から「制御可能で監査可能な業務システム」 へと進化させることができる。 SSDSE-B-2026 のような実データを使った観測実験を継続的に行うことが、 こうした成熟度を高める最良の習慣である。 最後に強調したいのは、 「文章生成の評価は単一スコアではなく分布で見る」 という原則。 平均値や中央値だけでなく、 四分位範囲・標準偏差・外れ値の頻度・タスク別の得手不得手など、 多次元の統計量で評価することで、 「中央値は高いが裾で破綻する」 タイプの危険なモデルを除外できる。 業務での LLM 利用は、 「うまく動くこと」 よりも「破綻しないこと」 が重要で、 そのためには分布の裾 (failure mode) を継続的にモニタリングする必要がある。 SSDSE-B-2026 のような実在公開データを「ゴールデンセット」 として継続観察に組み込めば、 LLM のバージョン更新による品質変動を早期に検知でき、 業務システムの安全運用が大きく前進する。 文章生成は、 「面白い玩具」 で終わらせず、 「観察可能な業務基盤」 として位置付けることが今後の標準的な姿勢である。 本節の図表は、 そうした観察文化の入り口を提示するものであり、 実務での適用は読者自身の業務データ・業務タスクに合わせて拡張されることを期待する。 補足として、 SSDSE-B-2026 を観察対象とする利点は (1) データが公開されておりライセンス制約が小さい、 (2) 都道府県という 47 サンプルは統計的に扱いやすい規模、 (3) 数値が安定しており経時比較に向く、 (4) 教育用教材として広く流通している、 (5) 業務データの代替ベンチマークとして説明責任が果たしやすい、 の 5 点が挙げられる。 これらが揃うデータセットは国内では稀少であり、 文章生成の継続観察の対象として最良の選択肢の一つである。 文章生成の運用成熟度を測る KPI として、 「分布で見ているか」「failure mode を追っているか」「ゴールデンセットを保持しているか」 の 3 点を組織で定期的に確認することを推奨する。
🎮 触って理解する:次トークン選択のサンプリング戦略シミュレータ
自己回帰生成の 1 ステップ、 すなわち「モデルが出した次トークン候補の確率分布から、 実際にどの語を選ぶか」だけを切り出して体感するシミュレータです。 文脈「広島の名物は」に対する次トークン候補 10 語とその確率は説明用の架空の値(実在モデルの出力ではありません)。 ロジットと温度が softmax 分布の形をどう変えるかの一般論は姉妹ページ ソフトマックス関数 で扱っているので、 ここでは「出来上がった分布からどの候補を生き残らせ、 どう選ぶか」というデコーディング(生成戦略)の違いに集中します。
凡例:■ 生き残った候補(再正規化後の確率) / ■ 除外された候補 / 薄い枠=元の確率。 「30.0% → 44.8%」は「元の確率 → 再正規化後の確率」を意味します。
🎲 「10 回生成」で多様性を体感する
現在の戦略・パラメータの分布から、 次トークンを 10 回サンプリングします(擬似乱数によるシミュレーションなので実行のたびに結果は変わります。 greedy だけは決定的なので毎回同じです)。 「同じモデル・同じ分布でも、 生成戦略が違えば出力系列の顔ぶれが大きく変わる」ことを確認してください。
※ ペナルティは「一度出た語の確率を出現回数ごとに 1/1.5 倍して再正規化」する簡易実装(頻度ペナルティ風)。 transformers の repetition_penalty はロジットを割る方式ですが、 「出た語ほど選ばれにくくする」という狙いは同じです。
💡 観察ポイント(数値はこの架空分布での厳密値)
- greedy:常に「お好み焼き」(元確率 30%)だけが確率 100% で生き残る。 10 回生成しても 10 回とも同じ語。 これが自己回帰で毎ステップ続くと、 同じフレーズを繰り返すループの温床になる。
- 温度 T:T=0.5 にすると「お好み焼き」は 30.0% → 49.6% に強調され、 T=2.0 では 30.0% → 19.1% に薄まり、 最下位の「あなご飯」(2%)でも 4.9% のチャンスを得る。 候補は除外されず、 分布の形だけが変わるのが温度の特徴。
- top-k(k=3):上位 3 語だけが生き残り、 再正規化で「お好み焼き 44.8%・もみじ饅頭 32.8%・牡蠣 22.4%」になる。 4 位以下は確率がどれだけあっても機械的にゼロ。
- top-p(p=0.9):確率の高い順に足し込むと 6 語目「日本酒」までで累積 0.89(<0.9)なので、 7 語目「カープ」まで含めた 7 語(累積 0.93)が生き残る。 候補数がしきい値ではなく分布の形で決まるのが top-k との本質的な違い。 分布が尖っていれば 1〜2 語、 平坦なら多数が残る。
⚠️ この 3 つの失敗パターンをスライダーで再現してみる
- greedy の繰り返しループ:greedy を選んで「10 回生成」を押すと、 ユニーク数は必ず 1/10。 実際の生成では「東京は東京は…」型の反復として現れる。 対策はサンプリング化・
no_repeat_ngram_size・繰り返しペナルティ(上のチェックボックスを greedy 以外で試すとユニーク数が増えるのが分かる)。 - 高温の脱線:T=3.0 では 10 語がほぼ横並びになり、 「広島の名物は熊野筆…はっさく…」のような文脈的に弱い候補が頻繁に顔を出す。 創作では味だが、 事実回答では hallucination の入口。
- top-k の固定幅問題:k=10(全候補)にすると温度 T=1 と同じ素の分布に戻り、 k=1 にすると greedy と一致する。 top-k は「何語残すか」を人間が固定するため、 分布が尖っている文脈ではゴミ候補を拾い、 平坦な文脈では良い候補を切り捨てる。 top-p はこれを累積確率で自動調整する改良版と言える。
🚀 発展:この先にあるデコーディング技術
本シミュレータは「1 ステップ・1 候補」の選択だが、 実際のデコーディング研究はさらに先へ進んでいる。 ビームサーチは系列全体の累積対数確率で複数候補列を並走させる方式(本ページ「🔬 深堀り比較」参照)。 contrastive decoding は大きいモデルと小さいモデルのロジット差を使い、 「小さいモデルでも出せる凡庸な候補」を割り引いて質を上げる。 speculative decoding は小型モデルに数トークン先まで下書きさせ、 大型モデルが一括検証・採択することで出力分布を変えずに生成を 2〜3 倍高速化する実装技術で、 現行の商用 LLM 推論基盤で広く使われている。 これらの土台にあるのはすべて本ページの $P(x_t \mid x_{<t})$ という同じ条件付き分布であり、 n-gram モデルの時代から Transformer・LLM に至るまで「分布の推定」が進化しても「分布からの選び方」は独立した設計課題であり続けている。 サンプリングそのものの統計的基礎は 標本抽出 も参照。
🧮 実値で計算してみる:SSDSE-B-2026 から「県紹介テンプレート文」を生成
SSDSE-B-2026 の 47 都道府県データ(人口・一般診療所数・出生率など)を素材に、 「テキスト生成のミニ実演」を行う。 ここでは 確率モデルを使わない テンプレート埋め込み型生成と、 transformers の GPT-2 を使った生成の両方を提示する。
🧮 ステップ A:SSDSE 47 県の数値を文章テンプレに埋め込む
| 都道府県 | 総人口(千人) | 一般診療所数(施設) | 生成文 |
|---|---|---|---|
| 北海道 | 5,092 | 3,403 | 「北海道の総人口は約 509 万人、 一般診療所数は 3,403 施設である。」 |
| 東京都 | 14,086 | 14,894 | 「東京都の総人口は約 1,409 万人、 一般診療所数は 14,894 施設である。」 |
| 広島県 | 2,738 | 2,521 | 「広島県の総人口は約 274 万人、 一般診療所数は 2,521 施設である。」 |
| 鳥取県 | 537 | 474 | 「鳥取県の総人口は約 54 万人、 一般診療所数は 474 施設である。」 |
テンプレートは「{県名}の総人口は約 {総人口/10000} 万人、 一般診療所数は {一般診療所数} 施設である。」という固定テンプレ。 これは確率モデルではないため同じ入力に対し常に同じ出力になる。 PPL の概念は適用不能だが、 「データから文章を作る」という意味で text-to-text 生成の最も単純な実装。
🧮 ステップ B:温度を変えた次トークン確率の手計算
「広島県の県庁所在地は」に続くトークン候補のロジットを次のように仮定する。 都道府県データから「県名 → 県庁所在地」というドメイン知識を学んだモデルを想定。
| 候補 | ロジット z | T=1.0 の確率 | T=0.3 の確率 | T=2.0 の確率 |
|---|---|---|---|---|
| 広島市 | 6.0 | 0.71 | 0.998 | 0.43 |
| 東広島市 | 4.0 | 0.10 | 0.001 | 0.16 |
| 呉市 | 3.5 | 0.06 | 0.0005 | 0.12 |
| 福山市 | 3.0 | 0.04 | <0.0001 | 0.10 |
| その他 50 候補 | 1.0 前後 | 合計 0.09 | ≈0 | 合計 0.19 |
T=0.3 では事実上「広島市」に決まる(安全だが多様性ゼロ)。 T=1.0 では 71% で広島市、 残り 29% で別の市が出てくる。 T=2.0 では福山市・東広島市までかなり高確率になり、 事実誤りの hallucination リスクが上がる。 事実回答タスクでは低 T、 創作タスクでは高 T を選ぶのが定石。
🧮 ステップ C:47 県の人口分布で「人口語彙の確率分布」を作る
SSDSE 人口を 6 ランクに離散化し、 各ランクの出現確率を実データから計算する。 これは「人口クラス」を語彙とする 1-gram 言語モデルに相当。
| 人口ランク | 該当県数 | 確率 P | $-\log_2 P$ (ビット) |
|---|---|---|---|
| 巨大 (1000万+) | 1 (東京) | 0.021 | 5.55 |
| 大 (500-1000万) | 8 | 0.170 | 2.55 |
| 中 (200-500万) | 7 | 0.149 | 2.75 |
| 小 (100-200万) | 21 | 0.447 | 1.16 |
| 極小 (50-100万) | 10 | 0.213 | 2.23 |
| 最小 (50万未満) | 0 (該当なし) | 0.000 | — |
この分布のエントロピー(平均ビット数)は約 1.96、 perplexity は $2^{1.96} \approx 3.9$。 つまり「47 県の人口ランクをランダムに当てる」 タスクは平均 約 3.9 択の難易度。 トークン語彙 50000 のサブワード LM の PPL=20 と比べると、 ずっと簡単なタスクであることが分かる。
🧮 数式に値を入れて手で計算する: テキスト生成のパープレキシティ
合成 5 トークンの予測確率から perplexity を計算する。
Step 1: 確率
Step 2: PPL
🐍 Python で再現
1 2 3 4 5 | import numpy as np p = np.array([0.6, 0.4, 0.5, 0.3, 0.7]) H = -np.log(p).mean() ppl = np.exp(H) print(f"H: {H:.3f}, PPL: {ppl:.3f}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🐍 Python での扱い
🐍 応用コード — SSDSE 説明文を学習し、 「47 都道府県の特徴を 1 文で説明」を生成
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 | import pandas as pd import numpy as np from collections import defaultdict # データ読み込み(SSDSE-B 都道府県・2023 年度の 47 県 × 112 列) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) print('shape:', df.shape) # (1) 学習用の「県の説明文」コーパスを 47 文つくる(数値の大小を言葉に置き換える) def size_word(v, col): # 47 県の中央値より上か下か return '多い' if v > df[col].median() else '少ない' aging = df['A1303'] / df['A1101'] * 100 # 高齢化率(%) sents = [] for i, r in df.iterrows(): sents.append(f"{r['Prefecture']} は 人口 が {size_word(r['A1101'], 'A1101')} 県 で 、 " f"高齢化率 は {aging[i]:.0f} % 、 診療所 は {size_word(r['I5102'], 'I5102')} 。") print('コーパス例:', sents[0]) # (2) 単語 2-gram(バイグラム)の遷移表を数える trans = defaultdict(list) for s in sents: w = ['<s>'] + s.split() + ['</s>'] for a, b in zip(w[:-1], w[1:]): trans[a].append(b) vocab = {w for s in sents for w in s.split()} print('語彙数:', len(vocab), ' 「は」の次に来た語:', sorted(set(trans['は']))) # (3) 遷移表から 1 語ずつサンプリングして新しい 1 文を生成(seed 固定) rng = np.random.default_rng(0) def generate(max_len=20): w, out = '<s>', [] while len(out) < max_len: w = rng.choice(trans[w]) if w == '</s>': break out.append(str(w)) return ' '.join(out) for k in range(3): print(f'生成 {k+1}:', generate()) |
💬 47 文・語彙 73 語のコーパスから作ったバイグラムでは、「は」の次に来うる語が高齢化率の数値 14 種と「人口」「多い」「少ない」の計 17 種に分かれる。直前の 1 語しか見ないので、生成 1 は「診療所 は 33 %」と主語と数値が食い違い、生成 3 の栃木県(総人口 190 万人で中央値 155 万人より多い)を「人口 が 少ない」と書くなど、文法らしさはあっても事実とは結びつかない。seed=0 で固定しているので同じ 3 文が出るが、seed を変えると別の文になる。
① 目的:総人口・高齢人口・一般診療所数(A1101 / A1303 / I5102)から合計特殊出生率(A4103)を予測できるかを、 ランダムフォレストで確かめます。 ② 橋渡し:前のセルで読み込んだ df から説明変数 X と目的変数 y を切り出します。 ③ コードは以下。 ④ 読み取り:train と test の R² が近いほど過学習が小さい、と判断します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_squared_error, r2_score X = df[['A1101', 'A1303', 'I5102']].fillna(0).values y = df['A4103'].fillna(df['A4103'].median()).values X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0) model = RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0).fit(X_tr, y_tr) pred_tr = model.predict(X_tr) pred_te = model.predict(X_te) print(f'train R^2 = {r2_score(y_tr, pred_tr):.3f}') print(f'test R^2 = {r2_score(y_te, pred_te):.3f}') print(f'test RMSE = {np.sqrt(mean_squared_error(y_te, pred_te)):.4f}') |
💬 訓練 R² 0.874 に対してテスト R² は -0.141 で、合計特殊出生率をまったく予測できていない。テスト RMSE 0.1243 はテスト 15 県の出生率の標準偏差 0.116 より大きく、平均値を答えるより誤差が大きいことになる。総人口・高齢人口・診療所数はいずれも県の大きさを表す量で、率である出生率とは結びつきにくい。
① 目的:予測がどれだけ当たっているかを散布図で目視します。 ② 橋渡し:直前で得た y_te(実測 出生率)と pred_te(予測)をそのまま使います。 ③ コードは以下。 ④ 読み取り:点が赤い対角線(完全予測ライン)に近いほど精度が高い、と読みます。
1 2 3 4 5 6 7 8 9 10 11 12 | import matplotlib.pyplot as plt plt.figure(figsize=(7,5)) plt.scatter(y_te, pred_te, alpha=0.7, edgecolor='k') lims = [min(y_te.min(), pred_te.min()), max(y_te.max(), pred_te.max())] plt.plot(lims, lims, 'r--', linewidth=2, label='完全予測ライン') plt.xlabel('実測 出生率') plt.ylabel('予測 出生率') plt.title('合計特殊出生率の予測精度(ランダムフォレスト・SSDSE-B-2026)') plt.legend() plt.tight_layout() plt.savefig('out_text-generation.png', dpi=150) |
① 目的:1 回の分割に依存しない汎化性能を、 5 分割交差検証で確かめます。 ② 橋渡し:同じ X・y を使い、 分割を変えて 5 回評価します。 ③ コードは以下。 ④ 読み取り:各 fold の R² のばらつき(±)が小さいほど安定したモデル、と判断します。
1 2 3 4 5 6 7 8 | from sklearn.model_selection import cross_val_score scores = cross_val_score( RandomForestRegressor(n_estimators=200, max_depth=4, random_state=0), X, y, cv=5, scoring='r2' ) print(f'5-fold CV R^2 = {scores.mean():.3f} (±{scores.std():.3f})') print('各 fold:', np.round(scores, 3)) |
💬 5 分割の平均 R² は -2.307 で、第 1 fold(北海道〜群馬県)の -6.423 が特に悪い。この 10 道県は出生率のばらつきが小さいので、少しの誤差でも R² が大きく負に振れる。東京都を含む第 2 fold だけが 0.444 とプラスで、県の並び順に分割したことが結果を大きく左右している。
🐍 実装パターン集 — 状況別レシピ
同じ「テキスト生成」を使うにも、 データの形・規模・目的によって書き方が変わります。 4 つの典型パターンを示します。
パターン A:探索的・最小構成
1 2 3 4 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) print(df.shape, df.head(3)) |
💬 (47, 112) で、先頭 3 行は北海道・青森県・岩手県の 2023 年度。#3 の 564 行と比べると、年度の絞り込みで 12 分の 1 になったことが分かる。列名は英字コードなので、I5102 が一般診療所数であることなどはファイル 2 行目の日本語名で確認する。
パターン B:パイプライン化(前処理+モデル)
1 2 3 4 5 6 7 8 9 10 | from sklearn.pipeline import Pipeline from sklearn.preprocessing import StandardScaler from sklearn.linear_model import Ridge pipe = Pipeline([ ('scaler', StandardScaler()), ('model', Ridge(alpha=1.0)), ]) pipe.fit(X_tr, y_tr) print('R^2 =', pipe.score(X_te, y_te)) |
💬 標準化 + Ridge(alpha=1.0) のテスト R² は 0.080 で、ランダムフォレストの -0.141 よりはましだが、出生率の差の 1 割も説明できていない。線形にしても説明変数自体に出生率の情報が乏しいので、モデルを替えるだけでは大きく改善しない。
パターン C:交差検証+ハイパーパラメータ探索
1 2 3 4 5 6 | from sklearn.model_selection import GridSearchCV params = {'model__alpha': [0.01, 0.1, 1.0, 10.0, 100.0]} gs = GridSearchCV(pipe, params, cv=5, scoring='r2', n_jobs=-1) gs.fit(X, y) print('best:', gs.best_params_, 'score:', gs.best_score_) |
💬 alpha=10.0 が選ばれても CV 平均 R² は -1.992 で、どの強さの正則化でも平均値予測に負けている。#9 の単発テスト 0.080 とは符号まで違い、1 回の分割の結果をそのまま文章にして報告すると誤った結論を伝えてしまう。
パターン D:可視化付きの結果保存
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import matplotlib.pyplot as plt import json pred = gs.predict(X_te) plt.figure(figsize=(7,5)) plt.scatter(y_te, pred, alpha=0.7, edgecolor='k') plt.plot([y_te.min(), y_te.max()], [y_te.min(), y_te.max()], 'r--') plt.xlabel('実測'); plt.ylabel('予測'); plt.title('Ridge(GridSearch 後)の出生率予測') plt.tight_layout(); plt.savefig('result_text-generation.png', dpi=150) with open('result_text-generation.json', 'w', encoding='utf-8') as f: json.dump({'best_params': gs.best_params_, 'cv_score': gs.best_score_, 'test_score': gs.score(X_te, y_te)}, f, ensure_ascii=False, indent=2) |
🐍 Python 実装(深掘り 4 連発)
🐍 実装 1:SSDSE-B-2026 から県紹介テンプレ文を 47 件生成
🎯 このコードでやること:SSDSE-B-2026 を読み込み、 47 都道府県の人口・一般診療所数を埋め込んだ紹介文をテンプレ生成する。 これはルールベース text generation の最小実装。
📥 入力例(2023 年抽出後の df_2023.head()):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() def gen_pref_intro(row): pop_man = row['A1101'] / 10000 clinics = row['I5102'] return f"{row['Prefecture']}の総人口は約 {pop_man:,.0f} 万人、 一般診療所数は {clinics:,.0f} 施設である。" texts = df_2023.apply(gen_pref_intro, axis=1).tolist() for s in texts[:3]: print(s) print(f"... 計 {len(texts)} 件生成") |
📤 実行例:
💬 結果の読み方:これは確率モデルではなくテンプレ埋め込みなので perplexity の概念は無いが、 「データ → 文章」変換の最も単純な実装。 BI ダッシュボードの自動コメント、 決算サマリ生成など実務応用が広い。
🐍 実装 2:温度を変えた softmax サンプリングを手作りで確認
🎯 このコードでやること:「広島県の県庁所在地は」に続くトークン候補のロジットを与え、 温度 T を 0.3/1.0/2.0 と変えて確率分布がどう変わるかを比較する。
📥 入力例:候補と固定ロジット(広島市=6, 東広島市=4, 呉市=3.5, 福山市=3, 三原市=2.5, その他=1.0)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import numpy as np candidates = ['広島市', '東広島市', '呉市', '福山市', '三原市', 'その他'] logits = np.array([6.0, 4.0, 3.5, 3.0, 2.5, 1.0]) def softmax_T(z, T): z = z / T z = z - z.max() p = np.exp(z) return p / p.sum() for T in [0.3, 1.0, 2.0]: p = softmax_T(logits, T) print(f"T={T}:") for c, pi in zip(candidates, p): print(f" {c}: {pi:.4f}") |
📤 実行例:
💬 結果の読み方:T=0.3 では実質「広島市」に決定、 T=1.0 で 77% 広島市・多少多様性、 T=2.0 では分布がフラットになり 47% まで広島市が下がる。 事実問題には低 T、 創作には高 T。 これが「LLM の創造性つまみ」の正体。
🐍 実装 3:47 県語彙の 1-gram LM と perplexity 計算
🎯 このコードでやること:SSDSE 47 県のうち「県名 → 人口ランク」というラベル予測を 1-gram 言語モデルとして扱い、 経験的 perplexity を計算する。 言語モデル評価の基礎演習。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np from collections import Counter df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df_2023 = df[df['SSDSE-B-2026'] == 2023].copy() bins = [0, 5e5, 1e6, 2e6, 5e6, 1e7, 2e7] labels = ['最小','極小','小','中','大','巨大'] df_2023['rank'] = pd.cut(df_2023['A1101'], bins=bins, labels=labels) cnt = Counter(df_2023['rank'].dropna()) total = sum(cnt.values()) probs = {k: v/total for k, v in cnt.items()} logprobs = [np.log2(probs[r]) for r in df_2023['rank'].dropna()] H = -np.mean(logprobs) ppl = 2**H print(f"分布: {probs}") print(f"エントロピー H = {H:.3f} bits") print(f"Perplexity = {ppl:.3f}") |
📤 実行例:
💬 結果の読み方:PPL≈3.9 は「47 県を 6 ランクに分けたとき、 平均して 約 3.9 択の難易度でランクを当てる」モデル。 実用 LLM(語彙 5 万、 PPL=20)と比べてずっと簡単。 PPL は語彙サイズとタスク難易度の両方に依存することがこの例で実感できる。
🐍 実装 4:transformers GPT-2 で実テキスト生成(温度比較)
🎯 このコードでやること:huggingface transformers の日本語 GPT-2 で「広島県の特徴は」というプロンプトに対し、 温度 0.3/0.8/1.3 で 3 種類の続き文を生成する。 サンプリング戦略の実モデル挙動を観察。
📥 入力例:プロンプト "広島県の特徴は" と、公開済みの日本語 GPT-2 モデル rinna/japanese-gpt2-small(SSDSE で学習したものではない)
1 2 3 4 5 6 7 8 9 10 11 12 13 | from transformers import pipeline, AutoTokenizer, AutoModelForCausalLM model_name = "rinna/japanese-gpt2-small" tok = AutoTokenizer.from_pretrained(model_name) model = AutoModelForCausalLM.from_pretrained(model_name) gen = pipeline("text-generation", model=model, tokenizer=tok) prompt = "広島県の特徴は" for T in [0.3, 0.8, 1.3]: out = gen(prompt, max_new_tokens=40, do_sample=True, temperature=T, top_p=0.9, num_return_sequences=1) print(f"--- T={T} ---") print(out[0]['generated_text']) |
📤 出力の形(モデルのダウンロードが必要なため実測ではない。温度ごとの典型的な傾向を示した例で、乱数シードでも変わる):
💬 結果の読み方:T=0.3 は教科書的で安全。 T=0.8 はバリエーションが出る。 T=1.3 では「妖怪が出没する」のような事実無根の hallucination が混ざる(広島には伝統的な妖怪伝承はある — 例:稲生物怪録 — が GPT-2 small の知識精度は低い)。 創作ならまだしも、 観光紹介としては T=1.3 は使えない。 タスク特性に応じて T と top-p を選ぶことが極めて重要。
⚠️ よくある落とし穴
⚠️ テキスト生成の落とし穴(深掘り 5 件)
- hallucination(幻覚):モデルは「もっともらしい次トークン」を出すだけで、 事実確認はしていない。 「広島県の県庁所在地は呉市である」と平然と出すことがある。 RAG、 fact-checking、 引用付き生成などで緩和。
- repetition(繰り返しループ):「広島県は広島県は広島県は…」のような無限ループ。 repetition penalty、 no_repeat_ngram_size、 top-p sampling で防止。 greedy デコードで頻出。
- bias(社会的バイアス):学習データに偏りがあると「医者 → 男性」「看護師 → 女性」のような偏った文が生成される。 都道府県でも「東京 → 先進的」「島根 → 田舎」など固定観念を強化する出力に注意。
- evaluation 困難:BLEU・ROUGE は表層一致のみで意味を測れない。 perplexity はモデル内部の困惑度に過ぎず、 出力の事実性・流暢性とは別。 人手評価が依然必須。
- cost と環境負荷:100B パラメータモデルの 1 トークン生成に数ジュール消費。 1 県紹介文(200 トークン)× 47 県でも見過ごせない。 蒸留、 量子化、 キャッシュで節約。
✅ 理解度チェック — このページの数値で答える
- 架空分布で「お好み焼き」の確率は 30.0%。 温度 T=0.5 と T=2.0 にするとそれぞれ何 % になり、 候補の数は変わるか。
答え:49.6% と 19.1%。 温度は分布の形を変えるだけで、 候補を除外しない(最下位の「あなご飯」2% も T=2.0 で 4.9% になる)。 - 同じ分布で top-k(k=3)を掛けると、 残る 3 語の確率はどうなるか。
答え:上位 3 語だけで再正規化され、 44.8%・32.8%・22.4%。 4 位以下は元の確率に関係なく 0 になる。 - top-p(p=0.9)で 6 語目までの累積が 0.89 だった。 残る語は何語か。
答え:7 語。 累積が 0.9 に届くまで足し込むので、 0.89 では足りず 7 語目(累積 0.93)まで含める。 - 5 トークンの予測確率が 0.6・0.4・0.5・0.3・0.7 のとき、 perplexity はいくつか。
答え:−log p の平均が 3.681 / 5 = 0.736、 exp(0.736) ≈ 2.088。 平均して約 2 択で迷っている状態。 - 2023 年度の 47 県を人口で 6 ランクに分けると 1・8・7・21・10・0 県。 この「人口ランク語彙」の perplexity が約 3.9 になるのはなぜ 6 ではないのか。
答え:21 県の「小(100〜200 万人)」に偏っているため。 エントロピーは約 1.96 ビットで 2^1.96 ≈ 3.9、 等確率の 6 択より当てやすい。 - greedy で 10 回生成すると、 何種類の語が出るか。
答え:1 種類(ユニーク数 1/10)。 毎回最も確率の高い語だけを選ぶので、 長い文では同じ句の繰り返しになりやすい。
🗺 概念マップ
「テキスト生成」を中央に置いて、 周辺概念を 5 つの方向に整理します。 これは記憶の足場になります。
| 方向 | 隣接概念 | 関係性 |
|---|---|---|
| 北 (上位) | 自然言語処理 (NLP) / 生成 AI | テキスト生成が属する大枠 |
| 南 (下位) | 機械翻訳 / 要約 / 対話 / コード生成 | テキスト生成の応用タスク |
| 東 (発展) | RLHF / 制御生成 / RAG | 幻覚や品質の弱点を補う発展技術 |
| 西 (前提) | トークン化 / Transformer / 自己回帰 | テキスト生成を支える基礎技術 |
| 中央 | テキスト生成 | 本ページの主役 |
🔗 隣接手法への橋渡し
文章生成は LLM パイプラインの中核で、 上流の前処理から下流の評価まで多様な手法と連携する。
- 上流: トークン化 (BPE / SentencePiece) → 埋め込み → Transformer エンコーダ で文脈を取り込む
- 並列: 自己回帰型 (GPT、 1 トークンずつ生成)、 Seq2Seq (encoder-decoder、 翻訳)、 拡散モデル (新興、 並列生成)
- 下流: BLEU / ROUGE / Perplexity で自動評価 → 人手評価 で品質確認 → RLHF で人間嗜好に合わせ調整
SSDSE-B-2026 の県別統計を題材にした「自然言語による要約 (例:『北海道は高齢化が進み、 65 歳以上比率が 33.0%』)」を生成するなら、 統計数値 → テンプレベース → GPT API で拡張、 という pipeline が現実的。
🌳 手法選択フロー
文章生成のモデル選択は、 タスク特性とデータ量で 4 通りに分岐する。
- 定型文 (帳票・レポート)? Yes → テンプレート + 変数埋め込み。 LLM 不要
- 少量データ (n < 1000)? Yes → Few-shot prompting + GPT-4 API。 Fine-tune より安価
- 大量データ + ドメイン特化? Yes → Fine-tuning (LoRA で軽量化)。 法律 / 医療文書に有効
- 高品質 + 安全性要求? Yes → RLHF + 出力ガードレール。 ChatGPT / Claude の現行方式
SSDSE-B-2026 の県別解説文生成 (例えば 47 県分) なら、 Few-shot prompting で GPT-4 に「都道府県名 + 統計値」を渡し、 文章生成させるのが最短経路。 Fine-tune は overkill。
🚀 発展解説:言語モデルの系譜と「生成を人間に合わせる」技術
🎨 直感の補強:なぜ argmax だけでは文章が壊れるのか
「一番確率の高い語を選び続ければ最良の文章になる」というのは自然な直感だが、 実際には逆である。 毎ステップ argmax(greedy)や beam search で「最も確からしい系列」を追うと、 同じフレーズの無限反復(テキスト退化、 degeneration)に陥りやすいことが知られている(Holtzman らの nucleus sampling 論文、 2019 年)。 人間の書く文章は「毎語が最頻出語」ではなく、 適度に確率の低い語(意外性)を含む。 だからこそサンプリングによる揺らぎが、 単なるおまけではなく自然さの必須成分になっている — これが本ページのウィジェットで温度や top-p を動かすと体感できる核心である。
🕰 言語モデルの系譜:N-gram → ニューラル → Transformer / LLM
テキスト生成の心臓部である「次トークン分布 $P(x_t \mid x_{<t})$ の推定器」は、 約 70 年かけて 3 世代進化してきた。
| 世代 | 代表 | 文脈の扱い | 限界 |
|---|---|---|---|
| 第 1 世代(統計) | N-gram・n-gram モデル(Shannon 1948 の情報理論が源流) | 直前 $n-1$ 語の出現頻度を数えるだけ | $n$ を増やすと組合せ爆発(ゼロ頻度問題)。 長距離依存を扱えない |
| 第 2 世代(ニューラル) | ニューラル言語モデル(Bengio 2003)→ RNN・LSTM(2010 年代前半) | 単語を埋め込みベクトルにし、 隠れ状態に文脈を圧縮 | 逐次計算で並列化しにくい。 長文で勾配消失 |
| 第 3 世代(Transformer) | Transformer(2017)→ GPT 系 LLM・ChatGPT(2022〜) | 注意機構で全トークン間の関係を並列計算 | 計算コストが文脈長の 2 乗。 学習データ由来のバイアス |
重要なのは、 3 世代とも解いている問題は同一(次トークン分布の推定)で、 変わったのは「文脈をどれだけ豊かに表現できるか」だけという点。 N-gram を理解していれば LLM の確率的本質は 8 割理解できている。 逆に言えば、 LLM も「巨大な条件付き確率表の近似」であり、 魔法ではない。
🧑⚖️ RLHF:「もっともらしい」から「望ましい」へ
次トークン予測だけを学習したモデル(base model)は「インターネット文書の続きを書く機械」であり、 質問に答えるとは限らない(質問文の続きとして別の質問を生成したりする)。 これを対話アシスタントに変える標準手順が RLHF(Reinforcement Learning from Human Feedback、 人間のフィードバックからの強化学習)で、 3 段階から成る:
- SFT(教師ありファインチューニング):人間が書いた「指示→模範回答」ペアでファインチューニングし、 指示に従う形式を教える。
- 報酬モデル学習:同じ指示への複数回答を人間がランキングし、 「人間の好み」を予測する報酬モデルを学習する。
- 強化学習(PPO 等):報酬モデルのスコアを最大化するよう生成方策を更新する。 近年は報酬モデルを介さず選好データから直接最適化する DPO(Direct Preference Optimization)も普及。
RLHF はハルシネーションや有害出力を減らす一方、 「自信がなくても断定口調で答える」「当たり障りのない長文に寄る」といった新たな偏り(reward hacking・過剰な同調)を生むこともある。 AI 安全性の主要研究テーマの 1 つである。
🎛 制御生成(controlled generation):出力を狙った方向へ誘導する
- プロンプトによる制御:指示・少数例・出力形式指定で誘導する最も手軽な方法(プロンプトエンジニアリング)。 ただし従う保証はない。
- 制約付きデコーディング:文法(JSON スキーマ等)に合うトークンだけに候補を制限してサンプリングする。 構造化出力ではほぼ確実に形式を守れる。
- 外部知識の注入:RAG で検索結果を文脈に入れ、 「文脈内の事実だけを使って書く」よう制約する。 SSDSE のような統計表を渡して要約させる使い方はこの系統。
- logit 操作:特定トークンの出現確率を直接加減する(禁止語リスト、 repetition penalty もこの一種)。
なお生成系モデルには自己回帰型のほかに拡散モデル系(並列に全体をデノイズする方式)もあり、 テキストへの応用(Diffusion-LM 等)が研究されている。 全体像は生成 AI を参照。
📏 評価の深掘り:perplexity と BLEU が測っているもの・いないもの
perplexity はクロスエントロピーの指数、 すなわち情報エントロピーに根ざす「モデル内部の迷い」の指標であり、 トークナイザが異なるモデル同士では直接比較できない(同じ文でもトークン分割が違えば平均対数尤度の分母が変わる)点に注意。 BLEU は機械翻訳用に設計された n-gram 表層一致の指標で、 「意味は同じだが言い回しが違う」正解を過小評価する。 このため近年は (1) 埋め込みベースの BERTScore、 (2) LLM に採点させる LLM-as-a-judge、 (3) 人手評価、 を目的に応じて組み合わせるのが実務標準である。 ただし LLM-as-a-judge には「自分と似た文体を高く評価する」自己選好バイアスが報告されており、 これも万能ではない。
🧮 合成ミニ例:温度が分布をどう変えるか(説明用の架空数値)
※ 以下は説明用の架空のロジット値で、 実在モデルの出力ではない。 候補 3 語のロジットを $z = (2.0,\ 1.0,\ 0.0)$ とすると、 softmax $P_T(v) \propto \exp(z_v/T)$ による確率は:
| 温度 $T$ | 候補 1(z=2.0) | 候補 2(z=1.0) | 候補 3(z=0.0) | 性格 |
|---|---|---|---|---|
| 0.5 | 0.867 | 0.117 | 0.016 | ほぼ 1 択(事実回答向き) |
| 1.0 | 0.665 | 0.245 | 0.090 | デフォルト |
| 2.0 | 0.507 | 0.307 | 0.186 | 平坦化(創作向き・暴走リスク増) |
ロジットの差は変えず、 差を $T$ で割ってから指数化するだけで、 分布の鋭さが連続的に変わることが読み取れる。 上の 🎮 ウィジェットのスライダはまさにこの計算を実行している。
⚠️ 落とし穴・追補:文脈長・制御・著作権・設定の実務
🧭 本ページ内の対応関係(追補の読み方)
この追補は既出セクションを次のように深める:文脈長 → 「📍 文脈ボックス」の前提、 制御の難しさ → 「🌳 手法選択フロー」の実装時注意、 著作権 → 「⚠️ 落とし穴」の社会的リスク側、 設定の実務 → 「🎮 ウィジェット」で体感した温度・top-p の現場での使い分け、 ハルシネーション → 「⚠️ 深掘り 5 件」の第 1 項の運用対策。 関連の基礎は自然言語処理・LLM・Transformer の各ページへ。