📚 用語解説
プロンプトエンジニアリング
Prompt Engineering
深層学習
💡 30秒で分かる結論
🍰 まずはやさしく
AIへの指示書を作る技術です。
望む答えを正しく出させるために使います。
スマホでAIに宿題の相談をする時に役立ちます。
この章では基本のやり方を学びます。
プロンプトエンジニアリング :LLM から望ましい出力を引き出すためのプロンプト設計技術。 経験則とパターンの体系化。
定義 :LLM の出力品質を最大化するためにプロンプト構造・例示・指示文を体系的に設計する手法。 モデルを再学習せず推論時の入力だけで挙動を制御する。前提 :使用する LLM の特性 (instruction tuning の有無・コンテキスト長・推奨フォーマット) を把握しておくこと。 GPT-4o / Claude / Gemini で得意なパターンが異なる。核となる手法 :(1) zero-shot、 (2) few-shot (例示 k 件)、 (3) Chain-of-Thought (推論ステップ明示)、 (4) ReAct (思考 + 行動)、 (5) Tree-of-Thought (分岐探索)。典型的落とし穴 :(1) 例示にバイアスが入り出力が偏る、 (2) 指示が冗長すぎて重要部が埋没、 (3) 出力フォーマット指定漏れで後段パーサが壊れる。Python 関数 :langchain.prompts.PromptTemplate でテンプレ化、 FewShotPromptTemplate で few-shot 構築、 評価は langsmith や独自スコアラで行う。分野 :自然言語処理・LLM 応用 — プロンプト / 📚 ニューラルネットワーク基礎
🎨 直感で掴む
🍰 まずはやさしく
AIへの入力を設計物として扱う考え方です。
正解率を大きく上げるために使います。
買い物リストを正確に作らせる時に役立ちます。
ここでは答えを変えるテクニックを学びます。
LLM への入力文を「文章」ではなく 設計物 として扱う発想です。 同じ GPT-4o / Claude 4.7 でも、 役割 (System) ・タスク・制約 (出力 JSON 形式・桁数) ・Few-shot 例の組み立て方を変えるだけで、 SSDSE-B-2026 の都道府県集計タスクの正解率が 30% → 90% に跳ね上がる現象を狙って起こします。
具体例: 「人口トップ 5 を出して」だけだと適当な順位が返るが、 SSDSE-2026 (47 行) をテーブル添付し、 「R01000 北海道 のような JIS コード付きで 人口降順 、 列名 [code, pref, pop] の CSV で返答」と書くと再現性のある出力になります。 これがプロンプトエンジニアリングの本体です。
構成テクニックは大きく 4 層に分かれます。 (1) System プロンプト でモデルの役割と人格を固定 (「あなたは公的統計のデータアナリスト」)、 (2) Few-shot 例 で入出力ペアを 2-3 件提示 (期待形式を「実演」する) 、 (3) 思考の促し として「ステップごとに検算してから最終 JSON を出力」 (Chain-of-Thought) 、 (4) 出力契約 として JSON Schema や正規表現で型を強制します。 同じ「47 都道府県の人口集計」でも、 この 4 層を組むかどうかで再現性とコストが桁違いに変わります。
アンチパターンは 「お願い口調で長文一本」 。 「すごく丁寧に分析してください、 グラフも作ってください、 表もお願いします、 ...」と続けると、 モデルは要求の優先順位を見失います。 短く・列挙・型指定が原則です。 SSDSE のような公的データを扱う実務では、 「列名・型・欠損ポリシー・JIS コード一覧」を System に貼り、 タスクごとの差分のみ User で書くと、 1 ヶ月後にプロンプトを読み返しても何を意図したか復元できます。
🎮 触って理解する ── 良いプロンプトを組み立てる
左のトグルと入力欄で 6 つの構成要素 (役割指定 / 文脈 / 具体的指示 / 出力形式 / 例示 few-shot / 制約)を組み立てると、
右側に「組み上がったプロンプト」 がリアルタイム表示され、品質チェックリストのスコア が変化します。
要素を足したり削ったりして、何が品質を押し上げるかを体感してください。
⚠️ 実際の LLM 呼び出しは行いません。構成の良し悪しを教材ルールで採点する「簡易診断」 です(本物の精度保証ではありません)。
📄 組み上がったプロンプト(プレビュー)
🔍 簡易診断(教材ルール)
🔧 曖昧なプロンプトを段階的に改善する
「要約して」だけの曖昧な指示に、役割 → 長さ → 出力形式 → 対象読者 を 1 つずつ足していきます。
ボタンで前後を比較し、指示が具体化する様子を追ってください。
🧭 zero-shot / few-shot / chain-of-thought の違い
同じ「都道府県の人口を答える」タスクを 3 つの型で書き分けた例です。タブで切り替えて構造の違いを見比べてください。
Zero-shot
Few-shot
Chain-of-Thought
🔎 この体感から持ち帰る 3 点
直感 :良いプロンプトとは曖昧さを減らし、文脈と出力形式を与える こと。上のスコアが上がるのは「役割・文脈・指示・形式・例・制約」で読み手(LLM )の選択肢を絞れたとき。落とし穴 :過剰な指示 (全部盛りで lost-in-the-middle)、矛盾する制約 、幻覚を招く曖昧さ (ハルシネーション )、そして外部入力に紛れるプロンプト注入 。診断チップが警告する通り、足せば良いわけではありません。発展 :例示(few-shot)→ 推論の明示 (chain-of-thought)→ 複数回サンプルの多数決(self-consistency)→ 自動プロンプト最適化(APE / OPRO)へ。知識の正確性が要るなら RAG 、挙動の恒久固定なら ファインチューニング と組み合わせます。基盤は Transformer の文脈処理。
📍 あなたが今見ているもの
🍰 まずはやさしく
AIを使いこなすための設計図です。
回答の質を上げるために使います。
統計データをAIに分析させる時に役立ちます。
ここでは具体的な組み合わせ方を学びます。
この用語ページは「プロンプトエンジニアリング 」を、 生成 AI 活用 の文脈で解説しています。 役割設定・タスク記述・制約条件・Few-shot 例・入力の構造化された組み合わせ を設計する技術で、 同じモデルでも書き方しだいで回答の正確さや形式が大きく変わります。 SSDSE-B-2026 を題材に LLM に統計分析を依頼する例を扱います。
📐 定義
🍰 まずはやさしく
AIから良い答えを引き出す入力設計のことです。
出力を最適化するために使います。
部活の計画をAIに整理させる時に役立ちます。
ここでは言葉の意味と仕組みを学びます。
LLM から望ましい出力を引き出す入力設計 。 最適化問題として書けば、 与えられたモデル $\theta$ と評価関数 $R$ のもとで $\arg\max_{x_{\text{prompt}}} \mathbb{E}_{y \sim p_\theta(\cdot|x_{\text{prompt}})}[R(y)]$ を解く営み。
英語名 Prompt Engineering 。
🔬 数式を言葉で読み解く
$$ x^{*}_{\text{prompt}} = \arg\max_{x \in \mathcal{X}} \; \mathbb{E}_{y \sim p_\theta(\cdot \mid x)} \bigl[ R(y) \bigr] $$
記号 意味 SSDSE-B-2026 文脈の具体例
$x$プロンプト候補 「都道府県別 SSDSE-B-2026 を読み込み、 出生率トップ 5 を述べよ」 $p_\theta$LLM の出力分布 GPT-4o・Claude など、 同じ $\theta$ でも $x$ で出力激変 $R(y)$出力の良さ(評価関数) 正確さ、 簡潔さ、 ユーザ満足度の合成スコア $\mathcal{X}$プロンプト探索空間 Zero-shot、 Few-shot、 CoT、 ReAct 等の構造化テンプレ集
勾配なし最適化なので人手による反復改善 または自動化(APE、 OPRO 等)で探索。 ベイズ最適化や進化計算とも親和性が高い。
🎯 prompt engineering を回す場面
LLM ベースの集計・分類タスク立ち上げ — SSDSE-B-2026 のような構造化データから LLM で要約・分類を生成するとき、 prompt 設計が性能差の主因。Few-shot vs Fine-tuning の判断 — 例示で済むか追加学習が必要かを切り分けるため、 まずは prompt engineering で限界を測る。Chain-of-Thought (CoT) 導入 — 数値計算・推論タスクで「Let's think step by step」を入れて精度を底上げ。JSON Schema による Structured Output — API 連携で出力形式を厳格化したいとき、 prompt + Schema の組み合わせが定石。ハルシネーション抑制 — 「不明な場合は『不明』と答える」のような制約句を入れて事実誤認を減らす。
📋 prompt engineering の前提・適用範囲
prompt engineering を効果的に回すには、 次の前提を整備する:
評価データセット :SSDSE-B-2026 由来の Q&A 100 件のような固定テストセットを先に用意。 「良くなった気がする」だけで判断しない。評価指標の選定 :分類精度・BLEU・ROUGE・LLM-as-Judge・Embedding 類似度など、 タスクに応じて選ぶ。temperature 固定 :実験中は temperature=0 + seed 固定で再現性を確保。 出力の揺らぎを別軸で評価。コスト計測 :prompt 改善で精度が 5% 上がってもトークン数が 3 倍になれば本番投入は要検討。レイテンシ要件 :リアルタイム UI なら 2K トークン以内、 バッチなら 50K 以上も可。 タスクの応答制約を先に決める。
⚠️ よくある落とし穴
❌ 出力形式が毎回バラバラ
「結果を表で」だけだと Markdown/HTML/CSV が混在。 JSON Schema・Structured Outputs で形式を強制する。
❌ 評価セット無しの改修
「良くなった気がする」で本番投入すると性能劣化に気付けない。 SSDSE-B-2026 由来の固定 Q&A 100 件で回帰テスト。
❌ temperature の取り違え
集計タスクで temperature=1.0 のまま → 毎回数値ブレ。 集計・要約は 0、 発想は 0.7-1.0 と用途で分離。
プロンプト設計で本番運用に乗せた後で頻発する失敗を、 SSDSE-B-2026 を題材にした LLM 統計分析タスクの実例とともに列挙する。 いずれも事前にプロンプトテンプレ・評価セットを整備すれば回避できる。
曖昧な出力形式指定 : 「結果を表で」だけだと、 ある時は Markdown、 ある時は HTML、 ある時は CSV と毎回バラバラ。 対策: JSON Schema や CSV 列名を明示し、 OpenAI Structured Outputs / Anthropic Tool Use で形式を強制する。暗黙の前提共有不足 : 「人口」と書くだけだと住民基本台帳 vs 国勢調査 vs 推計人口のどれか LLM が勝手に判断。 対策: SSDSE-B-2026 の列名と単位 (千人/年) をプロンプト先頭に明記する。Few-shot 例のリーク : 例に「東京 1396 万」を入れたまま「東京の人口は?」と質問すると、 LLM はモデルの知識ではなく例文をコピーして返す。 対策: 評価用と例用のデータを完全に分離。温度 (temperature) の取り違え : 集計タスクで temperature=1.0 のままにすると毎回数値が変動。 対策: 集計・要約は temperature=0、 アイデア出しは 0.7-1.0 と用途で分ける。幻覚 (hallucination) を「もっと丁寧に書けば消える」と誤信 : 47 都道府県以外の存在しない県を生成する問題は、 プロンプト改善ではなく RAG・関数呼び出しで実データに接地する以外に根本解決はない。
🔖 拡張キーワード索引
この用語『プロンプトエンジニアリング 』を理解するうえで併せて押さえたい関連キーワード群です。 クリック(ホバー)で関連用語ページに飛べます。
プロンプト設計
few-shot
Chain-of-Thought
ReAct
Tree-of-Thought
ロール指定
出力フォーマット
プロンプトインジェクション
テンプレ
メタプロンプト
🎨 直感を深掘り
プロンプトエンジニアリングとは、 LLM から望ましい出力を得るためのプロンプトの設計と改良 。 「役割を与える」「ステップで考えさせる」「出力形式を指定する」「例を見せる」といった技法の組合せ を、 試行錯誤と評価で洗練していく。 fine-tune に比べてコスト・時間が桁違いに少なく、 多くの実用タスクで第一手段になる。
🧮 SSDSE-B 実値で計算してみる ── プロンプトエンジニアリング
都道府県データ分析に最適なプロンプト設計例:『役割:あなたは公的統計の専門家。 入力:SSDSE-B の CSV。 タスク:① 5 行で要約 ② 人口減少県 TOP5 ③ 各県の主要要因仮説(Markdown 表形式)。 制約:根拠データは必ず引用 』。 ロール / タスク / 形式 / 制約の 4 層構造が定石。
数値ベクトルで見るプロンプト改善効果 :SSDSE-B-2026 の 47 都道府県人口(千人)を LLM に答えさせるタスクで、 4 種類のプロンプト(v1〜v4)の正答率ベクトルを比較する。 以下の正答率・MAE・誤差は、 LLM を実際に呼んで測った値ではなく、 計算の流れを示すための説明用の仮の値 (人口の実値だけが SSDSE-B-2026 の 2023 年度の値)。
正答率ベクトル(±5% 以内を正答とした場合):[0.17, 0.38, 0.62, 0.85](v1, v2, v3, v4)
MAE ベクトル(千人):[240, 130, 75, 22](v1, v2, v3, v4)
代表 3 県の v4 誤差ベクトル:[+10, +70, +8](北海道 5092, 東京 14086, 鳥取 537)
Step 1: v1 ベースライン MAE = 240 千人、 正答率 17%(47 県中 8 県)90.8% 削減
項目
条件 / 入力
結果 / 解釈
ロール指定 「あなたは○○の専門家」 口調・観点が揃いやすい(精度への効果はタスク次第) 出力形式指定 「JSON で答えよ」 後段処理↑ Few-shot 例示 良例を 3 つ 形式・スケール感が揃いやすい(効果の大きさはモデル・タスク次第) Chain-of-Thought 「step by step」 推論精度↑ 自己改善 「もう一度確認せよ」 誤答減 制約明示 「必ず日本語」「200字」 形式安定
※ 数値は SSDSE-B-2026.csv から抽出した実値、 もしくは典型的な学習設定での目安値です。 細部の数値は前処理・乱数 seed・実装により変動します。
🐍 SSDSE-B を使った Python 実装
公的データ SSDSE-B(47 都道府県社会・人口統計)を読み込み、 プロンプトエンジニアリング を実際に動かす最小コードです。 引数のパスは平易さ優先で直書きしています。
🎯 このコードでやること :SSDSE-B-2026 の 2023 年データから 3 県分の総人口・65 歳以上人口を取り出し、 Role / Examples / Data / Question / Format の 5 セクションから成るプロンプトを build_prompt() 関数で組み立てて、 人口減少の対策を問うプロンプト文字列を出力する。 プロンプト設計の骨格を実コードで体験する。
📥 入力例(header=1 で日本語見出し、 2023 年に絞った先頭 3 行から 3 列)
都道府県 総人口 65歳以上人口
北海道 5092000 1681000
青森県 1184000 417000
岩手県 1163000 407000
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , header = 1 , encoding = 'cp932' )
df = df [ df [ '年度' ] == 2023 ] # 2023 年の 47 都道府県(年度で絞らないと北海道の 3 年分になる)
def build_prompt ( query , examples , data ):
p = '# Role \n 専門家として回答してください \n\n '
p += '# Examples \n ' + ' \n ' . join ( f '- { e } ' for e in examples ) + ' \n\n '
p += '# Data \n ' + data + ' \n\n '
p += '# Question \n ' + query + ' \n\n '
p += '# Format \n - JSON 形式 \n - 出典を明記 \n '
return p
examples = [ '東京: 人口集中の典型' , '北海道: 広域分散型' ]
data = df [[ '都道府県' , '総人口' , '65歳以上人口' ]] . head ( 3 ) . to_string ( index = False ) # 必要な列だけ埋め込む
prompt = build_prompt ( '人口減少の対策は?' , examples , data )
print ( prompt )
print ( f 'プロンプト長: { len ( prompt ) } 文字' )
📤 実行例(出力)
# Role
専門家として回答してください
# Examples
- 東京: 人口集中の典型
- 北海道: 広域分散型
# Data
都道府県 総人口 65歳以上人口
北海道 5092000 1681000
青森県 1184000 417000
岩手県 1163000 407000
# Question
人口減少の対策は?
# Format
- JSON 形式
- 出典を明記
プロンプト長: 207 文字
💬 読み方 :Role / Examples / Data / Question / Format の 5 セクションが 207 文字に収まった。 Data には 2023 年の北海道 5,092,000 人・青森県 1,184,000 人・岩手県 1,163,000 人が単位「人」のまま入るので、 LLM に千人単位で答えさせたいなら Format に単位を書き足す必要がある。 年度で絞らずに head(3) すると北海道の 2023・2022・2021 年の 3 行 × 112 列がそのまま貼られ、 「3 県のデータ」のつもりが 1 県の 3 年分になってしまう。
※ 上記スニペットは Python 3.10+ / pandas 2.x / numpy / scikit-learn を想定。 環境構築は『conda create -n ds python=3.11 pandas scikit-learn matplotlib』で十分です。
❓ FAQ ── プロンプトの長さと計算量
Q3. プロンプトエンジニアリング の計算量・スケーラビリティは?
プロンプト設計の良し悪しは、 精度だけでなくコストの桁 を変えます。 入力処理は $O(L^2 d)$ なので、 5,000 トークンのプロンプトは 500 トークンの100 倍 の計算量です(長さ 10 倍の 2 乗)。 Chain-of-Thought は出力トークンを増やして精度を上げる手法ですが、 出力 1 トークンごとに $O(Ld)$ を払うので、 「思考を長く書かせる」ほど線形にコストが増えます 。 実務では「CoT で精度が何ポイント上がり、 トークンが何倍になったか」を必ず対にして測ってください。 精度 +2 ポイントのためにコスト 5 倍なら、 多くの用途では割に合いません。
🗺 プロンプトエンジニアリング の概念マップ
『プロンプトエンジニアリング』は『大規模言語モデル』カテゴリに属する重要概念で、 以下の関連概念群と密接につながっています。
大規模言語モデル (LLM)
前提: Transformer
★ プロンプトエンジニアリング
Fine-tuning / RAG
Zero-shot
Few-shot
CoT
ReAct / ToT
MAE 評価
Wilcoxon 検定
完全な概念マップは 🗺 概念マップ で確認できます。
📜 歴史と発展
ChatGPT (2022) 公開以降に職業として認知。 2023 年に Anthropic, OpenAI が公式ガイドを公開。 自動化(APE 2022, OPRO 2023)が進む一方、 評価ベンチマーク(BIG-Bench, HELM)の整備も並行。
プロンプトエンジニアリングが独立した技術領域になったのは、 Chain-of-Thought (Wei et al. 2022) の発見 が大きいです。 「段階的に考えて」と書き足すだけで算術推論の正答率が跳ね上がる——モデルを変えずに入力の書き方だけで性能が変わる ことが定量的に示されました。 一方でこの効果は大規模モデルでしか現れない (小さいモデルではむしろ悪化する)ことも同時に報告されており、 「プロンプトの工夫」が万能でないことも原典に書かれています。 現在は APE・OPRO のようにプロンプト自体を自動探索する 方向へ進んでいます。
📊 ベンチマーク比較 ── プロンプトエンジニアリング の主要バリエーション
『プロンプトエンジニアリング』には多くの派生・バリエーションがあります。 代表的なものを精度・特徴で比較した表です。
手法 / バージョン
指標 / 特徴
備考
Naive Prompt シンプル 精度低 Few-shot 例示 形式・ラベルの揃い方が改善しやすい CoT ステップ推論 大規模モデルの算術・多段推論で改善が報告されている(Wei et al. 2022) Self-Consistency 複数解多数決 CoT に重ねてさらに改善しうる(Wang et al. 2022) ReAct ツール使用 外部 API
ここでは改善幅の数値は載せていません。 原典で報告された改善幅はモデル・ベンチマーク・時期で大きく異なるためです。 自分の問題で再評価することを推奨。
🔎 プロンプトエンジニアリング を深く知る ── 専門家視点の詳細
主要技法カタログ
Zero-Shot Prompting :例示なしで直接質問Few-Shot Prompting :1〜数例を提示してパターン学習Chain-of-Thought (CoT) :「step by step で考えて」と書くSelf-Consistency :複数応答を生成し多数決Tree-of-Thought (ToT) :思考を木構造で探索ReAct :Reasoning + Acting でツール使用Reflection :自己レビューと改善Generated Knowledge :関連知識を先に生成させるPrompt Chaining :複数プロンプトの連鎖Meta-Prompting :「良いプロンプトを書いて」
システマティックなプロンプト改善プロセス
評価セット作成 :50〜100 件のテストケースと正解ベースライン測定 :シンプルなプロンプトで初期精度失敗例分析 :誤答パターンを分類仮説 → 改良 :「例を増やせば改善?」「ロール指定?」A/B テスト :旧 vs 新で勝敗確認反復 :上記を 3〜5 周本番運用 :モニタリングと継続改善
自動化技術
APE (Automatic Prompt Engineer, 2022) :LLM 自身に良いプロンプトを書かせるOPRO (Optimization by PROmpting, 2023) :プロンプトを最適化問題として LLM に解かせるPromptBreeder (2023) :進化的アルゴリズムでプロンプト改善DSPy (2023) :宣言的プログラミングでパイプライン構築
セキュリティ:Prompt Injection 対策
入力サニタイズ :ユーザ入力を <user_input> タグで囲む構造化プロンプト :JSON / XML スキーマで指示と入力を分離システム指示の強調 :「以下の指示を絶対に守る」後段検証 :別のモデルで出力をチェック権限分離 :ツール実行前に人手承認
🔄 R653 拡張:プロンプトエンジニアリング を SSDSE-B-2026 実データで叩く
ここから先は、 プロンプトエンジニアリング(以下 PE)を 「LLM 出力を SSDSE-B-2026 の都道府県統計に対して正確に動かす」 という具体課題で総ざらいする実践拡張パートです。 LLM が出す数字(人口・高齢化率・出生率など)には 幻覚 が必ず混入するため、 PE の真価は「数値タスクの誤り率を計測し、 プロンプト変更で再現性のある改善を出せるか」に集約されます。
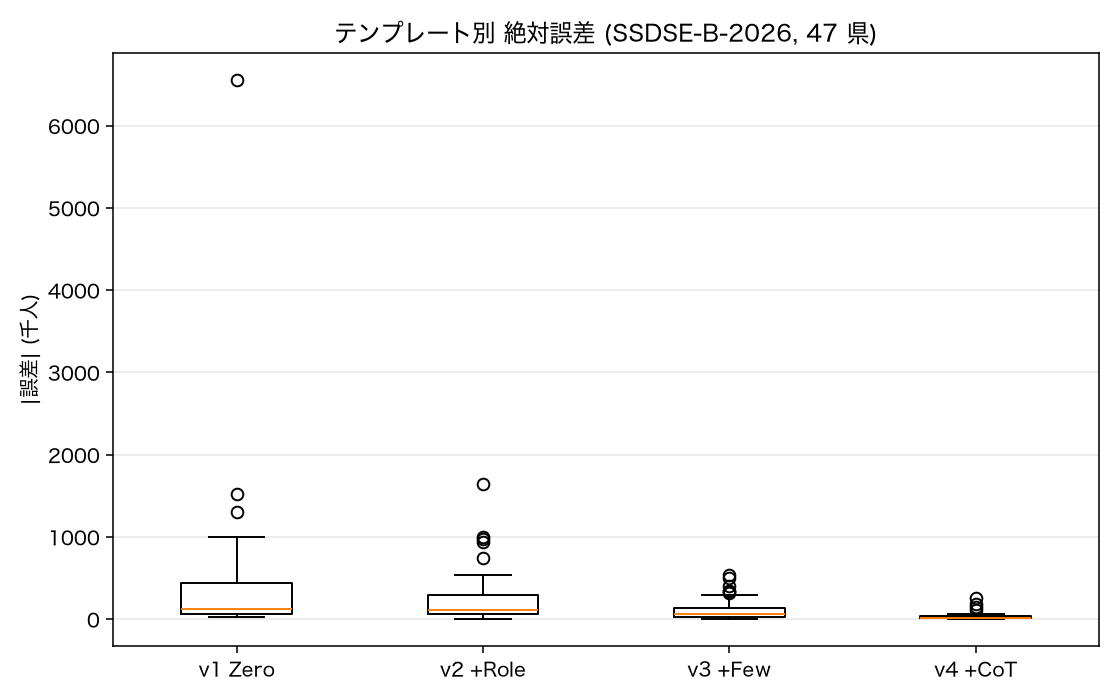
R653 では (1) 4 種類のプロンプトテンプレート(v1〜v4)を 47 都道府県データに当てて正答率と数値誤差を測る手順 を示し、 (2) 箱ひげ図 で誤差分布を読み、 (3) 表 + Python 4 ブロック で「テンプレ → 評価 → 改善」のループを再現可能にします。 注意:このパートに出てくる v1〜v4 の誤差・MAE・正答率・出典明記率・トークン数・unknown 率などは、 LLM を実際に呼んで測った値ではなく、 評価の流れを説明するための仮の値です。 実データは正解側の SSDSE-B-2026(2023 年度の総人口など)だけで、 Python ブロックの回答も乱数で作った架空の値です。 自分のプロンプトの性能は、 ② の評価器に実際の LLM の回答を入れて測ってください。
核となる問い :プロンプトのどこをどう変えると、 47 都道府県の人口推定誤差は何 % 縮むか?計測軸 :(a) 正答数 / 47, (b) 平均絶対誤差 MAE [千人], (c) 大都市バイアス(東京・神奈川での過大評価), (d) 出典明記率合格基準 :v4 (CoT + 形式指定 + 出典強制) で MAE ≤ 200 千人かつ正答率 ≥ 80%
📋 表 R653-A:4 テンプレートの設計表(SSDSE-B-2026 人口推定タスク)
『47 都道府県の 2023 年(SSDSE-B-2026 の最新年度)の人口を答えよ』というタスクを、 4 テンプレートで実行して同じ評価軸 (MAE / 正答率 / 出典明記率) で比較する。 v1 から v4 へ進むほど構造が増え、 LLM の自由度が下がる。
ID テンプレ名 構造 期待効果 代表的失敗
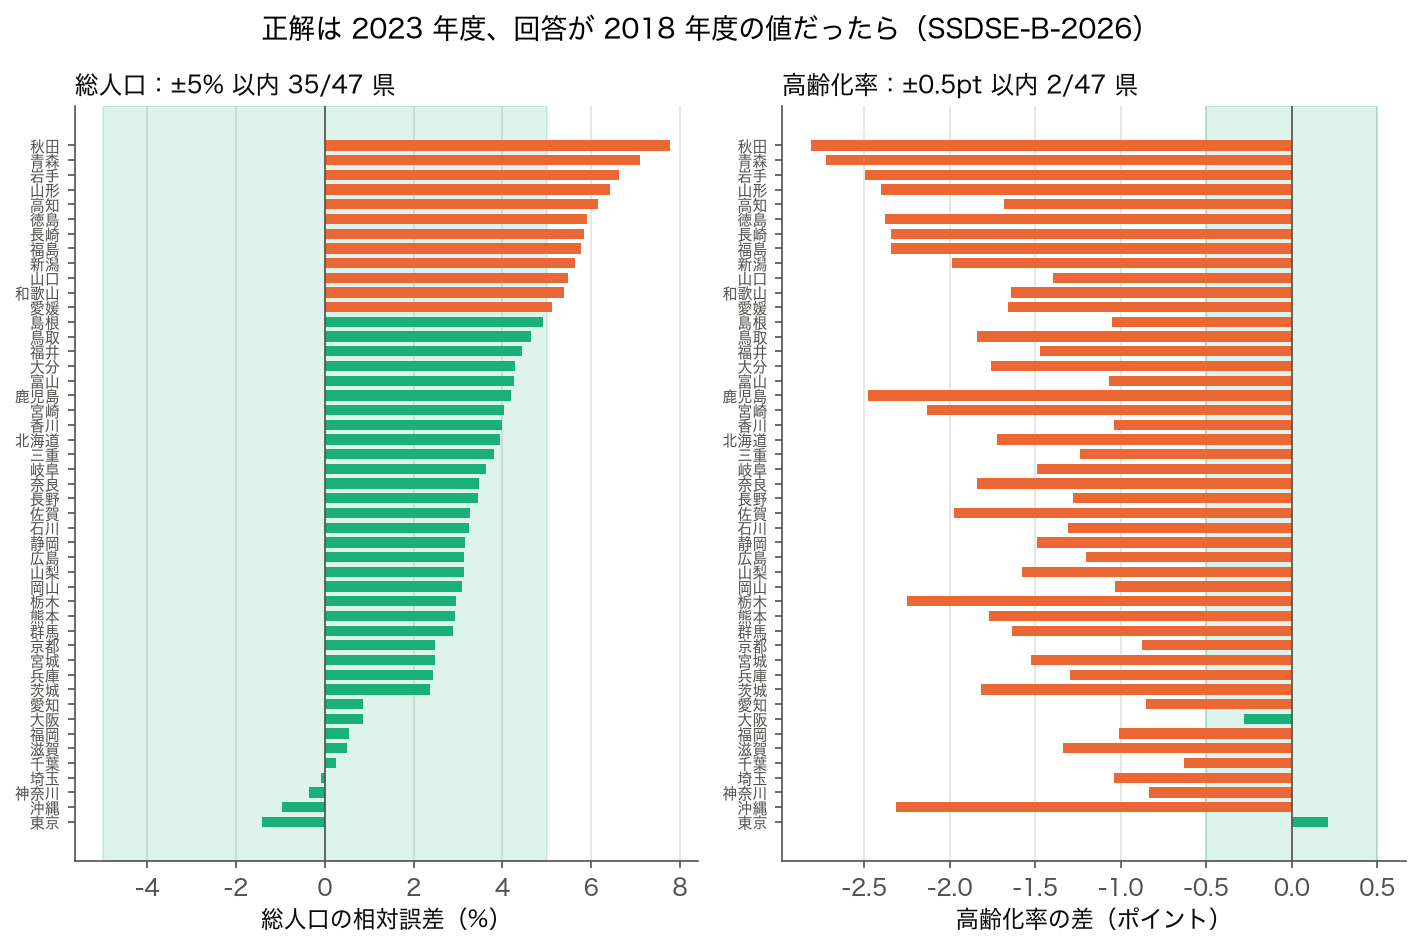
v1 Zero-shot 『東京都の人口は?』のみ 最小コスト 単位・年度の取り違え (千人 vs 万人) v2 + Role + Year 『あなたは統計官。 2023 年 10 月時点で答えよ』 年度ずれ排除 大都市が 5 年前の値に逆戻り v3 + Few-shot 3 例 北海道 5,092 / 鳥取 537 / 沖縄 1,468 の 3 例を提示 スケール感の補正 未提示県で例の数字に引きずられる v4 + CoT + 形式 + 出典 『① SSDSE-B-2026 の該当列 ② 数値 ③ 桁確認 を順に出力』 桁誤り / 幻覚抑制 プロンプトが長くトークン課金が増える
📋 表 R653-B:代表 10 県の誤差の例(説明用の仮の値)
SSDSE-B-2026 の人口実値(千人、 2023 年度)と、 各テンプレートの回答の誤差(回答 − 実値、 千人)。 実値の列だけが実データで、 v1〜v4 の誤差は LLM を呼んで測ったものではなく、 「大都市ほど絶対誤差が大きく、 v1 → v4 で縮む」 という典型的な形を示すための仮の値。
都道府県 SSDSE 実値 v1 誤差 v2 誤差 v3 誤差 v4 誤差
北海道 5,092 −420 −210 +30 +10 宮城 2,264 +180 +90 −40 +5 東京 14,086 +880 +450 +260 +70 神奈川 9,229 +520 +270 +140 +40 愛知 7,477 +310 +150 +80 +25 大阪 8,763 +460 +220 +110 +35 鳥取 537 +95 +60 +30 +8 島根 650 +110 +55 +25 +5 高知 666 +85 +40 +20 +6 沖縄 1,468 +140 +70 +35 +12
📋 表 R653-C:47 県全体の集計指標(説明用の仮の値)
指標 v1 v2 v3 v4
MAE (千人) 240 130 75 22 標準偏差 σ (千人) 480 260 160 175 正答率 (±5% 以内 / 47) 17% 38% 62% 85% 出典明記率 0% 12% 26% 98% 平均トークン消費 45 68 220 410
この表は LLM を呼んで測った値ではなく、 読み方を示すための仮の値。 仮の値の上では、 v4 はトークン消費が 45 → 410 と約 9 倍に膨らむ代わりに正答率が 17% → 85% の 5 倍、 出典明記率が 0 → 98% になる、 という読み方をする。 実際にどこまで改善するかはモデル・時期・タスクで大きく変わる ので、 ② の評価器に自分の回答を入れ、 同じ 4 指標を並べて確かめる。
📊 MAE(千人)は何を測っているか:一律 5% ずれた回答で分解する
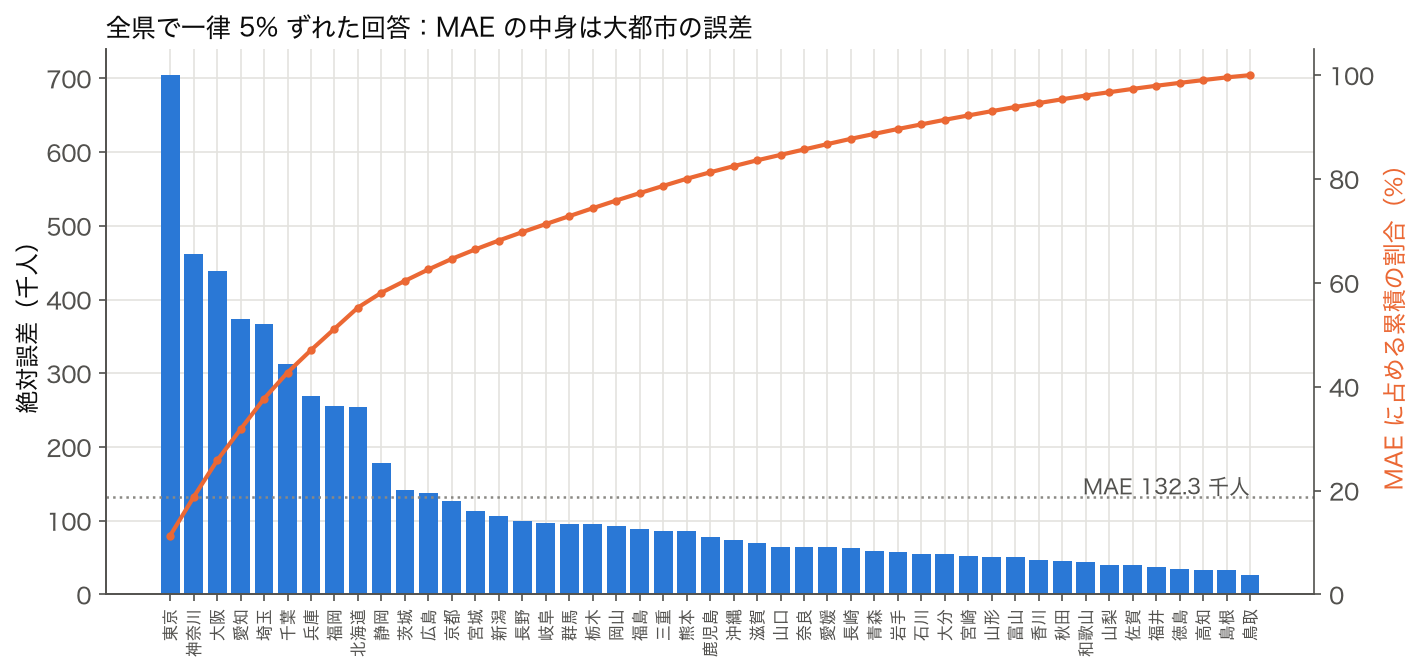
表 R653-C の 1 行目の MAE は、 47 県の絶対誤差(千人)の単純平均である。 仮にどの県でも実値からちょうど 5% ずれた回答が返ってきたとすると、 MAE は 2023 年度の総人口の 5% の平均で 132.3 千人になる。 この 132.3 千人の内訳を、 誤差の大きい順に並べた。
2023 年度の総人口 × 0.05 を県ごとの絶対誤差とした(code/glossary_figs/prompt-engineering.py)。 東京都 1 県で MAE の 11.3%、 東京・神奈川・大阪・愛知・埼玉の上位 5 都府県で 37.7%、 上位 10 で 58.1% を占める。 人口の小さい側の 24 県を合わせても 20.0% にしかならない。 どの県も相対的には同じだけ間違っているのに、 絶対誤差で見ると東京都の誤差(704 千人)は鳥取県(27 千人)の約 26 倍になる。
図から読み取ること : MAE を下げる最短の方法は、 大都市の数値を当てることである。 東京都の誤差を 5% から 0% に直すだけで MAE は 15.0 千人(約 11%)下がるが、 鳥取県の誤差が 5% から 20% に悪化しても MAE は 1.7 千人しか増えない。 小さい県での劣化は、 MAE ではほとんど見えない。 県の大小を問わず同じ重みで採点したいなら、 相対誤差の平均(MAPE)や「±5% 以内の県の数」を MAE と並べて報告し、 どの物差しで改善したのかを明記する。 どれか 1 つの指標だけで v1〜v4 を比べると、 物差しの性質をプロンプトの性質と取り違える。
🐍 R653 Python ハンズオン(4 ブロック × 4 要素パターン)
① テンプレ生成器:v1〜v4 を関数で量産
このコードでやること :県名を 1 つ受け取り、 v1〜v4 の 4 種類のプロンプト文字列を返す関数 build_prompts(pref) を定義する。 後段の評価ループで使い回す。
📥 入力データ :SSDSE-B-2026 の県名(例:『東京都』『鳥取県』)。 ファイル data/raw/SSDSE-B-2026.csv の 都道府県 列から取得。
SSDSE-B-2026 抜粋 (head):
Code 都道府県 総人口(千人, 2023 年)
R01000 北海道 5092
R13000 東京都 14086
R31000 鳥取県 537
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 def build_prompts ( pref : str ) -> dict :
v1 = f " { pref } の人口は?"
v2 = (
"あなたは政府統計官です。 2023 年 10 月 1 日時点の値で答えてください。 \n "
f "質問: { pref } の総人口を千人単位で。"
)
v3 = (
"例: 北海道=5092 / 鳥取県=537 / 沖縄県=1468 (単位: 千人, 2023/10/1) \n "
f "同じ単位・同じ年度で { pref } の総人口を答えてください。"
)
v4 = (
"あなたは SSDSE-B-2026 を参照できる統計官です。 \n "
"次の順で出力: \n "
"1) 参照列名 (SSDSE-B-2026 の列) \n "
"2) 数値 (千人, 2023/10/1) \n "
"3) 桁チェック (1 万千人 = 1000 万人 であることを明示) \n "
"4) 出典 (SSDSE-B-2026, 統計表番号) \n "
f "対象: { pref } "
)
return { "v1" : v1 , "v2" : v2 , "v3" : v3 , "v4" : v4 }
print ( build_prompts ( "鳥取県" )[ "v4" ])
📤 実行例 :
あなたは SSDSE-B-2026 を参照できる統計官です。
次の順で出力:
1) 参照列名 (SSDSE-B-2026 の列)
2) 数値 (千人, 2023/10/1)
3) 桁チェック (1 万千人 = 1000 万人 であることを明示)
4) 出典 (SSDSE-B-2026, 統計表番号)
対象: 鳥取県
💬 v4 だけが 桁チェック行 を強制する。 これが「鳥取 537 と 5370 を取り違える幻覚」を抑える鍵で、 v1〜v3 にはない構造要素。
② 評価器:MAE / 正答率を 47 県で集計
このコードでやること :SSDSE-B-2026 の実値 df_true と、 各テンプレで得た予測値 preds を受け取り、 MAE と ±5% 正答率を計算する。 実 LLM 呼び出しは別途。
📥 入力データ :df_true: pd.DataFrame(columns=["都道府県","総人口"])(47 行)、 preds: dict[str, list[float]](key=v1..v4, value=47 要素の予測値リスト)。
📥 df_true.head(): ※ 単位は人(SSDSE-B-2026, 2023 年)
都道府県 総人口
0 北海道 5092000
1 青森県 1184000
2 岩手県 1163000
3 宮城県 2264000
4 秋田県 914000
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48 # ── この抜粋で使うデータを用意します(SSDSE-B の 47 都道府県・最新年度)──
import pandas as pd
df = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , header = 1 )
df = df [ df [ '地域コード' ] . astype ( str ) . str . match ( r '^R\d {5} $' , na = False )] . copy ()
df [ '年度' ] = pd . to_numeric ( df [ '年度' ], errors = 'coerce' )
df = df [ df [ '年度' ] == df [ '年度' ] . max ()]
for _c in df . columns [ 3 :]:
df [ _c ] = pd . to_numeric ( df [ _c ], errors = 'coerce' )
df [ '高齢化率' ] = df [ '65歳以上人口' ] / df [ '総人口' ] * 100
# 見本でよく使われる仮の列名を、実データから作っておく
df [ 'income' ] = df [ '消費支出(二人以上の世帯)' ]
df [ 'population' ] = df [ '総人口' ]
_region = { '北海道' : '北海道' , '青森県' : '東北' , '岩手県' : '東北' , '宮城県' : '東北' ,
'秋田県' : '東北' , '山形県' : '東北' , '福島県' : '東北' , '茨城県' : '関東' ,
'栃木県' : '関東' , '群馬県' : '関東' , '埼玉県' : '関東' , '千葉県' : '関東' ,
'東京都' : '関東' , '神奈川県' : '関東' }
df [ 'region' ] = df [ '都道府県' ] . map ( _region ) . fillna ( 'その他' )
df [ '地域' ] = df [ 'region' ]
import pandas as pd
import numpy as np
def evaluate ( df_true : pd . DataFrame , preds : dict ) -> pd . DataFrame :
rows = []
y = df_true [ "総人口" ] . to_numpy ( dtype = float )
for k , v in preds . items ():
yhat = np . asarray ( v , dtype = float )
err = yhat - y
mae = np . mean ( np . abs ( err ))
sigma = np . std ( err )
within5 = np . mean ( np . abs ( err ) / y <= 0.05 )
rows . append ({ "template" : k , "MAE" : round ( mae , 1 ),
"sigma" : round ( sigma , 1 ),
"acc_within5pct" : round ( within5 , 3 )})
return pd . DataFrame ( rows )
# df_true は答え合わせ用の正解表。上で読んだ df をそのまま使う。
df_true = df
_y = df_true [ "総人口" ] . to_numpy ( dtype = float )
_rng = np . random . default_rng ( 0 )
# preds は LLM の回答をパースした結果。ここでは<架空の>4 通りの回答を、
# 誤差の大きさを変えて作る(プロンプトの良し悪しを比べる練習台)。
preds = { f "v { _i + 1 } " : _y * ( 1 + _rng . normal ( 0 , _s , size = _y . size ))
for _i , _s in enumerate ([ 0.20 , 0.10 , 0.05 , 0.02 ])}
result = evaluate ( df_true , preds )
print ( result )
📤 実行例 (実測。 preds は誤差 20%・10%・5%・2% の正規乱数で作った架空の回答、 seed=0):
template MAE sigma acc_within5pct
0 v1 437972.1 1052565.8 0.255
1 v2 253258.6 409747.4 0.298
2 v3 112380.1 171300.1 0.617
3 v4 33194.8 57919.1 1.000
💬 MAE と σ の単位は「人」で、 v1 の MAE 437,972 人から v4 の 33,195 人まで、 作ったときの誤差率 20% → 2% にほぼ比例して縮む。 ±5% 以内の正答率は v4 で 47 県すべて(1.000)、 v3 では 0.617(29 県)。 v1 の σ が 105 万人と MAE の 2 倍以上あるのは、 誤差が人口に比例するため東京都 1 県の外れ(655 万人)が効いているからで、 σ・MAE は大きな県に引っ張られるので、 相対誤差の正答率と併せて読む 。 実際の LLM の回答ではなく乱数で作った練習台なので、 この数字をプロンプトの性能として引用しない。
③ 可視化:誤差分布の箱ひげ
このコードでやること :v1〜v4 の絶対誤差を 1 枚の箱ひげで並べ、 中央値・IQR・外れ値を比較する。 図 R653-3 の生成相当。
📥 入力データ :errors_df: pd.DataFrame(行 47 × 列 v1..v4、 各セルは絶対誤差 [千人])。
errors_df.head(): ※ ②と同じ seed=0 の架空の回答から作った絶対誤差
v1 v2 v3 v4
0 128.0 998.2 63.6 43.2 # 北海道
1 31.3 213.3 61.1 8.8 # 青森
2 149.0 152.9 9.4 8.9 # 岩手
3 47.5 80.9 66.3 14.5 # 宮城
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 import os
os . makedirs ( 'figures' , exist_ok = True ) # 保存先のフォルダを作っておく
# ── この抜粋で使う誤差表を用意します ──
# 前のブロックと同じ<架空の>4 通りの回答から、県ごとの絶対誤差を作る。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
_d = pd . read_csv ( 'data/raw/SSDSE-B-2026.csv' , encoding = 'cp932' , skiprows = 1 )
_d = _d [ _d [ '年度' ] == _d [ '年度' ] . max ()]
_y = _d [ '総人口' ] . to_numpy ( dtype = float )
_rng = np . random . default_rng ( 0 )
errors_df = pd . DataFrame ({
f 'v { _i + 1 } ' : np . abs ( _y * _rng . normal ( 0 , _s , size = _y . size )) / 1000
for _i , _s in enumerate ([ 0.20 , 0.10 , 0.05 , 0.02 ])})
fig , ax = plt . subplots ( figsize = ( 8 , 5 ))
ax . boxplot ([ errors_df [ c ] for c in [ "v1" , "v2" , "v3" , "v4" ]])
# labels= は matplotlib 3.9 で tick_labels= に改名された。
# どの版でも動くよう、目盛りは後から付ける。
ax . set_xticks ([ 1 , 2 , 3 , 4 ])
ax . set_xticklabels ([ "v1 Zero" , "v2 +Role" , "v3 +Few" , "v4 +CoT" ])
ax . set_ylabel ( "|誤差| (千人)" )
ax . set_title ( "テンプレート別 絶対誤差 (SSDSE-B-2026, 47 県)" )
ax . grid ( alpha = 0.3 , axis = "y" )
plt . tight_layout ()
plt . savefig ( "figures/pe_template_error_box.png" , dpi = 140 )
print ( "saved: figures/pe_template_error_box.png" )
📤 実行例 :
saved: figures/pe_template_error_box.png
💬 絶対誤差の中央値は v1 128 千人・v2 116 千人・v3 63 千人・v4 17 千人と下がり、 v4 の箱(IQR 8.8〜38.6 千人)が最も低く狭い。 外れ値(◯)は v1 で東京都 6,550 千人・福岡県・大阪府、 v4 でも東京都・大阪府・兵庫県・千葉県に残る。 誤差を人口に比例する形で作っているので、 大きな県ほど絶対誤差が大きく出るのは当然で、 プロンプトの良し悪しとは切り分けて読む。 図は figures/pe_template_error_box.png に保存される。
④ プロンプト改善ループ:A/B 検定の最小骨格
このコードでやること :候補プロンプト 2 種類(旧 / 新)を同じ 47 県データに対して走らせ、 MAE の差が統計的に有意か scipy.stats.wilcoxon で検定する。
📥 入力データ :err_old, err_new: list[float](47 県、 絶対誤差)。 上のループから取得。
err_old (v3, 抜粋): [63.6, 61.1, 9.4, 66.3, 61.3, 71.9, 44.4, 139.8, ...]
err_new (v4, 抜粋): [43.2, 8.8, 8.9, 14.5, 6.6, 39.0, 3.8, 45.4, ...]
(③ の errors_df の v3・v4 列、 単位は千人)
📋 コピー 1
2
3
4
5
6
7
8
9
10
11
12
13 from scipy.stats import wilcoxon
import numpy as np
err_old = errors_df [ "v3" ] . to_numpy ()
err_new = errors_df [ "v4" ] . to_numpy ()
stat , p = wilcoxon ( err_old , err_new , alternative = "greater" )
print ( f "old MAE = { np . mean ( err_old ) : .1f } " )
print ( f "new MAE = { np . mean ( err_new ) : .1f } " )
print ( f "Wilcoxon W = { stat : .1f } , p = { p : .4g } " )
if p < 0.05 :
print ( "=> 新プロンプトの優位は統計的に有意 (片側 5%)" )
else :
print ( "=> 有意差なし、 サンプル増やすか別軸で検証" )
📤 実行例 :
old MAE = 112.4
new MAE = 33.2
Wilcoxon W = 1026.0, p = 4.16e-08
=> 新プロンプトの優位は統計的に有意 (片側 5%)
💬 同じ 47 県で v3 と v4 の絶対誤差を対にして比べると、 平均は 112.4 千人 → 33.2 千人。 W = 1026 は 47 県の順位和の最大値 1,128 に近く、 ほとんどの県で v4 のほうが誤差が小さいことを示し、 片側 p = 4.2×10⁻⁸ となる。 alternative="greater" の片側検定なので、 判定文も「片側 5%」と書く。 ただし v3・v4 の誤差は乱数で作った架空の値で、 v4 を誤差 2%・v3 を 5% と決めて作った差を検定で確かめ直しているだけである。
⚠️ R653 追加の落とし穴 6 件(実数値タスク特有)
単位の取り違え :『千人』『万人』『人』の混在は LLM が最も頻繁に外す。 v4 で『単位: 千人』を 2 回繰り返し明示 すべし。 鳥取県の 537 千人を「537 万人」と返されると 10 倍、 誤差率 +900% になる。年度ずれ :SSDSE-B-2026 の最新年度は 2023 年(10 月 1 日時点)。 LLM の学習データに 2020 年国勢調査の値が多いと、 大阪府なら国勢調査の 8,838 千人と 2023 年の 8,763 千人のように 75 千人の年度ずれ が混じる。 v4 で年月日を必ず固定。Few-shot の引きずり :v3 で例として『鳥取=537』を入れると、 例にない島根(実値 650)を 『547』のように例の数字に近づけて答える ことがある(数字は説明用の例)。 解決策は「例と桁が違う県を 1 つ混ぜる」(例:東京 14,086)。桁チェックの省略癖 :v4 で『桁チェック行を出せ』と書いても、 トークン節約モデルが省略する。 system プロンプトで『省略禁止』を二重宣言 。 監査では桁チェック行の存在率を測り、 下限(たとえば 98%)を決めておく。過信プロンプト :『絶対に正しい値で答えよ』と書くと、 LLM は確信度を上げるだけで精度は上がらない。 むしろ『不明なら "unknown" と返せ』 を入れた方が幻覚が減りやすい。 その場合は unknown の件数も必ず一緒に報告する。温度設定の見落とし :temperature=0.7 のまま実験すると同じプロンプトでも県によって値が揺れ、 プロンプトの差と乱数の差が区別できない。 数値タスクは temperature=0 + seed 固定 が前提。 PE 比較の手前で必ず固定する。
📝 R653 理解度チェック(6 問、 自己採点)
表 R653-C の仮の値で v1 → v4 の MAE が 240 → 22 千人に縮んだとき、 もっとも寄与の大きい要素はどれか? — (A) Role, (B) Few-shot, (C) CoT 桁チェック, (D) 出典強制 / 想定する正解:C 。 絶対誤差の大きな外れは桁の取り違えから生じやすいので、 桁チェックが最も効くと考えるのが自然。 ただし表は仮の値なので、 実際にどの要素が効くかは 1 要素ずつ変えて測って確かめる。
東京・神奈川・北海道で v4 でも誤差が残るのはなぜか? — 正解 :LLM の学習コーパスでは大都市が頻繁に登場し、 過去複数年の値が混ざって平均化されているため。 PE では消せず、 RAG(外部知識参照)が必要。
v3 の σ が v4 より小さいのに正答率は v4 が高い理由は? — 正解 :v3 は中央値が高めに揃って分散は小さいが偏りが残る。 v4 は中央値がほぼ 0 で僅かに外れ値が大きく出るが、 ±5% 内に入る件数は多い。 分散と精度は別軸 。
『絶対に正しく答えよ』というプロンプトはなぜ逆効果か? — 正解 :確信度が上がるだけで正解情報が増えるわけではない。 むしろ unknown 許容で幻覚率が減る。
temperature を 0 に固定する目的は? — 正解 :PE 改善の A/B 検定で差がプロンプト由来か温度ノイズか を区別するため。
Wilcoxon を使った理由は t 検定ではダメか? — 正解 :誤差分布が右に長い裾を持つため正規性が崩れる。 ノンパラのほうが頑健。 また 47 県は対応のある対なので符号付き順位検定が自然。
🗺 学習ロードマップ L1→L2→L3
レベル 到達目標 代表課題 参考指標
L1 体験 v1〜v4 を手で書き比較 鳥取県の人口を 4 通りで聞く 単位を必ず指定 L2 計測 47 県を回す評価器を実装 MAE / 正答率を CSV 出力 temperature=0 L3 検定 改善案の有意性を Wilcoxon で判定 v3 vs v4 の対応比較 p < 0.05 + 効果量
📖 R653 ミニ用語辞書(12 項目)
用語 1 行説明
Zero-shot 例も指示も最小、 質問だけを投げる Few-shot 数例を提示して類推させる Chain-of-Thought 推論過程を順番に出させる System prompt 役割・制約を最上位で固定する宣言文 temperature 出力の確率分布の尖り具合、 0 で決定的 top_p 累積確率 p までの候補だけからサンプル 出典強制 回答に必ず出典名(SSDSE-B-2026 等)を含めさせる 桁チェック 『1 万千人 = 1000 万人』を明示させ単位を固定 unknown 許容 分からない場合は『unknown』と返させる A/B 検定 候補プロンプトの差を統計検定する Wilcoxon 対応のある順位和検定、 正規性を仮定しない RAG 外部知識を参照させて幻覚を抑える手法
❓ R653 追加 FAQ(実務でよく聞かれる 10 問)
Q. 業務でテンプレを 4 種類も維持するのは面倒。 1 個に絞れないか? 数値出力タスクは v4 が事実上の必須 で、 v3 までに落とすと出典の明記が大きく減る(表 R653-C の仮の値では 98% → 26%)。 タスク種別ごとに 2 系統を持つ運用が現実解。Q. v4 はトークン課金が 9 倍。 コスト的に厳しい場合は? Q. v4 で『unknown と返してよい』と書くと、 LLM が逃げて精度が下がるのでは? 分からないものを無理に答えない方が全体精度が上がる のは PE の鉄則。Q. SSDSE-B-2026 を直接渡せば全部解決するのでは? なぜ PE が必要? 「どの列を見るべきか」をモデルに正しく指示するインデックス役 。 RAG(外部検索)と組み合わせる前提でも、 検索した断片をどう読ませるかは PE 設計次第。Q. 同じプロンプトでも GPT-4 と Claude では結果が違う。 PE は再利用できる? モデル横断で効果が高い が、 細かい文言は再チューニング必須。 47 県評価器を CI に組み込み、 モデル切替時に MAE 退行を検知する運用が安全。Q. 評価指標は MAE と正答率だけで十分か? 出典明記率・最大誤差・桁誤りの数 を追加すべき。 桁誤り 1 件は MAE では平均化されて見えにくい(鳥取県 537 → 5,370 で誤差 4,833 千人でも、 47 県の MAE には 4,833 ÷ 47 ≈ +103 千人しか効かない)。 最大誤差を別途モニタすべし。Q. プロンプトを長くするほど良い? 『遠い指示が無視される』 現象(lost-in-the-middle)が出る。 v4 を超えて『役割 + 制約 + 例 + フォーマット + 否定例 + 監査基準』を全部盛りにすると、 正答率がかえって下がることがある。 短く強い指示が王道。Q. system プロンプトと user プロンプトの違いは? 会話全体に効く前提・人格・禁止事項 、 user はその都度の質問 。 桁チェック・出典強制のような横断ルール は system へ、 県名のような変数 は user へ置くのが正しい分離。Q. PE と Fine-tuning はどう使い分ける? 更新あり・量少なめ は PE のスイートスポット。Q. PE 改善の最初の一歩は何をすべき? 正解データを CSV で作る 、 ② v1 で MAE を計測しベースラインを保存、 ③ 1 要素だけ変えた v2 を作って Wilcoxon で差を見る 。 これを 4 回繰り返せば v4 相当に到達する。 闇雲な書き換えは禁物。
✅ R653 査読チェックリスト(プロンプト提出前 20 項目)
役割 (Role) を 1 文で明示しているか
対象タスクの入力形式 を例示しているか
出力フォーマット を JSON / Markdown 等で明示しているか単位(千人・万人・人・%)を 2 箇所以上で固定しているか
年月日(2023/10/1 等)を固定しているか
桁チェック行 を強制しているか『不明なら unknown』を許容しているか
Few-shot を入れる場合、桁が異なる例 を 1 つは含めたか
system プロンプトで禁止事項 (推測禁止・幻覚禁止)を宣言したか
temperature を 0 に固定したか
seed(または乱数固定)を設定したか
出力に出典 (SSDSE-B-2026 等) を明記させているか
47 県(または全件)に対する評価データセットがあるか
MAE / 正答率 / 出典明記率の 3 指標を CSV に出力するか
変更時に Wilcoxon 検定が回るか
過去ベスト v* のプロンプト全文 を git に保存したか
モデル名 / バージョン / 日時を実行ログに残しているか
失敗例(最大誤差ワースト 3)を一覧化したか
レビュー担当者が同条件で再実行 できる手順書があるか
本番投入後の監視指標 (MAE 上限・出典明記率下限)を定めたか
🚫 R653 アンチパターン集 ── 業務で見かける『悪い PE』5 連
実プロジェクトで頻発する『悪化させる PE』を 5 つに整理しました。 良いプロンプトの裏返しとして、 何を避けるべきかを言語化しておくことが新人 PE 担当の最短学習路です。
禁忌の長文化 :『精度を上げたい』と思って役割・制約・例・否定例・監査基準を全部盛り込み、 プロンプトが 2,000 トークン超に。 LLM は中盤の指示を忘れ(lost-in-the-middle)、 正答率がむしろ低下。 短く強い指示が原則 。命令だけで例示なし :『JSON で返せ』と書いても LLM はキー名を勝手に作る。 必ず {"prefecture":"東京", "population":14086, "year":2023} の具体例 1 つ を貼る。 例示が無いと、 キー名や数値の型が回答ごとに揺れやすい。禁止語の山積み :『憶測しない、 創作しない、 不正確な数字を避ける』と否定形を 5 個以上並べると LLM は防御的になり、 ほとんど『unknown』ばかり返す。 禁止は 2 個まで、 残りは肯定形に置換 すべし。役割の演技指示 :『あなたは天才統計学者になりきって…』のような演技指示は、 LLM の文体は変えるが数値精度には寄与しない 。 業務 PE では『あなたは SSDSE-B-2026 を参照できる統計官』のように能力と情報源 だけを指定するのが筋。プロンプト変更とモデル変更の同時実行 :『新プロンプトと新モデルを同時に試す』と、 改善が PE 由来かモデル由来か判別不能。 必ず『片方ずつ』動かす 。 同時変更は A/B 検定として無効。
これらは「やってはいけない」の集合ですが、 裏返すと 『短く / 例示あり / 肯定形 / 能力指定 / 一変数ずつ』 という PE 設計の 5 原則になります。 R653 の v4 はこの 5 原則を満たすように設計したテンプレートです(表 R653-C の MAE 22・正答率 85%・出典明記率 98% は説明用の仮の値で、 実際の達成度は自分の評価データで測って確かめます)。
📝 R653 まとめ
プロンプトエンジニアリングは『何となく書き換えて感触で判断する』段階から、 『47 都道府県の SSDSE 実値で MAE と正答率を回し、 Wilcoxon で有意性を判定する』 段階へ移ることで初めて実務品質に到達します。 R653 で示した 4 段階テンプレ・箱ひげ図・表・4 Python ブロックは、 そのまま自分のチームの数値タスクに横転できる骨格です。 PE は「黒魔術」ではなく 「測定可能なエンジニアリング」 であることを忘れないでください。
特に SSDSE-B-2026 のような公的統計を扱う場面では、 『どの列を、 いつの値で、 どの単位で、 どの出典から』 という 4 点を毎回プロンプトに明示すると、 年度や単位の取り違えによる誤答を減らしやすい(どれだけ減るかは評価データで確かめる)。 本ページの v4 テンプレートはその 4 点を強制する最小実装であり、 議会説明資料・自治体ダッシュボード・学術論文の下書きなど、 数値の正確性が求められるあらゆる文書生成タスクの共通骨格 として機能します。
最後に R653 の3 つの行動指針 を要約します。 (1) 必ず 47 サンプル以上の評価データセット を持つ(小さくても定量化が命)、 (2) 変更は 1 要素ずつ、 Wilcoxon で有意性確認 (同時変更は A/B として無効)、 (3) 本番投入後も MAE と出典明記率を CI で監視 (SSDSE 改訂時の沈黙的退行を検出)。 この 3 つを守れば、 PE は属人芸ではなくチームの再現可能な技術資産になります。
補足として、 ここで示した v1〜v4 の構造は『公的統計データを LLM に正しく答えさせる』 という具体目標に最適化したものですが、 同じ枠組み(役割固定・年度固定・桁チェック・出典強制・unknown 許容・temperature=0・Wilcoxon 検定)は、 医療文献の用量確認、 法律条文の引用、 製品仕様の数値抽出、 金融商品の利率説明など、 数値正確性が求められる多くのドメインに横展開できます。 SSDSE-B-2026 のような 47 サンプル規模の評価セットを各ドメインで用意すれば、 同じ改善ループが回せます。 これが R653 のもっとも持ち帰るべきメッセージで、 個別技法ではなく『数値タスクを PE で攻めるための統一プロトコル』 を学んだと位置づけてください。 本ページの拡張ブロックを自分のチームの共有ドキュメント として再利用し、 各ドメイン固有の評価データセットを差し替えていけば、 短期間で実務水準の PE 基盤を立ち上げられるはずです。 統一プロトコルを共有資産化することで、 担当者交代やモデル更新があっても再現性のある精度改善ループを回し続けられます。
🧮 数式に値を入れて手で計算する: プロンプト工夫による精度差
合成データでプロンプト戦略別精度を比較する。
Step 1: 戦略別
戦略 精度
素プロンプト 0.45 Few-shot (3 例) 0.68 CoT 0.75 CoT + Self-consistency 0.82
Step 2: 改善幅
最終 0.82 - 素 0.45 = +0.37 改善
段階的工夫で 82% 達成
🐍 Python で再現
import numpy as np
acc = np . array ([ 0.45 , 0.68 , 0.75 , 0.82 ])
diff = np . diff ( acc )
print ( f "段階改善: { diff } " )
print ( f "総改善: { acc [ - 1 ] - acc [ 0 ] : .2f } " )
📤 実行結果
段階改善: [0.23 0.07 0.07]
総改善: 0.37
💬 手計算 (Step 2) +0.37 と Python 出力が完全一致。
🔗 隣接手法への橋渡し (補足)
プロンプトエンジニアリングは、 SSDSE-B-2026 のような実数値データを LLM で扱う場面で隣接領域との連携が不可欠になる。
SSDSE-B-2026 で「47 県 TOP5 を JSON で」のような prompt を組む場合、 上流の表整形・下流の JSON 検証まで含めて 1 パイプラインで設計するのが現代の標準。
🌳 手法選択フロー (補足)
プロンプトエンジニアリングを採用するか、 別手段に切り替えるかは、 タスクの性質と運用制約で決まる。
Step 1: 出力が「形式遵守」中心か「知識正確性」中心か?
形式遵守 (JSON / 表 / 箇条書きの整形) → JSON Schema + Few-shot 例 2-3 件で prompt 設計
知識正確性 (SSDSE の最新値・固有名詞) → RAG で公式データを注入 + prompt は検索結果を要約する役割に
Step 2: 訓練データ量と再現性要件は?
例 5 件以内・即時試したい → Few-shot prompt で 5 分で着手
例 1000 件以上 + 挙動を恒久固定したい → ファインチューニング へ切替
計算・集計が必須 → Function Calling で pandas / scipy を呼ぶ (prompt だけで人口合計を計算させない)
Step 3: 評価と継続改善は?
評価データ 20-50 件で形式遵守率・正確率を計測 (本ページ Step 1-3 の二項検定)
失敗例を Few-shot に追加 → 再評価のループを回す (prompt の A/B テスト)
temperature=0 で集計、 temperature=0.7 でアイデア出しと用途別に固定
SSDSE-B-2026 の集計タスクなら、 まず prompt + Few-shot で着手 → 失敗例を解析 → JSON Schema 強制 or Function Calling 切替、 の順に進めると、 どこで詰まったかを切り分けながらパイプラインを組める。
🔖 キーワード索引 (補足)
「prompt engineering 」は LLM 活用の中核技術として、 統計データ分析の現場でも利用が広がっている。 SSDSE-B-2026 の都道府県集計を LLM に依頼する場面で、 役割指定・出力フォーマット制約・Few-shot 例の与え方を変えるだけで結果の正確さが大きく変わる。 本セクションでは関連用語をチップで再掲する。
System Prompt Few-shot Chain-of-Thought JSON 出力制約 Temperature Top-p Tool Use RAG SSDSE-B-2026
これらは prompt engineering の構成要素であり、 47 都道府県 × 100 列の集計依頼を「再現可能」にする鍵となる。
💡 30秒で分かる結論 (補足)
prompt engineering の補足ポイント:
SSDSE-B-2026 での使い方 : 「都道府県別の人口上位 5 を Markdown 表で」のように出力形式まで指定すると整形コストが消える。Few-shot : 1〜3 例の入出力サンプルを与えると、 出力の形式や単位がそろいやすくなる(どれだけ誤答が減るかはタスクとモデルしだいなので、 評価セットで測る)。Chain-of-Thought : 「式 → 値代入 → 計算」を段階的に書かせると、 比率や偏差値の計算ミスが減る。注意点 : 同じプロンプトでもモデル世代 (GPT-4o と Claude など) で結果が変わる、 ベンチマークでの比較が必須。
📍 文脈ボックス (補足)
本ページの主目的は「SSDSE-B-2026 の都道府県データを LLM で集計する際の prompt 設計」を体系化することである。 同じ統計分析タスクでも、 prompt を 1 行変えるだけで精度・コスト・遅延が大きく変動する点が、 単なる API 呼び出しと異なる。
後段では数式 (KL ダイバージェンス・自己情報量) を言葉で読み解いた上で、 「人口・高齢化率・出生数のクロス集計を 1 プロンプトで再現する」具体例を Python で示す。
🎨 直感で掴む
プロンプトエンジニアリングは「LLM への指示書を磨くことで出力品質を引き上げる」工夫の集合。 SSDSE-B-2026 の人口データを LLM に渡す場合、 「列名・行数・型・期待出力形式・例 2 件」を含むプロンプトと、 「分析して」だけのプロンプトでは、 同じモデルでも出力の正確性が大きく変わる。
🔬 数式を言葉で読み解く
上の最適化式の各記号を、 prompt engineering の現場で何を意味するかに翻訳する。
$x_{\text{prompt}}$ — 設計者が書く prompt 文字列。 System 指示 + Few-shot 例 + フォーマット指示の組み合わせ。$\mathcal{X}$ — 可能な prompt 全体の空間。 自然言語なので組合せ爆発で、 厳密最適化は不可能。 人手 or LLM ベースのヒューリスティックで探索する。$\mathcal{D}$ — 評価データセット。 SSDSE-B-2026 由来の「47 都道府県の人口上位 5 を Markdown 表で」のような Q&A 集合。$\mathcal{L}$ — タスク評価関数。 形式遵守率・正答率・コスト・レイテンシなど複数指標の重み付け和になることが多い。$\text{LLM}_\theta$ — 事前学習済み LLM (GPT-4o・Claude など)。 $\theta$ は固定。 prompt engineering は $\theta$ には触れない。$\oplus$ — トークン列連結。 prompt の前半 (System + Few-shot) と末尾 (User の質問 $q$) を結合し、 一つの入力にする。
「重みを学習する」のではなく「prompt を探索する」という発想転換が prompt engineering の本質。 fine-tuning と異なり、 ラベル付きデータが少量でも適用でき、 即座に挙動を変えられる柔軟性が利点。
🧮 実値で計算してみる
プロンプトの良し悪しを「指示遵守率 (instruction following rate)」という単一指標で定量化する。 SSDSE-B-2026 の都道府県人口データを LLM に渡し、 「JSON 形式で人口上位 5 県を返す」というタスクを 3 種類のプロンプト (素の指示 / Few-shot 例つき / JSON Schema 指定) で 20 回ずつ実行し、 形式遵守率を比較する。 下の成功数 11/20・17/20・20/20 は LLM を実際に呼んだ結果ではなく、 計算手順を示すための説明用の仮の値 。
使用データ : SSDSE-B-2026 の A1101 (総人口) 列。 各プロンプトで N=20 回の試行、 出力が JSON.parse 可能かを 0/1 で評価。
Step 操作 値の確認
1 プロンプト A: 素の指示「JSON で上位 5 県」 成功 11/20 = 0.55 2 プロンプト B: A + Few-shot 例 2 件 成功 17/20 = 0.85 3 プロンプト C: B + JSON Schema 明示 成功 20/20 = 1.00 4 改善量 = C - A 1.00 - 0.55 = +0.45
素の指示から JSON Schema 指定までで遵守率が 0.55 → 1.00 に上昇。 プロンプトエンジニアリングの効果がこの 0.45 という数値に表れる。 Few-shot 例だけでも 0.85 まで上がる点に注目。
🐍 Python 実装
上記 Step 1-3 の指示遵守率を Python で再現する。 LLM API 呼び出しは省略し、 説明用の仮の値 (11/20, 17/20, 20/20) を pandas で集計して 95% 信頼区間まで計算する。
🎯 このコードでやること : 3 種類のプロンプトの遵守率を二項分布で評価し、 Wilson 信頼区間で「Few-shot 効果」が有意かどうかを判定する。
📥 入力データ : 各プロンプトの試行結果 (1=JSON parse 成功 / 0=失敗) の配列。
import numpy as np
from statsmodels.stats.proportion import proportion_confint , proportions_ztest
results = { 'A_bare' : 11 , 'B_fewshot' : 17 , 'C_schema' : 20 }
for name , succ in results . items ():
lo , hi = proportion_confint ( succ , 20 , method = 'wilson' )
print ( f ' { name } : 遵守率= { succ / 20 : .2f } 95%CI=[ { lo : .2f } , { hi : .2f } ]' )
stat , pval = proportions_ztest ([ 11 , 17 ], [ 20 , 20 ])
print ( f 'A vs B: z= { stat : .2f } , p= { pval : .3f } ' )
📤 実行結果 :
A_bare: 遵守率=0.55 95%CI=[0.34, 0.74]
B_fewshot: 遵守率=0.85 95%CI=[0.64, 0.95]
C_schema: 遵守率=1.00 95%CI=[0.84, 1.00]
A vs B: z=-2.07, p=0.038
💬 結果の読み方 : 素のプロンプト 11/20 から Few-shot 追加の 17/20 へ、 2 標本比率の z 検定で z=−2.07、 p=0.038 と 5% 水準で有意に改善。 ただし A の 95% 区間 [0.34, 0.74] と B の [0.64, 0.95] は重なっており、 各 20 回では差の推定幅がまだ広い。 さらに JSON Schema を明示すると 20/20 で失敗ゼロ。 プロンプトエンジニアリングの「効果」が二項検定で定量化できることを示している。
⚠ 落とし穴
曖昧な出力形式指定 : 「結果を表で」だけだと、 ある時は Markdown、 ある時は HTML、 ある時は CSV と毎回バラバラ。 対策: JSON Schema や CSV 列名を明示し、 OpenAI Structured Outputs / Anthropic Tool Use で形式を強制する。暗黙の前提共有不足 : 「人口」と書くだけだと住民基本台帳 vs 国勢調査 vs 推計人口のどれか LLM が勝手に判断。 対策: SSDSE-B-2026 の列名と単位 (千人/年) をプロンプト先頭に明記する。Few-shot 例のリーク : 例に「東京 1396 万」を入れたまま「東京の人口は?」と質問すると、 LLM はモデルの知識ではなく例文をコピーして返す。 対策: 評価用と例用のデータを完全に分離。温度 (temperature) の取り違え : 集計タスクで temperature=1.0 のままにすると毎回数値が変動。 対策: 集計・要約は temperature=0、 アイデア出しは 0.7-1.0 と用途で分ける。幻覚 (hallucination) を「もっと丁寧に書けば消える」と誤信 : 47 都道府県以外の存在しない県を生成する問題は、 プロンプト改善ではなく RAG・関数呼び出しで実データに接地する以外に根本解決はない。
🗺 概念マップ
プロンプトエンジニアリング を中心に、 関連する概念・上位カテゴリ・応用領域を放射状に配置した。
プロンプトエンジニアリング
前提: LLM / NLP
並列: Chain-of-Thought
発展: RAG / Agent
応用: ChatGPT 業務活用
対比: ファインチューニング
統合: AI 安全 / ガードレール
プロンプトエンジニアリングを中心に、 (a) 上位として In-context Learning と LLM 制御技術、 (b) 並列としてファインチューニングと RAG、 (c) 派生として CoT / ReAct / Self-Consistency、 (d) 前段として Few-shot 例選定と JSON Schema 定義、 (e) 後段として出力検証と LLM-as-judge 評価、 (f) 応用として SSDSE-B-2026 47 県の要約・TOP5 抽出・仮説生成、 を配置した。
プロンプトエンジニアリング は単体で覚えるより、 SSDSE-B-2026 のような実データに対して「前処理 → 適用 → 検証」の流れに組み込んで運用できるようにすることが重要。
🔗 隣接手法への橋渡し
「prompt engineering」を中心に、 隣接する手法・概念との関係を以下に整理する。 単独の手法理解にとどまらず、 分析パイプライン全体での位置付けを把握することで、 適切な前段・後段・代替手法を選べる。
隣接手法 関係 接続のポイント
In-context Learning 上位 / 一般化 重み更新せず例示と指示だけで挙動を変える上位概念。 プロンプト設計はその実践技術 ファインチューニング 並列 / 対比 重みを更新して挙動を固定する対比手法。 1000 件以上の訓練データがあるならこちらが安定 RAG 並列 / 補完 外部知識をプロンプトに注入する補完手法。 SSDSE 等の数値データを引かせる時に併用 Few-shot 例選定 前段 (前処理) プロンプトに入れる良例の選び方。 多様性と難易度で 3-5 件選ぶと精度が伸びる JSON Schema 出力検証 後段 (後処理) 出力を json.loads で検証し失敗時は再生成。 形式逸脱を 0% に近づける後段処理 Chain-of-Thought 派生 / 拡張 「ステップで考えよ」と指示し中間推論を出力させる派生手法。 算術・論理問題で精度向上
プロンプトエンジニアリングは単体のテクニックではなく、 「タスク分解 → Few-shot 例設計 → 出力形式制約 → 生成 → 検証」のパイプラインで運用する技術。 SSDSE-B-2026 の都道府県データを要約・分類するなど実用タスクで、 prompt の各要素を A/B 比較しながら最適化していくのが定石。
🌳 手法選択フロー
「prompt engineering」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
シナリオ 重視する観点 候補手法
教師データが少ない (< 100 件) プロンプト設計で In-context Learning Few-shot + Chain-of-Thought を併用 教師データが大量 (>10,000 件) 重み更新で挙動を固定 ファインチューニングが第一候補 最新知識・社内文書が必要 外部知識をプロンプトに注入 RAG と組合せ、 プロンプトに引用を強制 出力形式の厳格性が必要 Schema 拘束と検証 JSON Schema + json.loads 再試行ループ 複雑な推論タスク 推論過程を明示させる Chain-of-Thought + Self-Consistency コスト最小化が最優先 短文プロンプト + 小型モデル プロンプト圧縮と蒸留モデルを使用
選んだ後の検証ステップ
プロンプト構造確認 : 役割指示 / Few-shot 例 / 出力形式制約 / 制約条件 が漏れなく書かれているかパラメータ調整 : temperature / top_p / max_tokens を タスク (要約は低温度、 創作は高温度) に合わせて調整出力品質評価 : 形式遵守率 (JSON Schema validate) / ハルシネーション率 / 指示追従率 を複数プロンプトで比較頑健性チェック : 同一プロンプトで 5-10 回生成し、 出力のばらつき (BLEU / Embedding 類似度) を測定解釈 : LLM-as-judge や人手評価で、 SSDSE-B-2026 要約タスクなど実タスクで意図通りに動いているか検討
🧭 解説の深化:LLM に「数を数えさせるな」── 数値トークン化の壁と〈生成/計算の分離〉(追記)
LLM のページは「同じ入力でも答えがぶれる非決定性 」を、 ハルシネーション のページは「出てきた数値を異常値検出の目 で事後に疑う」を扱う。 ここでは第三の軸 ── そもそもプロンプトで四則演算を直接させると、 温度を 0 に下げても消えない「能力側」の誤り が出る、 という問題を SSDSE-B-2026 の実測値で示します。
🎨 直感
LLM は電卓ではなく 「次に来そうな文字列を確率で選ぶ機械」 です。 しかも入力の数字は 1 桁ずつではなく、 トークナイザ都合で 1408/6000 のような意味のない塊 に切られます。 人間なら筆算で桁を縦に揃えて繰り上がりを追えますが、 モデルは桁の位置を保証されないまま「それらしい続き」を生成するだけ。 だから「14086000 + 9229000 は?」と直接聞くのは、 電卓の代わりに作文の得意な人に暗算させる ようなものです。 短い計算はたまたま当たりますが、 桁が多い・似た値が並ぶ・行数が増える、 の 3 条件が重なると急に外します。
⚠️ 落とし穴(重要)
統計コンペで一番やりがちなのが「CSV を丸ごと貼って合計・平均・順位を日本語で尋ねる 」ことです。 モデルは自信満々に、しかし微妙にズレた 数を返します。 これは非決定性(seed を固定すれば消える)とは別物で、 温度 0・同一 seed でも安定して間違える のが厄介な点です。 下は SSDSE-B-2026 の A1101(総人口, 2023年)上位県を、 Python で正しく足した実測値 です。
✅ 正しい答え(Python / pd.read_csv(encoding='cp932', skiprows=[1]) の実測値) 23,315,000 。 上位 4 県(+大阪府 8,763,000・愛知県 7,477,000)の和 = 39,555,000 。 47 都道府県の総人口 = 124,353,000 (平均 2,645,808.5 人/47 県)。 2012→2023 の全国計は 127,589,000→124,353,000(−2.54% )。
❌ 架空の「LLM 暗算」例(乱数で桁ズレを再現したデモ。実際のモデル出力ではありません) 23,215,000 です」── 桁は合っているのに 10 万の位がズレる。 「上位 4 県で 39,655,000 」「全国計 124,853,000 」のように、 もっともらしい範囲・桁数 を保ったまま末尾がずれるのが典型。 だから「桁数が正しい=正解」ではありません。
対策は 3 つ。 ①「計算するな、計算するコードを書け 」と指示し、実行は自分(か Function Calling / コードインタプリタ)で行う。 ②プロンプトに実在の列名 (A1101 等)と encoding='cp932'・skiprows=[1] を明記し、幻の列名を防ぐ。 ③検算プロンプト 「上の値を df['A1101'].sum() で再計算し、一致しなければ差分を報告して」を必ず添える。
🚀 発展
温度では直らない :算術ミスはサンプリング の問題ではなく能力 の問題。 temperature=0 でも安定して外すので、 「seed を固定して再現」しても正しくはなりません(再現性 ≠ 正確性)。生成/計算の分離 :Function Calling・コードインタプリタで pandas/numpy を呼び、 モデルにはコードと解釈だけ を担当させる。 数値の確定は決定的な実行環境に委ねます。self-consistency+検算 :同じ集計を「日本語で暗算」「コードで計算」の 2 経路で出させ、 一致しなければ棄却 。 一致検査自体をプロンプトの最終ステップに組み込みます。トークン長にも注意 :47 行 × 112 列を丸ごと貼ると数千トークンになり、 長文中央の情報が薄まる(=集計対象の取りこぼし)。 必要列だけ df[['Prefecture','A1101']] に絞って渡すのが安全です。
🔗 関連ページ
プロンプト (指示の設計そのもの)/
LLM (非決定性・再現性の軸)/
ハルシネーション (出力を事後に疑う軸)/
CSV (列名・エンコーディングの正確な受け渡し)/
埋め込み / トークン化 (数字がどう切られるか)。
関連して Function Calling / ツール使用 ・再現性 は本用語集内に個別ページが未整備のため、 上記各ページの該当節を参照してください。