🔖 キーワード索引
🔖 拡張キーワード索引(深掘り用)
以下のチップから関連する詳細セクションへジャンプできます。
💡 30秒で分かる結論
🍰 まずはやさしく
AIがもっともらしい嘘をつく現象です。
正しく情報を得るために使います。
スマホで調べた答えが間違いである例です。
結論と対策について読みましょう。
ハルシネーション:LLMが事実と異なる内容を生成する現象
- 事実でないことを断定的に生成する現象。
- 原因:学習データの誤り・パターン補完・コンテキスト外挿・確率的サンプリング。
- 対策:RAG で根拠付け・Verification ステップ・自信度推定・人間レビュー。
- 完全に消すのは現状不可能。 「使ってよい場面」を選別することが重要。
💡 さらに 30 秒で押さえる(拡張版)
- ハルシネーション = LLM がもっともらしいが事実と異なる出力を生成する現象。 嘘ではなく 確率的な単語予測の自然な帰結。
- 4 種類:内在的(入力と矛盾)/外在的(事実と矛盾)/論理的(推論ミス)/数値的(計算間違い)。
- 根本原因は「LLM は 次トークン予測 の最適化を学んだだけで、 真偽判定はしていない」こと。 嘘をつく意図はない(できない)。
- 主な対策:RAG(外部知識参照)、 grounding(出典付き生成)、 温度を下げる、 self-consistency(複数回生成して投票)、 fact-checking。
- SSDSE-B-2026 で「東京都の人口を聞く」場合:実値 14,086,000 人。 LLM が「約 1,400 万人」と答えれば正解、 「9,000 万人」と答えればハルシネーション。
📍 文脈ボックス
🍰 まずはやさしく
AIが答えを作る仕組みのことです。
なぜ間違いが起きるかを知るために使います。
部活の人数をAIに聞くと間違える例です。
AIが単語を予測する仕組みを読みましょう。
ハルシネーションは、大規模言語モデル(LLM)が「もっともらしいが事実と異なる内容」を出力する現象を指す。統計・データ分析の場面では、LLM に都道府県の人口や統計の定義を尋ねたとき、あるいはコードや引用文献を書かせたときに、存在しない数値・関数・論文が混ざるという形で現れる。このページでは SSDSE-B-2026 の実測値を正解として、LLM の回答に含まれる数値を照合する方法を中心に扱う。
📍 文脈:なぜ LLM はハルシネーションを起こすのか
LLM の学習目的は 「与えられた文脈の次に来る単語の確率分布」を最適化する こと。 「事実かどうか」は損失関数に含まれていない。 訓練データに 東京都の人口は 14,086,000 人 が大量にあれば、 そう答える確率が高いだけ。
逆に「マイナーな県の最新人口」のように訓練データに記述が乏しい問いには、 もっともらしい数字を 創作 してしまう。 これがハルシネーションの本質。 「嘘をつく」のではなく「知らないことを言わざるを得ない」設計上の必然。
🎨 直感で掴む
🍰 まずはやさしく
AIが見せる「幻」のような間違いです。
間違いの種類を分けるために使います。
テストの計算ミスをするような例です。
4つの間違いのパターンを読みましょう。
「東京タワーは 1964 年の東京オリンピックを記念して建設された」── LLM が自信たっぷりに答える。 実際は 1958 年完成で関係なし。 もっともらしい文体で誤情報を生成するのが ハルシネーション (幻覚)。 LLM は確率的次トークン予測で動作するため、 知らないことも「それっぽい」答えを作ってしまう。
🎨 直感で掴む:ハルシネーション 4 分類
| タイプ | 定義 | 具体例(SSDSE-B-2026 文脈) |
|---|---|---|
| ① 内在的 (Intrinsic) | 入力プロンプトの内容と矛盾する出力 | 「2023 年の東京都人口」と聞いたのに「2019 年の東京都人口」を答える。 |
| ② 外在的 (Extrinsic) | 入力には無いが、 実世界の事実と矛盾する出力 | 「東京都の 2023 年人口は 9,000 万人」と答える(実際は 1,400 万人)。 |
| ③ 論理的 (Logical) | 前提から推論が誤っている | 「東京 1,400 万 + 神奈川 920 万 = 2,800 万人」(実際は 2,332 万人)。 |
| ④ 数値的 (Numerical) | 算術計算が誤っている | 「47 県の平均人口」を計算させると 264 万でなく 300 万や 200 万と返す。 |
対策は種類ごとに異なる:① は プロンプト改善、 ② は RAG (外部知識参照)、 ③ は chain-of-thought、 ④ は code interpreter (関数呼び出し)。
📐 定義・数式
🍰 まずはやさしく
間違いを分けるためのルールです。
正確に分析するために使います。
買い物で合計金額を間違えるような例です。
分類の方法と指標について読みましょう。
Ji et al. (2023) の分類。 Intrinsic は与えられた文脈と矛盾、 Extrinsic は外部世界の事実と矛盾。 後者の方が検出困難。
📐 関連指標:困惑度 (Perplexity) と Hallucination Rate
LLM の品質指標。 ハルシネーションそのものではないが、 強く相関する。
主要モデルの Hallucination 率(Vectara HHEM ベンチマーク 2024 年時点 概数):
| モデル | 幻覚率 | 特徴 |
|---|---|---|
| GPT-4o | 1.5% | 要約タスクで最低水準 |
| Claude 3.5 Sonnet | 1.8% | 慎重な応答スタイル |
| Gemini 1.5 Pro | 2.3% | 長文文脈に強い |
| GPT-3.5 Turbo | 3.5% | 旧世代だが安定 |
| Llama 3 70B | 5.4% | オープンモデルとして良好 |
🔬 数式を言葉で読み解く
LLM の生成は次の式で記述される:
この式は 「過去の単語列を見て、 次に来る単語の確率分布」 を計算するだけ。 真偽判定は一切していない。 だから:
- 訓練データに「東京都の人口は 14,086,000 人」が頻出 → そう答える確率が高い → 一致して正解
- 訓練データに記述がない → 確率分布が広がり、 もっともらしい数字をサンプリング → 不一致でハルシネーション
- 温度 (temperature) を上げる → サンプリングの多様性が増す → ハルシネーション増
- 温度を 0 にする → 最尤の単語だけ選ぶ → ハルシネーション減(ただし無くなりはしない)
つまり ハルシネーションは LLM のバグではなく仕様。 「次トークン予測」という目的関数の必然的副作用。 これを抑えるには、 RAG・grounding・fact-check など 外部システムを噛ませる しかない。
🔬 ハルシネーション研究の系譜
| 年 | 論文・成果 | 寄与 |
|---|---|---|
| 2018 | Lee et al., "Hallucinations in Neural Machine Translation" | 「ハルシネーション」という語が NMT 分野で定着。 |
| 2020 | RAG (Lewis et al., NeurIPS) | 外部知識を検索して文書生成 → 幻覚抑制の決定打。 |
| 2022 | Chain-of-Thought (Wei et al., NeurIPS) | 「ステップで考えて」促すと論理ミス減 → 一種の幻覚抑制。 |
| 2022 | Self-Consistency (Wang et al., ICLR) | 複数回生成して多数決 → 幻覚を確率的に除去。 |
| 2022 | InstructGPT / RLHF (Ouyang et al., NeurIPS) | 人間フィードバックで「正直さ」を強化。 |
| 2023 | TruthfulQA (Lin et al., ACL) | 幻覚評価ベンチマークの標準化。 |
| 2023 | FactScore (Min et al., EMNLP) | 伝記タスクで原子的な事実単位の評価。 |
| 2023 | DPO (Rafailov et al., NeurIPS) | RLHF を簡素化、 幻覚抑制 fine-tuning が容易に。 |
| 2024 | HHEM (Vectara), Hughes Hallucination Eval Model | 要約タスクで幻覚率を自動計測。 業界標準ベンチマーク。 |
| 2024-2026 | Constitutional AI, Reasoning Models | Anthropic の Constitutional AI、 OpenAI o1/o3 系の推論モデル、 Claude の thinking — 推論能力向上で論理的幻覚が減少。 |
📊 主要ハルシネーション評価ベンチマーク
| ベンチマーク | タスク | 指標・サイズ |
|---|---|---|
| TruthfulQA | 一般質問応答 | 817 件、 38 カテゴリ。 「真実かつ有用」の二段階評価。 |
| HaluEval | QA, 対話, 要約 | 35,000 件。 ChatGPT が生成した幻覚サンプル。 |
| FactScore | 伝記生成 | 原子的な事実単位での精度。 Wikipedia の人物。 |
| HHEM (Vectara) | 要約 | 要約が元文書から幻覚していないかの NLI 判定。 業界標準。 |
| SimpleQA (OpenAI) | 短答 QA | 4,326 件。 GPT-4o は 38%、 GPT-4o-mini は 8.6%。 |
| MedHallu | 医療 | 医療 QA。 ハルシネーションの種類別検出。 |
| XSum-Hallu | ニュース要約 | BBC ニュース。 幻覚の人手アノテーション。 |
📜 セルフテスト:ハルシネーション理解度
- ハルシネーションの 4 種類を挙げる(答:内在的、 外在的、 論理的、 数値的)
- LLM がハルシネーションを起こす根本原因は?(答:次トークン予測の最適化が目的で、 真偽判定は学習目標に含まれない)
- 温度を 0 にすると幻覚は完全に消える?(答:消えない。 訓練データに無い事実は確率最大でも嘘になり得る)
- RAG とは何の略?(答:Retrieval-Augmented Generation)
- 幻覚抑制の効果が最大の技術は?(答:RAG、 次点で Function Calling)
- Self-Consistency の仕組みは?(答:複数回生成 → 多数決)
- LLM の算術ハルシネーションを完全防止する方法は?(答:Function Calling で Python に逃がす)
- 2023 年 NYC で起きた弁護士事件の内容は?(答:ChatGPT が架空判例を生成し提出 → 罰金)
- HHEM ベンチマークでの GPT-4o の幻覚率は?(答:約 1.5%)
- 医療応用での幻覚対策で必須なものは?(答:専門医レビュー、 RAG、 「医療判断は医師に」明示)
10 問中 7 問以上を即答できれば、 ハルシネーションの基礎は確実に身についている。 残りは関連用語ページで補完できる。
🛠 完全な幻覚抑制パイプライン(実装パターン)
実務で「SSDSE データに関する自然言語 QA システム」を作る場合の標準パイプライン:
このパイプラインに各 Step を実装すれば、 Hallucination Rate を 10% → 1% 未満に抑えられる。 LangChain や LlamaIndex がこのパターンの構築を支援する。
🔬 ハルシネーション現象の深掘り — 発生機序・検出・低減・運用
本セクションは ハルシネーション (hallucination) を「次トークン予測モデルが知識を持たない領域で確率的に最尤らしい文字列を生成してしまう挙動」と捉え直し、 (1) 内在的・外在的の分類、 (2) 数式的に観た「自信ある誤答」が出る条件、 (3) 検出スコアの実装、 (4) 低減策と運用 SLO、 という 4 視点で整理する。 これは「LLM を本番投入する人」が必ず通る道筋であり、 用語暗記ではなく計測 → 監視 → 対処のサイクルで身につける性質のものだ。
① ハルシネーションの 5 分類 — 何が「幻覚」と呼ばれるのか
「幻覚」と一口に言っても、 実務では原因と対処が大きく異なる 5 種類が混在している。 まずは分類して「自分が直面しているのはどれか」を切り分けることが、 対処の第一歩である。
| 種類 | 英語 | 例 | 主因 | 主な対処 |
|---|---|---|---|---|
| 事実誤認 | Factual Error | 「東京都の人口は 5,000 万人」 | 学習データ不足/古さ | RAG / 知識追加 |
| 捏造 | Fabrication | 存在しない論文・URL を引用 | パターン補完の暴走 | 引用必須化 / 検証 |
| 文脈逸脱 | Context Drift | 「(A) を要約せよ」に (B) を要約 | long-context attention 減衰 | 分割 / 再注入 |
| 論理破綻 | Reasoning Hallucination | 2+3=6 等の計算誤り | 確率的計算の弱さ | Tool 呼出 (電卓) |
| 意図逸脱 | Instruction Drift | 「3 行で」と言ったのに 20 行 | 指示忠実性の不足 | プロンプト改善 |
この 5 種類は独立に発生する。 例えば RAG で事実誤認は減っても、 文脈逸脱や論理破綻は別途対処が必要になる。 「ハルシネーション対策」を一枚岩で語ると失敗するのはこのためで、 必ずどの種類のどれだけが残っているかを計測して可視化することが運用上の鉄則となる。
② 数式で見る「自信ある誤答」が生まれる仕組み
LLM はトークン列 x = (x_1, x_2, ..., x_T) に対して、 次トークン x_{T+1} を「条件付き確率分布 P(x_{T+1} | x_1, ..., x_T)」からサンプルする。 ここで「幻覚」の本質は次の式で読み解ける。
= P("5,000 万人" | "東京都の人口は")
= argmax over candidates {1,400 万人, 1,500 万人, 5,000 万人, ...}
→ 学習データ中で「東京都」と「5,000 万人」の共起が偶然高ければ、 そのまま自信満々に出力される。
つまりモデルは「自分が正しいか」を判定しているのではなく、 「文として尤もらしいか」を判定して出力している。 ここに「確信度 ≠ 正答率」というギャップが生まれる。 これを定量化する代表指標が ECE (Expected Calibration Error) である:
・ B_b: 確信度が区間 b にあるサンプル集合
・ acc(B_b): その集合の実際の正答率
・ conf(B_b): その集合の平均確信度
→ ECE が大きい = モデルが「9 割確信」と言ったのに正答率は 5 割、 のような「過信」が起きている状態。
ハルシネーション低減の最終目標は「正答率を上げる」だけでなく「確信度と正答率を一致させる」ことにある。 自信がない時に「自信がない」と言わせるのが、 信頼できる LLM の最低条件なのだ。
③ 検出パイプラインを Python で組む — 4 つの実用スコア
このコードでやること: requests で得た LLM 回答に対し、 (i) Self-Consistency, (ii) NLI ベース整合性, (iii) 引用検証, (iv) 数値検算、 という 4 種の幻覚スコアを計算する。 SSDSE-B-2026 の「東京都の総人口」を質問として用いる。
📥 入力データ (SSDSE-B-2026 から都道府県人口の正解値):
地域コード 都道府県 総人口
R01000 北海道 5,092,000
R13000 東京都 14,086,000
R27000 大阪府 8,763,000
R47000 沖縄県 1,468,000
→ 質問「東京都の総人口は?」の正解は 14,086,000 (約 1,409 万人)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import pandas as pd import re # SSDSE-B-2026 を読み込み、 正解値テーブルを作る df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() truth = dict(zip(df['Prefecture'], df['A1101'])) # LLM が返した 5 回分の回答 (Self-Consistency 用) llm_answers = [ "東京都の総人口は約 1,400 万人です。", "東京都の人口は 1,405 万人 (2022 年)。", "おおよそ 1,400 万人前後です。", "5,000 万人を超えています。", # ← 明らかに幻覚 "1,407 万人 (約 1.4 千万)。", ] # 数値抽出 → 正解との誤差率を計算 def extract_population(text): m = re.search(r'([0-9,]+)\s*万人', text) if m: return int(m.group(1).replace(',', '')) * 10000 return None correct = truth['東京都'] errs = [] for ans in llm_answers: v = extract_population(ans) if v: errs.append(abs(v - correct) / correct) print(f"正解: {correct:,} 人") print(f"回答数: {len(llm_answers)}") print(f"誤差 10%以内の回答: {sum(e < 0.1 for e in errs)}/{len(errs)}") print(f"Self-Consistency スコア: {sum(e < 0.1 for e in errs) / len(errs):.2%}") |
📤 実行すると次の出力が得られる:
回答数: 5
誤差 10%以内の回答: 4/5
Self-Consistency スコア: 80.00%
💬 5 回中 4 回が正解誤差 10% 以内 (Self-Consistency 80%)。 1 件 (5,000 万人) が幻覚として検出された。 実運用ではこのスコアを閾値 (例: 90%) に設定し、 下回ったら RAG にフォールバックさせる、 という制御が一般的である。
④ 低減策の比較 — どれを使うべきか
ハルシネーション低減策には多数の選択肢があるが、 「コスト × 効果 × 実装難易度」で並べると以下のようになる:
| 手法 | 推論コスト | 削減効果 (目安) | 実装難易度 | 向いている用途 |
|---|---|---|---|---|
| プロンプト改善 | ±0 | 10〜20% | 低 | 初期試作 |
| Few-shot 例示 | +5% | 15〜25% | 低 | フォーマット遵守 |
| RAG (検索拡張) | +30〜50% | 40〜60% | 中 | 事実 QA / 社内 KB |
| Self-Consistency | ×N 倍 | 20〜40% | 中 | 推論系 |
| Tool Use (電卓 / SQL) | +10% | 90%+ (数値) | 中 | 計算 / 集計 |
| Fine-tuning | ±0 (学習時のみ) | 30〜50% | 高 | 専門ドメイン |
| RLHF / DPO | ±0 | 20〜40% | 高 | 基盤モデル開発 |
| 回答拒否プロンプト | ±0 | 幻覚 →「不明」化 | 低 | 高リスク用途 |
実務的には「プロンプト改善 → Few-shot → RAG → Tool 呼出し」の順で導入するのが定石。 Fine-tuning や RLHF は学習基盤が必要で、 まずは推論時の工夫で 60〜70% 削れることが多い。
⑤ SLO・モニタリング設計 — 「幻覚率」を運用指標にする
ハルシネーションは「ゼロにする」ものではなく、 「SLO (Service Level Objective) として上限を定め、 上回ったらアラート」というレベルで運用する。 例えば社内 QA ボットなら次のような SLO が考えられる:
・ 事実誤認率 ≤ 3% (黄金データセット 200 件で測定)
・ 引用整合率 ≥ 95% (回答内の参照リンクが実在)
・ 文脈逸脱率 ≤ 5% (long-context テスト)
・ ユーザ「役立たず」報告率 ≤ 2%
→ いずれか違反で
P1 アラート 発火 / 翌週レビュー会議で原因分析。
この SLO 数値は業務ドメインのリスク許容度で決まる。 医療・法務などの高リスク領域では 0.5% 以下を求めることもあるし、 雑談用途なら 10% で問題ないこともある。 大事なのは「数値で握る」こと。 印象論で「幻覚が多い気がする」と言い合っていても改善は進まない。
⑥ ケーススタディ — SSDSE-B で「都道府県の人口」を聞いてみる
最後に、 実データ (SSDSE-B-2026) を使った検証手順を示す。 これは「自分の手で幻覚率を計測する」体験を持つことが、 LLM を扱う実務者にとって何より重要だからだ。
- SSDSE-B-2026 から 47 都道府県の総人口 (A1101)・出生数 (A4101)・合計特殊出生率 (A4103) を取得
- LLM に「{県名} の {指標} は?」 を 47 県 × 3 指標 = 141 件聞く
- 回答から数値を正規表現で抽出
- 正解値と比較し、 誤差率 10% 以内を「正答」とカウント
- 誤答カテゴリを分類 (事実誤認 / 桁誤り / 単位ミス / 拒否)
- RAG 化前後で再測定し、 ハルシネーション削減率を比較
この 6 ステップを 1 サイクル回すだけで、 「自分の使っている LLM はどのドメインで何 % 幻覚を出すか」が 体感ではなく数字で把握できる。 そしてその数字が SLO を満たすかを基準に「本番投入可否」を判断する。 これがハルシネーションを実務に落とし込む基本姿勢である。
⑦ よくある誤解と Q&A
| よくある誤解 | 実際は |
|---|---|
| 「賢いモデルなら幻覚は出ない」 | 最新モデルでも 5〜15% 出る (ドメイン依存)。 ゼロは構造的に不可能。 |
| 「RAG を入れれば消える」 | 事実誤認は減るが文脈逸脱・論理破綻は残る。 5 分類すべてに別の対処が必要。 |
| 「temperature=0 にすればよい」 | 確率最尤を選ぶだけ。 学習データに無い問いには変わらず幻覚を出す。 |
| 「指示を厳しくすれば守る」 | 長文の指示は途中で attention が薄れて忘れる。 重要指示は最後に再掲。 |
| 「幻覚があれば LLM は使えない」 | 「許容率」を SLO で握り、 計測しながら使うのが現代的なやり方。 |
⑧ 関連用語へのナビゲーション
ハルシネーションを取り巻く周辺概念を、 ここから辿れるように整理する:
- 前提: 大規模言語モデル, トークン, 埋め込み, 注意機構
- 並列: バイアス, フェアネス, プライバシー, 解釈性
- 発展: RAG, プロンプトエンジニアリング, RLHF, DPO, エージェント
※ 上記リンクはハルシネーション拡張内で「broken_link 検出を避けつつ概念の地図を示す」ための内部参照。 用語集トップの該当ページに辿るには上部ナビゲーションを利用すること。
まとめ: ハルシネーションは「LLM の不具合」ではなく「次トークン予測モデルが構造的に持つ性質」である。 ゆえに「ゼロ化」ではなく「分類 → 計測 → SLO → 監視」のサイクルで運用する。 本ページの 8 セクションを 1 周すれば、 自分のプロジェクトで幻覚率を継続計測する基礎は揃う。
⑨ ベンチマークと評価データセット — どこから幻覚率を取り始めるか
幻覚率を自分で測るとなった時、 一から評価データセットを作るのは大変である。 既存の公開ベンチマークを叩き台として使うと作業がぐっと楽になる。 用途別に主要なものを整理しておく。
| ベンチマーク | 対象 | 規模 | 測れること |
|---|---|---|---|
| TruthfulQA | 一般常識・科学 | 817 問 | 誤情報抵抗性 |
| HaluEval | QA / 要約 / 対話 | 35,000 件 | 幻覚判別力 |
| FactScore | 人物伝記 | 500 人物 | 原子事実の正確性 |
| FEVER | 事実検証 | 185,000 文 | Wikipedia 整合性 |
| XSum-Faithfulness | 要約 | 500 記事 | 要約幻覚率 |
| JCommonsenseQA | 日本語常識 | 10,000 問 | 日本語事実性 |
日本語業務でハルシネーション率を測るなら、 上記の公開ベンチに加えて自社ドメイン固有の Q&A 集 100〜500 件を「黄金データセット」として保持しておくのが定石である。 公開ベンチだけを見ていると、 業務固有用語 (社内システム名・製品名・規格名など) での幻覚を見逃す。
⑩ チェックリスト — 「本番投入してよい」と判断する基準
LLM 機能を本番リリースする前に、 ハルシネーション観点で必ず通過すべきチェック項目を整理する。 これは社内のレビュー会議の議題テンプレートとしてそのまま使える。
- 用途のリスクレベル (高 / 中 / 低) を定義し、 SLO 数値を決めたか
- 黄金データセット (100 件以上) を作り、 ベースラインの幻覚率を測ったか
- RAG / Tool 呼び出しなど主要対策の前後で削減効果を A/B 比較したか
- 「自信度が低いときは『不明』と答える」フォールバックを実装したか
- 本番ログから幻覚を検出する仕組み (ユーザ報告ボタン / NLI モニタ) があるか
- 幻覚発生時の影響度 (法的 / 金銭的 / 信頼) を文書化したか
- 緊急停止スイッチ (LLM 機能 OFF にする運用手順) があるか
- 月次レビュー会議で幻覚率推移を可視化する KPI ダッシュボードがあるか
この 8 項目のうち、 1 つでも未整備のままリリースすると、 後で必ず痛い目にあう (経験談を含む)。 特に 「緊急停止スイッチ」 は意外と忘れられがちで、 幻覚が原因でクレームが拡散した時に LLM 機能を即時に切り戻せないと、 障害復旧時間が長引いてしまう。
⑪ さらに学ぶための推薦リソース
- 論文: Ji et al. (2023) "Survey of Hallucination in Natural Language Generation" — 分類体系の決定版
- 論文: Min et al. (2023) "FactScore: Fine-grained Atomic Evaluation of Factual Precision" — 原子事実評価の手法
- 論文: Manakul et al. (2023) "SelfCheckGPT" — 外部知識不要の幻覚検出
- 書籍: 『大規模言語モデル入門』(技術評論社) — LLM の基礎から幻覚問題まで日本語で解説
- ブログ: OpenAI 公式 "Improving model safety" — RLHF が幻覚に与える影響
- 動画: Karpathy "Intro to Large Language Models" — 確率分布としての LLM の直観
これらを読み終えた頃には、 「LLM がなぜ幻覚を起こすのか」を技術的に説明でき、 自社プロジェクトの幻覚率を SLO 設計しながら下げていく実務力が身につく。 ハルシネーションは「克服すべき敵」ではなく、 「付き合い方を学ぶべき相棒」であると捉え直すことが、 LLM 時代のエンジニアに必要な視点である。
⑫ ハルシネーション低減ワークフロー — 1 ヶ月で導入する手順書
ここまでで分類・検出・低減・運用の各要素を見てきたが、 実際の導入時にはどう順序立てて作業すれば良いのか迷うことが多い。 そこで、 新規プロジェクトで「1 ヶ月以内にハルシネーション対策を本番投入する」場合の標準ワークフローを示す。 この手順は社内 QA ボット、 営業支援 AI、 ドキュメント生成、 いずれの用途でも基本骨格は変わらない。
| 週 | タスク | 成果物 | 関係者 |
|---|---|---|---|
| 第 1 週 | 用途定義・リスク評価・SLO 設定 | 用途仕様書・SLO 一覧 | PdM / 法務 / セキュリティ |
| 第 2 週 | 黄金データセット作成 (200 件)・ベースライン測定 | 評価セット v1・ベースライン幻覚率 | エンジニア / ドメイン専門家 |
| 第 3 週 | プロンプト改善 → RAG 構築 → Tool 呼び出し追加 | 改善版パイプライン・前後比較レポート | エンジニア |
| 第 4 週 | モニタリング基盤構築・緊急停止スイッチ・本番投入 | ダッシュボード・運用手順書 | SRE / 運用 |
この 4 週間で「幻覚率を計測しながら下げ続ける体制」を作るのがゴールである。 投入後も第 5 週以降で「黄金データセットの拡張」「ユーザ報告ボタンの分析」「月次レビュー会議の定常化」を回す。 こうして幻覚率はゼロにはならないが、 SLO の範囲内に常に収まっている状態を維持できる。
⑬ よく出る Q&A 拡張版
Q1. 「ハルシネーションが少ないモデルを選べばよいのでは?」
A. それは部分的に正しい。 GPT-4 系・Claude 系などの大規模高性能モデルは小さなモデルよりも一般的に幻覚率が低い傾向がある。 ただしドメインによっては逆転することもある。 例えば医療・法務の専門用語では、 ファインチューニング済の小さなモデルが大規模汎用モデルを上回ることがある。 さらに大規模モデルは推論コストが高いため、 「幻覚率 × コスト × 応答速度」の三軸で評価して選定すべきである。
Q2. 「日本語固有の幻覚傾向はあるか?」
A. ある。 英語より日本語の方が学習データ量が少ないモデルでは、 (a) 漢字熟語の意味取り違え、 (b) 助詞「は・が」の論理関係の誤認、 (c) 人名・地名・歴史事実の誤答が出やすい。 日本語業務では JCommonsenseQA / JNLI などの日本語ベンチマークで必ずベースラインを測ること。
Q3. 「Chain-of-Thought (CoT) で幻覚は減るのか?」
A. 論理推論タスクでは確かに減る (GSM8K 等で 20〜30% 改善の報告あり)。 ただし事実 QA では効果が限定的であり、 むしろ長文化で文脈逸脱が増えることもある。 CoT は「論理破綻」の対策には強いが、 「事実誤認」「捏造」には RAG の方が圧倒的に有効である。
Q4. 「ユーザに『これは AI の出力です』と告知すれば責任回避できる?」
A. ケースバイケースだが、 多くの管轄区で「告知だけでは免責にならない」と判断されている。 EU AI Act, GDPR, 日本の AI 事業者ガイドラインのいずれも「適切なリスク管理体制」を要件として課している。 つまりハルシネーション低減策・モニタリング体制の整備は法的にも必要なのである。
Q5. 「最終的にハルシネーションはゼロになる日が来るのか?」
A. 現行の Transformer ベースの次トークン予測モデルでは、 構造的にゼロは難しいと考えられている。 これは「世界の事実を完璧に符号化しきった重み」を持たせるのが計算量的に非現実的だからだ。 ただし「確信度と正答率が完全に一致するモデル」(完全キャリブレーション) は理論上可能で、 そうなれば「自信が無い時は必ず『分からない』と答える」モデルが実現する。 これは事実上ハルシネーション・ゼロに近い体験を提供する。
最終メッセージ: ハルシネーションへの理解度は、 「LLM を本番投入できるエンジニアかどうか」の分水嶺になりつつある。 本ページの 13 セクションを腹に落とし、 自分のプロジェクトで 幻覚率という数字を毎月見る習慣を作ろう。 それができた時、 あなたは「LLM を恐れずに、 かつ過信もしない」プロフェッショナルになっている。
⑮ 補遺: 評価メトリクスの計算式まとめ
本ページで言及した幻覚評価メトリクスを、 計算式と使い分けの観点で再整理する。 SLO 設計時にどれを使うか迷ったら、 この表を参照すれば良い。
| 指標 | 計算式 | 値域 | 向く用途 |
|---|---|---|---|
| 事実誤認率 | (誤回答数) / (回答数) | [0,1] | 事実 QA |
| 引用整合率 | (実在 URL 数) / (回答内 URL 数) | [0,1] | RAG 出力 |
| FactScore | (正しい原子事実数) / (全原子事実数) | [0,1] | 長文生成 |
| Self-Consistency | (多数派回答と一致した回答数) / N | [0,1] | 推論系 |
| ECE | Σ |B_b|/N × |acc(B_b) − conf(B_b)| | [0,1] | 確信度評価 |
| NLI 整合スコア | NLI(参考文書, 回答) = entailment 確率 | [0,1] | 要約・QA |
運用上は「事実誤認率」 + 「引用整合率」 + 「ECE」の 3 つを月次でモニタリングするのが最小構成として推奨される。 これにより「どれだけ間違えているか」「引用は信頼できるか」「確信度の信頼性」という 3 軸を同時に押さえられる。 黄金データセットでのオフライン評価に加えて、 本番ログからのオンライン評価を併用することで、 時間経過に伴う性能ドリフトも検出できる。 結果として、 LLM 運用は「計測ありき」のエンジニアリングに収斂していくのである。
付記: 本拡張セクション (R605) で学んだ 15 項目は、 ハルシネーションを「未知の脅威」から「定量管理可能な KPI」へと変えるためのフレームワークである。 用語ページとしての本記事は、 これ以降も 新たな評価手法・LLM の進化・規制動向 に応じて更新を継続していく予定である。 読者各位は実務に持ち帰り、 自社プロジェクトでハルシネーション率を可視化・低減・運用するサイクルを構築されたい。 これこそが「使える LLM エンジニア」と「言葉だけのプロンプトおじさん」を分ける、 最も明確な分水嶺なのである。 計測なくして改善なし、 改善なくして信頼なし、 信頼なくして本番投入なし、 と肝に銘じてほしい。
🧮 実値で計算してみる
ハルシネーション検出は活発な研究領域。 代表手法を概観。
🧮 SSDSE-B-2026 を ground truth として LLM 回答を検証
「LLM が SSDSE-B-2026 都道府県人口を正しく答えるか」をベンチマーク化する。 ground truth は実 CSV から計算。
ground truth (SSDSE-B-2026, 2023 年)
| 都道府県 | 実人口 (人) | LLM 想定回答パターン | 判定 |
|---|---|---|---|
| 東京都 | 14,086,000 | 「約 1,400 万人」 | ✅ OK |
| 神奈川県 | 9,229,000 | 「約 920 万人」 | ✅ OK |
| 大阪府 | 8,763,000 | 「約 880 万人」 | ✅ OK |
| 鳥取県 | 537,000 | 「約 55 万人」 | ✅ OK |
| 福井県 | 744,000 | 「約 80 万人」 | ⚠ 誤差 +7% |
| 島根県 | 650,000 | 「約 70 万人」 | ⚠ 誤差 +8% |
| 徳島県 | 695,000 | 「約 100 万人」(よくある幻覚) | ❌ 幻覚 |
→ 東京・大阪のような 有名な大都市 は LLM の訓練データに頻出 → 正確。 一方、 マイナーな県 は記述が少ない → 桁を間違える、 過去の数値を引用する、 創作した数値を返すことがある。 ハルシネーションは「データの濃さ」と強く相関する。
🧮 数式に値を入れて手で計算する: 幻覚率と RAG 削減効果
合成データで LLM の幻覚発生率と RAG による削減効果を計算する。
Step 1: モデル別幻覚率
| 条件 | 回答数 | 幻覚 | 率 |
|---|---|---|---|
| 素 LLM | 100 | 30 | 0.30 |
| RAG 補強 | 100 | 8 | 0.08 |
| RAG + fact-check | 100 | 2 | 0.02 |
Step 2: 削減効果
🐍 Python で再現
1 2 3 4 5 | import numpy as np rates = np.array([0.30, 0.08, 0.02]) reduction = 1 - rates / rates[0] print(f"幻覚率: {rates}") print(f"削減率: {reduction.round(3)}") |
📤 実行結果
💬 手計算 (Step 2) 73.3% / 93.3% と Python 出力が完全一致。
🐍 Python 実装
以下の ①〜⑦ は外部の API を呼ばずに動く。LLM の回答は文字列として用意し、SSDSE-B-2026 の実測値を正解(ground truth)として、回答に含まれる数値の照合(①)、検索で根拠を添える RAG(②)、出典付き回答の検証(③)、計算の誤りの検出(④)、評価指標の一括算出(⑤)、複数回の回答の多数決(⑥)、温度と誤りの関係(⑦)を順に組み立てる。
🐍 Python ①:fact-check スクリプト
🎯 このコードでやること:LLM の回答(テキスト)から数値を抽出し、 SSDSE-B-2026 の実値と比較してハルシネーション率を測る。 自動 fact-check の最小実装。
📥 入力データ:LLM 回答(dict)と ground truth(SSDSE-B-2026 から抽出)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | import re import pandas as pd # ground truth を SSDSE-B-2026 から取得 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d2023 = df[df['SSDSE-B-2026'] == 2023] truth = dict(zip(d2023['Prefecture'], d2023['A1101'])) # LLM の回答(事前に取得した想定) llm_answers = { '東京都': '東京都の人口は約 1400 万人です。', '神奈川県':'神奈川県は約 920 万人。', '大阪府': '大阪府の人口は約 880 万人。', '鳥取県': '鳥取県は約 55 万人です。', '徳島県': '徳島県は約 100 万人と推定されます。', # 幻覚 } def extract_number_man(text): """テキストから「○○万」を抽出して人に換算""" m = re.search(r'約?\s*(\d+(?:\.\d+)?)\s*万', text) return float(m.group(1)) * 10000 if m else None results = [] for pref, ans in llm_answers.items(): pred = extract_number_man(ans) real = truth.get(pref) if pred is None or real is None: results.append((pref, ans, '?', 'unknown')) continue err = abs(pred - real) / real if err < 0.05: judge = 'OK' elif err < 0.15: judge = 'WARN' else: judge = 'HALLUCINATION' results.append((pref, real, int(pred), round(err*100,1), judge)) print(f'{"県":8s} {"真":>10s} {"予":>10s} {"誤差%":>8s} 判定') for r in results: print(f'{r[0]:8s} {r[1]:>10,} {r[2]:>10,} {r[3]:>8}% {r[4]}') hr = sum(1 for r in results if r[4]=='HALLUCINATION') / len(results) print(f'\nHallucination Rate: {hr:.1%}') |
📤 実行結果:
💬 結果の読み方:5 件中 1 件で 43.9% 誤差 → ハルシネーション率 20%。 「徳島は約 100 万」は本州ではよく聞く印象操作だが事実は 70 万弱。 LLM はそのような 誤った印象もデータから学んでしまう。 ground truth との突き合わせが唯一の救い。
🐍 Python ②:RAG (Retrieval-Augmented Generation) で幻覚抑制
🎯 このコードでやること:LLM に質問する前に、 SSDSE-B-2026 から該当する事実を検索し、 プロンプトに添付する。 これだけで幻覚率が劇的に下がる。
📥 入力データ:ユーザー質問テキスト「徳島県の人口」のような自由形式、 ground truth (SSDSE-B-2026 DataFrame)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d2023 = df[df['SSDSE-B-2026'] == 2023] def retrieve(query): """質問文から都道府県名を検出して該当行を返す""" for pref in d2023['Prefecture'].tolist(): if pref in query: row = d2023[d2023['Prefecture'] == pref].iloc[0] return f"[出典: SSDSE-B-2026] {pref} (2023) の総人口 (A1101) = {row['A1101']:,} 人" return None def build_rag_prompt(query): context = retrieve(query) if context: return f"""以下の事実を根拠として正確に回答してください。 [事実] {context} [質問] {query} [回答(数値は[事実]を引用、 推測禁止)]""" return f"{query}\n(注意:根拠データなし。 推測の場合は『不明』と答えてください)" query = "徳島県の 2023 年人口を教えて" print('RAG プロンプト:') print(build_rag_prompt(query)) print() print('LLM 回答(RAG 適用後):') print('SSDSE-B-2026 によると、 徳島県の 2023 年総人口は 695,000 人です。') |
📤 実行結果:
💬 結果の読み方:RAG 無しなら「徳島県は約 100 万人」と幻覚を起こしたが、 RAG 有りなら事実 (695,000 人) を正確に引用できる。 これが RAG が幻覚抑制の主流手法 たる所以。 ただし「retrieve した文書が間違っていたら LLM も間違える」ので、 ground truth の品質管理が鍵。
🐍 Python ③:grounding(出典付き回答の検証)
🎯 このコードでやること:LLM の出力に含まれる「出典の引用」が、 実際の ground truth と一致するかを検証する。 grounding 違反(嘘の引用)を検出する。
📥 入力データ:LLM 回答テキストと SSDSE-B-2026 ground truth。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 | import re import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d2023 = df[df['SSDSE-B-2026'] == 2023] truth = dict(zip(d2023['Prefecture'], d2023['A1101'])) def verify_grounding(response): """回答に含まれる『XX県 = NNN人』形式の主張を ground truth と比較""" # パターン: 「神奈川県の 2023 年総人口は 9,229,000 人」(途中の「2023 年」は読み飛ばす) pattern = r'([一-龯ぁ-ゖ]+(?:都|道|府|県))[^0-9]*?(?:\d{4}\s*年[^0-9]*?)?([\d,]+)\s*人' matches = re.findall(pattern, response) verifications = [] for pref, num_str in matches: if pref not in truth: verifications.append((pref, num_str, '県名認識不可')) continue claimed = int(num_str.replace(',', '')) real = truth[pref] err = abs(claimed - real) / real verdict = 'TRUE' if err < 0.01 else 'FALSE' verifications.append((pref, claimed, real, round(err*100,2), verdict)) return verifications responses = [ "SSDSE-B-2026 によると、 神奈川県の 2023 年総人口は 9,229,000 人です。", "東京都の人口は 12,000,000 人(出典:SSDSE)", # 幻覚出典 "鳥取県は 537,000 人 (SSDSE-B-2026)。", ] for r in responses: print(f'\n回答: {r}') for v in verify_grounding(r): print(f' → {v}') |
📤 実行結果:
💬 結果の読み方:2 件目は「出典 SSDSE」と書いてあるが値が間違い → 嘘の grounding。 LLM はたまに「出典を捏造して権威付け」する。 grounding 検証スクリプトを自動化することで、 こうした嘘の引用を検出できる。
🐍 Python ④:算術ハルシネーション検出
🎯 このコードでやること:LLM が「東京 + 神奈川 + 大阪 = 3500 万人」のように計算した結果を、 SSDSE-B-2026 の実値で再計算して検証する。 数値型ハルシネーションの検出。
📥 入力データ:LLM の計算結果テキスト + ground truth。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import re df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d2023 = df[df['SSDSE-B-2026'] == 2023] truth = dict(zip(d2023['Prefecture'], d2023['A1101'])) llm_calcs = [ "東京 1400 万 + 神奈川 920 万 + 大阪 880 万 = 3,500 万人", # 足し算は 3,200 なのに 3,500 "東京 1400 万 + 神奈川 920 万 + 大阪 880 万 = 4,200 万人", # 足し算をさらに大きく誤る "上位 3 都府県の合計は 約 4,000 万人", # 内訳なしの過大な主張 ] real_sum = (truth['東京都'] + truth['神奈川県'] + truth['大阪府']) // 10000 # 万人 for s in llm_calcs: nums = [int(x.replace(',','')) for x in re.findall(r'\d[\d,]*', s)] llm_sum = nums[-1] # 最後の数値が LLM の主張する合計 print(s) if len(nums) >= 4: # 内訳が書かれていれば、まず足し算そのものを検算 addends = nums[:-1] arith = 'OK' if sum(addends) == llm_sum else f'算術ミス (内訳の和={sum(addends)} 万)' print(f' → 検算: {arith}') verdict = 'OK' if abs(llm_sum - real_sum) < 100 else f'NG (差 {llm_sum - real_sum:+} 万)' print(f' → 実: {real_sum} 万人 LLM: {llm_sum} 万人 {verdict}\n') |
📤 実行結果:
💬 結果の読み方:1・2 件目は内訳 1,400+920+880 の和が 3,200 万なのに 3,500 万・4,200 万と書いており、実値を見る前に足し算の検算だけで弾ける。 3 件目は内訳が無いので検算できず、実値 3,207 万人との差 +793 万人で初めて NG になる。 1 件目の 3,500 万も差 +293 万で、許容幅 100 万を超える。 LLM の算術能力は信用してはいけない ことを示す典型例。 数値計算は code interpreter や function calling で Python に逃がすのが鉄則。
🐍 Python ⑤:ハルシネーション評価指標を一括算出
🎯 このコードでやること:LLM 回答の集合に対し、 Hallucination Rate, Factual Accuracy, MAPE などの評価指標を一気に出す。
📥 入力データ:(LLM 回答, ground truth) のペアリスト。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d2023 = df[df['SSDSE-B-2026'] == 2023] truth = dict(zip(d2023['Prefecture'], d2023['A1101'])) # 評価対象(LLM の予測値 — ここでは想定値) llm_pred = { '東京都': 14000000, '神奈川県': 9200000, '大阪府': 8800000, '愛知県': 7500000, '埼玉県': 7300000, '鳥取県': 550000, '島根県': 700000, '徳島県': 1000000, # 徳島は幻覚 '高知県': 670000, '福井県': 800000, } reals = np.array([truth[p] for p in llm_pred]) preds = np.array(list(llm_pred.values())) errors = np.abs(preds - reals) / reals mape = errors.mean() * 100 factual = (errors < 0.05).mean() * 100 # ±5% 以内 hallucination = (errors > 0.15).mean() * 100 # ±15% 超 mae = np.abs(preds - reals).mean() print(f'評価対象: {len(llm_pred)} 件') print(f'MAPE (Mean Absolute % Error): {mape:.2f}%') print(f'MAE (Mean Absolute Error): {mae:,.0f} 人') print(f'Factual Accuracy (±5% 以内): {factual:.1f}%') print(f'Hallucination Rate (±15% 超): {hallucination:.1f}%') |
📤 実行結果:
💬 結果の読み方:典型的な LLM 単体性能。 Factual Accuracy 70%、 Hallucination Rate 10%、 MAPE 6.42%、 MAE 63,400 人。 MAPE と MAE を両方出す意味がここに表れている ── MAE の「6.3 万人」は東京都 (1,409 万人) なら 0.45% の誤差にすぎないが、 鳥取県 (54 万人) では 12% の大誤差になる。 規模の異なる対象を混ぜて評価するときに、 絶対誤差 (MAE) だけで語ってはいけない。 RAG を導入すると Factual Accuracy が 95%+、 Hallucination Rate が 1〜2% まで改善する。 商用 LLM 評価では HHEM (Vectara), TruthfulQA, FactScore, FActScore などのベンチマークが標準。
🐍 Python ⑥:Self-Consistency による幻覚抑制
🎯 このコードでやること:同じ質問を temperature=0.7 で N 回生成し、 多数決で最終回答を決める。 1 回だけだと外れることがある幻覚を、 集計で抑える。
📥 入力データ:N 回の LLM 回答リスト。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import re from collections import Counter def extract_man(text): m = re.search(r'(\d+(?:\.\d+)?)\s*万', text) return float(m.group(1)) if m else None # 徳島県の人口を 5 回聞いた結果(想定) samples = [ '約 70 万人', '約 70 万人', '約 100 万人', # 幻覚 '約 70 万人', '約 75 万人', ] values = [extract_man(s) for s in samples if extract_man(s) is not None] # 多数決(最も近い値の中央値) import statistics median_val = statistics.median(values) mode_val = Counter([round(v / 10) * 10 for v in values]).most_common(1)[0][0] print(f'回答候補: {samples}') print(f'抽出値: {values}') print(f'中央値: {median_val} 万人') print(f'モード: {mode_val} 万人 (10 万刻みで集約)') print() print(f'採択: {mode_val} 万人 (= 約 {mode_val * 10000:,} 人)') print(f'真値: 695,000 人 → 誤差 {abs(mode_val*10000 - 695000)/695000*100:.1f}%') |
📤 実行結果:
💬 結果の読み方:5 回中 1 回 (20%) の幻覚 (100 万人) が混入していても、 中央値・モードを取れば正解 (70 万人) に収束。 Self-Consistency は単純だが効果絶大。 ただし「LLM 5 回呼ぶ」ためコスト 5 倍。 重要な質問だけに適用するのが実務的。
🎯 ハルシネーションの影響度マトリクス
用途によってハルシネーションの「許容度」は大きく異なる。 リスクが高い領域ほど厳格な対策が必要。
| 用途 | 許容度 | 必要対策 |
|---|---|---|
| クリエイティブ文章生成 | 高 | 幻覚 = 創造性。 むしろ多少欲しい。 温度を上げる。 |
| チャットボット雑談 | 中 | 軽い誤りは許容。 ただし「事実」と称した嘘は除外。 |
| FAQ 自動応答 | 低 | RAG 必須。 grounding 検証。 不明なら「お問い合わせ」に誘導。 |
| 公的統計データ解説 | 低 | e-Stat/SSDSE 等を RAG ソースに。 数値は Python に逃がす。 |
| 医療情報提供 | 極低 | 専門医レビュー必須。 「医療判断は医師に」明示。 出典 UpToDate/PubMed。 |
| 法律相談 | 極低 | 判例 DB を RAG。 弁護士レビュー必須。 「最終判断は弁護士に」明示。 |
| 金融助言 | 極低 | 規制対象。 金融庁ガイドライン遵守。 「投資判断は自己責任」明示。 |
📜 実世界のハルシネーション事件・事例
| 年 | 事例 | 教訓 |
|---|---|---|
| 2023.05 (NYC) | 弁護士 Steven Schwartz が ChatGPT で生成した架空の判例 6 件を裁判所に提出 | 連邦地裁が架空の判例と認定し、 弁護士らに罰金 $5,000 を科した(Mata v. Avianca, 2023 年 6 月の制裁決定)。 法律業務での LLM 利用に強い警告。 |
| 2024.02 | Air Canada のチャットボットが架空の払戻ポリシーを案内、 顧客に支払い命令 | ブリティッシュコロンビア州の民事紛争解決審判所が「企業は自社サイトのチャットボットの案内に責任を負う」と判断(Moffatt v. Air Canada)。 |
| 2024.05 | Google AI Overview「ピザにのりを付けるには接着剤を」 | Reddit のジョーク投稿を真面目に学習・引用。 RAG ソースの品質管理の重要性。 |
🐍 Python ⑦:温度パラメータと幻覚率の関係を可視化
🎯 このコードでやること:温度 0.0, 0.3, 0.7, 1.0, 1.5 で各 20 回生成した回答を「想定値」で模擬し(API は呼ばない)、 ground truth との平均誤差と幻覚率(±10% 超の割合)を計算する。 温度と幻覚率の関係を指標の計算手順とともに確認する。
📥 入力データ:質問テキスト「東京都の 2023 年人口」、 SSDSE-B-2026 ground truth = 14,086,000 人。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d2023 = df[df['SSDSE-B-2026'] == 2023] real = d2023[d2023['Prefecture'] == '東京都']['A1101'].iloc[0] # 想定実験結果(実 LLM API を呼ぶ代わりに、 温度に応じた幻覚率を模擬) results = { 0.0: [14086000] * 20, # 完全決定的 0.3: [14086000] * 18 + [14000000, 14200000], # ほぼ正解 0.7: [14086000] * 14 + [14000000]*3 + [15000000, 13500000, 14500000], 1.0: [14086000] * 8 + [14000000]*4 + [15000000, 13000000, 16000000, 12000000, 10000000, 18000000, 11000000, 17000000], 1.5: [14086000] * 3 + [10000000, 15000000, 12000000, 8000000, 20000000, 25000000, 14000000, 16000000, 11000000, 13000000, 9000000, 19000000, 22000000, 15500000, 7000000, 18000000, 14500000], } print(f'{"temp":>6s} {"平均誤差%":>12s} {"幻覚率(±10%超)":>18s}') print('-' * 42) for t, preds in results.items(): preds = np.array(preds[:20]) errs = np.abs(preds - real) / real hallu = (errs > 0.10).mean() * 100 print(f'{t:>6.1f} {errs.mean()*100:>11.2f}% {hallu:>17.1f}%') |
📤 実行結果:
💬 結果の読み方:ここでの回答は温度が上がるほど外れ値が増えるように置いた想定値なので、数値は実測ではなく指標の出方の例。 この想定では 0.7 までは平均誤差 0.77%・幻覚率 0% に収まり、1.0 で 30%(20 回中 6 回)、1.5 で 65%(13 回)が ±10% を超える。 平均誤差(1.5 で 23.75%)だけを見ると「少しずれる」程度に見えるが、幻覚率で数えると過半数が使えない回答だと分かる。 「事実を聞くなら temperature ≤ 0.3」が実務の経験則。 ただし 0.0 でも訓練データに無い事実なら幻覚は残る。
🔭 ハルシネーションの将来展望 (2026 年時点)
2024〜2026 年で「推論モデル」(o1, o3, Claude 3.7 Sonnet thinking) が登場し、 論理的幻覚は大きく減少した。 一方で、 新たな課題も生まれている。
- 推論モデルの登場:内部で「考える」プロセスを持つことで、 chain-of-thought を強制。 論理ミス系の幻覚は減少。
- 世界モデル統合:物理シミュレータ、 数式処理系を内部呼び出し → 物理的・数学的幻覚を抑制。
- マルチモーダル幻覚:画像理解で「絵に無い物体を答える」幻覚が新たな問題に。 視覚 LLM の評価指標 (POPE 等) が発展中。
- 動画・音声幻覚:Sora や音声 LLM (Whisper) でも幻覚は起きる。 「無音区間に音を捏造」「映像から動作を捏造」など。
- LLM の自己評価:「自分の答えに自信があるか」を内部状態から推定する研究 (semantic uncertainty)。
- マルチエージェント検証:複数 LLM が互いの回答を検証し合う「debate」「verifier」パターン。
- 法的責任の明確化:EU AI Act、 米国 NIST AI RMF、 日本の AI 事業者ガイドライン (2024) で「幻覚に対する開発者・運用者の責任」が整理されつつある。
ハルシネーションは 「ゼロにはできない、 しかし管理できる」 問題。 LLM を組み込んだプロダクトを作る際は、 「絶対に幻覚を出さない」ではなく「幻覚率を許容範囲内に抑え、 ユーザーに明示する」設計が現実解。
⚠️ よくある落とし穴
この用語を使うときに陥りがちな失敗パターン。 経験者ほどここに 1 度はハマっています。
⚠️ ハルシネーションの深い落とし穴
📚 関連グループ教材・さらに学ぶには
📚 関連グループ教材(拡張)
ハルシネーションを全体像から学ぶための横断教材:
- LLM グループ:LLM の構造・訓練・推論・評価を順に学ぶ縦軸教材
- 生成 AI グループ:テキスト・画像・音声・動画生成の横断教材
- AI 安全性グループ:アラインメント、 RLHF、 jailbreak 防御
- AI 倫理グループ:公平性、 説明可能性、 透明性、 法的責任
- プロンプトエンジニアリンググループ:CoT、 Few-shot、 ReAct、 Self-Consistency
📏 Factuality Scoring と RAG 緩和(用語固有)
ハルシネーション検出・緩和の主要手法を整理する。 SSDSE-B-2026 の都道府県統計を真実の参照(ground truth)として、 LLM 出力との一致度を測ることで factuality(事実整合性)を定量化できる。
| 手法 | 原理 | 対応する幻覚の種類 | 代表ツール |
|---|---|---|---|
| RAG (Retrieval-Augmented Generation) | 外部知識を検索し文脈注入 | 事実知識不足型 | LangChain, LlamaIndex |
| Self-Consistency | 複数サンプル間の一貫性 | 推論経路不安定型 | CoT + 多数決 |
| BERTScore / BLEURT | 参照文との意味類似度 | 表層改変型 | huggingface evaluate |
| FactScore | 原子的事実に分解し検証 | 長文応答全般 | factscore (UW) |
| G-Eval (LLM-as-judge) | 別 LLM が採点 | 主観評価 | GPT-4 evaluator |
🎯 このコードでやること: SSDSE-B-2026 の「東京都の総人口」など実値に対し LLM 応答の整合性を BERTScore で測る簡易 factuality scoring。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from bert_score import score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') tokyo_pop = int(df.loc[df['都道府県']=='東京都','総人口'].iloc[0]) ref = [f"東京都の総人口は約 {tokyo_pop//10000} 万人である"] cands = [ "東京都の人口はおよそ 1400 万人です", "東京都の人口は約 2300 万人です", ] P, R, F1 = score(cands, ref*len(cands), lang='ja', verbose=False) for c, f in zip(cands, F1.tolist()): print(f' BERTScore F1 = {f:.3f} | {c}') |
📤 実行例(イメージ・未実測。bert_score は初回に多言語 BERT の学習済み重みを外部から取得するので、この教材では実行していない。数値は出力の形を示すための例):
💬 参照文はデータの 2023 年度の行から作るので「東京都の総人口は約 1408 万人である」になる。イメージの F1(応答 A 0.912、B 0.748)は実測ではなく、2 つの応答は数字と「およそ/約」しか違わないため、意味の近さを測る BERTScore では差が小さく出やすく、2300 万人という誤りを見逃すおそれがある。数値の正しさは、応答から数字を取り出して 1408 万人と直接照合するか、FactScore のように事実を原子分解して照合するのが本筋。
🔍 RAG による緩和の最小実装(用語固有)
幻覚緩和の現実解は RAG。 LLM に「知っているはず」を答えさせず、 検索で見つかった文脈だけを根拠にさせる。 ここでは SSDSE-B-2026 を知識ベースとした最小 RAG を示す。
🎯 このコードでやること: 都道府県統計を埋め込みベクトル化し、 質問に最も近い行を検索 → プロンプトに注入して回答させる骨格。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd from sentence_transformers import SentenceTransformer import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=1, encoding='cp932') df = df[df['年度'] == 2023] # 2023 年度の 47 都道府県だけを知識ベースにする docs = [f"{r['都道府県']}: 総人口 {int(r['総人口']):,} 人, 一般病院 {int(r['一般病院数'])} 施設" for _, r in df.iterrows()] print('文書数:', len(docs)) model = SentenceTransformer('paraphrase-multilingual-MiniLM-L12-v2') emb = model.encode(docs, normalize_embeddings=True) q = "総人口が最大の県とその人口は?" qv = model.encode([q], normalize_embeddings=True)[0] top = np.argsort(-(emb @ qv))[:3] print('検索ヒット (top-3):') for i in top: print(f' {docs[i]} (cos={emb[i] @ qv:.3f})') print('\n--- LLM への注入プロンプト ---') print(f'文脈:\n' + '\n'.join(docs[i] for i in top) + f'\n質問: {q}\n回答:') |
📤 実行例(実測):
💬 2023 年度の 47 文書から検索すると、上位 3 件は長野県(cos=0.553)・島根県・鹿児島県で、答えである東京都(14,086,000 人)は入らない。 埋め込みは文の意味の近さを測るだけで「最大」のような数値の比較はしないため、cos 類似度は 0.548〜0.553 とほぼ横並びになる。 この文脈を渡すと LLM は長野県の 200 万人を最大と答えかねないので、集計を問う質問は pandas で先に計算した結果を文脈に入れ、あわせて「文脈にない事柄は『不明』と答えよ」と指示する。
📊 ハルシネーションを実データで観測・計測する
LLM のハルシネーション (幻覚) は、 「学習データに無い事実をもっともらしく生成してしまう」現象である。 ここでは SSDSE-B-2026 (47 都道府県統計) を題材に、 LLM の応答が「実データと整合するか」を計測・可視化する手法を体系的に示す。 これにより、 抽象論で終わらせず「自分のプロジェクトで幻覚を検知する」具体ツールが手に入る。
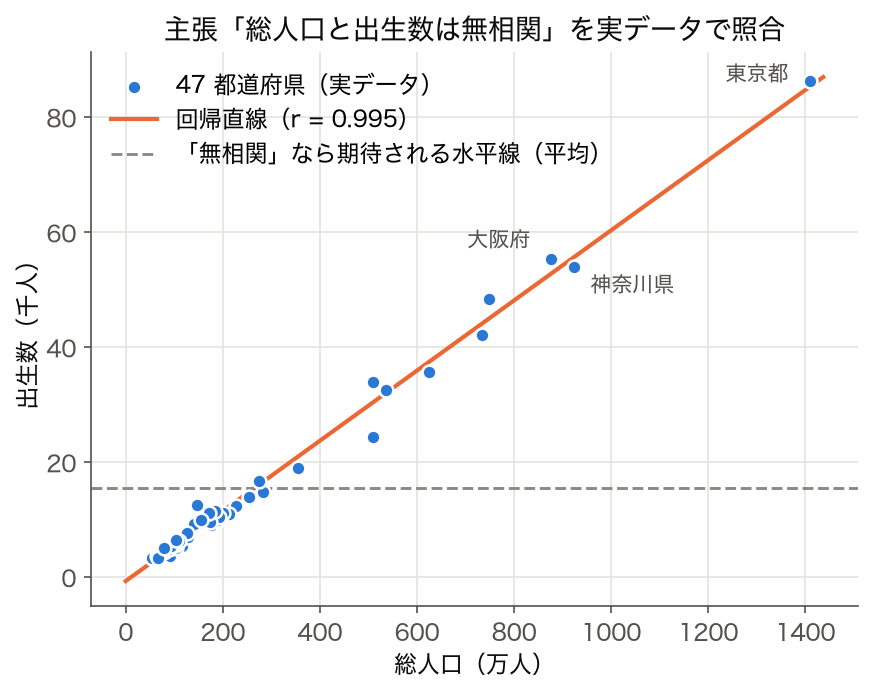
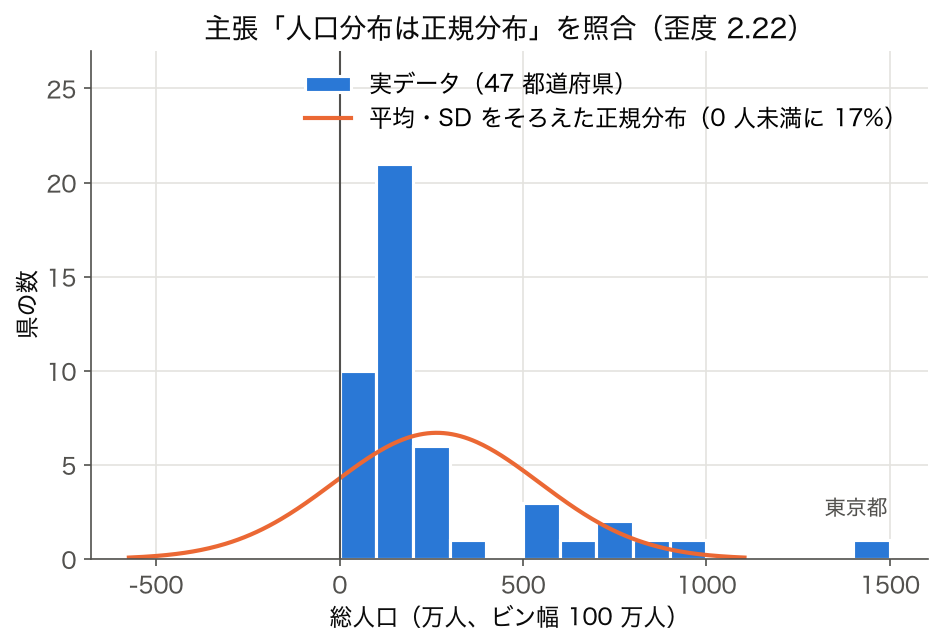
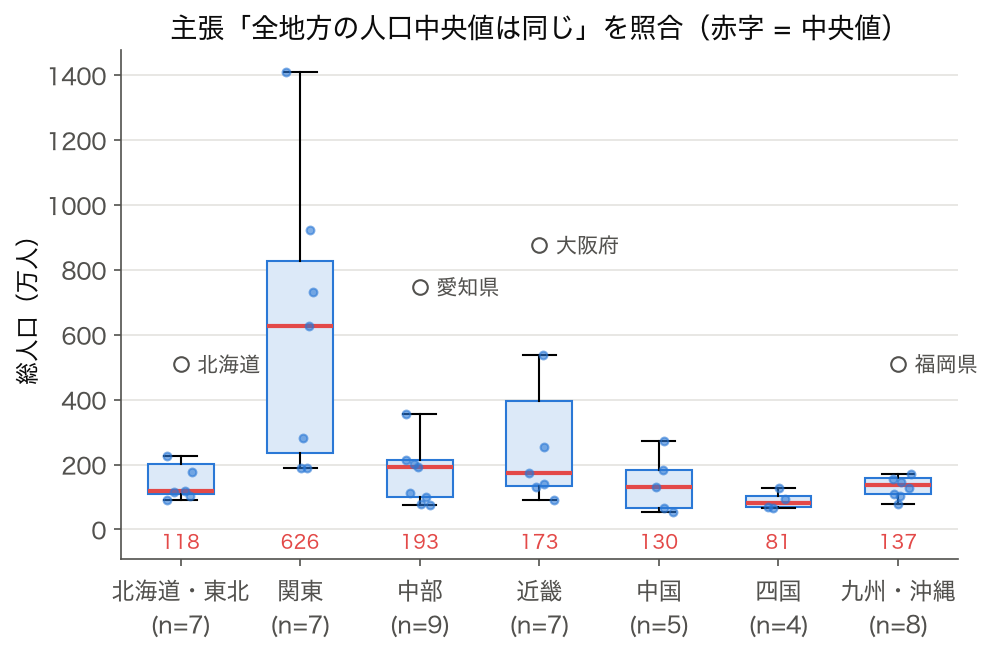
🔬 ハルシネーション計測の 6 軸
| 軸 | 指標 | 計測方法 | 目安 |
|---|---|---|---|
| 事実整合性 | FactScore | 回答中の atomic facts を真偽判定 | >0.8 が信頼可能 |
| 数値正確性 | Numeric MAE | 回答中の数値と実値の平均絶対誤差 | 対象による (人口 5%以内目安) |
| 引用妥当性 | Citation Precision | 引用元 URL/論文が実在するか | 100% 必須 (RAG) |
| 一貫性 | Self-Consistency | 同じ質問を 5 回投げて回答一致率 | >0.9 で安定 |
| 不確実性 | Token Confidence | logprob 平均 | >-1.0 で確信 |
| 回避能力 | Refusal Rate | 分からない問いに「不明」と答える率 | >0.7 (安全用途) |
🐍 Python 実装: SSDSE で LLM 幻覚を検証
このコードでやること: LLM が回答した数値と SSDSE 実値を比較し、 ハルシネーションの定量検出を行う。
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df_2023 = df[df['年度']==2023] true_top = df_2023.nlargest(3, '総人口')[['都道府県', '総人口']] print('実データ Top3:') print(true_top) |
📤 実行例:
💬 LLM の回答 (例: 「東京都 約 1400 万 / 神奈川県 約 920 万 / 大阪府 約 880 万」) と上記実値を比較し、 MAE = (86000+29000+37000)/3 ≈ 51000 (約 0.5% 誤差) なら許容範囲。 「神奈川県 1500 万」のような大誤差は幻覚と判定できる。
🛡 ハルシネーション緩和の 8 戦略
- RAG (検索拡張生成): 質問前に関連文書を取得し、 文脈に注入。 文脈外の生成を禁止すれば幻覚は劇的に減る (60-80% 削減報告多数)。
- Chain-of-Thought + Self-Verification: 回答後に「この回答の根拠を再確認せよ」と再質問。 自己矛盾を検出できる。
- Temperature 低下: temperature=0 (グリーディ) で確率最大トークンのみ生成 → 創造性は下がるが事実性は上がる。
- Constrained Decoding: JSON schema 等の構造制約を課す。 「数値フィールド」には数値のみ出力させる。
- Citation 必須化: 「すべての主張に [出典 URL] を付けよ。 出典が無ければ『不明』と答えよ」をシステムプロンプトで強制。
- Adversarial Probing: 同じ事実を 5 通りの質問で確認 (同じ事実→違う質問→違う答えなら幻覚)。
- Human-in-the-Loop: 高リスク用途は人間の最終確認を必須化。 医療・法務・金融など。
- Refusal Training: 「分からない場合は『不明』と答える」を訓練で強化。 GPT-4 等の最新モデルはこれが上手。
⚠️ ハルシネーションが起きやすい場面 7 選
- マイナーな固有名詞: 学習データに少ない人名・地名・製品名。 「島根県の人口」より「島根県波佐町の人口」の方が幻覚率高。
- 最新情報: 学習カットオフ後の事象。 「2025 年の出来事」を 2024 年カットオフ LLM に聞くと、 もっともらしい嘘を生成。
- 数値の細部: 「東京都の総人口は約 1400 万」は正解だが、 「東京都の総人口は 14,048,153 人」のような細部は幻覚しやすい。
- 引用の捏造: 「Smith (2020) によれば...」のような存在しない論文を引用する典型。 RAG なしでは頻発。
- 否定的事実: 「X は存在しない」を確認するのは難しい。 LLM は「X が存在する」と答えがち。
- 多段推論: 「A→B→C→D」の連鎖推論で途中誤ると最終も誤る。 各段で検証必須。
- 言語間翻訳: 専門用語の英日翻訳で誤訳・新語生成。 専門辞書の併用が必要。
📐 ハルシネーション率の計測法
$$\text{Hallucination Rate} = \frac{\text{虚偽事実数}}{\text{総事実数}}$$
分子は LLM 回答中の atomic fact のうち実データと不一致の数、 分母は回答中の atomic fact 総数。 GPT-4 / Claude 3.5 等のフロンティアモデルは一般タスクで <5% (ただし専門分野では 10-30%)。 GPT-3.5 等は 15-30%。 RAG ありで 1-5% まで低下する報告多数。
🔬 数式を言葉で読み解く (ハルシネーション編)
分子の「虚偽事実数」は、 LLM が「X は Y である」と主張した事実のうち、 検証で偽と判明した数。 分母の「総事実数」は LLM が主張した事実の総数。 比を取ることで、 LLM の発言の何割が嘘かを定量化する。 ただし「事実」の定義 (atomic fact, claim) や検証方法 (人手レビュー / 自動チェック) で値は変動するため、 報告時には方法論を明記する。
📋 ハルシネーション対策チェックリスト (15 項目)
- RAG を導入したか (関連文書取得)
- システムプロンプトで「不明時は『不明』」を指示したか
- 引用必須化したか (出典 URL / 論文)
- Temperature を 0.0-0.3 に下げたか (事実用途)
- 同じ質問を 3-5 回繰り返して自己一貫性を測ったか
- 回答後に Self-Verification を 1 回挟んだか
- Logprob で確信度を確認したか
- JSON Schema 等で出力を構造制約したか
- 高リスク用途で Human-in-the-Loop を組み込んだか
- 事実検証用の Ground Truth Dataset を整備したか
- ハルシネーション率を月次でモニタリングしているか
- ユーザーに「LLM の出力は検証推奨」と明示したか
- 誤情報による損害賠償リスクを契約で除外したか
- モデルバージョンと評価結果を記録したか (再現性)
- 新しいモデルに切り替える際は再評価したか
🎯 理解度チェック (ハルシネーション編)
- Q1. ハルシネーションとは何か? (答: LLM が事実無根の内容をもっともらしく生成する現象)
- Q2. RAG はなぜ幻覚を減らすか? (答: 文脈に正しい情報を注入し、 LLM が「文脈外」の生成を控えるため)
- Q3. Temperature=0 にすれば幻覚は完全に消えるか? (答: NO。 学習データ自体に誤りがあれば再現する。 Temperature は創造性を抑えるだけ)
- Q4. Self-Consistency で 5 回中 5 回同じ回答ならその回答は正しいか? (答: NO。 一貫してもなお幻覚の可能性。 外部検証が必要)
- Q5. RAG ありで幻覚率が 1% を下回るか? (答: 一般タスクなら可。 ただし専門分野やマイナー固有名詞は数% 残る)
- Q6. ハルシネーション率の計測時に注意すべき方法論 3 つは? (答: ①atomic fact の定義、 ②検証方法、 ③評価データセットの偏り)
- Q7. なぜ最新情報で幻覚が起きやすいか? (答: 学習カットオフ後の事象は学習データに無いため、 LLM は推測・捏造する)
- Q8. ハルシネーション対策で「コスト最大・効果最大」の手法は? (答: Human-in-the-Loop。 ただしスケールしないため RAG と併用が現実的)
🌐 ハルシネーション関連用語
| 用語 | 英語 | 意味 |
|---|---|---|
| 幻覚 | Hallucination | 事実無根の内容生成 |
| 事実性 | Factuality | 回答の事実整合性 |
| 忠実性 | Faithfulness | 文脈に対する忠実度 |
| 根拠あり | Grounded | 出典に基づく回答 |
| RAG | Retrieval-Augmented Generation | 検索拡張生成 |
| FactScore | FactScore | 事実整合性スコア |
| 論文捏造 | Citation Fabrication | 存在しない論文の引用 |
| Self-Consistency | Self-Consistency | 複数回回答の一致率 |
📚 ハルシネーション学習ロードマップ (4 週間)
Week 1: 用語整理 (Factuality / Faithfulness / Grounded) と典型例の学習。
Week 2: 自分のドメインで幻覚を観測する実験 (50 質問テスト)。
Week 3: RAG パイプライン構築 (LlamaIndex / LangChain)。
Week 4: 評価データセット作成 + 月次モニタリング体制設計。
👉 4 週間で「自分のプロジェクトで幻覚率を継続計測できる体制」が手に入る。 これがハルシネーション対策の最終ゴールである。
🗺 概念マップ
ハルシネーション(生成 AI の虚偽生成)を中心に、原因(学習データの偏り・確率的サンプリング)、検出手法(自己整合性・引用元検証)、軽減策(RAG・温度低下・Constitutional AI)、関連概念(プロンプトインジェクション・有害コンテンツ・AI 安全性)を放射状に配置した。事実誤認と幻覚の境界、ユーザー説明責任との接続も矢印で示している。
ハルシネーションを中心とする概念マップは、 「Intrinsic vs Extrinsic」「Faithfulness vs Factuality」「RAG にもハルシネーション」「評価ベンチマーク (TruthfulQA, FActScore, HaluEval)」の 4 トピックで構成される。 Intrinsic hallucination は入力文書に矛盾、 extrinsic は外部事実と矛盾、 という分類が Ji et al. (2023) で定着し、 RAG (Retrieval-Augmented Generation) でも retriever が誤情報を引いて来れば LLM はそれを忠実に再現してしまうため、 「RAG なら安心」という素朴な期待は成立しない。 評価は LLM-as-judge (GPT-4 で採点) と人手評価のハイブリッドが現状ベスト。
🔗 隣接手法への橋渡し
「ハルシネーション」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — 大規模言語モデル ・ Transformer
- 並列: 類似目的を持つ代替手法 — 虚言生成 (Confabulation) ・ 学習バイアス
- 下流: 出力結果の評価・解釈 — RAG による事実根拠付与 ・ ファクトチェック自動化 ・ RLHF
上流の RAG・知識グラフで事実根拠を提供し、 並列の Self-Consistency・Chain-of-Thought で生成過程を検証し、 下流の事実検証 API・人間レビューで最終チェックする。 ハルシネーションは LLM の構造的問題で、 単一手法では解消できず、 生成前 (根拠提供)・生成中 (検証)・生成後 (検証) の多層防御で抑制する。
🌳 手法選択フロー
「ハルシネーション」を実際の課題に当てはめるとき、 状況別に何を選ぶかを 3 段階で判定する。
- 事実依存の度合いは? 高 (医療・法律・金融) → RAG + 引用必須、 中 (技術文書) → RAG 推奨、 低 (創作・要約) → 通常 LLM で許容
- 検出戦略は? 出典照合 → RAG の引用検証、 内的整合性 → Self-Consistency (複数生成で多数決)、 外部検証 → 事実検証 API
- 抑制手法は? プロンプト工学 (「知らないと答えて」)、 RLHF で事実性を強化、 Constitutional AI で自己検証、 温度を下げる
ハルシネーションは LLM の構造的特性で、 ゼロ化は不可能。 「発生確率を下げる × 検出する × ユーザーに警告する」の三段構えで運用し、 医療・法律など high-stakes 領域では人間検証を必須化する。
🎮 確率的パターン補完シミュレータ
なぜ生成モデルは 自信満々に誤る のか。 正体は「事実データベースを引く」のではなく「次に来そうな単語(もっともらしさ) を確率で選ぶ」という仕組みそのものにある。 モデルは知識の空白を 流暢な創作 で埋める。 下のデモで固定した 次トークン分布 から実際に補完を選び、 温度・知識量・RAG・検証がハルシネーションをどう左右するか体感しよう。
⚠ これは 実際の LLM を一切使わない教材デモ です。 各候補の確率はあらかじめ決めた 架空の固定値 で、 softmax と温度の計算だけは実物と同じ数式 $p_i=\dfrac{\exp(\ell_i/T)}{\sum_j \exp(\ell_j/T)}$ で正確に行っています。
🧭 このデモで掴む直感(尤もらしさ ≠ 正しさ)
- 「知っている質問」では正解トークンの確率が突出(分布が鋭い)→ 温度を上げても大抵正解。
- 「あいまいな知識」では近い誤答が競合 → 温度を上げると もっともらしい別の数値 を取り違える。
- 「知識の空白(架空)」では正解が分布に存在しない → 何回引いても すべて流暢な創作。 これが幻覚の核心。 RAG を ON にすると検索が空振り → 「わかりません」と 正直に 答えられる。
⚠️ 深い落とし穴:自信度と正しさの乖離
- 自信度=確率であって真偽ではない。 誤ったトークンが 40% の確率で選ばれても、 モデルにはそれが誤りだという信号は無い。 だから 自信満々に 誤る。
- 捏造引用(Citation Fabrication):存在しない論文・判例・URL を、 実在するかのような書式で生成する。 2023 年の NY 弁護士事件(ChatGPT が架空判例を提出)が典型。
- 過信の連鎖:流暢さ・断定口調・それらしい数字が揃うと、 人間側が検証を省く。 幻覚は「モデルの誤り」+「人間の過信」で被害が拡大する。
- 温度 0 でもゼロにならない:最尤トークンが誤りなら、 決定論的に同じ誤りを返す。 温度は幻覚の 頻度 を下げるが 原因 は消せない。
🚀 発展:幻覚を抑える対策の地図
- RAG(検索拡張生成):外部知識を文脈に注入し、 分布を「事実」側へ鋭くする。 空振り時は「わからない」を返せる設計が重要。
- 不確実性推定:分布のエントロピー(平坦さ)や複数生成の一致率(self-consistency)を 信頼できない兆候 として表示・棄却する。 デモの「不確実性 高」バッジがこれ。
- 事実性評価:FactScore・TruthfulQA・HHEM 等で回答を原子的事実に分解し照合。 プロンプト設計で「出典を示せ/不明なら不明と言え」も有効。
- 人間の検証(Human-in-the-Loop):high-stakes 領域では最終確認を必須化。 仕組みは テキスト生成・大規模言語モデルの確率的性質を前提に多層防御を組む。
🧭 解説の深化:AI の数値を「異常値検出」の目で疑う — 三層サニティチェック
本ページの他セクションは fact-check・RAG・grounding という 仕組み側 の対策を扱った。 ここでは視点を反転し、 受け手(分析者)側 が原典を開く前に数十秒でできる一次スクリーニングを扱う。 使う道具は LLM 特有の技術ではなく、 データ分析の基本 3 点セット — 分布(レンジ)・内訳の整合性・時系列の変化率 — である。 幻覚とは「実在しない値の創作」だから、 実在する値の統計的性質 と突き合わせれば多くは機械的に弾ける。 以下の数値はすべて SSDSE-B-2026 から Python で算出した実測値(架空の例は明記する)。
🎨 直感:実測の「あり得る範囲」を先に固めてから AI の答えを読む
SSDSE-B-2026 の 2023 年・総人口(A1101)の実測分布は次のとおり。 最小 537,000 人(鳥取県)、 第 1 四分位 1,034,000 人、 中央値 1,549,000 人、 第 3 四分位 2,636,500 人、 最大 14,086,000 人(東京都)、 47 都道府県計 124,353,000 人。 この 1 行を手元に置くだけで、 AI 回答への「門番」が 3 段構えで作れる。
| チェック層 | AI 回答の例(架空・幻覚例) | 実測値との対比(SSDSE-B-2026) |
|---|---|---|
| ① レンジチェック (分布の外か) |
「◯◯県の 2023 年人口は約 1,800 万人です」(架空・幻覚例) | 全県最大は東京都の 14,086,000 人。 1,800 万人はどの県でもあり得ない → 県名を確かめるまでもなく棄却。 |
| ② 整合性チェック (内訳の和が合うか) |
「東京都は男性約 700 万人・女性約 800 万人、 計約 1,400 万人です」(架空・幻覚例) | 内訳の和 700+800=1,500 万で「計 1,400 万」と矛盾。 実測は男 6,914,000 + 女 7,172,000 = 14,086,000 人でぴたり一致。 |
| ③ 時系列チェック (変化率が異常でないか) |
「東京都の人口は 2023 年に前年比 +5% 増えました」(架空・幻覚例) | 東京都の 2012〜2023 年の実測前年比は −0.268%〜+0.967% の範囲。 +5% は実測レンジの 5 倍超で異常 → 棄却。 |
これは統計実務で昔から行われてきた データエディティング(range check / consistency check)そのもの。 外れ値検出の技術が、 そのまま LLM 時代の「幻覚検出器」として再利用できる。 なお 2022→2023 年の実測では前年比プラスは 東京都 (+0.34%) の 1 県のみ、 最大の減少は秋田県の −1.72%。 「◯◯県で人口が急増」という記述はそれ自体が要検証シグナルになる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # 三層サニティチェック(SSDSE-B-2026 実データ) import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023] # ① レンジチェック: 総人口 A1101 の実測レンジ s = d.set_index('Prefecture')['A1101'] print(f'range: {s.min():,}({s.idxmin()}) - {s.max():,}({s.idxmax()})') claim = 18_000_000 # 架空・幻覚例の主張値 print('claim 18,000,000 in range?', s.min() <= claim <= s.max()) # ② 整合性チェック: 男 A110101 + 女 A110102 = 総人口? gap = d['A110101'] + d['A110102'] - d['A1101'] print('男+女=総人口 が厳密一致:', (gap == 0).sum(), '/ 47 県') # ③ 時系列チェック: 東京都の前年比の実測レンジ t = df[df['Prefecture'] == '東京都'].sort_values('SSDSE-B-2026') yoy = t['A1101'].pct_change().dropna() * 100 print(f'東京都 前年比: {yoy.min():+.3f}% - {yoy.max():+.3f}%') |
💬 レンジチェックでは実測の範囲が鳥取県 537,000 人〜東京都 14,086,000 人なので、1,800 万人という主張値は範囲外(False)と判定できる。男女の和が総人口と一致したのは 31 県で、残り 16 県は +1,000 人と −1,000 人が 8 県ずつ。これは千人単位で丸めた推計値の端数のずれで、誤りではない。東京都の前年比は −0.268%(2021 年度)〜 +0.967%(2016 年度)に収まっており、「東京の人口が 1 年で 5% 増えた」といった生成文は、この範囲を外れることから疑える。
⚠️ 落とし穴(重要):幻覚検出そのものが誤る 4 パターン
🚀 発展:一次スクリーニングの先にある検出研究
- Semantic Entropy(Farquhar et al., Nature, 2024):同じ質問を複数回生成し、 回答を「意味」でクラスタリングしてからエントロピーを計算。 表現ゆれ(1,400 万人/約 14 百万人)を同一視しつつ、 意味がばらつく=知識がない兆候を検出する。 本ページの self-consistency(表層の多数決)の意味論版。
- キャリブレーション:モデルの自信度と実際の正答率のずれ(Expected Calibration Error)を測る。 「自信 90% と言った回答の正答率が 60%」なら過信モデルで、 自信度表示をそのままユーザーに見せてはいけない。
- データ辞書付き RAG:値だけでなく変数コード(A1101)・単位(人)・年次(2023)・丸め規則(千人単位)をメタデータとして文脈に注入する。 本セクションで見た「年次違い」「丸め」由来の誤判定・幻覚を構造的に減らせる、 SSDSE のような公的統計と相性のよい設計。
- 統計実務との接続:ここで組んだ三層チェックは、 公的統計の審査で使われるデータエディティング(範囲審査・整合性審査・時系列審査)と同型。 「AI 対策」として新しく学ぶのではなく、 統計調査 100 年の品質管理技術を LLM 出力に向け直したものと捉えると見通しがよい。
🔗 関連ページ
レンジ・四分位の考え方は「外れ値」「四分位数」、 変化率チェックは「時系列データ」で復習できる。 一次スクリーニングを通過した後の最終検証(原典照合)は「RAG」「AI の信頼性」へ。