💡 30秒で分かる結論
🍰 まずはやさしく
AIへの指示書のようなものです。
AIに正しい答えを出させるために使います。
スマホでAIに質問する時の文章のことです。
この章ではプロンプトの基本を学びます。
プロンプト (prompt):大規模言語モデル (LLM) に入力する指示・文脈・例示の総称。 LLM の挙動はプロンプトに強く依存する。
- 定義:モデルに与える入力テキスト全体。 役割 (system) ・指示 (instruction) ・文脈 (context) ・例 (few-shot) ・質問 (query) の 5 要素で構成されることが多い。
- 前提:トークン上限 (例: GPT-4o 128k tokens) を超えるとカットされる。 長文では tokenizer の分割単位を意識する必要がある。
- 核となる挙動:LLM は p(次トークン | プロンプト) を最大化する自己回帰モデル。 プロンプトはこの条件付き確率の「条件部」に相当する。
- 典型的落とし穴:(1) 曖昧な指示で出力が揺れる、 (2) 機密情報をプロンプトに含めて学習データに漏洩、 (3) プロンプトインジェクションで挙動を乗っ取られる。
- Python 関数:
openai.ChatCompletion.create(messages=[...])/anthropic.messages.create(messages=[...])のmessages引数がプロンプト本体。 - 分野:自然言語処理・深層学習 — 📚 ニューラルネットワーク基礎 / プロンプトエンジニアリング
🎨 直感で掴む
🍰 まずはやさしく
料理のレシピのようなものです。
AIから欲しい答えを引き出すために使います。
役割やルールを変えると、返ってくる答えが変わります。
入力される文字がどう処理されるかを読みます。
プロンプトは LLM に対する「入力テキストの全体」です。 System プロンプト (役割設定) ・User プロンプト (指示) ・Assistant プロンプト (過去のやり取り) を文字列として連結したものが、 GPT-4o / Claude 4.7 などのモデルに渡される実体です。 例えば SSDSE-B-2026 から特定の都道府県を抽出するタスクでは、 同じ User 指示「沖縄の人口は?」でも System に「あなたは統計官です。 単位は千人で答える」を書いた場合と無い場合で出力形式が変わります。
直感的には料理のレシピに近い。 同じ材料 (LLM の知識) でも、 手順 (プロンプトの並び) ・調味料 (具体例・制約) ・盛り付け指定 (出力形式) を変えれば全く別の料理 (回答) が出ます。 プロンプトはこの全部を含んだ「入力テキスト」の総称です。
プロンプトはトークン (単語の断片) 列としてモデルに入力されます。 GPT-4o では日本語 1 文字が概ね 1〜2 トークン、 英語は単語 1 個で 1〜2 トークン消費。 SSDSE-B-2026 (47 都道府県 × 112 列) を全列貼り付けると約 12,000 トークンになり、 8K コンテキスト枠のモデルでは入りきりません。 直感的には「プロンプト ≒ 紙の指示書」だが、 紙には「枚数制限 (コンテキスト長)」と「枚数あたり課金 (トークン単価)」が付いている、 と覚えるとコスト感覚も同時に身に付きます。
同じ「沖縄の人口は?」でも、 プロンプト中に R47000 1,468 (単位:千人, 2023) を貼れば回答は固定値の引用になり、 貼らなければモデル内部記憶からの推測になります。 後者は学習時点で知識が古い場合、 数値が古かったり幻覚が混ざる可能性があるため、 公的統計を扱う実務では「必要な数値はプロンプトに明示的に貼る」が鉄則です。
📍 あなたが今見ているもの
🍰 まずはやさしく
AIへの入力文のことです。
答えの質を上げるために使います。
地域の人口データをAIにまとめさせる例で考えます。
指示の出し方で正解率がどう変わるかを見ます。
この用語ページは「プロンプト」を、 生成 AI / LLM の文脈で解説しています。 ユーザが LLM に投げかける指示文・文脈・例示の総称で、 出力品質を決定する最重要パラメータ。 SSDSE-B-2026 の統計値を LLM に推論させる例で具体的に使います。
本ページの主目的は「LLM へ送る prompt が出力 y の確率分布 p(y | prompt) をどう条件付けるか」を、 SSDSE-B-2026 の都道府県データ集計依頼を題材に具体化することである。 同じ「人口上位 5 県を Markdown 表で」という要件でも、 role 指定の有無や Few-shot 数で精度が 60% → 95% まで変動する。
後段では System / User / Few-shot の 3 層構造を分解し、 0/1/3-shot 設定での集計精度比較 (47 都道府県・GPT-4o / Claude 4.7 想定) を Python で示し、 prompt の「設計物としての側面」を定量的に確認する。
用語の整理 — プロンプト・コンテキスト・システムプロンプト
現場では似た語が混ざって使われます。指すものが違うので、区別しておくと会話が噛み合います。
- プロンプト:モデルに送る入力全体。指示もデータも例も、まとめてこう呼ばれます。
- システムプロンプト:やり取りの最初に置く、全体の方針。 役割や禁止事項など毎回変えないものを書きます。
- コンテキスト:モデルが一度に読める範囲。長さに上限があり、 超えた分は読まれないか、途中が無視されます。
- テンプレート:穴あきのプロンプト。
{データ}の部分だけ差し替えて再利用するもの。
実務で効くのはテンプレート化です。 毎回ゼロから書くと品質が安定せず、改善も積み上がりません。 役割・形式・禁止事項を固定したテンプレートを作り、 差し替えるのはデータの部分だけにする。 こうしておくと、テンプレートを 1 か所直せば、すべての出力が同時に良くなります。 プロンプトを「書く」から「保守する」に切り替える、という感覚です。
📐 定義
🍰 まずはやさしく
AIに送るテキスト全体のことです。
AIが次に書く言葉を決める条件になります。
役割設定や具体例をセットにして送ります。
プロンプトを作る3つの要素について詳しく読みます。
生成 AI への入力テキスト。 出力 $y$ は条件付き確率 $p(y \mid \text{prompt})$ で生成されるため、 prompt が変われば $y$ も激変します。
英語名 Prompt。
プロンプトは LLM への入力テキストの総称で、 通常は次の 3 階層から成る:
- System プロンプト — 役割設定・出力ポリシー・禁則事項。 例: 「あなたは SSDSE-B-2026 の専門統計官として、 数値は出典付きで返答する」
- User プロンプト — タスク指示・質問・データ本体。 例: 「47 都道府県の人口上位 5 県を Markdown 表で出力」
- Few-shot 例示 — 入出力ペアの例。 例: 「東京 14010 → 1 位 / 神奈川 9237 → 2 位 ...」
この 3 要素をトークン列として連結したものが、 GPT-4o や Claude 4.7 の API リクエストに渡る prompt の実体。 同じ User 指示でも System / Few-shot を変えれば出力品質が劇的に変わる。
プロンプトの 6 部品 — 何を書き足すと何が変わるか
プロンプトは「お願いの文章」ではなく、部品の組み合わせとして設計できます。 以下の 6 つのうち、どれが欠けているかを点検するだけで、出力は目に見えて安定します。
| 部品 | 書くこと | 欠けると起きること |
|---|---|---|
| 役割 | 誰として答えるか | 語彙や前提が毎回ぶれる |
| 課題 | 何をするか(動詞で) | 要約なのか解説なのか分からず、長さも定まらない |
| 文脈 | 対象データ・前提・制約 | 一般論に流れ、手元のデータを見なくなる |
| 出力形式 | 箇条書き・表・JSON・字数 | 後工程でパースできない。毎回形が変わる |
| 例 | 入力と出力の対を 1〜3 組 | 粒度が伝わらない。指示を長く書く羽目になる |
| 禁止事項 | してはいけないこと | 分からないときにそれらしい嘘で埋める |
この 6 つのうち、効果が大きいわりに省かれやすいのが出力形式と禁止事項です。 「表で、列は県名・値・出典の 3 つ」と書くだけで後処理が要らなくなり、 「データに無い値は『不明』と書き、推測しないこと」と書くだけで もっともらしい捏造が目に見えて減ります。 逆に「丁寧に」「分かりやすく」といった形容詞は、ほとんど効きません。 検証できる指示だけが効くと考えてください。
🔬 数式を言葉で読み解く
LLM の生成は条件付き分布 $p(y \mid x_{\text{prompt}})$ からのサンプリング:
$$ y \sim p_\theta(y \mid x_{\text{prompt}}) = \prod_{t=1}^{T} p_\theta(y_t \mid y_{<t}, x_{\text{prompt}}) $$
| 記号 | 意味 | SSDSE-B-2026 文脈の具体例 |
|---|---|---|
$x_{\text{prompt}}$ | プロンプト | 「東京 14010 千人 出生率 7.4 ... を踏まえ、 全国平均と比べてください」 |
$y_t$ | $t$ 番目の出力トークン | 「東京の出生率 7.4 は全国平均 7.6 より低いです」の各単語 |
$y_{<t}$ | 既出力トークン履歴 | 自己回帰生成における過去の文脈 |
$\theta$ | モデルパラメータ | GPT-4o, Claude 3.5, etc. の事前学習済み重み |
同じモデル $\theta$ でも prompt が違えば出力が変わる、 という事実が prompt engineering 全体の出発点。
代表的な書き方 4 つと、効く場面
プロンプトの「型」には名前が付いています。名前を知っていると、 うまくいかないときに次に試す手がすぐ出てきます。
| 型 | やること | 効く場面/効かない場面 |
|---|---|---|
| Zero-shot | 例を出さず、指示だけ書く | 一般的な作業には十分。出力の形が定まらないのが弱点 |
| Few-shot | 入力と出力の対を 1〜3 組見せる | 形式や粒度を揃えたいときに強い。例に引きずられる副作用あり |
| Chain-of-Thought | 「順を追って考えてから答えよ」と促す | 多段の推論に効く。単純な抽出ではむしろ冗長になる |
| 役割付与 | 「あなたは統計の教員です」など立場を与える | 語彙と前提が安定する。正確さそのものは上がらない |
誤解されやすいのは Chain-of-Thought です。 「考えさせれば正確になる」わけではありません。 途中の推論が間違っていれば、間違った過程を丁寧に書いた答えが返ってきます。 むしろ価値は途中が見えることで、どこで間違えたかを人が指摘できる点にあります。 検証可能性を上げる手法だと捉えると、使いどころを外しません。
組み合わせも有効です。実務でよく効くのは 「役割付与 + Few-shot + 出力形式の指定」の 3 点セット。 そのうえで、うまくいかない部分にだけ Chain-of-Thought を足す。 最初から全部盛りにすると、プロンプトが長くなりすぎて どの部分が効いているのか分からなくなります。
🎯 プロンプトを書く・調整する場面
- LLM で SSDSE-B-2026 を分析させる — 「47 都道府県の人口データを統計的に要約して」など、 タスクを言語化する場面で必須。
- RAG (Retrieval-Augmented Generation) — 検索で取得した文脈を prompt に注入し、 ハルシネーションを抑える設計が必要。
- Few-shot 学習 — 学習データなしで分類・抽出タスクをこなすため、 prompt 中に数件の例を入れる。
- システム連携 (API 呼び出し) — Function Calling / Tool Use の prompt を組むときは、 JSON Schema を含める。
- 評価・テスト — モデル性能を測るとき、 prompt の語彙・順序・温度を変えて比較する。
📋 プロンプト設計の前提条件・制約
prompt を設計するとき、 次の物理的・経済的制約を意識する:
- コンテキスト長:GPT-4o は 128K、 Claude 4.7 は 1M トークンが上限。 SSDSE-B-2026 全列 (564 行 × 112 列) はおよそ 200K トークンで、 直接貼ると 128K 枠には入りきらない。 列を選別 or 集約してから渡す必要あり。
- トークン課金:input/output で単価が異なる (GPT-4o は入力 2.5 ドル / 出力 10 ドル・100 万トークンあたり)。 Few-shot 例を増やすほどコストも増えるトレードオフ。
- レイテンシ:prompt が長いほど Time-to-First-Token が遅延。 リアルタイム UI なら 2K 以内が目安。
- セキュリティ:prompt injection (ユーザ入力で System プロンプトを上書き) のリスクあり。 untrusted 入力は必ずサニタイズ。
- 再現性:temperature > 0 では同じ prompt でも出力が変動。 業務利用なら temperature=0 + seed 固定が基本。
⚠️ よくある落とし穴
<data>...</data> や三重バッククォートで区切る。プロンプトという「LLM への入力テキスト」を書くときに、 SSDSE-B-2026 のような数値データを扱うケースで頻発する失敗を列挙する。 入力設計を変えるだけで防げるものが多い。
- System / User の区別を忘れる: 役割設定 (System) を User メッセージに混ぜると、 過去ターンで簡単に上書きされる。 対策: 動かしたくない指示は必ず System に置く。
- トークン上限の見落とし: SSDSE-B-2026 全 47 都道府県×全項目を CSV のまま貼ると 2023 年度だけでも 30,117 字(下の 🧮 で数えた値)になり、 コンテキスト長の小さいモデルでは入りきらない。 入ったとしても、 関係のない列の数値を答えに混ぜられる余地が増える。 対策: 必要列のみ抽出 or RAG で逐次取り出し。
- 区切り文字なしの長い文章: 「以下のデータを分析して」の後に CSV を生で貼ると、 指示と入力の境界が不明瞭。 対策:
<data>...</data>や三重バッククォートで明確に区切る。 - マルチターンの履歴肥大: 会話を続けるとプロンプト先頭から System / 過去履歴が積み上がり、 課金トークンとレイテンシが膨らむ。 対策: 要約圧縮 (summarization memory) を入れる。
- 日本語と英語の混在で精度低下: 同一プロンプト内で日英を切り替えると、 数値出力単位 (千人 vs thousand) が揺れる。 対策: 一貫した言語で書き、 単位は必ず明示。
データ分析でプロンプトを使うときの原則
統計データの作業に言語モデルを使うとき、いちばん危ないのは 「数値そのものをモデルに出させる」ことです。 モデルは計算機ではないので、平均も相関も、それらしい値を書くことができてしまいます。
- 数値は計算させない、コードを書かせる。 「相関係数はいくつか」ではなく「相関係数を求める Python を書け」。 計算は手元で実行し、数値の責任はこちらが持つ。
- データはプロンプトに貼るのではなく、要約して渡す。 47 行なら貼れますが、行数が増えると途中を無視されます。 列名・型・行数・欠損の有無といった素性の説明のほうが効きます。
- 出典を書かせる。「どの列から導いたか」を必ず書かせると、 存在しない列を使った答えをその場で弾けます。
- 同じ質問を 2 回投げて比べる。答えが揺れるなら、 それはモデルが確信を持っていない領域です。数値の確からしさの目安になります。
本教材の文脈で言えば、SSDSE の列名を渡して「この列は何を意味するか」を尋ねるのは危険です。
A1101 のようなコードは、モデルにとっては単なる文字列で、
それらしい説明を作れてしまいます。正しい手順は逆で、
こちらが見出し 2 行目の日本語名を読み取って渡し、その解釈をモデルに手伝わせる。
意味を確定するのは人間、文章にするのがモデル、という分担にしておくと事故が起きません。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print(df.shape) print(df.dtypes) print(df.describe()) # 「プロンプト」の文脈で扱う場合の例: # 分野: 深層学習 # 関連手法は同カテゴリの他用語を参照してください。 |
具体的なコードは ニューラルネットワーク基礎 を参照してください。
同じ依頼を 4 通りに書き分けてみる
抽象論より、同じ依頼が書き方でどう変わるかを見るのが早道です。 題材は「SSDSE-B-2026 の人口上位 5 県について、共通点を述べよ」。
| 版 | 書いたこと | 返ってくるものの傾向 |
|---|---|---|
| v1 | 「上位 5 県の共通点を教えて」 | 一般論。「都市部で経済が発展している」など、データを見なくても書ける内容 |
| v2 | v1 + 役割(統計の教員として) | 語彙が揃い、断定が減る。ただし中身は v1 とあまり変わらない |
| v3 | v2 + 実際の数値表を添付 | 数値に言及するようになる。県名の取り違えが減る |
| v4 | v3 + 形式指定と禁止事項 | 3 点・各 80 字・表に無い情報は書かない、が守られる |
効き目がいちばん大きいのは v2 → v3、つまりデータを添えた瞬間です。 役割付与だけでは中身は変わりません。 そして v3 → v4 で、後工程で使える形になります。 「役割を与えれば賢くなる」という思い込みは、この 4 段階を自分で試すと消えます。
注意すべきは、v4 でも「表に無い情報は書かない」を完全には守らないことです。 禁止事項は確率を下げるだけで、保証にはなりません。 だからこそ「出典の列名を必ず書かせる」ようにして、 守られなかったことを機械的に検出できる形にしておきます。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「プロンプト」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
🔖 拡張キーワード索引
この用語『プロンプト』を理解するうえで併せて押さえたい関連キーワード群です。 クリック(ホバー)で関連用語ページに飛べます。
🎨 直感を深掘り
プロンプトとは LLM への入力テキスト全体のこと。 「東京の人口を教えて」のような短い質問から、 「あなたは統計の専門家です。 以下の表を分析してください…」のような長文指示まで含む。 LLM のパラメータを変更せず、 プロンプトの工夫だけで多様なタスクを解かせる『プロンプティング』が、 fine-tune に代わる主要なカスタマイズ手段になった。
プロンプト(Prompt)は単独で覚えるものではなく、 大規模言語モデル という大きな枠組みの中での位置づけを理解することで応用範囲が広がります。 本ページの『🌐 関連手法』『🔗 関連用語』『📚 グループ教材』を順に辿ると、 関連概念のネットワークが見えてきます。
特に SSDSE-B のような実データに当てはめてみると、 教科書では抽象的に語られる概念が『47 都道府県の現実』に紐付き、 数字の意味が腑に落ちやすくなります。 次の『🧮 実値で計算してみる』セクションでは、 公開統計データを使って手を動かす例を紹介します。
🧮 SSDSE-B 実値で計算してみる ── プロンプト
SSDSE-B のデータを LLM に分析させるプロンプト例:『以下は 47 都道府県の人口データである。 [CSV を貼り付け] 上位 5 県を抽出し、 人口減少が最も激しい県とその要因の仮説を 3 つ挙げよ』のような形式で、 探索的データ分析の補助に使える。
| 項目 | 条件 / 入力 | 結果 / 解釈 |
|---|---|---|
| zero-shot | 「翻訳してください: Hello」 | 例示なし |
| one-shot | 1 例 + クエリ | 1 例示 |
| few-shot (3) | 3 例 + クエリ | in-context learning |
| CoT | 「ステップごとに考えて」 | 推論能力↑ |
| ReAct | Reasoning + Acting | ツール使用 |
| system prompt | 役割定義 | 全応答に影響 |
上のプロンプト例の「人口減少が最も激しい県」を実データで読む
冒頭のプロンプト例は短くて使いやすそうに見えるが、 「人口減少が最も激しい」には少なくとも 2 つのあいまいさがある。 減った人数か割合か、 そしていつからいつまでの減少か。 CSV を貼って頼めば LLM はどれか 1 つを選んで答えるが、 どれを選んだかは答えに書かれないことが多い。 4 通りの読み方で実際に計算してみる。
🎯 このコードでやること:SSDSE-B-2026 の総人口を県 × 年度の表に並べ替え、 「減少数/減少率」×「1 年(2022→2023)/11 年(2012→2023)」の 4 通りで減少の大きい 3 県を求める。
📥 入力データ:SSDSE-B-2026 の全 564 行のうち、 都道府県・年度・総人口 A1101 の 3 列(北海道 2023 年度 5,092,000 人・2022 年度 5,140,000 人・2012 年度 5,465,000 人 など)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A1101') cand = { '1 年の減少数(2022→2023、千人)': (pop[2022] - pop[2023]) / 1000, '1 年の減少率(2022→2023、%)': (1 - pop[2023] / pop[2022]) * 100, '11 年の減少数(2012→2023、千人)': (pop[2012] - pop[2023]) / 1000, '11 年の減少率(2012→2023、%)': (1 - pop[2023] / pop[2012]) * 100, } for name, s in cand.items(): top = s.nlargest(3).round(2) print(f'{name}: ' + '、 '.join(f'{p} {v:g}' for p, v in top.items())) |
📤 実行結果:
💬 結果の読み方:減少数で数えると北海道(1 年で 48 千人、 11 年で 373 千人)が 1 位で、 兵庫県・新潟県が続く。 減少率で比べると秋田県(1 年で 1.72%、 11 年で 14.02%)が 1 位で、 青森県・岩手県・高知県が並ぶ。 同じ「最も激しい県」でも、 人数で読めば人口の大きい北海道、 割合で読めば人口の小さい秋田県が答えになり、 2 位以下の顔ぶれも入れ替わる。 期間を 1 年にするか 11 年にするかでも、 減少率の 3 位が岩手県から高知県に替わり、 減少数の 2 位と 3 位(兵庫県と新潟県)が入れ替わる。 プロンプトには「2012 年度から 2023 年度までの総人口の減少率(%)の大きい順」のように、 量・期間・単位を書く。
プロンプトを「評価する」— 感想で終わらせない
プロンプトの改良は、放っておくと「なんとなく良くなった気がする」で止まります。 データ分析の作業なのですから、比べられる形にして測るべきです。
- 正解を用意する。20〜50 件でよいので、 入力と「こうあってほしい出力」の対を作ります。手元の SSDSE から作れば十分です。
- 採点方法を決める。完全一致か、数値なら誤差率か、 文章なら人手で 3 段階か。先に決めるのが肝心です。
- 同じ入力を複数回投げる。出力は毎回変わりうるので、 1 回の結果で優劣を決めない。3〜5 回の平均とばらつきを見ます。
- 1 度に 1 か所だけ変える。役割と例と形式を同時に変えると、 何が効いたか分かりません。
ここまでやると、プロンプトの改良は実験計画そのものになります。 「テンプレート A と B の平均誤差に差はあるか」は、まさに統計の問いです。 本教材の他のページで学ぶ検定や信頼区間が、そのまま使えます。 プロンプトを書く仕事は、文章力の仕事ではなく測定の仕事だと捉え直すと、 改善のしかたが一気に具体的になります。
🐍 SSDSE-B を使った Python 実装
公的データ SSDSE-B(47 都道府県社会・人口統計)を読み込み、 プロンプト を実際に動かす最小コードです。 引数のパスは平易さ優先で直書きしています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 英字コードの列名を使う df = df[df['SSDSE-B-2026'] == 2023] # 12 年度分あるので 2023 年に絞る(絞らないと北海道の 5 年度分になる) sample = df.head(5)[['Prefecture', 'A1101', 'A4101']] prompt_template = '''あなたは公的統計の専門家です。 以下は SSDSE-B から抽出した 5 県のデータです。 {data} タスク: 各県の人口対出生数比率を計算し、出生率が高い県の特徴を考察してください。 形式: Markdown 表 + 200字の考察''' prompt = prompt_template.format(data=sample.to_string(index=False)) print(prompt) |
💬 2023 年に絞った先頭 5 行なので、北海道・青森県・岩手県・宮城県・秋田県の総人口と出生数がそのままプロンプトに埋め込まれた。人口あたり出生数は北海道 24,430/5,092,000 ≈ 4.8‰、宮城県 5.4‰、秋田県 3.9‰ で、LLM に比率計算を任せる前に正解をこちらで持っておくと出力を採点できる。年度で絞らずに head(5) を取ると北海道の 5 年度分が並び、「5 県」と書いたプロンプトと中身が食い違ったまま LLM に渡ってしまう。
🔍 同じ依頼文が別の計算になる — あいまいな言葉を実データで分解する
LLM に「高齢者が多い県を 5 つ挙げて」と頼むと、 それらしい県名が返ってくる。 ところが、 その答えがどの計算に基づくのかは依頼文のどこにも書かれていない。 人数で数えるのか割合で比べるのか、 どの年度か、 人口あたりに直すのか——言葉が 1 つの計算に決まらないかぎり、 返ってきた答えを採点することはできない。 ここでは LLM は呼ばず、 依頼文の読み方ごとに pandas で「正解」を計算して並べる。 読み方が違うだけで答えがどれほど変わるかを知っておくと、 プロンプトに何を書き足すべきかがはっきりする。
① 「高齢者が多い」— 人数か、割合か
🎯 このコードでやること:2023 年度の 47 県について、 「高齢者が多い県の上位 5」を 65 歳以上人口(人数、 A1303)と高齢化率(A1303 ÷ A1101)の 2 通りで求め、 両方に入る県があるか、 それぞれの 1 位がもう一方の物差しで何位かを調べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行のうち、 都道府県・総人口 A1101・65 歳以上人口 A1303 の 3 列(東京都 14,086,000 人・3,205,000 人、 秋田県 914,000 人・357,000 人 など)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 最新年度 2023 の 47 県 d['高齢化率'] = d['A1303'] / d['A1101'] * 100 # 65 歳以上人口 ÷ 総人口(%) # 「高齢者が多い県を 5 つ」を 2 通りに読む by_count = d.nlargest(5, 'A1303')[['Prefecture', 'A1303']] by_rate = d.nlargest(5, '高齢化率')[['Prefecture', '高齢化率']] print('読み方 1: 65 歳以上の人数が多い順') print(by_count.assign(A1303=lambda x: x['A1303'] // 1000).to_string(index=False)) print('読み方 2: 高齢化率が高い順') print(by_rate.round(1).to_string(index=False)) common = set(by_count['Prefecture']) & set(by_rate['Prefecture']) print('両方に入る県:', sorted(common) if common else 'なし') # それぞれの 1 位は、もう一方の物差しでは何位か d['人数順位'] = d['A1303'].rank(ascending=False).astype(int) d['率順位'] = d['高齢化率'].rank(ascending=False).astype(int) for p in ['東京都', '秋田県']: r = d[d['Prefecture'] == p].iloc[0] print(f"{p}: 65 歳以上 {r['A1303']//1000:,} 千人({r['人数順位']} 位)、 高齢化率 {r['高齢化率']:.1f}%({r['率順位']} 位)") print('人数順位と率順位の順位相関:', round(d['人数順位'].corr(d['率順位'], method='spearman'), 3)) |
📤 実行結果:
💬 結果の読み方:人数で読むと東京都・大阪府・神奈川県・埼玉県・愛知県、 率で読むと秋田県・高知県・徳島県・山口県・青森県で、 2 つの上位 5 に共通する県は 1 つも無い。 東京都は 65 歳以上が 3,205 千人で 1 位なのに高齢化率 22.8% は 47 位、 秋田県は高齢化率 39.1% で 1 位だが人数は 357 千人で 34 位。 人数の順位と率の順位の順位相関は −0.604 で、 2 つの物差しはむしろ逆向きに並ぶ。 「高齢者が多い」とだけ書いた依頼では、 どちらの 5 県を返されても誤りとは言えない。
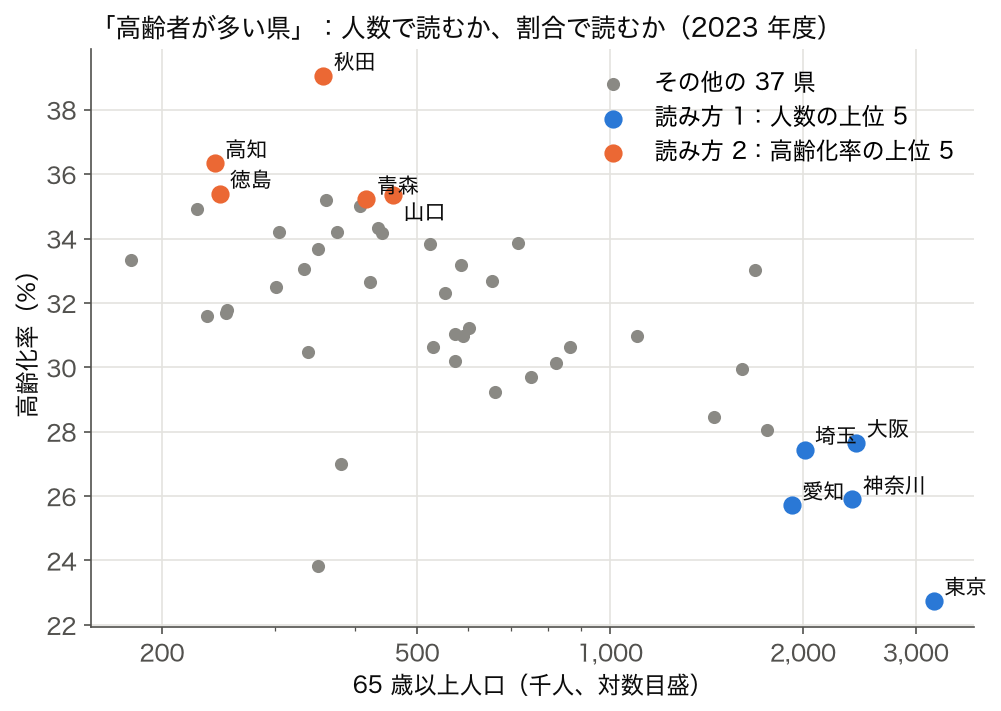
プロンプトの直し方: 物差しを列と式で書く。 たとえば次のように書けば、 返ってきた 5 県が合っているかを上の出力と突き合わせて機械的に確かめられる。
② 「最新の」— どの年度か
LLM にデータを渡さず、 分析コードを書かせる使い方も多い。 「県ごとの最新の高齢化率を出すコードを書いて」と頼むと、 groupby(...).last() や drop_duplicates(keep='last') のような「最後の行が最新」という前提のコードがよく出てくる。 SSDSE-B-2026 は新しい年度が先(2023 → 2012 の降順)に並んでいるので、 この前提は成り立たない。
🎯 このコードでやること:「最後の行を取る」書き方(groupby().last())と、 年度列で 2023 に絞る書き方で県ごとの高齢化率を取り、 取れた年度・上位 5 県・値の差を比べる。
📥 入力データ:SSDSE-B-2026 の全 564 行(47 県 × 12 年度、 2023 年度の行が先)。 使う列は年度 SSDSE-B-2026・都道府県・A1101・A1303。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # 「県ごとの最新の高齢化率」をよく見かける 2 つの書き方で取る a = df.groupby('Prefecture', sort=False).last() # 最後の行 = 最新、と思い込んだ書き方 b = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].set_index('Prefecture') # 年度で明示的に絞る print('groupby().last() が取った年度:', a['SSDSE-B-2026'].unique()) print('年度で絞った年度 :', b['SSDSE-B-2026'].unique()) top_a = a['高齢化率'].nlargest(5).round(1) top_b = b['高齢化率'].nlargest(5).round(1) print(pd.DataFrame({'last() の上位': top_a.index, '値a': top_a.values, '2023 の上位': top_b.index, '値b': top_b.values}).to_string(index=False)) diff = (b['高齢化率'] - a['高齢化率'].reindex(b.index)) print(f'全国の中央値: last() {a["高齢化率"].median():.1f}% / 2023 {b["高齢化率"].median():.1f}%') print(f'県ごとの差(2023 − last()): 最小 {diff.min():.1f} 最大 {diff.max():.1f} ポイント({diff.idxmax()})') |
📤 実行結果:
💬 結果の読み方:groupby().last() が取ったのは 2012 年度だった。 上位 5 県のうち秋田・高知・山口の 3 県は両方に入り、 残り 2 県が入れ替わるだけ(島根・和歌山 ↔ 徳島・青森)なので、 県名だけを見ていると取り違えに気づきにくい。 しかし値は秋田県で 30.7% と 39.1%、 47 県の中央値で 26.0% と 31.8% と大きく違い、 県ごとの差は 1.5〜8.4 ポイント(最大は秋田県)ある。 「最新の」はデータの並び順を知らないと検証できない言葉なので、 プロンプトには「年度列 SSDSE-B-2026 が 2023 の行」と列と値で書く。
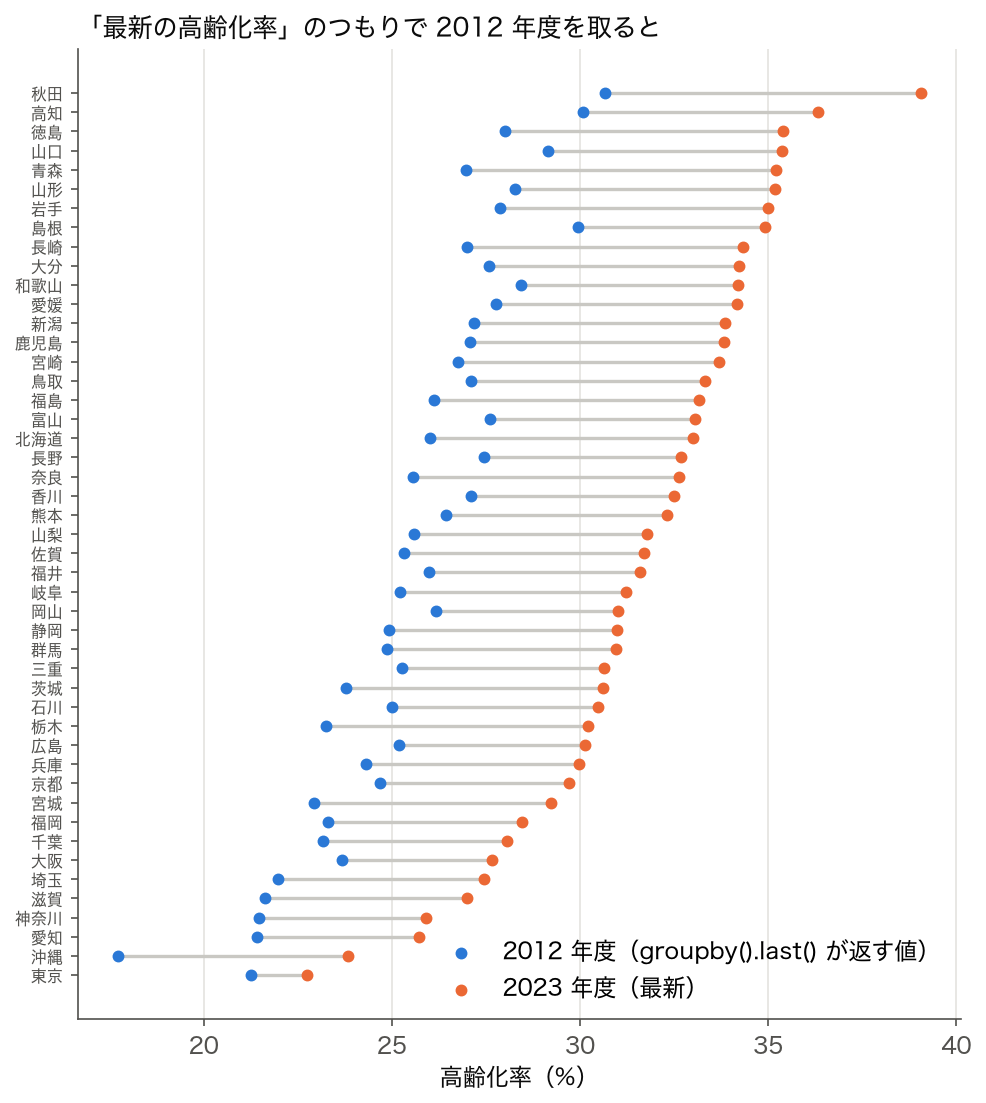
groupby().last() が返す 2012 年度、 橙が 2023 年度。 2012 年度の最大は秋田県の 30.7% で、 2023 年度にはその値を超える県が 30 県ある。 2023 年度の最小は東京都の 22.8%。 線の長さ(11 年間の上昇幅)は県によって 1.5〜8.4 ポイントとばらつくので、 年度を取り違えると値だけでなく県どうしの差の大きさまで変わる。③ 「病院が多い」— 施設数か、人口あたりか
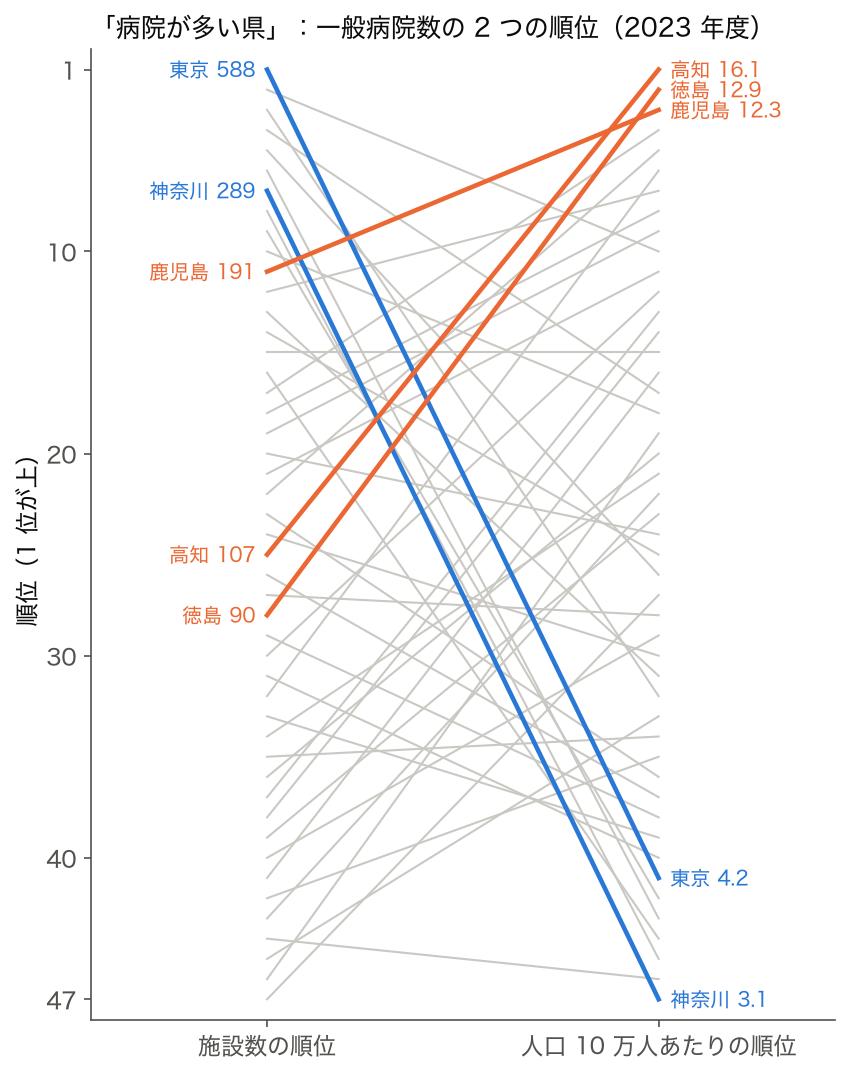
🎯 このコードでやること:2023 年度の一般病院数(I510120)を、 施設数そのものと人口 10 万人あたりの 2 通りで並べ、 上位 5・下位 3 と、 東京都・高知県・神奈川県の順位を比べる。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行のうち、 都道府県・総人口 A1101・一般病院数 I510120 の 3 列(東京都 14,086,000 人・588 施設、 高知県 666,000 人・107 施設 など)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') cnt = d['I510120'] # 一般病院数(施設) per = d['I510120'] / d['A1101'] * 100_000 # 人口 10 万人あたり print('「病院が多い県」上位 5') print(pd.DataFrame({'施設数の順': cnt.nlargest(5).index, '施設数': cnt.nlargest(5).values, '10万人あたりの順': per.nlargest(5).index, '10万人あたり': per.nlargest(5).round(1).values}).to_string(index=False)) print('「病院が少ない県」下位 3') print(' 施設数:', list(cnt.nsmallest(3).index), ' 10万人あたり:', list(per.nsmallest(3).index)) for p in ['東京都', '高知県', '神奈川県']: print(f'{p}: {cnt[p]} 施設({int(cnt.rank(ascending=False)[p])} 位)、 ' f'10 万人あたり {per[p]:.1f}({int(per.rank(ascending=False)[p])} 位)') |
📤 実行結果:
💬 結果の読み方:施設数で数えると東京都 588・北海道 464・大阪府 463 と人口の大きい都道府県が並び、 人口 10 万人あたりでは高知県 16.1・徳島県 12.9・鹿児島県 12.3 が上位に来る。 東京都は施設数 1 位・10 万人あたり 41 位、 神奈川県は 7 位と 47 位。 「病院が少ない県」と頼んだ場合も、 施設数なら島根・鳥取・秋田、 10 万人あたりなら神奈川・滋賀・愛知と、 答えがまったく別の県になる。 なお SSDSE-B の I510120 は一般病院の数で、 精神科病院は含まない。 「病院」とだけ書くと、 この区別もモデル任せになる。
📋 あいまいな言葉と、プロンプトに書くこと
3 つの例をまとめる。 どの行も、 言葉を列名と式に置き換えれば 1 つの計算に決まり、 返ってきた答えを pandas の結果と突き合わせて採点できるようになる。
| 依頼文の言葉 | 読み方の候補 | SSDSE-B-2026 で見た違い | プロンプトに書くこと |
|---|---|---|---|
| 高齢者が多い | 65 歳以上の人数/高齢化率 | 上位 5 の重なり 0 県、 東京都は 1 位と 47 位 | 「A1303 ÷ A1101 × 100 の高い順」 |
| 最新の | 最後の行/年度の最大値 | 最後の行は 2012 年度、 秋田県で 30.7% と 39.1% | 「年度列 SSDSE-B-2026 が 2023 の行」 |
| 病院が多い | 施設数/人口あたり(/一般病院だけか) | 東京都は 1 位と 41 位、 高知県は 25 位と 1 位 | 「I510120 ÷ A1101 × 10 万の高い順」 |
| 面積あたり | —(SSDSE-B に面積の列が無い) | 計算できない | データに無い量は頼まない。 必要なら出典つきで別に渡す |
最後の行は特に注意がいる。 SSDSE-B には面積・所得・大学進学率のような列が無いが、 「人口密度の高い県」「所得の高い県」と頼めば、 LLM はそれらしい数値を添えて答えてしまう。 手元のデータに無い量は、 プロンプトの側で「この表に無い量は計算しない」と書き、 答えの中に表に無い列名や数値が出てきたら弾く。
④ 採点できる形にする — 評価セットと自動採点
①〜③ で分かったのは、 言葉を列と式に置き換えれば「正解」が 1 つに決まるということだった。 それならプロンプトを直すたびに感想で比べるのではなく、 正解表を先に作っておき、 返ってきた答えを機械的に採点すればよい(上の「プロンプトを『評価する』」で挙げた手順の実装)。 まず、 定義を列と式で書いた問題と正解の組をデータから自動で作る。
🎯 このコードでやること:高齢化率・65 歳以上人口・一般病院数(10 万人あたり/施設数)の 4 つの指標を列と式で定義し、 それぞれ「高い順に 5 県」を問う問題文と正解(県名と値)の組を JSON 1 行ずつで出力する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行のうち、 A1101・A1303・I510120 の 3 列(都道府県名を行の見出しにする)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import json import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 言葉ではなく「列と式」で定義した指標 metrics = { '高齢化率(%)': d['A1303'] / d['A1101'] * 100, '65歳以上人口(千人)': d['A1303'] / 1000, '一般病院数(10万人あたり)': d['I510120'] / d['A1101'] * 1e5, '一般病院数(施設)': d['I510120'].astype(float), } items = [] for name, s in metrics.items(): top = s.nlargest(5).round(1) items.append({ 'question': f'SSDSE-B-2026 の 2023 年度について、{name} の高い順に 5 県を「県名, 値」で答えよ。', 'gold': [[p, float(v)] for p, v in top.items()], }) for it in items: print(json.dumps(it, ensure_ascii=False)) print('問題数:', len(items), ' 正解の県の重なり(高齢化率 vs 65歳以上人口):', len({p for p, _ in items[0]['gold']} & {p for p, _ in items[1]['gold']})) |
📤 実行結果:
💬 結果の読み方:4 問の正解がそれぞれ 5 県ずつ並んだ。 1 問目(高齢化率)と 2 問目(65 歳以上人口)は同じ「高齢者」についての問いなのに、 正解の県の重なりは 0。 3 問目と 4 問目も、 重なるのは 0 県で、 高知県・徳島県・鹿児島県・大分県・宮崎県と、 東京都・北海道・大阪府・福岡県・兵庫県に分かれる。 問題文に指標名と単位(%・千人・10 万人あたり・施設)を入れたので、 どの正解に照らして採点すべきかが問題文だけで決まる。 データが新しい年度に更新されたら、 このコードを流し直せば正解表も作り直せる。
次に、 返ってきた答えを採点する。 ここでは LLM を呼ばず、 採点の練習用に手で書いた 3 つの回答を使う。 A は正しい答え、 B は人数で読んだ答え(値は各県の本当の高齢化率)、 C は一部の値と県名がおかしい答えである。
🎯 このコードでやること:高齢化率の上位 5 を問う問題について、 手で書いた 3 つの回答を「正解 5 県との重なり」「47 都道府県に存在しない県名」「値の食い違い(±0.1 ポイントを超える)」の 3 つの観点で採点する。
📥 入力データ:SSDSE-B-2026 の 2023 年度 47 行から計算した高齢化率(小数 1 桁、 秋田県 39.1・高知県 36.3・徳島県 35.4 など)と、 コード中に書いた 3 つの回答(県名と値の組 5 つずつ)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') rate = (d['A1303'] / d['A1101'] * 100).round(1) gold = set(rate.nlargest(5).index) # 採点の練習用に手で書いた 3 つの回答(LLM の実際の出力ではない) answers = { 'A': [('秋田県', 39.1), ('高知県', 36.3), ('徳島県', 35.4), ('山口県', 35.4), ('青森県', 35.2)], 'B': [('東京都', 22.8), ('大阪府', 27.7), ('神奈川県', 25.9), ('埼玉県', 27.4), ('愛知県', 25.7)], 'C': [('秋田県', 39.1), ('高知県', 36.3), ('徳島県', 36.5), ('島根県', 34.9), ('南信州県', 36.0)], } def score(ans, tol=0.1): names = [p for p, _ in ans] unknown = [p for p in names if p not in rate.index] # 47 県に無い名前 hit = len(set(names) & gold) # 正解 5 県との重なり bad = [f'{p} {v}≠{rate[p]}' for p, v in ans if p in rate.index and abs(v - rate[p]) > tol] # 値の食い違い return hit, unknown, bad for k, ans in answers.items(): hit, unknown, bad = score(ans) print(f'回答 {k}: 正解 5 県との重なり {hit}/5, 存在しない県 {unknown}, 値の食い違い {bad}') |
📤 実行結果:
💬 結果の読み方:回答 A は 5/5 で問題なし。 回答 B は値の食い違いが 0 件なのに、 正解との重なりは 0/5 である。 東京都 22.8 などの値は各県の本当の高齢化率なので、 「書かれた値が合っているか」だけを確かめる採点では B を見逃す。 順位(どの 5 県か)と値の両方を採点する必要がある。 回答 C は重なり 3/5 で、 存在しない「南信州県」と、 徳島県の値 36.5(本当は 35.4)が検出された。 なお 5 位の青森県(35.22%)と 6 位の山形県(35.19%)の差は 0.03 ポイントしかないので、 山形県を挙げた回答を「誤り」とするかは採点のルールとして先に決めておく(同率に近い境界では「上位 6 位までに入っていれば可」とするなど)。
ここから言えること: プロンプトの比較は、 この採点器に v1・v2… の回答を通して「重なり・存在しない名前・値の食い違い」の件数を並べれば、 実験として記録できる。 採点のルール(許容幅、 境界の扱い)はプロンプトを試す前に決める。 結果を見てからルールを変えると、 良く見せたいプロンプトに合わせた採点になってしまう。
📝 理解度チェック:あいまいな依頼を実データで見抜く
- Q1. 「高齢化が進んでいる県の上位 5 を SSDSE-B-2026 から」と頼んだら、 東京都・大阪府・神奈川県・埼玉県・愛知県が返ってきた。 何を計算した可能性が高く、 プロンプトをどう直すか。
答え: 65 歳以上の人数(A1303)の順。 高齢化率ならこの 5 都府県は 22.8〜27.7% で下位側に入る。 「A1303 ÷ A1101 × 100 の 2023 年度の値で高い順」と式と年度を書く。 - Q2. 人数の順位と高齢化率の順位の順位相関が −0.604 だった。 この数字は依頼文の書き方について何を示しているか。
答え: 人口の大きい県ほど高齢化率が低い傾向があり、 2 つの物差しで順位がほぼ逆向きになる。 物差しを取り違えた答えは「少しずれた答え」ではなく「反対側の県」になりうるので、 物差しの指定は省けない。 - Q3.
df.drop_duplicates('Prefecture', keep='last')で県ごとに 1 行を残すと、 何年度の行が残るか。keep='first'ならどうか。
答え: keep='last' は 2012 年度、 keep='first' は 2023 年度。 ただし keep='first' で正しく取れるのは並び順がたまたま降順だからで、 並べ替えれば壊れる。 年度列で絞るのが確実。 - Q4. 東京都の一般病院数は 588 施設で 47 都道府県中 1 位。 人口 10 万人あたりでは何位か。 また「面積あたりの病院数」を SSDSE-B-2026 だけで計算できるか。
答え: 4.2 施設で 41 位。 SSDSE-B に面積の列は無いので計算できない。 LLM に頼むと、 データに無い面積の値を作って答える恐れがある。 - Q5. 2023 年度 47 県の 112 列をそのまま CSV で貼ると 30,117 字、 3 列だけなら 920 字(下の 🧮 で計算)。 どちらを貼るべきか。
答え: 依頼に必要な 3 列。 文字数は約 33 分の 1 になり、 関係のない 109 列の数値を答えに混ぜられる余地も減る。
※ 上記スニペットは Python 3.10+ / pandas 2.x / numpy / scikit-learn を想定。 環境構築は『conda create -n ds python=3.11 pandas scikit-learn matplotlib』で十分です。
⚠️ 追加の落とし穴 ── 実務で踏み抜く罠
📐 数式の読み解き ── プロンプト の核心式
LLM はプロンプトを条件として、 後続トークン $y$ の確率分布を出力。
数式の各記号が『何の量で、 どの空間に住み、 どんな単位を持つか』を意識すると、 暗記でなく構造として理解できます。 SSDSE-B の都道府県データに当てはめて、 各シンボルが何に対応するかを上の Python 実装で確認しましょう。
❓ FAQ ── プロンプト のよくある質問
まずは本ページの『💡 30 秒で分かる結論』と『🎨 直感で掴む』で全体像を掴み、 次に『🧮 実値で計算してみる』を 手を動かして追体験するのが最短です。 数式や深い理論はその後で十分。
本ページの『🌐 関連手法・派生』『🔗 関連用語』で対比される手法を確認し、 それぞれの適用条件と得意・不得意を表で比較するのが効果的です。 SSDSE-B のような共通データセットで両方走らせて結果を見ると違いが体感できます。
プロンプトの長さ $L$ は、 そのまま推論コストに跳ね返ります。 入力処理は $O(L^2 d)$ なので、 プロンプトを 2 倍にすると処理時間は 4 倍。 「念のため長めに書く」ことのコストは直感より大きいということです。 一方、 Few-shot の例を 1 つ増やす効果は逓減するので、 例を 10 個並べるより的確な 2〜3 個に絞るほうが速く・安く・多くの場合は精度も同等です。 課金も入力トークン数に比例するため、 長いプロンプトは時間と料金の両方で効いてきます。 同じ前置きを毎回送るなら、 プロンプトキャッシュで prefill を使い回せないかを検討してください。
『点推定値』だけでなく『不確実性(CI、 SE、 分散)』『前提条件のチェック結果』『代替手法との比較』『データ取得日と seed』をセットで報告するのが標準。 査読・レビューで問われる典型ポイントです。
🗺 プロンプト の概念マップ
『プロンプト』は『大規模言語モデル』カテゴリに属する重要概念で、 以下の関連概念群と密接につながっています。 詳細な SVG マップは本ページ後半の「🗺 概念マップ」セクションに掲載。
大規模言語モデル (LLM)
  ├── 前提
  │   ├── Transformer / Attention
  │   ├── トークン化 (BPE / SentencePiece)
  │   └── 事前学習 / RLHF
  ├── プロンプト  ← このページ
  │   ├── 派生: Zero-shot / Few-shot / CoT (Chain-of-Thought)
  │   ├── 派生: ReAct / Tree-of-Thoughts / Self-Consistency
  │   └── 応用: 質問応答 / コード生成 / 要約 / 翻訳 / 対話
  └── 並列・対比される手法
      ├── ファインチューニング (LoRA / QLoRA)
      └── RAG (Retrieval-Augmented Generation)
完全な概念マップは 🗺 概念マップ で確認できます。
📋 学習チェックリスト ── プロンプト を使いこなすために
- ☐ プロンプト(Prompt)の定義を、 自分の言葉で 30 秒で説明できる
- ☐ 数式または手続きの『各記号 / ステップ』が何を意味するか言える
- ☐ SSDSE-B(または同等の実データ)で手を動かして試した
- ☐ 主な落とし穴 5 つを挙げられる
- ☐ 類似手法との違いを 1 行で説明できる
- ☐ 何の前提(独立性、 線形性、 分布など)を要求するか把握した
- ☐ 結果の不確実性(信頼区間・予測区間・分散)を扱えるか確認した
- ☐ 上位カテゴリ『大規模言語モデル』のグループ教材を読んだ
- ☐ 関連手法と比較したうえで、 なぜ プロンプト を選んだか文書化した
- ☐ 結果を再現できるよう、 seed・バージョン・データ取得日を記録した
📜 歴史と発展
GPT-3 (2020) の few-shot learning 論文で『プロンプティング』という言葉が普及。 2021 年に PromptSource, OpenPrompt などのライブラリが登場。 Chain-of-Thought (Wei 2022) で大規模モデルの推論能力が解放され、 急速に研究分野化。
「プロンプト」が技術用語になったのは GPT-3 (Brown et al. 2020) からで、 それ以前は入力文を指す一般語にすぎませんでした。 転機は「重みを更新せずに、入力文だけでタスクを切り替えられる」という発見(in-context learning)です。 それまで新しいタスクにはファインチューニングが必要だったので、 「学習」と「入力」の境界が動いたことになります。 プロンプトが研究対象になったのは、 この境界の移動の帰結です。
🚀 応用事例 ── プロンプト はどこで使われているか
『プロンプト』は理論だけでなく、 産業・研究の様々な現場で実用されています。 ここでは代表的な応用を 6 つ挙げます。
- 質問応答 — 知識検索
- コード生成 — 「Python で〜書いて」
- 文書要約 — 長文要約
- 翻訳 — 言語間翻訳
- 対話 — ロールプレイ
- 分析支援 — データから洞察
どの応用も「何を入力とし、 何を出力すべきか」を整理した上で、 上の Python 実装をベースに拡張するアプローチが定石です。 SSDSE-B のような公開データセットで小さく試し、 動作確認できてから本番データに展開すると安全です。
📊 ベンチマーク比較 ── プロンプト の主要バリエーション
『プロンプト』には多くの派生・バリエーションがあります。 代表的なものを精度・特徴で比較した表です。
| 手法 / バージョン | 指標 / 特徴 | 備考 |
|---|---|---|
| zero-shot | 「翻訳して」 | 例なし |
| one-shot | 1 例 + クエリ | 簡単 |
| few-shot | 数例 + クエリ | in-context learning |
| Chain-of-Thought | 推論ステップ明示 | 数学・論理↑ |
| Role prompt | ロール指定 | 応答スタイル制御 |
数値は論文公表時点のもので、 計測条件(データ・前処理・ハイパーパラメータ)が異なります。 自分の問題で再評価することを推奨。
✨ 実装ベストプラクティス ── プロンプト を堅牢に使う
- 小さく始める — SSDSE-B の 47 行のような小データでパイプライン全体を確立してから本番データへ。
- seed を固定 — numpy, torch, random の全 seed を記録。 再現性チェックは必須。
- バージョン管理 — requirements.txt と環境スナップショット、 データの取得日を記録。
- 段階的に複雑化 — まずベースライン(線形、 ロジスティック)→ 古典的 ML → プロンプト の順。 突然複雑化しない。
- 可視化を欠かさず — 学習曲線、 特徴分布、 残差プロットを毎回確認する。
- テスト集合を分離 — 探索・調整に絶対使わない『最終評価』用データを別途確保。
- ハイパーパラメータは記録 — 全実験で何を試したか mlflow / wandb / spreadsheet に。
- 失敗パターンも残す — 「ダメだった設定」も価値がある。 後輩や未来の自分が助かる。
🔍 似た用語との違い ── プロンプト を正確に切り分ける
『プロンプト』は周辺の似た用語と混同されがちです。 ここでは特に紛らわしい用語との本質的な違いを整理します。
- 『プロンプト』は LLM カテゴリの中で特定の役割を持つ。 一般概念と混同しないよう注意。
- 類似手法と比べて得意な領域:上の『🚀 応用事例』で挙げた問題群。
- 類似手法と比べて不得意な領域:『⚠️ 落とし穴』に明示された制約に該当する場合。
- 使い分けの目安:データ量、 計算リソース、 解釈性要求、 精度要求の 4 軸でマトリクスを作る。
- 不確かなときは両方走らせて結果を比べるのが正解。 SSDSE-B のような小データなら 1 時間で試せる。
📖 さらに深く学ぶリソース
教科書・本
- Bishop『Pattern Recognition and Machine Learning』 — 統計的機械学習の古典
- Goodfellow『Deep Learning』 — 深層学習の標準教科書(無料 PDF あり)
- Murphy『Probabilistic Machine Learning』 — Bayes 視点の機械学習
- 有賀『仕事ではじめる機械学習』 — 実務寄り、 日本語
論文プラットフォーム
- arXiv.org — 最新プレプリント(cs.LG, stat.ML カテゴリ)
- Papers with Code — 論文と実装コードがセット
- OpenReview — NeurIPS, ICLR の査読プロセスが見える
- Google Scholar — 引用ネットワークで辿る
ライブラリ・実装
- scikit-learn — 古典的 ML の標準
- PyTorch / TensorFlow — 深層学習
- Hugging Face Transformers — Transformer 系モデル
- OpenAI / Anthropic / Google API — LLM の API
公開データセット
- SSDSE-B(本ページの実例で使用)—
data/raw/SSDSE-B-2026.csv。 47 都道府県の社会・人口指標 - SSDSE-A / SSDSE-C / SSDSE-D / SSDSE-E — 統計コンペで頻出
- e-Stat — 政府統計の総合窓口
- RESAS — 地域経済分析システム
🔎 プロンプト を深く知る ── 専門家視点の詳細
プロンプトの構成要素
良いプロンプトは典型的に以下の要素から構成される:
- ロール / コンテキスト:「あなたは○○の専門家です」
- タスク定義:「以下の入力を△△してください」
- 入力データ:実際のデータや質問
- 出力フォーマット:「JSON で」「箇条書きで」「300字で」
- 制約・禁止事項:「日本語のみ」「個人情報を含めない」
- 例(few-shot):望ましい入出力例
- 推論ガイド:「ステップごとに考えて」
プロンプトの種類
- system prompt:会話全体のキャラクタ・制約を定義
- user prompt:ユーザの実際の質問
- assistant prompt:モデルの過去応答(履歴)
- function prompt:呼び出すツール・関数の定義
- tool result:ツール実行結果のフィードバック
プロンプト設計のコツ
- 具体的に:「短く」より「200 字以内」、 「リスト」より「番号付き箇条書き」
- 例を見せる:抽象的な指示より 1〜3 例の実例
- ネガティブも明示:「○○はしないでください」
- 段階分解:複雑タスクは複数プロンプトに分解(Chain-of-Thought)
- 検証:同じプロンプトを 5 回実行し、 一貫性を確認
失敗パターン
- 曖昧な指示:「要約して」→ 字数・観点・形式が不明
- 矛盾する指示:「短く詳しく」
- 過剰な制約:詰め込みすぎでモデルが混乱
- 例の偏り:例示が特定パターンに偏る
- システムプロンプトの無視:ユーザプロンプトに上書きされる
本セクションは『プロンプト』の技術的核心を深掘りしました。 表面的な使い方を超えて、 内部の仕組みを理解することで、 トラブル時の診断や応用時のカスタマイズが可能になります。 SSDSE-B のような実データに当てはめながら、 ぜひ手を動かして確認してください。
💼 実務での プロンプト ── 補足と運用知識
プロンプトの長さと費用
LLM API は入力(プロンプト)と出力の合計トークン数で課金される。 料金はモデルと時期で変わる(たとえば GPT-4 Turbo の公表価格は入力 0.01 ドル / 1k トークン、 出力 0.03 ドル / 1k トークンだった)ので、 見積もりは使う時点の価格表で行う。 長いプロンプトはコストとレイテンシを増やすので、 必要最小限に絞るのが原則。 一方で短すぎる指示は精度を落とすため、 トレードオフがある。
プロンプトとファインチューニングの使い分け
| 観点 | プロンプト | Fine-Tuning |
|---|---|---|
| 初期コスト | ゼロ | 高(GPU・データ) |
| 実行コスト | 毎回プロンプト分 | 短くて済む |
| 柔軟性 | 高 | 低(再学習要) |
| 精度 | 中〜高 | 高(特化タスク) |
| 説明可能性 | 高(テキスト) | 低(重み) |
SSDSE-B 分析でのプロンプト例
『あなたは政府統計の分析家です。 以下に SSDSE-B の 47 都道府県データから抜粋した CSV があります。 [データ] このデータから、 ① 出生率の高い 5 県とその要因仮説、 ② 合計特殊出生率(A4103)と保育所等定員数(J2505、 人口あたり)の相関、 ③ 政策示唆を、 Markdown 表と 300 字の論考で報告してください。 出典として SSDSE-B-2026 を明記してください。』のような構造化プロンプトが効果的。 ② で頼む量は、 表にある列から選ぶ。 SSDSE-B には所得の列が無いので、 「出生率と所得の相関」と頼むと、 モデルがデータに無い所得の値を作って相関を語ってしまう。
理論を理解した次は、 実務に落とし込むためのノウハウが重要です。 SSDSE-B のような身近なデータで小さく試し、 動かしながら学ぶことで体得できます。 失敗してもコストは小さく、 学びは大きい。