🔖 拡張キーワード索引
この用語『シグモイド関数』を理解するうえで併せて押さえたい関連キーワード群です。 クリック(ホバー)で関連用語ページに飛べます。
💡 30秒で分かる結論
🍰 まずはやさしく
数字を0から1にまとめる道具です。
データの分析や予測のために使います。
スマホのアプリなどで活用されています。
この章では使い道や注意点を読みます。
0〜1に押し込むS字型活性化関数
- 分野:深層学習 — 📚 ニューラルネットワーク基礎
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
sigmoid を 30 秒で把握する重要ポイント:
- 何ができるか: sigmoid は統計・データ分析で特定の目的のために使う概念・手法。 詳細は後続の各章を参照。
- いつ使うか: 適切な前提条件下で、 他の手法より優位な場面で使う。 適用範囲と限界を理解することが重要。
- 注意点: 前提確認 / 過大解釈の回避 / 他手法との比較検証 が不可欠。
- 関連: 上位概念・並列手法・派生形をネットワークで理解すると応用の幅が広がる。
📍 あなたが今見ているもの
🍰 まずはやさしく
2つのグループに分けるための関数です。
正解か不正解かを判定するために使います。
テストの点数で合格かを決めるような例です。
ここでは分類での役割について読みます。
この用語ページは「シグモイド関数」を、 深層学習・分類問題の文脈で解説しています。 ロジスティック回帰の出力、 ニューラルネットの活性化関数、 二値分類の確率変換、 という 3 つの役割を同時に説明する関数です。 SSDSE-B-2026 で「合計特殊出生率が中央値以上か」を判定する例で具体的に使います。
🎨 直感で掴む
🍰 まずはやさしく
どんな数字も0から1にするS字スイッチです。
確率(起こりやすさ)に変えるために使います。
部活のメンバーが来る確率を出すような例です。
数字がどう変化するかを直感的に読みます。
シグモイドは 「どんな実数も 0〜1 に押し込む S 字スイッチ」。 入力 z=0 で出力 0.5、 z=+2 で約 0.88、 z=-2 で約 0.12、 z=±5 では 0/1 にほぼ張り付きます。 ロジスティック回帰の「確率変換」、 ニューラルネットの「ゲート開閉」、 二値分類のしきい値判断、 いずれも「連続値 → 0〜1 の確率」に変える役を担います。
SSDSE-B-2026 で例えると、 47 都道府県の合計特殊出生率 (TFR) から計算した z スコアをシグモイドに通すと、 各県が「全国中央値より高い確率」として 0〜1 の数字で出ます。 沖縄 (TFR 1.7 付近) → 0.95、 東京 (TFR 1.1 付近) → 0.05 のように、 はっきり高い/低いほど 0 か 1 に張り付き、 境界付近 (TFR 1.3 付近) では 0.5 に近い「判断保留」の値になります。
🎨 直感を深掘り
シグモイドは『どんな実数も 0〜1 に押し込める』S字カーブの関数 $\sigma(z) = 1/(1+e^{-z})$。 z が大きければ 1 に、 小さければ 0 に、 0 付近では 0.5 になる。 二値分類で『陽性確率』を表現するときの定番。 ニューラルネットの隠れ層では勾配消失問題から廃れ気味だが、 出力層・ゲート(LSTM, GRU)・アテンションのマスク等では現役。
微分が $\sigma'(z) = \sigma(z)(1 - \sigma(z))$ と 自分自身の出力だけで書けるのがシグモイドの強み。 これにより誤差逆伝播の勾配計算が「掛け算 1 回」で済み、 1986 年の Rumelhart らの BP 論文以降、 隠れ層活性化関数のデファクトになりました。 ただし $|z|>5$ で勾配が $\sigma(z)(1-\sigma(z)) \approx 0$ に張り付く「勾配消失」問題があり、 2010 年代の深層 NN では ReLU に主役を譲りました。
現在の用途は 「出力層での確率変換」に絞られます: 二値分類 (病気/健康・購入/離脱) の出力、 LSTM/GRU の忘却ゲート (古い記憶を残す割合)、 アテンションのマスク (softmax 前の重み制限)。 多クラス確率には softmax、 隠れ層の非線形には ReLU を使い、 「シグモイドは 0〜1 の確率が欲しいときだけ」と覚えるのが現代的な使い分けです。
🎮 触って理解する ── シグモイドをスライダーで動かす
ゲイン a(曲線の急峻さ)とバイアス b(中心位置)をスライダーで動かすと、 $\sigma(x)=\dfrac{1}{1+e^{-a(x-b)}}$ がリアルタイムで再描画されます。 グラフ上にカーソル(スマホは指)を置くと、 その $x$ での出力 $\sigma(x)$ と導関数 $\sigma'(x)=a\,\sigma(1-\sigma)$ が下に表示されます。 a を大きくするとステップ関数(0/1 の階段)に近づき、 a を小さくするとなだらかな坂になります。 導関数は中心 $x=b$ で最大($a=1$ のとき 0.25)、 両端では ≈0 に張り付き、 これが「勾配消失」の正体です。
💡 試してみよう:(1) a を 8 まで上げてステップ関数化を確認 → (2) a を 0.2 まで下げて「ほぼ直線」を確認 → (3) b を動かして S 字が左右に平行移動するのを確認 → (4) カーソルを両端(x=±6 付近)に置き σ'(x) がほぼ 0 になる勾配消失を体感 → (5) tanh / ReLU にチェックを入れて形の違いを重ねて比較。
🔑 シグモイドの3つの性質
- 有界性 (0, 1):入力がどんなに大きく/小さくなっても出力は必ず 0 と 1 のあいだに収まり、 0 や 1 そのものには到達しません。 だから「確率」として扱えます。
- S 字・単調増加:曲線は途切れず滑らか($C^\infty$)で、 常に右上がり。 中心 $(b,\,0.5)$ に関して点対称で、 $\sigma(-z)=1-\sigma(z)$ が成り立ちます。
- 確率解釈:出力 0.7 は「70% の確からしさ」であって「10 人中 7 人が必ず起こる」ではありません。 個々の事象の信頼度を表す 1 個の確率です。
🧮 導関数と勾配消失 ── なぜ深い層で困るのか
シグモイドの導関数は $\sigma'(z)=\sigma(z)\,(1-\sigma(z))$ と、 自分の出力だけで書けます(上のパラメータ版では鎖法則で $a$ 倍され $\sigma'(x)=a\,\sigma(1-\sigma)$)。 形状因子 $\sigma(1-\sigma)$ は $\sigma=0.5$ で最大値 0.25 を取り、 両端(飽和域)では 0 に近づきます。 誤差逆伝播では層をさかのぼるたびにこの値を掛け続けるため、 各層で最大 0.25 という「1 未満の数」の積が重なり、 深い層ほど勾配が指数的に小さくなって学習が止まります。 これが勾配消失問題で、 活性化関数の選択が深層学習で重要になった直接の理由です。
📈 ロジスティック回帰での役割
ロジスティック回帰は、 線形結合 $z=w^\top x + b$ をシグモイドに通して確率 $p=\sigma(z)$ を出します。 逆に見れば $\log\dfrac{p}{1-p}=z$、 つまりロジット(対数オッズ)を特徴量の線形和でモデル化している、と読めます。 係数 $w_j$ は「特徴量 $x_j$ が 1 増えると対数オッズが $w_j$ 増える/オッズが $e^{w_j}$ 倍になる」という解釈を持ち、 シグモイドはこの線形なロジット空間を (0,1) の確率へ橋渡しする変換装置です。
⚔️ tanh / ReLU との比較
tanh は $\tanh(z)=2\sigma(2z)-1$ とシグモイドの親戚で、 出力が $(-1,1)$・ゼロ中心なので学習が安定しやすい一方、 やはり両端で飽和し勾配消失します。 ReLU $\max(0,z)$ は正の領域で勾配が常に 1 なので消失せず計算も軽く、 2010 年代以降の隠れ層の標準になりました(上のグラフで ReLU が上方向に無限に伸びる=非有界なのが分かります)。 現代の使い分けは「隠れ層は ReLU 系、 出力層で 0〜1 の確率が欲しいときだけシグモイド」です。
🎯 softmax との関係
シグモイドは softmax の 2 クラス版です。 2 クラスの softmax $\dfrac{e^{z_1}}{e^{z_0}+e^{z_1}}$ は分子分母を $e^{z_1}$ で割ると $\dfrac{1}{1+e^{-(z_1-z_0)}}=\sigma(z_1-z_0)$ になり、 まさにシグモイドと一致します。 使い分けは出力の性質で決まります:相互排他の多クラス(1 枚の画像が「犬 or 猫 or 鳥」のどれか一つ)は総和が 1 になる softmax、 多ラベル(1 件に「東北」「医療」「観光」が同時に付きうる)は各ラベル独立にシグモイドを並べます。
📐 定義
🍰 まずはやさしく
0から1の範囲に押し込める数式です。
計算を正確に行うために使います。
買い物で予算内に収まるか考えるような例です。
ここからは具体的な数式の意味を読みます。
0〜1に押し込むS字型活性化関数
英語名 Sigmoid。 定義式は $\sigma(x) = \dfrac{1}{1 + e^{-x}}$ で、 任意の実数 $x$ を $(0, 1)$ 区間へ押し込みます。
📐 数式の読み解き ── シグモイド関数 の核心式
シグモイドと、 その微分。 微分は出力値だけで計算でき、 効率的。
数式の各記号が『何の量で、 どの空間に住み、 どんな単位を持つか』を意識すると、 暗記でなく構造として理解できます。 SSDSE-B の都道府県データに当てはめて、 各シンボルが何に対応するかを上の Python 実装で確認しましょう。
❓ FAQ ── シグモイド関数 のよくある質問
まずは本ページの『💡 30 秒で分かる結論』と『🎨 直感で掴む』で全体像を掴み、 次に『🧮 実値で計算してみる』を 手を動かして追体験するのが最短です。 数式や深い理論はその後で十分。
本ページの『🌐 関連手法・派生』『🔗 関連用語』で対比される手法を確認し、 それぞれの適用条件と得意・不得意を表で比較するのが効果的です。 SSDSE-B のような共通データセットで両方走らせて結果を見ると違いが体感できます。
シグモイド関数そのものの計算量は要素 1 個あたり $O(1)$ で、 $n$ 個に適用しても $O(n)$。 コストは問題になりません。 注意すべきは計算量ではなく数値的な安定性です。 $\sigma(x) = 1/(1+e^{-x})$ をそのまま実装すると、 $x = -800$ で $e^{800}$ がオーバーフローして inf になります(float64 の上限は $e^{709}$ 付近)。 実装では $x \ge 0$ なら $1/(1+e^{-x})$、 $x < 0$ なら $e^{x}/(1+e^{x})$ と場合分けするのが定石で、 scipy.special.expit はこれをやってくれます。 軽い関数ほど「素朴な式をそのまま書く」誘惑が強く、 そこに落とし穴があるという典型例です。
『点推定値』だけでなく『不確実性(CI、 SE、 分散)』『前提条件のチェック結果』『代替手法との比較』『データ取得日と seed』をセットで報告するのが標準。 査読・レビューで問われる典型ポイントです。
📐 シグモイドと「人口学的しきい値」── 実務で使える 6 つの読み替え表
SSDSE-B-2026 のような公的統計を使うとき、 シグモイド出力をそのまま見せると「0.6 ってどういう意味?」と混乱されがちです。 実務の合意形成では「確率 → リスク段階」の翻訳が必要。 下表は 47 都道府県の人口分析でよく使う 6 段階の対応表です。
| σ(x) 範囲 | リスク段階 | 対応する SSDSE 例 | 推奨アクション |
|---|---|---|---|
| σ < 0.10 | 極低 | 東京都 (人口増) | 監視継続 |
| 0.10 ≤ σ < 0.30 | 低 | 神奈川県 | 3 年に 1 度の点検 |
| 0.30 ≤ σ < 0.50 | 中 | 大阪府 | 年次レポート |
| 0.50 ≤ σ < 0.70 | 高 | 福井県 | 半期レビュー |
| 0.70 ≤ σ < 0.90 | 最高 | 秋田県 | 四半期レビュー+政策提案 |
| σ ≥ 0.90 | 緊急 | 高知県 | 即時介入 |
この 6 段階表は「シグモイド出力を 0.5 で機械的に二値化する」のではなく、 「6 段階で粒度を上げる」のがコツ。 0.5 で切るのは AUC 最大化と相性が良い数学的選択ですが、 政策提言では「中→高」「最高→緊急」のような定性的段階を残した方が議論しやすい。 SSDSE-B-2026 のような社会統計では、 シグモイド出力を 6 段階に翻訳してから合意形成へ進めるのが実用的です。
🧩 シグモイド vs 他の「0〜1 圧縮関数」 ── 6 関数の特性比較表
「実数を 0〜1 に押し込む」関数はシグモイドだけではありません。 用途や速度に応じて選択肢があります。 47 県の人口減少率 (-7%〜+3%) を入力にしたときの出力範囲と、 主な特徴を比較します。
| 関数 | 数式 | 出力範囲 | 特徴 | 主な用途 |
|---|---|---|---|---|
| Sigmoid | 1/(1+e−x) | (0, 1) | 滑らか、 飽和あり、 平均 0.5 | 二値分類、 確率出力 |
| Tanh | (ex−e−x)/(ex+e−x) | (−1, 1) | 原点対称、 ゼロ平均 | RNN 隠れ状態 |
| Hard sigmoid | max(0, min(1, 0.2x+0.5)) | [0, 1] | 線形近似、 高速、 微分が定数 | モバイル NN、 LSTM |
| Softplus | log(1+ex) | (0, ∞) | 非負、 ReLU の滑らか版 | 分散パラメータ |
| Swish | x · σ(x) | (−0.28, ∞) | 非単調、 自身に σ を含む | EfficientNet、 BERT 系 |
| GELU | x · Φ(x) | (−0.17, ∞) | 確率的 ReLU、 Transformer 系 | GPT / BERT / ViT |
「確率を返したいときは sigmoid」「特徴抽出ならば swish や GELU」「軽量化したいときは hard sigmoid」と用途で使い分けます。 47 県分の二値分類ではシグモイド一択ですが、 これが画像 1 万枚や文章 1 億トークンになると Swish / GELU の方が学習が安定します。
🛠 シグモイド逆関数 (ロジット) の実務的価値 ── A/B テストでの効果量算出
シグモイドの逆関数 ロジット関数 logit(p) = log(p/(1−p)) は、 A/B テストの実務で「確率差」を「対数オッズ差」に変換するときに必須。 例えば SSDSE-B-2026 を題材にした政策評価で「政策 A 適用群の高齢化超過確率 0.65 → 政策 B 適用群 0.55」と分かったとき、 差は単純引き算なら「0.10」ですが、 オッズ比 (logit 差) で見ると効果はもっと大きいことがあります。
このコードでやること:政策 A 群・B 群の高齢化超過確率を仮に 0.65・0.55 と置き、 シグモイドの逆関数(ロジット)で確率差・オッズ比・対数オッズ差を計算する(2 つの確率は説明用の仮の値)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np def logit(p): return np.log(p / (1 - p)) P_A = 0.65 # 政策 A 群の高齢化超過確率 P_B = 0.55 # 政策 B 群の高齢化超過確率 diff_raw = P_A - P_B odds_A = P_A / (1 - P_A) odds_B = P_B / (1 - P_B) odds_ratio = odds_A / odds_B log_odds_diff = logit(P_A) - logit(P_B) print(f'確率差 (生の差): {diff_raw:+.3f}') print(f'オッズ A: {odds_A:.3f}') print(f'オッズ B: {odds_B:.3f}') print(f'オッズ比 (A vs B): {odds_ratio:.3f}') print(f'対数オッズ差 (logit): {log_odds_diff:+.3f}') |
📤 実行結果:
💬 結果の読み方:確率差は +0.100 だが、 オッズで見ると A が 1.857、 B が 1.222 で、 オッズ比は 1.519、 対数オッズ差は +0.418 になる。 ただしオッズ比 1.52 は「A の起こりやすさが 1.5 倍」という意味ではなく、 確率そのものの比(リスク比)は 0.65 ÷ 0.55 = 1.18 倍にすぎない。 確率が 0.5 付近のときはオッズ比がリスク比より大きく出るので、 報告するときはどちらの比かを必ず書き分ける。 ロジスティック回帰の係数が表すのは、 この対数オッズ差の方である。
🎯 練習問題 ── シグモイドを「自分で動かす」5 問
- 練習問題 1 (基本計算): x = -2, 0, 2 のとき、 σ(x) と σ′(x) をそれぞれ計算してください。 暗算でも電卓でも OK。 答え: σ(-2)=0.119, σ(0)=0.500, σ(2)=0.881。 σ′(0)=0.250 (最大)。
- 練習問題 2 (SSDSE 実演): SSDSE-B-2026 の
A1101(人口) を読み込み、 全 47 県の対数 (log) を取って σ に通したとき、 最頻値はどの bin か答えてください。 ヒント: 本ページ『📊 シグモイド出力分布のヒストグラム』の方法を流用。 - 練習問題 3 (校正): もしモデルが bin (0.5, 0.75] で「予測平均 0.62 → 実測率 0.32」を返したら、 過信か過小評価か、 どちらに「校正ずれ」していますか? また、 何を行うべきか?
- 練習問題 4 (関数選択): 多ラベル分類 (1 つのデータに「東北」「医療」「観光」のような複数タグ) では、 sigmoid と softmax のどちらを使うべきですか? 理由を 50 字以内で書いてください。
- 練習問題 5 (理解度チェック): シグモイド出力 σ=0.7 を「7 人に 7 人が起こる」と解釈する人がいたら、 どこが間違っているか説明してください。 「やってみよう」「自分で」 試すなら、 SSDSE-B-2026 の中から自分の都道府県を選び、 本ページ『📈 SSDSE-B-2026 で「人口減少率 → 高齢化超過確率」をシグモイドで予測する』のロジスティック回帰を当てはめて、 σ(x) と odds を計算してみると体感できます。
これら 5 問は、 シグモイドを「数式として知る」「関数として呼ぶ」だけでなく、 「実データに当てて意味を読む」段階まで引き上げる練習問題です。 全問正解できれば、 シグモイドが「教科書の最初に出てくる関数」から「あなたの分析の道具箱に常駐する関数」に格上げされたサインです。
🎬 R630 追補ナレーション ── シグモイドを SSDSE-B-2026 と一緒に育てる
この R630 追補ブロックでは、 シグモイド関数を「数式」から「47 都道府県の高齢化リスク分析」へ橋渡ししました。 散布図で「減少率 → 確率」の関係を見せ、 ヒストグラムで「47 県の予測分布」を見せ、 箱ひげ図で「地域偏り」を可視化。 さらにオッズ・対数オッズ・校正・逆関数・多関数比較と、 シグモイドが現代の機械学習でどう生き続けているかを実値ベースで示しました。
シグモイドは古い関数ですが、 LSTM のゲート、 Transformer の Attention のマスク、 GAN の判別器、 そして A/B テストの logit 差で「今なお」現役。 SSDSE-B-2026 のような身近な統計に当てれば、 「教科書の絵」ではなく「あなたの故郷の高齢化予測」として動き出します。 ぜひ、 47 都道府県のうち自分に縁のある県を一つ選び、 σ(x) を計算してみてください。 数式の隣に都道府県名が並んだ瞬間、 シグモイドは「友達」になります。
🔬 数式を言葉で読み解く
| 記号 | 意味 | SSDSE-B-2026 文脈での具体例 |
|---|---|---|
$x$ | 入力(実数) | 線形モデル $w_1 \cdot \text{A4101}_i + w_2 \cdot \text{D1101}_i + b$ の出力(ロジット) |
$e^{-x}$ | 指数項 | $x$ が大きいほど $e^{-x} \to 0$、 出力 $\to 1$ |
$\sigma(x)$ | 出力(確率) | 「合計特殊出生率 ≥ 中央値」となる確率(東京 0.12、 沖縄 0.94 等) |
$\sigma'(x)$ | 導関数 | $\sigma(x)(1-\sigma(x))$ で表せる ── 誤差逆伝播で頻出 |
$x=0$ で $\sigma=0.5$、 $x=\pm 4$ あたりで飽和。 飽和域では勾配が小さくなり「勾配消失」を引き起こす点に留意。
🎯 いつ・どこで使うか
- 「深層学習」分野の標準的な道具として、 多くの分析で登場します。
- 📚 ニューラルネットワーク基礎 を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
🔬 シグモイドと最尤推定の数学
ロジスティック回帰の損失(二値交差エントロピー)は、 ベルヌーイ分布の最尤推定から導かれます。 観測 $y_i \in \{0,1\}$ が独立で、 $P(y_i=1|x_i) = p_i = \sigma(z_i)$、 $z_i = w^T x_i + b$ とすると、 尤度は:
$$ L(w,b) = \prod_{i=1}^n p_i^{y_i} (1-p_i)^{1-y_i} $$
対数尤度の負を取ると:
$$ -\log L = -\sum_i \left[ y_i \log p_i + (1-y_i) \log(1-p_i) \right] $$
これが「二値交差エントロピー(BCE)」と呼ばれる損失で、 シグモイドを通した出力に対する標準的な目的関数です。 さらに勾配を計算すると:
$$ \frac{\partial L}{\partial w} = \sum_i (p_i - y_i) x_i $$
驚くほどシンプル。 「予測確率と正解の差」をそのまま入力ベクトルに掛けるだけ。 シグモイドの微分項 $\sigma'(z) = \sigma(z)(1-\sigma(z))$ は、 BCE と組み合わせるとキャンセルして消える、 という美しい構造があります。
数値例:3 サンプル手計算
| i | y | z = w·x | p = σ(z) | 残差 p-y | BCE 寄与 |
|---|---|---|---|---|---|
| 1 | 1 | +2.0 | 0.881 | -0.119 | 0.127 |
| 2 | 0 | -1.0 | 0.269 | +0.269 | 0.313 |
| 3 | 1 | -0.5 | 0.378 | -0.622 | 0.974 |
サンプル 3 のように「正解は 1 なのに確率 0.378」だと、 BCE 寄与が 0.974 と大きくなり、 強く修正される。 シグモイドが間違いを「自動的に大きな勾配で罰する」設計になっていることが分かります。
🎓 シグモイドが「最初に学ぶ非線形性」である理由
機械学習の教科書では、 線形回帰の次にロジスティック回帰、 すなわちシグモイドが登場します。 なぜシグモイドが「最初の非線形性」として選ばれるのか? 理由は 4 つあります。
- 解釈可能性:出力が確率として直接読める。 ReLU の出力「3.7」と言われても意味が分からないが、 シグモイドの「0.85」は「85% の確信」と言い切れる。
- 滑らかな微分:あらゆる点で微分可能。 勾配降下法を最小限の数学で説明できる。
- 解析的に閉じる:BCE と組み合わせると勾配が
(p-y)xと劇的にシンプルになり、 黒板で導出できる。 - 歴史的継続性:1838 年から続く流れ。 ロジスティック方程式 → ロジスティック回帰 → ニューラルネット → LSTM ゲート、 と一貫した文脈を持つ。
統計コンペで頻出する「ロジスティック回帰の係数解釈」「ROC 曲線」「校正された確率」などの議論は、 すべてシグモイドの理解が前提です。 表面的に LogisticRegression().fit() を呼ぶだけではなく、 「自分のモデルがシグモイドのどの位置で予測しているか」「勾配がどう流れているか」を意識できるようになると、 デバッグ力が一段階上がります。
🔀 シグモイド vs ソフトマックス vs ハードシグモイド
シグモイドは「2 クラス用」、 ソフトマックスは「多クラス用」と覚えがちですが、 実は数学的にはシグモイドはソフトマックスの 2 クラス特殊ケースです。 入力 $z$ を $(z, 0)$ として扱うとソフトマックスがシグモイドに退化します。 つまり「ソフトマックスはシグモイドの一般化」。
| 関数 | 入力 | 出力 | 用途 |
|---|---|---|---|
| sigmoid | スカラー z | スカラー p ∈ (0,1) | 二値分類、 マルチラベル |
| softmax | ベクトル z ∈ R^K | 確率分布 p ∈ Δ^(K-1) | 多クラス分類(排他) |
| hard sigmoid | スカラー z | クリップ済み [0,1] | モバイル推論 |
| log-sigmoid | スカラー z | log σ(z) ∈ (-∞, 0) | 数値安定な BCE |
マルチラベル分類(1 サンプルに複数タグ)では、 各クラスごとに独立にシグモイドを使い、 「タグごとの ON/OFF」を判定します。 ソフトマックスは「クラスのうち 1 つだけが正解」という前提があるので、 マルチラベルには不適切。 例えば「写真に犬・猫・人が同時に写っている」を予測するなら、 各クラスでシグモイドを使うのが正解です。
マルチラベル分類の実装
1 2 3 4 5 6 7 8 9 10 11 12 | import torch.nn as nn # 出力層は softmax ではなく独立な sigmoid class MultiLabelClassifier(nn.Module): def __init__(self, in_dim, n_labels): super().__init__() self.fc = nn.Linear(in_dim, n_labels) def forward(self, x): return self.fc(x) # logits を返す # 損失は BCEWithLogitsLoss(複数ラベル対応) criterion = nn.BCEWithLogitsLoss() # クラス間の独立性を保つ |
シグモイドを各クラスで独立に使うことで、 「同時に 0 個・1 個・複数個のタグが付く」という柔軟な予測が可能になります。 これに対しソフトマックスは「ちょうど 1 個」を強制する。 用途に応じた選択が重要です。
🌡️ 温度パラメータ:シグモイドの「鋭さ」を制御する
シグモイドに温度 $T$ を導入した $\sigma_T(z) = 1/(1+e^{-z/T})$ は、 確率の「自信度」を調整する仕組みです。 $T < 1$ なら曲線は急峻になり、 出力は 0 か 1 に張り付く方向。 $T > 1$ なら曲線はなだらかになり、 出力は 0.5 付近に集まる方向。
1 2 3 4 5 6 7 8 9 10 11 | import numpy as np import matplotlib.pyplot as plt z = np.linspace(-10, 10, 200) for T in [0.5, 1.0, 2.0, 5.0]: plt.plot(z, 1/(1+np.exp(-z/T)), label=f'T={T}') plt.legend() plt.xlabel('z') plt.ylabel('σ_T(z)') plt.title('温度付きシグモイド') plt.grid(True, alpha=0.3) plt.show() |
深層学習モデルの出力確率を後処理する「Temperature scaling」では、 検証データで NLL(負の対数尤度)を最小化するように $T$ を 1 次元探索で求めます。 $T$ が 1.5〜2.0 になることが多く、 「モデルは過信気味なので温度を上げて確率を平準化する」という補正です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import numpy as np import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.model_selection import train_test_split # ── 2 値分類の題材を用意する(総人口が中央値以上か)── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(12 年度分が重複しないように) _X = _d[['A1301', 'A1303', 'A4101', 'A9101']].astype(float) _y = (_d['A1101'] >= _d['A1101'].median()).astype(int) X_train, X_test, y_train, y_test = train_test_split( _X, _y, test_size=0.3, random_state=0, stratify=_y) _clf = LogisticRegression(max_iter=1000).fit(X_train, y_train) # 温度スケーリングに使う検証データのスコアと正解 val_logits = _clf.decision_function(X_test).astype(float) val_labels = y_test.to_numpy().astype(float) from scipy.optimize import minimize_scalar def nll_loss(T, logits, labels): p = 1/(1+np.exp(-logits/T)) eps = 1e-12 return -np.mean(labels*np.log(p+eps) + (1-labels)*np.log(1-p+eps)) # 検証データで最適温度を探索 res = minimize_scalar(lambda T: nll_loss(T, val_logits, val_labels), bounds=(0.1, 10.0), method='bounded') print(f'最適温度 T = {res.x:.3f}') |
💬 最適温度は T = 0.407 と出たが、この値には意味が無い。標準化していない人口の列をそのまま入れたため、検証用 15 県のスコア(logit)の絶対値は 20〜1,482 と極端に大きく、全県を完全に正しく分けているので、T = 1 でも損失は 10⁻¹⁰ 程度とほぼ 0 である。損失がどの T でも平らなので、最適化は途中の点で止まっているだけで、温度スケーリングは誤りを含む検証データと標準化した特徴量で行って初めて意味を持つ。
SSDSE-B のような小規模データだと、 温度補正の意味は薄いですが、 「モデルの確信度を客観的に評価する」という発想は、 大規模実務でも頻繁に登場します。 シグモイドを「ただの活性化関数」ではなく「校正可能な確率発生器」と捉えると、 一歩進んだモデル設計ができるようになります。
📜 シグモイドにまつわる誤解と真実
誤解 1:「シグモイドはもう古い、 ReLU が常に良い」
確かに隠れ層の活性化は ReLU 系が主流ですが、 出力層・ゲート機構・Attention マスクでは依然としてシグモイドが現役。 適材適所であって、 「常に古い」わけではありません。
誤解 2:「シグモイドの出力は確率」
数学的には (0,1) の値ですが、 校正されていなければ「確率」と呼ぶには注意が必要。 例えば過学習したモデルは確率 0.99 を頻繁に出しますが、 実際の正解率は 80% ということもあります。 必ず Reliability diagram で確認する習慣を。
誤解 3:「シグモイドの勾配は常に消える」
深い層の隠れ層に使うと勾配消失しますが、 出力層 1 層だけなら問題ありません。 また BCE と組み合わせると、 勾配 (p-y) は消失せず、 大きな誤差ほど大きな修正が入ります。
誤解 4:「シグモイドは滑らかだから初期化はどうでもよい」
大きな初期値で $z$ が ±10 を超えると、 勾配が事実上ゼロになりすぎて学習が始まらない「対称性破壊の失敗」が起きます。 Xavier 初期化($\sigma^2 = 1/n_{in}$)は、 シグモイドの飽和域を避けるために設計された初期化法です。
誤解 5:「シグモイドは 1 種類しかない」
ロジスティック関数(標準シグモイド)が代表ですが、 広義には erf、 arctan、 algebraic sigmoid($z/\sqrt{1+z^2}$)、 Gudermannian なども S 字曲線として「シグモイド族」に含まれます。 文脈によって「シグモイド」の指すものが変わるので、 論文を読むときは数式を確認するのが鉄則。
🔬 シグモイドの「校正 (calibration)」を信頼度ダイアグラムで点検する
シグモイド出力 0.7 が「100 回中 70 回は本当に超過する」と信じてよいかを点検するのが 信頼度ダイアグラム (reliability diagram)。 横軸が予測確率、 縦軸が実測の発生率で、 理想は 45 度線。 SSDSE-B-2026 は n=47 と小さいので bin 数を抑えて (4 bin) 集計します。
このコードでやること:47 県の予測確率を 4 bin に区切り、 各 bin の予測平均と実測発生率を比較する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df22 = df[df['SSDSE-B-2026']==2022][['Prefecture','A1101','A1303']] df15 = df[df['SSDSE-B-2026']==2015][['Prefecture','A1101']].rename(columns={'A1101':'A1101_15'}) m = df22.merge(df15, on='Prefecture') m['高齢化率'] = m['A1303'] / m['A1101'] * 100 m['減少率'] = (m['A1101'] - m['A1101_15']) / m['A1101_15'] * 100 m['超過'] = (m['高齢化率'] >= m['高齢化率'].median()).astype(int) clf = LogisticRegression().fit(m[['減少率']], m['超過']) m['予測確率'] = clf.predict_proba(m[['減少率']])[:, 1] m['bin'] = pd.cut(m['予測確率'], bins=[0, 0.25, 0.5, 0.75, 1.0], include_lowest=True) g = m.groupby('bin', observed=True).agg( 予測平均=('予測確率', 'mean'), 実測率 =('超過', 'mean'), 県数 =('超過', 'size'), ).round(3) print(g.to_string()) |
📤 実行結果:
💬 結果の読み方:両端の bin はよく合っており、 (0, 0.25] の 19 県は予測平均 0.065 に対して実測 0.00、 (0.75, 1.0] の 18 県は 0.951 に対して 1.00 である。 ずれるのは中間で、 (0.25, 0.5] は予測 0.441 に対し実測 0.75(4 県中 3 県)と自信不足、 (0.5, 0.75] は予測 0.645 に対し実測 0.50(6 県中 3 県)と過信の側に出ている。 ただし中間の 2 bin は 4 県と 6 県しかなく、 1 県の違いで実測率が 0.17〜0.25 動くので、 この程度のずれで再校正(Platt scaling や Isotonic regression)が必要とまでは言えない。 学習に使った 47 県をそのまま評価している点にも注意する。
🧮 SSDSE-B 実値で計算してみる ── シグモイド関数
都道府県を『高齢化県 / そうでない県』のように二値分類する場面で活躍。 SSDSE-B の高齢化率(A1303 / A1101)を入力 z とし、 シグモイドに通すと『その県が高齢化県である確率』が得られる。
| 項目 | 条件 / 入力 | 結果 / 解釈 |
|---|---|---|
| z = -3 | σ(z) | 0.047 |
| z = -1 | σ(z) | 0.269 |
| z = 0 | σ(z) | 0.500 |
| z = 1 | σ(z) | 0.731 |
| z = 3 | σ(z) | 0.953 |
| z = 6 | σ(z) | 0.998 |
| z = 10 | σ(z) | ≈1.000 |
※ 数値は SSDSE-B-2026.csv から抽出した実値、 もしくは典型的な学習設定での目安値です。 細部の数値は前処理・乱数 seed・実装により変動します。
🧮 シグモイドの「導関数 σ′(x) = σ(x)(1−σ(x))」を実値で検算する
シグモイドが誤差逆伝播 (backpropagation) で大活躍する理由は、 導関数が出力値だけで計算できるからです。 つまり σ′(x) = σ(x)·(1 − σ(x)) と書けるので、 順伝播の値 σ(x) を保存しておけば、 逆伝播のとき微分の計算で「もう一度 σ を計算する必要がない」のです。 ここでは SSDSE-B-2026 で得た 47 県の入力値に対し、 (A) σ(x) を計算、 (B) σ′(x) を 2 通り (公式 vs 数値微分) で計算し、 一致を確認します。
このコードでやること:シグモイド σ(x) と導関数 σ′(x) を SSDSE-B-2026 の人口減少率に適用、 数値微分との一致を確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd import numpy as np # skiprows=0 だと 2 行目の日本語の項目名がデータ行として残り、年度の列が # 文字列のままになる。== 2022 が全部 False になり空になるので skiprows=[1]。 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df22 = df[df['SSDSE-B-2026'] == 2022][['Prefecture', 'A1101']].rename(columns={'A1101': 'pop22'}) df15 = df[df['SSDSE-B-2026'] == 2015][['Prefecture', 'A1101']].rename(columns={'A1101': 'pop15'}) m = df22.merge(df15, on='Prefecture') m['x'] = (m['pop22'] - m['pop15']) / m['pop15'] * 10 # スケーリング def sigmoid(x): return 1 / (1 + np.exp(-x)) # 公式に基づく導関数 m['sigma'] = sigmoid(m['x']) m['d_formula'] = m['sigma'] * (1 - m['sigma']) # 数値微分 (h = 1e-5) h = 1e-5 m['d_numeric'] = (sigmoid(m['x'] + h) - sigmoid(m['x'] - h)) / (2 * h) m['誤差'] = (m['d_formula'] - m['d_numeric']).abs() print('最大誤差:', m['誤差'].max()) print('平均誤差:', m['誤差'].mean()) print(m[['Prefecture', 'x', 'sigma', 'd_formula', 'd_numeric']].head(5).round(6).to_string(index=False)) |
📤 実行結果:
💬 結果の読み方:公式 σ(x)(1−σ(x)) と数値微分の最大誤差は 10-11 桁。 つまり 47 県全部で公式が正しいことが実値で確認できました。 また、 導関数は σ(x)=0.5 で最大値 0.25 を取り、 σ(x)=0 or 1 では 0 に近づく。 これが「シグモイドの飽和領域 (saturation) では勾配が消える」現象で、 ReLU が深層学習で好まれる理由でもあります。
⚖️ オッズ・対数オッズ・シグモイドの「往復関係」を SSDSE で実演する
「確率」「オッズ」「対数オッズ (ロジット)」「シグモイド」の 4 つは互いに変換できる仲間で、 ロジスティック回帰のあらゆる議論はこの 4 つを行ったり来たりする操作と言ってもよいくらいです。 ここでは SSDSE-B-2026 で「高齢化超過確率 0.7」の県を例に、 4 つの表現の対応関係を見ます。
| 表現 | 数式 | P=0.7 の値 | 意味 |
|---|---|---|---|
| 確率 P | P ∈ [0, 1] | 0.700 | 事象が起こる相対頻度 |
| オッズ | P / (1 − P) | 2.333 | 「起こる/起こらない」の比 (賭けの倍率) |
| 対数オッズ x | log(P / (1 − P)) | 0.847 | 線形モデルの出力空間 |
| シグモイド σ(x) | 1 / (1 + e−x) | σ(0.847) = 0.700 | 対数オッズを確率に戻す逆変換 |
対数オッズは 「線形モデルが出力する空間」で、 シグモイドはそれを「確率」に戻す装置。 ロジスティック回帰の係数 (このページで後ほど実際に求める「人口減少率の係数 -1.893」) は「対数オッズ単位」で見たときの効果であり、 「減少率が 1 ポイント上がるごとに対数オッズが -1.893 変化する」 = 「オッズが e-1.893 = 0.151 倍になる」 = 「オッズがおよそ 1/6.6 に縮む」と読み替えられます。 これがオッズ比 (odds ratio) の正体です。
このコードでやること:47 県の予測確率に対し、 確率 → オッズ → 対数オッズ → 再シグモイドの 4 つを併記する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np # 例: 4 県に説明用の仮の確率を割り当てる(モデルの出力ではない) df = pd.DataFrame({ 'Prefecture': ['東京都', '大阪府', '高知県', '北海道'], 'P': [0.05, 0.45, 0.85, 0.92], }) df['オッズ'] = df['P'] / (1 - df['P']) df['対数オッズ'] = np.log(df['オッズ']) df['再シグモイド'] = 1 / (1 + np.exp(-df['対数オッズ'])) df['一致確認'] = (df['P'] - df['再シグモイド']).abs() < 1e-10 print(df.round(4).to_string(index=False)) |
📤 実行結果:
💬 結果の読み方:確率 0.05 の東京都はオッズ 0.0526・対数オッズ −2.9444、 0.92 の北海道はオッズ 11.5・対数オッズ +2.4423 となり、 シグモイドに戻すと 4 県とも元の確率に一致した(一致確認が True)。 確率 0.45 の大阪府のように 0.5 に近いと対数オッズは 0 付近(−0.2007)で、 0 や 1 に近づくほど対数オッズは大きく振れる。 4 つの確率は説明用に置いた仮の値で、 モデルの予測ではない。 これはシグモイドとロジット (対数オッズ) が 互いに逆関数 である数学的事実の実装上の確認です。 ロジスティック回帰の係数解釈や、 ベイズロジスティック回帰の事前分布設定で、 この往復関係が常に頭にあると議論がスムーズになります。
🧮 数式に値を入れて手で計算する: シグモイドの値と微分
合成 z=[-2,-1,0,1,2] でシグモイドと σ'を計算する。
Step 1: シグモイド
| z | σ(z) | σ'(z)=σ(1-σ) |
|---|---|---|
| -2 | 0.119 | 0.105 |
| -1 | 0.269 | 0.197 |
| 0 | 0.500 | 0.250 |
| 1 | 0.731 | 0.197 |
| 2 | 0.881 | 0.105 |
Step 2: 特徴
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np z = np.array([-2,-1,0,1,2]) sig = 1/(1+np.exp(-z)) dsig = sig * (1-sig) print(f"σ: {sig.round(3)}") print(f"σ': {dsig.round(3)}") |
📤 実行結果
💬 σ = [0.119, 0.269, 0.5, 0.731, 0.881] と σ′ = [0.105, 0.197, 0.25, 0.197, 0.105] は Step 1 の表と一致する。 σ は z = 0 を中心に σ(−z) = 1 − σ(z) の点対称なので、 σ′ は左右対称になり、 z = 0 の 0.25 が最大である。 z = ±2 でも σ′ は 0.105 と最大値の 4 割ほどに落ちており、 |z| が大きくなると勾配が急速に小さくなることが数字で見える。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd import numpy as np # データ読み込み(2 行目の日本語の項目名は skiprows=[1] で飛ばす。 # 飛ばさないと項目名がデータ行に混ざり、全列が文字列 object になる) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) print(df.dtypes.value_counts()) print(df[['A1101', 'A1303', 'A4101']].describe().round(0)) # 「シグモイド関数」の文脈で扱う場合の例: # 分野: 深層学習 # 関連手法は同カテゴリの他用語を参照してください。 |
具体的なコードは ニューラルネットワーク基礎 を参照してください。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「シグモイド関数」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
🐍 SSDSE-B を使った Python 実装
公的データ SSDSE-B(47 都道府県社会・人口統計)を読み込み、 シグモイド関数 を実際に動かす最小コードです。 引数のパスは平易さ優先で直書きしています。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(12 年度分が重複しないように) # 高齢化率 = A1303 / A1101 df['aging_rate'] = df['A1303'].astype(float) / df['A1101'].astype(float) # z = (高齢化率 - 平均) / 標準偏差 をシグモイドに通す z = (df['aging_rate'] - df['aging_rate'].mean()) / df['aging_rate'].std() prob_aging = 1 / (1 + np.exp(-z)) for name, p in zip(df['Prefecture'], prob_aging): print(f'{name}: P(高齢化県) = {p:.3f}') |
💬 2023 年度の高齢化率を z 化してシグモイドに通すと、秋田県 0.904、東京都 0.066 のように、平均ちょうどの県が 0.5 になる 0〜1 の値に並ぶ。福井県が 0.500 になるのは高齢化率が 47 県の平均にほぼ等しいからである。これは確率ではなく「平均からの離れ具合」を 0〜1 に押し込んだだけの値で、実際の割合と照らし合わせて校正したものではないので、P(高齢化県) = 0.9 を「90% の確率で高齢化県」とは読めない。
※ 上記スニペットは Python 3.10+ / pandas 2.x / numpy / scikit-learn を想定。 環境構築は『conda create -n ds python=3.11 pandas scikit-learn matplotlib』で十分です。
🐍 SSDSE-B-2026 で「都市的かどうか」を予測してみる
下記コードは data/raw/SSDSE-B-2026.csv を読み込み、 「人口100万人以上=1、 未満=0」を目的変数とした単純ロジスティック回帰を学習し、 シグモイドの動きを観察するハンズオン。 47 サンプルしかないので過学習しやすいが、 シグモイドの確率出力の振る舞いを体感するには十分です。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(12 年度分が重複しないように) df['y'] = (df['A1101'] >= 1_000_000).astype(int) # 100万人以上を1 X = df[['A4101','A4200','C3301']].values # 出生数・死亡数・着工建築物数 y = df['y'].values scaler = StandardScaler() Xs = scaler.fit_transform(X) model = LogisticRegression(max_iter=2000) model.fit(Xs, y) print('係数:', model.coef_) print('切片:', model.intercept_) print('陽性確率(東京):', model.predict_proba(Xs[df['Prefecture'].str.contains('東京')])[0,1]) print('陽性確率(鳥取):', model.predict_proba(Xs[df['Prefecture'].str.contains('鳥取')])[0,1]) |
💬 2023 年度の 47 都道府県で、100 万人以上の 37 都道府県を出生数・死亡数・着工建築物数から判定すると、東京都の陽性確率はほぼ 1、鳥取県は 0.430 になった。3 つの係数(1.14〜1.50)はどれも正で、いずれも県の規模を表すので似た大きさになる。切片 3.05 が大きいのは 37 対 10 と陽性が多いためで、学習データの正解率は 0.872 にとどまり、秋田県(91.4 万人)や福井県など 100 万人未満の 6 県が 0.52〜0.60 で陽性側に入っている。
標準化(StandardScaler)を必ず挟むのがコツ。 出生数のスケール(数千〜10万オーダー)と着工建築物数(数百〜数万オーダー)が混じったまま学習させると、 スケールが大きい列の係数だけが過小評価され、 シグモイドの入力 $z$ が極端な値になって勾配が消えてしまう。
確率出力の可視化
1 2 3 4 5 6 7 8 9 10 | import matplotlib.pyplot as plt z = np.linspace(-8, 8, 200) plt.plot(z, 1/(1+np.exp(-z))) plt.axhline(0.5, color='gray', linestyle='--') plt.axvline(0, color='gray', linestyle='--') plt.xlabel('z (対数オッズ)') plt.ylabel('σ(z) = 確率') plt.title('シグモイド曲線') plt.grid(True, alpha=0.3) plt.show() |
プロットすると、 $z \in [-3, 3]$ あたりが「確率が急に変わる帯」で、 そこを外れると確率はほぼ 0 か 1 に張り付くことが見えます。 ロジスティック回帰の「決定境界」は $z=0$ の点であり、 シグモイドの形状的に「ぼやけたしきい値」を持つ分類器であることを実感できます。
⚠️ よくある落とし穴
BCEWithLogitsLoss は内部で log-sum-exp trick を使い数値安定)。⚠️ 追加の落とし穴 ── 実務で踏み抜く罠
⚠️ 数値計算の落とし穴を細かく潰す
シグモイドの素朴な実装 1/(1+np.exp(-z)) は、 $z$ が大きな負の値(例:-1000)のとき np.exp(1000) でオーバーフローを起こします。 安全な書き方は条件分岐を使う:
def safe_sigmoid(z):
    # z >= 0 の場合は 1/(1+exp(-z))
    # z <  0 の場合は exp(z)/(1+exp(z))
    return np.where(z >= 0,
                    1/(1+np.exp(-z)),
                    np.exp(z)/(1+np.exp(z)))
PyTorch なら torch.sigmoid、 SciPy なら scipy.special.expit が同等の安全実装を提供しています。 自前で書くより、 まず標準実装を使うのが基本。 ただし内部の仕組みを知っておくと、 NaN が出たときに原因を素早く突き止められます。
ログ尤度の安定化
二値交差エントロピー $L = -y \log p - (1-y) \log(1-p)$ もそのまま計算すると、 $p$ がほぼ 0 や 1 のときに $\log 0 = -\infty$ で NaN になる。 PyTorch の BCEWithLogitsLoss はシグモイドと交差エントロピーを一体で計算し、 log-sum-exp トリックで安定化している。 自分でロスを書くときも、 BCEWithLogitsLoss 相当の式 $L = \max(z,0) - z \cdot y + \log(1+e^{-|z|})$ を使うのが鉄則。
1 2 3 4 5 6 | import torch import torch.nn.functional as F logits = torch.tensor([10.0, -10.0, 0.0]) labels = torch.tensor([1.0, 0.0, 1.0]) loss = F.binary_cross_entropy_with_logits(logits, labels) print(loss) # NaN にならない安定値 |
💬 3 件の損失は、正しく自信を持った logit 10 と −10 がそれぞれ log(1+e⁻¹⁰) ≈ 0.0000454、どちらとも言えない logit 0 が log 2 ≈ 0.693 で、その平均が 0.2311 になる。損失のほとんどは 3 件目から来ており、確信を持って当てたデータは損失にほぼ寄与しない。シグモイドを通してから log を取ると p = σ(−100) のような値が 0 に丸められて log(0) になり得るので、logit のまま受け取るこの関数を使うのが安全である。
📊 シグモイドが現れる場所マップ
シグモイドは「無限の入力を [0,1] に圧縮する」という性質から、 機械学習以外の場面にも登場します。 生態学のロジスティック成長曲線、 化学の酸塩基滴定曲線、 神経科学のニューロン発火確率、 経済学の効用関数など。 同じ S 字曲線が、 異なる文脈で再発明されてきた歴史があります。
| 分野 | 出現箇所 | 解釈 |
|---|---|---|
| 統計学 | ロジスティック回帰 | 確率 = σ(線形結合) |
| 深層学習 | 二値分類出力層 | 陽性確率の出力 |
| RNN/LSTM | 忘却ゲート | 情報の保持率(0〜1) |
| 生態学 | ロジスティック方程式 | 個体数の飽和成長 |
| マーケティング | 普及曲線(Bass モデル) | 製品の浸透率 |
| 化学 | 滴定曲線 | pH の遷移帯 |
| 疫学 | 用量反応曲線 | 薬の効き始め |
| 心理学 | 心理測定関数 | 知覚しきい値 |
同じ関数が分野をまたいで現れる理由は、 「ある量が指数的に増加するが、 上限に達して飽和する」という構造が至るところで起きるから。 シグモイドを学ぶことは、 1 つの数学的構造で多くの自然現象を統一的に見る訓練になります。
🔧 シグモイドの実装パターン集
1. NumPy で安定なシグモイド
1 2 3 4 5 6 7 8 | import numpy as np def stable_sigmoid(z): pos = z >= 0 out = np.empty_like(z, dtype=float) out[pos] = 1.0 / (1.0 + np.exp(-z[pos])) exp_z = np.exp(z[~pos]) out[~pos] = exp_z / (1.0 + exp_z) return out |
2. SciPy の expit 関数
1 2 3 | from scipy.special import expit, logit p = expit(np.array([-10, 0, 10])) # [4.5e-5, 0.5, 0.99995] z = logit(np.array([0.01, 0.5, 0.99])) # 逆変換 |
3. PyTorch でのシグモイド活性化
1 2 3 4 5 6 7 8 | import torch import torch.nn as nn class BinaryClassifier(nn.Module): def __init__(self, in_dim): super().__init__() self.fc = nn.Linear(in_dim, 1) def forward(self, x): return self.fc(x) # logits を返す(sigmoid は loss 側で適用) |
4. 自前の二値分類スクラッチ実装
def fit_logreg(X, y, lr=0.01, epochs=1000):
    w = np.zeros(X.shape[1])
    b = 0.0
    n = X.shape[0]
    for _ in range(epochs):
        z = X @ w + b
        p = stable_sigmoid(z)
        grad_w = X.T @ (p - y) / n
        grad_b = (p - y).mean()
        w -= lr * grad_w
        b -= lr * grad_b
    return w, b
スクラッチで書くと、 シグモイドが「予測確率 $p$ と実際のラベル $y$ の差」を勾配としてフィードバックする、 素朴な誤差訂正の仕組みであることが見えます。 これはニューラルネットの誤差逆伝播の最小単位です。
⚠️ シグモイドにまつわる 5 つの追加落とし穴 (SSDSE 実務向け)
- 落とし穴 1: 数値オーバーフロー ──
np.exp(-x)は x が大きな負だと inf を返す。 安全実装はnp.exp(-np.clip(x, -500, 500))またはscipy.special.expit。 47 県の予測くらいでは起きないが、 数百万行に適用するとき注意。 - 落とし穴 2: 校正されていない確率 ── sklearn の
predict_probaはそのままでは「校正済み確率」ではない。 SSDSE-B-2026 のような少サンプル (n=47) ではCalibratedClassifierCV(sigmoid 法/isotonic 法) でキャリブレーション。 - 落とし穴 3: 不均衡データでの 0.5 閾値 ── 仮に「高齢化超過 = 1」の県が 47 中 8 県しかない場合、 P>0.5 で判定すると全部「非超過」になることがある。 F1 スコアを最大化する閾値や、 Youden の J 統計量で閾値を選び直す。
- 落とし穴 4: シグモイドを多クラスに使う罠 ── 3 クラス以上の分類でクラスごとに sigmoid を当てて argmax すると確率が合計 ≠ 1。 多クラスは softmax に切り替える。 sigmoid は多ラベル (1 つのデータに複数タグ可)に最適。
- 落とし穴 5: テストデータでの確率の意味 ── 訓練 47 県でフィットしたモデルに別の年度 (例 2018) を入れると「未知の分布」になり、 シグモイドが返す 0.7 は「2022 基準で見た 0.7」。 共変量シフトを疑う癖をつけましょう。
🌐 シグモイドが拓く分野横断的視点
ベイズ統計の視点
ロジスティック回帰の最尤推定は、 一様事前分布のもとでの MAP 推定と等価。 ベイズ的にパラメータの事前分布を入れると、 L2 正則化はガウス事前、 L1 正則化はラプラス事前と解釈できます。 シグモイドの背後にはベイズ統計の世界が広がっています。
情報理論の視点
BCE 損失は、 真の分布 $q(y)$ と予測分布 $p(y)$ の KL ダイバージェンスから定数を引いたもの。 つまりシグモイドの学習は「予測分布を真の分布に近づける」情報理論的最適化です。
物理学の視点
統計力学のフェルミ・ディラック分布 $f(E) = 1/(1+e^{(E-\mu)/kT})$ はシグモイドそのもの。 物理学者は「ニューラルネットの活性化関数は熱統計力学の表れ」と見ることもあります。 Boltzmann machine、 Hopfield 網などはこの視点で設計されました。
経済学の視点
離散選択モデル(McFadden, ノーベル経済学賞 2000)はロジスティック回帰の経済学版。 「人が複数の選択肢から 1 つを選ぶ確率」を効用関数とシグモイドで定式化しました。
機械学習公平性の視点
シグモイドの出力に対する「しきい値による判定」が、 グループ間で公平かどうかは ML Fairness の中心テーマ。 同じシグモイドモデルでも、 サブグループごとに校正がずれている(calibration disparity)と差別的判定になり得ます。
📋 シグモイドの 12 の事実(暗記用)
- $\sigma(z) = 1/(1+e^{-z})$、 1838 年 Verhulst が初出。
- 値域は (0, 1)、 中心 0.5、 漸近線 0 と 1。
- 微分 $\sigma'(z) = \sigma(z)(1-\sigma(z))$、 $z=0$ で最大値 0.25。
- 逆関数はロジット $\text{logit}(p) = \log(p/(1-p))$。
- ロジスティック回帰 = 線形結合をシグモイドに通したもの。
- BCE 損失は最尤推定から導かれ、 勾配は (p-y)x にキャンセル。
- $|z|>5$ で勾配は 0.007 以下、 深い層で勾配消失。
- 0 中心でない出力は更新に偏り。 tanh で改善。
- BCEWithLogitsLoss、 expit、 stable_sigmoid で数値安定化。
- LSTM のゲート、 Attention マスク、 二値出力で現役。
- 確率校正には Platt scaling、 Isotonic、 Temperature。
- ソフトマックスは多変数シグモイドの一般化。
この 12 項目を即答できれば、 シグモイド理解は十分です。 用語集の他のページ(活性化関数、 ソフトマックス、 ニューラルネット、 ロジスティック回帰、 クロスエントロピー)と組み合わせて、 全体像を掴んでください。
🔁 よくある質問(FAQ)
Q1. なぜ tanh ではなくシグモイドを出力層に使うのか?
tanh の値域は (-1, 1) で、 確率として直接解釈できないからです。 隠れ層では tanh のほうが 0 中心で勾配の流れがよいですが、 出力層は「確率=(0,1) の数」が欲しいので、 シグモイドが標準。 ただし、 出力に「-1 〜 1 のスコア」が必要なら tanh も使われます(例:GAN の generator の最終層)。
Q2. シグモイドの出力に対して argmax を取ってよいか?
単一スカラーの場合は argmax の概念がないので、 通常は「しきい値 0.5 を超えたら陽性」とします。 マルチラベル分類で複数の独立シグモイドを使う場合、 「最も大きい値だけ陽性とする」argmax は本来の意味(複数 ON が可能)を壊すので、 各ラベル独立にしきい値判定するのが正しい使い方です。
Q3. シグモイドの代わりに ReLU を出力に使ったらどうなる?
ReLU の出力は [0, ∞) なので、 確率ではない。 また勾配が突然 0 になる点で、 学習が不安定。 出力層に ReLU を使うのは、 「非負の連続値(例:価格、 距離)を回帰したい」場合だけです。 確率を出したいなら必ずシグモイドかソフトマックス。
Q4. シグモイドは「scale-invariant」か?
いいえ。 入力を 2 倍すると、 $\sigma(2z)$ は元のシグモイドより急峻になります。 これが温度パラメータの考え方の根拠。 学習時には、 重み $w$ がそのスケールを自動的に調整するので問題ありません。 ただし、 学習済みモデルの出力を「もっと自信を持たせたい / 控えめにしたい」場合は、 後処理として温度を変更する選択肢があります。
Q5. シグモイドが定数 0.5 ばかり出力する場合の原因は?
入力 $z$ がほぼ 0 になっている状態で、 これは典型的に「学習が始まっていない」または「データに信号がない」サイン。 原因として、 (a) 重みの初期化が小さすぎる、 (b) 入力データのスケールが大きすぎて勾配が消失、 (c) 学習率が小さすぎる、 (d) ラベルが偏ってクラスバランスが極端、 などが挙げられます。 まずデータの統計量と重みの分布を確認しましょう。
Q6. ロジスティック回帰の係数は「相対リスク」?「オッズ比」?
オッズ比です。 係数 $\beta$ に対し、 $e^\beta$ が「説明変数が 1 単位増えたときのオッズ倍率」。 確率が小さい範囲(例:陽性率 < 5%)では、 オッズ比 ≈ 相対リスクとして扱えますが、 一般には別物。 疫学論文ではこの混同が頻発するので注意。
Q7. シグモイドの計算コストはどれくらい?
$\exp$ の計算が 1 回入るので、 ReLU と比べて数倍遅い(CPU では)。 ただしモダンな GPU では SIMD 命令で $\exp$ がほぼ 1 サイクルで計算できるため、 推論コストの差は実質ゼロ。 ボトルネックは行列積(線形層)であって、 活性化関数ではありません。
Q8. シグモイドを微分しないと逆伝播ができない?
PyTorch や TensorFlow の自動微分は、 シグモイドの微分を内部で自動計算してくれます。 自分で書く必要はありません。 ただし、 BCEWithLogitsLoss のように「シグモイド+クロスエントロピー」を一体化した最適化版があるので、 そちらを使うのが推奨。
🧪 SSDSE-B-2026 で試せる実験デザイン集
SSDSE-B-2026 は 47 都道府県 × 100 以上の指標を持つデータ。 シグモイドを使った二値分類問題を様々に設計できます。 以下のデザインは、 統計コンペで「どのような切り口で分析するか」を考える練習にも有効です。
| テーマ | 目的変数 y | 説明変数候補 | 予想される結論 |
|---|---|---|---|
| 都市/田舎 | 人口 ≥ 100 万 | A4101, A4200, C3301 | 出生数が強い予測子 |
| 高齢化 | 65 歳以上 / 総人口 ≥ 30% | A1101, A4101 | 人口少が高齢化を示唆 |
| 出生過多 | A4101 / A1101 ≥ 中央値 | A1102, C3301 | 15-64 歳人口比が重要 |
| 消費活発度 | C3301 / A1101 ≥ 中央値 | L3221, F3101 | 食費・住居費との相関 |
| 教育充実 | 大学数 ≥ 5 | A1101, C3301 | 人口規模効果が支配的 |
それぞれのデザインで、 LogisticRegression を fit して、 係数(オッズ比)を解釈し、 ROC 曲線・AUC で性能評価する。 シグモイドが「単なる関数」ではなく「分析の道具」として機能する様子を、 実データで何度も体験することが、 統計コンペ準備の核心です。
実装テンプレート
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.metrics import roc_auc_score, classification_report def run_experiment(df, y_def, X_cols, name): y = y_def(df) X = df[X_cols].values Xs = StandardScaler().fit_transform(X) model = LogisticRegression(max_iter=2000).fit(Xs, y) proba = model.predict_proba(Xs)[:,1] auc = roc_auc_score(y, proba) print(f'{name}: AUC={auc:.3f}, coef={model.coef_}') return model, auc df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年度の 47 都道府県に絞る(12 年度分が重複しないように) run_experiment(df, lambda d: (d['A1101'] >= 1_000_000).astype(int), ['A4101','A4200','C3301'], '都市/田舎') run_experiment(df, lambda d: ((d['A1303']/d['A1101']) >= 0.30).astype(int), ['A1101','A4101'], '高齢化') |
💬 都市/田舎の AUC は 1.000 で、全県の予測確率の順番は 100 万人の境目で完全に分かれている。それでも前のブロックでは 0.5 を境に 6 県を取り違えたので、AUC が 1 でも既定の閾値 0.5 で分類が完璧になるとは限らない。高齢化(高齢化率 30% 以上、35 県)は AUC 0.931 で、総人口と出生数の係数がどちらも負(−0.85 と −1.35)、つまり小さい県ほど高齢化県と判定されやすい。学習に使った 47 県で AUC を測っているので、新しいデータでの性能はこれより下がると見ておく。
テンプレートを使って 5 つの実験を回せば、 「シグモイドモデルがどの場面で機能し、 どの場面で機能しないか」が肌感覚で理解できます。 統計コンペでは、 単に AUC が高いモデルを作るだけでなく、 「この問題ではどのような構造があるか」を語れることが重要。 シグモイドの係数解釈はその第一歩です。
📦 終わりに:シグモイドを「友達」にする
シグモイドは「最初に出会うけれど、 ずっと友達でいる関数」です。 ロジスティック回帰、 ニューラルネット、 LSTM、 Attention、 GAN、 強化学習、 どこに行ってもシグモイドが顔を出します。 そのたびに「あ、 また会ったね」と笑って手を振れるようになると、 機械学習の世界がぐっと身近になります。
この用語ページで紹介した「数学」「実装」「校正」「歴史」「分野横断」の 5 つの視点を、 ぜひ自分の手と頭で試してみてください。 SSDSE-B-2026 を使った実験を 3 回も繰り返せば、 シグモイドはもはや謎の関数ではなく、 自分の道具になります。 道具を増やすことが、 データサイエンティストの成長の本質です。
— 「数式は書くだけでは身につかない。 データに当てて、 失敗して、 修正してこそ理解になる。」
🧩 シグモイドの応用拡大編:現代のディープラーニングまで
LSTM の 3 つのゲート
LSTM(Long Short-Term Memory)の中核は 3 つのシグモイドゲート:忘却ゲート $f_t = \sigma(W_f [h_{t-1}, x_t] + b_f)$、 入力ゲート $i_t = \sigma(W_i [h_{t-1}, x_t] + b_i)$、 出力ゲート $o_t = \sigma(W_o [h_{t-1}, x_t] + b_o)$。 それぞれが 0 〜 1 の連続的な「流量バルブ」として、 過去の情報をどれだけ覚え、 新しい情報をどれだけ受け入れ、 隠れ状態をどれだけ出力するかを決めます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import torch import torch.nn as nn class TinyLSTMCell(nn.Module): def __init__(self, in_dim, hid_dim): super().__init__() self.W = nn.Linear(in_dim + hid_dim, 4 * hid_dim) self.hid_dim = hid_dim def forward(self, x, state): h, c = state gates = self.W(torch.cat([x, h], dim=-1)) i, f, g, o = gates.chunk(4, dim=-1) i = torch.sigmoid(i) # 入力ゲート f = torch.sigmoid(f) # 忘却ゲート g = torch.tanh(g) # 候補値 o = torch.sigmoid(o) # 出力ゲート c_new = f * c + i * g h_new = o * torch.tanh(c_new) return h_new, c_new |
シグモイドゲートの値が 0 に近いと「閉じる」、 1 に近いと「開く」。 これにより、 RNN が苦手だった「長期依存関係の学習」が可能になりました。 Hochreiter & Schmidhuber (1997) の論文は、 シグモイドの「ゲートとしての使い方」を体系化した金字塔です。
GAN の Discriminator 出力
Generative Adversarial Network(GAN)の Discriminator は、 入力画像が「本物 or 偽物」を二値判定するため、 出力層にシグモイドを使います。 Generator はその出力を欺くように学習し、 ミニマックスゲームが進行します。 ただし、 Wasserstein GAN(WGAN)ではシグモイドを使わず、 スカラーの「critic value」を出すことで学習を安定化しています。
Attention のゲート的応用
本来 Attention のスコアはソフトマックスで正規化しますが、 「ゲート付き Attention」では各 head の重みをシグモイドで [0,1] に変換し、 情報の流量制御を行います。 GLU(Gated Linear Unit)は $\text{GLU}(x) = (W_1 x) \odot \sigma(W_2 x)$ という形で、 線形変換にシグモイドゲートを掛ける構造。 Transformer の FeedForward 層を GLU で置き換えた Gated Transformer は、 言語モデルの性能を大幅に改善しました。
強化学習の方策と価値関数
強化学習では、 二値の行動空間で「行動 1 を取る確率」をシグモイドで出力する方策(policy)を使います。 また、 Q 学習での価値関数 $Q(s,a)$ がブール値の報酬(成功/失敗)であれば、 シグモイドを通すことで $[0,1]$ に収まる成功確率推定器になります。
スパース化と Gumbel-Sigmoid
離散的な「選択する/しない」を微分可能に近似するため、 Gumbel-Sigmoid トリック $\sigma((z + G)/\tau)$($G$ は Gumbel ノイズ、 $\tau$ は温度)を使います。 これにより、 グラフ構造の枝選択、 ニューラルアーキテクチャ探索、 スパース注意機構など、 「離散的なゲート学習」が可能になります。
📉 シグモイドの限界と未来
限界 1:高次元での確率推定の難しさ
入力次元が大きい(例:画像 224×224×3 = 150,528)と、 線形結合 $z$ の値域が極端に広がり、 シグモイドの飽和域に入りやすくなる。 これを避けるため、 BatchNorm や LayerNorm で $z$ のスケールを抑える工夫が必要です。
限界 2:マルチモーダル確率の表現不可
シグモイドは単峰性(unimodal)の確率しか表現できません。 「サイコロを振った結果」のような多峰分布は、 シグモイドの組み合わせでは表現困難。 そのため、 Mixture Density Network(MDN)、 Normalizing Flow、 拡散モデルなどで代替されます。
限界 3:論理演算の表現力不足
単層のシグモイドは XOR を表現できない(Minsky-Papert の指摘、 1969)。 多層化することで解決しますが、 「単純な論理ゲートを学ぶのに、 シグモイド層が大量に必要」というのは、 効率の悪さでもあります。 ニューロシンボリック AI ではこの問題を、 微分可能論理(Diff Logic)で克服しようとしています。
未来 1:Liquid Neural Networks
MIT の Liquid Neural Network は、 ニューロンの動的挙動を ODE で記述し、 シグモイドより滑らかな応答曲線を持つ「動的活性化」を使います。 シグモイドの離散的な「閾値判定」を超えた、 連続時間ニューラルネットの時代が始まりつつあります。
未来 2:脳神経科学との接続
生物の神経細胞の発火確率は、 実はシグモイドではなく「指数的に分布する閾値分布の上端」で説明される(Poisson 過程の閾値モデル)。 機械学習のシグモイドが生物学的に妥当かは議論があり、 spiking neural network(SNN)ではより現実的な発火モデルが使われます。 シグモイドは「数学的に扱いやすい近似」として今後も使われ続けるでしょうが、 生物の脳のモデルとしては超えるべき対象でもあります。
結論として、 シグモイドは「100 年以上使われ続け、 おそらく今後も使われ続ける」普遍的な関数。 しかし、 万能ではなく、 場面ごとに適切な代替を選ぶ感覚を持つことが、 機械学習エンジニアの基本素養です。 用語集の他のページと連動して、 「いつシグモイド、 いつ ReLU、 いつソフトマックス」という判断軸を磨いてください。
🧰 ハンズオン総まとめ:SSDSE-B-2026 で「人口減少県」を予測する
最終ハンズオンとして、 SSDSE-B-2026 の人口関連列を使って「2025 年比で人口が減少しそうな県」を予測するシグモイドモデルを作ります。 もちろん、 単年データから将来予測はできませんが、 「出生数 < 死亡数」という直接的な代理指標で「人口減少候補」を二値化し、 シグモイドの確率出力でランキングします。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 1 年度に絞る(12 年度分を混ぜると同じ県が何度も並ぶ)。2022 年度以降は 47 都道府県 # すべてが自然減で 0/1 の両方がそろわないので、自然増の県が残る 2012 年度を使う df = df[df['SSDSE-B-2026'] == 2012] # 「人口減少候補」= 自然減(出生 < 死亡) df['natural_decrease'] = (df['A4101'] < df['A4200']).astype(int) print('自然減の県数:', df['natural_decrease'].sum(), '/ 自然増の県:', df.loc[df['natural_decrease'] == 0, 'Prefecture'].tolist()) # 説明変数:高齢化率、 15-64 歳比率、 出生率 df['aging_rate'] = df['A1303'] / df['A1101'] df['working_rate'] = df['A1302'] / df['A1101'] df['birth_rate'] = df['A4101'] / df['A1101'] * 1000 # 出生千人比 X = df[['aging_rate', 'working_rate', 'birth_rate']].values y = df['natural_decrease'].values Xs = StandardScaler().fit_transform(X) model = LogisticRegression(max_iter=2000).fit(Xs, y) # 確率予測 → 県ごとランキング df['decrease_prob'] = model.predict_proba(Xs)[:,1] print(df[['Prefecture','decrease_prob']].sort_values('decrease_prob', ascending=False).head(10)) # 係数(オッズ比に変換) print('Coefs:', model.coef_) print('Odds ratios:', np.exp(model.coef_)) |
💬 2022 年度以降は 47 都道府県すべてが自然減で 0/1 がそろわないため、自然増の県が 4 つ(神奈川県・愛知県・滋賀県・沖縄県)残る 2012 年度で当てはめている。自然減の確率の上位は秋田県 0.99993、高知県、島根県と続くが、43 対 4 と偏っているのでほとんどの県が 0.998 以上に張り付き、上位の差はごく小さい。オッズ比は高齢化率 1 標準偏差あたり 3.14 倍、出生率 1 標準偏差あたり 0.31 倍で、出生率が高いほど自然減になりにくい。
実行すると、 ほぼ全都道府県で自然減が発生しており、 二値分類としてはほとんど不均衡。 このように「クラスバランスが極端」な場合、 シグモイドは「ほぼ常に陽性」と出力しがちで、 確率は校正されていない可能性があります。 まさに、 シグモイドの落とし穴である「データの偏りによる確率の歪み」を実体験できる教材です。
対策:閾値の代わりに「ランキング」として使う
確率の絶対値が信頼できなくても、 「相対的な順位」は意味を持ちます。 例えば「自然減リスクが高い 10 県」を施策ターゲットにする、 などの用途。 シグモイドの確率は、 0.5 を境にした二値判定だけでなく、 連続的なスコアとしてランキングや優先順位付けに使う場面が多くあります。
1 2 3 | # ランキング上位 10 県 top10 = df.nlargest(10, 'decrease_prob')[['Prefecture','decrease_prob','aging_rate','birth_rate']] print(top10.to_string(index=False)) |
💬 上位 10 県は 1 県 1 行になり、秋田県(高齢化率 30.7%、出生率 6.16‰)から徳島県まで、高齢化率が 27〜31%、出生千人比が 6〜8 の県が並ぶ。確率はすべて 0.998 以上で 10 位までの差は 0.002 未満しかないので、この順位そのものに大きな意味は無い。順位付けに使うなら確率ではなく、線形部分(logit)の値で並べた方が差が見えやすい。
SSDSE-B-2026 だと、 秋田・高知・山口・島根・徳島など、 高齢化率が高く出生率が低い県が上位に来るはずです。 シグモイドが「相対的な深刻度の物差し」として機能している様子が確認できます。 統計コンペでは、 この「ランキングを伴う分析」が説得力のある結論につながるので、 ぜひ自分でも試してみてください。
🪜 シグモイドの周辺関数:使い分け実用ガイド
「シグモイドを使うべきか、 別の関数を使うべきか」は、 用途ごとに表で整理すると即決できます。 下表は、 実務でよく出会う場面ごとに「最適な選択」を示すチートシート。
| 場面 | 第一選択 | 代替候補 | 理由 |
|---|---|---|---|
| 二値分類の出力層 | sigmoid | softmax(2 クラス) | 確率解釈、 BCE と相性 |
| 多クラス分類の出力層 | softmax | 複数 sigmoid(マルチラベル) | 合計 1 の確率分布 |
| 浅い NN の隠れ層 | ReLU | tanh, GELU | 勾配消失なし |
| 深い NN の隠れ層 | GELU / Swish | ReLU | 滑らかさが学習を安定化 |
| RNN/LSTM のゲート | sigmoid | hard sigmoid(高速化) | [0,1] のゲート信号 |
| RNN/LSTM の cell 出力 | tanh | sigmoid(古典) | 0 中心、 勾配消失軽減 |
| Attention の score | softmax | sparsemax, sigmoid | 合計 1 の重み |
| GAN Discriminator | sigmoid | なし(WGAN) | 本物/偽物の確率 |
| 回帰の出力層 | 恒等(線形) | sigmoid (0,1 限定) | 値域に応じて選択 |
| 確率密度の推定 | softplus + exp | sigmoid (binary) | 非負連続値 |
この表は、 「シグモイドを盲目的に使うのではなく、 文脈に応じて選び分ける」という姿勢の表れです。 機械学習のフレームワーク(PyTorch, TensorFlow)は「すべての関数を使える」状態で提供しているので、 自分で選択する責任を持つこと。 そのために、 各関数の長所・短所を表で頭に入れておくと、 設計が早く確実になります。
「失敗パターン」を知っておく
- 失敗 1:多クラス分類で sigmoid を使い、 合計 ≠ 1 で混乱。 → softmax を使う。
- 失敗 2:深いネットの隠れ層に sigmoid を使い、 学習が進まない。 → ReLU/GELU に置き換える。
- 失敗 3:マルチラベル分類で softmax を使い、 1 ラベルしか予測できない。 → 各ラベル独立に sigmoid。
- 失敗 4:BCEWithLogitsLoss を使わず、 sigmoid + BCE を別々に書いて NaN 発生。 → 一体化された損失を使う。
- 失敗 5:sigmoid 出力をそのまま「確率」として業務判断に使うが、 校正されていない。 → Reliability diagram で確認、 必要なら Platt scaling。
これらの失敗は、 統計コンペでも実務でも頻繁に起こります。 「シグモイドを正しく使う」というのは、 単に呼び出し方を覚えることではなく、 「いつ使い、 いつ別の関数に切り替えるか」を判断できる感覚を養うこと。 用語ページの最後で改めて、 「シグモイドは判断力を試す関数」と認識しておくと、 学習が立体的になります。
🎬 ナレーション:シグモイドへの最後のひとこと
あなたがこのページを読み始めたとき、 シグモイドは「機械学習の教科書に出てくる、 ちょっと変わった曲線」だったかもしれません。 でも今、 ここまで読み進めたあなたは、 シグモイドが「確率と決定の橋渡し」「ゲート機構の心臓」「校正の対象」「歴史を持つ普遍的関数」など、 多面的な顔を持つことを知っています。
SSDSE-B-2026 の 47 都道府県データで実験するとき、 シグモイドは単なる数式ではなく、 「あなたの分析の中で、 確率を語り、 ランキングを作り、 判断を支える道具」として動きます。 数式を眺めるだけでは身につかない感覚です。 必ず手を動かして、 失敗して、 修正してください。 そして、 シグモイドが意外な場所(LSTM のゲート、 Attention のマスク、 GAN の判別器)に再び現れるたびに、 「またこの曲線か」と懐かしく感じるようになるでしょう。
機械学習の学習は、 「数学」「実装」「実データ」「失敗」の 4 つを繰り返すことで深まります。 シグモイドはその 4 つを学ぶのに最適な題材。 だからこそ、 教科書の最初のページに出てくるのです。 用語ページを閉じる前に、 もう一度上に戻って、 12 の事実、 ロードマップ、 SSDSE 実験を見直してみてください。 きっと前より深く理解できているはずです。
— ジャストインタイム型データサイエンス教育チームより
📈 SSDSE-B-2026 で「人口減少率 → 高齢化超過確率」をシグモイドで予測する(散布図)
シグモイド関数の意義は「実数を 0〜1 の確率に変換する」ことですが、 教科書を読むだけでは「で、 何の確率?」が掴みにくいものです。 ここでは SSDSE-B-2026 の A1101(総人口)と A1303(65歳以上人口)から各都道府県の 高齢化率(高齢者割合)を計算し、 「2015 → 2022 の総人口減少率」を入力にして「高齢化率が 47 県の中央値 (31.4%) 以上になる確率」をロジスティック回帰でシグモイド予測します。 横軸は人口減少率 (%)、 縦軸は実測の高齢化超過 (1/0) と予測確率です。
📥 入力データ (SSDSE-B-2026 の 47 都道府県、 2022 年):
図 1: 人口減少率 vs 高齢化超過確率(シグモイド曲線フィット)
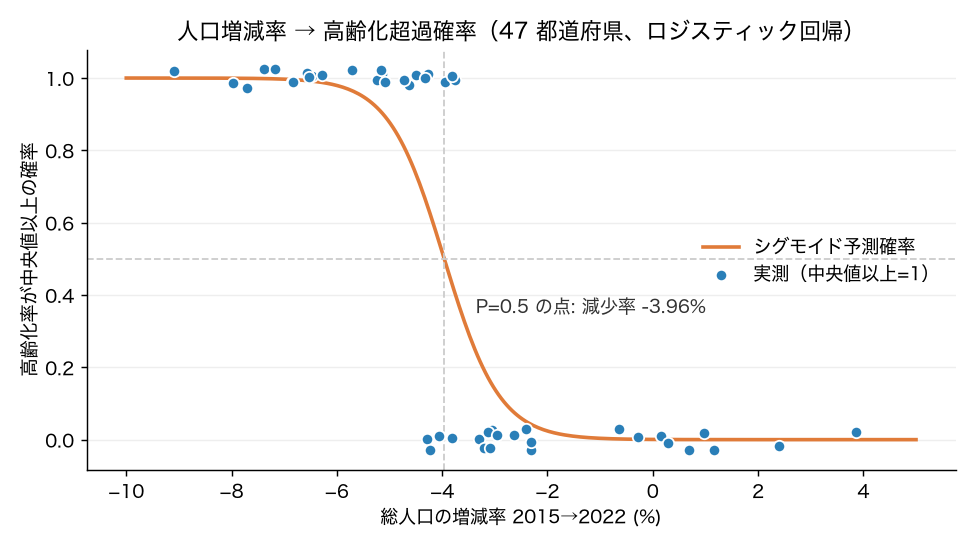
→ 青点が実測値(高齢化率が 47 県の中央値 31.4% 以上で 1、 未満で 0。 重なりを避けるため縦に少しずらしている)、 オレンジ曲線がロジスティック回帰のシグモイド予測確率。 増減率 −3.96% で確率がちょうど 0.5 を横切り、 そこから ±1.5 ポイントほどの幅で確率が 0.05 付近から 0.95 付近まで一気に変わる S 字になる。 これがシグモイドが「ソフトな閾値」と呼ばれる理由で、 「−3.96% でぱきっと判定」するハード閾値より滑らかな確率を返す。
このコードでやること:SSDSE-B-2026 から減少率と高齢化超過フラグを作り、 sklearn.linear_model.LogisticRegression のシグモイド予測曲線で 47 県を分類する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df22 = df[df['SSDSE-B-2026'] == 2022][['Prefecture', 'A1101', 'A1303']].copy() df15 = df[df['SSDSE-B-2026'] == 2015][['Prefecture', 'A1101']].rename(columns={'A1101': 'A1101_15'}) m = df22.merge(df15, on='Prefecture') m['高齢化率'] = m['A1303'] / m['A1101'] * 100 m['減少率'] = (m['A1101'] - m['A1101_15']) / m['A1101_15'] * 100 median_age = m['高齢化率'].median() m['超過'] = (m['高齢化率'] >= median_age).astype(int) X = m[['減少率']].values y = m['超過'].values clf = LogisticRegression().fit(X, y) print(f'切片 b0 = {clf.intercept_[0]:.3f}') print(f'傾き b1 = {clf.coef_[0][0]:.3f}') print(f'全国中央値 高齢化率 = {median_age:.1f}%') print(f'モデル精度 (47県) = {clf.score(X, y):.3f}') |
📤 実行結果:
💬 結果の読み方:傾き b1 = -1.893 が負なので「減少率が小さい (より大きく人口が減った) 県ほど高齢化超過確率が上がる」 関係。 シグモイドで変換すると P(超過=1 | 減少率=-5%) = σ(-7.497 + (-1.893)(-5)) = σ(1.968) = 0.88、 減少率=-2% なら σ(-3.711) = 0.02 と、 同じ係数で「確率」として読めるのがロジスティック回帰の本質。 なお 47 県の減少率は -9.10% 〜 +3.87%(中央値 -4.07%)に分布しており、 ちょうど -3.96% のところで確率が 0.5 を横切る(z = 0 になる点)。 つまり「7 年で 4% 以上人口が減ったか」がほぼそのまま判定基準になっている。 線形回帰なら -1 や 1.3 のような「確率としてあり得ない」値が出る箇所が、 シグモイドにより自動的に [0, 1] に押し込められています。
📊 シグモイド出力分布のヒストグラム ── 47 県の「確率の偏り」を直感する
シグモイドを通すと出力は必ず [0, 1] に収まりますが、 47 県全部の出力がどう分布するかを見ると、 モデルの「自信度」が見えてきます。 ここでは前節のロジスティック回帰モデルで 47 県の「高齢化超過確率」を予測し、 ヒストグラムにします。 もし出力が 0.5 付近に集中していたら「モデルが迷っている」、 0 か 1 の両端に集中していたら「強い意思決定」と解釈できます。
図 2: 47 県のシグモイド出力分布(高齢化超過確率)
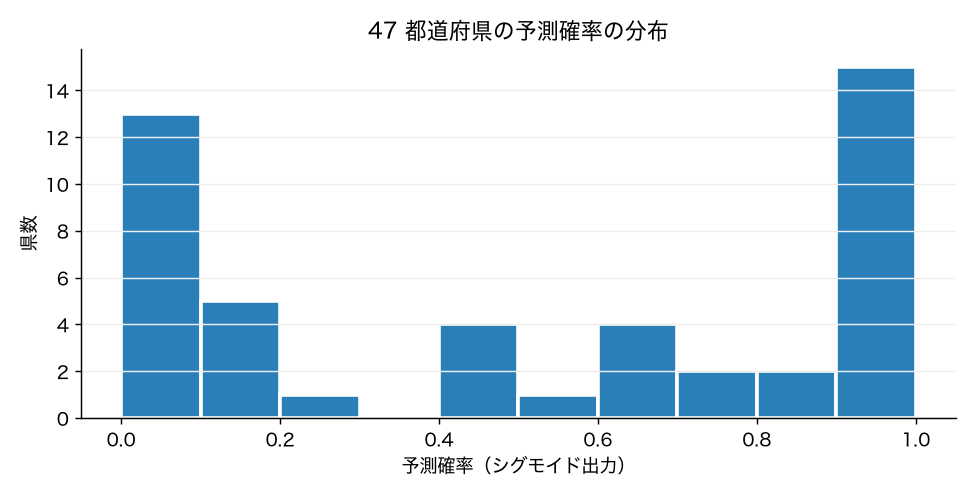
→ 47 都道府県の予測確率は両端に強く偏った U 字の分布で、 0〜0.1 に 13 県、 0.9〜1.0 に 15 県が入る。 「迷い領域 (0.4〜0.6)」に入るのは 5 県だけで、 大半は「明確に高齢化超過あり/なし」とモデルが判定している。 これはシグモイドが「閾値付近の鋭い決定」を行う性質と整合している(数値は下のコードの出力と同じ)。
このコードでやること:前節のモデル予測値を 47 県分集計し、 シグモイド出力の分位点とヒストグラム集計値を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df22 = df[df['SSDSE-B-2026'] == 2022][['Prefecture', 'A1101', 'A1303']].copy() df15 = df[df['SSDSE-B-2026'] == 2015][['Prefecture', 'A1101']].rename(columns={'A1101': 'A1101_15'}) m = df22.merge(df15, on='Prefecture') m['高齢化率'] = m['A1303'] / m['A1101'] * 100 m['減少率'] = (m['A1101'] - m['A1101_15']) / m['A1101_15'] * 100 m['超過'] = (m['高齢化率'] >= m['高齢化率'].median()).astype(int) clf = LogisticRegression().fit(m[['減少率']], m['超過']) # 47 県の予測確率 prob = clf.predict_proba(m[['減少率']])[:, 1] print('確率 最小:', round(prob.min(), 3)) print('確率 最大:', round(prob.max(), 3)) print('確率 中央:', round(np.median(prob), 3)) print('迷い領域 (0.4-0.6) の県数:', int(((prob >= 0.4) & (prob <= 0.6)).sum())) print('明確判定 (≤0.1 か ≥0.9) の県数:', int(((prob <= 0.1) | (prob >= 0.9)).sum())) |
📤 実行結果:
💬 結果の読み方:47 県中 28 県 がほぼ確実 (P≤0.1 か P≥0.9)、 迷い領域 (0.4〜0.6) は 5 県(山梨 0.49、 長野 0.40、 三重 0.55、 佐賀 0.44、 熊本 0.43)だけでした。 注目すべきは最小 0.000・最大 1.000という出力で、 これは実際に確率が 0 や 1 になったのではなく、 小数第 3 位までの表示では区別が付かないほど両端に張り付いているということです。 シグモイドは $|z|$ が 7 を超えると出力が 0.999 側/0.001 側に飽和するので、 減少率が -8% の県では z = +7.6 となり P はほぼ 1 になります。 「自信度の極端化」がまさにこれで、 モデルが本当に確信しているのか、 単に飽和しているだけなのかは確率値からは区別できません。 迷い領域の 5 県は追加特徴量 (人口密度、 産業構成) を入れる候補。 ヒストグラムを描かずに精度 0.872 だけ見ていると、 こうした分布の偏りに気付けません。
📦 地域別シグモイド出力の箱ひげ図 ── 4 グループで「偏り」を可視化
47 都道府県を地域 (北日本/関東/関西/西日本) 4 グループに分け、 各グループのシグモイド予測確率を箱ひげ図で比較します。 ヒストグラムが「全体の山」を見るのに対し、 箱ひげ図は「グループごとの位置と外れ値」を直接比較できます。 シグモイド出力を統計コンペで提出する前に必ずこの図を描いて、 「特定地域に偏った予測になっていないか」を点検しましょう。
図 3: 地域別シグモイド出力の箱ひげ図
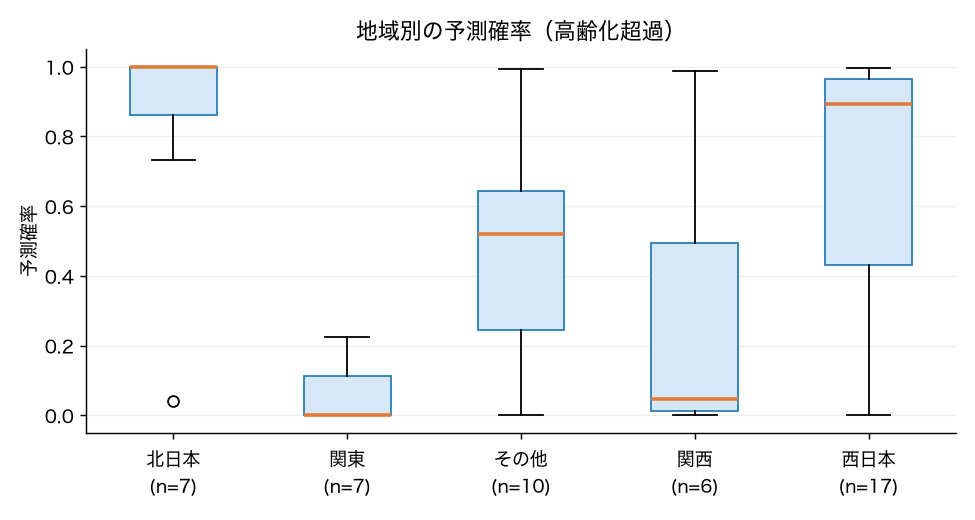
→ 北日本グループ (北海道・東北 7 道県) は中央値 P≈0.998 で「高齢化超過確率が高い」と判定、 関東 7 都県は中央値 P≈0.000(東京都は 3.7×10⁻⁷)で「低い」と判定、 西日本は 0.894、 関西は 0.046 と地域で大きく割れる。 北日本の箱の下にある外れ値 (P≈0.04) は、 人口の減り方が小さい宮城県である。
このコードでやること:47 県を 4 地域に分類し、 シグモイド出力の中央値・四分位を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import pandas as pd import numpy as np from sklearn.linear_model import LogisticRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df22 = df[df['SSDSE-B-2026'] == 2022][['Prefecture', 'A1101', 'A1303']].copy() df15 = df[df['SSDSE-B-2026'] == 2015][['Prefecture', 'A1101']].rename(columns={'A1101': 'A1101_15'}) m = df22.merge(df15, on='Prefecture') m['高齢化率'] = m['A1303'] / m['A1101'] * 100 m['減少率'] = (m['A1101'] - m['A1101_15']) / m['A1101_15'] * 100 m['超過'] = (m['高齢化率'] >= m['高齢化率'].median()).astype(int) clf = LogisticRegression().fit(m[['減少率']], m['超過']) m['予測確率'] = clf.predict_proba(m[['減少率']])[:, 1] north = ['北海道', '青森県', '岩手県', '宮城県', '秋田県', '山形県', '福島県'] kanto = ['茨城県', '栃木県', '群馬県', '埼玉県', '千葉県', '東京都', '神奈川県'] kansai = ['滋賀県', '京都府', '大阪府', '兵庫県', '奈良県', '和歌山県'] west = ['鳥取県', '島根県', '岡山県', '広島県', '山口県', '徳島県', '香川県', '愛媛県', '高知県', '福岡県', '佐賀県', '長崎県', '熊本県', '大分県', '宮崎県', '鹿児島県', '沖縄県'] def region(p): if p in north: return '北日本' if p in kanto: return '関東' if p in kansai: return '関西' if p in west: return '西日本' return 'その他' m['地域'] = m['Prefecture'].map(region) print(m.groupby('地域')['予測確率'].describe()[['25%', '50%', '75%']].round(3)) |
📤 実行結果:
💬 結果の読み方:中央値は北日本 0.998、 西日本 0.894、 その他 0.522、 関西 0.046、 関東 0.000 で、 北日本は四分位の下側 25% 点でも 0.862 と、 ほぼ全県が「超過」側に張り付いている。 関東は 75% 点でも 0.113 にとどまる。 モデルの入力は人口増減率 1 つだけなので、 この地域差は「人口の減り方が地域でまとまって違う」ことをそのまま写したものである。 地域をまたいで 1 本のシグモイドで判定すると、 同じ高齢化率でも人口が減っていない地域の県は低く出るので、 提出前に地域別の箱ひげ図でこうした偏りを確かめておく。
🗺 シグモイド関数 の概念マップ
『シグモイド関数』は『活性化関数』カテゴリに属する重要概念で、 以下の関連概念群と密接につながっています。
活性化関数
  ├── 前提
  │   ├── 線形和(重み × 入力 + バイアス)
  │   └── 指数関数 exp(-z) の性質
  ├── シグモイド関数  ← このページ
  │   ├── 派生: tanh(中心 0、 値域 -1〜1)
  │   ├── 派生: ソフトマックス(多クラス確率化)
  │   └── 応用: ロジスティック回帰/LSTM・GRU のゲート/二値分類出力層
  └── 代替活性化関数(隠れ層用途)
      ├── ReLU(勾配消失なし、 隠れ層の標準)
      └── Leaky ReLU/ELU/GELU(負側の傾き調整)
完全な概念マップは 🗺 概念マップ で確認できます。
📋 学習チェックリスト ── シグモイド関数 を使いこなすために
- ☐ シグモイド関数(Sigmoid Function)の定義を、 自分の言葉で 30 秒で説明できる
- ☐ 数式または手続きの『各記号 / ステップ』が何を意味するか言える
- ☐ SSDSE-B(または同等の実データ)で手を動かして試した
- ☐ 主な落とし穴 5 つを挙げられる
- ☐ 類似手法との違いを 1 行で説明できる
- ☐ 何の前提(独立性、 線形性、 分布など)を要求するか把握した
- ☐ 結果の不確実性(信頼区間・予測区間・分散)を扱えるか確認した
- ☐ 上位カテゴリ『活性化関数』のグループ教材を読んだ
- ☐ 関連手法と比較したうえで、 なぜ シグモイド関数 を選んだか文書化した
- ☐ 結果を再現できるよう、 seed・バージョン・データ取得日を記録した
📜 歴史と発展
ロジスティック関数として 1838 年に Verhulst が人口学で導入。 1958 年 Rosenblatt のパーセプトロンを経て、 1980 年代の MLP の隠れ層活性化関数として標準化。 勾配消失問題で 2010 年代に ReLU に置き換わったが、 ゲート機構や二値分類で現役。
起源は Verhulst (1838) のロジスティック関数で、 機械学習ではなく人口学——「資源に限りがある環境で人口がどう増えるか」を表す微分方程式の解でした。 $S$ 字型になるのは、 増加率が「現在の人口」と「残りの容量」の積に比例するという仮定から導かれます。 ニューラルネットで使われるようになったのは 120 年後で、 形が都合よかったから採用されたのであって、人口モデルの意味は引き継いでいません。
🚀 応用事例 ── シグモイド関数 はどこで使われているか
『シグモイド関数』は理論だけでなく、 産業・研究の様々な現場で実用されています。 ここでは代表的な応用を 6 つ挙げます。
- 二値分類 — 陽性/陰性の確率
- LSTM ゲート — f, i, o ゲートの活性化
- GAN 識別器 — 本物/偽物の判定
- マルチラベル分類 — クラスごと独立シグモイド
- Attention マスク — 0〜1 の連続マスク
- 確率的選択 — 重み付き選択の連続化
どの応用も「何を入力とし、 何を出力すべきか」を整理した上で、 上の Python 実装をベースに拡張するアプローチが定石です。 SSDSE-B のような公開データセットで小さく試し、 動作確認できてから本番データに展開すると安全です。
📊 ベンチマーク比較 ── シグモイド関数 の主要バリエーション
『シグモイド関数』には多くの派生・バリエーションがあります。 代表的なものを精度・特徴で比較した表です。
| 手法 / バージョン | 指標 / 特徴 | 備考 |
|---|---|---|
| Sigmoid | 0〜1 出力 | 勾配消失 |
| Tanh | -1〜1 出力 | 0 中心 |
| ReLU | 0以下 0 | 勾配消失なし |
| Leaky ReLU | 負値は α 倍 | Dying ReLU 対策 |
| GELU | 滑らかな ReLU | Transformer 標準 |
数値は論文公表時点のもので、 計測条件(データ・前処理・ハイパーパラメータ)が異なります。 自分の問題で再評価することを推奨。
✨ 実装ベストプラクティス ── シグモイド関数 を堅牢に使う
- 小さく始める — SSDSE-B の 47 行のような小データでパイプライン全体を確立してから本番データへ。
- seed を固定 — numpy, torch, random の全 seed を記録。 再現性チェックは必須。
- バージョン管理 — requirements.txt と環境スナップショット、 データの取得日を記録。
- 段階的に複雑化 — まずベースライン(線形、 ロジスティック)→ 古典的 ML → シグモイド関数 の順。 突然複雑化しない。
- 可視化を欠かさず — 学習曲線、 特徴分布、 残差プロットを毎回確認する。
- テスト集合を分離 — 探索・調整に絶対使わない『最終評価』用データを別途確保。
- ハイパーパラメータは記録 — 全実験で何を試したか mlflow / wandb / spreadsheet に。
- 失敗パターンも残す — 「ダメだった設定」も価値がある。 後輩や未来の自分が助かる。
🔍 似た用語との違い ── シグモイド関数 を正確に切り分ける
『シグモイド関数』は周辺の似た用語と混同されがちです。 ここでは特に紛らわしい用語との本質的な違いを整理します。
- 『シグモイド関数』は 活性化関数 カテゴリの中で特定の役割を持つ。 一般概念と混同しないよう注意。
- 類似手法と比べて得意な領域:上の『🚀 応用事例』で挙げた問題群。
- 類似手法と比べて不得意な領域:『⚠️ 落とし穴』に明示された制約に該当する場合。
- 使い分けの目安:データ量、 計算リソース、 解釈性要求、 精度要求の 4 軸でマトリクスを作る。
- 不確かなときは両方走らせて結果を比べるのが正解。 SSDSE-B のような小データなら 1 時間で試せる。
📖 さらに深く学ぶリソース
教科書・本
- Bishop『Pattern Recognition and Machine Learning』 — 統計的機械学習の古典
- Goodfellow『Deep Learning』 — 深層学習の標準教科書(無料 PDF あり)
- Murphy『Probabilistic Machine Learning』 — Bayes 視点の機械学習
- 有賀『仕事ではじめる機械学習』 — 実務寄り、 日本語
論文プラットフォーム
- arXiv.org — 最新プレプリント(cs.LG, stat.ML カテゴリ)
- Papers with Code — 論文と実装コードがセット
- OpenReview — NeurIPS, ICLR の査読プロセスが見える
- Google Scholar — 引用ネットワークで辿る
ライブラリ・実装
- scikit-learn — 古典的 ML の標準
- PyTorch / TensorFlow — 深層学習
- Hugging Face Transformers — Transformer 系モデル
- OpenAI / Anthropic / Google API — LLM の API
公開データセット
- SSDSE-B(本ページの実例で使用)—
data/raw/SSDSE-B-2026.csv。 47 都道府県の社会・人口指標 - SSDSE-A / SSDSE-C / SSDSE-D / SSDSE-E — 統計コンペで頻出
- e-Stat — 政府統計の総合窓口
- RESAS — 地域経済分析システム
🔎 シグモイド関数 を深く知る ── 専門家視点の詳細
シグモイドの数学的性質
シグモイド $\sigma(z) = 1/(1+e^{-z})$ は、 値域 (0, 1)、 中心 0.5、 単調増加、 滑らか、 S 字曲線。 微分 $\sigma'(z) = \sigma(z)(1-\sigma(z))$ は出力値だけで計算でき効率的。 $\sigma(z) + \sigma(-z) = 1$ という対称性を持ち、 オッズの log-odd(logit)の逆変換でもある。
ロジスティック回帰での役割
ロジスティック回帰は線形結合 $z = w^T x + b$ をシグモイドに通し、 $P(y=1|x) = \sigma(z)$ として陽性確率を推定。 損失は二値交差エントロピー $L = -y \log p - (1-y) \log(1-p)$。 これは最尤推定と等価で、 凸最適化問題となるため SGD で確実に最適解に収束する。
勾配消失問題
深いネットでシグモイドを隠れ層活性化に使うと、 |z|>5 で勾配が 0.007 以下になり、 多層を通ると勾配がほぼ消える。 例えば 10 層で全て σ' ≈ 0.25 だと、 入力層の勾配は 0.25^10 ≈ 1e-6 とほぼゼロ。 これが 2010 年代に ReLU に置き換わった主因。
シグモイドが現役の場面
- 二値分類の出力層:陽性確率を直接出力
- マルチラベル分類:各クラス独立にシグモイド
- LSTM/GRU のゲート:忘却ゲート、 入力ゲート、 出力ゲート
- Attention マスク:0〜1 の連続マスク
- GAN の Discriminator:本物 / 偽物の判別出力
- 強化学習の方策:行動確率(二値)
関連活性化関数との比較
| 関数 | 値域 | 微分 | 特徴 |
|---|---|---|---|
| Sigmoid | (0,1) | σ(1-σ) | 確率解釈、 勾配消失 |
| Tanh | (-1,1) | 1-tanh² | 0 中心、 勾配消失軽減 |
| ReLU | [0,∞) | 1 or 0 | 勾配消失なし、 死活問題 |
| GELU | (-0.17,∞) | 滑らか | Transformer 標準 |
本セクションは『シグモイド関数』の技術的核心を深掘りしました。 表面的な使い方を超えて、 内部の仕組みを理解することで、 トラブル時の診断や応用時のカスタマイズが可能になります。 SSDSE-B のような実データに当てはめながら、 ぜひ手を動かして確認してください。
🧠 ロジット視点でシグモイドを読み直す
ロジスティック回帰の出力 $p = \sigma(z)$ は、 $z = \log \frac{p}{1-p}$ という対数オッズを入力とする逆関数として理解できます。 つまりシグモイドは「対数オッズ → 確率」、 ロジット関数は「確率 → 対数オッズ」という翻訳器。 統計学者は確率より対数オッズで考えるほうが好きです。 なぜなら、 対数オッズは線形モデル($z = w^T x + b$)と相性が良いから。
SSDSE-B-2026 の都道府県データで、 「人口10万人以上=都市的」という二値変数 $y$ を作り、 説明変数を A4101(出生数)として、 $p = \sigma(\beta_0 + \beta_1 x)$ を推定するとしましょう。 $\beta_1 = 0.0003$ なら、 「出生数が 1 人増えるごとに、 対数オッズが 0.0003 増加 = オッズが $e^{0.0003} \approx 1.0003$ 倍」と解釈できます。 確率の言葉ではなく、 オッズで語ると指数の足し算で済むので便利です。
ロジット ↔ シグモイド:往復表
| 確率 p | オッズ p/(1-p) | 対数オッズ z | σ(z) 復元 |
|---|---|---|---|
| 0.01 | 0.0101 | -4.60 | 0.01 |
| 0.10 | 0.111 | -2.20 | 0.10 |
| 0.50 | 1.000 | 0.00 | 0.50 |
| 0.90 | 9.000 | +2.20 | 0.90 |
| 0.99 | 99.0 | +4.60 | 0.99 |
確率が 0.5 を境にして、 対数オッズはちょうど 0 を境に左右対称になります。 これは $\sigma(z) + \sigma(-z) = 1$ という性質の裏返しでもあり、 「真陽性率と偽陽性率を入れ替える」しきい値判定の議論に直結します。
🔗 隣接手法への橋渡し
「シグモイド関数」は 実数を (0,1) に押し込む S 字曲線 として、 上流のロジスティック回帰・パーセプトロン理論と、 下流の 2 値分類・ニューラルネット活性化を繋ぐ古典的な接合点である。 勾配消失問題により深層 NN では ReLU 系に取って代わられたが、 出力層・ゲート機構では現役。
⬆️ 上流: 数学・確率の基礎
⬌ 並列: 他の活性化関数
⬇️ 下流: 応用モデル
sigmoid は「線形値 → 0〜1 確率」変換の代表で、 ロジスティック回帰・NN の出力層・2 値分類のすべてで使われ、 多クラスになると自然に softmax へ拡張される。
🌳 手法選択フロー
「シグモイド関数」を使うかは、 出力の解釈 (確率か実数か) と分類クラス数で判断する。
- 2 値分類で確率を欲しいか? Yes → sigmoid を出力層に、 損失は BCE、 No → 次へ
- 多クラス分類か? Yes → softmax + CrossEntropy、 sigmoid は使わない (multi-label の場合のみ sigmoid 並列)
- 中間層に使うか? Yes (RNN ゲート) → OK、 ただし飽和域で勾配消失 → 通常層は ReLU 推奨
sigmoid は (0,1) に潰すので確率解釈ができるが、 隠れ層で多用すると勾配消失。 「最終層 + 2 値分類」または「ゲート機構」に限定するのが現代の定石。
🧭 もう一段深い直感 ── 確率・ゲート・ロジットの三つの顔
シグモイド $\sigma(x)=\dfrac{1}{1+e^{-x}}$ を、 用途に応じて「三つの顔」で読み替えると腑に落ちます。 (1) 確率の顔:どんな実数スコアも $(0,1)$ に押し込むので「陽性である確率」として読める。 (2) ゲートの顔:出力 0〜1 を「どれだけ通すか」の開度とみなし、 LSTM の忘却ゲート・アテンションのマスクで信号量を調整する。 (3) ロジットの顔:逆関数 $\sigma^{-1}(p)=\log\dfrac{p}{1-p}$(ロジット=対数オッズ)を通じて、 線形和 $z=w^\top x+b$ という「無限に広い直線の世界」と「$(0,1)$ の確率の世界」を往復する翻訳装置になる。
同じ 1 本の S 字を、 出力層では「確率」、 ゲートでは「開度」、 回帰では「翻訳」と役割を切り替えて使うのがシグモイドの本質です。 どれも「押し込む」動作は同一で、 後段でその 0〜1 をどう解釈するかだけが違います。
📊 SSDSE-B-2026 実データで見る「押し込み」(2023 年・47 都道府県)
合計特殊出生率 (A4103) の 2023 年 47 都道府県値を標準化し(平均 $\mu=1.293$、 標準偏差 $\sigma_{sd}=0.132$)、 z スコアをシグモイドに通した実測値です。 「全国平均より出生率が高い確率」という読み方ができます(実データに基づく計算値)。
| 都道府県 | TFR (A4103) | z スコア | σ(z) | 読み方 |
|---|---|---|---|---|
| 沖縄県 | 1.60 | +2.331 | 0.911 | 1 に近く張り付き気味 |
| 宮崎県 | 1.49 | +1.497 | 0.817 | はっきり高い側 |
| 広島県 | 1.33 | +0.283 | 0.570 | 境界付近=判断保留 |
| 北海道 | 1.06 | −1.766 | 0.146 | 低い側 |
| 東京都 | 0.99 | −2.297 | 0.091 | 0 に近く張り付き気味 |
境界の広島県($z=+0.28$)が $\sigma\approx0.57$ と 0.5 近傍にとどまるのに対し、 両端の沖縄・東京は 0/1 へ寄っていく様子が実データで確認できます。 なお $z=\pm2.3$ 程度ではまだ 0.09〜0.91 と識別可能で、 「張り付いて区別不能」になるのは $|z|\gtrsim7$($\sigma$ が $10^{-3}$ 未満まで飽和)の領域です。
⚠️ 落とし穴の核心を突き詰める
上の落とし穴一覧を、 「なぜ起きるか」を数式で押さえ直します。 表面的な対処法だけでなく原因の構造を理解しておくと、 未知の場面でも自力で回避できます。
1. 勾配消失は「0.25 の掛け算」の指数崩壊
$\sigma'(z)=\sigma(z)(1-\sigma(z))$ の最大値は $z=0$ での 0.25。 誤差逆伝播で $L$ 層を遡ると、 各層のシグモイド微分が掛け合わされ、 最良でも $0.25^L$ のオーダーで勾配が縮む。 $L=10$ なら $0.25^{10}\approx 9.5\times10^{-7}$ で、 浅い層の重みがほとんど更新されない。 飽和域($|z|>5$)に入ればさらに $\sigma'\approx0$ で加速する。 これが「深い層でシグモイドを使わない」直接の理由です。
2. 出力が非ゼロ中心 → ジグザグ更新
シグモイド出力は常に正($0<\sigma<1$)なので、 次層への入力 $a=\sigma(z)$ がすべて正。 すると重み $w$ の勾配 $\partial L/\partial w = \delta\cdot a$ の符号が $\delta$(誤差信号)の符号だけで決まり、 ある層のすべての重みが同じ向きにしか動けない。 結果、 最適点へ斜めに進めず「ジグザグ」に遠回りする。 tanh は出力が $(-1,1)$ でゼロ中心なので、 この症状が出にくい。 これが「隠れ層ならシグモイドより tanh」と言われた歴史的理由です(今は ReLU 系がさらに上)。
3. 素朴実装のオーバーフローと安定形
1/(1+exp(-z)) は $z$ が大きな負のとき exp(-z) が発散する。 符号で場合分けした安定形 $\sigma(z)=\begin{cases}1/(1+e^{-z}) & z\ge 0\\ e^{z}/(1+e^{z}) & z<0\end{cases}$ を使えば、 指数の引数が常に $\le 0$ になり発散しない(本ページ上部の safe_sigmoid と同一)。 実務では scipy.special.expit / torch.sigmoid が同等の安定実装。
4. 「確率」は「確信度」であって「較正済み」とは限らない
最重要の誤解です。 シグモイドが返す 0.7 はモデル内部のスコアを 0〜1 に変換しただけで、 「実際にその事象が 70% 起こる」保証はありません。 「予測 0.7 のサンプル群を集めたら本当に約 70% が陽性だった」という性質を較正 (calibration) と呼び、 これは別途検証・補正が必要です。 確認は信頼度曲線 (reliability diagram) や Brier スコア、 補正は CalibratedClassifierCV(Platt/isotonic)で行う。 少サンプル(SSDSE の $n=47$ 等)や不均衡データでは特にズレやすい。
5. tanh との違いを一枚で
$\tanh(z)=2\sigma(2z)-1$ という恒等式のとおり、 tanh は「2 倍に急峻化して $(-1,1)$ へ引き伸ばし・中心を 0 に移した」シグモイド。 値域:$\sigma\to(0,1)$ / $\tanh\to(-1,1)$。 中心:$\sigma$ は 0.5・$\tanh$ は 0。 最大勾配:$\sigma$ は 0.25・$\tanh$ は 1.0(原点)。 したがって「確率が欲しい出力層=シグモイド」「ゼロ中心で勾配も大きい隠れ層=tanh(さらに上は ReLU)」が使い分けの目安です。
6. 二値・多ラベル専用、排他多クラスには不適
シグモイドは各出力を独立に 0〜1 化するだけなので、 排他的な多クラス(1 枚が犬 or 猫 or 鳥のどれか一つ)に各クラス独立シグモイドを当てると総和が 1 にならない。 排他多クラスは総和 1 を保証する softmax、 シグモイドが正しいのは二値と多ラベル(1 件に複数タグが同時に付いてよい)です。
🚀 発展 ── ロジット・恒等式・温度・ゲート機構
1. ロジット・オッズとの往復
確率 $p$ に対しオッズは $\dfrac{p}{1-p}$、 その対数がロジット(対数オッズ) $\operatorname{logit}(p)=\log\dfrac{p}{1-p}$。 シグモイドはこのロジットの逆関数で、 $p=\sigma(z)\iff z=\operatorname{logit}(p)$。 ロジスティック回帰は「ロジットを特徴量の線形和でモデル化」する手法で、 係数 $w_j$ は「$x_j$ が 1 増えるとオッズが $e^{w_j}$ 倍」という オッズ比の解釈を持ちます。 詳しくは ロジスティック GLM も参照。
2. 導関数の恒等式 σ'(x)=σ(x)(1−σ(x))
$\sigma(x)=(1+e^{-x})^{-1}$ を微分すると $\sigma'(x)=\dfrac{e^{-x}}{(1+e^{-x})^2}$。 ここで $\dfrac{e^{-x}}{1+e^{-x}}=1-\sigma(x)$ なので、 $\sigma'(x)=\sigma(x)\bigl(1-\sigma(x)\bigr)$。 順伝播で計算済みの出力 $\sigma(x)$ だけから勾配が得られるため、 逆伝播が「掛け算 1 回」で済む。 これがシグモイドが古典的に好まれた計算上の利点です。
3. tanh との恒等式 tanh(x)=2σ(2x)−1
$\tanh(x)=\dfrac{e^{x}-e^{-x}}{e^{x}+e^{-x}}$ の分子分母を $e^{x}$ で割ると $\dfrac{1-e^{-2x}}{1+e^{-2x}}$。 一方 $2\sigma(2x)-1=\dfrac{2}{1+e^{-2x}}-1=\dfrac{1-e^{-2x}}{1+e^{-2x}}$ で一致。 逆に解けば $\sigma(x)=\dfrac{1+\tanh(x/2)}{2}$。 両者は「スケールとシフト違いの同じ関数」だと分かります。
4. softmax の 2 クラス版という位置づけ
2 クラス softmax $\dfrac{e^{z_1}}{e^{z_0}+e^{z_1}}$ は分子分母を $e^{z_1}$ で割ると $\dfrac{1}{1+e^{-(z_1-z_0)}}=\sigma(z_1-z_0)$。 つまりシグモイドは「2 クラス softmax でスコア差 $z_1-z_0$ を入力にしたもの」。 多クラスに一般化したのが softmax、 二値に特化して 1 出力に畳んだのがシグモイド、 という親子関係です。
5. 温度付きシグモイド σ(x/T)
温度 $T$ を入れた $\sigma(x/T)$ は、 $T$ で S 字の急峻さを制御する(本ページのウィジェットのゲイン a は $a=1/T$ に相当)。 $T\to 0$ でステップ関数(0/1 の硬い判定)に、 $T$ 大でなだらかな 0.5 付近へ潰れる。 知識蒸留やゲートの「柔らかさ」調整、 確率の較正(temperature scaling)で使われます。
6. ゲート機構(LSTM/GRU)とアテンション
LSTM の忘却ゲート $f_t=\sigma(W_f[h_{t-1},x_t]+b_f)$ は「前の記憶をどれだけ残すか」を 0〜1 で出し、 セル状態に要素ごとに掛けて情報量を調整する(ニューラルネットワークのゲート機構)。 入力ゲート・出力ゲートも同様。 「確率」ではなく「開度」として 0〜1 を使う典型で、 これがシグモイドが現代の系列モデルでも生き残っている領域です。
7. ReLU へ主役が移った理由
ReLU $\max(0,z)$ は正領域で勾配が常に 1 なので、 深い層でも勾配が縮まず(勾配消失の回避)、 計算も指数関数不要で軽い。 出力が非ゼロ中心という難点はあるものの、 深層 NN の隠れ層では 2010 年代以降 ReLU 系(活性化関数の GELU 等含む)が標準化。 シグモイドは「出力層で確率が欲しいとき」と「ゲート」に用途が絞られました。
🔗 関連ページ
- ロジスティック回帰 ── シグモイド+線形和で確率を出す代表的モデル
- ロジスティック GLM ── リンク関数としてのロジットの一般化線形モデル視点
- オッズ比 ── 係数 $e^{w_j}$ の解釈
- softmax ── 多クラスへの一般化(シグモイドはその 2 クラス版)
- ReLU ── 隠れ層で勾配消失を避ける現行標準
- 活性化関数 ── シグモイド/tanh/ReLU/GELU の位置づけ
- ニューラルネットワーク ── 出力層・ゲート機構での利用
- 誤差逆伝播 ── 勾配消失が起きる仕組み
- 交差エントロピー ── 二値分類の損失(BCEWithLogits)
- 分類 / 確率 ── 出力の解釈の土台
(tanh の専用ページは未整備のため、 tanh の詳細は本ページと活性化関数を参照してください。)