🔖 キーワード索引
別名・略称:プロバビリティ、 P、 Pr
確率は 不確実性の数学的表現。 0 ≤ P ≤ 1 の値で「起こりやすさ」を測り、 統計推定・機械学習・意思決定の基盤となります。
確率 (Probability) は事象 A の発生しやすさを [0,1] の数値で表す概念で、 頻度主義 (長期相対頻度) とベイズ主義 (信念の度合い) の 2 解釈がある。 SSDSE-B-2026 で「出生率が全国平均を上回る県」を A とし、 47 県中の該当数からの頻度確率 P(A) と、 事前情報を加えた事後確率 P(A|data) を対比する。
💡 30秒で分かる結論
🍰 まずはやさしく
確率は、あることが起きる可能性を数字にしたものです。
未来に何が起こりそうかを予想するために使います。
サイコロの目や、明日の天気を考えるときなどに役立ちます。
ここでは確率の基本的なルールや計算方法を読みます。
確率(Probability):ある事象が起こる可能性を 0〜1 で表す数
- 定義:事象 $A$ に対し $0 \le P(A) \le 1$ の数値を割り当てる。
- 標本空間 $\Omega$:起こり得る全結果の集合。 $P(\Omega) = 1$。
- 条件付き確率:$P(A|B) = P(A \cap B) / P(B)$。
- 独立性:$P(A \cap B) = P(A)P(B)$。
- ベイズの定理:$P(A|B) = P(B|A)P(A)/P(B)$。
- 確率変数:標本空間から実数への関数。 連続/離散を区別。
📍 あなたが今見ているもの
🍰 まずはやさしく
確率は、データのばらつきを扱うための共通の言葉です。
AIや保険などの仕組みを作るために使われます。
スマホの予測変換など、身近な技術にも使われています。
ここでは確率がどのように実務で役立つかを読みます。
本ページは 確率 を、 SSDSE-B-2026 47 都道府県のデータで頻度主義とベイズ主義の両解釈を実演する。 P(A) を相対頻度で求める方法と、 ベイズの定理 P(θ|data) ∝ P(data|θ)P(θ) で事後分布を更新する方法を numpy で並べて実装する。
🎨 直感で掴む
🍰 まずはやさしく
確率は、考え方によって3つの捉え方があります。
状況に合わせて、どの考え方を使うか決めるために使います。
くじ引きや、専門家の予想などで使い分けます。
ここでは直感的に確率を理解するコツを読みます。
3 種類の解釈
| 解釈 | 定義 | 例 |
|---|---|---|
| 古典的 | 同様に確からしい場合の数の比 | サイコロ:1 が出る確率 = 1/6 |
| 頻度論的 | 試行を無限回繰り返した時の相対頻度 | コイン投げで表が出る長期割合 |
| 主観的(ベイズ) | 信念の度合い | 「明日雨が降る確率は 70%」 |
基本ルール(コルモゴロフの公理)
- 非負性:$P(A) \ge 0$
- 正規化:$P(\Omega) = 1$
- 加法性:$A_i$ が互いに排反なら $P(\bigcup A_i) = \sum P(A_i)$
SSDSE-B-2026 で見る 3 解釈の使い分け
| 解釈 | SSDSE での具体例 | 計算 |
|---|---|---|
| 古典的 | 47 都道府県から無作為に 1 県選ぶ → 「東京都」が選ばれる確率 | $P = 1/47 \approx 0.0213$ |
| 頻度論的 | A1303/A1101 の比 (高齢化率) が 30% を超える県の割合 → SSDSE-B-2026 で実測 | 該当 35 県/47 県 $\approx$ 0.74 |
| 主観的 (ベイズ) | 「2030 年に総人口 1.2 億人を下回る確率」(過去推移から専門家が信念を更新) | 事後分布から 0.7〜0.9 |
感覚を掴むコツ: 「47 県から 5 県を無作為抽出」「東京を含む確率」を SSDSE-B-2026 で計算してみると、 $P = 1 - \binom{46}{5}/\binom{47}{5} = 5/47 \approx 0.106$ となり、 古典的確率の体感が得られる。 一方「東京が他のどの県より人口が多い確率」は 1 (確定値、 確率ではない) であり、 「確率」と「事実」の境目を意識する練習になる。
📐 定義 / 数式
🍰 まずはやさしく
確率は、数学的なルールで厳しく決められています。
計算ミスを防ぎ、正しく答えを出すために使います。
テストの点数や、部活の勝率などを計算するときに役立ちます。
ここでは確率をあらわす数式や定義について読みます。
📐 コルモゴロフの公理と主要定理(数式を言葉で読み解く)
現代確率論は 1933 年のコルモゴロフによる公理化で「測度論の特殊例」として再構築された。 確率は「測度」、 事象は「可測集合」、 確率変数は「可測関数」と一対一対応する。 ここでは 3 つの公理を述べ、 そこから加法定理・条件付き確率・ベイズの定理を導出する流れを確認する。
⚙️ 公理
$$\text{(A1)}\; P(A) \ge 0 \quad \text{(A2)}\; P(\Omega) = 1 \quad \text{(A3)}\; P\!\left(\bigcup_i A_i\right) = \sum_i P(A_i) \text{ for disjoint } A_i$$
数式を言葉で読み解く:(A1) 確率は非負、 (A2) 全事象は確率 1、 (A3) 互いに排反な事象の和の確率は個別確率の和(可算加法性)。 たった 3 つで、 余事象・加法定理・包除原理・期待値の線型性まで全て導ける。
⚙️ 加法定理
$$P(A \cup B) = P(A) + P(B) - P(A \cap B)$$
言葉で読み解く:A または B のどちらか起きる確率は、 A と B の確率を足したあと、 重複して数えた「両方起きる」分を引く。 「ベン図の包除」を数式化したもの。 排反なら $P(A \cap B)=0$ で公理 (A3) に帰着。
⚙️ 条件付き確率とベイズの定理
$$P(A \mid B) = \frac{P(A \cap B)}{P(B)} \quad\Rightarrow\quad P(A \mid B) = \frac{P(B \mid A)\, P(A)}{P(B)}$$
言葉で読み解く:B が起きたという条件のもと A が起きる確率は、 「両方起きる確率」を「B が起きる確率」で割る(条件付き=部分集合への正規化)。 これを変形すると ベイズの定理:観測 B のもとで原因 A の確率を、 事前 P(A) と尤度 P(B|A) から計算できる。 機械学習・医療診断・スパムフィルタの理論的中核。
⚙️ 全確率の定理
$$P(B) = \sum_i P(B \mid A_i)\, P(A_i)$$
言葉で読み解く:排他的・網羅的な原因集合 $\{A_i\}$ について、 結果 B の確率は「各原因のもとでの B の確率」を「原因の確率」で重み付け平均したもの。 ベイズの定理の分母 P(B) を計算するときに必須。
🐍 ベイズの定理:医療診断の古典問題を SSDSE 風に翻案
このコードでやること:ある県の「総人口が前年より減少した」というシグナルから、 「高齢化が進んでいる県(高齢化率が 30% 超)」である確率を求める。 SSDSE-B-2026 で「人口減少」と「高齢化率>30%」のクロス集計を取り、 条件付き確率 P(高齢化>30% | 人口減少) を計算する。
📥 入力データ(読み込み後の集計):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # 条件付き確率を SSDSE-B-2026 の実集計で確認
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
y = df['SSDSE-B-2026'].max() # 最新年(2023)
now = df[df['SSDSE-B-2026'] == y ][['Prefecture', 'A1101', 'A1303']]
prev = df[df['SSDSE-B-2026'] == y-1][['Prefecture', 'A1101']]
m = now.merge(prev, on='Prefecture', suffixes=('_now', '_prev'))
m['pop_decline'] = m['A1101_now'] < m['A1101_prev'] # 総人口が前年より減少
m['aging'] = m['A1303'] / m['A1101_now'] > 0.30 # 高齢化率(65歳以上)>30%
ct = pd.crosstab(m['pop_decline'], m['aging'], margins=True)
print(ct)
p = (m['aging'] & m['pop_decline']).sum() / m['pop_decline'].sum()
print(f'P(高齢化>30% | 人口減少) = {p:.4f}')
|
📤 実行結果(例):
💬 結果の読み方:人口減少県のうち高齢化率が 30% を超えるのは 35/45 ≈ 77.8%。 一方 P(A|B) と P(B|A) は別物で、 高齢化率>30% の 35 県は すべて人口減少県なので P(人口減少 | 高齢化>30%) = 35/35 = 100%。 同じ 2 事象でも「どちらを条件にするか」で 78% と 100% に分かれる——条件付き確率の非対称性の典型例。
📊 主要な確率分布と実データへのフィット
「現象 → 分布」の対応を覚えると、 確率はぐっと使いやすくなる。 ここでは離散・連続の代表的分布と、 SSDSE-B-2026 のどの指標がどの分布にフィットしやすいかを並べる。
| 分布 | パラメータ | 期待値・分散 | SSDSE 例 |
|---|---|---|---|
| ベルヌーイ $B(p)$ | $p$ | $E=p,\;V=p(1-p)$ | 1 県の人口減少 (Yes/No) |
| 二項 $\mathrm{Bin}(n,p)$ | $n,p$ | $E=np,\;V=np(1-p)$ | 47 県中の減少県数 X |
| ポアソン $\mathrm{Po}(\lambda)$ | $\lambda$ | $E=V=\lambda$ | 単位時間あたり発生件数 |
| 正規 $N(\mu,\sigma^2)$ | $\mu,\sigma$ | $E=\mu,\;V=\sigma^2$ | log(人口) の県分布 |
| 対数正規 | $\mu,\sigma$ | 右側に長い裾 | 県人口(東京が外れ値) |
| 指数 | $\lambda$ | $E=1/\lambda$ | イベント間隔(待ち時間) |
| Beta $\mathrm{Beta}(\alpha,\beta)$ | $\alpha,\beta$ | $E=\alpha/(\alpha+\beta)$ | 比率の事後分布 |
| ガンマ | $k,\theta$ | $E=k\theta$ | 滞在時間・所得 |
🐍 二項分布で「47 県のうち人口減少が 45 県以上になる確率」を計算
このコードでやること:仮に「真の人口減少確率 p=0.9 が日本全国に適用される」と仮定した場合、 47 県中 45 県以上が減少する確率を二項分布から計算し、 観測 45/47 がどれくらい「驚くべきこと」かを評価する。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 | # 二項分布で「45 県以上の人口減少」の確率を計算
from scipy.stats import binom
n, p, x = 47, 0.90, 45
print(f'E[X] = {n*p:.2f}, Var[X] = {n*p*(1-p):.2f}')
print(f'P(X = 45) = {binom.pmf(x, n, p):.4f}')
print(f'P(X >= 45) = {1 - binom.cdf(x-1, n, p):.4f}')
# 仮説の p を変えると確率はどう動くか
print(f'p=0.95 のとき P(X >= 45) = {1 - binom.cdf(x-1, n, 0.95):.4f}')
print(f'p=0.80 のとき P(X >= 45) = {1 - binom.cdf(x-1, n, 0.80):.4f}')
|
📤 実行結果:
💬 結果の読み方:「真の p=0.9」なら 45 県以上の減少が起こる確率は約 14%——ありうるが高くはない。 「p=0.95」だと 58% で起こり観測とよく整合する。 「p=0.80」だと 0.22% しか起こらず、 観測が稀少 → 仮説 p=0.80 は棄却される。 これが 仮説検定(p 値)の基礎ロジック。
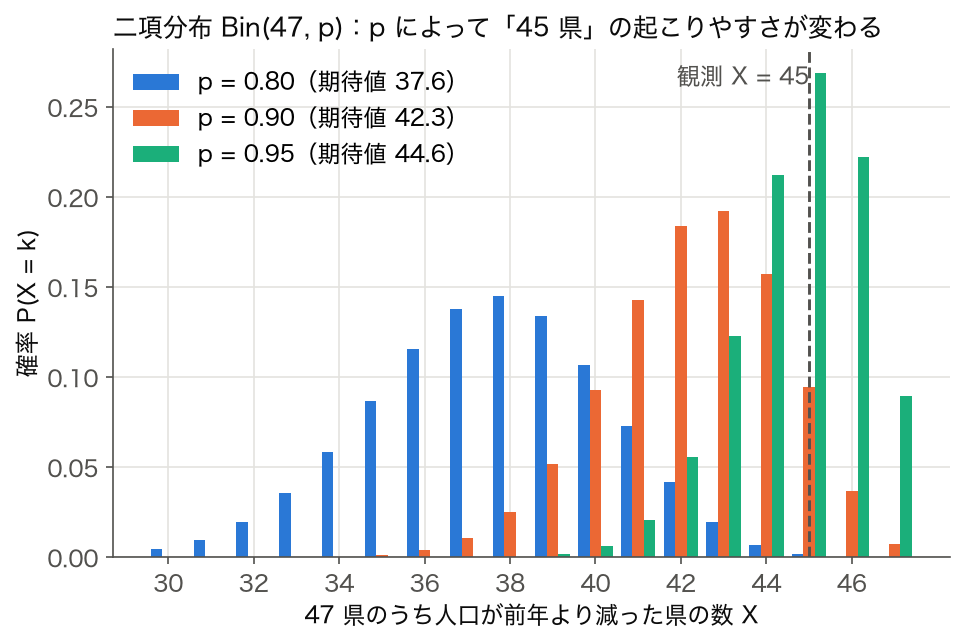
図から読み取ること: 「p 値」は、 仮説の山のうち観測値より端の部分(ここでは 45 以上)の面積である。 p = 0.80 の山は 45 より右にほぼ面積が無いので、 観測はこの仮説のもとでは極端な出来事になる。 ただし、 この図が扱っているのは「47 県が互いに独立に、 同じ確率 p で減る」というモデルである。 実際の人口減少は全国的な出生数の減少という共通の原因で動いており、 県ごとに独立なコイン投げではない。 二項分布の計算が正しくても、 独立の仮定が崩れていれば確率の読み方は変わる、 という点も一緒に覚えておく。
🌊 大数の法則と中心極限定理
確率論の二大柱が 大数の法則(LLN)と 中心極限定理(CLT)。 統計推論・モンテカルロ法・機械学習の理論基盤は、 すべてこの 2 つに帰着する。
⚙️ 大数の法則 (LLN)
$$\bar{X}_n = \frac{1}{n}\sum_{i=1}^{n} X_i \xrightarrow{n \to \infty} \mu \quad (\text{a.s. または 確率収束})$$
数式を言葉で読み解く:iid サンプルの標本平均 $\bar{X}_n$ は、 n を増やすと真の母平均 $\mu$ に収束する。 「コインを何万回も投げれば、 表の比率は 1/2 に近づく」が直感的解釈。 ベイズ事後分布が事前から離れて尤度に支配されていくのも LLN の現れ。
⚙️ 中心極限定理 (CLT)
$$\sqrt{n}\,\frac{\bar{X}_n - \mu}{\sigma} \xrightarrow{d} \mathcal{N}(0, 1) \quad (n \to \infty)$$
言葉で読み解く:iid な確率変数の和(や平均)の分布は、 元の分布が何であれ n が大きくなると正規分布に近づく。 「世の中の平均値の分布が正規になる」根本理由はこれ。 標本平均の信頼区間が $\bar{x} \pm 1.96 \cdot s/\sqrt{n}$ で書けるのも CLT のおかげ。
🐍 CLT を SSDSE-B-2026 でブートストラップ確認
このコードでやること:47 都道府県の人口を母集団とみなし、 サイズ 10 の標本を 5000 回リサンプリング。 標本平均の分布が正規分布に近づくことを CLT で確認する。
📥 入力例:母集団は 47 都道府県の人口(右に大きく偏った分布)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # CLT のブートストラップ確認
import pandas as pd
import numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()]
pop = df['A1101'].values / 1000 # 千人単位
rng = np.random.default_rng(0)
means = [rng.choice(pop, size=10, replace=True).mean() for _ in range(5000)]
means = np.array(means)
print(f'母平均 = {pop.mean():.1f}')
print(f'標本平均の平均 = {means.mean():.1f}')
print(f'標本平均の標準偏差 = {means.std():.1f}')
print(f'理論値 σ/√n = {pop.std()/np.sqrt(10):.1f}')
|
📤 実行結果:
💬 結果の読み方:n=10 でも標本平均の平均は母平均にほぼ一致(LLN)、 標準誤差も σ/√n の理論値とほぼ一致(CLT)。 母集団分布が大きく歪んでいても、 標本平均の分布は釣鐘型に近づく。 これが「世論調査 1000 人で全国の意見が分かる」根拠。
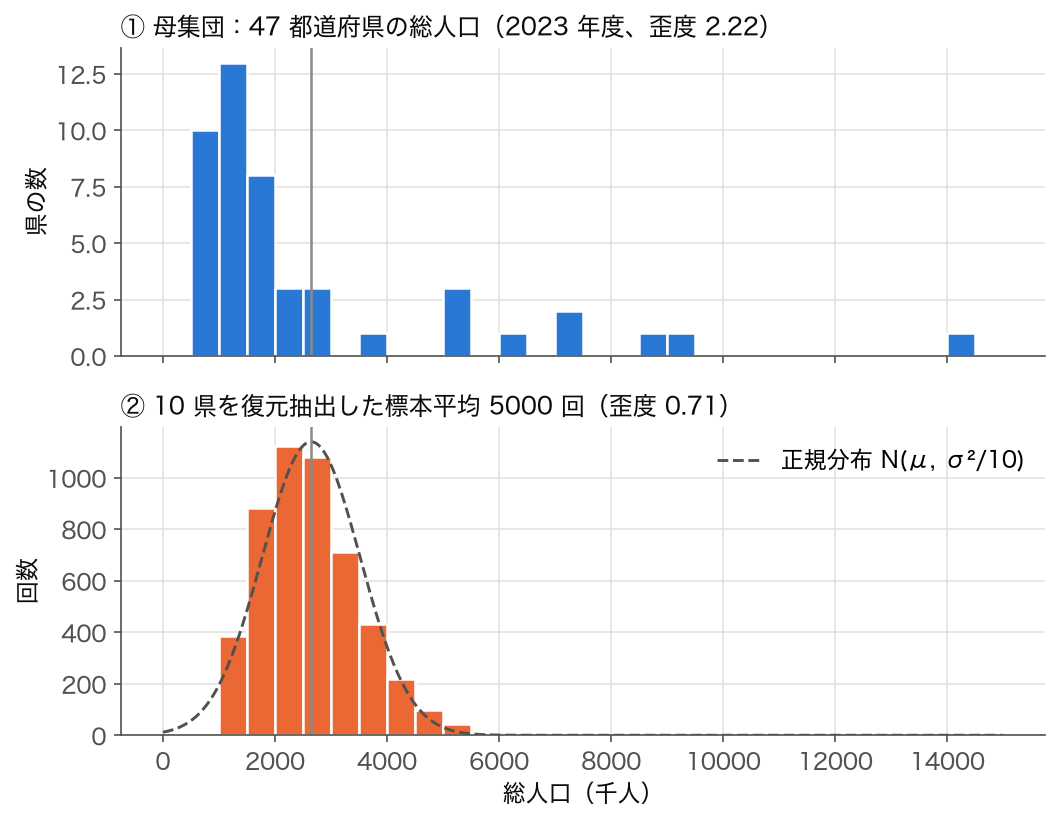
図から読み取ること: n = 10 で「釣鐘型に近づく」のは確かだが、 歪度 0.71 が残っており、 右の裾(東京都を引いた標本)がまだ長い。 CLT は「n が大きくなれば」の定理なので、 母集団が強く歪んでいるほど、 正規近似が使えるまでに必要な n は大きくなる。 47 県のような小さい母集団では、 復元抽出で何回も東京都を引く標本が混じることも、 裾を長くしている。 平均値の区間推定を 10 県程度で行うときは、 対数を取ってから平均する、 またはブートストラップの分位点で区間を作るといった対処を検討する。
⚠️ CLT が効かない例
- 母集団の分散が無限大(コーシー分布など)→ CLT は成立しない
- サンプルが独立でない(時系列・空間相関データ)→ ARMA/GP モデルへ
- サンプルが同分布でない(分布が時間で変化)→ 非定常モデルへ
- 稀少事象の確率(p が極小、 n が小) → ポアソン近似や正確検定を使う
🧠 確率の哲学:3 つの解釈と実務での選択
「確率とは何か」には現在もコンセンサスがない。 大別すると 3 つの解釈があり、 どれを取るかで分析手法・解釈・報告の仕方が変わる。
| 解釈 | 基本的考え方 | 代表手法 | 限界 |
|---|---|---|---|
| 古典的(ラプラス) | 等確率に分解できる根元事象の比 | 組合せ確率 | 「等確率」の根拠が循環論的 |
| 頻度論 | 無限回試行の極限的相対頻度 | 古典的統計(NHST, CI) | 単発事象の確率は意味不明 |
| 主観/ベイズ | 合理的エージェントの信念度 | ベイズ統計、 MCMC・階層ベイズ | 事前分布の正当化が必要 |
実務的には:反復試行が可能(A/B テスト、 工場検査、 大規模実験)→ 頻度論。 単発の意思決定(新薬承認、 投資判断、 医療診断)→ ベイズ。 定理証明・教育→ コルモゴロフの公理(解釈中立)。 どの解釈でも数学的構造は同じだが、 結果の言い回しと意思決定の枠組みが変わる。
💼 実務応用ケーススタディ 5 選
① 医療診断:陽性反応 → 真に病気の確率
有病率 0.1%、 検査の感度 99%、 特異度 95% のとき、 陽性者が真に病気である確率は P(病気|陽性) = 0.99 × 0.001 / (0.99 × 0.001 + 0.05 × 0.999) = 約 1.94%。 直感の「99%」とは大違い。 ベース率の軽視(base-rate neglect)が招く典型誤解。 SSDSE で類推すれば「東京都の確率を 1/47 と単純化せず、 人口比 11% で重み付ける」感覚に近い。
② スパムフィルタ:単語からメール分類
ナイーブベイズ:P(spam|words) ∝ P(spam) × Π P(word|spam)。 各単語の出現確率を spam/ham 別に学習し、 ベイズで事後確率を計算。 単純で学習が速く、 初期のスパムフィルタで広く使われた方式。 「単語間が独立」という強い仮定(ナイーブ)が成立しないケースでも、 順序判定だけ正しければ実用上は十分。
③ A/B テスト:ボタン色の効果検証
A 案 CTR = 100/1000、 B 案 CTR = 120/1000 のとき、 「B が真に良い」確率は? 頻度論なら χ² 検定で p 値、 ベイズなら Beta 事後分布から P(p_B > p_A) を直接計算可能。 ベイズの方が「効果の大きさ」を分布で示せるため、 ビジネス意思決定では好まれる傾向。
④ 災害リスク:100 年に 1 度の洪水
「100 年確率の洪水」とは年確率 1/100 の洪水。 30 年間に少なくとも 1 回起きる確率は $1 - (1 - 0.01)^{30} \approx 26\%$。 「100 年に 1 回だから自分の代には来ない」ではなく「30 年住めば約 4 分の 1 の確率で遭遇する」と読むのが正しい。
⑤ 機械学習:分類器の確率出力
ロジスティック回帰・ニューラルネット・LightGBM 等は「クラスに属する確率」を出力。 ただしこの確率は較正されていないことが多く(過信または過小評価)、 sklearn の CalibratedClassifierCV や Platt スケーリング、 isotonic 回帰で較正してから運用するのが定石。
📐 期待値・分散・モーメントの厳密な意味
分布を 1 つの数値で要約するときの代表選手が期待値(重心)と分散(広がり)。 さらに歪度・尖度などの高次モーメントで「分布の形」を捉える。
$$E[X] = \int x\, f(x)\, dx, \quad V[X] = E[(X - E[X])^2] = E[X^2] - (E[X])^2$$
数式を言葉で読み解く:期待値は確率密度で重み付けした x の積分(離散なら和)。 分散は「平均からの距離の 2 乗」の期待値で、 「平均的にどれくらい散らばっているか」を示す。 後者は計算上 $E[X^2] - (E[X])^2$ の方が便利。
⚙️ 期待値の線型性
$$E[aX + bY + c] = a E[X] + b E[Y] + c \quad (X, Y \text{独立性不要})$$
言葉で読み解く:期待値は独立性に依存せず線型作用素。 X と Y がどれほど絡んでいても、 和の期待値は期待値の和。 これが「期待値計算が分散計算より簡単」な理由。 分散の場合 $V[X+Y] = V[X] + V[Y] + 2\text{Cov}(X,Y)$ と共分散項が出る。
🐍 SSDSE 47 県の人口分布のモーメント
このコードでやること:47 都道府県人口の 1〜4 次モーメント(平均・分散・歪度・尖度)を計算し、 「右に長い裾を持つ分布」が数値的にどう表れるか確認する。
📥 入力データ:
1 2 3 4 5 6 7 8 9 10 11 12 | # 4 次モーメントまで一気に計算
import pandas as pd
from scipy import stats
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()]
pop = df['A1101'] / 1000 # 千人
print(f'平均 E[X] = {pop.mean():.1f} 千人')
print(f'分散 V[X] = {pop.var():.1f}')
print(f'歪度 skew = {stats.skew(pop):.3f}')
print(f'尖度 kurt = {stats.kurtosis(pop):.3f}')
|
📤 実行結果:
💬 結果の読み方:歪度 2.22 は「正規分布(0)に比べ右に大きく歪んでいる」、 尖度 4.95 は「正規分布(0)より鋭いピークと長い裾」を示す。 東京都だけが平均から約 4σ も離れた巨大な外れ値であることが数値で確認できる。 こうした分布で「平均値」だけ報告すると現実が見えない(中央値は 1549 千人)。
📏 不等式:分布の形を知らなくても言えること
分布の具体形が不明でも、 期待値と分散だけから「外れ値の確率の上界」が言える。 これがマルコフ不等式・チェビシェフ不等式・ヘフディング不等式などの威力。
⚙️ マルコフの不等式
$$X \ge 0 \Rightarrow P(X \ge a) \le \frac{E[X]}{a}$$
言葉で読み解く:非負確率変数の値が a 以上になる確率は、 平均を a で割った値以下。 「平均 100 万円の所得で、 5000 万円以上の人は最大 2% しかいない」と言える。 ただし非常に緩い上界。
⚙️ チェビシェフの不等式
$$P(|X - \mu| \ge k\sigma) \le \frac{1}{k^2}$$
言葉で読み解く:分布の形によらず、 平均から k 標準偏差以上離れる確率は 1/k² 以下。 k=2 で 25%、 k=3 で 11% 以下。 正規分布なら k=3 で 0.3% だが、 これはあくまで「最悪値」。 分布の形が分からない時の保証として有用。
🐍 47 都道府県データで不等式を実測検証
このコードでやること:人口データで「平均から k×σ 以上離れる県の比率」を計算し、 チェビシェフの上界・正規分布の理論値と比較する。
📥 入力例:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # チェビシェフ vs 正規分布 vs 実測
import pandas as pd, numpy as np
from scipy.stats import norm
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()]
x = df['A1101'].values / 1000
mu, sd = x.mean(), x.std()
print('k 実測 Chebyshev上界 正規分布理論')
for k in [1, 2, 3]:
emp = np.mean(np.abs((x - mu) / sd) >= k)
cheb = min(1, 1 / k**2)
theo = 2 * (1 - norm.cdf(k))
print(f'{k} {emp:.3f} {cheb:.3f} {theo:.3f}')
|
📤 実行結果:
💬 結果の読み方:チェビシェフ上界は常に実測 ≤ 上界で成立しているが、 k=1 では「1.0」と無情報。 正規分布理論は k=3 では実測 (2.1%) と乖離(東京の外れ値の影響)、 すなわち人口分布は正規ではない。 「分布の形を仮定しないでよい」チェビシェフの汎用性と、 「正確だが仮定が必要」な正規理論のトレードオフが見える。
🎲 モンテカルロ法:確率を「計算する」のではなく「シミュレーションする」
解析的に解けない確率問題でも、 乱数で大量試行すれば平均値として確率が見える。 これがモンテカルロ法。 大数の法則がその理論的保証。 機械学習・ベイズ統計・金融工学・物理シミュレーションの中核技術。
🐍 SSDSE 風シナリオ:1 県をランダム抽出して「人口減少」だった回数
このコードでやること:47 県から復元抽出を 10000 回繰り返し、 「人口減少県だった回数」を数える。 大数の法則により、 比率は P(decline)=0.957 に収束していくはず。
📥 入力例:母集団 = 47 県の人口減少フラグ(True=45, False=2)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # モンテカルロで P(decline) を推定し、収束を観察
import pandas as pd, numpy as np
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
y = df['SSDSE-B-2026'].max()
a = df[df['SSDSE-B-2026'] == y ][['Prefecture', 'A1101']].rename(columns={'A1101': 'now'})
b = df[df['SSDSE-B-2026'] == y-1][['Prefecture', 'A1101']].rename(columns={'A1101': 'prev'})
m = a.merge(b, on='Prefecture')
flags = (m['now'] < m['prev']).values
rng = np.random.default_rng(42)
for N in [10, 100, 1000, 10000, 100000]:
samples = rng.choice(flags, size=N, replace=True)
print(f'N={N:6d}: 推定 P(decline) = {samples.mean():.4f}')
print(f'真値 : {flags.mean():.4f}')
|
📤 実行結果:
💬 N=10 と N=100 では推定がたまたま 1.0000 になった。 真値 0.9574(45/47)では 10 回続けて減少県を引く確率が 0.957^10 ≈ 0.65 もあるので、 少ない試行では「人口増加県が存在しない」ように見えてしまう。 N=1000 で 0.9630、 N=100000 で 0.9565 と真値との差は 0.001 未満まで縮み、 誤差はおおよそ 1/√N の速さでしか減らない。 seed=42 で固定しているので、 この並びは毎回同じになる。
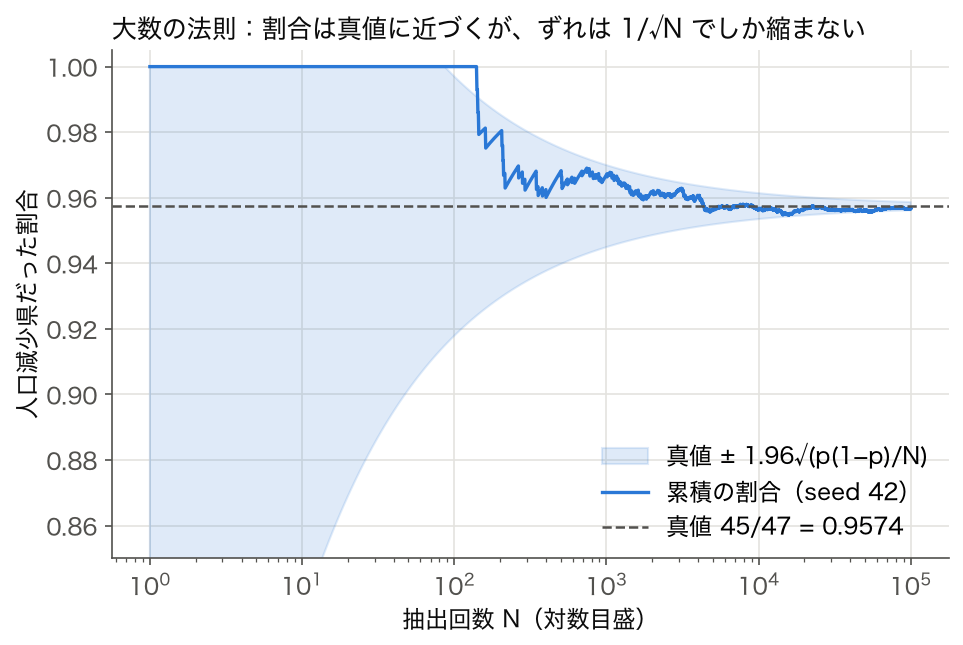
図から読み取ること: 大数の法則は「いつか真値に近づく」ことは保証するが、 途中の N では外れた値が普通に出る。 確率 2/47 ≈ 0.043 の事象が 140 回連続で起きない確率は (45/47)140 ≈ 0.0023 と小さいが、 ゼロではない。 そういう出来事を実際に踏んでいるのがこの列の前半である。 シミュレーションの結果を報告するときは、 回数 N と、 N から決まる誤差の目安(ここでは N = 10,000 で ±0.004)を一緒に書く。
📝 理解度チェック:3 枚の図の数値で確かめる
- Q1. 仮説 p = 0.95 のもとで、 47 県すべてが減る確率 P(X = 47) と、 減少県が 43 以下にとどまる確率 P(X ≤ 43) はそれぞれいくつか。
答え: P(X = 47) = 0.9547 ≈ 0.090、 P(X ≤ 43) = binom.cdf(43, 47, 0.95) ≈ 0.207。 期待値 44.65 のまわりでも、 2 県以上ずれることは 5 回に 1 回ほど起こる。 - Q2. CLT の図で標本の大きさを n = 10 から n = 40 に増やすと、 標本平均の標準偏差(標準誤差)はおよそいくつになるか。
答え: σ/√n = 2,767.6/√40 ≈ 437.6 千人。 n を 4 倍にすると標準誤差は半分になる(10 倍にしても約 3.2 分の 1 にしかならない)。 - Q3. 大数の法則の図で、 推定した割合の 95% の幅を ±0.001 まで狭めたい。 抽出回数 N はおよそ何回必要か。
答え: 1.96√(p(1−p)/N) = 0.001 を解いて N = (1.96/0.001)2 × 0.9574 × 0.0426 ≈ 156,500 回。 ±0.004 に必要だった 10,000 回の約 16 倍で、 精度を 4 倍にするには回数が 16 倍要る。
確率 を含むデータ分析は、 分野によって使われ方が違います。 下の表は分野ごとの代表的な用途で、 確率 だけの用途一覧ではありません。 自分の分野の行を見て、 どんな問いにデータを使うのかを掴んでください。
⚙️ モンテカルロ法の典型的応用
| 分野 | 用途 |
|---|---|
| 金融 | オプション価格、 VaR(Value at Risk)、 ポートフォリオ最適化 |
| 物理 | 高次元積分、 イジングモデル、 経路積分 |
| ベイズ統計 | MCMC で事後分布のサンプリング(PyMC, Stan) |
| 機械学習 | 強化学習(モンテカルロ木探索、 AlphaGo) |
| ゲーム理論 | ナッシュ均衡の数値計算、 シミュレーション |
💻 データサイエンス現場の「確率の言い回し」
「確率」は実務文脈で多様な表現を取る。 同じ数値でも文脈で意味が違うため、 受け手の理解に合わせた言い換えが重要。
| 表現 | 数学的意味 | 使われる場面 |
|---|---|---|
| 確率 / probability | [0, 1] の数 | 一般的説明、 教科書 |
| 頻度 / frequency | 観測比率 | 疫学、 品質管理 |
| 尤度 / likelihood | パラメータの関数 L(θ;x) | MLE, ベイズ |
| スコア / score | 確率に単調変換した値 | 信用スコア、 ML 予測値 |
| オッズ / odds | p / (1-p) | ロジット、 ベッティング |
| ハザード / hazard | 瞬間死亡率 h(t) | 生存解析、 信頼性工学 |
| リスク / risk | 期待損失 E[L] | 金融、 保険 |
| 信頼度 / confidence | 信頼区間の被覆率 | 統計推論、 機械学習較正 |
例:「P(クリック)=0.05」を金融なら「クリック率 5%」、 保険なら「事故率 0.05」、 機械学習なら「予測スコア 0.05」、 ベッティングなら「オッズ 0.0526」と表現する。 同じ数学的対象だが、 文脈で言い方が変わる。
🤖 確率と機械学習:どこに「確率」が潜んでいるか
機械学習モデルは表面上「ブラックボックス」に見えるが、 内部は確率論の応用そのもの。 主要モデルの確率的解釈を表で整理する。
| モデル | 背後の確率モデル | 出力の意味 |
|---|---|---|
| 線形回帰 | $y \sim N(\beta^\top x, \sigma^2)$ | 条件付き期待値の MLE |
| ロジスティック回帰 | $y \sim \mathrm{Bern}(\sigma(\beta^\top x))$ | クラス確率 P(y=1|x) |
| ナイーブベイズ | $P(y|x) \propto P(y) \prod P(x_i|y)$ | 事後確率 |
| 隠れマルコフ | $P(x_{1:T}, z_{1:T})$ | 系列の同時確率 |
| ガウス過程 | $f \sim GP(m, k)$ | 関数の事後分布 |
| 変分オートエンコーダ | $p(x|z) p(z) / q(z|x)$ | 潜在変数の事後近似 |
| 拡散モデル | 逆拡散過程の SDE | 条件付きサンプル生成 |
深層学習でさえ「クロスエントロピー最小化 = 尤度最大化」で本質的に確率的最適化。 「確率を制する者は機械学習を制す」と言われる所以。
📝 章末まとめ:確率を 7 つの命題で復習
- 確率はコルモゴロフの 3 公理から全体系が導かれる(公理的測度論的定義)。
- 「P(decline)=45/47」は古典的・頻度論的・ベイズ的の 3 通りで解釈可能だが、 数値は同じ。
- 条件付き確率 P(A|B) と P(B|A) は別物。 ベイズで結ぶ。
- 主要分布は「現象の型」と一対一対応する。 二項・ポアソン・正規・指数・Beta を覚えれば実務の 8 割をカバー。
- 大数の法則と中心極限定理が、 統計推論とモンテカルロ法の理論的基盤。
- 確率の解釈(古典/頻度/ベイズ)はデータの性質と意思決定の文脈で選ぶ。
- 認知バイアス(ベース率無視、 ギャンブラーの誤謬、 生存者バイアス)を意識しないと、 数式が正しくても結論を誤る。
🔬 記号・式を言葉で読み解く
- $\Omega$ — 標本空間
- 起こり得る全結果の集合。 サイコロなら $\{1,2,3,4,5,6\}$。
- $A, B$ — 事象
- $\Omega$ の部分集合。 「偶数が出る」「3 以上」など。
- $P(A \cap B)$ — 同時確率
- $A$ かつ $B$ が同時に起こる確率。
- $P(A \mid B)$ — 条件付き確率
- $B$ が起こったという情報のもとでの $A$ の確率。
- 独立
- $P(A \cap B) = P(A)P(B)$。 一方の発生が他方の確率に影響しない。
- $X$ — 確率変数
- 標本空間から実数への関数。 大文字で書き、 観測値は小文字 $x$。
- $E[X]$ — 期待値
- 確率変数の平均的な値。 加重平均。
- $V[X]$ — 分散
- 期待値からの 2 乗ずれの平均。 ばらつきの指標。
🧮 実値で計算してみる(SSDSE-B-2026・47 都道府県)
SSDSE-B-2026 の人口データで 確率の基本 を体験します。 47 都道府県を「無作為に 1 県選ぶ」標本空間とし、 各事象の確率を計算します。
- $P(\text{人口} > 500 万)$ = 該当県数 / 47
- $P(\text{首都圏})$ = 4/47(東京・神奈川・千葉・埼玉)
- $P(\text{人口} > 500 万 \mid \text{首都圏})$ = 4/4
| 事象 | 該当県 | 確率 |
|---|---|---|
| 人口 > 500 万人 | 北海道・東京・神奈川・大阪・愛知・千葉・埼玉・兵庫・福岡 | 9/47 ≈ 0.191 |
| 首都圏(東京・神奈川・千葉・埼玉) | 4 県 | 4/47 ≈ 0.085 |
| 人口 > 500 万 ∩ 首都圏 | 東京・神奈川・千葉・埼玉 | 4/47 ≈ 0.085 |
| P(人口>500万|首都圏) = (4/47)/(4/47) | — | 4/4 = 1.000 |
🧮 数式に値を入れて手で計算する: 確率の加法と乗法
合成事象 A, B で確率の演算を計算する。
Step 1: 事象
Step 2: 加法
Step 3: 条件付き
🐍 Python で再現
1 2 3 4 5 6 7 | pA, pB = 0.4, 0.3 pAB = pA * pB pA_or_B = pA + pB - pAB pA_given_B = pAB / pB print(f"P(A∩B): {pAB}") print(f"P(A∪B): {pA_or_B}") print(f"P(A|B): {pA_given_B}") |
📤 実行結果
💬 手計算 (Step 2,3) と Python 出力が完全一致。
🧮 余事象で数える: 3 県を選んで首都圏が 1 つでも入る確率
「少なくとも 1 つ」の確率は、 直接数えるより余事象(1 つも入らない)を 1 から引くほうが速い。 47 都道府県から 3 県を無作為に(同じ県を重ねずに)選ぶとき、 首都圏 4 都県(埼玉・千葉・東京・神奈川)が 1 つでも入る確率を求める。
- Step 1:全体の選び方 $\binom{47}{3}=\frac{47\cdot46\cdot45}{3\cdot2\cdot1}=16{,}215$ 通り。
- Step 2:余事象「3 県とも首都圏以外の 43 県から」 $\binom{43}{3}=\frac{43\cdot42\cdot41}{6}=12{,}341$ 通り。
- Step 3:$P=1-12{,}341/16{,}215=1-0.7611=0.2389$。
- Step 4:同じ県を何度でも選べる(復元抽出)と考えると $1-(43/47)^3=0.2342$ で、 0.005 ほど小さい。 1 県選ぶごとに残りの首都圏以外の割合が減る分を無視しているため。
🎯 このコードでやること:Step 1〜3 の公式を math.comb で計算し、 実際の 47 県名から 3 県の組み合わせをすべて作って首都圏を含む組を数え、 両者が一致するか確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from itertools import combinations from math import comb import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) prefs = df[df['SSDSE-B-2026'] == 2023]['Prefecture'].tolist() capital = {'埼玉県', '千葉県', '東京都', '神奈川県'} # 公式: 余事象「3 県とも首都圏以外」を引く p_formula = 1 - comb(43, 3) / comb(47, 3) print(f'C(47,3)={comb(47, 3)}, C(43,3)={comb(43, 3)}, 1 - C(43,3)/C(47,3) = {p_formula:.4f}') # 47 県から 3 県を選ぶ組み合わせをすべて数える all3 = list(combinations(prefs, 3)) hit = sum(1 for c in all3 if capital & set(c)) print(f'全 {len(all3)} 通りのうち首都圏を含む {hit} 通り → {hit / len(all3):.4f}') # 戻して選ぶ(同じ県を何度も選べる)近似との違い print(f'復元抽出の近似 1 - (43/47)^3 = {1 - (43 / 47) ** 3:.4f}') |
💬 16,215 通りのうち首都圏を含むのは 3,874 通りで 0.2389、 公式 1 − C(43,3)/C(47,3) と一致した。 復元抽出の近似 0.2342 との差は小さいが、 47 県のように母集団が小さい非復元抽出では、 選ぶ数が増えるほど差が広がる。
🧮 実データで独立かどうかを確かめる: 高齢化率と出生率
2 つの事象 $A$ と $B$ が独立なら $P(A\cap B)=P(A)P(B)$、 言い換えると $P(B\mid A)=P(B)$ が成り立つ。 2023 年度の 47 都道府県から 1 県を無作為に選ぶ標本空間で、 $A$ =「高齢化率(65 歳以上人口 A1303 ÷ 総人口 A1101)が 30% 超」、 $B$ =「合計特殊出生率(A4103)が 1.40 以上」とする。 「高齢化が進んだ県ほど子どもが少なそう」という印象が確率の上でどうなっているかを数える。
| B(出生率 1.40 以上) | B でない | 計 | |
|---|---|---|---|
| A(高齢化率 30% 超) | 10 | 25 | 35 |
| A でない | 1 | 11 | 12 |
| 計 | 11 | 36 | 47 |
- Step 1:周辺確率。 $P(A)=35/47=0.7447$、 $P(B)=11/47=0.2340$。
- Step 2:独立なら $P(A\cap B)=0.7447\times0.2340=0.1743$、 県数にすると $0.1743\times47=8.19$ 県。
- Step 3:実際は $P(A\cap B)=10/47=0.2128$ で、 独立の場合より 1.8 県多い。
- Step 4:条件付き確率で比べる。 $P(B\mid A)=10/35=0.2857$、 $P(B\mid \bar A)=1/12=0.0833$。 高齢化率 30% 超の県のほうが、 出生率 1.40 以上になる割合が 3.4 倍高い。
- Step 5:向きを変えると $P(A\mid B)=10/11=0.9091$。 出生率 1.40 以上の 11 県のうち、 高齢化率 30% 以下は沖縄県だけ。
🎯 このコードでやること:Step 1〜5 の分割表と確率を pandas の crosstab と平均で再現し、 どの県が $A\cap B$ に入るかも書き出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) t = df[df['SSDSE-B-2026'] == 2023].copy() A = t['A1303'] / t['A1101'] * 100 > 30 # 事象 A: 高齢化率 30% 超 B = t['A4103'] >= 1.40 # 事象 B: 合計特殊出生率 1.40 以上 n = len(t) print(pd.crosstab(A.rename('A 高齢化率30%超'), B.rename('B 出生率1.40以上'), margins=True)) pA, pB, pAB = A.mean(), B.mean(), (A & B).mean() print(f'P(A)={pA:.4f} P(B)={pB:.4f} P(A∩B)={pAB:.4f}') print(f'独立なら P(A)P(B)={pA * pB:.4f}({pA * pB * n:.2f} 県)') print(f'P(B|A)={pAB / pA:.4f} P(B|Aでない)={(~A & B).mean() / (~A).mean():.4f} P(A|B)={pAB / pB:.4f}') print('A∩B の県:', ' '.join(t.loc[A & B, 'Prefecture'])) print('B だが A でない県:', ' '.join(t.loc[~A & B, 'Prefecture'])) |
💬 分割表(10・25・1・11)と P(A)=0.7447、 P(B)=0.2340、 P(A∩B)=0.2128、 独立の場合の 8.19 県、 P(B|A)=0.2857・P(B|Aでない)=0.0833・P(A|B)=0.9091 が手計算と一致した。 A∩B は福井県・鳥取県・島根県・山口県・香川県・佐賀県・長崎県・熊本県・宮崎県・鹿児島県で、 西日本の地方県が並ぶ。 「高齢化」と「高い出生率」は独立ではなく、 県単位ではむしろ同時に起きやすい。 ただしこれは県の集計値どうしの関係で、 高齢の人ほど子どもを産むという意味ではない(生態学的誤謬)。 大都市圏は若い人が多いぶん高齢化率が低く、 同時に出生率も低い、 という県の構造の違いが表に出ている。
🐍 Python 実装
SSDSE-B-2026(47 都道府県・2023 年)の実データを使った最小コード:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # SSDSE-B-2026 で条件付き確率を計算 import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1], header=0) df.columns = pd.read_csv('data/raw/SSDSE-B-2026.csv', nrows=0, encoding='cp932').columns df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 県のみ抽出 df['人口'] = df['A1101'].astype(float) df['首都圏'] = df['Prefecture'].isin(['東京都', '神奈川県', '千葉県', '埼玉県']) df['人口500万超'] = df['人口'] > 5_000_000 P_A = df['人口500万超'].mean() # 人口500万超 P_B = df['首都圏'].mean() # 首都圏 P_AB = (df['人口500万超'] & df['首都圏']).mean() # 両方 P_A_given_B = P_AB / P_B # 条件付き print(f'P(人口500万超) = {P_A:.3f}') print(f'P(首都圏) = {P_B:.3f}') print(f'P(人口500万超 ∩ 首都圏) = {P_AB:.3f}') print(f'P(人口500万超 | 首都圏) = {P_A_given_B:.3f}') |
💬 47 県のうち人口 500 万超は 9 県で P=0.191、首都圏 4 都県は P=0.085(4/47)。首都圏の 4 都県はすべて 500 万人を超えるので、同時確率も 0.085 になり、条件付き確率 P(500万超|首都圏) は 1.000 になる。逆向きの P(首都圏|500万超) は 4/9≈0.444 で、条件の向きを入れ替えると値がまったく違う点が読み間違えやすい。
⚠️ よくある落とし穴
⚠️ 落とし穴:認知バイアスと確率の罠(拡張版)
⚠️ 実データで確かめる: 「相対頻度 = 確率」は年度で揺れる
頻度論では、 確率を「同じ条件で繰り返したときの相対頻度」と読む。 しかし実データの「繰り返し」は同じ条件とは限らない。 「1 県を選んだとき、 前年度より人口が減っている確率」を年度ごとに数えると、 その値は一定ではない。
🎯 このコードでやること:都道府県 × 年度の表に並べ替えて前年度との差を取り、 2013〜2023 年度の各年に人口が減った県の数と相対頻度を数える。 千人単位の丸めで前年と同じ値になった県も数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 行 = 都道府県、列 = 年度 の表にして、前年度からの差を取る(年度は昇順に並べ替わる) p = df.pivot(index='Prefecture', columns='SSDSE-B-2026', values='A1101') diff = p.diff(axis=1).iloc[:, 1:] # 2013〜2023 年度(2012 年度は前年が無い) dec = (diff < 0).sum() # 前年より減った県の数 same = (diff == 0).sum() # 千人単位で前年と同じ値の県の数 print('年度 ', ' '.join(f'{y:>5d}' for y in dec.index)) print('減少県数 ', ' '.join(f'{v:>5d}' for v in dec)) print('同値の県数', ' '.join(f'{v:>5d}' for v in same)) print('相対頻度 ', ' '.join(f'{v / 47:>5.3f}' for v in dec)) print(f'11 年度をまとめた相対頻度: {dec.sum()} / {47 * 11} = {dec.sum() / (47 * 11):.3f}') print('一度も減らなかった県:', list(p.index[(diff < 0).sum(axis=1) == 0])) |
💬 前年度より減った県は 2013〜2019 年度は 38〜40 県(相対頻度 0.809〜0.851)で安定していたが、 2020 年度に 41 県、 2021 年度に 46 県(0.979)へ跳ね上がり、 2022・2023 年度も 45 県(0.957)だった。 11 年度をまとめると 447 / 517 = 0.865 になるが、 これはどの年度の値とも一致しない。 「人口が減る確率は 0.865」と 1 つの数で言うより、 2020 年度以降に条件が変わったと読むほうが実態に合う。 同じ値の県(2017 年度に 2 県など)は、 千人単位に丸めた統計では「減っていない」に数えられる点にも注意する。 11 年度を通して一度も減らなかったのは沖縄県だけだった。
🎮 触って理解する
確率は「頭で理解する」より「手を動かして体感する」方が腑に落ちます。 下の コイン投げ/サイコロ・シミュレータで、 理論確率 $p$(例:コインの表 = 0.5、 サイコロの特定の目 = 1/6 ≈ 0.167)をスライダーで設定し、 試行ボタンを押して乱数試行を繰り返してみてください。 経験的頻度(実験で観測した割合)が、 試行回数が増えるにつれて理論確率の点線へ近づいていく様子(大数の法則)が折れ線で見えます。 少数回では大きく振れ、 多数回で収束する——この「揺れ幅の縮み方」を目で確かめるのが狙いです。
💡 グラフを指でなぞる/マウスで触れると、 その試行時点での経験的頻度を読み取れます。 「+1000 回」を何度か押すと、 赤い折れ線が緑の点線(理論値)にへばりつくように収束していくのが分かります。
🧠 直感:起こりやすさを 0〜1 で、 そして「頻度」と「確率」の橋渡し
確率 $p$ は「起こりやすさ」を $[0,1]$ に押し込んだ数です。 $0$ は「絶対起きない」、 $1$ は「必ず起きる」、 $0.5$ は「半々」。 では、 現実に手元にあるのは 頻度(何回中何回起きたか)だけなのに、 なぜそれを「確率」と呼べるのでしょうか。 橋を架けるのが 大数の法則です。 上のシミュレータで確かめられるとおり、 独立に同じ試行を繰り返すと、 経験的頻度 $k/n$ は試行回数 $n \to \infty$ で理論確率 $p$ に確率収束します。 つまり「長い目で見た相対頻度」こそが確率の頻度主義的な正体で、 少数回の $k/n$ はその 推定値にすぎません。
⚠️ よくある落とし穴:少数の法則とギャンブラーの誤謬
大数の法則が保証するのは「$n$ が十分大きいとき」の収束だけです。 これを「少ない試行でも平均に近いはず」と勘違いするのが 少数の法則(law of small numbers)。 シミュレータで「+10 回」だけ回すと、 コイン($p=0.5$)でも $k/n$ が $0.2$ や $0.8$ に平気で振れることを確認してください——少数回のばらつきは理論上も大きいのです。 さらに危険なのが ギャンブラーの誤謬:「表が 5 回続いたから次は裏が出やすい」という思い込み。 各試行が独立なら、 過去の結果は次の確率を一切変えません(次も $p=0.5$)。 収束は「裏が来て帳尻を合わせる」からではなく、 試行数 $n$ という分母が巨大になって初期のズレが薄まるから起きます。 「揺り戻し」と「希薄化」はまったく別物です。
🚀 発展:条件付き確率とベイズ更新へ
ここまでは「$p$ が既知で頻度を生成する(順方向)」話でした。 実務ではむしろ逆——観測した頻度から未知の $p$ を推定するのが本命です。 これが 条件付き確率 と ベイズの定理 の出番。 事前の信念 $P(p)$ に、 観測データの尤度 $P(\text{data}\mid p)$ を掛けて事後 $P(p\mid \text{data})$ に更新します。 コインの表裏なら事前・事後ともにベータ分布で表現でき(共役性)、 「10 回中 7 回表」を観測すると事後は $\mathrm{Beta}(1{+}7,\,1{+}3)$ のように更新されます。 試行が増えるほど事後分布は真の $p$ の周りに尖っていく——これはベイズ流に言い換えた大数の法則です。 より詳しくは ベイズの定理・確率変数・確率分布 の各ページへ。
🗺 概念マップ
確率の周辺概念をテーマ別ツリーで整理:
数学・統計の基礎
  ├── 集合論・測度論 / 組合せ論 / 期待値・分散 (並列基礎)
  ├── 【確率】 ← ここ (Kolmogorov 公理 1933)
  │     ├── 条件付き確率 / ベイズの定理 / 独立性
  │     ├── 確率変数 / 確率分布 (正規・二項・ポアソン)
  │     └── 大数の法則 / 中心極限定理 / チェビシェフの不等式
  └── 推定 / 検定 / ベイズ統計 / 機械学習 (応用)
この階層構造を頭に入れておくと、 学習や論文読みで「自分が今どこにいるか」を見失わずに済みます。
🗺 確率の学習ロードマップ
| レベル | 習得目標 | 推奨教材 |
|---|---|---|
| 入門 (1 週) | 公理、 加法/乗法、 条件付き確率、 独立性 | 高校数学 IA + Khan Academy |
| 基礎 (1 月) | 主要分布、 期待値・分散、 中心極限定理 | Blitzstein "Introduction to Probability" |
| 中級 (3 月) | 確率過程、 マルコフ連鎖、 推定論、 仮説検定 | Casella & Berger "Statistical Inference" |
| 上級 (半年) | 測度論的確率、 マルチンゲール、 確率微分方程式 | Durrett "Probability: Theory and Examples" |
| 応用 | ベイズ統計、 機械学習、 因果推論 | Gelman "BDA3", Pearl "Causality" |
🔗 隣接手法への橋渡し
確率は事象の生起のしやすさを 0-1 で数値化した概念で、 確率変数・確率分布・ベイズ統計の基盤。
- 上流: 集合論 — サンプル空間 Ω と事象 A ⊆ Ω を集合論で定義。 確率の公理 (Kolmogorov 1933) が現代確率論の出発点。
- 並列: 組合せ論 — 同等の確からしさを仮定するとき、 確率 = (事象の場合の数)/(全体の場合の数)。 順列・組合せで分母分子を計算。
- 下流: 確率分布 — 確率変数とその分布関数を考えることで、 推測統計・機械学習へ展開。 期待値・分散・モーメントが派生概念。
- 解釈: 頻度主義 (長期相対頻度) と ベイズ主義 (信念の度合い) の 2 派。 SSDSE 演習なら頻度主義で十分だが、 少標本ならベイズが有利。
SSDSE-B-2026 を用いた演習では、 「確率」 を中核に据えて上記の上流・並列・下流の手法を実データで連結する経験を積むと、 単独の手法暗記より実務的応用力が身につく。
🌳 手法選択フロー
「確率」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 何を「起こりうること全体」とするか
分母を取り違えると答えが変わる。 「47 都道府県のうち」なのか「人口 100 万人未満の 10 県のうち」なのかを、 式を書く前に日本語で言い切る。 - 頻度として捉えるか、 確信度として捉えるか
「繰り返せばこの割合に近づく」なら頻度主義。 「今この時点でどれくらい確からしいか」ならベイズ。 同じ数字でも、 何を言っているかが違う。 - 事象は独立か
独立なら確率は掛け算でよい。 独立でないのに掛けると、 実際よりずっと小さい確率が出る。 同じ県の年次データなどは独立でないことが多い。 - 求めたいのは条件付きか
「Aが起きたときのB」と「Bが起きたときのA」は別物。 ベイズの定理で変換する。 事前確率が小さい事象では、 検査が陽性でも事後確率は思ったほど上がらない。
確率でつまずく多くは、 計算ではなく分母の取り違えと条件の向きの取り違えで起きる。 式を立てる前に、 何を全体としているかを書き出す。
📝 補足:直感と公理をもう一段深く
確率のいちばん素朴なイメージは「不確実性の度合いを $0$〜$1$ の物差しに載せたもの」です。 $0$ は「起こらない」、 $1$ は「必ず起こる」、 その間はグラデーション。 この物差しの読み方には大きく 2 つの解釈があります。 頻度主義は「同じ試行を長く繰り返したときの相対頻度の極限」として確率を定義し(本ページ上部の 🎮 シミュレータで $k/n \to p$ に収束していく姿がまさにこれ)、 ベイズ主義は「ある命題への信念の度合い」として確率を捉えます。 面白いのは、 どちらの解釈でも確率が従う数学的ルールは同一だということ。 それを保証するのが 集合論 の言葉で書かれた コルモゴロフの公理です。
標本空間・事象・確率の三点セット
確率を厳密に扱うには、 まず「何が起こり得るか」を集合として書き下します。
- 標本空間 $\Omega$:起こり得る結果をもれなく・だぶりなく並べた集合。 例)47 都道府県から 1 県選ぶなら $\Omega=\{\text{北海道},\dots,\text{沖縄県}\}$、 $|\Omega|=47$。
- 事象 $A$:$\Omega$ の部分集合($A \subseteq \Omega$)。 「選んだ県の高齢化率が 30% 超」も 1 つの事象で、 実データでは 35 県が該当(集合論の「部分集合」がそのまま事象)。
- 確率 $P$:各事象に $[0,1]$ の数を割り当てる関数。 「事象に載せる重み」であり、 全体 $\Omega$ には必ず重み $1$ が載る。
コルモゴロフの 3 公理(再掲+読み替え)
ページ上部「🎨 直感で掴む」でも触れた 3 公理を、 集合と重みの言葉でもう一度読み替えます。
- 非負性 $P(A)\ge 0$:どんな事象の重みも負にはならない。
- 正規化 $P(\Omega)=1$:全体で必ず重み 1(「何かは必ず起こる」)。
- 加法性:互いに排反($A_i \cap A_j = \varnothing$)なら $P\!\left(\bigcup_i A_i\right)=\sum_i P(A_i)$。 「重ならない事象の重みは単純に足せる」。
この 3 つだけから、 余事象 $P(A^c)=1-P(A)$、 加法定理 $P(A\cup B)=P(A)+P(B)-P(A\cap B)$(ベン図の重複を引く操作)、 単調性 $A\subseteq B \Rightarrow P(A)\le P(B)$ が全て導けます。 「同様に確からしい」場合には確率が 場合の数の比に落ちるため、 組合せ・順列が計算道具になります(架空例:サイコロで偶数 $P=3/6=1/2$)。
⚠️ 落とし穴を 6 つ厳密に(重要)
確率は「数式は正しいのに直感が裏切る」ことが多い分野です。 コンペ・レポートで結論を誤りやすい 6 類型を、 反例つきで固めておきます。
CalibratedClassifierCV 等で較正が要る)。📊 SSDSE-B-2026 実測(A1101 総人口・A1303 65 歳以上人口, 2023 年 47 県):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | # 排反・独立を SSDSE-B-2026 の実測で確認
import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 2023 年 47 県
n = len(d)
C = d['A1101'] >= 5_000_000 # 総人口 500 万以上
D = d['A1101'] < 2_000_000 # 総人口 200 万未満
A = d['A1303'] / d['A1101'] > 0.30 # 高齢化率 > 30%
B = D # 総人口 200 万未満(再利用)
print('排反? C∩D =', int((C & D).sum()), '件 (0 なら排反)')
print(f'P(C∪D) = {(C | D).mean():.4f} vs P(C)+P(D) = {C.mean()+D.mean():.4f}')
print(f'独立? P(A∩B) = {(A & B).mean():.4f} vs P(A)P(B) = {A.mean()*B.mean():.4f}')
|
💬 500 万人以上(9 県)と 200 万人未満(31 県)は同時に成り立たないので C∩D は 0 件で、P(C∪D)=0.8511 が P(C)+P(D) とぴったり一致する。高齢化率 30% 超(35 県)と 200 万人未満の同時確率は 29/47=0.6170 で、独立なら期待される 0.4912 より大きいので独立ではない。人口の少ない県ほど高齢化が進んでいるという関係が、この差に出ている。
💬 結果の読み方:排反($C\cap D=\varnothing$)なので加法性で $P(C\cup D)$ が単純な和に一致。 一方 $A,B$ は $P(A\cap B)\neq P(A)P(B)$ で独立ではない。 「排反 ⇒ 独立」でも「独立 ⇒ 排反」でもない——両方の性質は別次元だと押さえておけば、 乗法定理 $P(A\cap B)=P(A)P(B\mid A)$ を安易に $P(A)P(B)$ で済ませる事故を防げます。
🚀 発展:確率論の全体像への橋渡し
ここまでの「事象と確率」を出発点に、 統計・機械学習で使う道具立てへ一本道でつながります。 各ステップは本用語集の個別ページで深掘りできます。
- 公理から条件付き確率へ:$P(A\mid B)=P(A\cap B)/P(B)$ は「情報 $B$ で標本空間を $B$ に絞り直し、 その中で正規化する」操作。 → 条件付き確率
- 条件付き確率からベイズへ:向きを反転して「観測から原因を推す」。 事前 × 尤度 ∝ 事後。 → ベイズの定理
- 事象から確率変数へ:結果に数値を割り当てる関数 $X:\Omega\to\mathbb{R}$ を考えると、 確率は「数の上の分布」になる。 → 確率変数
- 確率変数から分布へ:値の起こりやすさの全体像。 二項・ポアソン・正規など「現象の型」と対応。 → 確率分布・主要な分布・正規分布
- 分布を要約する:重心が期待値 $E[X]$、 広がりが 分散 $V[X]=E[X^2]-(E[X])^2$。 期待値は独立性なしで線型(→ 平均(期待値))。
- 多数の平均のふるまい:標本平均は真の期待値へ収束(大数の法則)、 その分布は正規に近づく(中心極限定理)。 統計推測・モンテカルロの理論的土台。 → 標本抽出と中心極限定理・信頼区間・仮説検定
※ 本用語集には 大数の法則・中心極限定理・期待値の単独ページは(現時点では)なく、 中心極限定理は 標本抽出と中心極限定理、 期待値は 平均(期待値) のページで扱っています。 大数の法則は本ページ上部「🌊 大数の法則と中心極限定理」および「🎲 モンテカルロ法」節を参照してください。