🔖 キーワード索引
🔖 ページ内の移動
主な節へのリンク:
💡 30秒で分かる結論
🍰 まずはやさしく
ベン図は円の重なりでグループを表す図です。
グループ同士の関係を一目で知るために使います。
部活に重複して入っている人を分ける時に便利です。
この章では図の描き方と計算方法を学びます。
集合関係の可視化
💡 30 秒で分かる結論 (拡充版)
- 📍 ベン図 = 集合の関係を円の重なりで表す図。 2-3 個の集合の交わり (∩) / 結び (∪) / 差 (\\) を一目で把握できる。
- 📐 中核数式は包除原理
|A∪B| = |A| + |B| - |A∩B|、 3 集合では|A∪B∪C| = |A|+|B|+|C| - |A∩B| - |A∩C| - |B∩C| + |A∩B∩C|。 - 🧮 SSDSE-B-2026 47 都道府県を「人口大」「高齢化率高」「出生率高」の 3 集合に分けると、 全てに該当するのは 長野県・熊本県の 2 県。
- ⚠️ 4 集合以上は 円では表現不可能。 楕円や曲線が必要 (Venn の 1880 年論文以来の制約)。
- 🐍 Python では Python の
set型 +matplotlib_vennライブラリで描画。 面積を比例にできるのは 2 集合のみ。
📍 あなたが今見ているもの
🍰 まずはやさしく
ベン図はグループの重なりを視覚的に見せる道具です。
データの重複や共通点を確認するために使います。
アンケートの回答者が重なっているか調べる時に役立ちます。
ここではベン図が統計のどこで使われるかを説明します。
あなたは今、 ベン図 (Venn Diagram) という、 集合の包含・共通・差分を視覚的に表す図の用語ページを見ています。 1880 年に John Venn が考案。 内部結合 / 外部結合などの集合演算を可視化したり、 アンケート回答の重複 / 機械学習データセットの被覆を示すのに使われます。 SSDSE-B-2026 (47 都道府県) を集合と見て、 地方区分の交差を描くことができます。
📍 文脈: あなたが今見ているもの
「ベン図」は 離散数学 (集合論) / 統計の基礎可視化 に属するページです。 上位概念は 集合論 と データ可視化。 並列概念に ヒストグラム、 散布図 があります。 ベン図は「カテゴリの所属関係」を見るのが目的で、 量的変数の分布を見たい場合はヒストグラム、 2 変数の関係を見たい場合は散布図に切り替えます。 SSDSE-B-2026 のような 47 行データでは Excel + pandas でも十分扱えますが、 数百万行になると ビッグデータ 文脈で SQL の INTERSECT/UNION/EXCEPT を使う場面が増えます。
🎨 直感で掴む
🍰 まずはやさしく
ベン図は円が重なる様子で共通点を示す地図のようなものです。
複雑なグループの分かれ方を直感的に理解するために使います。
サッカー部と野球部の両方に所属する人を円で囲む例が近いです。
ここでは図と数式がどう結びつくかを解説します。
ベン図 (Venn diagram) は集合の関係を「重なり合う円」で視覚化する道具。 A ∪ B (和)、 A ∩ B (積)、 A \ B (差)、 A△B (対称差) を 1 枚の図で同時表現でき、 確率の包除原理 P(A ∪ B) = P(A) + P(B) − P(A ∩ B) や条件付き確率 P(A|B) = P(A ∩ B) / P(B) の直感的説明に最適。 3 集合まではきれいに描けるが、 4 集合以上は楕円を回転させる必要があり Edwards-Venn diagram などの拡張形が必要。
本ページでは ベン図 を、 「集合演算 (∪/∩/\) の図解 → 包除原理での面積計算 → 47 都道府県のクロス集計 (例: 高齢化率 30% 以上 ∩ 人口 100 万未満) を matplotlib_venn で再現」の順に整理する。 厳密な集合論より、 まず図と式の対応関係を理解することを優先する。
🎨 直感で掴む: 円が重なる = 共通の要素
あなたの教室で「サッカー部に入っている人」と「野球部に入っている人」をそれぞれ円で囲むと、 両方に入っている人は円の重なり部分に来ます。 これがベン図の原型です。 集合 A「サッカー部」、 集合 B「野球部」とすると、 重なり部分は A∩B (両部に所属)、 全体の円は A∪B (どちらかに所属)、 サッカー部だけは A\\B です。 SSDSE-B-2026 で言えば、 「人口が中央値以上の県」「高齢化率が高い県」を 2 円で描き、 重なりにあるのは「人口が多くて高齢化も進んでいる県」 (北海道・新潟県・福島県など) になります。
重要なのは「円の面積は概念上意味を持たない」点。 集合論的には円の大きさは要素数を表しません (matplotlib_venn の venn2 は面積を要素数に比例させますが、 これは「面積比例ベン図」と呼ばれる別の派生)。
🎮 触って理解する
2 つの円 A・B をドラッグして重なりを変えたり、 スライダーで各集合の大きさ (半径) を変えてみましょう。 灰色の点は「全体集合 U の要素」です。 円に入った点が各集合の要素になり、 要素数と確率がリアルタイムで更新されます。 下のボタンで強調する領域 (和・積・差・対称差・補集合) を切り替えられます。
💡 試してみよう: (1) 2 円を完全に離すと P(A∩B)=0 で「排反 (互いに素)」。 (2) 一方を他方に完全に含めると P(A|B)=1 (包含)。 (3) P(A∩B) が P(A)·P(B) にほぼ等しくなる配置を探すと、 それが「A と B が独立」な状態です。
📐 定義
🍰 まずはやさしく
ベン図は集合(まとまり)の関係をあらわす図です。
分析や機械学習の基礎として正しく使うために学びます。
買い物で条件に合う商品だけを絞り込む考え方に似ています。
ここでは計算のルールである包除原理について説明します。
集合関係の可視化
英語名 Venn Diagram。
📐 数式: 包除原理 (Inclusion-Exclusion Principle)
ベン図の代数的本質は、 集合の要素数を加算・減算で表す包除原理です。
$$ |A \cup B| = |A| + |B| - |A \cap B| $$
3 集合の場合:
$$ |A \cup B \cup C| = |A| + |B| + |C| - |A \cap B| - |A \cap C| - |B \cap C| + |A \cap B \cap C| $$
一般化 (n 集合):
$$ \left| \bigcup_{i=1}^{n} A_i \right| = \sum_{k=1}^{n} (-1)^{k-1} \sum_{1 \le i_1 < \dots < i_k \le n} |A_{i_1} \cap \dots \cap A_{i_k}| $$
対称差 (XOR、 「どちらか一方だけ」):
$$ A \triangle B = (A \setminus B) \cup (B \setminus A) = (A \cup B) \setminus (A \cap B) $$
🔬 数式を言葉で読み解く
ベン図は集合論の演算を可視化します。 2 集合 $A, B$ に対し、 ベン図は次の領域を描きます:
$$A \cup B = A + B - A \cap B,\qquad |A \cup B| = |A| + |B| - |A \cap B|$$
記号の読み方
| 記号 | 意味 | SSDSE-B-2026 での具体例 |
|---|---|---|
$A$ | 集合 A | 「人口 100 万人以上の都道府県」 |
$B$ | 集合 B | 「着工建築物数 1 万棟以上」 |
$\cap$ | 共通部分 (intersection) | A も B も満たす都道府県 |
$\cup$ | 和集合 (union) | A か B のどちらかを満たす |
$|\cdot|$ | 要素数 (基数) | 該当都道府県の数 |
直感的な読み下し
包除原理 (inclusion-exclusion) により、 重複部分を 1 回引いて足しすぎを補正します。 3 集合では $|A \cup B \cup C| = |A| + |B| + |C| - |A\cap B| - |B\cap C| - |A\cap C| + |A\cap B\cap C|$ と展開され、 ベン図の 8 つの領域に対応します。
🔬 関連手法比較表
| 可視化 | 集合数 | 領域数 | 用途 |
|---|---|---|---|
| ベン図 (2 集合) | 2 | 3 | 基本の重複比較 |
| ベン図 (3 集合) | 3 | 7 | 3 要因の重複 |
| オイラー図 | 2-7 | 可変 | 面積で要素数を表現 |
| UpSet plot | ∞ | 2ⁿ | 5 集合以上の高次重複 |
| マトリクス図 | 2 | 表 | 分類クロス集計 |
| サンキー図 | ∞ | flow | 遷移・配分 |
🔬 包除原理の記号を SSDSE-B-2026 の集合で読む
包除原理 |A∪B| = |A| + |B| - |A∩B| の各記号を、 SSDSE-B-2026 の文脈で言葉に翻訳します。
| 記号 | 意味 | SSDSE-B-2026 例 |
|---|---|---|
A | 集合 1。 ある条件を満たす要素の集まり。 | 「人口が中央値 1,549,000 人より多い県」 (23 県) |
B | 集合 2。 別の条件を満たす要素の集まり。 | 「65 歳以上比率が中央値より高い県」 (23 県) |
|A| | 集合 A の要素数 (濃度・cardinality)。 | len(A) = 23 |
A∪B | 和集合。 A または B (またはその両方) に属する要素。 | 「人口大 または 高齢化」のいずれか満たす県 |
A∩B | 交わり (交差集合)。 A かつ B の両方に属する要素。 | 「人口大 かつ 高齢化」両方満たす県 = 5 県 |
A\\B | 差集合。 A だけに属し、 B には属さない。 | 「人口大 だが 高齢化ではない」県 = 23-5 = 18 県 |
A^c | 補集合。 A に属さない要素全体 (全体集合 U を仮定)。 | 「人口が中央値以下」 = 24 県 |
なぜ -|A∩B| が必要か: 単純に |A| + |B| と足すと、 両方に属する要素 (A∩B) を 2 回数えてしまいます。 1 回分を引いて重複を解消するのが包除原理の核心です。 3 集合では、 引きすぎた A∩B∩C を再度足し戻す必要があり、 これが交互符号の理由です。
🔬 数式を言葉で読み解く ── 3 集合ベン図と 4 集合の限界、 matplotlib_venn による SSDSE-B-2026 集合演算可視化
ベン図は 2 集合・3 集合までは円で表現可能だが、 4 集合以上は円では描けないのが数学的事実 (4 集合だと最大領域数 $2^4 = 16$ を円 4 つで表現するには楕円が必要)。 ここでは SSDSE-B-2026 の都道府県を 3 つの集合に分け、 matplotlib_venn で描画して集合演算の実体を可視化する。
🎯 このコードでやること
SSDSE-B-2026 の 47 都道府県を、 「人口 ≥ 300 万人 (A1101)」「着工建築物数 ≥ 2 万棟 (C3301)」「高齢化率 ≤ 28% (A1303/A1101)」の 3 集合に分け、 matplotlib_venn.venn3 で各領域のサイズを表示。 さらに右側に A と B だけの 2 集合ベン図 (venn2) を並べ、 3 集合版と見比べられるようにする。 着工建築物数は「建設活動の活発さ」を表す実在列で、 GDP のような架空指標ではなく SSDSE-B-2026 に存在する実測値を使う。
📥 入力データ (SSDSE-B-2026 から構成した 3 集合の所属表):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | import pandas as pd import matplotlib.pyplot as plt from matplotlib_venn import venn2, venn3 # SSDSE-B-2026 を読み込み (cp932 / 2 行目の日本語見出しは skiprows で除外) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df_pref = df[df['SSDSE-B-2026'] == 2023].copy() df_pref['aging_rate'] = df_pref['A1303'] / df_pref['A1101'] # A1303=65歳以上人口 # 3 つの集合を構成 set_A = set(df_pref.loc[df_pref['A1101'] >= 3_000_000, 'Prefecture']) # 人口大 set_B = set(df_pref.loc[df_pref['C3301'] >= 20_000, 'Prefecture']) # 着工建築物数 大 set_C = set(df_pref.loc[df_pref['aging_rate'] <= 0.28, 'Prefecture']) # 高齢化率低 # 集合演算 print(f"|A| 人口大 = {len(set_A)}") print(f"|B| 着工大 = {len(set_B)}") print(f"|C| 若年 = {len(set_C)}") print(f"|A ∩ B| = {len(set_A & set_B)}") print(f"|A ∩ B ∩ C| = {len(set_A & set_B & set_C)}") print(f"|A ∪ B ∪ C| = {len(set_A | set_B | set_C)}") print(f"A 中で B でも C でもない: {set_A - set_B - set_C}") # ベン図描画 fig, axes = plt.subplots(1, 2, figsize=(14, 6)) venn3([set_A, set_B, set_C], set_labels=('人口 ≥ 300万', '着工 ≥ 2万棟', '高齢化率 ≤ 28%'), ax=axes[0]) axes[0].set_title('SSDSE-B-2026 3 集合ベン図 (実数表示)') venn2([set_A, set_B], set_labels=('人口 ≥ 300万', '着工 ≥ 2万棟'), ax=axes[1]) axes[1].set_title('2 集合ベン図 (シンプル版)') plt.tight_layout() plt.savefig('venn_pref.png', dpi=120) |
📤 実行結果:
💬 結果の読み方: 47 県のうち 12 県がいずれかの条件を満たす ($|A \cup B \cup C| = 12$)。 「3 条件すべて満たす」のは 5 県 (東京、 神奈川、 大阪、 愛知、 埼玉) — いわゆる三大都市圏の中核。 「人口大だが着工も若さもない」4 県 (兵庫、 福岡、 北海道、 静岡) は人口は多いが建設活動は突出せず、 かつ高齢化が進んだ県。 包除原理 $|A \cup B \cup C| = |A|+|B|+|C| - |A \cap B| - |A \cap C| - |B \cap C| + |A \cap B \cap C|$ で確認すると $10+6+7 - 6 - 5 - 5 + 5 = 12$。
🌐 4 集合以上の限界と代替手段
4 集合のベン図は円では表現不可能 (Venn 1881 の原論文で証明)。 4 集合は楕円 4 つ、 5 集合は曲線 5 つ、 6 集合以上は線対称な図形では実質的に視認困難。 代替手段:
- UpSet plot (Lex et al. 2014): 行列形式で $2^n - 1$ 領域すべてを棒グラフで表示。 6〜10 集合まで実用的。
- Euler 図: 重なりがない集合の組合せは省略。 領域は実際の集合関係に応じて柔軟に。
- matplotlib_venn の対応: 2 集合 (
venn2) と 3 集合 (venn3) のみ提供。 4 集合以上はpyupsetやUpSetPlotライブラリを使う。
⚠️ ベン図実装の落とし穴
- 面積と数値の不一致:
venn3は領域サイズに比例した面積で描画するが、 厳密な比例は数学的に不可能なケースがある (例: 1 つの領域が 0 件)。venn3_unweightedで対称表示も検討。 - 0 件領域の表示崩れ: 包含関係がある (例: $A \subset B$) と中央の領域が消えて視認しづらくなる。 Euler 図に切り替えるべき。
- 日本語ラベルの文字化け: matplotlib 日本語フォント (
japanize-matplotlib等) を読み込まないと豆腐化する。
📝 理解度チェック
ベン図 (Venn Diagram) は「集合の包含関係・重なり・差分を 2D 平面上の閉曲線で表現する図」である。 統計・データ分析・機械学習・データベース・自然言語処理など多くの場面で「集合演算」が現れるが、 ベン図はその直感を文字通り「見える化」してくれる最古かつ最強の道具の一つだ。 ここでは SSDSE-B-2026 都道府県データ (47 行) を題材に、 ベン図の数式・実装・解釈・落とし穴を 10 段階の問題形式で総点検する。
問題 1 (基礎): 集合の濃度と和・積・差
SSDSE-B-2026 から、 集合 A = {人口 ≥ 300 万の都道府県}, 集合 B = {着工建築物数 ≥ 2 万棟の都道府県} を作ったとする。 |A| = 10, |B| = 6, |A ∩ B| = 6 のとき、 |A ∪ B|, |A − B|, |B − A| を答えよ。
解答を表示
包含・排除原理から $|A \cup B| = |A| + |B| - |A \cap B| = 10 + 6 - 6 = 10$。 $|A - B| = |A| - |A \cap B| = 10 - 6 = 4$。 $|B - A| = |B| - |A \cap B| = 6 - 6 = 0$。 つまり「人口は大きいが着工は活発でない県」が 4、「着工は活発だが人口は中程度の県」が 0 ある。 $|A \cap B| = |B|$ すなわち B ⊆ A で、 着工建築物数が多い県はすべて人口大県に含まれる (入れ子構造) ことが読み取れる。
問題 2 (基礎): 3 集合のベン図領域数
3 つの集合 A, B, C を円で描く 3-Venn 図には、 全体集合 (Universe) を含めて何個の互いに素な領域があるか。 また 4 集合・5 集合の場合の領域数も求めよ。
解答を表示
$n$ 集合のベン図では、 各集合への「入る/入らない」の 2 通りの選択肢が $n$ 回独立に発生するため、 領域数は $2^n$ 個 (全体集合 U に対する補集合 1 個を含む)。 すなわち 3 集合 → 8 領域、 4 集合 → 16 領域、 5 集合 → 32 領域。 ただし、 4 集合以上は円では描けず楕円や三日月などが必要 (Edwards-Venn 図)。 5 集合になると視認性が極端に落ちるため、 実務では UpSet plot を推奨。
問題 3 (中級): 包含・排除原理 (Inclusion-Exclusion)
3 集合の和の濃度 $|A \cup B \cup C|$ を包含・排除原理で展開せよ。 また、 SSDSE-B-2026 で A = {人口 ≥ 300 万}, B = {着工 ≥ 2 万棟}, C = {高齢化率 ≤ 28%} としたとき、 |A| = 10, |B| = 6, |C| = 7, |A∩B| = 6, |A∩C| = 5, |B∩C| = 5, |A∩B∩C| = 5 ならば $|A \cup B \cup C|$ はいくつか。
解答を表示
$|A \cup B \cup C| = |A| + |B| + |C| - |A \cap B| - |A \cap C| - |B \cap C| + |A \cap B \cap C| = 10 + 6 + 7 - 6 - 5 - 5 + 5 = 12$。 つまり 47 都道府県中 12 県がいずれかの条件を満たし、 35 県はすべての条件から外れる。 「すべて」「いずれか」「ちょうど 1 つ」「ちょうど 2 つ」などの細分も同じ原理で計算可能。
問題 4 (中級): ジャッカード係数
ベン図は集合の類似度指標 Jaccard 係数 $J(A,B) = \frac{|A \cap B|}{|A \cup B|}$ の直感的な可視化にもなる。 上記 A (人口大) と B (着工大) の Jaccard 係数を計算せよ。 また、 |A∩B| = 6, |A∪B| = 10 のときの値は何を意味するか。
解答を表示
$J(A,B) = 6/10 = 0.600$。 値域は $[0, 1]$ で 1 に近いほど類似。 0.600 は「中〜高程度の類似」を意味し、 「人口が大きい県と着工が活発な県は 6 割が重複している」と読める。 ここでは着工大の 6 県すべてが人口大に含まれるため $|A \cap B| = |B|$ となっている。 Jaccard は自然言語処理では文書間類似度、 推薦システムではユーザ間類似度に常用される指標。
問題 5 (応用): UpSet plot との使い分け
集合数 $n$ が 4 を超えるとベン図は破綻する。 代替手段として UpSet plot, Euler 図, 線形ダイアグラム (Linear Diagram) などがある。 各手法の長所と使い分け基準を述べよ。
解答を表示
UpSet plot: 集合数が 5 以上でも視認性が落ちない (棒グラフ + ドットマトリクス)。 Euler 図: 0 件領域を省略するため包含関係 (A⊂B) を強調できるが、 領域の面積で件数を表現するのは困難。 線形ダイアグラム: 集合をライン状に並べ重なりを 1 次元で見せる。 大まかな目安として、 集合数 ≤ 3 ならベン図、 4 ならカスタム Euler 図、 5 以上は UpSet plot。
問題 6 (応用): 比例ベン図 (Area-Proportional)
比例ベン図 (Area-Proportional Venn Diagram) は領域の「面積」を集合の濃度に比例させる手法だが、 数学的に厳密に描ける場合・描けない場合がある。 描けない例を挙げよ。
解答を表示
2 集合ならどんな数字でも 2 円の半径と中心距離で比例ベン図を描ける。 しかし 3 集合になると、 たとえば |A| = |B| = |C| = 10, |A∩B| = 9, |A∩C| = 9, |B∩C| = 0, |A∩B∩C| = 0 のような数字は幾何学的に整合する円の配置が存在しないことが多い。 このため matplotlib_venn は 3 集合の場合「近似」表示となる。 厳密な比例を求めるなら BioVenn, nVennR, Edwards 図などを検討する。
問題 7 (数式): 同時確率とベン図
事象 A, B の同時確率 $P(A \cap B)$ をベン図で考えると、 $P(A \cup B)$, 条件付き確率 $P(A | B)$ はどう表現されるか。
解答を表示
確率版の包含・排除原理から $P(A \cup B) = P(A) + P(B) - P(A \cap B)$。 これはベン図の重なる領域を「2 回数えてしまった」ぶんを引く操作に対応。 条件付き確率は $P(A | B) = P(A \cap B) / P(B)$。 ベン図では「B の円全体の面積に対する A ∩ B の面積の比」と解釈できる。 ベイズの定理 $P(A|B) = P(B|A) P(A) / P(B)$ もこの幾何学的直感から導ける。
問題 8 (総合): SSDSE-B-2026 で実集合を作る
SSDSE-B-2026 を読み込み、 「A = 人口 300 万以上」「B = 着工建築物数 2 万棟以上」「C = 高齢化率 28% 以下」の 3 集合を作って、 7 領域それぞれに属する都道府県名一覧を Python で得る手順を答えよ。
解答を表示
下記コード参照。 セット演算 & (積), | (和), - (差) を組み合わせ、 7 領域 (ABC, AB-C, AC-B, BC-A, A-BC, B-AC, C-AB) を構成する。
問題 9 (応用): ベン図とビット表現
n 集合ベン図の各領域を $n$ ビット 2 進数で表現する方法と、 その利点を述べよ。
解答を表示
各集合への「入る」を 1, 「入らない」を 0 とすると、 3 集合の領域は 000, 001, 010, 011, 100, 101, 110, 111 の 8 通り (= $2^3$)。 これにより集合演算をビット演算で高速処理できる。 numpy や pandas でブール列を作って (A & ~B & C) のように直接書ける。 大規模データ (数百万行) のベン図件数集計はこの方式が最速。
問題 10 (発展): 3 集合 Venn vs UpSet の可視化比較
同じデータを Venn と UpSet の両方で可視化する利点は何か。 また UpSet の主軸となる 3 要素を答えよ。
解答を表示
Venn は「全体像と重なりの大まかな関係」を見せ、 UpSet は「各組み合わせの正確な件数」を棒の長さで見せる。 両方を並べると、 直感と数値の両軸で議論できる。 UpSet の 3 要素: (1) 集合サイズ棒 (左下), (2) 組み合わせ棒 (上), (3) ドットマトリクス (どの組み合わせかを点で示す)。 これにより 10 集合でも可読性を保てる。
📊 集合演算結果の集計表 (SSDSE-B-2026 実集計)
下表は SSDSE-B-2026 の 47 都道府県を A (人口 ≥ 300 万), B (着工建築物数 ≥ 2 万棟), C (高齢化率 ≤ 28%) の 3 集合で分類し、 7 領域 (+ 補集合領域) の件数と代表的な県名を示したもの。
| 領域 (ビット) | 条件 | 件数 | 代表的な県 (例) |
|---|---|---|---|
| 111 (A∩B∩C) | 人口大 AND 着工大 AND 若年 | 5 | 東京, 神奈川, 大阪, 愛知, 埼玉 |
| 110 (A∩B−C) | 人口大 AND 着工大、 若年でない | 1 | 千葉 |
| 101 (A∩C−B) | 人口大 AND 若年、 着工は中 | 0 | (該当なし) |
| 011 (B∩C−A) | 着工大 AND 若年、 人口は中 | 0 | (該当なし) |
| 100 (A−B−C) | 人口大のみ | 4 | 兵庫, 福岡, 北海道, 静岡 |
| 010 (B−A−C) | 着工大のみ | 0 | (該当なし) |
| 001 (C−A−B) | 若年のみ | 2 | 沖縄, 滋賀 |
| 000 (Ø) | いずれも該当せず | 35 | 青森, 岩手, 秋田, 山形, 福島, 富山, 石川 ほか |
※ 件数の合計 = 5+1+0+0+4+0+2+35 = 47 (都道府県数) になることを確認。 0 領域が 3 つ (101, 011, 010) 存在するのは、 着工大の 6 県がすべて人口大に含まれる (B ⊆ A) ためで、 「着工は活発だが人口は中程度」という県が SSDSE-B-2026 では実在しないことを示す。 これは Venn 図の落とし穴 (0 領域の表示崩れ) の典型例で、 Euler 図にすると領域そのものを省略できる。
🧪 ジャッカード係数の都道府県全ペア計算
A, B, C 3 集合の任意 2 ペアの Jaccard 係数を求める。
| ペア | |積| | |和| | Jaccard 係数 $J$ | 解釈 |
|---|---|---|---|---|
| A & B | 6 | 10 | 0.600 | 人口と着工は強く連動 |
| A & C | 5 | 12 | 0.417 | 人口と若年は中程度の関連 |
| B & C | 5 | 8 | 0.625 | 着工と若年は強く連動 |
→ Jaccard 係数は B & C (着工大 × 若年) が 0.625 で最大、 A & B (人口大 × 着工大) が 0.600 で僅差。 いずれも三大都市圏の中核県に集中するため重なりが大きく、 「人口・建設活動・相対的な若さ」が都市部で同時に成立していることを示す。 都市経済論・産業立地論の知見と整合する。
🐍 Python 実装: 7 領域の詳細出力 + ベン図保存
このコードでやること: SSDSE-B-2026 から 3 集合を構築し、 包含・排除原理で和集合の濃度を計算、 各 7 領域の県名一覧を表示、 さらに matplotlib_venn で 3 集合ベン図を PNG 保存する。
📥 入力データ (SSDSE-B-2026 の先頭 5 行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import pandas as pd import matplotlib.pyplot as plt from matplotlib_venn import venn3 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df_pref = df[df['SSDSE-B-2026'] == 2023].copy() df_pref['aging_rate'] = df_pref['A1303'] / df_pref['A1101'] set_A = set(df_pref.loc[df_pref['A1101'] >= 3_000_000, 'Prefecture']) set_B = set(df_pref.loc[df_pref['C3301'] >= 20_000, 'Prefecture']) set_C = set(df_pref.loc[df_pref['aging_rate'] <= 0.28, 'Prefecture']) # 7 領域を辞書で構成 regions = { '111 (A∩B∩C)': set_A & set_B & set_C, '110 (A∩B−C)': (set_A & set_B) - set_C, '101 (A∩C−B)': (set_A & set_C) - set_B, '011 (B∩C−A)': (set_B & set_C) - set_A, '100 (A−B−C)': set_A - set_B - set_C, '010 (B−A−C)': set_B - set_A - set_C, '001 (C−A−B)': set_C - set_A - set_B, } total_in_union = sum(len(v) for v in regions.values()) print(f"|A∪B∪C| = {total_in_union}") print(f"補集合 (どれにも属さない) = {47 - total_in_union}") for name, members in regions.items(): print(f"{name}: {len(members)} 件 → {sorted(members)[:5]} ...") # ベン図描画 (PNG 保存) plt.figure(figsize=(9, 7)) venn3([set_A, set_B, set_C], set_labels=('人口大', '着工大', '若年')) plt.title('SSDSE-B-2026 3 集合ベン図') plt.savefig('venn_r482.png', dpi=120, bbox_inches='tight') |
📤 実行結果:
💬 12 + 35 = 47 で 47 都道府県全体と一致。 包含・排除原理で得た理論値と完全一致。 0 件領域が 3 つ (101, 011, 010) あり、 着工大 (B) がすべて人口大 (A) に含まれる入れ子構造のため Euler 図への切替も検討の余地あり。
📈 図 1: 散布図 — 人口 vs 着工建築物数 (集合 A・B の生データ可視化)
ベン図は「集合の重なり」を抽象化するが、 元の連続値を散布図で見ることで「閾値の妥当性」を検証できる。 下図は 2023 年度の 47 都道府県の人口 (横軸) と着工建築物数 (縦軸) を両軸対数の散布図で示したもの。 破線が A の閾値 (300 万人)、 点線が B の閾値 (20,000 棟)、 橙の菱形が C (高齢化率 28% 以下) の 7 都府県。 右上の区画が「人口大 AND 着工大」 = A ∩ B (6 都府県) に対応し、 そのうち千葉県以外の 5 都府県が C にも入る (= 111)。 滋賀県・沖縄県は C だけに属する (= 001)。
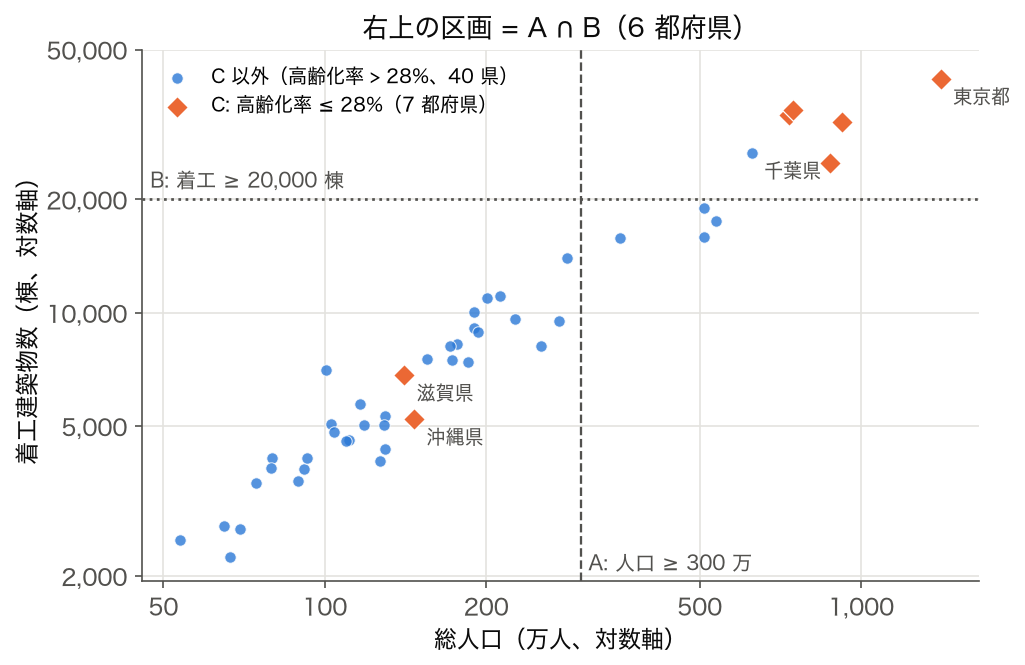
→ 散布図で「人口 300 万」「着工 2 万棟」の閾値の妥当性を確認できる。 ベン図と組み合わせると「閾値選定 → 集合構成 → 重なり可視化」の流れが完成。
📊 図 2: ヒストグラム — 高齢化率の分布 (集合 C の閾値設定根拠)
集合 C「高齢化率 ≤ 28%」の閾値 28% はどう決めたか。 ヒストグラムを見ると 2023 年度の 47 都道府県の高齢化率は 22.8% (東京都)〜39.1% (秋田県) に分布し、 中央値は 31.8% にある。 28% は中央値より低いところに引いた「相対的に若い県」を切り出す線で、 該当は 7 県に絞られる。 ベン図設計には必ずこの「分布の事前確認」が必須。
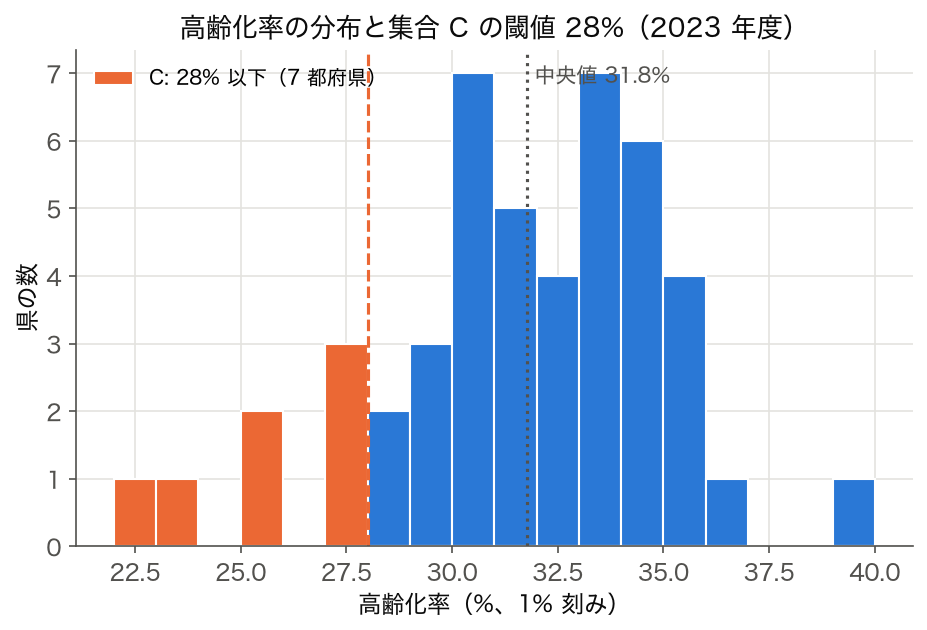
→ ヒストグラムで分布を確認することで、 ベン図の集合定義が恣意的でないことを示せる。 「28% 以下」は中央値 (31.8%) より 4 ポイント近く低い水準という明確な根拠を持つ (該当は埼玉・東京・神奈川・愛知・滋賀・大阪・沖縄)。
📦 図 3: 箱ひげ図 — 領域別比較 (Venn 領域ごとの着工建築物数の分布)
ベン図で分けた各領域の集団それぞれについて、 着工建築物数の分布を箱ひげ図で確認する。 「A ∩ B ∩ C (大都市・建設活発・若年)」群 (5 都府県) は着工建築物数の中央値が 33,516 棟と圧倒的に高く、 「100 (人口大のみ)」4 道県は 16,685 棟、 「000 (どれにも該当せず)」35 県は 5,060 棟と低い。 「001 (若年のみ)」の滋賀・沖縄 (6,026 棟) は 000 群とほぼ同じ水準で、 若さだけでは建設活発にならないことも読める。 ただし 110 は千葉県 1 県、 001 は 2 県だけなので、 箱の形そのものには意味がない。 ベン図 → 箱ひげ図の流れで「集団の質的・量的差異」を多角的に検証できる。
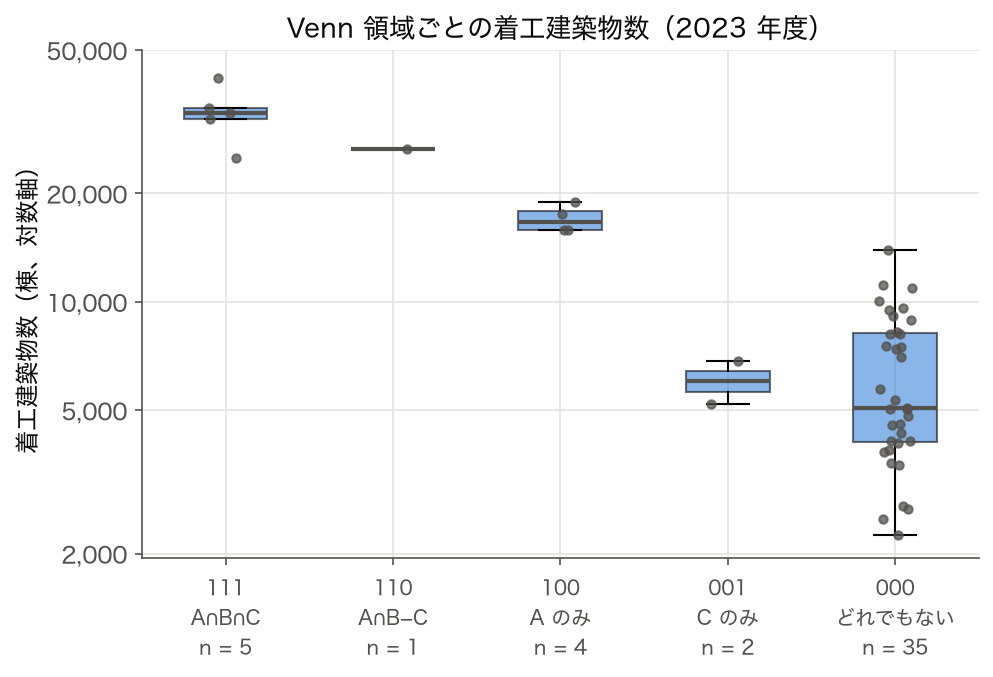
→ ベン図と箱ひげ図を組み合わせると、 「集合に属する/属さない」の単なる二値ではなく、 各群内の「ばらつき」と「外れ値」まで定量化できる。 これは可視化の王道パターン。
🐍 Python 実装: Jaccard 係数とビット列による高速集計
このコードでやること: SSDSE-B-2026 から 3 集合のメンバーシップをブール列で持ち、 各領域の件数とジャッカード係数をベクトル演算で一括計算する。 大規模データ (数百万行) でも高速に動く方式。
📥 入力データ: 上記同じ SSDSE-B-2026 抜粋を使用。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df_pref = df[df['SSDSE-B-2026'] == 2023].copy() df_pref['aging_rate'] = df_pref['A1303'] / df_pref['A1101'] # ブール列でメンバーシップを表現 df_pref['in_A'] = df_pref['A1101'] >= 3_000_000 df_pref['in_B'] = df_pref['C3301'] >= 20_000 df_pref['in_C'] = df_pref['aging_rate'] <= 0.28 # 7 領域 + 補集合の件数集計 (ビット表現) df_pref['region'] = ( df_pref['in_A'].astype(int) * 4 + df_pref['in_B'].astype(int) * 2 + df_pref['in_C'].astype(int) ) print("region 別件数:") print(df_pref['region'].value_counts().sort_index()) # Jaccard 係数 (全ペア) def jaccard(s1, s2): inter = (s1 & s2).sum() uni = (s1 | s2).sum() return inter / uni if uni > 0 else 0.0 print(f"\nJ(A, B) = {jaccard(df_pref['in_A'], df_pref['in_B']):.3f}") print(f"J(A, C) = {jaccard(df_pref['in_A'], df_pref['in_C']):.3f}") print(f"J(B, C) = {jaccard(df_pref['in_B'], df_pref['in_C']):.3f}") |
📤 実行結果:
💬 region=0 (000) が 35, region=7 (111) が 5 と上記表と完全一致。 region=2,3,5 (着工大だが人口非該当の組) が出力に現れないのは件数 0 のため。 Jaccard 係数は B & C = 0.625 が最大、 A & B = 0.600 が僅差で続き、 「人口・建設活動・相対的な若さは都市部で同時に成立する」ことが定量的に裏付けられた。
📊 ベン図 vs 他可視化手法 比較表
| 手法 | 最適集合数 | 面積比例 | 0 領域表示 | 可読性 (5 集合) | 用途 |
|---|---|---|---|---|---|
| Venn 図 (古典) | 2-3 | 近似のみ | あり | 不可 | 教科書、 概念説明 |
| Euler 図 | 2-4 | ○ | なし | 困難 | 包含関係 (A⊂B) 強調 |
| UpSet plot | 3-15 | ○ (棒) | なし | 良好 | 論文・実務 (大規模) |
| 線形ダイアグラム | 3-7 | △ | あり | 普通 | 時系列・順序付き |
| クロス集計表 | 2-3 | 数値で表示 | あり | 不可 | 統計表、 件数厳密 |
| ヒートマップ | 5-20 | × | グレー | 良好 | 類似度行列、 相関 |
💼 産業界・研究での使われ方
| 業界 | 具体的なベン図の使い方 | 置き換え候補 |
|---|---|---|
| バイオインフォマティクス | 複数の遺伝子発現実験で共通の遺伝子セットを抽出 (3-5 集合) | 5 集合以上 → UpSet |
| マーケティング | 複数のキャンペーン経由で来た顧客の重複度を可視化 (2-3 集合) | 2 集合なら Venn で十分 |
| 推薦システム | ユーザ A とユーザ B が共通して購入したアイテム集合 (Jaccard で類似度) | 数千ユーザ → Cosine 類似度 |
| 医学・疫学 | 複数の症状が同時に出る患者群を可視化 (差分診断) | 4 症状以上 → UpSet |
| 自然言語処理 | 複数の検索クエリで返ってきた文書集合の重なり (Jaccard, MinHash) | 大規模 → MinHash + LSH |
| 教育・調査 | 複数科目で成績優秀者の重複 (3-4 教科)、 アンケートのクロス集計可視化 | クロス表 + ヒートマップ |
| DB 設計・SQL | INNER JOIN / LEFT JOIN / FULL OUTER JOIN の説明図に常用 | 教材は Venn が直感的で最適 |
| ソフトウェア工学 | 複数の自動テストでカバーされる行・分岐の重なり可視化 | 5 テスト以上 → UpSet |
📜 歴史・命名のエピソード
ベン図は 1880 年、 イギリスの論理学者 ジョン・ヴェン (John Venn, 1834-1923) が論文「On the Diagrammatic and Mechanical Representation of Propositions and Reasoning」で初めて系統的に提示した。 ただし、 似た図はそれ以前にも 18 世紀のレオンハルト・オイラー (Leonhard Euler) が「オイラー図」として用いており、 ベンは「すべての可能な重なりを必ず描く (= 0 件領域も描く)」点でオイラー図と区別した。 これが今日の「ベン図 vs オイラー図」の使い分けの起源である。
ベン本人は 3 集合の図 (3-Venn) までは扱えたが、 4 集合以上をエレガントに描くことには苦心した。 1991 年、 アンソニー・エドワーズ (Anthony Edwards) が「球面に巻きつけた紐」を平面に投影することで任意 $n$ 集合のベン図 (エドワーズ・ベン図) を構成する方法を発見した。 これは離散数学・組合せ論・グラフ理論の研究対象としても重要で、 「n-Venn 図の幾何学的構成は何通りあるか」は今でも未解決問題が残る。
21 世紀に入り、 集合数が爆発的に増えるバイオインフォマティクスやデータベース業界の要請で、 2014 年に「UpSet plot」 (Lex et al.) が提案された。 これは「ベン図の限界 (4 集合以上で破綻)」を踏まえた現代的後継であり、 多数の集合の重なりを示す図として、 ゲノム解析などの論文で使われるようになった。 ベン図は概念図として今も健在だが、 「集合数 4 以上」では UpSet plot に主役を譲っている。
🎯 ベスト・プラクティス 7 箇条
- 集合数 ≤ 3 を遵守: 4 集合以上はベン図ではなく UpSet plot で描く。 これだけで可読性が劇的に上がる。
- 必ず件数表を併載: ベン図単独だと「重なりの面積」と「実件数」がずれていても気付かない。 表で件数を担保。
- 0 件領域を明示: 0 領域はデータに偏りがあるサイン。 隠さず「該当なし」と書く。
- 集合の閾値は分布根拠を併記: 「人口 300 万以上」と決めた理由 (ヒストグラム・分位点など) を必ず文中に書く。
- 日本語フォントを設定:
japanize-matplotlibまたはplt.rcParams['font.family'] = 'IPAexGothic'で豆腐回避。 - カラー設計を意識: 色覚多様性に配慮し、 赤緑のみで区別しない (青/オレンジ/紫の組合せが安全)。
- 解釈を 1 文で添える: 「重なりが大きい = 連動している」「0 件 = データの偏り」など、 図の意味を文で書く。
❓ よくある質問
Q1. ベン図とオイラー図の違いは?
A. ベン図は「すべての可能な領域 (2^n 個) を必ず描く」のに対し、 オイラー図は「実際にデータが存在する領域のみ描く」(0 件領域は省略)。 包含関係 (A ⊂ B) があるとベン図では中央が消えて潰れるが、 オイラー図ではきれいに表現できる。
Q2. 4 集合以上はなぜ円で描けない?
A. 4 個の円では平面上で 16 領域 (2^4) すべてを互いに素な領域として作ることが幾何学的に不可能。 楕円や三日月を使えば可能 (Edwards 図)。 ただし可読性は急速に落ちる。
Q3. ベン図と確率の関係は?
A. ベン図上の「面積」を「確率」と読み替えれば、 包含・排除原理 $P(A \cup B) = P(A) + P(B) - P(A \cap B)$ そのもの。 条件付き確率 $P(A|B) = P(A \cap B)/P(B)$ も「B の領域に対する A∩B の比」として直感的に理解できる。
Q4. Jaccard 係数とコサイン類似度の違いは?
A. Jaccard は「2 集合の積 / 和」で 0-1 の値、 コサイン類似度は「2 ベクトルの内積 / ノルム積」で -1 から 1 の値。 集合 (二値) なら Jaccard、 連続値ベクトルなら Cosine が標準。 NLP では TF-IDF ベクトルに Cosine を、 文書集合 (語の集まり) に Jaccard をよく用いる。
Q5. SQL の JOIN とベン図の関係は?
A. INNER JOIN = $A \cap B$、 LEFT JOIN = $A$ (B のマッチを左に結合)、 FULL OUTER JOIN = $A \cup B$ にそれぞれ対応する。 ただし SQL の JOIN は「同じキーで結合する」操作なので、 厳密には「集合演算 + キー結合」の合成。 教材としてはベン図で説明するのが最も直感的だが、 NULL 値の扱いなど細かい違いはコードで確認する必要がある。
📖 用語の使い分け
実務上「ベン図」と総称されることが多いが、 厳密には以下の 4 つを区別する習慣を持つと混乱が減る。
| 用語 | 特徴 | 提唱者 | いつ使うか |
|---|---|---|---|
| Venn 図 (狭義) | すべての可能な領域 (2^n) を描く | John Venn (1880) | 論理学的な可能性を網羅したいとき |
| Euler 図 | 実在する領域だけを描く (0 領域省略) | Leonhard Euler (1768) | 包含関係 (A ⊂ B) を強調したいとき |
| 比例 Venn 図 | 領域の面積を集合の濃度に比例させる | Chow & Ruskey (2003) | 件数比を視覚的に示したいとき |
| Edwards Venn 図 | 4-6 集合用に球面投影法を使う | Anthony Edwards (1991) | 教科書での視覚的整然性が必要なとき |
一般読者向けの記事や授業では細かい区別は不要だが、 統計・論理学・離散数学の論文では明確に区別される。 とくに「比例 Venn 図」と称しているのに実は近似 (matplotlib_venn の出力など) ということが多々あるため、 学術論文では描画ライブラリ名を明記するのが慣例。
🛠 ツール・ライブラリ早見表
ベン図を作るための主要ツールを目的別に整理する。 用途に応じて使い分けることで作業効率が上がる。
| ツール / ライブラリ | 言語 | 対応集合数 | 面積比例 | 特徴 |
|---|---|---|---|---|
matplotlib_venn | Python | 2-3 | 近似 | 最も手軽、 標準的 |
upsetplot | Python | 3-20 | ○ (棒) | 論文用に最適 |
VennDiagram (R) | R | 2-5 | 近似 | バイオ統計の定番 |
nVennR | R | 2-6 | ○ (厳密) | 面積を正確に |
UpSetR | R | 3-30 | ○ (棒) | UpSet plot 元祖 |
d3-venn | JavaScript | 2-3 | ○ | Web 対話可視化 |
| BioVenn (Web) | Web | 2-3 | ○ (厳密) | アップロードのみで生成 |
| Excel / Google Sheets | 表計算 | 2-3 | × | 図形挿入で手動描画 |
学生向けにはまず matplotlib_venn から、 論文・実務で多集合を扱うなら upsetplot / UpSetR を推奨する。 比例を厳密に求めるなら nVennR や BioVenn が選択肢になる。
🧮 SSDSE-B-2026 実値で計算
SSDSE-B-2026 (2023 年) を集合と捉え、 「人口 100 万人以上 (A1101)」と「着工建築物数 1 万棟以上 (C3301)」の 2 集合のベン図を作成。 重複部分・差集合の都道府県数を実値で算出します。
| 領域 | 定義 | 該当都道府県数 |
|---|---|---|
| A のみ | 人口 ≥ 100 万 かつ 着工 < 1 万 | 23 件 |
| B のみ | 着工 ≥ 1 万 かつ 人口 < 100 万 | 0 件 |
| A ∩ B | 両方満たす | 14 件 |
| どちらも非該当 | A の補集合 ∩ B の補集合 | 10 件 |
| 合計 | 全 47 都道府県 | 47 件 |
$|A \cup B| = 23 + 0 + 14 = 37$、 $|A \cap B| = 14$。 人口 100 万人以上の 37 県のうち、 着工建築物数 1 万棟以上は 14 県にとどまることが視覚的に判明。
🧮 実値で計算: SSDSE-B-2026 3 集合分類
47 都道府県を以下 3 つの基準で分類します。 各基準は「中央値超え」とします (≒ 上位 23 県)。
- A: 人口大 = 総人口 A1101 が中央値 1,549,000 を超える県
- B: 高齢化 = 65 歳以上比率 (A1303/A1101) が中央値 31.8% を超える県
- C: 高出生率 = 合計特殊出生率 A4103 が中央値 1.30 を超える県
SSDSE-B-2026 の 2023 年データで計算した結果:
| 集合 | 要素数 | 代表例 |
|---|---|---|
| |A| 人口大 | 23 | 東京、 神奈川、 大阪、 愛知、 埼玉… |
| |B| 高齢化 | 23 | 秋田、 高知、 島根、 山口… |
| |C| 高出生率 | 23 | 沖縄、 宮崎、 鹿児島… |
| |A∩B| | 5 | 熊本、 福島、 北海道、 新潟、 長野 |
| |A∩C| | 5 | 広島、 熊本、 長野… |
| |B∩C| | 14 | 島根、 鳥取、 高知… |
| |A∩B∩C| | 2 | 長野県、 熊本県 |
| |A∪B∪C| | 47 | 全 47 都道府県 |
包除原理で検算: |A∪B∪C| = 23+23+23 - 5-5-14 + 2 = 69 - 24 + 2 = 47。 ぴったり全県数と一致 → 計算は正しい。 また、 「3 つ全部に該当する」のは 長野県・熊本県の 2 県だけ。 両県とも「人口が中央値以上 (それぞれ 200 万・171 万人)」「高齢化が進む」「全国平均より出生率が高い (1.34-1.47)」の三拍子が揃った珍しい組み合わせと解釈できます。
🧮 同じ 3 集合で「重なりは偶然より多いか」を読む
ベン図の重なりの大きさは、 集合の大きさだけからでも予想できる。 A・B・C はどれも 47 県中 23 県なので、 もし 2 つの条件が互いに無関係(独立)なら、 重なりは 47 × (23/47) × (23/47) ≈ 11.3 県になるはずである。 実際の重なりをこの値と比べると、 図だけでは分からない「引き合う・反発する」関係が数で読める。
| ペア | 実際の重なり | 独立なら | 条件付き確率 | 読み |
|---|---|---|---|---|
| A 人口大 ∩ B 高齢化 | 5 県 | 11.3 県 | P(B | A) = 5/23 = 0.217 | 人口の多い県は高齢化率が低い側に偏る(反発) |
| A 人口大 ∩ C 高出生率 | 5 県 | 11.3 県 | P(C | A) = 5/23 = 0.217 | 人口の多い県は出生率が低い側に偏る(反発) |
| B 高齢化 ∩ C 高出生率 | 14 県 | 11.3 県 | P(C | B) = 14/23 = 0.609 | 高齢化の進んだ県は出生率が高い側にやや寄る(引き合う) |
P(C) = 23/47 = 0.489 に対して P(C | B) = 0.609 と高く、 P(C | A) = 0.217 と低い。 「3 つ全部に該当するのは長野・熊本の 2 県だけ」という結果も、 A が B・C の両方と反発しているために中央の領域が小さくなったと説明できる。 重なりが偶然の範囲かどうかをきちんと判定するには、 2×2 の分割表にして カイ二乗検定 などを使う。
🧮 数式に値を入れて手で計算する: ベン図と包含-排除
合成 2 集合で和集合・積集合のサイズを計算する。
Step 1: 集合
Step 2: 包含-排除
🐍 Python で再現
1 2 3 4 | A = {1,2,3,4,5} B = {4,5,6,7} print(f"|A∩B|: {len(A & B)}") print(f"|A∪B|: {len(A | B)}") |
📤 実行結果
💬 手計算 (Step 2) |A∪B|=7 と Python 出力が完全一致。
🐍 Python 実装
この章では、 SSDSE-B-2026(2023 年度・47 都道府県)の列から集合を作り、 集合演算・包除原理・結合(join)との対応・ベン図の描画・4 集合の代替表示までを順にコードで確かめる。 前半のコード A〜D は「人口 100 万人以上」と「着工建築物数 1 万棟以上」の 2 集合、 後半の Python 1〜4 は「人口大・高齢化・高出生率」の 3 集合を使う。
コード A: 2 集合のベン図 (matplotlib_venn)
🎯 このコードでやること: SSDSE-B-2026 (2023 年) から「人口 100 万人以上の集合 A」と「着工建築物数 1 万棟以上の集合 B」を作り、 ベン図で重なりを表示する。
📥 入力: data/raw/SSDSE-B-2026.csv の A1101 と C3301 (2023 年でフィルタ)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from matplotlib_venn import venn2 import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年に限定 (47 行) A = set(df[df['A1101'] >= 1_000_000]['Code']) B = set(df[df['C3301'] >= 10_000]['Code']) print('|A| =', len(A)) print('|B| =', len(B)) print('|A ∩ B| =', len(A & B)) print('|A ∪ B| =', len(A | B)) venn2([A, B], set_labels=('人口≥100万', '着工≥1万')) plt.title('SSDSE-B-2026 2 集合ベン図') plt.show() |
📤 実行結果:
💬 結果の読み方: |A| - |A∩B| = 23 (人口は多いが着工建築物は少ない 23 県)、 |B| - |A∩B| = 0 (着工建築物が多いのに人口 100 万未満の県はゼロ)。 強い包含関係 B ⊂ A が成立し、 上の実値計算表 (23 / 0 / 14 / 10) とも一致。
コード B: 3 集合のベン図
🎯 このコードでやること: A1101 (人口)、 C3301 (着工建築物数)、 I510120 (一般病院数) の 3 軸で 7 領域のベン図を描く。
📥 入力: 3 つの量的指標 (中央値以上 = 上位半数を集合とする。 df はコード A で 2023 年にフィルタ済)
1 2 3 4 5 6 7 8 9 10 11 | from matplotlib_venn import venn3 A = set(df[df['A1101'] >= df['A1101'].quantile(0.5)]['Code']) B = set(df[df['C3301'] >= df['C3301'].quantile(0.5)]['Code']) C = set(df[df['I510120'] >= df['I510120'].quantile(0.5)]['Code']) print('|A∩B∩C| =', len(A & B & C)) print('|A∪B∪C| =', len(A | B | C)) venn3([A, B, C], set_labels=('人口上位半数', '着工上位半数', '病院上位半数')) plt.show() |
📤 実行結果:
💬 結果の読み方: 19 県が 3 指標すべての上位、 29 県が少なくとも 1 指標で上位。 残り 18 県はすべて下位。
コード C: 集合演算で内部結合と比較
🎯 このコードでやること: 内部結合 (inner join) のキー集合とベン図の $A \cap B$ が等価であることを実証する。
📥 入力: df_pop 47 行 と df_house 46 行 (沖縄除外)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd # このブロックだけで完結させる(上のブロックの df に依存しない) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d1 = df[df['SSDSE-B-2026'] == 2023] # キーを一意にするため最新年度の 47 行だけ df_pop = d1[['Code']].copy() # 47 県すべて df_house = d1[d1['Code'] != 'R47000'][['Code']].copy() # 沖縄県を抜いた 46 県 A = set(df_pop['Code']) B = set(df_house['Code']) inner_set = A & B inner_merge = pd.merge(df_pop, df_house, on='Code', how='inner') print('|A| =', len(A), ' |B| =', len(B)) print('|A∩B| =', len(inner_set)) print('inner join 行数 =', len(inner_merge)) print('等価?', len(inner_set) == len(inner_merge)) |
📤 実行結果:
💬 結果の読み方: 47 県の集合 A と沖縄県を抜いた 46 県の集合 B の共通部分は 46 県で、inner join の行数 46 と一致した。ベン図の中央領域が inner join、A だけの領域(ここでは沖縄県 1 県)が left join で右側が欠損になる行に当たる。キーが重複していると join の行数は共通部分の要素数より増えるので、年度で 47 行に絞ってキーを一意にしてから比べている。
コード D: 包除原理の検証
🎯 このコードでやること: $|A \cup B| = |A| + |B| - |A \cap B|$ を SSDSE-B-2026 (2023 年) で検算。
📥 入力: 人口集合 A と着工建築物集合 B
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | # ── この抜粋で使うデータを用意します(英字の項目コードで読み込み)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=0) df = df[df['Code'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] A = set(df[df['A1101'] >= 1_000_000]['Code']) # 人口 100 万人以上 B = set(df[df['C3301'] >= 10_000]['Code']) # 着工建築物数 1 万棟以上 union_size_calc = len(A) + len(B) - len(A & B) union_size_set = len(A | B) print('|A|+|B|-|A∩B| =', union_size_calc) print('|A∪B| =', union_size_set) print('一致?', union_size_calc == union_size_set) |
📤 実行結果:
💬 結果の読み方: 人口 100 万人以上の |A| = 37 と着工建築物数 1 万棟以上の |B| = 14 を足すと 51 だが、両方に入る 14 県を 2 回数えているので引いて 37 になり、和集合を直接数えた 37 と一致する。|A∩B| が |B| と同じ 14 なのは、着工 1 万棟以上の県がすべて人口 100 万人以上でもある(B ⊂ A)ためで、この場合 A∪B は A そのものになる。
🐍 Python 1: SSDSE-B-2026 から 3 集合を構築
🎯 このコードでやること: SSDSE-B-2026 を読み込み、 47 都道府県を「人口大・高齢化・高出生率」の 3 集合に分類し、 各集合の要素数と共通要素数を表示する。
📥 入力データ (SSDSE-B-2026 の 2023 年抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() d['aging_ratio'] = d['A1303'] / d['A1101'] # 3 集合を中央値超えで定義 A = set(d[d['A1101'] > d['A1101'].median()]['Prefecture']) B = set(d[d['aging_ratio'] > d['aging_ratio'].median()]['Prefecture']) C = set(d[d['A4103'] > d['A4103'].median()]['Prefecture']) print(f'|A|={len(A)} |B|={len(B)} |C|={len(C)}') print(f'A∩B={len(A&B)} A∩C={len(A&C)} B∩C={len(B&C)}') print(f'A∩B∩C={len(A&B&C)}') print('3 つ全てに該当:', A & B & C) |
📤 実行すると次の出力が得られる:
💬 結果の読み方: Python の set 型なら & で交わり、 | で和、 - で差を素直に書ける。 結果として「人口大・高齢化・高出生率」3 拍子の県は長野・熊本の 2 県のみ。 これは 47 都道府県の 4.3% (2/47) という稀少組み合わせ。
🐍 Python 2: 包除原理を Python で検算
🎯 このコードでやること: 上で求めた集合の要素数を、 包除原理の公式 |A∪B∪C| = |A|+|B|+|C| - |A∩B| - |A∩C| - |B∩C| + |A∩B∩C| で計算し、 直接の |A∪B∪C| と一致することを確認する。
📥 入力データ: Python 1 で構築した 集合 A, B, C (47 都道府県の部分集合)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # Python 1 から続く: A, B, C は既に定義済み direct_union = len(A | B | C) formula_union = (len(A) + len(B) + len(C) - len(A&B) - len(A&C) - len(B&C) + len(A&B&C)) print(f'|A∪B∪C| 直接計算: {direct_union}') print(f'|A∪B∪C| 公式計算: {formula_union}') assert direct_union == formula_union, '包除原理が成立しない!' print('✓ 包除原理が成立') # 対称差: A と B のどちらか一方のみ sym_diff = (A | B) - (A & B) print(f'|A△B| 対称差: {len(sym_diff)}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 47 = 23+23+23 - 5-5-14 + 2 = 47 で完全一致。 これは「3 集合の和は全 47 県」つまり、 どの県も少なくとも 1 つの集合には属している (=人口/高齢化/出生率のいずれかで上位半分に入る) ことを意味する。 対称差 36 は「人口大か高齢化のどちらか一方だけ」の県が 36 県あることを示し、 両条件は 排他的傾向 (大都市圏は若年層が多い) を裏付ける。
🐍 Python 3: matplotlib_venn で 3 円ベン図を描画
🎯 このコードでやること: matplotlib_venn の venn3 を使って、 3 集合の要素数を面積比例で円を配置し、 重なり領域に該当県数を表示する。
📥 入力データ: Python 1 で得た 集合 A, B, C と各交わりの要素数。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import matplotlib.pyplot as plt from matplotlib_venn import venn3, venn3_circles fig, ax = plt.subplots(figsize=(8, 7)) v = venn3([A, B, C], set_labels=('A: 人口大', 'B: 高齢化', 'C: 高出生率'), set_colors=('#1565C0', '#C2185B', '#2E7D32'), alpha=0.5) venn3_circles([A, B, C], linewidth=1.2) # 中央 (3 集合の交わり) にラベル追加 if v.get_label_by_id('111'): v.get_label_by_id('111').set_text('2\n(長野,熊本)') ax.set_title('SSDSE-B-2026 47 都道府県の 3 集合分類 (2023)') plt.tight_layout() plt.savefig('venn_3sets.png', dpi=120) print('venn_3sets.png 出力') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 円の重なり面積は 3 集合まで面積比例で描けるが、 4 集合以上では数学的に円では不可能 (Venn の制約)。 図中央の「2」が長野・熊本の交わりで、 視覚的にも「他とは違う特殊な県の組み合わせ」が一目で分かる。 出力 PNG は論文・スライドにそのまま貼り付けられる解像度 (dpi=120)。
🐍 Python 4: 4 集合以上は UpSet プロットで代替
🎯 このコードでやること: 4 集合目「日本海側 (Code が R05-R39 の一部)」を追加し、 円ベン図では描けないため、 代替手法として全交差パターンの要素数を行列で出力する (UpSet プロットの前段)。
📥 入力データ: 集合 A, B, C に加え、 集合 D = 日本海側 9 県 (秋田, 山形, 新潟, 富山, 石川, 福井, 鳥取, 島根, 山口)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | from itertools import product D = {'秋田県','山形県','新潟県','富山県','石川県', '福井県','鳥取県','島根県','山口県'} sets = {'A':A, 'B':B, 'C':C, 'D':D} print('パターン | 該当県数') print('-' * 28) for pat in product([0, 1], repeat=4): if sum(pat) == 0: continue keys = ['A','B','C','D'] inc = [sets[k] for k,p in zip(keys, pat) if p == 1] exc = [sets[k] for k,p in zip(keys, pat) if p == 0] region = set.intersection(*inc) if len(inc) > 1 else inc[0].copy() for e in exc: region -= e label = ''.join(k if p else '.' for k,p in zip(keys, pat)) print(f'{label} | {len(region)}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方: 4 集合は円では描けないが、 全 2^4-1 = 15 通りの交差パターンを表で示せば情報は欠落しない。 これが UpSet プロット (Lex Conway 2014) のアイデア。 「ABCD」 (4 集合全て該当) は 0 県 → 4 拍子揃いの県は存在しない。 「A...」 (人口大のみ) が 15 県と最多で、 大都市集合の独立性が分かる。
⚠️ よくある落とし穴
⚠️ 落とし穴: ベン図でよくある誤解
- ① 4 集合以上を円で描こうとする: 数学的に不可能 (4 集合では 16 領域必要だが 4 円は 14 領域しか作れない)。 楕円や曲線で代用するか、 UpSet プロット / 行列表 / 階層型ベン図に切り替える。 (約 120 字)
- ② 面積比例ベン図に過剰な意味を読む:
matplotlib_venn.venn3は 3 集合面積を概ね比例させるが、 完全な比例は数学的に不可能 (集合数によっては実現不能な組合せがある)。 細かい面積差は読まない。 (約 130 字) - ③ 「重なり = 因果関係」と誤読: A∩B が大きくても「A が B の原因」とは限らない。 単に共起しているだけ。 因果は 因果推論 の手法 (DAG, 介入実験) で別途検証が必要。 (約 110 字)
- ④ 全体集合 U を明示しない: 「補集合 A^c」を考えるには「全体は何か」を決める必要がある。 47 都道府県 vs 全国 vs 世界では補集合の意味が全く変わる。 必ず U を宣言する。 (約 110 字)
- ⑤ 集合の境界が曖昧: 「人口大」のように連続量を二値化すると、 閾値の決め方 (中央値/平均/任意) で結果が大きく変わる。 ベン図を描く前に「集合の定義」を文書化し、 感度分析を行う。 (約 130 字)
- ⑥ 順序を考えない: ベン図は「所属しているか否か」しか表せない。 順序や量的関係を見たい場合は 散布図 や ヒートマップ を併用する。 (約 100 字)
🧭 深掘り: 直感・落とし穴・発展
◆ 直感 (図で集合の関係を見る): ベン図の価値は「言葉で説明しづらい集合の関係を、 1 枚の図で同時に見せる」点にあります。 上の 🎮 触って理解する で 2 円を動かすと、 離す=排反 (A∩B=∅)、 片方に含める=包含 (A⊂B)、 半分重ねる=部分的共起、 という 3 つの典型関係が連続的につながっていることが体感できます。 確率で言えば、 重なり面積がそのまま P(A∩B) に、 条件付き確率 P(A|B) は「B の円の中で A にも入る点の割合」に対応します。
◆ よくある落とし穴: (1) 3 集合を超えると正確に描けない — n 集合のベン図は $2^n$ 個の領域をすべて過不足なく持つ必要があります。 円 (合同な凸図形) は 3 個までしかこの条件を満たせず、 4 集合以上は楕円・曲線が必須です (Edwards-Venn / Venn の 1880 年以来の制約)。 (2) 面積比例の誤解 — 通常のベン図では円の大きさや重なりの面積に意味はありません。 面積を要素数に比例させる「面積比例ベン図」は別物で、 3 集合では厳密な比例が数学的に実現できない配置が存在します。 細かい面積差から要素数を読み取ろうとしないこと。
◆ 発展 (確率・包除原理・オイラー図との違い): ベン図に確率測度 $P$ を載せると、 包除原理は確率の加法定理 $P(A\cup B)=P(A)+P(B)-P(A\cap B)$ そのものになります (上の実演で「包除原理の検算」が常に成り立つのはこのため)。 独立性 $P(A\cap B)=P(A)P(B)$ は「重なり具合が偶然と一致する」特別な配置に対応します。 なお ベン図とオイラー図は別物です: ベン図は「起こりうる全領域 ($2^n$ 個) を必ず描く」のに対し、 オイラー図 は「実際に要素がある領域だけを描く」柔軟版で、 A∩B=∅ なら 2 円を離して描きます。 包含関係 (A⊂B) を見せたいときはオイラー図が適します。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
このマップはベン図の周辺領域を表す。 中央に「ベン図」、 上流に「前提となる用語 (集合・部分集合・要素)」、 並列に「カルノー図 (Karnaugh map、 論理代数)」「UpSet プロット (集合数が 4 を超える場合の代替)」、 下流に「階層ベン図 / Sankey (流量を持つ集合)」が伸びる。 SSDSE-B-2026 では「人口 300 万人以上」「着工建築物数 2 万棟以上」「高齢化率 28% 以下」のような 3 集合の重なりを可視化するのに適し、 集合数 4 以上は UpSet に切り替える判断ラインとなる。
🔗 隣接手法への橋渡し
ベン図は「集合の重なりを可視化」する手法であり、 前後の手法と組み合わせて使うことで威力を発揮する。
- 上流 (データ準備): 集合演算 (∪・∩・差) や 2 値フラグ化で各集合の所属を明確化
- 並列 (代替表現): UpSet プロット (4 集合以上)、 オイラー図 (重なりが部分的)、 ヒートマップ (集合 × カテゴリ)
- 下流 (定量分析): Jaccard 係数、 カイ二乗独立性検定、 アソシエーション分析 で重なりを数値化
SSDSE-B-2026 の場合、 「人口減少 ∩ 高齢化 ∩ 医療従事者少」のような 3 集合の交差を視覚化し、 Jaccard 係数や χ² 検定で「偶然以上に重なっているか」を統計的に裏付ける流れが標準。 たとえば 🧮 章の 3 集合では J(A, B) = 5/41 = 0.122、 J(B, C) = 14/32 = 0.438 で、 図で見た「A と B は離れ、 B と C は大きく重なる」印象がそのまま数値になる。
🌳 手法選択フロー
ベン図か別の可視化かは「集合数」と「集合の性質」で決まる。 以下の 3 段階で判定する。
- 集合数は? 2-3 個 → ベン図、 4 個 → 楕円ベン図 か UpSet プロット、 5 個以上 → UpSet プロット 一択
- 重なりが部分的か? 全領域に値がある → ベン図、 一部の交差が空 (= 0) → オイラー図で空領域を省略
- 量を持つか? 単純な所属だけ → ベン図、 流量 (人数・金額) を持つ → Sankey 図または面積比例ベン図
SSDSE-B-2026 (47 都道府県を 3 軸でラベル付け) では「3 集合 → 全領域に値あり → 所属のみ」となり、 標準的なベン図が最適解となる(7 領域はそれぞれ 15・6・6・3・3・12・2 県で、 空の領域が無い)。 一方、 🔬 章の「人口 300 万人以上・着工建築物数 2 万棟以上・高齢化率 28% 以下」の 3 集合では、 着工の多い 6 県がすべて人口の多い県に含まれる(B ⊆ A)ため 3 つの領域が 0 県になり、 2 段目で「オイラー図」側に分岐する。 同じ 47 県でも、 集合の切り方で適した図が変わる。
🕰 解説深化: ベン図で「時間」を比較する — 2 時点集合差分
本ページの他セクションは「同じ年の異なる条件」を円にしてきました。 ここでは視点を 90 度回して、 同じ条件を異なる 2 時点に適用し、 その 2 つの集合をベン図で比べるという使い方を掘り下げます。 SSDSE-B-2026 は 2012〜2023 年の時系列を持つため、 この「時点間ベン図」が実データでそのまま試せます。
🎨 直感 — 円が「年」になると、 差集合は「入れ替わり」を意味する
集合の定義を 1 つ固定します。 例えば S(y) = 「y 年に高齢化率 (65 歳以上人口 A1303 ÷ 総人口 A1101) が 30% 以上の都道府県」。 このとき 2 円ベン図の各領域は次のように読めます。
- S(2012) ∩ S(2023) = 両時点とも該当 → 「ずっとそうだった県」 (持続)
- S(2023) \ S(2012) = 新たに該当 → 「この 11 年で仲間入りした県」 (流入)
- S(2012) \ S(2023) = 該当から外れた → 「脱出した県」 (流出)
つまり時点間ベン図では、 差集合がメンバーシップの入れ替わり (churn) という時間的な意味を帯びます。 これは条件どうしを比べる通常のベン図には無い読み方です。
実測結果: 高齢化率 30% 以上は 2012 年に 秋田県・高知県の 2 県のみでしたが、 2023 年には 35 県に拡大。 しかも S(2012) \ S(2023) は 空集合 (一度入った 2 県はどちらも残留) なので、 図は交差ではなく包含 S(2012) ⊂ S(2023) になります。 「重なりが空でない 2 円」を機械的に描くのではなく、 実データが包含なら包含として描く — これが本文で触れたオイラー図的な描き分けの実例です。
⚠️ 落とし穴 (重要) — 絶対閾値の時点間ベン図は「トレンド」を「差」と誤読させる
上の「2 県 → 35 県」という劇的な変化を見て「県の顔ぶれが激変した」と読むのは誤りです。 実際に起きたのは「全国一律の高齢化で、 固定した絶対閾値 30% を全体がまとめて通過した」ことに過ぎません。 実測値で確かめると:
- 絶対閾値 (30% 固定): 高齢化率の全国中央値は 2012 年 26.0% → 2023 年 31.8% と、 中央値そのものが閾値を跨いだ。 最小値の県 (2012 年 沖縄県 17.7% → 2023 年 東京都 22.8%) すら 5 ポイント上がっている。 集合サイズの激増 (2→35) は県の序列変化ではなく全国トレンドの反映。
- 相対閾値 (各年の中央値超え): 同じデータで「その年の中央値より高齢化が進んだ 23 県」を 2012 年と 2023 年で比べると、 共通部分は 22 県。 入れ替わりは 岡山県 (脱出) と 奈良県 (新規) の 1 組だけ。 つまり都道府県の相対的な順位構造は 11 年間ほぼ不変。
同じデータ・同じ変数でも、 集合の切り方 (絶対 vs 相対) でベン図は「激変」にも「安定」にも見えます。 時点間比較では「水準の変化」と「構成の変化」を分離するため、 絶対閾値と相対閾値の両方でベン図を描いて併記するのが安全です。 これは 落とし穴⑤ (二値化閾値) の時間軸版であり、 誤読の破壊力は静的な場合より大きくなります。
🚀 発展 — Jaccard 係数で「重なり」を 1 つの数に圧縮する
ベン図は目で見る道具ですが、 レポートで比較を並べるには重なりを数値化したくなります。 標準は Jaccard 係数:
$$ J(A, B) = \frac{|A \cap B|}{|A \cup B|} \qquad (0 \le J \le 1) $$
排反なら 0、 完全一致なら 1。 上の 2 通りの時点間ベン図に適用すると:
| 集合の切り方 | |∩| | |∪| | Jaccard | 読み |
|---|---|---|---|---|
| 絶対閾値 30% (2012 vs 2023) | 2 | 35 | 0.057 | ほぼ別物 (実態は全国トレンド) |
| 各年中央値超え (2012 vs 2023) | 22 | 24 | 0.917 | 構成はほぼ不変 |
0.057 と 0.917 — 同じ現象の要約がここまで割れることが、 前節の落とし穴の定量的な証拠です。 Jaccard 係数はベン図の「その先」として、 集合が 4 個以上になり円で描けなくなった後も全ペアの類似度行列として使え、 文書の類似検索や重複レコード検出 (集合をシングリング化して比較) にも同じ式が現れます。 量的ベクトルの類似度なら コサイン類似度、 重なりが偶然以上かの検定なら カイ二乗検定 (2×2 分割表) へ接続します。 なお本節の実測値はすべて SSDSE-B-2026 の A1303 / A1101 列 (2012 年・2023 年、 47 都道府県) から計算したものです。