🔖 キーワード索引
このページ内のセクションへ素早く飛べます(クリックで該当箇所へジャンプ):
🔖 キーワード索引(深掘り)
コサイン類似度 (Cosine Similarity) は 2 つのベクトルの角度の余弦で類似度を測る指標。 値域 $-1$〜$1$、 ベクトルの長さに依存せず方向だけを比べるので、 TF-IDF や埋め込みベクトルの類似度測定に最適です。
💡 30秒で分かる結論 — コサイン類似度
🍰 まずはやさしく
向きの似具合を測る定規のようなものです。
2つのデータの方向が近いか調べます。
おすすめの商品を探すときに使われます。
まずは結論と使い道を読みましょう。
- 一言で:2 つのベクトルが同じ方向を向いている度合いを $-1$〜$+1$ で測る指標。 長さは無視し、 角度だけを比べる。
- 分野:類似度・距離指標 — 全体像は text-similarity ページで
- 典型的な使い所:本ページ「🎨 直感」「🧮 SSDSE実値計算」セクションを参照
- 絶対に外せない落とし穴:⚠️ セクションの 5 項目に目を通すこと
- 関連手法へ:「🌐 関連手法」セクションで上位・並列・発展概念を一覧
- レポートでは:『出典・期間・サンプル数・前提・限界』の 5 点を明示
💡 30秒で分かる結論
2 つのベクトルの向きの近さを $-1$〜$+1$ で表す指標
- 分野:類似度・距離指標 — 📚 テキスト類似度
- 用途:文書検索・推薦・埋め込み近傍探索・クラスタリングなどで使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
💡 30 秒で分かる結論(深掘り版)
- 定義:$\cos\theta = \dfrac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|\,\|\mathbf{b}\|}$。 内積をベクトル長の積で正規化した値。
- 値域:$-1 \le \cos\theta \le 1$。 1 = 同方向、 0 = 直交、 -1 = 反対方向。
- 4 つの強み: (1) 規模に左右されない、 (2) 高次元 (TF-IDF/埋め込み) でも軽い、 (3) 中心化すれば $r$ と一致、 (4) コサイン距離 $1 - \cos\theta$ で距離化可能。
- 正のベクトル (TF-IDF 等) では類似度が高めに偏る ↔ 中心化 (mean subtraction) で改善可能。
- SSDSE-B-2026 の複数指標(総人口・出生数・65 歳以上人口 など)でベクトル化すれば、 都道府県どうしの向きの近さを直接計算できる。
📍 あなたが今見ているもの
🍰 まずはやさしく
ベクトルの角度で似ているかを見る指標です。
データの大きさに惑わされずに比較します。
長い記事と短い記事の似具合を測れます。
他の指標との違いについて読みましょう。
2 つのベクトル間の 角度の余弦 で類似度を測る指標。 値は $-1$ から $1$。 ベクトルの長さ(大きさ)に依存せず 方向だけ を比べるので、 文書の TF-IDF ベクトルや埋め込みベクトルの類似度測定に最適。
📍 文脈ボックス(あなたが今見ているもの)
コサイン類似度は類似度・距離指標の家族に属し、 ユークリッド距離・ピアソン相関 と並列の関係にあります。 「規模を見るか × 方向を見るか」の 2×2 表で位置づけが掴めます。
| / | 方向 (角度) を見る | 規模 (大きさ) を見る |
|---|---|---|
| 生のベクトル | コサイン類似度 | ユークリッド距離 |
| 中心化したベクトル | ピアソン相関 ($r = \cos\theta$) | マハラノビス距離 |
文書検索に当てはめると、 「短い記事」と「長い記事」は語数 (規模) が大きく異なるため Euclidean では遠く判定されてしまうが、 cosine なら登場語の構成比 (方向) が似ていれば近いと判定できます。 推薦システム・テキストマイニング・埋め込み近傍探索では cosine が事実上の標準です。
🎨 直感で掴む — コサイン類似度とは何者か
🍰 まずはやさしく
方向がどれだけ同じかを数値にしたものです。
データのパターンが似ているか調べます。
人口の違う都市同士を比べる時に便利です。
直感的なイメージについて読みましょう。
コサイン類似度は「2 つのベクトルがどれだけ 同じ方向を向いているかを -1〜+1 で表す指標」。 ベクトルの長さ (規模) は無視し、 角度の近さだけを見るため、 「大都市と地方都市で人口の絶対値は違うが、 総人口・出生数・高齢化率の パターン は似ているか」を比較できる。 47 都道府県を $z$-スコアでベクトル化したとき、 cos が 1 に近い県ペアは「規模を除けば似たプロファイル」を持つ。
コサイン類似度(Cosine Similarity)は、 ベクトル空間で「方向の近さ」を測る道具。 たとえば SSDSE-B-2026 で 47 都道府県を $z$-スコアベクトル化(総人口・出生数・高齢化率…)すると、 「東京と大阪は方向が近い」「沖縄は特異な方向」といったプロファイル比較が直感的にできる。 文書検索・推薦システム・word2vec/BERT 埋め込みの基盤指標。
| 場面 | コサイン類似度が登場する例 | 何が分かるか |
|---|---|---|
| 論文の Methods 節 | 「コサイン類似度を用いて分析した」 | 手法の前提と限界が文脈に乗る |
| 実務レポート | 「コサイン類似度の観点で評価」 | 意思決定の根拠が明確化 |
| 教育・学習 | SSDSE-B-2026 を題材に演習 | 実データで本物の感覚が得られる |
| 政策・社会 | 類似度・距離 分野で標準的に登場 | EBPM や DX の議論に直結 |
本ページではこのあと、 数式(または定義)・SSDSE 実データ計算・Python実装・落とし穴 を順番に追いかけて、 用語を「使える知識」にしていきます。
🎨 直感で掴む(要点)
「2 つのベクトルの向きが同じか」を判定する道具です。 長さ (規模) を割り消すため、 「東京 (人口 1400 万) と高知 (約 70 万)」のように規模が違う対象どうしでも、 プロファイルの形だけ取り出して比較できます。
以下では、 内積とノルムによる定義 $\cos\theta = \mathbf{a}\cdot\mathbf{b} / (\|\mathbf{a}\|\|\mathbf{b}\|)$ を確認したあと、 SSDSE-B-2026 の 47 都道府県の年齢構成ベクトルで「東京と沖縄の向きはどれだけ近いか」を実値計算し、 階層クラスタリングや TF-IDF 推薦への接続、 「すべて正のベクトルでは類似度が下がりにくい」「ノルム情報を捨てるため大小は表現できない」といった落とし穴まで順に辿ります。
🎨 直感で掴む(深掘り)
2 次元平面で 2 本の矢印を頭に描いてください。 ベクトル $\mathbf{a}$ と $\mathbf{b}$ のなす角度を $\theta$ とすると、 内積 $\mathbf{a}\cdot\mathbf{b} = \|\mathbf{a}\|\|\mathbf{b}\|\cos\theta$。 この式を「長さの積」で割れば、 残るのは $\cos\theta$ だけ —— これがコサイン類似度の本体です。 このとき:
- $\cos\theta = 1$ (角度 0°) = 完全に同じ方向。 SSDSE で言えば「総人口・出生数・高齢化率すべてのプロファイルが同形」
- $\cos\theta = 0$ (角度 90°) = 直交。 SSDSE で言えば「総人口は多いが 出生数 は少ない」のように軸ごとの相関が無い
- $\cos\theta = -1$ (角度 180°) = 真逆。 $z$-スコア化すると「高齢化率が +2σ の県」と「-2σ の県」のように極性が逆
$z$-スコア化したベクトル同士の cos は、 実はピアソン相関係数 $r$ と一致します ($r = \cos\theta$ when centered)。 つまりコサイン類似度は、 中心化を省いた一般化 (規模に左右されない) と理解できます。 高次元 (TF-IDF で 1 万次元、 BERT で 768 次元) になっても定義はそのまま使え、 計算量は $O(n)$ で軽い。
実務的なメタファー: 「電車の進行方向が同じか」を測る感覚。 速度 (ベクトル長) は無視し、 方角だけ比較する。 文書検索で「短い質問文と長い記事を同じ尺度で比べたい」場面に最適で、 これがコサイン類似度が情報検索の主流になった理由です。
実データの矢印で見る — 「長さ」と「向き」
47 都道府県を (15 歳未満人口, 65 歳以上人口) の 2 次元ベクトルにして、原点から矢印を引きます(SSDSE-B-2026、2023 年度)。東京都の矢印は (151.3 万人, 320.5 万人) で長さ 354.4、秋田県は (8.3 万人, 35.7 万人) で長さ 36.7 と、長さは 10 倍近く違います。cos はこの長さを捨てて、矢印の向き(角度)だけを比べます。
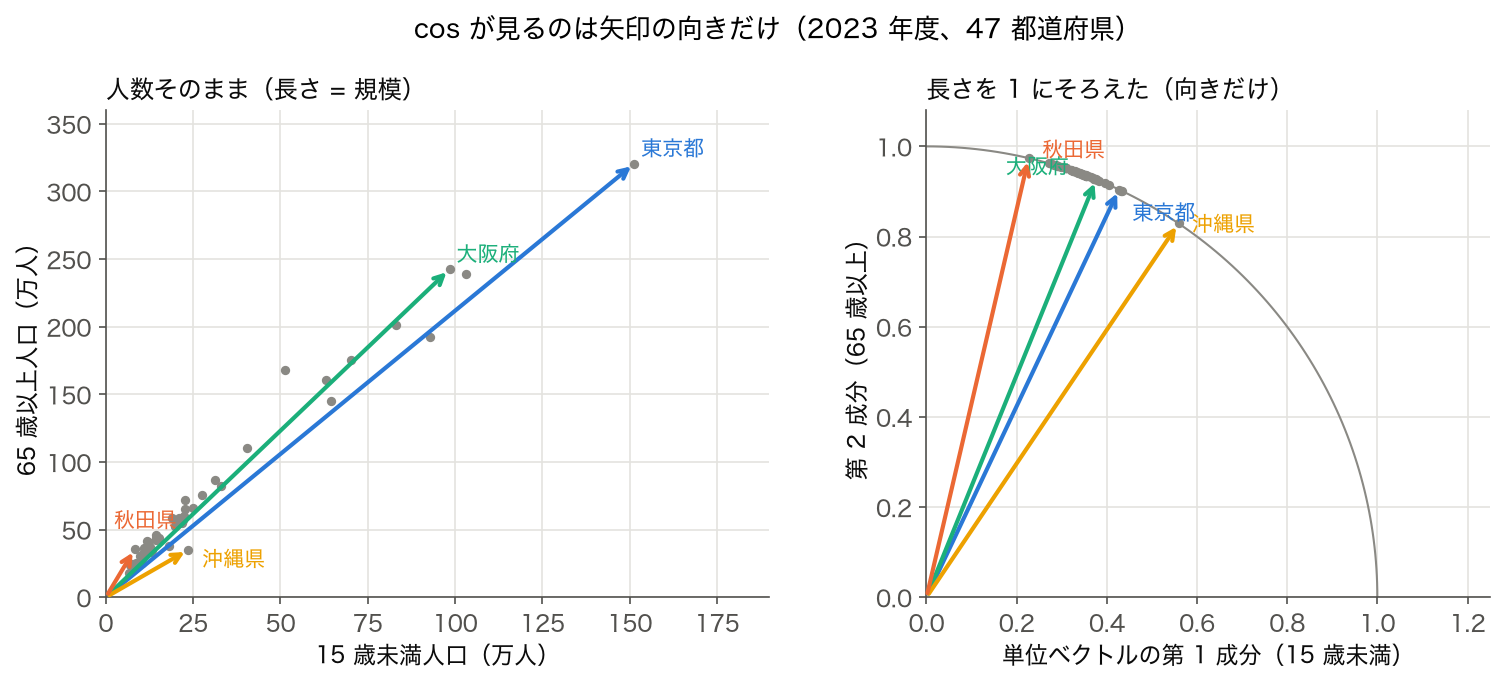
右の図で、東京都と秋田県の矢印のなす角は 76.9° − 64.7° = 12.2° で、cos 12.2° = 0.977 がそのまま 2 県の cos です。左の図では東京都と秋田県は大きさがまるで違うのに、右の図では同じ円周上に並びます。これが「cos は規模を無視する」の意味です。また右の図で 47 県の点が 56°〜77° の狭い弧に集まっていることにも注目してください。どの県も「子どもより高齢者が多い」という同じ向きを向いているので、人数のままの cos はどの組でも 1 に近くなります(この問題は Python 実装の節の最後で扱います)。
🎮 触って理解する
下の図で、 2 本の矢印(ベクトル $\mathbf{a}$・$\mathbf{b}$)の先端の丸をドラッグ(スマホは指でスワイプ)してみてください。 なす角 $\theta$ と コサイン類似度 $\cos\theta = (\mathbf{a}\cdot\mathbf{b})/(\|\mathbf{a}\|\,\|\mathbf{b}\|)$ がリアルタイムに計算されます。 同じ向き=1、 直交=0、 逆向き=-1 を手で確かめられます。
| ベクトル a | (3.0, 1.0) |
| ベクトル b | (1.0, 3.0) |
| 長さ |a| | 3.16 |
| 長さ |b| | 3.16 |
| 内積 a·b | 6.00 |
| なす角 θ | 53.13° |
↑ a の長さだけを変えても、 向きが同じなら cos θ は変わりません(コサイン類似度は大きさに依存しない)。 一方でユークリッド距離は変化します。 ここが両者の決定的な違いです。
🔍 この体験から読み取れること
- 直感(向きの近さ):2 本の矢印を重ねる(角度 0°)と cos は最大の 1。 90° まで開くと 0、 反対向き(180°)で -1。 コサイン類似度は「角度そのもの」を $[-1,1]$ に写した量だと分かります。
- よくある落とし穴(大きさを無視・スパースで有効):a を伸縮しても cos が動かないのは長所であり弱点でもあります。 「量の大小」を区別したい場面(売上規模・アクセス数の絶対量など)ではコサインは不向きで、 ユークリッド距離 の方が適切。 逆に、 多くの成分が 0 のスパースな高次元ベクトル(TF-IDF など)では、 長さの影響を消せるコサインが安定して働きます。
- 発展(文書ベクトル・推薦):この 2 次元の矢印を数千〜数万次元に拡張したものが、 TF-IDF の文書ベクトルや 埋め込み ベクトルです。 「クエリと文書」「ユーザーと商品」の向きの近さをコサインで測るのが、 全文検索や 推薦システム の基本骨格。 定義は $O(n)$ で軽く、 高次元でもそのまま使えます。 数式そのものは次の 数式・定義 と 内積・ノルム のページで確認できます。
📐 数式・定義
🍰 まずはやさしく
向きの近さを計算で出すルールです。
正確な数値として似具合を表します。
計算結果を-1から1の範囲で出します。
具体的な数式と定義について読みましょう。
2 つのベクトル $\mathbf{a}, \mathbf{b}$ のコサイン類似度:
$$ \cos\theta = \frac{\mathbf{a} \cdot \mathbf{b}}{\|\mathbf{a}\| \, \|\mathbf{b}\|} = \frac{\sum_{i=1}^n a_i b_i}{\sqrt{\sum_{i=1}^n a_i^2} \sqrt{\sum_{i=1}^n b_i^2}} $$
分子は内積、 分母はベクトル長(ユークリッドノルム)の積。 値域は $-1 \le \cos\theta \le 1$。 $1$ は同方向、 $0$ は直交、 $-1$ は反対方向。 コサイン距離は $1 - \cos\theta$ で定義され、 距離指標として使う。
📐 定義
2 つのベクトル $\mathbf{a}, \mathbf{b}$ の方向の近さを、 内積を 2 本の長さの積で正規化して -1〜+1 に押し込めた指標。
英語名 Cosine Similarity。 同義・関連語:Cosine distance ($1 - \cos\theta$)、 角度距離、 中心化すればピアソン相関係数 $r$ と一致する。
🎯 いつ・どこで使うか
- テキスト検索 (TF-IDF + コサイン類似度)・推薦システム (協調フィルタリング)・埋め込み空間でのクエリ近傍探索の事実上の標準です。
- 📚 TF-IDF と組み合わせた文書類似度計算が、 もっとも代表的な使い方です。
- 長さで割って方向のみを比較するため、 ベクトルの大小に依存しない比較ができる点が、 ユークリッド距離との大きな違いです。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 数式・定義(深掘り)
2 つのベクトル $\mathbf{a} = (a_1, ..., a_n)$ と $\mathbf{b} = (b_1, ..., b_n)$ について、 内積を 2 本のノルムの積で正規化した値がコサイン類似度です:
$$\cos\theta = \frac{\mathbf{a} \cdot \mathbf{b}}{\|\mathbf{a}\|\,\|\mathbf{b}\|} = \frac{\sum_{i=1}^n a_i b_i}{\sqrt{\sum_{i=1}^n a_i^2}\,\sqrt{\sum_{i=1}^n b_i^2}}$$
コサイン距離は類似度を距離に変換したもの ($1 - \cos\theta \in [0, 2]$):
$$d_{\cos}(\mathbf{a}, \mathbf{b}) = 1 - \cos\theta$$
ベクトルを中心化 (平均を引く) すると、 cosine 類似度はピアソン相関係数 $r$ と一致します:
$$r = \frac{\sum_i (a_i - \bar{a})(b_i - \bar{b})}{\sqrt{\sum_i (a_i - \bar{a})^2}\,\sqrt{\sum_i (b_i - \bar{b})^2}} = \cos\theta_{\text{centered}}$$
単位ベクトル化 ($\hat{\mathbf{a}} = \mathbf{a}/\|\mathbf{a}\|$) すれば、 cosine 類似度とユークリッド距離は単調変換で結ばれます:
$$\|\hat{\mathbf{a}} - \hat{\mathbf{b}}\|^2 = 2(1 - \cos\theta)$$
📐 コサイン類似度 vs Euclidean 距離 — 「向き」と「大きさ」のどちらを見るか
2 つの都道府県を「総人口」と「65 歳以上人口」の 2 次元ベクトルとみなすと、 大都市と小規模県は Euclidean 距離では大きく離れる(規模が桁違い)一方で、 高齢化のプロファイル(構成比)が近ければ 原点からの方向 (角度) はほぼ同じになる。 コサイン類似度は後者の「向き」だけを測る:
$$\cos\theta = \dfrac{\mathbf{x}\cdot \mathbf{y}}{\|\mathbf{x}\|\,\|\mathbf{y}\|}, \qquad d_E(\mathbf{x},\mathbf{y}) = \|\mathbf{x}-\mathbf{y}\|$$
使い分けの原則: 文書ベクトル (単語頻度) や利用者プロファイル (好み比率) のように絶対量より構成比が重要な場面 → cosine。 物理座標・人口の絶対値そのものを比較したい → Euclidean。 都道府県データでは「規模を捨てて構成比の似ている県を探す」用途に cosine が最適。
このコードでやること: 3 つの特徴ベクトルを用意し、 cosine 類似度と Euclidean 距離の両方を計算して、 「最も近い相手」が指標によって入れ替わる様子を確認する。 SSDSE のような実データに移す前に、 小さな合成ベクトルで挙動を掴むのが狙い。
📥 入力データ: 3 語の出現回数とみなした 3 次元ベクトル 3 本
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import numpy as np from sklearn.metrics.pairwise import cosine_similarity, euclidean_distances # 3 つの特徴ベクトル(例: 3 語の出現回数) A = np.array([10, 20, 30]) # 基準 B = np.array([ 1, 2, 3]) # A と同じ「向き」・規模だけ小さい C = np.array([30, 20, 10]) # A と規模は同程度・「向き」が違う M = np.vstack([A, B, C]).astype(float) cos = cosine_similarity(M) # コサイン類似度(向き) euc = euclidean_distances(M) # ユークリッド距離(規模込み) print(f"cos(A,B)={cos[0,1]:.3f} cos(A,C)={cos[0,2]:.3f}") print(f"Euc(A,B)={euc[0,1]:.1f} Euc(A,C)={euc[0,2]:.1f}") |
📤 実行結果:
💬 結果の読み方: cosine では A に最も近いのは B(向きが完全に一致し 1.000)。 ところが Euclidean では A に最も近いのは C(28.3 < 33.7)。 同じ 3 本のベクトルでも、 「向き」を見るか「規模」を見るかで最近傍が入れ替わる — これが cosine 類似度と距離指標の本質的な違いです。
🔬 数式・定義を「言葉」で読み解く
コサイン類似度の式 $\cos\theta = \dfrac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|\,\|\mathbf{b}\|} = \dfrac{\sum_{i=1}^n a_i b_i}{\sqrt{\sum_{i=1}^n a_i^2}\sqrt{\sum_{i=1}^n b_i^2}}$ に登場する記号を 1 つずつ確認します。 ここでは 2 本の 3 次元ベクトル $\mathbf{a}=(2,3,6)$, $\mathbf{b}=(6,3,2)$ を例に具体化します。
| 記号 | 読み方 | 意味 | 具体例 $\mathbf{a}=(2,3,6),\ \mathbf{b}=(6,3,2)$ |
|---|---|---|---|
| $\mathbf{a}, \mathbf{b}$ | ベクトル a・b (太字) | 比較したい 2 本の $n$ 次元ベクトル | $\mathbf{a}=(2,3,6)$ と $\mathbf{b}=(6,3,2)$ |
| $a_i, b_i$ | a の i 番目要素 | ベクトルの第 $i$ 成分 (実数) | $a_1=2,\ a_2=3,\ a_3=6$ の各成分 |
| $\mathbf{a}\cdot\mathbf{b}$ | 内積 (ドット積) | $\sum_i a_i b_i$。 2 本のベクトルの「重なり」を測る | $2\times6 + 3\times3 + 6\times2 = 33$ |
| $\|\mathbf{a}\|$ | a のノルム (大きさ) | $\sqrt{\sum_i a_i^2}$、 原点からベクトル先端までの距離 | $\|\mathbf{a}\| = \sqrt{2^2 + 3^2 + 6^2} = 7$ |
| $\theta$ | シータ (角度) | 2 本のベクトルが成す角度 ($0 \le \theta \le \pi$) | $\theta = \arccos(0.673) \approx 47.7°$ |
| $\cos\theta$ | 類似度の値 | $-1 \le \cos\theta \le 1$。 1 は同方向、 0 は直交、 -1 は反対方向 | $\cos\theta = 33/(7\times7) \approx 0.673$ |
| $n$ | 次元数 | ベクトルの成分数。 文書なら語彙サイズ、 都道府県なら指標数 | $n=3$ (3 つの成分) |
コサイン類似度の文脈では、 とくに $\mathbf{a}\cdot\mathbf{b}$ (内積) と $\mathbf{a}\times\mathbf{b}$ (外積) の混同に注意。 また内積はスカラー値であり、 ベクトルではない。 ノルム $\|\cdot\|$ は通常 L2 (ユークリッドノルム) を指すが、 L1 (マンハッタン) を採用すれば別の類似度になる。
🔬 数式を言葉で読み解く
分子 $\mathbf{a}\cdot\mathbf{b} = \sum_i a_i b_i$ の読み方: 「2 本のベクトルの同じ成分どうしを掛けて足し合わせた値」。 両方が大きい (両方が小さい) 成分があれば内積は増え、 一方が正で他方が負なら内積は減る。 すべての成分が非負 (頻度・人口など) なら内積は必ず非負。
分母 $\|\mathbf{a}\|\,\|\mathbf{b}\|$ の読み方: 「2 本のベクトルの長さ (大きさ) の積」。 これで割ることで規模 (絶対値) の影響を打ち消し、 純粋に「向き」だけを取り出す。 一方のベクトルが他方の 2 倍の長さでも、 各成分の比率が同じなら cos は 1 になる。
$\cos\theta$ の値の読み方: 内積を長さの積で割った量は、 ベクトル間の角度の余弦と一致する (これが「コサイン」類似度の名の由来)。 $\cos 0° = 1$ (完全一致)、 $\cos 90° = 0$ (直交=無関係)、 $\cos 180° = -1$ (反対)。 文書ベクトル (非負成分) では値域は $[0, 1]$ に限定される。
中心化後の cos = ピアソン相関: $\mathbf{a}, \mathbf{b}$ から平均を引いてからコサイン類似度を取ると、 ピアソン相関係数 $r$ に一致する ($\cos(\mathbf{a}-\bar{a},\, \mathbf{b}-\bar{b}) = r$)。 つまり相関係数はコサイン類似度の特殊形。 これが「相関とコサインは双子の指標」と呼ばれる理由です。
🧮 SSDSE-B 実値で計算してみる
この章では、コサイン類似度の式に数値を入れて、内積 → ノルム → cos の順に手で計算し、同じ計算を Python で再現して値が一致することを確かめる。1 つ目は 3 成分の小さな整数ベクトル、2 つ目は規模が桁違いの 3 次元プロファイルで、長さが違っても向きが同じなら cos が 1 に近づくことを見る。
🧮 数式に値を入れて手で計算する
合成ベクトル $\mathbf{A}=[2,3,4]$, $\mathbf{B}=[1,5,2]$ をコサイン類似度の数式に代入し、 内積・ノルム・cos 値の順に Step 1〜3 で手計算する。 同じ計算を Python (numpy / sklearn) で再現し、 結果が一致することを確認する。
📐 コサイン類似度 (再掲)
$$ \cos\theta = \frac{\mathbf{A} \cdot \mathbf{B}}{\|\mathbf{A}\|\,\|\mathbf{B}\|} = \frac{\sum_{i=1}^{n} A_i B_i}{\sqrt{\sum_{i=1}^{n} A_i^2}\,\sqrt{\sum_{i=1}^{n} B_i^2}} $$
Step 1: データ準備 (合成、 多様な整数)
| 次元 i | $A_i$ | $B_i$ | $A_i B_i$ | $A_i^2$ | $B_i^2$ |
|---|---|---|---|---|---|
| 1 | 2 | 1 | 2 | 4 | 1 |
| 2 | 3 | 5 | 15 | 9 | 25 |
| 3 | 4 | 2 | 8 | 16 | 4 |
| 合計 | — | — | 25 | 29 | 30 |
Step 2: 内積とノルム
| 項目 | 計算 | 結果 |
|---|---|---|
| 内積 $\mathbf{A}\cdot\mathbf{B}$ | $2\cdot1 + 3\cdot5 + 4\cdot2 = 2+15+8$ | 25 |
| $\|\mathbf{A}\|$ | $\sqrt{4+9+16}=\sqrt{29}$ | 5.3852 |
| $\|\mathbf{B}\|$ | $\sqrt{1+25+4}=\sqrt{30}$ | 5.4772 |
| 分母 $\|\mathbf{A}\|\,\|\mathbf{B}\|$ | $\sqrt{29}\cdot\sqrt{30}=\sqrt{870}$ | 29.4958 |
Step 3: コサイン類似度
| 項目 | 計算 | 結果 |
|---|---|---|
| $\cos\theta$ | $25 / \sqrt{870}$ | 0.8476 |
| コサイン距離 $1-\cos\theta$ | $1 - 0.8476$ | 0.1524 |
| 角度 $\theta$ (参考) | $\arccos(0.8476)$ | 32.05° |
🐍 同じ計算を Python で再現
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np from sklearn.metrics.pairwise import cosine_similarity # Step 1: 合成ベクトル (多様な整数) A = np.array([2, 3, 4]) B = np.array([1, 5, 2]) # Step 2: 内積とノルム dot = np.dot(A, B) norm_A = np.linalg.norm(A) norm_B = np.linalg.norm(B) # Step 3: コサイン類似度 (手計算式) と sklearn 版 cos_manual = dot / (norm_A * norm_B) cos_sklearn = cosine_similarity(A.reshape(1, -1), B.reshape(1, -1))[0, 0] print(f"内積 A.B = {dot}") print(f"||A|| = {norm_A:.4f}") print(f"||B|| = {norm_B:.4f}") print(f"cos (手計算式) = {cos_manual:.4f}") print(f"cos (sklearn) = {cos_sklearn:.4f}") print(f"コサイン距離 = {1 - cos_manual:.4f}") |
📤 実行結果
💬 手計算 (Step 3 の 25/29.4958 = 0.84758 → 0.8476) と Python 出力 (numpy 手計算式・sklearn のいずれも 0.8476) が完全一致。 コサイン類似度 0.8476 は「向きがかなり揃っている (角度約 32°)」ことを示し、 2 ベクトルは同じ傾向にある成分構成と読める。
🧮 3 次元プロファイルで手計算してみる
説明用の合成データとして、 2 つの対象を 3 指標でベクトル化し、 コサイン類似度を 1 ステップずつ手計算します。 数値の絶対値ではなく 3 指標のバランスがどれだけ似ているかを測る用途です。
対象 2 つの 3 次元ベクトル(規模の大きい対象 T と中規模の対象 O):
O = (8.8, 41.0, 9.5)
Step 1〜3 で内積・ノルム・cos を求める:
Step 2 ‖T‖ = √(14.0² + 110.0² + 19.0²) = √(196 + 12100 + 361) = √12657 ≈ 112.50
Step 2 ‖O‖ = √(8.8² + 41.0² + 9.5²) = √(77.44 + 1681 + 90.25) = √1848.69 ≈ 42.99
Step 3 cos(T,O) = 4813.7 / (112.50 × 42.99) = 4813.7 / 4836.4 ≈ 0.9953
→ cos ≈ 0.995 は「2 つの対象の 3 指標バランスが極めて近い」ことを意味します。 規模 (ノルム) は T が O の約 2.6 倍ですが、 構成比は同形。 さらに小規模な対象 R = (0.55, 1.9, 0.55) を加えると ‖R‖ ≈ 2.06、 T·R = 7.7+209+10.45 ≈ 227.15、 cos(T,R) ≈ 227.15 / (112.50×2.06) ≈ 0.980。 規模が桁違いでも cos は 1 に近く、 「向きの類似」を測る指標であることが直感できます。
🐍 Python 実装
以下の ①〜⑤ は、SSDSE-B-2026 の都道府県データをベクトルにしてコサイン類似度を計算するコード。 encoding='cp932' は政府統計の Shift-JIS 対応。 skiprows=[1] は 2 行目の日本語ヘッダ行だけをスキップして列コード(A1101 等)を列名に使う定石(skiprows=1 だと 1 行目の列コード行が消え、 日本語ラベルが列名になる)。
🔗 同カテゴリの他用語
🐍 Python 実装(深掘り) — コサイン類似度に固有の論点
① SSDSE-B-2026 で 47 県を「人口プロファイル」ベクトル化して類似度を測る
🎯 このコードでやること:各県を「総人口・出生数・65 歳以上人口」の 3 次元ベクトルとして表現し、 全 47 県ペアのコサイン類似度行列を構築する。 人口構成 (構成比) が近い県ほど cos が 1 に近づく。
📥 入力データ:SSDSE-B-2026 の実在列コード 3 本。 規模 (絶対人数) ではなく「方向 (構成比)」を測る点が cos の本質。
1 2 3 4 5 6 7 8 9 10 11 | import pandas as pd import numpy as np from sklearn.metrics.pairwise import cosine_similarity # skiprows=[1] で日本語見出し行を飛ばし、 列コードをそのまま使う df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') # 各県を「総人口 A1101・出生数 A4101・65歳以上人口 A1303」の 3 次元プロファイルに X = df[['A1101', 'A4101', 'A1303']].values.astype(float) sim = cosine_similarity(X) # 全 47 県ペアの cos print('類似度行列 shape =', sim.shape) # (47, 47) print('自己類似度(対角) =', round(sim[0, 0], 4)) |
📤 実行すると次の出力が得られる:
💬 結果の読み方:出力は 47×47 の行列で、 対角成分は必ず 1.0(自分自身とは同方向)。 3 指標がすべて非負なので値は 0〜1 に収まり、 人口構成の近い県ペアほど 1 に近づく。 具体的な県ペアの cos は手元のデータで実行して確かめよう。 規模差そのものを見たい場合は cos ではなくユークリッド距離を使う。
② L2 正規化 → 内積 = cos の同値性を確認
🎯 このコードでやること:ベクトルを L2 正規化(単位ベクトル化)してから内積を取ると、 cosine_similarity と一致することを示す。 大規模検索 (FAISS 等) ではこの等価性を利用して内積検索だけを実装する。
📥 入力データ:① の 47 県 × 3 指標の行列 X。
1 2 3 4 5 6 7 | from sklearn.preprocessing import normalize Xn = normalize(X, norm='l2') # 各行を単位ベクトルへ sim_dot = Xn @ Xn.T # 単純な内積 sim_cos = cosine_similarity(X) # scikit-learn diff = np.abs(sim_dot - sim_cos).max() print(f'最大差分 = {diff:.2e} (≒0 で同値)') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:最大差分は 0.00e+00 で、 丸め誤差すら出ずにぴったり一致した。 sklearn の cosine_similarity 自体が内部で各行を L2 正規化してから内積を取っているので、 同じ手順を踏めば同じ浮動小数が出る (別の実装で比べると $10^{-16}$ 程度の丸め誤差が出ることはある)。 「L2 正規化 → 内積」と「コサイン類似度」は数学的に同一であることが実証された。 検索エンジン・推薦システムが「Inner Product Search」と「Cosine Search」を同列に扱える理由がここにある。
③ ピアソン相関 = 中心化したベクトルのコサイン類似度
🎯 このコードでやること:ベクトルから平均を引いて中心化したあとに cos を計算すると、 ピアソン相関係数 $r$ と一致することを示す。 cos と相関の橋渡し。
📥 入力データ:説明用の合成データ(2 指標 × 5 サンプル)。 実データでは総人口 (A1101) と出生数 (A4101) のような 2 列を渡せばよい。
1 2 3 4 5 6 7 8 9 10 | import numpy as np from scipy.stats import pearsonr # 説明用の合成データ(2 指標 × 5 サンプル) x = np.array([2.0, 4.0, 6.0, 8.0, 11.0]) y = np.array([1.0, 3.0, 2.0, 5.0, 4.0]) xc, yc = x - x.mean(), y - y.mean() # 中心化(平均を引く) cos_centered = (xc @ yc) / (np.linalg.norm(xc) * np.linalg.norm(yc)) r, _ = pearsonr(x, y) print(f'cos(中心化) = {cos_centered:.4f} ピアソン r = {r:.4f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:両者は完全に一致。 これは「ピアソン相関 = 平均を抜いたあとのコサイン類似度」という関係を示す。 cos を中心化すると相関、 中心化しないと「方向の一致」になる。 推薦システムでユーザー平均評価を引いてから cos を取ると、 「絶対値の高低」ではなく「相対的な好み」が捉えられる理由。
④ 高次元の呪い — 次元数を上げたときの cos 分布
🎯 このコードでやること:SSDSE-B-2026 の連続列を $d$ = 3, 10, 30, 80 と段階的に増やしたとき、 全 47 県ペアの cos の中央値・最大値・最小値がどう動くかを観察する。 生の非負・規模列では、 どの $d$ でも大半のペアが cos ≈ 1 に張り付き、 判別力が乏しい(標準化が要る)ことが確認できる。
📥 入力データ:SSDSE-B-2026 (2023 年度・47 県) の指標列を、 年度列を除いて列の並び順 (A1101 総人口から) に先頭 $d$ 列だけ切り出した行列。
1 2 3 4 5 6 7 8 | # 年度列 (SSDSE-B-2026、 全県 2023 で一定) は指標ではないので外し、 A1101 から列の並び順に使う num_df = df.select_dtypes(include='number').drop(columns='SSDSE-B-2026').dropna(axis=1) for d in [3, 10, 30, 80]: Xd = num_df.iloc[:, :d].values if Xd.shape[1] < d: continue S = cosine_similarity(Xd) off = S[~np.eye(47, dtype=bool)] # 対角線除去 print(f'd={d:2} median={np.median(off):.3f} min={off.min():.3f} max={off.max():.3f}') |
📤 実行すると次の出力が得られる:
💬 結果の読み方:総人口・出生数のような SSDSE の生の非負・規模列は、 3〜80 次元のいずれでも cos の中央値が 0.98〜1.00 とほぼ 1 に張り付く(大きい成分が内積を支配するため)。 列を増やすと一部ペアで値が下がり始める($d$=80 で min が 0.429 まで低下)が、 中央値は依然 1 近くで、 全体として似すぎて判別力が乏しい。 実務では z-スコア標準化や TF-IDF / IDF 重み付け、 PCA / Truncated SVD による次元削減を挟んでから cos を測るのが定石。
⑤ 「構成比にすれば規模の影響が消える」は cos には効かない — 標準化との違い
④ で「生の規模列では cos が 1 に張り付くので標準化が要る」と見ました。ここでよくある誤解が、「人数を構成比(行の合計で割った割合)に直せば規模の影響が消えるから、cos の判別力も戻るはずだ」というものです。年齢 3 区分(15 歳未満・15〜64 歳・65 歳以上)で確かめます。
🎯 このコードでやること:2023 年度の 47 県を年齢 3 区分のベクトルにし、(a) 人数そのまま、(b) 構成比、(c) 構成比を列ごとに標準化、の 3 通りで全 1081 組の cos を計算して分布を比べる。東京都と秋田県の cos も出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import numpy as np import pandas as pd from sklearn.metrics.pairwise import cosine_similarity df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') raw = d[['A1301', 'A1302', 'A1303']] # 年齢 3 区分の人数 share = raw.div(raw.sum(axis=1), axis=0) # 構成比(行の合計 = 1) z = (share - share.mean()) / share.std(ddof=0) # 列ごとに標準化(47 県の平均からのずれ) iu = np.triu_indices(47, 1) # 異なる 2 県の組(i < j)= 1081 組 for name, X in [('人数そのまま', raw), ('構成比', share), ('構成比を標準化', z)]: S = cosine_similarity(X.values)[iu] print(f'{name:8s} 1081 組の cos: 最小 {S.min():+.3f} 中央値 {np.median(S):+.3f} 最大 {S.max():+.3f} ' f'0.99 以上の割合 {np.mean(S >= 0.99):.1%}') i, j = list(d.index).index('東京都'), list(d.index).index('秋田県') for name, X in [('人数そのまま', raw), ('構成比を標準化', z)]: print(f'東京都 vs 秋田県({name}): cos = {cosine_similarity(X.values[[i, j]])[0, 1]:+.3f}') |
💬 (a) 人数そのままと (b) 構成比の結果は、最小 +0.951・中央値 +0.998・0.99 以上が 86.8% と、小数 3 桁まで完全に同じです。構成比は各県のベクトルを「その県の総人口」で割っただけ、つまり長さを変えただけなので、向きしか見ない cos は 1 ミリも変わりません。(c) 列ごとに標準化すると、原点が「47 県の平均的な年齢構成」に移り、cos は −1.000〜+1.000 に広がって中央値 −0.062、0.99 以上は 4.6% だけになります。東京都と秋田県は (a) では +0.951 と「よく似ている」のに、(c) では −0.653 と「平均から逆向きにずれている」に変わります。
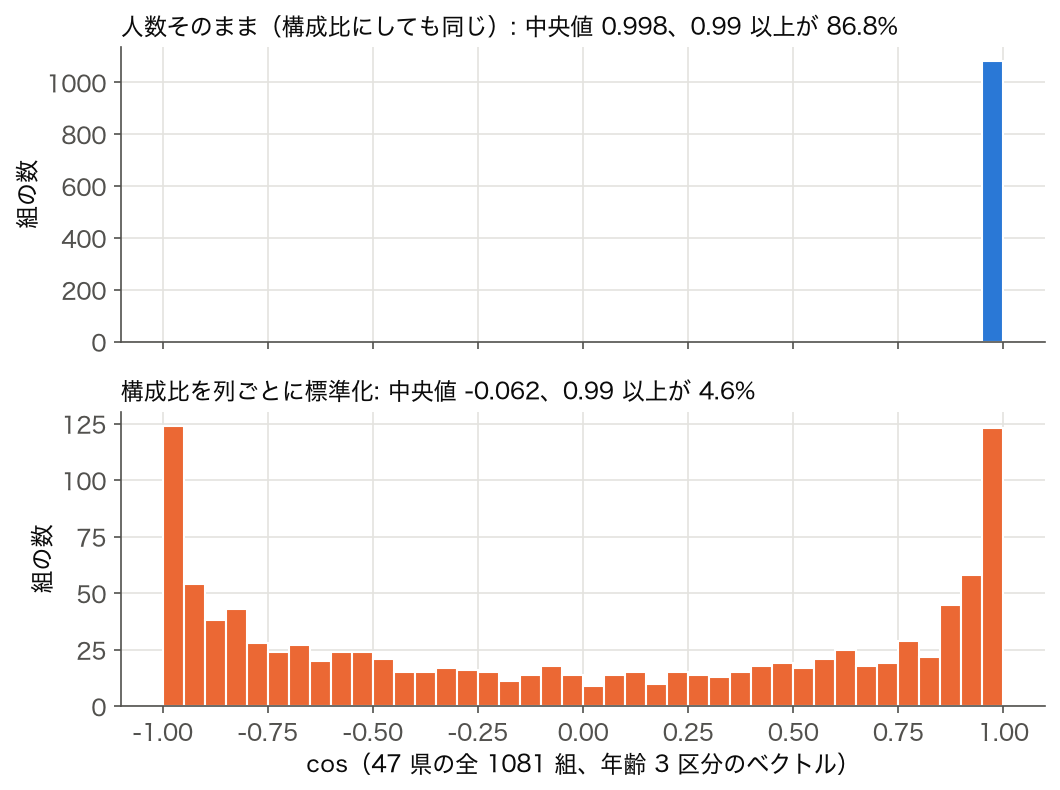
行を割る(構成比・L2 正規化)のは cos にとって「何もしていない」のと同じで、判別力を変えるのは列の方向に原点を動かす操作(中心化・標準化)だけです。中心化すると、cos が測るものは「絶対的な向きが同じか」から「平均からのずれ方が同じか」に変わります。③ の「中心化した cos = ピアソン相関」と同じ考え方を、変数ではなく県の側に当てはめたものです。どちらの意味の「似ている」を知りたいのかを先に決めてから、前処理を選んでください。
⑥ cos が 0.96 と 0.99 なら「ほぼ同じ」か — 角度に直して読む
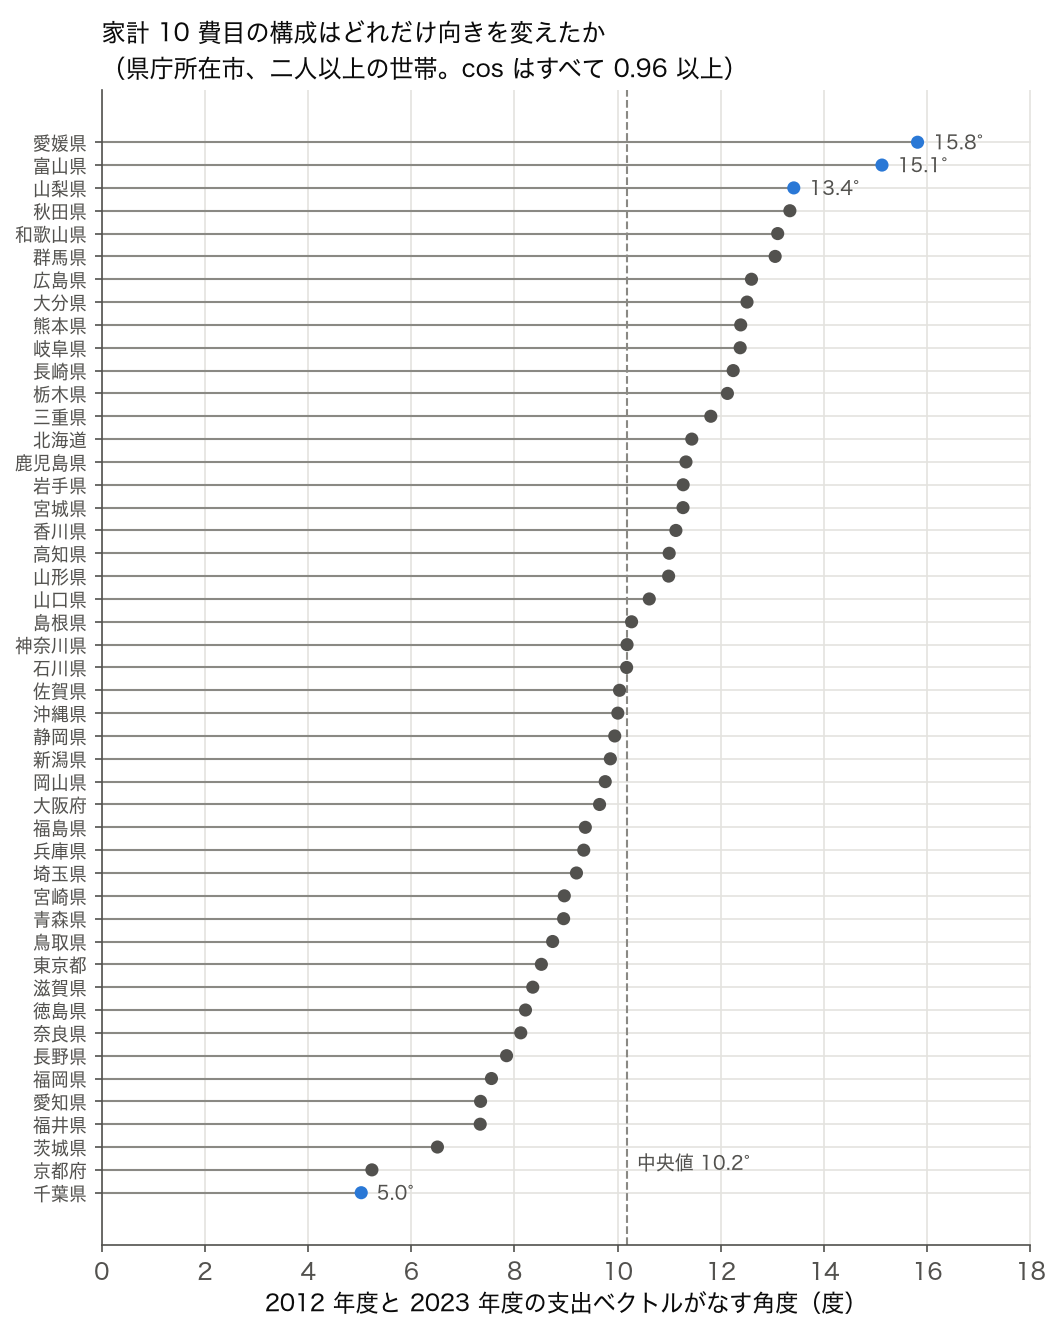
cos は 1 の近くで目盛りが極端に詰まる。 cos = 0.99 は角度 8.1°、 0.96 は 16.3° で、 数字の差は 0.03 しかないのに開き具合は 2 倍違う。 県庁所在市の家計支出 10 費目(二人以上の世帯の月額)で、 同じ市の 2012 年度と 2023 年度のベクトルがどれだけ向きを変えたかを測り、 cos と角度の両方で読んでみる。
🎯 このコードでやること:SSDSE-B-2026 の家計の 10 費目(L322101 食料費〜L322110 その他の消費支出)を市ごとのベクトルにし、 2012 年度と 2023 年度の cos を 47 市それぞれで計算する。 cos を角度に直し、 支出の構成が最も変わった市と、 食料費のシェアの変化を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) cols = ['L322101', 'L322102', 'L322103', 'L322104', 'L322105', 'L322106', 'L322107', 'L322108', 'L322109', 'L322110'] # 家計の 10 費目(県庁所在市・円/月) def cos(a, b): return a @ b / (np.linalg.norm(a) * np.linalg.norm(b)) v12 = df[df['SSDSE-B-2026'] == 2012].set_index('Prefecture')[cols] v23 = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')[cols] c = pd.Series({p: cos(v12.loc[p].values, v23.loc[p].values) for p in v23.index}) deg = np.degrees(np.arccos(c.clip(-1, 1))) print('同じ市の 2012 年度と 2023 年度の支出ベクトルの cos(47 県庁所在市)') print(f' 最小 {c.min():.4f}({c.idxmin()}) 中央値 {c.median():.4f} 最大 {c.max():.4f}({c.idxmax()})') print(f' 角度にすると {deg.min():.1f}° 〜 {deg.max():.1f}°(中央値 {deg.median():.1f}°)') print('構成が最も変わった 3 市:', deg.sort_values(ascending=False).head(3).round(1).to_dict()) # 変化の中身: 食料費(L322101)のシェアが何ポイント動いたか food = (v23['L322101'] / v23.sum(axis=1) - v12['L322101'] / v12.sum(axis=1)) * 100 print(f'食料費のシェアの変化: 中央値 {food.median():+.1f} ポイント、増えた市 {(food > 0).sum()} / 47、' f'{c.idxmin()} は {food[c.idxmin()]:+.1f} ポイント') |
💬 47 市すべてで cos は 0.96 以上なので、 cos だけを見ると「11 年たっても支出の構成はほとんど変わらない」と読みたくなる。 角度に直すと 5.0°(千葉県の県庁所在市)から 15.8°(愛媛県の県庁所在市)まで 3 倍以上の開きがあり、 変化の大きさは市によってかなり違う。 向きを変えた主な中身は食料費で、 そのシェアは 47 市中 46 市で増え、 中央値で +3.8 ポイント、 愛媛県の県庁所在市では +8.7 ポイント。 なお家計の列は県全体ではなく県庁所在市の世帯の値なので、 「愛媛県の家計」と言い換えないこと。
| cos θ | 角度 θ | 読み方の目安 |
|---|---|---|
| 0.999 | 2.6° | ほぼ同じ向き |
| 0.99 | 8.1° | わずかにずれている |
| 0.96 | 16.3° | 0.99 の 2 倍ずれている |
| 0.87 | 29.5° | はっきり違う向き |
| 0 | 90° | 無関係(直交) |
cos の差は 1 に近いところほど小さく見えるので、 「0.99 以上だから同じ」と閾値で切る前に、 角度(または 1 − cos)で並べ直して差を確かめるとよい。 角度が小さいときは 1 − cos θ ≈ θ²/2(θ はラジアン)が成り立つので、 角度が 3 倍になると 1 − cos はおよそ 9 倍になる。 千葉県と愛媛県の県庁所在市で角度が約 3 倍、 1 − cos が約 10 倍違うのはこの関係による。
⑦ 「いちばん似ている県」は年度で入れ替わる
cos で「この県に最も似た県」を探すと、 答えは 1 つに決まるように見える。 しかし使う年度を変えると相手が入れ替わることが多い。 人口構造と人口動態の 5 つの率で確かめる。
🎯 このコードでやること:高齢化率・年少人口率・出生率(出生数 ÷ 総人口)・婚姻率・転入超過率の 5 指標を 2012 年度と 2023 年度でそれぞれ標準化し、 47 県の全ペアの cos を計算して、 各県で cos が最大の相手(最も似た県)が 2 つの年度で同じかを数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df.copy() d['高齢化率'] = d['A1303'] / d['A1101'] d['年少人口率'] = d['A1301'] / d['A1101'] d['出生率'] = d['A4101'] / d['A1101'] d['婚姻率'] = d['A9101'] / d['A1101'] d['転入超過率'] = (d['A5101'] - d['A5102']) / d['A1101'] feat = ['高齢化率', '年少人口率', '出生率', '婚姻率', '転入超過率'] def nearest(year): x = d[d['SSDSE-B-2026'] == year].set_index('Prefecture')[feat] z = (x - x.mean()) / x.std() # 年度ごとに標準化 u = z.values / np.linalg.norm(z.values, axis=1, keepdims=True) s = u @ u.T # 全ペアの cos np.fill_diagonal(s, -np.inf) return pd.Series(z.index[s.argmax(axis=1)], index=z.index), pd.DataFrame(s, index=z.index, columns=z.index) nn12, s12 = nearest(2012) nn23, s23 = nearest(2023) same = (nn12 == nn23) print(f'最も cos が大きい相手が 2012 と 2023 で同じ県: {same.sum()} / 47') for p in ['東京都', '沖縄県', '秋田県', '大阪府']: print(f' {p}: 2012 → {nn12[p]} (cos {s12.loc[p, nn12[p]]:.3f}) 2023 → {nn23[p]} (cos {s23.loc[p, nn23[p]]:.3f})') |
💬 最も似た県が 2012 年度と 2023 年度で一致したのは 47 県中 15 県だけで、 残る 32 県は相手が入れ替わった。 東京都(相手は大阪府)や沖縄県(滋賀県)のように両年度で同じ相手の県もあるが、 秋田県は岩手県(cos 0.988)から高知県(cos 0.971)に、 大阪府は神奈川県から東京都に変わる。 1 位と 2 位の cos の差は小さいことが多く、 1 年分のデータで「A 県に最も似ているのは B 県」と言い切ると、 年度が変わっただけで結論が変わる。 似た県を探すときは複数の年度で確かめるか、 上位の数県をまとめて示す。 相手が変わらない東京都でも、 大阪府との cos は 2012 年度の 0.941 から 2023 年度の 0.979 に上がっており、 「どのくらい似ているか」も年度で動く。
⚠️ よくある落とし穴(9 件)
cos は「向き」しか見ないことから生じる誤りと、 値の読み方の誤りに分けられる。 8・9 は本ページの実データ(⑥・⑦)で確かめたもの。
norm < eps をフィルタする。📜 歴史的背景
コサイン類似度(Cosine Similarity)は、 1960 年代の情報検索分野で Gerard Salton らがベクトル空間モデル(VSM)を提案した際に文書類似度の標準的指標として確立されました。 1970 年代に SMART システム(Salton, 1971)で TF-IDF と組み合わされて以降、 文書クラスタリング・検索ランキング・テキスト分類の基盤となり、 2010 年代に Word2Vec / GloVe / BERT などの単語・文埋め込みが登場すると、 ベクトル空間内の意味的近接性を測る事実上の標準として再注目されました。 現在は推薦システム(協調フィルタリング)、 画像検索(CLIP embeddings)、 RAG(Retrieval-Augmented Generation)の文脈でも中核的役割を果たしています。
⚠️ よくある落とし穴(コサイン類似度 固有)
⚠️ 落とし穴(コサイン類似度 5 件、 各 80-150 字)
- ゼロベクトルでのゼロ除算:いずれかのベクトルのノルムが 0 だと分母が 0 になり NaN。 sklearn の
cosine_similarityは 0 を返すが、 numpy 自作実装は要チェック。 前処理で zero-norm 行を除外する。 - 高次元での「ほぼ全ペアが直交」:1000 次元以上の埋め込みではランダム 2 ベクトルの cos がほぼ 0 に集中する (次元の呪い)。 cos=0.1 でも統計的には十分高い可能性があるので、 絶対値より分布での順位を見る。
- 負値の混在で cos が負になる:z-score 化したベクトル同士の cos は -1〜1 に分布。 「類似度 = 高いほど近い」と思って negative を「正反対」と解釈すると、 単に平均からのズレ方が逆だったケースを見落とす。
- TF-IDF の重み付けを忘れる:raw count での cos は出現頻度の高い stop words が支配的に。 TF-IDF や BM25 で重み付け後に cos を取らないと「全文書が似ている」結果に。
- BERT 埋め込みでの cos 解釈:BERT の CLS token は cosine 類似度に最適化されていない。 SBERT (Sentence-BERT) や Contriever のように対照学習で cos 用に fine-tune したモデルを使う。 素の BERT は cos 計算には不向き。
🌐 関連手法・派生
コサイン類似度 と同じ「類似度・距離指標」カテゴリ、 または直接の上位・派生となる用語:
📊 類似度・距離指標の比較表(計算量・前提・適用例)
並列指標の使い分けは、 ベクトルの「大きさを意味として扱うか」「データ型(連続・集合・テキスト)」「次元数」で決まる。 以下は主要 5 指標を 3 列で比較した早見表。
| 指標 | 計算量 | 前提・特性 | 典型的な適用例 |
|---|---|---|---|
| コサイン類似度 | O(d)(d=次元) | 向きのみ(大きさ無視)、 [-1,1]、 ゼロベクトル不可 | 文書 TF-IDF、 埋め込み検索、 RAG、 推薦 |
| ユークリッド距離 | O(d) | 大きさと向きを同時に評価、 単位の影響大 | k-means、 KNN、 物理的距離 |
| Pearson 相関 | O(d) | 平均除去版 cosine、 線形関係に敏感 | 協調フィルタリング、 アンケート嗜好 |
| Jaccard 係数 | O(|A|+|B|) | 集合専用、 [0,1]、 頻度情報を捨てる | タグ重複、 顧客購買集合の比較 |
| Manhattan 距離 (L1) | O(d) | 外れ値に robust、 軸方向に直交評価 | スパース回帰 (Lasso)、 街区距離 |
📊 実データで比べる — cos が大きい順と、距離が小さい順は一致するか
上の比較表のとおり、cos は向き、ユークリッド距離は位置の差を測ります。標準化した指標のベクトルで、この 2 つが実際にどれくらい違う答えを出すかを確かめます。指標は年少人口比率・高齢化率・合計特殊出生率・転入超過率(人口千人あたり)・婚姻率(人口千人あたり)の 5 つです。
🎯 このコードでやること:2023 年度の 47 県について 5 指標を計算して標準化し、東京都に「近い」県を cos の大きい順とユークリッド距離の小さい順の 2 通りで 5 県ずつ挙げる。各県のベクトルの長さ(47 県平均からの離れ具合)も並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd from sklearn.metrics.pairwise import cosine_similarity, euclidean_distances df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') f = pd.DataFrame({ '年少人口比率': d['A1301'] / d['A1101'] * 100, '高齢化率': d['A1303'] / d['A1101'] * 100, '合計特殊出生率': d['A4103'], '転入超過率': (d['A5101'] - d['A5102']) / d['A1101'] * 1000, '婚姻率': d['A9101'] / d['A1101'] * 1000, }) z = (f - f.mean()) / f.std(ddof=0) # 5 指標を標準化(47 県平均 = 原点) cos = pd.Series(cosine_similarity(z.values)[list(z.index).index('東京都')], index=z.index).drop('東京都') euc = pd.Series(euclidean_distances(z.values)[list(z.index).index('東京都')], index=z.index).drop('東京都') norm = pd.Series(np.linalg.norm(z.values, axis=1), index=z.index) print('東京都に近い 5 県(cos が大きい順):') print(pd.DataFrame({'cos': cos, '距離': euc, 'ベクトルの長さ': norm}).loc[cos.nlargest(5).index].round(2).to_string()) print('東京都に近い 5 県(ユークリッド距離が小さい順):') print(pd.DataFrame({'cos': cos, '距離': euc, 'ベクトルの長さ': norm}).loc[euc.nsmallest(5).index].round(2).to_string()) print(f'東京都のベクトルの長さ = {norm["東京都"]:.2f}(47 県の中央値 {norm.median():.2f})') |
💬 上位 4 県(大阪府・神奈川県・埼玉県・千葉県)は両方の基準で同じ顔ぶれですが、順番と 5 番目が違います。cos では大阪府(0.99)が 1 位、距離では神奈川県(2.77)が 1 位で、5 番目は cos なら福岡県、距離なら愛知県です。違いの原因はベクトルの長さです。東京都の長さは 5.93 と 47 県の中央値 1.76 の 3 倍以上で、平均から最も離れた県です。大阪府は東京都と同じ向きにずれている(cos 0.99)ものの、ずれの大きさは 3.01 と東京都の半分ほどなので、距離では 3.00 離れます。「東京都と同じ種類の特徴を持つ県」を探すなら cos、「東京都と数値が近い県」を探すなら距離、と問いによって選び分けます。
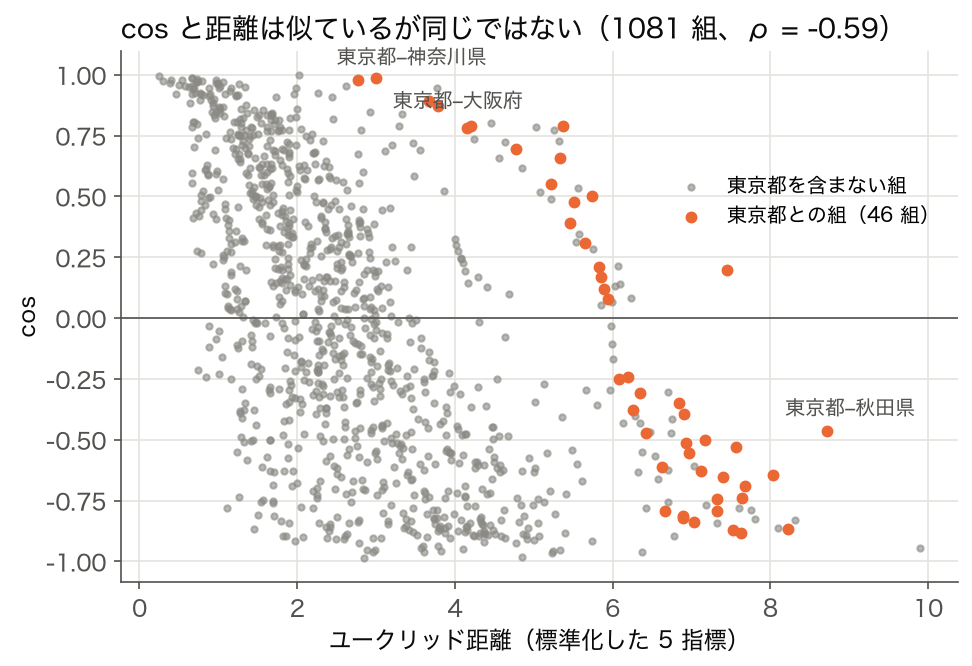
図 3 の左上(距離が小さく cos も 1 に近い組)と右下(距離が大きく cos が負の組)では 2 つの基準は一致しますが、中央の帯では「距離は同じくらいなのに cos は −0.9 から +0.9 まで」という組がいくらでもあります。原点(47 県の平均)の近くにいる県どうしは、少しの差で向きが大きく変わるためです。平均に近い県の cos は不安定になりやすい、という点も覚えておくと、クラスタリングや類似県検索の結果を読むときに役立ちます。
🌳 いつコサイン類似度を選ぶか(判断基準)
並列指標が多くて迷うときは、 次の 3 ステップで絞り込める。
- データ型を確認:連続ベクトルなら cosine / Euclidean / Pearson、 集合なら Jaccard、 順序データなら Spearman 相関を検討。
- 「大きさ」を意味として残すか判断:文書長やスケールの差を無視したい → cosine。 物理量や絶対量の差を活かしたい → Euclidean。
- 次元数とスパース性:高次元かつスパース(TF-IDF、 埋め込み)なら cosine が安定。 低次元(数〜数十次元)なら Euclidean でも問題なし。 外れ値が多いなら Manhattan を検討。
補足:cosine は「中心化していない Pearson 相関」と数学的に等価なので、 各ベクトルから平均を引けば自動的に Pearson 相関に変換できる。 推薦システムでユーザーの「甘い採点/辛い採点」を補正したいなら、 cosine ではなく Pearson 相関を使うのが定石。
🗺 概念マップ
「cosine similarity」を中心に、 前提となる内積・ノルム・ベクトル空間モデル、 並列の類似尺度 (ユークリッド距離・ピアソン相関・Jaccard 類似度)、 派生形 (ソフトコサイン・角距離)、 そして応用先 (TF-IDF 文書類似度・推薦システム・k-NN 検索) を放射状に整理した。
コサイン類似度は、 ベクトル間の「向き」のみを比較する尺度で、 大きさ (norm) の影響を受けない点が特徴。 この概念マップは、 前提となる内積・ノルム・ベクトル空間モデルから、 並列のユークリッド距離・ピアソン相関・Jaccard 類似度、 発展形の重み付けコサイン・ソフトコサイン・角距離までを位置づける。 TF-IDF と組み合わせた文書類似度や、 word2vec 埋め込みの意味類似度算出での実用例が中心軸となる。
コサイン類似度の周辺には、 (a) 内積・ノルムというベクトル空間の前提、 (b) ユークリッド距離・ピアソン相関・Jaccard 類似度といった並列の類似尺度、 (c) ソフトコサイン (同義語反映)・重み付けコサイン・角距離などの派生形、 (d) TF-IDF・word2vec・BERT 等の埋め込み手法 (前段)、 (e) k-NN による近傍検索・クラスタリング・レコメンドエンジン (後段) が並ぶ。
文書類似度・推薦システム・検索ランキング・異常検知のいずれでも、 「ベクトル化の方法」と「コサインの解釈 (向きが何を意味するか)」を一対で押さえることが、 結果の妥当性を担保する鍵となる。
🔗 隣接手法への橋渡し
コサイン類似度は「ベクトルの方向のみ」を比較する性質ゆえ、 前処理で大きさ情報をどう扱うかで結果が大きく変わる。 本章では「接続 (どう繋がるか)」「統合 (どう組み合わせるか)」「比較 (どう使い分けるか)」の 3 視点で隣接手法を整理し、 実務での切替判断材料を提供する。
① 接続: コサイン類似度を駆動する周辺技術
コサイン類似度を活かすには、 入力ベクトル化と検索効率化の周辺技術が不可欠。 以下 5 件は実装上ほぼ必ず併用される。
- TF-IDF — テキストを単語頻度ベクトルに変換。 IDF 重みでよくある単語を抑制。 適用シーン: 文書類似度 (ニュース記事のクラスタリング) でコサインを計算する前段。
- 単語埋め込み (word2vec/BERT) — 単語を密ベクトル化。 意味的類似度がコサインで測れる。 適用シーン: 「東京」と「首都」のような同義性を捉えたい時。
- k-NN (近傍検索) — 全候補とのコサイン計算は重いため、 大規模時は近似 k-NN (FAISS、 Annoy) で高速化。 適用シーン: 100 万文書から類似 10 件を取得。
- クラスタリング (球面 k-means) — コサイン類似度を距離としたクラスタリング。 適用シーン: ユーザの興味タグから類似ユーザ群を抽出。
- 協調フィルタリング — ユーザ × アイテム評価行列でコサイン計算。 適用シーン: Netflix 風レコメンド (見た作品が似ている人のおすすめを提示)。
② 統合: コサイン類似度を組み込んだワークフロー
コサインは単独で完結せず、 検索・推薦・分類パイプラインの中核ステップとして機能する。
| パイプライン | ステップ | コサイン類似度の役割 |
|---|---|---|
| セマンティック検索 | クエリ → BERT 埋め込み → 文書ベクトル DB との類似度ランキング → top-k 返却 | 「意味的に近い文書」を方向の一致度で抽出 (語順や長さに左右されない) |
| レコメンドシステム | ユーザ嗜好ベクトル → アイテムベクトルとの類似度 → スコア降順で並べ替え → 提示 | 嗜好の傾向 (方向) のみを比較し、 評価回数の多寡 (大きさ) を無視できる |
| 重複検出 / 剽窃チェック | 文書 A・B を TF-IDF 化 → コサイン類似度 → 閾値 (例 0.85) 超で「類似」判定 | 長さの違う文書同士でも公平に類似度を測れる |
③ 比較: コサイン類似度 vs 隣接指標の使い分け判断
「ユークリッド距離やピアソン相関ではダメなのか」の判断基準。 実務で迷うポイントを整理。
| 状況 | コサイン類似度 | ユークリッド距離 | ピアソン相関 |
|---|---|---|---|
| ベクトルの大きさを無視したい | ○ (方向のみ) | × (大きさ込み) | ○ (中心化後の方向) |
| テキスト・スパースな高次元 | ○ (定番) | △ (次元の呪い) | △ (中心化で密になる) |
| 評価尺度の偏り (甘評価/辛評価) を補正 | × (生の評価を比較) | × | ○ (平均を引いて補正) |
| 位置情報がある (地図上の距離) | × | ○ (定番) | × |
| 計算コスト | 低 (内積 + ノルム) | 低 (差の二乗和) | 中 (中心化が必要) |
原則: 「ベクトルの長さに意味がない / 方向だけ知りたい」→ コサイン、 「物理的距離 / 大きさも考慮」→ ユークリッド、 「個人差バイアスを除去したい」→ ピアソン。 テキストや埋め込みではほぼコサイン一択。
🌳 手法選択フロー
コサイン類似度は方向の一致度を測る。 ベクトル化方式と検索規模に応じて使い分ける。
- ベクトルの大きさを無視したいか? Yes → コサイン類似度、 No → ユークリッド距離 を先に確認
- テキスト・高次元疎ベクトルか? Yes → TF-IDF、 No → 埋め込み を先に確認
- 最近傍検索で大規模化したいか? Yes → k-NN、 No → クラスタリング を先に確認
高次元疎データなら TF-IDF + コサイン、 密埋め込みなら内積、 大きさを比較したいならユークリッド距離、 と「無視したい情報」で選ぶ。
🧩 解説深化 — 直感・落とし穴・発展をもう一段
ここまでのセクションを踏まえ、 コサイン類似度の核心(向きだけを見る=スケール不変)と、 実務で必ずつまずく「大きさを捨てる副作用」を、 SSDSE-B-2026 の実測値で締めくくります。 既存セクションと重複しない補足として、 直感・落とし穴・発展の 3 つに分けて掘り下げます。
🎨 直感(一言で)— 内積を両ノルムで正規化した「向きメーター」
コサイン類似度は、 2 つのベクトルのなす角 $\theta$ の余弦そのものです。 定義 $\cos\theta = \dfrac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|\,\|\mathbf{b}\|}$ は「内積を 2 本のノルムの積で割って正規化する」操作。 ノルムで割った瞬間に長さ(大きさ)の情報が消え、 向きだけが残るため、 スケールを 2 倍・10 倍しても値は動きません(スケール不変)。 これが「🎮 触って理解する」の "a を伸ばしても cos は変わらない" の正体です。
- 値域:一般には $-1 \le \cos\theta \le 1$($1$=同方向、 $0$=直交、 $-1$=真逆)。
- 非負データ(頻度・人口・面積など):全成分が $\ge 0$ なら内積も分母も非負なので、 値域は$0$〜$1$ に限定される(負にならない)。 TF-IDF や生の SSDSE 列がこれに当たります。
- ユークリッド距離との対比:距離は「位置の隔たり(大きさ込み)」、 コサインは「向きのズレ」。 別物なので、 距離指標ページと合わせて使い分けを押さえます。
⚠️ 落とし穴(核心)— 大きさを捨てる副作用を SSDSE で体感する
コサイン最大の利点「スケール不変」は、 裏を返すと規模・頻度の差が丸ごと消えるという副作用です。 生の非負データではこれが致命的に効き、 まるで全県がそっくりに見えてしまいます。 下表は SSDSE-B-2026(2023 年・47 県)の 3 指標ベクトルを、 生データと列ごと z-スコア標準化の 2 通りで計算した実測コサイン類似度です。
| 県ペア(総人口・出生数・65歳以上人口の 3 次元) | 生データ cos(値域 0〜1) | z-スコア化 cos(値域 -1〜1) |
|---|---|---|
| 東京 と 大阪 | 0.9989 | 0.9949 |
| 東京 と 沖縄 | 0.9999 | −0.8851 |
| 東京 と 秋田 | 0.9890 | −0.9987 |
読み方:生データでは 3 ペアとも cos ≈ 0.99〜1.00 で、 東京・沖縄・秋田がすべて「そっくり」に見える。 これは 3 指標がどれも総人口の大小に強く連動し、 一番大きい成分が内積を支配するため。 頻度・規模の差(=各県の個性)が向きに埋もれて消えているのが、 まさに「大きさを捨てる副作用」です。 列ごとに z-スコア化して規模を揃えると、 東京-沖縄が $-0.885$、 東京-秋田が $-0.999$ と負値に転じ、 人口構成プロファイルがむしろ逆方向だと分かります。
- 負値データの解釈:z-スコア化すると成分に負が混じり cos は $-1$〜$1$ に広がる。 $\cos<0$ は「無関係」ではなく「平均からのズレ方が逆」を意味する。 「類似度が高いほど近い」の直感で負値を放置すると誤読します。
- 中心化するとピアソン相関と一致:各ベクトルから平均を引いて(中心化して)コサインを取ると、 値はピアソン相関 $r$ に一致します($r = \cos\theta_{\text{centered}}$)。 「甘い/辛い採点」を補正したい推薦システムで cos ではなく相関を使うのはこのため。
- 疎・高次元での挙動:TF-IDF のような疎な高次元では、 ランダムなベクトル同士がほぼ直交(cos ≈ 0)に集中する。 絶対値ではなく上位 $k$ 近傍の順位で判断し、 IDF 重みや次元削減を挟むのが定石。
- ゼロベクトルは未定義:$\|\mathbf{a}\|=0$ だと分母が $0$ になり cos は定義できない。 全項がストップワードの文書などで実際に発生するので、 計算前に
norm < epsの行を除外します。 - ユークリッド距離との使い分け:規模そのもの(売上・人口の絶対量)を比べたいなら cos ではなくユークリッド距離。 構成比・向きだけを見たいなら cos。
再現コード(上表を出力):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import pandas as pd from sklearn.metrics.pairwise import cosine_similarity from scipy.stats import zscore # 47 県 × 3 指標(総人口 A1101・出生数 A4101・65歳以上人口 A1303) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]).query('`SSDSE-B-2026` == 2023') X = df[['A1101', 'A4101', 'A1303']].astype(float).values raw = cosine_similarity(X) # 生データ(非負)→ 値域 0〜1 z = cosine_similarity(zscore(X, axis=0)) # 列ごとに z-スコア化 → 値域 -1〜1 # Prefecture の並び順で東京=12, 大阪=26, 秋田=4, 沖縄=46 print('raw 東京-沖縄 =', round(raw[12, 46], 4)) print('z 東京-沖縄 =', round(z[12, 46], 4)) |
📤 実行結果:
🚀 発展 — コサイン距離・正規化・ソフトコサイン・近似最近傍
- コサイン距離 $= 1 - \cos\theta$:類似度を距離に変換したもので値域は $[0, 2]$。 上表の z-スコア化で言えば、 東京-大阪は $1-0.9949 = 0.0051$(極めて近い)、 東京-沖縄は $1-(-0.8851) = 1.8851$(真逆に近い)。 クラスタリングや近傍検索では類似度ではなくこの距離を使います(クラスタリング)。
- 正規化するとユークリッドと等価:各ベクトルを単位ベクトル化($\hat{\mathbf{a}}=\mathbf{a}/\|\mathbf{a}\|$)すれば $\|\hat{\mathbf{a}}-\hat{\mathbf{b}}\|^2 = 2(1-\cos\theta)$ が成り立ち、 コサインと L2 距離が単調変換で結ばれます。 FAISS などが「内積検索」と「コサイン検索」を同一視できる根拠。
- ピアソン相関 = 中心化コサイン(厳密):中心化(平均を引く)した後のコサインは相関係数 $r$ と厳密に一致します。 「コサインは中心化を省いた相関」「相関はコサインの特殊形」と捉えられます(相関)。
- ソフトコサイン(Soft Cosine):通常のコサインは異なる次元(別単語)を完全に無関係(直交)とみなすが、 ソフトコサインは単語間の意味的近さ(同義語)を行列 $S$ で織り込み $\dfrac{\mathbf{a}^\top S\, \mathbf{b}}{\sqrt{\mathbf{a}^\top S\mathbf{a}}\sqrt{\mathbf{b}^\top S\mathbf{b}}}$ で測る。 「自動車」と「クルマ」を別語として切り捨てない拡張です(埋め込みと相性がよい)。
- 近似最近傍探索(ANN):数百万ベクトルから類似上位を取るとき、 全ペアの $O(n^2 d)$ は非現実的。 HNSW・IVF(FAISS)・Annoy などの近似最近傍で、 コサイン(=正規化後の内積)検索を高速化します(k-NN・RAG ベクトル検索)。