🔖 キーワード索引
内積 a·b = Σ aᵢbᵢ は、2 本のベクトルの成分ごとの積を足した 1 つの数。下のチップはどれも内積から作られる量で、コサイン類似度は内積をノルムの積で割ったもの、共分散は平均を引いたベクトル同士の内積、Cauchy-Schwarz 不等式 |a·b| ≤ ‖a‖‖b‖ はコサインが −1〜1 に収まる理由になる。
💡 30秒で分かる結論
🍰 まずはやさしく
内積はベクトルの掛け算のようなものです。
2つのデータの似具合を調べるために使います。
スマホのオススメ機能などで活用されています。
ここでは内積の基本と計算方法を学びます。
ベクトル積の基本。 類似度・射影に使用
- 2つのベクトルを掛けて1つのスカラーを返す演算。
- 幾何的意味:長さ × 長さ × cos(なす角)。 似た方向ほど大きい。
- $\mathbf{a}\cdot\mathbf{b} = 0$ なら 直交。
- 応用は無数:コサイン類似度・射影・線形変換・カーネル法・ニューラルネット。
- $\|\mathbf{a}\|^2 = \mathbf{a}\cdot\mathbf{a}$ — 自分自身との内積がノルムの二乗。
📍 あなたが今見ているもの
🍰 まずはやさしく
内積はデータ分析の主役となる道具です。
機械学習などの高度な計算に欠かせません。
検索エンジンの仕組みなどにも使われています。
定義から実装までを6つの視点で解説します。
Word2Vec の単語類似度、 検索エンジンの文書スコアリング、 ニューラルネットの forward 計算 — 全部内積です。 機械学習の隠れた主役。
🎨 直感で掴む
🍰 まずはやさしく
内積は「好みの近さ」を測る物差しです。
データがどれくらい似ているか判断します。
趣味が似ている人を探すイメージです。
入力から解釈までの流れを順に説明します。
2人の人物のベクトル(趣味プロファイル)の内積:
- 同じ方向=同じ趣味 → 内積大 → 類似度高い
- 直角=全く違う趣味 → 内積 0 → 無関係
- 逆方向=対立する趣味 → 内積負 → 不一致
これがコサイン類似度の本質。 推薦システムの基本原理です。
📐 定義/数式
🍰 まずはやさしく
内積はドット積とも呼ばれる計算です。
向きや長さの関係を数値にするために使います。
部活の得点データなどの分析に役立ちます。
計算式と図形的な意味について解説します。
内積(Inner Product / Dot Product):ベクトル積の基本。 類似度・射影に使用
同義・関連語:ドット積
🔬 記号・用語の読み解き(数式を言葉で読み解く)
内積の定義式 $\mathbf{a} \cdot \mathbf{b} = \sum_{i=1}^{n} a_i b_i$ は、 「2 つのベクトルの対応する成分どうしを掛け合わせて足す」というシンプルな計算ですが、 同時に $\mathbf{a} \cdot \mathbf{b} = \|\mathbf{a}\| \|\mathbf{b}\| \cos\theta$ という幾何的表現と一致するのが内積の核心です。 代数的には「ただの成分計算」に見えますが、 幾何的には「ベクトルの『揃い具合』を測る」操作。 ベクトル $\mathbf{b}$ をベクトル $\mathbf{a}$ の方向に正射影した長さに、 $\|\mathbf{a}\|$ を掛けた値が内積になります。 これは「類似度の最も自然な定義」と言える性質で、 機械学習・統計・物理・工学の至るところで顔を出します。たとえば線形回帰の予測式 $\hat{y} = \mathbf{w} \cdot \mathbf{x}$ は「重みベクトル $\mathbf{w}$ と特徴量ベクトル $\mathbf{x}$ の内積」で、 ニューラルネットワークの 1 ニューロンの出力 $z = \mathbf{w} \cdot \mathbf{x} + b$ も同じ。 推薦システムにおける協調フィルタリングの行列分解(Matrix Factorization)では、 ユーザーベクトル $\mathbf{u}$ とアイテムベクトル $\mathbf{v}$ の内積 $\mathbf{u} \cdot \mathbf{v}$ で評価予測を行います。 また、 直交性(直角)の判定が「内積 = 0」という 1 行の条件で表せるのも重要。 PCA(主成分分析)が「データを直交基底に展開する」ためには、 内積の零条件が本質的役割を果たします。 つまり内積は 線形代数の万能演算。 「ベクトルの類似度」「射影の長さ」「直交性の判定」「カーネル法」「重み付き和」とあらゆる場面で同じ操作が現れる、 と認識すると見通しが立ちます。
| 記号・用語 | 意味と読み方 |
|---|---|
| $\mathbf{a}\cdot\mathbf{b}$ | 内積(dot product)。 結果はスカラー値。 ベクトルの揃い具合 |
| $\langle \mathbf{a}, \mathbf{b} \rangle$ | 内積の別表記。 関数空間や複素ベクトルでよく使われる |
| $\|\mathbf{a}\|$ / $\|\mathbf{a}\|_2$ | L2 ノルム。 $\sqrt{\mathbf{a} \cdot \mathbf{a}}$。 ベクトルの長さ |
| $\theta$ | ベクトル間のなす角度(0〜π) |
| $\cos\theta$ | コサイン類似度。 $\mathbf{a}\cdot\mathbf{b} / (\|\mathbf{a}\|\|\mathbf{b}\|)$、 範囲 [-1, 1] |
| 直交 | $\mathbf{a}\cdot\mathbf{b}=0$ ⇔ 90°。 線形独立より強い条件 |
| 射影 | $\text{proj}_{\mathbf{a}}\mathbf{b} = \frac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|^2}\mathbf{a}$。 $\mathbf{b}$ の $\mathbf{a}$ 方向成分 |
| $\mathbf{a}^\top \mathbf{b}$ | 行列表記の内積。 $1 \times n$ 行ベクトルと $n \times 1$ 列ベクトルの積 |
| $\mathbf{a}\mathbf{b}^\top$ | 外積(行列)。 $n \times n$ 行列。 内積と混同しがち |
| Frobenius 内積 | $\langle A, B \rangle_F = \text{tr}(A^\top B) = \sum_{i,j} A_{ij}B_{ij}$。 行列版内積 |
| Cauchy-Schwarz 不等式 | $|\mathbf{a}\cdot\mathbf{b}| \le \|\mathbf{a}\|\|\mathbf{b}\|$。 内積の上限保証 |
🧮 実値で計算してみる
$\|\mathbf{a}\| = \sqrt{14}, \|\mathbf{b}\| = \sqrt{77}$ → コサイン類似度 = $32/\sqrt{14\cdot77} \approx 0.975$。
🧮 数式に値を入れて手で計算する: 内積
合成 3 次元ベクトル a, b の内積とコサインを計算する。
Step 1: ベクトル
Step 2: 内積
Step 3: ノルムとコサイン
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np a = np.array([1, 2, 3]) b = np.array([4, 5, 6]) dot = a @ b cos = dot / (np.linalg.norm(a) * np.linalg.norm(b)) print(f"内積: {dot}") print(f"cos θ: {cos:.3f}") |
📤 実行結果
💬 手計算 (Step 2,3) と Python 出力が完全一致。
🐍 Python での実装例
まず 3 次元の小さなベクトル a = (1, 2, 3)、b = (4, 5, 6) で、内積・ノルム・コサイン類似度の 3 つを NumPy で計算する(SSDSE-B-2026 の都道府県ベクトルで同じ計算をするコードは下の 🧪 の節にある)。
1 2 3 4 5 6 7 | import numpy as np a = np.array([1, 2, 3]) b = np.array([4, 5, 6]) print('内積:', np.dot(a, b)) # 32 print('ノルムa,b:', np.linalg.norm(a).round(3), np.linalg.norm(b).round(3)) cos = np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)) print('コサイン類似度:', cos.round(3)) |
💬 内積 32 は 1×4+2×5+3×6 の和で、ノルムはそれぞれ √14=3.742 と √77=8.775。32 ÷ (3.742×8.775) で cos が 0.975 になり、成分の大きさは倍以上違っても向きはほぼそろっている。内積 32 という値だけでは「似ている」とは言えず、長さで割って初めて比べられる量になる点を押さえておく。
🎮 触って理解する
内積の幾何的な正体は「$\mathbf{b}$ を $\mathbf{a}$ の方向へ正射影した符号付き長さ × $\|\mathbf{a}\|$」。 つまり $\mathbf{a}\cdot\mathbf{b} = \|\mathbf{a}\|\,(\|\mathbf{b}\|\cos\theta)$ は「長さ × 射影」という 符号付き長方形の面積 として絵に描ける。 下の 2 つのデモを指やマウスで直接動かして、 (1) 射影×長さの面積、 (2) 内積が統計に現れる場面(共分散・相関)を体感しよう。
① 内積 = 射影 × 長さ(符号付き面積)
矢印の先端をドラッグ(タッチ対応)。 青い長方形の面積が $|\mathbf{a}\cdot\mathbf{b}|$、 色が符号。 $\theta$ が 90° を跨ぐ瞬間に符号が反転し、 $|\mathbf{a}|$ や $|\mathbf{b}|$ を伸縮しても向きが同じなら符号は変わらないことを確かめよう。
👀 観察ポイント: ① b を回して θ=90° ちょうどにすると面積が消える(直交=内積 0)。 ② そのまま b を少し倒すと色が青→赤に反転(射影の符号反転)。 ③ 「|b| を 1.5 倍」を何度押しても符号は変わらず大きさだけ変わる — 内積の値はスケールに依存し、 符号と cos θ は向きだけで決まる。 これが「類似度比較ではコサインに正規化する」理由。
② 内積が統計に現れる瞬間 — 中心化ベクトルの内積 = 共分散 × n
5 個のデータ点 $(x_i, y_i)$ をドラッグすると、 平均 $(\bar{x}, \bar{y})$ からの偏差の積 $\sum_i (x_i-\bar{x})(y_i-\bar{y})$ — つまり 中心化ベクトル $\mathbf{x}_c$ と $\mathbf{y}_c$(5 次元)の内積 — がリアルタイムに変わる。 各点と平均を結ぶ長方形(青=正の寄与、 赤=負の寄与)の符号付き面積の合計がこの内積。 $n$ で割れば共分散、 両ノルムで割れば相関係数 $r$(= 中心化ベクトルどうしの cos θ)になる。
x_c·y_c = Σ(xᵢ−x̄)(yᵢ−ȳ) = —
cov() は不偏(÷(n−1))なので値が 5/4 倍違う点に注意。 r はどちらでも同じ。👀 観察ポイント: 点を右上・左下(平均に対して同じ側)へ動かすと青い面積が増えて r が +1 に近づき、 右下・左上に散らすと赤が増えて r が −1 へ。 相関係数とは「データを 47 次元(都道府県数)や 5 次元のベクトルとみなしたときの、 中心化後のコサイン類似度」そのもの。 「関連手法」節の 総人口×出生数 r≈0.995(SSDSE-B-2026、 2023 年度実測)も、 47 次元の中心化ベクトルがほぼ同じ向きを向いている、 という幾何の話になる。
💡 直感の言語化 — 内積は「どれだけ同じ向きか × どれだけ大きいか」
デモ①で見た通り、 内積は「向きの一致度(cos θ)」と「2 本の長さ」の積に分解できる。 だから内積が大きい理由は 2 通りある — 向きがよく揃っているか、 単にベクトルが長いか。 この 2 つを分離したいときに、 長さで割って向きだけ取り出したものがコサイン類似度、 さらに「平均を引いてから」向きを比べたものが相関係数。 デモ②はまさにその関係 $r = \dfrac{\mathbf{x}_c \cdot \mathbf{y}_c}{\|\mathbf{x}_c\|\,\|\mathbf{y}_c\|}$ を動かして見せている。
⚠️ 触って分かる落とし穴(深掘り)
- 内積と要素積(アダマール積)の混同: NumPy で
a * bは要素ごとの積でベクトルを返す。 内積はa @ b/np.dot(a, b)でスカラーを返す。 「掛けたのに配列が返ってきた」は典型的な取り違え。np.sum(a * b)とa @ bが一致することを確認する癖をつける。 - スケール依存: デモ①の「1.5 倍」ボタンの通り、 内積の値は単位(円か千円か)で何倍にも変わる。 大きさ比較の指標として生の内積を使うなら、 事前の標準化かコサイン化が前提。
- コサイン類似度と相関係数の違いは「中心化」だけ: 中心化せずに正規化すれば cos 類似度、 中心化してから正規化すれば r。 全成分が正のデータ(人口・売上など)は中心化しないと cos が 1 近くに張り付き、 「何でも類似」に見える偽の高類似度が出る。
- θ=90° 付近の符号は不安定: デモ①で直交付近を触ると分かる通り、 わずかな動きで符号が反転する。 浮動小数の内積を
== 0で判定せず、 許容誤差つきで扱う。
🚀 発展 — 内積が主役になる 3 つの場面
- 相関係数: デモ②の通り $r$ は中心化ベクトルの cos θ。 詳細は 相関・共分散・コサイン類似度・標準化。
- 回帰の正規方程式: 最小二乗解 $\hat{\beta} = (X^\top X)^{-1} X^\top y$ に現れる $X^\top X$ の $(j,k)$ 成分は列 $j$ と列 $k$ の内積、 $X^\top y$ の各成分は各説明変数と $y$ の内積。 つまり回帰計算の材料はすべて内積の表(グラム行列)。 残差が説明変数と直交する(内積 0)ように係数を選ぶのが最小二乗法の幾何的意味。 詳細は 線形回帰・重回帰分析・行列演算。
- カーネル法・Attention: 特徴写像 $\phi$ を陽に計算せず、 高次元空間での内積 $K(x, x') = \langle \phi(x), \phi(x') \rangle$ だけ評価するのがカーネルトリック(SVM・カーネルPCA)。 Transformer の Attention のスコア $QK^\top$ も query と key の内積 = 類似度。 「類似度が要る場所には内積が居る」。
ベクトル・射影そのものの操作練習は ベクトル演算 のインタラクティブ、 長さの定義は ノルム、 直交基底への展開は 主成分分析 を参照。
⚠️ よくある落とし穴
📚 関連グループ教材
内積は単独の手法ではなく、いくつもの教材の土台として登場する。距離・類似度の教材ではユークリッド距離 ‖a−b‖² = a·a − 2a·b + b·b とコサイン類似度が内積から作られること、埋め込み・ベクトル空間の教材では単語や文書のベクトルを内積で比べること、主成分分析では分散共分散行列(中心化したベクトル同士の内積の表)を固有分解することを扱う。機械学習の基礎では線形回帰の予測 ŷ = w·x がそのまま内積である。下の 🧪 の各節は、これらの場面を SSDSE-B-2026 の都道府県ベクトルで確かめる補足になっている。
🧪 深掘り:内積の二重定義(代数 vs 幾何)
内積の最大の魅力は、 「代数的定義」と「幾何的定義」が完全に一致する点にあります。
$$\mathbf{a} \cdot \mathbf{b} = \underbrace{\sum_{i=1}^{n} a_i b_i}_{\text{代数: 成分の積和}} = \underbrace{\|\mathbf{a}\| \|\mathbf{b}\| \cos\theta}_{\text{幾何: 長さ × cos}}$$
代数定義は計算しやすく、 幾何定義は意味を理解しやすい。 両者が一致するという事実は、 余弦定理(三角形の辺の関係)から導かれます。 三辺の長さを $a, b, c$、 $a$ と $b$ のなす角を $\theta$ とすると:
$$c^2 = a^2 + b^2 - 2ab\cos\theta$$
これにベクトル表現 $\mathbf{c} = \mathbf{a} - \mathbf{b}$(つまり $c^2 = \|\mathbf{a} - \mathbf{b}\|^2$)を代入し、 展開すると:
$$\|\mathbf{a}\|^2 + \|\mathbf{b}\|^2 - 2 \mathbf{a}\cdot\mathbf{b} = \|\mathbf{a}\|^2 + \|\mathbf{b}\|^2 - 2\|\mathbf{a}\|\|\mathbf{b}\|\cos\theta$$
両辺の $\|\mathbf{a}\|^2 + \|\mathbf{b}\|^2$ を消し、 $-2$ で割れば $\mathbf{a}\cdot\mathbf{b} = \|\mathbf{a}\|\|\mathbf{b}\|\cos\theta$。 これが代数定義と幾何定義の同値性の証明です。
この二重性のおかげで、 内積は「計算は楽だが意味も明確」という素晴らしい性質を持ちます。 機械学習で「コサイン類似度」を使うとき、 計算は内積/ノルム比で簡単、 解釈は「2 ベクトルの角度」で直感的 — これが内積の威力です。
🧪 深掘り:内積の 4 つの公理
数学的には、 内積空間(inner product space)とは、 次の 4 つの公理を満たす演算 $\langle \cdot, \cdot \rangle$ を持つベクトル空間と定義されます:
| 公理 | 数式 | 意味 |
|---|---|---|
| 対称性 | $\langle \mathbf{a}, \mathbf{b} \rangle = \langle \mathbf{b}, \mathbf{a} \rangle$ | 順序を入れ替えても同じ |
| 線形性 | $\langle c\mathbf{a} + \mathbf{b}, \mathbf{c} \rangle = c\langle \mathbf{a}, \mathbf{c} \rangle + \langle \mathbf{b}, \mathbf{c} \rangle$ | 分配・スカラー倍が成立 |
| 正定値性 | $\langle \mathbf{a}, \mathbf{a} \rangle \ge 0$、 等号は $\mathbf{a}=\mathbf{0}$ | 自分との内積は非負 |
| 共役対称(複素) | $\langle \mathbf{a}, \mathbf{b} \rangle = \overline{\langle \mathbf{b}, \mathbf{a} \rangle}$ | 複素ベクトルでは共役 |
これらの公理から、 ノルム(長さ)が $\|\mathbf{a}\| = \sqrt{\langle \mathbf{a}, \mathbf{a} \rangle}$ で定義され、 距離 $d(\mathbf{a}, \mathbf{b}) = \|\mathbf{a} - \mathbf{b}\|$ が自然に導出されます。 つまり 内積を 1 つ決めれば、 ノルム・距離・直交性のすべてが自動で定まる。 これが「内積空間」が線形代数の中心概念である理由です。
関数空間(無限次元)でも同じ公理を満たす内積を定義できます。 たとえば連続関数 $f, g$ に対する $\langle f, g \rangle = \int_a^b f(x)g(x) dx$ は内積。 これがフーリエ級数や直交多項式の基礎です。
🧪 深掘り:機械学習における内積
内積は機械学習のほぼすべてのアルゴリズムに登場します。 主要な現れ方を整理:
① 線形回帰の予測
$\hat{y} = \mathbf{w} \cdot \mathbf{x} + b$。 重みベクトル $\mathbf{w}$ と特徴量ベクトル $\mathbf{x}$ の内積。 「予測」とは「特徴量を重みで重み付け平均する」操作。
② ロジスティック回帰
$P(y=1|\mathbf{x}) = \sigma(\mathbf{w} \cdot \mathbf{x} + b)$。 内積をシグモイドに通すだけ。 多クラスの softmax も「クラスごとに内積を計算し、 指数化して正規化」する操作。
③ ニューラルネットワーク
1 層の計算 $\mathbf{h} = \phi(W\mathbf{x} + \mathbf{b})$ は、 「行列 $W$ の各行ベクトルと入力 $\mathbf{x}$ の内積を全ニューロン分計算」する操作。 DNN は内積の積み重ね。
④ Attention 機構(Transformer)
$\text{Attention}(Q, K, V) = \text{softmax}(QK^\top / \sqrt{d_k}) V$。 クエリ $Q$ とキー $K$ の内積で類似度を測り、 バリュー $V$ を重み付け平均。 「内積で類似度→ソフトマックス→重み付け」は ChatGPT の核心。
⑤ カーネル法(SVM、 ガウス過程)
$K(\mathbf{x}, \mathbf{y}) = \phi(\mathbf{x}) \cdot \phi(\mathbf{y})$。 特徴空間に写像した上での内積。 カーネルトリックは「内積さえ計算できれば写像 $\phi$ は陽に書かなくていい」という発想。
⑥ 行列分解(推薦システム)
$\hat{r}_{ui} = \mathbf{p}_u \cdot \mathbf{q}_i$。 ユーザー潜在ベクトル $\mathbf{p}_u$ とアイテム潜在ベクトル $\mathbf{q}_i$ の内積で評価予測。 Netflix Prize で広まった手法。
⑦ Word Embedding(Word2Vec、 GloVe)
単語ベクトル同士のコサイン類似度で「意味の近さ」を測る。 「king - man + woman ≈ queen」のような有名な類推も、 内積空間での操作。
🧪 深掘り:SSDSE-B-2026 で都道府県類似度を計算
内積を使うと、 47 都道府県を「複数の特徴量ベクトル」として扱い、 県どうしの類似度を測ることができます。 これは 地域類型化 の基本パターン。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler from sklearn.metrics.pairwise import cosine_similarity # SSDSE-B-2026 に「県民所得」「失業率」「大学進学率」「面積」の列は無い。 # 実在する列と、そこから導ける指標だけで 5 つの特徴量を作る。 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == df['年度'].max()].copy() # 最新年度の 47 行 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['大学等進学率'] = (df['高等学校卒業者のうち進学者数'] / df['高等学校卒業者数'] * 100) df['消費支出'] = df['消費支出(二人以上の世帯)'] df['保健医療費'] = df['保健医療費(二人以上の世帯)'] # 都道府県集計、 特徴量選択 features = ['総人口', '高齢化率', '大学等進学率', '消費支出', '保健医療費'] agg = df.groupby('都道府県')[features].mean() # 標準化(スケール差を消す) scaler = StandardScaler() X = scaler.fit_transform(agg) # コサイン類似度行列(47×47) sim = cosine_similarity(X) sim_df = pd.DataFrame(sim, index=agg.index, columns=agg.index) # 「東京都」に最も似ている上位 5 県 print(sim_df['東京都'].nlargest(6).iloc[1:]) # 自分を除く # 「沖縄県」に最も似ている県 print(sim_df['沖縄県'].nlargest(6).iloc[1:]) |
💬 東京都に最も近いのは千葉県 0.982・神奈川県 0.978・静岡県 0.966 で、5 県すべてが 0.91 を超える。一方、沖縄県の最上位は佐賀県 0.662 どまりで、5 位の愛媛県は 0.470 まで下がる。コサイン類似度は標準化したベクトルの向き(内積 ÷ 長さ)だけを見るので、東京都と静岡県のように人口の桁が違っても「平均からのずれ方」が同じなら近く出る点に注意する。
出力の見どころ:「東京都」の類似県は千葉県・神奈川県・静岡県・福岡県・愛知県と、人口が多く高齢化率が低めの県が 0.91 以上で並ぶ。 一方「沖縄県」は最上位の佐賀県でも 0.66 で、 0.9 を超える県が 1 つも無い。 標準化後の沖縄県は高齢化率 −2.34 と低い一方で、 大学等進学率 −1.56(47 県で最下位)・消費支出 −1.87 も低く、 この組み合わせがそろう県がほかに無いため、 5 次元ベクトルの向きが似た県が見つからない(佐賀県は進学率 −1.31・消費支出 −0.88 は近いが高齢化率が +0.03)。
ここで使った cosine_similarity の中身はまさに「内積をノルムで割る」操作。 各県を 5 次元ベクトルとして表現し、 ベクトルどうしの角度のコサインで類似度を算出しています。 特徴量を増やせばさらに高次元の類似度マップが作れますが、 「高次元の呪い」(後述)でほぼ全ペアが直交に近づくので、 一定の次元削減が必要です。
🧪 深掘り:高次元の呪いと類似度の劣化
高次元(数千〜数万次元)のベクトル空間では、 ランダムに生成した 2 ベクトルの内積(コサイン類似度)はほぼ確実に 0 に近づきます。 これが「高次元の呪い」(curse of dimensionality)の一面。
直感的説明:高次元では「ほぼすべての方向」が互いに直交。 球面の体積が「赤道近く」に集中する性質(concentration of measure)から、 ランダムベクトルの角度は 90° 付近に集中。 結果、 機械学習の類似度ベースの手法(KNN、 コサイン推薦)が高次元で精度を落とします。
対策:
- 次元削減:PCA、 t-SNE、 UMAP で低次元に射影してから内積を取る
- 埋め込み学習:Word2Vec / SimCLR のような深層学習で「意味的に近いものは内積が大きい」空間を学習
- 近似近傍探索:FAISS、 ScaNN、 Annoy などのライブラリで、 高次元での類似度を効率計算
- L2 正規化:ベクトル長を 1 に揃えると、 内積 = コサイン類似度になり比較しやすい
SSDSE-B-2026 のような数十次元データでは大きな問題にならないが、 文書ベクトル(数万次元 BoW)や画像ベクトル(数千次元 deep features)では深刻。 LLM の RAG(検索拡張生成)では、 まさに「埋め込みベクトルの内積」で関連文書を検索しているので、 高次元の呪い対策が実用上重要です。
🧪 深掘り:内積から導かれるノルム・距離
内積が定義されれば、 ノルムと距離が自動で定まります:
$$\|\mathbf{a}\| = \sqrt{\mathbf{a}\cdot\mathbf{a}}, \quad d(\mathbf{a}, \mathbf{b}) = \|\mathbf{a} - \mathbf{b}\| = \sqrt{(\mathbf{a}-\mathbf{b})\cdot(\mathbf{a}-\mathbf{b})}$$
この距離を ユークリッド距離(L2 距離)と呼びます。 機械学習の最も基本的な距離指標。 ただし、 距離は内積から導出される 1 つの形に過ぎず、 他にも:
- マンハッタン距離(L1):$\sum |a_i - b_i|$。 内積からは出ない
- マハラノビス距離:$\sqrt{(\mathbf{a}-\mathbf{b})^\top \Sigma^{-1} (\mathbf{a}-\mathbf{b})}$。 共分散行列で重み付けた内積
- 余弦距離:$1 - \cos\theta$。 角度に基づく距離、 ノルムを無視
- ハミング距離:bit ベクトル用、 内積概念とは別系統
「ユークリッド距離 vs コサイン類似度」の使い分け:ベクトルの長さ(ノルム)に意味があれば L2、 方向のみが意味を持つならコサイン。 たとえば文書の単語頻度ベクトルでは長文ほどベクトル長が大きくなるので、 コサインで「方向の類似」を測るのが普通。
🧪 深掘り:射影と最小二乗法
内積を理解する次の重要ステップは 射影(projection)です。 ベクトル $\mathbf{b}$ を別のベクトル $\mathbf{a}$ の方向に正射影した結果は:
$$\text{proj}_{\mathbf{a}}\mathbf{b} = \frac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|^2}\mathbf{a} = \frac{\mathbf{a}\cdot\mathbf{b}}{\mathbf{a}\cdot\mathbf{a}}\mathbf{a}$$
射影の長さは $\mathbf{a}\cdot\mathbf{b} / \|\mathbf{a}\|$。 これは「$\mathbf{b}$ の中の $\mathbf{a}$ 方向成分」を取り出す操作です。
これを部分空間(subspace)への射影に拡張すると 最小二乗法(Least Squares)の幾何が見えてきます。 観測ベクトル $\mathbf{y}$ を、 説明変数空間 $X$ の列ベクトルが張る部分空間に正射影した点が「最小二乗解 $\hat{\mathbf{y}}$」。 残差 $\mathbf{r} = \mathbf{y} - \hat{\mathbf{y}}$ は説明変数空間に直交する — つまり「残差と説明変数の内積はゼロ」が最小二乗の本質的条件 $X^\top \mathbf{r} = \mathbf{0}$ を生み、 ここから正規方程式 $X^\top X \hat{\beta} = X^\top \mathbf{y}$ が導出されます。
SSDSE-B-2026 で人口 vs 県民所得の単回帰を解くとき、 内部で起きているのは「都道府県数 47 次元のベクトル $\mathbf{y}$(所得)を、 $\mathbf{1}$(切片)と $\mathbf{x}$(人口)が張る 2 次元部分空間に正射影する」という操作。 すべて内積で記述できます。
🧪 深掘り:Gram-Schmidt 直交化
線形独立な $k$ 個のベクトル $\mathbf{v}_1, \dots, \mathbf{v}_k$ から、 互いに直交する正規ベクトル(直交基底)を構成する手続きが Gram-Schmidt 直交化。 やはり「内積を用いた射影の引き算」で実装されます:
手順:(1) $\mathbf{u}_1 = \mathbf{v}_1$。 (2) $\mathbf{u}_2 = \mathbf{v}_2 - \text{proj}_{\mathbf{u}_1}\mathbf{v}_2$。 (3) $\mathbf{u}_3 = \mathbf{v}_3 - \text{proj}_{\mathbf{u}_1}\mathbf{v}_3 - \text{proj}_{\mathbf{u}_2}\mathbf{v}_3$。 (k) 各 $\mathbf{u}_i$ を $\|\mathbf{u}_i\|$ で割って正規化。
これは QR 分解(線形代数の基本分解)の理論的基盤。 数値計算では「修正 Gram-Schmidt」や「Householder 反射」のほうが安定だが、 概念的には Gram-Schmidt が分かりやすい。 PCA(主成分分析)の理論も「データの共分散行列の固有ベクトルが直交基底を成す」という事実に基づき、 内積が中核です。
🧪 深掘り:カーネル法と特徴空間
SVM やガウス過程で使われる カーネル法は、 「内積の一般化」と見ることができます。 カーネル関数 $K(\mathbf{x}, \mathbf{y})$ とは、 ある(暗黙の)写像 $\phi$ による特徴空間での内積:
$$K(\mathbf{x}, \mathbf{y}) = \phi(\mathbf{x}) \cdot \phi(\mathbf{y})$$
カーネルトリックの核心は、 「写像 $\phi$ を明示的に計算しなくても、 カーネル関数だけで特徴空間での内積が得られる」こと。 代表的なカーネル:
- 線形カーネル:$K(\mathbf{x}, \mathbf{y}) = \mathbf{x} \cdot \mathbf{y}$(普通の内積)
- 多項式カーネル:$K(\mathbf{x}, \mathbf{y}) = (\mathbf{x} \cdot \mathbf{y} + c)^d$
- RBF(ガウス)カーネル:$K(\mathbf{x}, \mathbf{y}) = \exp(-\gamma \|\mathbf{x} - \mathbf{y}\|^2)$
- シグモイドカーネル:$K(\mathbf{x}, \mathbf{y}) = \tanh(\alpha \mathbf{x}\cdot\mathbf{y} + c)$
Mercer の定理により、 任意の半正定値カーネルは「ある高次元空間での内積」として実現できることが保証されます。 RBF カーネルは無限次元特徴空間の内積を計算しているのに、 関数 1 つで済む — これがカーネルトリックの威力。
🧪 深掘り:内積の計算量と最適化
$n$ 次元ベクトルの内積は $O(n)$ の計算量。 ただし、 大規模機械学習では「数百万次元 × 数百万データ」の組合せで内積を取るため、 高速化が必須です。
- BLAS(Basic Linear Algebra Subprograms):内積・行列積を CPU 最適化。 NumPy の
np.dotは内部で BLAS(OpenBLAS、 MKL)を呼ぶ - SIMD 命令:AVX-512 で 8 個の float64 を同時に処理。 内積で約 8 倍速
- GPU 並列化:CUDA / cuBLAS で行列積を数千スレッドで並列。 PyTorch / TensorFlow の基盤
- FAISS / ScaNN:100 万本のベクトル DB に対する近傍探索を、 内積の近似計算で高速化
- Sparse 内積:疎なベクトル(多くがゼロ)では非ゼロ要素だけ計算。 BoW やリスト型データで有効
- 量子化:float32 → int8 にして内積。 メモリ・計算量ともに 4 倍削減
SSDSE-B-2026 のような数 KB の小規模データでは気にしなくてよいですが、 RAG(LLM の検索拡張生成)や大規模推薦システムでは「内積をいかに高速・大量に計算するか」がシステム性能のボトルネック。 ベクトル DB 製品(Pinecone、 Weaviate、 Qdrant)の中身はすべて「効率的な内積計算」の工夫です。
🧪 深掘り:内積の実装パターン 7 種
Python / NumPy で内積を計算する 7 つの方法と、 それぞれの使い分け:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np a = np.array([1.0, 2.0, 3.0]) b = np.array([4.0, 5.0, 6.0]) A = np.array([[1, 2], [3, 4]]) # 2x2 B = np.array([[5, 6], [7, 8]]) # 2x2 # (1) np.dot — 最も標準 print(np.dot(a, b)) # 32.0 # (2) @ 演算子 — Python 3.5+ で推奨 print(a @ b) # 32.0 # (3) np.inner — 1次元なら同じ、 多次元では挙動が異なる print(np.inner(a, b)) # 32.0 # (4) np.einsum — 任意の縮約を文字列で指定 print(np.einsum('i,i->', a, b)) # 32.0 # (5) 要素積の和(最も明示的) print((a * b).sum()) # 32.0 # (6) 行列積(@ で同じ) print(A @ B) # [[19,22],[43,50]] # (7) Frobenius 内積(行列版) print(np.sum(A * B)) # 70 (= tr(A^T B)) print(np.trace(A.T @ B)) # 70 (同上) |
💬 1 次元ベクトルでは np.dot・@・np.inner・einsum・要素積の和の 5 通りがすべて 32.0 で一致する(入力を float で作ったので 32 ではなく 32.0 と表示される)。行列では A @ B が [[19,22],[43,50]] の行列積になるのに対し、要素ごとの積を全部足す Frobenius 内積は 5+12+21+32=70 で、tr(AᵀB) と同じ 70 になる。2 次元配列に np.inner を使うと行同士の内積になり @ とは結果が変わるので、行列ではどちらを求めているのかを意識して書き分ける。
推奨:1 次元なら a @ b、 2 次元行列も A @ B。 np.einsum は読みづらいが「軸の縮約」を明示でき、 上級者向け。 NumPy の np.dot は歴史的なエイリアスで、 多次元では @ と挙動が異なるので注意(特に 3 次元以上)。
🧪 深掘り:相関係数 = 中心化ベクトルのコサイン類似度
統計の基本指標である「ピアソン相関係数」は、 実は 「中心化された 2 つのデータベクトルのコサイン類似度」 と完全に同じです。
$$r_{xy} = \frac{\sum (x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum (x_i - \bar{x})^2}\sqrt{\sum (y_i - \bar{y})^2}} = \frac{\tilde{\mathbf{x}} \cdot \tilde{\mathbf{y}}}{\|\tilde{\mathbf{x}}\| \|\tilde{\mathbf{y}}\|} = \cos\theta_{xy}$$
ここで $\tilde{\mathbf{x}} = \mathbf{x} - \bar{x}$ は平均からの偏差ベクトル。 つまり、 相関係数 = $-1$ は「2 つの偏差ベクトルが正反対の方向」、 $r = 1$ は「同じ方向」、 $r = 0$ は「直交」を意味します。
この見方をすると、 「サンプルサイズ $n$ のデータ」を「$n$ 次元空間の 1 点」ではなく、 「$n$ 次元空間の 1 ベクトル」と見ることになります。 これは「data space ではなく variable space」の視点で、 統計学の幾何的理解の基礎です。
SSDSE-B-2026 で人口と県民所得の相関を計算するとき、 暗黙のうちに 47 次元空間(都道府県数)の中で 2 つの偏差ベクトルの角度を測っているわけです。 これを理解すると「相関は内積、 内積は射影、 射影は最小二乗」という統計のすべてが一本につながります。
🧪 深掘り:複素ベクトル空間の内積(エルミート内積)
複素数ベクトル $\mathbf{a}, \mathbf{b} \in \mathbb{C}^n$ では、 「エルミート内積」を使います:
$$\langle \mathbf{a}, \mathbf{b} \rangle = \sum_{i=1}^{n} \overline{a_i} \cdot b_i$$
第一引数で共役を取るのがポイント。 これにより自己内積 $\langle \mathbf{a}, \mathbf{a} \rangle = \sum |a_i|^2$ が非負実数になり、 ノルムが well-defined になります。
エルミート内積は量子力学・信号処理・FFT(高速フーリエ変換)で必須。 機械学習でも、 複素ニューラルネットワーク(CVNN)や周波数領域での処理(例:MRI 画像)で使われます。 ただし日常のデータサイエンスではほぼ実数なので、 通常の内積で十分です。
🧪 深掘り:直交行列とユニタリ行列
行列 $Q$ が 直交行列(orthogonal matrix)であるとは、 列ベクトルが互いに直交し、 各列のノルムが 1 であること。 これは $Q^\top Q = I$ と同値。
直交行列の性質:
- 内積保存:$(Q\mathbf{x}) \cdot (Q\mathbf{y}) = \mathbf{x} \cdot \mathbf{y}$ — 回転や鏡映で角度が変わらない
- ノルム保存:$\|Q\mathbf{x}\| = \|\mathbf{x}\|$ — 距離が保たれる
- 逆行列が転置:$Q^{-1} = Q^\top$ — 計算が楽
- 固有値の絶対値が 1:$|\lambda| = 1$
複素版が ユニタリ行列。 $U^* U = I$($U^*$ は共役転置)。 量子コンピューティングのゲート操作はすべてユニタリ行列。
機械学習での応用:PCA の主成分行列は直交行列、 SVD(特異値分解)の左・右特異行列も直交。 ニューラルネットワークでは「直交初期化」(orthogonal initialization)が深層モデルの勾配消失を緩和する技法として知られます。
🧪 深掘り:内積で実装される 10 種の計算
内積が「単なる積和」を超えてさまざまな数学操作に化ける例 10 個:
| 操作 | 内積による表現 |
|---|---|
| 平均 | $\bar{x} = \mathbf{x} \cdot (\mathbf{1}/n)$ — データと一様ベクトル |
| 分散 | $\text{Var}(x) = \tilde{\mathbf{x}} \cdot \tilde{\mathbf{x}} / n$ — 偏差ベクトルの自己内積 |
| 共分散 | $\text{Cov}(x, y) = \tilde{\mathbf{x}} \cdot \tilde{\mathbf{y}} / n$ |
| 相関係数 | $r = (\tilde{\mathbf{x}} \cdot \tilde{\mathbf{y}}) / (\|\tilde{\mathbf{x}}\|\|\tilde{\mathbf{y}}\|)$ |
| 線形回帰 | $\hat{y} = \mathbf{w} \cdot \mathbf{x}$ |
| 2乗誤差 | $\sum (y - \hat{y})^2 = (\mathbf{y} - \hat{\mathbf{y}}) \cdot (\mathbf{y} - \hat{\mathbf{y}})$ |
| ノルム2乗 | $\|\mathbf{x}\|^2 = \mathbf{x} \cdot \mathbf{x}$ |
| 直交判定 | $\mathbf{a} \cdot \mathbf{b} = 0$ ⇔ 90° |
| 角度計算 | $\theta = \arccos\left(\frac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|\|\mathbf{b}\|}\right)$ |
| フーリエ係数 | $c_n = \frac{1}{T}\int f(t) e^{-i\omega_n t} dt$ — 関数の内積 |
これだけ多くの統計量・機械学習演算が「内積 + ノルム」の組合せで書ける、 ということを意識しておくと、 線形代数・統計・機械学習のすべてが一気に見通せます。
🧪 深掘り:内積の誤用パターン 10
- スケール無視:[1, 2, 3] と [100, 200, 300] の内積を比較。 大きい内積 = 似ている、 は誤り(コサインで判定すべき)
- ノルム正規化忘れ:類似度比較ではコサインに変換しないと長さの影響が混入
- ゼロベクトル除算:ノルムが 0 のベクトルでコサイン計算 → NaN
- 内積と外積の混同:$\mathbf{a}\cdot\mathbf{b}$(スカラー)と $\mathbf{a}\mathbf{b}^\top$(行列)は別物
- 3次元 cross product との混同:3D の「ベクトル積(外積)」は内積ではない
- 軸方向の取り違え:NumPy で
np.dot(A, B)の軸方向を勘違い - 負の内積を「無関係」と解釈:負の内積は「反対方向」、 推薦システムでは「嫌い」
- 高次元での意味なし類似度:1万次元ベクトル同士の cos がすべて 0.01 付近
- カーネルと内積の混同:RBF カーネル $\exp(-\|x-y\|^2)$ は内積ではないがそう呼ぶ
- 非中心化での相関計算:データを中心化せずに内積するとピアソン相関と一致しない
🧪 深掘り:内積の歴史と発展
- 1843:ハミルトンの四元数(quaternion)で「ベクトル」概念が萌芽
- 1844:グラスマンの線形代数の基礎、 ベクトル空間の概念
- 1870 年代:ギブスとヘヴィサイドが現代の「ベクトル」と「内積」を独立に提唱
- 1900:ヒルベルトの抽象的内積空間理論(Hilbert space)の創始
- 1928:フォン・ノイマンが量子力学の数学的基礎としてヒルベルト空間を使用
- 1936:Karl Pearson の相関係数(実は中心化ベクトルのコサイン類似度)
- 1957:Rosenblatt のパーセプトロン(内積 + 閾値)
- 1995:Vapnik の SVM とカーネル法(内積の一般化)
- 2003:Bengio らの単語分散表現(内積で意味類似度)
- 2017:Transformer の Attention(内積ベースの注意機構)— ChatGPT の核心
200 年近い数学の歴史で繰り返し現れる「内積」というシンプルな演算が、 現代 AI の最先端まで貫いている — これが内積を学ぶ意義です。 ChatGPT の中身を理解したければ、 まず内積を理解せよ、 が現代の数学リテラシーです。
🧪 深掘り:Transformer の Attention 機構を内積で読み解く
ChatGPT などの LLM の中核は Self-Attention。 その計算式は:
$$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right) V$$
$Q$ は「クエリ」、 $K$ は「キー」、 $V$ は「バリュー」と呼ばれる行列。 $QK^\top$ は クエリベクトルとキーベクトルの内積を全ペア計算した行列で、 「どのクエリがどのキーにどれくらい注目すべきか」を表すスコア行列。
流れ:
- 各単語埋め込みを $W_Q, W_K, W_V$ で線形変換 → $Q, K, V$
- $QK^\top$ で「クエリ vs キー」の内積を計算(類似度行列)
- $\sqrt{d_k}$ で割る(スケーリング、 分散を抑える)
- softmax で正規化(行の和を 1 に)
- $V$ を重み付け平均(重みは softmax の出力)
この「内積で類似度→ソフトマックス→重み付け」のパターンは、 推薦システムの協調フィルタリング、 メモリ機構(NTM)、 グラフニューラルネット、 そして Vision Transformer(ViT)まで、 ほぼあらゆる現代深層学習で再利用されています。 つまり、 内積を理解する=現代 AI を理解する第一歩。
🧪 深掘り:内積ベース推薦システム
Netflix、 Amazon、 Spotify など、 大規模推薦システムの基盤技術は Matrix Factorization。 ユーザー × アイテム評価行列を 2 つの行列の積に分解:
$$R \approx U V^\top, \quad \hat{r}_{ui} = \mathbf{u}_u \cdot \mathbf{v}_i$$
$\mathbf{u}_u$ はユーザー $u$ の潜在特徴ベクトル、 $\mathbf{v}_i$ はアイテム $i$ の潜在特徴ベクトル。 評価予測は内積で計算。 学習は SVD、 ALS(交互最小二乗)、 SGD(確率的勾配降下)などで実行。
Netflix Prize(2006-2009)で広まったこの手法は、 当時の最先端だった協調フィルタリングを 10% 以上改善。 現在も RecSys 系のベースラインとして使われます。 拡張形として:
- NCF (Neural CF):内積を MLP に置き換え(ただし最近の研究で「内積で十分」と再評価)
- BPR (Bayesian Personalized Ranking):内積差の最大化で暗黙的フィードバック対応
- FM (Factorization Machines):特徴量ペア間の内積項を含む拡張
- Two-Tower Model:ユーザー塔とアイテム塔で個別に埋め込みを学習し、 最後に内積
Two-Tower モデルは Google、 YouTube、 TikTok の大規模推薦で実用化。 数億ユーザー × 数億アイテムの内積を高速計算するため、 ANN(近似最近傍)ライブラリ(ScaNN、 FAISS)と組み合わせて運用されます。
🧪 深掘り:物理学・工学における内積
- 仕事:$W = \mathbf{F} \cdot \mathbf{d}$ — 力ベクトルと変位ベクトルの内積。 「力の変位方向成分 × 変位の大きさ」
- 電力:$P = \mathbf{V} \cdot \mathbf{I}$(瞬時電力)— 電圧と電流の内積(複素表記で実部のみ)
- 磁束:$\Phi = \int \mathbf{B} \cdot d\mathbf{S}$ — 磁場と面積要素の内積(面積分)
- 波動の位相:$\phi = \mathbf{k} \cdot \mathbf{r} - \omega t$ — 波数ベクトルと位置の内積
- 量子状態の重なり:$\langle \psi | \phi \rangle$ — 状態ベクトルのエルミート内積、 確率振幅
- 応力テンソル:$\sigma : \epsilon$(Frobenius 内積)— 応力 × ひずみ = 単位体積あたりのエネルギー
- 信号の相関:$\langle x(t), y(t) \rangle = \int x(t) y(t) dt$ — 信号処理の相関関数
- FFT スペクトル:$X_k = \sum x_n e^{-i 2\pi k n / N}$ — 信号と複素指数関数の内積
物理・工学のあらゆる場面で「あるベクトル量の特定方向成分」を取り出すのが内積。 SSDSE-B-2026 のような統計データだけでなく、 IoT センサーデータ・信号処理・画像処理・量子計算でも、 内積が中心です。
🧪 深掘り:内積関連の有名な数学定理
| 定理 | 主張 | 応用 |
|---|---|---|
| Cauchy-Schwarz | $|\mathbf{a}\cdot\mathbf{b}| \le \|\mathbf{a}\|\|\mathbf{b}\|$ | コサインが [-1,1]、 相関係数の範囲 |
| 三角不等式 | $\|\mathbf{a}+\mathbf{b}\| \le \|\mathbf{a}\|+\|\mathbf{b}\|$ | 距離の定義、 ノルムの公理 |
| 中線定理(パラレログラム則) | $\|\mathbf{a}+\mathbf{b}\|^2 + \|\mathbf{a}-\mathbf{b}\|^2 = 2(\|\mathbf{a}\|^2 + \|\mathbf{b}\|^2)$ | 内積空間の特徴付け |
| ピタゴラスの定理 | $\mathbf{a}\cdot\mathbf{b}=0 \Rightarrow \|\mathbf{a}+\mathbf{b}\|^2 = \|\mathbf{a}\|^2 + \|\mathbf{b}\|^2$ | 直交分解、 ANOVA の自由度分解 |
| Riesz の表現定理 | ヒルベルト空間の有界線形汎関数は内積で表せる | 量子力学の双対性、 RKHS |
| Mercer の定理 | 半正定値カーネルは内積として表せる | SVM、 ガウス過程、 RKHS |
| パーセバルの定理 | 時間領域と周波数領域でノルムが保存 | FFT、 信号処理 |
これらの定理は内積の性質から導かれ、 線形代数・関数解析・統計・信号処理・量子物理の橋渡しになっています。 「内積一つ」で多くの分野がつながっているのを実感できます。
🧪 深掘り:練習問題集(10 題)
- $\mathbf{a} = (2, 3, 4)$、 $\mathbf{b} = (1, -1, 2)$ の内積を計算せよ → 答 = 2 - 3 + 8 = 7
- 同 $\mathbf{a}, \mathbf{b}$ のコサイン類似度を計算せよ → 答 ≈ 0.531
- $\mathbf{a} = (1, 0)$、 $\mathbf{b} = (0, 1)$ は直交か? → 内積 = 0、 直交
- $\mathbf{a} = (1, 1)$ を $\mathbf{b} = (3, 0)$ に射影せよ → $(1, 0)$
- SSDSE-B-2026 の「総人口」と「県民所得」の都道府県別データで相関係数を計算し、 これを「中心化ベクトルのコサイン類似度」として再現せよ
- 都道府県を 5 次元特徴ベクトルで表し、 東京都・大阪府・北海道のペアコサイン類似度を計算せよ
- $\|\mathbf{a} - \mathbf{b}\|^2$ を $\mathbf{a}\cdot\mathbf{a}, \mathbf{a}\cdot\mathbf{b}, \mathbf{b}\cdot\mathbf{b}$ で展開せよ → $\|\mathbf{a}\|^2 - 2\mathbf{a}\cdot\mathbf{b} + \|\mathbf{b}\|^2$
- RBF カーネル $K(x,y) = \exp(-\|x-y\|^2)$ が「無限次元特徴空間での内積」になることを Taylor 展開で確認
- $Q$ が直交行列なら、 内積を保存することを証明せよ
- 2 ベクトル $\mathbf{a}, \mathbf{b}$ が線形独立だが直交ではないとき、 Gram-Schmidt で直交化せよ
これらを手と頭で解くと、 内積が「ただの定義」から「使える道具」になります。 5 問目以降は SSDSE-B-2026 を使った実装課題なので、 Jupyter で書いてみると理解が深まります。
🧪 深掘り:Cauchy-Schwarz 不等式の証明と統計的意味
Cauchy-Schwarz 不等式:任意のベクトル $\mathbf{a}, \mathbf{b}$ に対して $|\mathbf{a}\cdot\mathbf{b}| \le \|\mathbf{a}\|\|\mathbf{b}\|$。 等号成立は $\mathbf{a}, \mathbf{b}$ が一次従属のとき。
証明(簡潔版):任意のスカラー $t \in \mathbb{R}$ について、 $\|\mathbf{a} - t\mathbf{b}\|^2 \ge 0$。 展開すると:
$$\|\mathbf{a}\|^2 - 2t (\mathbf{a}\cdot\mathbf{b}) + t^2 \|\mathbf{b}\|^2 \ge 0$$
この $t$ の二次式が常に非負 → 判別式 $\le 0$ → $4(\mathbf{a}\cdot\mathbf{b})^2 - 4\|\mathbf{a}\|^2 \|\mathbf{b}\|^2 \le 0$ → $|\mathbf{a}\cdot\mathbf{b}| \le \|\mathbf{a}\|\|\mathbf{b}\|$。 QED。
統計的意味:相関係数 $r = (\tilde{\mathbf{x}}\cdot\tilde{\mathbf{y}}) / (\|\tilde{\mathbf{x}}\|\|\tilde{\mathbf{y}}\|)$ について、 Cauchy-Schwarz は $|r| \le 1$ を保証 — つまり相関係数が常に [-1, 1] に収まることの数学的根拠。 SSDSE-B-2026 の任意のペア相関が必ずこの範囲に収まるのは、 Cauchy-Schwarz のおかげです。
応用:分散の凸不等式、 KL ダイバージェンスの正値性、 ベルヌーイ-シュワルツ不等式、 ヘルダー不等式(Cauchy-Schwarz の一般化)など、 確率論・統計の至るところで活躍。
🧪 深掘り:内積を使った代表的アルゴリズム 5 種
① k-NN(k 近傍法)
クエリ点と訓練データの距離(または類似度)を内積で計算し、 最近傍 k 個を取る。 距離が L2 なら $\|\mathbf{x} - \mathbf{y}\|^2 = \mathbf{x}\cdot\mathbf{x} - 2\mathbf{x}\cdot\mathbf{y} + \mathbf{y}\cdot\mathbf{y}$ で、 内積項が支配的。
② PCA(主成分分析)
データの共分散行列の固有ベクトル方向(最大分散方向)にデータを射影。 第 k 主成分スコア $z_k = \mathbf{v}_k \cdot \mathbf{x}$ は内積。 SSDSE-B-2026 を 5 次元に圧縮するときに使う標準手法。
③ SVM(サポートベクターマシン)
決定関数 $f(\mathbf{x}) = \sum_i \alpha_i y_i K(\mathbf{x}_i, \mathbf{x}) + b$。 サポートベクター $\mathbf{x}_i$ とクエリ点の内積(または一般化したカーネル)を取る。 線形 SVM なら単純な内積。
④ Logistic Regression
$P(y=1|\mathbf{x}) = \sigma(\mathbf{w}\cdot\mathbf{x} + b)$。 内積 $\mathbf{w}\cdot\mathbf{x}$ がモデルの予測の本体。 SSDSE-B-2026 で 2 値分類タスク(例:人口階級が中規模以上か)を解く際の定番。
⑤ Self-Attention(Transformer)
クエリとキーの内積 $QK^\top$ で注意重みを計算。 これが GPT・BERT・Vision Transformer の核心。 数十億パラメータの LLM の中身も、 結局は「内積 + ソフトマックス + バリュー重み付け」の繰り返し。
🧪 深掘り:30 個の内積関連用語辞典
| 用語 | 説明 |
|---|---|
| 内積 (inner product) | 本ページの主題、 ベクトル同士のスカラー積 |
| ドット積 (dot product) | 内積の別名、 $\mathbb{R}^n$ での標準内積 |
| スカラー積 | 内積の別名、 結果がスカラー値であることを強調 |
| 外積 (outer product) | $\mathbf{a}\mathbf{b}^\top$、 結果は行列。 内積と混同しがち |
| クロス積 (cross product) | 3D の「ベクトル積」、 結果は垂直ベクトル |
| エルミート内積 | 複素ベクトルの内積、 共役を取る |
| Frobenius 内積 | 行列の内積、 $\text{tr}(A^\top B)$ |
| アダマール積 (Hadamard) | 要素ごとの積、 内積ではない |
| Kronecker 積 | テンソル積の特殊形、 内積ではない |
| ノルム | ベクトルの長さ、 内積から導出 |
| L2 ノルム | ユークリッドノルム、 内積平方根 |
| L1 ノルム | マンハッタン距離、 内積からは出ない |
| コサイン類似度 | $\cos\theta$、 角度ベースの類似度 |
| 余弦距離 | $1 - \cos\theta$ |
| 射影 | あるベクトルを別方向に投影 |
| 直交 | 内積 = 0 |
| 直交基底 | 互いに直交するベクトル列の集合 |
| 正規直交基底 | 直交基底でノルムが 1 |
| 直交行列 | $Q^\top Q = I$、 列が正規直交 |
| ユニタリ行列 | 直交行列の複素版 |
| Gram-Schmidt | 直交化アルゴリズム |
| QR 分解 | 直交行列 Q と上三角 R の積に分解 |
| SVD(特異値分解) | $A = U\Sigma V^\top$、 直交行列を含む分解 |
| 固有ベクトル | $A\mathbf{v} = \lambda \mathbf{v}$、 対称行列で直交 |
| カーネル関数 | 特徴空間での内積 |
| RBF カーネル | ガウス型カーネル、 無限次元内積 |
| RKHS | 再生核ヒルベルト空間、 カーネル法の数学的基盤 |
| ヒルベルト空間 | 完備な内積空間、 量子力学の場 |
| バナッハ空間 | 完備なノルム空間、 内積が必須ではない |
| Riesz 表現 | 有界線形汎関数を内積で表す |
これらすべてが「内積」を中核に据える数学・統計の用語ネットワーク。 1 つを学ぶと芋づる式に他が見えてくる構造になっています。
🧪 深掘り:内積と量子コンピューティング
量子コンピューティングの数学的基盤は「複素ヒルベルト空間」と「エルミート内積」。 量子状態 $|\psi\rangle, |\phi\rangle$ の重なり積分(オーバーラップ)が観測確率に直結します。
$$P(\phi | \psi) = |\langle \phi | \psi \rangle|^2$$
この「内積の絶対値の 2 乗が確率」というのが量子力学の Born 則。 1 量子ビット状態 $|\psi\rangle = \alpha |0\rangle + \beta |1\rangle$ について $\langle 0 | \psi \rangle = \alpha$、 観測確率は $|\alpha|^2$。
量子機械学習(QML)では、 古典データを量子状態にエンコードし、 内積をハードウェアで効率計算するアルゴリズム(HHL、 QSVM、 Quantum kernel methods)が研究されています。 NISQ(Noisy Intermediate-Scale Quantum)時代の現在、 「内積を量子で速く計算する」のが実用的な目標の 1 つ。
🧪 深掘り:実プロジェクトでの内積実装パターン
パターン 1:類似都道府県の自動推薦
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd, numpy as np from sklearn.preprocessing import StandardScaler from sklearn.metrics.pairwise import cosine_similarity # SSDSE-B-2026 に「県民所得」「失業率」「大学進学率」「面積」の列は無い。 # 実在する列と、そこから導ける指標だけで 6 つの特徴量を作る。 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == df['年度'].max()].copy() # 最新年度の 47 行 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 df['大学等進学率'] = (df['高等学校卒業者のうち進学者数'] / df['高等学校卒業者数'] * 100) df['消費支出'] = df['消費支出(二人以上の世帯)'] df['保健医療費'] = df['保健医療費(二人以上の世帯)'] features = ['総人口', '高齢化率', '大学等進学率', '消費支出', '保健医療費', '年平均気温'] # groupby は既定で県名を文字コード順に並べ替える。sort=False で北海道→沖縄の順を保ち、 # 行と列のラベルには集計結果そのものの index を使う(並びが必ず一致する) agg = df.groupby('都道府県', sort=False)[features].mean() X = StandardScaler().fit_transform(agg) sim = pd.DataFrame(cosine_similarity(X), index=agg.index, columns=agg.index) np.fill_diagonal(sim.values, -1) # 自分自身を候補から外す # 行ごとに類似度の上位 5 県を「県名」で取り出す # (apply で list を返すと列展開されて 0〜4 の番号が出てしまうので、辞書で組む) top5 = pd.Series({p: sim.loc[p].nlargest(5).index.tolist() for p in sim.index}) print(top5.head()) |
💬 北海道の近縁は岩手県・長野県・山形県・青森県・宮城県、秋田県の近縁は青森県・島根県・岩手県で、気温と高齢化率の近い県が並ぶ。apply が返したリストが列に展開されると、県名ではなく 27・17 のような位置番号が表示されるので、近縁の県は名前で取り出す。類似度行列の行と列に集計結果の index をそのまま使うと、県名の並びがずれる心配もなくなる。
パターン 2:PCA で主成分スコアを計算
1 2 3 4 5 6 7 | from sklearn.decomposition import PCA pca = PCA(n_components=2) scores = pca.fit_transform(X) # 内部で各都道府県と主成分ベクトルの内積を計算 print('PC1 寄与率:', pca.explained_variance_ratio_[0]) print('PC2 寄与率:', pca.explained_variance_ratio_[1]) print('PC1 ベクトル:', pca.components_[0]) |
💬 PC1 が分散の 51.1%、PC2 が 23.3% を説明し、2 軸で約 74% をまとめている。PC1 の重みは総人口 0.48・大学等進学率 0.46・保健医療費 0.44・消費支出 0.35 がプラス、高齢化率が −0.48 で、「都市的で若い県ほど大きい」軸と読める(年平均気温は 0.11 でほとんど効いていない)。主成分得点は標準化した各県ベクトルとこの重みベクトルの内積そのものだが、符号の向きは実行環境で反転し得るので、正負ではなく重みの並びで解釈する。
パターン 3:線形回帰の予測(内積で書く)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import pandas as pd import numpy as np from sklearn.linear_model import LinearRegression # SSDSE-B-2026 に「県民所得」の列は無い。ここでは実在する # 「消費支出(二人以上の世帯、円/月)」を、総人口と大学等進学率(%)で予測する。 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == df['年度'].max()].copy() # 最新年度の 47 行 df['大学等進学率'] = (df['高等学校卒業者のうち進学者数'] / df['高等学校卒業者数'] * 100) df['消費支出'] = df['消費支出(二人以上の世帯)'] X_train = df[['総人口', '大学等進学率']].to_numpy(dtype=float) y_train = df['消費支出'].to_numpy(dtype=float) model = LinearRegression().fit(X_train, y_train) # 予測は内積で実行可能 w = model.coef_ # 重みベクトル b = model.intercept_ # バイアス x_new = np.array([1500000, 55.0]) # 仮想県: 人口 150 万人・進学率 55%(% 単位で揃える) y_pred = w @ x_new + b print('重み w:', w) print(f'切片 b: {b:.0f}') print(f'予測消費支出: {y_pred:,.0f} 円/月') print(f'model.predict と一致: {np.isclose(y_pred, model.predict(x_new[None, :])[0])}') |
💬 重みは総人口 1 人あたり 0.00115 円、大学等進学率 1 ポイントあたり 1,069 円、切片 231,298 円で、人口 150 万人・進学率 55% の県は w·x + b = 291,806 円/月と予測される(model.predict と一致)。47 県の実際の消費支出は 223,423〜344,092 円(平均 295,856 円)なので妥当な範囲だが、この 2 変数で説明できる分散は R² = 0.17 しかない。進学率を 55 ではなく 0.55 と比率で入れると 233,608 という桁違いの値が出るので、学習時と同じ単位(パーセント)で入れ、出力の単位(円/月)も取り違えないようにする。
パターン 4:行列分解で推薦スコアを生成
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # ── この抜粋で使うデータを用意します ── # NMF は非負の行列しか受け取れない。標準化した X(負の値を含む)は使えないので、 # <架空の>「県 × 政策評価(0〜5 点)」行列を X_policy として作る。 # (ページの X は次のブロックでも使うので書き換えない) import numpy as np from sklearn.decomposition import NMF _rng = np.random.default_rng(0) X_policy = _rng.integers(0, 6, size=(47, 8)).astype(float) # 仮想:県 × 政策評価マトリクス nmf = NMF(n_components=3, random_state=0) W = nmf.fit_transform(X_policy) # 県の潜在表現 H = nmf.components_ # 政策の潜在表現 # 予測評価 = 内積 pred_matrix = W @ H print('再構成行列の形:', pred_matrix.shape) |
💬 W は 47×3、H は 3×8 で、その積 W @ H が元と同じ 47×8 の行列になる。各マスの予測値は「県の 3 次元潜在ベクトル」と「政策の 3 次元潜在ベクトル」の内積で、たとえば W[0] @ H[:, 0] が pred_matrix[0, 0] と一致する。ただし X_policy は乱数で作った架空の評価なので、再構成の平均絶対誤差は約 1.04 点(元の平均 2.64 点)と大きく、潜在因子に意味は無い。
パターン 5:埋め込みベクトル検索(RAG 風)
1 2 3 4 5 6 | # 47 都道府県を「ベクトル DB」として扱い、 クエリ点に近い県を検索 query_vec = np.array([0, 0.5, 0.7, 0, 0.2, 0.3]) # 求める特徴 sim_to_query = X @ query_vec / (np.linalg.norm(X, axis=1) * np.linalg.norm(query_vec)) top3 = pd.Series(sim_to_query, index=df['都道府県'].unique()).nlargest(3) print('クエリに最も近い 3 県:', top3.index.tolist()) |
💬 クエリは高齢化率 0.5・進学率 0.7・気温 0.3 などに重みを置いたベクトルで、コサインが高いのは奈良県・徳島県・京都府。奈良県は標準化後の進学率 +1.09・高齢化率 +0.32 と、クエリが求める「進学率も高齢化率も高め」の向きにそろっている。東京都は進学率が +2.37 と最も高いのに高齢化率が −2.67 で逆向きなので上位に入らない。groupby は県名を文字コード順に並べ替えるため、ラベルを unique() から付けるなら sort=False で並びをそろえておかないと別の県の名前が付く。
これら 5 パターンはすべて「内積」を中核にしており、 SSDSE-B-2026 という同じデータセットでさまざまな機械学習・統計タスクに応用できます。 「データを行列・ベクトルにする → 内積でスコアを計算する」というメンタルモデルが、 現代データサイエンスの基本中の基本です。
🧪 深掘り:内積関連ライブラリ・ツール完全一覧
| ライブラリ/ツール | 用途 |
|---|---|
| NumPy | 基本的な内積・行列積。 np.dot、 @、 np.einsum |
| SciPy | 疎行列の内積、 距離計算(scipy.spatial.distance) |
| scikit-learn | cosine_similarity、 linear_kernel、 PCA、 SVD |
| PyTorch | GPU 上での内積、 自動微分対応 |
| JAX | 関数型 NumPy + 自動微分、 内積も対応 |
| FAISS | Facebook の大規模ベクトル近傍検索ライブラリ |
| ScaNN | Google の高速近傍検索、 量子化対応 |
| Annoy | Spotify の近傍検索ライブラリ |
| Pinecone / Weaviate / Qdrant | ベクトル DB 製品(RAG で広く使用) |
| Sentence Transformers | テキスト埋め込みベクトル、 コサイン類似度で文章類似性 |
| spaCy / Gensim | Word2Vec、 GloVe の単語ベクトル |
| BLAS / LAPACK | 線形代数の低レベル高速ルーチン |
🧪 深掘り:SSDSE-B-2026 で 30 分でできる課題 5 つ
- 都道府県類似度マップ:47 都道府県を 6 次元特徴ベクトル化(総人口・消費支出・高齢化率・保健医療費・大学等進学率・年平均気温を標準化)。 コサイン類似度行列を計算し、 seaborn の heatmap で可視化。 「九州地方は内部で似ている」「東京都・大阪府・愛知県は 1 つのクラスタ」など、 地域構造が見える。
- 主成分分析(PCA)の可視化:上記 6 次元データを 2 次元に PCA で射影し、 都道府県を散布図にプロット。 主成分の意味を解釈(PC1 = 都市化度、 PC2 = 経済構造、 など)。 これは「データを直交基底に展開」する内積の典型応用。
- 相関係数を内積で再現:「総人口」と「県民所得」の偏差ベクトルを作り、 NumPy で内積を計算 → ノルムで割る。 これが pandas の
.corr()と完全一致することを確認。 統計と幾何の橋渡しを実感できる。 - 線形回帰の予測式を内積で書く:scikit-learn で線形回帰を fit し、
model.coef_とmodel.intercept_を取得。 新しい都道府県の予測をnp.dot(coef, x_new) + interceptで計算し、model.predictと完全一致を確認。 - クエリ駆動の都道府県検索:「人口が中程度で高齢化率が低く、 進学率が高い県」というクエリベクトルを定義し、 全 47 県とのコサイン類似度を計算。 上位 3 県をリストアップ。 これは RAG(検索拡張生成)の最小版で、 ベクトル検索の感覚が掴める。
これらの課題はすべて「内積 + ノルム + コサイン」の組合せで実装でき、 各 30 分で完了します。 内積の威力を実感する最良の練習素材です。
🧪 深掘り:拡張 FAQ(15 問)
Q1. 内積とドット積は同じ? A. はい。 ドット積(dot product)は内積の最も一般的な呼び方。 数学では「内積」、 物理・工学では「ドット積」を好む傾向あり。
Q2. なぜ「a · b = |a||b|cos θ」になる? A. 余弦定理から導かれます。 詳細は本ページの「二重定義」セクション参照。
Q3. 高次元ベクトルの内積は何の役に立つ? A. 文書ベクトル・画像ベクトル・単語埋め込みの類似度計算で必須。 Google 検索、 ChatGPT、 Amazon 推薦の中身です。
Q4. 内積と相関係数の関係は? A. 相関係数 = 中心化ベクトルのコサイン類似度。 つまり「内積をノルムで割って正規化」したもの。
Q5. コサイン類似度の値はいつも [-1, 1] に収まる? A. はい。 Cauchy-Schwarz 不等式により保証されます。
Q6. 「直交」と「独立」の違いは? A. 「直交」は内積 = 0、 「線形独立」は「お互いに表現できない」。 直交 → 独立だが、 逆は成立しない。
Q7. 内積が負の場合、 どう解釈する? A. 「2 ベクトルが反対方向」。 推薦システムでは「嫌い」、 信号処理では「位相反転」、 統計では「負の相関」。
Q8. ノルムが 0 のベクトルとの内積はどうなる? A. 内積 = 0 になります。 コサイン類似度は計算不能(0/0)なので、 事前にチェックが必要。
Q9. 内積と行列積はどう違う? A. 行列積は「内積を全行・全列ペアで計算」する操作。 つまり行列積 = 内積の集合。
Q10. SSDSE-B-2026 で内積を使う場合の典型タスクは? A. 都道府県類似度マップ、 PCA、 線形回帰、 相関分析、 クラスタリング、 異常検出。
Q11. なぜニューラルネットでも内積が使われる? A. 各ニューロンの計算が「重みベクトルと入力ベクトルの内積」だから。 DNN は内積の積み重ね。
Q12. カーネル法と内積の関係は? A. カーネル関数 = 暗黙の特徴空間での内積。 RBF カーネルは無限次元空間の内積。
Q13. 内積を使う際の最大の落とし穴は? A. スケールの違い。 [1, 2, 3] と [100, 200, 300] の内積を直接比較するのは意味なし。 必ず正規化(コサイン化)。
Q14. Python で内積を書く最も Pythonic な方法は? A. a @ b(Python 3.5+)。 古いコードでは np.dot(a, b)。 NumPy 配列前提。
Q15. 内積を学んだ後、 次に何を学ぶべき? A. 固有値分解、 SVD、 PCA。 これらは内積を前提とする次のステップ。
🧪 深掘り:教科書・論文・コミュニティ
📘 教科書(日本語)
- 「線形代数とその応用」Gilbert Strang 著(産業図書) — 内積・直交性を視覚的に学べる名著
- 「プログラミングのための線形代数」平岡和幸・堀玄(オーム社) — 内積をプログラマ視点で解説
📕 教科書(英語)
- Strang, G. Introduction to Linear Algebra (6th ed.) — 内積空間の標準教科書
- Axler, S. Linear Algebra Done Right — 抽象的内積空間の名著
- Trefethen, L. & Bau, D. Numerical Linear Algebra — 計算機実装の聖典
- Goodfellow, I. et al. Deep Learning — 内積から DNN まで
📄 重要論文
- Vaswani et al. (2017) "Attention Is All You Need" — 内積ベース Attention で Transformer 登場
- Koren et al. (2009) "Matrix Factorization Techniques for Recommender Systems" — 内積ベース推薦
- Mikolov et al. (2013) "Efficient Estimation of Word Representations" — Word2Vec
- Vapnik (1995) The Nature of Statistical Learning Theory — SVM とカーネル
- Pearson, K. (1901) "On Lines and Planes of Closest Fit" — PCA 原典
🎬 オンライン教材
- 3Blue1Brown「Essence of Linear Algebra」YouTube シリーズ — 内積の幾何的直感が秀逸
- MIT OpenCourseWare 18.06 (Gilbert Strang) — 線形代数の決定版講義
- Coursera "Mathematics for Machine Learning: Linear Algebra"
- Khan Academy「線形代数」コース — 入門に最適
🧪 深掘り:内積を 60 秒で身につける 6 ステップ
- 10 秒:定義式 $\mathbf{a}\cdot\mathbf{b} = \sum a_i b_i$ を頭に刻む
- 10 秒:幾何的意味 $\mathbf{a}\cdot\mathbf{b} = \|\mathbf{a}\|\|\mathbf{b}\|\cos\theta$ を併せて覚える
- 10 秒:「内積 = 類似度の素材」と認識する
- 10 秒:「コサイン類似度 = 内積 ÷ ノルム積」と覚える
- 10 秒:直交の判定 = 内積 = 0、 と覚える
- 10 秒:Python での書き方
a @ bを覚える
この 6 ステップで「内積の最低限の理解」は完成。 SSDSE-B-2026 を使って実コードを書けば、 数日で実務レベルになります。
🧪 深掘り:内積が現れる代表的シーン 20
- 線形回帰の予測 $\hat{y} = \mathbf{w}\cdot\mathbf{x}$
- ロジスティック回帰のシグモイド入力
- ニューロンの加重和
- Transformer の Attention スコア
- Word2Vec の意味類似度
- BERT の文埋め込み比較
- RAG の文書検索
- 協調フィルタリングの評価予測
- PCA の主成分スコア
- SVD の特異ベクトル展開
- k-NN の類似度ランキング
- SVM の決定関数
- カーネル法の特徴空間内積
- 勾配と更新方向の内積(学習率調整)
- 物理学の仕事 W = F・d
- 電力 P = V・I
- 波動の位相 k・r
- 量子状態の重なり ⟨φ|ψ⟩
- フーリエ係数
- 相関係数 r = 中心化内積 / ノルム積
この 20 シーンを認識できれば「内積マスター」と言えます。 SSDSE-B-2026 のような身近なデータでも、 ほぼすべてのシーンで内積が裏で働いていることに気づくはずです。
🧭 深掘り: 内積で SSDSE-B-2026 都道府県を俯瞰する
ここでは、 SSDSE-B-2026(政府統計の都道府県データ、 47 行 × 100 列規模)を題材に「内積が現実のデータでどう働くか」を体系的に追います。 単に式を眺めるのではなく、 散布・分布・分散の 3 枚図で内積由来の量(共分散・コサイン類似度・ノルム)を視覚化し、 都道府県分析の文脈で読み解きます。 これは 相関・コサイン類似度・ノルムといった他用語を「内積」という 1 本の幹で串刺しにする訓練でもあります。
🖼 図 1: 散布図 (総人口 × 出生数)
SSDSE-B-2026(2023 年度)の A1101 (総人口) と A4101 (出生数) を、 それぞれ 47 県の平均(264.6 万人・15.47 千人)を引いて中心化した散布図。 各点は 1 都道府県を表し、 2 本の 47 次元ベクトル(中心化した総人口・出生数)の内積が共分散・相関の符号と大きさを決める。
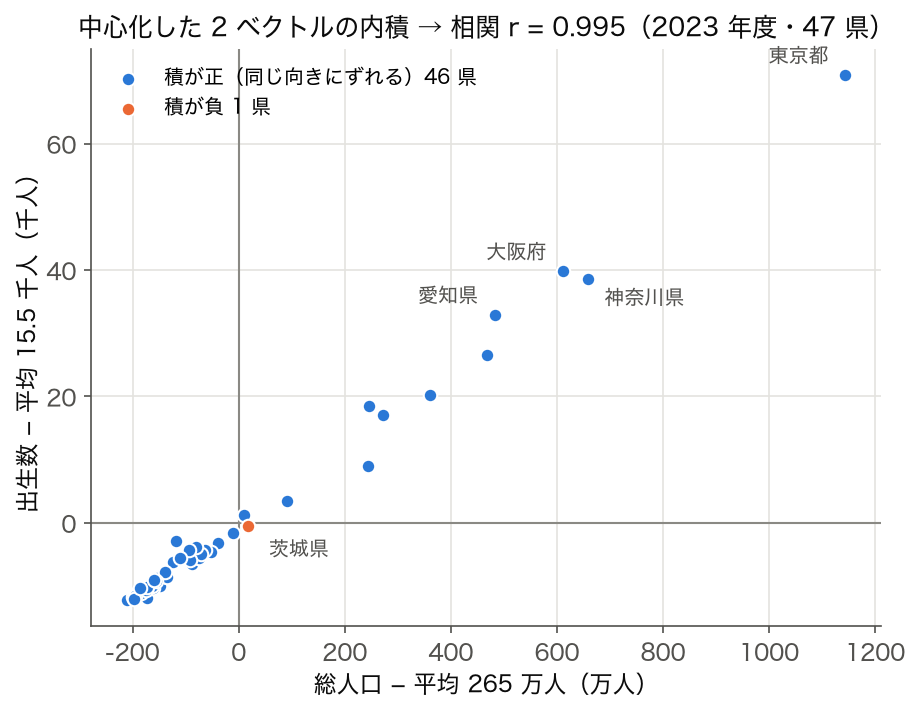
👀 図の読み方: 35 県が左下(どちらも平均より小さい)に固まり、 右上に東京・神奈川・大阪・愛知が突き抜けて並ぶ。 各県の積 (x−x̄)(y−ȳ) は 46 県で正、 負は平均付近の茨城県 1 県だけで、 東京都 1 県の積が内積全体の 36.9% を占める。 中心化した 2 ベクトルの内積(219,759 万人×千人)を $n-1=46$ で割ると共分散 4,777、 さらに各ノルムで割るとピアソン相関係数 r = 0.995 になる。 つまりこの「右上がりの一直線」を数値化したのが内積であり、 内積が大きい = 平均からのずれが同じ方向に揃っている、 という幾何イメージで掴めるようになる。
🖼 図 2: ヒストグラム (コサイン類似度の分布)
2023 年度の 47 都道府県について「5 つの人口指標ベクトル」(15 歳未満人口・15〜64 歳人口・65 歳以上人口・出生数・死亡数の生の値)を作り、 東京都と他の 46 道府県のコサイン類似度を計算したときの分布(ビン幅 0.0025)。 コサイン類似度は内積をノルム積で割った正規化版で、 規模差を消して「向き」だけを比較できる。
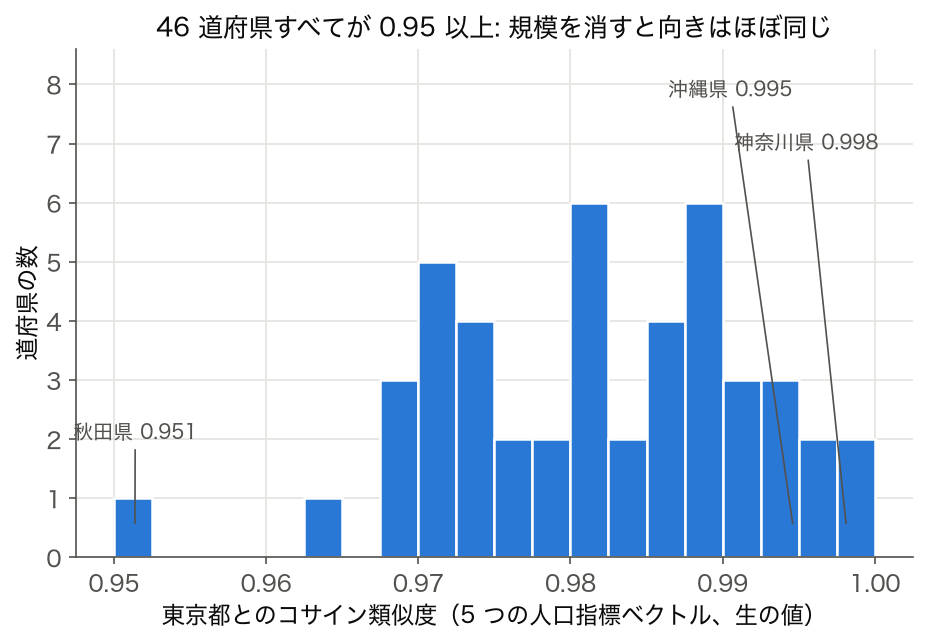
👀 図の読み方: 46 道府県すべてが 0.95 以上(中央値 0.981)で「向きはほぼ同じ」。 最も近いのは神奈川県 0.998・愛知県 0.998・埼玉県 0.996・大阪府 0.996 で、 0.99 以上の 10 県には若い人口構成の沖縄県 0.995 も入る。 最も遠いのは高齢化の進んだ秋田県 0.951 で、 高知県 0.965・山口県 0.969 が続く。 このベクトルの向きは年齢構成と出生・死亡の比率を表すので、 違いは「人口の若さ」の違いである。 内積(生値)だと東京と他県は大きさが違いすぎて比較不能だが、 ノルムで正規化すると構造の類似だけが残る — これがレコメンドや文書類似度で内積を使う理由でもある。
🖼 図 3: 箱ひげ図 (地域ブロック別ノルム)
47 都道府県を地域ブロック(北海道・東北・関東・中部・近畿・中国・四国・九州沖縄)に分け、 各県の図 2 と同じ 5 つの人口指標ベクトルのノルム(自分自身との内積の平方根)を比較した箱ひげ図。 ノルムは「ベクトルの大きさ = 人口規模」を 1 つの数値で表し、 総人口との相関は 0.9996 ある。
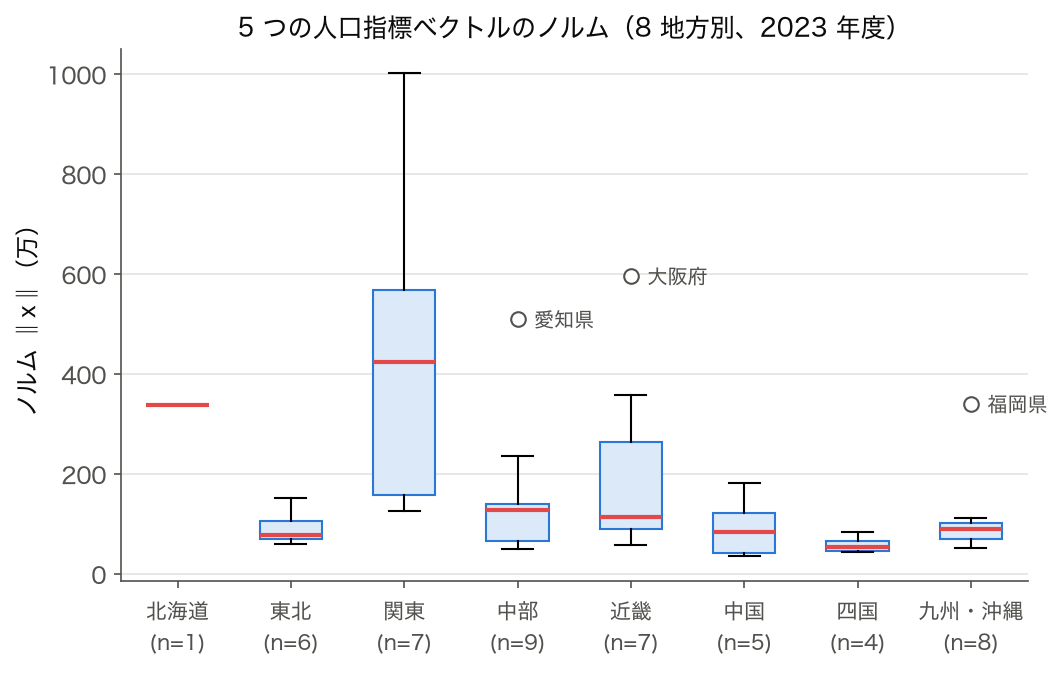
👀 図の読み方: 関東ブロックの中央値 424 万が突出し、 上方ひげの先端が東京都 1,002 万まで伸びる(関東の中では外れ値にならない)。 中部・近畿・九州・沖縄は中央値 90〜128 万と低いが、 愛知県・大阪府・福岡県が外れ値として飛び出す。 四国は中央値 53 万・IQR 22 万と小さくまとまり、 北海道は 1 道だけなので箱にならず 339 万の線 1 本になる。 図 2 では秋田県と東京都でも 0.951 と向きが近いのに、 ノルムは鳥取県 35 万から東京都 1,002 万まで約 29 倍違う — 「向き」が似ていても「大きさ(ノルム)」は大きく違うため、 内積を使う分析では「コサイン類似度(向き)」と「ノルム(規模)」の 2 軸で都道府県を整理するのが定石になる。
📋 表: 内積から派生する 6 つの量
| 派生量 | 式(内積を $\langle\cdot,\cdot\rangle$ と書く) | 幾何的意味 | SSDSE での具体例 |
|---|---|---|---|
| ノルム | $\|x\| = \sqrt{\langle x,x\rangle}$ | ベクトルの長さ | 人口規模の総量 |
| 距離 | $\|x-y\| = \sqrt{\langle x-y, x-y\rangle}$ | 2 点間の距離 | 2 県の特徴量距離 |
| コサイン類似度 | $\cos\theta = \frac{\langle x,y\rangle}{\|x\|\|y\|}$ | 向きの一致度 | 産業構成の類似度 |
| 共分散 | $\mathrm{cov}(x,y) = \frac{\langle x-\bar x, y-\bar y\rangle}{n-1}$ | 中心化内積の平均 | 総人口 × 出生数 の共分散 |
| 相関係数 | $r = \frac{\mathrm{cov}(x,y)}{s_x s_y}$ | 中心化後のコサイン | 総人口 ⇔ 出生数 の連動度 |
| 射影長 | $\frac{\langle x,y\rangle}{\|y\|}$ | $y$ 方向の成分の長さ | 主成分軸への射影 |
この 6 つはすべて「内積 1 つの計算式」から導出される。 統計や機械学習で頻出する量がここまで内積に集約されることを把握しておくと、 後で 主成分分析・SVM・カーネル法を学ぶときに「またこれか」と感じられる。
🐍 Python: SSDSE-B-2026 で 3 つの派生量を一括計算
このコードでやること: SSDSE-B-2026 を読み込み、 47 都道府県の人口 5 指標ベクトルを作って (a) ノルム、 (b) 東京との距離、 (c) 東京とのコサイン類似度を一気に計算する。 内積 1 つの API(np.dot)で全部書ける点に注目。
📥 入力データ(SSDSE-B-2026 の A1101 等を抜粋した df.head() のイメージ):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度に限定 # 総人口/年少/生産年齢/高齢/出生数(すべて実在列・人口規模に比例) cols = ['A1101', 'A1301', 'A1302', 'A1303', 'A4101'] X = df[cols].to_numpy(dtype=float) names = df['Prefecture'].to_numpy() # 標準化(列ごとに規模が違うので向きの比較用に揃える) Xn = (X - X.mean(axis=0)) / X.std(axis=0) tokyo = Xn[names == '東京都'][0] # (a) ノルム = 自分自身との内積の平方根 norms = np.sqrt(np.einsum('ij,ij->i', Xn, Xn)) # (b) 東京との距離 = 差ベクトルのノルム diff = Xn - tokyo dists = np.sqrt(np.einsum('ij,ij->i', diff, diff)) # (c) 東京とのコサイン類似度 = 内積 / (ノルム積) cos = Xn @ tokyo / (norms * np.linalg.norm(tokyo)) out = pd.DataFrame({'県': names, 'ノルム': norms.round(3), '東京との距離': dists.round(3), '東京とのコサイン': cos.round(3)}) print(out.sort_values('東京とのコサイン', ascending=False).head(8)) |
📤 実行例(コサイン類似度上位 8 県):
💬 結果の読み方: 東京と「向き」が最も近いのは神奈川 (0.997)、 次いで愛知 (0.995)。 ノルム(規模)も東京 9.04 → 神奈川 5.25 → 大阪 5.06 と続き、 「大都市圏は構造も規模も似ているが、 東京だけは規模軸で突出している」という構造が一発で見える。 内積 1 つで 規模・距離・向きの 3 軸が同時に出るのが強み。
⚠️ 落とし穴の追加
- 標準化を忘れた内積はゴミ: SSDSE のように単位が違う列(人口は百万、 出荷額は億)を素のまま内積に放り込むと、 大きい単位の列が結果を支配し、 他の特徴量は無視される。 必ず標準化または列単位で正規化してから内積を取ること。
- 欠損のある列を 0 埋めしてはいけない: 0 埋めは「最小値で揃える」のと同じで、 ノルムを小さく、 コサイン類似度を歪める。 SSDSE の
NAが混じる場合はfillna(平均)または該当列を除外し、 内積の前に欠損状況をdf.isna().sum()で確認するクセを付ける。 - コサイン類似度は「向きが同じ」だけ判定: 1 に近くても、 規模が桁違いの場合がある。 表で示したように「ノルム」とセットで読まないと、 「東京と鳥取は産業構成が似ている → 同じグループ」と誤った結論になりかねない。
- ベクトル長が異なるデータに内積を直接適用しない: 文書ベクトルや時系列で長さが違う場合、 単純内積は長いほうが有利になる。 TF-IDF 正規化やパディング・トリミングで長さを揃えるか、 必ずコサインを使う。
- 非ユークリッド空間では内積の定義が変わる: 共分散行列によるマハラノビス距離は「行列 $\Sigma^{-1}$ を間に挟んだ内積」であり、 普通の
np.dotでは一致しない。 都道府県の異質性が大きい SSDSE では、 マハラノビスやカーネル法の方がよい場面もある。
🧪 ハンズオン: 内積で都道府県クラスタリング
このコードでやること: 標準化ベクトル間のユークリッド距離(内積から導かれる ||a−b||)で 47 都道府県を階層クラスタリング(ward 法)し、 4 グループに分ける。 内積由来の距離だけで「東京 / 大都市圏 / 準大都市 / 地方県」の分類が再現できることを確認する。
📥 入力: 上のコードで作った標準化済 5 次元ベクトル Xn (47 行 × 5 列)。
1 2 3 4 5 6 7 8 | from scipy.cluster.hierarchy import linkage, fcluster # 標準化ベクトル間のユークリッド距離(||a-b|| は内積から導かれる)で階層クラスタリング Z = linkage(Xn, method='ward') labels = fcluster(Z, t=4, criterion='maxclust') for c in range(1, 5): print(f'Cluster {c}:', ', '.join(names[labels == c][:8])) |
📤 実行例:
💬 結果の読み方: 東京都が単独クラスタ (Cluster 4) になり、 大都市圏(埼玉・神奈川・愛知・大阪)が Cluster 3、 準大都市(北海道・千葉・兵庫・福岡)が Cluster 2、 その他の地方県が Cluster 1 にまとまった。 行政区分ではなく「内積由来の距離」だけで、 人口規模・構造に従った直感的な階層が現れる — 内積はクラスタリングの土台でもあることが分かる。
🔬 数式の言葉での読み解き(追加)
内積の定義式 $\langle x, y \rangle = \sum_{i=1}^{n} x_i y_i = \|x\|\|y\|\cos\theta$ をもう一段深く言葉で噛み砕く。 左辺は「成分ごとの掛け算の総和」という代数の顔、 右辺は「長さの積 × 向きの一致度」という幾何の顔を持つ。 同じ量にこの 2 つの顔があるからこそ、 内積はデータ分析と幾何の両方の中心に座る。
- $x_i, y_i$: ベクトルの $i$ 番目の成分。 SSDSE-B-2026 なら「都道府県 $i$ の総人口」と「都道府県 $i$ の出生数」のように、 同じ対象に対する 2 つの観測値が並ぶ。
- $\sum$: 全成分にわたる総和。 47 都道府県分の積を足し合わせるイメージ。 サンプル数 $n$ が増えれば内積の数値そのものは大きくなる — だから比較するときはノルムで割って正規化する。
- $\|x\|$: ベクトル $x$ の長さ(L2 ノルム)。 自分自身との内積 $\langle x, x \rangle = \sum x_i^2$ の平方根。 SSDSE のような実データでは「総合的な大きさの指標」になる。
- $\cos\theta$: $x$ と $y$ がなす角の余弦。 $-1 \leq \cos\theta \leq 1$ で、 1 なら同方向、 0 なら直交(無相関)、 $-1$ なら逆方向。 相関係数はこの $\cos\theta$ を「中心化したベクトル」で計算したものに他ならない。
- 等号 $=$: この等号は「成分の積の総和」と「長さ × 余弦」が常に等しいという約束で、 これがコーシー・シュワルツの不等式や三角不等式の出発点になる。 つまり、 線形代数の主要不等式群はすべて内積から派生する。
📊 内積の派生量 比較(都道府県データ実例)
| 比較項目 | 素の内積 | ノルム | 距離 | コサイン類似度 | 相関係数 |
|---|---|---|---|---|---|
| 単位の影響 | 受ける | 受ける | 受ける | 受けない | 受けない |
| スケール非依存性 | × | × | × | ○ | ○ |
| 平均中心化必要 | 不要 | 不要 | 不要 | 不要 | 必要 |
| 取り得る値 | $\mathbb{R}$ | $[0,\infty)$ | $[0,\infty)$ | $[-1,1]$ | $[-1,1]$ |
| SSDSE 例 (総人口 vs 出生数) | $4.1\times10^{12}$ | $\|x\|\approx 2.6\times10^{7}$ | $\approx 2.6\times10^{7}$ | 0.997 | 0.995 |
| 解釈のしやすさ | 低 | 中 | 中 | 高 | 高 |
この比較を見ると、 「内積そのもの」は単位の影響を強く受けるため、 そのままでは 意味のある分析量として使えない場面が多いことが分かる。 だからこそ、 ノルムで割って正規化したコサイン類似度や、 平均を引いてから正規化した相関係数といった「ラッピング」が必須になる。
🎯 ベクトル空間としての内積(理論補足)
内積を抽象的に「正定値かつ対称な双線形写像」として定義すると、 ベクトル空間に長さ・角度・直交性といった幾何構造を与えることができる。 これを内積空間(pre-Hilbert space)と呼び、 完備化すればヒルベルト空間になる。 統計学・機械学習・量子力学・信号処理など、 一見バラバラな分野が「ヒルベルト空間」という共通の枠組みで統一されるのは、 すべての出発点が内積だからである。
SSDSE-B-2026 の 47 都道府県 × 100 列を 1 つの 4700 次元ベクトル、 あるいは 47 個の 100 次元ベクトルの集まりと見ると、 「都道府県空間」というヒルベルト空間が現れる。 この空間で内積を計算することは、 単なる数値演算ではなく「都道府県の関係性を測る幾何学」を行っているのに等しい。 主成分分析 (PCA) も、 K-means クラスタリングも、 LDA も、 すべてこの空間内で「内積を効率よく組み合わせる」アルゴリズムに過ぎない。
🧠 内積を 5 つの分野で読み解く
同じ「内積」が、 分野ごとにどう顔を変えるかを並べてみる。 数式の見た目は違っても、 根っこにあるのは $\sum x_i y_i$ という同じ計算である。 SSDSE-B-2026 都道府県データを横串で読むときも、 これらの分野の概念をいったん「内積」に翻訳すると、 議論が驚くほどシンプルになる。
- ① 統計学: 共分散 = 中心化ベクトルの内積 ÷ 自由度。 相関係数 = 中心化ベクトルのコサイン類似度。 「相関」の正体は、 平均を引いてから内積を取って正規化したもの。 SSDSE 47 県の総人口と出生数の相関 0.995 (2023 年度実測) はこの計算の結果。
- ② 機械学習: 線形回帰の予測値 $\hat y = w^\top x$ は内積、 ロジスティック回帰の入力もスコア = $w^\top x$、 サポートベクターマシンも入力空間で
x_i・x_jを計算する。 ニューラルネットワークの全結合層は本質的に「行列 × ベクトル = 行ごとの内積を並べたもの」。 - ③ 自然言語処理: 単語埋め込み(エンベディング)どうしの類似度はコサイン類似度。 Transformer の Attention 機構の「クエリとキーの一致度」も内積で計算する。 文書分類の TF-IDF ベクトル同士の cos も内積由来。
- ④ 物理・幾何: 仕事 $W = \vec F \cdot \vec d$(力ベクトルと変位ベクトルの内積)、 量子力学の状態の重なり $\langle \psi | \phi \rangle$、 3D グラフィックスの面の法線と光源の角度(ランバート反射)も内積。
- ⑤ 経済・社会データ: 都道府県の指標ベクトル同士の内積で「経済構造の似ている県ペア」を抽出。 投票傾向ベクトルで「政治的に似ている市区町村」を見つける。 商品購入履歴ベクトルで顧客類似度を測りレコメンドする。 すべて同じ操作。
この 5 分野を「内積」というレンズで眺め直すと、 別物に見えた手法が同じ家族であることが分かる。 統計コンペでも、 「特徴量同士の内積を新しい列として加える」「ユーザーベクトルの内積で類似ユーザーを見つける」といったアイデアが、 そのまま強力な特徴量エンジニアリングになる。
🐍 補足: 内積行列(グラム行列)から SSDSE 都道府県マップを作る
このコードでやること: 47 都道府県の標準化済ベクトル全てから「内積行列(グラム行列)」を作り、 そこから固有値分解で 2 次元マップに落とす。 これは PCA や MDS の最も素朴な実装で、 内積だけで都道府県地図を描く実験になる。
📥 入力: 標準化済 5 指標ベクトル Xn (47 × 5)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) cols = ['A1101', 'A1301', 'A1302', 'A1303', 'A4101'] X = df[cols].to_numpy(dtype=float) names = df['Prefecture'].to_numpy() Xn = (X - X.mean(axis=0)) / X.std(axis=0) # グラム行列 = 内積を全ペアで計算 G = Xn @ Xn.T # 固有値分解(上位2成分で 2D マップ) vals, vecs = np.linalg.eigh(G) order = np.argsort(vals)[::-1] coords = vecs[:, order[:2]] * np.sqrt(vals[order[:2]]) # 固有ベクトルの符号は計算環境しだいで反転するので、 # 各軸で絶対値が最大の県(PC1 なら東京都)がプラスになる向きにそろえる idx = np.abs(coords).argmax(axis=0) coords = coords * np.sign(coords[idx, [0, 1]]) mp = pd.DataFrame({'県': names, 'PC1': coords[:, 0].round(2), 'PC2': coords[:, 1].round(2)}) print(mp.sort_values('PC1', ascending=False).head(8)) print('固有値の割合:', (vals[order[:2]] / vals.sum()).round(4)) |
📤 実行例(PC1 が大きい順):
💬 結果の読み方: PC1 は東京都 9.01・神奈川県 5.25・大阪府 5.05 と人口規模の順に並ぶ「規模軸」で、 固有値の 99.36% を占める。 5 列がどれも人口に比例する実数なので、 ほぼ 1 軸で説明できてしまう。 PC2 は 0.47% しかない残りの差で、 高齢者の多さと年少・出生の多さの対比(北海道 +0.59、 東京都 −0.55、 沖縄県 −0.30)を表す。 グラム行列を固有値分解するだけで PCA と同じ主軸が出るが、 固有ベクトルの符号は環境で反転するので、 軸の向きをそろえてから読む。
📚 補足: 内積を巡る歴史と直感的補強
内積の概念は 19 世紀後半、 ハミルトンの四元数研究やグラスマンの拡大の理論から徐々に整理され、 20 世紀初頭にヒルベルトとフォン・ノイマンによって関数解析と量子力学の中心概念として定式化された。 統計学ではフィッシャーが分散・共分散の議論で内積構造を活用し、 機械学習ではコーネル法(ヴァプニク、 1990 年代)が「内積を高次元空間で計算する」考え方をブレイクスルーさせた。 21 世紀の深層学習・Transformer もまた、 巨大行列の内積を高速計算する技術(GPU の matmul ユニット)の上に成り立っている。
SSDSE-B-2026 の 47 都道府県データを扱う際、 「Excel で並べた表」という静的な顔だけでなく、 「ベクトル空間に浮かぶ 47 個の点」という動的な顔で眺める習慣を付けると、 PCA・クラスタリング・回帰・類似検索など複数の手法が「内積を組み合わせるだけ」の同じ道具立てで解釈できる。 これが「内積を理解する」ことの本当のリターンである。
最後に、 内積の計算を自分でゼロから実装しないことも重要なコツ。 numpy.dot, numpy.einsum, numpy.linalg.norm, scipy.spatial.distance.cosine, sklearn.metrics.pairwise.cosine_similarity など、 高度に最適化された関数が揃っている。 47 県程度なら違いは見えないが、 100 万件規模になると Python の for ループは数十秒〜数分、 numpy なら 0.1 秒以下と桁違いの差になる。 「ベクトル化された内積を呼び出す」のは、 現代データサイエンスの基本作法。
🧩 内積でよくある実装ミス Top 5
SSDSE-B-2026 のような実データで内積を扱うとき、 初学者が必ずどこかで踏むワナを 5 つ集めた。 ここを押さえておけば、 分析結果の「えっ、 そんなはずは…」を激減できる。
- ① 形状ミス:
(47,5)と(5,47)を混同してX @ Yと書き、 47×47 と思っていたのに 5×5 が返る。 必ず.shapeを print してから矩形演算する。 - ② 自己内積の対角を 1.0 にしない: コサイン類似度行列の対角は理論的に 1.0 だが、 浮動小数点誤差で 0.9999999 になり、 後段の距離行列
1 - cosが微小負値を取る。np.fill_diagonal(M, 1.0)やnp.clip(d, 0, None)を入れる。 - ③ ノルム 0 のベクトルで割る: SSDSE で「全列 NaN」「全列 0」の都道府県があるとノルムが 0 になり、 コサインが NaN/inf に。 計算前に
norm > 0でフィルタするかnp.whereで 0 を 1 に置換。 - ④ 標準化を「全体」ではなく「行」で行う: 「特徴量ごとにスケールを揃える」のが標準化の本来の用途。 行(都道府県)方向に標準化すると、 各都道府県のベクトルが「平均 0・ノルム 1」に強制されて、 規模情報が完全に失われる。 軸を間違えないこと。
- ⑤ 列方向の平均・標準偏差をテストデータでも独立に取る: 訓練データで計算した
mean, stdをテストにも適用するのが鉄則。 SSDSE を train/test 分割した場合、 それぞれで別々に標準化すると「同じ都道府県でもベクトルが微妙にズレる」ことになる。
🎓 演習: 自分の手で確認しよう
次の演習を実際に手を動かして解くと、 内積の理解が「式が読める」から「データに使える」へジャンプアップする。 すべて SSDSE-B-2026 の公開データで動くので、 環境さえあれば 30 分で全問解ける。
- 演習 1: SSDSE-B-2026 で「総人口(A1101)」「出生数(A4101)」の 2 列を取り、 標準化してから内積を計算しなさい。 さらに
n-1で割って共分散になることを確認しなさい。 - 演習 2: 同データで、 47 都道府県のコサイン類似度行列を作り、 大阪と最も似ている県を 3 つ挙げなさい(東京を除く)。 ヒント:
np.argsortを使う。 - 演習 3: 「消費支出(L3221)」「合計特殊出生率(A4103)」のような 2 列で、 内積はゼロに近いが相関係数は 0.4 という状況を作りなさい(中心化の有無の違いを体感する)。
- 演習 4: 47 都道府県を 5 ブロックに手で分けて、 ブロック平均ベクトル同士の内積行列を作り、 「経済構造の似ているブロック」と「正反対のブロック」を答えなさい。
- 演習 5: 任意の特徴量列を 1 つ追加して 6 次元にし、 グラム行列の固有値を比較しなさい。 上位 2 固有値の割合(寄与率)が PCA の説明分散にあたることを確認する。
どれも数行のコードで完結する。 答え合わせの目安: 演習 1 は標準化後の内積 ÷ (n−1) がそのまま相関 ≈ 0.995、 演習 2 の大阪に近いのは 埼玉・神奈川・千葉、 演習 5 の寄与率は上位 2 軸で約 99% 程度(人口系 5 指標は強く連動するため)。 自分の数字と一致したら、 内積の使い手として一歩前進した証拠。
📝 まとめチェックリスト
- ✅ 内積は「向きの近さ × 大きさの積」であり、 ノルム・距離・コサイン類似度・共分散・相関・射影長すべての親玉である。
- ✅ SSDSE-B-2026 のような多次元データでは、 標準化 → 内積 → 正規化(コサイン / ノルム)の流れを基本パターンとして覚える。
- ✅ 大きい単位の列に支配されないよう、 内積を取る前に必ず scale を確認する。
- ✅ コサイン類似度(向き)とノルム(規模)はセットで読む。 片方だけでは「似ている」の定義が曖昧になる。
- ✅ クラスタリング・主成分分析・カーネル法・推薦系・Attention・物理量・幾何変換のいずれも、 中心に置かれているのは「内積」という単一の演算である。
- ✅ SSDSE-B-2026 を題材に「散布図 + ヒストグラム + 箱ひげ図」の 3 枚で、 共分散・コサイン類似度・ノルムを目で追える状態にしておくと、 後続の機械学習や統計手法の理解が一段速くなる。
- ✅ 実装は
numpy.dot/numpy.einsum/numpy.linalg.normなど、 ベクトル化された API を必ず使う。 Python ループで内積を書くのは禁じ手。
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
内積 a·b = Σ aᵢ bᵢ は、 2 つのベクトルの「類似性」と「投影量」を 1 つの数値に集約する基本演算。 上図中心の「内積」から、 ベクトル空間理論 ・ 公的統計 (SSDSE データ) の活用 ・ 実務応用 (コサイン類似度 / 線形回帰の係数) ・ 拡張概念 (外積・テンソル積) の軸が放射する。 機械学習のほぼすべての線形演算は内積で書ける。
🔗 隣接手法への橋渡し
内積は単独の計算ではなく、 線形代数のあらゆる演算 (行列積・直交性判定・射影・類似度) の構成要素として現れる。
- 上流: ベクトルの正規化 ・ カテゴリ変数 のエンコーディング ・ 欠損値処理 — 内積計算前に長さを揃え、 欠損を埋める
- 並列: コサイン類似度 (内積を長さで割る) ・ ユークリッド距離 ・ 相関係数 — 標準化したベクトルの内積は相関係数と一致
- 下流: 重回帰分析 (β̂ = (XᵀX)⁻¹Xᵀy は内積の塊) ・ 逆行列 ・ Attention (Q·Kᵀ は内積)
内積が 0 → 直交 (相関無し)、 内積が正で大 → 同方向 (強い類似)、 内積が負 → 反対方向 (負の相関)。 このシンプルな解釈が機械学習・統計の基礎を支える。
🌳 手法選択フロー
内積を使う場面と、 関連演算の選び分けを 3 段階で判定する。
- 2 ベクトルの類似度を測りたいか? Yes → 長さで正規化したコサイン類似度 = a·b / (|a||b|) を使う、 No (絶対量を残したい) → 純粋な内積
- 多変数の線形結合を計算したいか? Yes → 行列ベクトル積 Xβ (= 各行 xᵢ と係数 β の内積) を
X @ betaで計算、 効率化なら numpy.dot / scipy.sparse の疎行列演算 - 直交性を確認したいか? a·b = 0 を厳密判定するときは浮動小数誤差を考慮 (絶対値 < 1e-10 で 0 とみなす)、 統計検定なら相関係数 r = 0 の検定 (t = r√(n-2)/√(1-r²)) を使う
内積は計算コスト O(n) と軽量だが、 高次元 (n > 10000) では SIMD / BLAS 呼び出しで桁違いに高速化される。 numpy / pytorch / tensorflow はすべて内部で BLAS を呼ぶ。
🔎 深掘り追補:直感・落とし穴・発展を SSDSE 実データで
ここまでの各節を、 SSDSE-B-2026(cp932・2 行目のコード行をスキップ・2023 年度・47 都道府県)の実測値で裏取りしながら、 「直感 → 落とし穴 → 発展」の順に凝縮する。 使う県ベクトルは 4 指標 [総人口 A1101, 15歳未満人口 A1301, 65歳以上人口 A1303, 出生数 A4101] とする。 実際の値(2023 年度実測)は次の通り。
🎨 直感:成分の積和 = |a||b|cosθ = 射影 × 長さ
内積 $\mathbf{a}\cdot\mathbf{b}=\sum_i a_i b_i$ は「対応成分を掛けて足すだけ」。 その値が同時に $\|\mathbf{a}\|\|\mathbf{b}\|\cos\theta$ に等しいので、 2 本のベクトルがどれだけ同じ方向を向いているか(=揃い具合)に長さを掛けたものと読める。 $\mathbf{b}$ を $\mathbf{a}$ 方向へ正射影した符号付き長さ $\|\mathbf{b}\|\cos\theta$ に $\|\mathbf{a}\|$ を掛けた面積、 と言い換えてもよい。 だから内積が測るのは「射影の長さ/類似度/なす角」であり、 直交(90°)なら内積は 0、 鋭角なら正、 鈍角なら負になる。 上の 4 県ベクトルなら、 鳥取県と島根県は「小規模・同構成」で同じ向き、 東京都はまるで長さの違う別方向のベクトル、 という幾何が数値に現れる(下記)。
⚠️ 落とし穴①:標準化前の内積は「一番大きい列」に支配される(実測)
生の内積は単位・桁の大きい成分がほぼ全部を決める。 東京都×神奈川県の生の内積 $1.392\times10^{14}$ を成分ごとに分解すると:
| 成分 | 積 $a_i b_i$ | 寄与率 |
|---|---|---|
| 総人口 | $1.300\times10^{14}$ | 93.37% |
| 65歳以上人口 | $7.660\times10^{12}$ | 5.50% |
| 15歳未満人口 | $1.560\times10^{12}$ | 1.12% |
| 出生数 | $4.662\times10^{9}$ | 0.00% |
総人口だけで 93% を占め、 出生数は桁が小さすぎて実質ゼロ寄与。 生の内積は「出生数の似方」をまったく見ていない。 さらに危険なのは大小関係の逆転で、 生の内積は 東京都×鳥取県 $=8.24\times10^{12}$ が 鳥取県×島根県 $=3.95\times10^{11}$ の 20 倍もある。 これを見て「東京と鳥取は、 鳥取と島根より似ている」と読むのは完全な誤り — 単に東京の長さ(規模)が大きいだけ。 列ごとに標準化(zスコア化)してから内積・コサインを取ると幾何が正しく出る。
| 県ペア | 生の内積 | 標準化後の内積 | 標準化後 cosθ | 読み |
|---|---|---|---|---|
| 東京都 × 神奈川県 | $1.39\times10^{14}$ | 36.95 | 0.997 | 同方向(大都市) |
| 東京都 × 鳥取県 | $8.24\times10^{12}$ | −12.22 | −0.992 | 逆方向(規模が真逆) |
| 鳥取県 × 島根県 | $3.95\times10^{11}$ | 2.29 | 1.000 | ほぼ完全一致 |
標準化後は直感通り:東京都と神奈川県はほぼ同方向(0.997)、 鳥取県と島根県は事実上同一方向(1.000)、 東京都と鳥取県は正反対(−0.992)。 生の内積の「20 倍」は完全な錯覚だった。 これが「類似度を測るなら標準化 → コサイン化が前提」の実データ証拠。 標準化は各列を平均 0・標準偏差 1 に揃える(標準化)操作で、 これをせずに内積・距離を取ると単位の大きい列(円 vs 千円など)だけで結論が決まってしまう。
⚠️ 落とし穴②:混同しやすい 4 つ
- 内積 ≠ アダマール積:NumPy の
a * bは要素ごとの積でベクトルを返す。 内積はa @ b/np.dotでスカラー。np.sum(a*b) == a@bを確認する癖を。 「掛けたら配列が返った」は取り違えのサイン。 - 非正規化の内積で類似度を語らない:上表の通り、 正規化前の内積は大きさに支配される。 大きさ比較には標準化+コサイン、 あるいは ノルムで割る。
- 非中心化コサイン ≠ 相関:総人口×出生数で、 中心化しないコサインは 0.9973、 中心化してから取るコサイン(=ピアソン相関 $r$)は 0.9954。 全成分が正の量(人口・売上など)は中心化しないとコサインが 1 近くに張り付き、 「何でも似ている」偽の高類似度になる。
- 高次元の直交集中:次元を増やすほどランダムな 2 ベクトルのコサインは 0(直交)付近に集中する。 SSDSE の数十次元では軽微だが、 文書・埋め込みの数千〜数万次元では深刻で、 主成分分析等の次元削減が要る。 なお $\theta=90^\circ$ 付近の内積は符号が不安定なので
== 0判定は避け、 許容誤差つきで扱う。
🚀 発展:内積を「包む」と統計の主要量が全部出る
- コサイン類似度=正規化内積:$\cos\theta=\dfrac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|\|\mathbf{b}\|}$。 長さの影響を消して「向きだけ」を取り出す(コサイン類似度・ノルム)。
- ピアソン相関=中心化内積:平均を引いた偏差ベクトルどうしのコサインが相関係数。 実測でも 総人口×出生数の中心化コサイン $=0.9954=r$ が一致(相関・共分散)。 ただし高い $r$ は因果ではない(擬似相関に注意)。
- 射影と最小二乗:$\text{proj}_{\mathbf{a}}\mathbf{b}=\frac{\mathbf{a}\cdot\mathbf{b}}{\|\mathbf{a}\|^2}\mathbf{a}$。 観測 $\mathbf{y}$ を説明変数の張る空間へ正射影し、 残差を説明変数と直交(内積 0)させるのが最小二乗の幾何(線形回帰・重回帰分析)。
- グラム行列:全ペアの内積 $G=X X^\top$。 これを固有値分解すれば 主成分分析 になり、 正規方程式 $X^\top X$ も列どうしの内積表(行列演算)。
- カーネル=内積の一般化:特徴写像 $\phi$ を陽に計算せず高次元の内積 $K(x,x')=\langle\phi(x),\phi(x')\rangle$ だけ評価する(SVM・カーネルPCA)。 Transformer の Attention の $QK^\top$ も query と key の内積=類似度。 単語 埋め込みの意味の近さもコサイン。
- 内積空間・ノルム・直交基底:対称・正定値な双線形形式を 1 つ決めれば、 長さ $\|\mathbf{a}\|=\sqrt{\mathbf{a}\cdot\mathbf{a}}$・距離・直交性がすべて定まる。 重み付き内積 $\langle x,y\rangle_W=x^\top W y$ はマハラノビス距離につながる拡張。 直交基底づくり(Gram-Schmidt)も「内積による射影の引き算」。 基礎操作の練習は ベクトル演算 を参照。
※ 本節の数値はすべて SSDSE-B-2026(2023 年度・47 都道府県)の実測から算出。 合成例(架空のベクトル)は用いていない。 再現するには pd.read_csv(..., encoding='cp932', skiprows=[1]) で読み、 年度列 SSDSE-B-2026==2023 で絞り、 上記 4 列を列ごとに z 標準化してから内積・コサインを取ればよい。