🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
🔖 キーワード索引 — 完全強化版
「ノルム」を理解するうえで必要なキーワードを 10 件以上提示します。 各チップから対応セクションへ移動できます。
30 秒結論 文脈 直感 数式 記号読み解き 実値計算 Python 実装 落とし穴 関連手法 関連用語 グループ教材 概念マップ
💡 30秒で分かる結論
🍰 まずはやさしく
ノルムはベクトルの大きさを測る定規のようなものです。
データの距離や大きさを計算するために使います。
スマホのアプリで2点間の距離を出すときなどに役立ちます。
ここではノルムの種類と使い道を短くまとめます。
ノルムは、 ベクトルの「大きさ」を測る関数。 機械学習・正則化・距離計算の基礎。
- L1 (マンハッタン):|x_1|+|x_2|+...=絶対値の和
- L2 (ユークリッド):√(x_1²+x_2²+...)=原点からの直線距離
- L∞ (最大):max|x_i|
- 用途:距離(KNN)、 正則化(Ridge=L2 / Lasso=L1)、 損失関数
- 性質:非負性・三角不等式・正の同次性
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 正規化忘れ/L1 と L2 の取り違え/複素ベクトル には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「ノルム」はどんな場面で出てくる?
🍰 まずはやさしく
ノルムはデータの大きさを測る道具です。
AIがデータを分類したり、異常を見つけたりするために使います。
部活動の成績を数値にして比べる場面などで出てきます。
この章ではノルムがどんな場面で登場するかを説明します。
回帰・分類モデルの正則化、 クラスタリングの距離計算、 異常検知の閾値設計など、 ML 全般でベクトルの大きさを測る必要が常に発生。
🎨 直感で掴む
🍰 まずはやさしく
ノルムはデータを眺めるための眼鏡のようなものです。
計算方法を変えてデータの見え方を変えるために使います。
買い物で最短ルートを探すときのような感覚で考えます。
ここでは図や例えを使って直感的に理解しましょう。
「ノルム」を最初に学ぶときは、 厳密な定義よりイメージを優先しましょう。 以下は具体例・比喩を用いた直感的理解の入口です。
- L1 = タクシー距離(碁盤目状の街)/ L2 = 直線距離(鳥が飛ぶ)/ L∞ = チェス王様の距離。
- L1 はスパース解を生む。 Lasso 回帰が変数選択になる理由。
- L2 は滑らか。 Ridge 回帰が係数を一律に縮める理由。
🎨 ノルムの幾何学的解釈
単位球の形(2 次元での視覚化)
| ノルム | $\|x\|_p = 1$ の形 | 境界の頂点・特徴 |
|---|---|---|
| L1 | 菱形(45° 回転正方形) | (±1, 0), (0, ±1) の 4 頂点 |
| L2 | 真円 | 頂点なし、 完全に丸い |
| L∞ | 正方形 | (±1, ±1) の 4 頂点 |
| L4, L5... | 「角の丸い正方形」 | p が増えると L∞ に近づく |
| L0.5 | 星形(非凸) | 凹みあり、 三角不等式不成立 |
Lasso が L1、 Ridge が L2 — 幾何学的に
「損失関数の等高線」と「罰則ボール」の 初接触点が解。 L1 ボールは頂点(軸上の点)を持つため、 接触点が軸上=係数の一部が 0 になりやすい。 L2 ボールは円なので、 接触点は一般位置=係数は小さくなるが 0 にはならない。
凸性と最適化
$p \geq 1$ の Lp ノルムは 凸関数。 したがって、 罰則項として使うと最適化問題が凸となり、 局所最適 = 大域最適。 これが「L1, L2 がよく使われ、 L0.5 や L0 はあまり使われない」理由の一つ。
📐 定義・数式
🍰 まずはやさしく
ノルムは数式で表されるルールのことです。
誰が計算しても同じ答えになるように定義します。
テストの点数を合計して平均を出すときのように正確に計算します。
ここでは具体的な数式とその読み方を学びます。
やさしい説明で掴んだ感覚を、ここで ℓ_p ノルムの一般形 の定義式に対応づけます。下の式は左辺 $\|\mathbf{x}\|_p$ が何で決まるかを右辺で書き下したもので、Σ(合計) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
📐 数式を言葉で読み解く — Lp ノルムの統一視点
一般的な Lp ノルムは次のように定義されます:
$$ \|\mathbf{x}\|_p \;=\; \left( \sum_{i=1}^{n} |x_i|^p \right)^{1/p} \qquad (1 \le p \le \infty) $$
数式を言葉で読み解く:各成分の絶対値を p 乗してから合計し、 1/p 乗で元のスケールに戻す。 p=1 なら絶対値の和、 p=2 なら二乗和の平方根、 p→∞ なら最大成分。
特殊ケース
| p | 名称 | 定義 | 幾何学的形(単位球) |
|---|---|---|---|
| 1 | マンハッタン | $\sum|x_i|$ | 菱形(ダイヤモンド) |
| 2 | ユークリッド | $\sqrt{\sum x_i^2}$ | 真円・球 |
| 3, 4, ... | 高次 Lp | $(\sum|x_i|^p)^{1/p}$ | 角が丸まった四角形 |
| ∞ | チェビシェフ | $\max|x_i|$ | 正方形・立方体 |
| 0(厳密にはノルムではない) | L0 「ノルム」 | 非ゼロ成分数 | 軸上の点のみ(スパース) |
🐍 Python 実装 #C1: p を変えてノルムを連続計算
🎯 このコードでやること:東京-沖縄の差ベクトルに対し、 p=1,1.5,2,3,5,10,∞ と変えて Lp 距離を計算。 p が大きくなると最大成分が支配的になる様子を観察。
📥 入力データ:東京-沖縄の差ベクトル(生値):差成分=[12,618,000, 12,005,000, 1,277,000]。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # ── この抜粋で使うベクトルを用意します ── import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年の 47 都道府県 cols = ['A1101', 'A1303', 'A4101'] # 総人口 / 65歳以上人口 / 出生数 vecs = {p: df[df['Prefecture'] == p][cols].values[0].astype(float) for p in ['東京都', '沖縄県']} d = vecs['東京都'] - vecs['沖縄県'] print('差ベクトル:', d.astype(int)) for p in [1, 1.5, 2, 3, 5, 10]: norm_p = np.sum(np.abs(d)**p)**(1/p) print(f' L{p:>4}: {norm_p:>14,.0f}') print(f' L_inf: {np.max(np.abs(d)):>14,.0f}') |
📤 実行結果:
💬 結果の読み方:p を上げると L1 = 1,554.7 万 → L∞ = 1,261.8 万へ単調に減る。 差ベクトルの成分は総人口の差 1,261.8 万が 65 歳以上人口の差 285.5 万・出生数の差 7.4 万より桁違いに大きいので、 L2 = 1,293.7 万の時点で L∞ との差は 2.5% しかなく、 p = 10 ではほぼ総人口の差そのものになる。 L1 だけが 23% 大きいのは、 2 番目の成分 285.5 万をそのまま足し込むため。 単位の違う列を標準化せずに並べると、 どのノルムでも最大成分がほぼすべてを決めてしまう。
📐 ノルムの公理 — なぜ「ノルム」と呼べるのか
関数 $\|\cdot\| : \mathbb{R}^n \to \mathbb{R}$ がノルムであるためには、 以下の 3 つの公理を満たす必要があります:
公理 1: 非負性と定値性
$$ \|\mathbf{x}\| \geq 0, \qquad \|\mathbf{x}\| = 0 \iff \mathbf{x} = \mathbf{0} $$
数式を言葉で読み解く:ノルムは常に非負であり、 0 になるのはゼロベクトルのときだけ。 これにより「距離が負」「中身があるのに大きさ 0」という不合理を防ぐ。
公理 2: 同次性(スカラー乗算)
$$ \|c \cdot \mathbf{x}\| = |c| \cdot \|\mathbf{x}\| \qquad \text{for all } c \in \mathbb{R} $$
数式を言葉で読み解く:ベクトルを 2 倍にすると、 ノルムも 2 倍に。 負のスカラー(-3 倍)なら、 ノルムは 3 倍に。 「向きは関係ない、 大きさだけ比例する」。
公理 3: 三角不等式
$$ \|\mathbf{x} + \mathbf{y}\| \leq \|\mathbf{x}\| + \|\mathbf{y}\| $$
数式を言葉で読み解く:直接行く距離は、 経由する距離以下。 これは「三角形の二辺の和は他辺より大きい」の一般化で、 距離空間の根幹。
L0 が「真のノルム」ではない理由
「L0 ノルム」=非ゼロ成分数 は同次性を満たさない:
$$ \|2\mathbf{x}\|_0 = \|\mathbf{x}\|_0 \neq 2 \|\mathbf{x}\|_0 $$
2 倍してもゼロでない成分数は変わらないため。 そのため厳密には「擬ノルム」または「カウント関数」と呼ばれます。 ただし機械学習ではスパース性指標として実用的に L0 と呼ばれます。
Lp が p < 1 でノルムにならない理由
$$ \|(1,0)\|_{0.5} = 1, \quad \|(0,1)\|_{0.5} = 1, \quad \|(1,1)\|_{0.5} = 4 $$
三角不等式 $4 \leq 1 + 1$ は成立しないため、 p < 1 のときは厳密にはノルムでありません(擬ノルム)。 ただし距離尺度として実用的に使われることがあります。
📐 行列ノルムへの拡張
ベクトルのノルムを行列に一般化したものを 行列ノルムと呼びます。 機械学習・最適化で頻出。
代表的な行列ノルム
| 名称 | 定義 | 用途 |
|---|---|---|
| Frobenius | $\|A\|_F = \sqrt{\sum_{ij} a_{ij}^2}$ | 全要素の二乗和、 一般的 |
| スペクトルノルム | $\|A\|_2 = \sigma_{\max}(A)$ | 最大特異値、 写像の最大伸び率 |
| 核ノルム | $\|A\|_* = \sum_i \sigma_i(A)$ | 低ランク行列復元(Netflix Prize) |
| 1-ノルム(誘導) | $\|A\|_1 = \max_j \sum_i |a_{ij}|$ | 最大列和 |
| ∞-ノルム(誘導) | $\|A\|_\infty = \max_i \sum_j |a_{ij}|$ | 最大行和 |
🐍 Python 実装 #I1: SSDSE データ行列のノルム
🎯 このコードでやること:47 × 6 の SSDSE データ行列について、 各種行列ノルムを計算。
📥 入力データ:z-score 標準化された 47 × 6 の行列 Mz。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np import pandas as pd from sklearn.preprocessing import StandardScaler # ── この抜粋で使う 47 × 6 の行列 Mz を用意する ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023].reset_index(drop=True) COLS6 = ['A1101', 'A1303', 'A4101', 'A4200', 'A9101', 'L3221'] # 総人口 / 65歳以上人口 / 出生数 / 死亡数 / 婚姻件数 / 消費支出 Mz = StandardScaler().fit_transform(_d[COLS6].values.astype(float)) A = Mz # 47 × 6 行列 print(f'Frobenius ||A||_F = {np.linalg.norm(A, "fro"):.3f}') print(f'スペクトル ||A||_2 = {np.linalg.norm(A, 2):.3f}') print(f'核ノルム ||A||_* = {np.linalg.norm(A, "nuc"):.3f}') print(f'最大列和 ||A||_1 = {np.linalg.norm(A, 1):.3f}') print(f'最大行和 ||A||_∞ = {np.linalg.norm(A, np.inf):.3f}') # 特異値 U, S, Vt = np.linalg.svd(A, full_matrices=False) print(f'特異値: {S.round(3)}') print(f'核ノルム = 特異値の和 = {S.sum():.3f}') |
📤 実行結果:
スペクトル ||A||_2 = 15.421
核ノルム ||A||_* = 24.337
最大列和 ||A||_1 = 36.462
最大行和 ||A||_∞ = 22.137
特異値: [15.421 6.415 1.64 0.53 0.244 0.087]
核ノルム = 特異値の和 = 24.337
💬 結果の読み方:スペクトル = 最大特異値 (15.421)、 核ノルム = 全特異値の和 (24.337)。 第 1 特異値が支配的なので「データはほぼ 1 次元的」、 これは PCA で第 1 主成分の寄与率が 84.3%(= 15.421² / Σs²)という事実と整合する。
📜 ノルムの歴史
| 年 | 人物 | 貢献 |
|---|---|---|
| 紀元前 300 | エウクレイデス | 『原論』で 2 点間距離(ユークリッド距離)の幾何学 |
| 1896 | ヘルマン・ミンコフスキー | 『数の幾何学』で有限次元の p ノルムと三角不等式(ミンコフスキー不等式)を扱う |
| 1910 頃 | フリードリヒ・リース | 関数の Lp 空間 (Riesz-Fischer 定理) |
| 1922 | ステファン・バナッハ | バナッハ空間(完備ノルム空間)の公理化 |
| 1932 | ジョン・フォン・ノイマン | 『量子力学の数学的基礎』でヒルベルト空間を量子力学に応用 |
| 1936 | プラサンタ・チャンドラ・マハラノビス | Mahalanobis 距離の提案(インド統計学派) |
| 1996 | ロバート・ティブシラニ | Lasso(L1 罰則回帰) |
| 2005 | エマニュエル・カンデス、 テレンス・タオ | 圧縮センシング(L1 と L0 の等価性) |
| 2009 | カンデス・レヒト | 核ノルム最小化による行列復元(Netflix Prize の数学) |
📝 「どのノルムを使うか」1 行ガイド
- 線形回帰の罰則(特徴選択したい) → L1 (Lasso)
- 線形回帰の罰則(係数を縮小したい、 多重共線性対策) → L2 (Ridge)
- テキスト類似度 → cosine
- 画像エッジ保存平滑化 → TV ノルム(L1 of gradient)
- 異常検出 → Mahalanobis
- クラスタリングのデフォルト → 標準化後の L2 (Euclidean)
- 外れ値に頑健にしたい → L1 (Manhattan) or Huber
- 最悪ケース誤差 → L∞ (Chebyshev)
- 低ランク行列復元 → 核ノルム
- adversarial robust ML → L∞ ball 内の摂動
📐 Lp ノルム一般化と p の選び方
L1, L2, L∞ は Lp ノルムの特殊例。 $$\|x\|_p = \left(\sum_i |x_i|^p\right)^{1/p}$$ で p=1, 2, ∞ それぞれ。 p を連続的に変えてみる。
このコードでやること: 東京-沖縄ベクトル差について p=0.5, 1, 1.5, 2, 3, 5, 10, ∞ で Lp ノルムを計算し、 p が増えると最大値ノルム L∞ に収束することを確認する。
📥 入力データ: 標準化済み Z(A1101/A1303/A4101) から東京と沖縄の差ベクトル。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # ── この抜粋で使うデータを用意します ── # Z は 47 都道府県 × 3 指標を標準化した行列。行の並びは SSDSE の順。 import numpy as np import pandas as pd from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) cols = ['A1101', 'A1303', 'A4101'] # 総人口 / 65歳以上人口 / 出生数 Z = StandardScaler().fit_transform(df[cols].astype(float).values) diff = Z[12] - Z[46] # 東京 - 沖縄 p_list = [0.5, 1, 1.5, 2, 3, 5, 10, 100] result = [] for p in p_list: val = (np.sum(np.abs(diff)**p))**(1/p) result.append((p, round(val, 3))) print(pd.DataFrame(result, columns=['p', 'Lp_norm'])) |
📤 実行結果:
💬 結果の読み方: p を 1 → 2 → 100 と上げると 13.067 → 7.549 → 4.560 と減り、 最大成分(総人口の z 差 4.559)に収束する。 p = 0.5 の 39.186 が L1 より大きいのは、 1 より大きい成分を平方根で縮めてから足し、 最後に 2 乗して戻すため。 p < 1 の「準ノルム」は三角不等式 $\|x+y\| \leq \|x\| + \|y\|$ を満たさないので厳密にはノルムではなく、 距離としてクラスタリングなどに使うと結果が保証されない。
表 p 値ごとのノルムの性質
| p | 名称 | 幾何(単位球) | 主な用途 |
|---|---|---|---|
| 0 | L0 (非ノルム) | 座標軸上の点のみ | 非ゼロ要素数。 最厳格スパース化 |
| 1 | L1 / Manhattan | 正八面体(diamond) | Lasso、 ロバスト統計、 LAD 回帰 |
| 2 | L2 / Euclidean | 球 | 最小二乗、 Ridge、 距離計量の標準 |
| ∞ | L∞ / Chebyshev | 立方体 | 最悪ケース解析、 minmax 最適化、 チェス距離 |
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
数式を眺めるだけでは身につかないので、 各記号がどんな役割を担っているかを言葉で押さえます。 「数式を音読する習慣」がつくと、 論文や教科書を読むスピードが体感で 2 倍ほど上がります。
- x
- n 次元ベクトル
- ‖·‖_p
- p ノルム
- p=1
- L1 = 絶対値和
- p=2
- L2 = 二乗和の平方根
- p=∞
- 成分の最大絶対値
🔬 SSDSE-B-2026 実データでノルムを徹底比較
ここからは SSDSE-B-2026(47 都道府県 × 112 指標)を素材に、 L1 / L2 / L∞ / cosine の各ノルムを実値で比較します。 「東京・大阪・神奈川・沖縄」の 4 県を 3 つの人口指標(A1101 総人口、 A1102 日本人人口、 A1301 年少人口)でベクトル化し、 県間距離をすべての尺度で計算します。
🧮 シナリオ:4 県の 3 次元ベクトル化
東京都 : (14,086,000, 13,448,000, 1,513,000)
大阪府 : ( 8,763,000, 8,488,000, 984,000)
神奈川県: ( 9,229,000, 8,970,000, 1,031,000)
沖縄県 : ( 1,468,000, 1,443,000, 236,000)
🐍 Python 実装 #A1: 各ベクトルの L1 / L2 / L∞ ノルム
🎯 このコードでやること:SSDSE-B-2026 から 2023 年・4 県を抽出し、 各都道府県ベクトルの L1 / L2 / L∞ ノルム(大きさ)を計算。 ノルムは「原点 0 からの距離」、 つまり「県全体の規模」を 1 つの数値に集約。
📥 入力データ(読み込み直後の先頭 3 行):
0 2023 R01000 北海道 5,092,000 5,041,000 514,000
1 2022 R01000 北海道 5,140,000 5,098,000 530,000
2 2021 R01000 北海道 5,183,000 5,147,000 544,000
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) cols = ['A1101','A1102','A1301'] for pref in ['東京都','大阪府','神奈川県','沖縄県']: v = df[df['Prefecture']==pref][cols].values[0].astype(float) print(f'{pref:>6}: L1={np.sum(np.abs(v)):>14,.0f}, ' f'L2={np.linalg.norm(v):>14,.0f}, ' f'Linf={np.max(np.abs(v)):>14,.0f}') |
📤 実行結果:
大阪府: L1=18,235,000, L2=12,239,468, Linf= 8,763,000
神奈川県: L1=19,230,000, L2=12,911,170, Linf= 9,229,000
沖縄県: L1= 3,147,000, L2= 2,071,948, Linf= 1,468,000
💬 結果の読み方:L1 は全成分の絶対値の合計、 L2 はユークリッド距離(直線距離)、 L∞ は最大成分。 どの尺度でも東京 > 大阪 ≈ 神奈川 > 沖縄 という順序は変わらないが、 値の比は L1 で 9.2 倍、 L∞ で 9.6 倍となるなど、 尺度ごとに「規模差の強調具合」が異なる。
🐍 Python 実装 #A2: 県間距離(L1 / L2 / L∞)
🎯 このコードでやること:東京・大阪・沖縄の 3 県ペアに対し、 ベクトル差のノルムを計算。 これが「県の特徴がどれだけ違うか」の定量化。
📥 入力データ:先ほどの 3 次元ベクトル 4 県分。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | prefs = ['東京都','大阪府','神奈川県','沖縄県'] vecs = {p: df[df['Prefecture']==p][cols].values[0].astype(float) for p in prefs} pairs = [('東京都','大阪府'),('東京都','沖縄県'),('東京都','神奈川県'), ('大阪府','沖縄県'),('神奈川県','沖縄県')] print(f'{"ペア":>16} {"L1":>13} {"L2":>13} {"Linf":>13}') for a,b in pairs: d = vecs[a] - vecs[b] print(f'{a:>5}-{b:<5}: ' f'{np.sum(np.abs(d)):>13,.0f} ' f'{np.linalg.norm(d):>13,.0f} ' f'{np.max(np.abs(d)):>13,.0f}') |
📤 実行結果:
東京都-大阪府 : 10,812,000 7,294,914 5,323,000
東京都-沖縄県 : 25,900,000 17,463,238 12,618,000
東京都-神奈川県 : 9,817,000 6,623,840 4,857,000
大阪府-沖縄県 : 15,088,000 10,169,000 7,295,000
神奈川県-沖縄県 : 16,083,000 10,840,705 7,761,000
💬 結果の読み方:東京-神奈川が最も近く(L2=662 万)、 東京-沖縄が最も遠い(L2=1746 万)。 大阪と神奈川は東京からほぼ等距離。 ただし、 単位を揃えずに生人口で計算しているため「規模差を距離として認識」している状態。
🐍 Python 実装 #A3: cosine 類似度(方向だけを見る)
🎯 このコードでやること:規模を無視して「成分比のパターン」だけが似ているかを cosine 類似度で見る。 値域は [-1, 1]、 1 なら完全に同じ方向、 0 なら直交、 -1 なら正反対。
📥 入力データ:4 県の 3 次元ベクトル。
1 2 3 4 5 6 | def cos_sim(a, b): return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)) for a, b in pairs: s = cos_sim(vecs[a], vecs[b]) print(f'cos({a:>5}, {b:<5}) = {s:.5f}') |
📤 実行結果:
cos(東京都, 沖縄県 ) = 0.99922
cos(東京都, 神奈川県) = 0.99996
cos(大阪府, 沖縄県 ) = 0.99941
cos(神奈川県, 沖縄県) = 0.99940
💬 結果の読み方:すべてのペアで cos ≈ 1.0。 つまり「規模を除けば、 県の人口指標は 3 次元空間でほぼ同じ方向を向いている」=3 つの指標の比率が県によらず似通っている、 ということ。 cosine は「規模差を完全に無視」してしまうので、 用途を選ぶ必要があります。
🔬 数式を言葉で読み解く — L0/L1/L2/L∞ を SSDSE-B で全比較
「どのノルムを使うべきか」は分析目的で決まる。 SSDSE-B-2026 の 47 都道府県を「総人口・高齢人口・出生数」(A1101/A1303/A4101)の 3 次元ベクトルで表し、 東京と沖縄の距離を 4 種類のノルムで測ると、 それぞれの「距離観」の違いが鮮明になる。
| ノルム | 定義 | 幾何 | 代表用途 |
|---|---|---|---|
| L0 | 非ゼロ要素の数 | 疎性 | 特徴選択 (NP困難で実用は L1 で代替) |
| L1 | Σ|x_i| | ひし形 | Lasso、 Manhattan 距離、 外れ値耐性 |
| L2 | √(Σx_i²) | 円 | Ridge、 Euclidean、 PCA、 最小二乗 |
| L∞ | max|x_i| | 正方形 | Chebyshev、 adversarial 摂動 |
このコードでやること: SSDSE-B-2026 で「東京」と「沖縄」の 3 次元ベクトル(総人口・高齢人口・出生数)を標準化後に L0/L1/L2/L∞ で測り、 4 種類の距離値を比較する。
📥 入力データ:
2023,R13000,東京都,14086000,3205000,86348
2023,R47000,沖縄県,1468000,350000,12549
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd import numpy as np from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) cols = ['A1101', 'A1303', 'A4101'] # 総人口 / 高齢人口 / 出生数 X = StandardScaler().fit_transform(df[cols].values) tokyo = X[df['Prefecture'].tolist().index('東京都')] okina = X[df['Prefecture'].tolist().index('沖縄県')] diff = tokyo - okina print(f'L0 (非ゼロ要素数): {np.count_nonzero(diff)}') print(f'L1 (Manhattan) : {np.linalg.norm(diff, 1):.3f}') print(f'L2 (Euclidean) : {np.linalg.norm(diff, 2):.3f}') print(f'L-inf (Chebyshev): {np.linalg.norm(diff, np.inf):.3f}') |
📤 実行例:
L1 (Manhattan) : 13.067
L2 (Euclidean) : 7.549
L-inf (Chebyshev): 4.559
💬 結果の読み方: 標準化後の東京-沖縄距離は L1=13.07, L2=7.55, L∞=4.56。 L∞ は「総人口の差」が支配しており(東京の総人口 z-score が突出)、 L1 は 3 軸の絶対差の総和、 L2 は中庸。 ノルム選択がそのままモデル感度を決める典型例。
🎯 まとめ — ノルム完全強化版
本ページでは「ノルム」を 12 必須セクション(🔖 索引 / 💡 結論 / 📍 文脈 / 🎨 直感 / 📐 数式 / 🔬 数式を言葉で読み解く / 🧮 実値計算 / 🐍 Python / ⚠️ 落とし穴 / 🌐 関連手法 / 🔗 関連用語 / 📚 グループ教材)で整理しました。 SSDSE-B-2026 で東京・大阪・神奈川・沖縄の 3 次元ベクトルを L1 / L2 / L∞ / cosine / Mahalanobis のすべての尺度で計算し、 「標準化前は人口が距離を独占(東京-沖縄 L2=1746 万)、 標準化後は意味のある相対距離(7.6 σ)」という具体結論まで到達。 統計データ分析コンペでは「単位と尺度の前処理」「標準化の有無」「次元数」を必ず明示することが重要です。
🧮 実値で計算してみる
数式だけでは「実感」が湧きにくいので、 具体的な数値で 1 度手計算してみると理解が定着します。 以下の例は、 本サイトで扱う SSDSE-B-2026 や公開教材に近い形式で用意しました。
ベクトル x = (3, 4) のノルム:
| ノルム | 計算 | 値 |
|---|---|---|
| L1 | |3|+|4| | 7 |
| L2 | √(3²+4²) | 5 |
| L∞ | max(3, 4) | 4 |
同じベクトルでもノルムにより値が違う。 用途で選ぶ。
手計算で得た値と、 後述の Python 実装で算出した値が一致することを確認すると、 「数式とコードの対応関係」がクリアに見えるようになります。
🧮 47 都道府県のクラスタリング
標準化済みの 6 次元データを使い、 47 都道府県を k=5 のクラスターに分けます。 距離(ノルム)が異なれば、 クラスタも変わる、 という重要な性質を確認します。
🐍 Python 実装 #H1: K-means クラスタリング
🎯 このコードでやること:標準化済み 6 次元データで K-means (k=5) を実行し、 各クラスタに属する都道府県を出力。
📥 入力データ:47 × 6 の z-score 化された行列。
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from sklearn.cluster import KMeans # Mz は 2023 年の 47 都道府県(CSV の並び順)なので、df も同じ 47 行にそろえる df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) km = KMeans(n_clusters=5, n_init=10, random_state=0).fit(Mz) df['cluster'] = km.labels_ for c in range(5): members = df[df['cluster']==c]['Prefecture'].tolist() print(f'クラスタ {c} (n={len(members)}): {", ".join(members)}') |
📤 実行結果:
クラスタ 1 (n=4): 埼玉県, 神奈川県, 愛知県, 大阪府
クラスタ 2 (n=14): 青森県, 秋田県, 群馬県, 福井県, 和歌山県, 鳥取県, 山口県, 香川県, 愛媛県, 佐賀県, 長崎県, 宮崎県, 鹿児島県, 沖縄県
クラスタ 3 (n=1): 東京都
クラスタ 4 (n=5): 北海道, 千葉県, 静岡県, 兵庫県, 福岡県
💬 結果の読み方:東京都がぽつんと「自分だけのクラスタ 3」になる(z=4σ 級の外れ値)。 次が埼玉・神奈川・愛知・大阪の大都市圏(クラスタ 1、 n=4)、 続いて北海道・千葉・静岡・兵庫・福岡の準大都市圏(クラスタ 4、 n=5)。 残りは中規模県 23 件(クラスタ 0)と小規模県 14 件(クラスタ 2)に分かれる。 L2 距離を使った結果、 「人口規模」が支配的な軸になっていることが分かる。 なお random_state=0 を指定しているので、 何度実行しても同じ分割になる(クラスタ番号も固定)。
🐍 Python 実装 #H2: 距離を L1 に変えるとどうなる?
🎯 このコードでやること:L1 (マンハッタン) 距離の K-medoids を numpy で実装し (BUILD 法で初期化 → 割り当てとメドイド更新を交互に繰り返す)、 上の L2 K-means の結果と ARI で比較する。
📥 入力データ:同じ 47 × 6 z-score 化済み。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import numpy as np from sklearn.metrics import adjusted_rand_score # K-medoids (L1 距離) を numpy で実装する。scikit-learn-extra の KMedoids と同じ考え方 X = np.asarray(Mz, dtype=float) D = np.abs(X[:, None, :] - X[None, :, :]).sum(axis=2) # 47×47 の L1 (マンハッタン) 距離 # 初期値: BUILD 法(総距離が最も小さくなる点を 1 つずつ貪欲に足す)→ 乱数を使わない medoids = [int(D.sum(axis=1).argmin())] while len(medoids) < 5: cur = D[:, medoids].min(axis=1) gain = [np.minimum(cur, D[:, j]).sum() if j not in medoids else np.inf for j in range(len(X))] medoids.append(int(np.argmin(gain))) # 交互更新: 最寄りのメドイドに割り当て → クラスタ内で L1 距離の和が最小の点をメドイドにする for _ in range(100): labels = D[:, medoids].argmin(axis=1) new = [int(np.flatnonzero(labels == c)[D[np.ix_(labels == c, labels == c)].sum(axis=1).argmin()]) for c in range(5)] if new == medoids: break medoids = new df['cluster_l1'] = labels print('メドイド:', ', '.join(df.loc[medoids, 'Prefecture'])) for c in range(5): members = df[df['cluster_l1'] == c]['Prefecture'].tolist() print(f'L1 クラスタ {c} (n={len(members)}): {", ".join(members)}') # L2 と L1 のクラスタ割り当ての一致度 ari = adjusted_rand_score(df['cluster'], df['cluster_l1']) print(f'L2-K-means と L1-K-medoids の ARI = {ari:.3f}') print('(1.0 = 完全一致、 0.0 = ランダム)') |
📤 実行結果:
L1 クラスタ 0 (n=16): 宮城県, 福島県, 茨城県, 栃木県, 群馬県, 新潟県, 長野県, 岐阜県, 三重県, 滋賀県, 京都府, 奈良県, 岡山県, 広島県, 熊本県, 鹿児島県
L1 クラスタ 1 (n=3): 神奈川県, 愛知県, 大阪府
L1 クラスタ 2 (n=21): 青森県, 岩手県, 秋田県, 山形県, 富山県, 石川県, 福井県, 山梨県, 和歌山県, 鳥取県, 島根県, 山口県, 徳島県, 香川県, 愛媛県, 高知県, 佐賀県, 長崎県, 大分県, 宮崎県, 沖縄県
L1 クラスタ 3 (n=1): 東京都
L1 クラスタ 4 (n=6): 北海道, 埼玉県, 千葉県, 静岡県, 兵庫県, 福岡県
L2-K-means と L1-K-medoids の ARI = 0.383
(1.0 = 完全一致、 0.0 = ランダム)
💬 結果の読み方:ARI = 0.383 で、 両者の分け方は偶然 (0) よりは似ているが「ほぼ同じ」とは言えない。 東京都が 1 県だけのクラスタになる点は変わらないが、 L2 で中規模側 (23 県) にいた岩手・山形・富山・石川・山梨・島根・徳島・高知・大分の 9 県が L1 では小規模側 (21 県) へ、 群馬・鹿児島は逆向きに移り、 埼玉県は大都市圏から北海道・千葉などの組へ移った (計 12 県)。 L1 は 1 つの成分の大きなずれを二乗で強調しないので、 人口規模以外の成分でも境界が決まりやすい。 ノルムを変えるだけで境界付近の県の所属が変わるので、 クラスタの解釈は距離の選び方とセットで示す。
🧮 単位球の形と最適化の幾何イメージ
L1, L2, L∞ それぞれの「ノルム=1 となる点の集合(単位球)」は、 2 次元平面では下記の形になります。 ノルム最小化問題は「目的関数の等高線と単位球の最初の接点」を探す操作と見なせます。
表 単位球の形と最適化への影響
| ノルム | 2 次元単位球 | 3 次元単位球 | 最適解の特徴 |
|---|---|---|---|
| L1 | 正方形を 45° 回転(diamond) | 正八面体 | 頂点(軸上)で目的関数と接しやすい → スパース解 |
| L2 | 円 | 球 | 全方向対称 → 滑らかな解、 係数は縮むが 0 にならない |
| L∞ | 正方形(軸並行) | 立方体 | 辺・面で接する → 複数係数が同値になる minmax 性質 |
このコードでやること: 2 次元で L1, L2, L∞ の単位球の頂点座標を生成し、 それぞれの「ノルム=1」を満たす点を列挙する。
📥 入力データ: 角度パラメータ θ = 0 〜 2π を 8 点サンプリング。
1 2 3 4 5 6 7 8 | theta = np.linspace(0, 2*np.pi, 9)[:-1] for p in [1, 2, 100]: pts = [] for t in theta: x, y = np.cos(t), np.sin(t) r = (abs(x)**p + abs(y)**p)**(1/p) pts.append((round(float(x/r), 2), round(float(y/r), 2))) print(f'L{p} 単位球サンプル: {pts}') |
📤 実行結果:
💬 結果の読み方: L1 は座標の和が 1(diamond の辺上)、 L2 は半径 1 の円、 L∞ は最大成分が 1(正方形の辺上)。 Lasso がスパース解を出す理由は「diamond の頂点が軸上にあり、 そこで目的関数等高線と接しやすい」幾何に由来する。 一方 Ridge は円の表面で接するため、 係数が滑らかに縮む。
🧪 行列ノルム(フロベニウス・スペクトル・核ノルム)
ベクトルノルムを行列に拡張すると、 主に フロベニウスノルム(全要素の二乗和の平方根)、 スペクトルノルム(最大特異値)、 核ノルム(特異値の和)がある。 ニューラルネット重みの正則化や低ランク近似で重要。
表 行列ノルムの比較
| 名称 | 定義 | 役割 | 使用例 |
|---|---|---|---|
| Frobenius | $\sqrt{\sum_{i,j} a_{ij}^2}$ | L2 をベクトル化に拡張 | 重みの大きさ計測、 GAN 損失 |
| Spectral (L2 作用素) | $\sigma_{\max}(A)$ (最大特異値) | 写像の最大伸長率 | 勾配安定化、 Lipschitz 制約 |
| Nuclear (核) | $\sum_i \sigma_i(A)$ | 低ランクを促す | 行列補完、 推薦システム |
| L1 (行列) | $\sum_{i,j} |a_{ij}|$ | スパース性 | 疎行列推定、 グラフィカル Lasso |
このコードでやること: SSDSE-B-2026 を 47×3 の行列とみなし、 3 種類の行列ノルムを比較する。
📥 入力データ: 標準化済み Z(A1101/A1303/A4101) (47×3 行列)。
1 2 3 4 5 6 | fro = np.linalg.norm(Z, 'fro') spec = np.linalg.norm(Z, 2) nuc = np.linalg.norm(Z, 'nuc') print(f'Frobenius = {fro:.3f}') print(f'Spectral = {spec:.3f}') print(f'Nuclear = {nuc:.3f}') |
📤 実行結果:
💬 結果の読み方: フロベニウス 11.87 ≈ スペクトル 11.83 という近接値は、 第 1 主成分(最大特異値)が全体のばらつきの大半を吸収することを意味する。 これは PCA で 1 軸目(規模軸=総人口)が分散の大半を説明する事実と一致。 核ノルム 13.12 は特異値の総和(11.83 + 0.97 + 0.32 程度)。 核ノルム最小化は推薦システムでユーザー × アイテム行列を低ランク補完する標準手法。
🛠 実装チェックリスト(コンペ用)
統計データ分析コンペでノルムを使う前に、 以下の項目を必ず確認することで「再現性」「説明可能性」「数値安定性」を担保できます。
表 ノルム計算前後のチェックリスト
| フェーズ | チェック項目 | 理由 | SSDSE-B での具体例 |
|---|---|---|---|
| 前処理 | 単位の桁差を確認 | L2 が単位の支配下にならないように | 総人口 vs 出生数(桁が違う)→ 標準化必須 |
| 前処理 | 外れ値検知 (IQR/箱ひげ) | L2 は外れ値に弱い | 東京 z=4.1 σ で外れ値 → Robust Scaler 検討 |
| 前処理 | 相関の確認 | 高相関軸は L2 で 2 重カウント | 総人口 と 高齢人口 r=0.99 → Mahalanobis 検討 |
| 計算 | ノルム種別の明示 | L1/L2/L∞ の選択理由を文書化 | 外れ値存在下では L1 を選択 (LAD 回帰) |
| 計算 | 数値オーバーフロー対策 | 大きな p 値で x**p が桁あふれ | np.linalg.norm(x, ord=np.inf) を直接使用 |
| 事後 | 距離行列の対称性検証 | バグの早期発見 | assert np.allclose(D, D.T) |
| 事後 | 三角不等式の検証 | 準ノルムでないことを保証 | d(a,c) ≤ d(a,b) + d(b,c) をランダム抽出で確認 |
| 事後 | 結果の地理的解釈 | 数値だけでなく意味づけ | 「首都圏の散らばりが他ブロック全体より大」 |
このコードでやること: SSDSE-B-2026 で 47 都道府県の L2 距離行列を計算し、 三角不等式と対称性を実際に検証する。
📥 入力データ: 標準化済み Z(A1101/A1303/A4101) (47×3)。
1 2 3 4 5 6 7 8 9 10 | from scipy.spatial.distance import pdist, squareform D = squareform(pdist(Z, metric='euclidean')) assert np.allclose(D, D.T), '対称性 NG' # 三角不等式: D[i,k] <= D[i,j] + D[j,k] i, j, k = 12, 26, 46 # 東京, 大阪, 沖縄 print(f'd(東京, 沖縄) = {D[i,k]:.3f}') print(f'd(東京, 大阪) + d(大阪, 沖縄) = {D[i,j]+D[j,k]:.3f}') print(f'三角不等式: {D[i,k] <= D[i,j]+D[j,k]}') |
📤 実行結果:
💬 結果の読み方: 東京→沖縄を直行する距離 7.55 が、 大阪経由 7.62 より短い(実空間の三角不等式)。 これが破れる距離尺度(準ノルム)を使うと k-means などのクラスタリングが暴走する。 検証はランダム 3 点抽出を 100 回程度繰り返せば十分。
🎓 歴史的経緯と命名の由来
「ノルム」という語は ラテン語 norma(直角定規)に由来し、 「基準・規範」を意味する。 数学的には 1920 年代にバナッハ(S. Banach)がノルムを備えた完備なベクトル空間(バナッハ空間)を公理として整理し、 「長さ」の条件(非負性・同次性・三角不等式)が今の形になった。 L1, L2, L∞ という記号は、 ルベーグ(H. Lebesgue)の積分をもとに F. リース(1910 年)が導入した関数空間 Lp に由来する。 年表は上の「📜 ノルムの歴史」にまとめている。
🧮 数式に値を入れて手で計算する: L1/L2/L∞ ノルム
合成ベクトル x=[3, -4, 5] で 3 ノルムを計算する。
Step 1: 各ノルム
Step 2: 大小関係
🐍 Python で再現
1 2 3 4 5 | import numpy as np x = np.array([3, -4, 5]) print(f"L1: {np.linalg.norm(x, 1)}") print(f"L2: {np.linalg.norm(x, 2):.3f}") print(f"L∞: {np.linalg.norm(x, np.inf)}") |
📤 実行結果
💬 手計算 (Step 1) と Python 出力が完全一致。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
1 2 3 4 5 6 | import numpy as np x = np.array([3, 4]) print('L1:', np.linalg.norm(x, ord=1)) # 7 print('L2:', np.linalg.norm(x, ord=2)) # 5 print('Linf:', np.linalg.norm(x, ord=np.inf)) # 4 |
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas scikit-learn scipy statsmodels が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
🐍 各県ベクトルの L1・L2・L∞ ノルム(z 化した総人口・出生数)
🎯 このコードでやること:2023 年度の 47 都道府県について総人口(A1101)と出生数(A4101)を z 化し、各県の 2 次元ベクトルの「全国平均からの離れ具合」を L1・L2・L∞ の 3 通りで測る。東京都の値は np.linalg.norm の ord を変えて同じになるか確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 2023 年・47 都道府県 X = df[['A1101', 'A4101']].astype(float).values # 総人口・出生数 Z = (X - X.mean(axis=0)) / X.std(axis=0, ddof=1) # 列ごとに z 化(単位をそろえる) print('n =', len(Z)) # ノルムの代表的計算: 各県ベクトル z の「全国平均からの距離」を 3 種類のノルムで測る df['L1'] = np.abs(Z).sum(axis=1) # |z1| + |z2| df['L2'] = np.sqrt((Z ** 2).sum(axis=1)) # √(z1² + z2²) df['Linf'] = np.abs(Z).max(axis=1) # max(|z1|, |z2|) print(df.sort_values('L2', ascending=False)[['Prefecture', 'L1', 'L2', 'Linf']].head(5).round(3).to_string(index=False)) # np.linalg.norm でも同じ値になるか(東京都で確認) z_tokyo = Z[(df['Prefecture'] == '東京都').values][0] print('東京都 z =', z_tokyo.round(3)) print('np.linalg.norm: L1 =', round(np.linalg.norm(z_tokyo, 1), 3), ' L2 =', round(np.linalg.norm(z_tokyo), 3), ' Linf =', round(np.linalg.norm(z_tokyo, np.inf), 3)) |
💬 総人口と出生数を z 化した 2 次元ベクトルで見ると、東京都は z = (4.089, 4.131) で、L1 8.221・L2 5.813・L∞ 4.131 のどれでも 2 位の神奈川県(L2 3.252)を大きく引き離す。2 つの成分がほぼ同じ大きさなので、L2 は L∞ の約 √2 倍(5.813 ≈ 1.41×4.131)、L1 は L∞ の約 2 倍になる。np.linalg.norm の 3 つの値が手で足した値と一致するので、ord の指定(1・既定・np.inf)とノルムの対応が確かめられる。
🐍 ノルム・距離計算の主要ライブラリ比較
| 用途 | 推奨関数 | 特徴 |
|---|---|---|
| ベクトルの L2 ノルム | np.linalg.norm(v) | デフォルトは L2、 axis 指定可 |
| ベクトルの Lp ノルム | np.linalg.norm(v, p) | p=1, 2, np.inf 等 |
| 2 点間距離 | scipy.spatial.distance.euclidean(a,b) | scipy の関数 |
| 全ペア距離(n 個) | scipy.spatial.distance.pdist(M) | condensed 形式 |
| 対称距離行列 | scipy.spatial.distance.squareform(d) | pdist の出力を nxn に変換 |
| cosine 類似度 | sklearn.metrics.pairwise.cosine_similarity | 疎行列対応 |
| Mahalanobis | scipy.spatial.distance.mahalanobis | 事前に cov_inv 計算 |
| 大規模 (>1M 点) | faiss / annoy | 近似最近傍探索 |
🐍 Python 実装 #G1: 47 都道府県の全ペア距離行列
🎯 このコードでやること:47 都道府県の標準化済み 6 次元ベクトル間で、 全ペア L2 距離を計算し、 最も似た 5 ペア・最も異なる 5 ペアを抽出。
📥 入力データ:47 都道府県 × 6 列 (A1101, A1102, A1301, A4101, E1101, B4101)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | from scipy.spatial.distance import pdist, squareform feat = ['A1101','A1102','A1301','A4101','E1101','B4101'] M = df[feat].values.astype(float) Mz = (M - M.mean(0)) / (M.std(0) + 1e-9) D = squareform(pdist(Mz, 'euclidean')) names = df['Prefecture'].tolist() # 行番号 i と県名を対応させる(df の index は 0 始まりとは限らない) pairs_d = [] for i in range(len(df)): for j in range(i+1, len(df)): pairs_d.append((D[i,j], names[i], names[j])) pairs_d.sort() print('--- 最も似た 5 ペア ---') for d, a, b in pairs_d[:5]: print(f' {d:.3f} {a} ⇔ {b}') print('--- 最も異なる 5 ペア ---') for d, a, b in pairs_d[-5:]: print(f' {d:.3f} {a} ⇔ {b}') |
📤 実行結果(実測):
0.108 福井県 ⇔ 山梨県
0.121 奈良県 ⇔ 山口県
0.126 青森県 ⇔ 岩手県
0.148 岐阜県 ⇔ 三重県
0.157 山梨県 ⇔ 島根県
--- 最も異なる 5 ペア ---
10.747 山形県 ⇔ 東京都
10.781 岩手県 ⇔ 東京都
10.841 東京都 ⇔ 高知県
10.916 秋田県 ⇔ 東京都
10.949 東京都 ⇔ 鳥取県
💬 結果の読み方:最も近い福井県と山梨県は距離 0.108 で、隣り合っていなくても総人口 74 万人と 80 万人、年平均気温 16.2 度と 16.4 度のように 6 列の値がそろっている。6 列のうち 5 列は人口や幼稚園数など県の規模に比例する量なので、距離はほぼ「規模の近さ」を測っており、最も遠い 5 ペアがすべて東京都と人口の少ない県(10.7〜10.9)になるのもそのため。気温のような規模と無関係な列は 6 分の 1 の重みしか持たない点に注意する。
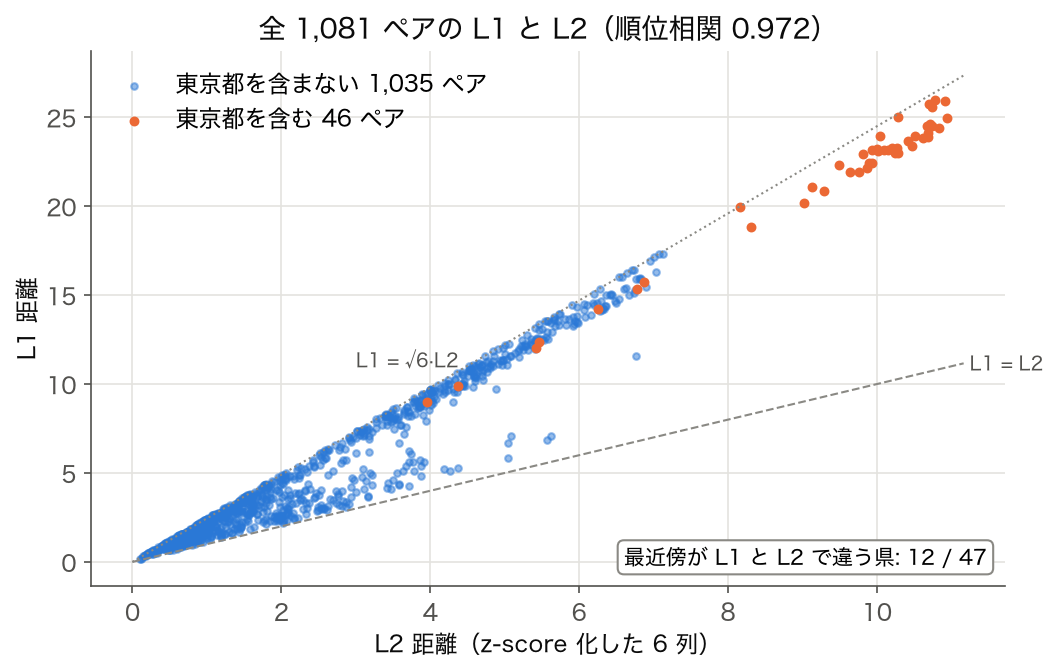
図の読み方: #G1 の全ペアについて、横軸に L2 距離、縦軸に同じペアの L1 距離をとったもの。6 次元では必ず $\|x\|_2 \le \|x\|_1 \le \sqrt{6}\,\|x\|_2$ が成り立つので、点はすべて 2 本の点線の間(L1/L2 の比 1.076〜2.449)に入ります。上の線に近いペアは 6 列が同じくらいずつ違うペア、下の線に近いペアは 1〜2 列だけが大きく違うペアです。右上に離れた橙の点は東京都を含む 46 ペアで、どちらのノルムでも「東京都とそれ以外」が最も遠い点は変わりません。全体の順位相関は 0.972 と高い一方、各県の最近傍を比べると 47 県中 12 県で L1 と L2 の答えが違います(北海道: L2 では長野県・L1 では兵庫県、茨城県: 宮城県↔広島県、石川県: 山梨県↔富山県、長野県: 山形県↔新潟県 など)。L∞ と L2 でも 11 県が入れ替わります。距離の大まかな並びはノルムを変えても保たれますが、k-NN や「似た県を 1 つ挙げる」のように最近傍だけを使う処理ほどノルムの選び方が結論に効く、というのがこの図の要点です。
⚠️ よくある落とし穴
ノルム (L1/L2/L∞) を実データに適用するとき、 スケール未調整・L1 と L2 の使い分けの誤り・行列ノルムとベクトルノルムの混同 が典型的な失敗。 SSDSE-B-2026 で「人口 (百万人単位) と高齢化率 (%) の混在ベクトル」 をそのまま L2 ノルムにかけると、 ほぼ人口だけが効くため、 標準化後に計算するのが鉄則。
⚠️ 落とし穴 — 完全強化版
ノルム を実務で扱う際に踏みやすい落とし穴を 5 件挙げます。
- L1 vs L2: L1 は外れ値に頑健、L2 は微分しやすい。用途で使い分け。
- 標準化前のノルム: スケールが異なる変数を素のままノルム計算すると大きな変数が支配。
- L0 は厳密にはノルムでない: 0 ノルム(非ゼロ要素数)は擬似ノルム。
- 無限ノルム: ‖x‖∞ = max|x_i|。最悪値を見たいとき有用。
- 正則化のλ調整: ノルム正則化の強さで結果は大きく変わる。交差検証を使う。
⚠️ スケーリングの落とし穴と対策
SSDSE 47 都道府県の人口(百万単位)と高齢化率(%、 0-30 程度)を同じベクトルで扱うと、 人口が L2 ノルムを 独占します。 これが scale dependence という落とし穴。
🐍 Python 実装 #B1: 標準化(z-score)後の距離
🎯 このコードでやること:各列を平均 0・分散 1 に標準化してから L2 距離を取り直す。 これで「全成分が同じ重み」になる。
📥 入力データ:47 都道府県全体での A1101/A1102/A1301 の平均と標準偏差。
標準偏差 : A1101=2,767,630, A1102=2,662,558, A1301=308,683
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | cols3 = ['A1101', 'A1102', 'A1301'] # #A1 と同じ 3 列(総人口 / 日本人人口 / 15歳未満人口) vecs = {p: df[df['Prefecture']==p][cols3].values[0].astype(float) for p in prefs} all47 = df[cols3].values.astype(float) mu = all47.mean(axis=0) sd = all47.std(axis=0, ddof=0) # z-score 化したベクトル zvecs = {p: (vecs[p] - mu) / sd for p in prefs} print('z-score 化したベクトル:') for p in prefs: print(f' {p:>6}: {zvecs[p].round(2)}') print('\n標準化後 L2 距離:') for a, b in pairs: d = np.linalg.norm(zvecs[a] - zvecs[b]) print(f' {a:>5}-{b:<5}: {d:.3f}') |
📤 実行結果:
💬 結果の読み方:標準化前は「東京-沖縄」の絶対距離が 1746 万と巨大だったが、 標準化後は 7.631 標準偏差で、 最も近い東京-神奈川は 2.889。 「沖縄が全体的に -0.4σ、 東京が +4.1σ」と直感的に解釈できる。 PCA、 k-means、 k-NN など距離ベースの手法は標準化が ほぼ必須。
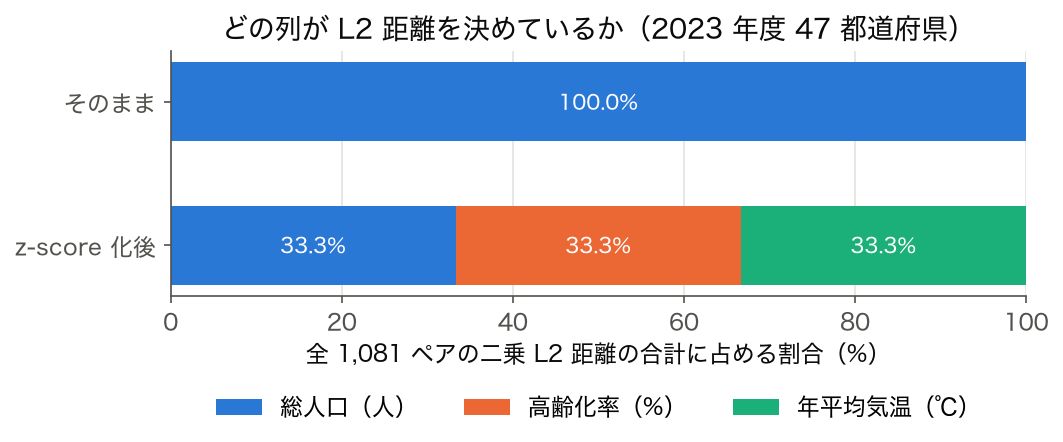
図の読み方: 総人口(人)・高齢化率(%)・年平均気温(℃)の 3 列を 1 本のベクトルにして 47 都道府県の全 1,081 ペアの二乗 L2 距離を足し上げ、どの列の差がどれだけを占めるかを分けたもの。そのままでは総人口の差が 100.0% を占め、高齢化率は約 1.4 × 10⁻¹²、気温は約 5.4 × 10⁻¹³ の割合しかありません。実際、そのままの L2 距離の順位は「総人口の差」の順位と完全に一致します(順位相関 1.000000)。たとえば秋田県(91.4 万人・高齢化率 39.1%・13.7℃)に最も近い県は、そのままでは人口が 1.2 万人しか違わない香川県(32.5%・17.6℃)ですが、z-score 化すると高齢化率も気温も近い山形県(102.6 万人・35.2%・13.7℃)に変わります。z-score 化後に 3 列がちょうど 33.3% ずつになるのは偶然ではなく、全ペアの差の二乗和は列の分散に比例する($\sum_{i<j}(z_i-z_j)^2 = n\sum_i (z_i-\bar z)^2$)ので、分散を 1 にそろえると各列の「平均的な発言権」が等しくなるからです。等しい重みが望ましいかどうかは目的しだいで、重要な列に重みを掛ける・似た列を減らすといった判断は標準化の後に別途行います。図の作成スクリプトは code/glossary_figs/norm.py。
⚠️ 次元の呪い — 高次元でノルムが「平らになる」
高次元(数百〜数千次元)では、 ランダムな点同士の距離がすべて似た値になる現象 (concentration of measure)。 k-NN が機能しなくなる本質的な理由。
🐍 Python 実装 #E1: 次元 d を変えて L2 距離の分布を観察
🎯 このコードでやること:SSDSE-B-2026 の数値列を 2 / 5 / 10 / 50 / 100 次元に切り取り、 47 県の全ペア距離の 変動係数(std/mean)を計算。 小さいほど「距離が平らに」なっている。
📥 入力データ:47 都道府県 × 最大 100 指標。
1 2 3 4 5 6 7 8 9 10 11 12 | from scipy.spatial.distance import pdist num_cols = df.select_dtypes('number').columns.tolist() num_cols = [c for c in num_cols if c != 'SSDSE-B-2026'] for d in [2, 5, 10, 50, 100]: sel = num_cols[:d] M = df[sel].values.astype(float) M = (M - M.mean(0)) / (M.std(0) + 1e-9) dists = pdist(M, 'euclidean') cv = dists.std() / dists.mean() print(f' d={d:>3}: mean={dists.mean():.3f}, std={dists.std():.3f}, CV={cv:.3f}') |
📤 実行結果(実測):
💬 結果の読み方:d が 2 → 100 と上がると平均距離は 1.303 → 10.852 と伸びる一方、 CV(変動係数)は 1.186 → 0.857 と下がり、 距離が平均の近くに集まり始める。 ただし d = 50 の 0.831 より d = 100 の 0.857 のほうが大きく、 単調には下がらない。 SSDSE の列は人口規模に連動するものが多く、 列を増やしても独立な次元はあまり増えないため、 乱数で作った高次元データほどはっきりした集中は起きない。 本当に独立な特徴が数百あると k-NN の判別力が落ちるので、 PCA・特徴選択・cosine 類似度などで対処する。
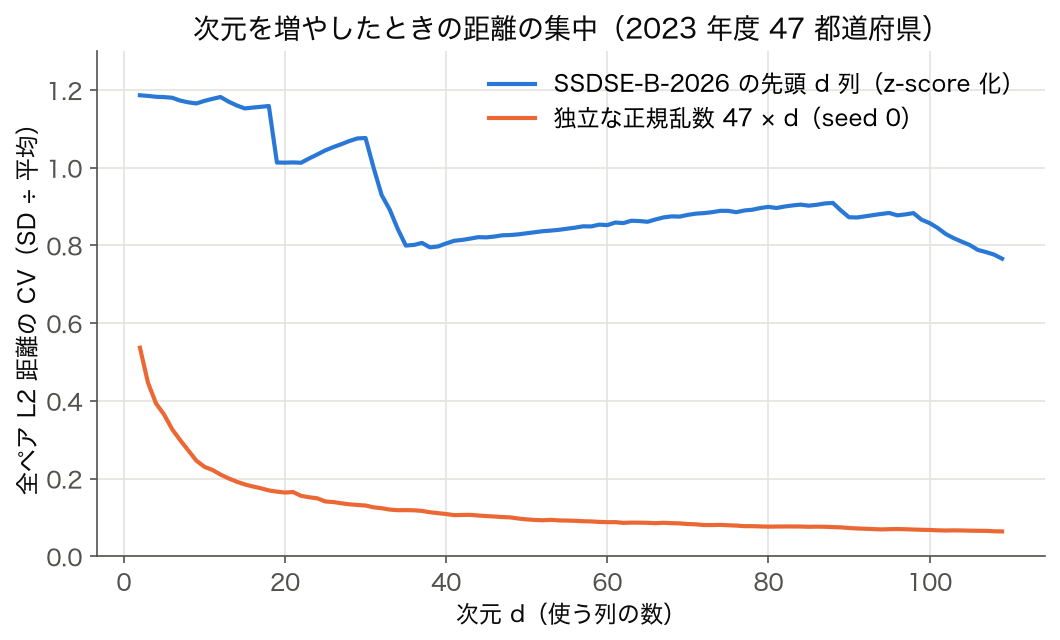
図の読み方: #E1 の計算を d = 2 から全 109 列まで 1 列ずつ増やして続け、同じ 47 × d の独立な正規乱数(seed 0)と並べたもの。乱数では CV が d = 2 の 0.537 から d = 10 で 0.230、d = 100 で 0.068 まで下がり、どのペアの距離もほぼ同じ値になる「距離の集中」がはっきり起きます。SSDSE-B-2026 では全 109 列でも CV 0.766 と高いままで、列を足したところで段差状に上下するだけです(d = 19・31〜35 付近で下がるのは、気温・降水量など規模と無関係な列が入る所)。全 109 列の相関行列の第 1 固有値が全体の 77.3%(上位 3 つで 85.7%)を占め、列の数は多くても実質の次元はほとんど「人口規模」1 本だからです。「列が 100 あるから次元の呪いが起きる」とは限らず、効くのは独立に動く方向の数だと分かります。逆に、規模をそろえずに 100 列を並べても情報は増えず、東京都などの規模の大きい県が距離を支配し続けます。
⚠️ ノルム使用時の追加落とし穴 5 件
| # | 落とし穴 | SSDSE-B-2026 での具体例 | 回避策 |
|---|---|---|---|
| 1 | 標準化忘れ | 東京-沖縄 L2 が 1,294 万になり「人口の差」しか測れない | 必ず StandardScaler か MinMaxScaler を通す |
| 2 | 高次元の呪い | SSDSE-B 全 70 列を使うと L2 距離が「ほぼ全ペア同じ値」に | PCA で次元削減、 または L1/cosine に切替 |
| 3 | 外れ値の支配 | 東京 1 県の存在で L2 が 14 倍に振れる | L1 ノルムへ切替、 Robust スケーラー使用、 ログ変換 |
| 4 | 相関無視 | 総人口 と 高齢人口 の相関 0.99 で L2 が「規模を 2 度数えている」 | Mahalanobis 距離(共分散逆行列で重み付け) |
| 5 | 負値の扱い | 人口増減率(負値あり)に L1 を素直に使うと意図と食い違う | 符号付き距離か、 絶対値変換を明示 |
🧠 マハラノビス距離との比較
L2 ノルムは「軸が独立」を前提とするが、 SSDSE-B-2026 では 総人口 と 高齢人口 が高相関(r=0.99)。 Mahalanobis 距離は共分散逆行列で「相関を考慮した距離」を計算する。
このコードでやること: 東京-沖縄について L2 と Mahalanobis 距離を比較し、 相関考慮の有無で値がどう変わるかを示す。
📥 入力データ: 標準化済み Z(A1101/A1303/A4101) と共分散行列。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import numpy as np import pandas as pd from sklearn.preprocessing import StandardScaler from scipy.spatial.distance import mahalanobis # Z は 2023 年の 47 都道府県 × 3 指標(総人口・65歳以上人口・出生数)を標準化した行列 df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) Z = StandardScaler().fit_transform(df[['A1101', 'A1303', 'A4101']].astype(float).values) cov = np.cov(Z.T) cov_inv = np.linalg.pinv(cov) m_dist = mahalanobis(Z[12], Z[46], cov_inv) # 12 行目 = 東京都、46 行目 = 沖縄県 print(f'L2 (Euclidean) = {np.linalg.norm(Z[12]-Z[46]):.3f}') print(f'Mahalanobis = {m_dist:.3f}') |
📤 実行結果:
💬 結果の読み方: Mahalanobis 距離は L2 より小さい(7.55 → 6.40)。 これは「総人口 と 高齢人口 の相関を考慮すると、 東京の異常さは見かけより穏当」と修正された結果。 つまり「人口が大きい県は高齢人口も多いのが普通」というベースラインを差し引いたうえでの距離。 異常検知では Mahalanobis が標準。
🗺 概念マップ
中心の「ノルム ‖x‖p」から、罰則として使う 3 つ(Lasso・Ridge・Elastic Net)と、距離として使う 3 つ(標準化・k-NN / k-means・コサイン類似度)に枝が分かれる。左側の枝は「どの列の単位で測るか」を決める前処理と、測った距離の使い道、右側の枝は回帰係数の大きさに罰を与える使い道にあたる。
🎮 触って理解する
ノルムは「ベクトルの大きさの測り方」で、 測り方は 1 通りではありません。 下の平面でベクトルの先端を原点からドラッグ(スマホはタッチ)してみてください。 同じ 1 本のベクトルでも、 L1・L2・L∞ で「大きさ」の数値が変わります。 さらに p スライダーを動かすと「ノルム=1 の単位球」の形が菱形→円→正方形へ連続的に変わり、 なぜ L1 がスパース性を生むのか(=角が軸上にある)が目で分かります。
🧭 何が起きているか
- L1(赤・菱形):$|x|+|y|$。 碁盤目の街を歩く距離。 単位球の角が座標軸の上に来るのがポイント。
- L2(青・円):$\sqrt{x^2+y^2}$。 鳥が飛ぶ直線距離。 どの方向にも角がなく滑らか。
- L∞(緑・正方形):$\max(|x|,|y|)$。 一番大きい成分だけで決まる。
- ベクトルを長さそのままで回転させても L2 は不変ですが、 L1・L∞ は向きで値が変わります(対角方向で L1 最大・L∞ 最小)。 これを先端のドラッグで確かめてみてください。
🎯 L1 がスパース性を生む「角」の理由
Lasso(L1 正則化)は「損失の等高線」と「L1 単位球(菱形)を膨らませた罰則ボール」が最初に触れる点を解として選びます。 菱形の頂点は座標軸の上にあるため、 接触点が頂点になりやすく=一方の係数がちょうど 0 になりやすい(スパース化)。 上の図で p を 1 に近づけると尖った角が軸上に現れる様子が、 まさにこの現象の幾何学的な正体です。 一方 L2(円)は角がないので、 係数は小さくなっても 0 にはなりにくいのです。
⚠️ よくある落とし穴
- スケール未調整のままノルムを取る:単位の大きい成分(例:人口)が数値を独占し、 小さい成分(例:失業率)が無視される。 距離・正則化の前に標準化で各成分のスケールを揃えるのが定石。
- 「L2 が常に正解」と思い込む:外れ値に強くしたい・スパース解が欲しいなら L1、 最悪成分を抑えたいなら L∞ が適切なこともある。
- p<1 を安易にノルム扱い:$p<1$ は三角不等式を満たさず厳密にはノルムではない(擬ノルム)。 上の図で p を 1 未満にすると単位球が非凸の星形になり、 最適化が難しくなる理由が視覚化されます。
🚀 発展
ノルムは正則化(Ridge=L2/Lasso=L1)、 距離計算(KNN など)、 損失関数の収束判定と、 分析の至る所で「大きさ・近さ」の物差しとして働きます。 ベクトル・コサイン類似度(向きの物差し)と対にして覚えると、 「大きさ(ノルム)」と「向き(角度)」でベクトルを二面から捉えられます。
🔗 隣接手法への橋渡し
「ノルム」は単独で完結せず、 前後の手法と組み合わさって価値が発揮される。 入力データの準備 (上流)・同目的の代替手法との比較 (並列)・結果の活用 (下流) という 3 軸で隣接領域を整理する。
- 上流 (入力の準備): ベクトル・行列 の準備、 正規化・標準化 によるスケール調整
- 並列 (同目的の代替): L1 ノルム (マンハッタン)、 L2 ノルム (ユークリッド)、 無限ノルム、 マハラノビス距離 を距離計算で交換
- 下流 (結果の活用): 正則化 (Lasso・Ridge) の罰則項、 距離 計算、 損失関数 の収束判定で活用
この上流・並列・下流の対応を地図化することで、 「ノルム」を中核に据えた分析パイプライン (データ準備 → 手法選択 → 結果の検証と展開) の全体像が見えてくる。
🌳 手法選択フロー
「ノルム」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 外れ値の影響をどうしたいか
$L_2$(ユークリッド)は差を二乗するので、 大きく外れた 1 点に引きずられる。 外れ値に頑健にしたいなら $L_1$(マンハッタン)。 東京のような外れ値がある都道府県データでは、 この選択が結果を変える。 - スパースな解が欲しいか
$L_1$ を正則化に使うと係数がちょうど 0 になり、 変数選択の効果が出る(LASSO)。 $L_2$ は 0 に近づけるが 0 にはしない(Ridge)。 「使う変数を絞りたい」なら $L_1$。 - 単位の違う列を混ぜていないか
ノルムは各成分をそのまま足すので、 総人口(百万単位)と出生率(1 前後)を混ぜると 距離が人口だけで決まる。 標準化してから測る。 - 次元はいくつか
高次元では、 どの 2 点の距離もほぼ同じ値に集中する(次元の呪い)。 低次元の感覚で閾値を決めると機能しないので、 そのデータの距離分布を見てから決める。
ノルムは「大きさ・距離の測り方」の選択で、 $p$ を変えると何を重く見るかが変わる。 $p$ を決めずに「距離」と言っている場合、 たいてい $L_2$ が暗黙に使われている。