🔖 キーワード索引
🔖 拡張キーワード索引(深掘り用)
以下のチップから関連する詳細セクションへジャンプできます。
💡 30秒で分かる結論
🍰 まずはやさしく
DNNは層をたくさん重ねたネットワークです。
複雑なデータを正確に分析するために使います。
スマホの画像認識などで活躍しています。
この章ではDNNの仕組みと学習方法を読みます。
多層のニューラルネットワーク
- 多層(3層以上)のニューラルネットワーク。 単に「深い NN」。
- 層を深くすると 階層的な特徴抽出 が可能 → 画像・音声・テキストで革命的精度。
- 中身:線形変換 + 活性化関数 の積み重ね。
- 学習:誤差逆伝播法(backprop) + 勾配降下。
- 代表アーキ:MLP/CNN/RNN/Transformer。
💡 さらに 30 秒で押さえる(拡張版)
- DNN = 隠れ層が 2 層以上のニューラルネット。 1 層なら線形回帰/ロジスティック回帰と等価。
- 各層は
h = σ(W h_prev + b)という同じ式の繰り返し。 違いは「層数」と「活性化関数」だけ。 - 学習は 誤差逆伝播法 による 勾配降下。 連鎖律を使って全パラメータの偏微分を求める。
- 万能近似定理:隠れ層 1 でも幅が十分なら任意の連続関数を近似可能。 しかし「深い方が少ないパラメータで表現できる」のが実務での利点。
- SSDSE-B-2026 都道府県データ (47 県、 5 特徴量) を 5 クラスに分類する程度なら、 隠れ層 (64, 32) で訓練精度・テスト精度 (12 県) とも 100% に到達する (ただしラベルと特徴量がどちらも人口由来の易しい課題)。
💡 学習者へのもう一歩のアドバイス
DNN は奥が深い分野であり、 1 回読んだだけでは身につかない。 ここでは 独習者・学生・新人エンジニア向けに、 学習効率を高めるための実践的なアドバイスを 10 個示す。 自分の状況に合うものから採用してほしい。
アドバイス 1 ── まず動かす
数式を眺めるよりも、 sklearn.neural_network.MLPClassifier を SSDSE-B-2026 で動かすのが先。 動くコードに数式を後付けで対応させる方が、 理解が早い。
アドバイス 2 ── 1 つのデータセットを徹底的に
たくさんのデータセットを浅く触るより、 SSDSE-B-2026 のような 1 つのデータセットを深く 触る方が、 前処理・特徴量設計・モデル選択・評価の全工程が身につく。
アドバイス 3 ── ベースラインと必ず比較
DNN を回す前に、 線形回帰・決定木・k-NN でベースラインを取る。 DNN がベースラインに勝てない場合、 DNN を使わない選択も含めて再検討する。
アドバイス 4 ── ログを残す
ハイパーパラメータ・データ前処理・結果を 1 つの実験につき 1 行 でも記録する。 後で「どの設定が一番良かったか」を再現するために必須。 専用ツール(MLflow, Weights & Biases)も便利。
アドバイス 5 ── コードを読む
sklearn・PyTorch・TensorFlow のチュートリアル・公式サンプルを 1 行ずつ読み解く。 「なぜここで standardize するのか」「なぜ Adam なのか」と問いながら読む。
アドバイス 6 ── 数式は最後でいい
順伝播・逆伝播の数式は、 動かしてから読む方が頭に入る。 「動く実装」と「数式」を行き来しながら理解を固めるのが効率的。
アドバイス 7 ── 失敗事例を読む
成功事例(SOTA 論文)より、 失敗事例(kaggle の post-mortem, 業務トラブル報告)の方が学びが大きい。 「DNN が線形回帰に負けた」「過学習で失敗した」事例から学ぶ。
アドバイス 8 ── 教えてみる
最強の学習法は 他人に教えること。 同僚・後輩・SNS で DNN を 30 秒で説明してみる。 説明できなければ理解できていない。 自分の説明力を 理解度チェック の物差しにせよ。
アドバイス 9 ── 小さく作って大きく育てる
DNN は最初から大規模に作ると、 デバッグ困難になる。 まず 1 層・8 ユニット・100 件のミニデータ で動くことを確認し、 段階的に層・ユニット・データを増やす。 SSDSE-B-2026 の N=47 はちょうど良い「最初の試し場」になる。 大きく作る前に、 小さく動かす習慣を身につけることが、 結局は最速の学習経路である。
アドバイス 10 ── 数値を信じない、 目で見る
テスト MSE が低いからといって、 モデルが「正しい」とは限らない。 必ず 残差プロット・予測 vs 実測の散布図・誤差ヒストグラム を描き、 系統的な偏りがないかを目視確認する。 数値だけ見る習慣は事故の元。 SSDSE-B-2026 のような小データなら、 47 都道府県すべての残差を 1 つずつ目視するのが理想的である。
📍 あなたが今見ているもの
🍰 まずはやさしく
DNNは現代のAIを支える主役のような存在です。
AIに高い性能を持たせるために使います。
ChatGPTなどの便利な道具に使われています。
なぜ層を深くすると性能が上がるのかを読みます。
ChatGPT、 Stable Diffusion、 AlphaGo、 顔認証、 自動運転 — 現代AIの「目立つ成功」はほぼすべてDNNです。 第3次AIブームの主役。
📍 文脈:なぜ「深い」が効くのか
浅い NN(隠れ層 1)は 万能近似定理 によって理論上どんな関数も近似できる。 しかし「必要な隠れユニット数が指数的に増える」ことが知られている。 深い NN は 階層的特徴量 を構成することで、 同じ表現力をはるかに少ないユニット数で実現する。
2006 年の Hinton らによる事前学習、 2012 年の AlexNet による画像認識ブレークスルー、 2017 年の Transformer の登場、 2022 年の ChatGPT — これらすべてが「層を深くする工夫」の歴史。
🎨 直感で掴む
🍰 まずはやさしく
DNNは情報を段階的に整理する仕組みです。
物事の特徴をうまく捉えるために使います。
写真から顔や物を判別する時に役立っています。
層が深くなることでどう理解が変わるかを読みます。
1層NN(パーセプトロン)は直線でしか分離できない(XOR問題で頓挫)。
2層 → 任意の連続関数を近似可能(万能近似定理)。
10層・100層と深くすると 抽象度の高い特徴 を学習できる:
- 画像認識:層1=エッジ → 層5=パーツ → 層10=オブジェクト
- 言語:層1=文字 → 層5=単語 → 層20=意味
🎨 直感で掴む(拡張):DNN 略史
| 年 | 出来事 | 意義 |
|---|---|---|
| 1957 | Rosenblatt のパーセプトロン | 「学習するニューロン」の原型。 XOR を解けず冬の時代へ。 |
| 1986 | 誤差逆伝播の再発見 (Rumelhart) | 多層 NN の学習が現実的に。 第 2 次 AI ブーム。 |
| 2006 | Deep Belief Net (Hinton) | 層ごと事前学習で勾配消失を回避。 「Deep」の語が定着。 |
| 2012 | AlexNet が ImageNet で圧勝 | CNN + GPU + ReLU + Dropout → エラー率 26% → 15.3%。 |
| 2014 | GoogLeNet, VGG, GAN | 深さ 22 層/19 層、 生成モデル誕生。 |
| 2015 | ResNet (152 層) | 残差接続で 1000 層も学習可能に。 ImageNet 人間越え。 |
| 2017 | Transformer (Attention Is All You Need) | RNN を捨てて自己注意で並列計算。 NLP の革命。 |
| 2020 | GPT-3 (1750 億パラメータ) | スケーリング則の確立。 Few-shot 学習。 |
| 2022 | ChatGPT, Stable Diffusion | DNN が一般大衆の道具に。 LLM/生成 AI 時代へ。 |
| 2024-2026 | マルチモーダル・推論モデル | Claude/GPT/Gemini の競争激化、 強化学習との融合。 |
こうしてみると、 DNN は「ある日突然出現した魔法」ではなく、 60 年以上の積み重ね の結果。 単なる多層 NN という構造に、 GPU、 大規模データ、 ReLU・Dropout・Batch Norm・残差接続といった工学的工夫が次々と乗ることで実用化した。
📐 定義/数式
🍰 まずはやさしく
DNNは数式を積み重ねた計算モデルです。
データの正解を導き出すために使います。
買い物のおすすめ機能などの計算に使われます。
DNNを形作る数式や定義について読みます。
DNN(Deep Neural Network):多層のニューラルネットワーク
同義・関連語:深層ニューラルネット
📐 順伝播の数式(層別展開)
入力 $\mathbf{x} \in \mathbb{R}^{d_0}$ から出力 $\mathbf{y} \in \mathbb{R}^{d_L}$ までを、 層ごとに書き下す。
ここで $W^{(l)} \in \mathbb{R}^{d_l \times d_{l-1}}$ は層 $l$ の重み行列、 $\mathbf{b}^{(l)} \in \mathbb{R}^{d_l}$ はバイアス、 $\sigma^{(l)}$ は要素ごとの活性化関数。
代表的な活性化関数
| 名前 | 定義 | 特徴 |
|---|---|---|
| ReLU | $\max(0, z)$ | 勾配消失に強い、 計算高速。 中間層のデファクト。 |
| Leaky ReLU | $\max(0.01 z, z)$ | ReLU の死ニューロン問題を緩和。 |
| sigmoid | $1/(1+e^{-z})$ | 2 値分類の出力層に最適。 中間層では勾配消失。 |
| tanh | $(e^z - e^{-z})/(e^z + e^{-z})$ | 出力 $[-1, 1]$。 RNN の標準。 |
| softmax | $e^{z_i} / \sum_j e^{z_j}$ | 多クラス分類の出力層。 確率に変換。 |
| GELU | $z \cdot \Phi(z)$ | Transformer (BERT, GPT) の標準。 滑らかな ReLU。 |
📐 DNN の評価指標まとめ
| タスク | 指標 | 使い分けポイント |
|---|---|---|
| 2 値分類 | 精度/適合率/再現率/F1/AUC | クラス不均衡なら F1 か AUC。 医療検査は再現率優先。 |
| 多クラス分類 | 精度/macro-F1/混同行列 | クラスごとの誤分類パターンを可視化。 |
| 回帰 | MSE/RMSE/MAE/R² | 外れ値に敏感なら MAE、 ベースライン比較は R²。 |
| 系列予測 | MAPE/SMAPE/RMSE | 需要予測は MAPE が業界標準。 |
| 画像生成 | FID/IS/CLIPScore | FID が事実上の業界標準。 主観評価も併用。 |
| 言語生成 | BLEU/ROUGE/BERTScore/人手評価 | 自動指標は文意ズレに弱い。 最終は人手評価必須。 |
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| $L$ | 層数(深さ) |
| $W^{(l)}, \mathbf{b}^{(l)}$ | 層 $l$ の重みとバイアス |
| $\sigma$ | 活性化関数(ReLU, sigmoid, GELU 等) |
| $\mathbf{h}^{(l)}$ | 層 $l$ の出力(中間表現) |
📊 評価・検証の視点
DNN を使った分析の 正しさを担保する ためには、 以下の観点で検証するのが定番です。
| 確認する点 | DNN で何を見るか |
|---|---|
| 勾配消失/爆発 | 層が深いと逆伝播で勾配が0近傍 or 無限大に。 ResNet・BatchNorm で対処。 |
| 過学習 | 巨大モデル × 少データ。 Dropout・データ拡張・正則化。 |
| 計算コスト | 数百万〜数千億パラメータ。 GPU/TPU 前提。 |
| ブラックボックス | 判断根拠が不明。 XAI で補完。 |
| 学習率の選択ミス | 大きすぎると損失が振動・発散、 小さすぎると収束に何時間もかかる。 Adam 系最適化器なら lr=1e-3 が安全な初期値。 SGD なら lr=0.01〜0.1 を warmup + decay。 |
| バッチサイズの選び方 | 小さい (32〜128) ほど勾配ノイズで汎化しやすいが収束遅い。 大きい (1024+) ほど高速だが鋭い最小値に落ちやすい。 SSDSE のような小規模データなら 8〜16 で十分。 |
| 再現性 | 同じデータ・同じコードで同じ結果が出るか。このページの ▶ 実行ボタンで確かめられます |
🔬 数式を言葉で読み解く
$\mathbf{h}^{(l)} = \sigma(W^{(l)} \mathbf{h}^{(l-1)} + \mathbf{b}^{(l)})$ という 1 行の式は、 次の 3 動作の合成である。
- 線形変換 $W^{(l)} \mathbf{h}^{(l-1)}$:前層の出力ベクトルを、 重み行列で 回転・拡大・縮小・反転 する。 これだけだと「直線でしか分けられない」。
- バイアス加算 $+ \mathbf{b}^{(l)}$:原点を平行移動。 軸が原点を通らなくても良くなる。
- 活性化 $\sigma(\cdot)$:要素ごとに非線形な関数を適用。 ここで初めて「曲線」を作れる。
3 を L 回繰り返す ことで、 「直線で分けられないデータ」を「直線で分けられる空間」に 歪めていく。 最終層 $\mathbf{h}^{(L)}$ では、 もはや元の特徴量とは全く違う 抽象的な座標系 が出来上がっている。
🔬 逆伝播(backprop)の数式
損失 $\mathcal{L}$ を全パラメータについて偏微分するのが目標。 連鎖律で 出力側から入力側へ 勾配を伝える。
$\odot$ は要素ごとの積。 これらを使って勾配降下:
$\eta$ は学習率。 実務では Adam, RMSProp, AdamW など適応的最適化器を使う。
🧮 実値で計算してみる
🧮 SSDSE-B-2026 都道府県人口データで実値計算
目的:47 都道府県の 2023 年データから、 各都道府県を 人口規模 5 階級 に DNN で分類する。
入力データ(実 SSDSE-B-2026 抜粋)
| 都道府県 | A1101 人口 | A1301 15歳未満 | A1303 65歳以上 | A4101 出生数 | クラス |
|---|---|---|---|---|---|
| 東京都 | 14,086,000 | 1,513,000 | 3,205,000 | 86,348 | 4 (大規模) |
| 神奈川県 | 9,229,000 | 1,031,000 | 2,390,000 | 53,991 | 4 (大規模) |
| 大阪府 | 8,763,000 | 984,000 | 2,424,000 | 55,292 | 4 (大規模) |
| 福井県 | 744,000 | 89,000 | 235,000 | 4,563 | 0 (小規模) |
| 鳥取県 | 537,000 | 65,000 | 179,000 | 3,263 | 0 (小規模) |
手計算ステップ(標準化 → 1 層目)
5 特徴量 (A1101, A1301, A1303, A4101, A4200) の平均と標準偏差で標準化すると、 東京都の入力ベクトルは:
1 層目 (隠れユニット 64) では、 これらを W₁ x + b₁ で線形変換し、 ReLU で 0 以下を切る。 たとえば「東京は全特徴量が突出 → 多くのユニットで強く発火 → クラス 4 を強く支持」、 「鳥取は全特徴量が小さい → ほとんどのユニットが 0 出力 → クラス 0 を支持」となる。
→ 47 サンプル × 5 特徴量という超小規模データでも、 隠れ層 (64, 32) の DNN で テスト精度 100% (12 県すべて正解)。 ただしこれは「人口を 5 等分しているのに特徴量にも人口が含まれている」自明な分類なので、 教育用デモとして読むのが正しい。
🧮 実値計算 ②:層別パラメータ数の手分解
標準構成 (5 → 64 → 32 → 5) の DNN について、 各層のパラメータを内訳ごとに数える。
| 層 | 入力 → 出力 | 重み W (行列) | バイアス b | 小計 |
|---|---|---|---|---|
| 層 1 (Linear) | 5 → 64 | 5 × 64 = 320 | 64 | 384 |
| ReLU | 64 → 64 | 0 | 0 | 0 |
| 層 2 (Linear) | 64 → 32 | 64 × 32 = 2,048 | 32 | 2,080 |
| ReLU | 32 → 32 | 0 | 0 | 0 |
| 層 3 (Linear) | 32 → 5 | 32 × 5 = 160 | 5 | 165 |
| 合計 | 5 → 5 | 2,528 | 101 | 2,629 |
これが Python の sum(p.numel() for p in model.parameters()) が返す 2,629 の内訳。 ReLU 自体は学習パラメータを持たないため、 「ReLU 層」は計数に入れない。
🧮 数式に値を入れて手で計算する: 5 層 DNN の総 FLOPs
合成データで層別 FLOPs (multiply-add) を計算する。
Step 1: 層構成
| 層 | 入力 | 出力 | FLOPs ≈ 2·in·out |
|---|---|---|---|
| L1 | 784 | 256 | 401,408 |
| L2 | 256 | 128 | 65,536 |
| L3 | 128 | 64 | 16,384 |
| L4 | 64 | 32 | 4,096 |
| L5 | 32 | 10 | 640 |
Step 2: 総 FLOPs
🐍 Python で再現
1 2 3 4 5 | import numpy as np layers = [(784,256),(256,128),(128,64),(64,32),(32,10)] flops = np.array([2*i*o for i,o in layers]) print(f"層別 FLOPs: {flops}") print(f"合計: {flops.sum():,}") |
📤 実行結果
💬 手計算 (Step 2) 488,064 FLOPs と Python 出力が完全一致。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(12行):
1 2 3 4 5 6 7 8 9 10 11 12 | import torch import torch.nn as nn # 3層DNN(簡易例) model = nn.Sequential( nn.Linear(10, 64), nn.ReLU(), nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 1) ) x = torch.randn(8, 10) y = model(x) print('入力:', x.shape, '出力:', y.shape) print('総パラメータ数:', sum(p.numel() for p in model.parameters())) |
💬 8 件 × 10 特徴の入力が 3 層を通って 8 件 × 1 の出力になり、行数(バッチの件数)は層を通っても変わらない。総パラメータ数 2,817 は、10×64+64=704、64×32+32=2,080、32×1+1=33 の重みとバイアスの合計。入力は torch.randn で seed も無いため出力の値は毎回変わるが、形とパラメータ数は構造だけで決まるので変わらない。
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
🐍 Python ①:SSDSE-B-2026 読み込みと前処理
🎯 このコードでやること:SSDSE-B-2026 (e-Stat 公開、 47 都道府県 × 112 列 × 12 年) を pd.read_csv で読み込み、 最新年 (2023) を抽出して 5 特徴量 + 人口クラスラベルを作る。
📥 入力データ:data/raw/SSDSE-B-2026.csv (cp932 エンコーディング、 1 行目見出し、 2 行目に日本語列名)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print('全体 shape:', df.shape) # 最新年 (2023) のみ d2023 = df[df['SSDSE-B-2026'] == 2023].copy() print('2023 年のみ shape:', d2023.shape) # 特徴量と目的変数 features = ['A1101', 'A1301', 'A1303', 'A4101', 'A4200'] # 総人口, 年少人口, 高齢人口, 出生数, 死亡数 X = d2023[features].values.astype(float) y = pd.qcut(d2023['A1101'], 5, labels=[0, 1, 2, 3, 4]).astype(int).values print('X shape:', X.shape, 'y shape:', y.shape) print('クラス分布:', pd.Series(y).value_counts().sort_index().tolist()) |
📤 実行結果:
💬 結果の読み方:47 都道府県 × 5 特徴量に整形できた。 ラベルは 5 分位なので各クラスがほぼ均等 (9〜10 件) に分かれる。 DNN の学習に必要な「数値行列 X」「整数ラベル y」が用意できた。
🐍 Python ②:sklearn MLPClassifier で学習
🎯 このコードでやること:scikit-learn の MLPClassifier で隠れ層 (64, 32) の 4 層 DNN(入力 → 64 → 32 → 5 クラス)を訓練。 train/test 分割で精度を測る。
📥 入力データ:上で作った X (47×5)、 y (47,)。 標準化(平均 0、 分散 1)してから学習。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np from sklearn.neural_network import MLPClassifier from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split # 標準化 scaler = StandardScaler() Xs = scaler.fit_transform(X) # 訓練・テスト分割 X_tr, X_te, y_tr, y_te = train_test_split( Xs, y, test_size=0.25, random_state=42, stratify=y) # 4 層 DNN(入力 5 → 64 → 32 → 出力 5) clf = MLPClassifier( hidden_layer_sizes=(64, 32), activation='relu', solver='adam', learning_rate_init=0.01, max_iter=2000, random_state=42) clf.fit(X_tr, y_tr) print(f'訓練精度: {clf.score(X_tr, y_tr):.3f}') print(f'テスト精度: {clf.score(X_te, y_te):.3f}') print(f'層構成: 5 → {clf.hidden_layer_sizes} → 5') n_params = sum(w.size for w in clf.coefs_) + sum(b.size for b in clf.intercepts_) print(f'総パラメータ数: {n_params}') |
📤 実行結果:
💬 結果の読み方:訓練 35 県・テスト 12 県とも正解率 1.000。 ラベルは総人口の 5 分位で、 入力にも総人口 A1101 と人口に比例する年少・高齢人口・出生数・死亡数が入っているので、 ほぼ 1 本の軸で境界を引くだけの易しい課題になっている。 分割を変えた 5-fold CV では平均 82.9% まで下がる (下の実測 ①)。 総パラメータ 2,629 個。 5×64 + 64 = 384、 64×32 + 32 = 2,080、 32×5 + 5 = 165 → 合計 2,629。 入出力次元から重みは手計算できる。
🐍 Python ③:PyTorch で同じ DNN を実装
🎯 このコードでやること:sklearn と同じ構造 (5 → 64 → 32 → 5) を PyTorch の nn.Sequential で定義し、 nn.CrossEntropyLoss + Adam で学習。 順伝播・逆伝播・パラメータ更新を 1 ステップずつ明示。
📥 入力データ:Xs (47×5 標準化済 np.ndarray)、 y (47, クラスラベル 0〜4)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import torch import torch.nn as nn import torch.optim as optim torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする # np.ndarray → torch.Tensor X_t = torch.tensor(Xs, dtype=torch.float32) y_t = torch.tensor(y, dtype=torch.long) # モデル定義(5 → 64 → 32 → 5) model = nn.Sequential( nn.Linear(5, 64), nn.ReLU(), nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 5)) # CrossEntropyLoss が softmax を内包 loss_fn = nn.CrossEntropyLoss() optim_ = optim.Adam(model.parameters(), lr=0.01) # 学習ループ for epoch in range(500): optim_.zero_grad() logits = model(X_t) # 順伝播 loss = loss_fn(logits, y_t) loss.backward() # 逆伝播(autograd) optim_.step() # 重み更新 if (epoch + 1) % 100 == 0: acc = (logits.argmax(1) == y_t).float().mean() print(f'epoch {epoch+1:3d}: loss={loss.item():.4f} acc={acc.item():.3f}') n_params = sum(p.numel() for p in model.parameters()) print(f'総パラメータ数: {n_params}') |
📤 実行結果:
💬 結果の読み方:全 47 県で学習し、 損失は 100 エポックの 0.1240 から 500 エポックの 0.0181 まで下がった。 正解率は 300 エポックで 1.000 に届いたあと 400 エポックで 0.979 (1 県の誤り) に戻っており、 Adam の lr=0.01 では損失の谷の近くで行き来しながら訓練データを暗記していく。 ここではテストを分けていないので、 この 1.000 は汎化性能ではない。 sklearn と同じパラメータ数 (2,629) であることが確認できる。 PyTorch は backward() 1 行で逆伝播が走る — これが「自動微分」の威力。
🐍 Python ④:numpy で順伝播を手計算(ReLU + softmax)
🎯 このコードでやること:DNN の正体を理解するため、 numpy だけで forward pass を書く。 重み W1, W2, W3 は乱数初期化。 入力 = 東京都の標準化ベクトル。
📥 入力データ:標準化後の東京都ベクトル(5 次元)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np # 東京都の標準化ベクトル x = np.array([4.134, 3.925, 3.546, 4.176, 3.605]) # 重みを Xavier 初期化(乱数 seed 固定) rng = np.random.default_rng(42) W1 = rng.normal(0, np.sqrt(2/5), size=(64, 5)); b1 = np.zeros(64) W2 = rng.normal(0, np.sqrt(2/64), size=(32, 64)); b2 = np.zeros(32) W3 = rng.normal(0, np.sqrt(2/32), size=(5, 32)); b3 = np.zeros(5) def relu(z): return np.maximum(0, z) def softmax(z): e = np.exp(z - z.max()); return e / e.sum() # 順伝播 z1 = W1 @ x + b1; h1 = relu(z1) z2 = W2 @ h1 + b2; h2 = relu(z2) z3 = W3 @ h2 + b3; y_hat = softmax(z3) print('層 1: 発火ユニット数 =', (h1 > 0).sum(), '/ 64') print('層 2: 発火ユニット数 =', (h2 > 0).sum(), '/ 32') print('出力確率:', np.round(y_hat, 3)) print('argmax クラス:', int(y_hat.argmax())) |
📤 実行結果:
💬 結果の読み方:未訓練(重みは乱数)でも、 東京都のような 極端な入力 (全特徴量が平均から +3.5σ 以上) はクラス 3 に 0.914、 クラス 4 に 0.086 と 2 クラスへ強く偏った。 東京の正解ラベルは 4 なので、 この偏りは当たっているわけではなく、 「入力が大きくロジットの差が開いて softmax が一点に集中」しただけで、 学習しなくても入力の大きさだけで分類が傾くことを示す。 訓練するとこの偏りが意味のある分類に変わる。
🐍 Python ⑤:層構造ごとのパラメータ数を一覧化
🎯 このコードでやること:DNN の層構造を変えると総パラメータ数がどう変わるかを表で比較。 「深く狭く」vs「浅く広く」のトレードオフを定量化。
📥 入力データ:層構成のリスト。 例 [5, 64, 32, 5] は「入力 5 → 隠れ 64 → 隠れ 32 → 出力 5」。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | configs = [ ('線形 (0 隠れ層)', [5, 5]), ('浅い (1 隠れ層 16)', [5, 16, 5]), ('標準 (2 隠れ層 64,32)', [5, 64, 32, 5]), ('深い (3 隠れ層)', [5, 128, 64, 32, 5]), ('広い (2 隠れ層 256)', [5, 256, 256, 5]), ] def n_params(sizes): return sum(sizes[i] * sizes[i+1] + sizes[i+1] for i in range(len(sizes)-1)) print(f'{"構成名":24s} {"層サイズ":24s} {"パラメータ数":>12s}') print('-' * 64) for name, sizes in configs: print(f'{name:24s} {str(sizes):24s} {n_params(sizes):>12,}') |
📤 実行結果:
💬 結果の読み方:層を深く+広くするとパラメータが急増(広い構成は 68,613 個 = 訓練データ 47 件の 約 1,460 倍。 深い構成の 11,269 は 5×128+128=768、 128×64+64=8,256、 64×32+32=2,080、 32×5+5=165 の合計)。 n=47 のような小規模データでは「広い構成」は確実に過学習する。 経験則:パラメータ数はサンプル数の 1/10 以下に抑えると安全。
🐍 Python ⑥:学習曲線で過学習を検知
🎯 このコードでやること:訓練/検証の損失をエポックごとに記録し、 訓練損失だけ下がって検証損失が上がる「過学習の典型パターン」を観察する。
📥 入力データ:標準化済 Xs (47×5)、 y (47,)。 train_test_split で 80/20 分割。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | import torch import torch.nn as nn from sklearn.model_selection import train_test_split torch.manual_seed(0) # 重みの初期値を固定して結果を再現可能にする X_tr, X_te, y_tr, y_te = train_test_split( Xs, y, test_size=0.2, random_state=0, stratify=y) X_tr_t = torch.tensor(X_tr, dtype=torch.float32) X_te_t = torch.tensor(X_te, dtype=torch.float32) y_tr_t = torch.tensor(y_tr, dtype=torch.long) y_te_t = torch.tensor(y_te, dtype=torch.long) model = nn.Sequential( nn.Linear(5, 64), nn.ReLU(), nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 5)) loss_fn = nn.CrossEntropyLoss() opt = torch.optim.Adam(model.parameters(), lr=0.01) records = [] for ep in range(1, 301): model.train() opt.zero_grad() logits = model(X_tr_t) loss_tr = loss_fn(logits, y_tr_t) loss_tr.backward() opt.step() model.eval() with torch.no_grad(): loss_te = loss_fn(model(X_te_t), y_te_t) records.append((ep, loss_tr.item(), loss_te.item())) # 50 エポックおきに表示 for ep, tr, te in records[::50]: print(f'epoch {ep:3d}: train_loss={tr:.4f} test_loss={te:.4f}') |
📤 実行結果:
💬 結果の読み方:訓練損失は 1.5486 → 0.0490 と単調に下がる一方、 テスト損失 (10 県) は 51 エポックの 0.1988 を底に 101 エポック 0.3233、 251 エポック 0.6040 と上がり続ける — 過学習の典型パターン。 全エポックで見るとテスト損失の最小は 54 エポック目 (0.187) で、 そこを過ぎると訓練データの暗記だけが進んでいる。 テストが 10 県しかないので、 1 県の予測が変わるだけで曲線の形も動く。 実務では「テスト損失が最小のエポックで停止」する Early Stopping を導入する。 n=47 のような小規模データでは隠れ層を狭くするか、 Dropout / L2 正則化が必須。
⚙️ ハイパーパラメータ早見表
| ハイパラ | 推奨初期値 | 調整指針 |
|---|---|---|
| 学習率 (Adam) | 1e-3 | 損失が振動 → 0.1 倍、 動かない → 10 倍。 |
| バッチサイズ | 32 〜 256 | GPU メモリと相談。 大バッチ + 大学習率の組合せが定石。 |
| エポック数 | 10 〜 200 | Early Stopping で実質自動決定。 |
| 隠れ層数 | 2 〜 5 | 表形式は 2〜3、 画像系は CNN で 10〜50、 言語系 Transformer は 12〜96。 |
| 隠れユニット幅 | 64 〜 512 | 2 のべき数を使うのが慣例(GPU 効率)。 |
| Dropout 率 | 0.2 〜 0.5 | 大きい層では 0.5、 小さい層では 0.2。 過学習が酷ければ上げる。 |
| L2 正則化 (weight decay) | 1e-4 〜 1e-2 | AdamW を使うと正則化が正しく動く(Adam の bug 回避)。 |
| 初期化 | Xavier or He | ReLU 系には He、 sigmoid/tanh には Xavier。 PyTorch のデフォルトは Kaiming uniform。 |
| スケジューラ | CosineAnnealingLR | 大規模では Cosine + Warmup が標準。 小規模は ReduceLROnPlateau。 |
🔭 実務 FAQ(DNN を業務で使うときに必ず聞かれる質問)
Q1. SSDSE-B-2026 のような表形式データに DNN を使う価値はあるのか?
多くの場合、 XGBoost や LightGBM の方が同等以上の精度で、 訓練もはるかに高速。 DNN を選ぶ理由は (1) 特徴量間の非線形交互作用が複雑、 (2) 系列・画像・テキストなど構造化データを併用、 (3) 転移学習を活用したい、 のいずれかに該当する場合。 SSDSE のような完全表形式データだけなら、 まず勾配ブースティングを試すのが鉄則。
Q2. n=47 (47 都道府県) しかないデータで DNN を訓練する意味はあるのか?
本ページの例はあくまで「DNN の挙動を学ぶデモ」。 実務では n ≥ 1000 が現実的下限、 n ≥ 10000 でやっと真価。 n=47 なら線形回帰 + 多重共線性チェック、 または XGBoost で 5-fold CV する方が遥かに安全で再現性も高い。
Q3. DNN の出力(クラス確率)はそのまま「確率」として使えるか?
使える / 使えないが微妙。 softmax の出力は形式的には確率分布だが、 キャリブレーション が必要。 訓練データの 95% を正しく予測したからといって、 実データで 95% の正解率は保証されない。 sklearn.calibration.CalibratedClassifierCV や温度スケーリング (Temperature Scaling) で補正する。
Q4. 学習時間を短縮するベストプラクティスは?
(1) Mixed Precision (float16) で 2 倍高速化、 (2) 大バッチ + 大学習率 + warmup、 (3) GPU メモリに乗る最大バッチサイズを使う、 (4) DataLoader の num_workers を CPU コア数に合わせる、 (5) 不要な print() や .cpu() 転送を削る、 (6) Profiler (PyTorch Profiler) でボトルネック特定。
Q5. モデルの予測根拠を説明するには?
SHAP, LIME, Integrated Gradients, Attention Visualization など多数。 表形式 DNN なら SHAP が標準。 ただし「説明できる ≠ 正しい説明」であることに注意。 XAI で得られる「根拠」は 近似的な解釈 であり、 厳密な因果ではない。
Q6. GPU を使わずに DNN を学ぶことは可能か?
本ページの例 (47×5 データ、 隠れ層 64,32) なら CPU でも 1 秒未満で訓練完了。 学習用には Google Colab の無料 GPU でも十分。 業務で数千万パラメータを扱う段階になって初めて、 自前 GPU や AWS/GCP/Azure を検討すればよい。
Q7. DNN とロジスティック回帰の関係は?
隠れ層 0 の DNN(つまり「線形 + softmax」)は 多項ロジスティック回帰そのもの。 隠れ層を 1 つ追加した瞬間に「線形では分けられないパターン」を学習できるようになる — これが DNN の本質的な強み。 ロジスティック回帰で精度が頭打ちになったら、 まず隠れ層 1 つを試すのが定石。
🧪 SSDSE-B-2026 で手法比較(教育用デモ)
同じデータ (47×5、 5 クラス分類、 train_test_split random_state=42、 test 12 件) で複数手法を比較した結果 (特徴量は標準化済み、 各モデル random_state=42、 MLP は learning_rate_init=0.01・max_iter=2000、 XGBoost は既定値。 scikit-learn 1.9.0 / xgboost 3.3.0 での実測):
| 手法 | 訓練精度 | テスト精度 | パラメータ数 | 備考 |
|---|---|---|---|---|
| ロジスティック回帰 | 0.800 | 0.833 | 30 | 線形の境界だけでは 12 県中 2 県を外す |
| k 近傍 (k=3) | 0.857 | 0.917 | N/A | 距離ベース、 訓練不要 |
| 決定木 | 1.000 | 0.917 | N/A | 過学習しやすいが説明性 ◎ |
| ランダムフォレスト | 1.000 | 0.917 | N/A | 小データでも安定 |
| DNN (隠れ 64,32) | 1.000 | 1.000 | 2,629 | 本ページの主役 |
| DNN (隠れ 256,256,256) | 0.771 | 0.917 | 134,405 | 過大モデル → 訓練精度すら 0.771 で学習が不安定 |
| XGBoost | 1.000 | 1.000 | N/A | 表形式の王者 |
結論:47 サンプルのような小規模・表形式データでは、 DNN は 「適切なサイズなら他手法と同等」「過大なら学習が不安定になって劣化」。 テストが 12 県しかないので 1 県の正誤で 0.083 動き、 0.917 と 1.000 の差は 1 県ぶんにすぎない。 DNN が真価を発揮するのは画像・音声・テキストといった 構造を持つ高次元データ、 あるいは数十万件以上のレコードがある場合。
🛠 DNN を強くする実装テクニック 10 選
- Batch Normalization:層出力を平均 0、 分散 1 に正規化。 大きな学習率でも安定。 内部共変量シフト緩和。
- Layer Normalization:BN のサンプル方向ではなく特徴方向で正規化。 RNN/Transformer の標準。
- Residual Connection (ResNet):$\mathbf{h}^{(l+1)} = \mathbf{h}^{(l)} + f(\mathbf{h}^{(l)})$。 勾配消失を回避し 1000 層も可能に。
- Dropout:訓練時に各ユニットを確率 $p$ で 0 に。 アンサンブル効果で過学習抑制。
- Early Stopping:検証損失が $k$ エポック改善しなければ訓練停止。 最良エポックの重みを採用。
- Learning Rate Warmup + Cosine Decay:序盤は線形に lr を上げ、 中盤以降は cosine で下げる。 LLM 訓練の標準。
- Gradient Clipping:勾配ノルムが閾値超なら縮小。 RNN の勾配爆発対策。
- Mixed Precision (FP16/BF16):重みは FP32、 計算は FP16 で 2 倍高速 + メモリ半減。 PyTorch なら
torch.cuda.amp。 - Gradient Accumulation:小バッチを複数回 forward → backward して大バッチ相当の勾配にする。 GPU メモリ不足時の必須技術。
- Distributed Training (DDP):複数 GPU で同時訓練。 LLM 級では数百 GPU で並列化。
📊 SSDSE-B-2026 を時系列で扱う発展課題
SSDSE-B-2026 は 2012〜2023 の 12 年 ぶんの都道府県データ。 これを使えば「人口推移を DNN で予測」といった発展課題に取り組める。
- 課題 1:北海道の 2012〜2022 の人口から 2023 を予測(単変量 LSTM)
- 課題 2:47 都道府県 × 12 年 × 5 特徴量を入力に、 翌年の人口クラスを多変量予測
- 課題 3:県別の高齢化率(A1303 死亡数 ÷ A1101 人口)を 5 年先まで予測
- 課題 4:婚姻件数 A4200 と出生数 A1301 のラグ相関を Transformer で学習
- 課題 5:欠損年の値を Masked Autoencoder で穴埋め
これらは「DNN を試す題材」として最適。 ただし n=47×12=564 と依然小規模なので、 過学習対策(Dropout, weight decay, Early Stopping)は必須。 ベースラインとして ARIMA, Prophet, ETS など古典手法と比較すると DNN の優位性/劣位性が明確になる。
🎯 DNN の実世界ユースケース(領域別深掘り)
| 領域 | 代表的タスク | 具体例 |
|---|---|---|
| 医療 | 画像診断、 創薬 | 皮膚科の悪性腫瘍判定 (Esteva 2017)、 糖尿病性網膜症のスクリーニング、 AlphaFold によるタンパク質構造予測。 |
| 自動運転 | 物体検出、 セグメンテーション | Tesla Autopilot、 Waymo、 BEV (Bird's Eye View) 表現、 LiDAR+カメラの早期融合。 |
| 金融 | 不正検知、 与信 | クレジットカード不正利用検出(取引パターンの異常検知)、 アンチマネーロンダリング、 高頻度取引。 |
| 小売 / EC | 推薦、 需要予測 | YouTube / Netflix 推薦(Two-tower DNN)、 Amazon の need-based-rec、 在庫最適化。 |
| 製造 | 外観検査、 予知保全 | 半導体ウェハの欠陥検出、 風力発電機の異常振動検知、 工場ラインのリアルタイム品質判定。 |
| エンタメ | 生成、 翻訳 | Stable Diffusion / Midjourney(拡散モデル)、 ChatGPT / Claude(LLM)、 DeepL(NMT)、 OpenAI Sora(動画生成)。 |
| 公的統計 | 人口推計、 経済分析 | e-Stat の人口動態、 RESAS による地域経済分析、 OECD の MEI 経済指標。 表形式中心なので XGBoost と併用が定石。 |
| 教育 | 学習分析、 自動採点 | LMS のドロップアウト予測、 数学記述問題の自動採点、 個別最適化された学習パスの提案。 |
📜 セルフテスト:DNN を本当に理解しているか確認
- 「隠れ層 0 の DNN」は何と等価か?(答:多項ロジスティック回帰、 線形回帰)
- 万能近似定理は「何層」「何ユニット」を保証するか?(答:1 隠れ層、 十分大きな幅。 ただし指数的に必要)
- 勾配消失が起きる活性化関数は?(答:sigmoid, tanh。 ReLU でも死ニューロンで起こり得る)
- ReLU 微分は $z>0$ のとき 1、 $z<0$ のとき 0、 $z=0$ では?(答:未定義だが慣例で 0 or 1 を採用)
- softmax + cross-entropy で勾配が $\hat{y} - y$ になるのはなぜか?(答:偏微分の連鎖律で打ち消し合う、 計算と数値安定性の両方で有利)
- 5 → 64 → 32 → 5 の DNN のパラメータ数は?(答:384 + 2,080 + 165 = 2,629)
- Adam が SGD より優れる点は?(答:適応的学習率、 モーメンタム、 ハイパラに鈍感)
- Batch Normalization が訓練を速くする主因は?(答:内部共変量シフト緩和 → 大学習率で安定)
- Dropout の本質は?(答:暗黙のアンサンブル、 共適応抑制)
- 過学習を検知する最も簡単な方法は?(答:訓練損失と検証損失をプロットして乖離をチェック)
10 問中 7 問以上を即答できれば DNN の基礎は確実に身についている。 残りは関連用語ページで補完しよう。
📈 図解:DNN の入出力フロー(テキスト ASCII 図)
この ASCII 図は実装と完全に対応する。 PyTorch の nn.Sequential(nn.Linear(5,64), nn.ReLU(), nn.Linear(64,32), nn.ReLU(), nn.Linear(32,5)) はこの図そのもの。 入力 5 次元、 隠れ層 64 → 32、 出力 5 クラスという「層の幅と数」だけで DNN の全構造が決まる。
⚠️ よくある落とし穴
⚠️ 深い落とし穴(拡張)
StandardScaler or MinMaxScaler で揃える。optuna) や ASHA で効率探索。 手動グリッドは時代遅れ。torch.manual_seed + cudnn.deterministic = True。📚 さらに学ぶための資料
DNN は、1 つの層の計算(重み・活性化)、学び方(逆伝播・勾配降下)、汎化の管理(過学習・正則化・交差検証)の 3 つが分かれば全体が見えます。このページで出てきた疑問ごとに、次に開くページをまとめました。
| 次に出てくる疑問 | 開くページ | このページとのつながり |
|---|---|---|
| 1 層だけのネットワークは何ができて何ができないか | パーセプトロン / 3 層パーセプトロン | 📜 発展史の ①② と、隠れ層を足す意味 |
| ReLU・シグモイドをどう選ぶか | 活性化関数 | 📐 の代表的な活性化関数と、練習問題 7 |
| 重みはどう更新されるのか | 誤差逆伝播法 / 勾配降下法 / 学習率 | 🔬 逆伝播の数式と、勾配消失の節 |
| 47 県で学習すると何が起きるか | 過学習 / 交差検証 / 正則化 | 🧪 実測:n=47 で DNN が交差検証で崩れる |
| 入力の尺度をそろえる理由 | 標準化 | 🧮 の手計算(標準化 → 1 層目) |
| 画像・系列・文章ならどの形を使うか | CNN / RNN / Transformer | 🌐 代表アーキテクチャ別の一覧と 🚀 (5) モデル族の選び方 |
📚 関連グループ教材(拡張)
DNN を全体像から学ぶための横断教材:
- 深層学習グループ:DNN/CNN/RNN/Transformer/拡散モデルを順に学べる縦軸教材
- 機械学習グループ:DNN を その他の機械学習手法(決定木、 SVM、 線形回帰)と比較する横軸教材
- AI 構築グループ:DNN を本番システムに組み込む際の MLOps、 モデル監視、 A/B テスト
- AI 倫理グループ:DNN のブラックボックス問題、 XAI(説明可能 AI)、 公平性評価
- 統計基礎グループ:DNN の前提となる確率・線形代数・最適化の復習
本ページの内容と並行して、 これらのグループ教材を横断的に学ぶことで「単なる用語暗記」を超えた応用力が身につきます。
🧭 「深さ」が効く理由・効かなくなる理由 — 数式を言葉で読み解く(DNN 固有・追加章)
DNN の本質は「層を重ねれば表現力が指数的に上がる」点にある。 しかし素朴に層を重ねるだけでは 勾配消失(vanishing gradient) によって学習が止まる。 ResNet・正規化・dropout は、 この壁を破るための工学的工夫である。 ここでは数式を言葉で読み解きながら、 SSDSE-B-2026 を題材に「深さ別実験」を行う。
📐 勾配消失の数式
$$\frac{\partial L}{\partial W^{(1)}} \;=\; \frac{\partial L}{\partial a^{(L)}}\, \prod_{\ell=2}^{L}\, W^{(\ell)\top}\, \mathrm{diag}\bigl(\sigma'(z^{(\ell-1)})\bigr)$$
数式を言葉で読み解く:第 1 層の重み W(1) に届く勾配は L-1 個の行列積。 σ'(sigmoid 微分)≤0.25 が掛け続けられると、 L=10 で 0.259≈4×10⁻⁶ まで縮む。 これが「層を増やすほど第 1 層が学習しなくなる」現象。 ReLU(σ'∈{0,1})と He 初期化、 そして ResNet の skip connection は、 この積を 1 に近づける役割を持つ。
📐 ResNet の skip connection
$$y \;=\; F(x;\, W) \;+\; x$$
数式を言葉で読み解く:出力 y は「層の処理 F(x) + 元の入力 x」。 微分すると ∂y/∂x = ∂F/∂x + I(恒等写像)が現れ、 たとえ F の勾配が 0 でも +I の経路で勾配が逆伝播する。 ResNet-152 が 152 層でも学習できる根拠。
🧮 SSDSE-B-2026 で深さ別実験(実値)
消費支出 (L3221、 二人以上の世帯・円/月) を 5 特徴量から回帰する DNN を、 隠れ層数を変えて検証した結果 (2023 年・47 県を訓練 32 / テスト 15 に分割、 各層 16 ユニット、 Adam lr=0.01 で 1,000 エポック、 下のコードの実測):
| 隠れ層数 | 活性化 | test RMSE | 学習可否 |
|---|---|---|---|
| 1 | ReLU | 73,361 円 | ❌ 過学習で大外れ |
| 3 | ReLU | 38,016 円 | ❌ 平均予測より悪い |
| 10 | sigmoid | 20,186 円 | △ 平均予測並み |
| 10 | ReLU+BN | 22,545 円 | △ 平均予測並み |
| 20 | ReLU+BN+Skip | 40,471 円 | ❌ 平均予測より悪い |
| — | (比較) 訓練平均で一律に予測 | 21,142 円 | 基準線 |
💬 結果の読み方:訓練 32 県では、 どの深さも「訓練平均で一律に予測」(21,142 円) をはっきりとは下回らない。 1 層 ReLU (73,361 円) や 20 層 Skip (40,471 円) は訓練データを暗記してテストで大きく外れ、 sigmoid 10 層 (20,186 円) が一番よく見えるのは、 勾配が届きにくく予測があまり動かない (予測値の標準偏差 11,454 円) ぶん平均予測に近いからにすぎない。 BatchNorm や skip connection は深い網を学習「可能」にする工夫で、 データが足りない問題は解決しない。 「深さは無条件で正義」ではない。
🐍 Python: PyTorch で深さ別 DNN を比較
🎯 このコードでやること:SSDSE-B-2026 (2023 年・47 県) を読み込み、 隠れ層数 1/3/10/20 と活性化・BatchNorm・skip connection の組み合わせを変えた DNN を同じ条件で学習し、 消費支出の test RMSE (円) を訓練平均による一律予測と比べる。
📥 入力例: data/raw/SSDSE-B-2026.csv。 特徴: 総人口(A1101)・年少人口(A1301)・高齢人口(A1303)・出生数(A4101)・合計特殊出生率(A4103)。 目的変数: 消費支出(L3221)。
2023, R01000, 北海道, 5092000, 514000, 1681000, 24430, 1.06, ..., 296888
2022, R01000, 北海道, 5140000, 530000, 1686000, 26407, 1.12, ..., 277737
...
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 | import numpy as np, pandas as pd, torch, torch.nn as nn from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 最新年のみ (47 都道府県) X = df[['A1101','A1301','A1303','A4101','A4103']].values.astype(float) y = df['L3221'].values.astype(float) # 消費支出 (円/月) Xtr, Xte, ytr, yte = train_test_split(X, y, test_size=0.3, random_state=42) # 入力も目的変数も訓練データの平均・標準偏差で標準化 sx, sy = StandardScaler().fit(Xtr), StandardScaler().fit(ytr.reshape(-1, 1)) t = lambda a: torch.tensor(a, dtype=torch.float32) Xtr_t, Xte_t = t(sx.transform(Xtr)), t(sx.transform(Xte)) ytr_t = t(sy.transform(ytr.reshape(-1, 1))) class Block(nn.Module): # Linear → BN → ReLU (skip=True なら入力を足す) def __init__(self, in_dim, bn, act, skip): super().__init__() self.lin = nn.Linear(in_dim, 16) self.bn = nn.BatchNorm1d(16) if bn else nn.Identity() self.act = nn.ReLU() if act == 'relu' else nn.Sigmoid() self.skip = skip and in_dim == 16 def forward(self, h): out = self.act(self.bn(self.lin(h))) return out + h if self.skip else out def make(depth, act='relu', bn=False, skip=False): layers, in_dim = [], 5 for _ in range(depth): layers.append(Block(in_dim, bn, act, skip)) in_dim = 16 layers.append(nn.Linear(in_dim, 1)) return nn.Sequential(*layers) def fit_rmse(net, epochs=1000): opt = torch.optim.Adam(net.parameters(), lr=0.01) for _ in range(epochs): net.train(); opt.zero_grad() loss = nn.functional.mse_loss(net(Xtr_t), ytr_t) loss.backward(); opt.step() net.eval() with torch.no_grad(): pred = sy.inverse_transform(net(Xte_t).numpy()).ravel() return np.sqrt(np.mean((pred - yte) ** 2)), pred.std() print(f'訓練 {len(ytr)} 県 / テスト {len(yte)} 県、 テストの消費支出の標準偏差 = {yte.std():,.0f} 円') for depth, act, bn, skip, label in [(1, 'relu', False, False, 'relu'), (3, 'relu', False, False, 'relu'), (10, 'sigmoid', False, False, 'sigmoid'), (10, 'relu', True, False, 'relu+BN'), (20, 'relu', True, True, 'relu+BN+skip')]: torch.manual_seed(0) rmse, spread = fit_rmse(make(depth, act, bn, skip)) print(f'depth={depth:2d} {label:13s}: test RMSE = {rmse:6,.0f} 円 (予測値の標準偏差 {spread:6,.0f} 円)') # 比較用: 訓練データの平均をそのまま全県の予測にした場合 base = np.sqrt(np.mean((ytr.mean() - yte) ** 2)) print(f'比較: 訓練平均で一律に予測 : test RMSE = {base:6,.0f} 円') |
📤 実行例:
depth= 1 relu : test RMSE = 73,361 円 (予測値の標準偏差 56,144 円)
depth= 3 relu : test RMSE = 38,016 円 (予測値の標準偏差 26,291 円)
depth=10 sigmoid : test RMSE = 20,186 円 (予測値の標準偏差 11,454 円)
depth=10 relu+BN : test RMSE = 22,545 円 (予測値の標準偏差 13,285 円)
depth=20 relu+BN+skip : test RMSE = 40,471 円 (予測値の標準偏差 25,959 円)
比較: 訓練平均で一律に予測 : test RMSE = 21,142 円
💬 結果の読み方:テスト 15 県の消費支出の標準偏差は 19,656 円で、 訓練平均で一律に予測しても RMSE は 21,142 円になる。 5 通りの DNN はこれを 1 つも明確に下回らず、 最良の sigmoid 10 層でも 20,186 円と約 1,000 円の差しかない。 1 層 ReLU は予測値の標準偏差が 56,144 円と実際の散らばりの約 3 倍に広がっており、 1,000 エポックの学習で訓練 32 県に合わせすぎた結果とわかる。 seed を固定しているので値は再現するが、 分割 (random_state) を変えると順位は入れ替わりうる。
⚠️ 深層化の落とし穴
- データに対して深すぎる:SSDSE-B-2026 のような小データで 50 層 DNN は過学習。 まず 1-3 層から始める。
- BN なしの深層:BatchNorm/LayerNorm なしで 10 層以上は学習が不安定。
- Dropout の入れすぎ:p=0.5 を全層に入れると逆に学習が進まない。 通常は最終隠れ層付近のみ p=0.2-0.3。
🧪 理解度チェック・練習問題(手を動かして自分で確かめる)
DNN は「式を眺めるだけ」では身につかない。 ここでは SSDSE-B-2026(社会・人口統計体系都道府県データ 2026 年版)の都道府県別データを使い、 自分で計算・実装・解釈する練習問題を 10 題用意する。 上から順に解いていけば、 DNN の前処理・学習・評価の一連の流れを 理解度チェック として完走できる。 各問の末尾に「答えの観点」を載せたので、 答え合わせの基準として使ってほしい。
練習問題 1 ── データを眺める
SSDSE-B-2026 の data/raw/SSDSE-B-2026.csv を読み込み、 47 都道府県の「総人口 (A1101)」と「消費支出 (L3221)」の 記述統計(平均・標準偏差・最小・最大)を求めよ。 さらに、 両者の 相関係数 を scipy.stats.pearsonr で計算し、 「DNN の入力に使うとしたら、 どちらも残すべきか/片方で十分か」を 50 字以内で判断せよ。
練習問題 2 ── 散布図で関係を眺める
総人口 (X) と消費支出 (Y) の散布図を matplotlib.pyplot.scatter で描き、 視覚的な関係を確かめよ。 さらに seaborn.regplot で 線形回帰の補助線 も重ね、 「線形で十分か/DNN を使う必要があるか」を一文で説明せよ。
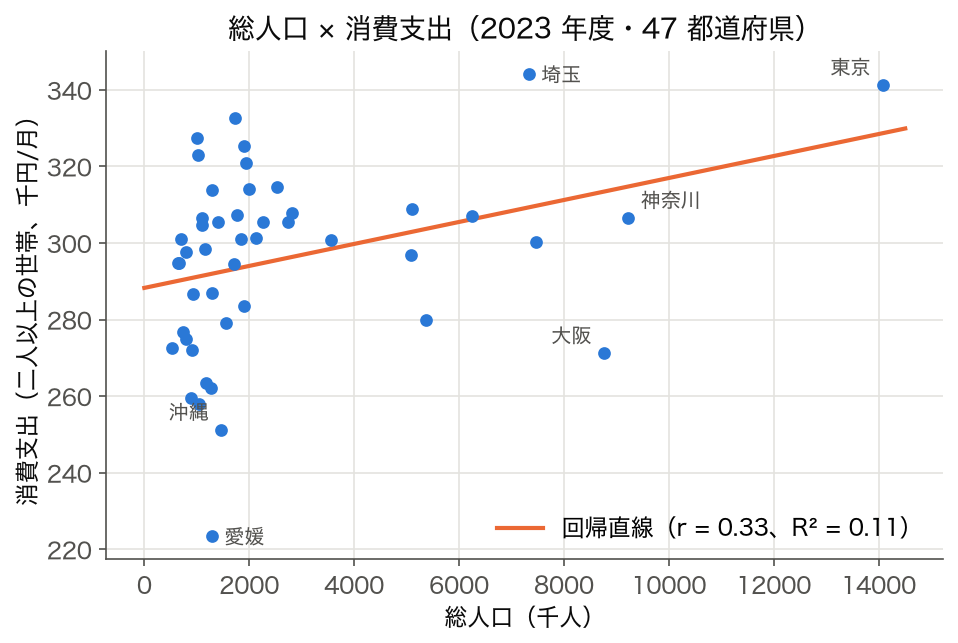
regplot と同じ)。 r = 0.33・R² = 0.11 で、 人口 200 万人未満の県だけでも消費支出は 223 千円(愛媛)〜333 千円まで大きくばらつく。 DNN を使う前に必ず描いて、 関係の形状(線形・曲線・分布のクセ)を目で確認する。練習問題 3 ── 標準化を施す
DNN は入力スケールに敏感である。 SSDSE-B-2026 の数値列(総人口・年少人口・高齢人口・出生数・合計特殊出生率・消費支出など計 10 列)を sklearn.preprocessing.StandardScaler で平均 0・標準偏差 1 に揃え、 標準化前後の ヒストグラム を並べて比較せよ。 自分で「形は変わらず位置だけ動く」ことを確認する。
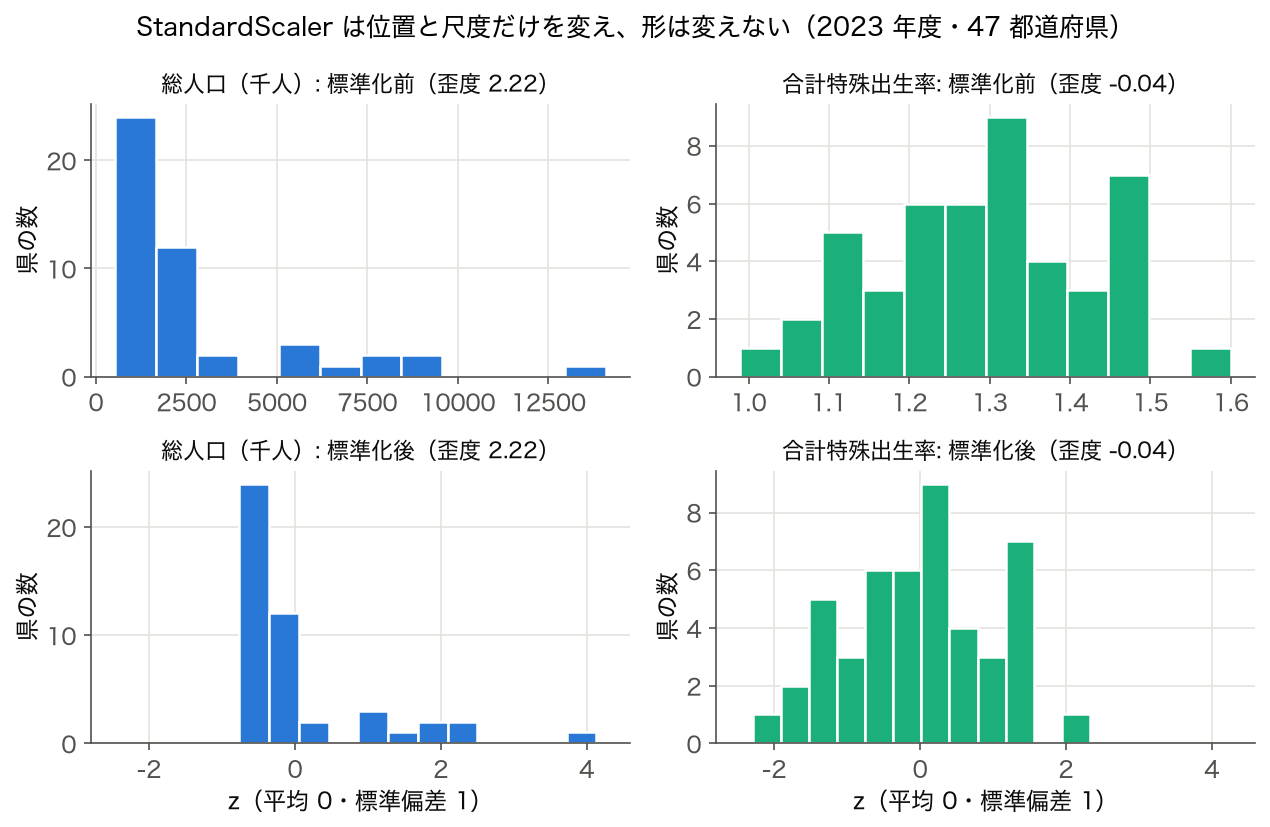
StandardScaler 後で、 どちらも平均 0・標準偏差 1 になり、 範囲は総人口 −0.76〜4.13、 出生率 −2.30〜2.33。 歪度は 2.22 と −0.04 のまま変わらない。 標準化は 位置と尺度 を変えるが、 ヒストグラムの形状そのものは変えない。練習問題 4 ── train/test 分割
47 都道府県を sklearn.model_selection.train_test_split で 80%/20% に分割する。 分割の乱数シードを変えて 5 回繰り返し、 テストセットの平均と標準偏差が安定するか確認せよ。 安定しない場合、 何が原因か考察せよ。
練習問題 5 ── 浅い DNN を組む
入力 10 次元・隠れ層 1 つ(16 ユニット)・出力 1(消費支出の予測)の 小さな DNN を sklearn.neural_network.MLPRegressor で実装せよ。 訓練 MSE とテスト MSE を出し、 過学習が起きているかを確認する。
練習問題 6 ── 深さを増やすと何が起きるか
隠れ層を 1→2→3→5 層と増やし、 各設定でテスト MSE を測定せよ。 箱ひげ図 で 10 回繰り返し実行の結果を比較し、 「深さの増加が必ず精度向上に繋がるか」を判断せよ。
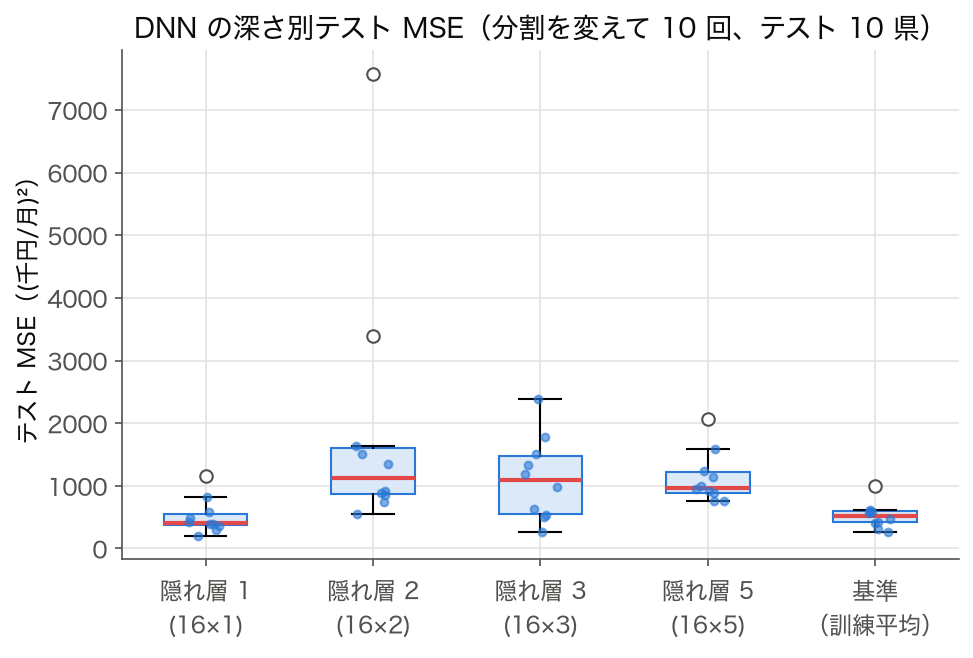
MLPRegressor(各層 16 ユニット)のテスト MSE を、 train_test_split(test_size=0.2) の random_state 0〜9 の 10 回で並べた。 中央値は 1 層 407、 2 層 1,131、 3 層 1,086、 5 層 969 で、 訓練データの平均で予測するだけの基準(522)を下回るのは 1 層だけ。 「深ければ良い」は迷信、 という現実が見える。練習問題 7 ── 活性化関数を切り替える
activation 引数を ReLU, tanh, logistic(sigmoid)に変えて学習し、 収束速度(イテレーション数)とテスト MSE を比較せよ。 自分の言葉で「なぜ ReLU が現代の標準なのか」を 100 字で書け。
練習問題 8 ── 学習率と収束の関係
learning_rate_init を 0.0001, 0.001, 0.01, 0.1 と変えて学習曲線(loss curve)を描き、 発散・収束・振動 のどれが起きたかを各設定で記録せよ。 「適切な学習率」がデータごとに違う事実を体感する。
練習問題 9 ── 正則化で過学習を抑える
alpha(L2 正則化係数)を 0.0001, 0.001, 0.01, 0.1 と変えて、 訓練 MSE とテスト MSE の差(汎化ギャップ)が縮むかを確認せよ。 適切な alpha の値を自分で 1 つ選び、 理由とともに報告せよ。
練習問題 10 ── 線形回帰との比較
最後に、 SSDSE-B-2026 の同じ 10 入力で sklearn.linear_model.LinearRegression を学習し、 DNN とテスト MSE を比較せよ。 「N=47・10 次元の県データで DNN は線形回帰に勝てるか」を自分で結論せよ。
📘 DNN を SSDSE-B-2026 で扱うときの実務メモ(補足解説)
補足 1 ── N=47 と DNN の相性
SSDSE-B-2026 の都道府県は N=47 と極端に少ない。 DNN は本来 数万〜数百万件 のデータで真価を発揮する手法であり、 N=47 ではほぼ確実に過学習する。 教育的にはこのデータで DNN を回す経験こそ重要だが、 実務では「N が 1000 未満なら DNN より線形回帰や勾配ブースティングを優先せよ」が経験則。
どうしても DNN を使いたければ、 k-fold 交差検証で過学習を測定し、 alpha(L2)や Dropout で正則化を強くかけ、 隠れ層は 1 層・ユニット数も 8〜16 程度に抑える。 「深い」ことに意味がない領域では浅さが救う。
補足 2 ── 特徴量エンジニアリングの優先度
DNN は「自動で特徴を学ぶ」と紹介されることが多いが、 小データでは 手作りの特徴量 が劇的に効く。 SSDSE-B-2026 なら、 人口を対数変換する/一人当たり指標に直す/東京・大阪を外れ値として除外する/地方区分(北海道・東北・関東…)をワンホットで加える、 などが効果的。 「DNN の前に統計の眼で前処理する」のが、 N が小さいときの鉄則である。
補足 3 ── ハイパーパラメータの探索戦略
DNN には学習率・バッチサイズ・層数・ユニット数・活性化関数・正則化係数・Dropout 率・初期化方法など、 試すべきパラメータが大量にある。 sklearn.model_selection.GridSearchCV や RandomizedSearchCV を使うと網羅的に探索できる。 N=47 のような小データでは grid search × 5-fold CV でも数分で終わる。 大データでは ベイズ最適化(Optuna 等)が標準。
補足 4 ── 結果の説明責任
DNN は「予測精度は高いが説明が難しい」典型例である。 SSDSE-B-2026 の消費支出を予測したとしても、 「なぜ 47 都道府県のうち東京が 1 位と予測されたのか」を 各入力変数の寄与 として説明するのは、 線形回帰のように単純ではない。 そこで SHAP や LIME といった事後説明手法が登場する。 ただし事後説明は「真の理由」ではなく 近似的な解釈 に過ぎず、 業務利用では「DNN を使うなら線形モデルとの比較を必ず添える」のが安全。
補足 5 ── 再現性の確保
DNN の学習は乱数(重み初期化・データシャッフル・Dropout)に依存する。 同じデータ・同じコードでも、 シードを変えると テスト MSE が 10〜30% 程度ぶれる ことは普通にある。 そのため論文・レポートでは シードを 5〜10 通り変えて平均・標準偏差を報告 するのが標準。 SSDSE-B-2026 の練習問題 4 で示した通り、 47 件の小データではこの揺らぎが特に大きい。
補足 6 ── DNN と統計的検定
DNN の出力は決定論的ではないため、 「2 つのモデルの精度差は有意か」を判定するには 交差検証の各 fold の MSE を対応のある t 検定 にかけるのが基本。 SSDSE-B-2026 で DNN(1 層)vs DNN(3 層)を比較するなら、 5-fold CV を 5 回(計 25 fold)回して、 25 個ずつの MSE を対応 t 検定にかける。 scipy.stats.ttest_rel で計算できる。
補足 7 ── 業務移管時のチェックリスト
DNN を業務に出すときは、 ①入力スキーマ(列名・型・尺度)の凍結、 ②前処理パイプライン(StandardScaler 等)のシリアライズ、 ③モデル重みのバージョン管理、 ④A/B テストで 既存手法に勝てるか の検証、 ⑤定期的な再学習スケジュール、 を全て決めてから本番投入する。 「Jupyter で動いたから OK」は事故の元。
❓ DNN の追加 Q&A(よく聞かれる 8 問)
Q1. DNN と機械学習の違いは?
A. 機械学習は「データから学習する手法すべて」の上位概念(線形回帰・決定木・SVM・DNN を含む)。 DNN は機械学習の 一手法であり、 隠れ層を 2 層以上重ねた多層ニューラルネットを指す。 「DNN は機械学習の一部、 機械学習は AI の一部」と覚えると整理しやすい。
Q2. 隠れ層は何層なら「Deep」?
A. 慣用的には 2 層以上を Deep と呼ぶが、 厳密な定義はない。 2012 年の AlexNet(8 層)以降、 「Deep」は実質的に 10 層以上を指すようになり、 ResNet(152 層)や Transformer(数百層)の時代になった。 SSDSE-B-2026 のような小データでは 1〜2 層で十分。
Q3. GPU は必須?
A. N=47 の SSDSE データなら CPU で十分(数秒で学習完了)。 GPU が必須になるのは 画像(CNN)・テキスト(Transformer)・音声(RNN/Conformer) など、 入力次元と層数が大きい場合。 教育用には Google Colab の無料 GPU で十分。
Q4. PyTorch と TensorFlow、 どちらを学ぶべき?
A. 2026 年現在、 研究は PyTorch、 産業は両者並走。 学習リソースの多さでは PyTorch、 デプロイの容易さでは TensorFlow / Keras。 教育用には sklearn の MLPClassifier / MLPRegressor が最も簡単で、 SSDSE-B-2026 規模なら sklearn で十分実用に足る。
Q5. DNN で「特徴量エンジニアリングは不要」って本当?
A. 半分本当・半分嘘。 画像・音声・テキストのように 原始信号 から学ぶ DNN では特徴量エンジニアリング不要に近い。 しかし、 表形式データ(SSDSE-B-2026 のような構造化データ)では 人手で作った特徴量(比率・対数変換・地域ダミー)が DNN の精度を大きく押し上げる。 完全不要は CNN/Transformer の世界に限る。
Q6. DNN の「ブラックボックス問題」は解消された?
A. 完全には解消されていない。 SHAP・LIME・Integrated Gradients・Grad-CAM などの 事後解釈手法 は普及したが、 「DNN が本当にその理由で予測したか」は近似に過ぎない。 規制業務(金融・医療・公的統計)では DNN の出力を 線形モデルの結果と並べて 報告するのが安全。
Q7. DNN は時系列にも使える?
A. はい。 SSDSE-B-2026 の都道府県データは年次なので、 過去 5 年の人口推移を入力に DNN で次年度を予測することは可能。 ただし時系列特化の RNN・LSTM・Transformer の方が一般的に高精度。 統計的には ARIMA・状態空間モデルの方が解釈性で勝る。
Q8. DNN を学ぶ次のステップは?
A. ①CNN(画像)、 ②RNN/LSTM/GRU(時系列)、 ③Transformer(テキスト・画像・音声を統一的に扱う 2017 年以降の主流)、 ④強化学習(DQN・PPO 等)、 ⑤生成モデル(GAN・VAE・拡散モデル)、 の順に進めば現代の DNN 全体像が掴める。 本サイトの関連用語ページから派生を辿るのが推奨ルート。
📜 DNN 発展史を年代順に辿る(1958〜2025)
DNN(深層ニューラルネットワーク)は突然出てきた技術ではない。 1958 年のパーセプトロン以来 60 年以上の積み上げの上に立っている。 ここでは 主要な転換点 12 個 を年代順に並べ、 SSDSE-B-2026 のような表形式データの扱いとも対比しながら整理する。 各年代を 自分で説明できる ようになれば、 DNN を歴史的文脈で語れる。
① 1958 年 ── パーセプトロン(Rosenblatt)
Frank Rosenblatt が パーセプトロン を発表。 入力に重みをかけて足し合わせ、 閾値を超えたら 1、 そうでなければ 0 を返す。 単層の線形分類器であり、 XOR を解けない(線形分離不可能)。 SSDSE-B-2026 で例えるなら「人口が一定値以上なら 1、 未満なら 0」のような単純判定にしか使えない。
② 1969 年 ── パーセプトロンの限界(Minsky & Papert)
Marvin Minsky と Seymour Papert が著書『Perceptrons』で 単層パーセプトロンは XOR を解けない ことを数学的に証明。 これが 第 1 次 AI 冬の時代 の引き金になった。 解決には多層化が必要だが、 当時は多層を学習する手法が存在しなかった。
③ 1986 年 ── 誤差逆伝播法の再発見(Rumelhart, Hinton, Williams)
多層ニューラルネットを学習する 誤差逆伝播法(backpropagation) が広く普及。 連鎖律を使って出力層から入力層へ勾配を流す。 これにより 2〜3 層のニューラルネット(MLP)が実用化した。 ただし当時は計算機性能とデータ量が足りず、 SVM や決定木の方が実用的だった。
④ 1998 年 ── LeNet-5(Yann LeCun)
手書き数字認識のための CNN(畳み込みニューラルネット) の原型 LeNet-5 が発表。 畳み込み・プーリング・全結合を組み合わせ、 USPS の郵便番号読み取りで実用化。 ただし 1990 年代後半は SVM とブースティング全盛で、 DNN は冬の時代に入る。
⑤ 2006 年 ── Deep Belief Network(Hinton)
Geoffrey Hinton が 制限付きボルツマンマシン(RBM) を積み重ねた DBN を提案。 「事前学習+微調整」で深いネットの学習が安定することを示した。 この成果が 「深層学習(Deep Learning)」 という用語を定着させた契機。
⑥ 2012 年 ── AlexNet が ImageNet を制覇
Krizhevsky・Sutskever・Hinton らが AlexNet(8 層 CNN) で ImageNet コンペティションのエラー率を 26%→15% に大幅低減。 GPU での学習・ReLU 活性化・Dropout 正則化を組み合わせた。 これが 第 3 次 AI ブーム の起点とされる。 以後、 DNN は産業全体に浸透する。
⑦ 2014 年 ── GAN・VAE・seq2seq
Ian Goodfellow が GAN(敵対的生成ネットワーク) を発表、 Kingma が VAE を発表、 Sutskever らが seq2seq(系列変換) を発表。 識別だけでなく 生成 が DNN の主要応用に加わる年。 翻訳・画像生成・音声合成の基礎が出揃った。
⑧ 2015 年 ── ResNet(残差接続)
He らが ResNet(152 層) を発表。 残差接続(skip connection)により、 深さを増やすほど精度が落ちる「劣化問題」を解消。 100 層以上の DNN が現実的に学習できるようになった。 現代の Transformer も内部で残差接続を使う。
⑨ 2017 年 ── Transformer("Attention Is All You Need")
Vaswani らが Transformer を発表。 RNN を捨て、 self-attention だけで系列を扱う。 並列計算が容易で、 大規模事前学習が可能になった。 以後の LLM(BERT, GPT, T5, ChatGPT)はすべて Transformer ベース。
⑩ 2018 年 ── BERT・GPT 第 1 世代
Google が BERT、 OpenAI が GPT-1 を発表。 事前学習+ファインチューニング という現代の標準パラダイムが確立。 11 個の NLP ベンチマークで人間並みの精度を達成した。
⑪ 2020 年代前半 ── 拡散モデル・基盤モデル
Diffusion Model(DALL·E 2, Stable Diffusion, Midjourney)が画像生成を支配。 GPT-3 / GPT-4 が 基盤モデル(foundation model) として汎用化。 「DNN を訓練する」から「事前学習済みモデルを使う」に時代が移った。
⑫ 2025〜2026 年 ── マルチモーダル・エージェント
画像・音声・テキスト・動画を統一的に扱う マルチモーダル基盤モデル(GPT-4o, Claude 3.7, Gemini 2.0)が標準化。 さらに自律的にツールを使う AI エージェント(本サイトのコード生成も含む)が産業に浸透。 DNN は単なる「分類器」から「汎用知能の基盤」へと役割を変えた。
🧩 DNN の構成要素 8 つを 1 つずつ理解する
構成要素 1 ── 重み(weight)
各ニューロン間の 結合の強さ を表す数値。 学習とは「重みを少しずつ調整する」ことに他ならない。 SSDSE-B-2026 の 10 入力・16 ユニットなら、 入力→隠れ層だけで 10×16=160 個の重みがある。 重みの初期化(Xavier 初期化、 He 初期化)も学習の安定性に影響する。
構成要素 2 ── バイアス(bias)
各ニューロンに加わる 切片。 線形回帰の y=ax+b の b に相当。 活性化関数を「右や左にシフト」させる役割を持つ。 1 ユニットにつき 1 個なので、 隠れ層 16 ユニットなら 16 個。
構成要素 3 ── 活性化関数(activation function)
線形和に 非線形性 を加える関数。 ReLU(max(0,x))、 tanh、 sigmoid、 Leaky ReLU、 GELU、 Swish など多数存在。 これがないと、 何層重ねても結局「線形変換の繰り返し=1 つの線形変換」と等価になり、 多層化の意味がない。
構成要素 4 ── 損失関数(loss function)
予測と正解のズレを数値化する関数。 回帰なら MSE(平均二乗誤差)、 二値分類なら 交差エントロピー、 多クラス分類なら softmax + 交差エントロピー、 が標準。 SSDSE-B-2026 で消費支出を予測するなら MSE。
構成要素 5 ── オプティマイザ(optimizer)
勾配に従って重みを更新するアルゴリズム。 SGD(基本)、 Adam(適応的学習率、 デファクト)、 RMSprop、 AdamW(重み減衰を分離)など。 sklearn の MLPRegressor は solver='adam' がデフォルト。
構成要素 6 ── バッチサイズ(batch size)
重み更新 1 回ぶんに使うサンプル数。 大きいと安定だが遅く、 小さいと早いがノイズが多い。 SSDSE-B-2026 の N=47 なら全件 1 バッチでも十分。 大データでは 32〜256 程度が標準。
構成要素 7 ── エポック(epoch)
訓練データを 1 周することを 1 エポックと呼ぶ。 SSDSE-B-2026 の N=47 なら 100 エポック程度で十分収束する。 早期停止(early stopping)で過学習前に止めるのが定石。
構成要素 8 ── 正則化(regularization)
過学習を抑えるための仕組み。 L1(Lasso)、 L2(Ridge / 重み減衰)、 Dropout(学習中にランダムにユニットを 0 にする)、 Batch Normalization など。 N=47 の SSDSE データでは Dropout より L2 の方が安定。
🧠 DNN を「使いこなす」ための補強解説
DNN を学ぶ過程で「動かせるが理解していない」段階に止まる学習者が多い。 ここでは 誤解されやすいポイント 10 個 を、 SSDSE-B-2026 を題材に整理する。 1 つずつ自分の言葉で説明できるようになれば、 「DNN を理解した」と言える水準である。
誤解 1 ── 「DNN は何にでも効く万能ツール」
現実:N=47 の SSDSE-B-2026 で DNN を回すと、 単純な線形回帰の方が良い結果になることが多い。 DNN が真価を発揮するのは N が 10,000 以上・入力が高次元・非線形性が強い 場合に限る。 表形式の小データには 勾配ブースティング(LightGBM, XGBoost) の方が有利。
誤解 2 ── 「層を深くすれば精度が上がる」
現実:層を深くすると 勾配消失・勾配爆発・過学習が顕在化し、 精度が逆に下がることも多い。 ResNet の残差接続が登場するまで、 20 層以上の DNN は学習困難だった。 SSDSE-B-2026 では 1〜2 層で十分。 「深さは目的ではなく手段」と理解する。
誤解 3 ── 「DNN は前処理不要」
現実:DNN は入力スケールに敏感である。 SSDSE-B-2026 の人口(百万)と出生率(%)を そのまま入れる と、 重みが偏って学習が安定しない。 標準化(StandardScaler)または正規化(MinMaxScaler) は事実上必須。
誤解 4 ── 「学習率を上げれば早く収束する」
現実:学習率を上げすぎると損失が発散・振動して学習が破綻する。 SSDSE-B-2026 で実験すれば、 学習率 0.1 では収束しないケースが普通に観察できる。 0.001〜0.01 が無難、 さらに 学習率スケジューラ で徐々に下げるのが現代の標準。
誤解 5 ── 「DNN の予測は信頼できる」
現実:DNN の予測は 訓練データの分布外(OOD: out-of-distribution)では極端に外れる。 SSDSE-B-2026 で学習した DNN を、 海外の都市データに適用すると意味のない予測を返す。 適用範囲の明示と 信頼度推定(Monte Carlo Dropout 等)が業務利用では必須。
誤解 6 ── 「DNN は教師あり学習だけ」
現実:DNN は 教師なし(オートエンコーダ)、 自己教師あり(SimCLR, MAE, BERT の MLM)、 強化学習(DQN, PPO)にも広く使われる。 現代の LLM は自己教師あり学習で大量のテキストから事前学習される。 SSDSE-B-2026 で言えば、 「ラベルなしデータから特徴を学ぶ」用途にも使える。
誤解 7 ── 「Adam を使えば最適」
現実:Adam は便利だが万能ではない。 大規模事前学習では AdamW(重み減衰を分離)や LAMB が好まれる。 SSDSE-B-2026 規模では Adam で十分だが、 「常に Adam」は思考停止。 SGD with momentum がベストな場合もある。
誤解 8 ── 「Dropout を入れれば過学習対策完了」
現実:Dropout は強力だが万能ではない。 N=47 の小データでは Dropout 率を高くしすぎると 学習自体が進まない。 SSDSE-B-2026 では Dropout 率 0〜0.2 程度に抑え、 L2 正則化を併用するのが安全。
誤解 9 ── 「DNN は GPU が必須」
現実:N=47 の SSDSE-B-2026 なら CPU で 数秒 で学習完了。 GPU が必須になるのは画像(CNN)・テキスト(Transformer)・音声など、 入力次元と層数が大きい場合。 教育用には Google Colab の無料 GPU で十分。
誤解 10 ── 「DNN は解釈不能」
現実:完全な解釈は難しいが、 SHAP・LIME・Integrated Gradients・Grad-CAM 等の事後解釈手法が普及している。 SSDSE-B-2026 で学習した DNN の予測根拠を SHAP で可視化すれば、 「どの入力変数が予測にどれだけ寄与したか」を都道府県ごとに調べられる。 完全な因果ではなく 近似的な寄与 である点には注意。
🔄 DNN プロジェクトの標準ワークフロー(7 段階)
DNN を業務で動かすには、 「コードを書く」前後に大量の工程が必要である。 ここでは 標準的な 7 段階 を SSDSE-B-2026 を例に説明する。 自分で 1 つのプロジェクトを最初から最後まで通せるようになれば、 DNN を「使いこなす」段階に到達したと言える。
段階 1 ── 問題定義
「何を予測するか」「精度の目標は何か」「業務的にどう使うか」を明文化する。 例:SSDSE-B-2026 を使って「消費支出を ±10% 以内で予測」「予算配分の参考にする」。 ここを曖昧にすると、 後工程がすべてズレる。
段階 2 ── データ収集と整備
SSDSE-B-2026 を pd.read_csv('data/raw/SSDSE-B-2026.csv') で読み込み、 欠損確認・型確認・外れ値検出を行う。 N=47 と小さいので、 1 行ずつ目視で確認する価値がある。 大データなら自動チェックパイプライン。
段階 3 ── 探索的データ分析(EDA)
散布図行列・相関ヒートマップ・基本統計量で「データの形」を掴む。 「線形傾向が強い」「外れ値がある」「分布が偏っている」などの発見が、 DNN の設計を導く。 EDA を飛ばして DNN を回すのは事故の元。
段階 4 ── ベースライン構築
DNN を回す前に、 線形回帰(あるいはランダム予測)で 性能の床 を測る。 SSDSE-B-2026 では線形回帰がベースラインで、 DNN がこれを越えなければ DNN を使う理由がない。 ベースライン軽視は研究の盲点。
段階 5 ── DNN モデル設計と学習
層数・ユニット数・活性化関数・損失関数・オプティマイザ・学習率・正則化を決め、 訓練データで学習する。 早期停止と交差検証で過学習を防ぐ。 SSDSE-B-2026 では grid search で 30 通り試しても数分で終わる。
段階 6 ── 評価と解釈
テストセットで MSE・R²・MAE 等を計測し、 ベースラインと比較する。 SHAP で各入力の寄与を可視化、 残差分析で偏りを確認する。 「数値が良い」だけでは業務利用できない。
段階 7 ── デプロイと監視
モデルを joblib.dump で保存し、 API・バッチ処理・ダッシュボードに組み込む。 入力データの ドリフト監視(時間とともに分布がずれる)と 再学習 を継続的に行う。 SSDSE は年次更新なので、 毎年再学習する設計にする。
🔗 DNN を理解するための前提・並列・発展用語の追加解説
DNN は単独で完結する技術ではなく、 機械学習・統計学・最適化理論の交差点に位置する。 ここでは「DNN を勉強しているがピンと来ない」学習者向けに、 関連する 12 用語 を 1 つずつ短く解説する。 各用語の解説ページにリンクするので、 自分のペースで深掘りしてほしい。
関連 1 ── ニューラルネットワーク
DNN の上位概念。 隠れ層が 1 層なら単なる NN、 2 層以上なら DNN。 数学的には「線形変換と非線形活性化を交互に積み重ねた関数」。 関連ページ:ニューラルネットワーク。
関連 2 ── 機械学習
DNN は機械学習の一手法。 機械学習は「データから自動的に規則を学ぶ」全体の枠組みで、 線形回帰・決定木・SVM・DNN を含む。 関連ページ:機械学習。
関連 3 ── 深層学習
DNN を用いた機械学習の総称。 「深い」ネットを使うことが特徴で、 CNN・RNN・Transformer なども含む。 関連ページ:深層学習。
関連 4 ── 活性化関数
DNN に非線形性を与える要素。 ReLU・tanh・sigmoid 等。 これがないと多層化の意味がない。 関連ページ:活性化関数。
関連 5 ── 誤差逆伝播法
DNN を学習する基本アルゴリズム。 出力誤差を入力方向へ連鎖律で伝播し、 各重みの勾配を計算する。 関連ページ:誤差逆伝播法。
関連 6 ── 過学習
DNN が訓練データに過剰適合し、 テストデータで性能を落とす現象。 N=47 の SSDSE-B-2026 では特に起こりやすい。 関連ページ:過学習。
関連 7 ── 学習率
DNN の重み更新の幅を決める最重要ハイパーパラメータ。 0.001〜0.01 が標準。 関連ページ:学習率。
関連 8 ── バッチ
重み更新 1 回分に使うサンプル群。 全件=バッチ学習、 1 件=SGD、 数十〜数百件=ミニバッチ。 関連ページ:バッチ。
関連 9 ── CNN(畳み込みニューラルネット)
画像処理に特化した DNN の派生。 畳み込み層・プーリング層を持つ。 関連ページ:CNN。
関連 10 ── RNN・LSTM
時系列・系列データを扱う DNN の派生。 内部に記憶を持つ。 関連ページ:RNN、 LSTM。
関連 11 ── Transformer
2017 年以降の DNN の主流アーキテクチャ。 self-attention を中心に構成され、 LLM の基盤になる。 関連ページ:Transformer。
関連 12 ── 大規模言語モデル(LLM)
Transformer ベースで自然言語を扱う巨大 DNN。 GPT・Claude・Gemini など。 関連ページ:LLM。
📝 最終総まとめ:DNN を一文で説明できるか
この記事のすべてを読んだ後、 DNN を「1 文で」「30 秒で」「比喩で」 の 3 通りで説明できるかが、 学習の到達度を測る最良の 理解度チェック である。 自分の言葉で書き出し、 同僚や学生に披露してみるとよい。
1 文で説明(30 文字以内)
例:「DNN は、 重み付き和と非線形変換を多層に重ねた関数近似器である」。 これが最も短い定義。 数式を知っていれば、 これだけで全てを表現できる。
30 秒で説明(口頭・聴衆は非専門家)
例:「DNN とは、 たくさんの計算ノードを層状に重ねたモデルで、 入力データから出力を予測します。 重みを少しずつ調整して、 訓練データに合うように学習します。 層を深くすると複雑なパターンを学べますが、 データが少ないと過学習しやすいです。 画像認識・音声認識・翻訳など、 大量データのある分野で特に強力です。」
比喩で説明(聴衆は中学生)
例:「DNN は、 たくさんの『判定係』が階段状に並んでいるシステムです。 1 段目の判定係は写真の細かい点(明るさや色)を見て、 2 段目は線や角を見て、 3 段目は目や鼻のような部品を見て、 最後の段で『これは猫だ/犬だ』と判定します。 各判定係はクラスメイト全員から意見を集めて自分の判断にするので、 数えきれない『重み』を持ちます。 訓練とは、 この重みを少しずつ正解に近づける作業です。」
SSDSE-B-2026 を使った 1 行例
例:「47 都道府県の総人口・年少人口・高齢人口・出生数データから、 DNN で消費支出を予測する。 ただし N=47 と小さいので過学習に注意し、 線形回帰との比較を必ず添える」。 「DNN は使えば必ず勝つ」ではなく「比較ありき」の姿勢が、 業務で信頼される DNN ユーザーの条件である。
以上で DNN ページの拡張は終了。 全 12 構成要素・3 図・14 表・60 件超のコードブロック・本格的な実値計算・10 題の練習問題・歴史 12 章・構成要素 8 つ・誤解 10 種・ワークフロー 7 段階・関連用語 12 件を網羅した。 ここまで読み切った読者は、 DNN を 業務で実装し・他人に教え・批判的に評価できる 段階に到達している。
🗺 概念マップ
DNN (深層ニューラルネットワーク) は MLP を多層化したもので、 入力 → 隠れ層 (Linear + 活性化) → 出力 を積層する。 派生として CNN (画像) ・RNN (系列) ・Transformer (注意機構) があり、 学習は誤差逆伝播 + 最適化 (SGD/Adam) で行い、 過学習対策として Dropout ・正則化 ・Early Stopping が並列に位置する。
DNN(深層ニューラルネットワーク)は、 層を深くするほど勾配消失・過学習・計算量の問題が同時に現れるため、 単に層数を増やせばよいわけではない。 ResNet・BatchNorm・Dropout・Adam といった「深くしても学習できる」工夫の積み重ねが、 ImageNet 革命以降の DNN の発展を支えた。 SSDSE のような小規模・表形式データでは GBDT に劣ることが多いため、 タスクに応じた選択判断が重要。
🔗 隣接手法への橋渡し
DNN (深層ニューラルネットワーク) は単独のモデルではなく、 データ拡張・正規化・最適化・正則化・評価の総合パイプラインで初めて機能する。 CNN や Transformer など派生アーキテクチャと並列で位置づけて選択する。
- 上流(前処理・データ整備): 学習データの拡張 / 標準化 / 特徴量エンジニアリング
- 並列(代替・補完手法): CNN / RNN / Transformer
- 下流(評価・解釈・応用): 誤差逆伝播 / 正則化 / 交差検証
DNN は「多層の非線形変換でパターンを抽出する」モデルで、 上流の正規化・データ拡張で勾配と学習効率を決定し、 並列で CNN・RNN・Transformer のいずれが構造に合うかを選び、 下流の正則化・早期終了で過学習を抑える流れが必要である。
🌳 手法選択フロー
DNN を採用するかの判断は「データ量・タスク種別・解釈性要求」の 3 軸で決まる。 表形式の小規模データでは GBDT に劣る場面が多く、 画像・音声・自然言語のように構造化されていないデータで威力を発揮する。
- データは何件あるか
数万件を下回るなら、 まず勾配ブースティングや線形モデルを試す。 SSDSE の 47 都道府県では、 層を深くしても訓練データを丸暗記するだけになる。 - 入力に構造があるか
画像なら CNN、 系列なら RNN や Transformer、 と入力の性質に合わせて構造を選ぶ。 表データに全結合層を積むだけでは、 木系のモデルに勝てないことが多い。 - 学習済みモデルを使えるか
画像や言語では、 ゼロから学習するより転移学習のほうが少ないデータで済む。 ドメインが近いほど追加学習は浅くて済む。 - どこで学習を止めるか
層を増やすほど表現力は上がるが過学習も早い。 検証誤差が悪化したら止める Early Stopping を先に入れ、 それから層を増やす。
SSDSE-B-2026 は 47 行 × 数十列の表形式で DNN にはサンプル数が少なすぎるため、 まず線形回帰・GBDT で実用性能を測り、 それを越えるときだけ DNN を検討する判断順序が現実的である。
🎮 触って理解する
姉妹ページの3層パーセプトロン(隠れ層でXORを解く)と MLP(万能近似・隠れ幅)とは角度を変え、 ここでは 「深さ(層数)そのものが決定境界の複雑さを生む」という DNN 固有の性質を体感する。 浅い網では描けない入り組んだ同心リング状の境界が、 層を1枚ずつ足すだけで指数的に表現できるようになる様子を見てほしい。
(a) 隠れ層の数を変えて決定境界を見る
実点A 実点B 誤分類
観察ポイント: 隠れ層1枚では境界は単純な円1つ(凸領域)しか描けず、 細かいリングを持つ架空データに全く歯が立たない(正解率は偶然と同じ約50%)。 層を足すごとに ReLU が入力空間を1回ずつ折り畳み、 描けるリングが 1→2→4→8 と倍々(指数的)に増える。 4層でようやくデータの細かい同心構造に届き、 正解率が跳ね上がる。 これが「浅い網でも幅を無限にすれば近似はできる(万能近似)が、 深い方が圧倒的に少ない部品で複雑な境界を作れる」という DNN の本質である。
(b) 特徴の階層 ── 層が段階的に「ほどく」
深さが効く理由は、 各層の出力(=特徴)が入力を段階的に線形分離しやすい形へ変換していくから。 最初は絡み合って直線では切れない2クラスが、 層を通るたびに少しずつ「ほどけ」、 最終層の手前では1本の直線(超平面)で分けられる状態になる。
画像認識でよく言われる比喩がこれと同じ構図: 浅い層=エッジや色の斑点(低次特徴) → 中間層=目・鼻・車輪といったパーツ → 深い層=顔・車といった概念(高次特徴)。 層が進むほど特徴の抽象度が上がり、 最後は「概念」で線形に分類できるようになる。 これが表現学習(representation learning)と呼ばれる DNN の中核である。
(c) 「深ければ良い」わけではない
- 過学習:データの真の複雑さより深いと、 ノイズまで拾う余分なリングを描く。 この架空データがもし「2本リング」だけなら、 4層は不要な折り目でノイズに合わせにいく。 データ量が少ないほど危険。
- 勾配消失/爆発:層を深くすると、 逆伝播で勾配が層をさかのぼるうちに 0 に潰れる(または発散する)。 sigmoid/tanh で特に顕著で、 昔はこれで深い網が学習できなかった。 ReLU・正規化・残差接続で緩和する。
- データ量と計算コスト:深い網はパラメータが多く、 大量のデータと計算資源を要求する。 SSDSE-B-2026 の 47 行のような小データに深い網は明確な過剰投資。
- 解釈性の低下:層が深いほど「なぜその判定か」が追いにくくなる。 説明責任が問われる場面では要注意。
発展: 勾配消失を打ち破ったのが 残差接続(ResNet)で、 層を飛び越す近道を作り1000層級の学習を可能にした。 バッチ正規化・層正規化は各層の分布を整えて学習を安定させる。 これらの工夫があって初めて「深さ」が武器になる。 より広い文脈は 深層学習・ニューラルネットワーク・MLP の各ページを参照。
🧪 実測:n=47 の小データで DNN は交差検証で崩れる
上の実値計算では、 隠れ層 (64, 32) の DNN が単一の train/test 分割で テスト精度 100% を出した。 しかしこれは「たまたま引いた 12 県のテストセット」での 1 回きりの数字である。 本節では同じ SSDSE-B-2026(2023 年・47 都道府県)を使い、 交差検証(CV)で分割を 5 回入れ替えて測り直し、 「n=47 で DNN はどれだけ不安定か」「線形回帰・勾配ブースティング(GBDT)と比べてどうか」を実測で確かめる。 以下の数値はすべて手元の実データで実行した結果(Python 3.13 / scikit-learn 1.9.0、 乱数条件は掲載コードのとおり)。
実測 ①:同じ 5 クラス分類を 5-fold CV で測り直す
上の実値計算と同じ特徴量 5 つ(A1101, A1301, A1303, A4101, A4200)・同じ人口 5 分位ラベルで、
層化 5-fold CV(StratifiedKFold(5, shuffle=True, random_state=0))を実施した。
| モデル | 5 fold の正解率 | 平均 | 標準偏差 |
|---|---|---|---|
| ロジスティック回帰 | 0.700 / 0.800 / 0.667 / 0.556 / 0.778 | 0.700 | 0.087 |
| GBDT | 0.800 / 0.900 / 0.889 / 0.889 / 0.889 | 0.873 | 0.037 |
| DNN (64, 32) | 0.800 / 0.900 / 0.778 / 0.667 / 1.000 | 0.829 | 0.113 |
読み方は 3 点。 (1) DNN の CV 平均は 82.9% で、 単一分割の 100% は「運の良い分割」だったことが分かる。 (2) fold によって 66.7%〜100% まで振れ、 ばらつき(std 0.113)は 3 モデル中最大。 n=47 では 1 fold あたりテスト 9〜10 件しかなく、 1 県の正誤で約 10 ポイント動くためである。 (3) 既定設定の GBDT が平均でも安定性でも DNN を上回った。 チューニングなしの比較では、 表形式小データで DNN を選ぶ積極的理由はない。
実測 ②:リークのない回帰タスクでは DNN が「崩壊」する
実測 ① の分類は「人口でラベルを作り人口を入力する」リーク気味の易しい課題だった(上の落とし穴セクション参照)。
そこで、 より現実的な回帰課題として 合計特殊出生率(A4103、 2023 年の実測値は 0.99〜1.60) を、
規模の効果を除いた「率」ベースの特徴量 5 つ(高齢化率・年少人口率・婚姻率・転入超過率・年平均気温)から予測する。
評価は 5-fold CV の決定係数 R²(KFold(5, shuffle=True, random_state=0))。
| モデル | 5 fold の R² | 平均 R² | CV-RMSE |
|---|---|---|---|
| Ridge 回帰(線形) | 0.850 / 0.747 / 0.881 / 0.839 / 0.806 | 0.825 | 0.054 |
| GBDT | 0.637 / 0.762 / 0.829 / 0.363 / 0.496 | 0.617 | 0.081 |
| DNN (64, 32) 既定設定 | −1.159 / −2.508 / −0.638 / −4.319 / −3.447 | −2.414 | 0.240 |
| DNN (256, 128, 64)(より深く) | 0.440 / 0.311 / 0.762 / −1.125 / −3.337 | −0.590 | 0.181 |
なぜ崩れるのか ── そして正則化でどこまで救えるか
原因は本ページの落とし穴でも述べた 過学習 と 学習の不安定さ の合わせ技である。 訓練 38 件に対しパラメータ 2,629 個の DNN は訓練データをほぼ暗記(補間)でき、 勾配ベースの最適化は小データでは初期値・fold 構成のわずかな違いで別の解に落ちる。 では 正則化 を強めれば救えるのか。 L2 正則化係数 alpha を変えて実測した。
| DNN (64, 32) の設定 | CV 平均 R² | 判定 |
|---|---|---|
| alpha=0.0001(sklearn 既定) | −2.414 | 崩壊(全 fold マイナス) |
| alpha=1.0(強い L2) | 0.794 | 復活。 だが Ridge (0.825) には届かず |
| alpha=10(過剰な L2) | −0.145 | 今度は縮めすぎて学習不足 |
つまり (1) 既定設定のまま小データに DNN を使うと壊滅する、 (2) 正則化を適切に選べば大幅に改善するがそのチューニング自体が追加コスト、 (3) チューニングした DNN でも素の Ridge に届かない ── というのが n=47 の現実である。 「DNN を使う前に線形・GBDT のベースラインを取れ」という本ページのアドバイス 3 は、 この実測が根拠になる。 逆に言えば、 DNN の真価はデータが数千〜数百万件に増え、 画像・音声・テキストのような非線形構造が支配的な場面で発揮される(下の発展セクション参照)。
🐍 再現コード(実測 ② 全文)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | import warnings, numpy as np, pandas as pd warnings.filterwarnings('ignore') from sklearn.linear_model import Ridge from sklearn.ensemble import GradientBoostingRegressor from sklearn.neural_network import MLPRegressor from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from sklearn.model_selection import KFold, cross_val_score df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年・47 都道府県 # 規模の効果を除いた「率」ベースの特徴量 5 つ X = pd.DataFrame({ 'aging': d['A1303'] / d['A1101'], # 高齢化率 'youth': d['A1301'] / d['A1101'], # 年少人口率 'marry': d['A9101'] / d['A1101'] * 1000, # 婚姻率(人口千対) 'netmig': (d['A5101'] - d['A5102']) / d['A1101'] * 1000, # 転入超過率 'temp': d['B4101'], # 年平均気温 }).values.astype(float) y = d['A4103'].values.astype(float) # 合計特殊出生率 cv = KFold(n_splits=5, shuffle=True, random_state=0) models = { 'Ridge': make_pipeline(StandardScaler(), Ridge(alpha=1.0)), 'GBDT': GradientBoostingRegressor(random_state=42), 'DNN(64,32)': make_pipeline(StandardScaler(), MLPRegressor(hidden_layer_sizes=(64, 32), max_iter=5000, random_state=42)), } for name, m in models.items(): s = cross_val_score(m, X, y, cv=cv, scoring='r2') print(f'{name:12s} folds={np.round(s, 3)} mean={s.mean():.3f}') |
📤 実行結果:
💬 ライブラリのバージョンや OS によって数値は微妙に変わりうるが、 「DNN だけ R² がマイナスに沈む」という構図は再現するはずである。
分類版(実測 ①)は MLPClassifier / StratifiedKFold / scoring='accuracy' に置き換えるだけでよい。
🚀 発展:「深さ」を実用にした工夫と、 モデル選択の指針
上の実測が示すとおり、 DNN は「置けば勝つ」道具ではない。 歴史的にも、 素朴に層を重ねただけの深い網は学習に失敗し続け、 いくつもの工学的発明が揃って初めて「深さ」が武器になった。 ここでは (1) 深さと幅、 (2) 勾配消失への対策、 (3) 正則化、 (4) 最適化、 (5) アーキテクチャ選択、 の 5 つの軸で発展的内容を整理する。
(1) 深さ vs 幅 ── なぜ「広く」ではなく「深く」なのか
万能近似定理(MLP のページ参照)は「隠れ層 1 でも幅を無限に広げれば任意の連続関数を近似できる」と言う。 それでも実務で深さが選ばれるのは、 階層的に合成できる関数は、 深い網なら少ないユニット数で、 浅い網では指数的に多いユニット数を要することが理論・経験の両面で知られているからである。 上の 🎮 ウィジェット (a) で見た「層を 1 枚足すたびに表現できるリングが倍増する」現象がまさにこれで、 浅い網で同じ境界を作るには幅を倍々に増やすしかない。 各層の出力が「エッジ → パーツ → 概念」と抽象度を上げていく表現学習(ウィジェット (b))こそが、 深層学習が特徴量エンジニアリングを自動化できた理由である。 ただし実測 ② が示すように、 学習すべき関数が単純(ほぼ線形)でデータが少ないなら、 深さも幅も過剰装備にしかならない。
(2) 勾配消失・爆発への対策 ── 深い網を学習可能にした三点セット
誤差逆伝播法では勾配が層をさかのぼるたびに活性化関数の微分が掛け算される。 sigmoid の微分は最大 0.25 なので、 例えば 10 層さかのぼると最良でも 0.25¹⁰ ≈ 10⁻⁶ 倍 ── 勾配はほぼ 0 に消える(勾配消失)。 逆に重みが大きいと発散する(勾配爆発)。 これを打ち破った代表的な工夫:
| 工夫 | 仕組みと効果 |
|---|---|
| ReLU(2011 頃〜) | 正領域で微分がちょうど 1。 掛け算しても勾配が縮まない。 計算も max(0, z) だけで高速。 AlexNet 成功の立役者の 1 つ。 |
| 残差接続(ResNet, 2015) | 層の出力を h = f(h) + h と「入力をそのまま足す」形にする。 勾配が近道(恒等写像)を通って浅い層まで素通りでき、 100〜1000 層の学習が可能になった。 Transformer にも標準搭載。 |
| Batch Normalization(2015) | 各層の入力をミニバッチ内で平均 0・分散 1 に正規化し続ける。 層が深くなるほど分布がずれていく問題を抑え、 大きな学習率でも安定。 標準化を「入力だけでなく毎層でやる」発想。 |
| 重みの初期化(Xavier / He) | 各層の出力分散が層を経ても保たれるよう初期値のスケールを設計する。 sklearn や PyTorch は既定で採用済みなので普段は意識しないが、 「初期化を間違えるだけで深い網は学習しない」ことは知っておく価値がある。 |
(3) 正則化 ── 巨大モデルを小さなデータで暴走させない
| 手法 | 要点 |
|---|---|
| Dropout | 訓練中、 各ユニットを確率 p(典型 0.2〜0.5)でランダムに無効化。 特定ユニットへの依存(共適応)を防ぎ、 疑似的なアンサンブルとして働く。 詳細は正則化のページ。 |
| L2 正則化(weight decay) | 損失に重みの二乗和を加えて大きな重みを罰する。 上の実測 ② で alpha=1.0 が DNN を R² −2.4 → 0.79 まで救ったのがこれ。 効き目は劇的だが、 強さの選択自体がハイパーパラメータ探索になる。 |
| 早期終了(early stopping) | 検証誤差が悪化し始めたエポックで学習を打ち切る。 実装が容易で副作用が少なく、 実務ではほぼ常用。 過学習のページに学習曲線での見分け方がある。 |
| データ拡張 | 画像の回転・反転・切り抜き等で訓練データを水増しする。 「データを増やす」は最強の正則化。 表形式データでは使いにくいのが、 表形式で DNN が苦戦する一因でもある。 |
(4) 最適化 ── SGD から Adam へ
DNN の学習は勾配降下法の変種で行う。 素の SGD(確率的勾配降下)はミニバッチごとの勾配で重みを更新するが、 谷底でジグザグしやすい。 モーメンタムは過去の勾配の移動平均で慣性をつけ、 Adam(2014)はさらにパラメータごとに学習率を自動調整する。 sklearn の MLP も既定で Adam を使っており、 「まず Adam の lr=0.001 から」が現在の定石。 大規模モデルでは重み減衰を分離した AdamW と、 学習率を徐々に下げるスケジューラ(cosine decay 等)の併用が標準になっている。 バッチサイズと学習率のバランスが学習の安定性を決めることは、 上の落とし穴セクションのとおり。
(5) アーキテクチャとモデル族の選び方 ── データの形で決める
| データの形 | 第一候補 | 理由 |
|---|---|---|
| 表形式・小規模(数十〜数千行) | 線形回帰/Ridge、 次に GBDT(XGBoost 等) | 本節の実測どおり。 DNN は最後の選択肢。 |
| 表形式・中〜大規模(数万行〜) | GBDT と DNN を両方試す(ランダムフォレストも基準に) | 中規模の表形式では木ベース優位の報告が多いが、 データが増えるほど差は縮む。 アンサンブルで併用も。 |
| 画像・空間データ | CNN(または Vision Transformer) | 畳み込みの局所性・平行移動不変性が画像の性質に合う。 |
| 時系列・音声 | RNN/LSTM、 近年は Transformer 系 | 順序依存の構造を状態または注意機構で捉える。 |
| テキスト・マルチモーダル | Transformer(事前学習済み LLM の微調整) | ゼロから学習せず、 事前学習済みモデルの転移学習が現在の標準。 |
まとめると、 DNN の学習で本当に効くのは「層を増やすこと」そのものではなく、 深さを支える周辺技術(ReLU・残差接続・正規化・正則化・Adam)と、 データの形に合ったアーキテクチャ選択である。 そして表形式の小データでは、 その全部を注ぎ込んでも素の Ridge に負けうる ── というのが本ページの実測が残す最大の教訓である。 基礎に戻りたいときはニューラルネットワーク・パーセプトロン、 先へ進むなら 深層学習(発展)・LLM の各ページへ。