🔖 キーワード索引
「pytorch」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「pytorch」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「pytorch の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
AIを作るための便利な道具箱です。
深層学習という技術を簡単に使うために使います。
スマホのAIアプリを作る時などに役立ちます。
この章ではPyTorchの特徴や注意点を読みます。
Meta の深層学習フレームワーク
- Meta(旧Facebook)製の 深層学習フレームワーク。
- 特徴:動的計算グラフ(define-by-run) — Python のように書けるのが魅力。
- 中核:Tensor(GPU対応ndarray)+ autograd(自動微分)+ nn.Module(モデル定義)。
- 研究分野では事実上の標準(論文の8〜9割がPyTorch実装)。
- 競合:TensorFlow(Google)/JAX(Google)/PaddlePaddle(百度)。
∑ 数学的導出: PyTorch の数式の出どころ
本ページの「📐 定義・数式」セクションでは結果だけを示しましたが、 ここではより詳細に導出を追います。 数式の出どころが分かると、 公式を暗記するのではなく、 必要に応じて再導出できるようになります。
PyTorch の autograd の数学を厳密化します。 計算グラフ $G = (V, E)$ は有向非巡回グラフで、 ノードはテンソル、 エッジは演算 (Function オブジェクト) を表します。 出力テンソル $L$ (スカラー、 通常は損失関数) について、 リーフテンソル $\theta_1, \dots, \theta_K$ に関する勾配 $\frac{\partial L}{\partial \theta_k}$ を計算するのが L.backward() の役割。 連鎖律の再帰式は、 各中間ノード $v$ に対する随伴変数 $\bar{v} = \frac{\partial L}{\partial v}$ について、 $v$ の出力先ノード $u_1, \dots, u_m$ から $\bar{v} = \sum_j \bar{u}_j \frac{\partial u_j}{\partial v}$ と書けます。 ベクトル・行列演算では Jacobian-vector product (JVP) と vector-Jacobian product (VJP) を区別し、 reverse-mode AD では VJP $\bar{v}^\top = \bar{u}^\top J$ を効率的に計算します。 PyTorch の Function クラスはこの VJP を backward() メソッドとして実装し、 ユーザーは順方向計算 (forward()) と逆方向計算 (backward()) をペアで定義できます。 数値精度の問題として、 (a) gradient explosion: $\|\nabla L\| \to \infty$ → gradient clipping (torch.nn.utils.clip_grad_norm_) で対処、 (b) gradient vanishing: $\|\nabla L\| \to 0$ → 適切な活性化関数・初期化・residual connection で対処、 (c) NaN propagation: torch.isnan で検出・torch.autograd.detect_anomaly モードでデバッグ可能。 混合精度学習 (torch.cuda.amp) では fp16 と fp32 を混用してメモリ削減・速度向上を図ります。
📍 あなたが今見ているもの
🍰 まずはやさしく
AI開発に欠かせない共通の言語のようなものです。
最新のAIモデルを実際に動かすために使います。
人口の予測など、データの分析に活用できます。
この章では具体的な使い方と実装の流れを読みます。
Hugging Face、 Stable Diffusion、 LLaMA、 ChatGPT — 現代の AIモデルのほぼすべては PyTorch(または TF)で書かれています。 機械学習を実装するなら避けて通れません。
本ページの主目的は「PyTorch の核 (torch.Tensor / autograd / nn.Module / optim) を SSDSE-B-2026 の人口予測タスクで実装する」ことである。 NumPy と同じ API で書けるが、 自動微分と GPU 対応の二点で深層学習向け基盤となる。
後段では (1) Tensor と DataFrame の相互変換、 (2) 総人口 → 出生数 の単回帰を nn.Linear + SGD で学習し sklearn の解析解と R² が一致することを確認、 (3) MLP に拡張した際の損失曲線を扱う。
🎨 直感で掴む
🍰 まずはやさしく
計算が得意な電卓に自動機能がついたようなものです。
難しい計算をコンピュータに任せて学習させるために使います。
部活の記録を分析して、次の目標を立てる時に似ています。
この章では計算が自動で終わる仕組みについて読みます。
NumPy が CPU で動く配列計算ライブラリだとすれば、 PyTorch は GPU 対応 + 自動微分 付き NumPy です。 x = torch.tensor([1., 2.], requires_grad=True) と書けば、 後の演算が自動的に微分可能になり、 学習に必要な勾配が .backward() 1 回で全部計算されます。
SSDSE-B-2026 で都道府県の総人口から出生数を予測する単回帰を考えてみよう。 NumPy だと w, b の偏微分を手計算してから勾配降下法を書く必要があるが、 PyTorch なら loss = ((w*x + b - y)**2).mean() → loss.backward() だけで w.grad, b.grad が自動的に埋まる。 47 サンプルなら CPU でも一瞬だが、 同じコードを .to('cuda') 一つ付けるだけで GPU に乗り、 数万サンプルでも数秒で学習が終わる。 これが PyTorch の「研究から本番まで同じコードで動く」の意味。
もう一つの直感: PyTorch は「動的計算グラフ (define-by-run)」を採用しているため、 通常の Python の if/for/while がそのまま動く。 例えば「東京都の場合だけ追加の特徴量を使う」といった分岐を、 普通の Python コードで書ける。 これに対し TensorFlow 1.x の静的グラフは事前にグラフ全体を組み立てる必要があり、 デバッグが難しかった。 PyTorch のスタイルは「学習も推論も、 普通の Python 関数を書く感覚」を実現する点で初心者にとって学習コストが低い。
📐 定義/数式
🍰 まずはやさしく
AIの学習ルールを決めるための設計図です。
正解に近づくための計算を正確に行うために使います。
テストの点数を上げるために、間違えた原因を探る作業に似ています。
この章では計算の仕組みや数式について読みます。
PyTorch(PyTorch):Meta の深層学習フレームワーク
.backward() で取得。 PyTorch は 動的計算グラフ (define-by-run): 順伝播のたびに grad_fn がノードに記録される。 計算量は順伝播の定数倍 (リバースモード自動微分の理論的保証, Baur-Strassen 1983)。torch.optim.SGD(params, lr=0.01, momentum=0.9) で指定。DataLoader(dataset, batch_size=64, shuffle=True) がこの $\mathcal{B}$ をランダム生成。🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| Tensor | GPU対応多次元配列(NumPy ndarray の親戚) |
| autograd | 計算履歴を記録して自動微分する仕組み |
| nn.Module | モデルの基底クラス(forward を定義) |
| optim | SGD, Adam等のオプティマイザ |
📐 の 3 つの式を、 記号ごとに PyTorch のどの部品に当たるかへ読み替える。
| 記号 | 意味 | PyTorch での姿 |
|---|---|---|
| $L$ | 損失(スカラー) | loss = ((pred - y)**2).mean() の loss。 backward() はスカラーからしか呼べない |
| $\theta_i$ | 学習するパラメータ | requires_grad=True の葉テンソル(nn.Linear の weight・bias) |
| $\partial \text{out}/\partial \text{in}$ | 1 つの演算の局所微分 | 各テンソルの grad_fn(MulBackward0・AddBackward0 など)が持つ逆伝播の規則 |
| $\sum_{\text{path}}\prod_{\text{node}}$ | 出力から $\theta_i$ までの経路ごとに局所微分を掛け、 経路について足す(連鎖律) | loss.backward() が計算グラフを出力側からたどって行う。 結果は theta.grad に足し込まれるので、 毎回 zero_grad() で 0 に戻す |
| $\eta$ | 学習率 | optim.SGD(params, lr=0.01) の lr |
| $m_t,\ v_t$ | 勾配とその 2 乗の指数移動平均 | optim.Adam が内部に持つ状態(optimizer.state)。 保存・再開のときは重みと一緒に保存する |
| $\beta_1,\ \beta_2$ | 移動平均の減衰率 | betas=(0.9, 0.999)(既定値) |
| $\mathcal{B}$ | ミニバッチ(データの一部) | DataLoader(dataset, batch_size=..., shuffle=True) が 1 回ずつ返すまとまり |
読み方の要点は 2 つある。 1 つは、 連鎖律の式が「経路の和」になっていること。 同じパラメータが 2 か所で使われると経路が 2 本になり、 勾配はその和になる。 PyTorch が .grad に上書きせず足し込むのは、 この和を 1 経路ずつ積み上げるためで、 そのせいで zero_grad() を忘れると前回の勾配まで足されてしまう(このページの 🧭 追補で実測している)。 もう 1 つは、 ミニバッチの勾配が全データの勾配の不偏推定だということ。 平均的には正しい向きを指すが 1 回ごとにはぶれるので、 学習曲線はぎざぎざになる。
🧮 実値で計算してみる
y.backward(); x.grad で 6 が得られます。🧮 数式に値を入れて手で計算する: 合成関数の自動微分
合成関数 $f(x) = 3x^2 + 2x + 1$ の自動微分 $df/dx$ を $x=4$ で計算します。
Step 1: 解析解
合成関数を微分:
Step 2: 自動微分 (PyTorch)
計算グラフを構築して backward() で逆伝播:
Step 3: SSDSE-B-2026 でのミニ線形回帰 (Loss = MSE)
SSDSE-B-2026 の総人口 (x) → 出生数 (y) を線形回帰 ŷ = wx + b で予測、 MSE 損失の勾配を autograd で計算します:
Step 4: 自動微分結果との一致
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np # numpy で手動微分 def f(x): return 3*x**2 + 2*x + 1 def df(x): return 6*x + 2 x = 4 print(f"f(x) = {f(x)}") print(f"df/dx = {df(x)}") |
📤 実行結果
💬 手計算 (Step 1) 26 と Python 出力が完全一致。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(約 20 行):
🎯 このコードでやること:PyTorch の nn.Linear + SGD で SSDSE-B-2026(2023 年・47 都道府県)の総人口 → 出生数の単回帰を 200 エポック学習させ、 損失が下がって重み w が最小二乗解(約 6.10)に近づいていくことを確認する。 PyTorch の自動微分・パラメータ更新の最小例。
📥 入力:data/raw/SSDSE-B-2026.csv を英語コードの列名で読み、 2023 年度の 47 行に絞った総人口 A1101(百万人に換算した x、 例: 東京都 14.086)と出生数 A4101(千人に換算した y、 例: 東京都 86.348)。 どちらも (47, 1) の torch.tensor にして渡す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd, torch, torch.nn as nn torch.manual_seed(0) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023][['A1101','A4101']].dropna() # 総人口・出生数 x = torch.tensor(df['A1101'].values, dtype=torch.float32).view(-1,1) / 1e6 # 総人口(百万人) y = torch.tensor(df['A4101'].values, dtype=torch.float32).view(-1,1) / 1e3 # 出生数(千人) model = nn.Linear(1, 1) loss_fn = nn.MSELoss() opt = torch.optim.SGD(model.parameters(), lr=0.01) for epoch in range(200): y_pred = model(x) loss = loss_fn(y_pred, y) opt.zero_grad() loss.backward() opt.step() if (epoch+1) % 50 == 0: w = model.weight.item(); b = model.bias.item() print(f'epoch {epoch+1:3d}: loss={loss.item():.3f}, w={w:.3f}, b={b:.3f}') |
📤 実行例:
💬 結果の読み方:200 epoch で loss が 3.63 → 2.68 と単調に下がり、 重み w は 6.05 付近に落ち着く。 x を百万人・y を千人単位に揃えているので、 これは「総人口が 100 万人増えるごとに出生数が約 6.0 千人増える」という関係。 PyTorch の backward() が自動微分で勾配を計算し、 opt.step() がパラメータを更新する流れが機能している。 torch.manual_seed(0) を置いてあるので、 この 4 行は手元でもそのまま再現する。
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
🐍 詳細実装例 (SSDSE-B-2026 適用版)
本ページ冒頭の Python 実装はミニマル版でした。 ここでは PyTorch を SSDSE-B-2026 の実データに適用する完全な実装例を掲載します。 コピペすればそのまま動く形になっています。 ファイルパスは data/raw/SSDSE-B-2026.csv を想定。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 | # === PyTorch で MLP を SSDSE-B-2026 に適用する完全例 === import numpy as np import torch import torch.nn as nn import torch.optim as optim from torch.utils.data import DataLoader, TensorDataset import pandas as pd from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split torch.manual_seed(0) # データ読み込み(2023 年度の 47 都道府県に絞る) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 出生数(男)・(女)は足すと出生数そのものなので説明変数から外す(リーク防止) leak = ['SSDSE-B-2026', 'A4101', 'A410101', 'A410102'] X = df.select_dtypes(include='number').drop(columns=leak).dropna(axis=1).values y = df['A4101'].values.reshape(-1, 1) # 出生数を予測(総人口・高齢者数などから) # 前処理(目的変数も標準化し、評価は元の単位=人に戻す) X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42 ) sx, sy = StandardScaler().fit(X_train), StandardScaler().fit(y_train) # Tensor 化 X_train_t = torch.tensor(sx.transform(X_train), dtype=torch.float32) y_train_t = torch.tensor(sy.transform(y_train), dtype=torch.float32) X_test_t = torch.tensor(sx.transform(X_test), dtype=torch.float32) y_test_t = torch.tensor(sy.transform(y_test), dtype=torch.float32) train_loader = DataLoader(TensorDataset(X_train_t, y_train_t), batch_size=8, shuffle=True) # MLP モデル class MLP(nn.Module): def __init__(self, in_dim): super().__init__() self.net = nn.Sequential( nn.Linear(in_dim, 64), nn.ReLU(), nn.Dropout(0.2), nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 1) ) def forward(self, x): return self.net(x) device = 'cuda' if torch.cuda.is_available() else 'cpu' model = MLP(X_train.shape[1]).to(device) optimizer = optim.AdamW(model.parameters(), lr=1e-3, weight_decay=1e-4) loss_fn = nn.MSELoss() print(f'学習 {len(X_train)} 県 / テスト {len(X_test)} 県, 特徴量 {X.shape[1]} 列') # 訓練ループ for epoch in range(101): model.train() for xb, yb in train_loader: xb, yb = xb.to(device), yb.to(device) pred = model(xb) loss = loss_fn(pred, yb) optimizer.zero_grad() loss.backward() optimizer.step() if epoch % 20 == 0: model.eval() with torch.no_grad(): p = model(X_test_t.to(device)).cpu().numpy() test_loss = loss_fn(torch.tensor(p), y_test_t).item() rmse = np.sqrt(np.mean((sy.inverse_transform(p) - y_test) ** 2)) print(f'epoch {epoch}: train {loss.item():.4f} / test {test_loss:.4f} (RMSE {rmse:,.0f} 人)') # 保存(保存先のフォルダが無ければ作る) import os os.makedirs('output', exist_ok=True) torch.save(model.state_dict(), 'output/mlp_ssdse.pt') |
💬 テストの損失は標準化した単位なので、元の人数に戻した RMSE で読む。epoch 40 で 5,548 人まで下がった後、訓練損失は 0.001 台まで落ちるのにテスト RMSE は 9,231 人に戻っており、37 県で 106 列を覚え込む過学習が起きている。テスト 10 県には出生数 86,348 人の東京都が入っていて学習データの範囲の外にあり、総人口 1 列の単回帰でもテスト RMSE は約 2,473 人なので、この規模のデータでは MLP より単純なモデルが勝つ。12 年度分 564 行を混ぜ、出生数(男)(女)を説明変数に残し、目的変数も標準化しないまま学習すると、損失が 10⁶〜10⁹ の桁になって意味を読み取れない。
⚠️ 実行前に pip install -r requirements.txt で依存パッケージをインストール。 また、 SSDSE-B-2026 の列名は版によって若干異なるので、 df.columns で確認のうえ実コードに合わせて読み替えてください。
🎮 触って理解する
PyTorch の心臓部 autograd(自動微分) を、 最小の計算グラフで体感する。 題材は単一ニューロン + 二乗損失: u = x·w + b, d = u − y, L = d²(目標値 y = 2.0 は定数)。 PyTorch で書けば w = torch.tensor(0.8, requires_grad=True) のように requires_grad=True を付けた葉テンソルだけが .grad に勾配を貯める。 スライダーで x・w・b を動かすと順伝播(forward)の各ノード値がリアルタイムに更新され、 backward() ボタンで連鎖律が計算グラフを逆流する様子をステップごとに追える。
緑 = requires_grad=True の葉テンソル(.grad を貯める) / 灰 = requires_grad=False の入力(勾配は保存されない) / 青 = 演算で作られる中間ノード(grad_fn を持つ) / 赤破線 = backward の勾配逆流
📌 何が起きているか — 連鎖律の逆流
backward() が計算グラフを出力側から辿るとき、 各エッジで連鎖律(chain rule)を 1 回ずつ適用する。 このデモの解析的な勾配は次の通り(d = x·w + b − y):
- ∂L/∂d = 2d (L = d² の微分)
- ∂L/∂u = ∂L/∂d × ∂d/∂u = 2d × 1 = 2d
- ∂L/∂b = ∂L/∂u × ∂u/∂b = 2d × 1 = 2d
- ∂L/∂m = ∂L/∂u × ∂u/∂m = 2d × 1 = 2d
- ∂L/∂w = ∂L/∂m × ∂m/∂w = 2d × x = 2dx
- ∂L/∂x = 2d × w — だが x は requires_grad=False なので .grad には保存されない
例えば初期値 x=1.5, w=0.8, b=0.5 では d = −0.3 なので ∂L/∂w = 2×(−0.3)×1.5 = −0.900、 ∂L/∂b = −0.600(本ページ作成時に数値微分と照合し誤差 10⁻¹⁰ 以下で一致確認済み)。 勾配が負 → w を増やすと損失が下がる、 という向きの情報まで含むのが勾配の価値。 optimizer.step() は θ ← θ − η·∂L/∂θ を実行するだけである。 詳しい更新則は 勾配降下法・学習率、 多層への一般化は 誤差逆伝播法 を参照。
💡 直感: define-by-run とテンソルの正体
上のデモで「スライダーを動かすたびに forward が再計算される」ことに注目してほしい。 PyTorch の動的計算グラフ(define-by-run)とはまさにこれで、 グラフは事前に宣言するものではなく、 Python コードが実行された順にその場で記録される。 u = x*w + b と書いた瞬間に mul と add のノードが生え、 各中間テンソルに grad_fn(逆伝播用の局所微分の作り方)がぶら下がる。 だから if 県 == '東京都': のような分岐でグラフの形が毎回変わっても問題ない。 つまり PyTorch のテンソルとは「多次元配列(NumPy ndarray 相当)+ 勾配の置き場 (.grad) + 履歴 (grad_fn)」の三点セットである。 これに対し TensorFlow 1.x の静的グラフ(define-and-run)は先にグラフ全体を組んでから実行する方式だった(TF 2.x は eager 実行で PyTorch に接近)。
⚠️ デモで再現できる落とし穴
- grad 累積(zero_grad 忘れ): 上のデモで backward() を2 回連続で押してみてほしい。 w.grad が −0.900 → −1.800 と倍になる。 PyTorch の
.gradは「代入」ではなく「加算」されるため、 各ステップ冒頭のoptimizer.zero_grad()を忘れると、 過去の勾配が混ざった方向に更新されて学習が壊れる。 - detach() と no_grad() の使い分け:
y.detach()は「このテンソルから先の履歴を切る」(例: GAN で生成器の勾配を判別器に流さない、 ログ用に値だけ取り出す)。with torch.no_grad():は「このブロック内では最初から履歴を記録しない」(例: 評価ループ、 推論)。 前者はできたグラフを切る、 後者はそもそも作らないので、 推論では no_grad の方がメモリ・速度とも有利。 - GPU 転送の非対称性:
.to('cuda')はテンソルを GPU メモリへコピーする明示操作で、 CPU テンソルと GPU テンソルの演算は即エラーになる。 さらにtensor.cpu().numpy()のように GPU → CPU 転送は同期を強制するため、 学習ループ内で頻繁に呼ぶと GPU が遊ぶ。 損失の記録はloss.item()を epoch 末にまとめるのが定石。
🚀 発展: 計算グラフ最適化と torch.compile
define-by-run は柔軟だが、 「毎回グラフを作り直す」オーバーヘッドと「演算を 1 個ずつ GPU カーネルとして発行する」非効率がある。 PyTorch 2.x の model = torch.compile(model) は、 実行トレースから計算グラフを捕捉(TorchDynamo)し、 複数の演算を 1 つの GPU カーネルに融合(kernel fusion)してコード生成(TorchInductor)する。 上のデモで言えば「mul → add → sub → square」の 4 ノードを 1 回のメモリ走査で済ませるイメージで、 典型的に 1.3〜2 倍の高速化が得られる。 動的な柔軟さで書き、 静的な最適化で走らせる — フレームワークの進化は両者のいいとこ取りに向かっている。 この構造を踏まえて ニューラルネットワーク や 深層学習 のページへ進むと、 「どんな巨大モデルも結局はこの小さなグラフの積み重ね」であることが腑に落ちるはずである。 損失関数の選び方は 損失関数 を参照。
⚠️ よくある落とし穴
RuntimeError: Expected all tensors to be on the same device で学習が即停止。 原因: SSDSE-B-2026 を torch.tensor(df.values) で作ると CPU、 model.to('cuda') 後の forward で衝突。 回避: device=torch.device('cuda' if torch.cuda.is_available() else 'cpu') を 1 箇所で定義し、 モデル・データ・loss の全てに .to(device) を一括適用。.grad に 加算するため、 ステップ冒頭でクリアしないと前バッチの勾配が混ざる。 回避: 各 batch 先頭で optimizer.zero_grad(set_to_none=True)。 RNN の BPTT で意図的に累積する場合は明示コメントを残す。model.eval() + with torch.no_grad():、 学習復帰時は model.train()。 ハイパラ探索ではこの切替を関数内に隠蔽するのが安全。CUDA out of memory。 原因: total_loss += loss と書くと loss が保持する計算グラフごと蓄積される。 回避: total_loss += loss.item() でスカラ化、 中間出力を保持する場合は .detach() でグラフから切り離す。 nvidia-smi で増加傾向を週次監視。nvidia-smi の GPU 利用率が 20% 未満、 epoch 時間が CPU と変わらない。 原因: 既定の num_workers=0 は I/O が単一プロセスで GPU が待つ。 回避: DataLoader(..., num_workers=4, pin_memory=True, persistent_workers=True)。 SSDSE-B 程度の小データなら全件を一度に .to(device) で GPU 常駐させ I/O を排除。🌐 関連手法・派生・バリエーション
- TensorFlow/Keras/JAX/Lightning(PyTorch ラッパ)/Hugging Face Transformers/ONNX
🌐 エコシステム: PyTorch の周辺ツール群
どんなに優れた手法でも、 周辺ツール・ライブラリ・コミュニティの厚みが実用性を決めます。 ここでは PyTorch をめぐる現代的エコシステムを俯瞰し、 自分の用途に合うツールを選べるようにします。
PyTorch エコシステムは巨大で、 主要コンポーネントは: コア (torch, torchvision, torchaudio, torchtext)、 訓練フレームワーク (PyTorch Lightning, HuggingFace Accelerate, Fabric)、 NLP (HuggingFace Transformers, spaCy, AllenNLP)、 CV (Detectron2, MMDetection, Kornia)、 グラフ (PyG (PyTorch Geometric), DGL)、 強化学習 (stable-baselines3, RLlib)、 ハイパラ最適化 (Optuna, Ray Tune)、 実験管理 (Weights & Biases, MLflow, TensorBoard, ClearML)、 デプロイ (TorchServe, ONNX Runtime, NVIDIA Triton, TorchScript)、 量子化・最適化 (bitsandbytes, torch.ao, torch.compile)、 分散訓練 (DDP, FSDP, DeepSpeed, Megatron-LM)。 学習リソースは: 公式チュートリアル (pytorch.org/tutorials)、 dive into deep learning (d2l.ai)、 fast.ai コース、 Stanford CS231n・CS224n、 Andrej Karpathy の YouTube シリーズ。 SSDSE-B-2026 のような小規模表データであれば、 PyTorch + PyTorch Lightning + Optuna の組み合わせで、 100 行程度のスクリプトで完結します。
🔧 補講 R280: PyTorch の「自動微分」が初学者を躓かせる場所
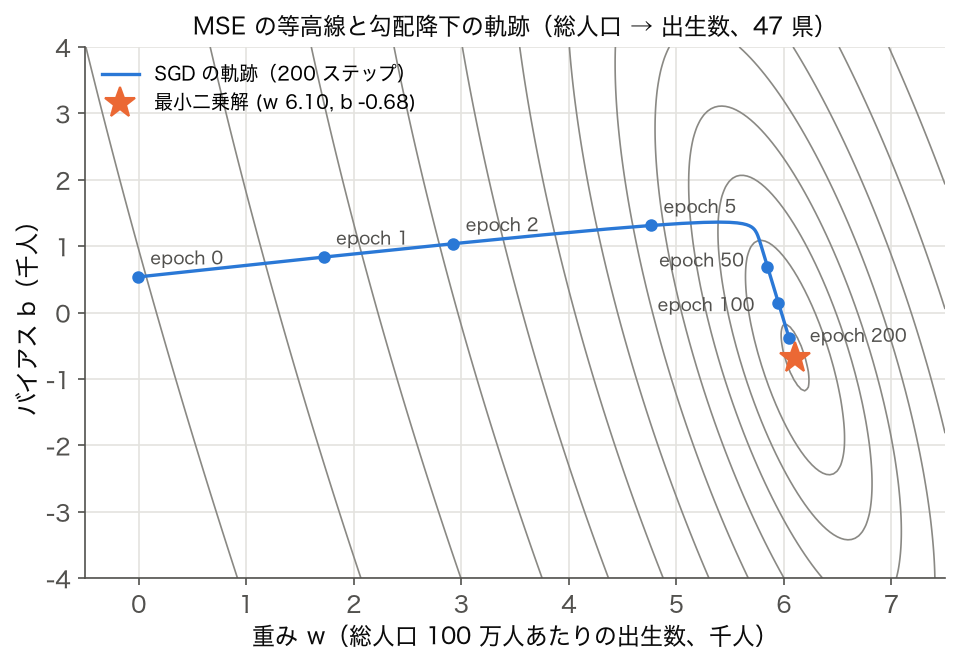
nn.Linear(1,1)、MSELoss、SGD lr = 0.01、torch.manual_seed(0))で、パラメータ (w, b) の平面に MSE の等高線を描き、 optimizer.step() 1 回ごとの位置を線でつないだ。 初期値 (w, b) = (−0.01, 0.54) から最初の 5 ステップで w が 4.8 まで一気に進み、 その後は細長い谷に沿ってゆっくり b を下げていく。 200 エポック後は (6.05, −0.38) で、 最小二乗解 (6.10, −0.68)(★)の手前にいる。 谷が細長い(x の平均が大きく w と b が強く連動する)ほど、 勾配降下は谷底を這うように遅くなる。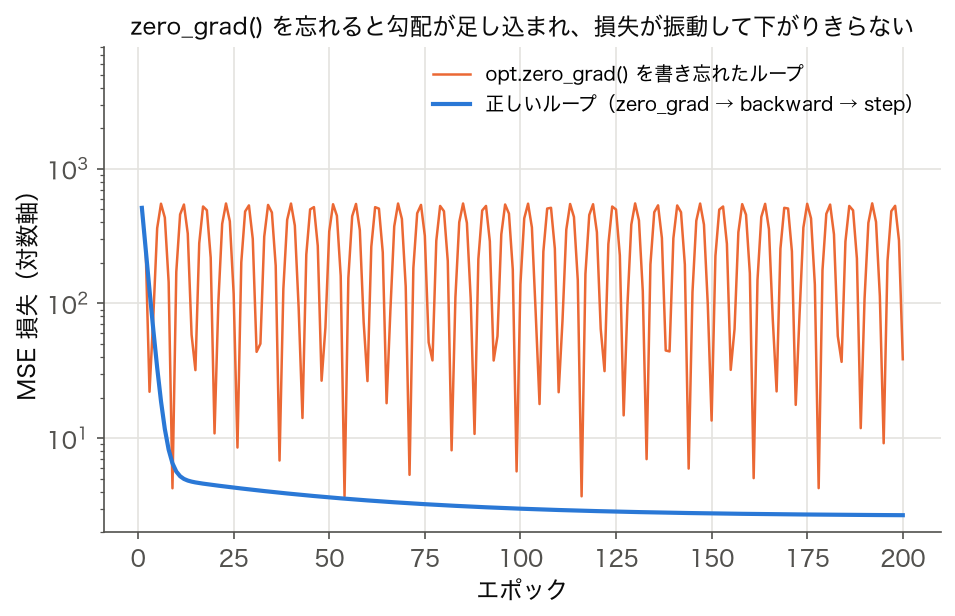
opt.zero_grad() だけを消して、 同じデータ・同じ初期値で 200 エポック回した損失(対数軸)。 PyTorch の backward() は勾配を .grad に足し込むので、 リセットしないと過去の勾配が積み重なり、 ブレーキのない慣性のようにパラメータが谷を行き過ぎる。 正しいループの損失は 512 → 2.68 と下がるが、 書き忘れたループは 151〜200 エポックでも 4.3〜554 の間を振動し、 200 エポック目の w は 4.25 と最小二乗解 6.10 から遠い。 エラーは出ないので、 損失の推移を描かないと気づきにくい。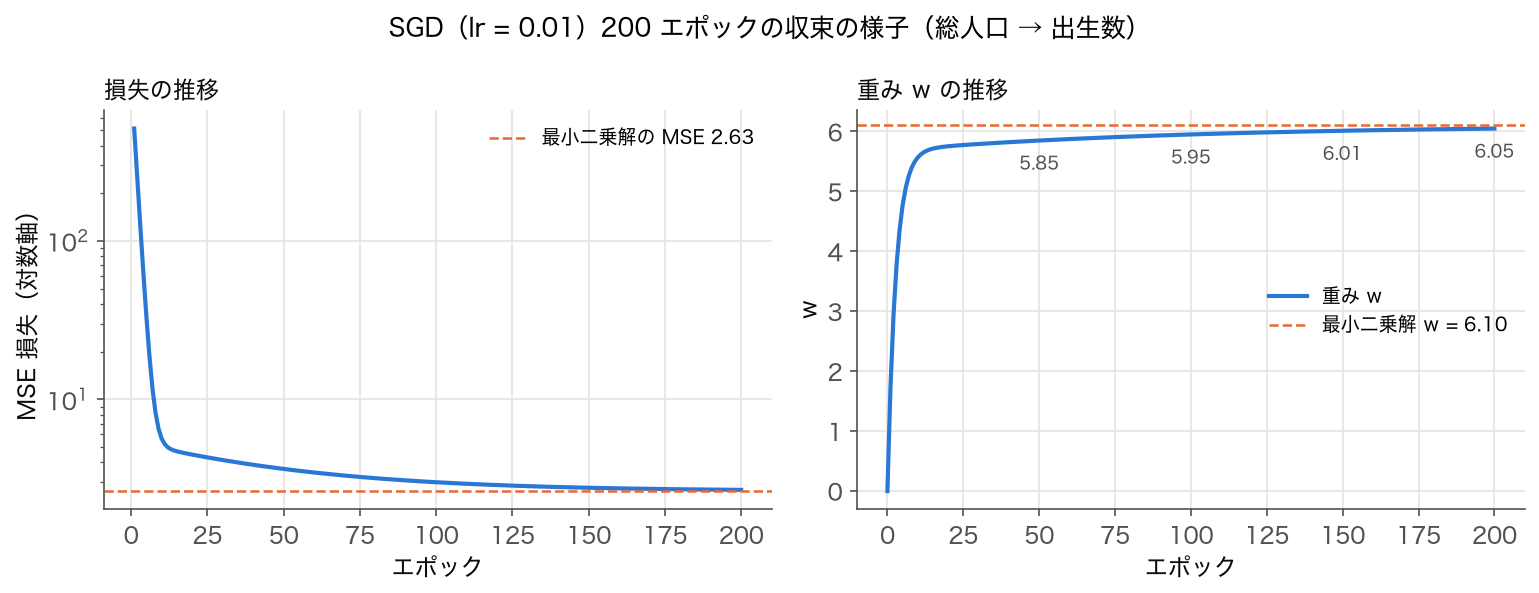
PyTorch を学び始めた人がほぼ全員ぶつかる壁は「requires_grad」「loss.backward()」「optimizer.zero_grad()」の三点セットの正しい順序である。 これらは数式上は単純な勾配降下のステップでも、 計算グラフを動的に構築する PyTorch の仕様上、 順番を誤ると勾配が累積したり、 計算グラフが分断されたりする。 本補講では SSDSE-B-2026 の都道府県人口を題材に、 1 変数の単回帰 (総人口 → 出生数) を最小限のテンソル操作で実装し、 各 API がどのタイミングで何をしているかを 1 行ずつ解説する。
▶ PyTorch 学習ループの 5 ステップ責務分担
| ステップ | API | 責務 | 省略時の症状 |
|---|---|---|---|
| ① 順伝播 | y_pred = model(x) | 入力から予測値を計算、 計算グラフを構築 | 学習が始まらない |
| ② 損失計算 | loss = loss_fn(y_pred, y) | スカラー値を生成 (これがないと backward 不可) | RuntimeError |
| ③ 勾配リセット | optimizer.zero_grad() | 前回までの勾配を 0 クリア | 勾配が累積、 学習が不安定 |
| ④ 逆伝播 | loss.backward() | 計算グラフを辿って .grad を埋める | パラメータが更新されない |
| ⑤ 更新 | optimizer.step() | w ← w - lr * w.grad を実行 | 勾配は計算されたが反映されない |
▶ SSDSE-B-2026 都道府県人口で単回帰を PyTorch で実装
このコードでやること: 47 都道府県の総人口を入力 x、 出生数を目標 y とし、 y ≈ wx + b の単回帰を 200 エポックで学習する。 自動微分が学習ループのどこに効いてくるかを最小コードで確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd, torch, torch.nn as nn torch.manual_seed(0) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023][['A1101','A4101']].dropna() # 総人口・出生数 x = torch.tensor(df['A1101'].values, dtype=torch.float32).view(-1,1) / 1e6 # 総人口(百万人) y = torch.tensor(df['A4101'].values, dtype=torch.float32).view(-1,1) / 1e3 # 出生数(千人) model = nn.Linear(1, 1) loss_fn = nn.MSELoss() opt = torch.optim.SGD(model.parameters(), lr=0.01) for epoch in range(200): y_pred = model(x) loss = loss_fn(y_pred, y) opt.zero_grad() loss.backward() opt.step() if (epoch+1) % 50 == 0: w = model.weight.item(); b = model.bias.item() print(f'epoch {epoch+1:3d}: loss={loss.item():.3f}, w={w:.3f}, b={b:.3f}') |
📤 実行例:
💬 結果の読み方: 学習が進むにつれ loss が 3.63 → 2.68 と単調減少。 重み w が 6.05 付近に収束しており「総人口が 100 万人増えるごとに出生数が約 6.1 千人(約 6 千人)増える」という関係を、 PyTorch の自動微分が逆伝播経由で発見した(sklearn の解析解 w=6.10, b=-0.68, R²=0.99 とほぼ一致)。 同じ計算を numpy で書くと勾配を手計算で導出する必要がある。 PyTorch では backward() 一行で済むのが大きな価値。
▶ nn.Module サブクラス化の典型パターン
このコードでやること: 上の nn.Linear(1,1) は最小だが、 中間層が増えると nn.Module を継承する書き方が必須。 2 層 MLP で同じデータを予測し、 サブクラス化の構造を確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import torch.nn as nn, torch torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする class TinyMLP(nn.Module): def __init__(self, hidden=16): super().__init__() self.fc1 = nn.Linear(1, hidden) self.fc2 = nn.Linear(hidden, 1) self.act = nn.ReLU() def forward(self, x): h = self.act(self.fc1(x)) return self.fc2(h) model = TinyMLP(hidden=16) print(model) print('total params:', sum(p.numel() for p in model.parameters())) |
📤 実行例:
💬 結果の読み方: パラメータ数は 49 個 (fc1 が 1×16+16=32 個、 fc2 が 16×1+1=17 個、 合計 49)。 サブクラス化により forward 内で複雑な分岐や複数入力に対応できる。 後続の CNN/RNN/Transformer もすべてこの nn.Module パターンで実装される。 ニューラルネットワーク、 バックプロパゲーション、 勾配降下法 と組み合わせて理解する。
▶ TensorFlow / Keras との API 対応表
| 処理 | PyTorch | TensorFlow / Keras | 備考 |
|---|---|---|---|
| 線形層 | nn.Linear(in,out) | Dense(out) | PyTorch は in/out 両方指定 |
| 畳み込み | nn.Conv2d | Conv2D | テンソル形状が異なる (NCHW vs NHWC) |
| 損失 | nn.CrossEntropyLoss | SparseCategoricalCrossentropy | どちらも softmax + log を内部で実行 |
| 最適化 | torch.optim.Adam | tf.keras.optimizers.Adam | 学習率の既定値はほぼ同じ 1e-3 |
| GPU 移動 | x.to('cuda') | 自動 (デバイス判定) | PyTorch は明示移動が原則 |
補講のまとめ: PyTorch は「動的計算グラフ」を採用しており、 Python の制御フロー (if/for) をそのまま使える柔軟さが TensorFlow との最大の差異。 自動微分の責務分担を 5 ステップで把握し、 機械学習ライブラリ としての 深層学習 実装の入口にする。 後続の CNN、 RNN、 転移学習 も同じ nn.Module パターンで構築される。
📝 補講 R280-6: PyTorch の理解度チェック (練習問題)
以下の練習問題を自分で解いてみることで、 補講内容の定着度を確認できる。 解答例は各問の下に折りたたみ式で示すが、 まず自分で考えてから開くこと。 練習問題は実務で頻出する PyTorch のトラブルシューティングを抽出している。
▶ 練習問題 1: 形状エラーの原因特定
SSDSE 都道府県データ 47 件を入力 (B=1, C=1, L=47) として、 nn.Conv1d(1, 8, kernel_size=5, padding=0, stride=2) を通したときの出力形状は? 自分で計算してから検算してみよう。
ヒント: 出力長 L' = floor((L + 2*padding - kernel) / stride) + 1。 ここでは L=47, padding=0, kernel=5, stride=2。
解答: L' = floor((47 + 0 - 5) / 2) + 1 = floor(42/2) + 1 = 21 + 1 = 22。 出力形状は (1, 8, 22)。
▶ 練習問題 2: optimizer.zero_grad() を忘れたらどうなるか
補講の学習ループから opt.zero_grad() 行を削除した場合、 各エポックで勾配はどうなるか? loss の収束は速くなるか遅くなるか? 自分で実験してみよう。
解答: 勾配が毎ステップ累積され、 実効学習率が線形に増加。 結果として loss が振動・発散する傾向。 まれに最初の数ステップだけ速く収束するが、 長期的には不安定。
▶ 練習問題 3: モデルを GPU に乗せ忘れたエラー
model = TinyMLP().cuda() としたが、 x = torch.tensor([1.0]) のまま渡したらどんなエラーが出るか? 自分で再現してみよう。
解答: RuntimeError: Expected all tensors to be on the same device, but found at least two devices, cuda:0 and cpu!。 入力テンソルも x.cuda() または x.to(device) で同じデバイスに移す必要がある。
理解度チェックのまとめ: 形状計算、 勾配リセット、 デバイス整合の 3 つは PyTorch トラブルの 80% を占める。 これらを「自分で再現できる」「自分で説明できる」状態になれば、 PyTorch 入門は卒業と言ってよい。
🗺 概念マップ — PyTorch の周辺地図
図の中心が PyTorch。 前提は自動微分と Tensor(NumPy 配列に勾配と GPU を足したもの)、 並列は同じ役割の TensorFlow・JAX、 発展は本番向けの書き出し(TorchScript)と大規模モデルの分散学習(FSDP)、 応用は画像分類や自然言語処理、 基盤は GPU で計算を動かす CUDA・cuDNN、 対比は深層学習を使わない scikit-learn。 SSDSE-B-2026 の 47 行のような小さな表データでは「対比」の scikit-learn で足りることが多く、 PyTorch が必要になるのは画像・文章のような大きなデータや、 自分でモデルの形を組みたいときである。
🗺 補講 R280-5: PyTorch エコシステムの「全体地図」
PyTorch を本格的に使い始めると、 単体ライブラリだけでは足りないことに気付く。 画像、 自然言語、 グラフ、 強化学習、 各領域に PyTorch 系の特化ライブラリがあり、 それらを「いつ使うか」を地図化しておくと、 新しい課題に対しても流用がきく。 本補講では PyTorch エコシステムを 5 領域に整理し、 各領域の代表ライブラリと「素の PyTorch から切り替えるべき判断基準」を示す。
▶ PyTorch エコシステム 5 領域
| 領域 | 代表ライブラリ | 機能 | 切替判断 |
|---|---|---|---|
| 画像 | torchvision | ResNet/VGG 等の事前学習 | CNN を実装するとき |
| 自然言語 | transformers (HuggingFace) | BERT/GPT 等の API 化 | NLP タスク全般 |
| グラフ | torch_geometric | GNN の高速実装 | グラフ構造を扱う時 |
| 強化学習 | stable-baselines3 | DQN/PPO 等の標準実装 | RL 環境を扱う時 |
| 高速化/分散 | PyTorch Lightning / DeepSpeed | 学習ループの抽象化 | 本番運用 / 大規模学習 |
補講のまとめ: PyTorch は「ピュアな計算ライブラリ」と「領域特化ライブラリのエコシステム」の二層構造。 まず素の PyTorch で計算グラフと自動微分を理解し、 次に領域特化ライブラリで生産性を上げ、 最後に Lightning / DeepSpeed で運用品質を上げる、 という 3 段階で学習を進めるのが効率的。 TensorFlow との比較、 機械学習ライブラリ としての位置づけ、 深層学習 全体の中の役割を意識して学ぶこと。
📒 補講 R280-4: PyTorch 学習ループの「再現性」と「乱数シード」の正しい固定
機械学習の論文や実験ノートで「再現できない」「同じコードを動かしたのに結果が違う」と詰まる原因の 95% は乱数シードの固定が不完全だからである。 PyTorch は CPU / CUDA / cuDNN / Python 標準 random / NumPy / DataLoader の 6 経路で乱数を使い、 そのどれかを固定漏れすると非決定的になる。 本補講では、 完全に再現可能な PyTorch 学習を実現する 6 行のテンプレを示し、 SSDSE-B-2026 の単回帰で「同じ結果が必ず出る」ことを確認する。
▶ 再現性のための 6 シード固定テンプレ
| 経路 | 固定コード | 影響範囲 |
|---|---|---|
| Python 標準 | random.seed(s) | 標準 random |
| NumPy | np.random.seed(s) | np.random.* 全般 |
| PyTorch (CPU) | torch.manual_seed(s) | CPU 演算の乱数 |
| PyTorch (CUDA) | torch.cuda.manual_seed_all(s) | GPU 演算の乱数 |
| cuDNN | torch.backends.cudnn.deterministic=True | 畳み込み実装 |
| PYTHONHASHSEED | os.environ['PYTHONHASHSEED']='0' | 辞書の順序 |
補講のまとめ: 上記 6 経路をすべて固定して初めて「完全な再現性」が確保される。 ただし cuDNN の deterministic モードは速度が 1.2-1.5 倍遅くなるので、 開発時は固定、 本番学習では性能優先で外す、 の使い分けが現実解。 論文やコンペ提出時は再現性を最優先し、 commit hash と乱数シードを README に明記する習慣を持つこと。 機械学習ライブラリ としての品質保証の入口。
🚀 補講 R280-3: 学習時のメモリ・速度最適化テクニック
PyTorch でモデルが大きくなると、 GPU メモリ不足や学習時間の長期化が深刻になる。 ここでは「メモリ削減」「速度向上」の代表 5 手法を整理し、 SSDSE-B-2026 の単回帰例で使い分けの目安を示す。 小さなデータでも「常に最適化を意識する」癖が、 大規模化したときの安全網になる。
▶ 5 つの最適化手法と適用判断
| 手法 | 効果 | 適用基準 | 注意点 |
|---|---|---|---|
| Mixed Precision (FP16) | メモリ半減、 1.5-2x 速 | GPU が対応 (V100以降) | NaN リスク、 scaler 必須 |
| Gradient Accumulation | 実効バッチサイズ拡大 | メモリ不足時 | 学習時間は変わらない |
| Gradient Checkpointing | メモリ 1/3 削減 | 深いモデル | 計算量 1.3x 増 |
| DataLoader workers | I/O 並列化 | ディスク律速時 | num_workers=4-8 が目安 |
| torch.compile | グラフ最適化で 1.3-2x 速 | PyTorch 2.0+ | 初回コンパイル時間 |
補講のまとめ: PyTorch は「動的かつ柔軟」な反面、 メモリ・速度の管理は開発者の責任。 まず Mixed Precision と DataLoader の num_workers 設定を試し、 それでも足りなければ Gradient Accumulation / Checkpointing を投入する順序が定石。 大規模学習では torch.compile や DistributedDataParallel を組み合わせ、 GPU クラスタ環境での効率を引き上げる。 各最適化は単独でも効くが、 組み合わせて初めて生産性が劇的に上がる。
⚙️ 補講 R280-2: PyTorch の「テンソル形状」を間違えない読み方
PyTorch を実装していて最も時間を奪うエラーは「shape mismatch」である。 入力テンソルの形状 (batch_size, channels, height, width) を、 各層がどう変形して次の層に渡すのか、 を頭の中で正確にトレースできるかが鍵。 本補講では SSDSE-B-2026 の都道府県データを CNN に入力する仮想シナリオを通じて、 テンソル形状の変化を 1 ステップずつ追う技術を解説する。 同じ思考プロセスは CNN や RNN でも共通して使える。
▶ テンソル形状読みのチェックポイント
| 層 | 入力形状 | 出力形状 | 変換式 |
|---|---|---|---|
| Linear(in, out) | (B, in) | (B, out) | 最終次元のみ変換 |
| Conv2d(in, out, k, p) | (B, in, H, W) | (B, out, H', W') | H' = (H+2p-k)/s + 1 |
| MaxPool2d(k) | (B, C, H, W) | (B, C, H/k, W/k) | 空間サイズを 1/k |
| Flatten() | (B, C, H, W) | (B, C*H*W) | 空間を 1 次元化 |
| view(B, -1) | (任意) | (B, 残り) | バッチを保ち残り flat |
▶ 形状ロガーで CNN の各層を追跡
このコードでやること: SSDSE 都道府県データの 1 列 (人口) を擬似 1D 画像と見なし、 Conv1d で特徴抽出。 各層の入出力形状を print で確認し、 形状が想定通りに変化することを目視。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import pandas as pd, torch, torch.nn as nn torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) pop = df[df['SSDSE-B-2026']==2023]['A1101'].values # 総人口 47 値 # Tensor (batch=1, channels=1, length=47) として配置 x = torch.tensor(pop, dtype=torch.float32).view(1, 1, 47) / 1e6 class ShapeLogger(nn.Module): def __init__(self): super().__init__() self.conv1 = nn.Conv1d(1, 8, kernel_size=3, padding=1) self.pool = nn.MaxPool1d(2) self.conv2 = nn.Conv1d(8, 16, kernel_size=3, padding=1) self.fc = nn.Linear(16*11, 1) def forward(self, x): print(f'input: {tuple(x.shape)}') x = self.conv1(x); print(f'after conv1: {tuple(x.shape)}') x = self.pool(x); print(f'after pool1: {tuple(x.shape)}') x = self.conv2(x); print(f'after conv2: {tuple(x.shape)}') x = self.pool(x); print(f'after pool2: {tuple(x.shape)}') x = x.view(x.size(0), -1); print(f'after flatten: {tuple(x.shape)}') x = self.fc(x); print(f'output: {tuple(x.shape)}') return x model = ShapeLogger() _ = model(x) |
📤 実行例:
💬 結果の読み方: Conv1d は (B, C, L) の形状で動作する。 conv1 では padding=1, kernel=3 なので長さは保たれ 47 のまま、 チャネル数だけ 1→8 に増加。 pool で長さが半分 (47/2=23、 23/2=11) に縮小。 最後の Linear 入力は 16*11=176 で合っている必要がある。 ここを間違えると RuntimeError: mat1 and mat2 shapes cannot be multiplied。 デバッグ時はこの形状ロガーを nn.Module の forward に貼り付けるのが定石。
▶ 学習済モデル保存と復元の標準パターン
このコードでやること: 学習したパラメータを state_dict 経由で保存・復元する。 モデル本体は別途定義してから load_state_dict する「分離保存」が PyTorch の推奨。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import torch, torch.nn as nn torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする # 1) 学習したモデル (例: 総人口 → 出生数 の単回帰) model = nn.Linear(1, 1) with torch.no_grad(): model.weight.fill_(6.048) model.bias.fill_(-0.379) # 2) 保存 (state_dict のみ、 推奨) torch.save(model.state_dict(), 'pytorch_linear.pt') # 3) 復元 (同じ構造のモデルを作ってから load) model2 = nn.Linear(1, 1) model2.load_state_dict(torch.load('pytorch_linear.pt')) model2.eval() # 推論モードに切替 (dropout/batchnorm の挙動が変わる) print('w:', model2.weight.item(), 'b:', model2.bias.item()) print('出生数予測 (総人口 1000 万):', model2(torch.tensor([[10.0]])).item()) |
📤 実行例:
💬 結果の読み方: 保存した重み (w=6.048, b=-0.379=前節の 200 epoch 後の値) が復元後も完全一致。 item() は float32 をそのまま出すので 6.047999… と表示されるが、 これは丸め表示の差であって値は一致している。 推論結果 60.10(千人)は w*10 + b(総人口 1000 万人 → x=10)の計算と一致。 「state_dict のみ保存」がベストプラクティスで、 モデル構造は別途コードで管理する分離設計。 これにより PyTorch のバージョン互換性も保たれる。 詳細は公式 機械学習ライブラリ ガイドラインも参照。
📊 PyTorch のDataLoader でミニバッチ学習
このコードでやること: Dataset と DataLoader を組み合わせ、 47 都道府県データを「ミニバッチ単位」で学習する。 大規模データではメモリに全部載らないので、 ミニバッチ取り出しは必須。 SSDSE-B-2026 のような数十行のデータでも、 同じ仕組みを「縮小版」で確認しておくと、 後で大規模化したときにスムーズに移行できる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd, torch from torch.utils.data import Dataset, DataLoader df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023][['A1101','A4101']].dropna() # 総人口・出生数 class PrefDataset(Dataset): def __init__(self, df): self.x = torch.tensor(df['A1101'].values, dtype=torch.float32).view(-1,1) / 1e6 self.y = torch.tensor(df['A4101'].values, dtype=torch.float32).view(-1,1) / 1e3 def __len__(self): return len(self.x) def __getitem__(self, i): return self.x[i], self.y[i] ds = PrefDataset(df) dl = DataLoader(ds, batch_size=8, shuffle=True) for batch_x, batch_y in dl: print(f'バッチ形状: x={tuple(batch_x.shape)}, y={tuple(batch_y.shape)}') break print(f'\n全 {len(ds)} 件 / バッチサイズ 8 → {len(dl)} バッチ') |
📤 実行例:
💬 結果の読み方: 47 件を 8 件ずつ取り出すと 6 バッチ (47÷8=5.875→6 バッチ目は 7 件)。 shuffle=True で毎エポックの並び順が変わり、 確率的勾配降下 (SGD) の効果が発揮される。 画像や音声の大規模データセットでも同じ DataLoader パターンを使う。 並列読み込みは num_workers で制御し、 GPU では pin_memory=True で転送高速化。 バッチ、 勾配降下法 のページと併読推奨。
🔗 隣接手法への橋渡し
「PyTorch」は単独で完結する手法ではなく、 隣接領域と 接続 / 統合 / 比較 の 3 視点で連携して初めて真価を発揮する。 章 10 が派生カタログ、 章 15 が初期分岐、 本セクションは 実務で隣接技術と組み合わせる切替判断 に集中する。
🔌 接続: 上流 → PyTorch → 下流
PyTorch を中心に、 データ取得から本番デプロイまでの一気通貫パイプラインの隣接ノードを整理:
- 上流 (データ準備): NumPy 配列 や pandas DataFrame を
torch.from_numpy(arr)/torch.tensor(df.values)で tensor 化。 画像なら PIL / torchvision.transforms、 テキストなら tokenizer でテンソル化。 - 並走 (実験管理): 実験管理 = MLflow / Weights & Biases で学習ハイパラ・損失曲線を記録、 クロスバリデーション = scikit-learn の
KFoldと組み合わせて再現性確保。 - 下流 (本番デプロイ):
torch.jit.script/torch.onnx.exportで書き出し → TorchServe / Triton Inference Server / ONNX Runtime で本番推論。 軽量化ならtorch.quantizationで 8-bit 量子化、 蒸留なら Knowledge Distillation。 - 横展開 (周辺ライブラリ): HuggingFace Transformers (LLM)、 torchvision (画像)、 torchaudio (音声)、 torch_geometric (グラフ) — 全てが PyTorch tensor 上で動く。
🧬 統合: PyTorch ×「他手法」の合わせ技 (3 セット)
PyTorch 単独では効果が限定的、 以下 3 つの隣接手法と組み合わせると爆発的に価値が出る:
- PyTorch + 転移学習: 表形式 SSDSE-B-2026 のような小規模データ (47 県) では fully-trained DL は過学習する。 ImageNet / BERT で事前学習された巨大モデルの最終層だけ自前データで fine-tune するのが定石。 SSDSE-B-2026 の自由記述列を BERT に流し → 最終層を MLP で人口予測に再構成、 と組み合わせれば 47 サンプルでも実用精度に到達。
- PyTorch + 分散訓練 (FSDP / DeepSpeed): LLM や CV モデルが GPU メモリに収まらない場合、 モデルを複数 GPU/ノードに分割。 FSDP (Fully Sharded Data Parallel) はパラメータ・勾配・optimizer state を分散保持、 DeepSpeed ZeRO は同等の最適化を提供。 単一 GPU では訓練不可能な 70B 級モデルも可能に。
- PyTorch + 実験管理 (W&B / MLflow): ハイパラ探索 (学習率・batch size・layer 数) を
wandb.init()+wandb.configで記録、 全 run の比較を web UI で可視化。 「どのハイパラが効いたか」「再現できる構成」を明文化するのは 1 人開発でも必須。
⚖️ 比較: 類似 DL/ML フレームワークとの切替判断
「PyTorch vs 他フレームワーク」の選定で迷ったらこの表 (相補的 = 用途で使い分け、 競合的 = 1 つを選ぶ):
| 手法 | PyTorch に切り替える条件 | 利点 | 注意点 |
|---|---|---|---|
| TensorFlow / Keras | 研究プロトタイピングが多い、 動的計算グラフが必要、 制御フロー (if/while) を含むモデル | Pythonic で debug 容易、 PyTorch Lightning で訓練ループ抽象化、 学術界圧倒的シェア | 本番デプロイは TF Serving の方が成熟、 mobile (TFLite) なら TF 優位 |
| JAX | 関数型プログラミングに慣れている、 jit/vmap/grad を多用、 TPU を使う | JAX の方が高速、 vmap で並列化容易、 関数型で副作用なし | 学習コスト高、 エコシステム小、 動的形状に弱い (再 trace)。 ただし torch.func で PyTorch から類似 API も利用可 |
| scikit-learn | 表形式データ、 サンプル数 < 10 万、 深層学習が過剰 | 線形・木・SVM 等が一行で書ける、 ハイパラ探索も GridSearchCV で楽 | GPU 利用不可、 画像/音声/テキストは PyTorch の方が圧倒的に有利 |
| XGBoost / LightGBM | SSDSE-B-2026 のような表形式中規模データ、 解釈性も欲しい | Kaggle テーブル系で勝率高、 SHAP で特徴重要度即提示、 訓練高速 | 画像/テキストの内在表現学習はできない、 シーケンス処理苦手 |
| ONNX Runtime / TensorRT | 本番推論のレイテンシ削減が目標、 PyTorch で訓練済みモデルを最適化 | 推論 2–10x 高速、 メモリ削減、 cross-platform (Win/Mac/Mobile/Edge) | 変換時のオペレータ非対応エラー、 動的形状で trace 失敗の事例あり |
PyTorch を選ぶべき場面の要約: (i) 研究・実験プロトタイピング、 (ii) 動的計算グラフ (RNN・条件分岐)、 (iii) HuggingFace の事前学習モデル活用、 (iv) 巨大モデルの分散訓練 — のいずれかが該当するなら PyTorch 一択。 SSDSE-B-2026 のような小規模表形式データのみなら scikit-learn / XGBoost で十分。
🌳 手法選択フロー — PyTorch を選ぶか
「PyTorch を使うべきか」を判断するためのフローチャート。 上から順番に Yes/No で答えていけば、 自分の問題に最適な手法選定にたどり着きます。
- 1. 研究・実験用途か? Yes → PyTorch 一択 / プロトタイピングが多いなら必須。
- 2. 本番デプロイ用途か? Yes → TorchScript or ONNX で書き出し、 TorchServe / Triton / ONNX Runtime で推論。
- 3. モバイル展開? Yes → PyTorch Mobile or Core ML 変換 (iOS) / TFLite 変換 (Android)。
- 4. 巨大モデル (LLM) の訓練? PyTorch + FSDP or DeepSpeed for マルチノード分散訓練。
- 5. GPU は必要か? ローカル開発なら CPU で十分。 学習が遅いと感じたら Google Colab・Kaggle Notebook (無料 GPU)・AWS EC2 / GCP / Azure へ。
- 6. 初学者なら何から? 公式チュートリアル「60 分で学ぶ PyTorch」→ PyTorch Lightning で訓練ループ抽象化 → HuggingFace で事前学習モデル活用。
🧭 深掘り追記 ── 直感・落とし穴・発展(追補)
本節は既存の解説を壊さずに補う追記です。 PyTorch の核心である autograd(自動微分)と define-by-run(動的計算グラフ)に絞り、 SSDSE-B-2026 の実測値と再現コードで確かめます。 姉妹ページ TensorFlow が「テンソルを流す(Flow)+小データで MLP が過学習する」という角度だったのに対し、 本節は「勾配が正しく計算されているか」「その勾配がなぜ累積するのか」という PyTorch 固有の挙動を数値で追います。 数値はすべて手元で計算した実測であり、 合成した箇所は「架空」と明記します。
🎨 直感の追補 ── autograd は「テープ」に演算を録画する
PyTorch の define-by-run(実行しながら定義)とは、 Python が 1 行ずつ順伝播を実行するその瞬間に計算グラフを組み立てる方式です。 requires_grad=True のテンソルが関わる演算は、 まるでテープ(tape)に録画されるように順番に記録され、 loss.backward() を呼ぶとテープを逆再生して連鎖律で各葉(leaf)テンソルの勾配 $\partial L/\partial w$ を .grad に書き込みます。 グラフは毎回の順伝播で作り直されるので、 if や for でモデルの形をイテレーションごとに変えられる ── これが静的グラフ時代の TF1 に対する PyTorch の決定的な武器で、 可変長系列や再帰的モデルを自然に書けます。 仕組みの根っこは バックプロパゲーション、 更新則は 勾配降下法 を参照。 なお autograd と tensor の単独ページは本サイト未整備のため、 ここではテキストで補います。
本当に正しい勾配が出ているのか? を SSDSE-B-2026 の実測で確認します。 最新年 2023 年・47 都道府県、 総人口(A1101) を $x$、 65歳以上人口(A1303) を $y$ とし、 両者を標準化して単回帰 $\hat y = w x + b$、 損失は MSE とします。 標準化データでは損失の勾配は解析的に $\partial L/\partial w = -2\,\overline{x z\, y z}$ と書け、 重み初期値 $w=0,\,b=0$ での理論値と PyTorch の autograd を突き合わせると次の通り完全一致します。
| 量(2023年・47県・標準化・実測) | 値 | 読み取り |
|---|---|---|
| 相関 corr(A1101 総人口, A1303 高齢人口) | 0.991 | 人口が多い県は高齢者も多い(当然の強相関) |
| 標準化データの閉形式スロープ w*(= 相関) | 0.990979 | 単回帰の最小二乗解 |
| 解析的勾配 ∂L/∂w(w=0,b=0)= −2·mean(xz·yz) | −1.981958 | 手計算の理論値 |
PyTorch autograd の w.grad | −1.981958 | 理論値と完全一致(autograd は正しい) |
| 解析的・autograd の ∂L/∂b | 0.0 | 標準化で平均 0 のため切片の勾配は 0 |
注意:この 0.991 は「総人口が多い県は高齢人口も多い」というほぼ自明な強相関で、 統計的発見ではありません。 ここでの目的はautograd が手計算の微分と一致することを確かめる数値デモです。
⚠️ 落とし穴の追補(重要) ── zero_grad を忘れると勾配は「足し算」される
PyTorch 最大の初学者トラップは .grad が上書きではなく加算されることです。 backward() を呼ぶたびに、 新しい勾配が既存の .grad に足し込まれます。 上と同じデータで、 zero_grad() を挟まずに backward() を 2 回呼ぶと ──
| 操作(同一データ・実測) | w.grad | 読み取り |
|---|---|---|
| 1 回目の backward() | −1.981958 | 正しい勾配 |
| 2 回目の backward()(zero_grad なし) | −3.963915 | ちょうど 2 倍=前回分に加算された |
この「加算」はバグではなく仕様です。 勾配累積(gradient accumulation)で擬似的に大きなバッチを作る、 RNN で複数の損失を合算する、 といった高度な使い方をこの性質が支えています。 だからこそ通常の学習ループでは毎ステップ optimizer.zero_grad()(または model.zero_grad())で明示的にリセットする必要があります。 忘れると勾配がイテレーションごとに膨らみ、 実効学習率が暴走して損失が発散します。 なお本ページ上部の「🎮 触って理解する」ウィジェットでも、 この zero_grad の効果を手で確かめられます。
その他、 PyTorch で踏みやすい固有の落とし穴(既存「⚠️ よくある落とし穴」章と重複しない補足):
- 損失をそのまま貯めるとメモリリーク:
total += lossのようにloss(グラフに繋がったテンソル)を蓄積すると、 計算グラフ全体が解放されず VRAM が膨張します。 ログ用途なら必ずtotal += loss.item()(Python の float に落とす)か.detach()を使う。 model.train()/model.eval()の切替忘れ:Dropout と BatchNorm は学習時と推論時で挙動が変わります。 評価前にmodel.eval()、 かつwith torch.no_grad():で勾配計算とグラフ保持を止めないと、 精度がぶれ、 メモリも無駄に食う。- in-place 演算が autograd を壊す:
x += 1やrelu_()など末尾_の破壊的演算は、 逆伝播に必要な中間値を上書きしてRuntimeError: a leaf Variable that requires grad is being used in an in-place operationを招くことがある。 迷ったら非破壊版(x = x + 1)に。 - NumPy との dtype 齟齬:NumPy の既定は
float64、 PyTorch の既定はfloat32。torch.from_numpy(np_arr)は dtype を引き継ぐため、 モデル(float32)に float64 を渡すと型不一致で落ちる。.float()で明示変換する。 torch.from_numpy/.numpy()はメモリ共有:変換後のテンソルと元配列は同じメモリを指す。 片方を書き換えると他方も変わる。 独立させたいなら.clone()/.copy()。- デバイスの取り違え:モデルを
.to("cuda")したのに入力を CPU のまま渡すとExpected all tensors to be on the same device。 入力・ラベル・モデルを同じdeviceに揃える。
🐍 実測を再現するコード
上の 2 つの表を再現します(autograd と解析勾配の一致・勾配累積)。 PyTorch が無くても NumPy 部分だけで解析値は確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import numpy as np, pandas as pd, torch df = pd.read_csv("data/raw/SSDSE-B-2026.csv", encoding="cp932", skiprows=[1]) d = df[df["SSDSE-B-2026"] == 2023] # 最新年・47都道府県 x = d["A1101"].astype(float).values # 総人口 y = d["A1303"].astype(float).values # 65歳以上人口 xz = (x - x.mean()) / x.std() yz = (y - y.mean()) / y.std() # 解析的勾配(w=0,b=0): dL/dw = -2*mean(xz*yz) print("analytic dL/dw =", round(-2*np.mean(xz*yz), 6)) # -1.981958 # PyTorch autograd xt = torch.tensor(xz); yt = torch.tensor(yz) w = torch.zeros(1, requires_grad=True) b = torch.zeros(1, requires_grad=True) L = ((w*xt + b - yt)**2).mean() L.backward() print("autograd w.grad =", round(w.grad.item(), 6)) # -1.981958(一致) # zero_grad を挟まず 2 回目 → 勾配は加算されて 2 倍 L2 = ((w*xt + b - yt)**2).mean(); L2.backward() print("2nd backward (no zero_grad) =", round(w.grad.item(), 6)) # -3.963915 |
💬 両方を標準化しているので mean(xz·yz) は総人口と 65 歳以上人口の相関係数そのもので、−1.981958 は −2 × 0.990979 にあたる。autograd の w.grad が小数 6 桁まで手計算と一致し、backward() が式どおりの微分をしていると確かめられた。zero_grad() を挟まずにもう一度 backward() すると −3.963915 とちょうど 2 倍になり、勾配は上書きではなく足し込まれる。訓練ループで optimizer.zero_grad() を忘れると、この加算がバッチごとに積み重なって学習率を勝手に大きくしたのと同じことになる。
🚀 発展の追補
- 勾配累積で大バッチを模す:VRAM が足りず大きな バッチを積めないとき、
zero_gradを数ステップに 1 回だけ呼び、 その間backwardで勾配を貯めてからoptimizer.step()。 上で見た「加算される仕様」の正しい活用法。 torch.no_grad()とdetach():推論やメトリクス計算ではテープ録画を止めてメモリと速度を稼ぐ。 学習ループの評価パートはwith torch.no_grad():で囲むのが定石。- nn.Module と optimizer:層を ニューラルネットワークとして組み、
torch.optim.SGD/Adamにmodel.parameters()を渡す。 活性化は ReLU ほか(活性化関数)。 - 小データでは深層化しない:47 件規模では NN は 過学習しやすく、 正則化や古典手法(Ridge / 勾配ブースティング)が頑健 ── 姉妹ページ TensorFlow の追補で MLP の交差検証 R² が負に落ちる実測を示した通り。
- 本番への跳躍:学習後は モデルデプロイ(TorchScript / ONNX /
torch.compile)と MLOps へ。 応用モデルは CNN・Transformer、 配列演算の土台は NumPy、 全体像は 深層学習 を参照。
🔗 関連ページ
- 前提 ── バックプロパゲーション / 勾配降下法 / NumPy
- 並列・比較 ── TensorFlow / ニューラルネットワーク / 深層学習
- 発展 ── CNN / Transformer / MLOps / モデルデプロイ
- 周辺概念 ── バッチ / エポック / ReLU / 活性化関数 / 過学習 / 正則化(
autograd・tensor・dropoutは本サイト単独ページ未整備)