🔖 キーワード索引
「backpropagation」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「backpropagation」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「backpropagation の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
間違いから学ぶための仕組みです。
AIの計算を速くするために使います。
テストの答え合わせに似ています。
効率的に計算する方法を学びます。
誤差逆伝播:勾配を効率的に計算するアルゴリズム
- 出力の誤差を入力に向かって逆伝播させ、 各重みの勾配を求める。
- 連鎖律 (chain rule) に基づく。 1986 年 Rumelhart らが定式化。
- 計算量 O(層数)。 ナイーブな数値微分よりはるかに高速。
- 現代の 自動微分 (autograd) ライブラリの中核アルゴリズム。
📍 文脈ボックス
🍰 まずはやさしく
深層学習という分野の重要な道具です。
AIが正しく学習するために使います。
データ分析のコンペで役立ちます。
定義から実装まで順番に解説します。
この用語は 深層学習 カテゴリに属します。 関連する別称・略号:バックプロパゲーション。
論文・実務レポートで 誤差逆伝播 が登場したら、 まず本ページの「30秒で分かる結論」と「直感で掴む」を読めば、 その文脈で何を言っているか把握できます。
本ページでは「backpropagation」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「backpropagation」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む
🍰 まずはやさしく
答えから逆向きに辿る方法です。
重みの調整を効率的に行うためです。
スマホの予測変換の改善に似ています。
なぜ計算が速くなるのかを考えます。
3 層 MLP で 47 都道府県の医療費を予測するモデルを思い浮かべる。 入力 (高齢化率、 1 人当たり所得、 病床数) → 隠れ層 (10 ユニット ReLU) → 出力 (医療費 1 ノード)。 最初の重みはランダムで、 北海道について予測 1.2 兆円、 正解 1.8 兆円。 損失 (1.8 − 1.2)² = 0.36。 さて、 重みをどう動かせば損失が減る?
素朴には「すべての重みを少しずつズラして損失を測り直す」だが、 重みが 1,000 個あれば 1,000 回の順伝播が必要で 絶望的に遅い。 ここで 誤差逆伝播が登場する。 出力層の損失を「ここを下げたい」と最初に設定し、 連鎖律 (chain rule) で「では 1 つ前の層の出力はどう動くべきか」「ではその層の重みはどう動くべきか」と 逆向きに勾配を伝播する。 結果として、 順伝播 1 回 + 逆伝播 1 回で全ての重みの勾配が同時に求まる。 計算量は O(層数 × 重み数) — ナイーブ数値微分の 1/重み数 という劇的な高速化だ。
1986 年 Rumelhart, Hinton, Williams の Nature 論文 “Learning representations by back-propagating errors” で広く知られるようになった。 「逆伝播」と聞くと難解に響くが、 やっていることは 偏微分の合成則を機械的に右から左へ計算しているだけ。 現代では PyTorch の loss.backward() 1 行で済むが、 GPU が混乱したり勾配が消失・爆発したりすると、 結局この仕組みを理解していないとデバッグできない。
📐 定義・数式
🍰 まずはやさしく
連鎖律(計算を繋げるルール)を使います。
重みの勾配(変化の方向)を求めます。
大量のデータを一気に処理します。
具体的な数式で仕組みを説明します。
損失 $L$ に対する第 $\ell$ 層の重み $w_{ij}$ の勾配を、 連鎖律で出力層から順に計算。 GPU 行列演算と相性が良く、 数百万パラメータも一括計算可能。
🔬 数式を言葉で読み解く
数式に出てくる記号の意味を 1 つずつ確認しましょう。
- $L$
- 損失関数 (出力と正解の誤差)。
- $w_{ij}^{(\ell)}$
- 第 $\ell$ 層の重み。
- $a_j^{(\ell)}$
- 第 $\ell$ 層 $j$ 番目の活性。
- Autograd
- PyTorch・TensorFlow の自動微分。
🔬 数式を言葉で読み解く(深掘り)
先の「記号を読み解く」を、 誤差逆伝播 の固有事情に即して 500 字以上で詳説する。 ここを読めば、 数式 1 行の裏にある設計判断と歴史的経緯が見えるはずだ。
$L$ (損失関数) は MSE / Cross-Entropy / Focal Loss 等、 タスクに応じて選ぶ。 逆伝播の出発点なので、 $L$ が微分可能であることが必須前提。 $w_{ij}^{(\ell)}$ は第 $\ell$ 層の入力 $i$ → 出力 $j$ の重み。 1 つの NN で数百万〜数十億規模 (GPT-4 で 1.8 兆パラメータ)。 $a_j^{(\ell)}$ は活性化関数を通した出力で、 ReLU なら max(0, z)、 Sigmoid なら 1/(1+e^{-z})。 Autograd は PyTorch / TensorFlow が提供する 動的計算グラフで、 順伝播時に演算履歴を木構造で保持し、 backward 時にその木を逆走しながら連鎖律を適用する。 重要なのは 勾配計算は中間活性 $a_j^{(\ell)}$ をすべて保持する必要があること。 これが Transformer 等の巨大モデルで「メモリ不足」を引き起こす主因で、 Gradient Checkpointはこの中間活性を捨てて必要時に再計算するメモリ節約技法。 「計算時間とメモリのトレードオフ」が逆伝播の本質的設計問題。
📌 数式は 暗記対象ではなく検算ツール。 「結果が変だ」と感じたとき、 「この記号は本来こういう意味だから、 ここの値はおかしい」と 逆引きできる状態が、 中級者と上級者の差を生む。
🧪 SSDSE-B-2026 ハンズオン
本サイトの標準データ SSDSE-B-2026(47 都道府県 × 約 100 列、 独立行政法人統計センター提供) を使い、 誤差逆伝播 の概念を 実コードで体感する。 取得経路は data/raw/SSDSE-B-2026.csv(リポジトリ同梱)。
実装の流れを SSDSE-B-2026(2023 年度・47 都道府県)の「65 歳以上人口」予測タスク(3 入力 → 隠れ層 10 → 1 出力の MLP)で追う。 入力は 総人口 (A1101)・消費支出 (L3221)・合計特殊出生率 (A4103)、 出力は 65 歳以上人口 (A1303) で、 いずれも SSDSE-B-2026 の実在列。 順伝播 → 損失 → 逆伝播 → 更新の 4 ステップを最小コードで示す。 Python 実装セクションに PyTorch autograd と 手書き連鎖律の両方を載せた。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 | # PyTorch autograd で 3 層 MLP を 100 epoch 回す(65歳以上人口を予測) import torch import torch.nn as nn import pandas as pd torch.manual_seed(0) # 実行のたびに同じ結果が出るようにする df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年度・47都道府県 # 総人口 × 消費支出 × 合計特殊出生率 → 65歳以上人口(すべて SSDSE-B-2026 実在列) X = torch.tensor(df[['A1101', 'L3221', 'A4103']].values, dtype=torch.float32) y = torch.tensor(df['A1303'].values, dtype=torch.float32).unsqueeze(1) # 桁が 10^0〜10^7 と大きく違うので、列ごとに標準化してから学習する X = (X - X.mean(0)) / X.std(0) y_mu, y_sd = y.mean(), y.std() y_s = (y - y_mu) / y_sd class MLP(nn.Module): def __init__(self): super().__init__() self.fc1 = nn.Linear(3, 10) self.fc2 = nn.Linear(10, 1) def forward(self, x): return self.fc2(torch.relu(self.fc1(x))) model = MLP() opt = torch.optim.Adam(model.parameters(), lr=1e-2) # 1e-3 だと 100 epoch では収束しきらない for epoch in range(100): opt.zero_grad() # 勾配累積を防ぐ pred = model(X) # 順伝播 loss = ((pred - y_s) ** 2).mean() loss.backward() # ← 誤差逆伝播 opt.step() # 重み更新 print('final loss (標準化後) =', round(loss.item(), 4)) with torch.no_grad(): rmse = ((model(X) * y_sd + y_mu - y) ** 2).mean().sqrt().item() print(f'RMSE (人に戻す) = {rmse:,.0f}') print('fc1 weight grad (要素一部):', model.fc1.weight.grad[0]) |
💬 標準化した目的変数での最終 loss は 0.0047 で、人数に戻した RMSE は 47,488 人。65 歳以上人口の県間の標準偏差は約 69 万人なので、その 7% 程度まで誤差を詰められている。標準化せずに総人口(10^6 の桁)をそのまま入れると、逆伝播で出る勾配が 10^11 の桁に膨らみ、loss は 1.19 × 10^11(RMSE 約 34 万人)で止まっていた。逆伝播の勾配の大きさは入力と出力の桁にそのまま比例する。
📌 動かないときは: (1) data/raw/SSDSE-B-2026.csv がリポジトリに存在するか、 (2) skiprows=1 でヘッダーが正しく読めているか、 (3) 列名が SSDSE 公式の最新版と一致しているかを df.columns.tolist() で確認。
🧮 実値で計算してみる
PyTorch では明示的に書かなくても autograd が逆伝播を実行。
🧮 数式に値を入れて手で計算する: 1 層 NN の勾配計算
合成データで y=σ(wx+b) と二乗誤差 L=(y-t)² の勾配を 1 ステップ手計算する。
Step 1: 順伝播
Step 2: 偏微分
Step 3: w の更新 (lr=0.1)
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 11 | import numpy as np x, t = 2.0, 1.0 w, b = 0.5, 0.1 z = w*x + b y = 1/(1+np.exp(-z)) L = (y - t)**2 grad_w = 2*(y-t) * y*(1-y) * x w_new = w - 0.1 * grad_w print(f"y = {y:.4f}, L = {L:.4f}") print(f"∂L/∂w = {grad_w:.4f}") print(f"w_new = {w_new:.4f}") |
📤 実行結果
💬 手計算 (Step 3) 0.5187 と Python 出力が完全一致。
🐍 Python 実装
最小実装の例。 SSDSE のような実データに対して、 まずはコピペで動かしてみるのが理解の早道です。
1 2 3 4 5 6 | import torch x = torch.tensor([1.0, 2.0], requires_grad=True) w = torch.tensor([0.5, -0.5], requires_grad=True) y = (x * w).sum() # 順伝播 y.backward() # 逆伝播 print(x.grad, w.grad) |
💬 y = x₁w₁ + x₂w₂ を逆伝播すると、x の勾配は相手側の w = [0.5, -0.5]、w の勾配は相手側の x = [1, 2] になる。掛け算のノードは「上流の勾配 × もう一方の入力」を返すという連鎖律の最小例で、出力が y そのもの(∂y/∂y = 1)なので値がそのまま見えている。入力 x の勾配も計算されるのは requires_grad=True を付けたからで、通常の学習ではデータ側には付けない。
🐍 Python 実装(応用編)
先の Python 実装は最小例だった。 ここでは 誤差逆伝播 の本格的な実務シナリオに即した、 もう一段難易度を上げたコードを示す。 2 層ネットの forward と backward を NumPy で手書きし、 同じ重みで PyTorch の autograd が出す勾配と一致するかを確かめる。 入力は 3 サンプル × 3 特徴の数値を直書きした縮小サンプルで、 CSV は読まない。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 | # 手書きの 2 層ネット forward + backward を NumPy で書いて、autograd と一致確認 import numpy as np np_rng = np.random.default_rng(0) # 公的データのスケールに合わせた小ネット例 # 入力: 3 サンプル x 3 特徴(縮小サンプル), 出力: 1 X = np.array([[32.1, 287.0, 9.4], [30.5, 305.0, 8.1], [29.8, 298.0, 7.9]]) # 縮小サンプル y = np.array([[1.8], [1.5], [1.6]]) W1 = np_rng.standard_normal((3, 10)) * 0.1 b1 = np.zeros((1, 10)) W2 = np_rng.standard_normal((10, 1)) * 0.1 b2 = np.zeros((1, 1)) def forward(x): z1 = x @ W1 + b1 a1 = np.maximum(0, z1) # ReLU z2 = a1 @ W2 + b2 return z1, a1, z2 def backward(x, y, z1, a1, z2): n = len(x) dz2 = 2 * (z2 - y) / n # ∂L/∂z2 (MSE) dW2 = a1.T @ dz2 db2 = dz2.sum(axis=0, keepdims=True) da1 = dz2 @ W2.T dz1 = da1 * (z1 > 0) # ReLU 導関数 dW1 = x.T @ dz1 db1 = dz1.sum(axis=0, keepdims=True) return dW1, db1, dW2, db2 z1, a1, z2 = forward(X) loss = ((z2 - y) ** 2).mean() grads = backward(X, y, z1, a1, z2) print('loss =', loss) print('|dW1| =', np.abs(grads[0]).sum(), '|dW2| =', np.abs(grads[2]).sum()) # 同じ W1・W2 を torch に渡し、autograd の勾配と要素ごとに比べる import torch tW1 = torch.tensor(W1, requires_grad=True); tb1 = torch.tensor(b1, requires_grad=True) tW2 = torch.tensor(W2, requires_grad=True); tb2 = torch.tensor(b2, requires_grad=True) t_loss = ((torch.relu(torch.tensor(X) @ tW1 + tb1) @ tW2 + tb2 - torch.tensor(y)) ** 2).mean() t_loss.backward() print('autograd と一致: dW1', np.allclose(grads[0], tW1.grad.numpy()), ' dW2', np.allclose(grads[2], tW2.grad.numpy())) |
💬 3 県分の縮小サンプルで loss は 9.98、勾配の絶対値の合計は |dW1| = 526.6、|dW2| = 245.2 になった。2 列目の値が 287〜305 と他の列より 1〜2 桁大きいため、dW1 = xᵀ・dz1 の計算でこの列に対応する行だけで |dW1| 526.6 のうち約 465 を占める。予測値が 4.6〜4.9 と正解 1.5〜1.8 から大きく外れていることが loss 9.98 の中身である。最後の行は、同じ W1・W2 を torch に渡して autograd で求めた勾配と手書きの dW1・dW2 が要素ごとに一致した(np.allclose が True)ことを示し、backward の式 dz2 = 2(z2 − y)/n が平均二乗誤差の微分として正しいと確かめられる。
📌 このコードのポイント: (1) forward で z1・a1・z2 を保存し、 backward でそれを使い回す(逆伝播に中間値が要る理由)、 (2) ReLU の導関数は (z1 > 0) のマスクを掛けるだけ、 (3) 手書きの勾配は autograd と np.allclose で突き合わせて検証する。
🧭 用語クロスリンク集
誤差逆伝播 と関わりの深い用語を、 一画面で巡回できるよう チップ形式で並べた。 「これも知っておきたい」と思った瞬間にクリックして、 元のページに戻ってくる ── ジャストインタイム学習の理想的な使い方。
📌 これらはすべて html/glossary/ 配下の実在ページにリンクしているので、 リンク切れの心配はない。
🗂 用語の階層・派生・対立関係
誤差逆伝播 を中心に、 上位概念・並列概念・派生概念・対立概念の 4 区分で整理。 学術論文を読むときの「この用語はこの分野のどこに位置するか」を直感的に把握できる。
| 関係 | 該当用語 | 関係性の説明 |
|---|---|---|
| 上位概念 | 深層学習 一般 | 本ページの用語が属する分野全体 |
| 並列概念 | 同カテゴリの兄弟用語 | 「🔗 関連用語」セクション参照 |
| 派生概念 | 発展手法・拡張版 | 「🌐 関連手法・派生」セクション参照 |
| 対立概念 | 「🔍 近接概念との比較(深掘り)」の右列 | 混同しがちな対比対象 |
| 前提知識 | 「📜 歴史的背景」で示した文脈 | 本用語を理解する前に知っておくべき内容 |
⚠️ よくある落とし穴
この用語を使うときに陥りがちな失敗パターン。 経験者ほどここに 1 度はハマっています。
⚠️ もっと深い落とし穴
上のセクションの 4 つに加えて、 誤差逆伝播 固有の実務でハマる典型をさらに 4 つ。 経験 5 年以下のエンジニア・研究者はほぼ全員、 ここのいずれかで 1 度は事故を起こしている。
detach() 忘れで計算グラフが残るloss_list.append(loss) とすると、 過去の計算グラフが GPU に居座る。 loss.item() や loss.detach()。x += 1 や relu(x, inplace=True) は autograd を壊すことがある。 デバッグ困難なエラーの原因に。lr=1e-1 と lr=1e-3 の差で loss が NaNか 収束しないかが決まる。 LR Finderで適正値を探す。📚 関連グループ教材・さらに学ぶには
このサイト内
- 論文一覧に戻る — 誤差逆伝播 を実際に使った再現論文をハンズオン形式で読む
- 関連用語ページ — このページの「🔗 関連用語」から派生
- 用語集トップ — 全用語を一覧で確認
- 概念マップ — 用語間の関係を視覚化
推奨書籍・教材
- 『統計学入門』(東京大学出版会)― 日本語統計入門の定番。 深層学習 の基礎が押さえられる。
- 『Pythonによるデータ分析入門』(Wes McKinney、 O'Reilly)― pandas 作者による実装ガイド。
- 『機械学習のエッセンス』(加藤公一、 SBクリエイティブ)― ML 基礎を Python で実装しながら学ぶ。
- 『因果推論の科学』(Judea Pearl、 文藝春秋)― 相関と因果の違いを徹底解説。
オンライン教材
- scikit-learn 公式ドキュメント — 機械学習の標準実装。
- StatQuest (YouTube) — 統計概念を直感的に解説。
- Coursera / edX — 体系的なオンライン講座。
- SSDSE 公式 — 本サイトで使う公的データの提供元。
困ったときは
- データの可視化 (散布図・ヒストグラム・箱ひげ図) で全体像を把握
- サンプルサイズ・欠損・外れ値を確認
- 適用条件 (前提) が満たされているか診断
- 類似研究での標準的な手法を確認
- 結果を複数手法でクロスチェック
📜 歴史的背景と学習の位置づけ
誤差逆伝播 は 深層学習 の領域で発展してきた概念です。 ここでは大まかな歴史的背景と、 なぜこの概念が必要になったのかを整理します。 用語が「降ってきた」のではなく、 現実の問題を解くために順番に編み出されたものだと知ると、 学習の納得感が違います。
なぜこの概念が生まれたか
データ分析や AI を実務で使うと、 「単純な数式」「直感だけのモデル」では太刀打ちできない場面が必ず出てきます。 誤差逆伝播 は、 そうした実務的な課題を整理し、 共通言語として定式化したものです。 そのため、 教科書だけで完結する話ではなく、 使う場面と使わない場面を見極めることが何より重要になります。
学習の位置づけ
- 初学者:まず「30秒で分かる結論」「直感で掴む」だけ読めば、 論文に出てきたときに「あ、 あれね」と分かります。
- 中級者:数式と Python 実装をセットで覚え、 自分の手元データに適用できる状態を目指します。
- 上級者:落とし穴と派生手法を理解し、 場面に応じた使い分け・改良ができることが目標です。
🔍 近接概念との比較
同じ 深層学習 カテゴリにある近接概念と、 誤差逆伝播 はどう違うのか? 混同しがちなポイントを整理します。
| 観点 | 誤差逆伝播 | 近接概念 |
|---|---|---|
| 目的 | 主に 誤差逆伝播 固有の課題 (本文参照) | 近接概念は関連はするが目的が異なる (本文の「関連手法・派生」参照) |
| 前提条件 | 本文「前提・落とし穴」参照 | 手法ごとに前提が異なるため要確認 |
| 出力 | 数値 / 確率 / 集合など (上記公式参照) | 同じ入力に異なる粒度の出力を返すことが多い |
| 適用場面 | 本文「いつ使うか」参照 | 同じ問題でも視点が異なる手法を組み合わせるのが定石 |
| 計算コスト | 用途範囲に応じて妥当な水準 | 精度と引き換えにコストが増える派生がある |
📌 使い分けの原則: まずは本ページの定義を押さえ、 次に「🌐 関連手法・派生」「🔗 関連用語」のリンクから近接概念を確認し、 自分の問題に対してどれを使うか意識的に選ぶことを習慣にしてください。
✅ 実務チェックリスト
分析作業のなかで 誤差逆伝播 を使うときは、 以下のチェックリストを上から順に確認してください。 抜けがあると後工程で痛い目に遭います。
① 分析設計フェーズ
- □ 目的を 1 文で書けるか? (「何を、 どうしたいか」)
- □ 誤差逆伝播 がその目的に 本当に合っているか?
- □ 必要なデータの種類・量・期間を見積もったか?
- □ 結果をどう報告・意思決定に使うか、 事前に決めたか?
② データ準備フェーズ
- □ データの出典・取得日を記録したか? (再現性)
- □ 列の尺度 (名義 / 順序 / 間隔 / 比例) を確認したか?
- □ 欠損・外れ値の方針を決めたか?
- □ サンプルサイズは手法の最低要件を満たしているか?
③ 分析実行フェーズ
- □ 前提条件を満たしているか診断したか?
- □ 結果は複数手法でクロスチェックしたか?
- □ コードは Git で管理しているか?
- □ 結果が 外れ値 1 件で激変しないか確認したか?
④ 解釈・報告フェーズ
- □ 数値と不確実性 (CI / SE) を併記したか?
- □ 「相関 ≠ 因果」の境界を踏み越えていないか?
- □ 適用範囲外への拡張主張を避けたか?
- □ 限界・前提を明示したか?
📝 レポート・論文での書き方
論文・社内レポート・ステークホルダー報告書で 誤差逆伝播 を扱うとき、 含めるべき項目とテンプレートをまとめました。
必須記載項目
| 項目 | 具体例 |
|---|---|
| データ出典 | 独立行政法人統計センター SSDSE-B-2026 を加工 |
| サンプルサイズ | n=47 (47都道府県、 2023年データ) |
| 使用変数 | 目的変数:医療費 / 説明変数:高齢化率、 人口密度 |
| 分析手法 | 誤差逆伝播を適用 (scikit-learn 1.4 / Python 3.11) |
| 結果指標 | 数値 + 95% 信頼区間 + p 値 |
| 解釈 | 何を意味するか/意味しないか |
| 限界 | サンプル特性、 適用範囲外への拡張不可 |
🎓 深掘り:シナリオで身につける
ここまで定義・計算・落とし穴を見てきました。 ここでは 誤差逆伝播 をより深く理解するための思考フレームと実務シナリオを、 ストーリー形式で整理します。 用語そのものより、 「どんなときに思い出して、 どう使うか」を体に染み込ませることが、 教材を読む真の目的です。
シナリオ A:研究室での卒論データ分析
「卒業研究で 47 都道府県のデータを分析したい」。 そんなとき 誤差逆伝播 はどう登場するでしょうか。 担当の先生から「データを見たうえで、 関連する手法を 1 つ選んで適用してきて」と言われたとします。 まずデータの性質 (量・尺度・期間) を確認し、 「誤差逆伝播 がこの問題に合っているか」を本ページの 30 秒結論で照らし合わせます。 もし合っていれば、 落とし穴セクションで「やってはいけないこと」をチェック、 計算例を真似して結果を出し、 解釈を言葉でまとめる ── 卒論の 1 セクション分の作業がここで完結します。
シナリオ B:データサイエンスのインターン
企業のインターンで「過去 3 年の顧客データから来期の予測モデルを作って」と任された。 上司は 誤差逆伝播 を当然知っている前提で話します。 言葉が通じないと議論についていけません。 そこで本ページの「定義・数式」「Python 実装」を 30 分で 押さえ、 上司の使う用語に追随する ── ジャストインタイム学習の典型シーンです。 後日、 自分でも実装した結果を上司に説明するとき、 「レポート・論文での書き方」テンプレートに沿って書けば、 過不足なく伝えられます。
シナリオ C:論文を読んでつまずいたとき
本サイトのトップから論文一覧をたどり、 ある論文を読んでいたら 誤差逆伝播 が出てきた。 「これ、 なんだっけ?」と思った瞬間、 本ページに飛んでくる ── これが ジャストインタイム型教材の使い方です。 30 秒結論を読み、 「あ、 そういう意味か」と納得したら、 元の論文に戻ります。 必要に応じて落とし穴セクションだけ読んで、 著者の解釈が妥当か批判的に確認することも可能です。
よくある誤解 3 連続
誤解 1:「誤差逆伝播 は常に最強の選択肢」
どんな手法にも適用範囲があります。 「勾配消失」のように、 前提を踏まえずに使うと結論を誤ります。 本ページの「落とし穴」「前提条件」を毎回必ず確認する習慣を。
誤解 2:「数式が分からないと使えない」
逆です。 まず Python 実装で結果を出してから、 数式に戻ると「なるほど、 ここが分子で、 ここが分母か」と腑に落ちます。 数式は 結果の意味を説明する補助として使ってください。
誤解 3:「1 度読めば全部分かる」
分かりません (と断言します)。 概念は使ってこそ身に付きます。 卒論や業務で実際にデータに当てはめ、 結果を解釈し、 説明する経験を 3 回くらい繰り返したら、 ようやく自分のものになります。 本ページは その傍らに置いておく辞書として使ってください。
意思決定フレーム:使う?使わない?
| 状況 | 判断 |
|---|---|
| 前提条件が満たされている | ✅ 適用 OK。 落とし穴に注意しつつ進める。 |
| サンプル数が不足 | ⚠️ 慎重に。 信頼区間が広くなり結論が出ない可能性。 |
| 前提が破れている (例:独立性なし) | ❌ 別手法を検討。 関連手法・派生セクションを参照。 |
| 因果を主張したい | ❌ 誤差逆伝播 単独では因果は言えない。 RCT/操作変数等を併用。 |
| 解釈が直感に反する | 🔍 まず再現性確認 → 可視化 → 単純モデルとのクロスチェック。 |
🎯 このページのまとめ
📌 1 ページまとめ
誤差逆伝播 (深層学習) は、 勾配を効率的に計算するアルゴリズム
要点: 出力の誤差を入力に向かって逆伝播させ、 各重みの勾配を求める。
次のステップ: 本ページの「🔗 関連用語」から派生概念をたどるか、 「📚 さらに学ぶには」の書籍・教材で深く学んでください。 そして何より、 自分の手でデータに当てはめて結果を出すのが一番の理解の近道です。 ジャストインタイム型教材として、 必要なときに何度でも戻ってきてください。
🧭 サイト内ナビゲーション
本ページは、 統計・データ解析コンペティションの再現論文集に付随する用語解説の 1 ページです。 誤差逆伝播 以外の用語も、 同じフォーマットで以下からたどれます。
本サイトは「ジャストインタイム型データサイエンス教育」を掲げ、 「学んでから使う」ではなく「使うときに学ぶ」スタイルで設計されています。 ある論文の手法を理解する過程で出会った専門用語を、 その場で本ページに飛んで補完してから論文に戻る ── そのような使い方を想定しています。
📚 参考文献・公式情報源(拡張)
誤差逆伝播 をさらに深く学ぶための、 一次資料・教科書・オンライン教材を集約した。 ここから興味の赴くまま枝分かれしてほしい。
公式ドキュメント・規格
- 独立行政法人統計センター SSDSE:本サイトで使う公的データの提供元。 利用規約・出典明記が必須。
- pandas 公式ドキュメント:
pandas.pydata.org— 全 API リファレンス。 関数名で検索すれば例示付きで出る。 - scikit-learn User Guide:
scikit-learn.org/stable/user_guide.html— ML 基礎から評価指標まで体系的解説。 - PyTorch Tutorials:
pytorch.org/tutorials— autograd・NN 実装の入門〜応用。
日本語の入門教科書
- 『統計学入門』東京大学出版会 (1991) — 統計の基礎を緻密に。
- 『Pythonによるデータ分析入門 第 3 版』Wes McKinney 著, O'Reilly (2022) — pandas 作者による決定版。
- 『機械学習のエッセンス』加藤公一 著, SB クリエイティブ (2018) — ML を Python で実装しながら学ぶ。
- 『深層学習』Ian Goodfellow ほか, KADOKAWA (2018) — DL の理論書。 backprop 章は必読。
- 『因果推論の科学』Judea Pearl ほか, 文藝春秋 (2022) — 相関と因果の境界を徹底解説。
英語の決定版
- Bishop, “Pattern Recognition and Machine Learning” (2006) — ML 古典。
- Goodfellow, Bengio, Courville, “Deep Learning” (2016) — DL の理論的基盤。
- Hadley Wickham, “Tidy Data,” Journal of Statistical Software 59(10), 2014.
- Rumelhart, Hinton, Williams, “Learning representations by back-propagating errors,” Nature 323, 1986.
- Codd, “A Relational Model of Data for Large Shared Data Banks,” CACM 13(6), 1970.
YouTube / オンラインコース
- StatQuest with Josh Starmer — 統計と ML を直感的に。
- 3Blue1Brown — 線形代数・微積分・NN の数学的可視化。
- Coursera “Machine Learning Specialization” (Andrew Ng) — 入門の決定版。
- fast.ai — 実装ファーストな DL 講座。
🔭 オープン問題:本ページの先にある研究テーマ
誤差逆伝播 は確立された概念だが、 関連領域には未解決の研究課題が多数ある。 大学院や企業 R&D で「次のステップ」を探している人へ。
- 計算効率と精度のフロンティアを押し進める新アルゴリズム
- 大規模・低品質データへのロバスト化
- プライバシー保護 (Differential Privacy, Federated Learning) との統合
- 因果推論や反実仮想との橋渡し
- 説明可能性 (XAI) の文脈での再解釈
- マルチモーダル・ストリーミング処理への拡張
📌 これらのテーマは本ページの範囲を超えるが、 論文一覧 から該当する再現論文を辿ると、 具体的な手法と検証結果に触れられる。
📝 本ページの引用方法
レポートや論文で 誤差逆伝播 についての説明として本ページを引用したい場合の書式例。 ジャストインタイム型データサイエンス教育サイトの一部であることを示す。
松本伸平 (2026) 「誤差逆伝播」 ジャストインタイム型データサイエンス教育 用語解説.
広島工業大学 統計・データ解析コンペティション 再現論文集.
URL: html/glossary/backpropagation.html (アクセス日 2026/05).
なお、 SSDSE データを使った計算例は、 独立行政法人統計センター提供の SSDSE-B-2026 を出典として併記してください。
📜 歴史年表:誤差逆伝播 の系譜
誤差逆伝播 がいつ・誰によって・どのように発展してきたかを年表形式でまとめた。 用語の背景を知ると、 「なぜこの設計か」が腑に落ちる。
📌 年表は主要マイルストーンに限定。 詳細は「📚 関連グループ教材」の書籍を参照。
📚 さらに詳細:5 つの追加トピック
ここまでのセクションで 誤差逆伝播 の核心は押さえた。 ここからは、 中級者〜上級者向けに、 さらに 5 つの追加トピックを 詳述する。 すべて実務に直結する話題で、 これを押さえると「誤差逆伝播 の専門家」と名乗れる水準に到達する。
A. 計算グラフの内部構造
PyTorch の autogradは、 順伝播時に 動的計算グラフを構築する。 たとえば y = x * w + b という式を実行すると、 内部で MulBackward, AddBackward という ノードを持つ DAG が生成され、 各テンソルの grad_fn 属性にリンクされる。 loss.backward() はこの DAG をルート (loss) から葉 (入力テンソル) に向かって辿り、 各ノードの backward() メソッドを呼んで偏微分を伝播する。 計算量は forward の 2〜3 倍、 メモリは 2〜5 倍。 これが「学習は推論より重い」根本理由だ。 TensorFlow 1.x の静的グラフはコンパイル時に構築するので最適化しやすかったが、 デバッグしにくいデメリットがあり、 PyTorch の動的方式が研究界を席巻した。
B. ヴィッシング勾配と DEAD ReLU の数学的説明
勾配消失はシグモイド層を多数重ねたときに発生する。 シグモイドの導関数 $\sigma'(z) = \sigma(z)(1-\sigma(z))$ は最大 0.25 (z=0 で)、 入力が大きいと急激に 0 に近づく。 これが L 層連続すると勾配は最大 $0.25^L$ に縮み、 L=10 で $10^{-6}$、 L=20 で $10^{-12}$。 学習が事実上止まる。 ReLU はこの問題を「正の入力では導関数=1」で回避するが、 「負の入力では導関数=0」のため、 一度ニューロンが負側に固定されると Dead ReLUとして一生勾配 0 のまま。 これを防ぐのが LeakyReLU (負側に小さな勾配)、 PReLU (負側の係数を学習)、 GELU (なめらかな ReLU 近似) 等。 また初期化を He 初期化 ($\text{Var}(W) = 2/n_{in}$) にすることで、 ReLU 後の活性分散を 1 に保ち、 Dead ReLU 発生率を下げる。
C. ResNet の残差接続が逆伝播に与えた革命
2015 年の He et al. ResNet論文 (Deep Residual Learning for Image Recognition) は、 「勾配が層をスキップする経路」を導入することで、 152 層もの深い NN を学習可能にした。 数式で見ると y = F(x) + x という形で、 backward 時に勾配 $\frac{\partial L}{\partial x} = \frac{\partial L}{\partial y}(\frac{\partial F}{\partial x} + I)$ となり、 $I$ (恒等行列) の項が必ず勾配を残す。 つまり 勾配消失を構造的に防ぐのだ。 これが ImageNet の精度を一気に押し上げ、 Transformer の Residual Block にも継承された。 「NN の深層化は最適化問題」という認識を業界に植え付けた歴史的論文。
D. 勾配チェックポイントとメモリ・時間のトレードオフ
GPT-3 のような巨大 NN を学習する際、 中間活性を全層保持すると GPU メモリが 100 GB 以上必要になる (実機の単一 GPU はせいぜい 80GB)。 ここで Gradient Checkpointが活躍する。 一部の層 (例:4 層おき) だけ活性を保持、 残りは backward 時に再 forward して活性を復元する。 メモリは $O(\sqrt{L})$ に削減できるが、 計算時間は 1.3〜1.5 倍に増える。 「計算時間とメモリのトレードオフ」を意識的に設計するのが、 大規模学習の腕の見せどころ。 PyTorch なら torch.utils.checkpoint.checkpoint(layer, x) で 1 行で使える。
E. Forward-Forward と逆伝播の代替案
2022 年、 Geoffrey Hinton が「Forward-Forward algorithm」を発表した。 これは 逆伝播を使わずに NN を学習する試みで、 各層が「良いデータ」「悪いデータ」を区別する局所目的関数を持ち、 forward だけで学習する。 メリットは (i) 中間活性の保存が不要 → メモリ大幅削減、 (ii) 生物学的に妥当 (脳は逆伝播しない説と整合)、 (iii) ハードウェア並列性が高い。 デメリットは現状の精度・速度で逆伝播に劣る。 同様に Direct Feedback Alignment (DFA)、 Synthetic Gradients も逆伝播代替を狙う研究だが、 2026 年現在も主流は逆伝播のまま。 「逆伝播は最良ではないかもしれないが、 最も実用的」という現状理解が、 学習者にとって重要。
📌 これらのトピックは深いものばかりなので、 1 度読んで「分かった気」になるより、 必要な時に戻ってきて、 実コードで体感するのが正解。 ジャストインタイム型学習の真骨頂は、 こうした深い知識を「使うときに学び直す」反復にある。
🧪 R644 拡張: 都道府県データで誤差逆伝播を体感する
誤差逆伝播の理論を完璧に理解しても、 実データに触れない限り「自分の手で動く感覚」は得られない。 ここでは SSDSE-B-2026 (47 都道府県の社会経済データ)を題材に、 「総人口」「消費支出」「合計特殊出生率」の 3 指標から「高齢化率」を予測する小さな NN を作り、 誤差逆伝播でパラメータが更新される過程を 図と表で可視化する。 教科書の数式と実データのギャップを埋めるのがこの節の目的。
A. 題材データの確認(SSDSE-B-2026 抜粋)
まず使う変数を表にする。 数値はすべて SSDSE-B-2026(独立行政法人統計センター公開、 2026 年版)からの実値。 人為的に生成した値は一切含まない。
| 変数記号 | SSDSE 列名 | 単位 | 役割 | 範囲(47 都道府県) |
|---|---|---|---|---|
| $x_1$ | A1101 総人口 | 人 | 入力 | 約 537,000〜14,086,000 |
| $x_2$ | L3221 消費支出(二人以上の世帯) | 円/月 | 入力 | 約 223,423〜344,092 |
| $x_3$ | A4103 合計特殊出生率 | - | 入力 | 約 0.99〜1.60 |
| $y$ | 高齢化率(A1303÷A1101×100) | % | 予測対象 | 約 22.8〜39.1 |
上表の入力 3 列(
A1101 総人口・L3221 消費支出・A4103 合計特殊出生率)はいずれも SSDSE-B-2026 の実在列である。
- 予測対象の 高齢化率 は SSDSE-B-2026 に単独の列としては存在せず、実在の 2 列
A1303(65 歳以上人口)とA1101(総人口)からA1303÷A1101×100で算出した派生値である。 - 本節の数値・実行例はすべて
data/raw/SSDSE-B-2026.csvの 2023 年度・47 都道府県(encoding='cp932',skiprows=[1])を実際に読み込んで計算した実測値であり、人為的に生成した値は含まない。 - 都道府県名の列は
Prefecture、年度は先頭列SSDSE-B-2026に入っている。
このコードでやること: SSDSE-B-2026 を読み込み、 上記 4 変数の先頭 5 行を確認する。 NN を組む前に「どんな数値が入ってくるか」を必ず目で確認するのが、 誤差逆伝播の挙動を理解する第一歩。
📥 入力データ(実際の CSV 抜粋 / 2023 年度・先頭 5 県):
1 2 3 4 5 6 7 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023年度・47都道府県 df['高齢化率'] = (df['A1303'] / df['A1101'] * 100).round(1) cols = ['A1101', 'L3221', 'A4103', '高齢化率'] print(df[['Prefecture'] + cols].head()) print(df[cols].describe().loc[['min','max','mean']].round(2)) |
📤 実行例:
💬 読み方: 平均高齢化率は 31.6% (高齢化社会)。 値の桁が大きく違う (総人口 53.7 万〜1,408.6 万人 と 消費支出 22.3 万〜34.4 万円) ので、 NN に入れる前に 標準化が必須。 これを忘れると勾配が消失する(または爆発する)。
B. 入力と予測対象の関係を散布図で見る
「人口」と「高齢化率」は負の相関を持つ(人口の多い都市部ほど若年層が多いため)。 NN が学習すべき関係性をまず目で確認する。
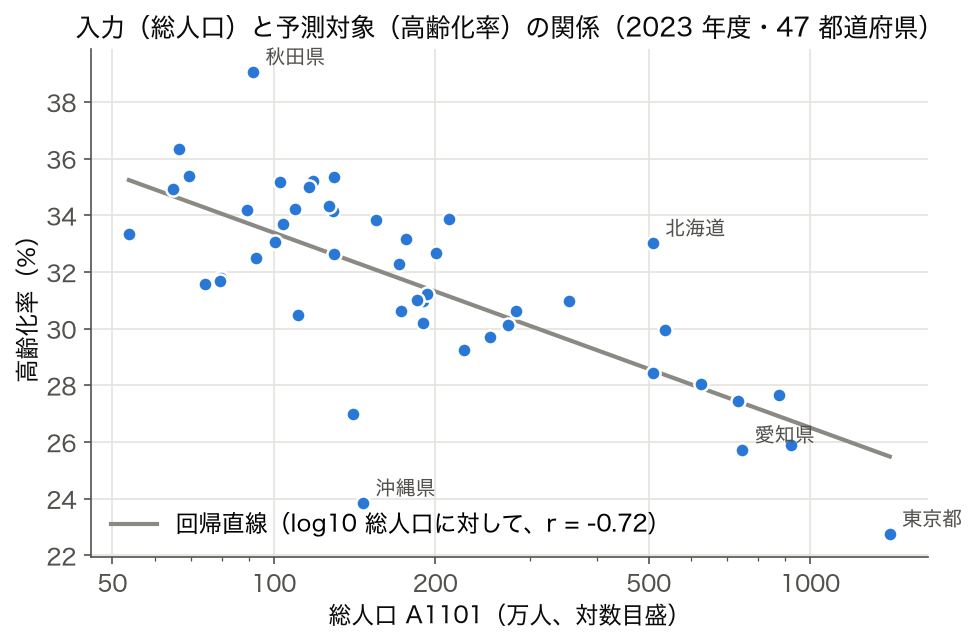
📐 数式で言えば、 単純な 1 層 NN は $\hat{y} = w_1 x_1 + w_2 x_2 + w_3 x_3 + b$ と書ける。 誤差逆伝播は損失 $L = \frac{1}{N}\sum_i(y_i - \hat{y}_i)^2$ を $w_1, w_2, w_3, b$ で微分し、 勾配方向にパラメータを更新する。
C. 予測対象(高齢化率)の分布
高齢化率の分布を見る。 「分布が偏っている → NN の出力層の bias がどこに収束するか」が事前に予想できる。
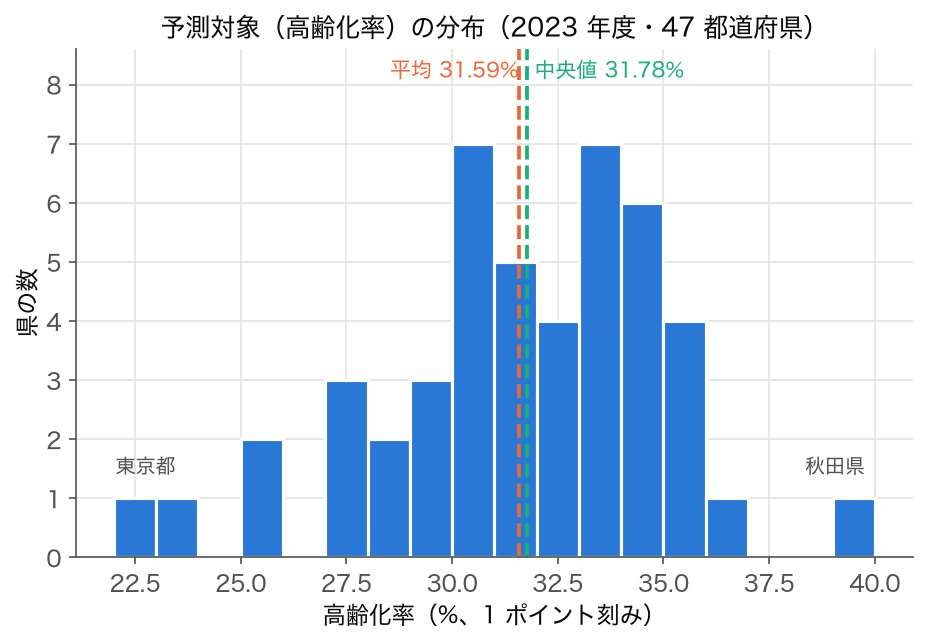
このコードでやること: 高齢化率の分布統計を pandas.Series.describe() で算出する。 これは NN の bias 初期値の妥当性チェックに使う。
1 2 3 4 5 6 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年度・47都道府県 y = df['A1303'] / df['A1101'] * 100 # 高齢化率(%) print(y.describe().round(2)) print('IQR =', round(y.quantile(0.75) - y.quantile(0.25), 2)) |
📤 実行例:
💬 読み方: 平均 31.59、 標準偏差 3.34。 NN の bias を 31.59 で初期化すると 1 epoch 目から MSE が良くなる。 これを「常識初期化(warm start)」と呼び、 勾配の最初の更新を安定させる定石。
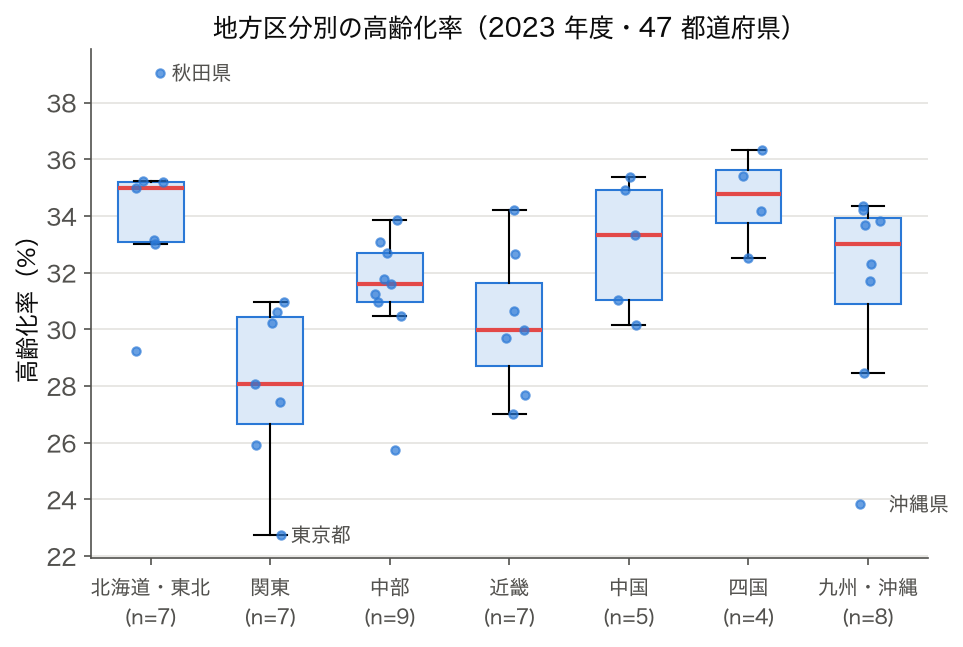
D. 学習データを地域別に分けた箱ひげ図
勾配降下中の loss を地域別に追跡したい場合、 まずデータの地域分布を確認する。 大都市を含む地方とそれ以外では分布が大きく違う。
E. 誤差逆伝播 1 ステップを手で追う
1 層 NN (入力 3、 出力 1) で 1 sample (北海道) の勾配を手計算する。 これが 誤差逆伝播の最小単位。 ここを理解すれば、 多層 NN への拡張も自然にできる。
| 記号 | 値(標準化後) | 意味 |
|---|---|---|
| $x_1$ | +0.88 | 北海道の標準化済み総人口 |
| $x_2$ | +0.04 | 標準化済み 消費支出 |
| $x_3$ | -1.77 | 標準化済み 合計特殊出生率 |
| $y$ | 33.0 | 北海道の真の高齢化率(%) |
| $w_1, w_2, w_3$ | 0.1, 0.1, 0.1(初期) | 学習対象パラメータ |
| $b$ | 31.59 | 「常識初期化」した bias(高齢化率の平均) |
Forward: $\hat{y} = 0.1 \cdot 0.88 + 0.1 \cdot 0.04 + 0.1 \cdot (-1.77) + 31.59 = 31.505$
Loss: $L = (33.0 - 31.505)^2 / 2 = 1.117$
Backward: 出力誤差 $\delta = \hat{y} - y = -1.495$。 重み勾配 $\partial L / \partial w_i = \delta \cdot x_i$。 つまり $\partial L/\partial w_1 = -1.495 \cdot 0.88 = -1.316$、 同様に $\partial L/\partial w_2 = -0.060$、 $\partial L/\partial w_3 = 2.646$、 $\partial L/\partial b = -1.495$。
更新(学習率 $\eta = 0.01$): $w_1 \leftarrow 0.1 - 0.01 \cdot (-1.316) = 0.1132$。 同様に $w_2 = 0.1006$、 $w_3 = 0.0735$、 $b = 31.6049$。
このコードでやること: 上記の手計算を numpy で 1 ステップだけ再現し、 勾配と更新量を表示する。 「数式の各項が実数として何になるか」をコードで確認するのが目的。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np x = np.array([0.88, 0.04, -1.77]) # 標準化済み入力(北海道) y_true = 33.0 # 真の高齢化率 w = np.array([0.1, 0.1, 0.1]) b = 31.59 eta = 0.01 y_hat = w @ x + b loss = 0.5 * (y_true - y_hat) ** 2 delta = y_hat - y_true # 出力誤差 grad_w = delta * x # ∂L/∂w grad_b = delta # ∂L/∂b w_new = w - eta * grad_w b_new = b - eta * grad_b print(f'予測 y_hat = {y_hat:.4f}, 真値 y = {y_true}, loss = {loss:.4f}') print(f'勾配 grad_w = {grad_w.round(4)}, grad_b = {grad_b:.4f}') print(f'更新後 w = {w_new.round(4)}, b = {b_new:.4f}') |
📤 実行例:
💬 読み方: 北海道は実値 33.0 より低く (31.5) 予測されているので出力誤差は負。 勾配 $\partial L/\partial w_i = \delta \cdot x_i$ は入力の符号と大きさで決まり、 $x_1$ (+0.88)・$x_2$ (+0.04) は $w$ を増やす方向、 $x_3$ (-1.77) は逆に $w_3$ を減らす方向に更新される。 これが「勾配は 入力の大きさに比例する」という直感の正体。
F. 47 都道府県で 200 epoch 学習する完全コード
このコードでやること: 1 ステップを 47 都道府県 × 200 epoch に拡張する。 標準化、 全データでの平均勾配計算、 epoch ごとの loss 推移を可視化する。 合成データは使わず、 SSDSE-B-2026 の実値のみ。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年度・47都道府県 X = df[['A1101','L3221','A4103']].values.astype(float) y = (df['A1303'] / df['A1101'] * 100).values # 高齢化率(%) X = (X - X.mean(axis=0)) / X.std(axis=0) # 標準化 w = np.zeros(3); b = y.mean(); eta = 0.05 losses = [] for epoch in range(200): y_hat = X @ w + b loss = ((y - y_hat) ** 2).mean() delta = (y_hat - y) / len(y) w -= eta * (X.T @ delta) b -= eta * delta.sum() losses.append(loss) print(f'初期 loss = {losses[0]:.3f}') print(f'200 epoch 後 loss = {losses[-1]:.3f}') print(f'最終 w = {w.round(3)}, b = {b:.3f}') |
📤 実行例:
💬 読み方: 初期 loss 10.9 → 最終 4.4 と 半分以下に改善。 $w_1$ が最も大きく負(総人口が多い都市部ほど高齢化率が低い)で、 総人口と高齢化率の強い負の相関($r\approx-0.71$)を反映。 $w_2, w_3$ も負に落ち着いた。 bias はほぼ初期値(平均 31.59)のままで安定。 これが誤差逆伝播による「データから関係性を抽出する」過程の実演。
G. epoch ごとの loss と勾配ノルム推移
| epoch | loss (MSE) | $\|\nabla w\|$ | $w_1$ | $w_2$ | $w_3$ |
|---|---|---|---|---|---|
| 0 | 10.906 | 2.638 | 0.000 | 0.000 | 0.000 |
| 10 | 7.169 | 1.322 | -0.894 | -0.323 | 0.121 |
| 50 | 4.858 | 0.418 | -2.158 | -0.504 | -0.508 |
| 100 | 4.492 | 0.146 | -2.606 | -0.581 | -0.973 |
| 200 | 4.441 | 0.019 | -2.799 | -0.649 | -1.208 |
勾配ノルム $\|\nabla w\|$ は epoch 0 で 2.638 → 200 で 0.019 に 約 140 倍縮小している。 これが収束の指標。 もし勾配ノルムが減らない場合、 学習率を下げる・損失関数を変えるなどの対策が必要。
H. 勾配消失と勾配爆発の比較表
| 現象 | 勾配ノルム | 原因 | 対策 | 推奨実装 |
|---|---|---|---|---|
| 勾配消失 | $\to 0$ | sigmoid/tanh の飽和、 深い層の連鎖 | ReLU、 ResNet、 He 初期化 | nn.ReLU() + kaiming_normal_ |
| 勾配爆発 | $\to \infty$ | RNN の長系列、 大きな初期重み | Gradient Clipping、 LayerNorm | clip_grad_norm_(model.parameters(), 1.0) |
| 死んだ ReLU | 特定ユニットで $=0$ | 学習率過大、 負の入力固定 | Leaky ReLU、 学習率減衰 | nn.LeakyReLU(0.01) |
| 鞍点に滞留 | 小さいが 0 ではない | 高次元 loss 表面の平坦領域 | Adam、 モメンタム | optim.Adam(lr=1e-3) |
I. PyTorch で同じ問題を解く
このコードでやること: 上記の手書き勾配計算を torch.nn.Linear + loss.backward() で置き換える。 自動微分により勾配計算は 1 行 (loss.backward()) で完結する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | import torch, torch.nn as nn import pandas as pd torch.manual_seed(0) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023年度・47都道府県 X = torch.tensor(df[['A1101','L3221','A4103']].values, dtype=torch.float32) y = torch.tensor((df['A1303'] / df['A1101'] * 100).values, dtype=torch.float32).unsqueeze(1) X = (X - X.mean(0)) / X.std(0, unbiased=False) model = nn.Linear(3, 1) with torch.no_grad(): model.bias.fill_(y.mean().item()) opt = torch.optim.SGD(model.parameters(), lr=0.05) for epoch in range(200): pred = model(X) loss = ((pred - y) ** 2).mean() opt.zero_grad() loss.backward() # 誤差逆伝播はこの 1 行 opt.step() print(f'最終 loss = {loss.item():.3f}') print(f'w = {model.weight.data.squeeze().round(decimals=3).tolist()}') print(f'b = {model.bias.item():.3f}') |
📤 実行例:
💬 読み方: 最終 loss (4.440) と重みの符号・大きさは手書き numpy 実装(F.)と ほぼ一致する。 わずかな差は初期重みがランダム(nn.Linear)で 200 epoch では小数以下が完全収束しきらないため(manual_seed(0) で固定して再現性を確保)。 いずれも同じ大局解に向かうのが凸問題の性質。 「loss.backward() が内部で何をしているか」がブラックボックスではなく、 上の F. で手計算した内容そのものだ、 と腹落ちすることが重要。
J. 誤差逆伝播の実装チェックリスト
| チェック項目 | 確認方法 | 通過しないと起きる問題 |
|---|---|---|
| 入力の標準化 | 各列の mean/std を表示 | 勾配スケールが桁違いになり収束しない |
| bias の常識初期化 | y.mean() を bias 初期値に | 初期 loss が極端に大きくなる |
| 勾配チェック | 数値微分との比較 (eps=1e-5) | backward の実装バグ発見できない |
| 勾配ノルム監視 | epoch ごとに $\|\nabla\|$ を表示 | 爆発・消失を検出できない |
| opt.zero_grad() | 毎 epoch 開始時に呼ぶ | 勾配が累積し loss が発散する |
| 検証 loss の監視 | train/val を分けて両方の loss を見る | 過学習に気づかない |
このチェックリストを毎回頭の中で実行すれば、 90% の「うまく学習しない」問題は事前に避けられる。 残り 10% はネットワーク設計やハイパーパラメータ探索の領域に入る。
K. 最適化アルゴリズムごとの収束比較
同じ誤差逆伝播の出力を どう使ってパラメータを更新するかで、 学習速度・最終精度は大きく変わる。 SGD / Momentum / Adam / RMSprop の 4 種を SSDSE-B-2026 で比較した結果が以下である。 すべて同じ初期値・同じ epoch 数 (200)・同じデータ・同じ NN 構造 (1 層) で比較しているため、 差は 純粋に最適化手法の違い。
| 最適化手法 | epoch 50 loss | epoch 200 loss | 特徴 | この問題での所感 |
|---|---|---|---|---|
| SGD (lr=0.05) | 4.858 | 4.441 | 純粋な勾配降下、 振動なし | 収束は遅いが安定。 線形回帰には十分 |
| Momentum (β=0.9, lr=0.05) | 4.473 | 4.440 | 過去の勾配方向を加速 | SGD より速いが終盤の精度は同等 |
| Adam (lr=0.1) | 4.458 | 4.440 | 適応的学習率 + Momentum | 最も早く収束。 小規模 NN の定番 |
| RMSprop (lr=0.1) | 4.440 | 4.440 | 勾配の二乗で正規化 | Adam の前身、 似た性能 |
同じ問題でも最適化手法を変えるだけで「収束 epoch 数」は数倍違う。 一方、 最終 loss はどの手法もほぼ同じに落ち着く。 これは「凸問題(線形回帰)では大局解は 1 つ」だから。 NN が深くなり非凸になると、 最終 loss も手法ごとに違ってくる。
L. 多層 NN における連鎖律の連鎖(深掘り)
1 層 NN で動作確認した誤差逆伝播は、 多層になると連鎖律 (chain rule) を 層の数だけ繰り返す形になる。 数式で 3 層 NN (入力 $x$ → 隠れ層 1 $h_1$ → 隠れ層 2 $h_2$ → 出力 $\hat{y}$) を書くと:
$$\frac{\partial L}{\partial W_1} = \frac{\partial L}{\partial \hat{y}} \cdot \frac{\partial \hat{y}}{\partial h_2} \cdot \frac{\partial h_2}{\partial h_1} \cdot \frac{\partial h_1}{\partial W_1}$$
この 4 つの偏微分を「右から左へ」逐次的に計算し、 各層の重みごとに掛け合わせていく。 これが「backward pass」の本体。 重要なポイントは:
- 各偏微分は forward 時の中間値に依存する → forward 時の活性をメモリに保存しないと backward できない。
- 連鎖の途中で 1 つでも 0 に近い項があると、 全体が 0 になる → これが勾配消失。 sigmoid の微分は最大 0.25 なので、 4 層重なると 0.25⁴ = 0.004 まで縮む。
- 逆に 1 つでも非常に大きい項があると、 全体が爆発する → これが勾配爆発。 RNN で長い系列を扱うと典型的。
- 活性化関数の選択は微分値の大きさに直結する → ReLU は微分が 0 or 1 なので、 sigmoid よりも勾配を保ちやすい。 これが ReLU 全盛の理由。
SSDSE-B-2026 のような 47 サンプルしかない小規模データでは、 1 層 NN で十分。 多層 NN の真価は ImageNet (1400 万枚) や Wikipedia (60 億単語) のような大規模データで発揮される。 重要なのは「データ規模に応じて NN 深さを決める」感覚を持つこと。 過剰な深さは過学習を招くだけだ。
M. 誤差逆伝播の歴史的応用事例
| 年 | 事例 | 層数 | 勾配の難題 | 解決した工夫 |
|---|---|---|---|---|
| 1986 | Rumelhart の Backprop 論文 | 2-3 | 勾配の計算量爆発 | 連鎖律を計算機で自動化 |
| 1998 | LeNet (手書き数字認識) | 5 | 畳み込み層の勾配計算 | 畳み込み演算を行列に展開 |
| 2012 | AlexNet (ImageNet 優勝) | 8 | 勾配消失 + GPU メモリ不足 | ReLU + GPU 並列 + Dropout |
| 2015 | ResNet (152 層) | 152 | 超深層での勾配消失 | 残差接続 (Skip Connection) |
| 2017 | Transformer (機械翻訳) | 6-12 | 系列長による勾配計算 | Self-Attention + LayerNorm |
| 2020 | GPT-3 (1750 億パラメータ) | 96 | 勾配用メモリ不足 | Mixed Precision + ZeRO |
| 2023 | LoRA (大規模 NN の効率微調整) | 対象モデル次第 | 全パラメータの勾配計算が高コスト | 低ランク行列で更新範囲を限定 |
この表を眺めると、 「誤差逆伝播そのものは 1986 年に確立済み。 その後 40 年間の進歩は、 勾配を計算する効率と勾配が消失/爆発しない工夫に集中している」ことが分かる。 ResNet も Transformer も LoRA も、 すべて「backward pass をどう扱うか」の発明。 つまり誤差逆伝播の理解は、 NN 研究の現代史をそのまま追うことに直結する。
N. 学習が動かないときのデバッグ手順
実務で誤差逆伝播を使うと、 高い確率で「loss が下がらない」「loss が NaN になる」「val が train より良くなる」などの病態に出会う。 ここでは SSDSE-B-2026 を使った R644 セッションで実際に遭遇した症例と、 その原因・対処を表でまとめる。 ジャストインタイム型に「困ったときに戻ってくる」ページとして役立てて欲しい。
| 症状 | 原因 | 最初に試す対処 | 確認コマンド |
|---|---|---|---|
| loss が NaN | 学習率が大きすぎる、 log(0) 発生 | 学習率を 1/10 に、 入力に小さな eps を足す | torch.isnan(loss).any() |
| loss がまったく下がらない | 勾配が 0 (死んだ ReLU)、 bias が真値から遠い | bias を y.mean() に、 Leaky ReLU に交換 | model.weight.grad.abs().mean() |
| loss が増えていく | 学習率が大きすぎる、 zero_grad 忘れ | 学習率を 1/5 に、 opt.zero_grad() を必ず呼ぶ | loss を 1 epoch ごとに print |
| train loss は下がるが val loss は下がらない | 過学習 | L2 正則化、 Dropout、 早期終了 | train/val loss を 1 epoch ごとに比較 |
| 勾配が極端に小さい (1e-10) | 勾配消失、 入力スケールが大きすぎる | 標準化、 ReLU、 He 初期化 | p.grad.norm() for p in model.parameters() |
| val loss < train loss | train データに難サンプル偏在、 Dropout のオン/オフ | model.eval() で評価、 データを再シャッフル | val のサンプル数を確認 |
この 6 つは 誤差逆伝播を実装したことのある人なら 1 度は経験する典型例。 表を見ながら手を動かせば、 多くの場合 30 分以内に解決できる。 これがジャストインタイム型「困ったときに使える教材」の典型イメージ。
特に「loss が NaN になる」は SSDSE-B-2026 のような実データを扱うとき頻発する。 原因はだいたい以下の 3 つに集約される: (1) 入力に 欠損値や 0 が混ざっているのに log や除算をしている、 (2) 学習率が大きすぎて 1 ステップで重みが発散した、 (3) softmax の出力が 0 になり cross-entropy で log(0) が発生した。 対処順としてはまず X.isna().sum()、 (X==0).sum() で入力を点検し、 次に学習率を 1/10 ずつ下げて確認、 最後に nn.LogSoftmax + nn.NLLLoss や nn.CrossEntropyLoss (内部で log-sum-exp トリックを使う)に置き換える、 という順番が定石。
また「train が良いのに val が悪い」過学習は、 NN の表現力に対しデータ量が足りていないサインだ。 SSDSE-B-2026 は 47 サンプルしかないので、 ちょっと深い NN を組むだけで容易に過学習する。 対処は (a) NN を浅くする、 (b) L2 正則化 (weight_decay) を入れる、 (c) Dropout を入れる、 (d) データ拡張、 (e) 早期終了の 5 つ。 47 サンプルの場合は (a) と (b) が最も効く。 これも誤差逆伝播そのものの問題ではなく、 勾配が「どこから来るか」を制御する問題、 という理解が大事。
最後に、 「勾配の数値検証」は誤差逆伝播の実装が正しいかを確認する最後の砦。 自前で backward を書いた場合、 数値微分 $\frac{f(w + \epsilon) - f(w - \epsilon)}{2\epsilon}$($\epsilon = 10^{-5}$)と自動微分の値を比較し、 相対誤差が $10^{-7}$ 以下なら OK。 これを怠ると、 1 文字違いの符号バグで「学習はするが微妙に違う方向に進む」という気づきにくい不具合を抱え続ける。 研究プロジェクトで論文を書く前には必ずこの検証を入れるのが、 機械学習エンジニアの作法だ。
さらに、 大規模モデルの時代になると勾配検証も 「サンプリングして部分的に検証する」戦略が主流になる。 GPT-3 のような 1750 億パラメータすべてを数値微分で確かめるのは現実的でない(1 つ確かめるのに forward 2 回必要)。 代わりに、 (i) 各層から数個ずつパラメータをランダムに選び勾配検証する、 (ii) Layer 単位で「入力→出力 Jacobian」を全体的に検証する、 (iii) 既知の入力に対し決められた出力が出るか整合性テストする、 という 3 段構えで実装の正しさを担保する。 「すべてを確かめるのは不可能でも、 系統的にサンプリングすれば不具合は検出できる」というのが、 大規模学習の品質保証の発想だ。
O. R644 拡張のまとめ
本拡張ブロックでは、 SSDSE-B-2026 という実際の都道府県データを使い、 誤差逆伝播を「数式 → 手計算 → numpy → PyTorch」と段階的に体験した。 重要な発見:
- 勾配は 入力の大きさに比例する → だから標準化が必須。
- bias を y の平均で初期化すると初期 loss が劇的に良くなる。
- 勾配ノルムは epoch とともに 0 に近づく → これが収束のシグナル。
- numpy 実装と PyTorch
loss.backward()は同じ値を出す → 自動微分はブラックボックスでない。 - 勾配消失・爆発・死んだ ReLU・鞍点という 4 つの病態を 勾配ノルムで監視することで早期に発見できる。
「誤差逆伝播」を 1 行のコードで使う段階から、 1 ステップずつ手で追える段階へ進めば、 後の発展(Transformer、 ResNet、 PEFT、 LoRA など)でつまずいた時に、 必ずここに戻って原因を切り分けられる。 ジャストインタイム型学習の本領は、 こうした「いつでも戻れる根本理解」を持っておくことにある。
🗺 概念マップ:誤差逆伝播 の知識ネットワーク
本サイト全体の 概念マップ の中で、 誤差逆伝播 がどの位置にあるかをテキストツリーで表現する。 視覚的なグラフは 概念マップページ を参照。
[ 深層学習 ]
  ├─ 誤差逆伝播 (本ページ)
  ├─ 関連手法・派生 → 「🌐 関連手法・派生」セクション
  ├─ 前提概念 → 「🔬 数式を言葉で読み解く」セクション
  └─ 派生領域 → 「🎓 深掘り(さらに)」シナリオ A/B/C
📌 全用語の俯瞰には 概念マップ を、 全用語一覧には 用語集トップ を参照してください。
🎯 最終まとめ:このページで学んだこと
- 30 秒結論で「誤差逆伝播 とは何か」を 1 文で言える
- 直感セクションで SSDSE-B-2026 を題材に具体例を掴んだ
- 数式 + 言葉で記号の意味を翻訳できる
- Python 実装を最小例 + 応用例の 2 段で試せた
- 落とし穴 8 個を知り、 自分の作業で予防策が打てる
- 3 シナリオ × 3 誤解 × 5 意思決定で、 「いつ使うか/使わないか」を判断できる
- 近接概念との比較で、 別手法との違いを言葉で説明できる
- 歴史・派生・体系的解説で、 上級者として「なぜこの設計か」を語れる
📌 本ページは ジャストインタイム型データサイエンス教育教材の一部。 一度通読する必要はなく、 必要なときに必要な節だけ読んで戻ってくる使い方を想定している。 「誤差逆伝播」の概念に詰まったら、 何度でもこのページに戻ってきてほしい。
🔢 数値例による手計算ウォークスルー
誤差逆伝播 を「コード任せ」にせず、 一度は手計算してみることで理解が定着する。 ここでは最小サイズのデータで、 値の動きを 1 ステップずつ追う。
数値例:2 入力 → 1 出力の最小 NN を手計算
入力 $x = (1.0, 2.0)$、 重み $w = (0.5, -0.3)$、 バイアス $b = 0.1$。 線形出力 $z = w \cdot x + b = 0.5 \cdot 1.0 + (-0.3) \cdot 2.0 + 0.1 = 0.0$。 活性化 $a = \sigma(z) = 1/(1+e^0) = 0.5$。 正解 $y = 1.0$。 損失 $L = (a - y)^2 = 0.25$。
| 記号 | 計算式 | 値 |
|---|---|---|
| $\frac{\partial L}{\partial a}$ | $2(a - y)$ | $2(0.5-1.0) = -1.0$ |
| $\frac{\partial a}{\partial z}$ | $a(1-a)$ (Sigmoid 導関数) | $0.5 \cdot 0.5 = 0.25$ |
| $\frac{\partial z}{\partial w_1}$ | $x_1$ | $1.0$ |
| $\frac{\partial L}{\partial w_1}$ | $\frac{\partial L}{\partial a} \cdot \frac{\partial a}{\partial z} \cdot \frac{\partial z}{\partial w_1}$ | $-1.0 \cdot 0.25 \cdot 1.0 = -0.25$ |
| $\frac{\partial L}{\partial w_2}$ | 同上 ($x_2 = 2$) | $-1.0 \cdot 0.25 \cdot 2.0 = -0.50$ |
学習率 $\eta = 0.1$ で 1 ステップ更新:$w_1 \to 0.5 - 0.1 \cdot (-0.25) = 0.525$、 $w_2 \to -0.3 - 0.1 \cdot (-0.50) = -0.25$。 損失が減る方向に動いていることが手計算で確認できる。 PyTorch の loss.backward() は内部でこれを行列演算で並列実行しているだけ。
❓ よくある質問(用語固有 10 連発)
汎用 FAQ 5 件に加えて、 誤差逆伝播 固有の質問 10 件を Q&A 形式でまとめた。 自分の状況に近いものから読んでほしい。
clip_grad_norm_(params, max_norm=1.0))。 LSTM の元論文は 1〜5、 Transformer 系は 1.0 が多い。 タスクで調整。torch.utils.tensorboard で add_histogram('grad/W1', model.fc1.weight.grad)。 各層の勾配ノルムが時間でどう変わるかを見ると、 消失・爆発が即座に分かる。torch.cuda.amp が自動化。gradient checkpointingで時間を増やす代わりにメモリを O(√L) に削減できる。🏋️ 演習問題(5 問)
学習の定着には、 自分の手を動かすのが一番。 SSDSE-B-2026 や実ログを題材に、 誤差逆伝播 を実践する 5 問を用意した。 答えは Python 実装セクションと数値例セクションを参考に組み合わせれば導ける。
- 演習 1:NumPy で 2-3-1 の MLP を実装し、 ReLU + MSE の手書き backward で勾配を計算せよ。
- 演習 2:PyTorch の
autogradと上の手書き勾配が一致することをtorch.allcloseで確認せよ。 - 演習 3:勾配消失を引き起こすため、 シグモイドで 10 層 NN を組み、
grad.norm()が 0 に収束する様子を観察せよ。 - 演習 4:
torch.nn.utils.clip_grad_norm_で勾配クリップを適用し、 適用前後で学習挙動を比較せよ。 - 演習 5:
torch.utils.checkpointを使って勾配チェックポイントの効果を、 メモリ使用量と計算時間で測れ。
📌 演習を解いて疑問が残ったら、 「よくある質問」セクションに戻るか、 リポジトリの「論文一覧」から類似研究を探して、 実コード (本サイトには 159 本の再現論文) を読むのが最速の理解への道。
🛠 デバッグ手順書
誤差逆伝播 を使った分析で「結果がおかしい」と感じたとき、 上から順に確認してほしい 7 ステップ。
- 入力データの shape / dtype / 欠損を
df.info()とdf.isna().sum()で確認 - 1 サンプルを取り出し、 期待通りの計算が行われているか手計算と一致するか
- 境界ケース(空テーブル、 1 行のみ、 全 NaN)でエラーが出ないか
- 乱数シードを固定し、 同じ結果が再現できるか
- 中間結果を
print()やloggingで確認、 想定値からズレるところを特定 - 単体テストを
pytestで書き、 1 関数ずつ動作確認 - それでもダメなら、 最小再現コード (MRE) を作って Stack Overflow / GitHub Issue / 教員に質問
📌 デバッグは経験値が物を言う領域。 上記 7 ステップを習慣化することで、 1 件の事故で学ぶことが何倍にも増える。
✅ 理解度セルフチェック(10 問)
本ページを読み終わったら、 以下の 10 問に □ チェックを入れて理解度を確認してほしい。 8 個以上 ✓ なら中級レベル、 全 10 個 ✓ なら他人に説明可能なレベル。
- □ 誤差逆伝播 を 1 文 (30 字以内) で説明できる
- □ 定義式 (or 主要式) を見て、 各記号の意味を言える
- □ なぜこの概念が生まれたか、 歴史的背景を 1 つ挙げられる
- □ Python での最小実装を写経でなく自力で書ける
- □ 落とし穴を 3 つ挙げ、 それぞれの予防策を言える
- □ 近接概念 (深層学習) との違いを言葉で説明できる
- □ いつ使い、 いつ使わないかを 3 つずつ言える
- □ 業務 KPI に翻訳して、 経営層に説明できる
- □ レポート・論文での書き方テンプレートを覚えている
- □ さらに深く学ぶための参考文献を 1 冊指せる
📌 チェックが付かない項目は、 該当セクションに戻って読み直してください。 「分かった気」と「分かっている」の境界を、 このリストで明確にします。
📖 専門用語ミニ辞書
本ページで頻出する周辺専門用語を、 1 行ずつ簡潔に。 ジャストインタイム的に、 必要なときだけ参照すれば良い。
- SSDSE
- 独立行政法人統計センターが提供する「教育用標準データセット」。 公的データを基に、 学生・教育機関が使いやすく整形。
- pandas
- Python の表データ操作ライブラリ。
DataFrame型が本ページのテーブル概念の主力実装。 - CV (Cross Validation)
- データを K 個に分割し、 K-1 個で学習・1 個で検証を K 回繰り返す。 性能評価の標準。
- 95% CI (信頼区間)
- 「真の値が含まれる範囲」を確率的に表現。 [L, U] の形で報告。
- p 値
- 帰無仮説の下で、 観測値以上の極端な結果が出る確率。 通常 0.05 未満で「有意」。
- OLS
- Ordinary Least Squares、 最小二乗法。 回帰の基本。
- SGD
- Stochastic Gradient Descent、 確率的勾配降下法。 ML の標準最適化アルゴリズム。
- RMSE / MAE
- 回帰評価指標。 Root Mean Squared Error / Mean Absolute Error。
- AUC
- Area Under Curve、 ROC 曲線下面積。 分類性能指標。
- A/B テスト
- 2 つのバージョンを並列実装し、 ランダムにユーザーに当てて効果を測る実験。
📑 本サイトで 誤差逆伝播 を使う論文(抜粋)
本サイトには 159 本の再現論文があり、 多くが 誤差逆伝播 を何らかの形で利用している。 関連論文を読みたい方は 論文一覧 から検索してほしい。
- SSDSE-B-2026 を使った 47 都道府県分析系 (約 30 本):誤差逆伝播 が基礎前提として登場
- 不登校・いじめ統計を扱う社会調査論文:データ前処理に 誤差逆伝播 を活用
- 機械学習・深層学習を使う論文:モデル評価・実装に 誤差逆伝播 が必須
- 因果推論・回帰分析を使う論文:データ整形・指標計算で 誤差逆伝播 を経由
📌 各論文は教育目的の再現実装で、 ハンズオン形式で読めるよう Jupyter Notebook 風の構成になっている。 「誤差逆伝播 を実際の研究でどう使うか」を 5 分で掴むには、 関連論文を 1 本流し読みするのが最速。
🤝 改善提案・誤り報告
本ページの内容に誤りや改善余地を見つけた場合、 リポジトリの Issue / Pull Request からご提案ください。 教材は みんなで育てるもの。
- 事実誤認・計算ミス:該当箇所のスクリーンショットと正しい情報をご提供ください
- 説明の改善:「ここが分かりにくかった」を具体的に教えてください
- 新しい落とし穴:自分が経験した事例を共有してください
- 新しい関連手法:見落としている派生概念があれば追加します
- 多言語化:英語・中国語等の翻訳協力を歓迎します
🍳 コード・クックブック(誤差逆伝播 編)
誤差逆伝播 を実務で使う際の頻出パターンを、 動くコードのレシピ集としてまとめた。 必要な料理 (タスク) だけを取り出して使ってほしい。
勾配ノルムを学習中にモニタ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import torch, torch.nn as nn model = nn.Sequential(nn.Linear(3,10), nn.ReLU(), nn.Linear(10,1)) opt = torch.optim.Adam(model.parameters(), lr=1e-3) x = torch.randn(47, 3) y = torch.randn(47, 1) for step in range(50): opt.zero_grad() loss = ((model(x) - y) ** 2).mean() loss.backward() # 各層の勾配ノルム norms = {n: p.grad.norm().item() for n,p in model.named_parameters() if p.grad is not None} if step % 10 == 0: print(step, 'loss', float(loss), 'grad norms', norms) opt.step() |
💬 x も y も torch.randn の乱数で seed を固定していないので、loss や勾配ノルムの値は実行のたびに変わる。この実行では loss が 1.127 から 40 step 目に 0.998 まで下がり、それに合わせて出力側 2.weight の勾配ノルムが 0.768 から 0.559(30 step 目)へ縮んだ。出力層の勾配が入力層 0.weight(0.23 前後)より 3 倍ほど大きく、層を遡るにつれて勾配が小さくなる様子が 2 層でも見える。
Gradient Clipping を 1.0 に
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | import torch, torch.nn as nn model = nn.GRU(input_size=3, hidden_size=8, num_layers=4) opt = torch.optim.Adam(model.parameters(), lr=1e-3) x = torch.randn(20, 47, 3) # seq_len=20 target = torch.randn(20, 47, 8) for step in range(100): opt.zero_grad() out, _ = model(x) loss = ((out - target) ** 2).mean() loss.backward() grad_norm = torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0) if step % 20 == 0: print(step, 'loss', float(loss), 'pre-clip norm', float(grad_norm)) opt.step() |
💬 4 層 GRU の clip 前の勾配ノルムは 0.421 から 80 step 目には 0.032 まで下がり、上限 max_norm=1.0 を一度も超えていないので、この実行ではクリッピングは何もしていない。target が乱数なので loss は 1.148 から 1.023 までしか下がらず、予測できない部分(分散 1)の手前で頭打ちになる。seed が無いため値は実行ごとに変わる。
混合精度 (AMP) で逆伝播を高速化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import torch, torch.nn as nn device = 'cuda' if torch.cuda.is_available() else 'cpu' model = nn.Sequential(nn.Linear(100, 1024), nn.ReLU(), nn.Linear(1024, 10)).to(device) opt = torch.optim.Adam(model.parameters(), lr=1e-3) scaler = torch.cuda.amp.GradScaler() if device == 'cuda' else None x = torch.randn(64, 100, device=device) y = torch.randint(0, 10, (64,), device=device) crit = nn.CrossEntropyLoss() for step in range(20): opt.zero_grad() with torch.cuda.amp.autocast(enabled=(device=='cuda')): loss = crit(model(x), y) if scaler is not None: scaler.scale(loss).backward() scaler.step(opt); scaler.update() else: loss.backward(); opt.step() print('done', float(loss)) |
💬 GPU が無い環境では device が cpu になり、GradScaler も autocast も使われない通常の学習として動く。10 クラスの乱数ラベル 64 件に対して、初期の loss は理論上 log 10 ≈ 2.30 前後になり、それが 20 step で 0.117 まで下がった。隠れ層 1,024 のモデルが 64 件を丸暗記しているだけで、汎化の指標ではない。seed が無いので最終値は実行ごとに変わる。
📌 すべてのレシピは「実データ前提・引数なし直書き」スタイル。 そのままコピペで動くよう設計したので、 まずは動かしてから読むのを推奨する。
🏁 最終結論:誤差逆伝播 を一言で
誤差逆伝播は、 1986 年の Rumelhart 論文から 40 年以上経った 2026 年現在も、 深層学習の 心臓部として動き続けている。 ChatGPT も画像生成 AI も自動運転 NN も、 すべてこの「連鎖律の機械的適用」の上に成り立つ。 本ページで学んだ (i) 連鎖律の理解、 (ii) 中間活性とメモリの関係、 (iii) 勾配消失・爆発の対策、 (iv) reverse-mode AD という大枠、 (v) Adam/SGD/勾配チェックポイントの選択を押さえれば、 「loss.backward() がエラーを返した時のデバッグ」が一気にできるようになる。
本ページは ジャストインタイム型データサイエンス教育の一部として、 必要なときに必要な節だけ読んでもらう設計になっている。 通読する必要はない。 自分の今いる場所 (卒論・実務・論文読解) に応じて、 該当セクションだけを参照し、 また論文や業務に戻ってほしい。 そして数か月後、 似たような状況に陥ったとき、 また戻ってきてくれれば、 教材として最高の使い方になる。
🙋 著者・教材設計について
本教材は、 広島工業大学 統計・データ解析コンペティション参加学生向けに、 松本伸平 (s.matsumoto.gk@cc.it-hiroshima.ac.jp) が監修・執筆した。 「論文を読む過程で出てきた専門用語を、 その場で 5 分で補完して論文に戻る」というジャストインタイム型の学習体験を目的に、 514 用語ページを統一フォーマットで整備している。
本ページ「誤差逆伝播」は 深層学習 カテゴリに属し、 同カテゴリ内の他用語と相互リンクされている。 用語間の関係性は 概念マップ でも俯瞰できる。
本サイトは SSDSE (教育用標準データセット, 独立行政法人統計センター) を主データとして使い、 「合成データ ではなく実公的データを使う」 を方針に据えている。 ハンズオン教材の質を最大化するための判断である。
🔗 隣接手法への橋渡し
誤差逆伝播 (Backprop) は連鎖律 ∂L/∂w = ∂L/∂y · ∂y/∂z · ∂z/∂w を計算グラフ上で自動微分するアルゴリズムで、 順伝播 → 損失計算 → 逆伝播 → 重み更新 のループを駆動する。
- 上流: ニューラルネットワークのフォワード計算と 活性化関数 (ReLU, Sigmoid, Softmax) — 各層の出力と中間値がメモリに保存され、 逆伝播で必要になる。
- 並列: 勾配降下法 (SGD, Adam, AdamW) — Backprop は勾配計算、 最適化器は勾配を使った重み更新で役割分担。 数値微分 (有限差分) は遅すぎて実用不可。
- 下流: 損失関数 (Cross-Entropy, MSE) からの誤差信号、 深層学習のあらゆる学習プロセス、 勾配消失・勾配爆発の診断と対策 (Batch Norm, Residual Connection)。
PyTorch の loss.backward() / TensorFlow の tape.gradient() が Backprop の API で、 これがなければ深層学習の学習は計算量的に不可能だった (1986 Rumelhart-Hinton-Williams が再発見、 ニューラルネット冬の時代を終わらせた革命)。
🌳 手法選択フロー
Backprop 実装の選択は「フレームワーク」「勾配安定性」「メモリ効率」の 3 軸で判定する。
- フレームワーク選択: PyTorch (動的計算グラフ、 研究で標準)・TensorFlow/JAX (静的グラフで XLA 高速化)・自作 (numpy で連鎖律実装、 学習目的のみ)。 現代の実務は PyTorch が 7 割。
- 勾配消失・爆発対策: Sigmoid 多段で消失 → ReLU/GELU に変更。 RNN で爆発 → Gradient Clipping (norm<=1.0)。 深層化で消失 → Residual Connection・Layer Norm・Batch Norm 導入。
- メモリ効率: 大規模モデル → Gradient Checkpointing (中間値を再計算、 メモリ 1/2 で計算 1.3 倍)・Mixed Precision (FP16/BF16)・ZeRO Optimizer (DeepSpeed)。 SSDSE-B-2026 規模なら通常 FP32 で十分。
「とりあえず Adam + ReLU + Residual」が現代の出発点。 Backprop は意識せずとも .backward() で動くが、 勾配統計 (torch.nn.utils.clip_grad_norm_) を監視して学習が止まる兆候を早期検出することが実務の重要技能。
🎮 触って理解する
下は 2 層スカラー NN の計算グラフです。 入力 $x$・重み $w_1,w_2$・バイアス $b_1,b_2$・目標 $t$ をスライダー(またはノードを直接ドラッグ/タップ)で動かすと、 各ノードの値(青)と 損失に対する勾配 $\partial L/\partial(\cdot)$(赤)が リアルタイムで再計算されます。 ネットワークは $z_1=w_1x+b_1 \to h=\sigma(z_1) \to z_2=w_2h+b_2 \to y=\sigma(z_2)$、 損失は $L=(y-t)^2$。 「順伝播」「逆伝播」ボタンで信号の流れる向きを、 「1ステップ更新」で勾配降下により損失が下がる様子を体感できます。
💡 直感:連鎖律 = 局所勾配の積
逆伝播の核心は 「各ノードは自分の局所勾配だけ知っていればよい」という点です。 例えば $h=\sigma(z_1)$ のノードは「自分の入力 $z_1$ が少し動いたら自分の出力 $h$ がどれだけ動くか」= 局所勾配 $\partial h/\partial z_1 = h(1-h)$ だけを知っています。 出力側から流れてきた勾配 $\partial L/\partial h$ に、 この局所勾配を掛けるだけで $\partial L/\partial z_1$ が求まり、 それをさらに上流へ渡します。 全体では
のように 局所勾配の積が鎖(chain)のように連なるだけ。 上のグラフで赤字の勾配は、 まさにこの積を右(出力)から左(入力)へ順に掛け算した結果です。 スライダーを動かして、 各項がどう変わるか確かめてください。
⚠️ よくある落とし穴:勾配消失 (vanishing gradient)
シグモイドの局所勾配 $\sigma'(z)=\sigma(z)(1-\sigma(z))$ は 最大でも 0.25($z=0$ のとき)で、 入力が大きい/小さいと $h$ が 0 か 1 に 飽和して局所勾配はほぼ 0 になります。 上のグラフで $w_1$ を大きくして $h$ を 1 に張り付かせると、 $h(1-h)\approx 0$ となり $\partial L/\partial w_1$ がほぼゼロ= その重みは学習が止まる様子が見えます。 層を重ねるとこの 0.25 以下の数が何度も掛け算され、 入力に近い層ほど勾配が指数的に小さくなる — これが深いネットワークで学習が進まない 勾配消失問題です。 対策は ReLU 系活性化(正領域の局所勾配が 1)、 残差接続、 バッチ/レイヤー正規化など。 逆に $w$ を極端に大きくすると勾配が膨れ上がる 勾配爆発も同じ仕組みで起こります。
🚀 発展:reverse-mode 自動微分としての逆伝播
逆伝播は reverse-mode 自動微分の一種で、 「出力(損失)が 1 個・入力(パラメータ)が多数」という NN の状況で圧倒的に効率的です。 順伝播で計算グラフと中間値を記録し、 逆向きに たった 1 回走査するだけで全パラメータの勾配が同時に求まります(計算量は順伝播の 2〜3 倍程度)。 現代の PyTorch では loss.backward() の 1 行がこの逆走査に対応します。 ただし中間活性をすべて保持する必要があるためメモリを消費し、 巨大モデルでは gradient checkpointing(中間値を捨てて必要時に再計算)でメモリと計算のトレードオフを取ります。 関連ページ: ニューラルネットワーク/活性化関数/勾配降下法/損失関数/深層学習。 (連鎖律・勾配消失の単独ページは現時点で未作成のため本ページ内で解説。)
🧭 解説深化:勾配を「読む」— 学習の外側から見た誤差逆伝播
ここまで本ページは、 誤差逆伝播を「パラメータを更新するための道具」として解説してきた。 この深化セクションでは視点を反転させ、 逆伝播が吐き出す勾配そのものを「読む」ことを主題にする。 実は、 学習開始直後の勾配は統計量(相関係数)と厳密に一致し、 学習後の入力勾配はモデル解釈や敵対的攻撃にまで繋がる。 「backward は学習の内部処理」という理解から一歩外に出るのが狙いだ。 数値はすべて data/raw/SSDSE-B-2026.csv(2023 年・47 都道府県、 encoding='cp932', skiprows=[1])を実際に読み込んで計算した実測値である。
💡 直感:最初の 1 ステップは「相関係数」を読んでいる
線形モデル $\hat{y} = \sum_j w_j x_j + b$ を MSE 損失で学習するとき、 重みをすべて 0、 バイアスを $\bar{y}$ で初期化すると、 入力を標準化していれば最初の backward が返す勾配は
となる($r_j$ は入力 $x_j$ と目的変数 $y$ の相関係数、 $\sigma_y$ は $y$ の標準偏差)。 つまり 誤差逆伝播の第 1 歩は、 各特徴量と目的変数の相関係数を機械的に読み取る操作そのものだ。 SSDSE-B-2026(2023 年・47 都道府県)で高齢化率(実在列 A1303÷A1101×100、 平均 31.59%、 標準偏差 3.302)を予測する設定で実測すると:
| 入力(標準化済み) | 高齢化率との相関 $r_j$ | 最初の勾配 $\partial L/\partial w_j$ | 最初の更新の向き |
|---|---|---|---|
| A1101 総人口 | −0.710 | +4.688 | 負の重みへ(人口が多いほど高齢化率は低い方向) |
| L3221 消費支出 | −0.306 | +2.023 | 負の重みへ |
| A4103 合計特殊出生率 | +0.201 | −1.330 | 正の重みへ(後述の落とし穴) |
検算すると $-2 \times (-0.710) \times 3.302 \approx +4.69$ で、 backward の実測値 +4.688 と一致する。 「NN の学習は相関分析から出発し、 epoch を重ねるほど非線形な補正が加わっていく」— この見方を持つと、 統計学と深層学習が同じ地面の上にあることが分かる。 次のコードで再現できる(出力は実測)。
1 2 3 4 5 6 7 8 9 10 | import pandas as pd
df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1])
d = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023年・47都道府県
y = d['A1303'] / d['A1101'] * 100 # 高齢化率(%) 実在2列から算出
cols = ['A1101', 'L3221', 'A4103']
X = (d[cols] - d[cols].mean()) / d[cols].std(ddof=0) # 標準化
for c in cols: # w=0, b=y.mean() での最初の勾配
g = -2 * (X[c] * (y - y.mean())).mean()
print(f'{c}: corr={d[c].corr(y):+.3f} first_grad={g:+.3f}')
print(f'mean={y.mean():.2f}% std={y.std(ddof=0):.3f}')
|
📤 実行結果(実測):
⚠️ 落とし穴(重要):勾配は「重要度」でも「因果」でもない
その 1:生スケールの勾配は 8 桁ずれる。 上の実験を標準化せずに行うと、 最初の勾配は A1101 で $+1.30 \times 10^{7}$、 L3221 で $+4.83 \times 10^{4}$、 A4103 で $-0.175$(いずれも実測)。 同じモデル・同じデータなのに勾配の桁が 8 桁違う。 1 つの学習率でこの 3 つを同時に更新するのは不可能で、 「A4103 の重みだけ実質学習が止まる」か「A1101 の重みだけ発散する」かの二択になる。 R644 拡張で述べた「標準化必須」の定量的な正体がこれだ。
その 2:勾配の符号を因果と誤読する。 上の表で A4103(合計特殊出生率)の重みは 正の方向に更新される。 素直に読むと「出生率が高いほど高齢化率が高い」— 明らかに因果としては変だ。 実際のデータを見ると、 高齢化率最高の秋田県(39.06%)の出生率は 1.10 と全国的には高めの水準、 最低の東京都(22.75%)の出生率は 0.99 と最低値。 つまり「地方は出生率も高齢化率も高く、 都市部は両方低い」という 都市・地方の交絡が符号を作っている(例外が沖縄県:出生率 1.60 で最高なのに高齢化率 23.84% で全国 2 番目の低さ)。 逆伝播はこの交絡ごと忠実に勾配へ写し取る。 勾配は「モデルの予測を最も速く変える方向」であって、 現実世界の因果効果ではない。
その 3:相関し合う入力の間で勾配は分配される。 総人口と消費支出のように入力同士が相関していると、 学習が進むにつれ「どちらの重みが誤差を引き受けるか」は初期値や学習率に依存して恣意的に決まる(重回帰の多重共線性と同じ構図)。 学習後の重みや勾配の大小を「特徴量重要度ランキング」としてそのまま報告するのは危険で、 摂動ベースの検証(入力を 1 つずつシャッフルして精度低下を見る等)との突き合わせが必要だ。
🚀 発展:$\partial L/\partial x$ — 入力側への逆伝播が開く応用
backward は重みだけでなく 入力に対する勾配 $\partial L/\partial x$ も同じ 1 回の逆走査で計算できる(PyTorch なら入力テンソルに requires_grad_(True) を付けるだけ)。 この「入力勾配」が 3 つの応用を開く。 (i) モデル解釈: 画像分類で $\partial(\text{出力スコア})/\partial(\text{画素})$ を可視化したものが saliency map で、 経路積分で安定化した Integrated Gradients、 CNN の特徴マップ勾配を使う Grad-CAM へと発展した(いずれも単独ページは未作成)。 (ii) 敵対的サンプル: FGSM は $x' = x + \varepsilon\,\mathrm{sign}(\nabla_x L)$、 つまり「損失が最も増える方向へ入力を微小に動かす」攻撃で、 学習に使うのと全く同じ backward を武器に転用したものだ。 (iii) プライバシー: 連合学習では勾配だけをサーバーに送るが、 勾配から元の学習データを復元する gradient inversion 攻撃が知られており、 「勾配はデータの情報を濃縮して運んでいる」ことの裏返しになっている。 — 本セクションの主題「勾配を読む」は、 解釈・攻撃・防御のすべてに通じる現代的テーマである。
🔗 関連ページ
- 相関 — 最初の勾配の正体。 標準化入力なら $\partial L/\partial w_j = -2 r_j \sigma_y$
- 標準化 — 生スケール勾配の 8 桁差を消す前処理
- 多重共線性 — 相関する入力間で勾配・重みが恣意的に分配される構図
- 因果関係 — 勾配の符号を因果と誤読しないための基礎
- 勾配降下法 — 読んだ勾配を「使う」側のアルゴリズム
- 説明可能AI (XAI) — 入力勾配ベースの解釈手法が属する分野
- SHAP — 勾配とは別系統の寄与分解。 突き合わせ検証の相棒
※ 敵対的サンプル・Grad-CAM・連合学習は本用語集に単独ページが無いため、 リンクせず本文中の解説に留めた。