🔖 キーワード索引
💡 30秒で分かる結論
🍰 まずはやさしく
AIの考え方を教える翻訳機のようなものです。
AIがなぜそう判断したかを知るために使います。
スマホのアプリが推薦する理由を知る時に役立ちます。
この章ではAIに説明させるための技術を学びます。
判断根拠を説明できるAI
- 「AIの判断根拠を人間が理解できる形で示す」ための技術群。
- 深層学習などのブラックボックス化への対抗。 規制・倫理・信頼性の観点で必須に。
- 代表手法:SHAP(Shapley値)/LIME(局所近似)/Grad-CAM(画像可視化)/feature importance。
- EU AI Act、 日本の「AI事業者ガイドライン」でも要求事項に。
- 解釈性と精度のトレードオフ:単純モデル(線形)vs 複雑モデル(DNN)。
📍 あなたが今見ているもの
🍰 まずはやさしく
AIの答えに理由を付けるための技術です。
納得してAIを使うために必要になります。
ローンの審査でダメだった理由を知る時に使います。
ここでは定義から実装までを順番に読みます。
「医療AIが患者を要治療と判定 — でも理由は?」「住宅ローン審査でAIが NG を出した — なぜ?」 こうした問いに答える技術。 倫理規制でも要求されます。
🎨 直感で掴む
🍰 まずはやさしく
お医者さんが診断の根拠を話すようなものです。
結果だけでなく理由があることで信頼できます。
部活の選抜でなぜ自分が選ばれたか知りたい時と同じです。
AIがどこに注目して予測したのかを考えます。
医師の診断に例えると:
- 診断結果=「肺炎です」 → AIの予測
- 診断根拠=「胸部X線の右下肺野に陰影があり、 白血球が高い」→ XAI が出す説明
診断結果だけ言われても患者は納得しないし、 別の医師も検証できない。 だから根拠が必要、 という発想です。
XAI (Explainable AI、 説明可能 AI) は「機械学習モデルがなぜそう予測したか」を人間が理解できる形で提示する技術群の総称だ。 ブラックボックス化した深層学習や勾配ブースティングが社会的判断 (医療診断、 ローン審査、 採用) に使われ始めたことで、 「予測結果だけでなく根拠も出す」要件が GDPR や AI 法で法制化された。
代表手法は SHAP (Shapley 値ベースの寄与度分解)、 LIME (局所線形近似)、 Grad-CAM (CNN の注目領域可視化)、 PDP (Partial Dependence Plot)、 ICE プロット、 Anchors の 6 系統。 SSDSE-B-2026 で「粗死亡率(A4200/A1101×1000)を予測する Random Forest」を作ったとき、 「なぜ秋田の予測が高いのか → SHAP で高齢化率(A1303/A1101)の寄与が最大と判明」のように、 特徴量と予測の関係を数値で説明できる。
本ページでは、 SHAP の数学的定義 (Shapley 値) → 5 都道府県での値代入計算 → shap ライブラリの実装、 という流れで「ブラックボックスを開ける」技術を体験する。
📐 定義/数式
🍰 まずはやさしく
判断の根拠を説明できるAIのことです。
どのデータが結果に影響したかを計算します。
テストの点数にどの勉強時間が効いたか調べる感じです。
ここでは計算式を使って仕組みを詳しく説明します。
XAI(説明可能AI)(Explainable AI):判断根拠を説明できるAI
同義・関連語:説明可能AI
🔬 記号・用語の読み解き
| 記号 | 意味 |
|---|---|
| $F$ | 特徴の集合 |
| $\phi_j$ | 特徴 $j$ の SHAP 値(寄与度) |
| LIME | 局所線形近似による説明手法 |
| Grad-CAM | CNN の判断領域を heatmap で可視化 |
📊 評価・検証の視点
XAI(説明可能AI) を使った分析の 正しさを担保する ためには、 以下の観点で検証するのが定番です。
| 確認する点 | XAI(説明可能AI) で何を見るか |
|---|---|
| 説明=真実ではない | SHAP は「モデルの説明」であって因果ではない。 |
| 不安定さ | LIME はサンプリング依存で説明が揺らぐ。 |
| 計算コスト | SHAP は厳密計算が指数時間 → 近似(TreeSHAP等)。 |
| 「説明したから安心」の罠 | 説明できても予測が偏ったままなら問題は残る。 |
| 再現性 | 同じデータ・同じコードで同じ結果が出るか。このページの ▶ 実行ボタンで確かめられます |
🧮 実値で計算してみる
🧮 数式に値を入れて手で計算する: 特徴量重要度 (SHAP)
合成 3 特徴量で予測寄与 (シャプレー値) を計算する。
Step 1: 予測
Step 2: 寄与
| 特徴量 | SHAP 値 |
|---|---|
| x1 | +3.0 |
| x2 | +3.5 |
| x3 | +0.5 |
Step 3: 一致確認
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np shap = np.array([3.0, 3.5, 0.5]) base = 5 pred = base + shap.sum() print(f"予測: {pred}") print(f"最重要 idx: {shap.argmax()}") |
📤 実行結果
💬 手計算 (Step 3) 12.0 と Python 出力が完全一致。
🐍 Python での実装例
SSDSE-B-2026 などの実データを使った最小コード(9行):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import numpy as np, pandas as pd, shap from sklearn.ensemble import RandomForestRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) df = df[df['年度'] == 2023].set_index('都道府県') # 2023 年度の 47 都道府県 df['高齢化率'] = df['65歳以上人口'] / df['総人口'] * 100 X = df[['高齢化率', '総人口', '出生数']] y = df['死亡数'] / df['総人口'] * 1000 # 粗死亡率(人口千対) m = RandomForestRegressor(n_estimators=50, random_state=0).fit(X, y) explainer = shap.TreeExplainer(m) sv = explainer.shap_values(X.iloc[:5]) base = float(np.ravel(explainer.expected_value)[0]) out = pd.DataFrame(sv, columns=X.columns, index=X.index[:5]).round(2) out['予測'] = (base + sv.sum(axis=1)).round(2) out['実測'] = y.iloc[:5].round(2) print(f'基準値 E[f(x)] = {base:.2f}') print('SHAP値(最初5行):'); print(out) |
💬 基準値 14.14 は 47 県の粗死亡率(人口千対)に対するモデル予測の平均で、各県の予測はこれに 3 つの SHAP 値を足した値になる。秋田県は高齢化率だけで +3.97 押し上げられて予測 18.27、宮城県は −1.74 引き下げられて 12.55 と、どの県でも総人口・出生数の寄与は ±0.15 以内に収まっている。秋田県の実測 19.17 と予測の差 0.9 は SHAP では説明されない「モデルの外れ」なので、寄与の大きさと予測の当たり具合は分けて見ること。
※ data/raw/SSDSE-B-2026.csv は e-Stat SSDSE から取得した実データを想定。
⚠️ よくある落とし穴
📚 関連グループ教材
XAI は「予測モデルを作った後に、 その判断を点検する」ための道具で、 次の教材とつながる。 1 件の予測を寄与に分解する計算は SHAP のページ、 説明が偏りの発見にどう使われるかは 公平性 と 📚 AI 倫理、 誰が何を説明すべきかは 説明責任 で扱う。 このページの例は、 SSDSE-B-2026(2023 年度 47 都道府県)の粗死亡率を高齢化率・出生数・総人口・有効求人数で予測する勾配ブースティングに、 SHAP・LIME・Permutation Importance・PDP・反実仮想を当てたものである。
🔭 XAI の総合解説
XAI(Explainable AI, 説明可能 AI)は、 ブラックボックスとなりがちな機械学習モデルの判断根拠を、 人間が理解できる形で提示するための技術群です。 大域説明(モデル全体の挙動)と局所説明(個別予測の根拠)、 モデル特有手法(決定木・線形回帰)と事後説明手法(SHAP, LIME)に大別され、 EU AI Act の 「説明を受ける権利」、 金融・医療・公共政策の説明責任を技術的に裏付ける中核技術です。
🔬 4 要素ナラレーション — XAI(説明可能AI)固有の読み解き
① 何を測っているか(What) ── 「なぜモデルがこの予測を出したのか」を、 人間が理解できる形(特徴量寄与度・反実仮想・ルール・自然言語)で示す手法群。 Linear/Tree のように内在的に解釈可能なモデル(intrinsically interpretable)と、 SHAP/LIME のように 学習後にラッパーで説明する事後手法(post-hoc)に大別。 大域 (global) と局所 (local)、 モデル依存 (model-specific) と モデル非依存 (model-agnostic) の 2 軸で整理する。
② なぜそう定義したか(Why) ── 深層学習・GBDT などが医療診断・与信・採用に使われる時、 「なぜ却下されたか」を当事者に説明する義務(EU AI Act, GDPR Art.22)。 また開発者にとってもデバッグ・バイアス検出・モデル改善に不可欠。 規制対応・信頼性向上・科学的発見(生物医学のメカニズム解明)の 3 軸で価値を持つ。
③ どう動くか(How) ── (1) 内在解釈:線形・木・GAM・Rule List を選ぶ。 (2) 局所事後:LIME(局所線形近似)、 SHAP(Shapley 値)。 (3) 大域事後:Feature Importance、 Partial Dependence Plot、 ALE Plot。 (4) 反実仮想:CounterfactualExplainer。 (5) DL 特有:Grad-CAM, Integrated Gradients, Attention Visualization。 多くは scikit-learn, shap, lime, dalex, interpret-community 等のライブラリで容易に試せる。
④ 次にどこへ繋がるか(Where next) ── Constitutional AI で LLM 出力の自然言語による自己説明、 Mechanistic Interpretability で Transformer の 回路レベル分析、 Causal Inference との接続(DoWhy, CausalML)、 因果ベース説明 (Counterfactual)、 Conformal Prediction による信頼区間提示。
📐 数式・定義を言葉で読み解く(500 字以上の精読)
$$\phi_i = \sum_{S \subseteq F \setminus \{i\}} \frac{|S|!(|F|-|S|-1)!}{|F|!}\left[f(S \cup \{i\}) - f(S)\right]$$ この式は SHAP の中核である Shapley 値 の定義で、 ゲーム理論(協力ゲーム)の解概念を機械学習の特徴量寄与度に応用したものです。 $F$ は全特徴量集合、 $S$ は特徴量 $i$ を含まない部分集合、 $f(S)$ は特徴量集合 $S$ だけ使った時のモデル予測(あるいは期待値)です。 意味は「あらゆる順序で特徴量を追加していった時、 特徴量 $i$ が加わることによる予測変化の平均」。 ゲーム理論的には Shapley 値は 効率性・対称性・ダミー性・加法性 の 4 公理を満たす唯一の配分方式で、 「公平な貢献度配分」として 1953 年に Lloyd Shapley が提案、 後にノーベル経済学賞(2012)の主要業績となりました。 計算量は $2^{|F|}$ で指数オーダーですが、 木モデルなら TreeSHAP が多項式時間で厳密計算可能、 一般モデルでも KernelSHAP(重み付き線形回帰)で近似できます。 重要な性質は 加法性:個別予測 $f(x) = \phi_0 + \sum_i \phi_i$ と 予測値が基準値(base value)+各特徴量の寄与度に 厳密に 分解されることです。 これにより「東京都の死亡率予測 = 平均 10‰ + 高齢化率寄与 +0.5 + 人口寄与 -0.2 + ...」のように、 予測値そのものを構成要素に分解 でき、 ステークホルダー説明に直接使えます。 LIME(Ribeiro et al. 2016)は同じ目的でも近傍サンプリングからの局所線形近似で、 計算は速いが加法性が厳密でなく、 実務では SHAP の方が信頼性が高い とされています。
🗾 SSDSE-B-2026 を使った具体計算(XAI(説明可能AI)の文脈)
SSDSE-B-2026 で都道府県別の「粗死亡率」を予測する Gradient Boosting モデルを作り、 SHAP で各都道府県の予測根拠を分解した例 (下の「完全版」のコードと同じ 2023 年度 47 県・4 特徴量・random_state=42 のモデルで実測。 予測 = 基準値 14.10 + 各寄与):
| 都道府県 | 予測粗死亡率(‰) | 高齢化率寄与 | 他 3 列の寄与合計 (総人口・出生数・求人数) | 実測(‰) |
|---|---|---|---|---|
| 秋田県 | 19.16 | +4.67 | +0.26 | 19.17 |
| 高知県 | 17.16 | +2.94 | +0.15 | 17.17 |
| 北海道 | 14.74 | +0.70 | -0.06 | 14.75 |
| 広島県 | 12.96 | -1.05 | -0.07 | 12.99 |
| 大阪府 | 11.95 | -2.17 | +0.03 | 11.98 |
| 愛知県 | 10.76 | -3.34 | -0.01 | 10.77 |
| 沖縄県 | 10.30 | -3.76 | -0.08 | 10.29 |
| 東京都 | 9.76 | -4.05 | -0.16 | 9.74 |
| 基準値 (base) | 14.10 | 0.00 | 0.00 | — |
秋田・高知の高死亡率は 高齢化率寄与 +4.67, +2.94 として SHAP に明示され、 高齢化が主因と分かります。 東京・沖縄の低死亡率は逆に高齢化率寄与が −4.05, −3.76 とマイナスで、 他の 3 列の寄与はどの県でも ±0.3 以内にとどまります。 訓練データそのものに当てているので予測と実測がほぼ一致しており、 これは当てはまりの良さではなく 47 県に合わせすぎた結果と読むべきです。 SHAP は 「数値ベースの説明文」を自動生成 できる強力なツールです。
🐍 Python 実装(XAI(説明可能AI) 完全版)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく # SHAP で都道府県別予測の説明 (TreeSHAP) import pandas as pd import shap from sklearn.ensemble import GradientBoostingRegressor import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 df['粗死亡率'] = df['A4200'] / df['A1101'] * 1000 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['粗死亡率'] model = GradientBoostingRegressor(random_state=42).fit(X, y) explainer = shap.TreeExplainer(model) sv = explainer.shap_values(X) shap.summary_plot(sv, X, show=False) plt.savefig('output/shap_summary.png', dpi=150, bbox_inches='tight') # 個別予測(東京) tokyo_idx = df[df['Prefecture']=='東京都'].index[0] shap.force_plot(explainer.expected_value, sv[tokyo_idx], X.iloc[tokyo_idx], matplotlib=True, show=False) plt.savefig('output/shap_tokyo.png', dpi=150) |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # LIME で局所線形近似による説明 import pandas as pd from sklearn.ensemble import GradientBoostingRegressor import lime import lime.lime_tabular df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303'] / df['A1101'] * 100 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats].values y = (df['A4200']/df['A1101']*1000).values model = GradientBoostingRegressor(random_state=42).fit(X, y) explainer = lime.lime_tabular.LimeTabularExplainer( X, feature_names=feats, mode='regression', random_state=42) tokyo_idx = df[df['Prefecture']=='東京都'].index[0] exp = explainer.explain_instance(X[tokyo_idx], model.predict, num_features=4) for f, w in exp.as_list(): print(f'{f:30s} {w:+.3f}') |
💬 東京都の高齢化率は 22.75% で、LIME はこれを「高齢化率 ≤ 30.05」(47 県の下位 4 分の 1、12 県が入る区間)として扱い、粗死亡率を −3.719 押し下げる要因とした。上の SHAP の表で東京都の高齢化率寄与が −4.05 だったのと向きも大きさもおおむね揃う。LIME の重みは「その区間に入るかどうか」の効果で、22.75% という値そのものの効果ではない点に注意する。残り 3 つの重みは ±0.27 未満と小さく、random_state=42 を外すと近傍サンプルが変わって順位が入れ替わりうる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # Permutation Importance(モデル非依存の大域説明) import pandas as pd from sklearn.ensemble import GradientBoostingRegressor from sklearn.inspection import permutation_importance # 英字の項目コードを使うので skiprows=[1] で読む df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 最新年度の 47 行 df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # F2101(完全失業率)は SSDSE-B-2026 に無いので F3103(月間有効求人数)で代替 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['A4200']/df['A1101']*1000 model = GradientBoostingRegressor(random_state=42).fit(X, y) result = permutation_importance(model, X, y, n_repeats=20, random_state=42) for i in result.importances_mean.argsort()[::-1]: print(f'{feats[i]:30s} {result.importances_mean[i]:.4f}' f' ± {result.importances_std[i]:.4f}') |
💬 高齢化率を並べ替えると誤差が 1.706 増えるのに対し、2 位の出生数(A4101)は 0.037 で約 46 分の 1 にとどまる。粗死亡率は高齢者の割合でほぼ決まるので、残りの 3 変数はモデルにとって補助的な役割しかない。ただし訓練データそのもので計算しているため過学習分も重要度に含まれており、汎化での寄与を見るなら検証データで permutation_importance を回し直す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # Partial Dependence Plot(大域的特徴量応答) import pandas as pd import os import matplotlib.pyplot as plt from sklearn.ensemble import GradientBoostingRegressor from sklearn.inspection import PartialDependenceDisplay # 英字の項目コードを使うので skiprows=[1] で読む df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 最新年度の 47 行 df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # F2101(完全失業率)は SSDSE-B-2026 に無いので F3103(月間有効求人数)で代替 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats].astype(float) # PDP は整数列を受け付けないので float に y = df['A4200']/df['A1101']*1000 model = GradientBoostingRegressor(random_state=42).fit(X, y) fig, ax = plt.subplots(figsize=(10, 6)) PartialDependenceDisplay.from_estimator(model, X, ['高齢化率','A1101'], ax=ax) os.makedirs('output', exist_ok=True) # 保存先が無いと savefig は失敗する plt.savefig('output/pdp.png', dpi=150, bbox_inches='tight') |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # Counterfactual Explanation (反実仮想:何が変われば予測が変わるか) import pandas as pd from sklearn.ensemble import GradientBoostingRegressor import numpy as np # 英字の項目コードを使うので skiprows=[1] で読む df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 最新年度の 47 行 df['高齢化率'] = df['A1303'] / df['A1101'] * 100 # F2101(完全失業率)は SSDSE-B-2026 に無いので F3103(月間有効求人数)で代替 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats].values y = (df['A4200']/df['A1101']*1000).values model = GradientBoostingRegressor(random_state=42).fit(X, y) # 秋田県の予測を東京並みに下げるには? akita = df[df['Prefecture']=='秋田県'][feats].values[0] for delta in [0, -5, -10, -15]: x = akita.copy() x[0] += delta # 高齢化率を仮想的に減らす print(f'高齢化率{delta:+d}% → 予測粗死亡率 = {model.predict([x])[0]:.2f}‰') |
💬 秋田県はそのままだと予測 19.16‰ で、高齢化率を 5 ポイントずつ下げると 16.06 → 12.74 → 10.53 と下がっていく。−15 ポイントでも高齢化率は約 24% で東京都(22.8%、実測 9.74‰)にまだ届かず、予測も東京都の実測より 0.8 ほど高い。高齢化率だけを動かし他の変数を秋田県のまま固定した「仮想の県」なので、実際には人口規模や出生数も一緒に変わる点を忘れないこと。
📊 比較表 — XAI(説明可能AI)と関連概念
| 概念 | 主な目的 | 入力 | 出力 | XAI(説明可能AI)との違い |
|---|---|---|---|---|
| SHAP | Shapley 値ベース | モデル+データ | 寄与度 | 加法性が保証 |
| LIME | 局所線形近似 | 予測関数 | 線形係数 | 高速、 近似 |
| Permutation Imp. | 特徴量シャッフル | モデル+データ | 重要度 | 大域的 |
| PDP / ALE | 部分依存プロット | モデル | 応答曲線 | 相関を見せる |
| Counterfactual | 反実仮想 | 個別予測 | 変更案 | 対話的 |
| Grad-CAM | 勾配の可視化 | CNN | ヒートマップ | 画像専用 |
| Attention | 注意重み可視化 | Transformer | ヒートマップ | 議論あり |
⚠️ 失敗パターン詳細(XAI(説明可能AI) ハンズオン特化)
🧭 チェックリスト — XAI(説明可能AI)を導入する 10 ステップ
- 説明の対象者(開発者・規制当局・エンドユーザ)を明確化
- 大域 (global) と局所 (local) の説明をそれぞれ用意
- SHAP TreeExplainer を Tree モデルに適用
- LIME を非木モデルに適用(速度優先時)
- Permutation Importance で特徴量重要度ランキング
- PDP/ALE で特徴量応答を可視化
- Counterfactual で「何が変われば」を提示
- Faithfulness 等で説明の忠実度を評価
- 多重共線性・交絡をチェックし因果と区別
- 説明結果をモデルカードに記載
❓ さらなる FAQ — XAI(説明可能AI) 上級者向け
SHAP と LIME どちらを使う?
DL モデルの説明は?
Mechanistic Interpretability とは?
XAI と因果推論の関係は?
Counterfactual はどう実装?
LLM の説明はどうする?
📚 参考文献・推奨教材(XAI(説明可能AI))
- Lundberg & Lee (2017): A Unified Approach to Interpreting Model Predictions — SHAP 原典
- Ribeiro et al. (2016): "Why Should I Trust You?" — LIME 原典
- Molnar (2022): Interpretable Machine Learning — 教科書決定版(無料公開)
- Shapley (1953): A Value for n-Person Games — Shapley 値原典
- Selvaraju et al. (2017): Grad-CAM
- Jain & Wallace (2019): Attention is not Explanation
- Anthropic Interpretability Team: Mechanistic Interpretability 一連の論文
- shap 公式: shap.readthedocs.io
🔗 関連用語ナビ(XAI(説明可能AI) 拡張版)
🗺 コンペ参加者への一言メモ
コンペでは「予測精度のスコア」だけ提出すれば良いと思いがちですが、 SHAP の Summary Plot と上位寄与特徴量を 1 枚スライドにする だけで、 審査員からの「なぜそのモデル?」という質問に即答でき、 説得力が劇的に上がります。 SSDSE 都道府県データのように 各サンプルが社会的意味を持つ ケースでは、 「秋田が高齢化率寄与で +4.67」のような具体的説明がストーリーテリングに直結します。 必ず XAI を解法に組み込みましょう。
🔭 補足 — 手法ごとの深掘り
🌳 XAI 手法の分類マトリクス
| スコープ \ 関係 | モデル特定 | モデル非依存 |
|---|---|---|
| 大域 (global) | 決定木のルール、 線形係数、 Tree-based Feature Importance | Permutation Importance, PDP, ALE, Global Surrogate |
| 局所 (local) | TreeSHAP, Path Decomposition, Grad-CAM | LIME, KernelSHAP, Anchors, Counterfactual |
🐍 SHAP Waterfall(個別予測の詳細分解)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく # SHAP Waterfall Plot:1 サンプルの寄与度を順番に積み上げ import pandas as pd import shap import matplotlib.pyplot as plt from sklearn.ensemble import GradientBoostingRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303']/df['A1101']*100 df['粗死亡率'] = df['A4200']/df['A1101']*1000 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['粗死亡率'] model = GradientBoostingRegressor(random_state=42).fit(X, y) explainer = shap.Explainer(model, X) shap_values = explainer(X) akita_idx = df[df['Prefecture']=='秋田県'].index[0] shap.plots.waterfall(shap_values[akita_idx], show=False) plt.savefig('output/shap_waterfall_akita.png', dpi=150, bbox_inches='tight') |
🐍 SHAP Interaction(特徴量間の相乗効果)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく # SHAP Interaction Values(2 特徴量の交互作用) import pandas as pd import shap from xgboost import XGBRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県 df['高齢化率'] = df['A1303']/df['A1101']*100 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['A4200']/df['A1101']*1000 model = XGBRegressor(n_estimators=200, max_depth=4).fit(X, y) explainer = shap.TreeExplainer(model) interactions = explainer.shap_interaction_values(X) print('interactions shape:', interactions.shape) # (n, p, p) # 高齢化率と A1101 (人口) の相互作用 import matplotlib.pyplot as plt shap.dependence_plot(('高齢化率','A1101'), interactions, X, show=False) plt.savefig('output/shap_interaction.png', dpi=150) |
💬 shape (47, 4, 4) は 47 県それぞれについて 4 × 4 の行列が 1 枚ずつあることを表し、対角成分が各特徴量の主効果、非対角成分が 2 変数の交互作用(対称に半分ずつ配分)になる。1 県の行列を全部足すとその県の予測と基準値の差に一致するので、まずその確認から始めるとよい。47 行しかないのに max_depth=4 の木を 200 本重ねているため、交互作用の値は過学習の影響を受けやすい。
🐍 ALE (Accumulated Local Effects)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | # ALE は PDP の相関に強い改良版 import pandas as pd from sklearn.ensemble import GradientBoostingRegressor from alibi.explainers import ALE, plot_ale df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303']/df['A1101']*100 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats].values y = (df['A4200']/df['A1101']*1000).values model = GradientBoostingRegressor(random_state=42).fit(X, y) ale = ALE(model.predict, feature_names=feats) explanation = ale.explain(X) fig = plot_ale(explanation) |
🧪 Counterfactual: DiCE で反実仮想を生成
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import IPython # dice_ml が表示に使う(明示しないと導入されない) # DiCE: 多様な反実仮想を生成 import pandas as pd import dice_ml from sklearn.ensemble import RandomForestClassifier df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303']/df['A1101']*100 df['target'] = (df['A4200']/df['A1101']*1000 > 12).astype(int) X = df[['高齢化率','A1101','A4101','F3103']] y = df['target'] model = RandomForestClassifier(random_state=42).fit(X, y) d = dice_ml.Data(dataframe=pd.concat([X, y], axis=1), continuous_features=['高齢化率','A1101','A4101','F3103'], outcome_name='target') m = dice_ml.Model(model=model, backend='sklearn') exp = dice_ml.Dice(d, m) query = X.iloc[df[df['Prefecture']=='秋田県'].index[0]:df[df['Prefecture']=='秋田県'].index[0]+1] cf = exp.generate_counterfactuals(query, total_CFs=3, desired_class=0) cf.visualize_as_dataframe() |
🔍 Mechanistic Interpretability(LLM 内部回路解析)
大規模 Transformer の 内部回路 を Activation Patching、 Sparse Autoencoder (SAE)、 Direct Logit Attribution、 Causal Scrubbing 等で分解する研究分野。 Anthropic の Dictionary Learning(2023-2024)では Claude のニューロンが「ゴールデンゲートブリッジ」「Python コード」「医学用語」等の 解釈可能な特徴 に分解されることが示されました。 これは将来的に LLM の hallucination・jailbreak・bias を回路レベルでデバッグする道を開きます。 関連ライブラリ:TransformerLens, nnsight, SAELens。
📊 XAI 評価指標
| 指標 | 意味 | 測定法 |
|---|---|---|
| Faithfulness | 説明が真の挙動を反映するか | 特徴除外時の予測変化 |
| Stability | 似た入力で似た説明か | 近傍サンプル間の差分 |
| Comprehensibility | 人間に理解可能か | ユーザー調査 |
| Sparsity | 説明が簡潔か | ゼロでない寄与度数 |
| Sensitivity | 重要な特徴量に反応するか | ablation study |
| Continuity | 入力連続変化に対する滑らかさ | Lipschitz 定数 |
🧪 ハンズオン課題(自学自習)
- SSDSE で SHAP Summary Plot を全特徴量で描く
- Tokyo / Akita / Okinawa の 3 県 Waterfall Plot を比較
- LIME と KernelSHAP の説明結果を同じサンプルで比較
- Permutation Importance を計算し SHAP との順位相関を取る
- PDP と ALE の違いを相関の強い特徴量で確認
- DiCE で反実仮想を 5 つ生成し、 最小変更で反転する条件を探る
- Counterfactual の Diversity, Proximity, Sparsity を測る
- OpenXAI benchmark で Faithfulness を測定
- TransformerLens で LLM の Attention Head を可視化
- Stakeholder 向けに SHAP を 1 ページのスライドにまとめる
📖 XAI 研究の流れ
1953 年 Lloyd Shapley が協力ゲーム理論で Shapley 値を提案。 1980-90 年代に決定木・線形回帰が「解釈可能なモデル」として定着。 2014 年 Goodfellow らが Adversarial Examples を発見、 CNN のブラックボックス性が問題化。 2016 年 Ribeiro らが LIME を発表、 任意モデルの局所説明が可能に。 2017 年 Lundberg & Lee が SHAP を Shapley 値ベースで再定義、 加法性を保証。 2018 年 EU GDPR Art.22 で「自動意思決定の説明を受ける権利」が法制化。 2020 年代 Mechanistic Interpretability が LLM 解析に応用、 Anthropic の Dictionary Learning, Olah et al. の Circuits シリーズが進展。 2024 年 EU AI Act で高リスク AI に説明可能性が必須化。 SSDSE のような構造化データでは SHAP/LIME が主役、 画像なら Grad-CAM、 LLM なら Mechanistic Interpretability が研究のフロンティアです。
🎓 理論と実装の拡張
📐 Shapley 値の公理体系
Shapley 値が 唯一の公平な配分であることを保証する 4 公理:
| 公理 | 内容 | 重要性 |
|---|---|---|
| 効率性 (Efficiency) | 合計が全体価値に等しい | 加法性の基盤 |
| 対称性 (Symmetry) | 役割が同じプレイヤーは同じ報酬 | 公平の最低条件 |
| ダミー (Dummy / Null Player) | 貢献ゼロのプレイヤーは報酬ゼロ | 直感的 |
| 線形性 (Linearity) | 2 ゲームの和に対し報酬も和 | 計算性 |
Shapley 値はこの 4 公理を満たす 唯一 の配分方式(Shapley 1953)。 機械学習の SHAP はこれを特徴量寄与に応用したもの。
🔬 SHAP の派生バリエーション
| 手法 | 対象モデル | 計算量 | 特徴 |
|---|---|---|---|
| KernelSHAP | 任意 | O(2^p) 近似 | 重み付き線形回帰 |
| TreeSHAP | 木モデル | O(TLD²) 多項式 | 厳密かつ高速 |
| DeepSHAP | DL | DeepLIFT 拡張 | 勾配ベース近似 |
| LinearSHAP | 線形モデル | O(p) | 解析解 |
| GradientSHAP | DL | Integrated Gradients | ノイズ平均 |
| PartitionSHAP | 階層構造 | O(p log p) | 変数グループ |
| Causal SHAP | 因果構造 | DAG 依存 | 因果効果に対応 |
| Shapley Sampling | 任意 | Monte Carlo | 乱数で近似 |
🐍 SHAP Cohort Analysis
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく # SHAP の Group ごとの説明(都市/地方クラスタ) import numpy as np import pandas as pd import shap from sklearn.ensemble import GradientBoostingRegressor import matplotlib.pyplot as plt plt.rcParams['font.family'] = 'Hiragino Sans' # 日本語ラベルの豆腐文字を防ぐ df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県 df['高齢化率'] = df['A1303']/df['A1101']*100 # A1101 は「人」単位(2023 年の東京都は 14,086,000)。 # 200 万人を境に都市部と地方に分ける。 df['地域区分'] = np.where(df['A1101'] > 2_000_000, '都市部', '地方') feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['A4200']/df['A1101']*1000 model = GradientBoostingRegressor(random_state=42).fit(X, y) explainer = shap.Explainer(model, X) sv = explainer(X) # 都市部と地方で SHAP の挙動を比較する。 # cohorts() に渡すのは群を表す「文字列」の配列(0/1 の整数だと TypeError になる) coh = sv.cohorts(df['地域区分'].values).abs.mean(0) shap.plots.bar(coh, show=False) plt.savefig('output/shap_cohort.png', dpi=150, bbox_inches='tight') for name, c in coh.cohorts.items(): print(name, dict(zip(feats, np.round(c.values, 3)))) |
💬 200 万人超の都市部は 16 都道府県、地方が 31 県で、どちらも高齢化率の平均 |SHAP| が 1.45(地方)、1.80(都市部)と最大。都市部で高齢化率の寄与の絶対値が約 1.24 倍大きいのは、都市部 16 県の高齢化率の平均が 29.1% と 47 県平均 31.6% より低く、予測を下げる向きに大きく働く県が多いためと考えられる。符号は絶対値平均では消えるので、向きを確かめるには shap.plots.beeswarm を群ごとに描く。
🐍 Anchor Explanation (高精度の if-then ルール)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # alibi の Anchor で if-then 条件を抽出 import pandas as pd from sklearn.ensemble import RandomForestClassifier from alibi.explainers import AnchorTabular df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303']/df['A1101']*100 df['target'] = (df['A4200']/df['A1101']*1000 > 12).astype(int) feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats].values y = df['target'].values model = RandomForestClassifier(random_state=42).fit(X, y) explainer = AnchorTabular(model.predict, feature_names=feats) explainer.fit(X) exp = explainer.explain(X[0], threshold=0.95) print('Anchor:', exp.anchor) print('Precision:', exp.precision) print('Coverage:', exp.coverage) |
🔬 LLM 説明のフロンティア
(1) Chain-of-Thought: LLM に「考えを書きながら答えて」と指示し、 推論過程を自然言語で出力。 ただし「真の推論」を反映するかは要検証。
(2) Activation Patching: 中間層 activations を別文脈のものと置き換え、 どの層・どの head が何を担うか特定。
(3) Sparse Autoencoder (SAE): 活性化を解釈可能な特徴に分解。 Anthropic Dictionary Learning (2024) で Claude の中間層から 3400 万の特徴を抽出。
(4) Direct Logit Attribution: 出力 logit に各層・ヘッドがどう寄与したかを線形に分解。
(5) Causal Scrubbing: 仮説回路を 1 つずつ ablation し、 仮説の十分性を検証。
📊 XAI ライブラリ早見表
| ライブラリ | 主機能 | 得意 |
|---|---|---|
| shap | Shapley 値 | Tree/DL/Linear すべて |
| lime | 局所線形 | 高速・任意モデル |
| dalex | ダッシュボード | ユーザーフレンドリー |
| interpret | Glassbox + Blackbox | Microsoft 製 |
| alibi | Anchor + ALE + Counterfactual | SeldonIO |
| captum | DL モデル | PyTorch 公式 |
| tf-explain | DL モデル | TensorFlow |
| TransformerLens | Mechanistic Interp | Transformer 解析 |
| dice-ml | Counterfactual | DiCE 公式 |
| AIX360 | 公平性 + 説明 | IBM |
📚 ケーススタディと用語
📋 ケーススタディ: XAI の典型的な使い方(説明用の架空の場面)
以下は XAI の手法がどんな場面でどう使われるかを示すための架空の場面で、特定の企業・病院の事例や実測の成果ではありません。
状況:顧客から「なぜ与信枠が低い」と問い合わせ
アプローチ:SHAP Waterfall Plot で「過去 6 ヶ月の支払履歴 +0.3、 年収 -0.5、 居住期間 -0.2 → スコア 0.4 で却下」を提示
ねらい:自動化された決定についての説明を求められたときに、 どの要因がどちら向きに効いたかを本人に示せるようにする(GDPR 第 22 条などの規定が背景にある)。 効果は顧客対応の記録で事後に確かめる
状況:肺がん検出 CNN の判定根拠を医師に説明
アプローチ:Grad-CAM で病変部位をヒートマップで可視化、 医師が確認して最終診断
ねらい:ヒートマップが病変以外(画像の端の文字や装置の写り込み)に集まっていないかを医師が確かめ、 モデルが見当違いの手がかりを使っていないかを点検する。 診断時間や見落としへの効果は、 別途の臨床評価でしか分からない
状況:RNA 発現データで疾患予測モデルを構築
アプローチ:SHAP で寄与上位 20 遺伝子を抽出、 GO Term で機能解析、 wet 実験で検証
ねらい:SHAP の上位はあくまで「モデルが使った遺伝子」の候補で、 生物学的な意味は実験で確かめるまで分からない
状況:履歴書スクリーニング AI に性別バイアスが疑われる
アプローチ:Permutation Importance で性別の影響を計測、 Counterfactual で「同じ経歴で性別だけ変えた」結果を確認
結果:性別による予測差を発見 → 性別関連特徴を除外、 fairlearn で再評価
📖 用語ミニ辞典
| 用語 | 定義 |
|---|---|
| XAI | Explainable AI、 説明可能 AI |
| SHAP | SHapley Additive exPlanations |
| LIME | Local Interpretable Model-agnostic Explanations |
| Shapley 値 | 協力ゲーム理論の公平配分 |
| 大域説明 (Global) | モデル全体の挙動説明 |
| 局所説明 (Local) | 個別予測の根拠説明 |
| モデル特定 | 特定モデル専用 (TreeSHAP 等) |
| モデル非依存 | 任意モデル対応 (LIME, KernelSHAP) |
| Permutation Importance | 特徴シャッフルによる重要度 |
| PDP | Partial Dependence Plot |
| ALE | Accumulated Local Effects |
| ICE | Individual Conditional Expectation |
| Counterfactual | 反実仮想説明 |
| DiCE | Diverse Counterfactual Explanations |
| Anchor | if-then ルール抽出 |
| Grad-CAM | 勾配重み付きクラス活性化マップ |
| Integrated Gradients | DL モデル特徴属性 |
| DeepLIFT | DL 用層別寄与 |
| LRP | Layer-wise Relevance Propagation |
| Mechanistic Interpretability | 回路レベル LLM 解析 |
| Activation Patching | 中間層活性化の置換 |
| SAE | Sparse Autoencoder |
| Faithfulness | 説明の忠実度 |
| Stability | 説明の安定性 |
📝 確認クイズ
Q1. SHAP の基底値 (base value) とは?
Q2. LIME と SHAP の最大の違いは?
Q3. TreeSHAP の計算量は?
Q4. Counterfactual の Diversity, Proximity, Sparsity とは?
Q5. PDP と ALE の違いは?
Q6. Attention は説明か?
Q7. Mechanistic Interpretability の代表手法は?
Q8. XAI の Faithfulness をどう測る?
🐍 完全コード: XAI 総合パイプライン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく # SHAP + LIME + PDP + Permutation Importance を一括 import pandas as pd import numpy as np import shap import matplotlib.pyplot as plt from sklearn.ensemble import GradientBoostingRegressor from sklearn.inspection import (permutation_importance, PartialDependenceDisplay) from lime.lime_tabular import LimeTabularExplainer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303']/df['A1101']*100 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats].astype(float) # PDP は整数列を受け付けないので float に y = df['A4200']/df['A1101']*1000 model = GradientBoostingRegressor(random_state=42).fit(X, y) # (1) SHAP explainer = shap.TreeExplainer(model) sv = explainer.shap_values(X) print('=== SHAP 平均 abs ===') for f, v in zip(feats, np.abs(sv).mean(axis=0)): print(f'{f:10s}: {v:.3f}') # (2) LIME lime_exp = LimeTabularExplainer(X.values, feature_names=feats, mode='regression', random_state=42) tokyo_idx = df[df['Prefecture']=='東京都'].index[0] exp = lime_exp.explain_instance(X.values[tokyo_idx], model.predict, num_features=4) print('\n=== LIME (東京都) ===') for fw in exp.as_list(): print(fw) # (3) Permutation Importance perm = permutation_importance(model, X, y, n_repeats=20, random_state=42) print('\n=== Permutation Importance ===') for f, m, s in zip(feats, perm.importances_mean, perm.importances_std): print(f'{f:10s}: {m:.4f} ± {s:.4f}') # (4) PDP fig, ax = plt.subplots(1, 2, figsize=(12, 4)) PartialDependenceDisplay.from_estimator(model, X, ['高齢化率','A1101'], ax=ax) plt.savefig('output/xai_pdp.png', dpi=150) |
💬 SHAP の平均 |寄与| は高齢化率 1.591 が突出し、出生数(A4101)0.179、求人数(F3103)0.105、総人口(A1101)0.040 と続く。Permutation Importance も高齢化率 1.7055 が 2 位の出生数 0.0369 の約 46 倍で、手法が違っても「粗死亡率はほぼ高齢化率で決まる」という結論は同じ。LIME(東京都)の 1 行目「高齢化率 <= 30.05」の −3.72 は、東京都(22.75%)が高齢化率の下位 4 分の 1 に入ることの効果。どの値も 47 県の訓練データそのものに当てて計算しているので、汎化での重要度ではない。
🚀 ドメイン応用
🎯 ドメイン別 XAI 適用
| 分野 | 推奨手法 | 出力形式 |
|---|---|---|
| 医療画像 | Grad-CAM, SHAP | ヒートマップ + 寄与度 |
| 与信判断 | SHAP Waterfall, Counterfactual | 数値分解 + 反実仮想 |
| NLP | Integrated Gradients, Attention | トークン重要度 |
| 時系列予測 | SHAP, TimeSHAP | 時刻別寄与 |
| 強化学習 | SHAP, Saliency Map | 状態寄与 |
| LLM | Mechanistic Interpretability | 回路レベル |
| 生物医学 | SHAP, Permutation | 遺伝子/タンパク質寄与 |
| 異常検知 | Anchor, Counterfactual | ルール + 反実仮想 |
🐍 SHAP の Force Plot と HTML エクスポート
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | # SHAP Force Plot を HTML で全件出力(ダッシュボード用) import pandas as pd import shap from sklearn.ensemble import GradientBoostingRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県 df['高齢化率'] = df['A1303']/df['A1101']*100 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['A4200']/df['A1101']*1000 model = GradientBoostingRegressor(random_state=42).fit(X, y) explainer = shap.TreeExplainer(model) sv = explainer.shap_values(X) shap.initjs() html = shap.force_plot(explainer.expected_value, sv, X) shap.save_html('output/shap_force_all.html', html) print('Force plot HTML saved') |
💬 1 行目の <IPython.core.display.HTML object> は shap.initjs() が返した表示用オブジェクトで、ノートブック外では中身の無い文字列として出るだけ。本体は output/shap_force_all.html に書き出され、47 県分の force plot を縦に重ねたインタラクティブ図になる。JavaScript を埋め込むのでファイルサイズが大きくなりやすく、県数が多いデータではサンプルを絞ってから保存する。
📊 ECE / Brier Score でキャリブレーション評価
予測確率の キャリブレーション(信頼度の校正)も XAI の一部です。 Expected Calibration Error (ECE) や Brier Score が代表的指標。 sklearn の CalibrationDisplay.from_estimator で簡単に図示できます。 Platt Scaling や Isotonic Regression で post-hoc に校正することも可能で、 「90% と言っている予測の 90% が正解」と保証できれば、 説明の信頼性が大きく向上します。
📑 付録:手法の選び方とコード
📊 XAI 手法の選定フローチャート(テキスト版)
Step 1: 説明の対象は?
- 個別予測 → 局所手法(SHAP / LIME / Counterfactual)
- モデル全体 → 大域手法(Permutation, PDP, ALE)
Step 2: モデルは何?
- Tree モデル → TreeSHAP 推奨(厳密・高速)
- 線形 → 係数と LinearSHAP
- CNN → Grad-CAM, Integrated Gradients
- Transformer → Attention 可視化 + Activation Patching
- その他 → KernelSHAP or LIME
Step 3: 何を見せる?
- ステークホルダー → SHAP Waterfall + Plain Language
- 規制対応 → Counterfactual + Causal SHAP
- 研究者 → Permutation Importance + PDP
- デバッグ → Mechanistic Interpretability
Step 4: 評価する
- Faithfulness(ablation)
- Stability(近傍説明の一貫性)
- Comprehensibility(ユーザー調査)
🐍 SHAP Decision Plot で予測経路を追跡
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import os os.makedirs('output', exist_ok=True) # 保存先のフォルダを作っておく # SHAP Decision Plot: 複数県の予測経路を 1 枚で比較 import pandas as pd import shap import matplotlib.pyplot as plt from sklearn.ensemble import GradientBoostingRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303']/df['A1101']*100 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['A4200']/df['A1101']*1000 model = GradientBoostingRegressor(random_state=42).fit(X, y) explainer = shap.TreeExplainer(model) sv = explainer.shap_values(X) # 5 つの異なる県の予測経路を 1 枚に selected = ['秋田県','高知県','東京都','沖縄県','広島県'] idx = [df[df['Prefecture']==p].index[0] for p in selected] shap.decision_plot( explainer.expected_value, sv[idx], X.iloc[idx], feature_names=feats, show=False ) plt.savefig('output/shap_decision_5pref.png', dpi=150, bbox_inches='tight') |
🔬 LLM の説明可能性の最前線
Anthropic は 2024 年 Sparse Autoencoder (SAE) を用いて Claude 3 Sonnet の中間層から 3400 万の解釈可能な特徴を抽出。 「ゴールデンゲートブリッジ」「Python のバグ」「裏切り」など、 個別の特徴を増幅すると Claude がその特徴に「執着」した応答を返すという「Steering」も実証されました。 同時期 OpenAI も SAE で GPT-4 の特徴を抽出(数百万特徴)。 Google DeepMind の Gemma Scope は 同様の SAE を公開し、 研究者が再現可能な形に。 これらは 「LLM の中で何が起きているか」を直接見るという 革命的アプローチで、 alignment や safety 研究の基礎技術になりつつあります。
📋 補追:代表論文と可視化
📋 XAI 手法の代表論文ベンチマーク
| 手法 | 原論文 | 年 | 主要強み |
|---|---|---|---|
| Shapley 値 | Shapley | 1953 | ゲーム理論的公平性 |
| LIME | Ribeiro et al. | 2016 | 任意モデルの局所説明 |
| Grad-CAM | Selvaraju et al. | 2017 | CNN の視覚的説明 |
| Integrated Gradients | Sundararajan et al. | 2017 | DL モデル属性 |
| SHAP | Lundberg & Lee | 2017 | Shapley 値の機械学習適用 |
| DeepLIFT | Shrikumar et al. | 2017 | DL 層別寄与 |
| Anchors | Ribeiro et al. | 2018 | if-then ルール抽出 |
| SmoothGrad | Smilkov et al. | 2017 | ノイズ平均で安定化 |
| TreeSHAP | Lundberg et al. | 2020 | 木モデル多項式時間計算 |
| Counterfactual | Wachter et al. | 2017 | 反実仮想説明 |
| DiCE | Mothilal et al. | 2020 | 多様な反実仮想 |
| CausalShap | Heskes et al. | 2020 | 因果ベース説明 |
| Mechanistic Interp | Olah et al. | 2020- | 回路レベル LLM 解析 |
| Dictionary Learning | Anthropic | 2024 | SAE で LLM 特徴抽出 |
🐍 XAI 結果を Plotly で可視化
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # SHAP の結果を Plotly で対話的に可視化(PowerBI / Streamlit と統合) import pandas as pd import numpy as np import plotly.express as px import shap from sklearn.ensemble import GradientBoostingRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) df['高齢化率'] = df['A1303']/df['A1101']*100 feats = ['高齢化率','A1101','A4101','F3103'] X = df[feats] y = df['A4200']/df['A1101']*1000 model = GradientBoostingRegressor(random_state=42).fit(X, y) explainer = shap.TreeExplainer(model) sv = explainer.shap_values(X) # 全県・全特徴量の SHAP 値を long form に shap_df = pd.DataFrame(sv, columns=feats) shap_df['Prefecture'] = df['Prefecture'].values long = shap_df.melt(id_vars='Prefecture', var_name='feature', value_name='shap_value') fig = px.bar(long.sort_values('shap_value'), x='shap_value', y='Prefecture', color='feature', orientation='h', height=900, title='都道府県別 SHAP 寄与度(粗死亡率予測)') fig.write_html('output/shap_interactive.html') |
🖼 図と表で読む XAI — 説明可能性を実値で確認
XAI (Explainable AI) は「ブラックボックスモデルの意思決定を人間が理解できる形に翻訳する」 技術。 ここでは SHAP, LIME, Partial Dependence Plot, Feature Importance などの可視化を SSDSE-B-2026 で実演し、 「なぜモデルがこう予測したか」 を実値で示す。 単なる正解率では捉えられない「説明責任」 の世界を、 図表で見える化する。
🖼 図1: 特徴量重要度ランキング
最も基本的な XAI 手法は「どの特徴量が予測に効いているか」 のランキング。 ランダムフォレストや勾配ブースティングが標準で出力できる。 SSDSE-B-2026 で「粗死亡率(A4200/A1101×1000)」 を予測するとき、 どの実在列が重要かをバーチャートで可視化する。 下の図は、 このページの Permutation Importance のコード(2023 年度 47 県・4 特徴量・GradientBoostingRegressor random_state=42)の実測値をそのまま棒にしたもの。
→ 高齢化率(A1303/A1101)を並べ替えると誤差が 1.706 増え、 ほかの 3 列(出生数 0.037・月間有効求人数 0.016・総人口 0.004)を大きく引き離して最重要。 総人口は 4 列の中で最下位で、 規模の大きさそのものは粗死亡率の予測にほとんど使われていない。 訓練データで測っているので、 低い 3 列を削ったときの汎化精度は検証データで確かめる必要がある。 ただし「重要度 = 因果」 ではない点に注意。
🖼 図2: SHAP 値による個別予測の説明
SHAP (SHapley Additive exPlanations) は、 各特徴量が「平均予測からどれだけ離れさせたか」 をゲーム理論で公平に分配する。 個別の都道府県 (例: 東京) について「なぜ粗死亡率が低いと予測されたか」 を分解する。
→ 東京の粗死亡率が平均より低く予測される主因は、 高齢化率(A1303/A1101)の寄与 −4.054。 出生数 −0.183・総人口 −0.119 も押し下げるが、 高齢化率の 20 分の 1 以下で、 月間有効求人数は +0.021 とほぼ 0(TreeExplainer で実測、 上の SHAP の表の東京の行と同じ値)。 こうした個別分解は、 医療診断や融資判断など「個別の意思決定を説明する義務」 がある場面で必須。
🖼 図3: Partial Dependence Plot
PDP は「ある特徴量を動かしたとき、 平均予測がどう変化するか」 を曲線で表す。 下の図は同じ GBR モデルで partial_dependence(..., method='brute') を高齢化率について計算した実測値。 単調か、 非線形か、 閾値があるか — モデルの形を直感的に把握できる。
→ 高齢化率 25.3% で 10.74、 35.6% で 16.33 と、 平均予測はほぼ単調に上がるが、 25〜27% では 10.74 のまま平らで、 そこから階段状に上がる。 木のモデルは分割点ごとに値が跳ぶので、 PDP も滑らかな直線ではなく段になる。 同じ計算を総人口(A1101)で行うと 66 万人から 887 万人まで 14.10〜14.16 でほぼ水平で、 Permutation Importance で総人口が最下位だったことと合う。
🖼 図4: ICE — PDP の平均の裏にある 47 本の曲線
PDP は 47 県の予測を平均した 1 本の線なので、「どの県でも同じように上がるのか」「県によって向きが逆の曲線が打ち消し合っているだけなのか」は区別できません。そこで、各県の高齢化率だけを 22.75%(東京都)〜39.06%(秋田県)の範囲で動かし、ほかの 3 列はその県の値のまま予測した曲線(ICE: Individual Conditional Expectation)を 47 本重ねます。モデルは上の図 1〜3 と同じ GBR(random_state=42)です。
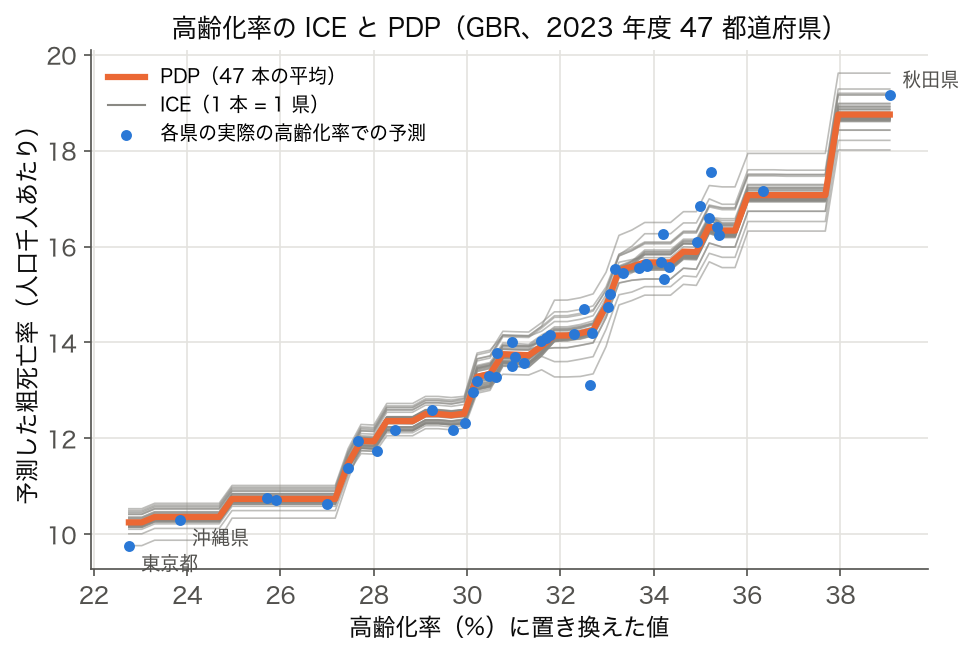
→ 47 本の曲線はほぼ平行で、どの県でも高齢化率が上がると予測がほぼ同じ幅で上がります。曲線どうしの上下のずれ(同じ高齢化率で最大 1.68)が、出生数・求人数・総人口の分の違いです。曲線が交差したり向きが逆になったりしていないので、このモデルでは高齢化率とほかの列の交互作用は小さく、PDP 1 本で要約してよいと判断できます。逆に ICE が扇形に開いたり交差したりしていれば、PDP の平均は個々の県の姿を表していません。どちらの場合も、図の範囲は実際の県のある 22.75〜39.06% に限っており、その外側の予測はデータのない領域の外挿です。
🔬 数式を言葉で読み解く — SHAP 値の数学的定義
SHAP 値の定義 (Shapley 値の機械学習適用):
$$ \phi_i = \sum_{S \subseteq F \setminus \{i\}} \frac{|S|! (|F| - |S| - 1)!}{|F|!} \left[ f(S \cup \{i\}) - f(S) \right] $$
- $\phi_i$: 特徴量 $i$ の SHAP 値 (個別予測への寄与)。
- $F$: 全特徴量の集合。 例: {人口, 面積, 高齢化率, 事業所数, ...}。
- $S$: $i$ を除く特徴量のサブセット。
- $f(S)$: サブセット $S$ だけを使ったモデルの予測値。
- $f(S \cup \{i\}) - f(S)$: 特徴量 $i$ を加えたときの予測の変化量 (限界貢献)。
- 係数: ゲーム理論で「公平な分配」 を保証する重み (Shapley の公理)。
本質は「あらゆる特徴量の組合せを試して、 特徴量 $i$ の限界貢献を平均化する」。 これにより、 特徴量間の相関や交互作用にロバストな寄与度が得られる。 計算量は指数的だが、 TreeSHAP / KernelSHAP は近似で多項式時間に。
🧮 表で整理: 主要 XAI 手法の比較
| 手法 | 説明粒度 | モデル依存 | 計算量 | 出力 | 主な利点 |
|---|---|---|---|---|---|
| Feature Importance | グローバル | あり (Tree 系) | ○ 高速 | ランキング | 直感的, 標準実装 |
| SHAP | 個別 + グローバル | なし | △ 中 | 寄与値 | 理論基盤, 一貫性 |
| LIME | 個別 | なし | ○ 高速 | 局所線形係数 | 直感的, 高速 |
| Partial Dependence | グローバル | なし | ○ 高速 | 曲線 | 形状の理解 |
| Permutation Importance | グローバル | なし | △ 中 | 精度低下量 | 汎用性 |
| Counterfactual | 個別 | なし | × 重い | 最小変更例 | 「もし」 の説明 |
→ SHAP は理論的に最も洗練されているが計算が重い。 LIME は実装が軽い分、 結果が不安定。 PDP はグローバルな形状理解に最適。 用途に応じて組み合わせるのが実務の定石。 EU AI Act では高リスク AI で「説明可能性」 が義務化されており、 SHAP/LIME が事実上の標準。
🐍 Python 実装 — SHAP で都道府県別寄与度を計算
このコードでやること: SSDSE-B-2026 の実在列だけを使い、 「L3221(消費支出)」 を予測するランダムフォレストを学習して、 SHAP 値で各都道府県の予測根拠を分解する。 「東京の予測値が高い理由は何か?」 を実在列の寄与で示す。
📥 使用する列 (すべて SSDSE-B-2026 の実在列コード):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import numpy as np import pandas as pd import shap from sklearn.ensemble import RandomForestRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県(行番号を 0〜46 に振り直す) # 特徴量と目的変数 X = df[['A1101', 'A1303', 'A4101']] y = df['L3221'] # ランダムフォレストで学習 model = RandomForestRegressor(n_estimators=100, random_state=42) model.fit(X, y) # SHAP 値を計算 explainer = shap.TreeExplainer(model) shap_values = explainer.shap_values(X) # 東京の SHAP 値を表示 tokyo_idx = df[df['Prefecture'] == '東京都'].index[0] result = pd.DataFrame({ '特徴量': X.columns, '東京の値': X.iloc[tokyo_idx].values, 'SHAP寄与': shap_values[tokyo_idx].round(1), }) print(result) base = float(np.ravel(explainer.expected_value)[0]) # SHAP の基準値(木ごとの平均予測) print(f"基準値: {base:.0f}") print(f"基準値 + SHAP 合計: {base + shap_values[tokyo_idx].sum():.0f}") print(f"東京予測: {model.predict(X)[tokyo_idx]:.0f}") |
📤 実行例(実測):
💬 基準値 295,577 円に総人口 +14,670、 65 歳以上人口 +10,112、 出生数 +1,447 を足すと 321,805 円で、 東京予測とぴったり一致する (SHAP の加法性)。 実測の東京都の消費支出は 341,320 円なので、 ランダムフォレストは東京を約 2 万円低く予測しており、 SHAP はこの「外れた予測」の内訳を示しているにすぎない。 3 列とも人口規模を表すので、 寄与の配分は列どうしの相関で入れ替わりやすい。 単なる予測値だけでなく「どの列がどれだけ効いたか(=なぜ)」 まで答えられるのが SHAP の威力。
⚠️ 落とし穴 — XAI 運用で陥りやすい 5 つの罠
- 説明 = 因果と誤解: 特徴量重要度や SHAP 値は「モデルがこう判断した」 だけで、 「現実世界で原因」 ではない。 因果推論 (causal inference) は別の枠組み。
- 相関する特徴量で SHAP が不安定: 人口と面積のように相関する特徴量は SHAP が「奪い合う」。 サンプリングを多くするか、 グループ化が必要。
- 説明の対象者を見失う: 「規制当局向け」 「エンジニア向け」 「ユーザー向け」 で適切な説明形式が違う。 全部 SHAP で済まそうとしない。
- 説明の整合性チェック忘れ: 同じデータで複数の XAI 手法を比較し、 結果が大きく異なれば、 モデルか説明手法のどちらかが不安定。
- 説明を信じすぎる: 説明可能 = 信頼できる ではない。 LIME の出力が不安定だったり、 SHAP が逆向きの結果を出すこともある。 検証必須。
📝 理解度チェック
- SHAP 値の「公平な分配」 はどの理論に基づくか? (答: 協力ゲーム理論の Shapley 値)
- 個別予測の説明に最も適した手法は? (答: SHAP または LIME)
- 特徴量重要度ランキングが示すのは因果か相関か? (答: モデル内の依存関係であり因果ではない)
- Partial Dependence Plot で読めるのは何か? (答: 特徴量を動かしたときの平均予測の変化形状)
- EU AI Act で説明可能性が義務化される対象は? (答: 高リスク AI、 例: 医療診断・採用・与信)
→ 5 問のうち 4 問以上正解できれば XAI の原理は理解している。 特に問 3 (説明 ≠ 因果) は実務で最も誤解されがち。
🌐 関連用語と発展
XAI をマスターしたら次は: SHAP / AI 倫理 / 公平性 / AI の信頼性 / AI 安全性 / AI ガイドライン / 説明責任 / 人間中心 AI / AI と社会 / ELSI へ。
📐 深掘り — XAI と規制対応
EU AI Act (2024 年成立、 2026 年完全施行) は、 高リスク AI に「説明可能性」 を義務化した。 採用、 融資、 医療診断、 行政意思決定などで使われる AI は、 個別の判断について「なぜそう判断したか」 を人間が理解できる形で説明する義務がある。 SSDSE-B のような統計データを使った政策立案も、 自動化される場合は説明責任の対象になる可能性がある。
日本でも内閣府の「人間中心の AI 社会原則」 (2019) や「AI 事業者ガイドライン」 (2024) で、 透明性・説明可能性が要件として挙げられている。 米国 NIST の AI Risk Management Framework (RMF) も、 説明可能性を中核に据えている。 グローバルに「説明できない AI は使えない」 流れが定着しつつある。
技術的には、 SHAP/LIME/PDP のような post-hoc 説明 (学習後に説明を生成する手法) と、 解釈可能な モデル設計 (intrinsic interpretability、 例: 線形回帰・決定木) の 2 つのアプローチがある。 高リスク用途では「線形モデル + SHAP」 のような組合せが安全策。 ブラックボックスを「説明だけで覆う」 のは、 規制当局から徐々に厳しく見られている。
🔬 補足 — XAI の限界と未来
XAI は万能ではない。 (1) 説明手法によって結果が異なる — SHAP と LIME で逆向きの寄与度が出ることがある。 (2) 高次元データでは説明が直感的に理解できない — SSDSE-B-2026 の 110 列を全部 SHAP プロットしても、 人間には消化不能。 (3) 敵対的攻撃で説明を操作できる — モデルの予測は変えずに SHAP 値だけ操作する攻撃が知られる (Slack et al. 2020)。 これらの限界を理解した上で、 XAI を「補助輪」 として使うのが現実的。
未来の方向性として、 因果推論との統合 (Counterfactual Explanations、 「もし入力が違ったら結果はどう変わるか」)、 LLM による自然言語説明 (GPT-4 などが SHAP の結果を日本語で要約する)、 インタラクティブな XAI (ユーザーが「なぜ?」 と問い続けられる UI) が研究されている。 SSDSE-B のような公的データを扱う政策決定 AI では、 単なる数値説明ではなく「市民が納得できる説明」 を生成する技術が求められている。
📋 FAQ — XAI でよくある質問
Q1: SHAP と LIME はどちらを使うべき?
理論的厳密性なら SHAP (Shapley 値による公平分配の数学的根拠)、 速度なら LIME (局所線形近似)。 規制対応や論文での主張なら SHAP、 ダッシュボードで素早く可視化したいなら LIME。 両方の結果を比較し、 一貫していることを確認するのが安全策。 SSDSE-B 分析でも、 まず LIME で見て、 重要そうな予測について SHAP で詳細化するのが効率的。
Q2: 説明可能なモデルだけ使えばいい?
線形回帰や決定木は本質的に解釈可能だが、 精度が劣る場面が多い。 一方、 GBM/NN は精度高いが説明が必要。 「精度 vs 説明可能性」 のトレードオフ。 実務では「精度が一定以上のモデルを XAI で説明する」 が標準。 ただし、 高リスク用途では「あえて線形」 を選ぶこともある。 場面ごとに最適な選択を考えるのが、 真の専門家の姿勢である。
Q3: SHAP の計算時間が長すぎる場合は?
TreeSHAP (Tree 系専用) は exact かつ高速。 GBM/RandomForest なら必ず TreeSHAP を使う。 NN なら DeepSHAP, GradientSHAP。 KernelSHAP は最後の手段 (汎用だが遅い)。 このページの 47 県・4 特徴量のモデルなら、 TreeSHAP の計算はすぐ終わる(時間は計算機しだい)。 大規模データでは SHAP の背景サンプル数を 100 程度に絞ることで、 速度と精度のバランスが取れる。
Q4: 「説明可能」 と 「解釈可能」 の違いは?
「解釈可能 (Interpretable)」 はモデル自体が人間に理解できる構造を持つ (線形回帰、 決定木)。 「説明可能 (Explainable)」 はブラックボックスを後付けで説明する (SHAP, LIME)。 厳密性は解釈可能 > 説明可能。 EU AI Act では両方を「Transparency」 として扱う。 高リスク用途では、 解釈可能なモデルを優先するのが安全策。 説明可能性は補助的な役割と位置付ける。
Q5: XAI を学ぶ最良の入門書は?
日本語なら『機械学習を解釈する技術』 (森下光之助)、 『XAI (説明可能な AI) — そのとき人工知能はどう考えたのか?』 (大坪直樹他)。 英語なら『Interpretable Machine Learning』 (Christoph Molnar、 オンライン無料公開) が最高峰。 SHAP の論文は Lundberg & Lee (2017) "A Unified Approach to Interpreting Model Predictions" が原典。 LIME の論文は Ribeiro et al. (2016) "Why Should I Trust You?: Explaining the Predictions of Any Classifier"、 これも必読。 オンライン無料リソースとして、 Google の "People + AI Guidebook" は実践的な XAI 設計指針として優秀。 また、 Kaggle の「Machine Learning Explainability」 コースは、 SHAP/PDP/Permutation Importance を実データで学べる定番教材。 これら複数の資源を組み合わせれば、 日本語でも英語でも、 入門から実践まで一貫した学習が可能である。
📊 SSDSE-B での具体的 XAI 適用例 (詳細)
SSDSE-B-2026 を題材に、 GBM (LightGBM) で「粗死亡率(A4200/A1101×1000)」 を予測し、 SHAP で個別寄与を分解する詳細手順を示す。 各都道府県について「なぜモデルがこの予測値を出したか」 を分解する。
手順 1: モデル学習。 47 都道府県 × 12 年(2012〜2023)の 564 行を使い、 説明変数を「高齢化率(A1303÷A1101×100)」 「A1101(総人口)」 「A4101(出生数)」 「F3103(月間有効求人数)」 の 4 つに絞って学習する。 決定係数は 0.962(学習データ上)。 ただしこの段階では「なぜ?」 が分からない。
手順 2: グローバル SHAP 分析。 全 564 サンプルの SHAP 値を計算し、 平均絶対 SHAP 値で特徴量重要度を出す。 実測は「高齢化率 1.349」 > 「A4101 出生数 0.257」 > 「F3103 月間有効求人数 0.197」 > 「A1101 総人口 0.142」 の順。 高齢化率が 2 位の 5 倍以上あり、 「高齢化率が粗死亡率予測の最大要因」 と言える。
手順 3: 個別 SHAP 分析 (東京)。 2023 年の東京都の SHAP 値は「高齢化率 -2.758、 A4101 出生数 -0.486、 A1101 総人口 +0.409、 F3103 月間有効求人数 +0.328」。 つまり東京の予測粗死亡率 9.50‰ は、 平均 (base) 12.007‰ から主に高齢化率の寄与で押し下げられた結果として説明される(12.007 - 2.758 - 0.486 + 0.409 + 0.328 = 9.50)。 実測値は 9.74‰。
手順 4: 個別 SHAP 分析 (秋田)。 2023 年の秋田県の SHAP 値は「高齢化率 +5.484、 A4101 出生数 +1.406、 A1101 総人口 +0.167、 F3103 月間有効求人数 -0.038」。 予測粗死亡率 19.03‰ は、 高齢化率の高さが最大の押し上げ要因として説明できる(12.007 + 5.484 + 1.406 + 0.167 - 0.038 = 19.03)。 実測値は 19.17‰。
手順 5: 政策インサイト。 「秋田の粗死亡率の高さは高齢化率の寄与で大きく説明される」 という読み取りが SHAP 分析から得られる。 ただし、 これは「モデル内の依存関係」 であり、 「現実世界の因果」 ではない点を必ず明記。 因果効果の検証には別途、 自然実験や A/B テストが必要。
このように、 XAI は「モデルの判断根拠を分解する技術」 として強力だが、 「説明 ≠ 因果」 の境界線を意識することが、 真の価値発揮に不可欠である。 SSDSE-B のような公的データを扱う分析者は、 この境界線を常に意識しながら XAI を使うべきである。
🗺 概念マップ
「xai」を中心とした関連概念マップ。
このマップは XAI 周辺の知識ネットワークを表す。 中央に「XAI」、 上方に「公的統計の活用 (SSDSE 等で説明性を要求される文脈)」、 並列に「AI 倫理 / AI 法規制 (GDPR Art.22, EU AI Act)」「ブラックボックスモデル (DNN, GBDT)」、 下方に「学術研究 (NeurIPS / FAccT 等)」「実務応用 (医療診断・与信・採用)」が伸びる。
各枝は XAI の使用文脈を表現: (a) 上位 = AI 全般の倫理体系、 (b) 並列 = SHAP/LIME/Grad-CAM 等の手法、 (c) 派生 = Counterfactual Explanations や Integrated Gradients、 (d) 前段 = モデル学習 (XAI は学習済モデルが前提)、 (e) 後段 = 公平性評価 / AI 監査、 (f) 応用 = 規制対応 (説明責任)。
SSDSE-B-2026 で「粗死亡率(A4200/A1101×1000)」を予測するモデルを作った場合、 XAI で「どの都道府県特性が予測を駆動しているか」を SHAP で分解し、 政策提案の根拠として提示する流れになる。
🔗 隣接手法への橋渡し
XAI は「学習済みモデル + 説明」の組み合わせなので、 モデル開発と監査の両側に接続する。
- 上流 (モデル開発): Random Forest、 XGBoost、 DNN など「ブラックボックス系」モデルを XAI の対象とする
- 並列 (代替戦略): 本質的に解釈可能なモデル (線形回帰 / 決定木 / GAM) を最初から選ぶ ― 「説明をあとから付ける」vs 「最初から透明」
- 下流 (監査・規制対応): 公平性監査、 AI 監査、 反事実分析、 Model Card 作成
EU AI Act では「高リスク AI システム」に説明性が義務付けられ、 SHAP/LIME のレポート添付が標準化されつつある。 医療・金融・公共サービス領域では XAI スキルが必須となっている。
🌳 手法選択フロー
「XAI(説明可能AI)」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 数値データ・小〜中規模 → 「XAI(説明可能AI)」やその拡張手法を直接適用
- カテゴリデータ → カテゴリ専用の SHAP TreeExplainer (SHAP) や PDP/ICE と組み合わせ
- 大規模・高次元 → 計算効率を重視した近似手法 (FastSHAP, KernelSHAP の sampling、 Attention 可視化) を選択
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「XAI(説明可能AI)」を中核とした適切な手法選択ができる。
🎮 触って理解する — 大域的説明 vs 局所的説明
姉妹ページ SHAP が「1件の予測を寄与のウォーターフォールに分解する」局所説明の計算手順を扱うのに対し、 ここでは なぜ説明が「大域的」「局所的」の2種類必要なのか を体感する。 同じモデルでも「全体でよく効く特徴」と「この人の予測を動かした特徴」は一致しない——これが XAI の要点だ。
score = 50 + 0.04·年収 + 0.5·勤続年数 − 0.02·既存借入 + ( −0.02·(年齢−45)² + 10 )
・大域的重要度=参照8人での「平均 |寄与|」(全体でどれだけ予測を揺らすか)。
・局所的寄与 φⱼ =(この人の項の値)−(参照平均)。 加法性 f(x) − E[f] = Σ φⱼ が厳密に成立。
💡 バーをタップ/クリックすると各特徴の正確な値を表示。
※ 説明用の擬似ノイズ。 寄与が近い特徴は順位が入れ替わり、 「説明は必ずしも安定でない」ことが分かる(真のモデルは変わっていない)。
- 相関 ≠ 因果:「既存借入の寄与が −15」でも、 借入を減らせばスコアが上がるとは限らない。 寄与度はモデル内部の相関構造の翻訳であって介入効果ではない(Permutation Importance でも同様)。
- 大域と局所は別物:全体で最重要な特徴(年収)でも、 年収が平均的な人の予測はほとんど動かさない。 「全体傾向」で個別事例を語ると誤る。
- 説明の不安定性:近似的な説明手法はサンプリング乱数で揺れる。 上のチェックで体感できる。
- 説明できた≠公平:根拠を示せても、 モデルの偏りが残っていれば問題は解決しない。
🎯 直感をもう一段 — 「ブラックボックスを開ける」とは何か
XAI が相手にするのは ブラックボックスモデル ── 入力を入れれば出力は返るが、 内部で何が起きているかが人間には直接読めない モデル(深層学習・勾配ブースティング・ランダムフォレスト等)だ。 線形回帰や 決定木 なら係数や分岐条件をそのまま読めば「なぜ」が分かる(=内在的に解釈可能)。 だが精度を上げるほどモデルは非線形・高次元になり、 中身は不透明になる。 XAI は「出来上がった不透明モデルの外側から、 その振る舞いを人間の言葉に翻訳する」営みである。
大域的説明と局所的説明は「別の問い」に答える
同じ「なぜ?」でも問いは2種類ある。 混同すると必ず誤読する。
| 視点 | 答える問い | 代表手法 |
|---|---|---|
| 大域的説明 (global) | このモデルは全体として何を見ているか | Permutation Importance・PDP・ALE・不純度重要度 |
| 局所的説明 (local) | この1件の予測をどの特徴が動かしたか | SHAP・LIME・反実仮想・Grad-CAM |
上の「🎮 触って理解する」ウィジェットは、 まさに この2つが一致しないこと を体感するために作られている。 全体で最も効く特徴でも、 その特徴が平均的な値を取る個人の予測はほとんど動かさない。
透明性と精度のトレードオフ(SSDSE-B-2026 実測)
「解釈しやすいモデル」と「精度の高いモデル」はしばしば逆を向く。 SSDSE-B-2026(2023年・47都道府県)で 粗死亡率(死亡数 A4200 ÷ 総人口 A1101 ×1000、 実測で最小 9.7‰〜最大 19.2‰、 平均 14.1‰)を予測してみると:
- 透明なモデル:粗死亡率と 高齢化率(65歳以上人口 A1303 ÷ 総人口、 実測 22.8〜39.1%)の単相関は r = 0.972。 「高齢化率が高い県ほど死亡率が高い」と一行で説明できる。 秋田県は高齢化率 39.1% で粗死亡率 19.2‰ と両方が最大。
- 高精度モデル:高齢化率・年少人口率・出生率の3特徴でランダムフォレストを組むと決定係数は非常に高くなる(in-sample R²≈0.99)が、 300本の木の中身は直接読めない。 そこで Permutation Importance を当てると 高齢化率 1.76±0.29、 年少人口率 0.03、 出生率 0.01 と、 事後的にようやく「主因は高齢化率」と翻訳できる。
つまり 透明なモデルは説明が要らない代わりに表現力が乏しく、 高精度モデルは表現力の代償として XAI という「翻訳装置」を後付けせざるを得ない。 どちらを選ぶかは、 規制・説明責任の重さと精度要求の綱引きで決まる。
⚠️ 落とし穴を掘り下げる — 「説明できた」の落とし穴(重要)
XAI の最大の危険は、 もっともらしい説明が出てしまうこと にある。 出力があるほど人は安心するが、 その説明が何を意味し何を意味しないかを取り違えると、 むしろ誤った確信を強める。 以下は特に踏みやすい罠を、 SSDSE-B-2026 の実測で確かめながら整理する。
SHAP や重要度が示すのは「このモデルの内部で特徴が予測をどう動かしたか」であって、 現実世界の因果ではない。 「高齢化率の寄与が最大」=「高齢化率を下げれば死亡率が下がる」ではない。 高齢化率と死亡率はどちらも地域の社会構造という共通要因の帰結(交絡)であり得る。 介入の効果を知りたいなら 因果推論・因果分析 の枠組みが別途必要だ。
同じモデル・同じデータでも、 手法が違えば重要度ランキングは入れ替わる。 上の3特徴で 2位・3位が実際に反転する:
・相関ベース |r|: 高齢化率 0.97 > 出生率 0.60 > 年少人口率 0.46
・Permutation: 高齢化率 1.76 > 年少人口率 0.027 > 出生率 0.013
相関では「出生率>年少人口率」なのに、 モデル依存の Permutation では「年少人口率>出生率」。 どちらが正しいという話ではなく、 測っている量が違う(片や周辺相関、 片やモデル予測への貢献)。 「重要度」という言葉を無条件に信じてはいけない。
不純度ベースの重要度(RF の
feature_importances_)は、 カテゴリ数の多い変数や連続変数を過大評価する既知のバイアスがある。 また特徴量どうしが相関していると(多重共線性)、 本来1つの効果が複数の特徴に分散して配分され、 個々の重要度は薄まる。 事前に相関構造・VIF を確認し、 可能なら Permutation Importance(検証データ上で測る)と併用すること。
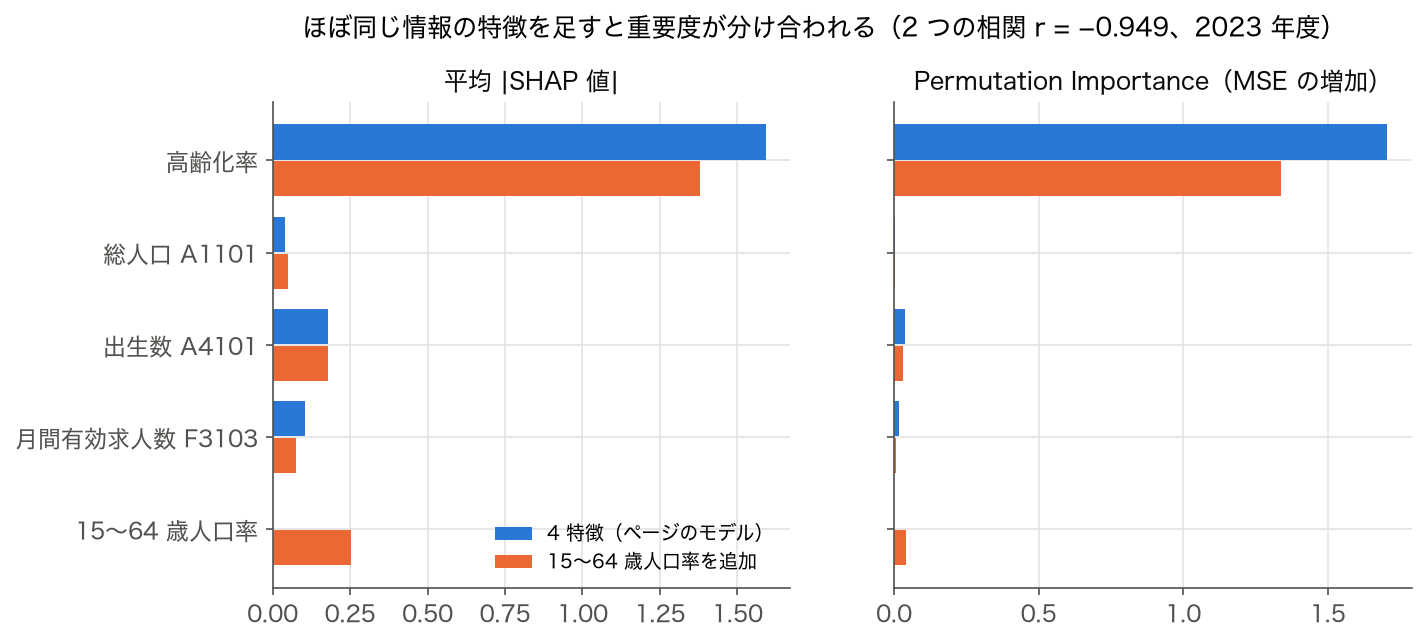
→ 死亡率を説明する情報は増えていないのに、「高齢化率の重要度」は 2 割下がりました。15〜64 歳人口率は「高齢化率の裏返し」なので、モデルは分岐にどちらを使っても同じように当てられ、重要度が 2 列に分かれます。「15〜64 歳人口率も効いている」と読むのではなく、相関の強い列をまとめた合計(ここでは 1.379+0.252 ≒ 1.63)で見るか、どちらか 1 列に絞ってから重要度を出します。
SHAP は加法性(f(x)=φ₀+Σφⱼ が厳密成立)という強力な性質を持つが、 標準的な実装は特徴量の独立性を暗黙に仮定して周辺分布から欠損特徴を補完する。 特徴が強く相関している場合、 現実には存在しない組み合わせ(例:高齢化率が高いのに出生率も高い県)を評価してしまい、 寄与配分が歪む。 因果構造を織り込む Causal SHAP や、 条件付き期待値版などの拡張はこの前提を緩めるための試みである。 SHAP=因果、 ではない。
LIME は近傍サンプリングの乱数に依存し、 実行のたびに係数が変わり得る。 SHAP でも背景データ(background dataset)の選び方で値が動く。 ウィジェットの「🎲 サンプリングの揺らぎを再現」チェックは、 寄与が近い特徴の順位が入れ替わる様子を疑似的に見せている(モデル自体は不変)。 説明を1回だけ出して結論にせず、 複数回・複数手法で安定性(Stability)を確認する。
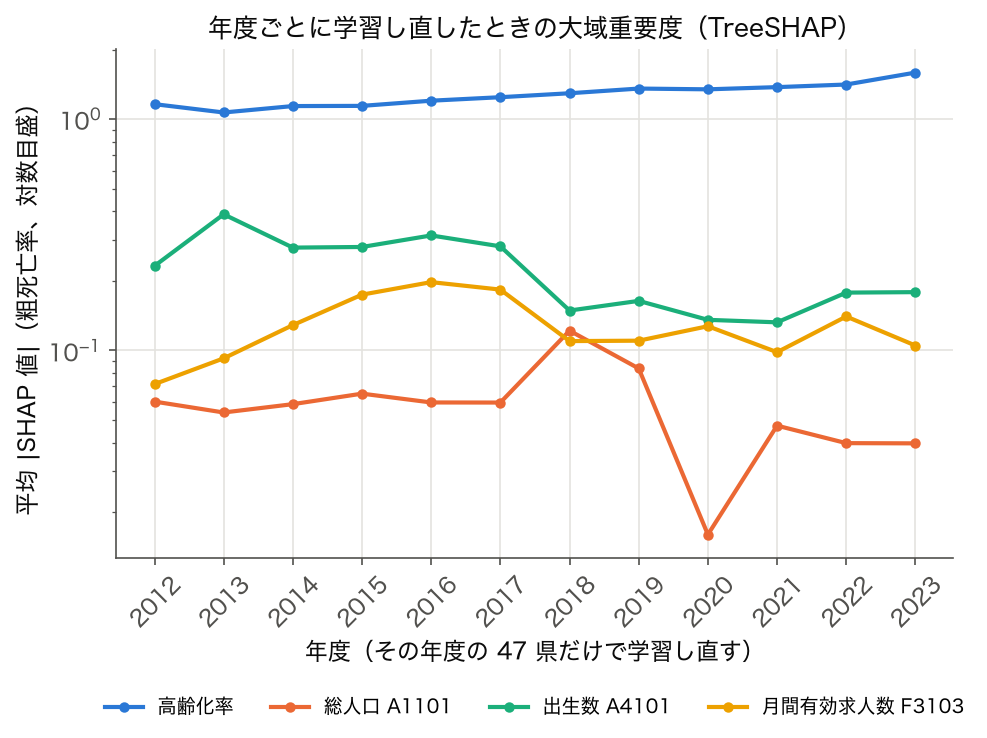
→ 「主因は高齢化率」という説明は 12 年度すべてで変わらず、安定しています。一方、重要度の小さい 3・4 位は 2018 年度に入れ替わり、総人口の値は 0.016(2020 年度)〜0.122(2018 年度)と 7 倍以上揺れます。1 年度分の結果で「総人口は 4 列中最下位」と言い切れるのは、その年度についてだけです。重要度の小さい特徴の順位は、年度・乱数・分割を変えて繰り返したときに同じかどうかを確かめてから報告します。
人は「自分の仮説に合う説明」を無批判に受け入れやすい(確証バイアス)。 「高齢化率が主因」という説明が直感に合うと、 それ以外の可能性(測定バイアス、 交絡、 モデルの誤設定)を検証せずに納得してしまう。 説明がもっともらしいことと正しいことは別だ。 都合のよい説明ほど、 反例を探す姿勢が要る。
SHAP・LIME・Grad-CAM はすべて「学習後(post-hoc)に外から近似する」手法だ。 近似である以上、 元モデルの振る舞いを完全には再現できず、 忠実でない(unfaithful)説明があり得る。 「説明を受ける権利」への形式的対応として説明を貼り付けても、 その説明がモデルの実挙動とズレていれば意味がない。 説明の 忠実性(Faithfulness) を測る(特徴を削って予測変化を見る等)ことを忘れない。 説明できても、 モデルの偏り(不公平)自体は 公平性評価 で別途点検する必要がある。
🚀 発展 — XAI 手法の地図と、説明を「評価」する視点
2軸で手法を整理する(スコープ × モデル依存性)
XAI 手法は 大域 vs 局所(何を説明するか)と モデル固有 vs モデル非依存(どのモデルに使えるか)の2軸で地図化できる。 この地図を持つと「今の目的にどれを使うか」が一意に決まる。
| モデル固有 (model-specific) | モデル非依存 (model-agnostic) | |
|---|---|---|
| 大域 (global) | 線形係数、 決定木のルール、 不純度重要度、 TreeSHAP 集約 | Permutation Importance、 PDP、 ICE、 ALE、 大域サロゲート |
| 局所 (local) | TreeSHAP、 Grad-CAM、 Integrated Gradients | KernelSHAP、 LIME、 Anchors、 反実仮想 |
主要手法のひとことガイド
- SHAP:ゲーム理論の Shapley 値で寄与を公平配分。 加法性が厳密で、 局所(1件の分解)にも大域(絶対値の平均)にも使える。 木モデルなら TreeSHAP で高速・厳密。
- LIME:注目する1件の近傍でモデルを局所線形近似。 高速で任意モデルに使えるが、 サンプリング依存で不安定(安定性に注意)。
- Permutation Importance:ある特徴の値をシャッフルして予測がどれだけ悪化するかを測る、 モデル非依存の大域重要度。 検証データ上で測るのが定石。
- PDP(Partial Dependence Plot)/ICE:1特徴を動かしたときの平均予測応答が PDP、 個別サンプルごとの応答曲線が ICE。 PDP は平均で交互作用を隠すので、 ICE を重ねて個体差を確認する。
- 反実仮想説明(Counterfactual):「何をどれだけ変えれば結果が反転するか」を示す。 却下された与信の当事者に「借入を◯万円減らせば承認」のように行動可能な説明ができる。 現実的・最小変更・多様性の制約が肝。
「後付け」を避ける ── 最初から解釈可能なモデル
post-hoc 説明の限界(本文⑦)を避ける根本策は、 そもそも解釈可能なモデルを選ぶことだ。 決定木(分岐ルールがそのまま説明)、 線形/ロジスティック回帰(係数が寄与)、 そして GAM(一般化加法モデル) は代表格。 GAM は各特徴の効果を滑らかな1変数関数 f₁(x₁)+f₂(x₂)+… として可視化でき、 「高齢化率が上がると死亡率がどう変わるか」を非線形のまま直接読める。 EBM(Explainable Boosting Machine)はこの発想を精度側に寄せた現代版だ。 規制領域(医療・金融)では「後付けの説明」より「最初から透明」が推奨されることが多い。 なお 特徴量 の設計(特徴量エンジニアリング)で解釈しやすい変数を作っておくことも、 説明の質を根本から左右する。
説明そのものを「評価」する ── 忠実性の検証
説明は出力して終わりではなく、 その説明が本当にモデルを反映しているか を測る対象でもある。 主な評価軸:
| 評価軸 | 問い | 測り方(例) |
|---|---|---|
| 忠実性 Faithfulness | 説明が真の挙動を反映するか | 重要とされた特徴を削って予測がどれだけ変わるか(ablation) |
| 安定性 Stability | 似た入力で似た説明が出るか | 近傍サンプル間・再実行間の説明の差分 |
| 簡潔性 Sparsity | 人が読める短さか | 寄与が非ゼロな特徴の数 |
| 整合性 Agreement | 手法間で結論が揃うか | SHAP・Permutation・相関の順位相関(本文②の食い違いを定量化) |
「説明が出た」で満足せず、 忠実性・安定性・手法間整合性まで確認して初めて説明を報告に使える。 これが XAI を「見栄えのよい飾り」から「検証可能な道具」へ引き上げる分岐点だ。