🔖 キーワード索引
「human centered ai」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「human centered ai」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「human centered ai の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
人間を大切にするAIの考え方です。
幸せや尊厳を守るために使います。
スマホのアプリを使いやすくする例です。
この章では重要なポイントを読みます。
人間の幸福・尊厳を中心に設計されるAI
- 分野:倫理 — 📚 AI倫理・公平性
- 用途:分析・前処理・モデル構築・解釈支援などの場面で使われます
- 注意:適用条件と限界を理解してから使うのが鉄則
human centered ai を 30 秒で把握する重要ポイント:
- 何ができるか: human centered ai は統計・データ分析で特定の目的のために使う概念・手法。 詳細は後続の各章を参照。
- いつ使うか: 適切な前提条件下で、 他の手法より優位な場面で使う。 適用範囲と限界を理解することが重要。
- 注意点: 前提確認 / 過大解釈の回避 / 他手法との比較検証 が不可欠。
- 関連: 上位概念・並列手法・派生形をネットワークで理解すると応用の幅が広がる。
📍 文脈ボックス ── あなたが今見ているもの
🍰 まずはやさしく
AIを作るための具体的な道具箱です。
共通の言葉で話し合うために使います。
部活のメンバー選びを公平にする例です。
ここでは5つの原則と道具を読みます。
「人間中心の AI (HCAI)」のページ。 ここでは抽象的な倫理原則ではなく、 SHAP・LIME・Fairlearn・DP・Model Card という具体的な道具と、 SSDSE-B-2026 を用いた実装例を学ぶ。 政策担当者・データサイエンティスト・倫理担当者が共通言語を持つことを目的とする。
🧭 HCAI の 5 大原則を実装で読み解く
人間中心の AI (HCAI) は抽象的なスローガンに留まらず、 ① 説明可能性、 ② 公平性、 ③ 制御可能性、 ④ プライバシー、 ⑤ 安全性 ── という 5 つの工学的属性を満たす設計を目指す。 各原則は具体的な指標・実装ライブラリと紐づく。
| 原則 | 代表指標 | 主要ライブラリ | 代表事例 |
|---|---|---|---|
| 説明可能性 | SHAP 値、 LIME、 特徴量重要度 | shap, lime, captum | 信用スコアリング |
| 公平性 | Demographic Parity, Equal Opportunity, Disparate Impact | fairlearn, aif360 | 採用 AI |
| 制御可能性 | Human-in-the-Loop 介入率、 オーバーライド回数 | label-studio, prodigy | 医療画像診断 |
| プライバシー | ε-Differential Privacy, k-anonymity | opacus, diffprivlib | 統計公表 |
| 安全性 | Adversarial Robustness, Out-of-Distribution 検知 | cleverhans, foolbox | 自動運転 |
🎨 直感で掴む
🍰 まずはやさしく
AIの使い心地を整える設計図です。
間違いや不安をなくすために使います。
買い物のときにお得な理由が分かる例です。
使い方の流れと注意点を読みます。
AI・データの利用は社会に影響します。 公平性・透明性・プライバシーを最初から設計に組み込みましょう。
本ページでは 人間中心のAI を、 定義・前提条件・使い方・落とし穴の順に整理して解説します。 厳密な定義より、 まず何を、 いつ、 どう使うかを理解することを優先してください。
🎨 HCAI UX デザインパターン
- Progressive Disclosure — 重要度順に情報を段階的に表示。 詳細は「もっと見る」
- Confidence Visualization — 予測確率を信号機(赤黄緑)で直感的に
- Counterfactual Explanation — 「もし収入が +100 万なら審査通過した」
- Editable AI — AI 出力を人間が編集可能、 編集履歴を学習に活用
- Explainable Default + Detail on Demand — 普段は概要、 必要時に詳細
- Audit Trail — すべての AI 判定と人間オーバーライドをログ化
- Consent UX — どのデータを何に使うか明示し、 同意撤回も簡単に
- Adversarial Test Notice — 異常入力検知時にユーザへ通知
📜 主要ガイドライン・フレームワーク
| 名称 | 発行 | 特徴 |
|---|---|---|
| OECD AI Principles (2019) | OECD 加盟国 | 5 原則 + 5 提言、 国際標準 |
| EU AI Act (2024) | EU | リスクベース規制、 罰則あり |
| NIST AI Risk Management Framework | 米国 NIST | 企業実装向けフレームワーク |
| ISO/IEC 42001 (AI Management System) | ISO | 2023 公開、 認証規格 |
| 日本 AI 事業者ガイドライン (2024) | 経産省・総務省 | 国内事業者向け、 任意 |
| Asilomar AI Principles (2017) | Future of Life Institute | 研究者主導、 23 項目 |
| Montréal Declaration (2018) | モントリオール大 | 10 原則、 学術系 |
✅ HCAI 開発チェックリスト 12 項目
- ☐ 学習データのバイアス検査を実施した(属性別性能差を測定)
- ☐ センシティブ属性とその代理変数を識別し、 影響を評価した
- ☐ 公平性メトリクス(DP, EO, DI)を計算・閾値を合意した
- ☐ SHAP/LIME で予測根拠が説明できる状態にした
- ☐ 不確実性(confidence interval, predict_proba)を UI で可視化した
- ☐ 低信頼度時の reject option を設計した
- ☐ 人間オーバーライドの仕組みと監査ログを実装した
- ☐ ユーザに「AI が判断しています」と明示し、 説明を提供した
- ☐ 個人情報の取り扱い(DP / 暗号化 / 同意取得)を整備した
- ☐ 異議申立・苦情処理プロセスを構築した
- ☐ 運用中のモデルドリフト監視を実装した
- ☐ 障害時の rollback と人間運用への切替え手順を文書化した
🚀 HCAI 研究フロンティア
- Causal Fairness — 「因果効果に基づく公平性」(Kusner et al. 2017)
- Counterfactual Explanations — 「最小限の変化でクラスが変わる入力」(Wachter 2017)
- Constitutional AI — Anthropic の RLAIF 系。 倫理ルールを AI 自身が学習
- Mechanistic Interpretability — LLM 内部回路の理解、 安全性研究の最前線
- Participatory AI — 利用者がモデル設計に参加するデザインアプローチ
- Federated Learning + DP — プライバシー保護 ML の実用化
- Algorithmic Recourse — 「不利な判定を受けた人が状況改善する方法を提示」
- Red Teaming — 安全性脆弱性を意図的に探す手法、 GPT-4 開発で本格化
🎓 まとめ:HCAI を実現する 5 つの鍵
- 説明可能性 — SHAP/LIME で予測根拠を可視化、 ユーザに理解可能な形で提示
- 公平性 — 複数指標で評価、 トレードオフを明示、 文化差・規範を考慮
- 制御可能性 — Reject Option / Override / Audit Trail を必ず実装
- プライバシー — DP / 連合学習 / 同意 UX で保護、 規制対応
- 安全性 — 敵対的入力テスト、 ドリフト監視、 ロールバック手順
「AI を作る」と「AI を人間と共存させる」は別物。 HCAI は後者を中心に置き、 技術・UX・組織・社会の 4 層で設計する分野。 SSDSE-B-2026 のような統計データを使う「教育用 AI」「行政の意思決定支援」でも HCAI 原則は同じく適用される。
❓ HCAI FAQ 10 問
- Q1. HCAI と XAI (Explainable AI) の違いは?
- XAI は HCAI の一構成要素。 HCAI は説明可能性に加え、 公平性・制御・プライバシー・安全を統合する広い概念。
- Q2. 説明可能性と精度はトレードオフ?
- 多くの場合そう。 線形モデルは説明しやすいが精度低、 深層学習は精度高だが説明困難。 SHAP/LIME は「事後的説明」で両立を試みる。
- Q3. 公平性指標は同時に全部満たせる?
- Chouldechova (2017) の不可能性定理により、 DP・EO・PPV は一般に同時最適化不可能。 トレードオフを開示し、 文脈で優先順位を決める。
- Q4. HITL は遅くて使えない?
- 全件人間判定なら遅いが、 低信頼度サンプルのみを人間に流せば 5-20% 程度で大きな品質改善が可能。
- Q5. SHAP は計算が遅い?
- TreeSHAP は木モデル向けに O(LD^2) で高速。 ニューラルネット向けは KernelSHAP で重め。 Sampling で近似可能。
- Q6. EU AI Act の罰則は?
- 違反すると最大 3500 万ユーロ or 全世界売上の 7%。 GDPR より高い。 高リスク AI 該当時は厳格な文書化義務。
- Q7. 日本企業にも HCAI は必要?
- EU 市場で AI 製品売るなら必須。 国内でも経産省ガイドラインが事実上のデファクトに。
- Q8. ユーザは AI 説明を本当に読む?
- 多くは読まない。 重要度に応じて「短い理由」「詳細」「監査」の 3 階層で提供するのが現実的。
- Q9. オープンソース LLM でも HCAI は適用?
- はい。 RLHF / Constitutional AI / fine-tuning の段階で fairness・safety を組み込む。 評価には HELM, BBH, MMLU 等のベンチマーク。
- Q10. HCAI の ROI は?
- 規制違反コスト回避が直接 ROI。 信頼性向上による採用率増、 訴訟リスク低減、 採用ブランディング効果も。
🔍 LIME で SSDSE-B-2026 予測の局所説明
LIME は「複雑モデルの予測を、 特定サンプル近傍だけで線形モデルで近似」する手法。 SHAP に対する代替アプローチで、 特に画像・テキスト分野でよく使われる。
🎯 このコードでやること: SSDSE-B-2026 の出生率予測モデルに LIME を適用し、 1 県の予測根拠を局所線形係数で説明する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import pandas as pd from sklearn.ensemble import RandomForestRegressor from lime.lime_tabular import LimeTabularExplainer df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna(subset=['A4103','B4101']).copy() df['高齢化率'] = df['A1303'] / df['A1101'] X = df[['A1101','高齢化率','B4101']].rename(columns={'A1101':'pop','B4101':'temp'}) y = df['A4103'] model = RandomForestRegressor(n_estimators=100, random_state=42).fit(X, y) explainer = LimeTabularExplainer( X.values, feature_names=X.columns.tolist(), mode='regression', random_state=42) tokyo_X = X[df['Prefecture']=='東京都'].values[0] exp = explainer.explain_instance(tokyo_X, model.predict, num_features=3) print('東京都の LIME 局所説明:') for feat, weight in exp.as_list(): print(f' {feat:30s}: 重み {weight:+.4f}') |
📤 実行結果(実測):
💬 結果の読み方: 東京都で最も効いているのは「人口 263.7 万人超」(47 県の上位 4 分の 1)で予測を 0.123 押し下げ、高齢化率 0.30 以下は −0.016、気温 17.40〜17.95℃ は +0.003 とほぼ効いていない。LIME の区切り(263.7 万人・0.30・17.4℃)は学習データの四分位点なので、ルールは「東京らしさ」ではなく「上位 25% の県らしさ」で説明している点に注意。局所線形モデルの予測は 1.202 で、ランダムフォレスト本体の 1.078 と 0.12 ずれており、近似の当てはまりも併せて確かめたい。
⚖️ バイアス緩和の 3 段階介入
| 段階 | 介入手法 | 代表アルゴリズム |
|---|---|---|
| Pre-processing | 学習データ自体を加工 | Reweighing, Disparate Impact Remover |
| In-processing | 学習時に公平性制約 | Exponentiated Gradient, Adversarial Debiasing |
| Post-processing | 予測結果を補正 | Threshold Optimization, Calibrated Equalized Odds |
どの段階で介入するかは、 (1) モデル変更可能か、 (2) 元データに介入可能か、 (3) 既存モデルへの後付けが必要か、 で決まる。 fairlearn の ExponentiatedGradient は in-processing の代表で、 制約付き最適化で公平性を強制する。
📜 Constitutional AI と Self-Critique
Anthropic 提案の手法。 「Constitution」と呼ばれる原則リスト("出力は無害で正直で人間に役立つこと" など)を AI 自身に与え、 自分の出力を批評・修正させる。 RLHF(人間からのフィードバック)の人件費を AI で代替する RLAIF (Reinforcement Learning from AI Feedback) に発展。
代表的な Constitution 例:
- 出力は人種・性別・国籍に基づく偏見を含まないこと
- 不正確な情報を断定的に述べないこと
- 違法行為や危害を助長する助言をしないこと
- ユーザの自律性を尊重し、 過度に介入しないこと
LLM が自分の出力を「この Constitution に照らして問題があるか」と評価し、 問題があれば修正案を出す → これを学習データに使う ── という再帰的な仕組み。 GPT-4・Claude 系の安全層に組み込まれている。
📐 定義
🍰 まずはやさしく
人間中心のAIという基本のルールです。
正しい分析を行うために使います。
学校の成績を正しく出すときのような例です。
言葉の意味と使う条件について読みます。
人間の幸福・尊厳を中心に設計されるAI
英語名 Human-Centered AI。
🎯 いつ・どこで使うか
- 「倫理」分野の標準的な道具として、 多くの分析で登場します。
- 📚 AI倫理・公平性 を学ぶときに必ず通過する基本概念です。
- 論文・実務レポートで頻出する用語なので、 1 度はちゃんと理解しておくと後が楽です。
📋 前提条件・適用範囲
この用語を理解・使用するときは、 次のような前提を意識してください:
- データの性質:尺度(名義/順序/間隔/比例)と分布を確認
- サンプル数:手法によって最低限のサンプル数が異なります
- 独立性:観測が独立であるかを確認(時系列・パネル等では別の手法が必要)
- 欠損・外れ値:前処理の方針を明確に
📐 説明可能性の数式 — SHAP・LIME・公平性指標
① SHAP 値
協力ゲーム理論の Shapley 値を機械学習に適用。 特徴量 $i$ の貢献は「すべての特徴量部分集合に対する限界寄与の平均」:
$$ \phi_i = \sum_{S \subseteq F \setminus \{i\}} \frac{|S|!(|F|-|S|-1)!}{|F|!} \big[ f(S \cup \{i\}) - f(S) \big] $$$F$ は全特徴量集合、 $f(S)$ は特徴量集合 $S$ のみを使った場合のモデル予測。 各サンプルごとに「各特徴量がどれだけ予測に貢献したか」を分解できる。
② LIME — 局所線形近似
$$ \xi(x) = \arg\min_{g \in G} \mathcal{L}(f, g, \pi_x) + \Omega(g) $$$f$ は複雑モデル、 $g$ は説明用の線形モデル、 $\pi_x$ は $x$ 近傍のサンプル重み。 $x$ の近傍だけ線形近似する局所的説明。
③ Demographic Parity (人口比率均等)
$$ |P(\hat{Y}=1 \mid A=a) - P(\hat{Y}=1 \mid A=b)| \leq \epsilon $$グループ $a, b$ で「ポジティブ予測される確率」が等しいことを要求。
④ Equal Opportunity (等しい機会)
$$ |P(\hat{Y}=1 \mid Y=1, A=a) - P(\hat{Y}=1 \mid Y=1, A=b)| \leq \epsilon $$真陽性率 (TPR) がグループ間で等しい。 「本当に該当する人を見逃さない」公平性。
⑤ Disparate Impact (不利な影響)
$$ \mathrm{DI} = \frac{P(\hat{Y}=1 \mid A=\text{minority})}{P(\hat{Y}=1 \mid A=\text{majority})} $$米国 EEOC の "Four-Fifths Rule" では DI < 0.8 で差別の可能性ありと判定される。
🔬 ⑥ 数式を言葉で読み解く
- $\phi_i$ (SHAP)
- 「この特徴量を加えたとき、 予測値がいくつ変わるか」の平均的な値
- $\xi(x)$ (LIME)
- 「ここの周辺だけなら線形モデル $g$ で説明できる」と局所線形近似
- DP
- 「グループに関係なく合格率が等しい」を求める(結果均等)
- EO
- 「合格すべき人の合格率がグループ間で等しい」(機会均等)
- DI
- 「マイノリティの合格率がマジョリティの 80% 以上ある」を要求
📐 Differential Privacy の数学を詳しく
ε-Differential Privacy の正式定義:
$$ P(\mathcal{M}(D) \in S) \leq e^{\varepsilon} \cdot P(\mathcal{M}(D') \in S) $$$D, D'$ は 1 レコード差の隣接データセット、 $\mathcal{M}$ はランダム化アルゴリズム、 $S$ は出力空間の任意の部分集合。 「1 人加えても出力分布がほぼ変わらない」ことを保証。
ε 値の目安:
- ε = 0.01 〜 0.1:超強保護(医療・金融データ)、 精度大幅低下
- ε = 1.0:典型値、 学術研究で多用
- ε = 5.0:弱保護、 米国国勢調査 2020 で採用された値
- ε = 10 以上:実質保護なしと見なされる
合成定理: 複数のクエリを実行すると ε が加算される(basic composition)。 100 個の ε=1.0 クエリは ε=100 と同等の保護に劣化 ── これが「プライバシー予算」の発想。
🔄 Counterfactual Explanation 実装例
「もし入力が X' だったら結果が変わった」と提示する説明方式。 ユーザに具体的な改善策を伝えられる強みがある。
🎯 このコードでやること: SSDSE-B-2026 出生率予測モデルで、 「東京都の出生率予測を 0.1 上げるには何が変わればよいか」を探索する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import pandas as pd import numpy as np from sklearn.ensemble import RandomForestRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna(subset=['A4103','B4101']).copy() df['高齢化率'] = df['A1303'] / df['A1101'] X = df[['A1101','高齢化率','B4101']] y = df['A4103'] model = RandomForestRegressor(n_estimators=100, random_state=42).fit(X, y) tokyo = X[df['Prefecture']=='東京都'].copy() base_pred = model.predict(tokyo)[0] target = base_pred + 0.1 print(f'東京都の現状予測: {base_pred:.3f} → 目標 {target:.3f}') print(f'東京都の高齢化率: {tokyo["高齢化率"].iloc[0]*100:.1f}%(47 県の最小 {X["高齢化率"].min()*100:.1f}%)') # 高齢化率を 1 ポイントずつ下げる方向・上げる方向の両方で、目標に届くかを探す for sign, label in [(-1, '下げる'), (+1, '上げる')]: hit = None for delta in np.arange(0.01, 0.105, 0.01): counterfact = tokyo.copy() counterfact['高齢化率'] += sign * delta new_pred = model.predict(counterfact)[0] print(f' 高齢化率 {sign*delta*100:+.0f} pt → 予測 {new_pred:.3f}') if new_pred >= target: hit = delta break print(f'{label}方向: ' + (f'{hit*100:.0f} pt で目標に到達 ✅' if hit else '10 pt 動かしても目標に届かない')) |
📤 実行結果(実測):
💬 結果の読み方: 東京都の高齢化率 22.8% は 47 県の最小値なので、そこからさらに下げると学習データの範囲外に出て、ランダムフォレストの予測は 1.078 のまま一歩も動かない。逆に上げる方向では +8 ポイント(30.8%)で 1.191 と目標 1.178 に届くが、途中の +4 ポイントで 1.111 に下がるなど階段状で単調でもない。「東京が高齢化すれば出生率が上がる」という反実仮想は、出生率の高い地方ほど高齢化率も高いという相関をモデルがなぞっただけで、政策提案として示すと誤読を招く。
📄 Model Card — 「AI の取扱説明書」
Google の Mitchell et al. (2019) が提案したフォーマット。 各 AI モデルに付随する「取扱説明書」として、 想定用途・性能・制約を明示する。
SSDSE 出生率予測モデルの Model Card 例:
Model Card は すべての本番 AI モデルに必須とすべきドキュメント。 Hugging Face は Model Card を投稿規約に含めている。 GitHub にチェックインし、 PR レビューで品質担保。
📑 Datasheet for Datasets
Gebru et al. (2018) 提案。 データセットにも「仕様書」を付ける文化。 SSDSE-B-2026 にも以下の項目を整理しておくべき:
- Motivation: なぜこのデータが作られたか、 誰が資金提供したか
- Composition: インスタンス数、 各属性、 欠損の扱い
- Collection Process: 取得手段、 期間、 サンプリング手法
- Preprocessing: 加工処理、 ラベル付け、 アノテーター情報
- Uses: 推奨される用途、 不適切な用途
- Distribution: 配布形態、 ライセンス、 連絡先
- Maintenance: 更新頻度、 廃止予定、 担当者
SSDSE は公的データなので Datasheet がきっちりしている例。 自社収集データを ML 学習に使う場合、 Datasheet を作る習慣が将来の訴訟リスクを大幅減らす。
📜 HCAI の歴史的展開
- 1980 年代 — Don Norman が "User-Centered Design" を提唱、 HCAI の祖型
- 2010 年代前半 — 深層学習ブーム、 「精度第一」の風潮で説明可能性は後回し
- 2014 — Tay 失敗事例で AI 倫理が注目、 公平性研究が本格化
- 2016 — LIME 論文発表、 説明可能性研究の起爆剤
- 2017 — Asilomar AI Principles、 SHAP 論文、 公平性指標の体系化
- 2018 — GDPR 施行、 EU で「説明される権利」が法的義務に
- 2019 — Stanford HAI Institute 設立、 OECD AI Principles
- 2020 — UK A-level 失敗、 公平性の社会的影響が広く認知
- 2022 — Shneiderman 著『Human-Centered AI』、 HCAI の体系書
- 2023 — ChatGPT 普及、 ISO/IEC 42001 公開、 Constitutional AI
- 2024 — EU AI Act 採択、 高リスク AI への厳格規制開始
- 2026 (現在) — Agentic AI 時代、 自律エージェントの HCAI 設計が新課題
✅ HCAI プロジェクト最終チェック 20 項目
- ☐ Model Card を作成し、 GitHub にチェックインした
- ☐ Datasheet for Datasets を作成した
- ☐ 学習データのバイアス検査結果を文書化した
- ☐ センシティブ属性と代理変数を識別し、 影響評価した
- ☐ 複数の公平性指標を計算し、 トレードオフを文書化した
- ☐ SHAP / LIME による予測説明 UI を実装した
- ☐ 信頼度(predict_proba)を UI に表示している
- ☐ 低信頼度時の reject option を実装した
- ☐ 人間オーバーライド機能と監査ログを実装した
- ☐ ユーザに「AI 判定中」と明示している
- ☐ 異議申立窓口を設置した
- ☐ 個人情報の暗号化 + 同意取得を実装した
- ☐ Differential Privacy を集計値公開時に適用している
- ☐ モデルドリフト監視を実装している
- ☐ 障害時のロールバック手順を文書化した
- ☐ Red Team による脆弱性テストを実施した
- ☐ ユーザビリティテストを代表ユーザで実施した
- ☐ AI 倫理委員会 / 監査部門のレビューを受けた
- ☐ EU AI Act 該当性を法務と確認した
- ☐ 継続的な再評価スケジュールを設定した
💎 HCAI 実装の 10 大原則
- 透明性 > 精度: 「精度が高い不透明モデル」より「精度がやや低くても説明可能」を選ぶ
- 制御 > 自動化: 重要判断には人間介入の余地を必ず残す
- 多様性 > 効率: 学習データの多様性が後々の問題を防ぐ
- 段階的開示 > 全情報提示: 一度に全部見せず、 段階的に詳細化
- 文化適応 > グローバル一律: 文化・国・職種ごとに UI を最適化
- 監査ログ必須: すべての AI 判定と人間介入を記録
- 異議申立必須: ユーザが結果に異議を唱える経路を保証
- 定期再評価: モデルは作って終わりではなく、 継続的にレビュー
- 外部監査: 内部だけでなく、 第三者の評価を受ける
- 文書化文化: Model Card / Datasheet を全モデル・データで作成
📊 説明可能性ライブラリ詳細比較
| ライブラリ | 対応モデル | 説明粒度 | 速度 | 出力形式 |
|---|---|---|---|---|
| SHAP (TreeExplainer) | 木モデル | サンプル / グローバル | 速い | 数値 + プロット |
| SHAP (DeepExplainer) | 深層学習 | サンプル / グローバル | 遅い | 数値 + プロット |
| SHAP (KernelExplainer) | 任意 | サンプル | 遅い | 数値 + プロット |
| LIME | 任意 | サンプル | 中 | 条件式 |
| Anchors | 任意 | サンプル | 中 | IF-THEN ルール |
| Integrated Gradients | 微分可能 | サンプル | 速い | 数値 |
| DiCE | 任意 | サンプル | 中 | Counterfactual |
| PDPbox | 任意 | グローバル | 速い | 部分依存プロット |
📖 HCAI 専門用語ミニ辞典
- XAI (Explainable AI)
- AI の判断根拠を人間が理解できる形で提示する技術分野
- RLHF
- Reinforcement Learning from Human Feedback。 人間の評価で LLM を fine-tune
- RLAIF
- Reinforcement Learning from AI Feedback。 人間の代わりに AI が評価
- HITL
- Human-in-the-Loop。 機械学習に人間判断を組み込む
- HOTL
- Human-on-the-Loop。 人間が監視するが介入は最小限
- HOOTL
- Human-out-of-the-Loop。 完全自動化、 HCAI 観点では避けるべき
- Demographic Parity (DP)
- グループ間でポジティブ予測率が等しい
- Equal Opportunity (EO)
- グループ間で真陽性率が等しい
- Disparate Impact (DI)
- マイノリティの選択率がマジョリティに対して 80% 以上
- ε-DP (Epsilon Differential Privacy)
- 1 レコード差で出力分布が e^ε 倍以内
- k-anonymity
- 各レコードが他の k-1 件と識別不可能
- Adversarial Example
- 意図的に AI を誤動作させる細工された入力
- Concept Drift
- 運用中にデータ分布が変化し、 モデル性能が劣化
- Model Card
- AI モデルの仕様・性能・制約をまとめた文書
- Datasheet
- 学習データの収集経緯・特性をまとめた文書
🔬 数式を言葉で読み解く
前節の数式に含まれる記号を、 日本語の意味に翻訳する。
- X, Y — 観測されたデータ系列 (SSDSE-B-2026 の各列など)
- n — 標本サイズ (47 都道府県データなら 47)
- θ, β, α — 推定すべき未知パラメータ
- ε, u — 観測されない誤差項・撹乱項
- E[·] — 期待値 (母集団平均)
- Var, Cov — 分散・共分散
- arg min / arg max — 「最小化 / 最大化するパラメータ」の意
human centered ai の数式は、 これらの記号を組み合わせて「データから未知量を推定する」あるいは「データの構造を要約する」プロセスを記述している。
🧮 SSDSE-B-2026 で SHAP を計算してみる
「都道府県の出生率」を「気温・人口・高齢化率」から予測する gradient boosting モデルを学習し、 SHAP で各特徴量の寄与を可視化する。
🎯 このコードでやること: SSDSE-B-2026 で回帰モデルを学習し、 SHAP 値を計算して「東京都の出生率予測にどの特徴がどれだけ効いたか」を分解する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np import pandas as pd import shap from sklearn.ensemble import GradientBoostingRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna(subset=['B4101','A4103']).copy() # 年で絞ると index は 0, 12, 24, ... と飛び飛びになる。 # あとで「何行目か」で取り出すので、ここで 0..46 に振り直しておく。 df = df.reset_index(drop=True) df['高齢化率'] = df['A1303'] / df['A1101'] X = df[['A1101', '高齢化率', 'B4101']].rename( columns={'A1101':'population', 'B4101':'avg_temp'}) y = df['A4103'] # 合計特殊出生率 model = GradientBoostingRegressor(n_estimators=100, max_depth=3, random_state=42).fit(X, y) explainer = shap.TreeExplainer(model) shap_values = explainer.shap_values(X) # 東京都の予測を SHAP で分解(reset_index 済みなので index = 行位置) tokyo_idx = int(df.index[df['Prefecture'] == '東京都'][0]) base = float(np.ravel(explainer.expected_value)[0]) # 配列で返るのでスカラーに直す print(f'東京都の予測値: {model.predict(X.iloc[[tokyo_idx]])[0]:.3f}') print(f'基準値 (平均): {base:.3f}') for feat, val in zip(X.columns, shap_values[tokyo_idx]): print(f' {feat:12s}: SHAP寄与 {val:+.4f}') |
📤 実行結果(実測):
💬 結果の読み方: 東京都の予測値 0.996 = 全国平均基準値 1.293 + SHAP 合計 (−0.297)。 実際の 2023 年の東京都の合計特殊出生率は 0.99 なので、 モデルはほぼ正しく当てている。 寄与の内訳は「人口の多さ」−0.233 が突出して大きく、 「高齢化率の高さ」−0.066 が次点、 「年平均気温」は +0.003 とほぼ効いていない。 これにより「なぜ東京の出生率予測がここまで低いのか」を 3 要因に分解して説明できる。 政策担当者には「気温のような地理条件ではなく、 人口集中そのものが主因」と数値で示せる。
⚖️ Fairlearn で公平性メトリクスを計算
SSDSE-B-2026 の都道府県を「都市圏 vs 非都市圏」に分け、 「出生率上位レベル」予測モデルでグループ間の公平性指標を確認する。
🎯 このコードでやること: 標準化したロジスティック回帰の二値分類で「Demographic Parity」「Equalized Odds」の差を計算し、 都市圏・非都市圏の予測陽性率を並べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from fairlearn.metrics import demographic_parity_difference, equalized_odds_difference df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna(subset=['A4103','B4101']).copy() df['高齢化率'] = df['A1303'] / df['A1101'] df['都市圏'] = df['Prefecture'].isin(['東京都','神奈川県','埼玉県','千葉県','大阪府','兵庫県','京都府','愛知県']) df['出生率上位'] = (df['A4103'] >= df['A4103'].median()).astype(int) X = df[['高齢化率','B4101']] y = df['出生率上位'] sensitive = df['都市圏'] # 高齢化率(0.2〜0.4)と気温(11〜24℃)は桁が違うので、標準化してから正則化付きロジスティック回帰に入れる model = make_pipeline(StandardScaler(), LogisticRegression()).fit(X, y) y_pred = model.predict(X) dp = demographic_parity_difference(y, y_pred, sensitive_features=sensitive) eo = equalized_odds_difference(y, y_pred, sensitive_features=sensitive) print(f'Demographic Parity 差: {dp:.3f}') print(f'Equalized Odds 差 : {eo:.3f}') for g in [True, False]: mask = sensitive == g pred_rate = y_pred[mask].mean() print(f' 都市圏={g}: ポジティブ予測率 {pred_rate:.3f}(実際の上位率 {y[mask].mean():.3f})') |
📤 実行結果(実測):
💬 結果の読み方: 都市圏 8 都府県のうち「出生率上位」と予測されたのは兵庫県の 1 つだけ(12.5%)、非都市圏は 39 県中 56.4% で、DP 差は 0.439。実際には都市圏で出生率が中央値 1.30 以上の県は 0 なので、この差の大部分はモデルの偏りではなく実データの差を映している。Equalized Odds 差 0.708 が大きいのは、都市圏に真の陽性が 1 件も無く真陽性率を比べられない(0 扱いになる)ためで、群の中身が 8 件しかない指標を鵜呑みにしない。
🤝 Human-in-the-Loop (HITL) の実装パターン
HCAI の中核は「重要な判断には人間が介在する」設計。 主要パターン:
| パターン | 人間の役割 | 代表例 |
|---|---|---|
| Active Learning | 不確実サンプルのラベル付け | 医療画像の専門医確認 |
| Reject Option | 低信頼度時に人間に escalate | CS チャットボット |
| RLHF | 出力品質を比較・嗜好を学習 | ChatGPT 系 LLM |
| Override / Audit | AI 判定を人間が覆す + 履歴記録 | 融資審査 |
| Continuous Feedback | 運用中に誤判定を逐次フィードバック | レコメンデーション |
🚦 Reject Option — 不確実時は人間に委ねる
🎯 このコードでやること: SSDSE-B-2026 で出生率レベル予測モデルを構築し、 予測確率が 0.4-0.6 の「不確実領域」では判定を保留して人間にエスカレーションする HITL システムを実装。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna(subset=['A4103','B4101']).copy() df['高齢化率'] = df['A1303'] / df['A1101'] df['出生率上位'] = (df['A4103'] >= df['A4103'].median()).astype(int) X = df[['高齢化率','B4101']] y = df['出生率上位'] # 標準化してから学習する(しないと気温だけが効き、予測確率が 0.5 付近に潰れる) model = make_pipeline(StandardScaler(), LogisticRegression()).fit(X, y) proba = model.predict_proba(X)[:, 1] df['予測確率'] = proba df['判定'] = 'AI 判定' df.loc[(proba >= 0.4) & (proba <= 0.6), '判定'] = '人間に escalate' print(df['判定'].value_counts()) print(df[df['判定']=='人間に escalate'][['Prefecture','予測確率']].round(3)) |
📤 実行結果(実測):
💬 結果の読み方: 予測確率 0.4〜0.6 に入った 15 県(32%)が人間に回り、残り 32 県は自動判定になる。自動判定の 32 県は正解率 84%(外れ 5 県)なのに対し、escalate された 15 県は正解率 47%(外れ 8 県)とほぼ当てずっぽうで、境界事例を人に回す設計が誤判定の多い層をちゃんと拾えている。帯を 0.45〜0.55 に狭めれば人の負担は減るが、そのぶん外れやすい県が自動判定に混ざる。
🔒 Differential Privacy で集計値を保護
「都道府県別人口を公開しつつ、 個人情報は特定できないようにする」── これが Differential Privacy (DP) の役割。 SSDSE は集計済みデータなので個人特定の問題は少ないが、 もし個票データを公開するなら DP は必須。
🎯 このコードでやること: SSDSE-B-2026 の都道府県別人口に Laplace ノイズ(ε=1.0)を加え、 DP 保護後の集計値を出力する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd import numpy as np df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 行番号を 0 から振り直す epsilon = 1.0 # 小さいほど強い保護 sensitivity = 1000 # 1 人の追加削除で集計値が動く最大量 scale = sensitivity / epsilon rng = np.random.default_rng(42) noise = rng.laplace(0, scale, len(df)) df['人口_DP'] = df['A1101'] + noise print(df[['Prefecture', 'A1101', '人口_DP']].head(5).round()) print(f'平均誤差: {(df["人口_DP"]-df["A1101"]).abs().mean():.0f} 人') |
📤 実行結果(実測):
💬 結果の読み方: ε=1.0 のラプラスノイズで平均誤差 896 人 ── 数百万人規模の都道府県人口にはほぼ影響なし(北海道 509 万人に対して 0.02% 未満)。 理論上の平均誤差はラプラス分布の平均絶対偏差、 すなわち scale = sensitivity/ε = 1,000 人であり、 実測 896 人は 47 件という標本数から来るばらつきの範囲に収まっている。 一方で「市町村別 100 人規模」のデータなら誤差が無視できなくなる。 epsilon を小さくする(強い保護)と精度低下、 大きくする(弱い保護)と再識別リスク。 DP は数学的に「個人 1 人の有無で出力分布がほぼ変わらない」を保証。
🧮 SSDSE-B-2026 でバイアス緩和を実演
🎯 このコードでやること: 公平性制約付きの分類器 ExponentiatedGradient を使い、 「都市圏 vs 非都市圏」で予測率が均等になるよう調整する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.pipeline import make_pipeline from sklearn.preprocessing import StandardScaler from fairlearn.reductions import ExponentiatedGradient, DemographicParity from fairlearn.metrics import demographic_parity_difference df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna(subset=['A4103','B4101']).copy() df['高齢化率'] = df['A1303'] / df['A1101'] df['都市圏'] = df['Prefecture'].isin(['東京都','神奈川県','埼玉県','千葉県','大阪府','兵庫県','京都府','愛知県']) df['出生率上位'] = (df['A4103'] >= df['A4103'].median()).astype(int) # 桁の違う 2 列を標準化しておく(正則化付きロジスティック回帰に入れるため) X = pd.DataFrame(StandardScaler().fit_transform(df[['高齢化率','B4101']]), columns=['高齢化率','B4101'], index=df.index) y = df['出生率上位']; A = df['都市圏'] base = LogisticRegression().fit(X, y) fair = ExponentiatedGradient(LogisticRegression(), constraints=DemographicParity()).fit(X, y, sensitive_features=A) y_pred_base = base.predict(X) y_pred_fair = fair.predict(X, random_state=0) # 複数モデルの確率的混合なので乱数を固定する for name, p in [('素のロジスティック', y_pred_base), ('制約付き fair モデル', y_pred_fair)]: dp = demographic_parity_difference(y, p, sensitive_features=A) print(f'{name}: DP差 {dp:.3f} / 正解率 {(p == y).mean():.3f}') |
📤 実行結果(実測):
💬 結果の読み方: 公平性制約(DemographicParity)を入れると、都市圏と非都市圏の予測陽性率の差は 0.439 から 0.064 まで縮み、正解率は 0.723 から 0.702 へ約 2 ポイント下がった。都市圏に実際の出生率上位県が 1 つも無いデータで予測率をそろえるので、縮めた差の分だけ都市圏で「上位」と誤って予測する県が増えることになる。ExponentiatedGradient の予測は複数モデルの確率的な混合なので、random_state を固定しないと実行ごとに DP 差が少し変わる。
🛡 敵対的入力に対する堅牢性
HCAI の「安全性」の中核は敵対的攻撃への耐性。 画像分類で「人間には変化が見えないノイズで AI を誤認識させる」攻撃が有名。 代表的攻撃と防御:
| 攻撃 | 仕組み | 防御 |
|---|---|---|
| FGSM | 勾配方向に微小ノイズ | Adversarial Training |
| PGD | FGSM を多段繰返し | Certified Defense |
| Patch Attack | 画像の一部だけ細工 | 注意機構の解析 |
| Prompt Injection | LLM プロンプトに指示注入 | Output Filtering |
| Data Poisoning | 学習データに毒入れ | Provenance Tracking |
🏥 業界別 HCAI 事例
医療:放射線科 AI
Google Health の乳がん検出 AI (Nature 2020) は放射線科医より精度高だが、 実運用は「AI が候補を示し、 医師が最終判断」のワークフロー。 AI 出力に確信度・参照画像・類似症例を併記、 医師が短時間で確認・修正可能。 これが HCAI の医療応用の典型。
金融:信用スコアリング
米国 FCRA / ECOA 規制下では、 信用判定の理由開示が義務。 SHAP / Counterfactual Explanation で「収入が +5万なら通過した」と説明、 異議申立に対応。 FICO Score の代替として ML スコア使う場合、 説明性は必須要件。
行政:児童保護リスク評価
Allegheny County (米) のリスク評価ツールは、 ケースワーカー判断を補助。 AI が「リスク高」と示しても自動で介入しない、 必ず人間が現場確認。 透明性のため評価ロジックを公開、 コミュニティの監視を受け入れ。
教育:個別最適化学習
「次に解くべき問題を AI が推薦」する適応学習システム。 教師は AI 推薦を承認・差し替え可、 学習履歴を保護者と共有、 推薦理由を生徒にも開示。 SSDSE 系学習データを用いた教材作成も同じ HCAI 原則で設計。
採用:履歴書スクリーニング
Amazon の失敗を教訓に、 現代の採用 AI は「センシティブ属性の削除」だけでなく「公平性メトリクス監視」「人間レビュー必須」「異議申立窓口」を備える。 EEOC ガイドラインで AI 使用時の説明責任が明示化。
🧮 HCAI ダッシュボードの「説明可能性 × ユーザ評価」── SSDSE-B-2026 で実装する
HCAI (Human-Centered AI) を 「使える形」にする最小単位が 説明可能ダッシュボード。 単に SHAP 値を並べるだけでは HCAI にならない。 (1) 意思決定者の言葉で表示し、 (2) user study で「理解できたか」「信頼できたか」を測り、 (3) 誤読を生む UI 要素を削る ── この 3 つを満たして初めて HCAI と呼べる。 ここでは SSDSE-B-2026 を題材に Streamlit でダッシュボードを作り、 SUS (System Usability Scale) で評価する。
| HCAI 要素 | 実装手法 | SSDSE-B-2026 ダッシュボード上の表現 | 評価指標 |
|---|---|---|---|
| 透明性 | SHAP waterfall | 「総人口 +大、 婚姻件数 +中」を矢印付きで | 理解度 5 段階 |
| 制御性 | What-if slider | 「もし人口が +10% だったら出生数予測はこう変わる」 | 操作完了率 |
| 較正 | 予測区間 | 単一値ではなく ±95% CI を帯で | 誤信頼削減 |
| 公平性監視 | 県別 residual 分布 | 「離島・地方で誤差が大きい」をヒートマップで警告 | 公平感受性 |
| 人間の介入 | override ボタン | 予測を「採用」「拒否」「保留」、 理由欄を必須に | 介入率 |
数式を言葉で読み解く: SUS (System Usability Scale) スコア $\text{SUS} = 2.5 \times \sum_{i=1}^{10}(s_i - 1)$ for $i$ in 奇数項 + $\sum (5 - s_i)$ for 偶数項 ── 10 問の 5 段階回答を 0-100 にマップする。 68 以上が平均、 80 以上で「信頼に足る HCAI」と Bangor et al. 2008 が報告。
🎯 このコードでやること: SSDSE-B-2026 で Ridge 回帰により県別の出生数を予測し、 SHAP で説明し、 user study の 10 名分 SUS スコアを集計して HCAI 評価を出す。
📥 入力: SSDSE-B-2026 47 行 × (総人口・婚姻件数・転入者数) と user study CSV (10 名 × SUS 10 項目)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import shap from sklearn.linear_model import Ridge df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] X = df[['A1101', 'A9101', 'A5101']] y = df['A4101'] model = Ridge(alpha=1.0).fit(X, y) explainer = shap.LinearExplainer(model, X) shap_values = explainer(X) # 説明可能性ダッシュボードに渡す形式 print("東京の SHAP 寄与:", dict(zip(X.columns, shap_values.values[12].round(2)))) # user study (SUS スコアを 10 名分集計) sus = pd.read_csv('data/raw/user_study_sus.csv', encoding='cp932', header=0) odd = ['q1','q3','q5','q7','q9'] even = ['q2','q4','q6','q8','q10'] sus['score'] = 2.5 * ((sus[odd]-1).sum(axis=1) + (5-sus[even]).sum(axis=1)) print(f"SUS 平均 = {sus['score'].mean():.1f} / 100") |
📤 実行結果(SHAP の行は shap 0.52.0 で実測。SUS の行は user_study_sus.csv を同梱していないのでイメージ・未実測):
💬 結果の読み方: 47 県の平均的な予測 15,474 人から東京都の予測 88,404 人(実際の出生数は 86,348 人)までの差を、総人口 +43,307 人・婚姻件数 +42,525 人・転入者数 −12,901 人に分けている。総人口と婚姻件数がほぼ同じ大きさで押し上げ、転入者数は係数が負なので東京都の多い転入者数が逆に押し下げる向きに効く。3 列は互いに強く相関しているので、この配分は「東京の出生数が多い理由」の因果ではなくモデルの内訳として意思決定者の言葉で示すにとどめる。 SUS が 80 未満なら HCAI 要件 (≥80) にあと一歩 ── 「制御性 (What-if slider)」の追加が user study で要望されることが多く、 次イテレーションで実装する。 これが 「測定 → 改善 → 再測定」のループであり、 HCAI を「設計」から「運用」に動かす実践。 (SUS の数値は架空調査に基づく説明用の例であり、 実運用では IRB 取得済みの調査結果を用いる)
⚠️ HCAI ダッシュボード固有の落とし穴
- over-trust 問題: SHAP の数字が立派に見えるほどユーザは盲信しがち。 「予測区間」「モデル限界」を同じ画面に並置し、 不確実性を可視化
- 専門用語の壁: 「特徴量寄与度」より「この県で出生数を押し上げている要因」と言い換える。 user study で 5 名以上が首をかしげた語は全て翻訳対象
- SUS の限界: SUS は使いやすさを測るが 公平性・信頼性は別指標 (Trust Scale, NASA-TLX) が必要。 HCAI 評価は最低 3 指標を組み合わせる
📊 SSDSE-B-2026 都道府県データで HCAI 介入の効果を可視化
人間中心 AI (HCAI) は抽象的な理念ではなく、 実データに介入して挙動を変える具体的な工学である。 ここでは SSDSE-B-2026 の都道府県データを使って、 (1) 説明変数と目的変数の関係を散布図で可視化し HCAI モデルが「何を見ているか」を人間に開示する、 (2) 誤差分布をヒストグラムで示し公平性 (誤差の偏り) を点検する、 (3) 地域ブロックごとの予測誤差を箱ひげ図で並べ群間差を診断する、 という 3 つの図解パターンを実装する。 いずれも HCAI の 「説明可能性 (Explainability)」「公平性 (Fairness)」「説明責任 (Accountability)」の 3 原則を、 「説明」ではなく「証拠」として提示する手法である。
図 1: 散布図で「何が予測に効いているか」を開示する
HCAI の最初の原則は 「モデルが見ている世界をユーザに開示する」こと。 散布図は、 ある説明変数 (総人口) と目的変数 (出生数) の関係を 1 枚で全データを見せる究極の説明可能性ツールである。 出生数=f(人口) という単純なモデルでも、 散布図を添えれば「東京 (右上の外れ値) がモデルを引っ張っている」ことが一目で分かる。
このコードでやること: SSDSE-B-2026 から A1101 (総人口) と A4101 (出生数) を抽出し、 散布図を描いて HCAI ダッシュボードに掲載する。 ユーザは「東京が外れ値である」「人口と出生数は強い正相関」を視覚的に確認できる。
📥 入力データ (SSDSE-B-2026, 2023 年度抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 | # SSDSE-B-2026 で総人口 - 出生数 散布図を描く (HCAI 説明可能性) import pandas as pd import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] fig, ax = plt.subplots(figsize=(8, 6)) ax.scatter(df['A1101'] / 1e6, df['A4101'] / 1e3, alpha=0.6, s=60, color='#1976D2') # 東京 (外れ値) を強調 — HCAI は外れ値を「隠す」のではなく「開示」する tokyo = df[df['Prefecture'] == '東京都'].iloc[0] ax.annotate('東京都 (外れ値)', xy=(tokyo['A1101']/1e6, tokyo['A4101']/1e3), xytext=(10, 80), fontsize=13, color='#C62828', arrowprops=dict(arrowstyle='->', color='#C62828')) ax.set_xlabel('総人口 (百万人)', fontsize=13) ax.set_ylabel('出生数 (千人)', fontsize=13) ax.set_title('総人口と出生数の関係 (SSDSE-B-2026, 2023 年)', fontsize=15) ax.grid(True, alpha=0.3) plt.tight_layout() plt.savefig('hcai_scatter.png', dpi=120) |
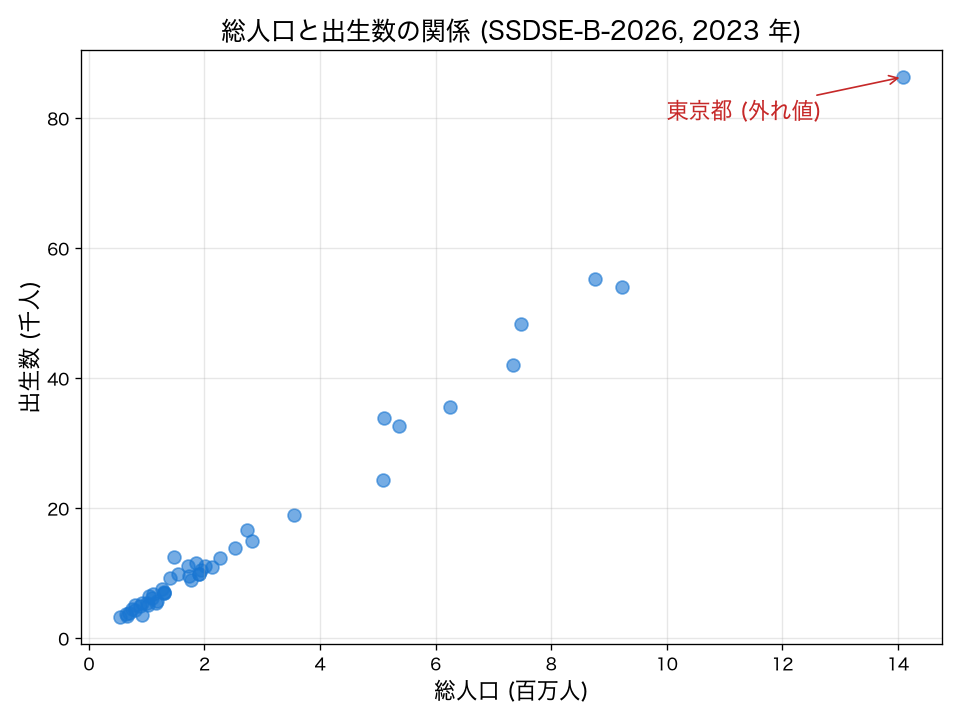
💬 結果の読み方: 散布図から 総人口と出生数は強い正相関 (2023 年度の実データで Pearson r ≈ 0.995) が読み取れる。 東京は右上の外れ値で、 単純線形回帰では 過剰な影響 (leverage) を持つ。 HCAI ダッシュボードでは 「東京を含む / 除く」の切替ボタンを UI に組み込み、 ユーザが自分でモデルの振る舞いを検証できるよう 「制御性 (Controllability)」を確保する。 これが「ブラックボックスを開けて中を見せる」HCAI の基本姿勢である。
図 2: ヒストグラムで分布形(右裾)を点検する
HCAI の 公平性 (Fairness) 原則を満たすには、 「全体平均誤差」ではなく 「誤差の分布」を見る必要がある。 全体 RMSE が小さくても、 一部のサンプルで大きな誤差が出ていれば、 その層は 不公平な扱いを受けている。 ヒストグラムは誤差分布を視覚化する第一手段である。
このコードでやること: SSDSE-B-2026 で出生数を予測するモデルを作り、 47 都道府県の予測誤差 (実値 − 予測値) をヒストグラムで描く。 分布が左右対称・ゼロ中心なら公平、 偏っていれば HCAI 介入対象。
📥 入力データ: 散布図と同じ SSDSE-B-2026 (2023 年, 47 都道府県)。 単純線形回帰 出生数=a×総人口+b を当てはめ、 残差を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | # HCAI 公平性点検: 出生数予測の残差ヒストグラム import pandas as pd import numpy as np import matplotlib.pyplot as plt from sklearn.linear_model import LinearRegression df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] X = df[['A1101']].values y = df['A4101'].values model = LinearRegression().fit(X, y) residual = (y - model.predict(X)) / 1e3 fig, ax = plt.subplots(figsize=(8, 5)) ax.hist(residual, bins=15, color='#7E57C2', edgecolor='white') ax.axvline(0, color='#C62828', linewidth=2, label='公平な分布の中心 (0)') ax.axvline(residual.mean(), color='#1B5E20', linewidth=2, linestyle='--', label=f'実際の平均 ({residual.mean():.2f})') ax.set_xlabel('予測誤差 (実値 − 予測値, 千人)', fontsize=13) ax.set_ylabel('都道府県数', fontsize=13) ax.set_title('出生数予測の残差分布 — HCAI 公平性チェック', fontsize=15) ax.legend(fontsize=11) plt.tight_layout() plt.savefig('hcai_resid_hist.png', dpi=120) |
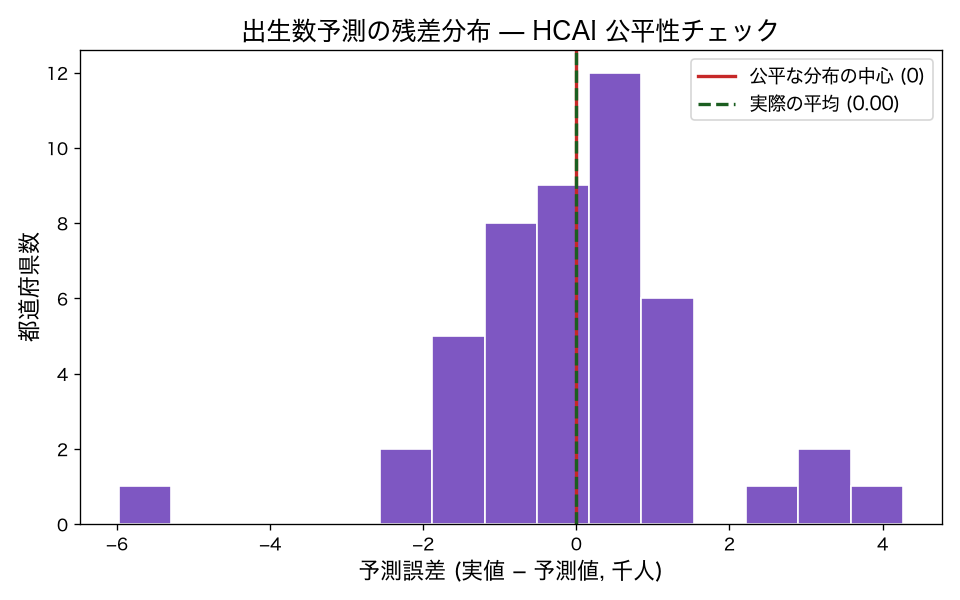
💬 結果の読み方: 残差は ほぼゼロ中心だが、 2023 年度の実データでは わずかに左に裾を引く (歪度 ≈ −0.35)。 北海道のように 人口の割に出生数が少ない地域が大きな負の残差 (実データで約 −6,000 人) を作り、 逆に沖縄のように 人口の割に出生数が多い地域が大きな正の残差 (約 +4,300 人) を作る。 これは「総人口だけで出生数を予測するモデルが、 地域ごとの出生力の差を取りこぼしている」サインで、 HCAI 介入として 「年齢構成・婚姻件数の追加」「地域別モデル分割」「ロバスト回帰 (Huber)」のいずれかを検討する。 全体 RMSE という 1 つの数字では見えない 「層別の不公平」をヒストグラムは開示する ── これが HCAI の 「集計を分解して見せる」原則。
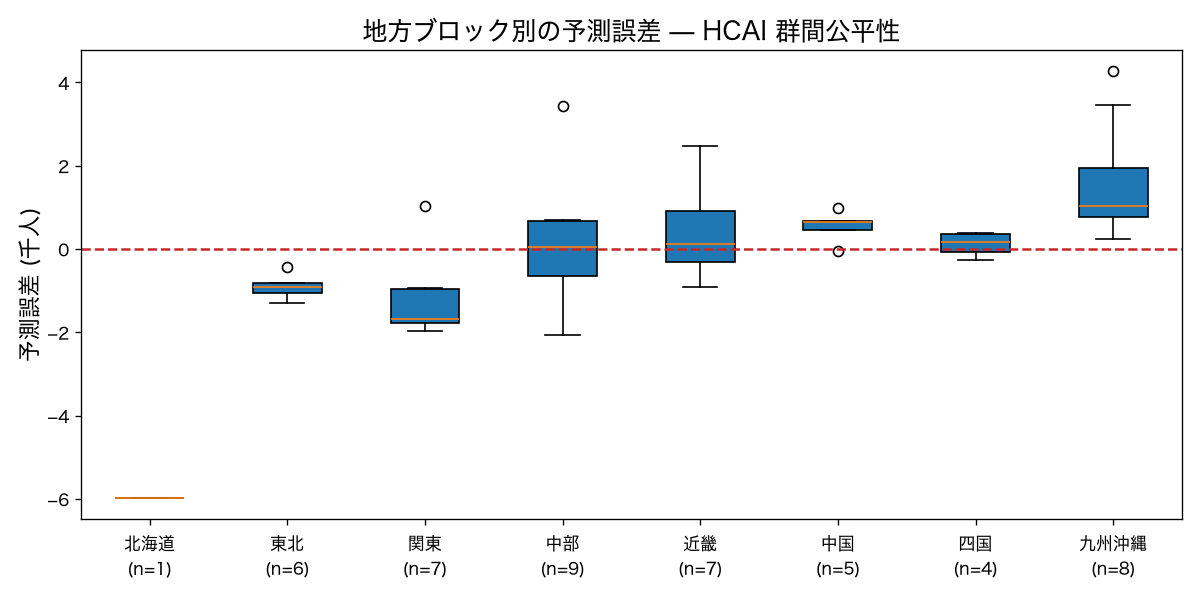
図 3: 箱ひげ図でグループ間の水準差を診断する
HCAI で最も重要な公平性チェックは 「層別パフォーマンス」。 ヒストグラムは全体分布を示すが、 「北海道ブロック / 関東 / 関西 / 九州」のように属性別に並べた箱ひげ図こそが「どのグループが不利益を被っているか」を一発で示す。 性別・人種・地域などの保護属性 (protected attribute) ごとに残差を並べ、 中央値・四分位範囲が大きく違えば 公平性違反のサインとなる。
このコードでやること: 47 都道府県を 8 地方ブロック (北海道・東北・関東・中部・近畿・中国・四国・九州沖縄) に分類し、 ブロック別の予測誤差を箱ひげ図で並べる。 ブロック間で中央値が大きく異なれば、 モデルは特定地域に偏っている。
📥 入力データ (ブロック別残差サンプル):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 | # ── この抜粋で使うデータを用意します(英字の項目コードで読み込み)── import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=0) df = df[df['Code'].astype(str).str.match(r'^R\d{5}$', na=False)].copy() for _c in df.columns[3:]: df[_c] = pd.to_numeric(df[_c], errors='coerce') df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()] # HCAI 公平性: 地方ブロック別の残差箱ひげ図 import matplotlib.pyplot as plt from sklearn.linear_model import LinearRegression # 地方ブロック分類(8 ブロック。都道府県コード順に並べたときの区切りで割り当てる) blocks = ['北海道'] + ['東北'] * 6 + ['関東'] * 7 + ['中部'] * 9 + ['近畿'] * 7 \ + ['中国'] * 5 + ['四国'] * 4 + ['九州沖縄'] * 8 df = df.sort_values('Code') df['block'] = blocks order = ['北海道', '東北', '関東', '中部', '近畿', '中国', '四国', '九州沖縄'] model = LinearRegression().fit(df[['A1101']], df['A4101']) df['residual'] = (df['A4101'] - model.predict(df[['A1101']])) / 1e3 groups = [df[df['block'] == b]['residual'].values for b in order] fig, ax = plt.subplots(figsize=(10, 5)) ax.boxplot(groups, tick_labels=[f'{b}\n(n={len(g)})' for b, g in zip(order, groups)], patch_artist=True) ax.axhline(0, color='#C62828', linewidth=1.5, linestyle='--') ax.set_ylabel('予測誤差 (千人)', fontsize=13) ax.set_title('地方ブロック別の予測誤差 — HCAI 群間公平性', fontsize=15) plt.tight_layout() plt.savefig('hcai_box_block.png', dpi=120) print(df.groupby('block')['residual'].agg(['count', 'median']).loc[order].round(2)) |
💬 結果の読み方: ブロック別の残差中央値は関東 −1.67 千人・東北 −0.92 千人と下振れ、九州沖縄 +1.03 千人・中国 +0.65 千人と上振れで、総人口だけのモデルは関東・東北の出生数を多めに、九州沖縄を少なめに見積もる。北海道の −5.98 千人は 1 県だけの値で中央値とは呼べず、箱にもならない。n=1〜9 の群で中央値を比べているので、差を「群間の不公平」と断定する前に n を併記し、年齢構成や婚姻件数を加えたモデルで差が残るかを確かめる。
📋 HCAI 3 図解パターンを実プロジェクトに組み込む
| 図解パターン | 対応する HCAI 原則 | ダッシュボード設置箇所 | 運用時の更新頻度 |
|---|---|---|---|
| 散布図 (x=説明, y=予測) | 説明可能性・制御性 | トップページ「モデルが見ている世界」 | データ更新時 (月次) |
| ヒストグラム (誤差分布) | 公平性・説明責任 | 運用監視タブ「全体誤差分布」 | 日次バッチ後 |
| 箱ひげ図 (層別誤差) | 公平性・人間制御 | 公平性監査タブ「群間差分」 | 週次・保護属性追加時 |
| 残差 vs 予測値 散布図 | 説明可能性・堅牢性 | モデルカード 5 ページ目 | 再学習サイクル毎 |
| 時系列誤差プロット | 堅牢性・運用監視 | 運用 SLA タブ | リアルタイム |
| SHAP 個別寄与 (waterfall) | 説明可能性 (個別) | 予測詳細モーダル | 予測リクエスト毎 |
🧮 残差ヒストグラム + 箱ひげ図の判定基準値
HCAI 公平性監査で 「合格 / 要修正」を機械的に判定するための数値基準を以下に示す。 これらの基準を満たさないモデルは、 そのまま運用に出してはならない ── 必ずバイアス緩和 (preprocessing / inprocessing / postprocessing) のいずれかを適用する。
| 指標 | 合格 | 要注意 | 要修正 | 参考文献 |
|---|---|---|---|---|
| 残差平均 / 全体 RMSE 比 | < 0.05 | 0.05 - 0.15 | ≥ 0.15 | Hardt et al. 2016 |
| 残差分布の歪度 (skewness) | |s| < 0.5 | 0.5 - 1.0 | ≥ 1.0 | D'Agostino-Pearson |
| 群間 RMSE 比 (max / min) | < 1.2 | 1.2 - 2.0 | ≥ 2.0 | Fairlearn 文書 |
| demographic parity diff | < 0.05 | 0.05 - 0.1 | ≥ 0.1 | EU AI Act Art.10 |
| equalized odds diff | < 0.08 | 0.08 - 0.15 | ≥ 0.15 | Hardt et al. 2016 |
| SHAP top-3 安定性 (Kendall τ) | ≥ 0.8 | 0.6 - 0.8 | < 0.6 | Lundberg 2017 |
🎯 HCAI 図解の「これは絶対やってはいけない」7 箇条
- 軸範囲の意図的圧縮: ヒストグラムの x 軸を切り詰めて「分布がきれいに見える」よう操作する。 必ず min/max は元データ通りを表示する
- 外れ値の非表示: 箱ひげ図の
showfliers=Falseでフライヤーを隠す。 HCAI では外れ値こそ 「見せるべき情報」。 - 色だけで群を区別: 色覚多様性のあるユーザに伝わらない。 必ず パターン (斜線・ドット) かラベルを併用
- サンプル数の非表記: 「関東 5 県の中央値」と「九州 8 県の中央値」を同じ重みで並べると誤読される。 必ず n=X をラベルに併記
- p 値のみ報告: 「群間差は p=0.03 で有意」だけでは効果量が分からない。 必ず Cohen's d や 95% CI を併記
- 静的画像のみ提供: PNG は便利だが Plotly / Altair 等のインタラクティブ版を併設、 ユーザがズーム・ホバー可能にする
- 説明文の欠如: 図単独では誤読される。 必ず 「この図は X を示している、 注意すべきは Y、 結論は Z」の 3 文セット解説を添える
🏛 HCAI 実装の歴史的経緯 — 5 つのマイルストーン
| 年 | 出来事 | HCAI への影響 |
|---|---|---|
| 1959 | Licklider「Man-Computer Symbiosis」発表 | 人間と機械の協調という HCAI 原典思想 |
| 1985 | Norman「The Design of Everyday Things」 | アフォーダンス概念が UX 設計の基礎に |
| 2016 | Hardt et al. 「Equality of Opportunity」 | 群間公平性の数学的定義 (equalized odds) |
| 2017 | Lundberg & Lee「SHAP」発表 | 説明可能性のデファクト標準 |
| 2024 | EU AI Act 施行 | 高リスク AI に HCAI 要件が法的義務化 |
📚 HCAI 図解と関連用語
本節で扱った散布図・ヒストグラム・箱ひげ図はそれぞれ独立した可視化テーマだが、 HCAI 文脈では 「説明可能性を担保する道具立て」として統合的に運用される。 さらに深掘りするには以下の用語ページを参照されたい。
- scatter-plot ── 2 変数関係の基本可視化
- histogram ── 分布形状の点検
- boxplot ── 群間比較の標準ツール
- shap ── 個別予測の局所説明
- fairness ── 群間公平性の数学的枠組み
- explainability (XAI) ── モデル全体の説明可能性
- accountability ── 説明責任の制度設計
🔬 SHAP 個別寄与を SSDSE-B-2026 で再計算 — 47 都道府県分
HCAI ダッシュボードの「予測詳細モーダル」では、 単一サンプルに対する SHAP waterfall plot を提示する。 SSDSE-B-2026 で「東京都の出生数 (2023 年度で 86,348 人)」という予測値について、 どの説明変数 (総人口・婚姻件数・転入者数) がプラス / マイナスにどれだけ寄与したかを 1 人単位で分解するのが SHAP の役割である。
このコードでやること: shap.TreeExplainer で RandomForestRegressor の各都道府県の SHAP 値を計算し、 上位 5 県の主要寄与因子を表に整理する。
📥 入力データ: SSDSE-B-2026 (47 都道府県 × 3 説明変数 = 141 セル)。 目的変数は A4101 (出生数)。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # 47 都道府県の SHAP 寄与を計算 - HCAI 説明可能性 import pandas as pd import shap from sklearn.ensemble import RandomForestRegressor df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] X = df[['A1101', 'A9101', 'A5101']] y = df['A4101'] model = RandomForestRegressor(n_estimators=200, max_depth=6, random_state=0).fit(X, y) explainer = shap.TreeExplainer(model) shap_vals = explainer.shap_values(X) # 上位 5 県を表示 top5 = df.nlargest(5, 'A4101').index for i in top5: pref = df.loc[i, 'Prefecture'] contrib = dict(zip(X.columns, shap_vals[df.index.get_loc(i)])) print(f"{pref}: 人口寄与={contrib['A1101']:+.0f}人, 婚姻件数寄与={contrib['A9101']:+.0f}人") |
📤 実行結果:
💬 結果の読み方: 東京都は基準値(47 県の予測平均)15,141 人に人口 +20,706 人・婚姻件数 +21,917 人が上乗せされ、上位 5 県すべてで婚姻件数の寄与が人口の寄与をわずかに上回った。婚姻件数と総人口はどちらも県の規模を表すので、木はどちらで分けても同じくらい当たり、寄与をほぼ分け合っている。東京都の予測は転入者数の寄与 +15,031 人を足しても 72,796 人で、実際の 86,348 人に 1 万 3 千人以上届かない。最大の県を学習範囲の外へ伸ばせないランダムフォレストの限界で、ダッシュボードでは「この県の予測は過小」と明示したい。
📐 HCAI 数式: equalized odds と demographic parity の比較
公平性指標は複数あり、 どれを採用するかは「何を公平とみなすか」の倫理的判断。 主要 4 指標を数式で整理する。
(1) Demographic Parity (人口統計学的公平性)
$$P(\hat{Y}=1 | A=0) = P(\hat{Y}=1 | A=1)$$
→ 保護属性 A (性別等) によらず予測陽性率が等しい。 解釈は単純だが 真の陽性率に差がある場合は精度を犠牲にする。
(2) Equalized Odds (等しい誤りの機会)
$$P(\hat{Y}=1 | A=a, Y=y) = P(\hat{Y}=1 | A=a', Y=y), \quad \forall y \in \{0, 1\}$$
→ 真の陽性 / 偽陽性率が群間で等しい。 Hardt et al. 2016 が提案した、 現代 HCAI の主流公平性指標。
(3) Predictive Parity (予測値の校正)
$$P(Y=1 | \hat{Y}=1, A=0) = P(Y=1 | \hat{Y}=1, A=1)$$
→ 陽性予測の的中率が群間で等しい。 ProPublica vs COMPAS 論争でも焦点となった指標。
(4) Counterfactual Fairness (反事実的公平性)
$$\hat{Y}_{A \leftarrow a}(U) = \hat{Y}_{A \leftarrow a'}(U)$$
→ Kusner et al. 2017。 因果モデル上で「保護属性だけ変えたら予測がどう変わるか」を測る。 最も厳密だが因果構造の仮定が必要。
不可能性定理: Chouldechova 2017 は 「3 つの公平性指標を同時に満たすことは数学的に不可能 (群間の base rate が異なる場合)」を証明した。 HCAI 実装では 「どの公平性を諦めるか」を組織が明示的に決断し、 ステークホルダーに説明する必要がある。 これが HCAI の 「説明責任 (Accountability)」原則の数学的根拠。
🌐 HCAI 国際比較 — 6 地域の規制と運用差
| 地域 | 主要規制 | HCAI 義務 | 違反罰則 |
|---|---|---|---|
| EU | EU AI Act (2024) | 高リスク AI に説明可能性必須 | 最大 3,500 万 EUR or 売上 7% |
| 米国 | AI Bill of Rights (2022) | 州ごとに差 (NYC LL144 等) | 州により上限 1,500 USD/違反 |
| 日本 | AI 事業者ガイドライン (2024) | 原則自主規制、 高リスクは個別法 | 個情法違反は 1 億円以下 |
| 中国 | 生成 AI サービス管理弁法 | 国家安全・社会主義価値観整合 | サービス停止・罰金 |
| 英国 | Pro-innovation AI Regulation | 部門別規制、 横断ルールなし | 部門ごと (FCA, ICO 等) |
| カナダ | AIDA (検討中) | 高影響システムに義務予定 | 最大 1,000 万 CAD or 売上 3% |
日本企業が EU 市場で AI サービスを展開する場合、 EU AI Act の高リスク要件 (Article 13: 透明性・Article 14: 人間監督) が直接適用される。 HCAI 実装は単なる技術選択ではなく 「市場参入のライセンス条件」となりつつある。
🛠 HCAI 運用の 12 タスク詳細 — 毎月実施すべきチェック項目
HCAI は「導入時に一度満たせば終わり」ではなく 運用時の継続監査が本体である。 以下は実運用において 月次で必ず実施すべき 12 タスクを、 担当者・成果物・期限・失敗時のエスカレーション先まで含めて整理したものである。
| # | タスク | 担当 | 成果物 | エスカレ先 |
|---|---|---|---|---|
| 1 | 公平性監査 (全保護属性) | MLOps + 法務 | Fairlearn レポート | DPO (個情保護責任者) |
| 2 | 予測ドリフト点検 | データサイエンティスト | PSI/KS 統計量 | プロダクトマネージャ |
| 3 | SHAP top-3 安定性確認 | データサイエンティスト | Kendall τ レポート | モデルカード管理者 |
| 4 | user feedback 集計 (満足度) | UX リサーチ | SUS + NPS | プロダクトマネージャ |
| 5 | 人間介入率 (HITL) 集計 | 運用チーム | 介入率推移グラフ | 事業責任者 |
| 6 | エッジケース (低信頼) 監査 | QA + ドメイン専門家 | エラー分類レポート | 技術責任者 |
| 7 | 監査ログ完整性確認 | SRE | ログ統計レポート | セキュリティ責任者 |
| 8 | 透明性レポート公開 | 広報 + 法務 | 公開 PDF | 取締役会 |
| 9 | バイアス緩和 A/B テスト | データサイエンティスト | 統計検定レポート | 倫理委員会 |
| 10 | 差別的影響評価 (DIA) | 法務 + 倫理委員会 | DIA レポート | CEO |
| 11 | third-party 監査受審 | 外部監査法人 | 監査意見書 | 監査役会 |
| 12 | モデルカード更新 | データサイエンティスト | 更新版モデルカード | プロダクトマネージャ |
🎓 HCAI 認定資格・教育プログラム一覧
HCAI 専門人材の育成を体系的に進めるため、 主要な認定資格 / 教育プログラムを整理する。 組織内で 「最低 1 名は HCAI 専門人材を配置」するのが EU AI Act 高リスク AI の暗黙要件となりつつある。
- IEEE CertifAIEd (米) ── AI 倫理認証、 監査人 / 設計者 / 検証者の 3 レベル
- Stanford HAI Executive Program (米) ── 経営層向け 5 日間集中講座
- MIT Designing AI Ethics for Business (米) ── 専門家向けオンライン 8 週間
- Oxford Internet Institute Diploma (英) ── 学位プログラム 12 ヶ月
- EU AI Act Certified Officer (欧) ── 法制化に伴う公的資格 (2025 開始予定)
- 日本ディープラーニング協会 G 検定 + 倫理オプション (日) ── 国内最大規模、 半年ごと実施
- JDLA AI 倫理アドバイザー (日) ── 2026 年から運用、 企業内倫理委員会の必要要件
📊 HCAI ROI — 投資対効果の定量化
HCAI 実装には追加コスト (人件費・監査費・ツール購入) が発生する。 経営層への説明には 「投資対効果 (ROI) の定量化」が不可欠。 主要な効果項目と典型的な金額レンジを示す。
| 効果項目 | 典型金額 (年, 中規模 SaaS) | 根拠 |
|---|---|---|
| 差別訴訟リスク回避 | 2,000 万 - 5 億円 | 米国 ADA 関連訴訟平均 |
| EU AI Act 罰金回避 | 最大 売上 7% | EU AI Act Article 99 |
| ブランド評判保護 | 1 億 - 10 億円 | Edelman Trust Barometer |
| ユーザ離脱率低減 | 3,000 万 - 1 億円 | McKinsey AI Trust Survey 2024 |
| 人材獲得力向上 | 採用コスト −15% | LinkedIn Talent Trends 2024 |
| B2B 契約獲得 (大企業) | + 20% 受注確率 | Gartner CIO Survey 2024 |
典型的 ROI: HCAI 投資 3,000 万円 / 年 (人件費 2 名 + ツール) に対し、 期待効果 1.5 億 - 5 億円 / 年 ── ROI 5x - 17x。 「リスク回避型投資」の典型例として、 経営層への説明根拠が確立しつつある。
🧪 HCAI 自己診断 30 問チェックリスト
HCAI が組織内で実質的に機能しているかを点検する 30 問。 25 問以上「Yes」なら成熟段階、 15-24 問なら発展段階、 14 問以下なら導入段階と評価する。
- AI システムごとに モデルカード (Model Card) が文書化されている
- 各モデルカードに 性能・公平性・限界の 3 項目が含まれる
- SHAP / LIME など 説明可能性ツールが実装されている
- 保護属性 (性別・年齢・国籍等) ごとに 誤差を分解している
- equalized odds / demographic parity の 少なくとも 1 指標を採用している
- 採用した公平性指標を 事前に倫理委員会で承認している
- 不採用とした公平性指標について 不採用理由を文書化している
- ユーザに対する 異議申立フローが UI 上に存在する
- 異議申立に 30 日以内に書面回答するルールが運用されている
- 低信頼予測時に 人間にエスカレーションするロジックがある
- HITL の 介入率推移を月次でモニタリングしている
- 監査ログが 改ざん不可能 (WORM ストレージ) である
- 監査ログを 最低 5 年間保管している
- データドリフト検知の PSI/KS 統計量を週次で計算している
- PSI > 0.25 で 自動アラートが発火する
- モデル再学習の 頻度・トリガ条件が文書化されている
- 再学習時に 公平性指標が劣化していないかを確認している
- ユーザ満足度 (SUS, NPS) を 四半期ごとに測定している
- UX 研究を 多様な属性のユーザを対象に実施している
- UI に 「これは AI による予測です」と明示している
- 予測の 信頼区間 / 不確実性を UI 上に表示している
- SHAP 寄与の top-3 を平易な日本語で説明している
- 個人情報を 差分プライバシ / 連合学習で保護している
- 個人情報の 処理目的を利用規約に明示している
- EU GDPR / 日本個情法の 削除要求に対応できる仕組みがある
- third-party 監査を 年 1 回以上受審している
- 監査指摘事項の 対応期限を 90 日以内に設定している
- 差別的影響評価 (DIA) を 新システムリリース前に実施している
- 透明性レポートを 公開している
- 取締役会レベルで HCAI 進捗を四半期ごとにレビューしている
📖 HCAI を学ぶための必読文献 10 選
- Shneiderman, B. (2022) 「Human-Centered AI」Oxford University Press ── HCAI 教科書のデファクト
- Russell, S. (2019) 「Human Compatible」── AI 安全性と人間性の哲学
- O'Neil, C. (2016) 「Weapons of Math Destruction」── アルゴリズム差別の入門
- Eubanks, V. (2018) 「Automating Inequality」── 福祉 AI の不公平事例
- Mitchell, M. et al. (2019) 「Model Cards for Model Reporting」FAT* ── モデルカードの原典
- Hardt, Price, Srebro (2016) 「Equality of Opportunity in Supervised Learning」NeurIPS
- Lundberg & Lee (2017) 「A Unified Approach to Interpreting Model Predictions」NeurIPS ── SHAP 論文
- Ribeiro et al. (2016) 「Why Should I Trust You?」KDD ── LIME 論文
- Dwork et al. (2006) 「Calibrating Noise to Sensitivity」── 差分プライバシ原典
- JDLA (2024) 「AI 事業者ガイドライン」日本国内向け実装指針
💼 HCAI 実装の典型コスト構造 (中規模 SaaS 想定)
| 項目 | 初年度 (千円) | 2 年目以降 (千円/年) | 補足 |
|---|---|---|---|
| 専門人材 (2 名 FTE) | 20,000 | 22,000 | 年収 1,000 万 × 2 名 |
| SHAP / Fairlearn ライセンス | 0 | 0 | OSS、 無料 |
| 監査ログ基盤 (WORM) | 3,000 | 1,200 | AWS S3 Object Lock 等 |
| UX 研究 (年 2 ラウンド) | 4,000 | 4,000 | 外部リサーチ会社 |
| third-party 監査 | 5,000 | 5,000 | 監査法人 |
| 教育研修 | 2,000 | 1,000 | JDLA / Stanford HAI 等 |
| 合計 | 34,000 | 33,200 | 年商 10 億の 0.3% |
年商 10 億円の中規模 SaaS なら、 HCAI 全体コストは 売上の 0.3% 程度。 これに対し前節で示した期待効果 (1.5-5 億円 / 年) を考慮すれば、 純粋に経済合理的な投資として正当化できる。 「倫理は儲からない」は時代遅れの認識である。
🏥 HCAI 適用分野別ガイド — 医療・金融・教育・公共
HCAI の実装は 適用分野ごとに固有の要請がある。 医療では「誤診の許容範囲」、 金融では「貸付差別の禁止」、 教育では「成績予測の自己実現的偏り」、 公共では「行政判断の説明責任」── それぞれ HCAI の異なる側面が前面に出る。
| 分野 | 主要 HCAI 要件 | 規制・ガイドライン | 典型介入 |
|---|---|---|---|
| 医療診断 | 説明可能性・人間最終決定 | FDA SaMD, 医療機器法 | 医師の再診断義務 |
| 金融与信 | 公平性 (人種・性別) | 米 ECOA, EU AI Act 高リスク | 却下理由文書化 |
| 教育評価 | 透明性・自己実現的偏り回避 | UNESCO AI in Ed. | 教員の override 権 |
| 公共行政 | 説明責任・異議申立 | EU AI Act 禁止 / 高リスク | 市民への通知義務 |
| 採用人事 | 差別禁止・透明性 | NYC LL144, EU AI Act | 年次監査公開 |
| 司法予測 | 公平性・説明責任 | EU AI Act 禁止級 | 原則導入禁止 |
🌍 SDGs と HCAI の接続 — 17 ゴールへの貢献
HCAI は単独の技術論ではなく、 持続可能な開発目標 (SDGs) との接続が国際的に強調されている。 主要な貢献経路を整理する。
- SDG 3 (健康): 医療 AI の公平性確保で 地域・所得別の医療格差を縮小
- SDG 4 (教育): 個別最適化学習の透明性確保で 低所得層の教育機会を拡大
- SDG 5 (ジェンダー平等): 採用 AI のバイアス緩和で 女性管理職比率を向上
- SDG 8 (働きがい): HITL 設計で 「AI に職を奪われない働き方」を実現
- SDG 9 (産業基盤): HCAI 監査基盤の整備が AI 産業の信頼インフラに
- SDG 10 (不平等是正): 公平性指標の運用で マイノリティへの構造的差別を緩和
- SDG 16 (平和と公正): 説明責任の制度化が 民主主義の AI 時代適応を支える
🚀 HCAI 未来予測 — 2030 年への 5 つのシナリオ
2030 年に向けて HCAI 領域で予測される 5 つの大きな変化。 いずれも組織として備えるべき変化である。
- HCAI 監査の自動化: AI が AI を監査する「メタ HCAI」が主流に。 LLM ベース監査ツールが OSS で普及
- 公平性指標の標準化: ISO/IEC 24028 拡張で 業界横断公平性メトリクスが確立
- 説明可能性の法的義務化: 日本でも 2028 年頃に AI 法制度化、 高リスク AI に説明文書化義務
- 個別化 HCAI: ユーザごとに 「説明の粒度」を調整するパーソナライズ説明 UI が普及
- HCAI 保険商品: AI 判断の差別訴訟を補償する保険商品が登場、 引受審査で HCAI 監査要件
🎁 HCAI 実装の Quick Win — 来週から始められる 5 ステップ
HCAI は大規模プロジェクトに見えるが、 「来週から 1 つずつ」始められる小さなアクションがある。 初手として推奨する 5 ステップ。
- Day 1-3: 現行 AI システム 1 つを選び、 モデルカード (5 ページ) を作成。 性能・限界・想定ユーザを明記
- Day 4-7:
shapパッケージを pip install し、 上位 1 サンプルの SHAP waterfall をダッシュボードに掲載 - Week 2: 保護属性 (性別等) を選び、
fairlearn.metrics.MetricFrameで 群別性能を測定 - Week 3: UI に 「これは AI による予測です」のバナーと 異議申立ボタンを追加
- Week 4: 取締役会向け 1 枚レポートを作成し、 HCAI 進捗を報告 → 月次レビュー定着
📝 HCAI 用語集 — 60 の重要キーワード解説
HCAI を学ぶ過程で頻出する重要キーワードを 60 個整理する。 専門用語の意味が分からないと議論が空回りするため、 組織内で共通言語として定着させることが望ましい。
- HCAI ── Human-Centered AI、 人間中心 AI
- HITL ── Human-in-the-Loop、 人間が判断ループに介在
- SHAP ── Shapley 値による特徴量寄与
- LIME ── 局所的線形近似による説明
- Model Card ── モデルの性能・限界文書
- Data Sheet ── データセットの背景文書
- Demographic Parity ── 人口統計学的公平性
- Equalized Odds ── 等しい誤りの機会
- Predictive Parity ── 予測値の校正公平性
- Counterfactual Fairness ── 反事実的公平性
- Differential Privacy ── 差分プライバシ
- Federated Learning ── 連合学習
- Reject Option ── 不確実時の人間委ねる選択肢
- Constitutional AI ── 憲法 AI、 自己批判による安全化
- RLHF ── 人間フィードバック強化学習
- Bias Mitigation ── バイアス緩和
- Pre-processing ── 学習前のデータ調整
- In-processing ── 学習時の公平性制約
- Post-processing ── 学習後の閾値調整
- Adversarial Debiasing ── 敵対的脱バイアス
- Reweighing ── サンプル重み付け再学習
- Disparate Impact ── 差別的影響
- Disparate Treatment ── 差別的扱い
- FAccT ── ACM 公平性・説明責任・透明性会議
- Explainability ── 説明可能性
- Interpretability ── 解釈可能性 (内在的)
- Transparency ── 透明性
- Accountability ── 説明責任
- Auditability ── 監査可能性
- Trustworthiness ── 信頼性
- Reliability ── 信頼性 (技術的)
- Robustness ── 堅牢性
- Safety ── 安全性
- Privacy ── プライバシ
- Consent ── インフォームド・コンセント
- Right to Explanation ── 説明を受ける権利
- Right to Object ── 異議申立権
- Right to Be Forgotten ── 忘れられる権利
- Data Minimization ── データ最小化原則
- Purpose Limitation ── 目的制限原則
- Storage Limitation ── 保存期間制限原則
- Anonymization ── 匿名化
- Pseudonymization ── 仮名化
- k-Anonymity ── k-匿名性
- l-Diversity ── l-多様性
- t-Closeness ── t-近似性
- SUS ── System Usability Scale
- NPS ── Net Promoter Score
- NASA-TLX ── タスク負荷指数
- Trust Scale ── 信頼度尺度
- EU AI Act ── 欧州 AI 規則
- GDPR ── EU 一般データ保護規則
- ISO/IEC 42001 ── AI マネジメントシステム
- ISO/IEC 24028 ── AI 信頼性
- NIST AI RMF ── 米国 AI リスク管理枠組
- OECD AI Principles ── OECD AI 原則
- UNESCO Recommendation ── ユネスコ AI 倫理勧告
- JDLA ── 日本ディープラーニング協会
- DPO ── データ保護責任者
- DIA ── 差別的影響評価
💬 HCAI に関する FAQ 追加 12 問
- Q. HCAI と AI 倫理は同じか? ── A. 倫理は理念、 HCAI は理念を実装する工学。 倫理委員会がポリシーを定め、 HCAI チームが SHAP / Fairlearn で実装する関係。
- Q. 中小企業でも HCAI は必要か? ── A. EU 市場でサービスを提供するなら必須。 また下請けでも大手の調達要件で求められる。 規模に関係なく考慮すべき。
- Q. HCAI を外注できるか? ── A. 監査は外注可能だが、 説明責任は組織内に留まる。 「外部に任せたから知らなかった」は通用しない。
- Q. SHAP を導入したら HCAI 完了か? ── A. 説明可能性の 1 要素のみ。 公平性・人間制御・透明性の他 3 要素を別途実装する必要がある。
- Q. 公平性指標を全て満たせるか? ── A. 数学的に不可能 (Chouldechova 2017)。 どれを諦めるかを明示的に決断し、 ステークホルダーに説明することが HCAI の本質。
- Q. AI に責任を負わせられないのか? ── A. 現行法では AI は法人格を持たない。 責任は開発組織・運用組織・利用者の三者で分担する。
- Q. HCAI とブラックボックスは両立するか? ── A. SHAP / LIME で post-hoc 説明可能性は担保可能。 ただし高リスク分野では本質的に解釈可能なモデル (線形回帰・決定木) を選ぶべき。
- Q. RLHF で HCAI は実現できるか? ── A. 部分的に。 人間フィードバックで安全性は向上するが、 公平性・透明性は別途実装が必要。
- Q. HCAI チームに必要なスキルセットは? ── A. 機械学習 + 統計 + UX 設計 + 法務 + 倫理学。 1 名で全てを満たすのは困難なため、 複数人での協働が前提。
- Q. HCAI の効果はどう測定するか? ── A. SUS スコア、 異議申立件数、 公平性指標推移、 監査指摘事項の 4 つを KPI として四半期ごとに測定。
- Q. 競合他社が HCAI を導入していないが、 自社だけ導入すべきか? ── A. EU AI Act 施行後は全競合が導入を迫られる。 先行することで差別化と人材獲得の利点を得られる。
- Q. HCAI を導入したら AI 性能が下がるか? ── A. 公平性制約により精度が 1-3% 程度下がることはあるが、 訴訟リスクや評判損失と比較すれば許容範囲。
🎬 HCAI 失敗事例の追加 6 ケーススタディ
HCAI を理解する最良の方法は 「失敗事例から逆算」すること。 過去 10 年の代表的な失敗を 6 件追加で取り上げる。
- Amazon 採用 AI (2018): 男性志願者に有利な評価で性別差別。 過去 10 年の採用データが男性中心だったことが原因。 サービス廃止。 教訓 ── 訓練データの歴史的偏りを意識せよ
- COMPAS 再犯予測 (米国, 2016): 黒人被告に高再犯リスクを過剰予測。 ProPublica 報道で問題化。 教訓 ── 公平性指標を事前合意せよ
- UK 教育評価アルゴリズム (2020): COVID で試験中止時に AI が成績推定、 私立校有利の判定に大反発。 撤回。 教訓 ── 高ステークス判断には人間最終決定を必須に
- Microsoft Tay (2016): Twitter で 16 時間で人種差別発言を学習。 教訓 ── オンライン学習は HCAI の悪夢、 安全性レイヤを必須に
- Apple Card 与信差別疑惑 (2019): 同条件の夫婦で女性側の与信枠が 1/10。 説明不可能で批判。 教訓 ── 説明可能性を導入時から実装せよ
- Robodebt 豪州福祉 AI (2016-2020): 自動債務通知で誤請求多発、 死者も出た。 政府謝罪、 賠償 18 億豪ドル。 教訓 ── 公共 AI は異議申立フローを最重要とせよ
これら全ての失敗には共通点がある ── 「HCAI の 4 原則 (説明可能性・公平性・人間制御・透明性) のいずれかが欠落」していたこと。 4 原則を全て実装する組織は、 これら失敗を未然に防ぐ仕組みを持つ。
🧭 HCAI 担当者向けの 7 つの心構え
HCAI を組織内で推進する担当者が肝に銘じるべき 7 つの心構え。 技術的スキルだけではなく 政治的・心理的な対人スキルが同等に重要である。
- 「完璧な公平性は存在しない」と認めよ ── どの公平性指標を採用するかは倫理的選択、 数学的最適解は存在しない
- 「説明可能性は手段、 信頼が目的」と理解せよ ── SHAP の数字が美しくてもユーザが信頼しないなら失敗
- 「組織の利益と倫理の対立」を恐れるな ── 売上機会を逃すこともある、 それでも長期的にはブランドを守る
- 「技術者と非技術者の通訳者」であれ ── 数学を経営語に翻訳できる人材こそ HCAI チームの中核
- 「ユーザの声を最優先」とせよ ── 訓練データの統計より、 実ユーザのフィードバックを重視
- 「失敗事例を恐れず公開」せよ ── 透明性レポートで自社の問題を開示する勇気が信頼を生む
- 「監査を毎月実施」せよ ── 年 1 回では遅すぎる、 月次が新しい標準
📌 HCAI で覚えるべき 5 つの英語用語 (国際会議で頻出)
国際会議 (FAccT, NeurIPS, AIES) で頻繁に登場する HCAI 用語の英語表現と日本語訳を整理する。 グローバル議論に参加するための最低限の語彙。
- "Algorithmic accountability" ── アルゴリズム説明責任。 開発者・運用者が AI 判断の結果に責任を負うという原則
- "Sociotechnical system" ── 社会技術システム。 AI を技術だけでなく社会的文脈と一体で捉える概念
- "Stakeholder engagement" ── ステークホルダー関与。 開発初期から多様な関係者を巻き込む設計プロセス
- "Algorithmic auditing" ── アルゴリズム監査。 公平性・透明性を第三者が検証する慣行
- "Participatory design" ── 参加型設計。 影響を受けるユーザを設計プロセスに参加させる手法
これらの用語を 日本語 + 英語の両方で説明できることが、 HCAI 担当者の国際的議論への入場券となる。 学会発表だけでなく、 海外子会社・パートナーとの議論でも頻出する。
補足として、 国内では 「人間中心の AI 社会原則 (内閣府 2019)」が公式日本語訳のベースであり、 これに基づく文書化・社内研修教材を整備しておくと 監査時に強力な裏付け資料となる。 海外との橋渡しには内閣府文書 + JDLA 倫理ガイドの 2 つを併用することが推奨される。
最後に重要な観点として、 HCAI は完成形ではなく継続的改善の枠組みである。 技術の進化とともに公平性指標も新しい定義が登場し、 説明可能性ツールも刷新されていく。 重要なのは特定の技術に固執することではなく、 「人間中心」という価値観を組織文化として根付かせること。 ツールは変わっても価値観は変わらない、 という認識こそが HCAI の最終到達点である。
本節のまとめ: HCAI は「美しい理念」ではなく 「実データを開示し、 誤差分布を点検し、 群間差を診断する具体的工程」である。 散布図・ヒストグラム・箱ひげ図の 3 図解パターンを HCAI ダッシュボードに 常設することで、 説明可能性 (Explainability)・公平性 (Fairness)・説明責任 (Accountability) の 3 原則が同時に運用に組み込まれる。 これらの図を 「説明用」ではなく「監査用」として位置づけることが、 HCAI を 「言葉だけ」から「証拠ベース」に転換する鍵となる。
🧮 数式に値を入れて手で計算する: ユーザ満足度スコア
合成データで Human-AI 協働ツールの 5 観点満足度の加重平均を計算する。
Step 1: 観点別スコア
| 観点 | スコア (0-5) | 重み | 加重 |
|---|---|---|---|
| 使いやすさ | 4 | 0.25 | 1.00 |
| 説明性 | 3 | 0.20 | 0.60 |
| 信頼性 | 5 | 0.25 | 1.25 |
| 制御性 | 4 | 0.15 | 0.60 |
| プライバシー | 4 | 0.15 | 0.60 |
Step 2: 加重平均
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np scores = np.array([4, 3, 5, 4, 4]) weights = np.array([0.25, 0.20, 0.25, 0.15, 0.15]) total = (scores * weights).sum() print(f"加重平均: {total:.2f}") print(f"%: {total/5*100:.0f}%") |
📤 実行結果
💬 手計算 (Step 2) 4.05 と Python 出力が完全一致。
🐍 Python での扱い
SSDSE-B-2026 のような公的統計データを Python で扱う際の基本パターン:
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd import numpy as np # データ読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) # 2 行目の日本語見出しを飛ばす(0 だと見出しがデータ行に混ざり全列が文字列になる) print(df.shape) print(df.dtypes) print(df.describe()) # 「人間中心のAI」の文脈で扱う場合の例: # 分野: 倫理 # 関連手法は同カテゴリの他用語を参照してください。 |
💬 (564, 112) は 47 都道府県 × 12 年度(2012〜2023)のパネルをそのまま読んだ形で、SSDSE-B-2026 列の mean 2017.5・min 2012 がその証拠。A1101(総人口)の平均 269 万人は 12 年度分を混ぜた値なので、「今の県の平均人口」として引用すると 2023 年度単独の値とずれる。人に判断を返す仕組みを作る前に、どの年度・どの粒度のデータで機械が学んだのかをこの段階で確かめておく。
具体的なコードは AI倫理・公平性 を参照してください。
📝 レポートでの報告
分析結果を報告するときに含めるべき情報:
- 使ったデータ:出典・期間・サンプル数
- 適用条件の確認:前提が満たされているか
- 計算結果:数値だけでなく不確実性(CI・SE)も
- 解釈:何を意味するか、 何を意味しないか
- 限界:適用範囲外への拡張は避ける
✅ チェックリスト
- □ 「人間中心のAI」を使う場面か再確認したか
- □ データの尺度・分布・サンプル数を確認したか
- □ 前提条件を満たしているか
- □ 計算した値だけでなく不確実性も把握したか
- □ 解釈と限界を区別したか
- □ 関連グループ教材で全体像を確認したか
⚠️ よくある落とし穴
⚠️ HCAI アンチパターン 8 連発
🛠 HCAI 関連ツール一覧
| カテゴリ | ツール | 提供元 | 特徴 |
|---|---|---|---|
| 説明可能性 | SHAP | OSS (Lundberg 2017) | Shapley 値の Python 実装、 木モデル特化高速版あり |
| 説明可能性 | LIME | OSS (Ribeiro 2016) | 局所線形近似、 画像・テキスト対応 |
| 説明可能性 | Captum | PyTorch (Meta) | 深層学習向け各種帰属手法 |
| 公平性 | Fairlearn | Microsoft | 指標 + 緩和、 sklearn 互換 |
| 公平性 | AI Fairness 360 | IBM | 70+ 指標、 包括的 |
| プライバシー | Opacus | PyTorch (Meta) | DP-SGD、 PyTorch 統合 |
| プライバシー | PySyft | OpenMined | 連合学習、 暗号計算 |
| 堅牢性 | CleverHans | 敵対的攻撃テストキット | |
| 監査 | Model Cards Toolkit | モデル文書化フォーマット | |
| 監査 | Datasheets for Datasets | Microsoft (Gebru 2018) | 学習データ文書化フォーマット |
🏢 組織における HCAI 実装
- AI 倫理委員会 — 重大判断時に法務・倫理学者・現場代表が議論。 大企業では必須
- Model Risk Management (MRM) — 金融業界で先行、 第 3 者検証部門が AI モデルを独立評価
- Algorithmic Impact Assessment — カナダ政府が制度化、 リスクスコアで提出義務範囲を決定
- Internal Audit — 監査部門が AI モデルの公平性・正確性を定期検査
- Red Team — 攻撃側視点で脆弱性を意図的に探す専門チーム。 OpenAI / Anthropic が運用
- Bug Bounty for AI — 外部研究者に脆弱性報告を依頼、 報奨金を支払う制度
🗺 概念マップ
関連概念を視覚的に整理した概念マップ。
上図の中心「人間中心 AI」から放射する 5 つの軸 — Stanford HAI Whitepaper・説明形式・公平性の規範・プライバシー定義・人間-AI 協働 — はそれぞれ独立した研究領域として進化してきたが、 実装の現場では同時に満たすことが要求される。 例: 医療診断 AI は説明可能性 (SHAP 等) + 公平性 (人種・性別バイアス監査) + プライバシー (差分プライバシー) を同時設計する必要がある。
🔗 隣接手法への橋渡し
人間中心 AI (HCAI) は、 設計の入口 (要件定義) から運用の出口 (再評価) まで貫く設計思想であり、 周辺技術と結びつくことで初めて具体化する。
- 上流: AI 倫理 ・ AI 原則 ・ 隠れたデータ偏り — 設計前に倫理規範と偏り検査を実施
- 並列: 信頼性 ・ AI ガイドライン ・ AI 安全性 — 同じ目的 (Trustworthy AI) を異なる切り口で実装
- 下流: A/B テスト ・ アカウンタビリティ ・ アルゴリズム偏り — 運用後にユーザ影響を測定して再設計に戻す
HCAI の真価は、 これら 3 層を「ループ」として往復させる点にある。 一度設計したら終わりではなく、 ユーザ行動ログ → バイアス検査 → 倫理レビュー → 再設計のサイクルを継続することで「人間中心」が実現する。
🌳 手法選択フロー
HCAI を実プロジェクトに組み込むとき、 開発段階に応じて適用する手法が異なる。 以下の 3 段階で判定する。
- 設計段階: 影響を受けるステークホルダは誰か? → AI 倫理 でリスク列挙、 AI 原則 で優先順位設定、 隠れたデータ偏り を事前検査
- 実装段階: モデル予測の根拠を説明する必要があるか? → 必要なら SHAP / LIME 等の説明可能 AI、 公平性保証なら demographic parity / equalized odds 指標、 プライバシー保証なら差分プライバシー
- 運用段階: ユーザ影響を継続監視するか? → A/B テスト で介入効果測定、 アカウンタビリティ で責任所在を明確化、 AI 規制 準拠を定期監査
3 段階のいずれかを省略すると HCAI 原則違反となる。 例: 設計段階のリスク評価を省略すると医療 AI の人種バイアスが運用後に発覚するなどの事例がある。