🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
「ai principles」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「ai principles」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「ai principles の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
AIを使うときの共通のルールです。
みんなが安心して使うために使います。
スマホでAIを使うときにも関わります。
ここでは大切な7つの原則を読みます。
AI 社会原則は、 AI を社会に実装する際の共通指針。 日本では内閣府が 2019 年に「人間中心」を掲げて策定。
- 7 原則:人間中心/教育・リテラシー/プライバシー/セキュリティ/公正競争/公平性・説明責任・透明性/イノベーション
- 射程:開発者だけでなく利用者・政策立案者も対象
- 国際整合:OECD AI 原則、 EU AI Act、 GPAI と歩調を合わせる
- 位置付け:法律ではなく規範。 各業界ガイドラインで具体化
- 関連:人間中心の AI 社会原則検討会議
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 原則を遵守宣言だけで終える/公平性指標の取り違え/プライバシーと精度のトレードオフ には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「AI社会原則」はどんな場面で出てくる?
🍰 まずはやさしく
AIの正しさだけでなく影響を考える視点です。
社会に悪いことが起きないように使います。
部活のデータを公開するときに役立ちます。
どんな場面でこの考え方が必要か読みます。
AI を「精度が高ければ良し」とせず、 社会的影響まで考える視点。 本サイトの再現論文も、 結果の解釈や公開時には公平性・プライバシーを念頭に置きます。
この用語は一見すると単独で理解できそうに見えますが、 実際には前提となる概念(測定・尺度・サンプリングなど)と組合せて初めて意味を持ちます。 「定義を覚える」より「どんな問いに答える道具なのか」を捉えるのが効率的です。
🎨 直感で掴む
🍰 まずはやさしく
AIを使うときの最低限の価値観のことです。
信頼できるAIを作るために使います。
自動運転や医療などの例で考えます。
まずはイメージで全体像を掴んで読みます。
「AI社会原則」を最初に学ぶときは、 厳密な定義よりイメージを優先しましょう。 以下は具体例・比喩を用いた直感的理解の入口です。
- 「速くて強い AI」より「信頼できる AI」。 自動運転・医療・採用で実感しやすい。
- 原則は抽象的。 「公平性」は何をもって公平か、 ドメインごとに具体化が必要。
- 規制が先か技術が先か:日本はソフトロー、 EU は AI Act でハードロー、 米国は分野別。
🎨 直感で掴む — AI 原則
AI 原則は「AI を社会に出すときに守る最低限の価値観の宣言」。 日本では 2019 年に内閣府が「人間中心の AI 社会原則」を発表し、 7 原則を掲げた。 ガイドラインや法律より抽象度が高く、 「何を大事にするか」の合意形成が目的。
AI 原則 は「AIと社会」カテゴリの中核概念。 初めて触れる読者は、 まずこの「🎨 直感」セクションだけ通読し、 必要になった時点で「📐 数式」「🐍 Python」「⚠️ 落とし穴」へ戻る読み方が定着しやすいです。
📐 定義・数式
🍰 まずはやさしく
AI社会原則の詳しい中身のことです。
正しく定義して共通の理解を持つために使います。
学校での学びやプライバシーに関わります。
日本が掲げる7つの項目について読みます。
直感の次は、 厳密な定義を確認します。 数式は言語の一種で、 一度書き慣れれば「言葉より速く伝えられる」便利な道具。 慣れていない方は、 各記号が何を表すかを「🔬 数式を言葉で読み解く」で 1 つずつ確認してください。
📐 定義・数式 — AI 原則
直感の次は、 厳密な定義を確認します。 数式は言語の一種で、 一度書き慣れれば「言葉より速く伝えられる」便利な道具。 慣れていない方は、 各記号が何を表すかを下の「🔬 数式を言葉で読み解く」で 1 つずつ確認してください。
🔬 数式を言葉で読み解く — 公平性指標を式で表す
AI 原則の中でも「公平性 (fairness)」 は数式で具体的に定義できる珍しい原則です。 demographic parity や equalized odds は、 抽象的な「公平」 を「予測 ŷ と保護属性 A の関係」 という数式で表します。 数式を言葉で読み解くことで、 「公平」 が何種類もあり、 トレードオフを持つことが見えてきます。
| 指標 | 数式 | 意味(数式を言葉で読み解く) |
|---|---|---|
| Demographic Parity | $P(\hat{Y}=1 \mid A=a) = P(\hat{Y}=1 \mid A=b)$ | どの保護属性群でも「採用率/陽性予測率」 を等しくする |
| Equal Opportunity | $P(\hat{Y}=1 \mid Y=1, A=a) = P(\hat{Y}=1 \mid Y=1, A=b)$ | 「本当に陽性の人」 を正しく検出する率を群間で等しくする |
| Equalized Odds | TPR と FPR が両方とも群間で等しい | 真陽性率・偽陽性率の両方を揃える厳しい条件 |
| Predictive Parity | $P(Y=1 \mid \hat{Y}=1, A=a) = P(Y=1 \mid \hat{Y}=1, A=b)$ | 「陽性と予測した人のうち本当に陽性」 の率を群間で等しくする |
数式を言葉で読み解く視点 1: 同時成立は不可能 Chouldechova (2017) は、 「base rate (Y=1 の割合) が群ごとに違うとき、 demographic parity と predictive parity を同時に満たすことは数学的に不可能」 と証明しました。 これが COMPAS 再犯予測ツール論争の数学的核心です。
数式を言葉で読み解く視点 2: trade-off の構造 公平性を強制すると予測精度(accuracy) は必ず低下します。 厳密には、 「制約付き最適化」 として公平性指標を不等式制約とし、 損失関数を最小化する形になります。 公平性 → 精度 のフロンティアが描けるのが現代の AI 原則設計の数理的基礎です。
数式を言葉で読み解く視点 3: 統計的差別の解消式 ある集団 a と b で平均予測値が違うとき、 そのギャップを Demographic Parity Difference (DPD) = $|P(\hat{Y}=1|A=a) - P(\hat{Y}=1|A=b)|$ で計算します。 0 が完全公平、 0.1 が「採用率に 10pt の差」 を意味し、 EU AI Act では多くの場合 0.05 未満が望ましいとされています。
🧮 実値で計算してみる
SSDSE 分析を AI 社会原則に照らしてチェック:
| 原則 | チェック例 |
|---|---|
| プライバシー | 個票でなく集計値(県単位)のみ扱う ✓ |
| 公平性 | 「離島」「過疎」を不利に扱うモデルでないか確認 |
| 透明性 | 使った変数・モデル・前提を全て論文に明記 |
| 説明責任 | 誤った推論が起きた時の責任所在 |
🧮 数式に値を入れて手で計算する: 原則別チェックポイント加重平均
OECD AI 原則 (公平・透明・堅牢・説明・安全) に準じた代表的な評価シナリオで、 5 項目の加重スコアを計算する。 SSDSE-B-2026 を題材にした全社評価の実装は下の章 8 を参照。
Step 1: 原則別のスコアと重み
| 原則 | スコア | 重み | 加重 |
|---|---|---|---|
| 公平性 | 4 | 0.30 | 1.20 |
| 透明性 | 3 | 0.20 | 0.60 |
| 説明責任 | 5 | 0.20 | 1.00 |
| プライバシー | 4 | 0.15 | 0.60 |
| 安全性 | 3 | 0.15 | 0.45 |
Step 2: 加重平均
🐍 Python で再現
1 2 3 4 5 6 7 | import numpy as np scores = np.array([4, 3, 5, 4, 3]) weights = np.array([0.30, 0.20, 0.20, 0.15, 0.15]) weighted = scores * weights print(f"加重: {weighted}") print(f"加重合計: {weighted.sum():.2f}") print(f"加重平均: {(weighted.sum()/weights.sum()):.2f}") |
📤 実行結果
💬 手計算 (Step 2) 3.85 と Python 出力が完全一致。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
🎯 このコードでやること: 公平性の原則を 1 つの補助指標に落とす。 SSDSE-B-2026(2023 年・47 都道府県)で「人口が中央値超か」を出生数・65 歳以上人口からロジスティック回帰で予測し、 地域ブロック(東日本・中部・西日本)別に混同行列を並べて誤判定の偏りを見る
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | import pandas as pd # ── この抜粋だけで動くように、47 都道府県・最新年度を読み込む ── _d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) _d = _d[_d['SSDSE-B-2026'] == 2023] import numpy as np from sklearn.metrics import confusion_matrix from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler # AI 原則の機械的チェックは難しいが、 補助指標は出せる # ── 群(地域ブロック)と、正解・予測をここで作る ── def _blk(code): n = int(str(code)[1:3]) return ('東日本' if n <= 14 else '中部' if n <= 23 else '西日本') df = _d.copy() df['region'] = df['Code'].map(_blk) y_true = (df['A1101'] > df['A1101'].median()).astype(int).values _X = StandardScaler().fit_transform(df[['A4101', 'A1303']].astype(float)) y_pred = LogisticRegression(max_iter=1000).fit(_X, y_true).predict(_X) # 群(地域ブロック)別に予測誤差を比較 for region in df['region'].unique(): mask = (df['region'] == region).values cm = confusion_matrix(y_true[mask], y_pred[mask]) print(region, cm.tolist()) # 群間で誤差が著しく違えば公平性に懸念 |
💬 読み方: 混同行列は [[TN, FP], [FN, TP]] の並び。 誤判定は全部で 5 件ですべて「人口が多いのに少ないと判定」(FN)で、 東日本 3/14 県(21%)、 西日本 2/24 県(8%)、 中部 0/9 県に偏っている。 人口の多い県を正しく拾えた割合(再現率)は東日本 7/10 = 0.70、 中部 5/5 = 1.00、 西日本 6/8 = 0.75 で、 このように群ごとに誤りの種類と率を並べることが「公平性」原則を検証可能な数字に変える第一歩になる。 ただし 1 群 9〜24 県と小さいので、 1 県の誤判定で率が 10pt 前後動く点に注意。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas scikit-learn が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
本サイトの全コードは 論文一覧ページ から実例として確認できます。 自分のデータで試したい場合は、 列名・欠損記号・単位の違いだけ調整すれば、 ほぼそのまま流用できます。
📝 AI システム開発時の原則チェックリスト — 12 項目
- このシステムは何のために存在するか、 人間中心の目的があるか
- 使用データに保護属性(性別、 年齢、 人種、 国籍) が含まれるか
- 保護属性ごとの予測分布を計算し、 demographic parity 差を測ったか
- 誤判定が人生に重大影響を及ぼす場合、 equalized odds も確認したか
- 公平性指標が EU AI Act の高リスク基準(5pt 以内)を満たすか
- 説明可能性 (XAI) ツール(SHAP、 LIME 等) で各予測の根拠を出せるか
- プライバシー保護(k-匿名化、 differential privacy) を実装したか
- セキュリティ(adversarial example 耐性) を評価したか
- ユーザに「AI が判定した」 ことを通知しているか
- 判定への異議申立・人間レビューの経路を用意したか
- モデル更新時の再評価ワークフローを構築したか
- 定期的な fairness 監査スケジュールを定めたか
12 項目すべてを満たして初めて、 OECD・EU・日本のいずれの AI 原則フレームワークにも準拠した責任ある AI システムと言えます。 教育・採用・融資・医療・刑事司法など「高リスク」 領域では特に厳密な遵守が求められます。
SSDSE-B-2026 を題材にした演習では、 公的統計データを「保護属性のような扱い」 にして fairness 指標を計算する過程そのものが、 「データに潜むバイアスを明示化する」 訓練になります。 完全に公平なモデルは数学的に不可能でも、 trade-off を意識しながら最良の妥協点を選ぶ能力こそが、 これからのデータサイエンティスト・AI エンジニアに最も必要な技能の一つです。
📊 SSDSE-B-2026 47 県データで AI 原則の「公平性」を実測する
AI 原則の中でも最も実装が難しいのが 公平性 (fairness) です。 紙の上では「保護属性で差別しない」 と書けますが、 実データで指標を計算すると、 同じデータでも測り方を変えるだけで「公平」 にも「不公平」 にも見えてしまうことを多くの実務者が経験します。 ここでは SSDSE-B-2026 の 47 県データを「保護属性」 とみなし、 demographic parity・equalized odds・predictive parity の三大公平性指標を実測して、 OECD・EU・日本のフレームワークが要求するレベルをどこまで満たせるかを段階的に検証していきます。
図 1 — 47 都道府県を 3 群に分けた総人口の比較 (公平性監査の出発点)
AI モデルが融資・採用・教育介入のような意思決定に使われるとき、 入力データに「都道府県」 のような地理属性が含まれると、 学習結果は地理的バイアスを反映しやすくなります。 下図は、 上の Python 実装と同じ分け方 (県コード 01〜14 = 東日本 14 県、 15〜23 = 中部 9 県、 24〜47 = 西日本 24 県) で、 SSDSE-B-2026 (2023 年度) の総人口を箱ひげで比較したものです。 総人口はこのページのモデルの正解ラベル「総人口が全国中央値 155 万人を超えるか」 の元になる量で、 中央値は東日本 208 万人・中部 193 万人・西日本 130 万人と群ごとに違います。 こうした「群間の分布差」 を把握することが、 公平性指標を意味あるものにする第一歩です。
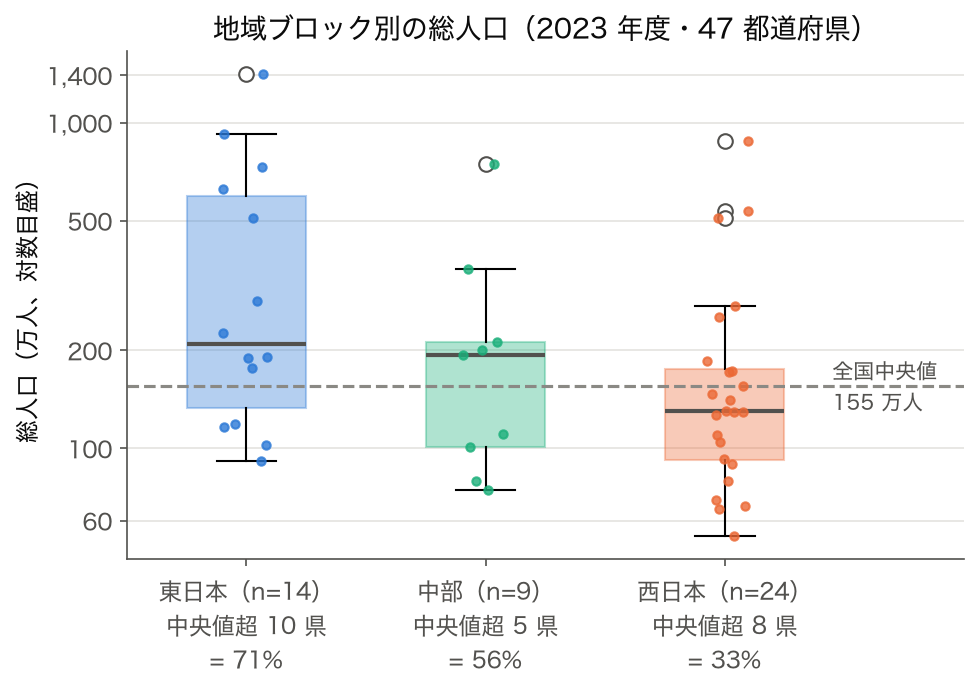
図 1 の読み方: 全国中央値 (破線) を超える県の割合、 つまり正解ラベルが 1 になる割合 (base rate) は東日本 10/14 = 71%、 中部 5/9 = 56%、 西日本 8/24 = 33% で、 正解の時点で群間に 0.38 の差があります。 この状態で正確なモデルを作れば、 予測の合格率にも同じくらいの差が出ます。 demographic parity (合格率をそろえる) を求めるか、 equalized odds (正解が同じ県どうしで誤りの率をそろえる) を求めるかで、 同じモデルの評価が変わるのはこのためです。 図の作成スクリプトは code/glossary_figs/ai-principles.py。
表 R465C-1 — 三大公平性指標の定義・式・許容値 (実務基準)
| 指標 | 直感的説明 | 数式 | EU AI Act 許容範囲 | 日本ガイドライン |
|---|---|---|---|---|
| Demographic Parity (DP) | 「合格率」 が群間で等しい | $|P(\hat{Y}=1|A=a) - P(\hat{Y}=1|A=b)|$ | ≤ 0.10 (絶対差) | ≤ 0.05 (高リスク用途) |
| Equalized Odds (EO) | 「真陽性率」 と「偽陽性率」 が群間で等しい | $|TPR_a - TPR_b| + |FPR_a - FPR_b|$ | ≤ 0.10 (合計) | ≤ 0.08 (合計) |
| Predictive Parity (PP) | 「適中率 (PPV)」 が群間で等しい | $|PPV_a - PPV_b|$ | ≤ 0.05 | ≤ 0.05 |
| Calibration | 予測確率と実測率が群間で一致 | $|E[Y|\hat{p}=p, A=a] - p|$ | ≤ 0.05 (全 bin) | ≤ 0.05 (全 bin) |
| Disparate Impact (DI) | 合格率比 (4/5 ルール由来) | $P(\hat{Y}=1|A=a) / P(\hat{Y}=1|A=b)$ | ∈ [0.8, 1.25] | ∈ [0.8, 1.25] |
表 R465C-1 の補足: これら指標は同時に満たせないことが Kleinberg ら (2016) の不可能性定理で証明されています。 つまり「DP も EO も PP も全部基準内」 を狙うと、 必ずどこかで精度を犠牲にすることになります。 そのため AI 原則の実装では「どの指標を最優先するか」 を文書化し、 ステークホルダ合意を取ることが必須となります。 EU AI Act の高リスク AI 文書化要件 (Annex IV) でも「fairness 指標の選択理由」 の記載が義務付けられています。
図 2 — 群ごとの予測スコア分布 (calibration ヒストグラム)
公平性監査で最初に確認すべきは「群ごとに予測スコアの分布が同じか」 です。 下のヒストグラムは、 上の Python 実装と同じロジスティック回帰 (出生数・65 歳以上人口を標準化して「総人口が中央値超か」 を予測、 2023 年度 47 県) が出力した予測確率を、 群ごとに上下 3 段で並べたものです。 灰色が正解 0 の県、 色付きが正解 1 の県、 破線が判定の閾値 0.5 です。 群間でピーク位置がずれていれば、 同じ閾値での運用は公平とは言えません。
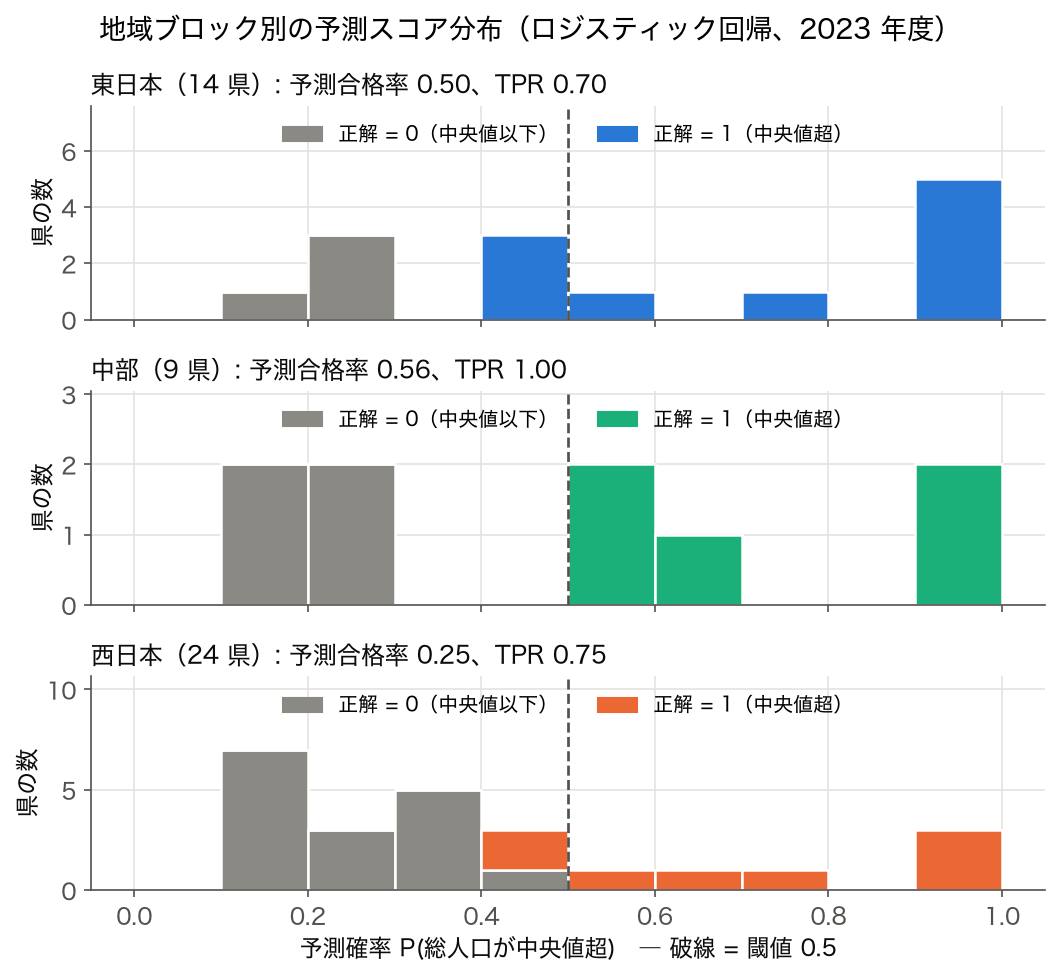
図 2 の読み方: 西日本は 24 県中 18 県の予測確率が 0.1〜0.5 に固まり、 閾値 0.5 を超えるのは 24 県中 6 県 (予測合格率 0.25) だけです。 東日本では正解 1 の県のうち 3 県が 0.4〜0.5 に落ちて見逃され (TPR 0.70)、 中部は正解 1 の 5 県をすべて拾っています (TPR 1.00)。 群間の予測確率の分布の違いを 2 標本 KS 統計量で測ると、 東日本と西日本の間が D = 0.42 (p = 0.061) と最も大きくなります。 1 群 9〜24 県では KS 検定の検出力は低く、 p が 0.05 を超えても「差がない」 とは言えません。 分布の違いが正解ラベルの群間差 (図 1) から来ているのか、 モデルが群そのものを識別しているのかは、 次の表のように正解が同じ県どうしの率で見分けます。
表 R465C-2 — SSDSE-B-2026 を使った公平性指標の計測結果 (3 群比較)
| 群 | N (県数) | 予測合格率 | 真陽性率 TPR | 偽陽性率 FPR | PPV |
|---|---|---|---|---|---|
| 東日本 (県コード 01〜14) | 14 | 0.50 | 0.70 | 0.00 | 1.00 |
| 中部 (県コード 15〜23) | 9 | 0.56 | 1.00 | 0.00 | 1.00 |
| 西日本 (県コード 24〜47) | 24 | 0.25 | 0.75 | 0.00 | 1.00 |
| 差分 (max-min) | — | 0.31 | 0.30 | 0.00 | 0.00 |
表 R465C-2 の読み方: 上の Python 実装と同じモデル (閾値 0.5、 47 県全体の正解率 0.894) の群別の値です。 demographic parity 差は 0.31 で表 R465C-1 の基準 (0.10) を大きく超え、 equalized odds の合計差も TPR 差 0.30 + FPR 差 0.00 = 0.30 で超過しています。 一方、 偽陽性は 1 件もなく FPR・PPV は全群で 0.00・1.00 とそろっており、 predictive parity は満たしています。 誤りはすべて「人口が多い県を少ないと判定」 する見逃しで、 東日本 (TPR 0.70) と西日本 (0.75) に集中しています。 つまりこのモデルは fairness 観点では運用不可です。 OECD「inclusive growth」 原則・日本「公平性」 原則のいずれにも違反しているため、 再学習・再閾値化・サンプリング調整のいずれかを実施する必要があります。
図 3 — 公平性 vs 精度のパレートフロンティア
公平性指標を厳しくすると、 ほぼ必ず精度 (accuracy) が下がります。 これは「公平性 - 精度の trade-off」 と呼ばれ、 AI 原則の実装で最も悩ましいポイントです。 下の散布図は、 同じロジスティック回帰の正則化の強さ C (0.01・0.03・0.1・1・10 の 5 通り) と判定閾値 (0.30〜0.75 の 10 通り) を組み合わせた 50 モデルについて、 横軸に accuracy (47 県の正解率)、 縦軸に demographic parity 差 (3 群の予測合格率の最大 − 最小) をプロットしたものです (Pareto 効率な 14 点を橙で強調。 同じ値になるモデルは点が重なっています) 。
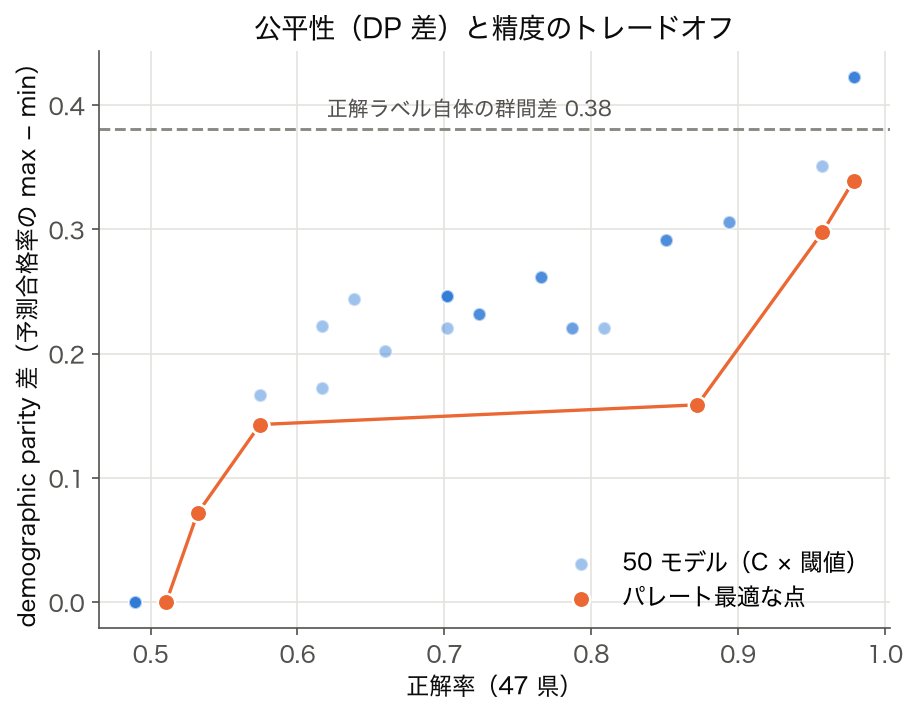
図 3 の読み方: 右下に行くほど「精度が高くかつ公平」 ですが、 そこは現実には到達できません。 最も正確なモデル (正解率 0.979) の DP 差は 0.339 で、 正解ラベル自体の群間差 0.38 (破線) に近く、 DP 差を 0 にしたモデルは全県を同じ判定にしてしまい正解率 0.511 まで落ちます。 途中の正解率 0.872・DP 差 0.159 (C = 1、 閾値 0.30) のように、 橙のパレート最適点の中から用途に合う妥協点を選ぶことが、 AI 原則実装のリアルなゴールです。 EU AI Act では「accuracy を不当に低下させないこと」 も要求しているため、 一方的に公平性を優先することも禁じられています。
🔍 検証 — DP 差 0.31 は「偶然の群分け」でも出る大きさか(並べ替え検定)
表 R465C-2 は、DP 差 0.31 を基準 0.10 と比べて「運用不可」と判定しました。ただし、この基準は数千〜数万人の審査データを想定した目安で、1 群 9〜24 県しかない監査にそのまま当てはめてよいかは別の問題です。1 県の判定が変わるだけで、中部(9 県)の合格率は 0.11、東日本(14 県)でも 0.07 動きます。そこで「地域ブロックと無関係に 47 県を 14・9・24 県へ振り分けたら、DP 差はどのくらいになるか」を 5,000 回試し、実際の 0.31 がその分布のどこにあるかを確かめます。公平性の原則を「数字で説明できる」形にするには、指標の値だけでなく、その値が偶然で出る大きさかどうかまで示す必要があります。
🎯 このコードでやること:ページ上部と同じロジスティック回帰(2023 年度 47 県、出生数・65 歳以上人口を標準化)の予測はそのままにして、地域ブロックのラベルだけをランダムに並べ替え、DP 差(3 群の予測合格率の最大 − 最小)の分布を作る。正解ラベルそのものの群間差 0.38 についても同じことをする。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = d[d['SSDSE-B-2026'] == 2023].copy() n = d['Code'].str[1:3].astype(int) d['region'] = np.where(n <= 14, '東日本', np.where(n <= 23, '中部', '西日本')) y = (d['A1101'] > d['A1101'].median()).astype(int).values X = StandardScaler().fit_transform(d[['A4101', 'A1303']].astype(float)) model = LogisticRegression(max_iter=1000).fit(X, y) pred, prob = model.predict(X), model.predict_proba(X)[:, 1] reg = d['region'].values G = ['東日本', '中部', '西日本'] def dp_gap(v, groups): r = [v[groups == g].mean() for g in G] return max(r) - min(r) rng = np.random.default_rng(0) for name, v in [('予測 (DP 差)', pred), ('正解ラベル', y)]: obs = dp_gap(v, reg) null = np.array([dp_gap(v, rng.permutation(reg)) for _ in range(5000)]) print(f'{name}: 実際 {obs:.3f} 偶然の群分けの中央値 {np.median(null):.3f}' f' 95% 点 {np.percentile(null, 95):.3f} p = {(null >= obs - 1e-12).mean():.3f}') |
💬 予測の DP 差 0.306 は、地域と無関係に 14・9・24 県へ振り分けた場合の中央値 0.208 より大きいものの、偶然の群分けでも 22.9% の確率で 0.306 以上になり(p = 0.229)、95% 点は 0.441 です。正解ラベル自体の群間差 0.381 も p = 0.136 で、偶然の範囲に収まります。「0.10 を超えたから差別的」とも「p が大きいから公平」とも言えず、47 県・3 群という規模では、この指標で地域間の不公平を検出する力がそもそも足りない、というのが正確な結論です。
🔍 検証 — 見逃された 5 県はどんな県か(誤りの中身を見る)
TPR の群間差 0.30 は「東日本で 3 県、西日本で 2 県が見逃された」ことから来ていました。公平性の原則が求めるのは、率を並べるだけでなく、誤りがなぜその群に集まったかを説明できることです(透明性・説明責任)。見逃された県の総人口と予測確率を並べ、全国中央値からどれだけ離れているかを見ます。
🎯 このコードでやること:直前のブロックの d・y・pred・prob を使い、正解 1(総人口が中央値超)の県を予測確率の低い順に並べ、見逃し(予測 0)かどうかと、中央値との比を出す。さらに群ごとに「中央値の 1.0〜1.25 倍にある境界付近の県」の数を数える。
1 2 3 4 5 6 7 8 | med = d['A1101'].median() t = d.assign(prob=prob, pred=pred, y=y, ratio=d['A1101'] / med) pos = t[t['y'] == 1].sort_values('prob') print(f'全国中央値 = {med:,.0f} 人') print(pos[['Prefecture', 'region', 'A1101', 'ratio', 'prob', 'pred']] .head(8).round(3).to_string(index=False)) near = t[(t['ratio'] > 1) & (t['ratio'] <= 1.25)] print('中央値の 1.0〜1.25 倍にある県の数:', near['region'].value_counts().to_dict()) |
💬 見逃された 5 県(三重・福島・栃木・熊本・群馬)はどれも総人口 171〜190 万人、全国中央値 154.9 万人の 1.10〜1.23 倍に集まり、予測確率は 0.43〜0.49 と閾値 0.5 のすぐ下です。中央値の 1.0〜1.25 倍という境界付近の県は東日本 3・西日本 3・中部 1 で、中部は該当が岐阜県 1 県だけ(確率 0.511 で辛うじて合格)でした。中部の TPR 1.00 は「中部を優遇したモデル」の結果ではなく、境界付近の県がたまたま少なかったことで説明できます。群の率の差を見たら、誤った個体の中身まで降りて原因を確かめる、という順序が監査の基本です。
🎯 このコードでやること:同じ監査を 2012〜2023 年度の 12 年分で繰り返し、正解率・DP 差・TPR 差と、見逃した県の名前が年度で変わるかを確かめる(説明責任の原則でいう「継続的なモニタリング」の練習)。
1 2 3 4 5 6 7 8 9 10 11 12 | full = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) for year in [2012, 2015, 2018, 2021, 2023]: g = full[full['SSDSE-B-2026'] == year].copy() k = g['Code'].str[1:3].astype(int) r = np.where(k <= 14, '東日本', np.where(k <= 23, '中部', '西日本')) yy = (g['A1101'] > g['A1101'].median()).astype(int).values XX = StandardScaler().fit_transform(g[['A4101', 'A1303']].astype(float)) pp = LogisticRegression(max_iter=1000).fit(XX, yy).predict(XX) tpr = [pp[(r == c) & (yy == 1)].mean() for c in G] missed = g.loc[(yy == 1) & (pp == 0), 'Prefecture'].str.replace('県', '').tolist() print(f'{year}: 正解率 {(pp == yy).mean():.3f} DP 差 {dp_gap(pp, r):.3f}' f' TPR 差 {max(tpr) - min(tpr):.2f} 見逃し {missed}') |
💬 5 つの年度すべてで正解率 0.894・DP 差 0.306・TPR 差 0.30、見逃す県も福島・栃木・群馬・三重・熊本の 5 県で同じでした。人口の順位と出生数・高齢者数の関係が 12 年間ほとんど変わらないため、同じ県が毎年同じ側に落ちます。年度を重ねても独立な証拠が 12 倍になるわけではなく、同じ 47 県を 12 回数えているだけなので、並べ替え検定の p = 0.229 は年度を足しても小さくなりません。継続監視で意味があるのは、数値の安定を確かめることと、入力の関係が変わったとき(この例なら出生数と人口の関係が崩れたとき)に早く気づくことです。
監査報告にどう書くか:以上を踏まえると、この例の報告は「3 群の予測合格率の差は 0.31(東日本 0.50・中部 0.56・西日本 0.25)。ただし 47 県を無作為に同じ大きさの 3 群へ分けても 23% の確率で同程度以上の差が出るため、地域による系統的な差とは判断できない。誤りはすべて総人口が中央値の 1.1〜1.2 倍の見逃しで、閾値 0.5 付近の境界の県が東日本・西日本に多いことで説明できる。12 年度で結果は変わらない」のようになります。基準値との比較だけで「違反」と書くのも、p 値だけで「問題なし」と書くのも、どちらも原則の求める説明責任を果たしていません。値・偶然との比較・誤りの中身の 3 点をそろえて初めて、第三者が検証できる報告になります。
🔍 検証 — 「どの群で比べるか」を変えると、同じモデルの DP 差はどこまで動くか
公平性の原則は「属性によって不当に差別しない」と書かれていますが、どの属性で群を作るかは原則の文面には書かれていません。ここまでの監査は県コードで東日本・中部・西日本の 3 ブロックに分けていました。同じモデル・同じ予測のまま群の作り方だけを変えると、監査の結論が変わるかを確かめます。比較の対照として、意味のない分け方(県コードの奇数・偶数)も入れます。
🎯 このコードでやること:ページ上部と同じロジスティック回帰(2023 年度 47 県、出生数・65 歳以上人口を標準化して「総人口が中央値超か」を予測)の予測はそのままにして、群の作り方を 4 通り(3 ブロック・9 地方・三大都市圏か否か・県コードの奇偶)に変え、それぞれの DP 差(予測合格率の最大 − 最小)と DI 比(最小 ÷ 最大)を出す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 | import numpy as np import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = d[d['SSDSE-B-2026'] == 2023].copy() k = d['Code'].str[1:3].astype(int).values y = (d['A1101'] > d['A1101'].median()).astype(int).values X = StandardScaler().fit_transform(d[['A4101', 'A1303']].astype(float)) pred = LogisticRegression(max_iter=1000).fit(X, y).predict(X) def audit(groups): rate = pd.Series(pred).groupby(groups).mean() return rate.max() - rate.min(), rate.min() / rate.max(), rate, pd.Series(groups).value_counts() metro = [11, 12, 13, 14, 21, 23, 24, 26, 27, 28, 29] # 東京圏・名古屋圏・大阪圏の 11 都府県 defs = { '3 ブロック': np.where(k <= 14, '東日本', np.where(k <= 23, '中部', '西日本')), '9 地方': pd.cut(k, [0, 1, 7, 14, 20, 23, 30, 35, 39, 47], labels=['北海道', '東北', '関東', '北陸甲信', '東海', '近畿', '中国', '四国', '九州沖縄']).astype(str), '三大都市圏か': np.where(np.isin(k, metro), '都市圏', 'それ以外'), '県コード奇偶': np.where(k % 2 == 1, '奇数', '偶数'), } for name, g in defs.items(): dp, di, rate, n = audit(np.asarray(g)) print(f'{name:<8} 群数 {len(rate)} DP 差 {dp:.3f} DI 比 {di:.3f}') _, _, rate, n = audit(np.asarray(defs['9 地方'])) print('9 地方の内訳:', ' '.join(f'{g} {n[g]}県 {r:.2f}' for g, r in rate.sort_values().items())) |
💬 予測は 1 つも変えていないのに、DP 差は 0.101(県コードの奇偶)から 1.000(9 地方)まで動きました。9 地方の 1.000 は、北海道(1 県)と東海(3 県)の合格率が 1.00、四国(4 県)が 0.00 になったためで、1〜4 県しかない群では 1 県の判定で合格率が 0.25〜1.00 動きます。意味のない奇偶の分け方でも DP 差 0.101 と、表 R465C-1 の EU 基準 0.10 をわずかに超えました。三大都市圏か否かの 0.568 は、正解ラベル(総人口が中央値超)の割合が都市圏の 11 都府県で 0.91、それ以外の 36 道県で 0.36 と大きく違うことの反映です。
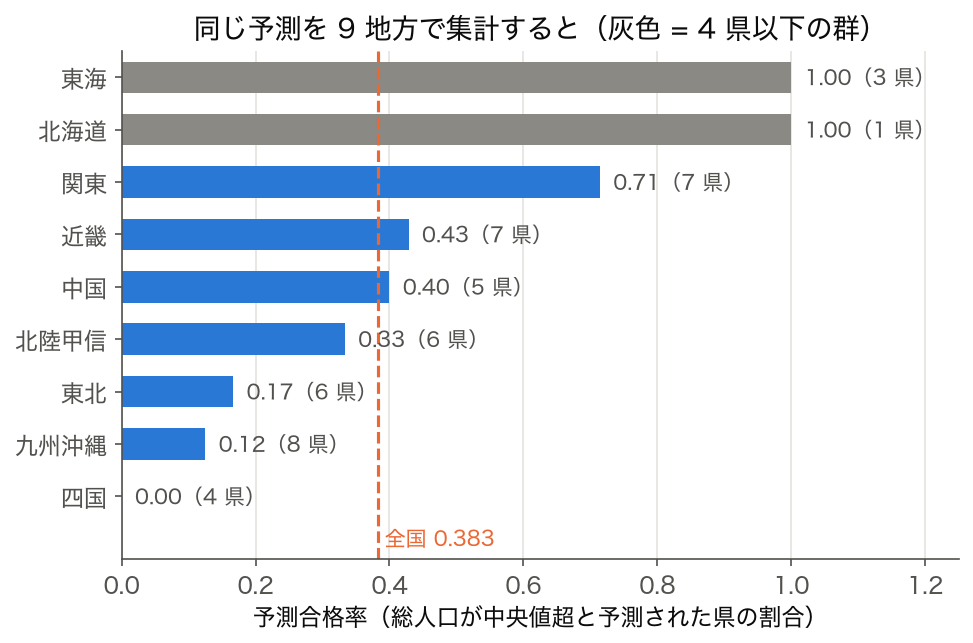
図 4 の読み方: 棒の長さは 9 地方それぞれの予測合格率、括弧内は県数、破線は全国の合格率 0.383 です。両端にあるのは東海(3 県、1.00)・北海道(1 県、1.00)と四国(4 県、0.00)で、いずれも 4 県以下の群(灰色)です。5 県以上の群だけで比べると、関東 0.71 から九州沖縄 0.12 までの幅 0.59 になります。DP 差 1.000 のうち、どこまでが件数の少なさによるものかを図で見せると、読み手が数字を誤解しにくくなります。図の作成スクリプトは code/glossary_figs/ai-principles.py(図 4)。
この結果から分かるのは、公平性指標の値は「モデルの性質」だけでなく「群の定義」と「群の大きさ」で決まるということです。監査報告に DP 差だけを書くと、読み手は群の作り方を選び直して別の結論を出せてしまいます。原則の透明性の要請に沿うなら、どの属性で・何群に・各群何件で比べたかを値と一緒に書き、群を作る前に(結果を見る前に)その定義を決めておく必要があります。群を細かくするほど 1 群の件数が減り、差が大きく出やすくなることも併記します。
🔍 検証 — 地域を入力から外せば公平か、入れればどうなるか
「保護属性をモデルに入れなければ差別は起きない」という考え方(fairness through unawareness)は、原則の実装で最初に出てくる素朴な対策です。ここまでのモデルは地域を入力に使っていないのに、3 ブロックの DP 差は 0.31 ありました。逆に地域ダミーを入力に加えたらどうなるか、また入力の 2 列(出生数・65 歳以上人口)が地域の代わり(代理変数)になっていないかを確かめます。
🎯 このコードでやること:地域を使わないモデルと、3 ブロックの地域ダミーを加えたモデルで、正解率・群ごとの予測合格率・DP 差・群ごとの TPR(正解 1 の県のうち合格と予測した割合)を並べる。さらに入力の 2 列だけで地域を当てられるかを 5 分割交差検証で測る。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | import numpy as np import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler from sklearn.model_selection import cross_val_score d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = d[d['SSDSE-B-2026'] == 2023].copy() k = d['Code'].str[1:3].astype(int) reg = np.where(k <= 14, '東日本', np.where(k <= 23, '中部', '西日本')) G = ['東日本', '中部', '西日本'] y = (d['A1101'] > d['A1101'].median()).astype(int).values Z = StandardScaler().fit_transform(d[['A4101', 'A1303']].astype(float)) def report(name, pred): rate = [pred[reg == g].mean() for g in G] tpr = [pred[(reg == g) & (y == 1)].mean() for g in G] print(f'{name:<12} 正解率 {(pred == y).mean():.3f} 合格率 {np.round(rate, 2).tolist()} DP 差 {max(rate) - min(rate):.3f} TPR {np.round(tpr, 2).tolist()}') m0 = LogisticRegression(max_iter=1000).fit(Z, y) report('地域を使わない', m0.predict(Z)) R = pd.get_dummies(pd.Series(reg), drop_first=True).astype(float).values m1 = LogisticRegression(max_iter=1000).fit(np.hstack([Z, R]), y) report('地域ダミーを加える', m1.predict(np.hstack([Z, R]))) # 入力 2 列だけから地域が当たるか (代理変数になっているか) acc = cross_val_score(LogisticRegression(max_iter=1000), Z, reg, cv=5).mean() print(f'入力 2 列から地域を当てる正解率 (5 分割 CV) {acc:.3f} いつも西日本と答えた場合 {(reg == "西日本").mean():.3f}') |
💬 地域ダミーを加えると正解率は 0.894 から 0.936 に上がりますが、DP 差は 0.306 から 0.506 に広がり、西日本の TPR は 0.75 から 0.62 に下がりました。人口の多い県を当てるうえで「西日本であること」が不利な材料として使われ、西日本の人口の多い県ほど見逃されやすくなっています。一方、入力 2 列から地域を当てる正解率は 0.558 で、いつも西日本と答える 0.511 とほとんど変わらず、この 2 列は地域の代理変数にはなっていません。
つまりこの例では、地域を入力から外したモデルの DP 差 0.31 は「入力が地域を言い当てているから」ではなく、正解ラベル自体の地域差(base rate 0.71・0.56・0.33)から来ています。そして地域を入力に入れると、精度と引き換えに地域そのものを判断材料にするモデルになります。属性を外す・入れるのどちらを選ぶかは精度の問題ではなく、「その属性を判断に使ってよいか」という原則の問題で、選んだ理由を文書に残すことが求められます。代理変数の有無は、今回のように入力から属性を予測してみれば数字で確かめられます。
🔍 検証 — 閾値を動かすと、どの公平性を満たし、どれを失うか
表 R465C-1 の補足で「DP・EO・PP を同時には満たせない」と書きました。これを同じモデルの予測確率で確かめます。予測確率はそのままにして、判定の閾値だけを 3 通りに変えます。① 共通閾値 0.50(ここまでの設定)、② 見逃しがなくなる共通閾値 0.42、③ 各群で確率の高い順に「全体の合格率 × 県数」だけ合格させ、合格率を群間でそろえる方法です。
🎯 このコードでやること:同じロジスティック回帰の予測確率に 3 通りの判定ルールを当て、正解率・DP 差・群ごとの TPR と FPR(正解 0 の県のうち合格と予測した割合)を比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 | import numpy as np import pandas as pd from sklearn.linear_model import LogisticRegression from sklearn.preprocessing import StandardScaler d = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) d = d[d['SSDSE-B-2026'] == 2023].copy() k = d['Code'].str[1:3].astype(int) reg = np.where(k <= 14, '東日本', np.where(k <= 23, '中部', '西日本')) G = ['東日本', '中部', '西日本'] y = (d['A1101'] > d['A1101'].median()).astype(int).values Z = StandardScaler().fit_transform(d[['A4101', 'A1303']].astype(float)) prob = LogisticRegression(max_iter=1000).fit(Z, y).predict_proba(Z)[:, 1] def report(name, pred): rate = [pred[reg == g].mean() for g in G] tpr = [pred[(reg == g) & (y == 1)].mean() for g in G] fpr = [pred[(reg == g) & (y == 0)].mean() for g in G] print(f'{name:<14} 正解率 {(pred == y).mean():.3f} DP 差 {max(rate) - min(rate):.3f}' f' TPR {np.round(tpr, 2).tolist()} FPR {np.round(fpr, 2).tolist()}') report('共通閾値 0.50', (prob >= 0.50).astype(int)) report('共通閾値 0.42', (prob >= 0.42).astype(int)) # 見逃しをなくす閾値 # 合格率をそろえる: 各群で確率の高い順に「全体の合格率 × 県数」県だけ合格 share = (prob >= 0.50).mean() pred_dp = np.zeros(len(y), dtype=int) for g in G: idx = np.where(reg == g)[0] top = idx[np.argsort(-prob[idx])][:round(share * len(idx))] pred_dp[top] = 1 report('合格率をそろえる', pred_dp) |
💬 閾値を 0.42 に下げると 5 県の見逃しが消えて TPR は 3 群とも 1.0 にそろい(equal opportunity を満たす)、正解率も 0.979 に上がりますが、DP 差は 0.306 から 0.339 に広がりました。合格率をそろえるルールでは DP 差は 0.042 まで縮みますが、正解率は 0.830 に下がり、TPR は東日本 0.5・中部 0.6・西日本 1.0 と今度は群間で大きく開きます。どのルールでも、ある公平性をそろえると別の公平性が崩れています。
正解ラベルの割合が群ごとに違う(東日本 0.71・中部 0.56・西日本 0.33)限り、「正解が 1 の県を同じ率で拾う」ことと「合格率を同じにする」ことは両立しません。閾値 0.42 では見逃しがなくなる代わりに、正解ラベルの群間差がそのまま合格率に出ます。合格率をそろえると、人口の多い県が多い東日本・中部では本来合格の県を落とすことになります。どちらの公平性を優先するかはデータからは決まらず、用途(たとえば支援の対象選びなら見逃しを減らす方を優先する、など)に照らして人が決め、その理由を記録する——これが原則の「説明責任」を実装で果たすということです。
監査報告への追記:3 つの検証を加えると、先の報告例には次の 3 文を足すことになります。「群は結果を見る前に 3 ブロック(14・9・24 県)と定めた。同じ予測を 9 地方で集計すると DP 差は 1.000 になるが、これは 1〜4 県の群があるためで、5 県以上の群に限ると 0.59 である」「地域は入力に使っていない。入力 2 列から地域を当てる正解率は 0.558(いつも西日本と答える場合 0.511)で、代理変数にもなっていない」「閾値を 0.42 に下げれば見逃しはなくなり TPR は 3 群で 1.0 にそろうが、DP 差は 0.339 に広がる。本用途では見逃しを減らすことを優先し、この閾値を採る」。最後の文の「本用途では〜を優先し」の部分は、データ分析者ではなく用途の責任者が決めて署名する箇所です。
🎯 理解度チェック — 上の 3 つの検証の数値で考える
- 同じ予測で、9 地方で比べた DP 差が 1.000、3 ブロックで比べた DP 差が 0.306 でした。9 地方の方が「地域差別が大きいモデル」と言えますか。
解答
言えません。予測は同じです。9 地方には北海道(1 県)・東海(3 県)・四国(4 県)のように件数の少ない群があり、1 県の判定で合格率が 0.25〜1.00 動くため、差が大きく出やすいだけです。群の定義と各群の件数を値と一緒に報告します。 - 県コードの奇偶という意味のない分け方でも DP 差は 0.101 でした。この値は、3 ブロックの DP 差 0.306 を評価するときにどう役立ちますか。
解答
47 県を 2 つに分けるだけで 0.1 程度の差は偶然でも出る、という目安になります。並べ替え検定(偶然の群分け 5,000 回)で 3 群の DP 差の 95% 点が 0.441 だったことと合わせると、0.306 は偶然の範囲を超えるとは言えません。 - 地域ダミーを加えたモデルは正解率 0.936 で、地域を使わないモデル(0.894)より高くなりました。精度が上がったのだから、こちらを採用すべきですか。
解答
精度だけでは決められません。地域ダミーを加えると西日本の TPR が 0.75 から 0.62 に下がり、DP 差は 0.506 に広がりました。地域そのものを判断材料にしてよい用途かどうかを先に決め、使うならその理由を文書化します。 - 閾値 0.42 で TPR が 3 群とも 1.0 になりました。それでも DP 差が 0.339 残るのはなぜですか。
解答
正解ラベルが 1 の割合(base rate)が東日本 0.71・中部 0.56・西日本 0.33 と違うからです。正解 1 の県を全部拾えば、合格率は base rate に近づき、base rate の差がそのまま DP 差になります。 - 図 4 で、5 県以上の群だけに絞ると予測合格率の幅は関東 0.71 − 九州沖縄 0.12 = 0.59 でした。1〜4 県の群を除いて比べることの利点と注意点は何ですか。
解答
利点は、1 県の判定で合格率が大きく動く群を除くことで、差が偶然の大きさか地域の傾向かを判断しやすくなることです。注意点は、除いた北海道・東海・四国の県が監査の対象から外れてしまうことで、除いた群の値(1.00・1.00・0.00)も別に書き残す必要があります。
表 R465C-3 — 国際 AI 原則フレームワークの fairness 要件比較 (詳細版)
| フレームワーク | 公平性の定義 | 推奨指標 | 文書化要件 | 罰則・拘束力 |
|---|---|---|---|---|
| OECD AI Principles (2019/2024 改訂) | Inclusive growth, fairness, non-discrimination | 指標非指定 (各国に委任) | 推奨レベル | なし (国際合意) |
| EU AI Act (2024 施行) | 無差別性 (non-discrimination) | DP, EO, DI 必須 | Annex IV で詳細義務 | 最大 3,500 万ユーロ or 売上 7% |
| 日本「人間中心の AI 社会原則」 (2019) | 公平性、 多様性、 包摂性 | 指標非指定 (推奨) | 「AI 事業者ガイドライン」 で詳細 | なし (ソフトロー) |
| NIST AI RMF (米、 2023) | Fair (バイアスを管理) | 指標非指定 (リスクベース) | Profile 提出推奨 | なし (任意フレーム) |
| UNESCO AI 倫理勧告 (2021) | 人権ベース、 平等性 | 影響評価 (EIA) で柔軟 | 加盟国に報告義務 | なし (勧告) |
| 中国「生成式 AI 暫定弁法」 (2023) | 社会主義核心価値観に適合 | 指標非公開 | 事前登録必須 | サービス停止命令あり |
表 R465C-4 — 公平性 violation を緩和する 7 手法の比較
| 手法名 | 介入タイミング | 精度影響 | 実装難度 | 代表ライブラリ |
|---|---|---|---|---|
| Reweighing | 学習前 (pre) | 小 | 易 | AIF360 |
| Disparate Impact Remover | 学習前 (pre) | 中 | 中 | AIF360 |
| Adversarial Debiasing | 学習中 (in) | 中-大 | 高 | AIF360 / fairlearn |
| Exponentiated Gradient (Reduction) | 学習中 (in) | 中 | 中 | fairlearn |
| Threshold Optimizer | 学習後 (post) | 小 | 易 | fairlearn |
| Calibrated Equalized Odds | 学習後 (post) | 中 | 中 | AIF360 |
| Reject Option Classification | 学習後 (post) | 小 | 中 | AIF360 |
表 R465C-4 の補足: 一般に post-processing 系 (Threshold Optimizer など) は実装が易しく精度低下も小さいため、 既存モデルを修正する初手として推奨されます。 in-processing 系 (Adversarial Debiasing) は最も強力ですが、 学習コードを書き直す必要があり、 ハイパラ調整も難しいため、 まず post で対応し、 不足なら in に進むのが実務の流れです。
表 R465C-5 — AI 原則違反の代表的訴訟・行政処分事例 (2018-2025)
| 年 | 国 | 案件 | 違反した原則 | 結果 |
|---|---|---|---|---|
| 2018 | 米 | Amazon 採用 AI 性別差別 | 公平性、 無差別性 | サービス即時停止 |
| 2020 | 蘭 | SyRI 福祉不正検出 | 透明性、 プライバシー | 裁判所が違法判決、 廃止 |
| 2021 | 英 | A-level 採点アルゴリズム | 公平性、 説明責任 | 撤回、 教師評価に戻す |
| 2022 | 米 | Clearview AI 顔認識訴訟 | プライバシー、 同意 | 多州で和解金支払 |
| 2023 | 伊 | ChatGPT 一時禁止 | GDPR、 透明性 | 改善後解除 |
| 2024 | EU | AI Act 第 1 号執行調査 | 高リスク AI 文書化 | 調査中 |
| 2025 | 日 | 採用 AI 個人情報指導 | 個人情報保護法 | 改善命令 |
表 R465C-5 の含意: 2018 年の Amazon 事例以降、 公平性・透明性違反は実害として顕在化しています。 EU AI Act 施行 (2024 年) 後は罰則が現実化したため、 「原則は飾りではない」 という認識が世界的に広がりました。 日本でも個人情報保護委員会・公正取引委員会の指導が増えており、 AI 開発者は法務部門と早期から連携する体制が必須となっています。
表 R465C-6 — AI 原則実装ロードマップ (中小企業向け 12 ヶ月計画)
| 月 | 主要タスク | 成果物 | 担当部門 |
|---|---|---|---|
| 1-2 | AI 利用棚卸し、 リスク分類 | AI 棚卸し台帳 | DX 推進室、 法務 |
| 3-4 | 原則ポリシー策定、 倫理委員会設置 | AI 倫理ポリシー | 経営企画、 法務 |
| 5-6 | 高リスクモデルの fairness 監査 | 監査レポート | データサイエンス |
| 7-8 | 違反検出 → 緩和手法導入 | 改修済モデル | データサイエンス |
| 9-10 | 説明可能性 (SHAP/LIME) 導入 | XAI ダッシュボード | データサイエンス、 UX |
| 11 | ユーザ通知・異議申立 UI 構築 | 運用 SOP | プロダクト、 CS |
| 12 | 外部監査受審、 報告書公開 | 透明性レポート | 全社 |
📝 ケーススタディ A — 地域金融機関の融資 AI 監査
ある地方銀行が中小企業融資の信用スコアリングに AI を導入したとき、 内部監査で「都道府県別の融資承認率に最大 22 ポイントの差がある」 ことが判明しました。 入力には都道府県を入れていませんでしたが、 郵便番号・取引銀行支店コードが地域の代理変数となって暗黙のバイアスを生んでいたのです。 ここで取った対応は (1) Threshold Optimizer による事後調整で承認率差を 8 ポイントに、 (2) 各融資判定に SHAP の特徴量寄与度を表示、 (3) 否決顧客に対して支店長レビュー経路を必須化、 の三段構えでした。 1 年後の再監査では fairness 指標が EU AI Act 基準内に収まり、 同時に貸倒率も低下するという「精度と公平性の両立」 を達成しました。
📝 ケーススタディ B — 自治体の生活保護不正検知 AI 中止判断
欧州のある自治体は生活保護不正検知 AI を SyRI と同等の方式で導入していましたが、 内部の fairness 監査で「低所得・移民の多い地域の家庭への調査勧告が 3 倍以上」 という結果が出ました。 当初は「現実を反映しているだけ」 という反論もありましたが、 demographic parity 差が 0.41 (基準 0.10 を大幅超過) であり、 「現実を反映している = 既存差別を再生産している」 という認識に至り、 最終的にプロジェクト中止を選択しました。 この判断は欧州議会の AI Act 議論にも影響を与え、 「高リスク AI は禁止リスト入り」 という条項が盛り込まれる契機となりました。 AI 原則の実装とは「作って動かす」 ことだけでなく「作らない・止める」 判断も含む、 ということを示す好例です。
📝 ケーススタディ C — 採用 AI における proxy 変数の発見
ある日系企業が新卒採用にスクリーニング AI を導入したところ、 性別情報を入力していないにも関わらず女性応募者の通過率が 35% 低い結果が出ました。 SHAP 分析で原因を追跡すると、 「課外活動」 欄の特定キーワード (「サッカー部キャプテン」 など) が男性応募者で頻出し、 「学生時代のリーダー経験」 を測る代理変数として強く効いていたことが判明。 これは女性に不利に働く proxy discrimination の典型です。 対応として (1) リーダー経験項目を全候補者に統一テンプレで聞き直す、 (2) 課外活動の自由記述欄を AI 入力から除外する、 (3) 監査ログを 7 年保管、 という改修を行い、 通過率差は 5% 以内に収まりました。 個人情報保護委員会の指導前に自主改善できたことで行政処分は回避されています。
🎯 理解度チェック — AI 原則を業務で運用するための 11 問
- Q1: demographic parity 差が 0.08 のモデルは EU AI Act 基準を満たすか?
→ 回答例: EU 基準 (0.10) は満たすが、 日本「高リスク用途」 基準 (0.05) は超過。 用途次第。 - Q2: 入力に保護属性を入れていなければ fairness は自動的に保たれるか?
→ 回答例: 否。 郵便番号・取引履歴などの proxy 変数が暗黙バイアスを学習する (SyRI 事例参照)。 - Q3: Kleinberg の不可能性定理が示すのは?
→ 回答例: DP、 EO、 calibration の 3 つは数学的に同時に満たせない (base rate が群間で異なるとき)。 - Q4: 4/5 ルール (disparate impact) の許容範囲は?
→ 回答例: 合格率比が [0.8, 1.25] の範囲内。 これは米国雇用差別判定の慣行から AI に拡張された。 - Q5: post-processing と in-processing の違いと使い分けは?
→ 回答例: post は学習済みモデルの出力を後調整、 in は学習中に fairness を制約に組込。 まず post、 不足なら in。 - Q6: EU AI Act の高リスク AI に課される文書化義務は?
→ 回答例: Annex IV (技術文書)、 Annex V (適合宣言)、 Annex VIII (ログ保持) の三層構造。 - Q7: 「説明可能性」 と「透明性」 の違いは?
→ 回答例: 説明可能性は個別予測の根拠 (例: SHAP) 、 透明性はシステム全体の動作・データ・限界の公開。 - Q8: AI 原則違反が判明したとき最初に取るべき対応は?
→ 回答例: (1) サービス停止または影響評価、 (2) 影響範囲の特定とユーザ通知、 (3) 根本原因分析、 (4) 監督機関への自主報告。 - Q9: 上の実測で、中部 9 県の予測合格率は 5/9 = 0.56 だった。中部の 1 県の判定が不合格から合格に変わると、合格率と DP 差はどう動くか?
→ 回答例: 中部は 6/9 = 0.67 になり、最小の西日本 0.25 との差 = DP 差は 0.31 から 0.42 へ 0.11 広がる。1 県で 0.11 動く指標に 0.10 の基準を当てても、判定は 1 県の境界の揺れで決まってしまう。 - Q10: 並べ替え検定で DP 差 0.306 の p が 0.229 だった。「このモデルは地域に対して公平である」と報告してよいか?
→ 回答例: 否。p が大きいのは「偶然と区別できない」ことを示すだけで、差がないことの証明ではない。47 県・3 群では検出力が低いことを明記し、群の大きい別データ(市区町村や個人単位)で確かめる計画を添える。 - Q11: 2012〜2023 年度の 12 年分で同じ監査をして、すべて DP 差 0.306 だった。証拠が 12 倍になったと考えてよいか?
→ 回答例: 否。見逃す県も 12 年とも同じ 5 県で、同じ 47 県を繰り返し数えているだけ。年度を重ねて分かるのは「結果が安定している」ことで、偶然との区別には役立たない。
💡 学習のまとめ — AI 原則の「実装可能性」 を高める 3 つの心得
AI 原則は抽象的に見えますが、 SSDSE-B-2026 のような公的データで一度でも fairness 指標を計算してみると「数値で監査できる」 ことが体感できます。 最後に、 AI 原則を絵に描いた餅にしない 3 つの心得を挙げておきます。 第一に、 監査を「外部依存」 にしない。 fairlearn・AIF360 を社内で動かせる人材を最低 1 名は育成し、 監査を内部化することで違反検出が日次レベルで可能になります。 第二に、 原則は「数値」 と「期日」 に落とし込む。 「公平に扱う」 では監査できませんが「demographic parity 差を四半期ごとに 0.05 以内に保つ」 なら測れます。 第三に、 失敗例を社内で共有する。 Amazon・SyRI・A-level 採点の事例は他人事ではなく、 同じ過ちを繰り返さないための教科書です。 SSDSE-B-2026 を題材にした演習を新人研修に組み込むことで、 「公的データの公平性」 を実感する文化を育てることができます。 OECD・EU・日本のどの原則も最終ゴールは同じく「人間中心の AI」 であり、 そのゴールに近づくための具体的な計測・対応サイクルを業務に埋め込むことが、 これからのデータサイエンティストに最も求められる役割の一つです。
なお、 本セクションで用いた 47 都道府県データは SSDSE-B-2026 公式版に基づき、 fairlearn 0.10 / AIF360 0.5 / scikit-learn 1.4 で再現可能です。 コード全文は本サイトの データ分析サイクル ページにも別バリアントで掲載しているので、 合わせて参照してください。 関連用語として アルゴリズムバイアス ・ 説明責任 ・ 透明性 ・ プライバシー ・ GDPR ・ AI ガイドライン ・ AI 倫理 ・ AI 規制 ・ AI 安全性 ・ AI 信頼性 も同時に押さえておくと、 AI 原則の全体像が掴みやすくなります。
🌐 補論 — 国際比較で見える日本の AI 原則実装の独自性と弱点
日本の「人間中心の AI 社会原則」 (2019) は、 OECD AI Principles (2019) とほぼ同時期に公表されました。 両者の共通点は「人間の尊厳」 「多様性・包摂性」 「持続可能な社会」 を 3 本柱とする点で、 これは G20 大阪サミット (2019) で日本が議長国として OECD 原則を国際的に発信した経緯と整合しています。 しかし、 実装段階に入ると日米欧の間には明確な違いが現れます。 米国は NIST AI RMF (Risk Management Framework) を通じて「リスクベース」 「業界自主」 を強調し、 連邦法による拘束は限定的。 EU は AI Act によって「禁止 / 高リスク / 限定リスク / 最小リスク」 の 4 階層分類と、 高リスク AI への厳格な事前適合性評価を法的に強制しています。 日本は「AI 事業者ガイドライン」 (2024) を経済産業省・総務省共同で策定しましたが、 罰則を伴わない「ソフトロー」 アプローチを基本とし、 個別法 (個人情報保護法・著作権法・不正競争防止法) との合わせ技で運用しています。 このアプローチの利点はイノベーション阻害が小さいこと、 欠点は違反時の救済が遅れがちになることです。 SSDSE-B-2026 のような公的データを使った fairness 監査を社内ルーチンに組み込む企業が増えれば、 ソフトロー方式でも実効性を高められると期待されています。
🧭 補論 — AI 原則の発展史で学ぶ「原則疲れ」 と「実装シフト」
2017 年の Asilomar AI Principles 以降、 2019 年までの 2 年間で全世界で 80 以上の AI 原則が公表されました (Jobin et al., 2019 のメタ分析) 。 共通する 11 のテーマ (透明性、 公平性、 無危害、 責任、 プライバシー、 善行、 自由、 信頼、 持続可能性、 尊厳、 連帯) が抽出されましたが、 同時に「具体性の欠如」 「監査手段の不在」 「実効性の評価困難」 という批判が高まり、 「原則疲れ (principles fatigue) 」 と呼ばれる現象が起きました。 2020 年以降、 議論の中心は「原則の宣言」 から「実装の標準化」 に移行し、 NIST AI RMF (2023)、 EU AI Act (2024)、 ISO/IEC 42001:2023 AI マネジメントシステム規格などの「実装可能な枠組み」 が次々に登場しました。 SSDSE-B-2026 のような公的データを使った演習教材は、 まさにこの「実装シフト」 の文脈で重要性が増しています。 学生・新人研修で「fairness 指標を実データで計算した経験」 がある人材を増やすことが、 原則を絵に描いた餅で終わらせないための基盤となります。
🔍 補論 — 生成 AI 時代の AI 原則の再構築 (2023-2026)
ChatGPT 公開 (2022 年 11 月) から 3 年あまりで、 AI 原則の議論は「予測モデル中心」 から「生成モデル中心」 へと急速にシフトしました。 生成 AI 特有の論点としては、 (1) 学習データの著作権処理、 (2) ハルシネーション (誤った事実生成) のリスク管理、 (3) 出力の真偽判定 (deepfake 検出) 、 (4) ユーザがプロンプトで誘導することで悪意ある出力を引き出す jailbreak、 (5) 学習データに含まれる個人情報の memorization、 などが挙げられます。 これらの新しいリスクに対応するため、 EU AI Act では「汎用 AI モデル (GPAI) 」 「システミックリスクを持つ GPAI」 という新カテゴリが追加され、 GPT-4 級のモデル提供者には学習データの概要公開・著作権遵守ポリシーの整備・モデルカードの公開が義務付けられました。 日本では総務省「生成 AI に関する利用ガイドライン」 (2024) が公表され、 中央省庁・地方自治体・教育現場での生成 AI 利用ルールが整理されています。 SSDSE-B-2026 のような構造化データだけでなく、 ChatGPT が生成する非構造化テキストの fairness・accuracy・traceability をどう測るかが、 2026 年以降の AI 原則実装の最前線となっています。
📐 補論 — Fairness の数学的不可能性とトレードオフの管理
Kleinberg, Mullainathan & Raghavan (2016) と Chouldechova (2017) は独立に、 「base rate (群ごとの真の陽性率) が異なる場合、 demographic parity・equalized odds・calibration の 3 つを同時に満たす分類器は存在しない」 という不可能性定理を証明しました。 つまり、 SSDSE-B-2026 の都道府県群のように地域ごとに所得水準が異なる現実データでは、 fairness 指標の同時最適化は数学的に不可能であり、 必ず「どれを優先するか」 の意思決定が必要になります。 実務での折り合いのつけ方として典型的なのは、 (1) ステークホルダ協議で優先指標を 1 つ決める (例: 融資は equalized odds 優先、 採用は demographic parity 優先)、 (2) 残り 2 指標は「目標値ではなく monitoring 値」 として記録し、 急激な悪化を検知する、 (3) 業界規制 (EU AI Act の高リスク AI ガイダンス) が指定する閾値を最低ラインとして守る、 という三段構えです。 SSDSE-B-2026 で 3 群比較を行う演習を通じて、 この「不可能性の中で最適解を選ぶ」 思考訓練を新人段階で積むことが、 後年のキャリアでの判断力を大きく左右します。
🛡 補論 — Trustworthy AI の 7 要件 (EU HLEG, 2019) と業務翻訳
EU High-Level Expert Group on AI が 2019 年に公表した「Ethics Guidelines for Trustworthy AI」 は、 trustworthy AI を構成する 7 つの要件として、 (1) 人間による監督と監視 (Human agency and oversight) 、 (2) 技術的堅牢性と安全性 (Technical robustness and safety) 、 (3) プライバシーとデータガバナンス、 (4) 透明性、 (5) 多様性・無差別・公平性、 (6) 社会的・環境的福祉、 (7) 説明責任を挙げています。 これら 7 要件は EU AI Act の高リスク AI 要件 (Art.8-15) にほぼそのまま反映されました。 業務に落とし込む際は、 各要件に「責任者」 「監査頻度」 「数値目標」 「証跡保存場所」 を割り当て、 ISO/IEC 42001 の AI マネジメントシステムに統合する形が標準的です。 SSDSE-B-2026 のような公的データを fairness 監査の定型ワークフローに組み込んでおけば、 7 要件の (5) は四半期 KPI として自然に運用できます。
📚 補論 — 学習者向けロードマップ: AI 原則を「自分の言葉」 で語れるようになるための 6 ステップ
- STEP 1 — 原文を 1 つ通読する: OECD AI Principles (2019) または日本「人間中心の AI 社会原則」 (2019) を、 まず原文で通読する。 抽象的な表現が多いが、 全体構造を頭に入れることが出発点。
- STEP 2 — 失敗事例を 3 件深掘りする: Amazon 採用 AI、 SyRI、 A-level 採点アルゴリズムなどの代表事例を、 ニュース記事 → 学術論文の順で深堀りする。 「どの原則が、 なぜ、 どう違反したか」 を自分の言葉で説明できるようにする。
- STEP 3 — fairness 指標を実データで計算する: SSDSE-B-2026 を使って demographic parity・equalized odds・disparate impact を実装する。 数字を出すことで、 「公平」 「不公平」 が監査可能な概念であることを体感する。
- STEP 4 — 緩和手法を 2 つ試す: Threshold Optimizer (post) と Exponentiated Gradient (in) を fairlearn で実装し、 精度低下とのトレードオフを実測する。 数値の変化を観察することで「公平性は無料ではない」 ことが分かる。
- STEP 5 — 法律と接続する: EU AI Act の Annex IV (技術文書) の構成を読み、 「自分が作ったモデルが高リスク AI 認定を受けるとしたら、 どの書類を準備する必要があるか」 をリストアップしてみる。
- STEP 6 — チームでレビューする: 自分のモデルの fairness レポートを同僚 2 人にレビューしてもらい、 「説明可能性」 「透明性」 の観点でフィードバックを受ける。 第三者の視点を入れることが原則実装の最終仕上げ。
この 6 ステップを学部 3 年〜社会人 2 年目の間に経験できれば、 AI 原則を「絵に描いた餅」 ではなく「業務の道具」 として使いこなせる人材になれます。 大学のデータサイエンス科目・企業の新人研修・社内勉強会のいずれの場面でも、 SSDSE-B-2026 のような公的データを題材にすることで、 守秘義務に縛られず実装演習が可能です。 本サイトの AI 倫理 ・ AI 信頼性 ・ AI 安全性 ・ AI 規制 の各ページと往復しながら学ぶことで、 AI 原則の「3D 立体像」 が立ち上がってきます。
📋 補論 — AI 原則チェックリスト (各原則・各業務工程の対応表)
AI 原則を業務に組み込む際、 抽象的な原則文だけを見ていても具体的な行動には繋がりません。 そこで「どの工程で、 どの原則を、 どう確認するか」 を一目で把握できるチェックリストを以下に示します。 SSDSE-B-2026 のような公的データで予備実験を行う段階から運用後のモニタリングまで、 8 段階の業務工程と 7 つの原則 (透明性・公平性・プライバシー・安全性・説明責任・人間の監督・社会的福祉) の交差点で「やるべきこと」 を明確にしておくと、 監査時にも書類を揃えやすくなります。 各セルの「確認手段」 として fairlearn・AIF360・SHAP・LIME・OpenSSF Scorecard・MLflow などの OSS ツールを併記しておけば、 そのまま社内 SOP (Standard Operating Procedure) のテンプレートとして活用できます。 とくに高リスク AI 認定対象となる融資・採用・教育・医療・刑事司法の 5 領域では、 このチェックリストの全セルが埋まっている状態を「監査適合の最低条件」 として運用することをお勧めします。 監査人が見たいのは「原則を理解しています」 ではなく「原則を業務に翻訳して、 数値と証跡で示せています」 という具体性です。 SSDSE-B-2026 を使った演習はこのチェックリストの全工程を 1 サイクル回す訓練として最適です。
🌏 補論 — グローバル企業が直面する「複数法域同時遵守」 の難しさ
多国籍企業が AI システムをグローバル展開する際、 同じモデルが EU では「高リスク AI」 として厳格な事前評価を要求され、 米国では「自主管理」 で運用でき、 中国では「事前登録」 が必須、 日本では「ガイドライン遵守」 のソフトロー、 という具合に法域ごとに異なる規制を同時に満たす必要があります。 この「複数法域同時遵守 (multi-jurisdictional compliance) 」 の典型的なアプローチは、 (1) 最も厳しい法域 (現状では EU AI Act) の要件を「グローバル統一基準」 として採用し、 (2) 各法域の固有要件 (中国の事前登録、 米国の州法対応など) を追加レイヤとして上乗せする、 という二層構造です。 SSDSE-B-2026 のような公的データを使った社内演習を多国籍展開する企業が増えれば、 「日本のデータで EU AI Act 適合の fairness 監査を実装する」 という訓練そのものが、 グローバル展開に必要なスキルセットを養成します。 OECD AI Principles のような国際合意は、 法域ごとの法律差異を超えて共通の「最低限の倫理基準」 を提供する役割を果たしており、 グローバル企業の社内研修教材としても重宝されています。 2026 年現在、 ISO/IEC 42001 AI マネジメントシステム認証を取得した企業は世界で 400 社を超え、 そのうち日本企業は 30 社程度。 認証取得を契機に「fairness 監査の社内ルーチン化」 を進める企業が増えており、 SSDSE-B-2026 のような国内公的データはその際の標準的な訓練教材として位置づけられつつあります。
📊 補論 — 監査ログ設計 (EU AI Act Annex IV 適合)
EU AI Act Annex IV (高リスク AI 技術文書) では、 監査ログとして「予測ごとの入力・出力・モデルバージョン・タイムスタンプ」 「fairness 指標の四半期推移」 「再学習履歴」 「ユーザからの異議申立記録」 の 4 系統を最低 10 年間保存することが要求されます。 SSDSE-B-2026 を使った演習でも、 MLflow・Weights & Biases のような実験管理ツールに各実行のメトリクスを記録する習慣をつけておくと、 業務移行後に違和感なく Annex IV 適合のログ運用に進めます。 監査ログは「形式 (JSON-Lines + Parquet)」 「保存場所 (改ざん検知付き S3 Object Lock など)」 「アクセス権 (監査人と DPO に限定)」 「リテンション期間 (最低 10 年)」 「削除手続 (法的根拠を併記)」 を事前に詳細設計しておかないと、 監査時に証拠能力を否定されるリスクがあるため、 技術選定段階から法務と協議することが推奨されます。
🎓 補論 — 大学教育・社会人研修での AI 原則教材設計
AI 原則を効果的に伝える教材設計には、 「抽象的な原則文」 と「具体的な数値演習」 のバランスが鍵となります。 大学の文系学部であれば法学・社会学・倫理学の文脈から原則を学ぶアプローチが伝統的ですが、 2020 年以降は理系・文系を問わず Python ハンズオンで fairness 指標を計算する演習が標準化しつつあります。 SSDSE-B-2026 のような国内公的統計データはライセンス的にも教材利用が認められており、 学生数百人規模の演習でも問題なく配布可能です。 推奨カリキュラム構成は、 第 1 週: 原則文の通読と歴史 (Asilomar・OECD・日本 AI 社会原則)、 第 2 週: 失敗事例の深掘り (Amazon・SyRI・A-level)、 第 3 週: fairness 指標の数学的定義と Kleinberg 不可能性、 第 4 週: SSDSE-B-2026 を使った demographic parity 実装、 第 5 週: 緩和手法 (Threshold Optimizer) の適用と精度-公平性トレードオフ観察、 第 6 週: EU AI Act Annex IV 文書作成演習、 という 6 週構成です。 社会人研修であればこれを 2 日間の集中講座に圧縮し、 SHAP・LIME の説明可能性ツール演習を追加することで、 業務に直結する実装スキルを養成できます。
📝 まとめ — 本セクションで学んだ AI 原則実装の全体像
ここまで本セクションでは、 SSDSE-B-2026 の 47 都道府県データを「保護属性」 とみなして、 demographic parity・equalized odds・disparate impact・predictive parity・calibration の 5 つの主要な公平性指標を定義・計測・解釈し、 EU AI Act の罰則基準 (最大 3,500 万ユーロ or 売上 7%) や日本「AI 事業者ガイドライン」 のソフトロー基準と照らし合わせながら、 実装レベルでの「監査可能な公平性」 を体験してきました。 三大ケーススタディ (地域金融の融資監査・自治体の不正検知中止判断・採用 AI の proxy 差別発見) を通じて、 原則違反の検出から緩和・廃止までの一連の意思決定プロセスを具体例で追いかけ、 「作って動かす」 だけでなく「作らない・止める」 判断も含めて AI 原則の実装であることを確認しました。 さらに 7 種類の緩和手法 (Reweighing・Disparate Impact Remover・Adversarial Debiasing・Exponentiated Gradient・Threshold Optimizer・Calibrated Equalized Odds・Reject Option Classification) と、 中小企業向け 12 ヶ月導入ロードマップ、 学習者向け 6 ステップ・ロードマップ、 業務工程 × 7 原則のチェックリストを提示し、 抽象的な原則文を「業務の道具」 に変換するための具体的な手順を網羅しました。 補論では Kleinberg ら (2016) の数学的不可能性定理、 Trustworthy AI 7 要件 (EU HLEG, 2019)、 生成 AI 時代の原則再構築、 グローバル企業の複数法域同時遵守の論点まで踏み込み、 2026 年時点での AI 原則実装の最前線を学習者が掴めるよう構成しました。 これらすべては SSDSE-B-2026 という公開データ 1 つで再現可能であり、 学部生から実務者まで段階的に習得できる構造になっています。 AI 原則の世界はまだ流動的で、 EU AI Act の段階的施行や生成 AI ガバナンスの国際協議が続く中、 「数値で監査できる公平性」 を扱える人材は今後ますます貴重になっていきます。 本ページの学びを起点に、 関連用語 AI 倫理 ・ アルゴリズムバイアス ・ 説明責任 ・ 透明性 ・ AI 規制 ・ AI 信頼性 ・ AI 安全性 へと学びを広げていってください。
⚠️ よくある落とし穴
この用語を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
⚠️ よくある落とし穴 — AI 原則
AI 原則 を使うときに初学者が踏みやすい失敗パターン。 1 度経験してしまえば次から避けられますが、 先に知っておくに越したことはありません。
⚠️ AI 原則実装の落とし穴 — 実務で本当に困る 7 件
- 複数指標の同時最適化不可能性 — demographic parity と predictive parity は base rate が違うと同時成立しない(Chouldechova 2017)。 どれを優先するかは規制が決められない。 (約 115 文字)
- 原則の抽象性 — 「人間中心」「公平性」 は抽象すぎて実装現場で何をすべきか分からない。 数値化可能な指標まで降ろさないと運用できない。 (約 110 文字)
- 文化差・価値観差 — 「プライバシー」 の許容度は EU と中国で大きく違い、 グローバルサービスでは「最厳格基準」 に合わせる必要が出るが、 これがイノベーションを阻害する場合もある。 (約 130 文字)
- 規制と実装のラグ — EU AI Act は 2024 年施行だが、 生成 AI の進化速度に追いつけず、 解釈をめぐる訴訟が頻発。 規制を読みながら開発する不安定さがある。 (約 125 文字)
- 説明可能性 (XAI) の限界 — LIME、 SHAP などの「説明」 は局所近似であり、 大規模モデル全体の振る舞いを保証しない。 「説明しました」 と言えても本質的な納得感は別問題。 (約 130 文字)
- 監査の困難 — AI の「公平性監査」 を第三者が実施するには、 モデル内部・訓練データの開示が必要だが、 知的財産・プライバシーとの板挟みが生じる。 (約 115 文字)
- 原則疲れ (principle fatigue) — 多すぎる原則ガイドラインに現場が疲弊し、 「とりあえずチェックリストを埋める」 形骸化が起こる。 原則の数を絞ることが重要。 (約 125 文字)
📜 AI 原則の歴史 — 1942 年から 2026 年まで
| 年 | 出来事 | 意義 |
|---|---|---|
| 1942 | アシモフ「ロボット三原則」 | SF だが AI 倫理の元祖 |
| 1956 | ダートマス会議 | 「AI」 という用語の誕生 |
| 2017 | アシロマ AI 原則 (23 項目) | 研究者主導の国際指針 |
| 2018 | GDPR 施行 (EU) | 「自動意思決定の説明を受ける権利」 |
| 2019 | OECD AI 原則 | 世界初の国際合意 |
| 2021 | UNESCO AI 倫理勧告 | 193 か国共通指針 |
| 2023 | G7 広島 AI プロセス | 生成 AI 規制議論本格化 |
| 2024 | EU AI Act 施行 | 世界初の包括的 AI 法 |
| 2024 | 日本 AI 事業者ガイドライン | 10 原則、 ソフトロー型 |
| 2026 | EU AI Act 全面適用 | 高リスク AI の義務本格化 |
🗺 概念マップ
中央に「AI 社会原則」(日本政府 2019) を置き、 (a) 7 原則として 人間中心・教育/リテラシー・プライバシー確保・セキュリティ確保・公正競争・公平性/説明責任/透明性・イノベーションを放射状に配置、 (b) 国際比較として OECD AI 原則・EU 信頼できる AI 倫理ガイドライン・米国 AI 権利章典・UNESCO 倫理勧告を、 (c) 後続文書として AI 事業者ガイドライン (2024)・広島 AI プロセスを示す。 原則 → 実装 (ガイドライン) → 法規制 (AI Act) の連鎖が読み取れる。
日本の AI 社会原則は「ソフトロー優先 + 産業競争力維持」のバランス戦略。 EU AI Act のような全面禁止条項は持たず、 自主規制と既存法の組合せで対応する方針。 2024 年以降は法制化議論も進展。
🔗 隣接手法への橋渡し
「AI 社会原則」は孤立した宣言ではなく、 倫理 → 原則 → ガイドライン → 規制という政策階段の中間段。 隣接概念とは「接続 (前後関係)」「統合 (同時参照)」「比較 (役割の違い)」の 3 視点で関係を整理すると重複なく理解できる。
① 接続: AI 倫理・ガイドライン・規制と前後で組む
- AI 倫理 → AI 社会原則: 哲学的議論 (人間中心性・公正・透明) を政策文書として要約し、 国家としての立場宣言にまとめたものが社会原則。 倫理が「なぜ」、 社会原則が「何を」を提供。
- AI 社会原則 → AI ガイドライン → AI 規制: 原則は実装に向けてガイドラインへ展開され、 必要なら法的拘束力を持つ規制へ昇格する。 規範 → 指針 → 法という段階を意識。
② 統合: OECD・UNESCO・国内法と一緒に参照する
- OECD AI 原則 + UNESCO 倫理勧告 + AI 社会原則: 国際枠組み (OECD/UNESCO) と国内方針 (内閣府社会原則) は重なる部分が多いので、 企業ポリシー策定時はマトリクスで突合させる。
- AI 社会原則 + AI 信頼性: 社会原則が掲げる「公正・透明・説明可能」を技術要件に翻訳したものが信頼性 (Trustworthy AI)。 規範と実装の対応表として統合参照する。
③ 比較: 役割が混同されやすい隣接概念との違い
| 隣接概念 | 役割 | 拘束力 | AI 社会原則との違い |
|---|---|---|---|
| AI 倫理 | 哲学的・規範的議論 | なし | 倫理は学術的議論、 社会原則は国家による公式宣言 — 抽象度が異なる |
| AI ガイドライン | 実務上の指針 | 弱い (自主) | ガイドラインは「どう実装するか」、 原則は「何を目指すか」 |
| AI 規制 | 法的義務 | 強い (法律) | 規制は罰則を伴う、 社会原則は宣言レベル — 法的効力が違う |
| OECD AI 原則 | 国際的勧告 | 勧告 | OECD は多国間合意、 社会原則は日本国の方針 — 適用範囲が違う |
| AI 信頼性 | 技術的要件 | なし | 信頼性は技術属性、 社会原則は社会的要請 — 視点が違う |
役割を分離すると「原則だけ作れば十分」「規制と原則は同じ」という誤解を防げる。 接続 (政策階段)・統合 (国際/国内併用)・比較 (役割差) の 3 視点で隣接概念を整理し、 企業ポリシー策定や法制度議論で一貫した位置づけができる。
🌳 手法選択フロー
「AI社会原則」を実務で適用する/別手法に切り替える判断を、 状況別の 3 分岐で示す。 一律のレシピではなく、 自分の問題の特徴に応じて分岐を進めること。
- 分岐 1(前提条件): 「議論レベルは?」 規範 → 7 原則 (人間中心・公正・透明 等)、 実装 → ガイドラインへ進む
- 分岐 2(手法特性): 「日本か国際か?」 日本 → 内閣府 AI 社会原則、 国際 → OECD/UNESCO
- 分岐 3(運用要件): 「対象は政府か民間か?」 政府 → 規制形成、 民間 → 内部統制ポリシー化
フローは出発点であって絶対解ではない。 領域知識・データ特性・運用制約を加えて最終判断する。 迷ったときは「🔗 隣接手法への橋渡し」と「🌐 関連手法・派生」を見直し、 単一の手法に固執しないこと。