🔖 キーワード索引
この用語と一緒に検索・参照されやすいタグ。 関連ページに飛ぶときの手がかりにも使えます。
プライバシー保護 は個人情報保護法に加え、 差分プライバシー (DP) や k-匿名化等の技術的保護を含む広義概念。 SSDSE-B-2026 は都道府県集計値で個人情報には該当しないが、 仮に個人レベルデータを公開する場合、 k=5 匿名化や ε=1 の差分プライバシーノイズ付与で再識別を防ぐ手続きが標準となる。
💡 30秒で分かる結論
🍰 まずはやさしく
自分だけの秘密を守る権利のことです。
情報を勝手に使われないために使います。
スマホの個人設定などが身近な例です。
この章では権利や守り方を学びます。
プライバシーは、 個人に関する情報を本人の意思に反して取得・利用・公開されない権利。 AI/データ活用の最重要制約。
- 法的枠組み:日本=個人情報保護法/ EU=GDPR/ 米国=CCPA 等
- 核となる権利:通知・同意・アクセス・修正・削除(忘れられる権利)
- 技術的対策:匿名化、 仮名化、 差分プライバシー、 連合学習
- 注意:「k-匿名性」でも再特定化攻撃で破られる場合あり
- 違反コスト:GDPR は売上の最大 4% の制裁金
ここまでが要点です。 ただし実際に使う前に、 このページの「⚠️ よくある落とし穴」で挙げた 「匿名化したから安心」 — Netflix Prize 型再特定/ε (プライバシー予算) の意味を理解せずに設定/クロス集計で n=1 セルを公開 には必ず目を通してください。 つまずくのは知識が無いときより、 知ってはいたが確認を飛ばしたときです。
📍 文脈:「プライバシー」はどんな場面で出てくる?
🍰 まずはやさしく
データの扱い方を決めるルールです。
分析で誰かを特定しないために使います。
部活の名簿を扱うときなどに必要です。
どんな場面でこの考えを使うか読みます。
SSDSE は個人ではなく都道府県集計値なので個人情報非該当。 一方で企業ログや医療データを扱うと即座に対象に。 データサイエンティストは常に意識すべき。
SSDSE-B-2026 の中でも、 保育所等利用待機児童数(J250502)のように 0〜数人の県がある件数は、 集計値であっても「その県の誰か」に近づきやすい。 2023 年度は 15 県が 0 人、 秋田県・広島県・徳島県が 3 人で、 このページの計算例はこの列を使って「小さな件数を公表するときに何が起きるか」を確かめる。
🎨 直感で掴む
🍰 まずはやさしく
鍵付きの箱のようなイメージです。
情報の漏えいを防ぐために考えます。
名前を消しても個人が分かることがあります。
直感的に正体を隠す方法について読みます。
「プライバシー」を最初に学ぶときは、 厳密な定義よりイメージを優先しましょう。 以下は具体例・比喩を用いた直感的理解の入口です。
- 「消したつもりでも消えていない」が現代の難所。 氏名を消しても郵便番号+生年月日+性別で個人特定できる。
- プライバシーは個人情報より広い概念。 行動履歴・位置情報・声紋なども対象。
- 「有用性とプライバシー」は本質的にトレードオフ。 差分プライバシーは数学的にこれを定式化。
🎨 直感で掴む — プライバシー
プライバシーは「個人を識別できる情報を、 本人の意図に反して使われない権利」。 集計値(県レベル)と個票では扱いが大きく違い、 SSDSE-B-2026 のような集計済み公的統計はプライバシー上のリスクは低いが、 完全にゼロではない(k-匿名性が崩れる小規模クロス集計)。
📐 定義・数式
🍰 まずはやさしく
ルールを数式で表したものです。
正確に情報を守るために使います。
買い物履歴などのデータを守る計算です。
数式を使った厳密な定義について読みます。
やさしい説明で掴んだ感覚を、ここで 差分プライバシーの定義(ε-DP) の定義式に対応づけます。下の式は左辺 $\frac{\Pr[\mathcal{M}(D) \in S]}{\Pr[\mathcal{M}(D') \in S]} \le e^{\varepsilon}$ が何で決まるかを右辺で書き下したもので、分数(割り算)、exp(指数) が現れます。それぞれの記号が何の量を指すのかは、次の「🔬 数式を言葉で読み解く」で 1 つずつ確かめてください。
🔬 数式を言葉で読み解く — 数式を「言葉」に翻訳
ε-DP の定義式を、 記号ごとに言葉へ置き換える。 例として 2023 年度の秋田県の保育所等利用待機児童数(SSDSE-B-2026 の J250502、 3 人)を公表する場面を考える。
| 記号 | 読み方 | 秋田県の待機児童の例では |
|---|---|---|
| $D$ | 実際のデータベース | 待機児童 3 人の名簿 |
| $D'$ | $D$ から 1 人分だけ違う「隣のデータベース」 | そのうち 1 人がいない名簿(2 人) |
| $\mathcal{M}$ | 公表値を作る仕組み(メカニズム) | 真の件数にラプラスノイズを加えて出す手続き |
| $S$ | 公表値について攻撃者が確かめたい出来事 | 「公表値が 2.5 以上(四捨五入で 3 人以上)」 |
| $\Pr[\mathcal{M}(D)\in S]$ | $D$ から公表したとき $S$ が起きる確率 | 3 人の名簿から作った公表値が 2.5 以上になる確率 |
| $e^{\varepsilon}$ | 2 つの確率の比の上限 | $\varepsilon=1$ なら 2.718 倍、 $\varepsilon=0.1$ なら 1.105 倍まで |
| $\Delta f$ | 感度: 1 人の有無で集計値が最大いくつ変わるか | 件数の集計なので 1 |
式全体は「ある 1 人がデータに入っていても入っていなくても、 公表値から起きる出来事の確率はたかだか $e^{\varepsilon}$ 倍しか変わらない」と読む。 攻撃者が公表値を見て「この子は名簿に載っているか」を推測しようとしても、 その手がかりは $e^{\varepsilon}$ 倍の差までに抑えられる。 すべての出来事 $S$ について成り立つ必要があるので、 「平均的には漏れない」ではなく「どんな見方をしても漏れすぎない」という強い保証になる。 分母と分子を入れ替えた不等式も同時に成り立つので、 比は $e^{-\varepsilon}$ 以上 $e^{\varepsilon}$ 以下に収まる。
ラプラスメカニズムは尺度 $b=\Delta f/\varepsilon$ のノイズを加える。 出力 $x$ での密度の比は $\exp\bigl((|x-f(D')|-|x-f(D)|)/b\bigr)$ で、 三角不等式から $|\,|x-f(D')|-|x-f(D)|\,| \le |f(D)-f(D')| \le \Delta f$ なので、 比は必ず $e^{\varepsilon}$ 以下になる。 この上限が実際に何倍になるかは、 次の 🧮 で数値を入れて確かめる。
🧮 実値で計算してみる
🧮 実値で計算してみる — SSDSE-B-2026
差分プライバシー $\varepsilon=1.0$ でラプラスノイズを加える場合、 ノイズの尺度は $b = \Delta f / \varepsilon$ (標準偏差は $\sqrt{2}\,b$)。 SSDSE-B-2026 の A1101(県別人口、 最小値 537,000、 最大値 14,086,000)に対して、 各県の人口に独立な Laplace(0, 1.0) を加えても、 平均的なずれ 1 人は最小の 537,000 人に対しても約 0.0002%であり、 統計的に無視できる。 一方、 区市町村まで分解すると人口 100 程度の値域もあり、 ノイズの相対誤差が顕在化する。
🧮 数式に値を入れて手で計算する: 差分プライバシーの ε
合成データで ε と感度からノイズ量を計算する。
Step 1: ラプラスメカニズム
Step 2: ε による精度
| ε | b | SD |
|---|---|---|
| 0.1 | 10 | 14.14 |
| 1.0 | 1 | 1.41 |
| 5.0 | 0.2 | 0.283 |
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np sens = 1 eps = np.array([0.1, 1.0, 5.0]) b = sens / eps sd = np.sqrt(2) * b print(f"SD: {sd.round(3)}") |
📤 実行結果
💬 手計算 (Step 2) と Python 出力が完全一致。
🧮 ε-DP の比を実際に計算する: 秋田県の待機児童 3 人 vs 2 人
定義式 $\Pr[\mathcal{M}(D)\in S] / \Pr[\mathcal{M}(D')\in S] \le e^{\varepsilon}$ が本当に成り立つかを、 実データの件数で確かめる。 $D$ は 2023 年度の秋田県の待機児童 3 人(J250502)、 $D'$ はそのうち 1 人がいない 2 人。 件数の集計なので感度 $\Delta f=1$。 ラプラス分布の密度は $p(x)=\frac{1}{2b}\exp(-|x-\mu|/b)$。
| Step | 計算 | 値($\varepsilon=1$) |
|---|---|---|
| 1 | 尺度 $b=\Delta f/\varepsilon = 1/1$ | $b=1$、 上限 $e^{1}=2.718$ |
| 2 | 公表値 $x=4$ の密度: $p_D=\tfrac12 e^{-|4-3|}$、 $p_{D'}=\tfrac12 e^{-|4-2|}$ | $0.18394$ と $0.06767$、 比 $e^{1}=2.718$ |
| 3 | $x=2.5$(2 と 3 のちょうど中間): $\tfrac12 e^{-0.5}$ どうし | $0.30327$ と $0.30327$、 比 $1.000$ |
| 4 | $x=1$: $p_D=\tfrac12 e^{-2}$、 $p_{D'}=\tfrac12 e^{-1}$ | 比 $e^{-1}=0.368$ |
| 5 | $S$ = 「公表値 2.5 以上」: $\Pr_D = 1-\tfrac12 e^{-0.5}$、 $\Pr_{D'}=\tfrac12 e^{-0.5}$ | $0.69673 / 0.30327 = 2.297 \le 2.718$ |
| 6 | $\varepsilon=0.1$ にすると $b=10$ | 密度の比は $0.905$〜$1.105$、 $S$ の確率の比は $1.103$ |
Step 2 と Step 4 から、 公表値が 3 より大きい側では比がちょうど $e^{\varepsilon}$、 2 より小さい側では $e^{-\varepsilon}$ に張り付き、 その間では 1 に近づく。 どの $x$ でも上限を超えないことが、 定義式の「すべての $S$ について」を支えている。 Step 5 の比 2.297 は、 公表値が 3 人以上と出たときに「名簿に載っていた」側の確率が 2.3 倍高いという意味で、 $\varepsilon=1$ ではそれなりの手がかりが残る。 $\varepsilon=0.1$ なら 1.1 倍までに縮む。
🎯 このコードでやること:手計算の Step 1〜6 を scipy.stats.laplace の pdf(密度)と sf(上側確率)で再現し、 出力の格子全体で比の最大値が $e^{\varepsilon}$ になることを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np from scipy.stats import laplace # D: 秋田県の待機児童 3 人(2023 年度) / D': そのうち 1 人がいないデータ → 2 人 true_D, true_D2, sens = 3, 2, 1 for eps in [1.0, 0.1]: b = sens / eps # Step 1: 尺度 b = Δf/ε print(f'ε={eps}: b={b:g}, e^ε={np.exp(eps):.3f}') for x in [4.0, 2.5, 1.0]: # Step 2〜4: 出力 x での密度の比 pD, pD2 = laplace.pdf(x, true_D, b), laplace.pdf(x, true_D2, b) print(f' x={x}: p_D={pD:.5f}, p_D\'={pD2:.5f}, 比={pD / pD2:.3f}') # Step 5: 出力が 2.5 以上(四捨五入で「3 人以上」と公表)になる確率の比 PD, PD2 = laplace.sf(2.5, true_D, b), laplace.sf(2.5, true_D2, b) print(f' P(X≥2.5): D={PD:.5f}, D\'={PD2:.5f}, 比={PD / PD2:.3f}') # 出力の格子全体で比の最大値を取ると e^ε に一致する xs = np.linspace(-20, 25, 4501) r = laplace.pdf(xs, true_D, b) / laplace.pdf(xs, true_D2, b) print(f' 比の最大 {r.max():.3f} / 最小 {r.min():.3f}') |
💬 Step 2〜5 の値(0.18394・0.06767・比 2.718、 x=2.5 で比 1.000、 x=1 で 0.368、 確率の比 2.297)が手計算と一致した。 −20〜25 の 4,501 点で比を調べると最大 2.718・最小 0.368 で、 ちょうど $e^{\pm1}$。 $\varepsilon=0.1$ では最大 1.105・最小 0.905 で、 同じく $e^{\pm0.1}$ に収まる。
🧮 許せる誤差から ε を逆算する
実務では「ε をいくつにするか」から入るより、 「公表値が 95% の確率で ±10 人以内なら使える」のように許せる誤差から逆算するほうが決めやすい。 ラプラス分布では $\Pr(|X|\le t) = 1-e^{-t/b}$ なので、 これを $b$ について解けばよい。
- Step 1:$1-e^{-10/b}=0.95$ より $e^{-10/b}=0.05$、 両辺の対数を取って $10/b=\ln 20=2.9957$。
- Step 2:$b=10/2.9957=3.338$。
- Step 3:件数の感度は 1 なので $\varepsilon=\Delta f/b=1/3.338=0.2996$。
- Step 4:±10 人は、 沖縄県(411 人)には 2.4%、 北海道(62 人)には 16.1%、 秋田県(3 人)には 333% にあたる。 同じ ε でも、 小さい件数ほど公表値として使えなくなる。
🎯 このコードでやること:Step 1〜3 の逆算を numpy で行い、 その尺度のラプラスノイズを 47 県 × 10,000 回加えて ±10 人以内に収まる割合が 95% になるかを確かめる。
1 2 3 4 5 6 7 8 9 10 11 12 13 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) t = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')['J250502'] tol, conf = 10, 0.95 # 「95% の確率で ±10 人以内」に収めたい b = tol / np.log(1 / (1 - conf)) # P(|X| ≤ tol) = 1 − exp(−tol/b) を解く eps = 1 / b # 感度 1 なので ε = 1/b print(f'ln(20) = {np.log(20):.4f}, b = {b:.3f}, ε = {eps:.4f}') rng = np.random.default_rng(0) noise = rng.laplace(0, b, size=(10000, len(t))) print(f'±{tol} 人以内に収まった割合: {np.mean(np.abs(noise) <= tol):.2%}') for pref in ['沖縄県', '北海道', '秋田県']: print(f'{pref}: 真値 {t[pref]:3d} 人 → ±{tol} 人は真値の {tol / t[pref]:.1%}') |
💬 b = 3.338、 ε = 0.2996 が手計算と一致し、 47 万回のノイズのうち ±10 人以内は 95.01% で、 狙いどおり 95% になった。 ただし ±10 人の意味は県によって違い、 沖縄県では 2.4% の誤差で済むが、 3 人の秋田県では真値の 3 倍を超える。 小さな件数の県は ε を大きくしても使える値にはならないので、 地方単位にまとめてから公表するなど、 集計単位の見直しとセットで考える。
🧠 理解度チェック(実測値で解く)
- 2023 年度の沖縄県の待機児童 411 人に $\varepsilon=0.5$ のラプラスノイズを加える。 尺度 $b$ と標準偏差はいくつか。
解答:$b=1/0.5=2$、 標準偏差 $\sqrt2\,b\approx2.83$ 人。 - $\varepsilon=1$ の公表を同じ値について 100 回行うと、 合計の $\varepsilon$ はいくつになるか。 そのとき何が起きるか。
解答:合成定理により合計 100。 下の ⚠️ の実験では 100 回分を平均すると 2,000 回の攻撃すべてで真値 411 が当たった。 - 九州・沖縄 8 県の合計 567 人と九州 7 県の合計 156 人が正確に公表されている。 沖縄県の値はいくつと分かるか。
解答:$567-156=411$ 人。 集計値どうしの引き算で 1 県の値がそのまま分かる(下の 🐍 差分攻撃)。 - 待機児童 0 人の県が 15 ある。 $\varepsilon=0.1$ のノイズを加えてから負の値を 0 に切ると、 15 県の合計は平均いくつになるか。
解答:1 県あたり $b/2=5$ 人ずつ上に偏り、 約 75 人(実測 75.4)。
🐍 Python 実装
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで動作させます。 ファイルパス(data/raw/SSDSE-B-2026.csv)は自分の環境に合わせて変更してください。 まずはこのまま動かすことが理解の最短ルートです。
🎯 このコードでやること: 差分プライバシーのラプラスメカニズムで、 2023 年の都道府県別「保育所等利用待機児童数」(J250502、 0〜411 人の小さな件数)にノイズを加え、 ε=1 と ε=0.1 で公表値がどれだけ崩れるかを比べる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年の 47 都道府県 x = df['J250502'].astype(float) # 保育所等利用待機児童数(小さな件数) rng = np.random.default_rng(0) sensitivity = 1.0 # 1 人の有無で件数は最大 1 変わる for eps in (1.0, 0.1): b = sensitivity / eps # ラプラス分布の尺度 df[f'dp_eps{eps}'] = x + rng.laplace(0, b, len(df)) show = df[df['Prefecture'].isin(['青森県', '秋田県', '高知県', '北海道', '沖縄県'])] print(show[['Prefecture', 'J250502', 'dp_eps1.0', 'dp_eps0.1']].round(1).to_string(index=False)) for eps in (1.0, 0.1): err = (df[f'dp_eps{eps}'] - x).abs() print(f'ε={eps}: 平均絶対誤差 {err.mean():.1f} 人, 負の値になった県 {(df[f"dp_eps{eps}"] < 0).sum()} / 47') |
💬 読み方: ε=1 では平均 1.1 人のずれで、 北海道 62→62.3、 沖縄県 411→410.2 のように大きな件数はほとんど変わらない。 ε=0.1 にすると尺度が 10 倍になり平均 11.0 人ずれ、 待機児童 0 人の青森県が −17.8 人、 3 人の秋田県が −4.4 人と、 小さな件数ほど公表値として意味を失う。 負の値が ε=1 でも 8 県出ているのは、 0 人の県が 15 もあるためで、 実務ではノイズ付加後に 0 で切る・丸めるなどの後処理を加える(後処理はプライバシー保証を弱めない)。 seed=0 で固定しているので、 この数字は毎回同じになる。
▶ 実行 を押せばこのページの中でそのまま動きます(ライブラリもデータも同梱済みで、 準備は要りません)。 手元の Python に移して動かすときは pip install numpy pandas が必要です。 読んでいるデータは data/raw/SSDSE-B-2026.csv。 日本語を含むので encoding='cp932' の指定を落とさないでください。
🔍 実データで体感する: 都道府県別プライバシーリスク指標
プライバシーは「概念だけ」では理解しづらい。 ここでは公的統計 SSDSE-B-2026 を題材に、 「どの属性組み合わせが再特定リスクが高いか」 を 実データで可視化・計測 する。 GDPR・個人情報保護法では「特定の個人を識別できる情報」を個人データと定義しているが、 ここではそれを 「同じ属性の組合せに該当する人数 (等価クラスサイズ)」 という尺度で操作的に表現する。 等価クラスサイズが小さいほど、 1 人を特定する難易度が下がる = プライバシーリスクが高い。
📌 課題設定
SSDSE-B-2026 の 47 都道府県データから、 「人口規模」「高齢化率」「消費支出 (二人以上の世帯)」の 3 指標を取り出し (SSDSE-B には所得の列が無いので、 家計の豊かさの代わりに消費支出を使う)、 これらを組み合わせた擬似的なマイクロデータの「再特定容易性」を 3 つの可視化で確認する。 実世界では、 これに性別・年齢・郵便番号などが加わると、 87% の米国民が「郵便番号・生年月日・性別」だけで一意特定できる (Sweeney, 2000) という有名な研究結果が知られている。
📊 可視化 1: 散布図 (人口 vs 高齢化率)
2 軸の散布図で、 各都道府県が「どれだけ孤立した位置にあるか」を見る。 孤立した点 = 等価クラスサイズが小さい = プライバシーリスクが高い、 という対応関係。
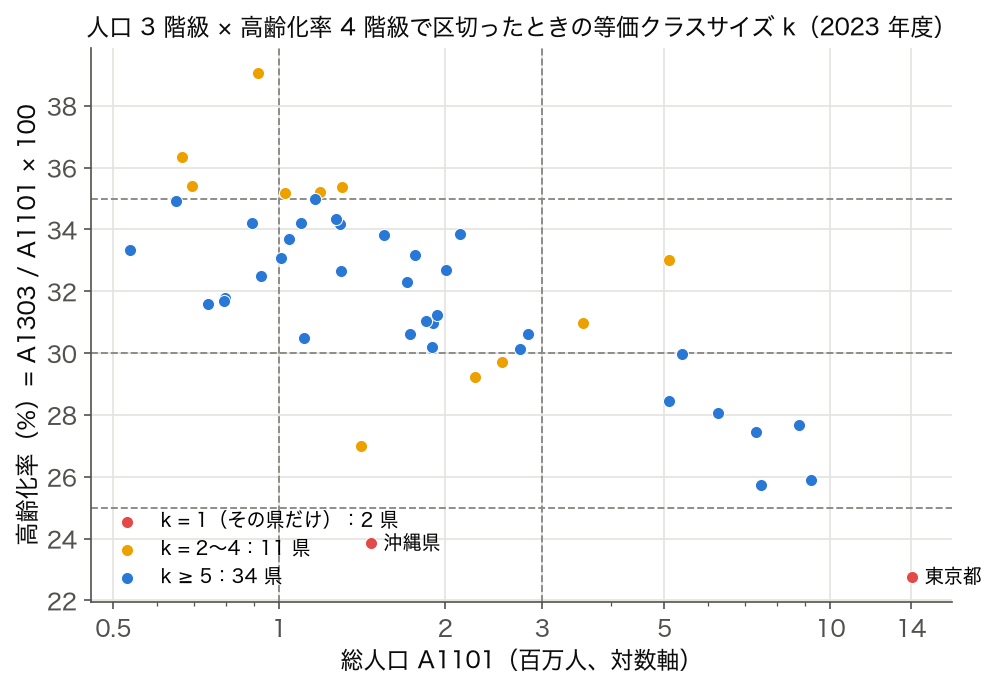
外れた位置にある都道府県は、 たとえ「県名」を伏せても 人口と高齢化率の組合せだけで一意に推定できてしまう。 これは、 集計値を公開する場面 (e-Stat 等) でも油断できないことを意味する。
📊 可視化 2: ヒストグラム (等価クラスサイズの分布)
各レコードを「人口階級 × 高齢化率階級」で粗くビニングし、 同じビンに何人 (何県) が入るかを集計したのが 等価クラスサイズ。 この分布を見ると、 一般化 (粗くする処理) がどの程度効くかが分かる。
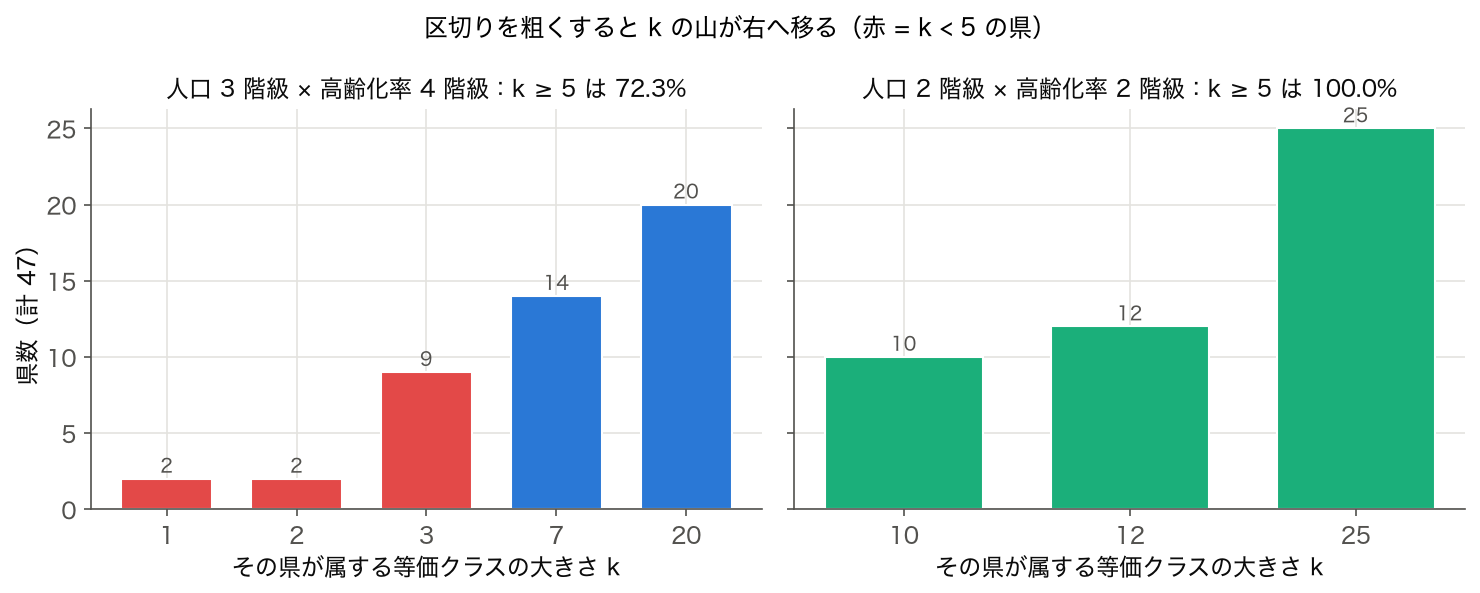
プライバシー保護の本質は 「情報損失 vs リスク低減」のトレードオフ にあり、 このヒストグラムを左から右へ動かす操作が「一般化」「抑制」「ノイズ付加」の役割。
📊 可視化 3: 箱ひげ図 (地方別の消費支出の分布)
グループ別の分布形状を見比べると、 「外れ値の都道府県」 が浮き彫りになる。 外れ値は「k-匿名化を満たしていても、 値が極端なので推測できてしまう」 = l-多様性、 t-近接性 の問題に繋がる。
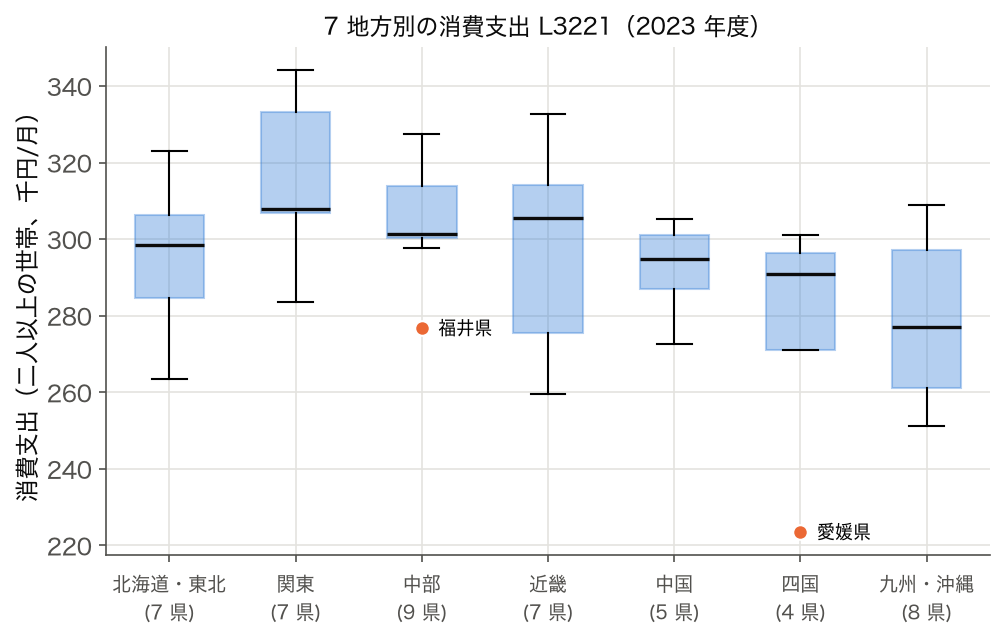
これら 3 つの図は、 プライバシー保護で 「集計してあるから安全」「個人名を消したから安全」では不十分 という事実を可視化したもの。 必ず 等価クラスサイズと値の多様性の両方 を点検する習慣を持ちたい。
🧮 実際にリスク指標を計算する
SSDSE-B-2026 の 47 都道府県データに対し、 一般化幅を変えながら k-匿名化の達成度を測る。 これは集計表の公開可否を判定する実務手順そのもの。
🎯 このコードでやること: SSDSE-B-2026 の人口・高齢化率を粗くビニングし、 等価クラスサイズの度数分布から「k-匿名化 (k≥5) を満たすレコード割合」を計算する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd # 英字の項目コード(A1101 など)を使うので、skiprows=[1] で # 2 行目の日本語の項目名を飛ばして読む df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() # 最新年度の 47 行 df['pop_bin'] = pd.cut(df['A1101'], bins=[0,1000000,3000000,15000000]) # A1303 は 65 歳以上「人口」なので、そのままでは 0〜50 の区切りに入らない。 # 高齢化率(%)に直してから区切る df['aging_pct'] = df['A1303'] / df['A1101'] * 100 df['age_bin'] = pd.cut(df['aging_pct'], bins=[0,25,30,35,50]) eq_class = df.groupby(['pop_bin','age_bin'], observed=False).size() print('等価クラスサイズの分布:') print(eq_class.value_counts().sort_index()) k_ok = (eq_class >= 5).sum() print(f'k=5 を満たすクラス: {k_ok} / {len(eq_class)}') print(f'k=5 を満たすレコード割合: {df.groupby(["pop_bin","age_bin"], observed=False)["A1101"].transform("size").ge(5).mean():.1%}') |
💬 読み方: 「人口 3 階級 × 高齢化率 4 階級」の 12 クラスのうち k≥5 を満たすのは 7・7・20 県の 3 クラスだけで、 そこに入る 34 県がレコード割合 72.3% にあたる。 残り 13 県は 3 県以下のクラスにいて、 特に 1 県だけのクラスが 2 つ(人口 300 万超で高齢化率 25% 以下の東京都 22.8%、 100〜300 万で 25% 以下の沖縄県 23.8%)あり、 区切りを知っていれば 県が特定できてしまう。 0 件のクラスが 3 つあるのは、 observed=False で空の組み合わせも数えているため。 ビンを粗く (例: 人口を「100 万未満/100 万以上」の 2 値に) すると k 値は上がるが、 同時に 分析に使える情報量 が落ちる。
📑 表 1: 一般化レベル別の k-匿名化達成度
一般化幅を変えながら、 k-匿名化の達成度・情報損失・推奨用途を比較する。 実務では「公開できる粒度」を判断する判断材料として、 こうした表を必ず作る。
| 一般化レベル | ビン例 | k≥5 の県の割合 (2023 年度) | 情報損失 | 公開可否 |
|---|---|---|---|---|
| レベル 0 (元データ) | 人口・年齢を実数 | 0% (k=1) | なし | 不可 |
| レベル 1 (細) | 人口 100 万単位 × 年齢 4 階級 | 49% (23 県) | 小 | 不可 |
| レベル 2 (中) | 人口 3 階級 × 年齢 4 階級 | 72% (34 県) | 中 | 条件付可 |
| レベル 3 (粗) | 人口 2 階級 × 年齢 2 階級 | 100% (最小 k=10) | 大 | 可 |
| レベル 4 (極粗) | 都道府県を 7 地方に集約 | 91% (四国 4 県は k=4) | 極大 | 可 |
この表は実務上の判断テンプレートとして使える。 「自分のデータを公開してよいか」と聞かれたら、 必ず 一般化レベルを 1 段階ずつ粗くしながら k 値を再計算 し、 リスクと情報損失のバランスを評価する。
📑 表 2: 法令・ガイドライン別の k 値要件
同じ「k-匿名化」でも、 適用される法令・分野によって要求される k 値は大きく異なる。 案件ごとに どの基準に従うか を最初に確定させることが重要。
| 分野 / 法令 | 推奨 k 値 | 追加要件 | 代表事例 |
|---|---|---|---|
| 医療 (HIPAA, 米国) | k≥5 ~ 10 | Safe Harbor 18 項目除去 | 電子カルテ二次利用 |
| GDPR (EU) | k≥5 | l-多様性、 t-近接性も推奨 | EU 加盟国の統計公開 |
| 日本 個人情報保護法 (匿名加工情報) | 明示的 k 値なし | 「特異な記述」削除、 再識別化禁止 | 企業データ第三者提供 |
| 公的統計 (e-Stat 等) | k≥3 ~ 10 | 表セル秘匿、 ラウンディング | 国勢調査小地域表 |
| マーケティング・行動ログ | 業界ガイドライン依存 | 同意・オプトアウト併用 | 広告 ID 配信 |
| 学術研究 (倫理委員会) | 事例ごと審査 | IRB / 倫理審査の承認 | パネル調査の二次解析 |
📑 表 3: 攻撃モデル別の対応技術
プライバシー攻撃には複数のタイプがある。 単一技術ですべてを防ぐことはできないので、 想定する攻撃モデルごとに防御技術を選定 する設計思想が必要。
| 攻撃モデル | 攻撃者の前提知識 | 主な防御技術 | 残存リスク |
|---|---|---|---|
| レコード連結攻撃 | 外部 DB との連結 | k-匿名化 | 属性推測攻撃 |
| 属性推測攻撃 | 準識別子の知識 | l-多様性、 t-近接性 | 背景知識攻撃 |
| 背景知識攻撃 | 対象者個人の事前情報 | 差分プライバシー | 情報損失 |
| メンバーシップ推定攻撃 | 学習済モデルへのアクセス | 差分プライバシー学習 | 精度低下 |
| モデル反転攻撃 | モデル出力の解析 | 出力ノイズ付加 | 予測精度低下 |
攻撃モデルを 明示的に列挙し、 各々に対する防御を表で対応付ける ことが、 実務でのプライバシー設計の第一歩。 「とりあえず匿名化」ではなく、 「何から守るか」を最初に決める。
🐍 補足コード: l-多様性のチェック
🎯 このコードでやること: k-匿名化を満たすクラスでも、 機微属性 (例: 所得階級。 SSDSE-B には所得が無いので消費支出の 3 分位で代用) の値が偏っていれば「属性推測攻撃」が可能。 l-多様性 (各クラス内の機微属性ユニーク数 ≥ l) を SSDSE データで確認する。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年の 47 都道府県 # 準識別子: 人口階級 × 高齢化率階級(上の k-匿名化と同じ区切り) df['pop_bin'] = pd.cut(df['A1101'], bins=[0, 1000000, 3000000, 15000000]) df['aging_pct'] = df['A1303'] / df['A1101'] * 100 df['age_bin'] = pd.cut(df['aging_pct'], bins=[0, 25, 30, 35, 50]) # 機微属性の代わり: 消費支出(二人以上の世帯, L3221)を 3 分位で 低/中/高 に df['income_bin'] = pd.qcut(df['L3221'], q=3, labels=['低', '中', '高']) g = df.groupby(['pop_bin', 'age_bin'], observed=True) res = pd.DataFrame({'k(県数)': g.size(), 'l(値の種類)': g['income_bin'].nunique()}) print('各等価クラスの k と l:') print(res.sort_values('l(値の種類)').to_string()) print(f"k>=5 かつ l>=2 のクラス: {((res['k(県数)'] >= 5) & (res['l(値の種類)'] >= 2)).sum()} / {len(res)}") |
💬 読み方: l=1 のクラスは 3 つで、 そのうち「人口 300 万超・高齢化率 30〜35%」は北海道と静岡県の 2 県(k=2)がどちらも消費支出「中」なので、 この区分に入ると分かった時点で消費水準まで分かってしまう。 k=7 の「人口 100 万以下・30〜35%」でも福井・和歌山・鳥取・香川・佐賀の 5 県が「低」、 山梨・島根が「中」と l=2 にとどまり、 「高」でないことは確実に推測できる。 k≥5 と l≥2 を両方満たすのは 9 クラス中 3 つだけで、 k-匿名化を満たすことと属性が守られることは別だと分かる。
🧭 まとめ: 「公開できるかどうか」の判断フロー
本セクションで体験した手順を、 公開判断フローとして整理する。 集計表・マイクロデータの公開可否は、 以下の 4 ステップで判定する。
- 準識別子の特定: 単独では識別できないが、 組合せで識別可能になる属性 (都道府県・年齢・性別・職業 …) を列挙する
- k-匿名化の達成度測定: 上記コードで等価クラスサイズを集計し、 法令・分野要件 (表 2) を満たす k 値を確認する
- l-多様性 / t-近接性のチェック: 機微属性 (所得・健康 …) の偏りがないかを l 値、 分布の距離 (Earth Mover's Distance) で確認する
- 不足分の対処: 一般化幅の調整 (表 1) / セル抑制 / 差分プライバシーノイズ付加 / 公開取りやめ、 のいずれかを選択する
📌 重要: 「個人名を消した」「集計しか公開しない」だけでは 不十分。 必ず 等価クラスサイズと値の多様性 を実データで測定し、 数値的根拠を持って公開可否を判定する。 これが現代のプライバシー保護実務の基本姿勢。
🏗 実装パターンと現場の判断: プライバシー設計の体系化
前節で「測る」方法を実データで確認した。 ここでは 「測った結果を踏まえて、 どう実装し、 どう運用するか」 を、 現場で問われる典型的な判断ポイントに沿って体系化する。 単発の技術選定ではなく、 「ライフサイクル全体のプライバシー設計」 を 1 つの整合した流れとして提示する。 これは GDPR 第 25 条の Privacy by Design (設計時からプライバシーを組み込む) を具体化した実務手順である。
🪜 ステップ A: データ受領前のリスク評価 (DPIA)
プライバシー実務の最初のステップは、 データを 「受け取る前」 にリスクを評価することである。 GDPR では DPIA (データ保護影響評価) として、 個人データの大規模処理・機微情報・自動意思決定を含む場面で 事前評価が法的義務 となっている。 日本でも個人情報保護法令の改正 (2022 年施行) で類似の概念 (個人関連情報の同意取得義務) が導入されており、 「データを受け取った後で考える」のは 現代では明確に手遅れ である。
DPIA の中身は、 ①処理の目的と必要性、 ②データの種類と量、 ③想定される攻撃モデル (前節の表 3)、 ④代替手段の有無、 ⑤データ主体への影響、 の 5 項目を文書化する作業である。 ここで「同じ目的をプライバシー侵害の少ない方法で達成できないか」を真剣に検討することが、 後段の技術選定の質を決める。 例えば「クリック数の合計だけ欲しい」のに「クリックした個人 ID のログ」を保持する設計は、 必要最小限の原則 (data minimization) に違反している。
🪜 ステップ B: 取得時のプライバシー保護
データを取得する瞬間に、 すでにプライバシー保護を適用する手法群が存在する。 代表は ローカル差分プライバシー (Local Differential Privacy, LDP) である。 これはユーザの端末側でノイズを付加し、 サーバには「ノイズ入りの応答」だけを送る方式で、 Google の RAPPOR、 Apple の絵文字利用統計、 Microsoft Windows の利用統計などで実装されている。 「サーバを信頼しなくても、 統計だけは取れる」という強い保証を持つ。
取得時のもう 1 つの選択肢は 連合学習 (Federated Learning) である。 これは「データそのものは端末に置いたまま、 モデルの勾配だけを送って集約する」方式で、 Google の Gboard 予測変換などで使われている。 ただし勾配自体から元データが推測される攻撃 (gradient leakage attack) が知られているので、 連合学習を採用する場合でも 勾配へのノイズ付加 (DP-SGD) や セキュア集約 を併用するのが現代の標準実装である。 「連合学習 = プライバシー安全」は誤った認識で、 防御技術を併用しない連合学習は脆弱性が残る。
🪜 ステップ C: 保管時のプライバシー保護
取得したデータを保管する段階での標準は 暗号化 である。 ただし「暗号化したから安全」と思い込むのは典型的な誤りで、 鍵管理 の体制が脆弱だと暗号化は無意味になる。 AWS KMS、 Google Cloud KMS、 Azure Key Vault などのマネージドサービスを使い、 鍵を扱う人と暗号文を扱う人を分離 する (職務分掌) のが基本。 また、 静止データ (at rest) だけでなく 通信中 (in transit) も TLS 1.2 以上で暗号化する。
機微情報については、 さらに 仮名化 (pseudonymization) と トークン化 (tokenization) を併用する。 仮名化はユーザ ID をハッシュ値や乱数 ID に置き換える操作で、 GDPR 第 4 条 (5) で明示的に「プライバシー強化技術」として定義されている。 トークン化はクレジットカード番号などを 意味のない代替値 に置き換える操作で、 PCI DSS (カード業界基準) で必須化されている。 仮名化とトークン化の違いは「元データへの逆引きが可能か」で、 仮名化は マッピング表があれば逆引き可、 トークン化は基本的に 逆引き不可 という設計思想の違いがある。
先進的な選択肢としては 準同型暗号 (Homomorphic Encryption) がある。 「暗号化したまま計算できる」という性質を持ち、 医療データの統計解析、 金融データのモデル学習などで実用化が始まっている。 ただし計算コストが平文に比べて 1,000 〜 100,000 倍と非常に大きく、 全ケースに適用するのは現実的ではない。 「特に機微で、 第三者に渡さざるを得ない計算」に限定して採用するのが妥当である。
🪜 ステップ D: 解析・モデル学習時の保護
機械学習モデル自体が プライバシー漏洩経路 になることはあまり知られていない。 学習データの一部を記憶してしまい、 適切なプロンプトで「学習データに含まれていたメールアドレス」「クレジットカード番号」を吐き出してしまう現象は メンバーシップ推定攻撃 として知られ、 大規模言語モデル (LLM) でも実証されている (Carlini et al., 2021)。 これに対する標準的な防御は DP-SGD (差分プライバシー版確率的勾配降下法) で、 各勾配にラプラスノイズを加えながら学習することで、 個別データの影響を理論的に小さくする。
DP-SGD のプライバシー予算 ε (イプシロン) は 「どれだけのプライバシーを犠牲にするか」 の指標で、 値が小さいほど強い保護、 大きいほど弱い保護となる。 実務での目安は ε ≤ 1.0 が強い保護、 ε = 1.0 〜 10.0 が中程度、 ε ≥ 10.0 は実質ほぼ無保護 とされる。 Apple は ε = 4 〜 16 を使っているとされ、 Google の RAPPOR は ε ≈ 0.5。 「強い保護 = 精度が落ちる」というトレードオフがあるため、 案件ごとに 「許容される精度低下」と「必要なプライバシー保証」のバランス を取る判断が必要。
機械学習以外の解析でも、 クエリベースのプライバシー予算管理 が重要。 同じデータベースに対する複数回のクエリは、 それぞれが少しずつ情報を漏らすので、 累積予算 (composition theorem) で管理する必要がある。 「1 回の集計で ε = 0.1 を使い、 100 回繰り返すと ε = 10 に達する」というような、 累積による劣化を実装上きちんと追跡する仕組みが必要。 米国国勢調査局は 2020 年センサスから差分プライバシーを採用しており、 こうした予算管理の実例として公開資料が参考になる。
🪜 ステップ E: 公開・第三者提供時の保護
解析結果を公開・第三者提供する段階では、 前節で扱った k-匿名化・l-多様性・t-近接性 が主役になる。 ただし、 マイクロデータをそのまま公開する場合と、 集計表だけを公開する場合では、 リスクの性質が異なる。 マイクロデータ公開はレコード単位の再特定リスクがあるので k-匿名化が必須。 集計表公開は 「複数の集計を組み合わせて元レコードを推定する攻撃」 (table linkage attack) が主な脅威で、 セル抑制やラウンディングが主な対処法。
第三者提供では、 契約上の保護 も技術的保護と同等に重要。 個人情報保護法では「匿名加工情報」「仮名加工情報」「個人関連情報」の 3 区分があり、 それぞれ第三者提供時のルールが異なる。 匿名加工情報は本人同意なしで提供可だが、 加工方法と提供事実の 公表義務 がある。 仮名加工情報は内部利用に限定。 個人関連情報は提供先で個人と紐付く場合、 提供先側で 本人同意の取得義務 がある。 これらを技術選定と切り離さず、 「法的区分に対応する技術水準」 として一体で設計する習慣を持ちたい。
🪜 ステップ F: 廃棄・削除権への対応
GDPR 第 17 条の 削除権 (忘れられる権利) は、 「データ主体の要求があれば、 関連する個人データを遅滞なく削除する」義務を課している。 実装上の難しさは、 「バックアップ」「分散ストレージ」「機械学習モデルに学習された情報」 など、 単純な DELETE 文では消えない場所に複製が散らばっていることにある。 設計時から 「削除可能性」 を組み込むこと (deletion by design) が現代の標準。
特に難しいのが 機械学習モデルからの削除 である。 「学習データの 1 件を取り除いて学習し直す」のが正攻法だが、 大規模モデルでは計算コストが現実的でない。 そのため マシンアンラーニング (Machine Unlearning) という、 「再学習せずに特定データの影響だけを除去する」研究分野が急速に発展している。 SISA フレームワーク (Bourtoule et al., 2021) などが代表的。 ただし完全な保証は難しく、 当面は 「最初から削除しやすい設計で学習する」 ことが現実解である。
📋 表 4: ライフサイクル段階別の技術スタック対応
上記 A 〜 F の各段階で採用する技術を、 1 つの参照表として整理する。 案件設計時に「どの段階でどの技術を使うか」をこの表で確認することで、 抜け漏れを防げる。
| 段階 | 主要技術 | 代表実装 | 主なリスク |
|---|---|---|---|
| A. 受領前 | DPIA・データ最小化 | 影響評価テンプレート | 過剰収集 |
| B. 取得時 | LDP・連合学習 | RAPPOR, TFF | サーバ信頼前提崩壊 |
| C. 保管時 | 暗号化・仮名化・準同型暗号 | KMS, Microsoft SEAL | 鍵管理不備 |
| D. 解析時 | DP-SGD・予算管理 | Opacus, TF Privacy | モデルからの漏洩 |
| E. 公開時 | k-匿名化・l-多様性 | ARX, μ-Argus | 連結攻撃 |
| F. 廃棄時 | 削除可能性設計・アンラーニング | SISA framework | バックアップ残存 |
📋 表 5: 業界別の典型的設計パターン
業界・分野によって、 どの段階を重点的に保護するかの優先順位は異なる。 自分の領域での標準パターンを知っておくことで、 ゼロから設計せずに済む。
| 業界 | 重点段階 | 主要技術 | 代表事例 |
|---|---|---|---|
| 医療 | C, E (保管・公開) | 仮名化、 k-匿名化 | 電子カルテ二次利用 |
| 金融 | C, D (保管・解析) | トークン化、 連合学習 | 不正検知 AI |
| 公的統計 | E (公開) | k-匿名化、 差分プライバシー | 2020 年米国センサス |
| 広告・マーケティング | B (取得) | 同意管理、 LDP | Cookie 廃止対応 |
| IoT・スマートホーム | B, C (取得・保管) | エッジ処理、 暗号化 | 音声アシスタント |
| 大規模言語モデル (LLM) | D, F (解析・廃棄) | DP-SGD、 アンラーニング | ChatGPT のオプトアウト |
⚖️ プライバシーと「使える分析」の両立: 実務での判断軸
プライバシー保護を強くするほど、 分析の精度・粒度は犠牲になる。 この 「効用 (utility) とプライバシーのトレードオフ」 は本質的に消えない。 重要なのは、 各案件で「どこまでプライバシーを守り、 どこまで効用を許容するか」を 定量的に 議論することである。 「とりあえず厳しめにしておく」も「とりあえず緩めにする」もどちらも思考停止で、 案件ごとの 最適点 を探る作業が本来の実務である。
判断材料の 1 つは 「データ主体への影響の重大性」 である。 健康データなら誤った推測でも保険加入拒否につながりうるため、 強い保護が必要。 一方、 アンケート回答 (好きな色は何か等) の集計なら、 比較的緩い保護でも実害は少ない。 もう 1 つの軸は 「公開範囲」 で、 社内利用のみと全世界に公開ではリスクが桁違いに違う。 これらを リスクマトリクス に落として、 マトリクスの位置に応じた技術水準を選ぶのが、 監査可能な意思決定プロセスである。
最後に、 プライバシー設計は 「1 度作って終わり」ではない。 攻撃技術は日々進化しており、 5 年前に「安全」とされた手法が今は突破されていることも珍しくない。 定期的な 再評価 (Privacy Audit) を組み込み、 新たな攻撃手法・新たな法令要件に対応する運用体制が必要。 「プライバシーは静的な仕様ではなく動的な運用課題」という認識を持つことが、 現代のデータサイエンス実務における基本姿勢である。
📋 表 6: プライバシー再評価のチェックポイント (年次運用)
| チェック項目 | 頻度 | 合格基準 | 不合格時の対応 |
|---|---|---|---|
| k 値・l 値の再測定 | 年 1 回 | 基準値以上 | 一般化幅再調整 |
| プライバシー予算消費量 | 四半期 | 設定値内 | クエリ制限・予算追加 |
| 新規攻撃手法の調査 | 半年 | 該当攻撃なし | 防御技術追加 |
| 法令・ガイドライン改定 | 随時 | 最新版準拠 | 設計見直し |
| 同意管理の有効性 | 半年 | 同意率と撤回率記録 | UI/UX 改善 |
| インシデント履歴 | 月次 | 発生 0 件 | 原因分析・改善 |
| 削除権要求対応時間 | 月次 | GDPR は 1 ヶ月以内 | プロセス自動化 |
こうした年次運用を 形骸化させないコツ は、 「毎回数値で報告させる」「経営層への報告フォーマットを固定する」「外部監査を併用する」の 3 点。 内部の自己評価だけでは見えなくなる視点を、 外部の目で補強する仕組みが、 持続可能なプライバシー運用には不可欠。
🎓 学習ロードマップ: ここから何を学べばよいか
本ページで扱った概念は、 プライバシー領域の入口に過ぎない。 ここから先の学習順序を、 段階別に整理する。 初級 (本ページ以降の 3 ヶ月) は 差分プライバシー と k-匿名化 の数学的定義を 1 度きちんと追う。 Dwork & Roth の教科書「The Algorithmic Foundations of Differential Privacy」が世界標準で、 オンラインで PDF が無料公開されている。
中級 (6 ヶ月) は 実装ライブラリ に手を動かす段階。 Python なら IBM の diffprivlib、 Google の tensorflow_privacy、 Meta の opacus が代表的。 まずは公開ノートブック (Google Colab) で動かし、 自分のデータで再現してみるのが定着への近道。 法令面では、 個人情報保護委員会の「個人情報の保護に関する法律についてのガイドライン」と、 EDPB (欧州データ保護会議) の各種ガイドラインを並行で読むと、 日米欧の差分が見えてくる。
上級 (1 年以上) は 最新研究 に追随する段階。 主要会議は USENIX Security、 CCS、 NeurIPS、 ICML、 PETS (Privacy Enhancing Technologies Symposium) の 5 つ。 特に PETS はプライバシー専門の会議で、 攻撃と防御の最新事例が毎年更新される。 査読論文を全部追うのは大変なので、 毎年の Best Paper だけでも読む習慣を持つと、 業界の進化方向が体感できる。
🌱 最初の一歩: 自分が今関わっているデータ案件で、 「もし全件流出したら何が起きるか」を 5 分間想像してみることから始めてほしい。 そこで思いついた懸念 1 つ 1 つに対し、 本ページの表 3・表 4 から対応技術を選ぶ。 これが 「プライバシー設計者」 としての最初の実務である。
🐍 Python 実装 — プライバシー
公的統計(SSDSE-B-2026)を題材に、 最小限の Python コードで プライバシー を動作させます。 まずはこのまま実行してみてください。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | # プライバシー を SSDSE-B-2026 で実行する最小コード import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023] # 2023 年のみ抽出 print(df.shape) # (47, 112) print(df[['Prefecture','A1101','A1303','L3221']].head()) # 差分プライバシー風ノイズ追加(教育用) import numpy as np eps = 1.0 sensitivity = 1.0 noise = np.random.default_rng(0).laplace(loc=0, scale=sensitivity/eps, size=len(df)) df_dp = df.copy() df_dp['A1101_dp'] = df['A1101'] + noise print(df_dp[['Prefecture','A1101','A1101_dp']].head()) # 相対誤差 rel = (df_dp['A1101_dp'] - df['A1101']) / df['A1101'] print('最大相対誤差:', rel.abs().max()) |
💬 尺度 sensitivity/ε = 1 のラプラスノイズを加えても、北海道の 5,092,000 人が 5.092000e+06 のままに見えるように、表示された 5 県の変化は 1〜3 人で、最大相対誤差は 3.0×10⁻⁶ にとどまった。1 人の有無で県の人口は 1 しか変わらないので、数百万人規模の集計値なら ε=1 の差分プライバシーは精度をほとんど損なわない。逆に、そもそも A1101 は千人単位に丸めた値なので、このノイズは丸め幅より 3 桁小さく、小さな地域や稀な属性の件数に同じ ε をかけたときに初めて保護と精度のトレードオフが目に見えてくる。
🐍 差分攻撃: 2 つの合計の引き算で 1 県の値が分かる
「個別の県の値は出さず、 地方の合計だけを出す」ことにしても、 範囲が 1 県だけ違う 2 つの合計を公表すれば、 引き算でその 1 県の値が分かる。 これを差分攻撃という。 差分プライバシーは、 まさにこの「1 人分だけ違う 2 つのデータ」を見分けにくくするための定義である。
🎯 このコードでやること:九州・沖縄 8 県と九州 7 県の待機児童の合計を正確に公表した場合と、 それぞれに $\varepsilon=0.5$(尺度 2)のノイズを加えた場合で、 引き算から沖縄県の値と 1 人分の違いがどこまで分かるかを比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) t = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture')['J250502'] kyushu = ['福岡県', '佐賀県', '長崎県', '熊本県', '大分県', '宮崎県', '鹿児島県', '沖縄県'] q1 = t[kyushu].sum() # 公表 1: 九州・沖縄 8 県の合計 q2 = t[kyushu[:-1]].sum() # 公表 2: 沖縄県を除く 7 県の合計(九州 7 県) print('公表 1(8 県合計):', q1, '/ 公表 2(7 県合計):', q2, '/ 差 =', q1 - q2) # 2 つの合計にそれぞれ ε=0.5 のラプラスノイズ(尺度 2)を加えて公表した場合 rng = np.random.default_rng(0) n = 10000 d = (q1 + rng.laplace(0, 2, n)) - (q2 + rng.laplace(0, 2, n)) print(f'ノイズ付きの差: 平均 {d.mean():.2f}, 標準偏差 {d.std():.2f}') print(f'差が 406〜416 に入る割合 {np.mean(np.abs(d - 411) <= 5):.1%}, 0 人との区別がつく割合 {np.mean(d > 200):.1%}') # 1 人だけの差を当てられるか: 沖縄県が 411 人か 410 人かを見分ける print(f'差が 410.5 以上になる割合 真値 411 のとき {np.mean(d >= 410.5):.1%}, 真値 410 のとき {np.mean(d - 1 >= 410.5):.1%}') |
💬 正確な合計 567 と 156 を引くと沖縄県の 411 人がそのまま出る。 ノイズ付きでも差は平均 410.96・標準偏差 3.98 で、 81.4% の確率で 406〜416 に入るので「沖縄県はおよそ 400 人」という県単位の値は守られない。 一方、 1 人分の違い(411 人か 410 人か)について、 差が 410.5 以上になる割合は 55.8% と 43.0% で、 比は 1.30 倍にとどまる。 2 回の公表で合計 $\varepsilon=1$ なので上限は 2.718 倍で、 実測はその内側に収まった。 差分プライバシーが守るのは「1 人がいるかどうか」であって、 県全体の値を隠すものではない。
⚠️ プライバシー固有の落とし穴(7 件、 各 100 文字超)
プライバシー保護を実装するときに踏みやすい失敗を、 SSDSE-B-2026 のような公的集計データを扱う立場で具体的に整理した。 「集計値だから個人特定はあり得ない」という思い込みが最も多くの事故を生んでいる。
⚠️ 実データで確かめる: 同じ値を何度も公表すると ε は足し算で減っていく
$\varepsilon$ は 1 回の公表ごとに消費される「予算」で、 同じデータから $k$ 回公表すると合計は $k\varepsilon$ になる(合成定理)。 1 回ごとのノイズが十分でも、 攻撃者が公表値を平均すればノイズは $1/\sqrt{k}$ に縮む。
🎯 このコードでやること:沖縄県 2023 年度の待機児童 411 人について、 $\varepsilon=1$ の公表を 1・10・100 回行い、 攻撃者が平均して四捨五入したときに真値が当たる割合を 2,000 回の模擬攻撃で数える。 総予算を $\varepsilon=1$ に固定して 10 回に分けた場合とも比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) y = df[(df['SSDSE-B-2026'] == 2023) & (df['Prefecture'] == '沖縄県')]['J250502'].iloc[0] print('沖縄県 2023 年度の待機児童(真値):', y) rng = np.random.default_rng(0) n_attack = 2000 # 攻撃を 2,000 回まねて、当たる割合を数える print('公表回数 合計ε 平均の標準偏差 四捨五入で真値に一致') for k in [1, 10, 100]: rel = y + rng.laplace(0, 1.0, size=(n_attack, k)) # ε=1 の公表を k 回 est = rel.mean(axis=1) # 攻撃者は k 回分を平均する hit = np.mean(np.round(est) == y) print(f'{k:6d} {k:6.0f} {est.std():12.3f} {hit:10.1%}') # 総予算を ε=1 に固定して 10 回に分けると、1 回あたり ε=0.1(尺度 10) rel = y + rng.laplace(0, 10.0, size=(n_attack, 10)) est = rel.mean(axis=1) print(f'総予算 ε=1 を 10 回に分割: 平均の標準偏差 {est.std():.3f}, 一致 {np.mean(np.round(est) == y):.1%}') |
💬 1 回だけなら平均の標準偏差 1.444 で、 四捨五入が真値に一致するのは 39.1%(理論値 $1-e^{-0.5}=39.3\%$)。 10 回で 75.9%、 100 回では 100.0% になり、 ノイズを加えていても合計 $\varepsilon=100$ ではほぼ何も守られない。 同じ 10 回でも総予算 $\varepsilon=1$ を分け合えば 1 回あたり尺度 10 になり、 一致は 8.9% に下がる。 公表の回数と合計の $\varepsilon$ を記録し、 予算を使い切ったら公表を止めるのが運用の要になる。
⚠️ 実データで確かめる: 負の値を 0 に切る後処理は合計を押し上げる
ノイズを加えると、 0 人の県の公表値が負になることがある。 0 に切る・四捨五入するなどの後処理はプライバシー保証を弱めないが、 値を上にだけ動かすので、 合計に偏り(バイアス)が生じる。
🎯 このコードでやること:47 県の待機児童(合計 2,680 人、 うち 0 人の県が 15)に県ごとのラプラスノイズを加え、 そのままの合計・0 で切った合計・切って四捨五入した合計を 5,000 回の平均で比べる。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 | import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) y = df[df['SSDSE-B-2026'] == 2023]['J250502'].to_numpy() print('47 県の待機児童の合計(真値):', y.sum(), '/ 0 人の県:', int((y == 0).sum())) rng = np.random.default_rng(0) n = 5000 for eps in [1.0, 0.1]: noisy = y + rng.laplace(0, 1 / eps, size=(n, len(y))) # 県ごとに ε のラプラスノイズ clipped = np.clip(noisy, 0, None) # 負の値を 0 に切る後処理 rounded = np.round(clipped) print(f'ε={eps}: 合計の平均 そのまま {noisy.sum(1).mean():8.1f}' f' / 0 で切る {clipped.sum(1).mean():8.1f} / 切って四捨五入 {rounded.sum(1).mean():8.1f}') zero = y == 0 print(f' 0 人の 15 県の合計の平均 そのまま {noisy[:, zero].sum(1).mean():6.1f}' f' / 0 で切る {clipped[:, zero].sum(1).mean():6.1f}') |
💬 そのままの合計は 2679.9 人($\varepsilon=1$)・2681.8 人($\varepsilon=0.1$)で真値 2,680 人とほぼ同じだが、 0 で切ると 2687.5 人・2788.0 人に上がる。 増えた分のほとんどは 0 人の 15 県で、 1 県あたり $b/2$($\varepsilon=1$ で 0.5 人、 $\varepsilon=0.1$ で 5 人)ずつ上に偏るため、 15 県の合計が 7.5 人・75.4 人になる。 0 に切った県別の値を足して地方や全国の合計を作ると、 真値より系統的に多く出る点に注意する。
⚠️ 実データで確かめる: 1 つずつは粗い属性も、 重ねると県が特定できる
「人口は 100 万人単位、 出生率は小数 1 桁に丸めたから個人(ここでは県)は分からない」という判断は、 属性を 1 つずつ見たときにしか成り立たない。 準識別子は組み合わせで効く。 Sweeney が示した「郵便番号 + 生年月日 + 性別」と同じ構造を、 47 都道府県の公表値で確かめる。
🎯 このコードでやること:県名を伏せ、 人口階級・高齢化率(整数 %)・合計特殊出生率(小数 1 桁)・年平均気温(整数 ℃)を 1 つずつ重ねたとき、 組み合わせが 1 県だけになる(k=1)県の数を数える。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) t = df[df['SSDSE-B-2026'] == 2023].set_index('Prefecture') # 県名を伏せ、粗く丸めた属性だけを残す(準識別子) q = pd.DataFrame({ '人口階級': pd.cut(t['A1101'], [0, 1e6, 2e6, 3e6, 5e6, 2e7], labels=['<100万', '100-200万', '200-300万', '300-500万', '500万+']), '高齢化率(整数%)': (t['A1303'] / t['A1101'] * 100).round().astype(int), '出生率(小数1桁)': t['A4103'].round(1), '年平均気温(整数℃)': t['B4101'].round().astype(int), }) cols = list(q.columns) for j in range(1, len(cols) + 1): size = q.groupby(cols[:j], observed=True)[cols[0]].transform('size') print(f'{" + ".join(cols[:j]):48s} 一意の県 {int((size == 1).sum()):2d} / 47, 最小の k = {size.min()}') size = q.groupby(cols, observed=True)[cols[0]].transform('size') print('4 属性でも一意にならない県:', list(q.index[size > 1])) print(q.loc[['秋田県', '沖縄県']].to_string()) |
💬 人口階級だけなら一意なのは 1 県(300〜500 万人の階級に静岡県しかない)だが、 高齢化率を重ねると 15 県、 出生率まで重ねると 32 県、 気温まで重ねると 42 県が 1 県だけの組み合わせになる。 残る 5 県も「岐阜県・三重県・岡山県」(31%・1.3・17℃)と「長崎県・宮崎県」(34%・1.5・18℃)の k=3 と k=2 にすぎない。 どの属性も単独ではかなり粗いのに、 4 つ重ねると 47 県中 42 県が特定できる。 公表する列を 1 つ足すたびに、 組み合わせ全体の k を測り直す必要がある。
🗺 概念マップ
プライバシー (Privacy) を中心に、 上位概念 (情報セキュリティ・人権・データ倫理)、 並列概念 (匿名化・仮名化・差分プライバシー・k-匿名性)、 法制度 (個人情報保護法・GDPR・CCPA)、 応用 (匿名加工情報・連合学習・SSDSE の都道府県集計値) を関係づけて整理する。
プライバシー (privacy) は「自分に関する情報を自分でコントロールする権利」で、 統計・データ解析の文脈では、 個人が特定されないようにマスキング・匿名化・差分プライバシーを施す技術と、 GDPR・個人情報保護法・改正個情法による法的枠組みの二本柱で扱われる。 SSDSE-B-2026 のような集計後の公的統計はそもそも個人特定不可能な形で公開されるが、 集計前のミクロデータ (e-Stat の調査票情報) を扱う場合は k-匿名化・l-多様性・差分プライバシー など定量的な保証手法が必要になる。
結果の可視化や解釈の段階でも、 サンプルサイズが小さいセルを公開すると個人特定リスクが残るため、 セル抑圧 (sec="X") やランダム丸めなどの開示制御 (statistical disclosure control) を経て公表されるのが標準で、 「集計値だから安全」とは限らない点に注意が必要である。
🔗 隣接手法への橋渡し
プライバシーは「法律 × 技術 × 倫理」の交差点にあり、 データ取得・処理・公開の各段階で隣接概念と接続する。
- 上流(法・倫理基盤): 個人情報・GDPR・AI 倫理・インフォームドコンセント がプライバシー保護の根拠となる。
- 並列(同じ「個人情報の保護技術」): 匿名化 (k-匿名性)、 差分プライバシー、 仮名化、 暗号化、 連合学習 はそれぞれ異なる保証レベルで個人を守る技術。
- 下流(運用・監査): アクセス管理・監査ログ・データガバナンス が運用段階の保護を担い、 PIA (プライバシー影響評価) で事前リスク評価を行う。
プライバシー保護は「技術だけ」「法律だけ」では不十分で、 データ取得時の同意プロセス、 処理段階の匿名化技術、 公開時の開示制御、 事故発生時の対応体制 (インシデントレスポンス) まで含めた総合的な設計が必要になる。
🌳 手法選択フロー
「プライバシー」を実際に使うとき、 何をどう選ぶかを順に判断する。 上から順に答えていくと、 使うべき手法と評価の仕方が決まる。
- 法令上の義務か、 それを超える配慮か
個人情報保護法などの義務は最低ラインで、 上限ではない。 「合法だが不快」な使い方は信頼を失う。 法令の確認と、 当事者がどう感じるかの検討は別に行う。 - 本人が知っているか、 選べるか
知らないうちに集められることが、 プライバシー侵害の中心。 何を集め何に使うかを分かる言葉で伝え、 断る選択肢を実際に機能させる。 - 匿名化でどこまで下げられるか
匿名化は状態ではなく程度。 他のデータと結合すれば再識別されうる。 $k$-匿名性などで定量的に示し、 結合されうる外部データも想定する。 - 集めない選択を検討したか
最も確実な対策は、 そもそも取らないこと。 目的に必要な最小限まで削ると、 守る対象そのものが小さくなる。
プライバシーは「漏らさないこと」だけではなく「本人の予期しない使い方をしないこと」も含む。 技術的な安全管理と、 使い方の妥当性は別の論点。