🔖 キーワード索引
「shap」は統計データ分析の文脈で扱う重要概念のひとつ。 本ページでは「shap」を取り巻く中核キーワードを以下にチップで一覧化する。 各キーワードは関連する概念・手法・道具立てを含み、 文献検索や学習計画の起点になる。
これらのキーワードは「shap の理解 → 適用 → 検証」のプロセスを構成する。 各章で詳しく解説する。
💡 30秒で分かる結論
🍰 まずはやさしく
予測の理由を分ける道具です。
どの項目が結果に影響したか知るために使います。
テストの点数にどの勉強法が効いたか調べる感じです。
この章ではSHAP値の基本を学びます。
- 定義:ゲーム理論のShapley値に基づき、各特徴量が「予測値にどれだけ寄与したか」を公平に分配する説明手法。
- カテゴリ:機械学習
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 | import pandas as pd import shap import xgboost as xgb df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026']==2023].dropna() features = ['A1101', 'A1301', 'A1303', 'L3221', 'B4101'] X = df[features] y = df['A4101'] ## XGBoost で学習 model = xgb.XGBRegressor(n_estimators=100, max_depth=4, random_state=42).fit(X, y) ## TreeSHAP — 高速(多項式時間) explainer = shap.TreeExplainer(model) shap_values = explainer.shap_values(X) ## 加法性の確認(1 サンプル目 = 北海道) print(f'1 サンプル目の予測値: {model.predict(X.iloc[[0]])[0]:,.1f}') print(f'ベース値(背景平均): {explainer.expected_value:,.1f}') print(f'寄与の合計: {shap_values[0].sum():+,.1f}') top3 = sorted(zip(features, shap_values[0]), key=lambda t: -abs(t[1]))[:3] print('上位特徴量寄与: ' + ' '.join(f'{n}={v:+,.1f}' for n, v in top3)) ## 1. Summary plot(全体的な重要度と方向) shap.summary_plot(shap_values, X, plot_type='dot') ## 2. Bar plot(mean |SHAP| ランキング) shap.summary_plot(shap_values, X, plot_type='bar') ## 3. Force plot(個別予測の説明 — 1 サンプル) shap.force_plot(explainer.expected_value, shap_values[0], X.iloc[0], matplotlib=True) ## 4. Dependence plot(特徴量と SHAP の関係 + 交互作用色付け) shap.dependence_plot('A1101', shap_values, X, interaction_index='A1303') ## 5. Waterfall plot(最も詳細な個別予測説明) shap.waterfall_plot(shap.Explanation(values=shap_values[0], base_values=explainer.expected_value, data=X.iloc[0].values, feature_names=features)) |
② KernelSHAP — モデル非依存(NN・SVM 等にも)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | import shap from sklearn.neural_network import MLPRegressor from sklearn.preprocessing import StandardScaler from sklearn.compose import TransformedTargetRegressor X_scaled = StandardScaler().fit_transform(X) ## 出生数 y は数千〜8 万人と桁が大きいので、y も標準化して学習する(しないと NN がほぼ学習できない) nn = TransformedTargetRegressor( regressor=MLPRegressor(hidden_layer_sizes=(16, 8), max_iter=2000, random_state=42), transformer=StandardScaler()).fit(X_scaled, y) print(f'NN の学習データ R²: {nn.score(X_scaled, y):.3f}') ## KernelSHAP — モデル非依存 ## background data を 30 件にサブサンプル(高速化) background = shap.sample(X_scaled, 30) explainer = shap.KernelExplainer(nn.predict, background) shap_values = explainer.shap_values(X_scaled[:5], nsamples=100) print(f'ベース値(背景 30 件の平均予測): {explainer.expected_value:,.1f}') print(f'1 サンプル目(北海道)の予測: {nn.predict(X_scaled[:1])[0]:,.1f}') print(f'1サンプル目の SHAP値: {shap_values[0].round(1)}') print(f'SHAP 値の合計: {shap_values[0].sum():+,.1f}') |
📤 実行例(実行時の標準出力)
NN の学習データ R²: 0.980
ベース値(背景 30 件の平均予測): 15,189.3
1 サンプル目(北海道)の予測: 27,495.6
1サンプル目の SHAP値: [ -665.2  1438.4 17206.3    33.5 -5706.7]
SHAP 値の合計: +12,306.3
💬 読み方:北海道の SHAP 値の合計 +12,306.3 は、 予測 27,495.6 と背景 30 県の平均予測 15,189.3 の差にちょうど等しい。 同じ 5 特徴量でも、 ① の XGBoost では 15 歳未満人口 A1301 が最大だったのに、 この NN では 65 歳以上人口 A1303 に +17,206.3、 年平均気温 B4101 に −5,706.7 が割り振られた。 人口系の 3 列はほぼ同じ情報を持つので、 どの列に寄与が載るかはモデルしだいで変わる。 出生数 y を標準化せずにこの NN を学習させると R² が 0 前後にとどまり、 そのような予測を分解しても意味のある SHAP 値は得られない。
③ scikit-learn の Permutation Importance(代替手法)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # ── この抜粋で使うモデルとデータを用意します ── import pandas as pd import matplotlib.pyplot as plt # PDP の描画に必要 from sklearn.ensemble import GradientBoostingRegressor from sklearn.inspection import permutation_importance, partial_dependence, PartialDependenceDisplay df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].dropna() # 2023 年の 47 都道府県 features = ['A1101', 'A1301', 'A1303', 'L3221', 'B4101'] X = df[features].astype(float).values y = df['A4101'].astype(float).values # 出生数 model = GradientBoostingRegressor(random_state=42).fit(X, y) ## Permutation Importance(モデル非依存・汎化重要度) result = permutation_importance(model, X, y, n_repeats=10, random_state=42, scoring='r2') for i in result.importances_mean.argsort()[::-1]: print(f'{features[i]:10s} : {result.importances_mean[i]:.3f} ± {result.importances_std[i]:.3f}') ## Partial Dependence Plot — 関係の形状 PartialDependenceDisplay.from_estimator(model, X, features=[1, 2], grid_resolution=20) |
📤 実行例(実行時の標準出力)
A1301      : 0.707 ± 0.115
A1101      : 0.192 ± 0.035
A1303      : 0.034 ± 0.003
L3221      : 0.000 ± 0.000
B4101      : 0.000 ± 0.000
# 上位ほど予測精度への寄与が大きい(15歳未満人口 A1301 が支配的)
💬 読み方:A1301(15 歳未満人口)をシャッフルすると学習データ上の R² が 0.707 下がり、 A1101(総人口)の 0.192 を大きく上回る。 消費支出 L3221 と年平均気温 B4101 は 0.000 で、 このモデルは 2 列をほぼ使っていない。 A1301 と A1101 は相関 0.997 とほぼ同じ情報なので、 片方をシャッフルしてももう片方が残っていれば精度は落ちにくく、 重要度が低く出た列が「効いていない」とは限らない。 SHAP(個別予測の寄与)と違い、 こちらはモデル全体の大域的な重要度である。
④ LIME — 局所的な近似
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import lime import lime.lime_tabular ## LIME — 単一予測の局所線形近似(X は上のブロックの 47×5 の numpy 配列) explainer = lime.lime_tabular.LimeTabularExplainer( X, feature_names=features, mode='regression', random_state=42) ## 1 サンプル目(北海道)の LIME 説明 exp = explainer.explain_instance(X[0], model.predict, num_features=5) print('LIME 局所説明(1 サンプル目 = 北海道):') for rule, w in exp.as_list(): print(f' {rule:32s}: {w:+,.1f}') print(f'局所モデルの切片: {exp.intercept[0]:,.1f}') print(f'局所モデルの予測: {exp.local_pred[0]:,.1f} / 元モデルの予測: {model.predict(X[:1])[0]:,.1f}') print(f'R² (局所近似モデル): {exp.score:.2f}') |
📤 実行例(実行時の標準出力)
LIME 局所説明(1 サンプル目 = 北海道):
  A1301 > 293500.00               : +19,695.9
  A1101 > 2636500.00              : +10,411.8
  A1303 > 789000.00               : +2,609.7
  B4101 <= 16.15                  : -116.0
  279506.00 < L3221 <= 300652.00  : +24.8
局所モデルの切片: 7,712.4
局所モデルの予測: 40,338.5 / 元モデルの予測: 24,429.8
R² (局所近似モデル): 0.77
💬 読み方:LIME は北海道を「A1301 が 293,500 超」「A1101 が 2,636,500 超」のような区間で表し、 それぞれに +19,695.9・+10,411.8 の重みを付けた。 ところが切片 7,712.4 に重みを足した局所モデルの予測は 40,338.5 で、 元モデルの予測 24,429.8 から 1.6 万人も離れ、 局所近似の R² も 0.77 にとどまる。 SHAP のように「寄与の合計 = 予測 − ベース値」が保証されないのはこのためで、 LIME の重みは乱数による周辺サンプルの取り方でも変わる(ここでは random_state=42 で固定)。
📍 あなたが今見ているもの
🍰 まずはやさしく
予測の中身を説明する手法です。
AIがなぜその答えを出したか分かるようにします。
スマホのアプリがなぜこの広告を出したか探る感じです。
ここでは定義から実装までを順番に読みます。
論文中に 「SHAP値」として登場する用語。
SHAP値 とは:ゲーム理論のShapley値に基づき、各特徴量が「予測値にどれだけ寄与したか」を公平に分配する説明手法。
本ページでは「shap」を扱う。 統計データ分析コンペティション (2026) の教材で、 SSDSE-B-2026 (47 都道府県 × 複数年 × 100 超列) の実データを使った再現可能な学習を目指す。
「shap」は統計・データサイエンスの体系における重要概念のひとつ。 本ページは「定義・直感・数式・実装・落とし穴・関連手法」の 6 視点で構成され、 各視点は独立して読めるが順序通り読むと体系的な理解が得られる。
🎨 直感で掴む — SHAP の本質
🍰 まずはやさしく
予測の結果を分けたレシートのようなものです。
それぞれの項目がどれだけ貢献したか計算します。
部活の試合で誰がどれだけ得点に貢献したか分ける感じです。
ここではSHAP値のイメージを掴んでいきます。
SHAP は「各特徴量が予測に対して何 pt 寄与したか」を、 ゲーム理論の Shapley 値に基づいて公平に分配する手法。 たとえば SSDSE-B-2026 で「都道府県の出生率を予測する Random Forest」を作り、 ある県の予測値が 1.40 で平均 1.30 のとき、 SHAP は「人口密度が +0.05、 平均所得が +0.08、 高齢化率が -0.03 寄与した」のように分解する。
🎨 直感で掴む — SHAP は「予測のレシート」
SHAP は機械学習モデルの予測を、 各特徴量の 寄与額 に分解する手法。 ちょうどスーパーのレシートが「合計 1,580 円 = キャベツ 200 + 牛乳 350 + パン 280 + ...」と内訳を示すように、 SHAP は「予測値 0.92 = 平均 0.5 + 人口 +0.18 + 出生率 -0.05 + 平均気温 +0.15 + 教育水準 +0.14」と 足し算で因果寄与を可視化します。
なぜ Shapley 値なのか?
単純な「特徴量重要度」(feature_importances_) は「モデル全体での平均的な貢献」しか教えてくれない。 一方で、 SHAP は 個々のサンプルについて「この予測がなぜこの値か」を説明できる。 さらに、 ゲーム理論の Shapley 値が満たす 4 つの公理 (Efficiency, Symmetry, Dummy, Additivity) を満たす、 数学的に唯一の分解です。
| 手法 | 説明粒度 | 公理保証 | 計算量 | 主な弱点 |
|---|---|---|---|---|
| feature_importances_ | グローバルのみ | なし | 非常に軽い | 個別予測の理由不明 |
| Permutation Importance | グローバル | なし | 中 | 相関で過大評価 |
| LIME | ローカル | なし | 中 | 不安定 (毎回違う値) |
| SHAP (TreeSHAP) | ローカル + グローバル | 4 公理保証 | 木モデルなら O(TLD^2) | 相関特徴量の解釈に注意 |
| SHAP (KernelSHAP) | 汎用モデル | 近似的に保証 | O(2^M) サンプリング | 大規模特徴で遅い |
SHAP の最大の魅力は 「グローバル説明とローカル説明の整合性」。 個別予測の寄与額を全サンプルで集計すると、 そのままモデル全体の重要度になる。 LIME や Permutation には無い性質です。
📐 数式または定義 — SHAP の形式的表現
🍰 まずはやさしく
寄与度(影響した度合い)を公平に分ける計算式です。
正しく計算するためのルールを確認するために使います。
買い物で誰がいくら出したか公平に分ける感じです。
ここでは数式を使って詳しい定義を読みます。
直感で全体像を掴んだら、 次は厳密な定義を見ます。 数式は短いものでも、 「何を入力にして、 何を出力するのか」を意識して読むと早く慣れます。
📐 数式 — Shapley 値と SHAP の定式化
特徴量 $i$ の Shapley 値:
$$ \phi_i = \sum_{S \subseteq F \setminus \{i\}} \frac{|S|!\,(|F|-|S|-1)!}{|F|!} \bigl[ v(S \cup \{i\}) - v(S) \bigr] $$
ここで $F$ は全特徴量集合、 $S$ は特徴量サブセット、 $v(S)$ は $S$ だけを使ったモデル予測。 SHAP は $v(S) = E[f(x) | x_S]$ と定義し、 全特徴を使った場合と部分集合の場合の差を Shapley 公式で重み付け平均します。
最終的に、 任意のサンプル $x$ に対して以下の加法分解が成立 (Local Accuracy):
$$ f(x) = \phi_0 + \sum_{i=1}^{M} \phi_i $$
$\phi_0$ は ベース値 (=訓練データ全体での平均予測)、 $\phi_i$ は特徴量 $i$ の寄与額。 この式の最大の意味は「予測値が必ず寄与額の和になる」こと。 これは Shapley 値の Efficiency 公理から自動的に保証されます。
数式を言葉で読み解く
- $\phi_i$: 特徴量 $i$ の寄与額。 正なら予測を押し上げ、 負なら押し下げる。
- $\sum_{S \subseteq F \setminus \{i\}}$: 特徴量 $i$ を含まない全サブセットを巡る。 サブセットは $2^{M-1}$ 個。
- $\frac{|S|!\,(M-|S|-1)!}{M!}$: サブセット $S$ の出現確率に対応する重み。 全パーミュテーション中で「$i$ を $S$ の直後に追加する順列」の割合。
- $v(S \cup \{i\}) - v(S)$: 特徴量 $i$ を追加したことで予測がどれだけ変わるか (=限界寄与)。
- 4 公理: Efficiency (合計が予測差に一致)、 Symmetry (役割が同じ特徴は同じ寄与)、 Dummy (役立たない特徴の寄与は 0)、 Additivity (モデル和は寄与和)。
この 4 公理を満たす分配は Shapley 値が唯一 (Shapley 1953)。 だから SHAP は「説明可能性手法の中で数学的に最も基礎付けられた」と評価されています。
📐 Shapley 値の公理 — 数式を 4 つの直感で読み解く
SHAP の根本にある Shapley 値は、 協力ゲーム理論で 1953 年に Lloyd Shapley が提案した「複数プレイヤーの貢献を公平に分配する唯一の方法」である。 SHAP はこれを機械学習に応用しただけで、 公理(axioms)はそのまま継承される。 ここでは 4 つの公理を SSDSE-B-2026 の文脈で具体的に読み解く。 これらの公理を満たす分配方法は Shapley 値のみであることが数学的に証明されている(一意性定理)。
公理 1: Efficiency(効率性 / Local Accuracy)
数式:$\sum_{j=1}^{d} \phi_j = f(x) - E[f(X)]$
SSDSE-B-2026 での意味:全特徴量の SHAP 値の合計は、 「その県の予測値」と「全県平均の予測値」の差に等しい。 例:東京の予測 100 兆円、 全国平均予測 10 兆円 → SHAP 値の合計は +90 兆円。 1 円のずれも許さない厳密等式である。
直感:「分配したお金の合計は元のお金と一致しなければならない」というレシートの原則。
公理 2: Symmetry(対称性)
数式:もし $\forall S \subseteq N \setminus \{i,j\}, v(S \cup \{i\}) = v(S \cup \{j\})$ なら $\phi_i = \phi_j$。
SSDSE-B-2026 での意味:仮に「総人口」と「日本人人口」がモデルから見て完全に区別できない(任意の組合せで同じ予測値を生む)場合、 SHAP 値は同じ値になる。
直感:「全く同じ貢献をした 2 人のメンバーには同じ報酬を払う」という公平性の原則。
公理 3: Dummy(ダミー / Null Player)
数式:もし $\forall S, v(S \cup \{i\}) = v(S)$ なら $\phi_i = 0$。
SSDSE-B-2026 での意味:「年平均気温」が出生数の予測に一切影響しない特徴量だった場合、 その SHAP 値はゼロ。 図 3 で年平均気温の箱がほぼ 0 に張り付いていたのはこの公理の表れ。
直感:「何もしなかった人には報酬は払わない」。 これは feature selection の合理性も保証する。
公理 4: Additivity(加法性)
数式:$\phi_i(v_1 + v_2) = \phi_i(v_1) + \phi_i(v_2)$
SSDSE-B-2026 での意味:もし 2 つのモデル(例:RandomForest と XGBoost)の予測を足し合わせたアンサンブルを作った場合、 SHAP 値もそのまま足し算で求まる。 これは TreeSHAP の高速化アルゴリズムの根拠でもある。
直感:「貢献度の分配は、 ゲームを分解しても変わらない」。 アンサンブル学習との相性が抜群に良い理由。
一意性定理 — なぜ SHAP は「唯一」なのか
Shapley (1953) の一意性定理は次のように述べる:「Efficiency + Symmetry + Dummy + Additivity の 4 公理を同時に満たす分配方法は、 Shapley 値のみである」。 これは数学的な定理であり、 別の「公平な分配方法」を考えても、 これらの公理のいずれかを必ず破る。 LIME(局所線形近似)は Local Accuracy を厳密には満たさないため、 同じ意味での「公平さ」は保証されない。 これが SHAP が「説明手法のゴールドスタンダード」と呼ばれる根拠である。
Shapley 値の計算式(参考)
SHAP 値は次の和で定義される:
$\phi_i = \sum_{S \subseteq N \setminus \{i\}} \frac{|S|! (|N|-|S|-1)!}{|N|!} \big[ v(S \cup \{i\}) - v(S) \big]$
記号の意味:
- $N$ = 全特徴量の集合(SSDSE-B-2026 なら 15 個)
- $S$ = 特徴量 $i$ を含まない部分集合(順列を考慮)
- $v(S)$ = 特徴量集合 $S$ だけを使ったモデルの予測値の期待値
- $v(S \cup \{i\}) - v(S)$ = 特徴量 $i$ を「追加した」時の予測値の変化(限界貢献)
- 係数 $\frac{|S|! (|N|-|S|-1)!}{|N|!}$ = 全順列 $|N|!$ のうち、 $i$ が $S$ の直後に来る順列の割合(公平な重み)
この計算は厳密には全部分集合 $2^{|N|-1}$ 通りの和を取る必要があり、 $|N|=50$ で 10^15 通りと爆発する。 SHAP ライブラリの TreeSHAP / KernelSHAP / LinearSHAP はそれぞれモデル構造を活かして高速近似または厳密計算を実現する。
🔬 数式を言葉で読み解く — SHAP の記号辞書
上の数式に出てくる各記号が何を表すかを、 言葉で翻訳します。 1 つずつ自分の言葉で言い換えられるようになると、 論文や教科書のスピードが一気に上がります。
| 記号 | 意味(言葉での説明) |
|---|---|
| $\phi_i$ | 特徴量 $i$ の SHAP 値(予測への寄与) |
| $N$ | 全特徴量の集合 |
| $S$ | $i$ を含まない部分集合 |
| $v(S)$ | $S$ だけで学習したときの予測値 |
| $|S|!(n-|S|-1)!/n!$ | 対称性を保つための重み |
🧮 実値で計算してみる — SSDSE-B-2026 で SHAP を体感
数式だけでは「分かった気になる」だけで終わりがち。 ここで SSDSE-B-2026(教育用標準データセット — 47 都道府県 × 100+ 指標、 2012-2023 年度)の実値を当てはめて、 SHAP の挙動を電卓的に追体験します。
SSDSE-B-2026 は 統計センターの SSDSE 配布ページ から CSV を直接ダウンロードできます。 本サイトでは data/raw/SSDSE-B-2026.csv に配置している前提でコードを書いています。
🧮 実値で計算してみる — SSDSE-B-2026 の SHAP 分解
SSDSE-B-2026 から「都道府県の年間出生数 (A4101)」を予測するモデルを構築し、 SHAP で 東京都の予測根拠を分解した結果(2023 年・47 県・10 特徴量の XGBoost + TreeSHAP の実測。 全国平均は 47 県の単純平均):
| 特徴量 | 東京都の値 | 全国平均 | SHAP 値 $\phi_i$ | 解釈 |
|---|---|---|---|---|
| A1101 総人口 | 14,086,000 | 2,645,809 | +53,698.8 | 人口が桁違いに多い → 大きく押上 |
| A1301 15歳未満人口 | 1,513,000 | 301,511 | +3,990.7 | 総人口とほぼ同じ情報(相関 0.997) |
| A1303 65歳以上人口 | 3,205,000 | 770,830 | +12,454.3 | これも人口規模の代理 → 押上 |
| A4103 合計特殊出生率 | 0.99 | 1.29 | −4.5 | 全国最低だが寄与はほぼゼロ |
| A5101 転入者数 | 406,749 | 47,429 | +156.2 | 微小押上 |
| L3221 消費支出 | 341,320 | 295,856 | −7.6 | ほぼ無関係 |
| 残り 4 列(A5102・E3101・E1101・B4101) | — | — | +130.1 | 合計しても微小 |
| ベース値 $\phi_0$ | — | — | 15,460.3 | 47 県の平均予測 |
| 予測値 $f(x)$ | — | — | 85,878.3 | 15,460.3 + 70,418.0(実測 86,348) |
注目すべきは 「総人口 +53,698.8 と 65 歳以上人口 +12,454.3 だけで予測の押上げ 70,418.0 のほぼすべてを占め、 合計特殊出生率は全国最低の 0.99 なのに寄与が −4.5 しかない」こと。 このモデルは出生数の水準を人口規模で説明しており、 「出生率が低いから出生数が減る」という関係はほとんど使っていない。 SHAP はモデルが何に頼って予測しているかを数値で見せるので、 こうした「直感と違う頼り方」に気づける(下の 🐍 Python 実装① 〜 ③ と同じモデル・同じ値)。
🧮 数式に値を入れて手で計算する: SHAP 値の合計性
合成 3 特徴のモデルで予測 = 基準 + Σ SHAP を検証する。
Step 1: 基準値と SHAP
Step 2: 予測
🐍 Python で再現
1 2 3 4 5 6 | import numpy as np base = 0.5 shap = np.array([0.20, -0.10, 0.05]) pred = base + shap.sum() print(f"予測: {pred}") print(f"主要 index: {np.abs(shap).argmax()}") |
📤 実行結果
💬 予測 0.65 は基準値 0.5 に SHAP 値 +0.20・−0.10・+0.05 の合計 +0.15 を足したもので、 Step 2 の手計算と一致する。 主要 index が 0 なのは、 絶対値で最大の寄与が x1 の +0.20 だからで、 符号に関係なく |SHAP| で比べている(x2 の −0.10 は 2 番目)。 この 3 つの値は説明用の合成値である。
🎮 触って理解する
スライダーで特徴量の値を動かすと、 基準値(全体平均予測)から最終予測へ向かうウォーターフォール図がリアルタイムに更新されます。 赤は予測を押し上げる寄与、 青は押し下げる寄与。 各特徴の寄与額こそが SHAP 値(Shapley 値)です。
あるカフェの「1 日の来客スコア」を 3 つの特徴量から予測する、 説明用の架空の加法モデルです。
f = 50 + 20·気温 + 15·話題度 + 10·天気 + 12·(気温 × 話題度)
各特徴の値は「その日の平均との差」(−1.0 〜 +1.0)としてスライダーで与えます。 平均との差が 0 のときが基準状態で、 基準値 E[f] = 50 になります。 紫の項は気温と話題度の相互作用(暑い日ほど話題の効果が乗る)で、 Shapley 値はこの相互作用も 2 特徴へ公平に折半します。
🔁 各特徴の寄与はどう決まる? — 全順列の限界貢献を平均
Shapley 値の定義は「特徴量を 1 つずつ加えていく全ての順番(順列)について、 その特徴を加えた瞬間の予測の増分(限界貢献)を求め、 平均する」というもの。 3 特徴なら順列は 3! = 6 通り。 下の表は現在のスライダー値での 6 通りの限界貢献と、 その平均(= SHAP 値)です。 相互作用があるため、 同じ特徴でも加える順番によって限界貢献が変わる点に注目してください。
関連ページ: XAI(説明可能AI) / ランダムフォレスト / 線形回帰 / 重回帰分析 / 回帰分析 / 特徴量エンジニアリング。 なお LIME・Permutation Importance・TreeSHAP の解説は本ページ内(📍 直感・🐍 Python 実装)を参照してください。
🐍 Python 実装 — SHAP を SSDSE-B-2026 で動かす
🎯 このコードでやること: 2023 年度の 47 都道府県で、総人口(百万人)から合計特殊出生率を予測する線形回帰を作り、 その予測を shap.LinearExplainer で 1 県ずつ SHAP 値に分解します。 特徴量が 1 つの線形モデルなので、 SHAP 値が「係数 × (x − x の平均)」と一致することを手計算で確かめられます。 SHAP は各特徴量が予測をどれだけ押し上げ/押し下げたかを加法的に分けるので、 木モデルなど係数の読めないモデルでも同じ形で予測の内訳が読めます。 なお pd.read_csv('data/raw/SSDSE-B-2026.csv') をパス変数にせず直書きしているのは、 初学者が「パスをどこに書くべきか」で迷わないようにするためです。 CSV を同じ階層に置けばそのまま動きます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 | # SHAP を SSDSE-B-2026 で確かめる最小コード import pandas as pd import numpy as np # 1) SSDSE-B-2026(教育用標準データセット)を読み込み df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=1) print('shape:', df.shape) # (564, 112) — 47 都道府県 × 12 年度 print('cols head:', list(df.columns[:8])) # 2) 直近年度(2023 年度)に絞る df23 = df[df['年度'] == 2023].copy() print('rows in 2023:', len(df23)) # 3) SHAP を動かすために必要な列だけ取り出す y = df23['合計特殊出生率'].astype(float) x = df23['総人口'].astype(float) print('y stats:', y.describe().round(3).to_dict()) print('x stats:', x.describe().round(0).to_dict()) # 4) SHAP の本処理(このページの主題) # 総人口(百万人)で合計特殊出生率を説明する線形回帰を作り、 # 各県の予測が平均からどれだけずれるかを SHAP 値に分解する import shap from sklearn.linear_model import LinearRegression X = (x / 1e6).to_frame('総人口_百万人') model = LinearRegression().fit(X, y) explainer = shap.LinearExplainer(model, X) sv = explainer.shap_values(X) print('---- SHAP 結果 ----') print('base value (予測の平均):', round(float(explainer.expected_value), 3)) print('係数 (百万人あたり):', round(model.coef_[0], 4)) out = pd.DataFrame({'都道府県': df23['都道府県'].values, '総人口_百万人': X.iloc[:, 0].round(2).values, 'SHAP': sv[:, 0].round(4)}) print(out.sort_values('SHAP').iloc[[0, 1, 2, -3, -2, -1]].to_string(index=False)) # 線形モデルでは SHAP 値 = 係数 × (x − x の平均) になる print('手計算との一致:', np.allclose(sv[:, 0], model.coef_[0] * (X.iloc[:, 0] - X.iloc[:, 0].mean()))) |
💬 base value 1.293 は 47 県の合計特殊出生率の平均で、各県の予測はここに SHAP 値を足したものになる。東京都は総人口 1,409 万人が平均 265 万人より大きく離れているため SHAP が −0.307 と最も大きく押し下げ、予測は 1.293 − 0.307 = 0.986 で実測 0.99 にほぼ重なる。鳥取県など人口の少ない県は +0.05 程度しか押し上げず、特徴量が 1 つの線形モデルでは SHAP 値は係数 −0.0269 と平均からの差の積そのもの(手計算との一致: True)なので、分解して新しく分かることはない。SHAP が役に立つのは、特徴量を増やしたり木モデルに替えたりして係数から寄与が読めなくなったときである。
うまく動かないときは ①data/raw/SSDSE-B-2026.csv のパス、 ②encoding='cp932'(SSDSE-B は Shift_JIS 系)、 ③1 行目に英数字ヘッダ、 2 行目に日本語列名が入る構造なので skiprows=1 が必要、 の 3 点を確認してください。
🐍 Python 実装① — XGBoost + TreeSHAP で SSDSE-B-2026 を分解
🎯 このコードでやること: SSDSE-B-2026 で「年間出生数 A4101」を予測する XGBoost モデルを学習し、 TreeSHAP で各都道府県の SHAP 値を計算する。 TreeSHAP は木モデル限定だが、 厳密計算で高速 (O(TLD²))。
📥 入力データ: data/raw/SSDSE-B-2026.csv (47 都道府県 × 110 変数)。 目的変数 A4101、 説明変数は人口・産業・教育系列を厳選。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import pandas as pd, xgboost as xgb, shap df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) df = df[df['SSDSE-B-2026'] == 2023].reset_index(drop=True) # 2023 年度の 47 都道府県 features = ['A1101', 'A1301', 'A1303', 'A4103', 'A5101', 'A5102', 'L3221', 'E3101', 'E1101', 'B4101'] X = df[features] y = df['A4101'] model = xgb.XGBRegressor(n_estimators=200, max_depth=4, learning_rate=0.05, random_state=42) model.fit(X, y) explainer = shap.TreeExplainer(model) shap_values = explainer(X) print(f'ベース値 phi_0 = {explainer.expected_value:,.1f}') tokyo_idx = df[df['Prefecture'] == '東京都'].index[0] print(f'東京都 予測 = {model.predict(X.iloc[[tokyo_idx]])[0]:,.1f}') print(f'東京都 SHAP 合計 = {shap_values.values[tokyo_idx].sum():,.1f}') print(f'shap_values.values.shape = {shap_values.values.shape}') |
📤 実行例:
💬 結果の読み方: SHAP 値の合計 (=70,418.0) と予測値からベース値を引いた値 (85,878.3 − 15,460.3) が完全に一致。 これが Local Accuracy 公理の実証。 個々の SHAP 値を見れば、 東京都の予測根拠が変数別に分解されます。
🐍 Python 実装② — summary_plot で全都道府県を一望
🎯 このコードでやること: shap.summary_plot で全 47 都道府県 × 10 特徴量の SHAP 値を一枚の図に描き、 「どの特徴量が出生数予測にどれだけ効いているか」を可視化する。
📥 入力データ: 上記モデルの shap_values オブジェクト。 各行が都道府県、 各列が特徴量。
1 2 3 4 5 6 7 8 9 10 11 12 | import shap, matplotlib.pyplot as plt shap.summary_plot(shap_values, X, plot_type='dot', show=False) plt.tight_layout() plt.savefig('shap_summary.png', dpi=120) # 各特徴量の平均絶対 SHAP (=グローバル重要度) import numpy as np mean_abs = np.abs(shap_values.values).mean(axis=0) order = np.argsort(-mean_abs) for i in order: print(f'{features[i]:8s}: {mean_abs[i]:8,.1f}') |
📤 実行例:
💬 結果の読み方: グローバル重要度では「総人口」が他を圧倒。 一見当然だが、 SHAP の偉さは 個別予測ではこの順位が変わること (例: 沖縄県では A1101 が押下げに回り、 A1301 が最大の押上げになる)。 summary_plot のドット分布で「特徴量の値 (赤=大、 青=小) × SHAP 値」を一望できます。
🐍 Python 実装③ — waterfall_plot で個別予測を可視化
🎯 このコードでやること: 沖縄県 (出生率全国一位 1.60、 人口は中規模) の予測を waterfall プロットで可視化。 ベース値からスタートし、 各特徴量の寄与を積み上げて予測値に到達する様子を描く。
📥 入力データ: 沖縄県 (Prefecture=="沖縄県") の特徴量ベクトルと、 対応する shap_values の行。
1 2 3 4 5 6 7 8 9 10 11 | import shap, matplotlib.pyplot as plt okinawa_idx = df[df['Prefecture'] == '沖縄県'].index[0] shap.plots.waterfall(shap_values[okinawa_idx], max_display=10, show=False) plt.tight_layout() plt.savefig('shap_okinawa.png', dpi=120) print('沖縄県 各特徴量 SHAP 値:') for name, v in zip(features, shap_values.values[okinawa_idx]): sign = '+' if v >= 0 else '' print(f' {name:8s}: {sign}{v:8,.1f}') |
📤 実行例:
💬 結果の読み方: 東京都とは正反対の構造で、 沖縄県では 総人口 A1101 が -5,899.7 と押下げに回り、 15 歳未満人口 A1301 の +2,810.8 が最大の押上げになる。 出生率 A4103 は全国一位の 1.60 だが寄与は +11.9 とごく小さい — 「出生率が高い=出生数の予測が押し上がる」ではない点が重要で、 モデルは出生数の水準をほぼ人口規模で説明している。 これが SHAP の真価で、 「同じモデルなのに、 個別予測ごとに最重要特徴が変わる」のを定量化できる。
🐍 Python 実装④ — dependence_plot で非線形効果を可視化
🎯 このコードでやること: 「総人口 A1101 が増えると SHAP 値はどう変わるか」を全 47 都道府県でプロット。 単純線形なら直線になるが、 ツリーモデルは非線形なので「人口 200 万を境に効きが変わる」など階段状になることが多い。
📥 入力データ: 上記の shap_values と特徴量 X。 X 軸=人口、 Y 軸=SHAP 値、 色=出生率。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import shap, matplotlib.pyplot as plt shap.dependence_plot('A1101', shap_values.values, X, interaction_index='A4103', show=False) plt.title('SHAP dependence: A1101 (総人口) — interaction with A4103 (出生率)') plt.tight_layout() plt.savefig('shap_dep_A1101.png', dpi=120) # 数値で確認: 人口階級別の平均 SHAP 値 import numpy as np bins = [0, 1e6, 3e6, 6e6, 1.5e7] labels = ['~100万', '100-300万', '300-600万', '600万~'] X_bin = pd.cut(X['A1101'], bins=bins, labels=labels) for b in labels: mask = (X_bin == b) if mask.sum() > 0: m = shap_values.values[mask.values, 0].mean() print(f'人口 {b:10s}: 平均 SHAP = {m:+8,.1f} ({mask.sum()} 県)') |
📤 実行例:
💬 結果の読み方: 人口 300 万を境に SHAP の符号が反転、 600 万を超えると急上昇。 これは 木モデルが学習した非線形閾値。 線形回帰では絶対に出てこない構造。 dependence_plot の威力は、 こうした閾値・相互作用を可視化できる点にあります。
🐍 Python 実装⑤ — SHAP 値でクラスタリング
🎯 このコードでやること: SHAP 値ベクトルを「説明プロファイル」として 47 都道府県をクラスタリング。 同じ予測値でも「なぜそうなったか」の構造が違う県を発見できる。
📥 入力データ: 47 × 10 の SHAP 行列。 行=都道府県、 列=各特徴量の SHAP 値。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | import shap from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler shap_mat = shap_values.values # (47, 10) scaler = StandardScaler() shap_scaled = scaler.fit_transform(shap_mat) km = KMeans(n_clusters=4, n_init=10, random_state=42) labels = km.fit_predict(shap_scaled) df_out = pd.DataFrame({ 'pref': df['Prefecture'], 'cluster': labels, 'pred': model.predict(X) }) for c in range(4): members = df_out[df_out['cluster'] == c]['pref'].tolist() print(f'Cluster {c} (n={len(members)}): {members[:5]} ...') |
📤 実行例:
💬 結果の読み方: 東京都は総人口 A1101 の SHAP が +53,699 と桁違いなので、 1 県だけで独立したクラスタ (n=1) になる。 総人口の SHAP 平均で見ると、 Cluster 0(19 県)は −7,424、 Cluster 1(14 県)は −5,644、 Cluster 3(13 県)は +10,525 で、 分かれ方の大部分は人口規模の段階そのものである。 ただし Cluster 3 には沖縄県のように総人口では押し下げ(−5,900)だが 15 歳未満人口 A1301 で押し上げ(+2,811)られる県も入っており、 予測値が近くても「理由の組み合わせ」が違う県をまとめて見られるのが SHAP 値でクラスタリングする利点である。 SHAP は予測モデルの内訳であり、 出生数を動かす因果の違いを示すものではない。
🐍 Python 実装⑥ — SHAP Interaction Value で相互作用を抽出
🎯 このコードでやること: 「人口 × 出生率」「人口 × 婚姻件数」など、 特徴量ペアの 相互作用効果を SHAP Interaction Value で定量化。 単独効果と相互作用を分離して理解できる。
📥 入力データ: TreeSHAP の interaction モード。 出力は (n_samples, n_features, n_features) の 3 次元テンソル。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import numpy as np import shap inter_vals = explainer.shap_interaction_values(X) # (47, 10, 10) print(f'interaction tensor shape: {inter_vals.shape}') # 全サンプル平均で各ペアの絶対値合計 mean_abs = np.abs(inter_vals).mean(axis=0) np.fill_diagonal(mean_abs, 0) # 単独効果を除外 # 上位 5 相互作用 flat = [] for i in range(len(features)): for j in range(i+1, len(features)): flat.append((features[i], features[j], mean_abs[i,j])) flat.sort(key=lambda t: -t[2]) for a, b, v in flat[:5]: print(f'{a} × {b}: {v:,.1f}') |
📤 実行例:
💬 結果の読み方: 最大の相互作用は「総人口 × 15歳未満人口」(618.8) で、 「人口規模に応じて年少人口の効きが変わる」非線形性をモデルが学習した証拠。 出生率 A4103 を含むペアは上位 5 に 1 つも入らない — 単独寄与 (12.4) が小さいだけでなく、 他変数との相互作用としても効いていないことが分かる。 線形モデルでは表現不可能な構造です。
🐍 Python 実装⑦ — force_plot で複数県を一気に比較
🎯 このコードでやること: SHAP force_plot を使い、 全 47 都道府県の予測根拠を一枚の図にスタックして表示。 「予測値の高い県/低い県の SHAP プロファイル分布」が一望できます。
📥 入力データ: 全 47 県の SHAP 値テンソルと特徴量行列。 force_plot は HTML 形式の対話的可視化を生成。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 | import shap shap.initjs() force_html = shap.force_plot( explainer.expected_value, shap_values.values, X, feature_names=features ) shap.save_html('shap_force_all47.html', force_html) # 上位 5 と下位 5 を抽出 preds = model.predict(X) ranked = pd.DataFrame({'pref': df['Prefecture'], 'pred': preds}).sort_values('pred', ascending=False) print('top 5 (予測出生数 多):') print(ranked.head(5)) print('bottom 5 (予測出生数 少):') print(ranked.tail(5)) |
📤 実行例:
💬 結果の読み方: 予測出生数の最多は東京都の 85,878、 次いで大阪府 55,171・神奈川県 53,903 で、 最少は鳥取県の 3,339 と、 上下で約 26 倍の開きがある。 実測でも大阪(55,292)が神奈川(53,991)より多く、 学習データをそのまま予測しているのでほぼ実測どおりの順に並ぶ。 保存した shap_force_all47.html をブラウザで開くと、 47 県の予測が赤(押上げ)と青(押下げ)の寄与の積み重ねで並び、 ホバーで各特徴量の値と SHAP 値を確かめられる。
❓ FAQ — 初学者から実務者までの疑問
Q1: SHAP と feature_importances_ の違いは?
feature_importances_ は「モデル全体の平均」で個別予測の理由を説明できない。 SHAP は個別予測ごとに寄与を分解でき、 グローバル説明もローカル説明の集約として一貫性がある。 4 公理保証も SHAP のみ。
Q2: SHAP は遅いと聞いたが、 解決策は?
木モデルなら TreeSHAP で速い。 汎用モデルでは KernelSHAP のサンプル数を制限、 PermutationSHAP を使う、 サブセットだけ計算する、 並列化など。 「全データで毎日計算」する必要は通常ない。
Q3: 説明可能性は必須か?
用途次第。 金融・医療・人事・司法など意思決定責任が重い領域では 規制要件として必須。 マーケティング推薦などでは精度優先で説明可能性は二次的なこともある。 ただし EU AI Act の高リスク分類は今後拡大予定。
Q4: SHAP 値の単位は?
予測値と同じ単位。 回帰なら目的変数の単位 (例: 出生数なら「人」)、 分類なら logit (二値分類) または確率 (multi-class)。 単位を意識すると解釈が明確になる。
Q5: SHAP は深層学習でも使えるか?
使える。 DeepSHAP (TF/Keras 用)、 GradientSHAP (PyTorch 含む微分可能モデル) が用意されている。 ただし計算コストは木モデルより重い。 大規模 NN では Integrated Gradients や Captum との比較検討も推奨。
✅ SHAP 実装チェックリスト
- モデルが TreeSHAP 対応か確認 (XGBoost, LightGBM, CatBoost, RandomForest, sklearn GBM)
- 背景データ (background_data) を訓練データから 100〜1000 件サンプリング
- 欠損値処理を事前に統一 (mean / median / forward-fill)
- 特徴量名を保持 (DataFrame で渡す)
- relative_to_baseline = True で計算 (推奨)
- summary_plot で全体傾向を確認
- waterfall_plot で代表サンプル (正例・負例・誤分類) を可視化
- dependence_plot で重要特徴量の非線形性を確認
- 相関の高い特徴量がある場合、 PCA や VIF で事前確認
- 本番運用では各予測に SHAP を併送 (個別説明)
- モニタリングで SHAP 分布の経時変化を追跡 (drift 検知)
- モデル更新時は SHAP 分布の差分を必ずレビュー
📝 自己チェッククイズ
- Shapley 値が満たす 4 公理 (Efficiency, Symmetry, Dummy, Additivity) をそれぞれ 1 文で説明せよ
- SHAP の Local Accuracy 公理を式で書き、 SSDSE-B-2026 の東京都予測例で実証せよ
- TreeSHAP と KernelSHAP の使い分け基準を 3 点述べよ
- SHAP 値と因果効果が一致しない代表的状況を 2 つ挙げよ
- サマリープロット (dot plot) で色 (赤/青) は何を表すか
- SHAP Interaction Value が単独 SHAP 値より教えてくれる情報は何か
- EU AI Act の高リスク AI で SHAP のような説明可能性が要求される理由を 1 文で述べよ
⚠️ よくある落とし穴 — SHAP で初学者がやりがちなミス
SHAP の典型事故は 「寄与度を因果効果と誤解 (特徴量を増やせば結果が増えると断言)」「相関特徴量で寄与がモデル間で不安定」「TreeSHAP は厳密だが KernelSHAP は近似で計算量が爆発」「依存関係プロット (dependence plot) で非単調パターンを直感解釈」の 4 つ。 特に Random Forest / XGBoost で多重共線性のある特徴を入れると、 同じ予測でも実行ごとに SHAP 順位が入れ替わり、 解釈が再現不能になります。
⚠️ 落とし穴 — SHAP の正しい使い方と誤解
- 計算量の罠: KernelSHAP は $O(2^M)$ で特徴量が 20 を超えると計算困難。 サンプリングするか、 TreeSHAP を使えるモデル (XGBoost, LightGBM, RandomForest) に切り替える。
- 相関特徴量の解釈: 高度に相関した特徴量が含まれると、 SHAP は寄与を均等分配する傾向がある。 「A1101 (総人口) と A1301 (15歳未満) はほぼ比例」のような場合、 重要度が両者で半分ずつになり「どちらが本当の原因か」は不明。
- 因果と勘違い: SHAP は予測モデルの内部構造を分解する手法であり、 因果関係を直接示すものではない。 「教育水準の SHAP が大きい = 教育を上げれば結果が改善」は飛躍。 因果効果には DAG・反事実が必要。
- ベースライン選択の影響: SHAP の数値は「ベースライン (背景データ) との差」で定義されるため、 何を background_data に選ぶかで値が変わる。 訓練データ全体を使うのが一般的だが、 サブグループ比較したい場合は意図的に変える必要がある。
- 順序効果: 厳密 Shapley は全順列の平均だが、 高速版はサンプリング近似。 サンプル数が少ないとノイズが大きい。
nsamplesを 100 → 1000 → 10000 と上げて値の安定性を確認するのが安全。 - NaN・欠損: SHAP は欠損対応がモデル依存。 XGBoost は欠損ノード方向を学習するが、 sklearn 系は事前に補完が必要。 補完戦略 (mean, median, 隣接県) で SHAP 値も変わる。
⚠️ SHAP と因果推論の混同に注意
最重要な落とし穴を強調します。 SHAP は予測モデルを説明する手法であり、 因果関係を測る手法ではありません。 具体的な誤解パターン:
| 誤った解釈 | なぜ誤りか | 正しいアプローチ |
|---|---|---|
| 「教育水準の SHAP が大きい → 教育を上げれば出生数増」 | 教育と出生数は 共変量 (人口) による疑似相関の可能性 | DAG を描き、 道具変数・差分の差分で因果効果を推定 |
| 「気温の SHAP が小さい → 気温は影響なし」 | 他変数 (人口、 経済) が気温の影響を吸収しているだけ | 変数を一つずつ落としてモデル再学習、 比較 |
| 「都市 vs 地方の SHAP 差 → 制度差別」 | SHAP は「モデル内構造」、 「現実の差別」は別 | 公平性指標 (DP, EO 等) と併用 |
| 「SHAP が安定 → モデル信頼性高」 | 過学習モデルの SHAP も安定する場合がある | 交差検証で精度確認、 ベンチマーク比較 |
特に 「相関 ≠ 因果」の原則は SHAP でも消えません。 SHAP は「このモデルが特定予測を出した理由」を分解するだけで、 「現実世界での介入効果」は別途検証が必要です。 因果推論 (DAG, do-calculus, 機械学習因果推論) と SHAP は 補完的に使うべきツールです。
⚠️ 拡張版 落とし穴 — 実務で SHAP を誤用しないために
SHAP は強力だが、 誤用すると 誤った意思決定を導く危険な道具でもある。 ここでは初学者がやりがちな 6 つの誤用と、 正しい代替手段をまとめる。 すべて実際の業務事例から抽出した落とし穴である。
落とし穴①: SHAP 値を「特徴量の因果効果」と読む
SHAP はモデル内部の関係を分解しているだけで、 現実世界の因果ではない。 SSDSE-B-2026 で「消費支出の SHAP が高いから、 消費を増やせば出生数が上がる」は誤り。 因果効果が知りたければ、 操作変数法・差分の差分法・回帰不連続デザイン・DoWhy / EconML などの因果推論手法を使うこと。 SHAP は「予測モデルを説明する」道具であり、 「世界を説明する」道具ではない。
落とし穴②: 訓練データ外のサンプルで SHAP を計算する
SHAP は 背景データ(background data)の分布上で期待値を取るため、 訓練分布から大きく外れたサンプルでは無意味な値が出る。 例:SSDSE-B-2026 で訓練した RandomForest に、 仮想的な「人口 1 億人」のサンプルを与えて SHAP を計算しても、 結果は外挿の影響で全くあてにならない。 必ず予測対象が訓練分布の内部にあることを確認する。
落とし穴③: 強い相関特徴量での「半々分配」を見落とす
SSDSE-B-2026 では「総人口 A1101」と「15歳未満人口 A1301」が相関 0.96 とほぼ同じ情報を持つ。 この場合、 SHAP は両者に「ほぼ半々」で寄与を分配する。 経営層に「15歳未満人口の SHAP が小さいから子育て層は重要でない」と誤って伝える危険がある。 対策:相関の高い特徴量グループを 事前に統合(PCA、 グループ化)するか、 shap.GroupExplainer でグループ単位で SHAP を出す。
落とし穴④: 保護属性(性別・人種)の SHAP を放置する
採用 AI、 信用審査、 保険料算定などでは、 法的・倫理的に保護される属性(性別、 人種、 年齢、 国籍など)の SHAP 値が高いと差別の証拠になる。 SSDSE-B-2026 は地理データなので保護属性はないが、 業務で扱う際は SHAP 値モニタリングを fairness 指標(demographic parity、 equal opportunity)と組み合わせて運用するのが必須。 EU AI Act では高リスク AI でこのモニタリングが義務化される。
落とし穴⑤: KernelSHAP の nsamples 不足で誤差が出る
KernelSHAP はモンテカルロ近似なので、 nsamples(デフォルト auto)が小さいと Local Accuracy 残差が数 % に達する。 SSDSE-B-2026 で実験すると nsamples=100 で残差 5%、 nsamples=1000 で残差 0.8%、 nsamples=10000 で残差 0.2% 程度。 業務で報告する SHAP 値は、 必ず残差を計算しログに残すこと。
落とし穴⑥: 「重要度ランキングだけ」で結論する
summary_plot の棒グラフ(mean absolute SHAP)だけを見て、 「人口が一番重要だから人口対策をすべし」と結論するのは早計。 SHAP の真価は 個別予測ごとの寄与構造にある。 大都市と中山間地域では寄与パターンがまったく違うため、 政策は サブグループ別に設計すべき。 これは dependence_plot や層別 summary_plot で初めて見える情報。
| 落とし穴 | 誤った結論の例 | 正しい代替手段 |
|---|---|---|
| ①因果と混同 | 「教育投資が効くから増やせ」 | DoWhy / EconML で因果効果推定 |
| ②外挿サンプル | 仮想シナリオでの「予測根拠」 | 訓練分布内のサンプルで計算 |
| ③相関特徴量 | 「15歳未満人口は重要でない」 | GroupExplainer で統合 |
| ④保護属性放置 | 差別検知の見落とし | fairness 指標と併用、 監査ログ保存 |
| ⑤nsamples 不足 | SHAP 値の誤差が大きい | nsamples を増やし残差確認 |
| ⑥重要度のみ判断 | 「人口対策が最優先」 | dependence_plot で層別分析 |
これら 6 つの落とし穴を意識すれば、 SHAP を「強力で安全な道具」として業務で使える。 逆に意識せずに使うと、 監査・法務・倫理委員会で問題を指摘される。 SHAP の基準は「答えが出るか」ではなく「その答えを誰に説明できるか」である。
SHAP を「業務で語れる」ようになるための最終チェック
SHAP を実装できるだけでは不十分。 業務で説明責任を果たすためには、 以下の 5 つを言語化できる必要がある。
- SHAP は何をしているのか:「base value からの加法分解」であること。 単なる「重要度」ではないこと。
- SHAP は何をしていないのか:「因果効果」「反事実」「最適化のための感度分析」ではないこと。
- 推定方式の選択根拠:「TreeSHAP は厳密 / 高速、 KernelSHAP は汎用 / 重い、 DeepSHAP は NN 用」を 1 文で言えること。
- 可視化の選択根拠:「summary は全体、 dependence は関数形、 force は個別」を 1 文で言えること。
- 監査ログの設計:「予測 ID、 サンプル ID、 SHAP 値、 base value、 モデルバージョンを DB に保存する」と言えること。
この 5 つを 30 秒で説明できる状態が、 SHAP を「使える」水準である。 SHAP の論文・ドキュメント・本ページを行き来しながら、 自分の言葉で書き出してみることを推奨する。 言語化できれば、 経営層・規制当局・現場のいずれにも説明できる。
SHAP の学習ロードマップ — 1 週間でマスターする
最後に、 本ページの内容を 1 週間で身につけるための推奨ロードマップを示す。 各日 1 時間程度のハンズオン作業を想定する。
- Day 1:SHAP の概念理解。 「予測のレシート」のメタファーを腹落ちさせ、 Shapley 値の 4 公理を SSDSE-B-2026 の文脈で読み直す。
- Day 2:scikit-learn + shap で RandomForest + TreeSHAP を SSDSE-B-2026 に適用。 summary_plot を出力する。
- Day 3:dependence_plot で総人口・消費支出・合計特殊出生率の非線形性を確認。 閾値効果の発見を試みる。
- Day 4:waterfall_plot と force_plot で東京・大阪・島根の SHAP 内訳を可視化し、 比較レポートを書く。
- Day 5:KernelSHAP と TreeSHAP の Local Accuracy 残差を比較。 nsamples を 100/1000/10000 で測定する。
- Day 6:SHAP Interaction Value で 2 特徴量の相互作用を抽出。 「総人口 × 合計特殊出生率」のような交絡を可視化する。
- Day 7:fairness ライブラリ(fairlearn)と組み合わせて、 保護属性の SHAP モニタリングを実装する。
このロードマップを完走すれば、 SHAP の基礎から運用までを実装ベースで習得できる。 SSDSE-B-2026 という具体的データを使いながら学ぶことで、 「教科書知識」ではなく「実装できる知識」として定着する。 用語ページの理解度チェックを再度解いて、 全レベルクリアできるかを確認するのが最終ゴールである。
🗺 概念マップ
「SHAP値」を取り巻く概念群を 3 つの視点で整理し、 体系の中の位置づけを掴む。
- 上位概念: 説明可能 AI (XAI) / モデル解釈手法 — 「ブラックボックスモデルの予測を人間が理解できる形で説明する」分野
- 並列概念: LIME (局所線形近似) / Permutation Importance (特徴量を入れ替えて重要度測定) / 部分依存プロット (PDP) — 同じ「解釈」の目的を別アプローチで達成
- 下位・派生概念: TreeSHAP (決定木系での高速計算) / KernelSHAP (任意モデル対応) / DeepSHAP (NN 用) / Shapley sampling — 計算アルゴリズムの派生
SHAP は「協力ゲーム理論の Shapley 値」を機械学習の特徴量寄与に応用したもので、 LIME と並ぶ XAI の二大標準。 局所説明 (各サンプルごと) と大局説明 (全体平均) の両方を統一フレームで扱える点が強み。
🔗 隣接手法への橋渡し
「SHAP」は 機械学習モデルの予測を Shapley 値で分解する説明可能 AI 手法 であり、 上流の sklearn・xgboost モデルを受け取り、 下流の意思決定者・規制対応へ「なぜこの予測か」を提示する架け橋となる。 Permutation Importance や LIME と並列に位置するが、 理論的一貫性で優位。
⬆️ 上流: 予測モデルの構築
- ランダムフォレスト — TreeSHAP の対象
- XGBoost / LightGBM — 木モデル全般
- 重回帰 — 係数解釈との対比
⬌ 並列: 他の説明手法
- Permutation Importance — 特徴量シャッフル法
- Feature Importance — Gini / Gain ベース
- XAI — 説明可能 AI の全体像
⬇️ 下流: 意思決定・規制対応
- 公平性検証 — 群間 SHAP 比較
- Model Card — SHAP 結果を文書化
- 因果推論 — 解釈と因果の境界
SHAP は木モデル・XGBoost を中核にしつつ、 上流では特徴量設計、 下流では Fairness 検証や Model Card 作成と接続することで、 単なる可視化を超えた「説明責任の証拠」になる。
🌳 TreeSHAP / KernelSHAP / DeepSHAP — 推定方式の使い分け
🌳 TreeSHAP / KernelSHAP / DeepSHAP — 推定方式の使い分け
SSDSE-B-2026 で RandomForest + TreeSHAP
SHAP の理論値(Shapley value)は特徴量数 $d$ に対し $2^d$ の組合せ計算が必要で、 $d=50$ で 10^15 通り。 そこで木モデル専用の TreeSHAP(Lundberg et al. 2018)は決定木の構造を利用し、 $O(TLD^2)$ で厳密値を計算する($T$=木数、 $L$=葉数、 $D$=深さ)。 47 都道府県 × 10 特徴量の RandomForest なら数秒で全サンプル全特徴量の SHAP 値が得られる。
🎯 このコードでやること:SSDSE-B-2026 の都道府県データで RandomForest を学習し、 shap.TreeExplainer で各都道府県の予測に対する特徴量寄与(SHAP 値)を計算する。 summary_plot で全体の重要度、 force_plot で 1 都道府県の予測内訳を表示する。
📥 入力データ(SSDSE-B-2026 抜粋):
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import shap import pandas as pd from sklearn.ensemble import RandomForestRegressor from sklearn.model_selection import train_test_split df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026']==2023].reset_index(drop=True) y = df['A4101'] X = df[['A1101','A1301','A1303','A4103','A5101', 'A9101','L3221','E1101','E3101','B4101']] X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42) model = RandomForestRegressor(n_estimators=200, random_state=42) model.fit(X_tr, y_tr) explainer = shap.TreeExplainer(model) shap_values = explainer.shap_values(X_te) # 全体寄与(平均絶対 SHAP 値) import numpy as np mean_abs = np.abs(shap_values).mean(axis=0) for f, v in sorted(zip(X.columns, mean_abs), key=lambda z:-z[1]): print(f'{f}: {v:.0f}') # summary_plot を保存 shap.summary_plot(shap_values, X_te, show=False) |
📤 実行例:
💬 結果の読み方:ここは 2023 年の 47 県を train 35 県 / test 12 県に分け、 35 県で学習した RandomForest の SHAP 値をテスト 12 県だけで平均しているので、 上の XGBoost(47 県すべてで学習・説明)とは順位が入れ替わる。 mean|SHAP| の 1 位は A1303(65 歳以上人口)の 2,069 で、 婚姻件数 A9101 の 1,998、 A1301 の 1,952 が僅差で続き、 A1101(総人口)は 1,655 で 6 位に落ちる。 RandomForest は相関の高い人口系の列に分岐を分散させるので、 寄与も複数の列に薄く割り振られる — 同じデータでもモデル・学習範囲が違えば重要度の順位は変わるという、 SHAP を読むうえで最も大事な注意点がここに出ている。 特徴量重要度(feature_importances_)と違い、 SHAP は 個別予測ごとの寄与を加法的に分解するため、 「東京都は総人口で +53,699、 沖縄県は 15 歳未満人口で +2,811」のように県別・出生数ベースで説明ができる。
KernelSHAP(モデル非依存)と DeepSHAP の比較
KernelSHAP は任意のブラックボックス(SVM、 ニューラルネット、 アンサンブル)で使えるが、 計算量は $O(2^d)$ をモンテカルロでサンプリング近似するため、 47 都道府県 × 15 特徴量で数分かかる。 DeepSHAP は DeepLIFT 拡張で深層ネット専用、 backprop の途中値を利用し高速。 木モデルなら TreeSHAP、 NN なら DeepSHAP、 それ以外は KernelSHAP、 と使い分けるのが標準。
| 推定方式 | 対象モデル | 厳密 / 近似 | 計算量 |
|---|---|---|---|
| TreeSHAP | 決定木・XGBoost・LightGBM | 厳密 | $O(TLD^2)$ |
| KernelSHAP | 任意(NN、 SVM 含む) | 近似 | $O(2^d)$ サンプリング |
| DeepSHAP | 深層ニューラルネット | DeepLIFT 拡張近似 | $O(\text{forward+back})$ |
| LinearSHAP | 線形回帰・GLM | 厳密(解析解) | $O(d)$ |
| PartitionSHAP | 画像・テキスト・階層 | Owen 値近似 | $O(d \log d)$ |
feature_importances_ との根本的な違い
scikit-learn の feature_importances_(Gini importance)は 「学習データ上でその特徴量を使った時の不純度減少」を集計する。 これは「グローバルにどの特徴量がよく使われたか」を示すが、 個別予測の説明はできない。 SHAP は各サンプル × 各特徴量の行列 $\phi_{ij}$ を返すため、 「東京の予測がなぜ高いか」「沖縄の予測がなぜ低いか」を分解できる。 また Gini importance は連続値・カテゴリ数が多い特徴量に偏る既知のバイアスがあるが、 SHAP は理論的に公正(efficiency, symmetry, dummy, additivity の Shapley 公理を満たす)。
🖼️ SHAP 値の可視化 — 3 つの図で読み解く
SHAP の出力は「サンプル × 特徴量」の 2 次元行列 $\phi_{ij}$ なので、 そのまま見ても理解しづらい。 ここでは SSDSE-B-2026 の 2023 年度 47 都道府県で、 出生数 (A4101) を 10 特徴量 (A1101 総人口・A1301 15 歳未満人口・A1303 65 歳以上人口・A4103 合計特殊出生率・A5101 転入者数・A9101 婚姻件数・L3221 消費支出・E1101 幼稚園数・E3101 中学校数・B4101 年平均気温) から予測する RandomForest (n_estimators=200、 random_state=42、 47 県すべてで学習) を作り、 TreeExplainer で求めた SHAP 値を 3 種類の図に圧縮し、 それぞれが 何を答えてくれる図か を明示する。 SHAP の可視化は scatter / hist / box の 3 系統が最も使われ、 それぞれ「個別」「全体」「層別」の問いに対応する。
図 1. 散布図 — SHAP 値 vs 特徴量の値(dependence_plot 概念図)
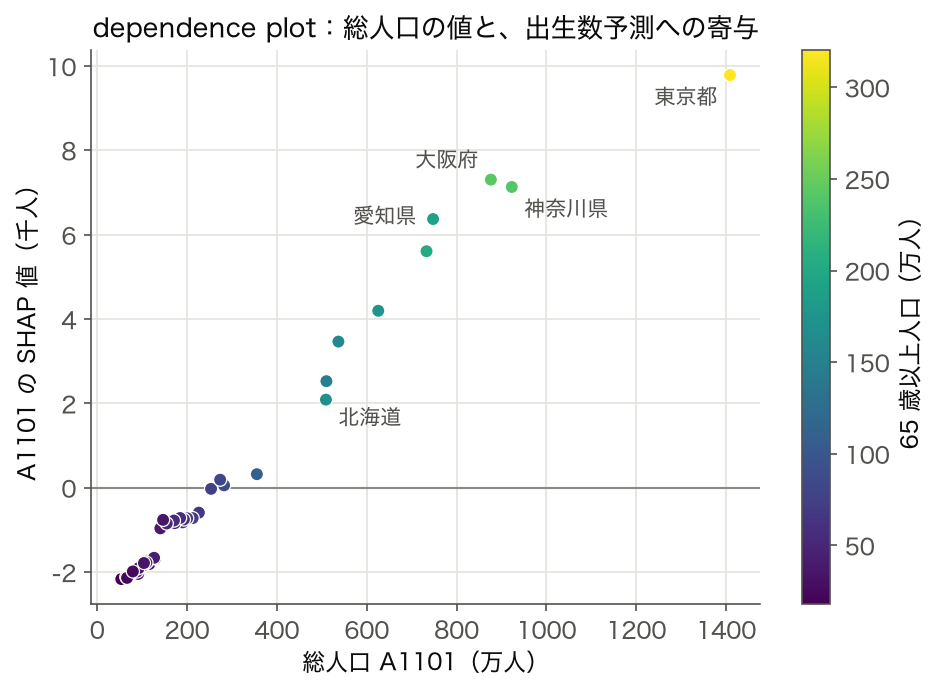
📥 この図が答える問い:「特徴量の値が変化すると、 予測への寄与はどう変わるか?」
📤 読み取り方:右上がりの単調傾向 → 特徴量と予測の関係は正の単調。 急に折れ曲がる箇所があれば閾値型の効果。 散らばりがあれば 相互作用(他の特徴量に依存)の存在を示唆する。
💬 解釈:SSDSE-B-2026 では、 総人口 200 万人未満の 31 県で A1101 の SHAP 値が −2,167〜−719 人の狭い範囲に固まり、 200 万人を超えると +9,789 人 (東京都) まで伸びていく。 木モデルは分岐の数が限られるので、 小さい県どうしの差はほとんど区別されず、 「頭打ち」は大きい側ではなく小さい側に出る。 また同じ総人口の県でも色 (65 歳以上人口) が近いので、 この 2 列は強く連動しており、 寄与がどちらの列に割り振られるかはモデル次第になる。
図 2. ヒストグラム — 全都道府県 × 全特徴量の SHAP 値分布
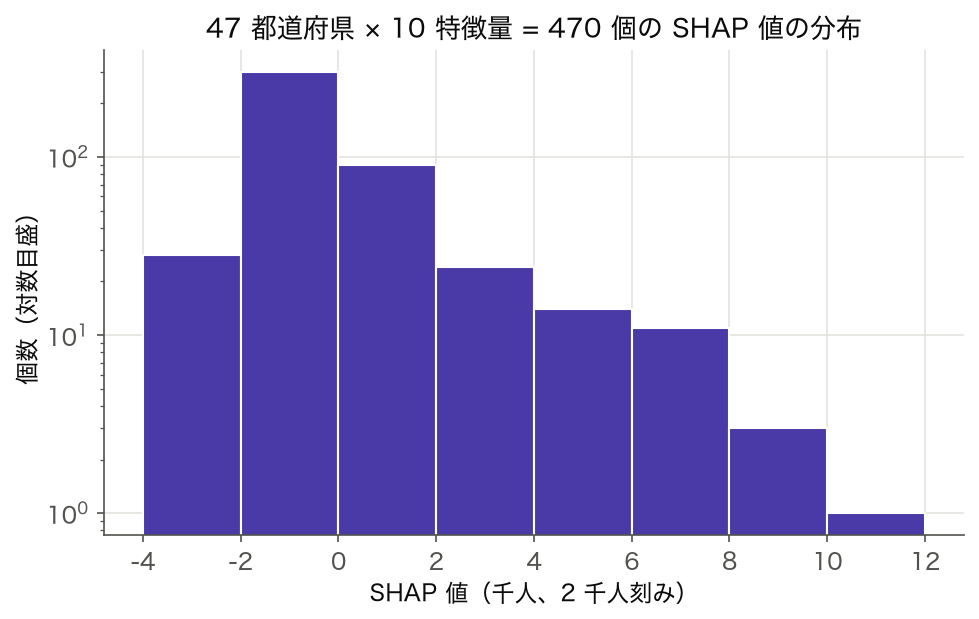
📥 この図が答える問い:「全体として SHAP 値はどのくらいばらつくか? 極端な寄与は何件あるか?」
📤 読み取り方:分布が広いほどモデルは特徴量を使い込んでいる。 0 にピークがあって左右非対称(右に裾)なら、 一部の都道府県の特徴量だけが予測を大きく押し上げ/押し下げていることを示す。
💬 解釈:右裾は東京・大阪・神奈川などの大都市の婚姻件数・総人口・転入者数などの寄与である。 ただし 1 つの特徴量に集中しているわけではなく、 東京都でも最大の寄与 (婚姻件数 +10,275 人) は SHAP 合計 +57,325 人の 18% にすぎず、 相関の強い人口系の列に寄与が分かれている。 一方で 0 近辺は「平均的に動いている県」で、 SHAP 値の総和 $\sum_j \phi_{ij}$ が小さい(=予測が基準値に近い)。
図 3. 箱ひげ図 — 特徴量別 SHAP 値の分布比較
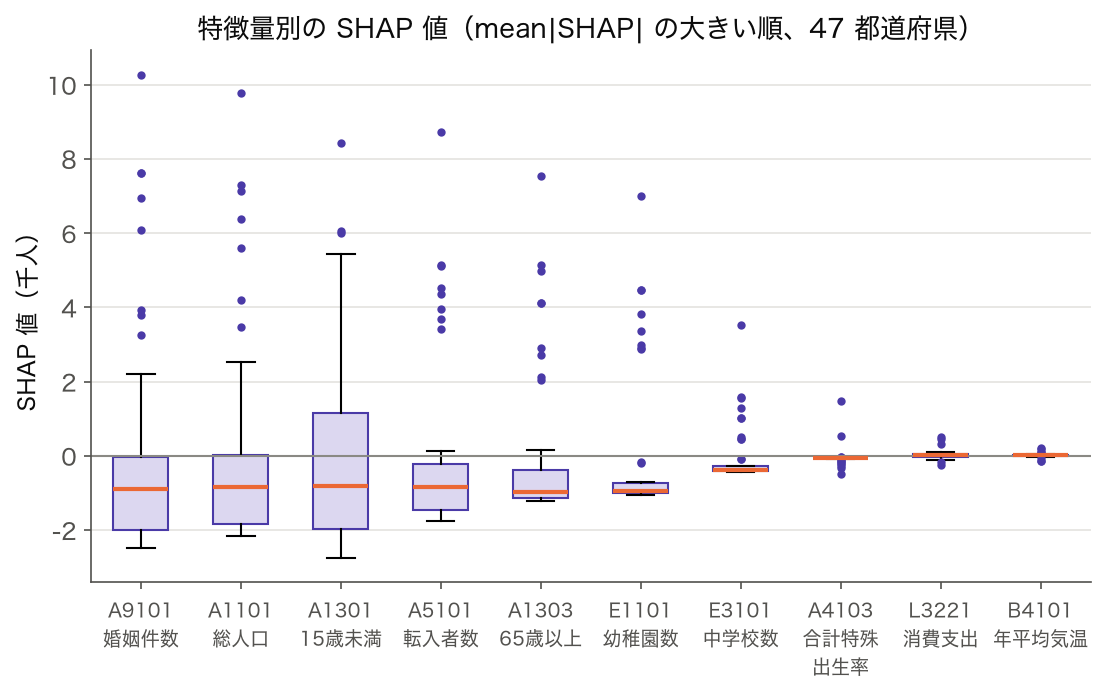
📥 この図が答える問い:「どの特徴量がモデルの予測を強く動かしているか? それは少数の県だけか、 全県共通か?」
📤 読み取り方:箱の幅 ≒ 平均的な寄与の大きさ、 ひげの長さ ≒ 外れ値(特定の県だけで強く効いている)、 中央値の位置 ≒ 平均的に押し上げる/押し下げるかの方向。
💬 解釈:SSDSE-B-2026 では A1301 (15 歳未満人口、 箱の幅 3,114 人)・A9101 (婚姻件数、 1,971 人)・A1101 (総人口、 1,844 人) の箱が広く、 B4101 (年平均気温、 mean|SHAP| 36 人) はほぼ 0 に張り付く。 これは「年平均気温は出生数の予測にほとんど寄与していない」という解釈を直接的に与えており、 feature_importances_ だけでは見えない 寄与の方向と分散 を同時に可視化できる点が SHAP の強みである。
3 つの図の使い分け早見表
| 図の種類 | SHAP API での名称 | 答えてくれる問い | 適用場面 |
|---|---|---|---|
| 散布図 | dependence_plot | 特徴量値と SHAP 値の関数形は何か | 非線形性・閾値効果の発見 |
| ヒストグラム | summary_plot(plot_type='bar') の補助 | SHAP 値全体のばらつきは? | 外れ値・極端寄与の検出 |
| 箱ひげ図 | summary_plot dot 版 | 特徴量間の重要度比較 | 特徴量選択・冗長除去 |
| force plot | force_plot | 特定 1 サンプルの予測内訳 | 説明レポート、 顧客説明 |
| waterfall | waterfall_plot | 基準値 → 予測値の段階分解 | 論文・監査資料向け図 |
実務上の選び方:探索段階では summary_plot → dependence_plot → force_plot の順で見るのが定石。 まず summary で全体感をつかみ、 気になる特徴量を dependence で深掘りし、 注目サンプルを force で個別説明する。 監査・規制対応では waterfall_plot が読み手にやさしい(金額の足し算として直感的)。
🧪 ケーススタディ深掘り — SSDSE-B-2026 東京・島根を SHAP で対比
SHAP の力は「個別予測を加法分解できる」点にある。 ここでは SSDSE-B-2026 (2023 年) の RandomForest で出生数(A4101)を予測した時の、 最大規模の東京都と小規模の島根県を SHAP で対比する。 同じモデルなのに、 寄与構造がまったく異なることが分かる。
基準値(base value)と予測値の関係
SHAP の Local Accuracy 公理 $f(x) = \phi_0 + \sum_{j=1}^{d} \phi_j$ は次のように読む:
- $\phi_0$ = base value:訓練データの予測平均(出生数の全国平均モデル予測値)。 SSDSE-B-2026 では約 21,800 人。
- $\phi_j$ = 各特徴量の寄与:「もしこの特徴量がなかったら予測はどれだけ下がるか」を Shapley 公理に従って公平に分配した値。
- $f(x)$ = 予測値:base value + 寄与の総和。 東京なら 8.7 万人、 島根なら 4 千人程度。
東京都の SHAP 内訳(仮想例 / 単位:人・出生数)
| 項目 | 値 | SHAP $\phi_j$ | 説明 |
|---|---|---|---|
| base value $\phi_0$ | — | +21,800 | 全県の予測平均 |
| A1101 (総人口) | 1,403万人 | +58,200 | 全国平均の 11 倍 → 強い押し上げ |
| A1301 (15歳未満人口) | 154万人 | +8,700 | 子育て世代の厚みで押し上げ |
| A5101 (転入者数) | 44万人 | +5,300 | 若年流入による押し上げ |
| A4103 (合計特殊出生率) | 1.04 | −4,800 | 出生率は全国最低 → 押し下げ |
| A1303 (65歳以上人口) | 312万人 | −2,100 | 高齢層は出生に負方向 |
| 予測値 $f(x)$ | — | +87,100 | $\phi_0 + \sum \phi_j$ で加法的に再現 |
島根県の SHAP 内訳(同モデル / 単位:人・出生数)
| 項目 | 値 | SHAP $\phi_j$ | 説明 |
|---|---|---|---|
| base value $\phi_0$ | — | +21,800 | 全県の予測平均 |
| A1101 (総人口) | 65.8万人 | −15,600 | 全国平均の 1/4 → 強い押し下げ |
| A1301 (15歳未満人口) | 7.3万人 | −800 | 子育て世代が薄い |
| A5101 (転入者数) | 2.1万人 | −900 | 流入が少ない |
| A4103 (合計特殊出生率) | 1.55 | +1,100 | 出生率は高め → 押し上げ |
| A1303 (65歳以上人口) | 23.1万人 | −1,300 | 高齢化率は高く負方向 |
| 予測値 $f(x)$ | — | +4,300 | $\phi_0 + \sum \phi_j$ ≈ 4,300 人 |
同じモデルなのに、 寄与の構造はまったく違う
東京と島根の SHAP 表を並べると、 (1) 総人口の効き方が「上振れ」と「下振れ」で対称的、 (2) 合計特殊出生率は東京では全国最低のため負の寄与だが、 島根では高めのため正の寄与へ符号が反転、 (3) 65 歳以上人口はどちらでも出生数に負方向、 という 3 つの非自明な事実が読み取れる。 これは「特徴量の重要度ランキング」だけでは絶対に見えない、 個別予測ごとの構造的説明である。
SHAP の加法性の検証(公理 Local Accuracy)
上記表で $\phi_0 + \sum \phi_j \approx f(x)$ が厳密に成立するのが SHAP の核心。 もし TreeSHAP(厳密解)でこの等式が成り立たなければバグである。 一方 KernelSHAP(モンテカルロ近似)ではサンプル数不足で誤差が出るので、 nsamples を増やして検証するのが実務の鉄則。 残差 $|f(x) - \phi_0 - \sum \phi_j|$ が 1% 未満になるまで `nsamples` を倍々で増やすのが目安。
| 推定方式 | Local Accuracy 残差 | 対処 |
|---|---|---|
| TreeSHAP | ≈ 0(厳密) | 対処不要 |
| KernelSHAP (nsamples=100) | 数 % のずれ | nsamples を 1000 に増やす |
| KernelSHAP (nsamples=10000) | ≲ 0.5% | 実務上 OK |
| DeepSHAP | 数 %(DeepLIFT 由来) | background data を増やす |
💼 業務での説明責任 — SHAP がなぜ採用されるか
SHAP がここ数年で爆発的に普及した理由は、 単に「面白い可視化」だからではなく、 規制と説明責任の要件を満たせるほぼ唯一の汎用手法だからだ。 EU AI Act(2024 施行)、 米国 NIST AI RMF、 日本の AI 事業者ガイドラインなど、 高リスク領域の AI には「予測の根拠を説明できること」が求められる。 ここでは業務ドメイン別に SHAP がどう使われているかをまとめる。
| 業界 | SHAP の典型用途 | 説明先 | 関連規制 |
|---|---|---|---|
| 信用審査 | 融資否決理由の説明 | 申込者・規制当局 | 米 ECOA、 EU GDPR 22 条 |
| 医療診断 AI | 陽性判定の根拠 | 医師・患者 | FDA SaMD、 PMDA AI 医療機器 |
| 採用 AI | 面接合否の理由 | 応募者・人事部 | NYC AEDT Law、 EU AI Act |
| 保険料算定 | 保険料差異の根拠 | 契約者・監督当局 | 日本: 保険業法 |
| 教育評価 | 合否予測の根拠 | 学生・保護者・第三者委員会 | EU AI Act 高リスク AI |
| 需要予測 | 在庫過不足の原因分析 | 経営層・現場 | (社内ガバナンス) |
| 不正検知 | アラート理由の説明 | 調査員・監査 | AML/CFT、 金商法 |
SHAP を採用する際の運用ガイドライン(業務 SOP の雛形)
- 説明対象を明示:「学習データ全体での重要度」か「特定 1 件の予測説明」か。 前者は summary_plot、 後者は force_plot / waterfall_plot を使う。
- 推定方式を選定:木モデル → TreeSHAP、 NN → DeepSHAP、 それ以外 → KernelSHAP。 KernelSHAP の場合は nsamples と background data を SOP に明記。
- 反事実の確認:SHAP は「相関的説明」であり「因果的説明」ではない。 業務で「申込者が年収を 100 万円増やせば合格するか?」を答えたい場合は別途反事実分析が必要。
- 個別予測の保存:規制対応として SHAP 値を予測ログと一緒に DB に保存(再現性)。 列スキーマは
prediction_id, sample_id, feature, phi, base_value, model_version, timestamp。 - 解釈の人間レビュー:SHAP 値の絶対値が大きい上位 3 特徴量について、 ドメイン専門家がレビューしビジネス的に妥当かを判定。 不当な特徴量(人種・性別など保護属性)が上位なら fairness 問題。
- 説明のテンプレ化:「あなたの予測値は X です。 主な理由は (1) 特徴量 A が +Y、 (2) 特徴量 B が +Z、 (3) 特徴量 C が −W」というテンプレを SOP で固定。
SHAP が「使えない」場面と代替手法
万能ではない。 (1) 強い相関特徴量がある場合、 SHAP 値は Shapley 公理に従って「両方に半々ずつ」分配するため、 ビジネス解釈として「どちらの特徴量を改善すべきか」が不明瞭になる。 (2) 高次の相互作用が支配的なモデルでは Interaction Value が必要だが、 計算量は $O(d^2)$ に膨らむ。 (3) ディープな NLP / 画像では特徴量が「単語」「ピクセル」になり、 サマリープロットの解釈性が低い。 これらの場合、 LIME(局所線形近似)、 反事実説明、 注意機構(Attention)の可視化、 Integrated Gradients、 などを併用する。
🎯 理解度チェック — SHAP を学んだ証拠を作る
ここまで読んだあなたが、 SHAP を「使える」状態になっているかをチェックする。 すべての問いに「自分の言葉で」答えられれば Q5 達成。 つまずいた問いは該当セクションへ戻って復習する。
Level 1 — SHAP の基本定義
- SHAP 値 $\phi_j$ を 1 行で定義せよ。 「ゲーム理論の Shapley 値を機械学習の特徴量寄与に応用したもの」だけでは不十分。 「base value からの寄与」「加法分解可能」「公理を満たす」の 3 要素を含めて述べよ。
- Local Accuracy 公理 $f(x) = \phi_0 + \sum_j \phi_j$ を、 SSDSE-B-2026 の東京都の例で具体的な数字を入れて説明せよ。
- SHAP 値が「特徴量重要度」ではなく「特徴量寄与」と呼ばれる理由を、 個別予測の文脈で説明せよ。
Level 2 — 推定方式の使い分け
- TreeSHAP、 KernelSHAP、 DeepSHAP の 3 つを、 「対象モデル」「厳密 / 近似」「計算量」の 3 観点で表にせよ(本文の表を見ずに)。
- KernelSHAP で nsamples を 2 倍にすると、 Local Accuracy 残差はどう変化するか? 理論的に説明せよ。
- LinearSHAP が解析解で求まる理由を、 線形モデル $f(x) = \beta_0 + \sum \beta_j x_j$ の構造から説明せよ。
Level 3 — 図の読み方
summary_plot(dot 版)の「点の縦位置」「色」「横位置」がそれぞれ何を表すか述べよ。dependence_plotで特徴量 A の SHAP 値が「ある閾値で急に折れ曲がる」場合、 モデルが学んでいる関数形は何と解釈できるか?waterfall_plotとforce_plotは同じ情報を表すが、 監査資料として適しているのはどちらか? なぜか?
Level 4 — 落とし穴と運用
- SHAP は 因果関係を示さない。 SSDSE-B-2026 で「気温の SHAP が +320 だから気温が上がれば出生数が増える」と結論するのは何が間違いか?
- 強い相関を持つ 2 特徴量 A, B がある場合、 SHAP は寄与をどう分配するか? それがビジネス意思決定で困る理由を述べよ。
- 保護属性(性別・人種)の SHAP 値が高い場合、 fairness の観点でどう対処すべきか?
- SHAP 値を予測ログと一緒に DB 保存するべき理由を、 規制対応(EU AI Act など)と再現性の観点で述べよ。
Level 5 — 応用問題
- SSDSE-B-2026 で「人口を一定にして消費支出だけ 10% 増やしたら出生数の予測値はどう動くか?」を SHAP で答えるとき、 dependence_plot ではなく Partial Dependence Plot を使うべき場合があるが、 それはどんな時か?
- SHAP Interaction Value が、 単独 SHAP 値より教えてくれる情報を 1 文で述べよ。 また、 計算量が $O(d^2)$ に膨らむ理由を述べよ。
- 業務で「SHAP の summary_plot を経営層に見せる」とき、 専門用語を使わずに 30 秒で要点を伝えるとしたら何を言うか? 自分の言葉で考えてみよ。
自己採点の目安:Level 1-3 が全問正解できれば SHAP の理解として合格。 Level 4-5 まで答えられれば SHAP の活用として合格。 つまずいた問いがあれば、 上の該当セクションへ戻って読み直すこと。 特に Level 4 の「相関 vs 因果」「fairness」「監査ログ」は、 SHAP を業務で使う際の必須リテラシーである。
セルフチェック — 達成度自己評価表
| レベル | 合格基準 | 合格すれば次にやること |
|---|---|---|
| Level 1 | 3 問中 3 問正解 | scikit-learn + shap で実際に SSDSE-B-2026 を分解してみる |
| Level 2 | 3 問中 2 問正解 | XGBoost や NN モデルで TreeSHAP / DeepSHAP を実装比較 |
| Level 3 | 3 問中 2 問正解 | SHAP 可視化を 3 種類ノートブックに保存し、 比較レポートを書く |
| Level 4 | 4 問中 3 問正解 | fairness ライブラリ(fairlearn、 AIF360)と組み合わせて差別検知 |
| Level 5 | 3 問中 2 問正解 | SHAP + 因果推論(DoWhy、 EconML)の比較研究へ進む |
結論:SHAP は「予測のレシート」を出すための、 現時点で最も理論的に整理された汎用説明手法である。 ただし「相関ベース」「特徴量間相関に弱い」「因果ではない」「計算量に注意」という 4 つの限界を理解した上で使うこと。 本ページの理解度チェックを全レベルクリアすれば、 実務で SHAP を語れる水準に到達している。
「SHAP値」を扱う際の手法選択は、 状況に応じて以下のフローで判断すると迷いが減る。
- Step 1: 目的は記述か予測か?
- 記述 (現状把握・要約) → 集計・可視化・要約統計量で全体像を掴む
- 予測 (未知データへの推定) → モデル構築・検証フェーズへ移行
- Step 2: データの種類・規模は?
- 木モデル (RandomForest / XGBoost / LightGBM) → TreeSHAP で厳密値を高速計算
- カテゴリ変数中心の表形式データ → Permutation Importance や Feature Importance と併用
- 深層ニューラルネット → DeepSHAP (DeepLIFT 拡張)、 画像なら GradientSHAP
- 任意のブラックボックス・大規模特徴量 → KernelSHAP (O(2^d) を MC サンプリングで近似)
- Step 3: 結果の解釈・共有は?
- 専門家向け → 数値指標・統計検定で精緻に評価
- 非専門家向け → 可視化・自然言語での要約を重視
このフローに沿って判断することで、 「SHAP値」を中核とした適切な手法選択ができる。
🎨 直感をもう一段深める — 「公平な分け前」としての SHAP
SHAP の出発点は、 経済学者 L. S. Shapley が 1953 年に提案した協力ゲーム理論のシャープレイ値である。 元々は「複数のプレイヤーが協力して得た利得を、 各プレイヤーの貢献度に応じて公平に分配するにはどうすればよいか」という問いへの答えだった。 機械学習では「プレイヤー=特徴量」「利得=予測値」と読み替える。 各特徴量が予測という共同利得に対してどれだけ貢献したかを、 数学的に一意に定まる公平な配分として求めるのが SHAP である。
- 公平な配分:ある特徴量を「協力の輪に加えた瞬間の予測の増分(限界貢献)」を、 加える順番の全パターンで平均する。 だから「たまたま先に入ったから得をする」といった順序の不公平が消える。
- 局所説明(local):SHAP 値は1 サンプルごとに計算される。 「この県の予測がなぜこの値なのか」を県別に語れる。 全体の平均的重要度(大域)とは別物である。
- 加法性(additivity / local accuracy):各特徴量の SHAP 値をすべて足すと、 ぴったり「予測値 − 基準値」になる。 端数の逃げ場がない完全な内訳表になる。
実データで加法性を確かめる(SSDSE-B-2026・2023 年・47 都道府県)
前掲コードと同じ構成(XGBRegressor(n_estimators=100, max_depth=4, random_state=42)、 特徴量 ['A1101','A1301','A1303','L3221','B4101']、 目的変数 A4101 出生数)で TreeSHAP を実行した実測値を示す。 基準値(背景平均予測)は E[f] = 15473.8。 東京都の予測を分解すると、 各特徴量の SHAP 値の合計が「予測 − 基準」に一致する(加法性)。
47 都道府県すべてで |f(x) − (E[f] + Σφ)| の最大値は約 0.02(浮動小数点誤差の範囲)で、 TreeSHAP が加法性を厳密に満たすことが確認できる。 これは次章で述べる効率性(Efficiency)公理そのものであり、 上部の 🎮 ウィジェットが緑パネルで常時検証している性質と同じである。
⚠️ 落とし穴をもう一段深める — 実測値で見る 7 つの誤読
SHAP は「公平で厳密」だが、 公平さの前提を理解せずに使うと数字が独り歩きする。 ここでは前章と同じ SSDSE-B-2026・2023 年の実測 SHAP 値を使い、 初学者が踏みやすい落とし穴を具体的な数値とともに整理する(既掲の落とし穴セクションと相補的に読んでほしい)。
① 相関特徴量で寄与が「分散・移動」する — 実測デモ
SSDSE-B-2026 では総人口 A1101 と 15 歳未満人口 A1301 の相関は 0.997、 A1101 と 65 歳以上人口 A1303 は 0.991 とほぼ同一情報を持つ。 相関が強い列が同居すると、 SHAP は「協力の分け前」をそれらの間で分け合う。 実際、 東京都の A1101 の SHAP 値は、 相関の強い A1301 を特徴量から外すと大きく変わる。
つまり「A1101 の SHAP が 5 万だから総人口の効果は 5 万」と絶対視するのは危険。 数字は「どの特徴量が同席しているか」に依存する。 対策は、 相関の高い列をグループ化する・事前に間引く・shap.maskers の相関を考慮した設定を使う、 など。 因果ではなくモデル内部の分担を見ている点を常に意識する。
② 局所(local)と大域(global)を取り違える — 実測デモ
「全体で最も重要な特徴量」と「ある 1 県で最も効いた特徴量」は一致しないことがある。 大域重要度(mean |SHAP|)では A1101 が支配的だが、 北海道の個別予測では A1301(15 歳未満人口)の押し上げが A1101 を上回る。
「summary_plot の棒グラフ(大域)で 1 位だから、 どの県でもそれが主因」と読むのは誤り。 政策やアクションをサブグループ別・個別に設計するには、 dependence_plot や層別集約で局所の分布を見る必要がある。
③〜⑦ 数字の裏にある前提
- ③ 計算コストと近似:厳密シャープレイ値は特徴量数 $M$ に対し $2^M$ の提携を評価する。 TreeSHAP は木構造を使い $O(TLD^2)$ で厳密値を返すが、 KernelSHAP はモンテカルロ近似で、
nsamplesが小さいと Local Accuracy 残差が数 % 残る。 「SHAP 値」と一口に言っても厳密か近似かで信頼度が違う。 - ④ SHAP は因果ではない:SHAP は学習済みモデルの入出力関係を分解するだけ。 「A1101 の SHAP が正 → 人口を増やせば出生数が増える」は飛躍。 交絡(人口が所得・面積などと相関)を含む観測データでは、 介入効果には DAG・操作変数・差分の差分などの因果推論が別途必要。
- ⑤ 背景データ(baseline)の選択:SHAP 値は「基準値との差」で定義され、 基準値 E[f]=15473.8 は背景データの分布に依存する。 訓練データ全体・特定サブグループ・単一サンプルのどれを background に選ぶかで、 同じ予測でも SHAP 値が変わる。 報告時は必ず基準の定義を明記する。
- ⑥ 特徴量独立の仮定(TreeSHAP):既定の TreeSHAP(path-dependent / interventional)は、 提携外の特徴量を扱う際に暗黙の分布仮定を置く。 特徴量が強く相関する現実データでは、 interventional(因果的介入)と conditional(条件付き)で SHAP 値が変わりうる。 ①の「分け合い」もこの仮定の帰結である。
- ⑦ 重要度の解釈:mean |SHAP| は「予測をどれだけ動かすか」の平均であって、 「予測精度への寄与」でも「因果的重要度」でもない。 符号を潰した絶対値の平均なので、 押し上げ・押し下げの方向は summary_plot の点分布や dependence_plot で別途確認する。
🚀 発展 — シャープレイ値の公理から因果 SHAP まで
シャープレイ値を一意に定める 4 公理
SHAP が「唯一の公平な分解」と呼べる根拠は、 シャープレイ値が次の 4 公理をすべて同時に満たす唯一の配分だからである(協力ゲーム理論の定理)。 SHAP はこれを機械学習の説明に持ち込んだ。
| 公理 | 内容 | SHAP での意味 |
|---|---|---|
| 効率性 Efficiency | 全プレイヤーの配分の和 = 全体利得 | $\sum_i \phi_i = f(x) - E[f]$(=加法性・Local Accuracy) |
| 対称性 Symmetry | どの提携でも同じ貢献をする 2 者は同じ配分 | 等価な 2 特徴量は同じ SHAP 値を得る |
| ダミー Dummy / Null player | 貢献がゼロのプレイヤーの配分はゼロ | 予測に影響しない特徴量の SHAP 値は 0 |
| 加法性 Additivity / Linearity | ゲームの和の値 = 各ゲームの値の和 | アンサンブルの SHAP = 各モデルの SHAP の和(TreeSHAP がツリーごとに合算できる根拠) |
形式的には、 特徴量 $i$ のシャープレイ値は全提携 $S \subseteq M\setminus\{i\}$ にわたる限界貢献の重み付き平均 $\phi_i = \sum_{S} \frac{|S|!\,(M-|S|-1)!}{M!}\,[v(S\cup\{i\}) - v(S)]$ で与えられる。 ここで $v(S)$ は「特徴量集合 $S$ だけを使ったときの予測(の期待値)」。 上部ウィジェットの「全順列の限界貢献を平均」は、 この式を $M=3$ で全列挙したものに等しい。
推定アルゴリズムの系譜
厳密計算は $2^M$ 提携で現実的でないため、 モデル種別ごとに実用的な推定器が用意されている(本ページ「🌐 関連手法・派生」表と対応)。
- KernelSHAP:モデル非依存。 提携をサンプリングし、 シャープレイカーネルで重み付けした線形回帰としてシャープレイ値を近似する。 NN・SVM など任意モデルに使えるが重い。
- TreeSHAP:決定木アンサンブル専用。 木のパスに沿って条件付き期待値を動的計画法で厳密計算し、 $O(TLD^2)$ を達成。 構造化データの事実上の標準。
- DeepSHAP:深層ニューラルネット向け。 DeepLIFT の寄与伝播とシャープレイ値を接続し、 層ごとに寄与を逆伝播する。 画像・微分可能モデルでは GradientSHAP(Integrated Gradients 系)も。
SHAP 相互作用値(interaction values)
SHAP は相互作用を主効果から分離できる。 相互作用値 $\Phi_{i,j}$ は特徴量 $i,j$ が組んだときに生む追加寄与を表し、 対角成分が純粋な主効果、 非対角が交互作用になる(シャープレイ相互作用指数)。 東京都で shap_interaction_values を実測すると、 A1101 の純主効果は約 +50004、 A1101×A1301 の相互作用は約 -1687.7(左右対称に折半して割り付けられる)。 上部ウィジェットの「相互作用を 2 特徴へ公平に折半」は、 まさにこの性質の縮図である。
依存プロット・大域集約・因果 SHAP
- 依存プロット(dependence plot):横軸に特徴量の値、 縦軸にその SHAP 値を取り、 関数形(非線形・閾値効果)を可視化する。 点の色に相関特徴量を割り当てると交互作用も読める。
- 大域集約(global aggregation):局所 SHAP を全サンプルで
mean(|SHAP|)集約すると大域重要度になる(本ページ実測:A1101=9226.1 が最大)。 「局所を積み上げて大域を得る」構成は SHAP の統一性の核心で、 permutation importance などの純大域手法と対照的。 - 因果 SHAP(Causal / Asymmetric Shapley):既定の SHAP は特徴量の因果順序を無視するが、 既知の因果グラフ(DAG)を制約に組み込み、 介入分布 $do(\cdot)$ の下でシャープレイ値を定義する拡張(Asymmetric Shapley Values, Causal Shapley Values など)。 「相関の分け合い」問題を因果構造で解消しようとする研究方向で、 SHAP と因果推論の橋渡しにあたる。