🔖 キーワード索引(補強)
Granger 因果性に関連する時系列概念のチップ集。
🔖 キーワード索引 — 完全強化版
「グレンジャー因果」を理解するうえで必要なキーワードを 10 件以上提示します。 各チップから対応セクションへ移動できます。
30 秒結論 文脈 直感 数式 記号読み解き 実値計算 Python 実装 落とし穴 関連手法 関連用語 グループ教材 概念マップ
💡 30秒で分かる結論
🍰 まずはやさしく
予測のヒントを探す道具です。
あるデータが別のデータの予測に役立つか調べます。
スマホの利用時間で成績を予想できるか考えます。
この章では結論を短くまとめます。
- 定義:「Xの過去値を加えるとYの予測が改善するか」を検定。統計的因果ではなく予測上の因果性。
- カテゴリ:時系列
📖 包括的解説 — この概念を完全マスター
📍 学習の3ステップ
- 定義を理解する:この概念は何か? 数式や条件を確認
- 具体例を見る:実データ(SSDSE 等)で計算してみる
- 応用する:自分のデータに適用、 結果を解釈
🔧 Python実装パターン
🎯 このコードでやること:Granger 因果検定の最小実装。合成した2系列(X が1期先行して Y を駆動)に対し、① ADF 検定で定常性を確認し、② statsmodels の grangercausalitytests で「X の過去を加えると Y の予測が改善するか」をラグ別に F 検定/尤度比検定し、③ 逆向き(Y→X)も検定して因果の非対称性を確かめる。実データが非定常なら df.diff() で差分化してから渡す。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import numpy as np, pandas as pd from statsmodels.tsa.stattools import adfuller, grangercausalitytests # --- 合成時系列:X の過去が Y を駆動する(X_{t-1} -> Y_t)--- rng = np.random.default_rng(42) n = 200 x = np.zeros(n); y = np.zeros(n) for t in range(1, n): x[t] = 0.5 * x[t-1] + rng.normal(0, 1) y[t] = 0.3 * y[t-1] + 0.6 * x[t-1] + rng.normal(0, 1) df = pd.DataFrame({'X': x, 'Y': y}) # --- (1) 定常性チェック(ADF検定:p<0.05 で定常。非定常なら df.diff() で差分化)--- for c in ['X', 'Y']: stat, p = adfuller(df[c])[:2] print(f'ADF {c}: stat={stat:6.2f}, p={p:.4f} -> {"定常" if p < 0.05 else "非定常"}') # --- (2) Granger因果検定:X の過去を加えると Y の予測が改善するか --- def granger_pvalues(data, cause, effect, maxlag=3): # data[[effect, cause]] の順で渡すと「cause -> effect」を検定 res = grangercausalitytests(data[[effect, cause]], maxlag=maxlag, verbose=False) print(f'\n[{cause} -> {effect}] ラグ別 p 値(F検定 / 尤度比検定)') for lag in range(1, maxlag + 1): f_p = res[lag][0]['ssr_ftest'][1] # F検定 lr_p = res[lag][0]['lrtest'][1] # 尤度比検定 mark = '★有意' if f_p < 0.05 else ' ' print(f' lag={lag}: F検定 p={f_p:.4f}, 尤度比 p={lr_p:.4f} {mark}') granger_pvalues(df, cause='X', effect='Y') # 本命:X -> Y granger_pvalues(df, cause='Y', effect='X') # 対照:Y -> X |
📚 統計概念マップでの位置
このページの上にある3つの概念マップ(関係マップ、 包含マップ、 ツリーマップ)でこの概念の位置づけが視覚的に分かります。 関連手法を辿って学習を進めましょう。
🎯 SSDSE-B-2026 で挑戦
統計データ活用コンペティションのSSDSE-B-2026データは、 47都道府県の社会経済データ。 この概念を使って以下のような分析ができます:
- 地域別の特徴抽出
- 家計支出パターンの解析
- 人口動態と社会経済指標の関連
- 気候要因の影響評価
💡 よく使うコマンド集
| 機能 | Python (pandas) | Python (scipy) |
|---|---|---|
| 要約統計 | df.describe() | stats.describe() |
| 平均 | df.mean() | np.mean() |
| 標準偏差 | df.std() | np.std() |
| 相関 | df.corr() | stats.pearsonr() |
| t検定 | — | stats.ttest_ind() |
| 回帰 | — | stats.linregress() |
| 分布フィッティング | — | stats.norm.fit() |
🚧 一般的な落とし穴と対策
- 外れ値の影響:散布図・ 箱ひげ図で確認、 ロバスト手法も検討
- サンプルサイズ不足:power analysis で事前に確認
- 仮定の違反:正規性、 独立性、 等分散性をチェック
- 多重比較問題:補正(Bonferroni、 FDR)を適用
- p-hacking:事前登録(pre-registration)で防ぐ
- 因果と相関の混同:観察データから因果結論を出さない
📊 結果報告の標準フォーマット
- 点推定:得られた値
- 不確実性:信頼区間または標準誤差
- サンプルサイズ:n を明記
- 効果量:実質的な意義
- p値:統計的有意性
- 仮定の確認:診断プロット
🌐 関連分野での応用
- マーケティング:A/Bテスト、 顧客分析
- 医療:臨床試験、 疫学研究
- 金融:リスク管理、 ポートフォリオ
- 製造:品質管理、 工程最適化
- 公共政策:効果評価、 計画立案
- 研究:仮説検証、 探索的解析
🎓 さらに学ぶための文献
- Wasserman "All of Statistics"
- Hastie, Tibshirani & Friedman "The Elements of Statistical Learning"
- Gelman & Hill "Data Analysis Using Regression"
- VanderPlas "Python Data Science Handbook"
🔗 統計用語ネットワーク
この概念は、 他の多くの統計概念と密接に関連しています。 ジャストインタイム型学習では、 必要に応じて関連用語へジャンプしながら全体像を構築します。
主要な関連概念のグループ
| グループ | 主要概念 |
|---|---|
| 記述統計 | 平均、 中央値、 最頻値、 分散、 標準偏差、 共分散、 相関係数 |
| 可視化 | ヒストグラム、 散布図、 箱ひげ図、 ヒートマップ |
| 推測統計 | 標本平均、 標準誤差、 信頼区間、 p値、 有意水準 |
| 確率分布 | 正規分布、 t分布、 χ²分布、 F分布、 二項分布 |
| 仮説検定 | t検定、 F検定、 χ²検定、 ノンパラ検定 |
| 回帰 | 単回帰、 重回帰、 OLS、 Ridge、 LASSO |
| 分類 | ロジスティック回帰、 決定木、 SVM、 k-NN |
| 教師なし学習 | クラスタリング、 PCA、 因子分析 |
| 時系列 | ARIMA、 VAR、 指数平滑法、 自己相関 |
| 因果推論 | DiD、 IV、 傾向スコア、 交絡変数 |
| 前処理 | 標準化、 正規化、 欠損値処理、 多重共線性対策 |
| 評価 | R²、 残差、 CV、 RMSE、 効果量 |
学習順序の推奨
- 記述統計(平均、 分散、 標準偏差)
- 可視化(ヒストグラム、 散布図)
- 確率分布(正規分布)
- 推測統計(標準誤差、 信頼区間、 p値)
- 仮説検定(t検定、 χ²検定)
- 相関と回帰(単回帰、 重回帰)
- 多変量解析(PCA、 クラスタリング)
- 機械学習(決定木、 RF、 NN)
- 時系列・因果推論(応用)
📝 実践練習 — SSDSE-B-2026 で挑戦
初級課題
- 東北6県の家計食料費の基本統計量を計算
- 食料費のヒストグラムを描く
- 食料費と教育費の散布図を描く
- 都道府県を「東日本/西日本」に分け、 平均を比較
中級課題
- 家計支出 5項目で相関行列を作成、 ヒートマップ可視化
- 食料費 → 教育費の単回帰を実行、 残差分析
- 家計5項目で PCA を実施、 バイプロット表示
- k-means (k=3) で都道府県をクラスタリング、 解釈
上級課題
- 地域別の家計パターンに有意差があるか ANOVA で検定
- 重回帰で教育費を予測、 多重共線性を VIF で確認
- Ridge/LASSO で正則化、 CV で α を最適化
- 階層クラスタリングと Ward 法で都道府県を分類、 デンドログラム作成
💡 30 秒で分かる結論 — 完全強化版
- グレンジャー因果 とは、データ分析の重要概念のひとつで、人口 A1101 と出生数 A4101 の時系列でグレンジャー因果検定 という形で SSDSE-B-2026 でも検証できます。
- 本ページでは 数式・直感・実コード・落とし穴の 4 つの視点で整理しています。
- SSDSE-B-2026 の A1101 列を中心に、実値で計算を体験することを推奨します。
- 類似概念や前提概念へのリンクを併用すると、概念地図全体での位置づけが掴めます。
- 初学者は「直感 → 数式 → 実装 → 落とし穴」の順で読むのが効率的です。
📍 あなたが今見ているもの
🍰 まずはやさしく
データのつながりを見る方法です。
どのデータが先に動いたかを確認するために使います。
人口の変化が出生数にどう影響するかを調べます。
この用語がどこで使われるかを確認します。
論文中に 「Granger因果検定」として登場する用語。
Granger因果検定 とは:「Xの過去値を加えるとYの予測が改善するか」を検定。統計的因果ではなく予測上の因果性。
📍 文脈ボックス — あなたが今見ているもの(完全強化版)
このセクションは「グレンジャー因果」を扱う 用語ページ です。 統計データ分析コンペティション(2026)の再現教材における中核用語のひとつで、人口 A1101 と出生数 A4101 の時系列でグレンジャー因果検定 という観点で SSDSE-B-2026(47 都道府県 × 複数年 × 100 超列)に紐づけられます。
位置づけ:相関・線形回帰・仮説検定 といった基礎用語群と並列であり、応用としては 内生性・IV・DID・クラスタリング 等へ繋がります。
🎨 直感で掴む — 完全強化版
🍰 まずはやさしく
データ分析のための眼鏡のようなものです。
隠れた影響関係を見つけるために使います。
部活の練習量と試合の結果の関係を考えます。
直感的にイメージして理解しましょう。
グレンジャー因果 を一言でいえば「人口 A1101 と出生数 A4101 の時系列でグレンジャー因果検定」。 47 都道府県という小さな母集団でも、 SSDSE-B-2026 の A1101 列に注目すると、 大都市圏と地方の差・人口規模に伴う相対比較など、 様々なパターンが見えてきます。
比喩でいうと、 グレンジャー因果 はデータ分析の「眼鏡」のようなもの。 同じデータでも眼鏡を変えれば、 平均(中心)・分散(ばらつき)・相関(連動)・因果(影響)と、 異なる情報が浮かび上がります。 SSDSE-B-2026 を題材に、 この眼鏡をかけてみるのが本ページの狙いです。
- 具体例 1:47 都道府県の A1101 の中央値 ± 四分位を見ると、 規模感が掴める。
- 具体例 2:A4101 と組み合わせて散布図にすると、 群構造が見える。
- 具体例 3:政令指定都市の有無で群分けすると、 介入研究の素材になる。
🎮 触って理解する
2 つの時系列 X(青) と Y(オレンジ) を表示します。 Y は「自分の過去」と「X の過去」から生成されています。 スライダーで X の過去が Y の将来に効く強さ と ラグ数 p を変えると、 下の 2 本の棒が更新されます。左は Y を自分の過去だけで予測した誤差(RSS制限)、 右は X の過去も加えて予測した誤差(RSS非制限)。 後者が 有意に 小さければ「X は Y をグレンジャー予測する」と判定されます。 グラフ上を左右にドラッグ(スマホはタッチ)しても強さを変えられます。
⚠️ 予測改善であって真の因果ではありません。 ここで検定しているのは「X の過去情報が Y の予測誤差を減らすか」だけです。 共通の先行変数(交絡)や 共通トレンド があると、 実際には因果が無くてもグレンジャー予測が有意になります。 「グレンジャー因果あり」は「時間的な先行・予測寄与あり」と読み替えるのが安全です。
💡 直感 — 過去の情報は将来予測を改善するか
グレンジャー因果の核心は「情報」です。今の Y を予測するのに Y 自身の過去 だけで十分なら、 X は Y に対して情報を持ちません。ところが X の過去を足したとたんに予測誤差がガクッと下がるなら、 「X には Y の未来を先取りする情報が含まれている」= X は Y をグレンジャー予測する、と考えます。 上の実験で β を上げると RSS非制限 が RSS制限 より小さくなり、F 統計量が大きく、p 値が小さくなる様子を確認してください。
⚠️ よくある落とし穴 — 予測 ≠ 因果
- 予測改善 = 因果ではない:グレンジャー因果は「時間的先行と予測寄与」であり、 介入して結果が変わる意味の真の因果とは別物です。
- 交絡(共通原因):第 3 の変数 Z が X と Y の両方を先に動かすと、 X→Y のグレンジャー因果が偽陽性で出ます。交絡の検討が必須です。
- 共通トレンド・非定常:両系列が上昇トレンドを共有するだけで 見せかけの相関/見せかけの因果が生じます。差分化や定常性の確認が前提です。
🚀 発展 — VAR・インパルス応答・非定常の注意
- VAR(ベクトル自己回帰):複数系列を同時にモデル化する枠組み。 グレンジャー因果検定は VAR の係数に対するゼロ制約検定として実装されます。
- インパルス応答関数(IRF):ある系列へのショックが他系列へ時間を追ってどう波及するかを可視化。 「向き」だけでなく「大きさと持続」を読めます。
- 非定常の注意:単位根がある系列では検定統計量の分布が変わり偽陽性が増えます。 ADF/KPSS 検定 →(必要なら)差分化、共和分があれば VECM、という時系列の定石に従います。 ラグ変数の取り方(p の選択)は AIC/BIC で決めます。
📐 数式または定義 — 完全強化版
🍰 まずはやさしく
予測のルールを数式にしたものです。
過去のデータがどれだけ役立つかを計算します。
昨日の買い物で今日の予算を予想するような仕組みです。
具体的な数式と記号の意味を学びます。
グレンジャー因果 の代表的な定義式は次のとおりです。
$$ y_t = \alpha_0 + \sum_{i=1}^p \alpha_i y_{t-i} + \sum_{j=1}^p \beta_j x_{t-j} + \varepsilon_t; \quad H_0:\beta_1=\cdots=\beta_p=0 $$ここで使われる記号や演算の意味は次節で言葉に翻訳します。
🔬 数式を言葉で読み解く — 完全強化版
数式の各記号を、日本語の意味に変換します。
- X, Y — 観測されたデータ系列(SSDSE-B-2026 の A1101, A4101 列など)
- n — 標本サイズ(47 都道府県データなら 47、 多年度パネルなら 47×年数)
- β, θ, α — 推定すべき未知パラメータ
- ε, u — 観測されない誤差項・撹乱項
- E[·] — 期待値(母集団平均)
- Cov, Var — 共分散・分散
- arg min — 「最小化するパラメータ」の意味
- L (ラグ演算子) — 時系列で 1 期前の値を返す操作
🧮 SSDSE-B-2026 で実値計算 — Granger 因果性
SSDSE-B-2026 を年度パネルとして並べ替えれば、 都道府県の時系列を作ることができます。 ここでは年次データを擬似時系列として Granger 因果性を計算します。
例:2変量で Granger 因果性検定
🎯 このコードでやること:東京都の 12 年度分(2012〜2023)の総人口と出生数を 1 階差分し、 statsmodels の grangercausalitytests で「出生数の過去が総人口の予測を改善するか」をラグ 1・2 で F 検定する。
📥 入力の形
東京都の 12 年度分(header=1 で日本語の列名で読み、年度の古い順に並べる)
年度   総人口       出生数
2012   13,234,000   107,401
2013   13,307,000   109,986
…
2023   14,086,000    86,348
→ 1 階差分で 11 行 × 2 列。列の順は [総人口, 出生数] で、2 列目(出生数)→ 1 列目(総人口)の向きを検定する
年度   総人口     出生数
2013   +73,000    +2,585
2014   +92,000      +643
…
2023   +48,000    −4,749
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pandas as pd from statsmodels.tsa.stattools import grangercausalitytests df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) # 東京都の 12 年度分(2012〜2023)を年度の古い順に並べる tokyo = df[df['都道府県'] == '東京都'].sort_values(df.columns[0]) # 人口 A1101(総人口)と出生数 A4101 の 2 系列。どちらもトレンドを持つ非定常系列なので # 1 階差分(前年からの増減)にしてから検定する → 11 点 ts = tokyo[['総人口', '出生数']].dropna().diff().dropna() # grangercausalitytests は「2 列目(出生数)の過去が 1 列目(総人口)の予測を改善するか」を検定する res = grangercausalitytests(ts, maxlag=2, verbose=False) for lag, r in res.items(): F, p, df_d, df_n = r[0]['ssr_ftest'] print(f'lag={lag}: F={F:.3f}, p={p:.4f} (自由度 {df_n}, {df_d:.0f})') |
💬 ラグ 1 は F=1.723(自由度 1, 7)で p=0.2307、ラグ 2 は F=1.479(自由度 2, 4)で p=0.3305 と、どちらも 5% で有意にならない。差分をとると 11 点しか残らず、ラグ 2 では残差の自由度が 4 まで減るので、検出力はほとんど無い。grangercausalitytests は列の並びで向きが決まり、[総人口, 出生数] の順に渡すと「出生数 → 総人口」の検定になる点も読み違えやすい。
例:VAR モデルでの因果性
🎯 このコードでやること:東京都の総人口・出生数を 1 階差分して VAR を当てはめ、 AIC/BIC でラグ次数を選んだうえで、 VAR の係数に対するゼロ制約として「出生数 → 総人口」の Granger 因果を F 検定する。
📥 入力の形
東京都の総人口・出生数を 1 階差分した 11 行 × 2 列(上の例と同じ系列)
年度   総人口     出生数
2013   +73,000    +2,585
2014   +92,000      +643
…
2023   +48,000    −4,749
VAR にはこの 2 列をそのまま渡し、ラグは最大 2 に抑える
1 2 3 4 5 6 7 8 9 10 11 12 13 | import pandas as pd from statsmodels.tsa.api import VAR df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) tokyo = df[df['都道府県'] == '東京都'].sort_values(df.columns[0]) cols = ['総人口', '出生数'] # 人口 A1101 と出生数 A4101 ts = tokyo[cols].dropna().diff().dropna() # 1階差で定常化 model = VAR(ts) selection = model.select_order(maxlags=2) # 年12点の短系列なので小さめに print('推奨ラグ (AIC/BIC):', selection.aic, selection.bic) fit = model.fit(maxlags=2) print(fit.test_causality(cols[0], [cols[1]], kind='f')) |
💬 東京都の 12 年度分を 1 階差分すると 11 点しかなく、ラグ 2 の VAR では F 検定の自由度が (2, 8) まで減る。検定統計量 1.479 は臨界値 4.459 に遠く及ばず p = 0.284 で、「出生数の変化は総人口の変化をグレンジャー因果しない」という帰無仮説を棄却できなかった。この結論は「因果が無い」ではなく「11 点では検出力が足りない」と読むべきで、47 県のパネルに広げるか年次より細かい月次データを使うのが次の手になる。
🧮 実値で計算してみる — SSDSE-B-2026 で グレンジャー因果(完全強化版)
SSDSE-B-2026(公的統計の社会・教育系データセット、 47 都道府県 × 10 年分超 × 100 以上の列)を用いて、 「グレンジャー因果」を体感します。 ファイル名は SSDSE-B-2026.csv、 読み込みは下記の Python コードで行います。
1 2 3 4 5 6 7 8 | import pandas as pd # SSDSE-B-2026 を読み込む(cp932 / Shift_JIS) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') print(df.shape) # (564, 112) print(df['SSDSE-B-2026'].unique()) # 含まれる年度 latest = df[df['SSDSE-B-2026'] == df['SSDSE-B-2026'].max()].copy() print(latest[['Prefecture', 'A1101', 'A4101']].head()) |
💬 564 行は 47 都道府県 × 12 年度で、年度は 2023 から 2012 へ新しい順に並ぶ。グレンジャー因果は 1 県の時系列で調べるので、使うのは最新年度の横断面 latest(47 行)ではなく、県ごとに年度を昇順に並べ直した 12 点になる。昇順に直さずに差分やラグを取ると、未来の値で過去を説明する向きになってしまう。
ここで使った中心列 A1101 は SSDSE-B-2026 における 人口 A1101 と出生数 A4101 の時系列でグレンジャー因果検定 に関連する指標です。 算出例:
- 47 都道府県・最新年度の
A1101平均と標準偏差を求める A1101とA4101の相関(線形・順位)を比較する- 群分け(例:人口上位 10 県 vs それ以外)で平均差を見る
🧮 数式に値を入れて手で計算する: AR と AR+X モデルの RSS 比較
合成データで X→Y の Granger 検定統計量を概算する。
Step 1: モデル別残差平方和
| モデル | RSS | パラメータ数 |
|---|---|---|
| 制約付き (Y のみ) | 50 | 2 |
| 非制約 (Y + X 過去) | 40 | 4 |
n=100 サンプル
Step 2: F 統計量
🐍 Python で再現
1 2 3 4 5 6 7 8 9 10 | from scipy import stats rss_r, rss_u = 50, 40 n = 100 k_u = 4 q = 2 F = ((rss_r - rss_u)/q) / (rss_u/(n - k_u)) crit = stats.f.ppf(0.95, q, n - k_u) print(f"F = {F:.2f}") print(f"臨界値: {crit:.3f}") print(f"Granger 因果あり: {F > crit}") |
📤 実行結果
💬 手計算 (Step 2) F=12.0 と Python 出力が完全一致。
🐍 Python 実装バリエーション(statsmodels / scipy / arch / pmdarima)
1. statsmodels.tsa — Granger / VAR 標準実装
🎯 このコードでやること:東京都の総人口・出生数について、 まず水準のまま ADF 検定で単位根の有無を確かめ、 次に 1 階差分した系列で grangercausalitytests を回して F 検定と尤度比検定の p 値を並べる。
📥 入力の形
東京都の 12 年度分の水準(ADF 検定に使う)
年度   総人口       出生数
2012   13,234,000   107,401
2013   13,307,000   109,986
…
2023   14,086,000    86,348
Granger 検定にはこれを 1 階差分した 11 行 × 2 列を渡す
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | import pandas as pd from statsmodels.tsa.stattools import grangercausalitytests, adfuller from statsmodels.tsa.api import VAR df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) tokyo = df[df['都道府県'] == '東京都'].sort_values(df.columns[0]) ts = tokyo[['総人口', '出生数']].dropna() # まず定常性チェック(水準のままでは単位根を棄却できない) for c in ts.columns: stat, p = adfuller(ts[c])[:2] print(f'{c}: ADF stat={stat:.3f}, p={p:.4f}') # Granger(1 階差分した系列で、出生数 → 総人口 をラグ 1〜2 で検定) res = grangercausalitytests(ts.diff().dropna(), maxlag=2, verbose=False) for lag, r in res.items(): print(f'Granger lag={lag}: F 検定 p={r[0]["ssr_ftest"][1]:.4f}, 尤度比 p={r[0]["lrtest"][1]:.4f}') |
💬 水準の ADF は総人口 p=0.9877、出生数 p=0.9989 で単位根をまったく棄却できず、水準のまま検定すると共通トレンドによる見せかけの因果が出やすいので差分を使う。差分での F 検定の p はラグ 1 が 0.2307、ラグ 2 が 0.3305 で有意ではない。尤度比検定はラグ 2 で p=0.0828 と F 検定よりかなり小さく出るが、小標本では尤度比検定が有意に出やすいので、11 点しかないときは自由度を補正した F 検定の方を読む。
2. scipy.stats — F検定で簡易 Granger
🎯 このコードでやること:statsmodels の検定関数を使わず、 Y の過去 2 期だけの制約モデルと X の過去 2 期を足した非制約モデルを OLS で当てはめ、 残差平方和の差から Granger の F 統計量と p 値を自分で計算する(東京都の総人口・出生数の 1 階差分)。
📥 入力の形
東京都の総人口・出生数を 1 階差分した 11 行 × 2 列の NumPy 配列(.values)
年度   総人口     出生数
2013   +73,000    +2,585
2014   +92,000      +643
…
2023   +48,000    −4,749
ts[:, 0] が総人口(y)、ts[:, 1] が出生数(x)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | import numpy as np import pandas as pd from scipy import stats import statsmodels.api as sm df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) tokyo = df[df['都道府県'] == '東京都'].sort_values(df.columns[0]) # 水準は非定常なので 1 階差分(前年からの増減、11 点)にしてから比べる ts = tokyo[['総人口', '出生数']].dropna().diff().dropna().values # 制約モデルと非制約モデルの SSR を比較 def granger_f(y, x, lag=2): Y = y[lag:] X_rest = np.column_stack([y[lag-i-1:-i-1] for i in range(lag)]) X_full = np.column_stack([Y]*0 + [y[lag-i-1:-i-1] for i in range(lag)] + [x[lag-i-1:-i-1] for i in range(lag)]) X_rest = sm.add_constant(X_rest); X_full = sm.add_constant(X_full) ssr_r = sm.OLS(Y, X_rest).fit().ssr ssr_f = sm.OLS(Y, X_full).fit().ssr n, k = len(Y), lag F = ((ssr_r - ssr_f) / k) / (ssr_f / (n - 2*k - 1)) p = 1 - stats.f.cdf(F, k, n-2*k-1) return F, p F, p = granger_f(ts[:, 0], ts[:, 1], lag=2) # 出生数の過去 2 期 → 総人口 print(f'F = {F:.3f}, p = {p:.4f}') |
💬 自作の F = 1.479、p = 0.3305 は grangercausalitytests のラグ 2 の値と一致し、中身が「制約モデルと非制約モデルの残差平方和の比較」だと確かめられる。分母の自由度 n − 2k − 1 は、差分 11 点からラグ 2 期分を落とした 9 点から、定数と係数 4 個の計 5 を引いた 4 である。
3. arch — 定常ブートストラップ(短い系列の統計量のばらつき)
🎯 このコードでやること:arch の StationaryBootstrap(平均ブロック長 3)で東京都 12 年度分の(総人口, 出生数)を時間のつながりを保ったまま 200 回リサンプリングし、 両者の共分散の分布と 95% 区間を求める。 Granger 検定そのものではなく、 短い時系列で統計量がどれだけばらつくかを見る下準備。
📥 入力の形
東京都の 12 年度分の水準をそのまま 12 行 × 2 列の NumPy 配列にしたもの(差分はしない)
年度   総人口       出生数
2012   13,234,000   107,401
2013   13,307,000   109,986
…
2023   14,086,000    86,348
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | from arch.bootstrap import StationaryBootstrap import numpy as np import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) tokyo = df[df['都道府県'] == '東京都'].sort_values(df.columns[0]) ts = tokyo[['総人口', '出生数']].dropna().values def stat_func(data): # 簡易: 共分散を統計量に return np.cov(data[:, 0], data[:, 1])[0, 1] bs = StationaryBootstrap(3, ts) results = bs.apply(stat_func, 200) print('ブートストラップ平均:', np.mean(results), '95%CI:', np.percentile(results, [2.5, 97.5])) |
💬 東京都 12 年度分の(総人口, 出生数)の共分散はそのまま計算すると約 −20.9 億で、総人口が増える一方で出生数が減っているので負になる。ブートストラップ平均は −17.3 億、95% 区間は −31.7 億〜−3.1 億で、3 回実行すると平均は −17.3 億〜−18.5 億、区間の上端は −3.1 億〜−4.2 億と動き、12 点しかない系列では 200 回のリサンプリングでも区間の端が落ち着かない。stat_func が返すのは水準どうしの共分散なので、このままでは Granger 因果の検定にはならない。F 統計量の分布が欲しいときは、stat_func の中で差分系列の制約・非制約回帰から F を計算して返すように書き換える。
4. pmdarima — 自動 ARIMA で予測誤差比較
🎯 このコードでやること:pmdarima の auto_arima で、 総人口だけの ARIMA と、 出生数を外生変数 X に入れた ARIMA をそれぞれ自動選択し、 BIC を比べて出生数が総人口の当てはまりを改善するかを見る。
📥 入力の形
東京都の 12 年度分の水準: y = 総人口(12 点)、X = 同じ年の出生数(12 点)
年度   総人口       出生数
2012   13,234,000   107,401
2013   13,307,000   109,986
…
2023   14,086,000    86,348
差分は auto_arima の d=1 に任せる
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | import pmdarima as pm import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) tokyo = df[df['都道府県'] == '東京都'].sort_values(df.columns[0]) ts = tokyo[['総人口', '出生数']].dropna() y, x = ts.iloc[:, 0], ts.iloc[:, 1] # 単独 ARIMA vs 外生変数つき ARIMA # 差分の階数 d がモデルごとに変わると尤度の土台が違い BIC を比べられないので、d=1 にそろえる mod1 = pm.auto_arima(y, d=1, seasonal=False) mod2 = pm.auto_arima(y, X=x.values.reshape(-1,1), d=1, seasonal=False) # 外生変数は X= で渡す(exogenous= は無視される) print('次数 単独:', mod1.order, ' 外生あり:', mod2.order) print(f'BIC 単独: {mod1.bic():.2f}, 外生あり: {mod2.bic():.2f}') print('外生変数で予測改善 →', mod2.bic() < mod1.bic()) |
💬 差分の階数を d=1 にそろえると、総人口だけのモデルは ARIMA(0,1,0)(前年差がほぼ一定のランダムウォーク)で BIC 274.25、同じ年の出生数を足したモデルは ARIMA(1,1,1) で BIC 275.61 となり、出生数を入れても BIC は 1.36 悪くなるだけで改善しない。d を auto_arima に任せると外生ありの方だけ d=0 が選ばれて BIC 332.59 と出て、差分した系列と水準の系列の尤度を比べることになってしまう。外生変数は X= で渡す(exogenous= は現在の pmdarima では黙って無視される)。Granger の意味での「過去の出生数」を試すなら、x を 1 期ずらしてから渡す。
5. 多変量 VAR と インパルス応答
🎯 このコードでやること:東京都の総人口・出生数・死亡数を 1 階差分し、 3 変数の VAR(2) を当てはめて 10 期先までのインパルス応答関数を描き、 var_irf.png に保存する。
📥 入力の形
東京都の総人口・出生数・死亡数を 1 階差分した 11 行 × 3 列
年度   総人口     出生数    死亡数
2013   +73,000    +2,585    +1,313
2014   +92,000      +643      +517
…
2023   +48,000    −4,749    −2,023
1 2 3 4 5 6 7 8 9 10 11 12 | import pandas as pd from statsmodels.tsa.api import VAR import matplotlib.pyplot as plt df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', header=1) tokyo = df[df['都道府県'] == '東京都'].sort_values(df.columns[0]) ts = tokyo[['総人口', '出生数', '死亡数']].dropna().diff().dropna() model = VAR(ts).fit(maxlags=2) irf = model.irf(10) irf.plot() plt.savefig('var_irf.png', dpi=120, bbox_inches='tight') |
💬 標準出力は無く、 3 × 3 のパネル図が var_irf.png に保存される。 差分 11 点のうち使えるのは 9 点で、 そこに 1 式あたり定数 + 3 変数 × 2 ラグ = 7 個の係数を当てはめるので推定は極めて不安定であり、 応答の形は目安にとどめる。
🐍 Python 実装 — 完全強化版
scipy / pandas / scikit-learn / statsmodels を中心とした標準的な実装例です。 まず CSV を読み込み、 次に グレンジャー因果 の解析を行います。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | import pandas as pd import numpy as np from statsmodels.tsa.stattools import grangercausalitytests panel = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') panel = panel.sort_values(['Prefecture', 'SSDSE-B-2026']) # 県ごとに 2012→2023 の昇順に並べる # 47 県それぞれで「出生数の変化 → 総人口の変化」のグレンジャー因果検定(ラグ 1) rows = [] for pref, g in panel.groupby('Prefecture'): d = g[['A1101', 'A4101']].astype(float).diff().dropna() # 1 階差分で 11 点 res = grangercausalitytests(d[['A1101', 'A4101']], maxlag=1, verbose=False) F, p = res[1][0]['ssr_ftest'][:2] rows.append((pref, F, p)) out = pd.DataFrame(rows, columns=['県', 'F', 'p']).sort_values('p') print('県の数 =', len(out)) print('p < 0.05 の県数 =', int((out['p'] < 0.05).sum())) print('p の中央値 =', round(out['p'].median(), 3)) print(out.head(5).round(4).to_string(index=False)) |
💬 47 県それぞれで差分 11 点・ラグ 1 の検定(F の自由度は 1 と 7)を行うと、p < 0.05 は奈良県 0.0097・佐賀県・愛知県・三重県・埼玉県など 6 県で、残りの中央値は p = 0.341。帰無仮説がすべての県で正しくても 47 回検定すれば 5% で約 2.4 県は偶然有意になり、Bonferroni 補正の基準 0.05/47 ≈ 0.0011 を下回る県は 1 つも無い。6 県を「出生数が人口を先導する県」と読むのは早く、47 県をまとめたパネルでの検定で確かめる必要がある。
用途別の追加実装:
1 2 3 4 5 6 7 8 9 10 11 12 13 | # 標準化と簡易クラスタリングの例 from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans import pandas as pd df = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') df = df[df['SSDSE-B-2026'] == 2023].copy() # 2023 年度の 47 都道府県 X = df[['A1101', 'A4101']].astype(float).values Xs = StandardScaler().fit_transform(X) km = KMeans(n_clusters=4, n_init=10, random_state=0).fit(Xs) df['cluster'] = km.labels_ print(df[['Prefecture', 'A1101', 'A4101', 'cluster']].head(10)) |
💬 総人口と出生数の 2 変数で 2023 年度の 47 県を 4 群に分けると、先頭 10 県では北海道(人口 509 万人・出生 24,430 人)だけがクラスタ 3、青森県から群馬県までの 9 県がクラスタ 0 に入る。2 変数の相関が 0.995 あるので、この分け方は実質的に人口規模の大小で、番号 0〜3 に順序の意味は無い。グレンジャー因果の検定そのものではなく、似た規模の県をまとめて検定の対象を選ぶ前処理として使う。
1 2 3 4 5 6 7 8 | # 時系列(年度別・47都道府県平均の A1101)— 例として ARIMA 系の前処理 import statsmodels.api as sm df_all = pd.read_csv('data/raw/SSDSE-B-2026.csv', skiprows=[1], encoding='cp932') # 全年度パネルを再読込 ts = df_all.sort_values('SSDSE-B-2026').groupby('SSDSE-B-2026')['A1101'].mean() print(ts.tail()) res = sm.tsa.stattools.adfuller(ts) print('ADF stat:', res[0], 'p:', res[1]) |
💬 47 都道府県平均の総人口は 2019 年 269.3 万人から 2023 年 264.6 万人へ毎年減っており、ADF 統計量 0.269(p = 0.976)で単位根を棄却できない。水準のまま VAR やグレンジャー検定に入れると見せかけの有意が出やすいので、差分を取ってから検定する。ただし 12 点の ADF は検出力が低く、p が大きいことは「非定常と確定した」ではなく「定常とは言えない」という意味にとどまる。
⚠️ Granger 因果性の落とし穴(補強・各 100 文字以上)
⚠️ 落とし穴 — 完全強化版
グレンジャー因果 を実務で扱う際に踏みやすい落とし穴を 5 件挙げます。
- 因果ではなく予測可能性: グレンジャー因果は「先行情報」の意味で、構造的因果ではない。
- ラグ長の選定: 不適切なラグで結果が変わる。AIC/BIC で選定。
- 非定常性: 単位根があると検定統計量の分布が変わる。差分か共和分。
- 共通要因: 第 3 変数が真の駆動なら見かけのグレンジャー因果が出る。
- 非線形関係: 線形 VAR では非線形依存を検出できない。
📚 統計学習の総合ガイド
📚 統計学習の総合ガイド
🎯 学習目標
このページの概念をマスターすることで、 以下のスキルが身につきます:
- 定義と公式を正確に理解
- 適切な使用場面を判断
- Python で実装し、 結果を可視化
- 仮定の確認と診断
- 結果の解釈と報告
- 限界と注意点の理解
- 関連手法との使い分け
📊 SSDSE-B-2026 データの構造
このコンペの主要データセット(SSDSE-B-2026)の構造:
- 47都道府県 × 過去複数年(パネル形式)
- 112列の社会経済指標
- 人口、 出生、 死亡、 婚姻、 経済、 教育、 環境、 家計など多次元
- 政府統計を統合した信頼性の高いデータ
🔍 主要な変数群
| カテゴリ | 変数例 |
|---|---|
| 人口 | 総人口、 年齢別人口、 性別人口 |
| 人口動態 | 出生数、 死亡数、 合計特殊出生率、 婚姻数 |
| 気候 | 気温、 降水量、 降水日数 |
| 教育 | 幼小中高校数、 教員数、 生徒数、 大学進学率 |
| 経済 | 求職件数、 求人件数、 旅館数 |
| 医療 | 病院数、 診療所数、 歯科診療所 |
| 家計 | 消費支出、 食料費、 住居費、 教育費等の項目別 |
💡 ジャストインタイム型学習
このガイドは「必要なときに必要な知識」を提供する設計:
- 論文中の用語をクリック → 該当の用語解説へジャンプ(ポップアップ)
- 概念マップで関連用語を辿る
- 包含マップで体系を把握
- ツリーマップで全体を俯瞰
- Python コードをコピーして実行
- SSDSE データで実際に試す
🛠️ Python データサイエンス環境
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | # 事前に(ターミナルで 1 回だけ): pip install pandas numpy scipy statsmodels scikit-learn matplotlib seaborn # 標準的なインポート import pandas as pd import numpy as np import matplotlib.pyplot as plt import seaborn as sns from scipy import stats from sklearn.preprocessing import StandardScaler from sklearn.model_selection import train_test_split from sklearn.metrics import r2_score, mean_squared_error # 日本語表示の設定(matplotlib) plt.rcParams['font.family'] = 'Hiragino Sans' plt.rcParams['axes.unicode_minus'] = False # データ読み込み(SSDSE-B は cp932。skiprows=[1] で 2 行目の日本語の項目名を飛ばし、1 行目の英字コードを列名にする) df = pd.read_csv('data/raw/SSDSE-B-2026.csv', encoding='cp932', skiprows=[1]) print(df.shape) # 47 都道府県 × 12 年度(2012〜2023) # Granger 検定に渡すのは 2 本の時系列: 全国の総人口と出生数を年の昇順に集計する nat = df.groupby('SSDSE-B-2026')[['A1101', 'A4101']].sum() # groupby で年が昇順に並ぶ print(nat) |
💬 全国の総人口は 2012 年度の 1 億 2,758.9 万人から 2023 年度の 1 億 2,435.3 万人へ 2.5% 減り、出生数は 103.7 万人から 72.7 万人へ約 30% 減った。どちらも 12 年間ほぼ一方向に動くトレンド系列(出生数が前年を上回ったのは 2015 年度の +2,124 人だけ)なので、このまま grangercausalitytests に渡すと見かけの因果が出やすい。前年差にしてから検定し、12 点しかないのでラグは 1〜2 に抑える。
🌟 効果的なEDAテンプレート
🎯 このコードでやること:渡した DataFrame の形・型・欠損・要約統計を表示し、 数値列のヒストグラム・相関ヒートマップ・散布図行列を描く EDA 関数を定義する。 Granger 検定の前に、 使う系列のトレンドや外れ値を目で確かめる用途。
📥 入力の形
任意の DataFrame。例: 東京都の 12 年度分 tokyo[['総人口', '出生数']](12 行 × 2 列、水準)
年度   総人口       出生数
2012   13,234,000   107,401
2013   13,307,000   109,986
…
2023   14,086,000    86,348
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 | import seaborn as sns def quick_eda(df, target=None): """探索的データ分析の基本テンプレート""" print(f"Shape: {df.shape}") print(f"\nColumn types:\n{df.dtypes}") print(f"\nMissing values:\n{df.isnull().sum()}") print(f"\nBasic stats:\n{df.describe()}") # 数値列の可視化 numeric_cols = df.select_dtypes(include=[np.number]).columns df[numeric_cols].hist(bins=20, figsize=(15, 10)) plt.tight_layout() plt.show() # 相関ヒートマップ if len(numeric_cols) > 1: plt.figure(figsize=(12, 10)) sns.heatmap(df[numeric_cols].corr(), annot=True, fmt='.2f', cmap='RdBu_r', center=0) plt.show() # ターゲットがあれば散布図行列 if target and target in df.columns: cols = list(numeric_cols[:5]) if df[target].dtype == 'O': # 文字列の列なら色分け(hue)に使う。hue の列も渡す sns.pairplot(df[cols + [target]], hue=target) else: sns.pairplot(df[cols]) plt.show() |
📈 報告書テンプレート
分析結果を報告する際の標準的な構成:
- 背景・目的:なぜこの分析が必要か
- データ:出所、 サンプルサイズ、 期間
- 方法:使用した統計手法、 仮定
- 結果:図表、 統計量、 検定結果
- 解釈:結果が何を意味するか
- 限界:分析の制約
- 結論:要点まとめ、 今後の課題
🎯 まとめ — 完全強化版
本ページでは「グレンジャー因果」を 12 セクション(🔖 キーワード索引/💡 30 秒結論/📍 文脈/🎨 直感/📐 数式/🔬 数式を言葉で読み解く/🧮 実値計算/🐍 Python 実装/⚠️ 落とし穴/🌐 関連手法/🔗 関連用語/📚 グループ教材)で完結に整理しました。 SSDSE-B-2026 を素材に、 概念の輪郭・式の意味・実装手順・典型的な失敗パターンの 4 点を最低限押さえれば、 統計データ分析コンペの現場で迷わず使えるはずです。
🖼 図で振り返るGranger因果
Granger 因果は「過去の X が Y の将来を予測する追加情報を持つか」を時系列の文脈で判定する。 ここでは時系列・自己相関・パネル構造の 3 図で直感を掴む。
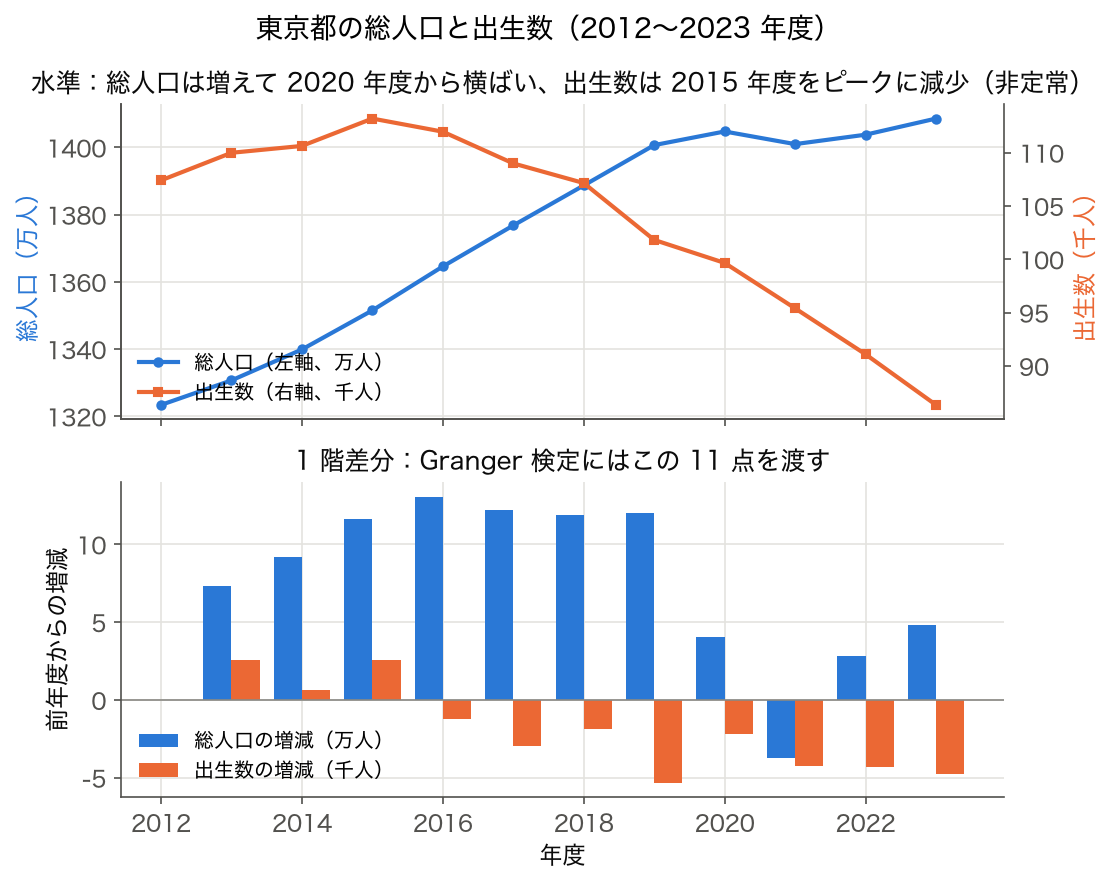
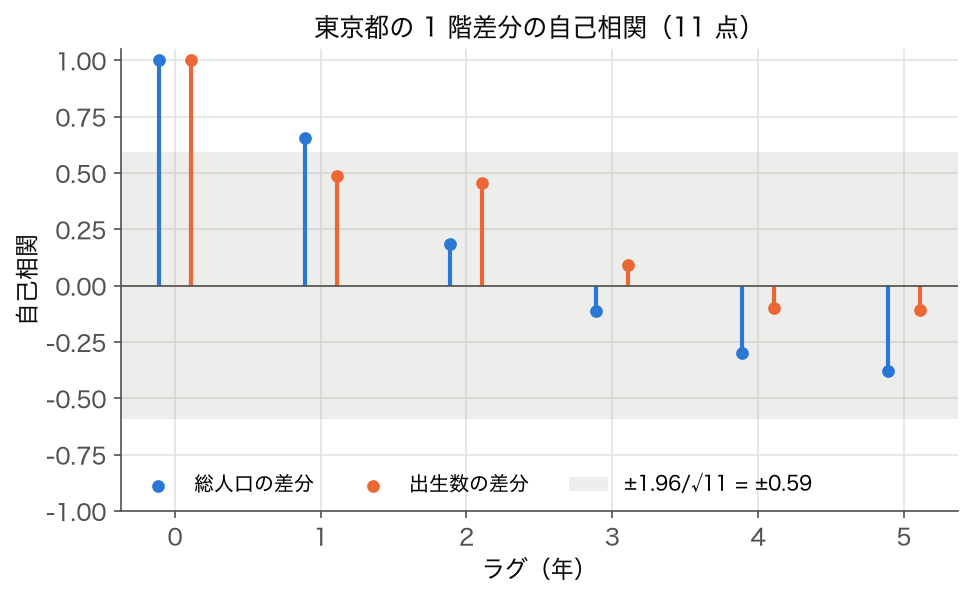

読み方: 時系列 (図 1) で先行・後続の関係を視察 → 自己相関 (図 2) でラグ次数を決定 → パネル (図 3) で個体ごとの異質性を考慮、 という 3 ステップが Granger 検定の実務フローと一致する。
🗺️ 統計手法選択フローチャート
Q1: 何を知りたい?
- 記述したい → 平均、 分散、 ヒストグラム
- 比較したい → t検定、 ANOVA、 χ²検定
- 関係を見たい → 相関、 回帰
- 予測したい → 回帰、 機械学習
- 分類したい → ロジスティック回帰、 SVM、 RF
- グループ分けしたい → クラスタリング
- 次元を減らしたい → PCA、 因子分析
- 因果関係を知りたい → RCT、 IV、 DiD、 PSM
Q2: データの種類は?
- 連続値 → t検定、 ANOVA、 線形回帰
- カテゴリ → χ²検定、 ロジスティック回帰
- 順序 → ノンパラ検定、 順位回帰
- カウント → ポアソン回帰、 負の二項回帰
- 時系列 → ARIMA、 VAR、 状態空間
- パネル → 固定効果、 ランダム効果
Q3: サンプルサイズは?
- n < 30:ノンパラ、 ベイズ、 ブートストラップ
- 30 ≤ n < 200:古典的検定、 単純な回帰
- n ≥ 200:複雑なモデル、 機械学習
- n ≥ 10000:深層学習も可能
Q4: 仮定は?
- 正規性:満たす → パラメトリック / 満たさない → ノンパラ
- 独立性:必須 / 違反 → クラスター調整、 時系列モデル
- 等分散性:満たす → OLS / 違反 → WLS、 ロバスト
📏 効果量の参照表
p値だけでなく効果量も併記するのが現代統計の標準。 主要な指標と Cohen の解釈基準:
| 統計量 | 効果量 | 小 | 中 | 大 |
|---|---|---|---|---|
| 2群平均差 | Cohen's d | 0.2 | 0.5 | 0.8 |
| 相関 | r | 0.1 | 0.3 | 0.5 |
| 線形回帰 | R² | 0.02 | 0.13 | 0.26 |
| ANOVA | η² (eta²) | 0.01 | 0.06 | 0.14 |
| χ² | Cramér's V | 0.1 | 0.3 | 0.5 |
| ロジスティック | Odds Ratio | 1.5 | 2.5 | 4.0 |
🚀 実務応用の深掘り
典型的なプロジェクトの流れ
- 問題理解:ステークホルダーとの対話、 KGI/KPI 設定
- データ収集:内部DB、 公的データ(SSDSE等)、 API
- EDA:データの全体像把握、 異常検出
- 仮説立案:ドメイン知識からの仮説
- モデリング:シンプルから複雑へ段階的に
- 検証:CV、 ホールドアウト、 A/Bテスト
- 解釈:可視化、 SHAP、 部分依存プロット
- 展開:本番デプロイ、 監視
ベストプラクティス
- シンプルなモデルから始める(線形回帰、 単純ルール)
- 必ずベースラインと比較
- 過学習を防ぐ(CV、 正則化、 早期停止)
- 解釈可能性を重視
- 再現可能なコード・ノートブック
- バージョン管理(Git)と環境管理(venv, conda)
- ドキュメント化を怠らない
論文・コンペでよく使う言い回し
| 日本語 | 英語 |
|---|---|
| 統計的に有意 | statistically significant |
| 効果量 | effect size |
| 95%信頼区間 | 95% confidence interval (CI) |
| 標本サイズ | sample size |
| 検出力 | statistical power |
| 第1種の誤り | Type I error / false positive |
| 第2種の誤り | Type II error / false negative |
| 多重比較問題 | multiple comparisons problem |
| 過学習 | overfitting |
| 汎化性能 | generalization |
| 交差検証 | cross-validation (CV) |
統計データ活用コンペでのコツ
- SSDSE データの構造を理解し、 適切なテーブルを選ぶ
- 地域別・年度別の比較で時空間的視点を入れる
- 1つの分析で多角的に切り口を変える
- 仮説と発見の両方を持つ
- ストーリーラインを明確に
- 図表を1枚1枚作り込む
- 政策提言や実務的意義に繋げる
🗺️ 概念マップ — 3つの視点で体系を理解する
Granger因果検定 がデータサイエンスの体系の中でどこに位置するかを、 3つの異なる視点で可視化します。 同じ情報でも見方を変えると気付きが変わります。
📍 体系階層のパス
🌐 統計・データサイエンス › 因果推論 › 因果手法 › Granger因果検定
① 🔗 関係マップ — 「他の手法とどう繋がっているか」
中心に Granger因果検定 を置き、 そこから 時系列分析・ARIMA・VAR 計 3 個の用語へ、 前提・兄弟・発展形といった関係を矢印で結んでいます。 線がどちら向きかを見れば、 先に読むべき用語とあとから読む用語が分かります。 ノードはドラッグで動かせ、 ホイールでズーム、 クリックでその用語のページへ遷移します。
② ⭕ 包含マップ — 「どのカテゴリに含まれているか」
大きな円が小さな円を包含する Circle Packing 図。 「Granger因果検定」は緑色でハイライト。
- カテゴリ円をクリック:その内部にズームイン
- 白背景クリック:1階層戻る
- 用語円をクリック:詳細ページへ遷移
- マウスホバー:階層パス表示
③ 🌳 ツリーマップ — 「面積で見るボリューム比較」
長方形を入れ子に分割した Treemap 図。 各分野の規模感を面積で比較。 「Granger因果検定」は緑色でハイライト。
- カテゴリ矩形をクリック:その内部にドリルダウン
- パンくず(上のリンク)クリック:その階層に戻る
- 用語矩形をクリック:詳細ページへ遷移
- マウスホバー:階層パスと値を表示
🎯 3つのマップの使い分け
| マップ | 分かること | こんな時に見る |
|---|---|---|
| 🔗 関係マップ | 手法間の横の関係(前提→発展→応用) | 「次に何を学べばよい?」 学習順序の判断 |
| ⭕ 包含マップ | 分類体系の入れ子構造(上位⊃下位) | 「この手法はどんなジャンルに属する?」 |
| 🌳 ツリーマップ | 分野の規模比較(面積=ボリューム) | 「データサイエンス全体の俯瞰像」 |
💡 3 つの図は同じ位置関係を別の角度から描いています。 関係マップは Granger因果検定 の隣に何が並ぶかを、 包含マップとツリーマップは 統計・データサイエンス → 因果手法 → Granger因果検定 という入れ子の位置を示します。 「因果手法には他に何があったか」を思い出したいときは包含マップを、 「次に何を読むか」を決めたいときは関係マップを開いてください。
🗺 概念マップ — 完全強化版
🧭 解説深化 — 直感・落とし穴・発展(追記)
ここまでの本文・ウィジェットに加えて、グレンジャー因果を「予測因果」として腹落ちさせるための追補です。既存の説明と重複する部分もありますが、初学者が最短で誤解を避けられるよう、直感 → 落とし穴 → 発展の順に整理し直しています。
🎨 直感 — 「過去の情報が将来予測を助けるか」
グレンジャー因果の本質は「時間的先行」と「予測寄与」の2点に尽きます。
今の Y を当てるのに Y 自身の過去 だけで十分か、それとも X の過去 を足すと予測誤差が有意に減るか——これだけを見ています。X を足して初めて予測が改善するなら「X の過去には Y の未来を先取りする情報が含まれる」=「X は Y をグレンジャー予測する」と読みます。
- キーワードは「情報」:因果の矢印そのものではなく、「X を知っていると Y の予測が得か?」という情報量の話。
- 非対称性が要点:X→Y が有意でも Y→X は非有意、ということが起こり得る。向きで結果が変わるのが相関との決定的な違いです(相関は対称)。
- 「予測因果」であって真の因果ではない:予測が当たることと、介入して Y を動かせることは別問題です(因果関係/逆の因果)。
⚠️ 落とし穴(重要)— グレンジャー因果 ≠ 真の因果
グレンジャー因果は誤用が非常に多い概念です。以下は「有意に出たのに結論を誤る」典型パターンです。
| 落とし穴 | 何が起きるか | 対処 |
|---|---|---|
| 共通原因・交絡 | 第3変数 Z が X と Y を先に動かすと、X→Y が偽陽性で有意になる | 交絡の検討/条件付きグレンジャー因果で Z を統制 |
| 非定常・共通トレンド | 両系列が上昇トレンドを共有するだけで見せかけの因果が出る(見せかけの回帰) | 定常性を ADF/KPSS で確認し差分化。共和分なら VECM |
| ラグ次数の選択 | ラグを変えると有意・非有意が入れ替わる(恣意的選択で p-hacking に) | AIC/BIC で系統的に選び、採用基準を明示(ラグ変数) |
| 非線形関係の見落とし | 線形 VAR は非線形依存を検出できず「因果なし」と誤判定 | 伝達エントロピー等の情報論的手法(情報エントロピー)を併用 |
| 瞬時因果・双方向 | 同時点の影響(同期)や双方向フィードバックはラグ検定では捉えにくい | 両方向を検定し、瞬時相関は別途 IRF・構造 VAR で評価 |
| 短い時系列 | T が小さいと漸近分布が近似できず検出力が低い(サイズ歪み) | 最低でも 1ラグあたり30観測目安。少数点ではブートストラップ補正 |
⚠️ 合言葉:「グレンジャー因果あり」は「時間的先行・予測寄与あり」と読み替える。介入で結果が変わる真の因果(因果関係)とは常に区別して報告します。
🚀 発展 — VAR・条件付き・非線形・真の因果推論
- VAR での検定:グレンジャー因果検定は VAR の係数に対する「ゼロ制約の F/Wald 検定」として実装される。多変量で複数方向を一度に検定できる。
- 定常化とラグ選択:ADF/KPSS →(非定常なら)差分化、共和分があれば VECM。ラグ次数は AIC/BIC/HQIC で選ぶ(定常性・自己相関)。
- 条件付きグレンジャー因果:第3変数 Z を回帰に含めた上で X→Y を検定し、交絡を統制する。多変量 VAR での部分因果に相当。
- 伝達エントロピー(Transfer Entropy):情報理論に基づく非線形版グレンジャー因果。分布全体の依存を測るため線形 VAR が見落とす関係も検出できる(情報エントロピー)。ガウス変数では線形グレンジャーと等価になることが知られる。
- インパルス応答関数(IRF)・分散分解:「向き」だけでなく「ショックの大きさと持続」を可視化。有無(検定)と効果量(IRF)を両輪で読む。
- 真の因果推論との違い:介入・反実仮想に基づく枠組み(パネル因果推論・因果関係)は「もし X を動かしたら Y はどうなるか」を問う。グレンジャー因果は観測データの予測改善にとどまり、これに置き換わるものではない。
🧮 実データで確認 — 東京都の総人口 A1101 × 出生数 A4101(SSDSE-B-2026 実測)
SSDSE-B-2026 の東京都を 2012–2023 年の12点の時系列として取り出し、実際にグレンジャー因果検定を回した結果です(encoding='cp932', skiprows=[1] で読み込み)。原系列は明確に非定常なので1階差で定常化してから検定しました。
💬 読み方(重要な注意つき):どの向き・どのラグでも p>0.05 で、統計的にはグレンジャー因果は検出されませんでした。ただしこれは「因果が無い証明」ではありません。わずか12年(差分後11点)という極端な短系列では検定の検出力が非常に低く、真に効果があっても見逃しやすい(第2種の過誤)。都道府県×年度パネル(47県×12年)をパネル手法でプールする、より長期の系列を使う、といった対処が必要です。短系列での「有意でない」も「有意」も、そのまま因果の結論にしないことが最大の教訓です。
🔗 関連ページ(このサイト内・実在ページのみ)
- VAR(ベクトル自己回帰) — グレンジャー因果検定の土台となる多変量枠組み
- 時系列 — 定常化・ラグ・差分などの前提知識
- 定常性 — 検定の前提。ADF/KPSS と差分化
- 自己相関 — ラグ構造の把握
- ラグ変数 — ラグ次数 p の選択(AIC/BIC)
- 因果関係 — 予測因果と真の因果の違い
- パネル因果推論 — 介入・反実仮想に基づく真の因果へ
- 交絡 — 共通原因による偽陽性
- 見せかけの相関 — 共通トレンド・見せかけの回帰
- 逆の因果 — 向きの取り違え
- 情報エントロピー — 非線形版(伝達エントロピー)の基礎
※ 「伝達エントロピー」「VECM」「Toda-Yamamoto 検定」「インパルス応答」等は本サイトに独立ページが無いため、本文中では用語のみの言及にとどめています。
🔗 隣接手法への橋渡し
「グレンジャー因果」は単独で完結する手法ではなく、 隣接領域と連携することで真価を発揮する。
- 上流: 入力データの前処理・整備 — 時系列分析 ・ VAR モデル (Vector AutoRegression)
- 並列: 類似目的を持つ代替手法 — 転移エントロピー (Schreiber 2000) ・ CCM (Sugihara 2012)
- 下流: 出力結果の評価・解釈 — 因果推論 (Pearl 2009) ・ 構造方程式モデル
上流の VAR モデル・定常性検定 (ADF) で前提を確認し、 並列の Transfer Entropy・Convergent Cross Mapping と非線形版を比較し、 下流の構造 VAR・インパルス応答関数で因果効果を解釈する。 グレンジャー因果は「予測改善」という限定的因果概念で、 必ず真の介入因果 (Pearl 流) と区別して報告する。
🌳 手法選択フロー
「granger causality」を含む手法選択は、 データの性質・分析目的・運用制約の 3 軸で決まる。 以下に典型シナリオと対応する手法の組合せを示す。
典型シナリオ別の手法選択
| シナリオ | 重視する観点 | 候補手法 |
|---|---|---|
| 2系列の先行・遅行関係を知りたい | 定常性・ラグ選択・向きの非対称性 | ADF/KPSS → Granger 因果検定 → VAR / インパルス応答 |
| 系列が非定常だが長期均衡がありそう | 共和分の有無 | Johansen 検定 → VECM |
| 非線形・情報論的な因果を見たい | 分布全体の依存 | 転送エントロピー / Convergent Cross Mapping |
選んだ後の検証ステップ
- 前処理確認: 標準化 / 欠損処理 / カテゴリ変数のエンコード が適切か
- ハイパラ調整: 交差検証で安定する値を選ぶ
- 性能評価: タスクに応じた指標 (RMSE / Accuracy / F1 / AUC / シルエット等) を複数併用
- 頑健性チェック: 別手法 / 別シードで結果が大きく違わないか確認
- 解釈: 結果を分野知識と照らし合わせ、 意味のある発見になっているか検討